本文研究了一种融合Transformer与PPO强化学习的动态调度优化算法,重点解决调度联合活动过程中频繁出现的资源冲突与响应延迟问题。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
为解决工会活动管理中因频繁的资源分配冲突和调度响应延迟导致的组织效率下降问题,本文提出了一种融合 Transformer 与 PPO(近端策略优化,Proximal Policy Optimization)的动态调度算法。在具体实现中,首先设计统一的调度场景建模结构,将活动、人员和资源状态转化为张量输入,实现多维度约束的集成。接着,利用 Transformer 的多头注意力机制对历史活动请求与资源状态的时间序列进行编码,提取多维时空特征,增强对冲突风险的感知能力。随后,基于编码结果与 PPO 策略网络,从当前状态生成调度动作,提升策略对复杂环境的适应性。最后,通过剪枝更新与优势函数校正机制,保障策略在迭代过程中的稳定性并提升调度性能。实验结果表明,在任务密度为 1000 时,该调度算法的平均决策时间为 0.72 秒,平均响应延迟为 1.59 秒,显示出较高的响应速度与决策效率。在七类活动类型及不同复杂度水平下,资源冲突率为 0.05–0.12,平均资源利用率为 0.75–0.86,调度稳定性指数为 0.8–0.91,有效减少了频繁的资源分配冲突,实现了高调度稳定性。在高并发条件下,资源均衡指数与策略迁移鲁棒性指数分别为 0.88 和 0.85,表明算法对任务并发负载具有良好的适应能力。
引言
工会活动涉及多项任务和资源的复杂调度,要求系统具备高效的动态响应能力1,2。活动需求频繁变化,人员与场地资源分布复杂,容易导致调度冲突和资源浪费3,4。准确捕捉活动历史与实时资源状态,提升对潜在冲突的识别与响应能力,是提高组织运行效率的关键5,6。融合先进的时间序列建模技术与强化学习算法,可在复杂调度环境中实现深度理解与智能优化,有助于最大化资源利用率、加快调度响应速度,推动工会活动管理的智能化升级。
然而,现有的调度方法在实践中主要基于规则且为静态模式,难以适应频繁的任务变更和资源波动,常常导致响应时间延长和严重的资源冲突。在工会活动的调度中,任务类型高度多样;资源使用受到严格限制且频繁变化;活动之间的依赖关系以及资源之间的竞争关系构成了复杂的调度图谱7,8。在实际操作中,活动安排难以高效匹配人员、场地等资源的可用时间窗口9,10,经常发生冲突,削弱了组织运作的整体协调性11,12。调度系统面临的并非单一优化目标,而是在多个维度指标之间寻求平衡,例如最小化资源冲突、最大化响应速度、调度策略稳定性以及任务完成率13,14,这些特征体现了典型的多目标优化问题。此外,工会活动具有明显的阶段性和周期性,调度策略必须能够动态适应不同任务阶段中资源需求结构的变化。一次性生成的静态计划无法支持高频变化的执行环境15,16。现有调度逻辑缺乏对历史任务行为及资源状态变化模式的深入挖掘,无法对未来进行准确预测和策略推演17,18。系统对突发任务和资源临时变动的响应速度较慢,影响了整体运行的可持续性19,20。构建具备预测性、灵活性和稳定性的调度系统已成为实际应用中的关键技术需求。这要求模型具备高维信息感知能力、序列记忆能力以及策略迁移能力,并能在多任务环境中保持稳健的决策与资源平衡,从而实现工会活动调度的智能化、最优协同。
许多研究针对动态调度问题提出了各种解决方案。其中,深度学习与强化学习相结合的方法展现出强大的适应性和优化能力。一些学者采用LSTM(长短期记忆网络)21,22对时间序列数据进行建模,并结合强化学习策略优化调度行为,取得了一定成果。另一类研究采用基于贪心算法的启发式方法,强调调度决策的简洁性与高效性,适用于规则明确的场景23,24。还有研究探索了深度Q网络(DQN)在调度中的应用,通过值函数逼近实现策略优化25,26。然而,这些方法在面对复杂多变的联合活动场景时,存在对长期依赖关系捕捉不足、策略更新不稳定以及响应延迟较大等问题,难以满足高密度、多样化任务的调度需求。因此,如何构建具备高效特征提取能力和稳定策略更新机制的调度算法,已成为当前研究亟待突破的瓶颈。
在多领域调度研究中,由于Transformer架构具有多头自注意力机制,能够有效捕捉长时间范围的时间依赖关系,因此已被应用于多种时间序列预测与调度优化任务27,28。当与强化学习中的PPO算法结合时,通过裁剪目标函数实现策略的稳定且高效的更新,该方法在机器人控制和智能制造等领域表现出良好性能29,30,31。一些研究尝试将Transformer与强化学习相结合,用于复杂资源调度32。然而,在工会活动的动态调度中,鲜有研究关注多种活动类型与复杂资源约束的结合问题。部分研究利用图神经网络对资源与任务之间的关系进行建模,从而提高冲突识别的准确性33,34。一些学者基于边缘计算优化资源调度,以提升模型的效率与性能35,36。然而,此类方法对时间上下文的建模能力仍较为有限。基于此,本文提出采用Transformer对历史活动与资源状态序列进行编码,并结合PPO策略网络,以实现对冲突风险的高感知能力以及调度策略的稳定更新,从而应对工会活动变化且复杂的调度需求。
最近的研究从不同角度探讨了资源调度优化问题,例如面向云计算中能源效率的虚拟机整合37、蜂窝网络中的认证算法38、结合实时迁移的增强型虚拟机整合以实现可持续云计算39、利用等待预测与进化算法进行的流量优化40,以及基于区块链的云存储系统,具备增强的优化能力与完整性保障41。尽管这些研究为资源分配与优化算法提供了有价值的见解,但其主要针对云计算基础设施、通信网络或存储系统,并未专门解决工会活动管理中所特有的多类型活动约束、动态的人力与场地资源冲突,以及实时调度需求。这一差异进一步凸显了构建一个专门针对工会活动组织环境的调度框架的必要性。
现有的工会活动调度方法通常难以捕捉长期的时空依赖关系,并在动态变化中保持策略稳定性,导致响应速度慢和资源冲突严重。为解决这些研究空白,本研究提出了一种基于以下原理的调度优化模型:Transformer 多头注意力机制能够有效编码历史序列以实现冲突预测,而具有截断目标函数的近端策略优化(Proximal Policy Optimization, PPO)可确保策略更新的稳定性与适应性。具体而言,采用 Transformer 对活动与资源状态序列进行编码,提取关键时空特征以增强冲突预见能力,并结合 PPO 实现高效的调度动作生成与稳定的策略更新。设计了一种统一的约束矩阵,用于映射活动、人员与场地,提升对复杂依赖关系的识别能力。本工作的核心创新包括:(1)将时序编码与强化学习方法专门集成于工会活动调度任务中;(2)提出一种关注冲突感知的注意力机制,优先强化风险识别;(3)引入带有优势函数校正的剪枝更新机制,以在高并发场景下保障策略的鲁棒性。在多种任务密度与复杂度下的大量实验验证了该模型在响应速度、资源利用率和系统稳定性方面均优于现有方法,为工会活动管理提供了一种实用且可扩展的智能调度解决方案。
访问受限。请登录或开始试用以查看此内容。
方案
图1展示了集成时间序列建模与强化学习的工会活动调度系统结构。输入层整合活动计划、资源可用性及人员时间窗口信息,并通过约束图模块构建多维任务与资源冲突关系矩阵。Transformer 对活动与资源状态的历史序列进行多头注意力编码,生成具有时间依赖性的隐含状态。策略模块利用编码结果生成动作分布与状态估计,并在动作采样后执行调度决策。执行结果反馈至环境,更新资源状态并生成即时奖励。在此基础上,优化模块构建裁剪目标函数,评估优势函数,并校正值网络的估计,以限制策略漂移,确保调度行为的稳定更新。各模块之间形成闭环数据流,实现对动态环境中资源冲突的高度敏感感知与自适应策略更新,从而提升工会活动调度系统在多任务、高约束场景下的智能响应能力与资源分配效率。
工会活动安排的情景建模
调度系统中的所有活动请求均基于时间步长被组织为离散的调度序列。每个活动均明确定义了开始时间、结束时间、资源类别、阶段和优先级。场地使用状态被建模为一个二维时隙矩阵,其中横轴表示标准化的时间单位,纵轴表示空间资源编号。资源状态标记为可用或占用,从而形成具有静态结构的初始资源分布图。人员调度信息在时间-身份维度上进行扩展,以构建连续的时间窗口向量,每个向量记录人员的任务-空闲状态及所属部门编号。所有输入信息被整合为一个三维张量结构,其中表示离散时间步长,表示资源实体数量,表示对应的资源使用属性编码(如是否被占用、活动编号、使用优先级等)。该结构使调度系统能够在任意时刻读取资源配置,确保不同类型资源状态的统一表示。
在将任务信息与模型关联后,根据活动优先级和资源使用时段设置任务强度向量。通过时间窗口重叠检测方法标记可能引发冲突的任务组合。将冲突组合转换为节点集,并依据共享的资源类型和时段构建边集,以显式表达隐含的依赖关系。最终构建的任务图包含时间序列、资源重叠或约束冲突的边界信息,为后续的冲突检测与调度策略生成提供结构基础。该结构保留了任务调度的动态特性以及资源状态的持续变化,支持对调度约束变化的实时感知。
冲突检测利用张量结构中时间和资源维度的稀疏重叠区域作为判断的初始条件。它对具有重叠调度目标的任务对实施静态关系编码处理。构建一个图结构 G=(V,E,C),其中 V 表示活动节点的集合,E 表示基于资源冲突生成的边,C 是边的冲突权重编码矩阵。冲突权重函数定义如下形式:
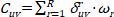 (1)
其中, Cuv 是活动之间的冲突权重 u 和 v; u, v 是活动指数; R 是资源类型的总数; δuvr ∈ {0,1} 表示活动的时间窗口是否 u 和 v 资源重叠 r; ωr 是资源的冲突敏感性权重 r该函数对冲突强度进行加权求和,考虑了资源冲突对调度结果重要性的差异,同时保留了冲突强度分布的可量化表达。
上述冲突图结构通过稀疏矩阵表示法被转换为约束边界矩阵。矩阵中的每个元素包含资源冲突的程度。该矩阵嵌入到调度决策过程中,用于判断任务是否可以并行调度,而动作屏蔽逻辑则位于策略网络中。为应对周期性活动聚集和高密度任务突发的情况,系统实现了动态更新机制,以监控任务状态的变化,并在资源释放或新增时实时调整矩阵内容,从而确保在整个任务演化过程中调度边界的连续性和一致性。
这种冲突图结构的应用使调度系统能够直观地建模潜在的资源瓶颈和任务重叠模式,从而提高决策网络在复杂约束场景下进行解耦分析的效率。调度行为不再依赖基于规则的逻辑匹配,而是寻求约束空间中的最优路径,增强在全局任务图中动态平衡局部资源冲突的能力。该系统能够在资源波动、任务频繁增减的环境中保持调度的稳定性与任务的一致性。
图2展示了基于任务冲突权重关系的网络结构图。图中每个节点代表一个待调度的任务,节点之间的连线表示资源使用冲突。边的粗细反映冲突的权重,冲突越严重,线条越粗。权重计算综合了资源重叠情况,并结合各类资源的冲突敏感性,形成任务间的综合冲突强度。该图结构显示,部分任务形成了密集连接的区域,表明在资源使用上存在显著竞争。此类局部冲突聚集现象是调度过程中资源瓶颈和任务延迟的主要来源,调度算法可据此设定优先调解目标。节点布局采用力导向布局策略,自动聚集高冲突任务,使调度系统能够识别关键任务组并优化策略分配,从而提升整体调度的一致性与资源协调性。
历史状态序列编码
基于构建的冲突图和约束矩阵,下一步是对活动和资源状态的历史序列进行编码,以便提取这些约束背后的时间模式,用于后续决策。 调度场景中的核心信息包括活动请求、资源状态变化以及任务反馈记录。这些信息构成了多个异构时间序列,对应于事件时间点、资源使用标识和活动执行状态等属性。为了统一处理结构,每种输入类型均被编码为等长的向量序列,并建立统一的时间索引,以确保在时间同步下的状态对齐。每一时刻的输入单元由三组特征向量拼接而成:活动特征向量表示任务类型、优先级和阶段编号;资源特征向量记录当前资源占用情况、剩余容量和可用时间窗口位置;反馈特征向量描述在上一时刻任务是否顺利执行,以及是否发生了资源冲突或延迟事件。
所有特征经过线性变换并映射到相同的维度空间,以获得标准化的嵌入矩阵 X ∈ ℝT×d,其中 T 表示时间步数,d 为统一的嵌入维度。为了保留时间结构,将输入矩阵与位置编码矩阵 P 逐元素相加,形成具有位置感知能力的输入:
Z = X + P (2)
Z 是最终的输入序列,作为后续注意力机制的输入。位置编码设计采用固定的正弦和余弦函数模板,以防止未来信息泄露,并确保在编码过程中严格满足因果约束。上述结构使模型能够同时感知任务特征、资源状态和时间位置,具备完整的状态记忆基础,为后续的注意力机制提供高分辨率的统一结构。
注意力模块对输入序列进行处理,以捕捉多个时间步之间的潜在关系。采用多组注意力头分别处理序列,从而增强模型对不同类型状态演化路径的敏感性。每个注意力头从输入序列生成查询矩阵 Q、键矩阵 K 和值矩阵 V,计算权重分布矩阵,并生成加权表示。单头注意力的输出为:
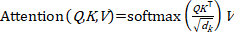 (3)
dk 是每个注意力头的特征维度数。在该公式中, QK⊤ 表示矩之间的相似性,√dk 用于确保数值稳定性,softmax 函数可实现权重归一化。不同的注意力头关注时间步长的不同组合,其所捕获的动态依赖关系也各不相同,有助于揭示任务冲突的前兆、资源消耗模式以及异常反馈趋势等隐含规律。
所有注意力头的输出被拼接后,通过一个线性变换层生成统一的编码序列,该序列作为状态输入传递给调度策略生成网络。该序列嵌入了当前调度窗口内的任务行为轨迹、资源变化特征以及先前执行偏差的影响,有效解决了调度行为中历史依赖性高和特征表达稀疏的问题。在编码输出层中引入了残差连接和层归一化模块,以增强深度网络的训练稳定性和特征表达保持能力。
输出的隐状态序列不仅保留了时间演化信息,还能响应突发任务或临时资源不匹配所引起的变化,表现出强大的适应性。该结构设计避免了显式规则定义,能够对动态调度环境进行结构化建模,并支持后续策略模块在多目标条件下生成具有全局一致性和局部适应性的调度方案。
动态调度策略生成
编码后的隐藏状态序列包含了时间依赖性和资源冲突信息,随后被输入至策略网络,以生成适应当前环境的调度动作。 编码模块输出的隐藏状态序列作为调度策略网络的输入。每一时刻的状态向量集合构成了对当前环境的观测表达,涵盖任务特征的演变、资源使用趋势以及历史反馈轨迹。状态表示的维度和时间窗口长度是固定的,状态变化的连续性通过滑动更新机制来捕捉。在状态向量送入策略网络之前,会对其进行归一化和特征重组,以确保输入在高维空间中保持稳定的数值分布,从而减少梯度爆炸和收敛波动。
策略网络结构采用双分支输出模块,其中一个分支生成动作分布,另一个分支输出状态值函数估计。动作空间包含所有可调度的任务和可分配的资源。候选筛选机制会过滤掉非法或冗余的操作组合,从而形成一个有限且合法的动作集合。策略分支输出一个概率分布 π(at|st),其中 at 表示在当前时间步的调度动作,st 为当前状态输入。通过标准化高斯采样或 softmax 采样策略,从该分布中选择动作以进行实际调度。另一个输出为状态值函数估计,表示在给定状态下对未来长期奖励的期望,用于策略评估与更新。
在策略网络中,隐藏层通过应用激活函数和批归一化来提升非线性表达能力并加速网络收敛。在决策过程中,不同任务的执行优先级、资源调度成本和历史表现被作为注意力因子,通过特定的权重矩阵应用于动作选择机制,从而形成可自适应调节的策略输出框架。该设计避免了对固定规则的依赖,从而增强了策略在应对突发冲突和结构瓶颈时的灵活性。
调度策略采用随机采样机制生成实际的动作序列。在每个调度周期中,从当前的动作分布中采样一个可执行动作,并更新资源状态和任务节点标记。动作执行后,系统根据资源变化和任务进展结果计算即时反馈奖励,以衡量本轮调度对整体目标的影响。奖励设计考虑了多个维度,包括任务完成率、资源利用效率以及冲突抑制程度,并通过综合指标向策略更新模块提供反馈。
整个调度过程构建一个马尔可夫决策链,并使用经验轨迹采样方法记录状态-动作-奖励序列,表示为(st, at, rt, st+1)。策略优化依赖于优势函数的构建,其中优势估计定义为以下形式:
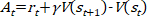 (4)
At 表示优势值,rt 为当前时刻的即时奖励,γ 为奖励折扣因子,V(st) 和 V(st+1) 分别为当前状态和下一状态的状态价值函数输出。优势函数反映了当前动作相对于策略平均性能的优越程度,用于指导后续策略的改进。若 At > 0,表示当前动作优于平均期望,应提高其被选择的概率;否则,应降低其被选择的倾向。
在策略更新过程中,为避免因更新幅度过大导致策略振荡,采用目标分布截断机制来限制新旧策略之间的变化范围,从而保持网络输出的连续性与稳定性。该机制在动作分布与反馈奖励之间建立紧密耦合关系,使策略能够对复杂约束条件的变化做出即时响应。此机制可在任务频繁变更或资源突发性失配的情况下,维持决策的稳定性与合理的资源调度,有效避免重复分配、资源拥塞或任务队列积压等问题。调度系统能够在不同任务密度与资源短缺条件下保持较优的运行状态,展现出强大的适应能力。
策略迭代与稳定更新机制
为确保生成的调度策略在多次训练轮次中保持稳定且不退化,本节引入了一种结合截断和优势校正的迭代更新机制。 设定新旧策略之间的截断更新间隔,并采用截断目标函数限制策略偏移,以防止策略更新过程中出现调度震荡。结合优势函数对估值网络进行校正,以提高长期调度的准确性。
策略网络动作输出的概率分布在连续的调度迭代过程中容易出现剧烈波动,可能导致行为不稳定或资源分配混乱。为减轻策略漂移引起的调度冲击,设计了截断更新区间以控制新旧策略之间的变化范围,并构建约束项来优化目标函数。在采样轮次中记录历史策略概率,并结合当前策略概率构造比率项。策略更新目标设定为:
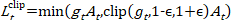 (5)
其中,gt = πθ(at|st)/πθold(at|st) 表示新旧策略之间的概率比值;ε 为裁剪阈值,用于限制策略更新的范围。当该比值超出边界时,将采用裁剪后的数值,以防止策略因极端样本产生过大的梯度,从而确保网络参数的调整保持在预设范围内。该结构在每轮调度过程中动态约束输出策略的变化范围,能够在密集任务分布下维持策略输出的平滑性与一致性,显著降低调度行为的抖动率。
在更新过程中,策略目标函数通过添加正则化项和熵奖励项,以增强动作分布的多样性并抑制过早收敛。每轮策略更新使用多批次的经验轨迹样本进行滚动训练,从而维持在状态空间中的覆盖广度。当比较更新前后输出动作序列的概率分布时,计算分布的偏差率,并通过硬阈值筛选出策略可接受的扰动范围。该机制为跨周期迁移调度策略提供了边界控制,从而抑制因资源状态剧烈变化导致的过拟合。
策略更新依赖于价值函数提供的状态评估。状态价值估计的偏差会直接影响优势函数的正确性,从而改变策略迭代的方向。为了提高估值的准确性,构建了一种多时间序列回溯机制,并利用未来奖励的折扣累积值来校正当前状态的价值。回溯奖励采用广义优势估计(Generalized Advantage Estimation, GAE)结构,其定义如下:
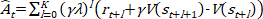 (6)
Ât 是校正后的优势值;λ 是回溯平衡系数;rt+l 表示第 (t+l) 步的即时奖励;V(st+l) 是由估值网络输出的状态值。该结构通过整合短期即时反馈与长期状态预期,校正策略对未来资源冲突、峰值负载及任务累积等情形下响应预测的偏差。λ 控制回溯深度,并在资源动态剧烈波动期间自动调整,以增强估值网络对突发情况响应的鲁棒性。
优势函数中嵌入的多尺度时变结构使估值网络能够建模长期资源趋势。在检测策略输出偏差时,采用策略行为一致性指数来评估网络对估值误差是否存在过度响应。反馈差分残差项用于监控策略更新行为,并对训练目标及价值函数的权重更新幅度进行动态校正。价值网络与策略网络联合优化,以确保价值估计不偏离任务完成目标,同时防止高频调度对资源冲突状态产生误判。
这种稳定的策略更新机制能够在高维动态任务环境中有效保持策略行为更新的可控性和一致性,提高任务覆盖效率和资源利用的灵活性,形成持续迭代的智能调度结构。调度行为可避免在长期演化过程中陷入局部最优,增强对任务模式变化和资源周期波动的整体适应能力。
图3A展示了在不同截断阈值条件下,目标函数值随训练迭代次数变化的趋势。横轴为训练迭代次数,纵轴为截断后的目标函数数值。ε 设置为 0.1、0.2 和 0.3,代表不同程度的策略漂移控制强度。较小 ε 值对应的曲线波动更小,目标函数保持稳定。当 ε = 0.1 时,目标函数值整体介于 0.8 至 1 之间,体现出策略更新的渐进性与稳定性。然而,较大的 ε 值会导致明显波动;当 ε = 0.3 时,目标函数值整体在 0.65 至 0.95 之间,目标函数曲线呈现更大的振荡幅度,反映出策略更新过程中出现严重偏离的风险。阈值越小,策略越稳定,适用于高约束的调度环境。图3B展示了在不同回溯平衡系数下广义优势估计(GAE)的变化情况。λ 分别设为 0.8、0.9 和 1.0,用于控制对未来奖励的回溯深度。曲线显示,λ 值越高,GAE 的波动越小,长期趋势更平滑,能够更准确地捕捉多步之后调度行为的潜在影响。λ 为 0.8 的曲线表现出明显的周期性波动,说明其对即时奖励更敏感,更适合短期突发性任务;而 λ 为 1.0 时更侧重于长期趋势建模,适用于周期性任务场景。
计算复杂度与可扩展性分析
所提出的 Transformer-PPO 框架的计算复杂度由两个主要组成部分决定:Transformer 编码器和 PPO 策略优化。
对于具有 L 层、H 个注意力头、嵌入维度 d 以及输入序列长度 T(历史时间窗口)的 Transformer 编码器,每次前向传播的时间复杂度为 O(L·T2·d + L·T·d2),其中 T2 项来源于自注意力机制。在本实现中,L = 3,H = 4,d = 128,且 T 固定为 100 个时间步,从而保证了可接受的计算开销。当历史窗口更长时,二次项 T2 将成为主导因素;但在实际应用中,工会活动调度通常涉及有限的历史时间范围(例如,季度或年度滚动窗口),且可通过调整时间步长的分辨率来平衡精度与效率。
对于 PPO 组件,策略网络和价值网络均为轻量级的多层感知机(MLP)(每个隐藏层分别包含 256 和 128 个神经元),其推理复杂度为 O(d·m),其中 m 表示隐藏单元的数量,与 Transformer 编码器相比可忽略不计。训练过程中的策略更新涉及多个小批量梯度更新的训练周期,其复杂度为 O(B·E·d2),其中 B 为批量大小,E 为更新周期数。
在可扩展性方面,该框架表现出三个有利特性。首先,注意力机制可以在时间步上并行化,从而实现高效的 GPU 加速。其次,模型规模与活动或资源的数量无关,因为约束矩阵是在每个调度步骤动态构建的,而不是作为固定参数嵌入的。这使得同一个训练好的模型可以在不同规模的问题上部署而无需重新训练。第三,对于极大规模的场景,可以通过权衡减少历史时间窗口长度 T 和嵌入维度 d,或者采用稀疏注意力变体,将计算复杂度从 O(T2) 降低至 O(T log T) 或 O(T)。
访问受限。请登录或开始试用以查看此内容。
结果
实验数据
为全面评估本文提出的 Transformer-PPO 动态调度算法的性能,实验采用某大型企业工会近三年的活动管理数据作为基准数据集。该数据集包含超过 5,000 条活动记录,涵盖会议、培训、娱乐等多种类型,并包含场地、设备和人员等多类资源的调度信息。每条记录详细描述了活动的起止时间、资源需求、优先级以及实际执行状态(包括冲突事件和资源利用率)。为模拟真实场景中的动态变化,数据中额外增加了 10% 的随机突发任务和资源变更事件(如临时占用场地和人员时间窗口调整),以验证算法在高度不确定环境下的鲁棒性。连续的状态序列为 Transformer 的时序建模和 PPO 策略训练提供了结构化输入。实验通过不同任务密度和复杂度下的调度性能进行对比,确保评估覆盖实际应用中的典型场景,并与当前主流的 LSTM-PPO 模型、贪心搜索调度模型以及 DQN 策略调度模型进行了比较。
Transformer 编码器包含 3 层,每层具有 4 个注意力头、128 的嵌入维度以及 256 的前馈隐藏层大小。策略网络和价值网络共享相同的 Transforme...
访问受限。请登录或开始试用以查看此内容。
讨论
实验结果表明,所提出的 Transformer-PPO 算法在所有评估指标上均持续优于基线方法(LSTM-PPO、贪婪搜索和 DQN)。其优越性能可归因于两个关键因素。首先,Transformer 的多头自注意力机制能够有效捕捉活动与资源状态序列中的长程时间依赖关系,从而主动识别潜在冲突。这解释了为何即使在高复杂度场景下(例如跨部门协作和临时任务插入),冲突率仍能保持在较低水平,因为该模型能够在资源争用发生前进行预判。其次,PPO 中的截断目标函数和基于广义优势估计(GAE)的优势修正机制确保了策略更新的稳定性,避免调度决策出现剧烈波动,从而在不同任务负载下均保持较高的鲁棒性。
与现有的调度方法相比,所提出的方法解决了基于LSTM的模型在长序列中存在梯度消失的问题,并克服了贪婪算法和DQN方法在动态环境中泛化能力差的缺陷。尽管LSTM-PPO表现出中等性能,但在任务依赖跨越较长时间范围时难以保持稳定性,这体现在其高并发情况下的冲突率较高且资源均衡性较低。贪婪算法虽然计算效率较高,但缺乏前瞻性,导致资源分配次优,增加了响应延迟。而DQN由于缺乏信任域约束,表现出策略振荡现象,从而在多...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明不存在任何经济利益冲突。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | 核心编程语言 |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | 深度学习框架(Transformer/PPO 实现) |
| NumPy 1.23 | NumPy 开发者团队 | https://numpy.org/doc/stable/release/1.23.0-notes.html | 数值计算库 |
| Matplotlib 3.5 | Matplotlib 开发团队 | https://matplotlib.org/stable/users/installing.html | 结果可视化 |
| 工会活动调度数据集 | 合作企业内部数据库(已匿名化) | 因保密协议不对外公开;研究人员可联系通讯作者申请访问 | 来自某大型企业工会三年内的 5,000 多条活动记录(会议、培训、娱乐等) |
| NVIDIA A100 GPU | |||
| PyTorch |
参考文献
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.
访问受限。请登录或开始试用以查看此内容。