本研究探讨了用于区分阿尔茨海默病、额颞叶痴呆和健康对照的脑电图生物标志物。采用均方根、功率谱密度和熵特征构建随机森林模型,并结合可解释的人工智能方法和效应量分析对模型进行解读。去除影响较小的熵特征后,分类性能得到提升,在测试集上达到了94%的准确率。
本文内容
摘要
摘要
脑电图(EEG)已被研究作为一种无创手段,用于表征神经退行性疾病中的脑活动。本研究评估了多模态脑电图生物标志物是否能够区分阿尔茨海默病(AD)、额颞叶痴呆(FTD)和健康对照者(HC)。公开可用的数据集包含88名参与者的静息态闭眼脑电图记录,其中包括36名AD患者、23名FTD患者和29名健康对照者。提取多模态脑电图生物标志物和人口统计学特征,用于机器学习分类。脑电图衍生的特征包括均方根(RMS)、功率谱密度(PSD)和熵值测量。使用组合特征集训练随机森林分类器,并通过可解释的人工智能方法进行解释。通过特征稳定性分析和Cohen’s d效应量分析评估各特征的贡献,随后进行消融分析。基于熵的特征对分类的贡献最低。完整的多模态模型在训练集上达到96%的准确率,在测试集上达到92%的准确率。在移除熵特征后,测试准确率提升至94%。这些结果描述了所选多模态脑电图和人口统计学特征在随机森林框架内的分类性能。
引言
阿尔茨海默病(AD)是一种与认知功能和运动功能进行性衰退相关的神经系统疾病。其患病率随年龄增长显著上升,而痴呆是老年人发病和死亡的主要原因之一1,2,3,4,5。由于诊断和疾病分类仍具挑战性,研究者已探索通过分析脑信号来表征与痴呆相关的神经生理变化。
脑电图(EEG)是一种记录大脑电活动的非侵入性方法,已被广泛应用于阿尔茨海默病及其他神经系统疾病的研究中6,7,8,9,10,11。EEG信号反映了神经元活动所产生的电位,可通过多个头皮位置无创记录12,13,14。大脑活动通常通过δ、θ、α、β和γ频段进行表征15。阿尔茨海默病与EEG慢化、信号复杂性降低以及同步性改变相关16。频谱分析显示,与健康对照者相比,阿尔茨海默病(AD)患者δ和θ频段活动增强,而α和β频段活动减弱17,18,19。既往的EEG分类研究在区分AD与健康对照(HC)以及额颞叶痴呆(FTD)与HC方面表现出较高的准确性。相比之下,AD与FTD之间的鉴别通常更具挑战性10,11。
机器学习方法已被用于识别与神经系统疾病相关的脑电图(EEG)信号中的模式20,21。因此,特征提取是基于脑电图分类的重要组成部分。以往的研究已探讨了频谱、时域、复杂度和功能连接特征与机器学习模型的结合应用3,15,22,23。其中,频谱特征尤为相关,因为它们能够量化脑活动随频率变化的改变,包括在阿尔茨海默病(AD)中报道的α活动减少和θ活动增强23,24,25,26。
多项基于脑电图(EEG)的研究已评估了不同特征组合、分类器及验证策略的效果。基于连接性的分析已被用于区分阿尔茨海默病(AD)、额颞叶痴呆(FTD)和健康对照(HC),其分类性能因比较方式和特征选择方法的不同而有所差异27。基于傅里叶变换的特征也被用于区分AD、轻度认知障碍(MCI)和健康对照,但其局限性包括预处理不足以及验证策略可能导致的过拟合问题28。非线性EEG复杂性指标在AD分类中显示出一定的鉴别潜力,部分方法达到了较高的准确率、敏感性和特异性,但其在MCI及疾病分期鉴别中的适用性仍有限21。
基于时频脑电图(EEG)表征的深度学习方法也已被用于阿尔茨海默病(AD)、轻度认知障碍(MCI)和健康对照(HC)的多类别分类研究29。尽管已有研究报道了较高的分类性能,但仍存在若干局限性,包括样本量小或受试者选择性偏倚、类别不平衡、疾病严重程度异质性、缺乏外部验证以及模型可解释性降低等问题29。验证策略也是一个重要的方法学考量因素。独立于受试者的验证方法表明,当同一受试者的脑电片段同时出现在训练集和测试集中时,传统的片段级交叉验证可能会高估模型性能30。这一局限性在比较采用不同验证方案的研究结果时尤为突出。
复杂性和连接性指标还通过支持向量机分类器进行了评估,基于相位的连接性和多尺度熵显示出不同程度的判别性能31,32。其他采用基于傅里叶变换和小波变换提取特征的研究在阿尔茨海默病(AD)、轻度认知障碍(MCI)和健康对照(HC)之间的比较中报告了表现不一的结果,其中多类别分类通常比二分类更具挑战性14。基于熵和同步性的方法也已证明能够区分阿尔茨海默病组与对照组,但对照人群的特征可能影响所观察到的效应量大小2。
本研究评估了一个多域特征集,该特征集包含从脑电图(EEG)频段中提取的均方根(RMS)、功率谱密度(PSD)和熵值,以及作为人口学变量的年龄。RMS 表示每个频段内的信号幅度,而 PSD 表示频域中的功率。熵值被纳入作为信号复杂性的度量。这些特征对 EEG 活动提供了互补的描述,并通过随机森林分类器进行评估。研究进一步分析了特征重要性、特征稳定性、可解释的人工智能以及效应量,以评估所提取特征的相对贡献。本研究探讨了多域 EEG 特征(包括基于频谱、时域和复杂性的度量)在利用机器学习区分阿尔茨海默病(AD)、额颞叶痴呆(FTD)和健康对照(HC)方面的有效性。同时,研究还考察了在使用功率谱密度(PSD)、均方根(RMS)和熵值度量时,哪些 EEG 频段特征对分类的贡献最为显著。此外,研究比较了基于功率的特征(包括 PSD 和 RMS)与基于熵的特征的贡献,并评估了年龄在分类模型中的作用。
方案
脑电图预处理、特征提取和分类工作流程的示意图如图1所示。本研究中使用的材料和软件列在材料表中。
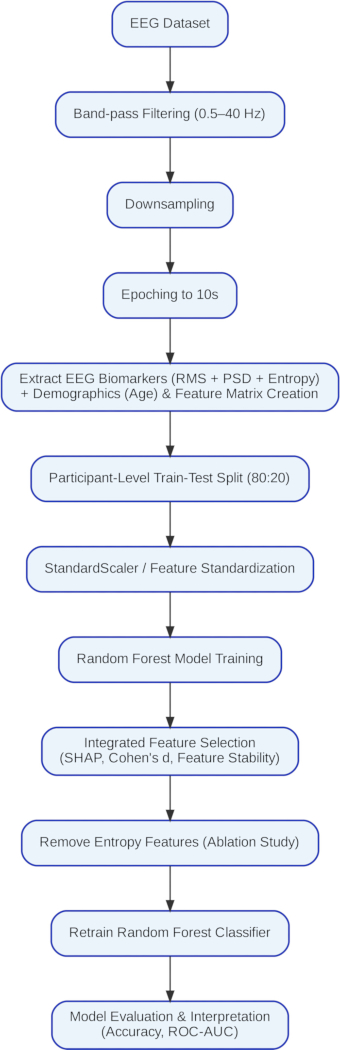
图1:脑电图预处理、特征提取与分类流程的工作流程图。 研究流程的示意图,包括脑电数据验证、带通滤波与重参考、均方根(RMS)、功率谱密度(PSD)和熵特征的提取、年龄信息的添加、训练集与测试集的划分、随机森林模型的构建、特征稳定性分析、SHAP分析、Cohen’s d效应量分析、综合特征选择、熵特征消融、模型重新训练以及性能评估。请点击此处查看该图的放大版本。
1. 数据采集
公开的静息态脑电图(EEG)数据集来自 OpenNeuro 仓库(数据集 ds004504,版本 1.0.9)33。已核实参与者的标签和人口统计学信息。该数据集共包含 88 名参与者,其中包括 36 名阿尔茨海默病(AD)患者、23 名额颞叶痴呆(FTD)患者和 29 名健康对照者(HC)。
2. 脑电图记录导入
针对每位受试者,使用 MNE-Python 库加载脑电图记录。逐一检查每个脑电图文件,以确认其可访问、能够成功导入,并包含有效的受试者标识符。文件缺失或损坏的记录被排除。此阶段保留原始脑电图采样频率 500 Hz。对信号进行降采样,以在保留本研究所需全部临床相关脑电信息的同时降低计算负荷。
3. 带通滤波
连续的脑电图记录采用四阶带通滤波器进行滤波,低截止频率为 0.5 Hz,高截止频率为 40 Hz。
4. 公共平均参考与分段
对滤波后的脑电图(EEG)记录应用了公共平均参考(CAR)方法。在每个时间采样点,计算所有可用EEG通道信号的平均值,并从每个通道中减去该平均值。参考处理后的EEG信号被保留用于后续分析。使用MNE-Python中的make_fixed_length_epochs()函数,将每段参考处理后的EEG记录分割为固定长度的片段。片段时长为10 s,无重叠。
5. 时段验证
对每位参与者,仅保留完整的10秒时段。在记录结束时任何短于10秒的剩余脑电图片段均被舍弃。每个保留的时段随后被用作特征提取的独立样本。
6. 特征准备
尽管源数据集中提供了简易精神状态检查(Mini-Mental State Examination, MMSE)数据,但本分析未将其纳入。提取的脑电图(EEG)特征与参与者的 demographics 信息(包括年龄和诊断标签)进行了合并,这些信息来自 participants.csv 元数据文件。以参与者标识符作为共同键,仅保留同时具有 EEG 特征记录和相应 demographics 信息的参与者。
多域特征矩阵包含五个均方根(RMS)特征(delta_rms、theta_rms、alpha_rms、beta_rms 和 gamma_rms)、五个功率谱密度(PSD)特征(delta_psd、theta_psd、alpha_psd、beta_psd 和 gamma_psd)以及五个熵特征(delta_entropy、theta_entropy、alpha_entropy、beta_entropy 和 gamma_entropy)。年龄被纳入作为补充的人口统计学变量。由于不同诊断组之间的年龄分布可能存在差异,因此无法完全排除人口统计学上的混杂因素。诊断组(定义为 AD、HC 或 FTD)被指定为目标标签。
7. 数据预处理与训练-测试集划分
预处理过程中,将记录数据从 500 Hz 降采样至 250 Hz,以在保留感兴趣 EEG 频率信息的同时降低计算需求。
采用分组划分策略,在受试者层面将数据集划分为训练集(80%)和测试集(20%)。通过对每位参与者的预测片段进行多数投票,获得受试者层面的预测结果。主要评估采用受试者层面的分组训练-测试划分方法,以防止同一参与者的片段同时出现在两个子集中。通过对其所属的各个预测片段进行多数投票,得到每位受试者的预测结果。对数据集进行了缺失值检查,并根据实际情况删除或填补了缺失的观测值。诊断标签进行了编码处理。在训练数据上拟合StandardScaler,然后将其应用于训练和测试数据集。
8. 随机森林模型构建
使用80棵树、最大树深度为10、最多四个特征、每个叶节点最少样本数为5,以及随机种子为42的参数初始化随机森林分类器。该分类器使用标准化的训练数据集进行训练。
9. 模型评估
对训练集和测试集数据均进行了类别标签的预测。构建了混淆矩阵,并结合分类报告计算了准确率、精确率、召回率和 F1 分数。记录了训练集与测试集的准确率。
在参与者层面的评估中,需确保每位参与者的全部脑电片段仅被分配至训练集或测试集之一。随机森林分类器采用与主要分析中相同的超参数进行训练。
10. 交叉验证
作为额外的模型评估步骤,采用 shuffle = True 和 random_state = 30 进行了五折分层交叉验证。计算了五折验证的平均准确率及其标准差。该分析独立于主要的受试者水平留出评估进行考虑。
11. 特征稳定性分析
通过使用从 0 到 9 的随机种子重复随机森林训练 10 次来评估特征稳定性。每次运行时,记录测试准确率和特征重要性得分。计算每个预测变量在 10 次运行中特征重要性得分的均值和标准差,并根据其稳定性对预测变量进行排序。该分析用于评估特征排序的一致性,而非替代主要的受试者水平评估。
12. 可解释人工智能分析
对训练好的随机森林模型应用了SHAP TreeExplainer方法。通过计算SHAP值来评估每个特征对模型预测结果的贡献程度。计算每个特征的平均绝对SHAP值,并根据其SHAP贡献对特征进行排序。识别出SHAP值持续较低的特征,并将其与特征稳定性分析和Cohen’s d分析的结果进行比较。选择那些贡献持续较低的特征,用于后续的消融实验及模型重新训练。
13. 统计效应量分析
为每种AD的EEG生物标志物计算了Cohen’s d 与 健康对照,阿尔茨海默病 与 额颞叶痴呆,以及额颞叶痴呆 与 HC比较。效应量大小的解释采用以下标准:0.20表示小效应,0.50表示中等效应,0.80表示大效应。
14. 综合特征筛选
比较了随机森林特征重要性分析、SHAP 分析和 Cohen’s d 分析的结果。那些在特征重要性、SHAP 贡献值和效应量方面 consistently 表现较低的预测变量被确定为待剔除的候选变量。
15. 特征消融
通过探索性消融分析评估了熵特征,并构建了一个包含均方根(RMS)、功率谱密度(PSD)和年龄的简化特征矩阵。使用相同的超参数重新训练随机森林分类器。采用简化后的特征集重复进行模型训练、测试、交叉验证以及受试者工作特征(ROC)分析。
16. ROC 分析
通过优化后的随机森林分类器获得类别概率。采用一对余(one-versus-rest)策略生成多类别 ROC 曲线。计算每个类别的曲线下面积(AUC)值以及平均 AUC。
17. 性能比较
将完整特征模型的性能与经过熵特征消融后获得的简化特征模型的性能进行了比较。
结果
随机森林模型的训练准确率达到96%,测试准确率达到92%。宏平均F1分数为92%,加权平均F1分数也为92%,表明三个类别之间的性能表现相当,其中阿尔茨海默病(AD)类别的分类性能最高,而额颞叶痴呆(FTD)类别的性能相对较低,如表1所示。
采用受试者工作特征(ROC)分析来评估不同分类阈值下的类别分离情况。如图2所示,三个类别的ROC曲线下面积(AUC)均超过0.98,表明阿尔茨海默病(AD)、额颞叶痴呆(FTD)与健康对照(HC)组之间具有良好的可分性。
使用TreeExplainer进行SHAP分析,以评估各特征对随机森林分类模型的贡献。如图3中的汇总条形图所示,展示了功率谱密度(PSD)、均方根(RMS)、熵以及人口统计学特征的相对贡献程度。具有较高绝对SHAP值的特征对模型预测的贡献更强,而与熵相关的特征则表现出相对较低的贡献。
通过在指定的随机种子下重复随机森林训练来进行特征稳定性分析。记录每次运行的测试准确率和特征重要性得分,并计算特征重要性的均值和标准差。在本分析中,模型的平均分类准确率达到95%,标准差为0.17%。这些重复运行主要用于评估特征排序的一致性,与主要的受试者水平留出评估分开考虑。年龄在特征稳定性分析中排名较高,如表2所示。theta_psd 和 theta_rms 特征同样排名较高,而 alpha_psd、alpha_rms、beta_psd 和 beta_rms 显示出中等程度的特征重要性。
采用 Cohen’s d 计算组间差异的效应量,结果如表3所示。阿尔茨海默病(AD)患者与健康对照组之间,α频段衰减(alpha_rms,d = 0.97;alpha_psd,d = 0.87)和θ活动增强(theta_rms,d = 0.72)表现出最大的差异。这些结果与痴呆症脑电图研究中报道的皮层慢化现象一致34。基于熵的特征显示出相对较小的效应量。AD 与额颞叶痴呆(FTD)之间的比较主要表现为小到中等的效应量。
Alpha频段特征在AD中显示出较大的效应量与-亨廷顿病和额颞叶痴呆-与-健康对照组(HC)比较。对于AD 与 HC中,alpha_psd的报告效应量为−0.87,alpha_rms的报告效应量为−0.97。对于FTD 与 HC中,alpha波段衰减为−0.73。theta_psd特征在AD中的效应量为0.61 与 HC,而 theta_rms 的效应量为 0.72。AD 组间差异较小 与 额颞叶痴呆
Beta频段特征显示出以小到中等为主的组间效应量。AD组的beta_psd效应量为−0.35 与 HC 和 AD 的相关系数为 −0.41 与 FTD的gamma_psd效应量为0.47,而beta_rms大多表现为较小效应。某些比较中,gamma波段特征显示出中等效应。 与 HC 和 AD 的值分别为 0.20 与 HC,而gamma_rms在FTD中显示出0.50的效应量 与 HC.
Delta PSD 和 RMS 对 AD 显示出较小的正效应量 与 HC(分别为0.29和0.34)和FTD 与 HC(分别为0.25和0.25)。AD的效应量 与 FTD 接近于零。Delta 熵在全部三项比较中均显示较小的效应量(0.08、0.20 和 −0.11)。
特征稳定性、SHAP 值和效应量分析均表明,熵特征的贡献相对较低。因此,通过排除熵特征并保留均方根(RMS)、功率谱密度(PSD)和年龄进行消融分析。在特征消融后,随机森林模型达到了 96% 的训练准确率和 94% 的测试准确率。该结果被解释为在所评估的特征选择框架内的探索性比较。阿尔茨海默病(AD)、健康对照(HC)和额颞叶痴呆(FTD)类别的精确率、召回率、F1 分数和支持数详见表 4。
在表5中比较了进行熵特征消融前后的性能。移除熵特征后,测试准确率从92%提高到94%。各类别的变化情况见表6。对于FTD类别,精确率提高了4%,F1分数提高了2%。HC组的召回率提高了4%,而精确率下降了2%。特征消融后,宏平均和加权平均性能指标均提高了约1%–2%。
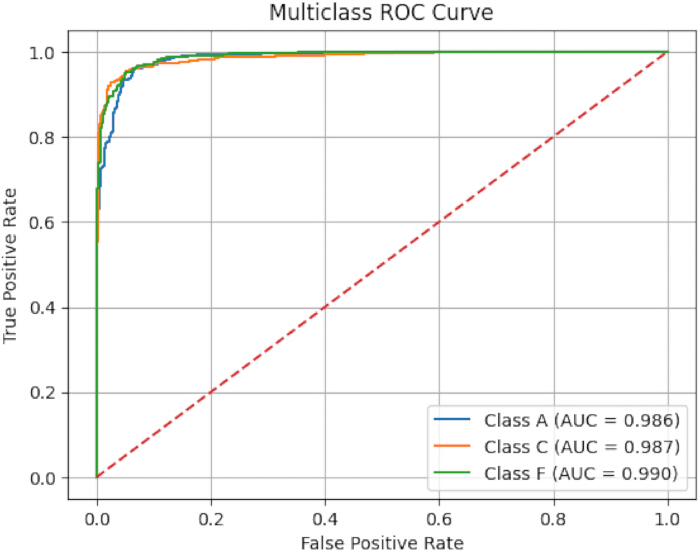
图2阿尔茨海默病、额颞叶痴呆及健康对照受试者的受试者工作特征曲线 使用一对一方法生成的多类别受试者工作特征(ROC)曲线与-rest 策略用于阿尔茨海默病(A类)、额颞叶痴呆(F类)和健康对照(C类)。针对每一类计算曲线下面积(AUC)。 请点击此处以查看此图的放大版本。
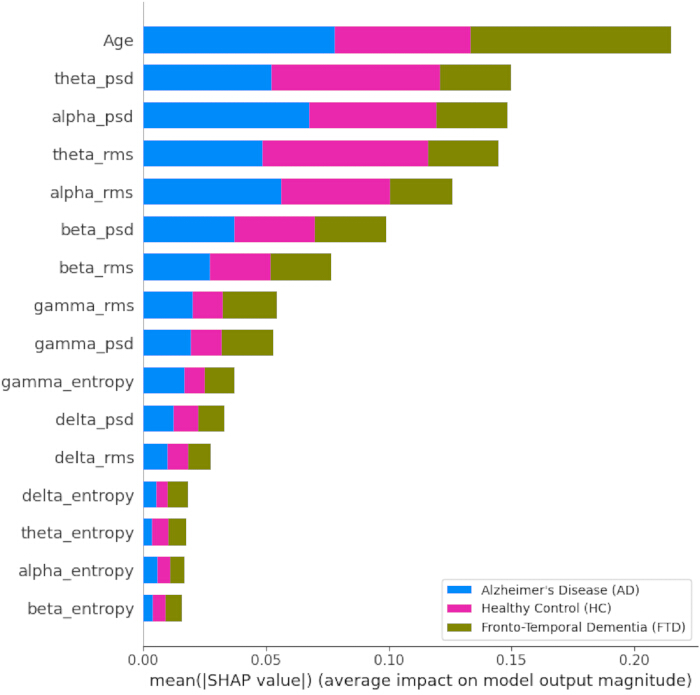
图3:训练后的随机森林模型的SHAP汇总分析。 汇总条形图显示了由脑电图提取的特征和人口统计学特征对随机森林分类模型的相对贡献。采用平均绝对SHAP值对均方根(RMS)、功率谱密度(PSD)、熵和年龄特征的贡献度进行排序。请点击此处查看该图的放大版本。
| 精确率 | 召回率 | F1分数 | 样本数 | |
| 阿尔茨海默病 | 0.92 | 0.95 | 0.94 | 579 |
| 对照组 | 0.93 | 0.92 | 0.93 | 480 |
| 额颞叶痴呆 | 0.93 | 0.87 | 0.9 | 314 |
| 宏平均 | 0.93 | 0.92 | 0.92 | 1373 |
| 加权平均 | 0.93 | 0.92 | 0.92 | 1373 |
表1:测试数据的分类报告。 测试数据集中阿尔茨海默病、健康对照和额颞叶痴呆类别的精确率、召回率、F1得分及支持数,以及宏观平均和加权平均性能指标。
| 特征 | 均值 | 标准差 |
| 年龄 | 0.1966 | 0.0017 |
| theta_psd | 0.0936 | 0.0027 |
| theta_rms | 0.0911 | 0.0023 |
| alpha_psd | 0.0824 | 0.0022 |
| alpha_rms | 0.0824 | 0.0024 |
| beta_psd | 0.0638 | 0.0013 |
| beta_rms | 0.0629 | 0.0012 |
| gamma_psd | 0.0534 | 0.001 |
| gamma_rms | 0.0527 | 0.0014 |
| delta_psd | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| gamma_entropy | 0.0326 | 0.0008 |
| alpha_entropy | 0.0325 | 0.0006 |
| beta_entropy | 0.0283 | 0.0009 |
| theta_entropy | 0.0258 | 0.0004 |
| delta_entropy | 0.0255 | 0.0005 |
表2:随机森林模型的特征稳定性排序。 使用0到9的随机种子重复进行随机森林训练所得到的平均特征重要性值及其相应的变异性。特征根据其在各次运行中的稳定性进行排序。
| 特征 | AD 与 HC 比较 | AD 与 FTD 比较 | FTD 与 HC 比较 |
| Delta PSD | 0.293 | -0.069 | 0.253 |
| Theta PSD | 0.612 | 0.23 | 0.355 |
| Alpha PSD | -0.869 | -0.219 | -0.64 |
| Beta PSD | -0.352 | -0.408 | 0.201 |
| Gamma PSD | 0.201 | -0.326 | 0.468 |
| Delta Entropy | 0.081 | 0.199 | -0.111 |
| Theta Entropy | 0.208 | 0.033 | 0.163 |
| Alpha Entropy | -0.061 | 0.071 | -0.137 |
| Beta Entropy | -0.37 | -0.042 | -0.332 |
| Gamma Entropy | -0.338 | 0.047 | -0.391 |
| Delta RMS | 0.342 | 0.041 | 0.251 |
| Theta RMS | 0.718 | 0.354 | 0.318 |
| Alpha RMS | -0.977 | -0.205 | -0.73 |
| Beta RMS | -0.494 | -0.365 | 0.015 |
| Gamma RMS | 0.187 | -0.33 | 0.5 |
表3:各诊断组间Cohen’s d效应量比较 阿尔茨海默病中脑电图生物标志物的科恩d值 与 健康对照,阿尔茨海默病 与 额颞叶痴呆,以及额颞叶痴呆 与 健康对照比较
| 精确率 | 召回率 | F1分数 | 支持数 | |
| 阿尔茨海默病 | 0.94 | 0.95 | 0.94 | 579 |
| 对照组 | 0.91 | 0.96 | 0.94 | 480 |
| 额颞叶痴呆 | 0.97 | 0.89 | 0.92 | 314 |
| 宏平均 | 0.94 | 0.93 | 0.93 | 1373 |
| 加权平均 | 0.94 | 0.94 | 0.94 | 1373 |
表4:特征消融后的分类报告。 在移除熵特征并重新训练随机森林模型后,阿尔茨海默病、健康对照和额颞叶痴呆类别的精确率、召回率、F1得分及支持数。
| 指标 | 消融前 | 消融后 | 变化 |
| 训练准确率 | 0.96 | 0.96 | 0% 变化 |
| 测试准确率 | 0.92 | 0.94 | +2% 提升 |
| 宏平均精确率 | 0.93 | 0.94 | +1% 提升 |
| 宏平均召回率 | 0.92 | 0.93 | +1% 提升 |
| 宏平均 F1 分数 | 0.92 | 0.93 | +1% 提升 |
| 加权精确率 | 0.93 | 0.94 | +1% 提升 |
| 加权召回率 | 0.92 | 0.94 | +2% 提升 |
| 加权 F1 分数 | 0.92 | 0.94 | +2% 提升 |
表5:特征消融前后的性能比较。 完整的多域特征集与移除熵特征后得到的简化特征集在模型性能指标上的比较。
数据可用性:
用于模型开发和分析的已处理 CSV 数据集作为补充文件1提供。预处理代码可在以下网址的 Python 笔记本中获取:https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing,模型构建与分析代码可在 https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing 获取。通过提供的预处理代码也可重新生成已处理的 CSV 数据集。
| 类别 | 指标 | 干预前 | 干预后 | 变化 |
| 阿尔茨海默病 | 精确率 | 0.92 | 0.94 | 0.02 |
| 召回率 | 0.95 | 0.95 | 无变化 | |
| F1分数 | 0.94 | 0.94 | 无变化 | |
| 对照组 | 精确率 | 0.93 | 0.91 | −2% |
| 召回率 | 0.92 | 0.96 | 0.04 | |
| F1分数 | 0.93 | 0.94 | 0.01 | |
| 额颞叶痴呆(FTD) | 精确率 | 0.93 | 0.97 | 0.04 |
| 召回率 | 0.87 | 0.89 | 0.02 | |
| F1分数 | 0.9 | 0.92 | 0.02 |
表6:特征消融前后各类别的性能变化。 去除熵特征后,阿尔茨海默病、健康对照和额颞叶痴呆类别在精确率、召回率和F1分数上的变化。
补充文件 1:用于模型开发与分析的预处理时段级脑电图特征数据集。请点击此处下载该文件。
讨论
采用随机森林分类器,利用多域特征(包括功率谱密度(PSD)、均方根(RMS)和熵值测量)将脑电图(EEG)样本分类为阿尔茨海默病(AD)、额颞叶痴呆(FTD)和健康对照(HC)组。年龄被纳入作为补充的人口统计学变量。由于不同诊断组之间的年龄分布可能存在差异,无法完全排除人口统计学的混杂影响,因此报告的分类性能反映了人口统计学信息与电生理信息的共同贡献。该分析考察了多域EEG特征在区分AD、FTD和HC组方面的能力,并评估了δ、θ、α、β和γ频段特征对分类的贡献35。特征稳定性与效应量分析表明,基于功率的特征(包括PSD和RMS)的贡献强于基于熵的特征。所提取的EEG生物标志物还反映了与节律减慢和α活动减弱相关的模式。
既往研究已采用不同的机器学习方法评估了基于熵值、功率谱密度(PSD)和均方根(RMS)的脑电图(EEG)特征2,14,27,28,36,37。其中,熵值被用于表征EEG信号的复杂性和不规则性,而功率谱密度(PSD)被用于量化频谱特征2,14,27,28,36。RMS也已被评估作为频带特征之一37。在使用相同基础数据集的先前研究中,采用了基于PSD的二分类方法,并结合留一受试者交叉验证进行验证33。本研究则在多分类框架下,综合了α、β、γ、θ和δ频段的RMS、熵值和PSD特征。此外,本研究在相同数据集上采用留一受试者交叉验证的二分类策略评估了一种轻量级EEG Transformer模型。该轻量级EEG Transformer模型报告的准确率为83.28%。由于分类任务和验证流程存在差异,与本研究结果进行直接数值比较时应谨慎对待38。
Alpha频段特征在区分阿尔茨海默病(AD)与健康对照(HC)以及额颞叶痴呆(FTD)与健康对照(HC)时表现出最大的效应量,而theta频段活动的增强也对AD与HC的区分具有贡献。Beta频段特征在各组间的效应较小,而基于熵的特征则显示出相对有限的判别能力。Gamma频段特征在某些比较中(包括FTD versus HC)表现出中等效应。既往研究已报道,在AD及相关诊断比较中存在alpha功率降低和theta活动改变23,25,39。熵也被认为可能是神经退行性疾病中一个具有潜在信息价值的生物标志物36,表明其贡献可能随数据集、特征定义及分析方法的不同而有所变化。
支持向量机在以往的脑电图分类研究中已被频繁使用3,21,24,37。本分析中采用的随机森林分类器可提供特征重要性估计,且适用于本研究中所使用的结构化特征集40,41。在去除熵特征后,训练准确率和测试准确率分别达到96%和94%。移除熵特征与模型性能的提升相关,这支持了在稳定性分析、SHAP分析和效应量分析中观察到的这些特征相对贡献较低的结果。深度学习和基于变换器的方法也已被应用于脑电图分类,但此类方法通常需要更大的数据集,并且专为更高维度或序列化表示而设计27,39,42,43,44,45。
脑电图信号具有噪声大且非平稳的特点,而基于集成树的模型在分析结构化特征表示时能够提供较强的鲁棒性。本研究评估了均方根(RMS)、功率谱密度(PSD)、熵以及年龄作为随机森林模型的互补输入特征。其中,RMS表示频带内的信号幅度,PSD表示频谱功率,熵表示信号复杂度。研究结果表明,在所评估的框架中,PSD和RMS对分类的贡献强于熵。年龄也对模型有一定贡献,但其引入可能带来人口学混杂因素的影响。未来的研究可在更大规模的数据集中评估其他人口学变量,以及采用其他机器学习或深度学习方法,以进一步评估模型的泛化能力和分类性能。
披露
未声明任何已知的可能影响本研究工作的竞争性财务利益、个人关系、财务关系或其他活动。
致谢
本研究使用的公开 EEG 数据集以及为使该数据集可供研究而做出贡献的研究人员均予以致谢。本研究未从公共、商业或非营利性资助机构获得任何特定资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Google Colab | [confirm environment]colab runtime | 用于运行分析笔记本的基于云的计算环境 | |
| MNE-Python | MNE-Python project | 1.12.1 | 用于脑电图预处理、参考电极设置、滤波和片段分割 |
| NumPy | NumPy project | (2.0.2) | 用于数值计算和基于数组的运算 |
| OpenNeuro EEG dataset | OpenNeuro | ds004504, (1.0.9) | 公开可用的静息态脑电图数据集,包含阿尔茨海默病、额颞叶痴呆和健康对照组的记录 |
| Python | Python Software Foundation | [3.12.13 (main, Mar 4 2026, 09:23:07) [GCC 11.4.0]] | 用于数据处理和模型开发的编程环境 |
| scikit-learn | scikit-learn project | 1.6.1 | 用于预处理、分组数据划分、随机森林分类和性能评估 |
| SciPy | SciPy project | (1.16.3) | 用于信号处理和统计计算 |
| SHAP | SHAP project | 0.52.0 | 用于基于TreeExplainer的可解释人工智能分析 |
参考文献
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379