本方案描述了如何构建、训练和评估一种多视角视觉Mamba U形网络框架,用于医学图像分割,通过标准化的数据集准备、模型实现和性能评估,实现皮肤病变和腹部器官的可重复分割。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
医学图像分割需要计算方法能够准确捕捉全局上下文、局部边界以及多尺度解剖结构,同时在不同应用中保持可重复性。本文介绍了一种用于二维医学图像分割的多视图视觉Mamba U形网络框架的构建、训练与评估方案。该方案提供了一个可重复的工作流程,包括公开数据集获取、图像与掩膜预处理、网络构建、模型训练、检查点选择,以及定量与定性性能评估。该框架引入多视图特征扫描,以捕获互补的空间、轮廓、尺度和边界信息,并在U形编码器-解码器架构中应用多阶段特征融合,以提升分割过程中的特征整合能力。本方案通过公开的皮肤病变和腹部器官分割数据集进行演示。在所述的实现工作流程下,该框架在标准评估指标上表现出具有竞争力的分割性能。通过遵循本方案中提供的步骤,研究人员可复现模型实现,使用既定的实验设置训练网络,评估分割性能,并将该工作流程适配于需要可重复的基于深度学习分析的相关医学图像分割任务。
引言
医学图像分割是计算机视觉和医学图像分析领域的基本任务1,2,3。该任务旨在将图像划分为多个区域或对象,以便进行进一步的分析和处理。这项技术在医学影像中尤为重要,因为它有助于临床医生识别和定位病灶区域,从而提高诊断准确性和治疗规划水平。随着磁共振成像(MRI)、计算机断层扫描(CT)和正电子发射断层扫描(PET)等医学影像技术的进步,对精确医学图像分割技术的需求持续增长。目前的医学图像分割方法大致可分为三类:基于卷积神经网络(CNN)的方法4、基于Transformer的方法5以及基于状态空间模型(SSM)的方法6,7。基于CNN的方法通常采用U形网络架构进行医学图像分割。该类别中最广泛使用的架构是U-Net8,其证明了U形编码器-解码器架构在生物医学图像分割中的有效性。U-Net3+结合了来自UNet++9的密集跳跃连接与全尺度跳跃连接,以增强多尺度特征聚合能力。然而,基于CNN的方法在捕捉长距离依赖关系方面能力有限,因此可能无法有效建模长距离上下文信息。
基于Transformer的方法通过自注意力机制有效捕捉长距离依赖关系,该机制支持并行计算,并为不同感兴趣区域分配不同的注意力权重。UNETR++10引入了高效的配对注意力(EPA)模块,以减少参数数量和计算成本。nnFormer11结合了交错的卷积操作与自注意力机制,并提出了一种基于局部-全局体数据的自注意力机制,用于学习三维(3D)医学图像分割中的体素表示。H2Former12提出了一种高效的分层混合视觉Transformer,其在编码器中将注意力机制与基于CNN的特征提取相结合。然而,随着序列长度的增加,基于Transformer的方法呈现出二次方的计算复杂度,导致计算成本显著升高。图1展示了MVM-UNet的设计动机,并将所提出的多视角扫描策略与现有的基于SSM的分割框架进行了比较。
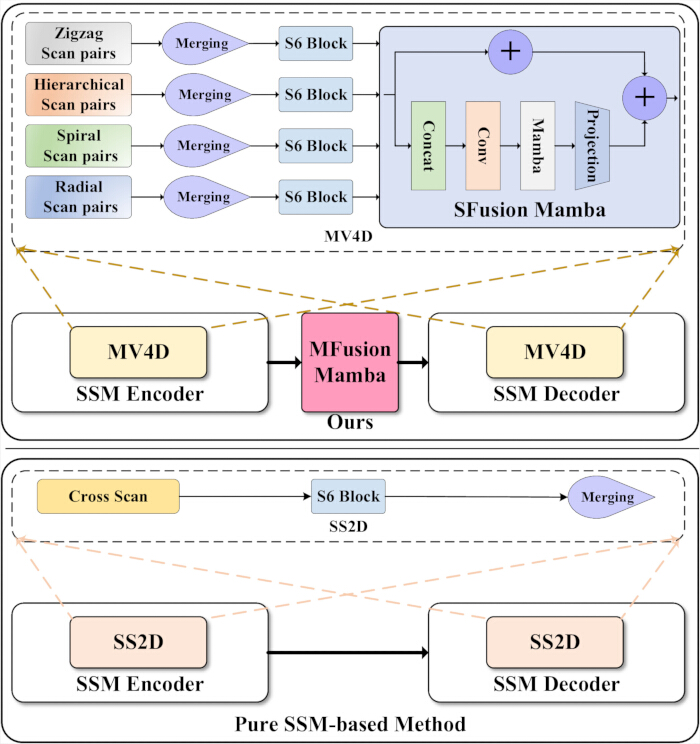
图 1.MVM-UNet 与现有纯基于状态空间模型(SSM)的分割架构的比较。 传统纯基于状态空间模型(SSM)的分割框架与所提出的多视图 Mamba U-Net(MVM-UNet)架构之间的比较。上方面板展示了 MVM-UNet,其中多视图四方向(MV4D)模块利用锯齿形、分层、螺旋形和径向扫描对提取互补特征,并通过空间融合 Mamba(SFusion Mamba)进行整合,而多阶段融合 Mamba(MFusion Mamba)在解码前聚合多尺度编码器特征。下方面板展示了一种使用选择性扫描二维(SS2D)模块并结合交叉扫描的代表性纯 SSM 架构。该图突出了传统基于 SSM 的分割网络与所提出的 MVM-UNet 之间的架构差异。请点击此处查看此图的放大版本。
基于SSM的方法结合了Transformer的全局建模能力与线性计算复杂度。Mamba架构利用选择性状态空间模型(Selective-SSM)选择性地处理输入信息,使模型能够根据输入动态调整参数,同时过滤无关信息并突出重要特征。Vim13 和 VMamba14 将Mamba架构适配于计算机视觉任务。U-Mamba15 采用混合CNN–SSM架构,探索SSM在医学图像分割中的应用,而Mamba-UNet16 则采用完全基于SSM的编码器-解码器架构进行医学图像分割。这些方法在使用显著更少参数的同时,达到了具有竞争力的性能。然而,当前基于SSM/Mamba的方法主要通过简单的图像块和SS2D扫描策略提取图像特征,这在医学图像分割中存在若干局限性。首先,SS2D和基于图像块的技术主要针对通用计算机视觉任务设计。Local Mamba17 和 Motion Mamba18 表明,SS2D扫描策略并不适用于所有视觉任务,因为不同的扫描策略捕获不同类型的视觉信息。其次,SS2D扫描策略相对简单,仅依赖水平和垂直扫描方向,因此可能无法充分捕捉复杂的空间关系和精细的结构细节。医学图像分割需要同时建模全局空间上下文和精确的局部解剖特征。此外,当前基于SSM/Mamba的方法在编码器与解码器之间的特征融合能力有限。UNet++和FATNet等架构通过增强特征融合提高了分割精度,凸显了有效特征整合在医学图像分割中的重要性。
为解决这些局限性,本文提出一种基于 Mamba 的新型医学图像分割框架,称为 MVM-UNet。如图1所示,所提出的多视角四向(MV4D)模块是 MVM-UNet 的核心特征提取组件,通过融合四种不同扫描策略的信息,专为医学图像分割而设计。每种扫描策略提取互补的图像特征,并表示输入图像的不同视角。Zigzag 扫描19在每行或每列末端交替遍历方向,从而平衡局部与全局空间信息。相比之下,螺旋扫描和径向扫描策略20通过从中心向外扩展或从外围向内延伸,实现全面覆盖。分层扫描18在多个尺度上捕获局部和全局特征。为提高每种扫描策略的鲁棒性,在输入 S6 模块前先将扫描对进行合并。随后,扫描视角融合 Mamba(SFusion Mamba)模块整合来自四种扫描模式提取的特征。为有效利用多尺度编码器特征,本文进一步提出多尺度 Mamba 融合模块(MFusion Mamba),该模块在将融合特征传递给解码器之前,累积并融合每个编码器阶段的输出。MVM-UNet 在 ISIC 2017、ISIC 2018 和 Synapse 数据集上进行了评估。实验结果表明,MVM-UNet 在 ISIC 2017、ISIC 2018 和 Synapse 数据集上均取得了具有竞争力的分割性能。
具有代表性的分割架构进一步推动了医学图像分割的发展。U-Net 已成功应用于细胞计数、检测和形态测量等生物医学图像分析任务21。基于注意力机制增强的卷积神经网络架构(如 CA-Net22)通过综合性的注意力机制提升了特征表示能力。典型的基于 Transformer 的分割框架,包括 TransUNet23、Pyramid Medical Transformer24、Swin U-Net25、TransAttUNet26 和 TransCUNet27,进一步证明了基于注意力的全局特征建模在医学图像分割中的有效性。
MVM-UNet 的设计源于现有基于 SSM/Mamba 的分割方法存在的两个局限性。首先,当前许多视觉 Mamba 模型依赖于简单的二维扫描策略,这在处理包含不规则病灶边界、小目标区域和多尺度解剖结构的医学图像时可能表现不足。其次,传统的 U 形编码器-解码器架构主要通过对应的跳跃连接传递特征,限制了解码过程中对多阶段编码器信息的直接利用。因此,MVM-UNet 引入了 MV4D 以增强多视角空间建模能力,并提出 MFusion Mamba 以显式聚合多阶段编码器特征。该设计旨在使基于 Mamba 的长距离建模能力更好地适应医学图像分割的具体需求。
尽管 MVM-UNet 建立在通用的编码器-解码器范式和基于 Mamba 的序列建模基础之上,但其创新之处在于这些组件如何针对医学图像分割任务进行适应性改进与集成。该框架并非简单地将标准 Mamba 模块嵌入 U 形网络主干,而是通过多个面向任务的扫描对分支重新设计了空间建模过程,引入 SFusion Mamba 以融合特定扫描的表征,通过残差与投影路径增强 MVV 模块,并在编码器与解码器之间插入 MFusion Mamba,以在解码前聚合多阶段的编码器特征。这种架构层面的设计旨在应对医学图像中常见的不规则边界、小目标区域以及多尺度解剖结构等挑战。
该方案最适合用于需要同时建模二维医学图像中长距离上下文信息、不规则物体边界以及多尺度解剖结构的分割任务。与基于卷积神经网络(CNN)的分割方法相比,基于 Mamba 的编码器-解码器设计在保留医学图像分割研究人员所熟悉的 U 形工作流程的同时,提供了一种有效的上下文建模机制。与基于 Transformer 的方法相比,该框架避免了二次型自注意力机制的直接使用,适用于希望采用相对高效的序列建模机制实现全局上下文建模的研究人员。因此,本方案适用于皮肤病变分割、腹部器官分割等二维医学图像分割任务,尤其适用于既需关注全局结构信息又需保留局部边界细节的场景。
本方案在使用前也存在一些需要考虑的局限性。对于相对简单的分割任务,若轻量级卷积神经网络(CNN)已能提供足够的性能,则可能无需采用本方案。此外,若不进行架构上的调整,本方案并非直接适用于完整的三维体积分割。对于标注数据极为有限、图形处理器(GPU)资源有限,或需要高度可解释的传统模型的研究人员,也应在应用本方案前充分考虑这些限制条件。总体而言,本方法适用于希望复现并评估基于 Mamba 的 U 形分割框架的研究人员,该框架在长距离上下文建模、局部边界表征以及多阶段特征融合之间实现了平衡。
主要贡献如下:
1. 本文提出了一种基于 Mamba 的新型医学图像分割框架,称为 MVM-UNet。与直接引入现有基于 SS2D 或标准 Mamba 模块的方法不同,MVM-UNet 引入了 MV4D 模块,从四种互补的扫描配对视角对医学图像特征进行建模,包括之字形、层次化、螺旋形和径向扫描。
2. 本文设计了SFusion Mamba和MVV模块,用于整合特定扫描的表征并增强特征变换。SFusion Mamba融合了来自不同扫描配对分支提取的特征,而MVV模块内的残差分支和上下投影分支则提供了互补的特征通路,以稳定并丰富特征表征。
3. 本文在编码器与解码器之间引入MFusion Mamba作为一种中间多阶段融合模块。与主要传递同阶段特征的传统跳跃连接不同,MFusion Mamba通过从粗到细的融合方式显式地聚合多阶段编码器特征,从而为解码提供更丰富的信息。
4. 大量实验结果表明,所提出的 MVM-UNet 在 ISIC 2017 和 ISIC 2018 数据集上实现了具有竞争力的分割性能,在 Synapse 多器官分割数据集上表现出色。此外,全面的消融实验验证了 MVM-UNet 中各个组件的贡献。
访问受限。请登录或开始试用以查看此内容。
方案
本研究仅使用了公开且去标识化的医学图像数据集,包括 ISIC 2017、ISIC 2018 和 Synapse。本研究未收集任何新的受试者、动物实验对象或可识别的私人医疗记录。本研究使用的 ISIC 2017 数据集为 ISIC 2017 挑战赛皮肤病变分割数据集,来源于国际皮肤影像协作组织官方挑战赛数据存储库(https://challenge.isic-archive.com/data/#2017)。本研究所用数据集版本对应于 ISIC 2017 病变分割任务,包含官方提供的训练集、验证集和测试集。该数据集于 2024 年 3 月 15 日下载。本研究使用的 ISIC 2018 数据集为 ISIC 2018 挑战赛任务 1 病变边界分割数据集,来源于国际皮肤影像协作组织官方挑战赛数据存储库(https://challenge.isic-archive.com/data/#2018)。本研究所用数据集版本对应于 ISIC 2018 任务 1:病变边界分割。该数据集于 2024 年 7 月 8 日下载。
本研究使用的 Synapse 数据集为超越颅骨范围的多图谱标注腹部 CT 数据集,该数据集从 Synapse 数据库获取,编号为 syn3193805(https://www.synapse.org/Synapse:syn3193805)。本研究所用数据集对应于常用的 30 例腹部 CT 多器官分割数据集。下载的压缩包为 Abdomen/RawData.zip,获取自编号 syn3193805。数据库在下载时未提供独立的版本号、发布标签或带日期的发布标记。按照先前研究采用的标准划分方式,18 例用于训练,12 例用于测试。数据划分遵循 TransUNet 所使用的病例列表23具体而言,训练样本为case0031、case0007、case0009、case0005、case0026、case0039、case0024、case0034、case0033、case0030、case0023、case0040、case0010、case0021、case0006、case0027、case0028和case0037,而测试样本为case0008、case0022、case0038、case0036、case0032、case0002、case0029、case0003、case0001、case0004、case0025和case0035。该数据集于2024年7月9日下载。由于本研究仅使用公开可用的去标识化数据集,未涉及新的人类受试者数据收集或可识别的私人信息,因此本方案中所述的计算实验无需机构审查委员会批准。未获得正式的书面机构豁免认定。若当地机构政策有要求,研究人员应在对公开可用数据集进行二次分析前获取机构豁免认定。本研究未提供机构伦理豁免编号或正式豁免文件。
1. 数据集的制备
- 从国际皮肤影像协作组织(International Skin Imaging Collaboration)的官方资料库下载 ISIC 2017 皮肤病变分割数据集。使用官方提供的训练集、验证集和测试集划分。确认该数据集包含 2,000 张训练图像、150 张验证图像和 600 张测试图像。
- 从国际皮肤影像协作组织(International Skin Imaging Collaboration)的官方资料库下载 ISIC 2018 皮肤病变分割数据集。使用官方提供的训练集、验证集和测试集划分。确认该分割数据集包含 2,594 张训练图像、100 张验证图像和 1,000 张测试图像。
- 下载 Synapse 多器官分割数据集。使用标准划分方式,即 18 个病例(共 2,212 张轴向切片)用于训练,12 个病例(共 1,567 张轴向切片)用于测试。不引入独立的验证集。
- 将 12 个测试病例专门保留用于最终评估。不得将测试病例用于模型训练、超参数调优或模型选择。该分割任务包含八个腹部器官:主动脉、胆囊、脾脏、左肾、右肾、肝脏、胰腺和胃。
- 使用以下 Synapse 数据集划分方式:18 个训练病例为 case0031、case0007、case0009、case0005、case0026、case0039、case0024、case0034、case0033、case0030、case0023、case0040、case0010、case0021、case0006、case0027、case0028 和 case0037;12 个测试病例为 case0008、case0022、case0038、case0036、case0032、case0002、case0029、case0003、case0001、case0004、case0025 和 case0035。
- 将每个数据集分别组织为独立的图像和掩码文件夹。确保每张图像都有对应且病例标识相同的分割掩码。
- 将每张皮肤病变掩码转换为二值前景-背景分割图。对 Synapse 数据集保留原始的多类别器官标签。
- 对于 ISIC 2017 和 ISIC 2018 数据集,在二值掩码转换后,将背景像素的标签值设为 0,病变(前景)像素的标签值设为 1。原始掩码值大于 0 的像素视为前景并转换为 1,原始掩码值等于 0 的像素视为背景并保持为 0。对于 Synapse 数据集,保留原始整数标签值,其中 0 表示背景类别,1–8 表示八个前景器官类别。
- 将 ISIC 2017 和 ISIC 2018 的图像和掩码调整为 256 × 256 像素,不保持原始宽高比。不进行裁剪或填充操作。
- 将每个 Synapse CT 切片及其对应的标签图调整为 224 × 224 像素。对 RGB 图像使用双线性插值,对 CT 切片使用三阶样条插值,对分割掩码使用最近邻插值。
- 在 Python 中调整图像大小。
- 对于 ISIC 2017 和 ISIC 2018 数据集,使用 utils.py 中实现的自定义 myResize 变换,调用 torchvision.transforms.functional.resize 将图像和掩码张量均调整为 256 × 256 像素。在此变换中不指定显式的插值模式或抗锯齿参数。
- 对于 Synapse 数据集,在 datasets/dataset.py 中使用 scipy.ndimage.zoom。使用三阶样条插值(order = 3)将 CT 图像切片调整为 224 × 224 像素,使用最近邻插值(order = 0)调整标签图。在调整大小过程中不应用单独的抗锯齿操作或 anti_aliasing=True 设置。
- 在张量转换前,使用数据集特定的均值和标准差(SD)对每个 ISIC RGB 图像进行归一化处理,使用 公式 1 如下:
 (1)
随后使用最小-最大归一化将归一化后的图像重新缩放到 0–255 范围。- ISIC 2017 训练集使用 µ = 159.922 和 σ = 28.871;ISIC 2017 验证集和测试集使用 µ = 148.429 和 σ = 25.748。ISIC 2018 训练集使用 µ = 157.561 和 σ = 26.706;ISIC 2018 验证集和测试集使用 µ = 149.034 和 σ = 32.022。
- 将每个归一化后的图像转换为形状为 3 × 256 × 256 的张量。将每个二值掩码转换为形状为 1 × 256 × 256 的张量。
- 在完成数据集特定的均值-标准差归一化后,对每张图像独立进行最小-最大归一化。具体而言,从每张图像中减去数据集特定的均值,并除以对应的标准差。
- 根据归一化后图像的最小和最大强度值,使用每张图像自身的最小和最大值将图像重新缩放到 0–255 范围。此最小-最大重缩放步骤中不得使用整个数据集的全局最小和最大值。
- 将每个 Synapse CT 切片准备为二维灰度图像。将每个 CT 切片转换为 float32 类型,并添加一个单通道维度,得到形状为 1 × 224 × 224 的输入张量。
- 将每个 Synapse 标签图保留为单通道整数掩码,形状为 224 × 224。在数据加载器中不应用额外的数据集级均值-标准差归一化。
- 使用提供的预处理后的 Synapse 文件,训练切片为 .npz 格式,测试体数据为 .npy.h5 格式。训练期间直接从每个 .npz 文件加载图像和标签数组,测试期间直接从每个 .npy.h5 文件加载。在发布的数据加载器中不应用额外的强度截断、CT 窗宽处理、数据集级归一化或原始体数据重采样。
- 在模型训练过程中,将每个加载的二维切片转换为 float32 类型,使用 scipy.ndimage.zoom 将其调整为目标空间尺寸(图像切片使用 order = 3,标签图使用 order = 0),然后将调整后的数组转换为带单通道维度的张量。
- 仅对训练集应用数据增强。对于 ISIC 2017 和 ISIC 2018,应用随机水平翻转(p = 0.5)、随机垂直翻转(p = 0.5)和随机旋转(p = 0.5),旋转角度从 0° 到 360° 中采样。
- 对每对图像-掩码应用相同的几何变换。在验证和测试阶段,仅应用调整大小、归一化和张量转换。
- 对于 Synapse 数据集,在训练期间应用随机旋转和随机翻转。随机将每对图像-标签旋转 k × 90°,其中 k ∈ {0,1,2,3},或沿一个空间轴随机翻转图像-标签对,或随机将图像-标签对旋转一个从 −20° 到 20° 中采样的角度。
- 在测试期间不应用随机增强。
- 使用 RandomGenerator 变换中实现的互斥分支对 Synapse 数据集应用数据增强。
- 对于每个训练样本,首先判断条件 random.random() > 0.5。若满足该条件,则应用 random_rot_flip,即先进行随机 90° 旋转(k = 0, 1, 2, 或 3),然后沿一个空间轴进行随机翻转。
- 若未选择第一个分支,则判断第二个条件 random.random() > 0.5。若满足该条件,则应用 random_rotate,使用从 −20° 到 20° 中随机选择的旋转角度。若两个条件均不满足,则不对该样本应用随机增强。
- 对输入图像和对应的标签图应用相同的变换。
- 在数据集加载、预处理和训练之前设置随机种子。主比较实验使用随机种子 1、52 和 100,消融研究使用种子 100,除非另有说明。
- 在构建数据加载器之前,初始化 Python、NumPy、PyTorch CPU、PyTorch CUDA 和 cuDNN 的随机数生成器。在所有种子运行中保持数据集划分、预处理流程、增强设置、归一化参数、调整大小策略和评估预处理不变。
- 将 ISIC 和 Synapse 实验的 num_workers 均设为 0,以在主进程中执行数据加载。在构建数据集和创建 DataLoader 之前,使用 set_seed 函数初始化全局随机种子,以设置 Python、NumPy、PyTorch CPU、PyTorch CUDA 和 cuDNN 的随机数生成器。不定义单独的 worker_init_fn 或 DataLoader 特定的随机生成器,因为这些在发布的实现中未使用。
2. MVM-UNet 架构的构建
- 采用U形编码器-解码器架构构建所提出的多视图视觉Mamba UNet(MVM-UNet)。
- 将输入图像的维度设为 H × W × 3,并将输入图像传入图像块嵌入层。
- 使用卷积核大小为 4 × 4、步长为 4、输入通道数为 3、输出通道数为 96 的二维卷积实现图像块嵌入层。
- 将输入特征图转换为具有 H/4 × W/4 空间分辨率和 C = 96 输出通道的表示。
- 构建四个编码器阶段和四个解码器阶段。在每个编码器阶段之后,将空间分辨率降低一半,同时将通道维度加倍。
- 采用对称的编码器-解码器结构。在编码器和解码器中均设置 {2, 2, 2, 2} 个 MVV 模块。
- 在每个编码器阶段和每个解码器阶段中各放置两个 MVV 模块。
- 在每个编码器和解码器阶段中插入一个 MVV 模块。在每个 MVV 模块内部使用 MV4D 模块作为核心特征提取模块。
- 在编码器与解码器之间插入 MFusion Mamba 模块。使用该模块在解码前融合来自多阶段编码器的特征。
- 配置整体 MVM-UNet 工作流程。在编码器中全程使用 MV4D 进行特征提取。
- 将编码器输出保留为跳跃连接,并将这些输出传递至对应的解码器阶段。
- 在解码前将编码器特征传入 MFusion Mamba 模块。通过解码器逐步上采样融合后的表示,并通过分割头生成最终的分割图。
- 将输入图像 I ∈ ℝB×H×W×3 传入图像块嵌入层,得到
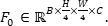 。其中,C = 96。
- 生成编码器特征图:E1 ∈ ℝB×H/4×W/4×C、E2 ∈ ℝB×H/8×W/8×2C、E3 ∈ ℝB×H/16×W/16×4C 和 E4 ∈ ℝB×H/32×W/32×8C。在每个编码器阶段中使用包含 MV4D 的 MVV 模块。
- 保留每个编码器特征用于对应的跳跃连接。将所有编码器特征传入 MFusion Mamba 模块以进行多阶段特征融合。
- 在 MFusion Mamba 模块内进行粗粒度和细粒度融合前,先将编码器特征对齐至统一的特征空间。将融合后的表示传递至解码器。
- 逐步上采样解码器的表示。在 H/16 × W/16 分辨率处与 E3 融合,在 H/8 × W/8 处与 E2 融合,在 H/4 × W/4 处与 E1 融合。
- 将最终的解码器特征上采样至原始图像分辨率。生成预测图
 ∈ ℝB×H×W×K。其中,K = 1 用于病灶二值分割,K = 8 用于 Synapse 多器官分割。
- 参见 图2 获取整体网络架构,以及 补充表1 获取完整的逐层架构说明,包括各阶段的操作、主要参数和输出特征维度。
- 编码器-解码器过渡层
- 使用图像块合并过渡层对编码器特征进行下采样。在每次过渡中,从 2 × 2 邻域中采样四个空间交错的特征组,沿通道维度进行拼接,应用层归一化(LayerNorm),并通过无偏置的线性层将得到的 4C 维特征投影至 2C 通道。该操作将空间分辨率降低 2 倍,同时将通道维度加倍。
- 使用图像块扩展过渡层对解码器特征进行上采样。应用无偏置的线性投影,对扩展后的特征进行空间重排以将分辨率提高 2 倍,并在空间扩展后应用 LayerNorm。重复该操作,逐步将特征图从 H/32 × W/32 重建至 H/16 × W/16、H/8 × W/8 和 H/4 × W/4。
- 在 MFusion Mamba 模块内,通过双线性插值(align_corners = False)将编码器特征调整至目标空间分辨率,然后应用可学习的线性通道投影,再进行特征融合。
- 分割头
- 使用最终的图像块扩展层将最终解码器特征图从 H/4 × W/4 上采样至原始图像分辨率(H × W)。应用线性投影,以 4 倍扩展因子进行空间重排,并应用 LayerNorm。
- 在将张量转换为通道优先格式后,使用 1 × 1 卷积将重建的特征图投影至 K 个输出通道。
- 在评估阶段生成最终预测结果:对于病灶二值分割,应用 Sigmoid 激活函数;对于 Synapse 多器官分割,应用 Softmax 激活函数后接 argmax 操作。分割头内部不应用激活函数。
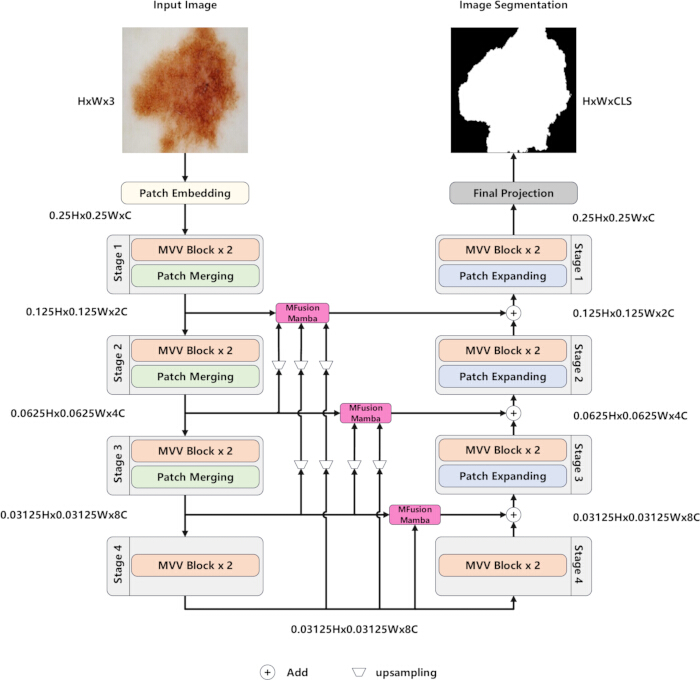
图 2.多视角Mamba U-Net(MVM-UNet)的整体架构。所提出的多视角Mamba U-Net(MVM-UNet)架构概览。输入图像被转换为嵌片嵌入,并通过四个由嵌片合并操作分隔的多视角视觉(MVV)模块组成的编码器阶段进行处理。编码器特征由多阶段融合Mamba(MFusion Mamba)聚合,并通过跳跃连接传递至解码器。解码器通过嵌片扩展操作逐步恢复空间分辨率,并经由投影层生成最终的分割图。请点击此处查看该图的放大版本。
3. MV4D 模块的构建
- 在 MVV 模块中使用 MV4D 模块作为基础特征提取单元。将输入的特征块送入四个扫描对分支。有关空间展平、扫描对索引构建、序列收集、S6/Mamba 处理、逆向空间重排序、扫描对融合、SFusion Mamba 融合、投影及输出重塑的完整伪代码,请参见算法 1,补充文件 1。
- 使用在 models/mvmunet/core.py 中实现的精确的之字形(zigzag)、分层式(hierarchical)、螺旋形(spiral)和径向(radial)扫描索引生成过程。对于每种扫描策略,将前向扫描顺序与其反向顺序组成一个双向扫描对。
- 构建之字形扫描对。在每一行或列的末端以交替方向遍历图像特征。使用此扫描模式以平衡局部与全局空间信息。
- 构建分层式扫描对。在多个空间尺度上捕获特征。使用此扫描模式以增强局部与全局表征的提取能力。
- 构建螺旋形扫描对。从图像中心向边界或从边界向中心扫描图像特征。使用此扫描模式以增强全局轮廓信息的提取。
- 构建径向扫描对。沿多个径向方向扫描图像特征。使用此扫描模式以增强局部边界与边缘细节的提取。
- 在将合并后的序列送入 S6 模块之前,先合并每个扫描对。采用成对设计以提高每种扫描策略的鲁棒性,同时保持计算效率。
- 将每个扫描对分支的输出序列送入一个 S6 模块。获得对应于之字形、分层式、螺旋形和径向扫描视角的四个特征表示。
- 使用 SFusion Mamba 模块融合四个提取的特征表示。采用两条并行融合路径。在第一条路径中,通过逐元素相加的方式整合四个特征。
- 在第二条 SFusion Mamba 路径中,将四个特征进行拼接。使用 Conv1d 和 Mamba 处理拼接后的表示,并通过投影层降低通道维度,使其与 S6 模块的输出维度一致。
- 使用特征维度 C 作为模型维度来配置 S6/Mamba 模块。在融合前,使用投影层将每个合并后的扫描对特征映射回通道维度 C。
- 在 SFusion Mamba 中,第一条路径执行逐元素相加操作;在第二条路径中,先对四个扫描视角特征进行拼接,再进行 Conv1d、Mamba 和线性投影处理。使用第 4 步中描述的围绕 MV4D 的归一化、线性投影、深度可分离卷积和激活操作。
- 将两条融合路径的输出相加以获得 MV4D 模块的最终输出。
- 构建四个互补的扫描对分支,而非仅使用水平和垂直扫描方向。使用之字形扫描以强调连续的空间遍历,使用分层式扫描以增强多尺度表征,使用螺旋形扫描以捕获从中心到边界的轮廓信息,使用径向扫描以增强面向边界的局部细节提取。
- 独立处理每个扫描对分支。使用 SFusion Mamba 融合所得特征。在融合前,将每个处理后的序列映射回其原始空间顺序。
- 对于输入特征图 X ∈ ℝB×H×W×C,将其展平为 Xseq ∈ ℝB×L×C,其中 L = H × W。
- 根据每个扫描对分支的扫描索引对展平后的序列进行重排序。使用 S6 模块处理每个重排序后的序列,并将处理后的序列恢复至原始空间顺序。
- 通过加法路径和 SFusion Mamba 路径融合四个扫描视角特征,以获得 MV4D 模块的最终输出。有关 MV4D 架构,请参见图 3;有关完整的张量级实现流程,请参见算法 1,补充文件 1。
- 使用 models/mvmunet/core.py 中的完整软件实现。该文件包含扫描索引生成器、PairwiseScanMamba、SequenceS6、SFusion Mamba 以及 MV4D 封装模块。
- 生成多视角扫描索引
- 按照 models/mvmunet/core.py 中发布的实现生成扫描索引。对于空间尺寸为 H × W 的输入特征图,使用 index = r × W + c 将每个像素位置展平为一维索引,其中 r 和 c 分别表示行和列坐标。
- 通过遍历满足 r + c 为常数的图像对角线生成之字形扫描。收集每条对角线上的有效像素索引,并通过反转每个偶数编号对角线的顺序来交替遍历方向。
- 通过递归地将图像划分为四个象限生成分层式扫描。依次访问左上、右上、左下和右下象限,直到子区域的高度或宽度不超过 2 像素,然后以行优先顺序遍历剩余像素。
- 通过从左到右沿顶行、从上到下沿右列、从右到左沿底行、从下到上沿左列遍历外层图像边界,并逐步向图像中心收缩边界,生成螺旋形扫描。
- 通过将每个像素按照其到图像中心的平方距离排序,再根据使用 atan2 函数计算的极角排序,生成径向扫描。
- 通过反转相应前向扫描顺序生成每种扫描策略的反向扫描。在将扫描对送入 MV4D 模块之前,将前向和反向扫描序列组合成每种扫描策略的一个扫描对。
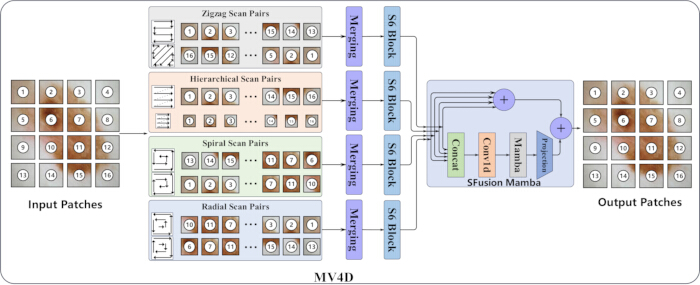
图 3.多视角四向(MV4D)模块的结构。 多视角四向(MV4D)特征提取模块的结构。输入图像块通过四个互补的扫描对分支进行处理,包括之字形、层次化、螺旋形和径向扫描。从四个分支中提取的特征被合并,经由状态空间模块处理,并通过空间融合 Mamba(SFusion Mamba)整合,以生成输出特征表示。请点击此处查看此图的放大版本。
4. MVV 区块的构建
- 使用一个主分支和两个辅助分支构建 MVV 模块。采用 图 4 所示的整体结构。
- 对主分支中的输入特征应用层归一化。将归一化后的特征输入至线性层。将变换后的特征传递给深度可分离卷积。
- 使用深度可分离卷积处理变换后的特征。应用 GELU 激活函数。将激活后的特征输入至 MV4D 模块。
- 将第一个辅助分支构造成恒等残差连接。将输入特征直接连接至最终输出。使用该分支保留原始表示并稳定训练过程。
- 将第二个辅助分支构造成投影下采样-上采样分支。使用下投影层压缩输入特征。使用上投影层恢复特征维度。
- 合并主分支和两个辅助分支的输出。获得最终的 MVV 模块输出。完整架构请参见图 4。
- 将主分支的隐藏维度设置为等于输入通道维度 Cs。在主线性投影前应用 LayerNorm(Cs),并使用维度为 Cs→Cs 的线性层。采用由 3×3 深度卷积(填充为 1,groups = Cs,无偏置)后接 1×1 点卷积(无偏置)组成的深度可分离卷积。
- 在深度可分离卷积之后应用 GELU 激活函数。将激活后的特征输入 MV4D,并应用维度为 Cs→Cs 的输出线性投影。配置投影下采样-上采样分支时,使用 LayerNorm(Cs)、投影比为 4、下投影 Cs→Cs/4、GELU 激活函数以及上投影 Cs/4→Cs。
- 通过逐元素相加的方式融合恒等分支、投影下采样-上采样分支以及经过 drop-path 处理的主分支,得到最终的 MVV 模块输出。
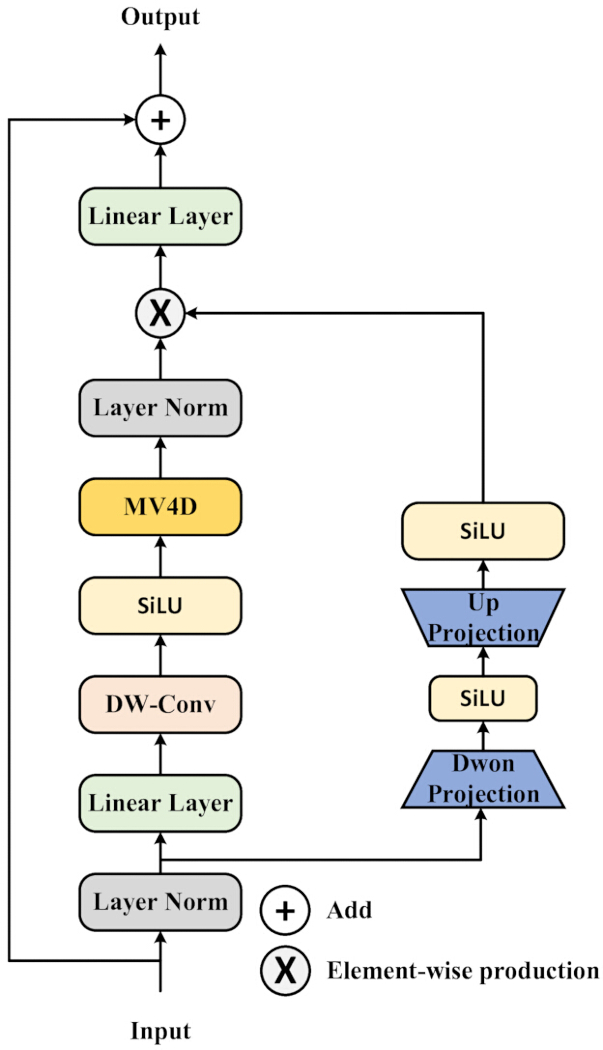
图 4。多视角视觉(MVV)模块的架构。多视角视觉(MVV)模块的结构。该模块包含一个主特征提取分支,其中包含多视角四方向(MV4D)模块,以及深度卷积、归一化和线性投影层。一个辅助的上下投影分支通过逐元素相乘提供门控特征调制,然后进行残差相加以生成输出特征表示。请点击此处查看此图的放大版本。
5. 构建 MFusion Mamba
- 收集所有编码器阶段的特征图。在必要时通过调整大小或投影,将编码器特征对齐到统一的表示空间。有关完整的张量级实现流程,请参见补充文件1中的算法2。
- 在必要时将编码器特征调整至目标空间分辨率。将具有不同通道维度的特征投影到相同的通道维度。在多阶段融合之前对齐所有编码器特征。
- 将对齐后的编码器特征输入至粗融合(Coarse Fusion)组件。使用哈达玛积(Hadamard product)执行粗融合。生成粗融合表示。
- 将粗融合表示输入至细融合(Fine Fusion)组件。构建两条并行的细融合通路。独立处理两条通路。
- 使用线性层处理第一条细融合通路。使用上投影、一维卷积(Conv1d)、Mamba 模块和下投影处理第二条细融合通路。在下投影后恢复特征维度。
- 使用哈达玛积合并两条细融合通路的输出。应用最终的线性层。获得 MFusion Mamba 输出。
- 将 MFusion Mamba 输出输入至解码器。结合编码器-解码器跳跃连接特征,解码融合后的多阶段表示。生成最终的分割图。
- 在粗融合之前,将来自不同阶段的编码器特征对齐到统一的特征空间。使用粗融合和细融合阶段处理对齐后的特征表示。有关 MFusion Mamba 架构的详细信息,请参见图5,有关完整的张量级实现流程,请参见补充算法2。
- 按如下方式设置 MFusion Mamba 的实现参数:对于每个编码器特征 Ei,将通道维度从 Ci 投影至 Ct。在必要时,使用双线性插值(align_corners=False)将投影后的特征调整至目标空间尺寸。
- 使用哈达玛积对对齐后的编码器特征执行粗融合。配置第一条细融合通路:使用维度为 Ct → Ct 的线性层。配置第二条细融合通路:使用上投影 Ct → 2Ct、一维卷积(Conv1d)、模型维度为 2Ct、单扫描方向、状态维度为 16 的 Mamba/S6 模块,以及下投影 2Ct → Ct。
- 使用哈达玛积融合细融合通路的输出。应用维度为 Ct 到 Ct 的最终线性投影。将融合后的多阶段表示输入至解码器。
- 使用 MFusion Mamba 融合多阶段编码器特征
- 收集来自全部四个编码器阶段的特征(E1、E2、E3 和 E4),并将其作为 MFusion Mamba 模块的输入。不要仅选择对应阶段的编码器特征用于解码器融合。
- 将所有编码器特征对齐至当前解码器阶段所需的空间分辨率。在特征融合前,将编码器特征调整至目标分辨率,并投影至所需的通道维度。
- 对每个解码器阶段重复执行特征对齐过程。当解码器在 H/16 × W/16、H/8 × W/8 和 H/4 × W/4 尺度下运行时,将 E1、E2、E3 和 E4 调整并投影至相应的目标特征空间。
- 使用 MFusion Mamba 模块中的粗融合和细融合操作融合对齐后的多阶段编码器特征,并将融合后的表示与对应尺度的解码器特征结合。
- 根据 models/mvmunet/core.py 中发布的实现执行特征投影、调整大小和融合操作。
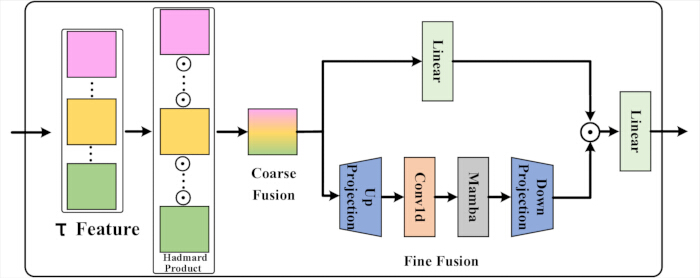
图 5。多阶段融合 Mamba(MFusion Mamba)模块的架构。 多阶段融合 Mamba(MFusion Mamba)模块的结构。多尺度编码器特征首先通过粗粒度融合进行合并,随后经由精细融合模块进行优化,该模块包括线性投影、一维卷积(Conv1d)、一个 Mamba 模块以及特征投影层,最终生成解码器所使用的融合特征表示。请点击此处查看该图的放大版本。
6. 模型训练
- 在配备 13 代 Intel Core i9-13900K CPU 和 NVIDIA A800 GPU 的工作站上,使用 Ubuntu 22.04.1 操作系统(Linux 内核版本 6.8.0)训练 MVM-UNet。在整个训练与评估过程中使用相同的硬件配置。
- 使用 PyTorch 2.0.1 框架(CUDA 11.8)实现并训练模型。在训练前安装所有必需的软件依赖项。
- 使用 AdamW 优化器,初始学习率为 3 × 10⁻⁵,β1 = 0.9,β2 = 0.999,ε = 1 × 10⁻⁸,权重衰减为 0.01。除非另有说明,批量大小设为 32。
- 每个模型训练 300 个周期。采用余弦退火学习率调度策略,ηmin = 1 × 10⁻⁵。对于 ISIC 2017 和 ISIC 2018 数据集,输入图像尺寸设为 256 × 256;对于 Synapse 数据集,设为 224 × 224。
- 主比较实验使用三个独立的随机种子(1、52 和 100)。对每个随机种子重复完整的训练与评估流程。最终的定量结果以三次运行的均值 ± 标准差(SD)形式报告。
- 所有消融实验使用固定的随机种子 100,除非另有说明。在所有消融实验中保持数据集划分、预处理策略、网络架构、优化器、学习率、批量大小和训练周期数不变。
- 对 ISIC 2017 和 ISIC 2018 上的二分类病灶分割任务使用 BCE-Dice 损失函数,BCE 和 Dice 损失权重均设为 1.0。对 Synapse 数据集使用 CE-Dice 损失函数,交叉熵和 Dice 损失权重均设为 1.0。
- 使用第 1 步中描述的预处理流程对 ISIC 2017 和 ISIC 2018 的训练图像进行缩放、归一化和数据增强。对 Synapse 训练图像应用第 1 步中描述的缩放、随机旋转和随机翻转操作。所有训练运行中使用相同的预处理设置。
- 根据各数据集特定的验证协议选择模型检查点。对 ISIC 2017 和 ISIC 2018,保存验证性能最佳的检查点,并每 30 个周期进行一次验证。Synapse 模型训练 300 个周期,不使用验证集,测试时采用最终训练结束时的检查点。
- 仅对 ISIC 2017 和 ISIC 2018 使用官方验证集进行模型选择。不得将 Synapse 测试集用于训练、超参数调优或检查点选择。所有测试数据仅保留用于最终评估。
- 为确保可重复性,使用以下训练参数:所有数据集的批量大小设为 32;使用 AdamW 优化器,初始学习率为 3 × 10⁻⁵,β1 = 0.9,β2 = 0.999,ε = 1 × 10⁻⁸,权重衰减为 1 × 10⁻²。
- 对 ISIC 2017 和 ISIC 2018,配置余弦退火学习率调度器,Tmax = 50,ηmin = 1×10⁻⁵;对 Synapse,Tmax = 100,ηmin = 1×10⁻⁵。所有重复实验中保持调度器配置不变。
- 所有模型均使用全精度 FP32 算术进行训练。禁用自动混合精度训练。优化过程中不应用梯度裁剪。
- 在所有比较实验、消融研究和可重复性运行中,保持精度设置、梯度更新策略、优化器配置、学习率调度和随机种子协议不变。
- 选择最佳模型检查点
- 对 ISIC 2017 和 ISIC 2018 数据集,在每次训练周期结束后在验证集上评估模型。
- 计算每个验证批次的二元交叉熵(BCE)-Dice 损失,并在整个验证集上计算平均验证损失。
- 当平均验证损失低于此前记录的最小验证损失时,将当前模型保存为最佳检查点。
- 在验证过程中仅用于性能监控,记录平均交并比(mIoU)、Dice 相似系数(DSC)、准确率(Acc)、特异性(Spe)和敏感性(Sen)。这些指标不作为检查点选择的标准。
7. 模型评估
- 使用每个数据集的官方测试集评估训练好的模型。仅将测试集用于最终性能评估。
- 对于 ISIC 2017 和 ISIC 2018,计算 mIoU、DSC、Acc、Sen 和 Spe。所有计算均基于像素级别的真阳性(TP)、假阳性(FP)、真阴性(TN)和假阴性(FN)。
- 对 ISIC 2017 和 ISIC 2018 的模型输出应用 sigmoid 激活函数。使用 0.5 的阈值将概率图转换为二值分割掩码。使用 公式 2–6 计算评估指标:
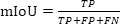 (2)
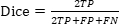 (3)
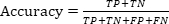 (4)
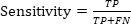 (5)
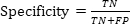 (6)
- 对于 Synapse 数据集,对模型输出应用 softmax 激活函数。通过 argmax 操作将每个像素或体素分配给概率最高的类别。计算每个前景器官的 DSC 和第 95 百分位豪斯多夫距离(HD95),并报告所有测试样本上的平均值。
- 将 MVM-UNet 与具有代表性的基于 CNN、基于 Transformer 和基于状态空间模型(SSM)的分割方法进行比较。所有方法使用相同的数据集划分、预处理流程、输入分辨率和评估指标。
- 对 ISIC 2017 和 ISIC 2018 使用官方的训练、验证和测试划分。对 Synapse 使用标准划分,即 18 个训练样本和 12 个测试样本。将 ISIC 数据集和 Synapse 的输入分辨率设置为指定值。
- 尽可能使用基线方法的官方实现进行复现。将复现结果以多次运行的均值 ± 标准差(SD)形式报告。保留文献中原始报告的数值,并在相应表格注释中予以区分。
- 除非另有说明,消融实验使用固定的随机种子 100。在所有消融实验中保持数据集划分、预处理流程、输入分辨率、优化器、学习率调度、批量大小、训练轮数(epochs)、损失函数和评估指标不变。
- 评估 MV4D、SFusion Mamba、MVV 模块中上下投影分支、MFusion Mamba、输入图像尺寸、dropout 值以及编码器-解码器层数配置的贡献。每次消融实验仅修改目标组件或参数。
- 对 ISIC 2017 和 ISIC 2018 使用成对的每图像结果,对 Synapse 使用成对的每病例结果,执行 Wilcoxon 符号秩检验。若 p 值小于 0.05,则认为具有统计学显著性。
- 在相同硬件环境和输入分辨率下评估各方法的计算效率。测量每轮训练时间、每张图像推理时间、训练期间峰值 GPU 显存占用、模型参数数量和浮点运算次数(FLOPs)。通过单次前向传播计算 FLOPs。
- 仅在完成模型评估后,从测试集中选取具有代表性的定性示例。使用相同的测试样本,比较原始图像、真实掩码和预测掩码。选取包含小目标、不规则边界、模糊边界以及典型多器官结构的代表性示例。
- 计算评估指标并进行统计分析
- 使用 Python 中的 NumPy 和 sklearn.metrics.confusion_matrix 计算 ISIC 2017 和 ISIC 2018 数据集的分割指标。将预测的概率图以 0.5 为阈值进行二值化,获取像素级别的 TP、FP、TN 和 FN,并基于这些值计算 mIoU、DSC、Acc、Sen 和 Spe。
- 使用 medpy.metric.binary.dc 和 medpy.metric.binary.hd95 分别计算 Synapse 数据集的 DSC 和 HD95。在计算评估指标前,先对模型输出应用 softmax 再进行 argmax 操作。
- 使用 thop.profile 通过单次前向传播计算 FLOPs 数量和可训练参数数量。
- 在 Python 中使用 scipy.stats.wilcoxon 执行 Wilcoxon 符号秩检验。对 ISIC 2017 和 ISIC 2018 数据集使用成对的每图像指标值,对 Synapse 数据集使用成对的每病例指标值。
8. 损失函数定义
- 对于多类分割任务,使用标准的交叉熵(CE)损失函数;对于二分类分割任务,使用标准的二元交叉熵(BCE)损失函数。分割任务中采用标准的 Dice 损失函数公式。公式 7–11 定义了本实验方案所使用的损失函数。
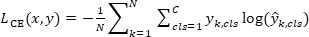 (7)
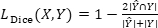 (8)
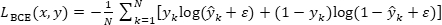 (9)
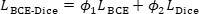 (10)
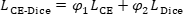 (11)
- 对于 ISIC 2017 和 ISIC 2018 数据集,将 BCE 损失与 Dice 损失的权重均设为 1.0,即
 1 = 1.0 且 2 = 1.0。对于 Synapse 数据集,将 CE 损失与 Dice 损失的权重均设为 1.0,即 φ1 = 1.0 且 φ2 = 1.0。
- 在 utils.py 文件中实现上述损失函数。BCE 项使用 nn.BCELoss,CE 项使用 nn.CrossEntropyLoss。计算二元 Dice 损失时,需将每个预测掩码和真实标签掩码展平,分别计算每个样本的 Dice 损失,再对整个批次的损失取平均值。计算多类 Dice 损失时,需将目标标签图转换为 one-hot 格式,对模型输出应用 softmax 函数,分别计算每一类的 Dice 损失,再对所有类别的损失取平均值。
- 将二元 Dice 损失的平滑常数设为 1,多类 Dice 损失的平滑常数设为 1×10⁻⁵。使用 BceDiceLoss 类实现 BCE-Dice 损失,其中 wb = 1 且 wd = 1;使用 CeDiceLoss 类实现 CE-Dice 损失,其中 loss_weight = [1, 1]。对于所有数据集、随机种子和实验,保持平滑常数、损失约简策略及软件实现方式不变。
- 配置损失函数的约简方式
- 实例化 nn.BCELoss() 和 nn.CrossEntropyLoss() 时,不显式指定 reduction 参数。
- 对两个损失函数均使用 PyTorch 默认的损失约简设置(reduction = "mean"),不得使用 reduction = "sum" 或不进行约简的输出形式。
9. 可重复性设置与执行
- 从 https://github.com/LIXUEGUANG002/MVM-UNet 下载已发布的实现版本。将该代码库与材料表中列出的软件包、数据集、硬件规格和计算资源一并使用。
- 通过运行 git clone https://github.com/LIXUEGUANG002/MVM-UNet.git,然后执行 cd MVM-Unet,克隆代码库并进入项目目录。
- 通过在 configs/config_setting.py 中设置数据集名称、数据集路径、输入尺寸、批量大小、训练轮数、损失函数、优化器、学习率调度器和随机种子,配置 ISIC 2017 或 ISIC 2018 实验。在代码库根目录下运行 python train.py 启动训练脚本。
- 通过在 configs/config_setting_synapse.py 中设置数据集名称、训练数据路径、测试数据体路径、列表目录、输入尺寸、类别数量、批量大小、训练轮数、损失函数、优化器、学习率调度器和随机种子,配置 Synapse 实验。在代码库根目录下运行 python train_synapse.py 启动训练脚本。
- 通过在相应配置文件中将 only_test_and_save_figs 设置为 True,best_ckpt_path 设置为已训练的检查点路径,img_save_path 设置为输出目录,执行仅推理评估。运行 python train.py(用于 ISIC 2017 或 ISIC 2018)或运行 python train_synapse.py(用于 Synapse),以生成预测结果和定性图像。
- 使用已发布的源代码版本
- 克隆已发布的 GitHub 代码库,并在配置数据集、训练脚本和评估设置之前,切换到主分支上的提交 ee891b42c2f083c4990eed72f1d4463adc5e103e。
- 使用此提交版本复现本研究中报告的实验结果。在稿件修订时,该代码库尚无可用的标签发布版本。
访问受限。请登录或开始试用以查看此内容。
结果
预期结果与解释
当本方案正确实施时,训练好的 MVM-UNet 模型应在多次重复运行中表现出稳定的分割性能,大多数评估指标在不同随机种子下仅有微小波动。对于 ISIC 2017 和 ISIC 2018 数据集,成功的实验结果表现为较高的 DSC、mIoU、Acc、Sen 和 Spe 数值,同时预测的病灶掩膜能够紧密贴合真实标注的病灶边界(图 6 和图 7)。对于 Synapse 数据集,成功的实验结果表现为前景器官的平均 DSC 值较高,且 HD95 值较低(图 8)。在方案执行过程中,应将定量指标与相应的定性分割结果结合进行解读。若模型虽取得较高的 DSC 值,但存在边界渗漏、小结构遗漏或预测结果碎片化等现象,则应视为仅部分成功,需重新核查预处理流程、检查点选择及推理设置。
访问受限。请登录或开始试用以查看此内容。
讨论
本方案描述了一种基于 Mamba 架构的医学图像分割框架 MVM-UNet。该方法旨在解决现有分割模型的两个局限性。首先,传统的基于卷积神经网络(CNN)的方法在建模复杂医学图像中的长距离依赖关系和层次化上下文信息方面能力有限43。其次,基于 Transformer 的方法虽能建模全局上下文,但通常需要更高的计算成本23,25。MVM-UNet 采用 Mamba 架构13,14,15,16,17,18,19
访问受限。请登录或开始试用以查看此内容。
披露
作者声明不存在任何竞争性经济利益。
致谢
本研究未获得外部资金支持。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 硬件 - GPU 工作站或 GPU 服务器 | 机构计算平台 / 本地工作站 | 自建本地 GPU 工作站;Ubuntu 22.04.1 操作系统,Linux 内核 6.8.0;Intel Core i9-13900K CPU;NVIDIA A800 GPU;128 GB 内存;512 GB 本地存储。 | 用于训练、验证、测试、消融实验及仅推理实验的计算平台。 |
| 硬件 - 图形处理器(GPU) | NVIDIA Corporation | NVIDIA A800 GPU(80 GB 显存)。 | 用于加速模型训练与推理。 |
| 硬件 - 中央处理器(CPU) | Intel Corporation / AMD | 第 13 代 Intel Core i9-13900K CPU。 | 用于数据加载、预处理和实验执行的主机处理器。 |
| 硬件 - 系统内存(RAM) | 机构计算平台 / 本地工作站 | 128 GB 系统内存 | 用于数据集加载、预处理和训练的内存空间。 |
| 硬件 - 存储设备 | 机构计算平台 / 本地工作站 | 2 TB NVMe 固态硬盘。 | 用于存储数据集、检查点、日志和生成的预测图像。 |
| 软件环境 - 操作系统 | Canonical Ltd. | 推荐:Ubuntu 22.04.1 LTS | 计算环境所使用的操作系统。 |
| 软件环境 - Conda 环境 | Anaconda, Inc. / Miniconda | 环境名称:mvmunet | 用于安装和隔离依赖项的 Python 环境。 |
| 软件环境 - Python | Python Software Foundation | Python 3.8 | 用于实现和执行实验的编程语言。 |
| 软件环境 - CUDA 工具包 | NVIDIA Corporation | CUDA Toolkit 11.8 | PyTorch 和 Mamba 相关包所需的 GPU 计算后端。 |
| 软件环境 - cuDNN | NVIDIA Corporation | cuDNN 8.7.0。 | 通过 PyTorch 使用的 GPU 加速深度学习基础操作。 |
| Python 包 - PyTorch | PyTorch | torch == 2.0.1 | 用于模型训练、损失计算、优化和推理的深度学习框架。 |
| Python 包 - Torchvision | PyTorch | torchvision == 0.14.0 | 在预处理和数据增强中使用的图像变换工具。 |
| Python 包 - Torchaudio | PyTorch | torchaudio == 0.13.0 | 随推荐的 PyTorch 环境一同安装。 |
| Python 包 - timm | timm 开发者 | timm == 0.4.12 | 在代码仓库环境说明中列出的模型组件或工具依赖项。 |
| Python 包 - triton | OpenAI / Triton 开发者 | triton == 2.0.0 | 由 GPU 加速序列建模组件使用的依赖项。 |
| Python 包 - causal-conv1d | causal-conv1d 开发者 | causal_conv1d == 1.0.0 | Mamba 实现所需的高效因果卷积依赖项。 |
| Python 包 - mamba-ssm | Mamba SSM 开发者 | mamba_ssm == 1.0.1 | 用于 Mamba/S6 相关组件的状态空间序列建模包。 |
| Python 包 - NumPy | NumPy 开发者 | NumPy 版本 1.24.3。 | 用于数值计算和数组操作。 |
| Python 包 - SciPy | SciPy 开发者 | SciPy 版本 1.10.1。 | 科学计算包;在 utils.py 中导入了 scipy.ndimage.zoom。 |
| Python 包 - SimpleITK | Insight Software Consortium | SimpleITK 版本 2.2.1。 | 在 utils.py 中导入的医学图像输入/输出和预处理工具。 |
| Python 包 - MedPy | MedPy 开发者 | MedPy 版本 0.4.0。 | 在 utils.py 中导入的医学图像度量计算包。 |
| Python 包 - scikit-image | scikit-image 开发者 | scikit-image 版本 0.21.0。 | 在 README 中列出的图像处理依赖项。 |
| Python 包 - scikit-learn | scikit-learn 开发者 | scikit-learn 版本 1.3.2。 | 在 README 中列出的机器学习工具包。 |
| Python 包 - matplotlib | Matplotlib 开发者 | Matplotlib 版本 3.7.2。 | 用于保存定性可视化图像。 |
| Python 包 - h5py | h5py 开发者 | h5py 版本 3.9.0。 | 为 Synapse 测试数据体提供 HDF5 文件支持。 |
| Python 包 - thop | THOP 开发者 | THOP 版本 0.1.1.post2209072238。 | 用于计算 FLOPs 和参数相关的计算成本。 |
| Python 包 - packaging | Python Packaging Authority | packaging 版本 23.1。 | 在 README 中列出的依赖项。 |
| Python 包 - pytest | pytest 开发者 | pytest 版本 7.4.0。 | 在 README 中列出的依赖项。 |
| Python 包 - chardet | chardet 开发者 | chardet 版本 5.2.0。 | 在 README 中列出的依赖项。 |
| Python 包 - yacs | YACS 开发者 | yacs 版本 0.1.8。 | 在 README 中列出的配置工具依赖项。 |
| Python 包 - termcolor | termcolor 开发者 | termcolor 版本 2.3.0。 | 在 README 中列出的日志/终端工具依赖项。 |
| Python 包 - submitit | submitit 开发者 | submitit 版本 1.4.5。 | 在 README 中列出的实验/任务工具依赖项。 |
| Python 包 - tensorboardX | tensorboardX 开发者 | tensorboardX 版本 2.6.2.2。 | 在 README 中列出的训练日志可视化工具。 |
| Python 包 - ml-collections | ml_collections 开发者 | ml-collections 版本 0.1.1。 | 被 configs/config_setting_synapse.py 导入。 |
| 数据集 - ISIC 2017 挑战赛数据集 | 国际皮肤影像协作组织 | ISIC 2017 皮肤病变分割数据集 | 公开的、去标识化的皮肤镜下皮肤病变图像和掩码,用于二分类分割任务。 |
| 数据集 - ISIC 2018 挑战赛任务 1 数据集 | 国际皮肤影像协作组织 | ISIC 2018 任务 1:病变边界分割 | 公开的、去标识化的皮肤镜下皮肤病变图像和掩码,用于二分类分割任务。 |
| 数据集 - Synapse 多图谱标注(超出颅腔范围)数据集 | Synapse / Sage Bionetworks | 访问编号:syn3193805 | 公开的腹部 CT 多器官分割数据集。 |
| 数据组织 - ISIC 2017 数据文件夹 | 作者 / 代码仓库结构 | data/isic2017/ | 预期的本地文件夹,包含训练和验证图像/掩码。 |
| 数据组织 - ISIC 2018 数据文件夹 | 作者 / 代码仓库结构 | data/isic2018/ | 预期的本地文件夹,包含训练和验证图像/掩码。 |
| 数据组织 - Synapse 数据文件夹 | 作者 / 代码仓库结构 | data/Synapse/ | 预期的本地文件夹,用于存放 Synapse 列表、train_npz 和 test_vol_h5。 |
| 源代码 - MVM-UNet 源代码仓库 | 作者 / GitHub | 分支:master;Git 提交哈希:ee891b42c2f083c4990eed72f1d4463adc5e103e。 | 本协议的完整源代码实现。 |
| 源代码 - ISIC 配置文件 | 作者 | configs/config_setting.py | 用于 ISIC 风格二分类分割的配置文件。 |
| 源代码 - Synapse 配置文件 | 作者 | configs/config_setting_synapse.py | 用于 Synapse 多器官分割的配置文件。 |
| 源代码 - ISIC 训练脚本 | 作者 | train.py | ISIC 风格二分类分割的训练和验证入口点。 |
| 源代码 - Synapse 训练脚本 | 作者 | train_synapse.py | Synapse 多类别分割的训练和验证入口点。 |
| 源代码 - ISIC 引擎文件 | 作者 | engine.py | 用于 ISIC 风格实验的训练/验证引擎。 |
| 源代码 - Synapse 引擎文件 | 作者 | engine_synapse.py | 用于 Synapse 实验的训练/验证引擎。 |
| 源代码 - 损失函数和工具函数 | 作者 | utils.py | 实现随机种子设置、优化器/调度器工具、BCE-DICE 损失、CE-DICE 损失、Dice 损失、数据变换以及定性图像保存功能。 |
| 源代码 - MVM-UNet 架构实现 | 作者 | models/mvmunet/mvmunet.py | MVM-UNet 网络的主要定义。 |
| 源代码 - 自定义模块实现 | 作者 | models/mvmunet/core.py | 实现 MV4D、MVV Block、SFusion Mamba、MFusion Mamba、S6/Mamba 相关组件以及扫描索引生成器。 |
| 训练配置 - ISIC 损失函数 | 作者 / PyTorch | BceDiceLoss(wb=1, wd=1) | 用于皮肤病变二分类分割的组合 BCE-DICE 损失。 |
| 训练配置 - Synapse 损失函数 | 作者 / PyTorch | CeDiceLoss(num_classes=9, loss_weight=[1,1]) | 用于多类别器官分割的组合 CE-DICE 损失。 |
| 训练配置 - 优化器 | PyTorch | AdamW | 默认配置文件中使用的优化器。 |
| 训练配置 - ISIC 学习率调度器 | PyTorch | CosineAnnealingLR | 默认 ISIC 配置中的学习率调度器。 |
| 训练配置 - Synapse 学习率调度器 | PyTorch | CosineAnnealingLR | 默认 Synapse 配置中的学习率调度器。 |
| 训练配置 - 随机种子控制 | 作者 / PyTorch / NumPy | utils.py 中的 set_seed(seed) | 用于设置 Python、NumPy、PyTorch CPU、PyTorch CUDA 和 cuDNN 的确定性行为的函数。 |
| 训练配置 - 混合精度设置 | 作者 / PyTorch | amp = False | 自动混合精度训练标志。 |
| 输出 - 训练结果目录 | 作者 / 代码仓库结构 | results/mvmunet_* | 用于存储检查点、日志和生成输出的目录。 |
| 输出 - 仅推理输出路径 | 作者 / 配置文件 | img_save_path | 在仅推理评估期间保存定性预测图像的目录。 |
| 输出 - 最佳检查点路径 | 作者 / 配置文件 | best_ckpt_path | 用于仅推理评估的检查点路径。 |
参考文献
- Zhang F, et al. Cross co-teaching for semi-supervised medical image segmentation. Pattern Recognit. 2024;152:110485.
- Gu Y, et al. Dual-scale enhanced and cross-generative consistency learning for semi-supervised medical image segmentation. Pattern Recognit. 2025;158:111140.
- Zhu X, Wang W, Zhang C, Wang H. Polyp-Mamba: A hybrid multi-frequency perception gated selection network for polyp segmentation. Inf Fusion. 2025;115:103161.
- Iqbal S, et al. TBConvL-Net: A hybrid deep learning architecture for robust medical image segmentation. Pattern Recognit. 2025;158:111147.
- Zhao Z, et al. Balanced feature fusion collaborative training for semi-supervised medical image segmentation. Pattern Recognit. 2025;157:110986.
- Zhou T, et al. MambaYOLACT: You only look at Mamba prediction head for head-neck lymph nodes. Artif Intell Rev. 2025;58(6).
- Zhao Y, et al. MGF-GCN: Multimodal interaction Mamba-aided graph convolutional fusion network for semantic segmentation of remote sensing images. Inf Fusion. 2025;122:103268.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2015.
- Zhou Z, Siddiquee MMR, Tajbakhsh N, Liang J. UNet++: Redesigning skip connections to exploit multiscale features in image segmentation. IEEE Trans Med Imaging. 2019;39(6):1856-1867.
- Shaker A, et al. UNETR++: Delving into efficient and accurate 3D medical image segmentation. IEEE Trans Med Imaging. 2024;43(9):3377-3390.
- Zhou HY, et al. nnFormer: Volumetric medical image segmentation via a 3D Transformer. IEEE Trans Image Process. 2023;32:4036-4045.
- He A, et al. H2Former: An efficient hierarchical hybrid Transformer for medical image segmentation. IEEE Trans Med Imaging. 2023;42(9):2763-2775.
- Zhu L, et al. Vision Mamba: Efficient visual representation learning with bidirectional state space model. In: Proceedings of the 41st International Conference on Machine Learning (ICML). 2024.
- Liu Y, et al. VMamba: Visual state space model. Adv Neural Inf Process Syst. 2024;37:103031-103063.
- Ma J, Li F, Wang B. U-Mamba: Enhancing long-range dependency for biomedical image segmentation. arXiv. 2024;arXiv:2401.04722.
- Wang Z, et al. Mamba-UNet: UNet-like pure visual Mamba for medical image segmentation. arXiv. 2024;arXiv:2402.05079.
- Huang T, et al. LocalMamba: Visual state space model with windowed selective scan. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Zhang Z, et al. Motion Mamba: Efficient and long sequence motion generation. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Hu VT, et al. Zigma: A DiT-style zigzag Mamba diffusion model. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Rahman MM, et al. Mamba in vision: A comprehensive survey of techniques and applications. arXiv. 2024;arXiv:2410.03105.
- Falk T, et al. U-Net: Deep learning for cell counting, detection, and morphometry. Nat Methods. 2019;16(1):67-70.
- Gu R, et al. CA-Net: Comprehensive attention convolutional neural networks for explainable medical image segmentation. IEEE Trans Med Imaging. 2020;40(2):699-711.
- Chen J, et al. TransUNet: Rethinking the U-Net architecture design for medical image segmentation through the lens of Transformers. Med Image Anal. 2024;97:103280.
- Zhang Z, Zhang W. Pyramid medical Transformer for medical image segmentation. arXiv. 2021;arXiv:2104.14702.
- Cao H, et al. Swin-Unet: UNet-like pure Transformer for medical image segmentation. In: European Conference on Computer Vision (ECCV). Springer; 2022.
- Chen B, et al. TransAttUNet: Multi-level attention-guided U-Net with Transformer for medical image segmentation. IEEE Trans Emerg Top Comput Intell. 2023.
- Jiang S, Li J. TransCUNet: UNet cross-fused Transformer for medical image segmentation. Comput Biol Med. 2022;150:106207.
- Wu R, Liu Y, Liang P, Chang Q. H-vmunet: High-order Vision Mamba UNet for medical image segmentation. Neurocomputing. 2025;624:129447.
- Liu J, et al. Swin-UMamba: Adapting Mamba-based vision foundation models for medical image segmentation. IEEE Trans Med Imaging. 2024.
- Huang X, et al. MISSFormer: An effective Transformer for 2D medical image segmentation. IEEE Trans Med Imaging. 2023;42(5):1484-1494.
- Ruan J, et al. MALUNet: A multi-attention and lightweight U-Net for skin lesion segmentation. In: 2022 IEEE International Conference on Bioinformatics and Biomedicine (BIBM). IEEE; 2022.
- Ruan J, Xiang S. VM-UNet: Vision Mamba UNet for medical image segmentation. arXiv. 2024;arXiv:2402.02491.
- Valanarasu JMJ, Patel VM. UNeXt: MLP-based rapid medical image segmentation network. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2022.
- Ren S, Li X. HResFormer: Hybrid residual Transformer for volumetric medical image segmentation. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10558-10566.
- Karimijafarbigloo S, Azad R, Kazerouni A, Merhof D. MedScale-Former: Self-guided multiscale Transformer for medical image segmentation. Med Image Anal. 2025;103.
- Yan S, et al. Multi-scale convolutional attention frequency-enhanced Transformer network for medical image segmentation. Inf Fusion. 2025;119.
- Gao Y, Zhou M, Metaxas DN. UTNet: A hybrid Transformer architecture for medical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2021.
- Mei J, et al. SANet: A slice-aware network for pulmonary nodule detection. IEEE Trans Pattern Anal Mach Intell. 2021;44(8):4374-4387.
- Hu XZ, Jeon WS, Rhee SY. ATT-UNet: Pixel-wise staircase attention for weed and crop detection. In: 2023 International Conference on Fuzzy Theory and Its Applications (iFUZZY). IEEE; 2023.
- Wang X, et al. Transferable normalization: Towards improving transferability of deep neural networks. Adv Neural Inf Process Syst. 2019;32.
- Azad R, et al. TransDeepLab: Convolution-free Transformer-based DeepLabV3+ for medical image segmentation. In: International Workshop on Predictive Intelligence in Medicine (PRIME). Springer; 2022.
- Ruan J, Gao J, Xie M, Xiang S. Learning multi-axis representation in frequency domain for medical image segmentation. Mach Learn. 2025;114(1):10.
- Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press; Cambridge, MA; 2016.
- Milletari F, Navab N, Ahmadi SA. V-Net: Fully convolutional neural networks for volumetric medical image segmentation. In: 2016 Fourth International Conference on 3D Vision (3DV). IEEE; 2016.
访问受限。请登录或开始试用以查看此内容。