本研究提出了一种轻量级框架,通过命题级别验证和自适应统计阈值法来减少大语言模型中的幻觉现象。该方法利用自然语言推理选择性地修正缺乏支持的命题,在保持较低响应延迟和高效实际部署的同时,提升了事实准确性。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
大语言模型(LLMs)表现出一种关键倾向,即生成在语言上流畅但事实错误的输出——这一现象被称为“幻觉”——在对精度要求较高的应用中带来了严重风险。现有的缓解策略,包括检索增强生成和自一致性采样,要么引入了显著的推理延迟,要么依赖外部知识基础设施,限制了其在实时部署中的适用性。本文提出一种轻量级的两步声明验证框架,该框架将大语言模型的响应分解为原子性事实声明,并针对通过独立的事实回忆提示单独生成的参考内容,对每个提取出的声明进行独立验证。尽管生成器与验证器共享相同的基础语言模型,但将响应生成与事实回忆分离,减少了对直接响应的条件依赖,并在验证过程中通过自然语言推理(NLI)减轻了确认偏倚,同时应用一种自适应统计阈值——定义为 NLI 置信度分布上的 τ = µ + kσ——仅对被反驳的声明进行选择性修正。与依赖固定决策边界的先前基于 NLI 的方法不同,所提出的框架能够根据每条响应的置信度分布动态调整其验证阈值,在无需重新训练模型的情况下,在多个评估基准上表现出一致的性能。在 TruthfulQA 和 FEVER 上的评估结果显示,该框架将 TruthfulQA 上的幻觉率从 28% 降低至 9%,实现了 67.9% 的相对降幅,且相较于基线大语言模型仅增加 160 毫秒的额外延迟,在幻觉检测准确率方面优于 SelfCheckGPT 和 FActScore。这些结果表明,该框架在所评估的基准上能够在事实可靠性与响应延迟之间实现良好的平衡,但仍需在不同领域和部署场景中进一步验证。
引言
大型语言模型(LLMs)已成为现代人工智能系统的基础组成部分,在多种自然语言任务中展现出卓越的能力,包括文本生成、问答、摘要生成以及复杂推理1它们生成流畅且上下文连贯回答的能力,已加速了在临床决策支持、法律分析、软件工程和教育技术等高影响力领域的应用。2然而,一个关键且持续存在的局限性削弱了这些模型在上述场景中的可靠性:幻觉现象,即模型生成的语言流畅但事实错误、缺乏依据或完全虚构的回应3。实证研究报道的幻觉发生率因任务和模型而异,范围从15%到超过40%,即便是GPT-4等最先进的系统,在特定领域评估下也表现出可测量的事实不一致现象。2,3这一局限性在对精度要求较高的应用中构成了严重风险,错误的输出可能导致信息误导、误诊或决策失误4幻觉现象从根本上源于语言模型的概率特性——大语言模型通过预测输入序列在统计学上可能的后续标记来生成内容,而非通过检索或推理经过验证的事实知识。5因此,生成的输出可能包含看似合理但不准确的陈述、引入缺乏依据的断言,或混淆语义相关但事实不同的概念。6.
现有的缓解策略通过多种范式来解决这一问题,但每种方法都有明显的局限性。检索增强生成(Retrieval-Augmented Generation, RAG)通过将响应基于外部检索到的文档来减少幻觉现象,但会引入显著的延迟开销,需要访问维护良好的知识库,并且在专业领域或资源匮乏的领域中仍容易受到检索失败的影响7,8,9。
尽管响应生成器和参考生成器使用相同的底层 GPT-3.5 Turbo 模型实例化,但二者在不同的提示目标和执行上下文中运行。响应生成器针对用户查询生成无约束的答复,而参考生成器则执行独立的事实回忆任务,无法访问先前生成的响应。这种分离减少了对响应的直接条件依赖效应,并在声明验证过程中限制了确认偏倚。因此,该框架将生成的参考视为程序上独立,而非统计上独立。
近期研究还探索了轻量级解码策略,以在不依赖外部检索或重复验证的情况下减少文本生成中的幻觉现象。一种代表性方法是层间对比解码(Decoding by Contrasting Layers, DoLA),该方法通过在解码过程中对比Transformer模型中间层与最终层的表征来提升生成内容的事实性。与生成后验证框架不同,此类方法直接干预令牌生成过程,因而优化了语言生成流程中的不同阶段。这些互补性策略表明,幻觉缓解既可在解码阶段实现,也可通过生成后验证完成,每种方法在计算开销、实现复杂度和事实可靠性方面各有不同的权衡。
自洽性方法通过采样多个响应并选择最频繁或最连贯的输出来提高事实可靠性,但其计算成本随采样数量线性增长,因此不适用于对延迟敏感的部署场景8。迭代优化方法通过自我反馈循环反复修订输出,可逐步降低错误率,但每次额外的迭代都会显著延长推理时间9。基于自然语言推理(NLI)的验证方法通过评估生成陈述与参考文本之间的语义蕴含关系,提供了一种更具针对性的替代方案,但现有实现依赖固定的决策阈值,无法适应不同置信度分布、领域或模型行为的变化10,11。总体而言,这些方法要么带来不可接受的计算开销,要么依赖外部基础设施,要么缺乏通用部署所需的适应性。这些幻觉验证方法的主要特征比较见补充表1。
本文提出了一种轻量级的两步式声明验证框架,旨在减少大语言模型(LLM)输出中的幻觉现象,同时保持较低的响应延迟。第一步中,LLM生成初始响应,并将其分解为若干原子性事实声明;第二步中,利用自然语言推理(NLI)对每个声明进行验证,所依据的事实参考文本通过一次独立的推理过程生成,该过程不访问原始生成的响应内容,且声明层级的接受或修正决策由统计推导出的置信度阈值控制。本研究的主要贡献如下:(1)提出一种两步式、声明级别的验证流程,将响应生成与事实验证解耦,从而能够在无需外部检索或完整响应重生成的前提下,独立且有针对性地评估每一个原子性声明;(2)设计一种基于NLI置信度得分分布的自适应统计阈值机制(τ = µ + kσ),通过动态确定接受与修正边界,而非依赖固定决策规则,提升了在不同置信度分布下的鲁棒性;(3)采用一种选择性修正策略,仅对被分类为矛盾的声明进行重生成,相较于全响应重采样或迭代优化方法,显著降低了计算开销;(4)在聚焦幻觉问题的基准数据集上进行了实证评估,结果表明,所提出的框架将幻觉率从28%降低至9%,同时将响应延迟维持在实际部署可接受的范围内。
访问受限。请登录或开始试用以查看此内容。
方案
本研究未涉及人类受试者、动物、生物样本或患者数据,因此无需机构伦理审批和知情同意。
研究设计概述
为提高大语言模型(LLM)输出结果的事实可靠性,实施了一种两阶段验证框架。该流程包括响应生成、主张提取、孤立参考构建、基于自然语言推理(NLI)的验证、自适应统计决策、选择性修正以及最终响应整合。该框架通过TruthfulQA和FEVER基准数据集进行了评估。
整体工作流程
用户查询 → 初始响应生成 → 声明提取 → 独立参考文献生成 → 自然语言推理验证 → 统计阈值计算 → 声明修正 → 最终验证响应。自适应声明验证框架的整体工作流程如图1所示。
数据集准备
TruthfulQA 数据集12包含 817 个以事实为导向的问题,已下载并准备用于评估。 FEVER 数据集13包含 185,445 条标注声明,标签为“支持”、“反驳”或“信息不足”;评估使用了带有声明、证据和真实标签字段的标注开发数据。每条声明均根据其提供的证据进行评估,同时保留原始 FEVER 标签作为验证的参考结果。 包含事实验证声明-证据对的 FEVER 数据集已被获取并进行预处理。输入问题和声明被转换为标准化的文本格式。在实验前,删除了重复条目和不完整的样本。TruthfulQA 被划分为验证和测试子集。约 20% 的 TruthfulQA 样本(164 个问题)用于阈值调优,其余 653 个问题保留用于性能评估。对于 FEVER,直接使用基准提供的声明作为验证单元,未进行适用于 TruthfulQA 的响应生成和声明提取流程。用于框架开发与评估的基准数据集特征总结于表 1中。
初始反应生成
每个查询均提交至基础语言模型。使用温度为0.7、top-p为0.9的nucleus采样生成响应。最大输出长度限制为256个token。生成的响应在未经过任何后处理或人工修改的情况下进行存储。生成的文本直接转发至声明提取阶段。
声明提取
将每个生成的回复分解为可独立验证的事实陈述。采用结构化分解提示来识别原子性声明。将复合陈述拆分为最小事实单元。去除主观意见、修辞表达和对话填充内容。每个提取出的声明均作为独立的验证单元进行存储。
示例:
原始回复:
玛丽·居里(Marie Curie)是一位出生于波兰的物理学家和化学家,她对放射性现象进行了开创性研究。
提取的声明:(1)玛丽·居里出生于波兰;(2)玛丽·居里是一位物理学家和化学家;(3)玛丽·居里开展了关于放射性的研究。
独立参照构建:
针对每个提取出的声明,均生成一个独立的事实参考文献。验证模型仅接收原始用户查询,无法访问原始生成的响应,以避免确认偏倚。采用事实召回提示语,以促使生成简洁且基于证据的回答。所生成的参考文献被保存下来,用于后续验证。
自然语言推理验证
每个声明-参考文献对均被提交至一个预训练的自然语言推断(NLI)模型。该NLI模型将两者关系分类为:蕴含、中性或矛盾。记录了所有三个类别的置信概率。赋予一个带符号的验证分数:蕴含对应正值,中性对应零值,矛盾对应负值。收集所有验证分数用于阈值计算。
自适应统计阈值计算
NLI 模型生成的验证置信度在不同回答之间存在显著差异,因为不同的查询会产生不同数量的命题、语义复杂程度以及置信度分布。固定的全局阈值假设所有回答具有相似的置信度分布特征,而这种情况在实际中很少出现。为了适应这种变异性,所提出的框架利用每个回答的验证得分的均值和标准差,分别估计其独立的决策边界。均值反映了该回答整体的置信水平,而标准差则刻画了所提取命题之间置信度值的离散程度。这种自适应的设定使得接受标准能够根据每个回答特有的不确定性进行调整,而非对所有输入依赖单一的固定阈值。
计算了所有带符号验证分数的平均值(µ)和标准差(σ)。
自适应决策阈值的计算公式如下:

其中,τ 表示自适应阈值,µ 表示验证分数的均值,σ 表示标准差,k 表示灵敏度参数。
敏感性参数的初始值设为 0.7。将分类为“蕴含”且得分大于或等于 +τ 的声明予以接受;将分类为“矛盾”且得分小于或等于 −τ 的声明标记为需修正;得分位于区间 (−τ, +τ) 内的声明则保留为中性。
选择性权利要求更正
仅当NLI模型将声明-参考文献对分类为“矛盾”(Contradiction),且其对应的带符号验证分数满足自适应阈值条件 si ≤ -τ 时,该声明才会被提交进行更正。因此,更正决策由NLI分类标签和响应特异性的统计阈值共同决定。被分类为“蕴含”(Entailment)且 si ≥ τ 的声明被接受,而落在区间 -τ < si < τ 内的声明被视为中性,予以保留而不进行更正。这一联合判据确保了仅对同时表现出语义矛盾和足够强的负向验证证据的声明实施更正。
反应重建
已接受并修正的陈述按其原始顺序排列。恢复了句子边界以保持可读性。必要时进行了轻微的语法调整。组装后的输出被保存为最终的验证响应。
性能评估
该框架通过以下四个指标进行评估:(1)准确率:验证后仍保持事实正确的回答所占的比例;(2)F1 分数:幻觉检测精确率与召回率的调和平均值;(3)响应延迟:从提交查询到生成已验证响应的总处理时间;(4)幻觉率
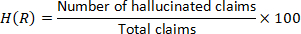
延迟报告为多次测量的平均执行时间。由于未保留每次运行的个体延迟值,因此未计算标准差和置信区间。
特定基准的正确性评估
对于 TruthfulQA,将最终验证后的回答与基准中人工验证的答案参考及错误答案列表进行比较。当回答中的事实主张与公认答案信息一致,且不包含与已识别的错误回答模式相对应的内容时,该回答被视为正确。对于 FEVER,将最终输出中的每一项声明与其相关证据及原始 FEVER 标注进行比对;被标记为“支持”的声明视为事实正确,而被标记为“反驳”的声明则视为错误。标注为“信息不足”的情况被保留为不确定结果,而不作为正面事实证据处理。最终,将每个基准测试中的声明级别判断结果进行汇总,以计算报告的准确率和幻觉率。
实验环境
该框架使用 Python 3.9 实现。数据处理操作通过数值计算和表格分析库完成。自然语言推理(NLI)模型以推理模式运行,未进行额外的微调。实验在配备 Intel Core i5 处理器、16 GB 内存和 64 位操作系统的计算机上执行。所有评估均采用单次前向推理设置,以确保低延迟运行。所有实验均在相同的硬件和软件配置下进行,以保证在不同数据集和基线方法之间的评估一致性。
预期结果
该方案旨在通过识别可能缺乏支持的声明,并有选择性地将明显矛盾的声明转发以进行修正,从而生成针对声明级别的验证结论。预期输出为经过验证的回复,其事实不一致性减少,且额外处理开销有限,具体效果取决于实验评估中观察到的性能表现。
访问受限。请登录或开始试用以查看此内容。
结果
初始反应生成
基线语言模型针对两个基准数据集中的问题生成了流畅且上下文相关的回答。然而,详细检查发现,部分回答中存在缺乏依据和事实错误的陈述。在TruthfulQA数据集中,基线系统的幻觉率为28%,而在FEVER数据集中观察到的幻觉率为26%。这些结果证实,仅依靠直接语言生成对于需要高事实可靠性的应用而言是不足的,并确立了后续所有验证程序所比较的基线条件。
声明提取
声明提取过程成功地将生成的回答分解为可独立验证的事实单元。TruthfulQA 中的回答平均包含 3.2 个原子级声明,而 FEVER 样本通常仅包含一个声明。该分解过程在不引入额外信息的情况下分离出事实陈述,使得每条陈述均可被单独评估。这一结果支持了如下假设:以声明为单位的验证比将整个回答视为单一整体进行评估具有更高的精确度。
独立参考构建
...访问受限。请登录或开始试用以查看此内容。
讨论
该框架在避免重复采样和外部检索的同时,提升了事实验证性能。在 TruthfulQA 数据集上,幻觉率从基线大语言模型的 28% 下降至完整框架的 9%,准确率则从 0.72 提升至 0.87。在 FEVER 数据集上,幻觉率从 26% 降至 10%,准确率从 0.74 提高到 0.89。这些比较结果应结合本研究中所采用的实验设置与实现方式来理解,而非作为该框架在所有部署条件下普遍优越的证据。该框架通过独立的事实参考和选择性修正,执行生成后的声明级别验证,在外部知识关联、重复推理与轻量级生成后验证之间实现了权衡。响应生成器与参考生成器均基于相同的底层 GPT-3.5 Turbo 模型,但在不同的提示目标和隔离的执行环境中运行。参考生成器仅接收原始查询,无法访问先前生成的响应。因此,这两个生成过程在程序上是相互独立的,但在统计上并非完全独立,可能保留源自其共享预训练模型的相关事实性偏差。
与现有方法的比较
基于先前关于基于自然语言推理(NLI)的事实性检查的研究,固定阈值NLI基线方法采用0.7的...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明无利益冲突。
致谢
作者谨向其所在机构致以诚挚感谢,感谢提供了开展本研究所必需的学术环境和计算资源。作者同时感谢本研究中所使用的公开基准数据集的开发者与维护者,这些数据集使得对所提出框架的全面评估成为可能。作者感谢同事和审稿人提出的建设性意见,这些意见有助于提升本研究的质量与表述清晰度。作者还感谢开源研究社区提供了促进实验、数据分析和结果可视化的软件库与工具。社区成员的持续努力极大地推动了自然语言处理与可信人工智能领域的研究进展。作者声明,本研究未接受任何外部财政支持或资助。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| FEVER 基准数据集 | FEVER 共享任务(Thorne 等) | https://fever.ai/dataset/fever.html | 公开可用的事实验证数据集,包含声明-证据对,用于评估 |
| GPT-3.5 Turbo(大型语言模型 B10+2:12:12) | OpenAI | 模型 ID:gpt-3.5-turbo;https://developers.openai.com/api/docs/models/gpt-3.5-turbo | 既用作响应生成器,也用作独立的参考生成器,通过 OpenAI API 访问 |
| NumPy | NumPy 开发者(开源) | https://numpy.org/ | 用于统计计算的数值计算库,包括 NLI 验证得分的均值和标准差计算 |
| Openai(Python API 客户端库) | OpenAI | https://github.com/openai/openai-python | Python 客户端库,用于向 GPT-3.5 Turbo 提交提示并获取生成结果 |
| pandas | pandas 开发团队(开源) | https://pandas.pydata.org/ | 用于表格数据处理的库,用于数据集预处理和结果处理 |
| 预训练自然语言推理(NLI)分类模型 | Hugging Face 模型中心(基于微软 DeBERTa-v3-large 架构构建的模型) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | 以推理模式使用,未经微调,用于将每个声明-参考对分类为蕴含、中立或矛盾 |
| Python | Python 软件基金会 | 版本 3.9;https://www.python.org/downloads/release/python-390/ | 用于实现验证框架的核心编程语言 |
| SciPy | SciPy 开发者(开源) | https://scipy.org/ | 科学计算库,用于支持实验结果的统计分析 |
| Transformers(Hugging Face Transformers 库) | Hugging Face | https://github.com/huggingface/transformers | Python 库,用于加载和运行预训练的 NLI 模型 |
| TruthfulQA 基准数据集 | 由 Lin、Hilton 和 Evans 首次发布 | https://github.com/sylinrl/TruthfulQA | 公开可用的基准数据集,包含 817 个面向事实的问题,用于阈值调优和评估 |
| 工作站计算机 | 文稿中未指明(请确认制造商/型号) | Intel Core i5 处理器;16 GB 内存;64 位操作系统 | 用于在相同配置下执行所有实验的硬件设备 |
| 注:上述所有 URL 均已在本表格发布日期前核实为有效链接。 |
参考文献
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
访问受限。请登录或开始试用以查看此内容。
重印与许可
本文已发表
视频即将推出