本文提出了一种基于可解释卷积神经网络(CNN)的皮肤病变分类框架,该框架结合了高诊断准确率与模型可解释性。该方法可对病变图像进行分类,并为其预测结果生成可视化解释。实验结果表明,该框架具有优异的性能和更高的透明度,有助于临床决策,并协助皮肤科医生实现皮肤疾病的早期检测。
本文内容
摘要
摘要
在多项研究中,利用深度卷积神经网络对皮肤区域疾病进行诊断已被证明可达到与皮肤科医生相当的准确度水平。然而,目前仍存在诸多挑战,包括在某些情况下性能欠佳、泛化能力差,以及由于使用“黑箱”模型而导致的可解释性较低等问题。这些问题为实际应用带来了重大障碍,因为在实现准确诊断的同时,还必须具备可解释性,因此亟需找到有效的解决方案。为克服上述困难,本研究开发了一种用于皮肤病变分类的可解释深度学习框架(EDLF-SLC)。该框架结合多种机器学习与可解释人工智能(XAI)方法,以三阶段方式提升模型的准确性与可解释性。在第一阶段,融合从多个预训练CNN架构中提取的深度表征,以保留不同网络架构所学习到的互补性判别信息,随后采用径向基函数核的支持向量机(SVM)进行分类。第二阶段使用具有径向基函数核的支持向量机(SVM)对所获得的特征进行分类。最后,在第三阶段,通过局部可解释的模型无关解释方法(LIME)对模型的预测结果进行解释。实验结果表明,EDLF-SLC在准确率上达到88.0%,精确率为89.0%,召回率为87.0%,F1分数为88.0%,在本研究考虑的实验条件下,其性能优于多种近期报道的方法,展现出较强的竞争力。
引言
皮肤病变是皮肤病学和肿瘤学中的主要问题,因其范围从良性异常到恶性肿瘤(如黑色素瘤)不等,而黑色素瘤是最致命的皮肤癌类型。2020年,全球黑色素瘤新发病例约达32.5万例,死亡人数超过5.7万例1。尽管筛查和治疗技术的进步已改善了患者的预后,但诊断延迟以及医疗资源获取受限仍导致较高的死亡率和寿命损失年数,尤其是在年轻人群中尤为显著2,3。
传统诊断主要依赖肉眼观察和皮肤镜检查,导致诊断过程依赖于临床医生的经验,容易产生主观性、观察者间差异、不必要的活检以及延长的检查时间4,5,6。为克服这些局限性,深度学习特别是卷积神经网络(CNN)已成为实现皮肤病变自动分类的有效解决方案。基于CNN的模型,包括DDCNN-F7、YOLOv7-XAI8以及多种其他架构9,10,11,12,13,已能够通过自动学习具有区分性的图像特征,实现较高的诊断准确率。尽管这些模型取得了成功,但大多数深度学习模型以“黑箱”方式运行,限制了临床医生的信任,阻碍了其在常规医疗实践中的应用。因此,可解释性人工智能技术被引入,通过提供对预测结果的可视化解释来提高模型的透明度。在这些方法中,局部可解释模型无关解释(Local Interpretable Model-Agnostic Explanations)通过识别对模型决策影响最大的图像区域,生成可解释的局部解释14。
皮肤病变分类已从传统的临床评估发展为基于人工智能的先进诊断系统,这一演变源于对准确、可靠且早期检测皮肤癌的需求。该领域的发展经历了五个主要阶段——传统诊断方法、计算机辅助诊断(CAD)、机器学习(ML)、深度学习(DL),以及近年来的可解释人工智能(XAI)和联邦学习(FL)——反映了人们持续努力提高诊断准确性、一致性、可扩展性和临床可信度,同时克服传统检查方法的局限性。早期的计算方法试图通过源自ABCD规则的手工设计图像描述符来模拟临床推理,这些规则包括不对称性、边界不规则性、颜色变化和病变直径。这些特征与贝叶斯网络、决策树、专家系统和模糊推理模型相结合,用于支持黑色素瘤的诊断,多项研究报道其分类准确率超过90%15,16,17。尽管这些方法为计算机辅助诊断奠定了重要基础,但它们完全依赖于人工设计的特征和预定义的诊断规则,因此在面对图像质量、病变形态、光照条件和采集环境的变化时,表现出有限的鲁棒性。
为解决这些不足,传统的计算机辅助诊断(CAD)系统作为介于常规图像分析与现代基于人工智能的框架之间的中间步骤应运而生。CAD 系统结合手工设计的特征提取方法与传统分类器,以提高诊断的一致性并辅助临床决策。一些混合方法将层次聚类与循环神经网络及长短期记忆网络架构相结合,实现了接近 99.5% 的分类准确率18。其他基于 CAD 的框架则融合了梯度提升分类器与基于 SHAP 的解释方法,在保持较强诊断准确性的同时提升了模型的可解释性19。尽管这些系统相较于纯规则驱动的方法已有显著改进,但仍高度依赖手工设计的特征提取、大量预处理、精细标注的数据集以及多阶段的处理流程。
机器学习技术通过实现数据驱动的学习而非显式规则设计,进一步推动了皮肤病变自动分类的发展。结合卷积神经网络与传统机器学习分类器(包括逻辑回归和k近邻算法)的混合框架在基准数据集上表现出优异的分类性能,准确率超过95%9。自监督多模态学习通过联合利用皮肤镜图像和临床图像,进一步改善了特征表示,在减少对大量人工标注依赖的同时提升了分类性能20。其他研究将卷积神经网络与广义判别分析、SURF描述符以及优化算法相结合,以提高特征区分能力和分类准确性21。采用DenseNet-201、InceptionV3和二叉树优化算法的自动特征选择技术在保持较高诊断性能的同时进一步增强了特征表示能力22。迁移学习方法利用预训练模型(如AlexNet和GoogLeNet),即使在训练数据有限的情况下也展现出良好的分类能力23。然而,大多数机器学习方法仍依赖于精心设计的预处理流程、人工构建的优化策略、平衡的数据集以及大量的超参数调优。其外部验证有限以及对类别不平衡的敏感性进一步限制了其在多样化临床环境中的实际应用。
深度学习(DL)的引入通过直接从原始图像数据进行端到端学习,从根本上改变了皮肤病变分类的自动化方式。卷积神经网络(CNN)消除了对手工设计特征工程的依赖,同时在多个基准数据集上显著提升了诊断性能。大多数基于CNN的方法通过日益复杂的网络架构,在病变分类方面表现出显著改进。关注对称性的CNN模型探索了具有临床意义的病变特征,但仅实现了中等水平的平衡准确率24。其他研究将EfficientNet架构与LIME和SHAP解释方法相结合,在提高可解释性的同时引入了定量的可信度评估指标25。结合病变分割、集成学习与CNN的混合深度学习系统在多个ISIC数据集上表现出优异性能,但仍对分割质量与类别不平衡问题较为敏感26。
近年来,日益复杂的混合架构通过整合互补的深度学习技术,进一步提高了分类准确率。结合YOLOv5和独立成分分析的条件生成对抗网络实现了超过99%的分类准确率,但其较高的计算复杂度限制了实际部署应用27。类似地,LSTM–ResNet混合架构能够有效学习时空特征表示,但需要显著增加计算资源28。基于Transformer的模型(如Sap-Former)利用全局上下文信息以增强特征表示能力,但需要大量预处理、大规模标注数据集以及强大的计算能力29。轻量级替代方案如S-MobileNet试图在计算效率与诊断准确性之间取得平衡30,而无监督域自适应方法尽管在训练样本有限时效果有所下降,仍可提升跨域泛化能力31。结合改进的卷积注意力模块与快照集成学习的注意力增强型混合网络在猴痘皮肤病变分类中也表现出良好性能,但类别不平衡、图像多样性以及可解释性不足等问题仍未得到解决32。采用更深网络结构和混合损失函数的定制化残差架构进一步将分类准确率提升至99%以上,但带来了显著增加的计算开销和训练时间33。多项系统综述研究一致指出,深度学习能够通过自动学习判别性图像特征,在性能上显著优于传统手工特征方法,但成像伪影、光照变化、计算复杂性以及临床泛化能力有限等问题仍持续存在34。
尽管深度学习显著提高了诊断准确性,但关于模型透明度、不确定性估计以及临床可信部署的担忧,促使人们对可解释人工智能(XAI)和联邦学习的兴趣日益增长。多项研究探讨了不确定性量化技术,包括保形预测、蒙特卡洛丢弃法和证据深度学习,表明可靠的置信度估计能够显著提升决策支持能力,尽管这会带来额外的计算和数据相关限制35。基于Transformer的互学习框架也被提出,以解决类别不平衡问题,同时提高特征学习效率36。其他方法将全分辨率卷积神经网络与基于图的优化技术相结合,以改善病灶分割与分类37,而整合多种互补特征表示的混合深度学习框架在需要大量预处理的情况下,仍实现了接近99.5%的分类准确率38。
近年来,研究 increasingly focused on 将可解释性直接整合到深度学习框架中,以增强临床医生的信任并促进实际临床应用。采用多种卷积神经网络架构并结合 Grad-CAM 和 Score-CAM 的可解释系统,在内部和外部数据集上均成功定位了具有诊断意义的病灶区域,同时保持了具有竞争力的分类性能39。将皮肤镜图像与临床元数据相结合的混合 CNN–Transformer 框架,在利用 SHAP 和 Grad-CAM 生成具有临床意义的可视化解释的同时,进一步提升了预测性能40。其他基于 Transformer 的混合架构整合了 EfficientNetV2S、Swin Transformers、改进的 Xception 网络以及图注意力机制,有效捕捉了病灶的全局与局部互补特征,但其庞大的参数量以及在少数类别上的有限性能限制了实际部署41。类似地,混合 YOLOv8–Vision Transformer 框架通过自适应增强结合 SHAP 和 Grad-CAM 解释,在病灶定位、多类别分类和可视化可解释性方面表现出改进;然而,这些方法仍主要依赖基准数据集,在少数病灶类别上的鲁棒性有限42。多篇综述文章总结了这些进展,强调了现代深度学习技术所取得的显著成就,同时也指出了在计算效率、可解释性、数据集依赖性和临床验证方面持续存在的挑战43,44,45。表1总结了近期发表的一些利用深度学习算法进行皮肤病变分类的研究工作。
尽管近期深度学习方法在皮肤病变分类方面取得了显著进展,但大多数现有方法仍受限于高计算复杂度、对大规模标注数据集的依赖、模型可解释性不足,以及在多样化真实临床环境中的验证不充分。为克服这些局限性,本文提出了一种EDLF-SLC框架,该框架将从多种卷积神经网络(CNN)架构中提取的互补特征与支持向量机(SVM)分类器相结合,以实现稳健且准确的分类。该框架进一步采用增强的预处理方法以提升图像质量并缓解类别不平衡问题,同时引入LIME技术对个体预测提供可视化解释,从而增强模型的透明度及临床可信度。
本研究的贡献主要体现在以下三个方面。首先,作者提出了一种鲁棒的框架EDLF-SLC,该框架将先进的卷积神经网络(CNN)与支持向量机(SVM)分类器相结合,以实现准确且可靠的皮肤病变分类。其次,作者实施了增强的预处理技术,以解决类别不平衡问题并降低图像噪声,从而提升输入图像的质量以及分类模型的整体性能。第三,作者引入了局部可解释模型无关解释方法(LIME),通过突出显示对分类决策影响最大的图像区域,来可视化和解释模型的个体预测结果,从而提高所提出框架的透明度和可解释性。
方案
本研究未涉及人类受试者的招募或可识别患者数据的收集。所有实验均使用从Kaggle资源库获取的公开可用的ISIC 2020皮肤病变数据集进行,因此无需机构伦理委员会批准和知情同意。本研究使用的所有材料均列于材料表中。
特征提取与融合
皮肤病变图像通过多个预训练的卷积神经网络(CNN)模型进行处理。从选定的预训练CNN架构中提取的深度特征向量被拼接,以构建每张皮肤病变图像的统一特征表示。所采用的融合策略保留了不同CNN架构学习到的互补视觉信息,使后续的支持向量机(SVM)分类器能够同时利用低层次的纹理特征和高层次的语义表示。尽管主成分分析或基于互信息的特征选择等降维技术可降低特征维度,但本研究有意保留完整的融合特征表示,因为融合后的特征空间对于所使用的径向基函数SVM(RBF-SVM)分类器而言在计算上仍可处理,同时保留了来自异构CNN骨干网络提取的互补诊断信息。
分类
利用融合的特征向量训练具有径向基函数(RBF)核的支持向量机(SVM)分类器。采用超参数优化技术确定最优的分类设置。随后,该分类器将皮肤病变划分为相应的类别。
可解释性
为了提高可解释性,采用LIME生成可视化解释,突出显示对分类结果贡献最为显著的图像区域。这些解释将有助于临床医生理解和验证模型的决策。
评估方案
使用基准皮肤病变数据集对所提出的框架进行评估。通过准确率、精确率、召回率和 F1 分数来评估性能。通过与现有的机器学习和深度学习方法进行对比实验,以证明所提出框架的有效性。
预期结果
本研究预期将产生一个准确且可解释的皮肤病变分类系统。初步实验结果表明,EDLF-SLC 的准确率达到 88.0%,精确率为 89.0%,召回率为 87.0%,F1 得分为 88.0%,优于多种竞争方法。通过整合 LIME 解释,预期可增强系统的可信度,并促进人工智能辅助诊断系统在临床实践中的应用。
意义
本研究通过解决皮肤病变诊断中可解释医疗人工智能领域的性能与透明度挑战,推动了该领域的发展。所提出的框架有望帮助皮肤科医生做出更可靠且可解释的诊断决策,最终改善患者诊疗效果。此外,本节中,作者提供了本研究中所应用的材料与方法的相关信息。具体而言,作者首先描述了实验所用的数据集,随后深入讨论了用于皮肤病变分类的可解释深度学习框架。
数据集
本研究基于公开可用的 ISIC 2020 数据集(国际皮肤影像协作组织),该数据集可在 Kaggle 网站获取(https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign)。ISIC 数据库被公认为皮肤影像学领域最优质的资源之一,因其提供了多种不同类型皮肤病变的皮肤镜图像,如图1所示。尤为重要的是,该数据集包含良性与恶性病变的图像,适用于进行皮肤癌的二分类任务46。当前数据集共包含 3,297 张图像,其中 1,800 张为良性,1,497 张为恶性。为了更高效地开展实验,需将数据划分为训练集与测试集。具体而言,训练集包含 2,637 张图像,其中良性 1,440 张,恶性 1,197 张;测试集包含 660 张图像,其中良性 360 张,恶性 300 张。数据集的汇总信息见表2。
提出的EDLF-SLC模型
本文提出了一种高效且易于理解的皮肤病变良恶性分类解决方案,该方法基于一种新颖的可解释深度学习技术,采用混合策略,结合了多个预训练卷积神经网络模型的优势。卷积神经网络在从医学图像中提取高层语义特征方面已被证明非常有效。利用这一能力,所提出的用于皮肤病变分类的可解释深度学习框架(EDLF-SLC)通过融合多个预训练CNN模型,实现了更优越的性能。为确保医学决策过程所需的透明性,本方法引入LIME技术,以生成对输出结果的局部人类可读解释。整个框架可分为三个主要阶段,如图2所示,分别为:(1)数据预处理,(2)特征提取与分类,(3)可解释性。
模型架构与集成
作为初步步骤,我们选取了七种流行的深度学习模型(MobileNetV2、ResNet50、EfficientNetB0、Xception、InceptionResNetV2、NASNetLarge 和 MobileNet),并分别在验证数据集上进行评估。最终选定了其中效果最好的四种模型(ResNet50、EfficientNetB0、MobileNet 和 Xception)用于特征提取阶段。在所提出的框架中,每张输入图像 x 会独立地通过选定的预训练模型。这些模型的最后一个全连接层均被移除,并从其前一层中提取特征向量。fResNet50(x)、fEfficientNetB0(x)、fMobileNet(x) 和 fXception(x) 分别表示上述各模型输出的特征向量。通过将这些特征向量进行拼接,得到一个新的聚合特征向量 F(xi):
F(xi) = [f(ResNet50)(xi);f(EfficientNetB0)(xi);f(MobileNet)(xi);f(Xception)(xi)] (1)
随后,F(xi)已通过具有径向基函数(RBF)核的支持向量机(SVM)分类器,以获得分类结果。所提出框架的完整算法如下所示: 补充文件 1.
该框架采用直接的特征级融合,因为每个预训练的卷积神经网络(CNN)架构通过其独特的网络结构和学习到的特征层次,捕捉皮肤病变的不同判别特征。因此,拼接这些异构的特征表示能够保留互补信息,从而在分类前实现更全面的病变表征。尽管主成分分析(PCA)或基于互信息的特征选择等降维技术可降低融合后特征的维度,但本研究有意保留完整的融合特征向量,因为其维度对于所采用的径向基函数支持向量机(RBF-SVM)分类器而言在计算上仍可处理,同时保留了不同CNN主干网络提取的互补诊断信息。因此,该设计优先保留互补的深度特征表示,而非在分类前剔除可能具有信息量的特征。
数据准备
数据准备包括数据预处理以及将数据集划分为训练集和测试集。预处理旨在通过消除不一致性、删除重复元素、格式化输入图像以及进行特征缩放,以提高数据质量,从而稳定地训练出性能良好的模型。所有图像均已通过 Z 分数归一化方法归一化至 [−1, 1] 范围内:
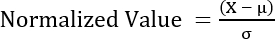 (2)
其中 µ and σ 分别代表相应图像的平均值和标准差。数据集已被分为两个子集,即训练集(70.0%)和测试集(30.0%)。
数据增强
为避免过拟合并提高模型的泛化能力,对训练集采用了一些数据增强方法。图像增强通过修改图像来人工扩展数据集,同时不改变医学状况的本质特征。增强流程使用 Keras Sequential API 构建,采用的变换包括随机水平翻转、小角度旋转、调整大小、缩放、亮度/对比度调整、缩放以及一些轻微的位移。增强后图像的代表性示例如图3所示。
预训练模型
在所提出的框架中,采用了多种预训练的深度学习模型,用于从输入图像中提取特征。这些模型包括 MobileNet、ResNet50、EfficientNetB0、Xception、NASNetLarge、Inception-ResNet-v2 和 MobileNetV2。MobileNet 和 MobileNetV2 是轻量级深度学习模型,通过使用深度可分离卷积实现高效的计算。ResNet50 采用残差连接机制来训练模型,从而避免训练过程中出现梯度消失问题。EfficientNetB0 通过复合缩放方法在效率与精度之间取得平衡。Xception 利用深度可分离卷积对 Inception 网络进行扩展。NASNetLarge 采用神经网络架构搜索技术构建最优的深度神经网络结构,而 Inception-ResNet-v2 则结合了 Inception 模型与残差连接机制,形成一种混合结构。从 ResNet50(1,024 个特征)、EfficientNetB0(1,280 个特征)、MobileNet(1,024 个特征)和 Xception(2,048 个特征)中提取的特征向量被拼接,生成一个统一的 5,376 维表示。选择这种融合策略是为了保留不同卷积神经网络架构所学习到的互补性表征,而非在分类前降低表征维度。生成的特征向量随后输入至 RBF-SVM 分类器,由其在融合后的特征空间中确定最优的非线性决策边界。
可解释的人工智能模型(LIME)
为了对模型的预测结果提供一定的局部可解释性,作者采用了为每个具体模型预测生成局部人类可读解释的方法,即LIME47。对于任意输入图像,LIME首先将其分割为称为超像素的较小单元。随后,从原始图像生成若干扰动样本,并利用深度神经网络模型对每个扰动样本进行预测。接着,通过拟合一个加权线性模型来分析这些扰动样本,其权重取决于各扰动与原始输入样本的接近程度。在线性模型拟合完成后,估算各特征的重要性得分,以表明每个超像素在最终标签预测中的作用。这些重要性得分将在最终的解释图像中以可视化方式突出显示。LIME算法详见补充文件2。
结果
所开发分类框架的性能评估基于源自混淆矩阵的传统评价指标。混淆矩阵通过表示针对每个定义类别所做出的正确与错误分类数量,能够全面地理解分类器的性能,从而可以分析所有类型的错误。例如,在疾病诊断中,假阳性与假阴性均尤为重要。假阳性值较高可能表明分类器具有高灵敏度,但同时,大量的假阴性则表明其灵敏度较低,并可能带来潜在的健康风险。本文采用了以下性能指标:准确率(accuracy)、精确率(precision)、召回率(recall)、F1分数(F1-score)、特异性(specificity)、真阳性率(TPR)和假阳性率(FPR)。这些指标的计算公式如下所示:
准确率 = (TP + TN) / (TP + TN + FP + FN) (3)
精确率 = TP/(TP+FP) (4)
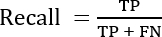 (5)
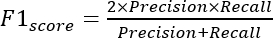 (6)
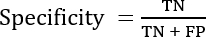 (7)
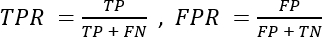 (8)
在此情况下,TP 表示该框架检测出的恶性皮肤癌数量,而 TN 表示良性病变的数量。FP 表示将实际为良性的病变错误分类为恶性的错误决策数量。FN 反映了被错误识别为良性的样本数量。在皮肤癌分类中,由于假阴性可能带来严重的不良后果,因此将其降至最低至关重要。
基线模型的性能
所有计算实验均在基于云的 Google Colab 环境中进行。值得注意的是,该平台允许使用预定义的 Ubuntu 20.04 作为操作系统的虚拟机实例运行。为训练基线模型,采用了 Python 3.9 版本和 PyTorch 框架 2.3.1 版本。此外,所有计算节点均具有相同的配置,即主频为 2.2 GHz 的 Intel Xeon CPU、NVIDIA Tesla T4 GPU、16 GB 内存以及 70 GB 的存储容量。因此,该实验设置有助于减少不同硬件平台引入的变异性,提高结果的可靠性和可重复性。实验环境的完整汇总见表3。
图4展示了ResNet-50架构在100个训练周期中的学习曲线。训练基于包含2,110张图像的数据集进行,验证数据集的大小为660张图像。可以看出,在训练过程中,准确率持续上升,接近90.0%。同时,准确率在前50个周期内不断提升;此后,准确率趋于稳定,表明模型已接近收敛。在验证集上,模型的AUC值达到86.0%,显示出良好的判别能力。
所展示的混淆矩阵 图5 以包含660张图像的测试集评估ResNet-50模型的分类准确率。在评估过程中,模型正确识别出360个良性样本中的310个,以及300个恶性样本中的239个。然而,有相对较多的恶性样本被错误分类,导致假阴性数值较高。由于此类错误在实际应用分类器时可能带来严重后果,该结果需进一步详细分析。总体而言,模型的准确率达到83.0%,精确率为83.3%,召回率为83.3%,F1分数为83.3%。
表4详细描述了ResNet-50模型在两个类别上的性能特征。该分类器在精确率方面表现出相对均衡的性能:对于良性样本,其值为83.0%,而恶性样本的精确率为84.0%。类似地,召回率在良性病变中达到88.0%,在恶性病变中为78.0%。表中的支持数(support)表示对应每个类别的样本数量。
提出的 EDLF-SLC 模型
图6 展示了所提出模型在300个训练周期内的训练集与验证集AUC值。AUC指标反映了模型区分良性和恶性类别样本的能力,数值越高表明模型的判别性能越优。如图所示,训练集AUC在整个训练过程中持续稳定上升,在约第200个周期达到最大值1.00。验证集AUC在训练初期也逐步提升,但在约第150个周期后开始趋于平缓,表明模型已趋于收敛。最终验证集AUC为0.95,显示出模型具有较强的泛化能力和良好的类别可分性。
如图7所示,所提出模型的混淆矩阵显示,该模型正确分类了299个良性样本和272个恶性样本,同时将28个良性病例误分类为恶性,将61个恶性病例误分类为良性。总体而言,模型实现了571次正确预测和89次误分类。值得注意的是,假阴性(将恶性病例误分类为良性)数量较高,突显出一个关键局限性,因为此类错误可能带来显著的临床影响。尽管如此,模型的整体分类性能仍然稳健。与在分类前有意去除维度的特征选择方法不同,所提出的框架保留了由多个异构CNN架构生成的完整融合深度表征。采用此设计的原因在于,每个骨干网络提取的病变特征具有互补性,而保留完整表征可使SVM分类器充分利用组合的判别信息,而不排除潜在有用特征。因此,所采用的特征融合策略在保持计算可行性的前提下,优先考虑了互补表征学习。
图8展示了所提出模型生成的分类结果的代表性示例。结果表明,该模型对正确分类的样本赋予了较高的置信度分数。具体而言,良性病例表现出较高的预测概率(例如,99.84% 和 99.85%),而恶性病例也显示出较强的置信水平(例如,99.98% 和 99.96%)。这些发现表明,即使在视觉上具有挑战性的情况下,该模型仍能有效区分良性和恶性病变。为了增强可解释性,采用LIME框架生成针对模型预测的局部解释,如图9A–D所示。LIME通过使用局部可解释的线性模型来近似模型复杂的决策边界。对于每张输入图像,该方法通过选择性遮蔽超像素并评估相应的预测结果来生成扰动样本。随后,基于径向基函数核,根据样本与原始输入的接近程度确定权重,并拟合一个加权线性模型。所得系数表示每个超像素对最终预测的贡献,其定义为:
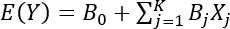 (9)
其中 Xj ∈ {0, 1} 表示第 j 个超像素的存在或缺失,Bj 表示相应的贡献权重,以及 B0 是基线预测。正系数(Bj > 0)表示对恶性类别有贡献的区域,而负系数(Bj < 0)对应良性特征。基于LIME的可视化结果如图所示 图9B, D,突出显示对每个分类决策贡献最大的区域。对于良性病变,模型强调具有均匀色素和边界清晰的区域。相比之下,对于恶性病例,高亮区域对应于临床上显著的特征,如边界不规则、颜色异质性和非典型纹理。高亮区域的强度反映了相应系数 B 的大小j.
这些结果表明,EDLF-SLC 模型关注的是与已建立的皮肤科标准(如 ABCD 法则)一致的具有临床意义的特征。这种一致性增强了模型的可解释性和可信度,使其更适用于临床决策支持。此外,图10 展示了使用其他可解释性技术(包括 Grad-CAM、HiResCAM、GradCAM++、XGradCAM、LayerCAM、EigenGradCAM 和 EigenCAM)获得的对比可视化结果,进一步验证了不同方法在识别显著区域上的一致性。关于所提出的 EDLF-SLC 模型与七种基线模型在完成 100 轮训练后的性能表现,表5 中展示了相应的比较结果。在实验背景下,EDLF-SLC 在各项评估指标上均取得了 0.88 的竞争性表现,优于或相当于所评估的基线架构。EfficientNetB0 和 ResNet50 也表现出良好的结果,准确率分别为 0.85 和 0.83。相反,Inception-ResNetV2 在所评估模型中的分类性能最差。然而,尽管其分类准确率相对较低,其计算效率仍与基线模型相当。在采用的实验条件下,所提出的 EDLF-SLC 模型相较于评估的基线模型展现出具有竞争力的性能。
为了评估所提出框架相对于现有方法的性能,表6展示了与代表性最先进皮肤病变分类方法的对比结果。例如,47报道的准确率为0.86,而48采用了一种基于集成的模型,虽然准确率相近,但精确率、召回率和F1分数较低。基于集成学习和多种卷积神经网络(CNN)架构的近期研究25,49报道的准确率最高达到0.87。在本研究采用的实验条件下,所提出的EDLF-SLC框架在使用统一的可解释架构且无需额外组件(如病变分割模型)的情况下,实现了0.88的准确率。
数据可用性
支持本研究结果的数据在 Kaggle 上公开获取,网址为 https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign。
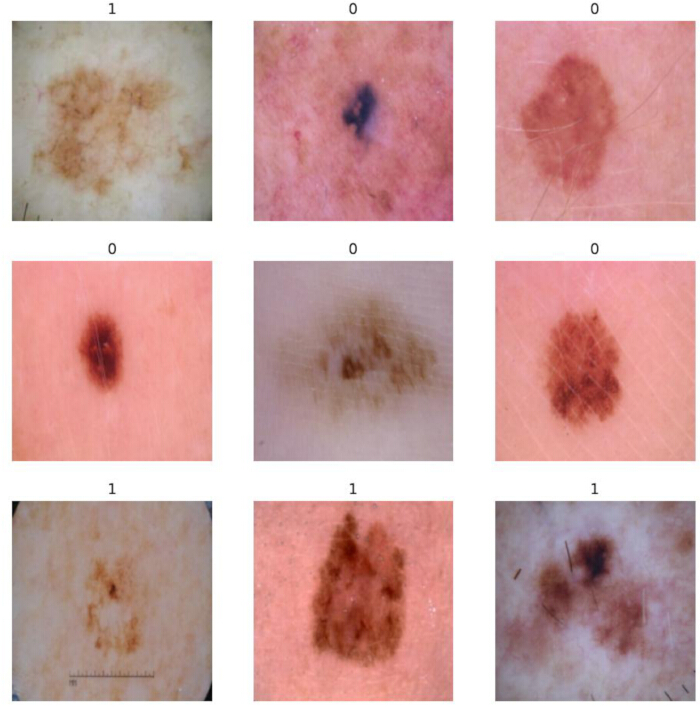
图1:来自ISIC数据集的代表性皮肤镜图像,展示了本研究中使用的两种诊断类别。 样本标注为良性(0)和恶性(1),突显了数据集中病变在形态、颜色和纹理上的多样性。请点击此处查看该图的放大版本。
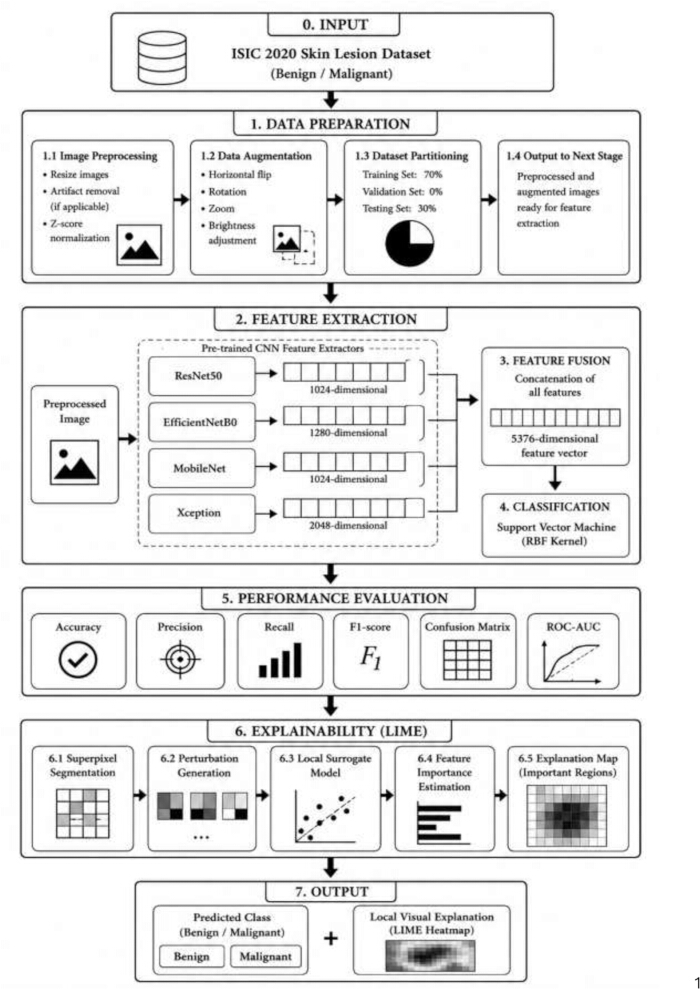
图2:所提出的EDLF-SLC框架的完整工作流程。该方案从ISIC 2020图像获取开始,随后进行预处理、数据增强、数据集划分、利用四种预训练CNN架构进行深度特征提取、特征融合、SVM分类、性能评估以及基于LIME的解释生成。请点击此处查看该图的放大版本。
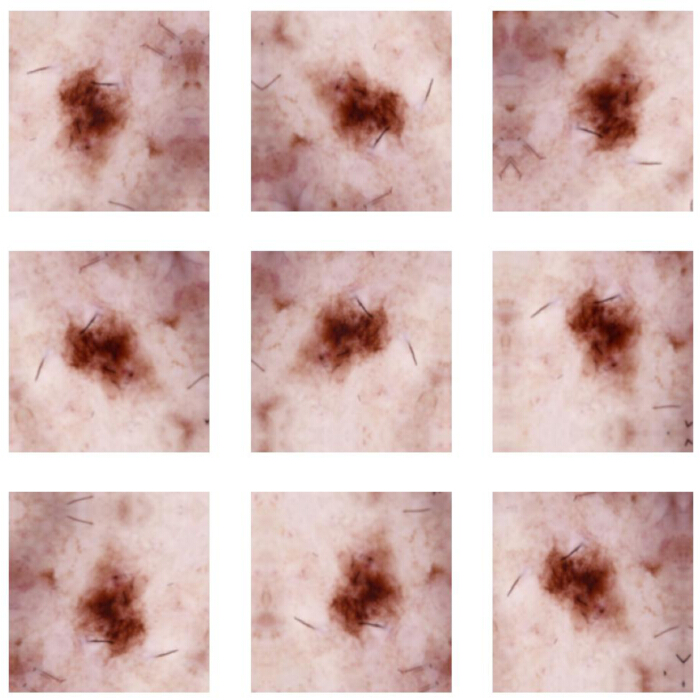
图3:使用数据增强技术生成的皮肤病变图像示例。包括水平和垂直翻转、旋转、缩放以及亮度调整。这些变换可增加数据集的多样性,提高模型的鲁棒性,并降低训练过程中的过拟合风险。请点击此处查看该图的放大版本。
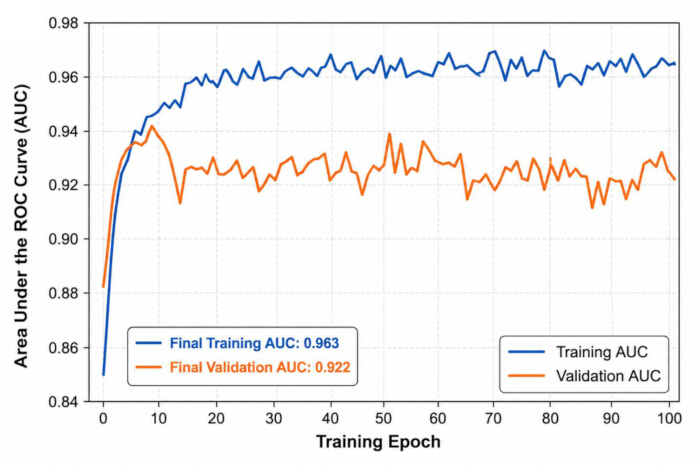
图 4:ResNet-50 模型在 100 轮训练过程中训练集与验证集的受试者工作特征曲线下面积(ROC-AUC)变化情况。蓝色曲线表示训练集的 AUC,橙色曲线表示验证集的 AUC。曲线显示模型在初始训练阶段迅速收敛,随后进入稳定优化阶段,验证性能持续保持在较高水平,表明模型学习效果良好,在验证数据集上具有满意的泛化能力。请点击此处查看该图的高清版本。
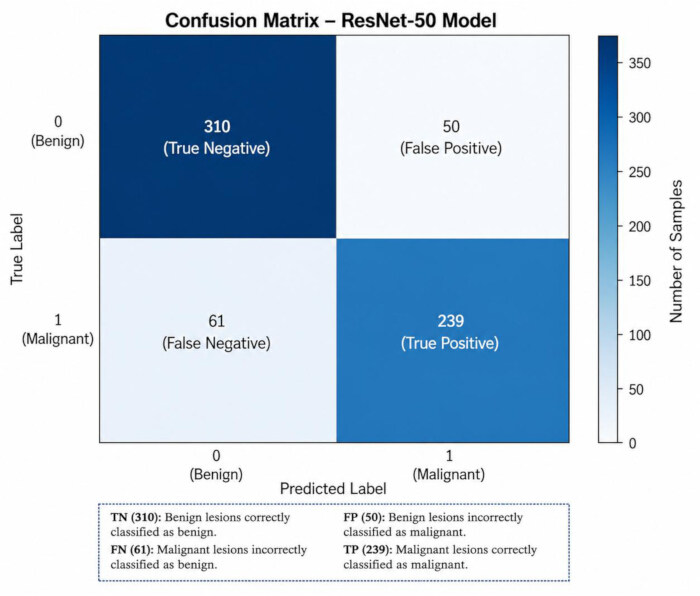
图 5:ResNet-50 模型在测试数据集上的混淆矩阵。行表示真实类别标签(0 = 良性,1 = 恶性),列表示预测类别标签。对角线元素表示正确分类的样本(310 例良性,239 例恶性),非对角线元素表示分类错误的样本,包括 50 例假阳性与 61 例假阴性。请点击此处查看该图的放大版本。
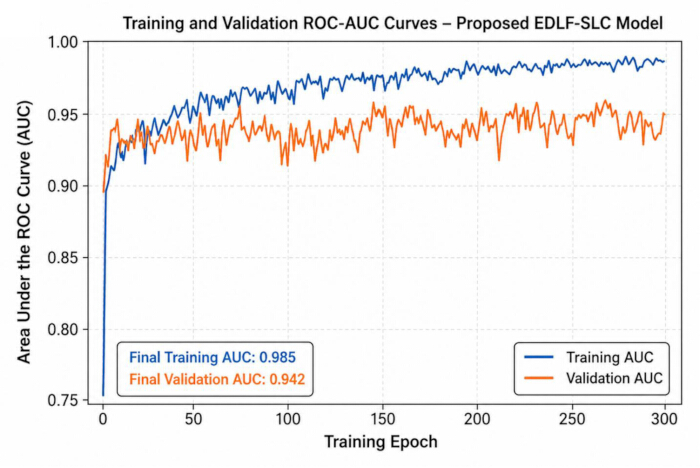
图6:所提出的 EDLF-SLC 模型在 300 个训练周期内的训练和验证受试者工作特征曲线下面积(ROC-AUC)。蓝色曲线表示训练 AUC,橙色曲线表示验证 AUC。该模型在初始训练周期中表现出快速收敛,随后在剩余周期中保持稳定优化,训练和验证 AUC 值始终较高。持续稳定的验证性能表明所提出的 EDLF-SLC 框架在验证数据集上具有良好的泛化能力和稳定的训练行为。 请点击此处查看该图的放大版本。
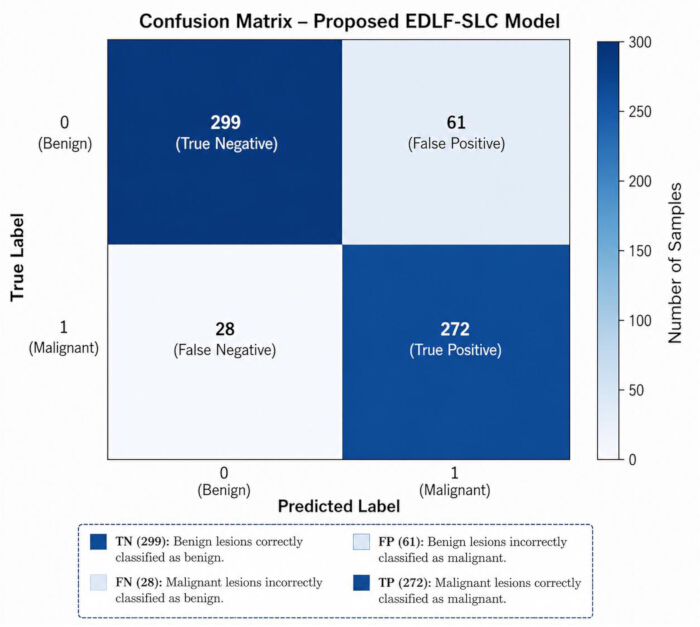
图7:所提出的 EDLF-SLC 模型在测试数据集上的混淆矩阵。行表示真实类别标签(0 = 良性,1 = 恶性),列表示预测类别标签。对角线元素表示正确分类的样本(299 例良性,272 例恶性),而非对角线元素表示分类错误的样本,包括 61 例假阳性与 28 例假阴性。请点击此处查看该图的放大版本。
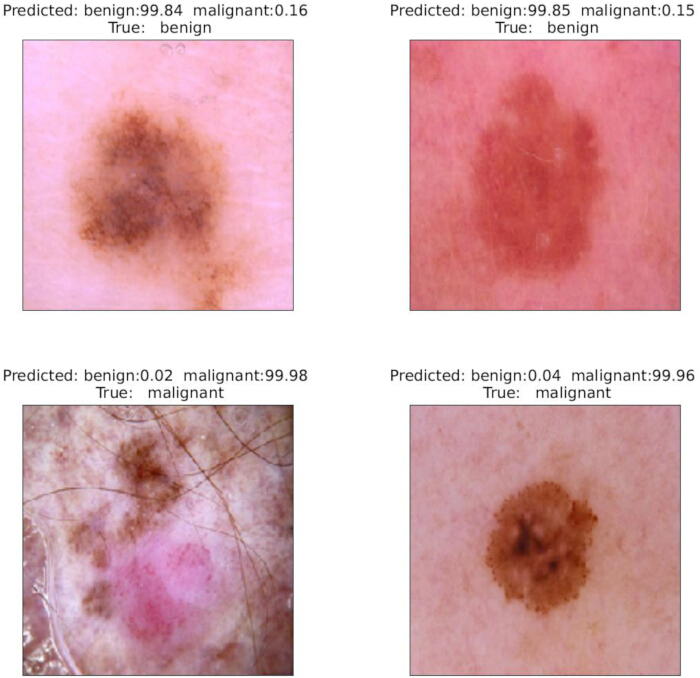
图8:所提出的EDLF-SLC模型生成的示例预测结果。 本图展示了模型对良性与恶性病变的分类置信度水平,体现了其判别能力。请点击此处查看该图的放大版本。
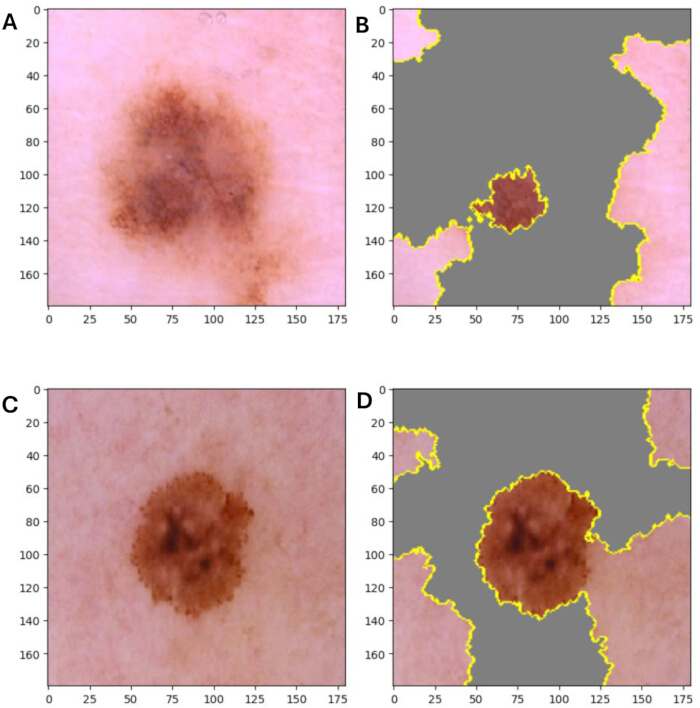
图 9:基于LIME的所提出EDLF-SLC模型的局部解释。 该图突出了对模型分类决策贡献最大的超像素区域。(A)良性皮肤病变的原始皮肤镜图像。(B)良性病变的LIME解释,其中高亮的超像素表示对良性预测贡献最大的区域。(C)恶性皮肤病变的原始皮肤镜图像。(D)恶性病变的LIME解释,显示了主要影响恶性分类的判别性超像素区域。黄色边界勾勒出LIME识别出的有影响力的超像素,而灰色区域代表对预测贡献极小的区域。请点击此处查看该图的放大版本。
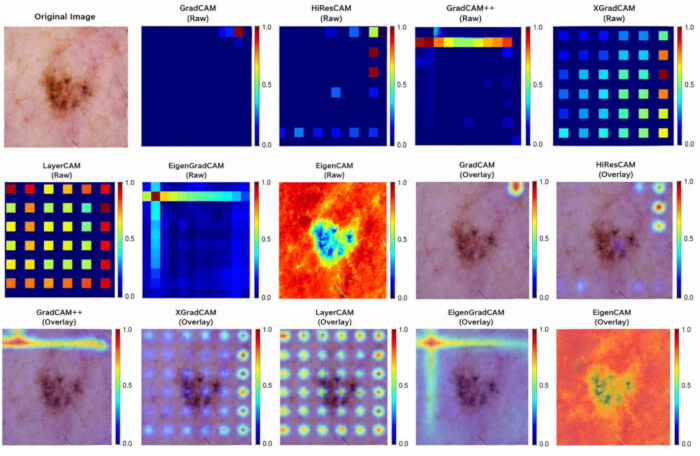
图10:应用于所提出的EDLF-SLC模型的基于类激活映射(CAM)的可解释性方法比较。该图比较了GradCAM、HiResCAM、GradCAM++、XGradCAM、LayerCAM、EigenGradCAM和EigenCAM对同一皮肤镜图像生成的定位图。第一个面板显示原始输入图像,随后是每种可解释性方法生成的相应原始激活图和热图叠加结果。这些可视化结果展示了不同方法在空间定位上的差异,并突出了对所提出的EDLF-SLC框架分类决策贡献最大的图像区域。请点击此处查看该图的放大版本。
| 参考文献 | 年份 | 数据集 | 数据规模 | 特征提取 | 方法 | 准确率 |
| 9 | 2022 | HAM10000 dataset | 10015 张皮肤病变图像 | 颜色和形状特征 | 机器学习算法和卷积神经网络模型 | 95.1% |
| 19 | 2023 | PH2 dataset | 200 张标注图像 | 不对称性、条纹、点状/团块、退行区域特征 | 机器学习模型 | 94.0% |
| 30 | 2024 | HAM10000 dataset | 10000 张图像 | 颜色和形状特征 | S-MobileNet | 97.7% |
| 28 | 2025 | ISIC2020 和 HAM10000 数据集 | ISIC2020(12,670 张图像)和 HAM10000(10,015 张图像) | 颜色和形状 | 残差网络-长短期记忆网络(R-LSTM50) | 95.7%(ISIC2020);94.2%(HAM10000) |
| 32 | 2026 | 猴痘皮肤病变数据集(MSLD) | 770 张图像 | 上下文和纹理 | DenseNet121、Xception、InceptionV3 和 CBAM | 88%(DenseNet121) |
| 39 | 2025 | HAM10000 | 38,569 张图像 | 上下文和纹理 | MobileNet、ResNet50、InceptionV3 和 EfficientNet | 93.6%(MobileNet) |
| 40 | 2025 | ISIC 2019 | 2357 张图像 | 上下文和空间特征 | 基于 CNN-Transformer 的多模态深度学习 | 98.71% |
| 41 | 2026 | ISIC 2019 | 25,000 张图像 | 上下文和纹理 | TransXV2S | 95.26% |
| 42 | 2025 | HAM10000 | 10,015 张图像 | 颜色和形状 | ViT 与 YOLOv8 结合 | 93% |
表1:文献比较。近期发表的利用深度学习算法进行皮肤病变分类的部分研究工作汇总。
| 数据集 | 良性 | 恶性 | 总计 |
| 训练数据 | 1440 | 1197 | 2637 |
| 测试数据 | 360 | 300 | 660 |
| 总数据 | 1800 | 1497 | 3297 |
表2:数据集分布。 ISIC 2020 数据集中良性与恶性样本的分布情况,包括训练集与测试集的划分。
| 组件 | 规格 |
| 操作系统 | Ubuntu 20.04 |
| 编程语言 | Python 3.9 |
| 深度学习框架 | PyTorch 2.3.1 |
| 优化器 | Adam |
| 学习率调度 | 1e−3 |
| 训练轮数 | 100/300 |
| CPU | 2 vCPU 2.2 GHz |
| GPU | Tesla T4 (16 GB) × 1 |
| 内存 | 16 GB |
| 可训练参数 | 2,430,353 (9.27 MB) |
| 不可训练参数 | 133,434,397 (509.01 MB) |
表3:系统规格。 计算环境的详细规格,包括用于模型训练与评估的软件框架和硬件资源。
| 类别 | 精确率 | 召回率 | F1分数 | 样本数 |
| 良性类别 | 0.83 | 0.88 | 0.85 | 360 |
| 恶性类别 | 0.84 | 0.78 | 0.81 | 300 |
| 准确率 | - | - | 0.832 | 660 |
| 宏平均 | 0.84 | 0.83 | 0.83 | 660 |
| 加权平均 | 0.84 | 0.83 | 0.83 | 660 |
表4:分类报告。 ResNet-50 模型在测试数据集上的分类性能,包括每一类的精确率、召回率、F1分数和支持数量。
| 模型 | 准确率 | 精确率 | 召回率 | F1 分数 | 时间 (s) |
| NASNetLarge | 0.77 | 0.76 | 0.77 | 0.76 | 2002.47 |
| EfficientNetB0 | 0.85 | 0.85 | 0.85 | 0.85 | 734.8 |
| Xception | 0.8 | 0.81 | 0.8 | 0.8 | 732.23 |
| ResNetV2 | 0.63 | 0.64 | 0.63 | 0.611 | 1072.34 |
| MobileNet | 0.79 | 0.8 | 0.79 | 0.79 | 629.29 |
| MobileNetV2 | 0.77 | 0.79 | 0.77 | 0.77 | 660.5 |
| ResNet50 | 0.83 | 0.83 | 0.83 | 0.83 | 749.77 |
| EDLF-SLC | 0.88 | 0.89 | 0.87 | 0.88 | 3279.77 |
表5:模型性能比较。 所提出的EDLF-SLC模型与基线深度学习模型在准确率、精确率、召回率、F1分数及计算时间方面的性能对比。
| 模型 | 准确性 | 精准度 | 回忆 | F1分数 |
| ResNet-18 [25] | 0.85 | 0.85 | 0.85 | 0.85 |
| ResNet-50 与 SVM [50] | 0.87 | 0.88 | 0.98 | 0.93 |
| 混合深度学习模型 + 支持向量机 [48] | 0.86 | 0.84 | 0.8 | 0.84 |
| 混合深度学习模型 + 支持向量机 [49] | 0.86 | 0.8 | 0.6 | 0.68 |
| 建议的EDLF-SLC | 0.88 | 0.89 | 0.87 | 0.88 |
表6:模型比较指标。 所提出的EDLF-SLC框架与近期先进方法在皮肤病变分类任务中的性能对比。
补充文件 1:算法 1。 所提出的 EDLF-SLC 框架的工作流程,概述了数据预处理、使用多种 CNN 架构进行深度特征提取、基于 SVM 的分类,以及基于 LIME 的皮肤病变预测可解释性分析。请点击此处下载该文件。
补充文件 2:算法 2。 基于 LIME 的局部解释流程工作流,展示超像素生成、扰动采样、代理模型构建,以及对分类决策贡献最大的图像区域的可视化。 请点击此处下载该文件。
讨论
本文提出的用于皮肤病变分类的可解释深度学习框架(EDLF-SLC)表明,将互补的深度特征表示与可解释的人工智能相结合,能够同时提升分类性能和模型透明度。该框架通过整合多种预训练的卷积神经网络架构(ResNet50、EfficientNetB0、MobileNet 和 Xception)进行特征提取,并采用支持向量机(SVM)完成最终分类,充分利用不同特征提取器的优势,生成比单一主干网络更丰富且更具判别性的病变表征。此外,通过引入局部可解释模型无关解释方法(LIME),该框架可提供局部化的视觉解释,使临床医生能够理解对每项预测贡献最大的图像区域,从而增强对模型诊断决策的信心。
实验结果表明,EDLF-SLC 在与基准 CNN 模型(包括 MobileNet、Xception 和 ResNet50)的比较中表现出具有竞争力的性能,凸显了互补特征融合与基于 SVM 分类方法的有效性。与近期先进方法的对比进一步验证了所提出框架的竞争力。例如,两项研究48,49 报道了使用基于集成的方法获得约 0.86 的准确率,而其他混合 CNN-SVM 框架25,50,51,52,53 的准确率可达 0.87,但依赖更复杂的架构以及额外的预处理或分割模块。相比之下,所提出的框架在无需显式病灶分割的情况下,采用相对简化的架构即实现了 0.88 的准确率,同时通过 LIME 提供可解释的预测结果。这些结果表明,在 SVM 分类之前融合互补的 CNN 特征提取器,能够在保持架构简洁性和透明性的同时提升诊断性能。
尽管所提出的框架提高了分类准确性和可解释性,但这种改进是以增加计算成本为代价的。EDLF-SLC 的总训练时间约为 3279.77 s,明显高于 ResNet50(749.77 s)和 MobileNet(629.29 s)等单个 CNN 模型。这一额外的计算开销源于对多个预训练 CNN 模型的训练以及在分类前进行特征融合的过程。此类权衡在混合模型和集成学习方法中较为常见,即通过更高的计算需求来换取预测性能的提升。然而,在临床决策支持系统中,诊断的准确性、稳健性和可靠性通常比训练效率更为重要,因为它们直接影响患者的诊疗结果。
该框架的另一个重要优势在于其可解释性。与通常作为“黑箱”运行的传统深度学习模型不同,EDLF-SLC 引入了 LIME 方法,为预测过程提供针对具体病例的可视化解释。这些解释有助于临床医生验证模型是否关注具有临床意义的病灶区域,从而提高透明度,支持临床判读,并增强对人工智能辅助诊断的信任。因此,该框架在预测性能与模型可解释性之间实现了有效的平衡,使其成为皮肤病变分类中一种具有前景的计算机辅助决策支持工具。
尽管这些结果令人鼓舞,但仍需承认存在若干局限性。首先,该框架仅使用公开的 ISIC 数据集进行了评估,其在不同临床条件、成像设备和患者人群中获取图像的泛化能力仍有待验证。其次,采用多种预训练 CNN 架构不可避免地增加了计算复杂性和训练时间,相较于单一主干模型更为耗时。第三,实验过程中采用了固定的超参数设置,进一步优化这些参数可能有助于提升模型在不同数据集上的性能与适应性。最后,尽管 LIME 能够增强模型的透明性,但其解释是局部的且依赖于扰动,这意味着不同运行之间的解释一致性可能存在差异,因此在常规临床应用之前,还需进一步由皮肤科专家进行验证。
未来的研究将聚焦于使用多个大规模、多中心的皮肤病变数据集来验证所提出的框架,通过轻量级特征融合和模型压缩技术优化计算效率,探索先进的超参数优化策略,并将该框架扩展至多类皮肤病变分类。此外,整合更多可解释的人工智能技术,并与皮肤科医生开展前瞻性临床评估,将进一步增强该框架在真实临床环境中的可靠性、可解释性及实际应用价值。
披露
作者声明不存在利益冲突。
致谢
作者谨向泰夫大学表示诚挚的感谢,感谢其提供的研究环境和机构支持,这些支持促进了本工作的顺利完成。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| ISIC 2020 皮肤病变数据集 | 国际皮肤影像协作组织 (ISIC) | ISIC 2020 挑战赛数据集 | 用于模型开发与评估的皮肤镜图像数据集。 |
| Keras | Keras 团队 | 集成于 TensorFlow | 深度学习模型的构建与训练。 |
| LIME(局部可解释模型无关解释方法) | Ribeiro 等人 | Python 软件包 | 为模型预测生成局部可视化解释。 |
| Matplotlib | Matplotlib 开发者 | 最新兼容版本 | 学习曲线、混淆矩阵及评估图表的可视化。 |
| NumPy | NumPy 开发者 | 最新兼容版本 | 数值计算与数组操作。 |
| NVIDIA Tesla T4 GPU | NVIDIA 公司 | 16 GB VRAM | 模型训练与推理加速。 |
| Pandas | Pandas 开发团队 | 最新兼容版本 | 数据处理与实验结果管理。 |
| 预训练 CNN 模型 | TensorFlow/Keras Applications | ResNet50、EfficientNetB0、MobileNet、Xception | 从皮肤镜图像中提取深度特征。 |
| Python | Python 软件基金会 | 版本 3.9 | 实现所用的编程语言。 |
| PyTorch | PyTorch 基金会 | 版本 2.3.1 | 用于特征提取与模型实现的深度学习框架。 |
| Scikit-learn | Scikit-learn 开发者 | 最新兼容版本 | 支持向量机(SVM)、评估指标与数据预处理。 |
| 支持向量机(RBF 核) | Scikit-learn | SVC | 融合后的深度特征表示的分类。 |
| TensorFlow | Google LLC | 版本 2.x | 用于模型训练与推理的深度学习框架。 |
| Ubuntu 操作系统 | Canonical Ltd. | Ubuntu 20.04 | 实验运行环境。 |
参考文献
- Chan S, Reddy V, Myers B, Thibodeaux Q, Brown-Stone N, Liao W. Machine learning in dermatology: current applications, opportunities, and limitations. Dermatol Ther (Heidelb). 2020;10:365-386.
- Olsen CM. Global trends in melanoma mortality differ by sex and age. Br J Dermatol. 2020;183(6):985-986.
- Sun Y, Shen Y, Liu Q, Zhang H, Jia L, Chai Y, et al. Global trends in melanoma burden: a comprehensive analysis from the Global Burden of Disease Study, 1990-2021. J Am Acad Dermatol. 2025;92(1):100-107.
- Monika MK, Vignesh NA, Kumari CU, Kumar M, Lydia EL. Skin cancer detection and classification using machine learning. Mater Today Proc. 2020;33:4266-4270.
- Hosny KM, Elshora D, Mohamed ER, Vrochidou E, Papakostas GA. Deep learning and optimization-based methods for skin lesions segmentation: a review. IEEE Access. 2023.
- Baghdadi NA, Farghaly Abdelaliem SM, Malki A, Gad I, Ewis A, Atlam ES. Advanced machine learning techniques for cardiovascular disease early detection and diagnosis. J Big Data. 2023;10(1):144.
- Veeramani N, Jayaraman P, Krishankumar R, Ravichandran KS, Gandomi AH. DDCNN-F: double decker convolutional neural network feature fusion as a medical image classification framework. Sci Rep. 2024;14(1).
- Veeramani N, Jayaraman P. YOLOv7-XAI: multiclass skin lesion diagnosis using explainable artificial intelligence with fair decision making. Int J Imaging Syst Technol. 2024;34(6).
- Shetty B, Fernandes R, Rodrigues AP, Chengoden R, Bhattacharya S, Lakshmanna K. Skin lesion classification of dermoscopic images using machine learning and convolutional neural network. Sci Rep. 2022;12(1):18134.
- Ali AR, Li J, Yang G, O'Shea SJ. A machine learning approach to automatic detection of irregularity in skin lesion border using dermoscopic images. PeerJ Comput Sci. 2020;6:e268.
- Pham TTH, Luu TN, Nguyen TV, Huynh NT, Phan QH, Le TH. Polarimetric imaging combining optical parameters for classification of mice non-melanoma skin cancer tissue using machine learning. Heliyon. 2023;9(11).
- Liu N, Rejeesh M, Sundararaj V, Gunasundari B. ACO-KELM: anti coronavirus optimized kernel-based softplus extreme learning machine for classification of skin cancer. Expert Syst Appl. 2023;232:120719.
- Masud M, Almars AM, Rokaya MB, Meshref H, Gad I, Atlam ES. A novel lightweight convolutional neural network model to predict Alzheimer's disease applying weighted loss function. J Disabil Res. 2024;3(4):20240042.
- Kumar A, Veeraiah V, Gongada TN, Ahamad S, Khan H, Gupta A. Explainable machine learning models for clinical decision support systems. In: 2024 15th International Conference on Computing Communication and Networking Technologies (ICCCNT). Piscataway (NJ): IEEE; 2024. p. 1-6.
- Shahzad K, Wasim M, Pires IM, Garcia NM. Multi-classification of skin lesions using a deep learning-based convolutional neural network. Procedia Comput Sci. 2024;241:588-593.
- Celebi ME, Kingravi HA, Uddin B, Iyatomi H, Aslandogan YA, Stoecker WV, et al. A methodological approach to the classification of dermoscopy images. Comput Med Imaging Graph. 2007;31(6):362-373.
- Li CX, Shen CB, Xue K, Shen X, Jing Y, Wang ZY, et al. Artificial intelligence in dermatology: past, present, and future. Chin Med J (Engl). 2019;132(17):2017-2020.
- Ramprasad M, Nagesh S, Sahith V, Lankalapalli RK. Hierarchical agglomerative clustering based skin lesion detection with region-based neural networks classification. Meas Sens. 2023;29:100865.
- Khater T, Ansari S, Mahmoud S, Hussain A, Tawfik H. Skin cancer classification using explainable artificial intelligence on pre-extracted image features. Intell Syst Appl. 2023;20:200275.
- Wang H, Ahn E, Bi L, Kim J. Self-supervised multi-modality learning for multi-label skin lesion classification. Comput Methods Programs Biomed. 2025;265:108729.
- Thapar P, Rakhra M, Alsaadi M, Quraishi A, Deka A, Naga Ramesh JV. A hybrid grasshopper optimization algorithm for skin lesion segmentation and melanoma classification using deep learning. Healthc Anal. 2024;5:100326.
- Kumar S, Nath VK, Hazarika D. Blend of deep features and binary tree growth algorithm for skin lesion classification. Symmetry (Basel). 2023;15(12):2213.
- Chandrahaas BV, Mohanty SN, Panda SK, et al. An empirical study on classification of monkeypox skin lesion detection. EAI Endorsed Trans Pervasive Health Technol. 2023;9:e4.
- Talavera-Martínez L, Bibiloni P, Giacaman A, Taberner R, de Paz Hernando LJD, González-Hidalgo M. A novel approach for skin lesion symmetry classification with a deep learning model. Comput Biol Med. 2022;145:105450.
- Ieracitano C, Morabito FC, Hussain A, Suffian M, Mammone N. TIXAI: a trustworthiness index for explainable artificial intelligence in skin lesion classification. Neurocomputing. 2025;630:129701.
- Hasan MK, Elahi MTE, Alam MA, Jawad MT, Martí R. DermoExpert: skin lesion classification using a hybrid convolutional neural network through segmentation, transfer learning, and augmentation. Inform Med Unlocked. 2022;28:100819.
- Koparde S, Kotwal J, Deshmukh S, Adsure S, Chaudhari P, Kimbahune V. Conditional generative adversarial networks and YOLOv5 Darknet-based skin lesion localization and classification using an independent component analysis model. Inform Med Unlocked. 2024;47:101515.
- Padhy S, Dash S, Kumar N, Singh SP, Kumar G, Moral P. Temporal integration of ResNet features with LSTM for enhanced skin lesion classification. Results Eng. 2025;25:104201.
- Xin C, Liu Z, Ma Y, Wang D, Zhang J, Li L, et al. Transformer-guided self-adaptive network for multi-scale skin lesion image segmentation. Comput Biol Med. 2024;169:107846.
- Sulthana R, Chamola V, Hussain Z, Albalwy F, Hussain A. A novel end-to-end deep convolutional neural network-based skin lesion classification framework. Expert Syst Appl. 2024;246:123056.
- Chamarthi S, Fogelberg K, Brinker TJ, Niebling J. Mitigating the influence of domain shift in skin lesion classification: a benchmark study of unsupervised domain adaptation methods. Inform Med Unlocked. 2024;44:101430.
- Maity S, Paul S, Guha S, Dasgupta S, Ghosh M. Automated classification of monkeypox skin lesions using a hybrid deep learning model. Biomed Signal Process Control. 2026;126:110955.
- Nasir S, Bilal M, Khalidi H. Detection and classification of skin cancer by using CNN-enabled cloud storage data access control algorithm based on blockchain technology. Int J Theor Appl Comput Intell. 2025:145-169.
- Saba T. Computer vision for microscopic skin cancer diagnosis using handcrafted and non-handcrafted features. Microsc Res Tech. 2021;84(6):1272-1283.
- Fayyad J, Alijani S, Najjaran H. Empirical validation of conformal prediction for trustworthy skin lesion classification. Comput Methods Programs Biomed. 2024;253:108231.
- Liu P, Qian W, Li H, Cao J. A relationship-aware mutual learning method for lightweight skin lesion classification. Digit Commun Netw. 2025;11(3):603-612.
- Adla D, Reddy GVR, Nayak P, Karuna G. A full-resolution convolutional network with a dynamic graph cut algorithm for skin cancer classification and detection. Healthc Anal. 2023;3:100154.
- Thamizhamuthu R, Maniraj SP. Deep learning-based dermoscopic image classification system for robust skin lesion analysis. Trait Signal. 2023;40(3).
- Di Giammarco M, Santone A, Cesarelli M, Martinelli F, Mercaldo F. A method for skin lesion detection and localization by means of deep learning and reliable prediction explainability. Image Vis Comput. 2025;162:105675.
- Haq IU, Joarder HA, Khan AA, Shi X, Alsayaydeh JAJ, Yusof MFB, et al. XAAI-ledger: an explainable CNN-transformer-based multimodal deep learning framework for early detection of melanoma and non-melanoma skin cancers using dermoscopic and clinical data. Biomed Signal Process Control. 2026;123:110410.
- Saeed K, Shehzad M, Malik MGA, Ahmed S, Azar AT. TransXV2S-NET: a novel hybrid deep learning architecture with dual-contextual graph attention for multi-class skin lesion classification. Knowl Based Syst. 2026;337:115407.
- AbuAlkebash H, Saleh RAA, Ertunç HM. Automated explainable deep learning framework for multiclass skin cancer detection and classification using hybrid YOLOv8 and vision transformer (ViT). Biomed Signal Process Control. 2025;108:107934.
- Hasan MK, Ahamad MA, Yap CH, Yang G. A survey, review, and future trends of skin lesion segmentation and classification. Comput Biol Med. 2023;155:106624.
- Li H, Pan Y, Zhao J, Zhang L. Skin disease diagnosis with deep learning: a review. Neurocomputing. 2021;464:364-393.
- Wu Y, Chen B, Zeng A, Pan D, Wang R, Zhao S. Skin cancer classification with deep learning: a systematic review. Front Oncol. 2022;12:893972.
- Fanconic. Skin cancer: malignant vs benign dataset. Kaggle; 2023. Available from: https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16). New York (NY): ACM; 2016. p. 1135-1144.
- Bassel A, Abdulkareem AB, Alyasseri ZAA, Sani NS, Mohammed HJ. Automatic malignant and benign skin cancer classification using a hybrid deep learning approach. Diagnostics (Basel). 2022;12(10):2472.
- Bhardwaj A, Rege PP. Skin lesion classification using deep learning. In: Advances in Signal and Data Processing: Select Proceedings of ICSDP 2019. Singapore: Springer; 2021. p. 575-589.
- Keerthana D, Venugopal V, Nath MK, Mishra M. Hybrid convolutional neural networks with SVM classifier for classification of skin cancer. Biomed Eng Adv. 2023;5:100069.
- Ahmed A, Siam AI, Atwa MA, Atwa EM, Abdelrahim EM, Atlam ES. An explainable YOLO-based deep learning framework for pneumonia detection from chest X-ray images. Algorithms. 2025;18(11):703.
- Farsi M, ZainEldin H, Sayed RF, El-Agamy ES, Atlam SA, Alsaedi M, et al. Deep learning for pathology: YOLOv8 with EigenCAM for reliable colorectal cancer diagnostics. Bioengineering (Basel). 2025;12(11):1203.
- Atwa EA, Atlam ES, Ahmed A, Atwa MA, Abdelrahim EM, Siam AI. Interpretable deep learning models for arrhythmia classification based on ECG signals using the PTB-XL dataset. Diagnostics (Basel). 2025;15(15):1950.