本文提出了一种用于基于会话推荐的新型模型——门控槽位线性注意力图神经网络,该模型基于双重构建的会话图采用门控槽位线性注意力机制。该方法提升了推荐的准确性和效率,在三个公开数据集上优于当前最优方法。
本文内容
摘要
摘要
基于会话的推荐(Session-based Recommendation, SBR)系统旨在根据用户在当前会话中的行为序列,预测其接下来可能交互的下一个项目。近年来,利用Transformer注意力机制的方法(例如GC-SAN)在性能上优于传统方法;然而,由于自注意力机制的二次计算开销,这些方法面临较高的计算负载和空间复杂度。为解决这些局限性,本文提出了一种名为GSLA4Rec(用于会话推荐的门控槽位线性注意力图神经网络)的新模型,该模型将线性注意力机制与可学习的门控机制以及受门控槽位注意力启发的基于槽位的记忆更新策略相结合。具体而言,GSLA4Rec首先构建两个图结构:会话图用于捕捉会话内项目的转移关系,邻近全局图用于编码跨会话的协同信号,从而建模局部和全局上下文信息。该方法的核心是门控槽位线性注意力机制,其特点包括:(1)采用门控单元抑制长会话中无关或冗余交互带来的噪声;(2)利用槽位单元动态存储并更新紧凑的会话表征,降低内存开销;(3)以线性注意力替代自注意力,实现线性时间复杂度。上述组件共同显著提升了模型在捕捉用户兴趣演化方面的预测准确性和效率。在多个公开基准数据集(包括Diginetica、Tmall和NowPlaying)上的大量实验表明,GSLA4Rec在推荐性能上 consistently 优于当前最先进的SBR方法,验证了GSLA机制的有效性。
引言
随着在线服务(如电子商务、短视频平台和新闻推送)的快速发展,信息过载问题日益突出且愈发严重。推荐系统1,2通过深入分析用户行为数据,提供个性化和精准的信息推送服务。然而,在许多实际应用场景中,由于存在匿名访问、未登录用户、隐私保护以及交互时间短等特点,传统的推荐方法(如协同过滤3和矩阵分解4,5)极大地限制了推荐算法的适用性。为应对这些挑战,基于会话的推荐(SBR)6,7,8,9应运而生。SBR聚焦于用户当前会话内的交互序列数据,以预测下一个可能感兴趣的项目。该范式不仅避免了对用户长期历史数据的依赖,还能敏锐捕捉短期动态兴趣变化,因此在电子商务、短视频、音乐推荐等场景中展现出独特的应用价值。
早期方法主要依赖于马尔可夫链5,10,11,12 对会话序列中项目间的转移概率进行建模。尽管这些方法能够捕捉一阶序列依赖关系,但在刻画复杂的高阶依赖关系以及用户兴趣的非线性动态方面仍存在局限性,限制了模型在复杂场景下的有效性。随着深度学习技术的发展13,14,基于神经网络的方法已广泛应用于会话型推荐(SBR)。GRU4REC15首次应用了循环神经网络14 (RNNs) 用于基于会话的推荐,有效捕捉序列中的时间依赖性;NARM16通过将注意力机制与RNN结合,进一步增强了挖掘核心用户兴趣的能力;STAMP17 采用多层感知机(MLPs)结合注意力机制以捕捉用户的短期兴趣。尽管这些方法在序列建模方面取得了一定进展,但仍面临诸如难以处理长期依赖关系和对噪声敏感等挑战。
近年来,图神经网络(Graph Neural Networks, GNNs)18,19,20,21为会话推荐(SBR)任务带来了新的视角。例如SR-GNN22通过构建会话图(session graph, SG)显式建模复杂的转移关系,在推荐准确性方面实现了显著提升。然而,大多数现有的基于GNN的方法仅在单个会话内部进行图构建和消息传递,未能有效利用全局项目关联信息。为解决这一问题,GCE-GNN23通过构建邻域全局图(neighbor global graph, NGG),结合自注意力机制融合全局语义与会话图,自适应地加权项目重要性,从而取得了显著的性能提升。尽管如此,现有的基于GNN的方法仍面临两个主要瓶颈:第一,自注意力机制的计算复杂度随会话长度呈二次方增长,在处理长会话时导致显著的计算开销;第二,传统的GNN在信息聚合过程中缺乏动态调节项目重要性的能力,难以区分噪声行为与关键行为,影响了表征质量。
为应对这些挑战,本文提出一种用于基于会话推荐的门控槽位线性注意力图神经网络(GSLA4Rec):(1)设计一种门控槽位机制,通过门控过滤噪声,并将关键语义信息存储在会话槽位中,从而增强模型的鲁棒性并降低存储开销;(2)引入线性注意力机制,将计算复杂度从O(N2) 降低至 O(N)(其中 N 为会话长度),同时保持对长距离依赖关系的建模能力;(3)在三个公开基准数据集(Diginetica、Tmall 和 NowPlaying)上进行了大量实验,结果表明 GSLA4Rec 显著优于现有的最先进方法,尤其在长会话和稀疏场景下表现出明显优势。
方案
体验基于会话的推荐
基于会话的推荐可以从三个角度进行研究:SBR、全局上下文学习和 GSLA(参见材料表)。本研究未涉及任何人类参与者或动物。本研究所使用的全部实验数据集均为公开可用,并作为补充文件:GSLA4Rec.zip提交。
基于会话的推荐
基于会话的推荐(SBR)是一种通过多轮自然语言对话与用户交互,以动态理解用户偏好并提供个性化推荐的人工智能系统。SBR 从传统方法逐步发展为基于深度学习和混合方法的模型,并进一步演进为基于大语言模型(LLM)的解决方案。
传统的基于会话的推荐
传统的序列推荐(SBR)通常由基于马尔可夫链的方法和协同过滤来代表。前者通过分解用户特定的概率转移矩阵生成推荐。例如,Guy Shani24提出了一种基于马尔可夫决策过程的推荐方法,通过分解相应的矩阵来生成推荐;Wanrong Gu25通过将马尔可夫链与购买时间间隔相结合,提升了推荐性能。后者则通过矩阵分解提取相邻交互项目之间的隐含序列关系来生成推荐。例如,Sarwar B1基于用户的历史行为(如评分和点击)计算项目之间的相似性,以推荐符合用户过去偏好的项目。如果用户A喜欢项目a,且项目c与a高度相似,则系统会向A推荐c;Rendle S5提出了FPMC模型,这是一种将矩阵分解与马尔可夫链相结合的序列推荐模型,用于捕捉相邻交互项目之间的隐含序列关系。然而,这类传统的SBR方法主要关注相邻项目之间的序列关系,难以建模复杂的依赖关系。
基于深度学习的会话推荐
基于深度学习的会话推荐(session-based recommendation)经历了多个发展阶段,先后引入了卷积神经网络(CNN)26,27,28,29、循环神经网络(RNN)以及图神经网络(GNN)。基于CNN的会话推荐方法利用卷积和池化等操作来学习每个会话上下文的表示,并将其用于后续推荐。Caser30将用户最近交互过的 L 个物品通过嵌入层转换为 d 维向量,形成一个嵌入矩阵,并将其视为在时间和潜在空间中映射的“图像”。随后,该模型采用三种序列模式卷积滤波器——点级、无跳跃的联合级以及单次跳跃的联合级——以学习序列模式,从而提升会话推荐性能。Tuan 等人31通过三维卷积核统一建模会话点击流和内容特征,构建了时空内容联合表示。
RNN 是一类专门用于处理序列数据的神经网络架构。其核心思想是通过循环结构(如长短期记忆网络,LSTM)来捕捉时间依赖性。13 以及门控循环单元(GRUs)32,它们在自然语言处理(NLP)等领域得到了广泛应用33,语音识别34,文本翻译35,旅行36,37,犯罪38, 以及未来趋势预测39 (例如,交通)40,股票市场41,42和气象学43)。由Hidasi等人提出的GRU4Rec是序列化行为推荐(SBR)研究中的一个里程碑,首次将循环神经网络(RNN)引入SBR领域,并利用门控循环单元(GRU)捕捉用户的序列化行为模式,从而实现个性化推荐。
图神经网络(GNNs)44 在建模图结构数据中的复杂关系方面表现出强大的表达能力,一些研究人员已将 GNNs 引入以建模会话内或会话间的复杂转移。根据不同的 GNNs 模型架构,基于 GNNs 的会话推荐(SBR)方法通常被分为门控图神经网络(GGNNs)45、图卷积网络(GCNs)46 和图注意力网络(GATs)47。SR-GNN 首次将 GNNs 应用于 SBR,通过将会话序列表示为有向图,并利用 GGNNs 捕获会话内复杂的项目转移关系,再结合注意力机制获得最终的会话嵌入,从而提升推荐性能。Chen L48 提出了一种多视角 GNNs 框架,融合结构化属性与非结构化关键词来建模多维商品关联,提高了 SBR 的准确性。Driss E49 设计了一种创新的会话推荐系统,采用胶囊图神经网络来捕捉复杂的项目特征,增强 SBR 的预测准确性。
上述深度学习技术拓展了基于会话的推荐(SBR)的研究范畴,并有效提升了性能,但仍存在一定的局限性,主要表现在:1)对于新出现的项目或会话记录极为稀疏的情况,由于缺乏全局上下文信息,模型难以做出准确预测;2)无法充分利用所有历史会话中蕴含的全局模式。
混合会话推荐
混合会话推荐方法融合了协同过滤、深度学习和注意力机制等不同技术的优势,以提升会话推荐(SBR)的性能。GC-SAN50 在SR-GNN基础上引入自注意力机制,以更有效地捕捉会话中关键项目的交互信息。FGNN51 通过多头注意力机制进一步聚合邻近项目的信息,学习目标项目的多种关联关系。SR-HetGNN52 属于基于异构图的会话推荐方法;通过引入多种类型节点(用户、项目、会话)和多类关系边(点击、购买、共现、属性关联),构建全局知识网络,突破了单一项目序列的局限性,是近年来建模匿名用户行为及跨会话兴趣关联的重要方法。KGSR-SAP53 通过多种关系边连接项目构建知识图谱,以描述多样的用户-项目交互,解决了全局图仅包含单一类型边(用户-项目交互)所导致的信息丢失问题。Wang ZH54 提出了DiffSBR,一种基于扩散模型的会话推荐方法。该方法通过模拟去噪过程生成可靠的下一项目偏好,从而提升对用户动态点击序列的建模能力。Qiao ST55 构建了一种结合多视角意图学习与大语言模型对齐的SBR框架。该框架从多个角度挖掘用户的隐式意图,并利用语言模型对齐语义特征,以进一步提升推荐性能。
全局背景
为克服“孤立地看待会话”的不足,研究人员意识到可以利用全局信息来增强当前会话的表征能力,从而解决传统会话推荐(SBR)中存在的数据稀疏性、冷启动和语义鸿沟等问题。同时,在构建全局上下文时,需要将全局信息整合到单个会话中,并尽可能减少噪声干扰。CSRM56通过整合当前会话与邻近会话之间的协同信息,利用外部记忆编码器(OME)从协同信息中提取协同意图,从而优化会话级表征。CA-TCN57提出了一种跨会话感知的时间卷积网络模型,构建全局图和会话上下文图以模拟跨会话对物品和会话的影响,同时时间卷积网络(TCN)通过空洞卷积扩展感受野,其层数可覆盖指数长度的序列(感受野 = ),解决了RNN的梯度消失问题。Chen58提出了一种基于超图神经网络的会话推荐方法(SR-HGNNs),该方法融合了混合阶次(低阶与高阶)传播与注意力机制,以解决传统图神经网络(GNN)在短会话中的过平滑问题,并区分不同传播阶次的重要性,从而更准确地捕捉依赖关系并避免噪声干扰。GCE-GNN利用多阶共现物品对构建无向加权图,通过统计物品共现频率来反映物品在会话中的重要性;AGNN-GC59利用跨会话的物品转移关系构建全局协同图,计算全局图中的物品转移概率以反映会话中的兴趣变化;DA-GCN60采用最短路径更新邻接矩阵以构建动态加权图,计算全局图中物品的共现频率及路径距离。受上述文献启发,本文提出通过基于邻居的方法构建全局图,即使用Jaccard相似性系数计算相似会话,这种方法不仅利用了全局信息,还过滤了噪声(剔除无关物品),实现了精确构建全局上下文的目标,为后续的会话推荐算法奠定了坚实基础。
门控槽线性注意力
传统的变换器61由于需要在整个序列上进行全连接的注意力操作,导致时空复杂度较高,如下所示:
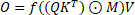 (1)
何处 Q, K, V ∈ RN×d 是输入项的线性变换, M = {Mij = 1 如果 i ≥ j,否则 −∞ } 是用于防止未来信息泄漏的因果掩码, ⊙ 表示逐元素乘积,且 f 表示激活函数 softmax。
为了实现线性注意力机制62,最直接的想法是移除激活函数 softmax。然而,如果直接移除激活函数 softmax,线性注意力必然会导致一些潜在问题:丧失神经网络强大的表达能力,并且无法解决复杂的现实世界问题。
具有限内存控制的槽线性注意力
假设需要保留激活函数 softmax,则 K 和 V 被分别压缩为 K̃、Ṽ ∈ Rm×d。从记忆网络的角度来看,K̃ 和 Ṽ 拥有记忆槽位,其长度随序列增长而增加,即槽位数量 m = N。如果 m 固定,则显然可以实现线性化。受限界记忆控制(Bounded-memory Control)63 的启发,要求将长度为 N 的输入项中的每个标记竞争性地写入 m 个槽位中。
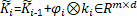 ,
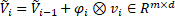 ,
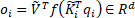 (2)
其中 f 为激活函数 softmax,φi 为用于控制键值 ki 的有效输入的向量,如下所示。
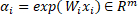 ,
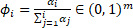 (3)
此处,(φi)j 表示第 i 个标记对第 j 个槽位的书写强度,通过累积 softmax 函数获得。
为了实现高效的线性计算,将公式(2)重写为公式(4),通过 {οi|i=1T, qi, ki, vi)|i=1T} 从 qi、ki 和 vi 计算 οi(公式 4),并采用两遍顺序计算:
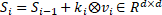 ,
 (4)
因此可以推导出SLA操作:
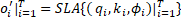 ,
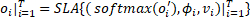 (5)
其中 oi′ ∈ ℝm,οi ∈ ℝd。因此,SLA 能够实现硬件高效的线性时间分块训练64。
门控槽线性注意力
具有限记忆控制的槽线性注意力机制可降低计算和空间复杂度。然而,信息的累积也可能将噪声信息引入会话交互中,因此依赖于数据的衰减机制对于有选择性地保留和遗忘信息至关重要,这种选择性机制已在近期的选择性状态空间模型中被重新审视65。具有数据依赖性的 GSLA 可表示为:
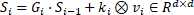 ,
 (6)
此处,衰减门通过外积形式进行参数化,即 Gi = αi ⊗ βi,其中 αi, βi ∈ [0,1]d。在下文中,通过通常设定 βt = 1 并采用矩阵乘法形式,GSLA 也可写作如下等价形式64:
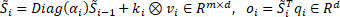 (7)
其中αi和ki分别表示遗忘门和输入门,受门控循环神经网络(gated RNNs)相关文献的启发,这两个门可被耦合为ki = 1 − αi。显然,GSLA可通过如公式(8)所示的两步顺序计算进行建模。该二阶结构支持块并行训练,从而提高训练效率;同时,在二阶结构中间插入softmax操作,增强了对有限时隙记忆的建模能力。
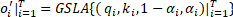 ,
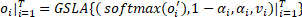 (8)
转换会话数据
问题定义
设给定的会话序列为 S = {v1s, v2s, ⋯, vns},其中 vis 表示用户点击的第 i 个物品。通过分析用户在此序列中的点击行为,系统预测用户可能感兴趣的下一个物品 vn+1s。
图构建
会话图构建
对于一个会话 S = {v1s, v2s, ⋯, vns},构建了一个有向图 Gs = (Vs, εs),其中 Vs 是给定会话 S 中的项目集合,εs = {eijlocal|vi, vj, vi, vj ∈ Vs} 是该会话 S 的边集合。ε(vi-1s, vis) 表示该会话中连续点击的项目。边 eijlocal 可分为四种类型:ein、eout、ein-out 和 eself。由于同一项目可能在序列中重复出现,因此每条边的权重值会被统计。
当前会话 s = [v1, v2, v4, v2, v3] 被转化为SG,如图所示 图1A.
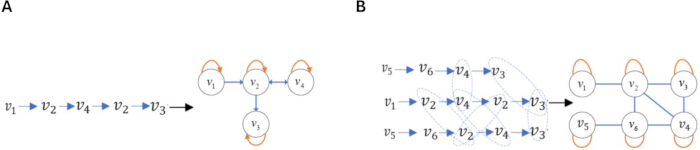
图1:将交互项目转换为图结构。(A)通过将一个会话转换为图来构建会话图(SG)的示意图。(B)通过将多个会话合并为一个图来构建邻域全局图(NGG)的示意图。本图使用 Visio 自行绘制,所有元素均为完全自定义。未使用受版权保护的外部图形资源,因此无需额外的第三方版权许可。图的版权属于作者,若被录用将遵守期刊的版权规定。请点击此处查看此图的放大版本。
邻域全局图构建
基于当前会话 S,构建了相应的 NGG Gg = (Vg, εg),以跨会话方式增强当前会话的表征学习。Vg 是包含 Gg 中所有项目的项目集合,εg = {eijglobal|vi, vj, vi, vj ∈ Vg} 是 Gg 的边集合。ε(vi-1g, vig) 表示 NGG Gg 中直接交互的项目 vi-1g 和 vig。该过程包含两个步骤:邻居会话获取与 NGG 构建。
邻近会话数据采集
在整个数据集中,搜索与当前会话同时出现项目数量最多的会话。选择共现次数最高的前N个会话,构建候选邻居会话集S。随后,采用杰卡德相似性系数计算当前会话cu与候选集S中会话Sr ∈ S之间的相似度,如公式(9)所示。
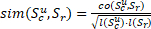 (9)
此处,co(Scu, Sr) 表示同时出现在 Scu 和 Sr 中的项目数量,而 l(Scu) 和 l(Sr) 分别表示 Scu 和 Sr 的长度,其中 Scu 和 Sr 分别表示当前会话和一个邻居会话。相似度低于某一阈值(该阈值可设为超参数)的会话被过滤掉,剩余的会话构成当前会话的邻居会话集 Ns。
邻域全局图构建
基于邻居会话集合 Ns 构建了 NGG,如图 1B所示。在构建邻接矩阵时,若两个项目(vi、vj)之间存在交互,则对应的元素 Aij 设为 1,否则设为 0。此外,项目之间的交互被处理为无向关系,并添加了自环,随后进行归一化处理,如表 1所示。
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
表1:邻域全局图的归一化邻接矩阵。 该表格展示了所构建的邻域全局图中节点间加权连接关系的归一化邻接矩阵。
基于会话的推荐算法设计
本部分详细阐述了所提出的创新模型GSLA4Rec,该模型通过在SG与NGG的联合特征表示上引入GSLA机制,提升了SBR的性能。
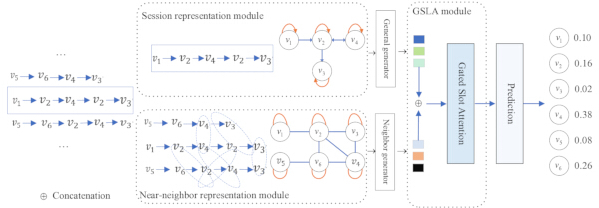
图2:GSLA4Rec 框架。该框架融合了会话图与邻域全局图结构学习,通过门控机制过滤交互噪声,利用记忆槽机制平衡存储与效率,并采用线性注意力机制捕捉项目相关性,以预测用户的下一次点击偏好。本图通过 Visio 自主绘制,所有元素均为完全自定义。未使用受版权保护的外部图形资源,因此无需额外的第三方版权许可。图的版权归属于作者,并将在论文被接收后遵守期刊的版权规定。GSLA4Rec 代表用于会话推荐(SBR)的门控槽位线性注意力图神经网络。请点击此处查看该图的放大版本。
图2展示了GSLA4Rec的框架,该框架包含四个主要组件:1)会话级项目表示。它在会话图(SG)上采用图神经网络(GNNs)模型,以学习当前会话内的会话级项目嵌入;2)邻居全局级项目表示。它基于邻居全局图(NGG),利用门控循环单元(GRU)递归地融合每个项目的邻居嵌入,从而学习所有会话上的全局级项目嵌入;3)GSLA。它通过聚合会话级和全局级学习到的项目表示,建模用户在当前会话中的偏好;4)预测层。它输出对候选项目的预测概率。以下将详细阐述这四个组件。
会话表征
在基于会话的推荐(SBR)中,理解用户的交互行为至关重要。为此,构建了会话图(SG)和负样本图(NGG)用于会话表示学习,旨在全面理解用户的交互行为,从而捕捉用户更真实的需求意图。
会话级项目表征
根据图1A中的SG,采用了一种加权双向图注意力(WBGAT)方法来提取SG的特征。该方法在标准GAT机制基础上引入了边权重和项目方向性(入邻居和出邻居),实现了增强重要边并捕捉双向依赖关系的效果,从而解决了传统GAT在项目关系不对称性和交互强度方面的不足。其计算过程如下:
首先,计算项目入度归一化权重。
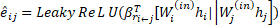 (10)
其中 eij 表示项目的首阶入邻权重 j的功能与项目 i,  项目之间的关系 i 和项目 j, β* ∈ ℝd 是权重向量, hi 和 hj 分别为项目的表示 i 和 j, Wi(在) ∈ ℝd*d 和 Wj(在) ∈ ℝd*d 是可训练参数,|| 表示拼接操作。为了区分不同的入度关系,采用了两个权重向量,即 r在 和 rin-self,进行了训练。激活函数采用LeakyReLU。
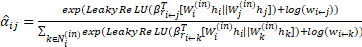 (11)
为了使不同项目之间的系数具有可比性,注意力权重通过 softmax 函数进行了归一化。其中,Ni(in) 表示项目 i 的一阶入邻节点集合, 表示在 SG 中有向边 (i←j) 的入邻权重,该方法通过对边权重取对数并将其加入原始注意力得分 eij,使模型能够在学习项目特征相关性的同时,保留图结构固有的连接强度信息。
其次,计算项目出度归一化权重。
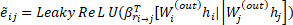 (12)
其中 ẽij 表示该项目的一阶出邻居权重 j的功能与项目 i,  项目之间的关系 i 和 j,两个权重向量,即 r出 和 rout-self,接受了培训。
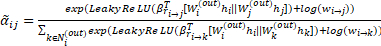 (13)
其中,Ni(out) 表示项目 i 的一阶出邻居集合, 表示有向边 (i→j) 在 SG 中的出邻居权重。
第三,信息聚合。在对项目 i 的一阶入度和出度嵌入进行加权并求和后,可获得该项目的更新嵌入表示。
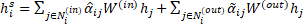 (14)
其中  和 α̃ij 分别表示项目 i 的入度权重和出度权重,
 表示项目 i 的更新后表示。
邻近全局水平项目表征
近期研究普遍认为,构建全局图能够增强数据表征,从而提升SBR性能,这一点毋庸置疑。然而,全局性地增强数据也可能引入噪声等无关信息。在所提出的模型中,为了在实现全局数据增强的同时尽可能减少噪声,构建了一种近邻全局图。
根据图1B中的NGG和表1中的归一化邻接矩阵,将当前会话及其相邻会话转换为NGG,并采用GGNNs45方法提取NGG的特征。NGG中项目向量的学习过程如公式(15)所示。
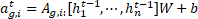
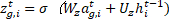
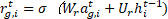
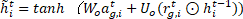
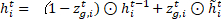 (15)
W ∈ ℝd×2d 表示对照组重量, zg,i 和 rg,i 分别代表更新门和重置门。[h1t-1, ⋯, hnt-1] 表示会话中所有项目向量的列表 s. σ(x) = 1/(1 + e-x)是逻辑斯蒂函数, ⊙ 表示逐元素相乘,且 hi ∈ ℝd 表示门控更新后的向量。邻接矩阵 As ∈ ℝn×n 表明了相邻会话中项目之间的连接性,以及 As,i: ∈ ℝ1×n 代表一个柱状块 As 对应项目 vs,i 在邻接矩阵中。对于当前会话 s = [v1, v2, v4, v2, v3],NGG 和归一化邻接矩阵显示在 图1B 和 表1分别。
项目表征
项目表示通过将会话级别的项目向量与邻居全局级别的项目向量相加得到,如公式(16)所示:
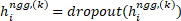
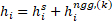 (16)
在全局层级的邻居项目表示上使用了 dropout 以缓解过拟合。
门控槽线性注意力
本文中的门控槽线性注意力(GSLA)将线性注意力与有界内存控制及数据依赖的门控机制相结合。一方面,它继承了基于注意力的控制器(ABC)模型的有限内存槽机制,将原本随序列长度增长的键值对压缩到固定数量的槽中,并通过竞争性写入方式更新每个槽,从而解决了Transformer全局注意力的计算复杂度问题。另一方面,它引入了一种类似于GLA的细粒度门控机制,其中输入数据通过遗忘门 αi 动态调节历史信息的保留比例,解决了ABC因缺乏遗忘机制而引起的噪声问题。
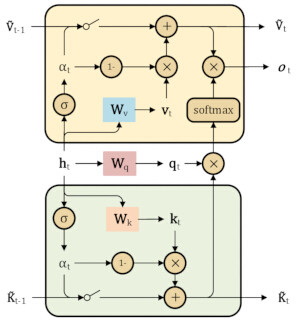
图3:GSLA 的示意图。输入向量分别映射为查询向量、关键词向量和值向量,随后通过带有有限内存控制和数据依赖门控机制的线性注意力机制进行处理,以获得更新后的查询向量、关键词向量、值向量以及输出向量。该图通过 Visio 自主绘制,所有元素均为完全自定义。未使用受版权保护的外部图形资源,因此无需额外的第三方版权许可。图的版权属于作者,若被录用将遵守期刊的版权规定。GSLA 代表门控槽位线性注意力(gated-slot linear attention)。请点击此处查看该图的放大版本。
如图3中具体所示,输入向量被分别映射为查询向量、键向量和值向量64:
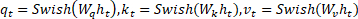 (17)
其中 Wq、Wk、Wv ∈ ℝd×d 分别表示查询(query)、键(key)和值(value)对应的变换权重矩阵,ht 表示会话输入序列中第 t 个时间步的嵌入向量。Swish 函数定义为 Swish(x) = x · σ(x),是一种自门控激活函数,其中 σ 为 Sigmoid 函数,该函数在多个深度学习任务中优于传统的 ReLU 激活函数。
GSLA 利用一个遗忘门 αi 和一个输入门 1 − αi(二者均依赖于输入数据),动态更新第 i 个记忆单元中的信息。该过程如下64:
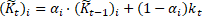 (18)
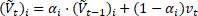 (19)
此处,K̃t 和 Ṽt 表示在时间步 t 的键向量槽和值向量槽,而 K̃t-1 和 Ṽt-1 表示在时间步 t−1 的键向量槽和值向量槽。遗忘门 αi = σ(Wαht)1/τ,其中 Wα ∈ ℝd 为变换权重矩阵,σ 为 Sigmoid 函数,τ 为阻尼系数(通常设为 8),用于控制遗忘门的平滑程度。这使得 GSLA 能够平滑地调节对历史信息的遗忘速率:αi 越大,GSLA 越依赖历史信息;αi 越小,GSLA 越关注当前输入。
第 t 步时,槽位中的关键向量槽 K̃t 和值向量槽 Ṽt 以矩阵形式表示,如公式 (20) 和 (21) 所示65:
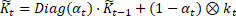 (20)
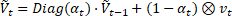 (21)
接着,利用具有二阶性质的 GSLA(参见公式 (8))计算每个时间步 i ∈ [1, …, T] 的输出 oi |i=1T。对每个时间步的输出应用线性变换,得到结果 h̃t。最后,计算会话序列中所有项目表示的平均值,以生成带有动态记忆更新的会话嵌入 S̃e:
 (22)
 (23)
此处,ot 表示门控槽在时间步 t 的输出,h̃t 表示对 ot 进行线性变换的结果。S̃e 表示所有时间步上 h̃t 的平均值。
预测层
基于获得的会话表征 S̃e 和项目 i 的初始嵌入,通过点积运算计算每个候选项目 hi 的得分。随后,使用 softmax 函数获取候选项目 i 的推荐概率:
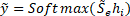 (24)
此处,ỹ 表示候选项目的推荐概率,hi 表示候选项目的向量,模型训练采用交叉熵损失函数。
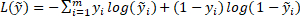 (25)
此处,y 是真实标签的独热编码表示。
结果
数据集与预处理
在实验中,选取了三个基于实际应用场景中真实交易数据的公开序列化行为推荐(SBR)数据集来评估模型性能:Diginetica 数据集源自 CIKM Cup 2016 竞赛,包含用户的交易和点击记录;Tmall 数据集来源于天猫平台的用户日志,记录了用户的浏览和购买行为;Nowplaying 数据集则包含用户在音乐平台上的播放历史记录。这些数据集在 SBR 研究中被广泛使用,能够全面评估模型的有效性和适用性。
在数据预处理阶段,对数据集进行了标准化处理,以确保数据质量的一致性。具体而言,过滤掉了长度小于 2 的所有会话,并移除了出现次数少于 5 次的项目。此外,对于每个会话 S = {v1, v2, ..., vn},生成了多个子序列用于模型的训练与测试。这些子序列的形式为:([v1]|v2)、([v1, v2]|v3)、...、([v1, v2, ..., vn-1]|vn)。完成上述预处理后,对数据集进行了统计分析,详细信息见Table 2。
| 数据集 | Diginetica | Tmall | Nowplaying |
| 点击 | 982961 | 818479 | 1367963 |
| 训练集 | 719470 | 351268 | 825304 |
| 测试集 | 60858 | 25898 | 60417 |
| 物品数 | 43097 | 40728 | 60417 |
| 平均长度 | 5.12 | 6.69 | 7.42 |
表2:数据集描述。 该表格总结了Diginetica、Tmall和Nowplaying数据集的统计信息,包括点击次数、训练和测试样本数量、物品数量以及平均会话长度。
实验设置
参数设置
为确保实验的公平性,采用预处理方法对三个数据集进行处理,并预设了GSLA4Rec模型的参数。对于Diginetica和Nowplaying数据集,批处理大小设置为150,Tmall数据集则设置为300。该模型参数使用均值为0、标准差为0.1的高斯分布进行初始化,维度设为100;优化器采用Adam,初始学习率设为0.001,每3个训练周期学习率乘以0.1;在NVIDIA TITAN V GPU和PyTorch 1.11.0(cu113)平台上共训练30个周期,并根据材料表选取最优结果;邻居会话过滤的阈值设为0.5,实验中应用了L2正则化。对于每个数据集,按交易时间排序后,取最后10%的数据作为测试集,其余的10%和80%分别随机选取作为验证集和训练集。GSLA中的记忆槽数量设置为{0, 1, 2, 3, 4, 5}中的某一数值。
评估指标
本文采用了P@N(Precision@N,N = 10/20)和MRR@N(Mean Reciprocal Rank@N,N = 10/20)。P@N用于衡量前N个推荐结果中正确推荐所占的比例,MRR@N用于计算正确项目倒数排名的平均值,MRR值越高,排序性能越好。
分析性能
GSLA4Rec模型的有效性在代表不同技术发展阶段的基线模型上进行了评估。在早期阶段,机器学习方法被用于会话式推荐(SBR),例如FPMC5基于马尔可夫链预测序列效应。随后,随着人工智能的发展,深度学习方法被广泛应用于SBR,例如GRU4Rec10基于循环神经网络(RNN),通过堆叠多层门控循环单元(GRU)对SBR建模,并设计了专门的损失函数以优化SBR;NARM16引入了注意力机制(AM)以捕捉用户的主要兴趣,并生成下一个可能推荐项目的最终嵌入表示;STAMP17采用注意力机制增强的多层感知机,同时捕捉用户的长期兴趣和即时兴趣。近年来,由于图神经网络(GNN)在非欧几里得数据学习方面的强大能力,其在SBR中也得到了广泛应用。例如,SR-GNN22首次将GNN应用于SBR,通过门控图神经网络(GGNN)获取复杂的项目转移关系,并结合注意力机制关注用户的即时兴趣;GCE-GNN23利用图注意力网络(GAT)获取局部和全局上下文中的项目转移关系,并通过相对位置编码(RPE)和软注意力机制(soft-AM)生成会话表示;S2-DHCN66将会话数据转换为超图和线图,并利用自监督学习来增强SBR性能。
最近,研究者采用了一种综合性的方法来提升基于会话的推荐(SBR)性能。例如,GC-SAN50 将图神经网络(GNN)与多层自注意力网络相结合,通过建模短期和长期依赖关系来提升推荐性能;TASRec67 通过在不同时间戳构建动态图快照序列,引入了时间信息;CT-GNN68 采用融合时间信息的图神经网络,以学习项目之间的额外时间关联信息;CORE69 融合了项目共现信息与时间信息,以获得最终的会话表示;RESTC70 提出了受对比学习中一致性与对齐特性启发的时空交互模式;COTRec66,71 在两个会话图视图上采用自监督学习并结合协同训练,以解决SBR中的数据稀疏性问题;RAIN71 利用边掩码和结构重建,并联合训练一个边指示器以显式识别并消除噪声边,显著提升了SBR的准确性和鲁棒性。
| 数据集 | Diginetica | Tmall | Nowplaying | ||||||||||
| 方法分类 | 评估指标 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| 机器学习 | FPMC | 15.42 | 22.10 | 6.20 | 6.66 | 13.12 | 16.05 | 7.10 | 7.30 | 5.28 | 7.35 | 2.66 | 2.82 |
| 深度学习 | GRU4REC | 17.92 | 30.80 | 7.73 | 8.20 | 9.47 | 10.93 | 5.78 | 5.89 | 6.74 | 7.92 | 4.40 | 4.48 |
| 深度学习 | NARM | 35.44 | 48.32 | 15.12 | 16.00 | 19.16 | 23.30 | 10.40 | 10.70 | 13.60 | 18.59 | 6.62 | 6.92 |
| 深度学习 | STAMP | 33.97 | 46.62 | 14.26 | 15.13 | 22.63 | 26.47 | 13.10 | 13.35 | 13.20 | 17.65 | 6.57 | 6.88 |
| GNNs | SR-GNN | 38.42 | 51.26 | 16.89 | 17.76 | 23.41 | 27.57 | 13.46 | 13.72 | 14.17 | 18.86 | 7.15 | 7.47 |
| GNNs | S2 -DHCN | 40.21 | 53.66 | 17.59 | 18.51 | 26.22 | 31.42 | 14.60 | 15.05 | 17.35 | 23.50 | 7.87 | 8.18 |
| GNNs | GCE-GNN | 41.16 | 54.22 | 18.15 | 19.04 | 28.01 | 33.42 | 15.08 | 15.42 | 16.94 | 22.37 | 8.03 | 8.40 |
| GNNs+Att | TASRec | 39.85 | 52.53 | 17.19 | 18.22 | 25.72 | 29.58 | 14.22 | 14.51 | 16.35 | 20.52 | 7.30 | 7.78 |
| GNNs+Att | GC-SAN | 38.40 | 51.30 | 16.80 | 17.80 | 23.50 | 27.60 | 13.50 | 13.80 | 14.20 | 18.90 | 7.20 | 7.50 |
| GNNs+Tem | CT-GNN | 39.40 | 52.71 | 17.50 | 18.56 | 25.95 | 31.42 | 14.52 | 15.00 | 16.55 | 22.28 | 7.75 | 8.06 |
| GNNs+Tem | CORE | 41.03 | 52.84 | 17.95 | 18.47 | 32.97 | 39.16 | 18.72 | 19.16 | 17.65 | 21.81 | 7.92 | 7.35 |
| GNNs+Tem | RESTC | 42.35 | 55.93 | 18.75 | 19.65 | 35.57 | 42.47 | 18.05 | 18.52 | 18.39 | 24.79 | 8.31 | 8.72 |
| GNNs+COT | COTRec | 39.87 | 54.18 | 17.53 | 19.07 | 30.62 | 36.35 | 17.65 | 18.04 | - | - | - | - |
| GNNs+ReStr | RAIN | - | 55.50 | - | 19.20 | - | 38.73 | - | 19.12 | - | 24.17 | - | 8.47 |
| GNNs+Gated-Slot | GSLA4Rec | 43.35 | 56.47 | 19.38 | 19.98 | 36.56 | 43.60 | 19.46 | 19.96 | 19.80 | 27.10 | 8.86 | 9.32 |
| SD | ±0.0009 | ±0.0011 | ±0.0008 | ±0.0009 | ±0.0018 | ±0.0021 | ±0.0016 | ±0.0018 | ±0.0028 | ±0.0031 | ±0.0024 | ±0.0026 | |
| p值 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.01 | |
| Tinference | 0.294 | 0.296 | 0.295 | 0.297 | 0.168 | 0.169 | 0.169 | 0.171 | 0.472 | 0.478 | 0.475 | 0.479 | |
表3:在三个数据集上的性能比较。 该表格比较了GSLA4Rec与基于机器学习、深度学习、图神经网络(GNN)、注意力机制、时序以及其他推荐方法在Diginetica、Tmall和Nowplaying数据集上的表现,评估指标包括P@10、P@20、MRR@10和MRR@20。同时报告了GSLA4Rec的SD值和p值。
为了验证 GSLA4Rec 模型的性能,并消除由随机因素引起的性能提升的随机性,对测试集进行了多次分组实验与统计分析。具体而言,将测试集按每批 150 个会话进行分组,并采用随机种子方法重复实验 30 次。所有分组实验的平均结果和耗时分别作为 GSLA4Rec 模型的性能指标与推理时间。进一步计算了 GSLA4Rec 模型的标准差(SD)以及统计显著性 t-检验,以验证其性能提升的稳定性与确定性。表 3 展示了所提出的推荐模型 GSLA4Rec 在三个数据集上与基线模型相比的性能、标准差(SD)、p 值以及 Tinference。下划线标注的数值表示最佳基线方法,各评价指标下性能最优的模型以粗体黑字标出。
基于机器学习的推荐方法:在基于会话的推荐(SBR)任务中,传统的FPMC方法表现最差,主要原因是马尔可夫链模型无法捕捉项目之间的复杂转移模式。2)基于深度学习的推荐方法:GRU4REC、NARM和STAMP等模型采用了序列建模方法,并取得了一定的性能提升。其中,NARM和STAMP的表现优于GRU4REC,主要原因是NARM引入了注意力机制以捕捉用户的主导兴趣。3)基于图神经网络(GNNs)的推荐方法:GNN在SBR中的应用带来了显著的性能提升。例如,SR-GNN率先将会话序列转化为图结构,以捕捉项目的空间结构信息,其性能优于以STAMP为代表的深度学习方法,提升幅度为0.36–4.64%,体现了图结构在处理序列数据时的空间优势。S2-DHCN采用双通道超图卷积来捕捉项目间的高阶依赖关系,并结合自监督对比学习以增强表征能力,克服了传统GNN仅能建模成对关系且信息表达不足的局限性,其性能比以STAMP为代表的深度学习方法高出1.30–7.04%。GCE-GNN通过有效整合单个会话与全局会话信息,性能优于以STAMP为代表的深度学习方法1.46–7.60%,并超过SR-GNN模型0.88–5.85%,表明融合全局上下文信息的图结构方法可显著提升SBR性能。4)基于GNNs与注意力机制结合的推荐方法:TASRec通过引入时间感知机制,更精确地捕捉用户行为序列中的短期与长期偏好,其性能比深度学习方法提升0.73–5.91%,优于SR-GNN模型0.30–2.31%,但较GCE-GNN模型仍低0.59–3.84%。GC-SAN将由会话序列转换而来的图结构与多头自注意力机制相结合,成功捕捉会话内的局部与长期依赖关系,其性能与SR-GNN模型相当或略优,但弱于TASRec和GCE-GNN模型。这表明引入注意力机制可有效提升SBR性能,但其增益效果不及全局信息,再次印证了全局上下文信息的重要性。5)基于GNNs与时间编码结合的推荐方法:CT-GNN首次将图结构与时间编码相结合,以同时捕捉“空间结构”与“时间动态”,性能优于GC-SAN模型0.55–3.82%。CORE分别通过统计全局会话中项目的共现频率以捕捉长期偏好,并为当前会话设计时间位置加权以捕捉短期意图,进而融合共现信息与时间信息以获得最终的会话表征,其性能优于TASRec模型0.25–9.58%,优于GC-SAN模型0.67–11.56%,在Tmall数据集上较GCE-GNN模型显著提升3.64–5.74%。RESTC提出了一种基于时空GNN的对比学习模型,以解决传统GNN仅关注空间图结构、忽略时间信息以及时空融合不足等问题,其性能优于CORE模型0.39–3.31%,优于GCE-GNN模型0.28–7.56%,表明时间编码与对比学习均能有效提升SBR性能。RAIN利用边掩码与结构重建技术联合训练边指示器,以显式识别并消除噪声边,性能接近RESTC模型。
所提出的模型GSLA4Rec融合了全局上下文信息和门控槽位线性注意力机制,能够有效捕捉用户的上下文信息,同时过滤噪声并降低计算复杂度。该模型在所有数据集上均表现出性能提升,优于两个表现最佳的基线模型——相比RESTC模型提升了0.54–2.31%,相比GCE-GNN模型提升了0.83–10.18%。在SBR中长会话场景下的序列依赖关系处理方面,这一优势尤为显著(具体而言,在Tmall和Nowplaying数据集上,相比GCE-GNN分别提升了10.18%和4.73%,相比RESTC分别提升了1.44%和2.31%)。简而言之,所提出的GSLA4Rec模型通过高效的图结构构建来捕捉用户上下文并过滤噪声,其性能在所有数据集上持续优于当前最优方法(SOTA)。
分析效率
如图4所示,在Diginetica数据集上的实验结果表明,所提出的GSLA4Rec模型在每轮训练时间上比基线模型具有更快的训练速度,所有实验均在NVIDIA TITAN V GPU上运行,内存消耗约为9300MB。基于深度学习的模型(包括STAMP、NARM和GRU4Rec)运行效率较高,但性能最弱;基于图神经网络(GNN)和自注意力机制的TASRec和GC-SAN模型性能有所提升,但耗时显著。尽管基于GNN的S2-DHCN和CORE模型带来了计算时间的轻微上升,但整体性能取得了显著提升,尤其是所提出的GSLA4Rec模型,在性能上表现出明显改进。其主要原因是GSLA4Rec模型在图构建上花费的时间少于基线模型,此外,该模型采用了具有固定内存槽m的双通路门控线性注意力机制,实现了线性时间复杂度O(Ldm)。该设计在通过softmax增强的槽读取机制保持强大记忆能力的同时,显著优于标准自注意力机制的O(L2d)时间复杂度。在测试集上进行性能测试实验以同步统计推断时间,如表3最后一行所示,进一步验证了GSLA4Rec模型的效率优势,避免了“虚假高准确率但不可用”的情况,真正实现了有效性与效率之间的平衡。
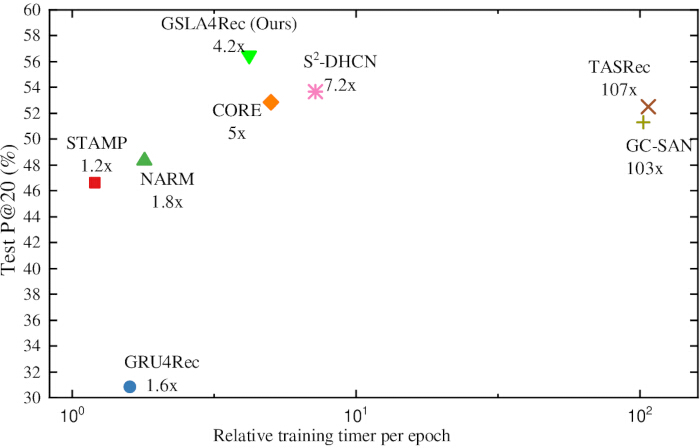
图4:GSLA4Rec 在 Diginetica 数据集上的运行时间性能。该图显示了本文提出的 GSLA4Rec 模型与基线模型在 NVIDIA TITAN V GPU 上使用 Diginetica 数据集进行训练时每个训练周期的相对训练时间,GSLA4Rec 的训练速度优于基线模型。该图通过 OriginPro 软件绘制,并完全自定义了图形元素。未使用受版权保护的外部图形资源,因此无需额外的第三方版权许可。该图的版权归属于作者,在论文被接收后将遵守期刊的版权规定。GSLA4Rec 代表用于序列化行为推荐(SBR)的门控槽位线性注意力图神经网络。请点击此处查看该图的放大版本。
总之,所提出的具有线性复杂度门控槽注意力机制的GSLA4Rec模型在所有数据集上的性能 consistently outperformed SOTA。特别是在Tmall和Nowplaying数据集的长会话推荐场景中,GSLA4Rec取得了显著的性能提升,并展现出更优的序列依赖建模能力。
分析消融实验
SG、NGG 和 GSLA 的影响
为了评估子图(SG)、邻域图生成器(NGG)、门控机制、记忆槽和线性注意力对当前会话基于推荐(SBR)模型的影响,在 Diginetica、Tmall 和 Nowplaying 数据集上进行了消融实验。其中,GSLA4Rec‑NotSG 排除了 SG 特征编码但保留了 NGG 编码;GSLA4Rec‑NotNGG 舍弃了 NGG 编码,仅基于 SG 进行特征提取;GSLA4Rec‑NotGM 仅移除了 GSLA 中的门控机制;GSLA4Rec‑NotMS 仅去除了 GSLA 中的记忆槽;而 GSLA4Rec‑NotLA 则仅省略了 GSLA 中的线性注意力模块。
| 数据集 | Diginetica | Tmall | Nowplaying | |||
| 评估指标 | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54.28 | 18.87 | 31.40 | 15.11 | 22.48 | 7.45 |
| GSLA4Recs-NotNGG | 52.65 | 17.67 | 28.90 | 14.61 | 20.17 | 7.74 |
| GSLA4Rec-NotGM | 53.82 | 18.21 | 39.26 | 16.52 | 23.14 | 7.62 |
| GSLA4Rec-NotMS | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-NotLA | 51.86 | 16.92 | 29.12 | 13.96 | 20.82 | 7.28 |
表4:GSLA4Rec消融实验的性能。 该表格报告了在Diginetica、Tmall和Nowplaying数据集上移除GSLA4Rec的各个模型组件后的消融性能,评估指标为P@20和MRR@20。
表4展示了在不同数据集上进行消融实验的结果,所有性能指标相较于完整模型均有所下降。移除近邻全局会话图编码(GSLA4Rec-NotNGG)导致的性能下降程度大于移除会话图特征编码(GSLA4Rec-NotSG)。删除GSLA中的任一子模块均会导致性能下降,其中性能下降程度从高到低依次为线性注意力机制、记忆槽和门控机制。其原因为SBR中每个项目的重要性明显不同,且项目之间需要存在关联记忆。由此可见,GSLA是本文模型的关键组成部分。
不同聚类方法的影响
为了评估不同信息聚合方法对GSLA4Rec模型性能的影响,研究了以下三种经典的信息聚合方法:1)平均池化:对SG和NGG生成的向量执行平均池化操作;2)向量拼接:将SG和NGG生成的向量进行拼接;3)向量求和:对SG和NGG生成的向量进行求和。结果如表5所示。在Diginetica、Tmall和Nowplaying数据集上,采用向量求和(Vec-Sum)的GSLA4Rec模型取得了最佳性能。相比之下,平均池化在所有数据集上的表现均较差。平均聚合与拼接聚合性能较差的原因可能是由于参数过多导致过拟合,从而降低了模型的整体性能。
| 数据集 | Diginetica | Tmall | Nowplaying | |||
| 评估指标 | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| 均值池化 | 45.26 | 15.63 | 38.84 | 16.3 | 23.56 | 7.55 |
| 向量拼接 | 51.77 | 17.24 | 39.83 | 18.24 | 24.06 | 8.88 |
| 向量求和 | 56.47 | 19.98 | 43.6 | 19.96 | 27.1 | 9.32 |
表5:不同聚合方法的效果。 该表格比较了平均池化、向量拼接和向量求和在 Diginetica、Tmall 和 Nowplaying 数据集上对 GSLA4Rec 模型性能的影响,评估指标为 P@20 和 MRR@20。
分析超参数设置
不同内存插槽尺寸的影响
记忆槽存储了来自先前时间步的信息,这对于具有时间依赖性的任务尤为重要。本节研究了记忆槽大小 m = [0, 1, 2, 3, 4, 5] 对 SBR 模型性能的影响。实验结果如表6所示,当记忆槽大小 m 设为3时,三个数据集上的指标 P@20 和 MRR@20 均达到最优表现。这表明适度的记忆槽大小能有效提升模型的推荐准确性和排序质量;记忆槽过小时难以记忆足够的历史信息,更倾向于关注用户的短期兴趣;而当记忆槽大小增加至4或更大时,模型会存储过多的历史信息,导致过度依赖历史兴趣,忽视更为关键的当前输入信息,从而降低推荐性能。
| 数据集 | Diginetica | Tmall | Nowplaying | |||
| 评估指标 | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-m1 | 55.43 | 18.92 | 41.55 | 17.12 | 25.60 | 8.43 |
| GSLA4Rec-m2 | 56.02 | 19.35 | 42.90 | 18.25 | 26.62 | 8.95 |
| GSLA4Rec-m3 | 56.47 | 19.98 | 43.60 | 19.96 | 27.10 | 9.32 |
| GSLA4Rec-m4 | 53.96 | 19.25 | 43.06 | 19.09 | 26.34 | 8.35 |
| GSLA4Rec-m5 | 52.18 | 18.03 | 42.12 | 17.56 | 24.86 | 8.85 |
表6:不同记忆槽大小的影响。 该表格报告了GSLA4Rec在Diginetica、Tmall和Nowplaying数据集上,采用不同记忆槽配置(m0–m5)时的P@20和MRR@20性能表现。
不同 dropout 比率的影响
为防止过拟合,引入了 dropout 正则化方法。在对会话级项目向量与邻居全局级项目向量进行求和之前,随机丢弃邻居全局级项目向量 hingg,(k) 中神经元的输出,以增强 GSLA4Rec 模型的鲁棒性与泛化能力。
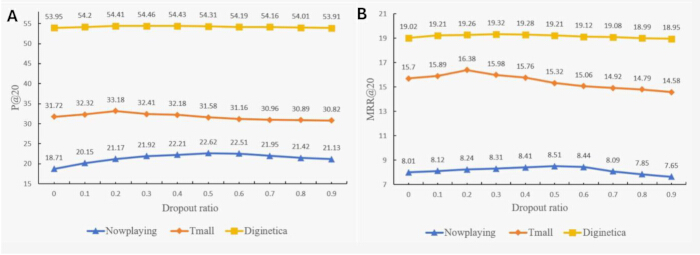
图5:GSLA4Rec在不同dropout比例下的性能表现。(A)GSLA4Rec在Nowplaying、Tmall和Diginetica数据集上不同dropout比例下的P@20,以及(B)MRR@20。随着dropout比例的增加,模型性能先上升后下降,表明该模型具有较强的鲁棒性和泛化能力。GSLA4Rec,即基于门控槽位线性注意力机制的图神经网络,用于会话推荐(SBR)。本图使用OriginPro软件绘制,所有元素均为自定义设计,未使用受版权保护的外部图形资源,因此无需额外的第三方版权许可。本图的版权归作者所有,并将在论文被接收后遵守期刊的版权规定。请点击此处查看该图的高清版本。
图5A–B展示了公式(16)中不同dropout比例对模型性能的影响。实验结果表明,当dropout比例较低时,模型表现较差;然而,随着dropout比例的增加,模型性能逐渐提升,直至达到最优水平。具体而言,在Diginetica数据集上,最优dropout比例为0.3;在Tmall数据集上为0.2;在Nowplaying数据集上为0.5。当dropout比例超过这些最优值后,模型性能开始下降,主要原因是过多的神经元被丢弃,导致模型无法从会话数据中有效学习重要特征。
不同嵌入尺寸的影响
为了在保持模型最佳性能的同时尽可能降低计算开销,研究了不同嵌入维度 d 对 GSLA4Rec 模型性能的影响。如图 6A–B 所示,在 Diginetica、Tmall 和 Nowplaying 三个公开数据集上,当嵌入维度 d 为 10–40 时,GSLA4Rec 模型表现较差;然而,随着 d 值的增加,模型性能迅速提升;当 d 值处于 80 至 120 范围内时,性能指标趋于稳定;随后,随着 d 进一步持续增加,性能反而下降,可能是由于较大的嵌入维度导致过拟合。因此,最终将项目嵌入向量的维度设定为 100。
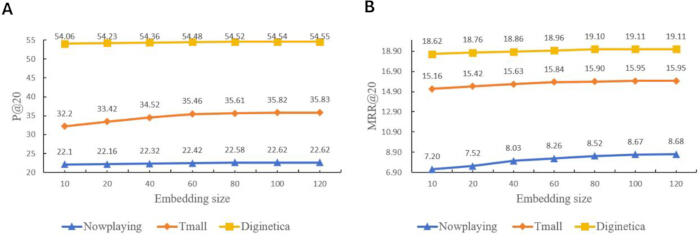
图6:不同嵌入维度下GSLA4Rec的性能表现。(A)Nowplaying、Tmall和Diginetica数据集上不同嵌入维度下GSLA4Rec的P@20和(B)MRR@20。模型性能随着嵌入维度的增加而逐步提升,最终趋于稳定。GSLA4Rec,即用于基于会话的推荐(SBR)的门控槽位线性注意力图神经网络。该图使用OriginPro软件绘制,所有元素均为自定义。未使用受版权保护的外部图形资源,因此无需额外的第三方版权许可。图的版权属于作者,若被录用将遵守期刊的版权规定。请点击此处查看该图的放大版本
不同会话时长的影响
众所周知,三个真实世界的 SBR 数据集(Diginetica、Tmall 和 Nowplaying)中每个会话的长度各不相同。为了验证 GSLA4Rec 模型在不同会话长度下相较于基线模型的鲁棒性,将 Diginetica 和 Tmall 中的所有会话分别划分为三组:短组(S,长度为 1 至 6)、中组(M,长度为 7 至 12)和长组(L,长度大于 12)。采用 MRR@20 而非 P@20 来评估各方法的性能,因为 MRR 能更好地反映正确结果的排序质量。图 7A–B 表明,GSLA4Rec 模型在不同长度的会话下均优于基于序列的基线模型 NARM、基于图神经网络(GNN)的基线模型 SR-GNN、引入对比学习的 GNN 基线模型 S2-DHCN,以及时空建模基线模型 RESTC。同时还可以观察到,随着会话序列长度的增加,所有方法的性能均有所下降,因为长距离的项目转移使得捕捉用户偏好变得更加困难;但所提出的 GSLA4Rec 模型相较于基线模型下降速度最慢,这得益于门控槽(Gated-slot)机制能够过滤无关项目。在 Diginetica 和 Tmall 的长组中,GSLA4Rec 的性能分别比 NARM 模型高出 6.3 和 8.85。
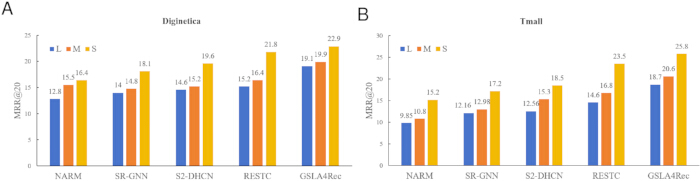
图7:GSLA4Rec 在不同会话长度下的性能表现。GSLA4Rec 与基线模型在不同会话长度分组下于(A)Diginetica 和(B)Tmall 数据集上的性能,评估指标为 MRR@20。会话长度分组标记为 L、M 和 S。GSLA4Rec 指基于门控槽位线性注意力图神经网络的会话推荐模型(SBR)。本图使用 OriginPro 绘制,所有元素均为自定义;未使用受版权保护的外部图形资源,因此无需额外的第三方版权许可。该图的版权归作者拥有,并将在论文被接收后遵守期刊的版权规定。请点击此处查看此图的高清版本。
结论
本文提出了一种用于会话推荐(SBR)的全局上下文门控槽线性注意力网络。该方法通过结合槽门控(SG)与归一化门控图(NGG),并引入门控槽线性注意力机制,使其能够聚焦于会话序列中的关键项目,捕捉长期与短期依赖关系,有效降低噪声干扰,并减少计算复杂度。实验结果表明,该方法在三个公开数据集上表现出优异的推荐准确率与效率,尤其在长期依赖建模任务中表现突出。
数据可用性:
支持本研究结论的三个常用公开数据集(Diginetica、Tmall 和 Nowplaying,其网址可在材料表中找到)在互联网上公开获取。同时,三个广泛使用的公开数据集以及本研究的源代码已作为补充文件夹:GSLA4Rec.zip提交。请点击此处下载该文件。
讨论
与基线模型相比,GSLA4Rec 模型在性能和效率上实现双重提升,主要基于三个核心原因。首先,将门控机制应用于 NGG 有效缓解了数据稀疏性并过滤了噪声。其次,记忆槽机制通过超参数 m 的调整平衡了存储容量与效率。 m 调整。第三,线性注意力机制以 O(N) 复杂度计算项目相关性, O(N) 的复杂度,远低于 O(N2)61GSLA4Rec 模型过度依赖于用户的' 交互序列,并忽略了项目的多模态属性。48与此同时,邻域图门控(NGG)的构建采用固定的 Jaccard 阈值,缺乏动态调整功能,且记忆槽(memory slots) m cannot achieve adaptive adjustability65.
GSLA4Rec模型,它构建了SG&NGG and adopts gated-slot linear attention, especially fits anonymous session recommendation39 在电子商务和在线流媒体平台中。在电子商务平台中,该模型通过捕捉用户的浏览、点击或将商品加入购物车的行为来向用户推荐匹配的商品,而无需依赖用户特征属性。本文使用的 Diginetica 和 Tmall 数据集是电子商务推荐数据集。对于短视频和音乐流媒体平台,该方法分析用户' 通过回放序列推断用户的隐含偏好,更新内容摘要以留住用户,并延长观看时间。本文使用的数据集 Nowplaying 为音乐推荐数据集。
存在可替代门控槽线性注意力架构的备选方案。新兴的 Mamba65 基于状态空间模型作为一种替代方案,具有选择性状态存储空间和线性计算复杂度的特点,在平衡线性复杂度和长序列拟合能力的同时,结合LLM55 增强框架,该框架从用户' 从原始交互日志中提取用户的隐含意图,从而实现良好的推荐性能与效率。未来工作可从多个角度优化GSLA4Rec:构建动态NGG以替代固定的Jaccard过滤,实现可变记忆槽以自动匹配不同长度的会话,并整合用户多模态信息以提升推荐准确性。此外,借助LLM增强模型,可从交互序列中挖掘用户的隐含意图,并更精准地过滤噪声对话数据。55, users' 可从交互序列中挖掘用户的隐含意图,并能更精确地过滤噪声对话数据。72.
披露
作者声明,他们不存在任何已知的可能影响本文报道工作的竞争性财务利益或个人关系。
致谢
作者感谢评审专家在审稿过程中提出的宝贵意见和建议,感谢我的博士生导师江楠教授给予的悉心指导。本研究部分得到国家自然科学基金(项目编号:6217072713 和项目编号:62061019)的资助,部分得到江西省无人感知系统与人工智能技术工程研究中心2025年开放研究课题的资助,部分得到江西省先进电子材料与器件重点实验室(编号:2024SSY03012)的资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | NONE | CUDA 11.3 是 NVIDIA 于 2021 年发布的一个并行计算平台和编程模型版本,旨在提升 GPU 加速应用程序的性能和开发灵活性。 |
| Diginetica | Diginetica | NONE | Diginetica 是 2016 年 CIKM(国际信息检索会议)竞赛的官方比赛数据集,曾用于 CIKM 算法竞赛,以解决电子商务中结合搜索上下文的个性化商品推荐问题。目前,它已成为基于会话的推荐(SBR)领域中最主流的标准电商基准数据集。 |
| Nowplaying | Zenodo | NONE | 该数据集是基于“#nowplaying”标签的推文挖掘构建的大规模音乐收听行为数据集,主要用于音乐对话推荐、上下文感知推荐以及情感关联分析研究。 |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | NONE | OriginPro 是由 OriginLab Corporation 开发的一款商业专业科学绘图与数据分析软件,常用于绘制论文级别的图表、数据统计、曲线拟合、信号处理等。本文使用 OriginPro 绘制实验对比图、折线图和柱状图。 |
| PyTorch 1.11.0 | PyTorch Foundation | NONE | PyTorch 是一个由 Facebook 于 2016 年发布的开源深度学习框架,主要用于机器学习和深度学习,其核心实现了自动微分,并引入了动态计算图,使模型构建更加灵活。 |
| TITAN V GPU | NVIDIA | NONE | NVIDIA TITAN V 是 NVIDIA 于 2017 年底推出的一款旗舰级显卡,主要面向高性能计算和人工智能领域。 |
| Tmall | Tmall | NONE | 该数据集源自 2015 年 IJCAI 阿里巴巴天猫推荐竞赛,由阿里巴巴天池平台公开发布的脱敏真实天猫在线日志。它是 SBR 领域三大标准数据集(Diginetica、Yoochoose、Tmall)之一,也是中文电商场景下的首选评估数据集。 |
| visio 2021 | Microsoft | NONE | Visio 是微软开发的一款矢量绘图软件,用于绘制科研论文中的模型结构图、流程图、框架图、网络拓扑图,并输出矢量图形作为论文插图 |
参考文献
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.