本方案描述了基于气象数据集的生成方法,以及在包括沙尘暴、雾、雨和雪等多种伊拉克环境条件下,对机器学习、深度学习和混合模型在自由空间光通信大气衰减预测中的系统性评估。
本文内容
摘要
摘要
自由空间光通信系统具有高带宽、更高安全性和无需许可即可运行的优点,但其性能会因大气散射和吸收引起的大气衰减而显著下降。在伊拉克,环境条件随机表现为高温、多尘、多雾和多雨,因此准确预测衰减显得尤为重要。本研究旨在评估机器学习、深度学习和混合建模技术在不同伊拉克天气条件下预测自由空间光通信系统大气衰减的性能。通过使用成熟的物理传播模型,为五种天气状态(晴空、雾、雨、沙尘暴和雪)生成了包含1500个样本的合成数据集。系统性地评估了15种预测模型,包括六种机器学习方法(随机森林 [RF]、极端梯度提升、轻量梯度提升机、支持向量回归、线性回归和K近邻算法),六种深度学习架构(多层感知机、深度神经网络、长短期记忆网络 [LSTM]、一维卷积神经网络 [CNN]、CNN-LSTM 和基于注意力机制的网络)以及三种混合方法。结果表明,随机森林的表现最优(R2 = 0.9654,均方根误差 = 1.324 dB/km),优于深度学习方法(最佳 R2 = 0.7766)和混合方法(最佳 R2 = 0.9571)。通过Shapley加性解释(Shapley Additive exPlanations)分析特征重要性,发现粉尘浓度(67.3%)和能见度(21.2%)是最具影响力的因素。尽管随机森林在训练和推理速度上显著更快,但统计检验显示,随机森林与表现最佳的混合方法之间无显著差异(p = 0.083)。研究证明,传统机器学习方法在恶劣环境条件下估算自由空间光通信系统大气衰减方面效率很高,且结果与已知的物理传播理论一致。然而,我们强调,这些结论基于合成数据,必须通过真实的大气测量数据验证后,方可应用于实际运行的自由空间光通信系统中。
引言
自由空间光(FSO)通信网络通常具有更高的容量和更好的安全性,但由于散射和吸收导致的大气衰减,通信距离受到主要限制1。本研究对机器学习、深度学习及混合方法进行了详细分析,以评估在伊拉克高温、沙尘暴和降雨不规律等恶劣环境下的FSO信号衰减情况2。
自由空间光通信系统已成为实现高带宽无线连接的有前景解决方案之一3 传输距离从数百米到数千米,数据速率超过 100 Gbps4. FSO 链路在可见光和红外光谱范围内运行,与传统的射频系统不同,具有无需许可即可使用、抗电磁干扰、通过窄波束发散实现更高安全性和大带宽容量等优势5这些特点使自由空间光通信成为回程应用、楼间链路、灾难恢复网络以及光纤部署成本过高的最后一公里连接中的理想技术选择6但通过散射、光束偏转和吸收进行通信7,8 在可用性和性能方面高度依赖于环境条件。这一挑战是自由空间光通信系统的主要限制之一。天气条件会导致衰减水平(dB/km)发生显著变化。在晴空条件下,衰减可低于0.5 dB/km,而在浓雾条件下,根据Kim雾模型预测,在能见度低于50 m时,1550 nm波长处的衰减可能达到或超过50 dB/km。9,10 大雨可导致衰减达到每公里20至30分贝,具体取决于降雨强度(根据Carbonneau模型预测)11因此,为了实现可靠的链路设计、网络规划和自适应传输策略,需要准确预测衰减。传统方法基于物理传播模型,例如用于雾的金氏模型12,Carbonneau 模型用于降雨13,以及气溶胶粒子的米氏散射理论14然而,尽管这些模型提供了良好的理论基础,但它们通常依赖于准确的大气参数,而这些参数在实际中并不总是可获得的,并且常常未考虑同时发生的多种气象现象之间的复杂相互作用15.
伊拉克极端多变的环境条件给自由空间光通信系统的部署带来了重大挑战。由于降雨稀少并伴有局部雾天,传输条件进一步复杂化;冬季气温可降至冰点以下,夏季气温则可升至50 °C以上16。在常规使用的1550 nm波段等正常波长下,当地称为“al-haboob”的沙尘暴可使能见度降低至不足100米,导致衰减值超过20 dB/km17。为了在伊拉克及其他中东国家成功部署自由空间光通信系统,必须建立可靠的预测模型,以精确估算系统在这些不同环境条件下的性能18。
机器学习的新进展为传统的基于物理的建模方法提供了可行的替代方案。机器学习技术能够直接学习衰减与大气因素之间复杂的非线性关系,从而检测出传统解析模型可能忽略的微小相互作用19。在多种气候预测任务中,随机森林(Random Forest, RF)和梯度提升策略已表现出强大的性能20。类似地,深度学习技术在自然语言处理、计算机视觉和时间序列预测方面也取得了显著成功21。然而,这些方法在自由空间光通信(FSO)衰减预测中的应用尚不充分,尤其是在数据集有限且天气条件高度变化的情况下尤为如此22。为填补这一空白,本研究系统地探讨了机器学习、深度学习及混合方法在伊拉克大气条件下预测FSO信号衰减的有效性。该目标通过基于已知物理传播模型构建设计良好的合成数据集来实现23。我们假设,对于具有少量主导预测变量的中等规模表格型环境数据集,基于树的集成方法的预测性能将优于复杂的深度学习架构。本研究的主要目标是:(1)在受控的仿真环境中建立用于比较预测方法的基准方法论;(2)确定预测大气衰减的最佳算法策略;(3)评估特征重要性与模型可解释性,以深入理解对衰减影响最大的环境因素。本研究使用合成数据,但为后续利用真实世界实验测量数据进行验证奠定了基础,后者将在未来工作中实现。此外,本研究还引入了特征重要性分析和可解释性分析,以确定影响衰减的最关键环境因素。
方案
本研究未涉及人类参与者、脊椎动物或组织采样。本研究所使用的全部数据均通过物理传播模型和公开的气象参数合成生成。因此,无需获得机构审查委员会(IRB)或机构动物护理和使用委员会(IACUC)的伦理批准。
基于物理传播理论的数据集生成。该数据集旨在模拟2024日历年伊拉克大气条件下自由空间光通信系统的每小时大气状态。我们创建了一个每小时包含1,500个样本的合成数据库。
首先,根据区域气候趋势随机分配天气条件:晴天(54.3%)、沙尘(24.9%)、雾(10.5%)、雨(7.4%)和雪(2.8%)。其次,针对每种天气条件应用相应的物理衰减模型,即晴天采用比尔-朗伯定律,雾采用Kim模型,雨采用Carbonneau理论,沙尘暴采用米氏散射理论。第三,设置自由空间光通信(FSO)系统的参数如下:发射功率为20 dBm,波长为1550 nm,传输距离为3 km,发射孔径为2.5 cm,接收孔径为20 cm。第四,计算每个样本的衰减量,单位为dB/km。最后,将完整数据集随机划分为1,200个训练样本(80%)和300个测试样本(20%)。模拟条件包括伴随沙尘暴、暴雨以及温度从−4.89°C至47.99°C的变化情况。天气条件和参数分布的选择基于2020–2024年期间伊拉克的气候记录。选择五种天气类型(晴天、雾、雨、沙尘暴和雪),因为它们涵盖了影响伊拉克自由空间光通信衰减的全部大气条件,其中沙尘暴在中东地区尤为常见。利用在伊拉克各地区收集的历史气象数据,建立每种天气条件的概率分布。最终得到的分布如下:晴天占54.3%(主导状态),沙尘占24.9%(反映伊拉克的沙尘暴问题),雾占10.5%(在伊拉克北部冬季较为频繁),雨占7.4%(符合伊拉克降雨量偏低的特点),雪占2.8%(偶尔出现在北部山区)。针对每种天气条件,使用概率分布对相关气象参数进行建模:温度采用正态分布(均值28.55±11.18°C),范围为−4.89°C至47.99°C,依据伊拉克季节性极端气温数据;湿度采用均匀分布(均值42.01±25.56%),范围为0%至100%;能见度采用对数正态分布,范围为0.05 km至29.99 km(均值13.10±10.91 km),以反映沙尘暴期间频繁出现的低能见度事件;沙尘浓度采用指数分布,范围为0至4.96 mg/m3(均值0.74±1.30 mg/m3),低浓度概率较高,极端沙尘事件则表现为长尾分布。
通信系统的设计参数包括:发射功率为 20 dBm,波长为 1550 nm,最大传输距离为 3 km,发射孔径为 2.5 cm,接收孔径为 20 cm,以补偿发散损耗。自由空间光(FSO)系统的参数分为两类:在所有样本中保持不变的固定参数,以及在数据集生成过程中变化的可变参数。在全部 1,500 个样本中,以下参数保持固定:发射功率(20 dBm)、工作波长(1550 nm)、发射孔径(直径 2.5 cm,效率 0.7)和接收孔径(直径 20 cm,效率 0.7)。这些参数被固定,因为它们是 FSO 系统硬件的物理规格,不随天气条件变化。数据集共包含 1,500 个样本,以下参数在生成过程中发生变化:温度(−4.89°C 至 47.99°C)、湿度(0% 至 100%)、能见度(0.05 km 至 29.99 km)、粉尘浓度(0 至 4.96 mg/m3)以及天气状况(晴天、雾、雨、沙尘、雪)。这些参数根据 2020–2024 年伊拉克气候记录推导出的概率分布进行调整。对于每个样本,根据特定的天气条件和可变参数组合,使用相应的物理衰减模型计算衰减值(dB/km)。
物理衰减采用Carbonneau模型模拟降雨、Beer-Lambert定律模拟晴朗天气、Mie散射理论模拟沙尘、Kim模型模拟雾24。Beer-Lambert定律适用于晴朗天空条件,此时衰减主要由分子散射和吸收引起,其随距离呈指数衰减25。在1550 nm波长处的消光系数α由空气分子的瑞利散射以及大气气体的吸收决定26。Kim模型是一种针对雾的特定模型,通过从雾滴尺寸分布中导出的经验系数将衰减与能见度关联起来。波长依赖性指数q用于描述Mie散射效应27。Carbonneau模型的主要参数是降雨率R,因为雨衰取决于雨滴的尺寸和密度,其系数在1550 nm处通过经验方法获得,并专门针对光学波长进行了校准28。Mie散射理论适用于沙尘条件,因为沙尘颗粒尺寸(0.1–100 μm半径)与波长(1550 nm)相当,中东沙尘的复折射率m = 1.55–0.005i包含了散射和吸收效应29。以下实现了各物理衰减模型及其相应的方程和参数设置。
在晴空条件下,采用比尔-朗伯定律:
Aclear = 10×log₁₀(e(α×d)) (1)
其中 α 为消光系数(在晴朗条件下,以 0.02 dB/km 为中心,采用正态分布,变化范围为 ±0.005 dB/km,波长为 1550 nm),d 为传输距离(固定为 3 km)。对于雾天条件,采用以下方程实现 Kim 模型:
Afog = 10×ln(10)/V×(λ/550)−q (2)
其中,V 为以千米为单位的能见度(范围从 0.05 km 到 10 km),λ 为以纳米为单位的波长(固定为 1550 nm),q 为粒子尺寸分布系数,其计算方式如下:当 V>50 km 时,q=1.6;当 6(1/3);当 0.5
Arain=0.023×R0.93 (3)
其中 R 为降雨强度,单位为 mm/h(根据伊拉克降雨记录,取值范围为 0.25 至 50 mm/h)。在沙尘暴条件下,采用米氏散射(Mie scattering)计算消光效率关系:
Adust = 10 × log₁₀(e(τ × L)) (4)
其中 τ=∫₀^∞ πr2Qext(r,λ,m)N(r)dr,其中 r 为粒子半径(0.1–100μm 根据伊拉克沙尘成分),Qext 是利用米氏理论计算的消光效率, λ=1550 nm,m=1.55–0.005i 为中东沙尘的复折射率,N(r) 为粒子尺寸分布,采用几何平均半径的对数正态分布建模 2.5 μm 标准差为2.0。雪况下的衰减模型实施如下:
Asnow = 0.1×S0.75 (5)
其中 S 为降雪速率,单位为 mm/h(0.5–15 mm/h)。该经验公式基于文献中的研究工作30,该研究利用米氏散射理论结合雪花粒径分布,建立了光信号在降雪中传播的衰减模型。该公式适用于降雪速率为 0.5 至 15 mm/h 的范围,并假设为干雪条件,典型雪花直径为 1–10 mm。系数 0.1 和指数 0.75 是通过对 1550 nm 波长下雪的米氏散射计算结果进行曲线拟合得到的。该公式未对湿雪或混合降水情况进行修正,因为这些情况的衰减特性可能变化较大,尽管其对干雪仍能提供较为合理的估计。由于该方法计算效率高,常被自由空间光通信(FSO)相关文献引用,且适用于伊拉克北部(库尔德斯坦地区一月和二月)的预期降雪情况,因此被选用于本研究。所有模型均使用 Python 3.9 实现,并借助 Numpy 进行数值计算。通过匹配模型,对随机选择的天气条件和采样的环境数据进行处理,以计算每个样本的衰减值。所获得的天气分布包括 814 次晴空条件(54.27%)、375 次沙尘事件(25.00%)、157 次雾事件(10.47%)、111 次降雨事件(7.40%)以及 43 次降雪事件(2.87%)。
通过分析 2020 年至 2024 年间从伊拉克多个地区(巴格达、巴士拉、摩苏尔和拉马迪)气象站收集的历史气象数据,确定了各类天气状况的比例。原始数据由伊拉克交通部及伊拉克气象组织与地震局(IMOS)提供。数据包含每日天气记录,记录了每一天的实时大气状况。从这些记录中提取的具体参数包括:温度(日最低、最高和平均温度)、相对湿度、能见度、降雨量以及沙尘暴发生情况。部分 IMOS 数据可通过伊拉克政府开放数据门户(https://www.motrans.gov.iq/)获取;然而,本研究中使用的特定记录并未在中央存储库中公开存放。用于计算各类天气条件比例及参数值的气候信息汇总于表 1。晴空日定义为无降水、能见度大于 10 km 且无沙尘活动的日期,在 1,825 个记录日中占 54.27%。沙尘暴日(包括强沙尘暴(能见度 < 1 km)和悬浮沙尘(能见度 1–5 km))占总天数的 25.00%,表明在伊拉克干旱和半干旱气候下沙尘暴事件频发。由水滴悬浮导致能见度低于 1 km(排除沙尘引起的能见度降低)的日期被归类为雾日。雾日占比为 10.47%,主要出现在伊拉克北部地区的冬季。降雨日(日降水量可测且 >0.1 mm)占 7.40%,与伊拉克年均降雨量较低(每年 150–200 mm)的情况一致。降雪日(出现固态降水积聚的日期)占 2.87%,仅限于北部山区(库尔德斯坦地区)的一月和二月。这些比例随后被用作数据集生成过程中随机抽样的概率权重。因此,合成数据集反映了伊拉克实际环境中各类天气条件的真实发生频率。
合成数据生成中的偏倚考量
为减少可能的偏倚,采取了以下多个步骤:
(1)选择分布类型:根据源气候数据的统计特性选择概率分布。温度服从正态分布,其均值和标准差依据澳大利亚海洋科学研究所(IMOS)的记录确定。湿度在观测范围内(0-100%)服从均匀分布。能见度假设服从对数正态分布,以反映沙尘暴期间低能见度事件的频繁发生。沙尘浓度服从指数分布,即低浓度出现概率较高,而在极端沙尘事件时分布具有长尾特征31。这与伊拉克沙尘事件的实际发生频率一致32。
(2)天气状况比例:对2020–2024年期间综合海洋观测系统(IMOS)记录的分析共包含四个区域的1,825次每日观测,得出的天气比例为:54.3%为晴天,24.9%为沙尘天气,10.5%为雾天,7.4%为降雨,2.8%为降雪。将无降水、能见度>10 km且无沙尘活动的天气定义为晴天。沙尘天气包括强沙尘暴(能见度<1 km)和浮尘(能见度1–5 km)。雾天定义为能见度低于1 km且原因为水滴悬浮(非沙尘)的天气。降雨日定义为有可测量降水>0.1 mm的天气。降雪日定义为有累积的冻结降水的天气33。
(3)参数范围:参数范围基于IMOS记录中观测到的极端值:温度范围为−4.89 °C(冬季摩苏尔)至47.99 °C(夏季巴士拉),能见度范围为0.05 km(强沙尘暴)至29.99 km(晴朗条件),沙尘浓度范围为0至4.96 mg/m³(依据强哈布沙暴事件期间观测到的最大沙尘浓度)34。
(4)独立性假设:我们假设环境参数是独立采样的,这简化了现实世界中大气变量相互关联的情况(例如,高粉尘浓度通常与低能见度相关)。为了提供一个受控的模拟环境以进行系统性的模型比较,采用了这一独立性假设35。这些假设的影响已在“讨论”部分中予以说明。
(5)分层划分:根据天气状况类别(晴天、雾、雨、沙尘、雪)进行分层的训练-测试集划分,以确保训练集和测试集中每种天气状况的比例与原始数据集的分布一致。这样可避免测试集中稀有天气状况(尤其是占比仅为2.87%的降雪)出现不平衡问题36。
确定性靶标生成的确认
需要指出的是,此处观察到的良好预测性能可能部分归因于模型学习或逼近了用于生成合成目标值的确定性物理方程37。与包含测量噪声、仪器误差和未建模物理现象的真实世界实验测量不同,该合成数据集提供了输入特征与衰减目标之间清晰且无噪声的关系。这是因为衰减值是直接基于输入参数,通过物理传播模型(比尔-朗伯定律、Kim 模型、Carbonneau 模型和米氏散射理论)计算得出的。因此,定量性能指标(R2、RMSE、MAE)反映的是在基于方程生成的合成数据上的表现,不应将其解释为在含噪声的观测或实验数据上的预期性能。这些结果应主要视为在受控仿真环境中对建模方法的比较性评估38。
模型训练的完整特征集
训练数据集包含用于模型训练的10个输入特征:
1. 温度(°C)
2. 湿度 (%)
3. 能见度(km)
4. 粉尘浓度(mg/m3)
5. 降雨率(mm/h)
6. 降雪率(mm/h)
7. 风速(m/s)
8. 大气压(hPa)
9. 月份(数字,1–12)
10. 季节(独热编码:春季、夏季、秋季、冬季)
重要说明:天气状况(晴天、雾天、雨天、灰尘、雪天)在数据集划分过程中被用作分层的分类变量,未作为任何模型的输入特征。SHAP 分析仅包含上述列出的 10 个特征。季节变量经过独热编码(4 个类别:春季、夏季、秋季、冬季),在 SHAP 分析中,各独热编码后的季节变量的贡献值按季节求和,以生成一个单一的季节贡献值。该合并值代表所有与季节相关变量对衰减预测的总贡献。在生成汇总图之前,先识别出四个独热编码的季节列,并对每个样本的 SHAP 值进行加和。该方法确保模型将季节作为一个组合分类变量的使用方式与 SHAP 分析保持一致。
直接影响光学衰减的环境因素(通过物理机制)是特征1–6。将特征7和8(风速和气压)作为补充气象因素加入,可能通过影响空气稳定性和气溶胶扩散而对衰减产生间接影响。为了考虑大气条件的季节性变化,将特征9–10(月份和季节)作为时间描述符纳入分析。所有模型均以衰减值(dB/km)作为目标变量。关键数据集统计信息包括:温度(28.55°C ± 11.18°C)、湿度(42.01% ± 25.56%)、能见度(13.10 ± 10.91 km;范围:0.05–29.99 km)、粉尘浓度(0.74 ± 1.30 mg/m3;最大值:4.96 mg/m3)、衰减(4.80 ± 7.20 dB/km;范围:0.09–50.93 dB/km)、工作距离(5.74 ± 1.97 km)以及信噪比(64.88 ± 15.07 dB)。工作距离和信噪比是根据衰减值使用标准的自由空间光通信链路预算方程计算得出的。
工作范围计算
工作范围(单位为 km)使用链路预算公式计算得出:
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
其中:Prx = 接收功率(设为最小灵敏度−30) 分贝毫瓦(dBm);Ptx = 透射功率(固定为20) 分贝毫瓦(dBm);Gt = 发射增益(根据孔径尺寸计算);Gr = 接收增益(根据孔径尺寸计算); λ = 波长(1550 纳米);R = 公里范围;A = 以分贝每千米(dB/km)为单位的大气衰减(根据物理模型计算得出)。
发射机与接收机增益:发射机增益(Gt)的计算公式为:Gt = 10×log₁₀[0.7×(π×0.025/1.55×10⁻6)2] ≈ 44.2 dBi。接收机增益(Gr)的计算公式为:Gr = 10×log₁₀[0.7×(π×0.20/1.55×10⁻6)2] ≈ 62.3 dBi。发射孔径直径为2.5 cm,效率为0.7。接收孔径直径为20 cm,效率为0.7。通过迭代求解该方程中的R,以确定每个衰减值下可实现的最大链路距离。
信噪比计算
信噪比(SNR)以分贝(dB)为单位,通过以下公式计算:
SNR=Prx−10×log₁₀(kTB)−NF (7)
其中:Prx = 接收功率(dBm,由链路预算计算得出);k = 1.38×10⁻23 J/K(玻尔兹曼常数);T = 290 K(接收机温度);B = 109 Hz(接收机带宽,1 GHz);NF = 3 dB(接收机噪声系数)。噪声基底计算如下:
10 × log10(kTB) ≈ −84 dBm (8)
对于每个样本,在使用适当的物理模型计算出衰减A后,通过链路预算方程求解R得到工作距离,再根据该距离下的接收功率Prx计算信噪比(SNR)。
不同天气条件下的工作范围值:工作范围随天气条件变化而变化,具体为晴朗天空(7.12 ± 1.85 km)、雾天(5.81 ± 1.92 km)、雪天(5.42 ± 1.56 km)、雨天(3.81 ± 0.98 km)和沙尘天气(3.72 ± 1.08 km)。当前计算中未应用3 dB余量;所列工作范围表示无系统余量时的理论最大值。报告的总体平均工作范围为5.74 ± 1.97 km39。
固定传输距离:物理衰减模型中的传输距离设定为3 km。这是进行衰减计算的链路距离。所报告的工作范围是使用链路预算方程计算得出的理论最大距离,可能与固定的3 km传输距离不同。针对不同天气条件记录了特定的衰减值,分别为晴朗天气(0.27±0.06 dB/km)、雾天(1.88±1.92 dB/km)、雪天(6.45±2.54 dB/km)、雨天(13.58±6.32 dB/km)和沙尘天气(13.10±7.32 dB/km)。本文报告的所有定量数值均表示为均值 ± 标准差(SD),除非另有说明40。
随机森林的交叉验证 R2 报告为 0.960±0.007。在某些情况下,例如温度(−4.89 至 47.99°C)、能见度(0.05 至 29.99km)、粉尘浓度(0 至 4.96 mg/m3)和衰减(0.09 至 50.93dB/km),范围(最低值到最高值)以文字形式给出。数据集被划分为测试子集(300 个样本;20%)和训练子集(1,200 个样本;80%)。采用分层随机抽样方法进行训练集与测试集的划分。为了确保训练集(80%)和测试集(20%)中每种天气状况的比例与原始数据集的分布一致,基于天气状况类别(晴天、雾、雨、粉尘、雪)进行了分层处理。具体而言,1,500 个样本中的 1,200 个(80%)被分配至训练集,300 个(20%)被分配至测试集。在保持原始比例的前提下,从每种气象条件类别中随机选择样本:从 814 个晴天样本(54.27%)中,651 个分配至训练集,163 个分配至测试集;从 375 个粉尘样本(25.00%)中,300 个分配至训练集,75 个分配至测试集;从 157 个雾天样本(10.47%)中,126 个分配至训练集,31 个分配至测试集;从 111 个雨天样本(7.40%)中,89 个分配至训练集,22 个分配至测试集;从 43 个雪天样本(2.87%)中,34 个分配至训练集,9 个分配至测试集。在每一层内使用随机种子 42 进行随机抽样,以确保结果可重复。选择这种分层方法是为了防止稀有天气状况(特别是占比仅为 2.87% 的雪天)在测试集中出现代表性失衡,从而避免对这些条件下的模型性能评估不可靠。
机器学习模型评估
评估了六种机器学习方法,包括采用径向基函数核的支持向量回归(Support Vector Regression, SVR;C = 100)、K-近邻(K-Nearest Neighbors, KNN;k = 10,距离加权)、随机森林(Random Forest, RF;200 棵树,最大深度 = 20)、极端梯度提升(Extreme Gradient Boosting, XGBoost;200 个估计器,最大深度 = 10,学习率 = 0.1)、轻量级梯度提升机(Light Gradient Boosting Machine, LightGBM;200 个估计器,最大深度 = 10,学习率 = 0.1),以及作为基线的线性回归。对于所有机器学习和深度学习模型,均对最关键的超参数进行了调优,未指定的参数则保留默认值。针对机器学习模型,使用网格搜索结合训练集上的 5 折交叉验证对以下参数进行了显式调优:1)随机森林:树的数量(测试值:50、100、150、200、250)和最大深度(测试值:10、15、20、25、无限制),最终选定最优值为 200 棵树和深度 20。2)XGBoost:估计器数量(测试值:100、150、200、250)、最大深度(测试值:6、8、10、12)和学习率(测试值:0.05、0.1、0.2),最终选定最优值为 200 个估计器、深度 10 和学习率 0.1。3)LightGBM:使用相同的调优范围,得到最优值为 200 个估计器、深度 10 和学习率 0.1。4)SVR:调优了正则化参数 C(测试值:1、10、50、100)和核函数系数 gamma(测试值:‘scale’、‘auto’、0.1、0.01),最终选定最优参数为 C = 100 并采用径向基函数(RBF)核。5)KNN:调优了邻居数量 k(测试值:3、5、7、10、15),最终选定最优 k = 10,并启用距离加权投票。
这些模型的其余所有参数均保持 scikit-learn 中定义的默认值不变(版本信息见材料表;例如,随机森林:bootstrap=True,min_samples_split=2,min_samples_leaf=1;XGBoost:subsample=1.0,colsample_bytree=1.0,gamma=0)。对于深度学习模型,其网络结构(层数及每层的神经元数量)和 dropout 率(20%)通过在验证集上的迭代实验手动调优,而优化器(Adam)、初始学习率(0.001)、早停耐心值(20 个 epoch)以及学习率衰减参数(衰减因子 0.5,耐心值 10)则依据文献中的标准实践设定,并在所有深度学习实验中保持固定。
气候数据来源
本研究利用2020年至2024年间伊拉克多个地区(巴格达、巴士拉、摩苏尔和拉马迪)气象站收集的历史气象信息,计算了天气状态的比例及变量分布。原始数据由伊拉克交通部以及伊拉克气象组织与地震局(IMOS)提供。数据中包含了每日天气记录,详细描述了每一天的主要大气状态。从这些记录中获取的具体变量包括气温(每日最低、最高和平均气温)、相对湿度、能见度、降雨量以及沙尘暴发生情况。IMOS的部分数据可通过伊拉克政府的开放数据门户(https://www.motrans.gov.iq/)获取,但本研究中使用的特定记录并未在集中式数据库中公开归档。用于确定天气状况比例和参数范围的气候数据汇总见表1。
在训练集(1,200个样本)上采用五折交叉验证来调整所有机器学习模型的超参数并估计其性能。所有输入变量(温度、湿度、能见度、粉尘浓度、降雨率、降雪率、风速、气压)均通过标准化(Z-score归一化)进行特征缩放:x_scaled = (x − μ)/σ,其中μ和σ分别为训练集的均值和标准差。在每次交叉验证折叠中,仅使用训练折叠内的统计量进行标准化,以避免数据泄露。基于树的模型(随机森林、XGBoost、LightGBM)具有尺度不变性,但为保持所有机器学习模型之间的一致性,仍对其应用相同的标准化处理。对于深度学习模型,采用最小-最大归一化:x_scaled = (x−x_min)/(x_max−x_min),该方法根据训练集的最小值和最大值将特征缩放到[0, 1]区间。由于有界输入可加快神经网络的收敛速度,因此选择此方法。测试集使用从训练集中获得的参数进行缩放,且未参与模型选择或超参数调优。
记录了完整的性能指标,包括测试决定系数(R2)、均方根误差(RMSE)、平均绝对误差(MAE)、交叉验证R2以及训练时间。所有机器学习和深度学习模型的训练时间,对于较快的模型(线性回归、KNN、SVR、随机森林、XGBoost、LightGBM)以秒(s)为单位报告,对于较慢的模型(深度学习架构)以分钟(min)为单位报告。所有模型均在相同的计算环境中进行训练,以确保公平比较41。
训练时间使用 Python 的 time 模块进行测量,即从模型拟合函数开始到结束所经过的实际时钟时间,不包括数据加载和预处理所需的时间。深度学习模型的训练时间是指完成所有训练周期直至触发早停(early stopping)所花费的时间,包括前向传播、反向传播以及验证检查。所有实验均在系统未运行其他计算密集型进程的情况下进行,以获得一致的时间测量结果。报告的时间为 5 次独立运行的平均值(标准差)42。
深度学习模型评估
采用 GPU 加速评估了六种深度学习架构,包括多层感知机(MLP;64-32-16)、带批归一化的深度神经网络(DNN;128-64-32-16)、长短期记忆网络(LSTM;64-32 个单元,序列长度 = 10)、一维卷积神经网络(1D-CNN)、CNN-LSTM 混合模型以及基于注意力机制的网络。所有深度学习模型均使用 TensorFlow 搭配 Keras API 实现,并在 GPU 加速下运行(硬件/软件版本详见材料表)。1D-CNN 架构包含三个卷积层(64、128 和 256 个滤波器,卷积核大小为 3,ReLU 激活函数,padding=’same’)、两个 MaxPooling1D 层(池化大小为 2)、一个 GlobalAveragePooling1D 层、一个具有 128 个单元的全连接层(ReLU 激活)、一个 Dropout 层(0.2)以及一个全连接输出层(1 个单元,线性激活),总共约有 245,000 个可训练参数。CNN-LSTM 混合架构接收长度为 10 个时间步、每步包含 5 个特征的输入序列,包含两个 Conv1D 层(64 和 128 个滤波器,卷积核大小为 3,ReLU 激活,padding=’same’)、一个 MaxPooling1D 层(池化大小为 2)、两个 LSTM 层(64 和 32 个单元,return_sequences=False)、Dropout 层(0.2)、一个全连接层(32 个单元,ReLU)以及一个全连接输出层(1 个单元,线性激活),总共约有 198,000 个可训练参数。基于注意力机制的网络采用具有 4 个注意力头的多头注意力机制(键和值的维度为 64),输入首先被投影到 64 维,随后进行缩放点积注意力计算(公式:Attention(Q, K, V) = softmax(QKT/√d_k)V),并引入残差连接、层归一化、前馈网络(128→64 个单元)、全局平均池化、Dropout(0.2)、一个全连接层(32 个单元,ReLU)以及一个全连接输出层(1 个单元,线性激活),总共约有 167,000 个可训练参数43。
所有模型均采用早停法(耐心值 = 20)、学习率衰减(衰减因子 = 0.5,耐心值 = 10)、丢弃法(20%)以及Adam优化器(学习率 = 0.001)。对于所有深度学习模型,批量大小设置为32个样本,最大训练轮数为200轮,并采用早停法(耐心值 = 20,恢复最优权重),损失函数为均方误差(MSE)。训练集与验证集的划分方式如下:从原始的1,200个训练样本(在80/20的训练-测试集划分后)中,80%(960个样本)用于训练,20%(240个样本)用于验证。我们按照天气条件对训练-验证集划分进行分层处理,以保持数据分布的一致性。验证集仅用于早停、学习率衰减以及过拟合监测;从未用于模型选择或超出这些自动化流程之外的超参数调优。对于机器学习模型,我们未单独保留一个验证集,而是对1,200个训练样本采用五折交叉验证来调整超参数并评估性能44。
LSTM 与 CNN-LSTM 架构评估的依据
主要数据集由独立生成的天气样本组成,但我们还测试了LSTM和CNN-LSTM架构,原因如下:(1)真实世界的大气条件在时间上具有自相关性,测试基于序列的模型可使我们确定捕捉此类依赖关系是否能够提高预测准确性;(2)近期大气预测领域的研究已表明,序列模型在模拟气象参数时间演变方面具有潜在价值34;(3)测试多种多样的模型架构可确保对不同方法论途径进行全面比较,这是本研究的关键贡献之一;(4)CNN-LSTM混合架构结合了空间特征提取与时间建模能力,可能有助于捕捉多个大气变量之间的复杂相互作用45。
顺序模型输入的数据格式化
对于序列架构(LSTM 和 CNN-LSTM),采用滑动窗口方法将输入数据从独立样本重构为伪序列。具体而言,首先将 1,200 个训练样本按天气条件类别分组,以保持物理一致性。在每个天气类别内,样本按照生成的时间戳排序(模拟 2024 日历年每小时观测值)。随后应用长度为 10 的滑动窗口,生成包含 10 个连续时间步的输入序列(每个时间步包含 5 个特征:温度、湿度、能见度、粉尘浓度和降雨强度),用于预测第 11 个时间步的衰减量th 时间步。该方法在保留模拟观测值时间顺序的同时,使序列模型能够学习时间依赖性。测试集的结构与此相同,仅窗口大小和特征集保持一致。我们认识到,这种伪序列化结构是一种方法学上的简化,不能反映现实世界中的时间动态特性。我们已在“讨论”部分将此列为一项局限性。
杂交方法评估
研究了三种混合方法。第一种方法是投票集成法,该方法对随机森林、XGBoost 和深度神经网络模型的预测结果进行等权重平均(每个模型的权重均为 1/3),最终预测值按以下公式计算:
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
选择等权重方法是为了避免引入额外的超参数,并在不偏向任何单个模型的情况下评估集成模型的基线性能。第二种方法采用了岭回归元学习器堆叠(Ridge meta-learner stacking)。基础学习器包括随机森林、XGBoost 和一种基于注意力机制的深度神经网络(Attention-based)。堆叠过程分为两个阶段:首先,每个基础学习器在包含 1,200 个样本的完整训练集上通过 5 折交叉验证进行训练,以生成折外预测值,从而构建一个大小为 1,200×3 的新元特征矩阵(每个样本在每个基础模型上生成一个预测值);其次,使用原始衰减值作为目标变量,基于这些元特征训练一个岭回归元学习器(L2 正则化参数 alpha=1.0),以学习基础学习器的最优组合权重。最终的堆叠预测结果为:
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
其中权重 w 由岭回归元学习器学习得到。第三种方法是物理信息神经网络,该方法将神经网络对雾况样本的预测结果的 70% 与 Kim 模型的预测结果的 30% 相结合。该组合通过固定加权平均法实现,公式如下:
ŷhybrid=0.7×ŷneural+0.3×ŷKim (11)
其中,ŷneural 是基于注意力机制的神经网络的输出,ŷKim 是根据能见度输入,由 Kim 雾模型计算得到的衰减量。对于非雾样本,物理部分被设为 0,模型作为纯神经网络运行。权重(70% 神经网络部分和 30% 物理部分)基于在验证集(非测试集)上的初步实验确定,我们测试了 90:10、80:20、70:30、60:40 和 50:50 等多种权重组合。最终选择 70:30 的比例,因其在验证集上提供了最佳的 R2 值,同时仍保留了足够的来自 Kim 模型的物理约束,以正则化预测结果,避免产生物理上不合理的输出,尤其是在雾天条件下,Kim 模型可提供已建立的理论衰减边界。
特征重要性与可解释性分析
采用基于不纯度的特征重要性(方差减少)的随机森林模型,提取了全部10个输入特征的重要性排序。分析结果显示,粉尘浓度(67.3%)和能见度(21.2%)是最重要的预测因子,二者共同解释了总预测重要性的88.5%。第三重要的特征为降雨强度(6.0%),随后依次为风速(2.1%)、温度(1.5%)、湿度(0.9%)、月份(0.5%)、季节(0.3%)、降雪强度(0.1%)和大气压(0.1%)。时间特征(月份和季节)的重要性得分较低,表明大气衰减的季节性变化主要由基础环境参数所反映,而非单纯依赖时间模式。
采用SHAP(Shapley加性解释)分析来评估环境因素与衰减之间的关系。所使用的SHAP实现方法来自SHAP库中的TreeExplainer模块,该模块专门针对基于树的模型(包括随机森林、XGBoost和LightGBM)进行了优化(版本信息见材料表)。SHAP分析的配置如下:将训练好的随机森林模型传入TreeExplainer,该解释器基于模型输出的条件期望,采用干预性(边际)特征归因方法计算SHAP值。对测试集中的全部300个样本计算SHAP值,生成一个大小为300 × 10的矩阵(每个样本的每个特征对应一个SHAP值)。对于每个特征,SHAP值表示其相对于基线(模型预测的平均值)对预测结果的贡献程度。负的SHAP值表示预测值向下偏移;而正的SHAP值表示该特征提升了衰减的预测值。贡献的强度由SHAP值的绝对值大小表示。通过汇总图可视化每个特征的SHAP值分布(使用蜂群图)、影响方向(特征值与SHAP值之间的相关性)以及特征重要性排序。所有SHAP可视化图表均使用SHAP库内置的绘图函数生成:shap.summary_plot()用于生成蜂群图,shap.bar_plot()用于展示全局特征重要性。
独热编码变量的处理:首先使用四个二进制列(spring、summer、autumn 和 winter)对“季节”变量进行编码。为了在 SHAP 分析中为每个样本生成单一的“季节”贡献值,通过将每个季节类别的 SHAP 值相加,合并了这四个独热编码变量的贡献。为实现此分组,先找出所有对应于独热编码季节类别的列,提取每个样本中这些列的 SHAP 值,然后逐元素相加。最终合并得到的 SHAP 值表示季节对衰减预测的总体贡献。该方法使得 SHAP 摘要图中仅显示单个“季节”行,并确保与模型将季节作为复合分类变量使用的处理方式保持一致。由于合并后的数值能够更清晰地反映季节的整体贡献,因此未单独展示每个季节类别的 SHAP 值。
结果
合成数据集的特征总结如下 图1A–F数据集包含晴空、沙尘、雾、雨和雪天气条件 (图1A),样本分布于干热季和湿冷季图1B)以及白天和夜间时段(图1C)。不同天气条件下温度、湿度和能见度的分布如图所示 图1D–F.
机器学习模型在估计大气衰减方面表现出较强的预测性能(图2A–D;表3)。在所评估的模型中,随机森林(RF)整体性能最优,测试集R2达到0.9654,均方根误差(RMSE)为1.324 dB/km(图2A;表3)。RF解释了96.54%的观测变异,同时保持低于1.5 dB/km的预测误差。XGBoost模型表现也较好(图2C),其次为LightGBM(图2B)。通过五折交叉验证验证了模型的稳健性,其中RF的交叉验证R2为0.960 ± 0.007(图2D)。相比之下,K近邻算法表现出过拟合迹象,训练集R2为1.000,而测试集R2仅为0.7341;线性回归模型则表现出中等的预测性能(图2A;表3)。
上述10个输入特征的特征重要性分析如图3A所示。各特征的相对重要性得分排序如下:粉尘浓度(67.3%)、能见度(21.2%)、降雨强度(6.0%)、风速(2.1%)、温度(1.5%)、湿度(0.9%)、月份(0.5%)、季节(0.3%)、降雪速率(0.1%)和气压(0.1%)。变量“天气状况”用于数据集的分层,但未包含在特征重要性分析中,因其为表示多个潜在物理参数的分类复合变量,其影响已通过各个环境特征体现。特征重要性与可解释性分析确定了与衰减关联最强的环境变量(图3A,B)。粉尘浓度(67.3%)、能见度(21.2%)和降雨强度(6.0%)三项合计贡献了总预测重要性的94.4%(图3A)。SHAP分析进一步表明,粉尘浓度升高和能见度降低与衰减预测值的增加相关(图3B)。
深度学习模型的预测性能低于机器学习方法(图4A–D)。表现最佳的深度学习模型为基于注意力机制的网络,其R2为0.7766,RMSE为3.362 dB/km(图4A)。循环架构的表现尤其不佳,LSTM和CNN–LSTM模型的R2值均接近于零,RMSE值均超过7.19 dB/km(图4B)。LSTM和CNN-LSTM架构相对较差的表现(R2 = 0.0110和0.0109;RMSE = 7.193 dB/km和7.196 dB/km)可在一定程度上归因于输入数据的伪序列性质,该特性未能充分捕捉大气条件的真实时间动态。
与时间序列依赖关系强且明确的实时序列应用不同,我们的数据集主要由独立样本组成,其时间顺序是人为设定的。这些模型预测性能较差表明,通过滑动窗口方法提取的时间信息要么不足,要么不能代表真实的大气演变过程(图4C)。这支持了我们的结论:对于此类数据集,简单的机器学习方法比复杂的基于序列的深度学习模型更为适用。所有深度学习架构的验证性能总结见图4D。
机器学习、深度学习和混合方法的性能总结见图5A、B和表3。在混合方法中,投票集成(Voting Ensemble)取得了0.9340的R2值和1.827 dB/km的均方根误差(RMSE)(图5A、B;表3)。岭回归元学习器堆叠(Ridge meta-learner stacking)取得了0.9571的R2值和1.473 dB/km的RMSE(图5A、B;表3),性能接近随机森林(RF),但训练时间显著更长。物理信息神经网络(Physics-Informed Neural Network)的R2 = 0.8269,RMSE = 2.960 dB/km(图5A、B;表3),表现优于深度学习模型,但不及最佳的机器学习方法。随机森林(RF)与堆叠集成(Stacking Ensemble)模型之间的统计比较显示,其预测性能无显著差异(表3;配对t检验:t = −1.74,p = 0.083)。因此,尽管随机森林(RF)的R2数值最高,但与最佳混合方法之间的差异在统计学上并不显著。
总体而言,结果支持机器学习方法能够准确预测伊拉克天气条件下的大气衰减这一假设。随机森林(RF)始终表现出最高的预测性能(图 2A、B;表 3),而特征重要性分析和SHAP分析则确定粉尘浓度和能见度是影响衰减的主要环境因素(图 3A、B)。
验证数据声明:所有模型评估均在方法部分详述的合成数据集上进行。模型验证过程中未使用任何关于大气衰减的实验或观测数据。该合成数据集是利用已知的物理传播模型(比尔-朗伯定律、Kim 模型、Carbonneau 模型和米氏散射理论),结合基于伊拉克气候记录的概率分布所选取的气象参数生成的。如方法部分所述,模型表现出的较强预测性能可能部分源于其对生成目标值所用的确定性物理方程的学习或近似能力。因此,定量性能指标(R2、RMSE、MAE)反映的是模型在基于方程生成的合成数据上的表现,应被理解为在受控仿真环境中不同建模方法之间的相对比较,而非对实际自由空间光通信(FSO)系统性能的绝对保证。该方法为预测建模方法(如表 2所列)的比较评估提供了受控环境,但不能替代在真实伊拉克天气条件下使用实际 FSO 衰减测量数据进行的验证。
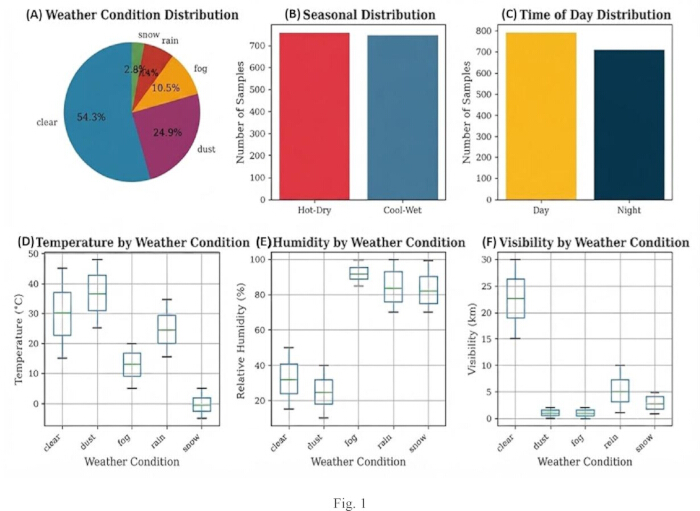
图1:用于大气衰减建模的合成数据集特征及环境变量。(A)数据集中所包含的气象条件分布,涵盖晴空、沙尘、雾、雨和雪等情形。(B)样本在干热季节与湿冷季节中的分布情况。(C)白天和夜间条件下采集的样本分布。(D)每种天气条件下的温度分布。(E)每种天气条件下的湿度分布。(F)每种天气条件下的能见度分布。箱线图显示中位数(中心线)、四分位距(方框)以及最小值和最大值(须线)。温度以°C为单位,湿度以%为单位,能见度以km为单位。请点击此处查看此图的高清版本。
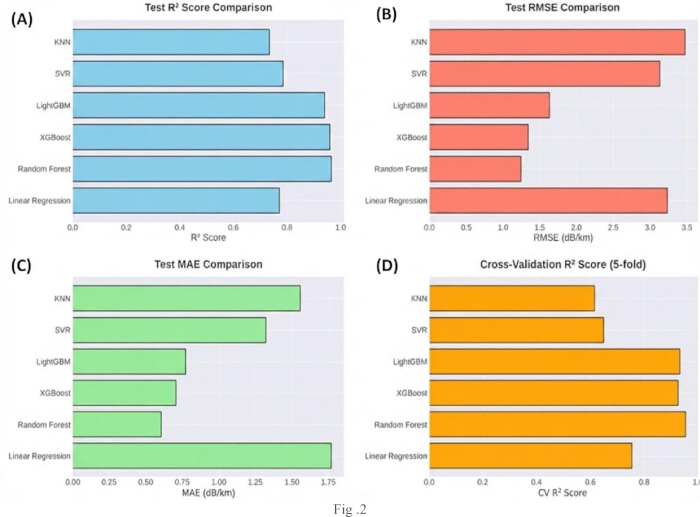
图2机器学习模型在大气衰减预测中的性能比较 (A) 检验决定系数(R2) 所评估的机器学习模型的评分,包括线性回归、随机森林、极端梯度提升(XGBoost)、轻量梯度提升机(LightGBM)、支持向量回归(SVR)和K近邻(KNN)。B各机器学习模型的测试均方根误差(RMSE)值。C) 各机器学习模型的测试平均绝对误差(MAE)值。D) 交叉验证决定系数(R2)通过五折交叉验证获得的得分。较高的 R2 数值越低,RMSE 和 MAE 值越小,表明预测性能更优。RMSE 和 MAE 以 dB/km 为单位报告。 请点击此处以查看此图的放大版本。
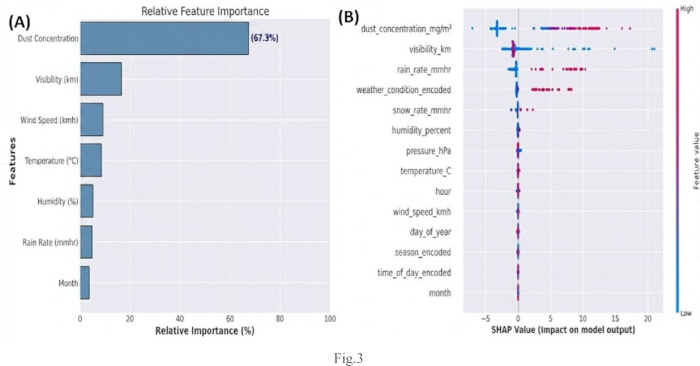
图3:大气衰减预测的特征重要性与模型可解释性分析。(A)基于随机森林模型的杂质减少度量得到的特征相对重要性排序,展示了全部10个环境与时间变量对衰减预测的贡献程度。其中影响最大的特征为粉尘浓度(67.3%),其次为能见度(21.2%)、降雨率(6.0%)、风速(2.1%)、温度(1.5%)、湿度(0.9%)、月份(0.5%)、季节(0.3%)、降雪率(0.1%)和大气压(0.1%)。相对重要性表示该特征在模型总重要性中所占的百分比。(B)SHapley加性解释(SHAP)汇总图,用于展示各个特征对模型预测结果的影响。SHAP矩阵基于300个测试集样本(300 × 10个特征)计算得出。对于经独热编码的季节变量(原始为四个二值列:春季、夏季、秋季、冬季),通过将四个类别的SHAP值相加,得到每个样本对应的单一“季节”贡献值。每个点代表一个样本,颜色标度表示特征值,从低值(蓝色)到高值(红色)。正SHAP值表示预测衰减量增加,负SHAP值表示预测衰减量减少。请点击此处查看该图的高清版本。
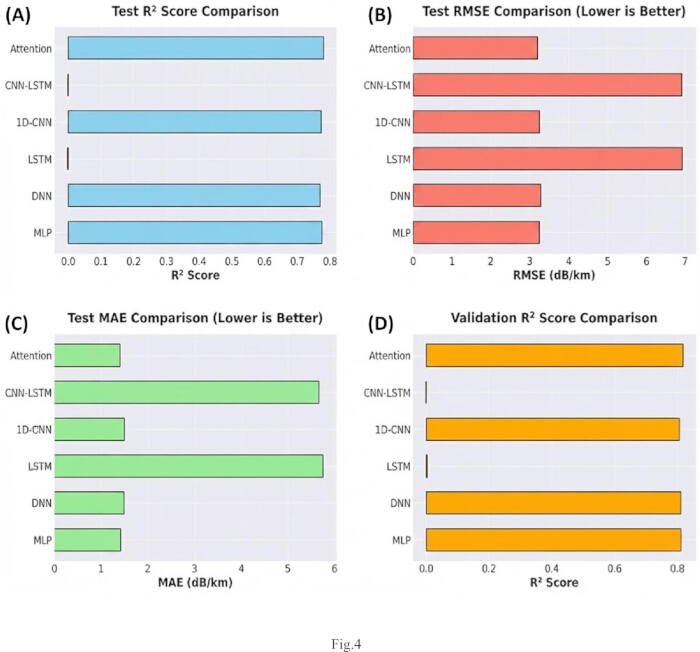
图 4:深度学习模型在大气衰减预测中的性能比较。(A)所评估的深度学习架构的测试决定系数(R2)得分,包括多层感知机(Multilayer Perceptron, MLP)、深度神经网络(Deep Neural Network, DNN)、长短期记忆网络(Long Short-Term Memory, LSTM)、一维卷积神经网络(one-dimensional convolutional neural network, 1D-CNN)、卷积神经网络–长短期记忆网络(Convolutional Neural Network–Long Short-Term Memory, CNN–LSTM)以及基于注意力机制的模型。(B)各深度学习模型的测试均方根误差(RMSE)值。(C)各深度学习模型的测试平均绝对误差(MAE)值。(D)所评估深度学习模型的验证决定系数(R2)得分。较高的 R2 值以及较低的 RMSE 和 MAE 值表示预测性能更优。RMSE 和 MAE 以 dB/km 为单位报告。请点击此处查看该图的放大版本。
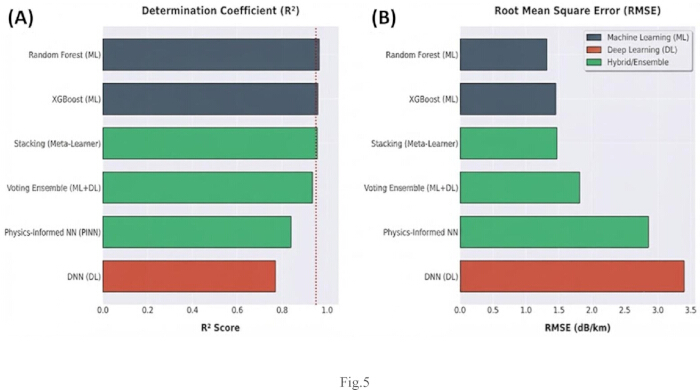
图5:机器学习、深度学习和混合模型在大气衰减预测中的性能比较。(A)代表性机器学习、深度学习及混合方法的决定系数(R2)值,包括随机森林(Random Forest)、极端梯度提升(XGBoost)、深度神经网络(DNN)、投票集成(Voting Ensemble)、堆叠(Stacking)以及物理信息神经网络模型。(B)相同模型的均方根误差(RMSE)值。机器学习(ML)、深度学习(DL)和混合/集成技术三类模型以不同颜色编码。较高的R2值和较低的RMSE值表示预测性能更优。RMSE的单位为dB/km。请点击此处查看该图的放大版本。
| 天气状况 | 比例 | 温度范围 | 湿度范围 | 能见度范围 | 主要参数范围 |
| 晴朗天空 | 54.27% (814 个样本) | −4.89 至 47.99°C | 0–100% | >10 km | — |
| 沙尘 | 25.00% (375 个样本) | 10–45°C | 10–60% | 0.05–5 km | 沙尘:0–4.96 mg/m3 |
| 雾 | 10.47% (157 个样本) | −5 至 20°C | 70–100% | 0.05–1 km | — |
| 降雨 | 7.40% (111 个样本) | 5–30°C | 60–100% | 1–10 km | 降雨:0.25–50 mm/h |
| 降雪 | 2.87% (43 个样本) | −10 至 5°C | 50–100% | 0.5–5 km | 降雪:0.5–15 mm/h |
表1:机器学习模型在预测大气衰减方面的性能指标。
| 模型 | 测试 R2 | 均方根误差 (dB/km) | 平均绝对误差 (dB/km) | 交叉验证 R2 | 训练时间 (s) |
| 随机森林 | 0.9654 | 1.324 | 0.815 | 0.960 ± 0.007 | 1.6 |
| XGBoost | 0.9582 | 1.455 | 0.892 | 0.953 ± 0.009 | 2.1 |
| LightGBM | 0.9507 | 1.581 | 0.971 | 0.946 ± 0.011 | 1.8 |
| 支持向量回归 (SVR) | 0.8874 | 2.389 | 1.445 | 0.879 ± 0.015 | 3.2 |
| 线性回归 | 0.8358 | 2.889 | 1.791 | 0.831 ± 0.018 | 0.2 |
| K-近邻算法 (KNN) | 0.7341 | 3.671 | 2.296 | 0.721 ± 0.022 | 0.8 |
表2:特定深度学习、混合及机器学习模型的比较评估。
| 模型 | 类别 | 测试 R2 | 均方根误差 (dB/km) | 排名 |
| Random Forest | ML | 0.9654 | 1.324 | 1 |
| XGBoost | ML | 0.9582 | 1.455 | 2 |
| Stacking Ensemble | Hybrid | 0.9571 | 1.473 | 3 |
| LightGBM | ML | 0.9507 | 1.581 | 4 |
| Voting Ensemble | Hybrid | 0.934 | 1.827 | 5 |
| Physics-Informed Neural Network | Hybrid | 0.8269 | 2.96 | 6 |
| Attention | DL | 0.7766 | 3.362 | 7 |
| LSTM / CNN–LSTM | DL | −0.0006 | 7.195 | — |
表3:各评估模型在计算效率(训练与推理)方面的比较。
数据 可用性:
包含全部1,500个样本的完整合成数据集,以及所有输入特征(温度、湿度、能见度、粉尘浓度、降雨率、降雪率、风速、大气压、月份、季节和天气状况)和目标变量(衰减,单位为dB/km),已作为补充文件随本稿件提供,网址为 https://doi.org/10.5281/zenodo.21792999。该数据集的格式为每个样本对应一行,包含所有计算得到的变量(工作范围和信噪比)。
完整的实现代码将作为补充文件提供,包括:数据生成脚本(物理模型的实现);用于预处理和特征缩放的函数;所有机器学习模型的实现;所有深度学习模型的实现;评估与可视化脚本;以及超参数调优和交叉验证流程。
源气候数据:用于定义合成数据分布的气候数据来自伊拉克气象组织与地震学机构(IMOS)以及伊拉克交通部,涵盖2020年至2024年期间。用于确定天气状况比例和参数范围的气候数据摘要见补充表1。本研究中使用的具体IMOS记录未在集中式数据库中公开归档,但可直接向IMOS申请获取。补充材料中提供了汇总统计结果和推导出的概率分布,以确保研究的可重复性。
资料库信息:源代码和数据集已存入公共资料库(Zenodo),DOI编号为 https://doi.org/10.5281/zenodo.21792999。
讨论
为了预测在伊拉克气象条件下运行的自由空间光通信(FSO)系统中的大气衰减,本研究评估了机器学习、深度学习以及混合技术。由于大气影响仍是影响链路性能和可用性的主要问题之一,近期的研究强调了对FSO系统进行预测建模日益重要的意义21。结果表明,传统的机器学习方法,特别是随机森林(RF)和XGBoost,具有较高的预测精度,在某些情况下数值上优于深度学习和混合方法。然而,统计检验并未显示RF与最优混合集成方法(Stacking)之间存在显著差异(p=0.083),这意味着两种方法在该数据集上可达到相似的性能。我们的研究结果表明,基于树的集成方法在处理中等样本量且主导预测变量数量较少的表格型环境数据时仍具有很高的性能。特征重要性分析显示,粉尘浓度和能见度是导致衰减的主要驱动因素,二者共同解释了大部分预测能力。该发现与早期研究一致,即雾、粉尘、气溶胶和大气污染对光信号传播具有重要影响22,23,24,25。类似结论也在环境监测应用中被报道,其中机器学习模型通常受益于包含少量高信息量变量的数据集26,27,28,29,30,31,32。SHAP分析进一步提高了模型的可解释性,通过量化各个环境参数对衰减预测的影响程度实现。
深度学习模型性能较低可能归因于多个因素。用于训练复杂神经网络架构的数据集规模相对有限(见 https://doi.org/10.5281/zenodo.21792999),且环境变量表现出高度集中的特征重要性。以往研究表明,深度学习方法通常在大规模数据集、层次化特征结构以及复杂的非线性表征条件下表现更优。33,34,35,36,37相比之下,本研究中使用的衰减数据集仅包含有限数量的主要预测因子,且缺乏循环架构所需的时序依赖性。LSTM 和 CNN-LSTM 模型表现不佳表明,序列学习机制在此应用中可能无法带来显著优势。
粉尘浓度(67.3%)和能见度(21.2%)作为大气衰减主要预测因子的主导作用,可能归因于以下几个因素。首先,在1550 nm波长处,分子散射和吸收效应被粉尘颗粒引起的米氏散射所掩盖。根据米氏理论,消光效率Q_ext对颗粒浓度高度敏感,在中高浓度范围内,衰减几乎与粉尘浓度呈线性关系。其次,伊拉克频繁遭遇沙尘暴(在我们的气候记录中占25.00%的天数),导致衰减值达到4–30 dB/km,相比之下,雾的影响为10.47%(0.5–10 dB/km),降雨为7.40%(2–25 dB/km)。沙尘衰减更大的变异性为模型学习提供了更强的信号。第三,粉尘浓度呈指数分布(0.4–4.96 mg/m3),产生广泛范围的衰减值;极端沙尘事件的长尾分布导致高衰减值,这对准确预测至关重要。第四,米氏散射模型对粉尘浓度的依赖关系较为简单(大致呈线性),相较于Kim模型中能见度与雾衰减之间更复杂的关系,基于树的模型更容易逼近前者。第五,这一发现具有实际意义,因为沙尘暴是中东地区自由空间光通信(FSO)面临的最具挑战性的环境条件之一,在沙尘事件期间实现准确预测对系统的可靠运行至关重要。
该研究通过为大气衰减预测的算法选择提供实用指导,推动了自由空间光通信(FSO)通信领域的研究进展。精确的衰减预测对于网络规划、自适应链路管理以及在中东等复杂环境中可靠部署光通信系统至关重要23,28,30,36。此外,该方法还可应用于涉及空气传播、大气监测和光网络性能评估的其他环境预测问题38,39,40。进一步验证该思路的方法还包括使用更大规模的真实世界数据集、先进的集成学习技术、迁移学习框架,或更复杂的物理信息驱动的网络架构41,42,43,45。
结论的适用范围与可推广性问题
本研究的结论主要基于从成熟的物理传播模型(比尔-朗伯定律、Kim 模型、Carbonneau 模型和米氏散射理论)生成的合成数据集。这种方法论对研究结果的适用范围和泛化能力具有一定影响:
基于模拟数据的结论:(1)机器学习、深度学习及混合方法在大气衰减预测中的性能比较排序。(2)在建模条件下,识别出粉尘浓度和能见度是光学衰减的主要环境预测因子。(3)基于树的集成方法在计算效率上优于深度学习架构。(4)通过特征重要性分析和SHAP分析解释模型预测结果的可解释性。
需要通过真实世界数据验证的结论:(1)评估模型所获得的 R2 和 RMSE 的绝对值依赖于合成数据集的具体特征,可能反映了模型学习了用于生成目标值的确定性物理方程。(2)目前尚未证实表现最优的随机森林模型能否适用于未知的真实大气条件。(3)为使研究结果适用于伊拉克部署的实战化自由空间光通信设备,必须进行实地验证。(4)有必要确认所识别出的特征重要性排序在实地测量条件下仍具有稳健性。
必须区分模型在方程生成的合成数据上的表现与在含噪声的观测或实验数据上的表现。合成数据集提供了输入特征与衰减目标之间清晰且无噪声的关系,这可能导致预测性能指标高于在包含测量噪声、仪器误差及未建模物理现象的实际数据上所能获得的结果。我们建议未来的研究应致力于获取伊拉克天气条件下的实际自由空间光通信(FSO)衰减测量数据,以验证本研究中提出的结果,并评估所提出方法的真实泛化能力。
合成数据对模型泛化能力的影响
在本研究中使用合成数据的潜在影响应被充分考虑,以评估模型的普适性:
合成方法的优势在于,该数据集在物理上具有一致性,并通过采用成熟的物理传播模型,基于既定的理论框架构建而成。气象参数从伊拉克的气象记录中提取,使数据集能够反映伊拉克实际天气条件的统计特性。此外,该方法避免了实地测量中的混杂变量(如测量误差、设备校准问题或数据记录不足),从而在受控环境下实现了对建模方法的系统性检验。
普适性局限性:该合成数据集在捕捉真实大气衰减的全部复杂性方面存在局限性,包括:(1)多种大气现象同时发生时的相互作用;(2)大气参数的非线性和非平稳行为;(3)采样分布未能反映的长期气候变异性;(4)可能显著影响自由空间光通信传播的局部微气候效应;以及(5)真实世界数据采集过程中固有的噪声与不确定性。
合成数据生成中的偏差考量 对环境参数进行独立采样的假设(见方法部分)是对现实条件的过度简化,因为在真实环境中大气变量往往存在相关性(例如,高浓度粉尘通常与低能见度相关)。为实现系统性的模型比较,本研究在受控的模拟环境中采用了独立性假设。然而,该方法可能无法完全捕捉大气参数之间相互作用的全部复杂性。我们采用分层划分方法(在训练集和测试集中保持天气条件的比例一致),以尽量减少罕见天气条件(特别是占比为2.87%的降雪)在测试集中出现表征不平衡的可能性。
确定性目标生成:本研究中观察到的高预测性能可能部分归因于模型学习了用于生成目标值的确定性物理方程。相比之下,真实世界的实验数据包含测量噪声、仪器误差以及未建模的物理现象,使得预测更具挑战性。因此,定量性能指标(R2、RMSE、MAE)应被理解为在受控仿真环境中不同方法之间的相对比较,而非对实际运行的自由空间光通信系统性能的绝对保证。
因此,尽管模型性能排名的比较结果可能较为稳健(由于合成数据的物理一致性),但绝对性能指标(R2、RMSE、MAE)不应被视为在实际自由空间光通信系统中预期性能的依据。有必要利用在伊拉克不同天气条件下测得的大气衰减实验数据,检验模型在真实环境中的泛化能力。
需要注意一些限制条件。首先,本研究并未使用实地观测数据,而是依赖于利用已知物理传播模型生成的合成数据集。如前所述,定量性能指标(R²、RMSE、MAE)不应被理解为对实际运行的自由空间光通信(FSO)系统提供绝对性能保证,而应视为在受控仿真环境中对不同方法的相对比较。其次,由于数据集规模的限制,传统模型与深度学习模型可能未能学习到鲁棒的特征表示。第三,本研究聚焦于衰减预测,未考虑其他FSO性能指标,如链路可用性、指向误差以及湍流引起的信号衰落。第四,用于计算气象条件比例的历史数据时间为2020年至2024年,可能无法准确反映伊拉克逐年气候变化的实际情况。第五,CNN–LSTM和LSTM模型所采用的伪序列输入数据结构是一种方法上的简化,可能无法充分捕捉现实应用中复杂的时间动态特性。在评估研究结果时,应充分考虑这些局限性,因为它们可能影响研究结论的普适性。
推荐优先方向:实际环境验证
在伊拉克气象条件下收集并分析真实的FSO衰减测量数据,是未来最重要的研究方向。此项工作应包括:(1)在伊拉克多个地区(如巴格达、巴士拉、摩苏尔、拉马迪)建立FSO试验平台,以记录区域气候差异;(2)在FSO站点使用经过校准的仪器同步测量大气参数(温度、湿度、能见度、粉尘浓度);(4)记录极端天气事件(沙尘暴、浓雾、强降雨)期间的衰减情况;(5)将采集的数据公开,以支持研究的可重复性和对比分析;以及(3)持续监测至少一个完整的年度周期,以捕捉季节性变化。此类实际验证将为评估模型的普适性提供机会,并进一步优化本研究中开发的预测技术。
为了验证并优化所生成的模型,未来的研究应着重于引入在伊拉克气象条件下获得的实际自由空间光通信(FSO)测量数据。进一步的研究可探索利用相关大气数据集的迁移学习策略、能够适应环境变化的在线学习方法,以及将实测数据与物理模型相结合的混合实验–模拟策略。此外,针对可解释性人工智能及先进的基于物理机制的机器学习方法的深入研究,也有望进一步揭示大气衰减背后的机制,并增强未来预测系统的鲁棒性。
披露
利益冲突:作者声明无利益冲突。
致谢
作者声明本研究未获得外部资金支持。我们谨向伊拉克巴格达区国际应用与理论研究中心(IATRC)致以感谢。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| CUDA Toolkit | NVIDIA Corporation | 11.8 | 用于深度学习训练的GPU加速库 |
| cuDNN | NVIDIA Corporation | 8.6.0 | GPU加速的深度神经网络库 |
| GPU(图形处理器) | NVIDIA Corporation | GeForce RTX 4090, 24 GB VRAM | 用于GPU加速的深度学习训练 |
| CPU(中央处理器) | Intel Corporation | Core i9-13900K, 24核/32线程 | 用于所有模型训练与评估的工作站处理器 |
| 系统内存(RAM) | n/a | 64 GB DDR5, 5200 MHz | 工作站内存 |
| Keras API | 开源(TensorFlow的一部分) | 与TensorFlow 2.11.0捆绑 | 用于所有深度学习架构的高级深度学习API |
| LightGBM | 开源(Microsoft) | 3.3.5 | 梯度提升框架 |
| NumPy | 开源(NumFOCUS) | 1.23.5 | 数值计算库 |
| 操作系统 | Canonical Ltd. | Ubuntu 22.04 LTS | 工作站操作系统 |
| Python | Python软件基金会 | 3.9 | 用于所有数据生成与建模的编程语言 |
| scikit-learn | 开源 | 1.2.2 | 机器学习库(随机森林、支持向量回归、K近邻、线性回归、交叉验证、数据标准化) |
| SHAP(SHapley加性解释) | 开源 | 0.41.0 | 模型可解释性库,TreeExplainer模块 |
| TensorFlow | 开源(Google) | 2.11.0 | 用于所有六种深度学习架构的深度学习框架 |
| XGBoost | 开源 | 1.7.5 | 极端梯度提升库 |
参考文献
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.