本方案提出 FedMediFormer-XAI,一种通过联邦学习、多模态变换器、基于扩散的数据增强、基于图的个性化药物推荐以及可解释人工智能技术来保护隐私的多模态糖尿病智能框架,用于实现精准预测、透明决策和个性化糖尿病管理。
本文内容
摘要
摘要
糖尿病管理面临诸多障碍,例如医疗数据碎片化、隐私问题、可解释性差以及缺乏个性化的治疗指导。本研究提出了 FedMediFormer-XAI,这是一个统一且完善的框架,融合了联邦学习、多模态变换器、基于扩散的数据增强、用于药物推荐的图神经网络(GNN)以及可解释人工智能(XAI),以实现糖尿病智能管理。该系统利用多种类型的医疗健康数据,例如临床记录、人群健康指标、连续血糖监测数据、视网膜眼底图像、可穿戴传感器测量值以及药理学信息。为生成合成样本并解决类别不平衡问题,采用了扩散模型,并使用多模态变换器架构来学习不同数据源之间的关联。联邦学习使得在不共享原始患者数据的前提下,以保护隐私的方式协同训练模型。GNN 组件用于捕捉患者-药物和药物-药物相互作用,从而实现个性化药物推荐。SHapley 加性解释(SHAP)、注意力可视化、积分梯度和反事实推理等可解释性方法,为预测和推荐结果提供了透明的解释。在代表性实现中,所提出的框架达到了 94.2% 的准确率、93.1% 的精确率、92.8% 的召回率、92.9% 的 F1 分数、0.88 的马修斯相关系数(MCC)以及 0.96 的受试者工作特征曲线下面积(AUC-ROC)。基于图的推荐模块实现了精确率 = 0.89、召回率 = 0.84 和归一化折损累计增益(NDCG)= 0.91。该方案提供了一种结构化方法,用于整合异构医疗数据,结合多模态变换器、联邦学习、基于扩散的数据增强、基于图的推荐以及可解释人工智能。报告的计算结果表明,该框架在糖尿病预测和个性化用药推荐方面具有潜力,而联邦化设计支持去中心化的数据处理。未来仍需开展前瞻性多中心临床评估,以验证其临床实用性、泛化能力及实际应用价值。
引言
糖尿病是影响人类健康的最主要的慢性代谢性疾病之一,其患病人数持续增长,长期后果严重,且患者治疗费用高昂,已成为重大的公共卫生问题1,2。据报告,目前全球有超过5.37亿成年人患有糖尿病,预计在未来几十年内这一数字将显著上升3。如果血糖水平得不到有效控制,患者将面临最严重的并发症,如冠心病4、肾功能损伤5、神经损伤6、视力丧失7和脑卒中8。因此,尽早识别疾病、定期监测患者病情,并通过先进的医疗手段对患者进行指导和干预,是帮助患者实现更健康生活的重要措施,同时也有助于减轻国家医疗系统的经济负担9,10。
如今,电子健康记录(EHR)、可穿戴设备、持续葡萄糖监测(CGM)系统、视网膜成像技术以及移动健康应用程序的使用正在迅速普及,产生了大量异构的医疗健康数据,可供分析利用11。这些不同的数据采集工具能够提供关于人体在疾病不同阶段的功能状态、患者对不同类型治疗的反应,以及其在现实生活中的行为模式等多方面的信息12。人工智能(AI)已被证明是处理高度复杂数据、预测糖尿病、监测疾病进展以及辅助医生进行临床决策的最佳解决方案13。此外,包括随机森林、支持向量机和梯度提升方法在内的机器学习算法,在评估糖尿病风险方面已取得优异成果14。近年来,深度学习架构实现了自动特征提取,并在多种医疗健康应用中显著提升了预测性能15。
通过多模态学习方法,糖尿病智能分析能力已得到显著提升,该方法将结构化临床记录、生理测量数据、视网膜图像和行为指标整合到一个统一的预测框架中16。利用多种信息来源,多模态模型能够识别出在单独分析每种模态时无法察觉的模式17。基于Transformer的模型最近已能非常有效地从多种类型的医疗健康数据中学习长距离依赖关系和上下文关联18。然而,类别不平衡、数据缺失、数据异质性以及泛化能力有限等问题,仍然阻碍了多模态人工智能系统在临床环境中的广泛应用19。
尽管取得了这些进展,许多现有的糖尿病智能系统仍依赖于集中式学习框架,这种框架本质上要求将来自不同机构的患者数据集中到一个单一的存储库中20。此类方法已引发关于患者隐私、数据保管、网络安全和法规合规性的争议21。事实上,由于法律和伦理方面的考虑,医疗机构在共享敏感患者数据方面常常受到限制22。在此背景下,联邦学习正成为一种可行的解决方案,因为它能够在不共享实际患者数据的情况下训练协作模型23。通过去中心化的优化和安全的参数聚合,联邦学习能够利用地理上分散的数据集进行知识整合,从而实现隐私保护下的健康数据分析24。然而,在联邦医疗场景中,通信开销、客户端异质性和收敛稳定性仍然是主要挑战25。
目前使用的糖尿病智能系统另一个缺点是缺乏透明度以及对个体化治疗的支持。许多深度学习模型表现得如同“黑箱”,这给希望了解预测和推荐背后逻辑的临床医生带来了困扰26。可解释性人工智能(XAI)方法,例如SHAP、积分梯度法、注意力可视化和反事实推理,正显示出在提升模型透明度和增强临床医生信任方面的巨大潜力27。此外,图神经网络(GNNs)已成为捕捉患者-药物和药物-药物相互作用的最先进工具,从而实现个体化用药推荐和药物安全性评估28。新兴的扩散模型还为生成真实的合成医疗数据以及解决类别不平衡问题提供了有效解决方案29。
Transformer、联邦学习、基于扩散的合成数据生成、图神经网络以及可解释的人工智能在医疗健康应用中均已展现出良好的前景;然而,这些技术在单一可重复的糖尿病智能框架内的整合仍十分有限。现有方法通常独立处理上述各个组成部分,例如仅关注隐私保护学习而缺乏个性化治疗推荐,或进行多模态预测但未采用去中心化训练,又或实现可解释性却缺少基于图结构的临床决策支持。尽管扩散模型可用于类别平衡,Transformer 架构能够学习异构医疗数据模态间的关联,但将这些互补技术进行标准化整合的方案仍然匮乏。因此,本研究提出一种统一的方法学流程,将多模态预测、基于扩散的数据增强、联邦优化、基于图结构的个性化药物推荐以及可解释的人工智能整合于一个可重复的工作流程中,为未来的临床验证与转化应用奠定基础。
与假设可获取患者层面多模态数据集的研究不同,本方案整合了异构的公开数据集,而无需进行直接的患者匹配。针对每个数据源分别训练独立的模态特异性模型,并通过跨模态注意力机制融合潜在特征嵌入。该设计在保持方法学严谨性的同时,实现了跨多种医疗数据仓库的多模态知识整合。
本方案主要适用于方法学开发和分布式医疗人工智能环境,在此类环境中,不同来源的异构数据分布于多个独立的存储库或机构中,且无法直接进行数据集中。在当前的实现中,模态特定的数据集相互独立,且未按患者进行匹配;因此,多模态融合是在学习得到的表征层面进行,而非通过患者层面的直接对应关系实现。实际应用时需具备适当关联的多模态患者数据、各参与单位间一致的数据预处理流程和结局定义、合适的计算基础设施,以及符合相关的伦理、隐私和监管要求。
本文介绍了FedMediFormer-XAI,一种联邦多模态Transformer框架,能够在统一架构下通过预测、推荐和可解释性功能实现保护隐私的糖尿病智能分析。该框架集成了基于扩散的数据增强技术以解决类别不平衡问题、用于糖尿病预测的多模态Transformer学习、用于协作式模型开发的联邦学习、基于图神经网络的个性化药物推荐,以及可解释的人工智能方法,以透明的方式支持临床决策。所提出的FedMediFormer-XAI框架的整体架构和工作流程如图1所示。
所提出的 FedMediFormer-XAI 框架的主要贡献总结如下:(1)提出了一种统一的协议,将联邦学习、多模态 Transformer、基于扩散的数据增强、基于图神经网络的个性化药物推荐以及可解释的人工智能整合到一个可重复的糖尿病智能工作流程中。(2)开发了一种保护隐私的联邦学习策略,能够在模拟的分布式医疗客户端之间进行协同模型训练,而无需共享原始患者数据。(3)引入了一种多模态 Transformer 架构,用于从结构化临床记录、连续血糖监测数据、眼底图像以及人群健康指标中联合学习互补表征。(4)采用基于扩散的合成数据生成方法,以减少类别不平衡问题,在保留原始训练数据统计特征的同时提升模型鲁棒性。(5)采用基于 GraphSAGE 的异质图学习模块,建模患者-药物和药物-药物关系,实现个性化用药推荐及考虑药物相互作用的治疗方案排序。(6)集成了多种可解释人工智能技术,包括 SHapley Additive exPlanations(SHAP)、积分梯度、注意力可视化和反事实解释,以提高模型透明度,并提供可解释的预测与推荐结果。(7)提供了一套全面的验证协议,包括预测性能评估、联邦学习效果评估、推荐系统评估、可解释性分析、以临床医生为中心的评估、外部验证以及可重复性评估。
方案
本研究中使用的所有数据集均来自公开可用的存储库,并包含去标识化的患者信息。这些数据集包括Pima印第安人糖尿病数据集、美国疾病控制与预防中心(CDC)糖尿病健康指标数据集、OhioT1DM数据集、APTOS 2019致盲性检测数据集、药物评论数据集以及药物-药物相互作用数据集。本研究未涉及直接的患者招募、干预措施、样本采集或对可识别个人健康信息的访问。本研究仅限于对公开可用的匿名数据集进行二次分析,以用于方法学的开发与验证,并依照机构对这类数据使用的要求开展。本方案中所述的以人为中心的评估旨在未来实施,未在当前研究中进行。开展此类评估的研究人员应获得机构伦理委员会的适当批准,获取所有参与者的书面知情同意,并遵守适用的机构要求、数据使用协议及国家法规。
1. 配置计算环境
- 安装 Python 3.11 作为主要编程环境。安装 PyTorch 2.3 和 TensorFlow 2.15 以进行深度学习模型的开发与训练。安装 Transformers 库(v4.45)以实现基于 Transformer 的架构。
- 安装 PyTorch Geometric(v2.5)以支持图神经网络的构建与训练。安装 SHAP(v0.47)和 Captum(v0.8)以执行可解释性分析和特征归因分析。
- 安装 NumPy、Pandas 和 Scikit-learn 用于数值计算、数据预处理及机器学习工具。安装 OpenCV 和 Matplotlib 用于图像处理与可视化任务。安装 NetworkX 用于构建和分析药物相互作用图谱。
- 安装 CUDA Toolkit 及兼容的 NVIDIA GPU 驱动程序,以实现硬件加速计算。配置至少具备 32 GB 系统内存的 NVIDIA RTX 4090 GPU。将训练、验证和测试过程中的随机种子设置为 42,以确保结果的可重复性。检查所用软件库的安装情况与兼容性。记录分析过程中使用的软件版本、硬件规格及模型配置参数。
2. 准备并预处理数据集
- 下载并整理所需的临床、生理、影像和药理数据集,将其归入特定模态的存储库,并验证其完整性。根据指定要求确认数据集特征、预测目标及整合层次 表1和表2工作流程如图所示。 图2.
- 删除重复、无效或不一致的记录以及缺失关键变量的记录。将每个适用的数据集划分为患者独立的训练集(70%)、验证集(15%)和测试集(15%)。仅使用训练集拟合中位数填补、最小-最大值缩放和分类变量编码,并将拟合后的转换不变地应用于验证集和测试集。仅在训练集上进行合成数据生成。根据以下要求验证数据划分及防止数据泄露: 补充表1。
- 导入葡萄糖、食物摄入、胰岛素剂量、体力活动和睡眠数据。标准化时间戳,将事件对齐至固定时间间隔,对未记录的葡萄糖值进行线性插值,将连续记录划分为等长的时间窗口,并应用z分数归一化以生成时序变换器输入。
- 加载眼底视网膜图像,剔除损坏或无法读取的文件、重复图像、标签缺失的图像,以及存在严重伪影或视网膜视野显示不足的图像。
- 将保留的图像调整为 224 像素大小 × 224 像素,将像素强度归一化至 [0, 1],并应用限制对比度自适应直方图均衡化(CLAHE)。
- 使用随机旋转增强训练图像 ±15°,以0.5的概率进行水平翻转,0.9–1.1范围内的随机缩放×,以及亮度调节在 ±20%。不要对验证或测试图像应用随机增强。将处理后的图像存储,用于Vision Transformer的训练。
- 根据摘要中所述的数据集整合策略,整合模态特异性表征 表2. 当缺乏通用的患者标识符时,不得在独立的数据库之间进行直接的患者层面匹配。
- 将每个公开数据集存储为独立的、特定模态的数据集,因为不同数据仓库之间不共享患者标识符。
- 独立使用相应的数据集训练模态特异性特征提取器:(a)临床记录 → TabTransformer 编码器;(b)人群健康指标 → TabTransformer 编码器;(c)连续血糖监测 → 时间变换器;(d)视网膜眼底图像 → 视觉Transformer;(e)药理学数据 → GraphSAGE 模块
- 分别从每种模态中独立提取潜在特征嵌入。仅通过所提出的跨模态注意力融合模块融合学习到的潜在嵌入,而非合并原始患者记录。
- 确保在独立的公共数据集之间不进行人为的患者匹配。在整个预处理、数据增强和模型开发过程中,为每个数据集保持独立的训练、验证和测试划分。
- 存储融合的多模态特征表示,用于下游预测、联邦学习、可解释性分析和个性化药物推荐图2).
3. 执行基于扩散的数据增强
- 使用 TabDDPM 对结构化的表格型临床和人群健康数据集应用基于扩散的增强方法。仅从预处理后的训练数据分区生成合成样本,以防止信息泄露。模型配置请参照补充表 2。
- 使用 Adam 优化器(学习率 = 1 × 10⁻4;批量大小 = 256)训练 TabDDPM,最多训练 500 个轮次。若验证损失在连续 20 个轮次中未改善至少 0.001,则触发早停机制。针对代表性不足的类别生成合成样本。
- 使用 Kolmogorov–Smirnov (KS) 统计量、Jensen–Shannon 散度、Wasserstein 距离、逐特征相关性分析以及下游分类性能评估合成数据的质量。通过直方图重叠、核密度估计和成对相关系数比较原始数据与合成数据的特征分布。
- 仅当各类别的特征分布与原始训练数据保持一致(KS 检验,p > 0.05;Jensen–Shannon 散度 < 0.10)且不包含不合理的临床数值时,才接受合成样本。将被接受的样本与原始训练数据集合并,以生成类别均衡的数据集。增强流程如图 3所示。
- 通过使用原始训练数据集和增强后的训练数据集重新训练糖尿病预测模型,验证合成数据的有效性。比较准确率、F1 分数、MCC 和 AUC-ROC,以评估模型泛化能力与分布偏差的变化。
4. 开发多模态变换器模型
如图4所示,为结构化临床数据、连续血糖监测(CGM)序列和眼底视网膜图像配置模态特异的编码器,构建多模态Transformer模型。利用跨模态注意力机制整合所得表征,用于糖尿病预测及基于图结构的个性化药物推荐。
- 开发临床编码器
- 初始化 TabTransformer 编码器架构。输入标准化的临床变量和人群健康指标。利用 Transformer 注意力机制生成上下文特征表示。
- 配置 TabTransformer 编码器,包含 32 个结构化临床输入变量、128 的嵌入维度、4 个 Transformer 层、8 个注意力头、512 的前馈维度、0.20 的 dropout 率,以及高斯误差线性单元(GELU)激活函数。
- 学习能够捕捉患者属性间关系的潜在临床嵌入。存储生成的临床嵌入,用于多模态整合。
- 开发连续血糖监测编码器
- 初始化时序 Transformer 编码器。将连续血糖监测序列和生理测量数据输入其中。使用自注意力机制对时间依赖性进行编码。
- 配置时序 Transformer,序列长度为 96 个时间步,采样间隔为 15 分钟,嵌入维度为 128,包含 4 个 Transformer 层、8 个注意力头,采用正弦位置编码,dropout 率为 0.20。
- 生成反映患者血糖动态的序列嵌入。保留时间嵌入,以供后续融合过程使用。
- 开发视觉 Transformer 编码器
- 初始化视觉 Transformer 架构。输入预处理后的视网膜眼底图像。将图像划分为固定大小的图像块。
- 配置视觉 Transformer,输入图像分辨率为 224 × 224 像素,图像块大小为 16 × 16 像素,嵌入维度为 768,包含 12 个 Transformer 模块、12 个注意力头,dropout 率为 0.10。
- 生成图像块级别的特征表示。获取表征视网膜病变和疾病相关生物标志物的视觉特征。保留图像嵌入,用于多模态融合。
- 执行跨模态融合
- 从临床、CGM 和视觉 Transformer 编码器中提取潜在表示,并通过独立的线性投影和层归一化(Layer Normalization),将每种模态投影到一个共同的 256 维潜在空间。
- 拼接投影后的模态标记,添加可学习的模态类型嵌入,并应用多头跨模态注意力机制,以实现临床、CGM 和视网膜表示之间的信息交换。将注意力模块配置为 8 个注意力头、256 维的模型空间、1,024 维的前馈层、GELU 激活函数、0.10 dropout、残差连接和层归一化。
- 对每种模态特定的标记组进行均值池化,并拼接所得表示。将拼接后的 768 维向量投影为 512 维的统一多模态表示,并保留注意力权重和融合后的表示,用于后续的可解释性分析和消融实验。
- 将统一表示传递至糖尿病预测模块和基于 GraphSAGE 的药物推荐模块。在整个融合过程中保持原始的模态特定训练、验证和测试划分,不在独立数据集间进行人为的患者级别匹配。
- 根据 补充表 3 中总结的模型参数配置多模态 Transformer。
5. 配置联邦学习
- 配置联邦学习框架,以实现地理上分散的医疗机构之间的协作式模型训练,同时不交换患者级别的数据。各参与机构利用本地可用数据进行本地模型优化。仅向中央聚合服务器共享受保护的模型参数。在保护患者隐私的同时,推动多模态模型的协同开发。
- 将多模态数据集进行分离,并分发给多个联邦客户端,以模拟不同医疗机构在不共享数据的情况下进行协作的场景。
- 配置联邦学习网络,包含10家参与医院客户端、1个中央聚合服务器、每轮通信进行5个本地训练周期、共进行100轮通信、客户端参与比例为80%、每轮通信随机选择客户端,且每轮至少有8家客户端参与。
- 为每位客户端分配属于特定机构的数据集,以确保数据的本地化和保密性。使用基于狄利克雷分布的非独立同分布(非IID)策略,将多模态训练数据划分给10个模拟的医院客户端。 以生成异质的类别分布、人口构成以及客户端数据集规模。
- 使用固定的随机种子以确保可重复性。验证生成的客户端级别分布,并在联邦训练过程中保持这些数据划分不变。验证集和测试集应独立于客户端划分。
- 使用从中央聚合服务器接收到的全局模型参数初始化每个本地客户端。利用客户端的本地训练数据对本地多模态Transformer模型进行五个训练周期的训练。采用AdamW优化器对本地模型进行优化,学习率为1 × 10⁻4.
- 完成本地训练后计算本地模型参数更新。在将本地模型参数传输至中心聚合服务器之前对其进行保护。将受保护的本地模型参数传输至中心聚合服务器以进行全局聚合。
- 从所有参与的医院客户端接收受保护的模型参数。在聚合前验证所接收模型更新的完整性。使用联邦平均(FedAvg)算法聚合本地模型权重。利用聚合后的模型参数更新全局多模态Transformer模型。
- 将更新后的全局模型参数分发给参与的医院客户端。重复进行本地训练和全局聚合过程,直至完成100轮通信或满足预设的收敛条件。
- 使用指定的安全聚合机制和 AES-256 加密来保护传输的模型参数。通过数字证书对参与的客户端进行身份认证。
- 使用传输层安全协议(TLS)1.3 建立加密通信通道。每轮通信结束后,仅保留聚合后的全局模型参数。
- 使用原始数据暴露、未经授权的数据共享、成员推断和模型反演评估来评价隐私与安全性。对于成员推断,将攻击的AUC-ROC与随机基线(0.50)进行比较;对于反演评估,针对视网膜图像采用结构相似性指数度量(SSIM)和峰值信噪比(PSNR),针对数值特征采用归一化重建误差进行评估。
- 通过确认服务器无法访问未聚合的单个客户端更新,验证安全聚合的有效性。验证 AES-256/TLS 1.3 加密保护机制,并确认不存在未加密的模型更新传输。
- 在适用的情况下,比较联邦式与集中式配置之间的隐私度量,并报告其中指定的度量指标 补充表4.
- 估计局部Transformer训练的计算复杂度为O(N × L × d2,其中 N 表示样本数量,L 表示 Transformer 层数,d 表示嵌入维度。
- 估计联邦聚合的计算复杂度为 O(K × P),其中 K 表示参与的客户端数量,P 表示可训练模型参数的数量。
- 在每轮通信过程中,仅在参与的客户端与中心聚合服务器之间交换受保护的模型参数。根据模型大小、参与客户端数量以及通信轮数计算通信开销。
- 将参数交换的开销与传输相应多模态医疗数据集的预估成本进行比较。根据汇总的参数配置联邦学习框架 补充表4。 联邦学习的工作流程和参数聚合过程如图所示 图5.
6. 构建个性化药物推荐模块
- 将药理学、药物、患者治疗和药物相互作用数据导入计算环境。构建包含患者、药物、疾病、实验室检测和临床风险因素节点的异质医疗图谱。
- 将患者-疾病、患者-药物、疾病-药物、药物-药物相互作用以及患者-实验室检测关系定义为图谱中的边。在模型训练前验证图谱结构,并移除重复、无效或断开的关联。
- 使用年龄、性别、体重指数(BMI)、糖化血红蛋白(HbA1c)、血糖、血压和糖尿病病程表示患者节点。使用药物类别、作用机制、剂量、给药频率和已知不良反应表示药物节点。
- 使用疾病严重程度、疾病分期和相关并发症表示疾病节点。在进行GraphSAGE训练前,对分类属性进行编码,并对连续型节点特征进行归一化处理。
- 利用预处理后的节点特征初始化节点嵌入。在邻域聚合过程中,为每个目标节点最多采样25个相邻节点。采用均值聚合方法整合相邻节点的表示,并利用聚合后的邻域表示更新目标节点的嵌入。
- 在每一层GraphSAGE后应用修正线性单元(ReLU)激活函数。对生成的节点嵌入进行归一化处理。在整个模型中重复邻域聚合过程,共进行三层GraphSAGE操作。
- 配置GraphSAGE模型:隐藏层维度为256,嵌入维度为128,共三层GraphSAGE层,邻域采样大小为25,dropout率为0.30,学习率为1 × 10⁻4,批量大小为512,最大训练轮数为100。使用Adam优化器对模型进行优化。
- 从训练好的GraphSAGE模型中计算患者特异性嵌入。计算候选药物的嵌入向量。计算患者表示与候选药物表示之间的适配得分。根据预测的适配得分对候选药物进行排序。
- 利用现有的药物-药物相互作用信息识别并剔除禁忌或潜在不安全的药物。返回排名最高的五种符合条件的药物,作为个性化的Top-5推荐方案。
- 使用贝叶斯个性化排序(BPR)损失函数训练推荐模型。优化排序目标,使临床适宜的药物得分高于较不合适的候选药物。
- 识别对每项药物推荐有影响的邻近节点及具有临床意义的图谱关系。计算患者、疾病、实验室检测和药物相关特征在推荐中所贡献的特征归因得分。
- 生成基于图谱的可视化解释,展示影响每项个性化药物推荐的关系。GraphSAGE推荐模型的配置参数详见补充表5。基于图谱的个性化药物推荐工作流程见图6。
7. 进行可解释性评估
- 进行 SHAP 分析
- 将训练好的多模态 Transformer 模型和保留的测试数据集加载到计算环境中。
- 使用训练好的预测模型和由 100 个训练样本组成的背景样本初始化 SHAP 解释器,背景样本需从训练数据集中通过按糖尿病结局类别分层的随机抽样方法选取。背景样本应保持完整训练集分区的近似类别分布,并使用固定的随机种子 42 以确保样本选择的可重复性。计算所选测试样本的 SHAP 值。
- 根据绝对 SHAP 值计算全局特征重要性,生成全局和局部 SHAP 可视化结果,并保留计算出的数值用于后续的定量和统计分析。
- 进行积分梯度分析
- 从保留的测试数据集中选择具有代表性的正确分类和错误分类样本。在计算积分梯度前,定义模态特定的基线输入。对归一化的临床和连续血糖监测(CGM)数值特征使用零基线,表示归一化特征贡献为零;对归一化的视网膜图像输入使用全零值基线图像。
- 在基线与原始输入之间使用 100 个插值步长计算积分梯度归因分数。对得到的归因分数进行归一化处理,以便在不同特征和模态间进行比较。生成归因可视化图,以识别对模型个体预测有影响的临床、时序和影像特征。
- 进行注意力可视化
- 从训练好的 Transformer 层中提取代表性测试样本的注意力矩阵。计算相应注意力头的平均注意力权重。生成注意力热图,以可视化临床、时序和视网膜影像表征之间的跨模态交互。识别在预测过程中获得高注意力权重的主要临床、时序和视网膜特征。
- 从训练好的多模态 Transformer 中提取一个随机选择的保留测试样本的注意力权重,并可视化相应的临床特征、CGM 时序、视网膜空间以及跨模态注意力分布。
- 生成反事实解释
- 从保留的测试数据集中选择具有代表性的患者记录。在生成反事实样本前,定义可修改患者特征的临床允许范围和约束条件。将连续型特征限制在训练数据中观察到的范围内,将分类特征限制在训练数据中出现的有效类别内。不得修改不可变的人口统计学特征,包括年龄和性别。
- 仅对允许修改的特征进行最小程度的修改,同时保持预定义的临床和特征域约束,以生成反事实样本。拒绝包含超出训练数据范围的值、无效分类状态或对不可变特征进行修改的反事实样本。识别能够改变预测结果所需的最小临床合理特征修改。
- 报告被修改的特征、原始值、反事实值以及模型预测的相应变化。可解释性评估工作流程如图7所示,代表性注意力可视化和反事实解释输出见补充图1。
- 评估解释质量
- 计算保真度以量化生成的解释与预测模型行为之间的一致性。通过在微小输入扰动下重复生成解释并比较所得归因模式来计算稳定性。通过比较临床相似测试样本生成的解释来评估一致性。
- 通过确定对每个解释有显著贡献的特征数量或比例来计算稀疏性。评估完整性以判断归因特征是否充分解释了相应的模型输出。通过测量输入特征在受控扰动后归因分数的变化来评估敏感性。
- 计算不保真度以量化特征归因与模型预测实际变化之间的不一致程度。记录所有定量可解释性指标以供后续统计分析。
- 进行前瞻性临床医生验证
- 为未来前瞻性临床验证,招募临床专家前须获得相应机构伦理委员会的批准。在获得伦理批准后,招募 12 名临床医生,包括 6 名内分泌科医生、3 名糖尿病专科医生和 3 名临床药理学家,并在评估开始前获得所有参与者的知情同意。
- 随机选择代表性模型预测及其对应的解释供临床医生评估。使用标准化评估格式将所选解释独立呈现给每位参与评估的临床医生。
- 要求每位临床医生使用五点李克特量表评估解释的有用性、临床相关性、可解释性和可信度。记录匿名化的临床医生评分,并按第 7.7 步规定计算评分者间一致性及相关统计指标。
- 进行统计分析
- 在选择统计比较方法前,先评估定量评价分数的分布情况。对正态分布的配对测量数据采用配对 t 检验,对非正态分布的配对测量数据采用 Wilcoxon 符号秩检验。
- 计算 Fleiss' kappa 以量化参与临床医生之间的评分者间一致性。计算主要可解释性指标和临床医生评估指标的 95% 置信区间。设定统计显著性阈值为 p < 0.05。
- 报告计算得到的检验统计量、置信区间和 p 值,并结合相应评估结果进行阐述。根据补充表6中总结的标准评估并报告可解释性指标。
8. 评估模型性能
- 使用准确率、精确率、召回率、F1分数、MCC和AUC-ROC,将FedMediFormer-XAI与逻辑回归、随机森林、XGBoost、TabTransformer、视觉Transformer、时序Transformer以及集中式多模态Transformer进行比较。
- 对每个基线模型采用相同的预定义训练、验证和测试策略进行评估,以确保与所提出的框架进行一致的比较。
- 在独立的实验运行中重复模型评估,并记录每次运行中获得的性能指标。计算准确率、精确率、召回率、F1分数、MCC和AUC-ROC的均值、标准差(SD)和95%置信区间(CI)。以均值±标准差的形式报告性能结果,并附上相应的95%置信区间。
- 评估FedMediFormer-XAI与每个基线模型之间成对性能差异的正态性。对符合正态分布的成对测量值采用配对t检验,对非正态分布的成对测量值采用Wilcoxon符号秩检验。设定统计显著性阈值为 p < 0.05。
- 报告相应的检验统计量、p值和95%置信区间,以量化观察到的性能差异的统计显著性和不确定性。
- 统计模型最终收敛所需的全部通信轮次。密切关注全局模型在联邦训练过程中的表现。研究通信轮次随时间变化的收敛情况。
- 检查参数聚合的效果。分析去中心化学习对预测性能的影响。比较联邦学习与集中式学习的结果。
- 评估各通信轮次中的联邦收敛情况,并比较联邦学习与集中式学习的预测性能。使用Precision@5、Recall@5和NDCG@5评估药物推荐效果。
- 生成负样本——从符合条件的候选药物池中选择未在相应患者中观察到的阳性患者-药物相互作用的药物作为负样本。从负样本池中排除所有已知的阳性相互作用和所有禁忌药物。在推荐训练中保持固定的负样本与正样本采样比例为1:1,并使用固定的随机种子42以确保负样本选择的可重复性。
- 仅根据保留的评估数据为每位患者建立相关项目集。将患者u的相关项目集Ru定义为在保留的真实记录中满足阳性患者-药物标准的药物集合。不得使用模型预测来构建Ru。在排序前从候选推荐集中移除禁忌药物。
- 为每位评估患者生成排名最高的五种符合条件的药物。计算Precision@5,即五种推荐药物中属于该患者相关项目集Ru的比例。计算Recall@5,即在五种推荐中检索到的患者相关药物所占比例。使用推荐药物的分级相关性计算NDCG@5,对临床适宜的药物赋予更高的相关性,对不相关药物赋予零相关性。在所有评估患者中汇总这些指标,并报告平均的Precision@5、Recall@5和NDCG@5。
- 在模型评估前构建推荐真实情况,并将保留的患者-药物相互作用与推荐训练数据分开。在GraphSAGE训练、负采样或候选排序过程中,不得使用测试集中的药物相互作用、测试集标签或未来的治疗信息。
- 通过测量保真度来检查解释结果与模型行为的一致性。通过多次检验评估解释的稳定性。根据面向医生的标准判断解释的可理解性。
- 探究不同类型数据之间解释结果的一致性。验证所生成解释的临床价值。本研究中使用的所有评估指标汇总于补充表7中。
9. 进行前瞻性临床医生验证
- 在获得适当的伦理审批和知情同意后,按照第7.6–7.8步中所述的受试者招募、评估、数据收集和统计分析流程,开展前瞻性临床医生验证。前瞻性临床医生验证设计(包括受试者构成、评估标准、比较条件及计划的统计分析)详见补充表8。
10. 进行验证与可重复性评估
- 通过系统地从完整的 FedMediFormer-XAI 框架中移除各个组件,同时保持相同的数据集划分、预处理流程、训练设置和评估标准,开展消融研究。评估完整模型以及不含扩散增强、联邦学习、基于 GraphSAGE 的药物推荐和多模态融合的配置方案。
- 使用准确率、精确率、召回率、F1 分数、马修斯相关系数(MCC)和受试者工作特征曲线下面积(AUC-ROC)将消融后的配置与完整的 FedMediFormer-XAI 框架进行比较。量化每项性能指标的变化,以确定每个框架组件的贡献。将验证结果与内部测试结果进行比较,以评估泛化能力。进行统计显著性检验,以确定观察到的性能差异的可靠性。
- 当存在具有兼容输入变量和结局定义的独立外部数据集时,使用该数据集评估框架的泛化能力。采用与内部测试数据集相同的预处理和评估流程,并将所得性能指标与内部测试结果进行比较。
- 在多次重复实验中进行统计显著性分析。在统计检验前评估成对性能差异的正态性。对符合正态分布的成对测量值采用配对 t 检验,对非正态分布的成对测量值采用 Wilcoxon 符号秩检验。设定统计显著性阈值为 p < 0.05。
- 计算准确率、精确率、召回率、F1 分数、MCC 和 AUC-ROC 的均值及 95% 置信区间。报告主要模型比较对应的检验统计量、p 值和置信区间。记录所有用于复现所报告实验的模型参数、预处理流程、训练配置和评估协议。
- 保存所报告实验使用的源代码、配置文件、评估脚本和训练模型的规格说明。详细记录模型训练过程、实验设置、随机种子和评估结果。
- 验证可用的可复现性材料的完整性和一致性。确保所记录的方法和材料为独立复现实验流程提供了充分的信息。
- 在 补充表 9 中总结本研究使用的可复现性资源和验证流程。记录消融研究的流程及评估主要框架组件贡献的评估标准。
结果
预测性能分析
与评估的单模态和传统基线模型相比,FedMediFormer-XAI 表现出更优的预测性能。基于扩散的数据增强改善了少数类别的表征,其最终的预测性能总结于表3中。重复运行评估表明,各模型的预测性能在多次实验中保持稳定。FedMediFormer-XAI 实现了最高的整体性能,准确率为 94.20 ± 0.34%(95% 可信区间:93.78–94.62),精确率为 93.10 ± 0.30%(95% 可信区间:92.73–93.47),召回率为 92.80 ± 0.28%(95% 可信区间:92.45–93.15),F1 分数为 92.90 ± 0.28%(95% 可信区间:92.55–93.25)。该模型的马修斯相关系数(MCC)为 0.88 ± 0.02(95% 可信区间:0.86–0.90),ROC 曲线下面积(AUC-ROC)为 0.96 ± 0.01(95% 可信区间:0.95–0.97)。集中式多模态 Transformer 模型取得了次优的整体性能,而单模态和传统机器学习模型的预测性能相对较低。这些结果表明,多模态表征学习结合联邦优化可实现更优且更稳定的糖尿病分类性能。
消融研究
采用逐项消融法评估了扩散增强、联邦学习、基于 GraphSAGE 的药物推荐以及多模态融合的贡献。完整的 FedMediFormer-XAI 框架在五次独立运行中达到了 94.20 ± 0.34% 的准确率、93.10 ± 0.30% 的精确率、92.80 ± 0.28% 的召回率、92.90 ± 0.28% 的 F1 分数、0.88 ± 0.02 的马修斯相关系数(MCC)以及 0.96 ± 0.01 的 AUC-ROC 值。移除扩散增强后,准确率下降至 91.80 ± 0.42%,相对下降了 2.40 个百分点,F1 分数和 AUC-ROC 分别下降至 90.30 ± 0.38% 和 0.94 ± 0.01。该性能下降表明基于扩散的增强方法对少数类样本表征和预测鲁棒性的贡献。
移除联邦学习后,准确率为93.10 ± 0.37%,相较于完整框架下降了1.10个百分点。精确率、召回率、F1分数、马修斯相关系数(MCC)和ROC曲线下面积(AUC-ROC)也分别降低至92.20 ± 0.34%、91.80 ± 0.32%、92.00 ± 0.33%、0.86 ± 0.02和0.95 ± 0.01。该对比表明联邦配置对预测性能具有贡献。
移除基于 GraphSAGE 的个性化药物推荐组件后,糖尿病预测性能仅出现相对较小的变化,准确率下降至 93.80 ± 0.35%,F1 分数下降至 92.60 ± 0.30%。相应的 MCC 和 AUC-ROC 分别为 0.87 ± 0.02 和 0.96 ± 0.01。该结果表明,GraphSAGE 主要贡献于个性化用药推荐,而非直接决定糖尿病分类性能。
当移除多模态融合时,性能下降最为显著。准确率降至87.60 ± 0.55%,下降了6.60个百分点;精确率、召回率、F1分数、马修斯相关系数(MCC)和受试者工作特征曲线下面积(AUC-ROC)分别降至86.80 ± 0.51%、85.90 ± 0.54%、86.30 ± 0.52%、0.76 ± 0.03和0.91 ± 0.01。该结果表明,联合建模来自临床、连续血糖监测(CGM)和视网膜模态的互补信息具有重要意义。
联邦学习分析
联邦学习框架支持在分布式客户端之间进行协作式模型训练,同时保持原始患者数据的去中心化处理。在训练过程中,每个客户端的本地模型被单独微调,并通过联邦平均(Federated Averaging)方法进行聚合。经过100轮通信后,全局模型收敛,其预测性能与集中式学习相当。尽管各客户端的数据分布存在异质性,联邦学习框架在多轮通信中仍表现出稳定的收敛性。受保护的参数交换机制保障了数据的去中心化处理,同时全局模型相对于集中式基线仍保持具有竞争力的预测性能。表4比较了集中式与联邦学习的实现方式。由于通信开销,联邦学习需要更长的训练时间,但其预测性能与集中式学习相当。
数据集级别性能分析
为评估在不同医疗模式下的泛化能力,我们分别在各个数据集上独立评估了模型性能。多模态 FedMediFormer-XAI 模型在所评估的数据集中表现出较强且总体具有竞争力的性能。其在 Pima Indians Diabetes、CDC Diabetes Health Indicators、OhioT1DM 和 APTOS 2019 数据集上的准确率分别为 91.8%、93.1%、92.4% 和 94.2%。尽管 APTOS 2019 数据集在准确率(94.7%)和精确率(93.9%)上略高于多模态模型,但所提出的多模态方法在所有数据集中均保持了具有竞争力的性能,并取得了 0.96 的 AUC-ROC 值,与各数据集中最高的 AUC-ROC 值相当。数据集层面的整体结果如表 5所示。对于单一数据集,单独使用视网膜图像分析时性能最佳,而多模态融合则产生了最稳定且均衡性最佳的预测结果。
个性化药物推荐分析
基于图神经网络的推荐组件利用药物有效性信息和药物相互作用数据进行评估,在生成推荐时根据学习得到的患者-药物适宜性评分对候选药物进行排序,并排除禁忌组合。通过采用异质图结构,能够充分建模患者-药物和药物-药物之间的相互作用,从而支持个性化的用药选择和安全性评估。GraphSAGE 推荐模型有效捕捉了患者、疾病、实验室检查结果与药物之间的复杂关系。个性化推荐在保持高排序性能的同时,通过图邻域分析和特征归因提供了具有临床意义的解释。
根据表6,个性化药物推荐模块使用 Precision@5、Recall@5 和 NDCG@5 进行评估。这些指标用于量化基于 GraphSAGE 的推荐模块生成的前五种个性化药物推荐的相关性与排序质量。该推荐系统表现出优异的排序性能,精确率为 0.89,召回率为 0.84,NDCG 为 0.91。
可解释性分析
该框架结合了SHAP、积分梯度、注意力可视化和反事实解释,以支持对多模态预测结果的解读。其中,SHAP用于量化特征层面的贡献,积分梯度用于将预测结果归因于输入特征,注意力可视化用于考察模型在不同模态上的关注区域,反事实解释则用于识别与替代性预测相关的特征变化。图8展示了由训练好的FedMediFormer-XAI模型生成的代表性SHAP汇总图,而图9展示了从训练好的Transformer模型中提取的代表性注意力可视化结果。这些图像均为模型评估过程中获得的实际输出,而非所提出架构的示意图。
在图8中展示了特征重要性的聚合层级排序。具有较高绝对SHAP值的特征对模型预测的影响更大,并且与现有的临床知识高度一致。
图9展示了从训练好的FedMediFormer-XAI模型中直接提取的代表性注意力可视化结果,该结果来自一个随机选择的独立测试样本。可视化内容包括临床特征注意力、连续血糖监测(CGM)时间注意力、眼底图像空间注意力,以及三种模态之间的跨模态注意力。注意力可视化进一步揭示了模型在多个模态之间学习到的注意力分配机制。所选样本在临床特征中相对更关注HbA1c、糖尿病病程和年龄;CGM注意力图谱突出了多个血糖变异性显著的时间段;眼底图像注意力图谱识别出对模型表征有贡献的特定图像区域;跨模态注意力矩阵则展示了模态内和跨模态的注意力模式。如图9所示,该代表性模型生成的注意力图谱在一个独立测试样本中突显了特定的时间血糖模式、具有影响力的临床变量以及具有诊断意义的眼底图像区域。
以人为中心的评估结果
设计了一项前瞻性以人为中心的评估方案,用于评估在仅提供预测结果以及同时提供预测与解释两种条件下,临床医生对系统的信任度、可解释性、可用性、临床实用性及解释相关性。本评估将邀请内分泌科医生、糖尿病专科医生和临床药理学家参与,并已获得机构伦理委员会的适当批准及参与者的知情同意。由于该评估旨在未来进行前瞻性实施,本方案中未报告针对临床医生层面的结局评分。
表7 总结了拟议的前瞻性临床医生评估设计,以及用于评估解释对临床医生信任度、可解释性和感知效用影响的预定义标准。该前瞻性评估将使用预定义的李克特量表标准,比较临床医生在有和没有相应解释的情况下对模型预测的评估。拟议的前瞻性以人为中心的可解释性评估框架见图10
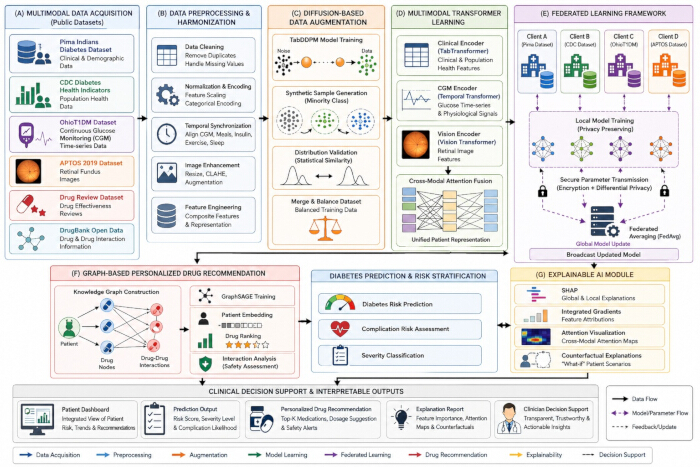
图1:FedMediFormer-XAI 框架整体架构。 FedMediFormer-XAI 框架的示意图,展示了多模态数据采集与预处理、基于扩散的数据增强、模态特异性 Transformer 学习、联邦模型训练、基于 GraphSAGE 的个性化药物推荐以及可解释性分析。该框架可生成糖尿病预测结果、个性化用药建议以及可解释的模型输出。请点击此处查看该图的放大版本。
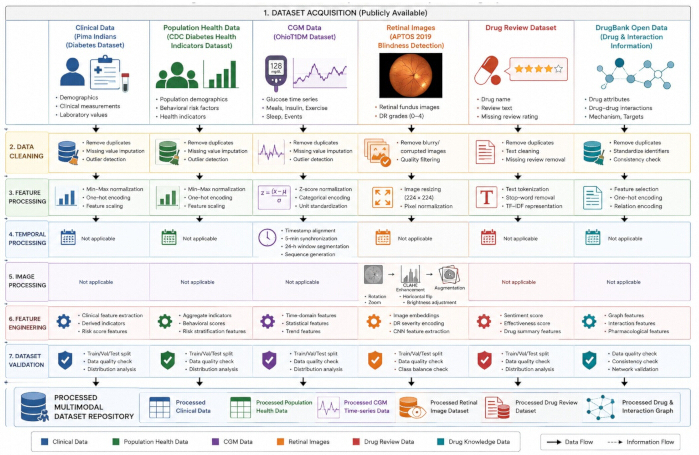
图 2:多模态数据集获取与预处理流程。 获取和预处理 FedMediFormer-XAI 中所用多模态数据集的示意图工作流程。临床与人群健康数据、连续血糖监测记录、视网膜图像以及药理学信息在转换为适合模型使用的表示形式以进行下游分析之前,需经过特定模态的质量控制、预处理、归一化、编码和数据增强。请点击此处查看该图的放大版本。
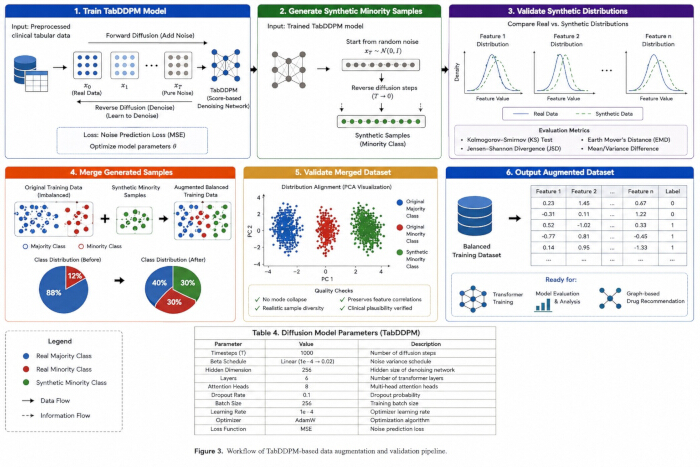
图3: 基于扩散模型的数据增强工作流程。使用 TabDDPM 对结构化表格训练数据进行基于扩散模型增强的示意图流程。生成的样本在与原始训练数据合并以改善类别平衡之前,需经过质量评估和分布相似性评估。请点击此处查看该图的放大版本。
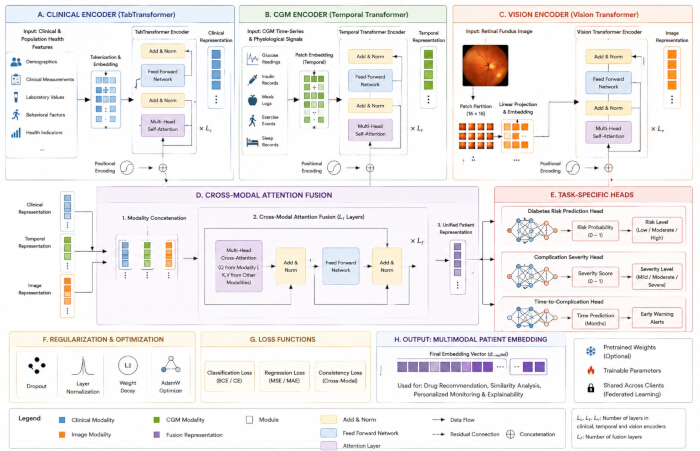
图4:所提出的多模态Transformer框架的架构。示意图架构包括(A) 一种用于临床数据的 TabTransformer 编码器, (B) 用于CGM数据的时间变换器编码器,以及 (C) 用于视网膜图像的视觉Transformer编码器 (D) 模态特异性表征通过跨模态注意力机制进行整合,以生成统一的多模态表征。 (E) 任务特定的预测头生成模型输出。 (F) 正则化与优化组件支持模型训练, (G分类、回归和跨模态一致性损失共同指导优化过程。所得到的多模态表示可支持下游的预测、推荐和可解释性任务。 请点击此处以查看此图的放大版本。
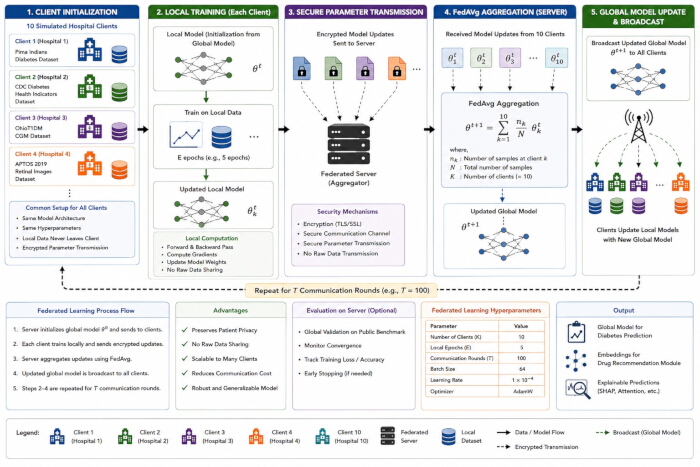
图5:联邦学习通信框架。跨分布式医院客户端的联邦训练示意图。使用各客户端特定的数据训练本地多模态模型,并将受保护的模型更新传输至中央服务器进行联邦平均。聚合后的全局模型被重新分发至各客户端,用于后续的通信轮次。该框架还展示了安全的参数交换,以及对隐私性、通信和计算需求的评估。请点击此处查看此图的放大版本。
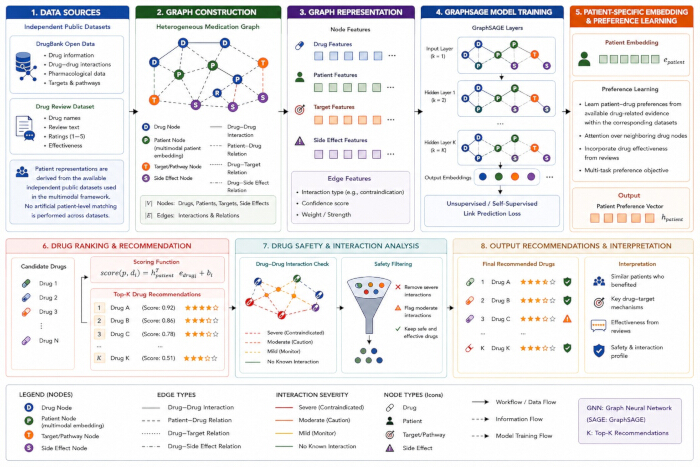
图6:基于图的个性化药物推荐工作流程。 基于GraphSAGE的个性化药物推荐示意图。药理学数据与患者表征数据被组织成一个包含相关医疗实体及其关系的异质图。GraphSAGE学习患者和药物的表征,并据此计算患者与药物之间的适用性评分,对候选药物进行排序。在生成最终的Top-K推荐结果之前,会过滤掉禁忌或不安全的药物组合,基于图的信息有助于解释推荐结果。请点击此处查看该图的放大版本。
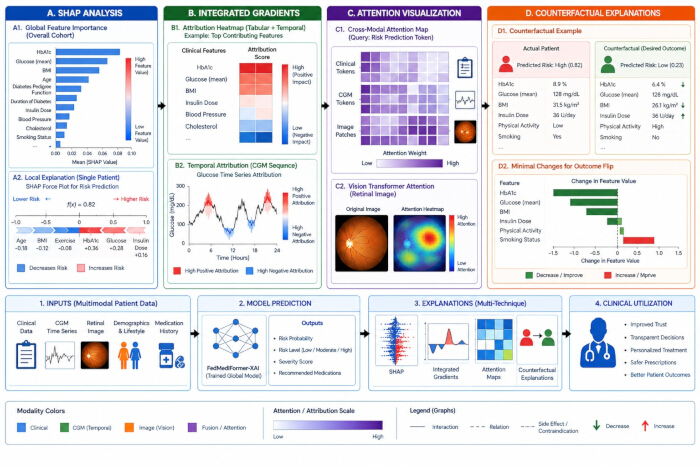
图7:可解释性评估框架。可解释性工作流程的示意图。(A)SHAP分析评估全局和局部特征贡献;(B)集成梯度提供基于归因的解释;(C)注意力可视化识别关键特征及模态间相互作用;以及(D)反事实分析识别与预测结果变化相关的特征改变。所生成的解释输出有助于模型预测的解读及个性化推荐的制定。 请点击此处查看该图的放大版本。
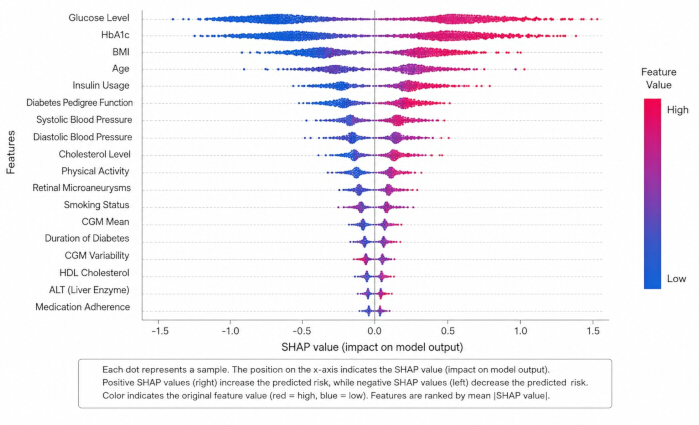
图8:由训练好的 FedMediFormer-XAI 模型生成的代表性基于模型的 SHAP 特征重要性分析。SHAP 汇总图展示了在评估样本中 SHAP 值的分布情况,特征按其平均绝对 SHAP 贡献度进行排序。正 SHAP 值表示对预测糖尿病风险升高有贡献,而负值表示对预测风险降低有贡献。颜色代表相应的特征值,较高的特征值以红色表示,较低的特征值以蓝色表示。该图展示的是实际由模型生成的可解释性输出结果,而非示意图。请点击此处查看该图的放大版本。
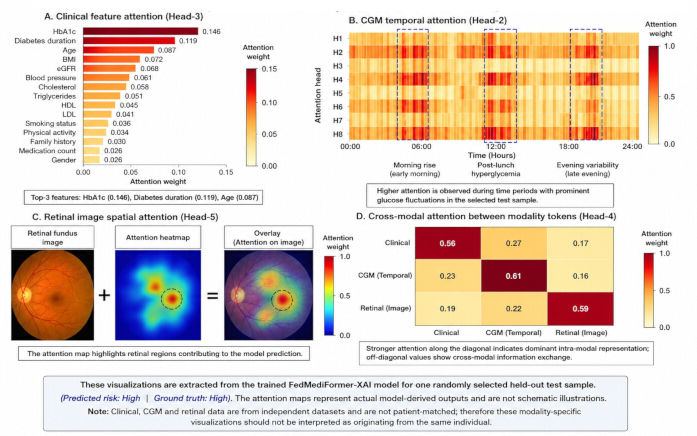
图9:FedMediFormer-XAI 模型对一个随机选择的保留测试样本生成的代表性注意力输出。(A)来自多模态 Transformer 中一个注意力头的临床特征注意力,显示分配给各临床特征的相对注意力权重。(B)连续血糖监测(CGM)序列上的时间注意力,展示模型关注程度较高的时间段。(C)眼底图像的空间注意力,包括原始图像、注意力热图及注意力叠加图。(D)临床特征、CGM 和眼底模态标记之间的跨模态注意力,展示模态内与跨模态的信息加权。所示可视化结果为训练后模型生成的输出。注意力权重针对所选测试样本展示,应被解释为模型的注意力模式,而非临床因果关系的独立度量。请点击此处查看该图的放大版本。
| 数据集 | 数据类型 | 样本/记录数 | 特征/内容 | 用途 | 公开可用性 |
| Pima Indians Diabetes Dataset | 临床表格数据 | 768 名患者 | 8 个临床变量 | 糖尿病风险预测 | 公开 |
| CDC Diabetes Health Indicators | 人群健康数据 | 253,680 条记录 | 人口统计学、生活方式、健康指标 | 人群风险分析 | 公开 |
| OhioT1DM Dataset | 连续血糖监测时间序列数据 | 12 名受试者 | 血糖、胰岛素、饮食、运动、睡眠 | 糖尿病时序建模 | 公开 |
| APTOS 2019 Blindness Detection | 视网膜图像 | 3,662 张图像 | 带有严重程度标签的眼底照片 | 糖尿病视网膜病变分析 | 公开 |
| Drug Review Dataset | 药理学数据 | 215,063 条评论 | 药物疗效、评分、用户评论 | 药物推荐 | 公开 |
| DrugBank Open Data | 药物知识图谱 | 数千种药物 | 药物-药物相互作用、靶点、通路 | 图谱构建 | 公开/学术访问 |
表1:数据集特征。 本研究中使用的公开数据集的汇总信息,包括数据集类型、样本量、数据模态、特征内容、预期用途和可获取性。
| 数据集 | 模态 | 预测目标 | 融合层次 |
| Pima Indians Diabetes | 临床 | 糖尿病分类 | 特征嵌入 |
| CDC Diabetes Health Indicators | 人群健康 | 糖尿病风险预测 | 特征嵌入 |
| OhioT1DM | 连续血糖监测 | 血糖趋势预测 | 特征嵌入 |
| APTOS 2019 | 眼底视网膜图像 | 糖尿病视网膜病变分析 | 特征嵌入 |
| Drug Review + DrugBank | 药理学 | 药物推荐 | 图嵌入 |
表2:多模态数据集整合策略。 用于多模态糖尿病智能分析的数据集汇总,包括数据模态、预测目标以及模态特异性表征的整合层级。临床数据、人群健康数据、连续血糖监测数据和视网膜图像数据均表示为特征嵌入,而药理学信息则通过图嵌入进行整合,以实现个性化药物推荐。
| 模型 | 准确率,均值 ± 标准差(95% 置信区间) | 精确率,均值 ± 标准差(95% 置信区间) | 召回率,均值 ± 标准差(95% 置信区间) | F1 分数,均值 ± 标准差(95% 置信区间) | MCC,均值 ± 标准差(95% 置信区间) | AUC-ROC,均值 ± 标准差(95% 置信区间) |
| Random Forest | 83.60 ± 0.74 (82.68–84.52) | 82.70 ± 0.60 (81.96–83.44) | 81.90 ± 0.56 (81.21–82.59) | 82.30 ± 0.56 (81.61–82.99) | 0.67 ± 0.03 (0.63–0.71) | 0.88 ± 0.01 (0.87–0.89) |
| XGBoost | 85.30 ± 0.71 (84.42–86.18) | 84.70 ± 0.60 (83.96–85.44) | 83.80 ± 0.56 (83.11–84.49) | 84.20 ± 0.56 (83.51–84.89) | 0.70 ± 0.03 (0.66–0.74) | 0.90 ± 0.01 (0.89–0.91) |
| TabTransformer | 87.50 ± 0.52 (86.85–88.15) | 87.00 ± 0.60 (86.26–87.74) | 86.20 ± 0.56 (85.51–86.89) | 86.60 ± 0.56 (85.91–87.29) | 0.75 ± 0.03 (0.71–0.79) | 0.92 ± 0.01 (0.91–0.93) |
| Vision Transformer | 88.80 ± 0.50 (88.18–89.42) | 88.20 ± 0.60 (87.46–88.94) | 87.60 ± 0.56 (86.91–88.29) | 87.90 ± 0.56 (87.21–88.59) | 0.78 ± 0.03 (0.74–0.82) | 0.93 ± 0.01 (0.92–0.94) |
| Temporal Transformer | 87.20 ± 0.51 (86.57–87.83) | 86.60 ± 0.60 (85.86–87.34) | 85.90 ± 0.56 (85.21–86.59) | 86.20 ± 0.56 (85.51–86.89) | 0.74 ± 0.03 (0.70–0.78) | 0.91 ± 0.01 (0.90–0.92) |
| CNN-LSTM | 86.90 ± 0.58 (86.18–87.62) | 86.30 ± 0.60 (85.56–87.04) | 85.60 ± 0.55 (84.92–86.28) | 85.90 ± 0.56 (85.21–86.59) | 0.73 ± 0.03 (0.69–0.77) | 0.91 ± 0.01 (0.90–0.92) |
| Centralized Multimodal Transformer | 91.30 ± 0.12 (91.15–91.45) | 90.70 ± 0.60 (89.96–91.44) | 90.10 ± 0.56 (89.41–90.79) | 90.40 ± 0.56 (89.71–91.09) | 0.83 ± 0.03 (0.79–0.87) | 0.95 ± 0.01 (0.94–0.96) |
| FedMediFormer-XAI | 94.20 ± 0.34 (93.78–94.62) | 93.10 ± 0.30 (92.73–93.47) | 92.80 ± 0.28 (92.45–93.15) | 92.90 ± 0.28 (92.55–93.25) | 0.88 ± 0.02 (0.86–0.90) | 0.96 ± 0.01 (0.95–0.97) |
表3:糖尿病预测性能。使用准确率、精确率、召回率、F1分数、MCC和AUC-ROC指标,对FedMediFormer-XAI与基线机器学习及深度学习模型的预测性能进行比较。
| 指标 | 集中式学习 | 联邦学习 |
| 准确率 (%) | 94.7 | 94.2 |
| AUC-ROC | 0.97 | 0.96 |
| 隐私保护 | 否 | 是 |
| 是否需要共享原始数据 | 是 | 否 |
| 通信轮次 | N/A | 100 |
| 训练时间(小时) | 4.8 | 5.6 |
| 法规合规性 | 中等 | 高 |
表4:联邦学习与集中式学习的性能对比。 在预测性能、原始数据共享需求、通信轮次和训练时间方面,对集中式学习与联邦学习实现方式进行比较。
| 数据集 | 准确率 (%) | 精确率 (%) | 召回率 (%) | AUC-ROC |
| Pima Indians Diabetes Dataset | 91.8 | 90.5 | 89.8 | 0.93 |
| CDC Diabetes Health Indicators | 93.1 | 92.2 | 91.6 | 0.95 |
| OhioT1DM Dataset | 92.4 | 91.8 | 91.1 | 0.94 |
| APTOS 2019 Blindness Detection | 94.7 | 93.9 | 93.5 | 0.96 |
| Multimodal Fusion (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
表5:数据集层面的结果。在各个独立数据集及多模态融合设置下的性能分析。结果展示了不同数据模态对整体预测性能的贡献。
| 指标 | 数值 |
| Precision@5 | 0.89 |
| Recall@5 | 0.84 |
| NDCG@5 | 0.91 |
| 药物相互作用检测准确率 | 0.95 |
| 推荐覆盖率 | 0.88 |
| 平均倒数排名(MRR) | 0.86 |
| 安全性合规评分 | 0.94 |
表6:个性化药物推荐性能。基于图的个性化药物推荐在排序指标、相互作用检测准确率、推荐覆盖范围和用药安全性评估方面的评价。
| 评估标准 | 拟议的评估设计 |
| 临床医生信任度 | 五点李克特量表评估 |
| 可解释性 | 五点李克特量表评估 |
| 临床相关性 | 五点李克特量表评估 |
| 解释的有用性 | 五点李克特量表评估 |
| 感知效用 | 五点李克特量表评估 |
| 评价者间一致性 | Fleiss' kappa,将在前瞻性评估后计算 |
| 统计学比较 | 配对统计检验,根据数据收集后情况选择适当方法 |
| 参与者 | 12名临床医生,需获得伦理批准并签署知情同意书 |
| 评估状态 | 前瞻性/未来评估 |
表7:拟议的以人为中心的评估标准。 拟议的以临床医生为中心的前瞻性评估框架,用于评估 FedMediFormer-XAI 解释的有用性、临床相关性、可解释性、可信度和可用性。评估包括标准化的五点李克特量表评分、使用 Fleiss' kappa 进行评分者间一致性分析、仅预测与预测加解释条件的统计比较,以及 95% 置信区间。临床医生的评估必须在获得相应机构伦理委员会批准并取得知情同意后方可进行。
补充表 1:数据集验证策略。为确保可重复性及可靠的模型评估,采用了数据集划分、验证流程、类别平衡策略和质量控制措施。请点击此处下载该文件。
补充表 2:扩散模型参数。TabDDPM 扩散模型的配置设置,包括训练参数、优化设置、潜在维度、噪声调度策略以及合成样本生成规范。请点击此处下载该文件。
补充表 3:多模态 Transformer 配置。多模态 Transformer 架构的配置,包括临床、时序和图像编码器、嵌入与融合维度、注意力头数、优化器、学习率、批量大小、训练轮数、早停准则以及联合训练损失。请点击此处下载该文件。
补充表4:联邦学习配置。 用于隐私保护的联邦训练的参数,包括参与的医院数量、通信轮次、本地训练周期数、客户端参与率、聚合算法、优化器、学习率、加密方法、通信协议以及原始数据共享策略。请点击此处下载该文件。
补充表5:GraphSAGE 配置。 基于异构 GraphSAGE 的个性化药物推荐模块的配置,包括图类型、隐藏层维度与嵌入维度、图层数量、邻域采样大小、优化器、学习率、批量大小、训练轮数、贝叶斯个性化排序损失函数,以及推荐药物的前 N 个数量。请点击此处下载该文件。
补充表6:可解释性评估指标。 用于评估FedMediFormer-XAI框架可解释性的定量与以人为中心的指标。这些指标用于评估解释的保真度、稳定性、一致性、稀疏性、完整性、敏感性、不保真度、评分者间一致性以及临床医生感知的解释质量。请点击此处下载该文件。
补充表 7:评估指标。采用预测性、联邦学习、推荐和可解释性指标来评估框架的性能、鲁棒性、排序质量及可解释性。请点击此处下载该文件。
补充表 8:以人为中心的评估设计。以临床医生为中心的评估研究设计,包括参与者分组、评估条件、评估标准和统计分析流程。请点击此处下载该文件。
补充表 9:可重复性资源。支持所提出的 FedMediFormer-XAI 框架可重复性的数据集、实现规格、配置文件、评估流程、文档和实验记录的汇总。请点击此处下载该文件。
讨论
关键发现的解读
代表性结果表明,可以将多模态 Transformer 学习、联邦学习、基于扩散的数据增强、基于图神经网络的药物推荐以及可解释的人工智能整合为一个统一的糖尿病智能框架。通过整合临床记录、人群健康指标、连续血糖监测数据、视网膜眼底图像和药理学信息,所提出的 FedMediFormer-XAI 框架在支持可解释性和去中心化模型开发的同时,表现出强大的预测性能。该多模态学习方法从不同的医疗数据模态中提取出具有信息量的特征,从而实现了更准确的糖尿病预测和个性化的治疗推荐。
联邦学习的优势
所提出框架的一个重要贡献是整合了联邦学习,以实现去中心化的协作式模型构建。与传统的集中式学习方法不同,联邦学习允许多个机构参与模型训练,而无需直接共享原始患者数据。关键研究结果表明,联邦学习在支持去中心化数据处理的同时,仍能保持与集中式学习相当的预测准确性。这一特性在医疗场景中尤为重要,因为在这些场景中,数据共享常受到机构政策和隐私保护要求的限制。
可解释性分析
可解释性评估发现,SHAP分析、积分梯度法、注意力可视化以及反事实解释均能对模型行为提供具有临床意义的洞察。从临床角度来看,全局和局部解释在最重要的预测因子上基本一致(即血糖测量值、体重指数、年龄、胰岛素给药模式以及视网膜异常)。注意力可视化还显示,Transformer架构关注的是具有临床相关性的时间序列和影像特征。这些方法通过提供对模型预测结果及特征贡献的互补性解释,提升了模型的透明度。
个性化药物推荐分析
我们提出了一种基于图神经网络(GNN)的推荐模型,该模型在建模患者-药物和药物-药物关系的同时,提供个性化的药物推荐。事实上,异质图拓扑结构不仅有助于掌握治疗效果的模式,还能兼顾用药安全性。本研究取得的优异药物推荐结果表明,基于图的学习方法在糖尿病智能系统开发中具有广阔前景,不仅限于疾病预测,还可进一步构建个性化的治疗支持框架。
以人为核心的评估
该框架纳入了一项前瞻性以人为核心的评估方案,用于评估可解释性对临床医生信任度、可理解性、可用性及感知临床效用的影响。所提出的评估将采用标准化评估标准,比较仅提供预测结果与同时提供预测结果和解释两种条件下的表现。在未来获得机构伦理委员会的适当批准并取得知情同意后,实施此项评估将为临床医生对生成解释的接受程度及其实际应用价值提供实证依据。
成功且可重复实施的关键步骤
在所提出的方案中,多个阶段需要特别注意以确保可重复性。数据集的预处理与划分应保持以患者为单位的分离,防止数据泄露,同时在联邦学习过程中应保持规定的非独立同分布(non-IID)客户端数据分布。跨模态融合应维持预设的潜在维度、注意力配置、模态类型嵌入、归一化方法以及最终投影方式。基于扩散的增强方法应使用一致的预处理和训练参数,而基于 GraphSAGE 的推荐方法应保持患者-药物表征、相互作用筛选、相关项目定义以及 Top-K 排序标准的一致性。可解释性分析应采用固定的 SHAP 背景样本、Integrated Gradients 基线、注意力提取流程以及临床允许的反事实约束条件。软件版本、随机种子、模型配置、数据集划分及评估参数均应详细记录,以尽量减少因实现环境不同而带来的变异。
局限性
在解读本研究结果时,应考虑若干局限性。首先,该框架的开发与评估依赖于公开可用的数据集,这些数据集可能无法充分代表真实世界医疗人群和临床环境的多样性。其次,尽管联邦学习在模拟的医院客户端上进行了评估,但尚未在独立的医疗机构中开展大规模验证。第三,联邦学习会引入额外的通信和计算开销,可能影响在资源受限环境中的可扩展性。最后,本研究采用的可解释性技术主要是事后解释方法,可能无法完全捕捉复杂模型的行为。
拟议的以人为中心的验证方案包括一个由12名临床专家组成的初始专家组,成员涵盖内分泌学家、糖尿病专家和临床药理学家。该样本量旨在对可用性和可解释性进行初步评估,而非用于确证性临床验证。由于专家小组规模相对较小,可能会限制统计效能和结果的普适性。因此,未来应开展前瞻性研究,纳入更大规模、多中心的临床医生队列,以代表多样化的临床环境和专业领域。
该框架的一个关键局限性在于,临床数据、连续血糖监测(CGM)、视网膜影像和药物相关模态数据来源于独立的公开数据集,而非来自同一患者的匹配多模态记录。因此,跨模态融合组件应被理解为一种整合互补模态表征的方法学框架,而非基于同一患者同步采集的多模态测量数据所得出的证据。源数据集在人群特征、采集协议、特征分布以及疾病定义方面的差异可能引入分布偏差,并限制所学习到的跨模态关系真实反映患者个体层面关联的程度。尽管该方案明确避免在独立数据集之间进行人为的患者层面匹配,但这种设计限制了对患者特异性多模态交互作用的直接评估,并可能影响临床可推广性。因此,所报告的多模态性能不应被视为等同于在一个前瞻性收集的、患者匹配的多模态队列上的验证结果。未来的研究应使用更大规模、独立采集且包含同一患者同步临床、CGM、视网膜和治疗信息的数据集对该框架进行验证。
故障排除与方案优化
在实施本方案时,可能存在若干实际影响因素。当少数类别样本不足时,类别不平衡问题可能降低模型的预测性能;可通过基于扩散的数据增强和重采样策略缓解该问题。缺失值及数据格式不一致可能影响模型稳定性,需通过严格的预处理流程予以解决。在联邦学习中,若各客户端数据集存在显著异质性,可能导致收敛过程不稳定;调整本地训练轮数、学习率及聚合频率可提升稳定性。硬件资源限制也可能影响训练效率,尤其是在处理大规模多模态数据集和Transformer架构时。在此类情况下,降低批量大小或模型复杂度可在保持可重复性的同时提升计算可行性。
未来研究方向
未来的研究可能聚焦于整合数字孪生技术,用于个性化疾病模拟与治疗方案规划。基于大规模多模态医疗数据集训练的基础模型,有望进一步提升表征学习能力与模型泛化性能。因果可解释性技术可提供对疾病机制和治疗效应的深入理解,超越基于相关性的解释。此外,强化学习方法可能支持自适应治疗优化及动态药物推荐策略。这些进展有望进一步增强糖尿病智能系统的临床实用性和个性化能力。同时,人工智能生成的预测结果与药物推荐应被视为决策支持工具,而非专业临床判断的替代。适当的人为监督对于医疗人工智能系统的负责任和合乎伦理的部署至关重要。
结论
FedMediFormer-XAI 提供了一个可重复的框架,将多模态学习、联邦训练、个性化药物推荐和可解释性整合用于糖尿病智能分析。代表性结果支持了所提出工作流程的可行性,但在临床部署前,仍需通过患者匹配的多模态数据集、更大规模的临床环境以及前瞻性临床医生评估进行进一步验证。
披露
作者声明,他们不存在可能影响本研究工作报道的任何竞争性财务利益、利益冲突或个人关系。在本文撰写过程中,人工智能工具仅用于协助语言润色、稿件组织、格式编排和编辑。所有科学内容、研究设计、方法、数据分析、结果解释和结论均由作者开发、验证并批准。作者对本稿件中所呈现工作的准确性、完整性和原创性负全部责任。
致谢
作者感谢本研究中使用的公开数据集和开源软件资源的开发者与维护者。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| AES 加密 | NIST | AES-256 | 联邦学习中静态数据/受保护的模型参数加密 |
| APTOS 2019 盲症检测数据集 | Kaggle/APTOS | 2019年发布 | 视网膜眼底图像数据集;公开可用且去标识化;https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta AI | 版本 0.8 | 模型可解释性与归因分析 |
| CUDA 工具包 | NVIDIA | 版本 12.2 | GPU加速计算 |
| 糖尿病健康指标数据集(美国疾病控制与预防中心行为风险因素监测系统 2015) | 美国疾病控制与预防中心/行为风险因素监测系统;Kaggle | 2015年发布 | 人群健康指标;公开可用且去标识化;https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| 糖尿病视网膜病变检测数据集 | Kaggle | 公开发布 | 视网膜图像数据集;公开可用且去标识化;https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| 数字证书 | - | - | 联邦学习中的客户端认证 |
| 药物相互作用数据集 | Kaggle | 公开发布 | 药物-药物相互作用图数据;公开可用且已去标识化;https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| 药物评价数据集 | 加州大学欧文分校机器学习资料库 | 数据集 462 | 药物疗效与评论数据集;公开可用且已去标识化;https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Matplotlib 开发者 | 版本 3.9 | 可视化 |
| MTS 糖尿病数据集 | Kaggle | 公开发布 | 可穿戴传感器/糖尿病预测数据集;公开可用且已去标识化;https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | NetworkX 开发者 | 版本 3.3 | 药物相互作用图谱的构建与分析 |
| NumPy | NumPy 开发者 | 版本 1.26 | 数值计算 |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | 模型训练与推理;至少 32 GB 系统内存 |
| OhioT1DM 数据集 | 俄亥俄大学 | 公开发布 | 连续血糖监测数据集;公开可用且已去标识化;https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | OpenCV 基金会 | 版本 4.10 | 图像处理 |
| Pandas | PyData | 版本 2.2 | 数据处理与预处理 |
| 皮马印第安人糖尿病数据集 | UCI 机器学习库 | 数据集 34 | 临床糖尿病预测数据集;公开可用且已去标识化;https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Python 软件基金会 | 版本 3.11 | 主要编程环境 |
| PyTorch | Meta AI | 版本 2.3 | 深度学习模型开发与训练 |
| PyTorch Geometric | PyG 团队 | 版本 2.5 | 图神经网络的构建与训练 |
| Scikit-learn | Scikit-learn 开发者 | 版本 1.5 | 机器学习工具与评估 |
| 安全聚合机制 | - | - | 联邦学习中局部模型参数的安全聚合 |
| SHAP | SHAP 开发者 | 版本 0.47 | 可解释人工智能与特征归因分析 |
| TensorFlow | 谷歌 | 版本 2.15 | 深度学习模型开发与训练 |
| 变换器 | Hugging Face | 4.45 版本 | 基于Transformer的架构实现 |
| 传输层安全 | IETF | TLS 1.3 | 用于联邦参数交换的加密通信通道 |
| 工作站 | 通用型 | - | 计算环境;至少 32 GB 系统内存 |
参考文献
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.