本方案提供了一种可重复的工作流程,用于义县—黄山世界遗产地景观的多情景土地利用预测、碳储量评估及地形关联分析。
本文内容
摘要
摘要
土地利用变化会改变陆地碳储量,但在以旅游为导向的世界遗产地景观中,用于评估基于情景变化的可重复工作流程仍然有限。本方案结合了定制的马尔可夫元胞自动机、与“生态系统服务与权衡综合评估”框架等效的四库碳核算方法,以及基于最优参数的地理探测器,用于评估中国安徽省南部黟县及黄山周边区域的土地利用和碳储量变化。采用2005年、2010年和2015年的中国土地覆盖数据集地图进行模型校准和跨期验证。模拟了四种探索性情景——照常发展、旅游扩展与开发、生态保育优先、以及乡村振兴与活化——并预测其在2030年和2050年的变化。在4,632,329个有效像元上的验证结果显示总体精度为96.61%,Kappa系数为0.850,优势度指数(Figure of Merit)为0.107。基准碳储量为59.505太克碳,其中森林贡献了95.9%。预计到2050年,不同情景下的碳损失介于生态保育优先情景的5.01%至旅游扩展与开发情景的13.49%之间。单因素逐一扰动分析支持相同的情景排序结果。基于最优参数的地理探测器识别出坡度、地形起伏和海拔是所评估地形因子中最强的关联变量。所提供的输入数据、参数、输出结果和脚本支持研究的可重复性;然而,这些情景应被理解为比较性的压力测试,而非经过校准的预测结果。
引言
陆地生态系统将碳储存在植被、土壤和枯落有机物中,从而有助于气候调节1,2。土地利用方式的转变可能迅速改变这些碳储量;因此,开展具有空间明确性的评估对于土地利用规划和碳管理至关重要。
皖南地区的分析范围涵盖广阔的亚热带森林、农业盆地,以及与黄山和西递-宏村世界遗产地相关的区域3,4。有关文化遗产土地覆盖、世界遗产旅游及传统村落保护的研究表明,在该区域需综合考虑生态状况、游客压力和地方认同5,6,7。
基于情景的土地利用模型将观测到的转变转化为具有明确空间分布的预测,而碳库核算则量化了这些模式所带来的影响。以往的研究已在中国及其他景观区域中,将斑块生成型土地利用模拟(Patch-generating Land Use Simulation, PLUS)或元胞自动机–马尔可夫(cellular automaton–Markov, CA–Markov)分配方法与生态系统服务与权衡综合评估(Integrated Valuation of Ecosystem Services and Tradeoffs, InVEST)框架以及基于最优参数的地理探测器(optimal parameters-based geographical detector, OPGD)相结合,出现了若干近期集成应用8,9,10,11,12,13,14,15,16,17,18,19,20。这些研究为方法学提供了先例,尽管本研究所采用的模拟器为自主开发的马尔可夫元胞自动机(Markov cellular automaton, Markov-CA)实现,而非PLUS模型。
相关研究已评估了基于政策的碳排放路径、耦合卫星与土地利用模型、考虑地形的碳储量、城市及校园应用、土壤碳管理、耕地转换、国家森林制图以及尺度依赖性21,22,23,24,25,26,27,28,29,30,31,32,33,34。总体而言,这些研究支持多情景比较,同时表明研究结论依赖于数据尺度、土地利用类型转换、碳参数以及模型所假设的政策条件。本研究采用的自定义实现方法提供了一个透明的工作流程,其中转移矩阵、情景乘数、分配程序、碳密度查找表、敏感性分析以及地形关联分析均可在单一可重复的框架内进行检验。本研究中,该自定义工作流程的实际价值在于:转移矩阵、情景参数、像元分配规则、验证过程、敏感性分析、碳核算以及地形关联分析均在一个可重复的计算框架中得以实现并完整记录。该结构使得情景分析中所使用的假设和中间分析步骤能够被审查和复现。由于该工作流程未直接与PLUS模型或其他CA–Markov实现方法进行基准对比,因此不声称其在准确性、效率或预测性能方面具有优越性。
关于地形与土壤因子控制、地貌对土壤碳持久性的影响、空间尺度效应、OPGD 应用、黄山生产力、景观格局指标、湿地以及森林碳储量的研究进一步支持了对地形效应进行谨慎的、基于关联性的解释35,36,37,38,39,40,41,42,43,44。在此背景下,本方法的总体目标是为中国安徽黟县—黄山世界遗产地景观提供一个透明且可重复的多情景土地利用预测、碳储量评估及地形关联性分析工作流程。该工作流程采用自定义的 Markov-CA 模型实现,结合与 InVEST 等效的四库碳核算方法和 OPGD 方法,对 2005–2015 年期间进行模型的跨时段验证,并开展包含 28 次运行的单因素逐次敏感性分析。配套提供的栅格数据、情景规则、混淆矩阵、环境文件和脚本,可支持对该自定义模拟工作流程的直接审查与复现。该工作流程适用于具备兼容的分类土地覆被栅格数据、类别特异的碳密度参数以及适当地形数据的研究场景,其目标为进行不同情景间的比较评估,而非精确的空间预测。
本研究包含三个目标:(1)在“照常营业”(BAU)、“旅游扩张与发展”(TED)、“生态保育优先”(ECP)和“村庄振兴与激活”(VRA)四种压力测试情景下,模拟2030年和2050年的土地利用;(2)采用完整的九类四库查表法量化碳储量;(3)评估海拔、坡度、北向性及地形起伏度与2015年碳密度之间的单独及联合关联性8,9,10。这些目标将土地利用预测、碳核算和地形关联分析整合到一个可重复的工作流程中,同时保持模拟土地利用结果与地形变量统计关联之间的区分。
情景标签表示的是对比性假设,而非拟合预测或编码的法定规划。因此,该方法最适合用于可重复地比较不同的土地利用假设及其相关的碳储存结果,而不是将生成的地图解释为对未来土地利用的校准预测。
方案
本研究未涉及人类参与者、动物或受保护物种。分析仅使用了公开可获取的遥感产品和已发表的碳密度参数;因此,无需伦理委员会批准。
在开放且可重现的工作流程中,使用 Python 3.11 实现所有计算步骤。遵循以下七个部分:(1) 定义研究区域;(2) 获取并预处理输入数据;(3) 估算转移矩阵并初始化自定义马尔可夫-元胞自动机模型;(4) 配置情景、敏感性测试及未来模拟;(5) 校准与验证模型;(6) 计算碳储量;(7) 检测地形与 OPGD 的关联。遵循图 1所示的完整工作流程。
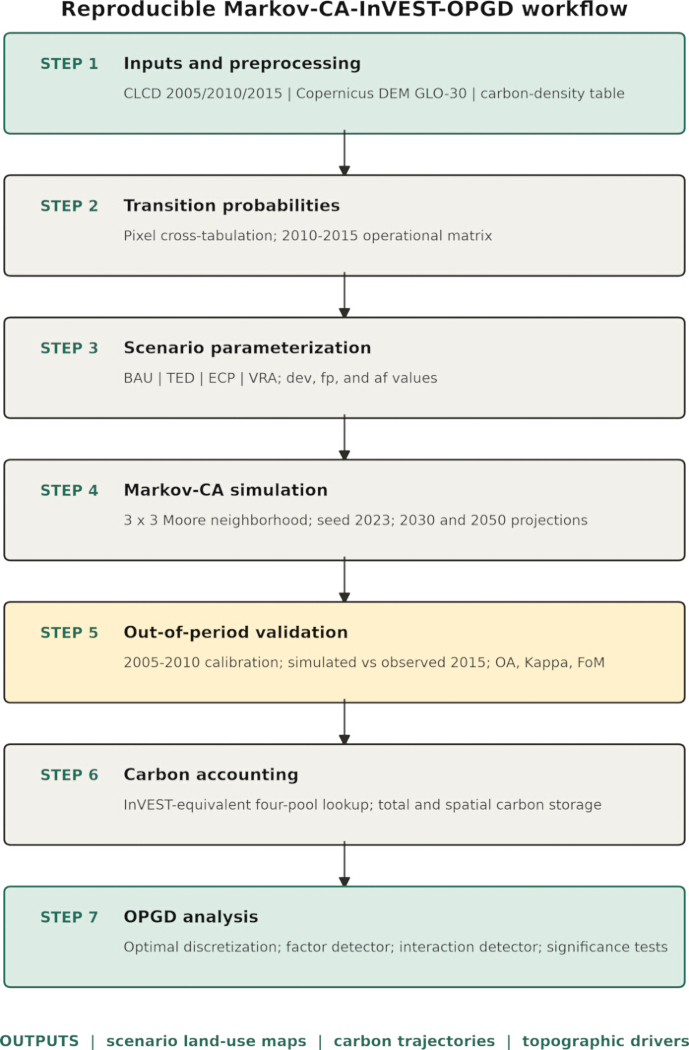
图 1. 多情景土地利用预测、碳储量评估与地形关联分析的可复现工作流程。 该七步工作流程包括:(1) 使用中国土地覆盖数据集 (CLCD) 图、哥白尼数字高程模型 (DEM) GLO-30 数据和碳密度表进行输入准备与预处理;(2) 通过像元交叉表估算转移概率;(3) 对常规发展 (BAU)、旅游扩张与发展 (TED)、生态保护优先 (ECP) 和乡村活化振兴 (VRA) 情景进行参数化;(4) 使用 3 × 3 摩尔邻域进行马尔可夫元胞自动机 (Markov-CA) 模拟;(5) 使用总体精度 (OA)、Kappa 系数和优值指数 (FoM) 进行期外验证;(6) 使用与生态系统服务与权衡综合评估 (InVEST) 等效的四库查找法进行碳核算;(7) 基于最优参数的地理探测器 (OPGD) 分析。该工作流程生成特定情景的土地利用图、碳储量轨迹以及地形关联评估。请点击此处查看此图的更大版本。
1. 研究区域
- 将分析网格定义为 117.60–118.38°E 和 29.72–30.22°仅将黄山与西递–宏村世界遗产地作为地理背景处理;请勿将矩形分析范围或有效掩膜解读为官方行政边界或世界遗产边界。3,4.
- 将网格重投影至 EPSG:32650 坐标系,并应用有效掩膜,获得 4,632,329 个分辨率为 30 米的栅格单元,对应面积为 4,169.1 平方公里。2将所有栅格分析的范围设定为此区域,该区域覆盖黟县、黄山风景区邻近部分及休宁县北部。图 2).
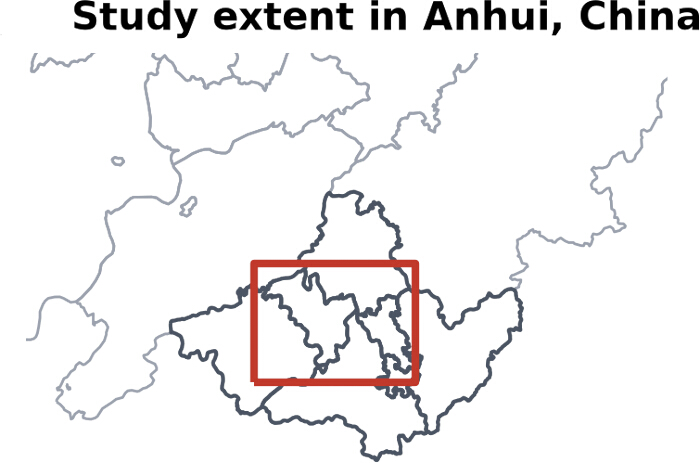
图 2. 中国安徽南部黟县–黄山景观的研究范围。 该分析范围位于中国安徽省内的位置,研究区域以红色矩形标出。关联分析中使用的地形变量展示于图 5。 请点击此处查看此图的更大版本。
2. 数据来源
- 使用三个输入组:CLCD年度土地覆盖数据、哥白尼DEM GLO-30地形数据,以及一份按类别划分的四库碳密度表。在表1中记录每个输入数据的时间覆盖范围、分辨率、来源和分析作用。
- 提取2005年、2010年和2015年分辨率为30米的CLCD图层。保留九个类别:耕地、森林、灌木、草地、水体、冰雪、裸地、不透水面和湿地45。
- 从哥白尼DEM GLO-30数据中导出高程、坡度、北向度和地形起伏度46。分配Cheng等人表6中报告的完整九类碳库值;不得应用未引用的默认值或零值惯例47。
- 将所有图层重投影至通用30米网格上的WGS 84 / UTM 50N投影带(EPSG:32650)。对分类土地覆盖数据使用最近邻重采样,对连续地形数据使用双线性重采样。
- 在进行交叉制表、验证、碳核算和OPGD采样之前,对每个图层应用相同的有效掩膜。
- 使用Python 3.11.9,配合numpy 2.4.6、scipy 1.17.1、rasterio 1.4.4、matplotlib 3.11.0、pandas 3.0.3、geopandas 1.1.4和shapely 2.1.2。请参考存档的环境文件和相对路径脚本以实现精确复现。
- 使用3 × 3摩尔邻域和种子2023配置Markov-CA模型。为每个情景年份和敏感性运行初始化一个独立的种子生成器,并使用种子42进行OPGD采样。
| 数据集 | 时间覆盖范围 | 原始空间分辨率 | 主要来源 / 持久标识符 | 在分析工作流中的作用 |
| 中国土地覆盖数据集 (CLCD; Yang & Huang45) | 2005年、2010年、2015年 | 30 m | Zenodo DOI: 10.5281/zenodo.4417810 | 土地利用分类、变化检测、验证、转移矩阵估算、观测基线,以及马尔可夫元胞自动机输入 |
| 哥白尼数字高程模型 (DEM) GLO-30 | 2019年参考期;本研究中为静态 | 30 m | 哥白尼数据空间生态系统 / Microsoft Planetary Computer STAC | 高程数据,并用于在450米半径邻域内推导坡度、北向度和地形起伏度 |
| 碳密度参数 | 静态 | 按土地利用类别;类别查找表 (Mg C ha⁻¹) | Cheng et al.47 Table 6 | 完整的九类四库查找表,用于生态系统服务与权衡综合评估等效的碳核算 (Table 3) |
| 研究区分析范围与边界 | 静态 | 矢量 / 30 m 掩膜 | 根据手稿范围重建:东经117.60–118.38°,北纬29.72–30.22°;存档的GeoJSON和掩膜文件 | 统一的空间掩膜、分析范围和分析网格 |
表1: 分析工作流中使用的主要空间与表格数据集。 该表总结了中国土地覆盖数据集(CLCD)、哥白尼数字高程模型(DEM)GLO-30、类别特异性碳密度参数以及研究区分析范围的时间覆盖范围、原始空间分辨率、来源或持久标识符和分析作用。碳密度值以每公顷碳的兆克数(Mg C ha−1)表示。
3. 估算转移矩阵并初始化马尔可夫-元胞自动机模型
- 对2010年至2015年有效的CLCD像素进行交叉制表。对于源类别 i 和目标类别 j,计算 。
- 将得到的9 × 9转移矩阵用于未来情景预测。另推导一个独立的2005–2010年转移矩阵用于模型验证。
- 将模拟器作为自定义的Python马尔可夫-元胞自动机实现运行;不调用PLUS8。
- 在每个五年时间步,同步记录起始状态的快照。根据该快照计算转移数量。
- 按升序评估目标类别1–9和源类别1–9。将每个选定的源像素从后续分配中移除,以确保其在五年时间步内最多发生一次转移。
- 根据时间步开始时3 × 3摩尔邻域内目标类别邻居的数量,加上0到0.5之间的均匀随机扰动,对符合条件的候选像素进行排序。
- 对于每个源到目标的转移,所需像素数计算为源类别中有效像素数、相应的转移概率以及适用的缩放因子的乘积,并进行四舍五入。
- 对于向不透水地面的转移,使用缩放因子 dev;对于森林向不透水地面的转移,使用缩放因子 dev × fp;其他情况,缩放因子为1。所需数量上限为符合条件的候选像素数量。
- 如果所需数量小于符合条件的候选数量,则根据目标类别邻域得分加上上述均匀随机扰动,选择排名最高的候选像素;如果所需数量等于符合条件的候选数量,则选择所有符合条件的候选像素。
4. 配置情景、敏感性测试与未来模拟
- 将三个参数应用于共同的转移矩阵。令 dev 将预期转移缩放至不透水类别 8,仅对森林到不透水的转移应用 fp,并将 af 定义为无不透水摩尔邻域的耕地每步转换为森林的概率。
- 将 BAU 情景的 (dev, fp, af) 设为 (1.4, 1.0, 0.005),TED 情景设为 (6.0, 2.0, 0.001),ECP 情景设为 (0.4, 0.4, 0.025),VRA 情景设为 (2.5, 0.7, 0.012)。相应的计算规则、政策叙述和参数值请使用表 2。
- 将这些乘数解释为围绕经验转移矩阵的透明低、中、高强度发展压力测试。不要将它们视为从旅游、村庄节点、分区、交通、保护区或生态红线数据中估计出的系数。
- 仅使用政策标签来描述参数的相对方向。不要将这些标签解释为模型中编码的法律或空间约束。
- 将 dev、fp 和 af 视为作者定义的探索性压力测试参数,而非经验估计或校准的系数。这些标称值指定了发展压力 (dev)、森林保护 (fp) 和造林 (af) 的对比数值情景假设;它们并非拟合 2015 年后观测到的土地利用变化,也不应解释为特定政策效应的估计值。使用这些标称值进行主要情景比较,并通过下文描述的单因素敏感性分析评估其稳健性。
- 对于每个情景,运行标称的 2050 年案例。在将 dev、fp 或 af 之一乘以 0.5 或 1.5 而其他参数保持不变后,重复模拟。
- 为 28 次运行中的每一次重新初始化种子 2023。比较碳储量、碳损失、森林份额和不透水份额,并报告匹配案例的排名和完整的单因素分析范围,不要将其视为概率置信区间。
- 所有未来模拟均从观测到的 CLCD 2015 数据初始化。对于不透水地表分配,允许耕地在整个有效掩膜内保持合格,并要求非耕地源像元与步骤开始时的不透水像元相邻。
- 在完成类别间分配后,符合条件的耕地以概率 af 独立转换为森林。对于 2030 年预测运行三个五年步,对于 2050 年预测运行七个五年步。
- 在有效掩膜外保留类别 0。以 30 米分辨率导出每个预测地图。
| 情景 | 已实施的计算规则 | 政策叙事(非编码约束) | 参数 (dev / fp / af) |
| 常规发展情景 (BAU) | 中等不透水面乘数;基线森林易感性;每步0.5%的孤立耕地造林 | 延续基准 | 1.4 / 1.0 / 0.005 |
| 旅游扩张与发展情景 (TED) | 强不透水面乘数;森林转不透水面易感性加倍;弱造林 | 高发展压力测试 | 6.0 / 2.0 / 0.001 |
| 生态保护优先情景 (ECP) | 降低不透水面转化与森林易感性;最强造林 | 生态保护压力测试 | 0.4 / 0.4 / 0.025 |
| 乡村复兴与活化情景 (VRA) | 中等不透水面乘数;森林易感性低于常规发展情景;中等造林 | 乡村复兴叙事;无乡村节点层 | 2.5 / 0.7 / 0.012 |
表 2: 四种土地利用情景的计算规则与参数值。 该表格汇总了“一切照常”(BAU)、“旅游拓展与开发”(TED)、“生态保护优先”(ECP)以及“乡村活力与振兴”(VRA)四种情景下所实施的计算规则、政策叙事和参数值。政策叙事描述了每种情景的预期解读,并非编码的空间约束。dev,不透水地表开发乘数;fp,森林向不透水地表转化敏感性乘数;af,每个模拟步骤中孤立农田的造林比例。
5. 校准与验证土地利用模型
- 根据观测到的2005–2010年变化估算校准矩阵。使用种子2023,基于观测到的2010年数据模拟2015年情况。
- 在有效掩膜内,将模拟的2015年地图与观测到的CLCD 2015数据进行逐像素比较。计算总体精度、Kappa系数、9 × 9混淆矩阵以及变化像元的FoM48。
- 在验证计算中,将无效像元同时从分子和分母中排除,以防止掩膜外零值夸大一致性。
- 将总体精度和Kappa系数与FoM结合解读,因为稳定的森林和耕地主导了前两项指标,而FoM评估的是较小的变化像元集。使用验证结果支持区域情景比较;切勿将其解读为建立了精确的变化位置预测。
6. 计算碳储量
- 针对每个有效像元,分配表3中列出的四个类别特定碳库密度。将四个库密度相加,得到以 Mg C ha⁻1 为单位的总碳密度。
- 将总碳密度乘以 0.09 ha 的像元面积。将得到的 Mg C 值转换为 Tg C。
- 将此查找计算作为 InVEST 碳储量公式的代数等价形式应用。请勿应用碳汇速率、估值或经济模块9,47。
| 土地利用类型 (CLCD) | 地上碳 (Mg C ha⁻¹) | 地下碳 (Mg C ha⁻¹) | 土壤碳 (Mg C ha⁻¹) | 死亡有机碳 (Mg C ha⁻¹) | 总碳 (Mg C ha⁻¹) | 来源 |
| 1 耕地 | 3.56 | 7.45 | 26.9 | 9.82 | 47.73 | Cheng 等人47,表 6 |
| 2 森林 | 53.59 | 17.36 | 84.85 | 2.8 | 158.6 | |
| 3 灌木 | 4.25 | 4.65 | 72.9 | 1.59 | 83.39 | |
| 4 草地 | 4.15 | 16.58 | 78.2 | 1.55 | 100.48 | |
| 5 水体 | 6.38 | 0 | 0 | 0.12 | 6.5 | |
| 6 冰雪 | 0 | 0.33 | 5.35 | 0 | 5.68 | |
| 7 裸地 | 1.3 | 0.33 | 21.6 | 0 | 23.23 | |
| 8 不透水面 | 0 | 0 | 9.28 | 0 | 9.28 | |
| 9 湿地 | 12.24 | 9.18 | 95.73 | 4.08 | 121.23 |
表 3: 用于碳核算的九类中国土地覆盖数据集土地利用类型的碳密度参数。 中国土地覆盖数据集(CLCD)各土地利用类型的地上、地下、土壤、死亡有机质及总碳密度值均已提供。总碳密度为上述四个碳库之和。所有碳密度值均以每公顷碳的兆克数(Mg C ha⁻¹)表示。−1)。数值取自 Cheng 等人。47表6。
7. 利用 OPGD 检测地形关联
- 以2015年碳密度作为响应变量,以海拔、坡度、北向度和地形起伏度作为解释因子。使用种子值42对200,000个有效像素进行采样。
- 针对每个解释因子,测试2至15个分位数区间。保留能产生最大q值的离散化方案。
- 使用999次置换计算解析F检验p值和置换p值。置换p值计算公式为p = (超出次数 + 1) / 1000。
- 将每对解释因子的优化层合并,以计算交互作用结果。将所有因子及交互作用的输出解释为空间关联性,而非因果效应10。
结果
土地利用的空间分布与时间动态
分析工作流程、研究范围以及主要输入数据集分别在图1、图2和表1中进行了总结。图1展示了用于土地利用预测、验证、碳核算以及地形关联分析的七步工作流程。图2显示了研究区域的位置及分析范围。表1汇总了主要空间数据集和表格数据集的时间覆盖范围、空间分辨率、数据来源及分析用途。在4,632,329个有效像元上,将模拟的2015年结果与观测到的CLCD 2015数据进行比较,得到总体精度(OA)为96.61%,Kappa系数为0.850,变化命中率(FoM)为0.107。一致性结果主要由稳定的森林和耕地类别主导,而以变化为重点的FoM表明在再现变化位置方面的准确性有限。因此,该验证结果支持进行情景间的比较分析,而非精确的空间预测。补充表1(工作表S3)提供了验证指标、变化命中数、漏报数、误报数以及完整的混淆矩阵。归档文件中包含验证用栅格数据及用于计算的完整脚本。
在28次敏感性运行中,所有匹配的扰动均保持了ECP > BAU > VRA > TED的排序。碳损失范围分别为:ECP为4.22–5.86%,BAU为6.87–8.55%,VRA为6.99–9.61%,TED为10.45–15.84%。BAU与VRA的范围存在重叠,因此解释仅限于匹配案例的顺序关系,而非OAT范围的完全分离。完整的敏感性结果见补充表1(工作表S4)和补充图1。2010–2015年运行矩阵(见补充表1(工作表S1))显示,森林、耕地和不透水地表的保留概率分别为98.23%、94.66%和99.43%。最大的非对角线转移包括:耕地转为不透水地表(3.39%)、耕地转为森林(1.71%)以及森林转为耕地(1.71%)。在同一时期,森林覆盖面积从87.63%下降至86.27%,而耕地从10.99%增加至11.92%,不透水地表从1.08%增加至1.50%。图3A、B分别展示了2010年和2015年观测到的土地利用格局,图4展示了相应的变化类型,但未推断分析中未包含的驱动因素。
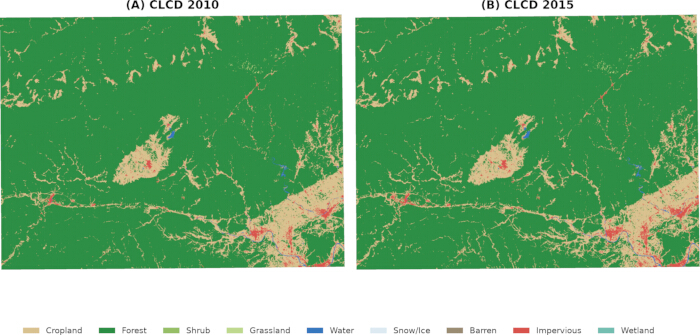
图3.2010年与2015年黟县—黄山景观中观测到的土地利用模式。 中国土地覆盖数据集(CLCD)地图展示了分析范围内九类土地利用类型的空間分布。(A) 2010年观测到的土地利用情况。(B) 2015年观测到的土地利用情况。土地利用类型包括耕地、森林、灌木地、草地、水体、冰雪、荒地、不透水面和湿地。请点击此处查看此图的高清版本。
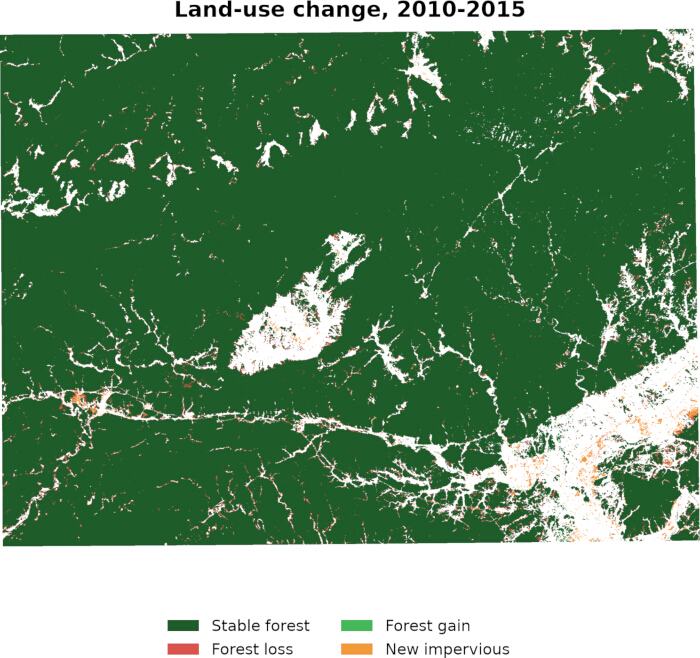
图4. 2010年至2015年中国宜兴–黄山景观区域观测到的土地利用变化。 该地图展示了2010年与2015年中国土地覆被数据集地图之间稳定森林、森林损失、森林增加以及新开发的不透水地表的空间分布情况。白色区域表示未被归类为上述四种显示变化类别的区域。请点击此处查看该图的放大版本。
地形特征与地形异质性
在有效掩膜范围内,高程介于 82.3 至 1,830.3 m 之间(平均值为 388.0 m),坡度介于 0 至 87.3° 之间(平均值为 22.4°),北向指数介于 −1 至 1 之间,地形起伏度介于 3.2 至 1,398.2 m 之间(平均值为 230.0 m)。地形起伏度定义为半径 450 m 的圆形邻域内的局部高程变化范围,通过 31 × 31 像素的窗口实现。图 5A–D 分别展示了高程、坡度、北向指数和地形起伏度。这些图层用于表征空间地形变异;任何相关的生态学机制均被视为假设,而非因果性结果35,36,37,38,39,40,41,42,43,44。
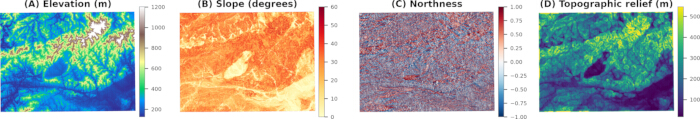
图5.关联分析中使用的地形变量。 四个地形变量在整个分析范围内的空间分布:(A)海拔,单位为米;(B)坡度,单位为度;(C)北向性,量表范围为−1至1;(D)地形起伏度,单位为米。这些变量被用于基于最优参数的地理探测器分析,以研究其与2015年碳密度的单独及联合关联性。请点击此处查看该图的放大版本。
多情景土地利用预测
使用补充表2中提供的数值土地覆被类别标识符,基于表2中汇总的通用转移矩阵和情景参数,生成了不同的综合变化轨迹。图6展示了森林、耕地和不透水地表的观测值与预测占比,而图7A–D分别显示了2030年在BAU、TED、ECP和VRA情景下的空间预测结果,图7E–H则显示了2050年对应的情景预测结果。到2050年,预计森林覆盖比例在BAU情景下为78.0%,在TED情景下为74.6%,在ECP情景下为80.3%,在VRA情景下为78.2%;相应的不透水地表占比分别为6.3%、17.6%、2.8%和9.0%。相对于2015年观测值,预计不透水地表扩张面积在BAU情景下约为202 km2,在TED情景下为675 km2,在ECP情景下为57 km2,在VRA情景下为317 km2。这些数值为压力测试输出结果,而非拟合预测。预测的变化在空间上呈聚集分布,因为候选单元排序依赖于目标类别的邻域计数,且非耕地向不透水地表的转化仅限于边缘单元。模型未包含交通走廊、村庄节点、保护区、生态红线或法定规划图层,因此结果中与特定基础设施或管制区域表现出的明显对齐关系并不代表已编码的影响效应。
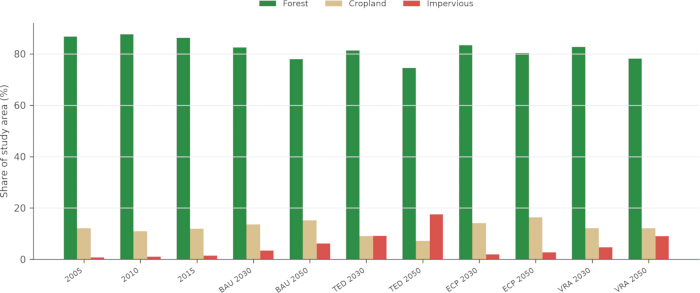
图6。四种情景下主要土地利用类型的观测值与预测值占比。 本图展示了研究区域中森林、耕地和不透水地表在2005年、2010年和2015年观测年份以及在“照常发展”(BAU)、“旅游扩展与发展”(TED)、“生态保护优先”(ECP)和“村庄振兴与激活”(VRA)四种情景下2030年和2050年预测值所占的百分比。柱状图表示每种土地利用类型在研究区域总面积中的模拟占比;由于数值为确定性情景输出结果,而非基于重复实验的估计值,因此不适用误差线。请点击此处查看此图的高清版本。
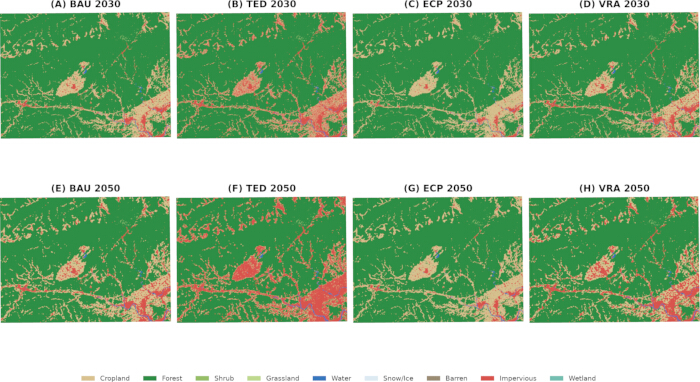
图7四种情景下2030年和2050年土地利用的空间分布预测 在“照常发展”(BAU)、“旅游扩张与发展”(TED)、“生态保护优先”(ECP)和“村庄振兴与激活”(VRA)情景下的土地利用格局预测。(A–D)分别为2030年BAU、TED、ECP和VRA情景的预测结果;(E–H)分别为2050年BAU、TED、ECP和VRA情景的预测结果。土地利用类别包括耕地、森林、灌木地、草地、水域、冰雪、荒地、不透水地表和湿地。所有情景模拟均以观测得到的2015年中国土地覆盖动态(CLCD)图为基础初始化,因此未发生模拟土地利用转换的像元保留其2015年的土地利用类别及基线空间格局。 请点击此处以查看此图的放大版本。
多情景预测下的碳储存动态
应用表3中的完整四组查表法,得出2015年碳储量为59.505 Tg C,相当于平均密度为142.73 Mg C ha−1。森林碳储量占57.04 Tg C(95.9%),耕地碳储量占2.37 Tg C(4.0%)。不透水地表贡献虽小但非零,因为所采用的数据源为该类别分配了9.28 Mg C ha−1的碳储量。在森林类别中,土壤、地上、地下和死有机物碳库分别占总碳储量的53.5%、33.8%、10.9%和1.8%31,32,33,34,44,47。所有情景下2050年的碳储量均低于2015年。预计在BAU情景下碳储量为54.895 Tg C(减少7.75%),TED情景下为51.475 Tg C(减少13.49%),ECP情景下为56.523 Tg C(减少5.01%),VRA情景下为54.540 Tg C(减少8.34%)。ECP与TED情景之间的差异为5.048 Tg C。这些差异源于设定的数值参数,并未估算具体命名政策的实际影响。图8A展示了2015年的总碳储量以及2030年和2050年的各情景预测;图8B展示了相应的平均碳密度;图8C展示了到2050年相对于2015年基准的碳损失;图8D展示了预测森林面积比例与碳损失之间的关系。这些数值为确定性情景输出结果,而非基于重复模拟的估计值。
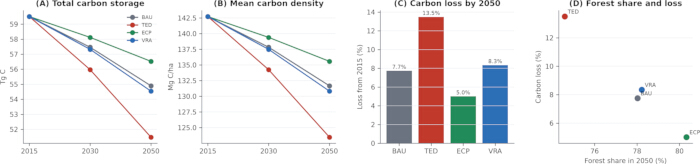
图8。四种土地利用情景下碳储量的预测及其与森林覆盖率的关系。 (A)2015年总碳储量以及在照常发展(BAU)、旅游扩张与发展(TED)、生态保护优先(ECP)和村庄振兴与激活(VRA)四种情景下2030年和2050年的预测值,单位为太克碳(Tg C)。(B)相应年份和情景下的平均碳密度,单位为每公顷兆克碳(Mg C ha-1)。(C)到2050年各情景下相对于2015年基准的总碳储量百分比损失。(D)2050年研究区域森林面积占比的预测值与相对于2015年的碳储量百分比损失之间的关系。数值为确定性情景输出结果,不适用误差线。请点击此处查看该图的放大版本。
地形与碳储量空间异质性的关联
OPGD因子检测器将坡度排在首位(q = 0.557),其次是地形起伏度(q = 0.460),海拔(q = 0.352)以及北向度(q = 0.003),如图所示 图9A. 在999次置换下,置换 p每个因子的 p 值均为 0.001,即达到的最小值;析因 F 检验 p-值也均低于0.001。完整的因子和交互探测器统计结果,包括优化的离散化区间以及解析和置换检验 p-值,已在下文提供 补充表3统计学显著性与效应量有所区别:从实际角度来看,与北向性的关联微乎其微,且所有 q-数值代表四种评估地形变量内的关联性,而非因果效应10,40所有因子对均产生相互作用 q-值大于其各自个体中的较大者 q-值。最强的相互作用为斜率 ∩ 缓解q = 0.628),海拔 ∩ 斜率(q = 0.618),以及高程 ∩ 缓解q = 0.510),如图所示 图9B这些数值表明成对因子之间存在更强的分层关联,但由于未对土壤、气候、森林年龄、管理和可及性进行建模,因此无法确立地貌学机制。
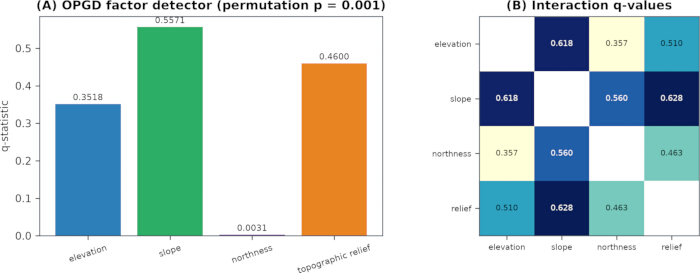
图9基于最优参数地理探测器识别的2015年碳密度与地形因子的空间关联性 (A) 因子探测器 q- 高程、坡度、北向性及地形起伏度的统计值。相应的 q值分别为 0.3518、0.5571、0.0031 和 0.4600;置换检验得出 p = 0.001。(B)相互作用检测器 q四个地形变量两两组合的值。较大的 q-值越大,表示与2015年碳密度空间分布的统计关联性越强。OPGD,基于最优参数的地理探测器。 请点击此处以查看此图的放大版本。
总体结果
图10A–D 分别总结了该工作流程的主要结果:森林覆盖率预测、总碳储量、地形关联性的排序以及关键的定量指标。2015年的分析基线包含59.505 Tg C的碳储量。在四组探索性参数集下,到2050年预测的碳损失范围为5.01%至13.49%,所有敏感性情景均保持了ECP > BAU > VRA > TED的排序。坡度和地形起伏显示出最强的地形关联性。鉴于FoM = 0.107,且未纳入明确的规划、社会经济和气候图层,该结果适用于区域间的比较评估,而非确定性的空间预测。
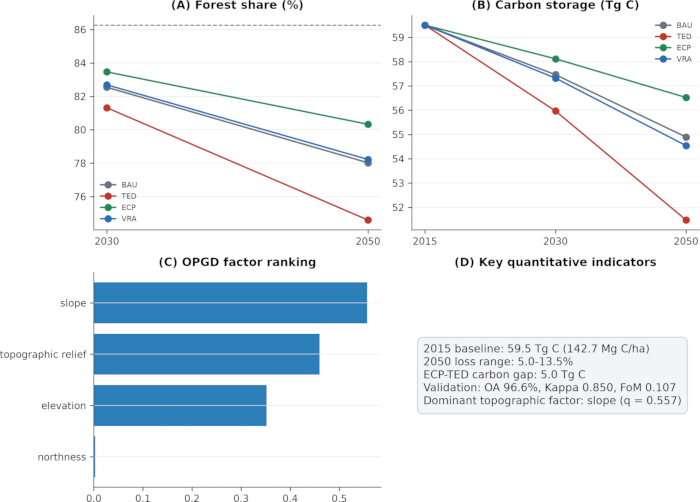
图10土地利用与碳储量变化预测结果及其与地形关联性的总结 (A)在“照常发展”(BAU)、“旅游扩展与开发”(TED)、“生态保育优先”(ECP)和“村庄振兴与激活”(VRA)四种情景下,2030年和2050年研究区域森林覆盖率的预测结果;虚线表示2015年基准年森林覆盖率。(B)2015年及在四种情景下预测的2030年和2050年总碳储量,以碳的太克(Tg C)表示。(C)按重要性排序的海拔、坡度、北向性和地形起伏度 q- 基于最优参数地理探测器(OPGD)获得的统计量,数值越大 q- 表示与2015年碳密度具有更强统计关联性的值。(D)关键定量指标汇总,包括基线碳储量和碳密度、预测的2050年碳损失范围、ECP与TED情景间碳储量差异、验证指标以及评估中最强的地形关联性。OA,总体精度;FoM,优势度指标;Mg C ha-1每公顷碳的兆克数。 请点击此处以查看此图的放大版本。
补充图1. 四种土地利用情景下2050年碳储量的单因素敏感性分析 (A)BAU、TED、ECP 和 VRA 情景下2050年名义碳储量及其完整的OAT敏感性范围。点表示名义情景值,垂直范围表示通过将其中一个参数乘以敏感性系数所得的最小和最大碳储量值 开发, fp,或 af 通过保持其他参数不变,分别改变0.5或1.5。(B)相对于相应基准情景值,2050年碳储量的变化在0.5之后的变化× 和 1.5× 扰动 开发, fp,和 af大于零的值表示碳储量高于基准情况,小于零的值表示碳储量较低。范围表示确定性的一次单参数扰动,而非概率性置信区间。请点击此处下载此文件。
补充表1. 土地利用转移矩阵、情景参数化、模型验证及单因素敏感性分析结果 工作簿包含四个工作表: S12010–2015年土地利用变化转移矩阵 S2参数值、实施规则及四种情景的解释边界; S3,第9 × 9 个混淆矩阵及相关模型验证结果; S4,通过逐一变化得到的名义敏感性和单因素敏感性结果 开发, fp,以及 af 0.5× 和 1.5× 在保持其他参数不变的情况下。敏感性范围表示确定性参数扰动,而非概率性置信区间。请点击此处下载该文件。
补充表 2. 计算流程中使用的土地覆盖类别标识符。 该表格列出了栅格分析中使用的数值类别标识符及其对应的土地覆盖类别。类别 0 表示有效研究区域掩膜之外的无数据值;类别 1–9 分别表示耕地、森林、灌木地、草地、水体、冰雪、荒地、不透水面和湿地。请点击此处下载该文件。
补充表3. 2015年碳密度的OPGD因子及交互作用探测器结果。 该表列出了基于999次置换检验得到的海拔、坡度、北向性和地形起伏的优化q统计量、离散化区间数、分析F检验p值和置换p值。成对交互作用结果报告了交互作用q统计量、各单因子q统计量以及交互作用分类。所报告的统计量代表空间关联性,不能确立因果效应。请点击此处下载该文件。
补充说明1:论文插图的逐图描述、数据来源及解读说明。 本说明指出了各插图分图的内容及其基础数据来源,并提供了有关共享空间范围、重复信息以及所展示变量解读的相关信息。请点击此处下载该文件。
补充数据存档(压缩包)。 该存档包含26个可直接用于分析的GeoTIFF文件、边界文件、元数据、结果、脚本、图表、工作簿、精确的计算环境文件、一个README文件以及SHA-256校验和。
讨论
在四种胁迫测试中,随着模拟转变改变了高密度和低密度土地覆被类型的构成比例,碳储量随之下降。其中,旅游开发(TED)导致的碳储量下降最为显著,而生态保护(ECP)引起的下降最小。因此,应用该协议的关键步骤在于对dev、fp和af参数的配置与解释。由于不同情景的差异源于这些设定的参数值,因此它们反映的是条件性模型响应,而非旅游开发、村庄振兴或生态调控实际观测到的影响。到2050年,旅游开发(TED)情景下的预测碳储量比生态保护(ECP)情景低5.048 Tg C。根据所采用的查找表,将1公顷森林转为不透水地表会使分配的碳储量减少149.32 Mg C,而将1公顷耕地转为不透水地表则使其减少38.45 Mg C。这些核算上的差异解释了模拟森林转化对总碳储量产生强烈影响的原因。然而,依赖文献推导的数值而缺乏本地校准,会使绝对估算结果存在不确定性。
另一个关键步骤是OPGD中所用地形变量的推导与离散化。在经过优化离散化后,地形起伏与碳密度相关(q = 0.460)。起伏定义为半径450 m圆形邻域内的局部高程范围,通过31 × 31像素的窗口实现。高起伏像元可能与陡峭的森林地形重合,但OPGD无法区分地形、可达性、土地利用历史、土壤、管理措施及其他相关解释因素。成对的地形分层产生的q值强于单一因子,尤其是坡度 ∩ 起伏组合(q = 0.628)。该模式属于描述性而非机制性。同样,北向性(northness)的q值较小(0.003),并不表明太阳辐射差异较弱;验证这一解释需要辐射、微气候、植被及野外实测数据。
该方法支持区域假设的生成:限制模拟森林转化、减缓不透水层扩张以及增加农田向森林的转变,能够保留更多的指定碳储量。针对具体地点的管理方案需要更多证据支持。若要将该工作流程修改用于以决策为导向的应用,需整合经验证的保护区、生态红线、交通网络、地块和村落节点图层,同时纳入利益相关方参与度、生态系统服务权衡、激励机制、恢复成本、文化服务、生计以及生物多样性等方面的评估49,50,51,52,53,54,55,56。这些扩展至关重要,因为当前协议并未纳入此类空间或社会经济约束条件。更广泛的文献还表明,植物储碳策略、森林结构、非树木植被、旅游行为以及建成环境生命周期效应,均需区别于当前土地覆被核算的独立分析57,58,59,60,61。
该方法的适用性和解释受到若干局限性的制约。这些局限性包括:基于文献的碳密度数据缺乏本地实地校准、潜在的CLCD分类误差、简化的自定义Markov-CA模型、以变化为重点且FoM值为0.107的验证方法、未经过拟合的压力测试参数,以及单次随机种子评估。其他局限性还包括采用单因素轮换实验设计而非概率性不确定性分析,未纳入规划、社会经济、可达性、土壤、森林年龄和气候变化等图层,以及OPGD关联关系的非因果性。这些局限性意味着,该工作流程适用于区域情景的比较评估,但无法提供确定性的空间预测结果、经过本地校准的碳储量清单,或政策有效性的因果估计。
与现有及替代方法相比,该方案的意义在于将土地利用模拟、四库碳计量、验证、敏感性测试以及地形关联分析整合到一个可重复的工作流程中,同时对结果解释保持明确的局限性。故障排除和方案修改应特别关注对后续解释影响最大的步骤:土地覆被预处理与掩膜、转移与情景参数化、模型验证、碳密度赋值以及地形离散化。
该工作流程可用于替代性土地利用路径的比较评估,并识别需要进一步研究的空间关联,而针对特定地点的应用则需要额外的本地验证证据。未来研究的重点包括收集本地碳测量数据、比较不同的分配模型和随机种子、将参数拟合到独立驱动因子,以及传播分类、参数和气候不确定性。这些进展将使当前的工作流程超越比较性压力测试,为在更多不确定性来源下评估土地利用和碳储存结果提供更坚实的基础。
披露
作者声明无利益冲突。
致谢
作者感谢 CLCD 和 Copernicus DEM GLO-30 数据集的提供方。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 中国土地覆盖数据集 (CLCD) | 武汉大学 (Yang J & Huang X) | 1985–2022 年年度产品;30 m;Zenodo DOI: 10.5281/zenodo.4417810 | 基础土地覆盖输入数据;使用 2005、2010 和 2015 年图层进行校准、验证、转移矩阵估计和基线分析 |
| Copernicus DEM GLO-30 | 欧洲航天局 / Copernicus 计划 | 参考历元 2019 年;2021 年公开发布;30 m | 地形输入数据,用于推导 OPGD 分析所需的高程、坡度、北向性和地形起伏度 |
| 自定义马尔可夫元胞自动机 | 自定义 Python 实现 | Python 3.11;随机种子 2023;同步更新;3 × 3 Moore 邻域;已归档源代码 | 土地利用情景模拟;不调用 PLUS 模型的自定义实现 |
| geopandas (Python 库) | geopandas 开发者 | 1.1.4 | 矢量数据处理、空间查询和边界操作 |
| InVEST 四库碳储量模型 | 自然资本项目 | InVEST 文档;自定义 Python 查表计算;已归档脚本 | 基于类别的四库碳核算;不含固碳速率、估值或经济模块 |
| matplotlib (Python 库) | Matplotlib 开发者 | 3.11.0 | 图形渲染与科学可视化 |
| numpy (Python 库) | NumPy 开发者 | 2.4.6 | 数组级数值计算 |
| OPGD 因子与交互探测器 | 基于 OPGD 方法论的自定义 Python 实现 | 随机种子 42;200,000 像素样本;2–15 分位区间;999 次置换;已归档脚本 | 分析 2015 年碳密度与高程、坡度、北向性和地形起伏度之间关联的因子及交互作用 |
| pandas (Python 库) | pandas 开发者 | 3.0.3 | 表格数据处理与分析结果后处理 |
| Python 编程语言 | Python 软件基金会 | 3.11.9 | 用于预处理、模拟、验证、碳核算、OPGD 分析和后处理的计算环境 |
| rasterio (Python 库) | rasterio 维护者 | 1.4.4 | 栅格数据的输入/输出、重投影、重采样以及土地覆盖和地形栅格的处理 |
| scipy (Python 库) | SciPy 开发者 | 1.17.1 | 地形处理中使用的数值与形态学运算 |
| shapely (Python 库) | Shapely 开发者 | 2.1.2 | 支持矢量与空间处理的几何运算 |
| 研究区范围与有效掩膜 | 根据论文坐标重建的自定义研究输入 | EPSG:32650;30 m;已归档 GeoJSON 和 GeoTIFF;4,632,329 个有效像元 | 定义 4,169.1 km² 的共同分析区域和有效栅格掩膜 |
参考文献
- Costanza R, et al. The value of the world's ecosystem services and natural capital. Nature. 1997;387(6630):253-260. doi:10.1038/387253a0.
- Millennium Ecosystem Assessment. Ecosystems and Human Well-Being: Synthesis. Island Press; Washington, DC; 2005.
- UNESCO World Heritage Centre. Mount Huangshan [Internet]. UNESCO; Paris; [cited 2026 Aug 18]. Available from: https://whc.unesco.org/en/list/547
- UNESCO World Heritage Centre. Ancient Villages in Southern Anhui—Xidi and Hongcun [Internet]. UNESCO; Paris; [cited 2026 Aug 18]. Available from: https://whc.unesco.org/en/list/1002
- Megarry WP, et al. Land use and land cover analysis of cultural World Heritage to inform assessments of climate vulnerability. Journal of Cultural Heritage. 2026;77:243-253. doi:10.1016/j.culher.2025.11.008.
- Wang Y, Chen S, Rabeeu A. Does world heritage site initiation promote tourism? A difference-in-difference approach. Tourism Economics. 2024;30(8):2111-2133. doi:10.1177/13548166241253306.
- Wang Y, Sulaiman MKAM, Harun NZ. Reframing place identity for traditional village conservation: A theoretical model with evidence from Dali Dong Village. Heritage. 2025;8(10):427. doi:10.3390/heritage8100427.
- Liang X, et al. Understanding the drivers of sustainable land expansion using a patch-generating land use simulation (PLUS) model: A case study in Wuhan, China. Comput Environ Urban Syst. 2021;85:101569. doi:10.1016/j.compenvurbsys.2020.101569.
- Sharp R, et al. InVEST User's Guide: Integrated Valuation of Ecosystem Services and Tradeoffs. [Internet]. Natural Capital Project, Stanford University; 2020. Available from: https://naturalcapitalproject.stanford.edu/software/invest
- Song Y, Wang J, Ge Y, Xu C. An optimal parameters-based geographical detector model enhances geographic characteristics of explanatory variables for spatial heterogeneity analysis: cases with different types of spatial data. GISci Remote Sens. 2020;57(5):593-610. doi:10.1080/15481603.2020.1760434.
- Bozali N. Spatiotemporal simulation of land use and land cover changes in Türkiye through a CA–Markov framework. Scientific Reports. 2026;16(1). doi:10.1038/s41598-026-35807-9.
- Gita B, Pankaj L. Modeling alternative futures: Scenario-based land-use and land-cover projections for Nepal (2030–2050). Land. 2026;15(5):873. doi:10.3390/land15050873.
- Cui J, et al. An integrated land use–carbon modeling framework for net carbon emissions and spatial optimization in Northeast China. Journal of Cleaner Production. 2025;525:146545. doi:10.1016/j.jclepro.2025.146545.
- Tang H, et al. Analysis of spatiotemporal variations and driving factors of carbon storage based on the PLUS-InVEST-OPGD model: A case study of Tai'an City. Sustainability. 2026;18(8):4017. doi:10.3390/su18084017.
- Zhang Y, Liao X, Sun D. A coupled InVEST-PLUS model for the spatiotemporal evolution of ecosystem carbon storage and multi-scenario prediction analysis. Land. 2024;13(4):509. doi:10.3390/land13040509.
- Huang M, et al. Integrated assessment of land use and carbon storage changes in the Tulufan-Hami Basin under the background of urbanization and climate change. Int J Appl Earth Obs Geoinf. 2024;135:104261. doi:10.1016/j.jag.2024.104261.
- Ma Y, et al. Assessing carbon storage dynamics and policy impacts: Application of InVEST-PLUS framework in the Qinling Mountains, China. Land Use Policy. 2026;164:107947. doi:10.1016/j.landusepol.2026.107947.
- Li Z, Yan T, Du Y. Scenario-based simulation of carbon storage in Chengdu using MCCA-InVEST: land use change, spatial patterns, and driving mechanisms. Carbon Balance Manag. 2025;20:40. doi:10.1186/s13021-025-00328-x.
- Zhao H, Guo B, Wang G. Spatial-temporal changes and prediction of carbon storage in the Tibetan Plateau based on PLUS-InVEST model. Forests. 2023;14(7):1352. doi:10.3390/f14071352.
- Hasan F, Makhtoumi Y, Chen G. Impact of land use and land cover changes on ecosystem services: a multi-module InVEST-LCM analysis. Earth Syst Environ. 2026;10:7019-7041. doi:10.1007/s41748-025-00995-3.
- Zhang H, Luo J, Wu J, Dong H. Dynamic response of carbon storage to future land use/land cover changes motivated by policy effects and core driving factors. J Plant Ecol. 2024;17(4):rtae042. doi:10.1093/jpe/rtae042.
- Lu L, et al. Spatiotemporal variation and quantitative attribution of carbon storage based on multiple satellite data and a coupled model for Jinan City, China. Remote Sens. 2023;15(18):4472. doi:10.3390/rs15184472.
- Ma J, Hao Z, Shen Y, Zhen Z. Spatial-temporal evolution of carbon storage and its driving factors in the Shanxi section of the Yellow River Basin, China. Ecological Modelling. 2025;502:111039. doi:10.1016/j.ecolmodel.2025.111039.
- Mi Y, Li S, Wu B. Study on the variation of carbon storage in the Chang-Zhu-Tan urban agglomeration in China based on topographic relief. Frontiers in Environmental Science. 2024;12. doi:10.3389/fenvs.2024.1481540.
- Li C, Huang J, Luo Y, Wang J. Spatial synergy between carbon storage and emissions in coastal China: Insights from PLUS-InVEST and OPGD models. Remote Sensing. 2025;17(16):2859. doi:10.3390/rs17162859.
- Ocloo DM, Mizunoya T. Carbon storage and land use dynamics in Ghanaian university campuses: A scenario-based assessment using the InVEST model. Land. 2025;14(10):1987. doi:10.3390/land14101987.
- Wang Z, Zhang Y, Zhang Z. Scenario analysis of carbon reduction potential through forest carbon sink mechanisms in the Beijing–Tianjin–Hebei Region, China. Sustainability. 2025;17(17):7992. doi:10.3390/su17177992.
- Ma J, Shi P. Remotely sensed inter-field variation in soil organic carbon content as influenced by the cumulative effect of conservation tillage in northeast China. Soil and Tillage Research. 2024;243:106170. doi:10.1016/j.still.2024.106170.
- Li M, Cui Y, Dong J, Qin Y. Abandoned cropland compensates the decrease in net ecosystem productivity of impervious surface expansion in China. Environmental Impact Assessment Review. 2024;104:107363. doi:10.1016/j.eiar.2023.107363.
- Wang J, Zhang M, Zhou S, Huang Y. Research on the spatiotemporal evolution and driving factors of forest carbon sink increment—based on data envelopment analysis and production theoretical decomposition model. Forests. 2025;16(1):104. doi:10.3390/f16010104.
- Cai Y, et al. Dynamics of China's forest carbon storage: the first 30 m annual aboveground biomass mapping from 1985 to 2023. Earth System Science Data. 2025. doi:10.5194/essd-17-6993-2025.
- Piao S, et al. The carbon balance of terrestrial ecosystems in China. Nature. 2009;458(7241):1009-1013. doi:10.1038/nature07944.
- Fuller M, et al. Global carbon storage in harvested wood products: a forest sector model inter-comparison. Environmental Research Letters. 2025;20. doi:10.1088/1748-9326/ae0ce0.
- Milodowski D, Smallman T, Williams M. Scale variance in the carbon dynamics of fragmented, mixed-use landscapes estimated using model–data fusion. Biogeosciences. 2023. doi:10.5194/bg-20-3301-2023.
- Zeyu X, et al. Topographic and edaphic drivers of community structure and species diversity in a subtropical deciduous broad-leaved forest in eastern China. Forests. 2025;16(12):1837. doi:10.3390/f16121837.
- Hunter BD, Roering JJ, Silva LCR, Moreland KC. Geomorphic controls on the abundance and persistence of soil organic carbon pools in erosional landscapes. Nature Geoscience. 2024;17(2):151-157. doi:10.1038/s41561-023-01365-2.
- Li L, et al. Spatial scale effects of interacting abiotic and biotic factors on aboveground carbon storage in a subtropical evergreen broadleaf forest in southern China. Journal of Forestry Research. 2024;36(1). doi:10.1007/s11676-024-01804-9.
- Zhaoxue G, et al. Temporal and spatial characteristics and influencing factors of carbon storage in black soil area under topographic gradient. Land. 2024;14(1):16. doi:10.3390/land14010016.
- Nie Q, et al. Exploring scaling differences and spatial heterogeneity in drivers of carbon storage changes: a comprehensive geographic analysis framework. Ecological Indicators. 2024. doi:10.1016/j.ecolind.2024.112193.
- Liu J, et al. Analysis of the evolution characteristics and driving mechanisms of salinization in arid regions based on multi-factor interaction with optimized parameter geographic detector (OPGD)1. Journal of Environmental Management. 2025;394:127487. doi:10.1016/j.jenvman.2025.127487.
- Wang Z, Zhou Y, Sun X, Xu Y. Estimation of NPP in Huangshan District based on deep learning and CASA model. Forests. 2024;15(8):1467. doi:10.3390/f15081467.
- Vancine MH, et al. ATLANTIC SPATIAL: a dataset of landscape, topographic, hydrological, and anthropogenic metrics for the Atlantic Forest. Ecology. 2026;107(4). doi:10.1002/ecy.70360.
- Qiu M, et al. Spatio-temporal changes and hydrological forces of wetland landscape pattern in the Yellow River Delta during 1986–2022. Landscape Ecology. 2024;39. doi:10.1007/s10980-024-01850-y.
- Anand S, Khushboo K, Garkoti S. Influence of vegetation and soil properties on carbon stocks in Shorea robusta. forests under different disturbance regimes. Journal of Environmental Management. 2025;380:124916. doi:10.1016/j.jenvman.2025.124916.
- Yang J, Huang X. The 30 m annual land cover dataset and its dynamics in China from 1990 to 2019. Earth Syst Sci Data. 2021;13(8):3907-3925. doi:10.5194/essd-13-3907-2021.
- Copernicus Data Space Ecosystem. Copernicus DEM GLO-30 [Internet]. European Union; [cited 2026 Aug 18]. Available from: https://documentation.dataspace.copernicus.eu/Data/Others/CCM.html
- Cheng Z, et al. Identification of eco-functional zones based on ecosystem service bundles: a case study of the Fujiang River Basin. Front Environ Sci. 2026;14:1754712. doi:10.3389/fenvs.2026.1754712.
- Pontius RG Jr, et al. Comparing the input, output, and validation maps for several models of land change. Ann Reg Sci. 2008;42(1):11-37. doi:10.1007/s00168-007-0138-2.
- Li Y, et al. Dissemination, manipulation or monopolization? Understanding the influence of stakeholder information sharing on resident participation in neighborhood rehabilitation of urban China. Land Use Policy. 2024;147:107359. doi:10.1016/j.landusepol.2024.107359.
- Peng J, et al. A landscape ecological approach to spatial conservation planning—ecological security pattern. Trends in Ecology & Evolution. 2025. doi:10.1016/j.tree.2025.07.014.
- Roh H, Park J, Chon J. Trade-off analysis of ecosystem services in regulated river areas: supporting, regulating, and cultural services. Sustainability. 2025;17(9):3788. doi:10.3390/su17093788.
- Roy Chowdhury PK, Brown DG. Modeling the effects of carbon payments and forest owner cooperatives on carbon storage and revenue in Pacific Northwest forestlands. Land Use Policy. 2023;131:106725. doi:10.1016/j.landusepol.2023.106725.
- Savo V, et al. Evaluation of main regulating, provisioning, and supporting ecosystem services of urban street trees: a literature review. Ecosystem Services. 2025;71:101690. doi:10.1016/j.ecoser.2024.101690.
- Shibo Z, Gui J. The cost of ecological protection and restoration: evidence from the impact of the Shan-shui project on land values. Land Use Policy. 2026;164:107919. doi:10.1016/j.landusepol.2026.107919.
- Deng H, Zhou X, Liao Z. Ecological redline delineation based on the supply and demand of ecosystem services. Land Use Policy. 2024;140:107109. doi:10.1016/j.landusepol.2024.107109.
- Xu H, et al. Revealing youth-perceived cultural ecosystem services for high-density urban green space management: a deep learning spatial analysis of social media photographs from central Beijing. Landscape Ecology. 2025;40. doi:10.1007/s10980-025-02115-y.
- Binter J, Doležal J. High-elevation angiosperms maintain extensive living storage tissue with large non-structural carbohydrate pools. Annals of Botany. 2026. doi:10.1093/aob/mcag023.
- Arayaselassie A, Bekele T, Lulekal E. An insight into Northern Wollo Monastery Forests: examining plant species diversity, vegetation structure, and regeneration analysis of these relict ecosystems. PLoS ONE. 2025;20. doi:10.1371/journal.pone.0330689.
- Slate ML, et al. Impact of changing climate on bryophyte contributions to terrestrial water, carbon, and nitrogen cycles. New Phytologist. 2024;242. doi:10.1111/nph.19772.
- Sun D, Yang D, Wang J, Tan F. How animal metaphors increase tourists' waste classification intention? Environmental Research Communications. 2024;6(10):105012. doi:10.1088/2515-7620/ad82b0.
- Sindhu Pradeep M, Rismanchi B, Stephan A, Ngo T. Synergising circularity and temporal dynamics into life cycle sustainability assessment of prefabricated buildings: a system dynamics-based assessment with static–dynamic comparison. Building and Environment. 2026;302:114795. doi:10.1016/j.buildenv.2026.114795.
重印与许可
本文已发表
视频即将推出