本研究结合情景实验与脑电图,探讨在不同医疗任务情境下,专家与同伴角色框架如何影响信任水平。
本文内容
摘要
摘要
在线医疗人工智能已从后端分析工具演变为面向患者的服 务接口,使得信任校准成为一个日益重要的设计与治理问题。基于角色一致性理论,本研究探讨了在不同医疗任务情境下,专家角色与伙伴角色的框架设定如何影响信任。研究1采用2(角色:专家 vs. 伙伴)×2(任务:疾病咨询 vs. 健康咨询)的情景实验设计(N = 300)。结果显示,专家角色框架提升了感知专业性,而伙伴角色框架增强了社会临场感;当两者同时纳入分析时,这两种感知均独立地与整体信任相关。通过感知专业性的间接关联受到任务情境的调节,但直接的自举比较并未显示两种有调节的中介效应在整体信任上存在显著差异。测量诊断表明,感知专业性与认知信任之间、社会临场感与情感信任之间存在显著重叠,需谨慎解释结果。研究2在39对配对观察中使用脑电图(EEG)比较了专家框架与伙伴框架陈述的效果。专家框架伴随更高的额中区theta事件相关同步(ERS)以及较不显著的基线校正FCz-F6 theta相位滞后值变化(ΔPLV),但在行为层面,信任率、反应时间或缺失反应率均未表现出可靠差异。这些脑电图发现是探索性的过程层面相关指标,而非对条件间接模型的神经验证。总体而言,角色线索似乎塑造了非互斥的能力导向与关系导向评价。角色设计应通过能力边界设定、不确定性传达、基于风险的警示以及适当的升级机制来支持校准后的依赖,而非单纯追求信任最大化。
引言
目前,医疗人工智能已涵盖图像识别、病理分析和药物发现等后端应用,以及面向患者的医疗服务界面。行业分析预测,医疗人工智能市场将持续增长至2033年1。大型语言模型使医疗人工智能系统能够以自然语言回答健康问题、解读检验结果、总结信息并提供建议2。这一转变改变了用户与技术之间的关系。后端分析工具由临床医生和机构进行评估,而面向患者的界面则必须向用户传达其角色、依据、不确定性及局限性。医疗人工智能可能表现为诊断助手、家庭医生界面或健康管理伴侣,每种形式都可能影响用户对系统服务身份的理解。随着这些系统越来越多地参与疾病咨询和日常健康管理,信任已不仅仅是对技术的一种态度,它还影响着用户是否愿意披露信息、是否认为建议可信、是否与系统互动以及是否遵循健康指导。因此,信任是数字健康平台设计与治理的核心问题。
仅凭技术能力并不能决定用户是否认为医疗人工智能可信且可接受。对医疗保健对话代理的综述表明,其实施效果取决于交互质量、临床相关性、透明度以及部署条件。3最近关于医学人工智能可信证据的研究同样指出,除非相关主张能够得到与其预期用途相匹配的证据支持,否则模型的性能是不足的4透明度至关重要,因为患者必须能够识别出能力的边界、不确定性以及建议的依据,而不能仅凭语言的流畅性来推断其可靠性。5信息系统的相关研究同样将人工智能辅助诊断的采纳视为一种信任配置问题,其中可解释性、隐私保护和界面提示共同影响着用户的接受程度6这些考量对于语言模型界面至关重要。流畅性可能使回答易于理解,但却无法解决系统是否具备临床知识、其建议是否适用于用户的实际情况,以及何时需要转诊至合格的临床医生等问题。关键问题不仅在于医学人工智能能否生成回答,更在于用户能否以恰当的信任程度对其作出评估。
对医疗人工智能的信任程度受任务情境的影响。关于医疗人工智能抵触情绪的研究表明,用户可能在高风险决策中拒绝算法建议,因为他们认为算法无法顾及自身的独特性7。然而,这种抵触并非普遍存在。算法认可研究指出,当任务更具客观性且规则更明确时,人们可能更倾向于依赖算法判断8。在线健康咨询中,人工智能生成建议的个性化程度和细致程度会影响用户的信任与采纳行为9。比较传统、数字化及基于人工智能的咨询方式的离散选择研究表明,不同咨询形式下的偏好和信任预期存在差异10。人机协作还可通过将人类专业能力的信任转移至人工智能支持的服务架构,从而降低抵触情绪11。因此,对医疗人工智能的信任是在感知风险、任务需求、沟通风格与系统评估的交互作用中逐步形成的。疾病咨询突显了不确定性、潜在损失、诊断后果以及错误成本;而健康咨询更多涉及饮食、运动、睡眠、依从性及预防性管理,在这些场景中,持续互动和关系可及性可能具有更重要的意义。因此,当用户寻求帮助的是可能的疾病问题,而非长期健康管理时,相同的界面提示可能会被解读为不同的含义。
角色设定是传达这些期望的一种界面特征。医疗人工智能可被设定为强调专业权威、结构化推理、临床边界和能力证据的专家,也可被设定为强调共情、安慰、社会支持和连续性的伙伴。这种区分与社会认知的两个维度——能力与热情相关,但并非简单地在有能力的系统和有温度的系统之间做出选择12。交流风格与能动性设定会影响对对话代理的评价13。在移动医疗应用中,社会线索与隐私顾虑共同影响信任度和行为意愿14。医疗保健对话代理中的拟人化线索可增强社会临场感、信任感和接受度,但也可能引发超出系统实际能力的期望15。关于人机协作团队的研究进一步表明,热情与能力可预测不同形式的接受性16。在高风险任务中,信任取决于团队角色、任务情境与性能偏差之间的匹配程度17。聊天机器人的社会角色与其实际表现之间的一致性也会影响信任的建立与修复18。因此,专家与伙伴的提示信号并非仅仅改变对话语气,而是凸显了不同的评价标准。
目前仍存在两个空白。首先,研究尚未阐明能力导向和关系导向线索的相关性如何随医疗任务需求的变化而变化。关于人类对人工智能信任的综述强调了情境依赖性,但并未阐明专家型和伙伴型线索在疾病咨询与健康咨询中的作用机制19。其次,针对医疗人工智能信任的研究依赖于自我报告数据,因而对角色框架化评估所涉及的认知加工过程提供的证据有限。隐私、透明度、问责制和偏见等因素也限制了前端角色线索的解释力20,21。为弥补这些不足,本研究借鉴角色一致性理论,该理论通过角色线索与情境显著需求之间的匹配程度来解释评估过程22。研究1采用一项随机化的2(角色:专家 vs. 伙伴)×2(任务:疾病咨询 vs. 健康咨询)情境实验(N = 300),考察角色框架化、任务情境以及通过感知专业性和社会临场感产生的平行间接关联。研究2则采用另一项被试内设计的脑电图实验(N = 39),比较面对专家型与伙伴型陈述时theta频段活动的差异。研究1评估行为关联及情境调节效应;研究2提供探索性的过程层面比较,而非对条件间接模型的神经验证。
理论框架与假设提出
医学人工智能中的角色定位
医学人工智能在涉及疾病风险、治疗建议、责任归属和伦理界限的高风险环境中运行23。因此,角色设定至关重要,因为前端语言会影响用户对人工智能能力范围、证据基础和责任边界的感知程度。透明度研究同样强调,医学人工智能系统应明确传达其能力限制和证据依据5。专家型回应通过使用专业术语、结构化推理、边界声明和行动建议来传递专业能力;而伙伴型回应则通过共情、安慰和协作性措辞来传递关系支持。这些提示信号不仅仅是界面装饰:它们会塑造用户在评估系统时所采用的评判标准24,25。拟人化可能引发社会性反应,但也可能造成不切实际的期望,并模糊责任边界26,27。关于人机协作团队和聊天机器人的研究进一步表明,亲和力、专业能力、角色与情境的适配性,以及社会角色与实际表现之间的一致性,均会影响用户的接受度和信任度16,17,18。在本研究中,角色一致性指的是人工智能回应所传递的信号与其在咨询任务中所面对的评估需求之间的契合程度22。
双路径信任:感知专业性与社会临场感
角色一致性是通过观察到的角色与任务交互作用推断得出的,而非作为独立的主观构念进行测量。因此,该解释受限于实验中的交互作用,并不意味着参与者有意识地报告了角色契合的感受。信任包含对能力与可靠性的认知判断,以及对关系安全感和舒适感的情感判断28,29,30。在医疗人工智能的应用中,用户既会评估系统是否能够支持健康决策,也会评估与其交互是否感觉足够安全和易于使用。专家框架应使以能力为导向的评估更加突出。临床决策支持研究的证据表明,系统推理过程的解释和相关信息会影响信任与依赖程度31。在在线健康咨询中,个性化和关怀也与信任及接受度相关9。感知到的专业性反映了与信任相关的以能力为导向的评估25。关于在线健康咨询的研究同样指出,信息来源的可信度与用户对健康建议的接受程度相关32。因此,本研究检验专家框架是否与更高的感知专业性相关。
H1:与专家型医疗人工智能相比,伙伴型角色会降低感知到的专业性。
伴随式框架应使关系评估更加突出。社会临场感指的是对媒介化互动中人际质量的感知,而非认为系统具有人类属性33。它与在线服务及健康对话代理中的互动质量、信任和接受度相关15,34。
社会临场感可能会降低网络咨询中自我表露的心理成本,并促进信息交流32。因此,本研究检验陪伴式框架是否与更高的社会临场感相关。
H2:与伙伴型医疗人工智能相比,专家型角色产生较低的社会临场感。
感知到的专业性和社交临场感被视为与信任相关的并行且非排他的关联因素。对高风险自动化系统的恰当依赖取决于系统能力、系统边界以及任务需求,而不仅仅取决于最大化信任程度35。
H3:在同时建模时,感知到的专业性和社会临场感均对信任具有正向预测作用。
任务情境的调节作用
相同的角色提示在不同的医疗任务中可能具有不同的心理权重。任务-技术适配理论为考察角色提示是否符合任务需求提供了情境化依据36。疾病咨询涉及更高的不确定性、损失风险和错误成本,因此专业性、准确性和清晰的界限尤为突出7,37。相较于同伴型提示,专家型提示应更紧密地契合这些需求。健康咨询则侧重于长期健康管理、行为坚持以及互动的持续性。针对基于人工智能的临床决策支持系统和健康对话代理的研究综述强调了情境信息、可操作性、交互性及实施条件的重要性3,38,39。
本研究预测,在疾病咨询中,专家与同伴在感知专业性方面的差异将大于健康咨询中的差异。研究并未将社会临场感上无显著交互作用的结果视为不变性的证据。假设提出如下:
H4:任务情境显著调节专家角色对感知专业性的影响。这种影响在疾病咨询中比在健康咨询中更强。
方案
研究概述
本研究遵循《赫尔辛基宣言》进行,并得到了华侨大学伦理委员会(M2025021)的批准,该批准涵盖在线情景实验和脑电图实验。所有参与者均签署了知情同意书,并在实验结束后获得了相应报酬。
本文包含两项互补的研究(见图1)。研究1是一项随机化的2 × 2情境实验,用于估计角色框架和任务情境效应,评估测量结构,并通过感知专业性和社会临场感检验平行的条件间接关联。研究2是一项被试内设计的脑电图(EEG)实验,比较在专家框架与伙伴框架陈述下的theta频段活动,其结果被解释为一种探索性的过程层面比较。这两项研究在不同层面上提供了行为与神经证据;它们并未被视为单一的渐进机制。
研究1:情景实验
参与者与实验设计
研究1采用了一个平衡的2 × 2组间设计,包含角色框架(专家 vs. 伙伴)和任务情境(疾病咨询 vs. 健康咨询)。最初的G*Power计算假设了一个中等的整体ANOVA效应(f = 0.25),α = .05,检验力 = .80,结果表明至少需要128名参与者40。由于该计算并未针对条件间接效应进行调整,因此仅作为原始招募依据报告,而非作为调节中介效应的检验力证据。当N = 300且分为四个平衡组时,敏感性分析显示,在α = .05水平下,检验力为80%时可检测到f = 0.162(偏η2 = .026)的交互作用。
我们还使用包含300个案例的SPSS问卷数据集,针对调节中介效应指数进行了事后基于模拟的统计功效分析。该模拟通过重采样经验残差,从拟合的平行中介模型中生成了1,000组平衡的2 × 2样本;每个模拟数据集采用500次案例重采样的百分位自助法计算置信区间。置信区间排除零的估计概率分别为:专业性指数为0.698,社会临场感指数为0.157,两个指数之间直接差异为0.279。该分析结果依赖于观察到的系数、残差分布及模型设定,不能作为先验的样本量依据。完整的事后基于模拟的统计功效分析见补充表S1。
通过Credamo招募了300名参与者,并随机分配到四个条件组中(每组n = 75)。样本包括109名男性(36.3%)和191名女性(63.7%);43.7%的参与者年龄在21至30岁之间,41.3%在31至40岁之间,69.7%拥有学士学位。所有必需的问卷项目均已完成。未使用专门的注意力检查题项或预注册的完成时间排除标准,且未排除任何参与者。中位完成时间为268秒(范围= 67–1,894秒)。一项事后稳健性分析排除了完成时间低于第5百分位的作答(<125秒;保留n = 285),以评估对异常快速作答的敏感性。详细的操纵检验统计结果及完成时间敏感性分析见补充表S2。
实验刺激与实验流程
刺激材料包括任务情景介绍和人工智能医生对话回应,共组成四套完整的实验材料。疾病咨询情景要求参与者想象自己反复出现夜间胸闷和心悸,并担忧是否需要立即前往医院就诊。健康咨询情景则要求参与者想象自身总体健康状况良好,希望获得个性化的饮食与运动计划。每种任务类别均由一个情景代表,因此结论仅限于这两种情景,不能推广至所有疾病和健康咨询场景。
所有四张问卷截图均使用了相同的图标,并显示系统名称“Medical AI (DiagnosPro)”,从而在不同条件下保持所呈现的身份一致。专家角色框架下的回复采用了结构化分析、风险或证据陈述、指导性语言以及明确的行动建议;而同伴角色框架下的回复则采用共情表达、安慰性语言、协作性措辞以及灵活的建议。因此,该实验操纵代表了一组与角色相符的沟通方式和信息提示的组合,并未将角色框架与具体性、可操作性、确定性、医学细节或情感支持等因素分离开来。共用的名称“DiagnosPro”本身也可能在所有条件下传递了专家身份的提示。完整的刺激材料见补充文件1。
参与者首先阅读知情同意书,然后被随机分配到四种实验条件之一。阅读完情境和对话刺激材料后,他们根据自己的反应完成问卷。问卷以操纵检验开始,随后测量感知到的专业性、社会临场感、信任感以及人口统计学信息。该过程大约需要15分钟。
所有量表均采用7点李克特评分,其中1表示强烈不同意,7表示强烈同意。感知专业性通过三个题项测量:“该医疗人工智能能够提供医疗建议”、“该医疗人工智能看起来非常专业”以及“该医疗人工智能是医疗领域的专家”(α = .883)41。社会临场感通过三个题项测量:“在与该医疗人工智能的互动中,我感受到了人性化的关怀”、“与该医疗人工智能的互动让我感到亲近”以及“该医疗人工智能在互动过程中显得友善合群”(α = .932)42。认知信任包含三个题项:“我可以信赖该医疗人工智能,因为它具备提供建议所需的专业技能”、“我对该医疗人工智能所提供建议的准确性有信心”以及“该医疗人工智能有足够的能力处理我的健康问题”(α = .837)。情感信任包含三个题项:“该医疗人工智能让我感受到温暖与关怀”、“依赖该医疗人工智能让我感到安心,因为它似乎关心我的健康”以及“我相信该医疗人工智能不会故意对我造成任何伤害”(α = .700)。总体信任度为全部六个信任题项的均值(α = .784)。这些测量指标被分析为以能力为导向、人际取向、认知信任、情感信任及总体信任的结果,而非彼此互斥的构念。
分析分为四个步骤。首先,验证性因子分析将提出的四因子模型与双因子和单因子替代模型进行比较;同时考察了组合信度、平均方差提取量、潜变量相关性以及异质-单调比值。其次,完整的2 × 2因子模型用于估计感知专业性、社会临场感、认知信任、情感信任和总体信任的主效应及交互效应,报告内容包括各单元格均值、置信区间和偏η2值。估计的边缘均值及95%置信区间见图2。第三,采用PROCESS 4.2 beta Model 7,将感知专业性和社会临场感同时作为平行中介变量,进行基于5,000次百分位自举抽样的分析43。角色框架编码为1 = 专家,2 = 伙伴;任务情境编码为1 = 疾病咨询,2 = 健康咨询。通过共同重抽样自举法直接比较两种调节中介指数。第四,将认知信任和情感信任分别作为探索性结果变量进行分析。由于中介变量与结果变量为同时测量,因此结果解释为与中介作用一致的间接关联,而非因果性的心理机制。
研究2:脑电图实验
参与者
研究2招募了40名参与者。其中1名参与者因至少一种实验条件下受伪迹污染的试验比例超过30%而被排除,最终纳入39名参与者进行脑电图(EEG)分析。该标准确保了每位保留的参与者在每种条件下至少贡献了70%的试验数据。所有参与者均签署了书面知情同意书,并在实验结束后获得了报酬。人口统计学信息无法与所有保留的EEG记录关联,因此未对最终EEG样本的人口统计学特征进行汇总。
实验刺激与实验流程
实验在标准的脑电图(EEG)实验室中进行,采用被试内设计,刺激材料通过E-Prime 2.1呈现。要求参与者想象与一个医疗人工智能系统进行互动,并针对每种医疗咨询情境评估其对该系统的信任程度。实验操纵了医疗人工智能系统的感知角色,包括专家型和伙伴型两种变体。
共构建了40个中文句子刺激材料。专家型条件包含20个以“医学人工智能专家”开头的刺激材料,而伙伴型条件包含20个以“医学人工智能伙伴”开头的平行刺激材料。医学场景涵盖了专业诊断功能(如询问病史、分析检查报告、评估心率数据、解读基因检测、判断疾病风险和推荐治疗方案)以及支持性健康管理功能(如关心身体状况、询问睡眠质量、缓解焦虑情绪、记录健康数据、鼓励坚持治疗和提供日常健康建议)。因此,两种条件在语义内容和复杂性上也存在差异;未进行独立的刺激材料匹配或前测。
正式实验开始前,参与者先完成一个简短的练习环节。每次试验以一个持续500 ms的注视十字开始,随后是一个300–500 ms随机变化的空白间隔,接着呈现一条持续1,600 ms的医学人工智能陈述。之后,参与者通过按键自行控制节奏,做出二元信任判断:按F键表示信任,按J键表示不信任(见图3)。专家框架和同伴框架的陈述以随机顺序呈现。E-Prime任务日志显示,每条任务记录包含80次正式试验:其中40次为专家陈述,40次为同伴陈述,每种角色下的20条独特陈述各呈现两次。
行为任务数据
最终 EEG 样本中,39 名参与者中有 38 名的行为任务数据可用;其中 1 名参与者的 E-Prime 任务记录不可用。因此,行为分析采用 N = 38。详细的行为结果和样本统计信息见补充表 S3。信任反应被编码为按 F 键;按 J 键表示不信任。空白反应或记录的反应时间为 0 毫秒的情况被编码为缺失值。信任率基于已作答的试验进行计算,反应时间则对已作答的试验进行汇总。可用于分析的神经数据包含条件聚合的测量指标,但无单个试验水平的 EEG 指标,也无经验证的标识符将每个行为记录与其对应的 EEG 记录关联;因此,未建立 EEG 与信任判断的试验水平混合模型。
脑电图记录与分析
使用Quik-Gel导电电解质凝胶以保持电极-皮肤阻抗低于5 kOhm。FCz为设备默认的在线参考电极,采样率为1,000 Hz。离线分析时,使用CURRY软件内置的重参考功能将参考电极重设为双侧乳突的平均值;FCz信号被保留,并相对于新参考电极自动重建,未使用任何自定义重建命令或脚本。后续离线处理在MATLAB R2020b环境中使用EEGLAB44和ICLabel45完成。数据被降采样至500 Hz,并进行0.1至40 Hz的带通滤波。通过目视检查识别并剔除坏通道及严重受污染的数据片段;未应用自动插值或自动片段剔除阈值。随后采用EEGLAB默认的runica实现方法(Infomax ICA),当ICLabel将某一成分判定为伪迹类(如眼动、肌电、心电、工频干扰或通道噪声)的概率不低于0.70时,该成分即被剔除。若参与者在任一条件下超过30%的试验被伪迹污染,则予以排除,以确保每种条件下至少保留70%的试验。时间窗范围为−1,000至1,996 ms。在进行功能连接分析时,预处理后的数据进一步降采样至250 Hz,并在相位同步性估计前剔除外周电极(包括P7、P8、F7和F8)。
在额中线头皮位点记录到的θ活动与认知控制需求所涉及的计算过程相关46。内侧与外侧额部电极位点之间的θ频段相位同步也与控制相关加工过程中的协调活动相关47。特别是,在冲突或错误检测之后,FCz与F6等位点之间的θ频段相位同步增强现象已被观察到48。由于这些头皮电生理指标并非认知控制所特有,因此本文将其视为汇聚性的过程指标,而非单一认知机制的直接读出信号。
首先,在刺激后800–1,000 ms时间窗内,对4–8 Hz频段的额中区theta事件相关同步(ERS)进行量化。ERS通过时频分析计算,相对功率变化以刺激前−500至−200 ms为基线进行归一化。正值表示功率增强(同步),而负值表示功率抑制(去同步)。其次,在将预处理后的数据进一步降采样至250 Hz并排除P7、P8、F7和F8等外周电极后,估算功能连接性。在计算FCz与F6之间theta频段的相位锁定值(PLV)之前,应用短时傅里叶变换(STFT)。基线校正后的PLV变化量(ΔPLV)以刺激前−600至−200 ms为基线进行计算。原始PLV的取值范围为0到1;因此,负的ΔPLV值表示相对于基线的降低,而非负的相位锁定。这些头皮测量指标被解释为与控制相关加工和前额叶协调有关的探索性模式;它们并不能直接识别特定的认知过程或神经源。
结果
研究1:情景实验结果
测量模型。四因子模型的拟合优度优于二因子和单因子替代模型,但绝对拟合指标结果参差不齐:χ2(48) = 223.93,p < .001;CFI = .935;TLI = .911;RMSEA = .111;SRMR = .140。标准化因子载荷介于 .382 至 .937 之间。感知专业性的组合信度为 .886,社会临场感为 .932,认知信任为 .840,情感信任为 .709;相应的 AVE 值分别为 .722、.821、.636 和 .474。区分效度有限:感知专业性与认知信任之间的 HTMT 值为 .935,社会临场感与情感信任之间为 .926。因此,对条件过程分析结果应谨慎解读,且针对特定维度的信任分析属于探索性分析(表 1)。
操纵检验。专家框架组参与者(n = 150,M = 5.57,SD = 1.18)对医疗人工智能的专业性评分高于同伴框架组参与者(n = 150,M = 3.21,SD = 1.76)。由于方差不等,F = 47.42,p < .001,采用韦尔奇t检验,t(259.90) = 13.63,p < .001,均值差异 = 2.36,95% 置信区间 [2.02, 2.70]。疾病情境组参与者(n = 150,M = 2.51,SD = 1.53)的预防健康取向评分低于健康情境组参与者(n = 150,M = 5.98,SD = 1.22),F = 10.96,p = .001;韦尔奇t(284.11) = −21.70,p < .001,均值差异 = −3.47,95% 置信区间 [−3.79, −3.16]。当方差不等时,韦尔奇自由度不等于 N − 2;所有分析均使用 N = 300。
不同实验条件下的描述性统计结果。在专家框架条件下,疾病和健康咨询情境下的专业性感知均值分别为 5.69(标准差 = 0.83)和 5.85(标准差 = 0.63),社会临场感均值分别为 4.28(标准差 = 1.54)和 4.25(标准差 = 1.64),总体信任度均值分别为 5.45(标准差 = 0.86)和 5.28(标准差 = 0.87)。在同伴框架条件下,疾病和健康情境对应的专业性感知均值分别为 4.52(标准差 = 1.47)和 5.25(标准差 = 0.94),社会临场感均值分别为 5.68(标准差 = 1.07)和 5.93(标准差 = 0.74),总体信任度均值分别为 5.30(标准差 = 1.02)和 5.61(标准差 = 0.64)。表 2 报告了所有条件特异性的置信区间以及完整的因子检验结果。
完全因子设计结果。感知专业性表现出角色框架的主效应,F(1, 296) = 56.92,p < .001,偏η2 = .161;任务情境的主效应,F(1, 296) = 14.37,p < .001,偏η2 = .046;以及角色与任务的交互效应,F(1, 296) = 5.89,p = .016,偏η2 = .020。社会临场感表现出角色框架的主效应,F(1, 296) = 105.57,p < .001,偏η2 = .263;但任务主效应,F(1, 296) = 0.59,p = .442,以及交互效应,F(1, 296) = 0.84,p = .359,均不显著。后一结果表明未检测到调节作用;并不能证明不同任务之间具有等效性。对于认知信任,角色与任务的交互效应显著,F(1, 296) = 5.60,p = .019,偏η2 = .019;而对于情感信任,相应的交互效应不显著,F(1, 296) = 3.48,p = .063,偏η2 = .012。总体信任在角色框架主效应上不显著,F(1, 296) = 0.81,p = .369,任务主效应也不显著,F(1, 296) = 0.55,p = .459,但角色与任务的交互效应显著,F(1, 296) = 5.78,p = .017,偏η2 = .019。在疾病咨询情境中,同伴框架与专家框架之间的总体信任无显著差异,平均差异 = −0.15,标准误 = 0.14,t(296) = −1.06,p = .288,95% 置信区间 [−0.42, 0.13]。在健康咨询情境中,同伴框架下的总体信任更高,平均差异 = 0.33,标准误 = 0.14,t(296) = 2.34,p = .020,95% 置信区间 [0.05, 0.60]。
平行条件间接关联。当感知专业性和社会临场感同时作为变量输入时,二者均与总体信任呈正相关:b = 0.4872,SE = 0.0258,p < .001,95% CI [0.4294, 0.5460];以及 b = 0.3293,SE = 0.0208,p < .001,95% CI [0.2762, 0.3829]。角色框架的直接关联不显著,b = 0.0119,SE = 0.0680,p = .861,95% CI [−0.1071, 0.1361]。专业性的间接关联在疾病咨询中为−0.5695,95% 自助法置信区间 [−0.7687, −0.3851],在健康咨询中为−0.2923,95% 自助法置信区间 [−0.4288, −0.1634]。社会临场感的间接关联在疾病咨询中为0.4625,95% 自助法置信区间 [0.3165, 0.6091],在健康咨询中为0.5532,95% 自助法置信区间 [0.3855, 0.7383](表3)。通过感知专业性的调节中介指数为0.2772,95% 自助法置信区间 [0.0594, 0.5035],而通过社会临场感的调节中介指数为0.0907,95% 自助法置信区间 [−0.0984, 0.3008]。两个指数之间的直接自助法对比不显著,差异值 = 0.1864,95% 自助法置信区间 [−0.0856, 0.4447]。因此,结果支持专业性在间接关联中的情境调节作用,但未证实两种关联之间存在统计学上显著不同的情境调节效应。
探索性信任维度分析。对于认知信任,专业性与社会临场感的调节中介效应指数之间的差异为正值,差异值 = 0.3707,95% 自助法置信区间 [0.0493, 0.6996]。对于情感信任,相应的差异未得到支持,差异值 = 0.0022,95% 自助法置信区间 [−0.3421, 0.3127]。两个中介变量均与两个信任维度保持正向关联,表明其影响为跨路径而非排他性效应。鉴于HTMT值较高,不应将这些结果解释为认知与情感机制的明确分离。
事后调节中介效应的统计检验力。在拟合模型和残差重抽样假设下,基于百分位数自助法置信区间排除零值的估计概率分别为:专业素养指数为0.698,社会临场感指数为0.157,两者直接差异为0.279(1,000次模拟;每次模拟进行500次自助重抽样)。这些基于观察设计的估计结果解释了为何支持性的专业素养指数与无统计学意义的直接对比不应被解读为不同情境调节作用的确凿证据。
完成时间的稳健性。排除125秒以下的15个响应后,剩余285个案例。总体信任交互作用仍显著,p = .029;专业性指数仍得到支持,95%自助法置信区间[0.0242, 0.4827];调节中介指数之间的对比仍不显著,95%自助法置信区间[−0.1027, 0.4506]。主要结论不依赖于最快的5%响应。
研究2:脑电图结果
额中区θ波ERS。在最终的分析样本中(N = 39),在4–8 Hz、800–1,000 ms时间窗内,专家框架条件下的θ波ERS(M = 0.2948,SD = 0.8218)高于同伴框架条件(M = −0.0422,SD = 1.2155),平均差异 = 0.3369,95% CI [0.0125, 0.6614],t(38) = 2.10,p = .042,Cohen’s dz = 0.337,partial η2 = .104。两项报告的配对EEG结果经Holm校正后的p值为.042。该差异表明在此任务时间窗内存在θ频段处理的差异;但仅凭θ波ERS本身无法识别特定的心理过程。
FCz-F6 基线校正后的 theta 相位锁定值变化(ΔPLV)。在最终的分析样本中(N = 39),专家框架下的 theta ΔPLV 负值小于同伴框架下的 theta ΔPLV(专家框架:M = −0.0111,SD = 0.0546;同伴框架:M = −0.0350,SD = 0.0473),平均差异 = 0.0239,95% 置信区间 [0.0058, 0.0420],t(38) = 2.68,p = .011,Cohen’s dz = 0.429,偏 η2 = .159。在报告的两项配对 EEG 结果中,经 Holm 校正后的 p 值为 .022。该模式表明,在专家框架下,theta 相位一致性的基线下降幅度较小;但这一结果本身并不能确立前额叶控制增强或特定的认知机制(见 图 4 和 表 4)。
行为任务结果。在分析的38项任务记录中,专家框架下的信任反应率为83.1%(SD = 15.8%),同伴框架下的信任反应率为82.4%(SD = 17.5%),平均差异为0.7个百分点,95% CI [−0.9, 2.4],t(37) = 0.91,p = .371,dz = 0.147。平均反应时间分别为828.7 ms(SD = 204.6)和826.1 ms(SD = 208.9),平均差异为2.5 ms,95% CI [−14.0, 19.1],t(37) = 0.31,p = .758,dz = 0.050。缺失反应率分别为6.3%(SD = 7.4%)和5.2%(SD = 6.3%),平均差异为1.1个百分点,95% CI [−1.0, 3.1],t(37) = 1.05,p = .302,dz = 0.170。
数据可用性声明:
研究1的去标识化问卷数据、预处理后的脑电图(EEG)文件以及支持研究2的汇总EEG输出文件均已公开,可在开放科学框架(Open Science Framework, OSF)获取,网址为 https://doi.org/10.17605/OSF.IO/JKSP7。补充材料包括完整的实验刺激材料(补充文件1)、操纵检验、额外的行为分析、事后功效分析以及支持性的方法学信息。
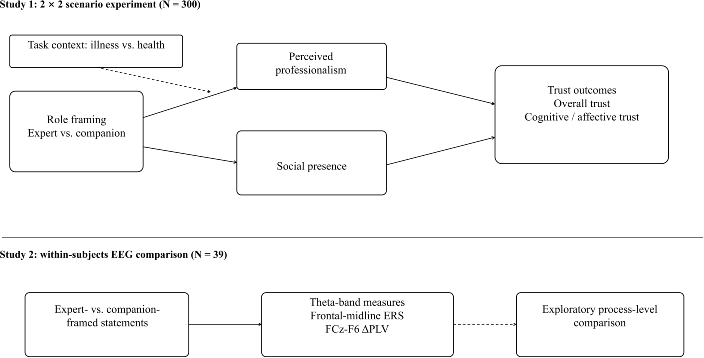
图1.研究框架。研究1是一项2 × 2情境实验(N = 300),考察角色框架、任务情境以及通过感知专业性和社会临场感产生的平行间接关联。研究2提供了对专家型与同伴型框架陈述的探索性脑电图比较(N = 39);该研究未直接检验条件间接模型。请点击此处查看此图的放大版本。
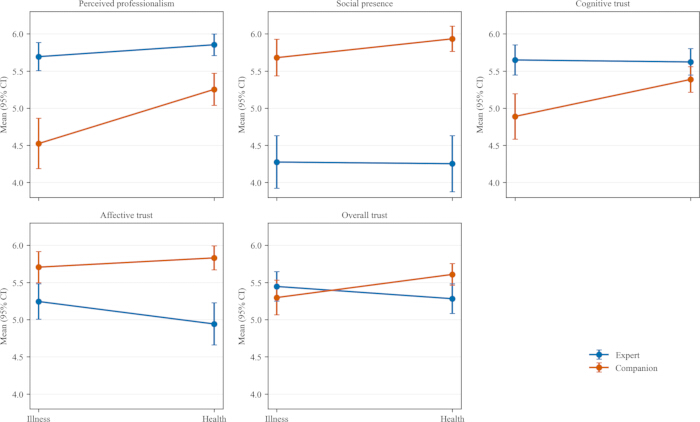
图 2。感知专业性、社会临场感、认知信任、情感信任及总体信任在角色框架与任务情境交互作用下的图表。 图中点表示各组均值,误差线表示95%置信区间(每组 n = 75)。请点击此处查看此图的放大版本。
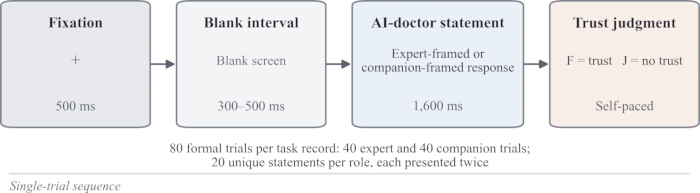
图3.研究2中的单次试验序列。 每次试验包括500 ms的注视阶段、300–500 ms随机抖动的空白间隔、1,600 ms的专家框架或同伴框架AI医生陈述,以及一次自定节奏的二元信任判断。E-Prime任务日志显示,每个任务记录包含80个正式试验,每种角色框架条件下各40个试验,且每种条件下20条独特陈述各呈现两次。请点击此处查看该图的放大版本。
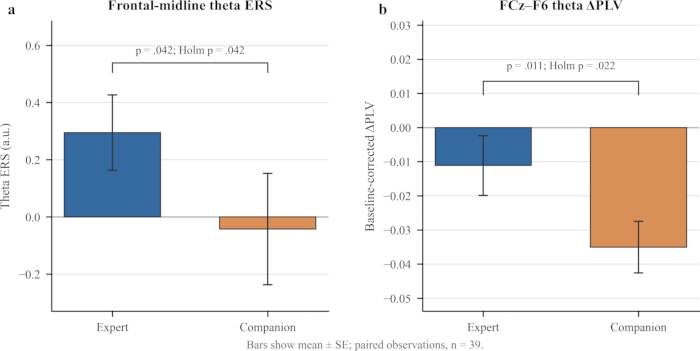
图4。医学人工智能角色设定对前额中线θ波事件相关同步化及FCz-F6 θ波相位锁定值的影响。(A)前额中线θ波事件相关同步化。(B)基线校正后的FCz-F6 θ波相位锁定值变化(ΔPLV);负值表示相较于刺激前基线有所下降。柱状图显示n = 39的均值 ± 标准误。配对t检验结果显示,θ波ERS的p值为.042,ΔPLV的p值为.011;经Holm校正后,这两个结果的p值分别为.042和.022。缩写:请点击此处查看该图的放大版本。
表1:研究1的测量模型诊断结果。 该表格报告了感知专业性、社会临场感、认知信任和情感信任的标准化载荷、Cronbach’s α系数、组合信度、平均方差提取量、潜变量相关系数以及HTMT值。N = 300。四因子模型拟合优于其他替代模型,但RMSEA和SRMR表明绝对拟合度较弱,且有两个HTMT值超过0.90。缩写:CR = 组合信度;AVE = 平均方差提取量;HTMT = 异质-单质比值。请点击此处下载该表格。
表2:研究1的四条件描述性统计与完整的2 × 2因子检验。 表格单元格中报告了样本量(n)、均值、标准差和95%置信区间;因子检验报告了F值、p值和偏η2。总样本量N = 300;每个单元格n = 75。角色框架编码为1 = 专家,2 = 陪伴者;任务情境编码为1 = 疾病,2 = 健康咨询。系数与置信区间均为非标准化值。请点击此处下载该表格。
表3:研究1中的并行条件间接关联。 N = 300。角色框架编码为1 = 专家,2 = 陪伴者;任务情境编码为1 = 疾病咨询,2 = 健康咨询。感知专业性和社会临场感同时纳入分析。估计值为非标准化系数,百分位自助法置信区间基于5,000次重采样。该表包含条件间接关联、两种有调节的中介效应指数及其直接自助法对比结果。针对总体信任的两个有调节中介效应指数之间的直接对比结果为0.1864,95% CI [-0.0856, 0.4447]。请点击此处下载该表格。
表4:研究2中的配对脑电图结果。 最终分析样本包含39对配对观测值。该表报告了额中区theta ERS和基线校正后的FCz-F6 theta ΔPLV的各条件均值、配对均值差异、95%置信区间、配对t检验、Cohen’s dz、偏η2以及经Holm校正的p值。Holm校正仅针对所报告的两项配对脑电图结果进行,未对电极、频段或时间窗的其他未报告探索性分析进行校正。请点击此处下载该表格。
补充文件1:研究1中使用的实验刺激材料。 该文件包含在疾病咨询和健康咨询情境中所使用的专家框架和同伴框架的医学人工智能回复的完整文本。同时提供了原始中文文本及英文翻译。请点击此处下载该文件。
补充表 S1. 基于模拟的调节中介模型事后功效分析。 请点击此处下载该文件。
补充表 S2. 研究1的操纵检验统计结果与完成时间敏感性分析。 请点击此处下载该文件。
补充表 S3. 研究2的行为任务结果、样本统计及描述性统计信息。 请点击此处下载该文件。
讨论
理论意义
这两项研究在不同层面上提供了证据。研究1通过随机情景实验识别了角色与任务之间的关联以及并行的间接关联,而研究2则提供了探索性的过程层面脑电图(EEG)比较。因此,这些研究支持对角色框架评价的有限性解释,而非单一的渐进机制。研究结果通过将一致性定义为角色线索与任务显著性评价需求之间的匹配,将角色一致性理论拓展至医学人工智能领域22。该解释不同于能力-热情维度内容以及任务-技术匹配概念。算法厌恶与算法欣赏现象可被理解为对角色线索和能力线索是否与特定任务相匹配的情境敏感性评价49,50。
研究结果还支持角色定位、感知到的专业性、社会临场感与信任之间的平行且非互斥的关联。由于专业性与认知信任存在重叠,社会临场感与情感信任存在重叠,因此证据支持存在差异化的评价内容,但并不支持两种截然分离的作用机制。在感知专业性方面,角色与任务的交互作用与所提出的角色一致性解释相一致。证据支持情境对专业性关联的调节作用,但并未证实情境机制在统计学上的不对称性,或社会临场感路径中的情境不变性。
脑电图(EEG)结果提供了一种探索性的过程层面视角。专家框架下的陈述伴随着独特的theta频段模式,但各条件在语义内容和复杂性上也存在差异,且在条件层面上的行为表现未显示出信任度的可靠差异。因此,EEG指标并未确立明确的认知控制或信任机制。神经科学发现应被视为假设生成性的。研究2未操纵任务情境,也未测量感知到的专业性或社会临场感,亦未将试次层面的EEG指标与信任判断相联系;因此,EEG结果是对条件间接模型的补充,而非验证。
研究结果表明,应适当依赖而非过度依赖自动化系统。对自动化系统的依赖程度应根据系统能力、适用范围及任务需求进行校准。35相关研究描述了可能支持校准信任与依赖的适应性认知机制51神经信息系统(NeuroIS)的视角支持在研究具有时间分辨率的过程时,将神经测量作为行为证据的补充。52先前的fMRI研究表明,在线信任判断过程中的神经活动因对象和情境不同而存在差异53.
管理启示
对于在线医疗平台而言,实际意义在于有节制地依赖,而非简单地最大化信任。角色提示应与任务需求相匹配,并结合不确定性沟通、明确的能力限制、基于风险的警告,以及向合格的临床医生升级处理。
在涉及诊断、异常结果解读、医疗建议或分诊等高风险模块中,以能力为导向的提示可能有助于用户识别证据和行动的边界,而不会赋予不必要的权威性。在饮食、运动、睡眠、依从性和情绪支持等较低紧急程度的模块中,以关系为导向的提示可能有助于促进用户参与,而不会产生虚假的安慰或不恰当的拟人化印象。
角色设计应采用模块化和基于场景的方式,而非固定的个性设定。角色配置应与解释说明、隐私提示、风险标签及升级机制相结合。治理研究强调,透明度、问责制、偏见管理与隐私保护必须协同设计,以确保可信的前端角色提示不会掩盖后端风险6,20,21。
研究局限性与未来研究方向
研究1是一项情境实验,而非真实的临床咨询。实验条件未在长度、词频、可读性、准确性、可操作性、情感效价、唤醒度、风险、熟悉度或复杂性方面进行独立的预测试。未来的研究应使用多个情境、中性系统名称、内容匹配的刺激材料、独立的操纵或时间上分离的测量,以及参与者和刺激材料水平的随机效应。
研究2提供了过程层面的脑电图证据,但最终的39人人口学数据链接不完整,脑电图语句未在句子长度、词频、可读性、情感效价、唤醒度、感知风险、熟悉度和复杂性等方面进行独立匹配或预测试,且明确的角色标签可能引发了需求特征。本研究采用基线校正后的相位锁定值(ΔPLV)作为预定义的功能连接性测量指标。尽管加权相位滞后指数(wPLI)对容积传导的敏感性较低,但它未被纳入原始分析流程中。未来的研究应探讨当前发现是否能通过wPLI或其他互补的连接性指标得到重复验证。现有的神经输出数据是按条件聚合的,无法与试次水平的信任判断相对应,因此未建立试次水平的脑电-行为混合模型。头皮PLV还容易受到公共参考和容积传导效应的影响。这些局限性意味着神经层面的发现仍应视为探索性的,不应被解释为存在独特认知控制或信任机制的证据。
披露
作者声明无任何利益冲突。
在本研究的撰写过程中,作者使用了 ChatGPT 来改进语言表达。在使用该工具/服务后,作者根据需要对内容进行了审阅和修改,并对出版物的内容负全部责任。
致谢
本研究项目由中华人民共和国国家社会科学基金一般项目资助(项目编号:22BGL006)。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 克雷达莫在线调查平台 | Credamo (Jianshu), 中国 | 不适用 | 研究1中使用的在线问卷、随机分组和参与者招募平台。 |
| CURRY 重参考功能 | Compumedics Neuroscan, 美国 | 版本未指定 | 将在线参考电极从FCz离线重参考至双侧乳突平均参考;FCz相对于新参考自动重建。 |
| 64通道脑电电极帽 | Compumedics Neuroscan (Compumedics Limited), 澳大利亚 | 型号/目录号未指定 | 用于连续脑电记录的64通道Ag/AgCl电极帽。 |
| EEGLAB | 加州大学圣地亚哥分校斯沃茨计算神经科学中心, 美国 | 版本 2023.0 | 用于脑电预处理和独立成分分析的MATLAB工具箱。 |
| E-Prime | 心理学软件工具公司, 美国 | 版本 2.1 | 研究2中的刺激呈现和反应采集。 |
| G*Power | 德国杜塞尔多夫海因里希·海涅大学, 德国 | 版本 3.1.9.7 | 研究1中原有的先验样本量计算、交互敏感性分析以及事后基于模型的统计功效分析。 |
| IBM SPSS Statistics | IBM 公司, 美国 | 版本 27 | 用于运行PROCESS宏的统计分析环境。 |
| ICLabel | 加州大学圣地亚哥分校斯沃茨计算神经科学中心, 美国 | 版本 1.7 | 用于分类伪迹独立成分的EEGLAB插件。 |
| MATLAB | The MathWorks, Inc., 美国 | Release R2020b | 用于脑电数据处理与分析的计算环境。 |
| SPSS的PROCESS宏 | Andrew F. Hayes, 加拿大 | 版本 4.2 beta | 在研究1中,使用5000个百分位自助抽样样本,将感知专业性和社交临场感同时作为平行中介变量输入模型7。 |
| Quik-Gel 导电电解质凝胶 | Compumedics Neuroscan (Compumedics Limited), 澳大利亚 | 目录号未指定;32盎司 | 在脑电记录期间用于降低电极-皮肤阻抗的导电凝胶。 |
| SynAmps2 脑电放大器 | Compumedics Neuroscan (Compumedics Limited), 澳大利亚 | SynAmps2;目录号未指定 | 配置为64通道记录的64-256通道脑电放大器。 |
参考文献
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.