该纵向研究方案结合重复的护理依赖量表评估与增长混合模型分析,以识别急性心肌梗死后不同的护理依赖轨迹,并评估与轨迹分类归属相关的 demographics(人口统计学)、临床及心理社会因素。
本文内容
摘要
摘要
本研究旨在识别急性心肌梗死(AMI)患者护理依赖轨迹的潜在类别,并探讨与轨迹类别归属相关的因素。这项单中心纵向观察性研究纳入了2024年1月至2026年1月期间在中国安徽临泉县人民医院住院的260例AMI患者。研究基线定义为成功急诊治疗并恢复意识后的时点。采用护理依赖量表(CDS)在基线(T1)、入院第3天(T2)、出院时(T3)及出院后1个月(T4)评估患者的护理依赖程度。通过增长混合模型识别不同的纵向轨迹类别,并进一步采用多分类逻辑回归分析评估临床与心理社会特征,以确定与轨迹类别归属独立相关的因素。共识别出四种不同的护理依赖轨迹:高独立-缓慢改善型(C1,n = 66,25.4%)、中度依赖-快速恶化型(C2,n = 54,20.8%)、高度依赖-显著改善型(C3,n = 90,34.6%)和高度依赖-缓慢加重型(C4,n = 50,19.2%)。年龄、婚姻状况、抑郁与焦虑症状、社会支持以及基础疾病史与轨迹类别归属存在独立且类别特异性的关联。AMI患者的护理依赖程度存在明显的个体间异质性,共识别出四种不同的纵向轨迹模式。与轨迹类别归属相关的因素可能有助于识别需要更密切护理评估和个体化随访的患者;然而,针对这些因素的干预措施的有效性仍需前瞻性验证。
引言
急性心肌梗死(AMI)通常由冠状动脉突然闭塞引起,导致心肌血流显著减少或中断,并继发心肌坏死。由于心肌功能受损及急性并发症的影响,AMI 仍是主要的危及生命的心血管疾病,可显著影响患者的短期和长期预后1。再灌注治疗策略,包括经皮冠状动脉介入治疗和溶栓疗法,能够恢复冠状动脉血流,已显著改善了 AMI 的急性期管理。然而,即使在成功进行急性期治疗后,部分患者仍存在自我护理和日常生活活动能力的限制,因而需要不同程度的护理支持2。
护理依赖可能影响患者的生活质量、社会参与、功能恢复以及整体康复进程3。既往关于急性心肌梗死(AMI)的研究主要集中于诊断与治疗策略、并发症的预防与管理,以及预后因素。既往针对经皮冠状动脉介入治疗后冠心病患者的横断面研究已发现,衰弱、自我效能和心理状态是与护理依赖相关的因素;然而,单一时点的评估无法刻画患者个体内部依赖性的变化,也无法区分随时间推移的异质性恢复模式4。本研究通过在四个时间点重复评估护理依赖,并应用增长混合模型,拓展了既往静态分析,识别出具有不同纵向轨迹的潜在患者亚组。识别这些异质性模式可能有助于临床医生识别具有不同康复特征的患者,并为个体化的护理评估、随访和支持性护理提供依据。
因此,本研究旨在识别急性心肌梗死(AMI)患者从急诊治疗后基线至出院后1个月期间护理依赖的不同纵向类别,并探讨与轨迹类别归属相关的社会人口学、临床及心理社会因素。鉴于本研究具有探索性质,未预先设定关于特定轨迹类别的方向性假设。
方案
本研究在安徽省阜阳市临泉县人民医院急诊科进行。研究方案经临泉县人民医院伦理委员会审查并批准(批准号:24XNLC-HL1015)。所有参与者在入组前均签署了书面知情同意书。涉及人类受试者的全部操作均按照机构伦理要求及适用的伦理原则进行。
研究背景与参与者确定
本研究在中国安徽阜阳临泉县人民医院急诊科开展,是一项单中心纵向观察性研究。研究对象于2024年1月至2026年1月期间招募,随访期从急诊治疗后的基线时间点开始,持续至出院后1个月。
采用方便抽样方法确定因急性心肌梗死(AMI)入院的符合条件的患者。对所有潜在受试者均应用相同的纳入标准和筛选程序。由于方便抽样可能引入选择偏倚,因此在解读研究结果的普遍性时,已考虑了这一潜在的偏倚来源。
共筛查了287例患者,其中27例未入组。8例患者既往发生过心肌梗死,6例因意识障碍或认知功能受损无法完成研究评估,5例患有其他器质性心脏病,4例患有恶性肿瘤、多器官功能衰竭或其他严重全身性疾病,4例拒绝参与。其余260例患者被纳入本研究。
纳入标准与基线定义
如果患者已确诊为急性心肌梗死(AMI),且为首次发生心肌梗死,年龄≥18岁,意识清醒,认知功能完好,能够理解并完成研究评估,并已签署书面知情同意书,则可纳入研究。患有其他器质性心脏病、恶性肿瘤、多器官功能衰竭或其他严重全身性器质性疾病者被排除在外。
为减少既往心肌梗死、先前血运重建、慢性梗死后功能损害以及自我护理或康复方面已有适应性改变等因素带来的异质性,入组对象仅限于首次发病的心肌梗死患者,因为这些因素均可能独立影响基线护理依赖程度及后续的变化轨迹模式。
T1 定义为成功完成急诊治疗并恢复意识后的时间点,此时受试者能够可靠地完成所需的各项评估。
人口统计学和心血管相关临床数据的收集
采用一项针对本研究的通用信息问卷来收集年龄、性别、体重指数(BMI)、婚姻状况、心功能分级、心肌梗死类型、再灌注治疗策略以及基础疾病史。根据具体情况,通过问卷评估和病历审查获取人口统计学和心理社会信息。与心血管相关的临床特征,包括心功能分级、心肌梗死类型、再灌注治疗策略以及基础疾病史,均依据预先定义的标准从首次住院病历中提取。心功能分级从首次住院病历中提取,并在分析时分为I–II级和III–IV级。心肌梗死类型根据首次住院期间记录的诊断分为ST段抬高型心肌梗死(STEMI)和非ST段抬高型心肌梗死(NSTEMI)。基础疾病史以二分法编码为“无”(0)或“有”(1),“有”表示病史中至少记录了一种预先定义的慢性共病情况。
经皮冠状动脉介入治疗(PCI)和溶栓治疗的记录依据患者在首次住院期间实际接受的治疗,而非计划的治疗方案。年龄和体重指数(BMI)的原始连续数值被保留用于统计分析。
重复护理依赖性评估
在T1时间点使用了护理依赖量表(Care Dependency Scale, CDS5)。该量表包含15个条目,每个条目按1(完全依赖)至5(几乎独立)进行评分,总分范围为15至75分。得分越高,表示独立性越强,护理依赖程度越低。根据既定的CDS分类标准,60–69分表示有限程度的护理依赖,70–75分表示接近独立;因此,本研究将CDS总分<70分视为存在护理依赖的指标4,5。
CDS评估在入院后第3天(T2)、出院时(T3)以及出院1个月后(T4)重复进行。所有评估均采用相同的指导语、项目顺序、评分规则和辅助程序,以尽量减少测量不一致性。T4评估在计划的出院后1个月随访期间进行,可通过门诊现场访视完成,若无法现场访视时则通过电话进行。在两种情况下,均由经过培训的研究团队成员使用相同的标准化指导语、项目顺序和评分标准完成全部CDS项目的评估。
所有260名入组参与者均在全部四个时间点完成了CDS评估,在为期1个月的观察期内无失访参与者。
基线心理社会评估
在T1时间点进行了一次17项汉密尔顿抑郁量表(HAMD-17)6评估。第1–3、7–11、15和17项的评分范围为0到4,而第4–6、12–14和16项的评分范围为0到2。将各项得分相加,得到总分,范围为0到54,分数越高表示抑郁症状越严重。
在 T1 时间点进行一次广泛性焦虑障碍-7 项(GAD-7)7评估。七个条目中的每一项均按 0(完全不)到 3(几乎每天)评分,总分范围为 0 到 21。得分越高,表明焦虑症状越严重。
在T1时间点施测了一次社会支持评定量表(SSRS)8。该量表共包含10个条目。条目1–4和8–10采用1至4的4点计分法;条目5根据报告的支持水平从1到4计分;条目6和7则根据可用支持来源的数量计分。总分范围为12至66分,分数越高表示社会支持程度越高。
所有临床评定量表(CDS)和心理社会评估均由研究团队中受过培训的成员进行施测或监督。在受试者入组前,评估人员接受了关于问卷施测、条目解释、允许提供的帮助以及评分程序的标准化培训。研究过程中始终采用相同的标准化指导语、条目顺序和评分标准。不要求同一评估人员在每个时间点都对同一位受试者进行评估;通过标准化培训和统一的评估流程来确保不同评估人员之间的一致性。在可能的情况下,要求受试者独立完成问卷。当受试者在阅读、理解或书写方面遇到困难时,可提供标准化的一对一协助,但不得提示答案、代替受试者解释条目内容,或更改受试者的回答。
数据质量控制与缺失数据处理
在发放问卷之前,向参与者说明了研究目的、填写流程以及保密要求。所有参与者均采用标准化的指导语和相同的评估流程。问卷填写完成后立即检查是否存在遗漏或明显无效的条目。若某一条目未作回答,将要求参与者回顾该遗漏条目,并在愿意的情况下提供答案。当参与者需要协助时,研究人员不得为其提供建议、解释或代为作答。临床变量根据预先定义的标准进行提取,所有填写完毕的表格在数据录入前均经过核对验证。
所有260名参与者均完成了T1至T4时间点的CDS评估,无失访情况。纵向CDS数据以及分析中包含的人口统计学、临床和心理社会变量均完整。因此,所有260名参与者均被纳入分析,无需进行数据填补。
纵向CDS评分的增长混合模型分析
使用 Mplus 8.3 版本进行增长混合模型分析(GMM)。拟合了一个无协变量的无条件 GMM,将 CDS_T1、CDS_T2、CDS_T3 和 CDS_T4 作为连续的显变量输入。
采用稳健的最大似然估计法(MLR)依次拟合了一类至五类模型。为降低收敛至局部极大值的风险,生成了1,000组随机起始值,并保留最优的200组用于最终阶段的优化。针对每种模型,均确认了正常终止、在不同随机起始条件下最佳对数似然值的可重复性,以及无不可接受的参数估计值。
为每种模型解记录了赤池信息准则(AIC)、贝叶斯信息准则(BIC)、样本量调整的BIC(aBIC)、熵值、Lo-Mendell-Rubin调整似然比检验(LMR-LRT)以及自助法似然比检验(BLRT)。AIC、BIC和aBIC值越低,表明模型相对拟合越好;而熵值越接近1,则表示类别区分越清晰。
采用LMR-LRT和BLRT将每一 k 类解与相应的 k − 1 类解进行比较。最终模型的选择不仅基于信息准则的降低;还同时考虑了收敛稳定性、类别大小、后验成员概率、简约性以及临床可解释性。每位参与者被分配至后验成员概率最高的类别中,并计算类别特异的平均后验概率,作为分类质量的额外评估指标。
重复CDS测量结果的分析
为了评估整个队列中参与者在T1、T2、T3和T4时间点CDS评分的组内变化,采用单因素重复测量方差分析(RM-ANOVA),以评估时间作为组内因子。对近似正态性和球对称性假设进行了检验。采用Mauchly球对称性检验评估球对称性,当球对称性假设不满足时,采用Greenhouse–Geisser校正结果。所有检验均为双侧检验,P < 0.05被认为具有统计学显著性。
轨迹类别间的单变量比较
除GMM外的所有分析均使用IBM SPSS Statistics 26.0版完成。年龄、BMI、HAMD-17、SSRS和GAD-7评分均作为连续变量进行分析,未进行分类。
近似正态分布的连续变量以均值 ± 标准差表示,并通过单因素方差分析在四个轨迹类别间进行比较。分类变量以参与者数量表示,并采用皮尔逊卡方检验进行比较。所有 P 值均为双侧检验,以 P < 0.05 作为筛选变量纳入初始多变量模型的阈值。
在单因素分析中,年龄、婚姻状况、心功能分级、心肌梗死类型、经皮冠状动脉介入治疗(PCI)、溶栓治疗、HAMD-17 评分、SSRS 评分、GAD-7 评分以及基础疾病史符合 P < 0.05 的标准,因此被纳入初始多变量模型。性别和体重指数(BMI)不符合该标准。
多项逻辑回归及模型诊断
将四种轨迹类别视为名义型结局变量,采用多分类逻辑回归而非二元逻辑回归进行分析。C1(高独立性-缓慢改善)被设定为参照结局类别。
单变量分析中 P < 0.05 的所有变量均被纳入初始模型。随后采用向后似然比选择法,逐步剔除 P > 0.10 的变量。最终模型中保留了具有统计学意义的主要效应。
使用容差和方差膨胀因子(VIF)值评估多重共线性。在最终分析中,容差值范围约为 0.81 至 0.97,VIF 值范围为 1.03 至 1.24,表明不存在显著的多重共线性。
为降低过拟合风险,交互作用检验仅限于预先指定的临床合理术语。采用似然比检验分别评估了三个预先指定的交互项:年龄 × 基础疾病史、婚姻状况 × SSRS 评分、HAMD-17 评分 × GAD-7 评分。相应的 P 值分别为 0.655、0.301 和 0.908;因此,未保留任何交互项。
使用似然比检验将整体模型性能与仅截距模型进行比较;Pearson 和偏差优度拟合检验;Cox-Snell、Nagelkerke 和 McFadden 伪R²2 统计学;分类准确性;收敛性;完全或准完全分离的评估
报告了C2与C1、C3与C1以及C4与C1比较中所有最终预测因子的校正后比值比(OR)及其95%置信区间(CI)。较宽的置信区间被解释为提示估计精度有限,而非效应量较大的明确证据。
样本量考虑与报告
高斯混合模型(GMM)未采用单一通用的样本量阈值。样本充分性需结合模型复杂度、类别比例、类别可分性、缺失数据模式、熵值、后验概率及收敛性综合考虑9。
由于本研究是基于预设招募期间可获得的合格人群进行的探索性纵向调查,因此未进行正式的基于模拟的先验功效计算。最终的四分类解决方案包含66、54、90和50名参与者,熵值为0.879,平均后验概率范围为0.871至0.927。
对于多项逻辑回归,需根据每个结果类别中的参与者数量以及候选预测参数的数量来评估样本的充分性10。由于某些轨迹类别的样本量相对较小,该回归分析应被解释为一种探索性关联分析,而非构建明确的预测模型。
该观察性研究按照流行病学中观察性研究报告加强规范(STROBE)框架进行报告,包括研究设计、研究场所、参与者流程、数据来源、潜在偏倚来源、样本量、统计学方法、缺失数据处理、主要结果、局限性及可推广性。
结果
参与者流程与完整性
在招募期间,共评估了287名急性心肌梗死(AMI)患者是否符合入组条件。其中27名患者未被纳入:8名患者既往发生过心肌梗死,6名因意识障碍或认知功能受损无法完成研究评估,5名患有其他器质性心脏病,4名患有恶性肿瘤、多器官衰竭或其他严重全身性疾病,4名拒绝参与。其余260名参与者进入研究,完成了出院后1个月内全部四次认知功能筛查(CDS)评估,并被纳入最终的广义估计方程模型(GMM)及后续分析。所有纵向CDS数据均无缺失,无失访病例,报告分析中亦无任何需要插补的缺失人口统计学、临床或心理社会数据。
四类高斯混合模型的选择
从单类别到四类别模型,拟合指数逐步改善(表1)。四类别模型的AIC值为6978.826,BIC值为7047.822,aBIC值为6978.741,熵值为0.879,LMR-LRT P = 0.027,BLRT P < 0.001。模型估计的各类别比例分别为25.8%、21.0%、34.1%和19.1%。当增加第五个类别时,AIC、BIC和aBIC分别轻微下降至6963.213、7038.208和6962.613,熵值上升至0.912。然而,LMR-LRT(P = 0.128)和BLRT(P = 0.063)均未显示具有统计学意义的改善。此外,第五个类别仅占样本的6.4%。因此,最终保留四类别模型,因其在模型拟合度、稳定性、简洁性、类别规模及临床可解释性之间提供了最佳平衡。
收敛性与分类质量
四类别模型正常终止,且在多次随机起始点中最佳对数似然值被成功复制了18次。未发现不可接受的参数估计值。各类别最可能归属的平均后验概率分别为:C1为0.914,C2为0.889,C3为0.927,C4为0.871,表明类别间分离度可接受。
随时间变化的整体护理依赖性
在T1时点,总体平均CDS评分为48.28 ± 10.25;T2时为54.16 ± 14.33;T3时为52.82 ± 12.17;T4时为56.58 ± 15.15。单因素重复测量方差分析显示,四个评估时间点之间的CDS评分存在显著的总体差异(F = 13.692,P < 0.001)。在组水平上,CDS评分在第3天升高,出院时略有下降,出院后1个月再次升高。后期时间点观察到的更大变异性表明,总体平均模式掩盖了参与者之间的显著异质性。
轨迹模式
最可能的类别划分识别出四条轨迹:C1,高独立性-缓慢改善(n = 66,25.4%);C2,中度依赖性-快速恶化(n = 54,20.8%);C3,高度依赖性-显著改善(n = 90,34.6%);以及 C4,高度依赖性-缓慢加重(n = 50,19.2%;图1)。C1 在 T1–T4 时间点的平均 CDS 评分分别为 55.50、59.00、60.00 和 64.00;C2 的对应评分为 50.00、49.00、39.00 和 39.00;C3 为 43.22、59.35、61.86 和 70.90;C4 为 46.00、44.00、42.00 和 40.00。
单变量组间比较
C1–C4 组间的年龄差异具有显著性(分别为 58.20 ± 7.80、61.50 ± 7.40、55.80 ± 7.60 和 63.10 ± 7.20 岁;F = 12.572,P < 0.001;表 2)。各组间的体重指数(BMI)差异无显著性(分别为 23.60 ± 2.70、23.40 ± 2.80、23.80 ± 2.90 和 23.50 ± 2.60 kg/m2;F = 0.270,P = 0.847),性别分布也相似(χ2 = 0.142,P = 0.986)。婚姻状况(χ2 = 14.749,P = 0.002)、心功能分级(χ2 = 15.283,P = 0.002)、心肌梗死类型(χ2 = 15.035,P = 0.002)、经皮冠状动脉介入治疗(PCI)(χ2 = 12.863,P = 0.005)、溶栓治疗(χ2 = 15.622,P = 0.001)以及基础疾病史(χ2 = 27.903,P < 0.001)均存在显著差异。
C1–C4组的HAMD-17平均得分分别为10.80 ± 2.70、13.10 ± 2.90、11.20 ± 2.60和14.10 ± 3.00(F = 19.040,P < 0.001)。SSRS平均得分分别为43.00 ± 4.80、38.50 ± 5.00、42.00 ± 4.90和36.80 ± 5.10(F = 20.742,P < 0.001),GAD-7平均得分分别为9.50 ± 2.50、12.10 ± 2.80、10.00 ± 2.60和13.70 ± 3.00(F = 30.585,P < 0.001)。
最终的多项式回归
候选预测因子的编码方式见表3。通过向后似然比选择法,最终的多项逻辑回归模型保留了年龄、婚姻状况、HAMD-17、SSRS、GAD-7以及基础疾病史(表4)。在C2与C1的比较中,已婚状态与较低的C2类别归属概率相关(校正后OR = 0.241,95% CI = 0.095–0.612,P = 0.003);而较高的HAMD-17评分(OR = 1.324,95% CI = 1.121–1.564)、较高的GAD-7评分(OR = 1.374,95% CI = 1.160–1.626)、较低的SSRS评分(OR = 0.787,95% CI = 0.711–0.871)以及有基础疾病史(OR = 3.107,95% CI = 1.212–7.968)则与C2类别归属相关。在此比较中,年龄无统计学意义(P = 0.089)。在C3与C1的比较中,年龄是唯一具有统计学意义的保留预测因子(OR = 0.954,95% CI = 0.912–0.997,P = 0.036)。
与C1相比,C4类别的成员特征包括年龄较大(OR = 1.077,95% CI = 1.005–1.154)、未婚状态(已婚:OR = 0.248,95% CI = 0.085–0.720)、HAMD-17评分较高(OR = 1.466,95% CI = 1.214–1.772)、SSRS评分较低(OR = 0.727,95% CI = 0.646–0.819)、GAD-7评分较高(OR = 1.605,95% CI = 1.318–1.955),以及有基础疾病史(OR = 4.454,95% CI = 1.511–13.134)。
模型诊断
最终的多分类模型相较于仅含截距的模型具有显著改善(似然比 χ2 = 190.966,df = 18,P < 0.001)。Pearson(χ2 = 745.020,df = 759,P = 0.635)和偏差(deviance)(χ2 = 515.576,df = 759,P > 0.999)拟合优度检验均未提示模型拟合不佳。Cox-Snell、Nagelkerke 和 McFadden 伪 R2 值分别为 0.520、0.557 和 0.270,分类准确率为 53.1%。该模型在七次迭代后收敛,未发现完全或准完全分离的证据。部分基础疾病史的估计值具有相对较宽的 95% 置信区间(CI),提示精确度有限,需谨慎解释这些关联性。
数据可用性:
本研究发现的原始数据作为补充文件1随本文提供。
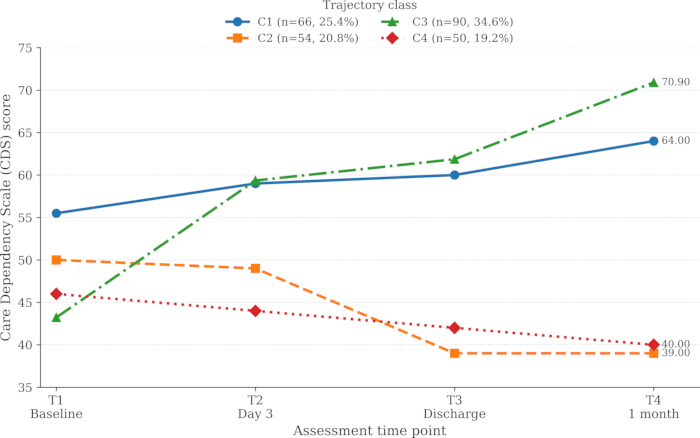
图1:急性心肌梗死患者护理依赖的纵向轨迹。 通过增长混合模型(GMM)识别出的四个潜在轨迹类别分别为:高独立性-缓慢改善(C1,n = 66,25.4%)、中度依赖-快速恶化(C2,n = 54,20.8%)、高度依赖-显著改善(C3,n = 90,34.6%)和高度依赖-缓慢加重(C4,n = 50,19.2%)。T1表示成功急诊治疗并恢复意识后的基线;T2表示入院后第3天;T3表示出院时;T4表示出院后1个月。纵轴表示各类别的特异性平均CDS评分,评分越高表示独立性越强,护理依赖程度越低。缩写:AMI = acute myocardial infarction;CDS = Care Dependency Scale;GMM = growth mixture modeling。 请点击此处查看该图的高清版本。
| 模型 | AIC | BIC | aBIC | 熵 | LMR-LRT P 值 | BLRT P 值 | 类别比例 (%) |
| 1 | 7353.11 | 7384.108 | 7355.567 | — | — | — | — |
| 2 | 7141.412 | 7184.409 | 7156.355 | 0.726 | 0.002 | <0.001 | 48.2/51.8 |
| 3 | 7032.275 | 7086.271 | 7049.704 | 0.813 | 0.015 | <0.001 | 35.1/42.7/22.2 |
| 4 | 6978.826 | 7047.822 | 6978.741 | 0.879 | 0.027 | <0.001 | 25.8/21.0/34.1/19.1 |
| 5 | 6963.213 | 7038.208 | 6962.613 | 0.912 | 0.128 | 0.063 | 29.7/31.2/20.4/12.3/6.4 |
表1:护理依赖轨迹的单类至五类增长混合模型的拟合指数。 较低的信息准则值表示相对模型拟合更优,而接近1的熵值表示类别区分更清晰。LMR-LRT 和 BLRT 用于比较 k 类模型与其对应的 k − 1 类模型。类别比例为模型估计的比例;最终的参与者数量和百分比基于最可能的后验类别分配。缩写:AIC = Akaike 信息准则;BIC = 贝叶斯信息准则;aBIC = 样本量调整的贝叶斯信息准则;LMR-LRT = Lo-Mendell-Rubin 调整似然比检验;BLRT = 自助法似然比检验。
| 项目 | 分类 | 高独立性-缓慢改善 (C1) (n = 66) | 中度依赖-快速恶化 (C2) (n = 54) | 高度依赖-显著改善 (C3) (n = 90) | 高度依赖-缓慢加重 (C4) (n = 50) | 统计量 | P 值 |
| 年龄(岁) | − | 58.20 ± 7.80 | 61.50 ± 7.40 | 55.80 ± 7.60 | 63.10 ± 7.20 | 12.572 | <0.001 |
| 性别 | 男性 | 43 | 35 | 58 | 31 | 0.142 | 0.986 |
| 女性 | 23 | 19 | 32 | 19 | |||
| BMI (kg/m²) | — | 23.60 ± 2.70 | 23.40 ± 2.80 | 23.80 ± 2.90 | 23.50 ± 2.60 | 0.27 | 0.847 |
| 婚姻状况 | 已婚 | 46 | 24 | 64 | 25 | 14.749 | 0.002 |
| 未婚 / 离异 / 丧偶 | 20 | 30 | 26 | 25 | |||
| 心功能分级 | I–II 级 | 41 | 22 | 60 | 20 | 15.283 | 0.002 |
| III–IV 级 | 25 | 32 | 30 | 30 | |||
| 心肌梗死类型 | ST段抬高型 | 50 | 35 | 44 | 37 | 15.035 | 0.002 |
| 非ST段抬高型 | 16 | 19 | 46 | 13 | |||
| 经皮冠状动脉介入治疗 | 是 | 45 | 38 | 62 | 21 | 12.863 | 0.005 |
| 否 | 21 | 16 | 28 | 29 | |||
| 溶栓治疗 | 是 | 52 | 49 | 66 | 29 | 15.622 | 0.001 |
| 否 | 14 | 5 | 24 | 21 | |||
| HAMD 评分 | − | 10.80 ± 2.70 | 13.10 ± 2.90 | 11.20 ± 2.60 | 14.10 ± 3.00 | 19.04 | <0.001 |
| SSRS 评分 | − | 43.00 ± 4.80 | 38.50 ± 5.00 | 42.00 ± 4.90 | 36.80 ± 5.10 | 20.742 | <0.001 |
| GAD-7 评分 | - | 9.50 ± 2.50 | 12.10 ± 2.80 | 10.00 ± 2.60 | 13.70 ± 3.00 | 30.585 | <0.001 |
| 基础疾病史 | 是 | 20 | 32 | 28 | 34 | 27.903 | <0.001 |
| 否 | 46 | 22 | 62 | 16 |
表2:不同护理依赖轨迹类别间特征的单变量分析。 连续变量以均值±标准差表示,采用单因素方差分析进行比较。分类变量以参与者数量表示,采用皮尔逊卡方检验进行比较。所有P值均为针对四个轨迹类别间的双侧总体比较。缩写:BMI = 体质指数;HAMD-17 = 17项汉密尔顿抑郁量表;SSRS = 社会支持评定量表;GAD-7 = 广泛性焦虑障碍-7项量表;PCI = 经皮冠状动脉介入治疗。
| 变量 | 赋值说明 |
| 年龄 | 输入原始数值 |
| 婚姻状况 | 未婚/离异/丧偶 = 0;已婚 = 1 |
| 心功能分级 | Ⅰ级、Ⅱ级 = 0;Ⅲ级、Ⅳ级 = 1 |
| 梗死类型 | 非ST段抬高 = 0;ST段抬高 = 1 |
| 介入治疗 | 否 = 0;是 = 1 |
| 溶栓治疗 | 否 = 0;是 = 1 |
| HAMD评分 | 输入原始数值 |
| SSRS评分 | 输入原始数值 |
| GAD-7评分 | 输入原始数值 |
| 基础疾病史 | 无 = 0;有 = 1 |
表3:多分类逻辑回归中候选预测因子的编码。 年龄、HAMD-17、SSRS 和 GAD-7 采用其原始的连续值输入。对于二分类变量,编码为0的类别作为参照类别:婚姻状况中的未婚/离异/丧偶;心功能I–II级;非ST段抬高型心肌梗死(NSTEMI);无经皮冠状动脉介入治疗(PCI);无溶栓治疗;无基础疾病史。缩写:HAMD-17 = 17项汉密尔顿抑郁量表;SSRS = 社会支持评定量表;GAD-7 = 广泛性焦虑障碍-7项量表;NSTEMI = 非ST段抬高型心肌梗死;PCI = 经皮冠状动脉介入治疗。
| 组间比较 | 变量 | β | SE | Wald χ² | P | 校正后 OR (95% CI) |
| C2 与 C1 比较 | 年龄 | 0.052 | 0.03 | 2.885 | 0.089 | 1.053 (0.992–1.118) |
| 已婚 | −1.422 | 0.475 | 8.951 | 0.003 | 0.241 (0.095–0.612) | |
| HAMD-17 | 0.281 | 0.085 | 10.893 | <0.001 | 1.324 (1.121–1.564) | |
| SSRS | −0.240 | 0.052 | 21.236 | <0.001 | 0.787 (0.711–0.871) | |
| GAD-7 | 0.317 | 0.086 | 13.607 | <0.001 | 1.374 (1.160–1.626) | |
| 基础疾病 | 1.134 | 0.48 | 5.567 | 0.018 | 3.107 (1.212–7.968) | |
| C3 与 C1 比较 | 年龄 | −0.047 | 0.023 | 4.389 | 0.036 | 0.954 (0.912–0.997) |
| 已婚 | 0.085 | 0.367 | 0.054 | 0.817 | 1.088 (0.531–2.233) | |
| HAMD-17 | 0.053 | 0.064 | 0.682 | 0.409 | 1.054 (0.930–1.195) | |
| SSRS | −0.048 | 0.034 | 1.982 | 0.159 | 0.953 (0.891–1.019) | |
| GAD-7 | 0.078 | 0.066 | 1.375 | 0.241 | 1.081 (0.949–1.231) | |
| 基础疾病 | 0.019 | 0.374 | 0.003 | 0.959 | 1.020 (0.490–2.123) | |
| C4 与 C1 比较 | 年龄 | 0.074 | 0.035 | 4.438 | 0.035 | 1.077 (1.005–1.154) |
| 已婚 | −1.394 | 0.544 | 6.574 | 0.01 | 0.248 (0.085–0.720) | |
| HAMD-17 | 0.383 | 0.097 | 15.733 | <0.001 | 1.466 (1.214–1.772) | |
| SSRS | −0.318 | 0.06 | 27.91 | <0.001 | 0.727 (0.646–0.819) | |
| GAD-7 | 0.473 | 0.101 | 22.111 | <0.001 | 1.605 (1.318–1.955) | |
| 基础疾病 | 1.494 | 0.552 | 7.332 | 0.007 | 4.454 (1.511–13.134) |
表4:与护理依赖轨迹归属相关因素的多分类Logistic回归分析。 C1(高独立性-缓慢改善)被设定为参照结果类别。报告了C2与C1、C3与C1以及C4与C1比较的校正后比值比(OR)及其95%置信区间(CI)。最终的主效应模型通过向后似然比选择法获得。该最终模型相较于仅含截距的模型有显著改善(似然比χ2 = 190.966,df = 18,P < 0.001),Nagelkerke伪R2为0.557,整体分类准确率为53.1%。缩写:OR = 比值比;CI = 置信区间;HAMD-17 = 17项汉密尔顿抑郁量表;SSRS = 社会支持评定量表;GAD-7 = 广泛性焦虑障碍-7量表。
补充文件 1: 支持本研究结果的原始数据。请点击此处下载该文件。
讨论
护理依赖性的纵向变化应进行描述性解读。在全队列水平上,CDS 评分的平均值为 48.28 ± 10.25(T1时),表明AMI急性期后早期存在显著的护理需求11CDS 评分增加至 54.16 ± 14.33 在急性治疗和早期恢复期间的 T2 时间点12,适度降低至 52.82 ± 出院时为12.17,之后再次升高至56.58 ± 出院1个月后为15.15。既往研究已指出急性心肌梗死(AMI)后参与心脏康复所面临的相关挑战。13然而,本研究并未直接评估康复参与情况或其他特定因素是否解释了所观察到的时间变化。潜在类别分析进一步表明,总体平均模式掩盖了四种显著不同的轨迹。这种异质性与既往心血管轨迹研究 broadly 一致,包括急性心肌梗死(AMI)后与健康相关的生活质量轨迹。14 冠心病患者自我护理轨迹15不同研究中类别数量和形态的差异可能反映了所测量的构念、评估时间表、患者人群、随访持续时间以及潜在类别模型分析方法的不同。
多个实验步骤对于结果的可重复性至关重要。首先,T1时间点的定义必须保持一致。基线评估应在成功完成急诊治疗并恢复意识后进行,因为在更早的时间点进行评估可能会捕捉到短暂的临床不稳定状态,而非可靠的生理功能状态。其次,CDS的施用应在全部四个时间点保持标准化,因为指导语或辅助程序的变化可能引入人为的纵向差异。第三,基线心理社会评估应与重复进行的CDS评估明确区分。HAMD-17、GAD-7和SSRS仅在T1时施测一次,而CDS则在T1至T4期间重复施测。最后,GMM模型的拟合应使用足够数量的随机起始点,并通过重复验证最优对数似然值、合理的参数估计、后验概率以及具有临床意义的类别规模来进行评估,而不应仅依据AIC或BIC值的降低来选择模型。
四分类解的选取说明了混合模型分析中的一个重要考量。增加第五个类别虽略微降低了信息准则并提高了熵值,但根据 LMR-LRT(P = 0.128)和 BLRT(P = 0.063)检验,五分类解并未表现出统计学上显著的改善,且引入了一个仅占样本 6.4% 的微小亚组,其临床区分意义有限。在类似的应用中,因此不应自动将每一个新增的类别解释为具有实际意义的生物学或临床亚群。当模型产生极小的类别、出现不稳定收敛、无法重复最优对数似然值、生成不合理的发展轨迹,或在起始值微小变动时表现出类别构成的显著变化时,应重新考虑更简化的模型。相反,若一个统计上更简单的模型混淆了临床上 distinct 且纵向轨迹明显分离的不同模式,则该模型可能并不合适。
相关因素分析应被视为探索性分析,而非预测性或因果性分析。年龄与轨迹类别归属存在特定类别的关联。既往针对急性心肌梗死(AMI)患者开展的前瞻性研究已发现,年龄较大是后续健康状况及日常生活活动能力下降的重要相关因素16,17。婚姻状况也与轨迹类别归属相关,一项系统综述和荟萃分析报告了婚姻状况或伴侣状况与心肌梗死后患者报告结局之间的关联18。AMI后较低的感知社会支持水平与较差的健康状况及抑郁症状相关19,而心肌梗死后心理困扰在临床上也具有重要意义20。前瞻性证据进一步表明,较低的感知社会支持与AMI后较差的躯体健康和心理健康结局相关21。在本研究中,基础疾病史与多个轨迹类别的比较存在关联,既往研究证据表明,共病情况与有AMI病史患者的机能障碍相关22。然而,本分析并未评估这些关联背后潜在的生理、行为或心理社会机制。因此,不应将研究结果解读为改变这些因素必然会影响轨迹类别归属的证据。
该方法存在若干局限性。本研究为单中心研究,采用便利抽样方法,可能引入了选择偏倚,并限制了外部有效性。研究仅纳入了首次发生心肌梗死的患者,因此所识别出的轨迹结构可能无法推广至有复发事件的患者。随访在出院后1个月结束,无法评估四种轨迹类别在更长时间内是否保持稳定。一些重要的心血管变量未被系统纳入,包括左心室射血分数、Killip分级、罪犯血管特征、手术成功率、住院期间并发症、详细的药物治疗、B型利钠肽、运动耐量以及是否参与结构化心脏康复。因此,无法排除与疾病严重程度、治疗强度及康复状态相关的残余混杂因素。
另一个局限性涉及某些类别特异性回归估计的精确性。未进行正式的基于模拟的先验样本量计算。尽管四类别GMM模型表现出稳定的收敛性和满意的分类质量,但某些轨迹组的样本量相对较小。因此,对于部分估计值(尤其是基础疾病史的相关估计)较宽的置信区间应谨慎解读。未来需要更大规模、多中心、前瞻性队列研究,延长随访时间,进行更全面的心血管表型分析,并开展独立验证,以确认所识别的类别结构及其相关因素。尽管存在这些局限性,结合重复CDS与GMM的分析框架仍为识别AMI人群早期恢复过程中的异质性模式提供了一种实用方法,并可能促进更个体化的护理评估与随访管理。
披露
作者声明无竞争利益。在本稿件的准备、撰写、编辑或图表生成过程中,未使用任何人工智能(AI)工具。
作者贡献:
所有作者均参与了本研究的构思与设计、数据收集与解读,以及稿件的撰写与修改。所有作者均审阅并批准了稿件的最终版本,并同意对工作的各个方面承担责任
致谢
作者感谢参与本研究的患者以及协助进行问卷发放、数据收集和随访的临床工作人员。本研究未从公共、商业或非营利机构的任何资助机构获得特定资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 护理依赖量表(CDS) | Dijkstra A, Buist G, Dassen T | N/A | 原始15项护理依赖性评估量表;得分越高,表明独立性越强。 |
| 中文版照顾依赖量表 | 张 SQ,朱 YM,李 L,等 | N/A | 本研究中引用的手稿中所使用的中文版本/验证来源,用于支持CDS申请。 |
| 一般信息问卷 | 研究团队,中国台湾林泉县人民’医院 | 研究开发;无目录号 | 用于收集年龄、性别、体重指数(BMI)、婚姻状况、心功能分级、心肌梗死类型、再灌注策略及基础疾病史的特定研究表格。 |
| 广泛性焦虑障碍-7(GAD-7) | Spitzer RL, Kroenke K, Williams JBW, Lö我们 B | N/A | 基线时(T1)施用的一次性7项焦虑量表。 |
| 17项汉密尔顿抑郁量表(HAMD-17) | Hamilton M | N/A | 已发表的临床医生评定抑郁量表;基线(T1)时采用17项评分方法。 |
| IBM SPSS Statistics | IBM 公司 | 版本 26.0 | 用于描述性统计、单因素方差分析、卡方检验和多分类逻辑回归的统计软件。 |
| IBM SPSS Statistics 26 文档 | IBM 公司 | 第26版文档 | IBM SPSS Statistics 26 官方文档资源 |
| Mplus | Muthén & Muthén | 版本 8.3 | 用于拟合一至五类别增长混合模型的统计软件;2019年4月30日发布了8.3版。 |
| Mplus 用户指南 | Muthén & Muthén | 第八版 / 版本 8 | 作为方法学软件资源使用的 Mplus Version 8 官方用户文档 |
| 社会支持评定量表(SSRS) | Xiao SY | N/A | 基线时(T1)施测一次已发表的10条目中国社会支持评定量表。 |
| STROBE 队列研究核对清单 | STROBE倡议 | 队列研究检查清单 | 用于审查纵向观察性研究报告完整性的报告清单 |
| STROBE 声明 | STROBE 倡议 | 2007年指南 | 观察性研究报告指南;用于研究设计、参与者、偏倚、统计方法、结果和局限性等方面的报告参考。 |
参考文献
- Cai D, et al. Sex differences in outcomes in patients with acute myocardial infarction. BMC Cardiovasc Disord. 2025;25(1):272.
- Liu M, et al. A patient with acute myocardial infarction with electrocardiogram Aslanger's pattern. BMC Cardiovasc Disord. 2024;24(1):3.
- Yu F, Yuan X, Fu S. Optimizing emergency nursing protocols to enhance outcomes in patients with acute myocardial infarction: a retrospective study. Medicine (Baltimore). 2025;104(23):e41412.
- Guo J, Chen Y, Dai Y, Chen Q, Wang X. Influencing factors of care dependence in patients with coronary heart disease after percutaneous coronary intervention: a cross-sectional study. Nurs Open. 2023;10(1):241-251.
- Zhang SQ, Zhu YS, Li L, Ye WQ. Reliability and validity analysis of the Chinese version of the Care Dependency Scale for elderly patients. J Nurs Sci. 2014;29(3):7-9. [in Chinese].
- Li CQ, Zhong GK. Application of several commonly used mental health rating scales in psychiatry. Chin J Clin Rehabil. 2005;(12):34. [in Chinese].
- Spitzer RL, Kroenke K, Williams JBW, Löwe B. A brief measure for assessing generalized anxiety disorder: the GAD-7. Arch Intern Med. 2006;166(10):1092-1097.
- Xiao SY. The theoretical basis and research application of the Social Support Rating Scale. J Clin Psychiatry. 1994;4(2):98-100. [in Chinese].
- Muthén LK, Muthén BO. How to use a Monte Carlo study to decide on sample size and determine power. Struct Equ Modeling. 2002;9(4):599-620.
- Pate A, et al. Minimum sample size for developing a multivariable prediction model using multinomial logistic regression. Stat Methods Med Res. 2023;32(3):555-571.
- Shen Y, et al. Observation on the application effect of stressor perception and response meticulous nursing in the perioperative period of acute myocardial infarction. Altern Ther Health Med. 2024;30(1):63-67.
- Nakamura K, Ohbe H, Uda K, Fushimi K, Yasunaga H. Early rehabilitation after acute myocardial infarction: a nationwide inpatient database study. J Cardiol. 2021;78(5):456-462.
- Wang L, Liu J, Fang H, Wang X. Factors associated with participation in cardiac rehabilitation in patients with acute myocardial infarction: a systematic review and meta-analysis. Clin Cardiol. 2023;46(11):1450-1457.
- Munyombwe T, et al. Quality of life trajectories in survivors of acute myocardial infarction: a national longitudinal study. Heart. 2020;106(1):33-39.
- Ingadóttir B, Svavarsdóttir MH, Jurgens CY, Lee CS. Self-care trajectories of patients with coronary heart disease: a longitudinal, observational study. Eur J Cardiovasc Nurs. 2024;23(7):780-788.
- Hajduk AM, Dodson JA, Murphy TE, Chaudhry SI. A risk model for decline in health status after acute myocardial infarction among older adults. J Am Geriatr Soc. 2023;71(4):1228-1235.
- Hajduk AM, et al. Risk model for decline in activities of daily living among older adults hospitalized with acute myocardial infarction: the SILVER-AMI study. J Am Heart Assoc. 2020;9(19):e015555.
- Zhu C, Tran PM, Leifheit EC. Association of marital/partner status and patient-reported outcomes following myocardial infarction: a systematic review and meta-analysis. Eur Heart J Open. 2023;3(2):oead018.
- Leifheit-Limson EC, et al. The role of social support in health status and depressive symptoms after acute myocardial infarction: evidence for a stronger relationship among women. Circ Cardiovasc Qual Outcomes. 2010;3(2):143-150.
- Levine GN, et al. Post-myocardial infarction psychological distress: a scientific statement from the American Heart Association. Circulation. 2025;152(16):e298-e310.
- Bucholz EM, et al. Effect of low perceived social support on health outcomes in young patients with acute myocardial infarction: results from the VIRGO (Variation in Recovery: Role of Gender on Outcomes of Young AMI Patients) study. J Am Heart Assoc. 2014;3(5):e001252.
- Bagai A, et al. Multimorbidity, functional impairment, and mortality in older patients stable after prior acute myocardial infarction: insights from the TIGRIS registry. Clin Cardiol. 2022;45(12):1277-1286.