本项计算研究提出了一种区分样本来源部位的流程,用于评估公共呼吸道病毒转录组数据,表明鼻腔和血液的宿主反应在基因水平上的一致性有限,但在独立数据集、临床比较、纵向恢复分析及稳健性分析中均能产生可重复且具有生物学可解释性的部位特异性模块。
本文内容
摘要
摘要
公共的呼吸道病毒转录组数据对于研究宿主反应具有重要价值,但组织来源、对照定义以及研究设计的差异可能干扰合并分析。我们开发了一种区分组织区室的计算流程,旨在确定是否能够在保留鼻腔和血液生物学背景的前提下,识别出可重复的宿主反应活性。配对的GSE117827儿童队列作为锚定数据集,包含来自有症状的微小核糖核酸病毒(picornavirus)感染、有症状的呼吸道合胞病毒感染、无症状的微小核糖核酸病毒检出以及病毒阴性对照的鼻拭子和全血转录组数据。在经过HUGO基因命名委员会(HGNC)筛选后,共分析了27,685个基因。分别从鼻腔和血液中基于最强的正向反应定义了独立的50个蛋白编码基因模块,并在外部验证前锁定。基因水平的鼻腔和血液效应几乎相互独立(Pearson r = 0.015),两个模块之间仅有六个探索性排序重叠基因(Jaccard指数 = 0.064)。尽管如此,在独立的上呼吸道队列中,鼻腔模块能够区分感染与对照,受试者工作特征曲线下面积(AUROCs)分别为0.749、0.693和0.609;而血液模块在外部血液队列中达到的AUROCs分别为0.832、0.924和0.870。在纵向自然感染数据中,配对评分从急性发病期到出院时均下降,鼻腔样本的配对差值为0.436,血液样本为0.330。另外三个包含666个外部样本的基准数据集,结合随机基因零模型、模块大小扫描、自举稳定性分析、标志物程序相关性以及方差分解,共同界定了该流程的稳健性与局限性。Pandya 33信使核糖核酸(mRNA)基因集在病毒与细菌鉴别方面仍表现更强,而血液模块在细菌性肺炎中也有所升高。这些结果支持将组织区室特异性的模块作为可重复使用的宿主反应活性评分工具,用于队列间比较和恢复过程追踪,而非作为通用的跨组织生物标志物或独立的病原体分类器。
引言
宿主转录组特征被广泛用于对感染综合征进行分类,并比较不同病原体之间的免疫应答1,2,3,4,5。呼吸道病毒通常会激活重叠的干扰素刺激基因(ISGs)、炎症介质以及抗原呈递通路6,7,8,9,10。近期的一些配对和纵向研究还表明,局部气道和全身性免疫应答在时间、细胞组成和强度方面可能存在差异11。这一问题不仅涉及流感病毒、呼吸道合胞病毒(RSV)、鼻病毒和SARS-CoV-2。人类偏肺病毒仍是导致呼吸道疾病的重要病因,但其宿主应答及相关干预措施的研究仍在发展之中12,13。这些关于呼吸道病毒感染的观察结果进一步凸显了局部气道与全身宿主应答之间的差异14。因此,对于计算型宿主-病毒研究而言,实际问题不仅在于某种应答是否存在,更在于公共数据是否能够通过一个透明的工作流程被重复利用,从而保留组织微环境信息,并生成可重复的宿主应答评分。
大多数公共的呼吸道病毒转录组数据集并非为清晰的跨病毒或跨组织推断而设计。组织来源、采样时间、疾病严重程度、年龄、对照定义以及检测平台等因素往往同时变化。高通量表达数据集也容易受到非预期的技术性变异和研究层面变异的影响15,16。因此,合并分析可能会恢复出强烈的干扰素或炎症信号,但却掩盖了其来源。鼻腔样本可捕获上皮和黏膜免疫生物学信息,而全血则反映全身性白细胞反应。将这些不同生物学区室视为可互换,虽便于评分计算,却导致结果难以解释。
我们围绕GSE117827构建分析,这是一个来自同一研究的配对鼻腔-血液队列,而非可获取的最大发现数据集17。该队列规模较小,但在比较鼻腔和血液效应量大小时,可减少不同研究之间的混杂因素。该队列包括有症状的微小核糖核酸病毒(picornavirus)感染、有症状的呼吸道合胞病毒(RSV)感染、无症状的微小核糖核酸病毒检出以及病毒阴性对照。因此,我们仅将其用作独立的、特定组织模块的锚定点。模块成员关系在外部验证前已固定。通过分层自助重抽样、随机基因零分布以及模块大小敏感性分析,评估了小队列筛选结果的稳定性。
我们添加了一个包含细菌性和非感染性对照的基准测试层。GSE63990 包含全血急性呼吸道疾病样本,标注为病毒性、细菌性或非感染性18。GSE40012 包含重度社区获得性肺炎、全身炎症反应综合征(SIRS)以及健康对照样本19。这些队列用于检验一个模块是反映宿主普遍应答活性,还是具有病原体类别特异性。GSE53543 被单独分析,作为体外外周血单个核细胞(PBMC)鼻病毒扰动的基准测试,用于测量白细胞在受控刺激下的应答能力,但其并不等同于自然感染。
我们的假设是有意保守的。我们并不试图从异质的公共数据中证明一种普适的抗病毒特征。相反,我们探讨的是:一种区分不同生物学区室的工作流程是否能够产生在外部验证中仍具实用价值的模块评分。这些模块的设计用途是作为诊断分类器(如 Pandya 33-mRNA)的补充。这些模块可在不同队列、恢复过程及症状梯度中对鼻腔和血液的宿主反应活性进行评分,但其并非用于判定病原体类别。
方案
本研究对已去标识的公开数据进行了重新分析,未涉及新的受试者招募、干预措施或样本采集。因此,本次二次分析无需机构伦理审批和新的知情同意。原始研究的伦理审批和知情同意情况已由相应的数据提供方报告。
研究设计与工作流程逻辑
我们开展了一项回顾性的公共数据生物信息学研究,使用了存放在基因表达综合数据库(Gene Expression Omnibus)中的数据集20,21。本研究未产生新的患者样本、细胞培养实验、动物模型或湿实验验证。工作流程采用“锚定优先”设计,以GSE117827数据集用于效应量估计、模块构建、跨舱室一致性分析及症状梯度分析。独立数据集仅在模块成员关系确定后才被引入。该工作流程包括配对舱室锚定、HGNC映射与蛋白编码基因筛选、分别进行鼻腔和血液模块构建、组织匹配及纵向验证、临床基准测试以及稳健性分析。验证性分析包括预先设定的组织匹配和纵向检验。重叠基因、症状梯度、标志物程序及方差分析则属于探索性或描述性分析。
锚定队列与主要对照
GSE117827 包含来自26名儿童的鼻拭子和全血表达谱:9例有症状的鼻病毒病例、5例无症状的鼻病毒检出、6例有症状的呼吸道合胞病毒(RSV)病例,以及6例无症状且病毒检测阴性的对照17有两例RSV病例缺乏血液标本。因此,完整的锚定设计共包含50个样本,在排除无症状小RNA病毒检出样本后,主要的感染组与对照组对比分析包含40个样本。在主要对比中,有症状的小RNA病毒感染样本和有症状的RSV样本被标记为感染组,无症状且病毒检测阴性的样本被标记为对照组。无症状的小RNA病毒检出样本未被归为对照组,因为无症状病毒检出在生物学上与病毒阴性健康状态存在本质区别。这些样本在模块构建阶段被排除,后续用于症状梯度分析。
探针定位与预处理
GSE117827 数据集基于 GPL23126 平台生成。使用 GEO 平台 GPL24539 提供的 Clariom D Human na36 hg38 注释文件,将转录本簇标识符映射至基因符号。仅保留经 HGNC 批准的基因符号22。去除对照探针、ERCC 探针、未映射的转录本簇以及未经批准的基因符号。对于映射到同一经批准基因符号的多个转录本簇,通过中位表达值进行合并。经过滤和合并后,共有 27,685 个基因可用于锚点分析。仅当表达矩阵的第 95 百分位数超过 50 时,才对数据进行 log₂(x + 1) 转换,以判断其是否处于未取对数的强度尺度。剔除缺失值比例超过 20% 的基因;其余基因的缺失值以该基因在所有样本中的中位值填补。随后,对每个基因在该数据集的所有样本中进行标准化处理,公式为 z = (x − 均值)/样本标准差(ddof = 1)。对于方差为零的基因,其标准化值设为 0。模块构建仅限于 HGNC 完整基因集中被分类为蛋白编码基因的条目。
效应量分析与模块构建
分别对鼻腔和血液样本进行分析。采用 Hedges g 标准化均值差和双侧 Welch 检验,将有症状病毒感染样本与病毒阴性对照组进行比较23。Hedges g 的计算方法为:(感染组均值减去对照组均值)除以合并标准差,再乘以小样本校正系数 1 − 3/(4df − 1),其中 df = ninfected + ncontrol − 2。Welch 检验采用异方差假设。在每个样本舱室中,所有检测基因的 Benjamini–Hochberg 错误发现率(FDR)均经过校正24。由于在小型锚定队列中,没有任何蛋白编码基因同时达到预设的严格标准(FDR < 0.05 且 Hedges g > 0.8),因此阳性效应基因首先按双侧 Welch 检验 P 值升序排列,其次按 Hedges g 降序排列,基因符号作为最终确定性的并列排序依据。排名前 50 的基因构成每个主要模块。预先选择 50 个基因作为中等大小的模块,旨在保持生物学多样性的同时,尽量减少不同检测平台间因基因缺失而导致的信息损失。该模块大小并未针对外部 AUROC 进行优化。使用 10、25、50、100 和 200 个基因进行的敏感性分析均得到一致的定性锚定分离结果。本研究的目标是模块水平的可重复性,而非单个基因的发现。
跨区室一致性
通过基因匹配对鼻腔和血液的 Hedges g 估计值进行比对,并采用皮尔逊相关系数和斯皮尔曼相关系数进行比较。鼻腔前50个模块与血液前50个模块之间的重叠情况以重叠基因数量和雅卡尔指数进行总结。重叠基因被解释为探索性的跨区室排序重叠候选基因,而非已验证的保守生物标志物。
外部组织匹配验证
模块评分验证使用了具有可解释来源分组的独立公共数据集。上呼吸道验证包括 GSE41374 RSV 鼻洗样本以及 SARS-CoV-2 数据集 GSE152075 和 GSE156063。血液验证包括 GSE171110 和两个分别标准化的 GSE38900 子集:GPL10558(36 个样本;28 个 RSV 样本和 8 个对照)和 GPL6884(138 个样本;107 个 RSV 样本和 31 个对照)。对于每个外部数据集,探针被映射到 HGNC 基因符号,并通过中位表达值合并重复的基因符号。每个数据集内部均应用了与锚定数据集相同的转换方法、缺失值过滤、中位值填补以及每个基因的 z 标准化规则。模块评分被计算为对应模块基因标准化表达值的未加权均值。报告的 AUROC、平均精确度和 Welch 检验 FDR 作为可迁移性指标,而非临床诊断性能的估计值。
大型临床基准和离体扰动数据集
使用了两个全血数据集作为临床基准,而非发现队列。在GSE63990中,样本根据已提交的感染状态元数据被分配至病毒性呼吸道感染(n = 117)、细菌性呼吸道感染(n = 73)或非感染性疾病(n = 90);未明确标注上述任一类别的样本被排除18。在GSE40012中,已提交的诊断字段被归类为甲型流感肺炎(n = 39)、非流感性细菌性肺炎(n = 61)、无肺炎的全身炎症反应综合征(SIRS)(n = 40)、健康对照(n = 36)或混合性细菌/流感肺炎(n = 14)19。混合性细菌/流感样本虽有描述,但在二分类基准比较中被排除。
GSE53543 包含来自 98 名个体的 196 个离体外周血单个核细胞(PBMC)表达谱。每名个体提供一个仅含培养基的样本和一个暴露于鼻病毒 16 型 24 小时的样本;受试者标识符确认了 98 对完整配对样本。主要基准分析在 98 个刺激样本和 98 个未刺激样本之间报告了 AUROC,因为 AUROC 是一种排序分离度量指标。受试者配对信息保留在元数据中,并用于对评分差异进行配对敏感性分析。该实验独立于自然临床感染进行分析,未用于支持临床诊断声明。
从GEO数据库下载了GSE63990、GSE40012和GSE53543系列的原始数据矩阵。GSE63990使用GPL571平台,GSE40012使用GPL6947平台,GSE53543使用GPL10558平台。探针被映射到HGNC批准的基因符号,并通过中位表达值合并重复映射。使用已提交的标准化矩阵数据。通用的第95百分位规则仅对未取对数尺度的矩阵触发log₂(x + 1)转换。GSE53543数据已由原始研究者完成log₂转换、基于秩不变性的标准化,并校正了样本处理日期的影响,因此未再进行额外的对数转换。在剔除缺失值超过20%的基因后,对剩余的缺失值采用中位数填补法进行插补,随后在每个数据集中对所有样本中的每个基因进行z标准化。基准层包含470例临床全血样本和196例体外分离的外周血单个核细胞(PBMC)样本。
参考特征基准测试
锚定的鼻腔和血液模块针对三个未加权的参考集进行了基准测试。官方Pandya 33-mRNA集合从原始分类器报告的补充表1中转录而来5。Andres-Terre比较集包含33个以干扰素为导向的基因,这些基因选自已报道的多病毒特征3。Hallmark比较集包含一个由33个基因组成的干扰素-α核心子集,与MSigDB HALLMARK_INTERFERON_ALPHA_RESPONSE集合相关联25,26。所有三个参考集的完整基因列表见补充数据1。这些参考评分并未重现原始的加权分类器。对于每个数据集,评分计算为可用的单基因z得分的未加权均值;要求至少包含三个代表基因,并报告代表基因的数量。基准比较包括病毒 vs 细菌、病毒 vs 非感染性、病毒 vs 细菌或非感染性、病毒 vs 健康/对照,以及细菌 vs 健康/对照(在具备相应组别的情况下)。AUROC和平均精确度被用作基准评估指标。Welch检验的P值通过Benjamini–Hochberg方法,在基准表中所有有效的数据集-比较-模块组合范围内进行多重检验校正。
独立纵向验证
配对的急性期与出院期数据集 GSE97741 和 GSE97742 仅用于纵向验证27。根据数据库中注释为呼吸道合胞病毒单一感染(RSVsi)或鼻病毒(hRV)的样本进行主要分析;呼吸道合胞病毒共感染(RSVco)样本仅保留在补充结果中。急性期和出院期标签从样本名称中提取。样本按数据集、部位、病毒组和受试者标识符进行匹配,仅保留具有两个时间点的受试者。主要合并组包括 38 对 RSVsi 和 30 对 hRV 样本(每个部位共 68 对样本)。
未对GSE97741或GSE97742使用基因筛选、模块优化或阈值调整。这些数据集保留用于外部验证。探针标识符被映射到经批准的HGNC符号,并通过中位表达值合并重复的符号。在计算固定的GSE117827模块评分之前,对所有数据应用相同的第95百分位对数转换规则、缺失值过滤、中位值填补以及每数据集内基因的z标准化处理流程。
针对每种组织和模块,根据受试者和病毒分组对急性期和出院时的评分进行配对。计算每对评分的急性期减去出院时的差值。Cohen dz 通过配对差值的均值除以其样本标准差计算得出。报告了双侧配对 t 检验和双侧 Wilcoxon 符号秩检验,同时报告急性期与出院时评分分离的 AUROC 值。在完整的纵向分析结果中,对全部 20 个有效的配对 t 检验(两个数据集、两种模块来源和五种预先指定的病毒分组汇总)计算 Benjamini–Hochberg FDR 值。
症状梯度与事后分析
在模块成员关系确定后,GSE117827 中保留的无症状小RNA病毒检出数据仅用于症状梯度分析。有序临床评分定义如下:病毒阴性对照组评分为 0,无症状小RNA病毒检出者评分为 1,有症状感染者评分为 2。采用斯皮尔曼相关分析评估有序趋势,而克鲁斯卡尔-沃利斯检验用于评估三组之间的总体差异。随后进行双侧曼-惠特尼 U 检验,对三组两两之间进行事后比较。在每个 compartment 内,对三个成对比较组成的检验家族分别进行本杰明尼-霍赫伯格校正。
功能富集分析
通过 gseapy 软件,使用 MSigDB Hallmark 2020、Reactome 2022 和 GO 生物过程 2023 数据库,对鼻腔和血液模块基因进行 Enrichr 分析25,26,28,29,30,31。Enrichr 采用基于 Fisher 精确检验的标准超几何富集分析框架。以数据库报告的经 Benjamini–Hochberg 校正的 P 值 < 0.05 作为显著性阈值。针对每个模块,在三个数据库中查询得到的最显著的八个功能条目按校正后的 P 值进行排序。富集分析结果仅用于生物学意义解读。
稳健性、标记基因程序及方差分析
稳健性分析用于检验结果是否依赖于模块大小或随机选择。评估了包含 10、25、50、100 和 200 个基因的模块大小。在随机基因零模型分析中,可用基因集为经处理的 GSE117827 矩阵中所包含的 HGNC 蛋白编码基因。使用 NumPy 随机种子 20260622,无放回地抽样 500 次,每次抽取 50 个基因组成的基因集。Bootstrap 重抽样限制在每个区室原始锚定分析中正效应排名最高的 1,000 个蛋白编码基因内进行。在每次重抽样中,正向蛋白编码基因首先按双侧 Welch P 值升序排列,再按平均差异降序排列,选取排名前 50 的基因。基因稳定性定义为被选中次数除以 100。展示每个区室中被选中频率最高的前 20 个基因。
标记物程序评分被用作描述性辅助工具,而非细胞组分的估计值。共评估了六种经过整理的程序:上皮细胞(EPCAM, KRT8, KRT18, KRT19, MUC1, KRT5, KRT14, SCGB1A1, FOXJ1)、单核细胞/巨噬细胞(LYZ, LST1, S100A8, S100A9, FCGR3A, FCGR1A, CD14, MS4A7, CTSS)、中性粒细胞(S100A8, S100A9, MPO, ELANE, CEACAM8, FCGR3B, OLFM4, MMP8)、T/NK细胞(CD3D, CD3E, TRAC, NKG7, GNLY, PRF1, GZMB, KLRD1, IL7R)、B细胞/浆细胞(MS4A1, CD79A, CD79B, MZB1, JCHAIN, IGHG1, SDC1)以及髓系干扰素反应(SIGLEC1, IFI27, IFI44L, ISG15, MX1, OAS1, RSAD2, IFIT3)。每个程序评分计算为所有可用基因z分数的平均值,且要求至少包含三个代表基因。Spearman P 值通过Benjamini–Hochberg方法对整个数据集-模块-程序相关性家族进行校正。单因素eta平方值通过每个模块-因子对的组间平方和除以总平方和计算得出。在该计算中,排除了缺失相应因子的行。此分析为描述性分析,未对相互关联的因子进行调整。
可重复性
所有分析均使用 Python 3.12.13 中的脚本化工作流程进行,并在材料表中报告了所用软件包及其版本。随机化过程采用固定的随机种子 20260622。公共 GEO 表达矩阵的处理采用一致的项目结构,将原始输入、处理后的数据、统计输出、表格和图表分离开来。模块定义、样本管理记录、效应量估计、验证统计结果、富集分析结果、稳健性分析结果以及图表源数据均予以保留,以支持独立验证。分析代码、依赖项说明及相关的衍生数据详见数据可用性声明。
结果
通过锚定步骤基准测试,将组织特异性基因效应与泛组织基因效应区分开来
经过人工审校的 GSE117827 锚定矩阵包含 27,685 个经 HGNC 批准的基因。主要的鼻腔对比包括 15 个有症状感染样本和 6 个病毒阴性对照样本;血液对比包括 13 个有症状感染样本和 6 个对照样本(表 1)。由于该小规模队列无法支持稳定的单基因发现,因此被用作配对比较的锚定参照。模块水平的稳定性通过自助重抽样、随机基因零假设检验、外部验证以及模块大小敏感性分析进行评估。
| 来源 | 组别 | 条件 | 主要对照 | n |
| 血液 | RSV | 感染 | 是 | 4 |
| 血液 | 无症状性鼻病毒 | 次要 | 否 | 5 |
| 血液 | 有症状性鼻病毒 | 感染 | 是 | 9 |
| 血液 | 病毒阴性对照 | 对照 | 是 | 6 |
| 鼻腔 | RSV | 感染 | 是 | 6 |
| 鼻腔 | 无症状性鼻病毒 | 次要 | 否 | 5 |
| 鼻腔 | 有症状性鼻病毒 | 感染 | 是 | 9 |
| 鼻腔 | 病毒阴性对照 | 对照 | 是 | 6 |
表1:经主要对照筛选后的GSE117827锚定设计。 在完成主要对照筛选后,配对锚定数据集中血液与鼻腔样本的分布情况。有症状的呼吸道合胞病毒(RSV)和有症状的鼻病毒样本被归类为感染组,并纳入主要对照;病毒检测阴性对照样本被归类为对照组,同样纳入主要对照。无症状的鼻病毒样本被指定为次要组,不参与模块构建,仅用于探索性症状梯度分析。两例RSV病例缺乏血液样本,因此共有4份血液样本和6份鼻腔样本来自RSV感染者。
在27,685个共有基因中,鼻腔和血液的Hedges g 估计值几乎不相关(Pearson r = 0.015;图1)。该结果来自同一项研究,相较于合并的跨队列比较,受研究间差异的影响更小。密集的中心云状分布表明,大多数基因在两个部位中的变化趋势并不一致。被突出显示的重叠基因则是两个排序列表顶端的例外情况。这一模式支持分别构建鼻腔和血液的模块。
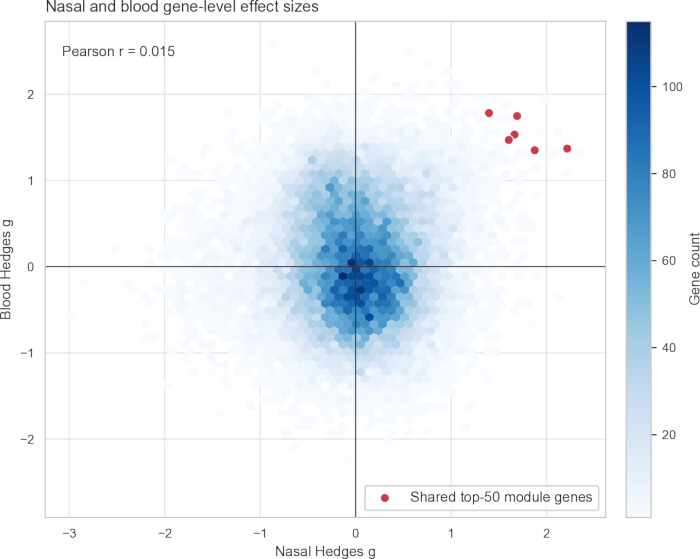
图1。配对GSE117827锚定队列中鼻腔和血液的基因水平效应量。 Hedges g 值比较了27,685个基因在有症状感染个体与病毒阴性对照之间的差异。x轴显示鼻腔估计值(15名感染者,6名对照),y轴显示血液估计值(13名感染者,6名对照)。六边形箱的着色表示每个箱内的基因数量。红色点表示鼻腔和血液前50个模块中共同存在的6个基因。Pearson r = 0.015。 请点击此处查看该图的放大版本。
模块构建产生了一个以干扰素为中心的小范围重叠
鼻腔和血液的前 50 个模块共有六个基因:ISG15、ACRBP、IFIT1、RSAD2、CCRL2 和 XAF1(Jaccard 指数 = 0.064;表 2;图 2)。ISG15、IFIT1、RSAD2 和 XAF1 与干扰素相关的抗病毒生物学功能一致32,33,34。CCRL2 更适合在炎症性白细胞迁移的背景下进行解释35。ACRBP 目前尚无明确的抗病毒作用。出于透明性考虑,所有六个基因均被列出,但并未声称其中任何一个为经过验证的跨组织生物标志物。这些单个基因在小型锚定队列中的 FDR 值均无统计学意义。因此,主要推论基于锁定的模块水平验证,而非重叠基因列表。
| 基因 | 鼻部 Hedges g | 鼻部 FDR | 血液 Hedges g | 血液 FDR | 解释 |
| ISG15 | 2.215 | 0.213 | 1.369 | 0.442 | 干扰素刺激的抗病毒基因;探索性重叠 |
| ACRBP | 1.69 | 0.205 | 1.748 | 0.429 | 无明确抗病毒功能;为透明性保留 |
| IFIT1 | 1.875 | 0.213 | 1.35 | 0.442 | 干扰素刺激的抗病毒基因;探索性重叠 |
| RSAD2 | 1.663 | 0.213 | 1.532 | 0.442 | 干扰素刺激的抗病毒基因;探索性重叠 |
| CCRL2 | 1.396 | 0.217 | 1.782 | 0.442 | 与炎症性白细胞迁移相关;非病毒特异性 |
| XAF1 | 1.603 | 0.226 | 1.47 | 0.442 | 与干扰素相关的凋亡因子;探索性重叠 |
表2:鼻腔和血液模块前几位的探索性重叠分析。 所有六个共享基因均列出了其在鼻腔和血液中的Hedges g值以及基因水平的FDR值。由于在较小的锚定队列中基因水平FDR值未达到显著性,这六个基因均被视为探索性的排序重叠候选基因。尽管ACRBP缺乏已确立的抗病毒功能,仍为透明起见予以保留。这六个基因中无一被作为已验证的通用生物标志物呈现;主要证据基于模块水平的外部验证。
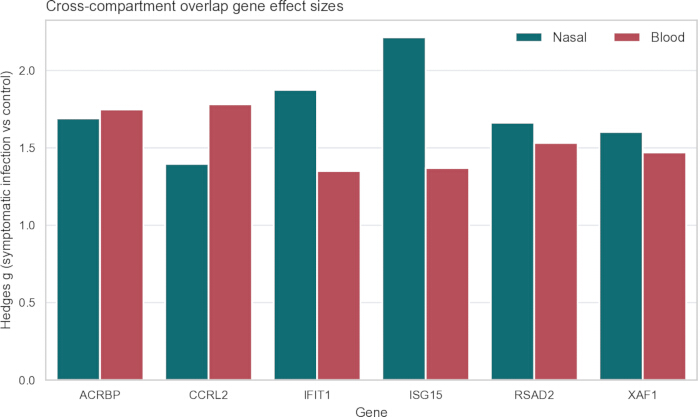
图2。六个探索性鼻腔-血液重叠基因的效应量。 在GSE117827数据集中展示了ACRBP、CCRL2、IFIT1、ISG15、RSAD2和XAF1的鼻腔和血液Hedges g估计值。正值表示在有症状感染组中的表达高于病毒阴性对照组。此处展示了完整的重叠结果以保证透明性;单个基因的FDR值无显著性,因此这些基因不作为已验证的通用生物标志物呈现。请点击此处查看该图的放大版本。
功能富集分析为模块内容提供了生物学验证
两个模块均富集于干扰素和抗病毒通路,但基因组成和富集强度存在差异(图3)。图中展示了每个模块中富集最显著的八个术语。在鼻腔模块中,Hallmark干扰素-γ反应(校正后P = 2.23 × 10⁻24)、Hallmark干扰素-α反应(校正后P = 1.40 × 10⁻22)、Reactome干扰素-α/β信号通路(校正后P = 3.64 × 10⁻19)以及GO病毒防御反应(校正后P = 5.47 × 10⁻15)位居前列。血液模块显示出相似的生物学功能,但富集强度较低:干扰素-α反应(校正后P = 3.87 × 10⁻6)、Reactome干扰素-α/β信号通路(校正后P = 5.70 × 10⁻6)、干扰素-γ反应(校正后P = 8.89 × 10⁻6)以及病毒防御反应(校正后P = 1.07 × 10⁻4)。这些结果支持模块内基因集合具有生物学一致性,但并不意味着不同组织间基因排序完全相同。
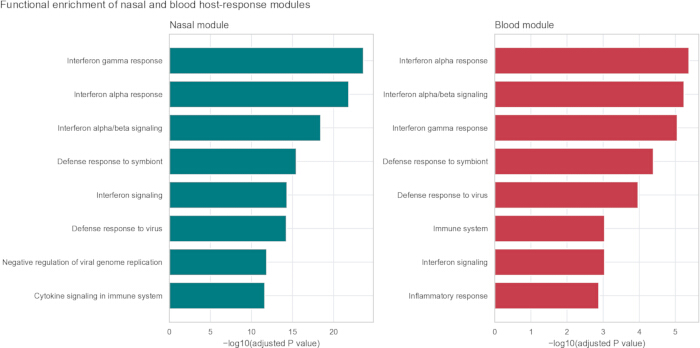
图3鼻腔和血液模块的精选富集术语。 使用 Enrichr 对 Hallmark 2020、Reactome 2022 和 GO 生物过程 2023 数据库进行通路富集分析。选取 Benjamini–Hochberg 校正后 p 值最小的八个术语 P 每个模块的值均已显示。条形长度代表 −log10(调整后) P 值)。左侧面板和右侧面板分别显示鼻腔模块和血液模块。术语以句子首字母小写形式呈现。富集分析未改变模块成员归属。 请点击此处以查看此图的放大版本。
在组织匹配的外部验证中测试了锁定模块
锁定的鼻腔模块在 GSE41374 中达到 AUROC 0.749,在 GSE152075 中为 0.693,在 GSE156063 中为 0.609(表 3;图 4)。锁定的血液模块在 GSE171110 中达到 AUROC 0.832,在 GSE38900 GPL10558 单元中为 0.924,在 GPL6884 单元中为 0.870。内部锚点性能被省略,因其在构建上存在乐观偏差。外部 AUROC 被视为可移植性总结指标,不能用于确立临床敏感性、特异性或诊断适用性。
| 队列 | 样本/病毒 | 模块 | 阳性数 | 阴性数 | 表达的基因数 | AUROC | 平均精确度 | Welch检验FDR |
| GSE152075 | SARS-CoV-2 上呼吸道 | 鼻腔 | 430 | 54 | 50 | 0.693 | 0.935 | 2.20 × 10⁻⁴ |
| GSE156063 | SARS-CoV-2 上呼吸道 | 鼻腔 | 93 | 100 | 49 | 0.609 | 0.551 | 1.38 × 10⁻² |
| GSE171110 | SARS-CoV-2 全血 | 血液 | 44 | 10 | 50 | 0.832 | 0.959 | 7.94 × 10⁻⁴ |
| GSE38900-GPL10558 | RSV 全血 | 血液 | 28 | 8 | 50 | 0.924 | 0.979 | 7.94 × 10⁻⁴ |
| GSE38900-GPL6884 | RSV 全血 | 血液 | 107 | 31 | 49 | 0.87 | 0.962 | 3.47 × 10⁻¹⁵ |
| GSE41374 | RSV 鼻洗液 | 鼻腔 | 76 | 10 | 50 | 0.749 | 0.951 | 2.63 × 10⁻² |
表3:外部组织匹配模块评分验证。 锁定的鼻腔模块在GSE41374、GSE152075和GSE156063中进行了测试,锁定的血液模块在GSE171110以及GSE38900平台单元GPL10558和GPL6884中进行了测试。该表报告了阳性与阴性样本数量、代表性模块基因、AUROC、平均精确度以及Welch检验的FDR。内部锚点性能未列出。AUROC和平均精确度作为可移植性总结进行报告,而非临床诊断性能的估计值。
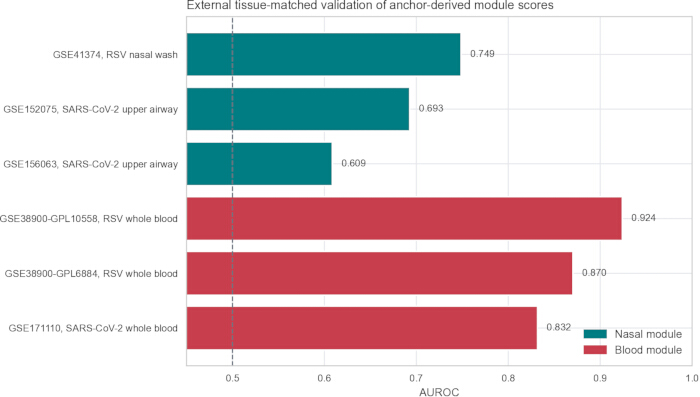
图 4.外部组织匹配的模块评分可转移性。 显示了在 GSE41374(76 例 RSV,10 例对照)、GSE152075(430 例 SARS-CoV-2,54 例对照)和 GSE156063(93 例 SARS-CoV-2,100 例对照)中鼻腔模块的 AUROC,以及在 GSE171110(44 例 SARS-CoV-2,10 例对照)、GSE38900-GPL10558(28 例 RSV,8 例对照)和 GSE38900-GPL6884(107 例 RSV,31 例对照)中血液模块的 AUROC。评分为各基因 z 值的未加权平均值。虚线表示 AUROC = 0.5。这些数值为可转移性汇总结果,而非临床诊断估计值。请点击此处查看该图的放大版本。
纵向验证用于检测评分在恢复期间是否下降
GSE97741/GSE97742 配套数据集提供了一个独立的自然感染验证环境,包含住院儿童的急性期和出院时的样本27。这些样本未被用作健康对照的发现数据,而是用于评估由锚点推导出的模块评分是否从急性发病期到出院期间有所下降。
对于预先设定的 RSV 单独感染与鼻病毒组合组,每种组织中均分析了 68 对配对样本(表 4;图 5)。血液模块在从急性发病期到出院期间的血液样本中下降(平均 delta = 0.330;Cohen dz = 0.740;配对检验 FDR = 1.98 × 10⁻7;AUROC = 0.765)。鼻腔模块在鼻咽样本中也出现下降(平均 delta = 0.436;Cohen dz = 0.477;配对检验 FDR = 3.06 × 10⁻4;AUROC = 0.679)。配对轨迹及其标准误表明,群体水平的下降并非由少数未配对的极端值所驱动。
| 数据集 | 样本来源 | 模块 | 组织匹配 | 配对数 n | 平均急性期-出院期差值 | Cohen dz | AUROC | 配对检验FDR |
| GSE97741 | Blood | Blood | 是 | 68 | 0.330 | 0.740 | 0.765 | 1.98 × 10⁻⁷ |
| GSE97741 | Blood | Nasal | 否 | 68 | 0.479 | 0.721 | 0.755 | 3.19 × 10⁻⁷ |
| GSE97742 | Nasopharyngeal | Blood | 否 | 68 | 0.361 | 0.914 | 0.845 | 9.42 × 10⁻¹⁰ |
| GSE97742 | Nasopharyngeal | Nasal | 是 | 68 | 0.436 | 0.477 | 0.679 | 3.06 × 10⁻⁴ |
表4:独立纵向急性期与出院时对比验证。 该表报告了在GSE97741和GSE97742中,固定模块的完整配对样本数量、急性期减去出院时评分差值的均值、Cohen dz、AUROC以及配对检验的FDR。正的delta值表示急性期模块评分更高。配对检验FDR值是经Benjamini–Hochberg法校正的双侧配对t检验P值,基于全部20个有效配对t检验在完整纵向结果中计算得出。
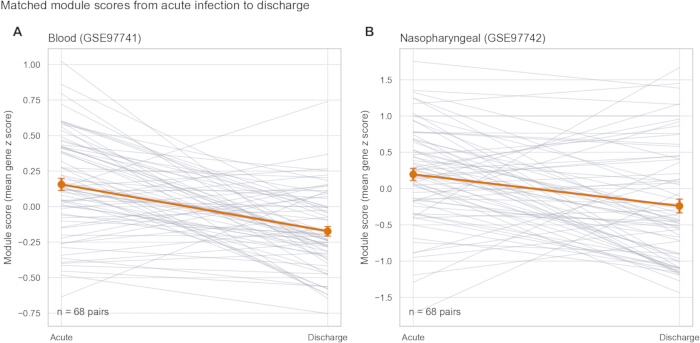
图5.从急性发病期到出院期间配对的模块评分变化。 (A)全血样本中的血液模块评分(GSE97741)。(B)鼻咽样本中的鼻腔模块评分(GSE97742)。每个图包含68对完整的受试者数据:38例呼吸道合胞病毒(RSV)单一感染和30例鼻病毒(rhinovirus)感染。细线连接同一受试者前后匹配的测量值。橙色点表示组均值,橙色误差线表示均值的标准误。采用双侧配对t检验和Wilcoxon符号秩检验;对20项有效的纵向配对t检验结果应用Benjamini–Hochberg法进行FDR校正。请点击此处查看该图的放大版本。
跨区室检测揭示了一个有用的细微差异。将血液模块应用于鼻咽样本时,其AUROC为0.845,尽管在锚定样本中,鼻腔和血液的个体效应量一致性较弱。对成对轨迹的检查显示,评分呈一致下降趋势,而非标签分布反转。因此,该结果并不能证明相同的关键基因在两种组织中均占主导地位。这表明,协调性的干扰素/炎症程序可通过不同但部分冗余的基因集进行概括。区室特异性在基因排序水平上最强,而在通路或评分水平上并非绝对。
排除的无症状检出样本用于检验症状梯度效应
在GSE117827数据集中,无症状的微小核糖核酸病毒(picornavirus)检出样本被排除在模块构建之外,以避免其被纳入主要对照组。该被排除的组别随后提供了生物学验证。在两个区室中,模块评分均随着病毒阴性对照、无症状微小核糖核酸病毒检出及有症状感染的有序分组呈现上升趋势(图6A、B)。
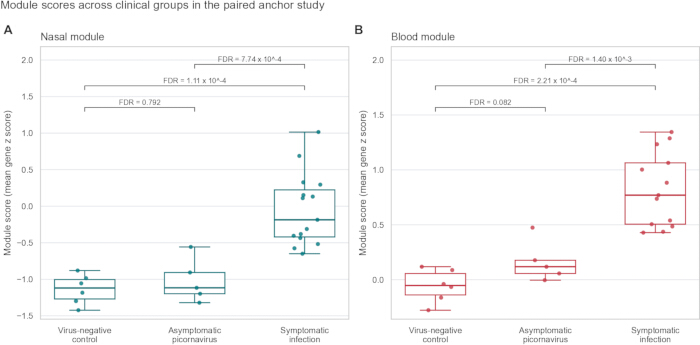
图 6。在保留的症状梯度中各模块评分的分布。(A)鼻腔模块:6 例病毒阴性对照,5 例无症状小核糖核酸病毒感染检出,以及 15 例有症状感染。(B)血液模块:6 例病毒阴性对照,5 例无症状小核糖核酸病毒感染检出,以及 13 例有症状感染。数据点代表单个样本。中心线表示中位数;方框范围为第 25 至第 75 百分位数;须线延伸至 1.5 倍四分位距范围内的最极端值。标签显示每个区室中三组两两比较的双侧 Mann–Whitney U 事后检验结果,并经 Benjamini–Hochberg 方法校正。请点击此处查看该图的高清版本。
鼻腔模块与症状评分等级呈正相关(Spearman rho = 0.818,P = 3.28 × 10⁻7;Kruskal-Wallis P = 1.57 × 10⁻4)。血液模块也表现出类似的梯度变化(rho = 0.861,P = 6.89 × 10⁻8;Kruskal-Wallis P = 1.92 × 10⁻4)。在校正每组三个比较关系后,有症状感染组在两个部位均显著区别于对照组和无症状检出组。无症状检出组与病毒阴性对照组之间无显著差异(鼻腔FDR = 0.792;血液FDR = 0.082)。因此,这两个模块比单独检测病毒更能清晰地反映有症状宿主的免疫应答活动。
临床基准界定了宿主反应与病原体特异性之间的界限
临床基准明确了宿主反应活性与病原体分类之间的区别(表5;图7)。在GSE63990数据集中,鼻腔模块对病毒性与细菌性疾病的AUROC为0.782,对病毒性与非感染性疾病的AUROC为0.791;血液模块的相应AUROC分别为0.678和0.753。Pandya 33-mRNA比较器表现更优,其AUROC分别为0.867和0.852。该结果对于专为病毒/非病毒鉴别设计的基因集而言是预期之中的,表明锚定模块不应被当作替代性诊断分类器来呈现。
| 数据集 | 对比 | 鼻部锚定基因 | 血液锚定基因 | Pandya 33 mRNA | Andres-Terre ISG | Hallmark 干扰素-α |
| GSE63990 | 病毒性 vs 细菌性 | 0.782 | 0.678 | 0.867 | 0.833 | 0.831 |
| GSE63990 | 病毒性 vs 非感染性 | 0.791 | 0.753 | 0.852 | 0.851 | 0.848 |
| GSE40012 | 病毒性肺炎 vs 细菌性肺炎 | 0.755 | 0.789 | 0.893 | 0.867 | 0.872 |
| GSE40012 | 病毒性肺炎 vs 全身炎症反应综合征(SIRS) | 0.897 | 0.907 | 0.985 | 0.965 | 0.956 |
| GSE40012 | 病毒性肺炎 vs 健康对照 | 0.804 | 0.986 | 0.923 | 0.906 | 0.891 |
| GSE40012 | 细菌性肺炎 vs 健康对照 | 0.476 | 0.917 | 0.465 | 0.391 | 0.378 |
| GSE53543 | 体外鼻病毒刺激 vs 未刺激的外周血单个核细胞(PBMCs) | 1 | 0.957 | 1 | 1 | 1 |
表5:锚定模块与参考宿主应答集的AUROC基准。 GSE63990和GSE40012为临床全血队列。GSE53543是一项体外PBMC扰动实验,涉及98对配对受试者,其结果与自然临床队列分开报告。参考集以基因未加权均值进行评分,而非采用其原始的加权分类器。AUROC值作为基准度量指标报告,而非作为临床诊断性能的估计值。
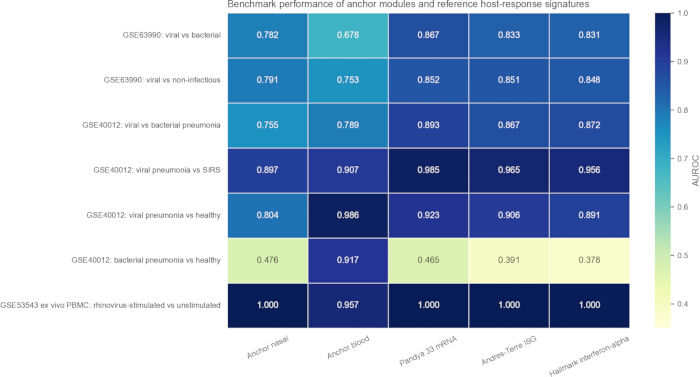
图 7。锚定模块与参考宿主反应集的 AUROC 基准评估。 行表示 GSE63990、GSE40012 和 GSE53543 中预设的对比;列表示两个锚定模块和三个未加权的参考集。GSE53543 标注为体外(ex vivo)鼻病毒刺激与未刺激的外周血单个核细胞(PBMCs),并独立于自然临床队列单独展示。Hallmark 比较集标注为 Hallmark I 型干扰素(interferon-alpha)。单元格数值表示用于方法学基准评估的 AUROC 值,不应将其解释为临床诊断效能的估计值。 请点击此处查看该图的放大版本。
GSE40012 数据集进一步明确了这一界限。Pandya 比较器在区分病毒性与细菌性肺炎时达到 0.893 的 AUROC,在区分病毒性肺炎与全身炎症反应综合征(SIRS)时 AUROC 达到 0.985。血液模块能够区分甲型流感肺炎与健康对照(AUROC = 0.986)以及与 SIRS(AUROC = 0.907),但也能区分细菌性肺炎与健康对照(AUROC = 0.917)。因此,该血液模块反映的是广泛的全身性炎症及干扰素相关活性。该模块并非病毒特异性,高评分无法用于判定病原体类别。
在独立的 GSE53543 体外 PBMC 基准测试中,鼻腔模块和干扰素对照方法在鼻病毒刺激与仅培养基处理的 PBMC 样本间区分上达到了 1.000 的 AUROC;血液模块达到了 0.957 的 AUROC。全部 98 名受试者均提供了配对条件样本。该受控结果支持所评分的程序对鼻病毒刺激具有响应性,但并不用于评估临床诊断性能。
稳健性检验评估了模块大小、随机替代方案以及选择稳定性
在排名前10、25、50、100和200的基因集中,锚点分离结果保持不变(图8A)。这些内部AUROC值并非外部验证,但表明定性结果不依赖于恰好选择50个基因。在500组随机选取的50基因集合中,鼻腔样本的零模型AUROC中位数为0.489,血液样本为0.705;相应的第99百分位数分别为0.722和0.872(图8B)。实际观察到的模块AUROC值均超过这些零分布。自举法(bootstrap)选择频率呈分布状态,而非集中于单一不变的基因列表(图8C)。该结果直接反映了锚点样本量较小的情况,提示尽管存在稳定的总体信号,但不应将每一个被选中的基因视为固定不变。
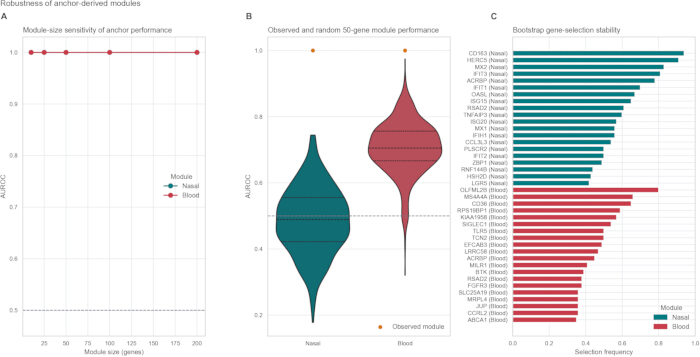
图8.模块大小、随机基因及自举稳健性分析。 (A)在包含10、25、50、100和200个基因的模块大小下,锚定AUROC的变化情况;这些值代表内部敏感性检验结果。(B)从GSE117827数据集中所包含的基因中无放回随机抽取500次、每次50个蛋白编码基因所得到的AUROC分布(随机种子=20260622)。橙色点表示实际观察到的模块AUROC值。每个小提琴图内的水平线表示第25百分位数、中位数和第75百分位数。(C)自举重选过程限制在各 compartment 中原始锚定分析排名最高的1,000个具有正向效应的蛋白编码基因范围内。条形图显示了每个 compartment 中选择频率最高的前20个基因;选择频率计算方式为被选中次数除以100。请点击此处查看该图的放大版本。
标志物模块和方差分析阐明了评分所衡量的内容
在 GSE40012、GSE53543 和 GSE63990 数据集中,两个模块均最一致地与髓系干扰素程序相关(图 9A)。鼻腔模块的相关系数分别为 0.812、0.878 和 0.882;血液模块的相关系数分别为 0.517、0.843 和 0.774。方差分解具有描述性(表 6;图 9B)。对于血液模块,疾病状态和详细分组解释的方差比例(eta-squared = 0.282 和 0.250)高于数据集(0.066)、样本类型(0.026)或来源分组(0.025)。对于鼻腔模块,详细分组和疾病状态解释的方差比例也高于数据集、样本类型或来源分组。因此,生物学状态和详细分组解释的模块评分方差比例高于数据集或样本类型,尽管数据集和样本组成带来的非零影响仍是公共批量数据再利用的局限性。
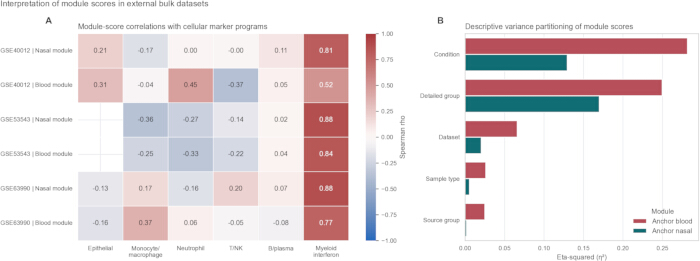
图9.标志物程序相关性与描述性方差分解。(A)GSE40012、GSE53543 和 GSE63990 数据集中模块评分与六个标志物程序评分之间的 Spearman 相关性。程序要求至少包含三个代表性基因。P 值在所有数据集-模块-程序相关性中进行了校正。空白单元格表示在满足基因和样本要求后不可用或无法估算的组合。(B)针对条件、详细分组、数据集、样本类型和来源分组的一元 eta 平方(η2;组间平方和/总平方和)。该分析包含 934 个血液模块评分和 1,469 个鼻腔模块评分,仅为描述性分析,不涉及因果推断。请点击此处查看该图的放大版本。
| 模块 | 因素 | Eta平方 | 样本数 |
| Anchor blood | 条件 | 0.282 | 934 |
| Anchor blood | 详细分组 | 0.25 | 934 |
| Anchor blood | 数据集 | 0.066 | 934 |
| Anchor blood | 样本类型 | 0.026 | 934 |
| Anchor blood | 来源分组 | 0.025 | 934 |
| Anchor nasal | 详细分组 | 0.17 | 1469 |
| Anchor nasal | 条件 | 0.13 | 1469 |
| Anchor nasal | 数据集 | 0.021 | 1469 |
| Anchor nasal | 样本类型 | 0.006 | 1469 |
| Anchor nasal | 来源分组 | 0.002 | 1469 |
表6:模块得分的描述性方差分解。 每个模块-因子对对应一行,列出相应的η²值和样本量。η²通过将组间平方和除以总平方和计算得出,计算时已排除缺失相应模块得分或因子数据的行。各因子被单独评估,因此该分析为描述性分析,未对因子间的相互相关性进行校正,不应作因果解释。
数据可用性:
本研究中分析的所有转录组学数据集均可在基因表达综合数据库(Gene Expression Omnibus)中公开获取,登录号分别为 GSE117827、GSE41374、GSE152075、GSE156063、GSE171110、GSE38900、GSE97741、GSE97742、GSE63990、GSE40012 和 GSE53543。主图和表格中基于分析所得的数据以及分析代码可向通讯作者在合理申请下获取。本研究未使用任何受限或新生成的个体水平数据。
讨论
主要经验在于操作层面:应从已取样的特定区室开始分析,而非从最大的合并组织矩阵入手。GSE117827 数据集虽小,但其配对设计使得在同一研究中直接比较鼻腔与血液样本成为可能。接近零的基因水平效应相关性表明,合并多种组织的全局排序列表会掩盖显著的区室特异性结构。因此,采用独立模块的分析策略更为合理。这些模块在外部验证和纵向分析中的表现支持了模块水平上的宿主应答活性具有可重复性,而非依赖于一个普适的基因列表。
基因水平和模块水平的可移植性存在差异。尽管鼻腔与血液效应量之间的个体一致性较弱,但血液模块在鼻咽部纵向样本中表现良好(AUROC 0.845)。配对轨迹未出现标签反转现象。更可能的解释是通路冗余性:在不同组织 compartment 中,干扰素和炎症反应的协同活动可由不同的基因子集来表征。6,7,8,9,10,11,32,33,34因此,我们将这些模块描述为具有区室感知性,而非区室排他性。尽管具体排序存在差异,但仍然可以检测到共同的通路水平组分。批量分析的表达谱同样混合了基因表达变化与细胞组成变化。标志物-程序相关性分析可提示这一问题,但无法提供细胞分辨率层面的机制解释。36,37.
临床基准定义了第二个界限。Pandya 33-mRNA 和干扰素比较指标在区分病毒与细菌方面表现更强。而锚定模块回答的是另一个问题:样本表达急性宿主反应程序的程度有多强?血液模块在细菌性肺炎中也有所升高。因此,应将其解读为广泛的系统性炎症/干扰素活性评分,而非特异性针对病毒的分类器。高评分可能有助于队列比较、反应追踪或炎症状态描述,但无法识别病原体。诸如人偏肺病毒等病毒在临床上的重要性日益增加,这进一步表明应针对多种病原体并匹配相应组织进行验证,而不是从有限的病毒集合中推断结论12,13。
这六个重叠基因具有探索性。ISG15、IFIT1、RSAD2 和 XAF1 具有合理的与干扰素相关的功能32,33,34;CCRL2 与炎症性白细胞迁移相关35;ACRBP 目前尚无明确的抗病毒功能解释。由于样本量较小且基因水平的错误发现率(FDR)未达到显著性,因此无法得出更强的结论。方法学上的创新体现在其他方面:同一研究内的配对锚点、锁定的细胞区室特异性模块、组织匹配的外部验证、配对恢复性分析、临床对照基准比较,以及明确的随机性、样本量、自助法(bootstrap)、标志物和方差检验。这一证据层级为结果的解读提供了一个保守的分析框架。
仍存在若干局限性。锚定队列仅包含15份感染和6份对照鼻腔样本,以及13份感染和6份对照血液样本。Bootstrap分析结果证实,单个基因的归属尚不稳定。有症状的呼吸道合胞病毒(RSV)与鼻病毒被合并分析,因此锚定效应并非病毒特异性。外部队列在年龄、检测平台、疾病严重程度、采样时间点及对照定义方面存在差异。GSE53543是一项体外配对扰动研究。GSE63990和GSE40012提供了有价值的临床对照数据,但缺乏配对的鼻腔-血液样本。病毒载量、症状持续时间、需氧情况及疾病严重程度等信息并未一致提供。更优的前瞻性设计应从同一受试者在匹配的时间点采集鼻拭子和血液样本,并测量病毒载量和症状,同时纳入细菌感染及有症状但病毒检测阴性的对照组,并进行单细胞分辨率的验证11,14,36,37。
综上所述,现有的公共转录组数据在保留组织背景的情况下,支持可重复的鼻腔和血液宿主反应活性模块;但不支持可互换的泛组织基因特征。成对锚定基因在基因水平上的一致性较低,而锁定的模块评分在相同组织间可转移,并在恢复期下降。血液模块在细菌性肺炎中的反应,以及既定分类器在区分病毒与细菌感染方面的优越性能,界定了其预期用途:这些模块用于描述宿主反应活性,并支持透明的队列基准比较,而非作为独立的病原体分类工具。分析代码和衍生数据详见数据可用性声明,以支持对工作流程的独立验证和再利用。
披露
作者声明本研究不存在任何与本工作相关的财务或非财务利益冲突。
致谢
作者感谢本研究中重新分析的公共 GEO 研究项目的调查人员和参与者。没有其他个人符合作者资格标准。本研究未从公共、商业或非营利机构的任何资助机构获得特定资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Andres-Terre 多病毒干扰素刺激基因集 | Andres-Terre et al. | 33基因比较器;补充数据1 | 基于已报道的多病毒特征整理的无权重干扰素导向比较器;完整基因列表见补充数据1。 |
| Enrichr | Ma'ayan 实验室 | 2026年8月18日访问;RRID:SCR_001575 | 通过 gseapy 访问的基因集富集分析资源。 |
| 基因表达综合数据库 | 美国国家生物技术信息中心 | GEO;RRID:SCR_005012 | 用于获取分析数据集的公共转录组数据库。 |
| 基因本体数据库 | 基因本体联盟 | GO 生物过程 2023;RRID:SCR_002811 | 通过 Enrichr 使用的功能注释数据库。 |
| GPL10558 | NCBI GEO | GPL10558 | GSE53543 和包含36个样本的 GSE38900 验证单元所用平台。 |
| GPL23126 | NCBI GEO | GPL23126 | GSE117827 的表达分析平台。 |
| GPL24539 | NCBI GEO | Clariom_D_Human.na36.hg38. probeset.csv | 用于 GSE117827 转录本簇映射的 Clariom D Human na36 hg38 注释文件。 |
| GPL571 | NCBI GEO | GPL571 | 应用于 GSE63990 的平台注释。 |
| GPL6884 | NCBI GEO | GPL6884 | 包含138个样本的 GSE38900 RSV 全血验证单元所用平台。 |
| GPL6947 | NCBI GEO | GPL6947 | 应用于 GSE40012 的平台注释。 |
| GSE117827 | NCBI GEO | GSE117827 | 主要的配对鼻拭子与全血锚定数据集。 |
| GSE152075 | NCBI GEO | GSE152075 | 外部 SARS-CoV-2 上呼吸道验证数据集。 |
| GSE156063 | NCBI GEO | GSE156063 | 外部 SARS-CoV-2 上呼吸道验证数据集。 |
| GSE171110 | NCBI GEO | GSE171110 | 外部 SARS-CoV-2 全血验证数据集。 |
| GSE38900 | NCBI GEO | GSE38900;GPL10558 和 GPL6884 | 作为分别标准化的36样本和138样本平台单元进行分析的外部 RSV 全血验证数据集。 |
| GSE40012 | NCBI GEO | GSE40012 | 临床流感A肺炎、细菌性肺炎、全身炎症反应综合征(SIRS)及健康对照的基准数据集。 |
| GSE41374 | NCBI GEO | GSE41374 | 外部 RSV 鼻灌洗验证数据集。 |
| GSE53543 | NCBI GEO | GSE53543 | 涉及98名受试者和196个样本的配对体外 PBMC 鼻病毒扰动基准数据集。 |
| GSE63990 | NCBI GEO | GSE63990 | 临床病毒性、细菌性及非感染性全血基准数据集。 |
| GSE97741 | NCBI GEO | GSE97741 | 纵向全血急性期与出院期对比验证数据集。 |
| GSE97742 | NCBI GEO | GSE97742 | 纵向鼻咽部急性期与出院期对比验证数据集。 |
| gseapy | gseapy 开发者 | 版本 1.3.1 | 用于查询 Enrichr 的 Python 接口。 |
| HGNC 基因符号资源 | 人类基因命名委员会 | 2026年8月18日访问;RRID:SCR_002827 | 经批准的基因符号标准化及蛋白编码分类资源。 |
| Matplotlib | Matplotlib 开发团队 | 版本 3.11.1 | 图表生成。 |
| MSigDB 标志性基因集 | Broad 研究所 | 标志性 2020;RRID:SCR_016863 | 通过 Enrichr 访问的标志性富集基因库。 |
| MSigDB 标志性干扰素-α反应基因集 | Broad 研究所 | HALLMARK_INTERFERON_ALPHA_ RESPONSE;补充数据1中的33基因核心子集 | 无权重干扰素-α比较器;确切子集见补充数据1。 |
| NumPy | NumPy 开发者 | 版本 2.5.2 | 数值计算与带种子的随机抽样。 |
| pandas | pandas 开发团队 | 版本 3.0.5 | 表格数据处理。 |
| Pandya 33-mRNA 宿主应答基因集 | Pandya et al. | 补充表1;补充数据1 | 作为无权重比较器评分的官方33基因集。 |
| Python | Python 软件基金会 | 版本 3.12.13 | 计算分析环境。 |
| Reactome | Reactome | Reactome 2022;RRID:SCR_003485 | 通过 Enrichr 访问的通路富集数据库。 |
| scikit-learn | scikit-learn 开发者 | 版本 1.9.0 | AUROC 与平均精度计算。 |
| SciPy | SciPy 开发者 | 版本 1.18.0 | Welch 检验、配对 t 检验、Wilcoxon 检验、Mann–Whitney 检验及相关性检验。 |
| Seaborn | Seaborn 开发团队 | 版本 0.13.2 | 统计图形。 |
| statsmodels | statsmodels 开发者 | 版本 0.14.6 | 统计工具。 |
参考文献
- Zaas AK, et al. Gene expression signatures diagnose influenza and other symptomatic respiratory viral infections in humans. Cell Host Microbe. 2009;6(3):207-17.
- Woods CW, et al. A host transcriptional signature for presymptomatic detection of infection in humans exposed to influenza H1N1 or H3N2. PLoS One. 2013;8(1):e52198.
- Andres-Terre M, et al. Integrated, multi-cohort analysis identifies conserved transcriptional signatures across multiple respiratory viruses. Immunity. 2015;43(6):1199-211.
- Herberg JA, et al. Diagnostic test accuracy of a 2-transcript host RNA signature for discriminating bacterial vs viral infection in febrile children. JAMA. 2016;316(8):835-45.
- Pandya R, et al. A machine learning classifier using 33 host immune response mRNAs accurately distinguishes viral and non-viral acute respiratory illnesses in nasal swab samples. Genome Med. 2023;15(1):64.
- Ioannidis I, et al. Plasticity and virus specificity of the airway epithelial cell immune response during respiratory virus infection. J Virol. 2012;86(10):5422-36.
- Mejias A, et al. Whole blood gene expression profiles to assess pathogenesis and disease severity in infants with respiratory syncytial virus infection. PLoS Med. 2013;10(11):e1001549.
- Blanco-Melo D, et al. Imbalanced host response to SARS-CoV-2 drives development of COVID-19. Cell. 2020;181(5):1036-45.e9.
- Hadjadj J, et al. Impaired type I interferon activity and inflammatory responses in severe COVID-19 patients. Science. 2020;369(6504):718-24.
- Mick E, et al. Upper airway gene expression reveals suppressed immune responses to SARS-CoV-2 compared with other respiratory viruses. Nat Commun. 2020;11(1):5854.
- Yoshida M, et al. Local and systemic responses to SARS-CoV-2 infection in children and adults. Nature. 2022;602(7896):321-7.
- Jamali MC, et al. Respiratory infections by human metapneumovirus: epidemiological evidence and treatment prospects. Res J Pharm Technol. 2026;19(8):3905-12. doi:10.52711/0974-360X.2026.00549.
- Gao G, Lin R, Ma D. Human metapneumovirus: pathogenesis, epidemiology, diagnostic technologies, and potential intervention strategies. Virol J. 2025;22(1):376.
- Lim FY, et al. homeRNA self-blood collection enables high-frequency temporal profiling of presymptomatic host immune kinetics to respiratory viral infection: a prospective cohort study. EBioMedicine. 2025;112:105531.
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-27.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882-3.
- Yu J, et al. Host gene expression in nose and blood for the diagnosis of viral respiratory infection. J Infect Dis. 2019;219(7):1151-61.
- Tsalik EL, et al. Host gene expression classifiers diagnose acute respiratory illness etiology. Sci Transl Med. 2016;8(322):322ra11.
- Parnell GP, et al. A distinct influenza infection signature in the blood transcriptome of patients with severe community-acquired pneumonia. Crit Care. 2012;16(4):R157.
- Edgar R, Domrachev M, Lash AE. Gene Expression Omnibus: NCBI gene expression and hybridization array data repository. Nucleic Acids Res. 2002;30(1):207-10.
- Barrett T, et al. NCBI GEO: archive for functional genomics data sets-update. Nucleic Acids Res. 2013;41(D1):D991-5.
- Tweedie S, et al. Genenames.org: the HGNC and VGNC resources in 2021. Nucleic Acids Res. 2021;49(D1):D939-46.
- Welch BL. The generalization of Student's problem when several different population variances are involved. Biometrika. 1947;34(1-2):28-35.
- Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. J R Stat Soc Series B Stat Methodol. 1995;57(1):289-300.
- Subramanian A, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545-50.
- Liberzon A, et al. The Molecular Signatures Database Hallmark Gene Set Collection. Cell Syst. 2015;1(6):417-25.
- Do LAH, et al. Host transcription profile in nasal epithelium and whole blood of hospitalized children under 2 years of age with respiratory syncytial virus infection. J Infect Dis. 2018;217(1):134-46.
- Ashburner M, et al. Gene Ontology: tool for the unification of biology. Nat Genet. 2000;25(1):25-9.
- The Gene Ontology Consortium. The Gene Ontology resource: enriching a GOld mine. Nucleic Acids Res. 2021;49(D1):D325-34.
- Gillespie M, et al. The Reactome pathway knowledgebase 2022. Nucleic Acids Res. 2022;50(D1):D687-92.
- Kuleshov MV, et al. Enrichr: a comprehensive gene set enrichment analysis web server 2016 update. Nucleic Acids Res. 2016;44(W1):W90-7.
- Schoggins JW, et al. A diverse range of gene products are effectors of the type I interferon antiviral response. Nature. 2011;472(7344):481-5.
- Schneider WM, Chevillotte MD, Rice CM. Interferon-stimulated genes: a complex web of host defenses. Annu Rev Immunol. 2014;32:513-45.
- Perng YC, Lenschow DJ. ISG15 in antiviral immunity and beyond. Nat Rev Microbiol. 2018;16(7):423-39.
- Schioppa T, et al. Molecular basis for CCRL2 regulation of leukocyte migration. Front Cell Dev Biol. 2020;8:615031.
- Avila Cobos F, et al. Benchmarking of cell type deconvolution pipelines for transcriptomics data. Nat Commun. 2020;11(1):5650.
- Maden SK, et al. Challenges and opportunities to computationally deconvolve heterogeneous tissue with varying cell sizes using single-cell RNA-sequencing datasets. Genome Biol. 2023;24(1):288.