本研究提出了一种方法FusionNetX,通过增强DenseNet121和EfficientNetB7的特征融合能力,对五个公开可用的数据集进行脑肿瘤分类。该方法结合了数据增强、预处理和混合模型定制(中间融合),在多个评估参数上均表现出更优性能,准确率达到了98.77%至99.89%之间。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
脑肿瘤被认为是世界上最致命的疾病之一,误诊会危及患者生命并降低生存率。基于深度学习技术(尤其是卷积神经网络)的磁共振成像(MRI)对于克服这一难题至关重要,因为它能够更详细地检查大脑内部结构,并具备出色的學習和预测能力。目前,对脑部肿瘤进行准确诊断的需求仍然十分迫切。因此,本文提出了一种基于增强特征融合的深度学习模型(FusionNetX),该模型利用了两个预训练模型DenseNet121和EfficientNetB7的优势,并采用定制的微调超参数,包括可训练层和不可训练层。所提出的FusionNetX模型应用于五个公开的脑肿瘤数据集:Br35H、Figshare、Sartaj、Masoud和Balanced Brain Tumor。通过调整图像尺寸和数据增强等预处理步骤,提升了图像质量并缓解了过拟合问题。使用多种性能评估指标(如准确率、损失值、阳性预测值、阴性预测值、真阳性率、真阴性率、F1分数、假阴性率和假阳性率)进行评估,结果表明,所提出的FusionNetX模型在Br35H数据集上的准确率达到99.33%,在Figshare上为99.13%,在Masoud上为99.89%,在BBT-Dataset上为99.19%,在Sartaj上为98.77%。此外,还采用晚期融合和基于注意力机制的融合方法对这五个脑肿瘤数据集进行了评估,以凸显所提出FusionNetX模型的有效性,结果显示其性能显著更优,在所有数据集上的准确率提升了0.3%至1.9%。进一步地,计算了受试者工作特征曲线(ROC曲线),结合各项性能评估指标的结果表明,所提出的FusionNetX模型能够准确检测和预测脑肿瘤,有助于医疗从业人员及时做出临床决策。
引言
如今,癌症因其严重性和发病率不断上升,已成为人体最致命的疾病。人体内发现的多种癌症疾病,如脑肿瘤、乳腺癌、肺结节、肾癌等,导致死亡率持续升高。当人体内的细胞或组织异常增殖时,便会形成癌症。 当癌症发生转移时,可能损害其他人体器官,从而变得更加危险1。由于大脑控制着所有身体功能,任何对大脑的损害都可能对全身造成深远影响。 因此,脑肿瘤或脑癌对人类具有极高的致死性2。此外,脑肿瘤主要分为良性和恶性两大类。“良性”基本指非癌性,仅表示脑部存在可通过改变周围环境而修复的问题。而恶性肿瘤则因其具有转移性而被视为危险,异常细胞或组织可在身体其他部位之间迁移,干扰其他器官功能,从而增加体内癌症扩散的风险3。
此外,根据美国脑肿瘤协会和世界卫生组织(WHO)的分类,垂体瘤、脑膜瘤和胶质瘤是脑癌的三大主要类型4。胶质瘤起源于胶质细胞,这类细胞为大脑中的神经元提供营养支持。垂体瘤起源于位于大脑底部的垂体,该腺体负责调控多种身体功能;而脑膜瘤则起源于脑膜,脑膜是保护包裹大脑和脊髓的膜状结构。此外,临床上常采用多种医学影像技术对机体内部结构进行诊断性检查,包括X射线、计算机断层扫描(CT)和磁共振成像(MRI)5,6。每种影像技术均有其优缺点。MRI是一种能够提供机体软组织和细胞详细图像的成像方式,尤其适用于脑部。癌症表现为机体组织或细胞的异常,而MRI能够清晰显示这些异常结构,因此在诊断脑肿瘤或癌症方面具有更高的应用价值。此外,MRI在检查人体内部解剖结构时不会产生有害辐射,因此相较于其他影像技术更为安全。
此外,许多计算方法也被用于解决与脑肿瘤诊断相关的挑战,包括机器学习(ML)、图像处理(IP)和深度学习(DL),每种方法均应用于成像模态获取的图像以诊断癌症7。这些方法通过学习图像中不同对象的隐藏模式和结构,识别病变区域的特征模式,从而实现癌症诊断。每种计算方法在诊断过程中都有其优缺点。基于ML和IP的方法提取手工设计的特征,这在大多数情况下会导致预测不准确,尤其在较大数据集上容易造成误诊8。为克服手工特征提取的局限性,研究人员正转向基于深度学习的模型,通常称为卷积神经网络(CNN)模型,这类模型能够从图像中自动学习并提取最优特征,从而更准确地诊断肿瘤。基于深度学习的方法目前在医学影像中广泛应用,用于诊断人体疾病,尤其是在脑肿瘤、乳腺癌、肺癌及其他疾病的早期和准确检测方面,因其具备从大规模数据中学习和提取复杂模式的能力,可提供更精确的结果9。深度学习模型面临的主要问题是资源消耗大和数据采样需求高,这一问题可通过另一种基于深度学习的方法——迁移学习10(TL)——得以缓解,该方法利用预训练模型进行疾病诊断,从而节省时间和资源。预训练模型已在大规模数据集上学习了与纹理、颜色、边缘等相关的基础特征,因此能够实现对健康问题的早期且准确的诊断。随后,可通过利用该模型并添加超参数以及可训练和不可训练层,将这些模型迁移到此前从未见过的新数据集上11。目前已有大量关于脑肿瘤分类的研究,表112,13,14,15,16,17,18,19,20,21,22,23汇总了这些研究的详细信息,包括所采用的方法、数据集及结果。然而,目前尚无研究工作采用将两种迁移学习模型相结合以实现鲁棒特征提取,并调整正则化技术以确保训练和测试过程平稳的综合方法。对所提出方法的充分评估有助于深入理解模型在不同脑肿瘤特征下的性能表现。
| 参考文献 | 方法 | 数据样本 | 结果 | 局限性 |
| 12 | 定制CNN | Br35H | 准确率 = 97.45%, | 结果仍有改进空间;相比使用自定义CNN,采用现有CNN模型并加以修改效果更佳。 |
| 损失 = 0.1141%, | ||||
| 召回率 = 98.09%, | ||||
| F1分数 = 97.69%, | ||||
| 精确率 = 97.29%, | ||||
| 增强Br35H | 准确率 = 98.99%, | |||
| 精确率 = 98.90%, | ||||
| 损失 = 0.0570%, | ||||
| 召回率 = 98.91%, | ||||
| F1分数 = 99.04% | ||||
| 13 | 特征融合DNN模型 | Br35H | 准确率 = 98.22%, | 结果仍需改进,且相比使用定制模型,仍需采用现有模型进行特征融合。 |
| FNR = 1.77%, | ||||
| 灵敏度 = 98.2%, | ||||
| F1分数 = 98%, | ||||
| 特异性 = 98%, | ||||
| Figshare | 准确率 = 98.01%, | |||
| 灵敏度 = 96.03%, | ||||
| F1分数 = 96%, | ||||
| 特异性 = 98.67%, | ||||
| FNR = 3.96% | ||||
| 14 | 采用SGD的AlexNet | Br35H | 准确率 = 98.79%, | 结果仍需部分改进,还需在不同数据样本上测试更先进的基于CNN的模型。 |
| MCR = 1.20%, | ||||
| 灵敏度 = 98.98%, | ||||
| 特异性 = 98.58%, | ||||
| F1分数 = 98.82% | ||||
| 15 | InceptionV3 | Figshare | 准确率 = 98.89%, | 作者使用了包含三类肿瘤的Figshare数据集;但未对肿瘤分类,而是仅判断是否存在肿瘤,结果仍需改进,且应进一步对肿瘤类别进行分类。 |
| 灵敏度B = 95.28%, | ||||
| 灵敏度M = 94.47% | ||||
| 16 | 优化的ResNet50 | Figshare | 准确率 = 99.03%, | 其他性能评估参数需计算,且结果仍需进一步提升。 |
| 召回率 = 99%, | ||||
| F1分数 = 99% | ||||
| 17 | Res-BRNet | Br35H | 准确率 = 98.22%, | 结果仍需改进。 |
| 灵敏度 = 98.11%, | ||||
| 精确率 = 98.22%, | ||||
| Figshare | F1分数 = 98.41% | |||
| 18 | ResNet101 + DenseNet121 | Figshare | 准确率 = 99.18%, | 结果略有提升,但仍需测试更多与脑肿瘤相关的数据集。 |
| 召回率 = 99.11%, | ||||
| F1分数 = 99.08, | ||||
| 精确率 = 99.07%, | ||||
| Sartaj | 准确率 = 97.24%, | |||
| 召回率 = 97.58%, | ||||
| F1分数 = 97.28%, | ||||
| 精确率 = 97.06%, | ||||
| 19 | CNN-SVM | Brats | 准确率 = 98.02%, | 需将现有模型与SVM结合应用,且结果仍需改进。 |
| F1分数 = 98.31%, | ||||
| 精确率 = 98.09%, | ||||
| 灵敏度 = 98.53%, | ||||
| 特异性 = 97.30%, | ||||
| Sartaj | 准确率 = 96.83%, | |||
| 精确率 = 95.36%, | ||||
| 灵敏度 = 94.73%, | ||||
| 特异性 = 97.56%, | ||||
| F1分数 = 95% | ||||
| 20 | 微调的EfficientNetB3 | Figshare | 准确率 = 98.70% | 需采用前述EfficientNetB3变体以提升结果。 |
| Sartaj | 准确率 = 97.50% | |||
| 21 | InceptionV4 | Masoud | 准确率 = 98.7%, | 需结合更多数据集进一步改进结果。 |
| 精确率 = 99%, | ||||
| 灵敏度 = 98%, | ||||
| 特异性 = 99%, | ||||
| F1分数 = 99.1% | ||||
| 22 | VGG16 | Masoud | 准确率 = 98% | 需通过测试更多深度神经网络模型来改进结果。 |
| 23 | MFR-CNN | Masoud | 准确率 = 94%, | 该方案采用了一种复杂的架构。 |
| 召回率 = 96%, | ||||
| F1分数 = 96%, | ||||
| 精确率 = 96%, |
表1:最新研究工作的比较分析。 该表格总结了现有研究及其采用的方法、数据样本、结果和局限性。请点击此处下载该表格。
表1回顾了现有方法,强调了这些方法在提升结果方面的局限性,以及在评估不同统计参数性能时必须使用预训练的深度学习模型,所有这些都需在一个高效的框架内完成,以在不同的脑肿瘤数据集上实现更优的性能。
研究目标与问题陈述
人工判读耗时较长,且存在观察者间变异;因此,从磁共振成像(MRI)中快速准确地对脑肿瘤类型进行分类对于临床决策至关重要。目前大多数用于自动脑肿瘤分类的深度学习(DL)方法基于单一主干网络或简单的决策级融合,未能充分利用多个预训练架构提供的互补特征表示,且通常仅在单一数据集上进行验证,限制了对其泛化能力的信心。
本研究项目旨在开发并提供一种完整且准确的方法,利用双主干深度学习框架(EfficientNetB7 和 DenseNet121)对人类大脑中的脑癌进行诊断。该框架通过融合互补的特征表示,实现基于磁共振成像(MRI)的鲁棒性脑肿瘤分类。同时,本研究还在多个独立的公开数据集上评估了该框架的鲁棒性。该方法可帮助放射科医生和急救医务人员快速有效地诊断脑肿瘤,通过实现肿瘤的识别与分类,挽救患者生命。
为解决特定的研究问题并实现本研究项目的目标,以下是拟探讨的研究问题及针对这些问题的贡献:1)特征级(中间层)融合两种预训练主干网络的方法是否优于决策级(晚期)融合和基于注意力的融合技术,用于脑肿瘤分类?2)所提出的系统是否能在多个独立获取的脑肿瘤 MRI 数据集上提供稳定一致的分类性能?
本研究的范围仅限于图像级别(二维MRI切片)分类,使用五个公开可用的脑肿瘤MRI数据集(Br35H、Figshare、Sartaj、Masoud和BBT-Dataset)进行独立评估,不进行跨数据集评估,并采用方法部分所述的特定架构、预处理流程和实验配置。本研究未包含患者级别的验证,也未在临床部署环境中进行测试。
本研究工作的主要贡献如下:1)本研究工作的首要贡献是利用双预训练模型进行更优的特征提取,包括DenseNet121和EfficientNetb7,并采用优化后的超参数。2)提出一种创新的模型架构,将先进的正则化技术与来自双预训练模型的拼接特征相结合,以实现稳健的性能表现。3)采用有效的数据增强策略,增加训练样本的多样性,从而学习到更具通用性和特异性的特征,克服过拟合问题。4)在五个不同的公开可用脑肿瘤数据集上评估了所提出模型的性能,重点关注多种统计评估参数,包括准确率、误分类率、精确率、阴性预测值、敏感性、特异性、F1分数、假阴性率和假阳性率。
访问受限。请登录或开始试用以查看此内容。
方案
世界上最严重的疾病是脑肿瘤。准确的诊断有助于提高患者的生存率。然而,目前仍需要一种能够在早期检测出脑肿瘤的精确诊断系统。为解决这一问题,本文提出了一种更为可靠的检测方法,该方法采用基于DenseNet121和EfficientNetB7模型的混合双深度学习机制,并结合优化的超参数和精细调整的网络层,以实现对脑肿瘤早期阶段的精确检测。所提出的方法以2D MRI图像作为输入,针对Br35H二分类数据集输出是否存在肿瘤的预测结果,同时对另外四个多分类数据集实现肿瘤分类。因此,本节展示了该方法从数据收集到最终输出的主要步骤,包括数据获取、数据预处理、数据划分、模型选择、特征提取、肿瘤预测以及所提出模型的评估,如图1所示。
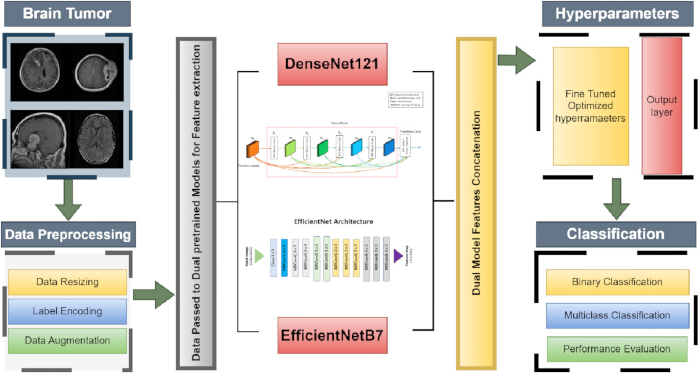
图 1:所提出方法的工作流程。该示意图展示了所提出模型的整体架构,包括数据获取与预处理;两个用于特征提取的预训练模型;其特征的拼接;以及针对肿瘤分类和类型的超参数微调。请点击此处查看该图的放大版本。
数据采集
在任何实验研究中,第一步都是数据采集。为此,选择了五个不同的公开可用数据集,包括 Br35H24、Figshare25、Sartaj26、Masoud27 以及来自开源库 Kaggle 的脑肿瘤 MRI 图像数据集28,这些数据集已被众多研究人员用于脑肿瘤检测的诊断研究。Br35H 数据集包含 3,000 张图像,分为两类:健康和不健康(肿瘤)脑图像,每类各 1,500 张;而 Figshare 数据集包含 3,064 张图像,根据肿瘤类型分为三组:胶质瘤图像 1,426 张,脑膜瘤图像 708 张,垂体瘤图像 930 张。Sartaj 数据集包含 3,264 张图像,分为四类肿瘤:胶质瘤(926 张图像)、脑膜瘤(937 张图像)、垂体瘤(901 张图像)以及健康或无肿瘤(500 张图像)。此外,Masoud 数据集也包含四类不同的肿瘤,其图像来自上述三个数据集,共 7,023 张图像,进一步分类为胶质瘤(1,621 张图像)、脑膜瘤(1,645 张图像)、垂体瘤(1,757 张图像)以及健康或无肿瘤(2,000 张图像)。最后一个数据集是一个基于 MRI 图像的数据集,同样包含四类共 5,248 张图像,进一步按肿瘤类型划分为:1,312 张胶质瘤图像、1,312 张脑膜瘤图像、1,312 张垂体瘤图像和 1,312 张健康或无肿瘤图像,各类图像数量相等,被视为一个平衡数据集。
数据预处理
数据采集完成后,下一步是预处理,这对于获得更优的结果至关重要,并有助于计算方法从数据中提取和学习最佳特征,从而产生更准确的结果。首先进行的是图像缩放。本研究选取了五个公开可用的数据集,这些数据集包含不同的类别且图像尺寸各异,即使在同一数据集中不同肿瘤类别的图像尺寸也不同;所有图像均被统一调整为 224 × 224 像素,以利于模型更好地解释和学习。此外,对所有数据集应用了数据增强技术,通过从不同角度生成额外的样本,从而提升深度学习模型的特征提取与学习能力。具体操作包括:对所有图像施加 ±7% 的旋转范围,即最多旋转 7 度;同时在水平和垂直方向上对所有图像进行 5% 的随机平移,即相对于原始图像在高度和宽度上各偏移 5%;随后,将图像相对于原始图像放大(zoom in)10%;最后,对所有图像进行水平和垂直翻转。实施数据增强29的主要目的是通过在原始数据样本的多种变换版本上进行训练,以克服过拟合问题并提高模型的泛化能力。在将数据集划分为训练集和验证集之前,先进行了标签编码,这有助于在训练和验证过程中更准确地计算损失函数,同时使模型能够更有效地处理标签信息。此外,数据集按照 80% 训练集和 20% 验证集的比例30进行划分,表 2展示了数据样本的总体分布及其训练与验证比例。
| 数据集 | 肿瘤类别 | 总图像数 | 训练图像数 | 验证图像数 |
| Br35H | 健康 | 1500 | 1200 | 300 |
| 肿瘤 | 1500 | 1200 | 300 | |
| 总图像数 | 3000 | 2400 | 600 | |
| Figshare | 胶质瘤 | 1426 | 1141 | 285 |
| 脑膜瘤 | 708 | 566 | 142 | |
| 垂体瘤 | 930 | 744 | 186 | |
| 总图像数 | 3064 | 2451 | 613 | |
| Sartaj | 胶质瘤 | 926 | 741 | 185 |
| 脑膜瘤 | 937 | 749 | 188 | |
| 无肿瘤 | 500 | 400 | 100 | |
| 垂体瘤 | 901 | 721 | 180 | |
| 总图像数 | 3264 | 2611 | 653 | |
| Masoud | 胶质瘤 | 1621 | 1297 | 324 |
| 脑膜瘤 | 1645 | 1316 | 329 | |
| 无肿瘤 | 2000 | 1600 | 400 | |
| 垂体瘤 | 1757 | 1405 | 352 | |
| 总图像数 | 7023 | 5618 | 1405 | |
| 平衡脑肿瘤数据集(BBT-Dataset) | 胶质瘤 | 1312 | 1050 | 262 |
| 脑膜瘤 | 1312 | 1050 | 262 | |
| 无肿瘤 | 1312 | 1050 | 262 | |
| 垂体瘤 | 1312 | 1050 | 262 | |
| 总图像数 | 5248 | 4200 | 1048 |
表2:数据集分布。该表格展示了脑肿瘤数据集中各类别的总数、训练集和验证集图像数量的统计情况。
Br35H 数据集包含 3000 张图像,其中 2400 张用于训练,600 张用于验证。Figshare 数据集包含 3064 张图像,其中 2451 张用于训练,其余 613 张用于验证。Sartaj 数据集共有 3264 张图像,其中 2611 张用于训练,其余 653 张用于验证。Masoud 数据集共有 7023 张图像,其中 5618 张用于训练,其余 1405 张用于验证。BBT 数据集共有 5248 张图像,其中 4200 张用于训练,其余 1048 张用于验证。此外,下方 图 2展示了多种脑肿瘤图像。
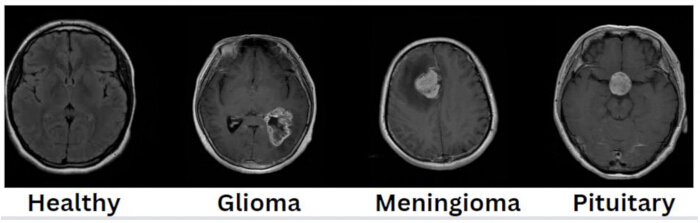
图2:脑肿瘤图像,包含不同肿瘤类型。 该数据集包含四幅健康脑组织图像和三幅肿瘤图像:胶质瘤、脑膜瘤和垂体瘤。请点击此处查看该图的放大版本。
提出的模型
在预处理阶段之后,下一步是提出一种仅针对脑肿瘤分类有效的训练模型。为此,本文提出了一种专门用于脑肿瘤分类的高效训练模型。该模型是一种新颖且高效的基于混合特征融合的预训练模型,结合了DenseNet12131,32和EfficientNetB733,用于从图像中提取特征;随后将提取的特征进行拼接,并输入到不同的微调超参数中,包括可训练和不可训练的网络层,以实现对脑肿瘤的准确诊断。该模型已在五个公开可用的数据集上实现,这些数据集在前述相关章节中已作讨论。此外,DenseNet121模型由Gao Huang及其同事于2017年开发,共包含121层。该模型的主要目标是最大化特征重用,并避免梯度消失问题34。该模型中的层被组织为密集块(dense blocks),每个密集块包含多个卷积层,用于提取和学习特征。每一层将前面所有层的特征图作为输入,其输出则与这些层的输出连接,并以前馈方式作为同一密集块中后续层的输入。此外,在密集块之间加入了过渡层(transition layers),每个过渡层由一个1 × 1卷积层、一个批归一化(BatchNormalization)层和一个2 × 2平均池化层组成,用于降低特征图尺寸,从而控制模型复杂度。最后,在全局平均池化层之前添加了一个带有SoftMax激活函数(AF)的分类层。DenseNet121模型的基本结构如下方图334所示。
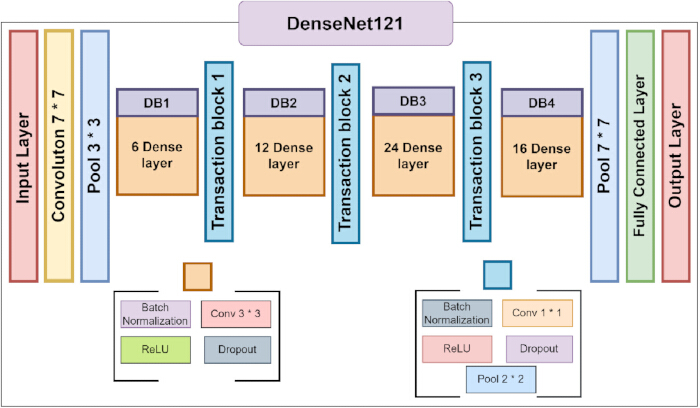
图 3:DenseNet121 架构细节34。 本图展示了 DenseNet121 模型的架构细节,包括所有密集块和过渡块。请点击此处查看该图的放大版本。
此外,EfficientNetB7 模型由 Tan 和 Lee 于 2019 年提出。它属于 EfficientNet 系列,包含从 B0 到 B7 的多个变体,其主要目标是在使用更少参数和更低计算资源的前提下超越其他模型。该模型的核心特性是通过复合缩放方法对模型宽度(每层的通道数)、深度(层数)和分辨率进行精细调整。该模型由 MBConv(移动倒置瓶颈卷积)模块构成,每个模块包含一个 1×1 卷积扩展层,用于增加通道数量;一个深度可分离卷积层,用于对每个通道单独进行卷积操作;以及一个 1×1 卷积投影层,用于将通道数恢复至原始数量。此外,每个 MBConv 模块中还包含“压缩与激励”(Squeeze and Excitation, SE)模块35,用于重新校准通道维度的特征,帮助网络聚焦于最重要的特征。该模型未采用 Sigmoid 或其他激活函数(AF),而是使用 Swish 激活函数,该函数允许负值输出,相较于 ReLU 更有利于梯度传播。此外,在全局平均池化层之前,添加了一个带有 SoftMax 激活函数的最终输出层,用于分类任务。图 435 展示了 EfficientNetB7 模型的基本设计结构,而 图 5 展示了推荐的模型架构。
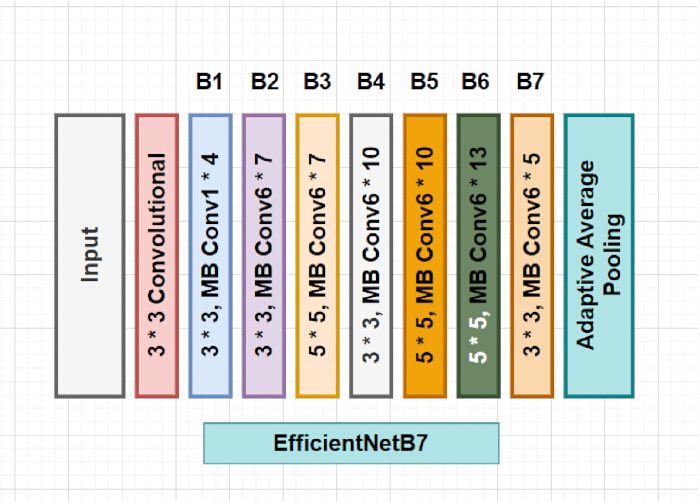
图 4:EfficientNetB7 架构细节35。 本图展示了 EfficientNetB7 模型的架构细节,包括所有移动端倒置瓶颈卷积模块。请点击此处查看该图的放大版本。
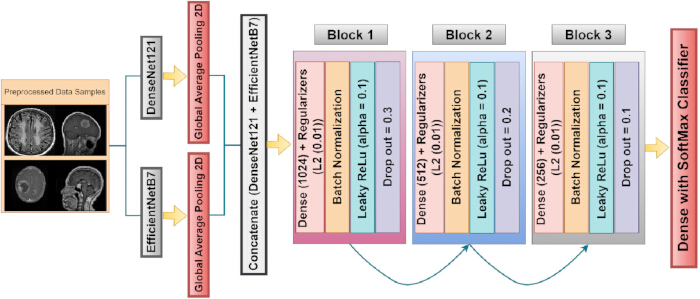
图5:所提出的混合融合模型架构。该架构展示了预处理后的图像如何输入至特征提取器,特征提取器由三个具有不同超参数的自定义模块组成,随后连接输出层。请点击此处查看该图的放大版本。
此外,从预训练的 DenseNet121 和 EfficientNetB7 模型中提取了初始特征。将预训练模型更新后的权重加载到训练模型中,并冻结模型中不可训练的基底层,以防止模型被再次训练。这有助于模型保留其先前获得的最佳知识,根据新的数据样本进行调整以改善收敛效果,并专注于额外的可训练层以提取更高级的特征。以下公式 1 和公式 2 展示了 DenseNet121 和 EfficientNetB7 模型的工作原理。
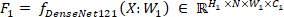 (1)
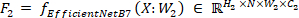 (2)
上述公式1和公式2展示了预训练模型在特征提取方面的工作原理;F1表示预训练DenseNet121模型生成的输出特征图,F2表示预训练EfficientNetB7模型通过对输入图像X进行处理后生成的输出特征图。进一步地,W1和W2分别为DenseNet121和EfficientNetB7模型的第一块结构和层中可学习的参数或权重。此外,∈ RN ×H1×W1×C1和∈ RN ×H2×W2×C2分别表示DenseNet121和EfficientNetB7模型输出特征图的维度,其维度分别为H1 ×N×W1×C1和H2 ×N×W2×C2,其中N表示图像的批量大小,本文中设为16。进一步地,H1×W1分别表示DenseNet121模型中图像的高度和宽度,H2×W2表示EfficientNetB7模型中图像的高度和宽度,本文中选择为224 × 224的尺寸。C1和C2分别表示DenseNet121和EfficientNetB7模型的颜色通道数。在从模型获得输出特征图后,EfficientNetB7输出2560个通道,DenseNet121输出1024个通道,随后对这些输出特征图应用全局平均池化2D36层,通过对所有空间维度取平均值将其降维为单个向量,从而更便于传递至下一层,以实现更优的特征提取和可解释性特征的模式识别。
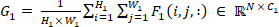 (3)
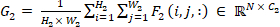 (4)
上述公式 3 和公式 4 分别展示了全局平均池化二维层在 DenseNet121 和 EfficientNetB7 模型中的工作原理,其中  和
 表示通过将总和除以两个模型的空间位置总数来实现归一化,以确保池化输出为平均值而非简单求和。
 和
 表示对特征图的空间维度进行求和,而 i 和 j 仅用于分别遍历高度和宽度,以对两个模型的特征图进行求和。此外,F1(i, j, :) 和 F2(i, j, :) 分别表示 DenseNet121 和 EfficientNetB7 模型在所有通道上特定空间位置 (i, j) 处的特征图数值。该池化操作将空间信息聚合为更紧凑且精确的表示形式,同时保留每幅图像中最重要特征。进一步地,将全局平均池化层的输出进行拼接,以生成每个样本的单一特征向量,这通常用于融合来自不同模型的特征,通过结合两个模型的优势来提升性能;公式 5 展示了其工作方式。
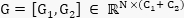 (5)
上述公式5展示了两个不同模型特征向量[G1, G2]的拼接过程,其中G1表示DenseNet121模型的特征向量,G2表示EfficientNetB7模型的特征向量,拼接后特征向量的形状表示为RN ×(C1+ C2),其中N为批量大小,代表并行处理的样本数量,(C1+ C2)为分别来自模型1和模型2的特征总数,约为3584,这些特征被并行处理,拼接后的输出特征向量用G表示。此外,为提取更复杂的特征、提升泛化能力并防止过拟合,从而获得更准确和高效的结果,已在融合模型中添加了三个不同的模块。每个模块均由具有不同神经元数量的全连接层组成:第一个模块的全连接层包含1024个神经元,主要用于捕获数据中广泛范围的特征和更通用的模式;第二个模块的全连接层包含512个神经元,通过降低维度并聚焦于更具体的模式来进一步细化特征;第三个模块的全连接层包含256个神经元,进一步专门化地提炼特征,确保仅有最相关的特征和模式传递至输出层,以执行更具针对性的任务。此外,为防止过拟合,每个模块中的每一层全连接层均引入了L2正则化37方法,通过对较大权重施加惩罚来实现,但这也会使模型变得更加复杂。同时,在每个模块之后引入了Dropout层38,分别随机忽略模块1、2和3中30%、20%和10%的神经元,迫使网络发展出更鲁棒的特征,避免对单个神经元的依赖。为进一步稳定训练过程,每个全连接层之后均应用了BatchNormalization39层,确保激活值保持在稳定的范围内,并帮助模型在训练阶段避免梯度消失和梯度爆炸等问题。此外,BatchNormalization层还加速了训练过程,通过平滑损失函数曲面使模型更快收敛,从而更易于优化器找到全局最小值。此外,在每个模块中,为引入非线性特性,采用了Leaky ReLU激活函数40,使模型能够学习复杂的模式。Leaky ReLU相较于其他激活函数的优势在于,它允许负输入具有较小的非零梯度,从而确保神经元不会失活。此外,以下公式6展示了集成于混合融合模型中的各个模块的工作机制。
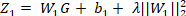 (6)
获得拼接向量后,G 被输入至第1个全连接层(密集层),该层包含1024个神经元。其中权重矩阵 W1 将输入向量 G 转换为一个1024维的输出向量,输出向量中的每个元素均为输入特征的线性组合。随后,将偏置向量 b1 加到输出结果的1024个元素中的每一个上,从而使模型能够独立地调整各输入特征的输出值。此外,L2正则化项:λ||W1||22 会对较大的权重进行惩罚,防止模型过度依赖单个神经元,有助于避免过拟合。其中,W1 表示神经网络中某一层的权重矩阵,||W1||22 表示权重矩阵 W1 的L2范数的平方,λ 为控制正则化程度的正则化参数,在所有模块中该参数均设为0.1。Z1 表示在拼接向量 G 传递的输入上应用全连接层及L2正则化后得到的新特征表示,如公式6所示。
在获得第1个模块中稠密层的输出 Z1 后,应用了批归一化层,该层用于加速训练过程,下述公式7展示了其工作原理。
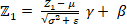 (7)
σ2 表示批量数据中最后一层输出 Z1 的方差,而 μ 是输出 Z1 的均值,该均值针对每个神经元单独计算,在第一个全连接层中神经元数量为 1024。ε 是一个微小常数,用于确保数值稳定性并防止除以零。模型可通过调整可学习的缩放参数 γ 来调节归一化后的输出,同时可通过可学习的偏移参数 β 来对归一化输出进行平移。最后,在全连接层输出上应用批归一化(BatchNormalization)层后,归一化输出 Z1 能够确保不同网络层的激活值具有稳定的分布,从而有助于训练过程的稳定性和加速。在批归一化之后,归一化输出 Z1 经过带泄漏的 ReLU(leaky ReLU)激活函数,该函数为网络引入非线性,有助于学习数据中的复杂模式。此处未选用 ReLU 或其他激活函数,而是选择了 leaky ReLU,它是 ReLU 函数的改进版本,能够保留较小的负值而非像 ReLU 激活函数那样将其置为 0,从而克服了“死亡 ReLU”问题。下方公式 8 展示了其工作原理。
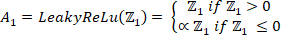 (8)
其中,Z1 为 BatchNormalization 层的输出,作为输入传递给 Leaky ReLU 以实现非线性变换,而 ∝ 是一个用于确定函数负半部分斜率的小常数。此外,A1 表示应用非线性变换后得到的输出。最后,将 Dropout 层应用于来自 Leaky ReLU 激活函数的输出 A1,如公式 9 所示。
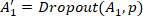 (9)
其中,A1 是从上一个 ReLu 激活函数接收到的原始激活函数输出,p 为 dropout 率,取值范围为 0 到 1,在三个模块层中分别被设定为 0.3、0.2 和 0.1,仅用于随机丢弃部分神经元。此外,A1′ 表示应用 dropout 层后的修改输出,其中部分神经元已被置为 0。使用 dropout 的主要优势在于防止过拟合问题以及减少神经元之间的共适应性。随后,模块 1 的输出 A1′ 被传递至下一个模块,以进一步提取更抽象的特征,并再次应用与模块 1 相同的参数,仅在全连接层中将神经元数量由 1024 改为 512,dropout 率由 0.3 改为 0.2,其余操作序列保持不变,具体如以下公式 10 至 13 所述。
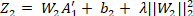 (10)
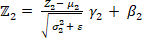 (11)
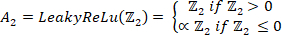 (12)
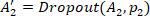 (13)
将模块1的输出 A1′ 输入至模块2的全连接层(密集层),该层包含512个神经元,其中权重矩阵 W2 将输入向量 A1′ 转换为一个512维的输出向量,输出向量中的每个元素均为输入特征的线性组合。随后,将偏置向量 b2 加到输出向量的512个元素上,从而使模型能够独立地调整各输入特征的输出值。此外,还应用了L2正则化,其形式为:λ||W2||22,用于惩罚较大的权重,通过防止模型在该特定模块中过度依赖任一特定神经元,以缓解过拟合问题。其中,W2 表示神经网络中某一层的权重矩阵,λ 为控制正则化程度的正则化参数,此处设定为0.1。Z2 表示在对来自模块1的输入应用全连接层及L2正则化后得到的新特征表示,如公式10所示。
此外,对新特征 Z2 应用了批归一化(BatchNormalization)层,以加速训练过程;其中 σ22 表示批次上的方差,μ2 是输出 Z2 的均值。尽管 ε 是一个用于保证数值稳定性的微小常数,γ 是一个可学习的缩放参数,使模型能够调整归一化后的输出,β 是一个可学习的偏移参数,使模型能够对归一化输出进行平移。最后,在应用批归一化层(如公式 11 所示)后,归一化输出 Z2 经过带泄漏修正线性单元(leaky ReLU)激活函数(AF),从而在网络中引入非线性,如公式 12 所示。其中 Z2 属于批归一化层的输出,作为输入传递给 Leaky ReLU 以实现非线性变换,而 A2 表示应用非线性后得到的输出。
最后,对来自Leaky ReLU激活函数的输出A2应用一个dropout层,如公式13所示。其中,A2为上一个ReLU激活函数接收到的输出,p2为dropout率,在本模块中设定为0.2,用于随机丢弃部分神经元。进一步地,A2′表示应用dropout层后得到的修改输出,其中部分神经元已被置为0。随后,第二模块的输出A2′被传递至第三模块,以进一步提取更高层次的抽象特征,并采用与第二模块相同的参数设置,仅在以下两方面有所区别:全连接层中的神经元数量为256而非512,dropout率为0.1而非0.2,其余操作序列均保持一致,具体如以下公式14至17所述。
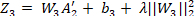 (14)
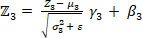 (15)
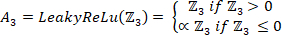 (16)
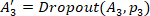 (17)
将第2个模块输出的A2′输入至第3个模块的全连接层(密集层),该层包含256个神经元,其中权重矩阵W3将输入向量A2′转换为一个256维的输出向量,输出向量中的每个元素均为输入特征的线性组合。随后,将偏置向量b3加到该输出向量的256个元素上,从而使模型能够独立地调整各输入特征的输出值。此外,还应用了L2正则化,其形式为:λ||W3||22,用于惩罚较大的权重,防止模型过度依赖单个神经元,有助于避免过拟合。其中,W3表示神经网络中某一层的权重矩阵,正则化的强度由正则化参数λ控制,本文中该参数设置为0.01。Z3表示在对来自第3个模块的输入应用全连接层及L2正则化后得到的新特征表示,如公式14所示。
此外,对新特征 Z3 应用了批归一化(BatchNormalization)层,以加速训练过程;其中 σ32 表示批次间的方差,μ3 是输出 Z3 的均值。ε 是为保证数值稳定性而添加的一个极小常数。归一化后的输出可通过可学习的缩放参数 γ3 进行调整,并通过可学习的偏移参数 β3 进行平移。最后,在应用批归一化层(如公式15所示)后,归一化输出 Z3 经过泄漏修正线性单元(leaky ReLU)激活函数,从而在网络中引入非线性特性,如公式16所示。其中 Z3 为批归一化层的输出,作为输入传递给 Leaky ReLU 以实现非线性变换,A3 表示应用非线性变换后得到的输出。
最后,对来自Leaky ReLU激活函数的输出A3应用一个dropout层,如公式17所示。其中,A3为上一级ReLU激活函数输出的结果,p3为dropout率,在本模块中设定为0.1,用于随机置零一部分神经元。此外,A3′表示应用dropout层后得到的修正输出,其中部分神经元已被设为0。
此外,来自第3个模块的输出 A3′ 会通过最后一个全连接层进行分类,该层包含 K 个神经元,代表数据集中实际的类别数量,如下面的公式18所述。
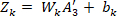 (18)
与厚层关联的权重矩阵为 Wk,其作用是将256维向量 A3′ 转换为 k 维向量,该向量表示从前一模块学习到的特征,并作为输出结果。此外,bk 表示偏置向量,用于调整预测值,以确保当输入为零时激活函数仍能产生非零输出;Zk 是在应用激活函数之前最终层的输出,其针对每个类别生成logit值;最后应用了SoftMax41分类器,将logit Zk 转换为每个类别的概率,如公式19和20所示。
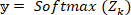 (19)
 (20)
其中,第 ith 类的预测概率由 yi 表示,K 为类别总数,Zk, i 表示第 ith 类的 logit 值,eZk, i 为第 ith 类 logit 值的指数。向量 y 表示所有可能类别的概率分布,并确保各概率之和为 1。表 3 以下列出了用于训练所提出混合模型的超参数细节,包括为提高可重复性与性能而采用的结构设计细节。
| 超参数 | 所提出的模型(FusionNetX) |
| 图像尺寸 | 224 × 224 |
| 主干网络架构 | 预训练的 EfficientNetB7 和 DenseNet121 分别作为 BBA1 和 BBA2 |
| 数据增强 | 旋转范围 = 7, |
| 宽/高平移范围最大为 0.05, | |
| 缩放范围最大为 0.01, | |
| 水平/垂直翻转 | |
| 数据划分比例 | 80% 用于训练,20% 用于验证,采用分层抽样且固定 random_state = 42 |
| 特征提取与融合 | 对每个主干网络的输出应用全局平均池化:BBA1 输出 2560 维特征,BBA2 输出 1024 维特征,融合后得到 3584 维联合特征向量。 |
| 全连接模块结构 | 包含 3 个全连接模块和 1 个输出层。每个模块依次包含 L2 正则化(λ=0.01)、批归一化(BatchNormalization)、LeakyReLU(α=0.01)、Dropout(分别为 0.3、0.2 和 0.1)以及隐藏层维度(分别为 1024、512、256)。融合头中未引入额外的跳跃连接。 |
| 激活函数 | Leaky ReLU 和 SoftMax |
| 优化器与学习率 | 使用 Adam 优化器,学习率固定为 0.00001,不采用学习率调度器。 |
| 损失函数 | sparse_categorical_crossentropy |
| 批量大小 | 16 |
| 训练轮数 | 每个数据集均固定训练 100 轮 |
| 使用平台 | Kaggle Notebook,配备 P100 GPU 和 16GB 显存,使用 TensorFlow 和 Keras 平台。 |
表3:用于训练所提出模型的超参数及所提出的架构细节。 本表提供了所提出模型的结构和架构细节,以及经过精细调整的参数和实现环境。
访问受限。请登录或开始试用以查看此内容。
结果
本部分详细介绍了在五种脑癌开源数据集(包括 Br35H、Figshare、Sartaj、Masoud 和 Balanced Brain Tumor 数据集)上测试所提出的双特征融合模型的结果,并根据多种统计性能评估参数对其性能进行评估,这些参数包括准确率42,43,44、误分类率(MCR)45、精确率(也称为阳性预测值,PPV)46、阴性预测值(NPV)、真阳性率(TPR,也称为灵敏度47或召回率)、真阴性率(TNR,也称为特异性)、F1 分数48、假阴性率(FNR)和假阳性率(FPR)。以下公式展示了上述性能评估参数的数学表达形式。
访问受限。请登录或开始试用以查看此内容。
讨论
综上所述,所提出的模型工作流程如下:首先,选择图像尺寸为 224 × 224,该尺寸适中,便于任何深度学习模型从数据样本中提取并学习合适的特征,同时保留所有重要信息;随后进行数据增强,这有助于使数据样本朝更多样化的方向变化,对模型从不同平面或角度提取特征具有重要作用。旋转范围设为 7%,宽度和高度平移范围为 0.05,缩放范围为 0.01。同时应用水平和垂直翻转,以将数据移动和缩放到不同角度。此外,数据集按 80% 训练集和 20% 验证集进行划分,以确保方法的平衡性,并采用固定随机种子(random_state = 42)进行数据打乱。接下来,在所提出的模型中应用 L2 正则化器,其系数(λ)为 0.01,该正则化器通过在训练过程中惩罚较大的权重,帮助模型防止过拟合并增强泛化能力,同时有助于平滑损失函数并减小权重的幅值。此外,在模型的全部 3 个模块中均应用了 Dropout 层,Dropout 比例分别为 0.3、0.2 和 0.1,对应于全连接层中 1024、512 和 256 个神经元,以克服每个模块在训练过程中的过拟合问题。每个全连接层均采用 Leaky ReLU 激活函数(AF),该函数在输入为负时允许存在较小梯度,有助于缓...
访问受限。请登录或开始试用以查看此内容。
披露
作者无任何利益冲突需要披露。此外,手稿及图表均未使用人工智能工具生成。
致谢
作者感谢沙特阿拉伯利雅得公主诺拉·宾特·阿卜杜勒拉赫曼大学研究人员支持项目(PNURSP2026R192)以及公主诺拉·宾特·阿卜杜勒拉赫曼大学提供的支持。作者同时感谢参与本研究的研究对象及相关机构。
资金支持:
本工作由韩国国家研究基金会(NRF)资助,该基金会由韩国政府(MSIT)提供资金(项目编号:RS-2023-00218176)以及顺天乡大学研究基金支持。沙特阿拉伯利雅得阿卜杜勒拉赫曼·宾特·努拉公主大学研究人员支持项目(PNURSP2026R192),阿卜杜勒拉赫曼·宾特·努拉公主大学。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Br35H 脑肿瘤数据集 | Kaggle(数据集贡献者) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | 公开数据集;二分类(有肿瘤 / 无肿瘤)300 张 MRI 图像 |
| Figshare 脑肿瘤数据集 | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | 公开数据集;多分类(胶质瘤、脑膜瘤、垂体瘤)3064 张 MRI 图像 |
| Sartaj 脑肿瘤分类 MRI 数据集 | Kaggle(Sartaj Bhuvaji 提供的数据集) | https://doi.org/10.34740/kaggle/dsv/12745533 | 公开数据集;多分类(胶质瘤、脑膜瘤、无肿瘤、垂体瘤)3264 张 MRI 图像 |
| Masoud 脑肿瘤 MRI 数据集 | Kaggle(Masoud Nickparvar 提供的数据集) | https://doi.org/10.34740/kaggle/dsv/14832123 | 公开数据集;多分类(胶质瘤、脑膜瘤、无肿瘤、垂体瘤)7023 张 MRI 图像 |
| BBT-数据集(脑肿瘤数据集) | Kaggle(数据集贡献者) | https://doi.org/10.34740/kaggle/dsv/6758053 | 公开数据集;平衡的多分类脑肿瘤数据集,共 5248 张 MRI 图像 |
| Python | Python 软件基金会 | https://www.python.org | 编程语言,版本 3.10.13 |
| TensorFlow / Keras | Google / TensorFlow 开发团队 | https://www.tensorflow.org | 深度学习框架;用于模型构建、训练与评估,版本 2.15.0 |
| EfficientNetB7(预训练模型) | Google / Keras Applications | https://keras.io/api/applications/efficientnet/ | 基于 ImageNet 预训练的主干网络;用于特征提取 |
| DenseNet121(预训练模型) | Keras Applications | https://keras.io/api/applications/densenet/ | 基于 ImageNet 预训练的主干网络;用于特征提取 |
| scikit-learn | scikit-learn 开发团队(NumFOCUS) | https://scikit-learn.org | 标签编码、训练集-测试集划分、评估指标(分类报告、混淆矩阵、ROC/AUC) |
| OpenCV (cv2) | OpenCV 团队 | https://opencv.org | 图像加载与尺寸调整 |
| NumPy | NumPy 开发团队(NumFOCUS) | https://numpy.org | 数值计算与数组操作 |
| pandas | pandas 开发团队(NumFOCUS) | https://pandas.pydata.org | 数据组织与指标表格化 |
参考文献
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
访问受限。请登录或开始试用以查看此内容。