本文介绍了一种由人工监督的计算工作流程,用于分析433幅清代外销画中女性形象的重复性表征。七个由人工确定的参考类别及反复出现的视觉线索揭示了该语料库中的模式,但研究结果仅限于所采样的图像,无法衡量清代的社会现实或历史接受情况。
本文内容
摘要
摘要
本研究分析了433幅1757–1911年间中国清代外销画中女性身份的重复性表征及与社会阶层相关的视觉线索。研究流程结合了CLIP ViT-B/32模型进行初步标注、借助Segment Anything Model(SAM)实现目标定位、降维与聚类分析,以及由两名独立编码员进行的人工图像志编码。CLIP标签用于初步分类,SAM作为定位辅助工具,经仲裁后的人工编码则提供参考分类标准。综合结果识别出七类与人物相关的类别:仕女/美人(n = 112)、劳作(n = 72)、家居(n = 64)、侍从(n = 58)、礼仪/婚嫁(n = 45)、市井(n = 43)和表演(n = 39)。在433幅画作中,初步计算标注与人工参考标注一致的样本达356幅(82.2%),各类别的召回率介于73.3%至88.4%之间。通过服饰、空间场景、物品、姿态及所描绘的社会关系的重复组合,刻画了这些类别的视觉特征。对433个样本层级的AI–人工标签配对进行评估,获得了全面的类别级精确率、召回率与F1分数,并生成了详述分类模式的混淆矩阵。聚类验证支持所选聚类方案,并表明所生成的聚类与人工定义的参考类别具有一致性。总体而言,服饰、空间场景、物品、姿态与社会关系的重复组合,表明在所采样的画作语料库中存在规律性的图像类型学。这些发现刻画了清代中国外销画中的视觉表征,但不应将其解读为对法律地位、实际生活经验、市场需求或历史上外国受众接受度的直接度量。
引言
18世纪末以来,清代外销画成为连接广州与其他收藏中心和欧美买家之间的商业与文化网络的组成部分1,2,3,4,5。商人、旅行者、外交官、传教士和收藏家将这些画作作为便携商品、纪念品、视觉信息来源,以及对地域、职业、生产活动、风俗习惯和社会类型的形象呈现而加以购藏。因此,这些画作的流传既反映了中国本地作坊的制作实践,也体现了外部市场需求的期待。
海外市场的需求倾向于选择具有辨识度的主题、系列化形式、重复出现的图案以及便于收藏和比较的场景。作坊为销售目的调整了媒介、尺幅、构图和题材,而买家通常偏爱对行业贸易、仪式活动、室内陈设、园林景观、街道风貌以及富有画面感的社会人物形象的清晰描绘。广州作坊反复制作同类场景的作品,进一步表明艺术家及其助手如何针对海外 patrons 调整图像程式与西方绘画技法1,2,3,4,5。尽管市场需求可能影响了作品的创作与留存,但现有文献资料并不能直接反映个体买家的具体偏好或实际反馈。
因此,这些画作应被视为经过选择和中介的资料,而非对日常生活的全面记录。画中的场景可能通过作坊惯例、市场选择、博物馆收藏、编目和数字化等过程,对社会习俗进行理想化、简化、标准化或改编1,2,3,4,5。历史解读必须区分画作中可直接观察到的特征,以及关于所描绘个体、创作背景和后世观者赋予作品意义等方面的推论。
女性形象为考察这一区别提供了集中的途径。服饰、发型、姿态、空间场景、物品、活动以及与其他人物的关系,可将女性组织成视觉上反复出现的角色类型,包括精英/美人、家庭、仆人、劳作、市集、表演以及仪式/婚礼等类别。这些类别是对图像模式的分析性描述,其本身并不能确立法律地位、财富、职业、民族、旗籍或汉族归属、道德品质或实际身份。
数字艺术史与计算机视觉不仅能够促进对数字化视觉藏品的大规模比较,还能对计算模型中隐含的假设进行批判性审视6,7。视觉–语言模型有助于识别和整理反复出现的视觉母题,但当使用当代模型词汇处理历史性的非西方图像时,文化偏见仍是一个重要局限8。有关中国传统绘画的同类计算研究同样表明,将定量的模式检测与基于历史背景的阐释相结合具有重要价值9。
本研究探讨三个问题:(1)语料库中呈现了哪些经裁决的人工编码女性身份类别?(2)这些类别的特征由哪些服装、空间场景、物品、姿势和社会关系组合构成?(3)总体精确匹配准确率和类别级别的召回率在七个类别之间有何差异?该工作流程借鉴了中国传统绘画的计算分析方法9,同时将其历史主张限定于所采样的图像及已有记录的分析范围之内。
本研究的贡献兼具史学方法与技术层面。通过语料库规模的比较,可识别出反复出现的图像程式,进而通过深入的历史分析对其进行语境化阐释。该方法有助于推动关于性别、等级制度、日常生活表征以及跨文化交流的研究,而无需将图像出现频率视为社会普遍性的证据,或将视觉相似性当作历史同一性的证明。
方案
研究设计与分析单位
每幅绘画作品或目录记录被视为一个独立的分析单位。本研究采用基于语料库的观察性设计,结合元数据审查、初步计算组织、独立人工编码以及艺术史解释。研究时段界定为1757年至1911年,在此时间范围内应用了纳入与排除标准。对历史艺术作品及其相关目录元数据进行了分析。在比较不等时间区间的分布时,数据量按区间时长进行了归一化处理,同时在结果解释中考虑了可能存在的存世偏差与收藏偏差。
语料库构建与筛选
候选记录从所引用的博物馆目录、数字档案和已发表的目录中获取。针对每条候选记录,保留了机构、标题、日期或日期范围、媒介、入藏号或目录编号、稳定的来源网址、检索日期以及权利声明。即使相应图像文件因法律原因无法再分发,仍保留了来源链接。报告的筛选流程始于612幅候选图像。其中,85幅因超出1757–1911年的时间范围或不属于外销画传统而被排除;58幅因属于现代复制品、图像模糊或主题错误而被排除;29幅因缺乏可识别的女性人物或图像分辨率不足而被排除;7幅因元数据不充分而被排除。最终的分析语料库包含433条记录。
元数据标准化与图像预处理
最终分析语料库中的每幅画作均被分配一个稳定的QEP标识符,范围从QEP_001至QEP_433。保留了相关的博物馆元数据,包括机构、藏品编号、标题、年代、媒介或材料、原产地、来源链接以及可获得的目录描述。用于视觉分析的信息包括:初步的AI标签、经人工判定的类别、女性人物数量、年龄组、姿势、服饰、空间场景、相关物品及社会关系。每幅画作被归类为七个主要类别之一:仕女/美人、家庭生活、侍女、劳作、市井、表演或仪式/婚礼。对于包含多个女性人物的场景,根据视觉显著性和叙事中心性确定主要人物。当无单一女性人物占主导地位时,则依据画面中主要描绘的活动和整体场景背景确定主类别。在类别重叠的情况下,优先依据所描绘的活动和场景背景进行判断,而非仅凭服饰或外貌。存在歧义的情况由两位编码员独立复核,并通过协商达成一致。源图像以JPEG或PNG格式保存。仅裁剪网页边框、目录框架或非图像边距部分。未对画作内容进行重构、重着色、增强或修复。
基于CLIP的初步标记
采用 CLIP ViT-B/32 图像编码器进行初步的图像–文本相似性分析9。候选身份术语包括 elite woman、domestic woman、female servant、working woman、market woman、female performer、bride 和 ritual woman。场景术语包括 Chinese interior、garden、street market、workshop、tea production、textile work 和 ceremonial scene。针对每幅图像,均保留完整的提示模板集合、模板顺序、任何提示集成方法、文本归一化流程、决策规则、置信度评分及并列情况。
使用 Python 3.10 和 PyTorch 2.0.1 实现的 OpenAI CLIP ViT-B/32 模型,将完整的提示词列表一致地应用于所有图像。推理过程在支持 CUDA 的 GPU 上进行,批量大小为 32,采用 FP32 精度。每幅图像均被调整大小并中心裁剪至 224 × 224 像素,并使用与 ViT-B/32 模型相关的预处理变换对 RGB 通道进行归一化。文本提示词由上述定义的身份和场景描述符构建,并通过 CLIP 文本编码器进行编码。计算归一化后的图像嵌入与文本嵌入之间的余弦相似度,并将相似度得分最高的提示词指定为初步的人工智能标签。所有候选标签的相似度得分均被保留,以供后续人工审核。实验中使用固定的随机种子 42,并对全部 433 幅画作应用相同的预处理流程、提示词模板和决策规则。
基于 SAM 的辅助定位
Segment Anything Model(SAM)仅被严格用于对人物、服装、家具、工具、仪式用品以及建筑区域进行定位,以供人工视觉检查。必须强调的是,SAM 并未参与分类流程;其生成的掩膜、裁剪区域及衍生特征均与 CLIP 的标注和聚类过程相互隔离,从而确保 SAM 的应用仅提供定位辅助,而不会影响或夸大分类性能。
必要时采用手动点提示或边界框来优化视觉元素的定位。对女性形象、服饰、家具、工具、仪式物品以及建筑元素生成 SAM 掩膜,并对每次分割结果进行目视检查,以确保区域覆盖恰当。生成的掩膜有助于识别和审查相关图像学特征,但未用于 CLIP 标注或类别分配。
降维与聚类
计算了CLIP图像嵌入,并使用余弦距离的UMAP进行二维可视化10。记录了用于聚类的表示方法及其预处理流程、维度和距离定义。
对图像特征表示应用了K均值聚类和层次聚类,以识别语料库中反复出现的视觉组合模式11。使用轮廓系数和戴维斯-布尔丁指数评估了k = 5–9的候选K均值聚类方案。K均值++初始化采用以下参数:n_init = 10,max_iter = 300,tol = 1 × 10⁻4,random_state = 42。层次聚类采用平均连接和余弦距离的凝聚聚类方法进行。通过定量验证指数、聚类稳定性以及艺术史可解释性对候选聚类方案进行比较,最终选择能够最连贯地表征反复出现视觉模式的聚类方案。每幅画作(共433幅)的最终聚类分配结果被保留下来,用于后续与人工编码类别的比较。
人工编码、培训与裁决
两名编码员使用一份版本化的编码手册,独立审查全部433幅图像,编码内容包括主要类别、图像数量、年龄组、姿势、服装、空间场景、物体及社会关系。在进行裁决前,保留了每位编码员的独立记录。编码员具备艺术史与视觉分析相关背景,并通过标准化编码手册及绘画语料库中的代表性样例接受了培训。在正式编码开始前,他们完成了一项包含30幅绘画的校准练习,以促进对七个身份类别和五个视觉线索维度的一致理解。
在正式编码过程中,两名编码员在相互盲态下独立评估所有符合条件的画作,且对初步的AI标签和聚类分配均不知情。采用Cohen's kappa系数评估编码员间信度。主要身份类别的kappa值为0.88,各类视觉线索变量的kappa值介于0.79至0.92之间,表明编码员之间具有高度一致性。对于存在分歧的条目,通过讨论达成共识后予以解决,并将裁决后的类别及视觉线索编码记录下来用于后续分析12。预裁决标签得以保留。
人工智能与人类的一致性及性能评估
以仲裁后的人类分类作为参考,与每幅画作的一个初步人工智能标签进行描述性比较。总体完全匹配准确率为 356/433(82.2%)。类别召回率计算为每个类别中人工智能与人类完全匹配的数量除以该类别人类参考样本的支持数。各类别的支持数、完全匹配数、不匹配数及相应的分母均被明确列出。
基于433个病例层面的成对人工智能与人工标注结果,计算了目标类别的假阳性率、各类别的精确率、召回率和F1分数。构建了完整的混淆矩阵,用于分析非对角线上的分类模式,进而指导对不一致结果的审查、错误分类的记录以及裁决规则的制定。
可重复性数据包与材料
计算工作流程及相关研究材料已整理至一个版本控制的代码仓库中。该可重复性数据包包含用于预处理、CLIP 分析、SAM 定位、UMAP 降维、聚类、一致性分析及图表生成的脚本,同时附带人工编码代码本、配置文件、依赖信息、个案层级的衍生结果,以及图像来源与版权信息的机器可读清单。归档的研究材料已分配持久性标识符,以促进研究的可重复性与再利用。
使用 Microsoft Excel 2021 对元数据进行整理和管理。计算分析采用 CLIP ViT-B/32 进行初步的视觉-语言标注,SAM 用于视觉元素定位,UMAP 结合余弦距离进行降维,K 均值聚类和层次聚类用于探索性模式分析。聚类结果通过轮廓系数和戴维斯–布尔丁指数进行评估,编码者间一致性通过 Cohen’s kappa 进行评估。整个工作流程中所使用的软件环境、模型配置、计算设置和随机种子均被详细记录,以支持结果的可重复性。
结果
语料库构建与描述性构成
图1 展示了语料库的四部分概览。图1A 显示了从612条候选记录筛选至433条保留记录的报告过程。图1B 展示了媒介和格式的代表性示例。图1C 呈现了四个时间区间的数量分布,而 图1D 总结了语料库的来源与媒介构成。由于时间区间所涵盖的时间段不相等,这些数量仅描述了采样语料库的构成,不应被解读为历史生产速率。
表1总结了语料库的总体特征。其中博物馆收藏记录为302条,数字档案记录为81条,已出版目录记录为50条。媒体类型分为外销水彩画(n = 176)、通草纸绘画(n = 112)、外销册页(n = 83)、人物画(n = 41)及其他形式(n = 21)。元数据完整性分为完整(n = 288)、部分(n = 118)和极少(n = 27)。女性人物的呈现方式分为中心人物(n = 214)、次要人物(n = 102)或多个人物(n = 117)。每项分类均涵盖全部433条记录。
初步的人工智能标注与人工参考分类
表 2 总结了433幅画作中初步由人工智能生成的标签与人工参考分类之间的总体一致性,同时 补充表1 提供相应的病例级别初步人工智能标签、编码员分类、裁决后的人类参考类别、匹配状态及聚类分配。 总体而言,人工智能与人工参考标签在356幅画作上一致,对应精确匹配准确率为82.2%。类别级召回率计算为每个类别中人工智能与人工精确匹配的数量占该类别人工参考支持数量的比例。
类别级召回率在仪式/婚礼场景中为73.3%(33/45),在精英/美容场景中达到88.4%(99/112)。劳动场景的召回率为84.7%(61/72),表演场景为82.1%(32/39),家庭场景为79.7%(51/64),仆人场景为79.3%(46/58),市场场景为79.1%(34/43)。总体而言,完全一致的比对结果为356/433(82.2%)。通过对样本层级的配对进行评估,可计算出所有七个类别的精确率和F1分数,其中精确率范围为74.5%至89.2%,F1分数范围为0.75至0.88。详细的混淆矩阵(包含目标类别的假阳性及非对角线模式)见补充图1。
报告的计算模式摘要
图2展示了四种报告的计算分析结果。图2A显示了九幅画作的图集,其上叠加了彩色分割图层,用于视觉定位与审查。图2B展示了报告的CLIP图像嵌入的UMAP散点图,密度等高线标记为C1–C7。图2C比较了报告的画作数量(实心点)与类别级召回率(空心圆),而图2D则展示了根据相同标签分组的代表性画作图集。聚类验证支持所选的聚类方案,其轮廓系数为0.54,戴维斯-博尔丁指数为0.92。聚类结果与人工分类之间的映射显示出高度一致性,每个推导出的聚类主要对应一个独立的人工参考类别。
表3展示了七种已报道的计算谱型,其样本量对应于七种人类参考类别支持。聚类与类别的列联表见补充表2,显示了七种经裁定的人类参考类别在C1–C7聚类中的分布情况。对这些个体水平聚类分配的分析表明,计算聚类结果还原出了与七种人类参考类别高度对应的视觉结构。
视觉线索关联与解释性综合
表4 总结了用于描述七种人工编码类别的定性视觉线索特征。这些特征描述了服装、空间环境、姿势、物体以及社会关系之间的常见关联。这些特征并非源自定量的交叉列表分析,因此不涉及法律身份、种族、社会成因或受众反应的判定。
图3 将编码后的视觉特征的描述性定量总结与解释性概念模型相结合。 图3A 展示了七个经裁定的人类参考类别及其样本量。 图3B 展示了这些类别与五个维度(服装、空间场景、物体、姿势和社会关系)中的编码视觉标记之间的相对关联。所显示的关联强度是根据每个以人为参考的类别内的案例级注释计算得出的。 图3C 总结了人类参照类别、视觉标记维度与类别隐含原型之间的关系,使用基于编码观察得出的加权流进行表示。这些定量关系刻画了样本绘画中反复出现的表征模式,不应被解读为对历史人口或社会分布的估计。 图3D 提出了一种概念性的跨文化诠释模型,应将其理解为一种基于历史背景的解释框架,而非经过实证检验的因果路径。
视觉模式的综合解读
在整个样本中,七个女性身份类别均表现出服饰、空间场景、物品、姿态和社会关系的重复性组合。这些组合为所选画作中存在的模式化视觉惯例提供了描述性证据。关于性别、等级制度和跨文化调停的历史解释则仍属推论性质。
综合来看,汇总结果确定了七种以人类为参照的女性身份类别,以及用于描述这些类别的五个反复出现的维度:服饰、空间场景、物品、姿势和社会关系。在433幅画作中,初步的人工智能标签与经裁决后的人类分类在356幅(82.2%)上一致,其中仪式/婚礼场景类别的类别级召回率最低(73.3%)。这些发现支持了语料库的描述性组织与比较。基于个案的人工智能与人类标签实现了类别级的精确率和F1值估计。此外,聚类分析识别出与七种人类参照类别相对应的结构。然而,这些计算结果描述的是视觉表征惯例,而非对历史社会现实或受众接受情况的因果性论断。
数据可用性:
支持本研究的数据,包括元数据、来源信息和筛选记录,可通过 Zenodo 获取,网址为 https://doi.org/10.5281/zenodo.21130291。
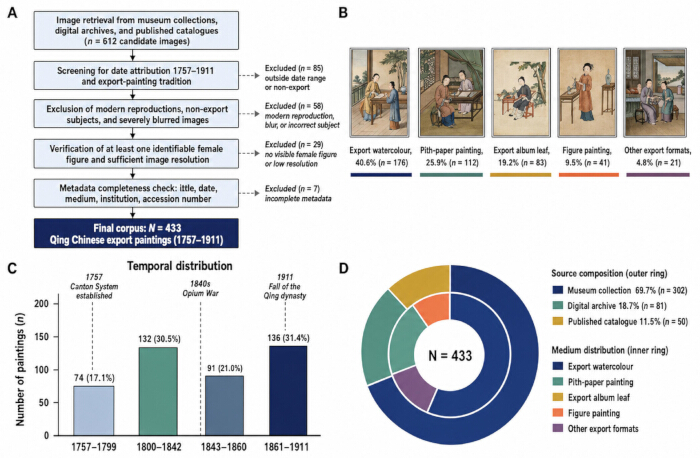
图1:433幅画作样本的语料库构建与描述性构成。(A)对612幅候选图像进行逐级筛选,最终获得433幅符合条件的画作。排除项包括:不属于研究时段或外销画传统的作品(n = 85)、现代复制品、模糊图像或主题错误的图像(n = 58)、无明确女性人物或分辨率不足的图像(n = 29),以及元数据不完整的记录(n = 7)。(B)五类媒介与形式的代表性示例:外销水彩画(40.6%,n = 176)、通草纸画(25.9%,n = 112)、外销册页(19.2%,n = 83)、人物画(9.5%,n = 41)及其他外销形式(4.8%,n = 21)。(C)样本画作在四个时间区段中的分布情况。(D)收藏来源(外环)与媒介/形式(内环)的分布。百分比基于总样本量(N = 433)计算,并保留一位小数。请点击此处查看该图的高清版本。
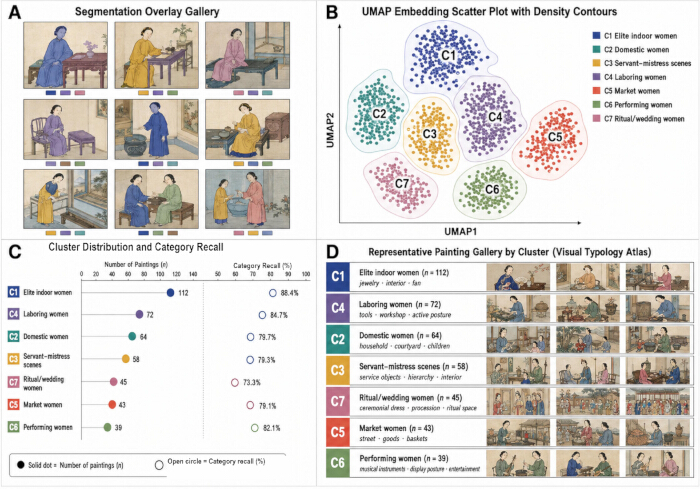
图2:报告的图像分割、嵌入可视化、聚类分布、类别召回率及代表性绘画。(A)九幅绘画作品图集,带有彩色分割叠加层,用于定位需审阅的人物或视觉元素。(B)报告的CLIP图像嵌入的UMAP散点图,包含密度等高线及标签C1–C7。(C)报告的绘画数量(实心圆点,上轴)和类别召回率(空心圆圈,下轴);类别召回率等于精确匹配数除以人工参考支持数。未显示置信区间或误差条。(D)按C1–C7标签分组的代表性绘画图集,图像根据其与相应聚类质心的接近程度进行选择。缩写:AI = artificial intelligence;CLIP = Contrastive Language–Image Pre-training;SAM = Segment Anything Model;UMAP = Uniform Manifold Approximation and Projection;C1–C7 = 报告的标签1–7。请点击此处查看该图的放大版本。
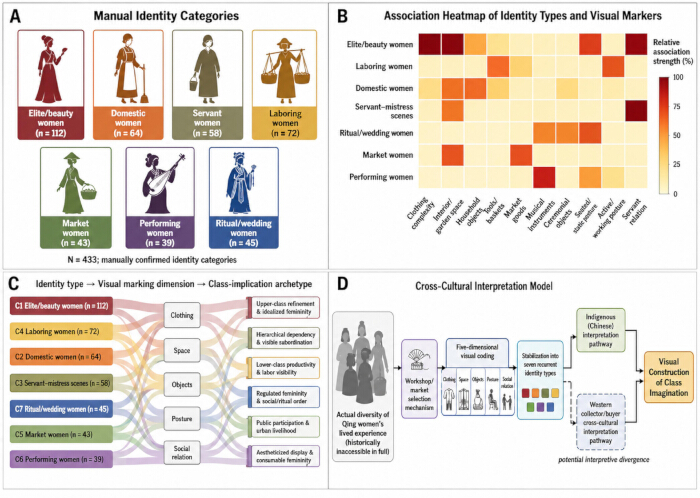
图3:视觉线索关联与跨文化解释框架。(A)在433幅画作语料库中,经裁定的七类人类参照女性身份分类及其样本量。(B)关联热图,显示七类人类参照分类与编码的视觉标记(包括服饰、空间场景、物品、姿势和社会关系)之间的关系相对强度。关联强度基于每类中的个案级注释得出。(C)桑基图,总结基于编码观察所得的人类参照分类、视觉标记维度与类别推论原型之间的加权关系。(D)概念性跨文化解释模型,连接所描绘的活动、作坊与市场选择、五维视觉编码、反复出现的身份类型以及潜在的解释路径。请点击此处查看该图的放大版本。
表1:语料库特征与元数据完整性(N = 433)。 计数与百分比汇总了六个独立部分:时间区间、来源、媒介或格式、元数据完整性、女性形象的呈现以及场景类型。每个部分均以 N = 433 作为分母,总和为 433;百分比为各部分内部语料库比例,保留一位小数。 请点击此处下载该文件。
表2:初步AI标签与人工参考类别(N = 433)。 支持度表示分配给各人工参考类别的画作数量。完全匹配指初步由AI生成的标签与人工参考类别一致的画作。类别级召回率计算方式为完全匹配数量除以人工参考支持度数量。请点击此处下载该文件。
表3:报告的计算特征谱摘要。 C1–C7 重现了经过验证的特征谱大小和主要标签。通过整合病例层面的聚类分配结果与聚类-类别列联表,证实无监督聚类有效捕捉到了与七种人工参考类别相对应的视觉结构。请点击此处下载该文件。
表4:女性身份类别的定性特征及其与阶级相关的视觉线索。 统计数量和百分比总结了以人类为参照的身份类别,而服装、空间、物品、姿势和社会关系则刻画了与每一类别相关的重复出现的视觉特征。这些与阶级相关的解读是对图像模式的图像学分析,而非对历史社会地位的直接度量。请点击此处下载该文件。
补充图1:433幅画作语料库中初步AI标签与仲裁后人工参考类别之间的混淆矩阵。 行表示仲裁后的人工参考类别(真实标签),列表示初步由CLIP生成的类别(预测标签)。单元格中的数值表示每种AI与人工标签组合对应的画作数量。对角线单元格表示AI与人工标签完全匹配的情况,相应的类别级召回率以百分比形式显示。非对角线单元格表示初步AI分类结果与仲裁后人工参考类别之间的不匹配情况。整体精确匹配准确率为82.2%(356/433)。请点击此处下载该文件。
补充表 1:初步人工智能标签、裁决后的人类参考类别与 UMAP 聚类分配的个案级比较。 每一行代表分析语料库中包含的 433 幅清代外销画中的一幅。该表列出了稳定的 QEP 图像标识符、初步的 CLIP ViT-B/32 标签、人类编码员 1 和人类编码员 2 的独立分类结果、裁决后的人类参考类别、人工智能与人类匹配状态以及 UMAP 聚类分配。“完全匹配”表示初步人工智能标签与裁决后的人类参考类别一致;“不匹配”表示两者不一致。裁决后的人类类别被用作人工智能与人类一致性分析的参考分类。请点击此处下载该文件。
补充表 2:人类参考类别与计算聚类分配的列联表。 行表示七个人类判定的参考类别,列表示通过计算聚类分析获得的 C1–C7 聚类。单元格数值表示被分配到每个类别–聚类组合的画作数量。总支持数表示每个人类参考类别中的画作数量。各类别–聚类组合中观测值的集中程度,可描述独立生成的计算聚类与人类判定参考类别之间的一致性情况。请点击此处下载该文件。
讨论
在提供的汇总数据中,433 条记录被划分为七个以人类为参照的类别,并通过五种视觉提示家族进行描述。精英/美貌类是最大的类别(112/433),356 个初步标签与报告中的人类参照相符(82.2%)。这些是语料库中的观察结果。它们支持对重复出现的图像模式进行研究,但不足以支持更强的论断,即这些模式忠实地再现了清代社会,或在外国观众中引发了特定反应13。
规范性性别话语、家庭地位、劳作以及清代法律共同塑造了女性的生活,但并未以单一方式决定其命运。关于清盛期女性的研究记录表明,女性在参与家庭规范和贞节制度的同时,也广泛参与劳作、写作、礼仪、宗教及娱乐活动。八旗制度是由法律和行政实践所界定的世袭性、多民族身份群体;因此,旗籍身份不应自动等同于满族血统14,15,16,17。在本研究中,服饰、姿态、器物与场景是图像线索,而非法律等级、旗人/汉人归属、族裔、道德顺从或实际身份的证据。若要作出上述判断,需依赖档案与法律证据。
计算结果还需要在文化和技术上保持审慎。不应假设通用的视觉-语言模型在文化上是中立的。已发表的 CulturalVQA 结果表明,模型在不同地区和文化维度上的表现不均衡,但该基准既未评估 CLIP ViT-B/32,也未使用历史东亚艺术数据8,18,19。因此,这凸显了针对本语料库建立匹配案例基准的必要性,而非将其替代。在相关实验结果出现之前,CLIP 仅可作为对清代身份或等级结构的初步组织辅助工具,而非权威判断依据。计算流程确认,SAM 严格作为辅助性定位证据使用;未将任何掩膜或由掩膜导出的特征用作标注或聚类的输入,从而确保视觉分类完全依赖于未分割图像的全局语义嵌入。数字文化遗产研究还强调文化敏感性、跨学科监督、可及性、数据保护以及透明的工作流程20。
从历史上看,这些图像模式的重要性源于外销画贸易:中国的作坊与外国市场需求共同选择并标准化了那些便于携带、易于辨识且具有收藏价值的主题;反复出现的作坊图像也表明,其复制方式是带有变异的模仿,而非纯粹的机械复制1,2,3,4,5。因此,该图像语料库有助于研究性别、等级制度、日常生活图像以及跨文化交流的历史,揭示哪些图像模式在大规模范围内反复出现。但这并不意味着这些图像构成了全面的民族志记录。计算比较可为细读和跨文化语境化提供指引21,而关于市场意图或受众意义的论断,则必须由生产记录、购买历史和接受证据来支撑。
情感与认知反应仍是未来进一步研究的方向,而非本研究的结果。Shi 及其同事结合偏好评分、潜在维度分析和眼动追踪,以区分观众对《下山碰头灯彩图》的情感、形式美学和认知反应路径22。类似的研究设计可用于检验观众在观看外销画时,是否对服饰、器物、姿态或等级关系等元素的关注存在差异。由于本研究未收集任何评分、眼动数据或其他受众反馈信息,因此无法仅从图像内容推断出情感唤醒程度、视觉显著性或观众接受度。
这些局限性体现在理论、方法和实践层面。理论上,物质线索分类简化了性别、家庭关系、法律等级、族群以及生活经验等复杂维度。方法上,推论受到文物存世情况、收藏偏好、数字化程度、元数据质量、零样本模型、编码方式以及时期分布不均等偏差的制约。尽管分析流程展示了强大的模式识别能力,但这些结构性偏差凸显出有必要将计算结果视为对图像惯例的分析,而非对清代社会现实的透明反映。实践中,图像版权限制了内容的再分发,且研究发现可能无法在不同机构、时期、媒介或计算环境中普遍适用。在上述限制条件下,本研究提供了一个由人工监督的框架,旨在将重复出现的视觉观察转化为可检验的历史问题,而非自动生成结论。作为一项解释性研究而非干预性研究,本研究并未评估任何可持续发展目标(SDG)或指标的进展状况。然而,其研究主题与目标5相关,其注重权利意识的记录方式以及跨文化的教育框架在概念上与目标11.4和4.7相一致;但并未测量任何SDG成果。所提供的可重复性数据包使本研究符合近年来对透明数字遗产工作流程的倡导,并满足FAIR原则关于持久标识符、丰富元数据、许可协议、来源信息,以及可复用的数据、算法、工具和工作流程的要求20,23。
披露
作者无任何利益冲突需要披露。
致谢
作者感谢维多利亚与阿尔伯特博物馆、大英博物馆、大都会艺术博物馆、史密森尼国立亚洲艺术博物馆、皮博迪·埃塞克斯博物馆、中国香港艺术馆、大英图书馆、盖蒂研究所及其他收藏机构和目录团队,这些机构的在线记录为语料库的发现提供了支持。访问在线记录并不意味着获得其图像再分发的许可;因此,面板级别的权利信息和来源链接将单独记录。作者还感谢支持 CLIP 和 SAM 的开放研究社区,以及来自澳门城市大学和广东技术师范大学的行政支持。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| CLIP ViT-B/32 | OpenAI | OpenAI CLIP, ViT-B/32 | 用于初步图像–文本相似性分析及初步人工智能标签分配的视觉-语言模型。 |
| 计算工作站 | 作者’的计算工作站 | CUDA-enabled GPU;具体硬件配置需报告 | 用于执行CLIP与SAM推理及计算分析的工作站;应从原始运行环境中报告GPU、CPU、内存、操作系统及CUDA的具体参数。 |
| Matplotlib | Matplotlib开发团队 | Python包;具体版本需报告 | 用于计算可视化以及分析图表和曲线图的生成。 |
| Microsoft Excel 2021 | 微软公司 | Microsoft Excel 2021 | 用于元数据整理、筛选记录以及表格化研究数据的管理。 |
| NumPy | NumPy开发者 | Python包;具体版本需报告 | 用于数值计算及图像特征与分析数组的操作。 |
| pandas | pandas开发团队 | Python包;具体版本需报告 | 用于结构化数据处理、元数据加工以及病例级别分析结果的组织。 |
| Python 3.10 | Python软件基金会 | Python 3.10 | 用于实现计算图像分析流程的编程环境。 |
| PyTorch 2.0.1 | PyTorch基金会 | PyTorch 2.0.1 | 深度学习框架,用于基于CLIP的图像与文本编码及GPU推理。 |
| scikit-learn | scikit-learn开发者 | Python包;具体版本需报告 | 用于K均值聚类、凝聚聚类、轮廓系数、戴维斯–博尔丁指数及科恩’s kappa系数的计算。 |
| 通用分割模型(Segment Anything Model, SAM) | Meta AI Research | SAM | 用于定位女性人物、服饰、家具、工具、仪式用品及建筑区域以进行视觉检查的分割模型。 |
| umap-learn | McInnes等 | UMAP的Python实现 | 用于对CLIP图像嵌入向量进行降维,并基于余弦距离实现二维可视化。 |
参考文献
- Gao J, Zhang Y, Liu J, Sousa JP. A digital humanities approach to Chinese export watercolours: a case study on the Victoria and Albert Museum collection. Digit Scholarsh Humanit. 2026;41(2):692-714.
- Liu H, Fu C, Li W. Silk road heritage: the artistic representation of port trading culture in the images of characters in Qing Dynasty Guangzhou export paintings. PLoS One. 2024;19(10):e0308309.
- Ao J, Ye Z, Li W, Ji S. Impressions of Guangzhou city in Qing Dynasty export paintings in the context of trade economy: a color analysis of paintings based on k-means clustering algorithm. Herit Sci. 2024;12:77.
- Mok MKW. Chinese export paintings: a marketing success story. Cambridge Scholars Publishing; Newcastle upon Tyne; 2025.
- Yaron E. The many versions of the painting of Tingqua's studio: painting copying and originality in nineteenth-century Canton. Humanit Soc Sci Commun. 2020;7:132.
- Impett L, Offert F. There is a digital art history. Vis Resour. 2022;38(2):186-209.
- Münster S. Artificial intelligence for digital heritage innovation: setting up a R&D agenda for Europe. Heritage. 2024;7(2):794-816.
- Foka A, Griffin G. AI, cultural heritage, and bias: some key queries that arise from the use of GenAI. Heritage. 2024;7(11):6125-6136.
- Zhang W. Computational approaches for traditional Chinese painting: from the Six Principles of Painting perspective. J Comput Sci Technol. 2024;39(2):269-285.
- McInnes L, Healy J, Saul N, Großberger L. UMAP: Uniform Manifold Approximation and Projection. J Open Source Softw. 2018;3(29):861.
- Rousseeuw PJ. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis. J Comput Appl Math. 1987;20:53-65.
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46.
- Stejskal J. Art-historical empiricism and digital visualization of cultural heritage. Synthese. 2025;205:132.
- Mann S. Precious records: women in China's long eighteenth century. Stanford University Press; Stanford; 1997.
- Porter DC. Slaves of the emperor: service, privilege, and status in the Qing Eight Banners. Columbia University Press; New York; 2023.
- Sommer MH. Sex, law, and society in late imperial China. Stanford University Press; Stanford; 2000.
- Theiss JM. Disgraceful matters: the politics of chastity in eighteenth-century China. University of California Press; Berkeley; 2005.
- Nayak S, et al. Benchmarking vision language models for cultural understanding [conference paper]. Presented at: 2024 Conference on Empirical Methods in Natural Language Processing; Miami, Florida, USA; 2024. https://aclanthology.org/2024.emnlp-main.329/
- Vitaloni C, Shullani D, Baracchi D. A comparative study of vision language models for Italian cultural heritage. Heritage. 2025;8(3):95.
- Li W. Systematic review: a scientometric analysis of the status, trends and challenges in the application of digital technology to cultural heritage conservation (2019-2024). npj Herit Sci. 2025;13:90.
- Zhang W, et al. CultiVerse: towards cross-cultural understanding for paintings with large language model [conference paper]. Presented at: 33rd ACM International Conference on Multimedia; Dublin, Ireland; 2025. https://doi.org/10.1145/3746027.3755698
- Shi W. A dual-path approach to emotional arousal and visual cognition in intangible cultural heritage: the case of Xiashi Pinprick Lantern Pictures. Digit Scholarsh Humanit. 2026;41(1):376-395.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.