VoiceNet-RAI 从语音数据中融合 MFCC 特征、多语言 wav2vec 2.0 嵌入表示以及 EfficientNet-Lite,用于性别和年龄分类。该框架在英语子集上的准确率最高可达 97.87%,并支持在语音识别、身份认证和数字取证中的负责任应用。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
研究文章
VoiceNet:一种用于性别与年龄分类的负责任人工智能多语言语音框架
127 次观看
⸱
2026年9月11日
本文内容
摘要
摘要
从语音数据中准确进行性别和年龄分类对于实现个性化、安全且符合伦理的人机交互(HCI)具有重要意义。随着 wav2vec 2.0 等大规模预训练语音模型的广泛应用,亟需以负责任的方式利用这些表示方法,实现多语言环境下的、兼顾隐私保护的人口统计学特征推断。本研究提出 VoiceNet-RAI,这是一种深度学习(DL)框架,将梅尔频率倒谱系数(MFCCs)与基于 Transformer 的多语言 wav2vec 2.0 嵌入表示相结合,并集成于 EfficientNet-Lite 架构中,以支持在多样化语言背景下实现准确、公平且透明的分类。该框架融合了上下文信息与频谱特征,从而在不同录音条件下提升模型鲁棒性。在涵盖 28 种语言的多语言语音数据上的实验表明,该方法具有优异的分类性能,其中英语子集的准确率达到 97.87%,精确率为 98.61%,召回率为 98.70%,F1 分数为 98.65%。使用 Mozilla Common Voice 数据集进行外部验证时,性别分类的准确率达到 98.27%,证明了模型在独立数据集上的良好泛化能力。消融分析进一步表明,相较于仅使用原始音频或仅使用 MFCC 特征的表示方法,结合 MFCC 与 wav2vec 2.0 特征可显著提升分类性能。这些结果表明,混合频谱-上下文语音表示在实现鲁棒且负责任的性别与年龄分类方面具有巨大潜力。
引言
语音识别是人类交流的核心组成部分,人们通过语音表达情感、思想和目标。人类的声音是通过一个生物学过程产生的,即空气从肺部呼出,并由唇、舌、牙齿等构音器官塑造成声音1。耳朵在语音识别中起着至关重要的作用,能够根据音量和音高等特征区分男性和女性的声音。导致男女声音音高存在显著差异的一个特征是性二态性2。基于语音进行年龄和性别分类在许多应用中具有重要意义,包括人机交互、自动性别识别、个性化问候、语音情感预分类以及基于性别的电话分类3。
言语是人类互动的固有组成部分。人类声音包含多种因人而异的特征,能够提供有关情绪状态、心理状态以及年龄和性别的信息。这些多维度特征可应用于基于语音的安全系统和面向语音的人工智能(AI)助手等领域。语音分析在其他领域也具有重要意义,包括自动说话人验证(ASV)系统和基于情绪的AI系统。基于语音的输入系统还可以减少数据库内的搜索空间4,5。此外,基于AI的安全系统可利用语音数据应用于刑事侦查和受害者保护等场景。由于声道共振特性的差异,男性和女性的声音表现出不同的特征。这些特征可以从语音信号中提取出来,并转化为适合计算机处理的形式,从而实现基于语音数据的性别分类6,7。因此,需要有效的学习算法来实现基于语音的性别分类。深度学习(DL)算法因其能够从音频数据中学习复杂模式,特别适用于与语音相关的分类任务。此类模型可能包含卷积层、循环层、时域卷积层或全连接层,具体取决于网络结构。这些层能够学习相关的声学特征,包括音调和音高。模型训练完成后,可对先前未见过的音频记录进行性别分类8。机器学习(ML)研究的另一个重要领域是从语音记录中进行年龄分类。ML算法可以利用音高、音色和振幅等声学特征识别与年龄相关的模式。主成分分析(PCA)等技术也可用于从语音数据中提取有意义的模式,并可能提升分类性能9。
深度学习(DL)在图像、情感和语音识别等应用中表现出色。特别是深度神经网络(DNNs)被广泛用于与语音相关的任务。本研究将基于深度学习的方法与成熟的特征提取技术相结合,应用于语音分类。梅尔频率倒谱系数(MFCCs)能够捕捉语音信号的关键频谱特征,为后续处理提供高效的表示。提取的特征随后被整合到迁移学习框架中,用于基于语音的性别和年龄分类10,11。
近期研究越来越多地采用自监督和基于Transformer的语音表征来进行说话人属性分类。研究人员已针对自监督语音模型(如HuBERT和wav2vec 2.0)中的性别和年龄等人口统计学偏差进行了探究,强调了公平性感知评估的重要性12。最近,基于Transformer的语言无关方法在多语言和噪声条件下展示了所学习的上下文语音表征在性别识别任务中的有效性13。Sinha等人进一步研究了wav2vec 2.0模型中逐层表征在年龄和性别分类中的表现,表明不同的Transformer层捕获了不同层次的说话人相关信息14。这些进展推动了本研究提出的VoiceNet-RAI框架,该框架将传统的基于MFCC的频谱信息与上下文wav2vec 2.0表征相结合,同时融入了多语言和负责任人工智能(Responsible AI)的考量。
近期研究表明,说话人的年龄和性别可以通过传统的声学特征以及基于深度学习的表征方式进行识别。结合声学与时间信息的方法表明,互补的语音特征能够提升年龄和性别的分类性能15,16相关研究还表明,利用深度瓶颈表示生成的转换语音特征可提升说话人年龄和性别的分类性能17这些发现支持在涉及语音及语音衍生信号的分类任务中,更广泛地使用谱特征、时序特征以及学习得到的表征。
已有若干研究采用机器学习和深度学习方法,探讨了通过语音进行年龄和性别识别的问题18,19,20,21,22,23,24,25,26,27,28,29,30。较新的研究方法探索了转换后的MFCC表示形式以及深度神经网络在说话人年龄和性别分类中的应用31,而在构建鲁棒的基于语音的人口统计分类系统时,多语言性及语言依赖性差异仍是重要的考虑因素。发音、音系结构、说话人特征以及录音条件的差异可能降低模型在不同语言和人群间的泛化能力。因此,在多语言环境下,结合使用互补的频谱和上下文语音表示方法可能有助于提升系统的鲁棒性。
尽管以往的混合方法已将多种声学特征或集成分类器相结合用于基于语音的人口统计学识别,但 VoiceNet-RAI 的不同之处在于,在统一框架内整合了两种互补的语音表征层级。具体而言,传统的 MFCC 特征保留了局部的频谱和发声特性,而 wav2vec 2.0 则通过 Transformer 编码器从原始语音中学习获得上下文化表征。VoiceNet-RAI 并非仅依赖手工设计的声学描述符或单一的深度表征,而是对时序聚合后的 MFCC 与 wav2vec 2.0 表征进行特征级融合,并利用 EfficientNet-Lite 对所得的混合表征进一步优化。因此,该研究的科学创新性在于:协同整合了频谱特征、自监督上下文特征与轻量级深度表征,用于性别与年龄分类,同时开展了多语言评估、独立数据集验证以及亚群公平性分析。这一组合策略将传统的混合语音分类流程从以准确率为导向的特征融合,拓展为一个同时兼顾表征互补性、轻量级模型设计、泛化能力与负责任人工智能(Responsible AI)的综合框架。
本研究的主要贡献包括开发了一种通过融合MFCC与wav2vec 2.0特征并结合EfficientNet-Lite模型,从语音数据中识别性别与年龄的方法。研究在包含28种语言的语音数据集上开展了大量实验,评估了原始特征、MFCC特征、wav2vec 2.0特征及其组合在机器学习(ML)与深度学习(DL)模型中的表现。模型性能分别基于完整的多语言数据集以及英语子集进行评估。该框架还从多语言和负责任的人工智能(Responsible AI)角度,通过性别和语言特异性亚组分析、说话人无关评估以及使用Mozilla Common Voice数据集进行验证,进一步进行了评估。此外,本研究将所提出框架的性能与现有文献中报道的最先进方法进行了比较,并提供了交叉验证结果。已有大量相关研究,表1对这些研究进行了总结,包括所使用的模型、数据集及报告的结果19,20,21,22,23,24,25,26,27,28,29,30,31。
访问受限。请登录或开始试用以查看此内容。
方案
本研究使用了公开的 BVC 挑战性语音集和 Mozilla Common Voice 数据集,未直接涉及参与者。因此,无需机构伦理审批和额外的知情同意。仅处理了用于性别和年龄分类所必需的数据,且未尝试识别任何个体说话者。所提出框架的完整工作流程方法见图1。
数据采集
本研究所采用的数据集包含来自BVC挑战性语音集(BVC Challenging Voice Set)的.wav音频文件,该语音数据集由生物特征识别视觉与计算(Biometrics Vision and Computing, BVC)团队开发,并公开托管于GitHub32。该数据集包含来自526名个体的语音记录,其中包括336名男性和190名女性说话者,共包含约3,964条录音,每名说话者均包含单句和多句语音录音。表2总结了本研究所提出的VoiceNet-RAI框架中语音数据集所涉及的人口统计学特征、语言覆盖范围、录音属性、数据划分策略以及预处理设置。
特征提取
音频文件经过处理以提取关键属性,随后将这些属性存储在 CSV 文件中。从相应的 README 文件中提取了包括年龄、性别和说话者发音在内的元数据。使用 Python 及其 SciPy 软件包对 WAV 文件进行处理并提取相关特征。采用 NumPy 的快速傅里叶变换(FFT)和频率函数,将音频信号从时域转换到频域。WAV 文件以时间为函数表示振幅;然而,对于分类任务而言,能够区分男性和女性声音的与频率相关的特征更具研究价值33。
为了将音频信号转换为频域表示,采用快速傅里叶变换(FFT)算法实现了离散傅里叶变换(DFT)。傅里叶变换将时域信号转换为频谱。由于该频谱不保留时间信息,因此将音频信号划分为重叠的片段,并使用短时傅里叶变换(STFT)方法对每个片段进行傅里叶变换。函数 np.fft.fft 生成复数形式的频率谱,而 np.fft.fftfreq 提供对应的采样频率。在样本目录中,某一位说话人提供了10个音频文件。每个WAV文件通过200 ms的滑动窗口进行处理,以提取主频成分。例如,一段4秒长的音频录音可生成包含20个频率值的列表。对于包含10段录音的目录,将生成10个对应的列表(每个列表包含20个频率值),并将其合并为一个列表的列表。频率经过滤波处理,仅保留20 Hz至280 Hz范围内的值,同时排除50 Hz附近可能存在的噪声干扰。
混合 MFCC 与 wav2vec 2.0 特征表示
为了同时捕捉高层级的语境语音表征和低层级的声学特征,本研究采用了一种混合特征提取策略,将梅尔频率倒谱系数(MFCC)特征与基于 Transformer 的 wav2vec 2.0 嵌入表示相结合。
MFCC 特征提取
梅尔频率倒谱系数(MFCCs)是语音和音频信号处理中广泛使用的特征,尤其适用于语音识别和说话人识别等应用34,35。在本研究中,MFCC 提取将音频信号转换为表征语音感知相关特性的特征向量。该过程首先通过预加重增强高频成分,随后通过分帧和加窗将信号划分为短时、重叠的帧。每个音频样本首先被重采样至 16 kHz,并分割为 25 ms 的帧,帧间重叠 10 ms。然后对每一帧应用快速傅里叶变换(FFT),将信号从时域转换到频域。
将得到的频率谱通过一系列梅尔滤波器组,以逼近人类听觉感知的非线性频率响应。这些滤波器组增强了感知上更相关的频率成分,同时降低了信息量较少频率的贡献。随后计算每个滤波器组输出的对数,以模拟人类听觉对响度的对数敏感性。接着对对数滤波器组能量应用离散余弦变换(DCT),以消除系数间的相关性,并生成音频信号的紧凑表示。所得到的系数称为梅尔频率倒谱系数(MFCCs),能够捕捉语音的重要频谱特征。由于MFCCs能够反映因性别和年龄而异的声学特征,因此被用于性别与年龄分类。
wav2vec 2.0 嵌入特征提取
wav2vec 2.0 Base 模型在大规模无标注语音语料库上进行了预训练。该模型包含一个多层 Transformer 编码器,可处理原始波形输入并生成上下文化的语音嵌入表示36。
给定输入波形 x ∈ RT,wav2vec 2.0 模型生成了一系列潜在表示:
Z = {z₁, z₂, ..., zₙ}, zᵢ ∈ R768 (1)
其中每个嵌入向量的维度为768。为了获得适用于分类的固定长度表示,对所有时间步进行了时间均值池化操作。
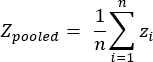 (2)
特征融合机制
MFCC 特征与 wav2vec 2.0 特征通过特征级拼接方式进行融合。具体而言,首先对 MFCC 特征进行时间维度上的平均池化,以生成固定长度的向量。
m ∈ R40 (3)
最终的混合特征向量表示如下:
h = [m || zpooled] ∈ R808 (4)
其中 || 表示拼接。该融合方法将深度上下文嵌入与人工设计的频谱特征相结合,使模型能够同时捕捉高层语义信息和细粒度的声学模式。
所有音频样本首先被重采样至 16 kHz。MFCC 特征按帧计算,并在时间上进行平均,生成一个固定的 40 维向量;而 wav2vec 2.0 嵌入特征则在时间维度上进行平均池化,生成一个 768 维的表示。由于这两组特征在融合前均已被转换为固定长度的向量,因此无需进行帧级的时间对齐。随后,将得到的 MFCC 和 wav2vec 表示拼接成一个 808 维的混合特征向量,再输入分类模型。
与 EfficientNet-Lite 的集成
融合后的特征向量 h 被重塑为适合特征学习的格式,并作为输入提供给 EfficientNet-Lite 模型进行训练。首先,一个全连接投影层将 808 维的向量映射到更高维的潜在空间,随后由 EfficientNet-Lite 模块进一步提炼分层特征。采用批量归一化和 Dropout 层以减少过拟合并提升模型的泛化能力。SoftMax 激活函数用于生成性别和年龄类别的最终预测概率。融合表示 h ∈ R808 最初被视为一维特征向量,通过一个全连接投影层将其映射至 4,096 维。投影后的表示随后被重塑为 1 × 64 × 64 的张量,再输入至 EfficientNet-Lite 架构中。
为了适应单通道语音特征表示,而非传统的三通道图像输入,原始 EfficientNet-Lite 的输入卷积层被从三个输入通道修改为一个输入通道。其余的 EfficientNet-Lite 特征提取模块在未进行重大结构修改的情况下被保留。在最终的特征图上应用自适应全局平均池化层,以生成固定长度的表示。原始分类头被替换为针对特定任务的全连接层,该层包含两个用于性别分类的输出单元,以及对应于预定义年龄组数量的输出单元。最后,应用 SoftMax 激活函数以生成类别概率。所提出的混合表示方法将现代自监督语音嵌入与传统信号处理特征相结合。wav2vec 2.0 嵌入捕捉了上下文信息和长距离依赖关系,而 MFCC 特征则提供了互补的低层声学信息。这些表示方法的融合提升了分类性能,特别是在噪声环境和多语言语音条件下。
机器学习分类器
本研究分析了多种机器学习算法在基于语音的性别和年龄组分类中的性能。
随机森林
随机森林(Random Forest, RF)作为一种稳健的机器学习(ML)分类器,通过组合多个决策树(DTs)来提高预测准确性并减少过拟合。RF采用一种集成学习方法,通过整合多棵决策树的预测结果,生成最终预测结果37,38。该方法使RF能够捕捉数据中的多样化模式,同时降低单个决策树常见的过拟合问题。在构建决策树过程中引入的随机性增强了模型的泛化能力,使其适用于基于语音数据的性别和年龄分类等分类任务。
逻辑回归
逻辑回归(Logistic Regression, LR)被用作分类任务的统计机器学习模型39。对于二分类问题,LR 利用逻辑函数(即 S 型函数,sigmoid)基于输入特征估计结果发生的概率,并根据所得概率生成类别预测。LR 同样适用于包含两个以上类别的多分类问题。在多分类任务中,LR 根据具体的分类设置采用诸如“一对多”(one-vs-rest)或 SoftMax 回归等方法。
极端随机树分类器
采用极限树分类器(Extra Trees Classifier, ETC)作为集成学习算法,通过结合多个决策树(DT)生成预测结果40,41。与随机森林(RF)不同,ETC 在构建树的过程中通过随机选择候选特征和分裂阈值引入额外的随机性。该方法生成的树之间相关性更低,降低了模型对个别特征的敏感性,从而增强了对噪声的鲁棒性。采用基尼指数(Gini index)作为分裂准则,用于评估特征重要性并对数据进行划分。
支持向量机
支持向量机(SVM)被用作一种机器学习分类器,用于在高维特征空间中识别最优决策边界42。其目标是确定一个能够最大化类别间间隔的超平面。决策边界与最近数据点之间的间隔越大,通常越有利于实现更好的类别分离和泛化能力。SVM 可应用于多种机器学习任务,包括分类、回归以及基于特征的数据分析。
卷积神经网络
卷积神经网络(CNN)被用作深度学习(DL)模型,以执行涉及图像和音频数据结构化表示的分类任务。一维卷积神经网络(1D-CNN)也已广泛应用于序列和文本数据。CNN 架构通过使用卷积滤波器和池化操作,从输入数据中提取具有区分性的特征43,44。在基于语音数据进行性别和年龄分类时,CNN 被应用于语音衍生的表示形式,以学习与音高、频率、音调以及其他与区分性别和年龄组相关的声学特征相联系的模式。
VGG19
VGG19 被用作一种深度学习架构,其特点是具有较深且相对均匀的分层特征提取结构45。该架构在19层中均采用较小的3 × 3卷积核,能够逐步提取具有区分性的特征。当应用于语音衍生的表征时,VGG19 能够捕捉低层次的声学模式(如音高和频率变化)以及更高层次的判别性特征。其深层架构实现了特征的逐级抽象,可用于建模与性别和年龄相关的发声特征。
EfficientNet-Lite
EfficientNet-Lite 被用作一种计算高效的深度学习架构46,47。该模型采用了一种平衡的缩放策略,在实现强大分类性能的同时,比更复杂的深度学习架构所需计算资源更少。其复合缩放方法同时考虑了模型的深度、宽度和输入分辨率,以实现高效的特征提取。
选择EfficientNet-Lite作为所提出的VoiceNet-RAI框架的基础,是因其轻量级架构以及在分类性能与模型复杂度之间良好的平衡性。与更复杂的架构相比,它采用高效的卷积模块和复合缩放方法,以更少的参数和更低的计算需求实现有效的特征学习。这些特性使EfficientNet-Lite适用于所提出的语音分类框架,并具备在资源受限环境中部署的潜力。
MobileNet
MobileNet 被用作一种轻量级深度学习架构,适用于计算资源受限的应用场景,包括移动设备和边缘计算环境48。其计算效率主要通过深度可分离卷积实现,与传统卷积架构相比,显著减少了参数数量和计算操作。这些特性使 MobileNet 适用于基于语音数据进行性别与年龄分类的评估,同时保持相对较低的计算需求。
InceptionV3
采用InceptionV3作为深度架构,用于从语音衍生的表征中提取分层特征49。该架构结合了卷积、池化和混合操作,以在不同抽象层次上提取特征。在基于语音数据进行性别和年龄分类时,InceptionV3被用于学习与声音特征变化相关的复杂声学模式及分层表征。
评估参数
准确率是分类任务中最常用的评估指标之一50。尽管准确率能够有效衡量整体分类性能,但在处理不平衡数据集时,它并不总能提供全面的评估结果。因此,还需采用其他指标,包括精确率、召回率和F1分数,以评估模型性能。这些指标通过考虑每个类别的正确与错误预测,提供了更为全面的评估。
准确率定义为正确分类的观测值数量与观测值总数的比值。尽管准确率对于平衡数据集特别具有参考价值,但本研究中使用的数据集是不平衡的。因此,在计算和解释分类指标时,需考虑真正例(TP)、假正例(FP)、真反例(TN)和假反例(FN)。以下公式表示准确率的标准定义:
准确率 = (真阳性 + 真阴性) / (真阳性 + 真阴性 + 假阳性 + 假阴性) ×100 (5)
精确率用于评估分类器仅返回相关实例的能力:
精确率= TP/(TP+FP) ×100 (6)
召回率,也称为灵敏度,用于衡量分类器识别所有相关实例的能力:
召回率 = TP/(FN+TP) × 100 (7)
F1分数将精确率和召回率结合为一个单一指标,对于评估不平衡数据集上的分类性能尤为有用:
F1分数 = 2 × (PPV × TPR) / (TPR + PPV) × 100 (8)
访问受限。请登录或开始试用以查看此内容。
结果
使用基于 MFCC 的特征表示和混合特征表示,结合 ML 和 DL 模型,对年龄和性别分类的实验结果进行了评估。数据集按 80:20 的比例划分为训练集和测试集,其中 80% 用于训练,20% 用于测试。采用了说话人级别的划分,以防止同一说话人的录音同时出现在两个集合中。
所提出框架的超参数与实现细节总结于表3。实验在一台配备 Intel i7-8265U CPU、16 GB RAM 以及运行 Windows 11 系统的 NVIDIA Tesla K80 GPU 的系统上进行。使用 Python 和 Scikit-learn 库开发机器学习模型,而所提出的深度学习框架则使用 PyTorch 实现。这些模型针对从语音数据进行性别和年龄分类的任务进行了评估。
采用 Adam 优化器,初始学习率为 1 × 10⁻4,β₂ = 0.999,ε = 1 × 10⁻8。批处理大小为 64,最大训练轮数为 50,并设置早停法,耐心值为 4 轮,以减少过拟合。在全...
访问受限。请登录或开始试用以查看此内容。
讨论
本研究开发并评估了一种从语音数据中进行性别和年龄分类的自动化框架,该框架通过将MFCC特征与wav2vec 2.0嵌入表示结合EfficientNet-Lite模型实现。在初步实验中,EfficientNet-Lite使用原始特征时达到83.48%的准确率、82.87%的精确率、84.28%的召回率以及83.54%的F1分数。在引入MFCC特征后,性能显著提升,在包含28种语言的数据集上,准确率达到92.64%,精确率为93.79%,召回率为94.92%,F1分数为94.84%。在英语子集上使用MFCC与wav2vec 2.0的混合表示时,EfficientNet-Lite的准确率达到97.87%,精确率为98.61%,召回率为98.70%,F1分数为98.65%。该框架在Mozilla Common Voice数据集上的进一步测试也表现出良好的泛化能力。此外,通过五折交叉验证对模型的稳定性进行了评估。
整合MFCC特征后观察到的性能提升表明,低层次的频谱特征(包括音高、音色和声道信息)在性别和年龄分类中仍具有高度的区分能力。采用MFCC与wav2vec 2.0混合表示方法所获得的...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明无利益冲突。
致谢
作者 谨此感谢沙特阿拉伯利雅得公主诺拉·宾特·阿卜杜勒拉赫曼大学研究人员支持项目(PNURSP2026R748)对本研究的资助。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| BVC 挑战性语音数据集 | Biometrics Vision and Computing Group / OgeNI | BVC 挑战性语音数据集 | https://github.com/OgeNI/BVC_Challenging_Voice_Set |
| EfficientNet-Lite | EfficientNet-Lite,实验中使用的具体变体 | https://github.com/tensorflow/tpu/tree/master/models/official/efficientnet/lite | |
| 图形处理器 | NVIDIA | Tesla K80 | https://www.nvidia.com/ |
| Mozilla Common Voice 数据集 | Mozilla 基金会 | Common Voice,实验中使用的版本 | https://www.kaggle.com/datasets/mozillaorg/common-voice/data |
| NumPy | NumPy 开发者 | 实验中使用的具体版本 | https://numpy.org/ |
| 处理器 | Intel | Intel Core i7-8265U | https://www.intel.com/ |
| Python | Python 软件基金会 | 实验中使用的具体版本 | https://www.python.org/ |
| PyTorch | PyTorch 基金会 | 实验中使用的具体版本 | https://pytorch.org/ |
| Scikit-learn | Scikit-learn 开发者 | 实验中使用的具体版本 | https://scikit-learn.org/ |
| SciPy | SciPy 开发者 | 实验中使用的具体版本 | https://scipy.org/ |
| wav2vec 2.0 Base | Meta AI | facebook/wav2vec2-base | https://huggingface.co/facebook/wav2vec2-base |
| Windows 11 | Microsoft | Windows 11,若有则注明具体版本/构建号 | https://www.microsoft.com/windows/windows-11 |
参考文献
- Pahwa A, Aggarwal G. Speech feature extraction for gender recognition. Int J Image Graph Signal Process. 2016;8:17.
- Ericsdotter C, Ericsson AM. Gender differences in vowel duration in read Swedish: Preliminary results. Work Pap Lund Univ Dep Linguist Phon. 2001;49:34-37.
- Gamit MR, Dhameliya K, Bhatt NS. Classification techniques for speech recognition: A review. Int J Emerg Technol Adv Eng. 2015;5:58-63.
- Rabiner LR, Juang BH. Fundamentals of Speech Recognition. PTR Prentice Hall; Englewood Cliffs, NJ; 1993.
- Hansen JHL, Hasan T. Speaker recognition by machines and humans: A tutorial review. IEEE Signal Process Mag. 2015;32(6):74-99.
- Zhang Y, et al. Towards end-to-end speech recognition with deep convolutional neural networks [conference presentation]. Presented at: Interspeech 2016; San Francisco, CA; 2016. p. 410-414. Available from: https://www.isca-archive.org/interspeech_2016/zhang16b_interspeech.html
- Kabil SH, Muckenhirn H, Magimai-Doss M. On learning to identify genders from raw speech signal using CNNs [conference presentation]. Presented at: Interspeech 2018; Hyderabad, India; 2018. p. 287-291. Available from: https://www.isca-archive.org/interspeech_2018/kabil18_interspeech.html
- Albawi S, Mohammed TA, Al-Zawi S. Understanding of a convolutional neural network [conference presentation]. Presented at: 2017 International Conference on Engineering and Technology (ICET); Antalya, Türkiye; 2017. p. 1-6. Available from: https://ieeexplore.ieee.org/document/8308186
- Abdi H, Williams LJ. Principal component analysis. Wiley Interdiscip Rev Comput Stat. 2010;2(4):433-459.
- Mavaddati S. Voice-based age, gender, and language recognition based on ResNet deep model and transfer learning in spectro-temporal domain. Neurocomputing. 2024;580:127429.
- Jiang H, et al. 3WD-DRT: A three-way decision enhanced dynamic routing transformer for cost-sensitive multimodal sentiment analysis. Inf Sci. 2026;725:122704.
- Jameel HK, Al Ghrairi AHT, Neamah MM. Self-supervised learning for speech recognition: A review. Dijlah J Eng Sci. 2026;3(2).
- Anidjar OH, Yozevitch R. Transformer-based language-independent gender recognition in noisy audio environments. Sci Rep. 2025;15(1):14421.
- Sinha A, Kathania HK, Kurimo M. A study on the layer-wise transferability of self-supervised learning features for children's speech processing tasks. Speech Commun. 2026;180:103392.
- Li M, Han KJ, Narayanan SS. Automatic speaker age and gender recognition using acoustic and prosodic level information fusion. Comput Speech Lang. 2013;27(1):151-167.
- Sánchez-Hevia HA, Gil-Pita R, Utrilla-Manso M, Rosa-Zurera M. Age group classification and gender recognition from speech with temporal convolutional neural networks. Multimed Tools Appl. 2022;81:3535-3552.
- Abu Mallouh A, Qawaqneh Z, Barkana BD. New transformed features generated by deep bottleneck extractor and a GMM–UBM classifier for speaker age and gender classification. Neural Comput Appl. 2018;30:2581-2593.
- Almomani A, et al. Age and gender classification using backpropagation and bagging algorithms. Comput Mater Contin. 2023;74(2):3045-3062.
- Sahar RM, Rao TS, Anuradha S, Rao BS. Performance analysis of ML algorithms to detect gender based on voice. In: Recent Trends in Intensive Computing. 2021. p. 163-171. Available from: https://journals.sagepub.com/doi/abs/10.3233/APC210192
- Kone VS, et al. Voice-based gender and age recognition system [conference presentation]. Presented at: 2023 International Conference on Advancement in Computation & Computer Technologies (InCACCT); Gharuan, India; 2023. p. 74-80. Available from: https://ieeexplore.ieee.org/document/10141801
- Alhussein M, Muhammad G. Voice gender recognition under unconstrained environments using self-attention. Appl Acoust. 2021;175:107823.
- Yücesoy E. Automatic age and gender recognition using ensemble learning. Appl Sci. 2024;14(16):6868.
- Alnuaim AA, et al. Speaker gender recognition based on deep neural networks and ResNet50. Wirel Commun Mob Comput. 2022;2022:4444388.
- Ibrahim F, Nahar KMO, Al-Shannaq MA. Gender identification and age estimation of Arabic speaker using machine learning. J Theor Appl Inf Technol. 2020;98(19):3242-3256.
- Kannapiran P, Sindha MMR. Voice-based gender recognition model using FRT and LightGBM. Teh Vjesn. 2023;30:282-291.
- Alkhammash EH, Hadjouni M, Elshewey AM. A hybrid ensemble stacking model for gender voice recognition approach. Electronics. 2022;11:1750.
- Mutiany M, Herlistiono IO. Gender detection by voice using deep learning. Int J Innov Sci Res Technol. 2020;5(10):841-845.
- Raahul A, Sapthagiri R, Pankaj PK, Vijayarajan V. Voice based gender classification using machine learning. IOP Conf Ser Mater Sci Eng. 2017;263(4):042083. Available from: https://iopscience.iop.org/article/10.1088/1757-899X/263/4/042083
- Iloanusi O, et al. Voice recognition and gender classification in the context of native languages and lingua franca [conference presentation]. Presented at: 2019 6th International Conference on Soft Computing & Machine Intelligence (ISCMI); Johannesburg, South Africa; 2019. p. 175-179. Available from: https://ieeexplore.ieee.org/document/9004306
- Gupta Y, Gangwar K, Singhal M, Hemavathi D. Gender and age recognition using audio data-artificial neural networks. In: Soft Computing for Security Applications: Proceedings of ICSCS 2021. Springer; 2022. p. 449-470. Available from: https://link.springer.com/chapter/10.1007/978-981-16-5301-8_34
- Qawaqneh Z, Mallouh AA, Barkana BD. Deep neural network framework and transformed MFCCs for speaker’s age and gender classification. Knowl-Based Syst. 2017;115:5-14.
- OgeNI. BVC Challenging Voice Set [Internet]. GitHub; 2025 [cited 2026 Aug 16]. Available from: https://github.com/OgeNI/BVC_Challenging_Voice_Set
- Oppenheim AV, Schafer RW. Discrete-Time Signal Processing. 3rd ed. Pearson; Upper Saddle River, NJ; 2010.
- Logan B. Mel frequency cepstral coefficients for music modeling [conference presentation]. Presented at: International Society for Music Information Retrieval Conference (ISMIR); Plymouth, UK; 2000. Available from: https://ismir.net/conferences/ismir-2000/
- Davis SB, Mermelstein P. Comparison of parametric representations for monosyllabic word recognition in continuously spoken sentences. IEEE Trans Acoust Speech Signal Process. 1980;28(4):357-366.
- Baevski A, Zhou H, Mohamed A, Auli M. wav2vec 2.0: A framework for self-supervised learning of speech representations [conference presentation]. Presented at: Advances in Neural Information Processing Systems 33 (NeurIPS 2020); Virtual; 2020. p. 12449-12460. Available from: https://proceedings.neurips.cc/paper/2020/hash/92d1e1eb1cd6f9fba3227870bb6d7f07-Abstract.html
- Yıldırım Ş, Bingöl MS. Metaheuristic approaches to enhance voice-based gender identification using machine learning methods. Appl Sci. 2025;15(23):12815.
- Breiman L. Random forests. Mach Learn. 2001;45:5-32.
- Hosmer DW Jr, Lemeshow S, Sturdivant RX. Applied Logistic Regression. 3rd ed. Wiley; Hoboken, NJ; 2013.
- Geurts P, Ernst D, Wehenkel L. Extremely randomized trees. Mach Learn. 2006;63:3-42.
- Yücesoy E, Nabiyev VV. A new approach with score-level fusion for the classification of a speaker age and gender. Comput Electr Eng. 2016;53:29-39.
- Cortes C, Vapnik V. Support-vector networks. Mach Learn. 1995;20:273-297.
- Abdel-Hamid O, et al. Convolutional neural networks for speech recognition. IEEE/ACM Trans Audio Speech Lang Process. 2014;22(10):1533-1545.
- Nasaruddin N, Pratama Tresma MAP, Muchamad MK, Fuadi Z. Voice frequency-based gender classification using convolutional neural network for smart home. IEEE Access. 2024;12:104190-104203.
- Simonyan K, Zisserman A. Very deep convolutional networks for large-scale image recognition [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); San Diego, CA; 2015. Available from: https://iclr.cc/archive/www/2015.html
- Tan M, Le QV. EfficientNet: Rethinking model scaling for convolutional neural networks [conference presentation]. Presented at: 36th International Conference on Machine Learning (ICML); Long Beach, CA; 2019. p. 6105-6114. Available from: https://proceedings.mlr.press/v97/tan19a.html
- Ertam F. An effective gender recognition approach using voice data via deeper LSTM networks. Appl Acoust. 2019;156:351-358.
- Zhao L, Wang L, Jia Y, Cui Y. A lightweight deep neural network with higher accuracy. PLoS One. 2022;17(8):e0271225.
- Szegedy C, et al. Rethinking the Inception architecture for computer vision [conference presentation]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition (CVPR); Las Vegas, NV; 2016. p. 2818-2826. Available from: https://openaccess.thecvf.com/content_cvpr_2016/html/Szegedy_Rethinking_the_Inception_CVPR_2016_paper.html
- Sokolova M, Lapalme G. A systematic analysis of performance measures for classification tasks. Inf Process Manag. 2009;45(4):427-437.
- Mozilla Common Voice Project. Common Voice Dataset [Internet]. 2024 [cited 2024 Jun 18]. Available from: https://www.kaggle.com/datasets/mozillaorg/common-voice/data
访问受限。请登录或开始试用以查看此内容。