本方案整合了多模态行为记录,用于评估英译汉书面翻译与视译过程中认知努力的可观测指标以及修订行为的功能有效性。该方法结合了键盘记录、屏幕录制、音频分析、基于转录文本的编码以及标准化质量评估。
本文内容
摘要
摘要
本文介绍了一种多模态行为实验方案,用于考察在英译汉书面翻译和视译过程中可观察到的认知努力与策略性修改的相关表现。对于书面翻译,采用键盘记录与屏幕录制同步的方法;而对于视译,则使用音频录音及逐字转录文本。修改和自我修正片段按类型及其功能结果(有效、中性或有害)进行编码,且独立于整体产出质量评分。在一项包含62名参与者(分为新手组与训练组)的示范研究中,两组参与者以交叉平衡顺序完成两种任务条件。训练组在书面翻译中的平均产出质量得分更高(20.1 ± 2.1 vs. 16.8 ± 2.3),在视译中亦然(18.9 ± 2.4 vs. 15.4 ± 2.6),且有效修改或自我修正的比例更大。由于停顿、删除、反应起始潜伏期和修改密度等指标具有间接性和任务敏感性,因此应将其解释为需通过三角验证的行为相关指标,而非单一构念的直接测量。该方案适用于受控的说明性文本,经重新校准输入方式处理、停顿时长阈值、文本可比性及评分程序后,可适配于其他语言对。
引言
书面翻译与视译在源文本理解、跨语言转换及目标语生成方面具有共性,但二者所面临的任务条件存在差异。书面翻译允许反复阅读和延迟修改,而视译则需在更严格的时间限制下完成口头产出。认知负荷、加工难度与认知努力密切相关,但并非可互换的概念:前者关注任务本身的要求,后者则反映受试者在特定任务要求下所投入的资源。认知努力具有潜在性与多维性;因此,反应时、停顿、删除及修订密度在此被视为行为相关指标,可能反映计划、监控、运动执行过程或加工困难,需综合解读,而不能作为认知努力的直接测量指标1,2,3,4,5,6,7,8。
以过程为导向的研究将产物评分与时间对齐的行为记录相结合,以确定翻译决策发生的时间和方式。击键记录可为产出和修改序列提供信息,但中文输入法的组字过程可能导致物理按键事件与最终输入的字符相分离;因此,需要同步的屏幕录制来重构可见的文本状态9,10,11。停顿阈值是分析时的选择,而非普适的认知边界,较短的阈值可能显著改变基于停顿得出的结论8,12。因此,该实验方案需要明确的同步性核查、阈值敏感性分析,并区分任务特异性指标与共性指标。
仅凭修订频率无法判断监控是否改善了输出结果。书面修订和口头自我修正可能涉及词汇选择、句法、意义或风格,但其功能结果必须根据源文含义及此前的目标语段落来评判。关于英汉和汉英视译处理的研究表明,培训、翻译方向、眼-口协调以及语言特异性问题诱因均可能改变表现模式13,14,15,16。因此,将翻译单元类型、单元结果、最终产出质量以及与表达相关的行为分别编码为独立变量。
该方案适用于成年学习者或经过培训的翻译/口译人员,在受控的计算机会话中处理简短的非专业说明性文本。当能够捕获击键和屏幕记录以用于书面产出,同时能够录制高质量音频以用于口头产出时,该方案最为适用。该框架可适用于其他语言对,但需针对每一对语言及书写系统重新验证文本匹配、信息单元的切分、键盘或输入法行为、停顿阈值以及评分基准17。本示例比较的是任务条件的差异,而非将所有差异单纯归因于模态不同,因为文本长度、时间限制、输出方式和修改机会也各不相同。
方案
所有涉及人类受试者的研究方法均遵循机构指南,并已获得桂林信息科技学院人类研究伦理委员会的明确批准(批准编号:UYHAJ2025899)。在参与研究之前,已从所有参与者处获得书面知情同意。有关本研究中所用设备和软件的完整清单,请参见材料表。
1. 受试者招募与分组
- 招募62名参与者,包括英语或翻译专业学生以及职业口译培训学员。确认所有参与者均为母语为中文者,且具有正常或矫正至正常的视力和听力。
- 将接受过少于12个月系统化翻译训练的参与者分配至新手组,将接受过至少12个月训练者分配至受训组。分别报告所有参与者的先前书面翻译经验及视译练习情况。
- 在任务分配前对参与者进行筛选,排除曾接触过源文本、存在未矫正的感觉功能障碍,或无法使用标准化中文输入法的个体。
- 仅在录音后因预先规定的原因排除任务,例如使用禁用的外部工具、任务执行不完整、文件损坏或音频无法使用。
- 保留不含个人身份信息的任务排除记录。在正文及图1A–D中一致报告最终纳入分析的样本量。
2. 材料选择与初步评估
- 从通用学术、教育、社会或公共传播领域的短篇英文说明性文本中进行选择。书面翻译文本的长度约为180–220词,视译文本的长度约为120–160词。
- 在不同任务条件下,匹配或通过统计方法调整文本长度、词汇难度、句法复杂性、信息密度和主题熟悉度。
- 要求三名双语专家独立对词汇难度、句法复杂性、信息密度、主题熟悉度和迁移适用性进行1至5分的评分(1 = 非常低,5 = 非常高)。
- 基于平均评分计算双因素随机效应组内相关系数(ICC),并提供95%置信区间。对于一致性较差的项目(ICC < 0.75),应进行修订。
- 仅当标准化匹配变量处于±10%容差范围内时,保留文本配对。
- 将信息单元定义为源文本中表达一个可独立评分的思想、关系或事件的最小命题。在任务实施前解决信息单元边界划分的分歧。
- 使用不参与主分析的受试者对指导语、输入方式、同步性、音质和时间限制进行预实验。记录完成时间分布以及达到各时间限制的受试者比例。
- 当预实验参与者表现出天花板/地板效应、持续性歧义或录音不稳定时,应对文本或时间限制进行修订。在启动主研究前记录每一项修改。
3. 任务实施与记录设置
- 在安静、隔音的房间内,使用标准化的硬件和软件配置对测试参与者进行单独测试。
- 宣读标准化的指导语,并允许进行一次非实验性的练习任务。禁止使用词典、搜索引擎、生成式人工智能、机器翻译和外部语料库。
- 在每个训练组内对两种任务顺序(先书面翻译 vs. 先视译口译)进行平衡,并保持5分钟的休息间隔。
- 在招募完成前准备好分配列表,并在确认符合资格前隐藏分组信息。若使用多个源文本,需独立于任务顺序对文本身份进行平衡,并保留文本编号变量用于后续分析。
- 连续呈现英文源文本,指导参与者在指定输入区域生成准确且自然的中文译文。允许自由编辑,但严格禁止粘贴外部文本。
- 采用预实验确定的20分钟时间上限,不显示倒计时,记录是否达到时间上限。
- 持续完整记录书面翻译全过程,使用与连续屏幕录制同步的键盘记录软件。保留最终译文输出及带时间戳的日志文件,用于后续行为数据提取。
- 在屏幕上呈现视译口译的源文本,指导参与者在无书面笔记的情况下开始口头中文表达。
- 统一采用6分钟时间上限,并记录是否达到该上限。区分限时观察与正常完成的观察。
- 使用数字音频采集软件记录口头输出。基于录音生成严格的逐字转录文本,以便后续编码分析。
4. 行为过程指标的提取
- 从日志文件中提取书写任务的行为相关指标,将初始潜伏期定义为从刺激开始到第一个输入的汉字之间的时间间隔。
- 提取总任务时间、停顿次数与持续时间、删除率、修订密度和产出率。保留原始时间戳以及用于每个标准化测量指标的确切分母。
- 以 2 秒作为书面停顿的操作阈值。需报告光标移动、文本选择或输入法候选词选择期间的停顿是否被纳入统计。
- 从波形图和经核实的转录文本中提取口语任务的行为相关指标,将起始潜伏期定义为从刺激呈现到首次出现有意义的目标语言语句之间的时间间隔。
- 在计算起始潜伏期时,排除吸气、清嗓及未完成的非词汇性声音。提取总口译时间、无声停顿、有声停顿、重复、错误起始、自我修正和语速。
- 将口语中的无声停顿定义为语句内部持续至少 1.0 秒的静默。需结合波形图和经核实的转录文本检查停顿边界,并在统计语句内部停顿时排除起始和结尾的静默段。
- 为每项实施的任务完成一份质量控制记录。记录相应的过程文件是否可读且完整,转录文本是否已核实,以及编码是否已完成或经过裁定。保留原始记录,并在审计轨迹中追踪所有更正信息。
5. 策略性修正与口语自我修复的编码
- 通过整合按键日志、屏幕录像和最终文本,重建每一次书面修改过程。
- 将一个编辑片段定义为针对同一目标文本段落的连续编辑操作序列;当编辑活动转移到其他位置并持续至少 2 秒,或开始编辑不同段落时,视为该片段结束。
注意:对于中文输入,需区分提交前的输入法组合修改与提交后的目标文本删除行为,仅将后者编码为文本修改。 - 根据语义、句法、词汇或文体上的变化,为每次修改分配一个主要修订类型;在存在重叠情况时可附加一个次要标签,但在互斥统计中以主要标签为准。参照补充文件 1中提供的示例进行编码。
- 在对口头自我修正进行编码前,先生成带时间戳的逐字转录文本。指导首位转录员标注词汇内容、填充停顿、重复、错误起始、中断以及无法辨识的片段。
- 由第二位经过培训的审核员对照原始音频检查转录文本,解决差异,并在保留原始音频时间戳的前提下完成校订。
- 将口头自我修正定义为对紧接其前的目标语言片段进行公开的替换、补全或纠正的重新表述行为。仅凭沉默不得推断存在隐性监控过程。对口头自我修正应用与书面修改相同的词汇、句法、语义和文体判断规则。
- 将无纠正性变化的完全重复编码为不流畅现象;将放弃起始后重新构建的表达编码为“错误起始+修正”;将未通过公开重述进行纠正的遗漏或误译视为输出错误。
- 当音频不清晰或两种分类可能性相当时,将该片段标记为“模糊”。保留对模糊片段的临时标签,并在进行信度分析前统一裁定。
- 通过比较修改前后目标段落与源信息单元及局部目标语境的一致性,判断其功能结果。此判断应在知晓整体评分前完成。不得将整体评分的变化作为有效性的定义标准。
- 对来自两组及不同任务顺序中至少 20% 的输出样本进行双人独立编码,并在裁定前基于独立编码结果计算信度指标。
- 当评分者间一致性低于 Cohen’s kappa 系数 0.80 时,须重新培训并重新编码。需明确记录此阈值及所采取的任何纠正措施。
6. 质量评估与统计建模
- 使用补充文件1中的25分制分析性评分量表,对每份最终书面翻译和视译表现进行评分。
- 根据既定锚定点,从0到5分对准确性、完整性、词汇恰当性、连贯性以及目标语言的自然度进行评分。在查看组别信息后,不得对评分标准进行插值调整。
- 指导评分员在评估视译表现时同时参考音频和已核实的转录文本。将停顿和不流利程度的测量指标与量表评分分开分析。
- 使用编码手册及至少10个练习样本培训两名独立评分员,并对评分员设盲,使其不知晓参与者所属组别及任务顺序。
- 在独立评分和事件编码完成后,先计算信度再进行讨论。通过共识解决分歧,仅在无法达成共识时咨询第三名评分员。
- 报告基于平均连续质量评分的双因素随机效应、绝对一致性组内相关系数(ICC)。报告主要分类修订代码的Cohen's kappa值,以及有效/中性/有害结果代码的单独kappa值。说明双人编码事件的确切数量及所占百分比。
- 在分析前确认每个过程文件均可读且完整,将书面任务日志与相应的屏幕记录对齐,并核对转录文本与音频的一致性。
- 在质量控制日志中记录对齐失败、可懂度问题及纠正措施。使用每100个源文本信息单元标准化停顿频率,使用每100个产出的汉字标准化书面修订密度。
- 功能结果的编码应独立于最终的整体质量评分。若修订后片段在不引入新问题的前提下提升了文本质量,则编码为“有效”;若未产生实质性改变,则编码为“中性”;若引入了错误,则编码为“有害”。
- 有效率计算方式为:有效事件数除以所有可分类事件数,分母中排除模糊事件。
- 将数据分析视为一项探索性的重复测量数据集。设定固定效应模型,以任务条件、培训组别、停顿指标、修订密度、有效率、不流利负担和语速来预测总质量评分。
- 纳入参与者随机截距;仅当实验设计包含足够多独立抽样的文本时,才纳入源文本的随机效应。
- 对连续型预测变量进行中心化处理,检查残差并评估共线性。报告估计方法、软件版本、β值、标准误(SE)、95%置信区间(CI)、精确p值、方差成分、AIC、BIC以及边际/条件R2。明确说明分析为探索性性质,避免做出确证性因果推断。
- 导出一个可重复的分析包,包含去标识化数据、数据字典、编码手册、评分量表、软件信息、分析脚本和输出结果。在发布前确认每个图表中的数值均可追溯至具体的变量名称和分析步骤。
结果
参与者基线特征与数据可获得性
问卷共包含62名参与者(31名新手和31名受训者),任务表中共有124条记录,表明每位参与者完成了两项任务记录(表1)。新手组接受系统化翻译训练的时间少于12个月(观察到的最大值为8.6个月),而受训组至少接受了12个月的训练(观察到的最小值为13.3个月)。两组在年龄、性别、英语学习时长、熟练程度以及任务顺序分布方面相似。图1展示了最终分析的样本,并明确区分了任务相关的数据:击键日志和屏幕录屏适用于笔译任务,音频录音和逐字转录适用于视译任务,而质量评分则适用于两种任务。
不同任务条件下的行为特征
两种任务条件之间以及训练组之间在行为特征上存在差异(表2;图2A–E)。书面翻译的完成时间更长,平均停顿时间也更长,而视译在每100个信息单位中低于报告阈值的停顿次数更多。在每种任务条件下,受训组完成任务更快,且平均输出得分更高。这些差异不应被简单解释为纯粹的模态效应,因为文本长度、时间限制、输出方式和修订机会也有所不同。停顿并非总是具有干扰性:一次停顿可能反映未解决的困难、成功的计划、监控过程或输入方式的操作活动,因此停顿指标需结合修订、输出和质量指标共同解读。
策略性修订、自我修复与预测建模
编码框架将事件类型与功能结果分离开来(表3;图3A–D)。与新手相比,受训参与者产生的书面修改类事件更多(每项任务12.4 ± 3.7 次 vs. 8.9 ± 3.0 次),而两组在口头自我修正的总次数上无显著差异(每项任务4.9 ± 1.6 次 vs. 4.4 ± 1.5 次)。然而,在两项任务中,受训组的有效事件比例更高。表4中报告的混合效应汇总展示的是关联性而非因果路径;因此,图3E展示的是报告的固定效应估计值及其置信区间,而非因果图。
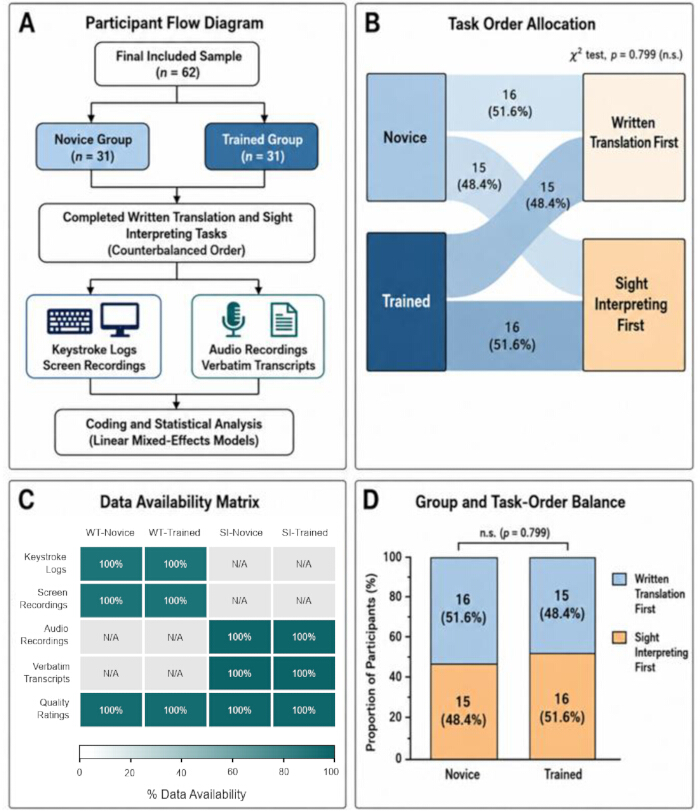
图1:参与者流程、任务顺序分配及任务特异性数据可用性。(A)最终纳入分析的62名参与者和124条任务记录。(B)新手组与训练组内的任务顺序交叉平衡分配。(C)数据可用性矩阵,其中击键日志和屏幕录制仅适用于笔译任务,音频录音和逐字转录仅适用于视译任务,而质量评分则适用于两项任务。(D)组别与顺序的平衡性(卡方检验,p = 0.799)。n = 62名参与者(每组31人)。请点击此处查看该图的放大版本。
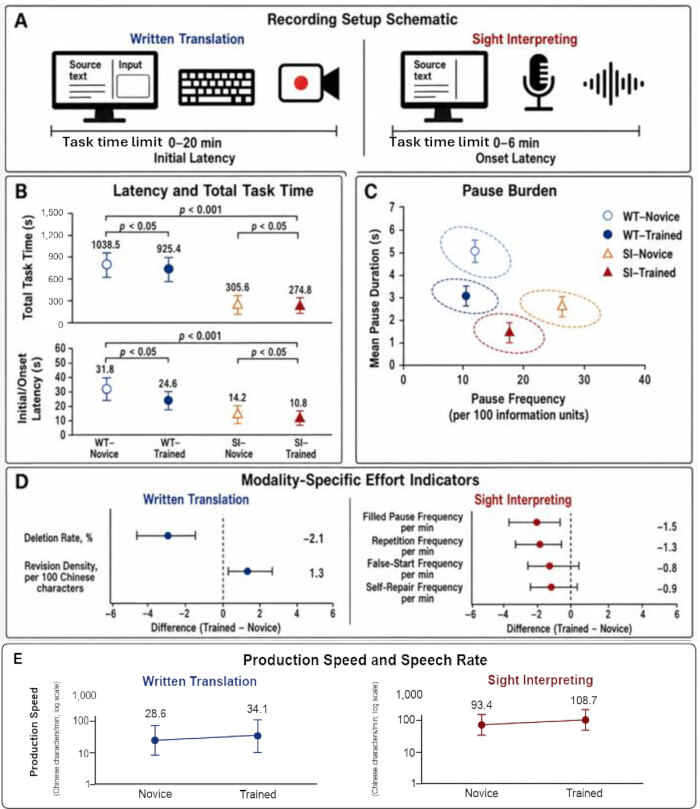
图2:书面翻译与视译任务条件下的行为特征。 (A) 任务特异性录音设置。(B) 初始/起始延迟和总任务时间。(C) 停顿频率与平均停顿持续时间的联合分布。(D) 任务特异性的删除、修改及口语不流畅指标。(E) 书面产出速率与口语语速。在图B、C和E中,数据点和误差线表示组均值±标准差(SD);在图D中,数据点表示训练组减去新手组的均值差异,误差线表示95%置信区间。每组n = 31名参与者。在图E中,y轴采用对数刻度显示。请点击此处查看该图的放大版本。
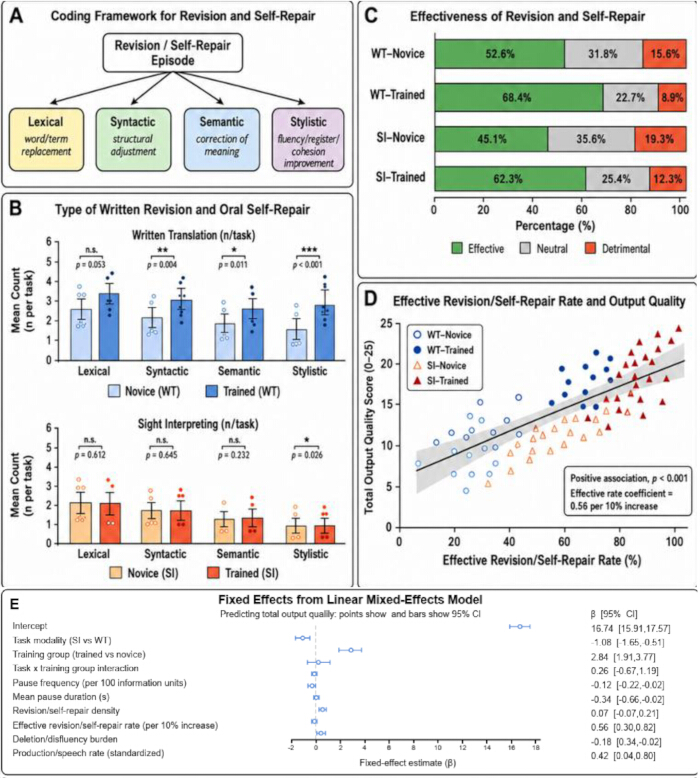
图 3:修订/自我修复编码、功能结果与输出质量的关联。(A)独立分配事件类型和功能结果的决策框架。(B)各任务条件下词汇、句法、语义和文体类事件的平均发生次数。(C)有效、中性和负面事件的平均比例。(D)有效事件率与总输出质量得分之间的描述性关联。(E)森林图,显示具有95%置信区间的线性混合效应模型的固定效应(详见表 4);该图表示关联关系,并不代表因果路径模型。请点击此处查看此图的放大版本。
| 变量 | 新手组 (n = 31) | 训练组 (n = 31) | p 值 |
| 年龄,年 | 21.9 ± 1.7 | 22.4 ± 1.9 | 0.279 |
| 女性,n (%) | 22 (71.0) | 21 (67.7) | 0.779 |
| 英语学习时长,年 | 12.4 ± 2.1 | 12.9 ± 2.2 | 0.36 |
| 英语水平得分 | 548.6 ± 41.3 | 562.4 ± 45.8 | 0.216 |
| 笔译训练时长,月 | 5.6 ± 3.0 | 18.7 ± 5.4 | <0.001 |
| 视译训练时长,月 | 2.3 ± 2.1 | 13.9 ± 5.7 | <0.001 |
| 先前完成书面翻译任务 ≥5 次,n (%) | 9 (29.0) | 24 (77.4) | <0.001 |
| 先前完成视译任务 ≥5 次,n (%) | 5 (16.1) | 20 (64.5) | <0.001 |
| 先进行书面翻译,n (%) | 16 (51.6) | 15 (48.4) | 0.799 |
| 先进行视译,n (%) | 15 (48.4) | 16 (51.6) | 0.799 |
表1:按组别划分的参与者特征及基线语言训练情况。 连续性数据以均值±标准差表示,分类数据以例数(百分比)表示。报告的p值反映组间比较结果,用于验证基线人口学特征的均衡性,并确认训练时长的预期差异。
| 变量 | 初学者笔译(n = 31) | 受训者笔译(n = 31) | 初学者视译(n = 31) | 受训者视译(n = 31) | 任务效应 p | 组别效应 p |
| 初始/起始潜伏期,s | 31.8 ± 12.4 | 24.6 ± 9.7 | 14.2 ± 5.6 | 10.8 ± 4.2 | <0.001 | 0.003 |
| 总任务时间,s | 1038.5 ± 168.2 | 925.4 ± 151.6 | 305.6 ± 59.3 | 274.8 ± 50.7 | <0.001 | 0.004 |
| 停顿频率,每100个信息单位 | 18.6 ± 6.1 | 14.2 ± 5.0 | 24.8 ± 7.4 | 19.6 ± 6.3 | <0.001 | 0.001 |
| 平均停顿持续时间,s | 4.1 ± 1.2 | 3.3 ± 1.0 | 2.7 ± 0.8 | 2.3 ± 0.7 | 0.012 | 0.002 |
| 产出/语速,汉字/分钟 | 28.6 ± 6.7 | 34.1 ± 7.5 | 93.4 ± 18.9 | 108.7 ± 20.4 | 0.001 | |
| 删除率,% | 8.9 ± 3.4 | 6.8 ± 2.7 | 0.009 | |||
| 修订密度,每100个汉字 | 7.6 ± 2.8 | 8.9 ± 3.1 | 0.087 | |||
| 填充停顿频率,每分钟 | 5.7 ± 1.9 | 4.2 ± 1.6 | 0.002 | |||
| 重复频率,每分钟 | 4.9 ± 1.8 | 3.6 ± 1.4 | 0.004 | |||
| 错误起始频率,每分钟 | 2.8 ± 1.1 | 2.0 ± 0.9 | 0.006 | |||
| 自我修正频率,每分钟 | 4.8 ± 1.7 | 3.9 ± 1.4 | 0.031 | |||
| 总质量评分,0–25 | 16.8 ± 2.3 | 20.1 ± 2.1 | 15.4 ± 2.6 | 18.9 ± 2.4 | 0.002 | <0.001 |
| 准确性,0–5 | 3.4 ± 0.7 | 4.1 ± 0.6 | 3.1 ± 0.8 | 3.8 ± 0.7 | 0.004 | <0.001 |
| 完整性,0–5 | 3.3 ± 0.8 | 4.0 ± 0.6 | 3.0 ± 0.8 | 3.7 ± 0.7 | 0.006 | <0.001 |
| 词汇恰当性,0–5 | 3.2 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.041 | <0.001 |
| 连贯性,0–5 | 3.5 ± 0.6 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.003 | <0.001 |
| 目标语言自然度,0–5 | 3.4 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.7 | 0.007 | <0.001 |
表2:不同任务条件和组别下的行为过程指标及产出质量。 数值以均值±标准差表示。报告的p值反映了任务模式(书面翻译与视译)和培训背景(新手与受训者)对各项过程和质量变量的主效应。
| 变量 | 新手书面翻译 | 训练者书面翻译 | p 值 | 新手视觉口译 | 训练者视觉口译 | p 值 |
| 词汇修订/自我修正,n/任务 | 3.4 ± 1.5 | 4.2 ± 1.7 | 0.053 | 1.8 ± 0.8 | 1.7 ± 0.7 | 0.612 |
| 句法修订/自我修正,n/任务 | 2.1 ± 1.1 | 3.0 ± 1.2 | 0.004 | 1.1 ± 0.7 | 1.2 ± 0.8 | 0.645 |
| 语义修订/自我修正,n/任务 | 1.8 ± 1.0 | 2.5 ± 1.1 | 0.011 | 0.9 ± 0.6 | 1.1 ± 0.7 | 0.232 |
| 风格修订/自我修正,n/任务 | 1.6 ± 0.9 | 2.7 ± 1.2 | <0.001 | 0.6 ± 0.4 | 0.9 ± 0.6 | 0.026 |
| 总修订/自我修正事件数,n/任务 | 8.9 ± 3.0 | 12.4 ± 3.7 | <0.001 | 4.4 ± 1.5 | 4.9 ± 1.6 | 0.209 |
| 有效事件比例,% | 52.6 ± 13.5 | 68.4 ± 12.1 | <0.001 | 45.1 ± 14.2 | 62.3 ± 13.0 | <0.001 |
| 中性事件比例,% | 31.8 ± 10.4 | 22.7 ± 8.8 | 0.001 | 35.6 ± 11.7 | 25.4 ± 9.6 | 0.001 |
| 有害事件比例,% | 15.6 ± 7.1 | 8.9 ± 5.6 | <0.001 | 19.3 ± 8.6 | 12.3 ± 6.8 | 0.001 |
表3:不同任务条件下书面修改和口头自我修正的类型及有效性。 各类事件以每项任务的平均次数(±标准差)表示,功能结果以平均百分比(±标准差)表示。p值表示每种任务模式下组间差异的显著性。
| 固定效应 | β | 标准误 | 95% 置信区间 | p 值 |
| 截距 | 16.74 | 0.42 | 15.91 至 17.57 | <0.001 |
| 任务模态:视译 vs. 书面翻译 | -1.08 | 0.29 | -1.65 至 -0.51 | <0.001 |
| 训练组:受训者 vs. 新手 | 2.84 | 0.47 | 1.91 至 3.77 | <0.001 |
| 任务模态 × 训练组 | 0.26 | 0.47 | -0.67 至 1.19 | 0.581 |
| 停顿频率,每 100 个信息单位 | -0.12 | 0.05 | -0.22 至 -0.02 | 0.018 |
| 平均停顿持续时间,秒 | -0.34 | 0.16 | -0.66 至 -0.02 | 0.041 |
| 修订/自我修正密度 | 0.07 | 0.07 | -0.07 至 0.21 | 0.334 |
| 有效修订/自我修正率,每增加 10% | 0.56 | 0.13 | 0.30 至 0.82 | <0.001 |
| 删除/不流畅负担 | -0.18 | 0.08 | -0.34 至 -0.02 | 0.027 |
| 产出/语速,标准化 | 0.42 | 0.19 | 0.04 至 0.80 | 0.032 |
表4:线性混合效应模型预测总体输出质量的报告固定效应。 该汇总详细列出了所有指定任务和行为预测因子的非标准化系数(β)、标准误(SE)、95%置信区间(CI)以及精确的p值。
讨论
本研究展示了一种多模态方案,用于测量英汉书面翻译与视译过程中可观察的流程指标,并对策略性修改进行编码。该方案并不直接测量单一的认知努力变量,而是将延迟、停顿、删除及修改模式解读为对任务敏感的行为相关指标,其意义需结合同步记录与产出质量证据进行三角验证。1,2,3,4,5,6,7,8两项任务在材料、时间安排、输出方式和修改机会上也存在差异,因此这些典型对比描述的是任务条件的差异,而非孤立的模态效应。本研究主要的分析贡献在于将修改频率与功能结果分离开来。在所报告的摘要中,经过训练的参与者进行书面修改的次数更多,而非更少,而各组之间口头自我修正的总次数并无显著差异。他们较高的有效修改比例表明,监控质量可能比原始频率更具信息价值,但这一解释依赖于透明的决策规则、独立的结果编码以及报告的信度。代码本与实例分析见 补充文件 1 旨在使这一区分具有可重复性,而非出于宣传目的。
关键步骤包括跨记录对齐、音频质量检查、转录文本验证以及编码一致性。在对齐日志与录音时,应核对可用的时间戳和任务边界提示。转录前必须检查音频是否存在削波及是否清晰可辨,且需根据波形图和转录文本核实所建议的停顿边界。对于中文输入,不应将组字按键操作等同于已提交字符的修改。上述检查与纠正措施均应记录在质量控制日志中。
本研究的解释存在若干局限性。该研究使用了学生和受训人员群体、简短的通用说明性文本、不同长度的任务和时间限制,以及基于可获得性的样本。任务条件在输出方式和修改机会方面也存在差异,且数据集未包含独立抽样的源文本标识符,无法估计文本层面的变异情况。此外,停顿阈值属于操作性选择,较长的停顿可能既反映有效的计划过程,也可能反映尚未解决的困难。若要将结论推广至专业人员、特定领域、其他语言对或其他书写系统,需重新验证材料、输入方式处理、阈值设定及评分锚定点。
未来的研究可将行为记录与眼动追踪、瞳孔测量或主观工作负荷测量相结合,以检验哪些停顿和修改与注意力、感知到的努力程度或成功的计划相对应5,6,13,14,15,16。Shreve 等人将眼动追踪用于视译研究,不应被引用为瞳孔测量研究18;Seeber 直接讨论了瞳孔测量的应用5。此类多模态扩展研究应保持任务需求、投入的努力、观察到的行为与表现之间的区分。因此,本方案最适合作为一种透明的过程评估框架,其指标可支持但本身不足以确立关于潜在认知努力的结论。
披露
作者声明不存在任何商业或财务利益冲突。关于人工智能的使用,作者披露在修订过程中仅使用了OpenAI Codex,以协助语言编辑、一致性检查、修订标记的生成,以及基于作者提供的数据重新生成图表布局。作者已仔细审阅所有人工智能辅助生成的内容,并对最终稿件的准确性、完整性和原创性承担全部责任。本研究所依据的结构化工作簿已在Zenodo公开获取(https://doi.org/10.5281/zenodo.21189434)。补充文件1包含编码手册和锚定质量评估标准。
致谢
作者感谢桂林信息科技学院提供的实验室支持,感谢对源文本进行评估的双语专家、独立评分员以及参与人员。本研究未从公共、商业或非营利机构的任何资助单位获得特定资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 声学分析软件(Praat) | Paul Boersma and David Weenink | https://www.fon.hum.uva.nl/praat/ | |
| 台式计算机 | Dell | OptiPlex | |
| 数字音频录制软件(Audacity) | Audacity Team | https://www.audacityteam.org/ | |
| 按键记录软件(Inputlog) | University of Antwerp | https://www.inputlog.net/ | |
| 屏幕录制软件(OBS Studio) | OBS Project | https://democreator.wondershare.com/ | |
| 统计分析软件(SPSS) | IBM | Version 27 |
参考文献
- Gieshoff AC, Heeb AH. Cognitive load and cognitive effort: probing the psychological reality of a conceptual difference. Transl Cogn Behav. 2023;6(1):3–28.
- Sweller J, van Merriënboer JJG, Paas F. Cognitive architecture and instructional design. Educ Psychol Rev. 1998;10(3):251–96.
- Paas F, Tuovinen JE, Tabbers H, Van Gerven PWM. Cognitive load measurement as a means to advance cognitive load theory. Educ Psychol. 2003;38(1):63–71.
- Gile D. Basic Concepts and Models for Interpreter and Translator Training. Amsterdam: John Benjamins; 2009.
- Seeber KG. Cognitive load in simultaneous interpreting: measures and methods. Target. 2013;25(1):18–32.
- Ferreira A, Schwieter JW, Gottardo A, Jones JA. Cognitive effort in direct and inverse translation performance: insight from eye-tracking technology. Cad Trad. 2016;36(3):60–80.
- Zou D, Zhang J. Measuring the invisible: clarifying the concept of cognitive effort in translation and interpreting processes. Curr Trends Transl Teach Learn E. 2023;10:217–58.
- Lacruz I, Shreve GM, Angelone E. Average pause ratio as an indicator of cognitive effort in post-editing: a case study. Workshop on Post-Editing Technology and Practice. San Diego: Association for Machine Translation in the Americas; 2012. p. 21–30.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589–604.
- Ma X, Li D. Effect of word order asymmetry on the cognitive load of English–Chinese sight translation: Evidence from eye movement data. Transl Interpret Stud. 2024;19(1):105–31.
- Leijten M, Van Waes L. Keystroke logging in writing research: using Inputlog to analyze and visualize writing processes. Written Commun. 2013;30(3):358–92.
- Heilmann A, Neumann S, editors. Dynamic pause assessment of keystroke logged data for the detection of complexity in translation and monolingual text production. Proceedings of the Workshop on Computational Linguistics for Linguistic Complexity; 2016; Osaka: COLING.
- Su W, Li D. Identifying translation problems in English-Chinese sight translation: an eye-tracking experiment. Transl Interpret Stud. 2019;14(1):110–34.
- Su W, Li D. Exploring processing patterns of Chinese-English sight translation: an eye-tracking study. Babel. 2020;66(6):999–1024.
- Su W, Li D. Exploring the effect of interpreting training: eye-tracking English-Chinese sight interpreting. Lingua. 2021;256:103094.
- Su W. Eye-voice span in sight interpreting: an eye-tracking investigation. Perspectives. 2023;31(5):969–85.
- Rojo López AM, Muñoz Martín R. Research Methods in Cognitive Translation and Interpreting Studies. Amsterdam: John Benjamins; 2025.
- Shreve GM, Lacruz I, Angelone E. Cognitive effort, syntactic disruption, and visual interference in a sight translation task. Transl Interpret Stud. 2010;5(1):63–84.
重印与许可
标签
本文已发表
视频即将推出