本文介绍了一种可重复的生物信息学工作流程,该流程整合了公共转录组数据集、机器学习、外部验证、定量反转录PCR、Connectivity Map筛选和分子对接技术,用于鉴定肺动脉高压的生物标志物及候选治疗化合物。
本文内容
摘要
摘要
本研究旨在利用公共转录组数据和独立验证资源,鉴定与肺动脉高压(PH)相关的分子生物标志物及候选小分子化合物。在进行标准化、探针注释和ComBat批次效应校正后,整合了三个基因表达综合数据库(GSE22356、GSE33463和GSE48149)。通过差异表达分析、加权基因共表达网络分析、功能富集分析、蛋白质-蛋白质相互作用网络分析以及三种机器学习算法,识别核心特征基因。采用受试者工作特征曲线评估诊断效能。外部验证包括一个独立的肺组织队列(GSE117261)、一个肺动脉单细胞RNA测序数据集(GSE210248),以及在独立肺组织样本中进行的定量反转录PCR验证。基于Connectivity Map的药物重定位分析和分子对接用于筛选候选化合物。共鉴定出78个差异表达基因,筛选出CXCL10、JUN、IFIH1、MX1和TLR7作为核心特征基因。在独立的GSE117261肺组织队列中,JUN获得最强的外部支持,而其他基因的重复验证结果存在差异。在20个生物学独立的肺动脉高压样本和20个对照样本中进行的定量反转录PCR证实,这五个基因均显著上调。五基因qRT-PCR模型在训练集中以及经过100次重复分层五折交叉验证分析均获得曲线下面积为1.000的结果,但因样本量较小,需谨慎解读,尚需独立的前瞻性验证。对GSE210248数据集的单细胞分析支持免疫细胞与结构细胞间通讯异常以及平滑肌细胞表型转换的假说。在Connectivity Map筛选中,BRD-K91900765/VX-745得分最高。将其已知的药理学靶点MAPK14/p38α作为阳性对照对接蛋白,而针对五个生物标志物相关蛋白的对接则视为探索性分析。上述研究结果支持这五个基因为候选的PH生物标志物,同时提出VX-745作为需实验验证的计算性药物重定位假说。
引言
肺动脉高压(PH)是一种进行性心肺综合征,其特征是肺动脉压力持续升高、肺血管阻力增加,并最终导致右心室衰竭。目前的血流动力学标准将PH定义为:在静息状态下,通过右心导管检查测得的平均肺动脉压>20 mmHg1。在不同的临床亚型中,肺动脉高压(PAH)是最严重的形式之一,其特征是进行性的肺血管重构。其病理特征包括内皮功能障碍、肺动脉平滑肌细胞异常增殖与迁移、外膜成纤维细胞活化、细胞外基质沉积、炎性细胞浸润,以及远端肺动脉的狭窄或闭塞2。这些改变表明,PH/PAH不仅是一种血管收缩障碍性疾病,更是一种由分子、细胞及免疫-炎症机制共同驱动的复杂性血管重构疾病。
目前,肺动脉高压(PAH)的治疗主要靶向前列环素、内皮素、一氧化氮-可溶性鸟苷酸环化酶以及5型磷酸二酯酶通路3˒4。尽管这些治疗方法可改善症状、运动耐量和血流动力学参数,但其作用仍主要局限于血管扩张和血流动力学效应。它们对已形成的肺血管重构的逆转能力有限,许多患者即使接受联合治疗,疾病仍持续进展。因此,识别能够反映血管重构过程的新型分子生物标志物和潜在治疗靶点,已成为尚未满足的重要临床需求。特别是免疫-炎症激活、干扰素相关信号通路、Toll样受体通路、趋化因子介导的免疫细胞募集以及平滑肌细胞表型转换,已被认为可能参与肺动脉高压(PH/PAH)的疾病进展5˒6。
高通量转录组数据集为识别肺动脉高压(PH/PAH)相关分子特征提供了宝贵的资源。然而,基于单一数据集的研究常受限于样本量小、批次效应、平台异质性以及验证不足等问题。差异表达分析能够识别表达改变的基因,但可能无法充分捕捉与疾病相关的共表达模块或网络层面的相互作用。加权基因共表达网络分析(WGCNA)可用于鉴定与疾病特征相关的基因模块,而蛋白质-蛋白质相互作用(PPI)网络分析则可揭示生物网络中高度连接的基因。机器学习方法也可用于优先筛选具有诊断或分类价值的基因。然而,依赖单一算法可能引入模型特异性偏差。因此,整合差异表达分析、WGCNA、PPI 网络分析以及多种机器学习算法,有望提高生物标志物发现的稳健性。
转录组学生物标志物研究的另一个主要挑战是生物学意义的解读。组织整体信号可能反映了血管固有细胞内基因表达的变化、免疫细胞浸润,或多种细胞群体比例的改变。单细胞RNA测序为将来自组织整体分析的候选基因置于具体的细胞背景下提供了机会。在肺动脉高压(PH/PAH)中,肺血管重构涉及内皮细胞、平滑肌细胞、成纤维细胞、单核细胞/巨噬细胞、淋巴细胞以及其他免疫或结构细胞。疾病进展还与细胞间通讯的改变以及平滑肌细胞表型转换相关。因此,将组织整体转录组筛查与单细胞验证相结合,有助于确定候选生物标志物是否与免疫激活、血管结构重塑或多细胞通讯失衡相关。
除了生物标志物的发现外,转录组特征还可用于计算药物重定位。连接图谱(Connectivity Map,CMap)将疾病相关的基因表达谱与可能逆转或调节这些特征的小分子联系起来7。当该方法与化合物筛选及分子对接相结合时,可生成可进行实验验证的治疗假说。尽管CMap预测和分子对接无法确定药物的有效性,但它们能够优先筛选出候选化合物,用于后续的靶点结合实验、基于细胞的实验以及动物模型验证。
本研究建立了一种整合性且可重复的工作流程,用于鉴定肺动脉高压(PH/PAH)的生物标志物及潜在治疗化合物。研究整合了三个公开的基因表达综合数据库(Gene Expression Omnibus)转录组数据集,并在标准化和批次效应校正后进行分析。通过差异表达分析、加权基因共表达网络分析(WGCNA)、功能富集分析、蛋白质-蛋白质相互作用(PPI)网络分析以及三种机器学习算法,筛选出稳定的特征基因。进一步采用受试者工作特征曲线分析、独立的肺组织验证队列、肺动脉单细胞RNA测序证据,以及在独立样本中进行的定量反转录PCR验证,对所选基因进行评估。最后,应用基于CMap的药物重定位分析和分子对接技术,鉴定潜在化合物。本研究的创新之处在于其多层次的验证框架,将群体转录组学发现、机器学习优先排序、独立验证、实验性定量反转录PCR确认、单细胞水平的机制解读以及计算化合物筛选有机结合。本研究的假设是,PH/PAH由协调的免疫-炎症反应与血管重塑程序共同驱动,该程序中的稳定基因可能作为候选生物标志物,并为药物重定位提供机会。
方案
本研究分析的公共基因表达综合数据库(Gene Expression Omnibus,GEO)数据集包含来自先前已发表研究的去标识转录组数据,无需额外的伦理审批。怀化学院伦理委员会批准了独立的人类肺组织定量逆转录聚合酶链式反应(qRT-PCR)验证研究(批准号:2024(A05112))。在样本采集前,已从所有参与者或其法定授权代表处获得书面知情同意。该批准和知情同意程序适用于qRT-PCR验证中所包含的20例肺动脉高压(PAH)患者和20例对照肺组织样本。本实验方案所用的研究工具列于材料表中。
1. 公共转录组数据集的收集与预处理
与肺动脉高压(PH)相关的微阵列数据集 GSE22356、GSE33463 和 GSE48149 从 GEO 数据库中获取。根据原始表型注释提取了 PH/肺动脉高压(PAH)和对照样本。使用可重复的 R 脚本和 GEOquery 软件包下载了表达矩阵和平台注释文件。
在各数据集中一致地进行了探针注释和基因符号映射。当多个探针对应同一基因时,计算其平均表达值。采用分位数归一化方法,并去除低表达或低变异度的基因。合并数据集后,使用 sva 软件包中的 ComBat 算法校正批次效应8。通过箱线图和主成分分析对校正效果进行评估。
2. 差异表达基因的鉴定
采用limma软件包对批次校正后的表达矩阵中肺动脉高压(PH)样本与对照样本之间的表达水平进行比较9。拟合线性模型并应用经验贝叶斯统计方法。差异表达基因的定义标准为校正后的P值<0.05且绝对log2倍数变化>0.585。结果通过火山图和热图进行可视化展示。
3. 加权基因共表达网络构建
使用WGCNA软件包构建加权基因共表达网络10。通过样本聚类检测离群值。根据无标度拓扑拟合指数选择软阈值幂参数。采用动态树剪切算法识别基因模块。将模块特征基因与肺动脉高压(PH)表型进行相关性分析,并选取与疾病相关性最强的模块。将关键模块中的基因与差异表达基因取交集,以获得共识基因。
4. 功能富集分析
使用 clusterProfiler 分析基因本体论的生物过程、细胞组分和分子功能类别11。通过京都基因与基因组百科全书(Kyoto Encyclopedia of Genes and Genomes)通路富集分析鉴定信号通路12。以 P 值 < 0.05 和 q 值 < 0.2 作为富集阈值,富集的条目通过气泡图进行可视化展示11。
5. 蛋白质-蛋白质相互作用网络构建与枢纽基因鉴定
将共识基因列表提交至 STRING 数据库,选择物种为 Homo sapiens,相互作用置信度阈值设为 > 0.413。将相互作用文件导入 Cytoscape,利用 CytoHubba 插件根据节点度对基因进行排序。将连接度较高的基因定义为枢纽基因。
6. 使用机器学习选择诊断特征基因
应用了三种独立的特征选择算法。首先,使用 glmnet 软件包进行最小绝对收缩与选择算子(LASSO)逻辑回归分析,并通过 10 折交叉验证识别具有非零系数的基因14。其次,采用支持向量机递归特征消除法,去除冗余特征,并选择交叉验证准确率最高的特征子集15。第三,构建随机森林模型,并根据基尼不纯度平均减少量对特征进行排序16。将三种算法所得基因集合的交集作为最终的核心特征基因集合。使用 pROC 软件包绘制受试者工作特征曲线,并计算曲线下面积值17。
7. 使用独立的批量和单细胞数据集验证核心基因
GSE117261 被用作一个独立的外部肺组织验证队列,包含 58 个肺动脉高压(PAH)样本和 25 个失败供体对照样本18。该数据集未用于发现阶段的差异表达分析、加权基因共表达网络构建或机器学习特征筛选。表达矩阵经过标准化和注释,并使用 limma v3.68.0 进行差异表达分析。在整个注释转录组范围内应用了 Benjamini-Hochberg 法进行假发现率校正。单基因受试者工作特征(ROC)曲线使用 pROC v1.19.0.1 计算,采用 DeLong 95% 置信区间和 Youden 指数确定截断值。在 GSE117261 中拟合了一个探索性的五基因逻辑回归模型,并通过重复嵌套交叉验证进一步评估其内部性能。
GSE210248(表1)被用作单细胞肺动脉验证数据集,包含来自3名肺动脉高压(PAH)患者和3名健康供体的样本19。使用Seurat v5.5.1对数据进行质控、标准化、降维、聚类和细胞注释20。鉴定出主要的细胞群体,包括内皮细胞、平滑肌细胞、成纤维细胞、单核细胞/巨噬细胞以及T细胞/自然杀伤细胞。采用CellChat v2.1.2及CellChatDB.human配体-受体数据库分析细胞间通讯21。基于标准化的Seurat表达矩阵和细胞类型元数据构建CellChat对象。识别出高表达基因及配体-受体相互作用;计算通讯概率;剔除涉及少于10个细胞的细胞群的相互作用;推断并汇总通路水平的通讯网络。该数据集仅用于外部机制验证,不用于模型训练。
| 项目 | 描述 |
| 数据集 | GSE210248 |
| 数据类型 | 10x Genomics/基于微滴的单细胞RNA测序;高通量转录组分析 |
| 人源样本 | 三个肺动脉高压(PAH)肺动脉样本和三个健康供体肺动脉样本 |
| 组织来源 | 离体肺动脉组织,主要反映肺血管壁的细胞生态及血管重塑过程 |
| 主要分析目的 | 细胞类型定位、平滑肌细胞表型转换、免疫-结构细胞间通讯以及候选基因机制一致性的验证 |
表1:GSE210248单细胞验证数据集的基本信息。 该表格总结了单细胞肺动脉验证分析的数据集登录号、测序平台、组织来源、样本组成及分析目的。
8. 通过qRT-PCR验证基因表达
qRT-PCR 验证包括来自肺动脉高压(PH/PAH)患者的 20 个生物学独立的肺组织样本和 20 个生物学独立的对照肺组织样本。使用总 RNA 提取试剂盒提取总 RNA。采用分光光度计测定 RNA 浓度和纯度,并通过琼脂糖凝胶电泳评估 RNA 完整性。仅纳入 A260/280 值在 1.8 至 2.1 之间且无可见降解的 RNA 样本。
使用Solarbio Universal RT-PCR试剂盒(AMV;货号RP1200)将等量的RNA逆转录为互补DNA。采用SYBR Green PCR Master Mix在实时PCR系统上对CXCL10、JUN、IFIH1、MX1和TLR7进行定量PCR检测。每个生物学样本均设置三个技术重复,并同时设置无模板对照和无逆转录对照。后续分析采用三个技术重复的平均Ct值;技术重复不视为独立观测值。引物跨外显子-外显子连接区设计,扩增产物长度为80–200 bp(表2)。引物特异性通过NCBI Primer-BLAST和熔解曲线分析验证22。
采用β-肌动蛋白(ACTB)作为内参基因,对目标基因的表达水平进行标准化。相对表达量通过2-ΔΔCt法计算23。根据数据分布情况,组间比较采用双侧Mann-Whitney U检验,并对五个基因进行Benjamini-Hochberg错误发现率校正。单基因ROC曲线使用DeLong法计算95%置信区间,并利用Youden指数选择最佳截断值。五基因逻辑回归模型首先在同一组40个生物学样本上进行拟合和评估;因此,该估计值被定义为样本内表观性能。为评估潜在的过拟合情况,采用L2正则化的逻辑回归模型对数据进行100次分层五折交叉验证,并计算各折外ROC性能的汇总结果。
| 基因 | RefSeq 登录号 | 正向引物 (5′–3′) | 反向引物 (5′–3′) | 产物大小 (bp) | Tm (°C) | 跨外显子 |
| CXCL10 | NM_001565.4 | GTCAAGCCAT AATTGTTC | ATAGTGCCAG GGTAGAGT | 141 | 46.1 | 是 |
| JUN | NM_002228.4 | ACAAGTGGCA GAGTCCCG | CGCCCAAGTT CAACAACC | 152 | 54.5 | 是 |
| IFIH1 | NM_022168 | GCACAGAGCG GTAGACCCT | GCCCTGAAGC ACGAGATG | 182 | 54.7 | 是 |
| MX1 | NM_002462.5 | TTAGCCGTGG TGATTTAGC | CAAGGTGGAG CGATTCTG | 156 | 52.3 | 是 |
| TLR7 | NM_016562.4 | ATTGCCCTCGT TGTTATA | TTCCTGGAGTT TGTTGAT | 179 | 48.1 | 是 |
| ACTB | NM_001101.3 | CTCACCATGGAT GATGATATCGC | AGGAATCCTTCT GACCCATGC | 194 | 56.2 | 是 |
表2:用于定量反转录PCR的引物序列。 该表格列出了用于qRT-PCR的引物所针对的目标基因、RefSeq登录号、正向与反向引物序列、产物大小、熔解温度以及是否跨越外显子的信息。
9. 候选化合物筛选与分子对接
将上调和下调的核心基因特征提交至 Connectivity Map 数据库,以鉴定可逆转肺动脉高压相关表达谱的小分子7。候选分子根据 Logit 评分和预测概率进行排序。
BRD-K91900765/VX-745 的三维结构来自 PubChem,CID 为 303852524。化合物相关的药理学信息来自公共药物数据库,结构描述符使用 DrugBank 和 SwissADME 计算获得25,26。蛋白质结构来自 RCSB 蛋白质数据库,使用的 PDB 编号如下:CXCL10,1LV9;JUN,1JUN;IFIH1,3B6E;MX1,5GTM;TLR7,7CYN;以及 MAPK14/p38α,1OUK27。盲腔检测和分子对接采用 CB-Dock2 v2.0 并结合 AutoDock Vina v1.2.0 评分引擎完成28,29。将蛋白质和配体文件上传至 CB-Dock2,系统自动检测候选结合腔,并在服务器生成的特定腔体对接框内进行对接。针对每种蛋白质,记录了腔体编号、Vina 评分、腔体体积、对接框中心位置、对接框尺寸以及蛋白质-配体复合物文件。选择 Vina 评分最负的构象作为排名最高的预测构象。MAPK14/p38α 被纳入作为 VX-745 已知的药理学靶点及阳性对照对接蛋白。对 CXCL10、JUN、IFIH1、MX1 和 TLR7 的对接属于探索性分析,不解释为对这些靶点存在直接药理作用、结合、抑制或功效的证据。
10. 统计分析与可重复性控制
所有统计分析均在 R 中进行,除非另有说明。双侧 P 值 < 0.05 被视为具有统计学显著性。如上所述,对差异表达、富集分析、外部验证和qRT-PCR分析均进行了多重检验校正。采用交叉验证评估机器学习模型及联合qRT-PCR模型的稳定性。
结果
公共转录组数据预处理与差异表达基因鉴定
对GSE22356、GSE33463和GSE48149数据集进行整合及ComBat校正后,降低了各数据集之间的系统性差异。箱线图显示,校正后样本的表达分布更加一致。主成分分析表明,校正前样本主要按数据集来源聚类,而校正后样本的聚类趋于混合,说明批次效应得到了有效消除(图1)。
使用绝对 log2 倍数变化的阈值 >0.585 和校正后的 P 值 < 0.05,共鉴定出78个差异表达基因,包括44个上调基因和34个下调基因(图2A)。热图显示,与干扰素相关的基因,包括 XAF1、MX1、IFI44L、EPSTI1、PARP9、IFIH1、CXCL10、GBP1、STAT1、SAMHD1、TNFSF10 和 TLR7,在与肺动脉高压(PH)相关的样本中普遍上调。相比之下,与红细胞生成相关的基因,包括 HBG1、HBD、ALAS2、CA1 和 SLC4A1,则倾向于下调。图2B).
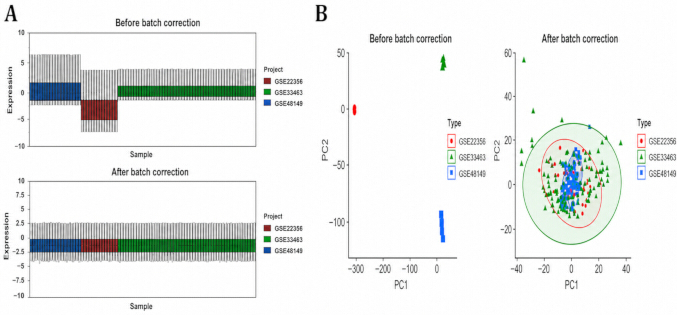
图1:批次效应校正。(A)合并后的表达矩阵在ComBat校正前后的箱线图。(B)主成分分析图,显示批次效应校正前后样本的分布情况。请点击此处查看该图的放大版本。
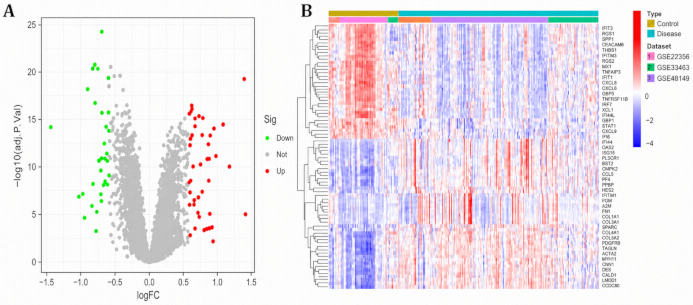
图2:差异表达基因。(A)显示与肺动脉高压(PH)相关样本中上调和下调基因的火山图。(B)显示对照组与疾病组之间差异表达基因的热图。请点击此处查看该图的放大版本。
加权基因共表达网络构建与功能富集
样本聚类显示整体聚类稳定,无明显离群样本(图 3A)。无标度拓扑拟合指数在幂值为 9 时接近 0.8,因此选择 β = 9 用于构建网络(图 3B)。基因聚类与动态模块识别得到了多个共表达模块(图 3C)。其中,蓝色模块与肺动脉高压(PH)状态的相关性最强(r = 0.55,P = 1 × 10⁻¹⁹),而青色模块和灰色模块也显示出与 PH 的相关性(图 3D)。
通过将关键加权基因共表达网络分析模块基因与差异表达基因取交集获得的共识基因,在抗病毒免疫防御、NF-κB 和 JAK-STAT 调控、炎症因子反应、细胞因子和趋化因子受体结合以及转录调控方面显著富集(图 4A)。京都基因与基因组百科全书(Kyoto Encyclopedia of Genes and Genomes)富集分析显示,细胞因子-细胞因子受体相互作用、趋化因子信号通路、NOD 样受体信号通路、Toll 样受体信号通路、肿瘤坏死因子信号通路以及白细胞介素-17 信号通路显著富集(图 4B),支持免疫-炎症失调作为肺血管重塑的分子基础。
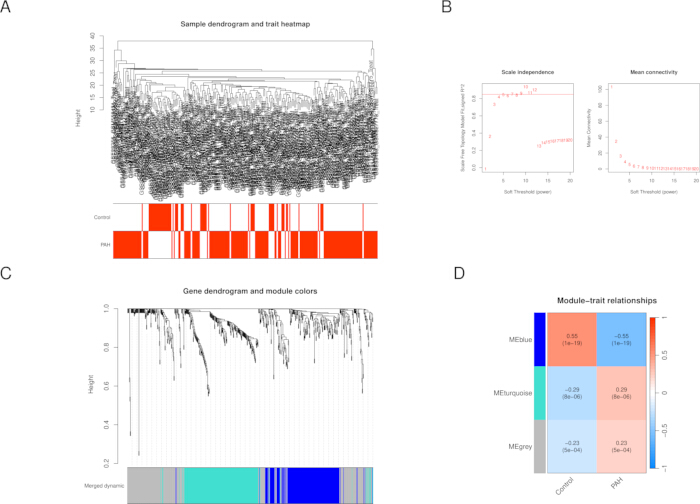
图 3:加权基因共表达网络分析。(A)样本聚类树与性状热图。(B)软阈值选择图。(C)基因树状图与模块颜色。(D)模块-性状关系热图。请点击此处查看该图的放大版本。
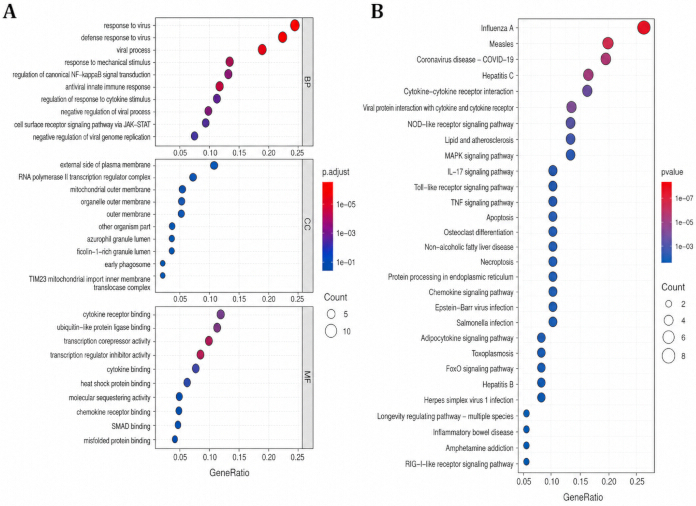
图4:功能富集分析。(A)共识基因的基因本体(Gene Ontology)富集分析结果。(B)共识基因的京都基因与基因组百科全书(Kyoto Encyclopedia of Genes and Genomes)通路富集分析结果。请点击此处查看该图的放大版本。
蛋白质-蛋白质相互作用网络与枢纽基因筛选
基于共识基因构建的 STRING 蛋白质-蛋白质相互作用网络揭示了一个相互关联的免疫-炎症网络(图 5A)。基于节点度的 CytoHubba 排序显示,FN1、CD44、JUN、TGFB1、CXCL8 和 BCL2 具有较高的连接性(图 5B)。这些枢纽基因可能参与炎症信号传导、细胞黏附、细胞外基质重塑以及肺血管结构重塑。
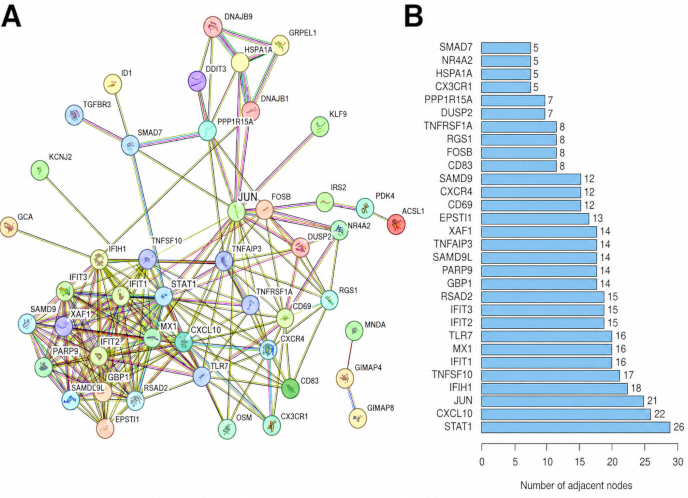
图 5:蛋白质-蛋白质相互作用网络与枢纽基因。(A)共识基因的 STRING 蛋白质-蛋白质相互作用网络。(B)使用 CytoHubba 鉴定的按度排序的枢纽基因。请点击此处查看该图的放大版本。
机器学习特征选择与诊断性能
经过交叉验证后,最小绝对收缩与选择算子回归筛选出六个具有非零系数的候选基因(图 6A,B)。支持向量机递归特征消除法保留了八个基因,交叉验证准确率达到 0.883,误差为 0.117(图 7A)。当决策树数量 ≥100 时,随机森林的袋外误差趋于稳定,根据重要性评分,IFIH1、JUN 和 TLR7 位列前茅(图 7B)。
最小绝对收缩与选择算子、支持向量机递归特征消除以及随机森林结果的交集确定了五个核心基因:CXCL10、JUN、IFIH1、MX1 和 TLR7(图 8A)。单基因受试者工作特征分析显示中等至良好的诊断区分能力,曲线下面积值分别为:IFIH1 0.842,JUN 0.833,TLR7 0.827,CXCL10 0.814,MX1 0.759(图 8B)。
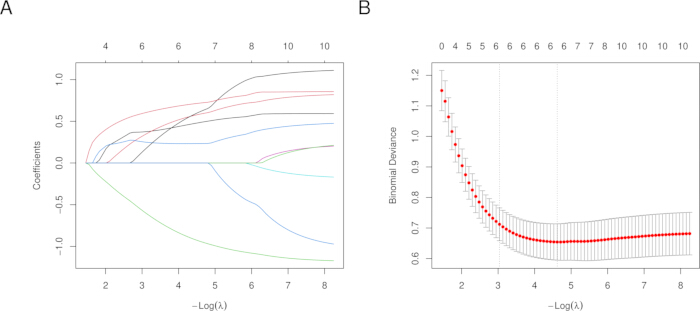
图 6:最小绝对收缩与选择算子回归分析。(A)由最小绝对收缩与选择算子回归生成的系数路径。(B)交叉验证误差图。请点击此处查看该图的放大版本。
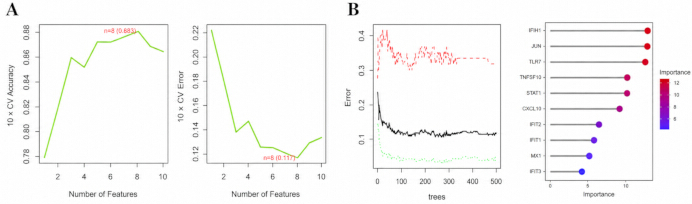
图 7:支持向量机-递归特征消除与随机森林分析。 (A)支持向量机-递归特征消除的特征选择图。(B)随机森林模型及基因重要性排序。请点击此处查看该图的放大版本。
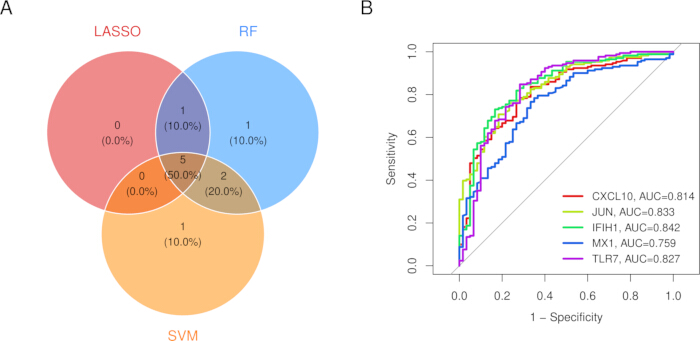
图8:机器学习结果汇总。(A)三种特征筛选算法结果交集的维恩图。(B)五个核心基因的受试者工作特征曲线。请点击此处查看该图的高清版本。
在中国台湾 GSE117261 中进行外部验证
GSE117261 被用作独立的肺组织验证队列,未参与差异表达筛选、加权基因共表达网络构建或机器学习特征选择(表 3)。完成的验证结果显示,在五个基因中复制情况存在异质性(表 4)。CXCL10 表达上调(log₂ 倍数变化 = 0.677;P = 0.0410;FDR = 0.144),其 AUC 为 0.639(95% CI,0.491–0.786),截断值为 6.245,敏感性为 0.724,特异性为 0.600。JUN 表达上调(log₂ 倍数变化 = 0.463;P = 0.00248;FDR = 0.0194),其 AUC 为 0.714(95% CI,0.593–0.835),截断值为 8.708,敏感性为 0.707,特异性为 0.720。
IFIH1(log2 倍数变化 = 0.107;P = 0.371;FDR = 0.591;AUC = 0.543,95% CI,0.398–0.687)、MX1(log2 倍数变化 = 0.109;P = 0.488;FDR = 0.690;AUC = 0.475,95% CI,0.337–0.614)和 TLR7(log2 倍数变化 = -0.050;P = 0.543;FDR = 0.733;AUC = 0.546,95% CI,0.414–0.679)均未达到预设的外部支持标准。TLR7 的变化方向还与 qRT-PCR 结果相反。在 GSE117261 数据集中拟合并评估的探索性五基因模型显示出明显的 AUC 为 0.740,而重复的嵌套交叉验证得到的 AUC 为 0.656。因此,JUN 获得了最强的独立支持,CXCL10 显示出有限的一致性证据,而 IFIH1、MX1 和 TLR7 的重复验证结果较弱或不一致。
| 项目 | 描述 |
| 数据集登录号 | GSE117261 |
| 数据来源 | 基因表达综合数据库(Gene Expression Omnibus, GEO) |
| 样本类型 | 人类肺组织转录组微阵列数据 |
| 样本量 | 58 个肺动脉高压(PAH)样本和 25 个供体失败对照样本 |
| 检测平台 | GPL6244 / Affymetrix Human Gene 1.0 ST Array |
| 验证目的 | CXCL10、JUN、IFIH1、MX1 和 TLR7 的表达差异、单基因 ROC 分析,以及探索性五基因联合 ROC 建模 |
| 在本研究中的作用 | 独立的外部验证数据集;未参与原始训练、WGCNA 或特征筛选分析 |
表3:GSE117261独立外部验证数据集的基本信息。 该表格总结了数据集来源、样本类型、样本量、检测平台、验证目的以及GSE117261在本研究中的作用。
| 基因/模型 | PAH n | 对照组 n | log2 倍数变化 | P 值 | FDR | AUC | AUC 95% 置信区间 | 约登截断值 | 灵敏度 | 特异性 |
| CXCL10 | 58 | 25 | 0.677 | 0.041 | 0.144 | 0.639 | 0.491–0.786 | 6.245 | 0.724 | 0.6 |
| JUN | 58 | 25 | 0.463 | 0.00248 | 0.019 | 0.714 | 0.593–0.835 | 8.708 | 0.707 | 0.72 |
| IFIH1 | 58 | 25 | 0.107 | 0.371 | 0.591 | 0.543 | 0.398–0.687 | 5.3 | 0.759 | 0.44 |
| MX1 | 58 | 25 | 0.109 | 0.488 | 0.69 | 0.475 | 0.337–0.614 | 6.833 | 0.724 | 0.4 |
| TLR7 | 58 | 25 | -0.05 | 0.543 | 0.733 | 0.546 | 0.414–0.679 | 4.065 | 0.138 | 1 |
| 五基因模型(表观/样本内) | 58 | 25 | / | / | / | 0.74 | 0.621–0.859 | 0.613 | 0.845 | 0.6 |
| 五基因模型(重复嵌套交叉验证) | 58 | 25 | / | / | / | 0.656 | 0.517–0.795 | 0.655 | 0.845 | 0.52 |
表4:GSE117261数据集中五个基因及探索性组合模型的实际表达差异与ROC验证结果。 该表格列出了肺动脉高压(PAH)与对照样本的数量、log₂倍数变化、P值、经假发现率校正后的值、AUC值、95%置信区间、约登指数截断值、敏感性、特异性以及对结果的解释。
定量逆转录 PCR 验证
定量逆转录 PCR 验证包括 20 个生物学独立的肺动脉高压肺组织样本和 20 个生物学独立的对照样本,每个生物学样本取三个技术重复的平均值。CXCL10、JUN、IFIH1、MX1 和 TLR7 在肺动脉高压中显著上调(表 5;图 9A)。其平均相对表达量分别为 CXCL10 约 3.470,JUN 约 2.560,IFIH1 约 2.760,MX1 约 2.650,TLR7 约 2.580。相应的 P 值/FDR 值分别为 1.43 × 10⁻7/7.15 × 10⁻7、4.17 × 10⁻5/4.17 × 10⁻5、1.10 × 10⁻5/1.38 × 10⁻5、1.58 × 10⁻6/2.63 × 10⁻6 和 1.37 × 10⁻6/2.63 × 10⁻6。
基于qRT-PCR表达的单基因ROC分析显示,CXCL10的AUC为0.988(95% CI,0.961–1.000),JUN为0.880(95% CI,0.758–1.000),IFIH1为0.908(95% CI,0.820–0.995),MX1为0.945(95% CI,0.874–1.000),TLR7为0.948(95% CI,0.886–1.000)(图9B;表5)。五基因逻辑回归模型获得的表观AUC为1.000(DeLong 95% CI:1.000–1.000),敏感性和特异性均为1.000(图9C)。通过热图可视化展示了定量逆转录PCR验证与GSE117261数据集之间表达方向的一致性(图9D)。由于拟合和评估均使用相同的40个样本,该结果反映的是样本内的表观性能。在使用L2正则化逻辑回归模型进行的100次分层五折交叉验证中,合并的跨折AUC仍为1.000(95% CI,1.000–1.000),每次重复的AUC均为1.000。尽管模型内部稳定性良好,但队列规模较小,仍需进行独立的前瞻性验证。与GSE117261的方向性比较显示,CXCL10、JUN、IFIH1和MX1的表达变化方向一致,但TLR7的变化方向不一致(图9D)。
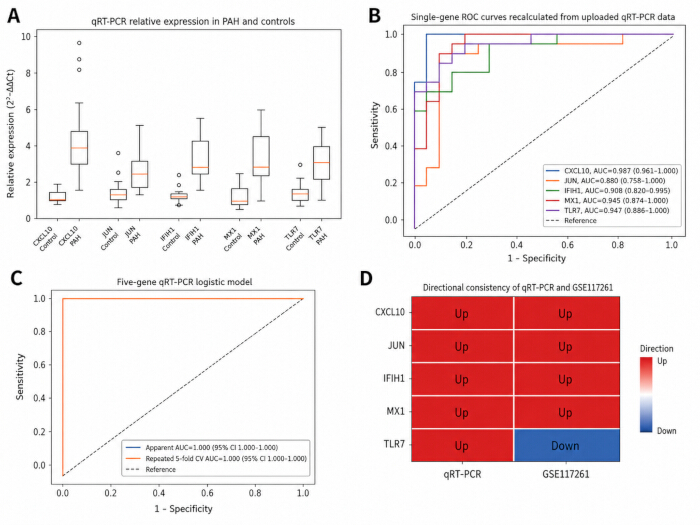
图9:定量反转录 PCR 验证结果。(A)箱线图显示了20个生物学独立的肺动脉高压(PAH)肺组织样本和20个生物学独立的对照样本中 CXCL10、JUN、IFIH1、MX1 和 TLR7 的相对表达水平。每个生物学样本均进行三次技术重复检测,分析时采用平均 Ct 值。每个箱线图中,中心线代表中位数,方框代表四分位距,须线延伸至四分位距的1.5倍,须线以外的单独数据点为离群值。(B)基于qRT-PCR表达值的单基因ROC曲线;图中显示曲线下面积(AUC)及DeLong法计算的95%置信区间。(C)五基因逻辑回归模型的ROC曲线,展示模型在样本内( apparent/in-sample)的表现以及基于100次重复分层五折交叉验证的汇总样本外(pooled out-of-fold)表现。(D)qRT-PCR与GSE117261数据集之间表达方向一致性的热图;其中CXCL10、JUN、IFIH1和MX1表达变化方向一致(上调),而TLR7则不一致。请点击此处查看该图的放大版本。
| 基因/模型 | PAH n | 对照组 n | 对照组 2^-ΔΔCt,均值 ± 标准差 | PAH 2^-ΔΔCt,均值 ± 标准差 | 方向 | P 值 | 错误发现率 | AUC | AUC 95% CI | 约登截断值 | Sensi- 活性 | 特异性- 城市 | 验证类型 | ||||
| CXCL10 | 20 | 20 | 1.099 ± 0.502 | 3.470 ± 1.043 | 上调 | 1.43E-07 | 7.15E-07 | 0.987 | 0.961–1.000 | 2.028 | 1 | 0.95 | 单基因qRT-PCR分析 | ||||
| JUN | 20 | 20 | 1.158 ± 0.738 | 2.560 ± 1.609 | 上调 | 4.17E-05 | 4.17E-05 | 0.88 | 0.758–1.000 | 1.423 | 0.85 | 0.9 | 单基因qRT-PCR分析 | ||||
| IFIH1 | 20 | 20 | 1.091 ± 0.440 | 2.760 ± 1.398 | 上调 | 1.10E-05 | 1.38E-05 | 0.908 | 0.820–0.995 | 1.579 | 0.8 | 0.85 | 单基因qRT-PCR分析 | ||||
| MX1 | 20 | 20 | 1.132 ± 0.582 | 2.650 ± 1.085 | 上调 | 1.58E-06 | 2.63E-06 | 0.945 | 0.874–1.000 | 1.779 | 0.9 | 0.9 | 单基因qRT-PCR分析 | ||||
| TLR7 | 20 | 20 | 1.080 ± 0.444 | 2.580 ± 1.284 | 上调 | 1.37E-06 | 2.63E-06 | 0.947 | 0.886–1.000 | 1.764 | 0.85 | 0.9 | 单基因qRT-PCR分析 | ||||
| 五基因模型(表观/样本内) | 20 | 20 | 不适用 电缆 | 不适用 电缆 | 不适用 | / | / | 1 | 1.000–1.000 | 0.998 | 1 | 1 | 用于模型拟合与评估的相同40个生物学样本 | ||||
| 五基因模型(100次重复的5折交叉验证) | 20 | 20 | 不适用 电缆 | 不适用 电缆 | 不适用 | / | / | 1 | 1.000–1.000 | 0.716 | 1 | 1 | 使用 L2 正则化逻辑回归进行内部交叉验证 | ||||
表5:CXCL10、JUN、IFIH1、MX1和TLR7的完整qRT-PCR表达及ROC分析结果,包括五基因联合模型分析。 该表格报告了肺动脉高压(PAH)组和对照组的样本量、相对表达值、表达方向、P值、经假发现率校正的值、AUC值、95%置信区间、约登指数截断值、敏感性、特异性以及各单个基因和联合模型的验证类型。
在 GSE210248 中进行单细胞转录组学验证
GSE210248 通过显示肺动脉高压(PAH)肺动脉重塑伴随免疫细胞与血管结构细胞之间通讯的改变,提供了单细胞水平的机制支持。该发现与整体转录组中炎症反应、趋化因子信号通路、Toll样受体信号通路以及肿瘤坏死因子信号通路的富集结果一致。
单细胞证据表明,肺动脉高压(PAH)肺动脉信号网络向结构细胞(包括平滑肌细胞和成纤维细胞)发生转移。平滑肌细胞表现出多种状态,包括氧感知/周细胞样、收缩型、合成型以及成纤维细胞样状态。这些结果支持一种疾病模型,即免疫-炎症激活与血管结构细胞重塑共同驱动肺动脉高压(PH/PAH)的进展。
候选化合物筛选与分子对接
Connectivity Map 筛选结果显示,在排名前十的候选化合物中,BRD-K91900765 的排名最高,其 Logit 得分为 10.13,预测概率为 0.085(图 10)。化合物注释表明,BRD-K91900765 对应 VX-745/neflamapimod,是一种选择性 p38α/MAPK14 抑制剂,PubChem 化合物编号为 3038525,分子质量为 436.27 g/mol(表 6)。
BRD-K91900765/VX-745 与五种生物标志物相关蛋白的探索性对接结果显示,CXCL10 的最佳 Vina 得分为 -7.5 kcal/mol,JUN 为 -7.6 kcal/mol,IFIH1 为 -7.5 kcal/mol,MX1 为 -8.7 kcal/mol,TLR7 为 -8.1 kcal/mol(表 7–11;图 11A–E)。这些结果仅表明预测的结构相容性,并未证实这五种蛋白为该化合物的直接药理学靶点。初步的吸收、分布、代谢、排泄和毒性预测表明,该化合物具备多种类药性质,但其相对较高的计算 cLogP 值仍需进一步评估(表 12)。为提供阳性对照参考,研究同时进行了针对已知 VX-745 靶点 MAPK14/p38α(PDB ID: 1OUK)的对接分析。其中,最佳的 MAPK14 腔穴 C1 的 Vina 得分为 -7.9 kcal/mol,腔穴体积为 3560 Å3,对接盒中心坐标为 (2, 22, 34),尺寸为 (22, 31, 31)(表 13;图 11F)。
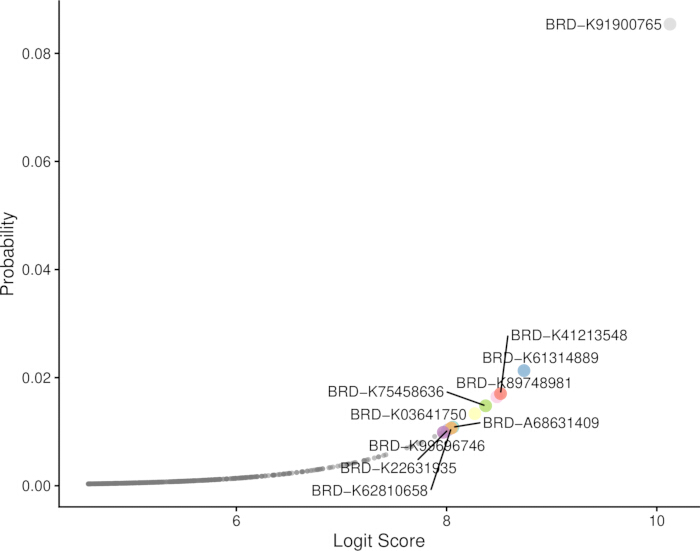
图 10: Connectivity Map 候选化合物排序。 通过 Connectivity Map 筛选鉴定出的候选化合物排序结果。BRD-K91900765 为排名最高的化合物,其 Logit 分数为 10.13,预测概率为 0.085。 请点击此处查看该图的放大版本。
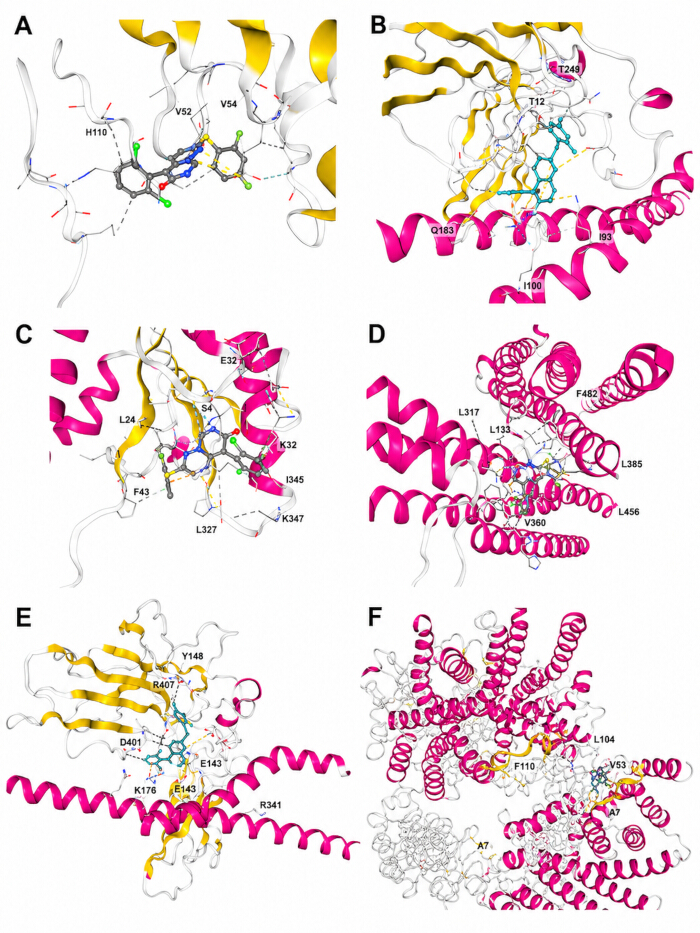
图 11:BRD-K91900765/VX-745 的三维分子对接图。(A)与 CXCL10 的探索性对接。(B)与 JUN 的探索性对接。(C)与 IFIH1 的探索性对接。(D)与 MX1 的探索性对接。(E)与 TLR7 的探索性对接。(F)与已知药理学靶点 MAPK14/p38α(PDB ID: 1OUK)的阳性对照对接。图 A–E 显示了预测的结构相容性,但并未确立直接的药理学靶向作用。请点击此处查看该图的放大版本。
| 项目 | 描述 |
| CMap/Broad ID | BRD-K91900765(常见批次格式:BRD-K91900765-001-xx-x) |
| 通用名/别名 | VX-745; neflamapimod; VRT-031745; VD-31745 |
| 化学名称 | 5-(2,6-二氯苯基)-2-(2,4-二氟苯基)硫代嘧啶并[1,6-b]哒嗪-6-酮 |
| PubChem CID | 3038525 |
| CAS编号 | 209410-46-8 |
| 分子式 / 相对分子质量 | C19H9Cl2F2N3OS; 436.27 g/mol |
| 标准SMILES | C1=CC(=C(C(=C1)Cl)C2=C3C=CC(=NN3C=NC2=O)SC4=C(C=C(C=C4)F)F)Cl |
| InChIKey | VEPKQEUBKLEPRA-UHFFFAOYSA-N |
| 已知主要药理学靶点 | MAPK14/p38α;也有报道称对p38β具有抑制作用,但选择性低于p38α |
表6:BRD-K91900765/VX-745的化学与药理学信息。 该表格总结了化合物BRD-K91900765/VX-745的化合物标识符、别名、化学名称、分子式、分子量、结构描述符及其已知的药理学靶点。
| CurPocket ID | Vina 评分 (kcal/mol) | 空腔体积 (ų) | 中心坐标 (x, y, z) | 对接尺寸 (x, y, z) |
| C1 | -7.5 | 7568 | 49, 15, 4 | 34, 33, 35 |
| C4 | -7 | 160 | 46, 0, 4 | 22, 22, 22 |
| C3 | -6 | 208 | 34, 15, 9 | 22, 22, 22 |
| C2 | -5.8 | 465 | 45, -6, 19 | 22, 22, 22 |
| C5 | -5.1 | 150 | 63, 0, 20 | 22, 22, 22 |
表7:BRD-K91900765/VX-745 与 CXCL10(PDB ID: 1LV9)的预测对接口袋。 该表格列出了由 CB-Dock2 生成的排序后的空腔标识符、Vina 评分、空腔体积、对接盒中心位置及对接盒尺寸。
| CurPocket ID | Vina 评分 (kcal/mol) | 空腔体积 (ų) | 中心坐标 (x, y, z) | 对接尺寸 (x, y, z) |
| C3 | -7.6 | 1593 | 26, 35, 70 | 22, 22, 22 |
| C2 | -7.5 | 1927 | 25, 21, 60 | 35, 22, 22 |
| C1 | -7.4 | 5420 | 32, 37, 48 | 35, 22, 31 |
| C5 | -6 | 464 | 26, 5, 48 | 22, 22, 22 |
| C4 | -5.3 | 683 | 59, 32, 39 | 22, 22, 22 |
表8:BRD-K91900765/VX-745 与 JUN(PDB ID: 1JUN)的预测对接口袋。 该表格列出了由 CB-Dock2 生成的排序后的空腔标识符、Vina 评分、空腔体积、对接盒中心位置及对接盒尺寸。
| CurPocket ID | Vina 评分 (kcal/mol) | 空腔体积 (ų) | 中心坐标 (x, y, z) | 对接尺寸 (x, y, z) |
| C1 | -7.5 | 583 | 15, 4, 17 | 22, 22, 22 |
| C3 | -7.2 | 146 | 19, 21, 24 | 22, 22, 22 |
| C4 | -6.6 | 141 | 31, 19, 15 | 22, 22, 22 |
| C2 | -6.2 | 273 | 38, 9, 24 | 22, 22, 22 |
| C5 | -6.2 | 125 | 27, -7, 10 | 22, 22, 22 |
表9:BRD-K91900765/VX-745 与 IFIH1(PDB ID: 3B6E)的预测对接口袋。 该表格列出了由 CB-Dock2 生成的排序后的空腔标识符、Vina 评分、空腔体积、对接盒中心坐标及对接盒尺寸。
| CurPocket ID | Vina 评分 (kcal/mol) | 空腔体积 (ų) | 中心 (x, y, z) | 对接尺寸 (x, y, z) |
| C1 | -8.7 | 523 | -18, -14, -5 | 22, 22, 22 |
| C4 | -7.3 | 262 | -13, -6, -9 | 22, 22, 22 |
| C3 | -7 | 306 | 12, 12, -7 | 22, 22, 22 |
| C2 | -6.9 | 408 | -3, 1, -12 | 22, 22, 22 |
| C5 | -6.2 | 179 | 24, 25, 13 | 22, 22, 22 |
表10:BRD-K91900765/VX-745与MX1(PDB ID: 5GTM)的预测对接口袋。 该表格列出了由CB-Dock2生成的按优先级排序的空腔标识符、Vina评分、空腔体积、对接盒中心位置及对接盒尺寸。
| CurPocket ID | Vina 评分 (kcal/mol) | 空腔体积 (ų) | 中心坐标 (x, y, z) | 对接尺寸 (x, y, z) |
| C2 | -8.1 | 7347 | 112, 137, 148 | 33, 28, 35 |
| C3 | -8.1 | 2604 | 124, 124, 176 | 30, 22, 22 |
| C1 | -8 | 7676 | 137, 112, 148 | 34, 29, 35 |
| C5 | -6.9 | 1976 | 117, 157, 88 | 22, 22, 22 |
| C4 | -6.6 | 2040 | 132, 92, 91 | 22, 22, 22 |
表11:BRD-K91900765/VX-745与TLR7(PDB ID: 7CYN)的预测对接口袋。 该表格列出了由CB-Dock2生成的按优先级排序的空腔标识符、Vina评分、空腔体积、对接盒中心位置及对接盒尺寸。
| 类别 | 参数 | 结果 | 解释 |
| 理化性质 | 分子量 | 436.27 g/mol | 低于 500 Da,符合 Lipinski 分子量阈值 |
| 理化性质 | cLogP | 约 5.49 | 略高于 5,提示具有较高脂溶性,需考虑溶解度和非特异性结合问题 |
| 理化性质 | TPSA | 约 47.26 Ų | 极性表面积较低,与潜在良好的膜通透性一致 |
| 类药性 | HBA/HBD | May-00 | 符合 Lipinski 对氢键受体和供体的阈值要求 |
| 类药性 | 可旋转键数 | 3 | 构象柔性较低,有利于形成稳定的结合构象 |
| 结构警示 | PAINS/Brenk 警示 | 未检出 | 未检测到常见的全筛干扰或反应性结构警示基团 |
| 毒性预测 | Ames 致突变性 | 预测为非 Ames 毒性 | 提示预测致突变风险较低;仍需实验验证 |
| 毒性预测 | 致癌性 | 预测为非致癌性 | 提示预测长期致癌风险相对较低;仍需实验验证 |
| 药代动力学说明 | 口服生物利用度/入脑性 | 文献和数据库表明该小分子可口服给药并具有入脑能力 | 与其作为 p38α 抑制剂的开发背景一致;针对 PH 适应症仍需重新评估 |
表12:BRD-K91900765/VX-745的初步理化性质、类药性、ADMET及毒性预测。 本表总结了预测的理化性质、类药性指标、结构警示、毒性终点以及药代动力学特征。这些计算预测结果为初步数据,不能替代实验性的药代动力学或毒理学验证。
| CurPocket ID | Vina 评分 (kcal/mol) | 空腔体积 (ų) | 中心坐标 (x, y, z) | 对接尺寸 (x, y, z) |
| C1 | -7.9 | 3560 | 2, 22, 34 | 22, 31, 31 |
| C5 | -7.5 | 254 | -9, 28, 60 | 22, 22, 22 |
| C3 | -7.4 | 351 | 12, 7, 37 | 22, 22, 22 |
| C2 | -6.3 | 827 | 18, 5, 28 | 22, 22, 22 |
| C4 | -6.3 | 334 | -16, 17, 38 | 22, 22, 22 |
表13:以BRD-K91900765/VX-745与其已知药理学靶点MAPK14/p38α(PDB ID: 1OUK)的对接口袋预测结果,作为阳性对照分析。 该表格列出了使用相同对接流程对五个生物标志物相关蛋白进行分析时所生成的对接腔体编号、Vina评分、腔体体积、对接盒子中心坐标及对接盒子尺寸的排序结果。
综合发现分析和qRT-PCR结果表明,CXCL10、JUN、IFIH1、MX1和TLR7可作为与免疫-炎症失调及肺血管重塑相关的肺动脉高压(PH/PAH)候选生物标志物,尽管在独立数据集GSE117261中的验证结果对JUN最为显著,而其他基因的表现则存在差异。BRD-K91900765/VX-745是一种通过计算优先筛选出的药物重定位候选药物,其可能的作用机制为抑制MAPK14/p38α;但在得出治疗学意义结论之前,仍需进行靶点结合、细胞实验、药代动力学、毒性以及动物模型的验证。
数据可用性:
本研究中使用的所有公开转录组学数据集均可在基因表达综合数据库(Gene Expression Omnibus)中获取,登录号分别为 GSE22356、GSE33463、GSE48149、GSE117261 和 GSE210248。所有代码文件、已处理的数据集、去标识化的qRT-PCR原始数据及分析结果、模型输出结果以及分子对接的输入/输出文件均已整合至一个结构化的Zenodo知识库中。该知识库包含一份README文件,详细说明了每个文件的内容、软件及程序包版本、脚本执行顺序以及完整的可重复性操作步骤——https://zenodo.org/records/21682282
讨论
本研究建立了一种整合性且可重复的工作流程,通过整合公共转录组学数据、加权基因共表达网络分析、功能富集分析、蛋白质-蛋白质相互作用网络分析、三种机器学习算法、外部验证、单细胞转录组学解析、定量反转录PCR验证、Connectivity Map筛选以及分子对接技术,系统性地识别与肺动脉高压(PH/PAH)相关的分子生物标志物及潜在治疗化合物。CXCL10、JUN、IFIH1、MX1和TLR7被一致优先识别为核心特征基因,并共同映射到一个与免疫炎症反应及干扰素相关通路的分子轴。这些发现支持以下观点:PH/PAH不仅是一种血流动力学障碍性疾病,更是一种复杂的血管重塑疾病,涉及免疫激活、炎症信号传导、先天性核酸感知以及结构和细胞表型的改变2,5,6。
五种基因的诊断潜力得到了多种算法特征筛选和发现队列ROC分析的支持。在GSE117261中的独立验证结果呈现异质性而非一致性:JUN达到了预设的FDR和AUC标准,CXCL10显示出方向一致的名义上升趋势,但在全转录组水平上未达到FDR显著性,IFIH1和MX1的重复性有限,而TLR7则表现出方向不一致。这些结果不支持所有五种基因均获得独立验证的结论,并提示队列构成、组织异质性、平台差异和疾病严重程度可能对结果产生影响。相比之下,在20例肺动脉高压(PAH)患者和20例对照肺组织样本中进行的qRT-PCR验证证实,这五种基因均显著上调,且单基因ROC表现良好。
五基因qRT-PCR逻辑回归模型获得了1.000的表观AUC值(95% CI,1.000–1.000),在100次重复的分层五折交叉验证分析中,其合并的组外AUC值仍保持为1.000。然而,该模型仅基于40个生物学样本开发,小样本回顾性队列中可能出现完全分离现象,从而导致性能评估结果过于乐观且不稳定。因此,该检测组合应被视为一种探索性分子标志物,而非经过临床验证的诊断工具。在实现临床转化之前,尚需更大规模的多中心队列研究、预设的固定模型系数、蛋白质水平验证、免疫组织化学分析以及前瞻性验证。
在五个核心基因中,CXCL10 可能促进免疫细胞向肺血管微环境的募集以及局部炎症的放大。IFIH1 和 TLR7 参与先天性核酸感应,可能反映了抗病毒样炎症通路的激活。MX1 是一种经典的干扰素刺激基因,可能代表 I 型干扰素通路激活的下游标志物。JUN 是一种应激反应性转录因子,可将炎症刺激与细胞增殖、凋亡及组织重塑过程相联系。这些基因共同提示了一个生物学上连贯的模型,即在肺动脉高压(PH/PAH)中,先天免疫激活和干扰素相关信号通路与血管重塑过程相互作用。该解释与既往证据一致,即炎症、免疫及干扰素相关通路参与了 PAH 的病理生物学过程2,5,6。
单细胞验证为基于组织整体的研究发现提供了机制性解释。GSE210248 数据表明,肺动脉高压(PAH)中的肺动脉重塑伴随免疫细胞与血管结构细胞(包括平滑肌细胞、成纤维细胞、内皮细胞以及单核细胞/巨噬细胞)之间相互作用的改变。多种平滑肌细胞表型状态的存在,如收缩型、合成型、氧感知/周细胞样以及成纤维细胞样表型,支持一种疾病模型,即免疫激活与细胞结构重塑同时发生。这一细胞层面的证据至关重要,因为组织整体转录组信号的变化可能源于细胞比例的改变、免疫细胞浸润,或驻留血管细胞的转录水平变化。因此,单细胞分析将 CXCL10、JUN、IFIH1、MX1 和 TLR7 定位于一个多细胞参与的肺血管重塑生态系统中,而非局限于单一细胞类型的过程18,19,20,21。
药物重定位分析鉴定出 BRD-K91900765,即 VX-745/neflamapimod,为排名最高的计算候选药物。VX-745 是一种选择性 p38α/MAPK14 抑制剂,其与炎症应激通路的关系使其在肺动脉高压(PH/PAH)相关炎症背景下具有合理的机制可行性30。因此,针对 MAPK14/p38α 的分子对接被纳入作为具有机制相关性的阳性对照分析。相比之下,针对 CXCL10、JUN、IFIH1、MX1 和 TLR7 的对接分析属于探索性质,仅提示预测的结构相容性;并未证明这些生物标志物相关蛋白是 VX-745 的直接靶点,也未证实其直接结合、靶点抑制或治疗效果。一个更具生物学合理性的假设是,VX-745 可能通过抑制 MAPK14 间接调控所鉴定出的免疫炎症及干扰素相关转录特征。 Connectivity Map 预测结果、对接评分及 ADMET 估算均属于计算层面的证据。后续研究应包括生化靶点结合实验、肺动脉内皮细胞和血管平滑肌细胞实验、炎症刺激模型、药代动力学与毒理学评估,以及动物模型验证。
缺氧性肺动脉高压的近期实验研究也强调了中性粒细胞与肺血管细胞之间相互作用的重要性。已有研究报道,中性粒细胞与肺动脉平滑肌细胞之间的HCK介导相互作用,以及中性粒细胞与内皮细胞之间的SERPINB3介导相互作用,均参与了肺血管重塑过程31˒32。SERPINB3–STAT1/3轴尤其与本研究结果密切相关,因为在转录组学分析中发现了与干扰素相关的STAT1信号以及JAK–STAT信号通路。综合来看,这些发现支持以下解释:免疫细胞的活化及其与血管结构细胞的相互作用可能促进了肺动脉高压(PH/PAH)的进展。
本研究具有多项优势。研究采用了多个公共数据集并进行了批次效应校正,以降低特定数据集带来的偏倚。通过结合差异表达分析、加权基因共表达网络分析、蛋白质-蛋白质相互作用分析以及三种机器学习算法,提高了特征的稳健性。独立的批量验证、qRT-PCR验证以及单细胞证据提供了互补但不完全相同的多层证据。然而,GSE117261数据集结果的异质性以及qRT-PCR队列样本量较小,也凸显了若干重要局限性,包括外部重复验证不充分、潜在的组织特异性和平台特异性效应,以及过拟合风险。研究还将生物标志物的发现拓展至候选化合物筛选,但分子对接分析仍仅为提出假设。未来研究应在更大规模的独立队列中,利用空间转录组学、蛋白质组学、免疫组织化学以及类器官或芯片血管模型,对这五个基因进行验证。总体而言,CXCL10、JUN、IFIH1、MX1和TLR7仍是与免疫炎症及干扰素相关血管重塑相关的肺动脉高压/肺动脉高压候选生物标志物,而BRD-K91900765/VX-745则是一个通过计算药物重定位预测的候选化合物,其治疗相关性尚需实验验证。
披露
作者声明无竞争利益。
致谢
本研究由湖南省创新省份建设项目(编号:2022JJ30465)资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 2× SYBR Green PCR Mastermix | 北京索莱宝科技有限公司 & 有限公司 | 目录号 SR1110 | 基于染料的定量实时PCR扩增与荧光检测 |
| AI21.msvmRFE.R 和 e1071 | 自定义 R 脚本,使用 CRAN e1071 包 | AI21.msvmRFE.R;e1071 v1.7-17 | 支持向量机-递归特征消除 |
| 琼脂糖 | 北京索莱宝科技有限公司 & 有限公司 | 目录号 A8201;CAS 9012-36-6 | 通过琼脂糖凝胶电泳评估总RNA完整性 |
| 琼脂糖凝胶电泳装置 | 北京六一生物科技有限公司 | Model DYCZ-24DN | RNA完整性电泳评估 |
| AutoDock Vina 评分引擎 | 斯克里普斯研究所计算结构生物学中心 | v1.2.0;RRID:SCR_011958 | CB-Dock2 工作流程中的蛋白质-配体构象评分 |
| CB-Dock2 | 曹实验室,CB-Dock2 网络服务器 | v2.0;访问时间:2026年7月 | 盲腔检测及VX-745与选定蛋白质结构的分子对接 |
| CellChat | CellChat R 软件包 | v2.1.2 | 从单细胞表达矩阵推断与可视化细胞间通讯 |
| CellChatDB.human | 随 CellChat R 软件包分发 | CellChatDB.human;分泌信号通路子集;最小细胞数阈值 = 10 | 用于 CellChat 的人类配体-受体相互作用数据库 |
| clusterProfiler | Bioconductor R 软件包 | v4.20.0;Bioconductor 版本 3.23 | 基因本体论与京都基因与基因组百科全书富集分析 |
| 连接图谱(Connectivity Map,CMap/CLUE) | 布罗德研究所 | L1000/CLUE 资源;RRID: SCR_016204;2026年7月访问 | 计算药物重定位分析 |
| 定制寡核苷酸引物 | 北京索莱宝科技有限公司 & 有限公司 | 定制合成;引物序列见表2 | ACTB、CXCL10、JUN、IFIH1、MX1 和 TLR7 的扩增 |
| cytoHubba | Cytoscape 应用商店 | v0.1 | 基于度的蛋白质相互作用网络中枢纽基因排序 |
| Cytoscape | Cytoscape 联盟 | v3.10.4;RRID:SCR_003032 | 蛋白质-蛋白质相互作用网络的可视化与分析 |
| DrugBank | DrugBank 知识库 | v6.0;RRID:SCR_002700 | 化合物鉴定与药理学信息整理 |
| 凝胶成像系统 | 北京六一生物科技有限公司 | Model WO-9413B | 琼脂糖凝胶RNA完整性结果的可视化与记录 |
| 基因表达综合数据库(GEO) | 国家生物技术信息中心 | GSE22356、GSE33463、GSE48149、GSE117261 和 GSE210248;RRID: SCR_005012 | 获取批量和单细胞转录组数据集 |
| GEOquery | Bioconductor R 包 | v2.80.0;Bioconductor 版本 3.23 | GEO表达数据与表型数据的程序化下载与导入 |
| glmnet | CRAN R 软件包 | v5.0 | 最小绝对收缩与选择算子逻辑回归及正则化逻辑建模 |
| limma | Bioconductor R 软件包 | v3.68.0;Bioconductor 版本 3.23;RRID: SCR_010943 | 差异表达分析与经验贝叶斯统计 |
| NanoDrop 分光光度计 | 赛默飞世尔科技 | NanoDrop ND-1000;软件 v3.8 | RNA浓度及A260/280、A260/230纯度比值的测定 |
| NCBI 引物-BLAST | 国家生物技术信息中心 | 网络工具;RRID: SCR_003095;访问时间:2026年7月 | 引物特异性验证 |
| pROC | CRAN R 软件包 | v1.19.0.1;RRID: SCR_024286 | 受试者工作特征曲线分析、DeLong 置信区间和 Youden 指数截断值 |
| 蛋白质数据库(PDB) | RCSB 蛋白质数据库 | CXCL10:1LV9;JUN:1JUN;IFIH1:3B6E;MX1:5GTM;TLR7:7CYN;MAPK14/p38α: 1OUK; RRID: SCR_012820 | 实验测定蛋白质结构的获取及其在分子对接中的应用 |
| PubChem | 国家生物技术信息中心 | PubChem CID 3038525;RRID:SCR_004284 | BRD-K91900765/VX-745 三维结构及化学标识符的获取 |
| R | R 统计计算基金会 | v4.6.1;RRID:SCR_001905 | 统计计算、数据处理、机器学习与可视化 |
| randomForest | CRAN R 软件包 | v4.7-1.2 | 随机森林特征选择与变量重要性排序 |
| 实时荧光定量PCR系统 | Stratagene,现为 Agilent Technologies | Mx3000P 实时荧光定量 PCR 系统 | qRT-PCR 扩增、荧光采集、熔解曲线分析和 Ct 值导出 |
| Seurat | CRAN R 软件包;Satija 实验室 | v5.5.1;RRID:SCR_016341 | 单细胞RNA测序质量控制、标准化、降维、聚类与注释 |
| STRING | STRING 联盟 | v12.0;RRID:SCR_005223 | 蛋白质-蛋白质相互作用网络构建 |
| sva(ComBat) | Bioconductor R 软件包 | v3.60.0;Bioconductor 版本 3.23 | 校正数据集间的批次效应 |
| SwissADME | 瑞士生物信息学研究所 | 网络服务器;访问时间:2026年7月 | 类药性、理化性质及ADME预筛 |
| 总RNA提取试剂盒 | 北京索莱宝科技有限公司 & 有限公司 | 目录号 R1200 | 从肺组织样本中提取和纯化总RNA |
| 通用RT-PCR试剂盒(AMV) | 北京索莱宝科技有限公司 & 有限公司 | 目录号 RP1200 | 总RNA逆转录为互补DNA |
| WGCNA | CRAN R 软件包 | v1.74 | 加权基因共表达网络构建与模块-性状分析 |
参考文献
- Simonneau G, et al. Haemodynamic definitions and updated clinical classification of pulmonary hypertension. Eur Respir J. 2019;53(1):1801913. doi: 10.1183/13993003.01913-2018.
- Rabinovitch M, Guignabert C, Humbert M, Nicolls MR. Inflammation and immunity in the pathogenesis of pulmonary arterial hypertension. Circ Res. 2014;115(1):165–175.
- Humbert M, et al. 2022 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2022;43(38):3618–3731.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Respir J. 2015;46(4):903–975.
- Soon E, et al. Elevated levels of inflammatory cytokines predict survival in idiopathic and familial pulmonary arterial hypertension. Circulation. 2010;122(9):920–927.
- George PM, et al. Evidence for the involvement of type I interferon in pulmonary arterial hypertension. Circ Res. 2014;114(4):677–688.
- Subramanian A, et al. A next-generation Connectivity Map: L1000 platform and the first 1,000,000 profiles. Cell. 2017;171(6):1437–1452.e17.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. doi: 10.1093/nar/gkv007.
- Langfelder P, Horvath S. WGCNA: an R package for weighted correlation network analysis. BMC Bioinformatics. 2008;9:559. doi: 10.1186/1471-2105-9-559.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–287.
- Kanehisa M, Goto S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 2000;28(1):27–30.
- Szklarczyk D, et al. The STRING database in protein–protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638–D646.
- Friedman J, Hastie T, Tibshirani R. Regularization paths for generalized linear models via coordinate descent. J Stat Softw. 2010;33(1):1–22.
- Guyon I, Weston J, Barnhill S, Vapnik V. Gene selection for cancer classification using support vector machines. Mach Learn. 2002;46:389–422.
- Breiman L. Random forests. Mach Learn. 2001;45(1):5–32.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. doi: 10.1186/s12859-011-0077-8.
- Stearman RS, et al. Systems analysis of the human pulmonary arterial hypertension lung transcriptome. Am J Respir Cell Mol Biol. 2019;60(6):637–649.
- Crnkovic S, et al. Single-cell transcriptomics reveals skewed cellular communication and phenotypic shift in pulmonary artery remodeling. JCI Insight. 2022;7(20):e153471. doi: 10.1172/jci.insight.153471.
- Hao Y, et al. Integrated analysis of multimodal single-cell data. Cell. 2021;184(13):3573–3587.e29.
- Jin S, et al. Inference and analysis of cell–cell communication using CellChat. Nat Commun. 2021;12(1):1088. doi: 10.1038/s41467-021-21246-9.
- Bustin SA, et al. MIQE 2.0: revision of the Minimum Information for Publication of Quantitative Real-Time PCR Experiments guidelines. Clin Chem. 2025;71(6):634–651.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2−ΔΔCt method. Methods. 2001;25(4):402–408.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51(D1):D1373–D1380.
- Knox C, et al. DrugBank 6.0: the DrugBank Knowledgebase for 2024. Nucleic Acids Res. 2024;52(D1):D1265–D1275.
- Daina A, Michielin O, Zoete V. SwissADME: a free web tool to evaluate pharmacokinetics, drug-likeness, and medicinal chemistry friendliness of small molecules. Sci Rep. 2017;7:42717. doi: 10.1038/srep42717.
- Burley SK, et al. RCSB Protein Data Bank: powerful new tools for exploring 3D structures of biological macromolecules for basic and applied research and education. Nucleic Acids Res. 2021;49(D1):D437–D451. doi: 10.1093/nar/gkaa1038.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891–3898. doi: 10.1021/acs.jcim.1c00203.
- Liu Y, et al. CB-Dock2: improved protein-ligand blind docking by integrating cavity detection, docking, and homologous template fitting. Nucleic Acids Res. 2022;50(W1):W159–W164. doi: 10.1093/nar/gkac394.
- Duffy JP, et al. The discovery of VX-745: a novel and selective p38α kinase inhibitor. ACS Med Chem Lett. 2011;2(10):758–763.
- Sheng Y, et al. Crocin inhibits neutrophil migration and activation to treat hypoxic pulmonary hypertension through targeting HCK. Phytomedicine. 2025;148:157334. doi: 10.1016/j.phymed.2025.157334.
- Cui H, et al. Leonurine ameliorates hypoxic pulmonary hypertension by inhibiting cross-talk between neutrophils and endothelial cells via SERPINB3 targeting. Int Immunopharmacol. 2026;176:116467. doi: 10.1016/j.intimp.2026.116467.