本方案通过去标识化、术语规范化、来源验证和可重复可视化,从真实世界中医门诊记录中生成可审计的汇总结果。
方法文章
利用合甘健脾方对真实世界中医病例记录进行源数据审核的挖掘与可视化研究
* These authors contributed equally
本文内容
摘要
摘要
真实的中医门诊记录包含诊断、证候要素、症状描述及个体化处方的纵向信息,但其半结构化格式使可重复分析变得复杂。本文介绍了一种经过源数据审核的方案,用于将去标识化的病例记录转化为可追溯的汇总表格和适合发表的可视化结果。该工作流程定义了纳入标准和分析单元,保留原始术语与标准化术语之间的映射关系,验证所有报告的分子和分母数据,并基于版本化的源表格重新生成图表。应用于2015年1月至2024年6月期间的记录时,该方案共识别出396名患者的555次符合条件的处方就诊。最终数据集包含324个标准化中药标签和9,339次中药使用记录。该工作流程生成了并行的西医与中医疾病谱、明确的证候要素谱及共现矩阵、中药使用频率与药材特征谱、基于病史提取的37项症状谱、15条有向关联规则、层次聚类结果以及按诊断分层的中药使用热图。在474次就诊中(占85.41%)检测到至少一个预设的病史关键词。在机构政策允许的情况下,可采用人工监督的人工智能(AI)辅助进行术语核查、跨文件一致性审查及图注与图像的对齐。任何AI的使用均须在独立的审计记录中予以说明,且不得替代原始数据的审阅。通过将数据治理、术语标准化、计算分析、临床解读与可视化输出整合为一个可重复的工作流程,该方法将分散的临床记录转化为可审查的研究资源。该方案可推广至其他专家临床实践数据集、多中心术语项目以及前瞻性临床数据平台。
引言
真实世界中的中医门诊记录通过叙述性症状、并行的诊断体系、证候描述以及个体化处方保留了纵向的临床思维过程。早期的知识发现研究已认识到,病例记录属于复杂的经验性数据,在能够可靠地研究其模式之前,需要专门的信息学方法1。后续研究表明,同义症状表达、细粒度实体以及本地记录的诊断术语必须在不抹除原始表述的前提下进行标准化2,3,4,5,6。当临床背景和数据来源清晰可追溯时,电子健康记录(EHR)数据还可支持处方的计算研究及可复用分析工具的应用7,8。因此,需要权威的中药学参考资源,以规范中药名称、炮制形式、药性、药味及归经等信息9,10。在报告层面,RECORD 和 STROBE 声明要求对数据来源、纳入标准、变量定义和分析决策进行透明化描述,而 FAIR 原则则强调研究对象的可追溯性和可复用性11,12,13。当记录中包含重复就诊、缺失字段、术语重叠和自由文本时,这些考量尤为重要。适用性评估必须涵盖完整性、合规性、合理性以及来源一致性14,15。自由文本的去标识化同样需要明确的操作流程和人工审核,因为自动化方法虽可保留有用的临床内容,但仍可能遗留隐私风险16,17,18。
在确立治理框架和术语体系后,频率分析、关联规则挖掘和层次聚类可提供关于处方结构的互补性视角19,20,21。网络分析与科学绘图方法进一步表明,协调一致的可视化表征能够揭示单个排序列表无法捕捉的关系22,23,24,25。近期关于类风湿关节炎合并抑郁、溃疡性结肠炎中使用JAK抑制剂以及类风湿关节炎合并纤维肌痛的研究,展示了版本锁定的检索标准、共现网络、聚类分析、时间序列解释以及对分析局限性的明确陈述所具有的价值26,27,28。本研究将这些可迁移的设计原则应用于临床记录挖掘,而非文献计量学分析。在原始记录中,“和肝健脾方”指代一种与姚乃礼教授临床实践相关联的经验方29,30。相关出版物描述了他更广泛的调和肝脾及调理脾胃的临床思路29,30。在本文中,该方剂名称仅用于标识源记录的上下文,不构成对其固定组成、剂量、治疗适应证或疗效主张的确认。计算流程采用确定性规则和通用统计方法。可重复的计算实践还需保留输入数据、记录参数设置、脚本化数据转换过程以及可审查的输出结果31,32。在记录使用过程的前提下,可引入人工监督的人工智能(AI)辅助进行术语核查、跨文件一致性审查和可视化质量控制。临床专业判断、隐私保护措施以及可问责的人类决策必须始终居于主导地位(补充表1)33,34。本方法的总体目标是将去标识化的中医病例记录转化为经过来源审核的、按疾病、证候、症状、中药使用、关联性、聚类及诊断分层的输出链条。示例部分基于396名患者的555次合格处方就诊记录,演示如何整合治理、标准化、计算、临床解读与可视化发布,同时不披露患者个体记录、确切配方细节、剂量比例或处方指导信息。
方案
本研究对去标识化的临床记录进行回顾性分析,已通过中国中医科学院广安门医院医学伦理委员会审查并批准(批件号:2026-108-KY;2026年7月13日)。伦理委员会已豁免知情同意要求。
1. 建立伦理、治理与数据安全机制
- 指定数据管理员、源数据分析师、临床术语审核员、定量审核员以及有权批准汇总数据发布的研究人员。在项目日志中记录每个角色。
- 制定数据管理计划,明确允许使用的源系统、研究时段、字段范围、存储位置、访问权限、备份流程、保存期限以及链接密钥的使用限制。
- 仅导出预设分析所需的最少变量。包括本地患者标识符、就诊日期、在允许情况下提供的年龄或出生日期、性别、西医诊断、中医病名、去标识化的病史文本、舌象文本、脉象文本、证候文本以及处方-中药字段。
- 在受控的机构环境中删除姓名、身份证号码、电话号码、详细地址、保险标识、联系信息及其他直接标识信息。将每个病历号替换为项目专用的患者标识符。
- 对自由文本字段进行扫描,查找残留的标识信息,并对所有检测到的项目进行遮蔽处理。将任何链接密钥与分析数据集分开存储,并从工作目录、协作文件夹和提交文件夹中排除。
- 将初始去标识化导出文件作为只读源快照予以保留。在源文件清单中记录其文件名、创建日期、行数、列数、文件大小和校验和。
- 分别为源文件、工作文件、字典、汇总表、图表、脚本和审计记录创建独立的目录。
- 仅允许发布或共享汇总表、经批准的去标识化字典、脚本和出版用图表。不得将可识别或可能被重新识别的记录上传至公共生成式人工智能系统、未经批准的云服务或公共存储库。
注意:当机构政策允许人工监督下使用人工智能辅助时,仅提供去标识化的文本片段或汇总表。在审计日志中记录使用目的、审核后的输出内容、采纳的修改、审核人及日期。
2. 定义记录识别规则和分析单元
- 在筛选前明确机构、门诊环境、负责的临床团队、电子病历系统及数据来源时间段。以本实例为例,使用2015年1月到2024年6月期间的记录。
- 在查看分析结果之前,将队列识别规则存储于受控的、版本管理的文件中。记录可接受的术语变体以及所有纳入和排除条件,但不得在稿件中披露保密的规则制定细节。
- 在完成草药名称标准化后,以处方-就诊层级应用版本锁定的记录识别规则。将源文件、词典、队列规则和分析参数最终确定为一个完整的发布版本集合。
- 每当任一版本锁定组件发生变更时,创建新版本并重新生成所有依赖性输出。在查看疾病分布、草药频率、关联规则或聚类结果后,不得修改队列识别规则。
- 当一次门诊就诊发生在版本锁定的研究时间段内、可映射至有效的项目患者标识符、包含可解析的处方记录,并满足受限的记录识别规则时,将其纳入队列。
- 排除完全重复的导出记录、研究时间段外的记录、无可用处方记录的记录,以及未通过版本锁定识别规则的行。为每条被排除的记录指定一个主要的排除原因。
- 区分系统重复导出与真实的随访就诊。仅删除完全重复的系统或导出记录,保留真实的重复就诊记录。
- 为患者和处方-就诊分配稳定的标识符。创建一个队列清单,包含源版本、规则版本、筛选状态、纳入或排除原因、患者标识符、就诊标识符以及审核状态。
- 对于固定的 demographics 汇总(包括年龄和性别),每个唯一患者仅使用一条记录。以处方就诊作为疾病、证候、病史关键词、舌象、脉象、草药、关联规则及聚类分析的分析单位。
- 将队列纳入资格与变量可用性分开处理。当某一特定变量字段缺失时,仍保留其他方面符合资格的就诊记录,并为每项分析报告可评估的分母数量。
- 在进行描述性分析前冻结队列清单。记录符合条件的处方就诊次数和唯一患者数量;若纳入资格判断发生变更,需重新生成所有依赖性输出。
3. 规范术语并保留审计追踪
- 为中药、西医诊断、中医病名、证候要素、病史关键词、舌象术语、脉象术语以及药材属性分别建立独立的版本控制词典。
- 每个词典应包含原始术语、标准化术语、术语类别、来源字段、规则、参考来源、词典版本、审核人、审核日期和备注。标准化后仍需保留所有原始术语。
- 使用权威命名参考文献9,10对中药(CMM)名称进行标准化。校正拼写变体和系统缩写,同时保留具有临床意义的炮制品形式。
- 将炒制、醋制、蜜炙、姜制、酒制、炭制和生用等炮制修饰语作为独立标签保留。
- 将字形或临床上不同的中药分别保留,不合并白芍与白术,也不在未经来源核实的情况下从模糊缩写推断药材名称。
- 在可获得时,将原始剂量和单位分别保留在独立字段中。仅在构建就诊层面的药材存在变量时才移除剂量文本。
- 不得将出现频率解释为累积剂量或治疗强度。
- 分别对西医诊断和中医病名进行标准化。保留诊断体系和主要诊断状态,除非两者均明确记录,否则不得将中医病名标签翻译为西医诊断。
- 在必要时首次使用时定义音译的中医病名标签,以帮助读者理解,同时保留原始来源标签。
- 使用版本锁定的分隔符拆分多值的明确证候文本,并将来源表达式映射至标准化的证候要素。在每次就诊内对每个标准化要素去重。
- 将明确的证候文本与继承或评分推导的指标列分开处理。
- 将原始舌象、脉象、结构化症状及去标识化病史字段作为独立的数据产品保留。不得将病史关键词匹配视为等同于临床医生录入的结构化症状。
- 每项模糊或多对一映射应由一位审阅者提出,并由第二位具有临床背景的审阅者验证。在来源审查解决之前,不确定的映射不得纳入发布的分析中。
- 检查是否存在空白的标准化标签、一对多映射、多对一映射、重复的词典条目、未审核术语以及炮制标签意外丢失等情况。在生成汇总表前冻结词典版本。
4. 验证源字段并锁定可报告的输出
- 为每项文稿声明、表格和图注面板创建一个证据台账,每一行对应一项。记录分析单位、源字段、源版本、字典版本、脚本版本、分子、分母、输出文件、审核人和批准用语。
- 直接从版本锁定的文件中重新计算符合条件的就诊次数、唯一患者数、人口统计学汇总、疾病计数、明确综合征计数、病史关键词计数、合并中药频次以及中药使用总量。
- 将每个重新计算的数值与文稿、电子表格或图示中的相应数值进行比较。一旦确认存在差异,即修正文稿并重新生成相关输出结果。
- 在源字段层面解决每一项差异。在发布受影响结果之前,于证据台账中记录差异原因、修正内容、审核人及日期。
- 核实每个汇总表是否包含再现实对应陈述所需的标准化标签、分子、分母、百分比定义、分析单位和源标识符。
- 核实每个百分比所使用的分母。对于固定的人口统计学特征,使用唯一患者数;对于动态的临床和处方变量,使用处方就诊次数。
- 将图示中的标签、数值、排序及面板定义与其版本锁定的汇总表进行比对。在汇总表修正后应重新生成图像,而非手动修改绘图数值。
- 请临床审核人验证术语映射关系,请定量分析审核人验证计数、率值、规则指标及热图分母的准确性。
- 在文稿整合前,将证据台账、汇总表和图示数据源统一锁定在一个版本标识下。
5. 生成描述性谱图和共现输出结果
- 基于每位唯一患者的单行数据,生成个体层面的年龄和性别汇总信息。保留未知类别,并明确报告。
- 在处方-就诊层面分别生成西医和中医疾病谱。保留原始诊断体系,并使用统一的就诊次数作为分母,计算主要标准化诊断标签。
- 从明确的标准化证候文本字段中生成证候要素谱。使用版本锁定的分隔符拆分术语,在每次就诊内对每个术语去重,并计算就诊层面的频次。
- 基于同一就诊内的术语集合构建证候共现矩阵。以就诊频次编码节点大小,以成对共现次数编码边的宽度或热图强度。
- 当症状信息主要为叙述性文本时,预先设定精确的病史关键词词典。仅扫描去标识化的病史字段,并在每次就诊内对每个概念计数不超过一次。
- 计算包含至少一个病史关键词的合格就诊所占比例,并对所有关键词频次进行排序。导出完整表格及用于绘图的子集。
- 基于标准化处方数据生成合并药材频次。每次就诊内每种标准化药材标签计数不超过一次,并将具有临床意义的炮制形式作为独立标签保留。
- 基于版本锁定的中药字典生成四气、五味及归经属性谱。对每个属性编码的药材,将四气视为单一取值的分类变量。
- 将五味和归经视为多标签属性。明确属性编码的分母,并保持独立的分析单位。
- 在生成最终图表前,为每个描述性分析域导出一份机器可读的汇总表格。
6. 进行关联规则与层次聚类分析
- 从版本锁定的标准化处方表中构建一个二元的“处方就诊-草药”矩阵。每个符合条件的就诊对应一行,每个标准化草药标签对应一列。
- 计算有向单草药关联规则的支持度、置信度和提升度19。保留每条规则的方向,因为置信度依赖于前件。
- 应用预设的阈值:支持度 ≥ 0.30,置信度 ≥ 0.70,提升度 > 1.0。导出每条保留规则及其共现次数和全部三项指标。
- 将所有保留的规则集绘制为有向二分规则网络和有序规则强度图谱。在网络中,以边的宽度编码支持度,以边的颜色编码提升度。
- 在有序图谱中以点的大小编码支持度,并标注置信度。
- 验证两种规则展示方式包含相同的保留规则集,并保持规则方向一致。在发布前,将每一处不一致与导出的规则表进行核对并修正。
- 选择出现频率最高的20个草药存在变量进行层次聚类。计算成对的Jaccard距离,并采用平均连接法。
- 用标准化草药名称标注系统发育树。仅将分支的接近程度解释为在就诊层面出现模式的相似性。
- 在生成图表前,导出二元矩阵定义、规则表、网络边列表、聚类输入顺序、距离矩阵和连接矩阵。
- 请一位定量评审人员手动复现其中一条规则的指标。将每一条网络边与规则表进行比对。
- 每当队列、术语词典或草药存在矩阵发生变化时,重新运行完整的规则提取与聚类工作流程。
- 对于示例分析,通过为每位患者保留最早源序记录,执行确定性的“每位患者一次就诊”敏感性分析。将得到的12条规则与基于就诊层面分析的15条规则进行比较。
- 将该变化报告为描述性稳健性结果,而非患者层面的验证。使用 补充文件1 中提供的确定性重计算结果。
7. 生成诊断分层模式及临床解读框架
- 在检查特定诊断的中药分布之前,先选择具有临床意义的主要西医诊断分层。
- 在每个诊断分层内,每次就诊对每种标准化中药标签最多计数一次。 prevalence 计算方式为:包含该标签的就诊次数除以该分层中符合条件的总就诊次数。
- 在不同诊断分层间使用相同的显示中药集合和固定的 0%–100% 颜色标度。显示单元格数值以确保精确解读。
- 在独立的汇总表格中报告每个显示单元格的分子和分母。
- 在完成描述性热图后,构建单独的临床解读面板。保持计算结果与专家解读在视觉上相互区分。
- 仅使用可追溯至版本锁定的历史关键词表或明确的标准化证候文本的术语填充提示层。
- 要求两位临床评审人员就所选提示的简明背景解读达成一致。在证据记录表中记录评审人员及最终表述。
- 将每项背景解读关联至具体的研究用途,例如变量筛选、前瞻性验证或假设生成。
- 解读层使用虚线、无方向性连接线。省略剂量、固定组方及治疗建议内容。
- 同时审阅热图与解读面板。确保计算得出的流行率、专家背景信息及未来研究用途保持清晰分离。
8. 组装并验证可重复性数据包
- 将源清单、队列清单、字典版本、证据记录、分析脚本、汇总表格、图表源文件及最终图表分别导出至独立的目录中。
- 使用稳定的图表编号和版本日期为每个文件命名。保留一个权威的当前版本,并将已废弃的输出单独归档。
- 将每个图表生成为一个包含多个子图的图像文件。导出高分辨率 PDF 文件和 300 dpi 的 PNG 文件用于审阅。
- 将图注置于文稿中,不要包含在图像文件内。需描述每个子图、分析单元、分母以及视觉编码方式。
- 为每个表格准备一个独立的 XLSX 文件。
- 请一位独立审阅者核对文稿中的数据与汇总表中的数值,以及百分比与其分子和分母的一致性。
- 比对规则边与规则表,以及热图单元格与源矩阵的一致性。
- 运行自动化检查,验证文件名一致性、必要章节的完整性、图表尺寸、表格数量、参考文献数量、模板残留内容以及受限用语。
- 请临床作者团队审阅术语使用、结果解读、知识产权边界、作者信息、资助顺序、伦理表述以及最终的整套图表。
- 从提交材料包中移除患者层面的文件、链接密钥、无限制的自由文本、内部往来通信以及临时审阅产生的中间文件。
- 冻结已发布的材料包,并记录其版本、日期、校验和、文稿版本及作者批准状态。每次后续更正均需创建新版本并生成变更日志。
结果
成功应用该方案后,生成了一个可追溯的链条,连接了去标识化的源快照、队列清单、术语词典、汇总表、脚本以及最终图表。通过版本锁定的筛选流程,从396名唯一患者中确定了555次符合条件的处方就诊记录。图1总结了该方法的三个协调阶段:治理、术语规范化以及结合临床审查的分析。相应的透明度和审计文档,包括仅限汇总数据的AI辅助审查边界,详见补充表1。
最终队列包含由396名独特患者贡献的555次符合条件的处方就诊记录(图2 和 表1)。对于真实的重复就诊,保留其动态的临床和处方变量,而年龄和性别则在患者层面去重后进行汇总。患者年龄范围为13至94岁,平均年龄为47.11岁,标准差为14.88岁。队列中包括228名女性患者(57.58%)、167名男性患者(42.17%)以及1名性别未知的患者(0.25%)。这种分析单位的划分方式在不夸大人口统计学分母的前提下,保留了纵向随访数据。
西医与中医疾病谱总结见图3。西医诊断主要集中在胃肠、肝胆及胰腺疾病。根据层次聚类分析,271次就诊归类为胃肠疾病,222次归类为肝胆或胰腺疾病,62次归类为其他系统疾病(图3A)。最常见的具体诊断为慢性胃炎(133次就诊,占23.96%)、脂肪肝(77次就诊,占13.87%)和肝硬化(46次就诊,占8.29%),其次为慢性萎缩性胃炎、腹痛、慢性乙型肝炎、消化不良、反流性食管炎、慢性浅表性胃炎及慢性胰腺炎(图3C 和 表2)。
根据平行诊断体系,对应的中医病名谱系对相同就诊记录进行了分类整理。其中,脾胃或肠道病名共280次就诊,肝胆病名223次,气血津液类病证26次,心胸头类病证12次,经络或肢体类病证5次,妇科类病证4次,其他类别5次(图3B)。"胃痞"是中医用于描述上腹胀满或不适的保留病名标签,在163次就诊中被记录(占29.37%)。"积病"(一种积聚类的原始中医病名标签)、"肝着"(字面意为肝部固定不适;一种保留的经典中医病名标签)、"痹病"(阻滞类疾病)以及"消渴"均作为原始中医病名标签予以保留,未转换为现代生物医学诊断。"肝痞"是当代中国共识中用于脂肪肝疾病的中医病名标签,在77次就诊中被记录(占13.87%)35。西医诊断与中医原始字段保持独立,彼此之间未相互替代(图3D 和 Table 3)。"泄泻"(大便稀溏或水样便)和"腹泻"为两个独立的原始中医病名标签,分别记录6次和2次,均未等同于现代生物医学诊断。将两个病名谱系并列展示,既保留了各自诊断体系的逻辑结构,也体现了原始记录的临床广度。
标准化的证候-文本字段共包含555条符合条件的就诊记录。在去除单次就诊内的重复项后,出现频率最高的证候要素为脾,见于362次就诊(65.23%);其次为肝,见于304次(54.77%);气虚见于295次(53.15%);胃见于171次(30.81%);湿见于151次(27.21%);气滞见于109次(19.64%;图4A 和 表4)。其余显示的证候谱还包括热、水停、血、血瘀、经络、肾、心及阴虚。由于单次就诊中可出现多个证候要素,因此百分比为非排他性统计。
网络图和计数矩阵均基于相同的访视层级词元集合生成(图4B、C)。高频共现症状主要围绕脾、肝和气虚,此外还与胃、湿、气滞、热和水液潴留存在关联。通过使用一个版本锁定的矩阵生成频次图、网络图和热图,确保了这三个图示在不同细节层次上均反映相同的底层证据。恢复的审计数据在555行记录中未发现任何精确的证候文本与指标匹配项,文本-指标Jaccard相似性平均为0.1806。因此,指标列未纳入实质性结果报告。保留的材料中不包含可重建的清洗前分布向量;因此,未评估跨版本的分布稳定性。单次访视每患者敏感性分析则用于考察重复访视的影响。源审计及数据质量结果汇总于补充表2中。
在完成术语标准化并保留具有临床意义的炮制品形式后,555次就诊记录中共包含324种不同的合并中药标签及9,339次中药使用记录。白芍出现在531次就诊中(95.68%),其次为茯苓(520次,93.69%)、当归(510次,91.89%)、赤芍(467次,84.14%)以及炒白术(361次,65.05%;图5A 和 表5)。前36位中药标签的频次排序曲线呈现出陡峭的高频段,随后为逐渐延展的长尾分布(图5B),清晰反映了共性用药基础与个体化处方成分的结合特征。中药命名所依据的原始名称至标准化名称的映射关系、炮制修饰语、标准中药名称、来源物种及证据边界详见补充表3。
辅助性本草字典包含9,115条具有属性编码的草药使用记录。四气类别中居前的依次为温(2,588条,28.39%)、微寒(2,339条,25.66%)、平(2,330条,25.56%)和寒(1,221条,13.40%;图5C)。在对复方来源的味觉术语进行标准化处理后,五味类别中居前的为苦(4,488条,49.24%)、甘(4,377条,48.02%)和辛(2,893条,31.74%;图5D)。归经编码中居前的依次为脾(5,541条,60.79%)、肝(4,801条,52.67%)、肺(3,358条,36.84%)、胃(2,988条,32.78%)和心(2,702条,29.64%;图5E)。图5F记录了独立的就诊层级与属性编码分析单元及其可重复性关联。这些图表共同展示了如何在不丢失炮制相关术语的前提下,对处方频次和标准化的本草描述符进行汇总分析。
预设的病史字典包含37个精确的症状概念。在555次符合条件的就诊中,有474次检测到至少一个症状概念(85.41%)。最常见的术语包括:口干,出现在178次就诊中(32.07%);疲劳,151次(27.21%);睡眠差,139次(25.05%);腹胀,115次(20.72%);反酸,100次(18.02%);口苦,99次(17.84%);烧心,90次(16.22%);呃逆,87次(15.68%);嗳气,87次(15.68%);稀便,77次(13.87%)(图6A、B 和 表6)。
完整的秩-频次曲线展示了全部37个术语的分布情况,而累积线则总结了所有关键词在不同秩次上的集中程度(图6C)。图6D 记录了生成该谱图的可重复操作流程:锁定词典、扫描去标识化的病史文本、在每次就诊内对概念进行去重,然后导出汇总的计数和频率。
关联规则挖掘使用了版本锁定的555行处方-就诊-单味药存在矩阵。15条有向单味药规则满足支持度≥0.30、置信度≥0.70且提升度>1.0(图7A、B 和 表7)。保留的支持度值范围为0.3009至0.7892,置信度值范围为0.7302至0.9748,提升度值范围为1.0010至1.1226。
基于438次就诊记录,最常被共同记录的有向对为Chi Shao > Fu Ling,其支持度为0.7892,置信度为0.9379,提升度为1.0010。反向规则具有相同的支持度,置信度为0.8423,这说明了为何必须保留规则的方向性。在支持度≥0.25或≥0.35、置信度≥0.65或≥0.75、提升度>1.02或>1.05的阈值下,敏感性分析分别保留了18、11、21、14、7和4条规则。在每位患者仅计入一次就诊的分析中,该配对出现在316次就诊中,支持度为0.7980,置信度为0.9489,提升度为0.9994;因此,在提升度>1.0的筛选标准下未被保留。阈值扰动及重复就诊敏感性分析结果见补充表4,确定性重计算结果见补充文件1。因此,高水平的就诊层面支持度不应被解释为患者层面的验证。
甘草的提升值最大 > 炒白术(1.1226)和甘草 > Chi Shao (1.1200) 图7A 将所有15条保留规则整合到一个有向二分网络中,其中边的宽度表示支持度,边的颜色表示提升度。 图7B 按提升度对相同规则进行排序,以支持度对每个点进行缩放,并标注置信度。因此,这两个图面板区分了网络拓扑结构与规则的定量强度,而非重复相同的视觉呈现。
基于20个最高频次的草药变量进行层次聚类分析,采用Jaccard距离和平均连接法(图7C)。该树状图提供了就诊层面存在模式相似性的全局视图,补充了关联规则所提供的局部方向性信息。这些图示共同展示了如何将互补的分析视角与单一版本锁定的二元矩阵相对齐。
根据诊断分层计算了脂肪肝(77次就诊)、肝硬化(46次就诊)和慢性胃炎(133次就诊;图8A 和 表8)的患病率。白芍、茯苓和当归在所有三个分层中均表现出较高的使用频率。肝硬化就诊病例中,丹参(95.65%)、醋制莪术(86.96%)、醋制鳖甲(84.78%)和生黄芪(60.87%)的记录尤为突出。脂肪肝就诊病例中,茵陈(41.56%)和泽泻(31.17%)的使用频率高于其他分层;而慢性胃炎就诊病例中,黄连(44.36%)、木香(34.59%)和柴胡(36.09%)则反复出现。因此,热图提供了主要临床背景下处方模式的紧凑描述性比较。
图8B 将计算与解释分开。经过验证的历史线索首先与简洁的专家背景相关联,然后进一步关联到研究用途,包括对综合征要素进行背景化分析、比较按诊断分层的模式、为前瞻性验证选择变量以及生成后续研究问题。该最终面板展示了临床专业知识如何在保持与计算得出的患病率明显区分的同时,丰富分析结果。
图8C通过区分已验证来源或重新分析的组分与需要谨慎对待或进一步确认的元素,总结了可重复性及释放边界。这一最终审核层级可防止未解决或无法重建的分析产物被作为已验证的输出结果呈现。
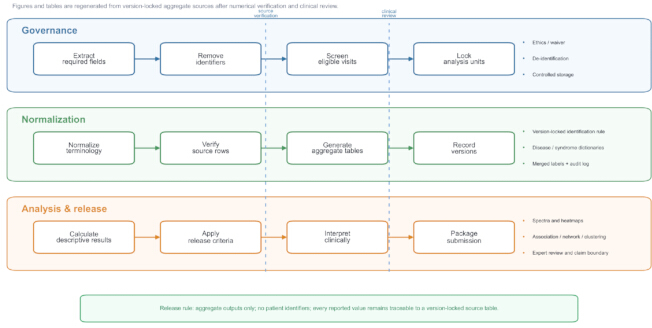
图 1:经来源审核的病例记录挖掘工作流程。 治理、术语规范化、汇总分析、临床审查和发布打包显示为工作流程的连续阶段。蓝色、绿色和橙色带区分工作流程的不同领域,虚线垂直线表示审核关卡。箭头表示工作流程的顺序,不表示生物学上的因果关系。发布规则规定仅发布汇总结果,排除患者标识符,且每个报告的数值均可追溯至版本锁定的源表。不适用误差线。 请点击此处查看此图的放大版本。
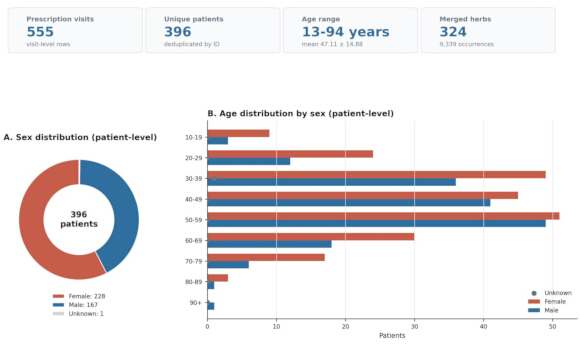
图2:数据集概况及患者层面的人口统计学特征。 汇总框显示共有555次处方就诊记录、396名唯一患者,患者年龄范围为13–94岁,平均年龄为47.11 ± 14.88岁,以及代表9,339次草药使用记录的324个合并后的草药标签。(A) 396名唯一患者的性别分布,包括女性、男性和未知类别。(B) 同一批396名患者按性别划分的年龄分布。汇总框根据具体情况使用所示的就诊层面或患者层面的分母。颜色用于区分性别类别和汇总元素,无推断意义。 请点击此处查看该图的放大版本。
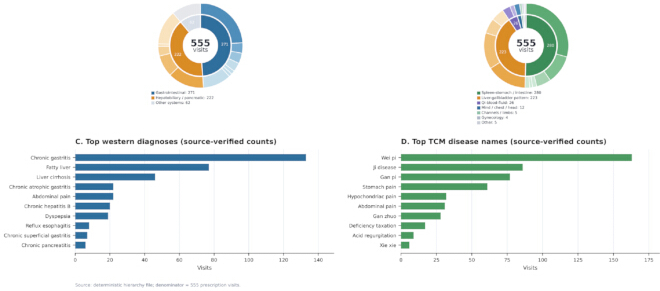
图3:从处方就诊中获得的疾病谱。(A)来自555次合格处方就诊的层级性西医疾病分组,以及(B)层级性中医疾病分组。(C)按相同就诊次数标准化后的常见西医诊断,以及(D)标准化后的常见中医疾病名称。环形图段和条形图代表就诊次数;颜色用于区分诊断体系或类别,并不表示治疗效果。保留的中医原始标签定义见表3:胃痞(上腹部胀满或不适)、积病(属积聚类的中医原始标签)、肝痞(用于脂肪肝类疾病的中医疾病标签)、肝着(字面意为“肝之留着”,为保留的经典中医疾病标签)、痹病(痹症)、消渴(消瘦伴多饮多尿)、泄泻(大便稀薄或水样便)和腹泻(腹泻)。这些解释性说明并未将原始中医标签转换为现代生物医学诊断。请点击此处查看该图的放大版本。
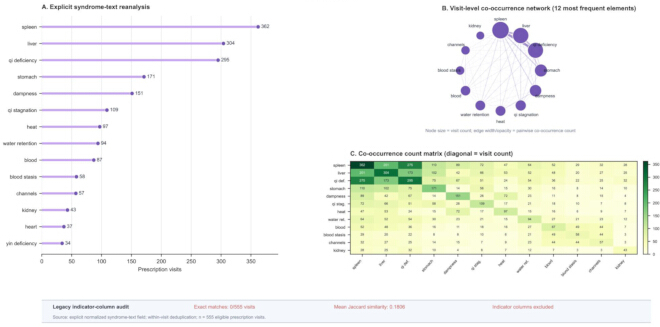
图4:证候文本谱及共现结构。(A)基于555次符合条件的处方就诊作为分母,在去除单次就诊内重复后,14种标准化证候要素的就诊层面频次。(B)12种最常见证候要素的共现网络;节点大小表示就诊频次,边的宽度和不透明度表示两两之间的共现次数。(C)对应的对称共现次数矩阵;对角线单元格表示各证候要素的单独就诊频次,非对角线单元格表示两两之间的共现次数。审核条显示,在555行数据中未发现任何完全匹配的证候文本/指标项,文本与指标的平均Jaccard相似性为0.1806;因此,传统的指标列未纳入实质性报告。矩阵中,Qi def. 表示气虚,Qi stag. 表示气滞,Water ret. 表示水湿内停。颜色仅为描述性用途。本图不涉及误差线。请点击此处查看该图的放大版本。
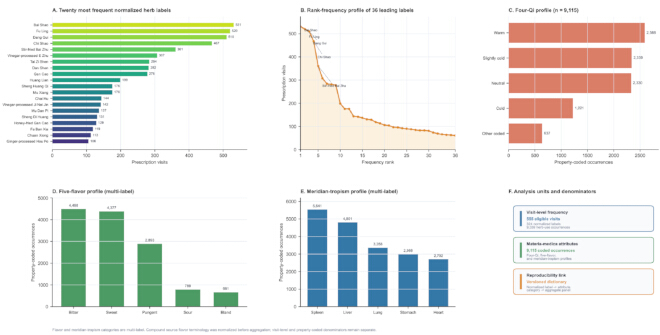
图5:高频药材及标准化中药属性谱。(A)在555次符合条件的处方就诊中,出现频率最高的二十种标准化药材名称。(B)36种主要标准化药材名称的排序-频率分布图。(C)基于9,115次具有属性编码的药材使用记录的四气分布情况;每次编码记录的四气为单值。(D)五味分布和(E)归经分布,基于相同的属性编码数据集;二者均为多标签属性,因此类别计数非互斥。(F)以就诊为单位和以属性编码为单位的分析层级及其可重复性关联。条形长度代表计数,颜色用于区分各子图。本图不适用误差线。请点击此处查看本图的放大版本。
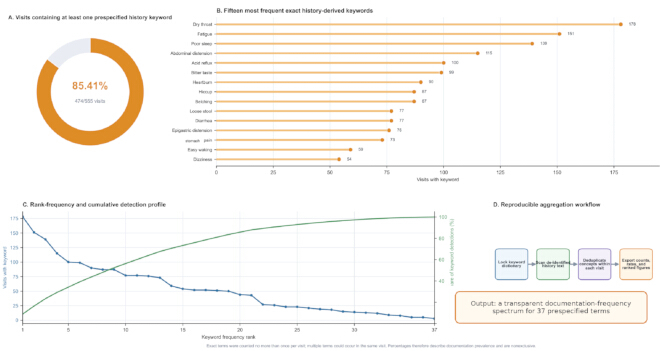
图6:基于病史的症状关键词谱及可重复的聚合分析流程。(A)555次符合条件的处方就诊中,包含至少一个预设病史关键词的比例;其中474次就诊(85.41%)包含至少一个关键词。(B)出现频率最高的15个精确的基于病史推导出的症状概念。(C)完整的37个术语的频次排序分布及关键词检出的累积占比。(D)从预设词典到聚合结果的版本锁定分析流程。每次就诊中,每个概念仅被计数一次,但同一次就诊可包含多个不同概念。橙色条形表示关键词检出数量,流程中的颜色用于区分不同处理阶段。本图不适用误差线。请点击此处查看该图的放大版本。
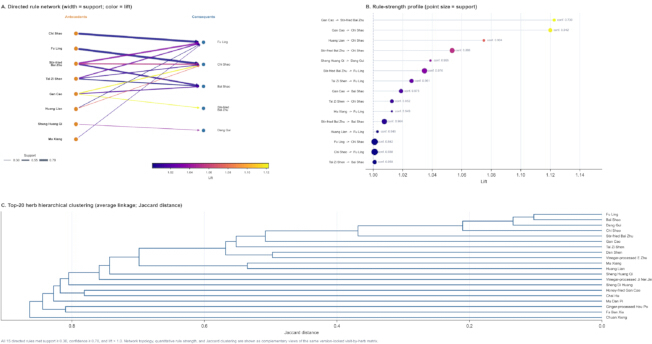
图7:单味药关联规则与层次聚类分析。(A)满足预设阈值(支持度 ≥ 0.30,置信度 ≥ 0.70,提升度 > 1.0)的全部15条单味药关联规则构成的有向二分网络。边的宽度表示支持度,边的颜色表示提升度。(B)按提升度排序的相同15条规则的规则强度分布;点的大小代表支持度,相邻标签显示置信度(conf.)。(C)基于Jaccard距离对出现频率最高的20种单味药变量进行平均连接层次聚类。所有图均以处方就诊次数为分析单位,描述的是共现模式,而非疗效、协同作用或推荐的固定配伍。本图不涉及误差条。请点击此处查看该图的高清版本。
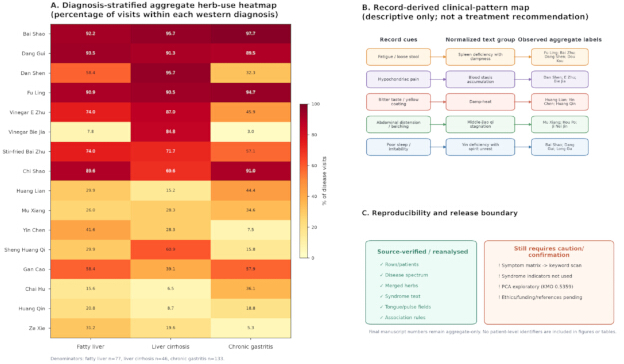
图8:按诊断分层的中药组方模式、临床证候图谱及发布边界。(A)按诊断分层的热图,显示脂肪肝(n = 77)、肝硬化(n = 46)和慢性胃炎(n = 133)患者就诊层面16种标准化中药标签的出现频率。每个单元格表示在相应西医诊断分层中符合条件的就诊比例,采用固定的0%–100%颜色标尺。(B)基于病历记录生成的临床证候图谱,将经核实的记录线索与标准化文本组及观察到的中药组方标签关联。虚线、非定向连接线用于区分该描述性解释层与计算得出的频率数据;本图不构成治疗建议。(C)可重复性与发布边界,用以区分已由原始资料验证或重新分析的组分与需谨慎对待或进一步确认的项目。请点击此处查看该图的高清版本。
| 指标 | 数值 | 单位/分母 | 状态 |
| 处方就诊次数 | 555 | 555 次处方就诊 | 已从恢复的 XLSX 文件中核实 |
| 唯一患者数 | 396 | 396 名唯一患者 | 已从恢复的 XLSX 文件中核实 |
| 患者层面的年龄范围 | 13–94 | 年 | 已核实 |
| 患者层面的平均年龄 ± 标准差 | 47.11 ± 14.88 | 年 | 已核实 |
| 就诊层面的平均年龄 ± 标准差 | 48.22 ± 15.82 | 年 | 已核实 |
| 患者层面的性别分布 | 女性 228;男性 167;未知 1 | 396 名患者 | 已核实 |
| 就诊层面的性别分布 | 女性 327;男性 227;未知 1 | 555 次就诊 | 已核实 |
| 合并后的药材种类数 | 324 | 个不同的合并名称 | 已核实 |
| 合并后的药材使用记录次数 | 9339 | 555 次处方就诊 | 已核实 |
表1:数据集概况。 使用各自的分母报告患者层面的人口统计学特征和处方-就诊层面的变量。同时提供标准化后的草药总量。
| 疾病名称 | 数量 | 就诊百分比 |
| 慢性胃炎 | 133 | 24 |
| 脂肪肝 | 77 | 13.9 |
| 肝硬化 | 46 | 8.3 |
| 慢性萎缩性胃炎 | 22 | 4 |
| 腹痛 | 22 | 4 |
| 慢性乙型肝炎 | 20 | 3.6 |
| 消化不良 | 19 | 3.4 |
| 反流性食管炎 | 8 | 1.4 |
| 慢性浅表性胃炎 | 7 | 1.3 |
| 慢性胰腺炎 | 6 | 1.1 |
| 溃疡性结肠炎 | 6 | 1.1 |
| 胆囊息肉 | 6 | 1.1 |
| 胆囊切除术后综合征 | 6 | 1.1 |
| 肠道功能紊乱 | 6 | 1.1 |
| 胆结石 | 6 | 1.1 |
| 慢性肝炎 | 5 | 0.9 |
| 疲劳 | 5 | 0.9 |
| 胃肠功能紊乱(原始标签不确定) | 5 | 0.9 |
| 慢性胃炎(原始标签不确定) | 5 | 0.9 |
| 自身免疫性肝硬化 | 4 | 0.7 |
表2:主要的标准化西医诊断。 在555次符合条件的处方就诊中记录的主要标准化西医诊断的例数及百分比。百分比以符合条件的处方就诊次数作为分母。
| 中医病名 | 例数 | 就诊比例 |
| 胃痞(上腹部胀满或不适) | 163 | 29.4 |
| 积病(积聚类中医证候标签) | 86 | 15.5 |
| 肝痞(用于脂肪肝类疾病的中医证候标签) | 77 | 13.9 |
| 胃痛 | 61 | 11 |
| 胁痛 | 32 | 5.8 |
| 腹痛 | 31 | 5.6 |
| 肝著(字面意为肝气固定;保留的古典中医病名) | 28 | 5 |
| 虚劳 | 17 | 3.1 |
| 反酸 | 9 | 1.6 |
| 泄泻(大便稀溏或水样便) | 6 | 1.1 |
| 失眠 | 4 | 0.7 |
| 痢疾 | 4 | 0.7 |
| 头痛 | 4 | 0.7 |
| 痹病(肢体阻滞性疾病) | 4 | 0.7 |
| 月经不调 | 3 | 0.5 |
| 胸痹 | 3 | 0.5 |
| 汗证 | 3 | 0.5 |
| 便秘 | 3 | 0.5 |
| 腹泻(腹泻) | 2 | 0.4 |
| 消渴(消瘦伴多饮多尿) | 2 | 0.4 |
表3:主要的标准化中医疾病名称。 在555次符合条件的处方就诊中记录的主要标准化中医疾病名称的计数及百分比。百分比以符合条件的处方就诊次数为分母。保留的原始标签及解释性注释并不表示与现代生物医学诊断等同。
| 排名 | 证候要素 | 处方就诊次数 | 符合条件的就诊次数 | 就诊百分比 |
| 1 | 脾 | 362 | 555 | 65.23% |
| 2 | 肝 | 304 | 555 | 54.77% |
| 3 | 气虚 | 295 | 555 | 53.15% |
| 4 | 胃 | 171 | 555 | 30.81% |
| 5 | 湿 | 151 | 555 | 27.21% |
| 6 | 气滞 | 109 | 555 | 19.64% |
| 7 | 热 | 97 | 555 | 17.48% |
| 8 | 水停 | 94 | 555 | 16.94% |
| 9 | 血 | 87 | 555 | 15.68% |
| 10 | 血瘀 | 58 | 555 | 10.45% |
| 11 | 经络 | 57 | 555 | 10.27% |
| 12 | 肾 | 43 | 555 | 7.75% |
| 13 | 心 | 37 | 555 | 6.67% |
| 14 | 阴虚 | 34 | 555 | 6.13% |
表4:主要的标准化证候要素。 证候要素从明确的标准化证候文本中提取,并在每次处方就诊内进行去重。计数以555次符合条件的处方就诊为分母;百分比为非排他性统计,因为单次就诊中可出现多个证候要素。
| 合并草药名称 | 使用次数 | 占就诊比例 |
| Bai Shao | 531 | 95.7 |
| Fu Ling | 520 | 93.7 |
| Dang Gui | 510 | 91.9 |
| Chi Shao | 467 | 84.1 |
| 炒白术 | 361 | 65 |
| 醋制莪术 | 307 | 55.3 |
| Tai Zi Shen | 284 | 51.2 |
| Dan Shen | 282 | 50.8 |
| Gan Cao | 278 | 50.1 |
| Huang Lian | 199 | 35.9 |
| 生黄芪 | 176 | 31.7 |
| Mu Xiang | 176 | 31.7 |
| Chai Hu | 144 | 25.9 |
| 醋制鸡内金 | 142 | 25.6 |
| Mu Dan Pi | 137 | 24.7 |
| 生地黄 | 131 | 23.6 |
| 蜜炙甘草 | 129 | 23.2 |
| 法半夏 | 119 | 21.4 |
| Chuan Xiong | 113 | 20.4 |
| 姜制厚朴 | 106 | 19.1 |
| Yin Chen | 104 | 18.7 |
| 生白术 | 97 | 17.5 |
| Dou Kou | 96 | 17.3 |
| 生龙骨 | 92 | 16.6 |
| Zhe Bei Mu | 90 | 16.2 |
| Huang Qin | 88 | 15.9 |
| Dang Shen | 85 | 15.3 |
| 醋制鳖甲 | 83 | 15 |
| Gui Zhi | 83 | 15 |
| 生牡蛎 | 81 | 14.6 |
| 焦栀子 | 74 | 13.3 |
| 合欢花 | 69 | 12.4 |
| 酒制黄精 | 66 | 11.9 |
| Chen Pi | 64 | 11.5 |
| 泽泻 | 63 | 11.4 |
| 金钱草 | 61 | 11 |
表5:按处方就诊频率排序的标准化草药标签。 每次处方就诊中,每种标准化草药标签最多计数一次。计数和百分比以555次符合条件的处方就诊为分母,具有临床意义的炮制品形式被保留为独立标签。
| 排名 | 病史来源关键词 | 处方就诊次数 | 符合条件的就诊次数 | 就诊百分比 |
| 1 | 咽干 | 178 | 555 | 32.07% |
| 2 | 疲劳 | 151 | 555 | 27.21% |
| 3 | 睡眠差 | 139 | 555 | 25.05% |
| 4 | 腹胀 | 115 | 555 | 20.72% |
| 5 | 反酸 | 100 | 555 | 18.02% |
| 6 | 口苦 | 99 | 555 | 17.84% |
| 7 | 烧心 | 90 | 555 | 16.22% |
| 8 | 打嗝 | 87 | 555 | 15.68% |
| 9 | 嗳气 | 87 | 555 | 15.68% |
| 10 | 稀便 | 77 | 555 | 13.87% |
| 11 | 腹泻 | 77 | 555 | 13.87% |
| 12 | 上腹胀 | 76 | 555 | 13.69% |
| 13 | 胃痛 | 73 | 555 | 13.15% |
| 14 | 易醒 | 59 | 555 | 10.63% |
| 15 | 头晕 | 54 | 555 | 9.73% |
| 16 | 呕吐 | 52 | 555 | 9.37% |
| 17 | 恶心 | 52 | 555 | 9.37% |
| 18 | 隐痛 | 51 | 555 | 9.19% |
| 19 | 胀痛 | 50 | 555 | 9.01% |
| 20 | 食欲差 | 44 | 555 | 7.93% |
| 21 | 腹痛 | 43 | 555 | 7.75% |
| 22 | 胸闷 | 27 | 555 | 4.86% |
| 23 | 易怒 | 26 | 555 | 4.68% |
| 24 | 头痛 | 23 | 555 | 4.14% |
| 25 | 肠鸣 | 23 | 555 | 4.14% |
| 26 | 上腹不适 | 21 | 555 | 3.78% |
| 27 | 心悸 | 19 | 555 | 3.42% |
| 28 | 尿黄 | 18 | 555 | 3.24% |
| 29 | 异物感 | 15 | 555 | 2.70% |
| 30 | 刺痛 | 14 | 555 | 2.52% |
| 31 | 便秘 | 13 | 555 | 2.34% |
| 32 | 嗜睡 | 12 | 555 | 2.16% |
| 33 | 咽部异物感 | 9 | 555 | 1.62% |
| 34 | 多汗 | 8 | 555 | 1.44% |
| 35 | 胁痛 | 5 | 555 | 0.90% |
| 36 | 里急后重 | 5 | 555 | 0.90% |
| 37 | 干便 | 3 | 555 | 0.54% |
表6:主要的病史来源症状关键词。 在去标识化的病史文本中检测到的确切症状概念。每个症状概念在一次处方就诊中仅被计数一次,但同一次就诊中可出现多个不同症状概念。计数和百分比均以555次符合条件的处方就诊作为分母。
| 前项 | 后项 | 共现次数 | 支持度 | 置信度 | 提升度 |
| Chi Shao | Fu Ling | 438 | 0.7892 | 0.9379 | 1.0010 |
| Fu Ling | Chi Shao | 438 | 0.7892 | 0.8423 | 1.0010 |
| Stir-fried Bai Zhu | Fu Ling | 350 | 0.6306 | 0.9695 | 1.0348 |
| Stir-fried Bai Zhu | Bai Shao | 348 | 0.6270 | 0.9640 | 1.0076 |
| Stir-fried Bai Zhu | Chi Shao | 320 | 0.5766 | 0.8864 | 1.0535 |
| Tai Zi Shen | Fu Ling | 273 | 0.4919 | 0.9613 | 1.0260 |
| Tai Zi Shen | Bai Shao | 272 | 0.4901 | 0.9577 | 1.0010 |
| Gan Cao | Bai Shao | 271 | 0.4883 | 0.9748 | 1.0189 |
| Gan Cao | Chi Shao | 262 | 0.4721 | 0.9424 | 1.1200 |
| Tai Zi Shen | Chi Shao | 242 | 0.4360 | 0.8521 | 1.0127 |
| Gan Cao | Stir-fried Bai Zhu | 203 | 0.3658 | 0.7302 | 1.1226 |
| Huang Lian | Fu Ling | 187 | 0.3369 | 0.9397 | 1.0029 |
| Huang Lian | Chi Shao | 180 | 0.3243 | 0.9045 | 1.0750 |
| Sheng Huang Qi | Dang Gui | 168 | 0.3027 | 0.9545 | 1.0388 |
| Mu Xiang | Fu Ling | 167 | 0.3009 | 0.9489 | 1.0127 |
表7:满足预设阈值的定向草药关联规则。 规则基于555条二元处方-就诊记录生成,支持度≥0.30,置信度≥0.70,提升度>1.0。支持度以555次处方就诊为分母,且由于置信度具有方向性,因此保留了规则的方向性。
| 草药标签 | 脂肪肝 (n) | 脂肪肝 (N) | 脂肪肝 (%) | 肝硬化 (n) | 肝硬化 (N) | 肝硬化 (%) | 慢性胃炎 (n) | 慢性胃炎 (N) | 慢性胃炎 (%) |
| Bai Shao | 71 | 77 | 92.21% | 44 | 46 | 95.65% | 130 | 133 | 97.74% |
| Dang Gui | 72 | 77 | 93.51% | 42 | 46 | 91.30% | 119 | 133 | 89.47% |
| Dan Shen | 45 | 77 | 58.44% | 44 | 46 | 95.65% | 43 | 133 | 32.33% |
| Fu Ling | 70 | 77 | 90.91% | 43 | 46 | 93.48% | 126 | 133 | 94.74% |
| Vinegar-processed E Zhu | 57 | 77 | 74.03% | 40 | 46 | 86.96% | 61 | 133 | 45.86% |
| Vinegar-processed Bie Jia | 6 | 77 | 7.79% | 39 | 46 | 84.78% | 4 | 133 | 3.01% |
| Stir-fried Bai Zhu | 57 | 77 | 74.03% | 33 | 46 | 71.74% | 76 | 133 | 57.14% |
| Chi Shao | 69 | 77 | 89.61% | 32 | 46 | 69.57% | 121 | 133 | 90.98% |
| Huang Lian | 23 | 77 | 29.87% | 7 | 46 | 15.22% | 59 | 133 | 44.36% |
| Mu Xiang | 20 | 77 | 25.97% | 13 | 46 | 28.26% | 46 | 133 | 34.59% |
| Yin Chen | 32 | 77 | 41.56% | 13 | 46 | 28.26% | 10 | 133 | 7.52% |
| Sheng Huang Qi | 23 | 77 | 29.87% | 28 | 46 | 60.87% | 21 | 133 | 15.79% |
| Gan Cao | 45 | 77 | 58.44% | 18 | 46 | 39.13% | 77 | 133 | 57.89% |
| Chai Hu | 12 | 77 | 15.58% | 3 | 46 | 6.52% | 48 | 133 | 36.09% |
| Huang Qin | 16 | 77 | 20.78% | 4 | 46 | 8.70% | 25 | 133 | 18.80% |
| Ze Xie | 24 | 77 | 31.17% | 9 | 46 | 19.57% | 7 | 133 | 5.26% |
表8:按诊断分类的草药使用率。 脂肪肝(n = 77)、肝硬化(n = 46)和慢性胃炎(n = 133)中16种标准化草药标签的分子数、分母数及就诊层面的使用率。每例符合条件的处方就诊中,每种草药标签仅计数一次。
补充表1:人工智能辅助的透明度与审计记录。 该文件用于区分原始分析记录与2026年8月21日进行的修订阶段一致性审查。表格中记录了所使用的工具/模型/版本、输入范围、使用目的、发现的四气基数不匹配问题、人工修正情况、使用限制、审查人员信息、处理结果及提示模板。未向人工智能系统提供任何原始的患者级别数据行。 请点击此处下载该文件。
补充表 2:源数据审计的数据质量结果。 报告了源临床字段和历史分析结构的字段回收完整性、审计发现、分析措施及发布状态。该表记录了未解决的历史综合征指标的排除、早期草药总量的校正、无法重建清洗前分布向量以进行跨版本稳定性估计的情况,以及无法重建的数量。 请点击此处下载该文件。
补充表 3:草药命名映射。 受控的草药显示标签与加工限定词、标准中药材名称、来源术语、植物、动物或矿物来源、参考版本、证据定位符以及证据范围相关联。在具有临床意义的情况下,保留特定加工的标签。 请点击此处下载该文件。
补充表4:阈值与重复就诊敏感性分析。 报告了关联规则阈值扰动、每位患者一次就诊规则集比较、赤芍 > 茯苓敏感性指标,以及190对聚类输入距离比较的结果。 请点击此处下载该文件。
补充文件 1:确定性阈值与重复就诊敏感性脚本。 用于从版本锁定的源数据集中重现汇总阈值和重复就诊敏感性指标的确定性脚本。该文件不包含任何患者层面的数据。 请点击此处下载该文件。
讨论
本方案的核心贡献是从去标识化的中医病例记录到汇总研究数据的完整且可追溯的路径。最关键的步骤包括:在查看分析结果之前冻结队列确定规则,区分不同患者与处方就诊记录,保留每一个从原始术语到标准化术语的映射关系,并在可视化前逐一验证每个分子和分母。这些控制措施将数据清洗从一项不可见的预处理工作转变为方法中可记录的组成部分。同时,该流程也与RECORD、STROBE、FAIR以及既有的电子健康记录(EHR)数据质量框架相一致11,12,13,14,15。只有当结果的来源字段、分析单元、字典版本、计算规则、分母、表格、图表及审阅者决策均能在证据台账中追溯时,该结果才被视为可发布。
该方法具有创新性,因为它将治理、术语工程、计算、可视化和临床审查整合为一体,而非作为独立任务处理。通过单一的显式证候矩阵,可生成频谱图、共现网络和热图;通过单一的处方-就诊-药材矩阵,可支持频率统计、有向关联规则和层次聚类19,20,21;通过单一的诊断分层表格,可同时支持精确百分比计算和最终热图生成。分析流程采用脚本化、可重复的开源工具36,37,38,39,40,使得上游字典或队列决策的任何修正均可传递至所有相关输出结果。此前的临床数据仓库研究也表明,源数据关联的预处理和结构化数据的再利用至关重要41,42。该架构减少了人工转录工作,保持了图形编码与源表格之间的一致性,并有助于审计、教学以及向其他研究团队的转移应用。
最近三项数据库挖掘研究提供了有用的设计原则,尽管这些研究的分析单位是出版物而非临床就诊记录。类风湿关节炎与抑郁症研究结合了预定义的检索策略,并进行了国家、机构、作者、期刊、关键词及时间线分析26。溃疡性结肠炎与Janus激酶抑制剂研究则采用协同合作、共被引分析、聚类分析和突现词分析,以区分持续存在的研究主题与新兴研究前沿27。类风湿关节炎与纤维肌痛研究在保持两类证据层次区分的前提下,将文献计量绘图与生物信息学方法相结合并加以拓展28。本方案应用了协调但不可互换的多种分析视角这一相同原则。若将该方法转移至妇科、呼吸内科、风湿病学或其他专科领域,需在重用规则集之前,重建与该专科相关的特定字段、术语词典、纳入与排除标准、结局指标以及临床审查流程。疾病谱、综合征网络、症状关键词、关联规则、聚类以及按诊断分层的模式均来源于版本锁定的数据源,但每一项分析均针对不同的科学问题,并保持其独立的分母和解释边界。
在仅限于使用已批准的去标识化摘录或汇总材料的情况下,由人类监督的人工智能可提供额外的质量控制层。在此工作流程中,人工智能可跨文件比对术语,标记图注与表格之间的不一致之处,识别超出图像边界的标签,验证每个显示的网络节点均具有有效的连接边,并建议更清晰的表述方式。人工智能不得判定队列入组资格、创建术语映射关系、推断治疗效应,或替代原始数据审查。这种职责划分符合更广泛的观点,即医学人工智能应增强而非模糊人类判断的责任归属33。这也体现了DECIDE-AI对透明的人为因素、错误处理和可问责性评估的重视34。因此,每次使用人工智能辅助时,均应在审计日志中保留每个提示的目的、审查后的输出结果、被采纳的修改内容、审查人员姓名及审查日期。
当输出结果看似具有临床合理性但未能通过来源核对时,故障排查尤为重要。在此类情况下,应暂停后续解释,直至追溯差异来源,明确其源于资格判定、去重、术语映射、字段选择、分母选取或图表组装等环节。所有依赖性输出均应在修正后重新生成。本实例仍基于单中心、回顾性、专家门诊数据集,其中多次就诊记录之间并非相互独立。每位患者仅保留一次就诊的敏感性分析将保留的规则集从15条减少至12条,同时保留了全部20种最常用中药的成员资格。在这20个共有变量之间的所有190个无序配对中,皮尔逊相关系数为0.9944,斯皮尔曼rho值为0.9836,杰卡德距离的平均绝对变化为0.0146,最大变化为0.0528(补充表4)。因此,较高的就诊层面支持度不应被解读为患者层面的验证。病史关键词谱反映的是原始记录文本,而非经过验证的症状量表。药材总结基于出现频率加权,而非剂量加权。关联规则描述的是共现记录关系,而非因果关系。按诊断分层的热图仅为描述性分析,不能确立比较疗效、疾病特异性或治疗必要性。
该方案可用于专家临床经验传承研究、专科门诊队列描述、多中心术语协调、病历文档质量评审、前瞻性注册研究的变量筛选,以及注重隐私保护的汇总协作数据集准备。未来的研究可进一步纳入前瞻性结构化症状采集、患者聚类模型、明确的剂量变量、预设的比较假设、外部验证、版本化术语服务、隐私保护计算以及交互式证据账本。在版本锁定规则和人工验证的监管下,自然语言处理与人工智能辅助评审可进一步减少重复性数据整理工作。更广泛而言,该方案使得分散的临床经验能够转化为一种透明的研究对象,可供检查、复现、质疑和拓展。该方法并不将出现频率转化为疗效判断,而是将未记录的分析决策转化为可见的证据,为提出更严谨的临床问题和开展更具可持续性的中医药真实世界研究奠定基础。
披露
作者声明无竞争利益。
致谢
在稿件修订过程中,仅使用了OpenAI Codex(gpt-5.6-luna和gpt-5.6-sol)进行跨文件的聚合层级一致性检查及文字表述建议。未向人工智能系统提供任何患者级别的数据记录。所有由人工智能辅助生成的内容均已由夏天于2026年8月21日独立对照原始资料进行核实。作者审阅并批准了最终内容,对稿件承担全部责任。本项目得到以下资助:中国国家重点研发计划——中医药现代化重点专项(编号:2025YFC3512800);中国国家科技重大专项(项目编号:2026ZD0554100;子项目编号:2026ZD0554101);中央高水平中医药医院临床研究与成果转化能力提升项目——名老中医药专家学术经验传承专项(编号:HLCMHPP2023016);新疆维吾尔自治区自然科学基金(编号:2025D01C213)。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 汇总重分析电子表格 | 作者生成的本地文件 | 不适用 | 用于生成汇总计数、表格和图表。 |
| 去标识化门诊病例记录导出文件 | 机构电子病历系统 | 不适用 | 仅在受控的机构环境中使用;患者级别的记录不属于提交材料。 |
| lxml | lxml 项目 | 6.1.1 | 在修订阶段重新生成过程中用于保留命名空间序列化的软件版本;并非历史上原始分析所用版本。 |
| Matplotlib | Matplotlib 项目 (matplotlib.org) | 3.11.1 | 在修订阶段重新生成环境及图3 SVG元数据中观察到的版本;并非历史上原始分析所用版本。 |
| NetworkX | NetworkX 项目 | PyPI 包: networkx | 记录的包标识符;在继承的环境中未验证确切的修订阶段版本。 |
| NumPy | NumPy 项目 | 2.3.5 | 用于重新生成修订后汇总输出的软件版本;并非历史上原始分析所用版本。 |
| openpyxl | openpyxl 项目 | 3.1.5 | 用于编写修订后汇总 XLSX 输出的软件版本;并非历史上原始分析所用版本。 |
| pandas | pandas 项目 | 3.0.1 | 用于重新生成修订后汇总输出的软件版本;并非历史上原始分析所用版本。 |
| PyMuPDF | PyMuPDF 项目 | 1.28.2 | 用于在修订阶段重新生成修订后图表输出的软件版本;并非历史上原始分析所用版本。 |
| Python | Python 软件基金会 | 3.13.15 | 用于重新生成修订后汇总输出的软件版本;并非历史上原始分析所用版本。 |
| SciPy | SciPy 项目 | PyPI 包: scipy | 记录的包标识符;在继承的环境中未验证确切的修订阶段版本。 |
参考文献
- Wang YH, et al. Study on knowledge discovery in traditional Chinese medical case records [in Chinese]. Zhong Xi Yi Jie He Xue Bao. 2007;5(4):368-372.
- Wang Y, et al. Automatic symptom name normalization in clinical records of traditional Chinese medicine. BMC Bioinformatics. 2010;11:40.
- Zhou L, et al. Natural language processing algorithms for normalizing expressions of synonymous symptoms in traditional Chinese medicine. Evid Based Complement Alternat Med. 2021;2021:6676607.
- Chu X, et al. Quantitative knowledge presentation models of traditional Chinese medicine (TCM): a review. Artif Intell Med. 2020;103:101810.
- Zhang T, et al. Constructing fine-grained entity recognition corpora based on clinical records of traditional Chinese medicine. BMC Med Inform Decis Mak. 2020;20:64.
- Wang Q, et al. A study of entity-linking methods for normalizing Chinese diagnosis and procedure terms to ICD codes. J Biomed Inform. 2020;105:103418.
- Zhang H, et al. Transformer- and generative adversarial network-based inpatient traditional Chinese medicine prescription recommendation: development study. JMIR Med Inform. 2022;10(5):e35239.
- Dan W, et al. SinoMedminer: an R package and Shiny application for mining and visualizing traditional Chinese medicine herbal formulas. Chin Med. 2025;20:80.
- Chinese Pharmacopoeia Commission. Pharmacopoeia of the People's Republic of China. 2025 ed. China Medical Science and Technology Press; Beijing; 2025.
- Editorial Committee of Zhonghua Bencao, State Administration of Traditional Chinese Medicine. Zhonghua Bencao. 10 vols. Shanghai Scientific and Technical Publishers; Shanghai; 1999. ISBN: 7532351068. Available from: National Diet Library record
- Benchimol EI, et al. The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLoS Med. 2015;12(10):e1001885.
- von Elm E, et al. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. Lancet. 2007;370(9596):1453-1457.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Weiskopf NG, Weng C. Methods and dimensions of electronic health record data quality assessment: enabling reuse for clinical research. J Am Med Inform Assoc. 2013;20(1):144-151.
- Kahn MG, et al. A harmonized data quality assessment terminology and framework for the secondary use of electronic health record data. EGEMS (Wash DC). 2016;4(1):18.
- Kovačević A, Bašaragin B, Milošević N, Nenadić G. De-identification of clinical free text using natural language processing: a systematic review of current approaches. Artif Intell Med. 2024;151:102845.
- Meystre SM, et al. Text de-identification for privacy protection: a study of its impact on clinical text information content. J Biomed Inform. 2014;50:142-150.
- Neamatullah I, et al. Automated de-identification of free-text medical records. BMC Med Inform Decis Mak. 2008;8:32.
- Agrawal R, Srikant R. Fast algorithms for mining association rules in large databases. Presented at: 20th International Conference on Very Large Data Bases; Santiago, Chile; 1994. p. 487-499.
- Hahsler M, Grün B, Hornik K. arules: a computational environment for mining association rules and frequent item sets. J Stat Softw. 2005;14(15):1-25.
- Murtagh F, Contreras P. Algorithms for hierarchical clustering: an overview. WIREs Data Min Knowl Discov. 2012;2(1):86-97.
- van Eck NJ, Waltman L. Software survey: VOSviewer, a computer program for bibliometric mapping. Scientometrics. 2010;84(2):523-538.
- Chen C. CiteSpace II: detecting and visualizing emerging trends and transient patterns in scientific literature. J Am Soc Inf Sci Technol. 2006;57(3):359-377.
- Aria M, Cuccurullo C. bibliometrix: an R-tool for comprehensive science mapping analysis. J Informetr. 2017;11(4):959-975.
- Donthu N, et al. How to conduct a bibliometric analysis: an overview and guidelines. J Bus Res. 2021;133:285-296.
- Zhao Y, Chen GY, Fang M. Research trends of rheumatoid arthritis and depression from 2019 to 2023: a bibliometric analysis. J Multidiscip Healthc. 2024;17:4465-4474.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-6771.
- Chen G, Yan Z, Wang Y, Tao Q. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-6827.
- Wang SL, et al. Yao Naili's experience in applying the harmonizing liver and spleen method. Journal of Traditional Chinese Medicine. 2008;49(7):596-597.
- Wang L, et al. Analysis of Professor Naili Yao's experience in treating spleen-stomach diseases [in Chinese]. Lishizhen Med Mater Med Res. 2022;33(6):1436-1438.
- Sandve GK, Nekrutenko A, Taylor J, Hovig E. Ten simple rules for reproducible computational research. PLoS Comput Biol. 2013;9(10):e1003285.
- Munafò MR, et al. A manifesto for reproducible science. Nat Hum Behav. 2017;1:0021.
- Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
- Vasey B, et al. Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. Nat Med. 2022;28(5):924-933.
- Branch of Gastrointestinal Diseases, China Association of Chinese Medicine. Expert consensus on traditional Chinese medicine diagnosis and treatment of Gan pi (2023). Chinese Journal of Integrative Digestive Diseases. 2024;32(9):741-747.
- McKinney W. Data structures for statistical computing in Python [conference paper]. Presented at: 9th Python in Science Conference; Austin, TX; 2010. p. 56-61. doi:10.25080/Majora-92bf1922-00a.
- Harris CR, et al. Array programming with NumPy. Nature. 2020;585(7825):357-362.
- Virtanen P, et al. SciPy 1.0: fundamental algorithms for scientific computing in Python. Nat Methods. 2020;17(3):261-272.
- Hunter JD. Matplotlib: a 2D graphics environment. Comput Sci Eng. 2007;9(3):90-95.
- Hagberg AA, Schult DA, Swart PJ. Exploring network structure, dynamics, and function using NetworkX. Presented at: 7th Python in Science Conference; Pasadena, CA; 2008. p. 11-15. doi:10.25080/TCWV9851.
- Zhou X, et al. Development of traditional Chinese medicine clinical data warehouse for medical knowledge discovery and decision support. Artif Intell Med. 2010;48(2-3):139-152.
- Liu B, et al. Data processing and analysis in real-world traditional Chinese medicine clinical data: challenges and approaches. Stat Med. 2012;31(7):653-660.