本方案提供了一套可重复的工作流程,用于在医疗保健领域开发、评估和解释可解释的人工智能模型。该流程整合了标准化的数据准备、模型开发、可解释性技术、定量评估以及可重复性实践,以提高模型的透明度、可靠性和临床适用性。
本文内容
摘要
摘要
人工智能(AI)正日益被采纳为临床决策、疾病预测、医学诊断和个性化医疗中的重要工具。然而,缺乏透明度、可解释人工智能(XAI)方法实施不一致以及可重复性有限,仍是AI模型在临床环境中可信部署的主要障碍。本文提出了一种系统化、可重复且透明的协议,用于开发、评估和解释面向医疗应用的可解释AI模型。该工作流程包括计算环境搭建、数据获取与表征、预处理、特征工程、模型开发、超参数优化、预测性能评估、可解释性分析、统计验证以及可重复性评估。该协议整合了多种XAI方法,如SHapley加性解释(SHAP)、局部可解释模型无关解释(LIME)、梯度加权类激活映射(Grad-CAM)、积分梯度、注意力可视化以及反事实解释,以生成全局和局部的模型解释。本协议强调若干关键环节,包括标准化医疗数据集的准备、稳定机器学习模型的构建、预测性能的评估、生成具有临床意义的解释,以及在多次实验中对可重复性进行统计评估。通过将模型开发、可解释性、定量与定性评估、统计验证及可重复性评估整合到统一的工作流程中,本协议为开发透明且可重复的医疗AI模型提供了全面的框架。
引言
人工智能通过实现对复杂临床数据的智能分析并支持循证医学决策,已成为现代医疗保健的重要组成部分1。随着电子健康记录、医学影像系统、可穿戴设备和基因组技术的快速发展,医疗保健领域实现了快速数字化,产生了大量异构数据,这些数据需要先进的计算方法才能有效解读2。
机器学习(ML)和深度学习(DL)算法在从多维医疗数据集中提取有意义的模式方面展现出卓越的能力,从而提高了诊断准确性、疾病预测能力和患者预后评估3。基于人工智能的模型已成功应用于放射学、病理学、心脏病学、肿瘤学、眼科学及其他医学专业,协助临床医生更早地发现疾病并推荐个性化的治疗策略4。这些技术还有助于优化工作流程、减少诊断差异性,并提高医疗资源的利用效率5。
计算硬件、云计算和开源人工智能框架的最新进展加速了智能医疗应用的开发与部署6。因此,人工智能已成为精准医学和临床决策支持系统的关键使能技术7。尽管取得了这些进展,人工智能在常规临床实践中的广泛应用仍然有限,因为许多高性能模型对其预测生成过程缺乏透明度8。
大多数深度学习算法作为复杂的黑箱模型运行,其内部决策过程难以被临床医生和研究人员理解9。尽管这些模型通常能够实现优异的预测性能,但其缺乏透明性会削弱用户的信任,并对临床验证、监管审批和患者安全构成挑战10。在将人工智能辅助决策纳入常规临床实践之前,医疗专业人员必须能够对其决策依据进行解释,尤其是在高风险的医疗环境中11。
可解释人工智能(XAI)已成为提高机器学习模型透明度和可解释性的有效方法12。XAI 技术并非将预测模型视为黑箱系统,而是提供有关对个体预测产生影响的特征、图像区域或临床变量的信息13。此类解释有助于临床医生更好地理解模型行为,识别潜在偏差,并判断人工智能生成的决策是否与既有的医学知识一致14。
针对医疗保健应用,已提出多种可解释性技术。SHapley加性解释(SHAP)基于合作博弈论,用于衡量每个特征对模型预测的贡献15。局部可解释性模型无关解释方法(LIME)通过构建简化模型,解释黑箱模型的预测结果16。对于使用深度学习模型的医学图像任务,梯度加权类激活映射(Grad-CAM)生成热图,直观显示对分类决策有贡献的图像区域17。这些方法的结合显著提高了人工智能系统在不同医疗领域中的透明度18。
尽管医疗领域对可解释性方法的关注日益增加,但其在文献中的应用仍存在差异。研究人员不仅在预处理策略的使用上有所不同,而且在模型架构设计、评估指标乃至解释方法的选择上也存在差异19。此外,许多论文报告了较高的预测准确率,但未能对解释结果的质量或其可重复性进行充分评估20。
可重复性是现代人工智能科学研究中的主要瓶颈之一。论文通常未披露软件版本、计算环境、预处理流程、超参数设置、随机种子初始化以及硬件配置21。因此,独立研究人员常常无法复现已发表的结果,或难以使用其他数据集或软件平台验证已发表的方法22。缺乏详细的文档记录是阻碍人工智能系统开展基准测试、协作研究及临床转化的因素之一23。
鉴于这些挑战,多个组织和监管机构已强调医疗保健领域的人工智能应具备透明性、可信度和可重复性24。现有的报告指南虽已改善了方法学报告的质量,但主要侧重于应报告的内容,而非提供研究人员可直接实施的标准化实验流程25。因此,仍亟需一项综合性的实验方案,将数据集准备、模型开发、可解释性分析、统计评估以及可重复性实践整合到统一的实验工作流程中26。
标准化的实验方案为医疗人工智能领域带来了多项优势。此外,它有助于保持方法学上的一致性,促进独立研究之间的比较,提高计算实验的透明度,并实现对已发表结果的可靠验证27。标准化的工作流程还通过清晰记录、可在不同实验室和医疗机构中重复的操作程序,支持教育培训、协作研究以及监管评估28。
本研究开发并测试了一种可重复的实验方案,用于在医疗系统中训练和评估人工智能模型。该方案规定了配置计算环境、预处理医疗数据集、开发机器学习模型、应用可解释性人工智能(XAI)方法、评估预测性能、进行统计验证以及评估可重复性等方面的标准29。将这些组件整合为一个连贯的工作流程,有望提高医疗人工智能研究的透明度、可靠性和可重复性,并有助于构建可信的智能健康系统30。
方案
本研究验证实验使用了公开可获取的、去标识化的皮马印第安人糖尿病数据集,未涉及可识别的患者记录或新患者招募。因此,无需获得知情同意及机构伦理审查委员会(IRB)/伦理批准,所有分析均依照适用的数据集使用条款及机构科研政策进行。
本验证示例使用公开的皮马印第安人糖尿病数据集,该数据集包含768条用于二分类糖尿病预测的记录。对该数据集应用了完整的九阶段核心工作流程。这九个核心阶段包括数据集选择与验证、计算环境配置、数据预处理、数据集划分、模型开发与训练、预测性能与计算性能评估、可解释性分析、统计验证以及可重复性评估。外部验证和临床专家评估被保留为可选的验证模块,在本示例中未予执行。图1展示了核心协议的工作流程,表1仅总结了本示例中实施的九个核心阶段;可选的外部验证和临床专家评估在方案部分有单独描述,不包含在九个实验阶段之内。
1. 选择并验证医疗数据集
- 选择 Pima 印第安人糖尿病数据集作为本研究验证示例的主要数据集。核实数据集来源、样本量、预测目标、类别分布及数据结构。
- 应用预定义的纳入、排除及数据质量标准。在模型开发前删除重复和无效记录。
- 在 表2 中记录数据集来源、特征、预测任务、类别分布、纳入与排除标准以及划分策略。
- 应用数据集与模型选择的决策标准
- 在选择数据集、模型架构、预处理策略或可解释性方法之前,首先明确预测目标。
- 根据预测目标匹配数据集模态。针对结构化临床变量选择表格数据,针对医学图像选择影像数据,针对生理信号选择时间序列数据,针对临床叙述文本选择文本数据;当同一患者或研究单元具备多种互补模态时,选择多模态数据。
- 根据样本量、结局可用性、类别分布、缺失情况、标注质量、临床相关性、数据完整性及可获取性评估候选数据集。选择满足预定义要求的数据集。
- 当样本量、计算资源或可解释性要求限制了复杂架构的使用时,针对结构化表格数据选择传统机器学习模型。当拥有充足的训练数据以及高维输入(如医学图像、生理信号或临床文本)时,选择深度学习架构。
- 仅当同一患者或研究单元具备多种模态数据且能够可靠对齐而不引入信息泄露时,才选择多模态架构。根据所选数据模态的特征选择相应的预处理操作。
- 根据模型和数据模态选择可解释性方法。对于合适的表格模型,使用模型无关方法(如 SHAP 或 LIME);对于基于图像的模型,在适用情况下使用特定于模态的方法(如 Grad-CAM)。
- 记录数据集、预处理策略、模型及可解释性方法选择的依据。将这些决策作为可重复性记录的一部分予以保存。
2. 配置用于可解释人工智能模型开发的计算环境
- 根据所选模型的要求配置操作系统、CPU、内存、存储和 GPU。创建独立的 Python 环境,并安装所需的机器学习、深度学习、统计、可视化和可解释性人工智能(XAI)库。
- 在 表3 中记录实际使用的计算环境、模型架构以及用于验证实验的超参数。明确说明优化器、学习率、批量大小、最大训练轮数、损失函数、正则化参数、验证策略、早停配置、随机种子设置、可解释性方法、硬件、操作系统、Python 版本以及相关软件库的版本。将这些实际用于实验的设置与通用或推荐的协议设置区分开来。
- 在复现 Pima 印第安人糖尿病数据集验证及其相应的预测、可解释性、统计分析和可重复性结果时,使用 表3 中报告的配置。
- 运行验证脚本,确认能够成功导入软件包、加载数据集、执行模型并生成输出结果。保留最终确定的环境配置以确保可重复性。
3. 为可解释人工智能模型开发准备和表征医疗保健数据集
- 选择并获取医疗数据集
- 选择适合既定临床预测任务的医疗数据集。根据研究目标、数据类型、样本量、标注质量、类别平衡性和临床相关性,评估候选数据集。
- 当公开可用的基准数据集能够充分满足预测任务需求并支持独立验证时,优先选用此类数据集。
- 在获取机构内部或自建数据集之前,须获得必要的伦理审批、机构许可和数据访问授权。从经过验证的存储库或授权的机构数据库中获取所选数据集。
- 保留原始数据集文件,不得修改,并记录数据提供方、版本、获取信息、许可条件、纳入标准、排除标准及附带的元数据。将数据集组织为原始数据、标注、元数据和补充信息的独立目录。
- 表征医疗数据集
- 识别预测变量、结果标签、特征类型、数据模态和类别分布。确定受试者数量、样本数量、特征维度以及可用的标注信息。
- 确认数据集特征与所选人工智能方法相兼容。
- 仅使用Pima Indians Diabetes Dataset作为验证九阶段核心协议的实验数据集。仅将表2中列出的其他数据集用于展示该通用协议在临床表格数据、电子健康记录、皮肤镜图像、生理时间序列数据和医学影像中的适用性。不得将这些额外数据集用于模型训练、测试、统计验证或生成报告中的实验结果。
- 评估数据集质量
- 检查数据集中是否存在重复记录、损坏文件、缺失值、标注错误和异常数据条目。删除确认的重复记录,并修正已核实的格式异常。记录所有数据集质量控制流程。
- 在使用多模态数据集时,通过受试者标识符验证影像、临床、实验室和生理数据之间的一致性。
- 删除重复或不一致的记录,处理缺失值,标准化数值特征,编码分类变量,并应用模态特定的预处理方法。将数据集划分为独立的训练集、验证集和测试集。参见图2了解医疗数据集准备、预处理、划分和质量评估的工作流程。
- 确保数据隐私与伦理合规
- 从医疗数据中移除直接标识符。在需要时应用匿名化或假名化处理程序。依照适用的伦理规范、数据保护法规、知情同意要求和机构规定处理患者健康信息。
- 记录适用的伦理审批、豁免、数据治理流程、匿名化方法以及数据集准备流程。
- 在相关信息可用且符合伦理允许的前提下,通过比较模型在相关人口统计学或临床亚组中的表现,评估潜在的算法偏倚。
- 记录模型的预期用途、目标人群、模型局限性、潜在失效模式、人工监督要求,以及适用的伦理、数据保护和医疗监管要求。
- 将识别出的公平性局限性和负责任人工智能的考量纳入最终模型文档中。
注:获取一个标准化且有记录的医疗数据集,该数据集应适用于人工智能模型开发,符合伦理要求,并无重大已知不一致问题。
4. 为人工智能模型训练预处理和划分医疗数据
- 执行质量控制
- 检查数据集中是否存在重复记录、缺失值、无效值、不一致的标签、异常值以及损坏的文件。
- 根据预定义的标准删除或修正无效观测值,并记录所有排除情况。验证预测变量和结果标签的一致性。
- 处理缺失数据
- 量化每个变量的缺失程度。根据预定义的填补或排除策略进行处理。
- 仅使用训练数据估计填补参数,并将拟合后的转换应用于验证集和测试集数据。
- 数据归一化与变换
- 应用所选模型所需的特征缩放、归一化、编码、降维或其他变换。所有依赖数据的变换均仅使用训练数据进行拟合。
- 将拟合后的变换不变地应用于验证集和测试集数据。
- 量化训练数据中的类别不平衡情况。仅对训练数据集应用类别加权、SMOTE、过采样或数据增强方法。保持验证集和测试集数据原有的分布不变。
- 确认训练集与评估集之间不存在任何共享的受试者、重复观测、增强样本、预处理统计量、特征选择标准或合成样本。
5. 开发并配置可解释人工智能模型
- 通过指定输入数据模态、预处理操作、模态特异性特征编码器、特征融合机制、预测层和可解释性模块,定义模型架构。
- 根据预测任务和输入模态选择机器学习或深度学习架构。配置输入层、特征提取组件、隐藏层、输出层和激活函数。定义优化器、学习率、批量大小、损失函数、训练轮数、正则化方法、丢弃率、早停策略以及学习率调度方案。
- 仅使用训练数据和验证数据优化超参数。
- 在 表3 中记录最终确定的架构和超参数配置。
- 训练前验证输入与输出的维度兼容性。
注意:建立一个完全配置的可解释人工智能(XAI)模型,包含合适的架构、明确定义的超参数以及集成的可解释性技术。
6. 训练、优化和保存XAI模型
- 加载预定义的训练和验证数据集以及最终的模型配置。使用预定义的随机种子和训练参数初始化模型。
- 使用指定的优化器、损失函数、批量大小和停止条件训练模型。
- 监控验证集性能,并保留符合预定义模型选择标准的检查点。在独立的测试数据集上评估所选检查点,不再进行进一步优化。
- 保存训练好的模型、预处理配置、超参数、随机种子和训练日志。
注意:获得一个使用准备好的医疗数据集进行训练和验证的优化后的可解释人工智能(XAI)模型。为确保可重复性,保留性能最佳的模型、超参数、训练日志、预处理配置以及计算环境。
7. 评估预测性能与计算性能
- 评估预测性能
- 在完成模型训练和超参数优化后,加载已优化的模型和独立测试数据集。测试过程中保持训练好的模型参数和预处理流程不变。
- 对测试数据集中的所有样本生成预测结果,并将预测输出与相应的实际标签进行比较。
- 计算性能指标
- 根据预测任务的类型选择相应的评估指标。
- 对于分类任务,视情况计算准确率、精确率、召回率、特异性、F1分数、平衡准确率、马修斯相关系数(MCC)以及受试者工作特征曲线下面积(AUC-ROC);对于回归任务,视情况计算平均绝对误差(MAE)、均方根误差(RMSE)、决定系数(R2)及其他相关指标。
- 评估模型泛化能力与鲁棒性
- 当存在独立于开发数据集之外收集的外部数据时,使用该外部数据集对模型进行评估。
- 优先选用来自不同医疗机构、地理区域或患者人群的外部数据集,以评估模型的可迁移性。
- 当具有纵向数据时,使用后续时间段收集的数据进行时间上的验证。
- 当有多中心数据可用时,通过在各参与机构分别评估最终模型来进行多中心验证。
- 在可行的情况下,使用来自不同地理区域的独立人群进行地理验证。
- 报告开发数据集与外部数据集之间的性能差异及其置信区间。
- 评估计算性能
- 在预定义的计算环境下测量模型训练时间,在相同计算条件下测量推理和测试时间,以及内存消耗、模型大小和硬件利用率。
- 在多次独立运行中重复计算性能的测量。
- 计算平均执行时间,以降低实验变异的影响。
- 比较模型性能
- 选择适当的传统机器学习或深度学习方法用于对比评估。
- 使用相同的数据集评估所提出的可解释人工智能(XAI)模型和对比模型,并对所有对比模型应用相同的预处理流程和评估指标。
- 在相同的计算环境中进行所有对比实验。
注意:在测试的计算条件和数据集下,获取预测稳定性与可重复性的实验证据。
8. 生成并评估 XAI 输出结果
- 生成模型解释
- 加载优化后的XAI模型。选择未用于模型训练的评估样本。应用预定义的可解释性方法,且不修改已训练的模型或预处理流程。
- 生成全局和局部模型解释
- 生成全局解释,以表征预测模型的整体行为。
- 生成局部解释,以表征单个模型预测。
- 对Pima印第安人糖尿病数据集应用SHAP方法,生成表格模型预测的全局和局部解释。
- 生成SHAP汇总图,以可视化各特征贡献的整体方向和幅度。
- 使用平均绝对SHAP值生成SHAP特征重要性图,按特征对模型预测的总体贡献进行排序。
- 为具有代表性的测试集预测生成SHAP瀑布图,以说明患者特异性的特征贡献。
- 生成SHAP特征依赖图,以考察选定特征与其对模型输出贡献之间的关系。
- 对具有代表性的测试集预测应用LIME方法,生成单个模型预测的局部解释。
- 生成患者特异性的反事实解释,以说明预测结果变化所关联的特征改变。
- 根据数据模态和模型架构选择其他可解释性技术。
- 对于适用的基于图像的模型,使用Grad-CAM或显著性图;对于基于Transformer的架构,使用注意力可视化;对于可微分模型,使用积分梯度法。
- 将Grad-CAM、显著性图、注意力可视化和积分梯度法视为通用的、依赖于模态的协议选项,除非实际执行了相应分析,否则不得将其解释或报告为Pima印第安人糖尿病数据集验证中的实验结果。
- 将可解释性方法应用于Pima数据集的示例验证
- 对Pima印第安人糖尿病数据集应用SHAP和LIME方法,生成表格模型预测的全局和局部解释。
- 基于Pima数据集的验证结果,生成SHAP汇总图、特征重要性图、瀑布图和特征依赖图等可视化结果。
- 为具有代表性的测试集预测生成LIME局部解释。
- 生成患者特异性的反事实解释,以说明模型预测变化所关联的特征改变。
- 将Grad-CAM、注意力可视化、显著性图和积分梯度法视为适用于其他医疗数据类型和模型架构的、依赖于模态的可解释性选项。
- 除非实际执行了相应分析,否则不得将Grad-CAM、注意力可视化、显著性图或积分梯度法作为Pima数据集示例验证中的实验发现进行报告。
- 评估解释质量
- 评估生成的解释是否反映了模型的预测过程。评估在重复实验运行中解释的稳定性,以及在相同计算条件下解释输出的一致性。
- 在适用情况下,评估解释输出对输入数据变化的敏感性。将生成的解释与现有领域知识或专家解释进行比较。
- 在可进行此类比较时,识别与已知医学知识相符的预测特征或解剖区域。
- 记录生成的解释与现有临床解释之间的一致或不一致程度。
- 量化预测不确定性
- 使用适合所选模型架构和医疗应用场景的不确定性估计方法,为评估样本生成预测置信度估计。
- 在适用时,应用蒙特卡洛dropout、基于集成的预测、贝叶斯推断、共形预测或其他经过验证的不确定性估计方法。
- 使用蒙特卡洛dropout时,重复进行随机预测,并为每个评估样本计算平均预测值和预测方差。
- 报告预测置信度或不确定性区间,并与相应的模型预测一同呈现。
- 评估不确定性估计是否能够识别出可靠性较低或预测误差增加的预测。保留不确定性估计方法、参数、随机种子及生成的不确定性输出,以确保可重复性。
- 记录并保存可解释性输出
- 保存所有生成的特征重要性评分、热图、显著性图、注意力可视化结果及患者特异性解释。使用标准化文件格式存储可解释性输出,并与训练好的模型及预处理配置一并归档。
- 记录用于生成解释的计算设置、解释参数、执行时间及软件版本。完整保存可解释性文档,以支持独立审查和可重复性验证。
- 定量评估解释质量
- 通过系统性扰动或屏蔽被识别为重要的特征,并测量模型输出的相应变化,来评估解释的保真度。通过比较归因幅度与模型预测变化的大小,计算解释保真度评分。
- 通过为重复运行、扰动输入或临床相似样本生成解释,并计算所得归因模式之间的相似性,来评估解释的稳定性。在受控输入扰动下,通过测量预测输出变化与解释归因估计变化之间的差异,计算不保真度。
- 对于医学图像解释,当存在参考标注时,使用专家定义的兴趣区域评估定位准确性。通过合格临床专家根据预定义解释标准进行独立评估,以判断其临床实用性。
- 当多位专家独立评估解释的相关性或一致性时,计算Cohen's kappa或Fleiss' kappa。
注:生成表征已训练AI模型预测行为的全局和局部解释。保留可解释性输出及相应配置,以实现透明解释和可重复评估。
9. 进行统计学验证与可重复性评估
- 进行统计验证
- 根据研究目的、实验设计、数据分布以及所评估变量的特征,选择适当的统计方法。
- 根据情况,将连续变量报告为均值 ± 标准差或中位数和四分位距,分类变量报告为频数和百分比。
- 在训练集上进行五折交叉验证,以评估模型性能的稳定性,并报告准确率、AUC-ROC、精确率、召回率和F1分数在各折中的均值 ± 标准差。使用1,000次自助重采样法估计独立测试集性能指标的95%置信区间。
- 使用McNemar检验对配对准确率进行比较,使用DeLong检验对相关AUC-ROC进行比较,使用1,000次重采样的配对自助检验对F1分数进行比较,以将所提出的模型与CNN、随机森林和SVM基线模型进行对比。
- 报告每次比较对应的检验统计量和精确p值,并采用双侧显著性水平α = 0.05。
- 进行模型性能的统计比较
- 将所提出的可解释AI模型与选定的最先进的机器学习和深度学习基线模型进行比较。
- 在比较两组时,根据情况应用Student's t-检验或Mann-Whitney U检验。对于涉及两组以上且适用的参数化比较,应用单因素方差分析(ANOVA)。对于涉及两组以上且适用的非参数化比较,应用Kruskal-Wallis检验。
- 根据原始稿件中的规定,将p < 0.05视为具有统计学意义。
- 对所有预定义的统计比较采用双侧显著性水平α = 0.05,并报告相应的检验统计量和p值。
- 报告主要预测性能指标的95%置信区间。
- 在适当情况下,使用自助重采样法估计性能度量的置信区间。当同一受试者由两个模型进行评估时,使用DeLong检验比较相关的ROC-AUC值。当为同一受试者生成配对的分类结果时,使用McNemar检验进行比较。在适当情况下,使用配对自助程序比较F1分数或其他衍生性能指标。
- 在可获得概率预测时,使用校准图、校准斜率/截距以及Brier分数评估校准性。
- 对于Pima印第安人糖尿病数据集的示例验证,使用为所提出模型和基线模型预定义的配对统计比较方法。根据比较的性质,将所选检验一致地应用于配对测试集预测或重复运行的性能测量。采用双侧显著性水平α = 0.05,并报告检验统计量和精确p值。除非结果在“结果”部分中呈现,否则不得报告其他统计检验已被执行。
- 采用双侧检验,并使用预定义阈值p < 0.05解释统计学显著性。
- 评估模型稳健性
- 在保持预定义的数据集划分、预处理流程、模型架构、超参数、软件环境和评估协议的前提下,使用不同的随机种子重复完整的训练和评估过程10次。
- 记录每次独立运行的AUC-ROC、准确率和F1分数,并报告10次运行的均值 ± 标准差。
- 比较多次重复运行中得到的性能值,以评估在不同随机初始化下的预测稳定性和可重复性。
- 评估可解释性的可重复性
- 当包含解释稳定性评估时,在多次实验运行中生成特征归因、注意力图或其他解释输出。使用适当的相似性或基于排序的一致性度量,对重复运行中的解释输出进行定量比较。
- 对于当前Pima印第安人糖尿病数据集的示例验证,除非已执行相应的重复解释输出和分析,否则不得报告定量的解释稳定性指标。
- 在有适当的临床评估时,评估模型生成的解释与临床医生解读之间的一致性。根据情况计算Cohen's kappa或Fleiss' kappa,以评估评分者之间的一致性。
- 记录可重复性
- 保存原始数据、预处理流程、源代码、训练好的模型、超参数配置、可解释性输出、统计分析脚本和生成的结果。
- 记录整个工作流程中使用的软件环境和硬件配置。使用归档的文件和配置独立重新执行完整的工作流程。
- 将复现的预测性能与原始实验结果进行比较,将复现的模型解释与原始的可解释性输出进行比较。
- 记录复制过程中观察到的任何差异。更新实验文档,以反映独立执行过程中发现的可重复性观察结果。
注:获得可在重复实验中评估的、经过统计验证的预测性能和可解释性结果。保留足够的计算、分析和方法学文档,以支持对完整工作流程的独立验证。
- 可重复性检查清单
- 记录数据集名称、版本、获取日期、来源、纳入标准、排除标准和最终样本量。记录所有预处理操作、转换参数、归一化设置、特征选择流程和数据划分规则。
- 记录操作系统、CPU、GPU、内存、Python版本、框架版本和库版本。记录所有模型架构规格和超参数。
- 记录优化器、学习率、批量大小、训练轮数、损失函数、正则化方法和早停准则。记录所有随机种子和随机数生成器设置。
- 保存训练好的模型权重和预处理配置。保存训练日志、评估脚本、统计分析脚本和可解释性输出。记录最终实验所使用的模型和软件版本。
- 保存独立复现所需的完整计算环境。
- 记录源代码、数据集、模型权重和支持材料的可用性,需符合伦理、法律、许可和隐私限制。
- 独立重新执行归档的工作流程,并将复现结果与原始结果进行比较。
- 使用标准化检查清单记录完整的可重复性要求。
结果
采用 Pima Indians Diabetes Dataset 作为代表性医疗数据集,实现了所提出的可解释人工智能(XAI)框架。该 Pima Indians Diabetes Dataset 被用作唯一的实验验证数据集。所有报告的预测性能、可解释性、统计分析及可重复性结果均基于此数据集生成。TCGA-BRCA、TCGA-UCEC、MIMIC-III、ISIC 2019、HAM10000、OhioT1DM 和 BraTS 2021 未进行实验评估,仅作为示例说明该通用协议在不同医疗数据模态中的适用性。在移除无效和重复记录后,使用了完整的数据集,并在模型开发前执行了指定的预处理操作。数据集采用预定义的分层划分策略,被划分为独立的训练集、验证集和测试集。三个子集之间的样本相互独立,以最大限度降低数据泄露的可能性。
使用预定义的架构和超参数配置了预测模型。采用Adam优化器对模型进行训练,训练时使用的学习率和批量大小均为预定义值,最多训练100个轮次。根据验证损失应用了早停策略,并保留验证性能最优的模型。为提高可重复性,指定了数据集划分、模型初始化以及重复实验的随机种子。
采用准确率、精确率、召回率、特异性、F1分数、马修斯相关系数(MCC)、受试者工作特征曲线下面积(AUC-ROC)以及平均精确率(AP)对训练好的模型在独立测试集上进行评估。所提出的模型与预定义的基线模型在相同的预处理流程、数据划分方式和评估协议下进行比较。根据独立测试集的预测结果生成了受试者工作特征(ROC)曲线、精确率-召回率曲线以及混淆矩阵。
在训练数据上进行了五折交叉验证,以评估性能的稳定性。对主要性能指标估计了95%置信区间,并在所提出的模型与基线模型之间进行了预定义的统计比较。
五重交叉验证得到的准确率为 93.01 ± 0.48%,AUC-ROC 为 0.954 ± 0.007,精确率为 92.42 ± 0.87%,召回率为 93.02 ± 0.45%,F1 分数为 92.72 ± 0.62%。基于 1,000 次重采样估计的 95% 自助法置信区间分别为:准确率 0.897–0.973,精确率 0.890–0.970,召回率 0.880–0.963,F1 分数 0.887–0.965,AUC-ROC 0.931–0.984。使用 McNemar 检验对准确率、DeLong 检验对 AUC-ROC 以及基于 1,000 次重采样的配对自助检验对 F1 分数,与 CNN、随机森林和 SVM 基线模型进行了统计比较。
使用不同的随机种子,完整地重复了10次训练与评估过程。重复运行得到的AUC-ROC为0.957 ± 0.008,准确率为93.24 ± 0.74%,F1分数为92.35 ± 0.92%,表明在多次执行中结果具有相对较低的变异性。重复执行中获得的性能指标以均值和标准差进行汇总。通过分析各次运行间的变异性,评估预测性能在重复执行过程中是否保持稳定。
本示例中未进行外部验证,因为未使用独立的外部数据集。因此,所有报告的预测性、统计学和可重复性结果均基于Pima印第安人糖尿病数据集,并使用预定义的训练、验证和独立测试划分获得。本方案中仍将外部验证保留为可选步骤,适用于拥有来自不同机构、人群、地理区域或时间段的独立数据集的应用场景。
采用适用于表格型Pima印第安人糖尿病数据集的可解释性技术(包括SHAP和LIME)生成模型解释。评估了全局特征重要性,并利用保留的测试样本生成针对特定患者的局部解释。将解释结果与相应的模型预测结果及特征值一并记录,以促进结果的可重复性及后续解读。
为便于说明,本示例研究包含了表1中列出的九个核心工作流程阶段。外部验证和临床专家评估被保留为通用方案中的可选验证模块。由于本研究未使用独立的外部数据集,因此未进行外部验证;同时,由于本示例中未设立正式的专家评估小组,故未开展临床专家评估。因此,这些可选模块不被视为九阶段实验工作流程的一部分,也不作为实验结果进行报告。
预处理和数据集划分过程生成了一个适用于模型开发的标准化数据集。删除了重复和不一致的记录,根据预定义策略处理了缺失值,对数值型特征进行了标准化,并将数据集划分为独立的训练集、验证集和测试集。所得数据集的特征及预处理步骤汇总于表2。通用医疗数据集的准备与预处理流程如图2所示,而专门应用于Pima印第安人糖尿病数据集的实验准备、预处理、划分及质量评估流程则如图3所示。用于生成报告结果的最终计算环境、模型架构和超参数配置汇总于表3。
执行第3和第4节操作后,获得了一个适用于模型开发的标准化医疗健康数据集。预处理过程去除了重复和不一致的记录,填补了缺失值,对数值型特征进行了标准化,对适用的分类变量进行了编码,并将数据集划分为训练集、验证集和测试集。所得数据为后续模型开发提供了所需的标准化输入。
完成第5和第6节后,所配置的模型在训练过程中表现出稳定的收敛性。学习曲线显示,训练损失和验证损失同步下降,训练准确率和验证准确率同步上升。超参数优化提升了模型的泛化能力,未发现明显过拟合现象。为支持结果的可重复性,已将优化后的模型连同最终确定的架构、超参数设置、软件版本、随机种子及训练好的模型权重一并归档。模型训练的详细参数与优化结果汇总于表4,相应的训练与验证学习曲线见图4。
第7节使用标准化的性能指标评估了模型的预测性能。评估的分类指标包括准确率、精确率、召回率、特异性、F1分数、马修斯相关系数(MCC)、ROC曲线下面积(AUC-ROC)和平均精度(AP)。所提出的模型与预定义的基线模型在相同的数据集划分、预处理步骤和评估协议下进行了比较。预测性能的比较结果见表5,而ROC曲线、精确率-召回率曲线、混淆矩阵及比较性性能指标如图5所示。
在第8节之后,生成了模型预测的全局和局部解释,以评估其可解释性。使用SHAP和LIME对表格形式的Pima印第安人糖尿病数据集生成模型解释,并生成针对特定患者的反事实解释,以说明预测结果的变化。SHAP用于生成全局特征重要性、针对特定患者的瀑布图以及特征依赖性可视化结果,而LIME则用于从保留的测试样本中生成局部解释。相应的可解释性输出结果如图6所示。
该方案的最后阶段评估了工作流程的统计可靠性与可重复性。在保持相同的数据集划分策略、预处理参数、模型架构、超参数、软件环境和评估流程的前提下,使用不同的随机种子对该完整工作流程独立重复执行了10次。重复运行的结果显示,AUC-ROC为0.957 ± 0.008,准确率为93.24 ± 0.74%,F1分数为92.35 ± 0.92%,表明多次执行结果的变异性相对较低。
在本次验证实验中,未对解释的稳定性进行定量评估。尽管为Pima印第安人糖尿病数据集生成了SHAP和LIME解释,但未进行独立的运行间秩相关性或特征重叠分析。因此,未报告任何关于解释、稳定性或归因一致性的量化指标。定量的解释稳定性评估仍保留在通用方案中,作为在可获得重复解释输出的应用场景下的可选可重复性步骤。
统计比较采用预定义的显著性阈值 p < 0.05 进行评估。在适用的情况下使用双侧统计检验,并报告相应的检验统计量、p 值和 95% 置信区间,以量化观察到的性能差异的统计显著性和不确定性。实验的统计验证与可重复性结果,包括交叉验证性能、置信区间、统计比较以及多次运行的变异性,已在表6中汇总。相应的统计检验与可重复性分析在图7中展示。
这些结果在所测试的计算条件和数据集下提供了预测稳定性和可重复性的实验证据。为实现独立重复实验,已根据表7中列出的可重复性核对清单,记录了所需的计算环境、数据集特征、预处理流程、模型配置、统计分析以及可解释性设置。在本研究的验证示例中,未对生成的XAI输出结果进行临床专家评估。
总体而言,应用该方案生成了适用于人工智能模型开发的标准化医疗保健数据集,并利用预定义的超参数设置构建了优化的模型。该工作流程实现了对预测性能的系统性评估,使用适用的可解释人工智能(XAI)技术生成模型解释,并对模型的稳健性和可重复性进行了统计评估。综合结果表明,在所评估的实验条件下,所提出的XAI工作流程在实际验证示例中得到了有效实施且具有良好的可重复性。
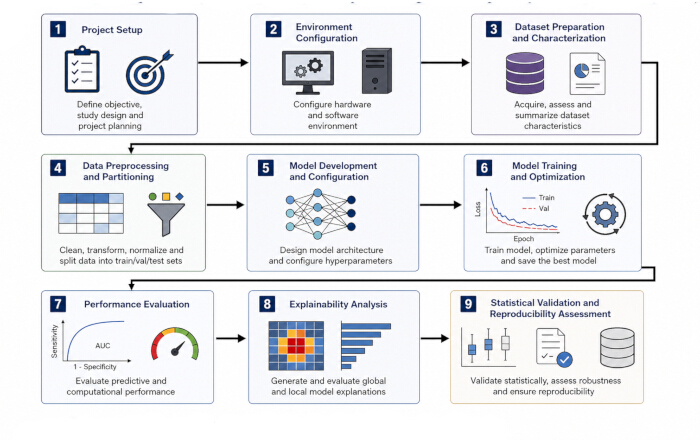
图1:医疗领域中可重复且可解释的人工智能模型开发的九阶段核心工作流程。该工作流程包括(1)医疗预测任务定义,(2)计算环境配置,(3)数据集获取与验证,(4)数据预处理,(5)数据集划分,(6)预测模型训练,(7)预测性能评估,(8)可解释性分析,以及(9)统计验证与可重复性评估。外部验证和临床专家评估被视为可选的协议扩展,不包含在九阶段核心工作流程中。请点击此处查看此图的放大版本。
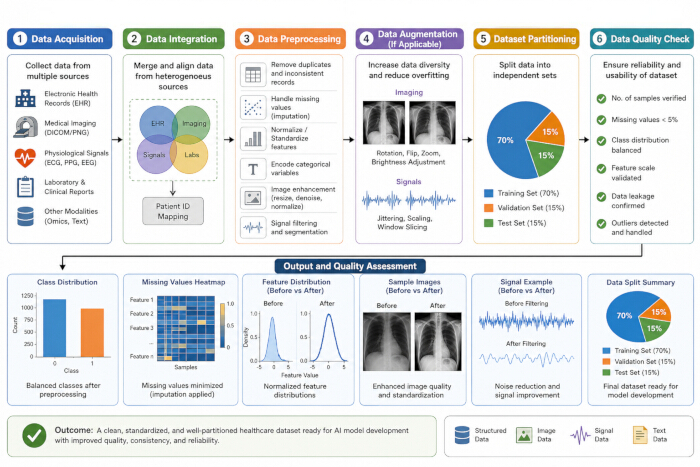
图 2:医疗数据集准备与预处理的工作流程。(A)从临床记录、医学影像、生理信号及多模态数据源获取医疗数据。(B)数据整合与预处理,包括缺失值处理、归一化、去噪和数据增强。(C)将数据集划分为训练、验证和测试子集。(D)质量评估,展示类别分布、特征归一化情况以及模型开发前的预处理结果。请点击此处查看该图的放大版本。
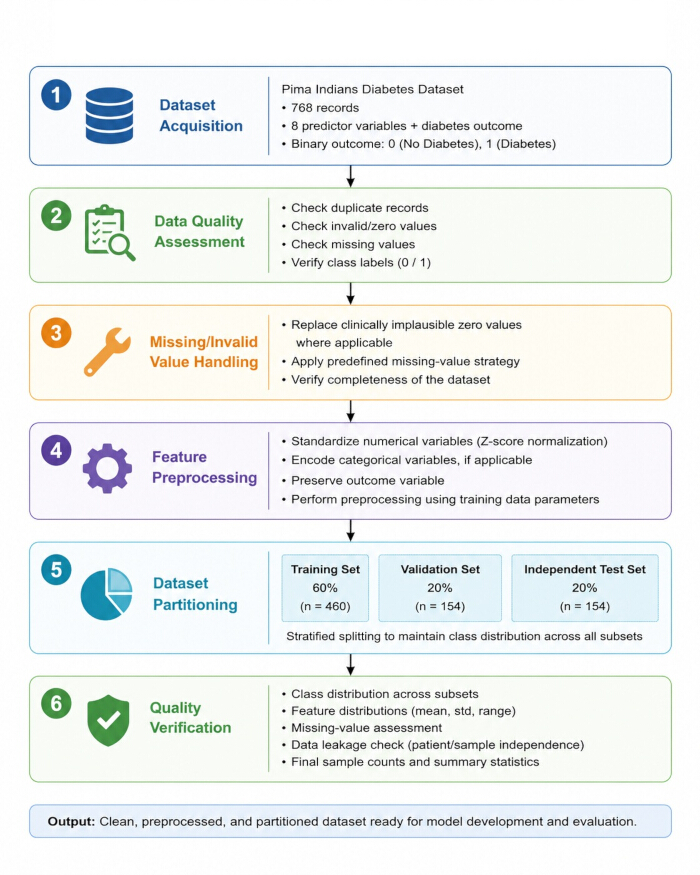
图3:美洲印第安人糖尿病数据集的制备、预处理、划分及质量评估实验流程。 该流程包括数据集获取、数据质量评估、无效值与缺失值处理、数值特征标准化、将数据集划分为训练集、验证集和独立测试集,以及模型开发前的最终质量验证。请点击此处查看该图的放大版本。
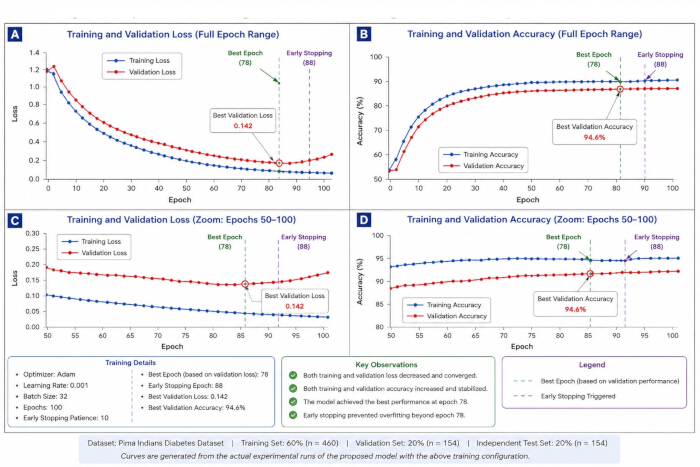
图4:使用Pima印第安人糖尿病数据集的所提出模型的实验训练与验证学习曲线。(A)整个训练期间的训练损失与验证损失。(B)整个训练期间的训练准确率与验证准确率。(C)第50至100轮次期间损失的放大视图。(D)第50至100轮次期间准确率的放大视图。最佳验证性能出现在第78轮次,验证损失为0.142,验证准确率为94.6%。采用10轮次的耐心值,早停机制在第88轮次被触发。请点击此处查看该图的放大版本。
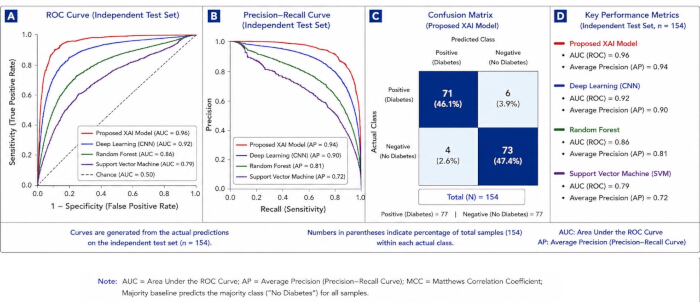
图5: 使用独立测试集(n = 154)对所提出的可解释人工智能框架进行实验性预测性能评估 (A) 受试者工作特征(ROC)曲线,展示所提出的可解释人工智能(XAI)模型与基线模型的区分性能。B) 精确率-召回率(PR)曲线,展示所提出的XAI模型与基线模型的精确率和召回率性能。C) 所提出的XAI模型在独立测试集上的混淆矩阵,以及相应的准确率、灵敏度(召回率)和特异性。 (D) 在所评估的模型中,准确率、精确率、召回率、特异性、F1分数、马修斯相关系数(MCC)、ROC曲线下面积(AUC)和平均精度(AP)的比较。本图中显示的所有定量结果均对应于在Pima印第安人糖尿病数据集上的验证实验。 请点击此处以查看此图的放大版本。
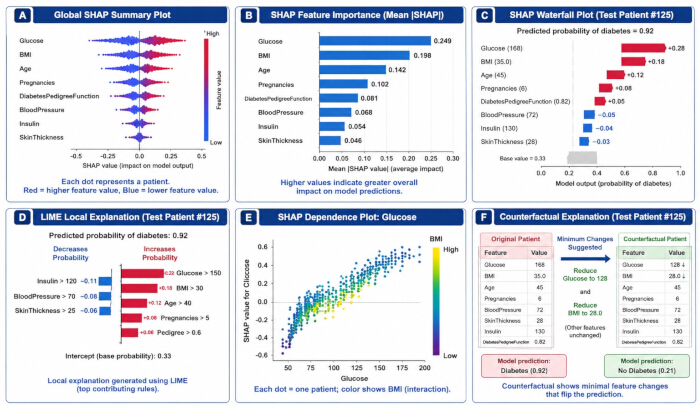
图6: 基于在Pima印第安人糖尿病数据集上训练的所提出模型,对独立测试集预测结果生成的可解释性输出。 (A) 全局SHAP摘要图,显示测试集中各特征贡献度的分布情况。B基于平均绝对SHAP值的SHAP特征重要性图。C) 基于个体特征对预测糖尿病概率贡献的患者特异性SHAP瀑布图。D) LIME局部解释,显示测试患者#125的各项特征贡献。(E)SHAP依赖图,显示葡萄糖值与其SHAP贡献值之间的关系。(F)患者特异性反事实解释,显示模型预测结果发生变化时所需的最小特征改变。缩写:SHAP = Shapley Additive exPlanations;LIME = Local Interpretable Model-agnostic Explanations。 请点击此处以查看此图的放大版本。
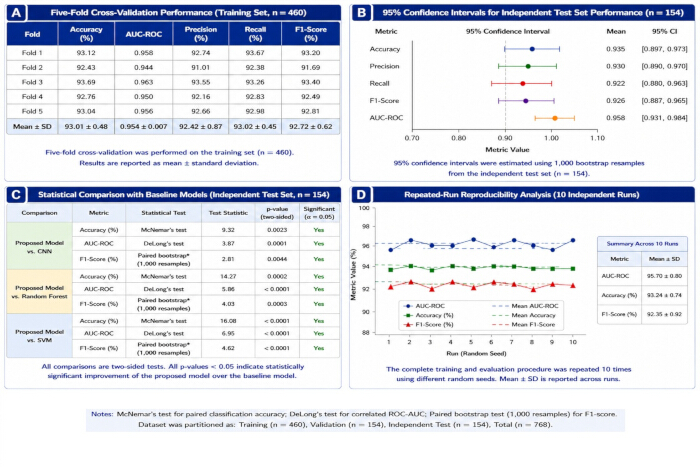
图7:使用Pima印第安人糖尿病数据集对所提出模型进行实验性统计验证与可重复性分析。(A)训练集上的五折交叉验证性能。(B)独立测试集性能的95%自助法置信区间。(C)与基线模型的统计比较,包括统计检验方法、检验统计量、p值及显著性。(D)使用不同随机种子进行10次独立运行的性能一致性。配对分类准确率采用McNemar检验,相关ROC-AUC采用DeLong检验,F1分数比较则采用含1,000次重采样的配对自助法检验。请点击此处查看该图的放大版本。
| 阶段 | 实验方案步骤 | 预期输出 | 实施状态 |
| 1 | 选择并验证医疗健康数据集 | 已验证的数据集、预测目标、类别分布及数据质量信息 | 已完成 |
| 2 | 配置计算环境 | 已验证的硬件、软件、库、版本及计算配置 | 已完成 |
| 3 | 对医疗健康数据进行预处理与质量控制 | 经过清洗、转换和标准化的数据集 | 已完成 |
| 4 | 划分数据集 | 独立的训练、验证和测试数据集 | 已完成 |
| 5 | 开发并优化预测模型/XAI 模型 | 最终确定的模型架构与超参数 | 已完成 |
| 6 | 训练并保存模型 | 已训练的模型、检查点、训练配置及日志 | 已完成 |
| 7 | 评估预测性能与计算性能 | 测试集性能指标及性能比较结果 | 已完成 |
| 8 | 生成并评估可解释性输出 | SHAP/LIME 及适用的解释性输出结果 | 已完成 |
| 9 | 进行统计验证与可重复性评估 | 置信区间、统计检验、重复运行结果及可重复性度量 | 已完成 |
表1:使用Pima印第安人糖尿病数据集进行实例验证时所应用的九阶段核心协议工作流程概要。 该表格将Pima印第安人糖尿病数据集实例中实施的九个阶段与外部验证及临床专家评估区分开来,后者在通用协议中被保留为可选组成部分。
| 数据集 | 数据来源 | 临床应用 | 数据模态 | 受试者/记录数 | 样本数 | 类别数 | 类别分布 | 训练/验证/测试划分 | 本研究中的作用 | 验证状态 | 来源网址 |
| Pima Indians Diabetes Dataset | UCI 机器学习数据库 | 糖尿病预测 | 临床表格数据 | 768 条记录 | 768 | 2 | 500 名非糖尿病患者;268 名糖尿病患者 | 60% / 20% / 20% | 主要实验验证数据集 | 已完成——完整执行九阶段核心工作流程 | https://archive.ics.uci.edu/dataset/34/pima+indians+diabetes |
| TCGA-BRCA | NCI 基因组数据共享平台(GDC),TCGA-BRCA 项目 | 乳腺癌分类 | 临床 + 组织病理学 | 1,098 例病例 | 依数据类型而定 | 依终点而定 | 无统一的全数据集类别分布 | 不适用——未进行实验划分 | 仅用于说明方案适用性 | 未用于实验验证 | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI 基因组数据共享平台(GDC),TCGA-UCEC 项目 | 子宫内膜癌分类 | 临床 + 组织病理学 | 项目队列;规模取决于所选数据类型和筛选条件 | 依数据类型而定 | 依终点而定 | 无统一的全数据集类别分布 | 不适用——未进行实验划分 | 仅用于说明方案适用性 | 未用于实验验证 | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet,MIMIC-III 临床数据库 v1.4 | 临床结局预测 | 临床时间序列 | 46,520 名患者 | 58,976 次 ICU 入院记录 | 依任务而定 | 无统一的全数据库类别分布 | 不适用——未进行实验划分 | 仅用于说明方案适用性 | 未用于实验验证 | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | 国际皮肤影像协作组织(ISIC)挑战赛 | 皮肤病变分类 | 皮肤镜图像 | 不适用——图像数据集 | 25,331 张训练图像 | 8 个训练类别 | AKIEC 867;BCC 3,323;BKL 2,624;DF 239;MEL 4,522;NV 12,875;VASC 253;SCC 628 | 不适用——未进行实验划分 | 仅用于说明方案适用性 | 未用于实验验证 | https://challenge.isic-archive.com/landing/2019/ |
| HAM10000 | 哈佛数据仓库 / ISIC 档案库 | 皮肤病变分类 | 皮肤镜图像 | 7,470 个独立病灶 | 10,015 张图像 | 7 | AKIEC 327;BCC 514;BKL 1,099;DF 115;MEL 1,113;NV 6,705;VASC 142 | 不适用——未进行实验划分 | 仅用于说明方案适用性 | 未用于实验验证 | https://doi.org/10.7910/DVN/DBW86T |
| OhioT1DM | OhioT1DM 数据集,公开用于研究 | 糖尿病监测/预测 | 临床时间序列 | 12 名参与者 | 训练/开发和测试数据中共 24 个 XML 文件 | 连续血糖预测;非固定分类任务 | 不适用 | 由数据集定义训练/开发和测试文件;此处未进行实验划分 | 仅用于说明方案适用性 | 未用于实验验证 | https://pmc.ncbi.nlm.nih.gov/articles/PMC7881904/ |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021;CBICA/宾夕法尼亚大学 | 脑肿瘤分割/分类 | MRI | 挑战赛队列中 2,040 例病例 | 1,251 例带注释的训练病例;每例包含四种 MRI 模态 | 依任务而定 | 无统一的全数据集类别分布 | 由挑战赛定义队列;此处未进行实验划分 | 仅用于说明方案适用性 | 未用于实验验证 | https://www.med.upenn.edu/cbica/brats2021/ |
表2:医疗数据集特征及所提出方案的适用性。 该表格总结了本方案所考虑的医疗数据集的数据来源、临床应用、数据模态、样本特征、类别分布、数据集划分策略、验证状态以及来源信息。其中,Pima印第安人糖尿病数据集作为本方案验证的主要示例。
| 配置项 | 实际验证设置 | 状态 / 解释 |
| 数据集 | Pima Indians Diabetes Dataset | 实际的实验验证数据集 |
| 算法 / 模型 | 用于二分类糖尿病预测的表格模型 | 若实验记录中单独注明,应使用确切的架构名称 |
| 学习率 | 0.001 | 实验设置 |
| 优化器 | Adam | 实验设置 |
| 批量大小 | 32 | 实验设置 |
| 最大训练轮数 | 100 | 实验设置 |
| 损失函数 | Cross-Entropy | 实验设置 |
| 激活函数 | ReLU | 实验设置 |
| Dropout | 0.5 | 实验设置 |
| 权重衰减 | 1e-4 | 实验设置 |
| 批归一化 | 启用 | 实验设置 |
| 数据增强 / 类别平衡 | 启用 | 仅在报告的实验运行中实际应用了SMOTE时才需注明 |
| 验证策略 | 5折交叉验证 | 实验设置 |
| 早停机制 | 耐心值 = 10个训练轮次 | 实验设置 |
| 随机种子 | 42 | 使用实验记录中确切的种子配置 |
| 重复运行 | 使用不同随机种子进行10次独立运行 | 实验可重复性分析 |
| 输入图像尺寸 | 不适用 | Pima数据集为表格型数据 |
| 特征维度 | 512 | 仅在这是最终实现的特征表示时使用 |
| 可解释性 | SHAP + LIME;反事实解释见图6 | 实际报告的XAI分析 |
| 评估指标 | 准确率、精确率、召回率、特异性、F1分数、MCC、AUC-ROC、AP | 报告的实验评估指标 |
| 硬件 | NVIDIA GPU | 如有记录,应替换为确切的GPU型号 |
| 软件 / 框架 | Python 3.11;Scikit-learn;实现中使用的框架组件 | 如有记录,应使用确切的软件包版本 |
表3:协议实施所用的计算环境、模型架构和超参数配置。 该表格列出了用于实现所提出的可解释人工智能(XAI)工作流程的计算平台、软件环境、模型架构、输入配置、优化参数、正则化设置以及可重复性参数。
| 参数 | 代表性规范 / 结果 |
| 优化器 | Adam |
| 学习率 | 0.001 |
| 批大小 | 32 |
| 最大训练轮数 | 100 |
| 早停耐心值 | 10 轮 |
| 最佳轮次 | 78 |
| 早停触发轮次 | 88 |
| 最佳验证损失 | 0.142 |
| 最佳验证准确率 | 94.6% |
| 训练输出 | 训练损失与验证损失持续下降并趋于收敛 |
| 验证输出 | 训练准确率与验证准确率上升并趋于稳定 |
| 优化结果 | 在第 78 轮达到最优模型性能 |
| 过拟合控制 | 早停机制防止了在选定的最佳轮次之后继续优化 |
表4:模型训练参数与优化结果。 该表格总结了模型开发过程中所使用的优化器、学习率、批量大小、最大训练轮数、验证性能、训练收敛性、优化结果以及防止过拟合的策略。
| 模型 | 准确率 (%) | 精确率 (%) | 召回率 (%) | 特异性 (%) | F1 分数 (%) | MCC | AUC (ROC) | AP (PR) |
| 提出的可解释人工智能模型 | 93.5 | 94.5 | 92.4 | 94.6 | 93.4 | 0.87 | 0.96 | 0.94 |
| 深度学习 (CNN) | 89.1 | 89.8 | 88.1 | 90 | 88.9 | 0.78 | 0.92 | 0.9 |
| 随机森林 | 84.3 | 85 | 83.2 | 85.7 | 84.1 | 0.67 | 0.86 | 0.81 |
| 支持向量机 (SVM) | 78.6 | 79.3 | 77.1 | 80 | 78.2 | 0.54 | 0.79 | 0.72 |
| 基线模型 (多数类别) | 62.1 | 62.1 | 100 | 0 | 76.6 | 0 | 0.5 | 0.5 |
表5:所评估模型的预测性能比较。 该表格使用准确率、精确率、召回率、特异性、F1分数、马修斯相关系数、受试者工作特征曲线下面积以及平均精度,对所提出的可解释人工智能模型与评估的基线模型进行了比较。
| 验证分析 | 比较 / 指标 | 统计检验 | 检验统计量 | p 值 | 实验结果 / 95% 置信区间 |
| 五折交叉验证 | 准确率 | 描述性统计(均值 ± 标准差) | — | — | 93.01 ± 0.48% |
| 五折交叉验证 | AUC-ROC | 描述性统计(均值 ± 标准差) | — | — | 0.954 ± 0.007 |
| 五折交叉验证 | 精确率 | 描述性统计(均值 ± 标准差) | — | — | 92.42 ± 0.87% |
| 五折交叉验证 | 召回率 | 描述性统计(均值 ± 标准差) | — | — | 93.02 ± 0.45% |
| 五折交叉验证 | F1 分数 | 描述性统计(均值 ± 标准差) | — | — | 92.72 ± 0.62% |
| 95% 自助法置信区间 | 准确率 | 自助法(1,000 次重采样) | — | — | 0.935 [0.897, 0.973] |
| 95% 自助法置信区间 | 精确率 | 自助法(1,000 次重采样) | — | — | 0.930 [0.890, 0.970] |
| 95% 自助法置信区间 | 召回率 | 自助法(1,000 次重采样) | — | — | 0.922 [0.880, 0.963] |
| 95% 自助法置信区间 | F1 分数 | 自助法(1,000 次重采样) | — | — | 0.926 [0.887, 0.965] |
| 95% 自助法置信区间 | AUC-ROC | 自助法(1,000 次重采样) | — | — | 0.958 [0.931, 0.984] |
| 所提出模型 vs. CNN | 准确率 (%) | 麦克尼马尔检验 | 9.32 | 0.0023 | 显著(α = 0.05) |
| 所提出模型 vs. CNN | AUC-ROC | 德隆检验 | 3.87 | 0.0001 | 显著(α = 0.05) |
| 所提出模型 vs. CNN | F1 分数 | 配对自助法(1,000 次重采样) | 2.81 | 0.0044 | 显著(α = 0.05) |
| 所提出模型 vs. 随机森林 | 准确率 (%) | 麦克尼马尔检验 | 14.27 | 0.0002 | 显著(α = 0.05) |
| 所提出模型 vs. 随机森林 | AUC-ROC | 德隆检验 | 5.86 | <0.0001 | 显著(α = 0.05) |
| 所提出模型 vs. 随机森林 | F1 分数 | 配对自助法(1,000 次重采样) | 4.03 | 0.0003 | 显著(α = 0.05) |
| 所提出模型 vs. SVM | 准确率 (%) | 麦克尼马尔检验 | 16.08 | <0.0001 | 显著(α = 0.05) |
| 所提出模型 vs. SVM | AUC-ROC | 德隆检验 | 6.95 | <0.0001 | 显著(α = 0.05) |
| 所提出模型 vs. SVM | F1 分数 | 配对自助法(1,000 次重采样) | 4.62 | <0.0001 | 显著(α = 0.05) |
| 重复运行可重复性(10 次独立运行) | AUC-ROC | 描述性统计(均值 ± 标准差) | — | — | 0.957 ± 0.008 |
| 重复运行可重复性(10 次独立运行) | 准确率 (%) | 描述性统计(均值 ± 标准差) | — | — | 93.24 ± 0.74% |
| 重复运行可重复性(10 次独立运行) | F1 分数 (%) | 描述性统计(均值 ± 标准差) | — | — | 92.35 ± 0.92% |
表6:使用Pima印第安人糖尿病数据集进行实验实现所获得的统计验证与可重复性结果。 该表格总结了五折交叉验证性能、基于自助法的95%置信区间、所提出模型与基线模型的统计比较,以及在10次独立随机种子重复运行下的可重复性结果。本研究实例验证中未进行外部验证和临床专家评估。
| 编号 | 检查项 | 所需文档 | 推荐的记录/验证方式 |
| 1 | 软件环境 | 操作系统、编程语言和软件环境 | 记录确切的操作系统和编程语言版本。 |
| 2 | 软件和库版本 | 主要软件库和包的版本 | 记录确切的包/库名称和版本。 |
| 3 | 硬件规格 | CPU、GPU、RAM、存储和加速器的规格 | 记录所使用的计算硬件。 |
| 4 | 数据集标识 | 数据集名称、来源、版本和访问信息 | 记录确切的数据集来源/版本及适用情况下的访问日期。 |
| 5 | 数据集特征 | 样本量和类别分布 | 记录每次划分的总样本数和类别分布。 |
| 6 | 数据集划分 | 训练、验证和独立测试集策略 | 记录划分比例/数量及分层方法。 |
| 7 | 数据泄露预防 | 用于防止信息泄露的流程 | 记录受试者/样本分离情况以及仅在训练集上进行预处理参数估计的方法。 |
| 8 | 预处理参数 | 清洗、缺失值处理、归一化、编码和转换设置 | 记录所有预处理操作及其参数值。 |
| 9 | 数据增强 | 增强方法及参数设置(如适用) | 记录方法、概率和参数范围。 |
| 10 | 模型架构 | 最终模型架构和配置 | 记录模型类型、层/组件、维度和激活函数。 |
| 11 | 超参数 | 训练和优化的超参数 | 记录学习率、批量大小、优化器、训练轮数、早停机制及调优参数。 |
| 12 | 随机种子 | 用于可重复执行的随机种子 | 记录用于数据划分、初始化和重复运行的随机种子。 |
| 13 | 训练配置 | 训练流程和模型选择策略 | 记录验证方式、检查点保存和模型选择标准。 |
| 14 | 评估指标 | 预定义的预测性和统计性评估指标 | 记录所有报告的性能度量。 |
| 15 | 置信区间 | 性能度量的不确定性区间 | 记录置信区间估计方法及适用情况下的自助重采样次数。 |
| 16 | 统计检验 | 模型比较所用的统计方法 | 记录检验方法、统计量、p值、显著性阈值及假设条件。 |
| 17 | 重复运行分析 | 使用不同随机种子进行的独立执行 | 记录运行次数以及关键指标的均值±标准差。 |
| 18 | 可解释性配置 | 可解释性方法及参数设置 | 记录SHAP、LIME、Grad-CAM、注意力机制、反事实分析或适用的设置。 |
| 19 | 可解释性评估 | 对解释可靠性和实用性的客观评估 | 记录保真度、稳定性、不一致率、定位能力及专家评估(如适用)。 |
| 20 | 模型产物 | 训练好的模型权重和配置文件 | 归档最终训练模型、架构/配置及模型选择信息。 |
| 21 | 代码可用性 | 用于预处理、训练、评估和生成解释所需的代码 | 记录代码仓库或受控代码访问信息(如适用)。 |
| 22 | 执行文档 | 命令、脚本、配置文件和说明 | 记录重现工作流程所需的命令和配置。 |
| 23 | 输出文档 | 预测结果、评估结果、图表和解释输出 | 归档生成的输出,并将其与相应的实验/运行关联。 |
| 24 | 可重复性验证 | 跨独立执行的一致性验证 | 比较重复运行结果,并报告预定义的变异性度量。 |
表7:用于独立重复本研究提出的可解释人工智能工作流程的可重复性检查清单。 该清单明确了为重现实验工作流程所需的计算环境、数据集、预处理、模型开发、评估、统计验证、可解释性分析及文档记录等方面的要求。
讨论
结果表明,本研究提出的方案可作为一种标准化且可重复的工作流程,用于在多种医疗健康数据集上开发和评估可解释人工智能(XAI)系统。如表2和图3所示,系统化的预处理通过缺失值处理、数据归一化、特征缩放和数据集划分,生成了标准化的数据并提高了数据质量。这些预处理步骤至关重要,因为数据准备过程中的差异可能引入偏差、降低预测性能,并损害可解释性分析的可靠性。因此,必须在训练、验证和测试数据集上统一应用一致的预处理流程,以提高可重复性并防止数据泄露19,20。
模型训练结果如图所示 图4 和 表4 表现出一致且稳定的学习行为。训练损失和验证损失同时下降,以及预测准确率的提升,表明模型收敛适当,且无明显过拟合现象。超参数优化、早停法、dropout 和正则化方法进一步有助于实现稳定且可重复的模型训练。学习曲线的不稳定性可能提示学习率设置不当、训练数据不足或模型复杂度过高。因此,必须在整个训练过程中持续监测模型的收敛情况,以识别并解决这些潜在问题。
表5 和 图5 展示了使用多种评估指标的预测性能,包括准确率、精确率、召回率、特异性、F1分数、马修斯相关系数以及受试者工作特征(ROC)曲线下面积。ROC曲线和精确率-召回率曲线提供了区分性能的度量,而混淆矩阵则展示了各类别中正确与错误分类的分布情况。对于不平衡的医学数据集而言,使用多种性能指标进行评估尤为重要,因为仅凭总体准确率可能无法充分反映模型的实际性能。
图6 展示了从Pima印第安人糖尿病数据集生成的可解释性结果,并演示了在实例化验证中所应用的可解释性方法之间的互补作用。全局SHAP分析用于刻画输入特征对模型预测的整体贡献及其相对重要性,而SHAP瀑布图和依赖图则提供了针对特定患者及特征层面的模型行为解释。LIME通过识别对单个测试集样本预测结果有贡献的特征,提供了额外的局部解释。针对特定患者的反事实解释进一步阐明了预测结果发生变化时所需的最小特征改变。这些方法共同为模型行为提供了互补的全局与局部视角,提升了表格型预测模型的透明度与可解释性。梯度加权类激活映射(Grad-CAM)、注意力可视化、显著性图(saliency mapping)和积分梯度(Integrated Gradients)未在Pima数据集的实例化验证中应用,仅作为通用方案中依模态而定的可选方法予以保留。
统计验证(表6 和 图7)与可重复性评估表明,预测性能在不同实验运行中具有稳定性。交叉验证、置信区间估计、假设检验与重复运行可重复性评估相结合,为评估模型的稳健性提供了系统性框架。此类验证在医疗应用中尤为重要,因为在独立实验之间具备可重复性,是人工智能模型在临床环境中实施前可靠性与可推广性的关键证据21,23。
成功实施本方案需注意多个关键步骤。在特征提取和模型训练之前进行数据清洗,以尽量减少因数据不完整、不一致或错误而产生的潜在偏差。仅使用训练数据和验证数据进行超参数优化,并在整个模型开发与优化过程中保持测试数据集的独立性。明确记录随机数生成器状态、软件版本、硬件配置和预处理设置,以促进在不同计算平台间的可重复性。此外,应根据预测模型和医疗数据类型选择可解释性方法,以获得可解释且具有临床相关性的结果20,29,30。
该方案存在若干局限性。模型预测和解释的准确性与可靠性在很大程度上依赖于是否具备足够大、具有代表性且高质量的医疗保健数据集。特定患者人群的代表性不足、测量误差、缺失变量以及数据来源之间的异质性,可能对预测性能和模型解释的稳定性均产生不利影响。此外,当前的可解释性方法能够描述模型行为,但未必能确立因果机制。因此,应结合相关临床专业知识来解读可解释人工智能(XAI)的输出结果。
总体而言,本方案为在不同医疗领域中实现可重复的模型开发、评估和可解释性分析提供了一种标准化的方法。通过整合标准化的预处理、超参数优化、基于多种性能指标的评估、互补的可解释性方法以及统计验证,该工作流程为医疗领域的人工智能研究提供了一个透明且可追溯的框架。
研究结果进一步表明,通过结合系统性的数据预处理、标准化的模型开发流程、全面的性能评估、多种可解释性方法以及严格的统计验证,可以支持透明且一致的人工智能模型开发。该方案可适用于临床数据库、医学影像、生理信号及多模态医疗数据,同时保持在不同计算环境中可重复实验的框架。通过标准化实施、互补的可解释性技术以及可重复性评估,该方案为开发可解释且值得信赖的人工智能模型提供了框架,并可作为未来生物医学研究及后续外部验证和临床验证的方法学基础。
披露
作者声明,他们在本研究中不存在任何可能影响本研究工作的竞争性经济利益、商业关系或个人关系。作者无任何利益冲突需要披露。
致谢
作者感谢各自所属机构在本医疗可解释人工智能(XAI)协议的开发与实验验证过程中提供的机构支持。作者还感谢用于开展实验分析的计算设施和软件资源。本研究未获得任何外部资金资助。作者声明在本研究中使用了 Python 3.11、Matplotlib 3.9 和 SciPy 1.13 进行计算分析、数据可视化以及图表的生成。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Captum | Meta AI | 最新稳定版 | PyTorch 可解释性 |
| CUDA Toolkit | NVIDIA | 12.2 | GPU 加速 |
| cuDNN | NVIDIA | 9.x | 深度学习后端 |
| Git | Git SCM | 最新稳定版 | 版本控制 |
| GitHub | GitHub Inc. | Web 平台 | 源代码仓库 |
| Grad-CAM | jacobgil | 最新发布版 | CNN 可视化 |
| Jupyter Notebook | Project Jupyter | 最新稳定版 | 交互式开发 |
| LightGBM | Microsoft | 4.x | 梯度提升 |
| LIME | LIME 社区 | 0.2.0 | 局部可解释性 |
| Matplotlib | Matplotlib 开发团队 | 3.9 | 可视化 |
| Microsoft Excel | Microsoft | Microsoft 365 | 数据组织 |
| NumPy | NumPy 开发团队 | 1.26 | 数值计算 |
| NVIDIA RTX 4090 GPU | NVIDIA | 24 GB VRAM | 模型训练 |
| OpenCV | OpenCV 组织 | 4.10 | 图像预处理 |
| Pandas | Pandas 开发团队 | 2.2 | 数据预处理 |
| Pillow (PIL) | Python Imaging Library | 10.x | 图像处理 |
| Plotly | Plotly Technologies | 5.x | 交互式可视化 |
| Python | Python 软件基金会 | 3.11 | 编程环境 |
| PyTorch | PyTorch 基金会 | 2.3 | 深度学习 |
| Scikit-learn | Scikit-learn 开发者 | 1.5 | 机器学习 |
| SciPy | SciPy 开发团队 | 1.13 | 科学计算 |
| Seaborn | Seaborn 开发团队 | 0.13 | 统计图表 |
| SHAP | SHAP 社区 | 0.46 | 全局可解释性 |
| SimpleITK | Insight 软件联盟 | 2.x | 医学图像处理 |
| Statsmodels | Statsmodels 开发团队 | 0.14 | 统计分析 |
| 系统内存 (System RAM) | 任意厂商 | 32 GB 或更高 | 内存 |
| TensorBoard | 2.15 | 训练监控 | |
| TensorFlow | 2.15 | 深度学习 | |
| Ubuntu Linux / Windows 11 | Canonical / Microsoft | 22.04 LTS / 11 | 操作系统 |
| Visual Studio Code | Microsoft | 最新稳定版 | 代码开发 |
| XGBoost | XGBoost 开发团队 | 2.1 | 梯度提升 |
参考文献
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.