Massenspektrometrie-basierte Proteomdaten sind in offenen Datenbanken verfügbar und mit kostenlosen Tools zugänglich. Angesichts der Komplexität von Datenbankrecherchen und -beschreibungen fehlt vielen Biologen das Wissen, um diese Datensätze zu nutzen. Hier finden Sie eine Anleitung zur Verwendung kostenloser Tools für die grundlegende Suche nach proteomischen Daten.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Methodenartikel
Navigieren in den massenspektrometrischen Proteomdaten mit kostenlosen Berechnungswerkzeugen
In diesem Artikel
Zusammenfassung
Zusammenfassung
Massenspektrometrie (MS)-basierte Proteomik-Daten, einschließlich datenabhängiger Erfassung (DDA) und datenunabhängiger Erfassung (DIA), werden in der biologischen Forschung häufig verwendet. Die Anwendung dieser Datensätze in Validierungsstudien ist jedoch noch begrenzt, da es an klaren Demonstrationen für die effektive Suche und Analyse von Proteomdaten mangelt. Um diese Lücke zu schließen, haben wir einen DDA- und einen DIA-Datensatz ausgewählt, die in der PRoteomics IDEntifications Database (PRIDE) hinterlegt sind, um den Arbeitsablauf der proteomischen Datenanalyse und die nachgelagerte Nachbearbeitung von Proteinsuchergebnissen besser zu veranschaulichen. Zu Demonstrationszwecken haben wir zwei kostenlose Berechnungstools verwendet: FragPipe (v22.0) für DDA-Datensätze und DIA-NN (2.1.0) für DIA-Datensätze. Nachbearbeitungsschritte, wie z. B. die Generierung von Vulkandiagrammen und Listen dysregulierter Proteine, wurden mit Hilfe des R-Codes demonstriert. Diese Studie bietet grundlegende Protokolle für die Suche und Analyse von Proteomdaten und dient als unverzichtbarer Leitfaden für Einsteiger für den effektiven Umgang mit Proteomdatensätzen. Durch diese Arbeit wollen wir Forschern das notwendige Wissen vermitteln, um proteomische Daten in ihren biologischen Untersuchungen zu nutzen.
Einleitung
Das Gebiet der Proteomik wurde durch die weit verbreitete Einführung von frei zugänglichen Datenrepositorien und freien Software-Tools1 revolutioniert, die maßgeblich dazu beigetragen haben, die Forschungskapazitäten voranzutreiben und eine Kultur des Datenaustauschs zu fördern. Die Einrichtung zentralisierter Ressourcen wie PRIDE2 und die Entwicklung standardisierter Datenformate durch die Human Proteome Organization (HUPO) Proteomics Standards Initiative (PSI)3 haben eine beispiellose Möglichkeit für die Wiederverwendung und Integration von Daten geschaffen. Die....
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
HINWEIS: In Abbildung 1finden Sie einen Überblick über den Arbeitsablauf und in der Materialtabelle eine detaillierte Beschreibung der verwendeten Software.
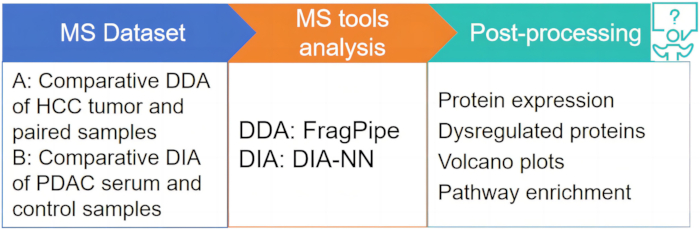
Abbildung 1: Überblick über das Studiendesign. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzuzeigen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Um die Suche nach proteomischen Datensätzen besser zu veranschaulichen, haben wir zwei Arten von Datensätzen für diese Analyse ausgewählt. Mit dem Ziel, dysregulierte Proteine in klinischen Kontexten zu demonstrieren, suchten wir in PRIDE mit Schlüsselwörtern wie clinic. Konkret wählten wir einen für die DIA-Analyse geeigneten Datensatz des Clinical Proteomic Tumor Analysis Consortium (CPTAC)21 und einen weiteren, der für die DDA-Analyse geeignet ist, vom Chinese H.......
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Das vorgestellte Protokoll veranschaulicht die proteomische Datenanalyse durch die Integration kostenloser Tools wie DIA-NN und FragPipe. Der Erfolg hängt von kritischen Schritten ab, wie z. B. der genauen Auswahl der Vorläuferionen, und den Einstellungen für die Massengenauigkeit für die Generierung von Spektralbibliotheken in DIA-NN (Schritt 2.3)27, die instrumentenabhängig und für die vollständige Peptididentifizierung entscheidend sind. In ähnlicher Weise ist .......
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
F.Z. ist der Gründer des Molemuse Biotech Studios.
Danksagungen
Dieses Projekt wird von Molemuse Biotech Studio unterstützt.
....Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| .NET SDK v. 9.0.203 | Microsoft | https://dotnet.microsoft.com/en-us/download | |
| DIA-NN v. 2.1.0 | https://github.com/vdemichev/DiaNN/releases/tag/2.0 | ||
| FragPipe v. 22.0 | https://github.com/Nesvilab/FragPipe/releases | ||
| MSFileReader v. 3.1 | Thermo Fischer | https://github.com/thermofisherlsms/MSFileReader/blob/main/MSFileReader_x64.exe | |
| R 4.5.0 | https://cran.rstudio.com/bin/windows/base/R-4.5.0-win.exe | ||
| Rstudio v. 2024.12.1+563 | https://posit.co/download/rstudio-desktop/ |
Referenzen
- Pedrioli, P. G. A., et al. A common open representation of mass spectrometry data and its application to proteomics research. Nat Biotechnol. 22 (11), 1459-1466 (2004).
- Perez-Riverol, Y., et al. The PRIDE database at 20 years: 2025 update. Nucl ....
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Nachdrucke und Genehmigungen
