Die aktuelle Studie beschreibt einen Workflow für die Nanoporensequenzierung von Plasmiden, wenn die chromosomale Sequenz bereits bekannt oder von Interesse ist. Ein anfänglicher Plasmid-DNA-Anreicherungsschritt sorgt für eine optimale Plasmidsequenztiefe und maximiert die Anzahl der pro Flusszelle sequenzierbaren Proben.
Methodenartikel
Langlesen-Plasmid-Sequenzierung und -Montage mit Workflows auf Basis von Nanoporensequenzierungen
* These authors contributed equally
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die vorliegende Studie beschreibt einen Workflow für die Nanoporensequenzierung, der darauf ausgelegt ist, die Plasmid-DNA-Ausbeute und die Sequenzierungsgenauigkeit zu maximieren. Forscher behandeln jeden Schritt des Prozesses, der die Extraktion von Plasmid-DNA, die Bibliotheksvorbereitung mit schneller Barcodierung und Adapterligierung, das Laden der Bibliothek auf eine Flusszelle zur Sequenzierung, Basenaufrufe (in Echtzeit oder post-hoc) und die Sequenzassemblierung mit Autocycler umfasst. Die Autoren legen außerdem die Computeranforderungen fest, die weitgehend davon abhängen, ob Basecalling in Echtzeit erfolgt. Die Autoren sequenzierten Plasmide, die aus zehn klinischen Stämmen gereinigt wurden, mithilfe dieses Workflows. Um Unterschiede zwischen Wirtszellstämmen als Variable auszuschließen, konjugierten die Autoren diese klinischen Stämme auch mit einem gemeinsamen Empfängerstamm und sequenzierten die Transkonjuganten. Diese Experimente erzeugten Plasmidassemblierten, die mit Plasmidgrößen übereinstimmen, die aus der Gelmobilität abgeleitet werden und die in zwei Dritteln der Fälle auch kurz gelesenen polierten Baugruppen übereinstimmen oder innerhalb von 0,05 % paarweise Sequenzidentität liegen. Die Anreicherung der Plasmid-DNA-Sequenzen maximiert zudem die Effizienz der Plasmidsequenzierung und ermöglicht eine parallele Sequenzierung von bis zu 24 Proben mit optimaler Abdeckung. Dieses Protokoll ist für Plasmide von 4 bis 174 kb ausreichend und toleriert bis zu 72 % chromosomale Kontamination, ohne die Genauigkeit zu beeinträchtigen. Dieses Protokoll ist ideal für Situationen, in denen die chromosomale Sequenz bereits bekannt oder nicht von Interesse ist, wie etwa zur Verifizierung von Plasmidsequenzen, zur Verbesserung der Genauigkeit bereits von WGS erhaltener Plasmidsequenzen oder zur Sequenzierung von durch Konjugation erfassten Plasmiden. Der Organismus, der diese Arbeit illustriert, ist Escherichia coli, der repräsentiert Wirte für die rekombinante Genexpression und für den Plasmideinfang durch Konjugation.
Einleitung
Plasmide sind sich selbst replizierende DNA-Stücke, die allgegenwärtig in Bakterien vorkommen. Sie variieren stark in der Größe, reichen von <800 bp bis 2,5 Mbp, und folgen typischerweise einer bimodalen Verteilung, mit einem kleineren Peak, der multikopien, nicht-konjugativen Plasmiden, und einem größeren Peak, der niedrig-kopierten, oft konjugativenPlasmiden 1,2 entspricht. Plasmide spielen eine Schlüsselrolle in der mikrobiellen Ökologie, da sie Gene tragen, die ihren Wirten helfen, sich an Umweltherausforderungen anzupassen oder neue ökologische Nischen zu erschließen. Plasmide dienen auch als Plattformen für beschleunigte Evolution, bieten eine erhöhte genetische Plastizität und vermitteln horizontalen Gentransfer zwischen Stämmen, Arten, Gattungen und sogar Familien 3,4. Netzwerk- und vergleichende genomische Analysen haben die Rolle des Umweltresistoms als persistentes Reservoir für klinisch relevante Antibiotikaresistenzgene (ARGs) bestätigt und so deren Erhaltung und Verbreitung in ökologischen Umgebungen erleichtert5. Die Verfolgung von Plasmiden und ihrer Ladung an Antibiotikaresistenz- und Virulenzgenen hilft, Übertragungswege6 zu identifizieren. Daher ist die Identifizierung und Charakterisierung von Plasmiden von großem Interesse für verschiedene Anwendungen im Bereich der öffentlichen Gesundheit, der klinischen Mikrobiologie und biotechnologischen Anwendungen.
Die Einführung von Next-Generation-Sequenzierungstechnologien (NGS), die die Hochdurchsatzsequenzierung unbekannter DNA-Vorlagen ermöglichen, hat die Tür zur genomischen Charakterisierung mikrobieller Isolate geöffnet. Die Wholee Genome Sequencing (WGS) ermöglicht die Nachverfolgung des Entstehens, der Ausbreitung und der Übertragung neuer Krankheitserreger, arzneimittelresistenter Stämme und impfentweichenden Varianten. Es wird zudem zunehmend genutzt, um Übertragungswege während klinischer Ausbrüche zu identifizieren und möglicherweise Interventionen für die zukünftige Ausbruchspräventionzu informieren 7. Schließlich ermöglicht WGS das Profilieren von ARGs, was therapeutische Entscheidungen unterstützen kann8, obwohl die Verknüpfung von ARGs mit qualitativen und quantitativen Phänotypen von Antibiotikaresistenzen noch in Arbeit ist9.
Die von WGS im Maßstab erzeugten Short-Read (SR)-Sequenzierungsdaten liegen jedoch in der Regel im Bereich von 400–500 bp. Diese Größe ist kürzer als die der meisten Mobile Genetic Elements (MGEs) und kann sie daher nicht10 auflösen. Die in silico Identifikation von Plasmidsequenzen in WGS-Daten wird durch unvollständige Abdeckung und durch gemeinsame Sequenzen zwischen Plasmiden sowie zwischen bakteriellen Chromosomen und anderen Plasmidenzusätzlich erschwert. Folglich sind Assemblierungen oft stark fragmentiert und unvollständig, sodass ihre subgenomische Position (chromosomal oder Plasmid) nicht mehr zugeordnet werdenkann.
Die Long-Read-(LR)-Sequenzierungstechnologie erzeugt hoch zusammenhängende Baugruppen, die sich über mehr Wiederholungen erstrecken, was die Herstellung vollständiger Plasmidbaugruppen erheblich erleichtert. Es gibt im Wesentlichen zwei Arten von Langlese-Einzelmolekül-Technologien, dieverfügbar sind: 11,12. Einer dieser Ansätze, die Nanoporensequenzierung, wird in der mikrobiellen Genomik aufgrund ihrer niedrigen Kosten, schnellen Bearbeitungszeiten und Eignung für ressourcenbegrenzte Umgebungen immer beliebter13,14.
Nanoporensequenzierungsgeräte verwenden Flusszellen mit Arrays von Tausenden von Nanoporen. Die DNA wird in die Flow-Zelle geladen, von einem motorischen Protein mit Helikasenaktivität geöffnet und durchläuft die Nanopore, die von einem Stromdifferential angetrieben wird. Wenn Nukleotide in einem bestimmten Einzelstrang durch einzelne Nanoporen fließen, wird der Strom unterbrochen, um ein charakteristisches Signal zu erzeugen, das von einem elektronischen Sensor gemessen wird, der an jede Pore angeschlossen ist. Dieses Signal wird mittels Basecalling-Algorithmen decodiert, und die resultierenden Daten werden später mit verschiedenen bioinformatischen Werkzeugen zusammengesetzt und analysiert.
Im Vergleich zu SR-Sequenzierungsansätzen führt die Nanoporensequenzierung tendenziell zu einer geringeren Lesequalität (niedrigere Q-Werte) und erzeugt Einfügungen/Deletionen in Homopolymersequenzen während der Datenanalyse elektrischer Signale (Basecalling)15. Es wurde auch festgestellt, dass nahegelegene Methylierung in nativer DNA systematische Basenruffehlerverursachen kann. Eine häufig verwendete Lösung war es, Kurzlesedaten zur Fehlerkorrektur nach der Montage einzubeziehen. Dieser Prozess (bekannt als "Polieren") erhöht jedoch die Kosten und die Komplexität auf17. Eine erhöhte Sequenzabdeckung kann ebenfalls die Genauigkeit verbessern, ist aber technisch nicht immer erreichbar.
Im Jahr 2024 wurde gezeigt, dass Oxford Nanopore Sequencing (ONT) R10.4.1-Flusszellen und V14-Chemie hochwertige und zusammenhängende Assemblierungen für G-Bakterien liefern, während feinskalige Analysen auf Einzelnukleotid-Niveaus weiterhin von SR-Sequenzierungsdatenprofitieren. Die Lücke zwischen der Genauigkeit der LR- und SR-Sequenzierung wird jedoch allmählich geschlossen. Verschiedene jüngste Verbesserungen umfassen einen präziseren Datenstichprobenprozess mit erhöhter Sequenzierungsgeschwindigkeit, die Einführung eines neuartigen Basecallers, der auf native bakterielle DNA und Methylierung zugeschnitten ist, was zu erhöhten Basenaufrufgenauigkeitenführte 19, sowie aktualisierte Analysetools wie neue Algorithmen für Phasing, Variantenaufrufe und Star-Allel-Calling. Beachten Sie auch, dass der neueste Dorado-Algorithmus V.0.9.0 ONT (2025) für den Rebase-Aufruf von rohen Squiggle-Daten verwendet werden kann. Tatsächlich berichten einige WGS-Studien bereits über die Erzeugung mikrobieller Genome durch Nanoporensequenzierung einer Qualität, für die kurzlesendes Polieren die Konsenssequenz20,21 nicht signifikant verbessern wird.
Plasmide enthalten oft den Großteil der erworbenen Resistenzgene, insbesondere in Enterobacteriaceae-Isolaten22. Daher ermöglicht die Auflösung von Plasmidsequenzen die Kontextualisierung von AR-Genen, was entscheidend für die Nachverfolgung der AMR-Übertragung23,24 ist. Die Nanoporensequenzierung wurde bereits verwendet, um die Mikroevolution von blaKPC mit Plasmiden25 zu untersuchen. MinION-Geräte wurden auch für die Echtzeit-Laborsequenzierung von Plasmiden und die Resistenzgendetektion in klinischen Isolaten im Krankenhaus eingesetzt26. Allerdings ist die Plasmiduntersuchung noch nicht Teil der routinemäßigen Infektionskontrollpraxis.
Trotz der erheblichen Verbesserung der LR-Sequenzierung gegenüber SR-Sequenzierung bei der Fähigkeit, Plasmide aus genomischerSequenz 27 zu retten, bestehen einige Probleme. Langgelesene Assembler wie Flye28, Canu29 und Raven30 produzieren chromosomale Assemblies von hoher Qualität, haben aber Schwierigkeiten, Plasmidsequenzen zusammenzusetzen. Dies liegt zum Teil an unzureichender Abdeckungstiefe, da Plasmid-DNA in den WGS-Sequenzierungsdaten31 unterrepräsentiert ist. Beachten Sie, dass aufgrund ihrer modularen Struktur, der Vielzahl sekundärer Strukturen und des häufigen Auftretens von Wiederholungen die hochwertige Assemblierung der Plasmid-DNA-Sequenz eine höhere Abdeckung als chromosomale DNA erfordert (50-facheLesetiefe 32).
Die Anreicherung der DNA-Proben mit Plasmidsequenzen ist ein effektiver Ansatz, um die Abdeckungstiefe zu erhöhen, aber die Isolierung oder Anreicherung der Plasmid-DNA vor der DNA-Sequenzierung ist für klinische Diagnostikanwendungen zu teuer oder aufwendig und könnte durch die Anreicherung ausgewählter DNA-Sequenzen zu Verzerrungen führen. Im Jahr 2017 wurde plasmidangereicherte DNA verwendet, um die vollständige Assemblierung von Plasmid-DNA in klinischen Proben zur Detektion von ARGs24 zu versuchen. Acht Isolate aus sechs verschiedenen Enterobacteriaceae-Arten wurden sequenziert, um die Populations- und Plasmidstrukturvielfalt zu maximieren. Nach mehreren Ausprobieren von Assemblern zeigte sich, dass Canu/Canu+Pilon die anderen deutlich übertraf; Diese Forschungsgruppe versuchte außerdem einen Meta-Assemblierungsansatz, der die Auflösung zusätzlicher Plasmidstrukturen erreichte, was zur vollständigen Assemblierung von 78 % aller bekannten Plasmide in den sequenzierten Proben führte. Allerdings stellten das Vorhandensein großer Wiederholungsstrukturen und (in geringerem Maße) Probleme mit der DNA-Extraktion weiterhin erhebliche Schwierigkeiten für den Nachweis aller Einzelkontig-Plasmidassemblierungen24.
In jüngerer Zeit wurde adaptive Probenahme als ergänzender Ansatz zur Anreicherung von Plasmidsequenzen mit geringer Häufigkeit untersucht, indem chromosomale Sequenzen in bakteriellen Isolatproben abgestoßen wurden, obwohl diese Methode bekannte Referenzsequenzen33 erfordert.
Hier beschreiben die Autoren Protokolle für die ONT-Sequenzierung, die für Proben angepasst sind, die mit Plasmid-DNA angereichert sind. Durch die Kombination einer erhöhten Repräsentation von Plasmid-DNA mit aktuellen Protokollen zur Bibliotheksvorbereitung, Flow-Cell-Technologie und Sequenzassemblierungswerkzeugen erzeugte der Workflow Assemblies, die den Größen entsprachen, die aus der Gelmobilität abgeleitet wurden und in zwei Dritteln der Fälle entweder SR-Sequenzpolierung entsprachen oder innerhalb von 0,05 % paarweise Sequenzidentität lagen. Die Anreicherung der Plasmid-DNA-Sequenzen maximiert zudem die Effizienz der Plasmidsequenzierung und ermöglicht eine parallele Sequenzierung von bis zu 24 Proben mit optimaler Abdeckung. Die Protokolle sollen nicht Standard-Nanoporen-WGS-Ansätze ersetzen, sondern die Genauigkeit und Effizienz der Plasmidsequenzierung in Situationen maximieren, in denen die chromosomale Sequenz bereits bekannt oder nicht von Interesse ist.
Der Arbeitsablauf umfasst die Extraktion von Plasmid-DNA, die Vorbereitung der Bibliothek mit Barcode, die Adapterligierung an ein motorisches Protein, die Überprüfung der Flusszelle, das Laden der Bibliothek auf eine Flusszelle zur Sequenzierung, Datenanalyse der elektrischen Signale (in Echtzeit oder nachträglich), Sequenzassemblierung mit Autocycler34 sowie verschiedene Downstream-Analysen (Abbildung 1).
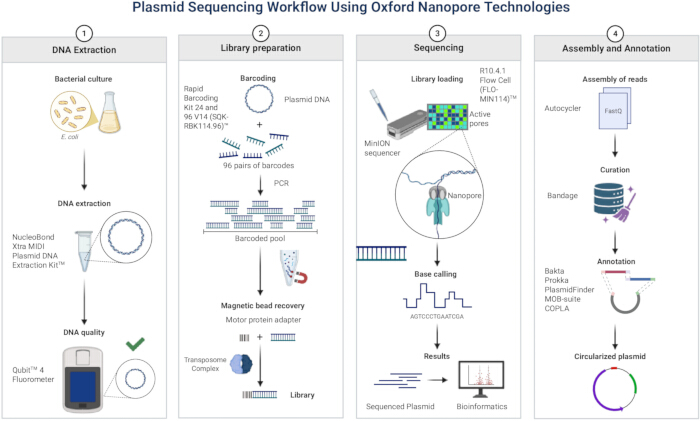
Abbildung 1: Plasmidsequenzierungs-Workflow mit Oxford Nanopore Technologies. Schritt 1: DNA-Extraktion; Schritt 2: Bibliotheksvorbereitung; Schritt 3: Sequenzierung; Schritt 4: Zusammensetzung und Annotation. Erstellt in BioRender. Cortés, G. (2026) https://BioRender.com/u3b15st. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Protokoll
1. Plasmid-DNA-Extraktion
HINWEIS: Dieses Protokoll wurde verwendet, um Plasmid-DNA aus einem klinischen Escherichia-coli-Stamm und seinen entsprechenden Transkonjuganten mit einem kommerziellen Plasmid-DNA-Extraktionskit35 zu extrahieren. Detaillierte Protokolle für Konjugation finden sich in36. Das Protokoll eignet sich sowohl für Hochkopie- als auch Niedrigkopie-Plasmide, die von ~3 kb bis ~200 kb reichen. Große Plasmide erfordern besondere Aufmerksamkeit, da sie tendenziell eine geringe Kopienzahl haben (so wenige wie 1–2 Kopien pro Zelle), was die DNA-Ausbeute begrenzt. Um das auszugleichen, empfiehlt das Protokoll, die Zellmasse sowie die Volumina an Lyse- und Neutralisationspuffern zu erhöhen, um ausreichend Plasmid-DNA für die Säulenbindung sicherzustellen. Plasmide bis zu 200 kb können mit diesem Protokoll weiterhin gewonnen werden; seine Anwendbarkeit auf Mega-Plasmide (>200 kb) ist jedoch begrenzt.
- Plasmidextraktion
- Tag 1: Proben auf Luria–Bertani (LB) Agarplatten abgeben, ergänzt mit dem geeigneten Antibiotikum zur Auswahl des jeweiligen plasmidgetragenen Resistenzmarkers und 24 Stunden bei 37 °C inkubieren.
HINWEIS: Fügen Sie Carbenicillin (oder geeignetes Antibiotikum) zu LB bei einer Endkonzentration von 100 μg/mL hinzu, indem Sie 1 μL einer 100 mg/ml-Fondlösung pro mL Medium hinzufügen. - Tag 2: Inokulieren Sie 3–5 ml LB mit dem passenden Antibiotikamedium und einer einzelnen isolierten Kolonie ab Tag 1. Inkubieren Sie mit einem Schütteln bei 37 °C für ~8 Stunden oder bis die Kultur einen OD₆₀₀₀ von 1–2 erreicht.
HINWEIS: Messung von OD600: Das Spektrophotometer mit frischem LB-Medium mit dem entsprechenden Antibiotikum abdecken, dann 1 ml Kultur in eine saubere Cuvette übertragen und den OD bei 600 nm messen. Überschreitet der Wert den linearen Bereich, verdünnen Sie die Probe und messen Sie erneut. - Inokulieren Sie 400 ml LB mit dem geeigneten Antibiotikamedium und 400 μL Day-2-Starterkultur. Inkubieren Sie mit Schütteln bei 37 °C für 8–12 Stunden oder bis der OD600 1–2 erreicht (wie zuvor beschrieben).
HINWEIS: Erhöhen Sie das Kulturvolumen über 400 mL, wenn OD600 nicht innerhalb von 12 Stunden 1–2 erreicht. Um das Risiko eines Plasmidverlusts oder einer Umlagerung zu verringern, sollten Sie die Passage in der Kultur so weit wie möglich begrenzen und die Antibiotikaselektion während aller Wachstumsschritte aufrechterhalten. Erhöhen Sie das Kulturvolumen nur, wenn eine höhere DNA-Ausbeute gewünscht ist. - Tag 3: Die Kultur in Zentrifugenflaschen umleiten, die dem Kulturvolumen entsprechen. Zentrifugiere bei 4200 x g für 10 Minuten und suspendiere das Pellet dann mit den vom Hersteller empfohlenen Reagenzienvolumen nach folgender Formel:
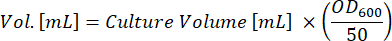
HINWEIS: Beispiel: Für 400 mL einer Bakterienkultur mit niedriger Kopie (OD600 = 2) zu lysieren, betragen die entsprechenden Volumina der Lysepuffer RES, LYS und NEU jeweils 16 ml.
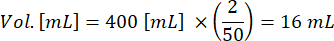
HINWEIS: Wenn die Reagenzienvolumina für Resuspension, Lyse oder Neutralisation nicht richtig auf die gesamte Kulturbiomasse (OD600 × Volumen oder ODV skaliert sind), kann die Lyse unvollständig sein, die Neutralisierung ineffizient und die Ausschlagbildung übermäßig. Dies kann zu geringerem Plasmidertrag, geringerer Reinheit und potenzieller Verstopfung der Reinigungssäulen führen. Die proportionale Skalierung der Puffervolumen unter Verwendung der Herstellerformel (Schritt 1.1.4.) gewährleistet eine effiziente Lyse, vollständige Neutralisation und eine konsistente Rückgewinnung hochwertiger Plasmid-DNA. - Führen Sie Zelllyse durch, filtern Sie das Benetzen mit dem entsprechenden Puffer und neutralisieren Sie sie wie vom Kit vorgeschrieben.
HINWEIS: Stapeln Sie zwei Filter, wenn das Niederschlagsvolumen groß ist, und passen Sie den Puffer proportional an. Führen Sie zusätzliche Zentrifugationsschritte durch, wenn das Überlagerungsmittel undurchsichtig bleibt. Nach der Neutralisation kann das hohe Niederschlagsvolumen zusätzliche Zentrifugationsschritte erfordern. Dies ist bei den meisten klinischen Proben von E. coli der Fall, möglicherweise weil sie in Kultur37 dazu neigen, Biofilm zu bilden, bei der eine dicke Matrix38 abgesegnet wird. Übermäßiger Niederschlag im Lysat kann die Säule verstopfen, die Entwässerungszeit verlängern und die Probe potenziell mit Proteinen kontaminieren. Wenn das Supernatant klar ist, sind diese zusätzlichen Schritte möglicherweise nicht notwendig. - Zentrifugiere das Lysat bei 4200 x g für 30 Minuten. Übertrage den Überstandsstoff in ein neues Rohr und zentrifugiere erneut für 30 Minuten. Wenn das Überstandsmittel nach diesen Spins undurchsichtig bleibt (Abbildung 2), führen Sie eine zusätzliche Zentrifugation bei 4200 x g durch.
HINWEIS: Das Übertragen des Lysats in ein 50-ml-Kulturrohr während der Zentrifugation kann die Entfernung des Überlagerungsmittels erleichtern, da das Ausschlaggut manchmal nicht richtig pelletiert und sich nahe der Röhrenoberseite festsetzen kann. Aufgrund der großen verarbeiteten Mengen kann eine einzelne Säule gesättigt werden und keine weiteren Proben aufnehmen können. Um die Filtrationsgeschwindigkeit zu erhöhen oder die DNA-Ausbeute zu maximieren, kann das Lysat auf zwei Spalten aufgeteilt werden. - Führe EQU-, WASH- und ELU-Schritte gemäß den Kit-Anweisungen durch.
- Fälle DNA mit Isopropanol aus.
HINWEIS: Inkubieren Sie bei -20 °C für ~10 Minuten, wenn das Pellet nicht sichtbar ist. Es ist jedoch im Allgemeinen am besten, das Supernatant vorsichtig zu entfernen und darauf zu vertrauen, dass das Pellet an den Rohrwänden haftet, auch wenn es nicht sichtbar ist. - Wasche die DNA wie angewiesen mit Ethanol. Führen Sie eine zusätzliche Wäsche durch, wenn der Proteinausschlag weiterhin vorhanden ist.
- Trockene DNA bei Raumtemperatur (~20 °C) für 15–30 Minuten.
- Die DNA in 100 μL nukleasefreiem Wasser resuspendieren; dieses kleine Volumen hilft, die Konzentration für die Nanopore-Bibliotheksvorbereitung zu maximieren.
HINWEIS: Dies ist ein praktischer Zwischenstopp. Plasmid-DNA kann mehrere Monate bei –20 °C gespeichert werden. Das in diesem Protokoll verwendete Extraktionskit ist so konstruiert, dass eine Kontamination durch chromosomale (genomische) DNA durch optimierte Pufferchemie, sanfte Lyse und Lysatklärungsschritte minimiert wird, obwohl eine erhebliche chromosomale DNA-Kontamination nicht ausgeschlossen werden kann und die Autoren sie in den Preps fanden (siehe Ergebnisse).
- Tag 1: Proben auf Luria–Bertani (LB) Agarplatten abgeben, ergänzt mit dem geeigneten Antibiotikum zur Auswahl des jeweiligen plasmidgetragenen Resistenzmarkers und 24 Stunden bei 37 °C inkubieren.
- DNA-Ausbeute und Qualitätskontrolle
Quantifizieren Sie DNA und bewerten Sie ihre Qualität mit fluoreszierenden Farbstoffen, die eine höhere Spezifität und Sensitivität bei niedrigen DNA-Konzentrationen im Vergleich zu UV-Absorptionsmethoden bieten. In diesem Protokoll verwenden Sie ein Fluorometergerät, um DNA-, RNA- oder Proteinprobenpräzise und bequem zu quantifizieren.- Fluorometer-Arbeitsablauf
- DNA-Proben auf Zimmertemperatur bringen. Bereiten Sie Tuben für Standards und Proben vor.
HINWEIS: Berechnen Sie die passenden Mengen Farbstoff und Puffer, die in die Arbeitslösung aufgenommen werden sollen, basierend auf der Anzahl der Proben. Für jeden Standard und jede Probe sollten 200 μL Arbeitslösung hergestellt werden, indem der Farbstoff im Puffer im Verhältnis 1:200 verdünnt wird. Das Gerät verfügt über einen eingebauten Reagenzrechner, der ebenfalls für diese Berechnungen verwendet werden kann. - Bereiten Sie die Prüfrohre gemäß Tabelle 1 vor.
- Wirbeln Sie jedes Rohr für ein paar Sekunden, bevor es bei Zimmertemperatur 2 Minuten inkubiert.
- Kalibrieren Sie das Fluorometer anhand der Standards. Probenröhrchen einführen und Messwerte aufnehmen. Für detaillierte Anweisungen siehe das Fluorometerhandbuch39.
HINWEIS: Für typische Plasmid-Midi-Präparate wird erwartet, dass die DNA-Erträge je nach Plasmidgröße, Kopienzahl und Wachstumsbedingungen zwischen ~50 und 150 μg pro 100–400 mL-Kultur liegen. Typische Nanoporen-Leselängen liegen zwischen ~2 kb und 20 kb, mit medianen Lesewerten oft um 5–10 kb für Standardplasmide. Ligationsbasierte Kits können längere Reads (>20 kb Median) für größere Plasmide erzeugen, aber das Rapid Kit ermöglicht eine schnellere Vorbereitung auf Kosten etwas kürzerer Reads.
- DNA-Proben auf Zimmertemperatur bringen. Bereiten Sie Tuben für Standards und Proben vor.
- Fluorometer-Arbeitsablauf
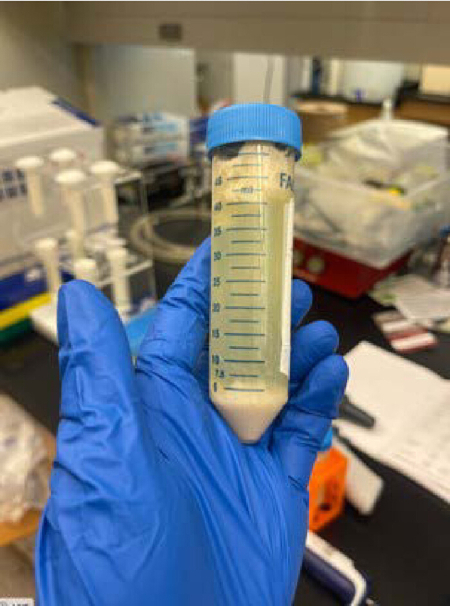
Abbildung 2: Trüber Lysat-Supernatant nach einem Zentrifugationsschritt. Eine serielle Zentrifugation ist erforderlich, bis das Supernatant klar ist, um eine Verstopfung der Filtersäule zu vermeiden. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
| Standard-Prüfröhren | Nutzerproben-Assay-Röhren | |
| Arbeitslösung (Farbstoff und Puffer, 1:200) | 190 μL | 180–199 μL |
| Standard (aus dem Kit) | 10 μL | – |
| Benutzerbeispiel | – | 1–20 μL |
| Gesamtvolumen in jedem Teströhrchen | 200 μL | 200 μL |
Tabelle 1: Reagenzvolumina und -mengen für das Fluorometer. Die Beträge werden für eine einzelne Probe angezeigt; Ein Pool kann basierend auf der Anzahl der zu analysierenden Proben vorbereitet werden.
2. Methode 2: Bibliotheksvorbereitung
HINWEIS: Überlegungen. Die Bibliotheksvorbereitung zur Sequenzierung der extrahierten Plasmide erfolgte gemäß den Anweisungen des BarcodingKit 40. Dieses Protokoll verwendet ein Kit, das einen transposasebasierten Ansatz verwendet, um DNA gleichzeitig zu fragmentieren und Barcodes zu verwenden, was einen schnellen und optimierten Workflow bietet, der die Hands-on-Zeit verkürzt und die Bibliotheksvorbereitung vereinfacht.
- DNA-Präparation
- Tag 1: Programmieren Sie einen Thermozyklus: 30 °C für 2 Minuten, dann 80 °C für 2 Minuten.
- Tau-Kit-Komponenten bei Raumtemperatur auftauen, herunterdrehen und mischen, gemäß Tabelle 2.
HINWEIS: Bei Verwendung einer Zentrifuge drehen Sie mit einer langsamen Drehzahl von maximal 330 x g. - Herstellung von DNA in nukleasefreiem Wasser: Übertragen Sie 200 ng DNA in 0,2 mL PCR-Röhrchen und geben Sie jeder Probe ein passendes Volumen nukleasefreies Wasser, um das Endvolumen auf 10 μL zu bringen. Mischen Sie durch sanftes Pipetieren 10–15 Mal. Kurz in einer Mikrofuge oder Zentrifuge bei 330 x g drehen, um das Pipettieren in den folgenden Schritten zu erleichtern.
- Bereiten Sie die Mischungen in PCR-Röhrchen wie in Tabelle 3 beschrieben vor.
- Mischen Sie durch Pipetteren und drehen Sie dann kurz herunter.
- Inkubiere PCR-Röhren mit dem thermischen Zyklusprogramm aus Schritt 1. Stelle die Schläuche auf Eis zum Abkühlen.
- Dreh kurz nach unten.
- Natives Barcode-Ligieren
- Barcode-Proben in einem sauberen 1,5-mL-Eppendorf-Röhrchen. Stellen Sie sicher, dass das Gesamtvolumen 1000 μL nicht überschreitet.
- Die Perlen durch Vortexen wieder aufhängen. Füge ein gleiches Volumen Beads zu den gepoolten barcodeartigen Samples hinzu und mixe durch Klick.
- Röhrchen 10 Minuten lang bei Zimmertemperatur auf einem Hula-Mixer inkubieren.
- Bereiten Sie 2 ml 80 % Ethanol in nukleasefreiem Wasser vor.
- Drehen Sie die Probe und das Pellet herunter, indem Sie das Rohr gegen einen Magneten halten. Wenn du das Rohr am Magneten behältst, pipettiere das Supernatant als Abfall.
HINWEIS: Jeder Magnet mit angemessener Stärke und Größe, einschließlich Neodym-Magneten, kann als effektive Alternative zu einem teuren Magnetgestell dienen. Magnete mit einer Haltekraft von etwa 5–12 Pfund und einem Durchmesser von 0,3–1 Zoll eignen sich typischerweise für Standard-Röhren von 0,2–1,5 mL, was eine saubere Entfernung des Supernatants während der Perlenreinigung ermöglicht. - Wasche die Perlen mit 1 ml 80% Ethanol, während du am Magneten hängst. Entferne Ethanol. Wiederholen, waschen.
HINWEIS: Eine Änderung der Position des Rohrs in Bezug auf den Magneten kann die Entfernung von Ethanol erleichtern. Nutzen Sie einen zusätzlichen langsamen Dreh, um ein vollständiges Perlenpelleting zu gewährleisten, falls das Pellet versehentlich gestört wird. - Drehe kurz herunter und setze das Rohr wieder auf den Magneten. Pipette jegliches restliches Ethanol ab. Trocknen Sie 30 Sekunden, aber trocknen Sie das Pellet nicht so sehr, dass es reißt.
- Entferne den Magneten und suspendiere die Perlen wieder im Elutionspuffer. Siehe Tabelle 4 für die entsprechenden EB-Bände, die je nach Anzahl der verwendeten Barcodes verwendet werden sollen.
- Inkubiere das Röhrchen 10 Minuten lang bei Raumtemperatur.
- Führen Sie das Rohr zurück zum Magneten, bis das Eluat frei ist.
- Quantifizieren Sie die DNA-Konzentration mit 1 μL der elutierten Probe auf dem Fluorometer, um sicherzustellen, dass die Bibliotheksvorbereitung erfolgreich durchgeführt wurde und eine Flow Cell bei einer fehlgeschlagenen Bibliothek nicht verschwendet wird.
- Adapterligatur
- Übertragen Sie 11 μL der DNA-Bibliothek in ein neues Rohr und Etikett.
HINWEIS: Lagern Sie zusätzliche DNA bei -20 °C für zukünftige Sequenzierungsläufe, falls nötig. - Verdünne den aufgetauten Rapid Adapter in einem neuen Rohr gemäß Tabelle 5 und pipette auf und ab, um zu mischen.
- Füge 1 μL verdünnte RA zur 11-μL-DNA-Bibliothek hinzu.
- Schnippen Sie die Röhre zum Mischen, drehen Sie kurz herunter, damit sich das gesamte Volumen am Boden des Rohrs ansammelt.
- Inkubiere 5 Minuten auf der Bank.
- Übertragen Sie 11 μL der DNA-Bibliothek in ein neues Rohr und Etikett.
| Reagenz | Auftauen bei Zimmertemperatur | Dreh nach unten | Mischen durch Pipettern |
| Schnelle Barcodes | Nicht eingefroren | ✓ | ✓ |
| Schnelladapter | Nicht eingefroren | ✓ | ✓ |
| AMPure XP-Perlen | ✓ | ✓ | Mischen Sie unmittelbar vor der Anwendung durch Pipetteren oder Vortexen |
| Elutionspuffer | ✓ | ✓ | ✓ |
| Adapterpuffer | ✓ | ✓ | Mischung durch Vortexing |
Tabelle 2: Reagenzvolumina und -mengen für die Nanoporen-Bibliotheksvorbereitung. Die mit jedem Reagenz durchzuführenden Aktionen sind markiert (✓).
| Reagenz | Lautstärke/Sample |
| 10 μL Template-DNA (200 ng aus dem vorherigen Schritt) | 10 μL |
| 1,5 μL schnelle Barcodes, einer pro Probe | 1,5 μL |
| Gesamtvolumen | 11,5 μL |
Tabelle 3: Reagenzien und Volumina für Schnellbarcode. Die Volumina werden pro DNA-Probe angezeigt; eine gepoolte Mischung kann vorbereitet und die DNA separat hinzugefügt werden.
| 1-24 Barcodes | 48 Barcodes | 72 Barcodes | 96 Barcodes | |
| Volumen des Elutionspuffers | 15 μL | 30 μL | 45 μL | 60 μL |
Tabelle 4: Elutionspuffervolumen, die für jeweils 24 Barcodes verwendet werden. Die Menge wird entsprechend der Anzahl der Barcodes angegeben.
| Reagenz | Band |
| Schneller Adapter (RA) | 1,5 μL |
| Adapterpuffer (ADB) | 3,5 μL |
| Gesamtvolumen | 5μL |
Tabelle 5: Reagenzien und Mengen für den Adapter. Die Lautstärke kann je nach Anzahl der Samples angepasst werden.
3. Durchflusszellenlauf
HINWEIS: Wählen Sie bei der Sequenzierung einer kleinen Anzahl von Plasmiden mit moderatem Abdeckungsbedarf eine Standard-Ausgangs-Flusszelle. Nanopore empfiehlt, eine Flow-Cell-Prüfung durchzuführen, um die Anzahl der aktiven Poren zu bestimmen; Die Durchflusszellen von Nanopore Devices sollten mindestens 800 aktive Poren gemäß den Garantiekriterien besitzen. Eine einzelne MinION-Flusszelle liefert ausreichend Output für die Sequenzierung mehrerer DNA-Proben, die mit Plasmid-DNA angereichert sind (siehe weitere Details zum Multiplexing im Diskussionsabschnitt), während sie kostengünstiger und flexibler ist als eine GRIDion- oder Promethean-Flow-Zelle.
- Anzünden und Laden der Durchflusszelle
HINWEIS: Die R10.4.1-Flowzellen (veröffentlicht 2022) wurden zur Entwicklung dieses Protokolls verwendet. Diese Durchflusszellen haben längere Poren mit einem doppelten Lesekopf, was zu einer verbesserten Homopolymer-Sequenzierung führt20,21. Dieses Sequenzierungsprotokoll und das Barcoding Kit sind mit anderen Flowzellen nicht kompatibel. Entscheiden Sie sich für eine hochproduktive Flow-Zelle bei groß angelegtem Multiplexing, mit dem Ziel einer hohen Abdeckung oder der Arbeit mit größeren Plasmiden oder Genomen. Berücksichtigen Sie die Anzahl der Proben und die Zieltiefe, um Kosten, Durchsatz und Sequenzierungsqualität auszubalancieren.- Entfernen Sie Reagenzien aus dem Kaltlager, einschließlich Sequenzierungspuffer (SB), Bibliotheksperlen (LIB) oder Bibliothekslösung (LIS), Rinderserumalbumin (BSA), Flow-Cell-Tether (FCT) und Flow-Cell-Flush (FCF). Taue auf Eis bei Zimmertemperatur auf. Sobald die Reagenzien aufgetaut sind, wirbeln Sie zum Mischen, Schnelldrehen und auf Eis lagern.
- Bereiten Sie das Priming der Flusszelle vor, indem Sie ein frisches DNA-Rohr mit den in Tabelle 6 aufgeführten Reagenzien mischen. Mischen Sie durch Inversion und Pipetten.
- Heben Sie den Deckel des Geräts an und setzen Sie die Durchflusszelle ein. Üben Sie sanften Druck aus, um die richtige Platzierung sicherzustellen.
- Legen Sie den Priming-Anschluss frei, indem Sie die Abdeckung zur Seite schieben.
- Überprüfe Luftblasen innerhalb oder neben dem Zündanschluss. Entziehe 20–30 μL Flüssigkeit, um Blasen zu entfernen.
HINWEIS: Entfernen Sie nicht mehr als 20–30 μL Puffer. Die Poren müssen jederzeit im Puffer versenkt bleiben. Poren, die der Luft ausgesetzt sind, können unbrauchbar werden. Stellen Sie sicher, dass der Puffer im gesamten sichtbaren Kanal kontinuierlich ist. - Ziehen Sie 800 μL Priming-Gemisch auf und geben Sie es in den Priming-Port ein. Vermeiden Sie es, Luftblasen einzuführen. Lass das Gerät 5 Minuten stehen.
- Suspendiere die Lib erneut, indem du auf und ab pipettierst.
HINWEIS: Sofort vor der Nutzung wieder suspendieren, da sich die Lib schnell stabilisiert. - Mische die DNA-Bibliothek mit dem entsprechenden Volumen der Bibliotheksperlen in einer neuen Röhre, wie in Tabelle 7 angegeben.
HINWEIS: Das von den Autoren verwendete Rapid Barcoding Kit verwendet einen transposasebasierten Ansatz, um DNA zu fragmentieren und Barcodes ohne bewusste Größenauswahl anzubringen, sodass die Leselängen hauptsächlich die ursprüngliche Eingabe-DNA widerspiegeln. Im Gegensatz zu ligationbasierten Bausätzen wie den Native Barcoding Kits enthält das Rapid Barcoding Kit keine separaten Puffer mit kurzen oder langen Fragmenten. Obwohl längere DNA weiterhin lange Reads erzeugen kann, ist die Verteilung variabler und im Allgemeinen kürzer als bei ligationbasierten Bibliotheken, die Long Fragment Buffer zur Anreicherung langer Fragmente verwenden. Das Fehlen von Puffern vereinfacht den Arbeitsablauf und verringert die Praxis, bietet aber weniger Kontrolle über die Verteilung der Bibliotheksgröße, was die Assemblerqualität beeinträchtigen kann. Ligationbasierte Kits, indem große Fragmente selektiv angereichert und kurze entfernt werden, liefern typischerweise höhere mittlere Leselängen und verbesserte Assemblierungskontinuität, insbesondere bei de-novo-Assemblierungen und komplexen Genomen. - Stellen Sie die Abdeckung des Sample-Ports so ein, dass der Port sichtbar wird. Lade 200 μL Priming-Gemisch in den Durchflusszellen-Priming-Port ein.
- Mische die vorbereitete DNA-Bibliothek vorsichtig vor dem Laden.
- Gib 75 μL der DNA-Bibliothek mit Perlen in den Probeport, tropfen für Tropfen, sodass jeder Tropfen absorbiert werden kann, bevor der nächste hinzugefügt wird.
- Setzen Sie die Abdeckung des Probeports erneut an und schließen Sie den Priming-Port.
- Fügen Sie den Lichtschutz an die Flusszelle an, indem Sie die Vorderkante des Lichtschilds mit dem Clip ausrichten und dann den Rest absenken, um die Flow-Zelle zu bedecken. Versuchen Sie nicht, den Lichtschutz unter den Clip zu legen. Der Lichtschutz sollte um die Abdeckung herum sitzen und den gesamten oberen Abschnitt der Flow-Zelle vor Lichteinwirkung schützen.
HINWEIS: Installieren Sie den Lichtschutz auf der Flow-Zelle, sobald die Bibliothek geladen wurde, um eine optimale Sequenzierung zu erzielen. Lassen Sie es bei weiteren Schritten eingeschaltet, bis die Bibliothek aus der Flow-Zelle entfernt wurde. Der Lichtschutz ist nicht sicher am Gerät befestigt; Behandle sie vorsichtig, damit sie nicht verrutscht. - Schließen Sie den Gerätedeckel und beginnen Sie mit der Sequenzierung.
- Beginn der Sequenzierung der Run-Computational-Anforderungen:
Mindest: 8-Thread-CPU, 16 GB RAM, 1070 NVIDIA GPU, 500 GB SSD
Empfohlen: 16-Thread-CPU, 32 GB RAM, 2070 NVIDIA GPU, 1 TB SSD
HINWEIS: Stellen Sie sicher, dass sowohl die Software als auch der Computer auf dem neuesten Stand sind und mindestens 500 GB freien Speicher haben, um neue Dateien unterzubringen. Software-Updates und andere Programme können die Sequenzierung stören. Stelle sicher, dass die Software entweder unter Windows oder Ubuntu läuft.- Setze das Laufzeitlimit: Je nachdem, wie viele Plasmide multiplexiert werden, setze das Laufzeitlimit. Standardmäßig sind 48 Stunden, eine maximale Zeit von 72 Stunden kann gelaufen werden. Für detaillierte Anweisungen siehe das Handbuch.
HINWEIS: Die Laufzeit hängt vom Multiplexing und der Plasmidgröße ab, nicht von der Plasmidanzahl. Die Anzahl der Proben oder Plasmide, die multiplexiert werden können, hängt von der gewünschten Sequenztiefe und dem Ausgang der Flusszelle ab. Für die typische Plasmidsequenzierung bietet das Multiplexen von 20–24 Proben pro Standard-Nanoporen-Flusszelle in der Regel eine ausreichende Abdeckung für eine genaue Assemblage und Variantendetektion, bei der Annahme von Plasmidgrößen unter ~200 kb. Größere Plasmide oder höhere Abdeckungsanforderungen erfordern möglicherweise weniger Proben pro Durchflusszelle. Strömungszellen mit höherer Leistung können pro Durchlauf deutlich mehr Proben (bis zu 96 oder mehr) unterstützen, was sie für Hochdurchsatz-Plasmidsequenzierungen oder Projekte mit sehr tiefer Abdeckung geeignet macht. Benutzer sollten die Anzahl der Barcodes, die Plasmidgröße und die Zieltiefe ausbalancieren, um sicherzustellen, dass jedes Plasmid ausreichend Lesungen für die vollständige Montage erhält. - Aktivieren Sie das Barcode-Trimmen, wenn Sie während der Sequenzierung Demultiplexen durchführen.
HINWEIS: Überwachen Sie die Lesewerte pro Barcode und beenden Sie den Lauf, wenn ausreichend Abdeckung erreicht ist, um die Lebensdauer der Flow-Zellen zu erhalten. - Wähle den supergenauen Basecall-Modus.
HINWEIS: Wählen Sie keine adaptive Sampling/Barcode-Balancing. Diese Option reduziert die Leseausgabe stark und verschlechtert die Poren schneller. Wenn du keine GPU hast, ist es besser, nach dem Lauf mit dem Basecalling zu warten. - Wählen Sie das passende Schnell-Barcode-Set (24 oder 96).
- Stelle sicher, dass das Gerät waagerecht ist und starte die Sequenzierung mit den Standardeinstellungen (min. Q-Wert 10).
HINWEIS: Dies ist ein praktischer Zwischenstopp. Das Gerät kann über Nacht betrieben werden. - Post-hoc-Basecalling (falls der Computer nicht über genügend Kapazität für Live-Basecalling verfügt oder um die Genauigkeit des Basecalling zu verbessern, die Rohdaten mit verbesserten Analysewerkzeugen neu zu analysieren): Öffnen Sie den fertigen Sequenzierungslauf in der Software
HINWEIS: Die nächsten Schritte gelten nur, wenn Sie Live-Basecalling nicht ausgewählt haben. - Wählen Sie Basecalling und wählen Sie das Super-Genauigkeitsmodell (SUP).
- Wähle die rohen FAST5/POD5-Daten aus und setze ein Ausgabeverzeichnis.
- Fang an, die Basis zu rufen.
- Setze das Laufzeitlimit: Je nachdem, wie viele Plasmide multiplexiert werden, setze das Laufzeitlimit. Standardmäßig sind 48 Stunden, eine maximale Zeit von 72 Stunden kann gelaufen werden. Für detaillierte Anweisungen siehe das Handbuch.
| Reagenzien | Volumen pro Durchflusszelle |
| Durchflusszellenspülung (FCF) | 1.170 μL |
| Bovines Serumalbumin (BSA) bei 50 mg/mL | 5 μL |
| Flow Cell Ther (FCT) | 30 μL |
| Endvolumen im Rohr | 1.205 μL |
Tabelle 6: Reagenzien und Volumina zum Primieren und Laden der Durchflusszelle. Die Mengen der Reagenzien sind pro Durchflusszelle angegeben.
| Reagenzien | Volumen pro Durchflusszelle |
| Sequenzierungspuffer (SB) | 37,5 μL |
| Bibliotheksperlen (LIB) oder Bibliothekslösung (LIS), falls verwendet | 25,5 μL |
| DNA-Bibliothek | 12 μL |
| Gesamt | 75 μL |
Tabelle 7: Reagenzien und Bände zum Laden der Bibliothek. Bände für die DNA-Bibliothek werden angezeigt; Bibliotheksperlen (BID) sollten unmittelbar vor der Verwendung gemischt werden.
4. Methode 4: Montage mit einem Autocycler
HINWEIS: Es gibt viele Möglichkeiten, Lesearten zu Contigs zusammenzusetzen. Jeder Assembler hat seine Vorteile und seine Verzerrungen. Dieses Protokoll empfiehlt die Verwendung von Autocycler, der viele verschiedene Assemblies verwendet und zu einer einzigen Assembly zusammenfasst. Das ist arbeitsintensiver, und du kannst einen einzelnen Assembler verwenden, um Zeit zu sparen. Bitte installieren Sie Conda im Terminal, um die entsprechende Software herunterzuladen. Das ergänzende Befehlsdokument enthält einen Link zu einer Umgebungsdatei zur Einrichtung des Systems.
- Bewertung der Laufqualität: Überprüfe die Qualität des Durchlaufs in der Minknow-Software oder im Laufbericht .html Datei, um Qualitätskennzahlen (Rendite, Q-Werte, Länge, Verteilung) zu notieren. Optional kann FASTQ-Dateien mit NanoPlot bewertet werden, um die Leselängenverteilung, N50- und Qualitätsscore-Profile für jeden Barcode zu bestätigen. Nur dann fortzufahren, wenn die Verteilungen von Sequenzerbeute und Leselänge mit den erwarteten Plasmidgrößen übereinstimmen.
- Barcodes entfernen: Stelle fest, ob das Barcode-Trimmen während des Sequenzierungslaufs aktiviert war. Wenn Barcodes nicht entfernt wurden, schneiden Sie FASTQ-Dateien mit Porechop (v0.2.4) und überprüfen Sie die erfolgreiche Entfernung der Barcode-Adaptersequenzen vor der nachgelagerten Analyse.
- Trim-Reads: Trim lange Reads mit Filtlong (v0.3.1), wobei etwa 5–10 % der qualitativ schlechtesten Reads entfernt werden, während ~90 % der Gesamtausbeute erhalten bleiben. Generiere eine gefilterte FASTQ-Datei für die Assemblierung. Wenn nachfolgende Assemblies chimäre Contigs erzeugen, erhöht man die Filterstrenge, indem man eine Mindestleselängen-Schwelle von ≥3.000 bp durchsetzt und gefilterte Lesearten regeneriert.
- Subsample- und Assemble-Readsubsets: Subsample liest mit Autocycler gemäß den empfohlenen Einstellungen und assemblert jede Leseteilmenge mit Raven (v1.8.3), Flye (v2.9.6), Canu (v2.3.0), Miniasm (v0.3.0), Myloasm (v0.2.0), NECAT (v0.0.1), Plassembler (v1.8.1) und allen anderen bevorzugten Assemblies. Beachten Sie die Längen der Kondigs und den Zirkularisierungsstatus für jede Baugruppe. Assembler, die Zirkularisierung melden (Raven, Flye, Miniasm, Myloasm und Plassembler), sollten für die Plasmidrekonstruktion priorisiert werden. Für Canu- und NECAT-Assemblierungen identifizieren Sie Kandidaten-Plasmidkontigs basierend auf der erwarteten Plasmidgröße aus den kreisförmigen Kontigs vorheriger Assemblierungen.
- Assemblierungen inspizieren und kuratieren: Visualisieren Sie jede Assembler-Graphdatei (.gfa) mit Bandage (v0.9.0) und bewerten Sie Contigs hinsichtlich Zirkarität, Größenkonsistenz zwischen Assembleren und Hinweisen auf chimäre Joins. Entfernen Sie lineare Contigs, die über mehrere Assembler hinweg keine Unterstützung haben, und behalten Sie kreisförmige Contigs mit konsistenten Größenschätzungen bei. Wenn viele Assemblies chimäre Joins enthalten, kehren Sie zu Schritt 4.3 zurück und erhöhen Sie die minimale Leselängengrenze (empfohlen ≥3.000 bp). In Fällen, in denen große Plasmide zirkularisiert sind, aber kleinere, nicht unterstützte Kontigs verbleiben, entfernen Sie kleinere Contigs vor der Konsenserzeugung. Fahren Sie mit der Consensus-Generierung fort, und die Polierungsschritte können in Batch nach manueller Kuratierung durchgeführt werden.
- Konsens und Endmontage erzeugen: Nach der manuellen Kuratierung fahren Sie mit der Autocycler-Konsensgenerierung mit den kuratierten Assemblies fort. Führe die verbleibenden Autocycler-Befehle aus, um die finale Konsens-Plasmidsequenz zu erzeugen. Detaillierte Kommandozeilenbefehle und Parametereinstellungen sind im Supplementary Material enthalten.
- Polieren: Sobald eine vollständige Assembly erstellt wurde, polieren Sie die Assembly mit den getrimmten Longreads mit Medaka (v2.1.1), um die Konsensgenauigkeit deutlich zu verbessern.
HINWEIS: Während zusätzliche Polierungspatronen zur Konsensgenauigkeit beitragen können, können sie auch Fehler verursachen. Es ist beste Praxis, ein Programm wie DNAapler zu verwenden, um den neuen Contig vor dem Polieren zu rotieren; Befehle finden Sie im Abschnitt Ergänzende Befehle.
5. Methode 5: Annotation
HINWEIS: Es gibt viele effektive Annotationswerkzeuge für Bakterien. Die folgenden Programme werden für eine gründliche Annotation empfohlen.
- Bakta eignet sich hervorragend für proteomische Analysen, da es derzeit aktiv gepflegt wird und als spiritueller Nachfolger von Prokka41,42 dient.
- Für Replikon-Typisierung, Plasmidmobilitäts-Typisierung und Konjugationstypisierung ist MOB-Suite zuverlässig6. MOB-Suite kann die Plasmid-Phylogenie mittels Maischdistanzierung ableiten und Insertion Sequence (IS)-Elemente43 identifizieren.
- COPLA ist auch ein nützliches Werkzeug für die Plasmidtaxonomie. Coplas einzigartiger Ansatz, der Plasmide in taxonomische Plasmideinheiten einteilt, wird im Bereich44 empfohlen.
HINWEIS: Die Plasmid-Phylogenie stellte historisch erhebliche Herausforderungen dar, da die modulare Struktur des Plasmids und die hohe Rekombinationsfrequenz Sequenzausrichtungen erschweren. COPLA adressiert diese Herausforderungen durch Berechnung der durchschnittlichen Nukleotididentitäten (ANI).
Ergebnisse
Klinische E. coli-Stämme
Um die Verwendung von ONT zur Sequenzierung von Plasmiden aus klinischen Stämmen zu veranschaulichen, sequenzierten die Autoren 10 Stämme, die ein großzügiges Geschenk von Dr. Stephen Salipante an der University of Washington waren. Diese Stämme waren Teil einer Sammlung von 312 blut- oder urinbasierten Isolaten von Extraintestinal Pathogenic E. coli (ExPEC), die während der routinemäßigen klinischen Versorgung am University of Washington Medical Center45 gewonnen wurden.
Plasmidkonjugation und Charakterisierung durch Gelmobilitätstest
Die Forscher führten außerdem einen Konjugationstest mit E.-coli-Stamm LMB100 als Empfänger durch. Die Konjugation ist ein Prozess, der zur Übertragung eines in einer Zelle vorhandenen Plasmids (dem Spender) auf eine andere Zelle (den sogenannten Empfänger)46 führt. Der Transfer erfordert physischen Kontakt zwischen den beiden Zellen und wird typischerweise anhand von Markern nachgewiesen, die auf das Vorhandensein des konjugativen Plasmids in den Empfängerzellen hinweisen. Dies ermöglichte es den Autoren, Unterschiede im Wirtsstamm als Variable zu eliminieren und die Verwendung des Protokolls zur Sequenzierung von Plasmiden zu veranschaulichen, die durch Plasmidaufnahme gewonnen wurden (eine Methode zur Profilierung von Plasmiden aus einer bestimmten ökologischen Nische). Alle Konjugationstests erzeugten Transkonjuganten, was das Vorhandensein eines konjugativen Plasmids in den Spendern bestätigte. Das Protokoll, dem die Autoren folgten, wird in36 beschrieben. Die Gruppe identifizierte die in den Spender- und Empfängerstämmen vorhandenen Plasmide und schätzte deren Mobilität mittels Pulsfeld-Gelelektrophorese (PFGE). Eine Liste von zehn repräsentativen Spenderstämmen ist in Tabelle 8 dargestellt, und die geschätzten Größen der darin vorhandenen Plasmide sind in der dritten Spalte aufgeführt. Plasmide außerhalb des Auflösungsbereichs des PFGE-Gels sind aus dieser Tabelle ausgeschlossen, aber die Forscher konnten mehrere kleinere Plasmide um etwa ~4 kb (nicht gezeigt) zusammenstellen.
| Spenderstamm | Plasmid | Geschätzte PFGE-Größe | Montagelänge | Mittlere Tiefe | bp Zero Depth | Abdeckungsquote % | Geänderte Positionen | Pre-SR Genauigkeit % |
| blood_08 _0081 | pblood_08_ 0081_1 | 170000 | 171829 | 100 | 99.941803 | 54 | 0.0314 | 99.9686 |
| blood_08 _0081 | pBlood_08_ 0081_2 | 82000 | 85576 | 46.9 | 0 | 100 | 2 | 99.9977 |
| blood_d-08 _0094 | pBlood_d-08 _0094 | 179000 | 173334 | 382.6 | 3121 | 98.19943 | 2,347 | 98.646 |
| blood_08 _1447 | pBlood_08 _1447 | 97000 | 99624 | 36.2 | 0 | 100 | 0 | 100 |
| blood_10 _0913 | pBlood_10 _0913_1 | 70000 | 71788 | 49 | 4 | 99.994428 | 188 | 99.7381 |
| blood_10 _0913 | pBlood_10 _0913_2 | 112000 | 118727 | 41.2 | 126 | 99.893874 | 276 | 99.7675 |
| blood_1 1_184 | pBlood_11 _184_1 | 150000 | 146583 | 65.1 | 287 | 99.804206 | 134 | 99.9086 |
| blood_11_184 | pBlood_11 _184_2 | 75000 | 74263 | 82.1 | 0 | 100 | 32 | 99.9569 |
| blood_2011 _0238 | pBlood_ 2011_0238 | 170000 | 167286 | 110.9 | 0 | 100 | 0 | 100 |
| upec_108 | pUPEC_108 | 130500 | 131039 | 103.9 | 0 | 100 | 0 | 100 |
| upec_134 | pUPEC_134 | 160500 | 157829 | 169 | 0 | 100 | 0 | 100 |
| upec_271 | pUPEC_271 | 145500 | 144519 | 86 | 33311 | 76.950436 | 1,557 | 98.9226 |
| upec_90 | pUPEC_90 | 70000 | 74624 | 139.8 | 0 | 100 | 6 | 99.992 |
Tabelle 8: Schätzungen der Plasmidgröße und Sequenzgenauigkeitsmetriken für ein Panel von 10 Spenderstämmen. Schätzungen der Plasmidgröße basierend auf PFGE oder zusammengesetzten ONT-Donorplasmidsequenzen sind aufgeführt. Die paarweisen Vergleiche von nur ONT- und SR-Sequenz-polierten Plasmid-Assemblies werden ebenfalls als Genauigkeitsindikator dargestellt. Kennzahlen umfassen: Montagelänge, mittlere Tiefe, Null-Tiefen-Regionen, Prozentsatz der Abdeckung, veränderte Positionen und Prozentsatz der Genauigkeit vor SR.
ONT-basierte Plasmidsequenzierungs-Ausgabemetriken
Der Sequenzlauf war für 24 Stunden angesetzt. Insgesamt wurden 24 Proben multiplexiert. Die technischen Daten für jede Stichprobe, einschließlich Qualitätsscore (Q), Länge und Abdeckung, sind in Tabelle 9 aufgeführt. Die Nanoporensequenzierung lieferte ausreichende Leseausgabe und Qualität für alle analysierten Proben. Über alle Bibliotheken hinweg erzeugte die Sequenzierung durchschnittlich 134.115 Lesevorgänge pro Stichprobe, was einer mittleren Ausbeute von 576,2 Mb entspricht. Lesungen hatten eine mittlere Leselänge von 8.797 bp mit einem durchschnittlichen N50 von 3.693 bp, was eine ausreichende Lesekontinuität für die Plasmidassemblierung gewährleistete. Der durchschnittliche Lesequalitätswert betrug Q16,0 mit einem Median von Q16,6, und einzelne Runs reichten von Q13,7 bis Q18,0.
| Sequenzierte Dehnung | Reads (KB) | Basen (Mb) | Mittlere Länge | Maximale Länge | Mindestlänge | N50 | Medianlänge | Mean Q | Median Q | |
| Blood_08_0081 Spender | 109.8 | 261 | 5713 | 508418 | 78 | 2377 | 1351 | 14.5 | 15 | |
| Blood_08_0094 Spender | 89.3 | 229 | 4177 | 114948 | 81 | 2565 | 1065 | 13.7 | 14 | |
| Blood_08_1447 Spender | 87.5 | 246 | 5041 | 135147 | 75 | 2816 | 1609 | 15.1 | 15.7 | |
| Bblood_10_0913 Spender | 247.7 | 1026 | 9260 | 174231 | 70 | 4143 | 1661 | 15.5 | 16.1 | |
| Blood_11_154 Spender | 51.5 | 110 | 4172 | 91148 | 73 | 2127 | 1387 | 16.1 | 16.5 | |
| Blood_2011_0238 Spender | 16.8 | 42 | 6707 | 104848 | 62 | 2534 | 845 | 15.3 | 15.2 | |
| UPEC_108 Spender | 50.6 | 77 | 1915 | 90234 | 67 | 1525 | 1103 | 15.8 | 16.2 | |
| UPEC_134 Spender | 50 | 143 | 7110 | 158393 | 72 | 2865 | 1133 | 16 | 16.2 | |
| UPEC_217 Spender | 64 | 236 | 7512 | 144275 | 78 | 3678 | 1895 | 17.4 | 17.9 | |
| UPEC_90 Spender | 52.9 | 157 | 5666 | 95944 | 72 | 2969 | 1593 | 16.8 | 17.2 | |
| Blood_08_0081 LMB100 Transkonjugant | 53.5 | 119 | 5162 | 225856 | 1 | 2232 | 1009 | 16 | 16.8 | |
| Blood_08_0094 LMB100 Transkonjugant | 160 | 442 | 7257 | 252176 | 1 | 2761 | 1083 | 17.3 | 18.2 | |
| Blood_08_1447 LMB100 Transkonjugant | 238 | 1029 | 10249 | 209221 | 1 | 4320 | 1857 | 17.7 | 18.7 | |
| Blood_10_0913 LMB100 Transkonjugant | 792.3 | 4341 | 11508 | 474325 | 1 | 5479 | 2731 | 17.7 | 18.8 | |
| Blood_11_184 LMB100 Transkonjugant | 42.5 | 281 | 17931 | 146626 | 87 | 6615 | 2448 | 16 | 16.7 | |
| Blood_2011_0238 LMB100 Transkonjugant | 147.7 | 585 | 9000 | 344203 | 1 | 3962 | 1781 | 18 | 18.9 | |
| UPEC_108 LMB100 Transkonjugant | 173.4 | 778 | 10127 | 168756 | 80 | 4485 | 2079 | 15.3 | 16.1 | |
| UPEC_134 LMB100 Transkonjugant | 105.4 | 667 | 17568 | 349230 | 71 | 6323 | 2232 | 15.5 | 16.3 | |
| UPEC_271 LMB100 Transkonjugant | 74.2 | 336 | 14521 | 342195 | 83 | 4520 | 1306 | 14.6 | 14.8 | |
| UPEC_90 LMB100 Transkonjugant | 75.2 | 418 | 15348 | 225661 | 83 | 5561 | 2016 | 15.7 | 16.4 | |
Tabelle 9: NanoQ-Bericht über Sequenzierungs-Outputmetriken für ein Panel von 10 Spenderstämmen. Die Sequenzierungsausgabe-Metriken sind aufgeführt. Dazu gehören Reads, Basen, Länge (Mittelwert, Median, Max und Min), Längen, N50 und Q (Mittelwert und Median) von Spendern und Transkonjuganten.
Plasmidassemblierung und Genauigkeit
Plasmidsequenzen wurden mit Autocycler34 zusammengesetzt. Die Größen der zusammengesetzten Plasmidsequenzen für 10 der Proben sind in Tabelle 8, vierte Spalte, aufgeführt und entsprachen in allen Fällen den Schätzungen zur PFGE-Mobilität (in der dritten Spalte aufgeführt). Die Genauigkeit wurde durch den Vergleich von Medaka-polierten Long-Read-Baugruppen mit Medaka (v2.2.0) plus Polypol (v0.6.1) bewertet. Die Sequenzidentität wurde mit Dnadiff aus MUMmer (v3.2.4) berechnet (Tabelle 8). Über alle analysierten Plasmide (n = 12) hatten die Assemblies eine mittlere Länge von 120,4 kb und wurden durch eine durchschnittliche Sequenzierungstiefe von 109x unterstützt, mit einer durchschnittlichen Abdeckung von 97,9 % über die Plasmidsequenzen hinweg. Vor dem Polieren wiesen Baugruppen eine mittlere Sequenzidentität von 99,74 % im Vergleich zur SR-Sequenz-polierten Baugruppe auf.
Schätzung der chromosomalen Kontamination
Um die Plasmidabdeckung und chromosomale Kontamination zu schätzen, wurden Reads auf zusammengesetzte Plasmidsequenzen und auf die E. coli LMB100-Chromosomsequenz abgebildet. Basecall-Nanopore-Lesungen wurden mit minimap2 (v2.2.6) ausgerichtet. Die resultierenden Ausrichtungen wurden mit SAMtools (v1.1.7) verarbeitet, um sortierte BAM-Dateien zu generieren und Mapping-Statistiken zu berechnen. Plasmidabdeckung und mittlere Tiefe wurden mittels der SAMtools-Abdeckung geschätzt. Die Plasmidsequenzierungstiefe variierte zwischen den Proben, blieb jedoch deutlich über der für eine genaue Montage erforderlichen Mindestabdeckung (50–70 x). Ein Bruchteil der Reads wurde auf das Chromosom abgebildet, was auf die Übertragung der Wirts-DNA während der Plasmidextraktion hinweist (Tabelle 10).
| Plasmide | Gesamtzahl der Lektüren | Chromosomale Anzeigen | % chromosomale Werte | Mittlere chromosomale Abdeckung | Mittlere Plasmidabdeckung | P:C-Verhältnis |
| pBlood_08_0081_2 | 53491 | 20116 | 37.61% | 5 | 1068 | 236 |
| pBlood_d-08_0094 | 160024 | 74827 | 46.76% | 37 | 1618 | 44 |
| pBlood_08_1447 | 238031 | 127967 | 53.76% | 62 | 7842 | 127 |
| pBlood_10_0913_1 | 792263 | 221610 | 27.97% | 87 | 7801 | 90 |
| pBlood_10_0913_2 | 792263 | 221610 | 27.97% | 87 | 7772 | 89 |
| pBlood_11_184_1 | 42494 | 15919 | 37.46% | 7 | 1637 | 250 |
| pBlood_11_184_2 | 42494 | 15919 | 37.46% | 7 | 2188 | 335 |
| pBlood_2011_0238 | 147680 | 80526 | 54.53% | 56 | 2965 | 53 |
| pUPEC_108 | 173409 | 107884 | 62.21% | 61 | 4008 | 65 |
| pUPEC_134 | 105418 | 68645 | 65.12% | 29 | 3640 | 127 |
| pUPEC_271 | 74232 | 53554 | 72.14% | 34 | 1202 | 35 |
| pUPEC_90 | 75193 | 30052 | 39.97% | 16 | 4488 | 278 |
Tabelle 10: Schätzungen der chromosomalen DNA-Kontamination. Die chromosomale Kontamination in Plasmiden, die von Empfängerstämmen gereinigt wurden, wurde als Anteil der Reads, die auf die LMB100-Chromosomsequenz bezogen auf Plasmidreads abbilden, quantifiziert. Für jedes Plasmid werden Plasmid-Lesungen, Gesamtwerte, chromosomale Werte, mittlere chromosomale Abdeckung, mittlere Plasmidabdeckung und P:C-Verhältnis aufgeführt. Beachten Sie, dass pBlood_08_0081_1 fehlt, weil es beim Empfänger nicht wiedergefunden werden konnte, und diese Schätzungen wurden bei den Empfängern aufgrund ihres einheitlichen chromosomalen Hintergrunds durchgeführt.
Die chromosomale Kontamination wurde als der Anteil der Lesungen quantifiziert, die auf die zusammengesetzte LMB100-Chromosomensequenz im Verhältnis zu Plasmid-Lesungen abgebildet sind. Die chromosomalen Kontaminationsraten lagen zwischen 72,1 % und 28,0 %, mit einem Durchschnitt von 46,9 % (Tabelle 10). Die Methode überschätzt wahrscheinlich die chromosomale Kontamination, da die Kartierungen sowohl auf das Plasmid als auch auf das Chromosom ausschließlich chromosomal gelten, aber dennoch auf einen erheblichen chromosomalen Übergang hinweisen. Trotz dieser chromosomalen Übertragung rekonstruierte der Assemblierungsworkflow erfolgreich vollständige Plasmidsequenzen, die weiterhin mit der aus der PFGE-Mobilität vorhergesagten Größe über alle Proben hinweg übereinstimmten (Tabelle 8, dritte und vierte Spalte).
Repräsentative Spender-Empfänger-Paare konjugativer Plasmide
Der Stamm upec271 wurde zwischen 2011 und 2013 aus einer Harnprobe isoliert und der Phylogruppe B2 sowie dem Sequenztyp ST131 zugeordnet. Die PFGE-Analyse zeigte das Vorhandensein eines Bands, das einem Plasmid von etwa 145 kb entspricht [Abbildung 3A, (Spender)]. Die Analyse der Kurzlesesequenz identifizierte das Vorhandensein eines IncF-Replicons.
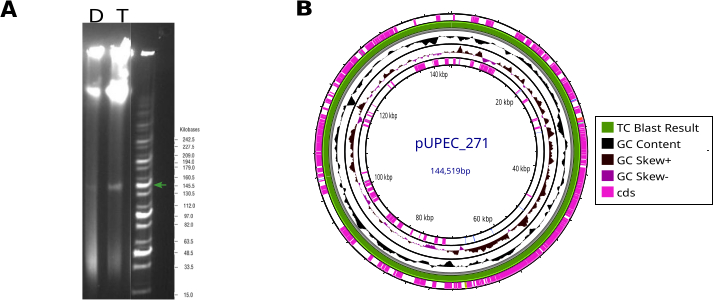
Abbildung 3: Charakterisierung von pUPEC271. (A) PFGE von Spender und Transkonjugant. Die PFGE-Bänder für den Spender (D) und den Transkonjuganten (T) sind dargestellt; die grünen Pfeile zeigen das Plasmidband an, das pUPEC271 entspricht. Das für PFGE verwendete Protokoll wird in einerStudie 36 beschrieben. (B) Karte von pUPEC271. Der Transkonjugant wurde gegen den Spender geschleudert, und der Konsens (der zu 100 % identisch ist) wird als grüner Ring angezeigt. Diese Darstellung wurde mit Proksee48 erstellt. Der äußerste Ring zeigt den Standort von CDS, zwei innere Ringe zeigen den GC-Gehalt und die Verschiebung, und der innerste Ring zeigt den Standort der tRNA-Gene. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Der Transfer dieses Plasmids, das die Autoren pUPEC271 nannten, wurde durch PFGE-Analyse unter Verwendung des zuvor in36 beschriebenen Protokolls bestätigt [Abbildung 3A, T(transkonjugant)]. Plasmid-DNA, gereinigt aus dem Spender-UPEC271-Stamm (pUPEC271_donor), wurde mittels Nanopore sequenziert. Im Einklang mit der Größe ihres Bandes im PFGE-Gel zeigte die pUPEC271_donor Sequenz ein Plasmid von 144.519 bp (Abbildung 3B). Dieses Plasmid besaß ein IncF-Typ-Replikon und enthielt Resistenzgene gegen sechs verschiedene Antibiotikaklassen (siehe Ergänzende Tabelle 1). Die Autoren reinigten außerdem DNA von einem der Transkonjuganten (pUPEC271_TC) und erhielten eine Sequenz, die identisch mit der des Spenders war. Die Endmontage ist im Vergleich zu pUPEC271_donor in Abbildung 3B dargestellt. Dies bestätigte, dass das konjugative Plasmid im Spender auf den transkonjuganten Stamm übertragen wurde. Die technischen Daten sind in Tabelle 9 dargestellt.
Strain Blood_10_0913 ist ein Beispiel für einen Stamm mit mehr als einem Plasmid. Diese Probe wurde zwischen 2008 und 2013 aus Blut entnommen, und die Short-Read-Sequenzierung zeigte das Vorhandensein von zwei Replicons, einem IncF und einem IncY-Replicon. Die PFGE-Analyse dieses Stamms identifizierte zwei Plasmide von etwa 70 bzw. 110 kb (Abbildung 4A). Dies wurde durch die Nanoporensequenzierung bestätigt, die zwei Baugruppen mit einer Größe von 71.182 bp bzw. 111.226 bp ergab. Die Autoren nannten diese beiden Plasmide pBlood_10_0913_1 und pBlood_10_0913_2 (Abbildung 4B). Die Assemblierungen konnten jedoch zunächst nicht zirkularisieren, da die extensive Sequenzhomologie im Abschnitt der Plasmide, die die Konjugationsmaschinerie tragen (der Abschnitt der extensiven Homologie ist in Abbildung 4B hervorgehoben). Das mit Bandage47 erstellte Montagediagramm ist in Abbildung 4C dargestellt. Die vollständige Assemblierung der beiden Plasmide war nur nach aggressivem Lese-Culling kürzerer Lesesequenzen (< 3000 bp) möglich.
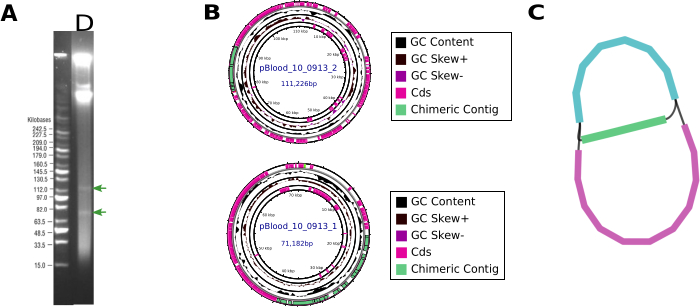
Abbildung 4: Identifikation und Assemblierung der Plasmide Blood_10_0913 Stämmes. (A) PFGE. Die grünen Pfeile zeigen Plasmidbänder an. Das für PFGE verwendete Protokoll wird inder 36 (B) Sequence Assembly beschrieben. Assemblierung der beiden kleineren Plasmide in der pBlood_10_0913 Probe, pBlood_10_0913_2 und pBlood_10_0913_2. (C) Zusammensetzung fehlgeschlagen. Darstellung eines Zusammensetzungsfehlers aufgrund der gemeinsamen Sequenz zwischen zwei verschiedenen Baugruppen. Diese Darstellung wurde mit Bandage47 erzeugt. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Ergänzende Tabelle 1: Resistenzgene, die von pUPEC271 übertragen werden. Die Plasmidgröße, Replikone und Resistenzgene, die mit pUPEC271 assoziiert sind, sind dargestellt. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Befehle. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Die Identifikation und Charakterisierung von Plasmiden ist von großem Interesse für die öffentliche Gesundheit, die klinische Mikrobiologie und die mikrobielle Ökologie, da sie die Erhaltung und Verbreitung adaptiver Gene in ökologischen Umgebungen ermöglichen 1,5 und als Plattformen für beschleunigte Evolution dienen4. Die Einführung von NGS-Technologien ermöglichte die Hochdurchsatzsequenzierung von Genomen mikrobieller Isolate und von Populationen, obwohl die postassemblierte Identifikation vollständiger Plasmide oder von Plasmid-abgeleiteten Kontigs in der Regel Long-Read-Sequenzen erfordert, da Short-Read-Sequenzierungsdaten keine Wiederholungsregionen auflösen können, die größer sind als die Reads. ONT ist zu einem sehr beliebten Long-Read-Sequenzierungsansatz geworden, mit Anwendungen, die über die Ganzgenomsequenzierung und Metagenomik hinausgehen und die Plasmidsequenzverifikation, Nachweis und Charakterisierung epigenetischer Modifikationen, RNA-Sequenzierung sowie die Bewertung der intrinsischen Instabilität von Tandem-Genarrays umfassen (Review in12,49).
Hier präsentieren die Forscher einen Workflow für die ONT-Sequenzierung von Plasmiden, die für Situationen entwickelt wurden, in denen die chromosomale Sequenz bereits bekannt oder nicht von Interesse ist. Der Grund dafür ist, dass die Plasmidextraktion arbeitsintensiv, kostspielig und zeitaufwendig ist (da die Wirtspopulation in Kultur gezüchtet und verarbeitet werden muss), und die Sequenzierung des gesamten Genoms mittels Nanoporentechnologie oft ausreicht, um vollständige Plasmidassemblierungen zu erhalten und gleichzeitig den genomischen Kontext zu liefern. Beispiele, bei denen das Protokoll hilfreich ist, sind die Verifikation einer Plasmidsequenz im Kontext der Plasmid-Gentechnik50,51, die Verbesserung der Genauigkeit bereits durch WGS24 gewonnener Plasmidsequenzen oder die Charakterisierung von Plasmiden, die aus klinischen oder Umweltproben durch Konjugation erfasst wurden.
DNA-Extraktion aus klinischen und Umweltproben muss möglicherweise individuell angepasst werden. Hier berichten die Autoren, dass einige der von ihnen verwendeten klinischen Stämme eine Biofilmmatrix erzeugten, die die Filter verstopfte, mehrere Pelletierungsschritte erforderte und manchmal das Hinzufügen von zwei Filtern erforderlich machte. Außerdem ist für die Sequenzierung konjugativer Plasmide ein größeres Kulturvolumen im Vergleich zur Sequenzierung von Multikopieplasmiden erforderlich, da natürlich vorkommende mittelgroße und große Plasmide tendenziell eine niedrige Plasmid-Kopienzahl2 aufweisen.
Das Protokoll hat die Sequenzierung von Plasmiden zwischen 4 kb und 173 kb ermöglicht. Dieser Bereich liegt eindeutig in die Herstellerspezifikationen (zwischen 2 und 200 kb). Kürzlich untersuchte eine Studie 23.000 Plasmidsequenzen, die in NCBI abgelagert wurden, und fand signifikante Größenunterschiede je nach Quelle, wobei Plasmide menschlichen Ursprungs die kleinste Mediangröße (76 kb) und Boden- und Pflanzenplasmide die größten (215 bzw. 427 kb); Plasmide aus allen anderen Quellen hatten eine mediane Größe zwischen 79 und 147 kB, daher sollte dieses Protokoll die meisten Plasmide abdecken, mit Ausnahme der Megaplasmide52 und Plasmide von Boden- oder Pflanzenherkunft3.
Die Autoren fügen einen Plasmid-DNA-Anreicherungsschritt hinzu, um die Genauigkeit von Plasmid-DNA-Assemblies zu verbessern. Das Vorhandensein großer Mengen chromosomaler DNA flutet die Zellporen der sequenzierenden Flow-Zelle mit nicht-Ziel-Reads und reduziert die Plasmid-DNA-Tiefe erheblich. Ein Plasmid-DNA-Anreicherungsschritt wurde bereits durchgeführt, um die vollständige Zusammensetzung von Plasmid-DNA in klinischen Proben zur Detektion von ARGs24 zu versuchen. Dies zeigte erhebliche Verbesserungen in der Effektivität der Abschluss der Plasmidassemblierung mit einer Nanoporen-reinen Sequenz (78 % vollständige Assemblierungen im Vergleich zum Benchmark). Weitere Beispiele folgten50, 53, 54.
Um die Lesegenauigkeit zu verbessern, verwendeten zwei dieser Studien eine von Nanopore entwickelte Technik namens "paired basecalling on pseudopaired reads"50,53. Dieser Ansatz beinhaltet die Ausrichtung der rohen elektrischen Signale von Sense- und Antisense-Strängen desselben DNA-Moleküls, was zu einer Genauigkeitssteigerung von etwa einer Größenordnung führt. Gepaarte Basecalling bei pseudogepaarten Reads ist mit Multiplexing kompatibel, solange die Strategie die Identifikation der Vorwärts- und Rückwärtsstränge desselben Moleküls ermöglicht. Daher kann es nicht in Plasmiden verwendet werden, die aus Proben unbekannten Plasmidkomplements gereinigt wurden oder eine Mischung von Plasmiden enthalten. Beachten Sie, dass die Anzahl der Plasmide in einem Genom typischerweise zwischen 0 und 7 Plasmiden liegt (insbesondere in klinischen Isolaten)2,55.
Die Forscher stellten ein hohes Maß an chromosomaler Kontamination in den Proben fest (Tabelle 10). Der Kontaminationsgrad der 10 analysierten Proben lag laut Lesekartierung zwischen 28 und 72 %. Als die Forscher diese Sequenz jedoch auf die Größe des Chromosoms relativ zur Größe des vorhandenen Plasmids normalisierten, stellte sich heraus, dass Plasmidsequenzen im Durchschnitt 144-mal häufiger waren als chromosomale. Um diese Zahl auf das Niveau der Plasmid-DNA-Anreicherung zu übertragen, müsste man die Plasmidkopienzahl der Plasmide in jeder Probe kennen.
MinION-Flusszellen erzeugen typischerweise eine Sequenzierungsausgabe von ~30 GB, was theoretisch die Sequenzierung von weit über 96 Plasmiden pro Durchlauf ermöglicht. In der Praxis ist Multiplexing auch durch das 96-Barcode-Limit eingeschränkt, wodurch 96 Plasmide die praktische obere Grenze pro Durchflusszelle darstellen. Chromosomale DNA-Kontamination und natürliches Barcode-Ungleichgewicht verringern jedoch die effektive Lesetiefe pro Probe. Um eine ausreichende Lesetiefe für jede Probe zu gewährleisten, ist ein konservativerer Ansatz, etwa 24 Plasmide pro Durchflusszelle zu multiplexen. Die empfohlene Tiefe für die genaue Montage der Plasmidsequenz liegt zwischen 50 und 70x32,56. In den in diesem Artikel vorgestellten illustrativen Beispielen haben die Autoren 21 multiplexierte Proben in einer Durchflusszelle durchgeführt und eine mittlere Tiefe (109x) erhalten, die gut mit dem empfohlenen Probenoptimum pro Durchflusszelle übereinstimmt.
Beachten Sie, dass bei übermäßiger Lesetiefe Bestanden/Nicht-bestanden-Lesepartitionen weniger informativ sind, um die Gesamtlesequalität zu beurteilen. Stattdessen liefern aus der Längenverteilung abgeleitete Kennzahlen eine klarere Darstellung der Datensatzqualität. Eine solche Metrik ist die N50, definiert als die Leselänge, bei der Lesungen dieser oder längeren Länge 50 % der Gesamtbasen ausmachen. Dieser Wert ist sehr empfindlich gegenüber Qualitätskontrollschritten. Zum Beispiel entfernt das Filtern von minderwertigen oder kurzen Lesungen mit Werkzeugen wie Filtlong einen erheblichen Teil des kürzeren Verteilungs, wodurch das N50 aufgebläht wird. Dieser Effekt ist in Tabelle 9 erkennbar.
Die Autoren verwendeten das Rapid Barcode Kit von ONT, das ein Transposom verwendet, um Plasmid-DNA zu fragmentieren, und daher keine Vorkenntnisse über das Restriktionsmuster des Plasmids erfordern. Eine frühere Studie ergab, dass für kleine Plasmide (<20 kb) eine enzymatische Fragmentierung notwendig ist, da kleine Plasmide bei den meisten DNA-Extraktionen zirkularisiert bleiben und daher keine freien Enden für die Adapterligation54 enthalten. Diese Studie verwendete keine Barcodes, die durch PCR-Amplifikation zusätzliche freie Enden erzeugen, daher ist das in diesem Fall wahrscheinlich ein Punkt von Bedeutung. OnRamp, eines der fortschrittlichsten Verfahren zur routinemäßigen Plasmidvalidierung, vermeidet die Verwendung von Barcodes, indem es vollständige Plasmidlesungen für die Assemblierung nutzt, was die Probenvorbereitung54 vereinfacht. In diesem Fall bevorzugten die Autoren aus drei Gründen Barcodes. Die erste ist, unabhängig von der Plasmidlänge eine Baugruppe zu bauen. Die zweite besteht darin, chromosomale DNA-Kontaminationen zu tolerieren. Der dritte ist, dass dies die Möglichkeit eröffnet, mehrere Samples zu multiplexen, wie oben erwähnt.
Eine frühere Studie stellte fest, dass die Aggregation verschiedener Assembler das Endergebnis verbesserte, indem sie die in einzelnenAssemblerplattformen eingebauten Verzerrungen aufhebt. Diese Metaanalyse ist eine Funktion, die in das von den Autoren verwendete Assemblerprogramm Autocycler34 integriert wurde. Im Vergleich zu seiner früheren Version namens Trycycler57 ist Autocycler etwas automatisierter; Es verwendet mehrere Teilmengen der Reads und (wie bereits erwähnt) führt es Assemblies mit mehreren Assemblern aus, um eine genauere Konsensassemblierung zu erzeugen. Allerdings haben die meisten Assembler, selbst die besten wie Flye28, Canu29 und Raven30, Schwierigkeiten mit dem Vorhandensein von Plasmiden mit umfangreicher Sequenzhomologie, fälschlichem Zusammenführen von Plasmidsequenzen oder der Erzeugung mehrerer Kopien eines einzelnen Plasmids und neigen dazu, kleine Plasmide58,59 zu übersehen (siehe auch Abbildung 4C). Wenn dies geschieht, kann das Ausschneiden von weniger hochwertigen Lesungen und das Entfernen kurzer Lesungen dazu führen, dass chimäre Kontigs gelöst werden.
Um die Gesamtgenauigkeit der Sequenzierungsprotokolle zu belegen, verglichen die Autoren die ONT-only Assemblies mit Assemblies, die durch die Kombination von Long-Read und Short-Read verfeinert wurden, was (abgesehen von PacBio-Daten) der aktuelle Goldstandard ist. Die Autoren hatten außerdem Geldaten, die die Anzahl der vorhandenen Plasmide und deren geschätzte Größe zeigen (Tabelle 8, dritte Spalte). Die Forscher konnten erfolgreich alle 13 Plasmide in den 10 Proben zusammenfügen und erhielten Größen, die mit den zusammengesetzten Sequenzen übereinstimmten. Dies ist ein echter Erfolg, da LR-Sequenz-Assembler oft nicht in der Lage sind, Plasmide mit strukturell komplexen Sequenzen zusammenzusetzen. Auf einer detaillierteren Ebene zeigten paarweise Vergleiche zwischen den beiden Sequenzsätzen eine variable Genauigkeit (Tabelle 8). Fünf der Plasmid-Assemblies hatten Bereiche ohne Abdeckung in den ONT-Assemblies, vermutlich das Ergebnis von Sequenzartefakten, die während der ONT-only Sequenz-Assembly hinzugefügt wurden. Von den anderen sieben zeigten drei Einzelnukleotid-Polymorphismen mit paarweisen Unterschieden zwischen 0,0023 und 0,05 %, und vier zeigten perfekte Konkordanz. Das Maß an Genauigkeit scheint nicht mit der DNA-Anreicherung oder Sequenzierungstiefe des Plasmids korreliert zu sein, aber das Vorhandensein von mehr als einem Plasmid in einer gegebenen Probe tut es, möglicherweise weil mehr als ein Plasmid dazu neigt, die Sequenzkomplexität zu verstärken (Tabelle 8). Zusammenfassend ist der Workflow darauf ausgelegt, die Ausbeute und Genauigkeit der Plasmidsequenz zu optimieren. Obwohl es in der Lage ist, Plasmidsequenzen zusammenzustellen, liefert es auf Nukleotidebene ein variables Maß an Genauigkeit. Das Protokoll kann verwendet werden, um Plasmide einer Vielzahl von Größen zu sequenzieren, toleriert mindestens 72 % chromosomale DNA-Kontamination und kann (je nach Plasmidgröße und Flowzellzustand) mindestens 24 Plasmide in einer einzelnen Durchflusszelle aufnehmen.
Offenlegungen
Die Autoren haben nichts offenzulegen.
Danksagungen
Wir sind Steve Salipante (University of Washington) sehr dankbar, dass er großzügig eine Reihe klinischer E. coli-Stämme geteilt hat, die in45 veröffentlicht wurden. Diese Arbeit wurde teilweise durch Forschungsunterstützungsmittel für eine Ernennung zum Direktor für Innovation und unternehmerische Entwicklung von der UCSC an MC sowie durch den Alianza MX-Stipendium der University of California mit dem Titel "Genomic profiling of Tuberculosis isolates Among High-Burden and Vulnerable Populations in Mexico: insights into transmission and drug resistance" zu MC unterstützt.
Materialien
```html
```
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| 1.5 mL Eppendorf DNA LoBind tube | Sigma Aldrich | EP022431081 | Kann durch eine andere Marke ersetzt werden |
| 1.5 mL tube racks | Thermo Fisher Scientific | 22-313630 | Kann durch eine andere Marke ersetzt werden |
| 15 mL conical tubes | FALCON | 352096 | Kann durch eine andere Marke ersetzt werden |
| 15 mL tube racks | Thermo Fisher Scientific | 8850 | Kann durch eine andere Marke ersetzt werden |
| 2.0 mL microcentrifuge tubes | Fisherbrand | 05-408-138 | Kann durch eine andere Marke ersetzt werden |
| 250 mL sterile flasks | PYREX | 5320 | Kann durch eine andere Marke ersetzt werden |
| Carbenicillin | GOLD BIOTECHNOLOGY | C-103-50 | Kann durch eine andere Marke ersetzt werden |
| Centrifuge | Eppendorf | 5424R-PR-R | Kann durch eine andere Marke ersetzt werden |
| Centrifuge | Eppendorf | 5810R-P-R | Kann durch eine andere Marke ersetzt werden |
| Centrifuge bottles | Sigma Aldrich | B1283-4EA | Kann durch eine andere Marke ersetzt werden |
| Disposable Inoculating Loops: 1 µL | Fisherbrand | 22-363-595 | Kann durch eine andere Marke ersetzt werden |
| Electronic Digital Scale | Denver Instrument | APX-2001 | Kann durch eine andere Marke ersetzt werden |
| Ethanol | Fisher Scientific | 04-355-720 | Kann durch eine andere Marke ersetzt werden |
| Ethanol-resistant markers | Sharpie | 37001; 37002; 37003 | Kann durch eine andere Marke ersetzt werden |
| Flow cell (R10.4.1) | Oxford Nanopore Technologies | FLO-MIN114 | |
| Flow Cell Wash Kit | Oxford Nanopore Technologies | EXP-WSH004 | |
| Gloves | X-GEN | 44-100M | Jede Marke von Nitrilhandschuhen funktioniert |
| Ice bucket | Thermo Fisher Scientific | 432128 | Kann durch eine andere Marke ersetzt werden |
| Isopropanol | Fisher Scientific | BP26184 | Kann durch eine andere Marke ersetzt werden |
| MinION Sequencing Device | Oxford Nanopore Technologies | MIN-101B | |
| Native Barcoding Kit 96 V14 | Oxford Nanopore Technologies | SQK-NBD114.96 | |
| NucleoBond Xtra MIDI Plasmid DNA Extraction Kit | Takara | 740410.5 | |
| PCR tube racks | AXYGEN | R96PCRFSP | Kann durch eine andere Marke ersetzt werden |
| PCR tubes: (0.2 mL) | AXYGEN | PCR-02-C | Kann durch eine andere Marke ersetzt werden |
| Program autocycler v0.5.2 | Ryan Wick / University of Melbourne | ||
| Program bcftools v1.22 | Wellcome Sanger Institute (HTSlib / Samtools team) | ||
| Program bwa v0.7.19 | Heng Li, ursprünglich am Broad Institute | ||
| Program canu v2.3 | University of California, Davis & Pacific Biosciences collaborators | ||
| Program flye v2.9.6 | University of California, San Diego (Pavel Pevzner lab) | ||
| Program medaka v2.1.1 | Oxford Nanopore Technologies | ||
| Program metamdbg v1.2 | INRIA | ||
| Program miniasm v0.3 | Heng Li | ||
| Program minimap2 v2.28 | Heng Li | ||
| Program minipolish v0.2.0 | Ryan Wick / University of Melbourne | ||
| Program porechop v0.2.4 | Ryan Wick / University of Melbourne | ||
| Program racon v1.5.0 | Genome Institute of Singapore | ||
| Program samtools v1.22.1 | Wellcome Sanger Institute (HTSlib / Samtools project) | ||
| Qubit™ 4 Fluorometer | Invitrogen | Q33226 | |
| Qubit™ Assay Tubes | Invitrogen | Q32856 | |
| Rapid Barcoding Kit 24 and 96 V14 | Oxford Nanopore Technologies | SQK-RBK114.96 | |
| Set of micropipettes that dispense between 1 – 10 μL (P10), 2 – 20 μL (P20), 20 – 200 μL (P200) and 200 – 1000 μL (P1000) | RAININ | 17008648; 17008650; 17008652; 17008653 | Mikropipetten sollten kalibriert sein |
| Spectrophotometer | Thermo Scientific | 335905P | Kann durch eine andere Marke ersetzt werden |
| Sterilized tips for 10 μL, 200 μL and 1000 μL | Eclipse | 1011-260-000-9; 1018-260-000; 1019-260-000-9 | |
| Thermal cycler C1000 Touch | Bio-Rad | 1851196 | Kann durch eine andere Marke ersetzt werden |
| Water bath | Thermo Scientific | 51221052 | Kann durch eine andere Marke ersetzt werden |
Referenzen
- Finks, S. S., Martiny, J. B. H. Plasmid-encoded traits vary across environments. mBio. 14 (1), e0319122(2023).
- Ramiro-Martinez, P., de Quinto, I., Lanza, V. F., Gama, J. A., Rodriguez-Beltran, J. Universal rules govern plasmid copy number. Nat Commun. 16 (1), 6022(2025).
- Redondo-Salvo, S., et al. Pathways for horizontal gene transfer in bacteria revealed by a global map of their plasmids. Nat Commun. 11 (1), 3602(2020).
- Rodriguez-Beltran, J., DelaFuente, J., Leon-Sampedro, R., MacLean, R. C., San Millan, A. Beyond horizontal gene transfer: the role of plasmids in bacterial evolution. Nat Rev Microbiol. 19 (6), 347-359 (2021).
- Castaneda-Barba, S., Top, E. M., Stalder, T. Plasmids, a molecular cornerstone of antimicrobial resistance in the one health era. Nat Rev Microbiol. 22 (1), 18-32 (2024).
- Robertson, J., Bessonov, K., Schonfeld, J., Nash, J. H. E. Universal whole-sequence-based plasmid typing and its utility to prediction of host range and epidemiological surveillance. Microb Genom. 6 (10), (2020).
- Conlan, S., et al. Single-molecule sequencing to track plasmid diversity of hospital-associated carbapenemase-producing Enterobacteriaceae. Sci Transl Med. 6 (254), 254ra126(2014).
- Zankari, E., et al. Identification of acquired antimicrobial resistance genes. J Antimicrob Chemother. 67 (11), 2640-2644 (2012).
- Eyre, D. W., et al. WGS to predict antibiotic MICs for Neisseria gonorrhoeae. J Antimicrob Chemother. 72 (7), 1937-1947 (2017).
- Arredondo-Alonso, S., Willems, R. J., van Schaik, W., Schurch, A. C. On the (im)possibility of reconstructing plasmids from whole-genome short-read sequencing data. Microb Genom. 3 (10), e000128(2017).
- Rhoads, A., Au, K. F. PacBio sequencing and its applications. Genomics Proteomics Bioinformatics. 13 (5), 278-289 (2015).
- Zhang, T., et al. Nanopore sequencing: flourishing in its teenage years. J Genet Genomics. 51 (12), 1361-1374 (2024).
- González, A., Fullaondo, A., Odriozola, A. Why are long-read sequencing methods revolutionizing microbiome analysis? Microorganisms. 13 (8), (2025).
- Wick, R. R., Holt, K. E. Polypolish: Short-read polishing of long-read bacterial genome assemblies. PLoS Comput Biol. 18 (1), e1009802(2022).
- Delahaye, C., Nicolas, J. Sequencing DNA with nanopores: Troubles and biases. PLoS One. 16 (10), e0257521(2021).
- Watson, M., Warr, A. Errors in long-read assemblies can critically affect protein prediction. Nat Biotechnol. 37 (2), 124-126 (2019).
- De Maio, N., et al. Comparison of long-read sequencing technologies in the hybrid assembly of complex bacterial genomes. Microb Genom. 5 (9), (2019).
- Lerminiaux, N., Fakharuddin, K., Mulvey, M. R., Mataseje, L. Do we still need Illumina sequencing data? Evaluating Oxford Nanopore Technologies R10.4.1 flow cells and the Rapid v14 library prep kit for Gram-negative bacteria whole genome assemblies. Can J Microbiol. 70 (5), 178-189 (2024).
- Dabernig-Heinz, J., et al. A multicenter study on accuracy and reproducibility of nanopore sequencing-based genotyping of bacterial pathogens. J Clin Microbiol. 62 (9), e0062824(2024).
- Sereika, M., et al. Oxford Nanopore R10.4 long-read sequencing enables the generation of near-finished bacterial genomes from pure cultures and metagenomes without short-read or reference polishing. Nat Methods. 19 (7), 823-826 (2022).
- Wick, R. R., Judd, L. M., Holt, K. E. Assembling the perfect bacterial genome using Oxford Nanopore and Illumina sequencing. PLoS Comput Biol. 19 (3), e1010905(2023).
- Paterson, D. L. Resistance in gram-negative bacteria: enterobacteriaceae. Am J Med. 119 (1), discussion S62-70 S20-S28 (2006).
- Peter, S., et al. Tracking of antibiotic resistance transfer and rapid plasmid evolution in a hospital setting by nanopore sequencing. mSphere. 5 (4), (2020).
- George, S., et al. Resolving plasmid structures in Enterobacteriaceae using the MinION nanopore sequencer: assessment of MinION and MinION/Illumina hybrid data assembly approaches. Microb Genom. 3 (8), e000118(2017).
- Dong, N., Yang, X., Zhang, R., Chan, E. W., Chen, S. Tracking microevolution events among ST11 carbapenemase-producing hypervirulent Klebsiella pneumoniae outbreak strains. Emerg Microbes Infect. 7 (1), 146(2018).
- Lemon, J. K., Khil, P. P., Frank, K. M., Dekker, J. P. Rapid nanopore sequencing of plasmids and resistance gene detection in clinical isolates. J Clin Microbiol. 55 (12), 3530-3543 (2017).
- Linde, J., et al. Comparison of Illumina and Oxford Nanopore Technology for genome analysis of Francisella tularensis, Bacillus anthracis, and Brucella suis. BMC Genomics. 24 (1), 258(2023).
- Bickhart, D. M., et al. Generating lineage-resolved, complete metagenome-assembled genomes from complex microbial communities. Nat Biotechnol. 40 (5), 711-719 (2022).
- Koren, S., et al. Canu: scalable and accurate long-read assembly via adaptive k-mer weighting and repeat separation. Genome Res. 27 (5), 722-736 (2017).
- Vaser, R., Sikic, M. Time-and memory-efficient genome assembly with Raven. Nat Comput Sci. 1 (5), 332-336 (2021).
- Lynch, M. D., Neufeld, J. D. Ecology and exploration of the rare biosphere. Nat Rev Microbiol. 13 (4), 217-229 (2015).
- Kruasuwan, W., et al. Comparative evaluation of commercial DNA isolation approaches for nanopore-only bacterial genome assembly and plasmid recovery. Sci Rep. 14 (1), 27672(2024).
- Ulrich, J. U., et al. Nanopore adaptive sampling effectively enriches bacterial plasmids. mSystems. 9 (3), e0094523(2024).
- Wick, R. R., Howden, B. P., Stinear, T. P. Autocycler: long-read consensus assembly for bacterial genomes. Bioinformatics. 41 (9), (2025).
- NucleoBond Xtra Plasmid DNA Purification User Manual. , Takara Bio USA. Available from: https://www.takarabio.com/documents/User%20Manual/NucleoBond%20Xtra%20Plasmid%20DNA%20Purification%20User%20Manual_Rev_15.pdf?srsltid=AfmBOorkdYVlr34yclNUgmBCn4imrn-gbvTafmkD2Yrnnch6fH-K_VwZ (2019).
- Mota-Bravo, L., et al. Detection of horizontal gene transfer mediated by natural conjugative plasmids in E. coli. J Vis Exp. (193), (2023).
- Hancock, V., Witso, I. L., Klemm, P. Biofilm formation as a function of adhesin, growth medium, substratum, and strain type. Int J Med Microbiol. 301 (7), 570-576 (2011).
- Hung, C., et al. Escherichia coli biofilms have an organized and complex extracellular matrix structure. mBio. 4 (5), e00645-e00713 (2013).
- Qubit 4 assays quick reference (Pub. No. MAN0017210 C.0). , Thermo Fisher Scientific. (2025).
- Rapid barcoding sequencing kit 96 v14. , Oxford Nanopore Technologies. Available from: https://store.nanoporetech.com/us/rapid-barcoding-sequencing-kit-96-v14.html (2026).
- Schwengers, O., et al. Bakta: rapid and standardized annotation of bacterial genomes via alignment-free sequence identification. Microb Genom. 7 (11), (2021).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Singh, H., et al. Integrons: the hidden architects of bacterial adaptation, evolution, and the challenges of antimicrobial resistance. Antonie Van Leeuwenhoek. 118 (7), 90(2025).
- Redondo-Salvo, S., et al. COPLA, a taxonomic classifier of plasmids. BMC Bioinformatics. 22 (1), 390(2021).
- Salipante, S. J., et al. Large-scale genomic sequencing of extraintestinal pathogenic Escherichia coli strains. Genome Res. 25 (1), 119-128 (2015).
- Couturier, A., et al. Real-time visualisation of the intracellular dynamics of conjugative plasmid transfer. Nat Commun. 14 (1), 294(2023).
- Wick, R. R., Schultz, M. B., Zobel, J., Holt, K. E. Bandage: interactive visualization of de novo genome assemblies. Bioinformatics. 31 (20), 3350-3352 (2015).
- Grant, J. R., et al. Proksee: in-depth characterization and visualization of bacterial genomes. Nucleic Acids Res. 51 (W1), W484-W492 (2023).
- MacKenzie, M., Argyropoulos, C. An Introduction to nanopore sequencing: past, present, and future considerations. Micromachines (Basel). 14 (2), (2023).
- Emiliani, F. E., Hsu, I., McKenna, A. Multiplexed assembly and annotation of synthetic biology constructs using long-read nanopore sequencing. ACS Synth Biol. 11 (7), 2238-2246 (2022).
- Brown, S. D., Dreolini, L., Wilson, J. F., Balasundaram, M., Holt, R. A. Complete sequence verification of plasmid DNA using the Oxford Nanopore Technologies' MinION device. BMC Bioinformatics. 24 (1), 116(2023).
- Hall, J. P. J., Botelho, J., Cazares, A., Baltrus, D. A. What makes a megaplasmid? Philos Trans R Soc Lond B Biol Sci. 377 (1842), 20200472(2022).
- Brown Kav, A., Benhar, I., Mizrahi, I. A method for purifying high-quality and high-yield plasmid DNA for metagenomic and deep sequencing approaches. J Microbiol Methods. 95 (2), 272-279 (2013).
- Mumm, C., et al. Multiplexed long-read plasmid validation and analysis using OnRamp. Genome Res. 33 (5), 741-749 (2023).
- Balbuena-Alonso, M. G., et al. Genomic analysis of plasmid content in food isolates of E. coli strongly supports its role as a reservoir for the horizontal transfer of virulence and antibiotic resistance genes. Plasmid. 123-124, 102650(2022).
- Zhao, W., et al. Oxford nanopore long-read sequencing enables the generation of complete bacterial and plasmid genomes without short-read sequencing. Front Microbiol. 14, 1179966(2023).
- Wick, R. R., et al. Trycycler: consensus long-read assemblies for bacterial genomes. Genome Biol. 22 (1), 266(2021).
- Johnson, J., Soehnlen, M., Blankenship, H. M. Long read genome assemblers struggle with small plasmids. Microb Genom. 9 (5), (2023).
- Boostrom, I., Portal, E. A. R., Spiller, O. B., Walsh, T. R., Sands, K. Comparing long-read assemblers to explore the potential of a sustainable low-cost, low-infrastructure approach to sequence antimicrobial resistant bacteria with Oxford Nanopore sequencing. Front Microbiol. 13, 796465(2022).
Nachdrucke und Genehmigungen
