Dieser Artikel stellt ein schrittweises Protokoll zur Datenerfassung mit hoher Präzision mittels Eye-Tracking bei menschlichen Leseexperimenten vor und behandelt die Auswahl von Hardware und Anzeigegeräten, den Laboraufbau, das Management der Teilnehmer, Kalibrierung und Validierung, die Online-Qualitätskontrolle sowie die Vorverarbeitung (Ereigniserkennung und Driftkorrektur), um Daten mit hoher Genauigkeit und Präzision sowie reproduzierbare Ergebnisse zu erzielen.
Methodenartikel
Methodisches Protokoll zur qualitativ hochwertigen Datenerhebung beim Eye-Tracking beim Lesen bei Menschen
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die Blickverfolgung ist ein zentrales methodisches Verfahren zur Untersuchung von Aufmerksamkeit und Sprachverarbeitung beim Lesen. Die Gültigkeit und Reproduzierbarkeit der Ergebnisse hängt von der Datenqualität, einer klaren Methodik und einer konsistenten Vorverarbeitung ab. Dieser Artikel stellt einen umfassenden, Schritt-für-Schritt-Protokoll zur Erfassung hochwertiger Blickverfolgungsdaten in Leseuntersuchungen vor. Das Protokoll beginnt mit der Vorbereitung der Laborumgebung und der Einrichtung der Ausrüstung, gefolgt von der Auswahl und Konfiguration der Hardware und Software für die Blickverfolgung sowie der Vorbereitung der Stimuli und des experimentellen Designs. Es umfasst das Management der Teilnehmer, die Einholung der informierten Einwilligung und die Dokumentation sprachlicher und psychometrischer Merkmale. Anschließend werden Kalibrierungs- und Validierungsverfahren durchgeführt, wobei der Komfort der Teilnehmer und die Datenqualität während der Datenerfassung kontinuierlich online überwacht werden. Die Vorverarbeitungspipeline beinhaltet das Exportieren der Rohdaten in Standardformaten, die Bereinigung der Daten, die Detektion von Fixationen und Sakkaden (unter Verwendung geschwindigkeitsbasierter und dispersitätsbasierter Algorithmen) mit klar definierten Parametern, die visuelle Überprüfung auf Signalverlust und Rauschunterdrückung, die Korrektur vertikaler Drift bei mehrzeiligen Texten sowie die Extraktion standardmäßiger Leseindikatoren (Fixationsdauer, Sakkadenmetriken, das Überspringen von Wörtern und Rückkehrraten). Im gesamten Protokoll wird besonders auf die Abstimmung zwischen Forschungsfragen und den Spezifikationen der Hardware, die Kontrolle von Drift durch regelmäßige Überprüfungen sowie eine detaillierte Dokumentation aller kritischen Parameter und Entscheidungen geachtet. Eine erfolgreiche Datenerfassung führt typischerweise zu einer stabilen Validierungsgenauigkeit innerhalb festgelegter Grenzen, geringen Raten an Datenverlust sowie interpretierbaren Verteilungen der Fixationsdauern und Sakkadenverhaltens, die bekannte Effekte in Bezug auf Wortlänge, Frequenz und Vorhersagbarkeit reproduzieren. Das Protokoll ist kompatibel mit stationären Blickverfolgungssystemen, gängigen Softwareumgebungen sowie sowohl kopfstabilisierten als auch kopffreien Anordnungen und berücksichtigt praktische Aspekte wie Beleuchtungsbedingungen, Reflexionen von Brillen und Veränderungen der Körperhaltung der Teilnehmer. Diese Studie stellt ein klares, praktisches Protokoll vor, das methodische Anleitungen in einen einheitlichen Arbeitsablauf integriert. Es zielt darauf ab, die zuverlässige Erfassung von Blickverfolgungsdaten in der Leseforschung zu unterstützen, Reproduzierbarkeit und Metaanalysen zu fördern, die Konsistenz zwischen verschiedenen Laboren und Forschungsgruppen zu verbessern und letztlich die wissenschaftliche Glaubwürdigkeit der Leseforschung zu stärken.
Einleitung
Die Blickverfolgung ist eine zentrale Methode zur Untersuchung von Aufmerksamkeit und Sprachverarbeitung beim Lesen, da Fixationen und Sakkaden die momentane Zuteilung visueller und kognitiver Ressourcen zu den Reizen anzeigen. Klassische und aktuelle Übersichtsarbeiten dokumentieren robuste Zusammenhänge zwischen Augenbewegungen und theoretischen Konstrukten wie dem Wahrnehmungsbereich, dem Vorschauvorteil und Modellen der Steuerung von Augenbewegungen1,2. Um verlässliche Studien zu diesen Zusammenhängen durchzuführen, ist methodische Sorgfalt bei der Auswahl der Ausrüstung, beim experimentellen Design, bei Kalibrierung und Validierung sowie bei der Vorverarbeitung unerlässlich; andernfalls führt eine Verschlechterung der Datenqualität zu verzerrten Schätzungen und beeinträchtigt die Reproduzierbarkeit3.
In den letzten zehn Jahren haben mehrere Leitfäden und Publikationen zu bewährten Methoden das methodische Wissen auf dem Gebiet zusammengeführt. Eine aktuelle Reihe zu Grundlagen verbindet Theorie mit Messverfahren, diskutiert Operationalisierung und algorithmische Variabilität und gibt Empfehlungen zur Auswahl von Eye-Trackern für spezifische Forschungsfragen4,5,6,7,8. Ergänzende Leitlinien stellen bewährte Praktiken zur Auswahl der Hardware, Sicherstellung von Genauigkeit und Präzision, Definition von Messgrößen und Berichterstattung vor, einschließlich Empfehlungen zur Minderung von Bedrohungen der Validität9. Einführende Ressourcen zur Lese-Forschung bieten zudem leicht verständliche Übersichten über Experimentaldesigns, gängige Messgrößen und Analyse-Pipelines10,11. In der angewandten Linguistik und beim Lesenverhalten fassen fachspezifische Übersichtsarbeiten die Auswahl von Messgrößen und Trackern zusammen und weisen auf aufgabenabhängige Einschränkungen hin12,13,14,15,16,17.
Dieser Artikel übersetzt diese Anleitung in ein schrittweises Protokoll zur Datensammlung mit hoher Präzision bei Eye-Tracking-Studien zum Lesen. Im Gegensatz zu bestehenden Ressourcen, die hauptsächlich allgemeine, theoretische Leitlinien für bewährte Verfahren bereitstellen oder sich eng auf spezifische Analysemethoden konzentrieren, setzt dieses Protokoll diese Konzepte in einen durchgängigen, umsetzbaren Arbeitsablauf um. Es zielt darauf ab, die tägliche Laborpraxis zu erleichtern, indem konkrete, schrittweise Anweisungen gegeben werden. Hinsichtlich der Anwendbarkeit ist dieses Protokoll speziell für hochkontrollierte Laborexperimente zum Lesen optimiert, die Eye-Tracker mit hoher Abtastrate und stationärem Aufbau (z. B. 500–2000 Hz) sowie eine stabilisierte Kopfhaltung (Kinn- oder Stirnauflage) verwenden. Es eignet sich am besten für Forschungsarbeiten, die strenge Anforderungen an die Datenqualität, hohe räumliche Genauigkeit und Präzision stellen – beispielsweise Studien, die präzise Fixationen auf Wortebene oder detaillierte Sakkadenmetriken analysieren.
Die Verwendung von headfreien oder naturalistischen Aufbauten gewinnt auch in der Lese-Forschung zunehmend an Beliebtheit, wobei wir den Umfang des Artikels auf Laborstudien beschränken. Wir behandeln die Auswahl von Hardware und Software, den Laboreinrichtung, die Stimuluspräparation, das Probandenmanagement, Kalibrierung und Validierung, die Online-Qualitätskontrolle sowie die Vorverarbeitung (einschließlich Ereigniserkennung und Driftkorrektur). Indem Forscher dem Protokoll folgen, können sie eine Datengüte dokumentieren und erreichen, die den aktuellen Standards entspricht, wodurch Transparenz, Glaubwürdigkeit und Reproduzierbarkeit lesebezogener Befunde verbessert werden.
Protokoll
Die ethische Genehmigung für die Datenerhebung im Rahmen von COST CA21131 wurde vom Forschungsethik-Komitee der Fakultät für Philosophie der Jagiellonen-Universität in Polen mit der Protokollnummer 221.0042.18_2024 erteilt. Von allen Teilnehmenden wurde eine informierte Einwilligung eingeholt.
1. Vorbereitung der Laborumgebung und Einrichten der Geräte
- Vorbereitung der Laborumgebung
- Überprüfen Sie die Licht- und Umgebungsgeräuschbedingungen. Fenster in der Laborumgebung können plötzliche Pupillenerweiterungen sowie Lichtreflexionen auf der Eye-Tracker-Kamera und dem Monitor verursachen. Falls möglich, sammeln Sie Daten in einem fensterlosen Raum oder verwenden Sie Verdunkelungsvorhänge, um Sonnenlicht auszublenden. Verwenden Sie künstliche Beleuchtung und beseitigen Sie reflektierende Lichtquellen. Stellen Sie sicher, dass keine Reflexionen auf dem Monitor sichtbar sind; passen Sie Jalousien oder Blickwinkel entsprechend an, bis keine Reflexionen mehr auftreten. Achten Sie darauf, dass der Raum ruhig ist, und vermeiden Sie Unterbrechungen (z. B. durch Hinweisschilder oder Türverriegelungen). Verwenden Sie externe Signale, um Störungen zu verhindern (z. B. ein Schild von außen mit dem Hinweis: „Experiment läuft. Bitte klopfen Sie nicht an die Tür oder betreten Sie den Raum.“)
- Überprüfen Sie die physische Ergonomie. Verwenden Sie einen stabilen, nicht drehbaren Stuhl; passen Sie die Tischhöhe (falls einstellbar) so an, dass eine aufrechte Haltung gewahrt bleibt und eine Kalibrierungsverschiebung durch Drehen des Stuhls vermieden wird.
- Vermeiden Sie soziale Präsenz. Die Anwesenheit eines Versuchsleiters im selben Raum kann den Teilnehmer ablenken. Trennen Sie den Steuerungsraum vom Teilnehmer-Raum oder halten Sie sich außer Sichtweite, um Effekte sozialer Präsenz zu minimieren.
- Überprüfen Sie die Raumluftbelüftung. Lüften Sie vor und nach den Experimentdurchgängen. Prüfen Sie die Raumtemperatur, da die Teilnehmer längere Zeit ruhig sitzen müssen.
- Auswahl der Eye-Tracking-Ausrüstung
- Überprüfen Sie die Kompatibilität zwischen Forschungszielen und Messgrößen. Die Ziele einer bestimmten Studie – und damit die Zielmessgrößen (abhängige Variablen) – sollten mit den Fähigkeiten der Eye-Tracking-Ausrüstung übereinstimmen. Die institutionelle Verfügbarkeit der Geräte kann Einschränkungen für den Umfang der geplanten Studie mit sich bringen. Prüfen Sie die drei wesentlichen Eigenschaften des Eye-Tracking-Systems (Abtastrate, Präzision und Genauigkeit) und deren Eignung für die Forschungsanforderungen. Wichtig ist, dass die Leistungsfähigkeit der Eye-Tracking-Ausrüstung mit den Zielen der Studie übereinstimmt.
HINWEIS: Abtastrate = Die Abtastrate wird in Hz angegeben und beschreibt die Anzahl der von der Eye-Tracker-Kamera pro Zeiteinheit erfassten Messwerte: Ein Eye Tracker mit 60 Hz erfasst alle 16 ms einen Wert, während ein Eye Tracker mit 500 Hz alle 1 ms einen Wert erfasst. Dies beeinflusst verschiedene Messgrößen, da Eye Tracker mit niedriger Abtastrate Sakkaden, die innerhalb eines 16-ms-Zeitraums beginnen, möglicherweise als Fixationen klassifizieren oder umgekehrt. Die Abtastrate wird manchmal mit der Datenaccuracy verwechselt, doch beides sind unterschiedliche Eigenschaften.
Präzision = Die Konsistenz, mit der der Eye Tracker über die Zeit hinweg Daten erfassen kann.
Genauigkeit = Der Betrag der Abweichung zwischen der vom Eye Tracker erfassten Blickposition und der tatsächlichen Blickposition.
Beispielsweise erfordert die Untersuchung von Fixationslandepunkten auf Wörtern, die in Bezug auf die Buchstabenposition innerhalb eines Wortes beschrieben werden, eine deutlich höhere Abtastrate (≥500–2000 Hz), Präzision und Genauigkeit als eine Studie, die sich ausschließlich auf den Anteil regressiver Sakkaden (im Vergleich zu progressiven Sakkaden) beim Lesen konzentriert. - Legen Sie die Methode der Augenbewegungsaufzeichnung fest. Verwenden Sie einen stationären Eye Tracker mit hoher Abtastrate, Präzision und Genauigkeit. Stabilisieren Sie den Kopf mit einem Kinn- oder Stirnhalter. Falls ein head-freies Eye Tracking (Remote-Eye-Tracking) verwendet wird, verwenden Sie gegebenenfalls Aufkleber auf der Stirn des Teilnehmers, um das Gesichtstracking zu verbessern; vermeiden Sie reflektierende Aufkleber, es sei denn, der Hersteller empfiehlt sie ausdrücklich.
HINWEIS: Der Einsatz tragbarer Eye-Tracking-Geräte war in Lesestudien bisher selten, da sie im Vergleich zu stationären Eye Trackern eine relativ niedrigere Abtastrate, Präzision und Genauigkeit aufweisen und die Analyse der Augenbewegungsdaten erschweren. In den letzten zehn Jahren gewinnen jedoch head-freie oder naturalistische Aufbauten zunehmend an Bedeutung, begleitet von verbesserter Datenqualität und automatisierten Analyse-Pipelines, wodurch der Untersuchungsbereich für Augenbewegungen beim Lesen auf naturalistische Szenarien und das Lesen in VR-Umgebungen erweitert wird.
- Überprüfen Sie die Kompatibilität zwischen Forschungszielen und Messgrößen. Die Ziele einer bestimmten Studie – und damit die Zielmessgrößen (abhängige Variablen) – sollten mit den Fähigkeiten der Eye-Tracking-Ausrüstung übereinstimmen. Die institutionelle Verfügbarkeit der Geräte kann Einschränkungen für den Umfang der geplanten Studie mit sich bringen. Prüfen Sie die drei wesentlichen Eigenschaften des Eye-Tracking-Systems (Abtastrate, Präzision und Genauigkeit) und deren Eignung für die Forschungsanforderungen. Wichtig ist, dass die Leistungsfähigkeit der Eye-Tracking-Ausrüstung mit den Zielen der Studie übereinstimmt.
- Einrichtung von Hardware und Software
- Hardware einrichten. Messen Sie die Abstände zwischen dem Gesicht des Teilnehmers, dem Monitor und dem Eye Tracker. Stellen Sie die Blickdistanz gemäß Herstellerangaben ein (z. B. ~60–70 cm) und die erforderliche Konfigurationsgeometrie, vorzugsweise unter Verwendung eines flachen 21–27 Zoll LCD-Monitors (z. B. 24 Zoll bei 60 cm, ~48° x 28° Sichtfeld), sodass der gesamte Text innerhalb des zentralen Sichtfelds und im effektiven Erfassungsbereich des Trackers bleibt. Überprüfen Sie Neigung und Drehung des Monitors sowie die Ausrichtung zwischen Blickvektor und der entsprechenden Bildschirmposition. Stellen Sie Bildschirmgröße und Bildwiederholfrequenz auf die gewünschten Werte ein. Stellen Sie die Bildschirmauflösung auf den vorgegebenen Wert ein. Messen Sie die Monitorhelligkeit auf weißem Hintergrund in der vorgegebenen Distanz. Notieren Sie den Helligkeitswert im Sitzungsbericht.
- Wo erforderlich, bevorzugen Sie LCD-Monitore mit hoher Bildwiederholfrequenz (120 Hz oder höher, z. B. 144–240 Hz), insbesondere bei blickabhängigen Aufgaben und exakter Zeitsteuerung. Deaktivieren Sie variable Bildwiederholtechnologien (G-Sync/FreeSync). Falls der Eye Tracker von verschiedenen Forschern für unterschiedliche Experimente verwendet wird, ist es wichtig, alle Änderungen während der Datensammlung zu dokumentieren. Am Ende jeder Datensammlung sollte die Konfiguration auf den ursprünglichen Zustand zu Beginn der Sitzung oder gemäß der Laborprotokollvorgabe zurückgesetzt werden.
- Software einrichten. Die meisten Eye-Tracker-Hersteller stellen entsprechende Software, Software-Entwicklungskits (SDKs) und/oder Bibliotheken zur Verfügung, um Kompatibilität und Integration mit Open-Source-Software zu gewährleisten.
HINWEIS: In jüngster Zeit stellen bestimmte Aufbauten weiterhin technische Herausforderungen dar, die maßgeschneiderte Lösungen erfordern. Beispielsweise erfordert die Zeitsynchronisation eines Eye Trackers mit komplementären Messmethoden wie EEG und fNIRS spezielle Hardware und/oder Softwarelösungen, um eine ausreichende Zeitgenauigkeit zwischen der Eye-Tracker-Uhr und der Stimuluspräsentationsuhr sowie eine Synchronisation mit der Bildschirmaktualisierung sicherzustellen. Daher bieten die meisten Herstellerwerkzeuge eine Umgebung zur Experimentgestaltung, die grundlegende Anforderungen der Forscher erfüllt, wie z. B. die Präsentation von Reizen und die Aufzeichnung von Augenbewegungen. Eine Liste der derzeit verfügbaren Softwarepakete finden Sie in der Tabelle der Materialien.
- Hardware einrichten. Messen Sie die Abstände zwischen dem Gesicht des Teilnehmers, dem Monitor und dem Eye Tracker. Stellen Sie die Blickdistanz gemäß Herstellerangaben ein (z. B. ~60–70 cm) und die erforderliche Konfigurationsgeometrie, vorzugsweise unter Verwendung eines flachen 21–27 Zoll LCD-Monitors (z. B. 24 Zoll bei 60 cm, ~48° x 28° Sichtfeld), sodass der gesamte Text innerhalb des zentralen Sichtfelds und im effektiven Erfassungsbereich des Trackers bleibt. Überprüfen Sie Neigung und Drehung des Monitors sowie die Ausrichtung zwischen Blickvektor und der entsprechenden Bildschirmposition. Stellen Sie Bildschirmgröße und Bildwiederholfrequenz auf die gewünschten Werte ein. Stellen Sie die Bildschirmauflösung auf den vorgegebenen Wert ein. Messen Sie die Monitorhelligkeit auf weißem Hintergrund in der vorgegebenen Distanz. Notieren Sie den Helligkeitswert im Sitzungsbericht.
2. Planung und Durchführung des Experiments
- Vorbereitung der Stimuli
- Bereiten Sie Leseunterlagen vor. Leseunterlagen werden in der Regel in Form von Sätzen oder Absätzen präsentiert, abhängig von den Zielen der Studie. Ziehen Sie es in Betracht, Leseunterlagen aus verfügbaren Quellen zu entnehmen, anstatt Texte manuell zu erstellen, solange diese Methode mit dem Ziel der Studie übereinstimmt.
- Prüfen Sie die Lizenzbedingungen für die Wiederverwendung von Texten. Überprüfen Sie die Lizenzbedingungen für alle Texte. Falls die Materialien aus veröffentlichten Experimenten quelloffen sind und somit für jeden öffentlich zugänglich sind, ist keine Genehmigung erforderlich. Andernfalls holen Sie die erforderlichen Genehmigungen vor der Nutzung ein. Es ist wichtig zu prüfen, ob die Stimuli für das Experiment verwendet werden dürfen und ob sie als ergänzendes Material geteilt werden dürfen.
- Bereiten Sie formatierte Stimuli vor. Die Formatierung von Textstimuli erfordert die Verwendung geeigneter Schrifteigenschaften (Schriftart, Größe, Buchstaben-, Wort- und Zeilenabstand). Verwenden Sie eine Schriftart mit fester Zeichenbreite (monospace) mit geeigneter Schriftgröße und Abständen, unter Berücksichtigung der in der Literatur verwendeten Einstellungen.
HINWEIS: Monospace-Schriftarten wie Courier New werden in Leseexperimenten empfohlen, die wortbasierte Interessenbereiche (AOIs) verwenden, da diese Schriften für unterschiedliche alphanumerische Zeichen und Symbole innerhalb des lateinischen Alphabets dieselbe Pixelgröße bieten. Der Forscher sollte die Kompatibilität der Schriftart, der Benutzeroberfläche und der spezifischen Eigenschaften der Stimuli überprüfen, beispielsweise die Darstellung der Stimuli in nicht-lateinischen Schriftzeichen oder Lese-Richtungen von rechts nach links, sowie prüfen, ob die Experiment-Software eine Methodik zur automatischen Definition von IA (Interessenbereich) oder AOI (Area of Interest) bereitstellt.
- Experimentablauf entwerfen
- Vorbereitung der Anweisungen
HINWEIS: Anweisungen sind wichtig, da sie einen erheblichen Einfluss auf die Augenbewegungen beim Lesen haben. Die Verwendung von Aufgabeanweisungen, auch in minimaler Form, ist entscheidend. Fehlen explizite Anweisungen, können unbeabsichtigte Konsequenzen eintreten, die das Blickverhalten der Teilnehmer beeinflussen. Beispielsweise könnte ein Teilnehmer die latente Annahme haben, sorgfältig zu lesen, während ein anderer eher überfliegt, anstatt natürliche Lesekompetenz zu zeigen.- Zeigen Sie standardisierte Bildschirmanweisungen an und protokollieren Sie den Beginn und die Dauer der Anweisungen; vermeiden Sie verbale Hinweise während der Aufnahme. Eine gängige Praxis ist es, die Teilnehmer aufzufordern, zum Verständnis zu lesen. Falls erwartet wird, dass die Teilnehmer so lesen, wie sie es im Alltag tun, informieren Sie sie, dass sie natürlich lesen sollen; das heißt, sie müssen nicht das Blinzeln vermeiden oder erneutes Lesen vermeiden. Informieren Sie die Teilnehmer außerdem, falls zusätzliche Aufgaben bestehen, wie beispielsweise Verständnisfragen (die wichtig sind, um sicherzustellen, dass die Teilnehmer zum Verständnis lesen). Die Anweisungen können sich nicht nur je nach Aufgabe, sondern auch je nach Versuchsphase (z. B. Training vs. Hauptaufgabe) unterscheiden. Zur Veranschaulichung wird unten ein Beispiel für Anweisungen während einer Trainingsphase angegeben18.
Wir beginnen nun mit einer Trainingssitzung. Dazu benötigen Sie die vier markierten Tasten (A, B, C, D). Weitere Anweisungen werden Ihnen gleich angezeigt. Nach dem Training wird Ihre Leistung ausgewertet, was etwa eine bis zwei Minuten dauern wird. Falls Ihre Trainingsleistung nicht ausreichend ist, wird der letzte Teil des Trainings wiederholt. Falls sie ausreichend ist, werde ich in den Raum zurückkehren. Wenn Sie bereit sind, drücken Sie einfach die Leertaste. - Es liegt im Ermessen des Forschers, ob solche Anweisungen für die Trainingssitzungen von Experimenten verwendet werden, die auf das Lesen abzielen. Verwenden Sie jedoch auf jeden Fall die Anweisungen für die Experimentssitzung. Ein Beispiel für Anweisungen, die in einer allgemeinen Relevanzanweisungsbedingung während der Experimentphase verwendet werden (sowohl mit als auch ohne Frage im Text), könnte wie folgt aussehen19.
Sie werden eine Reihe kurzer informativer Texte lesen. Wir möchten, dass Sie den Text sorgfältig lesen und so viel wie möglich davon verstehen. Danach werden Sie gebeten, mündlich eine Zusammenfassung der Hauptgedanken des Textes zu geben, um zu zeigen, wie gut Sie verstanden haben, was Sie gelesen haben.
Ein weiteres Beispiel für Anweisungen wird unten für ein Experiment angegeben, das Leseaufgaben mit einzelnen Sätzen verwendet20.
Willkommen zu unserer Lesestudie. In dieser Studie werden Ihnen ungefähr hundert Sätze präsentiert. Diese wurden zufällig aus verschiedenen Quellen ausgewählt und in zufälliger Reihenfolge angezeigt. Lesen Sie sie stillschweigend, um deren Bedeutung zu verstehen, in Ihrem eigenen, natürlichen Lesetempo, ähnlich wie Sie Sätze in einem Buch lesen würden. Nach einigen Sätzen werden möglicherweise Verständnisfragen gestellt. Bitte beantworten Sie diese. Falls Sie die Antwort nicht kennen, überspringen Sie die Frage. In der Mitte der Sitzung gibt es eine Pause. Sie können jederzeit eine Pause verlangen oder die Sitzung verlassen, falls Sie sich unwohl fühlen. Falls Sie Fragen haben, informieren Sie bitte den Versuchsleiter. Andernfalls drücken Sie eine Taste, um das Verfahren zu starten.
- Zeigen Sie standardisierte Bildschirmanweisungen an und protokollieren Sie den Beginn und die Dauer der Anweisungen; vermeiden Sie verbale Hinweise während der Aufnahme. Eine gängige Praxis ist es, die Teilnehmer aufzufordern, zum Verständnis zu lesen. Falls erwartet wird, dass die Teilnehmer so lesen, wie sie es im Alltag tun, informieren Sie sie, dass sie natürlich lesen sollen; das heißt, sie müssen nicht das Blinzeln vermeiden oder erneutes Lesen vermeiden. Informieren Sie die Teilnehmer außerdem, falls zusätzliche Aufgaben bestehen, wie beispielsweise Verständnisfragen (die wichtig sind, um sicherzustellen, dass die Teilnehmer zum Verständnis lesen). Die Anweisungen können sich nicht nur je nach Aufgabe, sondern auch je nach Versuchsphase (z. B. Training vs. Hauptaufgabe) unterscheiden. Zur Veranschaulichung wird unten ein Beispiel für Anweisungen während einer Trainingsphase angegeben18.
- Entwerfen Sie Durchgänge und Blöcke. Gestalten Sie den Ablauf des Experiments, indem Sie die Präsentation der Durchgänge in Blöcken und die Randomisierung der Reihenfolge der Durchgänge innerhalb und zwischen den Blöcken berücksichtigen. Verwenden Sie vor jedem Durchgang ein Fixierungskreuz (500–800 ms), um sicherzustellen, dass die anfänglichen Fixationen der Teilnehmer an derselben Stelle auf dem Bildschirm und fernab von jedem Textteil erfolgen.
Der Entwurf eines Eye-Tracking-Experiments, bei dem die Pupillengröße eine abhängige Variable darstellt, erfordert eine entsprechende Anpassung des Versuchsablaufs, da die Pupillengröße keine Momentanreaktion wie eine Fixations-Sakkaden-Sequenz ist. Insbesondere bei Verwendung der Pupillengröße als abhängige Variable ist es notwendig, ein Baseline-Fenster vor dem Stimulusbeginn und schwarze Bildschirmintervalle mit geeigneten Dauern einzuführen, um die Stabilisierung der Pupillengröße vor der Präsentation der Stimuli und des folgenden Durchgangs sicherzustellen. Der Forscher sollte aktuelle Studien zur Pupillometrie-Richtlinien prüfen, um sicherzustellen, dass die aufgezeichneten Pupillendaten als abhängige Variable angemessen interpretiert werden können21,22. - Planen Sie Pausen zwischen den Blöcken. Fügen Sie Drift-Korrekturbildschirme und optionale kurze Pausen zwischen den Experimentblöcken ein, um die Datengüte sicherzustellen und Ermüdung zu reduzieren. Führen Sie Drift-Checks nach einer vordefinierten Anzahl von Durchgängen durch oder wenn die Genauigkeit sichtbar abnimmt (prüfen Sie, ob es Tastenkürzel gibt, um Kalibrierung/Validierung während des Experiments manuell zu erzwingen); validieren Sie erneut, falls die Drift >1° des Sehwinkels beträgt (Mittelwert der x- und y-Koordinaten).
- Identifizieren Sie die Ziel-Unabhängigen Variablen. In Leseuntersuchungen umfassen spezifische Texteigenschaften wie Wortfrequenz und die satzliche Vorhersagbarkeit von Wörtern die wichtigsten Ziel-Unabhängigen Variablen. Listen Sie die unabhängigen Variablen des Experiments abhängig von den Zielen der Studie auf. In statistischen Analysen kann es erforderlich sein, die Metriken der unabhängigen Variablen zu normalisieren. Bewerten Sie die Relevanz jeder Variable basierend auf den Eigenschaften der Stimuli.
- Schließen Sie Wörter am Anfang einer Textzeile von der Analyse aus, da Fixationen auf diesen Wörtern meist ungenau sind: Sie können die erste vorläufige Fixation im Text/Satz oder die erste Fixation nach einem Zeilenumbruch (sogenannter Return-Sweep) widerspiegeln, die in jedem Fall ungenau sind und meist von korrigierenden Fixationen gefolgt werden. Schließen Sie das letzte Wort jeder Zeile aus, da diese Wörter weniger visueller Überlagerung (durch nachfolgende Wörter) unterliegen und Fixationen auf Wortenden oft das Ende eines Durchgangs oder die Programmierung eines Return-Sweeps zur nächsten Textzeile widerspiegeln.
HINWEIS: Die Dauer der ersten Fixation könnte in Sprachen mit vielen Funktionswörtern, wie beispielsweise Artikel vor Substantiven, weniger aussagekräftig sein (der Analysebereich sollte den Artikel und das Substantiv umfassen, aber die erste Fixation ist weniger wichtig, da sie möglicherweise nur die Verarbeitung des Artikels widerspiegelt).
- Schließen Sie Wörter am Anfang einer Textzeile von der Analyse aus, da Fixationen auf diesen Wörtern meist ungenau sind: Sie können die erste vorläufige Fixation im Text/Satz oder die erste Fixation nach einem Zeilenumbruch (sogenannter Return-Sweep) widerspiegeln, die in jedem Fall ungenau sind und meist von korrigierenden Fixationen gefolgt werden. Schließen Sie das letzte Wort jeder Zeile aus, da diese Wörter weniger visueller Überlagerung (durch nachfolgende Wörter) unterliegen und Fixationen auf Wortenden oft das Ende eines Durchgangs oder die Programmierung eines Return-Sweeps zur nächsten Textzeile widerspiegeln.
- Identifizieren Sie die Ziel-Abhängigen Variablen. In Leseuntersuchungen umfasst eine Reihe von Augenbewegungsmetriken wie Dauer der ersten Fixation, Dauer der einzelnen Fixation, Blickdauer, Rückkehrwahrscheinlichkeit und Wahrscheinlichkeit des Überspringens von Wörtern die wichtigsten Ziel-Abhängigen Variablen im Zusammenhang mit den Zielen der Studie. Legen Sie die zu analysierenden Augenbewegungsmetriken fest. Verwenden Sie diese Metriken als Grundlage für die statistische Analyse.
HINWEIS: Vermeiden Sie Aufgaben, bei denen die Teilnehmer Tastatureingaben vornehmen müssen, da dies das Verlassen der Kinnstütze erfordern könnte, wodurch die Kalibrierung verloren geht. Stattdessen können die Teilnehmer die Maus verwenden, um ihre Antwort auszuwählen. In Fällen, in denen mündliches Feedback während der Aufzeichnung der Augenbewegungen erforderlich ist, verwenden Sie eine Stirnstütze anstelle einer Kinnstütze und bitten Sie die Teilnehmer, verbal zu antworten oder einzelne Tasteneingaben zu tätigen, während sie auf der Stirnstütze verbleiben.
- Vorbereitung der Anweisungen
- Durchführung des Experimentablaufs
- Wählen Sie Software zur Stimuluspräsentation aus. Richten Sie das Experiment mit geeigneter Software zur Stimuluspräsentation ein. Sowohl vom Hersteller bereitgestellte Tools als auch allgemeine Experimentdesign-Tools können verwendet werden, um Texte darzustellen und Augenbewegungen aufzuzeichnen. Berücksichtigen Sie bei der Auswahl der Software die verfügbaren Hardware-Integrationen (z. B. native Unterstützung für den Eye-Tracker), den erforderlichen Grad an zeitlicher Genauigkeit sowie Ihre bevorzugte Stufe an Skripting gegenüber GUI-basiertem Design. Unabhängig von der Plattform muss die Software eine zuverlässige Synchronisation zwischen Stimulusereignissen (z. B. Wortbeginn, Satzbeginn) und dem Eye-Tracking-Datenstrom unterstützen, damit Fixationen und Sakkaden während der Analyse den entsprechenden Textelementen zugeordnet werden können. Falls externe Software verwendet wird, prüfen Sie die Kompatibilität zwischen der Eye-Tracker-Software und der externen Software, insbesondere hinsichtlich Datenvisualisierung und Datenausgabe.
HINWEIS: Beispiele für Software: Experiment Builder (SR Research, für EyeLink-Systeme) bietet eine grafische Benutzeroberfläche mit integrierter Unterstützung für Drift-Checks, Kalibrierungsroutinen und Ereignisnachrichten, die an den Aufnahmecomputer gesendet werden. Open-Source-Plattformen wie PsychoPy und OpenSesame bieten ähnliche Funktionalität und sind hardwareunabhängig, da sie das Design von Durchgängen über eine grafische Oberfläche oder Skripting (z. B. Python im Fall von PsychoPy) ermöglichen, die Stimulus-Timing steuern und Interessenbereiche (Interest Areas, IAs oder Areas of Interest, AOIs) um Wörter oder Textzeilen definieren. Manchmal ist die Verbindung zwischen Datenvisualisierung und Datenausgabe für Forscher am Anfang ihrer Karriere nicht einfach, weshalb es leichter sein kann, die Software des Herstellers zu verwenden. Ein wichtiger Aspekt bei der Auswahl von Eye-Trackern ist daher das Unterstützungsangebot der verschiedenen Hersteller oder der Entwickler-Community. - Testen Sie das Experiment. Testen Sie den implementierten Experimentablauf und prüfen Sie die aufgezeichneten Daten, um sicherzustellen, dass das Experiment wie erwartet abläuft. Führen Sie Pilotstudien in der Laborumgebung durch, um sicherzustellen, dass das Experiment wie geplant funktioniert, indem Sie vordefinierte Erfolgskriterien überwachen. Prüfen Sie die aufgezeichneten Daten, um zu bestätigen, dass alles, was für die Studie benötigt wird, erfasst wird.
- Wählen Sie Software zur Stimuluspräsentation aus. Richten Sie das Experiment mit geeigneter Software zur Stimuluspräsentation ein. Sowohl vom Hersteller bereitgestellte Tools als auch allgemeine Experimentdesign-Tools können verwendet werden, um Texte darzustellen und Augenbewegungen aufzuzeichnen. Berücksichtigen Sie bei der Auswahl der Software die verfügbaren Hardware-Integrationen (z. B. native Unterstützung für den Eye-Tracker), den erforderlichen Grad an zeitlicher Genauigkeit sowie Ihre bevorzugte Stufe an Skripting gegenüber GUI-basiertem Design. Unabhängig von der Plattform muss die Software eine zuverlässige Synchronisation zwischen Stimulusereignissen (z. B. Wortbeginn, Satzbeginn) und dem Eye-Tracking-Datenstrom unterstützen, damit Fixationen und Sakkaden während der Analyse den entsprechenden Textelementen zugeordnet werden können. Falls externe Software verwendet wird, prüfen Sie die Kompatibilität zwischen der Eye-Tracker-Software und der externen Software, insbesondere hinsichtlich Datenvisualisierung und Datenausgabe.
3. Rekrutierung und Information der Teilnehmer
- Teilnehmerauswahl
- Bestimmen Sie die Anforderungen an den Sehzustand. Rekrutieren Sie Teilnehmer mit normalem oder auf Normal korrigiertem Sehvermögen. Es ist möglich, Brillen und Kontaktlinsen zu berücksichtigen, die minimale Reflexionen verursachen (Antireflexbeschichtung, Bildschirmwinkel), gemäß den Herstellerangaben. Dokumentieren Sie die Art der Sehkorrektur (Brille, Kontaktlinsen) für Kovariatenprüfungen.
HINWEIS: In der Regel sind starre Kontaktlinsen (die heutzutage nicht mehr sehr verbreitet sind) sehr schwer zu erfassen. Obwohl Kontaktlinsen grundsätzlich kein Problem darstellen, kann manchmal eine Luftblase zwischen Linse und Hornhaut entstehen, was zu Reflexionen führt, die die Erfassung stören. Auch Brillen mit glänzenden Rahmen können die Aufzeichnung beeinträchtigen. Bei glänzenden Brillenfassungen reduzieren Sie die Erfassung des Blickfelds in der Eye-Tracker-Software. - Selektieren Sie Teilnehmer anhand spezifischer individueller Merkmale wie Alter, Lesekompetenz, sprachlicher Hintergrund, Händigkeit sowie üblicher Ausschluss- und Einschlusskriterien. Beispielsweise können Dyslexie, Zweisprachigkeit oder Lesebeeinträchtigungen die Augenbewegungsdaten beeinflussen. Legen Sie daher je nach Forschungsziel fest, unter welchen Bedingungen ein Leser als geeigneter Teilnehmer für das Experiment gilt, und definieren Sie entsprechende Einschluss- und Ausschlusskriterien (siehe Diskussion).
- Prüfen Sie Sehbehinderungen. Stellen Sie sicher, dass der Teilnehmer keine nicht korrigierbare Sehbeeinträchtigung aufweist, wie beispielsweise Katarakt (auch nach Operation), Glaukom oder Makuladegeneration.
- Prüfen Sie neurologische Erkrankungen. Stellen Sie sicher, dass der Teilnehmer keine Erkrankung hat, die ihn bei der Aufzeichnung von Augenbewegungen beeinträchtigen könnte. Die meisten Eye-Tracker verwenden Nah-IR-LEDs/Laser oder zertifizierte NIR-LED/VCSEL-Beleuchtung, die als augensicher gelten. Bestätigen Sie die augensicherheitsrelevante Zertifizierung des Geräts (z. B. Klasse 1 IEC 60825-1, IEC/EN 62471 oder vergleichbar). Informieren Sie den Teilnehmer über die Sicherheitsvorschriften des Geräts (wie beispielsweise die Verfügbarkeit eines CE-Zertifikats des Herstellers, allgemein bekannt als EU-Konformitätserklärung, ein Dokument, das der Hersteller ausstellt, um zu bescheinigen, dass ein Produkt alle notwendigen europäischen Gesundheits-, Sicherheits- und Umweltvorschriften erfüllt).
- Bestimmen Sie die Anforderungen an den Sehzustand. Rekrutieren Sie Teilnehmer mit normalem oder auf Normal korrigiertem Sehvermögen. Es ist möglich, Brillen und Kontaktlinsen zu berücksichtigen, die minimale Reflexionen verursachen (Antireflexbeschichtung, Bildschirmwinkel), gemäß den Herstellerangaben. Dokumentieren Sie die Art der Sehkorrektur (Brille, Kontaktlinsen) für Kovariatenprüfungen.
- Hygiene sicherstellen
- Treffen Sie Vorkehrungen bezüglich der persönlichen Distanz. Tragen Sie gegebenenfalls Einweghandschuhe und eine Maske, da die Durchführung von Experimenten eine verringerte persönliche Distanz erfordern kann.
- Desinfizieren Sie die Ausrüstung. Desinfizieren Sie die Kinnstütze und andere Zubehörteile mit Alkoholtüchern gemäß den aktuellen institutionellen Vorgaben. Achten Sie darauf, keine Chemikalien zu verwenden, die die Ausrüstung beschädigen könnten. Prüfen Sie die Spezifikationen des Herstellers. Die Teilnehmer fühlen sich möglicherweise wohler, wenn die Reinigung in ihrer Gegenwart erfolgt, insbesondere bei Kinn- und Kopfstütze, der Maus oder anderen Teilen der Ausrüstung, mit denen sie in Kontakt kommen.
- Information der Teilnehmer
- Informieren Sie den Teilnehmer über die Laborumgebung. Gestalten Sie eine mündliche Einweisung, in der der Versuchsleiter dem Teilnehmer die Laborumgebung und die Eye-Tracking-Ausrüstung vorstellt.
- Informieren Sie den Teilnehmer über das Experiment. Erklären Sie klar den Kontext des Experiments (Ziel und ungefähre Dauer der Studie; dies sollte während der Pilotstudien überprüft werden), das Anreiz- oder Vergütungsverfahren, den Beitrag des Teilnehmers zum Experiment sowie sein Recht, langfristig über die Ergebnisse der Studie informiert zu werden. Weisen Sie den Teilnehmer auf das Erlaubte und Unerlaubte während einer Aufzeichnungssitzung hin. Bitten Sie den Teilnehmer, während der Aufzeichnung möglichst wenig mit dem Kopf zu bewegen (bei fehlendem Kopfhalter) oder die Kinnstütze nicht zu verlassen, und erklären Sie, dass diese Maßnahmen der Sicherstellung einer qualitativ hochwertigen Datenaufzeichnung dienen (anderenfalls kann der Teilnehmer das Experiment jederzeit abbrechen und die Sitzung ohne Angabe von Gründen beenden).
- Holen Sie eine informierte Einwilligung ein. Geben Sie den Teilnehmern die Genehmigungs- und Einwilligungsdokumente der Ethikkommission und erläutern Sie diese vor Beginn der Sitzung. Bei Erwachsenen ist eine schriftliche, informierte Einwilligung einzuholen, nachdem sichergestellt wurde, dass sie den Zweck der Studie, den Ablauf und ihre Rechte verstanden haben, einschließlich der Freiwilligkeit der Teilnahme, des Datenschutzes und des Rechts auf Rückzug. Bei Minderjährigen ist die schriftliche Einwilligung eines Elternteils oder Erziehungsberechtigten sowie die Zustimmung des Minderjährigen selbst erforderlich. Setzen Sie die Kalibrierung und Aufzeichnung erst fort, nachdem alle erforderlichen Einwilligungs- und Zustimmungsformulare ausgefüllt wurden. Die Verfahren zur informierten Einwilligung unterscheiden sich erheblich zwischen erwachsenen und minderjährigen Teilnehmern. Daher sollte der Forscher den lokalen institutionellen Richtlinien folgen.
HINWEIS: Falls während des Experiments eine Pause oder Unterbrechung erfolgt, ist eine erneute Validierung der Kalibrierung erforderlich; schlägt diese fehl, muss eine erneute Kalibrierung durchgeführt werden.
4. Durchführung der Kalibrierung und Validierung
- Positionierung der Versuchsperson und Anpassung der Ausrüstung
- Positionieren Sie die Versuchsperson. Bitten Sie die Versuchsperson, sich bequem hinzusetzen. Passen Sie den Stuhl/den Tisch und/oder die Kinnauflage an, um eine stabile Kopfposition zu gewährleisten. Informieren Sie die Versuchsperson, dass dies die erwartete Kopfposition während der Kalibrierung, Validierung und Aufzeichnungsphase ist.
- Passen Sie die Ausrüstung an. Richten Sie die Eye-Tracking-Ausrüstung aus, indem Sie die Kamera des Eye Trackers so justieren, dass die Pupillen der Versuchsperson deutlich sichtbar und erkennbar sind. Einige Eye-Tracking-Systeme führen diese Ausrichtung automatisch durch, während andere eine manuelle Fokussierung der Kamera erfordern.
ANMERKUNG: Der Versuchsleiter sollte die Anpassung und Kalibrierung der Ausrüstung vor Beginn der eigentlichen Datenaufnahme üben, um die Versuchsperson nicht mit diesen Schritten zu belasten.
- Kalibrierung durchführen
- Informieren Sie die Versuchsperson. Erklären Sie der Versuchsperson den Ablauf der Kalibrierung (z. B., dass eine Reihe von Zielmarkierungen angezeigt wird und die Versuchsperson diese für etwa eine Minute verfolgen soll).
ANMERKUNG: Bei der Formulierung der Anweisungen sollte Vorsicht walten. Beispielsweise sollte der Versuchsleiter betonen, dass der Vorgang der Kalibrierung des Eye Trackers für die Versuchsperson dient und nicht umgekehrt. Außerdem ist sicherzustellen, dass mit der Eye-Tracking-Ausrüstung kein Video/Bild aufgezeichnet wird. Obwohl das Auge der Versuchsperson sichtbar ist, wird lediglich die Augenposition in Form von Koordinaten erfasst. - Führen Sie die Kalibrierung durch. Weisen Sie die Versuchsperson an, die Zielmarkierungen zu verfolgen und die Kopfposition konstant zu halten; beispielsweise nicht nach hinten zu lehnen, nachdem die Kalibrierung abgeschlossen ist. Instruktionen: Fixieren Sie den Mittelpunkt des Kalibrierungssymbols und bewegen Sie die Augen nicht, bis sich das Symbol bewegt. Die Versuchspersonen neigen dazu, die Bewegung des Symbols vorauszuahnen, insbesondere während der Validierung, was zu erhöhten Fehlern und unnötigen Kalibrierungsschritten führen kann. Fügen Sie diese Erklärung in die Instruktionen oder in die Beschreibung des Kalibrierungs-/Validierungsprozesses ein.
ANMERKUNG: Hersteller bieten verschiedene Arten von Symbolen für den Kalibrierungsprozess an (Punkte, kinderfreundliche Symbole, statische oder schrumpfende Symbole usw.) sowie unterschiedliche Kalibrierungskonfigurationen (d. h. die Anzahl der Kalibrierungspunkte). Es ist wichtig, die Unterschiede in der Kalibrierungsgenauigkeit bei diesen verschiedenen Konfigurationen zu prüfen und diejenige auszuwählen, die am besten den Anforderungen einer bestimmten Studie entspricht. Wenn beispielsweise die Stimuli den gesamten Bildschirm nutzen (z. B. ein Text mit vielen Absätzen), ist eine Kalibrierungskonfiguration erforderlich, die eine gute Kalibrierung von oben nach unten einschließlich der Ecken gewährleistet. Wenn jedoch Sätze in der Bildschirmmitte präsentiert werden, kann eine Konfiguration mit weniger Kalibrierungspunkten ausreichen. Zudem ist die Kalibrierungsgenauigkeit in horizontaler Richtung (x-Koordinate) für letztere wichtiger als für ersteres, das eine gute Genauigkeit sowohl in vertikaler als auch in horizontaler Richtung erfordert. - Beenden Sie die Kalibrierung. Informieren Sie die Versuchsperson nach Abschluss der Kalibrierung über den anschließenden Validierungsprozess.
ANMERKUNG: Bei anhaltenden Kalibrierungsproblemen überprüfen Sie die Kameraausrichtung des Eye Trackers, die Lichtverhältnisse und die Positionierung der Versuchsperson. Bei erwachsenen Versuchspersonen können reflektierendes Make-up, Brillen oder Kontaktlinsen die Augenverfolgung stören. Beruhigen Sie die Versuchsperson, gewähren Sie kurze Pausen oder wiederholen Sie die Kalibrierung nach Bedarf. Bestehen die Probleme weiterhin, erwägen Sie einen Neustart des Eye-Tracking-Systems. Wenn die Probleme auch nach einem Neustart des Eye-Tracking-Systems bestehen und nach Überprüfung der Konfigurationsparameter keine Ursache für das Kalibrierungsversagen gefunden wurde, informieren Sie die Versuchsperson, dass die Eye-Tracking-Technologie noch nicht ausreichend entwickelt sei und dass es sich um ein technologiebedingtes Problem handele, nicht um ein Problem der Versuchsperson.
- Informieren Sie die Versuchsperson. Erklären Sie der Versuchsperson den Ablauf der Kalibrierung (z. B., dass eine Reihe von Zielmarkierungen angezeigt wird und die Versuchsperson diese für etwa eine Minute verfolgen soll).
- Validierung durchführen
- Führen Sie die Validierung durch. Starten Sie die Validierung unmittelbar nach der Kalibrierung.
- Prüfen Sie die Fehler. Überprüfen Sie den durchschnittlichen Blickpositionierungsfehler und stellen Sie sicher, dass er innerhalb akzeptabler Grenzen liegt. Üblicherweise wird ein Sehwinkel von weniger als 1 Grad (<1°) angestrebt, was etwa 4 Zeichen entspricht (d. h., 0,5 entspricht ca. 2 Zeichen). Führen Sie eine erneute Kalibrierung durch, wenn die Fehler außerhalb dieser Grenzen liegen. Akzeptieren Sie beispielsweise die Kalibrierung, wenn der mittlere Fehler ≤0,5–1,0° und der maximale/pro-Punkt-Fehler ≤1,5–2,0° beträgt; andernfalls kalibrieren Sie erneut. Legen Sie den Zeitplan für die erneute Validierung fest (z. B. nach jedem Block oder nach einer Unterbrechung). Als Beispiel für Herstellerkriterien zur Bewertung der Kalibrierqualität bei SR Research gelten Fehler als akzeptabel für die meisten Aufgaben bei einem durchschnittlichen Fehler <1° und einem maximalen Fehler <1,5°; als mittelmäßig bei einem durchschnittlichen Fehler <1°–1,5° und einem maximalen Fehler <1,5°–2°; und als schlecht, wenn sie diese Werte überschreiten.
- Informieren Sie die Versuchsperson. Weisen Sie die Versuchsperson an, ihre Position so gleich wie möglich beizubehalten, und informieren Sie sie über den Beginn der Aufzeichnungssitzung.
5. Datensammlung
- Durchführung des Datenerfassungsverfahrens
- Aufnahmesitzung starten. Starten Sie die Aufnahmesitzung und vermeiden Sie Störungen des Teilnehmers während der Aufgabendurchführung, beispielsweise durch verbale Anweisungen.
- Teilnehmer überwachen. Überwachen Sie das Wohlbefinden des Teilnehmers während der Datenaufnahme. Stellen Sie sicher, dass der Teilnehmer eine stabile Körperhaltung beibehält, ohne Unterbrechungen oder Ermüdung. Achten Sie auf Anzeichen von Ablenkung, trockenen Augen oder Unbehagen durch Kinn- bzw. Stirnauflage.
- Datenaufnahme überwachen. Überwachen Sie die Datenqualität während der Aufnahme. Kalibrieren Sie erneut, falls der durchschnittliche Validierungsfehler oder die Online-Genauigkeit 1° (oder eine vorab festgelegte Genauigkeitsschwelle) überschreitet oder falls sich der Teilnehmer in der Haltung verändert.
- Protokoll führen. Führen Sie ein Protokoll der Aufnahmesitzung, indem Sie Notizen zu während des Experiments beobachteten Anomalien anfertigen (z. B. ungewöhnlich lange Kalibrierung oder unbeabsichtigte Unterbrechung während der Aufnahme) für die Nachuntersuchung nach dem Experiment. Verwenden Sie ein standardisiertes Sitzungsprotokollschema, um Zeitpunkte von Ereignissen, Unterbrechungen, Anzahl der durchgeführten Nachkalibrierungen und deren Fehler, Driftkontrollen sowie Änderungen der Beleuchtung zu dokumentieren.
- Ende der Sitzung
- Daten speichern. Speichern Sie die rohen Blickdaten am Ende der Experimentssitzung, vorzugsweise mithilfe einer systematischen Methode zur Beschriftung der Sitzung (z. B. dem Datum des Experiments und der Teilnehmernummer, beispielsweise 25071801 oder 250718-P01 für Teilnehmer 01 am 18. Juli 2025); vermeiden Sie die Verwendung personenbezogener Daten des Teilnehmers.
- Verabschiedung. Bedanken Sie sich beim Teilnehmer und beantworten Sie eventuelle Fragen zum Experiment; desinfizieren Sie die Geräte (siehe Schritt 3.2.2).
- Daten prüfen. Überprüfen Sie die Daten und Protokolle, um sicherzustellen, dass die Sitzung ordnungsgemäß abgeschlossen wurde.
6. Datenvorverarbeitung und Qualitätsprüfung
- Exportieren, Organisieren und Bereinigen der Rohdaten
- Daten exportieren. Rohdaten zur Blickverfolgung im Standardformat (z. B. .csv, .tsv, .edf) exportieren und die Sitzungs-ID standardisieren (z. B. 25071801 oder 250718-P01, siehe 5.2.1).
- Daten bereinigen. Rohdaten bereinigen, indem Algorithmen zur Erkennung von Lidschlägen und fehlenden Daten mithilfe integrierter Tools der Hersteller-Software oder benutzerdefinierter Skripte angewendet werden, die an das Gerät oder die Abtastrate angepasst sind.
HINWEIS: Erstellen Sie Sicherungskopien der Rohdaten, während die Bereinigungsroutinen ausgeführt werden.
- Erkennung von Augenbewegungsereignissen
- Algorithmus zur Erkennung von Augenbewegungsereignissen auswählen. Verfahren zur Fixierungserkennung auswählen und ausführen, wobei die Parameter der Algorithmen nach Bedarf anzupassen sind. Typische Algorithmen zur Identifizierung von Fixierungen basieren hauptsächlich auf Geschwindigkeitskriterien (z. B. I-VT, Geschwindigkeitsschwellen-Identifikation) oder Dispersionskriterien (z. B. I-DT, Dispersions-Schwellen-Identifikation) unter anderem23. Jeder Algorithmus verfügt über eigene Parameter.
HINWEIS: Die Software des Herstellers geht in der Regel standardmäßig von einem bestimmten Algorithmus und einem festgelegten Satz häufig verwendeter Parameter aus. Es liegt in der Verantwortung des Forschenden, einen geeigneten Algorithmus und dessen Parameter auszuwählen und diese in der Methodenbeschreibung der Studie anzugeben, beispielsweise Dispersions-/Geschwindigkeitsschwellen, eine minimale Fixationsdauerschwelle (z. B. 60 ms oder 100 ms), um kürzere Fixationen auszuschließen, eine maximale Fixationsdauerschwelle (z. B. 1000 ms), um längere Fixationen auszuschließen, das verwendete Glättungsfenster sowie Regeln zur Zusammenführung benachbarter Fixationen23. - Unzulässige Fixationen identifizieren. Fixationen außerhalb des Anzeigebereichs entfernen oder kennzeichnen. Fixationen, die kürzer als eine vordefinierte Mindestschwelle oder länger als eine vordefinierte Höchstschwelle sind, entfernen oder kennzeichnen.
- Daten visuell überprüfen. Die Daten mithilfe verfügbarer Visualisierungswerkzeuge visuell überprüfen, um die Datenvalidität sicherzustellen. Auf Signalverlust, übermäßiges Rauschen, fehlende Abtastwerte oder fehlerhafte Fixationen prüfen. Nach jeder Aufnahmesitzung die Daten mit den in der Eye-Tracking-Software enthaltenen Visualisierungswerkzeugen (z. B. Blickmusterdarstellungen, Scanpfade, zeitliche Verlaufsdiagramme) überprüfen. Dieser Schritt trägt dazu bei, sicherzustellen, dass die Daten ausreichender Qualität sind, bevor mit der Vorverarbeitung und Analyse fortgefahren wird.
- Prüfen Sie insbesondere auf Signalverlust und Tracking-Probleme, indem Sie nach langen Lücken in den Blickmustern oder Bereichen in den Stimuli suchen, in denen keine Blickabtastwerte erfasst wurden. Häufiger oder länger andauernder Verlust der Nachverfolgung kann darauf hindeuten, dass die Sitzung ausgeschlossen oder wiederholt werden sollte.
- Überprüfen Sie das Vorhandensein übermäßigen Rauschens, indem Sie die rohen x/y-Positionsverläufe auf plötzliche Sprünge oder fehlerhafte Abtastwerte, die nicht zur Stimulusanordnung passen, untersuchen. Übermäßiges Rauschen kann auf eine schlechte Kalibrierung, eine instabile Kopfposition oder Hardwareprobleme hindeuten.
- Um fehlende oder unregelmäßige Abtastwerte zu erkennen, prüfen Sie, ob die Abtastrate ungefähr dem Erwartungswert entspricht (z. B. 500 Hz) und ob unerwartete Häufungen fehlender Abtastwerte über normale Lidschläge hinaus auftreten.
- Um fehlerhafte Fixationen zu erkennen, überlagern Sie die Fixationen mit den dargestellten Stimuli und prüfen Sie, ob diese auf den vorgesehenen Zeilen und Wörtern liegen. Systematische Abweichungen (z. B. Fixationen, die konsequent außerhalb des Textes liegen), können auf eine Kalibrierungsdrift oder eine falsche Zuordnung zwischen Blickkoordinaten und Bildschirmkoordinaten hindeuten. Die aufgezeichneten Blickmuster sollten in etwa der Struktur des Textes folgen (z. B. von links nach rechts, zeilenweise), wobei die Fixationen auf den Wörtern liegen und relativ flüssige Sakkaden zwischen ihnen auftreten. Eine systematische Abweichung von diesem Muster oder ein häufiger Verlust nutzbarer Daten kann die Ausschließung der betroffenen Daten aus der weiteren Analyse erforderlich machen.
- Driftkorrektur durchführen. Korrektur des vertikalen Driftfehlers durchführen, wo erforderlich. Führen Sie eine zeilenweise vertikale Driftkorrektur bei mehrzeiligen Texten durch. Prüfen Sie die Anwendbarkeit validierter Methoden21.
HINWEIS: Abbildung 1 zeigt eine Darstellung der Schritte bei der Planung eines Eye-Tracking-Experimentaufbaus und der Datenanalyse-Pipeline, wie im Protokollabschnitt beschrieben. Der folgende Abschnitt präsentiert repräsentative Ergebnisse aus aufgezeichneten Sitzungen.
- Algorithmus zur Erkennung von Augenbewegungsereignissen auswählen. Verfahren zur Fixierungserkennung auswählen und ausführen, wobei die Parameter der Algorithmen nach Bedarf anzupassen sind. Typische Algorithmen zur Identifizierung von Fixierungen basieren hauptsächlich auf Geschwindigkeitskriterien (z. B. I-VT, Geschwindigkeitsschwellen-Identifikation) oder Dispersionskriterien (z. B. I-DT, Dispersions-Schwellen-Identifikation) unter anderem23. Jeder Algorithmus verfügt über eigene Parameter.
Ergebnisse
Datenqualität und Validierung
Erfolgreiche Sitzungen liefern in der Regel eine Validierungsgenauigkeit mit einem mittleren Fehler ≤0,5–1,0° und einem Maximalfehler bzw. Punktfehler <1,0–1,5° über alle Zielpositionen hinweg; dabei sollten sowohl der mittlere als auch der Punkt-für-Punkt-Fehler angegeben werden. Stellen Sie ein Histogramm des Fehlers pro Punkt sowie eine Tabelle bereit, die den Mittelwert ± SD und den maximalen Fehler pro Sitzung zusammenfasst. Diese Kriterien entsprechen der gängigen Praxis und den Empfehlungen der Hersteller; Sitzungen, die diese Schwellenwerte überschreiten, sollten je nach Studienregeln teilweise oder vollständig ausgeschlossen werden. Abbildung 2 zeigt ein Beispiel für ein Histogramm des Fehlers pro Punkt zur Kalibrierungsgenauigkeit bei einer 9-Punkt-Kalibrierung, basierend auf drei Kalibrierungsversuchen.
Präzision und Datenverlust
Berichten Sie die Präzision (z. B. RMS –Root Mean Square– Streuung von Probe zu Probe während der Fixation) und den Datenverlust (% fehlende Proben pro Durchlauf/Sitzung). Gute Durchläufe zeigen üblicherweise eine geringe Streuung während der Fixation und einen geringen Datenverlust (z. B. <5–10 %, abhängig von der Eye-Tracking-Ausstattung und dem Aufbau). Geben Sie die Verteilung der Datenverlust-Percentile sowie eine Streuung der Präzision gegenüber dem Verlust pro Durchlauf an, um Ausreißer zu identifizieren. Konsultieren Sie die aktuelle Fachliteratur hinsichtlich Definitionen und minimal erforderlicher Angaben3,4,5,6,7,8,9,10,11.
Drift-Verhalten (vorher/nachher Korrektur)
Gute Versuchsdurchläufe weisen kleine, nahezu konstante vertikale Abweichungen auf, die durch zeilenweise Korrektur – entweder mithilfe automatisierter Drift-Korrektur-Algorithmen21 oder manuell – deutlich reduziert werden. Problematische Durchläufe hingegen zeigen nicht-monotones oder starkes verbleibendes Driften. Geben Sie den medianen absoluten vertikalen Fehler vor und nach der Korrektur an. Überprüfen Sie die Anwendbarkeit automatisierter Drift-Korrektur-Methoden.
Verteilungen gängiger Lese-Messgrößen
Geben Sie Zusammenfassungen der Verteilungen für die Dauer der ersten Fixation (FFD), die Dauer einer einzelnen Fixation (SFD), die Erstdurchlaufdauer (FP) und die Gesamt- bzw. Blickdauer (GD), die Go-Past-Zeit, die Übersprungs-Wahrscheinlichkeit sowie die Wahrscheinlichkeit von Rücksprüngen an. Bei geübten erwachsenen Lesern alphabetischer Texte liegen die Fixationsdauern typischerweise bei etwa 200–250 ms (mit erheblicher Schiefe), und Sakkaden umfassen im Durchschnitt etwa 7–9 Zeichen. Werte, die weit außerhalb dieser Bereiche liegen, oder stark bimodale Verteilungen der Sakkaden sollten dahingehend überprüft werden, ob sie auf erwartete progressive und regressive Sakkaden aufgrund von Aufgabenbedingungen oder Verarbeitungsschwierigkeiten zurückzuführen sind, und nicht auf Zeitmessungsfehler. Die Auswahl und der Bereich der Messgrößen können je nach Population, spezifischer Sprache und Orthographie entsprechend variieren. Abbildung 3 zeigt ein Beispiel für eine Protokoll-Darstellung der Fixationsdauerverteilung aus einer repräsentativen Sitzung.
Plausibilitätsprüfungen
Eine Zunahme der Wortlänge (lange Wörter) führt gewöhnlich zu einer verminderten Überspringungsrate und längeren Blickdauern auf diese Wörter. Funktionale Wörter (z. B. Artikel oder Präpositionen) hingegen werden üblicherweise übersprungen. Häufige Wörter sowie Wörter mit hoher Vorhersagbarkeit basierend auf dem sprachlichen Kontext (innerhalb des Textes oder Satzes) führen typischerweise zu kürzeren Erstfixations- und Blickdauern sowie höheren Überspringungsraten (das Gegenteil wird bei seltenen und niedrig vorhersagbaren Wörtern erwartet). Prüfen Sie, ob die Daten einige dieser Muster zumindest in einer Richtung replizieren. Große Umkehrungen können auf Driftfehler, eine fehlerhafte Zuordnung von Wörtern und Fixationen oder Fehler bei der Datenverarbeitung hinweisen.
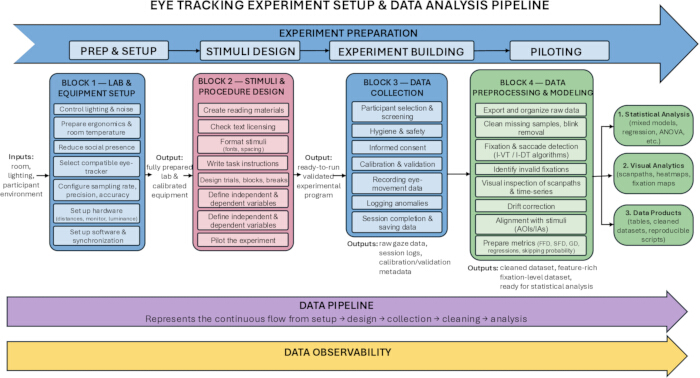
Abbildung 1. Eine Darstellung der Schritte bei der Planung eines Eye-Tracking-Experimentaufbaus und der Datenanalyse-Pipeline. Klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
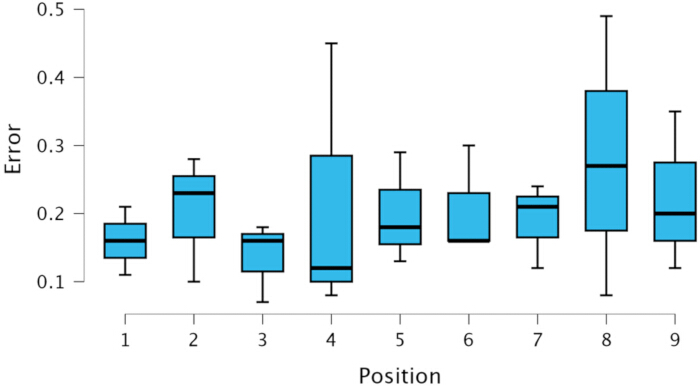
Abbildung 2. Fehlerhistogramm pro Punkt zur Kalibrierungsgenauigkeit für eine 9-Punkt-Kalibrierung, basierend auf drei Kalibrierungsversuchen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
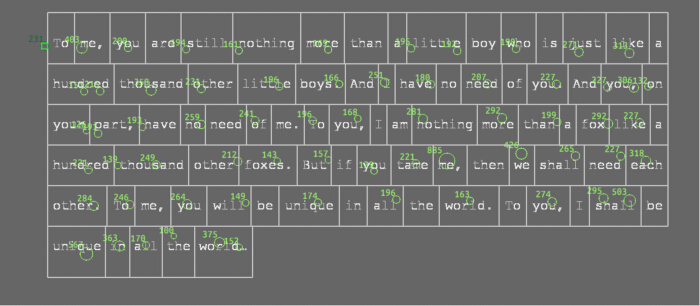
Abbildung 3. Protokoll der Fixationsdauerverteilung aus einer repräsentativen Sitzung; ein Teilnehmer liest eine Passage aus dem Roman „Der kleine Prinz“. Die Position und die Größe der Kreise zeigen jeweils die Fixationspositionen und -dauern an. Die Zahlen neben den Kreisen geben die Fixationsdauern in ms an. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Diskussion
Das hier vorgestellte Protokoll fasst die wichtigsten Schritte zusammen, die notwendig sind, um verlässliche Eye-Tracking-Daten in der Lese-Forschung zu erhalten. Obwohl viele dieser Schritte für erfahrene Forschende vertraut sein mögen, sind sie oft über verschiedene methodische Publikationen, Herstellerdokumentationen und informelle Laborpraktiken verstreut. Indem sie in einen einzigen Arbeitsablauf – von der Laboreinrichtung bis zur Vorverarbeitung – integriert werden, soll hier eine praktische Anleitung für Forschende bereitgestellt werden, die neu im Bereich von Eye-Tracking-Studien zur Leseleistung sind. Im Vergleich zu allgemeinen Eye-Tracking-Richtlinien oder Ressourcen, die sich hauptsächlich auf Algorithmen zur Detektion von Augenbewegungen konzentrieren, bietet dieses Protokoll einen durchgängigen Rahmen als Antwort auf die Anforderungen der Lese-Forschung, die eine Datenaufnahme mit hoher räumlicher Auflösung und hoher Abtastrate erfordert.
Ein zentrales Thema in allen Phasen des Arbeitsablaufs ist die proaktive Verwaltung der Datenqualität, beginnend mit der Kontrolle der Umgebungsbedingungen und der Einrichtung der Ausrüstung. Geringfügige Probleme wie Spiegelungen auf dem Bildschirm, instabile Stühle oder inkonsistente Blickabstände können systematische Verzerrungen in der Fixierungsposition oder -präzision verursachen. Die frühzeitige Behebung dieser Faktoren minimiert den Bedarf an aufwändigen nachträglichen Korrekturen und trägt zu einer zuverlässigeren Validierungsgenauigkeit bei (mittlerer Fehler ≤ 0,5–1°).
Das Protokoll betont außerdem die Bedeutung der Abstimmung zwischen Forschungsfragen und den Eigenschaften der Hardware. Viele Studien zum Lesen basieren auf präzisen räumlichen und zeitlichen Messungen von Fixationen, Sprunglandepositionen und Regressionen1,2. Die Auswahl eines Eye Trackers mit geeigneter Abtastrate, Präzision und Genauigkeit ist daher unerlässlich, insbesondere für Maße wie die Landeposition oder die parafoveale Vorschau, die empfindlich gegenüber kleinen räumlichen Fehlern sind. Abhängig von den spezifischen Studienbedingungen können diese Methoden angepasst werden. Wenn beispielsweise mit neurodivergenten Populationen gearbeitet wird, die einen Kinnhalter nicht vertragen, können Forschende auf entfernte, frei bewegliche Eye Tracker umsteigen und den Verlust an räumlicher Präzision ausgleichen, indem sie größere Schriftarten, größeren Zeilenabstand und breitere Interessenbereiche verwenden. Bei Verwendung solcher bewegungsfreier Systeme müssen Forschende eine erhöhte Bewegung und potenziellen Datenverlust berücksichtigen. Obwohl Fern-Tracker natürlichere Versuchsanordnungen ermöglichen, bleibt die Stabilisierung des Kopfes für die meisten Lesetasks derzeit nach wie vor die bevorzugte Methode.
Das Versuchsdesign ist ein weiterer entscheidender Faktor, der sowohl die Datenqualität als auch die Interpretierbarkeit beeinflusst. Standardisierte Bildschirmanweisungen, die Randomisierung von Durchgängen und eine geeignete Blockstruktur tragen dazu bei, ein stabiles Teilnehmerverhalten während der gesamten Sitzung aufrechtzuerhalten. Die Einbeziehung von Drift-Kontrollen in regelmäßigen Abständen ist besonders wichtig bei Leseexperimenten, da sich bereits geringfügige, schleichende Abweichungen über mehrere Textzeilen hinweg akkumulieren können. Das Protokoll unterstützt außerdem die Verwendung sprachabhängiger lexikalischer Normen und eine transparente Berichterstattung über unabhängige und abhängige Variablen, was die Reproduktion und den Vergleich zwischen Studien erleichtert.
Während der Datensammlung hilft die kontinuierliche Überwachung von Genauigkeit, Körperhaltung und Teilnehmerkomfort, umfangreiche Datenverluste zu vermeiden. Für häufig auftretende Probleme ist oft eine aktive Fehlersuche erforderlich. Beispielsweise kann die Kalibrierung an den Bildschirmecken fehlschlagen; in solchen Fällen lässt sich ein Verlust der peripheren Blickverfolgung durch Anpassen der Bildschirm- oder Stuhlhöhe beheben. Probleme durch reflektierende Brillen oder Kontaktlinsen können manchmal durch Veränderung der Umgebungsbeleuchtung oder des Bildschirmwinkels gelöst werden. Die Führung eines detaillierten Sitzungsprotokolls unterstützt die spätere Fehlersuche und erhöht die Transparenz, indem Unterbrechungen, Nachkalibrierungen und unerwartete Ereignisse dokumentiert werden. Dies wird zunehmend wichtiger, da viele publizierte Studien mittlerweile eine explizite Angabe von Qualitätskennzahlen verlangen, einschließlich Präzision und prozentualen Datenverlust.
Der Abschnitt zur Vorverarbeitung betont konsistente und gut dokumentierte Entscheidungen bei der Ereigniserkennung, Driftkorrektur und Bereinigungsverfahren. Da Algorithmen und Schwellenwerte zur Klassifizierung von Fixationen starken Einfluss auf die resultierenden Messungen haben können, sollten Forscher alle Parameterangaben genau angeben und von üblichen Voreinstellungen abweichende Werte begründen. Die visuelle Inspektion bleibt auch bei Anwendung automatisierter Werkzeuge ein entscheidender Schritt. Das Protokoll empfiehlt außerdem, standardmäßige Qualitätskennzahlen wie Validierungsgenauigkeit, Präzision, Datenverlust und Driftverhalten zu berichten, um einen zuverlässigeren Vergleich zwischen Studien zu ermöglichen.
Darüber hinaus empfiehlt das Protokoll einfache Plausibilitätsprüfungen des Leseverhaltens, wie beispielsweise die Effekte von Wortlänge, Häufigkeit oder Vorhersagbarkeit. Die Reproduktion dieser kanonischen Muster bietet eine zusätzliche Absicherung gegen unbemerkte Ausrichtungsprobleme, störende Drifts oder Fehler bei der Vorverarbeitung. Diese Prüfungen ersetzen keine vollständige statistische Analyse, liefern aber schnelle Rückmeldungen darüber, ob die Daten sich wie erwartet beim geübten Lesen verhalten.
Neben den bereits genannten Einzelheiten des experimentellen Protokolls ist es wichtig, die sprachlichen und psychometrischen Merkmale der Teilnehmer zu beschreiben. Der Hauptgrund hierfür liegt in der Schwierigkeit, vor der experimentelle Forscher hinsichtlich der Vergleichbarkeit verschiedener Studien stehen. Dies ist besonders im Zeitalter der offenen Wissenschaft von Bedeutung, da öffentlich zugängliche Datensätze von Forschern verwendet werden können, die die Daten ursprünglich nicht erhoben haben und daher möglicherweise nicht über potenzielle Besonderheiten infolge von Unterschieden in den (sozio)linguistischen Hintergründen der Teilnehmer informiert sind.
Bezüglich der sprachlichen Hintergründe sollte die Muttersprache der Teilnehmer vermerkt und Informationen über die von ihnen verwendeten Dialekte erfasst werden, um mögliche dialektale Unterschiede, die die Ergebnisse beeinflussen könnten, berücksichtigen zu können. Falls die Teilnehmer mehr als eine Sprache sprechen – eine häufige Situation in der heutigen Welt –, sollte die Beherrschung der Zweitsprache dokumentiert werden. In Studien zur Zweisprachigkeit oder zur Verarbeitung der Zweitsprache sollte die sprachliche Kompetenz in der Zweitsprache mithilfe validierter Einstufungstests für die Zweitsprache ermittelt werden. Zusätzlich können relevante Aspekte des sozioökonomischen Status erfasst werden (z. B. Leseverhalten der Teilnehmer).
Es sollten Tests durchgeführt werden, um psychometrische Merkmale der Teilnehmer zu erfassen, wie beispielsweise die Kapazität des Arbeitsgedächtnisses und kognitive Flexibilität (insbesondere bei bilingualen Studien). Aus methodischer Sicht sollte man überlegen, welche Tests ausgewählt werden, welche kognitiven und zeitlichen Anforderungen sie stellen und zu welchem Zeitpunkt diese Messungen im experimentellen Protokoll durchgeführt werden – vor oder nach der Eye-Tracking-Sitzung oder in einer separaten Sitzung.
Es ist entscheidend, sich daran zu erinnern, dass bei Leseuntersuchungen das Sprachverhalten anhand der sprachlichen Merkmale des Stimulus sowie der psychometrischen Merkmale der Lesenden (oder anderer Merkmale, die für das sprachliche Verhalten der Teilnehmenden relevant sind) gemessen und erklärt wird11,12,17,20. Um Vergleiche zwischen Studien zu ermöglichen, müssen alle Faktoren, die für die Dateninterpretation relevant sein könnten, berücksichtigt werden. Die Auswahl der einzubeziehenden Merkmale hängt vom Ziel der Studie ab. Die Daten müssen vergleichbar sein. Zusammenfassend sollten Daten ausreichend detailliert erhoben und beschrieben werden, um jedem potenziellen Nutzer die größtmögliche Flexibilität in der Verwendung zu ermöglichen. Diese Überlegungen sind zwar möglicherweise kein Bestandteil des Protokolls selbst, sind jedoch für jede einzelne Studie von Bedeutung. In der heutigen globalen wissenschaftlichen Umgebung erhöhen derartige Details die zukünftige Nutzbarkeit der erhobenen Daten.
Dieses Protokoll weist Einschränkungen auf, vor allem einen Kompromiss zwischen Datenqualität und ökologischer Validität, da das Lesen auf einem statischen Monitor mit fixiertem Kopf das natürliche Leseverhalten nicht vollständig abbildet, und strenge visuelle Ausschlusskriterien können die Repräsentativität der Stichprobe einschränken. Darüber hinaus unterscheiden sich Eye-Tracker erheblich hinsichtlich Koordinatenskalierung, Zeitstempelgenauigkeit und Ereignisklassifizierung. Eine Einschränkung des vorliegenden Protokolls besteht darin, dass nicht geklärt wird, wie diese Variabilität die Reproduzierbarkeit zwischen verschiedenen Laboren oder Hardwaremarken beeinflusst. Die Erstellung von Leitlinien zur Validierung über verschiedene Geräte hinweg sowie für realistische zukünftige Anwendungen – beispielsweise die Übertragung von Labormustern auf immersive Umgebungen des Virtuellen oder Augmentierten Lesens – und die Entwicklung digitaler Biomarker für kognitive oder Aufmerksamkeitsstörungen würde eine wichtige Lücke schließen.
Insgesamt fasst das Protokoll bestehende methodische Anleitungen zu einem klaren und transparenten Workflow zur Erfassung hochwertiger Eye-Tracking-Daten beim Lesen zusammen. Indem Forschende die Schritte befolgen und die zugehörigen Qualitätskennzahlen berichten, können sie die Reproduzierbarkeit und Glaubwürdigkeit von Leseuntersuchungen verbessern und zu einer stärkeren methodischen Konsistenz im Fachgebiet beitragen.
Danksagungen
Finanzierung: Dieses Projekt wurde unterstützt von COST – Europäische Zusammenarbeit in Wissenschaft und Technologie (CA21131 – Enabling multilingual eye-tracking data collection for human and machine language processing research (MultiplEYE), https://www.cost.eu/actions/CA21131)24, der Foundation for Science and Technology, Portugal (Zuschüsse: UID/214/2025, UI/BD/154500/2022), sowie dem strategischen Programm der Jagiellonian University im Rahmen der Initiative für Exzellenz in der Schwerpunktforschung DigiWorld (ID.UJ), Projekt „Cognitive Aspects of Interaction and Communication in Natural and Artificial Agents“. Wir danken Anna Maria Wilkosz für ihre freundliche technische Unterstützung.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Alkoholtücher (70 % Isopropanol) | Reinigungsmaterial | Lokaler Laborbedarf | |
| Kinnstütze mit einstellbarer Höhe | Kopfstabilisierungsvorrichtung | Verschiedene Labormaterialanbieter | |
| Einwilligungserklärung und Nachbesprechungsmaterialien | Dokumentation | Institutionell genehmigte Vorlagen | |
| Augenverfolgungsgerät (z. B. SR Research EyeLink 1000 Plus, Tobii Pro Fusion) | Hardware zur Augenverfolgung | SR Research Ltd., Tobii AB | |
| Software zur Analyse von Augenverfolgungsdaten (Data Viewer, Tobii Pro Lab) | Software zur Analyse von Augenbewegungsdaten | SR Research Ltd., Tobii AB | |
| Augenverfolgungssoftware (z. B. Experiment Builder, Tobii Pro Lab, PsychoPy) und deren SDKs | Software zur Stimuluspräsentation und Software-Entwicklungskits | SR Research Ltd., Tobii AB, Open Source | |
| Allgemeine Software zur Datenanalyse (R mit lme4, ggplot2, JASP, Python mit Pandas, NumPy, Matplotlib) | Datenvorverarbeitung und -analyse | Open Source, https://www.python.org, https://www.r-project.org, https://www.jasp.org | |
| Allgemeine Software zur Experimentplanung (PsychoPy) | Software zur Stimuluspräsentation | Open Source, https://www.psychopy.org | |
| Andere Software von Drittanbietern (z. B. E-Prime) | Software zur Stimuluspräsentation | Psychology Software Tools, Inc. | |
| Schallgedämmter Raum | Umweltkontrolle | Institutionelle Einrichtung | |
| Standard-24-Zoll-LCD-Monitor (oder kleiner) | Anzeigegerät | Jeder ISO-konforme Hersteller |
Referenzen
- Rayner, K. Eye movements in reading and information processing: 20 years of research. Psychol Bull. 124, 372-422 (1998).
- Rayner, K. Eye movements and attention in reading, scene perception, and visual search. Q J Exp Psychol. 62, 1457-1506 (2009).
- Carter, B. T., Luke, S. G. Best practices in eye tracking research. Behav Res Methods. 52, 278-295 (2020).
- Hessels, R. S., et al. The fundamentals of eye tracking part 1: The link between theory and research question. Behav Res Methods. 56, 16(2024).
- Hooge, I. T. C., et al. The fundamentals of eye tracking part 2: From research question to operationalization. Behav Res Methods. 57, 73(2025).
- Nyström, M., et al. The fundamentals of eye tracking part 3: How to choose an eye tracker. Behav Res Methods. 57, 67(2025).
- Niehorster, D. C., et al. The fundamentals of eye tracking part 4: Tools for conducting an eye tracking study. Behav Res Methods. 57, 46(2025).
- Hessels, R. S., et al. The fundamentals of eye tracking part 5: The importance of piloting. Behav Res Methods. 57, 216(2025).
- Dunn, M. J., et al. Minimal reporting guideline for research involving eye tracking (2023 edition). Behav Res Methods. 56, 4351-4357 (2024).
- Eskenazi, M. A. Best practices for cleaning eye movement data in reading research. Behav Res Methods. 56, 2083-2093 (2024).
- Schotter, E. R., Dillon, B. A beginner’s guide to eye tracking for psycholinguistic studies of reading. Behav Res Methods. 57, 68(2025).
- Conklin, K., Pellicer-Sánchez, A. Using eye tracking in applied linguistics and second language research. Second Lang Res. 32 (3), 453-468 (2016).
- Pellicer-Sánchez, A. Eye-tracking in vocabulary research: Introduction to the special issue. Res Methods Appl Linguist. 3 (1), 100095(2024).
- Hutton, S. B. Eye-tracking methodology. Eye movement research: An introduction to its scientific foundations and applications. , Springer International Publishing. 277-308 (2019).
- Pokhoday, M. Y., et al. Eye tracking methods in psycholinguistics and parallel EEG recording. Neurosci Behav Physi. 53, 220-229 (2023).
- Azman, H., Mihat, W., Soh, O. K. Analyzing stimuli presentations and exit-interview protocols to improve wearable eye-tracking data collection guidelines for reading research. IJCALLT. 11 (2), 51-65 (2021).
- Papadopoulos, T. C., et al. Eye-tracking in reading research: A systematic review of studies with children of varying reading ability. Eur Psychol. , (2026).
- Garlichs, A., Lustig, M., Gamer, M., Blank, H. Protocol to study how expectations guide predictive eye movements and information sampling in humans. STAR Protoc. 6 (2), 103737(2025).
- Moreno, J., León, J., Kaakinen, J. K., Hyönä, Relevance instructions combined with elaborative interrogation facilitate strategic reading: Evidence from eye movements. J Psicol Educ. 27 (1), 51-65 (2020).
- Acartürk, C. Eyes on Text: Eye movements in reading and language processing. , John Benjamins. (2025).
- Steinhauer, S. R., Bradley, M. M., Siegle, G. J., Roecklein, K. A., Dix, A. Publication guidelines and recommendations for pupillary measurement in psychophysiological studies. Psychophysiology. 59 (4), e14035(2022).
- Papesh, M. H., Goldinger, S. D. Modern pupillometry: Cognition, neuroscience, and practical applications. , Springer. (2024).
- Salvucci, D. D., Goldberg, J. H. Identifying fixations and saccades in eye-tracking protocols. Proc Symposium Eye Tracking Res Appl, , 71-78 (2000).
- Jakobi, D. N., et al. MultiplEYE: creating a multilingual eye-tracking-while-reading corpus. Proc Symposium Eye Tracking Res Appl, , ACM. 111(2025).