Dieser Artikel schlägt eine Methode zur Überwachung der Arbeitssicherheit in Produktionslinien vor, die You Only Look Once Version 11 (YOLOv11) mit faltenden neuronalen Netzen kombiniert. Die Methode erreichte eine mittlere durchschnittliche Präzision bei einem Intersection-over-Union-Schwellenwert von 0,5 (mAP@0,5) von 0,91, eine mAP@0,5:0,95 von 0,82 und 120 Bilder pro Sekunde auf einer Grafikverarbeitungseinheit, wodurch sie die evaluierten Basismodelle übertraf.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Methodenartikel
Echtzeit-Überwachung der Sicherheit von Produktionslinien mittels Deep-Learning-basierter Objekterkennung und Merkmalsverstärkung
In diesem Artikel
Zusammenfassung
Zusammenfassung
Mit der fortschreitenden Entwicklung von Industrie 4.0 haben sich die Automatisierungs- und Intelligenzniveaus von Produktionslinien deutlich verbessert, was höhere Anforderungen an die Echtzeitfähigkeit, Genauigkeit und Sicherheit der Überwachung stellt. Herkömmliche Überwachungssysteme, die auf manuellen Inspektionen oder einfachen schwellenbasierten Entscheidungen beruhen, weisen in der Regel langsame Reaktionszeiten, hohe Fehlalarmraten und eingeschränkte Intelligenz auf. Daher schlägt dieser Artikel ein Sicherheitsüberwachungssystem für Produktionslinien vor, das You Only Look Once Version 11 (YOLOv11) mit einem faltenden neuronalen Netzwerk (CNN) kombiniert. Zunächst wurden die erfassten Bilder vorverarbeitet. Anschließend wurde YOLOv11 verwendet, um Mitarbeiter, Anlagen und potenzielle Gefahrenquellen in Echtzeit zu identifizieren. Danach wurde ein erweitertes CNN-Netzwerk mit mehrskaliger Merkmalsfusion und Attention-Mechanismen eingeführt, um die Fähigkeit zur Merkmalsextraktion für kleine und verdeckte Objekte zu verbessern. Schließlich wurden die Detektionsergebnisse mit den durch das CNN verbesserten Merkmalen fusioniert, um den Sicherheitsstatus zu bewerten. Experimente wurden anhand eines selbst erstellten Datensatzes zur Sicherheit von Produktionslinien durchgeführt, wobei der Optimierer Stochastic Gradient Descent (SGD) mit einem Momentum von 0,9, eine initiale Lernrate von 0,01, eine Gewichtsreduzierung (weight decay) von 0,0005, eine kosinusförmig abgekühlte Lernratenanpassung, eine Batch-Größe von 32 und eine Trainingsdauer von 200 Epochen eingesetzt wurden. Als Bewertungskriterien dienten mAP@0,5 und die Detektionsgeschwindigkeit in Bildern pro Sekunde (FPS), um einen Vergleich mit den ausgewerteten Baseline-Algorithmen zu ermöglichen. Die Ergebnisse zeigen, dass das vorgeschlagene System einen mAP@0,5-Wert von 0,91 und eine Detektionsgeschwindigkeit von 120 FPS erreichte. Zudem zeigte es eine robuste Leistung unter komplexen Bedingungen wie Schattierung und wechselnden Lichtverhältnissen, was seine Effektivität und praktische Anwendbarkeit in der Sicherheitsüberwachung von Produktionslinien untermauert.
Einleitung
In der modernen industriellen Produktion ist Sicherheit die Grundlage, um die Produktionseffizienz und das Wohlergehen des Personals sicherzustellen. Die Produktionsumgebung umfasst typischerweise hochgeschwindigkeitsmechanische Ausrüstung, komplexe technologische Prozesse und kollaborative Operationen mit mehreren Aufgaben. Jede kleine potenzielle Sicherheitsgefahr kann zu schwerwiegenden Produktionsunfällen führen, die erhebliche wirtschaftliche Verluste und sogar Todesfälle verursachen. Daher ist es entscheidend, ein effizientes, intelligentes und echtzeitfähiges Überwachungssystem für die Sicherheit einzurichten, um die Sicherheit in der industriellen Produktion zu erhöhen1,2.
Herkömmliche Methoden zur Sicherheitsüberwachung stützen sich hauptsächlich auf manuelle Videoüberwachung und verschiedene Sensoren (wie Infrarot-, Rauch- und Vibrationssensoren)3. Die manuelle Überwachung ist nicht nur ineffizient, sondern auch anfällig für nicht erkannte Vorfälle aufgrund von Ermüdung des Überwachungspersonals und kann keine durchgängige sowie umfassende Abdeckung gewährleisten. Obwohl Sensoren eine gewisse Frühwarnfunktion bieten können, ist ihr Erfassungsbereich begrenzt, und sie reagieren empfindlich auf Umwelteinflüsse, was zu ausgeprägten Problemen mit Fehlalarmen führt4. Intelligente Überwachungssysteme rücken zunehmend in den Fokus der Forschung. Die Echtzeitanalyse eines Videostreams mithilfe eines Deep-Learning-Algorithmus kann automatisch abnormale Ereignisse, unsicheres Verhalten und potenzielle Gefahren erkennen und dadurch die Intelligenz des Überwachungssystems erheblich verbessern4,5.
Die Objekterkennung ist eine Kerntechnologie in der intelligenten Überwachung. Als Vertreter von einstufigen Objekterkennern weisen die Algorithmen der You Only Look Once (YOLO)-Serie erhebliche Vorteile auf. Von YOLOv1 bis YOLOv8 hat sich diese Algorithmenfamilie kontinuierlich weiterentwickelt, wobei Verbesserungen an der Netzwerkarchitektur, der Verlustfunktion und der Trainingsmethodik sowie weiteren Aspekten vorgenommen wurden6,7. YOLOv11 hat insbesondere eine höhere Erkennungsgenauigkeit erreicht, während gleichzeitig eine hohe Bildrate beibehalten wird, besonders bei komplexen Hintergründen und dicht gepackten Objekten8.
Trotz seiner hervorragenden Leistung bei allgemeinen Objekterkennungsaufgaben sieht sich YOLOv11 jedoch in bestimmten Szenarien der Sicherheitsüberwachung an Produktionslinien weiterhin vor Herausforderungen9. Beispielsweise kann die Erkennungsgenauigkeit von YOLOv11 abnehmen, wenn Arbeiter teilweise durch Ausrüstung verdeckt sind oder wenn Sicherheitszeichen klein sind und stark der Hintergrundfarbe ähneln. Dies erfordert stärkere Fähigkeiten des Modells in der Merkmalsextraktion und semantischen Verständnis10.
Faltungsneuronale Netze (CNNs) verfügen über leistungsstarke Fähigkeiten bei der Extraktion von Bildmerkmalen11. Durch die Entwicklung tieferer und komplexerer Netzwerkarchitekturen können CNNs umfassendere und abstraktere Bildmerkmale lernen. Die Kombination eines CNNs mit YOLOv11 nutzt die schnellen Erkennungsfähigkeiten von YOLOv11 und die tiefe Merkmalsextraktion des CNNs, wodurch ein robusteres und intelligenteres Sicherheitsüberwachungssystem entsteht.
Basierend darauf schlägt dieses Papier ein Produktionslinien-Sicherheitsüberwachungssystem unter Verwendung von YOLOv11 und einem CNN vor. Die innovativen Aspekte dieser Studie umfassen: (1) die Vorschlag einer tiefen Fusionsarchitektur aus YOLOv11 und einem verbesserten CNN; (2) die Einführung einer mehrskaligen Merkmalsfusion und eines zusammengesetzten Aufmerksamkeitsmechanismus zur Verbesserung der Erkennung wesentlicher Sicherheitsmerkmale; und (3) die Überprüfung der Leistungsvorteile des Modells an einem selbst erstellten Datensatz komplexer Szenen.
Entwicklung der YOLO-Reihe-Algorithmen
Seit ihrer ersten Vorstellung durch Redmon et al. im Jahr 201512 hat der Algorithmus „You Only Look Once“ (YOLO) großes Interesse geweckt. Im Gegensatz zu Zweistufen-Detektoren, die auf Regionsvorschlägen basieren, behandelt YOLO die Objekterkennung als Regressionsaufgabe. Durch die direkte Vorhersage der Klassen und Positionen von Objekten in einem Bild erhöht YOLO die Erkennungsgeschwindigkeit deutlich und eignet sich somit für den Echtzeiteinsatz13.
Als bahnbrechende Arbeit in dieser Serie ermöglicht YOLOv1 erstmals eine End-to-End-Zieldetektion14. Bei YOLOv1 wird das Eingabebild in eine Gitterstruktur unterteilt, wobei jede Gitterzelle, typischerweise in einem S × S-Format angeordnet, dafür verantwortlich ist, Objekte innerhalb ihrer Grenzen zu erkennen.
Speziell ist die Ausgabe von YOLOv1 ein Tensor. Unter den S × S × (B × 5 + C) enthält die Vorhersage jeder Begrenzungsbox fünf Elemente: Koordinate des Mittelpunkts (x,y), Breite w, Höhe h und Konfidenz c. Der Berechnungsprozess ist in Gleichung (1) dargestellt:
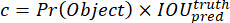 (1)
Dabei steht Pr(Object) für die Wahrscheinlichkeit, dass sich ein Ziel in der Zelle befindet, und IOU steht für das Verhältnis aus Schnittmenge zu Vereinigungsmenge zwischen der vorhergesagten Begrenzungsbox und der tatsächlichen Box. Jede Zelle prognostiziert außerdem eine Reihe von Klassenwahrscheinlichkeiten, wobei Pr die Wahrscheinlichkeit dafür angibt, dass das Ziel der i-ten Klasse angehört, sofern ein Ziel vorhanden ist. Die Verlustfunktion von YOLOv1 setzt sich aus drei Hauptkomponenten zusammen: dem Verlust für die Koordinatenvorhersage, dem Verlust für die Konfidenzschätzung und dem Verlust für die Kategorievorhersage15.
YOLOv2 führt die Batch-Normalisierung, einen Hochauflösungsklassifikator und eine mehrskalige Trainingsstrategie ein, die Stabilität und Genauigkeit verbessern16. YOLOv3 verwendet Darknet-53 als Backbonenetzwerk und greift auf das Konzept des Feature Pyramid Network (FPN) zurück, um die Objekterkennung zu verbessern17.
YOLOv4 hat im Vergleich zu YOLOv3 zahlreiche Optimierungen vorgenommen und Technologien wie das Cross Stage Partial Network (CSPNet)18, das Path Aggregation Network (PANet)19 und die Mosaic-Datenaugmentierung eingeführt, um die Leistung des Modells weiter zu verbessern. YOLOv5 hat bedeutende Beiträge im Bereich Engineering geleistet und bietet eine benutzerfreundlichere und effizientere Implementierung20.
In den letzten Jahren hat sich die YOLO-Serie kontinuierlich weiterentwickelt, wobei nacheinander Versionen wie YOLOv6, YOLOv7 und YOLOv8 veröffentlicht wurden. Durch die Einführung der erweiterten effizienten Layer-Aggregationsnetzwerkstruktur (E-ELAN) und von Modell-Re-Parametrisierungstechniken erzielt YOLOv7 neue Durchbrüche hinsichtlich Geschwindigkeit und Genauigkeit. Diese Verbesserungen steigern nicht nur die Effizienz des Merkmalslernens, sondern optimieren auch die Inferenzleistung des Netzwerks, wodurch YOLOv7 frühere Versionen sowie zahlreiche gängige Detektoren bei verschiedenen Echtzeit-Objekterkennungsaufgaben übertrifft. YOLOv8 optimiert die Netzwerkstruktur weiter, verwendet ein ankerfreies Design, vereinfacht das Modell und verbessert dessen Verallgemeinerungsfähigkeit21.
Aufbauend auf den Vorteilen früherer Versionen wurde YOLOv11, das in dieser Studie verwendet wurde, für komplexe industrielle Szenarien optimiert. Zu seinen zentralen Verbesserungen gehören ein Netzwerk zur Merkmalsextraktion, ein effizienteres Modul zur Merkmalsfusion und ein robusteres Design der Verlustfunktion. Diese Verbesserungen ermöglichen es YOLOv11, bei der Verarbeitung von Verdeckungen, kleinen Objekten und komplexen Hintergründen in Produktionsumgebungen bessere Leistungen zu erbringen. YOLOv11 ist eine Version der YOLO-Serie, die von Ultralytics veröffentlicht wurde. Im Vergleich zu YOLOv8 verbessert es das C3K2-Modul und den Pfad der Merkmalsfusion und führt eine adaptive Ankerbox-Strategie ein, wodurch eine stärkere Detektionsrobustheit in industriellen Szenarien erreicht wird.
Grundlagen und Fortschritte des Faltungs-Neuronalen Netzwerks (CNN)
Das faltungsneuronale Netzwerk (CNN) ist ein zentrales Modell, das den Erfolg des Deep Learnings in der Computer Vision maßgeblich beeinflusst hat. Es funktioniert, indem es lokale Bildmerkmale durch Faltungsoperationen extrahiert und anschließend die Dimensionalität der Merkmale durch Pooling-Operationen reduziert, wodurch eine hierarchische Bildabstraktion erreicht wird22.
Ein typisches FNN besteht aus mehreren Faltungsschichten, Pooling-Schichten und vollständig verknüpften Schichten. Die Faltungsschicht durchsucht das Eingabebild mit einem Faltungskern, berechnet Skalarprodukte über lokale Bereiche und erzeugt eine Merkmalskarte. Der Berechnungsprozess ist in Gleichung (2) dargestellt:
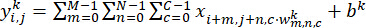 (2)
Dabei ist x das Eingabebild, wk und bk sind die Gewichtung und der Bias des Faltungskerns, bzw., und  sind die Werte der Ausgabe-Feature-Karte an der Position (i,j). Die Pooling-Schicht verwendet üblicherweise Max-Pooling oder Average-Pooling. Die vollverknüpfte Schicht ist dafür zuständig, Merkmale zu extrahieren und Klassifizierungswahrscheinlichkeiten vorherzusagen.
Basierend darauf entwirft diese Arbeit ein CNN-Feature-Verbesserungsmodul für YOLOv11, das aus zwei parallelen Zweigen besteht: einem Multiskalen-Faltungszweig, der 3 × 3- und 5 × 5-Faltungskerne verwendet, um Merkmale auf mehreren Skalen zu extrahieren, und einem Aufmerksamkeitszweig, der nacheinander das Kanal-Aufmerksamkeitsmodul (Squeeze-and-Excitation) und das räumliche Aufmerksamkeitsmodul verbindet, um die diskriminativen Merkmale der Schlüsselziele zu verstärken. Die Ausgaben der beiden Zweige werden durch elementweise Addition fusioniert, und die entsprechende Verlustfunktion für die Feature-Verbesserung ist in Formel (3) dargestellt:
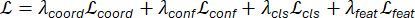 (3)
Lcoord ist der Verlust durch die Regressionsabweichung der Begrenzungsbox-Koordinaten; Lconf ist der Verlust durch die Zielzuversicht (Konfidenz); Lcls ist der Verlust durch die Kategorieklassifizierung; Lfeat ist der Verlust durch die Merkmalsverbesserung, der dazu dient, die diskriminativen Merkmale kleiner und verdeckter Ziele einzuschränken, die vom CNN-Verbesserungsmodul extrahiert werden; λcoord, λconf, λcls, λfeat sind die Gewichtungskoeffizienten der entsprechenden Verlustterme. Für diese Aufgabe wird λfeat = 0,05 festgelegt, und die übrigen Gewichte werden gemäß den Anforderungen der Erkennungsaufgabe ausgeglichen.
Klassische CNN-Architekturen wie VGGNet23 und ResNet24 haben bei Bildklassifizierungsaufgaben große Erfolge erzielt. Unter diesen Architekturen mildert ResNet das Problem des verschwindenden Gradienten beim Training tiefer Netzwerke wirksam ab, wodurch der Aufbau tieferer und komplexerer Netzwerkstrukturen erleichtert wird.
Bei Objekterkennungsaufgaben wird CNN gewöhnlich als Merkmalsextraktor (Backbone) verwendet. Beispielsweise basieren Darknet, cross-stage partial Darknet (CSPDarknet) und andere in der YOLO-Reihe von Algorithmen auf CNN25. Um die Fähigkeiten zur Merkmalsextraktion zu verbessern, haben Forscher zahlreiche verbesserte CNN-Strukturen vorgeschlagen. Beispielsweise extrahiert das Inception-Modul Merkmale parallel durch Faltungskerne verschiedener Skalen. DenseNet verbessert die Wiederverwendung von Merkmalen durch dichte Verbindungen. Das Squeeze-and-Excitation-Netzwerk passt die Wichtigkeit von Merkmalskanälen durch Aufmerksamkeitsmechanismen adaptiv an26.
In dieser Studie haben wir ein verbessertes CNN-Modul entwickelt, um die Fähigkeiten zur Merkmalsextraktion von YOLOv11 zu verbessern. Dieses Modul kombiniert die Fusion mehrskaliger Merkmale mit einem Aufmerksamkeitsmechanismus, um Schlüsselsicherheitsinformationen in Produktionsumgebungen effektiver zu erfassen.
Anwendungsstand des maschinellen Lernens im industriellen Sicherheitsmonitoring
Das maschinelle Lernen hat im Bereich des industriellen Sicherheitsmonitorings erhebliche Bedeutung erlangt. Auf CNN-basierten Algorithmen basierende Verfahren werden eingesetzt, um zu überprüfen, ob Arbeiter Sicherheitshelme ordnungsgemäß tragen, um unbefugte Eindringlinge in Gefahrenzonen zu erkennen und um den Zustand fehlerhafter Geräte zu überwachen27.
Bei der Verhaltenserkennung werden 3D-CNNs und rekurrente neuronale Netze eingesetzt, um das Betriebsverhalten von Arbeitnehmern zu analysieren und potenziell unsichere Handlungen zu identifizieren. Beispielsweise kann durch die Analyse von Körperhaltungsabfolgen der Arbeitnehmer ermittelt werden, ob sie gegen Sicherheitsvorschriften verstoßen28.
YOLO und Faster R-CNN werden häufig für die Erkennung von Personal und Ausrüstung in Echtzeit-Überwachungsvideos verwendet. Beispielsweise wurde in der Literatur ein Echtzeit-Helmerkennungssystem auf Basis von YOLOv5 vorgeschlagen, das die Intelligenz des Sicherheitsmanagements auf Baustellen effektiv verbessert29.
Obwohl in der bestehenden Forschung einige Fortschritte erzielt wurden, bleiben mehrere Herausforderungen bestehen. Erstens weisen industrielle Szenen typischerweise komplexe Beleuchtung, Verdeckungen und Hintergrundstörungen auf, was strenge Anforderungen an die Robustheit des Algorithmus stellt. Zweitens ist Echtzeitleistung eine zentrale Voraussetzung, und der Algorithmus muss eine Hochgeschwindigkeits-Inferenz erreichen, während er gleichzeitig die Genauigkeit beibehält. Schließlich konzentriert sich die bestehende Forschung hauptsächlich auf die Einzelaufgaben-Erkennung und untersucht kaum die Fusion von Mehrquelleninformationen und umfassende Analysen30.
In dieser Studie zielt das vorgeschlagene YOLOv11- und CNN-Fusionsmodell darauf ab, die oben genannten Herausforderungen zu bewältigen und durch verbesserte Fähigkeiten zur Merkmalsextraktion und -fusion eine umfassende, echtzeitfähige Überwachung von Sicherheitsrisiken in der Produktionslinie zu erreichen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
YOLOv11- und CNN-Algorithmus
Gesamtsystemarchitektur
Das in dieser Arbeit vorgeschlagene Überwachungssystem für die Sicherheit in der Produktionslinie verwendet eine hybride Architektur, die YOLOv11 mit einem verbesserten CNN kombiniert, um eine hochpräzise, schnelle Echtzeitsicherheitsüberwachung zu ermöglichen. Wie in Abbildung 1 dargestellt, besteht das System hauptsächlich aus einem Eingabevorverarbeitungsmodul, einem YOLOv11-Objekterkennungsmodul, einem CNN-Funktionsverbesserungsmodul und einem Fusionsentscheidungsmodul. Das Eingabebild wird zunächst durch das Vorverarbeitungsmodul normalisiert und erweitert, um die Generalisierungsfähigkeit des Modells zu verbessern. Anschließend werden Merkmale durch den CSPDarknet-Backbone extrahiert, und der Rezeptive Bereich wird durch das Spatial Pyramid Pooling-Fast-Modul (SPPF) erweitert. Nach dem Hochskalieren werden Mehrskalenmerkmale fusioniert, und Kanal- und räumliche Aufmerksamkeit werden nacheinander auf die fusionierten Merkmale angewendet, um die diskriminative Darstellung der Schlüsselziele weiter zu verbessern. Das CNN-Funktionsverbesserungsmodul ist hinter den Ausgängen der C3-, C4- und C5-Schichten des YOLOv11-Backbone-Netzwerks eingefügt und empfängt Mehrskalen-Funktionskarten mit den Größen 80 × 80 × 256, 40 × 40 × 512 bzw. 20 × 20 × 1.024. Das CNN-Funktionsverbesserungsmodul verbessert die Merkmalsextraktion für kleine und verdeckte Ziele weiter. Schließlich kombiniert das Fusionsentscheidungsmodul die Erkennungsergebnisse von YOLOv11 mit den durch das CNN verbesserten Merkmalen und optimiert diese gemeinsam über eine konzipierte Verlustfunktion, um die präzise Position, Kategorie und Konfidenzpunktzahl des Ziels auszugeben.
YOLOv11-Erkennungsframework
YOLOv11 hat mehrere entscheidende Verbesserungen eingeführt, die die Stärken des einstufigen Erkennungsframeworks der YOLO-Serie nutzen. Seine Architektur gliedert sich in drei Hauptkomponenten: ein Backbone-Netzwerk, ein Merkmalsfusion-Netzwerk und einen Detektionskopf. Das Backbone-Netzwerk verwendet eine verbesserte CSPDarknet-Struktur. Das Merkmalsfusion-Netzwerk integriert lokal übergreifende Verbindungen und tiefenweise separable Faltungen und orientiert sich dabei an Merkmalspyramidennetzwerken und Pfadaggregationsnetzwerken, um multimodale Merkmale effektiv zu kombinieren.
Modul zur Merkmalsverbesserung
Das Modul zur Merkmalsverbesserung zielt darauf ab, die Empfindlichkeit des Modells gegenüber wichtigen Sicherheitsmerkmalen zu erhöhen. Es verarbeitet die von jeder Schicht des YOLOv11-Backbone-Netzwerks erzeugten Merkmalskarten und verschmilzt Informationen über verschiedene Maßstäbe hinweg durch Hoch- und Herunterskalierungsoperationen. Insbesondere erfasst der Multiskalen-Zweig die räumliche Maßstabsvielfalt, während der Attention-Zweig dynamisch wichtige Kanäle und positionsbezogene Antworten verstärkt. Diese beiden Zweige wirken nicht unabhängig voneinander, sondern ergänzen sich und werden über Residualverbindungen und eine Neukalibrierung der Merkmale verschmolzen. Die vom Verbesserungsmodul auf jeder Skala verarbeitete Merkmalskarte wird durch eine 1 × 1-Faltung so angepasst, dass sie der ursprünglichen Anzahl an Kanälen der Merkmalskarte entspricht, und anschließend durch elementeweises Addieren mit der ursprünglichen YOLOv11-Merkmalskarte fusioniert. Die fusionierte Merkmalskarte wird danach in das nachfolgende Feature Pyramid Network (FPN) zur Multiskalenfusion eingespeist, wodurch eine hierarchische Repräsentation von Sicherheitsmerkmalen entsteht. Um eine nahtlose Integration zwischen den Modulen sicherzustellen, wird eine End-to-End-Joint-Training-Strategie angewandt, deren Verlustfunktion aus dem YOLOv11-Detektionsverlust und dem Verlust der CNN-Modul-Merkmalsverbesserung besteht.
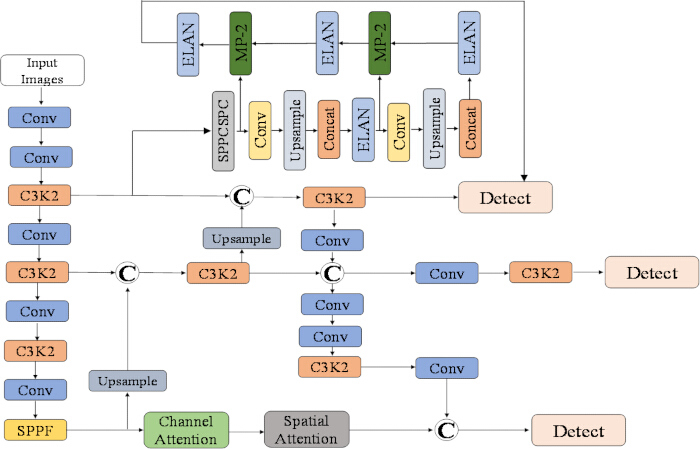
Abbildung 1. YOLOv11-CNN-Algorithmus. Das Feature-Verbesserungsmodul zielt darauf ab, die Empfindlichkeit des Modells gegenüber kritischen Sicherheitsmerkmalen zu erhöhen. Es verarbeitet Merkmalskarten aus verschiedenen Schichten des YOLOv11-Backbones und verschmilzt Merkmale unterschiedlicher Skalen durch Hoch- und Herunterskalierungsoperationen. Zudem integriert es Kanal- und räumliche Aufmerksamkeitsmechanismen. Um eine nahtlose Integration zwischen den YOLOv11- und CNN-Modulen sicherzustellen, wird eine gemeinsame Trainingsstrategie angewendet. Während des Trainings werden die Parameter beider Module end-to-end optimiert. Die Verlustfunktion kombiniert den Detektionsverlust von YOLOv11 mit dem Feature-Verbesserungsverlust des CNN-Moduls. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Um die Wirksamkeit des vorgeschlagenen YOLOv11- und CNN-Fusionsmodells für die Überwachung der Arbeitssicherheit in Produktionslinien zu überprüfen, wurde ein Datensatz erstellt, der verschiedene Gefahrensituationen abdeckt. Dieser Datensatz umfasst 12.000 Bilder von Produktionslinienszenen, die im Verhältnis 7:1,5:1,5 in Trainings-, Validierungs- und Testdatensätze aufgeteilt sind, wobei ein fester Zufallsstartwert (random seed) von 42 verwendet wurde. Er deckt verschiedene Arbeitsbedingungen ab, darunter Standardbeleuc...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Experimentelle Ergebnisse zeigen, dass das vorgeschlagene YOLOv11–CNN-Fusionsmodell die Erkennungsgenauigkeit und die Echtzeitleistung für die Überwachung der Arbeitssicherheit in der Produktionslinie verbessert. Durch die effiziente Einzelstufenerkennung von YOLOv11 und die Merkmalsverbesserung des CNN-Moduls identifizierte das System Arbeiter, Ausrüstung und Gefahrenbereiche unter komplexen Lichtverhältnissen und bei Verdeckungen. Die Fusion mehrskaliger Merkmale und Aufmerksamkeitsmechanismen verstärkten die Fähigkeit...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren erklären, dass keine Interessenkonflikte bestehen.
Danksagungen
Diese Arbeit wurde teilweise von der wissenschaftlichen Forschungsstiftung für hochqualifizierte Fachkräfte der Taizhou-Universität „Forschung zu Schlüsseltechnologien der Präzisionsdetektion für intelligentes Fertigen“ (TZXY2020QDJJ006) gefördert.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| COCO-API | N/V | Bewertungswerkzeug zur Beurteilung der Genauigkeit der Zielobjekterkennung und zur statistischen Analyse. | |
| CUDA 11.4 | NVIDIA | N/V | Plattform für paralleles Rechnen, die mit dem PyTorch-1.12-Framework verwendet wird. |
| Edge TPU | N/V | Einsatzplattform zur Messung von Latenz und Stromverbrauch; berichtete Latenz betrug 18 ms, der Stromverbrauch lag bei 15 W. | |
| Edge-Computing-Gerät Jetson Xavier | NVIDIA | Edge-Computing-Gerät zur Durchsatzmessung; berichtete Verarbeitungsgeschwindigkeit betrug 70 FPS, die Latenz im 99. Perzentil lag unter 50 ms. | |
| NVIDIA Tesla V100 GPU | NVIDIA | GPU, die auf dem Trainings-/Evaluierungsserver verwendet wurde. | |
| PyTorch 1.12 | N/V | Tiefenlern-Framework für das Modelltraining und die Modellbewertung. | |
| scikit-learn | N/V | Bewertungs- und statistisches Analysewerkzeug zur Modellbewertung. | |
| Eigens erstellter Datensatz zur Produktionsliniensicherheit | N/V | N/V | Datensatz mit 12.000 Bildern von Produktionslinienszenen im VOC-Format, abgedeckt sind Standardbeleuchtung, schwache Beleuchtung, teilweise Verdeckung, starke Verdeckung, Bewegungsunschärfe und komplexe Hintergründe; sechs Annotationkategorien: Arbeiter, Schutzhelme, Roboterarme, Gefahrenzonen, Werkzeuge und Fahrzeuge. |
| Trainings-Server | Server ausgestattet mit einer NVIDIA Tesla V100 GPU und dem Betriebssystem Ubuntu 20.04. | ||
| Ubuntu 20.04 Betriebssystem | N/V | Betriebssystem, das auf dem Trainings-/Evaluierungsserver verwendet wird. | |
| VOC-Annotationsformat | N/V | N/V | Annotationsformat für den eigens erstellten Datensatz zur Produktionsliniensicherheit. |
| Objekterkennungsmodell YOLOv11 | Ultralytics | N/V | Objekterkennungsmodell zur Echtzeiterkennung von Arbeitern, Ausrüstung und potenziellen Gefahren. |
Referenzen
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.