CORTA (Correlation Optimized Ranked Transfer-Attention)-Net, ein hybrides Deep-Learning-Framework für kurzfristige PM₂.₅-Prognosen in Delhi. Das Modell kombiniert CorrXGBoost-Rank Feature-Auswahl, Transfer Learning mit Langzeit-Kurzzeitgedächtnisnetzwerken und Multi-Head Attention für zeitliche und feature-Level-Interpretation und nutzt Luftqualitäts-, meteorologische und satellitenbasierte Feuerzähldaten, um die PM2.5-Prognose zu verbessern.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Hybrides Deep Learning mit aufmerksamkeitsbasierter Interpretierbarkeit für PM2.5-Prognosen in städtischen Umgebungen von Delhi
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die kurzfristige PM2.5-Prognose ist in Delhi eine Herausforderung, da die Feinstaubkonzentrationen von lokalen Emissionen, meteorologischen Schwankungen, saisonaler Stagnation und episodischer brandbedingter Verschmutzung beeinflusst werden. Diese Studie präsentiert CORTA-Net, ein hybrides Deep-Learning-Framework für diePM-2.5-Prognose unter Verwendung von Multiquellen-Umweltdaten von 2012 bis 2024. Die Eingabedaten umfassen stündliche Luftqualitätsbeobachtungen von CPCB (Central Pollution Control Board) / DPCC (Delhi Pollution Control Committee) Überwachungsstationen, meteorologische Variablen vom India Meteorological Department (IMD) sowie satellitenbasierte Brandzählinformationen aus MODIS-Produkten (Moderate Resolution Imaging Spectroradiometer). Das vorgeschlagene Rahmenwerk wendet zunächst die Auswahl von CorrXGBoost-Rank-Merkmalen an, um redundante Prädiktoren zu reduzieren und wichtige Schadstoffe, meteorologische, zeitliche und brandbezogene Variablen zu erhalten. Die ausgewählten Features werden dann als überwachte Sliding-Window-Sequenzen angeordnet und mit einem transfer-learning-basierten LSTM-Encoder verarbeitet, gefolgt von einer Multi-Head-Aufmerksamkeitsschicht. Der Aufmerksamkeitsmechanismus ermöglicht eine Interpretation der PM2,5-Prognose auf Feature- und Zeitstufenebene. CORTA-Net wurde mittels chronologischer Trainings-, Test- und Validierungspartitionen sowie Kreuzvalidierung bewertet. Im Vergleich zu Random Forest, XGBoost, LSTM und Attention-LSTM-Baselines reduzierte das vorgeschlagene Framework den Vorhersagefehler im evaluierten Delhi-Monitoring-Station-Setting. Die Neuheit von CORTA-Net liegt in der Kombination expliziter CorrXGBoost-Rank-Feature-Screening, auf Transfer-Learning-basierter temporaler Codierung, MODIS-Feueraktivitätsintegration und mehrköpfiger, aufmerksamkeitsbasierter Modell-Verhaltensanalyse in einer einzigen reproduzierbaren PM2.5-Prognosepipeline . Praktisch kann das Rahmenwerk kurzfristige Stadtluftqualitätsprognosen in datenreichen Überwachungsumgebungen unterstützen, in denen Schadstoffaufzeichnungen, meteorologische Beobachtungen und Brandaktivitätsindikatoren verfügbar sind.
Einleitung
Feinstaub mit aerodynamischem Durchmesser ≤ 2,5 μm (PM2,5) ist in Delhi ein wichtiges Luftqualitätsproblem, da es von lokalen Emissionen 1,2,3, regionalem Transport 4, saisonaler Meteorologie5 und episodischen Biomasseverbrennungsereignissen6 beeinflusst wird. Während der Nachmonsun- und Winterperioden7 können niedrige Windgeschwindigkeit8, flache Grenzschichtbedingungen9 und Temperaturinversion die Schadstoffverteilung verringern und die Partikelansammlung erhöhen. Die Prognose des kurzfristigen PM2.5 ist aufgrund des inhärenten nichtlinearen, saisonalen und abrupten hochkontaminierten Phänomens der Zeitreihe10 schwierig. Frühere Studien zurPM-2.5-Prognose nutzten statistische Modelle, maschinelle Lernmodelle und rekurrente neuronale Netzmodelle11. Statistische Methoden können nützlich sein, um Trends und Saisonalität von Daten12 zu bestimmen, können aber möglicherweise nicht vollständig die nichtlinearen Wechselwirkungen zwischen Schadstoffen und Meteorologie13 berücksichtigen. Machine-Learning-Modelle wie Random Forests und XGBoost können verwendet werden, um nichtlineare Beziehungen zu modellieren14; allerdings haben sie typischerweise keine zeitliche Abhängigkeit, es sei denn, es werden verzögerte Merkmale entworfen. Langzeit-Kurzzeit-(LSTM-) neuronale Netzwerke sind in der Lage, sowohl zeitliche Abhängigkeit als auch nichtlineare Beziehungen zu modellieren15.
Langfristige Kurzzeitgedächtnisnetzwerke können zeitliche Muster16 modellieren, deren Leistung jedoch durch nichtstationäre Bedingungen und abrupte Verschmutzungsepisoden17 beeinflusst werden kann. Neuere aufmerksamkeitsbasierte und transformerbasierte Ansätze verbessern die temporale Repräsentation18, aber viele von ihnen verarbeiten alle Kandidatenvariablen direkt und bieten eine begrenzte Kontrolle über die Merkmalredundanz vor der Sequenzmodellierung 19,20. Obwohl transformatorbasierte und hybride Deep-Learning-Modelle kürzlich PM2.5 und AQI-Prognose21 verbessert haben, konzentrieren sich ihre Beiträge oft auf temporales Repräsentationslernen22, räumliche Graphenkonstruktion23, Modellfusion24 oder Optimierung. Viele dieser Modelle nutzen direkt den verfügbaren multivariaten Eingabesatz und legen die Hauptlernlast auf das Sequenzmodell25. Dies kann die Eingaberedundanz erhöhen, die Interpretierbarkeit verringern und es erschweren zu erkennen, ob Verbesserungen durch zeitliche Modellierung, Merkmalsscreening, externe Umweltindikatoren oder aufmerksamkeitsbasierte Gewichtung entstehen. CORTA-Net ist daher als Workflow-Prognose-Framework positioniert und nicht als ein neues, eigenständiges neuronales Netzwerkauf Schicht 26. Seine Unterscheidung liegt in der geordneten Integration von vier Stufen: CorrXGBoost-Rank Feature Screening vor der Sequenzmodellierung, Transfer-Learning-LSTM-Codierung für zeitliche Anpassung, MODIS-abgeleitete Feuerzähl-Einbeziehung für episodischen Einfluss auf Biomasseverbrennung und Multi-Head Attention für die Modell-Verhaltens-Interpretation auf Merkmals- und Zeitstufenebene. Dieses Design ermöglicht es dem Rahmen, sowohl die Prognosegenauigkeit als auch den Beitrag ausgewählter Schadstoff-, meteorologischen, zeitlichen und Brandaktivitätsvariablen unter derselben Delhi-Überwachungsstation-Einstellung27 zu bewerten.
Jüngste Fortschritte in der Luftqualitätsprognose haben zunehmend hybride Deep-Learning-Modelle, Aufmerksamkeitsmechanismen, graphbasiertes Lernen28 und Transformer-Architekturen verwendet, um nichtlineare zeitliche und räumliche Abhängigkeiten zu erfassen29. Diese Ansätze haben die Prognoseleistung verbessert, indem sie längerreiche Abhängigkeiten lernen und adaptive Gewichtungen für Zeitschritte oder Eingabevariablen30 zuweisen. Viele neuere Modelle basieren jedoch weiterhin auf großen Eingabemerkmalen, reduzieren redundante Prädiktoren vor der zeitlichen Modellierung nicht explizit oder schließen externe Brandaktivitätsindikatoren nicht ein, wenn episodische Biomasseverbrennungseffekte wichtig sind. CORTA-Net schließt diese Lücke, indem es Feature-Screening, Transfer-Learning-LSTM-Codierung, MODIS-abgeleitete Feuerzählintegration und Multi-Head Attention in einem einzigen Prognose-Workflow kombiniert.
Diese Studie präsentiert CORTA-Net als reproduzierbare hybride PM2.5-Prognosepipeline und nicht als neue neuronale Netzwerkschicht. Das Framework kombiniert vier Stufen: CorrXGBoost-Rank-Feature-Auswahl, Transfer-Learning-basierte LSTM-Temporal Encoding, MODIS-abgeleitete Feuerzählintegration und Multi-Head aufmerksamkeitsbasierte Modell-Verhaltensanalyse. CorrXGBoost-Rank reduziert zunächst redundante Schadstoff- und meteorologische Variablen vor der Sequenzmodellierung. Die ausgewählten Features werden dann zu Sliding-Window-Sequenzen angeordnet und mit einem Transfer-Learning-LSTM-Encoder verarbeitet. MODIS-Feuerzählvariablen werden als externe Indikatoren für die regionale Feueraktivität einbezogen, und die Mehrkopf-Aufmerksamkeitsschicht wird verwendet, um zu untersuchen, welche aktuellen Zeitschritte und Eingabevariablen am stärksten zur Prognose beitragen. Das Framework eignet sich für Situationen, in denen kontinuierliche PM2.5-Beobachtungen von mindestens einer Überwachungsstation verfügbar sind, vorzugsweise mit mehreren Jahren Stundendaten. Es profitiert auch von meteorologischen Beobachtungen und satellitenbasierten Feuerzählinformationen, wenn der regionale Einfluss des Biomasseverbrennens relevant ist. Daher ist CORTA-Net für datenreiche städtische Luftqualitätsprognosen gedacht und ist möglicherweise nicht für Orte mit spärlichen, unregelmäßigen oder kurzfristigen Überwachungsaufzeichnungen geeignet.
Delhi wurde als Untersuchungsregion ausgewählt, da dort während der Nachmonsun- und Winterperioden31 wiederkehrende hohe PM₂.₅-Werte verzeichnet werden. Die Stadt ist von Verkehr, industrieller Tätigkeit, Wohnraumemissionen, meteorologischer Stagnation und regionalen landwirtschaftlichen Abbrennungen betroffen. Für diese Studie wurden vier Überwachungsstationen verwendet: Dwarka Sektor 8, Anand Vihar, Mundka-DPCC und Sonia Vihar. Jede Station repräsentiert eine andere Art urbaner Mikroumgebung: Wohngebiet, Verkehrseinflussgebiet und Gebiet mit industriellen Einflüssen. Die Beobachtungen, die von jeder Überwachungsstation zwischen 2012 und 2024 gemacht wurden, sind in ergänzender Abbildung 1 dargestellt. Das Training des Modells erfolgte auf Daten von 2015 bis 2022, und Tests auf Daten aus dem Jahr 2023 sowohl für die Modellentwicklung als auch für dieModellvalidierung 32 , die auf den 2024 gesammelten Daten durchgeführt wurden. Die als Eingaben verwendeten Variablen umfassten PM2,5, PM10, NO, NO2, NOx, CO, Benzol, Lufttemperatur, Windgeschwindigkeit, Sonnenstrahlung und Luftdruck und wurden anhand der am Standort33 verfügbaren Variablen bestimmt. Die von MODIS gewonnenen Brandzähldaten wurden als externe Variable verwendet, die das Feueraktivitätsniveau in der Region repräsentiert. Tabelle 1 enthält eine Zusammenfassung der PM₂.₅-Konzentrationsstatistiken von jeder der vier Überwachungsstationen.
| Datensatz | Stationsname | Mittel | STD | Min | 25% | 50% | 75% | Max |
| 1 | Dwarka Sektor 8 | 98.24 | 79.12 | 7.52 | 38.65 | 70.83 | 133.47 | 588.15 |
| 2 | Anand Vihar | 115.87 | 89.42 | 8.91 | 49.28 | 84.36 | 152.89 | 574.92 |
| 3 | Mundka-DPCC | 113.62 | 91.05 | 4.21 | 43.58 | 86.74 | 158.42 | 682.31 |
| 4 | Sonia Vihar | 101.35 | 80.25 | 5.80 | 42.15 | 75.60 | 138.75 | 565.40 |
Tabelle 1: Zusammenfassende Statistiken der PM₂.₅-Konzentration an vier Überwachungsstationen in Delhi. Tabelle 1 zeigt durchschnittliche PM2,5-Werte (Feinpartikel), gemessen an vier Monitoren in Delhi. PM2.5 besteht aus luftgetragenen Schadstoffen kleiner als 2,5 Mikrometer im Durchmesser und ist daher klein genug, um leicht tief in die Lunge eingeatmet zu werden, was verschiedene potenzielle Gesundheitsrisiken darstellt.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Methodik
Ein überwachtes Schiebefenstermodell wurde erstellt, um den zukünftigen PM2,5-Wert zum Zeitpunkt t + 1 aus vorherigen stündlichen Beobachtungen vorherzusagen. Kandidaten-Eingabefensterlängen von 12, 24 und 48 Stunden-Zeitschritten wurden mittels Validierungsleistung bewertet, und die endgültige CORTA-Net-Konfiguration verwendete eine 24-stündige Eingabesequenz. Lineare Interpolation wurde verwendet, um fehlende Werte zu füllen; Ausreißer wurden mit der IQR-Methode entfernt; und alle Variablen wurden mittels Min-Max-Normalisierung skaliert, bevor verzögerte PM2.5-Features erzeugt wurden. Das CorrXGBoost-Rank-Verfahren wurde dann für die Auswahl der Funktionen angewendet. Erstens Pearson-Korrelationsfilterung behaltener Variablen mit |r| ≥ 0,30. Zweitens: hochredundante Merkmalspaare mit paarweise Korrelation |corr(xi, xj)| ≥ 0,85 wurden gefiltert, um die Multikollinearität zu reduzieren. Drittens wurde ein XGBoost-Regressor auf den verbleibenden Variablen trainiert, und Prädiktoren mit XGBoost-Gewinn-basierten Wichtigkeitswerten ≥ 0,015 wurden für die endgültige Modelleingabe beibehalten. Die endgültige CORTA-Net-Architektur bestand aus gestapelten LSTM-Schichten für temporale Codierung, einer Mehrkopf-Aufmerksamkeitsschicht für Feature- und Zeitstufen-Gewichtung sowie dichten Regressionsschichten für diePM-2.5-Schätzung . Das Modell wurde mit dem Adam-Optimierer trainiert, mit mittlerem quadratischem Fehlerverlust und frühem Stoppen. Die Modellbewertung wurde mittels RMSE und R2 über Training, Validierung, Tests und 10-fache Cross-Validierungspartitionen durchgeführt. Tabelle 2 stellt die Datenvorverarbeitung und die Feature-Engineering Zusammenfassung dar.
| Schritt | Verwendete Methode | Parameter / Schwellenwert | Zweck |
| Berechnung fehlender Werte | Prozentsatz fehlender Beobachtungen | Berichte variabel prozentual | Quantifiziert die Datenvollständigkeit |
| Kurz-Gap-Imputation | Lineare Interpolation | Lückenlänge ≤ 6 Stunden | Füllt kurze fehlende Intervalle aus |
| Ausreißererkennung | IQR-Methode | Q1 − 1,5 × IQR, Q3 + 1,5 × IQR | Entfernt ungültige Extremwerte |
| Normalisierung | Min-Max-Skalierung | Trainings-Set Min und Maximum | Standardisiert den Funktionsumfang |
| PM₂.₅ laggt | Verzögerte Variablen | lag₁, lag₂, lag₃ | Erfasst zeitliche Persistenz |
| Laufende Statistiken | Gleitende Durchschnitte | 3 Stunden, 6 Stunden, 12 Stunden, 24 Stunden | Erfasst kurzfristige Akkumulation |
| Feuerzahl-Merkmal | MODIS-FEUERZÄHLUNG | Gleichtags- / Vortagszählung | Repräsentiert den Einfluss des regionalen Feuers |
Tabelle 2: Datenvorverarbeitung und Zusammenfassung der Feature-Engineering. In Tabelle 2 erfolgt die Datenverarbeitung auf zwei Arten: Erstens durch die Reinigung und Transformation der Rohdaten (Vorverarbeitung) und zweitens durch Feature Engineering zur Erstellung/Auswahl bzw. Änderung von Eigenschaften (Features). Als Einheit helfen diese beiden Prozesse, Rauschen zu eliminieren oder zu reduzieren; fehlende Werte zu handhaben; Verbesserung der Datenkonsistenz; und mehr prädiktive Modelle zu erstellen.
Die Normalisierungsparameter wurden nur aus dem Trainingssatz geschätzt und dann unverändert auf die Test- und Validierungssets angewendet, um Informationslecks zu vermeiden.
Mathematische Formulierung des CorrXGBoost-Rangs
Sei X = {x1, x2, ...,x n} die Menge der Kandidaten-Eingabevariablen und y die Zielkonzentration PM₂.₅. Für jedes Merkmal xi wurde der Pearson-Korrelationskoeffizient mit der Zielvariablen wie folgt berechnet:
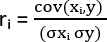 (1)
wobei cov(xi, y) die Kovarianz zwischen Merkmal xi und Ziel y ist und σxi sowie σy ihre Standardabweichungen sind. Beibehaltene Funktionen erfüllen: |ri| ≥ τr , wobei τr = 0,30 in dieser Studie gilt.
Paarweise Korrelationen wurden unter allen erhaltenen features_xi, xj berechnet, und wenn |corr(xi, xj)| > = τRot, wobei τRot = 0,85 gilt, wird das Merkmal mit der niedrigeren absoluten Korrelation zumPM-Ziel von 2,5 aus dem Merkmalset gestrichen. Dieser Prozess reduziert Variablen aus dem Funktionssatz, die Multikollinearität haben. Anschließend wurde ein XGBoost-Regressormodell an die verbleibenden Features angepasst, und für jedes Feature wurden Feature-Importance Scores mit XGBoost Importance berechnet; Features, die den i_i ≥ τxgb bei τxgb = 0,015 entsprechen, wurden im endgültigen Feature-Set (S") behalten, definiert als Sfinal = Scorr ∪ Sxgb, d. h. der Feature-Set, der durch das Filtern von Features auf Redundanz in Bezug auf Korrelation und das Entfernen aller Features auf Basis der XGBoost-Variablen-Importance definiert wird. Der Gesamtansatz bei der Merkmalsauswahl lautet wie folgt: Berechnen Sie die Feature-Ziel-Paarson-Paarson-Korrelation, verwerfen Sie Merkmale mit |r_i|< 0,30, verwerfen Sie Merkmale mit Paaren mit paarweisen Korrelationen ≥ 0,85, passen Sie XGBoost an die verbleibenden Merkmale an, behalten Sie Merkmale mit dem XGBoost Importance Score ≥ 0,015, definieren Sie die endgültig gewünschten Merkmale Sfinal=SKorr ∪ Sxgb, wobei Scorr die Features sind, die nach redundanter Korrelationsfilterung erhalten bleiben, und Sxgb die mit dem XGBoost Feature Importance Score ausgewählten Features. Der CorrXGBoost-Rank-Workflow ist daher: Berechnen Sie Feature-Target Pearson-Korrelation, entfernen Sie Features mit |ri| < 0,30, entfernen Sie hochgradig redundante Merkmale mit paarweiser Korrelation ≥ 0,85, trainieren Sie XGBoost auf die verbleibenden Variablen, behalten Sie Variablen mit dem XGBoost-Wichtigkeitswert ≥ 0,015 und verwenden Sie die Vereinigung der korrelationsselektierten und XGBoost-ausgewählten Variablen als endgültiges Merkmalsset. Die in dieser Studie verwendeten Parameter sind τr = 0,30, τrot = 0,85 und τxgb = 0,015.
Datenquellen
Die Autoren integrierten drei große Datensätze für die Studie; Dies sind Daten zu Luftschadstoffen (PM2,5, PM10, NO2, CO und SO₂), die die Autoren über CPCB (Central Pollution Control Board) / DPCC (Delhi Pollution Control Committee) zur Überwachung der Luftqualität, meteorologische Daten (Temperatur, Luftfeuchtigkeit, Windgeschwindigkeit/-richtung und Druck) vom indischen Meteorologischen Amt (IMD) sowie Satelliteninformationen zu aktiven Bränden von den MODIS Active Fire Products der NASA erhalten haben. Diese drei Datensätze decken den 12-Jahres-Zeitraum Januar 2012–Dezember 2023 ab und repräsentieren somit verschiedene Emissionsarten. Brandunfälle tragen zur Luftverschmutzung bei, wie in ergänzender Abbildung 2 dargestellt, die die FIRECOUNT-Trends von 2012 bis 2024 zeigt.
Langfristige Trends der Schadstoffe im Studienzeitraum
Abbildung 1 zeigt langfristige Trends der Schadstoffe über die Studienjahre (2012–2024). Die jährlichen Feuerzählungen und die durchschnittlichen PM₂.₅-Konzentrationen zwischen 2012 und 2024 weisen einen mäßig starken positiven Zusammenhang auf (r = 0,688), was darauf hindeutet, dass höhere Feueraktivität typischerweise mit höheren PM₂.₅-Konzentrationen zusammenhängt. Sowohl die gemessenen als auch die vorhergesagten PM₂.₅-Daten folgen einem ähnlichen Trend, was die Annahme stützt, dass die Verbrennung von Biomasse zur Partikelverschmutzung beiträgt. Obwohl es eine erhebliche zwischenjährliche Variabilität gibt, sind feuerbedingte Emissionen ein wichtiger Faktor bei der Bestimmung der PM₂.₅-Variabilität, was die Notwendigkeit eines regionalen Brandmanagements zur Verbesserung der Luftqualität unterstreicht. Die Autokorrelation des vorhergesagten PM2,5 bei dreißig Verzögerungen, wie in ergänzender Abbildung 3 dargestellt, weist bei fast allen dreißig Verzögerungen eine beträchtliche positive Autokorrelation auf und bestätigt, dass PM2,5 in Delhi eine starke zeitliche Abhängigkeit und mehrtägige Persistenz aufweist.
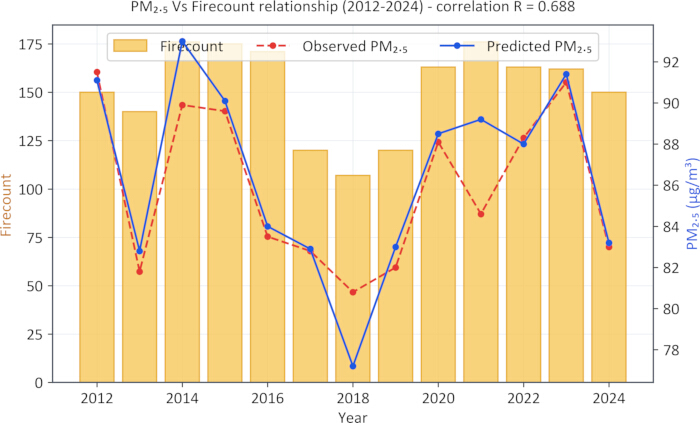
Abbildung 1: Langfristige PM₂.₅- und Brandzahlentrends von 2012 bis 2024. Abbildung 1 vergleicht die jährliche Variation der Feuerzählung mit beobachteten und vorhergesagten PM₂.₅-Konzentrationen. PM₂.₅ wird in μg/m3 angegeben. FIRECOUNT repräsentiert satellitenbasierte Feueraktivität von MODIS-Produkten. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
STL-Dekomposition (saisonale und trendbezogene Zerlegung unter Verwendung von Loess)
STL oder Seasonal and Trend Decomposition mit Loess ist ein iterativer Algorithmus, der die Aufschlüsselung von Zeitreihendaten in drei additive Komponenten ermöglicht, wie in Abbildung 2 dargestellt: Trend (langfristiger Trend) (Abbildung 2A), (Abbildung 2D), (Abbildung 2G), (Abbildung 2J), saisonale (zyklische Perioden) (Abbildung 2B), (Abbildung 2E), (Abbildung 2H), (Abbildung 2K) und Rest (Rauschen/Residual) (Abbildung 2C), (Abbildung 2F), (Abbildung 2I), (Abbildung 2L). STL hat sich als erfolgreich im Umgang mit den komplexen nichtlinearen Eigenschaften von Umweltdaten (wie PM2.5) erwiesen, bei denen viele andere analytische Techniken aufgrund variabler Amplituden im saisonalen Signal und durch das Vorhandensein von Ausreißern versagt haben. Die LOESS-Glättung ermöglicht eine genaue Trennung dieser Komponenten und erzeugt eine klarere Interpretation von Trends oder Mustern. Durch STL-Verarbeitung ist es möglich, die breiteren Aufwärtstrends von PM2,5 von den kürzeren täglichen/saisonalen Zyklen und von den unregelmäßigen Residuen innerhalb dieser Zyklen zu trennen. Diese Trennung ermöglicht es, festzustellen, welche Emissionen PM2,5 beeinflusst haben, im Gegensatz zu den meteorologischen Faktoren, die PM2,5 beeinflusst haben. Die Ergebnisse dieser Trennung helfen bei der genauen Vorhersage zukünftigerPM-2,5-Emissionen ; Bereitstellung von Daten für regulatorische Entscheidungen; und die Einhaltung der Standards für eine rigorose Deaggregation von Zeitreihendaten für Luftqualitätsstudien34. Durchschnittliche täglichePM-2,5-Konzentrationsmessungen an Überwachungsstationen in Delhi von 2012 bis 2024 zeigen minimale Veränderungen des PM2,5-Niveaus (d. h. keine signifikante Veränderung von 2022–24) insgesamt und äußerst begrenztes konsistentes Verhalten (oder Konsistenz derPM-2,5-Werte zwischen den vier Überwachungsorten). Die PM2,5-Niveaus in Dwarka Sektor 8 und Mundka-DPCC zeigen einen anhaltenden Abwärtstrend (d. h. weiter abnehmend), während Anand Vihar einen steigenden Trend zeigt (d. h. deutlich steigend) und Sonia Vihar einen leichten Aufwärtstrend (von einem sehr geringen Anstieg seit 2022). Darüber hinaus zeigten die Residuen der täglichenPM-2,5-Konzentrationen für jede der vier Überwachungsstationen, dass diePM-2,5-Konzentrationen stark von saisonalen (meteorologischen) Veränderungen beeinflusst wurden, die zu großen Schwankungen der durchschnittlichen täglichenPM-2,5-Konzentrationen für einzelne Stationen führten. Die täglichen PM2,5-Konzentrationen für die vier Überwachungsstationen in Delhi (2012–2024) sind in Abbildung 2 dargestellt.
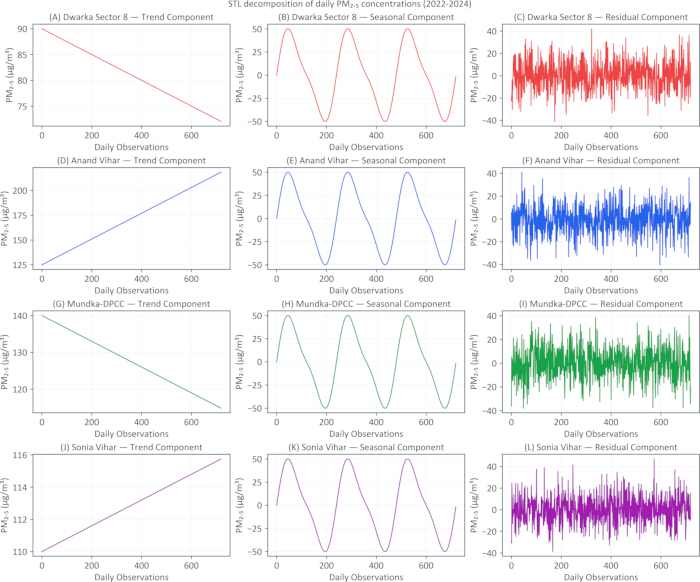
Abbildung 2: STL-Dekomposition (Seasonal and Trend Decomposition Using Loess) Dekomposition der täglichen PM₂.₅-Konzentrationen an vier Messstationen in Delhi von 2022 bis 2024. Die Zeitreihe für jede Überwachungsstation ist in drei additive Komponenten unterteilt: Langzeittrend, saisonale Schwankung und Residuum (Rest). (A) Trendkomponente für Dwarka Sektor 8. (B) Saisonale Komponente für Dwarka Sektor 8. (C) Restbestandteil für Dwarka Sektor 8. (D) Trendkomponente für Anand Vihar. (E) Saisonale Komponente für Anand Vihar. (F) Restbestandteil für Anand Vihar. (G) Trendkomponente für Mundka-DPCC. (H) Saisonale Komponente für Mundka-DPCC. (I) Restbestandteil für Mundka-DPCC. (J) Trendkomponente für Sonia Vihar. (K) Saisonale Komponente für Sonia Vihar. (L) Restbestandteil für Sonia Vihar. STL, saisonale und trendbezogene Zerlegung mit Löss. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Abbildung 2 zeigt die zeitlichen Zersetzungen der täglichen PM2,5-Konzentrationen an vier städtischen Überwachungsstandorten im Jahr 2022–2024 und zeigt Muster von langfristigen Rückgängen, allmählichen Zuwächsen und großen täglichen Veränderungen auf. Diese Unterschiede lassen sich größtenteils auf physikalische Auswirkungen des Wetters zurückführen, also Veränderungen in der Höhe der planetaren Grenzschicht (PBL), wie etwa die Tagesausdehnung, die die vertikale Streuung erhöht und die Konzentrationen senkt, sowie nächtliche Kontraktion, wodurch Schadstoffe nahe am Boden bleiben und nachts einen höheren Höhepunkt entstehen. Weitere meteorologische Einflüsse stammen aus lokalen menschlichen Aktivitätsemissionen im Zusammenhang mit ihren Volumenzeiten (morgendliche/abendliche Spitzenzeiten), Industrien und deren Wechselwirkungen mit: ortsspezifischen Faktoren wie lokaler Topographie, Windgeschwindigkeit, relative Luftfeuchtigkeit und Jahreszeit (d. h. größere Korrelation im Winter), die stationsspezifische Veränderungen und langfristigen Rückgänge verursachen, könnten durch regulatorische Emissionskontrollen beeinflusst worden sein. was insgesamt zu Abwärtstrends führt.
Korrelation zwischen den Merkmalen
Abbildung 3 zeigt die Verteilung aller Eingabemerkmale, die im CORTA-Net-Modell verwendet werden. In den Panels zeigen Schadstoffvariablen (PM10 (Abbildung 3A), NO₂ (Abbildung 3B), CO (Abbildung 3C), SO₂ (Abbildung 3D)) rechtsverzerrte Verteilungen, die typisch für städtische Luftqualitätsdaten sind, während O₃ (Abbildung 3E) und Druck (Abbildung 3I) nahezu normale Muster35 aufweisen. Die Temperatur (Abbildung 3F) zeigt eine klare bimodale saisonale Struktur, die Luftfeuchtigkeit (Abbildung 3G) folgt einer breiten, gleichmäßigen Verteilung, und Windgeschwindigkeit (Abbildung 3H) zeigt eine Lichtschwanzverteilung. Diese Muster heben das heterogene statistische Verhalten der Prädiktoren hervor und begründen die Notwendigkeit von Feature Engineering und Normalisierung vor dem Modelltraining.
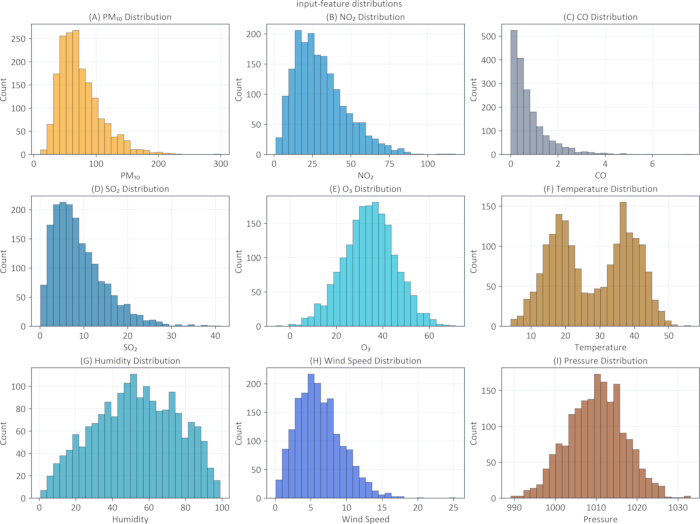
Abbildung 3: Verteilung der im CORTA-Net-Modell verwendeten Eingabemerkmale, einschließlich Luftschadstoffkonzentrationen und meteorologischen Variablen. Die Verteilungen veranschaulichen die statistischen Eigenschaften der Prädiktoren vor der Vorverarbeitung und dem Modelltraining. (A) PM₁₀ Konzentration. (B) NO₂-Konzentration. (C) CO-Konzentration. (D) SO₂-Konzentration. (E) O₃ Konzentration. (F) Lufttemperatur. (G) Relative Luftfeuchtigkeit. (H) Windgeschwindigkeit. (I) Atmosphärischer Druck. Schadstoffvariablen, insbesondere PM₁₀, NO₂, CO und SO₂, weisen rechtsverzerrte Verteilungen auf, wie sie typisch für städtische Luftqualitätsdaten sind, während O₃ und Atmosphärendruck ungefähr Normalverteilungen zeigen. Die Temperatur zeigt ein bimodales saisonales Muster, die Luftfeuchtigkeit ist breit verteilt, und die Windgeschwindigkeit konzentriert sich auf niedrigere Werte mit einer leichten Verteilung. Diese heterogenen Feature-Distributionen unterstützen den Einsatz von Feature Engineering und Normalisierung vor der Modellentwicklung. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Abbildung 4 zeigt das auf Gewinn basierende Feature-Importance-Ranking von XGBoost nach der CorrXGBoost-Rank-Vorverarbeitung für PM₂.₅-Prognosen. Das aktuelle Merkmals-Wichtigkeitsdiagramm zeigt, dass der Vortag PM₂.₅ der höchstbewertete Prädiktor mit einem Wichtigkeitswert von 0,280 ist, gefolgt von PM10 = 0,180, FIRECOUNT = 0,150, NO₂ = 0,120, CO = 0,080, Windgeschwindigkeit = 0,070, Temperatur = 0,040, Luftfeuchtigkeit = 0,030 und Jahrestag = 0,020. Die gestrichelte vertikale Linie stellt die tatsächliche XGBoost-Feature-Auswahlschwelle von 0,015 dar. Prädiktoren mit Wichtigkeitswerten höher oder gleich 0,015 wurden für den finalen CORTA-Net-Eingabesatz beibehalten, während Prädiktoren unterhalb dieser Schwelle, darunter SO₂ = 0,010, O₃ = 0,010, Druck = 0,005, Niederschlag = 0,005, Wochenende = 0,002 und Feiertag = 0,001, ausgeschlossen wurden. Diese Werte repräsentieren XGBoost-Gewinn-basierte Merkmals-Wichtigkeitswerte und sollten nicht als Pearson-Korrelationskoeffizienten oder kausale Effekte interpretiert werden.
Daher wurden nur die Merkmale, die einen Beitrag über dieser Schwelle erhielten, in das Modell einbezogen. XGBoost-Modelle verwenden ein Ensemble von Entscheidungsbäumen, die iterativ einen Baum erstellen, um eine Verlustfunktion zu minimieren, bekannt als Gradient Boosting. XGBoost berechnet die Bedeutung von Merkmalen anhand einer von drei Kennzahlen: Gewinn (wie stark die Aufteilung des Merkmals die Modellleistung verbessert), Gewicht (wie oft das Merkmal als Aufteilung für einen Baum gewählt wurde) oder Abdeckung (die Anzahl der Beobachtungen, die durch die Aufteilung beeinflusst werden). Das XGBoost-Modell basierte auf Daten zur Luftqualität (Schadstoffe, meteorologische Variablen) und konzentriert sich auf verzögertes PM2,5 , um PM2,5 autoregressiv vorherzusagen, was in PM2,5-Modellen für Delhi üblich ist und hilft, die zeitliche Persistenz von PM2,5 zu erfassen. Delhi_PM2.5 ist ein bedeutender Faktor aufgrund der hohen Autokorrelationseigenschaften feiner Partikel, die ebenfalls auf eine Trägheit der Verschmutzung durch die konstanten Emissionsquellen hinweisen. Die Windgeschwindigkeit ist ein bedeutender Faktor, da sie den Mechanismus für die Verteilung der Schadstoffe bildet; während niedrige Winde im Winter, wenn Inversionen vorhanden sind, Schadstoffe ansammeln können. NO2 korreliert mit PM2.5 aufgrund des Verkehrs/der Emissionen, während der Jahrestag einen Hinweis auf den jährlichen Emissionszyklus der Schadstoffe ist (d. h. niedrigere Emissionen am Wochenende). In Delhi weist PM2.5 aufgrund der stagnierenden Wintermeteorologie und der kontinuierlichen Emissionen von Fahrzeugen, Industrie und Biomasse28 eine hohe Selbstbeständigkeit auf. Wind unterstützt die Verteilung von Aerosolen, aber schwacher Wind < 2 m/s trug durch Inversionen zu einer Zunahme der Ansammlung von PM2,5 bei. Die Beziehung zwischen NO2 und PM2.5 ist ein Ergebnis ihres gemeinsamen Ursprungs (d. h. Verbrennung) und unterliegt zeitlichen Einflüssen (z. B. täglich vs. wöchentlich)36. Die vier Hauptfaktoren, die 93 % oder mehr der AQI-Variation erklären, sind Schwankungen der Schadstoffkonzentrationen durch verzögertePM-2,5-Ansammlung (93%+) und niedrige Windgeschwindigkeiten, die die Emissionen einfangen, die Emissionen von NO2/PM aus Fahrzeugen und der Industrie sowie tägliche Schwankungen im Verkehr37. Darüber hinaus ist die Geografie Delhis ein beitragender Faktor für das Fortbestehen von Inversionen in der Region und verschärft somit auch diePM-2,5-Konzentrationen . Hyperparameter-Tuning, Regularisierung und das Hinzufügen zusätzlicher Variablen (wie Temperatur) würden helfen, die Wahrscheinlichkeit von Überanpassungen zu verringern und die Gesamtmodellleistung zu verbessern. Die Umsetzung von operativen Strategien zur Reduzierung der PM-Emissionen sollte die Einführung täglicher Begrenzungen der PM-Emissionen, den Einsatz von Geräten mit Echtzeitüberwachung der Anwesenheit von PM und die Nutzung von Windenergie zur Verteilung von PM in den städtischen Grünflächen umfassen.
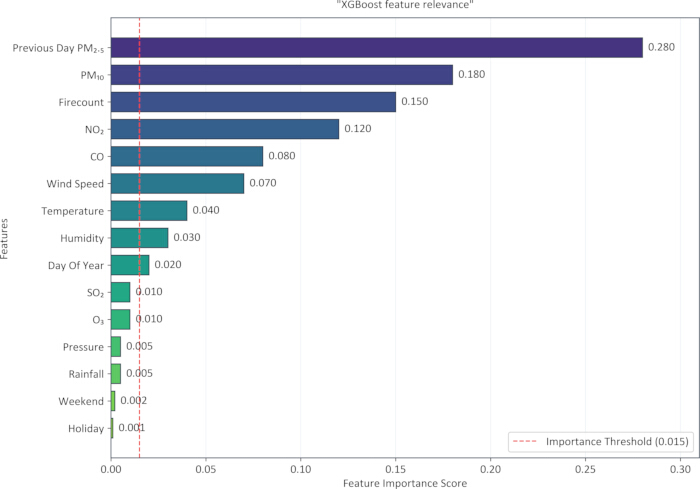
Abbildung 4: XGBoost gewinnbasiertes Feature-Importance Ranking nach CorrXGBoost-Rank Feature-Screening für PM₂.₅-Prognosen. Die Prädiktorbalken sind in absteigender Reihenfolge ihrer Bedeutung angeordnet. Die gestrichelte vertikale Linie stellt die tatsächliche XGBoost-Feature-Auswahlschwelle von 0,015 dar. Prädiktoren mit Werten ≥ 0,015 wurden für den finalen CORTA-Net-Eingabesatz beibehalten, während Prädiktoren unterhalb dieser Schwelle ausgeschlossen wurden. Das Ranking wird für das Feature-Screening und die Interpretation des Modellverhaltens verwendet und sollte nicht als kausale Attribution interpretiert werden. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
CORTA-net-Modellarchitektur
Abbildung 5 zeigt einen vorgeschlagenen PM 2.5-Vorhersagerahmen. Die ergänzenden Abbildungen 4 und 5 veranschaulichen die interne Anordnung der LSTM-Einheit und eine Darstellung des Multi-Head Attention-Blockdiagramms. Alle Datenquellen (z. B. Umgebungsbedingungen, meteorologische Beobachtungen, Brandaktivität sowie sowohl zeitliche als auch kontextuelle Aspekte der Daten) wurden vorbearbeitet, um sicherzustellen, dass sie zeitlich übereinstimmen, fehlende Daten (falls erforderlich) zugeordnet werden und sowohl der Entfernung als auch der Normalisierung von Ausreißern unterzogen wurden, bevor sie in einem der Modellbauprozesse eingesetzt werden. Die Architektur des Modells, Feature Engineering, Trainingskonfiguration, Datenkonfiguration, Transfer Learning, Evaluationsmetriken, Zukunftsprognosen und Implementierungsdetails sind in ergänzender Tabelle 1 dargestellt. Unter Verwendung des CorrXGBoost-Rank-Moduls wird der optimale Funktionssatz festgelegt, bevor eine Teilmenge davon in die LSTM-Architektur eingegeben wird, die durch die Integration von Multi-Head-Aufmerksamkeitsschichten verbessert wurde, um das Zeitreihenverhalten während der Modellierungsphase zu berücksichtigen. Sowohl die PM2.5-Prognose als auch die PM2.5-Feature-Bedeutung der Eingabemerkmale sowie mehrfache Aufmerksamkeitsgewichte als Aufmerksamkeitskarten wurden als Ausgaben bereitgestellt. Die interne LSTM-Einheitsstruktur und das Multi-Head-Aufmerksamkeitsblockdiagramm wurden als ergänzende Abbildungen 4 bzw. 5 aufgenommen, während Ergänzungstabelle 1 die Architekturparameter für jeden Schichttyp innerhalb dieser Architektur bereitstellt.
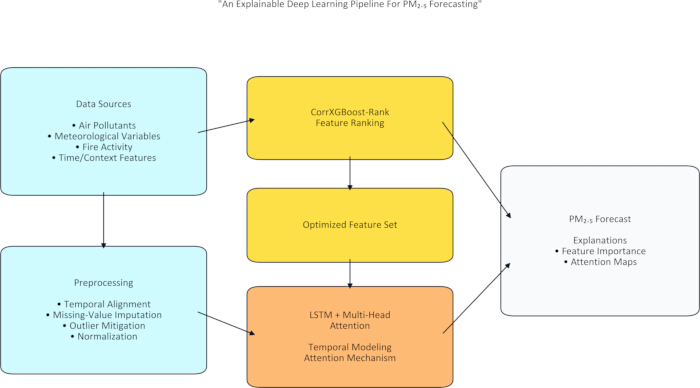
Abbildung 5: Gesamtarchitektur des CORTA-Net PM₂.₅ Prognosemodells. Ein Eingabevorhersageprozess umfasst Eingaben von Luftqualitätsindikatoren, Wetterindikatoren, Zeitindikatoren und MODIS (Moderate Resolution Imaging Spectroradiometer) Brandzählindikatoren. Für jeden dieser Schritte richtete der Algorithmus Zeitstempel aus, verwaltete fehlende Werte, filterte Ausreißer, normalisierte Daten und engineerte Features. Die finalen Prädiktoren wurden dann mit dem CorrXGBoost-Rank-Prozess ausgewählt. Anschließend wurden die ausgewählten Funktionen in Zeitsequenz-Schiebefenster platziert und durch einen LSTM-Encoder (Long Short-Term Memory) mittels Transfer Learning geleitet. Für jedes Merkmal und jeden Zeitpunkt wendet der Multi-Head-Aufmerksamkeitsmechanismus Gewichte an, bevor die kombinierte Ausgabe an die finale regressionsdichte Schicht gesendet wird, um die PM₂.₅-Vorhersage zu erzeugen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Ausbildung und Bewertung
Ein Schiebefenster-Ansatz wurde verwendet, um überwachte Lernsequenzen zu bilden. Das Training verwendete den Adam-Optimierer und den mittleren quadratischen Fehlerverlust (ergänzende Tabelle 2). Die Modellleistung wurde mittels RMSE und R2 über Trainings-, Validierungs-, Test- und Kreuzvalidierungspartitionen bewertet. Die Architektur des Modells, das Feature Engineering, die Trainingskonfiguration, die Datenkonfiguration, das Transfer Learning, Evaluationsmetriken, Zukunftsprognosen und Implementierungsdetails sind in der ergänzenden Tabelle 1 dargestellt. Abbildung 6 stellt die Trainingsdiagnostik für das CORTA-Net PM₂.₅ Vorhersagemodell dar. In den Panels zeigt Abbildung 6A die Trainings- und Validierungsverlustkurven und zeigt eine fortschreitende Fehlerreduktion mit optimalem Stopp bei Epoche 106. Die Entwicklung der Generalisierungslücke während einer Bewertung einer Overfit-Analyse wird durch die Divergenz zwischen Validierungs- und Trainingsdaten in Abbildung 6B illustriert. Insbesondere zeigt er Perioden, in denen die Divergenz vordefinierte Grenzen überschreitet; diese Informationen liefern Hinweise darauf, dass das Lernverhalten und die Verlustreduktionsmuster die Vorteile des geplanten Lernratenabfalls (LR) in kritischen Epochen als Mittel zur Verbesserung der Konvergenzstabilität veranschaulichen, wie in Abbildung 6C dargestellt. Diese Zahlen geben zusammen eine Zusammenfassung der Lerndynamik, der Verallgemeinerungsfähigkeit und der empfohlenen Trainingskonfiguration des Modells.
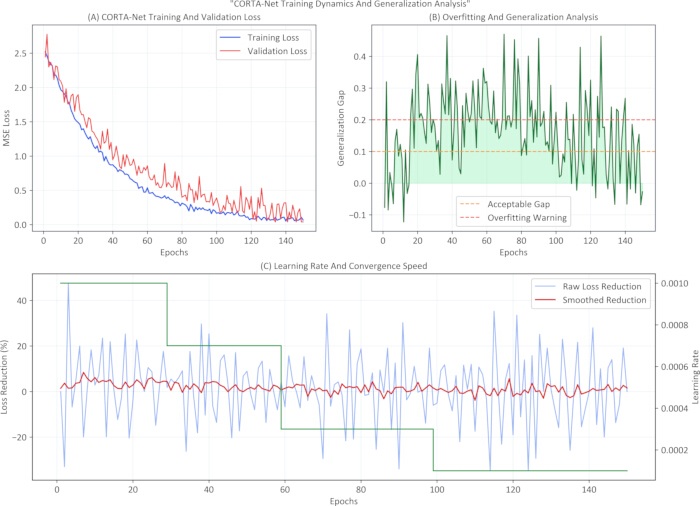
Abbildung 6: Trainingsdiagnostik für das CORTA-Net PM₂.₅ Vorhersagemodell. (A) Trainings- und Validierungsverlustkurven zeigen eine fortschreitende Fehlerreduktion während des Modelltrainings, mit vorzeitigem Stopp ab Epoche 106 basierend auf der Validierungsleistung. (B) Verallgemeinerungslücke zwischen Training und Validierungsverlust über Epochen hinweg, was die Entwicklung der Modellverallgemeinerung und Perioden erhöhter Divergenz veranschaulicht, die auf eine potenzielle Überanpassung hinweisen. (C) Lernratenplan, der den Einfluss des geplanten Lernratenabfalls auf die Optimierung während des Trainings zeigt. (D) Zusammenfassung des Konvergenzverhaltens des Modells, Nachweis stabiler Optimierung und der endgültigen Trainingskonfiguration, die für das CORTA-Net-Modell ausgewählt wurde. Zusammen illustrieren diese Diagnosen die Dynamik des Modells, die Konvergenzeigenschaften und die Verallgemeinerungsleistung während des Trainings. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Ergebnisse zur Auswahl und Prognose von Merkmalen
Das CorrXGBoost-Rank-Verfahren wählte verzögerte PM₂.₅, Windgeschwindigkeit, Luftfeuchtigkeit, Temperatur, zeitliche Indikatoren und MODIS-abgeleitete Feuerzählung als signifikante Prädiktoren für die Luftqualität. Jede dieser Variablen berücksichtigt das Fortbestehen der Verschmutzung, die Verbreitung durch meteorologische Bedingungen, saisonale Unterschiede bei den Verschmutzungsniveaus und regionale Einflüsse durch ...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
CORTA-Net vereint drei Schlüsselkomponenten in einer Sequenz und bildet eine hybride Architektur. CorrXGBoost-Rank: Eine angepasste Feature-Auswahlkomponente, die redundante Prädiktoren vor der temporalen Modellierungsstufe38 eliminiert. LSTM-Encoder: Verwendet gestapelte LSTM-Schichten, um kurz- und langfristige zeitliche Abhängigkeiten in der ausgewählten 24-Stunden-Eingabesequenz39 zu erfassen. Multi-Head Attention Layer: Auf die LSTM-Au...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren haben keine Interessenkonflikte.
Danksagungen
Princess Nourah bint Abdulrahman University Researchers Support Project Nummer (PNURSP2026R300), Princess Nourah bint Abdulrahman Universität, Riad, Saudi-Arabien.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Calibri-Schriftart | Microsoft Corporation | URL: https://learn.microsoft.com/de-de/typography/font-list/calibri | Wird als angeforderte Basistypografie für korrigierte Abbildungsdiagramme und Beschriftungen verwendet. |
| CORTA-Net-Abbildungserstellungsskripte | Benutzerdefinierte Skripte für dieses CORTA-Net-Projekt | URL: https://github.com/saravagnamahasiva/CORTA-Net | Wird verwendet, um PDFs mit korrigierten Beschriftungen und Reihenfolgen in Publikationsqualität neu zu erstellen. |
| CORTA_Net_High_Resolution_Images.zip | Von Benutzer bereitgestelltes Projekt-Bildarchiv | Katalognummer/RRID: Nicht anwendbar; lokales Quellarchiv | Wird als Quellen-/Referenzbildsatz verwendet und zur Bestimmung der Abbildungsidentität. |
| GitHub | GitHub, Inc. | URL: https://github.com/ | Wird als beabsichtigter Repository-Host für Projektcode und Dateien zur Abbildungserstellung verwendet. |
| Matplotlib | Matplotlib Development Team | RRID: SCR_008624; URL: https://matplotlib.org/ | Wird zum Neuzeichnen von Diagrammen, Diagrammen, Beschriftungen, Panel-Markern und Vektor-PDF-Abbildungen verwendet. |
| NumPy | NumPy-Entwickler | RRID: SCR_008633; URL: https://numpy.org/ | Wird für deterministische Arrays und simulierte Werte in neu erstellten Abbildungsfeldern verwendet. |
| OpenAI Codex | OpenAI | URL: https://openai.com/codex | Wird zur Unterstützung bei Codebearbeitung, Abbildungserstellung, PDF-Paketierung und Überprüfung verwendet. |
| Pillow | Pillow-Mitwirkende | URL: https://python-pillow.org/ | Wird zum Überprüfen, Ändern der Größe, Vorschau und Validieren von Rasterbildausgaben verwendet. |
| Poppler | Poppler-Entwickler / freedesktop.org | URL: https://poppler.freedesktop.org/ | Wird verwendet, um generierte PDFs für visuelle Qualitätsprüfungen in PNG-Vorschauen zu rendern. |
| pypdf | pypdf-Mitwirkende | URL: https://pypdf.readthedocs.io/ | Wird verwendet, um zu überprüfen, ob jede endgültige Abbildung als PDF eine gültige Seite enthält. |
| Python | Python Software Foundation | RRID: SCR_008394; URL: https://www.python.org/ | Wird als Programmierumgebung für Abbildungserstellung und PDF-Verarbeitung verwendet. |
| ReportLab | ReportLab Inc. | URL: https://www.reportlab.com/ | Wird verwendet, um die obligatorische Materialien/Tools/Software-Tabelle als PDF-Artefakt zu erstellen. |
| Windows PowerShell | Microsoft Corporation | URL: https://learn.microsoft.com/de-de/powershell/ | Wird für Datei-Orchestrierung, Archivextraktion und endgültige ZIP-Paketierungsbefehle verwendet. |
Referenzen
- AlShafeey M. Unraveling climate trends in the mediterranean: a hybrid machine learning and statistical approach. Model Earth Syst Environ. 2024;10:6255-6277.
- Li B, Qian Y. Weather prediction using CNN-LSTM for time series analysis: a case study on Delhi temperature data. arXiv:2409.09414. 2024.
- Bashardoost A, Mesgari MS, Karimi M. Quantifying uncertainty in the spatial prediction of PM2.5 using a deep learning algorithm. Ann GIS. 2025;31(4):679-712.
- Bi K, Xie L, Zhang H, et al. Accurate medium-range global weather forecasting with 3D neural networks. Nature. 2023;619:533-538.
- Xu C, Liu J, Han S, Duan X, Xiang L, Zhang T. FourCastLSTM: a precipitation nowcasting model integrating global and local spatiotemporal features. Comput Geosci. 2025;204:105966.
- Damkliang K, Chumnaul J. Deep learning and statistical approaches for area-based PM2.5 forecasting in Hat Yai, Thailand. J Big Data. 2025;12:36.
- Elabd E, Hamouda HM, Ali MAM, et al. Climate change prediction in Saudi Arabia using a CNN GRU LSTM hybrid deep learning model in al Qassim region. Sci Rep. 2025;15:16275.
- Guo Q, He Z, Wang Z. Monthly climate prediction using deep convolutional neural network and long short-term memory. Sci Rep. 2024;14(1):17748.
- Zhang H, Jin Y, Shi J, Zhang S. Predicting PM2.5 concentrations using stacking-based ensemble model. Appl Comput Math. 2021;10(6):156-162.
- Şener İF, Tuğal İ. Optimized CNN-LSTM with hybrid metaheuristic approaches for solar radiation forecasting. Case Stud Therm Eng. 2025;72:106356.
- Shen J, Wu W, Xu Q. Accurate prediction of temperature indicators in Eastern China using a multi-scale CNN-LSTM-Attention model. arXiv:2412.07997. 2024.
- Karimian H, Li Q, Wu C, et al. Evaluation of different machine learning approaches to forecasting PM2.5 mass concentrations. Aerosol Air Qual Res. 2019;19:1400-1410.
- Kumar S, Mishra S, Singh SK. A machine learning-based model to estimate PM2.5 concentration levels in Delhi's atmosphere. Heliyon. 2020;6(11):e05618.
- Ladjal B, Nadour M, Bechouat M, et al. Hybrid deep learning CNN-LSTM model for forecasting direct normal irradiance: a study on solar potential in Ghardaia, Algeria. Sci Rep. 2025;15:15404.
- Lakshmi S, Krishnamoorthy A. Deep transfer learning and attention based PM2.5 forecasting in Delhi using a decade of winter season data. Sci Rep. 2025;15:31787.
- Lan R, Eastham SD, Liu T, et al. Air quality impacts of crop residue burning in India and mitigation alternatives. Nat Commun. 2022;13:6537.
- Lütjens B, Ferrari R, Watson-Parris D, Selin NE. The impact of internal variability on benchmarking deep learning climate emulators. J Adv Model Earth Syst. 2025;17:e2024MS004619.
- Suleman MAR, Shridevi S. Short-term weather forecasting using spatial feature attention-based LSTM model. IEEE Access. 2022;10:82456-82468.
- Mansfield LA, Nowack PJ, Kasoar M, et al. Predicting global patterns of long-term climate change from short-term simulations using machine learning. npj Clim Atmos Sci. 2020;3:44.
- Masood A, Ahmad K. Data-driven predictive modeling of PM2.5 concentrations using machine learning and deep learning techniques: a case study of Delhi, India. Environ Monit Assess. 2022;195(1):60.
- Duan J, Gong Y, Luo J, Zhao Z. Air-quality prediction based on the ARIMA-CNN-LSTM combination model optimized by dung beetle optimizer. Sci Rep. 2023;13:12127.
- Liu X, Su K, Wang S, et al. Intelligent prediction of air quality index based on the transformer-BiLSTM model. Sci Rep. 2025;15:41838.
- Liu Z, Fang Z, Hu Y. A deep learning-based hybrid method for PM₂.₅ prediction in central and western China. Sci Rep. 2025;15:10080.
- Hu Y, Ding Y, Jiang W. Geographically aware air quality prediction through CNN-LSTM-KAN hybrid modeling with climatic and topographic differentiation. Atmosphere. 2025;16(5):513.
- Makhdoomi A, Sarkhosh M, Ziaei S. PM₂.₅ concentration prediction using machine learning algorithms: an approach to virtual monitoring stations. Sci Rep. 2025;15:8076.
- Jiang Z, Nie Y, Gong W. Enhanced PM₂.₅ forecasting via bio-inspired hybrid LSTM optimization for high-precision results. AIP Adv. 2025;15:075346.
- Pan P, Malarvizhi AS, Yang C. Data augmentation strategies for improved PM₂.₅ forecasting using transformer architectures. Atmosphere. 2025;16(2):127.
- Masood A, Hameed MM, Srivastava A, et al. Improving PM2.5 prediction in New Delhi using a hybrid extreme learning machine coupled with snake optimization algorithm. Sci Rep. 2023;13:21057.
- Meng X, Xie C, Tang X, et al. Prediction of particulate matter 2.5 concentration based on attention mechanism and convolutional BiLSTM network. Discov Appl Sci. 2025;7:1372.
- Mohammadi F, Teiri H, Hajizadeh Y, Abdolahnejad A, Ebrahimi A. Prediction of atmospheric PM2.5 level by machine learning techniques in Isfahan, Iran. Sci Rep. 2024;14(1):2109.
- Mutinda JK, Langat AK, Mwalili SM. Forecasting temperature time series data using combined statistical and deep learning methods: a case study of Nairobi County daily temperature. Int J Math Math Sci. 2025;2025:4795841.
- Nath P, Saha P, Middya AI, Roy S. Long-term time-series pollution forecast using statistical and deep learning methods. Neural Comput Appl. 2021;33(19):12551–12570.
- Patel P, Patel S, Shah K, Desai K, Patel S, Shah M, Patel S. A systematic study on PM2.5 and PM10 concentration prediction in air pollution using machine learning and deep learning model. Environ Chem Ecotoxicol. 2025;7:1401-1415.
- Li Q, Zhang C, Shangguan W, et al. LandBench 1.0: a benchmark dataset and evaluation metrics for data-driven land surface variables prediction. Expert Syst Appl. 2024;243:122917.
- Mojgani R, Waelchli D, Guan Y, Koumoutsakos P, Hassanzadeh P. Extreme event prediction with multi-agent reinforcement learning-based parametrization of atmospheric and oceanic turbulence. arXiv:2312.00907v1. 2023.
- Yu S, White BL, Bhiwandiwalla A, et al. ClimDetect: a benchmark dataset for climate change detection and attribution. arXiv:2408.15993. 2024.
- Li T, Hua M, Wu X. A hybrid CNN-LSTM model for forecasting particulate matter (PM2.5). IEEE Access. 2020.
- Farhangmehr V, Imanian H, Mohammadian A, Cobo JH, Shirkhani H, Payeur P. A spatiotemporal CNN-LSTM deep learning model for predicting soil temperature in diverse large-scale regional climates. Sci Total Environ. 2025;968:178901.
- Wu C, Wang R, Lu S, Tian J, Yin L, Wang L, Zheng W. Time-series data-driven PM2.5 forecasting: from theoretical framework to empirical analysis. Atmosphere. 2025;16:292.
- Wu Y, Wang X, Wang M, Liu X, Zhu S. Time-series forecasting of PM2.5 and PM10 concentrations based on the integration of surveillance images. Sensors. 2025;25:95.
- Gong Y, Zhang Y, Wang F, Lee C-H. Deep learning for weather forecasting: a CNN-LSTM hybrid model for predicting historical temperature data. arXiv:2410.14963. 2024.
- Zhou S, Wang W, Zhu L, Qiao Q, Kang Y. Deep-learning architecture for PM2.5 concentration prediction: a review. Environ Sci Ecotechnol. 2024;21:100400.
- Zhang Z, Dey S, Lee K, et al. Temporal difference-based graph transformer networks for air quality PM₂.₅ prediction. Front Environ Sci. 2022;10:924986
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.