Diese Studie stellt einen automatisierten Rahmen für die Benutzeroberflächen-Prototypenerstellung vor, der kognitive Designprinzipien, wahrnehmungsbasierte Farbmodellierung und Deep Learning integriert. Das System verbessert die Zugänglichkeit, die Klarheit des Layouts, die Farbharmonie und die Konsistenz über verschiedene Bildschirme hinweg und führt so zu kohärenten, benutzerzentrierten Oberflächendesigns.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Automatisiertes Framework für das Prototyping von Benutzeroberflächen unter Integration kognitiver und visueller Designprinzipien zur Verbesserung der Benutzerfreundlichkeit und Layoutklarheit
In diesem Artikel
Zusammenfassung
Zusammenfassung
Ein effektives Benutzeroberflächendesign erfordert ein harmonisches Gleichgewicht zwischen visueller Attraktivität, kognitiver Benutzbarkeit und Layout-Konsistenz. Aktuelle automatische Ansätze zur Generierung von Benutzeroberflächen konzentrieren sich jedoch hauptsächlich auf das visuelle Erscheinungsbild oder die Erkennung von Komponenten und verfügen nicht über einen einheitlichen Rahmen, der kognitive Prinzipien, Farbintelligenz und strukturelle Schlussfolgerungen integriert. Zudem weisen bestehende Methoden eine begrenzte Verallgemeinerungsfähigkeit bezüglich des Layouts, geringe Interpretierbarkeit, statische Farbauswahl und inkonsistentes Verhalten zwischen verschiedenen Bildschirmen auf. Vor diesem Hintergrund schlägt diese Arbeit einen automatisierten Prototyping-Rahmen für Benutzeroberflächen vor, der die Komponentenerkennung basierend auf Faster R-CNN (region-based convolutional neural network) und die wahrnehmungsbasierte Farbmodellierung mittels des einheitlichen Farbraums CIECAM02 (CAM02-UCS) integriert und um kognitive sowie visuelle Gestaltungsprinzipien erweitert. Faster R-CNN dient dabei der Identifizierung von UI-Komponenten und der Ableitung hierarchischer Strukturen aus umfangreichen Interface-Datensätzen. Ein erweiterter Farbgenerierungsmodul analysiert Marken- oder Referenzbilder, um wahrnehmungsmäßig einheitliche, harmonische und benutzbarkeitskonforme Farbthemen unter Verwendung von CAM02-UCS sicherzustellen. Diese Ergebnisse werden anschließend durch kognitive Gestaltungsregeln optimiert, darunter Gestalt-Gesetze zur Gruppierung, Fitts’ und Hick’s Gesetze, aufmerksamkeitsbasierte Abstände sowie Modellierung der visuellen Hierarchie, um automatisch verfeinerte, aufgabenorientierte UI-Layouts zu erzeugen. Experimente auf den Datensätzen RICO, ENRICO und Guo’s UI Color Datasets zeigen, dass das vorgeschlagene System eine Komponentenerkennungsgenauigkeit von 92,4 % erreicht, die Klarheit des Layouts und die Genauigkeit der Lesereihenfolge um 18,7 % verbessert und Farbpaletten generiert, die von Designern im Vergleich zu Baseline-Methoden als 24,5 % harmonischer bewertet werden. Benutzerevaluierungen deuten außerdem auf eine um 31 % reduzierte wahrgenommene kognitive Belastung und eine um 28 % erhöhte Gestaltungskonsistenz zwischen Bildschirmen hin. Diese Ergebnisse belegen, dass die Kombination eines auf Deep Learning basierenden strukturellen Verständnisses mit wahrnehmungsgerechter Farbmodellierung und kognitiven Gestaltungsprinzipien Benutzeroberflächen-Prototypen hervorbringt, die äußerst effizient, ästhetisch kohärent und benutzerfreundlich sind. Dieser Rahmen schafft einen neuartigen, durchgängigen Ansatz für intelligentes und menschenzentriertes, automatisiertes UI-Prototyping.
Einleitung
Grafische Benutzeroberflächen (GUIs) dienen als grundlegendes Kommunikationsmedium zwischen Menschen und Computersystemen und beeinflussen maßgeblich die Benutzbarkeit, Zugänglichkeit und die gesamte Benutzererfahrung (UX)1,2. Moderne Softwaresysteme setzen auf intuitive und visuell ansprechende Schnittstellen, um Benutzer anzuziehen und zu binden. Traditionell umfasst die Benutzeroberflächengestaltung die Erstellung grafischer Layouts, die anschließend von Entwicklern in Frontend-Code umgesetzt werden. Aufgrund unterschiedlicher plattformspezifischer Protokolle zwischen Betriebssystemen ist jedoch eine wiederholte Anpassung erforderlich, was den Entwicklungsaufwand und die Komplexität erhöht. Die automatisierte Generierung von UI-Code hat sich daher zu einem wichtigen Forschungsbereich entwickelt, um manuelle Arbeitsschritte zu reduzieren und die Entwicklungseffizienz zu steigern.
Frühe Ansätze zur automatisierten Erstellung von Benutzeroberflächen kombinierten traditionelle Bildverarbeitungstechniken mit Deep-Learning-Modellen zur Erkennung und Klassifizierung von Bereichen3,4. Derzeitige dominierende Strategien zur Generierung von GUI-Code wenden Techniken der Computer Vision an, um UI-Bilder zu analysieren und in strukturierte Frontend-Darstellungen umzuwandeln5,6,7. Während Bildverarbeitungsmethoden auf manuell erstellten Merkmalen basieren, extrahieren Deep-Learning-Ansätze hierarchische Darstellungen aus umfangreichen Datensätzen. Daher haben Forscher hybride Ansätze untersucht, die Deep Learning mit domänenspezifischen Bildverarbeitungstechniken kombinieren, um Robustheit und Genauigkeit zu verbessern.
Farbe ist ein weiterer entscheidender Faktor im UI-Design, der die Wahrnehmung, Benutzbarkeit und ästhetische Anziehungskraft der Benutzeroberfläche beeinflusst1. Die Aufrechterhaltung einer Konsistenz zwischen Bildinhalten und den Farbschemata der Benutzeroberfläche wird schwierig, wenn visuelle Eingaben in Farbton und Kontext variieren8,9,10. Daher hat die Forschung zunehmend Methoden zur automatischen Generierung von Farbpaletten und zur wahrnehmungsgerechten Farbmodellierung untersucht. Zu den bestehenden Verfahren zur Farbgenerierung gehören Techniken, die auf dem CIELAB-Farbraum basieren11. Andere Ansätze verwenden Clustering-Algorithmen wie k-Means, um dominierende Farben aus Bildern zu extrahieren12. Infolgedessen haben neuere Arbeiten verstärkt datengestützte, auf maschinellem Lernen basierende Ansätze für die Farbmodellierung übernommen.
Parallel dazu haben Deep-Learning-Verfahren die Erkennung von UI-Komponenten und das Verständnis von Layouts erheblich verbessert. Neuronale Netze haben eine genauere strukturelle Analyse mobiler Schnittstellen ermöglicht13. Diese Methoden konzentrieren sich jedoch hauptsächlich auf die Erkennungsgenauigkeit und vernachlässigen oft übergeordnete Aspekte wie kognitive Benutzerfreundlichkeit, Layout-Hierarchie und Interaktions-Effizienz. Generative Modelle zur Synthese von UI-Layouts wurden ebenfalls vorgeschlagen14,15, stehen jedoch vor Herausforderungen bei der Aufrechterhaltung der Konsistenz über mehrere Bildschirme hinweg und bei der Bereitstellung nachvollziehbarer Gestaltungsentscheidungen16. Andere Ansätze konzentrieren sich auf visuelle Ähnlichkeit oder Wiedergabequalität, verfügen jedoch nicht über einen einheitlichen Rahmen, der Komponenten-Semantik, Farbharmonie und Benutzerfreundlichkeitsbeschränkungen kombiniert17. Die Texterkennung ist ebenfalls wichtig für das Verständnis von UI-Inhalten. Techniken wie faltungsrekurrente neuronale Netze (CRNNs) ermöglichen die genaue Erkennung komplexer Textmuster in Interface-Bildschirmen18,19,20.
Es wurden mehrere Systeme vorgeschlagen, um UI-Code aus Skizzen oder Bildern zu generieren. Sketch2Code verwendet die Objekterkennung, um Skizzen in Code-Darstellungen umzuwandeln21,22, ist jedoch empfindlich gegenüber der Bildqualität. REDRAW bietet eine automatisierte Pipeline für Datensammlung und Modelltraining und kombiniert dabei faltende und rekurrente neuronale Netze, um strukturierte UI-Darstellungen zu erzeugen23,24. In nachfolgenden Arbeiten wurden verbesserte Evaluierungsmetriken eingeführt, um die Qualität generierter Benutzeroberflächen zu bewerten25. Neuere Ansätze beinhalten diffusionsbasierte und transformerbasierte Modelle zur Layoutgenerierung, wie beispielsweise Diffusion-Layout-Transformer ohne Autoencoder-Methoden, die Generierung von GUI-Layouts mithilfe transformerbasierter Anordnungsgraphen für grafische Benutzeroberflächen sowie die Erzeugung von UI-Layouts, die von großen Sprachmodellen gesteuert wird26,27,28. Ein vergleichender Überblick über diese Ansätze wird in Tabelle 1 bereitgestellt.
| Referenzen und zentrale Methode(n) | Ziel | Vorteile | Nachteile |
| Automatisierte, bildbasierte Generierung von Benutzeroberflächen-Farbthemen: Extraktion dominanter Farben + CAM02-UCS-wahrnehmungsbezogenes Farbmodell¹ | Automatische Generierung von Farbthemen für Benutzeroberflächen aus Referenzbildern unter Optimierung von Harmonie und Bedienbarkeit. | Starke wahrnehmungsbezogene Grundlage (CAM02-UCS); berücksichtigt explizit Harmonie und Bedienbarkeit (Kontrast und Diversität); beinhaltet webbasierte Implementierung und Bewertung durch Designer. | Fokussiert ausschließlich auf Farbe/Thema (nicht auf Layout oder Komponentenstruktur); regel- oder heuristikbasiert statt end-to-end gelernte Generierung von Benutzeroberflächen. |
| Einheitliche Layout-Generierung mit einem entkoppelten Diffusionsmodell (LDGM)²⁵ | Einheitliche, flexible Layout-Generierung für grafische Szenen und Benutzeroberflächen. | Zustandsderkunst-Verfahren hinsichtlich Diversität und Steuerbarkeit bei der Layout-Generierung; unterstützt bedingte Generierung und mehrere Attributtypen. | Diffusionsbasierte Ausgaben können Ausrichtungs- oder feingliedrige Layout-Probleme aufweisen, sofern nicht eingeschränkt; höhere Modellkomplexität und Inferenzkosten. |
| Diffusion Layout Transformers ohne Autoencoder-Methoden: Transformer + Diffusion für die Layout-Generierung (ohne Autoencoder)²⁶ | Verbesserung von Genauigkeit und Ausrichtung bei Layout-Generierungs-Benchmarks (FID, Ausrichtungs- und Überlappungsmetriken). | Bessere Erfassung semantischer Korrelationen zwischen benachbarten Objekten; starke Leistung bei FID- und Ausrichtungsmetriken. | Fokussiert hauptsächlich auf Layout-Geometrie (Positionen, Größen, Kategorien) statt auf Semantik von Benutzeroberflächen. |
| Generierung von GUI-Layouts mit transformerbasierten Modellen aus GUI-Anordnungsgraphen (GUI-AGs)²⁷ | Erstellung von GUI-Layouts aus positions- oder graphbasierten Beschränkungen zur Unterstützung von Designern. | Graphdarstellungen erfassen relationale Beschränkungen; Transformer ermöglicht flexible, beschränkungsbedingte Generierung. | Kann explizite Beschränkungsgraphen von Designern erfordern; geringer Fokus auf Farb- und Bedienbarkeitsmetriken. |
| Generierung von UI-Layouts mit durch UI-Grammatik gesteuerten großen Sprachmodellen (LLMs): Große Sprachmodelle (LLMs) + hierarchische UI-Grammatik²⁸ | Untersuchung von LLMs für die Layout-Generierung und Verbesserung der Erklärbarkeit und Steuerbarkeit mittels Grammatikdarstellungen. | Hohe Steuerbarkeit auf höherer Ebene und verbesserte Erklärbarkeit; kann In-Context-Learning von LLMs (GPT-Typ) nutzen. | Frühes Stadium mit begrenzter empirischer Validierung; Grammatik-Design und Robustheit über verschiedene UIs hinweg begrenzt. |
Tabelle 1: Vergleich bestehender Methoden zur Farbmodellierung und Layoutgenerierung in der Benutzeroberfläche. Die Tabelle fasst repräsentative Ansätze für das Design von Benutzeroberflächen zusammen, darunter die Generierung von Farbschemata, die layoutbasierte Generierung mittels Diffusion, transformatorbasierte Methoden und die layoutbasierte Generierung mithilfe großer Sprachmodelle. Für jede Methode werden die zugrundeliegende Technik, das Ziel, die Vorteile und die Einschränkungen dargestellt, wobei Unterschiede hinsichtlich der Wahrnehmungsmodellierung, der Fähigkeit zur Layoutgenerierung, der Steuerbarkeit und der Benutzerfreundlichkeit hervorgehoben werden.
Trotz dieser Fortschritte bleibt eine zentrale Einschränkung bestehen: Bisher gibt es kein System, das Komponentenerkennung, wahrnehmungsbasierte Farbmodellierung, kognitive Gestaltungsprinzipien und konsistente Multibildschirm-Layouts innerhalb eines einzigen, durchgängigen Gesamtrahmens gemeinsam integriert1. Aktuelle Ansätze optimieren typischerweise nur einen oder zwei Aspekte – wie Erkennung, Layout oder Farbe –, ohne deren gegenseitige Abhängigkeiten zu berücksichtigen. Diese Zersplitterung verdeutlicht eine entscheidende Forschungslücke bei der Entwicklung einheitlicher, auf den Menschen ausgerichteter automatisierter Systeme zur Erstellung von Benutzeroberflächen-Prototypen. Insbesondere kognitive Gestaltungsprinzipien wie die Gestaltgesetze, das Fitts’sche Gesetz und das Hick’sche Gesetz werden oft lediglich konzeptionell behandelt, statt formal in rechnergestützte Modelle integriert zu werden.
Um diese Einschränkungen zu beheben, schlägt diese Studie einen durchgängig automatisierten UI-Prototyping-Rahmen vor, der Komponentenerkennung, wahrnehmungsbasierte Farbmodellierung und kognitive Gestaltungsprinzipien in einem einheitlichen System integriert. Der Rahmen zielt darauf ab, die Layoutqualität zu verbessern, die kognitive Belastung zu verringern, die Farbharmonie zu steigern und die Gesamtnutzbarkeit zu erhöhen. Diese Verbesserungen werden durch Experimente anhand der Datensätze RICO, ENRICO und Guos UI-Farbdatensatz validiert, wodurch die Wirksamkeit der Kombination struktureller, wahrnehmungsbezogener und kognitiver Aspekte in einer einzigen automatisierten UI-Prototyping-Pipeline belegt wird. Es wird vermutet, dass die Integration einer auf Deep Learning basierenden Komponentenerkennung, wahrnehmungsbasierter Farbmodellierung und kognitiver Gestaltungsprinzipien in einem einheitlichen Rahmen die Qualität von UI-Prototypen im Vergleich zu bestehenden Ansätzen signifikant verbessert. Insbesondere besagt H1, dass der Rahmen die Layoutqualität verbessert, einschließlich Ausrichtung, Gruppierung und Lesereihenfolge. H2 postuliert, dass der Rahmen die kognitive Belastung des Nutzers reduziert. H3 vermutet, dass die wahrnehmungsbasierte Farbmodellierung die Farbabstimmung und visuelle Harmonie verbessert. H4 besagt, dass die Gesamtnutzbarkeit und ästhetische Qualität von UI-Prototypen gesteigert werden.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Diese Studie verwendet öffentlich zugängliche Datensätze und beinhaltet keine menschlichen oder tierischen Versuchspersonen.
Der vorgeschlagene automatisierte Rahmen für die UI-Prototyperstellung integriert eine strukturelle Verständnismethode auf Basis von Deep Learning, eine wahrnehmungsgemäß einheitliche Farbmodellierung und kognitive Gestaltungsprinzipien, um kohärente und nutzerzentrierte Interface-Prototypen zu erzeugen. Die Methodik beginnt mit einer Faster-R-CNN-Architektur, die auf den Datensätzen RICO und ENRICO trainiert wurde, um UI-Komponenten zu erkennen und ihre hierarchischen Beziehungen zu extrahieren, wodurch eine genaue Interpretation unterschiedlicher Bildschirmaufteilungen ermöglicht wird. Die erkannten Komponenten werden anschließend von einem Farbintelligenzmodul verarbeitet, das marken- oder bildbezogene Farbhinweise extrahiert, die wahrgenommene Ähnlichkeit mittels CAM02-UCS modelliert und harmonische, kontrastbewusste sowie barrierefreie Farbpaletten generiert. Danach werden kognitive Gestaltungsprinzipien – darunter Gestalt-Gesetze zur Gruppierung, Fitts’ Gesetz, Hick’s Gesetz, aufmerksamkeitsbasierte Abstände und Beschränkungen der visuellen Hierarchie – mithilfe einer kognitiven Optimierungs-Engine angewandt, um die räumliche Organisation und die Ausrichtung der Komponenten zu verfeinern. Schließlich integriert eine Layout-Reasoning-Schicht strukturelle, wahrnehmungsbezogene und kognitive Beschränkungen, um mehrseitig konsistente UI-Prototypen zu erzeugen, die Nutzbarkeit, Ästhetik und funktionale Klarheit ausbalancieren. Diese integrierte Pipeline gewährleistet Wahrnehmungskohärenz, reduziert die kognitive Belastung und folgt menschenzentrierten Gestaltungsprinzipien. Der vollständige Arbeitsablauf der vorgeschlagenen Methode ist in Abbildung 1 dargestellt.
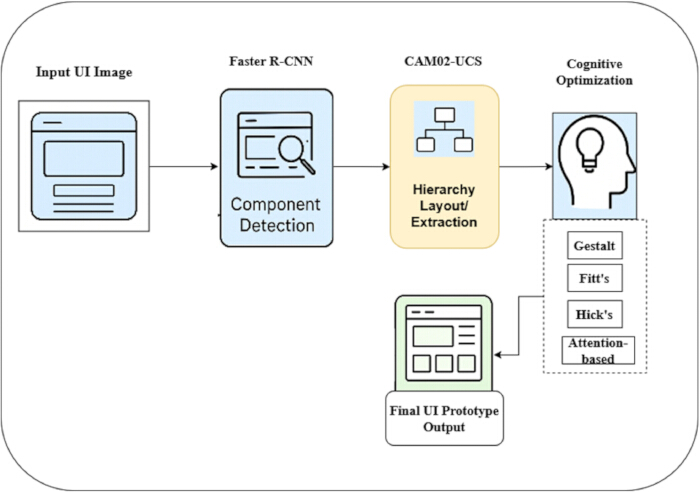
Abbildung 1. Gesamtarchitektur des vorgeschlagenen automatisierten Frameworks zur Erstellung von Benutzeroberflächen-Prototypen. Das Diagramm veranschaulicht die gesamte Pipeline, beginnend mit einem Eingabebild der Benutzeroberfläche. Die Erkennung von Komponenten erfolgt mithilfe von Faster R-CNN, um Schnittstellenelemente zu identifizieren. Die erkannten Komponenten werden anschließend mit einem CAM02-UCS-basierten Wahrnehmungsmodell zur Extraktion von Hierarchie und Layout verarbeitet. Im weiteren Schritt wird eine kognitive Optimierung unter Anwendung von Gestaltgesetzen, Fitts’ Gesetz, Hick’s Gesetz und aufmerksamkeitsbasierten Anpassungen durchgeführt. Pfeile zeigen den Datenfluss zwischen den Modulen an, was letztendlich zur Ausgabe des fertigen UI-Prototyps führt. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Überblick über das Framework
Abbildung 1 veranschaulicht den durchgängigen Arbeitsablauf des vorgeschlagenen automatisierten UI-Prototyping-Frameworks, das einen rohen UI-Screenshot in einen kognitiv optimierten Prototyp umwandelt. Der Prozess beginnt mit dem Eingangs-Bild der Benutzeroberfläche, das an das Komponentenerkennungsmodul basierend auf Faster R-CNN übergeben wird. Dieses Modul identifiziert Bedienelemente wie Schaltflächen, Symbole, Textfelder und Container und gibt deren entsprechende Begrenzungsrahmen und Klassenbezeichnungen aus. Die erkannten Komponenten werden anschließend in der Phase zur Extraktion von Hierarchie und Layout verarbeitet. Basierend auf räumlichen Beziehungen und strukturellen Mustern erstellt das System einen hierarchischen Layoutbaum, der widerspiegelt, wie Benutzer die Bildschirmorganisation natürlicherweise wahrnehmen. Diese Darstellung erfasst visuelle Gruppierungen und strukturelle Abhängigkeiten zwischen UI-Elementen. Das extrahierte Layout wird danach durch kognitive Optimierung unter Anwendung menschenzentrierter Gestaltungsprinzipien verfeinert. Dazu gehören Gestalt-Gesetzmäßigkeiten zur visuellen Gruppierung, das Fitts’sche Gesetz zur Optimierung der Größe und Erreichbarkeit von Touch-Zielen, das Hick’sche Gesetz zur Reduzierung der Entscheidungskomplexität sowie eine auf Aufmerksamkeit basierende Abstandsgestaltung zur Verbesserung der visuellen Hierarchie. Dadurch wird das Layout intuitiver, besser lesbar und effizienter für die Benutzerinteraktion. Schließlich wird das optimierte Layout mit einer wahrnehmungsbasierten Farbmodellierung kombiniert, um einen kohärenten UI-Prototyp zu erzeugen. Die resultierende Benutzeroberfläche ist strukturell genau, visuell harmonisch und entspricht den menschlichen Erwartungen an Benutzerfreundlichkeit.
Der Framework wurde mit PyTorch 2.0 unter Ubuntu 22.04 implementiert. Die Experimente wurden auf einem System mit einer NVIDIA RTX 4090 GPU (24 GB VRAM) durchgeführt. Das Faster R-CNN-Modell verwendete einen ResNet-50-Backbone, der zuvor auf dem ImageNet-Datensatz vortrainiert worden war. Das Training wurde mit dem Optimierer für stochastischen Gradientenabstieg (SGD) bei einer Lernrate von 0,001, einer Batch-Größe von 16 und bis zu 60 Epochen durchgeführt. Zur Vermeidung von Überanpassung wurde ein vorzeitiges Abbruchkriterium (Early Stopping) anhand eines Validierungsdatensatzes angewandt, der 20 % der Daten umfasste. Obwohl das Training bis zu 60 Epochen dauerte, wurde die Konvergenz üblicherweise früher durch Early Stopping basierend auf dem Validierungsverlust erreicht. Momentum und Weight Decay wurden auf 0,9 bzw. 0,0005 festgelegt. Die Datenaugmentierung beinhaltete Normalisierung, zufällige horizontale Spiegelung sowie zufälliges Zuschneiden und Ändern der Bildgröße.
Datensatzvorbereitung
Zur Unterstützung des vorgeschlagenen automatisierten UI-Prototyping-Frameworks wurden drei ergänzende Datensätze verwendet: ENRICO29, RICO30 und Guos UI-Farbendatensatz1. Der RICO-Datensatz enthält 66.261 Android-Benutzeroberflächen-Screenshots, die aus 9.700 Anwendungen gesammelt wurden, und bietet eine breite Vielfalt für die Erkennung von Komponenten sowie die extrahierende hierarchische Layoutanalyse. ENRICO umfasst 1.464 hochwertige UI-Screenshots, die manuell in 20 Designmuster kategorisiert wurden und eine verbesserte Generalisierung für strukturelle Schlussfolgerungen und die Modellierung von Layoutkonsistenz ermöglichen. Guos UI-Farbendatensatz besteht aus 128 kuratierten UI-Bildern mit annotierten Farbthemen, die für die modellhafte Wahrnehmung von Farben und die Bewertung von Farbpaletten genutzt werden. Aufgrund seines relativ geringen Umfangs kann dieser Datensatz jedoch gewisse Variabilität in den Layouteigenschaften verursachen. Für diese Studie wurde ein kombinierter Datensatz aus 5.128 Screenshots zur Schulung und Evaluierung erstellt. Konkret wurden etwa 4.000 Bilder aus RICO zur Schulung des Faster-R-CNN-Modells für die Komponentenerkennung verwendet, 1.000 Bilder aus ENRICO für das Lernen von Layoutmustern und die Modellierung struktureller Konsistenz sowie 128 Bilder aus Guos Datensatz für Farbevaluierungsaufgaben. Alle Bilder wurden auf eine Auflösung von 480 × 800 Pixel normalisiert, in einen einheitlichen sRGB-Farbraum konvertiert und mit standardisierten Begrenzungsrahmen sowie hierarchischen Metadaten neu annotiert, um die Kompatibilität zwischen den Datensätzen sicherzustellen. Ein Überblick über die in dieser Studie verwendeten Datensätze ist in Tabelle 2 dargestellt. Der RICO-Datensatz unterstützt die großskalige Erkennung von UI-Komponenten und die strukturelle Analyse, während ENRICO die Fähigkeit des Modells verbessert, Layoutmuster zu erkennen und konsistente Darstellungen über mehrere Bildschirme hinweg durchzusetzen. Guos UI-Farbendatensatz, obwohl kleiner im Umfang, spielt eine entscheidende Rolle bei der Bewertung der wahrgenommenen Farbharmonie und der Modellierung von Kontrasten. Zusammen bilden diese Datensätze eine umfassende und ausgewogene Grundlage für das Training, die Validierung und die Evaluierung des vorgeschlagenen automatisierten UI-Prototyping-Frameworks.
| Datensatz | Gesamtanzahl verfügbarer Bilder | Bilder, die in der Studie verwendet wurden | Zweck im vorgeschlagenen Framework |
| RICO Datensatz30 | 66.261 | 4.000 | Erkennung von Benutzeroberflächenkomponenten, Extraktion der strukturellen Anordnung |
| ENRICO Datensatz29 | 1.464 | 1.000 | Lernen von Designmustern, Modellierung der Layout-Konsistenz |
| Guos Farbdatensatz für Benutzeroberflächen1 | 128 | 128 | Extraktion von Farbthemen, wahrnehmungsbasierte Farbevaluation |
| Kombinierte Gesamtanzahl | 67.853 | 5.128 | Umfassender Datensatz für Erkennung, Layout- und Farbmodellierung |
Tabelle 2: Zusammenfassung der im vorgeschlagenen Framework verwendeten Datensätze. Die Tabelle zeigt die zur Schulung und Bewertung verwendeten Datensätze, einschließlich der RICO-, ENRICO- und Guos UI-Farbdatensätze. Sie enthält die Gesamtanzahl der verfügbaren Bilder, den in dieser Studie verwendeten Teilbereich sowie die spezifische Rolle jedes Datensatzes bei der Komponentenerkennung, der Layoutmodellierung und der wahrnehmungsbezogenen Farbanalyse innerhalb des vorgeschlagenen Frameworks.
Es wurde eine geschichtete Stichprobenstrategie angewandt, um die Vielfalt bei Benutzeroberflächenkomponenten, Layoutstrukturen und Farbverteilungen in den Datensätzen RICO, ENRICO und Guo zu bewahren. Der Datensatz wurde mithilfe geschichteter Stichprobenbildung in Trainings- (70 %), Validierungs- (15 %) und Testanteile (15 %) aufgeteilt. Die Bilder wurden mit dem Mittelwert (0,485, 0,456 und 0,406) und der Standardabweichung (0,229, 0,224 und 0,225) normalisiert. Die Datenaugmentierung umfasste zufälliges horizontales Spiegeln (Wahrscheinlichkeit = 0,5) und zufälliges Zuschneiden (Skalenbereich: 0,8–1,0), gefolgt von einer Größenänderung auf 224 × 224 Pixel, die während des Trainings angewandt wurde.
Komponentenannotation und Vorverarbeitung
Die Datensätze RICO, ENRICO und Guo’s UI Color Dataset unterstützen gemeinsam die drei zentralen funktionalen Komponenten des vorgeschlagenen automatisierten UI-Prototyping-Frameworks: die Erkennung von Komponenten, die Modellierung der Anordnung und die wahrnehmungsbezogene Farboptimierung. Der RICO-Datensatz enthält eine umfangreiche Sammlung von mehr als 66.000 mobilen Benutzeroberflächen (UI) und wird hauptsächlich zum Training des Moduls zur Komponentenerkennung verwendet. Aufgrund seiner Vielfalt kann das Faster-R-CNN-Modell robuste Repräsentationen gängiger UI-Elemente wie Schaltflächen, Bilder und Textfelder aus einer breiten Palette von Anwendungen erlernen. Dies gewährleistet eine genaue Erkennung und Lokalisierung von UI-Komponenten unter unterschiedlichen Gestaltungsbedingungen. Der ENRICO-Datensatz bietet hochwertige, musterbeschriftete UI-Bildschirme, um strukturelle Beziehungen und Layoutmuster zu erlernen. Er ermöglicht dem System, die Beziehungen zwischen Komponenten, die hierarchische Organisation sowie gängige Gestaltungsvorlagen zu verstehen. Dieser Datensatz spielt eine entscheidende Rolle bei der Modellierung von Layoutstrukturen und der Sicherstellung der Konsistenz über mehrere Bildschirme hinweg, wodurch das Framework Layouts erzeugen kann, die mit etablierten Gestaltungskonventionen übereinstimmen. Im Gegensatz dazu wird der Datensatz Guo’s UI Color Dataset speziell für die wahrnehmungs- und kognitionsbezogene Farbmodellierung verwendet. Im Unterschied zu RICO und ENRICO, die sich auf strukturelle Aspekte konzentrieren, enthält dieser Datensatz kuratierte UI-Bilder mit annotierten Farbthemen. Diese Anmerkungen dienen zum Training der Module zur Farbextraktion und Harmoniebewertung. Durch die Abbildung von Farbbeziehungen in wahrnehmungsbezogene Farbräume wie CAM02-UCS lernt das Framework, Farbpaletten zu generieren, die Kontrast, Barrierefreiheit und ästhetische Kohärenz ausbalancieren. Zusammen bilden diese Datensätze eine integrierte Pipeline: RICO unterstützt die Erkennung von Komponenten, ENRICO ermöglicht das Verständnis von Layoutmustern und strukturelle Konsistenz, und Guos Datensatz trägt zur wahrnehmungsbezogenen Farboptimierung bei. Diese Integration stellt sicher, dass die generierten UI-Prototypen strukturell korrekt, visuell harmonisch und kognitiv optimiert sind.
Die Normalisierung erfolgte mit einem Mittelwert von [0,485, 0,456, 0,406] und einer Standardabweichung von [0,229, 0,224, 0,225]. Zur Verbesserung der Generalisierungsfähigkeit des Modells wurden Techniken zur Datenaugmentierung angewendet, darunter zufälliges Zuschneiden, horizontales Spiegeln und Drehen. Zusätzlich wurden die Pixelwerte auf den Bereich [0, 1] skaliert, und alle Bilder wurden auf eine Auflösung von 480 × 800 Pixeln verkleinert, um Konsistenz zwischen den Datensätzen sicherzustellen. Für die Augmentierung während des Trainings werden Bilder auf 224 × 224 Pixel verkleinert, während die ursprüngliche Auflösung von 480 × 800 Pixeln für die Layoutanalyse beibehalten wird. Begrenzungsrahmen wurden angepasst, um irrelevante Annotationen mithilfe vordefinierter Schwellenwerte herauszufiltern. Um eine einheitliche Vorgehensweise über alle Datensätze hinweg zu gewährleisten, wurden alle Benutzeroberflächenelemente manuell mit dem Annotationstool LabelImg annotiert. Vor der Annotation wurde ein vordefiniertes Schema festgelegt, um Benutzeroberflächenelemente in Kategorien wie Schaltfläche, Text, Bild, Symbol und Container einzuteilen. Für die Darstellung der Begrenzungsrahmen wurde ein einheitliches Koordinatensystem verwendet, und hierarchische Informationen wurden basierend auf den räumlichen Beziehungen zwischen den Elementen und ihren Eltern-Kind-Beziehungen im Layoutbaum erstellt. Darüber hinaus wurden Richtlinien festgelegt, um eine konsistente Annotation von Elementen, eine ordnungsgemäße Behandlung überlappender Komponenten und die Einhaltung minimaler Größenschwellen in den Datensätzen RICO, ENRICO und Guo sicherzustellen.
Detaillierte mathematische Formulierungen für das Training zur Komponentenerkennung und die Extraktion von Layout-Mustern sind in Supplementary File 1 enthalten.
Das Faster-R-CNN-Modell wurde mit SGD und einem Impuls von 0,9 sowie einer Gewichtsreduzierung von 0,0005 trainiert. Die anfängliche Lernrate wurde auf 0,001 festgelegt und anhand einer Schritt-Abnahmestrategie basierend auf der Validierungsleistung angepasst. Das Training wurde für bis zu 60 Epochen mit einer Batch-Größe von 16 durchgeführt. Zur Vermeidung von Überanpassung wurde ein vorzeitiges Abbrechen angewendet, wobei ein Validierungsdatensatz verwendet wurde, der 20 % der Trainingsdaten umfasste.
Die Abbildungsfunktion f(.) verwendet erkannte Benutzeroberflächenelemente als Eingabe und erzeugt eine hierarchische Layoutdarstellung als Ausgabe. Sie berechnet Nachbarschaftsbeziehungen zwischen Benutzeroberflächenelementen basierend auf räumlichem Abstand und Ausrichtungskriterien und erstellt eine Adjazenzmatrix, um diese Beziehungen darzustellen. Anschließend wird ein Clustering-Algorithmus wie DBSCAN angewendet, um verwandte Komponenten zu gruppieren. Schließlich werden die gruppierten Elemente basierend auf übergeordneten und untergeordneten Beziehungen in hierarchische Strukturen organisiert, wodurch eine strukturierte Layoutdarstellung entsteht.
Detaillierte Formulierungen zur Farbharmoniemodellierung und zum einheitlichen Optimierungsziel sind in Supplementary File 1 enthalten.
Diese Zielfunktion formalisiert mathematisch die Integration der strukturellen Erkennung, der Layout-Interpretation und der wahrnehmungsbasierten Farbmodellierung und stellt sicher, dass alle Komponenten des Frameworks gemeinsam zur Erzeugung kohärenter und benutzerzentrierter UI-Prototypen beitragen. Die Optimierung erfolgt modulartig für jede Komponente des Frameworks. SGD wird zum Trainieren des Komponentenerkennungsmoduls verwendet, während der Adam-Optimierer während der gemeinsamen Optimierung der vereinheitlichten Zielfunktion zum Einsatz kommt. Die kombinierte Zielfunktion dient der Steuerung der Gesamtsystemleistung. In den Phasen der gemeinsamen Optimierung wird die Zielfunktion mithilfe des Adam-Optimierers mit einer Lernrate von 0,001 und einer Batch-Größe von 16 minimiert. Das Training wird für bis zu 60 Epochen durchgeführt, wobei ein vorzeitiges Abbruchkriterium greift, wenn die Änderung des Validierungsverlusts über fünf aufeinanderfolgende Epochen hinweg kleiner als 10−4 ist.
Erkennung von Komponenten mithilfe von Faster R-CNN
Der vorgeschlagene Ansatz verwendet Faster R-CNN zur automatischen Erkennung von Benutzeroberflächenkomponenten, einschließlich Schaltflächen, Symbolen, Textfeldern, Bildern und Containern. Faster R-CNN eignet sich gut für diese Aufgabe, da es eine hohe Objekterkennungsgenauigkeit mit einer effizienten Generierung von Regionsvorschlägen kombiniert, was für die Verarbeitung komplexer Benutzeroberflächenlayouts mit dicht angeordneten Elementen unerlässlich ist. Das Modell nutzt einen ResNet-50-Backbone, der zuvor auf dem ImageNet-Datensatz vortrainiert wurde, um faltungs-basierte Merkmalskarten aus jedem Benutzeroberflächenbildschirm zu extrahieren. Während des Trainings wurden die unteren Schichten fixiert, um allgemeine visuelle Merkmale beizubehalten, während die höheren Schichten (conv4_x und conv5_x) für die erkennungsspezifische Erkennung von Benutzeroberflächenkomponenten angepasst wurden. Diese Merkmalskarten erfassen visuelle Strukturen, Kanten, Texturen und Komponentengrenzen. Während der Erkennung identifiziert das Region-Vorschlags-Netzwerk (RPN) Kandidatenregionen (Anker), die wahrscheinlich Benutzeroberflächenkomponenten enthalten. Anker werden mithilfe mehrerer Skalen (128, 256 und 512) und Seitenverhältnisse (1:1, 1:2 und 2:1) definiert, um Benutzeroberflächenelemente unterschiedlicher Größe zu berücksichtigen. Während des Trainings werden Anker mit einem Überlappungsmaß (Intersection-over-Union, IoU) von mehr als 0,7 im Vergleich zu Referenzboxen als positiv gekennzeichnet, während Anker mit einem IoU-Wert unter 0,3 als negativ markiert werden; Anker mit mittleren IoU-Werten werden ignoriert. Jeder Anker erhält eine Wahrscheinlichkeit, die das Vorhandensein einer Komponente angibt. Anschließend wird eine Nicht-Maxima-Unterdrückung (Non-maximum Suppression, NMS) angewendet, um redundante und überlappende Vorschläge zu entfernen, wodurch eine effiziente Lokalisierung aussagekräftiger Benutzeroberflächenelemente auch in stark überladenen Schnittstellen gewährleistet wird. Sobald die Kandidatenregionen generiert sind, wird jeder Vorschlag in vordefinierte Kategorien klassifiziert, und seine Begrenzungsboxkoordinaten werden verfeinert. Eine Region-of-Interest-(ROI-)Align-Operation extrahiert feste, gleichgroße Merkmalsdarstellungen für jeden Vorschlag, die anschließend von vollvermaschten Schichten zur Klassifizierung und Regression verarbeitet werden. Der Klassifizierungszweig gibt Klassenwahrscheinlichkeiten aus, während der Regressionszweig präzise Koordinaten der Begrenzungsbox vorhersagt. Das gesamte Faster-R-CNN-Modell wird end-to-end trainiert, indem eine gemeinsame Verlustfunktion optimiert wird, die den RPN-Verlust mit dem endgültigen Erkennungsverlust kombiniert. Dadurch ist das System in der Lage, Benutzeroberflächenkomponenten nicht nur genau zu erkennen, sondern sie auch präzise über verschiedene Schnittstellenstrukturen hinweg zu lokalisieren. Eine detaillierte Beschreibung der Faster-R-CNN-Komponentenerkennung, einschließlich der RPN-Phase, der ROI-Klassifizierung, der Verfeinerung der Begrenzungsbox und des endgültigen Optimierungsziels, ist in Supplementary File 1 enthalten.
Algorithmus S1 enthält den detaillierten Arbeitsablauf zur Komponentenerkennung und strukturellen Extraktion (Zusatzdatei 1). Er beschreibt den gesamten Prozess der automatischen Erkennung von Benutzeroberflächenkomponenten und der strukturellen Extraktion aus einem rohen Bildschirmfoto. Das Eingabebild wird zunächst vorverarbeitet und anschließend über einen CNN-Hauptblock geleitet, um tiefe visuelle Merkmale zu extrahieren. Diese Merkmale werden von der RPN verwendet, um vorgeschlagene Begrenzungsboxen zu generieren, die dann durch Klassifizierung und Regression verfeinert werden. NMS entfernt überflüssige Erkennungen, um eine präzise Lokalisierung sicherzustellen. Nach der Erkennung werden Komponenten basierend auf räumlicher Nähe mithilfe der dichte-basierten räumlichen Clusteranalyse mit Rauschen (DBSCAN) gruppiert. Dieser Clustering-Schritt ermöglicht den Aufbau eines hierarchischen UI-Baums, der Eltern-Kind-Beziehungen und logische Gruppierungen zwischen den Komponenten erfasst. Diese hierarchische Darstellung bildet die Grundlage für nachfolgende Layout-Analysen und das Verständnis der Benutzeroberfläche. Abbildung 2 veranschaulicht den Komponentenerkennungsprozess mittels Faster R-CNN auf einem mobilen Benutzeroberflächenbildschirm. Die Eingabeschnittstelle (links) enthält Benutzeroberflächenelemente wie Schaltflächen und Textblöcke, die automatisch in Begrenzungsboxen eingeschlossen sind. Diese erkannten Bereiche werden anschließend in Komponentenkategorien (z. B. Schaltfläche und Text) klassifiziert, wie durch beschriftete Verbindungen angezeigt. Das Faster R-CNN-Erkennungsmodul (rechts) verfeinert die Koordinaten der Begrenzungsboxen, weist semantische Beschriftungen zu und gibt strukturierte, komponentenbasierte Informationen aus. Dieser Schritt stellt eine entscheidende Grundlage für nachgelagerte Prozesse dar, einschließlich der Layout-Extraktion, kognitiven Optimierung und der Generierung von UI-Prototypen, indem er genaue, semantisch aussagekräftige Darstellungen der UI-Komponenten bereitstellt.
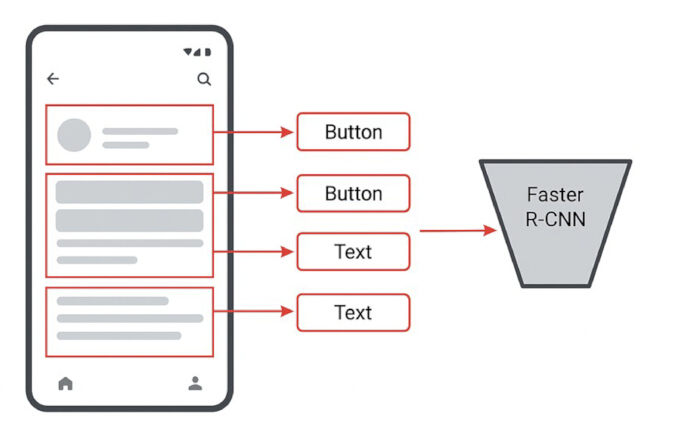
Abbildung 2. Erkennung von Benutzeroberflächenelementen mithilfe von Faster R-CNN. Die Abbildung veranschaulicht die Erkennung von UI-Komponenten anhand eines Screenshots einer Eingabeschnittstelle. Interessierende Bereiche werden mithilfe von Begrenzungsrahmen identifiziert, und Elemente wie Schaltflächen und Textfelder werden mit Faster R-CNN klassifiziert. Pfeile zeigen die Zuordnung der erkannten Komponenten zu ihren entsprechenden semantischen Bezeichnungen an. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Extraktion von Layout-Mustern und hierarchische Modellierung
Nach der Komponentenerkennung mithilfe von Faster R-CNN wird jedes Bedienelement durch eine umgebende Box repräsentiert. Allein diese umgebenden Boxen vermitteln jedoch nicht, wie die Elemente innerhalb der Benutzeroberfläche strukturell organisiert sind, beispielsweise welche Elemente zu Kopfzeilen, Navigationsleisten oder gruppierten Inhaltsbereichen gehören. Um diese Einschränkung zu beheben, werden die erkannten Komponenten in einen logischen UI-Baum umgewandelt, wobei jede Komponente als Knoten betrachtet wird und funktional oder visuell verwandte Komponenten unter gemeinsamen übergeordneten Knoten zusammengefasst werden. Um sinnvolle Layoutgruppen zu identifizieren, werden Clusterverfahren wie DBSCAN oder hierarchisches agglomeratives Clustering angewendet. Diese Methoden analysieren räumliche Nähe und Ausrichtungsmuster zwischen den Komponenten, um Beziehungen zwischen UI-Elementen zu erkennen. Analog zu menschlichen Gestaltungspraktiken lernt das System, häufige strukturelle Muster wie Kopf- und Fußzeilen, Raster sowie Inhaltsblöcke zu erkennen. Sobald die Gruppierung festgelegt ist, werden zusätzliche strukturelle Eigenschaften – einschließlich Ausrichtung, Rasteranordnung und Lesereihenfolge – analysiert, um eine umfassende Layoutdarstellung zu erstellen. Beispielsweise können gleich breite, nebeneinander angeordnete Komponenten auf ein Karten-basiertes Layout hindeuten, während vertikal gestapelte Elemente auf eine formular- oder feedbasierte Benutzeroberfläche schließen lassen. Durch die Integration von Clustering, räumlichem Schlussfolgern und Ausrichtungsregeln erstellt das Framework einen hierarchischen UI-Baum, der sowohl visuelle Gruppierungen als auch funktionale Beziehungen erfasst. Diese hierarchische Darstellung bildet die Grundlage für nachfolgende Layout-Verbesserungen und die Modellierung von Konsistenz über mehrere Bildschirme hinweg und ermöglicht es dem System, strukturierte, kohärente und benutzerzentrierte Interface-Designs zu generieren.
Detaillierte Formulierungen für räumliche Distanz und Alignmentsimilarität sind in Zusatzdatei 1 enthalten.
Clustering zur Layoutgruppierung (DBSCAN)
Zur Identifizierung von Layout-Gruppen wird DBSCAN angewendet. DBSCAN verwendet zwei Parameter: (1) ε = maximale Distanz zwischen benachbarten Komponenten und (2) = minimale Anzahl an Komponenten, die erforderlich sind, um einen Cluster zu bilden. Für diese Analyse wurden die DBSCAN-Parameter empirisch basierend auf der normalisierten UI-Auflösung (480 × 800 Pixel) ausgewählt. Der Nachbarschaftsabstandsparameter wurde auf ε = 50 Pixel festgelegt, um die räumliche Nähe zwischen benachbarten UI-Komponenten zu erfassen. Die minimale Anzahl an Punkten, die zur Bildung eines Clusters erforderlich ist, wurde auf MinPts = 3 gesetzt, um die Bildung unbedeutender oder zufälliger Gruppen von UI-Komponenten zu vermeiden.
Die detaillierte logische Formulierung zur Konstruktion des UI-Baums ist in Zusatzdatei 1 enthalten.
Wahrnehmungsbezogene Farbmodellierung mit CAM02-UCS
Das perzeptive Farbmodell stellt sicher, dass die in der generierten Benutzeroberfläche verwendeten Farben harmonisch, gut lesbar und kognitiv effizient sind. Dominante Farben werden mithilfe von Clusterverfahren aus Eingabequellen wie UI-Bildern extrahiert. Konkret wird das K-Means-Clustering mit K-Means++-Initialisierung über 300 Iterationen angewendet, um repräsentative Farbpaletten zu erhalten. Der RGB-Farbraum spiegelt jedoch die menschliche visuelle Wahrnehmung nicht genau wider, sodass numerisch ähnliche Farben wahrnehmungsmäßig unterschiedlich erscheinen können. Um diesen Nachteil auszugleichen, werden alle extrahierten Farben in den CAM02-UCS-Farbraum transformiert, der wahrnehmungsmäßig uniform ist. In diesem Raum entsprechen gleiche Distanzen gleichen wahrgenommenen Farbunterschieden, was ihn für die Modellierung von Farbharmonie und -kontrast geeignet macht. Nach der Abbildung in CAM02-UCS werden perzeptive Farbunterschiede mittels euklidischer Distanz berechnet, wodurch das System Kontrast, Harmonie und Variation zwischen Farben quantifizieren kann. Zu ähnliche Farben werden auseinandergezogen, um die Lesbarkeit zu verbessern, während übermäßig kontrastreiche Farben abgemildert werden, um visuelle Unannehmlichkeiten zu vermeiden. Die generierte Palette erfüllt außerdem Zugänglichkeitsstandards wie WCAG AA und AAA, um ausreichenden Kontrast zwischen Vorder- und Hintergrundelementen sicherzustellen. Außerdem wird Farbharmonie durch Beschränkung der Palettenbeziehungen auf komplementäre, analoge oder triadische Schemata erzwungen, abhängig vom vorgesehenen UI-Thema. Dadurch ist die resultierende Farbpalette nicht nur optisch ansprechend, sondern auch funktional zugänglich und kognitiv optimiert. Zur weiteren Feinabstimmung der Palette wird ein Optimierungsprozess unter Berücksichtigung der Zwänge perzeptiver Ähnlichkeit, Kontrast, Harmonie und Markenkonsistenz angewendet. Eine Primärfarbe wird ausgewählt (z. B. aus der Markenidentität), und Sekundärfarben werden hinsichtlich Helligkeit und Chroma angepasst, um die visuelle Hierarchie zu bewahren. Ein regelbasiertes Evaluationsverfahren bewertet Kandidatenpaletten anhand perzeptiver Distanzen und Zugänglichkeitsmetriken, um kognitive Belastung zu minimieren und gleichzeitig ästhetisches Gleichgewicht zu wahren. Dadurch erzeugt das Framework Farbschemata für Benutzeroberflächen, die professionelle Kohärenz, Lesbarkeit und perzeptive Konsistenz aufweisen.
Detaillierte mathematische Ausdrücke für die CAM02-UCS-basierte wahrnehmungsbezogene Farbmodellierung sind in Zusatzdatei 1 enthalten.
Algorithmus S2 (Zusätzliche Datei 1) beschreibt den CAM02-UCS-basierten Workflow zur perzeptuellen Farbextraktion und -optimierung unter Berücksichtigung von Harmonie- und Zugänglichkeitsanforderungen. Zunächst werden dominante Farben aus dem Eingabebild extrahiert und in den CAM02-UCS-Farbraum transformiert, um sicherzustellen, dass Farbunterschiede der menschlichen Wahrnehmung entsprechen. Anschließend werden die perzeptuellen Abstände zwischen den Farben berechnet und innerhalb vordefinierter Grenzen eingeschränkt, um sowohl Klarheit als auch Harmonie zu gewährleisten. Danach wird die Zugänglichkeit durch die Bewertung der Leuchtdichtekontrastverhältnisse gemäß den WCAG-Richtlinien sichergestellt. Die endgültige Farbpalette ergibt sich aus der Optimierung einer kombinierten Zielfunktion, die perzeptuelle Abstände, Kontrastanforderungen und Farbharmoniebedingungen ausbalanciert. Dadurch wird sichergestellt, dass die generierten Benutzeroberflächen-Farbschemata nicht nur visuell ansprechend, sondern auch lesbar, zugänglich und perzeptuell konsistent sind.
Kognitive Designoptimierung
Die kognitive Designoptimierung stellt sicher, dass die automatisch generierten UI-Prototypen nicht nur visuell konsistent, sondern auch leicht verständlich und benutzerfreundlich sind. Dieses Modul integriert zentrale Prinzipien des kognitiven Designs, darunter die Gestaltgesetze, das Fitts’sche Gesetz und das Hick’sche Gesetz, um die Anordnung, Gruppierung und den Abstand von UI-Komponenten zu steuern. Ausführliche mathematische Formulierungen zur kognitiven Designoptimierung finden sich in Supplementary File 1.
Integriertes kognitives Optimierungsziel
Der mathematische Ausdruck für das integrierte kognitive Optimierungsziel wird angegeben in Zusatzdatei 1. Die Koeffizienten, die die Bedeutung der visuellen Gruppierung, der Interaktions-Effizienz und der Entscheidungskomplexität repräsentieren, werden mit Alpha, Beta bzw. Gamma bezeichnet. In dieser Studie wurden die Werte von Alpha, Beta und Gamma empirisch anhand des Validierungsdatensatzes bestimmt. Für das vorliegende Experiment wurden die Koeffizienten wie folgt festgelegt: α = 0,5, β = 0,3 und γ = 0,2. Diese Konfiguration stellt ein wirksames Gleichgewicht zwischen visueller Gruppierung, Interaktions-Effizienz und Entscheidungseinfachheit her.
Konsistenz über mehrere Bildschirme hinweg und Erstellung der Benutzeroberfläche
Das Multiscreen-Konsistenzmodell gewährleistet, dass verschiedene Bildschirme innerhalb einer Anwendung eine kohärente visuelle Identität, eine einheitliche Struktur und ähnliche Interaktionsmuster aufweisen. Während Nutzer zwischen Bildschirmen navigieren, bilden sie Erwartungen hinsichtlich der Platzierung von Elementen, der Typografie, des Abstandsmaßes und der visuellen Hierarchie aus. Um diesen Erwartungen gerecht zu werden, analysiert das System Muster über mehrere Bildschirme hinweg anhand von Vorlagen, die aus den Datensätzen RICO und ENRICO abgeleitet sind. Diese Vorlagen erfassen gängige Benutzeroberflächenstrukturen wie Startseite–Detail-Anordnungen, Listen–Detail-Muster, mehrstufige Formulare und Dashboard-Flows. Durch den Vergleich von Komponentenplatzierungen und Gruppierungsverhalten erstellt das System ein strukturelles Profil über alle Bildschirme hinweg, das identifiziert, welche Elemente konsistent bleiben sollten und welche variieren dürfen. Sobald die strukturellen Muster erkannt sind, setzt das Framework Konsistenz bei Typografieskalen, Abstandsverhältnissen, Rasterlayouts und Navigationsankern um. Beispielsweise behalten Kopfleisten eine einheitliche Höhe, primäre Schaltflächen eine gleichbleibende Größe und Ausrichtung, und Inhaltsblöcke folgen einer vorhersagbaren visuellen Reihenfolge. Dies wird durch einen Prozess der Layout-Regularisierung erreicht, der jeden Bildschirm anhand globaler struktureller Vorgaben überprüft. Weicht ein Bildschirm von den erlernten Vorlagen ab – beispielsweise durch inkonsistente Auffüllabstände oder falsch ausgerichtete Überschriften –, passt das System das Layout automatisch an, um die Kohärenz wiederherzustellen. Solche Korrekturen tragen dazu bei, ein nahtloses Nutzererlebnis sicherzustellen und kognitive Umschaltkosten zwischen Bildschirmen zu verringern. Das Framework analysiert außerdem den Navigationsgraphen zwischen den Bildschirmen, um die Konsistenz des Interaktionsablaufs aufrechtzuerhalten. Gängige Navigationsmuster wie Vorwärts-/Rückwärts-Übergänge, Registerkartennavigation und mehrstufige Arbeitsabläufe werden erkannt und durchgesetzt. Jeder Übergang wird validiert, um sicherzustellen, dass er mit dem mentalen Modell des Nutzers übereinstimmt, wodurch die Benutzbarkeit verbessert und Verwirrung reduziert wird. Infolgedessen minimiert das Multiscreen-Konsistenzmodell visuelle Störungen, erhöht die Vertrautheit und fördert ein einheitliches Interaktionserlebnis.
Detaillierte mathematische Formulierungen zur Konsistenz mehrerer Bildschirme und zur Benutzeroberflächengenerierung sind in Supplementary File 1 enthalten.
Schließlich erzeugt die Render-Engine visuelle Ausgaben in Formaten wie SVG-Gerüsten, HTML/CSS-Prototypen oder pixelbasierten UI-Entwürfen. Die resultierenden Benutzeroberflächen verfügen über eine korrekte Lesereihenfolge, harmonische Farbbeziehungen, präzise Rasterausrichtung und eine konsistente visuelle Hierarchie über mehrere Bildschirme hinweg.
Algorithmus S3 liefert den Workflow zur kognitiv-visuellen Layout-Optimierung und zur konsistenten Gestaltung über mehrere Bildschirme hinweg (Zusatzdatei 1). Algorithmus S3 beschreibt den integrierten Prozess der kognitiven und strukturellen Optimierung, der zur Erstellung benutzerfreundlicher Benutzeroberflächen-Layouts verwendet wird. Er kombiniert Wahrnehmungsgruppierung (Gestaltgesetze), Interaktions-Effizienz (Fitts’sches Gesetz) und Entscheidungs-Einfachheit (Hick’sches Gesetz) innerhalb eines einheitlichen Optimierungsrahmens. Zunächst werden die räumlichen Beziehungen zwischen den Komponenten bewertet, um Wahrnehmungsgruppierungen zu bilden. Anschließend wird die Interaktions-Effizienz durch Anpassung der Größe und Position der Komponenten optimiert, während die Entscheidungskomplexität durch Begrenzung der Anzahl an Benutzern präsentierten Optionen kontrolliert wird. Zusätzlich stellt der Algorithmus eine konsistente Gestaltung über mehrere Bildschirme sicher, indem jeder Bildschirm anhand erlernter Layout-Vorlagen ausgerichtet wird, wodurch Einheitlichkeit in Typografie, Abständen und struktureller Organisation gewährleistet ist. Eine multikriterielle Optimierungsfunktion verfeinert das Layout anschließend, indem sie Ausrichtung, Abstände und kognitiven Aufwand ausbalanciert, was zu einer Benutzeroberfläche führt, die sowohl visuell stimmig als auch kognitiv effizient ist. Insgesamt gewährleistet dieser Algorithmus, dass generierte Multibildschirm-Layouts hohe Maßstäbe an visueller Konsistenz, Benutzbarkeit und Wahrnehmungsklarheit beibehalten.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Der vorgeschlagene automatisierte UI-Prototyping-Rahmen wurde anhand eines integrierten Datensatzes von 5.128 UI-Bildschirmen aus drei Quellen bewertet: 4.000 RICO-Bilder, 1.000 ENRICO-Bildschirme und 128 farblich annotierte UI-Beispiele aus Guos UI-Farbdatensatz. Dieser gemischte Datensatz bietet eine gut ausbalancierte Benchmark zur Bewertung der Genauigkeit der Komponentenerkennung, der Klarheit der Layout-Struktur, der Konsistenz über mehrere Bildschirme hinweg sowie der wahrnehmbaren Farbharmonie.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Die Ergebnisse zeigen statistisch signifikante Verbesserungen hinsichtlich der Benutzerfreundlichkeit, der strukturellen Organisation und der wahrgenommenen Qualität (p < 0,05), wodurch die Wirksamkeit der Einbindung kognitiver Gestaltungsprinzipien in die automatisierte UI-Prototyperstellung bestätigt wird. Im Gegensatz zu herkömmlichen Systemen zur UI-Generierung, die hauptsächlich auf visueller Erkennung oder regelbasierten Heuristiken beruhen, integriert der vorgeschlagene Ansatz Gestalt-Gruppierungen, Hierarchie...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren haben keine Interessenkonflikte.
Danksagungen
Die Autoren danken für die akademische und institutionelle Unterstützung durch das Wuhan College of Foreign Languages & Foreign Affairs, die Keimyung University und das Shanghai Institute of Commerce and Foreign Languages während der Durchführung dieser Forschung.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| CPU (Prozessor) | AMD Ryzen 9 7950X (16-Kern, 32-Thread, 4,5–5,7 GHz) | Advanced Micro Devices (AMD), USA | Ryzen 9 7950X |
| CUDA Toolkit | Version 11,8 | NVIDIA Corporation, USA | CUDA Toolkit 11,8 |
| cuDNN | Version 8,9 | NVIDIA Corporation, USA | cuDNN v8,9 |
| Faster R-CNN | Objekterkennungsmodell (mit Region Proposal Network) | Meta AI Research / Detectron2 | Detectron2-Framework |
| Matplotlib | Version 3,7 | Matplotlib-Entwicklungsteam | v3,7,0 |
| NVIDIA RTX 4090 GPU | 24-GB-GDDR6X-Grafikkarte | NVIDIA Corporation, Santa Clara, CA, USA | RTX 4090 |
| NumPy | Version 1,24 | NumPy-Entwickler | v1,24,0 |
| OpenCV | Version 4,8 | OpenCV Foundation | v4,8,0 |
| PyTorch | Version 2,0 | PyTorch Foundation (Meta AI) | v2,0,0 |
| ResNet-50 mit FPN | Backbone-CNN mit Feature-Pyramid-Netzwerk | Microsoft Research / Detectron2 | ResNet-50-FPN |
| Scikit-learn | Version 1,3 | Scikit-learn-Entwickler | v1,3,0 |
| SciPy | Version 1,10 | SciPy-Community | v1,10,0 |
| Arbeitsspeicher (RAM) | 64 GB DDR5 | Corsair / Kingston (oder vergleichbar) | DDR5-64-GB-Kit |
| Ubuntu-Betriebssystem | Version 22,04 LTS | Canonical Ltd., UK | Ubuntu 22,04 LTS |
Referenzen
- Weingerl P. Automated image-based user interface color theme generation. Appl Sci. 2024;14:2850.
- Feng Z, Fang J, Cai B, Zhang Y. Guis2Code: Computer vision tool to generate code automatically from graphical user interface sketches. In: Proc Int Conf Artif Neural Netw; 2021; p. 53–65.
- Chen C, Zhang X, Yang Y, Li Y. GalleryDC: Design search knowledge discovery through auto-created GUI component gallery. Proc ACM Hum Comput Interact. 2019;3:1–22.
- Chen J, et al. Object detection for graphical user interface: Old-fashioned deep learning combination. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1202–1214.
- Xie M, et al. UIED: Hybrid tool for GUI element detection. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1655–1659.
- Gijsenij A, et al. Determining key colors from a design perspective using dE-means color clustering. Color Res Appl. 2023;48:69–87.
- Yuan LP, et al. InfoColorizer: Interactive recommendation of color palettes for infographics. IEEE Trans Vis Comput Graph. 2022;28:4252–4266.
- Cao Y, et al. Influences of color salience and location of website links on user performance and affective experience. Int J Hum Comput Interact. 2021;37:547–559.
- Liu W, Cao Y, Proctor RW. App icon color and border shape influence visual search efficiency and user experience. Int J Ind Ergon. 2021;84:103160.
- Yamin PAR, Park J, Kim HK, Hussain M. Effects of button colour and background on augmented reality interfaces. Behav Inf Technol. 2023;43:663–676.
- Deng L, Zhang ZR, Zhou FY, Liu RY. Effects of app icon border form and interface background color saturation. Adv Multimed. 2022;2022:1166656.
- Weingerl P, Hladnik A, Javoršek D. Machine learning model for extracting image prominent colors. Color Res Appl. 2020;45:409–426.
- Huang K, et al. WovenProbe: Probing possibilities for on-skin systems. In: Proc ACM Des Interact Syst Conf; 2021; p. 1193–1207.
- Dewez D, Guillemot C, Bailly G, Isenberg T. Dual body representations during an isomorphic 3D manipulation. IEEE Trans Vis Comput Graph. 2022;28:2047–2057.
- Kim J, Kim C, Nam KY. ThinkWrite: Design interventions for online petition deliberation. In: Proc CHI Conf Hum Factors Comput Syst Ext Abstr; 2022.
- Gao L, Wang Y, Müller S, Hudson SE. DataLev: Mid-air data physicalisation using acoustic levitation. In: Proc CHI Conf Hum Factors Comput Syst; 2023; p. 1–14.
- Khorsandi PM, Ogata M, Rekimoto J, Inami M. FabriCar: In-car media interactions using e-textile sensors. In: Proc ACM Des Interact Syst Conf; 2023; p. 764–776.
- Zhang Z, Ding Y, Huang C. Automatic front-end code generation via multi-head attention. In: Proc Int Conf Comput Eng Appl; 2023; p. 869–872.
- Jain V, et al. Sketch2code: Transformation of sketches to UI using deep neural network [preprint]. arXiv:1910.08930; 2019.
- Chai Y, et al. Dynamic prototype network for few-shot malware detection. IEEE Trans Knowl Data Eng. 2023;35:4754–4766.
- Qiu J, et al. AI security in 5G networks: Adversarial examples. IEEE Veh Technol Mag. 2020;15:95–100.
- Qiu J, et al. Automatic concept extraction from big data in smart city. IEEE Trans Comput Soc Syst. 2020;7:225–233.
- Xie M. UI2CODE: Computer vision-based reverse engineering of UI design [Internet]. GitHub; 2021. Available from: https://github.com
- Wang C, Bochkovskiy A, Liao HYM. CSPNet: Backbone enhancing learning capability of CNNs. In: Proc IEEE Conf Comput Vis Pattern Recognit Workshops; 2020; p. 1571–1580.
- Hui M, et al. Unifying layout generation with decoupled diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18434–18443.
- Wang Y, et al. Dolfin: Diffusion layout transformers without autoencoder. In: Proc Eur Conf Comput Vis; 2024; p. 513–530.
- Sobolevsky A, et al. GuiLGet: GUI layout generation with transformer [preprint]. arXiv:2304.09012; 2023.
- Lu Y, et al. UI layout generation with LLMs guided by UI grammar [preprint]. arXiv:2310.15455; 2023.
- Leiva LA, Hota A, Oulasvirta A. ENRICO: A dataset for mobile UI design modeling. In: Proc Int Conf Hum Comput Interact Mobile Devices Serv; 2020.
- Li G, et al. Learning to denoise mobile UI layouts. In: Proc CHI Conf Hum Factors Comput Syst; 2022; p. 1–15.
- Beltramelli T. pix2code: Generating code from a GUI screenshot. In: Proc ACM SIGCHI Symp Eng Interact Comput Syst; 2018.
- Zheng G, et al. LayoutDiffusion: Controllable diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18424–18433.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.