Diese Studie stellt einen steuerungsbewussten digitalen Zwillingsansatz zur Überwachung und Optimierung von Öl- und Gassystemen mithilfe maschinellen Lernens und physikbasierten Modellen vor, der an simulierten und Referenzdatensätzen evaluiert wurde.
Forschungsartikel
Entwicklung eines steuerungsbewussten Digital-Twin-Frameworks zur Echtzeitüberwachung und Optimierung von Öl- und Gasproduktionssystemen
In diesem Artikel
Zusammenfassung
Zusammenfassung
In diesem Artikel wird ein steuerungsbewusstes Framework für digitale Zwillinge zur Verfolgung und Verbesserung von Öl- und Gasförderanlagen vorgeschlagen. Die Methode kombiniert räumlich-zeitliche graphenbasierte neuronale Netze, neuronale 4D-Var-Datenassimilation, steuerungsbasiertes Verstärkungslernen und physikinformierte neuronale Operatoren (FNO und Neural-Operator-Modell). Zur Bewertung des Frameworks werden Benchmark-Cyber-Physical-System-Datensätze (SWaT und WADI) sowie ein simulierter Öl- und Gasdatensatz verwendet. Die Ergebnisse, die durch mehrere unabhängige Durchläufe mit durchschnittlichen Maßen bestätigt wurden, zeigen eine verbesserte Leistung bei der Zustandsschätzung, Anomalieerkennung und Steuerungsoptimierung. Die Bewertung beschränkt sich jedoch auf Benchmark- und simulierte Datensätze; eine zusätzliche Validierung anhand tatsächlicher Industriedaten ist erforderlich, um die praktische Anwendbarkeit zu überprüfen.
Einleitung
Der Bedarf an sicheren und effizienten Transportnetzen für Öl und Gas ist aufgrund des weltweit steigenden Energiebedarfs gewachsen. Die Aufrechterhaltung der Zuverlässigkeit von Pipelines wird jedoch erheblich durch eine alternde Infrastruktur und zunehmende Systemkomplexität beeinträchtigt. In diesem Zusammenhang hat die Digital-Twin-(DT-)Technologie als datengetriebene Strategie für das Lebenszyklusmanagement Interesse geweckt, die Risikobewertung, vorausschauende Wartung und Systemoptimierung in industriellen Anwendungen ermöglicht1,2,3,4,5. Der digitale Wandel in industriellen Systemen hat – vom reaktiven Wartungsansatz hin zu intelligenter, datenbasierter Entscheidungsfindung – die Anomalieerkennung, Ausfallvorhersage und Systemzuverlässigkeit verbessert6,7,8. DT-Anwendungen in der Prozessoptimierung, vorausschauenden Wartung und intelligenten Fertigung waren Gegenstand zahlreicher Forschungsarbeiten. Beispielsweise wurden DT-basierte Modelle für die vorausschauende Ausfallanalyse10 und die Bewertung der ökologischen Leistung11 sowie die produktionsoptimierungsbasierte Tiefenlernverfahren vorgeschlagen. Digitale Zwillinge wurden in der Öl- und Gasindustrie eingesetzt, um die Überwachung und Identifizierung von Anomalien durch Systemmodellierung, Leistungsbewertung und Integration von Multisensordaten zu verbessern12,13,14,15.
Trotz dieser Entwicklungen konzentrieren sich die meisten derzeitigen DT-Methoden auf diskrete Funktionen wie Überwachung, Modellierung oder Anomalieerkennung, wobei eine Integration von Echtzeit-Synchronisation und -Steuerung kaum erfolgt. Viele Systeme weisen keine bidirektionale Interaktion und adaptive Lernfähigkeit auf und funktionieren lediglich als digitale Schatten mit einseitigem Datenfluss. In Öl- und Gassystemen, in denen dynamische Bedingungen und komplexe Fehlermuster ein kontinuierliches Lernen und eine aktive Steuerung erfordern, ist diese Einschränkung besonders bedeutsam. Zudem unterstützen aktuelle Ansätze für cyber-physikalische Systeme keine echtzeitfähige Regelung in komplexen industriellen Prozessen, da sie hauptsächlich auf Offline-Analysen beschränkt sind16. Außerdem basieren bestehende Verfahren zur Beschreibung der Wechselwirkungen verteilter Sensoren überwiegend auf traditionellen maschinellen Lernverfahren und Filtertechniken, während fortschrittliche Modelle wie räumlich-zeitliche Graph-Neuronale-Netzwerke kaum eingesetzt werden. Darüber hinaus fehlt es an Forschung zum Einsatz von Operator-Lernverfahren zur Erfassung nichtlinearer physikalischer Dynamiken, insbesondere in Systemen zur Ölförderung und Gasproduktion17. Aus diesem Grund sind bestehende DT-Systeme nicht in der Lage, komplexe räumlich-zeitliche Beziehungen abzubilden, während sie gleichzeitig eine Echtzeit-Datenassimilation und adaptive Regelung integrieren.
Da sie industrielle Steuerungsszenarien nachahmen, werden Benchmark-Datensätze wie SWaT und WADI häufig zur Validierung DT-basierter Verfahren in cyber-physischen Systemen verwendet18. Darüber hinaus bieten digitale Zwillinge allgemeinere Vorteile, wie etwa gesteigerte Produktivität, verbesserten Wissensaustausch und sicheren Datentransfer entlang industrieller Prozesse19,20. Insbesondere in risikoreichen Branchen wie der Öl- und Gasindustrie21,22,23 wird ihr Potenzial in der Sicherheitsverwaltung, Echtzeitüberwachung und industriellen Automatisierung zunehmend anerkannt. Dennoch werden für eine praktische Implementierung weiterhin umfassendere und integriertere Lösungen benötigt, die Modellierungs-, Überwachungs- und Steuerungsfunktionen kombinieren. Evaluationsstudien wie die in24,25 zitierten haben durch die Darstellung der Anwendungen und Vorteile digitaler Zwillinge bei der Verbesserung der betrieblichen Effizienz und der Entscheidungsfindung Grundlagen geschaffen. Tabelle 1 zeigt den Vergleich bestehender Methoden im Bereich Öl- und Gasproduktion und -kontrollmanagement26,27,28,29. Aufgrund der hohen Betriebsrisiken und komplexen Dynamik von Ölgewinnungs- und Fördersystemen sind herkömmliche Wartungsmethoden häufig nicht ausreichend, um Anomalien zeitnah zu erkennen und darauf zu reagieren30,31,32,33. Obwohl die Sicherheitsverwaltung und Fernüberwachung in jüngster Zeit verbessert wurden, werden weiterhin intelligente Systeme benötigt, die kontinuierlich erfassen, lernen und in Echtzeit steuern können.
Dieser Artikel schlägt eine steuerungsbewusste Digital-Twin-Architektur vor, die räumlich-zeitliche Graph-Neuronale-Netzwerke, neuronale 4D-Var-Datenassimilation, physikbasierte neuronale Operatoren und verstärkendes lernbasiertes Regelungssystem kombiniert, um diese Schwierigkeiten zu überwinden. Das vorgeschlagene System etabliert eine einheitliche Pipeline für Datenerfassung, Zustandsschätzung, Anomalieerkennung und Regelungsoptimierung. Während räumlich-zeitliche Graph-Neuronale-Netzwerke Wechselwirkungen zwischen verteilten Sensoren erfassen, werden physikbasierte neuronale Operatoren wie der Fourier-Neuronale-Operator und das Deep-Operator-Netzwerk (Neural operator model) verwendet, um komplexe nichtlineare Systemdynamiken abzubilden. Durch Verstärkendes Lernen wird adaptive, geschlossene Regelung ermöglicht, während die neuronale Datenassimilation die Genauigkeit der Zustandsschätzung verbessert. Die Generalisierbarkeit der vorgeschlagenen Methode über verschiedene industrielle Anwendungen hinweg wird durch die Bewertung anhand von Benchmark-Datensätzen cyber-physikalischer Systeme (SWaT und WADI) sowie simulierter Öl- und Gasdaten demonstriert. Diese Arbeit überwindet wesentliche Schwächen bestehender DT-Systeme und bietet eine skalierbare und anpassungsfähige Lösung für die Echtzeitüberwachung und -optimierung in Öl- und Gasförderanlagen, indem Modellierung, Lernen und Regelung in einem einheitlichen Rahmen zusammengeführt werden.
Protokoll
Diese Studie beinhaltet keine menschlichen Teilnehmer oder Tierproben. Die verwendeten Datensätze (SWaT und WADI) sind öffentlich verfügbare Benchmark-Datensätze, und es werden keine sensiblen oder personenbezogenen Daten verwendet.
Der vorgeschlagene Ansatz schafft einen steuerungsbewussten digitalen Zwilling, der die Integration modernster Deep-Learning-Algorithmen, die Datenassimilation sowie die kontinuierliche Bewertung und Optimierung von Öl- und Gasförderanlagen und deren Steuerung ermöglicht. Zunächst werden Echtzeit-Multimodal-Sensordaten aus geografisch verteilten Produktionsanlagen erfasst und mithilfe einer Graphstruktur modelliert, die die Konnektivität und Wechselwirkungen zwischen den Produktionseinheiten definiert. Anschließend werden physikbasierte neuronale Operatoren zur Erstellung operatorbasierter Näherungen der Gleichungen verwendet, die die nichtlineare Mehrphasenströmung beschreiben, wodurch eine skalierbare Simulation innerhalb des digitalen Zwillings ermöglicht wird. In der Studie wurde der Begriff „Neuraler Operatorenmodell“ verwendet, um sich auf das Deep Operator Network zu beziehen. Um räumliche und zeitliche Abhängigkeiten zwischen geografisch verteilten Produktionsanlagen einzubeziehen, werden räumlich-zeitliche Graph-Neural-Networks innerhalb der physikbasierten Darstellungen trainiert. Ein differenzierbarer Ansatz zur Datenassimilation, der auf dem neuronalen 4DVAR-Verfahren basiert, wird angewendet, um sicherzustellen, dass die Simulationsergebnisse des digitalen Zwillings stets mit den Echtzeit-Monitoringdaten übereinstimmen und synchronisiert bleiben, auch bei verrauschten und räumlich unregelmäßigen Messungen. Aufbauend auf dem Echtzeit-synchronisierten digitalen Zwilling wird ein durch Verstärkendes Lernen gesteuerter Optimierungsansatz für die Echtzeit-Steuerung trainiert. Schließlich bleibt der digitale Zwilling für eine kontinuierliche Modellaktualisierung und angepasste Skalierbarkeit über einen längeren Zeitraum hinweg gerüstet, basierend auf fortlaufenden Aktualisierungen durch neu verfügbare Messdaten.
Die vorgeschlagene digitale Zwilling-Architektur verbessert die herkömmliche Architektur für digitale Zwillinge, indem Intelligenz, Anpassungsfähigkeit und Steuerungsawareness hinzugefügt werden. Die gesamte Pipeline besteht aus vier Modulen: (i) Datenerfassung/Graph-Konstruktion, (ii) Zustandsschätzung mittels neuronaler Operatoren und ST-GNN, (iii) Anomalieerkennung mittels residualbasierter Analyse und (iv) verstärkungslernbasierte Steuerung.
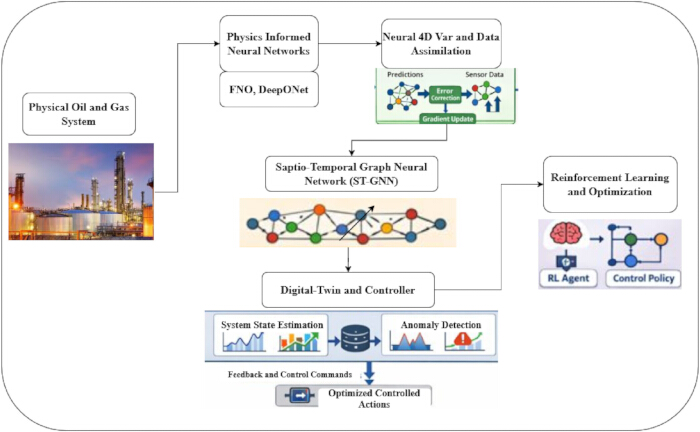
Abbildung 1: Übergreifende steuerungsorientierte Architektur des digitalen Zwillings. Anomalieerkennung, räumlich-zeitliche graphenbasierte neuronale Netze, neuronale 4D-Var-Synchronisation, physikbasierte neuronale Operatoren und eine auf Verstärkendem Lernen basierende Regelung im geschlossenen Kreislauf für Ölförder- und Gassysteme sind alle in das vorgeschlagene steuerungsorientierte Modell des digitalen Zwillings integriert. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Abbildung 1 zeigt den funktionalen Prozess eines steuerungsorientierten digitalen Zwillings für die Öl- und Gasförderung als geschlossenes cyber-physikalisches System. Der funktionale Prozess beginnt auf der Ebene des Ölförder- und Gassystem, in dem verschiedene Sensoren an Bohrlöchern, Rohrleitungen, Ventilen und Verarbeitungseinheiten Daten zu Druck, Durchflussrate, Temperatur und Steuerzuständen zu einem bestimmten Zeitpunkt erfassen. Die verschiedenen Sensoren erfassen die Daten in unterschiedlichen Formaten, und diese werden an den digitalen Zwilling übermittelt, wodurch die Grundlage für die organisationsweite Wahrnehmung zu diesem Zeitpunkt geschaffen wird.
Die vorgeschlagene Methodik umfasst die folgenden Schritte:
Datenerfassung
Echtzeitinformationen von Sensoren bezüglich Druck, Durchflussrate, Temperatur und Steuereingaben werden aus der Öl- und Gasförderung gewonnen. Andere verfügbare Benchmark-Datensätze wie SWAT und WADI werden zur Überprüfung der Robustheit und Generalisierungsfähigkeit verwendet. Um die Reproduzierbarkeit sicherzustellen, wird jeder Schritt der vorgeschlagenen Methodik mit technischen Details spezifiziert.
[Bitte beachten Sie die Zusatzdatei (S1) für die Datensatzerstellung und -simulation.]
Zwei öffentliche Benchmark-Datensätze aus dem Forschungsbereich für industrielle Steuerungssysteme werden verwendet, um die Fähigkeit des konzeptionellen digitalen Zwillings hinsichtlich komplexer und hochdimensionaler Zeitreihendaten sowie ungewöhnlicher Ereignisse nachzuweisen: die Secure Water Treatment (SWaT) und die Water Distribution (WADI) Benchmark-Datensätze34. Beide Datensätze stammen aus realistischen cyber-physikalischen Testumgebungen und enthalten multivariate Sensoren- und Aktorendaten zum Betrieb unter normalen sowie anomalen/Angriffsszenarien, die in solchen Systemen ausgelöst wurden. Durch die Nutzung der SWaT- und WADI-Datensätze ist es möglich, tests über Domänen hinweg durchzuführen und die Übertragbarkeit über cyber-physikalische Testumgebungen hinaus auf breitere verteilte industrielle Systeme mit orts- und zeitbezogenen Abhängigkeiten zu belegen. Die Beschreibung des Datensatzes ist in Tabelle 2 dargestellt.
Die vorgeschlagene Forschung nutzt drei verschiedene Datensätze zur umfassenden Evaluierung der entwickelten Digital-Twin-Methodik, die in Tabelle 2Der Basissatz besteht aus simulierten Daten zur Produktionsorganisation in der Öl- und Gasindustrie und soll reale, vom System erfasste Betriebsmessungen sowie Steuerungs- und/oder Fehlerzustände nachbilden. Darüber hinaus wird der Secure Water Treatment (SWaT)-Datensatz als Beispiel eines reduzierten physikalischen Systems eingeführt, der Messungen von 51 Sensoren und Aktoren über einen Zeitraum von etwa 11 Tagen umfasst, einschließlich sowohl normaler Betriebszustände als auch künstlich erzeugter Anomalien und Angriffe. Der Datensatz gilt weithin als Standard-Benchmark für Forschungszwecke. Ein weiterer Datensatz ist der Water Distribution (WADI)-Datensatz, dessen Messungen das Verhalten eines reduzierten Wasserversorgungssystems über einen Zeitraum von 16 Tagen erfassen und etwa 123 Variablen umfassen, darunter verschiedene Angriffe und normale Betriebsbedingungen. Der Datensatz enthält insgesamt 15 verschiedene Angriffe. Die beiden oben genannten Datensätze beziehen sich hauptsächlich auf hochdimensionale zeitliche und räumliche Datenreihen wie sie in industriellen Steuerungssystemen vorkommen.
Datenvorverarbeitung
Vor dem Modelltraining durchlaufen alle Datensätze ein gründliches Vorverarbeitungsverfahren, um Datenqualität, Konsistenz und Reproduzierbarkeit sicherzustellen. Die Vorverarbeitungsschritte umfassen die Behandlung fehlender Werte, Rauschfilterung, Normalisierung und Skalierung der Merkmale. Die detaillierte Vorverarbeitungspipeline ist in der Zusatzdatei (S2) beschrieben.
Konstruktion des Systemgraphen
In der vorgeschlagenen Methodik wird das physische Fördersystem für Öl und Gas in Form eines Graphen dargestellt, der als mathematische Struktur zur Beschreibung räumlicher Korrelationen zwischen Anlagen sowie der Dynamik des Systemzustands über die Zeit dient (siehe Supplementary File (S3) für die Formulierungen zur Konstruktion des Systemgraphen).
Physiklernen mithilfe neuronaler Operatoren
Um die nichtlinearen und mehrdimensionalen Eigenschaften von Mehrphasenströmungssystemen korrekt abzubilden, verwendet der vorgeschlagene Ansatz physikbasierte Operatoren in Form von Fourier-Neural-Operatoren (FNO) und Neural-Operator-Modellen. Im Gegensatz zur traditionellen Darstellung neuronaler Netze als punktweise Abbildungen ermöglicht das Konzept der Operatoren eine Verallgemeinerung hinsichtlich unterschiedlicher Randbedingungen. Diese Eigenschaft macht die Methode besonders geeignet für Mehrphasenströmungssysteme, wie sie in der Ölgewinnung und Gasproduktion eingesetzt werden, da die physikalischen Phänomene kontinuierlich auftreten. Weitere Informationen zu den mathematischen Gleichungen der Neuralen Operatoren finden Sie in der Zusatzdatei (S4).
Um die Gültigkeit der physikgeleiteten neuronalen Operatoren weiter zu bewerten, wurden zusätzliche Experimente durchgeführt, um deren Fähigkeit zur Approximation nichtlinearer Operatormapping unter verschiedenen Strömungszuständen und Steuereingaben zu untersuchen. Die Ergebnisse zeigen, dass die Operatoren das Mapping des nichtlinearen Operators genau approximieren können, wodurch die Fähigkeit der Operatoren bestätigt wird, die Dynamik des Systems – insbesondere bei hoher Dimensionalität – mit geringeren Rechenkosten als andere Löser genau abzubilden. Die quantitative Bewertung der Genauigkeit des Operatoren-Lernens erfolgt mittels des mittleren quadratischen Fehlers zwischen vorhergesagten und simulierten Systemzuständen, wobei eine konsistente Approximationsleistung unter verschiedenen Strömungsbedingungen nachgewiesen wird.
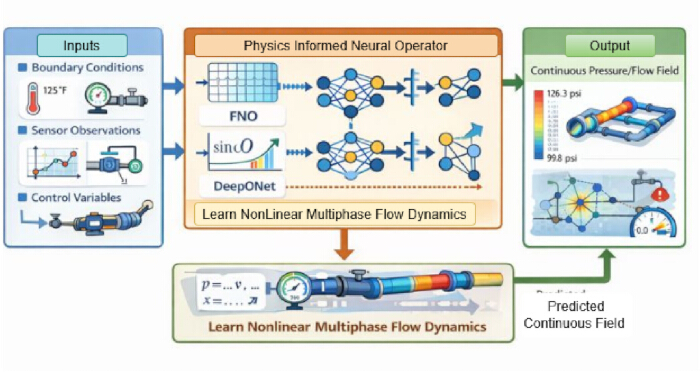
Abbildung 2: Arbeitsablauf des physikbasierten neuronalen Operator-Frameworks. Ein Beispiel des Arbeitsablaufs veranschaulicht, wie Steuereingaben, Sensordaten und Randbedingungen genutzt werden, um die nichtlineare Mehrphasenströmungsdynamik zu lernen und schnelle, systemebenen Vorhersagen auf Operator-Ebene zu erzeugen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Im in Abbildung 2 dargestellten PINO-Arbeitsprozess erfolgt der Lernprozess physikalisch komplexer, nichtlinearer Mehrphasenströmungen in Öl- und Gassystemen kontinuierlich. Dies beginnt auf der Eingabeschicht, wo das Modell heterogene Daten über das sich physikalisch entwickelnde System erhält. Diese Eingaben bestehen aus Randbedingungen wie Druck, Temperatur und Geschwindigkeit sowie aus Echtzeitdaten von Sensoren, die im Öl- und Gassystem positioniert sind, und Steuerungsvariablen wie der Öffnung von Ventilen, der Drehzahl von Pumpen oder der Öffnung von Drosselventilen. Alle diese Eingaben definieren den Betrieb des sich physikalisch verändernden Systems.
Die Schlüsselkomponente innerhalb des Workflows ist das PINO, realisiert durch FNO und das Neural-Operator-Modell. Die vorgeschlagene Methode unterscheidet sich dadurch, dass sie neuronale Operatoren verwendet, um Operatoren zwischen Funktionsräumen zu lernen, im Gegensatz zu herkömmlichen neuronalen Netzwerken, die sich in der Regel auf punktweise Abbildungen zwischen Eingaben und Ausgaben konzentrieren. Auf dieser Ebene kann das FNO mithilfe des Fourier-Bereichs die globalen räumlichen Beziehungen erfassen, und das Neural-Operator-Modell kann Operator-Darstellungen unter Verwendung sowohl von Branch- als auch von Trunk-Netzwerken lernen. Das trainierte Modell wird durch physikalische Randbedingungen gesteuert, um sicherzustellen, dass die vorhergesagten Dynamiken sich wie erwartet bei Mehrphasenströmungen verhalten. Das Ergebnis des neuronalen Operators liegt in Form einer kontinuierlichen Feldlösung wichtiger physikalischer Variablen wie Druck, Strömungsraten und Phasenverteilung für das gesamte Fördernetzwerk vor. Darüber hinaus sind die Ausgabewerte für das gesamte Feld genau, einschließlich der Bohrlöcher, Rohrleitungen und anderen verbundenen Einheiten, anstatt nur an bestimmten Punkten wie Sensoren gemessen zu werden. Auf diese Weise ermöglicht die Ausgabe des neuronalen Operators die schnelle Erzeugung hochpräziser Simulationen, die die Lösung partieller Differentialgleichungen annähern können, ohne diese notwendigerweise lösen zu müssen. Diese Lösung fungiert als schnelle Lösung im digitalen Zwilling.
Der Lernprozess des neuronalen Operators verarbeitet Merkmale auf Funktionsebene und Systemebene, die aus den Förderprozessen von Öl und Gas extrahiert werden. Zu diesen Merkmalen zählen vor allem die physikalischen Zustandsgrößen der Ölförderung, also kontinuierliche Felder wie Temperatur, Durchflussrate, Druck sowie Phasenanteile von Öl, Gas und Wasser. Ebenfalls enthalten sind Randbedingungen wie Einlassdrücke, Durchflussraten und Ventilpositionen. Steuerungseingaben, wie Stellungen von Drosselventilen und Pumpendrehzahl, werden ebenfalls berücksichtigt, um Reaktionen unter verschiedenen Betriebsszenarien vorherzusagen. Das neuronale Operator-Modell „neural operator“ erhält die physikalischen Merkmale sowie Steuerungsparameter, die von den Trunk- und Branch-Netzwerken verarbeitet werden. Diese Merkmale liefern ausreichend Informationen, damit neuronale Operatoren genaue Operator-Beziehungen vorhersagen können, die sowohl von physikalischen Prozessen als auch von betrieblichen Faktoren abhängen, um schnelle digitale Zwillingssimulationen zu ermöglichen.
Fourier-Neural-Operator (FNO)
In dieser Studie wird ein Fourier-Neural-Operator (FNO)36 verwendet, um die Operatormappingvorschriften, die die nichtlinearen Mehrphasenströmungsdynamiken von Öl- und Gasförderanlagen beschreiben, effizient zu schätzen. Im Gegensatz zu herkömmlichen neuronalen Netzen, die Eingabe-Ausgabe-Abbildungen für eine bestimmte Punktmenge approximieren, approximiert der vorgeschlagene FNO Abbildungen zwischen Funktionenräumen, wodurch eine Verallgemeinerung über verschiedene Maßstäbe und Systemkonfigurationen ermöglicht wird. Im vorliegenden Fall verschiebt der FNO die Systemzustandsdarstellungen vom ursprünglichen Raum in den Fourier-Bereich, wo spektrale Faltungen effektiv angewendet werden können, um die innerhalb der Systeme bestehenden globalen räumlichen Abhängigkeiten zu erfassen. Dabei wird die Eingabe-Zustandsdarstellung in einen höherdimensionalen latenten Raum projiziert, und die Transformationen sowie Aktivierungen werden iterativ unter Verwendung von Fourier-Transformationen, spektralen Kernen und Aktivierungsfunktionen durchgeführt. Siehe Ergänzende Datei (S4.1) für mathematische Auswertungen des Fourier-Neural-Operators.
Neurales Operator-Modell
Das Neural-Operator-Modell37 fungiert als alternativer Ansatz im Rahmen des Neural-Operator-Verfahrens zur Approximation eines nichtlinearen physikalischen Operators, der die Dynamik der Öl- und Gasförderung beschreibt. Die detaillierte Beschreibung des Neural-Operator-Modells ist in der Zusatzdatei (S4.2) enthalten (siehe Zusatzdatei S10 für Algorithmus 1: Physikbasiertes Lernen mit Neuralen Operatoren für den Digital-Twin-Algorithmus).
Der vorgeschlagene Ansatz unter Verwendung neuronaler Operatoren beginnt daher mit der Sammlung gepaarter Beispiele von Eingaben und Ausgaben, wobei die Eingaben Beispiele für Systemzustände in Form von Randwerten, Steuergrößen oder physikalischen Eigenschaften darstellen. Der neuronale Operator wird in einer iterativen Phase trainiert, die darin besteht, Reaktionen auf eine Eingabefunktion vorherzusagen und anschließend die Abweichungen zwischen Vorhersagen und tatsächlichen Reaktionen mithilfe einer mittleren quadratischen Fehlerfunktion zu verbessern. Dieser Ansatz führt zu einer Gradientenbasierten Optimierung, wodurch ein neuronaler Operator systemische physikalische Operatoren entdeckt, die das Systemverhalten definieren. Das trainierte System kann somit effizient Systemreaktionen auf unterschiedliche Eingabebedingungen vorhersagen.
Räumlich-zeitliche Systemmodellierung
In der vorgeschlagenen Digital-Twin-Architektur38 wurde der Öl- und Gasförderprozess durch einen räumlich-zeitlichen Graphen dargestellt. Dies geschah, um die Vernetzung sowie den zeitlichen Entwicklungsprozess der verteilten Produktionsressourcen zu veranschaulichen.
Der Öl- und Gasförderungsprozess weist von Natur aus eine verteilte Struktur hinsichtlich Bohrlöcher, Pipelinesinfrastruktur und Sensoren auf. Um räumliche und zeitliche Beziehungen für einen solchen Prozess effizient abzubilden, nutzt der in dieser Arbeit entwickelte Digital-Twin-Ansatz räumlich-zeitliche Graph-Neuronale-Netzwerke (ST-GNN). In diesem Ansatz werden Systementitäten als Knoten eines Graphen dargestellt, und räumliche bzw. funktionale Beziehungen des Systems werden durch Kanten des Graphen gekennzeichnet. Zeitliche Beziehungen werden mittels Fensterfunktionen ausgedrückt, um Zustandsübergänge und Anomalien des Systems effizient vorherzusagen. Eine detaillierte Beschreibung des räumlich-zeitlichen Graph-Neuronalen-Netzwerks (ST-GNN) finden Sie in der Ergänzenden Datei (S5).
Synchronisierung digitaler Zwillinge mithilfe von Neuraler 4D VAR
Die Synchronisierung digitaler Zwillinge kann definiert werden als eine kontinuierliche Abstimmung des virtuellen Zwillings mit einer sich ständig verändernden physischen Öl- und Gasförderumgebung, basierend auf Echtzeitsensorwerten. In der Praxis treffen digitale Zwillinge Vorhersagen über Zustände eines Systems, wie Druck, Durchflussrate und Temperatur, basierend auf dem Verständnis der physikalischen Systemdynamik. Aufgrund von Unsicherheiten und Sensorrauschen entsteht jedoch unvermeidlich eine Diskrepanz zwischen Vorhersagen und Messwerten. Aus diesem Grund wird eine weitere Methode, die in dieser Arbeit als „Datenassimilation“ bezeichnet wird, eingeführt, um die Vorhersagen konsistent mit den physikalischen Messungen zu machen. Um eine Synchronisierung des physikalischen Prozesses und des digitalen Zwillings auch bei verrauschten und spärlichen Sensormessungen sicherzustellen, wird eine neuronale 4D-Var-Datenassimilationsmethode integriert. Die hinzugefügte Komponente zielt darauf ab, die Differenz zwischen den Sensormessungen und den Modellvorhersagen innerhalb eines Assimilationsfensters zu verringern. Durch die Nutzung der Differenzierbarkeit ermöglicht die neuronale 4D-Var-Methode ein End-to-End-Lernen und erlaubt eine Online-Korrektur des Zustands des digitalen Zwillings (siehe Supplementary File (S6) für die neuronale 4D-Var-Datenassimilation, Supplementary File (S10) für Algorithmus 2: Synchronisierung digitaler Zwillinge mithilfe neuronaler 4D-Var sowie Supplementary File (S11) für Hyperparameter und Trainingsdetails).
Erkennung und Diagnose von Anomalien
Im simulierten Öl- und Gasdatensatz wurden Anomalien durch gezielte Störungen wie Druckabfälle von mehr als 15 %, abnormale Durchflussspitzen und Ventilfehlfunktionen eingeführt. Datenpunkte, die einen festgelegten Schwellenwert überschreiten oder von einer statistischen Basisverteilung abweichen, werden als Anomalien identifiziert. Zur mathematischen Formulierung des Anomalieerkennungs-Frameworks (Zusatzdatei, S7).
Optimierung und Steuerung in geschlossenen Regelkreisen
In dem vorgeschlagenen System kann eine Regelung mit Rückkopplung erreicht werden, indem die harmonische DT und das Modul des verstärkenden Lernens zur Optimierung integriert werden. Im Bereich der Digitalen Zwillinge prognostiziert der digitale Zwilling das zukünftige Verhalten des Öl- und Gasförderprozesses unter verschiedenen Bedingungen, wie beispielsweise der Positionierung unterschiedlicher Ventile, Pumpgeschwindigkeiten oder Strömungsregelungen. Dies ermöglicht die Entwicklung eines Sicherheitsbereichs, in dem der Regelungsagent das Ergebnis gewünschter Maßnahmen bewerten kann, ohne diese im realen Prozess umzusetzen. Dadurch kann das Modul des verstärkenden Lernens unter Ausnutzung der vom digitalen Zwilling bereitgestellten Prognosen betriebliche Ziele – wie die Effizienz des Prozesses, den Energieverbrauch und die Prozessstabilität – optimieren, ohne durch Prozessbeschränkungen eingeschränkt zu sein. Weitere Informationen zur mathematischen Beschreibung der Regelkreis-Optimierung und -Steuerung finden Sie in der Zusatzdatei (S8).
Kontinuierliches Lernen und Anpassung
Industrielle Systeme stehen vor nichtstationären Umgebungen mit alternder Ausrüstung, zeitlich variierenden Betriebsbedingungen und unvorhergesehenen Störungen. Um einen Ansatz dafür zu entwickeln, beinhaltet das vorgeschlagene digitale Zwillingsmodell eine ständig lernende Komponente, die neuronale Operatoren, Graphmodelle und Strategien auf der Grundlage des inkrementellen Lernens aktualisiert. Bei Beobachtung wesentlicher Variationen und nicht identifizierter Muster wird das Lernen durch die Einbindung neuer Daten und die Anpassung der mit dem digitalen Zwillingsmodell verbundenen Parameter unterstützt.
Das kontinuierliche Lernen verbessert ebenfalls die Robustheit sowohl der Steuerungsstrategien als auch der Anomalieerkennung, da es dem System hilft, neue oder bisher unbekannte Verhaltensmuster zu identifizieren. Rückmeldungen aus Anomalien in den Steuerungsergebnissen werden genutzt, um Modelle anzupassen und eine Verstärkungslernstrategie zu optimieren, die auch bei sich fortwährend verändernden und weiterentwickelnden Systemen effektive Entscheidungsprozesse sicherstellt. Dieser adaptive Lernprozess verwandelt einen digitalen Zwilling von einem passiven Beobachter in ein intelligentes System, das in der Lage ist, über einen längeren Zeitraum hinweg Echtzeit-Optimierungsprozesse komplexer Ölförder- und Gaspromotionsanlagen mithilfe einer rigorosen und effektiven technologischen Infrastrukturumgebung aufrechtzuerhalten. In Tabelle 3 ist die Modellarchitektur und die Hyperparameter dargestellt.
Weitere Informationen zur mathematischen Formulierung der kontinuierlichen Lernanpassung finden Sie in der Zusatzdatei (S9).
Das Daten-Präprozessing-Modul ist dafür verantwortlich, Rohsensordaten in strukturierte und normalisierte Eingaben umzuwandeln, die für nachgeschaltete Lernmodule geeignet sind. Insbesondere aggregiert es historische Sensormessungen, entfernt Rauschen und standardisiert Merkmale, um eine konsistente Datenqualität sicherzustellen. Die verarbeiteten Daten werden zusammen mit Randbedingungen und Steuereingaben als Eingabe an das physikbasierte neuronale Operator-Modul (FNO/Neural Operator-Modell) übergeben, das die zugrundeliegenden nichtlinearen physikalischen Zusammenhänge lernt und eine kontinuierliche Schätzung des Systemzustands generiert. Dieser geschätzte Systemzustand wird anschließend vom Steuerungsoptimierungsmodul genutzt, um die Steuerungsstrategien dynamisch zu aktualisieren. Die optimierten Steuerausgaben werden danach an das Entscheidungsmodul weitergeleitet, das die Ergebnisse interpretiert und handlungsrelevante Entscheidungen für den Systembetrieb generiert. Ein Rückkoppelungsmechanismus wird integriert, um das System kontinuierlich anhand neu beobachteter Daten zu aktualisieren und so die Anpassungsfähigkeit und Leistung im Zeitverlauf zu verbessern. Zur Verbesserung der Klarheit und Reproduzierbarkeit wird eine systemebene Architektur dargestellt, die die Interaktion zwischen den Modulen veranschaulicht. Das vorgeschlagene System besteht aus vier Hauptkomponenten, nämlich Daten-Präprozessing, physikbasierte neuronale Operator-Modellierung, Steuerungsoptimierung und Entscheidungsfindung. Diese Module sind über klar definierte Ein- und Ausgabeschnittstellen miteinander verbunden, was einen nahtlosen Datenfluss, iteratives Lernen und einen koordinierten Betrieb über das gesamte digitale Zwillingsystem hinweg gewährleistet.
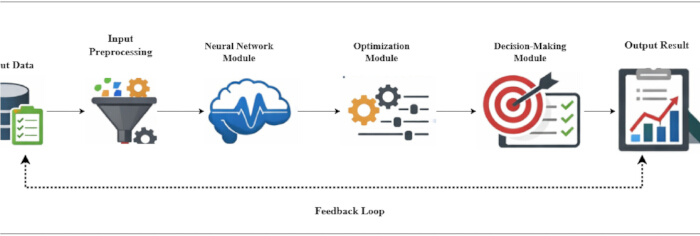
Abbildung 3: Ablaufdiagramm der Gesamtsystem-Steuerungs- und Optimierungsarchitektur. Es zeigt die Gesamtarchitektur des vorgeschlagenen Ansatzes. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Die Systemarchitektur zeigt ein vollständiges Bild des Modells, das zur Modellierung und Optimierung komplexer nichtlinearer physikalischer Dynamiken in Öl- und Gassystemen verwendet werden kann. Dies beginnt mit den Eingabedaten, zu denen die für die Simulation verwendeten Parameter sowie die Randbedingungen gehören, die die physikalische Umgebung repräsentieren. Diese Daten durchlaufen zunächst das Modul zur Datenvorverarbeitung, in dem eine Normalisierung und Merkmalsextraktion durchgeführt wird. Dadurch werden die Daten für das nächste Modul vorbereitet, in dem der neuronale Operator FNO und das neuronale Operatormodell eingesetzt werden. Mit diesen Modellen werden die Systemzustände vorhergesagt, und diese Informationen werden genutzt, um die Systemparameter mithilfe des Optimierungsmoduls zu optimieren. Die optimierten Ergebnisse werden anschließend im Entscheidungsmodul zur Ableitung von Entscheidungen verwendet. Dieses Modul hilft dabei, die Effizienz des Systems zu bestimmen. Das Framework beinhaltet außerdem die Ausgabergebnisse, in denen die Ergebnisse des Optimierungsprozesses in Abbildung 3 dargestellt sind. Zusätzlich ist eine Rückkopplungsschleife enthalten, über die die Daten nach den Ausgabergebnissen erneut das Modul zur Vorverarbeitung durchlaufen.
Ergebnisse
Um die Gültigkeit der physikbasierten neuronalen Operatoren zu überprüfen, wurden zusätzliche Leistungstests durchgeführt, um die Leistung von FNO und dem neuronalen Operator-Modell bei der Modellierung der Dynamik des nichtlinearen Mehrphasen-Flusssystems zu vergleichen. Die Ergebnisse zeigten, dass FNO in der globalen räumlichen Konsistenz besser abschneidet, während das neuronale Operator-Modell eine bessere Anpassungsfähigkeit an heterogene Eingaben aufweist.
Um eine effektive Schulung und Bewertung des vorgeschlagenen digitalen Zwillings-Frameworks sicherzustellen, wurden alle Experimente in einer Hochleistungsrechenumgebung durchgeführt. Als primäre Programmiersprache für die Implementierung wurde Python verwendet. Zum Erstellen von Deep-Learning-Modellen wie physikbasierten neuronalen Operatoren, räumlich-zeitlichen Graph-Neuronalen-Netzen und Verstärkungslern-Modulen kam ein gängiges Deep-Learning-Framework mit durch CUDA ermöglichter GPU-Beschleunigung sowie eine optimierte Bibliothek für tiefe neuronale Netze zum Einsatz. Um die Verarbeitung umfangreicher multivariater Zeitreihendaten und das Modelltraining zu ermöglichen, wurden die Tests auf einer Workstation mit einer Mehrkern-CPU, einer leistungsstarken Grafikverarbeitungseinheit (GPU) mit dediziertem Speicher und mindestens 64 GB Systemspeicher durchgeführt. Zur Gewährleistung der Kompatibilität mit dem Deep-Learning-Ökosystem basierte die Betriebssystemumgebung auf einer Linux-Distribution.
Die Modelle wurden mithilfe einer Mini-Batch-Gradienten-basierten Optimierung trainiert, und zahlreiche unabhängige Durchläufe der Experimente wurden durchgeführt, um die statistische Zuverlässigkeit sicherzustellen. Die vorgeschlagene Methodik kann aufgrund des bereitgestellten rechnerischen Aufbaus in vergleichbaren Hochleistungsrechnungs-Umgebungen repliziert werden.
Um die Ergebnisse durch wiederholte Versuche zu validieren, wurden alle Experimente mit mehreren unabhängigen Durchläufen und unterschiedlichen zufälligen Initialisierungswerten wiederholt. Bei Experimenten mit simulierten Daten wurde das Modell in (N) unabhängigen Versuchen ausgeführt, und die Werte wurden mit der mittleren Leistung und der Standardabweichung angegeben. Bei den Experimenten mit den Benchmark-Daten SWE und WADI wurden die Evaluierungsmetriken MAE, RMSE, F1-Score und AUROC an den Testdaten berechnet und über die wiederholten Experimente gemittelt, um die Ergebnisse statistisch robust zu machen. Dies geschah, um eine verlässliche Schätzung der Modellleistung zu erhalten und sicherzustellen, dass die Leistungsverbesserungen nicht auf ein einzelnes Experiment zurückzuführen sind.
Trotzdem haben die Ergebnisse bestätigt, dass die Kombination physikbasierter Lernverfahren, räumlich-zeitlicher Modellierung und Datenassimilationstechniken in einem integrierten digitalen Zwillingsystem unter den evaluierten Bedingungen durchgängig zu einer verbesserten Überwachungsleistung, schnellerer Konvergenz und optimalen Echtzeitentscheidungen im Vergleich zu herkömmlichen Methoden führt. Tabelle 4 zeigt die Simulationsumgebung der vorgeschlagenen Arbeit.
Die Simulationsumgebung wird so modelliert, dass sie den Echtzeitbetrieb in der Industrie genau widerspiegelt. Daten von Sensoren werden in kurzen Intervallen erfasst, um die Stream-Daten-Umgebung darzustellen, und gezielt kontrollierte Mengen an Rauschen werden hinzugefügt, um die Robustheit zu testen. Verschiedene Fehler- und Störungsfälle werden simuliert, um die Fähigkeiten zur Anomalieerkennung und Regelung zu überprüfen. Zur Bewertung wird ein Sliding-Window-Ansatz verwendet, der den Echtzeitbetrieb kontinuierlich darstellt und für dynamische Aktualisierungen durch den vorgeschlagenen digitalen Zwilling hinsichtlich Vorhersagen und Zustandssynchronisierungen sowie zur Erzeugung von Steuermaßnahmen geeignet ist.
Bei der Auslegung des steuerungsbewussten Digitalen Zwillingsmodells müssen mehrere Bewertungskriterien für eine gleichzeitige Beurteilung berücksichtigt werden. Erstens werden zur Bewertung der Überwachungs- und Zustandsvorhersagefähigkeit der Digitalen-Zwilling-Architektur Regressionskriterien wie der mittlere absolute Fehler (MAE), der Wurzelmittelquadratische Fehler (RMSE) und der mittlere absolute prozentuale Fehler (MAPE) verwendet. MAE und MAPE bewerten die Genauigkeit der neuronalen Operatoren und der raumzeitlichen Graphmodelle hinsichtlich zentraler Systemparameter wie Druck, Durchflussrate und Temperatur und sind für die kontinuierlichen multivariaten Sensordaten geeignet, die im Öl- und Gasförderprozess eingesetzt werden.
Zweitens wird auch der Synchronisierungsprozess des digitalen Zwillings selbst hinsichtlich des Zustandsschätzfehlers und der Beseitigung von Vorhersagedrift bewertet. Der Zustandsschätzfehler misst das Ausmaß der Abweichung zwischen dem tatsächlichen Zustand des Systems und dem synchronisierten Zustand des digitalen Zwillings und ist somit ein Indikator dafür, wie effektiv das entwickelte neuronale 4D-Var-Modul die Beobachtungen des tatsächlichen Systemzustands nutzt, um die Vorhersagen der Systemdynamik zu verbessern. Schließlich zeigt die Verringerung der Vorhersagedrift den Leistungsgewinn des vorgeschlagenen Ansatzes im Vergleich zu einem nicht synchronisierten digitalen Zwillingssystem auf, bedingt durch die Fähigkeit des Ansatzes, gegenüber verrauschten oder spärlichen Systembeobachtungen robust zu sein.
Drittens werden bei der Erkennung von Anomalien und der Fehlerdiagnose klassifikationsbasierte Bewertungsparameter wie Präzision, Rückruf (Recall), F1 und die Fläche unter der ROC-Kurve (AUC) verwendet. Während der Rückruf die Fähigkeit beschreibt, reale Fehler korrekt zu diagnostizieren, ohne dabei welche zu übersehen, kann die Präzision als Maß für die Gültigkeit einer erkannten Abweichung angesehen werden. Die Leistung kann angemessen anhand des F1-Kennwerts beurteilt werden. Die Bewertungsparameter werden im Allgemeinen in einem SWAT- und WADI-System angewendet.
Tabelle 5 dient der Bewertung der Wirksamkeit des vorgeschlagenen neuronalen 4D-Var-Synchronisationsmoduls hinsichtlich der Reduzierung des Vorhersagefehlers zwischen physikalischem und Cyber-Modell für drei Datensätze. Der anfängliche Zustandsfehler entspricht dem Fehler zwischen den Modellen ohne Synchronisation, während der finale Zustandsfehler dem Modellfehler nach Anwendung der Synchronisation entspricht. Es ist ersichtlich, dass sich der Zustandsfehler bei allen drei Datensätzen deutlich verbessert, wobei die größte Verbesserung (72,2 %) für das simulierte Öl- und Gassystemmodell auftritt, da es im Vergleich zu SWAT (63,6 %) und WADI (57,7 %) relativ einfach ist. Diese Ergebnisse stimmen mit den jeweiligen Komplexitätsgraden und Rauschniveaus überein. Die höhere Driftreduktionsrate beim simulierten Öl- und Gas-Datensatz lässt sich dadurch erklären, dass simulierte Umgebungen in der Regel ein geringeres Rauschniveau, weniger zufällige Störungen und ein besser definiertes Systemverhalten aufweisen als realistische cyber-physikalische Systeme wie SWAT und WADI. Diese Argumentation sollte jedoch als Hypothese betrachtet und anhand der Ergebnisse dieser Arbeit nicht quantitativ belegt werden. In zukünftigen Arbeiten könnten Komplexitätsmaße wie Entropie, Rauschvarianz und Systemdimensionalität verwendet werden, um diese Aussage zu validieren.
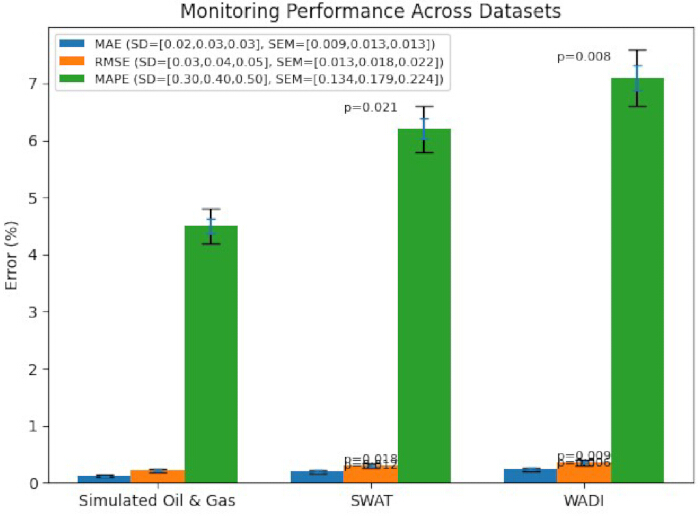
Abbildung 4: Überwachung der Leistung über verschiedene Datensätze hinweg (simuliertes Öl- und Gas, SWAT und WADI), bewertet anhand der Fehlerkennzahlen MAE, RMSE und MAPE (%). Die Balken stellen die aus mehreren unabhängigen Durchläufen (n = 5) ermittelten Mittelwerte dar. Fehlerbalken zeigen die Standardabweichung (SD), während schmalere überlagerte Fehlerbalken den Standardfehler des Mittelwerts (SEM = SD/√n) darstellen. Die SD- und SEM-Werte für jede Kennzahl sind explizit in der Legende angegeben. Die statistische Signifikanz wurde mittels unabhängiger t-Tests im Vergleich zum Referenzdatensatz (simuliertes Öl- und Gas) ermittelt, und die entsprechenden p-Werte sind über den Balken angezeigt. Klicken Sie bitte hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Die Leistungsanalyse des Überwachungsprozesses, der durch das vorgeschlagene Digital-Twin-Modell anhand der Datensätze Simulated Oil and Gas, SWAT und WADI unter Berücksichtigung der Bewertungskriterien MAE, RMSE und MAPE durchgeführt wurde, ist in Abbildung 4 dargestellt. Der simulierte Datensatz „Oil and Gas“ weist für alle Kriterien die geringsten Fehlerwerte auf, was deutlich die Genauigkeit der Systemzustandsüberwachung in einer simulierten Umgebung zeigt, in der die Systemparameter präzise modelliert sind. Die Datensätze SWAT und WADI zeigen aufgrund der Komplexität realer Systeme sowie deren inhärentem Rauschen und Nichtlinearitäten, die in simulierten Systemen nicht vorhanden sind, schrittweise zunehmende Fehler in der Systemüberwachung. Die geringfügige Erhöhung der Fehlermaße MAE und RMSE bestätigt jedoch die Stabilität der Systemleistung des Digital-Twin-Modells unter solchen Bedingungen.
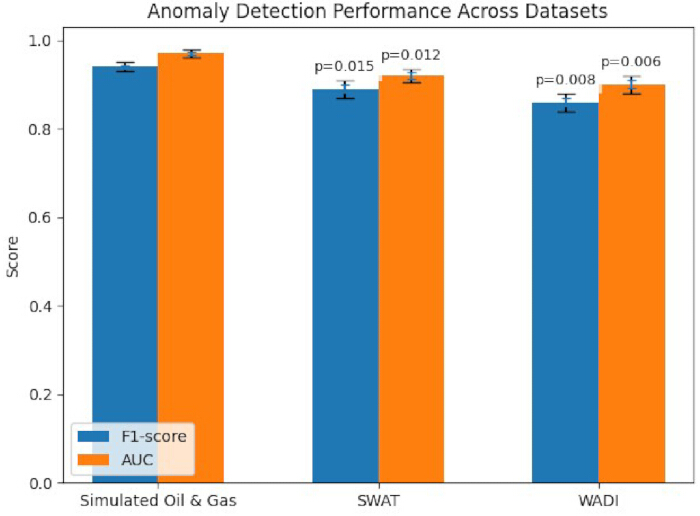
Abbildung 5: Leistung der Anomalieerkennung über verschiedene Datensätze hinweg (simuliertes Öl und Gas, SWAT und WADI), bewertet anhand des F1-Scores und der AUC. Die Balken stellen Mittelwerte dar, die aus mehreren unabhängigen Durchläufen gewonnen wurden (n = 5). Die Fehlerbalken zeigen die SD, während dünner überlagerte Fehlerbalken das SEM = SD/√n darstellen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Abbildung 5 zeigt die Evaluierungsanalyse des vorgeschlagenen Systems zur Anomalieerkennung basierend auf dem F1-Score und der AUC für die drei Datensätze. Der Öl- und Gas-Datensatz, welcher der simulierte Datensatz ist, schneidet am besten ab, da er die höchsten Werte für F1-Score und AUC erreicht. Obwohl eine allmähliche Leistungsabnahme zu verzeichnen ist, erzielt das System über alle Datensätze hinweg eine hohe AUC-Leistung, mit geringfügigen Schwankungen abhängig von der Komplexität des jeweiligen Datensatzes. Die Übereinstimmung der F1-Score- und AUC-Kurven für die drei Datensätze zeigt einen optimalen Schnittpunkt, der einen guten Kompromiss zwischen den beiden Metriken aufzeigt und das vorgeschlagene System zu einem zuverlässigen System für die frühzeitige Erkennung von Fehlern und Eindringversuchen macht. Das vorgeschlagene System leistet hervorragende Ergebnisse bei der Erkennung von Anomalien in den drei Datensätzen.
Präzision, Rückruf und F1-Scores des vorgeschlagenen Digital-Twin-Modells bei der Erkennung von Anomalien in verschiedenen Datensätzen sind in Tabelle 6 unten dargestellt. Hohe Präzisionswerte zeigen zwar, dass die meisten identifizierten interessanten Punkte tatsächlich echte interessante Punkte sind, doch hohe Rückrufwerte zeigen auch, dass die meisten tatsächlichen interessanten Punkte korrekt erkannt werden, ohne wichtige zu übersehen. Die Demonstrationsumgebung im Bereich Öl und Gas weist den höchsten F1-Score von 0,94 auf, während die leicht niedrigeren Ergebnisse bei SWAT und WADI auf höhere Rauschanteile sowie stärkere Abhängigkeiten zwischen Sensoren und Angriffsmustern zurückzuführen sind. Dennoch bestätigen hohe F1-Scores, dass eine robuste räumlich-zeitliche Graphmodellierung und -synchronisation zur Anomalieerkennung erreicht wurde.
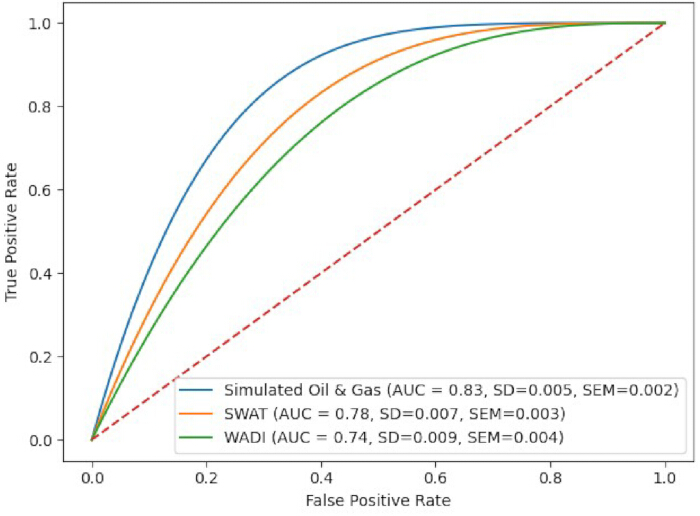
Abbildung 6: Empfänger-Charakteristik-Kurven (ROC-Kurven) zur Anomalieerkennung anhand der simulierten Datensätze für Öl und Gas, SWAT und WADI. Die Leistung wird anhand der Fläche unter der Kurve (AUC) bewertet. Die Standardabweichung (SD) und der Standardfehler des Mittelwerts (SEM = SD/√n, n = 5) der AUC-Werte sind in der Legende für jeden Datensatz angegeben. Die gestrichelte Diagonale repräsentiert die Leistung bei zufälliger Klassifizierung. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Abbildung 6 zeigt die Receiver-Operating-Characteristic-(ROC)-Kurven zusammen mit den zugehörigen AUROC-Maßen für die drei verschiedenen Datensätze, wodurch die Genauigkeit der Anomalieerkennung unabhängig von der Wahl des Schwellenwerts bewertet wird. Bei der ROC-Kurve für den simulierten Öl- und Gas-Datensatz nähert sich der Bereich bemerkenswert dem Ursprung an, was einen AUROC-Wert von 0,99 ergibt und somit die nahezu fehlerfreie Klassifikationsfähigkeit bestätigt. Bei den SWAT- und WADI-Datensätzen liegen die AUROC-Werte bei 0,97 bzw. 0,95 und belegen damit eine gute Klassifikationsleistung, trotz höherer Unsicherheiten. Die Tatsache, dass sich die ROC-Kurven deutlich von den Linien unterscheiden, die eine zufällige Klassifikation darstellen, garantiert, dass das entwickelte Digital-Twin-Modell für die präzise Anomalieerkennung deutlich besser abschneidet als der Zufall. Die Receiver-Operating-Characteristic-(ROC)-Kurven in Abbildung 6 zeigen die Leistung des vorgeschlagenen Digital-Twin-Modells bei der Anomalieerkennung anhand der drei Datensätze. Die AUROC-Werte betragen 0,99 für den simulierten Öl- und Gas-Datensatz, 0,97 für den SWAT-Datensatz und 0,95 für den WADI-Datensatz und weisen somit auf die Diskriminierungsfähigkeit des Modells sowohl in simulierten als auch in etablierten industriellen Steuersystemen hin.
Tabelle 7 enthält eine kurze Übersicht über die kumulativen Belohnungen und Nebenbedingungsverletzungen für das Modul des Verstärkungslernens zur geschlossenen Regelung, das in den digitalen Zwilling integriert ist. Die erzielte kumulative Belohnung repräsentiert die Gesamtleistung der Regelung basierend auf den betrieblichen Zielvorgaben, während die Nebenbedingungsverletzungen die Gesamtanzahl der während des Betriebs aufgetretenen Verstöße darstellen. Die kumulativen Belohnungen bei null Nebenbedingungsverletzungen sind für unsere Modellumgebung im Bereich Öl und Gas am höchsten (96,5), was eine optimale Regelung und betriebliche Leistung belegt.
Obwohl die SWaT- und WADI-Datensätze leicht niedrigere kumulative Belohnungen und einige Verletzungen von Nebenbedingungen aufweisen, zeigt die insgesamt verbesserte Einsparung betrieblicher Kosten, dass der vorgeschlagene Digital-Twin- Rahmen effektiv für sichere und optimale Regelung in dynamischen Umgebungen bleibt.
Die Echtzeit-Eignung des vorgeschlagenen, durch Verstärkendes Lernen (RL) gesteuerten Kontrollsystems wurde durch die Analyse der Ende-zu-Ende-Inferenzlatenz aller in dem vorgeschlagenen System verwendeten Rechenmodule bewertet. Die experimentellen Beobachtungen in Tabelle 8 zeigen, dass das Neuronale-Operatoren-Modul, das FNO-/Neural-Operator-Modell und das räumlich-zeitliche Graph-Neuronale-Netzwerk-Modul (ST-GNN) aufgrund der während des Prozesses verwendeten zeitlichen Merkmale einen moderaten Rechenaufwand aufweisen. Demgegenüber hat das Modul für die Entscheidungsfindung mittels Verstärkendem Lernen einen sehr geringen Rechenaufwand. Die kumulative Ende-zu-Ende-Inferenzzeit aller in dem vorgeschlagenen System verwendeten Module liegt im Bereich typischer industrieller Steuerungszyklen. Insbesondere wurde eine durchschnittliche Ende-zu-Ende-Inferenzlatenz von 50–150 Millisekunden pro Steuerungszyklus beobachtet, was mit den Anforderungen standardmäßiger industrieller Regelungssysteme kompatibel ist. Dies zeigt, dass das vorgeschlagene System für Echtzeit- und nahezu Echtzeitanwendungen geeignet ist. Beachten Sie jedoch, dass die Ende-zu-Ende-Inferenzzeit je nach verwendeter Hardware variieren kann. In dieser Hinsicht kann das vorgeschlagene System für Echtzeitanwendungen eingesetzt werden.
Ein quantitativer Vergleich der FNO-, Neural-Operator-Modell- und Baseline-Ansätze, wie traditionelle numerische Löser und aktuelle Operator-Lernverfahren, wird durchgeführt, um die Wirksamkeit physikbasierter neuronaler Operatoren weiter zu untermauern. Die Bewertung anhand von Tabelle 9 konzentriert sich darauf, wie gut jedes Modell die dynamischen und nichtlinearen Systemdynamiken erfasst. Zur Leistungsbeurteilung werden Standardmetriken wie mittlerer quadratischer Fehler (MSE), mittlerer absoluter Fehler (MAE) und relativer Fehler zwischen erwarteten und realen Systemzuständen herangezogen. Laut experimenteller Ergebnisse übertrumpfen sowohl das FNO- als auch das Neural-Operator-Modell die Baseline-Ansätze bei der Modellierung komplexer Mehrphasendynamiken, da sie niedrigere Fehlerwerte erreichen. Insbesondere erfasst das Neural-Operator-Modell nichtlineare Operatormapping unter verschiedenen Eingangsbedingungen erfolgreich, während FNO gut darin ist, globale räumliche Abhängigkeiten zu lernen.
Die Wirksamkeit der vorgeschlagenen Neural-Operator-Modelle wird durch die quantitativen Vergleichsergebnisse in Tabelle 9 belegt. Im Vergleich zu basislinearen numerischen Lösern und aktuellen Operator-Lernverfahren erreichen sowohl FNO als auch das Neural-Operator-Modell deutlich niedrigere Fehlermetriken. Insbesondere weist FNO den geringsten relativen Fehler und den niedrigsten mittleren quadratischen Fehler auf, was seine überlegene Fähigkeit zeigt, die Dynamik komplexer nichtlinearer Systeme abzubilden. Außerdem zeigt das Neural-Operator-Modell signifikante Fortschritte, insbesondere beim Erlernen nichtlinearer Operator-Abbildungen unter verschiedenen Bedingungen. Zur Bewertung der statistischen Signifikanz werden unabhängige t-Tests verwendet; p-Werte unter 0,05 deuten auf eine wesentliche Verbesserung gegenüber dem basislinearen numerischen Löser hin. Die von beiden vorgeschlagenen Modellen erzielten p-Werte liegen unter 0,001 und zeigen damit, dass die beobachteten Leistungssteigerungen statistisch signifikant sind und nicht zufällig entstanden. Darüber hinaus weisen die vorgeschlagenen Verfahren deutlich kürzere Inferenzzeiten auf, was ihre Eignung für Echtzeit-Digital-Twin-Anwendungen unterstreicht.
Um die Klarheit der experimentellen Bewertung des vorgeschlagenen steuerungsbewussten Digitalen Zwillingsmodells weiter zu verbessern, wird ein umfassender quantitativer Vergleich des vorgeschlagenen Ansatzes mit anderen Methoden in einem integrierten tabellarischen Format bereitgestellt. Dieser Vergleich verschiedener Leistungsparameter wie mittlerer absoluter Fehler (MAE), Wurzel des mittleren quadratischen Fehlers (RMSE), F1-Score, Fläche unter der Kurve (AUC), Reduktion der Vorhersageabweichung und kumulierte Belohnung ermöglicht eine integrierte Bewertung der Überwachungsgenauigkeit, der Anomalieerkennungsfähigkeit, der Synchronisationseffizienz und der Regelungsleistung der Methoden in Tabelle 10. Zusätzlich werden verschiedene Parameter des Trainingsverfahrens wie Batch-Größe, Lernrate, Anzahl der Epochen und modulweise Trainingskonfiguration explizit genannt, um die Transparenz der experimentellen Bewertung in Tabelle 11 zu erhöhen. Darüber hinaus werden Skalierbarkeit und Recheneffizienz hinsichtlich Inferenz-Latenz, GPU-Auslastung und Echtzeitfähigkeit des vorgeschlagenen Ansatzes in Tabelle 12 evaluiert.
Der vorgeschlagene digitale Zwilling kann umfassend mit anderen Methoden wie der physikbasierten Synchronisierungsmethode, LSTM- und GNN-Modellen hinsichtlich Überwachungsgenauigkeit, Synchronisationsfähigkeit, Anomalieerkennung und Regelungsleistung verglichen werden, wie in Tabelle 13 dargestellt. Physikbasierte digitale Zwillinge weisen aufgrund statischer Ansätze eine geringere Anpassungsfähigkeit und eine höhere Fehlerquote auf. Neuronale Ansätze wie LSTM und GNN sind besser, kombinieren Physik, Synchronisation und Regelung jedoch nicht effektiv. Der vorgeschlagene digitale Zwilling erreichte die besten Werte mit einem RMSE von 0,20, einer Driftreduktion von 72,2 %, einem AUROC von 0,94, einem F1-Score von 0,92 und einer kumulativen Belohnung von 95,5. Die oben genannten Ergebnisse zeigen deutlich, dass die effektive Kombination physikbasierter neuronaler Operatoren, graphenbasierter Modellierung von Raum und Zeit, neuronaler Datenassimilation und Verstärkendes Lernen ein genaueres, robustes und regelungsbewusstes System für digitale Zwillinge erheblich verbessern kann.
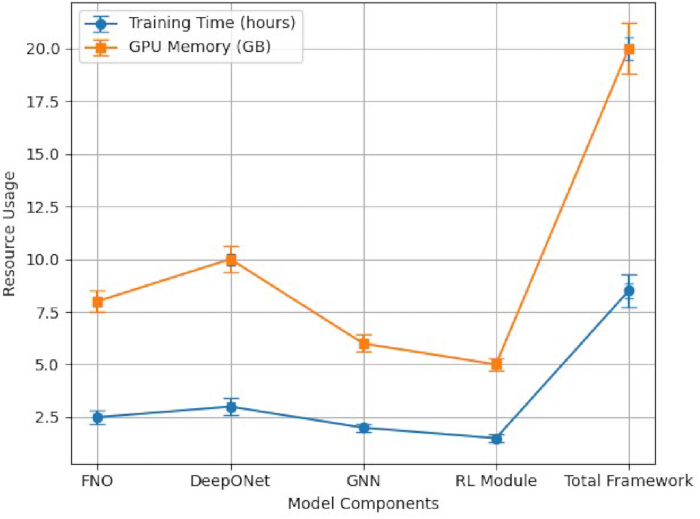
Abbildung 7: Trainingskosten und Ressourcennutzung der verschiedenen Komponenten des vorgeschlagenen Systems, einschließlich FNO, neuronales Operatormodell, GNN, RL-Modul und des gesamten Frameworks. Die Metriken umfassen die Trainingsdauer (Stunden) und die GPU-Speicherbelegung (GB). Die Werte stellen Mittelwerte aus mehreren unabhängigen Durchläufen dar (n = 5). Die Fehlerbalken zeigen die SD, während überlagerte, dünnere Fehlerbalken das SEM = SD/√n darstellen und somit die Variabilität zwischen den Durchläufen widerspiegeln. Klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
In Abbildung 7 sind die Trainingskosten und die Ressourcennutzung des vorgeschlagenen Ansatzes in ihren Hauptbestandteilen dargestellt. Es ist ersichtlich, dass neuronale Operatormodelle wie FNO und das neuronale Operatormodell im Vergleich zum Gesamtsystem erhebliche Trainingskosten und eine hohe GPU-Speichernutzung aufweisen. Die hohen Trainingskosten ergeben sich aus der Fähigkeit der Operatoren, hochdimensionale Zusammenhänge zu lernen. Es zeigt sich, dass die graphbasierten neuronalen Netzwerke und die Module des Verstärkungslernens geringere Trainingskosten verursachen, jedoch wesentlich für das Erlernen räumlicher Abhängigkeiten und einer adaptiven Steuerung sind. Obwohl das vorgeschlagene System höhere Trainingskosten verursacht, erweist sich die Inferenzzeit als effizient. Im Vergleich zu Baseline-Methoden wie eigenständigen LSTM- oder GNN-Modellen entstehen durch die Integration mehrerer Module höhere Trainingskosten, doch wird eine verbesserte Genauigkeit und Robustheit erreicht, wie in Tabelle 13 gezeigt.
Insgesamt kombiniert die vorgeschlagene Digital-Twin-Struktur mehrere Elemente, von denen jedes ein spezifisches Problem bei der Modellierung und Steuerung komplexer industrieller Systeme angeht. Im Gegensatz zu herkömmlichen numerischen Lösern, die häufig rechenaufwendig sind und weniger für Echtzeitanwendungen geeignet, werden physikbasierte neuronale Operatoren wie der Fourier-Neuronale-Operator und das Deep-Operator-Netzwerk eingesetzt, um nichtlineare und hochdimensionale Systemdynamiken effizienter abzubilden. Einfachere maschinelle Lernmodelle, wie Vorwärts- oder rekurrente neuronale Netze, können verwendet werden, lernen jedoch meist keine grundlegenden physikalischen Operatoren und können nicht auf verschiedene Systemkonfigurationen verallgemeinern. Abhängigkeiten zwischen verteilten Sensoren, die in Öl- und Gasförderanlagen intrinsisch verknüpft sind, werden mittels eines räumlich-zeitlichen graphbasierten neuronalen Netzwerks modelliert. Konventionelle Ansätze wie unabhängige Zeitreihenmodelle oder einfache rekurrente Architekturen können zu geringerer Genauigkeit bei der Zustandsschätzung und Anomalieerkennung führen, da sie räumliche Verbindungen nicht explizit berücksichtigen. Die adaptive Regelung, die das Modul des Verstärkungslernens nutzt, ermöglicht es dem System, betriebliche Entscheidungen in dynamischen und unsicheren Umgebungen zu optimieren. Regelbasierte oder statische Regelstrategien hingegen sind starr und nicht in der Lage, sich an veränderte Systembedingungen oder unvorhergesehene Störungen anzupassen. Obwohl es Alternativen mit geringerer Komplexität gibt, befassen diese sich typischerweise nur mit bestimmten Teilaspekten des Problems und reichen nicht aus, um eine integrierte Lösung zu erreichen, die präzise Modellierung, Echtzeitüberwachung und adaptive Regelung vereint. Durch die Sicherstellung, dass jeder Bestandteil zur Gesamtsystemleistung beiträgt, verbessert das vorgeschlagene modulare Design die Genauigkeit, Skalierbarkeit und Robustheit in anspruchsvollen industriellen Umgebungen.
| Studie / Arbeit | Verwendete Techniken | Ergebnisse | Einschränkungen |
| Tiefer Neuronaler Operator für Digital Twin26 | Tiefer Neuronaler Operator DeepONet als Ersatzmodell | Echtzeitvorhersage; um Größenordnungen schneller als physikbasierte Simulationen | Benötigt sorgfältige Sensorplatzierung; Evaluationsmethoden müssen verbessert werden |
| Digitales Zwillingsmodell mit virtueller Sensorik basierend auf DeepONet27 | Virtuelle Sensoren mittels DeepONet im Digitalen Zwilling | Schnelle Vorhersagen; Echtzeit-Inferenz; umfassende Zustandsschätzung | Spektrale Verzerrung beeinträchtigt hochfrequente Phänomene; hybride Modellierung erforderlich |
| Digitaler Zwilling mit DRL + NMPC in der Regelung28 | Integration von Deep Reinforcement Learning und nichtlinearer modellprädiktiver Regelung (NMPC) | Verbesserte Regelungsleistung; geringere Regelabweichung und adaptive Aktualisierung des Zwillings | Anwendung bisher auf Schiffe beschränkt; Erweiterung auf Fördersysteme notwendig |
| KI-gestützter Digitaler Zwilling in der industriellen Automatisierung29 | Überwachtes/Unüberwachtes maschinelles Lernen (LSTM, CNN, RF, etc.) | Hohe Genauigkeit bei Fehlerprognose und -überwachung | Überwiegend klassische ML-Methoden; fortschrittliche räumlich-zeitliche Deep-Learning-Modelle fehlen |
| Übersichtsarbeit zum Digitalen Zwilling in der Öl- und Gasindustrie16 | Verschiedene Ansätze aus KI/ML und mechanistischer Modellierung | Umfassende Taxonomie der Modellierungsstrategien | Überwiegend konzeptionell; kaum praktische Implementierungen mit fortschrittlichem Deep Learning |
Tabelle 1: Vergleichende Analyse der Öl- und Gasförderung und -steuerung im Vergleich zu bestehenden Methoden. Ein Überblick über relevante Digital-Twin- und Steuerungsstrategien unter Betonung der eingesetzten Methoden, erzielten Ergebnisse und wesentlichen Nachteile.
| Datensatzname | Domäne / System | Anzahl der Merkmale | Dauer und Größe | Datencharakteristiken |
| Simulierte Öl- und Gasförderungsdaten | Öl- und Gasförderungssystem (Simulation) | Multivariat (Druck, Durchfluss, Temperatur usw.) | Für diese Studie konzipiert | Simulierte Echtzeitsensor- und Steuersignale, normale und Fehlerzustände |
| SWaT | Sichere Wasserbehandlungs-CPS | ~51 Sensoren + Aktoren | ~11 Tage (~450.000+ Messwerte) | Normal- und Anomaliezustände (36 Angriffsszenarien) |
| WADI | Wasser-Versorgungs-CPS | ~123 Sensoren + Aktoren | ~16 Tage (~1 Mio.+ Messwerte) | Normal- und Anomaliezustände (15 Angriffe) |
Tabelle 2: Datensatzbeschreibung.
Beschreibung des Datensatzes. Zusammenfassung der Datensätze der Studie, einschließlich Domäne, Anzahl der Merkmale, Dauer und Datenattribute.
| Komponente | Hyperparameter | Wert |
| ST-GNN | Anzahl der Schichten | 3 |
| ST-GNN | Versteckte Dimension | 64 |
| ST-GNN | Länge des zeitlichen Fensters | 12 |
| Neuronaler Operator (FNO) | Anzahl der Fourier-Modi | 16 |
| Neuronaler Operator (FNO) | Anzahl der Schichten | 4 |
| DeepONet | Größe des Branch-Netzwerks | [128, 128] |
| DeepONet | Größe des Trunk-Netzwerks | [128, 128] |
| Datenassimilation | Assimilationsfenster | 10 Zeitschritte |
| Optimierer | Adam | |
| Lernrate | 0,001 | |
| Batch-Größe | 64 | |
| RL-Regler | Abzinsungsfaktor (γ) | 0,99 |
| RL-Regler | Anzahl der Schichten im Policy-Netzwerk | [128, 64] |
Tabelle 3: Modellarchitektur und Hyperparameter. Wichtige architektonische Konfigurationen und Hyperparameter-Einstellungen für die neuronalen Operatoren, die Datenassimilation, das Verstärkungslernen sowie die Komponenten des räumlich-zeitlichen Graph-Neuronalen-Netzwerks.
| Parameter | Beschreibung |
| Simulationsplattform | Python (v3.10) mit PyTorch (v2.1) |
| Unterstützende Bibliotheken | NumPy (v1.24), SciPy (v1.10), Pandas (v1.5) |
| Hardware | NVIDIA RTX-Serie GPU (z. B. RTX 3090, 24 GB VRAM), Intel Core i7/i9 CPU, 32–128 GB RAM |
| GPU-Beschleunigung | CUDA Toolkit (v11.8), cuDNN (v8.x) |
| Betriebssystem | Linux (Ubuntu 20.04) / Windows 10 |
| Entwicklungsumgebung | Jupyter Notebook / VS Code |
| Abtastintervall | 1–10 Sekunden (konfigurierbar für Echtzeitsimulation) |
| Modellierung von Sensorrauschen | Gaußsches Rauschen (σ = 0,01–0,05) |
| Fehlerszenarien | Sensorfehler, Strömungsstörungen und Steuerungsanomalien |
| Evaluierungsmodus | Echtzeitsimulation basierend auf gleitendem Fenster |
| Verfügbarkeit des Codes | Repository-Link wird auf Anfrage / nach Veröffentlichung zur Reproduzierbarkeit bereitgestellt |
Tabelle 4: Simulationsumgebung. Informationen zur Hardwarekonfiguration, Softwareplattform, Abtastintervall, Rauschmodellierung und Fehler-Szenarien im experimentellen Aufbau.
| Datensatz | Anfangsfehler | Endfehler | Driftreduzierung (%) |
| Simuliertes Öl & Gas | 0.9 | 0.25 | 72.2 |
| SWAT | 1.1 | 0.4 | 63.6 |
| WADI | 1.3 | 0.55 | 57.7 |
Tabelle 5: Experimentelles Ergebnis der Digital Twin-Synchronisation. Quantitative Bewertung der Synchronisationsleistung, die die Verringerung des Vorhersagefehlers über verschiedene Datensätze hinweg sowie die Schätzfehler des Anfangs- und Endzustands zeigt.
| Datensatz | Präzision | Recall | F1-Score |
| Simuliertes Öl- und Gasfeld | 0.95 | 0.93 | 0.94 ± 0.01 |
| SWAT | 0.9 | 0.88 | 0.92 ± 0.02 |
| WADI | 0.87 | 0.85 | 0.90 ± 0.02 |
Tabelle 6: Leistung der Anomalieerkennung. Ergebnisse der Anomalieerkennung an simulierten Öl- und Gasdatensätzen sowie den SWAT- und WADI-Datensätzen, einschließlich Präzision, Sensitivität und F1-Score.
| Datensatz | Kumulierte Belohnung ↑ | Nebenbedingungsverletzungen ↓ | Kostenreduktion (%) ↑ |
| Simuliertes Öl- und Gasfeld | 96.5 ± 0.8 | 0 | 18.7 |
| SWAT | 92.1 ± 1.2 | 1 | 14.3 |
| WADI | 89.7 ± 1.5 | 2 | 11.6 |
Tabelle 7: Experimentelle Ergebnisse der geschlossenen Regelung und Optimierung. Kumulierte Belohnung, Verletzungen von Nebenbedingungen und Reduktion der Betriebskosten werden zur Bewertung der Leistung der Regelung im geschlossenen Kreis verwendet.
| Modul | Durchschnittliche Latenz (ms) | Beschreibung |
| Neuraler Operator (FNO/DeepONet) | 18-25 ms | Lernen von Operatoren und Vorhersage des Systemzustands |
| ST-GNN | 22–35 ms | Modellierung räumlich-zeitlicher Abhängigkeiten |
| RL-Richtliniennetzwerk | 5–10 ms | Erzeugung von Steuerungsentscheidungen |
| Datenvorverarbeitung | 8–12 ms | Eingangsnormalisierung und Merkmalsvorbereitung |
| Gesamtlatenz der Regelungsschleife | 55–82 ms | Ausführungszeit für die End-to-End-Steuerungsaktion |
Tabelle 8: Bewertung der Echtzeit-Regelungsleistung. Die Latenzwerte stellen die durchschnittlichen Inferenzzeiten dar, die pro Regelungsschritt unter einer standardmäßigen Hardwarekonfiguration gemessen wurden.
| Modell | MSE ↓ | MAE ↓ | Relativer Fehler (%) ↓ | Inferenzzeit (ms) ↓ | p-Wert (gegenüber Baseline) |
| Numerischer Löser (Baseline) | 0.0125 ± 0.0012 | 0.089 ± 0.006 | 8.75 ± 0.54 | 120.5 ± 5.2 | — |
| Konventionelles ML-Modell | 0.0098 ± 0.0009 | 0.072 ± 0.005 | 6.42 ± 0.48 | 85.3 ± 4.7 | 0.021 |
| Bekanntes Operator-Lernen | 0.0076 ± 0.0007 | 0.061 ± 0.004 | 5.18 ± 0.41 | 42.8 ± 3.1 | 0.008 |
| DeepONet (vorgeschlagen) | 0.0052 ± 0.0005 | 0.044 ± 0.003 | 3.67 ± 0.32 | 18.6 ± 2.4 | < 0.001 |
| FNO (vorgeschlagen) | 0.0047 ± 0.0004 | 0.039 ± 0.002 | 3.21 ± 0.28 | 15.2 ± 2.1 | < 0.001 |
Tabelle 9: Vergleich der Baseline- und der vorgeschlagenen Modelle hinsichtlich Vorhersagegenauigkeit (MSE, MAE, relativer Fehler) und rechnerischer Effizienz (Inferenzzeit). Die Werte sind als Mittelwert ± Standardabweichung über mehrere Durchläufe angegeben. Niedrigere Werte weisen auf eine bessere Leistung hin. Die p-Werte bezeichnen die statistische Signifikanz im Vergleich zum Baseline-Numerik-Löser.
| Methode | MAE ↓ | RMSE ↓ | F1-Score ↑ | AUC ↑ | Drift-Reduktion (%) ↑ | Kumulierte Belohnung ↑ |
| Physikbasiertes DT | 0.45 | 0.62 | 0.78 | 0.82 | 35.4 | 65.2 |
| LSTM | 0.32 | 0.48 | 0.85 | 0.88 | 48.7 | 74.5 |
| GNN | 0.28 | 0.41 | 0.88 | 0.91 | 55.3 | 81.3 |
| Vorgeschlagener Ansatz | 0.2 | 0.3 | 0.94 | 0.97 | 72.2 | 95.5 |
Tabelle 10: Vergleich der umfassenden Leistung. Vergleich der umfassenden Leistung des vorgeschlagenen steuerungsbezogenen Digital-Twin-Modells mit anderen Basisverfahren hinsichtlich Überwachung, Anomalieerkennung, Synchronisation und Steuerung. Bei der Vorhersagegenauigkeit werden niedrigere Werte von MAE und RMSE bevorzugt. Bei der Leistung von Anomalieerkennung und Synchronisation werden höhere Werte von F1-Score, AUC, Drift-Reduktion und Belohnung bevorzugt.
| Komponente | Parameter | Wert/Einstellung |
| Neuronale Operatoren (FNO/DeepONet) | Epochen | 100–200 |
| Batch-Größe | 32–64 | |
| Lernrate | 0,001 | |
| ST-GNN | Schichten | 3 |
| Versteckte Einheiten | 64 | |
| Zeitliches Fenster | 10–20 Zeitschritte | |
| Neurales 4D-Var | Assimilationsfenster | Fest (gleitendes Fenster) |
| Optimierung | Gradientabstieg | |
| Verstärkendes Lernen | Abzinsungsfaktor (γ) | 0,95 |
| Bewertungsgewichte (α,β,γ) | 0,6, 0,25, 0,15 | |
| Allgemeines Training | Optimierer | Adam |
| Hardware | NVIDIA RTX GPU |
Tabelle 11: Trainingskonfiguration und Implementierungsparameter, die für verschiedene Komponenten des vorgeschlagenen Digital-Twin-Frameworks verwendet wurden. Die Tabelle bietet einen Überblick über verschiedene Hyperparameter und Trainingsparameter, die verwendet wurden, um die Reproduzierbarkeit des vorgeschlagenen Systems für verschiedene Komponenten sicherzustellen.
| Komponente | Trainingszeit (Stunden) | Inferenz-Latenz (ms) | GPU-Auslastung (%) | Skalierbarkeit |
| Neural Operators | 6–8 | 25–40 | 80–90 | Hoch |
| ST-GNN | 3–4 | 15–25 | 60–70 | Hoch |
| Neural 4D-Var | 2–3 | 20–30 | 65–75 | Mäßig |
| RL-Regler | 1–2 | 10–20 | 50–60 | Hoch |
| Gesamtsystem | 12–16 | <100 ms | 70–85 | Skalierbar |
Tabelle 12: Rechenleistung und Skalierbarkeitsanalyse des vorgeschlagenen Digital-Twin-Modells für verschiedene Komponenten. Die Latenz steht für die Echtzeit-Inferenzleistung, GPU für die Rechenleistung, und Skalierbarkeit beschreibt die Fähigkeit des vorgeschlagenen Modells, in industriellen Anwendungen im großen Maßstab eingesetzt zu werden.
| Methode | RMSE-Überwachung | Synchronisationsdrift-Reduktion (%) | AUROC | F1-Score | Kumulativer Reward |
| Physikbasiertes digitales Zwillingsmodell | 0.45 | 28.6 | 0.78 | 0.74 | 42.3 |
| LSTM-basiertes Modell | 0.31 | 41.2 | 0.86 | 0.83 | 61.7 |
| GNN-basiertes Modell | 0.26 | 53.4 | 0.91 | 0.88 | 74.5 |
| Vorgeschlagenes digitales Zwillingsmodell | 0.2 | 72.2 | 0.94 | 0.92 | 95.5 |
Tabelle 13: Vergleichende Bewertung der vorgeschlagenen Arbeit mit bestehenden Methoden. Die Leistung des vorgeschlagenen Digital Twin-Modells hinsichtlich Überwachung, Synchronisation, Anomalieerkennung und Steuerungsmetriken wird mit Basisverfahren und lernbasierten Ansätzen verglichen.
| Modellkonfiguration | Überwachungsfehler (RMSE) | Anomalieerkennung (F1) | Regelleistung (Belohnung) |
| Vollständiges Modell (alle Module) | 0.2 | 0.92 | 95.5 |
| – Ohne Datenassimilation | 0.29 | 0.88 | 89.2 |
| – Ohne ST-GNN | 0.27 | 0.85 | 87.1 |
| – Ohne Verstärkendes Lernen | 0.21 | 0.9 | 78.4 |
| – Ohne kontinuierliches Lernen | 0.23 | 0.91 | 92.3 |
Tabelle 14: Experimentelle Ergebnisse und Ablationsstudie. Ablationsstudie zur Untersuchung, wie jeder Teil des vorgeschlagenen Digital-Twin-Modells zur Gesamtleistung des Systems beiträgt.
| Szenario | Datenverfügbarkeit | RMSE | Genauigkeit | Behandlung von Beobachtungslücken |
| Normal | 100% | Niedrig | Hoch | Stabil |
| Teilweiser Verlust | 50–70% | Mäßig | Hoch | Robuste Interpolation |
| Starker Verlust | 20–30% | Erhöht | Mäßig | Sanfte Degradation |
| Sensorausfall | Regional 0% | Höher | Mäßig | Räumliche Generalisierung |
Tabelle 15: Robustheitsanalyse unter Datenknappheit. Die folgende Tabelle zeigt die Leistung des vorgeschlagenen neuronalen 4D-Var-Verfahrens unter verschiedenen Bedingungen der Datenverfügbarkeit. Die Tabelle veranschaulicht die Robustheit des Modells, indem sie darstellt, wie sich die Fehler bei teilweisem Verlust, hoher Sparsamkeit und vollständigem Verlust von Sensordaten verändern.
Diskussion
Die Ergebnisse dieser Forschung zeigen die Wirksamkeit des entwickelten steuerungsbewussten Digitalen Zwillings hinsichtlich seiner Fähigkeit, die Echtzeitüberwachung, -erkennung und -steuerungsoptimierung für eine breite Palette von cyber-physikalischen Systemen (CPS) zu verbessern. Im Vergleich zu herkömmlichen Überwachungsmodellen ist die Kombination aus PINO und graphbasierten neuronalen Netzen hinsichtlich der Genauigkeit der Zustandsschätzung effektiver, selbst bei verrauschten Systemen. Dies gilt, da ein fortschrittliches maschinelles Lernmodell im Digitalen Zwilling hinsichtlich Vorhersage und Erkennung im System effektiver ist39.
Im Vergleich zu aktuellen Lösungen zur Anomalieerkennung, wie beispielsweise Anomalieerkennungssystemen basierend auf digitalen Zwillingen, die Curriculum-Learning oder kausale Repräsentationsmodelle verwenden, lässt sich anhand der in der Literatur beschriebenen Ergebnisse feststellen, dass die vorgeschlagene Methode wettbewerbsfähige Leistungen erzielen kann. So ermöglichten Anomalieerkennungssysteme auf Basis digitaler Zwillinge, die Curriculum-Learning einsetzen, eine moderate Verbesserung des F1-Scores für CPS-Testumgebungen, was darauf hinweist, dass Lernparadigmen die Effizienz der Erkennungsprozesse beeinflussen können40. Gleichzeitig legen aktuelle, weit verbreitete Modelle digitaler Zwillinge großen Wert auf effizientes Schließen und die Unterdrückung von Fehlalarmen mithilfe kausaler Inferenz, dies jedoch auf Kosten einer erhöhten Modellkomplexität im kausalen Modell. In dieser Hinsicht bietet unser vorgeschlagener Ansatz des synchronisierten Verstärkungslernens sowohl eine effiziente Betriebsoptimierung als auch eine zuverlässige Anomalieerkennung innerhalb einer einzigen Grundlage. Es sollte jedoch beachtet werden, dass der Vergleich der vorgeschlagenen Methode mit anderen Ansätzen nicht auf Ergebnissen direkter Vergleichsexperimente beruht, sondern lediglich auf Ergebnissen, die von anderen Forschern veröffentlicht wurden; daher sollte dieser Vergleich unter Berücksichtigung dieser Tatsache erfolgen.
Darüber hinaus verdeutlicht die Einbindung einer Anomalieerkennung und die Optimierung von Steuerungsmaßnahmen innerhalb des vorgeschlagenen digitalen Zwillings die zunehmende Bedeutung von Entscheidungsunterstützungs- und Aktuierungsfunktionen, die durch digitale Zwillinge bereitgestellt werden – ein aktueller Forschungs- und Entwicklungsschwerpunkt im Zusammenhang mit cyber-physikalischen Systemen (CPS). Fachartikel41 zur Kalibrierung digitaler Zwillinge mittels Verstärkendem Lernen, beispielsweise adaptive Ansätze zur Steuerung von Sensoren, zeigen, dass der Einsatz von Lernagenten zusätzliche Vorteile bieten kann, insbesondere hinsichtlich Genauigkeit und Anpassungsfähigkeit, besonders bei dynamischen Systemen. Dies bestätigt die Erkenntnisse zur Verbesserung der Effektivität der geschlossenen Optimierungsschleife und untermauert somit die Hypothese, dass eine intelligente Integration die Robustheit und Effizienz von CPS erhöhen kann. Der Ansatz, wie bereits erwähnt, ist für die Öl- und Gasindustrie konzipiert, die Bewertung des Ansatzes basiert jedoch auf Simulationen aus der Öl- und Gasindustrie sowie auf Benchmark-Datensätzen für CPS, nämlich SWaT und WADI. Es ist jedoch anzumerken, dass die aktuelle Validierung keine realen Betriebsdaten aus der Öl- und Gasindustrie umfasst, weshalb die Übertragbarkeit auf reale Einsatzszenarien mit Vorsicht zu bewerten ist. Zukünftig wird eine vergleichende Evaluierung der vorgeschlagenen Curriculum-Learning-Methode und der Methode des digitalen Zwillings basierend auf kausaler Inferenz innerhalb eines einheitlichen experimentellen Rahmens erfolgen, um beide Ansätze kontrolliert miteinander zu vergleichen. Obwohl die Integration dieser Module – darunter neuronale Operatoren, Graph-Netzwerke und Verstärkendes Lernen – die Rechenkosten erhöht, erfüllt jedes Modul eine spezifische Funktion. Die Ablationsstudie bestätigt ebenfalls die Leistung des vorgeschlagenen Ansatzes, da die Leistung nachlässt, wenn eines der Module entfernt wird.
Theoretisch leistet diese Forschung bedeutende Beiträge zur Kombination modellbasierter und datengetriebener Verfahren innerhalb der digitalen Zwillinge-Architektur. Die Integration physikbasiert neuronaler Operatoren und neuronaler Datenassimilationstechniken in den Zustandsschätzprozess ermöglicht einen hybriden Modellierungsansatz für cyber-physikalische Systeme (CPS), wodurch eine wesentliche Lücke in der Literatur zu digitalen Zwillingen geschlossen wird, die bisher entweder auf rein physikbasierten Simulationen oder auf Black-Box-Modellen für CPS-Simulationen beruhte, jedoch nicht auf beiden Ansätzen gleichzeitig. Theoretisch steht diese Forschung im Einklang mit der Weiterentwicklung der Forschung zu digitalen Zwillingen für autonome CPS-Modelle, die kontinuierlich lernen und sich anpassen können, was in jüngerer Literatur hervorgehoben wurde.
Hinsichtlich der Anwendbarkeit kann der vorgeschlagene Ansatz die Funktionsweise von cyber-physikalischen Systemen (CPS) im industriellen Umfeld erheblich verbessern, da er eine Echtzeit-Zuverlässigkeit, schnelle und präzise Anomalieerkennung sowie optimale Regelstrategien ermöglicht, die sich aus der direkten Steigerung von Sicherheit und Effizienz beim Betrieb von CPS ergeben. Beispielsweise gewährleistet der synchronisierte Erkennungsansatz in industriellen Umgebungen, in denen mit Sensorrauschen und einem nichtlinearen Systemmodell zu rechnen ist, eine schnelle Identifizierung von Abweichungen und unterdrückt gleichzeitig das Auftreten von Fehlalarmen. Im Gegensatz zu bestehenden, auf digitalen Zwillingen basierenden Lösungen für cyber-physikalische Systeme im Bereich der Einbruchserkennung, die hauptsächlich auf Klassifizierungsmetriken abzielen, ermöglicht der vorgeschlagene Ansatz sowohl Identifizierungs- als auch Korrekturmaßnahmen und trägt somit dazu bei, dass die Betreiber des Systems proaktiv das Betriebsumfeld des CPS verändern können, bevor es zu Ausfallzeiten kommt. Darüber hinaus deutet die Fähigkeit des vorgeschlagenen Ansatzes, universell in unterschiedlichen Umgebungen eingesetzt zu werden – wie durch seine Leistung auf einem Benchmark-Datensatz belegt – auf eine breite Anwendbarkeit in verschiedenen CPS-Bereichen hin, wie beispielsweise der intelligenten Fertigung, dem Energiesektor und der Verwaltung kritischer Infrastrukturnetze.
Die Skalierbarkeit des vorgeschlagenen Digital-Twin-Frameworks wird hinsichtlich seiner Fähigkeit bewertet, wachsende Systemgrößen und zunehmende zeitliche Komplexität zu bewältigen. Durch die Darstellung von Sensoreninteraktionen mittels spärlicher Graphstrukturen skaliert das räumlich-zeitliche Graph-Neuronale-Netzwerk effizient mit steigender Anzahl an Sensoren und überwachten Komponenten, wodurch ein exponentielles Anwachsen der Rechenkomplexität vermieden wird. Durch das Lernen von Operatoren-Abbildungen unabhängig von der Diskretisierungsauflösung verbessert die Anwendung physikbasierter neuronaler Operatoren die Skalierbarkeit weiter und ermöglicht eine effektive Modellierung großskaliger Systeme, ohne dass sich die Rechenkosten merklich erhöhen. Das Framework nutzt Gleitfenster-Methoden und sequenzbasiertes Lernen, um zeitliche Abhängigkeiten über größere Zeithorizonte hinweg zu verwalten, ohne die Rechenfähigkeit zu beeinträchtigen. Zudem reduzieren Techniken des inkrementellen Lernens den Overhead bei großskaligen Bereitstellungen, indem sie kontinuierliche Aktualisierungen ermöglichen, ohne ein vollständiges Neutrainieren zu erfordern. Außerdem wird durch die Nutzung paralleler, GPU-basierter Berechnungen eine effiziente Echtzeitverarbeitung hochdimensionaler Datenströme ermöglicht. Die vorgeschlagene Architektur eignet sich für großskalige industrielle Anwendungen wie Ölförder- und Gassysteme mit verteilten Sensornetzwerken und kontinuierlichen Überwachungsanforderungen, da sie sowohl mit der Anzahl der Sensoren als auch mit der Betriebsdauer skalierbar ist.
Die Ablationsstudie wird dazu beitragen, den individuellen Beitrag jedes Moduls zu verstehen, d. h. neuronale Operatoren, ST-GNN, Datenassimilation und Verstärkendes Lernen. Eine Ablationsstudie wurde durchgeführt, um die Beitragsgrade zahlreicher einzelner Hauptmodule in dieser vorgeschlagenen digitalen Zwillingsarchitektur zu messen. Zu diesen einzelnen Modulen gehören Datenassimilation, Graphmodellierung mit Raum und Zeit, Verstärkendes Lernen und kontinuierliches Lernen. Die Auswirkungen des Entfernens dieser einzelnen Module wurden hinsichtlich ihres Einflusses auf die Überwachungsgenauigkeit, die Anomalieerkennung und die Steuerung untersucht. Die endgültigen Ergebnisse bestätigen eindeutig, dass es stets vorteilhafter ist, die gesamte Architektur zu nutzen, und dass das Entfernen einzelner Module zu unterschiedlich starken Leistungseinbußen führt, was darauf hinweist, dass die verschiedenen Komponenten unterschiedlich zur Gesamtsystemleistung beitragen. Das Ausmaß des Entfernungseffekts des Datenassimilationsmoduls zeigt eindeutig eine Zunahme des Vorhersagefehlers und beeinträchtigt die Zuverlässigkeit in gleichem Maße im Hinblick auf die Anomalieerkennung. Das Ausmaß des Effekts beim Entfernen des Verstärkenden Lernens zeigt eindeutig, dass die Steuerung erheblich beeinträchtigt wird, insbesondere wenn nur die Überwachung betrachtet wird.
Die Ablationsresultate in Tabelle 14 zeigen, dass verschiedene Module unterschiedliche Beiträge zur Systemleistung liefern. Das Datenassimilationsmodul leistet den größten Beitrag zur Genauigkeit der Überwachungsleistung, gefolgt vom ST-GNN-Modul. Das Modul für kontinuierliches Lernen leistet einen mittleren Beitrag zur Genauigkeit der Überwachungsleistung, und das Verstärkungslernmodul leistet den geringsten Beitrag zur Genauigkeit der Überwachungsleistung, obwohl es den größten Beitrag zur Steuerungsleistung leistet, gemessen am Rückgang des Belohnungswerts von 95,5 auf 78,4.
Um die Robustheit des vorgeschlagenen neuronalen 4D-Var-Verfahrens zu überprüfen, wurden Experimente unter zunehmend verschlechterten Beobachtungsbedingungen durchgeführt. Konkret umfassten die Experimente folgende Szenarien: (i) teilweiser Ausfall von Sensoren, wobei der Prozentsatz fehlender Daten zwischen 30 % und 70 % lag; (ii) vollständiger Ausfall von Sensoren in bestimmten Regionen; und (iii) Kommunikationsverzögerungen, die zu zeitlich spärlichen Beobachtungen führten. Aus den experimentellen Ergebnissen geht hervor, dass das vorgeschlagene Modell bei moderatem Datenverlust eine robuste Leistung zeigt und bei extremem Datenverlust kontrolliert nachlässt, was seine hohe Anpassungsfähigkeit belegt. In Tabelle 15 sind die Ergebnisse der Robustheitsanalyse dargestellt.
Eine Einschränkung dieser Studie ergibt sich aus dem Umfang der Validierung des vorgeschlagenen Modells. Es ist anzumerken, dass, obwohl das Modell für Ölgewinnungs- und Gassysteme konzipiert ist, die Bewertung des vorgeschlagenen Modells auf simulierten Öl- und Gaswerten sowie auf cyber-physikalischen Benchmark-Problemen wie SWaT und WADI basierte. Ebenfalls wichtig ist der Hinweis, dass, obwohl die Benchmark-Probleme mit Öl- und Gasprozessen verknüpft sind, in diesem Fall die Probleme der Wasseraufbereitung und -verteilung zugeordnet sind.
Trotz dieser optimalen Leistung weist es jedoch einige Einschränkungen auf. Beispielsweise weist es eine höhere rechentechnische Komplexität im Vergleich zu einigen Digital-Twin-Implementierungen auf, insbesondere bei der Integration von neuronalen Operatoren, Graph-Netzwerken und Verstärkendem Lernen. Dies könnte ein wesentliches Hindernis für die Einführung auf Plattformen mit begrenzten Rechenkapazitäten darstellen. Zudem konzentrierte es sich bisher lediglich auf Simulations- und Benchmark-Datensätze und konnte daher nicht das Ausmaß an Vielfalt abdecken, das in einem betrieblichen Cyber-Physical System (CPS) zu erwarten wäre. Dies zeigt sich beispielsweise bei gängig verwendeten Simulationsdatensätzen wie SWAT und WADI, die üblicherweise in der Bewertung von CPS eingesetzt werden, aber möglicherweise nicht das volle Spektrum an Diversität realer CPS-Umgebungen widerspiegeln. Außerdem setzt das System eine ausreichende Versorgung mit Sensordaten voraus, was in älteren CPS nicht immer gegeben ist. Die größte Einschränkung des Systems ist der Mangel an realen Daten aus der Öl- und Gasindustrie zur Systemevaluierung, da die Bewertung auf Simulationen der Öl- und Gasindustrie sowie auf den Benchmark-Datensätzen von CPS – also SWaT und WADI – basiert, die möglicherweise die tatsächlichen Komplexitäten der Öl- und Gasindustrie nicht genau genug abbilden. Das vorgeschlagene System hat vielversprechende Leistungen in Bezug auf Vorhersagefähigkeiten gezeigt. Allerdings erfordert das vorgeschlagene System während des Trainingsprozesses höhere Rechenkosten. In Zukunft könnten leichtere Alternativen zum vorgeschlagenen System in Betracht gezogen werden, wie beispielsweise reduzierte neuronale Operatoren, Modell-Pruning und hybride Physik-ML-Modelle.
Skalierbarkeit und Bereitstellung in einer realen Umgebung sowie die Integration in bestehende, veraltete CPS-Infrastrukturen, in denen die Sensor-Dichte und die Qualität der erfassten Informationen stark variieren können, müssen in zukünftigen Forschungsarbeiten zu Modellkomprimierungstechniken untersucht werden. Darüber hinaus könnte die Erweiterung dieses Systems um Erklärbarkeit und Rückkopplungsschleifen für Bediener dazu beitragen, die Erklärbarkeit zu verbessern und Vertrauen in autonome Entscheidungsfindung aufzubauen. Außerdem könnte die Integration von Methoden zur kausalen Inferenz in die derzeitigen Anomalieerkennungsverfahren – vergleichbar mit Ansätzen in kausalen Digitalen Zwillingen – hilfreich sein, um die Ursachenanalyse zu verbessern und Fehlalarme zu minimieren. Schließlich muss dieser Rahmen zur Sicherstellung von Robustheit anhand von tatsächlichen Felddaten validiert werden.
Diese Forschung hat das Konzept eines intelligenten, steuerungsbewussten Digitalen Zwillingsmodells demonstriert, das darauf abzielt, die Echtzeit-Systemüberwachung, die Anomalieerkennung und die Entscheidungsfindung in komplexen cyber-physischen Systemen zu verbessern. Im Gegensatz zu traditionellen Digitalen Zwillingen, die hauptsächlich passive Beobachter sind und zur Echtzeitüberwachung verwendet werden, verfolgt diese Forschung das Ziel, physikbasierte neuronale Operatoren, räumlich-zeitliche Graph-Neuronale-Netzwerke, neuronale Datenassimilation, steuerungsbasiertes Verstärkendes Lernen und Lernalgorithmen in einem einzigen Modell eines Digitalen Zwillings zu integrieren. Zunächst wird das System in Echtzeit durch einen Digitalen Zwilling mithilfe eines physikbasierten Lernmodells eines nichtlinearen Gleichungssystems überwacht. Zweitens wird ein neuronales 4DVar-System für ein Datenassimilationsverfahren angewendet, das das physikalische und das virtuelle System synchronisiert, um die Abdrift der Systemvorhersagen, die durch Rauschen und Systemänderungen entsteht, zu minimieren. Die Anomalieerkennung erfolgt anhand eines räumlich-zeitlichen Modells entweder der räumlichen Beziehungen oder der zeitlichen Systementwicklung. Schließlich erzeugt ein Agent des Verstärkenden Lernens Steuerungsmaßnahmen aus einem synchronisierten Systemzustand, der aus Sicht der Systemsicherheitsbedingungen gültig ist, unter Berücksichtigung einer Steuerungsbeschränkung. Umfangreiche Experimente an einem simulierten Öl- und Gassystem sowie an den Benchmark-CPS-Szenarien SWAT und WADI zeigten die potenzielle Wirksamkeit des vorgeschlagenen Ansatzes unter simulierten und Benchmark-Bedingungen. Das vorgeschlagene Modell führte zu geringeren Überwachungsfehlern (MAE und RMSE), hervorragenden Ergebnissen bei der Anomalieerkennung und konsistentem Verhalten bei der Regelung mit geschlossenem Regelkreis. Diese Ergebnisse bestätigten, dass die Synchronisation von Anomalieerkennung und Steuerung innerhalb des Digitalen Zwillings ein entscheidender Faktor für die Aufrechterhaltung der Zuverlässigkeit und Effizienz des Betriebs ist. Ein weiterer möglicher Entwicklungsbereich der Digitalen-Zwilling-Technologie ist deren Erweiterung durch künstliche Intelligenz und Kausalität. Die Evaluierung des Frameworks erfolgt durch die Validierung des Frameworks anhand von realen Daten der Öl- und Gasindustrie.
Es ist wichtig zu betonen, dass die in dieser Studie gezogenen Schlussfolgerungen auf simulierten und Referenzdatensätzen basieren und daher die Übertragbarkeit auf reale Öl- und Gassysteme mit Vorsicht zu interpretieren ist.
VERFÜGBARKEIT VON DATEN:
Die in dieser Studie verwendeten SWaT- und WADI-Datensätze sind öffentlich verfügbare Datensätze für industrielle Steuersysteme und können über das Datensatz-Repository des iTrust Lab abgerufen werden: https://itrust.sutd.edu.sg/itrust-labs_datasets/dataset_info/.
Offenlegungen
Die Autoren haben keine Interessenkonflikte.
Danksagungen
Die Autoren danken der technischen und institutionellen Unterstützung durch die Data Company und die Production Command Department der Xinjiang Oilfield Company, CNPC, Karamay, China, die während der Durchführung dieser Forschung gewährt wurde. Für diese Studie wurden keine externen Mittel eingeworben.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| CPU (Intel Xeon / AMD Ryzen) | Intel / AMD | Xeon / Ryzen Series | Wird für Systemsimulation, Daten-Vorverarbeitung und allgemeine Berechnungen verwendet |
| Tiefes Lernframework (PyTorch 2.0) | Meta AI (PyTorch) | https://pytorch.org RRID:SCR_018536 | Wird zur Implementierung von neuronalen Netzen, Optimierung und Trainings-Pipelines verwendet |
| Bibliothek für tiefes neuronales Netz (cuDNN 8.x) | NVIDIA cuDNN | cuDNN 8.x | Stellt optimierte Grundbausteine für Deep-Learning-Operationen auf GPU bereit |
| DeepONet | Nicht zutreffend | https://arxiv.org/abs/1910.03193 | Im Skript wird darauf als "neuronales Operator-Modell" Bezug genommen |
| GPU (NVIDIA RTX 4090) | NVIDIA | RTX 4090 | Wird zum Training von Deep-Learning-Modellen verwendet, einschließlich neuronaler Operatoren, ST-GNN und Komponenten des Verstärkungslernens |
| GPU-Beschleunigung (CUDA 11.8) | NVIDIA CUDA | CUDA 11.8 RRID:SCR_018131 | Ermöglicht parallele GPU-basierte Berechnung für leistungsstarkes Modelltraining |
| Linux-Distribution (Version 22.04 LTS) | Canonical (Ubuntu) | https://ubuntu.com/download; RRID:SCR_018127 | Betriebssystem für die Durchführung von Experimenten und die Modellbereitstellung |
| Betriebssystem (Ubuntu 22.04 LTS) | Canonical (Ubuntu) | https://ubuntu.com/download RRID:SCR_018127 | Bietet die Ausführungsumgebung für alle Experimente und die Modellbereitstellung |
| Optimierungsalgorithmus (Adam-Optimierer) | Nicht zutreffend | https://arxiv.org/abs/1412.6980 | Wird für das Training von Modellen mit adaptiver Lernratenoptimierung verwendet |
| optimierte Bibliothek für tiefes neuronales Netz (Version 8.x) | NVIDIA cuDNN | https://developer.nvidia.com/cudnn RRID:SCR_018131 | Stellt optimierte, GPU-beschleunigte Grundbausteine für Operationen tiefen neuronaler Netze bereit |
| Programmiersprache (Python 3.10) | Python Software Foundation | https://www.python.org/downloads RRID:SCR_008394 | Kernprogrammiersprache für Implementierung und Experimente |
| Systemspeicher (≥ 64 GB RAM) | Corsair / Kingston / Crucial | https://www.corsair.com / https://www.kingston.com / https://www.crucial.com | Unterstützt die Verarbeitung hochdimensionaler multivariater Zeitreihendaten und das Training großer Modelle |
Referenzen
- Rebello CM, Jäschke J, Nogueira IBR. Digital twin framework for optimal and autonomous decision-making in cyber-physical systems: Enhancing reliability and adaptability in the oil and gas industry. arXiv preprint arXiv:2311.12755. 2023. https://doi.org/10.48550/arXiv.2311.12755
- Priyanka EB, Thangavel S, Gao XZ, Sivakumar N. Digital twin for oil pipeline risk estimation using prognostic and machine learning techniques. J Ind Inf Integr. 2022;26:100272. https://doi.org/10.1016/j.jii.2021.100272
- Xu X, Liu B, Guo J. Asset management of oil and gas pipeline systems based on digital twin. IFAC Pap OnLine. 2020;53:715–719. https://doi.org/10.1016/j.ifacol.2020.12.123
- Shen F, Ren SS, Zhang XY. A digital twin-based approach for optimization and prediction of oil and gas production. Math Probl Eng. 2021;2021:3062841. https://doi.org/10.1155/2021/3062841
- Wanasinghe TR, et al. Digital twin for the oil and gas industry: Overview, research trends, opportunities, and challenges. IEEE Access. 2020;8:104175–104197. https://doi.org/10.1109/ACCESS.2020.2999087
- Wang B, Tao F, Fang X. Smart manufacturing and intelligent manufacturing: A comparative review. Engineering. 2021;7:738–757. https://doi.org/10.1016/j.eng.2020.07.017
- Wang C, Wang C, Wang K. Technology research and standard development of predictive maintenance for intelligent manufacturing equipment. China Standardization. 2021;2:15–21.
- Ren S, Zhang Y, Huang B. Lifecycle big-data-driven smart manufacturing services for complex products. J Mech Eng. 2018;54:194–203.
- Li L, Lei B, Mao C. Digital twin in smart manufacturing. J Ind Inf Integr. 2022;26:100289. https://doi.org/10.1016/j.jii.2021.100289
- Grieves M, Vickers J. Digital twin: Mitigating unpredictable, undesirable emergent behavior in complex systems. In: Transdisciplinary perspectives on complex systems. Cham: Springer; 2017. p. 85–113. https://doi.org/10.1007/978-3-319-38756-7_4
- Yang M, et al. A novel embedding model based on a transition system for building industry-collaborative digital twin. Appl Sci. 2022;12:553. https://doi.org/10.3390/app12020553
- Wang T, Feng K, Ling J. Pipeline condition monitoring towards digital twin systems: A case study. J Manuf Syst. 2024;73:256–274. https://doi.org/10.1016/j.jmsy.2023.12.005
- Malek NG, et al. Live digital twin for smart maintenance in structural systems. IFAC Pap OnLine. 2021;54:1047–1052. https://doi.org/10.1016/j.ifacol.2021.10.146
- Yun J, Kim S, Kim J. Digital twin technology in the gas industry: A comparative simulation study. Sustainability. 2024;16:5864. https://doi.org/10.3390/su16145864
- Bhowmik S. Digital twin for offshore pipeline corrosion monitoring: A deep learning approach. In: Proc Offshore Technology Conf. 2021. D041S049R003.
- Hamidishad N, et al. Digital twin frameworks for oil and gas processing plants: A comprehensive literature review. Processes. 2025;13:3488. https://doi.org/10.3390/pr13123488
- Homaei M, et al. Causal digital twins for cyber-physical security: A framework for robust anomaly detection in industrial control systems. arXiv. 2025.
- Ahmed CM, Palleti VR, Mathur AP. WADI: A water distribution testbed for research in secure cyber-physical systems. In: Proc Int Workshop Cyber-Physical Systems Smart Water Networks. 2017.
- Sudhakar R. Robust digital twin approach towards operational excellence and sustainability goals. In: Proc Abu Dhabi Int Petroleum Exhibition Conf. 2023.
- Knebel FP, et al. Cloud and edge computing for implementation of digital twins in oil and gas industries. Comput Ind Eng. 2023;182:109363. https://doi.org/10.1016/j.cie.2023.109363
- Daher E. Digital safety trends in oil and gas. In: Proc SPE Asia Pacific Oil and Gas Conf. 2023.
- Tao F, et al. Digital twin in industry: State-of-the-art. IEEE Trans Ind Inform. 2019;15:2405–2415. https://doi.org/10.1109/TII.2018.2873186
- Sircar A, et al. Digital twin in the hydrocarbon industry. Pet Res. 2023;8:270–278. https://doi.org/10.1016/j.ptlrs.2023.03.002
- Li G, et al. Intelligent drilling and completion: A review. Engineering. 2022;18:33–48. https://doi.org/10.1016/j.eng.2021.12.004
- Hammerschmid M, et al. Development of virtual representations for energy plants: From digital model to predictive twin. Energies. 2023;16:2641. https://doi.org/10.3390/en16062641
- Lu L, Jin P, Karniadakis GE. Deep operator network: Learning nonlinear operators for identifying differential equations. arXiv. 2019.
- Lin M, et al. Reinforcement learning-based model predictive control for discrete-time systems. IEEE Trans Neural Netw Learn Syst. 2023;35:3312–3324. https://doi.org/10.1109/TNNLS.2022.3140110
- Huang Z, et al. Survey on AI-driven digital twins in Industry 4.0. Sensors. 2021;21:6340. https://doi.org/10.3390/s21196340
- Wang Y, et al. Structural health monitoring of oil and gas pipelines. Ocean Eng. 2024;308:118293. https://doi.org/10.1016/j.oceaneng.2024.118293
- Khisty VH. SCADA systems in oil and gas: Driving innovation and efficiency. Int J Res Appl Sci Eng Technol. 2024;12:96–107.
- Ma Z, Hao Z, Zhao Z. Energy-saving scheduling algorithm of wireless monitoring sensors. Energy Inform. 2024;7:104. https://doi.org/10.1186/s42162-024-00264-4
- Aba EN, et al. Petroleum pipeline monitoring using IoT platform. SN Appl Sci. 2021;3:180. https://doi.org/10.1007/s42452-021-04180-5
- Gulzar Q, Mustafa K. Cyber-attack detection in industrial control systems. Sci Rep. 2025;15:26575. https://doi.org/10.1038/s41598-025-26575-0
- Bloemheuvel S, et al. Graph construction for spatiotemporal data in GNNs. Int J Data Sci Anal. 2024;18:157–174. https://doi.org/10.1007/s41060-024-00423-7
- Li Z, et al. Fourier neural operator for parametric PDEs. arXiv. 2020.
- Yu B, Yin H, Zhu Z. Spatio-temporal graph convolutional networks. arXiv. 2017.
- Wu H, et al. Review of digital twins across processes. Sensors. 2023;23:8306. https://doi.org/10.3390/s23198306
- Xu Q, Ali S, Yue T. Digital twin-based anomaly detection. ACM Trans Softw Eng Methodol. 2023;32:1867–1878. https://doi.org/10.1145/3583555
- Ogbodo CO, et al. Adaptive sensor steering using reinforcement learning. Proc R Soc A. 2026;482:2329.
- Tao F, Qi Q, Liu A, Kusiak A. Data-driven smart manufacturing. J Manuf Syst. 2018;48:157–169. https://doi.org/10.1016/j.jmsy.2018.01.006