Diese Studie untersuchte, ob Lebensstil- und gynäkologische onkologische Pflegeinterventionen die Lebensqualität bei Frauen mit gynäkologischen Krebserkrankungen verbessern. Eine signifikante Verbesserung zeigte sich nur in der Untergruppe der Eierstockkrebspatientinnen nach 6 Monaten, während die gesamten Belege aufgrund erheblicher Heterogenität, kleiner Untergruppengrößen und methodischer Einschränkungen weiterhin sehr unsicher blieben.
Forschungsartikel
Eine Metaanalyse über die Auswirkungen von Lebensstil- und pflegerischen Interventionen in der gynäkologischen Onkologie auf die Steigerung der Lebensqualität
* These authors contributed equally
In diesem Artikel
Zusammenfassung
Zusammenfassung
Diese Metaanalyse untersuchte die Wirkung von Lebensstil- und gynäkologisch-onkologischen Pflegeinterventionen auf die Lebensqualität (QoL). Eine systematische Suche bis Juni 2026 identifizierte 1.123 Einträge. Dreizehn randomisierte kontrollierte Studien mit insgesamt 915 Frauen mit gynäkologischem Krebs wurden eingeschlossen. Der Einfluss von Lebensstil- und gynäkologisch-onkologischen Pflegeinterventionen auf die QoL wurde anhand zusammengefasster mittlerer Unterschiede (MDs) mit 95 % Konfidenzintervallen bewertet, wobei für die allgemeine Analyse Random-Effects-Modelle und für die krebsspezifischen Subgruppenanalysen Fixed-Effect-Modelle verwendet wurden. Im Vergleich zur Kontrollgruppe führten die Interventionen bei Frauen mit Ovarialkarzinom zu einer signifikanten Verbesserung der QoL nach 6 Monaten (MD 4,28, 95 % KI: 0,45–8,10, p = 0,03; I2 = 0 %). Bei gemischten Krebsarten zeigten sich nach 6 Monaten keine signifikanten Unterschiede hinsichtlich der QoL (MD 2,11, 95 % KI: –0,90–5,12, p = 0,17; I2 = 71 %), ebenso wenig bei Endometriumkarzinom nach 6 Monaten (MD 2,00, 95 % KI: –1,49–5,49, p = 0,26; I2 = 0 %) oder bei gemischten Krebsarten nach 3 Monaten (MD 6,43, 95 % KI: –0,16–13,01, p = 0,06; I2 = 74 %). Allerdings begrenzen deutliche Heterogenität, unterschiedliche Studiendesigns und Interventionen, kleine Stichprobengrößen sowie variabler Bias-Risiko die Zuverlässigkeit der Ergebnisse, die vorsichtige Interpretation erfordern und durch robuste, standardisierte Studien bestätigt werden müssen. Lebensstil- und gynäkologisch-onkologische Pflegeinterventionen verbesserten die QoL nur bei Frauen mit Ovarialkarzinom nach 6 Monaten signifikant. Dennoch erfordern die erhebliche Heterogenität, methodische Einschränkungen und die sehr geringe Evidenzqualität eine vorsichtige Interpretation, und größere standardisierte Studien sind erforderlich.
Einleitung
Krebs, der in den weiblichen Fortpflanzungsorganen entsteht, wird als gynäkologischer Krebs bezeichnet. Gynäkologische Krebserkrankungen, zu denen Gebärmutterhals-, Eierstock-, Gebärmuttter-, Scheiden- und Vulvakrebs gehören, stellen weltweit nach wie vor ein erhebliches Problem für die öffentliche Gesundheit dar und betreffen Millionen von Frauen global1. Diese Tumore sind nicht nur körperlich verheerend, sondern verursachen auch erhebliche emotionale und psychologische Belastungen. Trotz Fortschritten in der Behandlung nimmt die globale Häufigkeit dieser Tumore zu, und die Gesamtprognose bleibt in mehreren Regionen, insbesondere dort, wo der Zugang zur Gesundheitsversorgung eingeschränkt ist, ungünstig. Studien zur pflegerischen Betreuung in der gynäkologischen Onkologie unterstreichen die Notwendigkeit umfassender, interdisziplinärer Strategien im Patientenmanagement angesichts der erheblichen Auswirkungen dieser Malignome auf die Lebensqualität von Frauen2. Im Gegensatz dazu reichen erfolgreiche pflegerische Maßnahmen über die Behandlung körperlicher Symptome wie Schmerzen und Übelkeit hinaus; sie umfassen auch emotionale Unterstützung, psychologische Beratung, Patientenaufklärung und ein umfassendes Symptommanagement. Solche Maßnahmen sind entscheidend, um die Behandlungsergebnisse zu verbessern, Frauen dabei zu helfen, die Komplexität der Therapieprotokolle zu bewältigen, und eine ganzheitliche Versorgung sicherzustellen.
Die Bedeutung von pflegerischen Maßnahmen für die Lebensqualität erfordert weitere Untersuchungen, insbesondere hinsichtlich der Auswirkungen verschiedener Aspekte der Pflegeversorgung auf das körperliche, emotionale und psychische Wohlbefinden in unterschiedlichen Patientengruppen3. Eine wirksame Pflegeversorgung für Krebspatienten kann ihr allgemeines Wohlbefinden verbessern. Die pflegerische Betreuung in der gynäkologischen Onkologie ist ein spezialisierter Bereich der Pflege, der darauf abzielt, Frauen mit einer gynäkologischen Krebserkrankung umfassende Unterstützung zu bieten. Gynäkologische Krebserkrankungen umfassen Granulosazell-Tumoren, Melanome des Genitaltrakts, zervikale Karzinome, die einer fruchtbarkeitserhaltenden Operation zugänglich sind, sowie Endometriumkarzinome4. Die Häufigkeit von Zervixkarzinomen ist in ganz Europa zurückgegangen; dennoch stellt diese Erkrankung weiterhin eine erhebliche Herausforderung für die öffentliche Gesundheit dar. Dies wird durch die Statistiken aus dem Jahr 2018 verdeutlicht, die 61.000 Neuerkrankungen und 25.800 Todesfälle verzeichnen. Die Überlebensraten zeigen regionale Unterschiede auf: Die relative Fünf-Jahres-Überlebensrate betrug zwischen 2000 und 2007 insgesamt 62 %, wobei sie von 57 % in Osteuropa bis 67 % in Nordeuropa reichte.
Krebs am Gebärmutterhals bleibt trotz Fortschritten bei Prävention und Behandlung ein weltweites gesundheitliches Hauptanliegen. Diese Ungleichheiten verdeutlichen die Notwendigkeit gezielter Pflegeinterventionen, um die Behandlungsergebnisse zu verbessern und Versorgungsunterschiede in verschiedenen Versorgungskontexten auszugleichen. Zusätzliche gynäkologische Malignome, wie Ovarial-, Uterus- und Vulvakarzinome, stellen erhebliche gesundheitliche Herausforderungen dar. Ovarialkarzinom ist weltweit die häufigste Todesursache unter den gynäkologischen Krebserkrankungen mit mehr als 300.000 Neuerkrankungen und 185.000 Todesfällen jährlich. Die Überlebensraten bei Ovarial- und Uterusmalignomen liegen in der Regel über denen beim Gebärmutterhalskrebs; dennoch bestehen signifikante Unterschiede zwischen Ländern und Regionen. Wie beim Gebärmutterhalskrebs werden auch diese Ungleichheiten durch den Zugang zur Gesundheitsversorgung, Methoden der Früherkennung und verfügbare Therapiemöglichkeiten beeinflusst. Gezielte pflegerische Maßnahmen sind bei diesen Krebserkrankungen unerlässlich, um die Behandlungsergebnisse zu verbessern und die Lebensqualität von Frauen weltweit zu erhöhen5.
Gynäkologische Onkologiepflegekräfte leisten eine ganzheitliche, patientenorientierte Betreuung, die über die emotionale Unterstützung hinausgeht. Neben der Bereitstellung emotionaler Unterstützung unterstützen sie die Therapieplanung, vertreten die Bedürfnisse der Patientinnen und begleiten sie während des gesamten Therapieprozesses. Effektive Therapien umfassen die Symptomkontrolle, einschließlich Schmerzlinderung, Verringerung von Müdigkeit und Kontrolle von Übelkeit, psychologische Therapie sowie Aufklärungsprogramme für Patientinnen, die sowohl die emotionalen als auch die körperlichen Behandlungsergebnisse verbessern.6Multidisziplinäre Behandlungsstrategien, die psychologische Unterstützung zusammen mit physikalischer Therapie beinhalten, haben sich besonders vorteilhaft für die Verbesserung der Lebensqualität erwiesen. Gynäkologische Onkologiekolleginnen sind daher unverzichtbar für das Symptommanagement, die Patientenaufklärung und die umfassende Behandlung, wodurch die Behandlungsergebnisse für die Patientinnen verbessert werden.6Diese spezialisierte pflegerische Versorgung umfasst die Verabreichung von Chemotherapien, die Überwachung und Interpretation von Vitalzeichen, die Analyse von Behandlungsreaktionen sowie die umfassende Betreuung, wofür besondere Ausbildung und Fachkenntnisse in der onkologischen Pflege erforderlich sind.7.
Die Pflegeversorgung trägt erheblich zur Verbesserung des Wohlbefindens von Individuen in unterschiedlichen Gesundheitsversorgungsumgebungen bei. In Krankenhäusern erfolgen Behandlungen, die Überwachung des Patientenzustands sowie die Zusammenarbeit mit dem medizinischen Team. Pflegekräfte in ambulanten Pflegezentren leisten kontinuierliche Unterstützung, überwachen chronische Erkrankungen und helfen Patienten dabei, ihre Selbstständigkeit zu bewahren8. Die Lebensqualität umfasst das physische, psychische, emotionale und soziale Wohlbefinden. Die Pflegeversorgung spielt eine entscheidende Rolle bei der Verbesserung dieser Aspekte durch gezielte Interventionen. Die kontinuierliche Betreuung von Patienten mit chronischen Erkrankungen beinhaltet die Überwachung der Vitalzeichen, die Verabreichung von Medikamenten sowie die Anleitung zu Selbstmanagement-Techniken8. Diese pflegerischen Interventionen ermöglichen eine wirksame Behandlung chronischer Erkrankungen, verringern Symptome und verbessern die körperliche Gesundheit, wodurch die allgemeine Lebensqualität gesteigert wird.
Gynäkologische Krebserkrankungen stellen weltweit ein erhebliches Problem der öffentlichen Gesundheit für Frauen dar, mit über einer Million Diagnosen pro Jahr, die zu erheblichen körperlichen Beeinträchtigungen und psychosozialen Störungen führen und dadurch die Lebensqualität mindern9. Untersuchungen zeigen, dass bis zu 40 % der Frauen mit einer Diagnose gynäkologischer Krebserkrankungen unter erheblichem seelischem Leid leiden, während 60 % während der Behandlung eine Verschlechterung der gesundheitsbezogenen Lebensqualität angeben (Global Cancer Statistics and Reports)10. Smits et al. fanden keine signifikanten Wirkungen ähnlicher Behandlungen, was die Bedeutung der aktiven Teilnehmerbeteiligung und der Qualität der Umsetzung für die Ergebnisse unterstreicht11. Die Studie betont die entscheidende Rolle von Pflegekräften bei der Krankheitsprävention, der Förderung eines gesunden Lebensstils sowie der Berücksichtigung der körperlichen und emotionalen Bedürfnisse der Patientinnen.
Die vorliegende Studie zielt darauf ab, die Wirkungen von Lebensstilinterventionen und gynäkologischer onkologischer Pflege auf die Verbesserung der Lebensqualität von Frauen mit gynäkologischen Malignitäten mittels systematischer Übersichtsarbeit und Metaanalyse zu bewerten. Das Ziel der Studie ist es, die Auswirkungen spezifischer Lebensstilinterventionen und der gynäkologischen onkologischen Pflege auf wesentliche Aspekte der Lebensqualität, einschließlich des körperlichen, emotionalen und sozialen Wohlbefindens, zu untersuchen. Die Fokussierung auf standardisierte Messungen der Lebensqualität und eindeutig definierte Interventionsstrategien liefert praktische Daten über die Wirksamkeit dieser Methoden. In dieser Studie werden insbesondere die kurzfristigen Effekte (innerhalb von sechs Monaten) intensiver psychologischer Pflege auf das emotionale und soziale Wohlbefinden untersucht. Diese gezielte Methodik ermöglicht eine umfassende Analyse der Wirkung spezifischer Interventionen auf Ergebnisse bezüglich der Lebensqualität und liefert Belege zur Unterstützung individualisierter Versorgungsstrategien.
Frühere systematische Übersichtsarbeiten, darunter die von Smits et al.11, bewerteten hauptsächlich Lebensstilinterventionen bei Frauen mit Endometrium- und Ovarialkarzinom und umfassten vergleichsweise wenige Studien. Seitdem sind zusätzliche Belege verfügbar geworden, und keine systematische Übersichtsarbeit hat bisher umfassend sowohl Lebensstilinterventionen als auch die pflegerische Betreuung in der gynäkologischen Onkologie über ein breiteres Spektrum gynäkologischer Malignome hinweg untersucht. Daher hatte diese systematische Übersichtsarbeit und Metaanalyse zum Ziel, die derzeit verfügbaren Belege zu den Wirkungen dieser Interventionen auf die Lebensqualität zusammenzufassen.
Protokoll
Teilnahmeberechtigungskriterien
Studien waren berechtigt, wenn sie alle folgenden Kriterien erfüllten: (1) Frauen mit einer gynäkologischen Malignität eingeschlossen hatten; (2) eine definierte Lebensstilintervention oder eine pflegerlich geleitete Intervention bewertet hatten; (3) quantitative Daten zur Lebensqualität berichtet hatten; und (4) entweder vergleichende (Intervention vs. Kontrolle) oder beobachtende Verlaufsstudien waren, die relevante beschreibende Lebensqualitätsdaten bereitstellten; (5) wurden in englischer Sprache veröffentlicht. . Für die quantitative Metaanalyse von Intervention im Vergleich zur Kontrolle war eine gleichzeitige Vergleichsgruppe erforderlich12. Zwei Studien ohne Vergleichsgruppe wurden nur für die narrative Synthese beibehalten13. Es wurden keine geografischen Einschränkungen vorgenommen.
Informationsquellen
Der vollständige Prozess zur Studienselektion ist in Abbildung 1 als PRISMA-Flussdiagramm dargestellt. Die Cochrane Library, Embase, Google Scholar, OVID und PubMed wurden von der jeweiligen Gründung des jeweiligen Datumsbanksystems bis Juni 2026 durchsucht. Die gefundenen Datensätze wurden in EndNote 20 importiert, und doppelte Einträge wurden entfernt. Zwei Prüferinnen bzw. Prüfer screeningten unabhängig voneinander Titel und Abstracts, gefolgt von einer vollständigen Textbewertung potenziell geeigneter Studien. Uneinigkeiten wurden durch Diskussion geklärt. Nur Publikationen in englischer Sprache wurden gemäß den vorab festgelegten Eingabekriterien berücksichtigt.
Suchstrategie
Die Suchstrategie wurde mithilfe des PICOS-Rahmenwerks entwickelt: Population – Frauen mit gynäkologischer Onkologie; Intervention – Lebensstil- oder Pflegeinterventionen; Vergleich – Standardversorgung oder alternative Interventionen; Ziel – Lebensqualität; Studiendesign – keine Einschränkungen14. Ein umfassender Satz an Suchbegriffen und kontrollierten Fachbegriffen wurde in allen Datenbanken verwendet; die detaillierten Suchabfragen für jede Datenbank sind in Tabelle 113 angegeben.
Auswahlverfahren
Nach der Beschaffung der Volltexte überprüften zwei Gutachter unabhängig voneinander, ob jeder Bericht alle Einschlusskriterien erfüllte. Zusätzlich verglichen sie Autorenlisten, Studiennamen (z. B. SUCCEED, WALC, BENITA, TOPCAT‑G), Rekrutierungszeiträume und Studienzentren, um sich überschneidende Patientenkohorten zu identifizieren. Möglicherweise überlappende Patientenkohorten wurden ermittelt und dokumentiert. Falls überlappende Berichte in die primäre Analyse eingingen, wurde ihr Einfluss in einer vorab festgelegten Sensitivitätsanalyse bewertet, die den überlappenden Datensatz ausschloss.
Datenextraktion und Outcome-Maße
Zwei Prüfer zogen unabhängig voneinander Daten aus allen 15 eingeschlossenen Berichten mithilfe eines standardisierten, erprobten Datenerfassungsformulars ab. Uneinigkeiten wurden im Konsens mit dem korrespondierenden Autor gelöst. Für jede Studie wurden folgende Informationen erfasst: Erstautor, Erscheinungsjahr, Land, Studiendesign, Krebsart, Beschreibung der Intervention, Beschreibung des Vergleichsarms, Stichprobengröße pro Gruppe, Alter und Krankheitsstadium der Teilnehmer, Instrument zur Erfassung der Lebensqualität (QoL), erfasste Zeitpunkte sowie alle numerischen QoL-Daten (Mittelwerte, Streuungsmaße und Stichprobengrößen pro Studienarm)15.
Quantitatives Pooling (13 vergleichende Studien)
Für die Metaanalyse von Intervention versus Kontrolle wurden die Endwerte nach der Intervention (Mittelwerte und Standardabweichungen) zu den vorgegebenen Zeitpunkten (3 und 6 Monate) für beide Gruppen extrahiert. Falls eine Studie sowohl Endwerte als auch Veränderungswerte angab, wurden ausschließlich die Endwerte berücksichtigt16. Der methodische Ansatz zur Metaanalyse und zur Bewertung der Studienqualität folgte den etablierten Cochrane-Richtlinien17. Bei der Wahl des metaanalytischen Modells wurde die erwartete klinische und methodologische Heterogenität zwischen den Studien berücksichtigt18, und die statistische Heterogenität wurde mithilfe der I2-Statistik nach Higgins et al. quantifiziert19. Die 13 vergleichenden Studien, die in die quantitative Synthese einbezogen wurden, sind in Tabelle 220,21,22,23,24,25,26,27,28,29,30,31,32 zusammengefasst.
Maße für die Lebensqualität als Zielgröße, Ausrichtung und Effektgröße
Das spezifische Lebensqualitätsinstrument, das in jeder Studie verwendet wurde, wurde dokumentiert. Zu den identifizierten Skalen gehörten die Functional Assessment of Cancer Therapy – General (FACT‑G), FACT‑Ovarian (FACT‑O), FACT‑Endometrial (FACT‑En), der European Organization for Research and Treatment of Cancer Quality of Life Questionnaire Core 30 (EORTC QLQ‑C30), der Short Form‑36 (SF‑36) sowie krankheitsspezifische Skalen. Bei allen Instrumenten deuteten höhere Werte auf eine bessere Lebensqualität hin, und es wurden keine umgekehrt gewerteten Instrumente einbezogen. Sämtliche extrahierten Lebensqualitätsdaten wurden daher auf dieselbe Maßstabsrichtung ausgerichtet, wobei eine positive mittlere Differenz (MD) stets zugunsten der Interventionsgruppe sprach.
Für die primäre Metaanalyse wurden die endgültigen Messwerte nach der Intervention anstelle von Veränderungswerten bezogen auf den Ausgangswert extrahiert. Diese Entscheidung basierte auf folgenden Gründen: (i) nicht alle Studien berichteten über Veränderungswerte oder deren Standardabweichungen; (ii) Endwerte spiegeln den absoluten Zustand der Lebensqualität (QoL) nach der Behandlung wider, was klinisch aussagekräftig ist; und (iii) die Verwendung von Endwerten maximierte die Anzahl der Studien, die zusammengefasst werden konnten. Wenn eine Studie mehrere QoL-Unterskalen angab, wurde der globale QoL-Wert oder der Gesamtwert des FACT-G als primäres Ergebnis bevorzugt; falls nicht verfügbar, wurde die Subskala zur körperlichen Funktion verwendet, wobei diese Abweichung in Tabelle 2 ausdrücklich als Fußnote vermerkt wurde.
Die rohe MD wurde als Effektmaß verwendet, anstelle der standardisierten Mittelwertdifferenz (SMD), da alle eingeschlossenen Instrumente zur Messung desselben zugrundeliegenden Konstrukts validiert sind.—gesundheitsbezogene Lebensqualität—auf konzeptionell ähnlichen Skalen (Gesamtwerte liegen zwischen 0–100 oder 0–148). Die MD ist direkt in den ursprünglichen Einheiten dieser Skalen interpretierbar und klinisch aussagekräftiger als eine in Standardabweichungseinheiten ausgedrückte SMD. Angepasste Schätzungen (z. B. mittels ANCOVA angepasste Mittelwerte) wurden nicht verwendet, da sich die Adjustierungs-Kovariaten zwischen den Studien stark unterschieden, was die Vergleichbarkeit beeinträchtigen würde.
Umrechnungen der Standardabweichung
Wenn Studien Standardfehler (SE) oder 95 % Konfidenzintervalle anstelle von Standardabweichungen (SD) angaben, wurden diese mithilfe standardisierter Formeln in SDs umgerechnet: SD = SE × √n für SEs und SD = √n × (oberes CI – unteres CI) / (2 × 1,96) für 95 % KIs. Bei Studien, die Medianwerte mit Interquartilsabständen (IQR) präsentierten, wurden weder Mittelwerte noch SDs geschätzt; solche Daten wurden beschreibend extrahiert und nicht in die gepoolten MD-Berechnungen einbezogen. Für die 13 Studien, die zur quantitativen Synthese beitrugen, war keine solche Schätzung erforderlich.
Umgang mit fehlenden Daten
Intention-to-treat- (ITT-)Schätzungen wurden bevorzugt extrahiert, wenn sie ausdrücklich angegeben waren, da sie die konservativste und unverzerrteste Schätzung des Behandlungseffekts liefern. Wo ITT-Daten nicht verfügbar waren, wurden Per-Protokoll- oder Complete-Case-Daten entsprechend der Angaben der ursprünglichen Autoren extrahiert. Fehlende Mittelwerte, Standardabweichungen (SD) oder Ergebniswerte wurden nicht imputiert; das Fehlen wurde für jede Studie dokumentiert und in der Sensitivitätsanalyse berücksichtigt. Studien mit nicht angegebenen SDs für wichtige Zeitpunkte wurden vermerkt, und die entsprechenden Autoren wurden per E-Mail um Zusendung der fehlenden Statistiken gebeten. Falls innerhalb von zwei Wochen keine Antwort einging, wurden die jeweils konservativsten verfügbaren Daten verwendet (z. B. gepoolte Baseline-SD, falls die SD nach der Intervention fehlte), oder der betreffende Zeitpunkt wurde von der Datenaggregation ausgeschlossen.
Mehrere Interventionsarme und gemeinsame Kontrollen
Keine der eingeschlossenen Studien wies mehr als einen aktiven Lebensstil-/Pflegeinterventionsarm im Vergleich zu einer einzigen gemeinsamen Kontrollgruppe auf, was eine Aufteilung der Kontrollstichprobe für die Analyse erforderlich gemacht hätte. Bei der einzigen faktoriell angelegten Studie (McCloy et al.30) wurden Daten aus dem kombinierten Arm für Bewegung und Achtsamkeit sowie aus dem Kontrollarm mit Standardversorgung extrahiert, um die Zusammenführung der Daten zu vereinfachen und eine Doppelerfassung zu vermeiden. Für die überlappenden Kohorten der SUCCEED-Studie (Von Gruenigen et al.21 und McCarroll et al.23) wurden beide Berichte in der Extraktionstabelle beibehalten. Für die primäre Metaanalyse wurden beide Datensätze einbezogen (da sie die Lebensqualität zum gleichen Zeitpunkt berichteten). In einer vorab festgelegten Sensitivitätsanalyse wurde der jüngere Bericht ausgeschlossen, um den Einfluss der Kohortenduplikation auf die gepoolte Schätzung zu bewerten; die Ergebnisse sind im Text angegeben.
Nicht-vergleichende Beobachtungsstudien
Bei zwei Studien (Budisan et al.33 und Betea et al.34), für die keine zeitgleiche Kontrollgruppe vorlag, wurden keine vergleichenden Daten zur Intervention im Vergleich zur Kontrolle extrahiert (d. h., kein MD konnte berechnet werden). Stattdessen wurden beschreibende Daten zur Veränderung der Lebensqualität über die Zeit (innerhalb-Gruppen-Veränderungen) extrahiert und im Text sowie in Tabelle 2 narrativ dargestellt. Sie wurden in keinem Forest-Plot und keiner zusammenfassenden quantitativen Analyse berücksichtigt.
Bewertung des Bias-Risikos
Mögliche Publikationsbias und andere Kleinstudien-Effekte wurden sowohl durch visuelle Inspektion von Inversionsplots als auch durch Eggers lineare Regressionsanalyse bewertet (bei der der standardisierte Interventionseffekt auf seiner Präzision regressiert wird). Da der Egger-Test bei einer geringen Anzahl von Studien (im Allgemeinen <10) eine begrenzte statistische Power aufweist, wurden Inversionsplots und Egger-Tests vorab festgelegt und nur für Metaanalysen mit 10 oder mehr Studien durchgeführt. Bei Ergebnissen mit weniger als 10 beteiligten Studien werden weder Inversionsplots noch Egger-p-Werte angegeben, da solche Tests unterdimensioniert sind und irreführende Ergebnisse liefern können17.
Zwei Gutachter bewerteten unabhängig voneinander die methodische Qualität der 15 eingeschlossenen Berichte, und Uneinigkeiten wurden durch Diskussion mit den entsprechenden Autoren geklärt. Da die eingeschlossenen Studien sowohl randomisierte kontrollierte Studien (RCTs; n = 13) als auch nicht randomisierte Beobachtungs-Kohortenstudien (n = 2; Budisan et al.33; Betea et al.34) umfassten, wurden studiendesignspezifische Bewertungsinstrumente angewandt.
Für RCTs (13 Studien) wurde das Cochrane-RoB-2.0-Tool (überarbeitete Version) verwendet, das jede Studie anhand von fünf Bereichen bewertet17: (1) Randomisierungsprozess – Erzeugung der Zufolge und Verdeckung der Zuordnung; (2) Abweichungen von den geplanten Interventionen – Verblindung von Teilnehmern und Personal sowie Durchführung einer Intention-to-treat-Analyse; (3) Fehlende Ergebnisdaten – Vollständigkeit der Nachbeobachtung und Umgang mit Ausscheidern; (4) Messung des Ergebnisses – Verblindung der Ergebnisprüfer (insbesondere relevant bei selbstberichteter Lebensqualität, wo Verblindung weniger praktikabel ist, aber dennoch berücksichtigt wird); (5) Auswahl der berichteten Ergebnisse – Risiko einer selektiven Berichterstattung über Ergebnisse (geprüft anhand von Studienregistern oder veröffentlichten Protokollen, sofern verfügbar).
Jedes Domäne wurde als geringes Risiko, einige Bedenken oder hohes Risiko eingestuft. Anschließend wurde für jede Studie ein Gesamtbewertung des Bias-Risikos vergeben: gering (alle Domänen gering), einige Bedenken (eine oder mehrere Domänen mit einigen Bedenken) oder hoch (mindestens eine Domäne mit hohem Risiko oder mehrere Domänen mit einigen Bedenken). Bei selbstberichteten Endpunkten wie der Lebensqualität ist die Verblindung der Teilnehmer oft nicht durchführbar; daher wurde bei fehlender Verblindung der Teilnehmer kein automatisches Urteil über ein hohes Risiko abgegeben. Stattdessen wurde der Mangel an Verblindung in der Bewertung der Domäne 2 ausdrücklich als potenzielle Quelle von Performance-Bias vermerkt.
Bei den nicht randomisierten Beobachtungs-Kohortenstudien (2 Studien) verzichteten Budisan et al.33 und Betea et al.34 auf eine zeitgleiche Vergleichsgruppe und wurden daher nicht in die quantitative Metaanalyse einbezogen. Für diese Studien wurde die Newcastle-Ottawa-Skala (NOS), angepasst für Kohortenstudien, verwendet, um die Auswahl, Vergleichbarkeit (nicht anwendbar aufgrund des Fehlens einer Vergleichsgruppe) und die Erfassung der Ergebnisse zu bewerten. Da ihnen jedoch eine Kontrollgruppe fehlte, wurden sie hinsichtlich möglicher Verzerrungen und Selektionsbias bei kausalen Schlussfolgerungen als hochgradig risikobehaftet eingestuft. Sie wurden lediglich zu deskriptiven Zwecken beibehalten; ihre Bias-Risikoprofile beeinflussen die gepoolten Effektschätzungen nicht, sind jedoch in Tabelle 2 dokumentiert.
Zusammenfassung des Bias-Risikos
Eine Zusammenfassungsgrafik zum Bias-Risiko (Ampeldiagramm) wurde erstellt, die die Bewertungen auf Domänen-Ebene für jede RCT darstellt. Kurz gefasst waren die häufigsten Probleme bei den RCTs: (i) fehlende Verblindung von Teilnehmern und Personal bezüglich der Lebensstilinterventionen (Domäne 2 – einige Bedenken/hohes Risiko in 9 von 13 Studien) und (ii) unvollständige Ergebnisdaten aufgrund von Dropouts (Domäne 3 – einige Bedenken in 4 Studien). Keine Studie wurde in allen Domänen als geringes Risiko eingestuft; die Mehrheit (8/13) wies einige Bedenken auf, und 5/13 wurden insgesamt als hohes Risiko eingestuft, hauptsächlich aufgrund fehlender Verblindung und kleiner Stichprobengrößen, die zu Ungenauigkeiten führten.
Sicherheit der Belege (GRADE)
Die Gesamtsicherheit der Evidenz wurde für jedes zusammengefasste Ergebnis mithilfe des Grading of Recommendations Assessment, Development and Evaluation (GRADE)-Rahmenwerk gemäß dem GRADE-Handbuch und unter Verwendung der GRADEpro GDT-Software. Die Sicherheit der Evidenz wurde bewertet als hoch, mäßig niedrig, oder sehr niedrig in fünf Bereichen: Bias-Risiko, Inhomogenität, Indirektheit, Ungenauigkeit und Publikationsbias. Bewertete Endpunkte umfassen (1) Lebensqualität nach 6 Monaten – allgemeine gynäkologische Onkologie (gepoolter MD aus 9 vergleichenden Studien); (2) Lebensqualität nach 6 Monaten – Eierstockkrebs (gepoolter MD aus 2 vergleichenden Studien); (3) Lebensqualität nach 6 Monaten – Endometriumkarzinom (gepoolter MD aus 4 vergleichenden Studien, einschließlich überlappender SUCCEED-Kohorten); (4) Lebensqualität nach 3 Monaten – allgemeine gynäkologische Onkologie (gepoolter MD aus 6 vergleichenden Studien)
Effektmaß und Meta-Analyse-Modell
Für die allgemeine 6-Monats- und 3-Monats-Analyse wurden Random-Effects-Inversvarianz-Modelle verwendet, da eine erhebliche klinische und methodische Heterogenität zwischen den Studien erwartet wurde, einschließlich Unterschiede in Krebstypen, Interventionskomponenten, Intensität, Dauer und Kontrollbedingungen18. Für die Subgruppenanalysen zu Eierstock- und Gebärmutterschleimhautkrebs kamen feste Effekt-Inversvarianz-Modelle zum Einsatz, bei denen keine statistische Heterogenität beobachtet wurde (I2 = 0 %). Die Heterogenität wurde mithilfe der I2-Statistik bewertet19.
Die Heterogenität wurde anhand der I2-Statistik quantifiziert, wobei Schwellenwerte von 25 %, 50 % und 75 % geringe, moderate bzw. hohe Heterogenität darstellten. Zusätzlich zu I2 wurde τ2 für Analysen mit zufälligen Effekten angegeben, um die absolute Größe der Varianz zwischen den Studien zu quantifizieren. Alle Analysen wurden mit den Paketen meta und metafor in R (Version 4.3.1) durchgeführt.
Begründung für die Zusammenführung trotz erheblicher Heterogenität und Umgang mit Heterogenität
Für die primäre 6-Monats-Analyse deutete ein I2 = 71 % auf eine erhebliche Heterogenität hin. Die Zusammenfassung der Ergebnisse wurde unter Verwendung des Zufallseffektmodells aus folgenden Gründen als angemessen erachtet: (i) die zusammengefasste Schätzung stellt den Durchschnittseffekt über eine Reihe von Interventionen und Populationen dar, was eine legitime Zusammenfassungsfrage darstellt; (ii) das Zufallseffektmodell berücksichtigt ausdrücklich die Varianz zwischen den Studien (τ2) im Standardfehler, wodurch das Risiko zu enger, irreführender Konfidenzintervalle verringert wird; (iii) vorgegebene Subgruppenanalysen wurden nach Krebsart (ovarian, endometrial) durchgeführt, um klinische Quellen der Heterogenität zu erklären; (iv) Einfluss- und Sensitivitätsanalysen wurden durchgeführt, um die Robustheit der zusammengefassten Schätzung zu überprüfen.
Die Entscheidung, Studien trotz erheblicher statistischer Heterogenität zusammenzufassen, basierte auf folgenden Grundsätzen: I2-Interpretation — I2-Werte von 25 %, 50 % und 75 % wurden im Voraus festgelegt, um geringe, moderate bzw. hohe Heterogenität darzustellen. Ein I2-Wert über 75 % weist auf erhebliche Heterogenität hin, wodurch das Zusammenfassen unangemessen sein könnte, falls die Heterogenität nicht sinnvoll durch klinische oder methodologische Faktoren erklärbar ist. Für die primäre allgemeine Analyse nach sechs Monaten (I2 = 71 %) waren vorgegebene Subgruppenanalysen nach Krebsart (ovarian, endometrial) geplant, um klinische Quellen der Heterogenität zu untersuchen. Die Unterteilung in Subgruppen verringerte I2 sowohl bei den ovariellen als auch bei den endometrialen Subgruppen deutlich auf 0 %, was darauf hindeutet, dass ein großer Teil der gesamten Heterogenität auf Unterschiede in der Krebsart und den damit verbundenen therapeutischen Zielstrukturen zurückzuführen ist. Da diese Subgruppen jedoch sehr wenige Studien umfassen, kann nicht zuverlässig geschlossen werden, dass die Heterogenität vollständig erklärt ist.
Die Fortsetzung mit der Zusammenfassung wurde für die allgemeine 6‑Monats‑Analyse als gerechtfertigt erachtet, weil: (i) sie einen zusammenfassenden Durchschnittseffekt über eine breite Palette von Interventionen liefert, was eine legitime metaanalytische Fragestellung darstellt; (ii) τ2 explizit angegeben wird, um die Varianz zwischen den Studien zu quantifizieren; (iii) Einflussanalysen durchgeführt wurden, um Ergebnisse, die durch Ausreißer verursacht wurden, zu überprüfen; und (iv) der gepoolte Schätzwert nicht als endgültig oder klinisch handlungsrelevant betrachtet wird — er wird als hypothetisch generierend interpretiert und in der Diskussion stark eingeschränkt.
In Übereinstimmung mit dem Cochrane Handbook sollten gepoolte Schätzungen mit äußerster Vorsicht interpretiert werden, wenn I2 75 % überschreitet und die Subgruppenanalysen die Heterogenität nicht überzeugend erklären. Angesichts der geringen Anzahl von Studien in den Subgruppen kann nicht sicher behauptet werden, dass die Heterogenität vollständig erklärt ist. Daher wird die primäre gepoolte Schätzung vorwiegend zu beschreibenden und explorativen Zwecken präsentiert und bildet keine Grundlage für klinische Empfehlungen. Alle Heterogenitätsstatistiken (I2, τ2) und Sensitivitätsanalysen werden transparent berichtet, sodass die Leser die Stabilität der Schätzungen selbst beurteilen können.
Untergruppen-, Sensitivitäts- und Einflussanalysen
Um Quellen der Heterogenität zu untersuchen, wurden die folgenden vorab festgelegten Analysen durchgeführt, ohne eine Meta-Regression durchzuführen: 1) Für Subgruppenanalysen wurde das allgemeine 6-Monats-Ergebnis nach Krebsart (ovarian, endometrial) stratifiziert, um zu prüfen, ob der Effekt je nach Tumorsitz unterschiedlich war; 2) Sensitivitätsanalyse (überlappende Kohorten): Um den Einfluss der überlappenden Kohorten der SUCCEED-Studie (Von Gruenigen et al.21 und McCarroll et al.23) zu bewerten, wurde die Subgruppenanalyse für das Endometrium-Karzinom erneut durchgeführt, wobei die Studie von McCarroll et al.23 ausgeschlossen wurde. 3) Einflussanalyse durch Ausschluss einzelner Studien (Leave-one-out): Jede Studie wurde nacheinander ausgeschlossen, und der gepoolte MD-Wert sowie I2 wurden für das allgemeine 6-Monats-Ergebnis erneut berechnet, um festzustellen, ob eine einzelne Studie die Ergebnisse oder die Heterogenität überproportional beeinflusste; 4) Vergleich mit dem Fixed-Effect-Modell: Der Vollständigkeit halber wurden die gepoolten Schätzungen zusätzlich unter Verwendung eines Fixed-Effect-Modells (inverse-variance weighting) berechnet, um sie mit den Ergebnissen des Random-Effects-Modells zu vergleichen; eine erhebliche Abweichung würde darauf hindeuten, dass die Heterogenität zwischen den Studien die Schätzung wesentlich beeinflusst.
Meta-Regression wurde nicht durchgeführt, um kontinuierliche Kovariaten (z. B. Alter, Ausgangs-QoL, Interventionsdauer) zu untersuchen, da die Anzahl der Studien pro Subgruppe (≤9 für das allgemeine 6-Monats-Ergebnis) nicht ausreicht, um verlässliche Regressionskoeffizienten zu erhalten. Mit <10 Studien pro Kovariate, ist eine Meta-Regression stark unterdimensioniert und anfällig für Fehler 1. Art, und die verfügbaren Kovariablen-Daten wurden inkonsistent zwischen den Studien berichtet.
Publikationsbias
Keiner der zusammengefassten Ergebnisse umfasste 10 oder mehr Studien. Daher wurden Funnel-Plots und Eggers Regressions-Tests nicht durchgeführt, da diese Analysen aufgrund der Anzahl verfügbarer Studien unterdimensioniert wären und zu irreführenden Ergebnissen führen könnten.
Ergebnisse
Studienauswahl
Eine systematische Literaturrecherche in PubMed, Embase, der Cochrane Library, Ovid und Google Scholar bis Juni 2026 ergab 1.123 Einträge. Nach Entfernung von 897 Duplikaten wurden 226 Einträge anhand von Titel und Abstract gescreent. Davon wurden 124 Einträge basierend auf den Eingabekriterien ausgeschlossen. Für 102 Berichte wurde eine vollständige Textbewertung durchgeführt, wobei 89 Berichte mit in dem PRISMA-Flussdiagramm dokumentierten Gründen ausgeschlossen wurden (Abbildung 1; Zusätzliche Datei 1). Schließlich erfüllten 15 Berichte die Aufnahmekriterien und wurden in die systematische Übersichtsarbeit einbezogen, darunter 13 vergleichende randomisierte kontrollierte Studien und 2 nicht vergleichende Beobachtungsstudien. Dreizehn randomisierte kontrollierte Studien lieferten extrahierbare Interventions-gegen-Kontroll-Daten für eine quantitative Metaanalyse, während zwei Beobachtungsstudien ausschließlich für eine narrative Synthese beibehalten wurden20,21,22,23,24,25,26,27,28,29,30,31,32.
Abbildung 1 zeigt das PRISMA-2020-Flussdiagramm, das den Screening- und Selektionsprozess darstellt. Die 13 randomisierten kontrollierten Studien lieferten extrahierbare Interventions-gegen-Kontroll-Daten für eine quantitative Metaanalyse20,21,22,23,24,25,26,27,28,29,30,31,32.
Studienmerkmale
Die Merkmale der 15 eingeschlossenen Berichte sind in Tabelle 2 zusammengefasst. Dreizehn vergleichende RCTs lieferten Daten für die quantitative Synthese, während zwei Beobachtungsstudien ausschließlich für die narrative Synthese beibehalten wurden. Insgesamt wurden in den 13 vergleichenden RCTs 915 Frauen eingeschlossen, wobei 468 Teilnehmerinnen ursprünglich wie berichtet auf Lebensstil- oder Pflegeinterventionsgruppen und 447 auf Kontrollgruppen verteilt wurden.
Für die quantitativen Metaanalysen trugen die 13 vergleichenden RCTs insgesamt 915 Teilnehmer bei (468 Intervention, 447 Kontrolle). Die eingeschlossenen RCTs wurden zwischen 2009 und 2025 veröffentlicht und in mehreren Ländern durchgeführt, darunter die Vereinigten Staaten, Dänemark, das Vereinigte Königreich, China, Ägypten und Rumänien. Zu den berücksichtigten Krebsarten gehörten Ovarialkarzinom (2 Studien), Endometriumkarzinom (4 Studien) und gemischte gynäkologische Krebserkrankungen (7 Studien). Die Interventionen waren sehr unterschiedlich und umfassten: strukturierte Bewegungsprogramme, Ernährungsumstellung, Beratung zur Gewichtsreduktion, psychoedukative Sitzungen, krankenschwestergeleitete Nachsorge, patientengestartete Versorgung, App-basiertes Achtsamkeitstraining sowie kombinierte Lebensstilinterventionen. Die Nachbeobachtungszeiträume lagen zwischen 3 und 6 Monaten.
Instrumente zur Erfassung der Lebensqualität umfassten: Funktionsbezogene Bewertung der Krebstherapie–General (FACT-G), FACT-Ovarial (FACT-O), FACT-Endometrial (FACT-En), Fragebogen zur Lebensqualität der europäischen Organisation für Forschung und Behandlung von Krebs, Kernmodul 30 (EORTC QLQ-C30), Kurzform-36 (SF-36) und krankheitsspezifische Skalen. Alle Instrumente wurden so gewertet, dass höhere Werte eine bessere Lebensqualität anzeigen.
Bewertung des Bias-Risikos
Das Verzerrungsrisiko wurde mit dem Cochrane RoB 2.0-Tool für die 13 randomisierten kontrollierten Studien (RCTs) und mit der Newcastle-Ottawa-Skala für die 2 beobachtenden Kohortenstudien bewertet. Eine Zusammenfassung der Bewertungen auf Ebene der Einzeldomänen ist im Verzerrungsrisiko-Traffic-Light-Plot dargestellt. Bei den RCTs waren die häufigsten methodischen Bedenken: (1) Domäne 2 (Abweichungen von den vorgesehenen Interventionen): Die Verblindung von Teilnehmern und Personal gegenüber Lebensstilinterventionen war in keiner Studie möglich; 9 von 13 Studien (69 %) wurden als having "einige Bedenken" oder "hohes Risiko" in diesem Bereich; (2) Bereich 3 (Fehlende Ergebnisdaten): Vier Studien (31 %) wiesen unvollständige Ergebnisdaten aufgrund von Ausscheidungsraten über 20 % auf, was als "einige Bedenken"; (3) – Bereich 1 (Randomisierungsprozess): Sieben Studien (54 %) beschrieben die Generierung der Zufolgssequenz und die Verblindung der Zuordnung angemessen; die übrigen wiesen unklare oder unzureichende Angaben auf; (4) Bereich 4 (Messung des Ergebnisses): Alle Studien verwendeten validierte, selbstberichtete QoL-Instrumente; die Verblindung der Ergebnisbeurteiler wurde jedoch nicht durchgängig berichtet; (5) Bereich 5 (Auswahl der berichteten Ergebnisse): Sechs Studien (46 %) hatten prospektiv registrierte Protokolle; die verbleibenden Studien verfügten über keine zugänglichen Protokolle, was Bedenken hinsichtlich einer selektiven Berichterstattung über Ergebnisse aufwirft.
Gesamtbewertung des Bias-Risikos: Keine Studie wurde in allen Bereichen als geringes Risiko eingestuft. Acht Studien (62 %) wurden als "einige Bedenken" insgesamt, und fünf Studien (38 %) wurden als "hohes Risiko" insgesamt hauptsächlich aufgrund fehlender Verblindung und kleiner Stichprobenumfänge, die zu Ungenauigkeiten führten
Bei den beiden Beobachtungs-Kohortenstudien (Budisan et al.33; Betea et al.34) führte das Fehlen einer zeitgleichen Vergleichsgruppe zu einem hohen Risiko für Störgrößen und Selektionsbias bei jeder kausalen Schlussfolgerung. Diese Studien wurden nur für die narrative Synthese beibehalten und trugen nicht zu den gepoolten Effektschätzungen bei.
Primäre Endpunkte
Lebensqualität nach 6 Monaten – allgemeine gynäkologische Onkologie
Neun vergleichende RCTs lieferten Daten zum Zeitpunkt von sechs Monaten, bestehend aus 693 Teilnehmern (358 Intervention und 335 Kontrolle). Die gepoolte mittlere Differenz (MD) unter Verwendung eines Zufallseffektmodells zeigte keine statistisch signifikante Verbesserung der Lebensqualität nach sechs Monaten im Vergleich zur Kontrollgruppe (MD = 2,11; 95 % KI: –0,90 bis 5,12; p = 0,17).
Abbildung 2 zeigt das Forest-Plot für diese Analyse. Die Heterogenität war erheblich: I2 = 71%, τ2 = 10,60.
Lebensqualität nach 6 Monaten – Untergruppe Ovarialkarzinom
Zwei Studien (Zhou et al.25; Maurer et al.29) lieferten spezifische Daten für Ovarialkarzinom und umfassten insgesamt 124 Teilnehmer (66 Interventionsgruppe, 58 Kontrollgruppe). Die gepoolte MD zeigte eine statistisch signifikante Verbesserung der Lebensqualität zugunsten der Interventionsgruppe (MD 4,28; 95 % CI 0,45–8,10; p = 0,03). Abbildung 3 zeigt das Forest-Plot für diese Analyse. Die Heterogenität war gering: I2 = 0 %, τ2 = 0.
Lebensqualität nach 6 Monaten – Untergruppe Endometriumkarzinom
Vier Studien (Von Gruenigen et al.21; McCarroll et al.23; Rossi et al.24; Jeppesen et al.26) lieferten Daten für Endometriumkarzinom, bestehend aus 172 Teilnehmern (92 Intervention, 80 Kontrolle). Um den Einfluss der überlappenden Kohorten der SUCCEED-Studie zu bewerten, wurde die Subgruppenanalyse für Endometriumkarzinom erneut durchgeführt, wobei McCarroll et al.23 ausgeschlossen wurden. Der gepoolte MD veränderte sich geringfügig von 2,00 (95 % KI: –1,49–5,49) auf 1,87 (95 % KI: –1,62–5,36), und I2 blieb bei 0 %. Der Ausschluss von McCarroll et al. veränderte die gepoolte Schätzung nicht wesentlich; der Effekt blieb statistisch nicht signifikant, und die Heterogenität blieb weiterhin nicht vorhanden (I2 = 0 %). Abbildung 4 zeigt das Forest-Plot für diese Analyse. Die Heterogenität war gering: I2 = 0 %, τ2 = 0.
Lebensqualität nach 3 Monaten – allgemeine gynäkologische Onkologie
Sechs vergleichende Studien (Von Gruenigen et al.21; Donnelly et al.22; McCarroll et al.23; Maurer et al.29; Elzeblawy Hassan et al.32; McCloy et al.30) berichteten über Ergebnisse nach 3 Monaten und umfassten insgesamt 275 Teilnehmer (140 Interventionsgruppe und 135 Kontrollgruppe). Die gepoolte MD zeigte keinen statistisch signifikanten Unterschied zwischen der Interventions- und der Kontrollgruppe (MD 6,43, 95 % KI: −0,16 bis 13,01, p = 0,06). Abbildung 5 zeigt das Forest-Plot für diese Analyse. Die Heterogenität war erheblich (I2 = 74 %, τ2 = 42,53).
Untergruppenanalysen
Vorab definierte Subgruppenanalysen nach Krebsart wurden durchgeführt, um Quellen der Heterogenität zu untersuchen. Für das allgemeine gynäkologisch-onkologische Ergebnis nach 6 Monaten: (1) Subgruppe Ovarialkarzinom (2 Studien): I2 = 0%, τ2 = 0; MD 4,28 (95 % CI 0,45–8,10); (2) Subgruppe Endometriumkarzinom (4 Studien): I2 = 0%, τ2 = 0; MD 2,00 (95 % CI: –1,49–5,49)
Die Unterteilung nach Krebsart verringerte die Heterogenität deutlich von I2 = 71 % in der Gesamtanalyse auf 0 % innerhalb jeder Untergruppe. Die geringe Anzahl an Studien innerhalb der einzelnen Untergruppen (jeweils 2 und 4) beschränkt jedoch die Genauigkeit dieser Untergruppenschätzungen.
Eine formale Interaktionstestung zwischen Subgruppen wurde nicht durchgeführt, da die Anzahl der Studien pro Subgruppe (<10) unzureichend war, um verlässliche Interaktionsschätzungen zu erhalten. Die scheinbaren Unterschiede in der statistischen Signifikanz zwischen den Subgruppen Ovarial- und Endometriumkarzinom sollten nicht als Hinweis auf unterschiedliche Behandlungseffekte je nach Krebsart interpretiert werden.
Ebenso wurde kein formeller Zeit-mal-Interaktionstest zwischen den Ergebnissen nach 3 und 6 Monaten durchgeführt.
Empfindlichkeitsanalysen
Ausschluss sich überlappender Kohorten
Um die Auswirkung der überlappenden Kohorten der SUCCEED-Studie (Von Gruenigen et al.21 und McCarroll et al.23) zu bewerten, wurde die Subgruppenanalyse für das Endometrium erneut durchgeführt, wobei die Daten von McCarroll et al.23 ausgeschlossen wurden.
Der gepoolte MD veränderte sich geringfügig von 2,00 (95 % KI: –1,49–5,49) auf 1,87 (95 % KI: –1,62–5,36), und I2 blieb bei 0 %. Dies zeigt, dass die doppelte Kohorte die Punktschätzung oder die Schlussfolgerung, dass kein signifikanter Effekt vorliegt, nicht wesentlich beeinflusst hat.
Für das allgemeine 6-Monats-Ergebnis änderte sich der gepoolte MD nach Ausschluss von McCarroll et al. von 2,11 (95% KI: −0,90–5,12) auf 2,33 (95% KI: −1,16–5,82), wobei sich das I2 von 71 % auf etwa 72 % veränderte. Der Effekt blieb statistisch nicht signifikant, was darauf hindeutet, dass der Ausschluss der überlappenden Kohorte die Gesamtschlussfolgerung nicht wesentlich veränderte.
Einflussanalyse mit Ausschlussverfahren
Die schrittweise Entfernung einzelner Studien ergab gepoolte MDs im Bereich von etwa 1,29 bis 4,33. Die Heterogenität blieb im Allgemeinen erheblich nach Ausschluss der meisten Studien; allerdings verringerte sich der I2-Wert durch den Ausschluss von McCorkle et al.20 auf 0 %, was darauf hindeutet, dass diese Studie maßgeblich zur beobachteten Heterogenität zwischen den Studien beigetragen hat. Die Gesamtergebnisse sollten daher mit Vorsicht interpretiert werden.
Vergleich des Fixed-Effect-Modells
Unter einem Fixed-Effect-Modell betrug der gepoolte MD für das allgemeine 6-Monats-Ergebnis 3,80 (95%-KI: 2,97–4,62), während das Random-Effects-Modell einen MD von 2,11 (95%-KI: −0,90–5,12) ergab. Der Unterschied in der statistischen Signifikanz zwischen den beiden Modellen zeigt an, dass die Heterogenität zwischen den Studien die gepoolte Schlussfolgerung wesentlich beeinflusst. Angesichts der erheblichen Heterogenität (I2 = 71 %) wurde die Schätzung nach dem Random-Effects-Modell als die geeignetere für die Interpretation angesehen.
Publikationsbias
Keiner der zusammengefassten Ergebnisse umfasste 10 oder mehr Studien. Daher wurden Funnel-Plots und Eggers RegressionsTests nicht durchgeführt, da diese Analysen aufgrund der verfügbaren Anzahl an Studien unterdimensioniert gewesen wären und potenziell irreführend gewesen sein könnten.
Obwohl aufgrund der geringen Anzahl an Studien keine formale Bewertung durchgeführt wurde, können Publikationsbias und selektive Berichterstattung nicht ausgeschlossen werden. Die Möglichkeit, dass negative oder nicht signifikante Ergebnisse unveröffentlicht bleiben, sollte daher bei der Interpretation der Evidenz berücksichtigt werden.
Datenverfügbarkeit
Der während der aktuellen Studie analysierte Datensatz ist verfügbar unter 10.5281/zenodo.21777130 (https://doi.org/10.5281/zenodo.21777130).
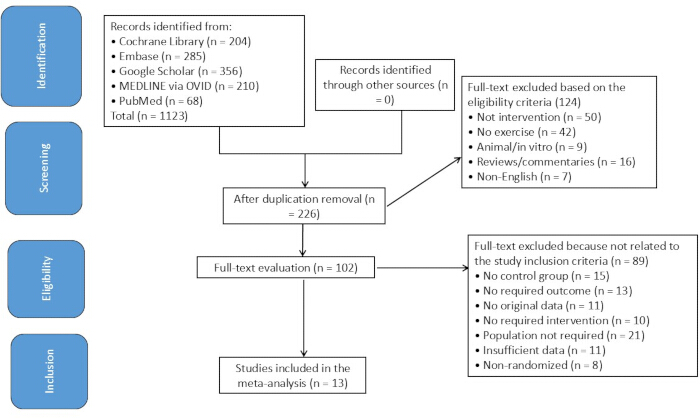
Abbildung 1: PRISMA-2020-Flussdiagramm zur Studienauswahl. Flussdiagramm, das die Identifizierung, Sichtung, Eignungsbeurteilung und Einschluss von Studien veranschaulicht, die Lebensstil- und gynäkologische onkologische Pflegeinterventionen zur Lebensqualität bei Frauen mit gynäkologischen Krebserkrankungen evaluieren. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
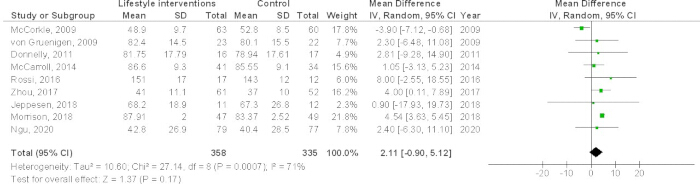
Abbildung 2: Forest-Plot zur Lebensqualität nach 6 Monaten bei Frauen mit gynäkologischen Krebserkrankungen. Forest-Plot zum Vergleich von Lebensstil- und gynäkologisch-onkologischen Pflegeinterventionen mit Kontrollgruppen hinsichtlich der Lebensqualität beim 6-Monats-Follow-up. Die Ergebnisse werden als mittlere Differenzen (MDs) mit 95 % Konfidenzintervallen (CIs) unter Verwendung eines Random-Effects-Modells dargestellt. Positive MD-Werte sprechen für die Interventionsgruppe. Die Heterogenität wird mittels der I2-Statistik angegeben. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
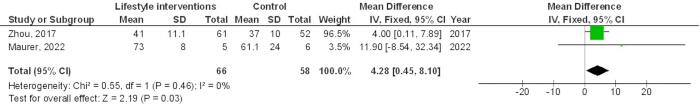
Abbildung 3: Forest-Plot der Lebensqualität nach 6 Monaten bei Frauen mit Ovarialkarzinom. Forest-Plot, das die Wirkung von Lebensstil- und gynäkologisch-onkologischen Pflegeinterventionen auf die Lebensqualität beim 6-Monats-Follow-up bei Frauen mit Ovarialkarzinom zeigt. Die Ergebnisse werden als mittlere Unterschiede (MDs) mit 95 % Konfidenzintervallen (CIs) dargestellt. Positive MD-Werte sprechen für die Interventionsgruppe, und die Heterogenität wird mithilfe der I2-Statistik zusammengefasst. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
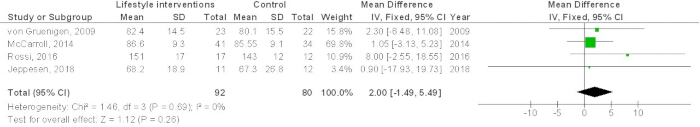
Abbildung 4: Forest-Plot der Lebensqualität nach 6 Monaten bei Frauen mit Endometriumkarzinom. Forest-Plot zum Vergleich von Lebensstil- und gynäkologisch-onkologischen Pflegeinterventionen mit Kontrollgruppen hinsichtlich der Lebensqualität beim 6-Monats-Follow-up bei Frauen mit Endometriumkarzinom. Die Ergebnisse werden als mittlere Differenzen (MD) mit 95 % Konfidenzintervallen (KI) angegeben. Positive MD-Werte sprechen für die Interventionsgruppe, und die Heterogenität wird mittels der I2-Statistik berichtet. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
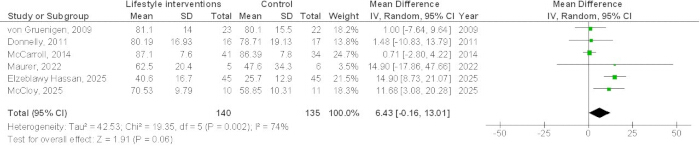
Abbildung 5: Forest-Plot zur Lebensqualität nach 3 Monaten bei Frauen mit gynäkologischen Krebserkrankungen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Forestplot zum Vergleich von Lebensstil- und gynäkologisch-onkologischen Pflegeinterventionen mit Kontrollgruppen hinsichtlich der Lebensqualität beim 3-Monats-Follow-up. Die Ergebnisse werden als mittlere Unterschiede (MDs) mit 95 % Konfidenzintervallen (CIs) unter Verwendung eines Zufallseffektmodells dargestellt. Positive MD-Werte sprechen für die Interventionsgruppe. Die Heterogenität wird mittels der I2-Statistik angegeben.
Tabelle 1: Datenbanksuchstrategien, die für die Literatursuche verwendet wurden. Um einschlägige Studien in PubMed, Embase, der Cochrane Library, Ovid und Google Scholar zu identifizieren, kamen umfassende Suchstrategien zum Einsatz. Die Suchbegriffe kombinierten kontrollierte Fachbegriffe und Freitextschlüsselwörter im Zusammenhang mit gynäkologischen Krebserkrankungen, Lebensstilinterventionen, onkologischer Pflege und Lebensqualität. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 2: Merkmale der eingeschlossenen RCTs. Zusammenfassung der Merkmale der eingeschlossenen Studien, einschließlich Studiendesign, Krebsart, Intervention und Vergleichsgruppe, Stichprobengröße, Instrument zur Lebensqualitätsbeurteilung, Dauer der Nachbeobachtung und Eignung für die quantitative Metaanalyse. Studien ohne geeignete Vergleichsgruppe wurden nur in die qualitative Synthese einbezogen. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Zusatzdatei 1: PRISMA 2020-Checkliste. Ausgefüllte PRISMA 2020-Checkliste, die die Seitenzahlen des Manuskripts angibt, die den einzelnen Berichtspunkten entsprechen, gemäß der PRISMA 2020-Erklärung zur Berichterstattung über systematische Übersichtsarbeiten und Metaanalysen.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Die primäre Analyse nach 6 Monaten zeigte keine statistisch signifikante Verbesserung der Lebensqualität bei gemischten gynäkologischen Karzinomen (MD 2,11, 95 % KI: −0,90 bis 5,12, p = 0,17), hingegen wurde in der Subgruppe der Ovarialkarzinome eine signifikante Verbesserung beobachtet (MD 4,28, 95 % KI: 0,45–8,10, p = 0,03). Nach 6 Monaten zeigte sich weder beim Endometriumkarzinom (MD 2,00, 95 % KI: −1,49 bis 5,49, p = 0,26) noch bei gemischten Krebserkrankungen nach 3 Monaten (MD 6,43, 95 % KI: −0,16 bis 13,01, p = 0,06) ein signifikanter Effekt.
Diese Ergebnisse zeigen nach 6 Monaten keinen signifikanten gesamten Lebensqualitätsgewinn, obwohl in der Untergruppe der Eierstockkrebspatientinnen eine signifikante Verbesserung beobachtet wurde. Die primäre Analyse nach 6 Monaten wies eine erhebliche Heterogenität auf (I2 = 71 %), und die GRADE-Evidenzsicherheit für alle gepoolten Ergebnisse wurde als sehr niedrig eingestuft. Folglich sollten diese Ergebnisse als hypothetisch generierend und nicht als praxisverändernd betrachtet werden.
Entscheidend ist, dass die scheinbaren Unterschiede in der Signifikanz zwischen Krebsarten und Zeitpunkten nicht formal auf Interaktion geprüft wurden und daher nicht als Hinweis auf unterschiedliche Wirksamkeit interpretiert werden sollten. Die beobachteten Muster könnten Unterschiede in den Studienpopulationen, Interventionselementen, Stichprobengrößen oder Zufall widerspiegeln, anstatt echte biologische oder zeitliche Unterschiede. Alle Schlussfolgerungen bezüglich des Zeitpunkts oder tumorspezifischer Effekte sind spekulativ und bedürfen der Bestätigung in zukünftigen direkten Vergleichsstudien.
Vergleich mit früheren Studien
Die vorliegenden Ergebnisse stimmen teilweise mit der früheren systematischen Übersichtsarbeit von Smits et al.10 überein, die Lebensstilinterventionen bei Frauen mit Endometrium- und Ovarialkarzinom bewertete und nur begrenzte Belege für signifikante Verbesserungen der Lebensqualität fand. Die breitere Einbeziehung von pflegerischen Interventionen sowie zusätzlicher seit 2015 veröffentlichter Studien liefert jedoch ein aktuelleres, wenn auch weiterhin unsicheres Bild. Die sehr niedrige GRADE-Evidenzsicherheit in dieser Übersichtsarbeit ist deutlich vorsichtiger als die Schlussfolgerungen einiger Originalstudien und spiegelt die strengere methodische Bewertung wider, die in der vorliegenden Übersichtsarbeit angewandt wurde, sowie die ausdrückliche Anerkennung der inhärenten Grenzen der Evidenzbasis11.
Der beobachtete Nutzen in der Untergruppe der Eierstockkrebspatientinnen stimmt mit früheren Untersuchungen von Zhou et al.25 und Maurer et al.29 überein, die berichteten, dass strukturierte Bewegungsinterventionen die körperliche Leistungsfähigkeit und das allgemeine Wohlbefinden bei Überlebenden von Eierstockkrebs verbessern. Dies könnte durch die erhebliche körperliche Beeinträchtigung, die neuropathischen Nebenwirkungen der Chemotherapie sowie abdominale Komplikationen erklärt werden, die die Mobilität dieser Patientengruppe beeinträchtigen und dadurch Bewegungsinterventionen besonders vorteilhaft machen. Allerdings verbietet die geringe Anzahl an Studien (n = 2) belastbare Schlussfolgerungen.
Im Gegensatz dazu widerspricht das nichtsignifikante Ergebnis für Endometriumkarzinom nach 6 Monaten früheren positiven Befunden einzelner Studien (z. B. Von Gruenigen et al.21; Rossi et al.24). Die Zusammenfassung dieser Studien, einschließlich überlappender Kohorten aus der SUCCEED-Studie, zeigte keinen signifikanten Effekt, was darauf hindeutet, dass frühere positive Ergebnisse aufgrund kleiner Stichprobenumfänge oder Publikationsbias überschätzt worden sein könnten. Das Fehlen eines signifikanten Effekts könnte auch auf die heterogene Natur von Überlebenden eines Endometriumkarzinoms zurückzuführen sein, die häufig Adipositas und metabolisches Syndrom aufweisen und daher intensivere oder individuell angepasste Interventionen benötigen, um messbare Verbesserungen der Lebensqualität zu erzielen.
Die vorliegenden Ergebnisse stimmen auch mit Mokhtari-Hessari und Montazeri35 überein, die signifikante Verbesserungen der Lebensqualität durch pflegerische Interventionen bei Brustkrebspatientinnen berichteten. Ebenso fanden Aktas und Terzioglu36, dass eine häusliche pflegerische Betreuung die Lebensqualität bei Frauen, die eine Behandlung in der gynäkologischen Onkologie erhielten, deutlich verbesserte, und Ma et al.37 zeigten, dass eine intensive psychologische Pflege die negativen Stimmungszustände verringerte und die Lebensqualität bei Patientinnen mit Gebärmutterhalskrebs verbesserte. Diese konsistenten Hinweise über verschiedene Krebsarten und Settings hinweg unterstreichen das potenzielle Wert umfassender pflegerischer Betreuung, auch wenn die methodische Qualität der zugrundeliegenden Evidenz weiterhin bedenklich ist.
Plausible Mechanismen
Obwohl die gepoolten Schätzungen keine Kausalität belegen können, lassen mehrere Wirkwege die beobachteten Signale bezüglich der Lebensqualität (QoL) erklären. Strukturierte körperliche Aktivität und Ernährungsumstellung reduzieren pro‑entzündliche Zytokine (z. B. IL‑6, TNF‑α) und C‑reaktives Protein, das mit Krebs in Verbindung steht‑bezogenen Müdigkeit, Schmerzen und Depression. Bei Überlebenden von Endometrium- und Brustkrebs senken Gewichtsreduktion und Bewegung außerdem Östrogen- und IGF-Spiegel‑1-Ebenen, was möglicherweise den Tumormetabolismus und die systemische Energiebalance beeinflusst. Psychosozial gesehen, Pflegefachkraft‑geleitete Psychoedukation, Beratung und regelmäßige Nachbetreuung‑kann die Selbst‑Wirksamkeit, Verringerung der Angst vor Rückfall und Verbesserung der Therapietreue. Die konsistentere 6‑Monat (im Vergleich zu 3)‑Monat) könnten (wenn auch nicht formell geprüft) die Zeit widerspiegeln, die erforderlich ist, damit sich Verhaltensänderungen verfestigen und biologische Anpassungen ansammeln können. Allerdings wurden keine dieser Mechanismen in den eingeschlossenen Studien direkt gemessen; diese Diskussion ist spekulativ und soll zukünftige mechanistische Forschungen leiten.
Methodische Einschränkungen
Fehlende prospektive Protokollregistrierung: Eine wesentliche Einschränkung ist das Fehlen einer Registrierung in einer prospektiven Datenbank (z. B. PROSPERO, INPLASY oder OSF Registries). Ohne ein öffentlich zugängliches, vorab registriertes Protokoll besteht die Möglichkeit von Berichts- oder Selektionsbias bezüglich der Ergebnisse, da die Entscheidungen zur Studienauswahl, Datengewinnung und -analyse nicht unabhängig anhand eines vorab festgelegten Plans überprüft werden können. Die Leser sollten die aggregierten Schätzungen im Hinblick darauf bewerten.
Hohe Heterogenität: Die primäre 6-Monats-Analyse wies ein I2 = 71 %, was gemäß den Cochrane-Richtlinien als "beträchtlich" und oft ein Kriterium dafür, keine Poolbildung vorzunehmen. Obwohl die Unterteilung nach Krebsart die I2 auf 0 % für beide Untergruppen, Eierstock- und Endometriumkarzinom, wobei jede Untergruppe nur wenige Studien umfasste (2 bzw. 4), wodurch diese Schätzungen ungenau sind. Die Heterogenität kann nicht eindeutig allein auf den Krebstyp zurückgeführt werden. Andere plausible Quellen—Unterschiede in der Intensität der Intervention, Dauer, Durchführungsmodus, Kontrollbedingungen, basalen Teilnehmermerkmalen und Ergebnismessung—wurden aufgrund unzureichender Kovariaten-Daten nicht formal untersucht. Angesichts dieser Überlegungen sollte der gepoolte MD für die primäre Analyse als mathematisch erzeugte Zusammenfassung und nicht als klinisch aussagekräftige Schätzung betrachtet werden.
Bias-Risiko: Keine RCT wurde in allen Domänen des Cochrane RoB 2.0 als geringes Risiko eingestuft. Die Mehrheit wurde als having "einige Bedenken" oder "hohes Risiko," hauptsächlich aufgrund fehlender Teilnehmer-Verblindung (unvermeidbar bei Lebensstilinterventionen) und unvollständiger Outcome-Daten. Die Einbeziehung überlappender Kohorten aus der SUCCEED-Studie erhöht das Gewicht dieser spezifischen Intervention in der Endometrium-Subgruppe künstlich; eine Sensitivitätsanalyse ohne die Duplikate veränderte den Punktschätzer nicht wesentlich, bleibt jedoch eine strukturelle Einschränkung.
Einbeziehung von Beobachtungsstudien: Zwei der 15 eingeschlossenen Berichte verfügten vollständig über keine Vergleichsgruppe (Budisan et al.33; Betea et al.34). Obwohl diese Studien zur vermeidung einer Selektionsverzerrung für die narrative Synthese beibehalten wurden, konnten sie nicht in die zusammengefassten Interventionseffekte einbezogen werden und wurden als hochgradig gefährdet durch Stör- und Selektionsverzerrungen eingestuft.
Interventions- und Ergebnisvielfalt: Die vergleichenden Studien umfassten eine breite Palette von Interventionen—strukturierte Bewegungsprogramme, Ernährungsumstellung, Beratung zur Gewichtsreduktion, psychoedukative Sitzungen, krankenschwestergeleitete Nachsorge, patienteninitiierte Versorgung und App-basiertes Achtsamkeitstraining. Zusammenfassung solch unterschiedlicher Interventionen unter dem Oberbegriff "Lebensstil-/Pflegeintervention" liefert eine Schätzung des durchschnittlichen Effekts, aber dieser Durchschnitt mag auf keinen spezifischen Interventionstyp zutreffen. Ebenso haben zwar alle Studien die gesundheitsbezogene Lebensqualität (QoL) gemessen, jedoch unterschiedliche Instrumente verwendet (FACT-G, FACT-O, FACT-En, EORTC QLQ-C30, SF-36), was eine indirekte Heterogenität verursachen kann.
Eine zuverlässige Beurteilung der Publikationsbias war nicht möglich, da keiner der zusammengefassten Endpunkte 10 oder mehr Studien umfasste. Daher wurden asymmetrische Testverfahren (Funnel-Plots) und Eggers Regressions-Tests nicht durchgeführt. Die geringen Stichprobengrößen und die vorherrschende Zahl positiver Studien in der Literatur legen die Vermutung nahe, dass negative oder nicht signifikante Ergebnisse möglicherweise unveröffentlicht geblieben sind.
Kurze Nachbeobachtungszeit und fehlende Subgruppenanalysen: Die meisten Studien umfassten kurze Nachbeobachtungszeiträume (3–6 Monate), wodurch das Verständnis der langfristigen Nachhaltigkeit von QoL-Verbesserungen eingeschränkt wurde. Das Fehlen umfassender Subgruppenanalysen (z. B. nach Alter, Krankheitsstadium, sozioökonomischem Status) erschwerte die Identifizierung spezifischer Patientenkategorien, die möglicherweise den größten Nutzen ziehen.
GRADE-Sicherheit
Die formale GRADE-Bewertung stufte die Gesamtsicherheit der Evidenz für alle vier zusammengefassten Ergebnisse als SEHR NIEDRIG ein. Dieses Urteil beruht auf: (i) einem ernsthaften bis sehr ernsthaften Bias-Risiko in den eingeschlossenen RCTs; (ii) einer sehr ernsthaften Inkonsistenz bezüglich des primären 6-Monats-Ergebnisses (I2 = 71 %); (iii) einer indirekten Evidenz für die Endometriums-Subgruppe, in der überwiegend übergewichtige bzw. adipöse Überlebende rekrutiert wurden, was die Verallgemeinerbarkeit einschränkt; und (iv) einer ernsthaften bis sehr ernsthaften Unpräzision aufgrund kleiner Gesamtstichprobenumfänge pro Subgruppe sowie breiter Konfidenzintervalle, die oft den Nullwert überschreiten. Folglich ist das Vertrauen in die Effektgrößen sehr begrenzt; die tatsächlichen Effekte unterscheiden sich vermutlich erheblich von den berichteten Punktschätzungen.
Klinische Implikationen
Angesichts der sehr geringen Evidenzsicherheit und der erheblichen Heterogenität sind diese Ergebnisse hypothetisch‑Erzeugung anstelle von Übung‑verändern. Ärzte sollten ihre routinemäßige supportivmedizinische Versorgung nicht aufgrund dieser gepoolten Schätzungen ändern. Dennoch können einige vorsichtige Beobachtungen die Patientengespräche beeinflussen: (i) Entscheidungen zur supportiven Versorgung sollten an die Präferenzen des Patienten und den klinischen Kontext individuell angepasst werden; (ii) die Subgruppe der Ovarialkarzinome zeigte das einzige statistisch kohärente Signal (MD 4,28, 95 % KI: 0,45–8,10), was darauf hindeutet, dass diese Patientengruppe möglicherweise besonders von Bewegungsinterventionen profitieren könnte, wenngleich diese Aussage nur auf zwei kleinen Studien basiert. Die durchgängig positiven Effekte in den Studien unterstreichen die Bedeutung einer umfassenden pflegerischen Betreuung – einschließlich Schmerzmanagement, emotionaler Unterstützung, Patientenbildung und Koordination der Versorgung – als zentralen Bestandteil der multidisziplinären Krebsbehandlung. Entscheidend ist, dass die scheinbaren Unterschiede zwischen Krebsarten und Zeitpunkten nicht formal auf Interaktionen geprüft wurden und daher nicht überinterpretiert werden sollten.
Zukünftige Forschung
Dieser Überblick macht kritische Wissenslücken deutlich, die zukünftige Forschungsarbeiten adressieren müssen. Hoch‑Qualitativ hochwertige, multizentrische RCTs sind dringend erforderlich, mit standardisierten und manualisierten Interventionen, veröffentlichte Protokolle, Absicht‑zu‑Behandlungsanalysen, längere Nachbeobachtung‑oben (≥12 Monate) sowie vorgegebene Subgruppenanalysen mit formalem Interaktionstest. Mechanistische Studien sollten Biomarker-Assessments (entzündliche Zytokine, hormonelle Profile) und validierte psychosoziale Vermittler (Selbst)‑Wirksamkeit, soziale Unterstützung), um festzustellen, welche Interventionskomponenten am wirksamsten sind und bei welchen Patientensubgruppen der größte Nutzen erzielt wird. Zudem sind ökonomische Evaluierungen erforderlich, um die Kosten zu bewerten‑Wirksamkeit und informieren die Ressourcenallokation. Künftige systematische Übersichtsarbeiten mit einer umfangreicheren Evidenzgrundlage sollten prüfen, ob eine Meta‑Analyse bleibt für derart unterschiedliche Interventionen angemessen oder wäre eine narrative Synthese aussagekräftiger. Schließlich Patient‑zentrierte Ergebnisse—einschließlich Domäne‑spezifische QoL-Maße und Patient‑berichtete Erfassungsmaße—sollte priorisiert werden, wobei die Einbindung von Patientinnen und der Öffentlichkeit in das Studiendesign sicherstellt, dass die Forschung Themen behandelt, die für Frauen mit gynäkologischen Malignitäten am wichtigsten sind.
Diese Metaanalyse ergab keine statistisch signifikante Verbesserung der allgemeinen Lebensqualität bei Frauen mit gynäkologischen Krebserkrankungen nach 3 oder 6 Monaten. Bei der Untergruppe der Eierstockkrebspatientinnen wurde nach 6 Monaten eine signifikante Verbesserung beobachtet, während in der Untergruppe der Endometriumkarzinompatientinnen kein signifikanter Effekt festgestellt wurde. Aufgrund erheblicher Heterogenität, methodischer Einschränkungen, kleiner Untergruppengrößen und Evidenz mit sehr geringer Sicherheit sind jedoch vorsichtige Interpretationen erforderlich. Größere, gut konzipierte Studien mit standardisierten Interventionen und längeren Nachbeobachtungszeiträumen sind notwendig, um die Wirkung von Lebensstil- und pflegerischen Interventionen auf die Lebensqualität bei Frauen mit gynäkologischen Malignitäten zu klären.
Offenlegungen
Die Autoren haben keine Interessenkonflikte offenzulegen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| EndNote | Clarivate Analytics | https://endnote.com | Referenzverwaltung, Entfernung von Duplikaten, Zitierformatierung |
| GRADEpro GDT | McMaster University und Evidence Prime | McMaster University / Evidence Prime; https://gradepro.org | GRADE-Zertifizierungsbeurteilung (Online-Version) |
| PRISMA 2020-Checkliste | PRISMA-Erklärung | PRISMA-Erklärung; https://www.prisma-statement.org | Berichtskonformität |
| R | R Foundation for Statistical Computing | R Foundation; https://cran.r-project.org | Statistische Analyse, Sensitivitätsanalysen, Einflussanalysen, Abbildungen (Version 4.3.1 oder höher) |
| R-Paket: meta | CRAN | CRAN; https://cran.r-project.org/package=meta | Funktionen für Metaanalysen (Pooling, Heterogenität, Forest-Plots, Funnel-Plots), Version 6.0.0 oder höher |
| R-Paket: metafor | CRAN | CRAN; https://cran.r-project.org/package=metafor | REML-Schätzung, Einflussdiagnose, zusätzliche metaanalytische Funktionen (4.0.0 oder höher) |
| Review Manager | RevMan | Cochrane Collaboration; https://training.cochrane.org/online-learning/core-software-cochrane-reviews/revman[reference:14] | Metaanalyse (Pooling, Forest-Plots, Heterogenität, Bias-Risikobewertung), Version 5.4 |
Referenzen
- Ackroyd SA, Shih YCT, Kim B, Lee NK, Halpern MT. A look at the gynecologic oncologist workforce – are we meeting patient demand Gynecol Oncol. 2021;163(2):229-36.
- Williams N, et al. The supportive care needs of women experiencing gynaecological cancer: a Western Australian cross-sectional study. BMC Cancer. 2018;18(1):912.
- Bizzarri N, et al. Building a personalized medicine infrastructure for gynecological oncology patients in a high-volume hospital. J Pers Med. 2022;12(1):3.
- Buckley L, Robertson S, Wilson T, Sharpless J, Bolton S. The role of the specialist nurse in gynaecological cancer. Curr Oncol Rep. 2018;20(10):83.
- Parkinson N, Pratt H. Clinical nurse specialists and the psychosexual needs of patients with gynaecological cancer. Br Menopause Soc J. 2005;11(1):33-5.
- Kobleder A, Mayer H, Gehrig L, Senn B. “Promoting continuity of care”—specialist nurses’ role experiences in gynaecological oncology: a qualitative study. J Clin Nurs. 2017;26(23-24):4890-8.
- Cook O, McIntyre M, Recoche K, Lee S. “Our nurse is the glue for our team”—multidisciplinary team members' experiences and perceptions of the gynaecological oncology specialist nurse role. Eur J Oncol Nurs. 2019;41:7-15.
- Lavdaniti M, et al. Factors influencing quality of life in breast cancer patients six months after the completion of chemotherapy. Diseases. 2019;7(1):26.
- Perry S, Kowalski TL, Chang CH. Quality of life assessment in women with breast cancer: benefits, acceptability and utilization. Health Qual Life Outcomes. 2007;5(1):24.
- Chhikara BS, Parang K. Global cancer statistics 2022: the trends projection analysis. Chem Biol Lett. 2023;10(1):451.
- Smits A, et al. The effect of lifestyle interventions on the quality of life of gynaecological cancer survivors: a systematic review and meta-analysis. Gynecol Oncol. 2015;139(3):546-52.
- Stroup DF, et al. Meta-analysis of observational studies in epidemiology: a proposal for reporting. JAMA. 2000;283(15):2008-12.
- Page MJ, et al. The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ. 2021;372:n71.
- Liberati A, et al. The PRISMA statement for reporting systematic reviews and meta-analyses of studies that evaluate health care interventions: explanation and elaboration. J Clin Epidemiol. 2009;62(10):e1-34.
- Gupta S, et al. Efficacy of generic oral directly acting agents in patients with hepatitis C virus infection. J Viral Hepat. 2018;25(7):771-8.
- Adeiza SS, Aminul I. Meta-meta-analysis of the mortality risk associated with MRSA compared to MSSA bacteraemia. Infez Med. 2024;32(2):131-7.
- Higgins J, et al., editors. Cochrane handbook for systematic reviews of interventions. 2nd ed. Wiley & Sons; Chichester, UK; 2019.
- Sheikhbahaei S, et al. FDG-PET/CT and MRI for evaluation of pathologic response to neoadjuvant chemotherapy in patients with breast cancer: a meta-analysis of diagnostic accuracy studies. Oncologist. 2016;21(8):931-9.
- Higgins JP, Thompson SG, Deeks JJ, Altman DG. Measuring inconsistency in meta-analyses. BMJ. 2003;327(7414):557-60.
- McCorkle R, et al. Effects of a nursing intervention on quality of life outcomes in post-surgical women with gynecological cancers. Psychooncology. 2009;18(1):62-70.
- Von Gruenigen VE, et al. A randomized trial of a lifestyle intervention in obese endometrial cancer survivors: quality of life outcomes and mediators of behavior change. Health Qual Life Outcomes. 2009;7(1):17.
- Donnelly CM, et al. A randomised controlled trial testing the feasibility and efficacy of a physical activity behavioural change intervention in managing fatigue with gynaecological cancer survivors. Gynecol Oncol. 2011;122(3):618-24.
- McCarroll ML, et al. Self-efficacy, quality of life, and weight loss in overweight/obese endometrial cancer survivors (SUCCEED): a randomized controlled trial. Gynecol Oncol. 2014;132(2):397-402.
- Rossi A, et al. Feasibility of a physical activity intervention for obese, socioculturally diverse endometrial cancer survivors. Gynecol Oncol. 2016;142(2):304-10.
- Zhou Y, et al. Randomized trial of exercise on quality of life in women with ovarian cancer: Women’s Activity and Lifestyle Study in Connecticut (WALC). J Natl Cancer Inst. 2017;109(12).
- Jeppesen M, Jensen P, Hansen D, Christensen R, Mogensen O. Patient-initiated follow up affects fear of recurrence and healthcare use: a randomised trial in early-stage endometrial cancer. BJOG. 2018;125(13):1705-14.
- Morrison V, et al. Trial of optimal personalised care after treatment—gynaecological cancer (TOPCAT-G): a randomized feasibility trial. Int J Gynecol Cancer. 2018;28(2):401-11.
- Ngu SF, et al. Nurse-led follow-up in survivorship care of gynaecological malignancies—a randomised controlled trial. Eur J Cancer Care (Engl). 2020;29(6):e13325.
- Maurer T, et al. Randomised controlled trial testing the feasibility of an exercise and nutrition intervention for patients with ovarian cancer during and after first-line chemotherapy (BENITA-study). BMJ Open. 2022;12(2):e054091.
- McCloy K, et al. Management of fatigue in gynaecological cancer: a feasibility study of an app-based exercise and mindfulness intervention. Gynecol Oncol Rep. 2025;60:101807.
- Darwish EAF, Tayel SEA, Meleis MEH, Abou Elwafa HE, Shaaban Marouf FSA. A randomized controlled trial of the effect of a psychoeducational intervention program on quality of life of patients with gynecological cancers. Alex J Med. 2025;61(1):6-14.
- Elzeblawy Hassan H, Khalaf Gooda W, Ragabahmed T, Shehta Said Farag D. Marital, sexual satisfaction and quality of life among post-hysterectomy women: impact of nursing counseling guided by BETTER model. Egypt J Health Care. 2025;16(1):99-116.
- Budisan C, et al. Physical, emotional, and stress-related dynamics over six months in newly diagnosed epithelial ovarian cancer survivors. J Clin Med. 2025;14(14):5087.
- Betea R, et al. Quality-of-life trajectories and perceived stress in women treated for uterine cancer: a six-month prospective study. Healthcare (Basel). 2025;13(15):1787.
- Mokhtari-Hessari P, Montazeri A. Health-related quality of life in breast cancer patients: review of reviews from 2008 to 2018. Health Qual Life Outcomes. 2020;18(1):338.
- Aktas D, Terzioglu F. Effect of home care service on the quality of life in patients with gynecological cancer. Asian Pac J Cancer Prev. 2015;16(9):4089-94.
- Ma Y, Kamalibaike M, Xin C, Li L. Effect of the intensive psychological nursing on adverse mood and quality of life in patients with cervical cancer. Am J Transl Res. 2021;13(8):9633-8.