Dieses Protokoll beschreibt die Entwicklung und Bewertung eines richtlinienbasierten, abruf-augmentierten Generierungs-Chatbots, der Inhalte aus webbasierten klinischen Praxisrichtlinien für Krebs abruft und zusammenfasst, um referenzbasierte Antworten auf Nutzerfragen zu generieren.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Methodenartikel
Entwicklung eines richtlinienbasierten Retrieval-Augmented Generation Chatbots, der webbasierte klinische Praxisrichtlinien für Krebs referenziert
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die weitverbreitete Verfügbarkeit medizinischer Informationen im Internet hat den Zugang zu gesundheitsbezogenem Wissen für Patienten verbessert; Allerdings hat sie auch die Exposition gegenüber ungenauen medizinischen Informationen erhöht. Die Krebsversorgung beinhaltet komplexe Informationen, was es Patienten erschwert, genaue und evidenzbasierte Quellen zu identifizieren. Große Sprachmodelle ermöglichen die natürliche Sprachinteraktion, erzeugen jedoch häufig Halluzinationen, was ihre Anwendung in der medizinischen Informationsvermittlung einschränkt. Retrieval-augmentierte Erzeugung (RAG) hat das Potenzial, diese Risiken zu mindern, indem sie Antworten in externen Referenzquellen verankert. Diese Studie beschreibt die Entwicklung und Bewertung eines richtlinienbasierten RAG-Chatbots, der öffentlich zugängliche, webbasierte klinische Praxisrichtlinien für Krebs verwendet. Das System extrahiert URLs aus den Inhaltsverzeichnis-Seiten einer Richtlinie, verarbeitet Seitentexte mittels morphologischer Analyse und Kosinusähnlichkeit basierend auf Begriffshäufigkeit und inverser Dokumentfrequenz und konstruiert Referenzinformationen aus hochrelevanten Seiten. Ein großes Sprachmodell verwendet diese Referenzen, um Antworten zu generieren, die auf Leitlinieninhalte beschränkt sind. Der JLCS-Leitfaden für Lungenkrebspatienten und -familien wurde als Referenzrichtlinie verwendet. Die Fragegruppen umfassten sowohl Krebsarten im Rahmen der Leitlinie als auch Krebstypen außerhalb des Scope zur Bewertung der Antwortkontrolle. Medizinische Informationen wurden erfolgreich aus den Inhaltsverzeichnissen extrahiert, wobei 98 % der extrahierten URLs referenzfähige medizinische Inhalte enthielten. Bei Fragen im Rahmen des Umfangs generierte der Chatbot Antworten durch Zusammenfassung der Leitlinieninhalte, und während der manuellen Überprüfung unter den definierten Testbedingungen wurden keine Halluzinationen festgestellt. Bei Fragen außerhalb des Themenbereichs lehnte der Chatbot konsequent eine Antwort ab und gab an, dass die verfügbaren Informationen unzureichend seien. Die Webstruktur der Richtlinie erleichterte ein effizientes Scraping und die Organisation von Referenzinhalten auf URL-Ebene. Dieses Protokoll bietet praktische Anleitungen für den Aufbau künstlicher Intelligenzsysteme, die medizinische Informationen mithilfe webbasierter klinischer Praxisrichtlinien liefern.
Einleitung
Die weitverbreitete Nutzung des Internets und der sozialen Medien hat es Patienten erleichtert, medizinische Informationenzuzugreifen 1,2. Informationen zur Krebsversorgung sind oft komplex und umfangreich, was es Patienten besonders schwer macht, Quellen zu identifizieren, die genau, relevant und auf wissenschaftlichen Evidenzen basieren3. Obwohl Online-Ressourcen das Verständnis der Patienten fördern können, enthalten sie auch erhebliche Mengen falscher medizinischer Informationen3, die die Entscheidungen der Patienten bezüglich ihrer Versorgung negativ beeinflussen können4. Da krebsbezogene Fehlinformationen die Patientenergebnissebeeinflussen können 5, besteht ein wachsender Bedarf an künstlichen Intelligenzsystemen (KI), die einzelnen Nutzern helfen können, medizinische Informationen zu suchen, zusammenzufassen und zu interpretieren6.
Große Sprachmodelle (LLMs) ermöglichen es Nutzern, Informationen über natürliche Sprachkonversationzuzugreifen 7; Die Entstehung von Fehlinformationen (d. h. Halluzinationen) bleibt jedoch im medizinischen Bereich ein ernstes Problem 8,9,10,11. Eine wichtige Quelle für Fehlinformationen ist die Qualität und Genauigkeit der Trainingsdaten, die zur Entwicklung des Chatbots verwendet werden. Außerdem führt die statische Natur des Modelltrainings dazu, dass Wissen im Laufe der Zeit veraltet werden kann, was die Fähigkeit von LLMs einschränkt, aktuelle und kontextuell angemessene Informationen bereitzustellen12,13. Diese Einschränkungen unterstreichen die Bedeutung effektiver Wissensmanagement-Strategien, um sicherzustellen, dass die Antworten von Chatbots genau, relevant und aktuell bleiben. Insbesondere Systeme sind in medizinischen Einrichtungen, in denen sich Empfehlungen und Versorgungsstandards kontinuierlich weiterentwickeln, wünschenswert, die sich leicht auf aktuelle evidenzbasierte Ressourcen wie klinische Richtlinien beziehen können. Um diese Herausforderung zu bewältigen, hat die Retrieval-Augmented Generation (RAG), die Antworten erzeugt, indem sie Informationen aus externen Wissensquellen einbezieht, zunehmend Aufmerksamkeit erhalten: 10,13,14,15,16,17.
Obwohl RAG zunehmend auf medizinische Chatbots angewendet wird, wurde nur begrenzte Aufmerksamkeit darauf gelegt, wie klinische Praxisrichtlinien systematisch als Referenzinformationsquellen integriert werden sollten18. Viele klinische Praxisrichtlinien sind öffentlich im Internet verfügbar; es bleibt jedoch unklar, ob ihre bestehende Webstruktur direkt als Abrufrahmen für RAG-Systeme18 dienen kann. Darüber hinaus sind praktische Methoden zur Erstellung von Referenzinformationen ohne manuelle Wissensentwicklung noch nicht gut etabliert.
In dieser Studie wollten wir Designprinzipien für leitlinienbezogene KI-Systeme im medizinischen Bereich etablieren, indem wir einen leitlinienbasierten RAG-Chatbot entwickelt und evaluieren, der öffentlich verfügbare, webbasierte klinische Praxisrichtlinien für Krebs nutzt und so einen einfachen und zeitnahen Zugang zu leitlinienbasierten Informationen ermöglicht. Als Proof of Concept haben wir die technische Machbarkeit von Leitlinienabruf, Antwortgenerierung und Antwortbeschränkung unter Verwendung der bestehenden Webstruktur öffentlich zugänglicher klinischer Praxisrichtlinien bewertet, mit dem Ziel, ein reproduzierbares Entwicklungsprotokoll für leitlinienbezogene RAG-Systeme vorzuschlagen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Diese Studie bezieht sich nicht auf menschliche Probanden ein, die Schutz vor Risiken benötigen, die mit der Forschung verbunden sind. Daher ist eine Überprüfung durch ein institutionelles Überprüfungsgremium gemäß den japanischen Ethikrichtlinien für medizinische Forschung mit menschlichen Probanden19 erforderlich. Diese Studie wird gemäß den Richtlinien20 der Transparent Reporting of a Multivariable Model for Individual Prognosis or Diagnosis (TRIPOD)-LLM berichtet.
Siehe Abbildung 1 für einen schematischen Überblick über das richtlinienbasierte RAG-Chatbot-Protokoll.
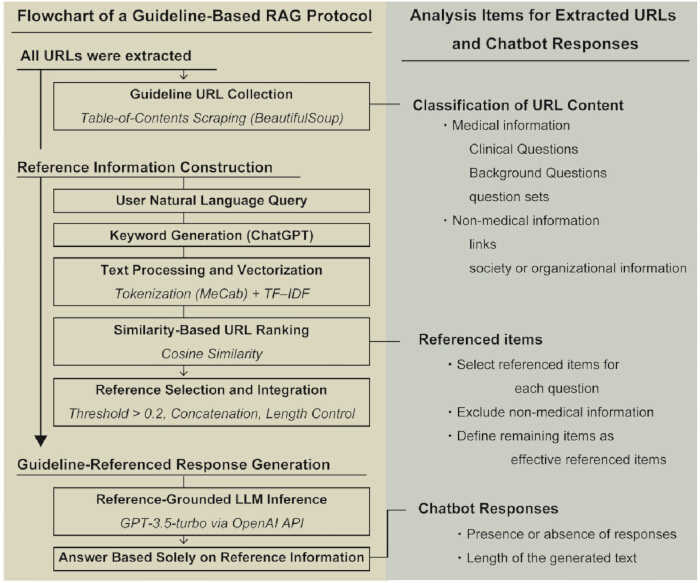
Abbildung 1. Workflow des richtlinienbasierten Retrieval-Augmented Generation (RAG) Chatbot-Protokolls. Schematische Übersicht des richtlinienbasierten RAG-Chatbot-Workflows. URLs werden aus der Inhaltsverzeichnis-Seite einer webbasierten klinischen Praxisrichtlinie extrahiert und zur Erstellung von Referenzinformationen verwendet. Nutzeranfragen werden in Schlüsselwörter umgewandelt, und Webseiteninhalte werden durch Tokenisierung, Termfrequenz–inverse Dokumentfrequenzvektorisierung und Kosinusähnlichkeitsanalyse verarbeitet, um relevante Leitlinienseiten zu identifizieren. Ausgewählte Referenzinformationen werden integriert und in ein großes Sprachmodell bereitgestellt, um Antworten ausschließlich basierend auf dem referenzierten Leitlinieninhalt zu generieren. Das rechte Panel fasst die Bewertungselemente zusammen, die für extrahierte URLs, Referenzinformationen und Chatbot-Antworten verwendet wurden. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
1. Erstellung von Referenzinformationen aus webbasierten Richtlinien
- Extrahieren Sie alle URLs aus den Inhaltsverzeichnis-Seiten der webbasierten klinischen Leitlinien für die Ziel-Web-Praxis mit BeautifulSoup 4 (HTML-Parsing-Bibliothek), implementiert in der Programmiersprache Python (Version 3.12).
HINWEIS: Implementierung des URL-Extraktionsskripts mit der Programmiersprache mit folgenden Paketen: HTML-Parsing-Bibliothek (Version 4.12.3) und Anfragen (Webseiten-Abrufbibliothek; Version 2.32.3). Installiere Pakete mit Pip. Der vollständige Quellcode für die URL-Extraktion ist in Supplementary File 1 bereitgestellt. Siehe die Materialtabelle für Details zur Software. - Überprüfen Sie alle extrahierten URLs manuell, um den erfolgreichen Zugriff und die Relevanz der Ziel-Leitlinie für klinische Praxis zu bestätigen.
- Klassifizieren Sie jede URL so, dass sie medizinische oder nichtmedizinische Informationen enthält. Führen Sie die URL-Klassifizierung nach einem Autor durch (S.N.). durch.
HINWEIS: Medizinische Informationen wurden als referenzfähige Leitlinieninhalte definiert, einschließlich klinischer Fragen (CQs), Hintergrundfragen und Fragestellen. Nichtmedizinische Informationen umfassten Links, Gesellschafts- oder Organisationsseiten sowie andere Zusatzinhalte, die nicht als Nachschlagewerk geeignet waren. - Kompiliere die validierten URLs in ein Microsoft Excel-Arbeitsbuch (.xlsx Format), wobei pro Zeile eine URL aufgezeichnet wird. Speichere die resultierende URL-Liste als Eingabedatensatz für nachfolgende Textabrufe, Vorverarbeitung und Ähnlichkeitsanalysen.
2. Schlüsselwortgenerierung aus Nutzeranfragen
- Geben Sie die natürliche Sprachanfrage in ChatGPT ein (Generative Pre-trained Transformer, Version 4o; Schlüsselwort-Generierungsmodell).
- Fordert das Modell auf, zwei Schlüsselwörter zu extrahieren, die der Benutzeranfrage entsprechen.
- Verwenden Sie den folgenden Prompt, auf Japanisch geschrieben, für die Schlüsselwortgenerierung:
"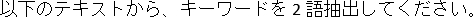 "
(Englische Übersetzung: "Zwei Schlüsselwörter aus dem folgenden Text extrahieren.") - Fügen Sie die natürliche Sprachanfrage des Nutzers dieser Anweisung an und senden Sie sie an das Keyword-Generierungsmodell zur Keyword-Generierung ein.
- Ändern Sie keine Modellparameter manuell. Führen Sie Keyword-Generierung mit den Standardeinstellungen des Keyword-Generierungsmodells durch.
- Generiere zwei Schlüsselwörter für jede Benutzeranfrage. Beibehalten Sie beide Schlüsselwörter ohne weitere Änderungen, Filterung oder manuelle Auswahl und verwenden Sie sie für spätere Ähnlichkeitsberechnungen.
- Speichere die generierten Schlüsselwörter in einem Microsoft Excel-Arbeitsbuch (.xlsx Format). Speichern Sie für jeden Datensatz die ursprüngliche Benutzeranfrage und die entsprechenden generierten Schlüsselwörter für eine spätere Ähnlichkeitsbasierte Abfrage.
3. Textverarbeitung und Ähnlichkeitsberechnung
- Rufen Sie den Volltextinhalt von jeder extrahierten URL mit der Webseitenabrufbibliothek und der HTML-Parsing-Bibliothek ab. Extrahiere Textinhalte aus der HTML-Quelle mit der Funktion BeautifulSoup get_text().
- Verarbeiten Sie den extrahierten Webseitentext und generierte Schlüsselwörter vor, indem Sie HTML-Tags und nicht-japanische Zeichen entfernen.
- Führen Sie eine japanische morphologische Analyse mit MeCab durch (Version 0.996; Japanischer morphologischer Analysator) mit dem Standardwörterbuch. Behalten Sie nur Substantive und fügen Sie sie zu einer raumbegrenzten Textfolge zusammen.
- Kombinieren Sie die generierten Schlüsselwörter zu einer einzigen Textfolge und wenden Sie die gleichen Vorverarbeitungs- und Tokenisierungsverfahren an, die auch für Webseitentexte verwendet werden.
- Erzeugen Sie Termfrequenz–inverse Dokumentfrequenz (TF–IDF)-Vektoren aus dem verarbeiteten Webseitentext und Schlüsselworttext mithilfe der TfidfVectorizer-Implementierung in der scikit-learn-Bibliothek (Version 1.6.1) mit Standardparametereinstellungen.
HINWEIS: Alle TfidfVectorizer-Parameter wurden auf ihren Standardwerten belassen, und es wurden keine benutzerdefinierten Parametereinstellungen angewendet. - Berechnen Sie die Kosinusähnlichkeit zwischen jedem Webseitenvektor und dem Schlüsselwortvektor mit der Kosinusähnlichkeitsfunktion.
- URLs in absteigender Reihenfolge nach Kosinus-Ähnlichkeitswerten zu rangieren. Wenden Sie keine zusätzlichen Entscheidungskriterien an.
- Wählen Sie Seiten mit einem Kosinus-Ähnlichkeitswert von ≥0,2 als Kandidatenreferenz aus.
HINWEIS: Die Kosinusähnlichkeitsschwelle (0,2) wurde empirisch während der Systementwicklung gewählt, um Rückruf zu priorisieren und potenziell relevante Leitlinieninhalte nicht auszuschließen. - Behalten Sie alle Kandidatenseiten, die die Ähnlichkeitsgrenze erfüllen.
4. Konstruktion von Referenzinformationen
- Extrahieren Sie nacheinander den Textinhalt der ausgewählten Seiten von oben in der Rangliste.
- Fügen Sie die extrahierten Texte zu einem einzigen Referenzdokument zusammen.
- Vor der Einreichung in das LLM ersetzen Sie Zeilenumbruch und aufeinanderfolgende Leerzeichen im Referenztext durch ein einzelnes Leerzeichen.
- Der zusammengekettete Referenztext wird auf die ersten 4.096 Zeichen abgekürzt, bevor er dem LLM bereitgestellt wird.
HINWEIS: Das Abschneidungslimit basierte auf Zeichen und nicht auf Token. Eine Begrenzung von 4.096 Zeichen wurde empirisch gewählt, um sicherzustellen, dass die kombinierten Prompt- und Referenzinformationen innerhalb der Eingabekapazität des GPT-3.5-turbo-16k-Antwortgenerierungsmodells blieben.
5. KI-basierte Antwortgenerierung
- Stellen Sie die konstruierten Referenzinformationen und die ursprüngliche Benutzeranfrage über die Application Programming Interface (API) für das Response-Generierungsmodell bereit.
- Weisen Sie die KI anhand folgender Eingabeaufforderung (vollständig auf Japanisch verfasst), um sicherzustellen, dass die Antworten ausschließlich auf Basis der bereitgestellten Referenzinformationen generiert werden:
"Du bist ein medizinischer Informationsassistent, der Krebspatienten Orientierung gibt. Erstellen Sie Antworten ausschließlich auf Grundlage der folgenden Referenzinformationen und verwenden Sie nicht Ihr eigenes Allgemeinwissen oder Ihre Begründung. Die Antworten sollten detailliert und leicht verständlich sein, etwa 500 Zeichen lang. Wenn die Referenzinformationen nicht genügend Informationen enthalten, um die Frage zu beantworten, antworten Sie mit: 'Es gibt nicht genügend Informationen im Text', ohne Spekulation oder Allgemeinwissen zu verwenden." - Stellen Sie die Referenzinformationen und die Benutzeranfrage zusammen in einer einzigen Benutzernachricht bereit. Strukturiere die Eingabe als: "Referenzinformation: [Referenztext]" gefolgt von "Frage: [Benutzeranfrage]".
- Antworten werden mit dem Antwortgenerierungsmodell mit folgenden Einstellungen generiert: Temperatur = 0,1, maximale Ausgabelänge = 1.024 Token, n = 1 und Stopp = Nichts.
- Holen Sie sich die KI-generierte Antwort zur späteren Bewertung.
HINWEIS: Reichen Sie die Referenzinformationen und die Benutzeranfrage als einzelne Benutzernachricht ein. Stellen Sie die Antwortgenerierungsbefehle separat als Systemnachricht bereit.
6. Referenzrichtlinie und Frageformulierung
- Wählen Sie das JLCS-Handbuch für Lungenkrebspatienten und -familien (Lung Guidebook)21, das online frei verfügbar ist, als Referenzinformation für das richtlinienbasierte RAG-Chatbot-System.
- Erstellen Sie zwei Kategorien von Bewertungsfragen basierend auf dem Krebstyp: thymische Tumore, die im Rahmen der Richtlinie fallen, und pädiatrisches Gliom, das außerhalb des Geltungsbereichs der referenzierten Informationen liegt.
- Formulieren Sie vier Fragen zu Diagnose und Behandlung für jede Krebsart:
"Welche diagnostischen Methoden stehen für XX (z. B. thymische oder pädiatrische Gliom-) Tumore zur Verfügung?"
"Was sind die pathologischen diagnostischen Ansätze für XX-Tumore?"
"Welche Behandlungsmöglichkeiten gibt es für XX-Tumore?"
"Welche chirurgischen Behandlungsmöglichkeiten gibt es bei XX-Tumoren?" - Stellen Sie Fragen zu Krebsarten, die durch die referenzierte Webrichtlinie abgedeckt sind, an den Chatbot. Reichen Sie zum Beispiel eine Frage zur Thymustumordiagnose ein und verwenden Sie das Lungenhandbuch als Referenzinformation.
- Stellen Sie Fragen außerhalb des Referenzrichtliniens an den Chatbot, um seine Fähigkeit zu bewerten, externe oder nicht zusammenhängende Informationen zu verwenden. Reichen Sie zum Beispiel eine Frage zum pädiatrischen Gliom ein, während Sie das Lungenhandbuch als Referenz verwenden.
- Bewerten Sie jede Frage in einer unabhängigen Chatsitzung. Überzeugen Sie die Gesprächshistorie nicht zwischen den Fragen.
- Zeichnen Sie die KI-generierten Antworten für eine spätere Bewertung auf.
7. Bewertung der Antwort
- Führen Sie eine manuelle Überprüfung aller generierten Antworten durch.
- Bewerten Sie, ob jede Reaktion Halluzinationen enthält.
- Bewerten Sie, ob jede Antwort durch Informationen in der Referenzrichtlinie unterstützt wird.
HINWEIS: Halluzinationen wurden definiert als Reaktionen, die nicht existierende Ereignisse, Namen oder Begriffe enthalten, die potenziell medizinischen Schaden verursachen könnten14. Alle generierten Antworten wurden von einem Autor mit 8 Jahren Erfahrung in einem Universitätskrankenhaus, einschließlich Patientenbetreuung und medizinischer Kommunikation für Krebspatienten, auf Genauigkeit und das Fehlen von Halluzinationen überprüft. Etwaige Unsicherheiten bezüglich der Antwortklassifikation wurden durch Gespräche mit einem Mitautor eines Arztes mit mehr als 20 Jahren Erfahrung in den Krebsinformationsdiensten am National Cancer Center Japan gelöst. - Betrachten Sie eine Antwort nur als gestützt, wenn alle klinisch relevanten Aussagen direkt aus der abgerufenen Referenzrichtlinie bestätigt werden können, ohne zusätzliches Wissen oder nicht belegten Schlussfolgerungen zu erfordern.
- Klassifizieren Sie jede Antwort mit vordefinierten Ergebnislabels. Klassifizieren Sie Antworten, die nur Informationen enthalten, die durch die Referenzrichtlinie unterstützt werden, als "Halluzination fehlt". Klassifizieren Sie Antworten, die nicht belegte oder gefälschte Informationen enthalten, als "Halluzination vorhanden".
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Abrufbarkeit medizinischer Inhalte über Inhaltsverzeichnis-Seiten
Die Web-Scraping-Architektur sammelte URLs von der Inhaltsverzeichnis-Seite der Richtlinie. Aus dem Lungenhandbuch wurden 106 URLs aus der Inhaltsverzeichnisseite extrahiert, von denen 104 (98 %) medizinische Informationen enthielten (Ergänzende Tabelle 1). Die Wirksamkeit der Chatbot-Antworten basierend auf den Inhaltsseiten der Leitlinien wird in Tabel...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
In dieser Studie untersuchten wir den Nutzen eines richtlinienbasierten RAG-Chatbots, der eine webbasierte klinische Praxisrichtlinie – den JLCS Guidebook for Lung Cancer Patients and Families – als Referenzinformationsquelle verwendete. Der Chatbot generierte Antworten, die auf den Inhalten der Leitlinie basierten, indem er die Webstruktur der Richtlinie ausnutzte und Seiten basierend auf deren Ähnlichkeit mit Nutzeranfragen abrufte. Dieser Ansatz zeigte, dass ähnlichkeitsbasierte Abruf...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren erklären keine konkurrierenden Interessen.
Danksagungen
Die Autoren danken Kenichi Inoue, MD, PhD (Shonan Memorial Hospital Breast Center), für seine umfangreiche technische Unterstützung bei der Entwicklung des richtlinienbasierten Retrieval-Augmented Generation-Chatbots. Die Autoren danken außerdem Chikako Yamaki, PhD, und allen Mitgliedern des Forschungsteams am Institute for Cancer Control des National Cancer Center Japan (Tokio, Japan) für ihre wertvollen Ratschläge zu dem in diesem Artikel behandelten Thema. Außerdem danken die Autoren Editage für die englischsprachige Redaktion. Diese Arbeit wurde durch ein Forschungsstipendium für Gesundheits- und Arbeitswissenschaften (R6–Cancer Control–23EA1026) unterstützt.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
```html
```
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Beautiful Soup 4 (Version 4.12.3) | Beautiful Soup-Projekt | N/A | Python-Bibliothek zur URL-Extraktion und HTML-Analyse |
| ChatGPT Version 4o | OpenAI | N/A | Zur Generierung von Schlüsselwörtern verwendet |
| GPT-3.5-turbo | OpenAI | N/A | Zur Generierung von Antworten verwendet |
| JLCS-Leitfaden für Lungenkrebspatienten und Familien | Japan Lung Cancer Society | N/A | Webbasierte klinische Praxisrichtlinie, die als Referenzinformation verwendet wird |
| MeCab (Version 0.996) | MeCab-Projekt | N/A | Japanischer morphologischer Analysator |
| OpenAI API | OpenAI | N/A | Zur Generierung von KI-basierten Antworten verwendet |
| Python (Version 3.12) | Python Software Foundation | N/A | Programmierumgebung |
| Requests (Version 2.32.3) | Requests-Projekt | N/A | Python-Bibliothek zur Webseitenabfrage |
| scikit-learn (Version 1.6.1) | scikit-learn-Entwickler | N/A | Zur TF–IDF-Vektorisierung und Berechnung der Kosinus-Ähnlichkeit verwendet. |
| urllib.parse | Python Software Foundation | N/A | Python-Bibliothek zur URL-Normalisierung und -Verbindung |
Referenzen
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.