Diese prospektive Beobachtungsstudie beschreibt die Entwicklung und interne Validierung eines Vorhersagemodells unter Verwendung von Ultraschallparametern der ersten Phase, die transabdominal und transperineal erhoben wurden, in Kombination mit mütterlichen klinischen Merkmalen, um eine frühzeitige Identifizierung von Frauen mit erhöhtem Risiko für eine verlängerte zweite Geburtsphase zu ermöglichen.
Forschungsartikel
Entwicklung und interne Validierung eines prädiktiven Modells für eine verlängerte zweite Geburtsphase unter Verwendung von Daten der ersten Geburtsphase: Eine prospektive Beobachtungsstudie
22 Aufrufe
⸱
11. September 2026
* These authors contributed equally
In diesem Artikel
Zusammenfassung
Zusammenfassung
Eine Verlängerung des zweiten Geburtsabschnitts ist mit ungünstigen maternalen und neonatalen Ergebnissen assoziiert, weshalb eine frühzeitige Risikoerkennung klinisch wichtig ist. Diese Studie untersuchte, ob die Kombination von transabdominalen und transperinealen Ultraschamparametern, die während des ersten Geburtsabschnitts erhoben wurden, eine verlängerte zweite Phase vorhersagen kann. In diese prospektive Beobachtungsstudie wurden Erstgebärende eingeschlossen, bei denen während der aktiven Phase des ersten Geburtsabschnitts eine transabdominale und transperineale Ultraschalluntersuchung durchgeführt wurde. Fetalposition, Winkel der Fortschrittsbewegung (AOP), Distanz Kopf–Schambein, Distanz Kopf–Perineum sowie mütterliche klinische Merkmale wurden dokumentiert. Die Teilnehmerinnen wurden in eine Gruppe mit normalem (≤120 min) und eine mit verlängertem (>120 Minuten) zweiten Geburtsabschnitt eingeteilt. Zur Auswahl der wichtigsten Prädiktoren wurde die Least-Absolute-Shrinkage-and-Selection-Operator-Regression (LASSO) verwendet, und mittels multivariater logistischer Regression wurden unabhängige Prädiktoren für die Modellentwicklung identifiziert. Die Vorhersagegenauigkeit wurde mittels ROC-Kurvenanalyse (Receiver Operating Characteristic), Kalibrierung und Entscheidungskurvenanalyse (DCA) bei der internen Validierung bewertet. Die Analyse umfasste 159 Erstgebärende (95 mit normalem und 64 mit verlängertem zweiten Geburtsabschnitt). Im Vergleich zur Normgruppe wiesen die Teilnehmerinnen mit verlängertem zweiten Geburtsabschnitt häufiger fetale Distress-Symptome (31,2 % vs. 15,8 %, p = 0,035) und niedrigere Apgar-Werte (70,3 % vs. 36,8 %, p < 0,001) auf. Die LASSO-Regression identifizierte vier wesentliche Prädiktoren – mütterliches Alter, gestationsbedingte Zunahme des Body-Mass-Index, neonatales Geburtsgewicht und AOP –, die alle als unabhängige Prädiktoren bestätigten wurden (p < 0,05). Das Vorhersagemodell erreichte eine Fläche unter der ROC-Kurve von 0,927 und zeigte bei der internen Validierung eine gute Diskriminierung, Kalibrierung und klinische Nutzen. Ultraschallparameter des ersten Geburtsabschnitts in Kombination mit mütterlichen klinischen Merkmalen könnten somit eine frühzeitige Identifizierung von hochriskanten Erstgebärenden ermöglichen und das Management während der Geburt unterstützen.
Einleitung
Eine verlängerte Geburt hat in der geburtshilflichen Praxis schon lange eine große Bedeutung. Insbesondere eine Verlängerung des zweiten Geburtsstadiums erhöht nicht nur die mütterliche Schmerzbelastung, sondern trägt auch zu ungünstigen neonatalen Ergebnissen bei1. Laut den neuesten Leitlinien der Weltgesundheitsorganisation (WHO) beträgt die normale Dauer des zweiten Geburtsstadiums ≤120 min. Mit anderen Worten, ein zweites Stadium, das >120 min dauert, gilt als verlängert. Die weltweite Häufigkeit eines verlängerten zweiten Stadiums wird auf 3 %–8 % geschätzt1,2. Eine solche Verlängerung erhöht das Risiko für mütterliche Infektionen, Kaiserschnitt (C-Schnitt), postpartale Blutungen, fetale Distresszustände, niedrige Apgar-Werte (Erscheinung, Puls, Grimasse, Aktivität und Atmung) sowie perinatale Mortalität1. Frühere Studien haben gezeigt, dass das mütterliche Alter, der gestationsbedingte Anstieg des Body-Mass-Index (BMI) und das Geburtsgewicht des Neugeborenen mit einem verlängerten zweiten Geburtsstadium assoziiert sind; deren Vorhersagewert bleibt jedoch begrenzt3. Daher ist die Identifizierung wirksamerer Prädiktoren von erheblicher Bedeutung, um rechtzeitige klinische Interventionen zu ermöglichen, den Geburtsverlauf zu optimieren, das Auftreten einer verlängerten Geburt zu verringern und die mütterlichen sowie neonatalen Ergebnisse zu verbessern.
In den letzten Jahren wurde die Ultraschallbildgebung zunehmend in die geburtshilfliche Versorgung integriert, insbesondere im Management während der Geburt, da sie eine zeitnahe, objektive Beurteilung der fetalen Lage, Orientierung und Deszentierung ermöglicht3,4. Studien belegen, dass der Ultraschall während der Geburt eine wichtige Rolle bei der Vorhersage des Geburtsverlaufs, der Beurteilung des fetalen Zustands und der Unterstützung klinischer Entscheidungen bezüglich der Entbindungsart spielt5. Dennoch bestehen in der aktuellen Literatur wichtige Wissenslücken. Erstens wurden bisher nur vergleichsweise wenige Studien speziell zur Nutzung von Ultraschallparametern zur Vorhersage einer verlängerten zweiten Geburtsphase durchgeführt. Zweitens gibt es nur begrenzte Untersuchungen, die die Ultraschallparameter der ersten Geburtsphase – wie die Lage des fetalen Kopfes, die fetale Position und deren räumliche Beziehung zum mütterlichen Becken – im Hinblick auf eine Verlängerung der zweiten Phase bewerten, obwohl diese Faktoren die Dauer der zweiten Phase direkt beeinflussen können6.
Vor diesem Hintergrund erfasste die vorliegende prospektive Beobachtungsstudie Entbindungsdaten aus einer einzigen Zentrale während des ersten Wehenstadiums. Ultraschallparameter wurden mittels transabdominaler und transperinealer Untersuchung erhoben, einschließlich des Kopf-Symphysis-Abstands (HSD), des Progressionswinkels (AOP) und des Kopf-Perineum-Abstands (HPD). Im Gegensatz zu früheren, auf Ultraschall basierenden Studien, die sich hauptsächlich auf die Vorhersage unmittelbarer Entbindungsergebnisse oder des Bedarfs an operativer Intervention während des zweiten Wehenstadiums konzentrierten, untersuchte die vorliegende Studie gezielt die frühe Vorhersage einer verlängerten zweiten Wehenphase anhand von Ultraschallparametern des ersten Stadiums. Diese Parameter wurden mit mütterlichen demografischen und klinischen Merkmalen kombiniert, um ihren prädiktiven Wert für eine verlängerte zweite Wehenphase zu bewerten. Dieser Ansatz schließt eine wichtige Wissenslücke, da bisher keine Studie mehrdimensionale Ultraschallbefunde des ersten Stadiums zusammen mit mütterlichen klinischen Merkmalen in ein Vorhersagemodell für eine Verlängerung des zweiten Stadiums integriert hat. Dementsprechend wurde ein Vorhersagemodell entwickelt und intern validiert. Die Studie soll Ärztinnen und Ärzten ein objektives Instrument zur frühen Identifizierung von Primiparae mit erhöhtem Risiko für eine verlängerte zweite Wehenphase während des ersten Wehenstadiums bereitstellen und dadurch ein individualisierteres Management während der Geburt sowie verbesserte mütterliche und neonatale Ergebnisse unterstützen.
Protokoll
Die Studie wurde gemäß der Deklaration von Helsinki durchgeführt und vom Ethikkomitee des Yuyao-Mütter-und-Kindergesundheitskrankenhauses (Yuyao Second People’s Hospital) genehmigt (Genehmigungsnummer: YMCH-EC-2023KT-0012). Alle Teilnehmer gaben ihre schriftliche informierte Einwilligung ab.
Studienteilnehmerinnen
Primipare Frauen mit spontan einsetzender Wehen, die eine erfolgreiche vaginale Entbindung erreichten, wurden eingeschlossen. Dies ermöglichte eine genaue Erfassung der Dauer des zweiten Geburtsabschnitts, die für das Vorhersagemodell erforderlich war. Die Einschlusskriterien waren wie folgt: (1) Einlingsschwangerschaft mit einem Gestationsalter von ≥37 Wochen; (2) Kopflage; und (3) schriftliche informierte Einwilligung der Teilnehmerin und ihrer Familie. Die Ausschlusskriterien umfassten: (1) absolute Kontraindikationen für einen Geburtsversuch, die während der aktiven Phase festgestellt wurden (z. B. Placenta praevia, Vasa praevia, Nabelschnurvorfall); und/oder (2) sekundäre Uterusstarre (definiert als Ausbleiben des Fortschritts der Zervixdilatation oder des fetalen Abstiegs für ≥4 h trotz Oxytocin-Augmentation oder Amniotomie). Frauen, bei denen eine Geburtseinleitung durchgeführt wurde, wurden ebenfalls ausgeschlossen.
Auffällig ist, dass Frauen, bei denen aufgrund akuten fetalen Distresses im zweiten Geburtsstadium ein chirurgischer Noteingriff (Kaiserschnitt oder instrumentelle Entbindung) erforderlich war, gemäß den klinischen Leitlinien versorgt wurden, jedoch zur Sicherstellung vollständiger Aufzeichnungen über die Dauer der Wehen nicht in diese Analyse einbezogen wurden.
Die Stichprobengröße wurde basierend auf den Ergebnissen einer Vorstudie berechnet (n = 30, bei der die Inzidenz einer Verlängerung der zweiten Phase bei 20 % lag). Bei einem α-Fehler von 0,05 und einem β-Fehler von 0,20 sowie einer geschätzten Inzidenz einer Verlängerung der zweiten Phase von etwa 20 % waren mindestens 150 Teilnehmer erforderlich, um einen signifikanten Prädiktor mit einer Odds Ratio (OR) ≥ 2,5 nachweisen zu können. In die endgültige Analyse wurden insgesamt 159 Frauen eingeschlossen.
Erfassung klinischer Daten
Zu den mütterlichen Variablen gehörten das Alter, der gestationsbedingte Anstieg des Body-Mass-Index (BMI) (definiert als Differenz zwischen dem prägravidem BMI und dem BMI vor der Entbindung), Schwangerschaftsdiabetes, Schwangerschaftshypertonie, psychischer Zustand (beurteilt mittels der Self-Rating Anxiety Scale, wobei ein Wert ≥50 auf Angstzustände hinweist), Uterusstarre (speziell bezeichnet ein klinisch festgestelltes hypotonisches Kontraktionsmuster, definiert als Uteruskontraktionen mit Intervallen >5 min oder Dauer <30 s, abgegrenzt von der Definition des American College of Obstetricians and Gynecologists [ACOG] für Geburtsstillstand) sowie die Parität. Zu den neonatalen Variablen zählten das Geburtsgewicht (kg), fetale Belastung (definiert als wiederholte späte oder variable Dekelerationen in der Kardiotokographie oder eine basale fetale Herzfrequenz von <110 Schlägen/min oder >160 Schlägen/min) sowie der Apgar-Score (ein Score nach 1 Minute <7 wurde als niedrig eingestuft).
Gestationsdiabetes wurde gemäß den Kriterien der International Association of Diabetes and Pregnancy Study Groups diagnostiziert (Nüchternblutzucker 5,1–6,9 mmol/L oder nach 1 h ≥10,0 mmol/L oder nach 2 h 8,5–11,0 mmol/L beim 75-g-oralen Glukosetoleranztest in der 24.–28. Schwangerschaftswoche). Gestationshochdruck wurde gemäß den ACOG-Leitlinien definiert (systolischer Blutdruck ≥140 mmHg oder diastolischer Blutdruck ≥90 mmHg, zweimal im Abstand von ≥4 h nach der 20. Schwangerschaftswoche gemessen, ohne Proteinurie). Fetale Belastung in der Kardiotokographie wurde definiert als wiederkehrende späte Dekelerationen (≥50 % der Wehen), wiederkehrende variable Dekelerationen von >60 s Dauer, prolongierte Dekeleration von 2–10 min Dauer oder eine basale fetale Herzfrequenz von <110 oder >160 Schlägen/min über ≥10 min (Kriterien des National Institute for Health and Care Excellence [NICE]). Uterine Inertia (hypotonische Wehen) wurde definiert als Wehenabstände >5 min oder Wehendauer <30 s innerhalb von 30 min, beurteilt durch Palpation oder Tokodynamometrie. Der psychische Zustand (Angst) wurde bei Aufnahme (Zervixdilatation < 4 cm) mittels der Self-Rating Anxiety Scale erfasst, wobei ein Rohwert von ≥50 (standardisierter Index) als auffällig klassifiziert wurde. Ein niedriger Apgar-Score wurde als 1-Minuten-Score <7 definiert (WHO).
Da es sich um eine Beobachtungsstudie handelte, folgte das Management der Wehen der routinemäßigen klinischen Praxis, ohne dass ein standardisierter Protokollansatz verfolgt wurde. Dennoch wurden die Periduralanästhesie (ja/nein, Zeitpunkt, Dauer), die Oxytocin-Augmentation (ja/nein, Gesamtdosis, Dauer), die künstliche Amnionitis (ja/nein, Zervixdilatation zum Zeitpunkt des Eingriffs) sowie die Entbindungsmethode (ausschließlich spontane vaginale Entbindung gemäß den Einschlusskriterien) systematisch erfasst. Es wurde keine signifikante Interaktion zwischen diesen Variablen und den primären Modellprädiktoren beobachtet.
Transabdominale und transperineale Ultraschalluntersuchung im frühen ersten Geburtsstadium
Die Ultraschalluntersuchung wurde zu Beginn der aktiven Phase der Geburt (Gebärmuttermundweitung ≥4 cm) durchgeführt. Die Gebärende wurde nach Entleerung der Harnblase in Rückenlage mit einer 15°-Linksdrehung positioniert. Für die transperineale Untersuchung wurden die Oberschenkel leicht abduziert und gebeugt. Alle Bilder wurden am Höhepunkt einer Gebärmutterkontraktion aufgenommen, der durch klinische Palpation in Kombination mit externer Tokodynamometrie (Kardiotokographie) zur Bestätigung des Kontraktionsmaximums ermittelt wurde. Jede Messung wurde während dreier separater Kontraktionen wiederholt, wobei der Mittelwert für die Analyse verwendet wurde. Die Ultraschalluntersuchungen wurden mit einem tragbaren diagnostischen Ultraschallsystem durchgeführt (siehe Tabelle der Materialien). Für die transabdominale Bildgebung kam eine konvexe Sonde (2–5 MHz) zum Einsatz; für die transperineale Bildgebung wurde eine hochfrequente lineare oder eine konvexe Kleinfootprint-Sonde (5–8 MHz) verwendet. Die Bildgebungseinstellungen waren standardisiert (Tiefe 6–10 cm, optimierte Verstärkung und eine einzelne Fokusebene am Schambein).
Zur Beurteilung der fetalen Lage wurde eine transabdominale Querschnittsaufnahme durchgeführt, um den fetalen Orbitus, das Kleinhirn und die thalamale Mittellinie in Bezug zum mütterlichen Becken zu identifizieren und so die okzipitale vordere (OA), seitliche oder hintere Lage zu bestimmen. Bei transperinealen Messungen wurde der Schallkopf mit einer sterilen Hülle überzogen und ohne übermäßigen Druck in der mittleren Sagittalebene auf das Perineum platziert. Zu den anatomischen Orientierungspunkten gehörten das gesamte Schambein, der Kontur des fetalen Schädels und die anorektale Übergangszone.
Folgende Parameter wurden gemessen (Abbildung 1A–D): Fortschrittswinkel (AOP), definiert als der Winkel zwischen der Längsachse der Symphysis pubica und einer Linie, die von ihrem unteren Rand zum tiefsten Punkt des fetalen Schädels verläuft; Mittellinienwinkel (MLA), definiert als der Winkel zwischen der mittigen Achse des fetalen Schädels (Falx cerebri) und der anteroposterioren Achse des mütterlichen Beckens; Distanz Kopf–Symphyse (HSD), definiert als der Abstand vom unteren Rand der Symphysis pubica zum nächstgelegenen Punkt am fetalen Schädel; und Distanz Kopf–Perineum (HPD), definiert als der kürzeste Abstand von der äußeren Schädeloberfläche des Feten zur Perinealhaut7.
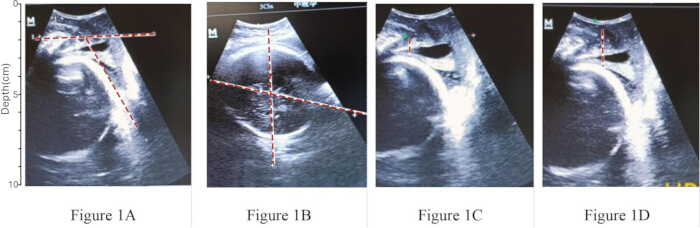
Abbildung 1. Ultraschallmessungen, die während des ersten Wehenstadiums durchgeführt wurden. (A) Messung des Fortschrittswinkels (AOP), definiert als der Winkel zwischen der Längsachse des Schambeins und einer Linie, die von dessen unterem Rand zum tiefsten Punkt des fetalen Schädels verläuft. (B) Messung des Mittellinienwinkels (MLA), definiert als der Winkel zwischen der mittleren Achse des fetalen Schädels (Falx cerebri) und der anteroposterioren Achse des mütterlichen Beckens. (C) Messung des Kopf-Symphysen-Abstands (HSD), definiert als der Abstand vom unteren Rand der Schamphysis zum nächstgelegenen Punkt am fetalen Schädel. (D) Messung des Kopf-Perineum-Abstands (HPD), definiert als der kürzeste Abstand von der äußeren Oberfläche des fetalen Schädels zur perinealen Haut der Mutter. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Jede Messung wurde dreimal während dreier separater Kontraktionsgipfel durchgeführt, und der Mittelwert wurde für die Analyse verwendet. Alle Untersuchungen wurden von drei erfahrenen Sonographen (jeweils mit ≥10 Jahren Erfahrung in der geburtshilflichen Ultraschalldiagnostik) durchgeführt, die vor der Studie eine standardisierte Schulung in intrapartaler transperinealer Ultraschallmessung absolviert hatten. Die Kompetenz wurde bestätigt, indem ein Intraklassenkorrelationskoeffizient (ICC) von ≥0,90 im Vergleich zu einem Goldstandard-Beurteiler (leitender Autor) erreicht wurde. Die inter- und intraobserver-Übereinstimmung wurde in einer Pilotphase an 10 Patientinnen (nicht in die Hauptstudie einbezogen) geprüft und ergab ICCs zwischen 0,89 und 0,96 für alle Parameter (AOP, HSD, HPD und MLA).
Für die Bildakzeptanz war eine klare Darstellung der Symphysis pubica, der fetalen Schädelkontur und der anorektalen Verbindung erforderlich. Bilder mit übermäßigem Transducerdruck oder schlecht sichtbaren anatomischen Landmarken wurden verworfen und erneut aufgenommen. Die Sonographen waren während der Bildaufnahme und -messung bezüglich der Gruppenzuordnung (normaler versus verlängerter zweiter Wehenstadium) und klinischer Daten verblindet. Die Daten wurden doppelt eingegeben und auf Plausibilität geprüft; Werte außerhalb des zulässigen Bereichs führten zu einer erneuten Bildüberprüfung. Fehlende Daten (<5 %) wurden mittels Complete-Case-Analyse behandelt, nachdem bestätigt wurde, dass die Daten zufällig fehlten (Little’s Test auf vollständig zufällige Datenlücken, p > 0,05).
Aufzeichnung und Einteilung der Geburtsdauer
Während des gesamten Geburtsvorgangs wurde der Geburtsverlauf jeder Teilnehmerin sorgfältig dokumentiert. Die erste Geburtsphase wurde definiert als der Zeitraum von Beginn regelmäßiger Uteruskontraktionen bis zur vollständigen Zervixdilatation (10 cm). Die aktive Phase der Geburt wurde definiert als eine Zervixdilatation ≥4 cm, begleitet von verstärkten, regelmäßigen Uteruskontraktionen. Die zweite Geburtsphase wurde definiert als der Zeitraum von der vollständigen Zervixdilatation (10 cm) bis zur vollständigen fötalen Austreibung. Ultraschalluntersuchungen wurden während der aktiven Phase der ersten Geburtsphase durchgeführt, um die Lage des fetalen Kopfes, die fetale Position und verwandte ultraschallbasierte Parameter zu beurteilen. Gemäß den Leitlinien der Weltgesundheitsorganisation (WHO) sollte eine normale zweite Geburtsphase 120 min2 nicht überschreiten. Um eine standardisierte Forschungsschwelle für alle Primiparae in dieser Studie beizubehalten, wurden die Teilnehmerinnen anhand dieses 120-Minuten-Kriteriums in zwei Gruppen eingeteilt: eine Gruppe mit normaler zweiter Phase (≤120 min) und eine Gruppe mit verlängerter zweiter Phase (>120 min).
Statistische Analyse
Alle statistischen Analysen wurden mit SPSS Version 26.0 (RRID:SCR_002865) und R Version 4.1.0 (RRID:SCR_001905) durchgeführt (siehe Materialtabelle). Folgende R-Pakete wurden verwendet: glmnet (Version 4.1-2) für die Regression mit der Methode der kleinsten absoluten Schrumpfung und Auswahl (LASSO), rms (Version 6.2-0) zur Erstellung und Kalibrierung von Nomogrammen, pROC (Version 1.18.0) für die Analyse der Receiver-Operating-Characteristic (ROC) sowie rmda (Version 1.6) für die Entscheidungskurvenanalyse (DCA). Die Normalverteilung stetiger Variablen wurde mithilfe des Shapiro-Wilk-Tests überprüft, um die Auswahl deskriptiver Statistiken und Vergleichsverfahren zu leiten. Normalverteilte Daten wurden als Mittelwert ± Standardabweichung (x̄ ± s) angegeben und mit dem t-Test für unabhängige Stichproben verglichen t-Test, der bei ausreichender Stichprobengröße robust gegenüber leichten Abweichungen von der Normalverteilung ist. Nicht normalverteilte Daten wurden als Median mit Interquartilbereich (M [P25, P75]) angegeben und mit dem Mann-Whitney-Test verglichen. U Test, der prüft, ob eine Verteilung tendenziell größere Werte aufweist als die andere, anstatt strikt Unterschiede in den Medianen zu testen. Kategoriale Variablen wurden als Häufigkeiten und Prozentanteile (n [%]) dargestellt und mittels des Chi-Quadrat-Tests (χ2) Test oder Fishers exakter Test, wenn die erwartete Häufigkeit war <5. Alle Tests waren zweiseitig, und ein p-Wert <0,05 wurde als statistisch signifikant betrachtet. Variablen mit p <0,1 in der univariaten Analyse wurden in die LASSO-Regression zur Variablenauswahl eingegeben. Die LASSO-Regression wurde mit dem glmnet-Paket unter Verwendung einer 10-fachen Kreuzvalidierung durchgeführt, um den optimalen Regularisierungsparameter (λ) zu bestimmen. Zur Auswahl der sparsamsten Menge an Prädiktoren mit nicht-null-Koeffizienten wurde das One-Standard-Error-Kriterium (der größte λ-Wert innerhalb einer Standardabweichung des minimalen Kreuzvalidierungsfehlers) angewandt. Vor der LASSO-Anpassung wurden alle stetigen Prädiktoren (mütterliches Alter, BMI-Zunahme während der Schwangerschaft, AOP, HSD, HPD und Geburtsgewicht des Neugeborenen) zentriert und standardisiert. z-Scores unter Verwendung der Standard-glmnet-Einstellung (standardize = TRUE), sodass die Koeffizienten unabhängig von den MessEinheiten gleichmäßig bestraft wurden. Die ausgewählten Variablen wurden anschließend in ein multivariates logistisches Regressionsmodell (Enter-Methode) eingegeben, um adjustierte Odds Ratios (aORs) und 95%-Konfidenzintervalle (CIs) zu berechnen. Die Modellsignifikanz wurde mittels des Likelihood-Ratio-Tests bewertet.
Basierend auf den logistischen Regressionskoeffizienten wurde ein Vorhersagemodell als Logit(P) = β0 + Σ(βiXi) konstruiert. Dieses Modell wurde mithilfe des rms-Pakets als Nomogramm dargestellt, wobei jeder Prädiktor einen Punktwert erhielt, der proportional zu seinem Regressionskoeffizienten war, und die Gesamtpunktzahl den vorhergesagten Wahrscheinlichkeiten zugeordnet wurde. Die Diskriminierung wurde durch Erstellung der ROC-Kurve und Berechnung der Fläche unter der Kurve (AUC) mit ihrem 95 % Konfidenzintervall (KI) mithilfe des pROC-Pakets (Bootstrap-Verfahren mit 1.000 Resampling-Schritten) bewertet. Die optimale Cutoff-Wahrscheinlichkeit wurde durch Maximierung des Youden-Index (Sensitivität + Spezifität − 1) bestimmt, wobei die entsprechenden Sensitivität und Spezifität angegeben wurden. Die Kalibrierung wurde anhand einer Kalibrierungskurve, die aus 1.000 Bootstrap-Resampling-Schritten generiert wurde (rms-Paket), überprüft und durch den Hosmer–Lemeshow-Test zur Anpassungsgüte ergänzt (ein nicht signifikanter p-Wert deutet auf eine gute Kalibrierung hin). Die klinische Nützlichkeit wurde mittels DCA mit dem rmda-Paket bewertet, das den Nettogewinn über einen Bereich von Schwellenwahrscheinlichkeiten (0 %–100 %) berechnet. Der Nettogewinn wurde definiert als (richtig positive Ergebnisse / n) − (falsch positive Ergebnisse / n) × (Schwellenwahrscheinlichkeit / [1 − Schwellenwahrscheinlichkeit]). Der gesamte Studienarbeitsablauf ist oben beschrieben und in ergänzender Abbildung 1 veranschaulicht. Dieses Modell ist explorativ; der Prädiktor neonatales Geburtsgewicht bezieht sich auf das tatsächlich nach der Entbindung gemessene Gewicht, und für eine klinische Vorhersage wäre eine Neuanpassung des Modells unter Verwendung des vor der Entbindung ermittelten fetalen Schätzwerts (EFW) erforderlich.
Ergebnisse
Studienpopulation und Gruppeneinteilung
Insgesamt wurden 159 Wöchnerinnen in die endgültige Analyse eingeschlossen. Davon hatten 95 eine normale Dauer des zweiten Geburtsstadiums, während 64 ein verlängertes zweites Stadium aufwiesen (Tabelle 1). Im Vergleich zur Normalgruppe zeigte die Gruppe mit verlängertem Stadium signifikant höhere Raten an fetaler Distresslage und niedrigen Apgar-Scores (beides p < 0,05). Hinsichtlich der perinatalen Mortalität wurde kein signifikanter Unterschied zwischen den Gruppen beobachtet (p > 0,05).
| Variable | Gesamt (N = 159) | Normale zweite Phase (N = 95) | Verlängerte zweite Phase (N = 64) | P-Wert |
| Dauer der zweiten Phase (min) | 109 [40,5; 172] | 88,4 [40,5; 125] | 139 [100; 172] | <0,0001 |
| Fetale Distress | 0,0347 | |||
| Abwesend | 124 (78,0 %) | 80 (84,2 %) | 44 (68,8 %) | |
| Vorhanden | 35 (22,0 %) | 15 (15,8 %) | 20 (31,2 %) | |
| Niedriger Apgar-Score | 0,0001 | |||
| Nein | 79 (49,7 %) | 60 (63,2 %) | 19 (29,7 %) | |
| Ja | 80 (50,3 %) | 35 (36,8 %) | 45 (70,3 %) | |
| Perinatale Mortalität | 0,5653 | |||
| Abwesend | 156 (98,1 %) | 94 (98,9 %) | 62 (96,9 %) | |
| Vorhanden | 3 (1,89 %) | 1 (1,05 %) | 2 (3,12 %) |
Tabelle 1: Wirkung einer verlängerten zweiten Geburtsphase auf neonatale klinische Ergebnisse. Stetige Variablen werden als Median [interquartiler Bereich (IQR)] angegeben, kategoriale Variablen als Anzahl (%). Die Gruppe mit normaler zweiter Geburtsphase umfasste Teilnehmerinnen mit einer Dauer der zweiten Phase von ≤120 min, während die Gruppe mit verlängerter zweiter Geburtsphase Teilnehmerinnen mit einer Dauer der zweiten Phase von >120 min umfasste. Ein niedriger Appearance, Pulse, Grimace, Activity, and Respiration (Apgar)-Score wurde als Apgar-Score nach 1 Minute <7 definiert. P-Werte stellen den Vergleich zwischen der Gruppe mit normaler und der mit verlängerter zweiter Geburtsphase dar.
Ein Vergleich der demografischen und klinischen Merkmale zwischen den beiden Gruppen ist in Tabelle 2 dargestellt. Gebärende mit verlängerter zweiter Geburtsphase wiesen ein höheres medianes mütterliches Alter und eine stärkere BMI-Zunahme während der Schwangerschaft auf als jene mit normaler zweiter Geburtsphase. Die Häufigkeiten von Schwangerschaftsdiabetes, Uterusinaktivität und verändertem Bewusstseinszustand waren ebenfalls in der Gruppe mit verlängerter Phase signifikant höher (alle p < 0,05). Hinsichtlich der Schwangerschaftshypertonie oder des Gestationsalters bei der Entbindung zeigten sich keine signifikanten Unterschiede zwischen den Gruppen (beide p > 0,05).
| Variable | Gesamt (N = 159) | Normale zweite Geburtsphase (N = 95) | Verlängerte zweite Geburtsphase (N = 64) | P-Wert |
| Alter (Jahre) | 28,8 [19,4; 44,9] | 26,3 [19,4; 33,2] | 32,4 [22,3; 44,9] | <0,0001 |
| Gestationsbedingte BMI-Zunahme (kg/m²) | 11,4 ± 3,62 | 10,1 ± 3,33 | 13,3 ± 3,17 | <0,0001 |
| Gestationsdiabetes | 0,0002 | |||
| Nicht vorhanden | 141 (88,7 %) | 92 (96,8 %) | 49 (76,6 %) | |
| Vorhanden | 18 (11,3 %) | 3 (3,16 %) | 15 (23,4 %) | |
| Gestationshochdruck | 0,8723 | |||
| Nicht vorhanden | 124 (78,0 %) | 75 (78,9 %) | 49 (76,6 %) | |
| Vorhanden | 35 (22,0 %) | 20 (21,1 %) | 15 (23,4 %) | |
| Neugeborenes Geburtsgewicht (kg) | 2,61 [1,68; 4,60] | 2,46 [1,68; 2,85] | 3,39 [1,71; 4,60] | <0,0001 |
| Geisteszustand | 0,0017 | |||
| Verändert | 139 (87,4 %) | 90 (94,7 %) | 49 (76,6 %) | |
| Gesund | 20 (12,6 %) | 5 (5,26 %) | 15 (23,4 %) | |
| Uterus-Inertia | <0,0001 | |||
| Nicht vorhanden | 123 (77,4 %) | 85 (89,5 %) | 38 (59,4 %) | |
| Vorhanden | 36 (22,6 %) | 10 (10,5 %) | 26 (40,6 %) | |
| Tragzeit (Wochen) | 38,1 ± 2,02 | 38,1 ± 1,99 | 37,9 ± 2,06 | 0,5156 |
Tabelle 2: Vergleich der demografischen und klinischen Merkmale zwischen den Gruppen. Stetige Variablen werden je nach Gegebenheit als Mittelwert ± Standardabweichung (SD) oder Median [Interquartilbereich (IQR)] angegeben. Kategoriale Variablen werden als Anzahl (%) angegeben. Ein Anstieg des Body-Mass-Index (BMI) wurde als Differenz zwischen dem BMI vor der Schwangerschaft und dem BMI vor der Entbindung definiert. Die Gruppe mit normalem zweitem Wehenstadium umfasste Teilnehmerinnen mit einer Dauer des zweiten Wehenstadiums von ≤120 min, während die Gruppe mit verlängertem zweitem Wehenstadium Teilnehmerinnen mit einer Dauer des zweiten Wehenstadiums von >120 min umfasste. Die P-Werte stellen den Vergleich zwischen den beiden Gruppen dar.
Klinische und Ultraschallparameter im aktiven Erststadium
Erststadium-Transabdominal- und Transperinealultraschallparameter wurden zwischen den Gruppen mit normalem und verlängertem Zweistadium verglichen (Tabelle 3). Der Anteil der occiput-anterior-fetalen Lage war in der verlängerten Gruppe signifikant niedriger als in der normalen Gruppe. Zusätzlich waren AOP, HSD und HPD bei den Gebärenden, die ein verlängertes Zweistadium erlebten, signifikant größer (alle p < 0,05).
| Variable | Gesamt (N = 159) | Normale zweite Phase (N = 95) | Verlängerte zweite Phase (N = 64) | P-Wert |
| Fetale Lage | <0.0001 | |||
| OA | 74 (46,5 %) | 60 (63,2 %) | 14 (21,9 %) | |
| Nicht-OA | 85 (53,5 %) | 35 (36,8 %) | 50 (78,1 %) | |
| AOP (°) | 124 [64,3; 158] | 111 [64,3; 142] | 138 [123; 158] | <0.0001 |
| HSD (cm) | 1,97 ± 0,39 | 1,81 ± 0,33 | 2,21 ± 0,34 | <0.0001 |
| HPD (cm) | 4,61 ± 0,71 | 4,23 ± 0,56 | 5,17 ± 0,51 | <0.0001 |
Tabelle 3: Vergleich der transabdominalen und transperinealen Ultraschallparameter während des ersten Wehenstadiums. Stetige Variablen werden entweder als Mittelwert ± Standardabweichung (SD) oder als Median [Interquartilsabstand (IQR)] angegeben, je nach Eignung. Kategoriale Variablen werden als Anzahl (%) angegeben. OA, Okziput anterior; nicht-OA, nicht-Okziput anterior; AOP, Winkel der Progression; HSD, Distanz Kopf–Symphyse; HPD, Distanz Kopf–Perineum. Der AOP wurde in Grad (°) gemessen, während HSD und HPD in Zentimetern (cm) gemessen wurden. Die Gruppe mit normalem zweitem Wehenstadium umfasste Teilnehmerinnen mit einer Dauer des zweiten Stadiums von ≤120 min, während die Gruppe mit verlängertem zweitem Wehenstadium Teilnehmerinnen mit einer Dauer des zweiten Stadiums von >120 min umfasste. P-Werte stellen den Vergleich zwischen den beiden Gruppen dar.
Eindimensionale Analyse potenzieller Prädiktoren
Eindimensionale Analysen wurden durchgeführt, um Variablen zu identifizieren, die mit einer verlängerten Geburtszweiten Phase assoziiert sind (Tabelle 4). Zehn Variablen unterschieden sich signifikant zwischen der normalen und der verlängerten Gruppe (p < 0,10): mütterliches Alter, BMI-Zunahme während der Schwangerschaft, Schwangerschaftsdiabetes, Geburtsgewicht des Neugeborenen, psychischer Zustand, Uterusinaktivität, fetale Lage, AOP, HSD und HPD. Hinsichtlich der Schwangerschaftshypertonie oder des Gestationsalters wurden keine signifikanten Gruppenunterschiede beobachtet (beide p > 0,10). Variablen mit p < 0,10 wurden anschließend in das LASSO-Regressionsmodell zur Variablenselektion eingegeben.
| Variable | Alle (N = 159) | Normaler zweiter Geburtsabschnitt (N = 95) | Verlängerter zweiter Geburtsabschnitt (N = 64) | Statistik | P-Wert |
| Demografische und klinische Merkmale | |||||
| Alter (Jahre) | 28,8 [19,4; 44,9] | 26,3 [19,4; 33,2] | 32,4 [22,3; 44,9] | Z = −5,891 | <0,001 |
| Zunahme des BMI während der Schwangerschaft (kg/m²) | 11,4 ± 3,62 | 10,1 ± 3,33 | 13,3 ± 3,17 | t = −5,912 | <0,001 |
| Graviditätsdiabetes, n (%) | 18 (11,3) | 3 (3,2) | 15 (23,4) | χ² = 15,207 | <0,001 |
| Graviditätsbedingte Hypertonie, n (%) | 35 (22,0) | 20 (21,1) | 15 (23,4) | χ² = 0,135 | 0,872 |
| Geburtsgewicht des Neugeborenen (kg) | 2,61 [1,68; 4,60] | 2,46 [1,68; 2,85] | 3,39 [1,71; 4,60] | Z = −6,234 | <0,001 |
| Veränderter Bewusstseinszustand, n (%) | 139 (87,4) | 90 (94,7) | 49 (76,6) | χ² = 10,912 | 0,001 |
| Uterusatonie, n (%) | 36 (22,6) | 10 (10,5) | 26 (40,6) | χ² = 20,156 | <0,001 |
| Schwangerschaftsalter (Wochen) | 38,1 ± 2,02 | 38,1 ± 1,99 | 37,9 ± 2,06 | t = 0,654 | 0,516 |
| Ultraschallparameter während des ersten Geburtsabschnitts | |||||
| Fetale Lage (nicht-OA), n (%) | 85 (53,5) | 35 (36,8) | 50 (78,1) | χ² = 26,543 | <0,001 |
| AOP (°) | 124 [64,3; 158] | 111 [64,3; 142] | 138 [123; 158] | Z = −6,781 | <0,001 |
| HSD (cm) | 1,97 ± 0,39 | 1,81 ± 0,33 | 2,21 ± 0,34 | t = −7,445 | <0,001 |
| HPD (cm) | 4,61 ± 0,71 | 4,23 ± 0,56 | 5,17 ± 0,51 | t = −9,332 | <0,001 |
Tabelle 4: Univariate Analyse der mit einer verlängerten zweiten Geburtsphase assoziierten Faktoren. Stetige Variablen werden je nach Gegebenheit als Mittelwert ± Standardabweichung (SD) oder Median [Interquartilsabstand (IQR)] angegeben. Kategoriale Variablen werden als Anzahl (%) dargestellt. BMI, Body-Mass-Index; OA, okziputanterior; nicht-OA, nicht-okziputanterior; AOP, Progressionswinkel; HSD, Kopf–Symphyse-Abstand; HPD, Kopf–Perineum-Abstand. Normalverteilte stetige Variablen wurden mittels des unabhängigen t-Tests t-Test, nicht normalverteilte stetige Variablen wurden mit dem Mann-Whitney-U-Test verglichen U Test (angegeben als der Z Statistik) und kategoriale Variablen wurden mittels des Chi-Quadrat-Tests (χ2) Test. Variablen mit P <0,10 wurden als Zulassungskriterium für die Regressionsanalyse mit dem Least Absolute Shrinkage and Selection Operator (LASSO) herangezogen.
Variablenauswahl mittels Regression mit der Methode der kleinsten absoluten Schrumpfung und Selektion (LASSO)
Um ein sparsames Vorhersagemodell zu erstellen und gleichzeitig das Risiko einer Überanpassung sowie den Einfluss von Multikollinearität zu verringern, wurden die 10 Kandidatenprädiktoren, die in der univariaten Analyse identifiziert worden waren (p < 0,10; Tabelle 4), in das LASSO-Regressionsmodell zur Variablenauswahl eingegeben. Der optimale Regularisierungsparameter (λ) wurde mittels 10-facher Kreuzvalidierung bestimmt. Der Koeffizientenpfad-Plot (Abbildung 2A) veranschaulicht die schrittweise Schrumpfung der Regressionskoeffizienten in Richtung Null mit steigendem λ. Die entsprechende Kreuzvalidierungskurve (Abbildung 2B) zeigt den Zusammenhang zwischen dem Kreuzvalidierungsfehler und verschiedenen λ-Werten. Die linke vertikale gestrichelte Linie markiert den λ-Wert, der den Kreuzvalidierungsfehler minimiert, während die rechte vertikale gestrichelte Linie den größten λ-Wert innerhalb einer Standardabweichung des Minimums angibt (One-Standard-Error-Kriterium). Letzterer wurde gewählt, um ein sparsameres Modell zu erhalten. Gemäß dem One-Standard-Error-Kriterium verblieben vier Prädiktoren mit nicht-null Koeffizienten: Geburtsgewicht des Neugeborenen (Koeffizient = 0,50), BMI-Zunahme während der Schwangerschaft (Koeffizient = 0,12), mütterliches Alter (Koeffizient = 0,05) und AOP (Koeffizient = 0,03). Diese Koeffizienten stellen die standardisierten, strafenden Koeffizienten aus dem endgültigen LASSO-Modell am gewählten λ-Wert dar. Die übrigen Kandidatenvariablen – HSD, HPD, Schwangerschaftsdiabetes, psychischer Zustand, Uterusstarre und fetale Lage – wiesen Koeffizienten auf, die auf null geschrumpft wurden, und wurden daher aus dem endgültigen Satz an Prädiktoren ausgeschlossen. Die verbliebenen Variablen wurden anschließend in das multivariable logistische Regressionsmodell eingegeben, um adjustierte Odds Ratios (ORs) mit entsprechenden 95 %-Konfidenzintervallen (CIs) zu berechnen.
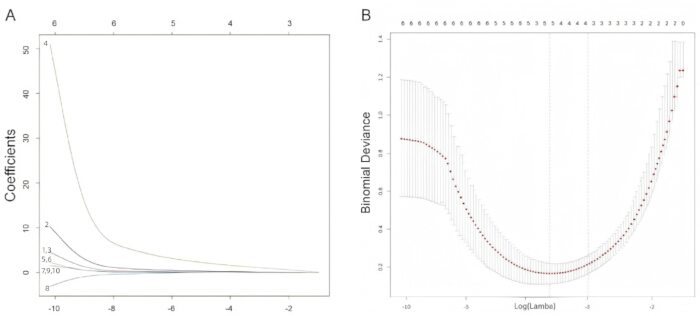
Abbildung 2. Regressionsanalyse mittels Least Absolute Shrinkage and Selection Operator (LASSO) zur Auswahl von Prädiktoren. (A) Koeffizientenpfade, die während der LASSO-Regression generiert wurden. Die x-Achse stellt den Logarithmus des Regularisierungsparameters (log λ) dar, und die y-Achse stellt die standardisierten Regressionskoeffizienten dar. Jede Kurve veranschaulicht die schrittweise Verkleinerung des Koeffizienten eines einzelnen Prädiktors in Richtung Null, während die Regularisierungsstrafe zunimmt. Die oben angegebenen Zahlen zeigen die Anzahl der beibehaltenen Variablen bei jedem Wert von λ an. Die nummerierten Koeffizientenpfade entsprechen den folgenden Kandidatenprädiktoren: (1) mütterliches Alter, (2) gestationsbedingte Zunahme des Body-Mass-Index (BMI), (3) Schwangerschaftsdiabetes, (4) Geburtsgewicht des Neugeborenen, (5) psychischer Zustand, (6) Uterusstarre, (7) fetale Lage, (8) Winkel des Fortschritts (AOP), (9) Distanz Kopf–Symphyse (HSD) und (10) Distanz Kopf–Perineum (HPD). (B) Zehnfache Kreuzvalidierungsdarstellung zur Bestimmung des optimalen Regularisierungsparameters. Die x-Achse stellt log(λ) dar, und die y-Achse stellt die Binomialabweichung dar. Die Punkte zeigen den mittleren Kreuzvalidierungsfehler an, und die Fehlerbalken repräsentieren ±1 Standardfehler. Die linke vertikale gestrichelte Linie zeigt den Wert von λ an, der den Kreuzvalidierungsfehler minimiert, während die rechte vertikale gestrichelte Linie den größten Wert von λ innerhalb einer Standardabweichung des Minimums anzeigt (Kriterium der einen Standardabweichung). Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Logistische Multivarianzregression und unabhängige Prädiktoren
Die vier von dem LASSO-Regressionsmodell beibehaltenen Prädiktoren – mütterliches Alter, BMI-Zunahme während der Schwangerschaft, Geburtsgewicht des Neugeborenen und AOP – wurden in ein logistisches Multivarianzregressionsmodell eingegeben (Tabelle 5). Alle vier Variablen zeigten auch nach gegenseitiger Anpassung eine unabhängige Assoziation mit verlängerter zweiter Wehephase (alle p < 0,05). In dem neu angepassten logistischen Multivarianzregressionsmodell wies das Geburtsgewicht des Neugeborenen die höchste adjustierte Odds Ratio (aOR = 8,45, 95 % KI: 3,21–22,24) auf. Die BMI-Zunahme während der Schwangerschaft war ebenfalls unabhängig mit einer verlängerten zweiten Wehephase assoziiert (aOR = 1,38, 95 % KI: 1,15–1,66). Mütterliches Alter (aOR = 1,18, 95 % KI: 1,05–1,32) und AOP (aOR = 1,07, 95 % KI: 1,02–1,12) waren ebenfalls unabhängig mit einer verlängerten zweiten Wehephase assoziiert. Das logistische Multivarianzregressionsmodell war gemäß dem Likelihood-Quotienten-Test statistisch signifikant (p < 0,001). Da das Geburtsgewicht des Neugeborenen erst nach der Entbindung gemessen wurde, ist das vorliegende Modell explorativer Natur und müsste vor einer klinischen Anwendung unter Verwendung des geschätzten fetalen Gewichts neu angepasst werden.
| Variable | β | SE | Wald χ² | P-Wert | aOR | 95% KI |
| Achsenabschnitt | −15.92 | 3.01 | 27.98 | <0.001 | — | — |
| Maternaler Alter (Jahre) | 0.16 | 0.06 | 7.11 | 0.008 | 1.18 | 1.05–1.32 |
| Gestationsbedingte BMI-Zunahme (kg/m²) | 0.32 | 0.09 | 12.65 | <0.001 | 1.38 | 1.15–1.66 |
| Geburtsgewicht des Neugeborenen (kg) | 4.26 | 0.9 | 22.41 | <0.001 | 8.45 | 3.21–22.24 |
| AOP (°) | 0.07 | 0.02 | 10.76 | 0.001 | 1.07 | 1.02–1.12 |
Tabelle 5: Multivariable logistische Regressionsanalyse zur Identifizierung unabhängiger Prädiktoren für eine verlängerte zweite Wehephase. Die Tabelle zeigt die Ergebnisse des multivariablen logistischen Regressionsmodells, das unter Verwendung von Variablen erstellt wurde, die mittels Regression mit der Methode der kleinsten absoluten Schrumpfung und Auswahl (LASSO) ausgewählt wurden. β, Regressionskoeffizient; SE, Standardfehler; Wald χ2, Wald-Chi-Quadrat-Statistik; aOR, adjustiertes Odds Ratio; CI, Konfidenzintervall; BMI, Body-Mass-Index; AOP, Winkel des Fortschritts. Der Achsenabschnitt repräsentiert die Modellkonstante. Die Gesamtsignifikanz des Modells wurde mittels des Likelihood-Quotienten-Tests bewertet (χ2 = 85,34, P <0,001).
Konstruktion des Vorhersagemodells und Nomogramm
Basierend auf den unabhängigen Prädiktoren und ihren Regressionskoeffizienten, die mittels multivariater logistischer Regressionsanalyse identifiziert wurden (Tabelle 5), wurde ein patientenspezifisches Vorhersagemodell erstellt, um die Wahrscheinlichkeit einer verlängerten Wehezweiten Phase bei Erstgebärenden abzuschätzen. Das Modell wird wie folgt ausgedrückt:
Logit(P) = —15.92 + 0.16 (mütterliches Alter) + 0,32 (BMI-Zunahme während der Schwangerschaft) + 4,26 (Geburtsgewicht des Neugeborenen) + 0,07 (AOP)
Hier steht P für die vorhergesagte Wahrscheinlichkeit einer verlängerten Geburtsphase zweiten Grades.
Zur besseren Veranschaulichung des Modells wurde die Regressionsgleichung als Nomogramm dargestellt (Abbildung 3). Jeder Prädiktor entspricht einer individuellen Punkteskala. Beispielsweise kann eine Gebärende mit einem mütterlichen Alter von 28 Jahren, einer BMI-Zunahme während der Schwangerschaft von 12 kg/m2, einem Geburtsgewicht des Neugeborenen (tatsächlich nach der Entbindung gemessen) von 3,6 kg und einem AOP von 115° bewertet werden, indem jeder Wert auf der entsprechenden Achse lokalisiert, senkrecht auf die Achse „Punkte“ projiziert, die einzelnen Punktwerte summiert werden, um die Gesamtpunktzahl zu erhalten, und anschließend die Gesamtpunktzahl nach unten auf die Achse „Risiko für verlängerte zweite Geburtsphase“ projiziert wird, um die vorhergesagte Wahrscheinlichkeit abzuschätzen. Dieses Nomogramm wird ausschließlich zu Veranschaulichungszwecken gezeigt, da es das tatsächliche Geburtsgewicht des Neugeborenen berücksichtigt. Für die klinische Anwendung müsste das Modell unter Verwendung des geschätzten fetalen Gewichts neu kalibriert werden.
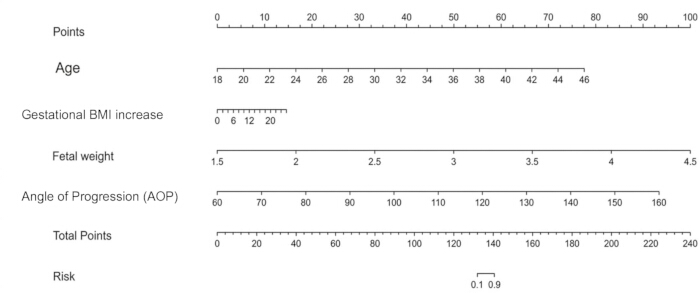
Abbildung 3. Nomogramm zur Vorhersage der Wahrscheinlichkeit einer verlängerten zweiten Wehephase. Das Nomogramm wurde anhand eines multivariablen logistischen Regressionsmodells unter Verwendung von vier Prädiktoren erstellt: mütterliches Alter, BMI-Zunahme während der Schwangerschaft, Geburtsgewicht des Neugeborenen (tatsächliches Geburtsgewicht nach der Entbindung gemessen) und AOP. Um die vorhergesagte Wahrscheinlichkeit einer verlängerten zweiten Wehephase abzuschätzen, finden Sie jeden Prädiktorwert auf der entsprechenden Achse und projizieren Sie senkrecht auf die Punkte-Achse, um die zugeordnete Punktzahl zu ermitteln. Addieren Sie die einzelnen Punktzahlen, um die Gesamtpunktzahl zu erhalten, und projizieren Sie anschließend die Gesamtpunktzahl auf die Risiko-Achse, um die vorhergesagte Wahrscheinlichkeit einer verlängerten zweiten Wehephase zu schätzen. Das Nomogramm dient ausschließlich Illustrationszwecken, da es das tatsächliche Geburtsgewicht des Neugeborenen berücksichtigt, das vor der Entbindung nicht verfügbar ist. Für die klinische Anwendung müsste das Modell unter Verwendung des EFW neu kalibriert werden. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Modellvalidierung: Diskriminierung, Kalibrierung und klinische Nützlichkeit
Die vorhersagende Leistung des Modells wurde intern hinsichtlich Diskriminierung, Kalibrierung und klinischer Nützlichkeit bewertet. Die Diskriminierung des Modells wurde mithilfe der ROC-Kurve (Abbildung 4) überprüft. Das Modell erreichte eine AUC von 0,927 (95 %-KI: 0,879–0,961), was auf eine hervorragende Diskriminierungsfähigkeit hinweist. Unter Verwendung des maximalen Youden-Index betrug der optimale Wahrscheinlichkeitsschwellenwert 0,48. Bei diesem Schwellenwert zeigte das Modell eine Sensitivität von 85,9 % und eine Spezifität von 84,2 % (Tabelle 6).
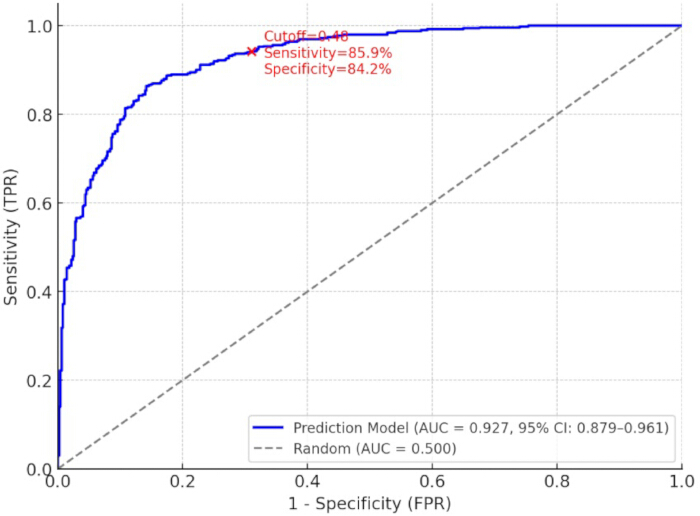
Abbildung 4. Receiver-Operating-Characteristic-(ROC)-Kurve zur Bewertung der Leistung des Vorhersagemodells. Die Receiver-Operating-Characteristic-(ROC)-Kurve veranschaulicht die Fähigkeit des Vorhersagemodells, zwischen normalem und verlängertem zweitem Geburtsabschnitt zu unterscheiden. Die blaue Kurve repräsentiert das Vorhersagemodell mit einer Fläche unter der Kurve (AUC) von 0,927 (95 %-Konfidenzintervall [KI]: 0,879–0,961). Der optimale Wahrscheinlichkeitsschwellenwert betrug 0,48, was einer Sensitivität von 85,9 % und einer Spezifität von 84,2 % entspricht. Die graue gestrichelte Diagonale repräsentiert eine zufällige Klassifizierung (AUC = 0,500). Die x-Achse stellt 1 − Spezifität (Falsch-positiv-Rate [FPR]) dar, und die y-Achse stellt die Sensitivität (Richtig-positiv-Rate [TPR]) dar. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
| Parameter | Wert | 95 % KI |
| AUC | 0.927 | 0.879–0.961 |
| Optimaler Cutoff | 0.480 | — |
| Sensitivität | 85,90 % | 75,0 %–93,4 % |
| Spezifität | 84,20 % | 75,3 %–90,9 % |
| Positiver Vorhersagewert (PPV) | 78,60 % | 67,5 %–87,3 % |
| Negativer Vorhersagewert (NPV) | 89,80 % | 81,9 %–95,0 % |
| Genauigkeit | 84,90 % | 78,3 %–90,1 % |
Tabelle 6: Leistung des Vorhersagemodells am optimalen Wahrscheinlichkeitsschwellenwert. Die Vorhersageleistung des multivariablen logistischen Regressionsmodells wurde anhand der Fläche unter der Receiver-Operating-Characteristic-(ROC)-Kurve (AUC) bewertet. Der optimale Wahrscheinlichkeitsschwellenwert von 0,48 wurde durch Maximierung des Youden-Index bestimmt. Die Sensitivität gibt den Anteil korrekt identifizierter echter Positiv-Fälle an, die Spezifität den Anteil korrekt identifizierter echter Negativ-Fälle, der positive prädiktive Wert (PPV) die Wahrscheinlichkeit, dass Teilnehmer, die als positiv klassifiziert wurden, tatsächlich eine verlängerte zweite Geburtsphase hatten, und der negative prädiktive Wert (NPV) die Wahrscheinlichkeit, dass Teilnehmer, die als negativ klassifiziert wurden, tatsächlich keine verlängerte zweite Geburtsphase hatten. CI, Konfidenzintervall.
Die Modellkalibrierung wurde anhand einer Bootstrap-Kalibrierungskurve, die aus 1.000 Resamples generiert wurde, sowie mit dem Hosmer-Lemeshow-Anpassungstest evaluiert (Abbildung 5A). Die Kalibrierungskurve folgte eng der idealen Referenzlinie, was auf eine gute Übereinstimmung zwischen vorhergesagten und beobachteten Wahrscheinlichkeiten hindeutet. Der Hosmer-Lemeshow-Anpassungstest war nicht statistisch signifikant (χ2 = 6,15, p = 0,630), was mit einer ausreichenden Kalibrierung in diesem intern validierten Modell übereinstimmt. Die klinische Nützlichkeit wurde mittels DCA bewertet (Abbildung 5B). Im Bereich der Schwellenwahrscheinlichkeit von etwa 10 % bis 70 % lieferte das Vorhersagemodell einen höheren Nettovorteil als entweder die Strategie „alle behandeln“ oder „keinen behandeln“. Bei Schwellenwahrscheinlichkeiten unter etwa 10 % ergab die Strategie „keinen behandeln“ einen höheren Nettovorteil, während bei Schwellenwahrscheinlichkeiten über etwa 70 % die Strategie „alle behandeln“ ähnlich gut oder besser abschnitt. Diese Ergebnisse deuten darauf hin, dass das Modell im mittleren Bereich der Schwellenwahrscheinlichkeiten einen klinischen Nutzen bieten kann. Insgesamt zeigte das Vorhersagemodell eine hervorragende Diskriminierung, ausreichende Kalibrierung und günstige klinische Nützlichkeit während der internen Validierung. Da die Validierung jedoch auf den Studiensatz beschränkt war und das Modell das tatsächliche Geburtsgewicht des Neugeborenen berücksichtigte, ist eine externe Validierung und Neuanpassung unter Verwendung des geschätzten fetalen Gewichts vor der klinischen Anwendung erforderlich.
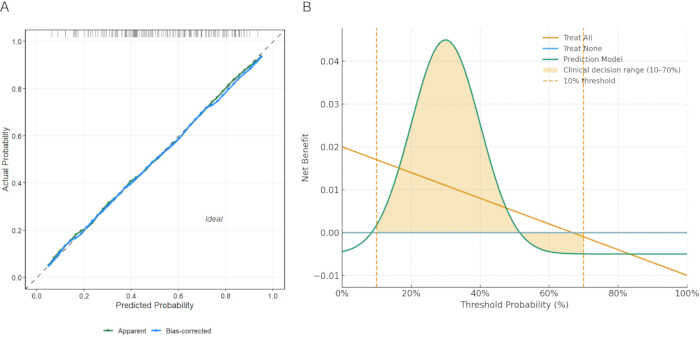
Abbildung 5. Kalibrierungs- und Entscheidungskurvenanalysen des Vorhersagemodells. (A) Kalibrierungskurve des Vorhersagemodells, erstellt anhand von 1.000 Bootstrap-Stichproben. Die „apparent“-Kurve zeigt die Modellleistung im Studiendatensatz, die bias-korrigierte Kurve zeigt die bootstrap-angepasste Kalibrierung, und die gestrichelte diagonale Linie zeigt die ideale Übereinstimmung zwischen vorhergesagten und beobachteten Wahrscheinlichkeiten an. Der Hosmer–Lemeshow-Test zur Anpassungsgüte ergab χ2 = 6,15 und p = 0,630. (B) Entscheidungskurvenanalyse (DCA) zur Bewertung des klinischen Nutzens des Vorhersagemodells über einen Bereich verschiedener Schwellenwahrscheinlichkeiten hinweg. Die grüne Kurve repräsentiert das Vorhersagemodell, die orangefarbene Linie die „behandle-alle“-Strategie und die blaue Linie die „behandle-keinen“-Strategie. Der schraffierte Bereich zeigt den in dieser Studie untersuchten Bereich der Schwellenwahrscheinlichkeit von 10 %–70 %, wobei gestrichelte vertikale Linien die untere (10 %) und obere (70 %) Schwelle markieren. Die x-Achse stellt die Schwellenwahrscheinlichkeit dar, die y-Achse den Nettogewinn. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Datenverfügbarkeit:
Der anonymisierte Datensatz auf Teilnehmerebene, der die Ergebnisse dieser Studie unterstützt, ist in Supplementär-Tabelle 1 enthalten. Dieser Datensatz umfasst die Rohdaten, die für alle statistischen Analysen, die Modellentwicklung, die interne Validierung sowie die Erstellung der berichteten Tabellen und Abbildungen verwendet wurden.
Abbildung 1 (zusätzlich). Gesamter Ablauf der Studie zur Entwicklung und internen Validierung des Vorhersagemodells. Der Ablauf veranschaulicht die Rekrutierung der Teilnehmerinnen und die Beurteilung der Eignung, die Erfassung mütterlicher klinischer Merkmale und intrapartaler Ultraschallmessungen während des aktiven ersten Wehenstadiums, die Einteilung in normale und verlängerte zweite Wehenphase gemäß dem 120-Minuten-Kriterium der Weltgesundheitsorganisation (WHO), die Auswahl der Prädiktoren mittels LASSO-Regression (least absolute shrinkage and selection operator), die Erstellung des multivariablen logistischen Regressionsmodells und des Nomogramms sowie die interne Modellbewertung mittels ROC-Analyse (receiver operating characteristic), Kalibrationsanalyse und Entscheidungskurvenanalyse (DCA). Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatz-Tabelle 1. Datensatz auf Teilnehmerniveau, verwendet für die Modellentwicklung und interne Validierung. Diese Tabelle enthält die anonymisierten Daten auf Teilnehmerniveau, die für alle statistischen Analysen verwendet wurden, einschließlich der Entwicklung und internen Validierung des Vorhersagemodells. Die Variablen umfassen das Ergebnis der zweiten Wehenphase, die Dauer der zweiten Phase, neonatale Ergebnisse, mütterliche demografische und klinische Merkmale sowie transabdominale und transperineale Ultraschallmessungen, die während der ersten Wehenphase erhoben wurden. Body mass index (BMI) = Body-Mass-Index; occiput anterior (OA) = okziputanteriorer fetaler Lage; angle of progression (AOP) = Winkel des Fortschritts; head–symphysis distance (HSD) = Kopf–Symphyse-Abstand; und head–perineum distance (HPD) = Kopf–Perineum-Abstand. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Durch kontinuierliche Verbesserungen im geburtshilflichen Management ist eine verlängerte zweite Geburtsphase zu einem zunehmend wichtigen Faktor für die mütterlichen und neonatalen Ergebnisse geworden. Frühere Studien haben gezeigt, dass eine verlängerte zweite Geburtsphase mit einer erhöhten Komplexität des Geburtsverlaufs, einer höheren Rate an Sectio-Caesarea-Entbindungen und niedrigeren neonatalen Apgar-Scores assoziiert ist1,2. Diese Ergebnisse unterstreichen die klinische Bedeutung einer optimierten perinatalen Versorgung sowie die Implementierung von Strategien zur frühzeitigen Identifizierung von Frauen mit erhöhtem Risiko für eine verlängerte zweite Geburtsphase. Unter Verwendung von demografischen Merkmalen, klinischen Parametern und Ultraschallbefunden entwickelte und intern validierte die vorliegende Studie ein prädiktives Modell für eine verlängerte zweite Geburtsphase und bewertete dessen potenzielle klinische Anwendbarkeit. Die Ergebnisse zeigten, dass das mütterliche Alter, die BMI-Zunahme während der Schwangerschaft, das Geburtsgewicht des Neugeborenen und der AOP unabhängig mit einer verlängerten zweiten Geburtsphase im endgültigen multivariaten Modell assoziiert waren, während Schwangerschaftsdiabetes, Uterusinertia und veränderte mentale Verfassung in der univariaten Analyse assoziiert waren, jedoch nicht im endgültigen prädiktiven Modell verblieben. Durch die Integration von demografischen, klinischen und ultraschallbasierten Daten in ein mehrdimensionales Vorhersagemodell liefert diese Studie einen objektiven Rahmen zur Identifizierung von Frauen mit erhöhtem Risiko für eine verlängerte zweite Geburtsphase bereits in der ersten Geburtsphase. Eine derartige frühe Risikostratifizierung könnte ein individualisiertes Geburtsmanagement erleichtern, einschließlich einer engeren Überwachung des Geburtsverlaufs und rechtzeitiger klinischer Entscheidungsfindung, mit dem Ziel, die mütterlichen und neonatalen Ergebnisse zu verbessern.
Unsere Ergebnisse zeigten, dass eine verlängerte zweite Geburtsphase stark mit ungünstigen fetalen Outcome-Werten assoziiert ist. In Übereinstimmung mit früheren Berichten erhöhte sich bei einer verlängerten zweiten Geburtsphase das Risiko signifikant für niedrige Apgar-Scores und fetale Distresszustände3,8. Mechanistisch könnte diese Assoziation auf fetaler Hypoxie und erhöhtem intrauterinem Stress während einer verlängerten Geburt beruhen. Wenn der fetale Kopf über einen längeren Zeitraum innerhalb des mütterlichen Beckens komprimiert bleibt, kann die plazentare Perfusion unzureichend werden, was zu Sauerstoffmangel und abnormalen fetalen Herzfrequenzmustern führt, die den unmittelbaren neonatalen Zustand beeinträchtigen können9. Aus demografischer Sicht zeigte diese Studie, dass ein höheres mütterliches Alter, eine stärkere BMI-Zunahme während der Schwangerschaft und Schwangerschaftsdiabetes mit einer verlängerten zweiten Geburtsphase assoziiert waren. Insbesondere ältere Mütter wiesen ein höheres Risiko für eine verlängerte Geburt auf, was mit früheren Untersuchungen übereinstimmt10. Physiologisch könnte das fortschreitende mütterliche Alter die Zervixreifung und die Uteruskontraktilität beeinträchtigen und somit den Geburtsverlauf verzögern. Eine stärkere BMI-Zunahme während der Schwangerschaft und Schwangerschaftsdiabetes können den Geburtsverlauf zusätzlich beeinflussen, indem sie die fetale Größe erhöhen und die Uteruskontraktionsmuster verändern. Außerdem waren Uterusinertia und veränderte psychische Zustände in der univariaten Analyse signifikant mit einer verlängerten zweiten Geburtsphase assoziiert. Diese Befunde unterstreichen die Bedeutung einer sorgfältigen Überwachung der Uteruskontraktilität und des psychischen Wohlbefindens der Mutter während der Geburt, da beide Faktoren indirekt durch Beeinflussung des Rhythmus und der Stärke der Uteruskontraktionen zu einer verlängerten Geburt beitragen können. Ultraschallparameter spielen ebenfalls eine wichtige Rolle bei der Vorhersage einer verlängerten zweiten Geburtsphase11,12,13,14. In der vorliegenden Studie identifizierte die multivariable logistische Regressionsanalyse den AOP als unabhängigen Prädiktor für eine verlängerte zweite Geburtsphase (p < 0,05). HSD und HPD waren in der univariaten Analyse signifikant mit einer verlängerten zweiten Geburtsphase assoziiert, wurden jedoch nach der Variablenselektion mittels LASSO nicht im endgültigen Vorhersagemodell beibehalten. Ein erhöhter HSD weist darauf hin, dass sich der fetale Kopf auf einer höheren Station innerhalb des Beckeneingangs befindet, was auf eine beeinträchtigte Abstiegsbewegung und eine erhöhte Wahrscheinlichkeit einer verlängerten zweiten Geburtsphase hindeutet15,16,17. Der AOP spiegelt sowohl den Abstieg als auch die Rotation des fetalen Kopfes wider und steht daher in direktem Zusammenhang mit dem Fortschreiten der Geburt6,18. Obwohl die mittels transabdominalem Ultraschall bestimmte fetale Lage im endgültigen Vorhersagemodell nicht beibehalten wurde, bleibt der transabdominale Ultraschall klinisch nützlich, um fetale Fehllagen (z. B. Okziput-posterior- oder Querlagen) zu identifizieren, die eine engmaschigere intrapartale Beurteilung erfordern könnten. Insgesamt legen diese Befunde nahe, dass der intrapartale Ultraschall objektive Informationen über die fetale Lage und den Kopfabstieg liefert, die bei der frühen Beurteilung von Frauen mit erhöhtem Risiko für eine verlängerte zweite Geburtsphase hilfreich sein können. Durch die Integration demografischer Merkmale mit Ultraschallparametern entwickelte diese Studie ein intern validiertes Vorhersagemodell. Die LASSO-Regression identifizierte vier Variablen mit von null verschiedenen Koeffizienten – mütterliches Alter, BMI-Zunahme während der Schwangerschaft, neonatales Geburtsgewicht und AOP –, die anschließend in das multivariable logistische Regressionsmodell zur Schätzung der adjustierten Effektgrößen eingegeben wurden. Unter Verwendung des Kriteriums des einen Standardfehlers für die Modellselektion erreichte das Modell bei der internen Validierung eine AUC von 0,927, was auf eine hervorragende Diskriminierungsleistung hinweist. Da das Modell jedoch das tatsächlich nach der Entbindung gemessene neonatale Geburtsgewicht berücksichtigte, sollte es als explorativ und illustrativ betrachtet und nicht direkt in der klinischen Praxis angewendet werden. Eine zukünftige klinische Anwendung würde eine Neukalibrierung des Modells unter Verwendung des geschätzten fetalen Gewichts sowie eine unabhängige externe Validierung erfordern. Innerhalb dieser Grenzen könnte die Integration demografischer Merkmale und Ultraschallparameter eine frühere Risikostratifizierung ermöglichen und ein individualisiertes intrapartales Management unterstützen19,20,21,22.
Im Vergleich zu früheren Untersuchungen weist die vorliegende Studie mehrere wichtige Stärken auf. Erstens ermöglichte die Integration von demografischen Merkmalen, klinischen Variablen und Ultraschallparametern eine mehrdimensionale Bewertung der mit einer verlängerten zweiten Geburtsphase assoziierten Faktoren. Zweitens wurde eine LASSO-Regression zur Variablenselektion und Koeffizientenschrumpfung verwendet, was helfen kann, Multikollinearität zu bewältigen und die Modellstabilität bei korrelierten Prädiktoren zu verbessern. Drittens bot die Stichprobengröße ausreichende statistische Power für die Modellerstellung und interne Validierung. Trotz dieser Stärken sind mehrere Limitationen zu berücksichtigen. Erstens handelte es sich um eine prospektive Einzelzentrenstudie, und nur Frauen, die letztendlich eine vaginale Entbindung erzielten, wurden eingeschlossen. Folglich wurden Frauen, die während der zweiten Geburtsphase eine operative vaginale Entbindung oder einen Kaiserschnitt erhielten, ausgeschlossen, was einen Selektionsbias verursacht und die Generalisierbarkeit der Ergebnisse einschränkt. Außerdem berücksichtigte die Outcome-Definition keine operative Entbindung als konkurrierendes Ereignis bei Frauen mit verlängerter Wehenphase. Daher ist eine externe Validierung in unabhängigen, multizentrischen, prospektiven Kohorten erforderlich, bevor eine klinische Anwendung möglich ist. Zweitens basierten alle Bewertungen der Modellleistung, einschließlich ROC-Analyse, Kalibrierung und DCA, auf der internen Validierung mittels derselben Studienpopulation, und es stand keine unabhängige externe Validierungskohorte zur Verfügung. Drittens wurden zwar Epiduralanästhesie, Oxytocin-Augmentation und künstliche Blasenruptur erfasst, diese Variablen jedoch nicht in das endgültige prädiktive Modell einbezogen. Weitere möglicherweise wichtige Faktoren, wie beispielsweise die Eigenschaften der Uteruskontraktionen, Strategien des Wehenmanagements und mütterliche Schmerzskalen, könnten den Geburtsverlauf ebenfalls beeinflussen und sollten in zukünftigen Studien untersucht werden. Viertens bleiben einige Ultraschallmessungen trotz standardisierter Schulung und hoher interindividueller Reproduzierbarkeit operatorabhängig, und es wurde nur eine einzige Beurteilung analysiert, die während der aktiven ersten Geburtsphase durchgeführt wurde. Da die Geburt ein dynamischer Prozess ist, könnte die Mittelung von drei Messungen, die während unterschiedlicher Kontraktionen erhoben wurden, zufällige Messfehler reduzieren, jedoch auch schnelle Veränderungen des fetalen Abstiegs verschleiern. Zukünftige Studien, die serielle, zeitgestempelte Ultraschalluntersuchungen einbeziehen – wie beispielsweise zeitliche Veränderungen des AOP –, könnten die prädiktive Leistung verbessern23,24. Schließlich wurde das prädiktive Modell unter Verwendung des tatsächlichen neonatalen Geburtsgewichts, gemessen nach der Entbindung, erstellt, um die physiologische Assoziation mit einer verlängerten zweiten Geburtsphase zu etablieren. Demnach sollte das Modell als explorativ betrachtet werden und ist nicht direkt für die intrapartale klinische Vorhersage anwendbar. Eine klinische Implementierung würde eine Neuentwicklung und externe Validierung des Modells unter Verwendung des vor der Entbindung geschätzten fetalen Gewichts erfordern, anstatt eine einfache Substitution in die aktuelle Gleichung. Da die Schätzung des fetalen Gewichts inhärenten Messfehlern unterliegt (typischerweise ±10–15 %), sollten die Modellkoeffizienten und -leistung in einer unabhängigen Kohorte vor der klinischen Anwendung neu geschätzt werden. Außerdem wurde in dieser Studie die Uterusinertia anhand der beobachteten Kontraktionsfrequenz und -dauer definiert, nicht nach den von ACOG oder NICE empfohlenen diagnostischen Kriterien für den Wehenstillstand, was den direkten Vergleich mit anderen Studien einschränken könnte. Schließlich könnte die Verwendung einer festen Schwelle von 120 Minuten zur Definition einer verlängerten zweiten Geburtsphase, ohne die möglicherweise akzeptableren längeren Dauern bei Frauen mit Epiduralanästhesie zu berücksichtigen, die Generalisierbarkeit des Modells weiter einschränken.
Künftige Forschungsarbeiten sollten alternative Ansätze zur Untersuchung der in dieser Studie geprüften Hypothese erforschen. Erstens könnten, anstelle der in dieser Studie verwendeten einzelnen Ultraschalluntersuchung zu Beginn der aktiven Phase der Wehen, serielle Messungen (z. B. Veränderungen des AOP oder des Fortschrittsabstands des kindlichen Kopfes über die Zeit) den dynamischen Prozess des kindlichen Abstiegs besser erfassen und die Vorhersagegenauigkeit verbessern, wie kürzlich publizierte Studien nahelegen23,24. Zweitens könnten, obwohl die Kombination aus LASSO-Regression und multivariater logistischer Regression ein sparsames und interpretierbares Modell ergab, andere maschinelle Lernverfahren – wie zufällige Wälder, Support-Vektor-Maschinen oder Gradient-Boosting – nichtlineare Zusammenhänge und komplexe Wechselwirkungen zwischen Prädiktoren besser erfassen, möglicherweise jedoch auf Kosten der Interpretierbarkeit. Drittens sollte, da sich die Definitionen für eine verlängerte zweite Wehenphase in klinischen Leitlinien unterscheiden – unter anderem durch längere Schwellenwerte für Frauen mit epiduraler Analgesie –, eine Neukalibrierung des Modells für alternative Outcome-Definitionen untersucht werden. Viertens sollten zukünftige Modelle anstelle des tatsächlichen Geburtsgewichts auf der geschätzten fetalen Körpermasse basieren, und alternative sonographische Methoden zur Schätzung des fetalen Gewichts – einschließlich dreidimensionaler Ultraschallverfahren – könnten helfen, Messfehler zu reduzieren. Schließlich könnte die Einbeziehung kontinuierlicher intrapartaler Monitoringdaten, wie z. B. der Stärke der Uteruskontraktionen oder der automatisierten Kardiotokographie-Analyse, die Risikostratifizierung weiter verbessern. Ein vergleichende Bewertung dieser Ansätze könnte helfen, die optimale Strategie zur Vorhersage einer verlängerten zweiten Wehenphase zu identifizieren.
Eine weitere Einschränkung dieser Studie besteht darin, dass nur Frauen eingeschlossen wurden, die eine erfolgreiche vaginale Entbindung erzielten, um eine genaue Messung der Dauer des zweiten Wehenstadiums sicherzustellen. Folglich wurden Frauen ausgeschlossen, die nach einem verlängerten zweiten Wehenstadium eine operative vaginale Entbindung oder einen Kaiserschnitt erhielten, obwohl sie der Studiendefinition eines verlängerten Wehenverlaufs entsprochen hätten. Dieses Selektionskriterium könnte die tatsächliche Inzidenz eines verlängerten zweiten Wehenstadiums unterschätzt und eine Verzerrung bei der Erfassung des Endpunkts verursacht haben. Außerdem stellt ein operativer Eingriff vor Abschluss des zweiten Stadiums ein konkurrierendes Ereignis und kein einfaches Nichtereignis dar und wurde daher nicht in das Vorhersagemodell einbezogen. Demzufolge schätzt das vorliegende Modell die Wahrscheinlichkeit eines verlängerten zweiten Wehenstadiums ausschließlich bei Frauen, die letztlich eine vaginale Entbindung erreichen, und sollte nicht zur Vorhersage des Bedarfs an operativer Entbindung verwendet werden. Eine externe Validierung an breiteren, nicht selektierten geburtshilflichen Populationen, die auch operative Entbindungen umfassen, wird notwendig sein, um die Übertragbarkeit und klinische Anwendbarkeit des Modells zu bestimmen. Die beobachtete Assoziation zwischen verlängertem zweitem Wehenstadium und ungünstigen Ergebnissen, einschließlich fetaler Distresszustände und niedriger Apgar-Scores, auch innerhalb einer Kohorte, die auf Frauen mit vaginaler Entbindung beschränkt war, unterstreicht die Bedeutung einer frühen Risikobewertung. Die hohe Rate an vaginalen Entbindungen in dieser Kohorte spiegelt die Einschlusskriterien der Studie wider und sollte nicht so interpretiert werden, dass operativer Beistand in der routinemäßigen klinischen Praxis unnötig gewesen wäre.
Das Vorhersagemodell bietet mehrere mögliche Anwendungen. Nach einer Neuentwicklung unter Verwendung des geschätzten fetalen Gewichts und einer unabhängigen externen Validierung könnte es in elektronische Gesundheitsakten-Systeme integriert werden, um das individuelle Risiko einer verlängerten zweiten Wehephase bereits während der aktiven ersten Wehephase abzuschätzen und so eine Echtzeit-Identifizierung von Frauen mit erhöhtem Risiko zu ermöglichen. Unter Verwendung des in dieser Studie ermittelten optimalen Wahrscheinlichkeitsschwellenwerts (0,48) könnte das Modell die individualisierte Geburtsbegleitung unterstützen, einschließlich intensiverer mütterlicher und fetaler Überwachung sowie zeitgerechter klinischer Entscheidungsfindung. Darüber hinaus könnte das Modell die Risikostratifizierung in zukünftigen interventionsbasierten Studien verbessern, die Geburtsmanagementstrategien, Periduralanästhesie-Protokolle oder uterine Stimulation untersuchen, indem es eine ausgewogenere Verteilung des Basisrisikos ermöglicht. Da die erforderlichen Eingangsvariablen routinemäßig während der klinischen Versorgung erfasst werden, könnte das Modell auch einen praktikablen Rahmen für zukünftige externe Validierungen und die Anpassung an andere geburtshilfliche Populationen bieten, einschließlich Mehrgebärenden und Frauen, die eine Einleitung der Wehen erhalten. Zusammenfassend ermöglichte die Integration transabdominaler und transperinealer Ultraschallparameter der ersten Wehephase mit mütterlichen demografischen und klinischen Merkmalen die Entwicklung eines intern validierten Vorhersagemodells für eine verlängerte zweite Wehephase. Die multidimensionale Bewertung zeigte, dass das mütterliche Alter, der BMI-Anstieg in der Schwangerschaft, das neonatale Geburtsgewicht und der AOP unabhängig mit einer verlängerten zweiten Wehephase assoziiert waren, und ergab eine exzellente Diskriminationsfähigkeit bei guter Kalibrierung während der internen Validierung. Obwohl diese Ergebnisse den potenziellen Nutzen dieses Ansatzes für eine frühe intrapartale Risikobewertung untermauern, sollte das Modell als explorativ betrachtet werden, da es das tatsächliche neonatale Geburtsgewicht einbezieht und bislang nur intern validiert wurde. Vor einer klinischen Anwendung sollte das Modell unter Verwendung des geschätzten fetalen Gewichts neu entwickelt und in unabhängigen, multizentrischen Kohorten extern validiert werden. Zukünftige Studien sollten zudem die Einbeziehung weiterer Prädiktoren untersuchen, darunter Merkmale der Uteruskontraktionen, Variablen der Schmerztherapie und intrapartale Interventionen, um ein umfassenderes und besser generalisierbares Vorhersagemodell für das individualisierte Geburtsmanagement zu entwickeln.
Offenlegungen
Interessenkonflikt:
Die Autoren erklären, dass keine konkurrierenden finanziellen oder nichtfinanziellen Interessen im Zusammenhang mit dieser Arbeit bestehen.
Danksagungen
Die Autoren danken dem Pflege- und Ärztlichen Personal der Abteilung für Geburtshilfe des Yuyao-Mütter-und-Kindergesundheitskrankenhauses (Yuyao Second People’s Hospital) für ihre Unterstützung bei der Rekrutierung der Teilnehmer und der Datensammlung. Diese Arbeit wurde durch das Wissenschafts- und Technologieprogramm des Gesundheitswesens der Stadt Yuyao 2024 (Förderkennzeichen Nr. 2024YYB03) unterstützt.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Tragbares diagnostisches Ultraschallsystem | Mindray | CAU-01040644 | Tragbares diagnostisches Ultraschallsystem für transabdominelle und transperineale Bildgebung; siehe Protokoll für die Bildgebungseinstellungen |
| Konvexer Ultraschallwandler (2–5 MHz) | Mindray | C5-2 | Wird für die transabdominelle Ultraschallbildgebung verwendet |
| Hochfrequenter linearer oder kleiner konvexer Ultraschallwandler (5–8 MHz) | Mindray | 75L38EA | Wird für die transperineale Ultraschallbildgebung verwendet |
| R-Software | R Foundation for Statistical Computing | Version 4.1.0 | Software für statistische Berechnungen (RRID:SCR_001905) |
| SPSS-Software | IBM Corp. | Version 26.0 | Software für statistische Analysen (RRID:SCR_002865) |
| Skala zur Selbstbeurteilung von Angstzuständen | Veröffentlichte Fragebogenskala (Zung-Skala zur Selbstbeurteilung von Angstzuständen) | Nicht zutreffend | Fragebogen zur Beurteilung von Angstzuständen, der bei der Aufnahme verwendet wird |
Referenzen
- American College of Obstetricians and Gynecologists, Society for Maternal-Fetal Medicine. Obstetric Care Consensus No. 1: Safe prevention of the primary cesarean delivery. Obstet Gynecol. 2014;123(3):693-711. doi:10.1097/01.AOG.0000444441.04111.1d.
- World Health Organization. WHO Guidelines Approved by the Guidelines Review Committee. World Health Organization; Geneva; 2015.
- Miyamoto K, et al. Prolonged second stage of labor in delivery using epidural analgesia is a risk factor for postpartum urinary retention. J Obstet Gynaecol Res. 2024;50(3):424-429. doi:10.1111/jog.15867.
- Kahrs BH. Ultrasound before operative vaginal delivery: Why and how. Minerva Obstet Gynecol. 2021;73(1):67-73. doi:10.23736/S2724-606X.20.04667-5.
- Yano E, et al. Anatomical identification of ischial spines applicable to intrapartum transperineal ultrasound based on magnetic resonance imaging of pregnant women. J Matern Fetal Neonatal Med. 2022;35(25):9736-9741. doi:10.1080/14767058.2022.2051007.
- Kahrs BH, Eggebø TM. Intrapartum ultrasound in women with prolonged first stage of labor. Am J Obstet Gynecol MFM. 2021;3(6):100427. doi:10.1016/j.ajogmf.2021.100427.
- Lee NMW, et al. Implementation of sonopartogram: Multicenter feasibility study. Ultrasound Obstet Gynecol. 2024;64(2):214-221. doi:10.1002/uog.27634.
- Saucedo AM, et al. First and second stage risk factors associated with perineal lacerations. Matern Child Health J. 2024;28(7):1228-1233. doi:10.1007/s10995-024-03919-1.
- Zhang M, et al. Risk factors for episiotomy during vaginal childbirth: A retrospective cohort study in Western China. J Evid Based Med. 2018;11(4):233-241. doi:10.1111/jebm.12316.
- Friedman EA, Cohen WR. The active phase of labor. Am J Obstet Gynecol. 2023;228(5 Suppl):S1037-S1049. doi:10.1016/j.ajog.2021.12.269.
- Kalache KD, et al. Transperineal ultrasound imaging in prolonged second stage of labor with occipitoanterior presenting fetuses: How well does the angle of progression predict the mode of delivery? Ultrasound Obstet Gynecol. 2009;33(3):326-330. doi:10.1002/uog.6294.
- Chan YT, et al. Relationship between intrapartum transperineal ultrasound measurement of angle of progression and head-perineum distance with correlation to conventional clinical parameters of labor progress and time to delivery. J Matern Fetal Neonatal Med. 2015;28(12):1476-1481. doi:10.3109/14767058.2014.958459.
- Chor CM, et al. Prediction of labor outcome using serial transperineal ultrasound in the first stage of labor. J Matern Fetal Neonatal Med. 2019;32(1):31-37. doi:10.1080/14767058.2017.1369946.
- Maged AM, et al. Measurement of the fetal occiput-spine angle during the first stage of labor as predictor of the progress and outcome of labor. J Matern Fetal Neonatal Med. 2019;32(14):2332-2337. doi:10.1080/14767058.2018.1432589.
- Gimovsky AC, Berghella V. Evidence-based labor management: Second stage of labor (part 4). Am J Obstet Gynecol MFM. 2022;4(3):100548. doi:10.1016/j.ajogmf.2021.100548.
- Barak O, et al. The routine use of intrapartum ultrasound in clinical decision-making during the second stage of labor: Does it have any impact on delivery outcomes? Gynecol Obstet Invest. 2018;83(1):9-14. doi:10.1159/000455847.
- Beck R, et al. Intrapartum sonography of fetal head in second stage of labor with neuraxial analgesia: A literature review and possible medicolegal aftermath. Eur Rev Med Pharmacol Sci. 2019;23(8):3159-3166. doi:10.26355/eurrev_201904_17673.
- Li N, et al. Risk factors and clinical prediction of shoulder dystocia in non-macrosomia. Zhonghua Fu Chan Ke Za Zhi. 2015;50(1):17-21. doi:10.3760/cma.j.issn.0529-567X.2015.01.005.
- Carvalho Neto RH, et al. Assessment of the angle of progression and distance perineum-head in the prediction of type of delivery and duration of labor using intrapartum ultrasonography. J Matern Fetal Neonatal Med. 2021;34(14):2340-2348. doi:10.1080/14767058.2019.1666818.
- Haberman S, et al. A novel partogram for stages 1 and 2 of labor based on fetal head station measured by ultrasound: A prospective multicenter cohort study. Am J Perinatol. 2021;38(S01):e14-e20. doi:10.1055/s-0040-1702989.
- Pan WL, et al. Accuracy of non-invasive methods for assessing the progress of labor in the first stage: A systematic review and meta-analysis. BMC Pregnancy Childbirth. 2022;22(1):608. doi:10.1186/s12884-022-04938-y.
- Ghi T, Dall'Asta A. Sonographic evaluation of the fetal head position and attitude during labor. Am J Obstet Gynecol. 2024;230(3 Suppl):S890-S900. doi:10.1016/j.ajog.2022.06.003.
- Nassr AA, et al. Intrapartum ultrasound measurement of angle of progression at the onset of the second stage of labor for prediction of spontaneous vaginal delivery in term singleton pregnancies: A systematic review and meta-analysis. Am J Obstet Gynecol. 2022;226(2):205-214. https://doi.org/10.1016/j.ajog.2021.07.031.
- Hans R, Reddy D, Shetty J. Serial intrapartum ultrasound to predict vaginal delivery using angle of progression and head-progression distance in term nulliparous women. Eur J Obstet Gynecol Reprod Biol. 2025;293:18-23.