Die Arbeit schlägt einen End-to-End-Multimodal-Emotionsanalyserahmen vor, der Transformer-Encoder, entkoppelte Emotionsrepräsentationen und eine graphenbasierte, multimodale Aufmerksamkeit mit visueller Abbildung nutzt, um die Genauigkeit der Emotionserkennung über zwei Datensätze hinweg zu verbessern.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Visuelle Kartierung multimodaler Emotionsmerkmale für das Design intelligenter Interaktion
In diesem Artikel
Zusammenfassung
Zusammenfassung
Durch die Fähigkeit, maschinelle Systeme menschliche affektive Zustände erfassen, interpretieren und darauf reagieren zu lassen, ist die visuelle Abbildung multimodaler Emotionseigenschaften entscheidend für das Design intelligenter Schnittstellen. Dennoch konzentrieren sich aktuelle Algorithmen zur multimodalen Emotionserkennung hauptsächlich auf die Vorhersageleistung und liefern nur begrenzte Einblicke in Interpretierbarkeit, Interaktionsbewusstsein oder Merkmalsebene-Interaktionen zwischen Modalitäten. In dieser Arbeit wird ein Framework zur visuellen Abbildung multimodaler Emotionsaspekte vorgestellt, das interaktionsorientierte Visualisierung, interpretierbares Repräsentationslernen und Emotionsvorhersage kombiniert. Ohne Verwendung manuell erstellter Merkmale kamen Transformer-basierte Encoder zum Einsatz, um hochgradige Emotionseinbettungen aus textuellen, audio- und visuellen Modalitäten zu extrahieren. Zur Verbesserung der Robustheit wurden emotions- und modalitätsspezifische Informationen mithilfe einer entkoppelten Repräsentationslernmethode getrennt. Zusätzlich wurde ein graphbasiertes, multimodales Attention-Netzwerk entwickelt, um mit adaptiver Attention-Gewichtung subtile emotionale Beziehungen zwischen den Modalitäten zu modellieren. Ein mehransichtiger Visualisierungsmodul wurde erstellt, um zeitliche Emotionsverläufe, Verteilungen der multimodalen Attention sowie latente Emotionseinbettungen darzustellen und so die Transparenz zu erhöhen. Das Framework wurde anhand des Carnegie Mellon University Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI)-Datensatzes und des Chinese Multimodal Sentiment Analysis Dataset (CH-SIMS) evaluiert. Die experimentellen Ergebnisse zeigen, dass das vorgeschlagene Framework eine verbesserte Interpretierbarkeit auf Merkmalsebene und interaktionsbewusste Visualisierung bietet und dabei hinsichtlich Genauigkeit, F1-Score, Korrelation und mittlerem absoluten Fehler konstant bessere Leistungen erbringt als repräsentative Baseline-Verfahren. Darüber hinaus ermöglichte der Visualisierungsmodul eine qualitative Interpretation multimodaler Emotionsrepräsentationen, multimodaler Interaktionen und zeitlicher Emotionsdynamiken und unterstützte so die interaktionsbewusste Visualisierung und Analyse.
Einleitung
Die Fähigkeit, menschliche Emotionen korrekt zu erkennen und zu verstehen, ist entscheidend geworden, um die Interaktion zwischen Mensch und Maschine zu verbessern. Neben ihrer zentralen Bedeutung für die Verbesserung der Mensch-Computer-Interaktion birgt die Emotionsanalyse das Potenzial, zahlreiche Bereiche zu revolutionieren, darunter die prädiagnostische medizinische Diagnose1, die Analyse des Klassenraumverhaltens2, die psychologische Überwachung von Patienten3, die Erkennung von Müdigkeit in Fahrzeugen4 und das intelligente Management in Smart-Home-Umgebungen5. Neuere Fortschritte im Bereich des affektiven Rechnens und des Deep Learning6 haben das Interesse an der Entwicklung von Echtzeitsystemen, die die Komplexität menschlicher Emotionen erfassen können, verstärkt.
Viele derzeitige Methoden stützen sich hauptsächlich auf unimodale Daten, wie textuelle, grafische oder auditorische Signale7,8,9Diese Ansätze versagen regelmäßig bei der Erkennung differenzierter Signale wie Sarkasmus oder kontextspezifischer Nuancen. Die Forschung hat sich daher der multimodalen Emotionsbewertung zugewandt, die komplementäre Daten aus mehreren Quellen einbezieht, um diese Einschränkungen zu überwinden.10,11,12Die Vorteile der Kombination mehrerer Modalitäten wurden durch Basismodelle wie Early Fusion-Long Short-Term Memory (EF-LSTM)13 und Light and FM Deep Neural Networks (LF-DNN) gezeigt.14, Tensor-Fusionsnetzwerke (TFN) und Ansätze zur multimodalen Fusion mit niedrigem Rang. Die meisten dieser Ansätze stützen sich jedoch auf die Offline-Generierung von Merkmalen und sind daher für dynamische, reale Situationen nicht geeignet.
Um emotionale Zustände zu berücksichtigen, hat die multimodale Emotionserkennung in Forschung und Anwendung in den letzten zehn Jahren stark zugenommen15. Einer der anspruchsvollsten und bedeutendsten Forschungsbereiche heutzutage ist die kontinuierliche Überwachung emotionaler Zustände mithilfe verschiedener Datenquellen16. Die Idee der Multimodalität ergab sich ganz natürlich aus dem Aufkommen eines derart vielfältigen Wissenssystems und führte zu zahlreichen Fortschritten bei der Anwendung von Emotionen in Bereichen wie emotionaler Datenverarbeitung, Mensch-Computer-Interaktion (HCI), Lernen, Videospielen, Kundenservice, medizinischer Versorgung, Usability-Tests (UX) usw. Dennoch war es bisher nicht immer einfach, Techniken der Emotionserkennung in der UX-Bewertung anzuwenden.
Einer der Hauptgründe, sich auf die multimodale Erkennung anstelle einmodaler Methoden zu konzentrieren, liegt in den inhärenten Nachteilen der ausschließlichen Nutzung einer einzigen Informationsquelle. Einmodale Systeme zur Emotionserkennung können aufgrund fehlender oder unklarer Daten eine geringere Genauigkeit aufweisen, während MER-Verfahren zuverlässiger sind und durch die Integration mehrerer Datenquellen ein umfassenderes und differenzierteres Verständnis expressiver Zustände ermöglichen17. Beispielsweise mag die alleinige Analyse der Gesichtssprache nicht ausreichen, um Gefühle präzise zu klassifizieren, insbesondere wenn die Gesten komplex oder unklar sind. Die Kombination von Gesichtsausdrücken mit anderen Kommunikationsformen wie Sprache oder körperlichen Hinweisen könnte hingegen die Genauigkeit der Gefühlserkennung verbessern.
Umfangreiche Forschungsarbeiten zur Emotionserkennung wurden in mehreren Modalitäten durchgeführt. Frühe Studien konzentrierten sich darauf, unterscheidende Merkmale aus verschiedenen Modalitäten wie grafischen, akustischen oder textbasierten Eingaben zu identifizieren. Allerdings wird zunehmend deutlich, dass die Integration verschiedener Modalitäten eine ausgewogene emotionale Information liefert, was zu einer zuverlässigeren und präziseren Stimmungserkennung führt. Dieser Abschnitt behandelt wesentliche Fortschritte in der einmodalen und multimodalen Emotionsanalyse, wobei der Schwerpunkt auf Grundverfahren, deren Schwächen sowie der Begründung für unsere Methode liegt.
Die erste Studie zur Emotionserkennung konzentrierte sich hauptsächlich auf eine einzelne Modalität. Im visuellen Bereich führte bahnbrechende Forschung zur Kategorisierung prototypischer Gesichtsbewegungen20. Spätere Fortschritte umfassten Techniken zur Erfassung zeitlicher Dynamiken, wie visuelle Bewegung21 und versteckte Markov-Modelle22, während Gesichtsreaktionen mithilfe des Facial Action Coding System (FACS) in Aktions-Einheiten unterteilt wurden23. LSTMs und faltende neuronale Netze (CNNs) wurden erfolgreich eingesetzt, um aussagekräftige Merkmale direkt aus rohen Audiosignalen zu extrahieren; Methoden zur Emotionsidentifikation basierend auf Audio haben sich von herkömmlicher Signalverarbeitung hin zum Deep Learning weiterentwickelt24. Die Extraktion kontextueller Stimmungssignale in der textbasierten Emotionsanalyse wurde durch rekurrente neuronale Netze (RNNs) mit Aufmerksamkeitsmechanismen erheblich verbessert und neuerdings durch transformerbasierte Modelle. Trotz ihrer Erfolge sind unimodale Techniken prinzipiell unfähig, die Komplexität menschlicher Erlebnisse genau abzubilden, da ihnen die zusätzliche Information anderer Modalitäten fehlt.
Einige auf Mechanismen der Aufmerksamkeit basierende Modelle, wie das DialogXL-Modell25, wurden 2021 vorgeschlagen, um langfristigere Umgebungsdaten im Bereich der Identifizierung von Stimmungen in Gesprächen zu erfassen. Kim et al.26 stellten das EmoBERTa-Modell im Jahr 2021 vor, um die Genauigkeit der ERC zu erhöhen. Dieses Modell nutzt Sprechdaten, um die Merkmale der Sprecher in Gesprächen und ihre Wechselwirkungen untereinander zu verbessern. Im Jahr 2022 untersuchten Li et al.27 stellte die CoG-BART-Methode vor. Die Organisation nutzt überwachtes kontrastives Lernen, um die Fähigkeit des Modells zur Interpretation relevanter Daten zu verbessern. Es ist darauf hinzuweisen, dass überwachtes Lernen eine erhebliche Menge an annotierten Daten erfordert.
Ein typisches Beispiel dafür ist das Framework für multimodale interaktionsbewusste Repräsentation (Multimodal Interaction-Aware Representation, MIAR)28, das Interaktions-Token für Merkmale und kontrastive Ausrichtung nutzt, um die Generalisierungsfähigkeit über verschiedene Modalitäten hinweg zu verbessern. MIAR verbessert die Ausrichtung der Modalitäten und erzielt eine hohe Leistung über mehrere Datensätze hinweg; es konzentriert sich jedoch hauptsächlich auf die Vorhersagegenauigkeit, ohne die visuelle Abbildung zu berücksichtigen. Ebenso erfasst das Modell zur cross-attentiven audiovisuellen Fusion29 feinabgestufte audiovisuelle Interaktionen effektiv zur Vorhersage von Valenz und Erregung, ist jedoch auf zwei Modalitäten beschränkt und verfügt nicht über Visualisierungsfunktionen. Ansätze zur zeitlichen Modellierung, die auf LSTM-Netzwerken und Autoencoder-Fusion basieren, erfassen die zeitlichen Dynamiken von Emotionen erfolgreich, liefern jedoch nur begrenzte Einblicke in die Wechselwirkungen zwischen Modalitäten und die gelernten emotionalen Repräsentationen. Neuerdings haben auf Transformatoren basierende Methoden wie das Transformer-basierte multimodale Fusionsnetzwerk (Transformer-based Multimodal Fusion Network, TMFN)30 durch verbesserte multimodale Fusion und kontrastives Lernen eine hohe Leistung auf CMU-MOSI und CMU-MOSEI gezeigt. Dennoch bleiben diese Ansätze vorwiegend leistungsorientiert und bieten nur begrenzte Unterstützung für Erklärbarkeit, interpretationsfähige Merkmalsebenen und visualisierungsorientierte Darstellung von Interaktionen.
Um die Integration von textuellen, akustischen und visuellen Daten zu verbessern, wurden mehrere Techniken zur multimodalen Emotionserkennung vorgeschlagen. Obwohl frühe Fusionsverfahren wie EF-LSTM und LF-DNN die Vorteile der Nutzung multimodaler Informationen für die Stimmungs- und Emotionsanalyse aufzeigten, konnten sie komplexe intermodale Wechselwirkungen nicht erfassen. Der TFN verbesserte zwar die Leistung auf etablierten Datensätzen wie CMU-MOSI und CMU-MOSEI und führte eine explizite Modellierung intermodaler Interaktionen ein, doch seine begrenzte Interpretierbarkeit und hohe Rechenkomplexität beeinträchtigten seine Nützlichkeit. Um die Modaliätsausrichtung und dynamische Merkmalsfusion zu verbessern, setzen neuere Verfahren wie MIAR, cross-attentionale Fusionsmodelle, TMFN und adaptive multimodale Transformer auf Transformer-Architekturen und Attention-Mechanismen. Diese Methoden konzentrieren sich hauptsächlich auf die Vorhersageleistung und liefern trotz konkurrenzfähiger Ergebnisse über gängige Evaluierungskennzahlen wie Genauigkeit, F1-Score und mittleren absoluten Fehler hinweg nur geringe Einblicke in emotionale Repräsentationen auf Merkmalsebene und intermodale Abhängigkeiten. Zudem haben nur wenige Studien Visualisierungstechniken entwickelt, die latente Emotionseinbettungen, Attention-Verteilungen und zeitliche Emotionsdynamiken offenlegen können, oder sie nutzen graphenbasierte Modellierungen intermodaler Interaktionen. Der vorgeschlagene Ansatz kombiniert Mehransichts-Visualisierung, graphenbasierte cross-modale Attention-Fusion und entkoppelte Repräsentationslernverfahren, um diese Nachteile zu überwinden und die Leistung der multimodalen Emotionserkennung zu steigern.
Ebenso schlägt der Adaptive Multimodale Transformer32 eine austauschbasierte Fusion vor, um adaptiv verrauschte oder fehlende modale Informationen zu reduzieren und dadurch die Leistung der Sentiment-Klassifizierung zu verbessern. Obwohl dieser Ansatz effektiv Diskrepanzen in der Verteilung modalitätsbezogener Informationen adressieren kann, ist sein Aufbau spezifisch auf die Sentiment-Analyse ausgerichtet und liefert nur begrenzte Erkenntnisse über die gelernten emotionalen Repräsentationen. Ein weiterer bedeutender Beitrag ist das Multimodale Fusionsmodell33, das Faltungsneuronale Netze (CNNs), multiplikative LSTMs und eine Transformer-basierte Aufmerksamkeit für die Echtzeit-Erkennung multimodaler Emotionen integriert. Das Modell führt eine vollständige Fusion von Video-, Audio- und Textmodalitäten durch und zeigt eine robuste Erkennungsleistung. Dennoch konzentriert auch es sich wie andere bestehende Modelle hauptsächlich auf Vorhersagegenauigkeit und weist nur unzureichende explizite Merkmale für Visualisierung und interaktionsorientierte Interpretierbarkeit auf.
Zusammenfassend lässt sich sagen, dass die derzeitigen multimodalen Ansätze zur Emotionserkennung zwar beträchtliche Fortschritte bei der Erfassung von intermodalen Wechselwirkungen und der Verbesserung der Vorhersagegenauigkeit erzielt haben, sich die meisten jedoch auf erkennungsorientierte Aufgaben konzentrieren. Aspekte wie die Interpretierbarkeit auf der Ebene von Merkmalen, die Visualisierung emotionaler Repräsentationen im Bildraum sowie die Einbindung des vorgeschlagenen Frameworks in die intelligente Interaktionsgestaltung wurden bisher wenig beachtet. Vor dem Hintergrund dieser Herausforderungen wird das vorgeschlagene Framework eingeführt.
Die meisten derzeitigen Methoden konzentrieren sich hauptsächlich auf die Verbesserung der Vorhersagegenauigkeit, bieten jedoch trotz bemerkenswerter Fortschritte bei der multimodalen Emotionserkennung28,29 nur geringe Interpretierbarkeit der gelernten emotionalen Repräsentationen und der Interaktionen zwischen den Modalitäten. Komplexe Wechselwirkungen zwischen textuellen, akustischen und visuellen Modalitäten sind für aktuelle Fusionsstrategien häufig schwer modellierbar, insbesondere bei Diskrepanzen zwischen den Modalitäten und Informationsdefiziten28,31. Obwohl transformerbasierte Architekturen und Aufmerksamkeitsmechanismen das Repräsentationslernen verbessert haben, wird ihre Transparenz und Interpretierbarkeit oft durch das Fehlen einer expliziten Trennung von emotionspezifischen und modalitätsspezifischen Informationen beeinträchtigt31,32,33. Zudem haben bisher nur wenige Studien graphbasierte Modellierungen intermodaler Interaktionen untersucht oder Visualisierungsrahmenwerke entwickelt, die zeitliche Emotionsdynamiken, Verteilungen der Aufmerksamkeit und Emotionsembeddings aufdecken können. Diese Nachteile verdeutlichen die Notwendigkeit eines interpretierbaren multimodalen Frameworks für intelligente Mensch-Maschine-Interaktionen, das interaktionsorientierte visuelle Abbildungen mit leistungsstarkem lernbasiertem Quermodal-Lernen kombiniert.
Diese Arbeit stellt einen interpretierbaren Rahmen für die visuelle Abbildung multimodaler Emotionsaspekte im intelligenten Schnittstellendesign vor. Ohne auf manuell erstellte Merkmale angewiesen zu sein, nutzt das System ein End-to-End-Deep-Learning-Verfahren, um hochwertige emotionale Repräsentationen aus textuellen, audio- und visuellen Modalitäten zu extrahieren. Quermodale emotionale Interaktionen werden mithilfe eines graphenbasierten Attention-Fusionsmechanismus modelliert, der emotionspezifische und modalitätsspezifische Informationen trennt, wodurch eine entkoppelte Repräsentationslernung ermöglicht und die Interpretierbarkeit sowie Robustheit verbessert wird. Zusätzlich wird ein Visualisierungsmodul mit mehreren Ansichten erstellt, um zeitliche Emotionsdynamiken, quermodale Attention-Muster und Emotions-Embeddings darzustellen. Die Wirksamkeit und Eignung des vorgeschlagenen Frameworks in intelligenten Mensch-Maschine-Interaktionssystemen wird durch Validierung an etablierten multimodalen Datensätzen zur Emotionserkennung überprüft.
Diese Arbeit bietet einen einzigartigen Rahmen für die visuelle Abbildung multimodaler Emotionsaspekte, der über herkömmliche, auf Vorhersage ausgerichtete Ansätze hinausgeht, um die unzureichende Modellierung von Quermodaleffekten und die begrenzte Interpretierbarkeit aktueller Systeme zur multimodalen Emotionsidentifikation zu überwinden. Innerhalb einer einzigen Architektur kombiniert der vorgeschlagene Ansatz transformerbasiertes multimodales Repräsentationslernen, entkoppeltes, emotionsbewusstes Merkmalsmodellieren, graphbasierte Fusion mittels Quermodal-Aufmerksamkeit sowie eine auf Interaktionen ausgerichtete Visualisierung. Im Gegensatz zu bestehenden Ansätzen, die hauptsächlich auf Klassifikationsleistung abzielen, trennt der Rahmen eindeutig emotions- und modalitätsspezifische Repräsentationen, um Interpretierbarkeit, Robustheit und Quermodal-Konsistenz zu verbessern. Zusätzlich wird ein graphbasiertes Aufmerksamkeitsverfahren vorgestellt, das eine adaptive Modellierung intermodaler Interaktionen ermöglicht, indem es feingliedrige emotionale Abhängigkeiten zwischen textuellen, auditiven und visuellen Modalitäten erfasst. Ein Visualisierungsmodul mit mehreren Ansichten wird entwickelt, um Transparenz zu erhöhen, indem zeitliche Emotionsverläufe, Muster der Quermodal-Aufmerksamkeit und latente Emotions-Embeddings sichtbar gemacht werden, die intuitive Einblicke in den Entscheidungsprozess des Modells liefern. Neben einer verbesserten Visualisierung und Interpretierbarkeit multimodaler emotionaler Dynamiken zeigte die experimentelle Evaluation auf den Benchmark-Datensätzen CH-SIMS und CMU-MOSEI wettbewerbsfähige Leistung hinsichtlich Genauigkeit, F1-Score, mittlerem absoluten Fehler und Korrelation.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Die vorgeschlagene Arbeit zielt darauf ab, das intelligente Interaktionsdesign durch einen interpretierbaren Rahmen für die visuelle Abbildung multimodaler Emotionsmerkmale zu verbessern. Für diese Arbeit wurden die öffentlich zugänglichen Datenbanken CH-SIMS und CMU-MOSEI verwendet. Beide Datensätze wurden von ihren offiziellen Quellen bezogen und gemäß den vom jeweiligen Ersteller festgelegten Nutzungsrichtlinien, Forschungsstandards und Lizenzbedingungen genutzt. Der multimodale Inhalt der Datensätze, einschließlich Text-, Audio- und Videodaten, wurde zunächst von den Anbietern der Datensätze unter Einhaltung ihrer autorisierten Teilnehmergenehmigungen und Datenerfassungsprotokolle gesammelt und annotiert. In dieser Studie fand keine direkte menschliche Interaktion statt, es wurden keine neuen Teilnehmer rekrutiert und keine personenbezogenen Daten erhoben. Alle Analysen wurden anhand öffentlich verfügbarer Forschungsdatensätze durchgeführt. Folglich war für unsere sekundäre Datenanalyse keine zusätzliche ethische Genehmigung oder Prüfung durch eine zuständige Ethikkommission (Institutional Review Board, IRB) erforderlich. Die Studie wurde unter Einhaltung der geltenden institutionellen Normen zur Nutzung öffentlich zugänglicher Datensätze, ethischer Forschungsverfahren und anwendbarer Daten-Nutzungsrichtlinien durchgeführt.
Ein graphbasiertes, multimodales Aufmerksamkeitsverfahren wurde eingesetzt, um Emotionscharakterisierungen über verschiedene Modalitäten hinweg mithilfe emotions- oder modalitätsspezifischer Merkmale zu erlernen und so das Verständnis zu verbessern. Eine Multiview-Visualisierungskomponente wird verwendet, um die Echtzeit-Emotionswahrnehmung in interaktiven Designs zu verbessern, und ihre Effizienz wird hinsichtlich der Emotionserkennung bewertet. Die Ergebnisse zeigen, dass die vorgeschlagene Methode sowohl die Interpretierbarkeit als auch die Effizienz emotionsbewusster intelligenter Benutzeroberflächen in der realen Welt verbessert. Abbildung 1 zeigt den architektonischen Arbeitsablauf der vorgeschlagenen Methode. Abbildung 1 zeigt den vollständigen Arbeitsablauf des vorgeschlagenen Visualisierungsrahmens für das multimodale Lernen von Emotionsmerkmalen im Kontext intelligenter Interaktionssysteme. Der Arbeitsablauf beginnt mit drei synchronisierten Eingabemodalitäten, nämlich Text, Audio und Video, die jeweils komplementäre emotionale Informationen aus den sprachlichen, prosodischen und Gesichtsausdrucksmodalitäten erfassen. Ein modalitätsspezifischer Transformer-Encoder verarbeitet jede Modalität, um hochwertige Repräsentationen der Rohdaten zu erhalten. Diese Repräsentationen werden anschließend in ein Modul für entkoppeltes Repräsentationslernen eingespeist, in dem die emotionspezifischen Einbettungen von den modalitätsspezifischen Merkmalen getrennt werden, um Konsistenz der erlernten Emotionen über heterogene Datenquellen hinweg sicherzustellen. Die emotionspezifischen Einbettungen jeder Modalität werden dann durch ein graphbasiertes, multimodales Aufmerksamkeitsnetzwerk aggregiert, das die intermodale emotionale Abhängigkeit modelliert und jeder Modalität dynamische Gewichtungen entsprechend dem Interaktionskontext zuweist. Schließlich liefert das Framework sowohl Ergebnisse zur Emotionsklassifizierung als auch Einblicke in die Interaktion, die transparente, emotionsbewusste Entscheidungsfindung und ein adaptives, intelligentes Interaktionsdesign ermöglichen.
Mehrmodes Datenerfassung
Die Datensätze CH-SIMS und CMU-MOSEI sind zwei bereits vorhandene öffentliche multimodale Datensätze, die multimodale Informationen wie synchronisierte Videos, Audio- und Textdaten erfasst haben. Der CH-SIMS-Datensatz umfasst multimodale Untersuchungen chinesischer Personen, darunter 2.281 Videosegmente, die aus mehreren Videosegmenten von Filmen, Fernsehserien und Unterhaltungssendungen stammen. Die Hinzunahme entsprechender Audio- und Textdaten zu diesen Videosegmenten macht Studien zur multimodalen Analyse von Emotionen anhand multimodaler Daten ansprechender und durchführbarer. Der CMU-MOSEI-Datensatz hingegen ist einer der größten multimodalen Datensätze zur Untersuchung von Meinungen, Gefühlen und Emotionen und wurde aus über 23.000 Videoclips mit Aussagen von mehr als 1.000 Sprechern zu verschiedenen Themen zusammengestellt. Der Datensatz wurde zufällig in Trainings- (70 %), Validierungs- (15 %) und Testanteile (15 %) unter Beibehaltung der Klassenverteilung unterteilt.
Schriftliche Transkripte, Audiosignale und Videobilder werden erfasst und feingranular zeitlich synchronisiert. Die Integration auf Ebene der Einzelbilder gewährleistet, dass die vorgeschlagenen Verfahren zum Erlernen von Repräsentationen und die graphbasierten Fusionsmechanismen gemeinsam emotionale Inhalte aus visuellen Ausdrücken, stimmlichen Tönen und sprachlichem Inhalt modellieren und nutzen können. Durch diese Art der multimodalen Erfassungstechnik wird eine effektive Extraktion intermodaler emotionaler Dynamiken ermöglicht, was für das Design intelligenter Interaktionen und verständliche visuelle Abbildungen unerlässlich ist.
Tabelle 1 zeigt die wichtigsten Strukturen der multimodalen Emotionsdatensätze, die in der vorgeschlagenen Methode verwendet werden. Um ein breiteres Spektrum verwandter Gefühle wie gesprochener Wörter, Stimmintonationen und Gesichtsausdrücke zu erfassen, integrieren CH-SIMS und CMU-MOSEI Video-, Audio- und Textmodalitäten aus diesen Datensätzen. Außerdem stehen in CH-SIMS nur begrenzte Datenproben zur Verfügung, was eine gründliche Untersuchung der Modalitätsinteraktionen und der Emotionsvariationen in China ermöglicht. Im Gegensatz dazu ist der CMU-MOSEI-Datensatz aufgrund seiner umfangreichen Daten über verschiedene Sprachen, Probanden und annotierte Emotionsstufen bedeutender für die Bewertung der Robustheit der in dieser Arbeit behandelten Repräsentationslern- und zugehörigen Visualisierungsalgorithmen. Zusätzlich verringert er im Vergleich zu früheren Studien die Schwierigkeiten bei der Informationsauswahl beim Testen von Modellen.
Multimodale Vorverarbeitung und Synchronisierung
Die Zeitstempel-Anmerkungen aus den Datensätzen CH-SIMS und CMU-MOSEI wurden verwendet, um textuelle, akustische und visuelle Modalitäten zu synchronisieren und ein konsistentes multimodales Repräsentationslernen sicherzustellen. Jede Äußerung fungierte als grundlegende Analyseeinheit und wurde mit entsprechenden Audio- und Videosegmenten innerhalb desselben Zeitintervalls verknüpft. Die Ausrichtung erfolgte auf Ebene der Äußerungen. Das Transkript wurde basierend auf den Start- und End-Zeitstempeln jeder Äußerung in Segmente unterteilt. Die Korrespondenz zwischen Transkript, Audio und Video wurde hergestellt, indem die entsprechenden Videobilder und Audiosignale extrahiert wurden, die innerhalb desselben Zeitintervalls lagen. Während Audiosegmente mithilfe von Wav2Vec 2.0 verarbeitet wurden, um akustische Repräsentationen zu erzeugen, wurden visuelle Bilder aus dem Videosegment mit einer vordefinierten Rate abgetastet und mit dem Vision Transformer (ViT) kodiert. Der RoBERTa-Encoder wurde verwendet, um textuelle Einbettungen aus den Transkripten der Äußerungen zu erstellen. Die zeitliche Synchronisation wurde erreicht, indem alle Modalitätsmerkmale an eine einheitliche Äußerungsgrenze angepasst wurden, da die drei Modalitäten Merkmalssequenzen unterschiedlicher Länge erzeugten. Ein Format fester Länge wurde verwendet, um Sequenzen unterschiedlicher Länge zu normalisieren. Längere Sequenzen wurden auf die maximal zulässige Sequenzlänge verkürzt, während kürzere Sequenzen mit Nullen aufgefüllt wurden. Während des Trainings kamen Masken zur Aufmerksamkeitssteuerung zum Einsatz, um gepaddete Elemente von gültigen Merkmalspositionen zu unterscheiden. Modalitysspezifische Einbettungen wurden vor der Fusion in einen gemeinsamen latenten Raum projiziert, um unterschiedliche Sequenzlängen zwischen den Modalitäten zu überwinden. Dies gewährleistete dimensionsale Konsistenz und ermöglichte es dem graphbasierten Aufmerksamkeitsmechanismus, effektives lernbasiertes Wechselwirken zwischen den Modalitäten zu fördern. Um die Datenqualität und Integrität der Synchronisation zu bewahren, wurden Proben mit beschädigten Dateien, fehlenden Anmerkungen oder unvollständigen Modalitätsinformationen aus den Studien ausgeschlossen.
Merkmalsextraktion auf Basis von Transformatoren
Eine Deep-Learning-Methode wird verwendet, um hochgradige, emotionsbewusste Merkmalsrepräsentationen aus Informationen mehrerer Modalitäten – wie beispielsweise Bild, Audio und Text – nach der Ausrichtung der multimodalen Daten und der erforderlichen Vorverarbeitungsschritte auf end-to-end-Basis zu erlernen. Durch den Einsatz eines Transformer-Encoders zur Erzeugung intrinsisch diskriminativer Merkmalsrepräsentationen aus rohen multimodalen Daten entfällt bei der vorgeschlagenen Methode die Notwendigkeit des Feature-Engineerings. Um die Konsistenz über die in dem vorgeschlagenen Ansatz verwendeten Datensätze hinweg zu gewährleisten, wird für jede Modalität ein Embedding fester Größe gelernt. Beispielsweise werden 768-dimensionale Merkmals-Embeddings über jede einzelne Modalität – einschließlich Bild-, Audio- und Textmodalitäten – gelernt, die gemeinsam einen einheitlichen Merkmalsraum bilden, der im gesamten Ansatz verwendet wird, insbesondere bei einem Merkmalsextraktionsansatz, der auf dem vorgeschlagenen CH-SIMS-Datensatz und dem CMU-MOSEI-Datensatz angewendet wird, um hochgradige Merkmale aus Daten unterschiedlicher Größe zu erlernen.
Visuelle Modalität: Visionstransformator für emotionsbewusste Frame-Embeddings
Ein Vision-Transformer-(ViT-Base-)Modell wurde verwendet, um visuelle Informationen aus Videobildern zu extrahieren, um räumliche, emotionsrelevante Darstellungen zu erhalten. Vor der Merkmalsextraktion wurden die Bilder jedes Videosegments auf (224 × 224) Pixel skaliert und in regelmäßigen zeitlichen Abständen abgetastet. Mit einer Patch-Größe von 16 × 16 Pixeln erzeugt die ViT-Base-Architektur eine Reihe visueller Token, die von 12 Transformer-Encoder-Schichten verarbeitet werden. Die gewonnenen Frame-Ebene-Darstellungen wurden mithilfe eines vortrainierten ViT-Modells als visuellem Backbone in einen 768-dimensionalen Einbettungsraum projiziert. Die Frame-Ebene-Einbettungen wurden durch Mittelwert-Pooling aggregiert, um die endgültige visuelle Darstellung für jedes Segment zu erzeugen. Während des Trainings wurden Bildnormalisierung und gängige Erweiterungsmethoden wie zufälliges Zuschneiden und horizontales Spiegeln verwendet, um die Generalisierungsfähigkeit zu verbessern. Anschließend wurde der vorgeschlagene multimodale Fusionsansatz verwendet, um diese visuellen Einbettungen mit textuellen und auditiven Darstellungen zu kombinieren.
Um die zeitlichen Dynamiken von Emotionen beizubehalten, werden Videoproben aus den Datensätzen CH-SIMS und CMU-MOSEI für die visuelle Modalität gleichmäßig abgetastet. Die Einzelbilder jedes Videos, 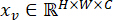 , können in N feste Abschnitte unterteilt werden, die anschließend abgeflacht und invers in einen latenten Einbettungsraum der Dimension
 überführt werden. Eine Serie wird durch Hinzufügen von Positions-Embeddings und einem lernbaren Gruppierungstoken erstellt:
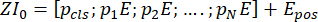 (1)
wobei  die Positions-Codierung bezeichnet und
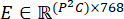 die Patch-Einbettungsmatrix ist.
Gestapelte Transformer-Encoder-Schichten, bestehend aus Feed-Forward-Netzwerken und Multi-Head-Self-Attention, werden verwendet, um die eingebettete Patch-Sequenz zu verarbeiten. Die Transformation in der Schicht l wird wie folgt beschrieben:
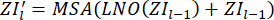 (2)
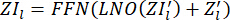 (3)
Um den emotionsbewussten visuellen Merkmalsvektor zu erhalten, wird die dem Klassentoken entsprechende Ausgabe als Merkmalsvektor  extrahiert. Um konsistente visuelle Emotionsrepräsentationen zu erreichen, trotz sprachlicher und inhaltlicher Unterschiede zwischen Datensätzen, werden Frame-Einbettungen aus jedem Videosegment kombiniert, um Gesichtsausdrücke und die Entwicklung von Emotionen zu erfassen.
Audiomodalität unter Verwendung von Wav2Vec 2.0 für Prosodie- und semantische akustische Einbettungen Kontextualisierte Sprach-Einbettungen wurden mithilfe eines vortrainierten Wav2Vec-2.0-Encoders als akustischem Grundgerüst erzeugt. Ein akustischer Merkmalsvektor fester Länge für jeden Satz wurde durch Aggregation der ausgegebenen versteckten Repräsentationen mittels Mittelwert-Pooling erhalten. Das Wav2Vec-2.0-Modell wurde verwendet, um akustische Repräsentationen aus Audiosignalen zu extrahieren, um kontextuelle und emotionsrelevante Sprachmerkmale zu erfassen. Vor der Merkmalsextraktion wurden die Tonaufnahmen normalisiert und auf 16 kHz neu abgetastet. Um die Synchronisation zwischen den textuellen und visuellen Modalitäten sicherzustellen, wurde jeder audioseitige Äußerungsabschnitt anhand der Zeitstempel-Grenzen isoliert, die durch die Datensatzannotationen vorgegeben waren. Der vortrainierte akustische Encoder wurde während des Modelltrainings angepasst, um eine aufgabenspezifische Anpassung zu verbessern, wodurch die abgeleiteten Repräsentationen die emotionalen Aspekte der Sprachsignale genauer widerspiegeln konnten. Anschließend erfolgten die graphbasierte multimodale Aufmerksamkeitsfusion und das Entflechtungslernen von Repräsentationen anhand der endgültigen Audioeinbettungen.
In der Audio-Modalität wird Wav2Vec-2.0 verwendet, um Sprachsignale aus den ursprünglichen Sprachinformationen der Datensätze CH-SIMS und CMU-MOSEI zu modellieren und direkt audiovisuelle Merkmale in Bezug auf Emotionen zu extrahieren. Für jedes Eingabe-Sprachsignal  existiert eine faltungsartige Merkmalskodierung:
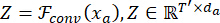 (4)
wobei Z für prosodische Merkmale auf niedriger Ebene wie Melodie, Tonhöhe und Energie steht. Ein auf Transformern basierendes Kontextnetzwerk ist für die oben genannten Strukturen nützlich, da es zeitbasierte Abhängigkeiten über längere Zeiträume hinweg darstellt:
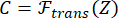 (5)
Prosodische und semantische akustische Daten, die für die Ausdrucksweise von Emotionen wesentlich sind, sind in diesen kontextuellen akustischen Repräsentationen enthalten. Ein Audio-Embedding fester Länge wird durch Durchführung eines zeitlichen Pooling-Verfahrens erstellt:
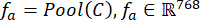 (6)
Das Verfahren verzichtet auf die Verwendung akustischer Merkmale wie MFCCs und erreicht Robustheit, indem es einfach Repräsentationen aus Wellenformen extrahiert, und zwar anhand englischer Sprachdaten von CMU-MOSEI und chinesischer Sprachdaten von CH-SIMS.
Textmodus unter Verwendung von RoBERTa für kontextuelle Emotionseinbettungen
Für die Textmodalität wird der tiefe bidirektionale Transformer RoBERTa auf die Sprachtranskripte aus den beiden Datensätzen angewendet, um kontextuelle Semantik und affektive Bedeutung zu generieren. RoBERTa-basierte Transformer-Encoder wurden verwendet, um textuelle Repräsentationen aus den Transkriptdaten zu extrahieren und so kontextuelle semantische sowie emotionale Informationen zu erfassen. Für den englischsprachigen Datensatz CMU-MOSEI kam ein vortrainiertes RoBERTa-Modell zum Einsatz, während für den chinesischen Datensatz CH-SIMS eine chinesische RoBERTa-Variante verwendet wurde, um sprachspezifische linguistische Merkmale besser berücksichtigen zu können. Die Textvorverarbeitung umfasste die Tokenisierung mithilfe des jeweils passenden RoBERTa-Tokenisierers pro Sprache sowie die Textnormalisierung. Um eine konsistente Batch-Verarbeitung sicherzustellen, wurden Eingabesequenzen in Token-Embeddings umgewandelt und entweder aufgefüllt oder gekürzt, um eine vordefinierte maximale Sequenzlänge einzuhalten. Gemäß dem RoBERTa-Eingabeformat wurden spezielle Klassifizierungs- und Trenntoken eingeführt. Ein festlanges textliches Embedding wurde durch Aggregation der kontextualisierten Token-Repräsentationen, die vom Transformer-Encoder erzeugt wurden, unter Verwendung der finalen [CLS]-äquivalenten Satzrepräsentation gewonnen. Um die erlernten Repräsentationen an die Aufgabe der Emotionserkennung anzupassen, wurden die vortrainierten RoBERTa-Encoder durch multimodales Training verfeinert. Anschließend wurde der vorgeschlagene multimodale Fusionsansatz verwendet, um die textuellen Embeddings mit den audiovisuellen Merkmalen zu kombinieren.
Die Token-Embeddings und Positionsencodierungen können für jede tokenisierte Eingabe kombiniert werden, 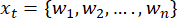 , um die Eingabed Darstellung in der tiefen bidirektionalen Transformationsmethode namens
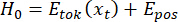 (7)
Diese Form wird durch die Schichten des L-Transformators dargestellt, der Selbst-Attention verwendet, um die kontextuellen Abhängigkeiten zwischen Wörtern zu erkennen:
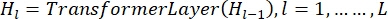 (8)
Das kontextuelle Emotions-Embedding wird unter Verwendung des endgültigen versteckten Zustands des Klassifikationstokens erhalten:
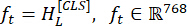 (9)
Stimmungspolarität, intensive Emotionen und damit verbundene Implikationen sind Beispiele für sprachliche Merkmale im Zusammenhang mit Emotionen, die durch diese Einbettung repräsentiert werden. RoBERTa vereinfacht die sprachunabhängige Modellierung. Dies ermöglicht dem System, dieselbe Einbettungsgröße sowohl für englische Texte aus dem CMU-MOSEI-Datensatz als auch für chinesische Texte aus dem CH-SIMS-Datensatz zu verwenden.
Drei modalitysspezifische Merkmalsvektoren mit 768 Dimensionen – jeweils für die visuelle fv, audiovisuelle fa und textuelle ft Modalität – werden durch den vorgeschlagenen Schritt des tiefen Lernens zur Merkmalsdarstellung extrahiert. In der intelligenten Interaktionsgestaltung erzeugen diese gelernten Darstellungen einen einheitlichen multimodalen Merkmalsraum, der als Grundlage für die merkmalsbasierte visuelle Abbildung, die graphbasierte multimodale Fusion sowie das entkoppelte Lernen von Darstellungen dient.
Gelernte entwirrte Darstellungen
Nachdem eine tiefere Merkmalsrepräsentation erlernt wurde, kann eine zusätzliche Verarbeitung der multimodalen Merkmalsvektoren aus den visuellen, auditiven und textlichen Modalitäten eine getrennte Emotionsbeschreibung liefern. Wenn die modalitysspezifischen Merkmalseinbettungen der auditiven, visuellen und textlichen Modalitäten, die im vorherigen Schritt verwendet wurden, entsprechend durch fv, fa und ft dargestellt werden, sodass  und
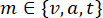 , besteht das Ziel dieses Schritts darin, alle Modalitätsmerkmale in zwei unterschiedliche latente Darstellungen zu zerlegen, zu denen auch die Emotionsdarstellungen gehören, nachdem die vorherigen Semantiken jeder einzelnen Modalität berücksichtigt wurden.
Dies wird erreicht, indem jedes Modalitätsmerkmal fm in zwei parallele Projektionsnetzwerke eingespeist wird: einen Emotionsencoder  und einen Modalitätsencoder
 , wodurch die beiden Kodierungen erzeugt werden.
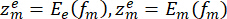 (10)
Dabei wird die latente Merkmalsdarstellung, die mit der Emotion verknüpft ist, durch  repräsentiert, während
 ein modenspezifisches latentes Merkmal darstellt. Dies ermöglicht es emotionsbezogenen Einbettungen, wiederholt über mehrere Eingaben – darunter Audio, visuelle Signale und Text – hinweg miteinander zu kommunizieren, während gleichzeitig die den einzelnen Modalitäten zugehörigen strukturellen Daten erhalten bleiben.
Eine wirksame Trennung wird durch die Rekonstruktion mit Unabhängigkeitsbeschränkungen erzwungen. Die Rekonstruktion des ursprünglichen Modalitätsmerkmals ergibt sich aus:
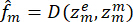 (11)
wobei  ein Dekodierungsnetzwerk ist. Der Rekonstruktionsverlust erhält die folgenden Daten:
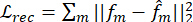 (12)
Zusätzlich beschränkt die Orthogonalität oder Entkorrelation zwischen Emotion und modalitytspezifischen Darstellungen häufig die Informationsüberlappung:
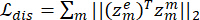 (13)
Indem diese Ziele erreicht werden, könnte das Modell Emotionsrepräsentationen erlernen, die zuverlässig, verständlich und robust gegenüber Modalitätsvariabilität sind. Spätere graphbasierte multimodale Fusionen und visuelle Abbildungsmerkmale, insbesondere für die intelligente Interaktionsgestaltung, hängen stark von interpretierbaren, strukturierten Emotionsrepräsentationen ab.
Gefühlsübereinstimmung über Modalitäten hinweg
Die Berücksichtigung der Emotionskonsistenz verbessert deutlich die Effektivität der Fusion zwischen den Modalitäten. Dies liegt daran, dass bei den Fusionsstrategien keine großen Unterschiede zwischen den beiden Darstellungen mehr berücksichtigt werden müssen, da die modalitysspezifischen Emotionseinbettungen einen latenten Raum teilen. Die kombinierte Darstellung der beiden Emotionen wird wie folgt beschrieben  . Die gewichtete Fusion wird stabiler sein, wenn die emotionspezifischen Darstellungen konsistent sind, da Variationen zwischen Signalen verschiedener Modalitäten dann keinen Einfluss mehr auf das Ergebnis haben.
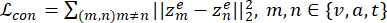 (14)
Durch die Durchsetzung einer semantischen Ausrichtung emotionaler Informationen minimiert dieses Ziel Diskrepanzen zwischen den Modalitäten und stellt sicher, dass die Emotionswahrnehmung unabhängig von der zur Ausdrucksweise verwendeten Modalität konsistent bleibt. Folglich wird ein kohärenter und affektiver Repräsentationsraum geschaffen, indem emotionale Hinweise, die aus Sprachsignalen, Gesichtsausdrücken und sprachlichem Inhalt gewonnen werden, projiziert werden.
Auswirkung auf die multimodale Fusion
Die multimodale Fusion wird effektiver, wenn emotionale Konsistenz über die Modalitäten hinweg eingeführt wird. Die Fusionsmechanismen müssen nicht mehr signifikante intermodale Repräsentationsunterschiede ausgleichen, da die emotionspezifischen Einbettungen in einem gemeinsamen latenten Raum ausgerichtet sind. Die fusionierte Emotionsrepräsentation wird wie folgt definiert:
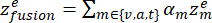 (15)
Dabei repräsentiert αm das Gewicht der Aufmerksamkeit, das der Modalität m zugewiesen wird. Die gewichtete Fusion wird stabiler und verständlicher, wenn die emotionspezifischen Darstellungen konsistent sind, da das Fusionsergebnis komplementäre emotionale Hinweise anzeigt, anstatt widersprüchliche Modalitätssignale.
Mathematisch gesehen, verringern  Varianz zwischen verschiedenen emotionspezifischen Repräsentationstypen in Bezug auf ist gleichbedeutend mit:
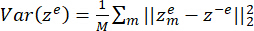 (16)
wobei  die durchschnittliche Emotionsäußerung darstellt. Eine verringerte Varianz führt dazu, dass die Eingabemodalitäten entsprechend ihrer genauen emotionalen Bedeutung und nicht gemäß Modalitätsrauschen gewichtet werden, was eine verbesserte Netzwerkkonvergenz und eine genauere Aufmerksamkeitsbewertung sicherstellt.
Das endgültige Lernziel entkoppelter Emotionsvisualisierungen besteht darin, Fragmentierung, Rekonstruktion und emotionale Gleichförmigkeit zu kombinieren:
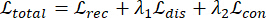 (17)
wobei zwei Hyperparameter, λ1 und λ2, die Beziehung zwischen der zuverlässigen Erkennung von Emotionen über verschiedene Modalitäten hinweg und deren Abgrenzung steuern. Das vorgeschlagene Modell erlangt modusunabhängige, interpretierbare und fusionierbare emotionale Repräsentationen, um dies zu erreichen, wobei der Schwerpunkt darauf liegt, eine solide Grundlage für die spätere, auf Graphen basierende Fusion sowie für die Repräsentation auf der Merkmalsebene im intelligenten Schnittstellendesign zu schaffen.
Graphbasierte, multimodale Aufmerksamkeitsfusion
Ein graphbasiertes, multimodales Attention-Netzwerk wurde verwendet, um feinkörnige emotionale Beziehungen zwischen den Modalitäten zu simulieren. Um den Informationsfluss zwischen den Modalitäten zu erleichtern, wurde ein vollständig verbundener multimodaler Graph erstellt, wobei jede modalitysspezifische Einbettung (Text, Audio und visuell) als Knoten im Graphen repräsentiert wurde. Die Beziehungen zwischen den Modalitäten dienten zur Erstellung der Adjazenzmatrix des Graphen, die anschließend mithilfe einer lernbaren Attention-Methode verbessert wurde. Ein gemeinsamer latenter Raum wurde durch Verkettung und Projektion der Ausgaben mehrerer Attention-Köpfe erzeugt. Eine einheitliche, multimodale Emotionsrepräsentation entstand dann durch Aggregation der Knotenrepräsentationen mittels attentiongewichteter Pooling-Verfahren. Diese fusionierte Repräsentation wurde anschließend an Vorhersage- und Visualisierungsmoduln für die interaktionsbezogene Analyse und Emotionserkennung weitergeleitet. Das Graph-Fusion-Modul wies eine Dimension der verborgenen Repräsentation von 256 auf und enthielt zwei Graph-Attention-Schichten, jede mit acht Attention-Köpfen. Um die relative Wichtigkeit benachbarter Modalitäten zu ermitteln, wurden die Attention-Koeffizienten zwischen verbundenen Knoten berechnet und mittels der Softmax-Funktion standardisiert. Jeder Graph-Attention-Schicht folgten eine Layer-Normalisierung, Residualverbindungen und eine Dropout-Rate von 0,2, um die Stabilität des Trainings zu erhöhen und Überanpassung zu reduzieren. Nachdem die Ausgaben mehrerer Attention-Köpfe verkettet und in einen gemeinsamen latenten Raum projiziert worden waren, wurden die Knotenrepräsentationen mittels attentiongewichtetem Pooling zu einer einzigen, multimodalen Emotionseinbettung kombiniert. Anschließend wurde die fusionierte Repräsentation für die multiview-basierte visuelle Abbildung und Emotionsvorhersage verwendet.
Unter Verwendung einer Multi-Head-Graph-Aufmerksamkeit wurden vielfältige multimodale Wechselwirkungen erfasst. Die Softmax-Funktion diente zur Normalisierung der Aufmerksamkeitskoeffizienten zwischen verbundenen Knoten für jeden Knoten. Um die Stabilität des Trainings zu erhöhen und Überanpassung zu vermeiden, folgten auf die gestapelten Graph-Aufmerksamkeitsschichten des Graph-Fusionsmoduls Residualverbindungen, Layer-Normalisierung und Dropout-Regularisierung.
Die Begriffe repräsentieren einzeln die Darstellungen, die den spezifischen Emotionen entsprechen, die durch die visuellen, auditiven und textlichen Modalitäten erfasst wurden; jede Komponente befindet sich im gemeinsamen latenten Raum  . Die Modelle für die Modalitätsknoten verwenden eine Notation für den Graphen
 , wobei die Knoten der Sammlung
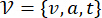 den drei Modalitätsknoten selbst entsprechen, um die emotionalen Abhängigkeiten zwischen den verschiedenen Modalitätsdarstellungen explizit zu stärken.
Nach der Zuweisung eines emotionspezifischen Merkmalsvektors zu jedem Knoten im Graphen haben wir:
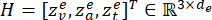 (18)
Im Gegensatz zu herkömmlichen Fusionsmethoden, die vorbestimmte oder feste Fusionsgewichte verwenden, lernt das vorgeschlagene Verfahren adaptive Kantengewichte basierend auf deren Bedeutung und gegenseitigen Abhängigkeiten, sowohl über Kanäle als auch über emotionale Situationen hinweg.
Ein Graph Attention Network (GAT) wird für die multimodale Fusion verwendet. Ein Aufmerksamkeitskoeffizient wird für jeden Knoten i und seine benachbarten Knoten, also Knoten j, berechnet:
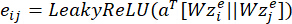 (19)
Die emotionale Wirkung des Wechsels von Modus j zu Modalität i wird durch die normalisierten Gewichte αij gemessen.
Anschließend wird das fusionierte Erscheinungsbild jedes Modalitätsknotens als gewichtete Gruppierung seiner Nachbarn berechnet:
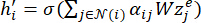 (20)
wobei die Aktivierungsfunktion  nichtlinear ist. Letztendlich werden die aktualisierten Merkmale jedes Knotens kombiniert, um eine globale fusionierte Emotionsrepräsentation zu erhalten:
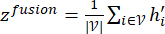 (21)
Es handelt sich um eine nützliche Technik für interpretierbare Emotionsmodellierung und anschließende visuelle Abbildung, da sie komplementäre Informationen aus verschiedenen Modalitäten erfasst und dabei komplexe intermodale Beziehungen bewahrt.
Algorithmus 1 (Supplementary File 1) liefert das allgemeine Schema zur Durchführung der graphbasierten multimodalen Fusion. Zunächst wird ein Graph erstellt, der die emotionspezifischen Merkmale mit jeder der visuellen, auditiven und textlichen Modalitäten verknüpft. Anschließend werden die Attention-Scores für jedes Paar von Knoten im Graphen berechnet, die die Kombination emotionaler Abhängigkeiten repräsentieren. Die Attention-Scores werden dann normalisiert, um den relativen Beitrag jeder Modalität zum festgelegten emotionalen Kontext anzugeben, wodurch das Lernen der Attention-Gewichte ermöglicht wird. Die generelle Emotions-Embedding wird im letzten Schritt durch Aggregation der mit den Knoten des Graphen verknüpften Merkmale erzeugt. In diesem Sinne zeigt die allgemeine Fusion multimodaler Merkmale, die mit den festgelegten Emotionen verknüpft sind, vielversprechende Eigenschaften hinsichtlich Anpassungsfähigkeit, Interpretierbarkeit und kontextueller Intelligenz.
Abbildung 2 zeigt die Struktur und Funktionsweise des vorgeschlagenen multimodalen Attention-Netzwerks zur multimodalen Sentimentfusion. Die emotionspezifischen Einbettungen, die unabhängig für die Modalitäten Text, Audio und Video gewonnen werden, durchlaufen zunächst modalityspezifische Attention-Mechanismen, die die relative Bedeutung sprachlicher, stimmlicher und mimischer Informationen für einen gegebenen emotionalen Kontext erlernen. Die attention-gewichteten Repräsentationen der Modalitäten werden anschließend zu einer einheitlichen Emotionseinbettung kombiniert, wobei die Attention-Matrix die intermodalen Abhängigkeiten und Wechselwirkungsstärken erfasst. Die vom Netzwerk gelernte Attention-Matrix moduliert dynamisch die Beiträge der einzelnen Modalitäten, sodass das Netzwerk sich auf die aussagekräftigste Modalität konzentrieren und störende, weniger informative Modalitäten ausblenden kann. Die fusionierte Emotionsrepräsentation ermöglicht eine präzise Emotionserkennung sowie eine differenzierte Analyse emotionaler Zustände wie neutral, Zuneigung und Sorge.
Visuelles Abbildungsmodul
Mit Hilfe des speziell für diesen Zweck erstellten visuellen Abbildungsabschnitts kann ein intelligenter Interaktionsdesigner die vereinheitlichte Darstellung des emotionalen Zustands anhand des Graphen nach dem multimodalen Fusionierungsprozess in eine visuelle Form umwandeln, die verständlich und leicht verdaulich ist.
Um latente emotionale Darstellungen leichter erfassbar zu machen, wurden Dimensionsreduktionsverfahren eingesetzt, um die gelernten multimodalen Emotionseinbettungen zu visualisieren. Nach der Reduzierung der Merkmalsdimensionalität unter Beibehaltung des größten Teils der Varianz mittels Hauptkomponentenanalyse (PCA) wurden die Einbettungen mithilfe von t-verteiltem stochastischem Nachbarn-Einbetten (t-SNE) in einen zweidimensionalen Raum projiziert, um sie darzustellen. Für t-SNE wurden eine Perplexitätszahl von 30, eine Lernrate von 200 und 1.000 Optimierungsiterationen verwendet. Emotionsspezifische Cluster und Modalitätsbeziehungen wurden anhand der erhaltenen Projektionen veranschaulicht. Die normalisierten cross-modalen Aufmerksamkeitsgewichte, die durch das graphenbasierte Aufmerksamkeitsnetzwerk ermittelt wurden, dienten der Erstellung von Aufmerksamkeits-Heatmaps. In diesen Heatmaps ist der relative Beitrag textueller, audiovisueller und visueller Modalitäten während der Emotionsvorhersage dargestellt. Die gelernten Aufmerksamkeitskoeffizienten wurden als Kantengewichte verwendet, um cross-modale Interaktionsgraphen zu erstellen, wodurch eine visuelle Untersuchung der intermodalen Beziehungen und des Informationsflusses innerhalb des Fusionierungsrahmens ermöglicht wurde. Emotionsverlaufsdiagramme wurden durch die Beobachtung der Entwicklung latenter Emotionseinbettungen über aufeinanderfolgende Äußerungen hinweg erstellt, um zeitliche emotionale Dynamiken zu untersuchen. Diese Verläufe liefern Erkenntnisse darüber, wie sich emotionale Zustände und Modalitätsbeiträge im Laufe der Zeit entwickeln. Matplotlib und Scikit-learn sind zwei Python-Pakete, die zur Erstellung aller Visualisierungen verwendet wurden. Zur Bewertung der Interpretierbarkeit, der Clusterbildung, der Modalitätsbeiträge und der zeitlichen Emotionsdynamik wurden qualitative Analysen der Einbettungsvisualisierungen, Interaktionsgraphen und Aufmerksamkeits-Heatmaps durchgeführt.
Der Variable 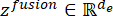 wird die fusionierte Darstellung des emotionalen Zustands durch die Graph-Attention-Netzwerk-Funktion zugeordnet. Im Gegensatz zur Visualisierung auf Ausgabeebene der emotionalen Zustandsplots verfolgt das Modul das Hauptziel, die Darstellungen des emotionalen Zustands sowie die entsprechenden Gewichtungen des Attention-Mechanismus in eine verständliche visuelle Form zu überführen.
Mithilfe des erlernten αji wird eine Attention-Heatmap erstellt, um den Beitrag jeder Modalität visuell zu überprüfen. Die eingehenden Attention-Gewichte werden anschließend addiert, um einen zusammengesetzten Wichtigkeitsscore für jede Modalität zu bestimmen:
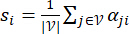 (22)
wobei si den relativen emotionalen Beitrag der Modalität I darstellt. Um eine Aufmerksamkeits-Heatmap zu erstellen, werden die erhaltenen Werte normalisiert und einer Farbskala zugeordnet, die es dem Benutzer erleichtert, die dominierende Modalität in verschiedenen Zeitschritten oder interaktiven Zuständen zu identifizieren. Durch verschiedene visuelle, akustische oder textbasierte Eingabemodalitäten hilft eine solche Schnittstelle dem Benutzer zu verstehen, wie der Aufmerksamkeitsmechanismus des Systems funktioniert.
Der erlernte Graph wird speziell als „gewichteter Interaktionsgraph“ modelliert, um die multimodalen Abhängigkeiten menschlicher Emotionen darzustellen. Jede Modalität wird durch einen Knoten im Graphen repräsentiert, und die Stärke der Wechselwirkungen im Zusammenhang mit menschlichen Emotionen wird durch Gewichtungen in Form von αji auf den sie verbindenden Kanten ausgedrückt. Der obige gewichtete Graph veranschaulicht die Intensität der emotionalen Wechselwirkungen zwischen Menschen. Die Definition von i und j lautet:
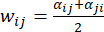 (23)
Die Linienstärke oder Transparenz der Graphdarstellung wird dank dieser Gewichtungen angemessen wiedergegeben. Dadurch wird das Verständnis der Wechselwirkungen zwischen den Modalitäten erleichtert. Mithilfe von intermodalen Interaktionsgraphen kann der Gestalter besser nachvollziehen, wie sich emotionale Indikatoren während des Fusionierungsprozesses beeinflussen.
Die fusionierten Emotionseinbettungen  zu verschiedenen Zeitpunkten werden mithilfe eines Dimensionsreduktionsalgorithmus wie PCA oder t-SNE auf einen niedrigdimensionalen Raum projiziert, um die zeitliche Entwicklung der Emotionen darzustellen:
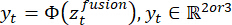 (24)
wobei die Projektionsfunktion durch  dargestellt wird. Das Entstehen von 2D-/3D-Emotionsverläufen, die Emotionsübergänge, -intensitäten und -stabilität in Interaktionen zeigen, kann als anschauliche Darstellung der zeitlichen Entwicklung emotionaler Zustände interpretiert werden. Diese Aspekte können für intelligente Interaktion, Entscheidungsfindung und Echtzeitüberwachung genutzt werden.
Im Gegensatz zu herkömmlichen Emotionssystemen, die lediglich Abbildungen auf bestimmte Klassen oder Bewertungen liefern, konzentriert sich dieses System darauf, zu demonstrieren, wie menschliche Emotionen innerhalb desselben entstehen. Es offenbart seinen Entscheidungsprozess, indem es Visualisierungen von Zwischenmerkmalen bereitstellt, einschließlich Gewichtungsfaktoren, Wechselwirkungen zwischen Modellen und deren entsprechenden Pfaden. Dies ermöglicht es dem Nutzer, zu verstehen, wie jeder Faktor – visuell, stimmlich oder sprachlich – die Erzeugung der Antworten des Systems auf menschliche Emotionen beeinflusst.
Die Abbildung von Emotionen in verständliche Formen durch visuelle Darstellungen kann somit die Lücke zwischen der Emotionsanalyse mithilfe von Deep-Learning-Methoden und deren Integration in die intelligente Gestaltung von Schnittstellen schließen. Die aus beiden Ansätzen gewonnenen Daten können anschließend genutzt werden, um präzisere Benutzeroberflächen zu entwickeln. Der vorgeschlagene Ansatz kann Interaktionsgestaltern daher wichtige Informationen liefern, um genauere Benutzeroberflächen zu entwerfen. Mit anderen Worten wird das Verständnis von Emotionen zu einem aktiven Bestandteil des Interaktionsdesigns. Nur wenn das Verständnis von Emotionen aktiv in das Interaktionsdesign eingebunden wird, kann die Genauigkeit weiter steigen.
Das visuelle Abbildungsmodul ermöglicht Erklärbarkeit auf mehrere miteinander verbundene, aber unterschiedliche Weisen: Die Erklärbarkeit auf Merkmalsebene offenbart die zugrundeliegenden Repräsentationen von Emotionen, die vom DNN erzeugt werden, und ermöglicht es uns, die Semantik zu verstehen, die zur Beschreibung jedes mit Emotionen verbundenen Merkmals verwendet wird; die Erklärbarkeit auf Modalebene nutzt Daten aus den Interaktionsgraphen und den visuellen Aufmerksamkeits-Heatmaps, um zu beschreiben, wie jeder Modus – visuell, audio oder textuell – zu den Entscheidungen über die Ausdrucksweise von Emotionen beiträgt; und schließlich ermöglichen es uns die aus dem Emotions-Embedding resultierenden Trajektorien, zu verstehen, wie sich jeder visuelle und textuelle Modus im Zeitverlauf aus einer dynamischen Interaktionsperspektive betrachtet verändert. Siehe Algorithmus 2 (Supplementary File 1).
Die fusionierten multimodalen emotionalen Merkmale werden mithilfe des vorgeschlagenen visuellen Abbildungs-Algorithmus 2 auf visuell signifikante Darstellungen abgebildet, um ein intelligentes Interaktionsdesign zu ermöglichen. Die graphenbasierten multimodalen Aufmerksamkeitsgewichte dienen dazu, Unterschiede zwischen den Eingabeelementen für visuelle, audiovisuelle und textliche Informationen zu jedem Zeitpunkt zu quantifizieren. Diese Unterschiede werden anschließend visuellen Darstellungen zugeordnet, um mithilfe von Heatmap-Elementen die Hauptquellen hervorzuheben, die die Emotionen beeinflussen. Um einen aufschlussreichen Einblick in die Wechselwirkungen zwischen den Eingabeelementen zu gewinnen und die durch die multimodalen Eingabeelemente erzeugte emotionale Entwicklung zu vermitteln, werden anschließend paarweise Interaktionsstärken berechnet, um die multimodalen Interaktionsgewichte zu erzeugen. Gleichzeitig wird eine Darstellung der emotionalen Entwicklung erzeugt, indem die über die Zeit gesammelten fusionierten emotionalen Elemente in einen niederdimensionalen Raum abgebildet werden, um eine kontinuierliche Entwicklung der emotionalen Elemente darzustellen.
Emotionsvorhersage und Interaktionsrückmeldung
Das Ergebnis der fusionierten Emotionsrepräsentation, dargestellt als , wird anschließend als Funktion sowohl für Interaktions-Feedback als auch für die Emotionsvorhersage verwendet. Außerdem wird die Emotionsvorhersage als Multitask-Modell beschrieben, das aus einer Regressionsaufgabe zur Erkennung kontinuierlicher Emotionsintensität und einer Klassifikationsaufgabe zur Erkennung diskreter Emotionen besteht. Für die Erkennung diskreter Emotionen kommt das folgende auf Softmax basierende Klassifikationsmodell zum Einsatz:
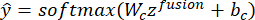 (25)
wobei  die erwarteten Wahrscheinlichkeiten der Emotionsklassen darstellt und Wc und bc lernbare Parameter sind. Der Kreuzentropieverlust wird verwendet, um das Klassifikationsziel zu verbessern:
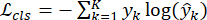 (26)
wobei yk das Ground-Truth-Tag und K die Anzahl der Emotionsklassen ist. Ein Regressionszweig wird parallel zur Schätzung der Emotionsintensität verwendet und liefert eine Vorhersage verschiedener kontinuierlicher affektiver Attribute, einschließlich Valenz und Erregung. Geben Sie ihm die folgende Definition:
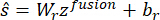 (27)
wobei die erwartete Emotionsintensität durch  angegeben ist. Zur Verbesserung der Regressionsaufgabe wird der Verlust aufgrund des mittleren quadratischen Fehlers verwendet:
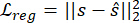 (28)
Im Allgemeinen werden die beiden Aufgaben im Vorhersageziel kombiniert:
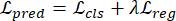 (29)
wobei die Ziele der Regression und Klassifikation durch λ ausgeglichen werden. Es wird eine dynamische Anpassung des Visualisierungsmoduls basierend auf dem ermittelten emotionalen Zustand vorgeschlagen, um eine solche interaktionsbezogene Rückmeldung zu ermöglichen. Der Interaktionskontext zu einem bestimmten Zeitpunkt t wird durch ct dargestellt. Die Antwort des Visualisierungsmoduls ergibt sich aus:
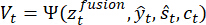 (30)
wobei die Visualisierungsanpassungsfunktion durch  dargestellt wird. Dies ermöglicht es, die Modalitäts-Heatmaps, Interaktionsgraphen und Emotionsverläufe in Echtzeit basierend auf erwarteten Veränderungen und Emotionen anzupassen. Dies zeigt, dass das System neben einer guten Leistung bei der Vorhersage von emotionalen Zuständen auch erhebliche Unterstützung für Feedback bietet.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Diese Arbeit validiert den vorgeschlagenen visuellen Abbildungsansatz für multimodale Emotionsmerkmale hinsichtlich sowohl der interaktionsbezogenen Interpretierbarkeit als auch der Vorhersagegenauigkeit anhand zweier Benchmark-Datensätze, CH-SIMS und CMU-MOSEI. Laut den experimentellen Ergebnissen schneidet der vorgeschlagene Ansatz über verschiedene Metriken hinweg – einschließlich Korrelation, Genauigkeit, F1-Score und mittlerem absoluten Fehler (MAE) – durchgängig besser ab als aktuelle Verfahren zur multimodalen Emo...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Die experimentellen Ergebnisse zeigen, dass der vorgeschlagene visuelle Abbildungsrahmen für multimodale Emotionseigenschaften auf den Datensätzen CH-SIMS und CMU-MOSEI die derzeitigen Techniken zur multimodalen Emotionserkennung übertrifft. Im Vergleich zu Early- und Late-Fusion-Modellen wie EF-LSTM und TFN erzielt die vorgeschlagene Methode höhere Genauigkeit und F1-Scores, was ihre Robustheit bei der Verarbeitung unterschiedlicher emotionaler Informationen belegt. Die Verbesserung der Methode ist auf die entkoppelte E...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren haben keine Interessenkonflikte.
Danksagungen
Die Autoren möchten die Unterstützung durch die School of Housing, Building and Planning, Universiti Sains Malaysia, Penang, Malaysia, sowie durch die School of Design Art, Changsha University of Science & Technology, Changsha, China, danken. Außerdem sprechen sie ihren Dank an die Xiamen Academy of Arts and Design, Fuzhou University, Xiamen, China, für die akademische und forschungsbezogene Unterstützung während dieser Arbeit aus.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Adam | PyTorch-Optimierer-Bibliothek | https://pytorch-optimizers.readthedocs.io/en/latest/ (Lernrate = 1 × 10⁻⁴) | Parameteroptimierung während des Modelltrainings |
| CH-SIMS | Ursprüngliches Datensatz-Repository | Neueste öffentliche Version | Benchmark-Datensatz zur chinesischen multimodalen Sentiment-/Emotionsanalyse |
| CMU-MOSEI | CMU Multimodal SDK Repository | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (Neueste öffentliche Version) | Benchmark-Datensatz zur multimodalen Sentiment- und Emotionserkennung |
| Entkoppelter Emotions-Encoder | Eigene Implementierung | https://pytorch-geometric.readthedocs.io/en/latest/(Dualer Encoder-Aufbau) | Trennung von emotions- und modalitätsspezifischen latenten Repräsentationen |
| Graphbasierte multimodale Aufmerksamkeitsschicht | Eigene Implementierung | Mehrfache Aufmerksamkeitsfusion | Lernen feingranularer emotionaler Abhängigkeiten zwischen Modalitäten |
| Graph Attention Network (GAT) | PyTorch Geometric | Mehrfacher GAT (https://pytorch-geometric.readthedocs.io/en/latest/) | Modellierung von cross-modalen emotionalen Beziehungen und adaptiver Merkmalsfusion |
| Matplotlib | Matplotlib-Projekt | 3.7+ | Erstellung von Diagrammen und visuellen Analysen |
| NetworkX | NetworkX-Projekt | 3.0+ | Erstellung und Visualisierung von cross-modalen Interaktionsgraphen |
| NVIDIA-GPU | NVIDIA Corporation | CUDA-fähige GPU | Beschleunigung des Trainings von Transformer- und graphbasierten neuronalen Netzen |
| Prinzipale Komponentenanalyse (PCA) | Scikit-learn | sklearn.decomposition.PCA | Anfängliche Reduktion hochdimensionaler Emotions-Embeddings |
| Python | Python Software Foundation | 3.8+ | Zentrale Programmiersprache zur Implementierung des multimodalen Emotionsanalyse-Frameworks |
| PyTorch | PyTorch Foundation | 2.0+ | Entwicklung, Training und Optimierung tiefer neuronaler Netze |
| RoBERTa | Hugging Face Transformers | https://huggingface.co/docs/transformers/index (roberta-base, 768-dim Embeddings) | Extraktion kontextueller linguistischer und semantischer Emotionsrepräsentationen |
| Seaborn | Seaborn-Projekt | 0.12+ | Erstellung von Aufmerksamkeits-Heatmaps und statistischen Visualisierungen |
| t-verteilte stochastische Nachbarn-Einbettung (t-SNE) | Scikit-learn | scikit-learn.org (Perplexität = 30, Iterationen = 1000) | Visualisierung latenter Emotionscluster und -verläufe |
| Ubuntu Linux | Canonical Ubuntu | 20.04 LTS oder neuer | Experimentelle Ausführungsumgebung |
| Vision Transformer (ViT-Base) | Google Research Vision Transformer | ViT-Base/16, 768-dim Embeddings | Extraktion emotionsbezogener visueller Repräsentationen aus Videobildern |
| Wav2Vec 2.0 | Meta AI Research | Basis-Modell, 768-dim Embeddings | Extraktion kontextueller akustischer und sprachlicher Emotionsmerkmale |
Referenzen
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.