Dieses Protokoll implementiert ein U-förmiges Deep-Learning-Netzwerk, das Pinwheel-Konfaltung, Dual Attention und multiskalige Fusion integriert, um kolorektale Polypen zu segmentieren.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Methodenartikel
Polypensegmentierungsnetzwerk basierend auf Pinwheel-Konvolution und doppelter Aufmerksamkeit für die Diagnose einer kolorektalen präkanzerösen Läsion
* These authors contributed equally
In diesem Artikel
Zusammenfassung
Zusammenfassung
Eine genaue Segmentierung der kolorektalen Polypen ist entscheidend für die frühzeitige Prävention und Diagnose von Darmkrebs. Aufgrund der hohen Heterogenität der Polypen hinsichtlich Form, Größe und Textur sowie der Komplexität der Darmumgebung (wie Falten, spekulare Reflexionen und Kotreste) stehen bestehende Methoden jedoch weiterhin vor erheblichen Herausforderungen bei der Randlokalisierung und der Erkennung von kleinen Polypen. Um diese Probleme anzugehen, schlägt dieses Papier ein Polyp-Segmentierungsnetzwerk vor, das auf Pinwheel-Konvolution und Dual Attention (PWD-Net) basiert. Das vorgeschlagene Netzwerk verwendet eine U-förmige Encoder-Decoder-Architektur, bei der ein vortrainiertes ResNet als Encoder verwendet wird, um mehrstufige lokale Features zu extrahieren. Konkret wird an der Flaschenhalsschicht ein Pinwheel-Faltungsmodul (PCM) eingeführt, um die globale geometrische Struktur und multidirektionale kontextuelle Informationen von Polypen durch mehreckig rotierte Faltungskerne zu erfassen. Ein Dual-Attention-Mechanismus (DAM), der Kanal-Aufmerksamkeit und räumliche Aufmerksamkeit integriert, ist darauf ausgelegt, Hintergrundrauschen adaptiv zu unterdrücken und Polypen-Regionen-Merkmale zu verbessern. Darüber hinaus wird eine Multi-scale Feature Fusion (MSF)-Strategie eingesetzt, um tiefe semantische Informationen mit flachen Randdetails zu kombinieren und so sowohl Vollständigkeit als auch Präzision der Segmentierungsergebnisse sicherzustellen. Experimente an den Datensätzen Kvasir-SEG und CVC-ClinicDB zeigen, dass PWD-Net durchschnittliche Würfelkoeffizienten von 0,865 bzw. 0,944 sowie IoU-Werte von 0,765 bzw. 0,892 erreicht und damit bestehende State-of-the-Art-Methoden deutlich übertrifft. Ablationsstudien überprüfen die Wirksamkeit jedes Moduls, und Datensatz-übergreifende Bewertungen bestätigen die starke Verallgemeinerungsfähigkeit des Modells. Diese Studie bietet eine hochpräzise und robuste Lösung für die klinische Polypensegmentierung, bietet einen erheblichen Nutzen für die frühzeitige Diagnose kolorektaler präkanzeröser Läsionen und unterstützt computergestützte Interventionen.
Einleitung
Darmkrebs ist einer der häufigsten bösartigen Tumore weltweit und weist durchgehend hohe Inzidenz- und Sterblichkeitsraten auf. Studien haben gezeigt, dass die meisten Darmkrebserkrankungen durch adenomatöse Polypen entstehen, ein Prozess, der typischerweise 10–15 Jahre dauert und ein wertvolles Zeitfenster für frühzeitige Erkennung und Intervention bietet. Ein Anstieg der Adenom-Erkennungsrate (ADR) um 1 % kann das Risiko für Darmkrebs um etwa 3 % senken und die Patientensterblichkeit signifikantsenken. Die Koloskopie, die als Goldstandard für die Darmkrebsvorsorge gilt, ermöglicht die direkte Entfernung von Polypen während der Untersuchung und reduziert so die Krebshäufigkeit und Sterblichkeit effektiv.
Die konventionelle Koloskopie hängt jedoch stark von der Erfahrung und dem Können der Endoskopisten ab. Faktoren wie subjektives Urteil, visuelle Müdigkeit und Ablenkung können zu einer Fehlquote von 20 % bis 30 % führen, was die Effektivität des Screenings direkt beeinflusst2. Daher ist die Entwicklung computergestützter Erkennungssysteme (CAD) zur automatischen Segmentierung kolorektaler Polypen von großer Bedeutung, um ADR zu verbessern und übersehene Diagnosen zu reduzieren. Jüngste klinische Umfragen haben zudem das Interesse an der Integration künstlicher Intelligenz in die Untersuchung endoskopischer Läsionen hervorgehoben, was die Notwendigkeit robuster und reproduzierbarerSegmentierungsmethoden unterstreicht.
In den letzten Jahren hat Deep Learning bemerkenswerte Fortschritte in der medizinischen Bildanalyse erzielt, insbesondere bei konvolutionellen neuronalen Netzwerken (CNNs), die eine starke Fähigkeit zur Feature-Extraktion und -Darstellung für Bildsegmentierungsaufgaben zeigen4. Als klassisches Modell der medizinischen Bildsegmentierung verwendet U-Net eine symmetrische Encoder-Decoder-Architektur und überspringt Verbindungen, um eine genaue Pixel-Segmentierung zu erreichen, womit es zu einem Maßstab in diesem Bereichwird. Aufbauend auf U-Net wurden viele verbesserte Architekturen vorgeschlagen, um komplexe Aufgaben der medizinischen Bildsegmentierung zu bewältigen. UNet++ verringert die semantische Lücke zwischen Encoder- und Decoder-Feature-Maps, indem es verschachtelte und dichte Skip-Verbindungen6 einführt. ResUNet++ integriert Residualblöcke, Quetsch- und Anregungsmodule, dilatierte Faltungen und Aufmerksamkeitsmechanismen und erzielt eine starke Leistung bei Polypensegmentierung7. U2-Net verwendet eine zweistufe, verschachtelte U-förmige Struktur, um mehrskalige Feature-Informationen8 zu erfassen. In jüngerer Zeit wurde ein auf Doppel-Encoder-Decoder-basiertem Deep Polyp Segmentation Network vorgeschlagen, das parallele Codierungs- und Dekodierungspfade nutzt, um die Segmentierungsgenauigkeitweiter zu verbessern.
Unterdessen bietet die Einführung von Aufmerksamkeitsmechanismen neue Lösungen zur Feature-Enhancement und Rauschunterdrückung. Aufmerksamkeits-U-Net verwendet Aufmerksamkeitsgatter, um sich auf Zielbereiche zu konzentrieren und dabei irrelevante Hintergrundinformationen zu unterdrücken10. Das Dual Attention Network (DANet) gewichtet adaptiv Features sowohl aus Kanal- als auch aus der räumlichenDimension 11 und verbessert so die Wahrnehmung kritischer Merkmale. Triple Attention Networks (TANet) verbessern die Segmentierungsleistung weiter durch adaptive Auswahl von Multi-Scale-Funktionen12.
Mit dem Erfolg von Transformer-Architekturen in der Verarbeitung natürlicher Sprachen und Computer Vision13 haben Forscher begonnen, deren Anwendungen in der Segmentierung medizinischer Bilder zu erforschen. TransUNet war das erste, das einen Transformator als Encoder einsetzte, um Langstreckenabhängigkeiten effektiv14 zu modellieren. Swin-UNet verwendet eine reine Transformer-Architektur und erreicht eine effiziente globale Informationsaggregation durch einen verschobenen Fenstermechanismus15. UTNet schlägt eine hybride Architektur vor, die die lokale Feature-Extraction-Fähigkeit von CNNs mit der globalen Modellierungsfähigkeit von Transformers16 kombiniert.
Im Bereich der Polypensegmentierung nutzt Polyp-PVT einen Pyramidenvision-Transformer, um multiskalige globale semantische Informationen17 zu erfassen, während multiskaliges verschachteltes UNet das kontextuelle Verständnis durch Integration von Transformers18 verbessert. Jüngste Studien haben auch negative Korrelationslernstrategien für domänenübergreifende Polypensegmentierung19, Gompertz-verstärkte Segmentierungsverbesserung20 und aufmerksamkeitsbasierte Architekturen mit Randsteuerung21 untersucht. Obwohl diese Ansätze die Segmentierungsleistung bis zu einem gewissen Grad verbessern, steht die Polypensegmentierung weiterhin vor mehreren Herausforderungen. Erstens zeigen Polypen eine hohe Heterogenität in Morphologie, Größe und Textur, die von Mikropolypen kleiner als 5 mm bis zu großen Polypen von über 30 mm reichen, mit Formen von kreisförmigen und elliptischen bis hin zu sehr unregelmäßigen Formen. Zweitens ist die Darmumgebung komplex und variabel, wobei Schleimhautfalten, spiegelnde Reflexionen, Fäkalrückstände und Nahrungsmittelreste starke Hintergrundstörungen verursachen. Drittens haben viele Polypen verschwommene Grenzen, können teilweise durch Falten verdeckt oder in Darmflüssigkeiten eingetaucht sein, was die präzise Grenzlokalisierung äußerstschwierig macht.
Bestehende Methoden weisen weiterhin klare Einschränkungen bei der Bewältigung dieser Herausforderungen auf. Traditionelle CNNs sind effektiv darin, lokale Textur- und Kantenmerkmale zu extrahieren; Allerdings eignen sich feste quadratische Faltungskerne nicht gut zur Erfassung verschiedener geometrischer Formen23, insbesondere für hochgradig unregelmäßige Polypen, und können multidirektionale geometrische Merkmale nicht effektiv modellieren. Transformatorbasierte Methoden können globale Abhängigkeiten modellieren, sind jedoch weniger effektiv bei der Erfassung feiner lokaler Details und Randinformationen. Darüber hinaus macht ihre hohe Rechenkomplexität sie für Echtzeit-klinische Anwendungenweniger geeignet 24. Jüngste Polypensegmentierungsansätze wie PraNet, das Reverse-Attention-Module zur Verfeinerung von Schlüsselregionen25 verwendet, randgelenkte Kaskaden-Aufmerksamkeitsnetzwerke, die die Randfeature-Extraktionverbessern 26, und CAFE-Net, das Encoder- und Decoder-Features durch Cross-Attention-Mechanismenfusioniert 27, stoßen weiterhin auf unzureichende Merkmalsrepräsentation und ungenaue Randlokalisierung bei kleinen Polypen28, verschwommene Grenzen und komplexe Hintergründe. Darüber hinaus vernachlässigen die meisten Methoden die geometrische Morphologie und nutzen multidirektionale kontextuelle Informationen nicht vollständig aus, was zu einer suboptimalen Segmentierung unregelmäßig geformter Polypen führt.
Zusammenfassend sind derzeit CNN-basierte Methoden nicht in der Lage, multidirektionale geometrische Merkmale zu erfassen, da sie auf Faltungskernen mit festen Quadraten angewiesen sind. Transformatorbasierte Ansätze bieten globale Modellierung, opfern jedoch die lokale Randgenauigkeit und verursachen hohe Rechenkosten. Unterdessen wurden bestehende aufmerksamkeitsverstärkte und multiskalige Fusionsstrategien nicht gemeinsam innerhalb eines einheitlichen Rahmens optimiert, der speziell auf Polypensegmentierungzugeschnitten ist 29. Diese Lücken motivieren die Entwicklung einer Methode, die gleichzeitig geometrische Merkmalsmodellierung, adaptive Rauschunterdrückung und maßstabsübergreifende Merkmalsintegration berücksichtigt.
Um diese Probleme zu lösen, stellt dieses Protokoll ein Polyp Segmentation Network auf Basis von Pinwheel Convolution and Dual Attention (PWD-Net) vor. Das vorgeschlagene Netzwerk integriert geometrische Merkmalsmodellierung, mehrdimensionale Aufmerksamkeitssteigerung und mehrskalige Merkmalsfusion, was eine präzise Segmentierung komplexer Polypen ermöglicht. Die Hauptbeiträge dieser Arbeit werden wie folgt zusammengefasst: Das Pinwheel-Faltungsmodul (PCM), inspiriert von der Struktur eines Windrads, ein neuartiges rotiertes Faltungskern-Design wird vorgeschlagen, das multidirektionale geometrische Merkmale von Polypen durch Faltungsoperationen in mehreren Winkeln (0°, 45°, 90°, 135°, 180°, 225°, 270° und 315°) erfasst. Dieses Modul ersetzt die konventionelle Faltungsschicht im Engpassstadium, ermöglicht eine effektive Wahrnehmung unterschiedlicher Kantenorientierungen und verbessert die Darstellung unregelmäßig geformter Polypen erheblich. Der Dual-Attention-Mechanismus (DAM) adressiert Hintergrundrauschen wie Falten, Reflexionen und Kotreste in Koloskopiebildern. Ein Dual-Attention-Modul wird entwickelt, das Kanal-Aufmerksamkeit und räumliche Aufmerksamkeit integriert. In Skip-Verbindungen eingebettet, unterdrückt dieses Modul adaptiv Hintergrundinterferenzen und verbessert die Feature-Reaktionen in Polypenregionen, indem es gemeinsam identifiziert, "was" wichtig ist (Kanaldimension) und "wo" sich das Ziel befindet (räumliche Dimension), wodurch sichergestellt wird, dass bei der anschließenden Fusion nur verfeinerte Merkmale beteiligt sind. Die Multi-Scale Feature Fusion Strategy (MSF) bewahrt sowohl tiefe semantische Informationen als auch oberflächliche Randdetails durch einen hierarchischen Mechanismus, der im Decoder eingeführt wurde. Durch die schrittweise Integration von DAM-verbesserten Encoderfunktionen mit hochgemusterten Decoderfunktionen kompensiert diese Strategie effektiv den durch Downsampling verursachten räumlichen Detailverlust und ermöglicht so eine genaue Erkennung kleiner Polypen und eine präzise Grenzabgrenzung.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Diese Studie verwendet ausschließlich öffentlich zugängliche, anonymisierte Koloskopie-Bilddatensätze (Kvasir-SEG). Es wurden keine neuen Daten aus menschlichen Probanden erhoben. Eine institutionelle Ethikgenehmigung und die informierte Patienteneinwilligung waren nicht erforderlich, wie die institutionellen Überprüfungsrichtlinien für retrospektive Analysen de-identifizierter öffentlicher Datensätze bestätigen.
1. Datenvorbereitung
- Laden Sie den Kvasir-SEG-Datensatz aus dem offiziellen Repository33 (https://datasets.simula.no/kvasir-seg/) herunter. Der Datensatz enthält 1.000 Polypenbilder mit entsprechenden pixelbasierten Ground-Truth-Masken.
- Teile den Datensatz zufällig in Trainingssets (800 Bilder), Validierung (100 Bilder) und Testset (100 Bilder) mit einem Verhältnis von 8:1:1 unter Verwendung eines festen Zufalls-Seed (Seed = 42). Überprüfen Sie, dass sich keine Bilder über die drei Teilmengen überschneiden, um Datenlecks zu verhindern.
- Alle Bilder und zugehörigen Masken werden auf 352 x 352 Pixel vergrößert, wobei bilineare Interpolation für Bilder und Masken-Nest-Neighbor-Interpolation verwendet werden.
- Normalisieren Sie die Pixelwerte auf [0, 1], indem Sie durch 255 teilen, und wenden Sie dann ImageNet-kanalweise Mittelabzug (0,485, 0,456, 0,406) und Standardabweichungsnormalisierung (0,229, 0,224, 0,225) an.
- Wenden Sie folgende Augmentationstransformationen nur auf die Trainingsmenge an (nicht auf die Validierungs- oder Testmengen): zufälliger horizontaler Flip (Wahrscheinlichkeit = 0,5); zufälliger vertikaler Flip (Wahrscheinlichkeit = 0,5); Zufällige Rotation (Bereich: −30° bis +30°, Wahrscheinlichkeit = 0,5); Zufällige Multi-Scale-Größenänderung (Skalierungsfaktor: 0,75 bis 1,25, Wahrscheinlichkeit = 0,5)
HINWEIS: Wenden Sie identische räumliche Transformationen sowohl auf das Bild als auch auf die entsprechende Maske an, um die Ausrichtung aufrechtzuerhalten. Überprüfen Sie die Korrektheit der Augmentation, indem Sie mehrere augmentierte Bild-Masken-Paare visuell inspizieren, bevor Sie mit dem Training beginnen.
2. Gesamtarchitektur
HINWEIS: Siehe Abbildung 1 für das Makro-Encoder-Decoder-Backbone von PWD-Net und Abbildung 2 für die Integration und Interaktion der Kernmodule im Feature-Flow. Die Gesamtarchitektur folgt einem U-förmigen Encoder-Decoder-Design, um Skalenvariationen von Polypen und Hintergrundinterferenzen in Koloskopiebildern zu bewältigen.
- Backbone und Kodierungspfad (Abbildung 1)
- Verwenden Sie einen ResNet-50, der auf ImageNet vortrainiert ist (bezogen vom offiziellen PyTorch-Modellzoo), als Backbone-Encoder30. Feinjustiere alle Encoder-Schichten während des Trainings.
- Führen Sie das Eingabe-Koloskopiebild (auf 352 x 352 Pixel verkürzt) durch fünf Stufen verbleibender Faltungsblöcke, um hierarchische Merkmale zu extrahieren. Die räumliche Auflösung von Feature-Maps wird schrittweise von zu über die fünf Stufen hinweg heruntergesampfelt, während die Kanaldimensionen entsprechend zunehmen (64 → 128 → 256 → 512 → 1024).
- Am Engpass (der tiefsten Encoderschicht) ersetzen Sie die Standard-Faltungsschicht durch das Pinwheel-Faltungsmodul (PCM, beschrieben in Abschnitt 3), um die globale geometrische Morphologie und multidirektionale kontextuelle Informationen mit niedriger Auflösung zu erfassen.
HINWEIS: Die fünf Encoder-Stufen entsprechen den Standard-ResNet-50-Schichtgruppen: conv1, layer1, layer2, layer3 und layer4. Vortrainierte Gewichte bieten eine robuste Initialisierung von Elementen auf niedriger und mittlerer Ebene und reduzieren die Konvergenzzeit bei kleinen medizinischen Datensätzen.
- Schlüsselkomponenten und Merkmalswechselwirkungen (Abbildung 2 und Abbildung 3)
- Wenden Sie den Dual-Attention-Mechanismus (DAM, beschrieben in Abschnitt 4) auf den Ausgang jeder Encoderstufe an, bevor Sie ihn über Skip-Verbindungen an den Decoder senden. Dieser Schritt unterdrückt adaptiv Hintergrundgeräusche, die durch Darmfalten und spekulare Reflexionen entstehen, während die Merkmalsreaktion in Polypenregionen gesteigert wird. Nur die gefilterten Features werden an die entsprechende Decoder-Schicht weitergegeben.
- Im Decoder wird die räumliche Auflösung schrittweise durch bilineare Upsampling wiederhergestellt. An jeder Decoder-Schicht werden die hochgesampleten Features der vorherigen Decoderstufe mit den DAM-verbesserten Encoder-Features derselben räumlichen Auflösung verbunden.
- Wenden Sie zwei aufeinanderfolgende Faltungsschichten an (jeweils gefolgt von Batch-Normalisierung und ReLU-Aktivierung), um die Multi-Skalen-Informationen zu fusionieren. Dies bildet die Multi-scale Feature Fusion (MSF)-Strategie, die in Abschnitt 5 beschrieben ist.
HINWEIS: Der Decoder bewegt sich von tiefen zu flachen Schichten (Stufe 5 → Stufe 1) und stellt sicher, dass Informationen zur tiefen semantischen Lokalisierung und Details zu flachen Randdetails auf jeder Ebene effektiv integriert sind.
- Ausgabegenerierung
- Wenden Sie eine Faltungsschicht gefolgt von einer Sigmoid-Aktivierungsfunktion auf die endgültige Decoder-Ausgabe an, um die Vorhersagemaske zu erzeugen.
- Binarisieren Sie die Vorhersagemaske mit einem Schwellenwert von 0,5, um das endgültige Segmentierungsergebnis zu erhalten, wobei Pixel mit einer vorhergesagten Wahrscheinlichkeit ≥ 0,5 als Polypen und die übrigen Pixel als Hintergrund klassifiziert werden.
3. Pinwheel-Faltungsmodul (Abbildung 3)
- Das Pinwheel-Faltungsmodul (PCM) ersetzt die Standard-Flaschenhals-Faltung, um multidirektionale geometrische Merkmale von Polypen zu erfassen. Implementieren Sie dieses Modul wie folgt:
- Definiere einen Basis-Faltungskern W der Größe 3 x 3 mit Cin den Eingangskanälen und Can den Ausgangskanälen .
- Definiere die Menge der Rotationswinkel Θ = {0°, 45°, 90°, ..., 315°}. Für jeden Winkel θ ∈ Θ erzeugt man den rotierten Kern Wθ , indem man eine bilineare interpolationsbasierte Rotation auf W anwendet. Alle acht rotierten Kernel teilen die gleichen Grundparameter; nur die räumliche Anordnung der Gewichte unterscheidet sich.
- Für jeden Winkel θ berechnen Sie die richtungsspezifische Merkmalsabbildung:

wobei X die Eingabe-Merkmalskarte ist. - Aggregieren Sie die acht Richtungsmerkmale durch kanalweise Verkettung entlang der Kanalachse, wodurch ein Tensor der Dimension (8 x Caußen) x H x W entsteht. Dann wenden Sie eine 1 x 1-Faltung an, um die Kanaldimension wieder aufC-Out zu reduzieren, gefolgt von Batch-Normalisierung und ReLU-Aktivierung31:

HINWEIS: Die Rotation und Interpolation erfolgen auf den Kernelgewichten und nicht auf der Eingabefeature-Karte. Dieses Design ermöglicht eine parametereffiziente, multidirektionale Feature-Extraktion, ohne die Eingabeauflösung zu erhöhen. In der aktuellen Implementierung gilt Cin = 1024 und Cout = 1024 in der Flaschenhalsphase, was der Ausgangskanaldimension der ResNet-50-Schicht4 entspricht. Siehe das ergänzende Codepaket für die vollständige Implementierung.
4. Dual-Aufmerksamkeits-Mechanismus (Abbildung 4)
HINWEIS: Der Dual-Attention-Mechanismus (DAM) ist in jede Skip-Verbindung eingebettet, um Hintergrundrauschen zu unterdrücken und Polypenregionenmerkmale sowohl in Kanal- als auch in räumlichen Dimensionen zu verbessern.
- Kanal-Aufmerksamkeit
Der Kanal-Aufmerksamkeitszweig identifiziert, welche Feature-Kanäle am informativsten sind. Gegeben eine Eingabefunktion F ∈ RC×H×W:- Komprimieren Sie die räumlichen Dimensionen mittels Global Average Pooling, um einen Kanalbeschreiber z ∈ RC×1×1 zu erhalten.
- Lassen Sie z durch ein zweischichtiges MLP (vollständig verbundene Schichten) mit einem Reduktionsverhältnis r = 16 durchlaufen. Die erste Schicht reduziert die Dimension von C auf C/16 mit ReLU-Aktivierung; die zweite Schicht stellt ihn von C/16 nach C mit Sigmoid-Aktivierung zurück, um den Kanalgewichtvektor Ac zu erzeugen:
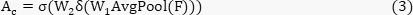
wobei δ ReLU und σ Sigmoid bezeichnet.
- Räumliche Aufmerksamkeit
Der räumliche Aufmerksamkeitszweig lokalisiert, wo sich die Zielregionen befinden:- Wende sowohl Max-Pooling als auch Average Pooling entlang der Kanaldimension an, um zwei 2D-Merkmalsabbildungen von Größe 1 x H x W zu erzeugen.
- Verkette die beiden Abbildungen entlang der Kanalachse, um einen 2 x H x W Tensor zu bilden. Wenden Sie eine 7 x 7 große Faltungsschicht an, gefolgt von Sigmoid-Aktivierung, um die räumliche Gewichtskarte As ∈ R1×H×W zu erzeugen:
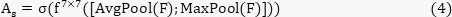
- Merkmalsfusion
- Verschmelzen Sie die Kanal- und räumlichen Aufmerksamkeitsausgaben mit der Eingangsfunktion durch elementweise Multiplikation:

wobei α und β lernbare Balancekoeffizienten sind, die beide auf 0,5 initialisiert und während des Trainings gemeinsam mit den Netzwerkparametern per gradientenbasierter Optimierung aktualisiert werden.
HINWEIS: Siehe das ergänzende Codepaket (dam_module.py) für die vollständige Implementierung.
- Verschmelzen Sie die Kanal- und räumlichen Aufmerksamkeitsausgaben mit der Eingangsfunktion durch elementweise Multiplikation:
5. Multi-Scale Feature Fusion
- Wenden Sie die Multi-Scale Feature Fusion (MSF)-Strategie im Decoder an, um den räumlichen Detailverlust in tiefen Features zu adressieren. In jeder Decoder-Phase führen Sie Folgendes aus:
- Erhöhe die Merkmalsabbildung aus der vorhergehenden Decoder-Stufe um den Faktor 2 mittels bilinearer Interpolation.
- Verketten Sie die hochgemusterten Merkmale mit den DAM-verbesserten Encodermerkmalen der entsprechenden räumlichen Auflösung entlang der Kanalachse.
- Wenden Sie zwei aufeinanderfolgende 3 x 3 Faltungsschichten an (jeweils gefolgt von Batch-Normalisierung und ReLU-Aktivierung32), um die verketteten Merkmale zu verschmelzen.
HINWEIS: Diese ebenenübergreifende Fusion stellt sicher, dass die Randdetails von Polypen (bereitgestellt durch flache Encodermerkmale) und semantischer Lokalisierung (bereitgestellt durch tiefe Features) gleichzeitig erhalten bleiben, was feinkörnige Segmentierungsergebnisse erzeugt.
6. Verlustfunktion und Trainingskonfiguration
- Verlustfunktion
- Eine hybride Verlustfunktion L_total verwendet wird, um das Netzwerk gemeinsam zu optimieren und so das allgegenwärtige Ungleichgewicht zwischen Vordergrund und Hintergrund bei der Polypensegmentierung zu beheben.
Binärer Kreuzentropieverlust (LBCE) misst die Klassifikationsgenauigkeit auf Pixelebene:
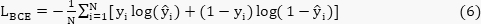
wobei N die Gesamtzahl der Pixel ist, yi ∈ {0,1} das Grundwahrheitslabel und ŷi ∈ [0,1] die vorhergesagte Wahrscheinlichkeit. - Dice Loss (LDice) quantifiziert die Mengenähnlichkeit zwischen den vorhergesagten und den Grundwahrheitsregionen:


wobei ε ein Glättungsfaktor ist (auf 1 x 10⁻5 gesetzt), um eine Division durch Null zu vermeiden.
Setze λ = 0,5, um die Beiträge der beiden Verlustterme auszugleichen.
- Eine hybride Verlustfunktion L_total verwendet wird, um das Netzwerk gemeinsam zu optimieren und so das allgegenwärtige Ungleichgewicht zwischen Vordergrund und Hintergrund bei der Polypensegmentierung zu beheben.
- Ausbildungskonfiguration
- Initialisieren Sie den Encoder mit ImageNet-vortrainierten ResNet-50-Gewichten. Initialisieren Sie alle Decoder-Schichten, PCM- und DAM-Parameter mit der Kaiming-Uniforminitialisierung.
- Konfigurieren Sie den Optimierer und den Trainingsplan wie folgt. Verwenden Sie den Adam-Optimierer mit β₁ = 0,9 und β₂ = 0,999. Stelle die anfängliche Lernrate auf 1 x 10⁻⁴ ein. Wenden Sie einen Koordinatus-Annealing-Lernratenplan mit Tmax = 50 und ηmin = 1 x 10⁻⁶ an. Verwenden Sie eine Chargengröße von 16 und trainieren Sie das Modell für 50 Epochen.
- Trainiere das Modell auf 50 Epochen auf dem Trainingsset (800 Bilder). Am Ende jeder Epoche wird das Modell anhand der Validierungsmenge (100 Bilder) unter Verwendung des Dice-Koeffizienten als primäre Überwachungsmetrik bewertet.
- Speichere den Modell-Checkpoint, der den höchsten Würfelkoeffizienten im Validierungssatz erreicht. Verwenden Sie diesen Checkpoint als Endmodell für alle nachfolgenden Bewertungen auf dem Testset.
HINWEIS: Frühzeitiges Stoppen wird nicht ausdrücklich angewendet. Die Checkpoint-Auswahlstrategie mit der besten Validierung dient als Kriterium für die Modellauswahl. Alle Experimente werden in der in der Materialtabelle angegebenen Hardware- und Softwareumgebung durchgeführt. Das Training für 50 Epochen auf 800 Bildern dauert unter der beschriebenen Konfiguration etwa 2 Stunden. Alle gemeldeten Ergebnisse werden aus einem einzelnen Trainingslauf mit dem angegebenen zufälligen Seed (Seed = 42) gewonnen. Siehe das ergänzende Codepaket für das vollständige Trainingsskript.
7. Pseudocode
- Verwenden Sie Algorithmus 1 als vollständige Workflow-Karte für PWD Net. Gleiche die PCM-, DAM-, Hauptarchitektur- und Trainingspipeline-Blöcke im Algorithmus mit den entsprechenden Dateien im ergänzenden Codepaket ab.
- Implementiere den PCM-Block, der in den Zeilen 4 bis 12 gezeigt ist. Definieren Sie einen Basis-3x3-Faltungskern und erzeugen Sie acht rotierte Kernel bei 0°, 45°, 90°, 135°, 180°, 225°, 270° und 315° mittels bilinearer Interpolation.
- Behalte für alle rotierten PCM-Kernel die gleichen lernbaren Basisparameter. Für jeden Drehwinkel berechnen Sie eine richtungsspezifische Merkmalskarte.
- Verbinden Sie die acht PCM-Feature-Karten entlang der Kanaldimension. Wenden Sie eine 1 x 1 Konvolution, Batch-Normalisierung und ReLU-Aktivierung an, um die ursprüngliche Kanaldimension wiederherzustellen.
- Implementiere den DAM-Block, der in den Zeilen 14 bis 19 gezeigt wird. Wenden Sie Global Average Pooling an, um den Kanaldeskriptor zu erzeugen, und leiten Sie ihn dann durch ein zweischichtiges MLP mit einem Reduktionsverhältnis von 16, um Kanalgewichte zu erhalten.
- Generiere die räumliche Aufmerksamkeitskarte, indem du kanalweise Average Pooling und Max-Pooling auf die Eingabefunktion anwendest. Verbinden Sie die beiden Karten und verarbeiten Sie sie mit einer 7 x 7 Konvolution gefolgt von einer Sigmoid-Aktivierung.
- Verbinde den DAM-Kanal und die räumlichen Aufmerksamkeitsausgaben mit der Eingangsfunktion mittels elementweiser Multiplikation. Gewichte die beiden Aufmerksamkeitskarten mit lernbaren Koeffizienten α und β, beide initialisiert auf 0,5.
- Baue die Haupt-PWD-Net-Architektur, wie sie in den Zeilen 21 bis 32 gezeigt wird. Das Eingabebild wird durch fünf Stufen eines vortrainierten ResNet-50-Encoders geleitet, um e1 bis e5 zu erhalten, wobei die räumliche Auflösung von H x W auf H/32 x W/32 abnimmt.
- Trage PCM auf E5 an der Engstelle an. Wenden Sie DAM auf e1 bis e4 an, bevor Sie diese Funktionen über Skip-Verbindungen an den Decoder senden.
- Entschlüssele die Merkmalskarte von tiefen zu flachen Schichten. Auf jeder Decoder-Ebene wird die vorherige Funktion hochgesampelt, mit der entsprechenden DAM-erweiterten Encoder-Funktion verknallt und DoubleConv für die Funktionsfusion angewendet.
- Generiere die Segmentierungsausgabe mit einer 1 x 1-Faltung gefolgt von einer Sigmoid-Aktivierung. Verwenden Sie die resultierende pixelweise Wahrscheinlichkeitsabbildung als vorhergesagte Maske.
- Implementieren Sie die in den Zeilen 34 bis 39 gezeigte Trainingsschleife. In jeder Epoche führt man die Vorwärtsausbreitung über das PWD Net durch und berechnet die vorhergesagte Maske.
- Berechne den Trainingsverlust als 0,5 x BCE-Verlust plus 0,5 x Würfelverlust. Aktualisieren Sie alle lernbaren Parameter mit dem Adam-Optimierer durch Backpropagation.
Algorithmus 1: PWD-Net-Polypensegmentierung
1: Eingabe: Koloskopie-Bild I ∈ RH×W×3
2: Ausgabe: Segmentierungsmaske M ∈ {0,1}(H×W)
3:
4: Funktion PCM(X) ▷ Pinwheel-Faltungsmodul
5: Definiere den Basiskern W (3 x 3), Winkel Θ = {0°, 45°, ..., 315°}
6: für jedes θ ∈ Θ tun
7: Wθ ← BilinearRotate(W, θ) ▷ Rotate Kernel
8: Yθ ← Conv2d(X, Wθ) ▷ Richtungsspezifische Merkmale
9: Ende für
10: Yout ← ReLU(BN(Conv1 x 1(Concat({Yθ})))) ▷ Aggregate
11: Yzurück
12: Funktion beenden
13:
14: Funktion DAM(F) ▷ Dual-Aufmerksamkeitsmechanismus
15: Ac ← Sigmoid(MLP(AvgPool(F))) ▷ Kanal-Aufmerksamkeit (r=16)
16: As ← Sigmoid(Conv7 x 7([AvgPool(F); MaxPool(F)])) ▷ Räumliche Aufmerksamkeit
17: F' ← F ⊗ (α · Ac + β · As) ▷ Verschmelzen mit lernbarer α, β (init=0.5)
18: Rückkehr F'
19: Funktion beenden
20:
21: Funktion PWD-Net(I)
22: Encoder: e1, e2, e3, e4, e5 ← ResNet50_Stages(I) ▷ 5-stufiger vortrainierter Encoder
23: Engpass: b ← PCM(e5) ▷ PCM am Engpass anwenden
24: Überspringverbindungen: si ← DAM(ei) für i = 1, 2, 3, 4 ▷ Funktionen des Filter-Encoders
25: Decoder:
26: d4 ← DoubleConv(Concat(Up(b), s4))
27: D3 ← DoubleConv(Concat(Up(D4), S3))
28: Sieg2 ← Doppelkonv (Concat (Oben(D 3), S.2))
29: Sieg1 ← DoubleConv(Concat(Up(D2), S. 1))
30: M ← Sigmoid (Konv1 x 1(d1))
31: Rückkehr M
32: Funktion beenden
33:
34: Training:
35: Für jede Epoche tun Sie
36: M̂ ← PWD-Net(I)
37: L ← 0,5 · BCE(M̂, Mgt) + 0,5 · DiceLoss(M̂, Mgt) ▷ λ = 0,5
38: Aktualisieren Sie Parameter über Backpropagation (Adam optimizer)
39: Ende für
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Versuchsaufbau
Datensatz
Der Kvasir SEG-Datensatz wurde verwendet, um das Segmentierungsverhalten von PWD Net auf Koloskopiebildern mit heterogenen Polypenerscheinungen zu bewerten. Der Datensatz enthält 1.000 Pixel annotierte Polypenbilder und beinhaltet Variationen in Polypengröße, Form, Textur, Beleuchtung und Hintergrundkomplexität, was ihn geeignet macht, um Kleinzielerkennung, Randlokalisierung und Robustheit gegenüber visuellen Inter...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Mehrere Designentscheidungen im PWD-Net-Protokoll sind entscheidend für die Erzielung zuverlässiger Segmentierungsergebnisse und erfordern sorgfältige Aufmerksamkeit während der Implementierung. Erstens beeinflusst die Auswahl und Initialisierung des Encoder-Backbone direkt das Konvergenzverhalten und die Endleistung. Das Protokoll verwendet einen ResNet-50-Encoder, der auf ImageNet vortrainiert ist und eine robuste Low-Level- und Mid-Level-Feature-Initialisierung ermöglicht. Dies ist be...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren haben nichts offenzulegen.
Danksagungen
Diese Studie wurde vom National Key R&D Program Chinas finanziert (Programmnummern 2022YFC3500200 und 2022YFC3500204).
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Adam Optimizer | — | — | In PyTorch enthalten |
| Albumentations | Albumentations Team | v1.0+ | Bibliothek für Datenerweiterung |
| CUDA Toolkit | NVIDIA | v11.3+ | GPU-Beschleunigung |
| Kvasir-SEG-Datensatz | SimulaMet | — | https://datasets.simula.no/kvasir-seg/ |
| Matplotlib | Matplotlib Community | v3.4+ | Visualisierung von Trainingskurven |
| NumPy | NumPy Community | v1.21+ | Numerische Berechnung |
| NVIDIA Tesla P100 | NVIDIA | P100-PCIE-16GB | GPU für Training und Inferenz |
| OpenCV | OpenCV Community | v4.5+ | Bildvorverarbeitung |
| Python | Python Software Foundation | v3.8+ | Programmiersprache |
| PyTorch | Meta Platforms | v1.12+ | Deep-Learning-Framework |
| ResNet-50 vortrainierte Gewichte | PyTorch Model Zoo | — | ImageNet-1K vortrainiert |
| Ubuntu | Canonical | 18.04+ | Betriebssystem |