Dieses Protokoll beschreibt einen Deep-Learning-Workflow zur semantischen Segmentierung, Rekonstruktion und künstlerischen Stilsynthese von Mustern des immateriellen Kulturerbes mithilfe einer auf Transformatoren basierenden Merkmalsextraktion, adversarialer Rekonstruktion und räumlich adaptiver Bilddarstellung, um die digitale Konservierung und kreative Anwendungen im Kulturerbe zu unterstützen.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Rekonstruktion und künstlerische Stilsynthese von Mustern des immateriellen Kulturerbes mittels eines Deep-Learning-Frameworks mit semantischer Segmentierungsführung
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die digitale Bewahrung und Rekonstruktion immaterieller Kulturerbe-Muster (ICH) hat mit dem Fortschritt bildsynthetisierender Techniken auf Basis von Deep Learning zunehmend an Aufmerksamkeit gewonnen. Bestehende, auf SegCycle-SPADE basierende Ansätze haben Potenzial für die strukturelle Segmentierung und künstlerische Rekonstruktion traditioneller Handwerksmuster gezeigt; dennoch bestehen weiterhin Einschränkungen, darunter begrenzte Datensatzvielfalt, unzureichende Einbindung kultureller Semantik und mangelhafte Erhaltung struktureller Mustereigenschaften während der Rekonstruktion. Um diese Herausforderungen zu bewältigen, schlägt diese Studie einen verbesserten SegCycle-SPADE- Rahmen für die semantische Segmentierung und künstlerische Rekonstruktion von ICH-Musterarten vor. Ein auf Transformatoren basierendes Segmentierungsmodell, SegFormer, wird eingesetzt, um Motivgrenzen und Musterbereiche präzise zu identifizieren. Zusätzlich wird ein Modul zur kulturellen Merkmalsfusion mit Kreuz-Attention eingeführt, um kulturell bedeutungsvolle Motive zu verstärken und die Merkmalsrepräsentation zu verbessern. Die Musterverwandlung und -rekonstruktion erfolgt mithilfe von CycleGAN, während eine räumlich adaptive Denormalisierung (SPADE) für die künstlerische Stilsynthese genutzt wird, um die semantische Konsistenz zwischen Segmentierungskarten und generierten Bildern aufrechtzuerhalten. Um die Generalisierungsfähigkeit des Modells und die künstlerische Vielfalt zu verbessern, wird das Framework sowohl mit dem kulturellen Motivdatensatz Miao Batik als auch mit dem WikiArt-Datensatz trainiert. Die experimentellen Ergebnisse zeigen, dass der vorgeschlagene, auf Attention basierende SegCycle-SPADE-Ansatz die Segmentierungsgenauigkeit und die Leistung bei der Rekonstruktion von Kulturerbe-Mustern im Vergleich zu bestehenden, auf generativen adversariellen Netzwerken (GAN) basierenden Rekonstruktionsmethoden verbessert. Der vorgeschlagene Ansatz bietet eine skalierbare Lösung für die KI-gestützte Dokumentation, Rekonstruktion und künstlerische Wiederbelebung traditioneller Mustergestaltungen.
Einleitung
Das kulturelle Erbe, das sowohl immaterielle Elemente wie Bräuche, Sprachen und Glaubensvorstellungen als auch materielle Elemente wie Kunstwerke, Gebäude und schriftliche Aufzeichnungen umfasst, ist eine grundlegende Erscheinungsform der menschlichen Geschichte, Kreativität und Identität1. Die Erhaltung des Kulturerbes zielt darauf ab, Gemeinschaften die Wiederverbindung mit ihren Ursprüngen zu ermöglichen und künftigen Generationen den Nutzen aus ihrem kollektiven kulturellen Gedächtnis zu sichern. Sie fördert außerdem das interkulturelle Verständnis, die Wertschätzung vielfältiger Traditionen und Bräuche sowie die Anerkennung unterschiedlicher historischer Narrative. Diese kulturellen Güter helfen uns, die Werte, Sichtweisen und Erfahrungen vergangener Generationen zu verstehen, und tragen zur Bildung zeitgenössischer sozialer Identitäten und zur kulturellen Kontinuität bei. Die grundlegenden Prinzipien der Erhaltung des Kulturerbes sind in Abbildung 1 dargestellt.
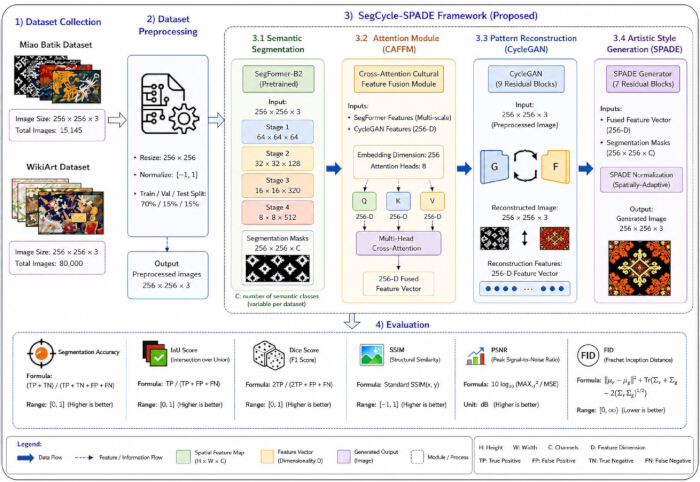
Abbildung 1. Konzeptionelle Übersicht der Rekonstruktion von Mustern des Kulturerbes mithilfe des SegCycle-SPADE-Frameworks. Schematische Darstellung des vorgeschlagenen Ansatzes zur Rekonstruktion und Verbesserung immaterieller Kulturerbemuster. Der Arbeitsablauf umfasst die Datensammlung aus den Miao-Batik- und WikiArt-Datensätzen, die Bildvorverarbeitung, die semantische Segmentierung mittels SegFormer-B2, die Merkmalsfusion mittels des Cross-Attention Cultural Feature Fusion Module (CAFFM), die Musterrekonstruktion mittels CycleGAN, die künstlerische Stilsynthese mittels SPADE sowie die abschließende Evaluierung anhand von Segmentierungs- und Rekonstruktionsmetriken. Pfeile zeigen den Datenfluss und die Weitergabe von Merkmalsdarstellungen im gesamten Framework an. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Das kollektive Gedächtnis und kulturelle Erbe der menschlichen Gesellschaft verkörpert sich im immateriellen Kulturerbe (IK), das als wichtiges Medium für künstlerischen Ausdruck und kulturelle Identität dient. Das IK steht jedoch aufgrund der Auswirkungen von Globalisierung und Digitalisierung vor erheblichen Herausforderungen2,3,4. Viele vom Aussterben bedrohte IK-Praktiken erfordern aufgrund des Rückgangs an erfahrenen Handwerkern und der geringen Anpassungsfähigkeit an moderne Märkte neue Ansätze zur Bewahrung und Entwicklung5,6. Als wichtiger Bereich der IK-Forschung betont das nachhaltige Design die integrierte Entwicklung von Kultur, Gesellschaft und Umwelt und bietet einen praktikablen Weg zur fortgesetzten Erhaltung des IK. Durch Ansätze des nachhaltigen Designs kann das IK revitalisiert und gleichzeitig an die Bedürfnisse der heutigen Gesellschaft angepasst werden7,8.
In dieser Studie bezeichnet der Begriff „Muster des immateriellen Kulturerbes“ visuelle Motivdarstellungen, die zugrundeliegende Werte des immateriellen Kulturerbes vermitteln und bewahren. Demzufolge zielt der vorgeschlagene Rahmen darauf ab, die mit diesen Motiven verbundenen kulturellen Informationen zu bewahren und zu dokumentieren, während gleichzeitig ihre visuellen Formen rekonstruiert werden.
Die Stickerei und Batik der Miao sind bedeutende Formen des chinesischen immateriellen Kulturerbes (ICH), die Geschichte, Glaubensvorstellungen und Traditionen der Miao-Gemeinschaft durch symbolische Motive wie Vögel, Schmetterlinge und Ahnentotems widerspiegeln9. Diese Motive sind tief in rituelle Kleidung und Festbräuche eingebunden und tragen zur lokalen kulturellen und wirtschaftlichen Entwicklung bei10,11. Fortschritte in digitalen Technologien, insbesondere künstliche Intelligenz (AI) und Deep Learning (DL), haben neue Möglichkeiten für die Bewahrung, Analyse, Rekonstruktion und Dokumentation des kulturellen Erbes geschaffen. Die Batik der Miao aus Guizhou, eine der am besten erhaltenen Batik-Traditionen Chinas, dient als wichtiges Medium zur Weitergabe des kulturellen Wissens, der Glaubensvorstellungen, Bräuche und Rituale des Miao-Volkes12,13,14,15,16.
Jüngste Studien haben das Potenzial von Deep Learning (DL) für den Erhalt des kulturellen Erbes und die Rekonstruktion von Mustern aufgezeigt und dabei im Vergleich zu U-Net und DeepLabV3+1 eine verbesserte Segmentierungsgenauigkeit (Pixelgenauigkeit = 88,6 %, mittlerer Intersection over Union [IoU] = 78,1 %) sowie eine bessere Rekonstruktionsleistung erzielt. Dennoch bestehen mehrere Herausforderungen. Bestehende, auf generativen adversariellen Netzwerken (GAN) basierende Ansätze haben häufig Schwierigkeiten, feine strukturelle Details in komplexen Mustern beizubehalten17, während eine begrenzte Datensatzvielfalt die Generalisierungsfähigkeit der Modelle über verschiedene kulturelle Bereiche hinweg einschränkt18. Außerdem können Modelle zur Bild-zu-Bild-Übersetzung wie CycleGAN die semantische Konsistenz zwischen Segmentierungskarten und erzeugten Bildern nicht aufrechterhalten19, und das Fehlen von Aufmerksamkeitsmechanismen kann zum Verlust kulturell bedeutsamer Motivdetails während der Rekonstruktion führen20. Daher ist ein erweitertes Framework erforderlich, das eine auf Transformatoren basierende Segmentierung, eine auf Aufmerksamkeit gestützte Merkmalslernung und ein Training mit mehreren Datensätzen integriert, um eine effektive Rekonstruktion von Mustern des immateriellen Kulturerbes (ICH) zu ermöglichen.
Neue Möglichkeiten zur Bewahrung des kulturellen Erbes ergeben sich durch die Digitalisierung der Miao-Stickerei und den rasanten Fortschritt generativer KI-Technologien. Diffusionsmodelle, eine neuartige Klasse tiefer generativer Modelle, haben aufgrund ihrer leistungsstarken Inhaltsgenerierungsfähigkeiten bemerkenswerte Ergebnisse bei Aufgaben der Computer Vision erzielt21,22,23,24,25. Im umgekehrten Diffusionsprozess lernt das Modell schrittweise, die ursprünglichen Eingabedaten aus verrauschten Darstellungen zu rekonstruieren26,27,28. Frühere Studien haben zudem die Anwendung von Technologien zur dreidimensionalen Rekonstruktion und zum computergestützten Entwurf (CAD) zur Bewahrung und Verbreitung des kulturellen Erbes untersucht.
Obwohl faltungsneuronale Netze (CNNs) und GANs bei der Bildgenerierung und Merkmalsbewahrung gut abschneiden, stehen sie weiterhin vor Herausforderungen im Zusammenhang mit begrenzten Rezeptivfeldern, Modus-Kollaps und Instabilität während des Trainings29. Auf Transformatoren basierende Architekturen wie SegFormer und Segmenter sind hervorragend darin, globale Kontexte und semantische Beziehungen zu erfassen; sie sind jedoch rechenaufwendig und können bei feinkörnigen Details Schwierigkeiten haben. Obwohl Diffusionsmodelle wie Stable Diffusion starke Fähigkeiten bei der Bildgenerierung zeigen, fehlt ihnen oft die präzise Kontrolle über die strukturellen und künstlerischen Eigenschaften der erzeugten Designs. Darüber hinaus verwenden die meisten bestehenden Ansätze unabhängige Trainingsstrategien, die den effektiven Informationsaustausch und die kooperative Optimierung zwischen Segmentierungs- und Generierungskomponenten einschränken, was zu einem Kompromiss zwischen struktureller Genauigkeit und künstlerischer Authentizität führt30.
Aktuelle diffusionsbasierte Modelle wie latente Diffusion und Stable Diffusion erreichen eine hochwertige Bildsynthese, erfordern jedoch eine iterative Rauschreduktion, was zu höheren Rechenkosten und längeren Inferenzzeiten führt. Zudem bleibt die Wahrung feiner kultureller Motive und struktureller Konsistenz ohne spezialisierte Konditionierungsmechanismen eine Herausforderung. Generative Modelle auf Basis von Transformatoren erfassen effektiv globale kontextuelle Beziehungen, benötigen jedoch oft umfangreiche Datensätze und erhebliche Rechenressourcen. Im Gegensatz dazu kombiniert das vorgeschlagene SegCycle-Spatially Adaptive Denormalization (SegCycle-SPADE)-Framework die Segmentierung basierend auf SegFormer, die Fusion von Merkmalen mittels Cross-Attention, die Rekonstruktion mit CycleGAN und die SPADE-gestützte Synthese, um eine explizite strukturelle Steuerung zu ermöglichen, wodurch die Erhaltung von Motiven, die semantische Konsistenz sowie die kontrollierbare Rekonstruktion von Mustern des kulturellen Erbes verbessert werden.
Die Mehrheit der modernen Techniken zur semantischen Segmentierung basiert auf vollständig faltenden neuronalen Netzen (FCNNs) mit U-förmigen Architekturen31. Während der Kodierungsphase werden tiefe Merkmale mit großen Empfangsfeldern durch eine Serie von Faltungs- und Downsampling-Operationen extrahiert. In der Dekodierungsphase wird die räumliche Auflösung schrittweise durch Upsampling wiederhergestellt, wodurch letztendlich semantische Vorhersagen auf Pixel-Ebene ermöglicht werden. Durch den Ausgleich des Verlusts räumlicher Informationen während des Downsamplings und die Verbesserung der Segmentierungsleistung über eine breite Palette von Anwendungen hinweg ermöglichen Skip-Verbindungen die direkte Integration hochauflösender Informationen aus verschiedenen Kodierer-Ebenen in den Dekodierer32.
Während neuere, auf GANs, CNNs und Diffusionsmethoden basierende Ansätze vielversprechende Ergebnisse bei der Bildgenerierung und Restaurierung des kulturellen Erbes gezeigt haben, haben sie oft Schwierigkeiten, die semantische Kohärenz aufrechtzuerhalten, feine strukturelle Motive zu bewahren und eine reproduzierbare Rekonstruktion über verschiedene kulturelle Muster hinweg sicherzustellen. Die meisten bestehenden Ansätze behandeln Segmentierung, Rekonstruktion und Stilsynthese als getrennte Prozesse, was zum Verlust kulturell bedeutsamer Elemente und inkonsistenter Ergebnisse führen kann. Um diese methodische Lücke zu schließen, schlägt diese Studie einen einheitlichen SegCycle-SPADE-Rahmen vor, der die auf SegFormer basierende semantische Segmentierung, ein neuartiges Cross-Attention Cultural Feature Fusion Module (CAFFM), die auf CycleGAN basierende Rekonstruktion und die SPADE-gesteuerte Stilsynthese integriert. Durch die explizite Integration struktureller Segmentierungsinformationen mit der generativen Merkmalslernung ermöglicht der vorgeschlagene Ansatz eine zuverlässigere, semantisch konsistente und reproduzierbare Rekonstruktion von ICH-Motiven, wobei sowohl die kulturelle Authentizität als auch die künstlerische Qualität erhalten bleiben.
In dieser Studie werden drei wesentliche Einschränkungen der derzeitigen Ansätze zur Rekonstruktion des kulturellen Erbes identifiziert: (i) unzureichende Erhaltung feiner struktureller Motive bei rekonstruktiven Verfahren auf Basis von Generative Adversarial Networks (GAN); (ii) eingeschränkte Generalisierbarkeit aufgrund des Trainings mit kleinen oder domänenspezifischen Datensätzen; und (iii) unzureichende semantische Konsistenz zwischen Segmentierungsergebnissen und erzeugten Bildern in Bild-zu-Bild-Übersetzungsverfahren. Zusätzlich werden Segmentierung, Rekonstruktion und Stilsynthese häufig als getrennte Prozesse behandelt, was zum Verlust kulturell wichtiger Elemente während der Rekonstruktion führt. Durch die Kombination einer auf Transformatoren basierenden semantischen Segmentierung, einer Merkmalsfusion mittels Cross-Attention, der CycleGAN-basierten Rekonstruktion und einer SPADE-gesteuerten künstlerischen Synthese innerhalb einer einheitlichen Architektur behebt das vorgeschlagene SegCycle-SPADE-Verfahren diese Einschränkungen und verbessert die Erhaltung von Motiven, die semantische Konsistenz sowie die künstlerische Authentizität bei der Rekonstruktion immaterieller Kulturerbe-Muster (ICH).
Das Hauptziel dieser Studie ist die Entwicklung eines verbesserten SegCycle-SPADE-Modells für die semantische Segmentierung gestützte künstlerische Rekonstruktion von ICH-Mustern. Das Modell kombiniert SegFormer zur präzisen Segmentierung kultureller Motive, CycleGAN zur Musterrekonstruktion und SPADE zur stilistisch konsistenten künstlerischen Synthese. Um die Merkmalsdarstellung zu verbessern und feine strukturelle Details zu bewahren, wird ein CAFFM eingeführt, das eine effektive Interaktion zwischen Segmentierungs- und generativen Merkmalen ermöglicht. Auf der Grundlage der Miao-Batik- und WikiArt-Datensätze trainiert, verbessert das vorgeschlagene Modell die Authentizität der Rekonstruktion, die Stilkonsistenz sowie die Erhaltung kulturell bedeutsamer Motive.
Durch die Kombination von semantischer Segmentierung, attention-gesteuerter Merkmalsfusion, Musterrekonstruktion und Stilsynthese innerhalb einer einheitlichen Architektur stellt diese Studie einen neuartigen SegCycle-SPADE-Ansatz für die künstlerische Rekonstruktion von ICH-Mustern vor. Die wesentlichen Beiträge dieser Arbeit sind wie folgt. Erstens wird ein neuartiges, durch semantische Segmentierung gesteuertes Rekonstruktionsframework durch die Integration von SegFormer entwickelt, das eine präzise Extraktion und Erhaltung fein strukturierter kultureller Motive und struktureller Elemente ermöglicht. Zweitens wird ein neues CAFFM eingeführt, um Segmentierungsmerkmale effektiv mit generativen Darstellungen zu verbinden, wodurch das Modell langreichweitige Beziehungen zwischen kulturellen Motiven und Mustern der künstlerischen Stilistik erfassen kann. Drittens verbessert das vorgeschlagene CAFFM die Erhaltung kulturell bedeutungsvoller Elemente und erhöht gleichzeitig die visuelle Realitätstreue und strukturelle Kohärenz der rekonstruierten Kulturmuster. Viertens gewährleistet das Framework durch die Integration von CycleGAN für die Rekonstruktion kultureller Muster und SPADE für die segmentierungsgesteuerte künstlerische Synthese sowohl semantische Genauigkeit als auch stilistische Authentizität der erzeugten Ergebnisse. Fünftens wird zur Verbesserung der Generalisierungsfähigkeit und künstlerischen Vielfalt das Modell mit dem Miao-Batik-Kulturmotive-Datensatz zum Erlernen kultureller Muster und dem WikiArt-Datensatz zur Repräsentation künstlerischer Stile trainiert. WikiArt dient dabei als Hilfsdatensatz zur Bewertung der Generalisierungsfähigkeit, der Robustheit des Merkmalslernens und der Wirksamkeit der Stilsteuerung in unterschiedlichen visuellen Kontexten, nicht jedoch als Zielstil für die direkte Anwendung in Produkten des Miao-Kulturerbes. Schließlich zeigen experimentelle Ergebnisse im Vergleich mit bestehenden, auf GANs basierenden Verfahren zur Rekonstruktion von Kulturerbe, dass das vorgeschlagene SegCycle-SPADE-Framework eine verbesserte Segmentierungsgenauigkeit, Rekonstruktionsqualität und stilistische Konsistenz erreicht.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Der vorgeschlagene Rahmen von SegCycle-SPADE ist darauf ausgelegt, traditionelle Kulturerbemuster durch semantische Segmentierung, Merkmalsverstärkung mittels Aufmerksamkeitsmechanismus, generative Rekonstruktion und künstlerische Stilsynthese zu rekonstruieren und zu verbessern. In dieser Studie wurden öffentlich verfügbare Datensätze kulturellen Erbes und künstlerischer Bilder verwendet, darunter der Miao-Batik-Datensatz und der WikiArt-Datensatz. Es wurden keine menschlichen Teilnehmer, Patientendaten, personenbezogenen Informationen, Tierexperimente oder klinische Aufzeichnungen in die Forschung einbezogen; daher war eine Genehmigung durch einen institutionellen Ethikausschuss und eine informierte Einwilligung nicht erforderlich. Zunächst werden der kulturelle Motiv-Datensatz der Miao-Batik und der WikiArt-Datensatz zur Evaluierung herangezogen. Der Miao-Batik-Datensatz wurde von Quan et al. (2024)32 beschrieben und umfasst 15.148 annotierte Bilder traditioneller Miao-Batik-Motive. Die vorhandenen Annotationen der Datensatzersteller wurden direkt verwendet, und in dieser Studie wurden keine zusätzlichen manuellen Annotationen erstellt. Anschließend erfolgt die Vorverarbeitung der Bilder durch Größenänderung, Normalisierung, Rauschunterdrückung und Erstellung einer Segmentierungsmaske. Die genauen Parameter der Vorverarbeitung sind im Unterabschnitt „Daten-Vorverarbeitung“ beschrieben. Der vorgeschlagene Rahmen nutzt ein auf Transformatoren basierendes Modell namens SegFormer-B2 für die semantische Segmentierung der Daten. Das Verfahren ist darauf ausgelegt, Schlüsselbereiche kultureller Motive zu erkennen und deren Strukturen zu lernen. Die segmentierten Merkmale werden anschließend durch einen Aufmerksamkeitsmechanismus verstärkt, wobei wichtige Informationen im Zusammenhang mit kulturellen Motiven hervorgehoben und irrelevante Informationen verworfen werden. Die Konfiguration des Aufmerksamkeitsmechanismus ist im Unterabschnitt CAFFM beschrieben. Die verstärkten Merkmale werden dann durch CycleGAN geleitet, wobei beschädigte Strukturen durch zyklisches Lernen rekonstruiert werden. Während des Trainings wurden unvollständige Motivbeispiele künstlich erzeugt, indem den ursprünglichen Miao-Batik-Bildern zufällige Maskierungen und teilweise Verdeckungen hinzugefügt wurden. Diese Degradationsverfahren simulierten fehlende Motivbereiche und strukturelle Schäden, wie sie häufig bei verfallenen Objekten des Kulturerbes auftreten. Die resultierenden unvollständigen Bilder dienten als Eingaben für das CycleGAN-Rekonstruktionsmodul, während die entsprechenden Originalbilder als Rekonstruktionsziele fungierten. Die rekonstruierten Kulturerbemuster werden anschließend durch SPADE verbessert, wobei eine künstlerische Verbesserung basierend auf den generierten Segmentierungskarten durchgeführt wird. Die Leistung des vorgeschlagenen Rahmens wird anhand quantitativer Segmentierungs- und Bildqualitätsmetriken bewertet, während die visuelle Authentizität der rekonstruierten kulturellen Motive qualitativ beurteilt wird. Die visuelle Authentizität wurde durch visuelle Inspektion der generierten kulturellen Muster beurteilt und nicht als unabhängige quantitative Metrik verwendet. Die Bewertung konzentrierte sich auf Motiverhaltung, semantische Konsistenz, kulturelle Merkmale, strukturelle Kohärenz und künstlerisches Erscheinungsbild im Vergleich zu den entsprechenden Referenzmotiven des Kulturerbes. Die quantitative Bewertung der Modellleistung erfolgte anhand von Segmentierungsgenauigkeit, IoU, Dice-Koeffizient, Structural Similarity Index Measure (SSIM), Peak Signal-to-Noise Ratio (PSNR) und Fréchet Inception Distance (FID). Abbildung 2 veranschaulicht den gesamten Arbeitsablauf des vorgeschlagenen SegCycle-SPADE-Rahmens und fasst die in dieser Studie verwendeten Evaluierungsmetriken zusammen.
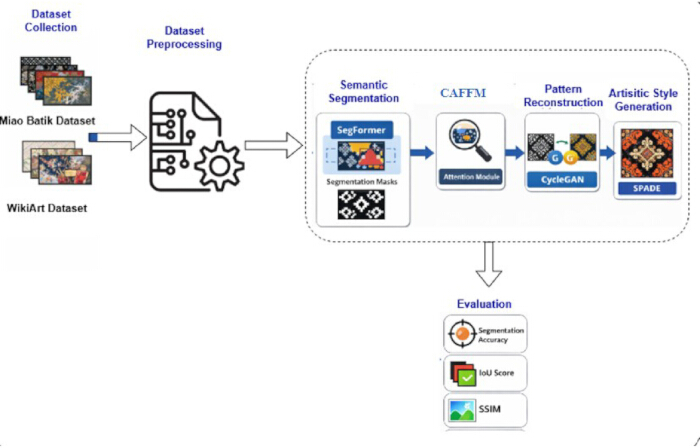
Abbildung 2. Übersicht über den Architekturablauf des vorgeschlagenen SegCycle-SPADE-Modells. Übersicht über den gesamten SegCycle-SPADE-Arbeitsablauf. Bilder aus den Datensätzen Miao Batik und WikiArt werden vorverarbeitet und anschließend durch semantische Segmentierung mittels SegFormer-B2, Merkmalsverbesserung mittels CAFFM, Musterrekonstruktion mittels CycleGAN und künstlerische Stilerzeugung mittels SPADE verarbeitet. Die Modellleistung wird anhand von Segmentierungsgenauigkeit, Intersection over Union (IoU), Dice-Koeffizient, Structural Similarity Index Measure (SSIM), PSNR und Fréchet Inception Distance (FID) bewertet, während die visuelle Authentizität qualitativ beurteilt wird. Bitte klicken Sie hier, um eine vergrößerte Ansicht dieser Abbildung einzusehen.
Das SegCycle-SPADE-Framework zur Rekonstruktion von Mustern im Bereich des kulturellen Erbes wurde entwickelt, um mehrere Deep-Learning-Komponenten zur präzisen Segmentierung, Rekonstruktion und künstlerischen Verbesserung von Motiven zu integrieren, wie in Abbildung 2 veranschaulicht. Bilder aus dem Miao-Batik-Kulturmotiv-Datensatz und dem WikiArt-Datensatz dienen zur Bereitstellung vielfältiger kultureller Muster und künstlerischer Stile. Zunächst werden die Bilder mithilfe eines auf SegFormer basierenden semantischen Segmentierungsmoduls verarbeitet, um kulturelle Motive vom Hintergrund zu trennen und abzugrenzen. Die Gesamtarchitektur umfasst vier Hauptphasen. Erstens extrahiert das SegFormer-Modell semantische Segmentierungskarten aus den Bildern der kulturellen Muster. Zweitens integriert das CAFFM Segmentierungsmerkmale mit generativen Darstellungen, um das Merkmalslernen zu verbessern. Drittens rekonstruiert das CycleGAN-Modul kulturelle Muster unter Verwendung der fusionierten Merkmalsdarstellungen. Schließlich erzeugt das SPADE-Modul stilistisch verbesserte Ausgaben, wobei die strukturelle Konsistenz durch segmentierungsgesteuerte Synthese erhalten bleibt. Die verfeinerten Merkmalskarten werden anschließend vom CycleGAN-Rekonstruktionsmodul verarbeitet, das lernt, unvollständige kulturelle Motive wiederherzustellen, indem es degradierte Muster ihren jeweils vollständigen Formen zuordnet. Unvollständige Motivproben wurden erzeugt, indem auf die ursprünglichen Miao-Batik-Bilder zufällige Maskierungen und teilweise Verdeckungen angewendet wurden, um fehlende Musterbereiche und strukturelle Degradationen nachzuahmen, wie sie häufig bei beschädigten kulturellen Artefakten beobachtet werden. Jedes degradierte Bild wurde mit dem entsprechenden Originalbild gepaart, das während des Trainings als Rekonstruktionsziel diente. Diese Strategie ermöglichte es dem CycleGAN-Modul, die Wiederherstellung fehlender Motivstrukturen zu erlernen, während gleichzeitig die semantische Konsistenz und kulturell bedeutsame Merkmale bewahrt blieben. Schließlich erzeugt der SPADE-Generator künstlerisch verbesserte visuelle Ausgaben, indem er die Bilderzeugung anhand der generierten Segmentierungskarten bedingt und dadurch die strukturelle Integrität der kulturellen Motive während des gesamten künstlerischen Verbesserungsprozesses erhält.
Die folgenden Schritte sind im vorgeschlagenen SegCycle-SPADE-Rahmenwerk enthalten.
Schritt 1: Datensammlung
Zwei Datensätze wurden verwendet, um die Ziele des kulturellen Musterlernens und der künstlerischen Stilgenerierung zu erreichen. Der Miao Batik Cultural Motif Dataset diente der Bereitstellung traditioneller kultureller Mustereinformationen. Der Datensatz ist öffentlich über Zenodo (https://doi.org/10.5281/zenodo.20807658) zugänglich und enthält 15.148 annotierte Bilder traditioneller Miao-Batik-Motive. Die vom Datensatz bereitgestellten bestehenden Annotationen wurden direkt verwendet, und in dieser Studie wurden keine zusätzlichen manuellen Annotationen erstellt. Der WikiArt-Datensatz wurde zur Bereitstellung vielfältiger künstlerischer Stilinformationen für die Generierung künstlerischer Stile verwendet und aus dem öffentlich zugänglichen WikiArt-Repository (https://www.wikiart.org/) bezogen.
Schritt 2: Datenpräprozessing
Alle Bilder wurden durch Größenänderung, Normalisierung und Rauschunterdrückung vorverarbeitet. Vorhandene Anmerkungen zu kulturellen Motiven, die aus den ursprünglichen Datensatzquellen stammten, wurden zur Unterstützung der semantischen Segmentierungsphase verwendet. Im Rahmen dieser Studie wurden keine zusätzlichen Annotationen oder Umkennzeichnungsverfahren durchgeführt.
Schritt 3: Semantische Mustersegmentierung mithilfe von SegFormer
Das SegFormer-Modell wurde zur Segmentierung kultureller Motive verwendet. Der genaue SegFormer-Backbone und die Initialisierungsstrategie werden im Unterabschnitt Semantische Mustersegmentierung mithilfe von SegFormer beschrieben. Konkret kam die SegFormer-B2-Architektur mit einem auf ImageNet vortrainierten MIT-B2-Backbone für die semantische Motivsegmentierung zum Einsatz. Dieses Modell erfasst effektiv globale Kontextinformationen und bewahrt gleichzeitig die komplexen strukturellen Details traditioneller kultureller Muster.
Schritt 4: CAFFM
Die CAFFM kombiniert semantische Segmentierungsmerkmale mit generativen Darstellungen, wodurch das Framework sowohl strukturelle Motivmerkmale als auch künstlerische Stilinformationen lernen kann. Integrationsdetails der CAFFM sind im Unterabschnitt CAFFM beschrieben. Das Modul ist zwischen der auf SegFormer basierenden semantischen Segmentierungsstufe und der generativen Rekonstruktionsstufe positioniert, wo es segmentierungsbezogene strukturelle Merkmale mit Rekonstruktionsmerkmalen über eine Multi-Head-Cross-Attention verbindet. Dieser Prozess verbessert die Erhaltung kultureller Motive und steigert die Realitätsnähe der rekonstruierten Ausgaben.
Schritt 5: Rekonstruktion von Mustern (CycleGAN)
Die fusionierten Merkmale werden anschließend vom CycleGAN-Modul verarbeitet, um kulturelle Musterstrukturen zu rekonstruieren. Die Architektur und Trainingskonfiguration von CycleGAN werden im Unterabschnitt Pattern Reconstruction Using CycleGAN beschrieben. Das Rekonstruktionsmodul besteht aus zwei Generatoren und zwei Diskriminatoren, verwendet eine Residual-Netzwerk-Generatorarchitektur mit neun Residualblöcken, setzt einen PatchGAN-Diskriminator ein und wird mithilfe von adversarialen Verlusten und zyklischen Konsistenzverlusten trainiert. Diese Konfiguration ermöglicht eine bidirektionale Abbildung zwischen Domänen und erleichtert die Rekonstruktion unvollständiger kultureller Musterstrukturen.
Schritt 6: Künstlerische Stilerzeugung (SPADE)
Die rekonstruierten Muster werden anschließend über das SPADE-Modul geleitet, um eine segmentierungsgesteuerte künstlerische Stilsynthese durchzuführen. Die Konfiguration des SPADE-Generators wird im Unterabschnitt Artistic Style Generation Using SPADE beschrieben. Das Modul verwendet SPADE-Residualblöcke, räumlich adaptive Normalisierungsschichten sowie semantische Bedingungen, die aus SegFormer-Segmentierungskarten und CAFFM-Feature-Darstellungen abgeleitet sind. Durch die bedingte Bildgenerierung anhand von Segmentierungskarten behalten die synthetisierten Ausgaben eine strukturelle Ausrichtung an den ursprünglichen kulturellen Motiven bei, während gleichzeitig künstlerische Stilmerkmale integriert werden.
Schritt 7: Leistungsbewertung
Der vorgeschlagene Ansatz wurde anhand mehrerer Metriken zur Segmentierung und Bildqualitätsbewertung evaluiert, darunter Segmentierungsgenauigkeit, IoU, Dice-Ähnlichkeitskoeffizient (Dice), SSIM, PSNR und FID. Zur Beurteilung der experimentellen Konsistenz wurden alle Experimente fünfmal mit unterschiedlichen Zufallszahlen wiederholt, und die Ergebnisse werden als Mittelwert ± Standardabweichung angegeben. Die statistische Signifikanz wurde mittels gepaarter t-Tests bewertet, mit einer Signifikanzschwelle von p < 0,05.
Datensammlung
Im vorgeschlagenen Rahmenwerk von SegCycle-SPADE werden zwei Datensätze zur Verständniserfassung kultureller Muster und zum Erlernen von Stilen verwendet. Der erste im vorgeschlagenen Rahmenwerk verwendete Datensatz ist der Datensatz kultureller Motive der Miao-Batik. Dieser Datensatz enthält kulturelle Motive der Miao-Batik, die im Allgemeinen Bilder traditioneller Miao-Batik darstellen, versehen mit Motiven wie Tieren, Pflanzen und geometrischen Formen, die in der Kunst der Miao-Ethnie verwendet werden. Der Datensatz umfasst Bilder mit reichhaltigen Texturinformationen, die im Allgemeinen wichtig für die Bewahrung des kulturellen Erbes sind. Der zweite im vorgeschlagenen Rahmenwerk von SegCycle-SPADE verwendete Datensatz ist der WikiArt-Datensatz. Dieser Datensatz enthält eine große Anzahl von Kunstwerken, die im Allgemeinen verschiedenen Stilen entstammen. Er wird für das Erlernen komplexer Stile verwendet, was sich generell zur Verbesserung von Kunstwerken eignet. Der Datensatz umfasst 80.000 Kunstwerke in HD mit 27 unterschiedlichen Stilrichtungen und ist daher besonders nützlich für auf Deep Learning basierende Aufgaben der Stilgenerierung oder -umwandlung.
Miao-Batik-Datensatz:
Der Miao-Batik-Datensatz (https://doi.org/10.5281/zenodo.20807658) umfasst 15.148 Bilder von Batikmustern mit kulturell bedeutsamen Motiven. Die Bilder enthalten eine Vielzahl traditioneller Designs, wie beispielsweise Tiermotive (z. B. Schmetterlinge und Fische), pflanzliche Muster und geometrische Motive, die kulturelle Symbolik tragen. Dieser Datensatz ist ein wesentlicher Bestandteil des vorgeschlagenen Frameworks, da er authentische kulturelle Strukturen bereitstellt, die es dem Segmentierungsmodul ermöglichen, Motivgrenzen während der Musterrekonstruktion genau zu identifizieren und zu erhalten (Tabelle 1). In dieser Studie beziehen sich kulturell bedeutende Motive auf symbolische visuelle Elemente, die in der Literatur zum kulturellen Erbe der Miao häufig dokumentiert sind und in den Datensatzannotationen enthalten sind, darunter Vögel, Schmetterlinge, florale Muster und Ahnentotems. Diese Motive wurden aufgrund ihrer belegten kulturellen Bedeutung und ihres wiederkehrenden Auftretens in traditionellen Miao-Batik- und Stickdesigns ausgewählt, nicht ausschließlich aufgrund ihrer Häufigkeit oder räumlichen Zusammensetzung. Die durch Experten erstellten Motivannotationen und Segmentierungskennzeichnungen stammen aus der ursprünglichen Quelle des Miao-Batik-Datensatzes und wurden in dieser Studie direkt verwendet. Die Autoren führten keine zusätzlichen manuellen Annotationen, Umetikettierungen oder erneuten, durch Experten geleiteten Annotationen durch. Die vom Datensatzersteller bereitgestellten Annotationen wurden für das Training und die Evaluierung der semantischen Segmentierung genutzt.
| Parameter | Beschreibung |
| Datensatzname | Miao Batik Kultureller Mustersatz |
| Datensatzquelle | Zenodo-Repository (DOI: 10.5281/zenodo.20807658) |
| Bereich | Immaterielles Kulturerbe (ICH) / Analyse textiler Muster |
| Gesamtanzahl der Bilder | 15.148 Bilder |
| Bildtyp | Digitalbilder traditioneller textiler Miao-Batik-Muster |
| Musterkategorien | Tiermotiven, Pflanzenmotiven und geometrischen Motiven |
| Kultureller Ursprung | Kultur der Miao-Ethnie, Provinz Guizhou, China |
| Ursprüngliche Bildauflösung | Hochauflösende Bilder (typischerweise ≥ 1.000 Pixel an der kürzeren Seite), erfasst als Rohscans oder Fotografien vor der Vorverarbeitung |
| Trainingsauflösung | Bilder wurden während der Vorverarbeitung auf 256 × 256 Pixel skaliert |
| Verfügbarkeit von Annotationen | Die vom Datensatz-Ersteller bereitgestellten Segmentierungsannotationen wurden ohne Änderung für Training und Evaluierung verwendet. In dieser Studie wurden keine zusätzlichen manuellen Annotationen, Umetikettierungen oder Bestätigungen durch Experten durchgeführt. |
| Anwendung in dieser Studie | Segmentierung kultureller Motive, Merkmalsextraktion, Motiverhaltung und Musterrekonstruktion |
Tabelle 1: Eigenschaften des Datensatzes kultureller Muster der Miao-Batik. Zusammenfassung des Datensatzes kultureller Motive der Miao-Batik, der für die semantische Segmentierung, die Analyse kultureller Muster und die Rekonstruktion von Motiven verwendet wurde. Die Tabelle beschreibt die Datenquelle, die Bildmerkmale, die Motivkategorien, den kulturellen Ursprung, die Bildauflösung sowie die Rolle des Datensatzes im vorgeschlagenen SegCycle-SPADE-Framework.
WikiArt-Datensatz:
Der WikiArt-Datensatz [https://www.wikiart.org/] ist ein beliebtes großangelegtes digitales Kunstrepositorium, das aus über 80.000 Bildern aus 27 verschiedenen künstlerischen Stilen in Tabelle 2 besteht. Zu den Stilen gehören Renaissancekunst, Impressionismus, Kubismus und Surrealismus. Der Datensatz ist im vorgeschlagenen Framework von großer Bedeutung, da er Wissen bereitstellt, das es dem SPADE-Modul ermöglicht, kulturell bereicherte Muster zu erzeugen, während gleichzeitig die aus dem Segmentierungsprozess gewonnenen strukturellen Informationen erhalten bleiben. Der Datensatz umfasst 56.000 Bilder für das Training sowie 12.000 Bilder für Validierung und Test. Die Bilder im Datensatz tragen wesentlich dazu bei, das Deep-Learning-Modell effektiv zu trainieren.
| Parameter | Beschreibung |
| Datensatzname | WikiArt-Datensatz |
| Datensatzquelle | WikiArt-Repository (https://www.wikiart.org/) |
| Bereich | Digitale Kunst und Gemälde |
| Gesamtanzahl der Bilder | Ungefähr 80.000 Kunstwerke |
| Trainingsbilder | 56.000 |
| Validierungsbilder | 12.000 |
| Testbilder | 12.000 |
| Künstlerische Stile | 27 künstlerische Stile, darunter Renaissance, Impressionismus, Kubismus, Surrealismus, Expressionismus, Realismus und Abstrakte Kunst |
| Ursprüngliche Bildauflösung | Die ursprünglichen Bildauflösungen variieren je nach Kunstwerk und Quelle. Die Bilder wurden während der Vorverarbeitung auf eine einheitliche Auflösung von 256 × 256 Pixeln skaliert. |
| Trainingsauflösung | Die Bilder wurden vor dem Erlernen künstlerischer Stile und der segmentierungsgesteuerten Bildsynthese während der Vorverarbeitung auf 256 × 256 Pixel skaliert. |
| Datensatz-Aufteilung | Stratifizierte zufällige Aufteilung (70 % Training, 15 % Validierung, 15 % Test) unter Verwendung eines festen Zufallsseeds von 42 |
| Stichprobenstrategie für Stile | Es wurde eine stratifizierte proportionale Stichprobenziehung angewandt, um die Verteilung der 27 künstlerischen Stile in den Trainings-, Validierungs- und Test-Teilmengen beizubehalten |
| Anwendung in dieser Studie | Lernen künstlerischer Stile, Stilrepräsentation und segmentierungsgesteuerte künstlerische Synthese |
Tabelle 2: Merkmale des WikiArt-Datensatzes. Zusammenfassung des WikiArt-Datensatzes, der für das Erlernen künstlerischer Stile und die stilgeleitete Bildsynthese verwendet wird. Die Tabelle beschreibt die Datenquelle, die Verteilung der Bilder, den Umfang der abgedeckten künstlerischen Stile, die Aufteilung des Datensatzes, die Bildauflösung sowie die Anwendung innerhalb des vorgeschlagenen SegCycle-SPADE-Frameworks.
Der Miao-Batik-Datensatz enthält 15.148 Bilder, die traditionelle kulturelle Miao-Motive darstellen.32 Der Datensatz ist öffentlich über Zenodo (https://doi.org/10.5281/zenodo.20807658) zugänglich. Vor dem Modelltraining wurden alle Bilder visuell überprüft, auf 256 × 256 Pixel skaliert, normalisiert und auf beschädigte oder doppelte Proben hin untersucht. Die Qualitätskontrolle führte nicht zum Ausschluss von Bildern; daher wurden alle 15.148 Bilder für die anschließende Analyse beibehalten. Der Datensatz wurde zufällig in Trainings- (70 %), Validierungs- (15 %) und Testanteile (15 %) unter Verwendung eines festen Zufallsstarts (Seed) von 42 aufgeteilt, um die Reproduzierbarkeit der Datensatzaufteilung zu gewährleisten. Auf den WikiArt-Datensatz wurde über das offizielle WikiArt-Repository (https://www.wikiart.org/) zugegriffen, der mehr als 80.000 Kunstwerke umfasst, die 27 künstlerische Stile repräsentieren. Für Experimente zum Stil-Lernen wurden 56.000 Bilder zum Training, 12.000 zur Validierung und 12.000 zum Testen verwendet.
Daten-Präprocessing
Bevor das vorgeschlagene SegCycle-SPADE-Framework trainiert wurde, wurden der Datensatz der kulturellen Muster der Miao-Batik und der WikiArt-Datensatz mehreren Vorverarbeitungsschritten unterzogen, um eine konsistente Bildqualität und eine genaue Merkmalsrepräsentation sicherzustellen. Beide Datensätze durchliefen eine identische grundlegende Vorverarbeitungspipeline, die eine Gaußsche Rauschunterdrückung, Normalisierung, Größenanpassung auf eine einheitliche Eingabematrix und Überprüfung der Bildqualität umfasste. Die Datensätze erfüllten jedoch unterschiedliche Funktionen innerhalb des Frameworks: Der WikiArt-Datensatz diente dem Erlernen und der Synthese künstlerischer Stile, während der Miao-Batik-Datensatz hauptsächlich für die Segmentierung und Rekonstruktion kultureller Motive verwendet wurde. Abgesehen von diesen aufgabenbezogenen Rollen wurden keine datensatzspezifischen Anpassungen in der Vorverarbeitung vorgenommen. Um eine konsistente Verarbeitung durch das Deep-Learning-Modell zu gewährleisten, wurden die Bilder zunächst auf eine feste Auflösung skaliert. Dieser Schritt war notwendig, da die Auflösung der Bilder in beiden Datensätzen je nach Quelle variierte. Die Größenanpassung verbesserte die Recheneffizienz und verhinderte, dass dimensionsbedingte Inkonsistenzen den Trainingsprozess beeinträchtigen. Der zweite Vorverarbeitungsschritt war die Normalisierung, bei der die Pixelwerte in einen standardisierten Bereich skaliert wurden, um die Stabilität der Gradientenaktualisierungen während des Trainings zu erhöhen. Anschließend wurden die Bilder mithilfe eines Gaußschen Filters bearbeitet, um Rauschen zu reduzieren, das die Struktur kultureller Motive stören könnte. Für den Miao-Batik-Datensatz wurden die vorhandenen Segmentierungsmasken für kulturelle Motive, die direkt aus der ursprünglichen Datenquelle stammten, unverändert für das Training und die Evaluierung der semantischen Segmentierung verwendet. Es wurden keine neuen Segmentierungsmasken speziell für diese Studie erstellt.
Sofern nicht anders angegeben, wurden Gleichungen, die etablierte Methoden beschreiben, aus früheren Studien übernommen und entsprechend zitiert. Gleichungen, die das vorgeschlagene CAFFM und den zusammengesetzten SegCycle-SPADE-Optimierungsansatz beschreiben, wurden von den Autoren für diese Studie entwickelt.
Es sei ein Eingabebild aus dem Datensatz dargestellt als Gleichung 1:
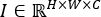 (1)
Hier bezeichnen H, W und C jeweils die Höhe, Breite und Anzahl der Farbkanäle des Bildes. Alle Bilder werden wie in Gleichung 2 gezeigt auf eine feste Dimension H′ × W′ skaliert:
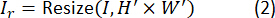
Hier ist Ir das skalierte Bild. Die normalisierten Pixelwerte werden gemäß Gleichung 3 berechnet:
 (3)
Dies trägt zur Stabilisierung des Trainingsverfahrens bei. Die Rauschfilterung erfolgt mithilfe eines Gauß-Filters, wie in Gleichung 4 dargestellt:
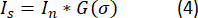
Hierbei ist G(σ) ein Gauß-Filter und * steht für die Faltung. Es wurde ein Gauß-Filter mit einem 5 × 5-Kernel und einer Standardabweichung von σ = 1.0 verwendet. Um Randartefakte zu reduzieren, wurden die Randpixel mit einer spiegelnden Auffüllung (reflective padding) versehen. Der Rauschunterdrückungsprozess wurde unmittelbar nach dem Laden der Bilder durchgeführt, bevor eine Skalierung und Normalisierung erfolgte. Um eine einheitliche Vorverarbeitung über die gesamte Studie hinweg sicherzustellen, wurde dieselbe Filterkonfiguration auf alle Bilder der Datensätze Miao Batik und WikiArt angewendet. Für den Miao-Batik-Datensatz werden die Segmentierungsmasken gemäß Gleichung 5 erstellt:

Hier ist M eine Segmentierungsmaske, die verwendet wird, um das SegFormer-Modell zu steuern.
Die Vorverarbeitungspipeline beginnt mit der Erfassung von Bildern aus dem Miao-Batik-Datensatz und dem WikiArt-Datensatz, wie in Abbildung 3 dargestellt. Während des Trainings kamen keine Techniken zur Datenaugmentierung zum Einsatz. Nach der Vorverarbeitung, zu der das Ändern der Bildgröße, die Normalisierung, die Gauss’sche Rauschunterdrückung und die Vorbereitung der Segmentierungsmasken gehörten, wurden die Bilder direkt für das Training, die Validierung und die Testung des vorgeschlagenen SegCycle-SPADE-Frameworks verwendet. Der erste Schritt der Vorverarbeitungspipeline besteht darin, die Bilder auf eine feste Größe zu skalieren, wodurch das DL-Modell die Bilder effizienter verarbeiten kann. Der zweite Schritt umfasst die Normalisierung, bei der die Pixelwerte in einen standardisierten numerischen Bereich umgewandelt werden, um die Konvergenz des Modells zu erleichtern. Der dritte Schritt beinhaltet die Rauschunterdrückung, bei der unerwünschtes Rauschen aus den Bildern entfernt wird, um die Mustererkennung zu verbessern. Zusätzlich werden für den Miao-Batik-Datensatz die kulturellen Motivbereiche annotiert, was die Erzeugung von Masken ermöglicht, die im Segmentierungsmodul des vorgeschlagenen Modells verwendet werden und sicherstellen, dass kulturelle Motive während der Generierung erhalten bleiben. Die endgültige Ausgabe dieses Schritts ist ein bereinigter Datensatz, der für das Training der Segmentierungs- und Generierungsmodule des vorgeschlagenen Modells bereitsteht.
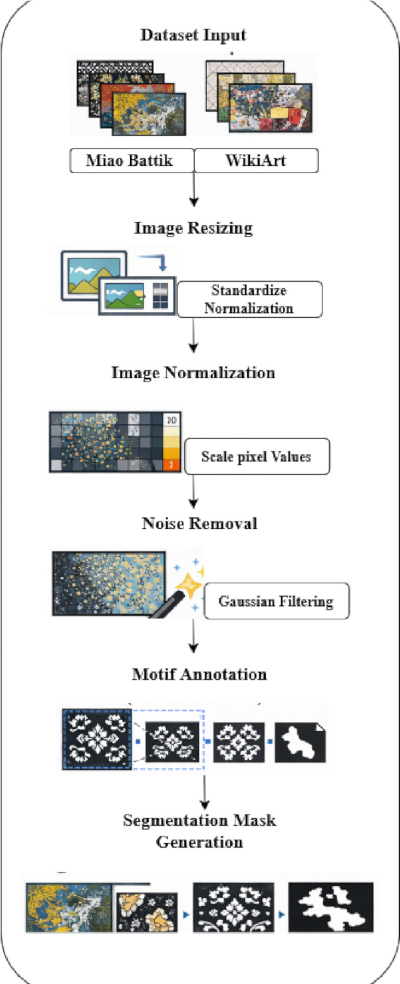
Abbildung 3. Daten-Vorverarbeitungspipeline für Kulturerbe-Bilder. Workflow zur Veranschaulichung der Bildvorverarbeitungsschritte, die vor dem Modelltraining durchgeführt werden. Die Pipeline umfasst die Datensammlung, Größenänderung der Bilder, Normalisierung, Gaußsche Rauschunterdrückung, vorhandene Annotationen kultureller Motive sowie die Vorbereitung von Segmentierungsmasken. Die resultierenden verarbeiteten Bilder und Masken dienen als Eingaben für die semantische Segmentierung und die Musterrekonstruktion. Klicken Sie bitte hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Jedes Bild wurde vor dem Modelltraining einem Qualitätskontrollverfahren unterzogen. Der Miao-Batik-Datensatz enthielt 15.148 Bilder. Beschädigte, doppelte und minderwertige Proben waren bereits von den ursprünglichen Erstellern des Datensatzes bearbeitet worden; daher wurden im Rahmen dieser Studie während der Qualitätskontrolle keine weiteren Bilder ausgeschlossen. Folglich wurden alle 15.148 Bilder für die Analyse beibehalten. Die Bilder wurden im RGB-Format beim Vorverarbeiten geladen und mittels bilinearer Interpolation auf 256 × 256 Pixel verkleinert. Die Pixelewerte wurden durch Division durch 255 vom Bereich [0, 255] auf [0, 1] skaliert. Anschließend wurde eine kanalweise Normalisierung unter Verwendung der Mittelwerte [0,485, 0,456, 0,406] und der Standardabweichungen [0,229, 0,224, 0,225] für den roten, grünen und blauen Kanal jeweils angewandt. Die Vorverarbeitungspipeline umfasste das Laden der Bilder, die Umwandlung in RGB, die Größenänderung, die Skalierung der Pixelewerte, die Normalisierung und die Umwandlung in Tensoren. Bei Bedarf wurden Graustufenbilder in ein dreikanaliges RGB-Format umgewandelt, um die Kompatibilität mit den DL-Modellen sicherzustellen. Nach der Vorverarbeitung wurden die Bilder in Trainings-, Validierungs- und Testteilmengen aufgeteilt. Alle Phasen des SegCycle-SPADE-Frameworks – einschließlich semantischer Segmentierung, Merkmalsfusion, Motivrekonstruktion und künstlerischer Synthese basierend auf SPADE – verwendeten eine einheitliche Eingabematrix von 256 × 256 Pixeln.
Semantische Mustersegmentierung mithilfe von SegFormer
Nach diesem Vorverarbeitungsschritt werden die bereinigten und normalisierten Bilder des kulturellen Motiv-Datensatzes der Miao-Batik sowie des WikiArt-Datensatzes in das Modul der semantischen Segmentierung eingespeist, das auf dem vorgeschlagenen Framework von SegFormer-B2 basiert. Ziel dieses Schritts ist es, kulturelle Motive, die in Erbe-Mustern enthalten sind, korrekt zu identifizieren und voneinander zu trennen. Das vorgeschlagene SegFormer-Framework basiert auf einer Transformer-Architektur, die einen hierarchischen Transformer-Encoder und einen leichten MLP-Decoder kombiniert, um globale Kontextinformationen sowie detaillierte strukturelle Informationen aus komplexen Erbe-Mustern präzise zu erfassen. Das Modell extrahiert zunächst Merkmalsrepräsentationen in mehreren Maßstäben aus dem Eingabebild, die anschließend im Decoder fusioniert werden, um genaue segmentierte Muster zu erzeugen. Dadurch wird sichergestellt, dass die Muster im Erbe-Bild korrekt in Motive wie geometrische Muster, florale Muster und symbolische Muster unterteilt werden, wodurch sie vom Hintergrund getrennt werden, während ihre strukturelle Integrität erhalten bleibt. Diese strukturelle Information wird anschließend in den späteren Phasen der Mustererzeugung innerhalb des SegCycle-SPADE-Frameworks verwendet.
Der vorverarbeitete Eingabebild sei dargestellt als Gleichung 6:
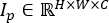 (6)
Der SegFormer-Encoder teilt das Bild in Patches auf und extrahiert hierarchische Merkmale mithilfe von Transformer-Schichten, wie in Gleichung 71 dargestellt:
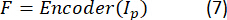
Hier bezeichnet F die Multiskalen-Feature-Maps, die aus dem Transformer-Encoder gewonnen werden. Diese Merkmale kodieren sowohl lokale Texturmuster als auch globale kontextuelle Beziehungen zwischen Motivbereichen. Das SegFormer-Modell extrahiert Feature-Maps in verschiedenen Skalen, wie in Gleichung 8 definiert:
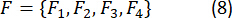
Die Verwendung von Multiskalen-Darstellungen erleichtert die Erkennung von Mustern unterschiedlicher Größe innerhalb kultureller Motive. Abschließend werden die Merkmale mithilfe des MLP-Decoders kombiniert, wie in Gleichung 91 dargestellt:
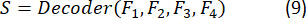
Hier bezeichnet S die endgültige vorhergesagte Segmentierungskarte.
Der SegFormer-B2-Backbone wurde mit ImageNet-vortrainierten Gewichten initialisiert und anschließend für die Segmentierung kultureller Motive auf dem Miao-Batik-Datensatz feinabgestimmt. Der vortrainierte Checkpoint wurde aus der offiziellen SegFormer-Implementierung bezogen. Konkret wurde der MIT-B2-Checkpoint (mit_b2.pth), der auf ImageNet-1K vortrainiert ist und von dem offiziellen SegFormer-Repository bereitgestellt wird, zur Initialisierung des SegFormer-B2-Backbones vor der Feinabstimmung verwendet. Die vortrainierten Gewichte entsprechen dem vom SegFormer-Autorenteam veröffentlichten MIT-B2-Backbone und dienten als Initialisierungsmodell für das Training der semantischen Segmentierung. Die verbleibenden, aufgabenbezogenen Schichten wurden vor dem Training mit den standardmäßigen PyTorch-Verfahren zur Gewichtsinitialisierung initialisiert.
Ein vierstufiger hierarchischer Transformer-Encoder mit überlappenden Patch-Embeddings wird in der Architektur verwendet. In der ersten Stufe wurde die Patch-Größe auf 7 × 7 mit einer Schrittweite von 4 festgelegt. Für jede der vier Encoder-Stufen betrugen die Embedding-Dimensionen 64, 128, 320 und 512. Über die vier Stufen hinweg gab es 1, 2, 5 und 8 Multi-Head-Self-Attention-Köpfe, und die entsprechenden Encoder-Tiefen betrugen 3, 4, 6 und 3 Schichten. Multiskalige Merkmale, die vom Encoder abgerufen wurden, wurden mithilfe eines leichten, ausschließlich aus MLPs bestehenden Decoders aggregiert. Vor der Erstellung der endgültigen Segmentierungskarte projizierte der Decoder Merkmale aus jeder Encoder-Stufe in einen einzigen Embedding-Raum. Alle Transformer-Blöcke verwendeten die Aktivierungsfunktion Gaussian Error Linear Unit (GELU). Zur Verbesserung der Generalisierung und Verringerung von Überanpassung wurde während des Trainings eine Dropout-Rate von 0,1 verwendet.
Während der Trainingsphase erhält das SegFormer-Framework die vorverarbeiteten Bilder aus beiden Datensätzen. Die Bilder aus dem Miao-Batik-Datensatz enthalten Motivbereiche, die als Bezeichnungen für das überwachte Lernen des Segmentierungsmodells dienen. Der Transformer-Encoder verarbeitet das gesamte Bild und erfasst langreichweitige Beziehungen zwischen Bilddaten, was besonders wichtig für traditionelle Batikmuster mit räumlich verteilten Motiven ist. Der hierarchische Mechanismus zur Merkmalsextraktion erfasst gleichzeitig lokale Strukturen wie wiederholte geometrische Texturen. Der MLP-Decoder verarbeitet diese extrahierten Merkmale und erzeugt eine Segmentierungsmaske, die die Motivbereiche hervorhebt. Die in diesem Schritt erzeugten Segmentierungskarten werden anschließend als strukturelle Eingaben für das Attention-Modul und die Musterrekonstruktion verwendet, wodurch die Authentizität der generierten Muster erhalten bleibt.
Kulturelle Motive wurden gemäß ihren visuellen und kulturellen Merkmalen in verschiedene Klassen für die semantische Segmentierung unterteilt. Die Segmentierungstaxonomie umfasste Tiermotive (z. B. Schmetterlinge, Fische, Vögel und andere symbolische Tierarten), Pflanzenmotive (z. B. Blumen, Blätter, Ranken und botanische Muster), geometrische Motive (z. B. sich wiederholende Formen, Bordüren und abstrakte geometrische Strukturen) sowie Hintergrundbereiche, die nicht-motivische Flächen darstellen. Zur Zuordnung jedes Pixels zu einer der vordefinierten Klassen wurden Segmentierungsmasken auf Pixelebene verwendet. Ganzzahlig codierte Kennzeichnungen waren wie folgt festgelegt: Kennzeichnung 0 = Hintergrund, Kennzeichnung 1 = Tiermotive, Kennzeichnung 2 = Pflanzenmotive und Kennzeichnung 3 = geometrische Motive. Die Segmentierungsannotationen und Motivkennzeichnungen stammten direkt aus der ursprünglichen Datenquelle des Miao-Batik-Datensatzes. In dieser Studie wurden keine zusätzlichen manuellen Annotationen, Umetikettierungen, Randüberprüfungen oder expertenbasierten Bestätigungsverfahren durchgeführt. Die vom Datensatz-Ersteller bereitgestellten Annotationen wurden ohne Änderungen für Training und Evaluierung verwendet.
Das SegFormer-Modell zur Segmentierung kultureller Motive verarbeitet die vorverarbeiteten Bilder aus dem Miao-Batik-Datensatz und dem WikiArt-Datensatz mithilfe eines auf Transformatoren basierenden Mechanismus zur genauen Erkennung kultureller Musterbereiche, wie in Abbildung 4 gezeigt. Zunächst wird das Eingabebild, das traditionelle kulturelle Motive enthält, dem SegFormer-Modell zugeführt. Der Transformer-Encoder extrahiert sowohl globale Kontextinformationen als auch lokale strukturelle Merkmale aus Bildausschnitten. Die resultierenden mehrskaligen Merkmale werden an den Segmentierungs-Decoder übergeben, der ein gemischtes Feed-Forward-Netzwerk nutzt, um die Merkmalsdarstellungen zu verfeinern und die Motiverkennung zu verbessern. Die Ausgabe des SegFormer-Modells ist eine Segmentierungsmaske, die Pixel hervorhebt, die kulturellen Mustern entsprechen, und irrelevante Hintergrundinformationen unterdrückt. Die isolierten kulturellen Muster dienen anschließend als strukturelle Vorgabe für die folgenden Phasen des SegCycle-SPADE-Frameworks.
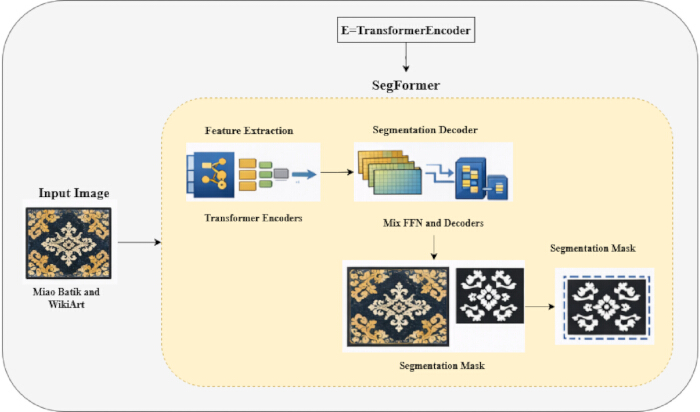
Abbildung 4. Semantische Segmentierung kultureller Motive basierend auf SegFormer-B2. Architektur des SegFormer-B2-Moduls zur semantischen Segmentierung, das zur Extraktion kultureller Motive verwendet und ausschließlich auf dem Miao-Batik-Datensatz trainiert wurde. Das Framework besteht aus einem auf Transformatoren basierenden Encoder zur Merkmalsextraktion in mehreren Skalen und einem leichten Segmentierungs-Decoder zur Erzeugung von Motivmasken. Das Modell prognostiziert vier semantische Klassen – Tier, Pflanze, geometrisch und Hintergrund –, wobei die resultierenden Segmentierungsmasken kulturell bedeutende Motivbereiche identifizieren und irrelevante Hintergrundinformationen unterdrücken. Diese Segmentierungsergebnisse liefern strukturelle Vorgaben für die nachfolgenden Phasen der Merkmalsfusion, Rekonstruktion und künstlerischen Synthese im vorgeschlagenen SegCycle-SPADE-Framework. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Es ist nicht erforderlich, im vorgeschlagenen Rahmen neue Segmentierungsanmerkungen zu erstellen. Der Miao-Batik-Datensatz wurde aus einer bereits vorhandenen öffentlichen Quelle bezogen, und das Modell wurde mit den von den Erstellern des Datensatzes bereitgestellten Informationen zu den Mustern trainiert. Während des Lernprozesses erzeugte das SegFormer-Modell semantische Segmentierungskarten. Daher waren für die vorliegende Studie keine zusätzlichen manuellen Annotationstools, Annotationsrichtlinien oder Qualitätskontrollverfahren für die Annotation notwendig.
CAFFM
Um die Interaktion zwischen den Merkmalen der semantischen Segmentierung und den Darstellungen der generativen Rekonstruktion zu verbessern, schlug die Studie außerdem eine CAFFM vor. Der SegFormer-B2-Encoder stellt dem CAFFM-Modul semantische Merkmalskarten zur Verfügung, während der CycleGAN-Rekonstruktionsschritt generative Merkmalskarten bereitstellt. Zunächst werden lineare Projektionsschichten verwendet, um beide Merkmalsströme in einen gemeinsamen Einbettungsraum zu projizieren. Für die Berechnung der Cross-Attention werden mithilfe der erzeugten Merkmalstensoren Abfrage- (Q), Schlüssel- (K) und Wert- (V)-Darstellungen erstellt. Die Beziehungen zwischen strukturellen Motivinformationen und künstlerischen Stilelementen werden anschließend mittels Multi-Head-Cross-Attention modelliert. Anschließend werden Layer-Normalisierung, Residualverbindungen und Feed-Forward-Schichten mit GELU-Aktivierung auf die fusionierten Merkmalsdarstellungen angewendet. Die Ausgabe des CAFFM-Moduls gelangt in die auf SPADE basierende Synthese-Phase, wodurch kulturell bedeutsame Themen bewahrt werden, ohne die künstlerische Kohärenz zu beeinträchtigen.
Um die Merkmalskompatibilität sicherzustellen, werden die Eingabemerkmale zunächst mithilfe linearer Projektionsschichten in einen gemeinsamen Embedding-Raum mit einer Embedding-Dimension von 256 projiziert. Die Wechselwirkungen zwischen semantischen Strukturinformationen und generativen Stildarstellungen werden anschließend mittels eines MultiHead-Cross-Attention-Mechanismus mit acht Attention-Köpfen modelliert. Für die Cross-Attention-Berechnung werden die Query- (Q), Key- (K) und Value- (V) Vektoren verwendet, die von spezifischen linearen Transformationsschichten erzeugt werden. Um die Stabilität des Trainings zu erhöhen und die Integrität der Merkmale beizubehalten, werden Residualverbindungen und Layer-Normalisierung eingesetzt, um die fusionierten Merkmalsdarstellungen weiter zu verbessern. Das nichtlineare Merkmal-Lernen wird danach durch ein Feed-Forward-Netzwerk mit der Aktivierungsfunktion Gaussian Error Linear Unit (GELU) verstärkt. Eine Ausgabemerkmalsdarstellung der Dimension 256 wird durch das Modul erzeugt und an nachfolgende Stufen zur kreativen Synthese weitergeleitet. Der CAFFM kombiniert erfolgreich künstlerische Stildaten mit kulturellen Motivstrukturen, indem er eine auf Cross-Attention basierende Fusionsmethode verwendet, wodurch die Erhaltung der Motive und die visuelle Kohärenz in den rekonstruierten Mustern des kulturellen Erbes verbessert wird.
In dem vorgeschlagenen System werden die strukturellen Merkmale aus dem Miao-Batik-Datensatz abgeleitet, während die stilistischen Merkmale aus dem WikiArt-Datensatz gelernt werden. Sei die aus dem SegFormer-Segmentierungsnetzwerk unter Verwendung von Bildern des Miao-Batik-Datensatzes abgeleitete Merkmalskarte mit Fs bezeichnet, während die aus dem Stil-Merkmalsextraktionszweig unter Verwendung von WikiArt-Bildern abgeleitete Merkmalskarte mit Fa bezeichnet wird. Der vorgeschlagene CAFFM kombiniert die beiden Merkmalsbereiche mithilfe eines Cross-Attention-Mechanismus, um sowohl strukturelle als auch stilistische Abhängigkeiten kultureller Muster zu lernen. Tabelle 3 gibt alle architektonischen Eigenschaften an, einschließlich Einbettungsdimensionen, Normalisierungsschichten, Aktivierungsfunktionen und Konfiguration der Attention-Köpfe. Bei einer Eingabebildgröße von 256 × 256 Pixeln erzeugte der SegFormer-B2-Encoder semantische Merkmalskarten der Größe 64 × 64 × 128, während der Stil-Merkmalsextraktionszweig Merkmalskarten der Größe 64 × 64 × 128 erzeugte. Beide Merkmalskarten wurden vor der Fusion mittels Cross-Attention durch lernbare lineare Schichten in einen gemeinsamen Einbettungsraum der Dimension 256 projiziert.
| Parameter | Konfiguration |
| Vorgeschlagenes Framework | SegCycle-SPADE |
| Semantisches Segmentierungsmodell | SegFormer-B2 |
| SegFormer-Encoder-Stufen | 4 |
| Gewichtsinitialisierung | Imagenet-1K vortrainiertes SegFormer-B2 (MIT-B2-Backbone) |
| Checkpoint-Quelle | Offizielles NVIDIA SegFormer-Repository (https://github.com/NVlabs/SegFormer); Checkpoint: segformer.b2.512x512.ade.160k |
| Feinabstimmungsstrategie | End-to-End-Feinabstimmung am Miao-Batik-Datensatz |
| Größe der Patch-Embeddings | 7 × 7 |
| Abstand zwischen Patches (Patch Stride) | 4 |
| Embedding-Dimensionen | 64, 128, 320 und 512 |
| Encoder-Tiefen | 3, 4, 6 und 3 |
| Attention-Heads | 1, 2, 5 und 8 |
| Decoder-Typ | All-MLP-Decoder |
| Aktivierungsfunktion | GELU |
| Dropout-Rate | 0,1 |
| Feature-Verbesserungsmodul | Cross-Attention Cultural Feature Fusion Module (CAFFM) |
| CAFFM-Embedding-Dimension | 256 |
| CAFFM-Attention-Heads | 8 |
| CAFFM-Fusionsskalen | 4 |
| Rekonstruktionsmodell | CycleGAN |
| Stilgenerierungsmodell | SPADE |
| Kultureller Datensatz | Miao-Batik-Datensatz |
| Stildatensatz | WikiArt-Datensatz |
| Miao-Batik-Bilder | 15.148 |
| WikiArt-Bilder | Ungefähr 80.000 |
| Eingabebildauflösung | 256 × 256 Pixel |
| Farbformat | RGB |
| Interpolationsmethode | Bilineare Interpolation |
| Rauschunterdrückungsmethode | Gaußsche Filterung |
| Gaußsche Kernelgröße | 5 × 5 |
| Gaußsche Standardabweichung (σ) | 1 |
| Normalisierungsbereich | [0, 1] |
| Batch-Größe | 16 |
| Anzahl der Epochen | 100 |
| Optimierer | Adam |
| Lernrate | 0,0002 |
| Adam-Parameter | β₁ = 0,5, β₂ = 0,999, ε = 1 × 10⁻⁸, Gewichtsverfall = 0 |
| Verlustfunktionen | Segmentierungsverlust, Adversarial-Verlust, Zyklenkonsistenz-Verlust, Rekonstruktionsverlust, Motiverhaltungs-Verlust und Stilkonsistenz-Verlust |
| Datensatz-Aufteilungsstrategie | Training / Validierung / Test |
| Trainingsmenge | 70 % |
| Validierungsmenge | 15 % |
| Testmenge | 15 % |
| Zufallsstartwert (Random Seed) | 42 |
| Evaluierungsmetriken | Segmentierungsgenauigkeit, IoU, Dice-Koeffizient, SSIM, PSNR und FID |
| Programmiersprache | Python 3.8.10 |
| Tiefenlern-Framework | PyTorch 1.10.0 |
| Hardware-Plattform | NVIDIA RTX 3090 GPU (24 GB VRAM), Intel Core i7 (11. Generation), 32 GB RAM |
| Betriebsumgebung | Ubuntu 20.04 LTS |
Tabelle 3: Experimenteller Aufbau und Modellkonfiguration. Zusammenfassung der architektonischen Komponenten, Trainingskonfiguration, Vorverarbeitungseinstellungen, Datensätze, Optimierungsparameter, Evaluierungsmetriken und des rechnerischen Umfelds, die für die Implementierung und Bewertung des vorgeschlagenen SegCycle-SPADE-Frameworks verwendet wurden.
Das Aufmerksamkeitsmodul bildet die Merkmalskarte zunächst mithilfe von Gleichung 10 in Abfrage-, Schlüssel- und Wertdarstellungen um:
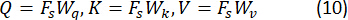
Hierbei handelt es sich bei Wq, Wk und Wv um lernbare Gewichtungsmatrizen. Die Attention-Gewichte werden basierend auf der Ähnlichkeit zwischen dem Query-Vektor und dem Key-Vektor mithilfe von Gleichung 1117 berechnet:
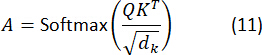
Hier ist dk die Dimension des Schlüsselvektors. Die verbesserte Merkmalsrepräsentation wird berechnet, indem die Attention-Gewichte mit der Wertematrix gemäß Gleichung 12 multipliziert werden:
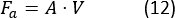
Hier ist Fa die verbesserte Merkmalsdarstellung der Merkmalskarte. Die verbesserte Merkmalsdarstellung wird berechnet, indem die ursprünglichen Segmentierungsmerkmale mit den unter Verwendung des Attention-Mechanismus gewonnenen verbesserten Merkmalen mithilfe von Gleichung 13 kombiniert werden:
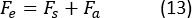
Hier ist Fe die verbesserte Merkmalskarte, die zur Musterrekonstruktion verwendet wird. Das CAFFM wird um einen mehrskaligen Cross-Attention-Mechanismus erweitert, um Merkmale für kulturelle Motive in verschiedenen Skalen zu extrahieren. Sei Fsi die Segmentierungsmerkmale in der Skala i und Faj die künstlerischen Stilmerkmale in derselben Skala. Die endgültige Merkmalsdarstellung wird mithilfe von Gleichung 14 definiert:
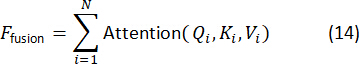
Hier repräsentieren Qi, Ki und Vi jeweils die Query-, Key- und Value-Matrizen auf der Skala i, während N die Anzahl der Merkmalskalen bezeichnet. In dieser Studie beträgt N = 4, was den auf räumlichen Auflösungen von 1/4, 1/8, 1/16 und 1/32 der Eingabebildgröße extrahierten Merkmalskarten entspricht. Diese mehrskaligen Merkmalsdarstellungen wurden vor der Rekonstruktion und künstlerischen Synthese mittels lernbarer Aufmerksamkeitsgewichte fusioniert. Die oben beschriebene Erweiterung ermöglicht es der Methode, globale kulturelle Motive und Texturen zu extrahieren, um kulturelle Muster rekonstruieren zu können. CAFFM befindet sich zwischen der auf SegFormer basierenden Segmentierungsstufe und der auf SPADE basierenden kreativen Synthesestufe im vorgeschlagenen SegCycle-SPADE-System. Zunächst erzeugt CycleGAN gleichzeitig Rekonstruktionsmerkmale mit stilistischen und musterspezifischen Informationen, während SegFormer-B2 semantische Merkmalskarten rekonstruiert, die die strukturellen Eigenschaften kultureller Motive darstellen. Das CAFFM-Modul empfängt diese beiden Merkmalsströme und nutzt eine auf Cross-Attention basierende Fusion, um Beziehungen zwischen strukturellen und künstlerischen Darstellungen zu identifizieren. Um kulturell authentische Muster zu erzeugen, dabei jedoch semantische Konsistenz und strukturelle Merkmale beizubehalten, werden die resultierenden fusionierten Merkmalskarten anschließend an das SPADE-Modul zur segmentierungsgesteuerten kreativen Synthese weitergeleitet.
Rekonstruktion von Mustern mithilfe von CycleGAN
Sobald die merkmalsbasierte Verbesserungsphase abgeschlossen ist, enthalten die Merkmalskarten die verstärkten Strukturen kultureller Motive. Die Merkmalskarten können jedoch weiterhin unvollständige oder beschädigte Musterbereiche enthalten. Um das Problem der Musterekonstruktion zu lösen, nutzt das vorgeschlagene Framework daher das CycleGAN-Modell. In diesem Framework stellen die beiden Domänen die ursprünglichen kulturellen Motivmuster und die rekonstruierten kulturellen Motivmuster dar. Mithilfe der verbesserten Merkmale aus den vorherigen Stufen rekonstruiert das CycleGAN-Modell die kulturellen Muster, während es die strukturelle Kohärenz bewahrt. Dadurch bleibt die räumliche Anordnung kultureller Muster wie geometrische, florale oder symbolische Muster erhalten. Die ursprünglichen Miao-Batik-Bilder wurden zufälligen Maskierungs- und teilweisen Verdeckungsoperationen unterzogen, um unvollständige oder beschädigte kulturelle Motive zu erzeugen. Diese Degradationsverfahren simulierten fehlende Musterbereiche und strukturelle Schäden, wie sie typischerweise bei verfallenden kulturellen Artefakten beobachtet werden. Die degradierten Bilder dienten als Eingaben für das Rekonstruktionsmodul, während die entsprechenden Originalbilder als Referenzbilder zur Leistungsbeurteilung und Qualitätsbewertung der Rekonstruktion dienten. Diese Strategie ermöglichte es dem Modell, die Wiederherstellung fehlender Motivstrukturen zu erlernen, wobei semantische Konsistenz und kulturelle Merkmale erhalten blieben.
Sei X der Bereich unvollständiger kultureller Muster und Y der Bereich rekonstruierter kultureller Muster. Die beiden Generatoren lernen, eine bidirektionale Abbildung mithilfe von Gleichung 15 durchzuführen:
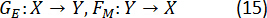
Hier wird GE verwendet, um Motivstrukturen zu rekonstruieren, und FM dient dazu, die Muster wieder in den ursprünglichen Bereich abzubilden. Der adversariale Verlust wird genutzt, um sicherzustellen, dass die rekonstruierten Muster realistisch sind (Gleichung 16)30
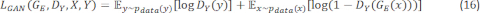
Hier ist DY der Diskriminator, der verwendet wird, um echte und rekonstruierte Muster zu unterscheiden, und GE(x) bezeichnet das erzeugte rekonstruierte Muster. CycleGAN erzwingt außerdem die zyklische Konsistenz, um die strukturelle Anordnung kultureller Motive beizubehalten (Gleichung 17)30.
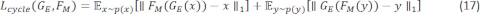
Die endgültige Verlustfunktion wird mithilfe von Gleichung 1830 definiert:
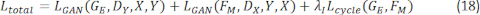
Hier bezeichnet λi den Gewichtungskoeffizienten für den zyklischen Konsistenzverlust, der während des Trainings auf 10 festgelegt wurde, was mit der ursprünglichen CycleGAN-Formulierung übereinstimmt. Dieser Wert wurde gewählt, um das gegnerische Lernen und die Rekonstruktionskonsistenz zwischen Quell- und Zielbereich auszugleichen.
Das CycleGAN-Rekonstruktionsmodul besteht aus zwei Generatoren und zwei Diskriminatoren für die bidirektionale Bildübersetzung. Jeder Generator folgt einer Residualnetzwerk-Architektur, die aus einer initialen 7 × 7-Faltungsschicht besteht, gefolgt von zwei herunterskalierenden Faltungsschichten, neun Residualblöcken und zwei hochskalierenden Schichten. Alle Faltungsoperationen verwenden eine Kernelgröße von 3 × 3, mit Ausnahme der Eingangsschicht, die einen 7 × 7-Kernel zur verbesserten Merkmalsextraktion nutzt. Nach jeder Faltungsschicht wird eine Instanznormalisierung (Instance Normalization) angewendet, um die Stabilität des Trainings zu verbessern, während im gesamten Generatornetzwerk die ReLU-Aktivierungsfunktion verwendet wird. Die Ausgabeschicht verwendet eine Tanh-Aktivierungsfunktion, um normalisierte Bildausgaben zu erzeugen. Der Diskriminator folgt einer 70 × 70-PatchGAN-Architektur, die aus einer Reihe von Faltungsschichten mit Kernelgrößen von 4 × 4 und schrittweise zunehmenden Merkmalskanälen besteht. Im Diskriminator werden Instanznormalisierung und LeakyReLU-Aktivierung (negativer Anstieg = 0,2) eingesetzt, um die Merkmalsdiskriminierung und das gegnerische Lernen (adversarial learning) zu verbessern. Das CycleGAN-Modul erhält vorverarbeitete Bilder kultureller Motive als Eingabe und erzeugt rekonstruierte Musterdarstellungen, die anschließend zur Integration mit Segmentierungsmerkmalen an das CAFFM weitergeleitet werden. Das Training des CycleGAN wurde mit dem Adam-Optimierer (β₁ = 0,5, β₂ = 0,999) und einer anfänglichen Lernrate von 0,0002 durchgeführt. Die Lernrate wurde für die ersten 100 Epochen beibehalten und anschließend linear über den verbleibenden Trainingszeitraum auf null abgebaut. Zur Stabilisierung des Diskriminator-Trainings wurde ein Replay-Puffer verwendet, der 50 zuvor generierte Bilder enthielt. Die Generatoren und Diskriminatoren wurden mit einem Aktualisierungsverhältnis von 1:1 aktualisiert, wobei pro Trainingsiteration eine Generatoraktualisierung einer Diskriminatoraktualisierung folgte.
Der Rekonstruktionsprozess des CycleGAN basiert auf den verbesserten Merkmalskarten, die mithilfe des CAFFM-Mechanismus in Abbildung 5 gewonnen wurden. Die Merkmalskarten enthalten verbesserte kulturelle Motive, die aus den vorherigen Stadien der Segmentierung und des CAFFM stammen. Diese Merkmalskarten werden als Eingabe an den ersten Generator GE übergeben. Der erste Generator GE lernt die Abbildung, die zur Rekonstruktion kultureller Muster erforderlich ist. Die Ausgaben werden anschließend an den Diskriminator DY weitergeleitet, um zwischen echten kulturellen Mustern und rekonstruierten Mustern zu unterscheiden. Der Diskriminator DY unterstützt den Generator GE dabei, realistische Ausgaben zu erzeugen. Um sicherzustellen, dass kulturelle Muster während der Rekonstruktion nicht verzerrt werden, führt der zweite Generator FM eine zyklische Konsistenzabbildung durch. Der zweite Generator FM bildet die Ausgaben zurück in die ursprüngliche Domäne ab. Die resultierenden Ausgaben werden dann vom Diskriminator bewertet, um deren Realismus zu überprüfen. Die endgültigen Ausgaben werden im Anschluss an das SPADE-Modul weitergeleitet, um im nächsten Schritt des vorgeschlagenen SegCycle-SPADE-Frameworks die künstlerische Stilgenerierung durchzuführen.
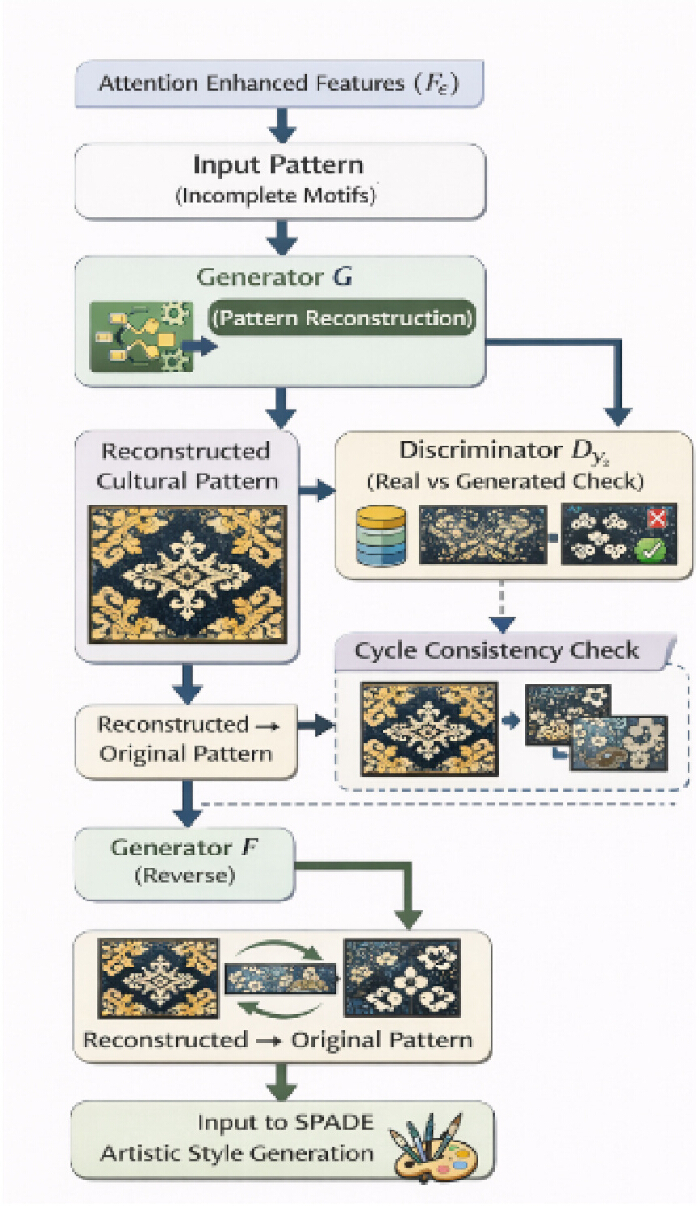
Abbildung 5. Workflow der Musterrekonstruktion basierend auf CycleGAN. Workflow des CycleGAN-Rekonstruktionsmoduls. Zur Rekonstruktion unvollständiger kultureller Motive werden dem Generatornetzwerk Feature-Darstellungen mit verbesselter Aufmerksamkeitssteuerung als Eingaben bereitgestellt. Der Diskriminator bewertet die rekonstruierten Ausgaben anhand von Referenzmustern, während die zyklische Konsistenzabbildung die strukturelle Integrität während der bidirektionalen Bildübersetzung erhält. Die rekonstruierten Motive werden anschließend an das SPADE-Modul zur künstlerischen Stilsynthese weitergeleitet. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Künstliche Stilerzeugung mithilfe von SPADE
Anschließend werden die rekonstruierten kulturellen Motive dem SPADE-Modul zur Erzeugung eines künstlerischen Stils unterzogen. Das Hauptziel des SPADE-Moduls besteht darin, den rekonstruierten kulturellen Motiven visuell anspruchsvollere Texturen eines künstlerischen Stils hinzuzufügen, ohne dabei die strukturelle Anordnung der Motive zu beeinträchtigen. Das SPADE-Modul ist eine bedingte Bildgenerierungstechnik, die das Konzept der Bildsegmentierung zur Bilderzeugung nutzt. Mehrkanalige semantische Karten, die den vordefinierten Motivklassen entsprachen, wurden aus den durch SegFormer-B2 erzeugten semantischen Segmentierungsmasken kodiert. Diese kodierten Karten wurden vom SPADE-Generator als konditionierende Eingaben empfangen. Die räumlich adaptiven Skalierungsparameter (γ) und Biassparameter (β) wurden erzeugt, indem die semantischen Karten innerhalb jedes SPADE-Layers durch konvolutionale Schichten verarbeitet wurden. Auf diese Weise konnte der Generator durch Anwendung dieser Parameter auf die normalisierten Merkmalsaktivierungen die Motivgrenzen, strukturellen Anordnungen und semantischen Informationen während der künstlerischen Synthese bewahren. Da der Konditionierungsprozess in mehreren Schichten des SPADE-Generators durchgeführt wurde, konnte die semantische Steuerung sowohl die rekonstruktive Synthese auf hoher Ebene als auch die texturbasierte Synthese auf niedriger Ebene beeinflussen. Infolgedessen enthielten die erzeugten künstlerischen Muster stilistische Merkmale, die aus dem WikiArt-Datensatz stammen, behielten dabei jedoch die Strukturen der kulturellen Motive bei, die im Segmentierungsprozess identifiziert wurden.
Der WikiArt-Datensatz, der Werke aus 27 verschiedenen künstlerischen Kategorien umfasst – wie Renaissance, Impressionismus, Kubismus, Expressionismus, Surrealismus, Realismus und Abstrakte Kunst –, wurde als zentrale Ressource zur Erfassung künstlerischer Stile verwendet. Um das Modell verschiedenen kreativen Merkmalen auszusetzen und die Verallgemeinerungsfähigkeit des Stils zu verbessern, wurden während des Trainings Stilbilder zufällig aus den verschiedenen Kategorien ausgewählt. Der Datensatz wurde in Trainings-, Validierungs- und Test-Teilmengen unter Berücksichtigung einer ausgewogenen Repräsentation der künstlerischen Kategorien unterteilt, um Stilverzerrungen zu verringern. Um eine ausgewogene Repräsentation aller 27 künstlerischen Kategorien sicherzustellen, kam eine geschichtete Stichprobenziehung (stratified sampling) zum Einsatz. Die Proben jeder Kategorie wurden anteilig den Trainings-, Validierungs- und Test-Teilmengen zugewiesen, wobei die ursprüngliche Klassenverteilung erhalten blieb. Das CAFFM-Modul wurde verwendet, um die aus WikiArt-Bildern abgeleiteten Stilmerkmale mit den von CycleGAN erzeugten Rekonstruktionsmerkmalen zu verbinden. Um dem Synthesenetzwerk die Übertragung künstlerischer Qualitäten zu ermöglichen, während die semantische Struktur und die Grenzen kultureller Motive aus den Segmentierungskarten erhalten bleiben, wurden die resultierenden fusionierten Darstellungen als konditionierende Information an den SPADE-Generator übergeben. Dank dieser stilbasierten Konditionierungstechnik war der vorgeschlagene Ansatz in der Lage, kulturell authentische künstlerische Muster mit konsistenten strukturellen und stilistischen Repräsentationen zu erzeugen.
SPADE führt außerdem räumlich adaptive Parameter ein, die von der Segmentierungskarte abhängen. Die Parameter können wie in Gleichung 191 gezeigt definiert werden:
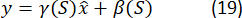
Hier ist γ(S) der räumlich variierende Skalenparameter und β(S) der räumlich variierende Bias-Parameter. Die Parameter können dem Generator helfen, je nach semantischem Bereich in den Bildern unterschiedliche Texturen und Stile zu erzeugen. Das endgültige kulturelle Kunstwerk kann wie in Gleichung 20 dargestellt definiert werden:
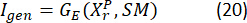
Hier ist GE der SPADE-Generator, XrP das rekonstruierte Muster und SM die Segmentierungskarte. Das endgültige Kunstwerk bewahrt die strukturelle Integrität kultureller Motive, während es gleichzeitig das künstlerische Erscheinungsbild verbessert. Zur Optimierung der vorgeschlagenen SegCycle-SPADE-Architektur wurde eine zusammengesetzte Verlustfunktion verwendet, die eine Balance zwischen semantischer Segmentierungsgenauigkeit, Erhaltung kultureller Motive, Qualität der Musterrekonstruktion und konsistentem künstlerischem Stil herstellt. Zur Definition des gesamten Trainingsziels wurde eine gewichtete Kombination aus Segmentierungsverlust (Lseg), adversarialem Verlust (Ladv), zyklischer Konsistenzverlust (Lcycle), Rekonstruktionsverlust (Lrecon), Motiverhaltungsverlust (Lmotif) und Stilkonsistenzverlust (Lstyle) verwendet. Die gesamte Verlustfunktion ist in Gleichung 21 definiert:
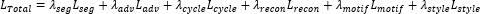 (21)
Um die strukturelle Konsistenz zwischen den Eingabe- und rekonstruierten kulturellen Motiven sicherzustellen, wurde der Zyklus-Konsistenzverlust-Koeffizient auf 10 festgelegt. Um feinkörnige Motivmerkmale beizubehalten und die visuelle Genauigkeit zu verbessern, wurde der Rekonstruktionsverlust-Koeffizient auf 5 gesetzt. Um die Erhaltung kulturell wesentlicher Strukturmuster während der künstlerischen Synthese hervorzuheben, wurde für den Motiv-Erhaltungsverlust ein Koeffizient von 2 verwendet. Um den künstlerischen Stiltransfer zu fördern, ohne die semantischen Motivstrukturen übermäßig zu verzerren, wurde der Stil-Konsistenzverlust-Koeffizient auf 1 eingestellt. Um einen ausgewogenen Beitrag zwischen realistischer Bilddarstellung und präziser Motivsegmentierung sicherzustellen, erhielten die Segmentierungs- und die adversariellen Verluste gleiche Gewichtungen. Die auf Merkmalen basierenden Stildarstellungen des WikiArt-Datensatzes wurden zur Berechnung des Stil-Konsistenzverlusts herangezogen. Insbesondere wurden künstlerische Stilmerkmale mithilfe von Gram-Matrix-Korrelationen erfasst, die aus tiefen Merkmalskarten abgeleitet wurden. Die Differenz der Frobenius-Norm zwischen den Gram-Matrizen des Zielstilbilds und des generierten Bilds wurde zur Berechnung des Stilverlusts verwendet, wie in Gleichung 22 dargestellt:
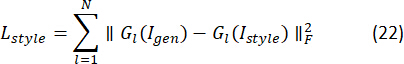
Hier ist Gl die Gram-Matrix, die aus der lten Merkmalschicht berechnet wird, Igen bezeichnet das generierte künstlerische Bild, Istyle bezeichnet das Ziel-Stilbild aus dem WikiArt-Datensatz und F bezeichnet die Frobenius-Norm. Diese Formulierung ermöglicht es dem vorgeschlagenen Framework, künstlerische Merkmale zu bewahren, während die strukturelle und semantische Integrität kultureller Motive erhalten bleibt.
Die fusionierten Merkmalsdarstellungen, die vom CAFFM-Modul erzeugt werden, dienen als konditionierende Eingaben für das SPADE-Modul, das die künstlerische Synthesekomponente des vorgeschlagenen Frameworks darstellt. Der SPADE-Generator besteht aus sieben SPADE-Residualblöcken mit einer latenter Merkmalsdimension von 256 Kanälen und erzeugt Ausgabebilder mit einer Auflösung von 256 × 256 Pixeln. Semantische Segmentierungskarten, die vom SegFormer–CAFFM-Modul erhalten wurden, werden als konditionierende Eingaben in allen SPADE-Residualschichten verwendet. SPADE-Schichten werden vor den Aktivierungsfunktionen innerhalb jedes Residualblocks angewendet, wodurch eine segmentierungsgesteuerte semantische Konditionierung ermöglicht wird. Durch aufeinanderfolgende Hochskalierungs- und faltungsbasierte Operationen wird die latente Merkmalsdarstellung schrittweise verfeinert, um hochauflösende künstlerische Muster zu erzeugen, wobei gleichzeitig die semantische Konsistenz und die Motivstruktur erhalten bleibt. Im gesamten Generator kommen LeakyReLU-Aktivierungsfunktionen zum Einsatz, und im Ausgabeschicht wird eine Tanh-Aktivierungsfunktion angewendet, um normalisierte Bilder zu erzeugen.
Algorithmus und Arbeitsablauf
Der SegCycle-SPADE-Algorithmus integriert semantische Segmentierung, Merkmalsfusion, Musterrückgewinnung und künstlerische Stilsynthese in eine einheitliche Trainingspipeline. Der Arbeitsablauf beginnt mit der Datensammlung und Vorverarbeitung, einschließlich Größenänderung der Bilder, Normalisierung, Rauschunterdrückung und Vorbereitung der Segmentierungsmasken. Die vorverarbeiteten Bilder werden anschließend mit dem SegFormer-B2-Segmentierungsnetzwerk verarbeitet, um semantische Motivdarstellungen zu extrahieren. Die resultierenden Segmentierungsmerkmale werden über das CAFFM mit Rekonstruktionsmerkmalen fusioniert, wodurch eine Interaktion zwischen strukturellen Motivinformationen und künstlerischen Merkmalsdarstellungen ermöglicht wird. Die fusionierten Merkmalskarten werden dann an das CycleGAN-Rekonstruktionsmodul übergeben, das unvollständige kulturelle Motivstrukturen wiederherstellt, während die semantische Konsistenz erhalten bleibt. Die rekonstruierten Muster werden anschließend an den SPADE-Generator zur segmentierungsgesteuerten künstlerischen Synthese übermittelt, wodurch eine stilistische Verbesserung unter Beibehaltung der Motivgrenzen und strukturellen Authentizität ermöglicht wird. Während des Trainings werden die Modellparameter mithilfe der in Gleichungen 21 und 22 beschriebenen zusammengesetzten Verlustfunktion optimiert, die eine Balance zwischen Segmentierungsgenauigkeit, Motiverhaltung, Rekonstruktionsqualität und stilistischer Konsistenz herstellt. Ein detaillierter schrittweiser Implementierungsablauf, einschließlich Laden des Datensatzes, Vorverarbeitung, Modellinitialisierung, Trainingsiterationen, Validierungsverfahren, Auswahl der Kontrollpunkte und abschließender Bewertung, ist in Zusatzdatei 1 (Algorithmus 1) enthalten. Der vollständige algorithmische Arbeitsablauf wurde mit einer Batch-Größe von 16, einer Lernrate von 0,0002 und 100 Trainingsepochen implementiert. Zur Datensatzunterteilung, Modellinitialisierung und allen Trainingsexperimenten wurde ein fester Zufallsstartwert (Seed) von 42 verwendet. Der Seed wurde einheitlich auf die Zufallszahlengeneratoren von Python, NumPy und PyTorch angewandt, um Reproduzierbarkeit zu gewährleisten. Der Adam-Optimierer wurde mit β₁ = 0,5, β₂ = 0,999 und ohne Gewichtsverfall (weight decay = 0) konfiguriert. Die Modellkontrollpunkte wurden basierend auf dem höchsten auf dem Validierungsdatensatz erreichten Validierungs-IoU-Wert ausgewählt.
Optimierung der Verlustfunktion
Um die Strukturen kultureller Motive während der Rekonstruktion und künstlerischen Synthese zu bewahren, verwendet das vorgeschlagene Framework eine zusammengesetzte Optimierungszielsetzung, die Segmentierungs-, Adversarial-, Zyklenkonsistenz-, Rekonstruktions-, Motiverhaltungs- und Stilkonsistenzverluste kombiniert. Die vollständige mathematische Formulierung, die Gewichtungskoeffizienten sowie die Definition des Stilverlusts sind in Gleichung 21 und 22 im Unterabschnitt Künstlerische Stilgenerierung mittels SPADE angegeben. Die Motiverhaltungskomponente bestraft strukturelle Abweichungen zwischen vorhergesagten Motivbereichen und den entsprechenden Ground-Truth-Segmentierungsmasken und fördert dadurch die Erhaltung kulturell bedeutsamer Musterelemente während des gesamten Rekonstruktionsprozesses.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Der vorgeschlagene SegCycle-SPADE-Ansatz wurde anhand zweier Datensätze evaluiert: dem Miao-Batik-Kulturmotiv-Datensatz und dem WikiArt-Datensatz. Der Miao-Batik-Datensatz enthält traditionelle Bilder des kulturellen Erbes und wurde hauptsächlich für semantische Segmentierung und strukturelle Rekonstruktionsaufgaben verwendet, während der WikiArt-Datensatz vielfältige künstlerische Stile umfasst und für das Erlernen und Generieren künstlerischer Stile eingesetzt wurde. Bilder aus beiden Datensätzen wurden durch die volls...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Die Konservierung und digitale Rekonstruktion von ICH-Mustern hat in den letzten Jahren zunehmend an Bedeutung gewonnen, aufgrund des allmählichen Verlusts traditioneller Handwerkskunst. Frühere Studien haben versucht, den Verlust des kulturellen Erbes mithilfe DL-basierter Bildverarbeitungstechniken entgegenzuwirken. Beispielsweise schlugen Quan et al.32 einen Rahmen für den Erhalt des kulturellen Erbes basierend auf Wissensgraphen und DL für die batikartige Miao-Kultur in Guizhou vor. Obwohl sic...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Interessenkonflikt:
Die Autoren erklären, dass kein Wettbewerbsinteresse besteht.
Danksagungen
Die Autoren danken Guangdong Engineering Polytechnic und der South China Normal University für die akademische und institutionelle Unterstützung während der Durchführung dieser Forschung. Diese Forschung wurde durch das Nationale Sozialwissenschafts-Fonds-Generalsprojekt 2023 (Nr. 23BH161) unterstützt, betitelt mit „Digital Regeneration Museum: Forschung zur Aktivierung und Vermittlung chinesischer klassischer Kalligraphie- und Malereikulturgüter“.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Adam-Optimierer | PyTorch-Optimierer-Bibliothek | Adam | Optimierungsalgorithmus, der während des Modelltrainings verwendet wird. |
| CUDA-Toolkit | NVIDIA Corporation | CUDA 11.3 | GPU-Beschleunigung für Deep-Learning-Berechnungen. |
| cuDNN | NVIDIA Corporation | cuDNN 8.2 | Bibliothek zur Beschleunigung tiefer neuronaler Netze, die für Training und Inferenz eingesetzt wird. |
| CycleGAN | University of California, Berkeley / Open Source | Offizielle PyTorch-Implementierung (https://github.com/junyanz/pytorch-CycleGAN-and-pix2pix) | Generatives adversariales Netzwerk zur Rekonstruktion kultureller Motive. |
| ImageNet-Vortrainierte Gewichte | ImageNet / Open Source | mit_b2.pth (ImageNet-1K-Vortrainierter Checkpoint) | Wird verwendet, um den SegFormer-B2-Backbone vor der Feinabstimmung auf dem Miao-Batik-Datensatz zu initialisieren. |
| Intel-Prozessor | Intel Corporation | Intel Core i7 (11. Generation) | CPU für die Bildvorverarbeitung, Unterstützung des Modelltrainings und Inferenz. |
| Matplotlib | Matplotlib-Entwicklungsteam | Matplotlib 3.5.1 | Visualisierung von Trainingskurven und Evaluierungsergebnissen. |
| Miao-Batik-Datensatz | Zenodo-Repository | DOI: 10.5281/zenodo.20807658 | Kultureller Motiv-Datensatz mit 15.148 Bildern, verwendet für semantische Segmentierung und Musterrekonstruktion. |
| NumPy | NumPy-Entwickler | NumPy 1.21.5 | Numerische Berechnungen und Datensatzverarbeitung. |
| NVIDIA-GPU | NVIDIA Corporation | NVIDIA RTX 3090 (24 GB VRAM) | Hardwareplattform für Modelltraining und Inferenz. |
| OpenCV | OpenCV Foundation | OpenCV 4.5.5 | Bildvorverarbeitung, Größenänderung, Interpolation und Gaußsche Rauschunterdrückung. |
| Betriebssystem | Canonical Ltd. | Ubuntu 20.04 LTS | Experimentelle Ausführungsumgebung. |
| Pillow (PIL) | Python Imaging Library | Pillow 8.4.0 | Bildlade- und Bearbeitungsfunktionen. |
| Python | Python Software Foundation | Python 3.8.10 | Programmiersprache für Implementierung und Experimente. |
| PyTorch | Meta AI | PyTorch 1.10.0 | Deep-Learning-Framework für Modelltraining und Inferenz. |
| Zufallsseed | Experimentelle Einstellung | 42 | Fester Seed für Datensatzpartitionierung, Modellinitialisierung und experimentelle Reproduzierbarkeit. |
| Scikit-learn | Scikit-learn-Entwickler | Scikit-learn 1.0.2 | Datensatzpartitionierung, statistische Analyse und Evaluierungsmetriken. |
| Seaborn | Open-Source-Community | Seaborn 0.11.2 | Statistische Datenvisualisierung. |
| SegFormer-B2 | NVIDIA Research / Open Source | SegFormer-B2 (MIT-B2-Backbone) | Transformer-basiertes Modell für semantische Segmentierung, verwendet für die Segmentierung kultureller Motive. |
| Segmentierungsmasken / Annotationen | Miao-Batik-Datensatz | Im Datensatz enthalten | Pixelgenaue semantische Segmentierungsetiketten für Motivklassifizierung und Training. |
| SPADE | NVIDIA Research / Open Source | Offizielle PyTorch-Implementierung (https://github.com/NVlabs/SPADE) | Segmentierungsgesteuertes Bildsynthesemodell für künstlerische Mustererzeugung. |
| TorchVision | Meta AI | TorchVision 0.11.1 | Bildverarbeitungsfunktionen und Datensatztransformationen für die Verwendung mit PyTorch. |
| WikiArt-Datensatz | WikiArt | https://www.wikiart.org/ | Künstlerischer Stildatensatz mit über 80.000 Kunstwerken aus 27 künstlerischen Stilen, verwendet für Stil-Lernen und -Synthese. |
Referenzen
- Huang B, Mo L. SegCycle-SPADE: An end-to-end framework for semantic segmentation-based automated extraction and artistic reconstruction of traditional craft patterns using conditional GAN. PLoS ONE. 2025;20:e0329100.
- Yan Z, et al. Digital sustainability of heritage: Exploring indicators affecting the effectiveness of digital dissemination of intangible cultural heritage through qualitative interviews. Sustainability. 2025;17:1593.
- Yan Z, et al. Construction of digital dissemination effects evaluation indicator system of traditional techniques of intangible cultural heritage. npj Heritage Science. 2025;13:224.
- Imon SS. Intangible cultural heritage as a tourism product in the historic city of Macao. In: Sustainable Management of Historic Settlements in Asia: Role of Intangible Cultural Heritage. Springer Nature Singapore; Singapore. 2025. p.233-240.
- Buragohain D, et al. Digitalizing cultural heritage through metaverse applications: Challenges, opportunities, and strategies. Heritage Science. 2024;12:295.
- Ma Y. The ghostly ethics of mediatized shaping: Cultural memory creative transformation of Anhui’s ICH in reviving the craftsmanship. Journal of Current Social Issues Studies. 2025;2:240-249.
- Wanju T, Wang Z, Tu Y. ICH and e-commerce: Bridging tradition and modernity in cultural creative products. Journal of Economics, Management and Trade. 2025;31:1-8.
- Sun L, et al. Research on the redesign of China’s intangible cultural heritage based on sustainable livelihood—The case of Luanzhou shadow play empowering rural development. Sustainability. 2024;16:4555.
- Pan S, et al. Constructing a sustainable evaluation framework for AIGC technology in Yixing Zisha pottery: Balancing heritage preservation and innovation. Sustainability. 2025;17:910.
- Na Z, Sharul Azim SR. Research on innovative development of Miao embroidery intangible cultural heritage in Guizhou, China based on digital design. Journal of Business and Economic Review. 2024;9:85-94.
- Guo S, Canessa A. Ethnic elder poverty: Miao household livelihoods and elderly self-sufficiency practices in Midwest China. Culture, Agriculture, Food and Environment. 2023;45:55-68.
- Han D, Cong L. Miao traditional patterns: The origins and design transformation. Visual Studies. 2023;38:425-432.
- Dong B, et al. Spatial distribution and tourism competition of intangible cultural heritage: Take Guizhou, China as an example. Heritage Science. 2023;11:64-80.
- Chen Z, Ren X, Zhang Z. Cultural heritage as rural economic development: Batik production amongst China’s Miao population. Journal of Rural Studies. 2021;81:182-193.
- Zhennan LY, Yahaya SR. An aesthetic study on traditional batik design of Miao ethnicity in China. Kupas Seni. 2021;9:12-25.
- Fu X, Razmjooy N. Preserving and enhancing cultural heritage through art design using feature pyramid network optimized by modified builder optimization algorithm. Scientific Reports. 2025;15:42603.
- Liu X, Wan J, Wang N. Ancient painting inpainting with regional attention-style transfer and global context perception. Applied Sciences. 2024;14:8777.
- Xu Q, Iwasaki M. Image restoration model of wood-structured raw lacquer cultural relics based on diffusion generation network. Journal of Asian Architecture and Building Engineering. 2025:1-19.
- Cherian A, Sullivan A. Sem-GAN: Semantically-consistent image-to-image translation [conference presentation]. Presented at: IEEE Winter Conference on Applications of Computer Vision (WACV); 2019. doi: 10.1109/WACV.2019.00196.
- Rombach R, et al. High-resolution image synthesis with latent diffusion models [conference presentation]. Presented at: IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR); 2022. p.10684-10695. Available from: http://openaccess.thecvf.com/content/CVPR2022/papers/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR_2022_paper.pdf.
- Gendy GGH, Nabil S. Diffusion models for image super-resolution: State-of-the-art and future directions. Neurocomputing. 2025;617:128911.
- Kazerouni A, et al. Diffusion models in medical imaging: A comprehensive survey. Medical Image Analysis. 2023;88:102846.
- Yang L, et al. Diffusion models: A comprehensive survey of methods and applications. ACM Computing Surveys. 2023;56:1-39.
- Croitoru FA, Hondru V, Ionescu RT, Shah M. Diffusion models in vision: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence. 2023;45:10850-10869.
- Cao H, et al. A survey on generative diffusion models. IEEE Transactions on Knowledge and Data Engineering. 2024;36:2814-2830.
- Po R, et al. State of the art on diffusion models for visual computing. Computer Graphics Forum. 2024;43:e15063.
- Thampanichwat C, et al. Mindful architecture from text-to-image AI perspectives: A case study of DALL-E, Midjourney, and Stable Diffusion. Buildings. 2025;15:972.
- Li W. Enhanced automated art curation using supervised modified CNN for art style classification. Scientific Reports. 2025;15:7319.
- Chen C. Algorithm and tool development for creative generation of graphic design of folk houses and ancient buildings integrating cultural and creative elements. Scalable Computing: Practice and Experience. 2024;25:4729-4736.
- Liu B, Ji J, Gu L, Jiang Z. An integrated CycleGAN-diffusion approach for realistic image generation [conference presentation]. Presented at: International Conference on Signal Processing and Machine Learning; 2024. p.92-101. doi: 10.1117/12.3027121.
- Bao Q, Zhao J, Liu Z, Liang N. AI-assisted inheritance of Qinghua porcelain cultural genes and sustainable design using low-rank adaptation and stable diffusion. Electronics. 2025;14:725.
- Quan H, et al. Protection of Guizhou Miao batik culture based on knowledge graph and deep learning. Heritage Science. 2024;12:1-22.
- Sun H, et al. HRPGAN: A GAN-based model to generate high-resolution remote sensing images. IOP Conference Series: Earth and Environmental Science. 2020;428:012060.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. Available from: https://proceedings.neurips.cc/paper/2020/file/4c5bcfec8584af0d967f1ab10179ca4b-Paper.pdf.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.