Die diabetische Nephropathie (DN) beinhaltet eine mitochondriale Dysfunktion. Mithilfe von Transkriptomik, Netzwerkpharmakologie und maschinellem Lernen identifizierten wir CAT, FABP1, MAOA und MAOB als potenzielle mitochondrienbezogene Biomarker für Ligustri Lucidi Fructus. Bei db/db-Mäusen erhöhte LLF die Expression von CAT und MAOA, was weitere mechanistische Untersuchungen unterstützt.
Forschungsartikel
Identifizierung mitochondrienbezogener Kandidaten-Biomarker von Ligustri Lucidi Fructus bei diabetischer Nephropathie
In diesem Artikel
Zusammenfassung
Zusammenfassung
Mitochondriale Dysfunktion und übermäßiger oxidativer Stress in den Mitochondrien sind zentrale pathologische Faktoren, die die tubuläre Nierenschädigung bei diabetischer Nephropathie (DN) vorantreiben. Obwohl Ligustri Lucidi Fructus (LLF) traditionell zur Behandlung der DN eingesetzt wird, sind die daran beteiligten Mechanismen, insbesondere jene, die mitochondrienassoziierte Gene und Signalwege betreffen, bisher nur unzureichend verstanden. In dieser Studie wurde eine Analyse der differentiellen Expression des GSE142025-Datensatzes durchgeführt, um differentiell exprimierte Gene (DEGs) im Zusammenhang mit DN zu identifizieren. Merkmalsgene wurden durch Abgleich der Ergebnisse aus vier maschinellen Lernmodellen ausgewählt. Gene, die eine signifikante differentielle Expression und konsistente Expressionsmuster in beiden Datensätzen aufwiesen, wurden anschließend mittels ROC-Kurvenanalyse (Receiver Operating Characteristic) bewertet. Solche Gene mit einer Fläche unter der Kurve (AUC) > 0,7 in beiden Datensätzen wurden als Kandidaten für Biomarker definiert. Es wurden funktionelle Anreicherungsanalysen, Untersuchungen zur Immuninfiltration, Netzwerkkonstruktion sowie molekulare Docking-Analysen durchgeführt. Ein DN-Mausmodell wurde verwendet, um Blutglukose, mikroalbuminurische Ausscheidung, histopathologische Veränderungen sowie die RT-qPCR-Expression der Kandidaten-Biomarker zu bewerten. CAT und MAOA waren in vivo signifikant hochreguliert. Die Kandidaten-Biomarker waren in Signalwegen angereichert, die mit Ribosomenfunktion, Valin-, Leucin- und Isoleucin-Abbau, Zytokin-Zytokinrezeptor-Interaktionen sowie Peroxisomen assoziiert sind. Sie zeigten eine negative Korrelation mit CD8+-T-Zellen und aktivierten Mastzellen sowie eine positive Korrelation mit aktivierten NK-Zellen und naiven B-Zellen. Taxifolin, Beta-Sitosterol und Eriodictyol wiesen Bindungsenergien unter -5 kcal/mol mit den Kandidaten-Biomarkern auf. CAT und MAOA stellen aussichtsreiche Kandidaten dar, die weitere mechanistische Untersuchungen rechtfertigen.
Einleitung
Die diabetische Nephropathie (DN), die weltweit führende Ursache für Niereninsuffizienz im Endstadium, ist eine der häufigsten Komplikationen des Diabetes mellitus. Pathologisch zeichnet sie sich durch eine übermäßige Ansammlung der extrazellulären Matrix in den glomerulären und tubulären Kompartimenten sowie durch Verdickung und Sklerose der intrarenalen Blutgefäße aus2. Die DN ist häufig mit Proteinurie und Hypertonie assoziiert3. Ihre Entstehung steht in engem Zusammenhang mit Schädigungen der vaskulären Endothelzellen, einer verstärkten Entzündungsreaktion und erhöhtem oxidativem Stress infolge anhaltender Hyperglykämie4. Die Inzidenz der DN nimmt weltweit zu, insbesondere bei mittelalten und älteren Diabetikern. Im Fortschreiten der Erkrankung kann es zur Niereninsuffizienz im Endstadium und sogar zu kardiovaskulären Komplikationen kommen, was die Lebensqualität und Prognose der Patienten erheblich beeinträchtigt5. Trotz Fortschritten in Diagnostik und Therapie der DN bleiben frühe und zuverlässige Biomarker für die Diagnosestellung weiterhin unentdeckt, und effektive Behandlungsstrategien zur Umkehrung der pathologischen Prozesse fehlen nach wie vor. Daher besteht ein dringender Bedarf an der Entwicklung neuartiger, gezielter Anti-DN-Wirkstoffe.
Mitochondrien sind entscheidend für die zelluläre Bioenergetik, die Synthese von Stoffwechselvorläufern, die Kalziumhomöostase, die Produktion reaktiver Sauerstoffspezies (ROS), die Immunsignalübertragung und die Apoptose, alles Prozesse, die für die Aufrechterhaltung der zellulären und organismischen Stabilität unerlässlich sind6. Als Kraftwerke der Zelle spielen Mitochondrien eine zentrale Rolle in grundlegenden Prozessen wie der Glykolyse, dem Tricarbonsäurezyklus und der oxidativen Phosphorylierung7. Adipositas stört den Krebszyklus und die mitochondriale Atmungskette, was zu mitochondrialer Dysfunktion und erhöhter ROS-Produktion führt. Erhöhte ROS-Spiegel in der mitochondrialen Atmungskette können oxidativen Stress auslösen, der die mit Adipositas assoziierte Entzündungsreaktion verschärft und die Apoptose fördert8. Neuere Forschungsergebnisse haben die bedeutende Rolle mitochondrialer Dysfunktion bei der Pathogenese und Progression der diabetischen Nephropathie (DN) hervorgehoben, einschließlich Störungen des Energiestoffwechsels, übermäßiger ROS-Produktion und verstärkter Apoptosesignalgebung9. Chronische mitochondriale Dysfunktion beschleunigt den Fortschritt der Nierenerkrankung10. Daher könnte die Verbesserung der mitochondrialen Funktion eine entscheidende Schutzstrategie gegen die DN darstellen.
Ligustri Lucidi Fructus (LLF) ist eine getrocknete, reife Frucht aus der Familie der Luteaceae, die für ihre leber- und nierenstärkenden Eigenschaften bekannt ist, außerdem für ihre Fähigkeit, das Haar zu verdunkeln und das Sehvermögen zu verbessern. Ein natürlich vorkommendes Heteropolysaccharid, das aus LLF gewonnen wurde, konnte identifiziert werden und zeigt ein Potenzial zum Schutz der Nieren vor Fibrose11. In den letzten Jahren hat die Anwendung von LLF bei der Behandlung von diabetischer Nephropathie (DN) zunehmend Beachtung gefunden, wobei bemerkenswerte nephroprotektive Effekte nachgewiesen wurden11,12,13. Darüber hinaus wurde der komplexe Zusammenhang zwischen LLF und den Mitochondrien umfassend erforscht und bestätigt. Insbesondere zeigte eine Studie, dass LLF seine vorteilhaften Wirkungen durch die Modulation der mitochondrialen Funktion über die Aktivierung des AMPK-Signalwegs entfaltet14. Dieser Mechanismus schützt die Mitochondrien wirksam vor Schäden durch oxidativen Stress. Diese Erkenntnisse unterstreichen weiterhin die entscheidende Rolle von LLF bei der Aufrechterhaltung des zellulären Energiestoffwechsels und der Verbesserung der Widerstandsfähigkeit der Zellen gegenüber oxidativem Stress. Der genaue therapeutische Wirkmechanismus, insbesondere im Hinblick auf die Wiederherstellung der mitochondrialen Funktion, ist jedoch noch weitgehend unverstanden.
Das Ziel dieser Studie war es, die biologischen Mechanismen aufzuklären, die der therapeutischen Wirkung von LLF auf die mitochondriale Funktion bei diabetischer Nephropathie (DN) zugrunde liegen. Öffentliche Datenbanken wurden mithilfe bioinformatischer Werkzeuge durchsucht, um Kandidaten-Biomarker zu identifizieren, die mit den nierenprotektiven Effekten von LLF assoziiert sind, wobei transkriptomische Daten und Informationen zu wirksamen Inhaltsstoffen integriert wurden. Weitere Analysen, einschließlich Immuninfiltration, Assoziation mit klinischen Merkmalen, m6A-RNA-Modifikation, funktionelle Anreicherung, Konstruktion regulatorischer Netzwerke und molekulares Docking, legten nahe, dass diese Kandidaten-Biomarker eine zentrale Rolle bei der Regulation der mitochondrialen Funktion während der DN-Behandlung spielen. Eine in vivo-Validierung bestätigte ihre Bedeutung weiter. Diese umfassende Analyse vertieft unser Verständnis der Mechanismen, durch die LLF die DN behandelt, und schafft eine solide Grundlage für die Entwicklung neuartiger therapeutischer Zielstrukturen basierend auf mitochondrialer Dysfunktion.
Protokoll
Datenerhebung
Die Genexpressionsmatrix und die entsprechenden klinischen Daten für die mit diabetischer Nephropathie (DN) assoziierten Datensätze GSE142025 und GSE96804 wurden aus der Gene Expression Omnibus (GEO)-Datenbank (https://www.ncbi.nlm.nih.gov/geo/) abgerufen15. Der Trainingsdatensatz (GSE142025) enthielt Nierengewebeproben von 27 Patienten mit DN und neun Kontrollpersonen, die mittels der GPL20301-Plattform sequenziert wurden. Der Validierungsdatensatz (GSE96804) umfasste Sequenzierungsdaten von 41 DN-Patienten und 20 Kontrollen, die mit der GPL17586-Plattform verarbeitet wurden. Beide Datensätze konzentrieren sich auf Nierengewebe; der Datensatz GSE96804 untersucht speziell das Glomerulum, die primäre Filtrationseinheit der Niere (Abbildung 1). Der GSE142025-Datensatz (Trainingsset) besteht aus Proben des gesamten Nierengewebes und bietet einen umfassenden Überblick über die transkriptomische Landschaft der DN. Der GSE96804-Datensatz (Validierungsset) hingegen konzentriert sich gezielt auf glomeruläres Gewebe, dem primären Ort der glomerulären Filtrationsschädigung. Da diese beiden Datensätze aufgrund von Unterschieden in Plattform und Gewebetyp nicht direkt zusammengeführt wurden, wurde keine Korrektur von Batch-Effekten vorgenommen. Stattdessen erfolgte die Validierung unabhängig zwischen den Datensätzen. Gene mit konsistenten, gleichgerichteten Veränderungen und einer Fläche unter der Kurve (AUC) größer als 0,7 in beiden Datensätzen wurden als robuste Kandidaten ausgewählt, was die Generalisierbarkeit über verschiedene Nierenkompartimente hinweg unterstützt.
Insgesamt 1.136 mitochondrienbezogene Gene (MRGs) wurden aus der MitoCarta3.0-Datenbank (https://www.broadinstitute.org/mitocarta) extrahiert. Die Wirkstoffe von LLF wurden anhand der Datenbank Traditional Chinese Medicine Systems Pharmacology (TCMSP) (http://sm.nwsuaf.edu.cn/lsp/tcmsp.php) vorhergesagt, unter Verwendung einer oralen Bioverfügbarkeit (OB) von ≥30 % und einer Arzneistoffähnlichkeit (DL) von ≥0,18. Anschließend wurden potenzielle Zielgene für die Wirkstoffe mittels der Swiss Target Prediction-Datenbank (http://www.swisstargetprediction.ch/) vorhergesagt.
Analyse der differentiellen Expression
Die Analyse der differentiellen Expression von GSE142025 (DN vs. Kontrolle) wurde mit dem limma-Paket (v3.54.1) durchgeführt, wobei die Signifikanzkriterien bei P.adj < 0,05 und |log2FoldChange| > 0.516 . Vulkanodiagramme und Heatmaps wurden mit den Paketen ggplot2 (v 3.3.6) und ComplexHeatmap (v 2.14.0) erstellt17,18bzw. DEGs, MRGs und potenzielle Zielgene der Wirkstoffe wurden überschnitten, und die gemeinsamen Gene wurden als Kandidatengene definiert. Das Netzwerk, das die Wirkstoffe mit den Kandidatengenen verbindet, wurde mithilfe der Cytoscape-Software (v 3.9.0) erstellt.19.
Funktionelle Anreicherungsanalyse und Konstruktion des Protein-Protein-Interaktionsnetzwerks (PPI)
Genontologie (GO) und Kyoto Encyclopedia of Genes and Genomes (KEGG) wurden mittels des clusterProfiler-Pakets (v 4.6.2) zur Untersuchung der biologischen Funktionen und assoziierten Signalwege analysiert (P.adjust < 0.05). Die Kandidatengene wurden anschließend in die STRING-Datenbank (https://cn.string-db.org/) eingegeben, um PPI-Beziehungen abzurufen (Vertrauenswert ≥ 0.4), gefolgt von der Erstellung eines PPI-Netzwerks mithilfe von Cytoscape (v 3.9.0)20.
Maschinelles Lernen
Vier Algorithmen des maschinellen Lernens, darunter Random Forest (RF), k-nächste Nachbarn (KNN), partielle kleinste Quadrate (PLS) und Support-Vektor-Maschine mit radiale Basisfunktion als Kern (SVM), wurden mithilfe des caret-Pakets (v6.0-93) basierend auf dem Datensatz GSE142025 implementiert. Die in der vorangegangenen Analyse identifizierten Kandidatengene dienten als Prädiktorvariablen, der Krankheitsstatus (DN oder Kontrolle) wurde als Zielvariable verwendet. Für das KNN-Modell wurde eine 10-fache Kreuzvalidierung mithilfe der Funktion trainControl durchgeführt, mit tuneLength = 10. Das RF-Modell wurde mit 20 Bäumen (ntree = 20) angepasst; die PLS- und SVM-Modelle wurden unter Verwendung der Einstellungen angepasst, die im ursprünglichen caret-Workflow implementiert waren.
Die Bewertung der Modell-Residualverteilungen erfolgte mithilfe des DALEX-Pakets (v2.4.3). Anschließend wurde eine permutationsbasierte Variablenbewertung unter Verwendung der Funktion variable_importance aus DALEX durchgeführt, wobei der Root-Mean-Square-Error (RMSE) als Verlustfunktion festgelegt wurde. Der resultierende dropout_loss stellt den RMSE dar, der nach Permutation der entsprechenden Variable erzielt wurde21,22. Im ursprünglichen analytischen Workflow wurden Variablen mit einem dropout loss < 0,281 über alle Modelle hinweg beibehalten, und Gene, die in allen vier Modellen gemeinsam vorkamen, wurden als konsensuelle Merkmal-Gene für die anschließende Validierung definiert.
Die vier maschinellen Lernmodelle wurden hauptsächlich zur Merkmalspriorisierung und nicht zum Aufbau eines endgültigen klinischen Klassifizierers verwendet. Entsprechend wurde die diagnostische Unterscheidungsfähigkeit anschließend auf Ebene einzelner Gene mittels ROC-Analyse sowohl in den Entdeckungs- als auch in den Validierungsdatensätzen bewertet.
Identifizierung von Biomarker-Kandidaten
In GSE142025 und GSE96804 wurden Expressionsunterschiede von Merkmalgenen zwischen DN- und Kontrollproben mittels des Wilcoxon-Tests bewertet. Nur Gene mit signifikant differenzieller Expression (P < 0,05) und übereinstimmenden Expressionsmustern in beiden Datensätzen wurden für die Analyse der Receiver-Operating-Characteristic-(ROC)-Kurve ausgewählt. Mithilfe des pROC-Pakets (v1.18.0) wurden ROC-Kurven erstellt und die Fläche unter der Kurve (AUC) berechnet; Gene mit einer AUC > 0,7 in beiden Datensätzen wurden als Biomarker-Kandidaten klassifiziert23.
Analyse der Gen-Set-Verdichtung (GSEA)
Die biologischen Funktionen und Signalwege, die mit den Kandidaten-Biomarkern assoziiert sind, wurden weitergehend mittels GSEA anhand des GSE142025-Datensatzes untersucht. Zunächst wurde eine Spearman-Korrelationsanalyse der Kandidaten-Biomarker mit allen anderen Genen unter Verwendung des psych-Pakets (v2.2.9) durchgeführt.24. Korrelationskoeffizienten wurden berechnet und (von hoch nach niedrig) geordnet. Als Referenz-Gen-Set diente c2.cp.kegg.v2023.1.Hs.symbols.gmt aus der Molecular Signatures Database (MSigDB, https://www.gsea-msigdb.org/gsea/msigdb/). Anschließend wurde eine GSEA-Analyse (Gene Set Enrichment Analysis) mithilfe des clusterProfiler-Pakets (v4.6.2) durchgeführt, um die Anreicherung der sortierten Gene im Hintergrund-Gen-Set zu bewerten. Es wurde eine Korrektur für Mehrfachvergleiche angewandt. über die FDR-Methode und angepasst P-Werte (bezeichnet als P.adjust) wurden als signifikant betrachtet, wenn < 0.05.
Analyse der m6A-Modifikation
Um RNA-Methylierungsmodifikationen von Kandidaten-Biomarkern zu untersuchen, wurde die SRAMP-Datenbank (http://www.cuilab.cn/sramp/) verwendet, um m6Modifikationsstellen an Kandidat-Biomarkern unter Berücksichtigung hochgradig verlässlicher Positionen innerhalb ihrer sekundären Strukturen. Anschließend wurde die ENCORI-Datenbank (https://starbase.sysu.edu.cn/) verwendet, um m6A-modifizierte Proteine zu identifizieren, die mit den Kandidat-Biomarkern interagieren, unter Verwendung der |HepG2 (shRNA)| > 1 Parameter zur Untersuchung zentraler Proteine. Die RPISeq-Datenbank (http://pridb.gdcb.iastate.edu/RPISeq/) wurde anschließend verwendet, um die Wahrscheinlichkeit von Wechselwirkungen zwischen zentralen Proteinen und Kandidaten-Biomarkern vorherzusagen. RNA-Sequenzen für beide wurden im reinen Textformat hochgeladen, um Vorhersage-Scores mittels RF- und SVM-Klassifizierer zu generieren. Eine Wechselwirkung galt als signifikant, wenn der Score 0,5 überstieg.25Die SRAMP-Analyse wurde mit der „hohen“ Schwelle für die Vorhersage von m6A-Stellen unter Verwendung des „Transkript“-Modus und der Standardparameter durchgeführt. Für die ENCORI-Analyse wurde die Funktion zur „miRNA-mRNA“-Interaktion mit dem Parameter „HepG2 (shRNA)“ verwendet. > 1. Die RPISeq-Analyse verwendete den RF-Klassifikator mit Standardparametern; die Werte > 0,5 deutete auf eine positive Interaktion hin. Dies sind computergestützte Vorhersagen, keine experimentellen Belege für m6A-Modifikationen oder RNA-Protein-Interaktionen im Nierengewebe. Das HepG2 shRNA-Kriterium wurde aus vorkonfektionierten Datensätzen von ENCORI abgeleitet und spiegelt möglicherweise keine nieren-spezifische Regulation wider.
Analysen zur Immunzellinfiltration
Der CIBERSORT-Algorithmus wurde angewandt, um die Anteile von 22 Immunzelltypen sowohl in Kontroll- als auch in DN-Proben aus GSE142025 abzuschätzen, wobei eine Visualisierung über eine mit dem ggplot2-Paket (v3.3.6)26 erstellte Heatmap erfolgte. CIBERSORT wurde mit der LM22-Signaturmatrix, 1.000 Permutationen und deaktivierter Quantilnormalisierung durchgeführt (wie für Microarray-Daten empfohlen). Proben mit einem CIBERSORT-p-Wert < 0,05 wurden für weitere Analysen berücksichtigt. CIBERSORT schätzt die Anteile von Immunzellen anhand der Expression in gesamtem Nierengewebe, was jedoch keine Aussage über kompartimentsspezifische Infiltration (z. B. glomerulär vs. tubulointerstitiell) erlaubt und nicht zwischen infiltrierenden Leukozyten und residenten Immunzellen unterscheiden kann. Daher liegen die angegebenen Korrelationen auf Gewebeebene vor und sollten mittels räumlicher Methoden validiert werden. Zur Durchführung der Spearman-Korrelationsanalyse zwischen unterschiedlich gehäuften Immunzellen und Kandidaten-Biomarkern wurde das psych-Paket verwendet.
Aufbau von Netzwerken und molekulares Docking
Mikro-RNAs (miRNAs), die mit den Kandidaten-Biomarkern interagieren, wurden mithilfe der miRNet-Datenbank (https://www.mirnet.ca) vorhergesagt. Anschließend wurden langkettige nichtcodierende RNAs (lncRNAs), die die identifizierten miRNAs gezielt beeinflussen, über die Datenbanken TarBase (http://www.diana.pcbi.upenn.edu/tarbase) und starbase (http://starbase.sysu.edu.cn/) vorhergesagt. Für den Netzwerkaufbau wurden lncRNAs ausgewählt, die in beiden Datenbanken gemeinsam vorkamen. Mithilfe der Software Cytoscape wurde anschließend ein lncRNA-miRNA-mRNA-Regulationsnetzwerk erstellt. Potenzielle Wirkstoffe, die die Kandidaten-Biomarker gezielt ansprechen, wurden zur Erstellung eines Wirkstoff-Biomarker-Netzwerks ausgewählt. Zusätzlich wurden Wirkstoffe, Kandidaten-Biomarker und in der GSEA identifizierte Signalwege in Cytoscape integriert, um ein Wirkstoff-Biomarker-Signalweg-Netzwerk zu erstellen.
Die molekulare Docking-Analyse wurde durchgeführt, um die Bindungsaffinität zwischen potenziellen Wirkstoffen und Kandidaten-Biomarkern zu bewerten. Die 3D-Strukturen der Biomarker-Proteine wurden im PDB-Dateiformat aus der Research Collaboratory for Structural Bioinformatics Protein Data Bank (RCSB PDB, https://www.rscb.org/pdb) bezogen. Die 2D-Strukturen der potenziellen Wirkstoffe wurden im SDF-Format aus der PubChem-Datenbank (http://pubchem.ncbi.nlm.nih.gov) abgerufen. Das molekulare Docking wurde mit der CB-Dock-Plattform (http://clab.labshare.cn/cb-dock/php/blinddock.php) durchgeführt. Eine Bindungsenergie von weniger als -5 kcal/mol deutete auf eine starke Bindungsaffinität hin27.
Herstellung und Authentifizierung von Ligustri Lucidi Fructus
Hier bezeichnet Ligustri Lucidi Fructus (LLF) die getrocknete reife Frucht von Ligustrum lucidum W. T. Aiton (Oleaceae). Das botanische Material wurde gemäß dem Chinesischen Arzneibuch authentifiziert, und eine Belegprobe mit der Nummer 20240506,20240911,20241103 wurde an der Shanxi University of Traditional Chinese Medicine hinterlegt.
Zur Zubereitung des Dekokts wurden 200 g qualifizierter LLF-Scheiben für 30 min bei Raumtemperatur in 1.000 mL destilliertem Wasser eingeweicht. Die Mischung wurde zunächst kräftig gekocht und anschließend 60 min lang sanft geköchelt. Der Filtrat wurde gesammelt, und das verbleibende pflanzliche Material wurde erneut mit weiteren 1.000 mL destilliertem Wasser 60 min lang dekocht. Beide Filtrate wurden vereinigt, filtriert, zentrifugiert und unter vermindertem Druck eingeengt, um eine endgültige Stammlösung mit einer Konzentration von 1 g Rohdroge/mL (Gesamtvolumen 100 mL) zu erhalten. Das hergestellte Dekokt wurde bei 4 °C für den kurzfristigen Gebrauch oder bei −20 °C für die Langzeitlagerung aufbewahrt. Die Qualität von LLF und dessen Dekokt wurde streng gemäß den Vorgaben der Chinesischen Arzneibuchnorm identifiziert und verifiziert, um die Zuverlässigkeit und Reproduzierbarkeit der Experimente sicherzustellen.
Zur qualitativen Identifizierung wurde eine Dünnschichtchromatographie durchgeführt. Kurz gesagt, wurde ein geeignetes Volumen der hergestellten Dekoktion zentrifugiert und der Überstand mit Methanol extrahiert. Nach der Filtration wurden die Probelösung und die Referenzstandardsolution von Specnuezhenid auf dieselbe Silicagel-G-Platte aufgetragen. Nach der Laufmittelentwicklung, dem Trocknen und der Prüfung unter ultraviolettem Licht zeigte der Fleck der Probelösung eine übereinstimmende Farbe und Position mit der Referenzverbindung, wodurch das Vorhandensein der charakteristischen bioaktiven Komponente von LLF bestätigt wurde.
Zur quantitativen Qualitätskontrolle wurde eine Hochleistungs-Flüssigkeitschromatographie-Detektion durchgeführt. Die Analyse erfolgte unter Verwendung einer C18-Säule mit Methanol–Wasser als mobiler Phase. Die Detektionswellenlänge wurde auf 224 nm eingestellt. Der Gehalt an Specnuezhenid im Dekokt wurde anhand der Standardkurve bestimmt. Die Ergebnisse zeigten eine stabile und gleichmäßige chemische Zusammensetzung des hergestellten Dekokts, wodurch eine konsistente Arzneimittelqualität während des gesamten Tierversuchs gewährleistet war.
Tierexperimente
Zwölf SPF-qualitative männliche db/db-Mäuse (8–9 Wochen alt) und sechs altersentsprechende db/m-Mäuse wurden in der SPF-Tierhaltung der Shanxi University of Traditional Chinese Medicine gehalten. Vor den Experimenten wurden die Tiere 7 Tage lang bei einem 12-Stunden-Licht-/12-Stunden-Dunkel-Wechsel akklimatisiert und hatten ad libitum Zugang zu Futter und Wasser. Die Studie wurde vom Ethikkomitee der Shanxi University of Traditional Chinese Medicine genehmigt (Genehmigungsnummer: 2022DW167). Tiere mit einem Körpergewichtsverlust von >20 %, einem sterbenden Zustand oder der Unfähigkeit, Futter oder Wasser zu erreichen, wurden vor dem geplanten Studienende human getötet. Am Ende der Studie wurden alle verbliebenen Mäuse gemäß den institutionellen Protokollen durch intraperitoneale Injektion von Natriumpentobarbital und anschließende Halswirbeldislokation euthanasiert.
Nach der Eingewöhnungsphase wurde die Erstellung eines DN-Modells bei db/db-Mäusen durch einen Blutzuckerspiegel im Schwanzvenenblut von ≥ 16 mmol/L und eine Mikroalbuminurie bestätigt, die durch einen positiven Harn-Mikroalbumin-Teststreifen angezeigt wurde. Nach erfolgreicher Erstellung des DN-Modells wurden die db/db-Mäuse zufällig in zwei Gruppen (n = 6 pro Gruppe) eingeteilt: die DN-Modellgruppe (DN) und die LLF-Behandlungsgruppe (Behandlung). Außerdem dienten db/m-Mäuse (n = 6) als Kontrollgruppe (Kontrolle). Die Dosierung wurde basierend auf früheren pharmakodynamischen Studien zu LLF an diabetischen Ratten ausgewählt und mithilfe der Normalisierung der Körperoberfläche auf die menschliche Äquivalentdosis umgerechnet28. Den Kontroll- und DN-Gruppen wurde destilliertes Wasser verabreicht, während die Behandlungsgruppe 3,5 g/kg LLF über einen Zeitraum von 8 Wochen erhielt. Nach 8-wöchiger Gabe wurden alle Mäuse getötet, um Serum, Urin und Nierengewebe für nachfolgende Untersuchungen zu sammeln.
Blut- und Urinmarker
Die Glukosekonzentration im Serum wurde mithilfe eines vollautomatischen Blutbiochemie-Analysators bestimmt. Die Konzentration von mikroalbumin im Urin wurde gemäß den Anweisungen des Kits gemessen (Zusatzdatei 1).
Pathologische Untersuchung von Maus-Nierengeweben
Die Nierengewebe wurden für die histopathologische Untersuchung aufbereitet. Nach Fixierung in 4 % Paraformaldehyd wurden die Gewebe gewaschen, dehydriert, in Paraffin eingebettet und geschnitten. Anschließend erfolgte eine Hämatoxylin-Eosin-(HE)-Färbung, und die gefärbten Schnitte wurden unter dem Lichtmikroskop auf pathologische Veränderungen untersucht.
Quantitative Reverse-Transkriptase-Kettenreaktion (RT-qPCR)
Die RT-qPCR wurde verwendet, um die Expression der Kandidaten-Biomarker in Mausnieregewebe zu bestimmen. Gesamt-RNA wurde gemäß den Herstelleranweisungen extrahiert, anschließend wurden RNA-Konzentration und -Qualität bewertet (Tabelle 1). Die cDNA wurde aus der extrahierten RNA unter Verwendung des cDNA-Synthese-Kits synthetisiert. Die Amplifikation wurde mit den in Tabelle 1 aufgeführten Primerpaaren durchgeführt, wobei GAPDH als Referenzgen diente. Die relativen Expressionsniveaus wurden mit der 2−ΔΔCt-Methode13,26 berechnet.
Statistische Analyse
Alle statistischen Analysen wurden mit der R-Software (Version 4.2.2) sowie der für die entsprechenden experimentellen Verfahren erforderlichen Software durchgeführt. Sofern nicht anders angegeben, waren alle statistischen Tests zweiseitig, und Unterschiede wurden als statistisch signifikant betrachtet bei P < 0,05. Die differentielle Expressionsanalyse der Transkriptomik wurde mit dem limma-Paket durchgeführt. Gene mit einem adjustierten P < 0,05 und einer absoluten log2-Faltungsänderung größer als 0,5 wurden als differentiell exprimiert definiert.
Zum Vergleich der Expression von Kandidatengenen zwischen unabhängigen DN- und Kontrollproben wurden, wo im ursprünglichen analytischen Workflow angegeben, nichtparametrische Wilcoxon-Rangsummentests verwendet. Die Korrelationen zwischen Kandidaten-Biomarkern und Anteilen von Immunzellen wurden mittels Rangkorrelation nach Spearman bewertet.
Experimentelle Daten werden als Mittelwert ± Standardabweichung angegeben. Vergleiche zwischen den drei unabhängigen Tiergruppen wurden mittels einfaktorieller Varianzanalyse durchgeführt, sofern die Voraussetzungen für eine parametrische Analyse erfüllt waren. Für post-hoc-Vergleiche wurde der Least-Significant-Difference-Test verwendet, wenn die Varianzen homogen waren, andernfalls der Dunnett's-T3-Test. Die pharmakodynamischen Messungen zum Basiswert und in der 8. Woche wurden getrennt analysiert und dargestellt; Rückschlüsse auf eine Wechselwirkung zwischen Gruppe und Zeit wurden nicht gezogen. Die für die Bioinformatik- und Machine-Learning-Analysen verwendeten R-Skripte und Rohdaten sind in Zusatzdatei 1 enthalten.
Ergebnisse
To systematically investigate potential mitochondria-related candidate biomarkers for LLF in the treatment of DN, we designed a four-phase analytical workflow (Figure 1). In Phase I, we integrated transcriptomic data from the GSE142025 dataset (training set, whole kidney, n=36) and GSE96804 (validation set, glomerulus, n = 61) with 1,136 mitochondria-related genes from the MitoCarta 3.0 database and 517 predicted targets of 9 active ingredients from the TCMSP database. Overlapping these three gene sets yielded 9 candidate genes. In Phase II, four machine learning models (RF, KNN, PLS, and SVM) were applied to prioritize feature genes using RMSE < 0.281 as the threshold. Cross-dataset validation using ROC analysis (AUC > 0.7 in both datasets) identified four candidate biomarkers: CAT, FABP1, MAOB, and MAOA. In Phase III, we performed GSEA to identify enriched KEGG pathways, immune infiltration analysis using CIBERSORT, m6A modification prediction, and constructed lncRNA-miRNA-mRNA, active ingredient–biomarker, and active ingredient–biomarker–pathway networks, followed by molecular docking. In Phase IV, the pharmacodynamic effects of LLF and changes in mRNA expression of the four candidate biomarkers were evaluated in a db/db mouse model of DN.
Screening of candidate genes for LLF treating DN
In the GSE142025 dataset, 3,810 DEGs were identified between the DN and control groups, including 1,904 upregulated and 1,906 downregulated DEGs (Figure 2A,B). Thirteen active ingredients from LLF were predicted using the TCMSP database, namely beta-sitosterol, kaempferol, taxifolin, Lucidumoside D, Lucidumoside D_qt, (20S)-24-ene-3,20-diol-3-acetate, eriodictyol, syringaresinol diglucoside_qt, Lucidusculine, Olitoriside, Olitoriside_qt, luteolin, and quercetin (Table 2). Four active ingredients—Lucidumoside D_qt, (20S)-24-ene-3,20-diol-3-acetate, syringaresinol diglucoside_qt, and Olitoriside_qt—did not predict any potential target genes, while the remaining nine ingredients predicted 517 potential target genes. By overlapping the 3,810 DEGs, 1,136 MRGs, and 517 potential target genes, nine candidate genes were identified: GPX1, BAX, CASP8, MAOA, MAOB, CAT, AKR1B10, ALDH2, and FABP1 (Figure 2C). An active ingredient-candidate gene network was subsequently constructed (Figure 2D). These nine candidate genes were enriched in 341 GO terms, including response to toxic substances, organic hydroxy compound catabolic process, and cellular detoxification (Figure 2E). Additionally, they were associated with 52 KEGG pathways, such as tryptophan metabolism, neurodegenerative pathways, and histidine metabolism (Figure 2F).
Screening of candidate biomarkers for DN treatment in LLF
The PPI network revealed seven nodes and eight edges, with MAOA, ALDH2, MAOB, and AKR1B10 interacting (Figure 3A). Genes with RMSE values less than 0.281 across four machine learning models were identified as feature genes: CAT, MAOB, MAOA, BAX, and FABP1 (Figure 3B-E). Expression analysis showed that CAT, FABP1, MAOB, and MAOA were significantly different between the DN and control groups and were consistent in both the GSE142025 and GSE96804 datasets (Figure 3F,G). Furthermore, their AUC values in ROC curve analysis exceeded 0.7 in both datasets, indicating that these genes could effectively differentiate DN samples from control samples and serve as candidate biomarkers for DN treatment in LLF (Figure 4A-H).
Significant enrichment of candidate biomarkers in inflammatory and immue-related pathways
GSEA identified four candidate biomarkers prominently enriched in the chemokine signaling pathway and cytokine-cytokine receptor interactions (Figure 5A-D). Among these, the peroxidase signaling pathway showed a significant association with CAT, MAOA, and MAOB.
Correlation of candidate biomarkers with immune cells
Notable differences in the expression of nine immune cell types-naive B cells, M0 Macrophage, M1 Macrophage, M2 Macrophage, activated Mast cell, activated NK cell, resting memory CD4+ T cell, naive CD4+ T cell, and CD8+ T cell—were observed between the DN and control samples (P < 0.05) (Figure 6A,B). A significant positive correlation (cor = 0.6) was found between naive B cells and activated NK cells, while a significant negative correlation (cor = -0.69) was detected between naive B cells and activated Mast cells (Figure 6C). All candidate biomarkers exhibited strong negative correlations with CD8+ T cells and activated Mast cells and positive correlations with activated NK cells and naive B cells (Figure 6D).
Interaction of key modified m6A proteins with candidate biomarkers
The m6A RNA methylation modification profoundly affects RNA synthesis and metabolism and is implicated in the pathogenesis of various diseases29. The locations of the m6A modification sites in the candidate biomarkers and their high-confidence positions in the secondary structures are illustrated in Figure 7A-H. Further analysis revealed that key m6A-modified proteins interacting with CAT included AQR and RBM22, while FABP1 interacted with both SF3A3 and AQR. MAOA was found to interact with IGF2BP3 and IGF2BP2, and MAOB with TIA1 (Table 3).
Favorable in silico binding predictions for taxifolin, beta-sitosterol, and eriodictyol in LLF treating DN
In miRNet, CAT was predicted to interact with 24 miRNAs, while FABP1 was associated with five miRNAs. Additionally, MAOB and MAOA were linked to 29 and 26 miRNAs, respectively. Among these, 23 lncRNAs were identified in both the TarBase and Starbase databases. A lncRNA-miRNA-mRNA regulatory network was then constructed, incorporating four candidate biomarkers, 74 miRNAs, and 23 lncRNAs (Figure 8A). Potential active ingredients targeting the candidate biomarkers included luteolin, beta-sitosterol, eriodictyol, kaempferol, quercetin, and taxifolin (Figure 8B). Moreover, an active ingredient-biomarker-pathway network was established based on the active ingredients, candidate biomarkers, and the top five pathways identified in GSEA (Figure 8C). For instance, taxifolin targeted CAT in the peroxisome pathway. The binding energies between CAT and taxifolin (-8.8 kcal/mol), FABP1 and beta-sitosterol (-8.1 kcal/mol), and MAOB and eriodictyol (-9.8 kcal/mol) were all below -5 kcal/mol, suggesting strong affinities between these candidate biomarkers and their respective active ingredients27. Taxifolin, beta-sitosterol, and eriodictyol were identified as potential active ingredients with favorable in silico binding predictions in LLF treating DN (Figure 8D-F). However, they are presented as database-predicted constituents rather than confirmed bioactive intermediates of the observed in vivo effects.
Validate candidate biomarkers in the DN mouse model
Pharmacodynamic evaluation of LLF in treating DN mice
During the administration period, blood glucose and urinary microalbumin levels in mice were monitored (Figure 9A-D). Compared with the control group, blood glucose and urinary microalbumin in DN model group was significantly increased (P < 0.01); compared with the DN model group, blood glucose of the mice in the treatment group were significantly decreased after 4 weeks of administration (P < 0.01) and urinary microalbumin of the mice in the treatment group were significantly decreased after 8 weeks of administration (P < 0.05). The results suggest that LLF could be beneficial in treating DN.
Pathological evaluation of LLF in treating DN mice
Following HE staining, the control group exhibited clear glomerular structures in kidney tissue. In contrast, the DN model group showed glomerular nuclear pyknosis and hyperchromasia, along with inflammatory cell infiltration around the glomeruli, compared to the normal group. Treatment with LLF ameliorated pathological damage in the kidneys of db/db mice (Figure 9E).
RT-PCR analysis of the expression of candidate biomarkers in DN mice
Following the successful establishment of a DN mouse model and the observation of significant improvement in symptoms with LLF treatment, RT-qPCR was further used to analyze the changes of candidate biomarkers. Compared to the control group, the DN group exhibited significantly reduced expression of CAT and MAOA (P < 0.05 or P < 0.001). Conversely, the treatment group showed significantly higher CAT and MAOA expression than the DN group (P < 0.05). However, no statistically significant differences were observed in the expression of MAOB and FABP1 among the groups (Figure 9F-I).
Data availability
Gene expression datasets analyzed in this study are publicly available from the Gene Expression Omnibus (GEO) under accession numbers GSE142025 and GSE96804. The R scripts used for the bioinformatics analyses, together with the experimental source data (blood glucose, urinary microalbumin, and RT-qPCR data), are provided in Supplemental File 1. All other databases, software, and web resources used in this study are listed in the Table of Materials.
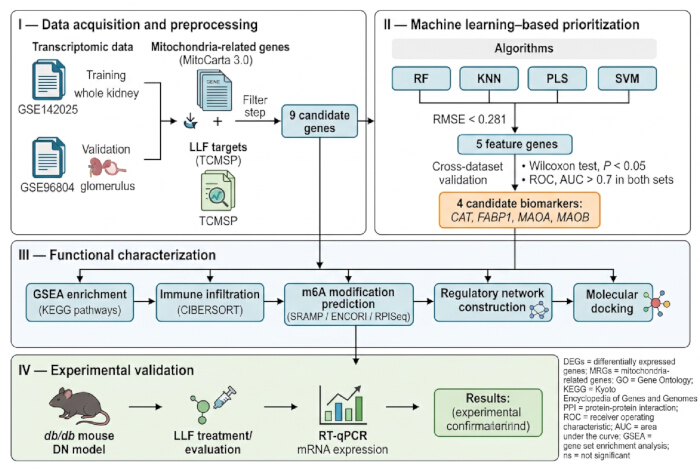
Figure 1: Workflow of the study. Transcriptomic datasets, mitochondria-related genes, and predicted targets of Ligustri Lucidi Fructus were integrated to identify candidate genes. Four machine-learning algorithms were then used to prioritize feature genes, followed by cross-dataset validation, functional characterization, and experimental validation in db/db mice. Abbreviations: DN = diabetic nephropathy; DEGs = differentially expressed genes; MRGs = mitochondria-related genes; LLF = Ligustri Lucidi Fructus; RF, random forest; KNN = k-nearest neighbor; PLS = partial least squares; SVM = support vector machine; RMSE = root mean square error; GSEA = gene set enrichment analysis; RT-qPCR = reverse transcription quantitative polymerase chain reaction. Please click here to view a larger version of this figure.
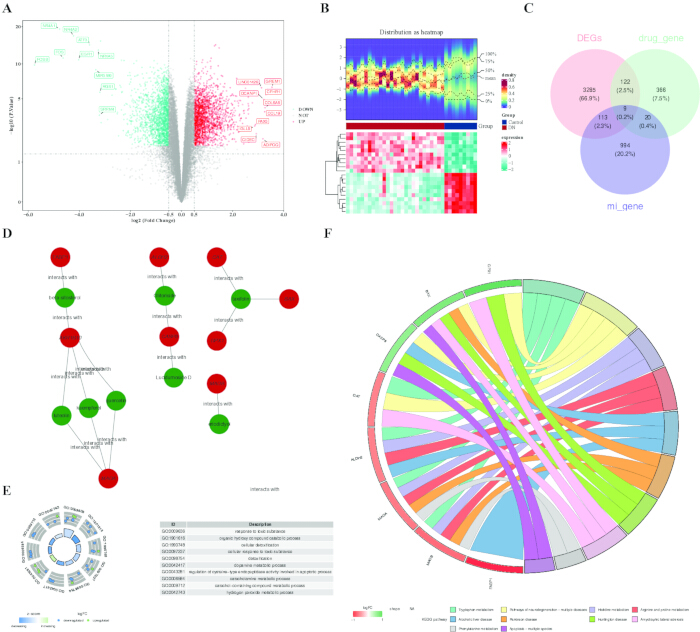
Figure 2: Screening and functional characterization of candidate genes for LLF treatment of DN. (A) Volcano plot showing differentially expressed genes between DN and control samples in GSE142025. (B) Heatmap of the top 10 upregulated and top 10 downregulated genes ranked by |log2FC|. (C) Venn diagram showing the intersection of DEGs, MRGs, and predicted LLF target genes. (D) Active ingredient–candidate gene network. (E) Gene Ontology enrichment analysis of candidate genes. Bar height represents enrichment significance, and the z-score indicates the predicted direction of functional regulation. (F) Kyoto Encyclopedia of Genes and Genomes pathway enrichment analysis of candidate genes. Abbreviations: DN = diabetic nephropathy; LLF = Ligustri Lucidi Fructus; DEGs = differentially expressed genes; MRGs = mitochondria-related genes; GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes. Please click here to view a larger version of this figure.
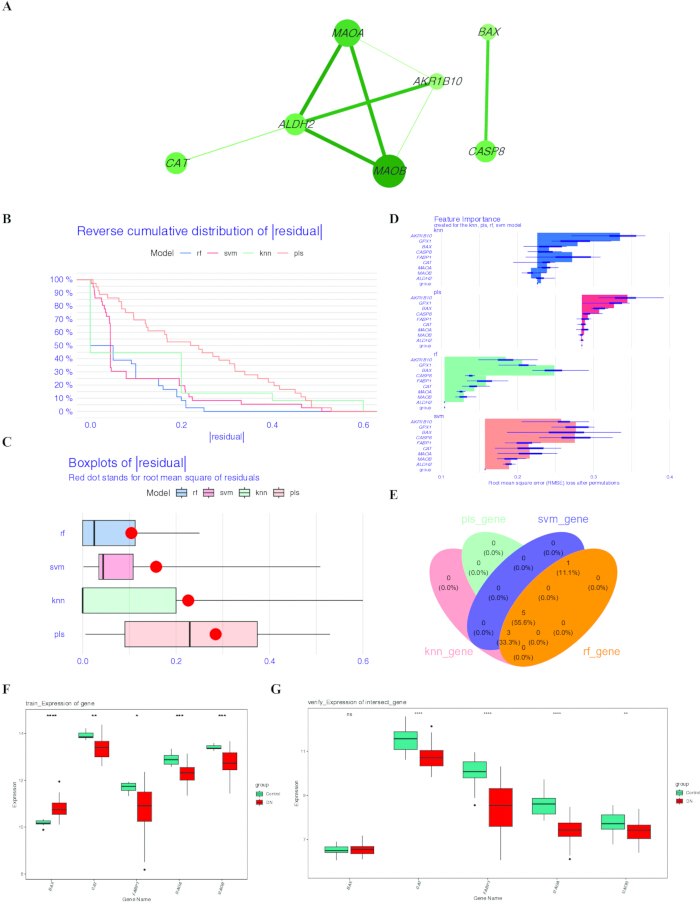
Figure 3: Machine-learning-based identification of candidate biomarkers. (A) Protein–protein interaction network of proteins encoded by the candidate genes. (B) Reverse cumulative distribution of residuals for the RF, KNN, PLS, and SVM models. (C) Boxplots showing residual distributions of the four models; the red point indicates the root mean square error. (D) RMSE-based importance of candidate genes across the four machine-learning models. (E) Intersection of feature genes meeting the RMSE < 0.281 criterion across all four models. (F,G) Expression of the selected feature genes in GSE142025 and GSE96804, respectively. Abbreviations: RF = random forest; KNN = k-nearest neighbor; PLS = partial least squares; SVM = support vector machine; RMSE = root mean square error. Please click here to view a larger version of this figure.
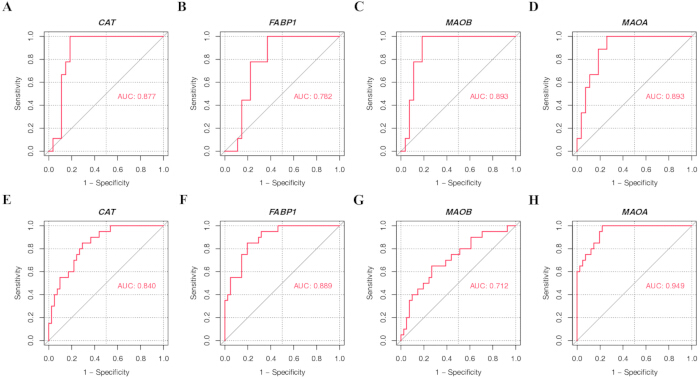
Figure 4: Receiver operating characteristic curves of the four candidate biomarkers. ROC curves for CAT, FABP1, MAOB, and MAOA in the (A-D) GSE142025 training dataset and (E-H) GSE96804 validation dataset. The AUC represents the area under the receiver operating characteristic curve. Abbreviations: ROC = receiver operating characteristic; AUC = area under the curve. Please click here to view a larger version of this figure.
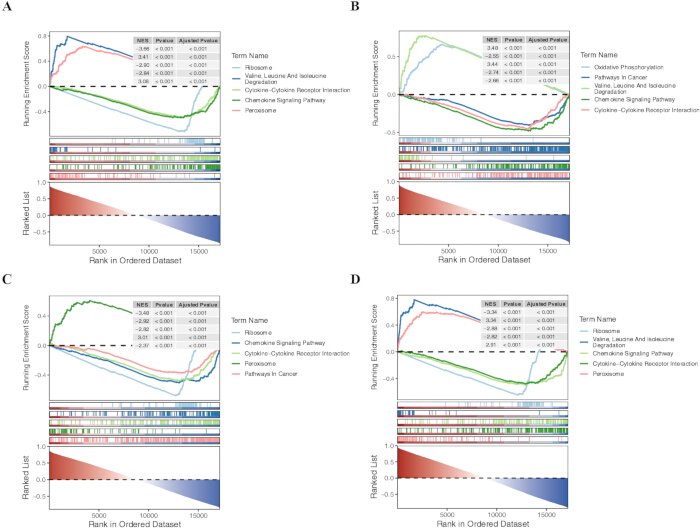
Figure 5: Gene set enrichment analysis of candidate biomarkers. GSEA showing significantly enriched KEGG pathways associated with (A) CAT, (B) FABP1, (C) MAOA, and (D) MAOB in the GSE142025 dataset. Abbreviations: GSEA = gene set enrichment analysis; KEGG = Kyoto Encyclopedia of Genes and Genomes. Please click here to view a larger version of this figure.
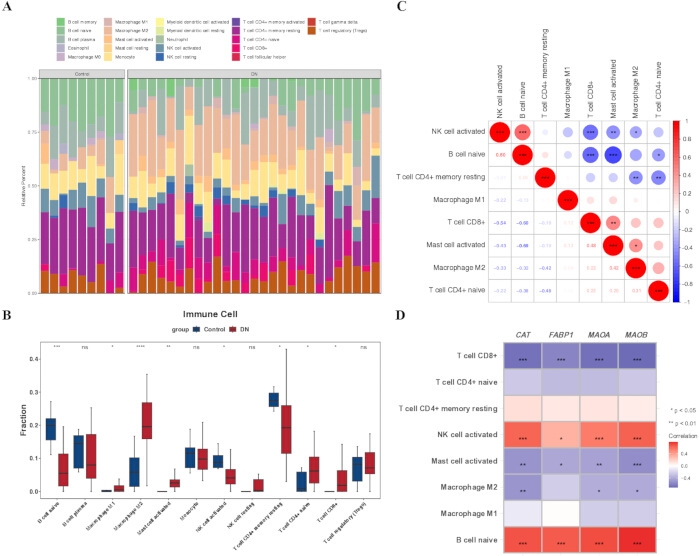
Figure 6: Immune-cell infiltration and its association with candidate biomarkers in DN. (A) Relative proportions of 22 immune cell types estimated by CIBERSORT in DN and control samples. (B) Comparison of significantly different immune-cell fractions between DN and control groups. (C) Correlation matrix among the differentially abundant immune cell types. (D) Spearman correlations between the expression of CAT, FABP1, MAOA, and MAOB and the differentially abundant immune cell types. Abbreviations: DN = diabetic nephropathy. Please click here to view a larger version of this figure.
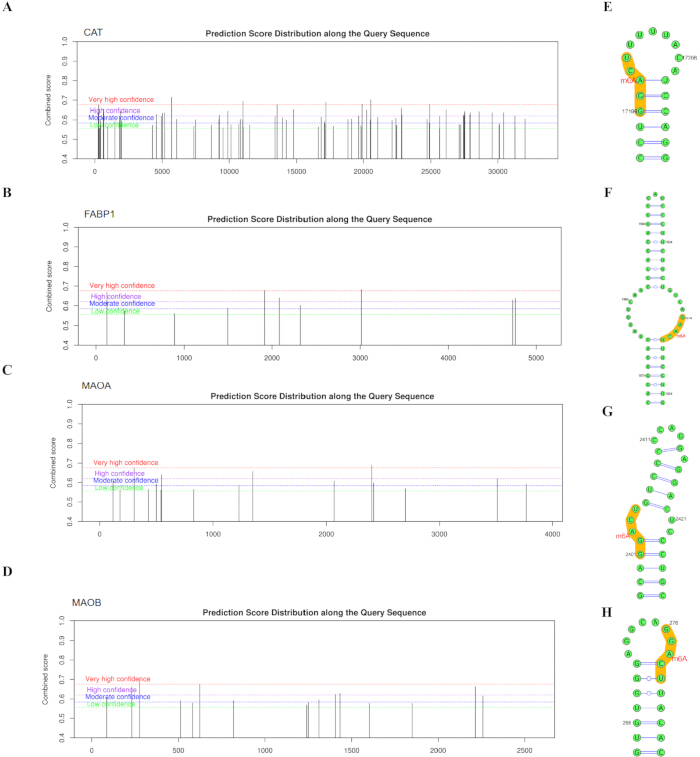
Figure 7: Predicted m6A modification sites and RNA secondary structures of candidate biomarker transcripts. Predicted m6A modification sites in (A) CAT, (B) FABP1, (C) MAOA, and (D) MAOB. Predicted RNA secondary structures showing high-confidence m6A-associated regions of (E) CAT, (F) FABP1, (G) MAOA, and (H) MAOB. Yellow-highlighted regions indicate the predicted sequence regions containing m6A modification sites. Abbreviation: m6A = N6-methyladenosine. Please click here to view a larger version of this figure.
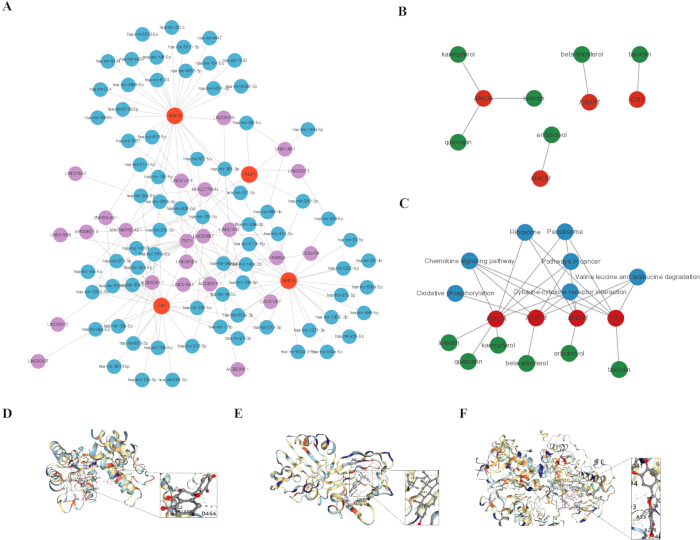
Figure 8: Regulatory networks and molecular docking of potential active ingredients of LLF. (A) Predicted lncRNA–miRNA–mRNA regulatory network involving the candidate biomarkers. (B) Network of potential LLF active ingredients and candidate biomarkers. (C) Active ingredient–biomarker–pathway network based on the GSEA results. (D-F) Predicted molecular docking conformations of (D) CAT with taxifolin, (E) FABP1 with beta-sitosterol, and (F) MAOB with eriodictyol. Abbreviations: LLF = Ligustri Lucidi Fructus; lncRNA = long noncoding RNA; miRNA = microRNA; GSEA = gene set enrichment analysis. Please click here to view a larger version of this figure.
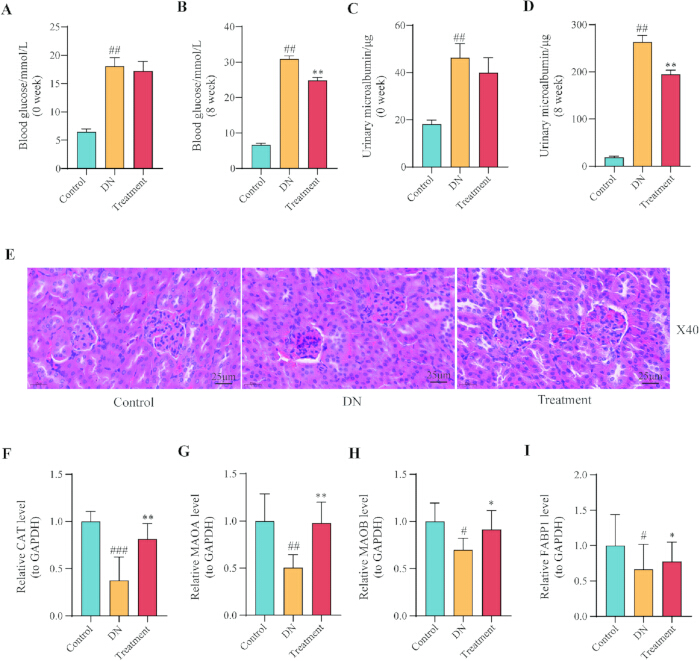
Figure 9: Effects of LLF treatment on biochemical indicators, renal histopathology, and candidate biomarker expression in db/db mice. (A,B) Blood glucose levels at baseline and week 8, respectively. (C,D) Urinary microalbumin levels at baseline and week 8, respectively. (E) Representative hematoxylin and eosin-stained kidney sections from the Control, DN, and Treatment groups (magnification, ×40; scale bar = 25 µm). (F-I) Relative renal mRNA expression levels of Cat, Maoa, Maob, and Fabp1, respectively, measured by RT-qPCR. #P < 0.05, ##P < 0.01, and ###P < 0.001 versus the Control group; *P < 0.05, **P < 0.01, and ***P < 0.001 versus the DN group. Abbreviations: LLF = Ligustri Lucidi Fructus; DN = diabetic nephropathy; RT-qPCR = reverse transcription quantitative polymerase chain reaction. Please click here to view a larger version of this figure.
| primer | sequences |
| CAT F | TCACTGACGAGATGGCACAC |
| CAT R | ATCGAACGGCAATAGGGGTC |
| FABP1 F | CAATAGGTCTGCCCGAGGAC |
| FABP1 R | GTCATGGTCTCCAGTTCGCA |
| MAOB F | GCACTGAAACAGCCTCACAC |
| MAOB R | TCGTGCAGGGACATCCAAAG |
| MAOA F | ACTTACCCATTCCGTGGTGC |
| MAOA R | ACCACAGGGCAGATACCTCA |
| M-GAPDH F | CCTTCCGTGTTCCTACCCC |
| M-GAPDH R | GCCCAAGATGCCCTTCAGT |
Table 1: Primer sequences used for RT-qPCR analysis of mouse kidney tissues. Abbreviations: F = forward primer; R = reverse primer; RT-qPCR = reverse transcription quantitative polymerase chain reaction.
| MOL ID | Molecule name | OB (%) | DL | Target number |
| MOL000358 | beta-sitosterol | 36.91 | 0.75 | 100 |
| MOL000422 | kaempferol | 41.88 | 0.24 | 103 |
| MOL004576 | taxifolin | 57.84 | 0.27 | 92 |
| MOL005146 | Lucidumoside D | 48.87 | 0.71 | 104 |
| MOL005147 | Lucidumoside D_qt | 54.41 | 0.47 | 0 |
| MOL005169 | (20S)-24-ene-3,20-diol-3-acetate | 40.23 | 0.82 | 0 |
| MOL005190 | eriodictyol | 71.79 | 0.24 | 101 |
| MOL005195 | syringaresinol diglucoside_qt | 83.12 | 0.8 | 0 |
| MOL005209 | Lucidusculine | 30.11 | 0.75 | 105 |
| MOL005211 | Olitoriside | 65.45 | 0.23 | 100 |
| MOL005212 | Olitoriside_qt | 103.23 | 0.78 | 0 |
| MOL000006 | luteolin | 36.16 | 0.25 | 102 |
| MOL000098 | quercetin | 46.43 | 0.28 | 103 |
Table 2: Thirteen active ingredients of Ligustri Lucidi Fructus identified using the TCMSP database. Abbreviations: OB = oral bioavailability; DL = drug-likeness.
| mRNA | Protein | RF | SVM |
| CAT | AQR | 0.7 | 0.98 |
| CAT | RBM22 | 0.8 | 0.97 |
| FABP1 | AQR | 0.65 | 0.94 |
| FABP1 | SF3A3 | 0.7 | 0.8 |
| MAOA | IGF2BP2 | 0.75 | 0.97 |
| MAOA | IGF2BP3 | 0.75 | 0.97 |
| MAOB | TIA1 | 0.85 | 0.89 |
Table 3: Predicted interactions between four mitochondrial biomarker mRNAs and m6A-related RNA-binding proteins. CAT, FABP1, MAOA, and MAOB denote human biomarker mRNAs; AQR, RBM22, SF3A3, IGF2BP2, IGF2BP3, and TIA1 denote RNA-binding proteins. RF and SVM scores > 0.5 indicate predicted RNA–protein interactions. Abbreviations: RF = random forest; SVM = support vector machine.
Supplemental File 1. Bioinformatics scripts and experimental source data. This archive contains the R scripts used for data processing, differential expression analysis, functional enrichment, machine learning, receiver operating characteristic analysis, gene set enrichment analysis, Spearman correlation analysis, and CIBERSORT immune-cell infiltration analysis, together with the source data for blood glucose, urinary microalbumin, and RT-qPCR experiments. Please click here to download this file.
Diskussion
LLF ist ein häufig verwendetes traditionelles chinesisches Arzneimittel, das hauptsächlich zur Stärkung der Leber und Nieren sowie zur Behandlung von Diabetes und seinen Komplikationen eingesetzt wird. Derzeit gibt es keine spezifischen Arzneimittel oder Therapien für die diabetische Nephropathie (DN), sodass die Behandlung vorwiegend auf blutglukosesenkenden, lipidregulierenden und blutdrucksenkenden Maßnahmen beruht30,31,32. Diese Therapien können jedoch bei nur einer geringen Zahl von Patienten den Fortschritt der Nierenschädigung verlangsamen33. Es wurde gezeigt, dass LLF in Rattenmodellen der DN nierenprotektive Wirkungen entfaltet, indem es Störungen des Glukose- und Lipidstoffwechsels korrigiert und oxidativen Stress vermindert34. Bemerkenswerterweise spielt eine gestörte mitochondriale Dynamik in der Niere – einem Organ mit außergewöhnlich hohem Mitochondriengehalt und Sauerstoffverbrauch – eine zentrale Rolle bei der Entstehung der DN35. Diese Studie beschreibt einen neuartigen Wirkmechanismus, über den LLF die mitochondriale Funktion durch spezifische Kandidat-Biomarker (CAT, FABP1, MAOB und MAOA) bei der Behandlung der DN beeinflussen könnte.
Frühere Studien haben gezeigt, dass Katalase (CAT), das Fettsäure-bindende Protein 1 (FABP1), die Monoaminooxidase B (MAOB) und die Monoaminooxidase A (MAOA) in unterschiedlichem Maße an der diabetischen Nephropathie (DN) beteiligt sind. CAT ist in das antioxidative Abwehrsystem eingebunden und schützt die Niere vor durch oxidativen Stress verursachten Schäden36. CAT, ein zentrales antioxidatives Enzym im Körper, wirkt an der Regulierung des Auftretens und Fortschreitens der DN durch die Modulation mitochondrienbezogener physiologischer Prozesse mit37. CAT katalysiert spezifisch den Zerfall von Wasserstoffperoxid (H₂O₂) in Wasser und Sauerstoff und beseitigt dadurch effektiv aus Mitochondrien stammende reaktive Sauerstoffspezies (ROS). Dadurch werden strukturelle und funktionelle mitochondriale Schäden durch oxidativen Stress verringert, die Stabilität des mitochondrialen Membranpotentials sowie die Effizienz der oxidativen Phosphorylierung erhalten, was wiederum hochglukosebedingte Nierenzellschäden abschwächt und das Fortschreiten der DN verzögert38. Außerdem führt eine verminderte Expression von CAT zu unzureichender Eliminierung von mitochondrialen ROS, wodurch die mitochondriale Fragmentierung und die Störung der Cristae verstärkt werden. Dies hemmt die mitochondriale Fusion und begünstigt die Fission, wodurch die mitochondriale Dynamik weiter destabilisiert wird. Folglich entwickeln intrinsische Zellen wie Mesangialzellen und Podocyten Stoffwechselstörungen, wodurch die Fibrose des Nierengewebes beschleunigt wird39.
FABP1, als Mitglied der Familie der Fettsäure-bindenden Proteine, ist hauptsächlich an dem Transport, dem Stoffwechsel und der intrazellulären Signalübertragung von langkettigen Fettsäuren beteiligt. Es wurde gezeigt, dass seine abnormale Expression eng mit verschiedenen Stoffwechselerkrankungen und Nierenschäden assoziiert ist und eine entscheidende regulatorische Rolle bei der Entstehung und Progression der diabetischen Nephropathie (DN) spielt40. Untersuchungen deuten darauf hin, dass FABP1 den Verlauf der DN durch Störung des Lipidstoffwechsels beeinflusst. Bei Diabetes stört eine abnormale FABP1-Expression den Transport und Stoffwechsel von Fettsäuren. Überschüssige freie Fettsäuren und ihre Metaboliten reichern sich im Nierengewebe an und schädigen direkt glomeruläre Endothelzellen und tubuläre Epithelzellen, wodurch Entzündungen und Fibrose in der Niere verstärkt werden41. Gleichzeitig verschärft FABP1 die Nierengewebeschädigung durch Vermittlung von oxidativem Stress und hypoxieinduzierten Schäden. Die Ausscheidung von FABP1 im Urin kann bereits vor einer Erhöhung der Albuminausscheidung im Urin zunehmen, was einen neuartigen Ansatzpunkt für die frühe Screening- und Diagnosestellung der DN darstellt41,42. Darüber hinaus spielt FABP1 eine zentrale regulatorische Rolle im mitochondrialen Fettsäurestoffwechsel43. Studien zeigen, dass eine Hochregulierung von FABP1 die Effizienz des Fettsäuretransports in die Mitochondrien signifikant erhöht, die mitochondriale β-Oxidationsaktivität sowie die Aktivität der Enzyme des Tricarbonsäurezyklus steigert und somit den zellulären Energiestoffwechsel verbessert44. Der Mechanismus, durch den FABP1 die Pathogenese der DN über mitochondriale Prozesse beeinflusst, bleibt jedoch unklar. Bei anderen DN-assoziierten Erkrankungen wurden MAOB und MAOA, Enzyme des Neurotransmitterstoffwechsels, mit dem Fortschreiten der DN in Verbindung gebracht und tragen zu einem Ungleichgewicht im Redoxzustand des Gewebes bei. Diese Studie bestätigt weiterhin die zentrale Rolle dieser vier Kandidaten-Biomarker bei der DN, wobei ihre Expressionsniveaus in der DN-Gruppe abnehmen. Es wird vermutet, dass die Modulation der Expression dieser Kandidaten-Biomarker helfen könnte, Entzündungen und oxidativen Stress bei der DN zu reduzieren.
Basierend auf der GSEA-Anreicherungsanalyse waren vier Kandidaten-Biomarker – CAT, FABP1, MAOB und MAOA – in mehreren Signalwegen angereichert, darunter der Chemokin-Signalweg, die Zytokin-Zytokin-Rezeptor-Interaktion sowie Peroxisomenwege. Chemokine sind Schlüsselkomponenten der Immunantwort und fördern Entzündungen. Der Peroxidase-(POD)-Weg ist mit oxidativem Stress assoziiert45. Es wurde berichtet, dass Baicalin diabetische Nephropathie (DN) durch Verringerung von oxidativem Stress und Entzündungen lindern kann, wobei sein Wirkmechanismus möglicherweise die Aktivierung des NrF2-vermittelten antioxidativen Signalwegs und die Hemmung des MAPK-vermittelten entzündlichen Signalwegs umfasst45. Darüber hinaus könnte eine Dysregulation von FABP1 im Lipidstoffwechsel zur Glomerulosklerose und interstitiellen Fibrose bei DN beitragen9. Diese Ergebnisse deuten darauf hin, dass die Kandidaten-Biomarker eine entscheidende Rolle in den entzündlichen Prozessen und beim oxidativen Stress bei DN spielen. Eine gezielte Beeinflussung dieser Kandidaten-Biomarker zur Modulation der von ihnen beeinflussten Signalwege könnte die mit DN assoziierten Entzündungen und oxidativen Stresszustände abschwächen und somit dem Fortschreiten der Erkrankung entgegenwirken.
Die Bioinformatik-Analyse zeigte, dass die Infiltrationsgrade von Immunzellsubtypen wie CD8+ T-Zellen im Nierengewebe bei diabetischer Nephropathie (DN) signifikant verändert waren und dass der Anstieg der CD8+ T-Zellen signifikant negativ mit der Expression von vier mitochondrienbezogenen Kandidaten-Biomarkern (CAT, FABP1, MAOB, MAOA) korrelierte. Diese computergestützten Vorhersagen stimmen mit den pathologischen Beobachtungsergebnissen aus Tierversuchen überein: H&E-gefärbte Nierenschnitte von Mäusen der DN-Modellgruppe wiesen eine deutliche Infiltration von Entzündungszellen um die Glomeruli auf; nach der Behandlung mit LLF war die Infiltration entzündlicher Nierenzellen in der Therapiegruppe deutlich reduziert und die pathologischen Schäden waren verbessert. Dies deutet darauf hin, dass eine erhöhte Infiltration von Entzündungszellen ein Schlüsselmerkmal der Nierenschädigung bei DN darstellt und dass LLF möglicherweise eine schützende Wirkung durch Regulierung der Immuninfiltration entfaltet. Dieses Ergebnis steht im Einklang mit früheren Studien: Die Infiltration von CD8+ T-Zellen ist mit der Entwicklung der DN assoziiert, und die Hemmung ihrer Aktivität kann die Erkrankung lindern46, was auch bei der Adriamycin-Nephropathie die Nierenschädigung verschlimmert47. Darüber hinaus zeigen sich bei der DN-Pathologie Veränderungen verschiedener Immunzellen, wie B-Zellen, M1-/M2-Makrophagen und NK-Zellen48. Der Biomarker CAT könnte die Funktion von Immunzellen bei der DN beeinflussen49, und MAOA könnte ebenfalls den immunologischen Mikromilieu durch Regulierung der Makrophagenpolarisation beeinflussen. Diese Ergebnisse deuten darauf hin, dass die nephroprotektive Wirkung von LLF eng mit der Regulation einer abnormalen Immuninfiltration, einschließlich der CD8+ T-Zellen, verbunden ist und so entzündliche Schäden reduziert. Die negativen Korrelationen zwischen den vier Kandidaten-Biomarkern und CD8+ T-Zellen sowie aktivierten Mastzellen legen nahe, dass diese Gene den immunologischen Mikromilieu in der Niere modulieren könnten. Die Expression von CAT wurde bereits mit der Makrophagenpolarisation und der T-Zell-Aktivität in metabolischen Geweben in Verbindung gebracht. Allerdings basieren unsere CIBERSORT-Schätzungen auf transkriptomweiten Analysen von gesamtem Nierengewebe, die nicht zwischen Immunzellsubtypen in glomerulären und tubulointerstitiellen Kompartimenten unterscheiden können. Die beobachteten Korrelationen sollten daher als hypothesengenerierende Assoziationen und nicht als Beleg für eine kausale Immunregulation interpretiert werden. Zukünftige Studien mittels multiplex Immunhistochemie oder Einzelzell-RNA-Sequenzierung sind erforderlich, um die Lokalisation dieser Interaktionen zwischen Immunzellen und Biomarkern zu bestimmen.
Frühere Studien berichteten über mitochondrienbezogene Biomarker bei DN, einschließlich OPA1, MFN2, DRP1, PGC-1α und SOD2. Unsere Ergebnisse zu CAT und MAOA ergänzen die bestehende Literatur, indem sie Peroxisomen- und Monoaminooxidase-Wege hervorheben, die im mitochondrialen Kontext von DN bisher weniger Beachtung fanden. Bemerkenswerterweise zielen zwar SOD2 und GPX1 als klassische ROS-abfängende Enzyme auf reaktive Sauerstoffspezies ab, CAT hingegen spezifisch auf peroxisomales H2O2, was auf einen eigenständigen subzellulären Kompartiment bei der Regulation oxidativen Stresses hinweist.
Als natürlicher Flavonoid hat Taxifolin (TA) bei diabetischen Ratten eine signifikante Senkung der Blutglukose-, Harnsäure-, Kreatinin- und Seruminsulinspiegel gezeigt und gleichzeitig pathologische Nierenveränderungen bei diesen Tieren gemindert50. β-Sitosterol könnte die diabetische Nephropathie (DN) indirekt verbessern, indem es das Lipidgleichgewicht reguliert und entzündungshemmende Wirkungen entfaltet. Die β-Sitosterol-Bestandteile der Huangqi-Gegen-Abkochung (HGD) sind an DN-bezogenen Signalwegen beteiligt und zielen auf Moleküle wie Vascular Endothelial Growth Factor A (VEGFA) und Interleukin-6 (IL-6) ab. Zu diesen Wirkungen zählen entzündungshemmende, antiapoptotische, antioxidative und autophagische Effekte, die die Nierenfibrose und kortikale Nierenschäden verringern sowie die Nierenfunktion verbessern und somit das Fortschreiten der DN verzögern51. Eriodictyol, ein weiterer natürlicher Flavonoid, hat sich als schützend gegen ischämischen Schlaganfall (IS) erwiesen, indem es oxidativen Stress und Entzündungen ausbalanciert52. Obwohl bisher nur wenige Studien zu Eriodictyol im Kontext der DN vorliegen, wird angesichts der Assoziation dieser Erkrankung mit Entzündungen und oxidativem Stress vermutet, dass es die DN über ähnliche Mechanismen lindern könnte. Arzneimittelvorhersagen in dieser Studie deuten ebenfalls darauf hin, dass Taxifolin, β-Sitosterol und Eriodictyol therapeutisches Potenzial bei der DN besitzen. Molekulares Docking sagt mögliche Bindungskonformationen und -affinitäten voraus, belegt jedoch keine in vivo-Targetbindung, Bioverfügbarkeit oder pharmakologische Aktivität. Diese Ergebnisse sollten daher als hypothetisch generierend und nicht als bestätigend interpretiert werden.
Frühere Netzwerkpharmakologie-Studien zur diabetischen Nephropathie (DN) konzentrierten sich weitgehend auf einzelne Signalwege (z. B. AGE-RAGE, PI3K-AKT und MAPK) und berücksichtigten weder mitochondriale Dysfunktion noch setzten sie maschinelles Lernen mit mehreren Modellen zur Priorisierung von Biomarkern ein. Unsere Studie stellt drei methodische und biologische Fortschritte vor: (1) die Integration transkriptomweiter differenziell exprimierter Gene (DEGs) mit mitochondrialen Gen-Sets und Vorhersagen von Arzneimittelzielen; (2) die Anwendung von vier verschiedenen Modellen des maschinellen Lernens mit Quer-Validierung über Datensätze hinweg zur Priorisierung robuster Kandidaten; und (3) die Identifizierung von peroxisomalen (CAT) und Monoaminooxidase-(MAOA/MAOB)-Signalwegen – die im mitochondrialen Kontext der DN bisher wenig erforscht sind – als vielversprechende therapeutische Ansatzpunkte.
Das Fehlen statistisch signifikanter Veränderungen in der Expression von MaoB und Fabp1 in der Mausniere könnte auf mehrere Faktoren zurückzuführen sein. Erstens stammten die beiden für die Kandidatenauswahl verwendeten Gene Expression Omnibus (GEO)-Datensätze von menschlichen Nierengewebeproben (jeweils gesamte Niere und Glomerulus), während unser Tierversuch murines Nierengewebe verwendete. Spezies-spezifische Unterschiede in der Genregulation könnten die Grundexpressionsspiegel und die Empfindlichkeit gegenüber Medikamenten beeinflussen. Zweitens könnte die relativ geringe Stichprobengröße (n = 6 pro Gruppe) die statistische Aussagekraft zur Detektion moderater Effektgrößen eingeschränkt haben. Drittens wurde das Gewebe acht Wochen nach der Behandlung entnommen, was möglicherweise nicht das optimale Zeitfenster zur Erfassung transkriptomischer Veränderungen in MaoB und Fabp1 abdeckt, da diese Gene auf Proteinebene oder in ihrer Aktivität und nicht auf mRNA-Ebene reguliert sein könnten. Viertens könnte die Gewebeheterogenität – zwischen der gesamten Niere und spezifischen Kompartimenten – zu Diskrepanzen beitragen. Eine weitere Untersuchung dieser Möglichkeiten ist erforderlich.
Diese Studie verwendete einen integrativen Bioinformatik- und maschinellen Lernansatz, um CAT, FABP1, MAOA und MAOB als potenzielle mitochondriale Kandidatengene für LLF bei DN zu identifizieren. In-vivo-Experimente bestätigten, dass LLF die Expression von CAT und MAOA im Nierengewebe signifikant hochreguliert, was darauf hindeutet, dass diese Gene vielversprechende Zielstrukturen für weitere mechanistische und therapeutische Untersuchungen darstellen. Im Gegensatz dazu zeigten MAOB und FABP1 nicht signifikante Tendenzen in dieselbe Richtung, was die Bedeutung experimenteller Validierung bei der Priorisierung computergestützter Vorhersagen unterstreicht. Diese Ergebnisse liefern eine Grundlage dafür, zukünftige Studien zur Erforschung mitochondrienbezogener therapeutischer Strategien bei DN durchzuführen.
Offenlegungen
Die Autoren haben keine Interessenkonflikte anzugeben.
Danksagungen
Wir möchten allen Einzelpersonen und Organisationen, die uns während dieser Forschung unterstützt und geholfen haben, unseren aufrichtigen Dank aussprechen. Diese Studie wurde unterstützt durch die Nationale Naturwissenschaftliche Stiftung Chinas (Nr. 81973486 und 82173974), die Forschungsprojekte der Verwaltung für Traditionelle Chinesische Medizin der Provinz Shanxi (Nr. 2024ZYYA021), das Fachdisziplin-Projekt der Shanxi-Universität für Chinesische Medizin (Nr. 2026XK24) und das wissenschaftliche Forschungsförderungsprojekt der Shandong-Universität für Chinesische Medizin (Nr. KYZK2024Q13). Wir danken Qinqing Li, außerordentlicher Professor an der Shanxi-Universität für Chinesische Medizin, der das botanische Material authentifiziert hat.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| 4 % Paraformaldehyd-Gewebe-Fixierungslösung | Saiyin Biotechnology Co., Ltd. | 71033600 | |
| Absolute Ethanol | Sinopharm Chemical Reagent Co., Ltd. | 10009218 | |
| Blutzuckermessgerät | Sinocare Inc. | GA-3 | |
| Blut-Harnstoff-Stickstoff-(BUN-)Testkit | Nanjing Jianwei Bioengineering Institute | C03-2-1 | |
| C57BLKS/J db/db-Mäuse | Changzhou Cavens Experimental Animal Co., Ltd. | SCXK (Su) 2021-0013 | |
| C57BLKS/J db/m-Mäuse | Changzhou Cavens Experimental Animal Co., Ltd. | SCXK (Su) 2021-0013 | |
| Zentrifuge | Hunan Xiangyi Laboratory Instrument Development Co., Ltd. | HI650 | |
| Chloralhydrat | Shanghai Aladdin Biochemical Technology Co., Ltd. | 302-17-0 | |
| Cytoscape (v3.9.0) | https://cytoscape.org | ||
| Datenbank für m6A-Modifikationsvorhersage | http://www.cuilab.cn/sramp/ | ||
| Datenbank für Wirkstoffe in der traditionellen chinesischen Medizin | http://sm.nwsuaf.edu.cn/lsp/tcmsp.php | ||
| ENCORI / Starbase | https://starbase.sysu.edu.cn/ | ||
| Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/ | ||
| HE-Färbekit (Hämatoxylin und Eosin) | Servicebio | C0105S | |
| Schnellzentrifuge | Labnet, USA | C2500-R-230V | |
| Werkzeug zur Analyse der Immuninfiltration | https://cibersort.stanford.edu/ | ||
| Ligustri Lucidi Fructus | Sichuan Quanyirun Biotechnology Co., Ltd. | 20240506 | |
| Magnet-Rührer | Jintan Zhongtian Instrument Factory, Jiangsu | T8-1 | |
| Mikroskop | Olympus | BX53 | |
| Mikrotom | Leica, Germany | RM 2016 | |
| Mikroliter-Spektrophotometer | Hangzhou Aosheng Instrument Co., Ltd. | Nano-300 | |
| miRNet | https://www.mirnet.ca | ||
| MitoCarta 3.0 | https://www.broadinstitute.org/mitocarta | ||
| R-Paket zur Modellinterpretation | https://cran.r-project.org/package=DALEX | ||
| Molekulares Docking-Portal | http://clab.labshare.cn/cb-dock/ | ||
| Maus-Mikroalbuminurie-ELISA-Kit | Fine Test | EM0632 | |
| Maus-Mikroalbuminurie-Teststreifen | Guangzhou Huadu Gaoerbao Biotechnology Co., Ltd. | 20211203 | |
| Maus-Serum-Kreatinin-ELISA-Kit | Abmart | AB5990A | |
| MSigDB | https://www.gsea-msigdb.org/gsea/msigdb/ | ||
| PCR-Thermocycler | Roche | Roche LightCycler 480 | |
| R-Software (v4.2.2) + R-Pakete | https://www.r-project.org / CRAN/Bioconductor | ||
| RCSB PDB | https://www.rcsb.org | ||
| RNA-Extraktionskit | Beijing Jumei Biotech Co., Ltd. | MF-036-01 | |
| RPISeq | http://pridb.gdcb.iastate.edu/RPISeq/ | ||
| RT-qPCR-Kit | Beijing Jumei Biotech Co., Ltd. | MF949-T | |
| Salidroside | Sichuan Quanyirun Biotechnology Co., Ltd. | 20211009 | |
| Serum-Kreatinin-Testkit | Nanjing Jianwei Bioengineering Institute | C011-2-1 | |
| SPF-Tierhaltungsanlage | Shanxi University of TCM | ||
| SRAMP | http://www.cuilab.cn/sramp/ | ||
| STRING | https://cn.string-db.org/ | ||
| SwissTargetPrediction | http://www.swisstargetprediction.ch/ | ||
| TCMSP | http://sm.nwsuaf.edu.cn/lsp/tcmsp.php | ||
| Tezhi Pigan | Sichuan Quanyirun Biotechnology Co., Ltd. | 20210602 | |
| Gewebeschwimmbecken | Wuhan Junjie | JK-6 |
Referenzen
- Thipsawat S. Early detection of diabetic nephropathy in patient with type 2 diabetes mellitus: a review of the literature. Diabetes Vasc Dis Res. 2021;18(6):14791641211058856.
- Kanwar YS, Sun L, Xie P, Liu FY, Chen S. A glimpse of various pathogenetic mechanisms of diabetic nephropathy. Annu Rev Pathol. 2011;6:395-423.
- Santulli G, et al. Prediabetes increases the risk of frailty in prefrail older adults with hypertension: beneficial effects of metformin. Hypertension. 2024;81(7):1637-43.
- Jin Q, et al. Oxidative stress and inflammation in diabetic nephropathy: role of polyphenols. Front Immunol. 2023;14:1185317.
- Alicic RZ, Rooney MT, Tuttle KR. Diabetic kidney disease: challenges, progress, and possibilities. Clin J Am Soc Nephrol. 2017;12(12):2032-45.
- Harrington JS, et al. Mitochondria in health, disease, and aging. Physiol Rev. 2023;103(4):2349-422.
- Peña FJ, et al. An integrated overview on the regulation of sperm metabolism (glycolysis-Krebs cycle-oxidative phosphorylation). Anim Reprod Sci. 2022;246:106805.
- de Mello AH, Costa AB, Engel JDG, Rezin GT. Mitochondrial dysfunction in obesity. Life Sci. 2018;192:26-32.
- Shen Y, et al. Notoginsenoside Fc, a novel renoprotective agent, ameliorates glomerular endothelial cells pyroptosis and mitochondrial dysfunction in diabetic nephropathy through regulating HMGCS2 pathway. Phytomedicine. 2024;126:155445.
- Zhang PN, et al. Mitochondrial dysfunction and diabetic nephropathy: nontraditional therapeutic opportunities. J Diabetes Res. 2021;2021:1010268.
- Zhang JL, et al. Structural characterization and protective effect against renal fibrosis of polysaccharide from Ligustrum lucidum Ait. J Ethnopharmacol. 2023;302(Pt A):115898.
- Luan R, et al. The protective effect of ethyl acetate and n-butanol fractions of wine-steamed Ligustri Lucidi Fructus on diabetic nephropathy in rats. Evid Based Complement Alternat Med. 2021;2021:6512242.
- Luan R, et al. Pharmacodynamics, pharmacokinetics, and kidney distribution of raw and wine-steamed Ligustri Lucidi Fructus extracts in diabetic nephropathy rats. Molecules. 2023;28(2):791.
- Seo HL, et al. Liqustri lucidi Fructus inhibits hepatic injury and functions as an antioxidant by activation of AMP-activated protein kinase in vivo and in vitro. Chem Biol Interact. 2017;262:57-68.
- Yan M, et al. Identification of pyroptosis-related genes and potential drugs in diabetic nephropathy. J Transl Med. 2023;21(1):490.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Gustavsson EK, et al. ggtranscript: an R package for the visualization and interpretation of transcript isoforms using ggplot2. Bioinformatics. 2022;38(15):3844-6.
- Gu Z, Eils R, Schlesner M. Complex heatmaps reveal patterns and correlations in multidimensional genomic data. Bioinformatics. 2016;32(18):2847-9.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-504.
- Wu T, et al. clusterProfiler 4.0: a universal enrichment tool for interpreting omics data. Innovation (Camb). 2021;2(3):100141.
- Dong H, et al. Identification through machine learning of potential immune-related gene biomarkers associated with immune cell infiltration in myocardial infarction. BMC Cardiovasc Disord. 2023;23(1):163.
- Pei B, et al. The development of prediction model for cuffed tracheal tube size from the middle finger in pediatrics: a concise and feasible approach. Transl Pediatr. 2023;12(12):2222-31.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77.
- Robles-Jimenez LE, et al. Worldwide traceability of antibiotic residues from livestock in wastewater and soil: a systematic review. Animals (Basel). 2021;12(1):60.
- Wang Y, et al. Bioinformatics analysis combined with clinical sample screening reveals that leptin may be a biomarker of preeclampsia. Front Physiol. 2022;13:1031950.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2^−ΔΔCT method. Methods. 2001;25(4):402-8.
- Klejborowska G, et al. Synthesis, anticancer activity and molecular docking studies of N-deacetylthiocolchicine and 4-iodo-N-deacetylthiocolchicine derivatives. Bioorg Med Chem. 2021;32:116014.
- Reagan-Shaw S, Nihal M, Ahmad N. Dose translation from animal to human studies revisited. FASEB J. 2008;22(3):659-61.
- An Y, Duan H. The role of m6A RNA methylation in cancer metabolism. Mol Cancer. 2022;21(1):14.
- Mazzieri A, Porcellati F, Timio F, Reboldi G. Molecular targets of novel therapeutics for diabetic kidney disease: a new era of nephroprotection. Int J Mol Sci. 2024;25(7):3969.
- Breyer MD, Susztak K. The next generation of therapeutics for chronic kidney disease. Nat Rev Drug Discov. 2016;15(8):568-88.
- Leoncini G, et al. Blood pressure reduction and RAAS inhibition in diabetic kidney disease: therapeutic potentials and limitations. J Nephrol. 2020;33(5):949-63.
- Pofi R, et al. Diabetic nephropathy: focus on current and future therapeutic strategies. Curr Drug Metab. 2016;17(5):497-502.
- Arellano Buendía AS, et al. Immunomodulatory effects of the nutraceutical garlic derivative allicin in the progression of diabetic nephropathy. Int J Mol Sci. 2018;19(10):3107.
- Zhang X, Agborbesong E, Li X. The role of mitochondria in acute kidney injury and chronic kidney disease and its therapeutic potential. Int J Mol Sci. 2021;22(20):11253.
- Liu Y, et al. DsbA-L interacting with catalase in peroxisome improves tubular oxidative damage in diabetic nephropathy. Redox Biol. 2023;66:102855.
- Zhong Y, et al. Jujuboside A ameliorates high fat diet and streptozotocin induced diabetic nephropathy via suppressing oxidative stress, apoptosis, and enhancing autophagy. Food Chem Toxicol. 2022;159:112697.
- Zhong Y, et al. Dioscin relieves diabetic nephropathy via suppressing oxidative stress and apoptosis, and improving mitochondrial quality and quantity control. Food Funct. 2022;13(6):3660-73.
- Issac PK, et al. Protective effect of morin by targeting mitochondrial reactive oxygen species induced by hydrogen peroxide demonstrated at a molecular level in MDCK epithelial cells. Mol Biol Rep. 2022;49(6):4269-79.
- Abo El-Asrar M, Ismail EAR, Elnhrawy AM, Thabet RA. Fatty acid binding protein 1 (FABP1) and fatty acid binding protein 2 (FABP2) as a link between diabetic nephropathy and subclinical atherosclerosis in children and adolescents with type 1 diabetes. J Diabetes Complications. 2023;37(3):108414.
- Gholaminejad A, Fathalipour M, Roointan A. Comprehensive analysis of diabetic nephropathy expression profile based on weighted gene co-expression network analysis algorithm. BMC Nephrol. 2021;22(1):245.
- Tanaka M, et al. Urinary fatty acid-binding protein 4 is a promising biomarker for glomerular damage in patients with diabetes mellitus. J Diabetes Investig. 2025;16(4):670-9.
- Liu Y, et al. Gastric cancer adapts high lipid microenvironment via suppressing PPARG-FABP1 axis after arriving in the lymph node. Redox Biol. 2025;85:103759.
- Borús DL, et al. Fatty acid binding protein 1 (FABP1) depletion promotes an oxidative metabolic shift in Caco-2 colorectal cancer cells. Biochim Biophys Acta Mol Cell Biol Lipids. 2025;1870(7):159661.
- Chu Y, et al. Glutathione peroxidase-1 overexpression reduces oxidative stress, and improves pathology and proteome remodeling in the kidneys of old mice. Aging Cell. 2020;19(6):e13154.
- Zhang F, et al. Mesenchymal stem cells alleviate rat diabetic nephropathy by suppressing CD103+ DCs-mediated CD8+ T cell responses. J Cell Mol Med. 2020;24(10):5817-31.
- Cao Q, et al. Renal F4/80+ CD11c+ mononuclear phagocytes display phenotypic and functional characteristics of macrophages in health and in adriamycin nephropathy. J Am Soc Nephrol. 2015;26(2):349-63.
- Zhou W, et al. The landscape of immune cell infiltration in the glomerulus of diabetic nephropathy: evidence based on bioinformatics. BMC Nephrol. 2022;23(1):303.
- Bloch K, Shichman E, Vorobeychik M, Bloch D, Vardi P. Catalase expression in pancreatic alpha cells of diabetic and non-diabetic mice. Histochem Cell Biol. 2007;127(2):227-32.
- Zhao Y, et al. Taxifolin attenuates diabetic nephropathy in streptozotocin-induced diabetic rats. Am J Transl Res. 2018;10(4):1205-10.
- Ding S, Wang W, Song X, Ma H. Based on network pharmacology and molecular docking to explore the underlying mechanism of Huangqi Gegen Decoction for treating diabetic nephropathy. Evid Based Complement Alternat Med. 2021;2021:9928282.
- Guo S, et al. Correction: Eriodictyol: a review of its pharmacological activities and molecular mechanisms related to ischemic stroke. Food Funct. 2023;14(10):4949.