Diese Studie untersucht die Entscheidungsfindung und Überarbeitungsverhalten von Studierenden der englischen Sprache beim Übersetzen von erzählenden Texten mit China-Bezug und integriert dabei Tastaturanschlag-Aufzeichnungen sowie ein Danmu-Korpus, um aufzuzeigen, wie textuelle Auffälligkeit den Bearbeitungsaufwand und die Übersetzungsqualität beeinflusst.
Forschungsartikel
Entscheidungsfindung und Revisionsverhalten bei der Übersetzung vom Chinesischen ins Englische: Belege von Englischstudierenden bei der Übersetzung chinazentrierter Narrative
In diesem Artikel
Zusammenfassung
Zusammenfassung
Während China-bezogene Narratives zunehmend in den internationalen Austausch gelangen, ist die Übersetzung aus dem Chinesischen ins Englische zu einem Ort der Bedeutungsverhandlung geworden, nicht zu einer einfachen sprachlichen Übertragung. Für Studierende, die Übersetzen, reicht die Hauptaufgabe über die lexikalische Auswahl hinaus; sie beinhaltet die Entscheidung, wie kulturell aufgeladene Referenzen, evaluative Haltungen und narrative Positionierungen für Leser außerhalb des Quellkontexts wiedergegeben werden sollen. Diese Studie untersucht die Echtzeit-Entscheidungsfindung und Überarbeitungsverhalten von 72 Englisch-Studierenden beim Übersetzen China-bezogener Narratives. Unter Verwendung eines Prozess-Produkt-Designs integriert die Forschung Tastenanschlagsdaten, die mit Translog-II erhoben wurden, Bewertungen der Übersetzungsprodukte sowie ein ergänzendes Danmu-(zeitlich synchronisiertes Kommentar-)Korpus, das als Schicht der Publikumssalienz behandelt wird, nicht als direktes Maß für linguistische Schwierigkeiten auf Segmentebene. Die Übersetzungsprozesse wurden hinsichtlich Pausendauer, Überarbeitungshäufigkeit, Überarbeitungslokalisation und Verteilung über die Phasen analysiert, während die Produktqualität durch Expertenbewertungen und gezielte Kodierung kulturbezogener Segmente beurteilt wurde. Ein Korpus von 18.642 Danmu-Kommentaren aus 24 Bilibili-Videos diente dazu, öffentlich saliente narrative Themen und kulturell sensible Ausdrücke zu identifizieren. Die Ergebnisse zeigen, dass kulturträchtige und evaluativ dichte Segmente längere Pausen, häufigere rekursive Überarbeitungen und dichtere Umformulierungen während des Prozesses auslösten. Übersetzungen höherer Qualität waren mit selektiven, strategisch getimten Überarbeitungen auf Diskurs- und kultureller Anpassungsebene verbunden, nicht mit einer höheren Gesamtanzahl an Überarbeitungen. Die Überschneidung zwischen danmu-salienten narrativen Auslösern und übersetzungsintensiven Segmenten wird als konvergierender Beleg für Publikumssalienz und translatorischen Verarbeitungsdruck interpretiert, nicht als Hinweis auf Kausalität. Die Studie trägt zur Forschung über den Übersetzungsprozess bei, indem sie Überarbeitungsverhalten mit der Übersetzung kulturell verankerter Narratives verknüpft und Implikationen für die translatorische Ausbildung in der interkulturellen Kommunikation aufzeigt.
Einleitung
In den letzten Jahren hat die Übersetzung von Diskursen zum Thema China sich von einer relativ spezialisierten Angelegenheit zu einer zentralen Frage der internationalen Kommunikation entwickelt1. Bei solchen Übersetzungen geht es nicht einfach um die Übertragung inhaltlicher Aussagen, sondern um die Neubestimmung öffentlicher Narrativen, die politische Positionierungen, kulturelle Rahmungen und Zielgruppendesign beinhalten. Arbeiten zur Übersetzung chinesischer politischer Texte haben diesen Punkt zunehmend verdeutlicht: Wenn Texte für Leser außerhalb Chinas übersetzt werden, werden Entscheidungen über Wortwahl, Modalität und textuelle Akzentuierung zugleich zu Entscheidungen darüber, wie China im Ausland erzählt und interpretiert wird2. Sobald das Problem auf diese Weise formuliert ist, reicht ein allein auf das Endprodukt fokussierter Ansatz nicht mehr aus. Eine fertige Übersetzung kann zeigen, was gewählt wurde, aber nicht, wann Unsicherheiten auftraten, wo die Neufassung begann oder wie konkurrierende Lösungen erprobt und schließlich verworfen wurden3.
Diese Einschränkungen verdeutlichen, warum die empirische Forschung zum Übersetzungsprozess zu einem wichtigen Zweig innerhalb der Translationswissenschaften geworden ist und dabei Prozess-Trace-Methoden einsetzt, um Pausen, Löschungen, Einfügungen sowie die zeitliche Struktur von Entscheidungsfindungen direkt zu erfassen, anstatt sie indirekt aus dem Endtext zu erschließen4. Dies verdrängt nicht produkt-, soziologisch-, kulturbasierte oder korpusgestützte Ansätze, sondern ergänzt sie um Belege zur momenthaften Entstehung von Übersetzungsentscheidungen. Neuere Arbeiten sind von der Beschreibung isolierter Pausen dazu übergegangen, den Übersetzungsprozess als zeitlich strukturierte Tätigkeit zu modellieren. Die Taxonomie von Zögern, Ausrichtung und Flüssigkeit beispielsweise betrachtet das translatorische Verhalten als ein geordnetes Wechselspiel zwischen Unsicherheit, Suche und fließender Produktion und erklärt so, warum bestimmte Phasen einer Aufgabe instabil werden und Neugestaltungen auslösen5. Diese Entwicklung ist besonders relevant im Bereich des Studierendenübersetzens, wo Sprachkompetenz, Fachwissen und strategische Steuerung gleichzeitig noch im Ausbau begriffen sind6.
Befunde aus kombinierter Eye-Tracking- und Tastenanschlag-Aufzeichnung zeigen, dass Anfänger Übersetzungsarbeit nicht gleichmäßig aufteilen und dass die Erstellung des Zieltextes während der chinesisch-englischen Übersetzung oft zu einer Hauptquelle kognitiver Belastung wird7. Folglich kann ein scheinbares lokales Formulierungsproblem im Endprodukt tatsächlich eine umfassendere Neuorganisation von Aufmerksamkeit und Aufwand während des Echtzeitprozesses widerspiegeln8. Neuere Befunde deuten zudem darauf hin, dass Studierende Übersetzungen mit ähnlicher oberflächlicher Angemessenheit produzieren können, dabei jedoch erheblich in Aufwand, Unsicherheit und erforderlicher Selbstüberwachung variieren. Eine zufriedenstellende Endfassung kann daher immer noch auf einem instabilen oder ineffizienten Entscheidungsweg beruhen, der nur mithilfe prozesssensitiver Messverfahren erfasst werden kann9. Darüber hinaus weisen vergleichende Untersuchungen darauf hin, dass Übersetzungskompetenz eine stabile metakognitive Steuerung darüber beinhaltet, wann unterbrochen, gesucht, das Verfassen fortgesetzt oder zur Überarbeitung zurückgekehrt wird10.
Die Überarbeitung ist der exakte Punkt, an dem dieser verborgene kognitive Prozess am deutlichsten zutage tritt. Hier kehren Übersetzer:innen zu früheren Formulierungen zurück, prüfen Alternativen und entscheiden, ob ein Problem lexikalischer, syntaktischer, diskursiver oder kultureller Natur ist. Die Überarbeitung sollte daher nicht als letzter Feinschliff betrachtet werden, sondern als zentraler Indikator für die Entwicklung der Übersetzer:innen. Bessere Ergebnisse hängen damit zusammen, wie Alternativen während der Erstellung konsolidiert werden. Dies zeigt, dass eine wirksame Überarbeitung selektiv, strategisch zeitlich abgestimmt und auf höhere textuelle Anforderungen ausgerichtet ist, anstatt sich lediglich aus einer Ansammlung von Änderungen zu ergeben11,12,13.
Die Komplexität von Entscheidungsfindung und Überarbeitung wird deutlicher, wenn der Ausgangstext ein auf China bezogenes Narrativ ist statt eines neutralen informativen Textes. Solche Texte stützen sich häufig auf kulturell geprägte Annahmen, historisch verankerte Ausdrücke und evaluative Hinweise, deren Bedeutung auf gemeinsamem Hintergrundwissen beruht und nicht auf expliziter Darlegung14,15,16. Die Textschwierigkeit verändert die Verarbeitungstiefe; narrative Texte mit kultureller oder evaluativer Dichte zwingen Übersetzer, in kleineren Einheiten zu arbeiten, nichtlineare Operationen durchzuführen und wiederholt lokale Umstrukturierungen vorzunehmen8. Für Studierende, die Übersetzen lernen, besteht das zentrale Problem darin, zu entscheiden, wie viel dieses impliziten Hinterwissens für Leser außerhalb der ursprünglichen Diskursgemeinschaft aufgebrochen oder neu organisiert werden sollte, ohne die kulturelle Spezifik zu verebnen.
Drei spezifische Forschungslücken motivieren die vorliegende Studie. Erstens werden Metriken des Übersetzungsprozesses wie Pausenlänge, Häufigkeit langer Pausen, Cursorunterbrechungen und Wörterbuchkonsultationen oft unabhängig von Revisionskategorien untersucht, was es erschwert, nachzuvollziehen, wie sich Entscheidungsdruck in späteren Neufassungen manifestiert. Zweitens haben kulturspezifische narrative Kategorien weniger prozessorientierte Aufmerksamkeit erfahren als allgemeine akademische oder exponierende Texte, obwohl auf China bezogene Narrative häufig erfordern, dass Übersetzer kulturelle Belastung, evaluative Dichte und komprimierte Hintergrundimplikation gleichzeitig bewältigen14,15,16. In dieser Studie bezeichnet kulturelle Belastung die Dichte kulturspezifischer Referenzen und geteilter Präsuppositionen; evaluative Dichte bezeichnet explizite oder implizite Standortnahmen, emotionale Intensität und wertgeladene Rahmungen; und narrative Kompression beschreibt das Ausmaß, in dem Hintergrundinformationen, kausale Beziehungen oder soziale Positionierungen in kurze Textabschnitte verdichtet sind. Drittens basieren Übersetzungsaufgaben gewöhnlich allein auf textinterner Analyse, ohne stärker zu berücksichtigen, ob als schwierig identifizierte Segmente mit Stellen übereinstimmen, die in digitaler Verbreitung öffentliche Aufmerksamkeit erhalten. Danmu (zeitlich synchronisierte Videokommentare) können als Paratext und partizipatives Diskurs fungieren und verdeutlichen, worauf Zuschauer achten, was sie hinterfragen und neu interpretieren17,18; jedoch muss die Salienz von Danmu als Indikator für die Rezeptionsbeteiligung auf semantischer Ebene verstanden werden, nicht als direkter Ersatz für linguistische Schwierigkeit auf Segmente-Ebene.
Um diese Lücken zu schließen, untersucht die vorliegende Studie, wie Studierende der englischen Sprache Entscheidungen treffen und überarbeiten, während sie auf China bezogene Erzählungen vom Chinesischen ins Englische übersetzen. Indem Daten zum Übersetzungsprozess und digitale Publikumsdiskurse in einen gemeinsamen analytischen Rahmen einbezogen werden, zielt die Studie darauf ab, nicht nur aufzuzeigen, wo angehende Übersetzer Schwierigkeiten haben, sondern auch zu erklären, warum sich diese Schwierigkeiten um bestimmte Arten narrativer Bedeutung konzentrieren.
Insbesondere befasst sich diese Studie mit vier Forschungsfragen: (1) Welche Entscheidungsfindungsmuster kennzeichnen die Übersetzung chinesischer Narrationen ins Englische durch Studierende der Anglistik? (2) Wie unterscheiden sich Überarbeitungsverhalten zwischen Textsegmenten mit unterschiedlichem kulturellem Gehalt und narrativer Dichte? (3) Welche Aspekte des Überarbeitungsverhaltens korrelieren mit einer höheren Übersetzungsqualität? und (4) Überlappen sich kulturell markante Punkte, die in der Danmu-Diskussion identifiziert wurden, mit den Segmenten, die während der Übersetzung den größten Verarbeitungsaufwand erfordern?
Demgemäß prüft die Studie vier miteinander verknüpfte Hypothesen in einer einzigen analytischen Sequenz: H1 besagt, dass Segmente mit höherer kultureller Belastung längere Pausen, stärkere Entscheidungsunsicherheit und häufigere Überarbeitungen hervorrufen als Segmente mit geringerer kultureller Belastung; H2 unterscheidet zwei Wege und prognostiziert, dass die evaluative Dichte die verzögerte Überarbeitung erhöht, während die narrative Verdichtung die diskursbezogene Neustrukturierung verstärkt; H3 sagt voraus, dass die Übersetzungsqualität stärker durch Selektivität und Zeitpunkt der Überarbeitung erklärt wird als allein durch die Gesamtanzahl der Überarbeitungen; und H4 sagt voraus, dass danmu-markante Segmente mit Segmenten hoher Übersetzungsaufwendungen überlappen, was eine assoziative Konvergenz zwischen der Wahrnehmbarkeit beim Publikum und dem kognitiven Druck auf den Übersetzer darstellt.
Protokoll
Alle Methoden an menschlichen Versuchspersonen wurden gemäß den institutionellen Richtlinien durchgeführt und von der institutionellen Prüfkommission (IRB) oder dem Ethikkomitee für Humorforschung der Hanshan Normal University genehmigt. Von allen Teilnehmern wurde vor Beginn des Experiments eine informierte Einwilligung eingeholt.
Konzeptioneller Rahmen und Forschungsdesign
Diese Studie verwendete ein Prozess-Produkt-Forschungsdesign mit einer zusätzlichen Diskursebene, um zu untersuchen, wie vom Publikum erzeugte Danmu-Kommentare die Untertitelübersetzung beeinflussen. Der analytische Rahmen integrierte textliche Merkmale, Indikatoren des Übersetzungsprozesses und Ergebnisse zur Übersetzungsqualität. Insbesondere wurde untersucht, ob die Aufmerksamkeit des Publikums, wie sie sich in der Danmu-Dichte widerspiegelt, die kognitiven Ressourcen der Übersetzer auf bestimmte textliche Merkmale lenkt und ob diese Verteilung der Aufmerksamkeit anschließend die Übersetzungsqualität beeinflusst.
Um diesen Rahmen anzuwenden, wurden zunächst textuelle Merkmale auf Segmentebene basierend auf vier Dimensionen etabliert: kulturelle Belastung, evaluative Dichte, narrative Verdichtung und Danmu-Salienz. Kulturelle Belastung bezog sich auf das Vorhandensein kulturspezifischer Anspielungen, die eine Anpassung oder Erklärung erforderten. Die evaluative Dichte maß die Konzentration emotional oder attitudinal aufgeladener Sprache innerhalb eines Segments. Die narrative Verdichtung erfasste, inwieweit semantische Inhalte unter den Beschränkungen der Untertitelung verdichtet wurden. Die Danmu-Salienz repräsentierte das Ausmaß an Zuschauer-Aufmerksamkeit, das jedem Untertitelsegment galt, quantifiziert durch das Volumen synchronisierter Danmu-Kommentare. Im Gegensatz zu herkömmlichen Maßen für Übersetzungsschwierigkeiten spiegelte die Danmu-Salienz eine sozial verteilte Aufmerksamkeit wider, nicht die intrinsische textliche Komplexität. Ein Segment, das umfangreiche Zuschauerbeteiligung erhielt, war nicht notwendigerweise schwieriger zu übersetzen; stattdessen markierte es einen Punkt erhöhter kommunikativer Bedeutung innerhalb des Seherlebnisses.
Der analytische Rahmen umfasste drei miteinander verbundene Datensätze. Der Teilnehmer-Datensatz enthielt individuelle demografische Merkmale und Informationen zur Übersetzungskompetenz. Der Prozess-Produkt-Datensatz verknüpfte jeden Untertitelabschnitt mit aus Tastenanschlag-Protokollen extrahierten Verhaltensindikatoren sowie mit qualifizierten Bewertungen der Übersetzungsqualität durch Experten. Der Danmu-Datensatz enthielt synchronisierte Zuschauerkommentare, die zeitlich mit den Untertiteln abgestimmt waren und anhand derer Salienzwerte für Danmu berechnet wurden. Diese Datensätze wurden über Identifikatoren für Teilnehmer und Abschnitte verknüpft, wodurch eine simultane Analyse jedes übersetzten Untertitelabschnitts in Bezug auf Übersetzermerkmale, kognitives Verarbeitungsverhalten, Zuschauerwahrnehmung und Übersetzungsergebnisse ermöglicht wurde. Die endgültige integrierte Datenbank umfasste 216 vollständige Übersetzungssitzungen und 3.168 Beobachtungen auf Ebene von Teilnehmer–Text–Abschnitt und bildete die empirische Grundlage für die anschließenden Prozess-Produkt-Analysen.
Teilnehmer-Screening und Hintergrundprofil
Die Stichprobe umfasste 72 Studierende der englischen Sprachwissenschaft, die an einer öffentlichen Universität in Südchina rekrutiert wurden und gleichmäßig auf das zweite, dritte und vierte Jahr des Bachelorstudiums verteilt waren (24 Teilnehmer pro Jahrgang). Alle Teilnehmer waren muttersprachliche Sprecher des Chinesischen, die eine formale Ausbildung im englischen Schreiben und Übersetzen erhielten. Um die Vergleichbarkeit innerhalb der Population von angehenden Übersetzern sicherzustellen, wurden Personen ausgeschlossen, die länger als sechs Monate in einem englischsprachigen Land gelebt hatten oder über eine professionelle Übersetzerzertifizierung verfügten. Die Teilnehmer wurden nicht in separate Versuchsgruppen anhand von Übersetzungserfahrung, kultureller Vertrautheit oder Kompetenz in der Zweitsprache eingeteilt. Stattdessen wurden das Studienjahr, aktuelle Ergebnisse aus Englisch-Kompetenztests, frühere Übersetzungslehrgänge, die eigene Einschätzung der Vertrautheit mit kulturspezifischen Themen Chinas sowie die durchschnittliche wöchentliche Beschäftigung mit zweisprachiger Praxis erfasst und als individuelle Kovariaten der Teilnehmer in die statistischen Modelle einbezogen. Diese Klarstellung löst auch die während des Peer-Review-Prozesses angesprochene Diskrepanz bezüglich der Teilnehmerzahl: Sowohl das Manuskript als auch der Replikationsdatensatz enthalten 72 Teilnehmer, 216 Aufgabensitzungen und 3.168 Segment-bezogene Beobachtungen.
Auswahl des Quelltexts und Aufbau der Aufgabe
Die Übersetzungsmaterialien bestanden aus drei zeitgenössischen, auf China bezogenen erzählenden Texten, die speziell für diese Studie entwickelt wurden, um authentische öffentliche Diskurse widerzuspiegeln und urheberrechtlich geschütztes Material zu vermeiden. Jeder Text enthielt 205–225 chinesische Schriftzeichen, unterschied sich jedoch systematisch in seinen internen Merkmalen. Text A präsentiert einen Erzählstrang zum Frühlingsfest-Heimkehrthema mit moderater kultureller Belastung und relativ einfacher Syntax. Text B schildert eine Erinnerung an das Drachenbootfest und enthält eine höhere Dichte kulturspezifischer Ausdrücke sowie implizites Hintergrundwissen. Text C beschreibt einen Erzählkontext über Livestreaming und E-Commerce auf dem Land, der durch dichte evaluative Sprache und komprimierte narrative Positionierung gekennzeichnet ist.
Die Texte wurden systematisch anhand von Satzgrenzen und anschließend anhand von Bedeutungseinheiten unterteilt, wodurch insgesamt 44 analysierbare Einheiten über die drei Übersetzungsaufgaben hinweg entstanden (Tabelle 1). Vor der eigentlichen Kodierung wurde anhand eines Kodierhandbuchs die kulturelle Belastung, die evaluative Dichte und die narrative Verdichtung mithilfe von ordinalen Skalen von 1 bis 5 definiert. Eine Pilotstudie mit 12 Studierenden, die nicht an der Hauptstudie teilnahmen, bestätigte die gewünschte Schwierigkeitskalibrierung, die Klarheit der Aufgabenanweisungen sowie die Stabilität der Segmentgrenzen für die Zuordnung der Tastenanschläge.
Aufbau eines Hilfskorpus und Abbildung der Salienz
Um öffentlich relevante narrative Hinweise zu identifizieren, wurde ein zusätzliches Danmu-Korpus aus 24 auf Bilibili zwischen Januar 2023 und Dezember 2025 hochgeladenen Videos zusammengestellt. Videos wurden nur dann einbezogen, wenn sie einer der drei semantischen Bereiche entsprachen, die in den Quelltexten vertreten sind, mehr als 50.000 Aufrufe erreicht hatten, eine dichte Danmu-Interaktion aufwiesen und den Export sowie die thematische Zuordnung zeitlich synchronisierter Kommentare zuließen. Nach Entfernung von Duplikaten sowie Filterung von Emojis, onomatopoetischen Füllwörtern und irrelevanten Textfragmenten umfasste das endgültige Korpus 18.642 Kommentare.
Inhaltswörter wurden standardisiert und mithilfe von schlüsselwortbezogenen Ankerbegriffen aus dem Quelltext gruppiert. Jedes Segment des Quelltexts erhielt anschließend einen kontinuierlichen Salienz-Score für Danmu, der auf einer gewichteten Kombination aus normalisierter Häufigkeit der Schlüsselwortgruppen, Kommentarkonzentration innerhalb des entsprechenden thematischen Clusters und durchschnittlicher evaluativer Intensität basiert. Dieses Vorgehen ermöglicht den Vergleich des Übersetzungsaufwands mit der Salienz der Zuschauer auf Ebene semantischer Cluster, anstatt durch direkte lexikalische Übereinstimmung. Da Danmu die Reaktionen des Publikums auf Online-Videos widerspiegelt und nicht die experimentelle Übersetzungsaufgabe selbst, wird die Danmu-Salienz als externer Indikator für das Zuschauerengagement und nicht als direkter Beleg für die sprachliche Schwierigkeit eines Quellsegments interpretiert.
Experimentelle Vorgehensweise und Datenerfassung
Die Übersetzungssitzungen wurden einzeln in einem kontrollierten Computerraum unter standardisierten Bedingungen bezüglich Hardware, Software und Internetzugang durchgeführt (Abbildung 2). Nach einer fünfminütigen Einführung, in der die Erstellung eines gut lesbaren Englisch für ein internationales Publikum betont wurde, absolvierten die Teilnehmer eine dreiminütige Eingewöhnungsphase mit englischem Tippen, um Effekte der Gewöhnung an die Tastatur zu minimieren. Die drei Übersetzungsaufgaben wurden nacheinander mit Translog-II durchgeführt, wobei die Reihenfolge der Aufgaben nach einem lateinischen Quadrat-Design gegengebalanciert wurde, um potenzielle Ermüdungs- und Reihenfolgeneffekte gleichmäßig über alle Teilnehmer zu verteilen. Den Teilnehmern stand für jeden Text maximal eine Bearbeitungszeit von 20 Minuten zur Verfügung, getrennt durch fünfminütige Ruhepausen.
Obwohl das integrierte zweisprachige Wörterbuch erlaubt war, waren maschinelle Übersetzungssysteme und externe Suchmaschinen untersagt. Alle Tasteneingaben, Pausen und Mausbewegungen wurden automatisch protokolliert und durch synchrone Bildschirmaufzeichnungen ergänzt, um nichtlineare Überarbeitungsepisoden zu überprüfen. Nach Abschluss jeder Aufgabe füllten die Teilnehmer eine selbstberichtete Schwierigkeitsbewertung aus, die ausschließlich zur Unterstützung bei der Interpretation von Grenzfall-Kodierungen diente.
Prozessmessung und Variablencodierung
Tastatureingaben wurden mit der vorgegebenen Segmentstruktur synchronisiert. Ein Synchronisierungsabschnitt begann mit der ersten Eingabe in der Zielsprache, die einem Segment entsprach, und endete, sobald der Teilnehmer endgültig zum nächsten Segment überging. Überlappende Überarbeitungen wurden mithilfe zeitgestempelter Mauszeiger-Tracking-Daten neu zugeordnet.
Das Entscheidungsverhalten wurde anhand von fünf Indikatoren quantifiziert: Dauer der ersten Pause vor der Übersetzung des ersten Segments, mittlere Pausendauer innerhalb eines Segments, Häufigkeit von Pausen, die zwei Sekunden überschreiten, Anzahl der Konsultationen eines Wörterbuchs sowie Anzahl der cursorbasierten Unterbrechungen, die Abweichungen von der linearen Texterstellung anzeigen (Tabelle 2). Das Überarbeitungsverhalten wurde entlang zweier Dimensionen klassifiziert: Zeitpunkt und Funktion. Der Zeitpunkt unterschied zwischen unmittelbaren lokalen Korrekturen und verzögerten Überarbeitungen, die vorgenommen wurden, nachdem die Texterstellung bereits über das aktuelle Segment hinaus fortgeschritten war. Die funktionale Kategorisierung unterteilte die Überarbeitungen in Oberflächenrevisionen (formale Korrekturen ohne semantische Veränderung), Bedeutungsrevisionen (lexikalische oder syntaktische Änderungen), diskursbezogene Revisionen (Anpassungen der Satzbeziehungen oder Kohärenz) sowie kulturelle Anpassungsrevisionen (umformuliert zur besseren Orientierung am Zielpublikum). Zwei geschulte Kodierer analysierten unabhängig voneinander jeden Überarbeitungsabschnitt, besprachen anschließend Uneinigkeiten und wiesen jedem Ereignis eine einzige primäre Funktionskategorie zu. Die Übereinstimmung zwischen den Ratern war bei allen kodierten Maßen hoch. Cohens ĸ zeigte eine hohe Übereinstimmung bei der kategorialen Kodierung der Überarbeitungsfunktionen (ĸ = 0.84, p < 0,001). Für die ordinalen textbezogenen Variablen zeigten die Intraklassen-Korrelationskoeffizienten (ICC, zweifaktorielles gemischtes Modell, absolute Übereinstimmung) eine hohe Zuverlässigkeit hinsichtlich kultureller Belastung (ICC = 0,86), evaluativer Dichte (ICC = 0,78) und narrativer Verdichtung (ICC = 0,82). Eventuelle anfängliche Diskrepanzen in der Kodierung wurden anschließend durch gemeinsame Besprechung und Konsensentscheidung aufgelöst.
Bewertung der Übersetzungsqualität
Die Übersetzungsqualität wurde unabhängig von den Prozessdaten durch zwei Bewertende mit Promotion und umfangreicher Erfahrung in der Übersetzungslehre evaluiert. Die Bewertenden, die weder über die Identitäten der Teilnehmenden noch über die Prozessmaße informiert waren, wandten einen 100-Punkte-Raster an, der gleichmäßig auf fünf Dimensionen verteilt war: semantische Genauigkeit, sprachliche Flüssigkeit, narrative Kohärenz, kulturelle Wiedergabe und Angemessenheit des Registers (Tabelle 3). Bewertungsunterschiede, die mehr als acht Punkte betrugen, führten zu einer gemeinsamen Überprüfung und einer erneuten Konsensbewertung, wobei der entschiedene Durchschnitt als endgültige Bewertung der Übersetzungsqualität verwendet wurde. Die Aufzeichnungen der Bewertungen vor der Entscheidung wurden aufbewahrt, um eine transparente Berichterstattung über die Inter-Rater-Reliabilität in den Replikationsmaterialien zu ermöglichen.
Statistische Modellierung
Die Analysen erfolgten in drei sequenziellen Stufen. Zunächst wurden deskriptive Statistiken berechnet, um alle Variablen über die Jahrgangsgruppen und Texttypen hinweg zusammenzufassen. Anschließend wurde der segmentbasierte Bearbeitungsaufwand mithilfe gemischter Regressionsmodelle mit Zufallseffekten analysiert, um die hierarchische Struktur der Segmente innerhalb der Texte sowie wiederholte Messungen einzelner Teilnehmer zu berücksichtigen. Abhängige Variablen wie die Dauer der ersten Pause und die Häufigkeit von Überarbeitungen wurden als Funktion der kulturellen Belastung, der evaluativen Dichte, der narrativen Verdichtung und der Danmu-Auffälligkeit modelliert, wobei die Sprachkompetenz der Teilnehmer als Kontrollvariable berücksichtigt wurde. Zur Verbesserung der statistischen Transparenz wurden Prädiktor-Korrelationen, Diagnosen zur Varianzinflationsrate, 95 %-Konfidenzintervalle, Effektgrößen-Schätzungen und Modellanpassungsindizes einbezogen.
Abschließend wurde die Übersetzungsqualität modelliert, um die prädiktiven Beiträge von Überarbeitungszeitpunkt und Überarbeitungsfunktion im Verhältnis zur Gesamtüberarbeitungshäufigkeit zu bewerten. Die Überschneidung zwischen danmu-markanten Segmenten und Übersetzungssegmenten mit hohem Aufwand wurde mithilfe des oberen Quintils jeder Verteilung, eines standardisierten zusammengesetzten Aufwandsindex und einer Analyse des Zufallsüberlappens untersucht. Es wurde keine explorative Faktoranalyse oder Strukturgleichungsmodellierung durchgeführt. Entsprechend werden die zugehörigen Abbildungen ausschließlich als konzeptionelle, deskriptive oder auf Regression basierende Zusammenfassungen dargestellt.
Ergebnisse
Gesamtprofil der Übersetzungssitzungen
Alle 72 Teilnehmer absolvierten die drei Übersetzungsaufgaben unter standardisierten experimentellen Bedingungen, was 216 vollständige Übersetzungssitzungen ergab. Nach der Segmentausrichtung umfasste der endgültige analytische Datensatz 3.168 Beobachtungen pro Teilnehmer-Text-Segment. Die durchschnittliche Aufgabenbearbeitungszeit betrug im Mittel 998,4 s pro Text, mit deutlichen Unterschieden zwischen den Jahrgängen und Ausgangstexten (Tabelle 4; Abbildung 3). Sowohl das Manuskript als auch die zugehörigen Daten unterstützen daher konsistent eine Stichprobengröße von n = 72 Teilnehmern; Zusammenfassungen, die Teilmengen darstellen, sollten diese explizit benennen.
Studierende im vierten Jahr absolvierten die Übersetzungsaufgaben schneller und mit weniger Unterbrechungen als Studierende im zweiten Jahr. Dieser Unterschied ging über die reine Verarbeitungsgeschwindigkeit hinaus. Die Kohorte der Viertklässler wies auch kürzere durchschnittliche Dauer der ersten Pausen, weniger lange Pausen und eine geringere Gesamtanzahl an Überarbeitungen auf, erreichte dabei jedoch die höchsten Bewertungen hinsichtlich der Übersetzungsqualität. Im Gegensatz dazu verursachten Studierende im zweiten Jahr die meisten Überarbeitungen, wobei es sich überwiegend um oberflächliche Änderungen und unmittelbare lokale Korrekturen handelte. Fortgeschrittene Studierende zeigten einen höheren Anteil an verzögerten Überarbeitungen und solchen, die kulturelle Anpassungen betrafen, was darauf hindeutet, dass eine überlegene Übersetzungsleistung mit selektiven Überarbeitungsstrategien und nicht mit einem größeren Umfang an Überarbeitungen verbunden war.
Die Unterschiede zwischen den drei Quelltexten waren ähnlich ausgeprägt. Text A ergab die kürzesten Bearbeitungszeiten, die geringste Anzahl langer Pausen und die niedrigste Überarbeitungsdichte. Texte B und C stellten beide höhere Verarbeitungsanforderungen, jedoch über unterschiedliche Mechanismen. Text B löste die höchste Zahl kulturspezifischer Überarbeitungsereignisse aus, während Text C die höchste Frequenz diskursbezogener Überarbeitungen und die längste mittlere Pausendauer innerhalb von Segmenten aufwies. Demnach unterschied sich die Ursache der Verarbeitungsschwierigkeiten zwischen den Texten. Bei Text B konzentrierten sich die Schwierigkeiten auf kulturgebundene Referenzen und implizite Hintergrundannahmen, während sie bei Text C hauptsächlich mit narrativer Verdichtung und evaluativer Positionierung verbunden waren.
Eine einfaktorielle Varianzanalyse bestätigte signifikante Unterschiede zwischen den Jahrgängen hinsichtlich der Gesamtübersetzungsqualität, F (2, 69) = 31,84, p < 0,001, mit einer großen Effektstärke (η2 ≈ 0,48 basierend auf den mittleren Werten pro Teilnehmer). Post-hoc-Vergleiche zeigten, dass Studierende im vierten Jahr signifikant höhere Werte erreichten als Studierende im dritten Jahr, die wiederum bessere Leistungen als Studierende im zweiten Jahr erbrachten. Dasselbe Muster zeigte sich für die Dauer des ersten Pausen, die Häufigkeit langer Pausen und das Verhältnis verzögerter Revisionen. Insgesamt legen diese Basisbefunde zwei wichtige Punkte für die nachfolgenden Analysen nahe. Erstens unterschieden sich die drei Ausgangstexte hinsichtlich des Verarbeitungsaufwands und nicht lediglich im thematischen Inhalt. Zweitens war eine höhere Übersetzungsqualität mit einer Umorganisation der Übersetzungsprozesse verbunden und nicht einfach mit einer Verringerung des Verarbeitungsaufwands.
Wirkungen der textlichen Hervorhebung auf Entscheidungsfindung und Überarbeitungsverhalten
Um zu bestimmen, ob textuelle Eigenschaften auf Segmentebene den Bearbeitungsaufwand vorhersagten, wurden Mixed-Effects-Modelle für die Dauer der ersten Pause, die Häufigkeit langer Pausen, die Gesamtdichte an Überarbeitungen und die Dichte verzögerter Überarbeitungen geschätzt. Kulturelle Belastung, evaluative Dichte, narrative Verdichtung und Danmu-Salienz wurden als feste Effekte eingegeben, wobei Teilnehmer und Segment als zufällige Achsenabschnitte berücksichtigt wurden (Tabelle 5; Abbildung 4). Die Prüfung der Prädiktoren bestätigte das Fehlen problematischer Multikollinearität, wobei alle Werte des Varianzinflationsfaktors (VIF) deutlich unter der konservativen Schwelle von 2,5 lagen (maximaler VIF = 1,45). Um die Modellanpassung und den Anteil der erklärten Varianz zu bewerten, wurden sowohl marginale als auch bedingte R2-Werte für alle Mixed-Effects-Modelle berechnet (marginales R2 zwischen 0,08 und 0,19; bedingtes R2 zwischen 0,46 und 0,64). Die vollständigen Varianzkomponenten für die zufälligen Effekte (Achsenabschnitte für Teilnehmer und Segment) sowie die entsprechenden Anpassungsindizes des Modells sind in Tabelle 5 detailliert aufgeführt. Die Koeffizientenschätzungen werden gemeinsam mit ihren 95 %-Konfidenzintervallen interpretiert, nicht allein anhand von p-Werten.
Die kulturelle Belastung zeigte den stärksten und konsistentesten Effekt über alle Modelle hinweg. Im ersten-Pause-Modell war jeder Anstieg des kulturellen Belastungswerts um eine Einheit mit einer Verlängerung der Dauer der ersten Pause um 0,91 s verbunden (b = 0,91, SE = 0,12, 95 % KI [0,67, 1,15], p < 0,001). Die kulturelle Belastung erhöhte auch signifikant die Häufigkeit langer Pausen (b = 0,19, SE = 0,04, 95 % KI [0,11, 0,27], p < 0,001) und die gesamte Revisionsdichte (b = 0,27, SE = 0,06, 95 % KI [0,15, 0,39], p < 0,001). Somit verzögerten kulturell belastete Segmente nicht nur die anfängliche Verarbeitung, sondern erhöhten auch die Wahrscheinlichkeit einer nachfolgenden Umformulierung.
Die narrative Kompression zeigte ein ebenso robustes, aber anderes Wirkungsmuster. Sie war ein starker Prädiktor für übergeordnete Überarbeitungen (b = 0.31, SE = 0.07, 95 % KI [0,17, 0,45], p < .001) und erhöhte signifikant die durchschnittliche Pausendauer innerhalb von Segmenten (b = 0,58, SE = 0,14, 95 % KI [0,31, 0,85], p < .001). Praktisch bedeutet dies, dass Segmente, die umfangreiche Hintergrundinformationen in kurze Textabschnitte verdichteten, weniger wahrscheinlich unmittelbare lexikalische Ersetzungen auslösten und eher eine umfassendere strukturelle Neubewertung erforderten.
Die evaluative Dichte trug ebenfalls signifikant bei, obwohl ihr primärer Effekt eher auf der verzögerten Überarbeitung als auf der Latenz der ersten Entscheidung lag. Im Modell der verzögerten Überarbeitung ergab die evaluative Dichte einen positiven Koeffizienten (b = 0.23, SE = 0.05, 95 % CI [0,13, 0,33], p < .001). Ihr Effekt auf die Dauer der ersten Pause war vergleichsweise geringfügig (b = 0,34, SE = 0,13, 95 % CI [0,09, 0,59], p = 0,010). Diese Befunde deuten darauf hin, dass evaluative Hinweise während der anfänglichen Übersetzung nicht immer als Verarbeitungsengpässe erkannt wurden. Stattdessen wurden sie häufig erst problematisch, nachdem ein erster Entwurf erstellt worden war, wodurch Übersetzer angeregt wurden, Fragen der Haltung, des Tons oder der narrativen Angemessenheit erneut zu überprüfen.
Die Salienz von Danmu blieb auch nach Kontrolle textinterner Variablen ein signifikanter Prädiktor. Sie sagte sowohl die Dauer der ersten Pause (b = 0,36, SE = 0,14, 95 % KI [0,09, 0,63], p = 0,011) als auch die gesamte Revisionsdichte signifikant voraus (b = 0,17, SE = 0,06, 95 % KI [0,05, 0,29], p = 0,006). Obwohl der Effekt kleiner war als der der kulturellen Belastung und der narrativen Verdichtung, deutet der konsistente Beitrag darauf hin, dass Abschnitte, die im Danmu-Korpus stärkere öffentliche Aufmerksamkeit erregen, tendenziell auch einen höheren Verarbeitungsaufwand bei der Übersetzung erfordern. Dieses Ergebnis wird als konvergierende Evidenz für semantische Salienz interpretiert, nicht jedoch als Beleg dafür, dass die Häufigkeit von Danmu die Übersetzungsschwierigkeit direkt verursacht.
Überarbeitungsverhalten und Übersetzungsqualität
Weitere Analysen untersuchten, ob die Übersetzungsqualität besser durch die Gesamtanzahl der Revisionen oder durch deren zeitliche und funktionale Merkmale erklärt wurde. Das Qualitätsmodell (Tabelle 5) ergab ein klares Muster an Ergebnissen. Die Gesamtanzahl der Revisionen sagte die Übersetzungsqualität nicht signifikant voraus (b = 0,04, 95 % KI [-0,06, 0,14], p = 0,412), während sowohl der Zeitpunkt der Revision als auch die Funktion der Revision signifikante Prädiktoren waren. Insbesondere das Verhältnis verzögerter Revisionen (b = 1,12, 95 % KI [0,39, 1,85], p = 0,003), revisionen auf Diskursebene (b = 1,76, 95 % KI [0,96, 2,56], p < 0,001) und kulturell angepasste Revisionen (b = 2,04, 95 % KI [1,14, 2,94], p < 0,001) waren alle positiv mit der Übersetzungsqualität assoziiert. Im Gegensatz dazu zeigten oberflächliche Revisionen eine kleine, aber statistisch signifikante negative Assoziation (b = -0,63, 95 % KI [-1,18, -0,08], p = 0,028).
Diese Ergebnisse zeigen, dass die reine Anzahl der Überarbeitungen nicht zwischen produktiver Neufassung und instabilem Entwurf unterscheiden kann (Abbildung 5). Eine qualitative Analyse der Übersetzungsskripte stützt diese Interpretation. Bei Übersetzungen mit niedrigerer Punktzahl konzentrierten sich die Überarbeitungen häufig auf lokale lexikalische Ersetzungen und grammatische Korrekturen, ohne tiefgreifende Diskrepanzen zwischen chinesischen narrativen Hinweisen und der englischen rhetorischen Struktur zu beheben. Bei Übersetzungen mit höherer Punktzahl betrafen verspätete Überarbeitungen oft die Neugliederung der Informationsstruktur, die gezielte Explizitmachung von Inhalten oder Anpassungen der evaluativen Sprache, um die Verständlichkeit für ein internationales Publikum zu verbessern. Beispielsweise enthalten repräsentative übersetzte Danmu-Kommentare Aussagen wie „dieser Ausdruck ist sehr chinesisch“, „der Hintergrund muss erklärt werden“ und „ausländische Zuschauer könnten diese Anspielung nicht verstehen“ – sie verdeutlichen die Art kulturell relevanter Zuschaueranliegen, die mit den entsprechenden Segmentclustern verbunden sind. Diese Beispiele dienen allein der Interpretationshilfe und sollten nicht als Beleg für die Absichten der Teilnehmenden verstanden werden.
Überlappung zwischen der Salienz von Danmu und Übersetzungsengpässen
Die abschließende Analyse untersuchte, ob öffentlich hervorstechende Segmente im Danmu-Korpus mit denen übereinstimmten, die während der Übersetzung den größten Bearbeitungsaufwand verursachten. Ein zusammengesetzter Aufwandsindex wurde für jedes Segment berechnet, indem Dauer der ersten Pause, Häufigkeit langer Pausen und Dichte der Revisionen standardisiert und summiert wurden. Die oberen 20 % der Segmente, basierend auf diesem zusammengesetzten Aufwandsindex, wurden anschließend mit den oberen 20 % verglichen, die nach Danmu-Hervorstechendheit rangiert wurden.
Die Überschneidung war beträchtlich: Sechs der neun Segmenten mit dem höchsten Aufwand tauchten auch unter den neun am stärksten danmu-auffälligen Segmenten auf, was einer Überschneidungsrate von 66,7 % entspricht. Da der Vergleich der oberen Quintile nur neun Segmente umfasste, war das Wilson-Vertrauensintervall relativ breit (95 % KI etwa 35,4 %–87,9 %). Dennoch zeigte eine exakte Analyse der zufälligen Überschneidung, dass eine Überschneidung von sechs oder mehr Segmenten bei zufälliger Zuordnung unwahrscheinlich wäre (p ≈ ,001). Auf der Ebene der Segmente bestand eine positive Korrelation zwischen der Danmu-Auffälligkeit und dem zusammengesetzten Aufwandsindex (Spearman-ρ = 0,41, p = 0,006). Die meisten überschneidenden Segmente traten in den Texten B und C auf und bezogen sich auf kulturell verankerte Referenzen, digitales Unternehmertum und evaluative Positionierungen. Diese Ergebnisse legen nahe, dass öffentliche Diskurse als externer Indikator dafür dienen, wo narrative Bedeutung besonders auffällig wird, auch wenn der Zusammenhang korrelativ und nicht kausal ist.
Zusammengenommen zeigen diese Ergebnisse, dass der Bearbeitungsaufwand bei der Übersetzung China-bezogener Erzählungen segmentenspezifisch ist und hauptsächlich durch kulturelle Belastung, narrative Verdichtung und evaluative Dichte geprägt wird. Die Übersetzungsqualität hängt nicht vom Gesamtumfang der Überarbeitung ab, sondern von verzögerten, diskursorientierten und kultursensiblen Überarbeitungsstrategien. Schließlich stützt die beobachtete Übereinstimmung zwischen anspruchsvollen Übersetzungssegmenten und danmu-auffälligen Erzählungspunkten einen assoziativen Zusammenhang zwischen der Wahrnehmbarkeit durch das Publikum und dem kognitiven Aufwand der Übersetzer, ohne darauf hinzuweisen, dass die Danmu-Wahrnehmbarkeit selbst die Übersetzungsschwierigkeit verursacht.
VERFÜGBARKEIT VON DATEN:
Alle Rohdaten, Tastaturanschlag-Protokolldateien, verarbeiteten Beobachtungen auf Segmentebene, Beobachtungen auf Sitzungsebene, Danmu-Video-Metadaten sowie die ersten 5.000 angezeigten Danmu-Kommentare sind in der Reproduktions-Datensatzarbeitsmappe enthalten. Die vollständige Danmu-Kommentar-Datei umfasst 18.642 Kommentare und ist zusammen mit dem Datensatzpaket hinterlegt. Auf den Datensatz kann über das Zenodo-Repository unter https://doi.org/10.5281/zenodo.19289665 zugegriffen werden.
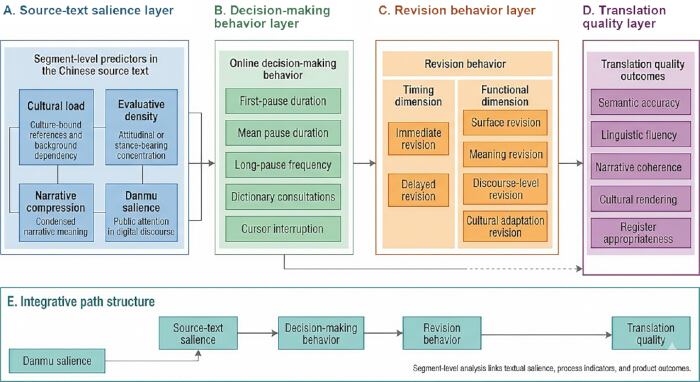
Abbildung 1: Konzeptioneller Rahmen der Studie. (A) Textliche Prädiktoren auf Segmentebene, einschließlich kultureller Belastung, evaluativer Dichte, narrativer Verdichtung und Danmu-Salienz. (B) Prozessindikatoren zur Operationalisierung des Online-Entscheidungsverhaltens, einschließlich Dauer der ersten Pause, mittlere Pausendauer, Häufigkeit langer Pausen, Wörterbuchkonsultationen und Cursorunterbrechungen. (C) Zweidimensionale Klassifizierung des Überarbeitungsverhaltens nach Überarbeitungszeitpunkt und Überarbeitungsfunktion. (D) Fünf Dimensionen zur Bewertung der Übersetzungsqualität: semantische Genauigkeit, sprachliche Flüssigkeit, narrative Kohärenz, kulturelle Wiedergabe und Registerangemessenheit. (E) Gesamter analytischer Rahmen, der die Beziehungen zwischen Quelltextsalienz, Entscheidungsverhalten, Überarbeitungsverhalten und Übersetzungsqualität zeigt, wobei die Danmu-Salienz als externer Indikator für die semantische Prominenz des Publikums dient. In dieser Studie wurde keine explorative Faktorenanalyse (EFA) durchgeführt oder dargestellt, ebenso wenig wie eine Strukturgleichungsmodellierung (SEM). Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
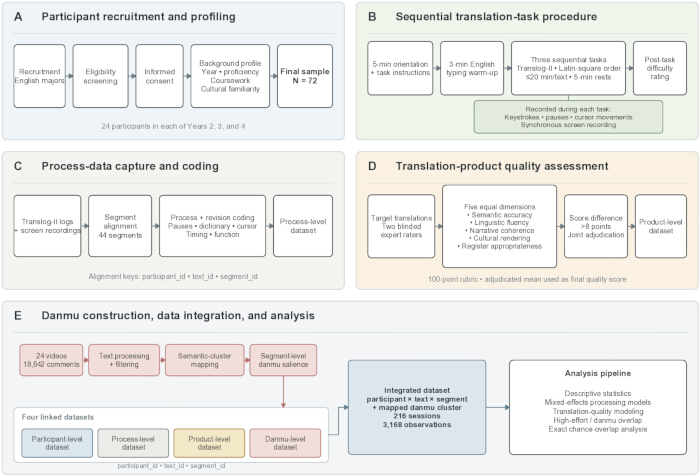
Abbildung 2: Ablauf der Datensammlung und Datenabgleichung. (A) Rekrutierung der Teilnehmer, Überprüfung der Eignung, Einholung der informierten Einwilligung und Erfassung von Hintergrundinformationen. (B) Durchführung der drei Übersetzungsaufgaben in Translog-II unter standardisierten experimentellen Bedingungen. (C) Erfassung von Prozessdaten, einschließlich Tastatureingaben, Pausen, Mausbewegungen, Überarbeitungsepisoden und synchronisierter Bildschirmaufnahmen. (D) Blinde Expertenbewertung der Übersetzungsprodukte, gefolgt von der Schlichtung von Bewertungsabweichungen. (E) Erstellung des Hilfs-Corpus mit danmu-Daten und deren Abgleichung mit Datensätzen auf Teilnehmer-, Text-, Segment-, Prozess- und Produktniveau, um den endgültigen integrierten Datensatz zu generieren, der für inferenzstatistische Analysen verwendet wird. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
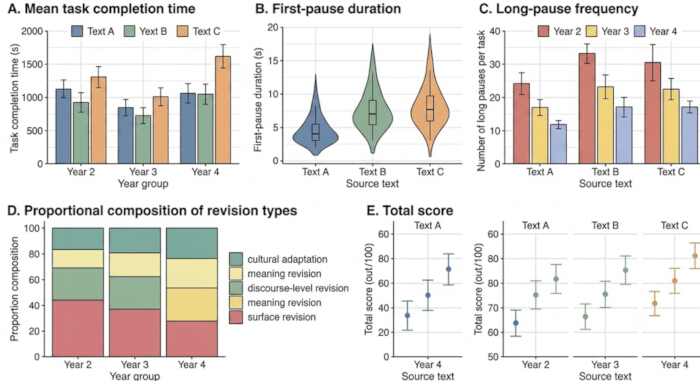
Abbildung 3: Verteilung von Prozess- und Produktparametern über die Jahrgangsstufen und Ausgangstexte hinweg. (A) Mittlere Aufgabendauer nach Ausgangstext und Jahrgangsstufe. (B) Verteilung der Erstpausendauer über die drei Ausgangstexte. (C) Häufigkeit langer Pausen nach Ausgangstext und Jahrgangsstufe. (D) Proportionale Verteilung der Überarbeitungskategorien über die Jahrgangsstufen, einschließlich oberflächlicher Überarbeitungen, inhaltlicher Überarbeitungen, diskursbezogener Überarbeitungen und kultureller Anpassungsüberarbeitungen. (E) Gesamtwerte der Übersetzungsqualität nach Jahrgangsstufe für jeden Ausgangstext. Insgesamt zeigen die Teilabbildungen, dass höhere Jahrgangsstufen mit weniger Verarbeitungsunterbrechungen, selektiveren Überarbeitungsstrategien und höherer Übersetzungsqualität assoziiert sind, während die Texte B und C höhere kognitive Anforderungen stellen als Text A. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
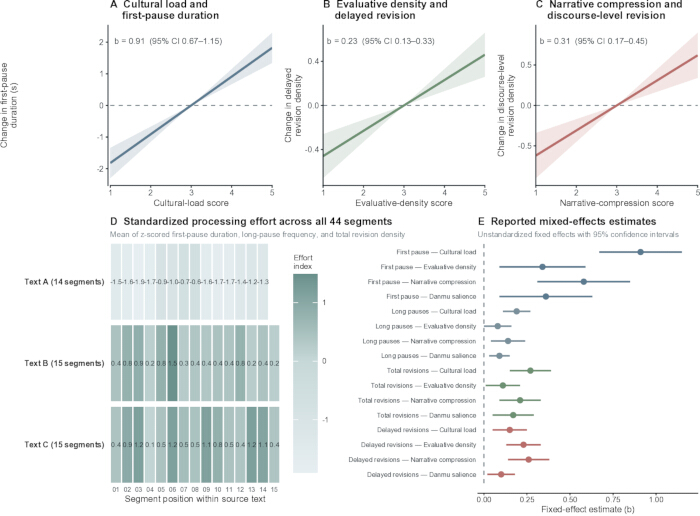
Abbildung 4: Einflüsse der textlichen Auffälligkeit auf Ebene von Textsegmenten auf das Übersetzungsverhalten. (A) Geschätzter marginaler Effekt der kulturellen Belastung auf die Dauer der Erstpause. (B) Geschätzter marginaler Effekt der evaluativen Dichte auf die Dichte verzögerter Überarbeitungen. (C) Geschätzter marginaler Effekt der narrativen Verdichtung auf die Dichte diskursbezogener Überarbeitungen. (D) Wärmekarte des standardisierten Index für Verarbeitungsanstrengung über alle Quelltextsegmente hinweg, gruppiert nach Quelltext. (E) Standardisierte feste Effektkoeffizienten, geschätzt aus den Regressionsmodellen mit gemischten Effekten. Die Abbildung zeigt, dass unterschiedliche textliche Merkmale spezifische Verarbeitungspfade aktivieren, wobei kulturelle Belastung, evaluative Dichte und narrative Verdichtung über teilweise verschiedene Mechanismen zu Zögern und Überarbeitungen beitragen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
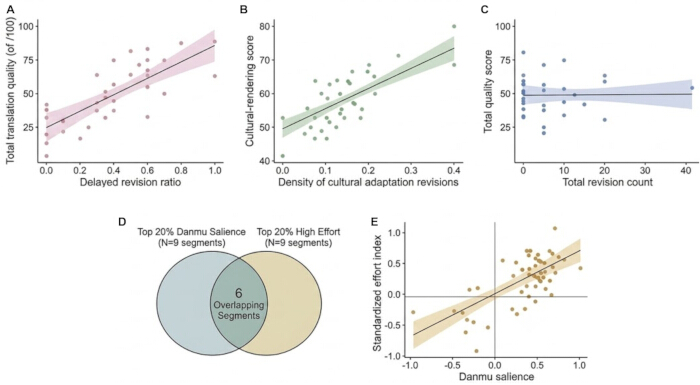
Abbildung 5: Zusammenhänge zwischen Übersetzungsprozess, Übersetzungsqualität und der Salienz von Danmu-Kommentaren. (A) Zusammenhang zwischen dem Anteil verzögerter Überarbeitungen und der Gesamtpunktzahl für die Übersetzungsqualität. (B) Beziehung zwischen Überarbeitungen zur kulturellen Anpassung und der Punktzahl für kulturelle Wiedergabe. (C) Zusammenhang zwischen der Gesamtanzahl an Überarbeitungen und der Gesamtübersetzungsqualität, wobei die begrenzte Vorhersagekraft der reinen Überarbeitsmenge gezeigt wird. (D) Überschneidung zwischen den oberen 20 % der danmu-salienten Segmente und den oberen 20 % der Segmente mit hohem Übersetzungsaufwand. (E) Segmentbezogener Zusammenhang zwischen Danmu-Salienz und dem standardisierten Index für den Verarbeitungsaufwand. Insgesamt zeigen die Teilabbildungen, dass eine erfolgreiche Übersetzungsleistung mit strategisch zeitlich geplanten und funktional gezielten Überarbeitungen verbunden ist, nicht allein mit der Menge an Überarbeitungen, und dass öffentlich saliente narrativen Segmente tendenziell mit Engpässen im Übersetzungsprozess zusammenfallen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
| Text-ID | Narratives-Thema | Chinesische Schriftzeichen | Anzahl der Segmente | Kulturlast-Score (1–5) | Bewertungsdichte-Score (1–5) | Narrative-Komprimierungsscore (1–5) | Vorhergesagte Schwierigkeit | Validierungshinweis |
| Text A | Narrativ zur Heimkehr zum Frühlingsfest | 212 | 14 | 3 | 2 | 3 | Mittel | Im Pilotversuch mit 12 nicht teilnehmenden Studierenden getestet |
| Text B | Narrativ zur Erinnerung an das Drachenbootfest | 219 | 15 | 5 | 3 | 4 | Hoch | Im Pilotversuch mit 12 nicht teilnehmenden Studierenden getestet |
| Text C | Narrativ über ländliches Live-Streaming und die Entwicklung der Heimatregion | 223 | 15 | 4 | 5 | 4 | Hoch | Im Pilotversuch mit 12 nicht teilnehmenden Studierenden getestet |
Tabelle 1: Profil des Quelltexts und Segmentstruktur.
| Variable | Stufe | Operationale Definition | Maßeinheit |
| Dauer der Erstpause | Segment | Zeit vom Segmentbeginn bis zur ersten relevanten Tastatureingabe in der Zielsprache | Sekunden |
| Mittlere Pausendauer innerhalb eines Segments | Segment | Mittlere Dauer aller Pausen innerhalb des Segments | Sekunden |
| Häufigkeit langer Pausen | Segment | Anzahl der Pausen länger als 2 Sekunden | Anzahl |
| Nachschlagen im Wörterbuch | Segment | Anzahl der Aktivierungen des Wörterbuchfensters während der Segmentverarbeitung | Anzahl |
| Cursor-Unterbrechungen | Segment | Anzahl cursorbasierter Abweichungen von der linearen Texterfassung vor abschließender Fertigstellung | Anzahl |
| Unmittelbare Überarbeitung | Segment | Überarbeitung, die erfolgt, bevor die Texterfassung den aktuellen lokalen Textbereich verlässt | Anzahl / Dichte |
| Verzögerte Überarbeitung | Segment | Überarbeitung, die erfolgt, nachdem die Texterfassung bereits einen späteren Textbereich erreicht hat | Anzahl / Dichte |
| Oberflächenüberarbeitung | Überarbeitungsfunktion | Korrektur auf Formebene ohne inhaltliche Veränderung | Anzahl / Dichte |
| Inhaltsbezogene Überarbeitung | Überarbeitungsfunktion | Lexikalische oder syntaktische Änderung, die die Bedeutungsausdrucksweise beeinflusst | Anzahl / Dichte |
| Überarbeitung auf Diskursebene | Überarbeitungsfunktion | Anpassung der Satzrelationen, Kohärenz oder Informationsreihenfolge | Anzahl / Dichte |
| Überarbeitung zur kulturellen Anpassung | Überarbeitungsfunktion | Zielgruppenorientierte Neugestaltung oder Explizitmachung kulturspezifischer Inhalte | Anzahl / Dichte |
| Index für zusammengesetzte Anstrengung | Segment | Standardisierte Zusammensetzung aus Dauer der Erstpause, Häufigkeit langer Pausen und Überarbeitungsdichte | z-Wert |
| Danmu-Auffälligkeit | Segment / semantisches Cluster | Gewichteter Proxy für semantische Cluster basierend auf normalisierter Häufigkeit von Stichwortclustern, Kommentarkonzentration und evaluativer Intensität | Kontinuierlicher Wert |
Tabelle 2: Operationale Definitionen der Prozessvariablen.
| Semantische Genauigkeit | Bewertungsbereich | Bewertungsschwerpunkt |
| Semantische Genauigkeit | 1-20 | Treue zur Quellenbedeutung, Präzision des übertragenen Inhalts und Abwesenheit wesentlicher Verzerrungen |
| Linguistische Flüssigkeit | 1-20 | Grammatikalität, Natürlichkeit, Idiomatik und Lesbarkeit auf Satzebene |
| Narrative Kohärenz | 1-20 | Informationsfluss, Verknüpfung von Gliedsätzen, Fortschreiten und textuelle Stabilität |
| Kulturelle Wiedergabe | 1-20 | Behandlung kulturspezifischer Bezüge, Explizitmachung, Rahmung und interpretative Zugänglichkeit |
| Angemessenheit des Registers | 1-20 | Eignung für die intendierte Leserschaft, stilistische Passgenauigkeit und Kontrolle des Tonfalls |
Tabelle 3: Bewertungsschema für die Übersetzungsqualität.
| Bereich | Variable | Jahr 2 (n = 24), Mittelwert ± SD | Jahr 3 (n = 24), Mittelwert ± SD | Jahr 4 (n = 24), Mittelwert ± SD |
| Sitzungsprofil auf Teilnehmerebene | Absolvierungszeit der Aufgabe (Sek) | 1070,84 ± 18,22 | 996,59 ± 20,08 | 927,76 ± 19,91 |
| Sitzungsprofil auf Teilnehmerebene | Mittlere Dauer der ersten Pause (Sek) | 7,09 ± 0,50 | 6,65 ± 0,40 | 6,38 ± 0,41 |
| Sitzungsprofil auf Teilnehmerebene | Häufigkeit langer Pausen pro Aufgabe | 21,04 ± 0,32 | 18,47 ± 0,30 | 16,31 ± 0,19 |
| Sitzungsprofil auf Teilnehmerebene | Gesamtanzahl Revisionen pro Aufgabe | 28,65 ± 2,87 | 26,24 ± 2,63 | 24,59 ± 2,42 |
| Revisionskonfiguration | Anteil verzögerter Revisionen | 0,45 ± 0,01 | 0,54 ± 0,01 | 0,63 ± 0,01 |
| Revisionskonfiguration | Anteil diskursbezogener Revisionen | 0,37 ± 0,01 | 0,40 ± 0,01 | 0,45 ± 0,01 |
| Revisionskonfiguration | Anteil kulturell angepasster Revisionen | 0,38 ± 0,01 | 0,42 ± 0,00 | 0,48 ± 0,01 |
| Revisionskonfiguration | Anteil oberflächlicher Revisionen | 0,04 ± 0,00 | 0,02 ± 0,00 | 0,00 ± 0,00 |
| Produktqualität | Gesamtbewertung der Qualität | 77,82 ± 4,65 | 84,03 ± 4,44 | 88,27 ± 4,56 |
| Produktqualität | Bewertung der kulturellen Wiedergabe | 77,73 ± 4,49 | 83,95 ± 4,85 | 88,18 ± 4,86 |
Tabelle 4: Deskriptive Statistiken für Prozess- und Produktvariablen.
| Ergebnisvariable | Prädiktor | b | SE | 95 % KI | t/z | p |
| Dauer der ersten Pause | Kulturelle Belastung | 0.91 | 0.12 | [0.67, 1.15] | 7.58 | < 0.001 |
| Dauer der ersten Pause | Evaluative Dichte | 0.34 | 0.13 | [0.09, 0.59] | 2.62 | 0.01 |
| Dauer der ersten Pause | Narrative Kompression | 0.58 | 0.14 | [0.31, 0.85] | 4.14 | < 0.001 |
| Dauer der ersten Pause | Danmu-Salienz | 0.36 | 0.14 | [0.09, 0.63] | 2.55 | 0.011 |
| Häufigkeit langer Pausen | Kulturelle Belastung | 0.19 | 0.04 | [0.11, 0.27] | 4.75 | < 0.001 |
| Häufigkeit langer Pausen | Evaluative Dichte | 0.08 | 0.04 | [0.00, 0.16] | 2 | 0.046 |
| Häufigkeit langer Pausen | Narrative Kompression | 0.14 | 0.05 | [0.04, 0.24] | 2.8 | 0.005 |
| Häufigkeit langer Pausen | Danmu-Salienz | 0.09 | 0.03 | [0.03, 0.15] | 3 | 0.003 |
| Gesamte Überarbeitungsdichte | Kulturelle Belastung | 0.27 | 0.06 | [0.15, 0.39] | 4.5 | < 0.001 |
| Gesamte Überarbeitungsdichte | Evaluative Dichte | 0.11 | 0.05 | [0.01, 0.21] | 2.2 | 0.028 |
| Gesamte Überarbeitungsdichte | Narrative Kompression | 0.21 | 0.06 | [0.09, 0.33] | 3.5 | < 0.001 |
| Gesamte Überarbeitungsdichte | Danmu-Salienz | 0.17 | 0.06 | [0.05, 0.29] | 2.75 | 0.006 |
| Verzögerte Überarbeitungsdichte | Kulturelle Belastung | 0.15 | 0.05 | [0.05, 0.25] | 3 | 0.003 |
| Verzögerte Überarbeitungsdichte | Evaluative Dichte | 0.23 | 0.05 | [0.13, 0.33] | 4.6 | < 0.001 |
| Verzögerte Überarbeitungsdichte | Narrative Kompression | 0.26 | 0.06 | [0.14, 0.38] | 4.33 | < 0.001 |
| Verzögerte Überarbeitungsdichte | Danmu-Salienz | 0.1 | 0.04 | [0.02, 0.18] | 2.5 | 0.013 |
| Gesamte Qualitätsbewertung | Gesamtanzahl der Überarbeitungen | 0.04 | 0.05 | [-0.06, 0.14] | 0.82 | 0.412 |
| Gesamte Qualitätsbewertung | Verhältnis verzögerter Überarbeitungen | 1.12 | 0.37 | [0.39, 1.85] | 3.03 | 0.003 |
| Gesamte Qualitätsbewertung | Überarbeitungen auf Diskursebene | 1.76 | 0.41 | [0.96, 2.56] | 4.29 | < 0.001 |
| Gesamte Qualitätsbewertung | Überarbeitungen zur kulturellen Anpassung | 2.04 | 0.46 | [1.14, 2.94] | 4.43 | < 0.001 |
| Gesamte Qualitätsbewertung | Oberflächenüberarbeitungen | -0.63 | 0.28 | [-1.18, -0.08] | -2.25 | 0.028 |
| Gesamte Qualitätsbewertung | Jahrgangsstufe | 3.48 | 0.69 | [2.13, 4.83] | 5.04 | < 0.001 |
Tabelle 5: Gemischte Modelle zur Vorhersage des prozessualen Verhaltens und der Übersetzungsqualität auf Segmentebene.
Diskussion
Die vorliegenden Ergebnisse zeigen, dass Schwierigkeiten bei der Übersetzung chinesischsprachiger Texte ins Englische nicht gleichmäßig über den Text verteilt sind. Stattdessen konzentrieren sie sich auf Textabschnitte, in denen kulturelle Bezüge, Bewertungshaltungen und verdichtete narrative Bedeutungen zusammenwirken. Dies untermauert eine prozessorientierte Sichtweise der Übersetzungsschwierigkeit, die nicht auf einem Vokabelmangel, sondern auf kognitiven Bearbeitungsanforderungen basiert. Empirische Forschung zum Übersetzungsprozess betont, dass Übersetzen eine zeitlich organisierte Tätigkeit ist, bei der Zögern, Orientierung und Produktion ungleichmäßig verteilt sind19. Die in dieser Studie beobachtete Konzentration der kognitiven Anstrengung spiegelt wider, wie bestimmte Textsegmente einen stärkeren interpretativen Druck ausüben und den linearen Schreibprozess tiefergehend stören als andere. Die Hypothesenprüfungen lassen sich wie folgt zusammenfassen: H1 wurde bestätigt, da ein hoher kultureller Gehalt zu früherem Zögern und einer erhöhten Dichte an Revisionen führte; H2 wurde präzisiert, da Bewertungsdichte und narrative Verdichtung über unterschiedliche Revisionspfade wirkten; H3 wurde bestätigt, da Zeitpunkt und Funktion von Revisionen die Qualität stärker vorhersagten als die Gesamtanzahl der Revisionen; und H4 wurde bestätigt als assoziative Überlappung zwischen der Salienz von Danmu-Kommentaren und Segmenten mit hohem Bearbeitungsaufwand, jedoch nicht als kausaler Zusammenhang.
Hinsichtlich des Überarbeitsverhaltens zeigen die Daten, dass die Gesamtanzahl der Überarbeitungen keine Vorhersage über die Übersetzungsqualität zulässt; vielmehr sind verspätete, diskursbezogene und kulturell angepasste Überarbeitungen die Hauptfaktoren für eine bessere Leistung. Diese Unterscheidung legt nahe, dass Überarbeitung nur dann produktiv ist, wenn sie als strukturierte Neubewertung und nicht als wiederholte lokale Korrektur durchgeführt wird. In Übereinstimmung mit Blickverlauf- und Tastaturprotokollierungsstudien, die darauf hinweisen, dass Anfängerübersetzer ihre Anstrengungen unterschiedlich aufwenden, wenn Aufgaben schwieriger werden, waren die leistungsstärkeren Studierenden in dieser Untersuchung nicht einfach aktiver7. Sie unterbrachen selektiv vorläufige Lösungen, bewerteten diese zu einem späteren Zeitpunkt erneut und lenkten die Überarbeitungen auf narrativen oder kulturellen Einklang. Daher alleinige Produktbewertungen nicht ausreichen, um die Leistung von Übersetzern zu erklären, da vergleichbare Endbewertungen oft aus sehr unterschiedlichen prozesshaften Verläufen resultieren9.
Dieses Phänomen lässt sich am besten anhand der Umwandlung von Aufwand verstehen. Bei Übersetzungen mit geringerer Punktzahl blieb der kognitive Aufwand auf lokaler Ebene stecken – die Studierenden machten Pausen, ersetzten lexikalische Einheiten oder passten Artikel an, konnten jedoch tiefgreifende Diskrepanzen zwischen den Implikationen des Ausgangstexts und der Struktur des Zieltexts nicht beheben. Im Gegensatz dazu zeigten die besser bewerteten Texte einen Aufwand, der in strukturelle Entscheidungen umgesetzt wurde und den Text für den Zielleser optimierte. In Einklang mit Forschungsergebnissen zur Nachbearbeitungsleistung von Studierenden bestätigen diese Ergebnisse, dass der aufgewendete Prozessaufwand nicht automatisch von Vorteil ist; sein Nutzen hängt davon ab, inwieweit er in nachvollziehbare Verbesserungen des Textes umgewandelt wird20.
Darüber hinaus aktivieren unterschiedliche textuelle Eigenschaften verschiedene Prozessmechanismen. Die kulturelle Belastung erhöhte zuverlässig die frühe Zögerlichkeit und die Dichte an Überarbeitungen, während narrative Verdichtung stark die diskursbezogene Überarbeitung vorhersagte. Diese Unterscheidung macht deutlich, warum anspruchsvolle Textpassagen sich im Übersetzungsprozess unterschiedlich manifestieren: Einige stören den kognitiven Zugriff bereits im Stadium der ersten Formulierung, während andere erst bei der Aufrechterhaltung der Kohärenz über größere Diskursabschnitte hinweg problematisch werden. In Einklang mit Studien, die zeigen, dass schwierige Texte kleinere Verarbeitungseinheiten und dichtere Unterbrechungen erzeugen, unterstreichen diese Ergebnisse, wie verdichtete kulturelle und evaluative Bedeutungen Übersetzer dazu zwingen, zwischen lokaler Ausdrucksweise und globaler narrativer Rahmung zu oszillieren8.
Ein wesentlicher methodischer Beitrag dieser Studie besteht in der Integration der Danmu-Salienz als eine Ebene des Zuschauerdiskurses. Die erhebliche Überschneidung zwischen Segmenten mit hohem Übersetzungsaufwand und danmu-salienten Segmenten zeigt, dass die Engpässe, auf die Studierende stoßen, häufig mit jenen Stellen zusammenfallen, die in der digitalen Verbreitung verstärkte Aufmerksamkeit des Publikums auf sich ziehen. Dadurch wird eine Verbindung zwischen Übersetzungsschwierigkeit und partizipativem Diskurs hergestellt, ohne beide Konstrukte gleichzusetzen. Danmu-Kommentare offenbaren, worauf das Publikum in der videovermittelten Verbreitung achtet oder was es hinterfragt, während Tastenanschlag- und Überarbeitungsdaten zeigen, wie Studierende als Übersetzer semantisch verwandte Segmente des Ausgangstexts verarbeiten. Die plausibelste Interpretation ist daher ein gemeinsamer Reizansatz: kulturell beladene Referenzen, komprimierte Hintergrundannahmen und evaluative Positionierungen können gleichzeitig die Aufmerksamkeit des Publikums auf sich ziehen und den kognitiven Verarbeitungsdruck für Übersetzer erhöhen21.
Pädagogisch gesehen deutet diese Überschneidung darauf hin, dass auf China bezogene Narrativen in Kontexten zirkulieren, in denen Bedeutung öffentlich und rasch verhandelt wird und die von konkurrierenden Anforderungen wie Unmittelbarkeit, Verständlichkeit und Zielgruppenorientierung geprägt sind22. Folglich muss die Übersetzerausbildung davon wegkommen, Überarbeitung als eine allgemeine Korrekturphase zu betrachten, und stattdessen funktionale sowie zeitlich strategische Eingriffe in den Vordergrund stellen. Die beobachteten Engpässe entstanden selten allein durch terminologische Schwierigkeiten; vielmehr traten sie dort auf, wo die narrative Bedeutung auf kulturell verankerten Präsuppositionen, relationalen Rahmungen und selektivem Zugang der Zielgruppe beruhte. Ähnlich wie bei der Verbreitung chinesischer ethnischer Erzählliteratur erfordert die Übertragung dieser Narrativen, über lexikalische Treue hinauszugehen und zu klären, wie lokale kulturelle Bedeutungsinhalte für eine breitere globale Verbreitung neu strukturiert werden sollten23. Die Methode kann in der Übersetzerausbildung angewandt werden, indem Tastenanschlagsprotokolle, Bildschirmaufzeichnungen und Beispiele aus publikumsbezogenen Diskursen genutzt werden, um Studierenden zu helfen, zu erkennen, wann ein Textabschnitt eine Explikation, Umstellung, kulturelle Rahmung oder Anpassung des Sprachstils erfordert – statt einer einfachen lexikalischen Ersetzung.
Mehrere Einschränkungen beeinträchtigen die Interpretation dieser Ergebnisse. Erstens ist die Salienz von Danmu ein semantisches Cluster-Proxy für die Zuschauerbeteiligung, kein direktes Maß für sprachliche Schwierigkeit, und das vorliegende korrelative Design kann keinen kausalen Zusammenhang zwischen öffentlicher Salienz und Übersetzungsaufwand nachweisen. Zukünftige Studien könnten kulturelle Belastung, evaluative Dichte und narrative Verdichtung experimentell manipulieren, um kausale Wirkwege zu prüfen. Zweitens beschränkt sich die Stichprobe auf angehende Übersetzer einer einzigen Universität, und Erfahrung der Teilnehmer, kulturelle Vertrautheit sowie Fremdsprachenkompetenz wurden statistisch kontrolliert, anstatt durch eine vollständig geschichtete Stichprobenziehung. Die Reproduktion mit professionellen Übersetzern, Studierenden mehrerer Institutionen und breiteren Kompetenzstufen würde die Generalisierbarkeit stärken. Drittens wurden die Ausgangstexte von den Forschenden konstruiert und in einer Vorstudie getestet, um die Aufgabe zu kalibrieren, zukünftige Untersuchungen sollten jedoch zusätzliche Validierungen unter Verwendung authentischer öffentlicher Texte und unabhängiger Materialentwicklungsgremien einbeziehen. Viertens basiert die Kodierung der kulturellen Belastung, evaluativen Dichte, narrativen Verdichtung und Revisionsfunktionen auf transparenten operationalen Definitionen, unabhängigen Kodierer-Aufzeichnungen und überprüfbaren Werten zur Interrater-Reliabilität zusammen mit der final abgestimmten Kodierdatei. Zukünftige Forschung könnte zudem Tastaturprotokollierung mit Blickverfolgung, retrospektiven Interviews, Lautdenkprotokollen oder Nachbearbeitungsaufgaben kombinieren, um die kognitiven Mechanismen hinter Revisionsentscheidungen zu triangulieren.
Letztlich verdeutlicht diese Studie die prozessualen Grundlagen der Leistung von Studierenden bei der Übersetzung chinesischer Narrationen ins Englische. Indem Tastenanschlag-Aufzeichnungen, Produktbewertungen und digitale Diskurse der Zielgruppe miteinander verknüpft werden, zeigt sich, dass Engpässe in der Übersetzung an Stellen entstehen, an denen die narrative Bedeutung öffentlich aufgeladen ist. Der entscheidende Faktor bei der interkulturellen Übersetzung ist nicht das bloße Ausmaß an Revisionen, sondern die Fähigkeit des Übersetzers, Segmente zu erkennen, die eine interpretative Neustrukturierung erfordern, und den Abschluss strategisch so lange hinauszuzögern, bis eine stabile, zielgruppenangemessene Lösung gefunden ist.
Offenlegungen
Die Autoren haben keine Offenlegungserfordernisse.
Autorbeiträge
Weijia Chen: Konzeption, Methodik, formale Analyse, Untersuchung, Erstellen des Originalmanuskripts.
Chunming Wu: Studienentwurf, Anleitung zur formalen Analyse und zu Datenverarbeitungsverfahren sowie Überprüfung und Feedback zu Überarbeitungen als Reaktion auf die Kommentare der Gutachter.
Danksagungen
Diese Forschung wurde finanziell durch zwei Fördermittel der Hanshan Normal University unterstützt. Konkret stellt sie ein Teilergebnis des Programms „Erste-Klasse-Grundkurs (präsenzbasierter Erste-Klasse-Kurs) 2023“ für „Theorie und Praxis der chinesisch-englischen Übersetzung II“ dar (Genehmigungsnummer: YHS [2023] 172). Darüber hinaus wurde die Studie durch das Projekt zur Unterrichtsqualität und Unterrichtsreform 2025 unterstützt, das als Modulkurs für die ideologische und politische Lehre im Fach „Chinesisch-Englische Übersetzung“ ausgewiesen ist (Genehmigungsnummer: YHSJ〔2025〕126). Die Autoren danken für die institutionelle Unterstützung, die zur Fertigstellung dieser Forschungsarbeit beigetragen hat.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Bilibili-danmu-Korpus | Bilibili | 24 Videos; 18.642 Kommentare;https://www.bilibili.com | Erstellung des unterstützenden danmu-Korpus und Berechnung der segmentbezogenen danmu-Relevanz |
| Microsoft Excel | Microsoft Corporation | Excel 2021;https://www.microsoft.com/microsoft-365/excel | Datenbereinigung, Codierungsorganisation und vorläufige Datenverwaltung |
| R | R Foundation for Statistical Computing | R 4.3.1;https://www.r-project.org | Mischmodelle, Korrelationsanalyse und Erstellung von Abbildungen |
| Bildschirmaufnahme-Software | Laborarbeitsplatz | Lokales Arbeitsplatz-Tool; keine Artikelnummer | Überprüfung nichtlinearer Überarbeitungsepisoden und Sicherung der Prozessdaten |
| SPSS | IBM Corporation | SPSS Statistics 27.0;https://www.ibm.com/products/spss-statistics | Deskriptive Statistik, Varianzanalyse und grundlegende statistische Analysen |
| Translog-II | Copenhagen Business School / CRITT | Translog-II;https://sites.google.com/site/centretranslationinnovation/translog-ii | Tastenanschlag-Logging und Aufzeichnung von Pausen, Mausbewegungen und Überarbeitungsepisoden während Übersetzungsaufgaben |
Referenzen
- Valdeón RA, Li S. Political discourse translation in contemporary Chinese and Western contexts. Translator. 2024;30(4):1-14.
- Du L, Afzaal M. Analyzing modality-mediated ideology in translated Chinese political discourses: An ideological square model approach. Humanit Soc Sci Commun. 2024;11:956.
- Carl M. Empirical translation process research: Past and possible future perspectives. Transl Cogn Behav. 2024;6(2):252-274.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589-1604.
- Carl M, et al. Hesitation, orientation, and flow: A taxonomy for deep temporal translation architectures. Ampersand. 2024;12:100164.
- Swar O, Mohsen M. Students' cognitive processes in L1 and L2 translation: Evidence from a keystroke logging program. Interact Learn Environ. 2023;31(10):6247-6263.
- Wang Y, Li S, Rasmussen YZ. Translators' allocation of cognitive resources in two translation directions: A study using eye-tracking and keystroke logging. Appl Sci. 2025;15(8):4401.
- Wang F, Xu Q. Processing of translation units by student and semi-professional translators in translating texts with different levels of translation difficulty. PLoS One. 2025;20(4):e0320809.
- Chen X, Yan JX. Examining student translators' writing and translation products: Quality, errors, and self-perceived mental workload. Interpret Transl Train. 2024;18(3):465-485.
- Dong D, Chen ML. Metacognitive strategies in translation: A comparative study of student and professional translators. Humanit Soc Sci Commun. 2025;12:890.
- Chen X, Yan JX. Investigating the processing effort in translation students' L2 writing and L2 translating: Evidence from keylogging. Humanit Soc Sci Commun. 2025;12:1810.
- Cao L, Doherty S, Lee JF. The process and product of translation revision: Empirical data from student translators using eye tracking and screen recording. Interpret Transl Train. 2023;17(4):548-565.
- Van Egdom GW, Schrijver I, Verplaetse H, Segers W. The impact of collaborative processes on target text quality in translator training. Interpret Transl Train. 2024;18(3):486-506.
- Riondel A. How to teach revision: Tips from an interview study. Interpret Transl Train. 2024;18(3):507-522.
- Lu S, Chen X. An experimental study on viewing perception and gratification of danmu subtitled online video streaming. J Spec Transl. 2024;42:217-238.
- Lei Y, Peng M, Han Y. Mistaken presuppositions and the translation of cultural texts: A study of two English translations of The Classic of Tea. Perspectives. 2025. doi:10.1080/0907676X.2025.2599854.
- Kim HR. Danmu as paratext: An exploratory study of paratextual functions in Chinese fan-subtitled videos. J Transl Stud. 2025;26(3):197-231.
- Wu X, Fitzgerald R. The danmu discourse of user engagement with cross-posted broadcast interviews in Chinese social media. Journalism. 2025;26(3):733-751.
- Yamada M, Carl M, Schaeffer MJ. Introduction to the special Ampersand issue on empirical translation process research. Ampersand. 2024;12:100179.
- Peng X, Wang X, Li X. When student translators meet with machine translation: The impacts of machine translation quality and perceived self-efficacy on post-editing performance. SAGE Open. 2024;14(4):21582440241291624.
- Yang Y. Making sense of the raw meat: A social semiotic interpretation of user translation on the danmu interface. Discourse Context Media. 2021;44:100550.
- Zeng D. Danmu subtitling as a self-regulative practice: A descriptive discourse analysis of Bilibili danmu subtitles from ethical perspectives. Front Psychol. 2025;16:1577260.
- Li Y, Cai X. The translation of ethnic literature: An analysis of the Chinese and English translations of the Yi folk narrative poem Ashima and their dissemination. Perspectives. 2025. doi:10.1080/0907676X.2025.2502935.