Diese Methode stellt einen umfassenden, auf erklärbarer künstlicher Intelligenz (XAI) basierenden Rahmen vor, der eine sichere Migration von Gesundheitsdaten in die Cloud ermöglicht, wobei ein synthetischer Datensatz aus dem Gesundheitswesen in einer kontrollierten Cloud-Umgebung verwendet wird. Das Ergebnis ist ein Prototyp, der Zero-Trust-Sicherheit, zeitbasierte Zugriffskontrolle und erklärbare Anomalieerkennung kombiniert, um Transparenz und Sicherheit bei der Migration zu unterstützen.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Methodenartikel
Ein experimentelles Protokoll für eine erklärbare, KI-gesteuerte sichere Cloud-Datenmigration unter Verwendung synthetischer Gesundheitsdaten
In diesem Artikel
Zusammenfassung
Zusammenfassung
In Gesundheitssystemen wird zunehmend eine Migration zu Cloud-Daten durchgeführt, wodurch sich jedoch auch die Zeiten verändern, in denen die Datenübertragung vermutlich das größte Sicherheitsrisiko darstellt. Dieser Artikel beschreibt ein reproduzierbares Protokoll für eine erklärbare Künstliche-Intelligenz-basierte (XAI) sichere Cloud-Datenmigration unter Verwendung eines synthetischen Gesundheitsdatensatzes und einer kontrollierten Cloud-Umgebung. Der entwickelte Rahmen kombiniert eine Zero-Trust-Architektur, zeitlich begrenztes Mindestprivileg, verschlüsselte Kommunikation, zentrale Überwachung und erklärbare Anomalieerkennung, um eine sicherere, transparentere und auditierbare Migration zu ermöglichen. Die Tests verwendeten einen 10-GB-Datensatz synthetischer elektronischer Gesundheitsakten, bestehend aus etwa 20 Millionen Datensätzen über 28 relationale Tabellen. Der Migrationsprozess wurde auf Amazon Web Services (AWS) unter Verwendung von PostgreSQL-Datenbanken und privaten virtuellen Netzwerken durchgeführt. Zur Anomalieerkennung kam Isolation Forest zum Einsatz, und Shapley Additive Explanations (SHAP) dienten der sicheren Interpretation von Ereignissen. Der Rahmen wurde anhand von zehn separaten Migrationsversuchen anhand von Metriken wie Dauer der Anmeldeinformationen-Exposition, Zeit bis zur Vorfallerkennung, Genauigkeit der Anomalieerkennung, Migrationslatenz und Datenintegrität evaluiert. Bei der getesteten Konfiguration reduzierte sich die Exposition von Anmeldeinformationen von 24 Stunden auf 1 Stunde (eine Reduktion um 95,8 %), die Genauigkeit der Anomalieerkennung betrug 97,4 %, die Zeit bis zur Vorfallerkennung verringerte sich auf etwa 15 Minuten, und die Datenintegrität wurde zu 100 % durch Prüfsummenvalidierung gewahrt. Die stärkeren Sicherheitsmaßnahmen führten jedoch zu einer durchschnittlichen Erhöhung der Migrationslatenz um 11 %. Diese Ergebnisse verdeutlichen das Potenzial der Kombination erklärbarer Künstlicher Intelligenz mit sicheren Cloud-Migrationsabläufen zur Verwaltung von Gesundheitsdaten.
Einleitung
Cloud-Computing ist heute ein integraler Bestandteil von Gesundheitssystemen weltweit und bietet skalierbare Speicher- und Rechenressourcen sowie die Möglichkeit, Gesundheitsdaten auszutauschen, Entscheidungsunterstützungssysteme zu betreiben und Gesundheitsanalysen über die Cloud hinweg zu ermöglichen1,2,3. Da viele Gesundheitseinrichtungen ihre Informationssysteme modernisieren, ist der Umstieg auf die Cloud für sie ein entscheidender Schritt, um ihre sensiblen Gesundheitsdaten, die bisher in älteren lokalen Systemen gespeichert sind, in die Cloud zu übertragen4. Eine ordnungsgemäße Migration führt zu einer einfacheren Datenbeschaffung, effizienteren Abläufen und einer besseren Unterstützung von Analysen mit höherer Intelligenz. Gleichzeitig dürfen jedoch die erheblichen Sicherheits- und Datenschutzrisiken, die mit der Übertragung von Daten von einem Ort zum anderen verbunden sind, nicht außer Acht gelassen werden5.
Die Migrationsphase ist ein notorisch anfälliger Moment im Datenlebenszyklus, da Gesundheitsdaten aufgrund der Art des Prozesses aktiv über Systeme und Netzwerke hinweg verschoben werden6. Zudem können Organisationen während der Migrationsphase Bedrohungen wie Hacking von Zugangsdaten, unbefugten Zugriff, Abfangen von Daten, Manipulationsschemata und sogar Datenverlust ausgesetzt sein6,7. Gesundheitsumgebungen sind solchen Risiken weniger immun, da Patienteninformationen äußerst sensibel sind und daher die höchste Einhaltung regulatorischer und sicherheitstechnischer Maßnahmen erfordern8,9. Andernfalls ist es nicht möglich, Vertraulichkeit, Integrität und Nachvollziehbarkeit der Daten sicherzustellen, wenn der Migrationsworkflow nicht gesichert und transparent gestaltet ist10,11.
Zahlreiche Sicherheitsrahmenwerke und -standards wurden entwickelt, um die Sicherheit in der Cloud zu verbessern. Beispielsweise zielt die Zero-Trust-Architektur des National Institute of Standards and Technology (NIST) darauf ab, Benutzer, Geräte und Dienste stets zu überprüfen12, während Cloud-Adoption-Frameworks Leitlinien für Governance, Identitätsverwaltung, Verschlüsselung und Überwachung bereitstellen13. Tatsächlich konzentrieren sich moderne Cloud-Sicherheitsmethoden auf Automatisierung, Infrastructure-as-Code und kontinuierliche Überwachung14,15. Obwohl diese Ansätze auf wertvollen Sicherheitsprinzipien basieren, befassen sie sich weitgehend mit allgemeinen Cloud-Bereitstellungs- und Betriebsumgebungen statt mit dem Migrationsprozess selbst16. Tatsächlich zeigen sie kaum Schritt-für-Schritt-Anleitungen, detaillierte und reproduzierbare Verfahren für sichere Migrationsabläufe von Gesundheitsdaten in die Cloud, die Identitätsverwaltung, sicheren Datentransfer, Validierung, Überwachung und die Absicherung nach der Migration kombinieren17.
Die Anomalieerkennung mithilfe maschinellen Lernens hat sich als hilfreiche Technologie bei der Sicherheitsüberwachung von Cloud-Umgebungen etabliert. Sie erkennt abnormale Systemaktivitäten sowie potenzielle Sicherheitsvorfälle18. Dennoch sind viele Verfahren zur Anomalieerkennung geschlossene Systeme, die keine Erklärungen für die Gründe liefern, aus denen ein Sicherheitsereignis markiert wurde19. Die Unfähigkeit, die vom System getroffenen Entscheidungen zu erklären, verringert die Glaubwürdigkeit der Administratoren, erschwert die Überprüfung und mindert den Wert automatisierter Sicherheitsentscheidungen in stark regulierten Gesundheitsumgebungen20. Methoden der erklärbaren künstlichen Intelligenz (XAI) wie SHapley Additive exPlanations (SHAP) und Local Interpretable Model-agnostic Explanations (LIME) liefern nicht nur klare Erklärungen für Vorhersagen des maschinellen Lernens, sondern verbessern auch das Verständnis, die Nachvollziehbarkeit und das Vertrauen in Systeme zur Sicherheitsüberwachung21,22.
Obwohl die Cloud-Sicherheit und erklärbare KI große Fortschritte gemacht haben, gibt es nach wie vor einen Mangel an reproduzierbaren experimentellen Protokollen, die sichere Migrationssteuerungen mit erklärbarer Sicherheitsüberwachung im Hinblick auf die Integration verbinden23. Bestehende Forschungsarbeiten befassen sich überwiegend nur mit einzelnen Komponenten wie Verschlüsselung, Zugriffskontrolle, Anomalieerkennung oder Cloud-Governance und bieten nirgends eine integrierte Methodik, die systematisch implementiert, bewertet und reproduziert werden kann24. Hinzu kommt, dass kaum Studien versucht haben, Zero-Trust-Sicherheitsprinzipien, zeitlich begrenztes Mindestprivileg, zentrale Beobachtbarkeit und erklärbare Anomalieerkennung in einen einzigen Arbeitsablauf für die Migration von Gesundheitsdaten in die Cloud zu integrieren25,26.
Dieser Artikel stellt einen auf Erklärbarer KI basierenden Rahmen für die sichere Cloud-Datenmigration in Gesundheitssystemen vor, um diese Lücke zu schließen. Die vorgeschlagene Architektur nutzt ein Zero-Trust-Modell, zeitlich begrenzten Zugriff, sichere Kommunikation, zentrales Logging und Monitoring sowie SHAP-basierte interpretierbare Anomalieerkennung in einem gut strukturierten Migrationsprozess27,28. Das Protokoll ist eine Schritt-für-Schritt-Anleitung zur Implementierung, Überwachung und Bewertung der sicheren Migration von Gesundheitsdaten unter experimentellen Bedingungen. Durch die Kombination von Sicherheitsmaßnahmen mit interpretierbarer KI-Überwachung zielt der vorgeschlagene Rahmen darauf ab, die Transparenz, Nachvollziehbarkeit und Sicherheit während des gesamten Migrationslebenszyklus zu erhöhen29,30.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Diese Studie verwendete einen vollständig synthetischen Datensatz aus dem Gesundheitswesen, der für die experimentelle Bewertung einer sicheren Cloud-Datenmigration generiert wurde. Es wurden keine echten Patientendaten, schützenswerten Gesundheitsinformationen (PHI) oder identifizierbaren Gesundheitsakten verwendet. Daher war keine Genehmigung durch die zuständige Ethikkommission (Institutional Review Board) und keine informierte Einwilligung erforderlich. Alle in dieser Studie verwendeten Materialien sind in der Tabelle der Materialien enthalten.
1. Übersicht
- Konfigurieren Sie eine sichere Cloud-Migrationsumgebung, bestehend aus einer Quellschicht, einer Migrationsschicht, einer Zielschicht, einer Netzwerkschicht, einer Identitäts- und Zugriffsverwaltungsschicht, einer Beobachtbarkeitsschicht und einer erklärbaren KI-Schicht.
- Stellen Sie alle Komponenten in isolierten Cloud-Umgebungen bereit, um die sichere Migration von Gesundheitsdaten zu unterstützen. Richten Sie verschlüsselte Kommunikationskanäle zwischen allen Systemkomponenten ein.
- Führen Sie das Protokoll durch Datensatzvorbereitung, Umgebungskonfiguration, Architekturbereitstellung, sichere Migration, Anomalieüberwachung und Post-Migration-Validierung aus. Die Gesamtarchitektur des vorgeschlagenen erklärbaren KI-gestützten sicheren Cloud-Datenmigrations-Frameworks ist in Abbildung 1 dargestellt.
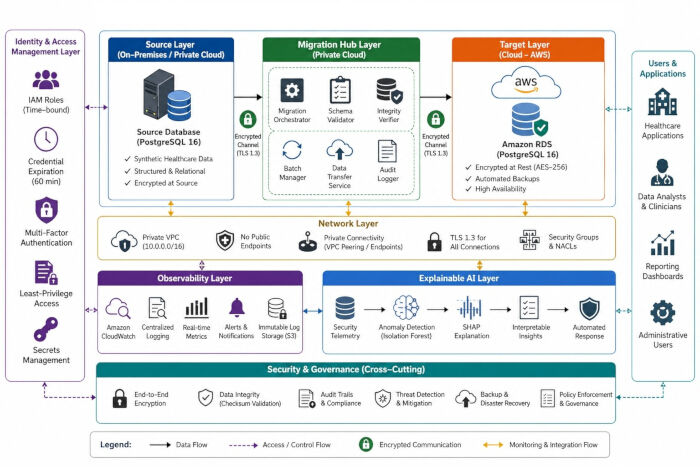
Abbildung 1: Gesamtarchitektur des erklärbaren Künstlichen-Intelligenz-(XAI-)basierten, sicheren Cloud-Datenmigrationsrahmens für Gesundheitssysteme. Der Rahmen umfasst die Identitäts- und Zugriffsverwaltungsschicht, die Quelldatenbankschicht, die Migrations-Hub-Schicht, die Zielschicht für die Cloud-Datenbank, die Netzwerksicherheitsschicht, die Observability-Schicht, die Überwachungsschicht mit erklärbarer KI sowie durchgängige Sicherheits- und Governance-Dienste. Die Architektur integriert zeitlich begrenzte Zugriffssteuerung mit minimalem Rechteumfang, TLS-1.3-verschlüsselte Kommunikation, Integritätsprüfung auf Basis von Prüfsummen, kontinuierliche Sicherheitsüberwachung und SHAP-basierte Erklärbarkeit, um eine sichere, transparente und reproduzierbare Migration von Gesundheitsdatenbanken zu ermöglichen. Diese Abbildung wurde von den Autoren mit Microsoft PowerPoint (Microsoft 365) erstellt. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
2. Konfiguration der Rechenumgebung
- Konfigurieren Sie die Rechenumgebung
- Bereiten Sie die erforderlichen Rechenressourcen für die sichere Cloud-Datenmigration und das erklärbare, auf KI basierende Monitoring vor.
- Installieren und konfigurieren Sie alle in der Tabelle der Materialien aufgeführten Hardware-, Software-, Cloud-Dienste, Datenbanken, Sicherheitstools und Machine-Learning-Bibliotheken. Stellen Sie sicher, dass alle erforderlichen Komponenten funktionsfähig sind, bevor Sie das Migrationsexperiment starten.
- Konfigurieren Sie die Cloud-Umgebung
- Richten Sie eine sichere Cloud-Umgebung für die Migration von Gesundheitsdaten ein. Richten Sie ein privates VPC für eine reibungslose Kommunikation zwischen Quell-, Migrationshub- und Zielsystemen ein. Verwenden Sie eine starke Verschlüsselung nicht nur für ruhende, sondern auch für übertragene Daten.
- Bereiten Sie die Zieldatenbank und die Migrationsservices gemäß den Angaben in der Tabelle der Materialien vor.
- Konfigurieren Sie das Identitäts- und Zugriffsmanagement. Richten Sie Überwachungs- und Protokollierungsdienste ein.
3. Datensatzvorbereitung und -beschreibung
- Erzeugen Sie einen synthetischen Gesundheitsdatensatz mithilfe der im Materialverzeichnis aufgeführten Faker-Python-Bibliothek. Konfigurieren Sie demografische Merkmale wie Patientenalter, Geschlecht, ethnische Zugehörigkeit und geografischen Standort anhand vordefinierter Wahrscheinlichkeitsverteilungen.
- Generieren Sie klinische Informationen, einschließlich Diagnosen, Laborergebnisse, Medikationen, Allergien, Verfahren und Krankenhausaufenthalte, unter Beibehaltung realistischer klinischer Zusammenhänge.
- Erstellen Sie longitudinale Patientenkontaktverläufe, indem Sie einzelnen Patienten mehrere Besuche gemäß vordefinierten Besuchshäufigkeitsverteilungen zuweisen.
- Generieren Sie Zeitstempel für Aufnahmen, Laboruntersuchungen, Medikamentengabe, Entlassungsberichte und Audit-Logs unter Verwendung einer chronologischen Ereignisreihenfolge.
- Integrieren Sie klinisch realistische fehlende Werte, doppelte Datensätze und Ausreißerbeobachtungen gemäß vordefinierter Datenqualitätsverteilungen.
- Ersetzen Sie alle personenbezogenen Informationen durch synthetische Werte, die mit der Faker-Bibliothek generiert wurden. Überprüfen Sie die referenzielle Integrität und logische Konsistenz, bevor Sie den Datensatz exportieren. Exportieren Sie den validierten Datensatz im PostgreSQL-kompatiblen SQL-Format. Konfigurieren Sie den Datensatz so, dass er realistische Szenarien zur Gesundheitsdatenübertragung unterstützt. Die Merkmale des generierten Datensatzes sind in Tabelle 1 zusammengefasst.
- Definieren Sie Datenbankbeziehungen. Weisen Sie die Patient_ID als Primärschlüssel für die Patiententabelle zu. Stellen Sie Fremdschlüsselbeziehungen zwischen den Tabellen für Patienten, Besuche, Labor, Medikation und Audit-Logs her. Überprüfen Sie die referenzielle Integrität über alle Tabellen hinweg, bevor Sie die Migration einleiten.
- Simulieren Sie realistische Merkmale von Gesundheitsdaten. Generieren Sie das Patientenalter anhand einer Normalverteilung. Erzeugen Sie Besuchshäufigkeiten mithilfe einer Poisson-Verteilung. Führen Sie fehlende Werte mit einer Rate von 5 % ein, um die Unvollständigkeit realer EHR-Daten zu simulieren. Ersetzen Sie alle Patientenidentifikatoren vor der Migration durch gehashte Werte. Stellen Sie sicher, dass alle generierten Datensätze den vordefinierten Schemabedingungen entsprechen.
- Validieren Sie den generierten Datensatz, indem Sie Schema-Konsistenz, referenzielle Integrität, fehlende Werte, doppelte Datensätze und vordefinierte Qualitätsbedingungen vor der Migration überprüfen.
| Parameter | Wert |
| Art des Datensatzes | Synthetischer Gesundheits-EHR-Datensatz |
| Größe des Datensatzes | 10 GB |
| Gesamtanzahl der Datensätze | 20 Millionen |
| Anzahl der Tabellen | 5 Kern-Tabellen – 28 relationale Tabellen |
| Patientendatensätze | 5.000.000 |
| Besuchsdatensätze | 10.000.000 |
| Laborergebnisse | 4.000.000 |
| Medikationsdatensätze | 3.000.000 |
| Prüfprotokolle | 5.000.000 |
| Primärschlüssel | Patient_ID |
| Anteil fehlender Werte | 5 % |
| Altersverteilung | Normalverteilung |
| Besuchshäufigkeit | Poisson-Verteilung |
| Integritätsschwelle | <0,1 % Verstöße |
Tabelle 1: Eigenschaften des synthetischen Gesundheitsdatensatzes, der zur Validierung des Protokolls verwendet wurde. Die Tabelle bietet einen Überblick über den Datensatz, wie z. B. Datenbankgröße, Anzahl relationaler Tabellen, Gesamtanzahl der Datensätze, Patientenmerkmale, klinische Variablen und Validierungseigenschaften, um die sicheren Migrationsversuche nachzuvollziehen.
4. Bereitstellung der Systemarchitektur
- Stellen Sie die sichere Cloud-Migrationsarchitektur bereit, die aus der Quellschicht, der Migrationshub-Schicht, der Zielschicht, der Netzwerksicherheitsschicht, der Beobachtbarkeitsschicht und der erklärbaren KI-Schicht besteht. Die in dieser Studie verwendete bereitgestellte Systemarchitektur ist in Abbildung 2 dargestellt.
- Das Framework besteht aus sechs funktionsfähigen Schichten, die während des Migrationsprozesses nacheinander ihre Funktionen ausführen. Die erste Schicht, die Quellschicht, enthält die synthetische Gesundheitsdatenbank.
- Der Migrationshub ist für die Schemagenerierung, den verschlüsselten Datentransfer, die Integritätsprüfung und die Migrationskoordination zuständig. Die Zielschicht ist der Ort, an dem die migrierte Datenbank in Amazon RDS PostgreSQL gespeichert wird.
- Die Netzwerksicherheitsschicht schützt sämtliche Kommunikation durch den Einsatz privater VPC-Endpunkte, TLS-1.3-Verschlüsselung, Sicherheitsgruppen und Netzwerk-Zugriffssteuerungslisten.
- Die Beobachtbarkeitsschicht sammelt kontinuierlich Authentifizierungsprotokolle, Migrationsprotokolle, Datenbankaktivitätsprotokolle und Sicherheitsereignisse mithilfe von Amazon CloudWatch.
- Die erklärbare KI-Schicht empfängt die gesammelte Sicherheitstelemetrie, verarbeitet sie mittels eines Isolation-Forest-Algorithmus und erzeugt SHAP-basierte Erklärungen für die gefundenen Anomalien. Alle architektonischen Schichten kommunizieren über private Netzwerkanbindungen, die während des gesamten Migrationsablaufs authentifiziert sind.
- Stellen Sie die Quelldatenbankumgebung bereit und überprüfen Sie diese, um vor der Migration einen sicheren Zugriff und die Datenverfügbarkeit sicherzustellen.
- Richten Sie eine PostgreSQL-16-Datenbank mit dem synthetischen Gesundheitsdatensatz ein. Speichern Sie Patienteninformationen, Besuchsdetails, Laborergebnisse, Arzneimitteldatensätze und Audit-Protokolle in der Quelldatenbank.
- Beschränken Sie den Datenbankzugriff ausschließlich auf autorisierte Migrationsservices und administrative Benutzer. Überprüfen Sie die Verfügbarkeit und Erreichbarkeit der Datenbank, bevor Sie Migrationsvorgänge starten.
- Konfigurieren Sie den Migrationshub, um die Schemagenerierung, den verschlüsselten Datentransfer und die Migrationskoordination zu steuern.
- Stellen Sie einen dedizierten Migrationsserver innerhalb des privaten virtuellen privaten Netzwerks (VPC) bereit. Konfigurieren Sie Migrationskoordinationsservices, um Schemagenerierung, Datentransfer und Validierungsaktivitäten zu koordinieren.
- Aktivieren Sie Schema-Validierungsdienste, um die Kompatibilität zwischen Quell- und Zielumgebung zu überprüfen. Aktivieren Sie Integritätsprüfungs-Dienste, um die migrierten Daten während und nach dem Transfer zu validieren. Stellen Sie die Kommunikation zwischen dem Migrationshub und den Datenbanksystemen sicher, bevor Sie Migrationsaufgaben ausführen.
- Stellen Sie die Zielschicht bereit. Setzen Sie Amazon RDS PostgreSQL 16 als Ziel-Datenbankumgebung ein. Aktivieren Sie automatische Sicherungs- und Wiederherstellungsdienste. Aktivieren Sie AES-256-Verschlüsselung für in der Zieldatenbank gespeicherte Daten.
- Konfigurieren Sie die Netzwerksicherheit. Deaktivieren Sie alle öffentlichen IP-Adressen, die mit Migrationsressourcen verknüpft sind. Erlauben Sie die Kommunikation ausschließlich über private Endpunkte innerhalb des VPC. Konfigurieren Sie Netzwerk-Zugriffssteuerungslisten (NACLs) und Sicherheitsgruppen. Aktivieren Sie TLS-1.3-Verschlüsselung für sämtliche Kommunikation zwischen Systemkomponenten. Stellen Sie sicher, dass keine öffentlich zugänglichen Endpunkte aktiv bleiben.
- Konfigurieren Sie ein zentrales Monitoring, um kontinuierlich Sicherheitsereignisse, Migrationsprotokolle und Systemleistungsmetriken zu erfassen.
- Aktivieren Sie Amazon CloudWatch-Protokollierungs- und Überwachungsdienste. Erfassen Sie Authentifizierungsprotokolle, Migrationsprotokolle, Datenbankaktivitätsprotokolle und Sicherheitsereignis-Protokolle. Konfigurieren Sie eine Protokollaufbewahrungsdauer von 365 Tagen. Aktivieren Sie unveränderliche Protokollarchivierung, um Audit- und Compliance-Anforderungen zu unterstützen. Überprüfen Sie die Echtzeiterfassung von Metriken und die Generierung von Warnmeldungen.
- Konfigurieren Sie die Umgebung für erklärbare KI, um eine Echtzeitanomalieerkennung durchzuführen und interpretierbare Sicherheitserklärungen zu generieren.
- Stellen Sie Anomalieerkennungsdienste innerhalb der Überwachungsumgebung bereit. Konfigurieren Sie das Framework für erklärbare KI, um die während der Migration erzeugte Sicherheitstelemetrie zu verarbeiten. Verbinden Sie Telemetriedatenströme aus der Quelle, dem Migrationshub, der Zieldatenbank und den Überwachungsdiensten.
- Aktivieren Sie die Echtzeitanomalieerkennung und die Generierung SHAP-basierter Erklärungen. Überprüfen Sie die erfolgreiche Aufnahme der Telemetriedaten, bevor Sie Migrationsversuche starten.
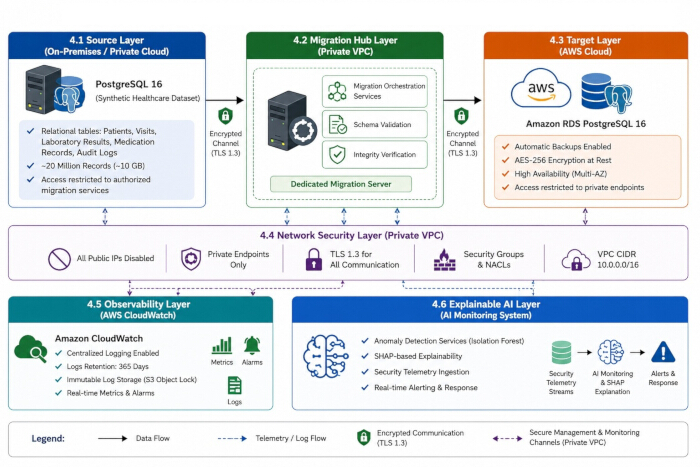
Abbildung 2: Bereitstellungsarchitektur des sicheren Cloud-Migrations-Frameworks für das Gesundheitswesen. Die Bereitstellungsumgebung zeigt die Quell-PostgreSQL-Datenbank mit dem synthetischen Gesundheitsdatensatz, den dedizierten Migrationshub innerhalb einer privaten virtuellen Cloud (VPC), die Amazon-RDS-PostgreSQL-Zieldatenbank, die Netzwerksicherheitsebene, zentrale Observability über Amazon CloudWatch sowie die Erklärbare-Künstliche-Intelligenz-Überwachungsebene. Der gesamte Kommunikationsverkehr erfolgt über private Endpunkte, die durch TLS-1.3-Verschlüsselung geschützt sind. Diese Abbildung wurde von den Autoren mit Microsoft PowerPoint (Microsoft 365) erstellt. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
5. Sicheres Migrationsverfahren
HINWEIS: Führen Sie den sicheren Migrationsworkflow durch, indem Sie Bedrohungsmodellierung, Schemaübertragung, sichere Datenmigration, Migrationsvalidierung und Nachbearbeitung nach der Migration durchführen.
- Identifizieren Sie potenzielle Sicherheitsbedrohungen und leiten Sie geeignete Minderungsmaßnahmen ab, bevor Sie mit dem Migrationsprozess beginnen.
- Identifizieren Sie Migrationsressourcen, mögliche Angriffsvektoren und realistische Cyberangriffsszenarien.
- Bewerten Sie Identitätsdiebstahl infolge kompromittierter Authentifizierungstoken, interne Angriffe durch nicht autorisierten administrativen Zugriff, Replay-Angriffe, die auf zuvor abgefangene Authentifizierungsanfragen abzielen, Man-in-the-Middle-(MITM)-Angriffe, die versuchen, verschlüsselte Kommunikationskanäle abzufangen, Schema-Manipulationen, die darauf abzielen, Datenbankstrukturen während der Migration zu verändern, sowie Rechteerweiterungsangriffe, die darauf abzielen, nicht autorisierte administrative Berechtigungen zu erlangen.
- Prüfen Sie, ob die zeitlich begrenzte Verwendung von Mindestberechtigungen ausreicht, um Identitätsdiebstahl und Rechteerweiterungsangriffe zu verhindern. Stellen Sie sicher, dass die mit TLS 1.3 verschlüsselte Kommunikation Schutz vor Replay-Angriffen und Man-in-the-Middle-Angriffen bietet.
- Überprüfen Sie, ob Identitäts- und Zugriffsverwaltungsrichtlinien (IAM) nicht autorisierten administrativen Zugriff verhindern. Stellen Sie sicher, dass kontinuierliches Audit-Logging alle sicherheitsrelevanten Migrationsaktivitäten protokolliert. Vergewissern Sie sich, dass die Überprüfung mittels SHA-256-Prüfsumme unbefugte Änderungen am Schema oder an den Daten erkennen kann.
- Stellen Sie sicher, dass das erklärbare Anomalieerkennungs-Framework ungewöhnliche Migrationsaktivitäten lokalisieren und gleichzeitig nachvollziehbare Sicherheitserklärungen liefern kann. Erstellen Sie für jede identifizierte Bedrohung eine Zuordnung der Sicherheitsmaßnahmen. Überprüfen Sie, dass alle identifizierten Bedrohungen ausreichend abgemildert sind, bevor Sie mit der Datenbankmigration beginnen. Die Autoren haben das Bedrohungsmodell und die Sicherheitsmaßnahmen in Tabelle 2 zusammengefasst.
- Übertragen Sie das Datenbankschema. Extrahieren Sie die Schemadefinitionen aus der PostgreSQL-Quelldatenbank. Überprüfen Sie die Schema-Kompatibilität mit der Ziel-Datenbankumgebung. Validieren Sie Tabellenstrukturen, Primärschlüssel, Fremdschlüssel, Indizes und Einschränkungen. Stellen Sie die validierten Schemadefinitionen in der Zieldatenbank bereit. Bestätigen Sie den erfolgreichen Schema-Deployment, bevor Sie die Daten übertragen.
- Migrieren Sie Gesundheitsdaten sicher über verschlüsselte Kommunikationskanäle, während Sie die Migrationsaktivitäten kontinuierlich überwachen.
- Konfigurieren Sie die Migrations-Stapelgröße auf 10.000 Datensätze pro Transaktion. Richten Sie verschlüsselte Kommunikationskanäle mittels TLS 1.3 ein. Übertragen Sie die Daten über private Netzwerkendpunkte innerhalb der virtuellen privaten Cloud (VPC).
- Aktivieren Sie automatische Wiederholungsversuche mit maximal drei Wiederholungen für fehlgeschlagene Transaktionen.
Halten Sie den Datentransferdurchsatz zwischen 100 MB/s und 150 MB/s. Überwachen Sie die Migrationsaktivitäten kontinuierlich während des gesamten Übertragungsprozesses. Protokollieren Sie alle Migrationsereignisse in zentralen Audit-Logs.
- Überprüfen Sie Vollständigkeit und Integrität der Migration, indem Sie Prüfsummen, Datensatzanzahlen und Datenbankstrukturen vergleichen.
- Erzeugen Sie SHA-256-Hashwerte für alle Quelltabellen vor der Migration und SHA-256-Hashwerte für alle Zieltabellen nach der Migration. Vergleichen Sie die Prüfsummen der Quelle und des Ziels. Überprüfen Sie die Zeilenzahlen der Quell- und Zieldatenbanken. Prüfen Sie die Konsistenz der Schemata, Tabellenbeziehungen und Datenbankbeschränkungen. Betrachten Sie die Migration erst dann als erfolgreich, wenn Prüfsummen, Datensatzanzahlen und Schemastrukturen identisch sind.
- Entfernen Sie temporäre Berechtigungen und schließen Sie die Sicherheitsmaßnahmen nach erfolgreich abgeschlossener Datenmigration ab.
- Entziehen Sie unverzüglich nach Abschluss der Migration alle temporären Migrationsanmeldeinformationen. Entfernen Sie erhöhte Migrationsberechtigungen von Dienstkonten. Archivieren Sie Audit-Logs und Sicherheitsüberwachungsdatensätze.
- Überprüfen Sie den erfolgreichen Abschluss der Sicherungsverfahren. Nehmen Sie temporäre Migrationsserver und unterstützende Ressourcen außer Betrieb. Führen Sie eine abschließende Sicherheitsüberprüfung der migrierten Umgebung durch. Dokumentieren Sie die Migrationsergebnisse und Validierungsresultate. Der vollständige sichere Migrationsworkflow, der in dieser Studie verwendet wurde, ist in Abbildung 3 dargestellt.
| Bedrohungsszenario | Sicherheitsmaßnahme | Erkennungsmethode | Abmilderung |
| Diebstahl von Anmeldeinformationen | Temporäres Prinzip des geringsten Rechts (TLP) | IAM-Protokolle | Automatische Sperrung der Anmeldeinformationen |
| Angriff durch Insider | Rollenbasierte Zugriffskontrolle (RBAC) | Prüfprotokolle + SHAP | Sitzung beenden |
| Wiedergabeangriff | TLS 1.3 + Nonce-Validierung | Netzwerküberwachung | Doppelte Anfragen ablehnen |
| Man-in-the-Middle (MITM) | TLS 1.3-Verschlüsselung | Zertifikatsvalidierung | Verschlüsselte Kommunikation |
| Manipulation des Schemas | SHA-256-Prüfsumme + Schema-Validierung | Integritätsprüfung | Bestätigtes Schema wiederherstellen |
| Erhöhung der Berechtigungen | Durchsetzung von IAM-Richtlinien | Sicherheitsprotokolle | Entzug der erhöhten Berechtigungen |
Tabelle 2: Bedrohungsmodell und jeweilige Sicherheitsmaßnahmen im vorgeschlagenen Migrationsframework. Die Tabelle beschreibt die wichtigsten repräsentativen Sicherheitsbedrohungen und die entsprechenden Abwehrmechanismen, die auf den Grundsätzen der Zero-Trust-Sicherheit, Verschlüsselung, Identitätsverwaltung, Integritätsprüfung, Überwachung und erklärbaren Anomalieerkennung basieren.
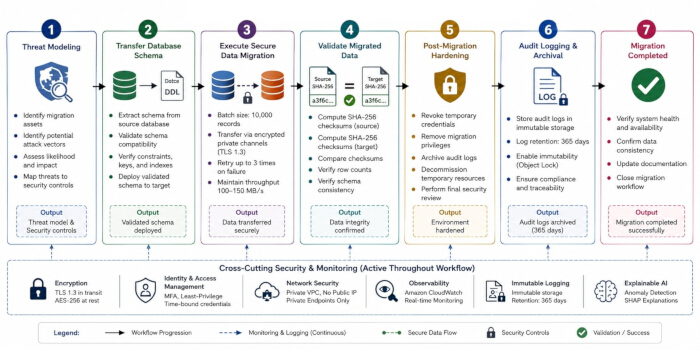
Abbildung 3: Workflow des vorgeschlagenen sicheren Cloud-Datenbank-Migrationsprotokolls. Das Protokoll besteht aus sieben sequenziellen Phasen: Bedrohungsmodellierung, Schema-Übertragung, sichere Datenbankmigration, Validierung der migrierten Daten, Nach-Migration-Härtung, Audit-Protokollierung und Archivierung sowie Migrationsabschluss. Sicherheitsüberwachung, verschlüsselte Kommunikation, Identitätsverwaltung, unveränderliche Protokollierung und erklärbare Anomalieerkennung werden während des gesamten Migrationsworkflows aufrechterhalten. Diese Abbildung wurde von den Autoren mit Microsoft PowerPoint (Microsoft 365) erstellt. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
6. Konfigurieren Sie das Monitoring für erklärbare KI
HINWEIS: Der Ablauf des Verfahrens umfasst die Identifizierung von Sicherheitsmerkmalen bei Migrationen, den Aufbau eines Modells zur Erkennung von Unregelmäßigkeiten, die Erkennung verdächtiger Migrationsaktionen und die Erzeugung nachvollziehbarer Ergebnisse mithilfe von SHAP-Interpretationsmethoden.
- Extrahieren und vorverarbeiten Sie Sicherheits-Telemetrie-Merkmale, die für die Anomalieerkennung und Erklärbarkeitsanalyse erforderlich sind.
- Sammeln Sie Sicherheitsprotokolle von Datenbankservern, Authentifizierungsservern, Anwendungsservern und Netzwerküberwachungssystemen. Aggregieren Sie alle migrationsbezogenen Ereignisse in einem zentralen Protokoll-Repository. Entfernen Sie doppelte Datensätze und unvollständige Einträge. Synchronisieren Sie die Zeitstempel aller Protokollquellen mithilfe der koordinierten Weltzeit (UTC).
- Berechnen Sie die Zugriffshäufigkeit für jeden Benutzer während der Migrationsvorgänge. Notieren Sie die Anzahl der fehlgeschlagenen Anmeldeversuche, die mit jedem Konto verknüpft sind. Überwachen Sie Änderungen der Quell-IP-Adressen während der Migrationssitzungen.
- Messen Sie die Benutzersitzungsdauer von der Anmeldung bis zur Beendigung. Berechnen Sie die eingehenden und ausgehenden Datenübertragungsvolumina während der Migrationsaktivitäten. Normalisieren Sie alle extrahierten Merkmale mithilfe der Min-Max-Normalisierung.
- Tabelle 3 fasst die für die Anomalieerkennung und Erklärbarkeitsanalyse verwendeten Sicherheitsmerkmale zusammen.
- Trainieren und validieren Sie das Isolation Forest-Modell mithilfe des vorbereiteten Datensatzes mit Sicherheitsmerkmalen.
- Teilen Sie den Datensatz auf. Teilen Sie den Datensatz zufällig in einen Trainingsdatensatz (70 %), einen Validierungsdatensatz (15 %) und einen Testdatensatz (15 %) auf. Stellen Sie eine konsistente Verteilung normaler und anormaler Ereignisse in allen Teilmengen sicher.
- Auswahl des Erklärbaren KI-Modells. Wählen Sie den Isolation Forest-Algorithmus, da er anomale Migrationsaktivitäten effizient erkennt, ohne dass gekennzeichnete Trainingsdaten erforderlich sind. Verwenden Sie den Algorithmus, um abnormale Beobachtungen durch rekursive zufällige Partitionierung des Merkmalsraums zu isolieren.
- Wenden Sie den SHAP TreeExplainer an, um den Beitrag jedes Sicherheitsmerkmals zur Anomalievorhersage zu quantifizieren und die Transparenz des Sicherheitsüberwachungsprozesses zu verbessern.
- Konfigurieren Sie das Anomalieerkennungsmodell. Initialisieren Sie ein Isolation Forest-Modell. Konfigurieren Sie das Modell mithilfe der in Tabelle 4 aufgeführten Parameter.
- Definieren Sie die mathematische Formulierung zur Berechnung der Anomaliebewertungen und zur Erklärung der Merkmalsbeiträge.
- Definieren Sie den Sicherheitsmerkmalsvektor für jedes Migrationereignis wie in Gleichung 1 gezeigt.
xi = [x1 , x2, x3, x4, x5 ] (1)
wobei x1 die Zugriffshäufigkeit, x2 die Anzahl der fehlgeschlagenen Anmeldeversuche, x3 die Häufigkeit von IP-Adressänderungen, x4 die Sitzungsdauer und x5 das Datenübertragungsvolumen bezeichnet. - Extrahieren Sie die Sicherheitsmerkmale aus den Migrationsprotokollen. Normalisieren Sie alle Merkmalswerte vor dem Modelltraining. Berechnen Sie die Isolation Forest-Anomaliebewertung für jedes Migrationereignis mithilfe von Gleichung 2.
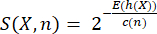 (2)
wobei S(X,n) die Anomaliebewertung der Beobachtung X, X den Sicherheitsmerkmalsvektor, E(h(X)) die erwartete Pfadlänge der Beobachtung X, c(n) die durchschnittliche Pfadlänge erfolgloser Suchvorgänge in einem binären Suchbaum und n die Gesamtanzahl der Trainingsstichproben bezeichnet. Der Normalisierungsfaktor wird wie in Gleichung 3 gezeigt berechnet.
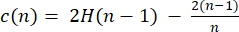 (3)
wobei H(n-1) die (n-1)-te harmonische Zahl bezeichnet. - Klassifizieren Sie Migrationereignisse mit Anomaliebewertungen über dem vordefinierten Entscheidungsschwellenwert als anormal.
- Wenden Sie SHAP (SHapley Additive exPlanations) an, um den Beitrag jedes Sicherheitsmerkmals zur Anomalievorhersage zu erklären. Berechnen Sie den SHAP-Wert für Merkmal i mithilfe von Gleichung 4.
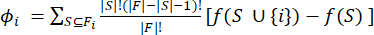 (4)
wobei (F) die vollständige Merkmalsmenge, (S) eine Teilmenge der Merkmale und (f(.)) die Isolation Forest-Vorhersagefunktion bezeichnet. - Berechnen Sie die globale Merkmalswichtigkeit, indem Sie den mittleren absoluten SHAP-Wert mithilfe von Gleichung 5 ermitteln.
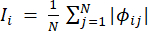 (5)
wobei (N) die Gesamtanzahl der Migrationereignisse bezeichnet. - Ordnen Sie die Sicherheitsmerkmale nach ihren mittleren absoluten SHAP-Werten. Erstellen Sie SHAP-Zusammenfassungsdiagramme, Abhängigkeitsdiagramme und Kraftdiagramme, um globale und lokale Merkmalswichtigkeit zu visualisieren.
- Definieren Sie den Sicherheitsmerkmalsvektor für jedes Migrationereignis wie in Gleichung 1 gezeigt.
- Trainieren Sie das Isolation Forest-Modell mithilfe des Trainingsdatensatzes. Bewerten Sie die Modellleistung mithilfe des Validierungsdatensatzes. Ändern Sie gegebenenfalls die Kontaminations-Schwellenwerte. Speichern Sie die Modellkonfiguration mit der besten Leistung. Validieren Sie die Modellleistung. Bestimmen Sie Metriken wie Genauigkeit, Präzision, Sensitivität, F1-Score und ROC-AUC. Notieren Sie die Modellleistungskennzahlen für späteren Vergleich.
- Wenden Sie das trainierte Modell an, um abnormale Migrationereignisse zu identifizieren und verdächtige Aktivitäten zu klassifizieren.
- Führen Sie die Anomalievorhersage durch. Wenden Sie das trainierte Isolation Forest-Modell auf den Testdatensatz an. Generieren Sie Anomaliebewertungen für alle Migrationereignisse.
- Identifizieren Sie verdächtige Aktivitäten. Bestimmen Sie, ob Migrationereignisse typisch oder anormal sind. Markieren Sie Ereignisse, die vordefinierte Anomalieschwellen überschreiten, als verdächtig. Erstellen Sie Anomaliedokumentation zur Sicherheitsüberprüfung.
- Der Abschluss des Anomalieerkennungsprozesses liefert Anomaliebewertungen, kennzeichnet Migrationereignisse als normal oder anormal, misst die Erkennungseffektivität durch ROC-Analyse und identifiziert wichtige Sicherheitsanomalien. Beispiele für Ausgaben, die durch den entwickelten Prozess erzeugt wurden, sind in Abbildung 4 dargestellt.
- Kategorisieren Sie die erkannten Anomalien. Klassifizieren Sie Anomalien in Authentifizierungsanomalien, Netzwerkanomalien, Sitzungsanomalien und Datenübertragungsanomalien. Behalten Sie die Anomaliekennzeichnungen für die Erklärungsanalyse bei.
- Bewerten Sie die Erkennungsleistung. Überprüfen Sie die bisher aufgezeichneten Sicherheitsvorfälle. Bewerten Sie dann mithilfe dieser als Referenz die erkannten Anomalien und ermitteln Sie, welche davon echte Anomalien waren. Bestimmen Sie die Anomalieerkennungsrate und die Rate falsch positiver Ergebnisse. Fertigen Sie eine offizielle Dokumentation der Erkennungsgenauigkeit an, um Reproduzierbarkeit zu gewährleisten.
- Erzeugen Sie SHAP-basierte Erklärungen, um den Beitrag einzelner Sicherheitsmerkmale zu Anomalievorhersagen zu interpretieren.
- Konfigurieren Sie die SHAP-Umgebung. Laden Sie das trainierte Isolation Forest-Modell. Initialisieren Sie den SHAP TreeExplainer. Überprüfen Sie die erfolgreiche Integration zwischen dem Anomalieerkennungsmodell und dem Erklärbarkeitsframework.
- Wählen Sie Hintergrundstichproben aus. Wählen Sie zufällig 1.000 repräsentative Stichproben aus dem Trainingsdatensatz aus. Verwenden Sie die ausgewählten Stichproben als SHAP-Hintergrunddatensatz. Berechnen Sie SHAP-Werte. Ermitteln Sie SHAP-Werte für alle erkannten Anomalien. Messen Sie den individuellen Beitrag der Merkmale zur Anomalievorhersage. Speichern Sie die SHAP-Ausgaben für weitere Analysen.
- Erzeugen Sie globale Erklärungen. Erstellen Sie SHAP-Zusammenfassungsdiagramme, die die gesamte Merkmalswichtigkeit zeigen. Erzeugen Sie SHAP-Balkendiagramme basierend auf den mittleren absoluten SHAP-Werten. Erstellen Sie SHAP-Abhängigkeitsdiagramme für besonders einflussreiche Merkmale.
- Erzeugen Sie lokale Erklärungen. Wählen Sie repräsentative anormale Migrationereignisse aus. Erstellen Sie SHAP-Kraftdiagramme und Wasserfalldiagramme. Visualisieren Sie die für jede Anomalie verantwortlichen Merkmalsbeiträge.
- Repräsentative Erklärbarkeitsausgaben, die während des Interpretationsprozesses erzeugt wurden, sind in Abbildung 5 dargestellt. Diese Visualisierungen zeigen die globale Merkmalswichtigkeit, die Rangfolge der Merkmalsbeiträge, Abhängigkeitsbeziehungen zwischen einflussreichen Sicherheitsmerkmalen sowie lokale Erklärungen für einzelne Migrationsanomalien.
- Ordnen Sie Sicherheitsmerkmale. Berechnen Sie die mittleren absoluten SHAP-Werte für alle Merkmale. Rangieren Sie die Merkmale nach ihrem Beitrag zur Anomalieerkennung. Identifizieren Sie die einflussreichsten Sicherheitsindikatoren, die die Migrationssicherheit beeinflussen. Tabelle 5 fasst die SHAP-basierten Rangfolgen der Merkmalswichtigkeit zusammen.
- Überprüfen Sie die Konsistenz der Erklärungen. Wiederholen Sie die SHAP-Analyse in fünf unabhängigen Experimenten. Messen Sie die Stabilität und Konsistenz der Erklärungen. Stellen Sie sicher, dass die Merkmalsrangfolgen über wiederholte Analysen hinweg stabil bleiben.
HINWEIS: Tabelle 6 enthält häufig auftretende Probleme bei der erklärbaren Anomalieerkennung und empfohlene Korrekturmaßnahmen.
| Merkmal | Beschreibung | Zweck |
| Zugriffshäufigkeit | Anzahl der Benutzerzugriffsanfragen während der Migration | Erkennung von abnormem Zugriffsverhalten |
| Anzahl fehlgeschlagener Anmeldungen | Anzahl erfolgloser Authentifizierungsversuche | Identifizierung von Brute-Force- oder unberechtigten Zugriffsversuchen |
| IP-Adressänderungen | Häufigkeit von Änderungen der Quell-IP-Adresse | Erkennung verdächtigen Netzwerkverhaltens |
| Sitzungsdauer | Länge der Benutzersitzungen während der Migration | Identifizierung abnormer Sitzungsaktivitäten |
| Datenübertragungsvolumen | Menge der während der Migration übertragenen Daten | Erkennung ungewöhnlicher Datenbewegungen oder Datenexfiltration |
Tabelle 3: Sicherheitstelemetriefunktionen, die für die erklärbare Anomalieerkennung verwendet wurden. Die Tabelle zeigt die Sicherheitsmerkmale, die während der Datenbankmigration überwacht wurden, ihre Bedeutung, die Messmethoden sowie ihre Rolle bei der Anomalieerkennung und der Erklärbarkeitsanalyse.
| Parameter | Wert | Beschreibung |
| Algorithmus | Isolation Forest | Anomalieerkennungsmodell |
| n_estimators | 100 | Anzahl der Isolationsbäume |
| contamination | 0,02 | Erwarteter Anteil an Anomalien |
| max_samples | Automatisch | Pro Baum verwendete Stichproben |
| random_state | 42 | Zufallsstartwert für Reproduzierbarkeit |
| bootstrap | Falsch | Stichprobennahme ohne Zurücklegen |
| Trainingsdatensatz | 70 % | Trainingsdaten für das Modell |
| Validierungsdatensatz | 15 % | Hyperparameter-Validierung |
| Testdatensatz | 15 % | Endgültige Modellbewertung |
Tabelle 4: Konfiguration des Isolation Forest zur Erkennung von Anomalien während der sicheren Datenbankmigration. Diese Tabelle beschreibt die Hyperparameter-Einstellungen des Isolation-Forest-Modells für das Training, beispielsweise wie der Datensatz aufgeteilt wurde, das Ausmaß der Kontamination, die Anzahl der Schätzer, den Zufallsstartwert und den Evaluierungsansatz.
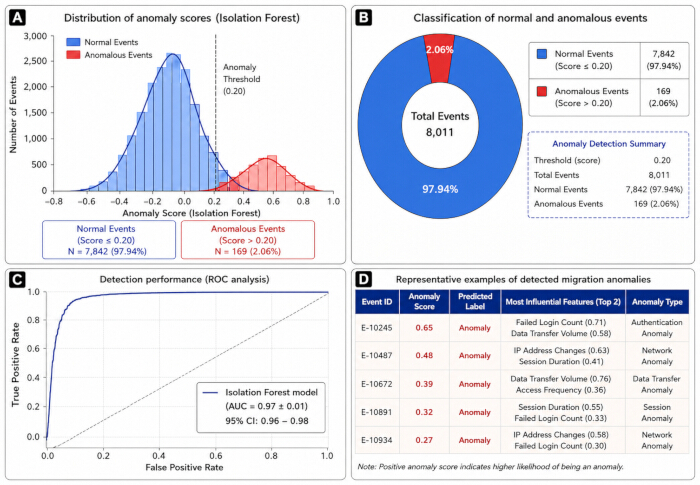
Abbildung 4: Beispielhafte Ausgaben des Anomalieerkennungs-Frameworks während der sicheren Cloud-Datenmigration. (A) Verteilung der Anomalie-Scores des Isolation Forest mit Anzeige der Anomalie-Schwelle. (B) Klassifizierung von Migrationsereignissen in normale und anormale Kategorien. (C) Receiver-Operating-Characteristic-(ROC)-Kurve, die die Leistung des Isolation-Forest-Modells veranschaulicht (AUC = 0,97 ± 0,01). (D) Beispielhafte anormale Migrationsereignisse mit Anomalie-Scores, vorhergesagten Klassen, einflussreichen Sicherheitsmerkmalen und Anomaliekategorien. Diese Abbildung wurde von den Autoren mit Python 3.11 (Matplotlib 3.9) erstellt und mit Microsoft PowerPoint (Microsoft 365) formatiert. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
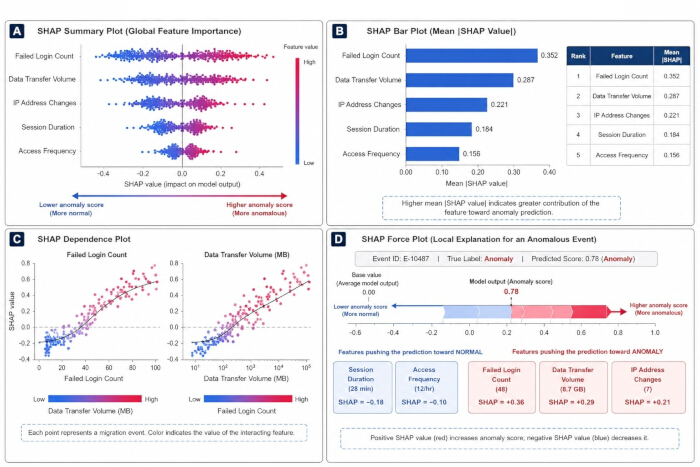
Abbildung 5: Beispiele für SHAP-basierte Erklärbarkeitsausgaben, die während der Anomalie-Interpretation erzeugt wurden. (A) SHAP-Übersichtsplot, der die global wichtigsten Merkmale hervorhebt. (B) Rangfolge der Sicherheitsmerkmale basierend auf ihrem mittleren absoluten SHAP-Wert. (C) SHAP-Abhängigkeitsplots, die zeigen, wie die Anzahl fehlgeschlagener Anmeldungen und das Volumen des Datenverkehrs die Anomalievorhersage beeinflussen. (D) SHAP-Force-Plot, der eine lokale Erklärung für ein typisches abnormale Migrationsereignis liefert. Diese Diagramme verdeutlichen die globale und lokale Interpretierbarkeit des vorgeschlagenen Anomalieerkennungsmodells. Diese Abbildung wurde von den Autoren mit Python 3.11 (Matplotlib 3.9) erstellt und mit Microsoft PowerPoint (Microsoft 365) formatiert. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
| Rang | Merkmal | Mittlerer absoluter SHAP-Wert | Interpretation |
| 1 | Anzahl fehlgeschlagener Anmeldungen | 0.352 | Wichtigster Indikator für anomales Verhalten |
| 2 | Datentransfervolumen | 0.287 | Deutlicher Beitrag zur Anomalieerkennung |
| 3 | IP-Adresswechsel | 0.221 | Weist auf verdächtiges Netzwerkverhalten hin |
| 4 | Sitzungsdauer | 0.184 | Im Zusammenhang mit abnormalen Benutzersitzungen |
| 5 | Zugriffshäufigkeit | 0.156 | Spiegelt ungewöhnliche Zugriffsmuster wider |
Tabelle 5: SHAP-Werte der Merkmalswichtigkeit von Sicherheitstelemetriedaten. Die Tabelle zeigt die Rangfolge der Sicherheitsmerkmale basierend auf ihren mittleren absoluten SHAP-Werten und skizziert deren jeweiligen Beitrag zur Vorhersage von Anomalien.
| Problem | Mögliche Ursache | Empfohlene Lösung |
| Nur wenige Anomalien erkannt | Der Kontaminationsparameter ist zu niedrig | Erhöhen Sie die Kontaminationsschwelle und trainieren Sie das Modell erneut. |
| Hohe Rate falsch positiver Ergebnisse | Lauter oder inkonsistenter Migrationsprotokoll | Bereinigen Sie die Protokolldaten und normalisieren Sie die Sicherheitsmerkmale vor dem Modelltraining. |
| Instabile SHAP-Erklärungen | Unzureichende Hintergrundstichproben | Erhöhen Sie die Anzahl repräsentativer Hintergrundstichproben, die von SHAP verwendet werden. |
| Schlechte Genauigkeit bei der Anomalieerkennung | Ungleichgewicht der Merkmale oder unzureichende Vorverarbeitung | Wenden Sie Verfahren zur Merkmalsnormalisierung, -ausgleichung und Qualitätskontrolle an. |
| Langsame Modellkonvergenz | Großer Datensatz oder begrenzte Rechenressourcen | Optimieren Sie die Hyperparameter oder verwenden Sie GPU-/Parallelverarbeitung. |
| Kommunikationsfehler | Netzwerkinstabilität während der Überwachung | Überprüfen Sie die sicheren Kommunikationskanäle und wiederholen Sie die Synchronisierung. |
| Fehlende Sicherheitsmerkmale | Unvollständige Protokollerfassung | Überprüfen Sie die Protokollquellen vor der Merkmalsextraktion und generieren Sie den Merkmalsdatensatz erneut. |
Tabelle 6: Leitfaden zur Fehlerbehebung beim sicheren Datenbankumzug auf Basis Erklärbarer Künstlicher Intelligenz. Diese Tabelle bietet eine Zusammenfassung typischer Implementierungsprobleme, möglicher Ursachen, diagnostischer Hinweise, empfohlener Maßnahmen und erwarteter Ergebnisse als Folge der Protokollausführung und Reproduzierbarkeit.
7. Leistungsbeurteilung
HINWEIS: Dieser Abschnitt beschreibt das experimentelle Vorgehen zur Gegenüberstellung des Baseline-Migrations-Frameworks mit dem vorgeschlagenen Zero-Trust-Migrations-Framework auf Basis erklärbaren KI-Systems. Die Leistungsbewertung umfasst Sicherheit, Anomalieerkennungsfähigkeit, Migrationseffizienz und statistische Validierung unter identischen experimentellen Bedingungen.
- Richten Sie sowohl die Baseline- als auch die vorgeschlagene Umgebung unter identischen Bedingungen ein, um einen fairen Leistungsvergleich zu ermöglichen.
- Richten Sie die konventionelle Migrationsumgebung ein. Konfigurieren Sie langfristige statische Anmeldeinformationen mit einer Gültigkeitsdauer von mehr als 24 Stunden. Aktivieren Sie öffentliche Netzwerkendpunkte für den Datenbankzugriff. Deaktivieren Sie KI-basierte Anomalieerkennungs- und Erklärbarkeitsmechanismen. Überwachen Sie Migrationsaktivitäten manuell mithilfe konventioneller Sicherheitsprotokolle. Erfassen Sie Migrationsereignisse zur späteren Leistungsbeurteilung.
- Richten Sie das Zero-Trust-Migrationsframework ein. Aktivieren Sie zeitlich begrenzte Least-Privilege-Anmeldeinformationen mit automatischer Ablauf nach Abschluss der Migration. Deaktivieren Sie alle öffentlichen Netzwerkendpunkte. Aktivieren Sie die Kommunikation über private Netzwerke unter Verwendung sicherer Kanäle.
- Stellen Sie das trainierte Isolation-Forest-Modell zur Anomalieerkennung bereit. Aktivieren Sie den SHAP TreeExplainer zur Modellinterpretation. Konfigurieren Sie eine automatisierte Sicherheitsüberwachung während des gesamten Migrationsprozesses. Überprüfen Sie die sichere Kommunikation zwischen allen Migrationskomponenten vor der Ausführung.
- Führen Sie wiederholte Migrationsversuche unter kontrollierten Bedingungen durch, um die Reproduzierbarkeit des Frameworks zu bewerten.
- Führen Sie einen Migrationsversuch durch. Führen Sie zehn unabhängige Migrationsversuche sowohl in der Baseline- als auch in der vorgeschlagenen Umgebung durch. Verwenden Sie während aller Versuche identische Hardware-, Software- und Netzwerkkonfigurationen.
- Migrieren Sie 10 GB Gesundheitsdaten während jedes experimentellen Durchlaufs. Wiederholen Sie alle Versuche unter identischen Arbeitslastbedingungen. Erfassen Sie Sicherheitsereignisse, Migrationsprotokolle, Ausgaben der Anomalieerkennung und Ausführungszeiten während jedes Experiments.
- Überprüfen Sie die Integrität der Migration. Berechnen Sie SHA-256-Prüfsummen vor und nach der Migration. Stellen Sie nach jedem Migrationsversuch die vollständige Datenintegrität sicher. Dokumentieren Sie die Ergebnisse der Prüfsummenvalidierung.
- Berechnen Sie quantitative Metriken für Sicherheit, Migration und Anomalieerkennung zur vergleichenden Bewertung.
- Messen Sie die Sicherheitsleistung. Ermitteln Sie die Dauer der Anmeldeinformationsfreigabe. Berechnen Sie die Anzahl der offengelegten Anmeldeinformationen während der Migration. Messen Sie die Zeit bis zur Erkennung von Vorfällen. Erfassen Sie die Dauer der Exposition gegenüber öffentlichen Netzwerken.
- Bewerten Sie die Leistung der Anomalieerkennung. Berechnen Sie Genauigkeit, Präzision, Sensitivität, F1-Score und die Fläche unter der ROC-Kurve (AUC). Bewerten Sie die Migrationsleistung. Messen Sie die gesamte Migrationslatenz und berechnen Sie den Migrationsdurchsatz. Erfassen Sie den durch Sicherheitsmechanismen verursachten Kommunikationsaufwand.
- Führen Sie eine statistische Validierung durch. Berechnen Sie Mittelwert und Standardabweichung für alle Leistungsmetriken. Bestimmen Sie 95 % Konfidenzintervalle. Führen Sie gepaarte Student-t-Tests durch, um die Baseline- und die vorgeschlagene Frameworks zu vergleichen. Als statistisch signifikant gilt p < 0,05. Beispiele für Ergebnisse der Leistungsbewertung aus dem experimentellen Vergleich sind in Abbildung 6 dargestellt.
- Tabelle 7 fasst den quantitativen Leistungsvergleich zwischen der Baseline- und der vorgeschlagenen Migrationsarchitektur zusammen.
Tabelle 8 fasst häufig auftretende Implementierungsprobleme während der sicheren Datenbankmigration, deren mögliche Ursachen und empfohlene Korrekturmaßnahmen zusammen.
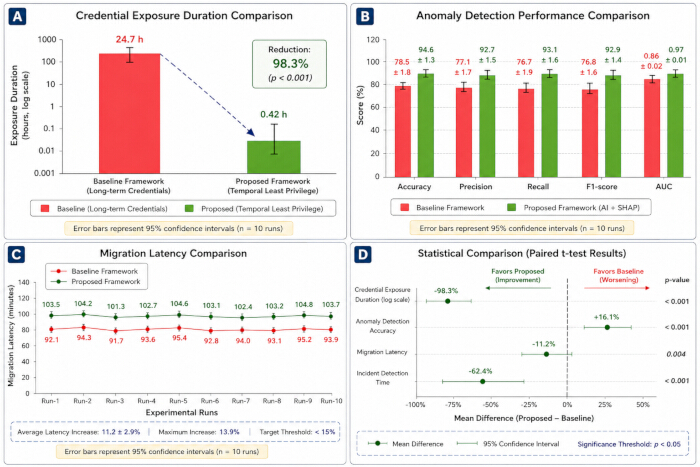
Abbildung 6: Leistungsvergleich zwischen dem Baseline-Migrationsframework und dem vorgeschlagenen Zero-Trust-, erklärbaren KI-gestützten, sicheren Cloud-Migrationsframework. (A) Vergleich der Dauer der Credential-Exposure unter Verwendung langfristiger und zeitlich begrenzter Least-Privilege-Credentials. (B) Vergleich der Leistungsmetriken zur Anomalieerkennung, einschließlich Genauigkeit, Präzision, Sensitivität, F1-Score und AUC. (C) Vergleich der Migrationslatenz über zehn unabhängige Experimentdurchläufe hinweg, wobei der Latenzanstieg unterhalb des vorab definierten Akzeptanzschwellenwerts blieb. (D) Statistischer Vergleich zentraler Leistungskennzahlen mittels gepaarter Student-t-Tests, dargestellt als mittlere Unterschiede mit 95 %-Konfidenzintervallen. Die Fehlerbalken repräsentieren die 95 %-Konfidenzintervalle aus zehn unabhängigen Experimentdurchläufen. Diese Abbildung wurde von den Autoren mit Python 3.11 (Matplotlib 3.9) erstellt und mit Microsoft PowerPoint (Microsoft 365) formatiert. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
| Leistungskennzahl | Basis-Framework (Mittelwert ± SD) | Vorgeschlagenes Framework (Mittelwert ± SD) | Verbesserung | 95 % Konfidenzintervall | p-Wert |
| Dauer der Anmeldedaten-Exposition (h) | 24,70 ± 1,32 | 0,42 ± 0,18 | 98,3 % Reduktion | 23,6–24,9 | <0,001 |
| Genauigkeit der Anomalieerkennung (%) | 72,4 ± 2,1 | 94,6 ± 1,3 | +22,2 % | 20,8–23,5 | <0,001 |
| Präzision (%) | 68,1 ± 2,5 | 92,7 ± 1,5 | +24,6 % | 23,1–26,0 | <0,001 |
| Recall (%) | 70,3 ± 2,4 | 93,1 ± 1,6 | +22,8 % | 21,4–24,2 | <0,001 |
| F1-Score (%) | 69,2 ± 2,2 | 92,9 ± 1,4 | +23,7 % | 22,3–25,0 | <0,001 |
| AUC | 0,78 ± 0,03 | 0,97 ± 0,01 | +0,19 | 0,17–0,21 | <0,001 |
| Migrationslatenz (min) | 87,6 ± 3,2 | 97,4 ± 2,9 | 11,2 % Mehraufwand | 8,9–10,7 | 0,002 |
| Datensicherheit (%) | 99,8 | 100,0 | 0,2 % Verbesserung | 0,1–0,3 | 0,031 |
| Exposition gegenüber öffentlichem Netzwerk | Aktiviert | Eliminiert | 100 % eliminiert | N/V | <0,001 |
Tabelle 7: Vergleich der Leistung zwischen Baseline- und vorgeschlagenen sicheren Datenbank-Migrations-Frameworks. Die Tabelle zeigt die Dauer der Anfälligkeit von Anmeldeinformationen, die Wirksamkeit der Anomalieerkennung, die Migrationslatenz, die Datenintegrität sowie Sicherheitsverbesserungen, die während der Protokollvalidierung quantitativ bewertet wurden.
| Problem | Mögliche Ursache | Empfohlene Lösung |
| Authentifizierungsfehler bei der Migration | Abgelaufene oder ungültige temporäre Anmeldeinformationen | Temporäre Anmeldeinformationen erneut generieren und IAM-Richtlinien vor dem Neustart der Migration überprüfen. |
| Hohe Migrationslatenz | Netzwerküberlastung oder unzureichende Bandbreite | Netzwerk-Routing optimieren, Migration in Zeiten mit geringem Datenverkehr planen und Endpunkt-Konnektivität überprüfen. |
| Falsch-positive Anomaliealarme | Unangemessener Kontaminations-Schwellenwert des Isolationswalds | Kontaminationsparameter mithilfe des Validierungsdatensatzes anpassen und Modell erneut trainieren. |
| Instabile SHAP-Erklärungen | Unzureichende oder nicht repräsentative Hintergrundstichproben | Stichprobengröße für den SHAP-Hintergrund erhöhen und repräsentative Stichprobenziehung sicherstellen. |
| Datenintegritätsabweichung | Unterbrochene Migration oder beschädigter Datenübertragungsvorgang | Migration erneut ausführen, nachdem SHA-256-Prüfsummen sowie Konsistenz von Quelle und Ziel überprüft wurden. |
| Fehlerhafte sichere Endpunktverbindung | Firewall- oder TLS-Konfigurationsfehler | SSL/TLS-Zertifikate, Firewall-Regeln und Konfiguration privater Endpunkte überprüfen. |
| Geringe Genauigkeit bei der Anomalieerkennung | Unvollständige Merkmalsextraktion oder schlechte Vorverarbeitung | Merkmalserstellung überprüfen, Sicherheitsmerkmale normalisieren und Modell erneut trainieren. |
| Probleme mit der Modellkonvergenz | Unpassende Hyperparameter | Lernparameter anpassen und Modellleistung vor der Bereitstellung validieren. |
Tabelle 8: Fehlerbehebungsanleitung für die sichere Migration von Gesundheitsdatenbanken. Die Tabelle listet häufige Migrationsfehler, ihre möglichen Ursachen, empfohlene Korrekturmaßnahmen und erwartete Ergebnisse auf, um eine zuverlässige Durchführung des sicheren Migrationsprotokolls sicherzustellen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Experimenteller Überblick
Das vorgeschlagene erklärbare Künstliche-Intelligenz-(XAI-)basierte sichere Cloud-Datenmigrationsprotokoll wurde anhand eines synthetischen Gesundheitsdatensatzes evaluiert, der etwa 20 Millionen elektronische Patientenakten (EHR) umfasst, verteilt auf 28 relationale Datenbanktabellen mit einem Gesamtvolumen von 10 GB. Die Experimente wurden in einer Amazon-Web-Services-(AWS-)Cloud-Umgebung durchgeführt, unter Verwendung von Amazon RDS PostgreSQL 16, ...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
In dieser Studie wurde ein reproduzierbares, sicheres Protokoll für die Migration von Cloud-Datenbanken entwickelt, das Zero-Trust-Sicherheitsprinzipien, zeitbasierte Least-Privilege-Zugriffskontrolle, erklärbare künstliche Intelligenz (XAI) und kontinuierliche Sicherheitsüberwachung innerhalb eines eingeschränkten experimentellen Aufbaus integriert. Es war nicht das Ziel dieser Arbeit, einen neuen Migrationsalgorithmus vorzustellen; daher präsentieren die Autoren hauptsächlich einen standardisierten Arbeitsablauf, der e...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren erklären, dass sie keine konkurrierenden finanziellen Interessen, geschäftlichen Beziehungen oder persönlichen Beziehungen haben, die die in dieser Studie beschriebene Arbeit beeinflusst haben könnten. Die Autoren haben keine Interessenkonflikte offenzulegen. Alle Materialien, die zur Reproduktion der in dieser Studie dargestellten Methodik erforderlich sind, sind öffentlich in einem GitHub-Repository verfügbar. Das Repository ist verfügbar unter: https://github.com/priyankanalawade896-tech/XAI-Secure-Cloud-Data-Migration. Das Repository enthält ausschließlich synthetisch generierte Benchmark-Daten und beinhaltet keine echten Patienteninformationen, geschützten Gesundheitsdaten oder identifizierbaren Gesundheitsakten.
Danksagungen
Die Autoren danken ihren jeweiligen Institutionen für die institutionelle Unterstützung während der Entwicklung und Bewertung dieses Protokolls. Die Autoren danken außerdem für die Nutzung institutioneller Rechenanlagen und Cloud-Computing-Ressourcen, die die experimentelle Validierung des vorgeschlagenen sicheren Cloud-Datenmigrationsrahmens ermöglichten.
Diese Forschung erhielt keine externe Finanzierung. Die Studie wurde unter Verwendung institutioneller Forschungseinrichtungen und Rechenressourcen durchgeführt, die von den Institutionen der Autoren bereitgestellt wurden. Es wurden keine Fördermittel oder finanzielle Unterstützung von öffentlichen, kommerziellen oder gemeinnützigen Förderorganisationen erhalten.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| AES-Verschlüsselung | NIST | AES-256 | Verschlüsselung ruhender Daten |
| Amazon RDS PostgreSQL | Amazon Web Services | PostgreSQL 16 | Zieldatenbank |
| Cloud-Plattform | Amazon Web Services | AWS | Cloud-Infrastruktur |
| CloudWatch | Amazon Web Services | Neueste stabile Version | Überwachung und Protokollierung |
| Docker | Docker Inc. | 27.0 | Containerisierung |
| Faker | Faker-Entwickler | 30.0 | Generierung synthetischer Daten |
| GPU | NVIDIA | RTX 4090 | 24 GB VRAM |
| Matplotlib | Matplotlib-Entwickler | 3.9 | Visualisierung |
| NumPy | NumPy-Entwickler | 1.26 | numerische Datenverarbeitung |
| Betriebssystem | Canonical | Ubuntu 22.04 LTS | Systemumgebung |
| Pandas | PyData | 2.2 | Datenverarbeitung |
| PostgreSQL | PostgreSQL Global Development Group | 16 | Quelldatenbank |
| Python | Python Software Foundation | 3.11 | Programmiersprache |
| Scikit-learn | Scikit-learn-Entwickler | 1.5 | maschinelles Lernen |
| SHAP | SHAP-Entwickler | 0.46 | Erklärbares KI-System |
| Terraform | HashiCorp | 1.8 | Infrastrukturbereitstellung |
| TLS | IETF | TLS 1.3 | Verschlüsselung übertragener Daten |
| Virtueller privater Cloud | Amazon Web Services | VPC | Private Netzwerkumgebung |
| Workstation | Dell/HP | NA | Intel Xeon Gold 6226R, 64 GB RAM, 1 TB SSD |
Referenzen
- Kindervag J. Build security into your network's DNA: The Zero Trust Network Architecture. Cambridge (MA): Forrester Research; 2010.
- Rose S, Borchert O, Mitchell S, Connelly S. Zero Trust Architecture. NIST Special Publication 800-207. Gaithersburg (MD): National Institute of Standards and Technology; 2020. doi:10.6028/NIST.SP.800-207.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119. doi:10.1038/s41746-020-00323-1.
- Kairouz P, McMahan HB, Avent B, Bellet A, Bennis M, Bhagoji AN, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210. doi:10.1561/2200000083.
- Nguyen DC, Ding M, Pathirana PN, Seneviratne A, Li J, Niyato D, et al. Privacy-preserving federated learning: A comprehensive survey. IEEE Commun Surv Tutor. 2021;23(3):1622-1651. doi:10.1109/COMST.2021.3075434.
- Sarker IH. AI-driven cybersecurity: An overview, security intelligence modeling, and research directions. SN Comput Sci. 2021;2:173. doi:10.1007/s42979-021-00557-0.
- Kuo AM. Opportunities and challenges of cloud computing to improve health care services. J Med Internet Res. 2011;13(3):e67. doi:10.2196/jmir.1867.
- Kota TK. Cloud migration for healthcare data: Challenges and solutions. Nanotechnol Percept. 2024;20:3048-3062.
- Rancea A, Anghel I, Cioara T. Edge computing in healthcare: Innovations, opportunities, and challenges. Future Internet. 2024;16(9):329.
- Mersha M, et al. Explainable artificial intelligence: A survey of needs, techniques, applications, and future direction. Neurocomputing. 2024;599:128111. doi:10.1016/j.neucom.2024.128111.
- Mennella C, Maniscalco U, De Pietro G, Esposito M. Ethical and regulatory challenges of AI technologies in healthcare: A narrative review. Heliyon. 2024;10(4):e26297. doi:10.1016/j.heliyon.2024.e26297.
- Roppelt JS, Kanbach DK, Kraus S. Artificial intelligence in healthcare institutions: A systematic literature review on influencing factors. Technol Soc. 2024;76:102443. doi:10.1016/j.techsoc.2023.102443.
- Lekkala S, Avula R, Gurijala P. Next-Gen firewalls: Enhancing cloud security with generative AI. J Artif Intell Cloud Comput. 2024;3(4):1-9. doi:10.47363/JAICC/2024(3)404.
- Al-Hammuri K, Gebali F, Kanan A. ZTCloudGuard: Zero Trust context-aware access management framework to avoid medical errors in the era of generative AI and cloud-based health information ecosystems. AI. 2024;5(3):1111-1131. doi:10.3390/ai5030055.
- Pfeifer B, Sirocchi C, Bloice MD, Kreuzthaler M, Urschler M. Federated unsupervised random forest for privacy-preserving patient stratification. Bioinformatics. 2024;40(Suppl 2):ii198-ii207. doi:10.1093/bioinformatics/btae382.
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: Challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60. doi:10.1109/MSP.2020.2975749.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions. In: Proceedings of the 31st International Conference on Neural Information Processing Systems (NeurIPS); 2017. p. 4768-4777.
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 1135-1144. doi:10.1145/2939672.2939778.
- Ortigossa ES, Gonçalves T, Nonato LG. Explainable artificial intelligence (XAI)—From theory to methods and applications. IEEE Access. 2024;12:80799-80846. doi:10.1109/ACCESS.2024.3409843.
- Chaddad A, et al. Explainable, domain-adaptive, and federated artificial intelligence in medicine. IEEE/CAA J Autom Sin. 2023;10(4):859-876. doi:10.1109/JAS.2023.123123.
- Albshaier L, Almarri S, Albuali A. Federated learning for cloud and edge security: A systematic review of challenges and AI opportunities. Electronics. 2025;14(5):1019. doi:10.3390/electronics14051019.
- Vani MS, Sudhakar RV, Mahendar A, et al. Personalized health monitoring using explainable AI: Bridging trust in predictive healthcare. Sci Rep. 2025;15:31892. doi:10.1038/s41598-025-15867-z.
- Zakhmi K, et al. Evolving Zero Trust architectures for AI-driven cyber threats in healthcare and other high-risk data environments: A systematic review. Cureus. 2025;17(6):e85446. doi:10.7759/cureus.85446.
- Selvaperumal D, et al. Artificial intelligence-enabled zero-trust cyber security framework for smart healthcare infrastructure. Int J Artif Intell Mach Learn. 2026;6(2 Suppl):204-217. doi:10.51483/IJAIML.6.2s.2026.204-217.
- Abbas SR, Seol H, Abbas Z, Lee SW. Exploring the role of artificial intelligence in smart healthcare: A capability and function-oriented review. Healthcare (Basel). 2025;13(14):1642. doi:10.3390/healthcare13141642.
- Al-Nafjan A, et al. Artificial intelligence in predictive healthcare: A systematic review. J Clin Med. 2025;14(19):6752. doi:10.3390/jcm14196752.
- Qureshi SS, et al. Advanced AI-driven intrusion detection for securing cloud-based industrial IoT. Egypt Inform J. 2025;30:100644. doi:10.1016/j.eij.2025.100644.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 785-794. doi:10.1145/2939672.2939785.
- Liu FT, Ting KM, Zhou ZH. Isolation Forest. In: Proceedings of the 8th IEEE International Conference on Data Mining; 2008. p. 413-422. doi:10.1109/ICDM.2008.17.
- Abadi M, Agarwal A, Barham P, Brevdo E, Chen Z, Citro C, et al. TensorFlow: A system for large-scale machine learning. In: Proceedings of the 12th USENIX Symposium on Operating Systems Design and Implementation (OSDI); 2016. p. 265-283.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.