Ein genetisch verankerter, mehrstufiger Ansatz, der Mendelsche Randomisierung, Tumor-Transkriptomik und Einzelzellanalysen integriert, stellte MAP1LC3A als ein mit Ferroptose assoziiertes Gen heraus, das mit der Anfälligkeit für Glioblastom verknüpft ist und als Kandidat für zukünftige experimentelle Validierung gilt.
Forschungsartikel
Mehrstufige genetische, transkriptomische und Einzelzell-Evidenz priorisiert MAP1LC3A unter ferroptose-bezogenen Genen im Glioblastom
34 Aufrufe
⸱
11. September 2026
* These authors contributed equally
In diesem Artikel
Zusammenfassung
Zusammenfassung
Glioblastom (GBM) bleibt eine äußerst aggressive maligne Erkrankung, und der Beitrag ferroptotischer Gene zur Krankheitsanfälligkeit ist noch nicht vollständig verstanden. Ein genetisch verankerter, mehrstufiger Ansatz wurde angewandt, um ferroptotische Gene zu identifizieren, die mit GBM assoziiert sind. Von 483 Genen, die aus FerrDb V2 zusammengestellt wurden, wiesen 315 kandidatenhafte cis-Expressions-Quantitative-Trait-Loci (cis-eQTLs) in eQTLGen auf, 250 behielten nach der Kopplungsungleichgewichts-Clustering mindestens drei unabhängige Instrumente bei, und 226 ergaben valide Mendelsche Randomisierungsschätzungen nach der Methode der inversen Varianzgewichtung (IVW) anhand einer genomweiten Assoziationsstudie zu GBM mit 6.183 Fällen und 18.169 Kontrollen. Vierunddreißig Gene erfüllten die explorativen Entdeckungskriterien mit einem P < 0,05 und einer Benjamini–Hochberg-False-Discovery-Rate (BH-FDR) < 0,20 sowie in gleicher Richtung zeigenden Schätzungen der bayesschen gewichteten Mendelschen Randomisierung (BWMR). Die Validierungsstufe der Mendelschen Randomisierung unter Verwendung von cis-eQTLs aus dem gesamten Blut aus GTEx V10 bestätigte vier Gene: ATG7, RPTOR, MAP1LC3A und CHMP6. Die Auswertung anhand von drei unabhängigen transkriptomischen Kohorten mit Tumor- und Kontrollproben zeigte, dass MAP1LC3A im Tumorgewebe konsistent herunterreguliert war und eine signifikante gepoolte Schätzung nach dem Zufallseffektmodell ergab (log₂-Faltungsänderung: −1,273; 95 % Konfidenzintervall: −1,625 bis −0,920; False-Discovery-Rate = 0,016), während die anderen drei Gene keine vergleichbare statistische Unterstützung über die Kohorten hinweg aufwiesen. Anschließend wurde eine virtuelle Einzelzell-Knockout-Analyse in einer patientengewichteten Teilmenge von 2.400 malignen Zellen durchgeführt, die aus 4.916 in Frage kommenden Zellen aus 20 adulten IDH-wildtypischen GBM-Tumoren ausgewählt wurden. In fünf unabhängig initialisierten Durchläufen wurden jeweils 3, 15, 4 und 7 robuste downstream liegende Gene für ATG7, RPTOR, MAP1LC3A und CHMP6 identifiziert. Die resultierenden Konsensmengen umfassten 17 einzigartige Gene, wobei RND3 bei allen vier Zielgenen gemeinsam war. Die Gen-Ontologie-Analyse zeigte eine Anreicherung von Prozessen der Zelladhäsion und der Zelloberfläche, während nach Korrektur für Mehrfachvergleiche keine KEGG- oder Reactome-Wege signifikant blieben. Insgesamt priorisieren diese Ergebnisse MAP1LC3A für zukünftige experimentelle Untersuchungen, während sie genetische Assoziation, Übereinstimmung der Tumor-Expressionsdaten und computergestützte Störungsanalysen von definitiven Beweisen für Kausalität oder Mechanismus abgrenzen.
Einleitung
Glioblastom (GBM) bleibt eine paradigmatische therapieresistente maligne Erkrankung. Trotz zunehmend verfeinerter molekularer Klassifizierung und multidisziplinärer Behandlung sind nachhaltige Verbesserungen der Patientenergebnisse begrenzt1. Bei medizinisch geeigneten Patienten besteht die derzeitige Therapie in einer maximal sicheren Resektion, gefolgt von Strahlentherapie mit gleichzeitiger und adjuvanter Gabe von Temozolomid, einem Behandlungsschema, das in einer wegweisenden randomisierten Studie etabliert wurde und in aktuellen klinischen Leitlinien beibehalten wird1,2. Dennoch begrenzen diffuse Infiltration und umfangreiche zelluläre sowie molekulare Heterogenität eine dauerhafte Krankheitskontrolle, und die meisten Patienten erleiden letztlich ein Fortschreiten oder Rezidiv der Erkrankung, für das es keine universell wirksame Standardtherapie gibt1,3. Diese anhaltende Diskrepanz zwischen Fortschritten in der Charakterisierung der Erkrankung und den klinischen Ergebnissen verdeutlicht die Notwendigkeit, biologisch relevante molekulare Abhängigkeiten zu identifizieren, die neue therapeutische Strategien beim GBM begründen könnten.
Ferroptose ist eine eisenabhängige Form des regulierten Zelltods, die durch eine unkontrollierte Peroxidation von Phospholipiden und das Versagen zellulärer antioxidativer Abwehrmechanismen gekennzeichnet ist und sich dadurch mechanistisch von der Apoptose und anderen kanonischen Zelltodprogrammen unterscheidet4,5. Dieser Prozess ist besonders relevant für das GBM, bei dem genetische Veränderungen und metabolische Plastizität die Eisenhomöostase, die Redox-Balance sowie den Lipidstoffwechsel neu gestalten. Integrierte genomische und lipidomische Profilierungen haben gezeigt, dass die Deletion von CDKN2A oxidierbare mehrfachungesättigte Fettsäuren umverteilt und dadurch eine genotypabhängige Empfänglichkeit für Ferroptose in GBM-Modellen schafft6. Ebenso haben vergleichende Analysen von primären und rezidivierten Tumoren relapsassoziierte Veränderungen in GPX4, ACSL4 und anderen Ferroptose-Regulatoren identifiziert7. Experimentelle Modulation von Ferroptose-Abwehrwegen hat zudem gezeigt, dass sie die Empfindlichkeit gegenüber Temozolomid in GBM-Zellen und Xenotransplantationsmodellen beeinflusst8. Insgesamt identifizieren diese Befunde die Ferroptose als biologisch plausible therapeutische Schwachstelle beim GBM. Diese Erkenntnisse spiegeln jedoch hauptsächlich assoziative Tumorzustände oder kontextabhängige experimentelle Beobachtungen wider und belegen nicht, ob konstitutive Variationen in der Genexpression ferroptoserelevanter Gene zu einer vererbten Anfälligkeit für GBM beitragen.
Die meisten humanen Studien zur Untersuchung der Ferroptose bei Gliomen stützten sich auf Analysen differentieller Expression, Überlebensmodellierung und molekulare Subtypisierung anhand der Datensätze von TCGA, CGGA und GEO9,10. Obwohl diese Studien die prognostische Relevanz ferroptosebezogener transkriptioneller Programme belegten, kann ihr Beobachtungsdesign nicht klären, ob veränderte Genexpression zur Anfälligkeit für Glioblastom (GBM) beiträgt oder stattdessen eine Folge der Tumorentwicklung darstellt. Mendelsche Zufallsstichprobenanalysen (Mendelian randomization) auf transkriptomweiter Ebene haben anschließend genetisch regulierte, gewebeabhängige Gene identifiziert, die mit dem Gliomrisiko assoziiert sind, während neuere, auf expressionsquantitativen Merkmalssorten (eQTL) und proteinquantitativen Merkmalssorten (pQTL) basierende Studien damit begonnen haben, potenzielle therapeutische Zielstrukturen für das GBM zu priorisieren11,12. Dennoch haben frühere Untersuchungen im Allgemeinen entweder transkriptomweite oder auf Arzneimittelziele ausgerichtete Ansätze verfolgt, anstatt eine vorab festgelegte, umfassende Genmenge im Zusammenhang mit Ferroptose zu bewerten. Zudem integrierten bisher nur wenige Studien eine große genomweite Assoziationsstudie (GWAS) zum GBM mit einer replikationsbasierten Mendelschen Zufallsstichprobe unter Verwendung einer unabhängigen eQTL-Ressource, gefolgt von einer Bewertung anhand mehrerer transkriptomischer Kohorten aus Tumor und Kontrollen. Diese Unterscheidung ist wichtig, da die genetische Regulation der Genexpression zwischen verschiedenen Geweben erheblich variiert und eQTL-Assoziationen aus Blutproben nicht ohne Weiteres als repräsentativ für regulatorische Effekte innerhalb von Hirntumoren angesehen werden können11,13. Daher ist ein integrativer Ansatz erforderlich, der genetische Assoziationen, replikationsbasierte Mendelsche Zufallsstichproben, transkohortenübergreifende Tumor-Transkriptomik und funktionelle Vorhersagen auf Basis patientenabgeleiteter Einzelzellanalysen kombiniert, um Ferroptose-assoziierte Gene zu identifizieren, die durch konvergierende Evidenzlinien in ihrer Beteiligung am GBM gestützt werden.
In dieser Studie wurde untersucht, ob die genetisch regulierte Expression eisenabhängigen Zelltods (Ferroptose) verwandter Gene mit der Anfälligkeit für Glioblastom (GBM) assoziiert ist. Im Entdeckungs- und Replikationsstadium wurden Mendelsche Zufallsbelegung (Mendelian randomization) mit Genexpressionsanalysen über drei unabhängige transkriptomische Kollektive aus Tumor und Kontrollen kombiniert. Gene, die durch beide Stadien der Mendelschen Zufallsbelegung gestützt wurden, wurden anschließend anhand von single-cell-transkriptomischen Daten von Patienten mithilfe virtueller Störungsanalysen (virtual perturbation) evaluiert, um vorhergesagte transkriptionelle Reaktionen in malignen Zellen zu charakterisieren. Anstatt Gene allein basierend auf Expressionsprofilen des Tumors zu priorisieren, nutzte dieser mehrstufige Ansatz zunächst vererbte genetische Variationen und bewertete danach krankheitsrelevante Expressionsmuster zusammen mit zellauflösenden computergestützten Störungsprofilen. Die resultierenden konvergenten Hinweise wurden verwendet, um ferroptoseassoziierte Gene für zukünftige experimentelle Untersuchungen beim GBM zu priorisieren.
Protokoll
Diese Studie wurde vom Medizinischen Ethikkomitee des First People's Hospital of Zhaoqing von der ethischen Prüfung befreit (Referenznummer B2026-08-03). Die Studie verwendete retrospektiv erhobene, anonymisierte genetische und transkriptomische Daten auf Zusammenfassungsebene, einschließlich von einem Data Access Committee genehmigter kontrollierter Zugriffsdaten aus EGAD00010001657 sowie Datensätze aus GEO, eQTLGen und GTEx gemäß deren jeweils geltenden Zugriffs- und Nutzungsvorgaben. Es wurden keine neuen Teilnehmer rekrutiert, keine Bioproben gesammelt und keine identifizierbaren individuellen Teilnehmerdaten abgerufen. Die ethische Genehmigung und die informierte Einwilligung für die ursprünglichen Studien wurden von den jeweiligen Datenanbietern eingeholt, und die kontrollierten Zugriffsdaten wurden gemäß der jeweils geltenden Data Access Agreement verwendet.
Studienaufbau
Diese Studie verwendete einen mehrstufigen Ansatz, um Eisenotose-assoziierte Gene zu identifizieren, die mit der Anfälligkeit für Glioblastom (GBM) verknüpft sind, und um deren krankheitsrelevante transkriptionelle Effekte zu bewerten (Abbildung 1). Zunächst wurden Eisenotose-assoziierte Gene, die aus FerrDb V2 zusammengestellt wurden, mittels zweistufiger Mendelscher Randomisierung (MR) unter Verwendung von cis-Expressions-Quantitative-Trait-Locus-(cis-eQTL)-Daten und einer umfangreichen genomweiten Assoziationsstudie (GWAS) zu GBM evaluiert. Die mittels inverser Varianz gewichtete MR (IVW-MR) diente dabei als primäre Screening-Methode, die bayessche gewichtete Mendelsche Randomisierung (BWMR) ermöglichte eine ergänzende Beurteilung der Robustheit, und ein unabhängiger eQTL-Datensatz wurde für die Replikationsstufe der MR-Analyse verwendet. Zweitens wurden Gene, die durch die genetischen Analysen gestützt wurden, anhand von drei unabhängigen transkriptomischen Kohorten mit Tumor- und Kontrollproben untersucht, gefolgt von einer Metaanalyse über die Kohorten hinweg. Drittens wurden transkriptomische Einzelzell-Daten von Patienten verwendet, um eine virtuelle Genmodulation in malignen Zellen durchzuführen und reproduzierbare downstream-transkriptionelle Reaktionen zu identifizieren. Diese Reaktionen wurden anschließend mittels funktioneller Anreicherungsanalysen und Analysen gemeinsamer Netzwerke charakterisiert. Insgesamt waren die genetischen Analysen darauf ausgelegt, Gene zu identifizieren, die mit der Anfälligkeit für GBM assoziiert sind, während die transkriptomischen und Einzelzell-Analysen die biologische Kohärenz beurteilten und Hypothesen für nachfolgende experimentelle Validierungen generierten.
Datenquellen
Ferroptosebezogene Gene wurden aus FerrDb V2 gewonnen, wodurch nach Harmonisierung der Gensymbole und Entfernung doppelter Einträge 483 eindeutige menschliche protein-kodierende Gene verblieben14. Als Expositionssatz für die Entdeckungsphase der Mendelschen Randomisierung (MR) wurden Zusammenfassungsstatistiken von Whole-Blood-cis-Expressionsquantitativmerkmal-Loci (cis-eQTL) des eQTLGen-Konsortiums verwendet, während die Whole-Blood-cis-eQTL-Daten der GTEx-Version V10 als unabhängiger Expositionssatz für die Replikationsphase der MR dienten11,15. Assoziationen mit dem GBM-Krankheitsverlauf wurden aus kontrolliert zugänglichen Zusammenfassungsstatistiken einer genomweiten Assoziationsstudie (GWAS) bezogen, die über das European Genome-phenome Archive verfügbar sind und 6.183 Fälle sowie 18.169 Kontrollen europäischer Abstammung umfassen16. Die gewebespezifische Expression genetisch priorisierter Gene wurde anhand von drei unabhängigen Genexpressions-Omnibus-(GEO)-Kohorten untersucht: GSE196533, bestehend aus 61 Gliomproben des Grades 4, die in den hinterlegten Metadaten als GBM annotiert sind, sowie neun nicht-neoplastischen Hirnproben; GSE4290, bestehend aus GBM- und epilepsieassoziierten nicht-tumoralen Hirnproben; und GSE116520, das gepaarte Tumor-Kern- und peritumorale Proben sowie nicht-neoplastische Kontrollen enthält17,18,19. Patientenstammende Smart-seq2-Daten aus GSE131928 wurden für die virtuelle Störungsanalyse maligner Zellen verwendet20. Die Merkmale der Datensätze und ihre jeweiligen analytischen Funktionen sind in Tabelle 1 zusammengefasst. Alle Analysen wurden anhand zuvor erhobener, anonymisierter Datensätze durchgeführt, für die in den ursprünglichen Studien eine ethische Genehmigung und informierte Einwilligung vorlagen.
Auswahl genetischer Instrumente und Harmonisierung der Daten
Kandidateninstrumente wurden auf cis-Expressions-Quantitative-Trait-Loci (cis-eQTLs) beschränkt, die mit der Genexpression auf genomweiter Signifikanz assoziiert waren (P < 5 × 10⁻8). Die Varianten wurden mithilfe des europäischen Referenzpanels des 1000 Genomes Project mit einer Kopplungsungleichgewichts-Schwelle (LD) von r2 < 0,001 innerhalb eines 10.000-kb-Fensters gruppiert. Gene, die nach der Gruppierung weniger als drei unabhängige Instrumente aufwiesen, wurden von der primären Mendelschen Zufallsanalyse (MR) ausgeschlossen. Angesichts des explorativen Screening-Ziels wurde im Voraus eine Mindestanzahl von drei Instrumenten festgelegt, um Gene mit sparsamer, aber starker cis-eQTL-Unterstützung beizubehalten und gleichzeitig die multivariate IVW-Schätzung mit mehreren Instrumenten zu ermöglichen. Dieser Schwellenwert wurde durch eine strenge LD-Gruppierung und eine Filterung nach F-Statistik ergänzt; Schätzungen, die nur auf drei oder vier Instrumenten basierten, wurden vorsichtig interpretiert, und Sensitivitätsanalysen wurden nur durchgeführt, wenn sie methodisch anwendbar waren. Die Stärke der Instrumente wurde für jede Variante anhand der F-Statistik bewertet (F = β2/SE2), wobei β und SE den cis-eQTL-Effektschätzwert bzw. dessen Standardfehler darstellen. Varianten mit F < 10 wurden ausgeschlossen, um Verzerrungen durch schwache Instrumente zu minimieren21,22. Die Expositions- und Outcome-Datensätze wurden harmonisiert, indem die Effektallelle und Effekt-Richtungen angeglichen wurden. Doppelte Varianten, Varianten, die im GBM-GWAS-Datensatz nicht verfügbar waren, sowie Varianten mit inkompatibler Allelkodierung wurden ausgeschlossen. Da Effektallel-Frequenzen für das GBM-GWAS nicht verfügbar waren, wurden palindromische Varianten mit mehrdeutiger Strangorientierung entfernt, anstatt sie abzuleiten. Aus demselben Grund wurde kein formaler Steiger-Richtungstest durchgeführt.
Mendelsche Zufallsanalysen
Der Zusammenhang zwischen genetisch vorhergesagter Genexpression und der Anfälligkeit für Glioblastom (GBM) wurde mittels zweistufiger Mendelscher Randomisierung (MR) untersucht. Im Entdeckungsstadium wurden nur Gene berücksichtigt, für die mindestens drei unabhängige cis-Expression quantitative Trait Locus (cis-eQTL)-Instrumente zur Verfügung standen, und die gewichtete Invers-Varianz-Methode (IVW) diente als primärer analytischer Ansatz. Die Effektgrößen wurden als Odds Ratios (ORs) mit 95 % Konfidenzintervallen (CIs) pro Einheit Anstieg der genetisch vorhergesagten Genexpression angegeben. Um Mehrfachvergleiche über alle untersuchten Gene hinweg zu berücksichtigen, wurden die IVW-P-Werte mittels der Benjamini-Hochberg-Methode23 korrigiert. Gene mit einem P-Wert < 0,05 und einer Benjamini-Hochberg-Falsch-Entdeckungs-Rate (BH-FDR) < 0,20 wurden als explorative Kandidaten beibehalten. Diese relativ großzügige FDR-Schwelle wurde gewählt, um ein vorzeitiges Ausschließen potenziell relevanter Gene im Entdeckungsstadium zu vermeiden; daher wurde der Kandidatenstatus stets im Kontext nachfolgender Analysen interpretiert und nicht als bestätigender Nachweis gewertet. Die Bayesianisch gewichtete Mendelsche Randomisierung (BWMR) wurde anschließend auf die Kandidaten des Entdeckungsstadiums unter Verwendung derselben harmonisierten Instrumente angewandt24. Die Übereinstimmung zwischen den Ergebnissen der IVW- und BWMR-Analysen wurde anhand der statistischen Signifikanz sowie der Effektrichtung beurteilt. Sofern die Anzahl verfügbarer Instrumente es zuließ, wurden Cochran-Q-Test, MR-Egger-Achsenabschnittstest, MR-PRESSO und Leave-one-out-Analysen durchgeführt, um Heterogenität, horizontale Pleiotropie, einflussreiche Ausreißer-Varianten sowie den Einfluss einzelner Einzelnukleotid-Polymorphismen (SNPs) zu prüfen22.
Die Replikationsstadium-MR wurde unter Verwendung der GTEx V10 Ganzblut-cis-eQTL-Daten durchgeführt. Die Wald-Quotienten-Methode wurde angewandt, wenn nur ein einziges Instrument verfügbar war, während die IVW-Methode für Gene mit zwei oder mehr Instrumenten verwendet wurde. Eine Replikation wurde definiert durch P < 0,05, BH-FDR < 0,20 und eine Effekt-Richtung, die mit der entsprechenden Schätzung aus der Entdeckungsphase übereinstimmte. Da mehrere GTEx-Replikationsschätzungen auf nur einem oder zwei Instrumenten basierten, wurden sie als unterstützender Hinweis für die Replikation und nicht als unabhängiger Nachweis von Kausalität interpretiert.
Auswertung der transkriptomischen Daten über verschiedene Kohorten hinweg
Die vier Gene, die in den Entdeckungs- und Replikationsstufen der Mendelschen Zufallsanalyse (MR) priorisiert wurden, wurden anhand von drei unabhängigen transkriptomischen Kohorten bewertet. Für GSE196533 wurden rohe RNA-Sequenzierungs-Zähldaten mit DESeq225 analysiert. Gene mit Zählwerten unterhalb von 10 in allen bis auf zwei Proben wurden ausgeschlossen, wohingegen die vier Zielgene unabhängig von der Expressionsfilterung beibehalten wurden. Der differentielle Expressionsgrad wurde zwischen 61 Gliomproben des Grades 4, die in den hinterlegten Metadaten als GBM annotiert waren, und neun nicht-neoplastischen Hirnproben untersucht.
Für GSE4290 wurden vier Proben ohne explizite histopathologische Diagnose ausgeschlossen, sodass 77 GBM- und 23 Nicht-Tumor-Gehirnproben verblieben. Die aufbereiteten Microarray-Signalintensitäten wurden log2-transformiert, quantil-normalisiert und mittels robuster empirischer Bayes’scher linearer Modelle analysiert, die in limma26 implementiert sind. Wenn mehrere Sonden auf dasselbe Gen abbildeten, wurde unabhängig von der Signifikanz der differentiellen Expression die Sonde mit der höchsten mittleren Expression über alle eingeschlossenen Proben ausgewählt.
GSE116520 umfasste gepaarte Tumor-Kern- und peritumorale Proben von 17 Patienten sowie acht nicht-neoplastische Kontrollen. Die hinterlegten log-transformierten, quantil-normalisierten Expressionsdaten wurden mit limma analysiert. Innerhalb-Patienten-Korrelationen zwischen Tumor-Kern- und peritumoralen Proben wurden mithilfe einer Patienten-Ebene-Blockierung und der Funktion duplicateCorrelation berücksichtigt. Der Vergleich Tumor-Kern versus Kontrolle war der vorab festgelegte Vergleich für die metaanalytische Auswertung über Kohorten hinweg, während die peritumoralen Vergleiche und der geordnete Trend Kontrolle–peritumoral–Tumor-Kern separat bewertet wurden.
Studienbezogene log2-Fold-changes und Standardfehler wurden mithilfe eines random-effects-Modells mit eingeschränkter Maximum-Likelihood-Schätzung und Hartung–Knapp-Inferenz, wie in metafor implementiert, zusammengefasst. Die Heterogenität zwischen den Studien wurde mittels des Cochran-Q-Tests und I2 bewertet. Die gepoolten p-Werte für die vier Zielgene wurden mit der Benjamini–Hochberg-Methode angepasst. Starke transkriptomische Evidenz wurde definiert durch eine Meta-Analyse mit einer falschen Entdeckungsrate (FDR) < 0,05, FDR-Signifikanz auf Ebene der Kohorten in mindestens zwei Datensätzen sowie übereinstimmende Effektrichtungen in allen drei Kohorten.
Virtuelle Einzelzell-Knockout-Analyse
Patientenstammende Smart-seq2-Daten aus GSE131928 wurden verwendet, um die vier MR-replizierten Gene in malignen Zellen zu bewerten. Adulte maligne Zellen wurden gemäß den Anmerkungen der Originalstudie identifiziert, und aus jedem in Frage kommenden Patienten wurden jeweils gleich viele Zellen zufällig ausgewählt, um ein Ungleichgewicht in der Patientenrepräsentation zu minimieren. Ein virtueller Knockout wurde mittels scTenifoldKnk durchgeführt und über fünf unabhängige Durchläufe wiederholt. Gene mit einem mittels Benjamini–Hochberg korrigierten P < 0,05 in einem einzelnen Durchlauf galten als signifikant. Nachgeschaltete Gene, die in mindestens drei der fünf Durchläufe reproduziert wurden, wurden als primärer Konsenssatz definiert, während für die Sensitivitätsanalyse ein strengereres Kriterium von vier aus fünf verwendet wurde. Diese Ergebnisse wurden als rechnergestützte Vorhersagen einer transkriptionellen Störung und nicht als Beleg für eine direkte molekulare Regulation interpretiert.
Funktionelle Anreicherung und Analyse gemeinsamer Netzwerke
Die funktionelle Anreicherungsanalyse wurde unter Verwendung zielgerichteter nachgeschalteter Gene durchgeführt, die in mindestens drei von fünf virtuellen Knockout-Durchläufen reproduzierbar identifiziert wurden. Die Anreicherung von Pfaden in der Gene Ontology (GO), der Kyoto Encyclopedia of Genes and Genomes (KEGG) und Reactome wurde mittels einseitiger hypergeometrischer Tests bewertet, wobei die 1.004 Gene, die in die Netzwerkinferenz einbezogen wurden, als Hintergrund-Gen-Set dienten. Die P-Werte wurden für jede Anmerkungsdatenbank einzeln mittels des Verfahrens nach Benjamini–Hochberg korrigiert, und ein adjustierter P < 0,05 galt als statistisch signifikant.
Ein bipartites Netzwerk wurde erstellt, um die Beziehungen zwischen den vier Knockout-Zielen und deren konsensuellen downstream-Genen darzustellen. Gene, die mit mehreren Zielstrukturen assoziiert sind, wurden basierend auf ihrem gemeinsamen Grad identifiziert, und die Überschneidung zwischen zielgruppenspezifischen Gensätzen wurde mithilfe von Schnittmengenanzahlen und Jaccard-Indizes quantifiziert. Die Kanten des Netzwerks repräsentieren Assoziationen zwischen reproduzierbaren computergestützten Störungen und sollten nicht als Hinweis auf direkte molekulare Wechselwirkungen interpretiert werden.
Statistische Analyse und Reproduzierbarkeit
Sofern nicht anders angegeben, waren die statistischen Tests zweiseitig, und multiple Vergleiche wurden mithilfe des Benjamini–Hochberg-Verfahrens kontrolliert. Die spezifischen Signifikanzkriterien für die Analysen sind in den entsprechenden Unterkapiteln beschrieben. Alle Analysen wurden mit R oder Python durchgeführt. Bei randomisierten Verfahren wurden vorab festgelegte Zufallszahlen-Samen verwendet, und der Analysecode, die Softwareversionen sowie detaillierte Parameter-Einstellungen wurden archiviert, um die Reproduzierbarkeit zu gewährleisten. Alle Datensätze wurden zuvor erhoben und anonymisiert; die ethische Genehmigung und die informierte Einwilligung wurden in den ursprünglichen Studien eingeholt.
Ergebnisse
Auswahl eisenabhängiger Todesweg-bezogener Gene und genetischer Instrumente
Insgesamt wurden 483 Eisensterbe-bezogene Gene aus FerrDb V2 abgeleitet (Abbildung 1). Davon konnten 315 Gene dem eQTLGen-Datensatz zugeordnet werden und wiesen mindestens einen Kandidaten für einen cis-Expressionsquantitativmerkmal-Locus (cis-eQTL) auf. Nach der Kopplungsungleichgewichtsbereinigung verblieben für 250 Gene mindestens drei unabhängige kandidatenbasierte Instrumente. Nach Durchführung der Outcome-Variante-Suche, der Allel-Harmonisierung und der Qualitätskontrolle ergaben sich für 226 Gene valide inverse-varianzgewichtete (IVW) Schätzungen, die in die entdeckungsphasenbasierte Mendelsche Randomisierungsanalyse (MR) einbezogen wurden (Zusätzliche Datei 1). Alle 3.578 in der Entdeckungsphase beibehaltenen Instrumente wiesen F-Statistiken >10 auf (Minimum: 29,72; Median: 70,76), was auf keinen Hinweis auf eine Verzerrung durch schwache Instrumente hindeutet. Unter den 34 Kandidatengenen der Entdeckungsphase betrug die mediane F-Statistik 67,22, mit einem Minimum von 29,72.
MR im Entdeckungsstadium identifiziert eisenabhängige Todesarten-bezogene Gene, die mit der Anfälligkeit für GBM assoziiert sind
Unter den 226 Genen, die gültige IVW-Schätzungen ergaben, erfüllten 34 die vorab festgelegten Kriterien der Entdeckungsphase mit einem IVW P < 0,05 und einer Benjamini–Hochberg-Falsch-Entdeckungsrate (BH-FDR) < 0,20, darunter 19 inverse und 15 positive Assoziationen mit der GBM-Anfälligkeit (Abbildung 2A). Die stärksten statistischen Hinweise ergaben sich für RPTOR (OR = 0,809, 95 % KI 0,737–0,887; P = 7,02 × 10⁻6; BH-FDR = 0,0012) und PLA2G6 (OR = 1,568, 95 % KI 1,281–1,920; P = 1,08 × 10⁻5; BH-FDR = 0,0012). Die bayesschen gewichteten Mendelschen Randomisierungsschätzungen (BWMR) waren für alle 34 Kandidatengene nominal signifikant und stimmten hinsichtlich der Richtung mit den IVW-Schätzungen überein (Abbildung 2A). MR-Egger-Intercept-Tests ergaben keine Hinweise auf gerichtete horizontale Pleiotropie. Cochran’s Q-Test wies nur bei MAP1LC3A Heterogenität nach (P = 0,043), während die globalen MR-PRESSO-Tests bei den 33 auswertbaren Genen keine signifikante Ausreißerverzerrung identifizierten. Für SLC7A11 konnte MR-PRESSO nicht durchgeführt werden, da nur drei Instrumente verfügbar waren (Zusätzliche Datei 1). Gen-spezifische Leave-One-Out-Analysen, Methodenvergleichsdiagramme und Einfallsdiagramme für die vier anschließend replizierten Gene sind in Zusätzliche Abbildung 1 dargestellt. Die 34 Kandidaten der Entdeckungsphase wurden anschließend mithilfe eines unabhängigen eQTL-Datensatzes evaluiert. Davon verfügten 26 über ausreichende Instrumente für die MR-Replikationsphase, und vier erfüllten die vorab festgelegten Replikationskriterien.
Unabhängige MR-Replikation stützt vier Kandidaten aus der Entdeckungsphase
Von den 34 Kandidaten im Entdeckungsstadium hatten 26 mindestens ein geeignetes cis-eQTL-Instrument im GTEx V10-Ganzenblut und wurden in die MR-Analyse im Replikationsstadium einbezogen. Dreizehn Gene wurden durch ein einzelnes Instrument repräsentiert und mittels Wald-Quotienten analysiert, während die verbleibenden 13 Gene zwei oder mehr Instrumente aufwiesen und mittels IVW analysiert wurden. Vier Gene erfüllten die vorab festgelegten Replikationskriterien von P < 0,05, BH-FDR < 0,20 und einer Wirkungsrichtung, die mit der Schätzung im Entdeckungsstadium übereinstimmte (Abbildung 2B; Zusatzdatei 1).
Eine höhere genetisch vorhergesagte Expression von ATG7 (OR = 0,523, 95 % KI 0,330–0,831; P = 0,0061; BH-FDR = 0,0976), RPTOR (OR = 0,718, 95 % KI 0,563–0,915; P = 0,0075; BH-FDR = 0,0976) und MAP1LC3A (OR = 0,830, 95 % KI 0,717–0,959; P = 0,0117; BH-FDR = 0,1012) war mit einer verringerten Anfälligkeit für GBM assoziiert. Im Gegensatz dazu war eine höhere genetisch vorhergesagte Expression von CHMP6 mit einer erhöhten Anfälligkeit verbunden (OR = 1,378, 95 % KI 1,032–1,838; P = 0,0295; BH-FDR = 0,1916). Die Wirkrichtungen für alle vier Gene waren konsistent mit denen aus der Entdeckungsanalysen. Bei den Genen, für die Cochran’s Q berechnet werden konnte, wurde keine signifikante Heterogenität festgestellt (Supplementary File 1). Da die meisten Replikationsschätzungen nur auf ein oder zwei Instrumenten basierten, waren formelle Tests auf horizontale Pleiotropie und Ausreißerverzerrung nur auf einen begrenzten Teil der Gene anwendbar (Supplementary File 1). Entsprechende Diagnoseplots für MAP1LC3A, RPTOR und CHMP6 sind in Supplementary Figure 2 dargestellt. ATG7 war für multivariate Instrumentendiagnoseanalysen nicht geeignet, da seine Replikationsschätzung aus einem einzelnen Instrument-Wald-Quotienten abgeleitet wurde.
Die transkriptomische Analyse über Kohorten hinweg priorisiert MAP1LC3A
Die vier Gene, die durch die MR-Analysen sowohl im Entdeckungs- als auch im Replikationsstadium unterstützt wurden, wurden anhand von drei unabhängigen transkriptomischen Kohorten bewertet, die verschiedene Expressionsplattformen repräsentieren (Abbildung 3; Tabelle 2; ergänzende Abbildung 3; ergänzende Datei 1). Die Expression von MAP1LC3A war in Tumorgewebe in allen drei Kohorten durchgängig verringert: GSE196533 (log₂FC = −1.553, transkriptomweite FDR = 3,21 × 10⁻8), GSE4290 (log₂FC = −1,243, FDR = 3,55 × 10⁻12) und GSE116520 Tumorkern im Vergleich zu nicht-neoplastischem Kontrollgewebe (log₂FC = −1,204, FDR = 9,78 × 10⁻8). In GSE116520 war die Expression von MAP1LC3A ebenfalls im peritumoralen Gewebe niedriger als in den nicht-neoplastischen Kontrollen (log₂FC = −1,056, FDR = 2,85 × 10⁻6) mit einem signifikanten abnehmenden Trend vom Kontrollgewebe über das peritumorale Gewebe bis hin zum Tumorkern (Trendkoeffizient = −0,531, FDR = 8,59 × 10⁻6).
Die Metaanalyse mit Zufallseffekten bestätigte eine signifikant niedrigere Expression von MAP1LC3A im Tumorgewebe (gepoolter log₂FC = −1,273, 95 % KI von −1,625 bis −0,920; Hartung–Knapp P = 0,0041; BH-FDR = 0,016), ohne Hinweise auf Heterogenität zwischen den Studien (I2 = 0 %; Zusätzliche Datei 1). Die Expression von RPTOR war in allen drei Kohorten einheitlich niedriger und erreichte genomweite Signifikanz in GSE4290, obwohl die gepoolte Schätzung statistisch nicht signifikant war (log₂FC = −0,258, 95 % KI von −0,655 bis 0,139; BH-FDR = 0,196; I2 = 42,3 %). Die Expression von CHMP6 war im Tumorgewebe durchgängig höher und erreichte Signifikanz in GSE4290, während die gepoolte Schätzung weiterhin nicht signifikant blieb (log₂FC = 0,150, 95 % KI von −0,130 bis 0,431; BH-FDR = 0,196; I2 = 52,0 %). ATG7 zeigte geringe, inkonsistente Unterschiede in der Richtung über die Kohorten hinweg und keine signifikante gepoolte Assoziation (log₂FC = 0,036, 95 % KI von −0,073 bis 0,146; BH-FDR = 0,291; I2 = 0 %). Somit zeigte MAP1LC3A unter den vier MR-replizierten Genen die stärksten und konsistentesten Hinweise auf eine tumorassoziierte differentielle Expression.
Virtueller Einzelzell-Knockout zeigt reproduzierbare, zielgerichtete transkriptionelle Störungen
Die vier MR-replizierten Gene wurden in 4.916 in Frage kommenden malignen Zellen aus 20 adulten IDH-wildtyp-GBM-Tumoren in GSE131928 untersucht. ATG7, RPTOR, MAP1LC3A und CHMP6 wurden in jeweils 42,78 %, 45,89 %, 46,89 % und 31,90 % der in Frage kommenden malignen Zellen nachgewiesen, was deren Einbeziehung in die virtuelle Knockout-Analyse unterstützt (Supplementary Figure 4; Supplementary File 1). Um Ungleichgewichte in der Patientenrepräsentation zu minimieren, wurden aus jedem Tumor zufällig 120 Zellen ausgewählt, wodurch ein patientenbalancierter Datensatz aus 2.400 malignen Zellen entstand. Jedes Zielgen wurde über fünf unabhängig angesetzte Durchläufe hinweg evaluiert, was insgesamt 20 virtuelle Knockout-Analysen ergab.
Unter Verwendung des vorgegebenen Kriteriums BH-FDR < 0,05 in mindestens drei von fünf Durchläufen identifizierte der virtuelle Knockout drei robuste downstream Gene für ATG7, 15 für RPTOR, vier für MAP1LC3A und sieben für CHMP6 (Abbildung 4A; ergänzende Abbildung 5). Die Konsensmenge für RPTOR umfasste RND3, NKAIN4, CHI3L1, CDKN1A, BCAN, PDGFRA, OLIG1, LHFPL3, ENO2, HILPDA, LGALS3, ANXA1, CNTN1, NAMPT und SCRG1. Die Konsensmenge für MAP1LC3A enthielt RND3, CD24, BCAN und S100B, während die Konsensmengen für ATG7 und CHMP6 jeweils drei und sieben Gene umfassten. Die Anwendung des strengeren Signifikanzkriteriums in mindestens vier von fünf Durchläufen reduzierte die Konsensmengen auf zwei mit ATG7 assoziierte Gene, neun mit RPTOR assoziierte Gene, ein mit MAP1LC3A assoziiertes Gen und vier mit CHMP6 assoziierte Gene. Insgesamt identifizierten diese Analysen reproduzierbare, zielgerichtete transkriptionelle Störungen innerhalb des rekonstruierten regulatorischen Netzwerks maligner Zellen.
Funktionelle Anreicherungs- und gemeinsame Netzwerkanalysen identifizieren konvergente, adhäsionsbezogene Reaktionen
Die vier zielgruppenspezifischen Konsenssätze umfassten 17 eindeutige downstream Gene. Die Netzwerkanalyse identifizierte RND3 als einziges Gen, das von allen vier virtuellen Knockouts geteilt wurde, während BCAN, CD24 und NKAIN4 jeweils von drei der vier virtuellen Knockouts geteilt wurden. CHI3L1, LHFPL3 und PDGFRA wurden von zwei Zielgruppen geteilt, während die verbleibenden zehn Gene zielgruppenspezifisch waren (Abbildung 4B,C). Die größte absolute paarweise Überschneidung ergab sich zwischen RPTOR und CHMP6, die sechs downstream Gene teilten. Basierend auf der Jaccard-Ähnlichkeit wurde die größte proportionale Überschneidung zwischen ATG7 und CHMP6 beobachtet (Jaccard-Index = 0,429), gefolgt von RPTOR–CHMP6 und MAP1LC3A–CHMP6 (jeweils 0,375).
Die Genontologie-Analyse des gepoolten 17-Gen-Konsenssatzes ergab nach Korrektur nach Benjamini–Hochberg zehn signifikant angereicherte Terme (Abbildung 4D; Abbildung S6). Angereicherte biologische Prozess-Terme umfassten Zelladhäsion (BH-FDR = 0,0028), positive Regulation der Zellpopulationproliferation (BH-FDR = 0,0028), Entzündungsreaktion (BH-FDR = 0,0139), positive Regulation der ERK1/ERK2-Kaskade (BH-FDR = 0,0165) und Zell-Zell-Adhäsion (BH-FDR = 0,0196). Signifikante zelluläre Komponenten-Terme umfassten Zelloberfläche, extrazellulären Bereich, Plasmamembran und extrazelluläre Matrix, während Kohlenhydratbindung der einzige signifikant angereicherte molekulare Funktionsterm war. Die Zelladhäsion blieb signifikant angereichert, wenn die Analyse auf Gene beschränkt wurde, die von mindestens zwei Targets gemeinsam genutzt wurden, sowie bei Anwendung des strengeren Konsenskriteriums „vier von fünf Läufen“. Kein KEGG- oder Reactome-Pfad blieb nach BH-Korrektur signifikant.
Die zielgerichtete Anreicherung war am ausgedehntesten für RPTOR, dessen Konsensmenge aus 15 Genen für vier biologische Prozessbegriffe und vier zelluläre Komponentenbegriffe angereichert war (ergänzende Abbildung 7). Die Konsensmenge von MAP1LC3A war angereichert für Zelladhäsion (BH-FDR = 8,74 × 10⁻4) und Entwicklung des zentralen Nervensystems (BH-FDR = 0,0364), während die Konsensmenge von CHMP6 für Zelladhäsion angereichert war (BH-FDR = 0,0075). Für die dreigenige Konsensmenge von ATG7 erreichte kein Begriff aus der Genontologie einen BH-FDR < 0,05.
VERFÜGBARKEIT VON DATEN:
Öffentliche transkriptomische Datensätze sind über die GEO unter den Zugangsnummern GSE196533, GSE4290, GSE116520 und GSE131928 verfügbar. Die Zusammenfassungsstatistiken zu den GBM-Ergebnissen sind unter kontrolliertem Zugang im European Genome-phenome Archive (EGA), Datensatz EGAD00010001657 (https://ega-archive.org/datasets/EGAD00010001657), hinterlegt. Der Zugang wird vom zuständigen Data Access Committee verwaltet und erfordert einen genehmigten Antrag sowie eine Data Access Agreement. Gemäß der geltenden Vereinbarung sind die Autoren nicht berechtigt, die Dateien weiterzugeben oder in einem öffentlichen Repository abzulegen. eQTL-Zusammenfassungsdaten sind vom eQTLGen Consortium und GTEx gemäß deren jeweiligen Zugangs- und Nutzungsbedingungen erhältlich. Die Analyse-Skripte, die diese Studie unterstützen, werden als Zusatzdatei mit Programmiercode 1 und Zusatzdatei mit Programmiercode 2 bereitgestellt.
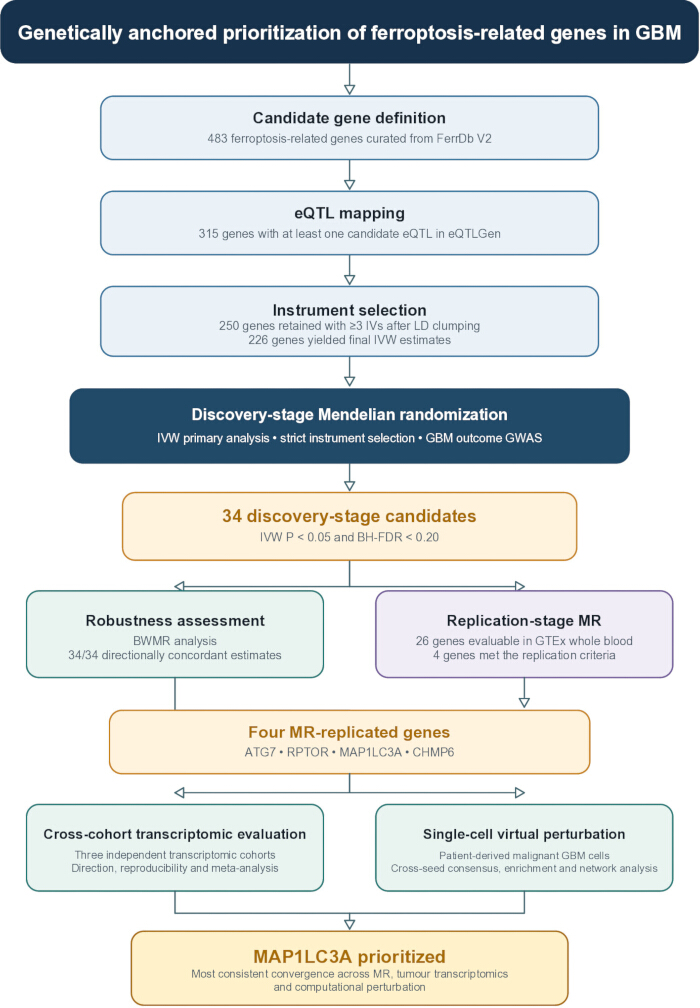
Abbildung 1: Studiendesign und Rahmenwerk zur evidenzbasierten Integration für die genetisch fundierte Priorisierung ferroptosebezogener Gene bei Glioblastom. Ferroptosebezogene Gene, die aus FerrDb V2 zusammengestellt wurden, wurden auf eQTLGen abgebildet, auf unabhängige cis-Expression quantitative trait locus (cis-eQTL)-Instrumente untersucht und in der Entdeckungsphase mittels Mendelscher Randomisierung (MR) bewertet. Von den 483 zusammengestellten Genen wiesen 315 mindestens ein Kandidaten-cis-eQTL auf, 250 behielten nach LD-Klumpung (linkage disequilibrium, LD) mindestens drei unabhängige Instrumente, und 226 ergaben gültige inverse-varianzgewichtete (IVW) Schätzungen nach Outcome-Varianten-Suche und Allel-Harmonisierung. Vierunddreißig Gene erfüllten die Kriterien der Entdeckungsphase, woraufhin die bayessche gewichtete Mendelsche Randomisierung (BWMR) zur Beurteilung der Robustheit eingesetzt wurde. Anschließend konnten 26 Gene in der Replikationsphase mittels GTEx V10 Ganzblut-cis-eQTLs mittels MR evaluiert werden. Vier Gene (ATG7, RPTOR, MAP1LC3A und CHMP6) erfüllten die Replikationskriterien und wurden anschließend in drei unabhängigen transkriptomischen Kohorten sowie durch virtuelle Störung in malignen, patientenabgeleiteten Zellen weiter untersucht. Die Integration dieser komplementären Analysen priorisierte MAP1LC3A für weitere Untersuchungen. BWMR = bayessche gewichtete Mendelsche Randomisierung; eQTL = Expression quantitative trait locus; IVW = inverse-varianzgewichtet; LD = Kopplungsungleichgewicht; MR = Mendelsche Randomisierung. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
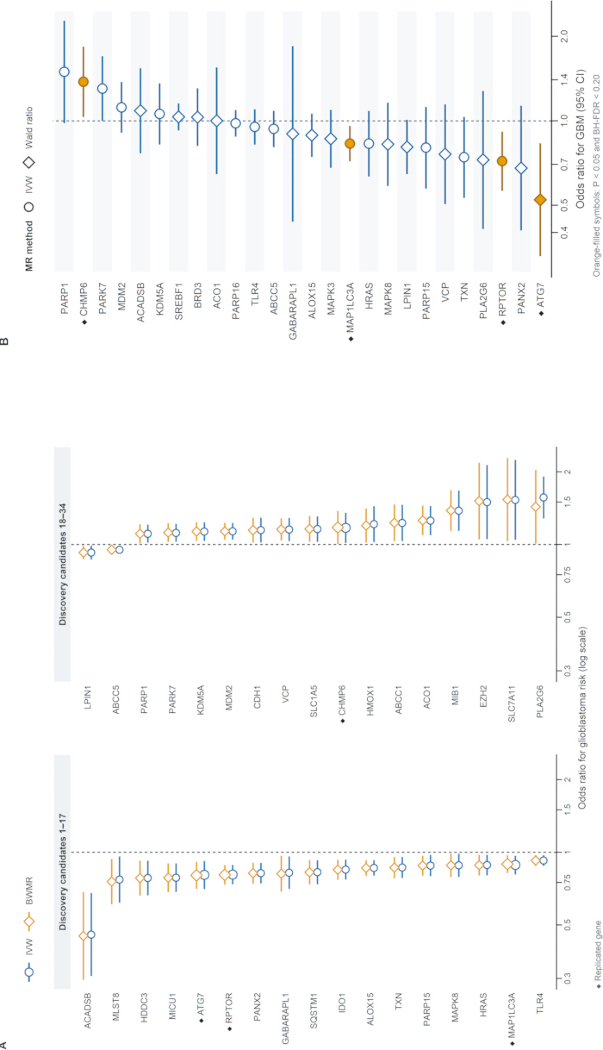
Abbildung 2: Robustheit in der Entdeckungsphase und unabhängige Reproduktion genetisch vorhergesagter Effekte von eisenabhängigen Zelltod (Ferroptose)-bezogenen Genen auf das Glioblastom-Risiko. (A) Paarweise dargestellte Wald-Plots zum Vergleich der Schätzungen nach der Methode des inversen Varianzgewichts (IVW) und der bayesschen gewichteten Mendelschen Randomisierung (BWMR) für die 34 Gene, die die Kriterien der Entdeckungsphase erfüllten (IVW P < 0,05 und Benjamini–Hochberg-Falsch-Entdeckungsrate (BH-FDR) < 0,20). Vor den Genbezeichnungen stehende Quadrate kennzeichnen Gene, die anschließend in der unabhängigen Reproduktionsanalyse bestätigt wurden. Das Dreieck markiert LPIN1, bei dem die IVW- und BWMR-Schätzungen unterschiedliche Wirkungsrichtungen aufwiesen. (B) Wald-Plot der 26 Gene, die im Datensatz der Reproduktionsphase ausgewertet wurden. IVW-Schätzungen sind für Gene mit mindestens zwei Instrumenten dargestellt, während Wald-Quotienten-Schätzungen für Gene mit nur einem Instrument angegeben sind. Orange gefüllte Symbole kennzeichnen ATG7, RPTOR, MAP1LC3A und CHMP6, die die Reproduktionskriterien erfüllten (P < 0,05 und BH-FDR < 0,20). Punkte und horizontale Linien stellen jeweils Odds Ratios (ORs) und 95 %-Konfidenzintervalle (CIs) dar; die vertikale gestrichelte Linie zeigt OR = 1 an. Die ORs sind auf einer logarithmischen Skala dargestellt. GBM = Glioblastom. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
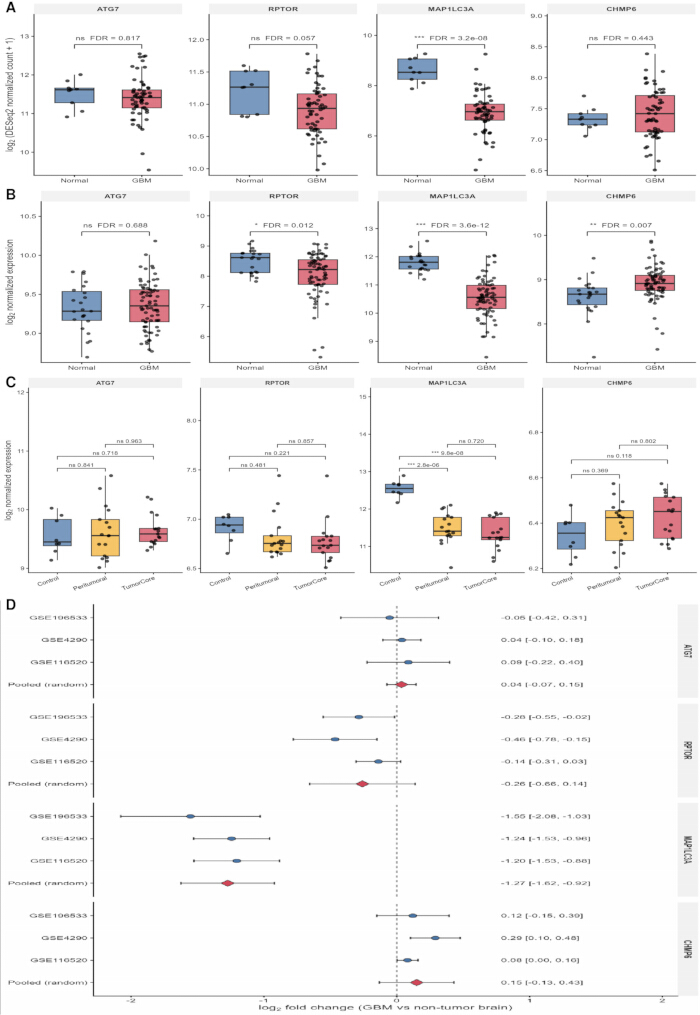
Abbildung 3: Querschnittsweite transkriptomische Bewertung der vier MR-replizierten Gene. Expression von ATG7, RPTOR, MAP1LC3A und CHMP6 in GSE196533 (61 Gliomproben des Grades 4, als GBM in den hinterlegten Metadaten annotiert, und neun nicht-neoplastische Gehirnproben); (A) GSE4290 (77 GBM- und 23 nicht-tumoröse Gehirnproben); (B) und GSE116520 (17 Tumor-Kern-, 17 patientenangepasste peritumorale und acht nicht-neoplastische Kontrollproben); (C) Die Boxen zeigen Median und Interquartilsabstand (IQR) an, die Whisker erstrecken sich bis 1,5 × IQR, und die Punkte repräsentieren individuelle Proben. (D) Studienspezifische log₂-Fold-Changes und Random-Effects-Metaanalyse zum Vergleich von Tumor- oder Tumor-Kern-Gewebe mit nicht-neoplastischem Gehirngewebe. Die Punkte und horizontalen Linien zeigen studienspezifische Schätzungen und 95 %-Konfidenzintervalle an, während die Rauten geschätzte gepoolte Werte nach der Methode der eingeschränkten maximalen Wahrscheinlichkeit mit Hartung–Knapp-Inferenz darstellen. Positive Werte deuten auf eine höhere Expression im Tumorgewebe hin. FDR = falsche Entdeckungsrate; GBM = Glioblastom; MR = Mendelsche Randomisierung. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
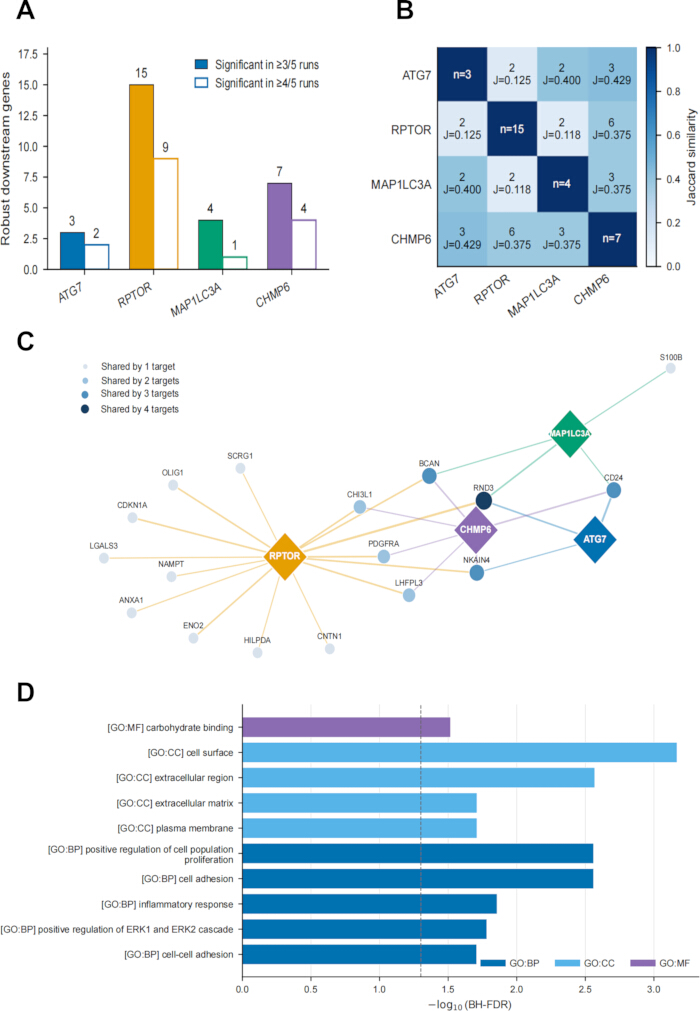
Abbildung 4: Quer-Saat-Konsens und funktionale Konvergenz von virtuellen Einzelzell-Knockouts in malignen Glioblastomzellen. (A) Anzahl der robusten downstream Gene, die für jedes Ziel unter Verwendung des vorgegebenen Signifikanzkriteriums in mindestens drei von fünf Durchläufen sowie des strengeren Sensitivitätskriteriums von vier von fünf Durchläufen identifiziert wurden. (B) Paarweiser Überlapp der robusten downstream Gene; die Zellen zeigen Überlappzahlen und Jaccard-Ähnlichkeitskoeffizienten. (C) Bipartites Netzwerk, das die vier virtuellen Knockout-Ziele (Rauten) mit den robusten downstream Genen (Kreise) verbindet. Die Farbe der Kanten kennzeichnet das gestörte Ziel, während die Größe der Kreise und die Farbintensität die Anzahl der Ziele anzeigen, die jeweils auf eine downstream-Reaktion reagieren. Die Kanten repräsentieren Assoziationen zwischen reproduzierbaren computergestützten Störungen, nicht direkte molekulare Interaktionen. (D) Signifikante Anreicherung der Gene Ontology (GO) für den gepoolten Konsenssatz aus 17 Genen. Die Balkenlänge entspricht −log10(BH-FDR), die gestrichelte Linie zeigt die Signifikanzschwelle (BH-FDR = 0,05) an, und die Farben kennzeichnen biologischen Prozess (BP), zelluläre Komponente (CC) und molekulare Funktion (MF). Für die funktionelle Anreicherungsanalyse wurde der patientengewichtete Hintergrund des regulatorischen Netzwerks mit 1.004 Genen verwendet. Kein KEGG- oder Reactome-Pfad blieb nach Benjamini–Hochberg-Korrektur signifikant. Abkürzungen: BH-FDR = Benjamini–Hochberg-Falschentdeckungsrate; BP = biologischer Prozess; CC = zelluläre Komponente; GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes; MF = molekulare Funktion. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Tabelle 1: Überblick über die Datenquellen und ihre analytischen Rollen in der Studie. Die Stichprobenanzahlen repräsentieren die Beobachtungen, die in die vorliegenden Analysen einbezogen wurden. BH-FDR = Benjamini–Hochberg-Falsch-Entdeckungsrate; cis-eQTL = cis-Expressionsquantitatives Merkmal-Lokus; EGA = Europäisches Genom-Phänom-Archiv; GBM = Glioblastom; GTEx = Genotyp-Gewebe-Expression; GWAS = genomweite Assoziationsstudie; IV = instrumentelle Variable; MR = Mendelsche Zufallsstichprobe; RNA-seq = RNA-Sequenzierung. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 2: Transkriptomische Belege über Kohorten hinweg für die vier MR-replizierten Gene. Die Werte stellen log₂-Fold-Changes für GBM- oder Tumor-Kerngewebe im Vergleich zu nicht-neoplastischem Hirngewebe dar. Poolschätzungen wurden mithilfe von Random-Effects-Modellen mit eingeschränkter Maximum-Likelihood und Hartung–Knapp-Inferenz ermittelt. CI = Konfidenzintervall; FDR = Falsch-Entdeckungs-Rate. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Abbildung 1 (zusätzlich): Sensitivitätsanalysen der Mendelschen Zufallsstichprobe im Entdeckungsstadium für die vier replizierten Gene. Jedes der Gene MAP1LC3A, ATG7, RPTOR und CHMP6 ist wie folgt dargestellt: (A) Analyse mit Auslassung einzelner Studien (Leave-one-out-Analyse); (B) Streudiagramm zum Vergleich der Methoden; und (C) Inversionsplot.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 2, Ergänzende Informationen: Diagnoseplots zur Mendelschen Zufallsstichprobenziehung in der Replikationsphase für die drei replizierten Gene mit mehreren Instrumenten. MAP1LC3A, RPTOR und CHMP6 sind jeweils wie folgt dargestellt: (A) Streudiagramm zum Vergleich der Methoden; und (B) Einfüllplot. ATG7 wurde mithilfe eines Wald-Quotienten mit einem einzigen Instrument geschätzt und war daher nicht für Diagnoseplots mit mehreren Instrumenten geeignet.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 3, Zusatzmaterial: Hauptkomponentenanalyse der drei unabhängigen transkriptomischen Kohorten. (A) GSE196533 RNA-Sequenzierungs-Kohorte. (B) GSE4290 Affymetrix GPL570-Kohorte. (C) GSE116520 Illumina GPL10558-Kohorte. Die Hauptkomponentenanalyse wurde anhand der 500 Gene oder Sonden mit der größten Varianz innerhalb jeder Kohorte durchgeführt. Jeder Punkt repräsentiert eine biologische Probe; die Farben kennzeichnen die Gewebegruppen; und die Achsenbeschriftungen geben die von jeder Hauptkomponente erklärte Varianz an.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Erweiterte Abbildung 4: Nachweisbarkeit der vier mittels MR replizierten Gene in adulten malignen GBM-Zellen. (A) Gesamtnachweisraten von ATG7, RPTOR, MAP1LC3A und CHMP6 unter 4.916 malignen Zellen aus 20 adulten IDH-Wildtyp-GBM-Tumoren in GSE131928/SCP393. (B) Patientenebene-Nachweisraten für dieselben Gene. Die Farbe zeigt den Prozentsatz maligner Zellen mit TPM > 0 an.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 5, Zusatzmaterial: Reproduzierbarkeit der downstream-Signale bei Cross-Seeding in virtuellen Knockouts. (A) Die Anzahl der BH-FDR-signifikanten downstream Gene, die in fünf unabhängigen Durchläufen für jedes Ziel identifiziert wurden. Die Punkte repräsentieren zufällige Startwerte (Seeds), und die horizontalen Balken zeigen die Mediane an. (B) Downstream Gene, die in mindestens drei von fünf Durchläufen signifikant waren. Die x-Achse zeigt die Anzahl der signifikanten Durchläufe, Farben kennzeichnen das gestörte Zielgen, und die Punktgröße repräsentiert die mediane scTenifoldKnk Z-Statistik. Das Zielgen selbst wurde ausgeschlossen.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 6, Zusatzmaterial: Pooled-, gemeinsame- und strikte-Schwellenwert-Analysen zur Anreicherungsempfindlichkeit. Funktionelle Anreicherung von (A) dem gepoolten Konsens, definiert durch Signifikanz in mindestens drei von fünf Durchläufen; (B) Genen, die von mindestens zwei Zielstrukturen unter dem Drei-von-fünf-Kriterium gemeinsam genutzt werden; (C) dem gepoolten strikten Konsens, definiert durch Signifikanz in mindestens vier von fünf Durchläufen; und (D) Genen, die von mindestens zwei Zielstrukturen unter dem Vier-von-fünf-Kriterium gemeinsam genutzt werden. Die x-Achse zeigt −log₁₀(nominelles P), die Punktgröße spiegelt die Überlappungsanzahl wider, und die Farben kennzeichnen die Anmerkungsdatenbank. Gefüllte Punkte erreichten ein BH-FDR < 0,05, während offene Punkte explorative Terme mit nominellem P < 0,05 darstellen. Als Hintergrund diente durchgängig ein regulatorisches Netzwerk aus 1.004 Genen.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatzabbildung 7: Zielspezifische funktionelle Anreicherung robuster virtueller Knockout-Antworten. Anreicherung robuster downstream Gene nach virtuellem Knockout von (AATG7 (BRPTOR; (C) MAP1LC3A; und (D) CHMP6. Die x-Achse zeigt −log₁₀(Nominal P), wobei die Punktgröße die Überlappungshäufigkeit widerspiegelt und die Farben GO: BP, GO: CC, GO: MF, KEGG oder Reactome kennzeichnen. Gefüllte Punkte erreichten den BH-FDR < 0,05, während offene Punkte explorative Termini mit nominellem P < 0,05. Die 1.004 Gene, aus denen das patientenbasierte regulatorische Netzwerk besteht, dienten als Hintergrund für die Anreicherung.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatzdatei 1: Zusatztabellen zur Unterstützung der mehrstufigen Priorisierung eisenabhängiger Zelltod-generelater Gene, die mit der Anfälligkeit für Glioblastom assoziiert sind. Diese Zusatzdatei enthält alle ergänzenden Tabellen, die die genetischen, transkriptomischen und Einzelzell-Analysen unterstützen. Dazu gehören die Screening- und Selektionsverfahren für eisenabhängige Zelltod-generelatierte Gene und genetische Instrumente; vollständige Ergebnisse der mendelschen Randomisierung aus Entdeckungs- und Reproduktionsphase sowie Sensitivitätsanalysen, einschließlich Bewertungen von Heterogenität, horizontaler Pleiotropie und MR-PRESSO; Kohortenmerkmale, Differenzialexpressionsanalysen und Metaanalysen über Kohorten hinweg für genetisch priorisierte Gene; sowie die virtuellen Einzelzell-Knockout-Analysen, Reproduzierbarkeitsbewertungen, funktionellen Anreicherungsanalysen und Ergebnisse zu gemeinsamen Netzwerken.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusätzliche Codierungsdatei 1: R- und Python-Skripte, die für die in dieser Studie beschriebenen Mendelschen Zufallsanalysen, transkriptomischen Analysen, virtuellen Knockout-Analysen auf Einzelzell-Ebene, funktionellen Anreicherungsanalysen und Netzwerkanalysen verwendet wurden.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Codierungsdatei 2: Unterstützende Analyse-Skripte, Plotroutinen und Workflow-Tools, die zur Erzeugung der Studienergebnisse, Abbildungen und ergänzenden Ausgaben verwendet wurden.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Diese Studie kombinierte genetische Assoziationsanalysen, eine replikationsstadienbasierte Mendelsche Randomisierung (MR), Tumor-Transkriptomik und patientenbasierte Einzelzell-Modellierung, um eisenbedingten Zelltod (Ferroptose) verwandte Gene zu identifizieren, die mit der Anfälligkeit für Glioblastom (GBM) assoziiert sind. Die Untersuchung von 483 kuratierten Genen gegenüber einer GBM-Genomweiten Assoziationsstudie (GWAS), die 6.183 Fälle und 18.169 Kontrollen umfasste, ergab 34 Kandidaten in der Entdeckungsphase, von denen vier – ATG7, RPTOR, MAP1LC3A und CHMP6 – in der Replikationsanalyse unter Verwendung einer unabhängigen Ressource für expression quantitative trait loci (eQTL) bestätigt wurden. Die Evidenz wurde im weiteren Verlauf nach den genetischen Analysen zunehmend selektiver. MAP1LC3A war in drei unabhängigen Tumorkohorten durchgängig herunterreguliert und blieb auch in der meta-analytischen Auswertung über die Kohorten hinweg signifikant. Dieses Muster der Tumor-Genexpression ergänzte die im Rahmen der MR-Analysen beobachtete schützende Assoziation, obwohl beide Ansätze unterschiedliche Aspekte der Krankheitsbiologie adressieren. RPTOR und CHMP6 zeigten zwar in die gleiche Richtung weisende, aber weniger überzeugende transkriptomische Hinweise, während ATG7 an reproduzierbarer Unterstützung auf Gewebeebene fehlte. Virtuelle Knockout-Analysen zeigten darüber hinaus genzielspezifische, jedoch teilweise überlappende transkriptionelle Reaktionen in malignen Zellen auf. Insgesamt verfeinerten diese aufeinanderfolgenden analytischen Ebenen die ursprünglichen MR-Befunde, indem sie Kandidaten mit unterschiedlichem Grad an krankheitsrelevanter Unterstützung voneinander trennten, wobei MAP1LC3A als der stärkste Kandidat insgesamt hervorging.
Ein Großteil der bisherigen menschlichen Hinweise auf einen Zusammenhang zwischen Ferroptose und Gliom stammt aus Tumor-Expressionsstudien. Analysen von TCGA, CGGA und anderen öffentlichen Kohorten haben wiederholt ferroptosebezogene Signaturen identifiziert, die mit Überleben, Tumorstadium, molekularen Merkmalen und immunologischen Eigenschaften assoziiert sind9,27. Obwohl diese Studien die klinische Relevanz ferroptosebezogener transkriptioneller Programme belegten, können aus etablierten Tumoren gewonnene Expressionsprofile nicht zwischen genetischer Anfälligkeit verursachenden Genen und transkriptionellen Veränderungen unterscheiden, die während des Tumorfortschritts entstehen oder Unterschiede in der zellulären Zusammensetzung widerspiegeln. Genetische Analysen bieten eine ergänzende Perspektive. Robinson und Kollegen kombinierten Gliom-GWAS-Daten mit eQTL-Datensätzen aus Gehirn und Vollblut unter Verwendung der MR und Kolokalisation, priorisierten putative Anfälligkeitsgene mit gewebeabhängigen Effekten und zeigten eine begrenzte Übereinstimmung zwischen aus Blut und Gehirn abgeleiteten Schätzungen11. Kürzlich führte eine integrative, auf eQTL- und pQTL-basierende MR-Studie genetische Beweise mit Differenzial-Expressions- und Kolokalisierungsanalysen zusammen, um GPX7 und CXCL10 für eine weitere Untersuchung im GBM12 zu priorisieren. Im Gegensatz dazu startete die vorliegende Studie mit einer vordefinierten Genmenge, die mit Ferroptose assoziiert ist, und bewertete genetisch priorisierte Kandidaten mittels Replikationsstadium-MR, Tumor-Transkriptomik und zellauflösender computergestützter Störungsanalyse. Die schrittweise Verfeinerung von 34 Assoziationen im Entdeckungsstadium auf vier replizierte Gene und letztlich auf MAP1LC3A als einziges Gen mit statistisch signifikanter differenzieller Expression über Kohorten hinweg verdeutlicht den diskriminativen Wert der Integration mehrerer komplementärer analytischer Ansätze. Wichtig ist, dass die transkriptomischen Analysen nicht dazu dienten, die aus Blut stammenden genetischen Instrumente zu validieren, sondern vielmehr zu ermitteln, ob genetisch priorisierte Gene ebenfalls reproduzierbare, krankheitsrelevante Expressionsmuster aufwiesen.
MAP1LC3A ist von besonderem Interesse, da die vorliegenden Ergebnisse seine bisherige Charakterisierung als tumorassoziierten und prognostischen Marker erweitern. Eine frühere bioinformatische Studie mit mehreren Kohorten integrierte MAP1LC3A in eine sechsgenige Signatur, die mit dem Überleben und dem Rezidiv von GBM assoziiert ist, und berichtete ebenfalls über veränderte MAP1LC3A-Methylierung, obwohl sein Beitrag zur Krankheitsanfälligkeit unklar blieb28. In dieser Studie war ein höherer genetisch vorhergesagter MAP1LC3A-Expressionsgrad in beiden MR-Stadien durchgängig mit einer geringeren Anfälligkeit für GBM assoziiert. Darüber hinaus wurde MAP1LC3A in drei unabhängigen Tumorkohorten reproduzierbar herunterreguliert, trotz Unterschieden in den Expressionsplattformen, der Probenzusammensetzung und den analytischen Methoden, und die geschätzte gepoolte Meta-Analyse zeigte keine nachweisbare Heterogenität zwischen den Studien. Obwohl diese Ergebnisse nicht belegen, dass eine verminderte MAP1LC3A-Expression GBM auslöst, liefern sie stärkere Hinweise auf einen Zusammenhang des Gens mit der Krankheitsanfälligkeit als alleinige Analysen der differentiellen Tumor-Expression. MAP1LC3A kodiert LC3A-Isoformen innerhalb der Säugetier-ATG8-Proteinfamilie. Bai und Kollegen zeigten, dass die LC3A-Variante 1 eine Konjugation mit Phosphatidylethanolamin eingeht, um LC3A-II zu bilden, und sich während der induzierten Autophagie in Autophagosomen lokalisiert29. Es wurde ebenfalls gezeigt, dass der autophagische Abbau von Ferritin die Empfindlichkeit gegenüber Ferroptose in GBM-Zellen beeinflusst, unter anderem bei Cystin-Deprivation und in ALDH1A3-abhängigen Modellen30,31. Diese Studien untersuchten jedoch hauptsächlich gesamtes LC3-II oder LC3B, nicht spezifisch MAP1LC3A. In den vorliegenden Einzelzell-Analysen führte eine virtuelle Störung von MAP1LC3A zu reproduzierbaren downstream-Effekten, die angereichert waren für Prozesse, die mit Zelladhäsion assoziiert sind. Insgesamt identifizieren diese Beobachtungen MAP1LC3A als gezielten Kandidaten, um zu untersuchen, wie autophagieassoziierte Regulation, Ferroptose-Anfälligkeit und das Verhalten maligner Zellen in GBM zusammenwirken.
Die übrigen MR-replizierten Gene erhielten unterschiedliche Unterstützung durch nachfolgende Analysen. Ein höherer genetisch vorhergesagter RPTOR-Expressionswert war in beiden MR-Stadien mit einer geringeren GBM-Anfälligkeit assoziiert, und sein Expressionsniveau war in allen drei Tumorkohorten durchgängig niedriger, obwohl die gepoolte Schätzung keine statistische Signifikanz erreichte. Der virtuelle Knockout von RPTOR führte zur umfangreichsten Menge reproduzierbarer downstream-transkriptioneller Veränderungen, wobei eine Anreicherung in Bezug auf ERK-Signalgebung, entzündliche Reaktionen, Zellproliferation und Zelladhäsion beobachtet wurde. Obwohl diese Befunde mit der etablierten Rolle von RPTOR als mTORC1-Gerüstprotein übereinstimmen, sollte die Stärke der transkriptionellen Antwort nicht als Hinweis auf einen stärkeren kausalen Effekt interpretiert werden32. CHMP6 zeigte ebenfalls konsistente MR-Assoziationen in beiden Stadien, wobei eine höhere genetisch vorhergesagte Expression mit einer erhöhten GBM-Anfälligkeit verknüpft war. Obwohl die CHMP6-Expression in allen drei Tumorkohorten durchgängig erhöht war, umfasste das gepoolte Konfidenzintervall den Nullwert, und die Heterogenität zwischen den Studien war moderat. Experimentelle Befunde, die zeigen, dass die CHMP6-abhängige ESCRT-III-Membranreparatur den eisenabhängigen Zelltod unterdrückt, liefern einen plausiblen mechanistischen Kontext, obwohl diese Ergebnisse außerhalb von GBM-Modellen erzielt wurden33. Im Gegensatz dazu zeigte ATG7 eine replizierte schützende genetische Assoziation, jedoch kein reproduzierbares Muster der Tumor-Expression. Der virtuelle Knockout identifizierte lediglich drei robuste downstream-Gene, und nach Korrektur für Mehrfachvergleiche blieb keine funktionelle Kategorie signifikant. Frühere experimentelle Studien haben die ATG7-abhängige Autophagie in der Anpassung und Behandlungsreaktion von GBM impliziert34,35, doch diese Beobachtungen klären nicht die hier beobachtete vergleichsweise schwache Unterstützung über verschiedene Plattformen hinweg. Demnach bleiben RPTOR, CHMP6 und ATG7 plausible sekundäre Kandidaten, während MAP1LC3A die stärkste Konvergenz über genetische, transkriptomische und computergestützte Störungsanalysen aufwies.
Die virtuellen Störungsanalysen identifizierten keinen einzigen downstream gerichteten Signalweg, der von allen vier priorisierten Genen gemeinsam genutzt wird. Stattdessen zeigten reproduzierbare transkriptionelle Antworten nur eine teilweise Überschneidung, wobei RND3 das einzige downstream gelegene Gen war, das in allen vier zielgenspezifischen Netzwerken vorkam. Die deutlichste funktionelle Konvergenz betraf Prozesse der Zelladhäsion sowie extrazelluläre oder zelloberflächenbezogene Vorgänge, und die Anreicherung für Zelladhäsion blieb auch unter dem strengeren Cross-Seed-Kriterium signifikant. Kein KEGG- oder Reactome-Signalweg blieb nach Korrektur für Mehrfachvergleiche signifikant. Diese Beobachtung ist bemerkenswert, da zwar die Kandidatengene aus einem kuratierten Satz eisenabhängiger Todesweg-assoziierten Genen stammten, ihre vorhergesagten downstream gerichteten Effekte in malignen GBM-Zellen jedoch nicht durch kanonische Ferroptose-Wege dominiert wurden. Vielmehr könnte ihr Beitrag zur Anfälligkeit für GBM breitere zelluläre Prozesse umfassen, innerhalb derer die ferroptoseassoziierte Maschinerie wirkt. Die vorliegenden Analysen belegen keinen gemeinsamen molekularen Mechanismus und identifizieren RND3 nicht als kausalen Vermittler. Stattdessen heben sie eine begrenzte Anzahl maligner Zellprogramme hervor, insbesondere solche, die mit der Zelladhäsion verbunden sind, die zukünftige experimentelle Untersuchungen rechtfertigen.
Diese Studie sollte als gestaffeltes Priorisierungsframework und nicht als endgültige Zuweisung kausaler Gene interpretiert werden. Keine einzelne analytische Ebene wurde als abschließend betrachtet; stattdessen wurden Assoziationen aus der Entdeckungsphase nacheinander mithilfe von BWMR, einer unabhängigen eQTL-Ressource, drei transkriptomischen Kohorten und der Modellierung der Regulationsmechanismen in malignen Zellen von Patienten bewertet. Mehrere Einschränkungen sind zu berücksichtigen. Erstens diente der BH-FDR-Schwellenwert in der Entdeckungsphase von < 0,20 der Kandidatenscreening und nicht der bestätigenden Schlussfolgerung, und nur 26 der 34 Kandidaten aus der Entdeckungsphase konnten in der Replikation ausgewertet werden. Zweitens waren mehrere Gene durch relativ wenige genetische Instrumente vertreten, und formale genbasierte Power-Analysen wurden nicht durchgeführt; daher sollten schwache oder nicht vorhandene Assoziationen vorsichtig interpretiert werden. Die Mindestanforderung von drei Instrumenten erhöhte die Genabdeckung, beschränkte jedoch den Umfang und die Stabilität der Sensitivitätsanalysen für Gene, die nur durch drei oder vier Varianten repräsentiert waren. Obwohl alle beibehaltenen Instrumente aus der Entdeckungsphase den konventionellen F > 10-Schwellenwert überschritten und die Kandidaten zusätzlich mittels BWMR und unabhängiger Replikation bewertet wurden, können diese Sicherheitsmaßnahmen den Mangel an Instrumenten nicht vollständig kompensieren; solche Schätzungen sollten daher weiterhin als explorativ angesehen werden. Drittens stammten beide eQTL-Ressourcen aus Vollblut und erfassen möglicherweise nicht genau die regulatorischen Effekte im Gehirn oder Tumorgewebe. Viertens enthielten die verfügbaren GWAS-Zusammenfassungsstatistiken für GBM nicht die Informationen, die für Steiger-Richtungstests und formale Kolokalisationsanalysen erforderlich sind. Daher bleibt ungewiss, ob die eQTL- und GBM-Assoziationssignale an jedem Locus von derselben kausalen Variante oder von unterschiedlichen, in Kopplungsungleichgewicht stehenden Varianten ausgehen. Obwohl BWMR darauf ausgelegt ist, umfassende horizontale Pleiotropie und ausreißerhafte Instrumente zu berücksichtigen, kann die Übereinstimmung zwischen IVW und BWMR eine verbleibende Pleiotropie nicht ausschließen oder formale Kolokalisationsanalysen ersetzen. Außerdem wurden in den transkriptomischen Kohorten etablierte Tumore und nicht die Anfälligkeit für die Erkrankung untersucht, und eine Kohorte bestand aus Gewebeproben von Gliomen des Grades 4 und nicht ausschließlich aus IDH-wildtyp-GBM. Schließlich beschränkten sich die Einzelzellanalysen auf maligne Zellen aus einem einzigen Datensatz und modellierten regulatorische Störungen computergestützt statt experimentell; sie untersuchten weder nicht-maligne Zellen im Tumormikroumfeld noch reproduzierten sie direkt eine Genstörung in vitro oder in vivo. Demnach müssen die zugrundeliegenden kausalen Varianten, die zelltypspezifischen Mechanismen und die biologischen Konsequenzen noch geklärt werden.
Unter den vier replizierten Genen zeigte MAP1LC3A die stärkste konsistente Unterstützung über die genetischen, transkriptomischen und Einzelzell-Analysen hinweg. RPTOR, CHMP6 und ATG7 behielten Hinweise aus den MR-Analysen in zwei Stufen bei, zeigten jedoch eine geringere Konsistenz in den anschließenden transkriptomischen und Störungsanalysen. Daher sollte MAP1LC3A als priorisierter Kandidat für weitere Untersuchungen betrachtet werden, nicht jedoch als etabliertes kausales Gen oder therapeutisches Ziel. Künftige Studien sollten zunächst klären, ob die eQTL- und GBM-Assoziations-Signale unter Verwendung vollständiger, lokusbezogener Datensätze sowie regulatorischer Ressourcen, die auf Gehirn oder Tumor spezifisch sind, räumlich zusammenfallen. Anschließende bidirektionale Störungsstudien in aus Patienten gewonnenen GBM-Modellen könnten dann die Empfindlichkeit gegenüber Ferroptose, Lipidperoxidation, Zellüberleben sowie die adhäsionsbezogenen transkriptionellen Programme untersuchen, die durch die computergestützten Analysen identifiziert wurden. Solche Experimente sind erforderlich, um Effekte auf die vererbte Krankheitsanfälligkeit von solchen zu unterscheiden, die das Verhalten etablierter Tumorzellen beeinflussen, und um die in dieser Studie identifizierten konvergenten Assoziationen direkt zu überprüfen.
Offenlegungen
Die Autoren erklären, dass kein Wettbewerbsinteresse besteht.
Danksagungen
Die Autoren danken dem Cancer Genomics-Team am Institute of Cancer Research für den Zugang zu den Zusammenfassungsstatistiken der Gliom-GWAS über das European Genome-phenome Archive (Datensatz EGAD00010001657). Die ursprüngliche Erstellung dieser Daten wurde von Cancer Research UK unterstützt, einschließlich des Bobby Moore Fund, des Wellcome Trust und des DJ Fielding Medical Research Trust (C1298/A8362).
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| BWMR | R-Paket | BWMR | Bayessche gewichtete Mendelsche Randomisierung |
| DESeq2 | Bioconductor | Version 1.46.0 | RNA-Sequenzierungs-Analyse zur differentiellen Genexpression |
| FerrDb V2 | FerrDb | Version 2 | Quelle für 483 kuratierte Eisen-spezifisch-regulierte Gene |
| Glioblastom Bulk-Mikroarray | NCBI Genexpressions-Omnibus | GSE4290 | Transkriptomische Evaluationskohorte |
| Zusammenfassende GWAS-Statistiken für Glioblastom | Europäisches Genom-Phänotyp-Archiv | EGAD00010001657 | Datensatz mit kontrolliertem Zugang; 6.183 Fälle und 18.169 Kontrollen |
| Glioblastom Smart-seq2 Einzelzell-RNA-Sequenzierung | NCBI Genexpressions-Omnibus | GSE131928 | Einzelzell-Virtual-Knockout-Analyse für maligne Zellen |
| Bulk-RNA-Sequenzierung von Grad-4-Gliomen | NCBI Genexpressions-Omnibus | GSE196533 | Transkriptomische Evaluationskohorte |
| Zusammenfassende cis-eQTL-Statistiken aus Vollblut (GTEx) | Genotyp-Gewebe-Expressionsprojekt | GTEx V10 | Expositionsdaten für die Replikationsphase |
| limma | Bioconductor | Version 3.62.2 | Mikroarray-Analyse zur differentiellen Genexpression |
| metafor | R-Paket | Version 4.8-0 | Metaanalyse mit zufälligen Effekten |
| R | R Foundation for Statistical Computing | Version 4.4.2 | Statistische Berechnungsumgebung |
| scTenifoldKnk | R-Paket | Version 1.0.3 | Einzelzell-Virtual-Knockout-Analyse |
| Bulk-Mikroarray von Tumorkern und peritumoralem Gewebe | NCBI Genexpressions-Omnibus | GSE116520 | Transkriptomische Evaluationskohorte |
| TwoSampleMR | R-Paket | Version 0.6.29 | Zwei-Stichproben-Mendelsche Randomisierung |
| Zusammenfassende cis-eQTL-Statistiken aus Vollblut | eQTLGen-Konsortium | eQTLGen | Expositionsdaten für die Entdeckungsphase |
Referenzen
- Weller M, et al. EANO guidelines on the diagnosis and treatment of diffuse gliomas of adulthood. Nat Rev Clin Oncol. 2021;18:170-186.
- Stupp R, et al. Radiotherapy plus concomitant and adjuvant temozolomide for glioblastoma. N Engl J Med. 2005;352:987-996.
- McBain C, et al. Treatment options for progression or recurrence of glioblastoma: a network meta-analysis. Cochrane Database Syst Rev. 2021;5:CD013579.
- Dixon SJ, et al. Ferroptosis: an iron-dependent form of nonapoptotic cell death. Cell. 2012;149:1060-1072.
- Stockwell BR, et al. Ferroptosis: A regulated cell death nexus linking metabolism, redox biology, and disease. Cell. 2017;171:273-285.
- Minami JK, et al. CDKN2A deletion remodels lipid metabolism, priming glioblastoma for ferroptosis. Cancer Cell. 2023;41:1048-1060.e1049.
- Kram H, et al. Glioblastoma relapses show increased markers of vulnerability to ferroptosis. Front Oncol. 2022;12:841418.
- Miao Z, et al. A targetable PRR11-DHODH axis drives ferroptosis- and temozolomide-resistance in glioblastoma. Redox Biol. 2024;73:103220.
- Liu HJ, et al. Ferroptosis-related gene signature predicts glioma cell death and glioma patient progression. Front Cell Dev Biol. 2020;8:538.
- Dong J, et al. Ferroptosis-related gene contributes to immunity, stemness, and predicts prognosis in glioblastoma multiforme. Front Neurol. 2022;13:829926.
- Robinson JW, et al. Transcriptome-wide Mendelian randomization study prioritizing novel tissue-dependent genes for glioma susceptibility. Sci Rep. 2021;11:2329.
- Zhang H, Wang Z, Qiao X, Wu J, Cheng C. Investigating potential drug targets for the treatment of glioblastoma: a Mendelian randomization study. BMC Cancer. 2025;25:654.
- GTEx Consortium. The GTEx Consortium atlas of genetic regulatory effects across human tissues. Science. 2020;369:1318-1330.
- Zhou N, et al. FerrDb V2: update of the manually curated database of ferroptosis regulators and ferroptosis-disease associations. Nucleic Acids Res. 2023;51:D571-D582.
- Võsa U, et al. Large-scale cis- and trans-eQTL analyses identify thousands of genetic loci and polygenic scores that regulate blood gene expression. Nat Genet. 2021;53:1300-1310.
- Melin BS, et al. Genome-wide association study of glioma subtypes identifies specific differences in genetic susceptibility to glioblastoma and non-glioblastoma tumors. Nat Genet. 2017;49:789-794.
- Zeng C, et al. Dissection of transcriptomic and epigenetic heterogeneity of grade 4 gliomas: implications for prognosis. Acta Neuropathol Commun. 2023;11:133.
- Sun L, et al. Neuronal and glioma-derived stem cell factor induces angiogenesis within the brain. Cancer Cell. 2006;9:287-300.
- Kruthika BS, et al. Transcriptome profiling reveals PDZ binding kinase as a novel biomarker in peritumoral brain zone of glioblastoma. J Neurooncol. 2019;141:315-325.
- Neftel C, et al. An integrative model of cellular states, plasticity, and genetics for glioblastoma. Cell. 2019;178:835-849.e821.
- Burgess S, Thompson SG. Avoiding bias from weak instruments in Mendelian randomization studies. Int J Epidemiol. 2011;40:755-764.
- Papadimitriou N, et al. Physical activity and risks of breast and colorectal cancer: a Mendelian randomisation analysis. Nat Commun. 2020;11:597.
- Song W, et al. Causal relationship between gut microbiota and lung squamous cell carcinoma: a bidirectional two-sample Mendelian randomization study. Postgrad Med J. 2025;101:526-534.
- Zhao J, et al. Bayesian weighted Mendelian randomization for causal inference based on summary statistics. Bioinformatics. 2020;36:1501-1508.
- Love MI, Huber W, Anders S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biol. 2014;15:550.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43:e47.
- Yun D, et al. A novel prognostic signature based on glioma essential ferroptosis-related genes predicts clinical outcomes and indicates treatment in glioma. Front Oncol. 2022;12:897702.
- Li R, et al. Identification of candidate genes associated with prognosis in glioblastoma. Front Mol Neurosci. 2022;15:913328.
- Bai H, Inoue J, Kawano T, Inazawa J. A transcriptional variant of the LC3A gene is involved in autophagy and frequently inactivated in human cancers. Oncogene. 2012;31:4397-4408.
- Hayashima K, Kimura I, Katoh H. Role of ferritinophagy in cystine deprivation-induced cell death in glioblastoma cells. Biochem Biophys Res Commun. 2021;539:56-63.
- Wu Y, et al. ALDH1-mediated autophagy sensitizes glioblastoma cells to ferroptosis. Cells. 2022;11:4015.
- Carriere A, et al. ERK1/2 phosphorylate Raptor to promote Ras-dependent activation of mTOR complex 1 (mTORC1). J Biol Chem. 2011;286:567-577.
- Dai E, Meng L, Kang R, Wang X, Tang D. ESCRT-III-dependent membrane repair blocks ferroptosis. Biochem Biophys Res Commun. 2020;522:415-421.
- Comincini S, et al. microRNA-17 regulates the expression of ATG7 and modulates the autophagy process, improving the sensitivity to temozolomide and low-dose ionizing radiation treatments in human glioblastoma cells. Cancer Biol Ther. 2013;14:574-586.
- Wang L, et al. Autophagy mediates glucose starvation-induced glioblastoma cell quiescence and chemoresistance through coordinating cell metabolism, cell cycle, and survival. Cell Death Dis. 2018;9:213.