Diese Studie entwickelt einen mehrschichtigen Rahmen für die Optimierung von Prompts auf der Grundlage von DeepSeek, um die Kompetenz im Transfer des englischen Schreibens in interkulturellen Kontexten zu verbessern. Mithilfe einer dreistufigen Prompt-Kette und eines Quasi-Experiments mit 60 Studierenden der englischen Sprache zeigen die Ergebnisse eine signifikante Verbesserung in der Experimentalgruppe im Vergleich zur Kontrollgruppe.
Forschungsartikel
Optimierung von DeepSeek-Prompts für die interkulturelle Englisch-Schreibdidaktik: Eine praktische Studie zur Transferkompetenz
In diesem Artikel
Zusammenfassung
Zusammenfassung
Um die Einschränkung zu beheben, dass traditioneller englischsprachiger Schreibunterricht die systematische Förderung von Sprachtransfers vernachlässigt und bestehende Prompt-Frameworks nicht in den Unterricht integrierbar sind, konstruiert diese Studie ein hierarchisches Transfertrainingsystem basierend auf dem DeepSeek-Modell, das vier progressive Aufgabenebenen abdeckt: Satz, Absatz, Diskurs und Kultur, wobei alle Aufgaben in dreifacher Form definiert sind. Eine fünfdimensionale Aufgabenbibliothek, die Syntax, Struktur, Kultur, Register und Logik umfasst, wird eingerichtet, und gezielte Prompts werden automatisch aus authentischen Schreibentwürfen der Studierenden generiert. In Kombination mit der Mixture-of-Experts-(MoE)-Architektur des Modells wird eine geschachtelte Prompt-Kette entwickelt, um komplexe Aufgaben in drei sequenzielle Phasen aufzuteilen: semantische Neuorganisation, sprachliche Überarbeitung und kulturelle Anpassung. Unter Anwendung eines quasiquantitativen experimentellen Designs wurden 60 Studierende des zweiten Jahres mit Englisch als Hauptfach an einer Universität rekrutiert und in eine Experimental- und eine Kontrollgruppe mit jeweils 30 Studierenden eingeteilt, die drei Wochen lang einer gestuften Intervention über drei Trainingsrunden unterzogen wurden. Die Ergebnisse nach dem Experiment zeigen, dass der Kulturtransfer-Score der Experimentalgruppe von 2,8 auf 4,5 anstieg, verglichen mit einem Anstieg von lediglich 0,3 in der Kontrollgruppe; die durchschnittliche, von Lehrenden vergebene Punktzahl verbesserte sich von 59,1 auf 74,4, während die Kontrollgruppe lediglich einen Anstieg von 60,1 auf 64,9 verzeichnete. Die meisten Korrelationskoeffizienten zwischen der KI-basierten Bewertung und der Bewertung durch Lehrende überschreiten 0,8, und über 90 % der Teilnehmenden äußern Zustimmung zu den Funktionen der KI-gestützten Umformulierung und strukturellen Optimierung. Aufgrund der geringen Stichprobengröße in dieser Studie ist dieser Optimierungsansatz jedoch als praktikabel für die Implementierung in universitären Englisch-Schreibkursen einzustufen.
Einleitung
Im Englisch-Schreibunterricht in einem interkulturellen Kontext stehen nicht muttersprachliche Lernende oft vor der Herausforderung, dass ihre Transferfähigkeit unzureichend ausgebildet ist, wenn sie vom Sprachwissen zur praktischen Anwendung übergehen1,2. Obwohl die Lernenden über eine gewisse grammatikalische und vokabulare Grundlage verfügen, fällt es ihnen schwer, Satzmuster, Strukturen und kulturelle Ausdrucksweisen effektiv in echtes Schreiben umzusetzen, was zu einer formalisierten Sprachproduktion und eingeschränktem Denken führt und dadurch die Gesamtqualität des Schreibens beeinträchtigt3. Zudem verschärfen interkulturelle Unterschiede in Sprachstruktur, logischer Gliederung und pragmatischen Normen die Komplexität des Schreibtransfers weiter4. In den letzten Jahren haben große Sprachmodelle (LLMs) neue technische Unterstützung für den Schreibunterricht bereitgestellt5. Intelligente Schreibwerkzeuge wie DeepSeek haben dabei starke Fähigkeiten in der Sprachgenerierung und -rekonstruktion gezeigt. In der Unterrichtspraxis beschränken sie sich jedoch meist auf oberflächliche sprachliche Korrekturen und sind noch nicht tiefgreifend in den auf die Förderung der Transferfähigkeit ausgerichteten Unterrichtsprozess integriert. Ihnen fehlt eine ausgerichtete Unterrichtszielsetzung sowie Kontrollierbarkeit des Generierungsverhaltens6,7. Gängige KI-gestützte Schreibanwendungen beschränken ihre Funktionen überwiegend auf die oberflächliche Korrektur grammatikalischer Fehler, anstatt gezielt die Entwicklung systematischer Transferkompetenz anzustreben, was zu einer mangelhaften, auf den Unterricht ausgerichteten Steuerung der Modellausgaben führt.
Die bisherige Forschung zur Unterstützung des Fremdsprachenschreibens gliedert sich in drei Hauptkategorien: konventionelle, promptgesteuerte Schreibrückmeldungen, generische KI-basierte Überarbeitungsmaßnahmen und manuell ausgerichtete Transfertrainings. Erstens steht bei der allgemeinen Prompt-Engineering-Forschung die technische Optimierung von Frage-Antwort-Systemen und Textumformungen im Vordergrund, ohne dass diese den hierarchischen Zielen des Transferunterrichts entsprechen8,9. Zweitens konzentriert sich der typische, auf ChatGPT basierende Fremdsprachenunterricht hauptsächlich auf die Verbesserung der allgemeinen Schreibgenauigkeit, statt auf den schrittweisen Erwerb syntaktischer, struktureller und kulturübergreifender Transferfähigkeiten10. Drittens fehlt bei der traditionellen Transferpädagogik, die auf Nachahmung und kontrastivem Schreiben beruht, ein geschlossener Rückmeldeprozess, der durch intelligente Werkzeuge unterstützt wird11. Im Unterschied zu den bisherigen Studien passt diese Arbeit zielgerichtete, hierarchische Prompts an mehrstufige Unterrichtsziele an und entwickelt einen beispielbasierten Workflow zur automatischen Promptgenerierung, wodurch ein einzigartiger geschlossener Trainingsmechanismus entsteht, der Modellgenerierung, Lehrerrückmeldung und Schülertextrevision verbindet.
Die bisherige Literatur vermutet einen möglichen Zusammenhang zwischen sprachlich-kultureller Divergenz, inhärenten strukturellen Modellbeschränkungen und fragmentierten Unterrichtspraktiken, doch bleibt eine solche kausale Kette in bestehenden empirischen Studien unzureichend überprüft und bildet daher die zentrale Forschungshypothese dieser Arbeit12,13. Hinsichtlich der in dieser Arbeit zitierten inhärenten Eigenschaften von DeepSeek sind dessen offene Instruktions-Schnittstelle und die auf MoE basierende Experten-Routing-Architektur bereits in bestehenden technischen Modellberichten sowie in angewandter Sprachforschung dokumentiert. Aufbauend auf diesen beschriebenen Modellmerkmalen entwickelt die vorliegende Studie geschachtelte Prompt-Ketten, um komplexe kulturübergreifende Transferaufgaben zu zerlegen, und entwirft dynamische Submodell-Zuteilungsregeln für differenzierte Transferaufgaben. Im Mittelpunkt steht die gezielte Förderung strukturierter Transferfähigkeiten; die Arbeit untersucht eine spezifische Optimierung von DeepSeek-Prompts mit dem Ziel, große Sprachmodelle von universellen Textbearbeitungswerkzeugen in spezialisierte Trainingsysteme für den Transfer im Hochschulenglischunterricht zu überführen.
Im Bereich der Forschung zum Schreiben in einer Fremdsprache ist das Phänomen der Übertragung seit langem ein zentrales Thema14,15. Die traditionelle Theorie der Sprachübertragung konzentriert sich vor allem auf die positiven und negativen Übertragungseffekte der Muttersprache auf den Erwerbsprozess der Zielsprache, wobei insbesondere Phonologie, Wortschatz und Syntax im Fokus stehen16. Mirzayev E. wies darauf hin, dass bei der Schreibausbildung im Englischen als Zweitsprache (ESL) die negative Übertragung aus der Erstsprache weiterhin ein entscheidender Faktor ist, der die Entwicklung der Schreibkompetenz der Lernenden einschränkt17. Mit der Erweiterung des Forschungsbereichs hat die wissenschaftliche Gemeinschaft ihr Interesse schrittweise auf die Übertragung der Schreibstruktur ausgeweitet18. Interlinguale Texte weisen aufgrund mehrerer Faktoren häufig sprachliche Fehler und Verfestigungen (Fossilisierungen) auf19. Gleichzeitig hat auch die Theorie der kognitiven Übertragung zunehmend an Bedeutung gewonnen20. Diese Theorie betont die Unterschiede in der kognitiven Organisation und in den Ausdrucksmustern während des Schreibprozesses. Beispielsweise legt das westliche Schreiben Wert auf lineare Argumentation und explizite Logik, während die chinesische Tradition einen spiralförmigen Ansatz und semantische Mehrdeutigkeit bevorzugt. Zwischen beiden besteht eine erhebliche Spannung. Die Sprachübertragung umfasst daher nicht nur die Umwandlung sprachlicher Einheiten, sondern auch die Anpassung und Transformation tieferliegender Denkstrukturen und kultureller Ausdrucksnormen, was eine wichtige Herausforderung im gegenwärtigen Englisch-Schreibunterricht darstellt21.
Bei der Vermittlung von Transferfähigkeiten setzen bestehende Studien häufig auf Strategien wie das Nachahmende Schreiben22, das Kontrastive Schreiben23 und das Übersetzungs-Training24, um das Verständnis und die Anwendung des Transfermechanismus der Zielsprache durch Lernende zu fördern. Das nachahmende Schreiben trägt zum Aufbau grundlegender Diskursfähigkeiten bei, kann jedoch leicht zu struktureller Starrheit führen; das kontrastive Schreiben verbessert den Sprachstil und das kulturelle Bewusstsein, weist aber einen Mangel an systematischer Aufgabenabstufung und personalisierter Rückmeldung auf; das Übersetzungs-Training kann die Erkennung kultureller Metaphern fördern, führt jedoch ohne Anleitung leicht zu semantischen Abweichungen oder pragmatischen Unangemessenheiten. Die genannten Strategien stützen sich hauptsächlich auf manuelle Demonstration und erfahrungsgeleitete Anleitung25, fehlen an einer expliziten Vermittlung von Transferstrategien und systematischen Feedback-Mechanismen und lassen sich nur schwer an individuelle Unterschiede in Sprachkompetenz und kognitiven Stilen anpassen. Obwohl einige Studien versucht haben, das Transfer-Training durch vielfältige Schreibaufgaben zu erweitern26,27, hat der Lehrprozess noch keinen geschlossenen Kreislauf aus „Transferziel – Sprachproduktion – Strategie-Rückmeldung“ gebildet; die Internalisierung von Transferstrategien ist begrenzt, und die Entwicklung der Transferfähigkeit der Studierenden in realen Schreibaufgaben bleibt unzureichend28.
Mit der Entwicklung der Technologie großer Sprachmodelle hat deren unterstützendes Potenzial im Sprachunterricht zunehmend an Aufmerksamkeit gewonnen29. Generative KI-Tools wie ChatGPT (Chat Generative Pre-trained Transformer)30 und DeepSeek31 werden bereits weitgehend in Szenarien wie Textpolitur, sprachlicher Umschreibung und Sprachanpassung eingesetzt. Diasamidze et al. stellten fest, dass Lernende mit englischer Zweitsprache (ESL), die ChatGPT nutzten, in Bezug auf grammatische Genauigkeit, Wortschatzvielfalt und Textorganisation bessere Leistungen erbrachten als die Gruppe mit traditionellem Unterricht32. Allerdings beschränken sich bestehende Anwendungen meist auf oberflächliche Sprachverarbeitung und fehlen systematische Anleitungen zu Transferzielen. Ranade wies darauf hin, dass auf Prompts basierende Projekte in aktuellen Bildungsszenarien hauptsächlich auf allgemeinen Vorlagen beruhen und die generierten Inhalte an mangelnder Kontextanpassungsfähigkeit und Aufgabenspezifität leiden33. Zudem basiert das Training gängiger Modelle auf einem offenen Korpus und beinhaltet keine tiefgreifende Modellierung der Unterschiede zwischen chinesischen und englischen kulturellen Ausdrucksformen. Kulturelle Unangemessenheiten und unnatürliche Pragmatik treten daher leicht in den generierten Texten auf34,35, was deren vertiefte Anwendung im transferorientierten schriftlichen Quer- und Kulturunterricht einschränkt.
Protokoll
Ethische Genehmigung
Vor dem Experiment erhielten die Autoren eine Genehmigung (Genehmigungsnummer: NBCC-ETH-2026-037) der Hochschule und verteilten Einverständniserklärungen an alle studentischen Teilnehmer. Alle Studierenden wurden ausführlich über die Forschungsziele, die experimentellen Verfahren und die Regelungen zur Datennutzung informiert. Die Teilnahme war freiwillig, und die Teilnehmer konnten das Studium jederzeit abbrechen. Alle personenbezogenen Daten und schriftlichen Arbeiten wurden anonymisiert, um die Privatsphäre zu schützen, und ausschließlich für akademische Analysen verwendet. Alle 60 Teilnehmer unterschrieben das Einwilligungsformular, bevor sie an der Studie teilnahmen. Die Teilnehmer wurden aus zwei parallelen Schreibkursen für fortgeschrittene Studierende im Fach Englisch derselben hochschulischen Berufsfachschule ausgewählt und mittels Convenience-Stichprobe rekrutiert. Die Einschlusskriterien umfassten: Bestehen der CET-6-Prüfung mit einem Ergebnis > 425, keine Fehlzeiten in diesem Semester sowie durchschnittliche Ergebnisse in den letzten beiden schriftlichen Kurztests. Zu den Ausschlusskriterien gehörten: langfristige Nutzung kommerzieller KI-Schreibsoftware für Englisch außerhalb des Unterrichts und schwere Legasthenie.
Die Variabilität aller stetigen Ergebnisvariablen wurde als Mittelwert ± Standardabweichung (SD) angegeben. Alle Analysen wurden mit einer Stichprobengröße von n = 30 Teilnehmern pro Gruppe (experimentelle Gruppe vs. Kontrollgruppe), insgesamt N = 60, durchgeführt. Für longitudinale Messwiederholungsdaten wurde eine varianzanalytische Auswertung mit Messwiederholungen (RM-ANOVA) verwendet, um die Haupteffekte der Gruppe und der Zeit sowie die Gruppen-mal-Zeit-Interaktion zu untersuchen. Für post-hoc paarweise Vergleiche zu einzelnen Zeitpunkten kamen t-Tests für unabhängige Stichproben zum Einsatz. Die Kontrollgruppe erhielt traditionellen Schreibunterricht sowie ein allgemeines, kostenloses, nicht individualisiertes KI-Schreibwerkzeug (keine gestuften Aufforderungen, keine transferorientierten Vorlagen). Die Unterrichtsstunden, Schreibaufgaben, Feedbackhäufigkeit und Trainingstexte waren identisch mit denen der experimentellen Gruppe, abgesehen davon, dass die in dieser Studie verwendete individualisierte, geschachtelte Prompt-Kette und die Aufgabenbibliothek mit fünf Ebenen fehlten. Die experimentelle Gruppe nutzte auf dem DeepSeek-Modell basierende Anweisungen zur Optimierung des Schreibunterrichts, einschließlich der Anleitung durch geschachtelte Prompt-Ketten, der Ausgabe mit interkultureller Anpassung sowie des „Erzeugung-Reflexion-Neuerzeugung“-Mechanismus. Die Kontrollgruppe hingegen setzte traditionelle Lehrmethoden oder nicht optimierte KI-gestützte Werkzeuge ein. Durch den Vergleich der Unterrichtseffekte beider Gruppen wurde die Wirksamkeit der auf dem großen Sprachmodell basierenden Transfertrainingsmethode zur Verbesserung der Schreibtransferfähigkeit der Studierenden überprüft.
Gesamte Forschungsidee
Diese Studie hatte zum Ziel, die Fähigkeit der Studierenden zur Übertragung im englischen Schreiben zu verbessern und effektive methodische Gestaltungsmethoden zu entwickeln, wobei ein besonderer Schwerpunkt auf die Anpassung von DeepSeek für den Bildungseinsatz lag. Zunächst wurde eine Strategie zur Optimierung von Instruktionen vorgeschlagen, um Modellanweisungen neu zu gestalten. Dadurch wurde die Übereinstimmung der generierten Ausgaben mit mehreren Übertragungszielen im Schreibunterricht verbessert, einschließlich syntaktischer Struktur, Absatzlogik und kultureller Ausdrucksweise. Zweitens wurden die Schreibaufgaben der Lehrenden in strukturierte und zielorientierte Anweisungsvorlagen umgewandelt. Anschließend wurde eine Zuordnungsbeziehung zwischen Lehraufgaben und Modellverhalten hergestellt. Dies erhöhte die Steuerbarkeit des Modells und stellte sicher, dass die generierten Inhalte pädagogisch relevant waren. Schließlich entwickelte die Studie einen geschlossenen Übertragungstrainingprozess: „Generierung–Reflexion–Neuschreiben–Neugenerierung“. Dieser Prozess ermutigte die Studierenden, Transferstrategien zu identifizieren und unter Modellunterstützung aktiv ihren sprachlichen Ausdruck zu verfeinern. Durch wiederholte Iterationen wurden die fachsprachlichen und interkulturellen Schreibtransferfähigkeiten der Studierenden kontinuierlich gestärkt. Die Schritte zur Transformation der Satzstruktur sind in Abbildung 1A–D dargestellt.
Um die vollständige Funktionslogik des KI-gestützten Schreibtrainings-Systems zu verdeutlichen und die Reproduzierbarkeit zu verbessern, ist der gesamte Implementierungsworkflow in Tabelle 1 zusammengefasst, einschließlich der Kernabschnitte wie Rohdateneingabe, Lehrereingriffe, Prompt-Anwendung, Schüleraktivitäten, endgültige Ausgaben und entsprechende Bewertungskriterien.
Strategie zur konstruktionsbasierten Aufgabenübertragung
Diese Studie konzentrierte sich darauf, die Transferfähigkeit im englischen Schreiben zu fördern. Sie entwickelte einen Transferaufgaben-Pfad, der von oberflächlich zu tiefgreifend fortschreitet und die Studierenden systematisch dabei unterstützt, mehrstufige sprachliche Transferstrategien zu beherrschen und anzuwenden. Um die Pfadstruktur insgesamt zu beschreiben, wurde sie als vierstufiges Aufgabenset definiert:
T = {T1,T2,T3,T4} (1)
T1 steht für die satzebene Transferaufgabe, die sich auf grundlegende grammatische Strukturoperationen konzentriert, wie beispielsweise die Erweiterung kurzer Sätze, die Änderung der Satzstimme und den Austausch von Nebensätzen, um Studierenden vielfältige Methoden der Satzstruktur zu vermitteln. T2 ist die absatzebene Transferaufgabe, die Studierende anleitet, die Organisation und Verknüpfung von Informationen innerhalb eines Absatzes zu beachten, und sie darin schult, durch die Extraktion der Hauptaussage sowie durch die Anpassung der logischen Beziehungen zwischen Sätzen Klarheit der Struktur und Kohärenz des Ausdrucks des Absatzes zu verbessern. T3 repräsentiert die diskursebene Aufgabe, die sich weiter auf das gesamte logische Gerüst und den Argumentationsrhythmus eines Kapitels erstreckt und Studierende dabei unterstützt, anhand der Umstellung der Absatzreihenfolge und der Optimierung der strukturellen Nebeneinanderstellung ein englisches Textstück mit vollständigem Argumentationssystem aufzubauen. T4 ist die kulturebene Transferaufgabe, bei der Studierende implizite kulturelle Ausdrucksmerkmale im muttersprachlichen Schreiben – wie indirekte Formulierungen und semantische Andeutungen – erkennen und diese in direkte Ausdrucksweisen oder logisch explizite Formen umwandeln sollen, die der Zielsprachkultur entsprechen. Der Verlauf ihrer Entwicklung ist in Abbildung 2 dargestellt. Um die Durchführbarkeit und Evaluierbarkeit der Aufgabengestaltung zu erhöhen, definierte diese Studie jede Aufgabenebene zusätzlich als Triple-Form:
Ti = (Si,Gi,Ei) (2)
Sj repräsentiert die Eingabestichprobe der Aufgabe, Gi repräsentiert die Ziel-Transferoperation und Ei repräsentiert die unterstützenden Evaluierungskriterien. Durch diesen strukturierten Ausdruck wurde sichergestellt, dass jede Ebene der Aufgabe auf der Beherrschung der Strategie der vorherigen Ebene aufbaute und mit entsprechenden Beispielen, Zielbeschreibungen und Leistungskriterien ausgestattet war, wodurch ein Mechanismus für die schrittweise Fortschrittsentwicklung des Transferpfads bereitgestellt wurde. Bei der Konstruktion des Transfertrainingsystems wurde zur systematischen Abdeckung von Aufgabentypen und effizienten Verwaltung von Lehranforderungen eine strukturierte Aufgabenbibliothek aufgebaut, die fünf Arten von Transferzielen abdeckt, basierend auf den gemeinsamen sprachlichen Umwandlungsdimensionen beim Schreibentransfer. Die Aufgabenbibliothek wurde formal ausgedrückt als:
M = {(Dj,TDj)∣j = 1,2,3,4,5} (3)
Dj entspricht fünf Transferdimensionen: syntaktischem Transfer, strukturellem Transfer, kulturellem Transfer, Registertransfer und logischem Transfer; die Aufgabensammlung TDj , die jeder Dimension zugeordnet ist, stellt deren operationellen Teilsatz dar. Bei der Entwicklung der Aufgabenbibliothek fassten die Autoren zunächst auf der Grundlage einer großen Anzahl realer Schreibanfertigkeiten von Studierenden gemeinsame Transferprobleme und Arten sprachlicher Fehler zusammen, verbanden diese mit den tatsächlichen Unterrichtsbedürfnissen und Bewertungsstandards, unterteilten die verschiedenen Transferarten in funktionale Bereiche und legten die zentralen Trainingsziele sowie Betriebsmodi jeder Aufgabe fest. Jede Aufgabe wurde abstrakt als folgende dreigliedrige Struktur dargestellt:
Ti,j = (Si,j,Gi,j,Ci,j) (4)
Si,j steht für die Aufgabeneingabe, Gi,j ist die Transfer-Zielbeschreibung der Aufgabe, und Ci,j ist die Evaluations- und Kontroll-Dimension der Aufgabe. Bei der syntaktischen Transferaufgabe entwarf diese Studie eine Satzumstellungssequenz, die von einfach zu schwierig fortschritt und die Satzverbindung, Klauselverschachtelung, Passivumwandlung sowie verwandte Konzepte abdeckte, um die Fähigkeiten der Lernenden in Satzerweiterung und grammatikalischer Transformation zu verbessern. Die strukturelle Transferaufgabe konzentrierte sich darauf, die logische Gliederung von Absätzen zu optimieren, die Informationsorganisation zu stärken und die Fähigkeit zum logischen Aufbau durch Neuschreiben der Hauptaussage, Sortieren von Stützsätzen sowie Neugestaltung von Ursache-Wirkungs- und Beispielbeziehungen zu verbessern. Die kulturelle Transferaufgabe basierte auf einem interkulturellen Korpus und zielte auf pragmatische Abweichungen wie implizite Ausdrucksweisen und Euphemismen ab. Sie entwarf ausdrucksmäßige Umwandlungen, die dem realen Kontext nahekamen, um die Entwicklung kultureller Anpassungsfähigkeit zu fördern. Die Register-Transferaufgabe leitete die Lernenden dabei an, mündliche Ausdrucksweisen in akademische Sprache umzuwandeln und Strategien für die Registerwechsel zu beherrschen. Die logische Transferaufgabe konzentrierte sich auf den Aufbau von Schlussketten und die Sicherstellung klarer Ausdrucksweise, wobei gleichzeitig Training zur Verwendung von Konjunktionen, zur Explizitmachung logischer Beziehungen und zu Absatzübergängen durchgeführt wurde.
Anhand tatsächlicher Schreibproben von Studierenden entwickelte diese Studie einen eng an Lehraufgaben angebundenen Prozess zur Erstellung von Aufgabenstellungen, um die Relevanz der Anweisungen und die Praxistauglichkeit der generierten Inhalte zu erhöhen. Der Prozess wurde von Lehrkräften geleitet, die während des Unterrichts repräsentative Textausschnitte der Lernenden auswählten und sich dabei auf typische Transferprobleme wie redundante Sätze, ungeordnete Strukturen und unangemessene kulturelle Ausdrucksweisen konzentrierten. Anschließend kennzeichneten sie die Proben über die Systemoberfläche mit Transferarten, um die Lernziele klarzustellen. Nach Erhalt der Annotationen aktivierte das System automatisch das Modul zur Identifizierung von Transferaufgaben. Danach verglich es die Eingabe mit der vordefinierten Aufgabensammlung und der Sammlung von Aufgabenstellungs-Vorlagen. Bei diesem Abgleich wurden Faktoren wie Transferart, sprachliche Merkmale und Textstruktur berücksichtigt. Auf dieser Grundlage wählte das System die am besten geeignete Vorlage aus und generierte eine erste Aufgabenstellung. Das System unterstützte zudem eine strukturierte Verbesserungsverarbeitung. Die Annotationen der Lehrkräfte wurden in ein standardisiertes Format umgewandelt, das vom Modell leicht interpretiert werden kann. Relevante instruktionale Hinweise wurden in die Aufgabenstellung eingebettet, um dem Modell ein genaues Verständnis sowohl der Absichten der Lehrkraft als auch der Fragen der Lernenden zu ermöglichen. Um die Flexibilität und Steuerbarkeit der Anweisungen zu verbessern, enthielt das System ein Unterstützungsmodul für Lehrkräfte. Dieses Modul ermöglichte es den Lehrkräften, Aufgabenstellungen zu verfeinern, indem sie die instruktionalen Vorgaben anpassten, den Kontext modifizierten und Ton sowie Stil individuell gestalteten. Dadurch erhielten die Lehrkräfte eine größere Kontrolle über den Generierungsprozess und konnten ihn besser an unterschiedliche Unterrichtssituationen anpassen.
Optimierungsmechanismus für Deepseek-Befehle
Basierend auf den praktischen Anforderungen des Transfertrainings im englischen Schreiben entwickelte diese Studie fünf Arten von transferorientierten Prompt-Vorlagen. Diese Vorlagen wurden konzipiert, um das Generierungsverhalten des großen Sprachmodells zu steuern und zu regulieren. Die strukturelle Transfer-Vorlage konzentrierte sich auf die Absatzorganisation und die Diskursstruktur. Sie half den Studierenden, Texte umzustrukturieren, indem sie Formen wie Einleitung–Hauptteil–Schluss übernahmen und den logischen Gedankenfluss verbesserten. Die syntaktische Transfer-Vorlage betonte die Satzebene und deren Komplexität. Sie förderte den Einsatz vielfältiger grammatikalischer Strukturen, darunter Passivkonstruktionen, Parallelstrukturen und komplexe Nebensätze, um die Ausdrucksweise schriftlicher Texte zu verfeinern. Die kulturelle Transfer-Vorlage befasste sich mit der kulturellen Angemessenheit im Schreiben. Sie leitete die Studierenden dabei an, Ausdrucksweisen, die von ihrer Muttersprache und Kultur geprägt waren, in Formen umzuwandeln, die im englischsprachigen Kontext natürlicher und akzeptabler sind. Die Register-Transfer-Vorlage konzentrierte sich auf die Anpassung des Stils und die Kontrolle des sprachlichen Registers. Sie half den Studierenden, ihren Sprachgebrauch an unterschiedliche Schreibzwecke, Zielgruppen und Gattungen anzupassen. Die logische Transfer-Vorlage zielte darauf ab, die logische Organisation zu stärken. Sie förderte den gezielten Einsatz von Beziehungen wie Ursache und Wirkung, Vergleich und Gegenüberstellung sowie paralleler Entwicklung, wodurch Kohärenz und argumentative Stringenz verbessert wurden. Zusammen deckten diese fünf Vorlagen die wesentlichen Dimensionen des Schreibtransfers ab. Sie boten strukturierte didaktische Unterstützung sowohl für die Gestaltung von Lehraufgaben als auch für die modellbasierte Textgenerierung.
Jeder Vorlagentyp folgte einem einheitlichen Format, um seine Universalität und Anpassungsfähigkeit in verschiedenen Unterrichtssituationen sicherzustellen. Die Vorlage enthielt vier Kernelemente: Das erste war das Anweisungsziel, das die erforderliche Transferaufgabe eindeutig angab; das zweite war die Beispiel-Eingabe, die den Studierenden reale Sprachfragmente als Korpusgrundlage für die Wirksamkeit der Anweisung bereitstellte; das dritte war die Ziel-Ausgabe, die den Standardstil einer idealen sprachlichen Ausgabe nach der Übertragung zeigte, mit der die Studierenden vergleichen und die sie zur Modellanpassung nutzen konnten; das vierte war der Nutzungsvorschlag, der das anwendbare Sprachniveau, Textformat und die Einsatzstrategie für die Vorlage erläuterte und anpassbare Parameterhinweise enthielt, um die Steuerung der Generierung sowie die didaktische Leitfunktion zu verbessern.
Um die Gestaltungslogik und praktische Anwendung der Promptvorlagen weiter zu veranschaulichen, werden im Folgenden repräsentative Beispiele für fünf transferorientierte Prompts vorgestellt. Alle Vorlagen entsprachen dem einheitlichen Rahmen, der aus einem Instruktionsziel, einer Beispieleingabe, einer Zielausgabe und einem Nutzungshinweis bestand. Die Studierenden wurden angeleitet, einfache Sätze zu erweitern, Satzformen umzuwandeln und Nebensätze einzubetten, um die syntaktische Vielfalt zu erhöhen. Beispielsweise lautete die optimierte Ausgabe für den Studententext „I study English writing. It is very important for cross-cultural communication“: „Learning English writing plays a vital role in improving learners’ ability of cross-cultural communication“. Dieser Prompt eignete sich für ein Training auf Satzebene für Studierende im zweiten Jahr des Englischfachs auf moderatem Schwierigkeitsniveau und konzentrierte sich auf grundlegende syntaktische Umstrukturierung und Verwandlung der Satzkonstruktion. Ein weiterer Prompttyp zielte auf kulturellen Transfer ab und hatte zum Ziel, chinglish-geprägte Äußerungen, die von muttersprachlichem kulturellem Denken beeinflusst sind, zu identifizieren und die Sätze in natürliche englische pragmatische Ausdrücke umzuformulieren, die den westlichen kulturellen Normen entsprechen. Am Beispiel des Studentensatzes „Many people think you must work hard if you want to succeed“ lautete die überarbeitete Version: „People generally believe that diligence is the key to success“. Dieser Prompt wurde im Training zum Transfer auf kultureller Ebene eingesetzt und konzentrierte sich darauf, implizite chinesische Denkmuster abzubauen und ein explizites Ausdrucksvermögen im englischen Sprachkontext zu fördern.
Diese Studie entwickelte außerdem eine dreistufige, geschachtelte Prompt-Kette, die die Absatzentwürfe der Studierenden als einheitliche Eingabe entgegennahm und nacheinander in aufeinanderfolgenden Phasen abarbeitete. Die erste Phase war die semantische Neugliederung, bei der der Prompt die Teilnehmenden aufforderte, die Sätze des gegebenen Absatzes neu anzuordnen, die logische Abfolge der Ideen zu optimieren und einen vollständigen Absatz mit klaren thematischen Hauptsätzen zu bilden. Die zweite Phase war die sprachliche Überarbeitung, in der der überarbeitete Absatz in formelles akademisches Englisch umgeschrieben, umgangssprachliche Wörter ersetzt und komplexe Sätze sowie Passivkonstruktionen angemessen verwendet werden sollten. Die dritte Phase war die kulturelle Anpassung, deren Prompt die Nutzer anleitete, den Text auf kulturpragmatische Ausdrücke zu überprüfen, kulturelle Einflüsse der Muttersprache zu entfernen und den Inhalt so zu verfeinern, dass er den englischsprachigen, interkulturellen Schreibkonventionen entsprach. Die oben genannten Beispiele demonstrierten vollständig die Funktionsweisen von Einzel-Prompt-Vorlagen und geschachtelten Prompt-Ketten. Auf dieser Grundlage entwarf die Studie eine vollständige, mehrphasige Prompt-Kette, die mit der MoE-Architektur von DeepSeek kombiniert wurde.
Um die Einschränkungen von Einzelprompts hinsichtlich der Generierungssteuerung und der Tiefe der Aufgabenbearbeitung zu überwinden, entwarf diese Studie eine geschachtelte Prompt-Kettenstruktur mit phasenweiser und kontinuierlicher Ausrichtung, die eine hierarchische Steuerung und die schrittweise Generierung komplexer Transferaufgaben ermöglicht. Dieser Mechanismus zerlegte eine vollständige Transferaufgabe in mehrere Teilziele und entwarf entsprechende Prompt-Vorlagen für jedes Teilziel, die in logischer Reihenfolge der semantischen Rekonstruktion, der sprachstilistischen Anpassung und der kulturpragmatischen Adaption hintereinander geschaltet wurden, wodurch eine kontextabhängige Generierungskette entstand. Diese Studie implementierte die Optimierung der geschachtelten Prompt-Kette für DeepSeek über dessen standardmäßige offene API. Das DeepSeek-Modell verwendete von Haus aus eine Mixture-of-Experts-(MoE-)Architektur mit einem automatischen Backend-Expert-Routing-System, das als inhärentes internes Schlussfolgerungsmodul unabhängig von externen Prompts agiert. Die angepassten mehrstufigen Prompts beeinflussten lediglich die inhaltsbezogenen Merkmale der Modell-Eingaben. Entsprechend den in den optimierten Eingaben verankerten semantischen, stilistischen und kulturellen Anforderungen aktivierte der native MoE-Routing-Mechanismus des Modells während der Textgenerierung autonom die am besten geeigneten Expertenmodule. Das dreistufige Prompt-Design, das auf semantische Neugestaltung, stilistische Anpassung und kulturelle Adaption ausgerichtet war, verfeinerte lediglich die Eingabetexte, griff jedoch nicht in die interne Logik der Expertenauswahl und -zuweisung des Modells ein.
Hinsichtlich des Ablaufs erhielt das System von Lehrkräften hochgeladene Schülerarbeiten, übertrug die Zielannotationen und bestimmte automatisch, ob die geschachtelte Kettenstruktur aktiviert werden sollte. Falls aktiviert, führte das System nacheinander drei Phasen aus: Die erste Phase war die semantische Neugliederung, bei der die Strukturübertragungsvorlage aufgerufen wurde, um die Absatzorganisation und logischen Hinweise zu optimieren; die zweite Phase war die Anpassung des Sprachstils, bei der mithilfe der Sprachvorlage umgangssprachliche Ausdrücke in wissenschaftliche Schreibsprache umgewandelt wurden; die dritte Phase war die kulturelle Anpassung, bei der die Kulturübertragungsvorlage aufgerufen wurde, um Ausdrücke zu identifizieren und zu ersetzen, die nicht der Zielsprachkultur entsprachen, und um authentischere Texte zu generieren.
Jede Generierungsrunde verwendete die Ausgabe der vorherigen Runde als Eingabe und behielt den Kontextvektor-Cache bei, um semantische Kohärenz sicherzustellen. Die Lehrenden passten die Struktur der Prompt-Kette in der Systemoberfläche an, einschließlich der Vorlagenauswahl, Anpassung der Anweisungen und Neuanordnung der Reihenfolge. Das System unterstützte zudem die Funktion „Vorlagen-Kombinationspaket“, die es Lehrenden erleichterte, Aufgaben wiederverwendend oder gebündelt zuzuweisen. Außerdem verfügte das System über einen integrierten dynamischen Unterbrechungs- und Feedback-Mechanismus, der nach jeder Generierung Zwischenergebnisse bereitstellte. Die Lehrenden kommentierten diese oder passten die nachfolgenden Anweisungen in Echtzeit an, wodurch sich eine geschlossene „Generierung-Anpassung-Neugenerierung“-Lehrschleife ergab.
Modellerstellung, Bewertung
Im Prozess der Textgenerierung und -bewertung auf Grundlage des DeepSeek-Modells entwickelte diese Studie einen mehrdimensionalen automatischen Bewertungsmechanismus, um generierte Texte systematisch zu analysieren und quantitativ hinsichtlich dreier Aspekte zu bewerten: syntaktische Komplexität, strukturelle Standardisierung und Diskurskohärenz. Zur Extraktion von Textmerkmalen und zur automatisierten Bewertung verwendete die Studie den spaCy-Abhängigkeitsparser sowie das Coreferee-Coreferenzauflösungs-Modul. Der spaCy-Abhängigkeitsparser analysierte die syntaktische Struktur englischer Texte und extrahierte zentrale Indikatoren wie die durchschnittliche Satzlänge und die Anzahl verschachtelter Nebensätze, wodurch eine quantitative Analyse der syntaktischen Komplexität ermöglicht wurde. Das Coreferee-Coreferenzauflösungs-Modul, das innerhalb des spaCy-Frameworks läuft, identifizierte vorrangig interne Referenzbeziehungen im Text und bewertete die referenzielle Kohärenz des Diskurses, wodurch technische Unterstützung für die automatisierte Bewertung der Schreibqualität bereitgestellt wurde. Aufgrund von Netzwerkeinschränkungen war der Zugriff auf die genannten ausländischen Open-Source-Webseiten nicht möglich.
Zunächst bewertete das System die syntaktische Komplexität. Es extrahierte Merkmale wie durchschnittliche Satzlänge, Verschachtelungstiefe von Nebensätzen und Satzvielfalt. Diese Merkmale wurden mithilfe von Dependenzanalyse und tiefen syntaktischen Baummodellen gewonnen. Anhand der Ergebnisse beurteilte das System, ob die Studierenden erfolgreich von einfachen Satzmustern zu komplexeren Strukturen übergegangen waren. Zweitens analysierte das System die Absatzorganisation. Es kombinierte BERT-basierte Textrepräsentationen mit Klassifizierungsmodellen, um zentrale Absatzelemente zu identifizieren, darunter thematische, unterstützende und abschließende Sätze. Anschließend wurde eine Absatzstrukturkarte erstellt, um zu prüfen, ob die Organisation den Konventionen des englischen wissenschaftlichen Schreibens entsprach. Drittens bewertete das System die Textkohärenz. Es untersuchte den Gebrauch logischer Konnektoren, die semantische Konsistenz zwischen Sätzen sowie die Qualität der referenziellen Verbindungen im gesamten Text. Diese Indikatoren dienten der Beurteilung der Klarheit der logischen Argumentationsentwicklung und des fließenden Übergangs der Gedanken. Zur Messung der thematischen Kohärenz berechnete das System die semantische Ähnlichkeit anhand vektorbasierter Repräsentationen. Die referenzielle Kohärenz wurde mittels Coreferenzauflösungstechniken bewertet, die dazu beitrugen, semantische Lücken und mehrdeutige Bezüge zu verringern. Schließlich wurden die Bewertungen aus allen Dimensionen zu einem einheitlichen Bewertungsvektor zusammengeführt. Die Ergebnisse wurden standardisiert, um ein umfassendes Evaluierungssystem zu schaffen, das einen zuverlässigen Vergleich zwischen verschiedenen Schreibanlässen ermöglicht.
In der Phase der manuellen Bewertung entwickelte diese Studie ein dreidimensionales Bewertungssystem für das Schreibtransfer-Training, das die Offensichtlichkeit des Transferverhaltens, die Natürlichkeit der Ausdrucksweise und die kulturelle Anpassungsfähigkeit umfasst, um die Relevanz der Lehrerbewertung und die Wirksamkeit des Unterrichts-Feedbacks zu verbessern. Das System kombinierte seine unterstützenden Funktionen, um eine organische Verbindung quantitativer Bewertungen und qualitativer Kommentare zu erreichen. In der Dimension des Transferverhaltens beurteilten die Lehrkräfte die Nutzung von Transferstrategien durch die Schüler beim Umschreiben von Texten anhand vorgegebener Aufgabenziele. Das System bot eine nebeneinanderstehende Vergleichsansicht des Originaltextes und der generierten Version, um den Lehrkräften bei der Identifizierung zu helfen, ob Maßnahmen wie Satzumstellungen und strukturelle Neugestaltungen effektiv den geforderten Transfer-Typ widerspiegelten.
Die Bewertung des natürlichen Ausdrucks konzentrierte sich auf die Flüssigkeit und Authentizität der sprachlichen Ausgabe. Die Lehrkräfte verwendeten die vom System generierten Sprachindikatoren, um zu beurteilen, ob die Sätze den Ausdrucksgewohnheiten muttersprachlicher Englischsprecher entsprachen, und um zu prüfen, ob die grammatikalische Struktur, die Wortkombinationen und der Satzrhythmus natürlich und angemessen waren. Zudem wiesen sie mittels Anmerkungen auf Probleme hin und schlugen alternative Formulierungen vor. Die kulturelle Anpassungsfähigkeit bezog sich auf die Angemessenheit der interkulturellen Pragmatik. Die Lehrkräfte mussten ermitteln, ob der Text unangemessene Äußerungen enthielt, die durch kulturelle Übertragung aus der Ausgangssprache verursacht wurden, beispielsweise semantische Mehrdeutigkeiten, rhetorische Konflikte oder vage Werturteile. Das System stellte häufige Beispiele kulturell abweichender Wörter bereit und ermöglichte es den Lehrkräften, in Kommentaren die Grundlage für Änderungen sowie kulturelle Kontextanforderungen zu erläutern, wodurch die Studierenden bei der Verbesserung ihres Bewusstseins für kulturelle Transferleistungen und ihrer Ausdrucksgenauigkeit unterstützt wurden. Jede Dimension wurde anhand einer 5-Punkte-Skala bewertet und enthielt freie Anmerkungen sowie vorgeschlagene Ergänzungsbausteine. Die endgültigen Bewertungsergebnisse wurden als Radar-Diagramm dargestellt.
Um die Bewertungseffizienz zu verbessern und die praktische Nutzung im Unterricht zu unterstützen, wurde in dieser Studie ein kollaborativer Bewertungsmechanismus entwickelt, der die KI-basierte Punktevergabe mit der Lehrerbeurteilung kombiniert. Das System führte zunächst eine mehrdimensionale Bewertung des von DeepSeek generierten Textes durch. Wesentliche Aspekte wie syntaktische Komplexität, Absatzstruktur und Textkohärenz wurden über das automatische Bewertungsmodul analysiert. Die Ergebnisse der Bewertung wurden anschließend in Echtzeit auf der Lehrerschnittstelle angezeigt. Die Lehrkräfte überprüften die detaillierten Bewertungen für jede Dimension und passten sie bei Bedarf an, basierend auf ihrem fachlichen Urteilsvermögen und ihrem Verständnis der Transferleistungen der Schüler. Zudem fügten sie gezielte Kommentare direkt in den Text ein, um Rückmeldungen und unterrichtliche Vorschläge zu geben, die durch die automatische Bewertung möglicherweise nicht erfasst wurden. Jede Bewertungsdimension verwendete eine Fünf-Punkte-Bewertungsskala. Die Schnittstelle enthielt außerdem Freitext-Anmerkungs- und Empfehlungsmodule, um individualisierte Rückmeldungen zu erleichtern. Die Bewertungsergebnisse wurden mittels eines Radar-Diagramms visualisiert, wodurch die Lehrkräfte schnell die Stärken und Schwächen der Schüler in den verschiedenen Transferdimensionen erkennen konnten.
Darüber hinaus ermöglichte das System Lehrkräften, die Gewichtung bestimmter Dimensionen oder der Gesamtergebnisse anzupassen, um sie an die Unterrichtsziele anzupassen. Diese Funktion stellte sicher, dass die abschließende Bewertung die tatsächliche Leistung und die Lernbedürfnisse der Schüler präziser widerspiegelte. Nach Abschluss der manuellen Überprüfung integrierte das System automatisch maschinell generierte und von Lehrkräften erstellte Bewertungsdaten und erstellte anschließend einen visuellen Feedback-Bericht. Der Bericht enthielt ein Radar-Diagramm zur Übertragungsleistung und ein Versionsverlauf-Diagramm. Diese Visualisierungen verdeutlichten deutlich die Veränderungen in den Übertragungsfähigkeiten der Schüler über mehrere Runden der Texterstellung und -überarbeitung hinweg und ermöglichten so eine kontinuierliche Überwachung des Lernfortschritts.
Übertragung des Trainingsprozesses
Diese Studie entwarf einen vollständigen Transfer-Trainingsprozess. Zunächst stellte die Lehrkraft spezifische englische Schreibaufgaben basierend auf den Unterrichtszielen und dem tatsächlichen Niveau der Studierenden und klärte den Transfer-Typ sowie den Schwerpunkt des Trainings. Anschließend generierte das System automatisch entsprechende Prompt-Anweisungen basierend auf den von der Lehrkraft festgelegten Aufgaben und rief das DeepSeek-Modell auf, um einen Erstentwurf des Textes zu erstellen, der als Grundlage für das Überarbeiten und Transfer-Training der Studierenden diente. Nach Erhalt des Erstentwurfs mussten die Studierenden aktiv die im Text reflektierten Transfermerkmale identifizieren und den Inhalt gezielt umschreiben, wobei sie die erlernten Transferstrategien anwendeten, um die Angemessenheit der Satzstruktur, der Abschnittsgliederung und der kulturellen Ausdrucksweise zu verbessern. Nach Abschluss der Überarbeitung führte die Lehrkraft eine detaillierte Rückmeldung zum eingereichten Text der Studierenden durch, wobei die Wirksamkeit der Transferstrategie hervorgehoben und konkrete Verbesserungsvorschläge sowie Schreibanleitungen gegeben wurden. Basierend auf dem Feedback der Lehrkraft wurde das DeepSeek-Modell erneut aufgerufen, um eine optimierte Version zu generieren, die die Studierenden weiterhin dabei unterstützte, ihre Texte zu verfeinern und ihre Anwendung der Transferstrategien zu vertiefen. Schließlich reichten die Studierenden den endgültigen Text ein, füllten die Transfer-Kognitionstabelle aus, führten eine Selbstevaluation durch, fassten die Transfermethoden und deren Wirkung zusammen und förderten so die Verbesserung der metakognitiven Fähigkeiten sowie die Internalisierung der Schreib-Transfer-Fertigkeiten. Die für diese Studie konzipierte Transfer-Kognitionstabelle ist in Tabelle 2 dargestellt.
Alle Elemente verwendeten eine Bewertungsskala von 1–5, die von 1 (keine Beherrschung) bis 5 (vollständige Beherrschung) reichte. Die Selbstbewertungsdaten wurden nach drei Runden sequenziellen Trainings erhoben; die Bewertungsbenchmarks beziehen sich auf vordefinierte Standards für Transferoperationen in der fünfdimensionalen Aufgabenbibliothek.
Ergebnisse
Lehre der Versuchsplanung
Diese Studie verwendete die grundlegende Open-Source-Version von DeepSeek und stützte sich auf die offene API-Schnittstelle der Plattform für Programm-Aufrufe. Der vollständige Satz aus fünf Prompt-Vorlagetexten, vier Ebenen von Beispielaufgaben, Transfer-Anmerkungskategorien-Tags sowie Regeln zur Zuordnung von Schreibfehler-Vorlagen wurde im ergänzenden Anhang zusammengestellt. Das System verwendete feste Aufrufparameter: einen Temperaturkoeffizienten von 0,7, und die erzeugte Textlänge wurde dynamisch je nach Art der Schreibaufgabe begrenzt. Es folgte strikt einer festgelegten Abfolge semantische Rekonstruktion > stilistische Anpassung > kulturelle Adaption und führte geschachtelte Prompt-Kettenaufrufe aus. Die Modell-Ausgaben wurden vom Dozenten manuell auf wirksame Texte für den Unterricht im Klassenzimmer überprüft und ausgewählt.
An dieser Studie nahmen drei Vollzeit-Lehrkräfte für englische Schreibkursstunden auf Hochschulniveau mit mehr als fünf Jahren Berufserfahrung als Gutachter bei der manuellen Bewertung teil. Alle Bewertenden erhielten vor der offiziellen Korrektur eine standardisierte Schulung, in der sie mit den Bewertungsdimensionen, dem 5-Punkte-Bewertungssystem, kulturellem Transfer, Syntax, Diskurs und weiteren Bewertungsdetails vertraut gemacht wurden, und absolvierten eine Vorkorrektur-Kalibrierung. Alle Schüleraufsätze wurden unabhängig voneinander von zwei Lehrkräften im verdeckten, doppelten Bewertungsverfahren korrigiert. Falls die Differenz zwischen den beiden Bewertungsergebnissen mehr als einen Punkt (von fünf) betrug, entschied eine dritte erfahrene Lehrkraft als Schiedsgutachter über die endgültige Bewertung, und der Durchschnitt der beiden gültigen Bewertungen wurde als endgültige manuelle Punktzahl für die jeweilige Arbeit festgelegt. Zwei Gruppen von Bewertenden waren in der Evaluierungsphase für unterschiedliche Forschungszwecke beteiligt. Drei Vollzeit-Lehrkräfte für englische Schreibfächer an Hochschulen führten im Rahmen des eigentlichen Experiments die verdeckte, doppelte Bewertung sämtlicher Schreibleistungen der Studierenden durch, wobei eine dritte erfahrene Lehrkraft als Schiedsgutachter einsprang, wenn die Abweichung der Bewertungen mehr als einen Punkt auf der 5-Punkte-Skala betrug. Im Gegensatz dazu nahmen fünf Bewertende an einem Test zur Bestimmung der Inter-Rater-Reliabilität mittels des Intraklassen-Korrelationskoeffizienten (ICC) teil, der separat durchgeführt wurde, um die Konsistenz der Bewertungsstandards zwischen den Gutachtern zu überprüfen. Der Unterschied in der Anzahl der Bewertenden resultiert aus unterschiedlichen funktionalen Anforderungen: die drei Kernlehrkräfte sicherten die praktische Bewertung der experimentellen Daten, während das erweiterte Gremium aus fünf Bewertenden stichhaltigere Belege für die Zuverlässigkeit des gesamten Bewertungssystems lieferte.
Syntaktische Komplexität, BERT-Textstruktur-Bewertung und semantische Ähnlichkeit werden alle in einem Bereich von 0–5 Punkten bewertet. Die Gewichtungen für jede Dimension wurden gemäß den Standards des Fremdsprachen-Schreibunterrichts und der dazugehörigen Forschung festgelegt: Syntax 0,35, Textstruktur 0,35 sowie Logik und Kultur 0,3. Die Gewichtungswerte basierten auf etablierten quantitativen Bewertungssystemen für Schreibfertigkeiten im jeweiligen Fachgebiet. Das automatische Bewertungsmodul der KI wurde anhand von Schwellenwerten kalibriert, die auf 15 vorab klassifizierten Musteressays beruhten. Die manuelle Bewertung erfolgte nach einheitlichem Fünf-Punkte-Bewertungsschema. Die maschinelle Bewertung und die menschliche Kalibrierung wurden für eine Vorversuchs-Verifizierung vor der offiziellen Evaluation kombiniert.
Die Lehraufgabe wurde anhand der dreistufigen Transferziele „Syntax-Struktur-Kultur“ durchgeführt, mit drei Trainingsrunden, die jeweils eine Woche dauerten. In der ersten Runde erfolgte eine umschreibende Bearbeitung auf Satzebene, um die syntaktische Vielfalt und Ausdrucksgenauigkeit zu verbessern; die zweite Runde beinhaltete eine strukturelle Neugestaltung auf Absatzebene, um die Gliederung der Absätze und die logische Kohärenz zu stärken; in der dritten Runde wurde ein Transfer auf kultureller Ebene durchgeführt, um das interkulturelle pragmatische Bewusstsein und die Anpassungsfähigkeit des sprachlichen Ausdrucks zu fördern. Da wiederholte Messungen von denselben Teilnehmern vor dem Training, während der drei aufeinanderfolgenden Trainingsrunden und nach dem Training erhoben wurden, wurde die Varianzanalyse mit wiederholten Messungen (RM-ANOVA) als primäre statistische Methode gewählt, um die Haupteffekte der Gruppe (experimentell vs. Kontrolle), die Haupteffekte des Messzeitpunkts sowie den Interaktionseffekt Gruppe × Zeit zu untersuchen, der angibt, ob sich die Leistungsänderungen im Verlauf des Trainings zwischen den beiden Kohorten unterschieden. Die Sphärizitätsannahme wurde mittels Mauchly-Test überprüft; bei Verletzung der Sphärizität wurde die Greenhouse-Geisser-Korrektur angewendet. T-Tests für unabhängige Stichproben wurden ausschließlich für post-hoc paarweise Gruppenvergleiche zu einzelnen Zeitpunkten verwendet, während die Pearson-Korrelation bzw. Cohens d weiterhin zur Beurteilung der Bewertungskonsistenz und zur Quantifizierung der Effektgröße dienten.
Alle statistischen Analysen wurden vor der Datenerhebung festgelegt. Um die Schreibindikatoren vor und nach der Intervention zwischen zwei Gruppen zu vergleichen, wurden t-Tests für unabhängige Stichproben verwendet, wobei die primäre Nullhypothese davon ausging, dass keine Gruppenunterschiede hinsichtlich der Schreibtransferleistung bestehen. Eine Pearson-Korrelationsanalyse diente zur Quantifizierung des linearen Zusammenhangs zwischen der automatischen Bewertung durch KI und den manuellen Bewertungen durch die Lehrkräfte; außerdem wurde Cohens d als standardisiertes Effektmaß für den Gruppenvergleich berechnet. Die Signifikanzschwelle wurde für alle Hypothesentests bei α = 0,05 festgelegt, und 95-%-Konfidenzintervalle wurden zusammen mit allen Teststatistiken berechnet. Alle statistischen Berechnungen wurden mit SPSS 26.0 durchgeführt. Es traten keine fehlenden Daten in den Testergebnissen der Schüler oder in den Fragebogendatensätzen auf, da alle Teilnehmer das vollständige dreirundige Training sowie die zugehörigen Bewertungen absolvierten; daher war keine Imputation oder Fallausschließung wegen fehlender Werte erforderlich.
Aufbau des Bewertungsindexsystems
Um die Leistung der Studierenden im Bereich des englischen Schreibtransfers umfassend zu bewerten, konstruierte diese Studie ein mehrdimensionales Bewertungssystem, das die dreistufigen Transferziele „Syntax-Struktur-Kultur“ abdeckte, Sprachkompetenz, Modellreaktion, Unterrichtsfeedback und Selbstwahrnehmung integrierte und sechs Kernindikatoren etablierte. Zunächst war der „Schreibtransferindex“ ein umfassender Bewertungsindikator, der syntaktische Vielfalt, strukturelle Klarheit und kulturelle Anpassungsfähigkeit umfasste und die automatische Bewertung des Systems mit der manuellen Bewertung durch die Lehrkraft zur quantitativen Analyse kombinierte. Die „Bewertung der syntaktischen Komplexität“ nutzte Technologien der natürlichen Sprachverarbeitung (Natural Language Processing, NLP), um Merkmale wie durchschnittliche Satzlänge, Anzahl der Satzverschachtelungsebenen und Häufigkeit der Verwendung von Verbphrasen zu extrahieren, um den Reichtum und die Komplexität der Sätze der Studierenden zu bewerten. Die Analyse der „Übereinstimmung mit dem akademischen Stil“ untersuchte den Anteil der Verwendung der Passivkonstruktion und den Anteil formaler Vokabeln mithilfe eines NLP-Modells, um festzustellen, ob der Text den stilistischen Normen des englischen wissenschaftlichen Schreibens entsprach. Darüber hinaus führte die Studie eine subjektive Bewertungsdimension ein, indem Feedback zur Akzeptanz und Praxistauglichkeit der vom Modell generierten Vorschläge durch Lehrerfragenbögen gesammelt wurde, um die tatsächliche Wirkung des KI-gestützten Unterrichts zu bewerten. „Veränderungen der Korrekturpunktzahlen der Lehrkräfte“ spiegelten die Auswirkung des KI-gestützten Unterrichts auf die Verbesserung der Schreibqualität wider, indem die Bewertungen der Lehrkräfte für die Aufsätze der Studierenden vor und nach dem Experiment verglichen wurden. Schließlich nutzte die „Selbsteinschätzung der Studierenden hinsichtlich ihrer Transferfähigkeit“ die Transferwahrnehmungstabelle, um die Studierenden bei der Selbsteinschätzung ihrer Beherrschung von Struktur, Syntax, Kultur und anderen Dimensionen zu unterstützen und so ihr metakognitives Bewusstsein und ihre Reflexionsfähigkeit zu stärken. Die genauen Beschreibungen und Datenquellen für jeden Indikator sind in Tabelle 3 dargestellt.
Syntaktische und stilistische Indikatoren wurden automatisch mithilfe von Abhängigkeitsanalyse und BERT-basierter Klassifizierung berechnet, wobei normalisierte Werte zwischen 0 und 5 resultierten; die manuelle Bewertung erfolgte anhand einer 5-Punkte-Skala. Bei den Berechnungsformeln für die syntaktische Komplexität wurde die Gesamtanzahl der Wörter geteilt durch die Anzahl der Nebensätze als zentraler Nenner verwendet. Rohdatenquelle: Schreibaufgaben aus Vortest und Nachtest aller 60 eingeschriebenen Studierenden.
Experimentelle Ergebnisse und Analyse
Um die umfassenden Leistungsunterschiede der Studierenden in den drei Dimensionen syntaktischer Transfer, struktureller Transfer und kultureller Transfer anschaulich darzustellen, vergleicht Abbildung 3 den durchschnittlichen Schreibtransferindex der Studierenden in der Versuchsgruppe und der Kontrollgruppe vor und nach dem Experiment: Abbildung 3 zeigt die Unterschiede in den durchschnittlichen Werten zwischen der Versuchsgruppe und der Kontrollgruppe in den drei Dimensionen syntaktischer Transfer, struktureller Transfer und kultureller Transfer. Die Versuchsgruppe wies nach dem Experiment eine signifikante Verbesserung der Transferfähigkeit in jeder Dimension auf, und der äußere Kreis des Spinnendiagramms ist deutlich größer als der innere Kreis, was darauf hinweist, dass die auf dem DeepSeek-Modell basierende Unterrichtsoptimierungsmethode eine positive Wirkung bei der Förderung der Entwicklung der englischen Schreibtransferfähigkeit der Studierenden hat. Im Gegensatz dazu blieben die verschiedenen Indikatoren für Transferfähigkeit in der Kontrollgruppe vor und nach dem Experiment weitgehend unverändert. Die Gesamtverbesserung war begrenzt, was darauf hindeutet, dass herkömmliche Unterrichtsmethoden oder KI-gestützte Werkzeuge, bei denen die Systemanweisungen nicht optimiert wurden, bei der Transferausbildung nur eine begrenzte Rolle spielen. Es war schwierig, das Lernpotenzial der Studierenden im mehrdimensionalen Sprachtransfer wirksam zu aktivieren.
Die durchschnittlichen Schreibtransferindizes der Experimentalgruppe in den Dimensionen syntaktischer Transfer, struktureller Transfer und kultureller Transfer vor dem Experiment betrugen jeweils 3,0, 2,9 und 2,8; nach dem Experiment stiegen sie auf 4,3, 4,1 und 4,5 an, was einer Steigerung von 1,3, 1,2 bzw. 1,7 entspricht. Dies weist darauf hin, dass die Unterrichtsmethode auf verschiedenen Transferstufen eine gute Interventionswirkung hatte. Die Werte der Kontrollgruppe vor dem Experiment lagen bei 3,0, 3,0 und 2,9. Nach dem Experiment erhöhten sie sich auf 3,4, 3,3 bzw. 3,2, was signifikant niedriger ist als bei der Experimentalgruppe. Besonders hervorzuheben ist, dass die Experimentalgruppe in der Dimension des kulturellen Transfers die stärkste Verbesserung zeigte und von 2,8 auf 4,5 anstieg, also um 1,7 Punkte – ein Anstieg, der deutlich höher liegt als der der Kontrollgruppe mit 0,3 Punkten. Dieses Ergebnis legt nahe, dass die vorgeschlagene Unterrichtsmethode eine bedeutende Rolle dabei spielt, Schülerinnen und Schülern zu helfen, englische kulturelle Ausdrucksnormen zu erkennen und sich an sie anzupassen. Dies spiegelte sich nicht nur in Anpassungen der Sprachform wider, sondern auch in der Steigerung des interkulturellen pragmatischen Bewusstseins der Lernenden sowie in der Vertiefung ihres Verständnisses für die kulturellen Ausdrucksgewohnheiten der Zielsprache. Der Sprachtransfer zeigte sich vor allem in der syntaktischen Komplexität und der Anpassung des Sprachstils sowie anderen Aspekten. Die Studie nutzte automatisierte NLP-Technologie, um Schreibtexte der Schüler eingehend zu analysieren, wichtige sprachliche Merkmale zu extrahieren und in Kombination mit Bewertungen durch Lehrkräfte systematisch Veränderungen in der Sprachtransferfähigkeit der Lernenden über drei Aufgabenrunden hinweg zu bewerten.
Syntaktische Komplexität und sprachlicher Stil
Hinsichtlich der syntaktischen Komplexität erfasste die Studie die durchschnittliche Satzlänge und die Anzahl der Klauselverschachtelungsebenen des von den Studierenden nach Abschluss der vorgegebenen Schreibaufgabe in jeder Runde erstellten Textes. Diese beiden Indikatoren wurden häufig verwendet, um die Komplexität des sprachlichen Ausdrucks zu messen. Sie spiegelten effektiv das Entwicklungsniveau der Studierenden in der Satzvielfalt und der Fähigkeit zur strukturellen Organisation wider, wie in Abbildung 4 dargestellt.
Bei der longitudinalen Entwicklung der syntaktischen Komplexität zeigte die Versuchsgruppe über die drei Aufgabenrunden hinweg einen deutlichen Aufwärtstrend, was auf eine wirksame Förderung der Transfertrainings auf die Fähigkeit der Studierenden zur sprachlichen Strukturierung hindeutet. Aus der Perspektive der durchschnittlichen Satzlänge stieg die Versuchsgruppe von 12,5 Wörtern in Aufgabe 1 auf 16,1 Wörter in Aufgabe 3 an, was einer Zunahme um 3,6 Wörter entspricht und signifikant höher lag als der Anstieg der Kontrollgruppe, die im selben Zeitraum lediglich um 0,9 Wörter zunahm (von 12,4 auf 13,3). Ebenso zeigte sich hinsichtlich der strukturellen Komplexität, gemessen an der Anzahl der Satzeinschachtelungsebenen, dass die Versuchsgruppe von 1,8 auf 2,7 Ebenen anstieg, während die Kontrollgruppe lediglich von 1,7 auf 1,9 Ebenen stieg und damit einen relativ langsamen Anstieg aufwies. Um weiter zu überprüfen, ob der Unterschied in der syntaktischen Komplexität zwischen den beiden Gruppen statistisch signifikant ist, wurden unabhängige Stichproben-t-Tests durchgeführt, um die durchschnittliche Satzlänge und die Anzahl der Satzeinschachtelungsebenen in den drei Phasen der Aufgabe zu analysieren. Die Ergebnisse zeigten einen signifikanten Unterschied zwischen der Versuchsgruppe und der Kontrollgruppe hinsichtlich der durchschnittlichen Satzlänge, t(58) = 4,23, p < 0,001, Cohen’s d = 0,98; ebenso bestand ein signifikanter Unterschied in der Anzahl der Satzeinschachtelungsebenen, t(58) = 3,15, p = 0,002, Cohen’s d = 0,78. Dieser Vergleich zeigte, dass das systematische Transfertraining nicht nur die Fähigkeit der Studierenden zur Konstruktion komplexer Sätze verbesserte, sondern auch ihre Beherrschung grammatischer Organisationsstrategien stärkte. Insbesondere in der dritten Phase der Aufgabe zeigten die Studierenden der Versuchsgruppe eine größere Flexibilität im Gebrauch mehrschichtiger Nebensätze und komplexer Satzstrukturen. Dies spiegelte eine bemerkenswerte Verschiebung ihres Sprachtransfers von einer „funktionalen“ auf eine eher „strategische“ Ebene wider. Der transferorientierte Trainingsansatz verbesserte kontinuierlich die syntaktischen Transferfähigkeiten der Studierenden und überwand damit effektiv die Grenzen des Einzelsatzschreibens sowie die festgelegten Ausdrucksmuster, die häufig im traditionellen Unterricht auftreten. Hinsichtlich der Anpassung des Sprachstils wurden die Schreibtexte der Studierenden vor und nach dem Experiment extrahiert. Mithilfe des NLP-Modells wurden der Anteil formaler Vokabeln und die Häufigkeit der Verwendung der Passivkonstruktion als zentrale Indikatoren zur Bewertung der Übereinstimmung des akademischen Sprachstils ermittelt. Diese Indikatoren spiegelten wider, ob die Studierenden über das sprachliche Bewusstsein und die Ausdrucksfähigkeit verfügen, um sich im englischen Schreiben an den Zielstil anzupassen. Die entsprechenden Ergebnisse sind in Abbildung 5 dargestellt.
Abbildung 5 zeigt die Veränderungen beim akademischen Stil-Matching der Versuchsgruppe und der Kontrollgruppe vor und nach der Aufgabe, wobei der Fokus hauptsächlich auf den beiden zentralen Indikatoren Anteil formaler Vokabeln und Häufigkeit der Passivkonstruktionen liegt. Insgesamt verbesserte sich nach Abschluss des Transfertrainings auf Basis des DeepSeek-Modells die Fähigkeit der Versuchsgruppe zur Anpassung an den akademischen Stil deutlich, was die Wirksamkeit dieser Unterrichtsmethode bei der Förderung des Bewusstseins der Studierenden für Sprachnormen und ihrer Anpassungsfähigkeit an akademische Schreibstile belegt. Hinsichtlich des Anteils formaler Vokabeln stieg die Versuchsgruppe von 0,42 vor der Aufgabe auf 0,56 nach der Aufgabe, was einen relativ deutlichen Anstieg darstellt. Im Gegensatz dazu stieg die Kontrollgruppe nur leicht von 0,43 auf 0,48, was auf eine begrenzte Verbesserung hindeutet. Dieses Ergebnis zeigt, dass die Studierenden der Versuchsgruppe nach systematischer Anleitung durch Prompts und Rückmeldungen des Modells im Schreibprozess stärker dazu neigten, formale Vokabeln zu verwenden, die den Anforderungen des akademischen Stils entsprechen, und dass sich ihr Sprachstil schrittweise den Standards des englischen wissenschaftlichen Schreibens annäherte. Bezüglich der Häufigkeit der Passivkonstruktionen stieg die Versuchsgruppe signifikant von 0,18 vor der Aufgabe auf 0,27 nach der Aufgabe, was einem Anstieg um 0,09 entspricht; die Kontrollgruppe hingegen stieg lediglich um 0,02.
Um weiter zu überprüfen, ob die oben genannten Veränderungen statistisch signifikant sind, wurde eine unabhängige Stichproben-t-Test-Analyse der Daten vor und nach der Aufgabe durchgeführt. Die Ergebnisse zeigten, dass die Versuchsgruppe eine signifikante Verbesserung im Anteil formaler Vokabeln aufwies, t(58) = 3,89, p < 0,001, Cohens d = 0,92; auch der Anstieg der Häufigkeit der Verwendung der Passivkonstruktion war signifikant, t(58) = 4,56, p < 0,001, Cohens d = 1,05. Dies zeigte, dass die Schüler der Versuchsgruppe bei der sprachstilistischen Anpassung deutliche Fortschritte erzielt hatten, und diese Fortschritte waren kein Zufall, sondern das Ergebnis der kombinierten Wirkung systematischer Hinweisgaben und Modell-Feedbacks.
Statistische Überprüfung
Zusätzlich wurde, um die Zuverlässigkeit von KI-generierten Inhalten im Lehrkontext weiter zu überprüfen, ein Vergleich der mittleren Bewertungen von KI-generierten und lehrergenerierten Inhalten bei verschiedenen Prompt-Typen durchgeführt. Die Übereinstimmung zwischen beiden wurde durch Berechnung des Pearson-Korrelationskoeffizienten ermittelt. Die entsprechenden Vergleichsergebnisse sind in Tabelle 4 dargestellt. Tabelle 4 zeigt die Konsistenz zwischen den von der KI generierten Bewertungen und den Bewertungen der Lehrkräfte bei fünf Typen von transferorientierten Prompts. Aus Sicht der mittleren Punktzahl lag die Bewertung durch die KI insgesamt leicht unter der Bewertung durch die Lehrkräfte, doch die Differenz befand sich bei den meisten Aufgabentypen im vertretbaren Bereich, was darauf hinweist, dass das DeepSeek-Modell bei der Bewertung von Schreibaufgaben mit Transfer eine hohe Stabilität und Referenzqualität aufweist. Bei syntaktischem Transfer betrug die durchschnittliche Bewertung durch die Lehrkräfte 4,1 und die KI-Bewertung 4,0, sodass lediglich eine Differenz von 0,1 bestand. Bei strukturellem und logischem Transfer lag die KI-Bewertung jeweils nur 0,1 Punkte unter der Bewertung der Lehrkräfte, was darauf hindeutet, dass das Modell die Bewertungskriterien der Lehrkräfte bei Aufgaben mit hohem strukturellem Sprachanteil und klaren Regeln gut nachbilden kann. Im Gegensatz dazu sind die Bewertungsabweichungen bei kulturellem Transfer und Registertransfer deutlicher: Die KI-Bewertungen betrugen hier 3,6 bzw. 3,7, also jeweils 0,2 Punkte weniger als die Bewertungen der Lehrkräfte. Dies spiegelt wider, dass die KI bei Aufgaben mit hoher Subjektivität, wie semantischen Implikationen und kultureller Pragmatik, noch gewisse Grenzen aufweist. Die Interrater-Reliabilität wurde mittels ICC (n = 5 Rater) ermittelt. Der Gesamt-ICC für die manuelle Bewertung betrug 0,86, und die ICCs für jede Dimension lagen zwischen 0,82 und 0,89, was auf eine zufriedenstellende Übereinstimmung zwischen den Bewertern hindeutet.
Eine weitere Analyse des Pearson-Korrelationskoeffizienten ergab, dass die Konsistenz der Bewertungen unter verschiedenen Aufgabenstellungen auf einem hohen Niveau lag. Dies zeigt, dass die KI-Bewertung nicht nur hinsichtlich des Wertes nahe bei der Einschätzung des Lehrers lag, sondern auch eine gute lineare Beziehung in ihrem Bewertungstrend aufweist. Dabei war der Konsistenzkoeffizient für die syntaktische Transfer-Aufgabe mit 0,87 am höchsten, während die Werte für die strukturelle und logische Transfer-Aufgabe bei 0,83 bzw. 0,85 lagen. Dies deutet darauf hin, dass die Bewertungsergebnisse der KI hinsichtlich syntaktischer Komplexität, Absatzorganisation und logischer Kohärenz mit der Einschätzung des Lehrers stark übereinstimmen. Dies könnte darauf zurückzuführen sein, dass diese Aufgaben klare Ziele und quantifizierbare sprachliche Merkmale aufweisen, was die Mustererkennung und eine stabile Bewertung durch das Modell erleichterte. Der Korrelationskoeffizient für die fachliche Transfer-Aufgabe beträgt 0,81. Obwohl dieser leicht gesunken war, zeigte er dennoch eine starke Bewertungsfähigkeit und legt nahe, dass die KI ein gewisses Maß an Beurteilungskompetenz auf der Ebene der stilistischen Anpassung besitzt. Der Konsistenzkoeffizient für die kulturelle Transfer-Aufgabe lag hingegen nur bei 0,79, was niedriger als bei den anderen Typen ist, aber dennoch im akzeptablen Bereich liegt.
Um die Anwendbarkeit verschiedener Arten von Prompts im Lehrkontext und deren Akzeptanz durch Lehrkräfte zu untersuchen, wurde ein Fragebogen zur Zufriedenheit mit der Prompt-Antwortreaktion konzipiert. Fünf Englischlehrer (mit den Nummern T1–T5) wurden eingeladen, die Generierungsvorschläge von fünf verschiedenen Prompt-Typen anhand einer fünfstufigen Skala (von sehr unzufrieden bis sehr zufrieden) zu bewerten, wie in Abbildung 6 dargestellt: Die Bewertungen der fünf Lehrkräfte für die fünf Prompt-Typen weichen leicht voneinander ab, insgesamt war die Anerkennung jedoch hoch. Dabei erzielten die Prompts „syntaktischer Transfer“ und „kultureller Transfer“ die höchsten Werte mit einem Durchschnitt von 4,0 und spiegeln eine hohe Praktikabilität und Anpassungsfähigkeit im Unterricht wider. Im Gegensatz dazu schnitt der Prompt-Typ „Register-Transfer“ relativ schlecht ab, mit einem Durchschnittswert von lediglich 2,4; einige Lehrkräfte wie T4 und T5 vergaben die niedrigsten Bewertungen, was darauf hinweist, dass die Leitfunktion und Anpassungsfähigkeit dieses Prompt-Typs im Unterrichtseinsatz noch verbessert werden müssen.
Auf individueller Ebene zeigten sich deutliche Unterschiede in den Bewertungstendenzen der Lehrkräfte. Die Gesamtpunktzahl von T1 war positiv, was auf ein hohes Maß an Akzeptanz des KI-unterstützten Schreibens hinweist, während die Bewertungen von T5 in mehreren Prompt-Dimensionen niedrig waren, insbesondere bei „Register Transfer“ und „Logic Transfer“. Dieser Unterschied könnte mit der Unterrichtserfahrung, der Sprachpräferenz oder der Vertrautheit der Lehrkräfte mit KI-Tools zusammenhängen, was darauf hindeutet, dass zukünftige Prompt-Konzepte personalisierte Anpassungsmechanismen berücksichtigen müssen, um die Akzeptanz bei verschiedenen Lehrergruppen zu erhöhen. Um den tatsächlichen Effekt des KI-unterstützten Unterrichts auf die Verbesserung der Schreibqualität der Schüler weiter zu überprüfen, verglich die Studie die Veränderungen der Gesamtpunktzahlen der Experimentalgruppe und der Kontrollgruppe, wie von den Lehrkräften bewertet, vor und nach dem Experiment. Die Vergleichsergebnisse sind in Abbildung 7 dargestellt.
Wie in Abbildung 7 dargestellt, zeigten die Gesamtpunktzahlen der Experimental- und Kontrollgruppe, wie von Lehrkräften vor und nach dem Experiment bewertet, signifikante Unterschiede. Insgesamt zeigte die Gesamtpunktzahl der Experimentalgruppe nach der unterrichtlichen Optimierungsmaßnahme, die auf dem DeepSeek-Modell basiert, einen signifikanten Anstieg. Im Gegensatz dazu war die Punktzahlanpassung in der Kontrollgruppe relativ geringfügig. Die durchschnittliche Bewertung der Experimentalgruppe durch die Lehrkräfte lag vor dem Experiment bei 59,1 Punkten und stieg nach dem Experiment signifikant auf 74,4 Punkte an, was einer Steigerung um 15,3 Punkte entspricht. Dies deutet darauf hin, dass der Einsatz von KI-gestütztem Unterricht einen positiven Einfluss auf die Schreibqualität der Schüler hatte. Aus dem Boxplot ging hervor, dass sich auch die Streubreite der Punktzahlen der Experimentalgruppe erweitert hatte. Insbesondere liegt der Punkte-„Box“ nach dem Experiment deutlich höher als vorher, und die oberen Maximal- sowie die unteren Minimalwerte sind angestiegen, was anzeigt, dass das allgemeine Niveau der Schüler signifikant gestiegen ist. Im Gegensatz dazu waren die Veränderungen der Punktzahlen in der Kontrollgruppe relativ gering. Vor dem Experiment lag die durchschnittliche Punktzahl der Kontrollgruppe bei 60,1 Punkten und stieg nach dem Experiment auf 64,9 Punkte, was einer Zunahme von 4,8 Punkten entspricht. Dieser Anstieg war deutlich geringer als der der Experimentalgruppe, und die Verteilung der Punktzahlen in der Kontrollgruppe veränderte sich vor und nach dem Experiment kaum, was darauf hinweist, dass herkömmliche Unterrichtsmethoden oder nicht optimierte KI-gestützte Werkzeuge nur eine begrenzte Wirkung auf die Verbesserung der Schreibqualität haben.
Darüber hinaus verwendete diese Studie die Transfer-Kognitionstabelle, um die Studierenden bei drei Runden der Selbsteinschätzung ihrer Fähigkeitsentwicklung in Bereichen wie Strukturumstellung, Satzumformung und kultureller Ausdruck zu begleiten, um den sich verändernden Trend des metakognitiven Bewusstseins der Studierenden und ihre Beherrschung von Transferstrategien widerzuspiegeln. Die Ergebnisse sind in Abbildung 8 dargestellt. Gemäß den Daten des Radarcharts zur Selbsteinschätzung der Studierenden bezüglich ihrer Transferfähigkeit, wie in Abbildung 8 gezeigt, wiesen die Selbsteinschätzungen der Studierenden in den fünf Dimensionen Strukturtransfer, syntaktischer Transfer, kultureller Transfer, Registertransfer und logischer Transfer über die drei Aufgabenrunden hinweg einen kontinuierlich ansteigenden Trend auf, was darauf hindeutet, dass unter der unterrichtsoptimierenden Lehrintervention basierend auf dem DeepSeek-Modell die Fähigkeit der Studierenden, Transferstrategien anzuwenden, signifikant verbessert wurde. In der ersten Runde der Aufgaben waren die Selbsteinschätzungswerte der Studierenden insgesamt niedrig. Unter den fünf Dimensionen erreichten „Strukturtransfer“ und „logischer Transfer“ jeweils 3,2 und 3,0 Punkte, während „kultureller Transfer“ und „Registertransfer“ 2,5 bzw. 2,7 Punkte erreichten, was darauf hinweist, dass die Studierenden bei der Identifizierung und Anwendung von Transferstrategien noch unerfahren waren. Bis zur zweiten Runde der Aufgaben hatten sich die Werte aller Kategorien verbessert: „Strukturtransfer“ stieg auf 3,8, „syntaktischer Transfer“ auf 3,5 und „logischer Transfer“ auf 3,7. Dies zeigte, dass die Studierenden unter Anleitung der Lehrenden und mit Unterstützung durch Modell-Feedback nach und nach die zentralen Aspekte grundlegender Transferoperationen erfasst und diese erstmals in der praktischen Textproduktion angewandt hatten. In der dritten Runde der Aufgaben stiegen die Selbsteinschätzungswerte der Studierenden deutlich an, wobei „Strukturtransfer“ und „logischer Transfer“ jeweils 4,5 und 4,3 erreichten, und die anderen Dimensionen lagen ebenfalls stabil über 4,0 Punkten, was den anhaltenden Effekt mehrfacher Transferübungen bei der Verbesserung der sprachlichen Formkontrolle und Textkonstruktionsfähigkeit der Studierenden zeigt. Zu diesem Zeitpunkt hatten die Studierenden eine grundlegende kognitive Schleife zwischen Verstehen, Ausführung und Reflexion von Transferstrategien ausgebildet. Neben der Lehrkräfte-Rückmeldung verteilte die Studie auch einen Fragebogen zur Zufriedenheit mit der KI-gestützten Schreibfunktion an alle Studierenden der Experimentalgruppe, wobei insgesamt 30 gültige Fragebögen eingesammelt wurden. Der Fragebogen bewertete die Leistung der KI in drei Funktionsmodulen: Umschreibungsvorschläge, strukturelle Optimierung und kulturelle Hinweise, und forderte die Studierenden auf, Optionen gemäß fünf Bewertungsstufen auszuwählen. Die Ergebnisse sind in Tabelle 5 dargestellt.
Laut den Ergebnissen der Studierenden-Zufriedenheitsumfrage zu KI-unterstützten Schreibfunktionen, wie in Tabelle 5 dargestellt, äußerten sich die Studierenden der Experimentalgruppe insgesamt positiv zur Leistung der KI in den drei Funktionsmodulen „Umschreibungsvorschläge“, „strukturelle Optimierung“ und „kulturelle Hinweise“, was die guten Anwendungsperspektiven von KI-gestützten Schreibsystemen bei der Verbesserung der Effizienz der Schreibförderung und der Qualität der Lehrunterstützung zeigt. Insgesamt gaben über 90 % der Studierenden bei den beiden Funktionsbereichen „Umschreibungsvorschläge“ und „strukturelle Optimierung“ an, „sehr zufrieden“ oder „zufrieden“ zu sein, wobei die Zufriedenheit mit „Umschreibungsvorschlägen“ am höchsten war und 91 % erreichte. Dies zeigt eine hohe Anerkennung der Fähigkeit der KI bei der syntaktischen Neugestaltung und sprachlichen Überarbeitung. Im Vergleich dazu war die Zufriedenheit mit der Funktion „kulturelle Hinweise“ etwas geringer, erreichte jedoch immer noch 83 %, was darauf hindeutet, dass, obwohl die KI bei der Anleitung zur kulturübergreifenden Ausdrucksweise gewisse Komplexität und Subjektivität aufweist, ihre Unterstützung dabei, native kulturelle Einflüsse zu erkennen und anzupassen, von den meisten Studierenden anerkannt wird. Hinsichtlich Unzufriedenheit lag der Anteil der Studierenden, die bei den drei Funktionen „unzufrieden“ oder „sehr unzufrieden“ ankreuzten, unter 5 %, was darauf schließen lässt, dass die KI-unterstützten Funktionen in den meisten Anwendungsszenarien eine gute Bedienbarkeit und Akzeptanz aufweisen. Bemerkenswert ist, dass der Anteil der Studierenden, die bei „kulturelle Hinweise“ die Bewertung „durchschnittlich“ wählten, relativ hoch war, was darauf hindeutet, dass die derzeitige KI bei der Bearbeitung kultureller Anpassungsfragen die Erwartungen der Studierenden noch nicht vollständig erfüllt und hier weiterer Verbesserungsbedarf besteht. Eine umfassende Analyse zeigt, dass das auf DeepSeek basierende Verfahren zur Optimierung von Anweisungen von den Studierenden weithin anerkannt wurde, insbesondere hinsichtlich der Unterstützung der Sprachform.
RM-ANOVA
Eine zweifaktorielle Varianzanalyse mit Messwiederholung (RM-ANOVA) wurde durchgeführt, um die Effekte der Gruppe (zwischensubjektiver Faktor: experimentelle Gruppe vs. Kontrollgruppe) und der Zeit (innerhalbssubjektiver Faktor: Pre-Test, Aufgabe 1, Aufgabe 2, Aufgabe 3, Post-Test) sowie deren Wechselwirkung auf die Transferleistung der Studierenden im englischen Schreiben zu untersuchen. Der Mauchly-Test zeigte eine Verletzung der Sphärizitätsannahme (p < 0,05), daher wurde die Greenhouse-Geisser-Korrektur angewandt, um die Freiheitsgrade für innerhalbssubjektive Effekte anzupassen. Alle Analysen basierten auf n = 30 Teilnehmenden pro Gruppe. Die Ergebnisse sind in Tabelle 6 dargestellt:
Die Ergebnisse der Varianzanalyse mit wiederholten Messungen und Greenhouse-Geisser-Korrektur zeigten signifikante Haupteffekte der Faktoren Gruppe, Zeit sowie der Gruppen-Zeit-Wechselwirkung über alle gemessenen Dimensionen hinweg (p < 0,001). Für den Gesamttransferindex wurde ein signifikanter Gruppeneffekt beobachtet (F(1,58) = 76,32), zusammen mit einem signifikanten Zeit-Effekt (F(2,14,124,12) = 92,75) und einer signifikanten Gruppe × Zeit-Wechselwirkung (F(2,14,124,12) = 68,49), was darauf hindeutet, dass sich die Veränderungen der Gesamttransferleistung im Zeitverlauf zwischen den Gruppen signifikant unterschieden.
Ebenso zeigte der syntaktische Transfer signifikante Effekte der Gruppe (F(1,58) = 52,18), der Zeit (F(2,11,122,38) = 71,26) und der Wechselwirkung zwischen Gruppe und Zeit (F(2,11,122,38) = 45,73), was auf unterschiedliche Entwicklungsverläufe in der Fähigkeit zum syntaktischen Transfer zwischen den Gruppen und Messzeitpunkten hinweist. Bei der strukturellen Übertragung wurden ebenfalls signifikante Gruppen- (F(1,58)=48,65), Zeit- (F(2,09,121,22) = 67,81) und Interaktionseffekte (F(2,09,121,22) = 41,36) gefunden, was auf konsistente Verbesserungen mit gruppenspezifischen Entwicklungsverläufen schließen lässt. Bemerkenswerterweise wies die kulturelle Übertragung die stärksten Effekte auf, mit einem signifikanten Gruppeneffekt (F(1,58) = 81,44), einem ausgeprägten Zeit-Effekt (F(2,07,119,96) = 98,52) sowie einer robusten Wechselwirkung zwischen Gruppe und Zeit (F(2,07,119,96) = 79,27), was auf das stärkste und am deutlichsten differenzierte Wachstumsmuster in dieser Dimension hindeutet. Insgesamt zeigen alle Indizes statistisch signifikante Effekte, was bestätigt, dass die Intervention über die Zeit hinweg einen stabilen und differenzierten Einfluss auf die Entwicklung des Transfers hatte.
VERFÜGBARKEIT VON DATEN:
Alle während dieser Studie generierten oder analysierten Daten sind in diesem Artikel enthalten. Die rohen Bewertungsdaten sind in Zusätzliche Tabelle 1 angegeben.
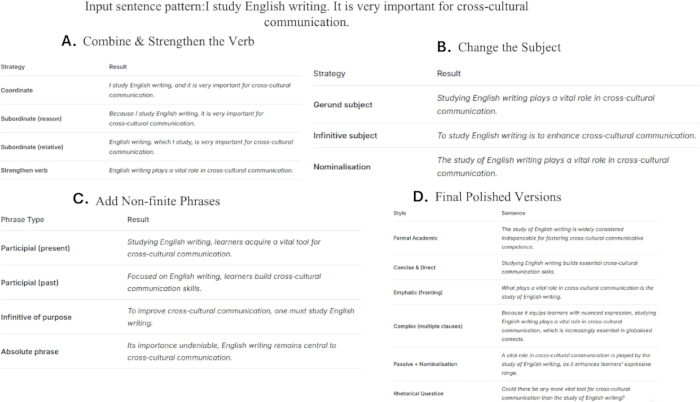
Abbildung 1: Schritte zur Transformation der Satzstruktur. (A) Strategien zum Kombinieren und Stärken von Verben zur Verbesserung der Satzstruktur. (B) Alternative Subjektumformungen, einschließlich gerundialer, infinitiver und nominalisierter Subjekte. (C) Nutzung nicht-finiter Phrasen zur Steigerung der Satzvielfalt und -prägnanz. (D) Beispiele überarbeiteter Endfassungen, die einen verbesserten akademischen Stil und eine interkulturell angemessenere englische Ausdrucksweise veranschaulichen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
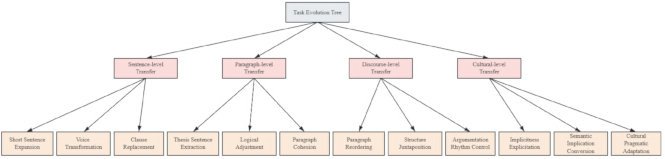
Abbildung 2: Aufgabenentwicklungsbaumdiagramm. Es zeigt die fortschreitende Struktur von vierstufigen Transferaufgaben, beginnend auf der Ebene des Satzes, über den Absatz und den Diskurs bis hin zur Kulturebene. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
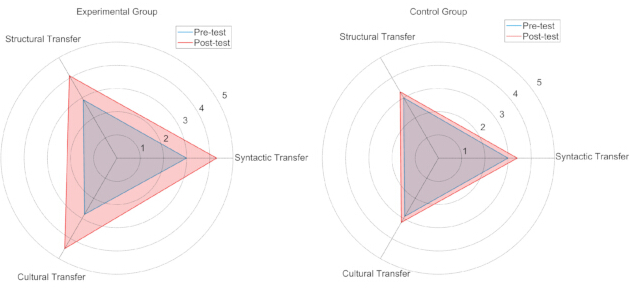
Abbildung 3: Vergleich der Schreibtransferfähigkeit vor und nach dem Experiment. Das Radar-Diagramm zeigt die Testergebnisse vor und nach dem Experiment für die Experimental- und Kontrollgruppe in den Dimensionen syntaktischer, struktureller und kultureller Transfer. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
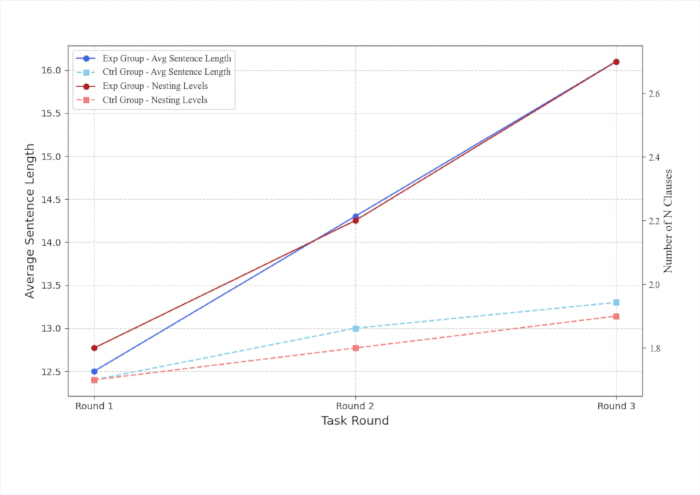
Abbildung 4: Diagramm zur Entwicklung der syntaktischen Komplexität. Dargestellt sind die Veränderungen der durchschnittlichen Satzlänge und der Anzahl der Nebensatzebenen über drei Trainingsaufgaben hinweg. Bitte klicken Sie hier, um eine vergrößerte Darstellung dieser Abbildung anzusehen.
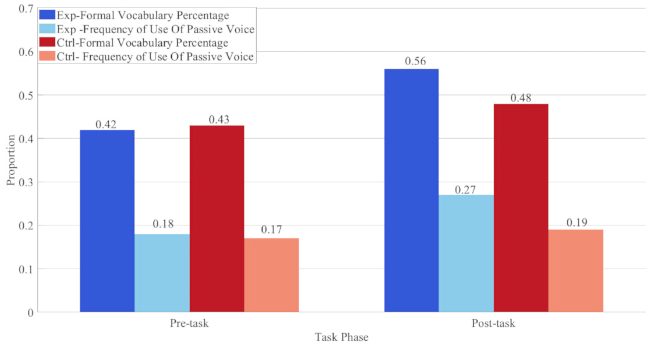
Abbildung 5: Übereinstimmung akademischer Fachbegriffe. Diese Abbildung zeigt die Unterschiede im Anteil des formalen Wortschatzes und in der Häufigkeit des Passivs vor und nach der Intervention. Klicken Sie bitte hier, um eine vergrößerte Darstellung dieser Abbildung anzusehen.
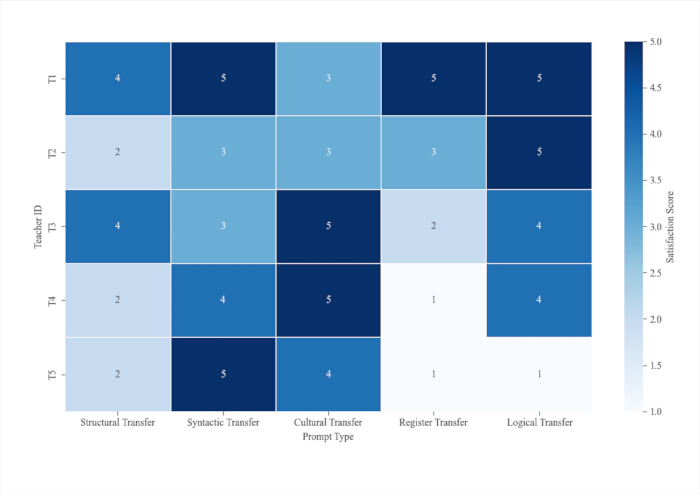
Abbildung 6: Heatmap der Zufriedenheit mit Prompt-Antworten. Hier werden Bewertungen von fünf Arten von Prompt-Vorlagen durch teilnehmende Lehrkräfte zusammengefasst. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
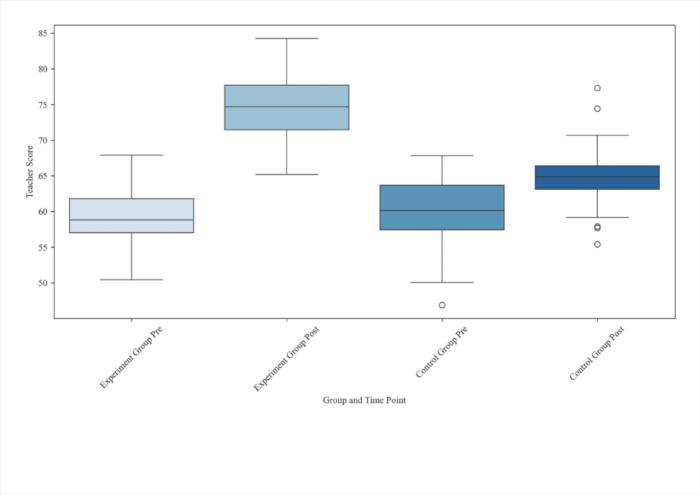
Abbildung 7: Boxplot der Veränderungen in den Lehrereinschätzungen. Der Boxplot zeigt die Verteilung und Gesamtveränderungen der vom Lehrer bewerteten Schreibfähigkeiten für zwei Gruppen vor und nach dem Experiment. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
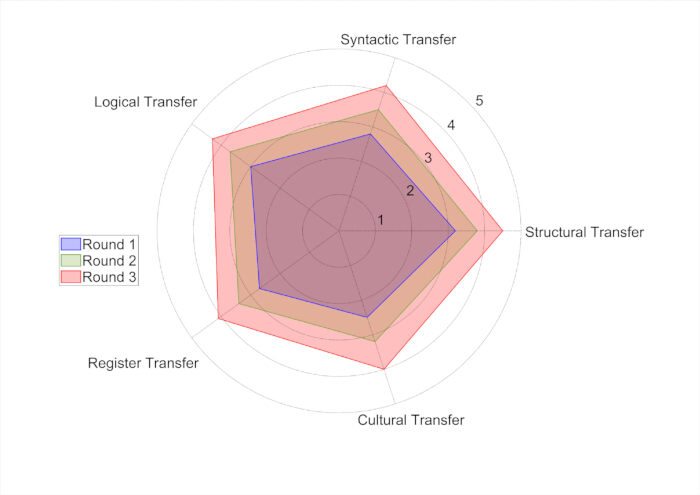
Abbildung 8: Radar-Diagramm zur selbst eingeschätzten Transferfähigkeit der Studierenden. Es zeigt die von den Studierenden vergebenen Bewertungswerte entlang fünf Transferdimensionen über drei Trainingsrunden hinweg. Bitte klicken Sie hier, um eine vergrößerte Darstellung dieser Abbildung anzusehen.
| Eingabe | Lehreraktion | Art der Aufforderung | Schüleraktion | Ausgabe | Bewertungskriterien |
| Ursprüngliche Schreibentwürfe der Schüler (Sätze/Absätze/Texte) | 1. Übertragungstypen und Aufgabenniveaus kennzeichnen 2. Bei Bedarf die Parameter der Aufforderung anpassen | Einfache Übertragungsaufforderung / Dreistufige verschachtelte Aufforderungskette | 1. Strategien zur Textübertragung erlernen 2. Entwürfe anhand des KI-Feedbacks überarbeiten 3. Selbstbewertung durchführen | Vom KI-System überarbeiteter Text + Endgültige, vom Schüler überarbeitete Fassung | Syntaktische Komplexität, strukturelle Nachvollziehbarkeit, kulturelle Angemessenheit, logische Kohärenz, Standardisierung des Sprachstils (Skala 0–5) |
Tabelle 1: Zusammenfassung der Arbeitsabläufe. Diese Tabelle fasst den gesamten operationellen Arbeitsablauf des KI-unterstützten Englisch-Schreib-Transfertrainings zusammen, einschließlich der Eingabematerialien, der Lehrer- und Schülertätigkeiten, der Prompt-Typen, der endgültigen Ausgaben und der entsprechenden Bewertungskriterien.
| Projektkategorie | Inhaltsverzeichnis |
| Verständnis der Missionsziele | Beschreiben Sie kurz die Migrationsziele dieser Runde von Schreibaufgaben, wie beispielsweise strukturelle Anpassung, kulturelle Adaption und Sprachumwandlung. |
| Verwendete Migrationsstrategie | Bitte listen Sie die von Ihnen angewandten Migrationsstrategien auf (mehrere Auswahlmöglichkeiten sind zulässig): |
| Strukturelle Anpassung | |
| Satzumformung | |
| Sprachwechsel | |
| Kulturelle Manifestation | |
| Stärkung der logischen Verbindung | |
| Sonstiges:_______ | |
| Beispiele und Anweisungen umschreiben | Wählen Sie 1–2 überarbeitete Sätze aus, zeigen Sie die Versionen vor und nach der Überarbeitung an, und erläutern Sie die Gründe für die Änderungen sowie die angestrebten Übertragungsziele. |
| Schwierigkeiten und auftretende Zweifel | Beschreiben Sie etwaige Herausforderungen, die während der Migration aufgetreten sind, oder Fragen, die Sie zu einem bestimmten Ausdruck hatten. |
| Selbsteinschätzungsskala (von 5 Punkten) | Bitte bewerten Sie Ihre Textumformulierung anhand der folgenden drei Aspekte: |
| • Genauigkeit der Strategieanwendung (/5) | |
| • Natürliche Ausdrucksflüssigkeit (/5) | |
| • Kulturelle Passung (/5) | |
| Zukünftige Ziele zur Verbesserung der Schreibfähigkeiten | Beschreiben Sie kurz die Übertragbarkeit, die Sie in der nächsten Trainingsrunde stärken oder optimieren möchten. |
Tabelle 2: Kognitionstabelle zum Wissenstransfer. Eine Bewertungsskala von 1 bis 5 (1 = keine Beherrschung, 5 = vollständige Beherrschung) wird für die Selbsteinschätzung der Studierenden hinsichtlich Strategien des Wissenstransfers beim Schreiben verwendet.
| Indikatorname | Beschreibung | Datenquelle |
| Schreibübertragungsindex (0–5) | Ein quantitativer Indikator, der umfassend die Fähigkeit zur Sprachübertragung misst und drei Ebenen abdeckt: Syntax, Struktur und Kultur. | Automatische Bewertung durch das System + manuelle Bewertung durch Lehrkräfte |
| Syntaxkomplexitätsbewertung | Enthält durchschnittliche Satzlänge, Anzahl der Nebensatzeinbettungen, Reichhaltigkeit der Verbphrasen usw. | Automatische NLP-Analyse |
| Übereinstimmung mit akademischem Stil | Erfüllt es die Standards des englischsprachigen wissenschaftlichen Schreibens? | Beurteilung durch Natural-Language-Processing-Modell |
| Zufriedenheit mit der Prompt-Beantwortung | Akzeptanz und praktische Bewertung der vom Modell generierten Vorschläge durch Lehrkräfte | Lehrerfragebogen |
| Änderungen in der Lehrerbewertung | Vergleich der Bewertungen durch Lehrkräfte vor und nach dem Experiment, um die Verbesserung der Schreibqualität widerzuspiegeln | Aufzeichnungen der Lehrerbewertungen |
| Selbsteinschätzung der Übertragungsfähigkeit durch Studierende | Studierende bewerten selbst ihre Beherrschung verschiedener Übertragungsdimensionen | Ausfüllen des Migrationsbewusstseinsformulars |
Tabelle 3: Zusammenfassung der Evaluierungskennzahlen, Beschreibungen und Datenquellen. Diese Tabelle erläutert die Definitionen, Messmethoden und ursprünglichen Datenquellen für jede zentrale Evaluierungskennzahl dieser Studie.
| Prompt-Typ | Durchschnittliche Bewertung durch Lehrkräfte | Durchschnittliche KI-Bewertung | Pearsonscher Korrelationskoeffizient |
| Strukturelle Übertragung | 4 | 3.9 | 0.83 |
| Syntaktische Übertragung | 4.1 | 4 | 0.87 |
| Kulturelle Übertragung | 3.8 | 3.6 | 0.79 |
| Registerübertragung | 3.9 | 3.7 | 0.81 |
| Logische Übertragung | 4.2 | 4.1 | 0.85 |
Tabelle 4: Vergleich der Konsistenz zwischen KI-generierten Inhalten und Lehrerbewertungen. Die Ergebnisse zeigen die Übereinstimmung zwischen KI-generierten Inhalten und Lehrerbewertungen über verschiedene Prompt-Typen hinweg.
| Funktionsmerkmale | Sehr zufrieden | Zufrieden | Teils zufrieden | Unzufrieden | Sehr unzufrieden |
| Vorschlag zur Überarbeitung | 66% | 25% | 7% | 1,50% | 0,50% |
| Strukturelle Optimierung | 60% | 30% | 7% | 2% | 1% |
| Kulturelle Hinweise | 55% | 28% | 12% | 3,50% | 1,50% |
Tabelle 5: Umfragestatistiken zur Zufriedenheit der Studierenden mit KI-unterstützten Funktionen. Die Statistiken zeigen die Verteilung der Zufriedenheit der Studierenden hinsichtlich der KI-Umschreibung, der strukturellen Optimierung und der kulturellen Anweisungsfunktionen.
| Maß | Gruppe F(df) | Zeit F(df)GG | Gruppe × Zeit F(df)GG | p |
| Gesamttransferindex | 76,32 (1, 58) | 92,75 (2,14, 124,12) | 68,49 (2,14, 124,12) | <0,001 |
| Syntaktischer Transfer | 52,18 (1, 58) | 71,26 (2,11, 122,38) | 45,73 (2,11, 122,38) | <0,001 |
| Struktureller Transfer | 48,65 (1, 58) | 67,81 (2,09, 121,22) | 41,36 (2,09, 121,22) | <0,001 |
| Kultureller Transfer | 81,44 (1, 58) | 98,52 (2,07, 119,96) | 79,27 (2,07, 119,96) | <0,001 |
Tabelle 6: Zusammenfassung der Ergebnisse der Varianzanalyse mit Messwiederholung. Es werden die Ergebnisse der zweifaktoriellen Varianzanalyse mit Messwiederholung für die Gesamtleistung im Schriftsprachtransfer und deren drei Teilbereiche dargestellt, einschließlich der Haupteffekte von Gruppe, Zeit und der Wechselwirkung zwischen Gruppe und Zeit. Abkürzungen: GG = Greenhouse–Geisser-Korrektur.
Zusatzliche Tabelle 1: Auswertung der Rohdaten. Enthält die Rohdaten, die in allen Analysen dieser Studie verwendet wurden.Bitte klicken Sie hier, um die Datei herunterzuladen.
Diskussion
Diese Studie entwickelt einen mehrstufigen Rahmen für die Optimierung von Anweisungen, der auf der MoE-Architektur von DeepSeek basiert und auf den transferorientierten Englischunterricht in kulturell vielfältigen Kontexten ausgerichtet ist. Ausgehend von vierstufigen progressiven Aufgaben – von der Satzebene bis hin zur kulturellen Dimension – sowie einer standardisierten Aufgabenbibliothek mit fünf Kategorien realisiert die Forschung eine automatische Generierung von Prompts anhand echter Schreibanfertigungen von Lernenden und etabliert dreistufige, geschachtelte Prompt-Ketten, um komplexe, kulturübergreifende Adaptationsaufgaben zu zerlegen. Im Unterschied zu herkömmlichen, allgemeinen Prompt-Designs, die auf Textnachbearbeitung beschränkt sind, verknüpft der vorgeschlagene Ansatz die Prompt-Erstellung eng mit den Zielen des sprachlichen Transferunterrichts und schafft einen geschlossenen Unterrichtszyklus aus Modellgenerierung, Lehrerannotierung und iterativer Überarbeitung durch die Lernenden. Aus fachlicher Perspektive erweitert die vorliegende Arbeit die praktische Anwendung von Prompt-Engineering im Bereich des Zweitspracherwerbs und liefert einen quantifizierbaren Ansatz zur Verknüpfung der parameterbezogenen Eigenschaften großer Sprachmodelle mit gezielter Schulung im Englisch-als-Fremdsprache-Unterricht. Zudem bereichert sie die empirischen Befunde zur pragmatischen Transferforschung in kulturell vielfältigen Kontexten unter KI-Unterstützung und ergänzt bestehende Studien, die sich bisher ausschließlich auf syntaktische negative Transferfehler konzentrierten36,37.
Empirische Quasi-Experiment-Daten bestätigen, dass die experimentelle Gruppe bei syntaktischen, strukturellen und kulturellen Transferindikatoren eine deutliche Verbesserung erzielte, doch mehrere inhärente Einschränkungen beeinträchtigen die Verallgemeinerbarkeit der Forschungsergebnisse. Aufgrund der Rahmenbedingungen der Studie wurde eine nicht randomisierte Klasseneinteilung ohne Verblindung der Auswerter gewählt, und alle Proben stammten ausschließlich von Englisch-Studierenden einer einzigen Hochschule, wodurch es schwierig ist, Störungen durch die eigenständige Lernmotivation der Lernenden sowie durch langfristige Unterrichtsgewohnheiten der Lehrenden bei der Bewertungsvariabilität auszuschließen. Zudem dauerte diese Intervention lediglich drei Wochen und stellt somit ein kurzfristiges Trainingsprogramm dar. In Kombination mit dem Einzelzentrum-Stichproben-Design, bei dem alle Teilnehmenden von einem einzigen Fachhochschulstandort rekrutiert wurden, könnten die beobachteten positiven Effekte in der langfristigen Unterrichtspraxis nicht vollständig stabil sein. Daher sollten die Forschungsergebnisse mit Vorsicht interpretiert werden, und es ist unangemessen, die Schlussfolgerungen direkt auf verschiedene Hochschultypen, längere Lehrzyklen oder Lerngruppen mit unterschiedlichem Sprachniveau zu übertragen.
In der praktischen Anwendung im Unterricht zeigt das aktuelle System zur Optimierung von Prompts in Kombination mit dem DeepSeek-Modell deutliche Einschränkungen und typische Fehlerfälle. Bei Aufgaben zur kulturellen und stilistischen Übertragung erzeugt das Modell gelegentlich pragmatisch unangemessene Äußerungen oder starre stilistische Umwandlungsergebnisse, wenn Texte mit subtilen kulturellen Konnotationen und kontextabhängigen stilistischen Anforderungen verarbeitet werden38,39; außerdem gelingt es dem Modell nicht, implizite, kulturell bedingte Denkmuster im Deutschen bei langen und komplexen Absätzen genau zu erkennen, was zu einer unvollständigen Korrektur von Chinglish-Ausdrücken führt. Bei der automatischen Bewertung sinkt die Konsistenz der KI-Beurteilung bei stark subjektiven, kulturpragmatischen Kriterien erheblich, und es kann nicht effektiv zwischen feinen Unterschieden in rhetorischen Ausdrucksformen und interkulturellen Implikationen differenziert werden. Zudem neigt die dreistufige, geschachtelte Prompt-Kette bei mehrfacher iterativer Generierung zu semantischen Abweichungen, wobei Fehler aus der ersten Phase der semantischen Neuorganisation in den nachfolgenden Schritten der sprachlichen Überarbeitung und kulturellen Anpassung übernommen und verstärkt werden40,41.
Hinsichtlich der zukünftigen Entwicklung können Verbesserungen in drei praktischen Dimensionen vorgenommen werden. Erstens sollte der Umfang der Aufgabensammlung erweitert werden, indem ein Schreibkorpus von Nicht-Englisch-Muttersprachlern und Studierenden mit unterschiedlichen Sprachkompetenzniveaus erhoben wird, um die Vorlagenkompatibilität für diversifizierte Lerngruppen zu stärken. Zweitens sollte eine kontinuierliche Feinabstimmung leichtgewichtiger DeepSeek-Teilmodule erfolgen, um die Abweichungen bei der KI-basierten Bewertung kultureller Transferleistungen zu verringern, die in den vorliegenden Statistiken im Vergleich zur Lehrerbeurteilung als weniger konsistent erwiesen haben. Drittens sollte das gesamte System zur Optimierung von Eingabeaufforderungen (Prompts) in herkömmliche Online-Plattformen für Fremdsprachenlernen integriert werden, um eine automatische langfristige Datensammlung zu ermöglichen, die einer kontinuierlichen iterativen Verbesserung der Prompt-Regeln dient. Mit der fortschreitenden Bereicherung der ressourcenübergreifenden, sprachübergreifenden kulturellen Korpora wird erwartet, dass der vorgeschlagene technische Rahmen in nachfolgenden Forschungsarbeiten auch auf den bilingualen Übersetzungsunterricht sowie auf Kurse zur interkulturellen Kommunikation ausgeweitet werden kann.
Offenlegungen
Die Autoren erklären, dass sie keine finanziellen Interessenkonflikte haben.
Danksagungen
Diese Arbeit wurde vom Zhejiang Provincial Education Planning Project 2026 unterstützt: Forschung zur Rekonstruktion des Lehrkompetenzrahmens und Förderstrategien von Hochschuldozenten unter digitaler und intelligenter Unterstützung (Projektnummer: ZWT26024; Genehmigungsnummer: 2026SCG360).
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| BERT vortrainiertes Sprachmodell | https://github.com/google-research/bert | Die Textrepräsentation, die Erkennung der Absatzstruktur, die Berechnung der semantischen Ähnlichkeit und die Textklassifizierung unterstützen die automatisierte Bewertung von Schreibinhalten. | |
| Coreferee | Explosion AI | https://github.com/explosion/coreferee | Referenzielle Beziehungen im Text werden identifiziert, und die diskursive referenzielle Kohärenz wird bewertet, um bei der automatischen Bewertung der Schreibqualität zu unterstützen. |
| DeepSeek großes Sprachmodell | DeepSeek AI | https://chat.deepseek.com/ | Auf der Grundlage der MoE-Modellarchitektur wurden Instruktionsoptimierung und Gestaltung von Prompt-Wortketten durchgeführt. Das Modell verwendet feste Parameter: einen Temperaturkoeffizienten von 0,7, und die erzeugte Länge wird dynamisch je nach Fragetyp begrenzt. |
| spaCy | Explosion AI | https://github.com/explosion/spaCy | Die Abhängigkeitssyntaktische Struktur englischer Texte wird analysiert, und Indikatoren wie durchschnittliche Satzlänge und Anzahl verschachtelter Nebensätze werden extrahiert, um die syntaktische Komplexität zu quantifizieren. |
| SPSS 26.0 | IBM | https://www.ibm.com/products/spss-statistics | Statistische Analysen wie Varianzanalyse mit Messwiederholungen (RM-ANOVA), t-Test für unabhängige Stichproben, Pearson-Korrelationsanalyse, Effektgrößenberechnung (Cohen’s d) und Reliabilitätstest (ICC) wurden durchgeführt. |
Referenzen
- Maqsood M, Zahid A, Asghar T, et al. Issues in teaching English in a cultural context. Migr Lett. 2024; 21(4): 1020–1027.
- Tran NT, Nguyen TT, Pham HH. Exploring the challenges of L1 negative transfer among Vietnamese English language learners: a qualitative study. rEFLections. 2024; 31(2): 837–857.
- Zhu P. Cultural dimensions as guidelines in handling language problems for effective written communication across cultures. Int J Linguist Lit Transl. 2023; 6(12): 85–95.
- Zeng Z, Nair SM, Wider W. A comparative study of Chinese EFL undergraduates' pragmatic competence in English letter writing between urban and suburban universities. World J Engl Lang. 2022; 12(6): 377–388.
- Litvinova TA, Mikros GK, Dekhnich OV. Writing in the era of large language models: a bibliometric analysis of the research field. Nauchnyi Rezultat Voprosy Teoreticheskoi i Prikladnoi Lingvistiki. 2024; 10(4): 5–16.
- Long M. Cultivating interdisciplinary foreign language talents through interdisciplinary synergy of on-campus teaching and off-campus practices under the new liberal arts. Educ Rev USA. 2025; 9(5): 520–526.
- Voss E, Cushing ST, Ockey GJ, et al. The use of assistive technologies including generative AI by test takers in language assessment: a debate of theory and practice. Lang Assess Q. 2023; 20(4-5): 520-532.
- Manyasa J. When language transfer is negative: analysis of morpho-syntactic interference errors by learners of French in Tanzanian higher learning institutions. J Foreign Lang. 2021; 13(1): 165-190.
- Fikri N. The study of language transfer in EFL students' translation work. J Pendidik Nonformal. 2023; 1(1): 9.
- Ahmat A, Yang Y, Ma B, et al. Cross-lingual prompting method with semantic-based answer space clustering. Appl Intell. 2025; 55(2): 1-17.
- Maity S, Deroy A, Sarkar S. Investigating large language models for prompt-based open-ended question generation in the technical domain. SN Comput Sci. 2024; 5(8): 1-32.
- Wu W, Cao Y, Yi N, et al. Detecting and reducing the factual hallucinations of large language models with metamorphic testing. Proc ACM Softw Eng. 2025; 2(FSE): 1432-1453.
- Kaganovich P, Münz-Manor O, Ezra-Tsur E. Style transfer of modern Hebrew literature using text simplification and generative language modeling. CEUR Workshop Proc. 2023; 1613: 73-95.
- Yuan Y. Influence of native language transfer on senior high school English writing. Theory Pract Lang Stud. 2021; 11(2): 170-176.
- Jiamin M. The influence of cultural factors on language transfer in second language acquisition. Res J Engl Lang Lit. 2024; 12(1): 186-195.
- Zhang L. Native language transfer in vocabulary acquisition: an empirical study from connectionist perspective. J Lang Teach Res. 2023; 14(2): 446-458.
- Mirzayev E. The influence of first language interference on ESL writing skills. EuroGlob J Linguist Lang Educ. 2024; 1(1): 33-39.
- Fujiwara Y, Iwao T, Ito H, et al. Exploring the transfer of topic-comment structures called unagi-sentences in Asian L2 Englishes: cross-proficiency-level and cross-varietal studies. Asian Englishes. 2025; 27(1): 25-40.
- Guo Q. Interlanguage and its implications to second language teaching and learning. Pac Int J. 2022; 5(4): 8-14.
- Vereeck A, Janse M, De Herdt K, et al. Why Plato needs psychology: proposal for a theoretical framework underpinning research on the cognitive transfer effects of studying classical languages. Psiholoska Obzorja. 2023; 32: 121-130.
- Zhang W. Study on the negative transfer of mother tongue on college students. Int J Front Sociol. 2023; 5(16): 164-171.
- Li C. A review of theories, pedagogies and vocabulary learning tasks of English vocabulary learning apps for Chinese EFL learners. J China Comput Assist Lang Learn. 2024; 4(2): 346-375.
- Nsengimana I, Niyibizi E, Ngabonziza JDA. The impact of language transfers on learners' writing skills in English learning among students in Mahama Refugee Camp, Rwanda. Afr J Empir Res. 2024; 5(3): 605-613.
- Jovein S K, Sharifabad E D, Yazdani M. On the relationship between university translator training programs and the translation market requirements: The case of English translation graduates and postgraduates of Imam Reza International University. Journal of Critical Studies in Language and Literature. 2024; 5(6): 1-13.
- Qin X. Collaborative inquiry in action: a case study of lesson study for intercultural education. Asian Pac J Second Foreign Lang Educ. 2024; 9(1): 66-91.
- Sun L, Asmawi A. The effect of WeChat-based instruction on Chinese EFL undergraduates’ business English writing performance. International Journal of Instruction. 2023; 16(1): 43-60.
- Moro G, Piscaglia N, Ragazzi L, et al. Multi-language transfer learning for low-resource legal case summarization. Artificial Intelligence and Law. 2024; 32(4): 1111-1139.
- Sun Y. A study of college English writing teaching based on dynamic assessment. Pac Int J. 2023; 6(1): 83-88.
- Jeon J, Lee S. Large language models in education: a focus on the complementary relationship between human teachers and ChatGPT. Educ Inf Technol. 2023; 28(12): 15873-15892.
- Kostka I, Toncelli R. Exploring applications of ChatGPT to English language teaching: opportunities, challenges, and recommendations. TESL-EJ. 2023; 27(3): n3-n22.
- Antara IMAR, Anggreni NPY. Analyzing grammatical errors in EFL students' opinion essays using DeepSeek AI: patterns and pedagogical implications. Stilistika. 2025; 13(2): 210-218.
- Diasamidze L, Tedoradze T. Enhancing ESL students' writing skills through natural language processing model ChatGPT. Eurasia Proc Educ Soc Sci. 2024; 35: 230-238.
- Ranade N, Saravia M, Johri A. Using rhetorical strategies to design prompts: a human-in-the-loop approach to make AI useful. AI Soc. 2025; 40(2): 711-732.
- Zhou W, Gao B. Construction and application of English-Chinese multimodal emotional corpus based on artificial intelligence. Int J Hum Comput Interact. 2025; 41(3): 1782-1793.
- Chen B, Bao L, Zhang R, et al. A multi-strategy computer-assisted EFL writing learning system with deep learning incorporated and its effects on learning: a writing feedback perspective. J Educ Comput Res. 2024; 61(8): 60-102.
- Jeon H. Designing teaching for transfer in English for academic purposes. RELC Journal. 2024; 55(2): 567-577.
- Pei Y J. Construction of a" Feedback-Revision" Teaching Model for Senior High School English Continuation Writing Based on Generative AI. International Journal of Educational Development. 2026; 3(1): 16-25.
- Holubnycha L, Kuznetsova O, Shchokina T, et al. AI-Powered Teaching: Literature Review of ChatGPT's Impact on University Educators. International Journal of Interactive Mobile Technologies. 2025; 19(15): 41.
- Almuhanna M A. Teachers' perspectives of integrating AI-powered technologies in K-12 education for creating customized learning materials and resources. Education and Information Technologies. 2025; 30(8): 10343-10371.
- Hastomo T, Mandasari B, Widiati U. Scrutinizing Indonesian pre-service teachers’ technological knowledge in utilizing AI-powered tools. Journal of education and learning (EduLearn). 2024; 18(4): 1572-1581.
- Cai H, Lu L, Han B, et al. Exploring pre-service teachers’ reflection mediated by an AI-powered teacher dashboard in video-based professional learning: a pilot study. Educational technology research and development. 2025; 73(2): 1129-1154.