Diese Studie integrierte Netzwerkpharmakologie, molekulares Docking, molekulare Dynamik und MM-PBSA, um potenzielle Proteinwechselwirkungen von Glutathion-responsiven, apurinischen Stellen abfangenden Prodrugs beim NSCLC zu priorisieren. Verbindung 5 wurde für die Nachverfolgung von MMP9 und SRC priorisiert; diese bleiben jedoch rechnergestützte Kandidaten. Die Ergebnisse sind hypothetenerzeugend und erfordern biochemische und zellbasierte Validierung.
Forschungsartikel
In-silico-Priorisierung potenzieller Protein-Interaktionen für glutathion-responsive, abasische Stellen fangende Prodrugs bei nicht-kleinzelligem Lungenkarzinom
In diesem Artikel
Zusammenfassung
Zusammenfassung
Das nicht-kleinzellige Lungenkarzinom (NSCLC) bleibt eine wesentliche Ursache krebsbedingter Mortalität, wobei die Behandlungswirksamkeit häufig durch erworbene Resistenz und systemische Toxizität begrenzt ist. Glutathion-responsiven, an abasischen Stellen andockende Prodrugs haben in früheren experimentellen Studien eine selektive Antitumor-Aktivität gezeigt, doch ob ihre freigesetzten Metaboliten ebenfalls bedeutende Wechselwirkungen mit tumorspezifischen Proteinen eingehen, ist bisher nicht belegt. In dieser Arbeit wurde ein integrierter in silico-Workflow, der Netzwerkpharmakologie, molekulares Docking, Molekulardynamik (MD) sowie die molekulare Mechanik nach der Poisson-Boltzmann-Oberflächenmethode (MM-PBSA) kombiniert, eingesetzt, um überprüfbare Hypothesen zu Protein-Interaktionen für zwei glutathion-responsiven Prodrugs (Verbindung 1 und Verbindung 2), deren Produkte mit Aminooxy-Gruppe (Verbindung 4 und Verbindung 5) sowie einem passenden, nicht andockenden Kontrollpaar (Verbindung 3 und Verbindung 6) zu priorisieren. Es wurden 21 überschneidende, mit Verbindungen und Erkrankung assoziierte Zielstrukturen identifiziert, wobei AKT-Serin/Threonin-Kinase 1 (AKT1), epidermaler Wachstumsfaktor-Rezeptor (EGFR), Tumornekrosefaktor (TNF), Matrix-Metalloproteinase 9 (MMP9) und SRC-Protonkogen, nicht-rezeptorassoziierte Tyrosinkinase (SRC) mittels Protein-Protein-Interaktions-Topologie priorisiert wurden. Verbindung 5 erzielte die günstigste einzelne AutoDock-Vina-Bewertung mit MMP9 (−8,418 kcal·mol⁻1) und zeigte im Vergleich dazu stabilere, aus dem Docking abgeleitete Bindungsmodi entlang der MD-Trajektorien von MMP9 und SRC. Die am höchsten bewertete Bindungsposition an MMP9 zeigte jedoch keine direkte Koordination des katalytischen Zn2⁺-Ions und keine direkte Interaktion mit His401, Glu402, His405 oder His411, weshalb ihr kein kanonischer inhibitorischer Bindungsmodus an MMP9 zugeordnet werden kann. MD- und MM-PBSA-Analysen charakterisieren lediglich das Verhalten der Trajektorien und die relative energetische Rangfolge dieser Komplexe; sie belegen jedoch keine intrazelluläre Zielstrukturenbindung, Enzymhemmung oder Regulationswirkung auf Signalwegen. Die nachgewiesene Aktivität an abasischen Andockstellen und die neu vorhergesagten Protein-Interaktionen werden daher als getrennte, möglicherweise parallele Hypothesen betrachtet, nicht als nachgewiesene Wirkmechanismenkette. Insgesamt priorisieren die Ergebnisse spezifische Verbindung-Zielstrukturen-Paare für zukünftige Untersuchungen, belegen aber keinen multimodalen anti-NSCLC-Wirkmechanismus.
Einleitung
Nicht-kleinzelliges Lungenkarzinom (NSCLC) ist die häufigste histologische Unterform des Lungenkarzinoms und bleibt weltweit eine der Hauptursachen für krebsbedingte Sterblichkeit1. Obwohl erhebliche Fortschritte in der zielgerichteten Therapie und der präzisen Onkologie erzielt wurden, wird die Langzeitwirksamkeit der Behandlung häufig durch erworbene Resistenz, begrenzte Dauer der Ansprechraten und therapieassoziierte Toxizität beeinträchtigt2. Wirkstoffe, die am epidermalen Wachstumsfaktor-Rezeptor (EGFR) ansetzen, haben die Behandlungsergebnisse bei molekular ausgewählten Patienten verbessert, doch entwickelt sich während der Therapie nahezu unvermeidlich eine Resistenz, wodurch ein dringender Bedarf an therapeutischen Strategien entsteht, die über alternative oder komplementäre Wirkmechanismen agieren3,4. Die konventionelle platinbasierte Chemotherapie bleibt ein wichtiger Bestandteil der Behandlung, doch ihr klinischer Nutzen ist durch kumulative Toxizität und Resistenzentwicklung bei längerer Anwendung eingeschränkt5,6. Insgesamt verdeutlichen diese Limitationen die Notwendigkeit, antitumorale Wirkstoffe zu identifizieren, die sowohl hinsichtlich ihres Wirkmechanismus als auch ihrer selektiven Aktivierung im Tumorumfeld einzigartig sind.
Unter endogenen DNA-Schäden sind apurinische bzw. apyrimidinische Stellen (abasic sites) sehr häufig und biologisch bedeutsam, wobei täglich Tausende solcher Läsionen pro Zelle entstehen7. Werden diese Schäden nicht effizient repariert, können sie in Strangbrüche umgewandelt werden, was genomische Instabilität und Zelltod begünstigen kann8,9. Die Apurin/Apyrimidin-Endonuklease 1 ist ein zentrales Enzym im Basisexzisionsreparaturweg, da sie apurinische Stellen schneidet und dadurch die nachfolgende Reparatur ermöglicht10,11. Diese Abhängigkeit der Reparatur hat Schäden an apurinischen Stellen zu einem attraktiven Ziel für die Entwicklung von Antikrebsmitteln gemacht12. Auf dieser Grundlage wurden zuvor glutathionresponsive Prodrugs entwickelt, die apurinische Stellen gezielt abfangen und die erhöhte Glutathion-Konzentration in Tumorzellen ausnutzen. Die durch Glutathion ausgelösten Wirkstoffe enthalten eine Aminooxy-Gruppe, die aldehydische apurinische Stellen abfangen kann. Frühere experimentelle Untersuchungen zeigten eine selektive Zytotoxizität, Zellzyklusarrest und Apoptose in H1299-Zellen13. Diese Daten stützen den DNA-Schadensabfang-Mechanismus im Wirkstoffdesign. Sie belegen jedoch nicht, dass MMP9, SRC, EGFR, AKT1 oder TNF downstream der apurinischen Stellenbindung reguliert werden. Jede Protein-Target-Interaktion, die in der vorliegenden computerbasierten Analyse identifiziert wurde, muss daher als separate Hypothese betrachtet werden, es sei denn, beide Prozesse werden im selben biologischen System nachgewiesen.
Die vorliegende Studie basiert auf dieser Unterscheidung. Die erste Ebene der biologischen Begründung ist die zuvor etablierte, glutathionabhängige Freisetzung und die Chemie der Bindung an apurinische/apyrimidinische Stellen14. Die hier untersuchte zweite Ebene stellt eine explorative Frage dar: ob die ursprünglichen Prodrugs oder ihre freigesetzten Produkte rechnerisch gesehen mit ausgewählten, krebsassoziierten Proteinen verträglich sind. Mithilfe der Netzwerkpharmakologie wurden Kandidatenproteine priorisiert, gefolgt von Docking-, MD- und MM-PBSA-Analysen zur Untersuchung ausgewählter Protein-Ligand-Komplexe15,16. Diese Berechnungen sollten nicht belegen, dass die vorhergesagten Proteine den bekannten Phänotyp der DNA-Schädigung vermitteln, noch einen kausalen Zusammenhang zwischen der Bindung an apurinische/apyrimidinische Stellen und onkogenen Signalwegen herstellen. Stattdessen diente der Arbeitsablauf dazu, eine Rangliste experimentell überprüfbarer Hypothesen zu generieren, die anschließend mittels direkter Bindungs-, Enzymaktivitäts-, Signalweg-, DNA-Schadens- und Phänotyp-Analysen evaluiert werden können.
Protokoll
Die Genehmigung durch eine institutionelle Prüfkommission war nicht erforderlich, da diese Studie vollständig rechnergestützt durchgeführt wurde und keine menschlichen Teilnehmer, Wirbeltiere, von Patienten stammende Biospezimen oder identifizierbare personenbezogene Daten umfasste. Die Einholung informierter Einwilligung war daher nicht anwendbar. Alle in diesem Protokoll verwendeten Datenbanken, Softwarepakete, Kraftfelder und rechnergestützten Ressourcen sind in der Tabelle der Materialien aufgeführt.
Studienverbindungen und analytischer Arbeitsablauf
Zuvor beschriebene glutathionresponsive Verbindungen zur Abfangung von apyrimidinischen/apyrurinischen Basenstellen wurden als Studienmoleküle verwendet17. Verbindung 1 und Verbindung 2 wurden als Ausgangsprodrugs ausgewählt, da die glutathionausgelöste Spaltung die aminooxyhaltigen Produkte Verbindung 4 bzw. Verbindung 5 erzeugt. Verbindung 4 und Verbindung 5 wurden für die strukturelle Analyse ausgewählt, da sie die freigesetzten Spezies darstellen, die die mit apyrimidinischen/apyrurinischen Basenstellen reaktive Aminooxygruppe behalten. Verbindung 3 wurde als strukturell vergleichbarer, glutathionresponder Kontrollstoff einbezogen; ihr Spaltprodukt, Verbindung 6, besitzt nicht die zur kovalenten Fixierung von Aldehyden an apyrimidinischen/apyrurinischen Basenstellen erforderliche Aminooxyfunktion. Daher wurden die Verbindungen 1–3 in die umgekehrte Zielvorhersage einbezogen, um die Ausgangsgerüste zu vergleichen, Verbindung 4 und Verbindung 5 wurden gegenüber den priorisierten Proteinen bewertet, und Verbindung 6 diente als negativer Kontrollligand im SRC-MD-Vergleich. Die SRC–Verbindung-6-Trajektorie wurde einbezogen, um einen strukturell vergleichbaren Kontrollfall für das aminooxyhaltige System Verbindung 5 bereitzustellen, nicht als Beleg dafür, dass die Aminooxygruppe selbst die SRC-Bindung bestimmt. Die chemischen Strukturen und Aktivierungsbeziehungen der Verbindungen 1–6 sind in Abbildung 1 dargestellt. Dieser Versuchsansatz trennt bewusst die etablierte Chemie zur Abfangung von DNA-Läsionen von der hier vorgenommenen hypothesengenerierenden Analyse möglicher Proteininteraktionen.
Vorhersage von verbindungsassoziierten Zielstrukturen
Die zweidimensionalen Strukturen von Verbindung 1, Verbindung 2 und Verbindung 3 wurden im MDL-MOL-Format gespeichert und mit Open Babel Version 3.1.1 unter Verwendung des kanonischen SMILES-Ausgabeformats in kanonische Simplified Molecular-Input Line-Entry-System-(SMILES-)Zeichenketten umgewandelt18. Jede exportierte Zeichenkette wurde erneut importiert, und die regenerierte Struktur visuell mit der entsprechenden zweidimensionalen Struktur abgeglichen, bevor sie zur SwissTargetPrediction übermittelt wurde, wobei die Art auf Homo sapiens beschränkt war19. Vorhergesagte Zielstrukturen mit Wahrscheinlichkeitswerten ungleich null wurden beibehalten. Die für die drei Verbindungen erhaltenen Zielstrukturenlisten wurden zusammengeführt, doppelte Einträge entfernt, und die verbleibenden Ziele auf offizielle humane Gensymbole standardisiert, bevor eine weitere Analyse erfolgte. Die standardisierten Verbindung-Zielstrukturen-Paare wurden als Netzwerktabelle in eine Software zur Netzwerkvisualisierung und -analyse importiert, wobei Verbindungen und vorhergesagte Zielstrukturen als Knotenpunkte und die Beziehungen zwischen Verbindung und Zielstruktur als Kanten dargestellt wurden, um die vorhergesagten Zielstrukturbeziehungen zu visualisieren20.
Identifizierung krankheitsbezogener Zielstrukturen und Ermittlung gemeinsamer Zielstrukturen
Krankheitsassoziierte Zielstrukturen wurden aus der GeneCards-Datenbank mit dem Suchbegriff „Lungenkrebs H1299“21 abgerufen. Es wurde ein Relevanzschwellenwert von mehr als 0,27 angewandt, um Gene mit stärkerer Relevanz für diese Anfrage beizubehalten. Die Gensymbole wurden standardisiert und doppelte Einträge manuell entfernt. Der Überlappungsbereich zwischen den vorhergesagten Wirkstoffzielen und den krankheitsassoziierten Zielstrukturen wurde mithilfe eines Online-Wenn-Diagramm/Schnittmengen-Analyse-Tools22 ermittelt. Nur die sich überschneidenden Zielstrukturen wurden für nachfolgende Protein-Protein-Interaktions- (PPI-), Anreicherungs- und Zielstruktur-Priorisierungsanalysen beibehalten.
Analysen zur Protein-Protein-Wechselwirkung und Screening von Kernzielen
Die sich überschneidenden Zielstrukturen wurden dem Search Tool for the Retrieval of Interacting Genes/Proteins (STRING), Version 11.5, übermittelt, wobei die Art auf Homo sapiens und die minimal erforderliche Interaktionsscore auf 0,400 festgelegt23Die resultierenden PPI-Daten wurden zur Visualisierung und Topologie-Analyse in Cytoscape Version 3.10.0 importiert. Innerhalb einer Netzwerk-Topologie-Analyse Plugin, Grad, Betweenness-Zentralität und Closeness-Zentralität wurden für jeden Knoten im ursprünglichen 21-Knoten-PPI-Netzwerk berechnet; die resultierenden Werte wurden anschließend für die unten beschriebene sequenzielle medianbasierte Filterung verwendet24. Zentralitätsmaße wurden am ursprünglichen 21-Knoten-PPI-Netzwerk berechnet und anschließend für eine schrittweise Filterung verwendet. Der mittlere Grad des ursprünglichen Netzwerks betrug 12, und Knoten mit einem Grad ≥ 12 wurden beibehalten, was 13 Kandidaten ergab. Unter diesen 13 Kandidaten betrug die mittlere Betweenness-Zentralität 0,031293 und die mittlere Closeness-Zentralität 0,769231. Der zweite Filter behielt Knoten mit einer Betweenness-Zentralität ≥ 0,031293 und einer Closeness-Zentralität > 0,769231, wodurch fünf Hub-Kandidaten identifiziert wurden: AKT1, EGFR, TNF, MMP9 und SRC. Die angegebenen Zentralitätswerte wurden aus dem ursprünglichen Netzwerk mit 21 Knoten übernommen, anstatt nach der Unterteilung neu berechnet zu werden. Die endgültigen fünf Hub-Kandidaten wurden für die anschließende strukturelle Analyse verwendet. Die ursprünglichen Topologiemetriken entsprechen einem ungerichteten PPI-Netzwerk mit 21 Knoten und 116 Kanten.
Anreicherungsanalyse der Genontologie und der Kyoto-Enzyklopädie von Genen und Genomen
Die sich überschneidenden Zielstrukturen wurden mittels der Datenbank für Annotation, Visualisierung und integrierte Entdeckung (DAVID) einer Gene-Ontology-(GO)- und Kyoto-Encyclopedia-of-Genes-and-Genomes-(KEGG)-Anreicherungsanalyse unter Einschränkung auf die Spezies Homo sapiens25 unterzogen. Die GO-Anreicherung wurde für biologische Prozesse (BP), zelluläre Komponenten (CC) und molekulare Funktionen (MF) sowie für KEGG-Signalwege ausgewertet. Für diese explorative Analyse wurde als Aufnahmeschwelle zur Beibehaltung von Anreicherungseinträgen ein nomineller p-Wert < 0,10 verwendet; Benjamini-korrigierte p-Werte, Bonferroni-Werte, Falsch-Entdeckungs-Raten und Werte des exakten Fisher-Tests wurden in den ergänzenden Tabellen angegeben, dienten jedoch nicht zur Definition der beibehaltenen Einträge. Die beibehaltenen Einträge wurden nach nominellen p-Werten sortiert. Für die anschließende Visualisierung und Interpretation wurden die 20 besten KEGG-Wege sowie jeweils die 10 besten Begriffe aus jeder GO-Kategorie beibehalten. Balkendiagramme und Blasendiagramme wurden mit einem Online-Bioinformatik-Visualisierungstool erstellt.
Herstellung von Rezeptoren und Liganden für das molekulare Docking
Die Kristallstrukturen der priorisierten Proteine wurden aus der RCSB Protein Data Bank (PDB) abgerufen: AKT1, PDB-ID 3O96; EGFR, PDB-ID 5UWD; TNF, PDB-ID 2AZ5; MMP9, PDB-ID 1GKC; und SRC, PDB-ID 2H8H. Zur Durchführung des Dockings wurden die Proteinstrukturen mit molekularer Visualisierungssoftware vorbereitet, indem ko-kristallisierte Liganden und Wassermoleküle entfernt wurden, gefolgt von der Aufbereitung in Software zur Docking-Vorbereitung. Für MMP9 wurde eine unveränderte Kopie der PDB 1GKC separat als kristallographische Referenz für die katalytische Zn2⁺-Umgebung und den Bindungsmodus von N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-methylpentanoyl]-N,3-dimethyl-L-valinamid (NFH) beibehalten. In Kette A von 1GKC wird das katalytische Zn2⁺ durch His401, His405 und His411 in Abständen von 2,21, 2,23 bzw. 2,22 Å koordiniert, während die beiden Sauerstoffatome von NFH Zn2⁺ in 2,07 und 2,38 Å Distanz koordinieren; Glu402 stellt das katalytische Säure/Base-Restglied dar. Diese kristallographischen Wechselwirkungen dienten als positive strukturelle Referenz zur Bewertung der Interaktionskarte des Dockings von Verbindung 5. Für SRC wurde die PDB 2H8H für die MD-Berechnungen an SRC verwendet. Diese strukturellen Vergleiche dienten ausschließlich der Interpretation und wurden nicht als Hinweis auf Enzymhemmung oder intrazelluläre Targetbindung gewertet.
Die dreidimensionalen Strukturen von Verbindung 4 und Verbindung 5 wurden aus PubChem bezogen und durch Energieminimierung in molekularer Modellierungssoftware26 optimiert. Die Liganden wurden unter physiologischen Bedingungen protoniert und mittels des Merck-Molekül-Kraftfelds 94 (MMFF94) minimiert, bis der Energiegradient unter 0,01 kcal·mol⁻1·Å⁻1 lag. Wasserstoffatome wurden hinzugefügt, Gasteiger-Ladungen zugewiesen und rotierbare Bindungen in einer Software zur Vorbereitung des Dockings definiert. Verbindung 6, das Glutathion-Spaltprodukt des nicht-bindenden Kontrollverbindung 3, wurde mit dem gleichen Arbeitsablauf vorbereitet und nur an SRC gedockt, um die Startpose für die entsprechende Kontroll-MD-Trajektorie zu generieren. Daher wurde Verbindung 6 weder als zusätzlich vorhergesagter therapeutischer Ligand eingeführt noch zur Unterstützung eines Multizielmechanismus verwendet.
Verfahren für das molekulare Docking
Das molekulare Docking wurde mithilfe von Molekulardocking-Software unter Verwendung eines semiflexiblen Docking-Protokolls durchgeführt, wobei die Rezeptoren starr gehalten und die Liganden flexibel belassen wurden27,28. Für jeden Rezeptor wurde der Docking-Box der Mittelpunkt auf die Position des cokristallisierten Liganden gelegt, sodass der Suchbereich der experimentell bestimmten Bindungstasche entsprach. Die Abmessungen der Docking-Box wurden auf 24 Å × 24 Å × 24 Å für AKT1, EGFR und SRC, auf 26 Å × 26 Å × 26 Å für MMP9 und auf 28 Å × 28 Å × 28 Å für TNF festgelegt. Die Exhaustiveness wurde auf 32, die Anzahl der Ausgabe-Konformationen auf 20 und der Energiebereich auf 4 kcal·mol⁻1 eingestellt. Die am höchsten bewertete Konformation jedes Docking-Laufs wurde für die Interaktionsanalyse beibehalten.
Um die interne Zuverlässigkeit des Docking-Setups zu bewerten, wurde jeder ko-kristallisierte Ligand mit denselben Parametern erneut in seine entsprechende Rezeptorbindungstasche gedockt, wobei eine Abweichung des schweratomigen Root-Mean-Square-Deviation (RMSD) unterhalb von 2,0 Å als Akzeptanzkriterium diente. Die endgültigen Docking-Posen wurden mittels molekularer Visualisierungssoftware überprüft. Für den MMP9–Verbindung 5-Komplex wurde die beibehaltene Interaktionskarte speziell hinsichtlich einer annotierten direkten Ligandenkoordination an das katalytische Zn2⁺-Ion sowie hinsichtlich Kontakte mit His401, Glu402, His405 und His411 analysiert, und die Ligandenposition wurde mit der kristallographischen NFH-Position in PDB 1GKC verglichen. Ein quantitativer Metallkoordinationsabstand wurde nur dann angegeben, wenn eine direkte Ligand-Zn2⁺-Koordination in der beibehaltenen Pose erkennbar war; andernfalls wurde dies als nicht zutreffend gekennzeichnet, statt es abzuleiten. Daher wurde eine MMP9-Docking-Pose, die diese kanonischen katalytischen Stellenmerkmale fehlte, als nichtkanonisch klassifiziert und nicht als Hinweis auf eine enzymatische Hemmung von MMP9 interpretiert. Allgemeiner wurden AutoDock Vina-Scores und Docking-Posen zur relativen Priorisierung und zur Hypothesenbildung verwendet, nicht jedoch als Nachweis für Bindungsaffinität oder intrazelluläre Targetbindung.
Protokoll der molekularen Dynamik
Für die MD-Analyse ausgewählte Protein-Ligand-Komplexe wurden aus den dockingbasierten Bindungspositionen aufgebaut. Die MD-Berechnungen wurden mit GROMACS29 durchgeführt. Proteine wurden mittels des CHARMM36-Kraftfelds parametrisiert, während Ligand-Atomtypen und -Parameter mit dem General Amber Force Field der zweiten Generation (GAFF2)30,31 zugewiesen wurden. Partielle Ladungen nach dem Austin-Modell 1 mit Bond-Charge-Korrektur (AM1-BCC) wurden mithilfe von Werkzeugen zur Parametrisierung kleiner Moleküle und zur Erzeugung der Ligand-Topologie generiert; anschließend erzeugte die Software für die Ligand-Topologie-Erstellung die mit GROMACS kompatiblen Ligand-Topologie-Dateien32,33,34. Jeder Komplex wurde unter periodischen Randbedingungen in eine TIP3P-Wasserbox platziert, wobei ein minimaler Abstand zwischen Solut und Boxwand von 1,0 nm eingehalten wurde. Natrium- und Chloridionen wurden hinzugefügt, um die Nettoladung jedes Systems zu neutralisieren, und zusätzliches NaCl wurde zugegeben, um eine endgültige Ionenstärke von 0,15 M zu erreichen.
Die Energieminimierung wurde mithilfe des steilsten Abstiegs-Algorithmus durchgeführt, bis die maximale Kraft unter 1000 kJ·mol⁻1·nm⁻1 fiel. Die minimierten Systeme wurden anschließend unter konstanter Teilchenzahl, Druck und Temperatur (NPT-Bedingungen) bei 310 K und 1 bar unter Anwendung von Positionsrestriktionen am Protein-Backbone equilibriert. Die Temperatur wurde mit dem V-rescale-Thermostat und der Druck mit dem Parrinello-Rahman-Barostat geregelt. Langreichweitige elektrostatische Wechselwirkungen wurden mit der Particle-Mesh-Ewald-Methode berechnet. Die kurzreichweitigen elektrostatischen und van-der-Waals-Abschneideradien wurden jeweils auf 1,0 nm festgelegt, und alle Bindungen, an denen Wasserstoffatome beteiligt waren, wurden mit dem Linear Constraint Solver (LINCS)-Algorithmus fixiert. Produktionsläufe wurden über 150 ns mit einem Integrationszeitschritt von 2 fs durchgeführt, und die Koordinaten wurden alle 10 ps zur nachfolgenden Analyse gespeichert.
Tracjektorienanalyse
Die Trajektorienanalysen wurden an den equilibrierten Abschnitten der Produktions-Trajektorien durchgeführt. Der RMSD des Protein-Backbones und der Liganden-RMSD wurden nach einer Least-Squares-Anpassung an die initiale Referenzkonformation berechnet. Die Werte der mittleren quadratischen Fluktuation (RMSF) wurden pro Rest basierend auf den Cα-Atomen ermittelt. Die Wasserstoffbrücken-Analyse zwischen jedem Liganden und seinem Rezeptor erfolgte unter Verwendung einer Donor-Akzeptor-Abstandsschwelle von 3,5 Å und einer Donor-Wasserstoff-Akzeptor-Winkelschwelle von 30°. Die Besetzung von Wasserstoffbrücken wurde als Anteil der analysierten Bilder definiert, in denen eine bestimmte Wasserstoffbrücke vorhanden war. Diese Metriken dienten zur Charakterisierung der strukturellen Stabilität, der Flexibilität auf Ebene einzelner Reste sowie der Beständigkeit intermolekularer Kontakte über die drei MD-Trajektorien hinweg.
Berechnung der bindenden Freien Energie nach der Methode der molekularen Mechanik mit Poisson-Boltzmann-Oberflächenberechnung (MM-PBSA)
Die Bindungs-Freie-Energie wurde mithilfe der MM-PBSA-Methode berechnet, die mit der MM-PBSA-Analysesoftware auf den equilibrierten Abschnitten der MD-Trajektorien implementiert ist35. Für jeden Protein-Ligand-Komplex wurden die letzten 50 ns der 150 ns langen Produktions-Trajektorie zur Freie-Energie-Analyse verwendet. Insgesamt wurden 500 gleichmäßig verteilte Frames in 100-ps-Intervallen von 100,0 ns bis 149,9 ns abgetastet; der Endpunkt bei 150,0 ns wurde von der Stichprobe ausgeschlossen. Die gesamte Bindungs-Freie-Energie wurde als Summe der van-der-Waals-Energie, der elektrostatischen Energie, der polaren Solvatisierungsenergie und der unpolaren Solvatisierungsenergie berechnet:
ΔG_bind = ΔE_vdW + ΔE_ele + ΔG_polar + ΔG_nonpolar (1)
Es wurde keine Entropiekorrektur vorgenommen. Die mittleren Bindungsenergien und Standardabweichungen wurden über alle abgetasteten Rahmen berechnet.
Reproduzierbarkeit und rechnerische Validierungskontrollen
Alle in den Schritten zur Zielvorhersage, zur Ermittlung von Krankheitszielen und zur Schnittmengenanalyse verwendeten Genbezeichnungen wurden vor der nachgeschalteten Analyse auf offizielle humane Gensymbole standardisiert. Bei allen Rezeptor-Ligand-Paaren wurden identische Docking-Parameter beibehalten. Die Docking-Parametrisierung wurde technisch überprüft, indem das jeweilige ko-kristallisierte Ligand in jede Rezeptorbindungstasche unter Verwendung derselben Suchparameter und der vorgegebenen Akzeptanzschwelle für die schweren Atome des RMSD von <2,0 Å erneut gedockt wurde. Der kristallographische MMP9–NFH-Komplex diente als positiver struktureller Referenzwert für die katalytische Zn2⁺-Umgebung, während SRC–Verbindung 6 als passender, nicht-bindender Vergleichswert für die SRC-Trajektorienanalyse fungierte. Die MD-Trajektorien wurden auf Temperatur- und Druckstabilität sowie auf das Fehlen eines abnormalen Boxvolumen-Drifts überprüft, bevor sie in nachfolgende Analysen einbezogen wurden. Alle Eingabedateien, Rezeptorstrukturen, Ligand-Topologiedateien, Docking-Konfigurationsdateien, MD-Parameterdateien und MM-PBSA-Frame-Auswahldatensätze wurden archiviert, um die Rechenreproduzierbarkeit zu gewährleisten.
Ergebnisse
Vorhersage von verbindungsassoziierten Zielstrukturen und Identifizierung sich überschneidender Zielstrukturen
Die umgekehrte Zielvorhersage der Verbindungen 1–3 ergab 212 potenzielle humane Zielstrukturen. Parallel dazu identifizierte die Abfrage von Krankheitszielen in GeneCards unter Verwendung des Schlüsselworts „Lungenkrebs H1299“ und einer Relevanzschwelle von mehr als 0,27 insgesamt 188 mit NSCLC assoziierte Zielstrukturen. Die Schnittmengenanalyse zwischen den vorhergesagten Wirkstoffzielen und dem pool der krankheitsassoziierten Zielstrukturen ergab 21 überschneidende Zielstrukturen, die für alle nachfolgenden Analysen beibehalten wurden. Die Überschneidung zwischen den beiden Zielgruppen ist in Abbildung 2 dargestellt. Diese Ergebnisse deuten darauf hin, dass die untersuchten Verbindungen auf eine begrenzte Teilmenge krankheitsrelevanter Zielstrukturen abzielen, anstatt einen diffusen, unspezifischen Zielbereich zu beeinflussen.
Analysen zur Protein-Protein-Wechselwirkung und Screening von Kernzielen
Die 21 überlappenden Zielstrukturen wurden in STRING importiert, um ein PPI-Netzwerk zu erstellen. Das resultierende Netzwerk enthielt 21 Knoten und 116 Kanten. Die Knoten-Grad-Werte in Zusatz-Tabelle 1 ergibt 232, was 116 ungerichteten Kanten entspricht. Für dieses ursprüngliche Netzwerk wurden Zentralitätswerte berechnet. Der mittlere Grad betrug 12; durch Anwendung eines Grades ≥ 12 verblieben 13 Kandidaten. Unter diesen 13 Kandidaten betrug die mittlere Zwischenzentralität (betweenness centrality) 0,031293 und die mittlere Nähezentralität (closeness centrality) 0,769231. Durch Anwendung der Bedingungen Zwischenzentralität ≥ 0,031293 und Nähezentralität ≥ 0,769231 > 0,769231 priorisierte fünf Hub-Kandidaten: AKT1, EGFR, TNF, MMP9 und SRC. Die angegebenen Werte für die beibehaltenen Teilmengen entsprechen den ursprünglichen Zentralitätsmaßen des 21-Knoten-Netzwerks, die während des Filterprozesses übernommen wurden; sie wurden nicht erneut für 13-Knoten- oder 5-Knoten-Subnetzwerke berechnet. Ihre Netzwerkzentralität diente lediglich zur Rangfolge der Kandidaten für die anschließende strukturbasierte Bewertung und sollte nicht als Hinweis darauf interpretiert werden, dass sie biologische Zielstrukturen der Verbindungen darstellen. Zusatz-Tabelle 1, Zusatz-Tabelle 2und Zusatz-Tabelle 3 berichten Sie die Metriken für das anfängliche 21-Knoten-Netzwerk, die 13 nach dem ersten Screening-Schritt verbliebenen Kandidaten und die endgültigen fünf Hub-Kandidaten. Das sequenzielle PPI-Netzwerk-Screening und die endgültigen fünf Hub-Kandidaten sind dargestellt in Abbildung 3A, Abbildung 3B, Abbildung 3C, und Abbildung 3D.
Anreicherungsanalyse der Genontologie und der Kyoto-Enzyklopädie der Gene und Genome
Die funktionelle Anreicherungsanalyse der 21 überlappenden Zielstrukturen identifizierte 121 KEGG-Wege, die die nominale p < 0,10-Inklusionskriterien erfüllten. Die 20 am höchsten eingestuften Wege sind in Abbildung 4A dargestellt. Darunter waren Endokrin-Resistenz, Krebswege, Proteoglykane beim Krebs, EGFR-Tyrosinkinase-Inhibitor-Resistenz und der ErbB-Signalweg besonders hervorragend. Diese Wege stehen in engem Zusammenhang mit der Tumorproliferation, dem Überleben, der Invasion und der Behandlungsresistenz bei NSCLC. Die vollständigen Anreicherungsstatistiken für alle 121 beibehaltenen KEGG-Wege, die das nominale p < 0,10-Kriterium erfüllten, sind in Ergänzungstabelle 4 angegeben.
Die GO-Enrichment-Analyse identifizierte zudem 177 BP-Terme, 29 CC-Terme und 61 MF-Terme, die denselben nominalen p < 0,10 Einschlusskriterium. Die 10 am höchsten eingestuften Begriffe aus jeder Kategorie sind dargestellt in Abbildung 4B, Abbildung 4C, und Abbildung 4DDie dominierenden biologischen Prozesse umfassten die positive Regulation der Proliferation vaskulär-assoziiierter glatter Muskelzellen, den Übergang von G2/M im mitotischen Zellzyklus, die Insulin-ähnliche Wachstumsfaktor-Rezeptor-Signalübertragung, die Proteinphosphorylierung, die negative Regulation der Apoptose und die Signaltransduktion. Zu den wichtigsten Begriffen für zelluläre Komponenten gehörten Zellkern, Membranraft, fokale Adhäsion, Plasmamembran und telomerer Bereich des Chromosoms. Im Gegensatz dazu wurden die wichtigsten molekularen Funktionen in Abbildung 4D einschließlich Proteinkinaseaktivität, Proteinserin-Kinaseaktivität, ATP-Bindung, Proteinserin/Threonin-Kinaseaktivität, Proteintyrosin-Kinaseaktivität, RNA-Polymerase-II-CTD-Heptapeptid-Wiederholungs-Kinaseaktivität, Kinaseaktivität, Histone-H2AXY142-Kinaseaktivität, Histone-H3Y41-Kinaseaktivität und identische Proteinbindung. Die vollständigen Anreicherungsstatistiken für BP, CC und MF sind angegeben in Zusatz-Tabelle 5, Ergänzungstabelle 6und Zusatz-Tabelle 7Zusammen weisen diese Anreicherungsergebnisse darauf hin, dass der überlappende Zielgen-Satz in Signalisierungs-, Überlebensregulations- und onkogenen Antwortprozessen konzentriert ist, die für das Fortschreiten von NSCLC relevant sind.
Priorisierung von Metabolit-Target-Komplexen basierend auf molekularem Docking
Das molekulare Docking wurde zwischen Verbindung 4 und Verbindung 5 sowie den fünf durch die Netzwerktopologie priorisierten Proteinen durchgeführt. Die in Tabelle 1 angegebenen Werte sind AutoDock-Vina-Docking-Scores und entsprechen nicht experimentell gemessenen Bindungs-Freie-Energie-Werten. Verbindung 5 erzielte den günstigsten Einzelscore mit MMP9 (–8,418 kcal·mol⁻1), gefolgt von Verbindung 4 mit MMP9 (–7,840 kcal·mol⁻1). Bei AKT1 und EGFR erzielte Verbindung 5 ebenfalls günstigere Scores als Verbindung 4, während Verbindung 4 bei SRC (–6,549 im Vergleich zu –6,204 kcal·mol⁻1) und TNF (–5,436 im Vergleich zu –5,299 kcal·mol⁻1) leicht günstigere Werte aufwies. Daher zeigte Verbindung 5 keinen einheitlichen Bewertungsvorteil über alle fünf Proteine hinweg. Die Docking-Ergebnisse wurden lediglich verwendet, um repräsentative Komplexe für eine weitere strukturelle Analyse zu priorisieren.
Repräsentative Docking-Konformationen sind in Abbildung 5 dargestellt. In der am höchsten bewerteten Interaktionskarte der MMP9–Verbindung 5 lagen die angezeigten Kontakte in der Nähe von Ala417 und Pro421 mit Abständen von etwa 3,0 Å bzw. 2,4 Å. In der beibehaltenen Interaktionskarte der Top-Pose wurde keine direkte Koordination zwischen Verbindung 5 und ZN2⁺ annotiert, und es wurden keine direkten Kontakte mit His401, Glu402, His405 oder His411 gezeigt. Dies steht im Gegensatz zum kristallographischen Referenzstruktur 1GKC, bei dem His401, His405 und His411 das katalytische ZN2⁺ bei 2,21, 2,23 bzw. 2,22 Å koordinieren, und der Reverse-Hydroxamat-Inhibitor NFH dasselbe ZN2⁺ über zwei Sauerstoffatome bei 2,07 und 2,38 Å koordiniert. Da keine direkte Koordination zwischen Verbindung 5 und ZN2⁺ in der beibehaltenen Interaktionskarte annotiert wurde, wurde kein Koordinationsabstand zwischen Verbindung 5 und ZN2⁺ angegeben; dies wird als Fehlen eines nachgewiesenen direkten Koordinationsmodus in der beibehaltenen Karte interpretiert und nicht als gemessener Metall-Abstandswert. Ein dreidimensionaler Vergleich mit der kristallographischen Referenz MMP9–NFH ist in Abbildung S1 dargestellt. Die Geometrie unterscheidet sich somit von einem kanonischen, zinkabhängigen inhibitorischen Bindungsmodus, und das vorliegende Docking-Ergebnis stützt nicht die Einstufung von Verbindung 5 als MMP9-Inhibitor. MMP9 wurde lediglich für die MD-Analyse beibehalten, um zu prüfen, ob diese spezifische, nichtkanonische Docking-Geometrie während der Trajektorie bestehen bleibt. Bei den anderen Komplexen zeigte Verbindung 5 vorhergesagte Kontakte mit AKT1 und SRC, während Verbindung 4 ebenfalls definierte Docking-Interaktionen mit MMP9 und SRC einging. In Übereinstimmung mit Abbildung 5F beschreiben diese Beobachtungen vorhergesagte Interaktionen und relative Docking-Scores, nicht experimentell verifizierte Affinitäten.
Zur vergleichenden, nicht bestätigenden Analyse wurden drei Komplexe für die MD-Analyse ausgewählt. Der MMP9–Verbindung 5-Komplex wurde gewählt, da er die günstigste einzelne Docking-Score aufwies, jedoch eine nichtkanonische MMP9-Positionierung zeigte, die eine vorsichtige strukturelle Überprüfung erforderte. Der SRC–Verbindung 5-Komplex wurde als zweiter Kandidatenkomplex ausgewählt, und der SRC–Verbindung 6-Komplex wurde als passender, nicht-bindender Kontrollverlauf hinzugefügt. Die entsprechenden Anfangskonformationen sind in Abbildung 6A, Abbildung 6B, und Abbildung 6C dargestellt. Dieser Ansatz ermöglichte den Vergleich der Stabilität ausgewählter Docking-Geometrien, ohne die MD-Stabilität als Beleg für Zielinteraktion oder funktionelle Regulation zu betrachten.
Analysen der molekularen Dynamik
Um die Stabilität ausgewählter, aus dem Docking abgeleiteter Geometrien unter dynamischen wässrigen Bedingungen zu vergleichen, wurden 150 ns lange MD-Trajektorien für die Komplexe MMP9–Compound 5 und SRC (PDB 2H8H)–Compound 5 generiert, wobei SRC (PDB 2H8H)–Compound 6 als passende negative Kontrolltrajektorie einbezogen wurde. Die anfänglichen Konformationen sind in Abbildung 6A, Abbildung 6B, und Abbildung 6C dargestellt. In diesen Trajektorien wies Compound 5 eine geringere Liganden-RMSD (Abbildung 6D) in den MMP9- und SRC-Systemen auf als Compound 6 in SRC. Die MMP9–Compound-5-Trajektorie erreichte einen Bereich mit vergleichsweise geringen Schwankungen, die SRC–Compound-5-Trajektorie stabilisierte sich nach einer anfänglichen Anpassungsphase, während die SRC–Compound-6-Trajektorie stärkere Fluktuationen zeigte. Diese Unterschiede deuten auf eine höhere Beständigkeit der ausgewählten Docking-Posen von Compound 5 während der MD hin. Sie belegen jedoch nicht, dass Compound 5 MMP9 oder SRC in Zellen bindet, und die MMP9-Trajektorie kompensiert nicht das Fehlen einer kanonischen katalytischen ZN2⁺-Wechselwirkung in der Ausgangsposition.
Der RMSD des Proteinrückgrats zeigte ein ähnliches vergleichbares Muster. Die Trajektorie von MMP9–Compound 5 erreichte nach etwa 30 ns ein relativ stabiles Rückgrat-Regime, während die Trajektorie von SRC–Compound 5 später eine Sättigung zeigte und die Trajektorie von SRC–Compound 6 größere Schwankungen aufwies. Diese Beobachtungen beschreiben lediglich das Verhalten der Trajektorien. Ein stabiles Proteinrücken- oder Liganden-Trajektorium kann keine intrazelluläre Targetbesetzung, Enzymhemmung oder Signalmodulation belegen. Die RMSD-Profile des Proteinrückgrats für alle drei Systeme sind in Supplementary Figure 2 dargestellt.
Tracjektorienanalyse
Analysen zur Wasserstoffbrücken-Besetzung und Restschwankungen wurden verwendet, um die Beständigkeit von Kontakten innerhalb der MD-Trajektorien zu beschreiben (Abbildung 7A). Verbindung 5 zeigte eine Wasserstoffbrücke mit hoher Besetzung mit Arg95 in der MMP9-Trajektorie (>85 %) sowie eine wiederkehrende Wechselwirkung mit Leu325 in der SRC-Trajektorie (>70 %), während repräsentative Kontakte in der SRC–Verbindung-6-Kontrolle niedrigere Besetzungen aufwiesen. Diese Reste werden nicht als Hinweis auf eine funktionelle Zielmodulation herangezogen; die Besetzungswerte geben lediglich an, wie häufig die angegebenen Kontakte während der analysierten Trajektorien auftraten.
Die RMSF-Analyse der Bindungstaschen-Reste zeigte systemspezifische Unterschiede in der lokalen Flexibilität (Abbildung 7B). Die Trajektorie von SRC–Verbindung 6 wies mehrere stärkere lokale Schwankungen auf als die Trajektorie von SRC–Verbindung 5, während die Trajektorie von MMP9–Verbindung 5 innerhalb ihres eigenen Satzes an Bindungstaschen-Resten ein vergleichsweise geringeres Schwankungsprofil zeigte. Da MMP9 und SRC unterschiedliche Proteine sind, wurden ihre RMSF-Werte auf Restebene nicht als direkter Reste-für-Reste-Vergleich interpretiert. Zusammen mit der Wasserstoffbrücken-Besetzungsrate charakterisieren diese Ergebnisse die Beständigkeit der Kontakte und die lokale Flexibilität und helfen dabei, Komplexe für experimentelle Untersuchungen zu priorisieren. Sie belegen jedoch nicht, dass MMP9 oder SRC intrazelluläre Zielstrukturen darstellen, noch zeigen sie, dass eines der beiden Proteine den Antikrebs-Phänotyp der Verbindungen vermittelt.
Berechnung der bindenden freien Energie nach der Methode der molekularen Mechanik mit Poisson-Boltzmann-Oberflächenbereich
In Abbildung 8 dargestellte MM-PBSA-Schätzungen, berechnet aus den equilibrierten Trajektorienabschnitten. Der MMP9–Verbindung 5-Komplex ergab eine ΔG_bind-Schätzung von -19,65 ± 6,43 kcal·mol⁻1, der SRC–Verbindung 5-Komplex -17,72 ± 6,84 kcal·mol⁻1 und die Kontrolle SRC–Verbindung 6 -10,37 ± 5,61 kcal·mol⁻1. Gemäß diesem Berechnungsprotokoll ergab sich somit die relative energetische Reihenfolge: MMP9–Verbindung 5, gefolgt von SRC–Verbindung 5 und SRC–Verbindung 6. Diese Werte sind methodeabhängige Schätzungen, die aus einem endlichen Trajektorienabschnitt abgeleitet wurden; dabei wurde keine Entropiekorrektur angewendet. Sie wurden daher ausschließlich für den internen Vergleich innerhalb der Studie verwendet und sollten nicht als experimentell bestimmte Bindungsaffinitäten oder als Hinweis auf funktionelle Proteinmodulation interpretiert werden.
Anhand von Docking-, MD-, Kontaktbesetzungs-, Restschwankungs- und MM-PBSA-Analysen wurde Verbindung 5 computergestützt für die Nachuntersuchung in den MMP9- und SRC-Komplexen priorisiert. Die Übereinstimmung dieser Berechnungen stärkt die Begründung für die Auswahl dieser Paare für nachfolgende Experimente, bestätigt jedoch nicht MMP9 oder SRC als direkte intrazelluläre Zielstrukturen. Insbesondere die nichtkanonische MMP9-Positionierung und das Fehlen eines nachgewiesenen katalytischen ZN2⁺-Koordinationskomplexes schließen die Schlussfolgerung eines kanonischen MMP9-hemmenden Wirkmechanismus aus den vorliegenden strukturellen Daten aus.
Schlussfolgerungen aus den Ergebnissen
Der rechnergestützte Arbeitsablauf priorisierte 21 überlappende, krankheitsassoziierte Zielstrukturen und identifizierte AKT1, EGFR, TNF, MMP9 und SRC als topologische Hub-Kandidaten. Strukturbasierte Analysen stellten Verbindung 5 für die experimentelle Weiterverfolgung in den MMP9- und SRC-Komplexen weiter in den Vordergrund. Diese Ergebnisse belegen weder eine direkte Zielstrukturenbindung, eine Hemmung von MMP9 oder SRC, eine Regulierung von Signalwegen noch einen kausalen, mechanistischen Zusammenhang zwischen Proteinwechselwirkungen und dem zuvor etablierten Effekt des Abfangens von apurinischen Stellen. Die Studie unterstützt daher einen Satz überprüfbarer rechnergestützter Hypothesen, nicht jedoch einen experimentell belegten multimodalen anti-NSCLC-Mechanismus.
VERFÜGBARKEIT VON DATEN:
Der Datensatz, der die Ergebnisse dieser Studie unterstützt, ist öffentlich verfügbar in Wang X, Peng Z, Xing Y, Xue L. In silico-Priorisierung potenzieller Proteinwechselwirkungen für Glutathion-reaktive Apurin/Apyrimidin-Stellen-abfangende Prodrugs beim nicht-kleinzelligen Lungenkarzinom [Datensatz]. Figshare; 2026. doi:10.6084/m9.figshare.33313620.v1.
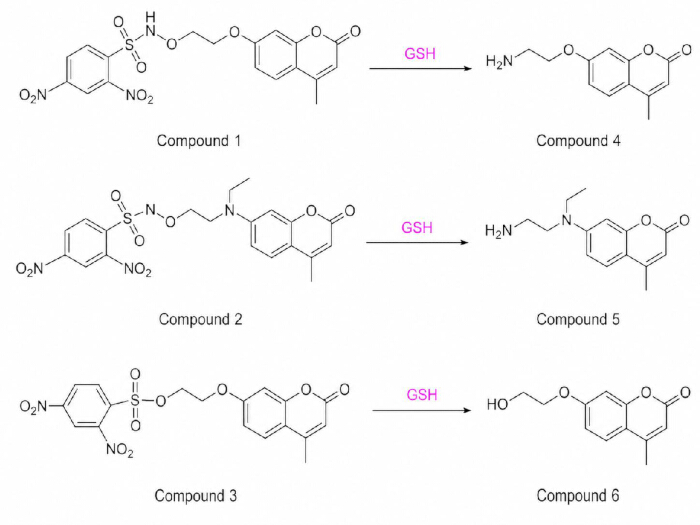
Abbildung 1: Chemische Strukturen und Glutathion-aktivierten Umwandlungsbeziehungen der untersuchten Verbindungen. Verbindung 1 und Verbindung 2 sind Glutathion-responsiven Prodrugs, die die Aminooxy-haltigen Metaboliten Verbindung 4 bzw. Verbindung 5 freisetzen. Verbindung 3 ist eine strukturell passende, Glutathion-responsiven Kontrolle, die Verbindung 6 erzeugt, welche die Aminooxy-abasische-Sequenz-bindende Funktion fehlt. Verbindungen 1–3 wurden für die reverse Zielvorhersage verwendet, Verbindung 4 und Verbindung 5 für das Hub-Ziel-Docking, und Verbindung 6 als negativer Kontrollligand im molekulardynamischen Vergleich von SRC. Abkürzungen: SRC, SRC-Proto-Onkogen, nichtrezeptorassoziierte Tyrosinkinase. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
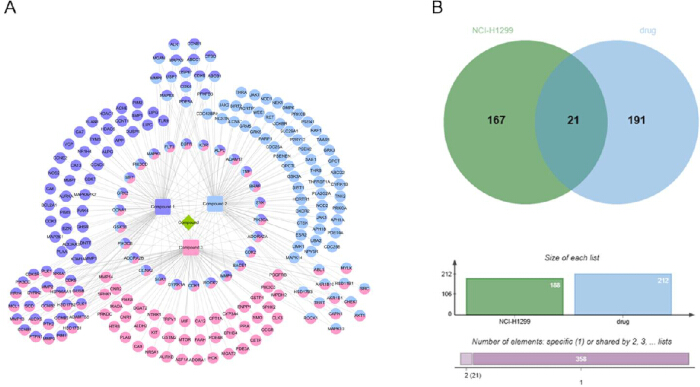
Abbildung 2: Schnittmenge zwischen vorhergesagten Wirkstoffzielen und mit nicht-kleinzelligem Lungenkarzinom assoziierten Zielstrukturen. (A) Wirkstoff-Ziel-Netzwerk, erstellt auf Grundlage der Ergebnisse der inversen Zielvorhersage für die Verbindungen 1–3. (B) Venndiagramm, das die Überschneidung zwischen den vorhergesagten Wirkstoffzielen und den mittels der H1299-Lungenkrebs-Anfrage ermittelten krankheitsassoziierten Zielstrukturen zeigt. Die 21 gemeinsamen Zielstrukturen wurden für die Analyse von Protein-Protein-Interaktionen, die Anreicherungsanalyse und die anschließende strukturbasierte Priorisierung beibehalten. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
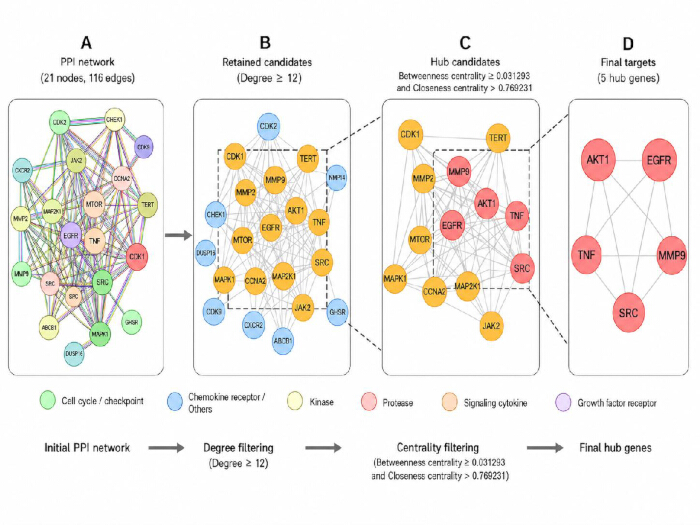
Abbildung 3: Netzwerk der Protein-Protein-Interaktionen und Screening der zentralen Zielstrukturen. (A) Netzwerk der Protein-Protein-Interaktionen der 21 überlappenden Zielstrukturen (116 Kanten). (B) Erster Screening-Schritt mittels Degree ≥ 12, wodurch 13 Kandidaten beibehalten wurden. (C) Zweiter Screening-Schritt der 13 verbliebenen Kandidaten mittels Zwischenzentralität (Betweenness Centrality) ≥ 0,031293 und Nähezentralität (Closeness Centrality) > 0,769231, der fünf Hub-Kandidaten ergab. (D) Endgültige fünf Hub-Kandidaten: AKT1, EGFR, TNF, MMP9 und SRC. Die für die schrittweisen Filter verwendeten Zentralitätswerte wurden am ursprünglichen Netzwerk mit 21 Knoten und 116 Kanten berechnet und anschließend übernommen, anstatt nach Bildung jeder Teilmenge neu berechnet zu werden. Abkürzungen: AKT1, AKT-Serin/Threonin-Kinase 1; EGFR, epidermaler Wachstumsfaktor-Rezeptor; TNF, Tumornekrosefaktor; MMP9, Matrix-Metalloproteinase 9; SRC, SRC-Proto-Onkogen, nichtrezeptorgebundene Tyrosinkinase. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
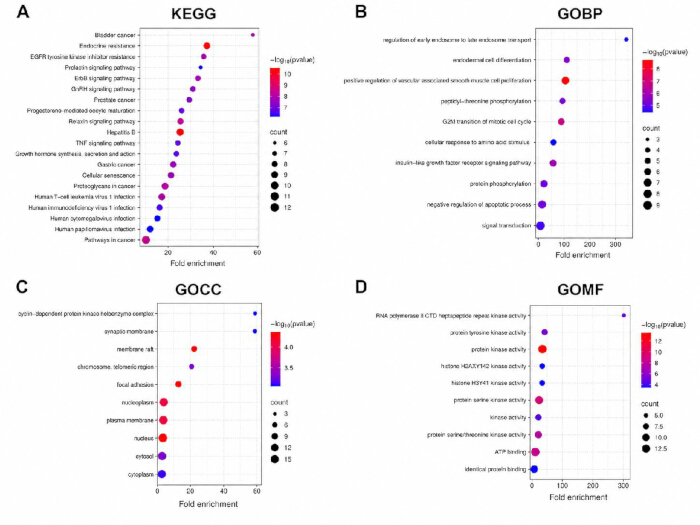
Abbildung 4: Funktionsanreicherungsanalyse der überlappenden Zielstrukturen. (A) Blasendiagramm der 20 am stärksten angereicherten Kyoto Encyclopedia of Genes and Genomes (KEGG)-Pfade. (B) Balkendiagramm der 10 am stärksten angereicherten Gene Ontology (GO)-Begriffe für biologische Prozesse. (C) Balkendiagramm der 10 am stärksten angereicherten Gene Ontology (GO)-Begriffe für zelluläre Komponenten. (D) Balkendiagramm der 10 am stärksten angereicherten Gene Ontology (GO)-Begriffe für molekulare Funktionen. Die Anreicherung ist in der endgültigen Darstellung auf der x-Achse angegeben; die Blasengröße in Panel A spiegelt die Genanzahl wider. Alle zugrundeliegenden KEGG- und GO-Einträge in den ergänzenden Tabellen 4–7 erfüllten das nominale Inklusionskriterium von p < 0,10; dargestellte Pfade/Begriffe waren diejenigen mit den niedrigsten nominalen p-Werten. Werte, die für Mehrfachvergleiche adjustiert wurden, sind in den ergänzenden Tabellen angegeben, wurden jedoch nicht für die Auswahl herangezogen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
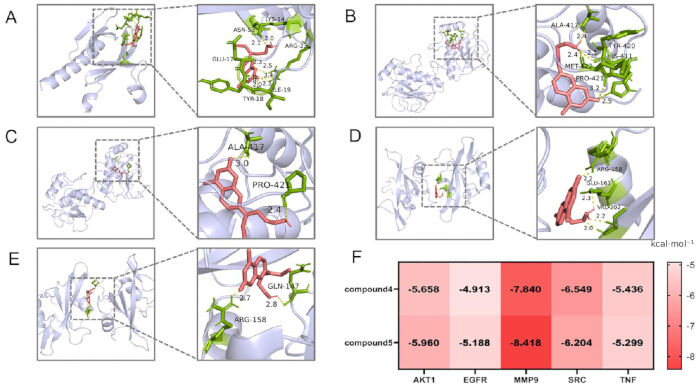
Abbildung 5: Molekulare Docking-Positionen und AutoDock Vina-Scores von Verbindung 4 und Verbindung 5 mit den priorisierten Proteinen. (A) Vorhergesagte Docking-Position von Verbindung 5 mit AKT1. (B) Vorhergesagte Docking-Position von Verbindung 4 mit MMP9. (C) Bester vorhergesagter Docking-Modus von Verbindung 5 mit MMP9; die dargestellten Kontakte liegen in der Nähe von Ala417 und Pro421, während keine direkte katalytische ZN2⁺-Koordination oder direkter Kontakt mit His401, Glu402, His405 oder His411 annotiert ist. Die Position wird daher nicht als kanonischer MMP9-hemmender Bindungsmodus dargestellt. Ein Vergleich mit der Interaktionskarte des NFH-gebundenen MMP9-Kristallstruktur (PDB 1GKC), einschließlich der kristallographischen ZN2⁺-Koordinationsabstände, ist in der ergänzenden Abbildung 3 enthalten. (D) Vorhergesagte Docking-Position von Verbindung 4 mit SRC. (E) Vorhergesagte Docking-Position von Verbindung 5 mit SRC. (F) Wärmekarte der AutoDock Vina-Docking-Scores (kcal·mol⁻1) für Verbindung 4 und Verbindung 5 gegenüber den fünf priorisierten Proteinen. Negativere Werte deuten auf günstigere Vina-Scores innerhalb dieses Docking-Protokolls hin; es handelt sich jedoch nicht um experimentell gemessene Bindungsaffinitäten. Abkürzungen: AKT1, AKT-Serin/Threonin-Kinase 1; MMP9, Matrix-Metalloproteinase 9; NFH, N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-methylpentanoyl]-N,3-dimethyl-L-valinamid; SRC, SRC-Proto-Onkogen, nicht-rezeptorassoziierte Tyrosinkinase; PDB, Protein Data Bank; Ala, Alanin; Pro, Prolin; His, Histidin; und Glu, Glutamat. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
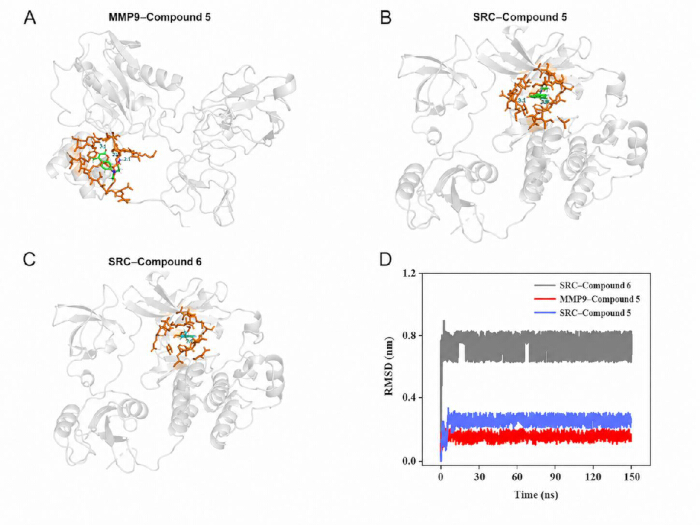
Abbildung 6: Strukturelle Übersicht und Liganden-Stabilitätsanalyse der MD-Komplexe. (A) Anfängliche Docking-Konformation von Verbindung 5 mit MMP9, die als Startstruktur für die Molekulardynamik (MD) verwendet wurde. (B) Anfängliche Docking-Konformation von Verbindung 5 mit SRC (PDB 2H8H). (C) Anfängliche Docking-Konformation von Verbindung 6 mit SRC (PDB 2H8H); Verbindung 6 ist das Glutathion-Spaltprodukt der Kontrollverbindung 3 und fehlt die Aminooxy-abasische-Stelle-Fanganordnung. (D) Wurzel-des-mittleren-Quadrat-Abweichung (RMSD) des Liganden relativ zur anfänglichen Docking-Konformation über die 150 ns langen Trajektorien für MMP9–Verbindung 5, SRC–Verbindung 5 und SRC–Verbindung 6. Das Panel vergleicht die Beständigkeit der Konformation während der MD und zeigt nicht die intrazelluläre Zielinteraktion an. Abkürzungen: MD, Molekulardynamik; MMP9, Matrix-Metalloprotease 9; SRC, SRC-Protoonkogen, nicht-rezeptorassoziierte Tyrosinkinase; PDB, Protein Data Bank; RMSD, Wurzel-des-mittleren-Quadrat-Abweichung. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
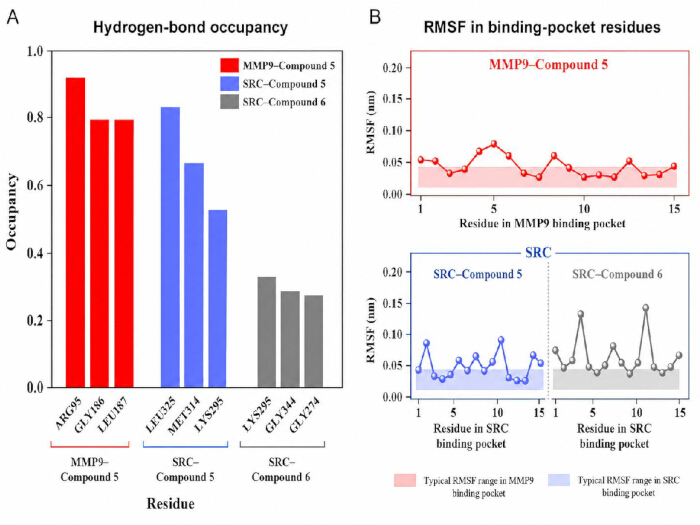
Abbildung 7: Dynamische Interaktionsmerkmale während der Molekulardynamik-Analyse. (A) Besetzung repräsentativer Ligand-Protein-Wasserstoffbrückenbindungen während der 150 ns Trajektorien für MMP9–Verbindung 5, SRC–Verbindung 5 und SRC–Verbindung 6. (B) Quadratisch gemittelte Fluktuation der Bindetaschen-Reste. Das MMP9-Profil wird im Kontext des MMP9-Systems interpretiert, während die SRC–Verbindung 5- und SRC–Verbindung 6-Profile einen direkten vergleichbaren Vergleich innerhalb von SRC ermöglichen. Diese Analysen beschreiben die Beständigkeit von Kontakten und die lokale Flexibilität während der MD und belegen nicht die intrazelluläre Zielstrukturenbindung oder die funktionelle Modulation von MMP9 oder SRC. Abkürzungen: MD, Molekulardynamik; MMP9, Matrix-Metalloproteinase 9; SRC, SRC-Proto-Onkogen, nichtrezeptorassoziierte Tyrosinkinase; RMSF, quadratisch gemittelte Fluktuation. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
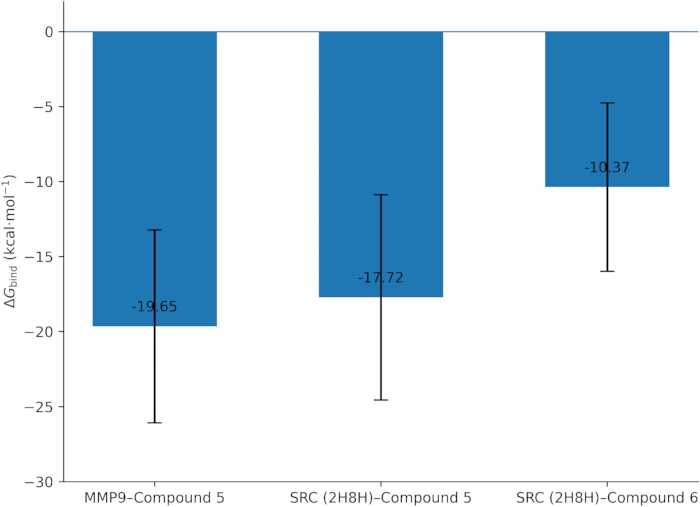
Abbildung 8: Molekulare Mechanik Poisson-Boltzmann Oberflächenareal-basierte energetische Schätzungen für die analysierten Komplexe. Geschätzte ΔG_bind-Werte, erhalten mittels der molekularen Mechanik Poisson-Boltzmann Oberflächenareal-Methode aus den equilibrierten Trajektoriensegmenten der MMP9–Verbindung 5, SRC (PDB 2H8H)–Verbindung 5 und SRC (PDB 2H8H)–Verbindung 6 Komplexe. Die Werte sind als Mittelwert ± Standardabweichung angegeben und dienen dem relativen innerhalb-studienvergleich, nicht als experimentell gemessene Bindungsaffinitäten. Abbildung 8 verwendet die y-Achsenbeschriftung ΔG_bind (kcal·mol⁻1), konsistent mit der im Abschnitt Methoden und Ergebnisse verwendeten Gleichung und Terminologie. Abkürzungen: MMP9, Matrix-Metalloproteinase 9; SRC, SRC-Protoonkogen, nichtrezeptorassoziierte Tyrosinkinase; PDB, Protein Data Bank; ΔG_bind, Bindungs-Freie Energie; MM-PBSA, molekulare Mechanik Poisson–Boltzmann Oberflächenareal-Methode. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
| Verbindung | AKT1 (kcal·mol⁻¹) | EGFR (kcal·mol⁻¹) | MMP9 (kcal·mol⁻¹) | SRC (kcal·mol⁻¹) | TNF (kcal·mol⁻¹) |
| Verbindung 4 | -5.658 | -4.913 | -7.840 | -6.549 | -5.436 |
| Verbindung 5 | -5.960 | -5.188 | -8.418 | -6.204 | -5.299 |
Tabelle 1: AutoDock Vina-Dockingscores von Verbindung 4 und Verbindung 5 gegenüber den fünf priorisierten Proteinen. AutoDock Vina-Dockingscores (kcal·mol⁻1) für Verbindung 4 und Verbindung 5 mit AKT1, EGFR, MMP9, SRC und TNF. Weitere negative Werte weisen auf günstigere Scores innerhalb des angegebenen Docking-Protokolls hin. Diese Werte sind berechnete Scores und sollten nicht als experimentell bestimmte Bindungs-Freie Energien oder Affinitäten beschrieben werden. Abkürzungen: AKT1, AKT-Serin/Threonin-Kinase 1; EGFR, epidermaler Wachstumsfaktor-Rezeptor; MMP9, Matrix-Metalloproteinase 9; SRC, SRC-Proto-Onkogen, nichtrezeptorgebundene Tyrosinkinase; TNF, Tumornekrosefaktor.
Abbildung ergänzend 1: Struktureller Vergleich des kristallographischen Referenzkomplexes MMP9–NFH mit der am höchsten bewerteten Docking-Konformation von MMP9–Verbindung 5. (A) Katalytische ZN2⁺-Umgebung des MMP9–NFH-Referenzkomplexes (PDB 1GKC), dargestellt mit His401, His405, His411, Glu402 und den angezeigten Koordinationsabständen von NFH. (B) Am höchsten bewertete Docking-Konformation von Verbindung 5, mit den angezeigten Wechselwirkungen zu Ala417 und Pro421. (C) Alternative dreidimensionale Ansicht derselben Docking-Konformation von Verbindung 5. Der Vergleich dient als strukturelle Referenz und belegt keine Hemmung von MMP9. Abkürzungen: MMP9, Matrix-Metalloprotease 9; NFH, N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-methylpentanoyl]-N,3-dimethyl-L-valinamid; PDB, Protein Data Bank; Ala, Alanin; Pro, Prolin; His, Histidin; Glu, Glutamat.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 2, Zusatzmaterial: Mittlere quadratische Abweichung des Protein-Backbones während der Molekulardynamik-Analyse. Profile der mittleren quadratischen Abweichung des Protein-Backbones für die Systeme MMP9–Verbindung 5, SRC (PDB 2H8H)–Verbindung 5 und SRC (PDB 2H8H)–Verbindung 6 über die gesamten Molekulardynamik-Trajektorien. Der endgültige Plot verwendet die standardisierten Bezeichnungen MMP9–Verbindung 5, SRC–Verbindung 5 und SRC–Verbindung 6, wobei die Achsen als RMSD (nm) und Zeit (ns) angegeben sind. Die Profile beschreiben das zeitabhängige konformationelle Verhalten während der MD und sollten nicht als Hinweis auf zelluläre Bindung oder Proteinsregulation interpretiert werden. Abkürzungen: MMP9, Matrix-Metalloprotease 9; SRC, SRC-Protoonkogen, nichtrezeptorassoziierte Tyrosinkinase; PDB, Protein Data Bank; RMSD, mittlere quadratische Abweichung; MD, Molekulardynamik.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 3 (zusätzlich): Vergleich der katalytischen ZN2⁺-Umgebung von MMP9 im Referenzkomplex 1GKC-NFH und der am höchsten bewerteten Docking-Pose von Verbindung 5. Im kristallographisch bestimmten Referenzkomplex MMP9–NFH (PDB 1GKC) koordinieren His401, His405 und His411 das katalytische ZN2⁺ in Abständen von 2,21, 2,23 bzw. 2,22 Å; zwei Sauerstoffatome von NFH koordinieren ZN2⁺ in Abständen von 2,07 und 2,38 Å; Glu402 fungiert als katalytische Säure/Base-Gruppe. Im Gegensatz dazu zeigt die beibehaltene, am höchsten bewertete Interaktionskarte von Verbindung 5 Kontakte mit Ala417 (3,0 Å) und Pro421 (2,4 Å), jedoch keine annotierte direkte ZN2⁺-Koordination oder direkte Kontakte zu His401, Glu402, His405 oder His411. Entsprechend wurde kein Koordinationsabstand zwischen Verbindung 5 und ZN2⁺ bestimmt. Dieser Vergleich stützt die Einstufung der Pose von Verbindung 5 als nichtkanonische, vorhergesagte Assoziation im Gegensatz zu einem kanonischen, zinkabhängigen inhibitorischen Bindungsmodus. Abkürzungen: MMP9, Matrix-Metalloprotease 9; PDB, Protein Data Bank; Ala, Alanin; Pro, Prolin; His, Histidin; Glu, Glutamat.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzungstabelle 1: Topologische Metriken für das anfängliche Protein-Protein-Interaktionsnetzwerk mit 21 Knoten und 116 Kanten. Topologische Parameter aller 21 überschneidenden Zielknoten vor der Zentralitätsbasierten Auswahl, einschließlich durchschnittliche kürzeste Pfadlänge, Zwischenwertzentralität, Nähezentralität, Clusterkoeffizient, Grad, Exzentrizität, Nachbarschaftsverbindung, Radialität, Stress und topologischer Koeffizient. Die Knotengrade summieren sich zu 232, was 116 ungerichteten Kanten entspricht.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Tabelle 2: Topologische Metriken des ursprünglichen Netzwerks für die 13 Kandidaten, die nach der gradbasierten Auswahl beibehalten wurden. Topologische Parameter für die 13 Knoten, die nach Anwendung des Grad-Kriteriums an dem anfänglichen 21-Knoten-, 116-Kanten-Netzwerk beibehalten wurden. Diese Werte entsprechen den Metriken des ursprünglichen 21-Knoten-, 116-Kanten-Netzwerks, die für den anschließenden Filterungsschritt mittels Betweenness- und Closeness-Zentralität übernommen wurden; sie wurden nicht erneut auf einem 13-Knoten-Teilnetzwerk berechnet.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Erweiterte Tabelle 3: Topologische Metriken des ursprünglichen Netzwerks für die endgültigen fünf Hub-Kandidaten, die nach schrittweiser Filterung beibehalten wurden. Ursprüngliche topologische Parameter des 21-Knoten-, 116-Kanten-Netzwerks für die endgültigen fünf Hub-Kandidaten AKT1, EGFR, TNF, MMP9 und SRC, die nach schrittweiser Filterung beibehalten wurden. Diese übernommenen Werte unterstützen lediglich die netzwerkbasierte Priorisierung und stellen keine neu berechneten Metriken für ein Unternetzwerk aus fünf Knoten dar oder bestätigen die Proteine als experimentell validierte Wirkstoffziele. Abkürzungen: AKT1, AKT-Serin/Threonin-Kinase 1; EGFR, epidermaler Wachstumsfaktor-Rezeptor; TNF, Tumornekrosefaktor; MMP9, Matrix-Metalloproteinase 9; SRC, SRC-Protonkogen, nichtrezeptorassoziierte Tyrosinkinase.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Tabelle 4: Vollständige Kyoto-Enzyklopädie der Gene und Genome (KEGG)-Anreicherungsergebnisse für 121 Signalwege, die das nominale Einbeziehungskriterium von p < 0,10 erfüllen. Vollständige statistische Angaben zur KEGG-Anreicherung für alle 121 beibehaltenen Signalwege unter den 21 überschneidenden Zielstrukturen (nominal p < 0,10), einschließlich Genverhältnis, Genanzahlen, Listeninhalte, Populationstreffer, Populationsgesamtzahlen, p-Werte, Benjamini-Werte, Anreicherungsfaktoren, Bonferroni-Werte, Falsch-Entdeckungs-Raten und Werte des exakten Fisher-Tests. Die 20 am höchsten eingestuften Signalwege sind in Abbildung 4A dargestellt. Die Einbeziehung erfolgte anhand des nominalen p-Wert-Kriteriums; Benjamini-, Bonferroni- und Falsch-Entdeckungs-Raten-Werte werden der Transparenz halber angegeben, wurden jedoch nicht zur Definition der beibehaltenen Menge herangezogen.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Tabelle 5: Vollständige Ergebnisse der biologischen Prozess-Enrichment-Analyse nach Gene Ontology (177 Terme, die das nominale Kriterium erfüllen) p < 0.10). Vollständige Anreicherungsstatistiken für alle 177 beibehaltenen biologischen Prozess-Terme der Genontologie (nomineller p-Wert < 0,10), einschließlich Genverhältnis, Genanzahl, Gesamtliste, Treffer in der Population, Gesamtpopulation, p-Wert, Benjamini-Wert, Anreicherungsgrad, Bonferroni-Wert, falscher Entdeckungsrate und Fishers exakter Test-Wert. Die 10 am höchsten eingestuften Terme sind in Abbildung 4B dargestellt. Der nominelle pDer -Wert-Kriterium definierte die Einschlusskriterien; angepasste Werte werden zur Transparenz angegeben und wurden nicht zur Definition der beibehaltenen Menge verwendet.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatz-Tabelle 6: Vollständige Ergebnisse der Gene-Ontology-Anreicherung für zelluläre Komponenten (29 Terme mit nominalem p < 0,10). Vollständige Anreicherungsstatistiken für alle 29 beibehaltenen Gene-Ontology-Terme für zelluläre Komponenten (nominaler p < 0,10), einschließlich Gen-Verhältnis, Gen-Anzahl, Listen-Gesamtzahl, Populationstreffer, Populations-Gesamtzahl, p-Wert, Benjamini-Wert, Anreicherungsfaktor, Bonferroni-Wert, falsche Entdeckungsrate und Wert des exakten Fisher-Tests. Die 10 am höchsten eingestuften Terme sind in Abbildung 4C dargestellt. Die Auswahl erfolgte anhand des nominalen p-Wert-Kriteriums; angepasste Werte wurden der Transparenz halber angegeben, zur Definition der beibehaltenen Terme wurden sie jedoch nicht herangezogen.Bitte klicken Sie hier, um die Datei herunterzuladen.
Erweiterte Tabelle 7: Vollständige Ergebnisse der Gene Ontology-Anreicherung für molekulare Funktionen (61 Terme mit nominalem p < 0,10). Vollständige Anreicherungsstatistiken für alle 61 beibehaltenen Gene Ontology-Terme für molekulare Funktionen (nominaler p < 0,10), einschließlich Genverhältnis, Anzahl der Gene, Gesamtanzahl der Liste, Treffer in der Grundgesamtheit, Gesamtgröße der Grundgesamtheit, p-Wert, Benjamini-Wert, Anreicherungsfaktor, Bonferroni-Wert, falsche Entdeckungsrate und Wert des exakten Fisher-Tests. Die 10 am höchsten eingestuften Terme sind in Abbildung 4D dargestellt. Die Aufnahme wurde anhand des nominalen p-Werts festgelegt; angepasste Werte werden der Transparenz halber angegeben, wurden jedoch nicht zur Definition der beibehaltenen Menge herangezogen.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Die vorliegende Studie sollte im Rahmen eines zweistufigen mechanistischen Konzepts interpretiert werden. Die erste Stufe stützt sich auf frühere experimentelle Arbeiten: Die durch Glutathion ausgelöste Aktivierung setzt eine Aminooxy-haltige Spezies frei, die aldehydische apurinische Stellen abfangen kann, und die Verbindungsklasse zeigte eine selektive Zytotoxizität sowie Effekte auf den Zellzyklus und Apoptose in H1299-Zellen. Die zweite Stufe ist explorativ und steht im Mittelpunkt der vorliegenden Arbeit: computergestützte Zielvorhersage und strukturbasierte Analysen legen nahe, dass dieselbe Substanzklasse möglicherweise auch mit ausgewählten, krebsassoziierten Proteinen kompatibel ist. Kein Experiment in dieser Studie belegt, dass die vorhergesagten Proteinwechselwirkungen in Zellen tatsächlich auftreten oder dass sie Folgeerscheinungen der Bindung an apurinische Stellen sind. Die beiden Ebenen werden daher bewusst getrennt gehalten und nicht zu einem nachgewiesenen Multitarget-Mechanismus zusammengeführt.
Auf Netzwerkebene waren die 21 überschneidenden Zielstrukturen in krebs- und resistenzbezogenen Signalwegen angereichert, und AKT1, EGFR, TNF, MMP9 und SRC nahmen zentrale Positionen im PPI-Netzwerk ein. Diese Ergebnisse sind für die Priorisierung von Kandidaten hilfreich, aber Netzwerkzentralität und Anreicherung können nicht zeigen, dass eine Verbindung eine Proteine direkt bindet oder einen Signalweg verändert. Hub-Proteine sollten daher als Kandidaten für gezielte Validierung betrachtet werden. Der Nachweis einer funktionellen Rolle würde direkte Störungs- oder Target-Bindungs-Experimente in derselben NSCLC-Zelllinie erfordern, die zur Messung des zellulären Phänotyps verwendet wurde.
MMP9 veranschaulicht, warum diese Unterscheidung wichtig ist. Verbindung 5 wies die günstigste einzelne Docking-Score mit MMP9 auf, doch die beibehaltene Interaktionskarte der Top-Pose zeigte keine Annotation einer direkten Koordination des katalytischen Zn2+ Ion oder direkte Bindung von His401, Glu402, His405 oder His411. In der kristallographischen Referenz 1GKC koordinieren His401, His405 und His411 Zn2+ bei 2,21, 2,23 und 2,22 Å, während die beiden Sauerstoffatome des NFH Zn koordinieren2+ bei 2,07 und 2,38 Å; Glu402 ist das katalytische Säure/Base-Rest. Die Karte der Verbindung 5 zeigte stattdessen Kontakte in der Nähe von Ala417 und Pro421. Zusatzabbildung 3 zeigt den Vergleich der Referenzinteraktionskarte. Aufgrund direkter Verbindung 5-Zn2+ Koordination wurde nicht annotiert, kein Compound 5-Zn2+ Die Koordinationsdistanz wurde zugeordnet. Demnach lässt sich das vorliegende strukturelle Ergebnis am besten als nichtkanonische vorhergesagte Assoziation mit MMP9 beschreiben, nicht jedoch als Nachweis einer katalytischen Hemmung der aktiven Stelle. Die anschließende MD-Trajektorie überprüft lediglich, ob diese spezifische Docking-Position über die Zeit hinweg stabil bleibt; sie kann jedoch keine nichtkanonische Docking-Geometrie in einen Nachweis enzymatischer Hemmung umwandeln.36,37MMP9 sollte daher als Kandidat für biochemische Tests verbleiben und nicht als primäres oder validiertes Target angesehen werden. MMP9 wurde hinsichtlich der Krebsinvasion, der Remodellierung der Tumormikroumgebung sowie bezüglich auf MMP9 ausgerichteter therapeutischer Strategien umfassend diskutiert.38,39.
Die gleiche Beweisgrenze gilt für SRC. Die Trajektorie von SRC–Verbindung 5 zeigte persistentere Kontakte als die Kontrolle mit SRC–Verbindung 6, aber die MD-Stabilität entspricht nicht der Besetzung des intrazellulären Targets40,41. Die Verwendung von Verbindung 6 ermöglicht einen vergleichbaren Vergleich mit dem nicht-bindenden Spaltprodukt und stärkt den internen strukturellen Vergleich, beweist jedoch nicht, dass die Aminooxy-Funktionalität für die Bindung an SRC verantwortlich ist oder dass die SRC-Signalübertragung in Zellen verändert wird. Eine direkte Bewertung der Gesamt-SRC-, p-SRC/SRC-, downstream-Signalmarkern sowie orthogonaler Target-Engagement-Messungen wäre erforderlich, um eine solche Behauptung zu untermauern.
MM-PBSA liefert ebenso eine relativ energetische Abschätzung für die untersuchten Trajektorien anstelle einer experimentellen Affinitätsmessung. Die günstigeren Abschätzungen für MMP9–Verbindung 5 und SRC–Verbindung 5 im Vergleich zu SRC–Verbindung 6 stimmen mit den vergleichenden Trajektorienbeobachtungen überein, doch die Berechnungen sind empfindlich gegenüber den abgetasteten Konformationen und methodischen Näherungen, und die vorliegende Analyse beinhaltete keine Entropiekorrektur. Eine Übereinstimmung zwischen Docking, MD und MM-PBSA erhöht daher lediglich die interne rechnerische Kohärenz; sie belegt jedoch keine funktionelle Modulation von MMP9 oder SRC.
Die Beziehung zwischen der Bindung von apurinischen/apyrimidinischen Stellen und den vorhergesagten Proteinwechselwirkungen ist weiterhin ungeklärt. Eine Möglichkeit ist, dass das durch Glutathion freigesetzte Aminooxy-Gerüst seine etablierte Aktivität zur Erfassung von DNA-Schäden beibehält und gleichzeitig unabhängige, parallele Wechselwirkungen mit ausgewählten Proteinen eingeht. Eine andere Möglichkeit ist, dass einige vorhergesagte Proteinwechselwirkungen bei biologisch relevanten Konzentrationen nicht auftreten oder nicht zum Phänotyp beitragen. Die vorliegenden Daten können diese Möglichkeiten nicht unterscheiden. Der Nachweis einer mechanistischen Verbindung würde gleichzeitige Messungen der DNA-Schadensantworten und der Veränderungen in Proteinwegen nach Behandlung mit der Verbindung erfordern, gefolgt von Störungsexperimenten, die zeigen, dass die Modulation eines Kandidatenziels den antigene Phänotyp verändert.
Die zukünftige experimentelle Validierung sollte in H1299-Zellen durchgeführt werden, demselben zellulären Modell, das bei der vorherigen experimentellen Charakterisierung dieser chemischen Substanzklasse verwendet wurde. Eine schrittweise Strategie würde zunächst Verbindung 5 mit dem Applikationsvehikel und der passenden, nicht bindenden Verbindung 6 in Konzentrations-Wirkungs-Kurven hinsichtlich Zellviabilität, Apoptose, Zellzyklus, Migration/Invasion sowie γH2AX-Assays vergleichen, um den phänotypischen Kontext und den DNA-Schaden zu bestimmen42. Anschließend sollte MMP9 mittels Gelatine-Zymographie und Proteinexpressionsanalyse untersucht werden, während die SRC-Signalübertragung über die Gesamt-SRC- und die Tyr416-phosphorylierte SRC-Proteinmenge bewertet werden sollte, wobei das p-SRC/SRC-Verhältnis als primärer Signalnachweis dient. Die direkte Verbindung-Protein-Interaktion sollte unabhängig mittels einer orthogonalen Target-Engagement-Methode wie der Oberflächen-Plasmonenresonanz43 überprüft werden. Eine potenzielle Interaktion sollte nur dann als experimentell bestätigt gelten, wenn der direkte Bindungsnachweis mit dem entsprechenden zellulären funktionellen Ergebnis übereinstimmt. Eine genetische oder pharmakologische Störung von MMP9 oder SRC würde eine weitere Prüfung ermöglichen, ob einer der beiden Kandidaten kausal zum H1299-Phänotyp beiträgt. Dieser schrittweise Ansatz bewahrt die Unterscheidung zwischen der zuvor etablierten Aktivität des Abasenstellen-Bindens und den rechnerisch priorisierten Hypothesen zur MMP9/SRC-Interaktion und definiert gleichzeitig einen direkten Weg für nachfolgende experimentelle Untersuchungen.
Offenlegungen
Die Autoren erklären, dass sie keine konkurrierenden finanziellen Interessen oder sonstigen Interessenkonflikte in Bezug auf diese Arbeit haben. Die Fördergeber hatten keinerlei Einfluss auf das Studiendesign; bei der Datenerhebung, -analyse oder -interpretation; beim Verfassen des Manuskripts oder bei der Entscheidung, die Ergebnisse zu veröffentlichen.
Danksagungen
Diese Arbeit wurde unterstützt durch das Nachwuchsprojekt der Erziehungsbehörde der Provinz Liaoning (JYTQN2023441), das Projekt zur Initiierung der Doktorandenforschung aus dem gemeinsamen Fonds der Wissenschafts- und Technologieabteilung der Provinz Liaoning (2023-BSBA-151) sowie das Förderprojekt für junge wissenschaftliche und technologische Talente der Jinzhou Medical University (JYQT202305). ChatGPT (OpenAI) wurde während der Manuskriptrevision zur Sprachbearbeitung, Gliederung und Überarbeitungshilfe eingesetzt. Die Autoren haben den wissenschaftlichen Inhalt, die Dateninterpretation und die endgültige Formulierung geprüft und verifiziert und übernehmen die volle Verantwortung für das Manuskript.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| ACPYPE | ACPYPE-Entwickler / Bio2Byte | Version 2023.11.14 | Erzeugung und Umwandlung von Topologie-Dateien kleiner Moleküle (Liganden) in ein mit GROMACS kompatibles Format. |
| AmberTools (Antechamber) | AMBER-Entwicklungsteam | AmberTools 23.3 | Zuweisung von AM1-BCC-Teilladungen und Erzeugung von GAFF2-Ligandenparametern. |
| AutoDock Vina | Forli Lab, Scripps Research | Version 1.2.5 | Molekulares Docking und Erzeugung von Rangfolgen für Protein-Ligand-Komplexe. |
| AutoDockTools (MGLTools) | Zentrum für Computerbasierte Strukturbiologie, Scripps Research | Version 1.5.7 | Vorbereitung von Rezeptoren und Liganden, Zuweisung von Gasteiger-Ladungen, Definition rotierbarer Bindungen und Umwandlung in das PDBQT-Format. |
| BIOVIA Discovery Studio Visualizer | Dassault Systèmes BIOVIA | Version 2025 | Visualisierung von Docking-Komplexen und Analyse von Protein-Ligand-Wechselwirkungen. |
| CHARMM36-Kraftfeld | MacKerell Laboratory / CHARMM-Kraftfeld-Entwickler | CHARMM36 | Parametrisierung von Proteinen für Molekulardynamik-Simulationen; CHARMM36 wurde durchgängig in der Studie verwendet (nicht CHARMM36m). |
| Chem3D Ultra (ChemOffice Professional) | Revvity Signals Software | Version 22.2 | Energieminimierung von Liganden unter Verwendung des MMFF94-Kraftfelds. |
| Verbindungen 1–6 | Zuvor synthetisiert, wie in Li et al., ACS Chemical Biology (2022) beschrieben | Nicht zutreffend | Glutathion-responsiven Prodrugs, freigesetzte Produkte und passendes Nicht-Fänger-Kontrollpaar, verwendet im rechnergestützten Workflow. |
| cytoHubba | cytoHubba-Entwickler / Cytoscape App Store | Version 0.1 | Analysen von Knotenzahl, Zwischenzentralität und Nähezentralität zur Priorisierung zentraler Zielstrukturen. |
| Cytoscape | Cytoscape-Konsortium | Version 3.10.0 | Visualisierung und topologische Analyse von Verbindung-Ziel- und Protein-Protein-Interaktionsnetzwerken. |
| DAVID Bioinformatik-Ressourcen | Labor für Humane Retrovirologie und Immuninformatik, Frederick National Laboratory for Cancer Research | Webressource | Analysen zur Genontologie und KEGG-Anreicherung; ein nomineller p-Wert < 0,10 diente als exploratives Aufnahmekriterium; angepasste Werte wurden berichtet, aber nicht zur Definition der behaltenen Menge verwendet. |
| GAFF2 | AMBER-Entwicklungsteam | GAFF2 | Parametrisierung des Liganden-Kraftfelds. |
| GeneCards Human Gene Database | GeneCards Suite / LifeMap Sciences, Inc. / Weizmann-Institut für Wissenschaft | Webressource | Abruf von krankheitsassoziierten Zielstrukturen mittels der Abfrage „Lungenkrebs H1299“. |
| gmx_MMPBSA | gmx_MMPBSA-Entwicklungsteam | Version 1.6.3 | Berechnung der MM-PBSA-Bindungsenergie aus GROMACS-Molekulardynamik-Trajektorien; 500 Frames wurden im Intervall von 100,0–149,9 ns in 100-ps-Schritten abgetastet, wobei der Endpunkt bei 150,0 ns ausgeschlossen wurde; keine Entropiekorrektur wurde angewendet. |
| GROMACS | GROMACS-Entwicklungsteam | Version 2024.4 | Erzeugung und Analyse von Molekulardynamik-Trajektorien. |
| Microbioinfo Online-Visualisierungsplattform | Shanghai Newcore Biotechnology Co., Ltd. / Microbioinfo | Webressource | Erzeugung von Balkendiagrammen zur Anreicherung und Blasendiagrammen. |
| Open Babel | Open Babel-Entwicklungsteam | Version 3.1.1 | Umwandlung von Strukturdateien in kanonische SMILES für die Eingabe in SwissTargetPrediction. |
| PubChem | Nationales Zentrum für Biotechnologie-Information, US National Library of Medicine, NIH | Webressource | Abruf dreidimensionaler Ligandstrukturen. |
| PyMOL Molecular Graphics System | Schrödinger, LLC | Version 2.5.4 | Proteinvorbereitung, strukturelle Visualisierung und Überprüfung von Docking-Komplexen. |
| RCSB Protein Data Bank | Research Collaboratory for Structural Bioinformatics (RCSB) | PDB-IDs: 3O96; 5UWD; 2AZ5; 1GKC; 2H8H | Abruf der Proteinstrukturen für AKT1, EGFR, TNF, MMP9 und SRC, jeweils. |
| STRING | STRING-Konsortium | Version 11.5 | Aufbau von Protein-Protein-Interaktionsnetzwerken; Homo sapiens; minimale erforderliche Interaktionsscore 0,400; die ursprünglichen Topologiemetriken entsprechen dem 21-Knoten, 116-Kanten ungerichteten PPI-Netzwerk. |
| SwissTargetPrediction | Molekulares Modellierungsteam, Universität Lausanne / SIB Schweizerisches Institut für Bioinformatik | Webressource | Reverse Zielvorhersage für Verbindungen 1–3; Spezies auf Homo sapiens beschränkt. |
| TIP3P-Wassermodell | Implementiert in GROMACS | TIP3P | Dreiatomiges explizites Solvent-Wassermodell zur Solvatisierung von Protein-Ligand-Komplexen. |
| Venny | BioinfoGP, Centro Nacional de Biotecnología (CNB-CSIC) | Version 2.1 | Schnittmenge der vorhergesagten Zielstrukturen der Verbindungen und der krankheitsassoziierten Zielstrukturen. |
Referenzen
- Sung H, et al. Global cancer statistics 2020: GLOBOCAN estimates of incidence and mortality worldwide for 36 cancers in 185 countries. CA Cancer J Clin. 2021;71:209-49.
- Herbst RS, Morgensztern D, Boshoff C. The biology and management of non-small cell lung cancer. Nature. 2018;553:446-54.
- Kim J, et al. Updates on the treatment of epidermal growth factor receptor-mutant non-small cell lung cancer. Cancer. 2025;131:e35778.
- Lin Y, Wang X, Jin H. EGFR-TKI resistance in NSCLC patients: mechanisms and strategies. Am J Cancer Res. 2014;4:411-35.
- Dasari S, et al. Pharmacological effects of cisplatin combination with natural products in cancer chemotherapy. Int J Mol Sci. 2022;23:1532.
- Ellie S, et al. Chemotherapy drugs cyclophosphamide, cisplatin and doxorubicin induce germ cell loss in an in vitro model of the prepubertal testis. Sci Rep. 2018;8:1773.
- De Bont R, van Larebeke N. Endogenous DNA damage in humans: a review of quantitative data. Mutagenesis. 2004;19:169-85.
- Ciccia A, Elledge SJ. The DNA damage response: making it safe to play with knives. Mol Cell. 2010;40:179-204.
- David SS, Williams SD. Chemistry of glycosylases and endonucleases involved in base-excision repair. Chem Rev. 1998;98:1221-62.
- Robson CN, Hickson ID. Isolation of cDNA clones encoding a human apurinic/apyrimidinic endonuclease that corrects DNA repair and mutagenesis defects in E. coli xth (exonuclease III) mutants. Nucleic Acids Res. 1991;19:5519-23.
- Sczepanski JT, et al. Rapid DNA-protein cross-linking and strand scission by an abasic site in a nucleosome core particle. Proc Natl Acad Sci U S A. 2010;107:22475-80.
- Krokan HE, Bjørås M. Base excision repair. Cold Spring Harb Perspect Biol. 2013;5:a012583.
- Li X, et al. Selective antitumor activity and photocytotoxicity of glutathione-activated abasic site trapping agents. ACS Chem Biol. 2022;17:797-803.
- Hopkins AL. Network pharmacology: the next paradigm in drug discovery. Nat Chem Biol. 2008;4:682-90.
- Meng XY, et al. Molecular docking: a powerful approach for structure-based drug discovery. Curr Comput Aided Drug Des. 2011;7:146-57.
- Hollingsworth SA, Dror RO. Molecular dynamics simulation for all. Neuron. 2018;99:1129-43.
- Genheden S, Ryde U. The MM/PBSA and MM/GBSA methods to estimate ligand-binding affinities. Expert Opin Drug Discov. 2015;10:449-61.
- O'Boyle NM, et al. Open Babel: an open chemical toolbox. J Cheminform. 2011;3:33.
- Daina A, Michielin O, Zoete V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 2019;47:W357-64.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13:2498-504.
- Stelzer G, et al. The GeneCards Suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 2016;54:1.30.1-1.30.33.
- Oliveros JC. Venny: an interactive tool for comparing lists with Venn's diagrams [Internet]. BioinfoGP, CNB-CSIC; 2007-2015.
- Szklarczyk D, et al. The STRING database in 2021: customizable protein-protein networks and functional characterization of user-uploaded gene/measurement sets. Nucleic Acids Res. 2021;49:D605-12.
- Chin CH, et al. cytoHubba: identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8:S11.
- Sherman BT, et al. DAVID: a web server for functional enrichment analysis and functional annotation of gene lists (2021 update). Nucleic Acids Res. 2022;50:W216-21.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51:D1373-80.
- Eberhardt J, et al. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61:3891-8.
- Gerek ZN, Ozkan SB. A flexible docking scheme to explore the binding selectivity of PDZ domains. Protein Sci. 2010;19:914-28.
- Abraham MJ, et al. GROMACS: high-performance molecular simulations through multi-level parallelism from laptops to supercomputers. SoftwareX. 2015;1-2:19-25.
- Best RB, et al. Optimization of the additive CHARMM all-atom protein force field targeting improved sampling of backbone and side-chain dihedral angles. J Chem Theory Comput. 2012;8:3257-73.
- Vassetti D, Pagliai M, Procacci P. Assessment of GAFF2 and OPLS-AA general force fields in combination with the water models TIP3P, SPCE, and OPC3 for the solvation free energy of druglike organic molecules. J Chem Theory Comput. 2019;15:1983-95.
- Jakalian A, Jack DB, Bayly CI. Fast, efficient generation of high-quality atomic charges. AM1-BCC model: II. Parameterization and validation. J Comput Chem. 2002;23:1623-41.
- Sousa da Silva AW, Vranken WF. ACPYPE—AnteChamber PYthon Parser interfacE. BMC Res Notes. 2012;5:367.
- Case DA, et al. AmberTools. J Chem Inf Model. 2023;63:6183-91.
- Valdés-Tresanco MS, et al. gmx_MMPBSA: a new tool to perform end-state free-energy calculations with GROMACS. J Chem Theory Comput. 2021;17:6281-91.
- Islam MT, Jang NH, Lee HJ. Natural products as regulators against matrix metalloproteinases for the treatment of cancer. Biomedicines. 2024;12:794.
- Mondal S, et al. Matrix metalloproteinase-9 (MMP-9) and its inhibitors in cancer: a minireview. Eur J Med Chem. 2020;194:112260.
- Rashid ZA, Bardaweel SK. Novel matrix metalloproteinase-9 (MMP-9) inhibitors in cancer treatment. Int J Mol Sci. 2023;24:12133.
- Kessenbrock K, Plaks V, Werb Z. Matrix metalloproteinases: regulators of the tumor microenvironment. Cell. 2010;141:52-67.
- Vandooren J, Van den Steen PE, Opdenakker G. Biochemistry and molecular biology of gelatinase B or matrix metalloproteinase-9 (MMP-9): the next decade. Crit Rev Biochem Mol Biol. 2013;48:222-72.
- Merchant N, et al. Matrix metalloproteinases: their functional role in lung cancer. Carcinogenesis. 2017;38:766-80.
- Chabanon RM, et al. Targeting the DNA damage response in immuno-oncology: developments and opportunities. Nat Rev Cancer. 2021;21:701-17.
- Das S, et al. Surface plasmon resonance as a fascinating approach in target-based drug discovery and development. TrAC Trends Anal Chem. 2024;171:117501.