Dieses Protokoll stellt einen reproduzierbaren Deep-Learning-Workflow unter Verwendung von Multikanal-Zyklusdaten und entwickelten Merkmalen zur Vorhersage des Gesundheitszustands, der verbleibenden Nutzungsdauer und der Energiespeicherleistung von Lithium-Ionen-Batterien vor.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Methodenartikel
Ein reproduzierbarer Deep-Learning-Workflow zur Vorhersage der Leistung von Lithium-Ionen-Batterien unter Verwendung von Mehrkanal-Zyklusdaten
In diesem Artikel
Zusammenfassung
Zusammenfassung
Dieses Protokoll stellt einen reproduzierbaren Deep-Learning-Workflow zur Vorhersage der Leistung von Lithium-Ionen-Batterien anhand von mehrkanaligen Zyklen-Daten vor. Um die bestehenden Einschränkungen datengetriebener Modelle hinsichtlich der Integration von Mehrquelleninformationen und der Merkmalsdarstellung zu überwinden, nutzt die Methode fünf öffentlich verfügbare Batteriedatensätze. Die Eingaben umfassen rohe Betriebssignale wie Spannung, Strom, Kapazität, Temperatur, Innenwiderstand sowie Coulomb- und Energieeffizienz, zusammen mit konstruierten Merkmalen wie inkrementeller Kapazität, differentieller Spannung und durchgespeister Energie. Das Protokoll beschreibt standardisierte Vorverarbeitungsverfahren zur Erstellung batterieebenenbasierter zeitlicher Tensoren über mehrere Beobachtungsfenster hinweg. Zur Verbesserung der Reproduzierbarkeit bewertet der Workflow ausgewählte neuronale Netzwerkarchitekturen – darunter tiefe neuronale Netze, Faltungsneurale Netze (CNNs), Long-Short-Term-Memory-(LSTM-)Netze, CNN–LSTM- und auf Transformatoren basierende Modelle – unter Verwendung fester Zufallsseeds, wiederholter Evaluationsläufe und Umgebungsprotokollierung. Repräsentative Ergebnisse zeigten, dass die CNN–LSTM-Architektur mit integrierten mehrkanaligen Daten und konstruierten Merkmalen im Vergleich zu den evaluierten Modellen eine vorteilhafte Vorhersageleistung erzielte. Die ausgewählte Konfiguration erreichte einen mittleren absoluten Fehler von 0,024 und einen R2-Wert von 0,955 bei der Zustandsgesundheits-Schätzung, während gleichzeitig eine hohe Vorhersagegenauigkeit für die Restlebensdauer und die entladbare Energie erhalten blieb. Ablations- und Robustheitsanalysen verdeutlichten zudem den Beitrag der mehrkanaligen Merkmalsintegration und die Stabilität des auf Reproduzierbarkeit ausgerichteten Workflows über wiederholte Evaluierungen hinweg. Diese standardisierte Methodik bietet einen reproduzierbaren Rahmen für das Lebenszyklusmanagement von Batterien und die prädiktive Modellierung unter unterschiedlichen Betriebsbedingungen.
Einleitung
Lithium-Ionen-Batterien spielen eine zentrale Rolle beim weltweiten Übergang zu erneuerbaren Energien, da sie über eine hohe Energiedichte, eine lange Zyklenlebensdauer und geringe Selbstentladungsraten verfügen, was sie für Anwendungen von tragbaren Elektronikgeräten bis hin zu großtechnischen Energiespeichersystemen geeignet macht. Allerdings führt ein langfristiger Betrieb unweigerlich zu einer schleichenden Kapazitätsabnahme und einem Anstieg des Innenwiderstands1. Dieser Leistungsverfall verringert nicht nur die Wirtschaftlichkeit, sondern birgt auch erhebliche Sicherheitsrisiken, darunter thermisches Durchgehen. Mit der zunehmenden Beschleunigung des Einsatzes großtechnischer Energiespeichersysteme ist das Batterielebenszyklus-Management immer komplexer geworden2. Herkömmliche, auf Schwellwerten basierende Überwachungsverfahren und manuelle Inspektionsprotokolle sind für dynamische Betriebsumgebungen unzureichend3. Darüber hinaus reicht die alleinige Betrachtung eines einzelnen Parameters nicht aus, um den Zustand der Gesundheit (SOH) oder die verbleibende Nutzungsdauer (RUL) der Batterie unter wechselnden Lade- und Entladeraten, unterschiedlichen Umgebungstemperaturen und variierenden Entladespannungen genau vorherzusagen4. Obwohl der aktuelle Arbeitsablauf hauptsächlich anhand von laborgeprüften Zyklen-Datensätzen validiert wurde, könnte die mehrkanalige Architektur und das zeitliche Modellierungsframework künftig auch für dynamische Betriebsbedingungen in Elektrofahrzeuganwendungen und variierenden Umweltbedingungen angepasst werden.
Die Alterung von Batterien ist ein äußerst komplexer, nichtlinearer elektrochemischer Prozess, der durch das Wachstum der festen Elektrolytzwischenschicht, den Verlust von aktivem Lithium und die strukturelle Zersetzung der Elektrodenmaterialien verursacht wird. Bisher basierte die Zustandsschätzung auf äquivalenten Schaltkreismodellen oder elektrochemisch-physikalischen partiellen Differentialgleichungen (PDEs)5. Obwohl diese physikalischen Modelle wertvolle mechanistische Einblicke liefern, leiden sie unter erheblichem Rechenaufwand und Schwierigkeiten bei der Parameteridentifikation, wenn multikanalige gekoppelte Signale verarbeitet werden. Folglich ist ihre Echtzeitanwendung in eingebetteten Batteriemanagementsystemen (BMSs) unter Hochstromentladung aufgrund komplexer Diffusionskinetik und Umweltvariabilität stark eingeschränkt6. Im Gegensatz dazu konzentriert der vorgeschlagene Deep-Learning-(DL-)Arbeitsablauf den größten Teil des Rechenaufwands auf die Offline-Trainingsphase, während das trainierte Modell während der Anwendung vergleichsweise schnelle Inferenzen durchführt. Dieses Framework könnte daher künftige Implementierungen in ressourcenbeschränkten BMSs und Edge-Computing-Umgebungen unterstützen.
Kürzlich haben datengetriebene DL-Ansätze aufgrund ihrer außergewöhnlichen Fähigkeiten zur nichtlinearen Anpassung als leistungsstarke Werkzeuge an Bedeutung gewonnen. Dennoch weisen bestehende DL-Methoden zwei wesentliche Einschränkungen auf. Erstens basieren viele Ansätze hauptsächlich auf einzelnen Kapazitätsabnahmekurven oder spezifischen Entlade-Spannungsschwellen, während sie die inhärenten räumlich-zeitlichen Korrelationen zwischen mehrkanaligen Zyklierungsantworten – wie Spannung, Strom und Temperatur – vernachlässigen. Diese Einschränkung verringert die Robustheit des Modells unter Betriebsbedingungen mit mehreren Szenarien7. Frühere Studien haben gezeigt, dass die Vernachlässigung thermischer Zustände während komplexer Betriebsabläufe die Anhäufung von Vorhersagefehlern beschleunigen kann8,9. Zweitens besteht eine anhaltende Reproduzierbarkeitsherausforderung im angewandten maschinellen Lernen (ML). Variationen in den experimentellen Bedingungen, unzureichend beschriebene Vorverarbeitungspipelines und willkürlich gewählte Hyperparameter neuronaler Netzwerke führen häufig dazu, dass ansonsten robuste Modelle bei der Validierung über verschiedene Datensätze hinweg versagen10. Um das Risiko von Informationslecks während der Vorverarbeitung und der Vorhersage in frühen Zyklen zu verringern, werden die im vorgeschlagenen Workflow verwendeten Normalisierungsfaktoren und die Baselines für extrahierte Merkmale ausschließlich aus den Trainingsdatensätzen abgeleitet, bevor eine externe Validierung und eine Bewertung über verschiedene Datensätze hinweg erfolgt.
Um diese entscheidenden Wissenslücken zu schließen, besteht das übergeordnete Ziel dieses Protokolls darin, einen automatisierten, hochgradig reproduzierbaren Deep-Learning-Workflow zur Vorhersage der Energiespeicherleistung von Lithium-Ionen-Batterien anhand von mehrkanaligen Zykeldaten vorzustellen. Die Grundidee dieses Verfahrens liegt darin, die komplexen langfristigen Abhängigkeiten, die mit dem Batteriealterungsprozess verbunden sind, gezielt abzubilden, indem querschnittliche Zeitreihendaten in einer hochdimensionalen neuronalen Netzwerkarchitektur integriert werden. Ein wesentlicher Vorteil dieses Protokolls im Vergleich zu bestehenden physikbasierten und Deep-Learning-Ansätzen ist die ganzheitliche Standardisierung, die eine vollständige Pipeline von der Rohsignalvorverarbeitung über die Merkmalsentwicklung bis hin zum Modelltraining und der Unsicherheitsbewertung etabliert. Obwohl hybride Architekturen neuronaler Netzwerke bereits früher untersucht wurden, legt der vorliegende Workflow besonderen Schwerpunkt auf standardisierte, mehrkanalige Integration, indem elektrochemische Zykeldaten und konstruierte Degradationsmerkmale innerhalb eines auf Reproduzierbarkeit ausgerichteten Trainingsrahmens synchronisiert werden. Im Gegensatz zu vielen bisher beschriebenen Workflows integriert dieses Protokoll standardisierte Parameterkonfigurationen, feste Zufallsinitialisierungen (random seeds), wiederholte Evaluierungsläufe und eine umfassende Nachverfolgung der Umgebungsbedingungen, um die Reproduzierbarkeit über heterogene Batteriedatensätze und verschiedene Laborumgebungen hinweg zu verbessern. Darüber hinaus vergleicht der Workflow systematisch mehrere Architekturen neuronaler Netzwerke, um die Vorhersagesicherheit und -leistung bei unterschiedlichen Eingabekonfigurationen zu bewerten. Innerhalb der ausgewerteten Datensätze und experimentellen Bedingungen zeigte die Architektur aus faltenden neuronalen Netzen und langen Kurzzeitgedächtnissen (CNN–LSTM) eine günstigere Vorhersageleistung im Vergleich zu den evaluierten reinen CNN- und transformerbasierten Modellen, indem sie die lokale Merkmalsextraktion mit der Modellierung zeitlich weiter reichender Sequenzen kombiniert, bei gleichzeitig moderater rechnerischer Komplexität. Dieses Protokoll eignet sich besonders für Forscher und Ingenieure, die reproduzierbare und an die Umgebung anpassungsfähige Vorhersagemodelle für das Batterielebenszyklus-Management entwickeln möchten.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Eine Genehmigung durch eine ethische Kommission war für diese Studie nicht erforderlich, da die Forschung ausschließlich öffentlich verfügbare Datensätze zum Zyklenverhalten von Lithium-Ionen-Batterien nutzte und keine menschlichen Probanden, Tierexperimente oder biologischen Proben einbezog.
1. Datenerfassung und -organisation
- Beschaffung von Mehrkanal-Zyklisierungsdatensätzen
- Laden Sie Lithium-Ionen-Batterie-Zyklisierungsdatensätze aus öffentlich zugänglichen Batterie-Repositories herunter, die Lade-Entlade-Zyklusaufzeichnungen enthalten. Beziehen Sie die Datensätze CALCE, SANYO, PANASONIC, KOKAM und GOTION direkt aus den jeweiligen institutionellen Open-Access-Repositories oder über Digital-Object-Identifier-Links, um die Konsistenz der Datensatzversionen sicherzustellen.
- Wählen Sie Batterieproben aus, die vollständige Zyklennummern, Kapazitätsmessungen und mindestens eine kontinuierliche Lade-Entlade-Kurve enthalten. Überprüfen Sie die Kontinuität, indem Sie sicherstellen, dass innerhalb eines einzelnen Zyklus keine Unterbrechung von mehr als zwei Stunden auftritt und dass sowohl die Phasen mit konstantem Strom als auch die Phasen mit konstanter Spannung vollständig erfasst sind.
- Bereinigung der Rohzyklisierungsdaten
- Bereinigen Sie die Rohzyklisierungsdaten, um Proben beizubehalten, die Temperatur, Innenwiderstand, coulombsche Effizienz und Energieeffizienz-Messungen enthalten. Schließen Sie Batteriezellen, die diese obligatorischen Zustandskanäle fehlen lassen, aus dem Analyseworkflow aus, da die anschließende Fusion von Mehrkanal-Features einen vollständigen Satz physikalischer Eingangsvariablen erfordert.
- Entfernen Sie Zyklen mit unvollständigen Aufzeichnungen, inkonsistenten Zeitstempeln, undefinierten Testverfahren oder unklaren Beendigungsbedingungen für Lade- und Entladevorgänge. Definieren Sie anormale Zyklen als solche, die einen plötzlichen Kapazitätsabfall von mehr als 5 % zwischen aufeinanderfolgenden Zyklen aufweisen, Spannungsmesswerte außerhalb des chemiespezifischen Betriebsbereichs aufweisen oder nicht monotone Zeitstempelintervalle aufweisen.
- Aufbau einer zeitlichen Batteriedatenbank
- Ordnen Sie die beibehaltenen Zyklisierungsdaten chronologisch an, um eine zeitbasierte Zeitreihendatenbank auf Ebene der Batterien zu erstellen.
- Speichern Sie die verarbeiteten Datensätze im Hierarchical Data Format Version 5 (HDF5). Verwenden Sie eine standardisierte Verzeichnisstruktur, die nach Quelle des Datensatzes, chemischem System und individuellem Batteriezellen-Identifier organisiert ist.
- Weisen Sie einzelnen Batteriezellen vor der Datensatz-Aufteilung eindeutige Kennungen zu. Implementieren Sie die Gruppierung basierend auf dem Batteriezellen-Identifier bei der Aufteilung in Trainings- und Testdatensätze, um sicherzustellen, dass alle aufeinanderfolgenden Zyklen einer physischen Batterie ausschließlich in einem Datensatz-Teilbereich verbleiben.
HINWEIS: Bewahren Sie die ursprünglichen Rohdatensätze vor der Vorverarbeitung, Normalisierung, Resampling oder Merkmalsgenerierung separat auf.
- Definition von Beobachtungsfenstern
- Erstellen Sie Mehrkanal-Beobachtungsfenster unter Verwendung der ersten 50 Zyklen, der ersten 100 Zyklen und der ersten 20 % der gesamten Lebensdauer der Batterie. Berechnen Sie die 20-%-Lebensdauer-Schwelle, indem Sie die gesamte Zyklenlebensdauer vor dem Kapazitätsverlust am Lebensende mit 0,2 multiplizieren.
- Stellen Sie die Spannungs-, Strom-, Kapazitäts-, Temperatur-, Innenwiderstands- und Effizienzmessungen innerhalb jedes Beobachtungsfensters vor der Tensorerstellung aufeinander ab.
- Formatieren Sie die endgültige Eingabestruktur als dreidimensionalen Tensor, bestehend aus der Länge des Beobachtungsfensters, 128 standardisierten intra-zyklischen Abtastpunkten und dem geordneten Satz von Mehrkanal-Merkmalen.
2. Datenvorverarbeitung und Merkmalsentwicklung
- Rohe Daten der Zyklierung vorverarbeiten
- Führen Sie eine einheitliche Vorverarbeitung der Rohdatensätze zur Zyklierung durch, um die Datenqualität über alle Batteriequellen hinweg zu standardisieren. Führen Sie alle Verfahren zur Vorverarbeitung, Synchronisierung und Standardisierung mit Python 3.10 durch, unter Verwendung der Bibliothek Pandas zur Zeitreihenmanipulation und SciPy zur numerischen Interpolation.
- Entfernen Sie Ausreißer, erkennen Sie fehlende Werte, kalibrieren Sie Zeitstempel, identifizieren Sie Lade- und Entladephasen und normalisieren Sie die Abtastraten vor der nachfolgenden Analyse. Wenden Sie eine modifizierte Z-Score-Schwellenwertmethode mit einem Ablehnungskriterium größer als 3,0 zur Anomalieerkennung an.
- Erkennen Sie fehlende Werte automatisch mithilfe der Identifizierung von NaN-Markierungen in allen numerischen Arrays. Unterscheiden Sie Lade- und Entladephasen anhand der Strompolarität, indem Sie positive Stromwerte Ladezyklen und negative Stromwerte Entladezyklen zuordnen.
- Rekonstruieren Sie fehlende Signalsegmente unter Verwendung stückweiser kubischer Hermite-Interpolationspolynome, um die elektrochemischen zeitlichen Dynamiken während der Phasenübergangsanpassung beizubehalten.
- Zyklierkurven erneut abtasten
- Erneuern Sie die Abtastung von Zyklierkurven, wenn Variationen in der Abtastdichte oder Signaldrift in den Datensätzen festgestellt werden. Lösen Sie eine automatische Neuaufnahme der Abtastung aus, sobald das Intervall zwischen aufeinanderfolgenden Messungen um mehr als 10 % von der medianen Abtastrate der entsprechenden Zyklierphase abweicht.
- Standardisieren Sie die Anzahl der Abtastpunkte innerhalb jedes Zyklus, um variationsbedingte Unterschiede durch die Plattform zu verringern. Ordnen Sie alle zeitlichen Sequenzen mittels eindimensionaler linearer Interpolation auf ein festes räumliches Gitter an.
- Komprimieren oder erweitern Sie jedes Lade-Entlade-Profil auf exakt 128 gleichmäßig verteilte Abtastpunkte vor der Tensorkonstruktion.
- Kontinuierliche Variablen normalisieren
- Normalisieren Sie alle kontinuierlichen Variablen vor dem Modelltraining, um die Netzwerkkonvergenz zu stabilisieren und skalenbedingte Verzerrungen zu reduzieren. Wenden Sie die Min-Max-Skalierung an, um alle kontinuierlichen Variablen in einen numerischen Bereich zwischen 0 und 1 zu transformieren.
- Berechnen Sie alle Normalisierungsparameter ausschließlich aus dem Trainingsdatensatz. Wenden Sie die festgelegten Skalierungsparameter auf die Validierungs- und Testdatensätze an, um das Risiko einer zeitlichen Datenleakage während der Vorhersage früher Zyklen zu verringern.
- Mehrkanalige Eingabetensoren konstruieren
- Teilen Sie die kontinuierlichen Zyklierdatensätze jeder Batterie in zeitlich feste Segmente ein. Strukturieren Sie die zeitlichen Segmente entsprechend den vordefinierten Beobachtungsfenstern, die den ersten 50 Zyklen, den ersten 100 Zyklen oder den ersten 20 % der Batterielebensdauer entsprechen.
- Stellen Sie Spannung, Strom, Kapazität, Temperatur, Innenwiderstand und Wirkungsgradmessungen innerhalb jedes zeitlichen Segments vor der Tensorkonstruktion aufeinander ab.
- Konkatenieren Sie die ausgerichteten Merkmatrizen zu einem dreidimensionalen Tensor im Format (N × 128 × C), wobei N die Länge des Beobachtungsfensters, 128 die standardisierten intra-zyklischen Abtastpunkte und C die Gesamtanzahl der physikalischen und konstruierten Merkkanäle darstellt.
- Konstruierte Merkmale extrahieren
- Extrahieren Sie konstruierte elektrochemische Merkmale aus den rohen Zyklier-Signalen, um die Identifizierung von Degradationsmustern zu verbessern. Berechnen Sie Inkremental-Kapazitäts- und Differential-Spannungsmerkmale durch die Berechnung von dQ/dV und dV/dQ über das standardisierte Abtastgitter.
- Wenden Sie eine Savitzky–Golay-Filterung an, um geglättete Kurven der Inkremental-Kapazität und der Differential-Spannung zu erzeugen.
- Extrahieren Sie Degradationsindikatoren wie Spannungspeakverschiebungen, Spannungsunterschiede bei Phasenübergängen und zyklusübergreifende Variationen des Energieverbrauchs aus den gefilterten elektrochemischen Merkmalen.
3. Aufbau und Training des DL-Modells
- Konstruieren Sie Kandidaten-Vorhersagemodelle
- Konstruieren Sie einen standardisierten Trainings- und Evaluierungsrahmen für alle in Abbildung 1A gezeigten Vorhersagemodelle. Implementieren Sie den Deep-Learning-Workflow mit PyTorch-Version 2.0 oder höher.
- Führen Sie den Trainingsworkflow mithilfe modularer Python-Skripte für das Laden von Daten, die Initialisierung des Modells, die Optimierung und die Evaluierung aus.
- Bereiten Sie traditionelle maschinelle Lern-Basismodelle vor, einschließlich linearer Regression, Random-Forest- und gradientenbasiertes Boosting von Entscheidungsbäumen. Konfigurieren Sie das Random-Forest-Modell mit 100 Bäumen und einer maximalen Tiefe von 10.
- Konfigurieren Sie das Framework für das gradientenbasierte Boosting von Entscheidungsbäumen mit einer Lernrate von 0,1 und einer maximalen Baumtiefe von 5 über die Scikit-learn-Bibliothek.
- Bereiten Sie Deep-Learning-Kandidatenarchitekturen vor, einschließlich Multilayer-Perzeptron, eindimensionales CNN, LSTM-Netzwerk, CNN–LSTM und transformerbasierte Modelle.
- Standardisieren Sie die Kern-Hyperparameter über alle Deep-Learning-Architekturen hinweg, indem Sie den AdamW-Optimierer, die Gaußsche Fehler-Linear-Einheit als Aktivierungsfunktion, eine versteckte Dimension von 128 und eine Dropout-Rate von 0,2 anwenden.
- Konfigurieren Sie die CNN–LSTM-Architektur
- Konfigurieren Sie die CNN–LSTM-Architektur, um mehrkanalige Zykleninformationen aus den Eingabetensoren zu fusionieren (Abbildung 1B). Konstruieren Sie die hybride Architektur, indem Sie den faltenden Merkmalsextraktor in zwei gestapelte rekurrente Schichten mit jeweils 128 versteckten Einheiten hintereinanderschalten.
- Beenden Sie die Architektur mit drei parallelen vollverbundenen Regressions-Ausgängen zur simultanen Vorhersage von SOH, RUL und entladbarer Energie.
- Verarbeiten Sie die mehrkanaligen Eingabetensoren durch drei aufeinanderfolgende eindimensionale faltende Schichten mit Kernelgrößen von 3, 5 und 7, um lokalisierte Merkmale auf mehreren Skalen zu extrahieren.
- Wenden Sie Batch-Normalisierung nach jeder faltenden Schicht an, um die Gradientenstabilität während der Optimierung zu verbessern.
- Formen Sie die faltenden Merkmalskarten in kontinuierliche zeitliche Sequenzen um, bevor die Sequenzmodellierung erfolgt.
- Leiten Sie die kodierten zeitlichen Sequenzen in gestapelte rekurrente Schichten weiter, um langreichweitige Abhängigkeiten im Degradationsverlauf über die vordefinierten Beobachtungsfenster hinweg zu erfassen.
- Teilen Sie Datensätze für das Modelltraining auf
- Teilen Sie die verarbeiteten Batteriezellen-Datensätze im Verhältnis 70:15:15 in Trainings-, Validierungs- und Test-Teildatensätze auf. Führen Sie die Datensatzaufteilung mit einem festen Zufallsstartwert (Seed) von 42 durch.
- Wenden Sie eine stratifizierte Stichprobe basierend auf der Batteriechemie an, um ausgeglichene Degradationsverteilungen über alle Teildatensätze hinweg zu gewährleisten.
- Führen Sie die Datensatzaufteilung strikt auf Ebene der Batteriezelle durch, anstatt einzelne Zyklen zu randomisieren, um sequenzielle Degradationsverläufe zu erhalten.
- Behandeln Sie jede Batteriezelle während der Aufteilung als unteilbare Einheit, um Informationslecks zwischen den Datensätzen zu vermeiden.
- Überprüfen Sie die Isolation der Datensätze programmatisch, indem Sie den Durchschnitt der Batteriezellen-Identifikatoren über die Trainings-, Validierungs- und Test-Teildatensätze berechnen und bestätigen, dass kein Überlapp besteht.
- Erstellen Sie einen externen Testdatensatz unter Verwendung des vollständigen GOTION-Lithium-Eisenphosphat-(LFP)-Datensatzes zur Evaluierung außerhalb der Verteilung und zur Beurteilung der Generalisierbarkeit über Datensätze hinweg.
- Machen Sie den Quellcode, die Umgebungskonfigurationsdateien und die verarbeiteten Datensatzaufteilungen über ein dediziertes GitHub-Repository öffentlich zugänglich, um methodische Transparenz und Reproduzierbarkeit zu unterstützen.
- Initialisieren Sie das Modelltraining
- Legen Sie die Regressionsverlustfunktion vor dem Training auf mittleren quadratischen Fehler fest. Berechnen Sie das globale Trainingsziel, indem Sie die Verlustwerte jedes Vorhersageziels mit gleicher Gewichtung aggregieren.
- Stellen Sie die anfängliche Lernrate auf 1 × 10⁻³ ein und wählen Sie eine Batch-Größe von 32 oder 64 entsprechend der Datensatzgröße.
- Verwenden Sie eine Batch-Größe von 64 für Datensätze mit mehr als 5.000 Zyklen, um die Hardware-Auslastung zu verbessern. Verwenden Sie eine Batch-Größe von 32 für kleinere Datensätze, um die Stabilität der Optimierung zu erhöhen.
HINWEIS: Wählen Sie diese Hyperparameter durch eine vorläufige Gittersuche aus, um die Konvergenzgeschwindigkeit und Gradientenstabilität über verschiedene Beobachtungsfenster hinweg auszugleichen.
- Wenden Sie Trainingssteuerungen an
- Wenden Sie einen dynamischen Lernraten-Planer basierend auf Änderungen des Validierungsverlusts an. Reduzieren Sie die Lernrate um den Faktor 0,5, wenn sich der Validierungsverlust über 5 aufeinanderfolgende Epochen nicht verbessert.
- Halten Sie eine minimale Lernraten-Schwelle von 1 × 10⁻⁵ während der Optimierung ein.
- Beenden Sie das Modelltraining nach maximal 100 Epochen, um Überanpassung zu verringern.
- Wenden Sie ein vorzeitiges Abbrechen an, wenn der Validierungsverlust über 15 aufeinanderfolgende Epochen nicht abnimmt. Stellen Sie die Modellparameter (Weights) der besten Validierungsiteration wieder her.
- Führen Sie Reproduzierbarkeitsdokumentationen
- Legen Sie vor der Modellinitialisierung und dem Training einen festen Zufallsstartwert (Seed) von 42 fest.
- Wenden Sie den festen Zufallsstartwert einheitlich auf das Python-Modul random, NumPy und die PyTorch-Backend-Umgebung an und deaktivieren Sie nichtdeterministische CUDA-Operationen.
- Dokumentieren Sie die Softwareumgebung, Abhängigkeitsversionen, Parametereinstellungen, Datenaufteilungen und Trainingsausgaben für jeden experimentellen Durchlauf.
- Führen Sie alle Deep-Learning-Workflows unter Ubuntu 22.04 mit CUDA 11.8-Beschleunigung auf einer Workstation mit einer NVIDIA RTX 3090-Grafikkarte oder vergleichbarer Hardware durch.
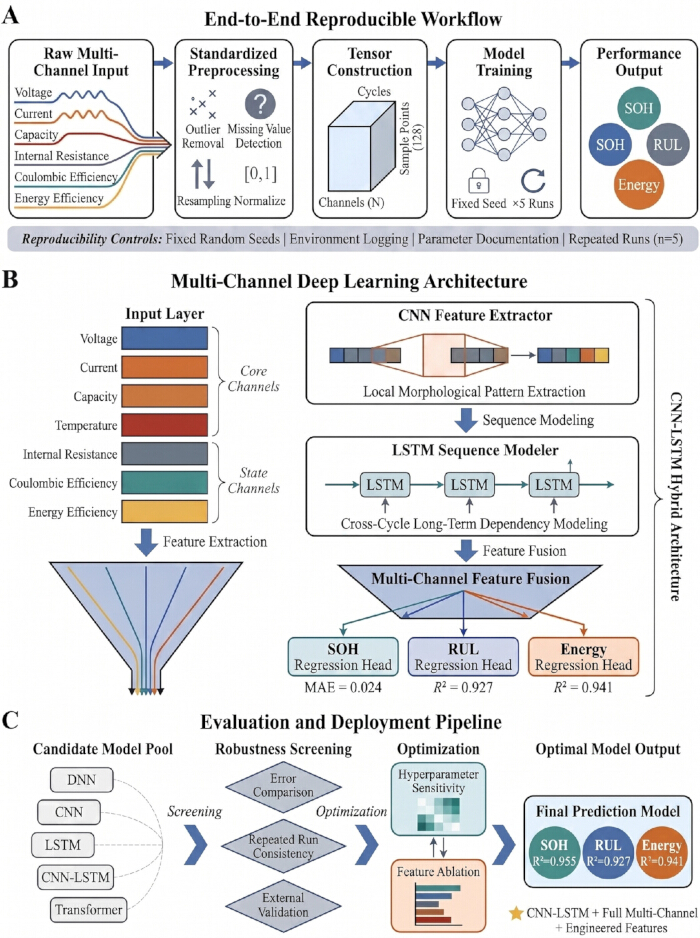
Abbildung 1. Reproduzierbarer Deep-Learning-(DL-)Ablauf für die Vorhersage der Leistung von Multikanal-Lithium-Ionen-Batterien. (A) Reproduzierbarer End-to-End-Ablauf zur Veranschaulichung der Datenerfassung über mehrere Kanäle, der standardisierten Vorbearbeitung, der Tensor-Konstruktion, des Modelltrainings und der Vorhersage von Leistungsindikatoren für Batterien. Maßnahmen zur Sicherstellung der Reproduzierbarkeit umfassen feste Zufallsstarts, wiederholte Trainingsläufe, die Nachverfolgung von Parametern und die Protokollierung der Umgebung. (B) Hybride CNN-LSTM-Architektur zur Merkmalsextraktion über mehrere Kanäle, Modellierung zeitlicher Sequenzen, Merkmalsfusion und Vorhersage des Zustands der Gesundheit (SOH), der verbleibenden Nutzungsdauer (RUL) und der abrufbaren Energie. (C) Evaluierungs- und Einsatz-Pipeline, die die Auswahl möglicher Modelle, die Bewertung der Robustheit, die Optimierung der Hyperparameter und die endgültige Modellselektion zeigt. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
4. Modellbewertung und Zielvorhersage
- Generieren Sie Modellvorhersagen
- Leiten Sie die Ziel-Testbatterie-Datensätze durch jedes trainierte Modell. Laden Sie die vorverarbeiteten Testdatensätze als serialisierte PyTorch-Tensoren vor der Inferenz.
- Führen Sie den Vorwärts-Inferenzschritt mithilfe eines Gradienten-deaktivierenden Kontextmanagers aus, um unbeabsichtigte Parameteraktualisierungen während der Evaluierung zu verhindern.
- Erzeugen Sie gleichzeitige Vorhersagen für jeden Leistungsindikator unter Verwendung der trainierten Regressionsköpfe.
- Extrahieren Sie simultane Ausgaben aus den drei parallel geschalteten Regressionsköpfen, die für SOH, RUL und Entladeenergie-Vorhersage konfiguriert sind.
- Berechnen Sie die Vorhersageziele
- Berechnen Sie die SOH, indem Sie die derzeit verfügbare Kapazität mit der anfänglichen Batteriekapazität vergleichen.
- Definieren Sie die anfängliche Batteriekapazität als die maximale Entladekapazität, die während der ersten drei Stabilisierungszyklen aufgezeichnet wurde.
- Berechnen Sie die SOH als Verhältnis zwischen der Kapazität des aktuellen Zyklus und der etablierten Referenzbasis der Anfangskapazität.
- Schätzen Sie die RUL, indem Sie den Betriebs-Schwellenwert identifizieren, bei dem die stabile Batteriekapazität endet.
- Definieren Sie das Lebensende als die Zyklenanzahl, bei der die Batteriekapazität unwiderruflich unter 80 % der nominalen Nennkapazität fällt.
- Berechnen Sie die RUL als verbleibende Zyklenanzahl vom aktuellen Beobachtungszeitpunkt bis zum definierten Lebensende-Schwellenwert.
- Prognostizieren Sie die entladbare Energie anhand der aufgezeichneten Entladebedingungen.
- Berechnen Sie die tatsächliche entladbare Energie, indem Sie das Produkt aus Entladespannung und Entladestrom über das Entladeintervall numerisch integrieren, unter Verwendung der Trapezregel.
- Bewerten Sie die Vorhersageleistung
- Berechnen Sie den mittleren absoluten Fehler (MAE), den Root-Mean-Square-Fehler (RMSE), den mittleren absoluten prozentualen Fehler (MAPE) und den Bestimmtheitsmaß-Koeffizienten (R2) für jedes Vorhersageziel.
- Berechnen Sie alle Evaluierungsmetriken mithilfe des Scikit-learn-Metrikenmoduls unter Verwendung standardisierter statistischer Formulierungen.
- Wenden Sie identische Metrikberechnungen auf alle Modelle, Datensätze und Eingabekonfigurationen an, um die Konsistenz der Evaluierung sicherzustellen.
- Aggregieren Sie alle Leistungsmetriken über die gepoolten Batterieproben innerhalb des unabhängigen Testdatensatzes, um die allgemeine Modellgeneralisierung zu bewerten.
- Berichten Sie stratifizierte Leistung
- Berechnen Sie den Mittelwert und die Standardabweichung für jede Evaluierungsmetrik über wiederholte experimentelle Durchläufe.
- Leiten Sie die berichteten statistischen Maße aus fünf unabhängigen Modellinitialisierungen ab.
- Berichten Sie 95 % Konfidenzintervalle zusammen mit den mittleren Leistungsmetriken, um die Vorhersageunsicherheit zu quantifizieren.
- Vergleichen Sie die Modellleistung über verschiedene Längen der Beobachtungsfenster und Eingangskanal-Konfigurationen hinweg.
- Stratifizieren Sie die vergleichende Analyse anhand von Beobachtungsfenstern, die 50 Zyklen, 100 Zyklen und 200 Zyklen entsprechen.
- Bewerten Sie die Vorhersageleistung über mehrere Eingabekonfigurationen, die von lediglich Kapazitäts-Eingaben bis hin zur vollständigen Integration mehrkanaliger Tensoren reichen. Siehe Abbildung 1C für den Workflow zur Evaluierung, Robustheitsprüfung und Auswahl für den Einsatz.
5. Reproduzierbarkeit, Robustheit und Sensitivitätsanalyse
- Überprüfen Sie die Reproduzierbarkeit und Robustheit
- Verwenden Sie identische Datenaufteilungen, Vorverarbeitungsworkflows und experimentelle Verfahren für alle in Abbildung 2A gezeigten Reproduzierbarkeitsbewertungen.
- Berechnen Sie den Variationskoeffizienten für die primären Evaluierungsmetriken über wiederholte Versuche hinweg, um die Konsistenz der Reproduzierbarkeit zu beurteilen.
- Wiederholen Sie alle Evaluierungsverfahren unter Verwendung desselben standardisierten Trainings- und Testworkflows.
- Initialisieren Sie jede wiederholte Evaluierung mit zufälligen Netzwerkgewichten, wobei die gleichen deterministischen Datenlade- und Mischverfahren beibehalten werden.
- Führen Sie wiederholte Trainingsexperimente durch
- Trainieren Sie die Vorhersagemodelle mehrfach unter identischen experimentellen Bedingungen unter Verwendung vordefinierter fester Zufallsstartwerte, um reproduzierbare Gewichtsinitialisierung sicherzustellen.
- Führen Sie fünf unabhängige Trainingsschleifen mit identischen Datensatzpartitionen durch, um datenbedingte Variabilität zu reduzieren.
- Berechnen Sie die endgültigen Leistungsmetriken durch Mittelung der Evaluierungsmetriken aus den fünf wiederholten Trainingsschleifen.
- Aggregieren Sie die endgültigen Robustheitsmetriken anhand der gemittelten Evaluierungsergebnisse, anstatt rohe Vorhersagetensoren zu kombinieren.
- Analysieren Sie die Empfindlichkeit gegenüber Hyperparametern
- Ändern Sie während der Sensitivitätsanalyse die Lernrate, die Batch-Größe, die Dimension der versteckten Schicht und das Dropout-Verhältnis jeweils einzeln.
- Testen Sie Lernraten im Bereich von 1 × 10⁻⁴ bis 1 × 10⁻², Batch-Größen von 32 bis 128, versteckte Dimensionen von 32 bis 256 und Dropout-Verhältnisse von 0,1 bis 0,5.
- Notieren Sie die entsprechenden Änderungen der Vorhersagegenauigkeit nach jeder Hyperparameteranpassung.
- Quantifizieren Sie die Variation der Vorhersageleistung mithilfe von RMSE und R2.
- Führen Sie eine Feature-Ablationsanalyse durch
- Entfernen Sie ausgewählte Eingabekanäle, einschließlich Temperatur, Innenwiderstand und konstruierte Merkmalsvektoren, aus dem mehrkanaligen Eingabestrom.
- Führen Sie die Feature-Ablation nach der Leave-one-out-Strategie durch, indem Sie jeweils eine Merkmalsgruppe entfernen, während die verbleibende mehrkanalige Eingabestruktur erhalten bleibt.
- Vergleichen Sie die resultierende Vorhersageleistung nach jedem Feature-Entfernungs-Experiment, um den Beitrag einzelner Merkmalsgruppen zur Modellstabilität und -genauigkeit zu bewerten.
- Quantifizieren Sie den relativen Beitrag jeder Merkmalsgruppe, indem Sie den prozentualen Anstieg des mittleren absoluten Fehlers im Vergleich zum vollständig integrierten mehrkanaligen Basismodell berechnen. Siehe Abbildung 2B für den Workflow zur Robustheitsbewertung und Sensitivitätsanalyse.
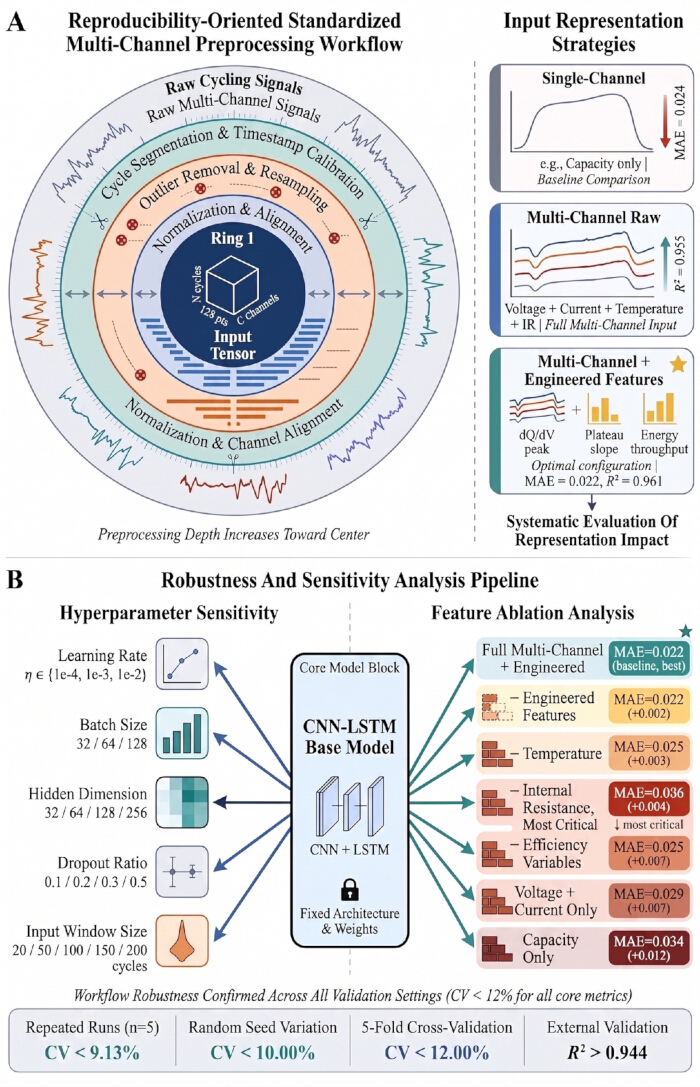
Abbildung 2. Standardisierte Vorverarbeitung, Bewertung der Robustheit und Workflow der Sensitivitätsanalyse. (A) Standardisierter Workflow zur Vorverarbeitung mit mehreren Kanälen, der die Verarbeitung roher zyklischer Signale, Zeitstempel-Kalibrierung, Entfernung von Ausreißern, Resampling, Normalisierung, Kanal-Ausrichtung und Tensor-Konstruktion veranschaulicht. Strategien zur Eingabedatenrepräsentation vergleichen Einzelkanal-Eingaben, Mehrkanal-Rohdateneingaben und Mehrkanal-Eingaben kombiniert mit extrahierten Merkmalen. (B) Pipeline zur Robustheits- und Sensitivitätsanalyse, die systematische Störungen von Hyperparametern, wiederholte Evaluierungen, Ablassanalyse von Merkmalen, Kreuzvalidierung und externe Validierung des CNN–LSTM-Workflows zeigt. Klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Mehrkanal-Radarsignale und Datenverteilung
Vertretende mehrkanalige Zyklierungssignale und Leistungsverteilungen wurden analysiert, um das Zyklierungsreaktionsverhalten von Lithium-Ionen-Batterien zu charakterisieren. Die Studie nutzte fünf Datensätze von Lithium-Ionen-Batterien, die mehrere chemische Systeme repräsentieren, darunter Lithium-Kobaltoxid (LCO), Nickel-Kobalt-Aluminium-Oxid (NCA), Nickel-Mangan-Kobalt-Oxid (NMC) und LFP (Tabelle 1). Kern-Zyklieru...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Der in diesem Protokoll beschriebene reproduzierbare DL-Workflow zeigte genaue Vorhersagen der Leistung von Lithium-Ionen-Batterien anhand von mehrkanaligen Zyklen-Daten. Der Workflow erreichte einen Test-MAE-Wert von 0,024 und einen R2-Wert von 0,955 bei der Schätzung des SOH unter den untersuchten experimentellen Bedingungen, was seine potenzielle Nützlichkeit für das Management des Batterielebenszyklus sowie für Anwendungen in der Überwachung von Energiespeichern untermauert11,<...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren erklären keine konkurrierenden finanziellen Interessen oder Interessenkonflikte.
Danksagungen
Die Autoren danken der institutionellen Unterstützung durch die Abteilung für Physik an der Southern University of Science and Technology und dem Homerton College der University of Cambridge, die das akademische Umfeld und die Rechenressourcen bereitgestellt haben, die für diese Forschung erforderlich waren. Die Autoren danken außerdem den Forschungseinrichtungen und Beiträgern, die die Open-Access-Datensätze zu Lithium-Ionen-Batterien, einschließlich CALCE, SANYO, PANASONIC, KOKAM und GOTION, öffentlich zugänglich gemacht haben, wodurch diese umfassende multikanalige Analyse ermöglicht wurde.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| CALCE-Batteriedatensatz | Zentrum für fortschrittliches Lebenszyklus-Engineering (CALCE), University of Maryland | https://calce.umd.edu/battery-data | Quelle für multikanalige Lithium-Ionen-Batterie-Zyklen-Daten zur Modelltrainierung und -validierung |
| CUDA Toolkit | NVIDIA | Version 11.8 | GPU-Beschleunigung für das Training von Deep-Learning-Modellen |
| GOTION IFP20100140A-Datensatz | Mendeley Data | https://doi.org/10.17632/vpw4t7ytbx.2 | Externe Validierung und Analyse des multikanaligen Batteriealterungsverhaltens |
| KOKAM SLPB533459H4-Datensatz | Mendeley Data | https://doi.org/10.17632/7w4y4fzzbb.1 | Modellierung und Validierung des multikanaligen Batteriealterungsverhaltens |
| Matplotlib | Matplotlib-Entwicklungsteam | Version 3.7.1 | Visualisierung der Modellleistung, Sensitivitätsanalyse und Reproduzierbarkeitsergebnisse |
| NumPy | NumPy-Entwickler | Version 1.24.3 | Numerische Berechnungen und Tensorerstellung |
| PANASONIC NCR18650BD-Datensatz | Mendeley Data | https://doi.org/10.17632/wykht8y7tg.1 | Quelle für multikanalige Zyklen-Daten und extrahierte Merkmale |
| Pandas | Pandas-Entwickler | Version 2.0.3 | Datenorganisation, Vorverarbeitung und Verwaltung tabellarischer Daten |
| PyTorch | PyTorch Foundation | Version 2.0.1 | Erstellung und Training von Deep-Learning-Architekturen, einschließlich des CNN–LSTM-Modells |
| Python | Python Software Foundation | Version 3.10.12 | Datenvorverarbeitung, Merkmalsengineering, Modelltraining und -bewertung |
| SANYO UR18650E-Datensatz | NASA Prognostics Data Repository | https://ti.arc.nasa.gov/tech/dash/groups/pcoe/prognostic-data-repository/ | Quelle für multikanalige Zyklen-Daten zur Bewertung der Reproduzierbarkeit und Modellvalidierung |
| Scikit-learn | Scikit-learn-Entwickler | Version 1.2.2 | Implementierung von Basislinienmodellen, Datensatz-Aufteilung und Berechnung von Leistungsmetriken |
Referenzen
- Lu J, Xiong R, Tian J. Deep learning to estimate lithium-ion battery state of health without additional degradation experiments. Nat Commun. 2023;14:2760.
- Zhang H, Li Y, Zheng S. Battery lifetime prediction across diverse ageing conditions with inter-cell deep learning. Nat Mach Intell. 2025;7:270–7.
- Zhang Y, et al. State-of-health estimation for lithium-ion batteries via incremental energy analysis and hybrid deep learning model. Batteries. 2025;11(6):217.
- Liu C, et al. Deep learning for state of health estimation of lithium-ion batteries in electric vehicles: A systematic review. Energies. 2025;18(6):1463.
- Chen C, Wei J, Li Z. Remaining useful life prediction for lithium-ion batteries based on a hybrid deep learning model. Processes. 2023;11(8):2333.
- Chen B, et al. Lithium-ion battery state of health estimation based on feature reconstruction and Transformer-GRU parallel architecture. Energies. 2025;18(5):1236.
- Zhao W, Ding W, Zhang S, Zhang Z. Enhancing lithium-ion battery lifespan early prediction using a multi-branch vision transformer model. Energy. 2024;302:131816.
- Hu J, et al. Early prediction of lithium-ion battery degradation with a generative pre-trained transformer. Nat Commun. 2026;17:126.
- Li Y, et al. Accurate and adaptive state of health estimation for lithium-ion battery based on patch learning framework. Measurement. 2025;250:117083.
- Geng M, et al. Interpretable deep learning with uncertainty quantification for lithium-ion battery SOH estimation. Energy. 2025;335:138027.
- Li Y, et al. State-of-health prediction of lithium-ion batteries using feature fusion and a hybrid neural network model. Energy. 2025;319:135163.
- Zhou J, et al. Deep learning estimation of state of health for lithium-ion batteries using multi-level fusion features of discharge curves. J Power Sources. 2025;653:237781.
- Wang Y, et al. A comprehensive review of machine learning-based state of health estimation for lithium-ion batteries: Data, features, algorithms, and future challenges. Renew Sustain Energy Rev. 2025;224:116125.
- Severson KA, et al. Data-driven prediction of battery cycle life before capacity degradation. Nat Energy. 2019;4(5):383–91.
- Wu R, et al. Confidence-aware quantile Transformer for reliable degradation prediction of battery energy storage systems. Reliab Eng Syst Saf. 2025;260:111019.
- Yang H, et al. Privacy-preserving collaborative battery fault warning for massive electric vehicles by heterogeneous data from charging stations. Nat Commun. 2026;17:974.
- Liu Y, et al. A hybrid deep learning approach for remaining useful life prediction of lithium-ion batteries based on discharging fragments. Appl Energy. 2024;358:122555.
- Bockrath S, Lorentz V, Pruckner M. State of health estimation of lithium-ion batteries with a temporal convolutional neural network using partial load profiles. Appl Energy. 2023;329:120307.
- Zhang Z, et al. Multi-cycle charging information guided state of health estimation for lithium-ion batteries based on pre-trained large language model. Energy. 2024;313:133993.
- Li Z, Zhang X, Gao W. State of health estimation of lithium-ion battery during fast charging process based on BiLSTM-Transformer. Energy. 2024;311:133418.
- Bao X, et al. Hybrid deep neural network with dimension attention for state-of-health estimation of lithium-ion batteries. Energy. 2023;278:127734.
- He N, et al. Early prediction of battery lifetime based on graphical features and convolutional neural networks. Appl Energy. 2024;353:122048.
- Rieger LH, et al. Uncertainty-aware and explainable machine learning for early prediction of battery degradation trajectory. Digit Discov. 2023;2(1):112–22.
- Li H, et al. A cross-material lithium-ion battery state of health estimation method based on three-stage domain adaptation. Energy. 2025;139376.
- Han T, et al. Source-free dynamic weighted federated transfer learning for state-of-health estimation of lithium-ion batteries with data privacy. IEEE Trans Power Electron. 2024;39(11):15085–100.
- Rhyu J, et al. Systematic feature design for cycle life prediction of lithium-ion batteries during formation. Joule. 2025;9(5):101884.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.