Der vorgeschlagene MSCNN-LSTM-Ansatz kombiniert die mehrskalige räumliche Merkmalsextraktion mit der Modellierung zeitlicher Sequenzen zur Erkennung von Aktionen in Sportvideos, wodurch feinkörnige räumliche Merkmale und zeitliche Bewegungsmuster erfasst werden, und gleichzeitig eine konkurrenzfähige Klassifizierungsleistung auf etablierten Datensätzen für Sportaktionen erzielt wird.
Forschungsartikel
Aktionserkennung in Sportvideos unter Verwendung von multiskaligen konvolutionalen Netzwerken mit zeitlicher Modellierung auf Basis von Long Short-Term Memory (LSTM)
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die Erkennung von Aktionen in Sportvideos bleibt aufgrund komplexer Bewegungsdynamiken, Verdeckungen und hoher intra-klassen Variabilität eine Herausforderung. Obwohl bestehende Deep-Learning-Ansätze, einschließlich CNN-BiLSTM und modellbasierte Transfer-Learning-Methoden, sich bei der Erkennung menschlicher Aktivitäten als wirksam erwiesen haben, können ihre Leistung in Szenarien mit schnellen, vielfältigen Bewegungen im Sportbereich begrenzt sein. Viele bestehende Methoden stützen sich auf feste, einheitliche Faltungskerne, die möglicherweise nicht gleichzeitig feinkörnige und grobe Bewegungsmerkmale effektiv erfassen. Um diese Einschränkung zu überwinden, schlägt diese Studie ein mehrskaliges faltendes neuronales Netzwerk (MSCNN) vor, das mit einem Long-Short-Term-Memory-Netzwerk (LSTM) für die Aktionserkennung in Sportvideos kombiniert wird. Das MSCNN extrahiert räumliche Darstellungen über mehrere Aufnahmefelder hinweg mithilfe paralleler Faltungskerne und ermöglicht so das Lernen sowohl detaillierter als auch kontextueller Bewegungsmerkmale. Diese Merkmale werden anschließend vom LSTM verarbeitet, um zeitliche Abhängigkeiten und Bewegungskontinuität über aufeinanderfolgende Einzelbilder hinweg zu erfassen. Die experimentelle Bewertung wurde an den Benchmark-Datensätzen UCF11, UCF Sports und JHMDB durchgeführt. Das vorgeschlagene MSCNN-LSTM-Modell erreichte Klassifizierungsgenauigkeiten von 98,3 %, 95,4 % bzw. 81,7 % und übertraf damit die in dieser Studie evaluierten vergleichbaren Ansätze. Eine Ablationsstudie zeigte zudem den Beitrag der mehrskaligen Merkmalsextraktion und der zeitlichen Modellierung zur Gesamtleistung auf. Diese Ergebnisse verdeutlichen das Potenzial des vorgeschlagenen Frameworks, räumliche und zeitliche Informationen für die Aktionserkennung in Sportvideos zu kombinieren.
Einleitung
Die Erkennung menschlicher Aktivitäten hat umfangreiche Anwendungen in verschiedenen realen Bereichen, darunter intelligente Überwachung, Anomalieerkennung, aktionsbasierte audiovisuelle Suche und die Patientenüberwachung im Gesundheitswesen1,2. Die Erkennung von Aktionen, insbesondere in Videostreams von Überwachungssystemen und sozialen Medienplattformen, bietet erhebliches Potenzial für die Anomalieerkennung und das Verständnis von Ereignissen3. Menschliche Aktionen werden in der Videoanalyse durch die Beobachtung verschiedener Körperteile wie Hände und Beine identifiziert. Im Gegensatz zu statischen Bildern reicht oft ein einzelner Frame nicht aus, um eine Aktion darzustellen4. Beispielsweise können die Anfangspositionen von Aktivitäten wie Fußballspielen und Seilspringen in einem einzelnen Frame ähnlich erscheinen. Die Unterschiede zwischen diesen Aktionen werden deutlich, wenn sie über eine Abfolge von Frames betrachtet werden, die Bewegungsmuster und Wechselwirkungen des menschlichen Körpers mit seiner Umgebung erfassen5,6,7. Die in dieser Arbeit verwendeten Abkürzungen sind in Tabelle 1 zusammengefasst, um die Lesbarkeit zu verbessern und eine konsistente Terminologie sicherzustellen.
| Abkürzung | Vollform |
| AI | Künstliche Intelligenz |
| AUC | Fläche unter der Kurve |
| BiLSTM | Bidirektionales Long Short-Term Memory |
| CNN | Faltendes neuronales Netzwerk |
| CUDA | Compute Unified Device Architecture |
| F1-Score | Harmonisches Mittel von Präzision und Rückruf |
| GPU | Graphics Processing Unit |
| HAR | Erkennung menschlicher Aktivitäten |
| JHMDB | Joint Human Motion DataBase |
| LSTM | Long Short-Term Memory |
| mAP-T | Temporale mittlere durchschnittliche Präzision |
| MCC | Matthews-Korrelationskoeffizient |
| MSCNN | Mehrschichtiges faltendes neuronales Netzwerk |
| ROC | Empfänger-Charakteristik |
| TSI | Temporaler Stabilitätsindex |
| UCF | University of Central Florida |
| VRAM | Video Random Access Memory |
Tabelle 1: Liste der im Manuskript verwendeten Abkürzungen. Häufig verwendete Abkürzungen und Akronyme, die in der gesamten Studie verwendet werden, sowie ihre jeweiligen vollständigen Formen.
Eine schnelle und genaue Klassifizierung von Sportvideos ist wichtig für eine Vielzahl von Anwendungen8,9,10, darunter Sportanalysen, Ereigniserkennung, inhaltsbasierte Abrufverfahren und Empfehlungssysteme11,12,13. Angesichts des rasanten Wachstums sportbezogenen Videomaterials sind die Grenzen früherer analytischer Rahmenwerke zunehmend offensichtlich geworden14. Folglich steigt die Nachfrage nach robusten Ansätzen, die in der Lage sind, die Komplexität und dynamische Natur von Sportaktivitäten zu bewältigen. Traditionelle Methoden zur Klassifizierung von Sportvideos stützten sich weitgehend auf manuell erstellte Deskriptoren wie optischen Fluss und Histogram of Oriented Gradients (HOG), um Bewegungsmuster und Aktivitäten in Sportvideos zu charakterisieren15.
ConvNets, die bei der Klassifizierung statischer Bilder bemerkenswerte Erfolge erzielt haben, wurden auch auf die Videoanalyse angewandt. Die Erkennung von Aktionen bleibt jedoch herausfordernder, da Videos dynamische räumlich-zeitliche Informationen enthalten. Aktuelle Ansätze auf Basis von Deep Learning lassen sich im Allgemeinen in drei Gruppen einteilen: Zwei-Strömungs-Netzwerke16, 3D-Faltungsnetzwerke und recheneffiziente Architekturen. Um zeitliche Informationen aus dem optischen Fluss zu lernen, verwenden Zwei-Strömungs-Netzwerke ein zusätzliches ConvNet17,18, wobei dieser Ansatz rechenintensiv ist. Während 3D-Faltungsarchitekturen wie C3D, I3D und R3D zeitliche Informationen direkt modellieren können, erhöhen sie die Anzahl der Parameter erheblich, was die Optimierung erschwert. Recheneffiziente Methoden versuchen, die Modellkomplexität zu verringern, indem sie zerlegte 3D-Operationen untersuchen.
Da CNNs in der Lage sind, lokale räumliche Merkmale zu extrahieren, und LSTMs zeitliche Kontextinformationen erfassen können, können hybride Modelle effektiv raumzeitliche Bewegungsmuster aus Sensoreingaben lernen. Kürzlich durchgeführte Studien, die CNN- und rekurrente neuronale Netzwerkarchitekturen kombinieren, haben vielversprechende Ergebnisse hervorgebracht18,19,20. Da jedoch LSTMs Informationen während der Sequenzverarbeitung komprimieren, kann Rauschen, das während der Merkmalsextraktion eingeführt wird, die Erkennungsleistung beeinträchtigen. Um dieses Problem zu beheben, haben mehrere Studien Aufmerksamkeitsmechanismen integriert21,22. Aufmerksamkeitsmechanismen ermöglichen es dem Modell, sich auf Merkmale zu konzentrieren, die für die Erkennungsaufgabe am relevantesten sind, wodurch die Klassifizierungsleistung verbessert wird.
Obwohl tiefe bidirektionale LSTM-Modelle in Kombination mit CNN-basierten Merkmalsextraktionsverfahren bereits vielversprechende Ergebnisse für die Erkennung menschlicher Aktivitäten erzielt haben, bestehen mehrere Herausforderungen, wenn diese Architekturen auf die Erkennung von Aktionen in Sportvideos erweitert werden. Erstens verwenden bestehende CNN-LSTM-Architekturen häufig eine fokussierte, einstufige fokussierte Merkmalsextraktion, was ihre Fähigkeit einschränken kann, Aktionen auf mehreren räumlichen und zeitlichen Auflösungsstufen zu erfassen, wie beispielsweise gleichzeitige Bewegungen von Spielern und Objekten in Sportszene. Mehrstufige fokussierte Netzwerke, darunter 3D-CNNs23 und Zwei-Stream-CNNs, haben die Bedeutung der Erfassung räumlicher und Bewegungshinweise auf unterschiedlichen Skalen gezeigt, obwohl dieses Konzept in LSTM-basierten hybriden Systemen bisher weniger erforscht wurde. Zweitens konzentrieren sich die meisten bisherigen CNN-BiLSTM-Modelle24 hauptsächlich auf kurzfristige zeitliche Abhängigkeiten, während langfristige Bewegungskontinuität und Inter-Objekt-Interaktionen, wie sie in Mannschaftssportarten häufig vorkommen, möglicherweise nicht ausreichend abgebildet werden. Viele auf Transferlernen basierende Ansätze, wie MobileNetV2 und ResNet, stützen sich auf statische Frame-Merkmale und nutzen zeitliche Aufmerksamkeitsmechanismen oder adaptive mehrstufige Merkmalsfusion25 nicht vollständig aus. Darüber hinaus wurden die meisten bestehenden Modelle hauptsächlich anhand von Benchmark-Datensätzen wie UCF11 und JHMDB evaluiert. Neuere, spezifisch auf Sport ausgerichtete Datensätze, die komplexe Kamerabewegungen und Aktivitätsmuster erfassen, wie beispielsweise SoccerNet und FineGym, sind bisher noch wenig erforscht. Diese Einschränkungen verdeutlichen die Notwendigkeit eines mehrstufigen CNN-basierten Merkmalsextraktionsframeworks, das mit zeitlichen Speichermodulen wie LSTM- oder BiLSTM-Netzwerken kombiniert ist, um sowohl feinkörnige räumliche Darstellungen als auch langfristige zeitliche Abhängigkeiten in der Erkennung von Sportvideo-Aktionen besser erfassen zu können.
Darüber hinaus können Faltungsneuronale Netze (CNNs) lokale räumliche Merkmale extrahieren, während LSTMs den zeitlichen Kontext modellieren können. Hybride CNN-RNN-Architekturen haben daher vielversprechende Leistungen bei der Erkennung menschlicher Aktivitäten gezeigt26,27. Neuere Studien haben herkömmliche CNN-LSTM-Strukturen erweitert, indem sie ergänzende Lernstrategien integrierten, um die Erkennung menschlicher Aktivitäten zu verbessern. Beispielsweise wurden Aufmerksamkeitsmechanismen eingeführt, um aufgabenspezifisch relevante Merkmale zu betonen und weniger informative Darstellungen zu unterdrücken, wodurch die Erkennungsleistung gesteigert wird28. Andere Ansätze nutzen das Mehrfachaufgaben-Lernen (Multi-Task Learning), um die Erkennung von Aktionen und die zeitliche Segmentierung gemeinsam zu optimieren, was die Lerneffizienz sowie die Merkmalsdarstellung verbessert29. Trotz dieser Fortschritte könnten bestehende Methoden weiterhin begrenzt darin sein, optisch ähnliche Aktionen zu unterscheiden, da fein abgestufte räumliche und zeitliche Merkmale nicht immer effektiv erfasst werden. Tabelle 2 fasst die Stärken und Schwächen bestehender Ansätze zusammen30.
| Referenz / Jahr | Verwendete Methode | Datensatz(e) | Leistungskennzahlen | Wesentliche Stärken | Einschränkungen |
| Hassan et al. (2024)1 | KFDI (Key Frame Dynamic Image) | UCF11 | Genauigkeit: 85,3 % | Effiziente Auswahl von Schlüsselbildern und verbesserte Darstellung dynamischer Bilder. | Anfällig für Fehler bei der Bildauswahl; eingeschränkte zeitliche Modellierung. |
| Zhou et al. (2023)24 | Dilatierendes CNN + BiLSTM + Residueller Block | UCF11, UCF Sports | Genauigkeit: UCF11: 89 % und UCF Sports: 92,2 % | Kombiniert räumliche und zeitliche Lernverfahren; erfasst multiscale Informationen. | Hoher Rechenaufwand; Risiko der Überanpassung bei kleinen Datensätzen. |
| Ullah et al. (2025)34 | Lokal–globaler Merkmalsansatz + QSVM | UCF11 | Genauigkeit: 82,6 % | Kombiniert manuell erstellte und tiefe Merkmale für eine robuste Erkennung. | Erfordert manuelle Feinabstimmung; eingeschränkte Skalierbarkeit. |
| Shin et al. (2025)25 | ViT-ReT (Vision Transformer + Rekurrenter Transformer) | UCF11, UCF50, UCF101 und JHMDB | Genauigkeit: UCF11: 97,73 %; UCF50: 98,81 %; UCF101: 98,46 %; JHMDB: 83,38 % | Erfasst langreichweitige räumliche und zeitliche Abhängigkeiten. | Hohe Rechenkosten und hoher Datenbedarf. |
| Su et al. (2024)23 | 3D-CNN | UCF11 | Genauigkeit: 85,1 % | End-to-End-Lernen räumlich-zeitlicher Merkmale. | Hoher Speicher- und GPU-Bedarf. |
| Karuppannan et al. (2024)35 | Tiefer Autoencoder + CNN | UCF11 | Genauigkeit: 96,2 % | Lernt kompakte Merkmalsdarstellungen. | Eingeschränkte Modellierung langfristiger zeitlicher Abhängigkeiten. |
| Sahoo et al. (2020)36 | HAR-Depth | KTH, UCF Sports, JHMDB, UCF101 und HMDB51 | Genauigkeit: KTH: 97,67 %; UCF Sports: 95,00 %; JHMDB: 73,13 %; UCF101: 92,97 %; HMDB51: 69,74 % | Effektives, auf Tiefendaten basierendes zeitliches Lernen. | Erfordert genaue Tiefenschätzung und umfangreiche Vorverarbeitung. |
Tabelle 2: Vergleich bestehender Deep-Learning-Methoden zur Erkennung von Aktionen in Sportvideos. Zusammenfassung repräsentativer Deep-Learning-Ansätze, einschließlich Datensätze, methodischer Merkmale, Vorteile und Grenzen, wobei die Forschungslücken hervorgehoben werden, die durch den vorgeschlagenen MSCNN-LSTM-Ansatz adressiert werden.
Ein Rahmenwerk für durch Audiosynchronisation gesteuerte Gesichtsanimation wurde vorgeschlagen, das ein Modell zur Gesichtsentrauschung (Facial Denoiser Model, FDM) mit einem lokal-zu-globalen latenten Diffusionsmodell (Local-to-global Latent Diffusion Model, LG-LDM) kombiniert, um emotional ausdrucksstarke Gesichtsanimationen zu erzeugen. Ein auf Emotionen fokussierter, vektorquantisierter Variationaler Autoencoder (Emotion-centric Vector Quantized Variational Autoencoder, EVQ-VAE) wurde verwendet, um detaillierte dreidimensionale Gesichtsgeometrie und subtile Expressionsvariationen rekonstruieren31. Zusätzlich wurde ein auf Okklusionserkennung ausgerichtetes Roboter-Greifrahmenwerk unter Verwendung einer binokularen Stereovision entwickelt, das Zielsegmentierung, Lokalisierung, Okklusionsinferenz und Schätzung von Griffposen für mehrere Ziele unter Bedingungen teilweiser Verdeckung ermöglicht32. Darüber hinaus wurde ein zweistufiges Verfahren zur Geländegewinnung aus Punktwolken vorgestellt, das eine Gitterprojektion und adaptive Klasseneinteilung nutzt, wobei nach einer groben Extraktion mittels gitterbasierter Merkmalsanalyse Wahrscheinlichkeiten für Höhe und Krümmung zur Verfeinerung der Grenzen zwischen Gelände und Hindernissen verwendet werden33.
Trotz erheblicher Fortschritte bei der Aktivitätserkennung basierend auf Deep Learning haben bestehende Methoden weiterhin Schwierigkeiten, die hohe Variabilität und Komplexität von Sportvideos zu bewältigen, einschließlich schneller Bewegungen, Kamerabewegungen und Interaktionen zwischen mehreren Spielern. Viele traditionelle Modelle, die auf CNNs oder LSTMs basieren, arbeiten auf einer einzigen räumlichen Skala und können daher möglicherweise lokale und globale Bewegungsmuster nicht effektiv erfassen. Darüber hinaus bleibt die Gewährleistung zeitlicher Kohärenz bei lang andauernden Sequenzen oder überlappenden Aktionen eine Herausforderung. Obwohl Methoden des Transferlernens die Merkmalsextraktion verbessert haben, ist ihre Anpassung an sportartspezifische Datensätze bisher vergleichsweise wenig erforscht.
Diese Studie zielt darauf ab, einen Multi-Skaligen Faltungs-Neuronalen Netzwerk–Langzeit-Kurzzeit-Speicher (MSCNN-LSTM) zu entwickeln und zu evaluieren, um die Erkennung von Aktionen in Sportvideos durch die Kombination einer mehrskaligen räumlichen Merkmalsextraktion mit einer LSTM-basierten zeitlichen Modellierung zu verbessern, wodurch sowohl feinkörnige räumliche Merkmale als auch langfristige zeitliche Abhängigkeiten erfasst werden. Der vorgeschlagene Ansatz nutzt komplementäre Faltungskerne und eine mehrstufige Merkmalsfusion, um die Repräsentation komplexer Sportaktionen unter anspruchsvollen Bedingungen zu verbessern. Die Leistung wurde anhand der Benchmark-Datensätze UCF11, UCF Sports und JHMDB anhand von Genauigkeit, Präzision, Sensitivität, F1-Score, mittlerem Durchschnittspräzisionswert über der Zeit (mAP-T), zeitlichem Stabilitätsindex (TSI), Cohens Kappa-Koeffizient (κ), Matthews-Korrelationskoeffizient (MCC) und Fläche unter der ROC-Kurve (AUC) bewertet. Die experimentellen Ergebnisse zeigen eine wettbewerbsfähige Leistung im Vergleich zu den in dieser Studie evaluierten Methoden und unterstreichen das Potenzial des Ansatzes für Sportanalysen, die Überwachung der Athletenleistung, die automatisierte Erkennung von Ereignissen sowie das Verständnis von Sportvideos.
Protokoll
Diese Studie verwendete ein zweistufiges Deep-Learning-Verfahren zur Erkennung von Sportvideobewegungen, das ein mehrskaliges faltendes neuronales Netzwerk (MSCNN) mit einem Long Short-Term Memory-Netzwerk (LSTM) kombiniert. Öffentlich verfügbare Benchmark-Datensätze, und zwar UCF11, UCF Sports und JHMDB, wurden zur Modellentwicklung und -evaluierung herangezogen. Es wurden keine neuen Daten von menschlichen Probanden erhoben, und es wurde kein persönlich identifizierbares Material zugänglich gemacht oder verarbeitet. Da die Studie eine sekundäre Analyse öffentlich zugänglicher, anonymisierter Datensätze umfasste und keine direkte Teilnahme von Menschen beinhaltete, waren eine institutionelle ethische Genehmigung und eine informierte Einwilligung nicht erforderlich.
Der Arbeitsablauf bestand aus der Bildratenabtastung und zeitlichen Normalisierung, gefolgt von der Merkmalsextraktion mithilfe des MSCNN-Moduls. Die extrahierten Merkmale wurden anschließend mit einem LSTM-Netzwerk zur zeitlichen Modellierung verarbeitet und danach an eine Multiklassen-Klassifizierungsschicht weitergeleitet. Schließlich wurde das Modell anhand der ausgewählten Benchmark-Datensätze trainiert und evaluiert. Abbildung 1 veranschaulicht die Gesamtarchitektur des vorgeschlagenen Frameworks.
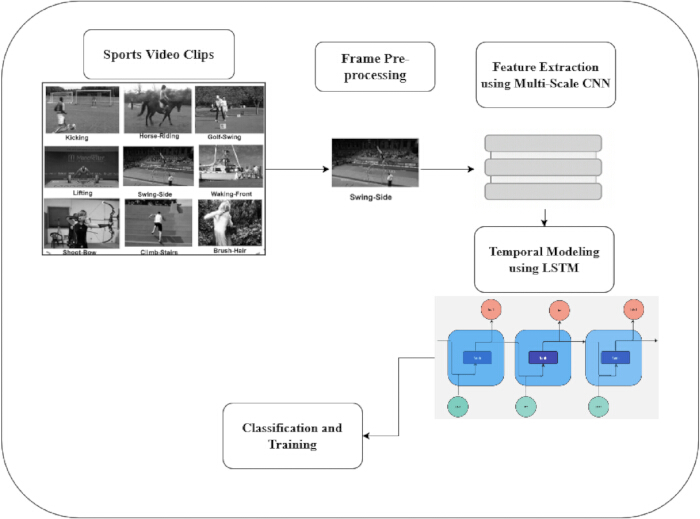
Abbildung 1: Vorgeschlagenes MSCNN-LSTM-Modell zur Erkennung von Aktionen in Sportvideos. Gesamter Arbeitsablauf zur Video-Vorverarbeitung, mehrskaligen räumlichen Merkmalsextraktion, zeitlichen Sequenzlernung und Aktionsklassifizierung. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Abbildung 1 veranschaulicht den Arbeitsablauf des vorgeschlagenen Frameworks zur Erkennung von Aktionen in Sportvideos basierend auf einer hybriden MSCNN-LSTM-Architektur. Der Prozess beginnt mit Sportvideoclips, die verschiedene sportliche Aktionen enthalten, wie Treten, Reiten und Golfschwung. Die Rohvideos wurden im Vorverarbeitungsschritt in einzelne Bilder zerlegt, wobei die Bilder zugeschnitten, standardisiert und für die Modell-Eingabe vorbereitet wurden. Die vorverarbeiteten Bilder wurden anschließend zur Merkmalsextraktion in das MSCNN-Modul eingespeist. Die mehrstufige faltende Architektur erfasst räumliche Merkmale in unterschiedlichen Rezeptivfeldern und ermöglicht so die Extraktion lokaler und kontextueller Informationen aus den Sportvideobildern. Die extrahierten Merkmalsvektoren wurden dann vom LSTM-Netzwerk verarbeitet, um zeitliche Abhängigkeiten und die Bewegungsentwicklung über aufeinanderfolgende Bilder hinweg abzubilden. Schließlich nutzte das Klassifizierungs- und Trainingsmodul die erlernten räumlich-zeitlichen Darstellungen, um die Aktionskategorie für jeden Videoclip vorherzusagen. Das vorgeschlagene Framework umfasste vier aufeinanderfolgende Schritte, beginnend mit Datensammlung und Vorverarbeitung unter Verwendung der Benchmark-Datensätze UCF11 (YouTube Actions), UCF Sports und JHMDB. Jedes Sportvideo wurde in eine Sequenz von Bildern umgewandelt, die verkleinert, normalisiert und durch Rotation, Spiegelung und Zuschneiden erweitert wurden, um die Robustheit gegenüber Umweltvariationen zu verbessern. Die vorverarbeiteten Bilder wurden dann durch das vorgeschlagene Multi-Scale Convolutional Neural Network (MSCNN) verarbeitet, bei dem parallele faltende Zweige mit 3 × 3, 5 × 5 und 7 × 7 Kernen komplementäre lokale und kontextuelle räumliche Merkmale extrahierten. Diese mehrstufigen Merkmale wurden konkateniert und mittels Batch-Normalisierung und Max-Pooling verfeinert, um kompakte Merkmalsdarstellungen zu erzeugen. Die resultierenden bildbasierten Merkmale wurden anschließend einem Long Short-Term Memory (LSTM)-Netzwerk zur Verfügung gestellt, um zeitliche Abhängigkeiten über aufeinanderfolgende Bilder hinweg abzubilden. Die finalen LSTM-Ausgaben wurden abgeflacht und über voll verbundene Schichten mit ReLU-Aktivierung weitergeleitet, gefolgt von einem Softmax-Klassifikator zur Vorhersage der Aktionskategorie. Das Netzwerk wurde mithilfe des Adam-Optimierers mit einer Kreuzentropie-Verlustfunktion und Dropout-Regularisierung trainiert, um Überanpassung zu reduzieren. Die Modellleistung wurde abschließend anhand der Benchmark-Datensätze UCF11, UCF Sports und JHMDB anhand von Genauigkeit, Präzision, Sensitivität und F1-Score bewertet.
1. Datensammlung und Vorverarbeitung
In dieser Studie wurden drei öffentlich verfügbare Benchmark-Datensätze für Sport und menschliche Aktionen verwendet. Diese Datensätze enthalten Videomaterial aus der realen Welt mit unterschiedlichen Kamerabewegungen, Blickwinkeln und komplexen Hintergründen. Konkret nutzte die Studie UCF11 (YouTube-Aktionen) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php), das 11 Aktionskategorien umfasst, die aus 1.168 YouTube-Videos stammen, die von etwa 25 Personen aufgezeichnet wurden, wobei es mehrere Beispiele pro Aktion gibt. Die Joint-Annotated Human Motion Database (JHMDB)34,35 enthält 21 Aktionsklassen und 928 annotierte Videos. Der UCF-Sportdatensatz umfasst 10 Aktionsklassen und 150 Videosequenzen, die aus Sendequellen mit einer Auflösung von 720 × 480 Pixeln aufgezeichnet wurden (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php).
Insgesamt umfassen diese Datensätze sowohl individuelle als auch Mannschaftssportarten und bieten eine Variation hinsichtlich zeitlicher Dauer und visueller Skalierung, um den vorgeschlagenen MSCNN-LSTM-Aktivitätserkennungsansatz zu evaluieren. Im Rahmen des Qualitätsprüfungsprozesses für die Daten wurden die Datensätze UCF11, UCF Sports und JHMDB auf beschädigte Videos, doppelte Dateien sowie Ausschnitte mit unvollständigen Annotationen überprüft. Es wurden keine Stichproben gefunden, die diesen Ausschlusskriterien entsprachen; daher wurden alle verfügbaren Videos für die anschließende Analyse beibehalten. Die Datensätze wurden anschließend mithilfe einer einheitlichen Zufallsaufteilungsstrategie in Trainings- (70 %), Validierungs- (15 %) und Testdatensätze (15 %) unterteilt. Abbildung 2 zeigt repräsentative Bilder, die für das Training und die Evaluierung verwendet wurden.
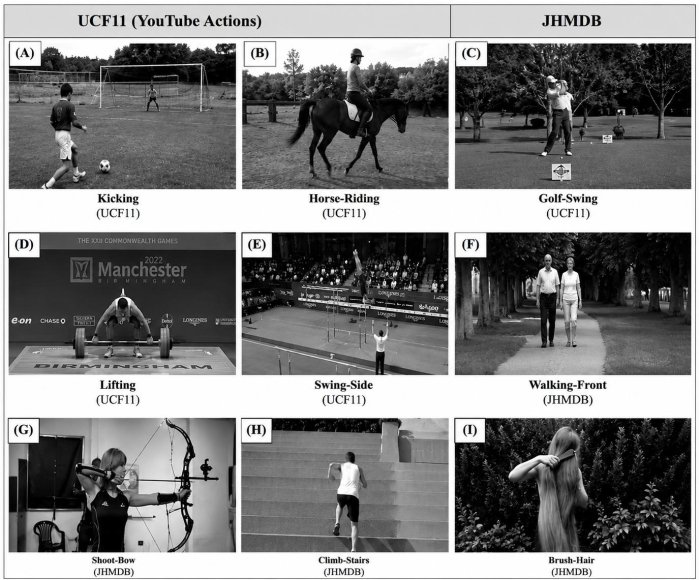
Abbildung 2: Repräsentative Einzelbilder aus etablierten Datensätzen zur Erkennung von Sportaktionen. Die Teilabbildungen (A–D) zeigen Beispiele aus dem UCF11 (YouTube Actions)-Datensatz, die Teilabbildungen (E–H) aus dem UCF Sports-Datensatz und die Teilabbildungen (I–L) aus dem JHMDB-Datensatz. Die Bilder veranschaulichen Variationen in Aktionsklassen, Blickwinkeln, Hintergründen, Beleuchtungsbedingungen und Bewegungskomplexität. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Das vorgeschlagene Aktionserkennungsmodell wurde anhand der Benchmark-Datensätze UCF11, UCF Sports und JHMDB evaluiert, wie in Tabelle 3 zusammengefasst. Diese Datensätze repräsentieren vielfältige Bewegungsmuster und herausfordernde Umgebungsbedingungen. Der UCF11-Datensatz (YouTube-Aktionen) enthält Sportaktionen aus 11 Klassen, die unter variierenden Lichtverhältnissen, Blickwinkeln und Hintergründen aufgenommen wurden. Der UCF Sports-Datensatz umfasst 150 Videos von Feldsportarten aus professionellen Übertragungen mit realistischen Bewegungsabläufen. Der JHMDB-Datensatz bietet detaillierte Annotationen menschlicher Bewegungen für 21 feingliedrige Aktionskategorien und dient als Referenzdatensatz für die räumlich-zeitliche Aktionserkennung. Gemeinsam wurden diese Datensätze verwendet, um die Modellleistung in Szenarien mit Sport- und Mensch-Aktionen zu bewerten. Das Netzwerk wurde mit dem Adam-Optimierer über 100 Epochen mit einer Batch-Größe von 32, einer anfänglichen Lernrate von 0,001 und einer Cross-Entropy-Verlustfunktion trainiert. Das Modell mit dem geringsten Validierungsverlust wurde für die finale Bewertung ausgewählt. Alle Experimente verwendeten einen festen Zufallsstartwert (random seed) von 42. Frühzeitiges Abbrechen (Early stopping) und Lernratenreduktion bei Plateaus wurden angewendet, um die Konvergenz zu verbessern, und Gradient-Clipping mit einem Schwellenwert von 5,0 wurde während des LSTM-Trainings eingesetzt, um explodierende Gradienten zu verhindern. Das vorgeschlagene MSCNN-LSTM-Modell enthielt etwa 15 Millionen trainierbare Parameter. Die Hardware- und Software-Konfiguration, die für die Implementierung verwendet wurde, ist in Tabelle 4 zusammengefasst. Da die Klassenverteilungen ausreichend ausgeglichen waren, wurden keine zusätzlichen Klassen-Gewichtungen oder Resampling-Verfahren angewendet. Vergleichsmodelle wurden mit den Hyperparametern aus den jeweiligen Originalstudien implementiert, wobei die Trainingsparameter soweit möglich harmonisiert wurden. Die Leistungswerte wurden als Mittelwert ± Standardabweichung aus fünf unabhängigen Durchläufen mit unterschiedlichen Zufallsinitialisierungen angegeben. Unterschiede zwischen dem vorgeschlagenen Modell und den Vergleichsmodellen wurden mittels gepaarter t-Tests an einem Signifikanzniveau von p < 0,05 bewertet.
| Datensatz | Anzahl der Klassen | Anzahl der Videos | Auflösung (px) | Quelle | Beschreibung |
| UCF11 (YouTube Actions) | 11 | 1168 | variabel (≈ 320×240) | University of Central Florida | Enthält 11 menschliche Aktionen aus Sportarten (z. B. Basketballwerfen, Tauchen, Golfschwung, Fußballjonglieren). Die Videos wurden von YouTube gesammelt und weisen eine hohe Variabilität bezüglich Beleuchtung, Blickwinkel und Hintergrund auf. |
| UCF Sports | 10 | 150 | 720×480 | UCF Sports Action Dataset | Enthält Sportaktivitäten wie Tauchen, Reiten, Golfschwung, Laufen und Gewichtheben, die aus echtem Fernsehübertragungsmaterial (BBC, ESPN) aufgezeichnet wurden. |
| JHMDB | 21 | 928 | 320×240 | Max-Planck-Institut für Intelligente Systeme | Enthält alltägliche und sportliche Aktivitäten wie Fangen, Springen, Haarebürsten, Schießen und Laufen mit Gelenkannotationen zur Bewegungs- und Haltungsanalyse. |
Tabelle 3: Merkmale der Benchmark-Datensätze, die zum Training und zur Evaluierung verwendet wurden. Übersicht der Datensätze UCF11, UCF Sports und JHMDB, einschließlich der Anzahl von Aktionsklassen, Videobeispielen, Datensatzmerkmalen sowie deren Rolle beim Modelltraining, der Validierung und dem Testen.
| Verwendete Parameter | Beschreibung |
| Programmiersprache | Python 3.8.18 [4] |
| Tiefenlern-Framework | TensorFlow 2.15.0 [1] |
| GPU-Beschleuniger | NVIDIA GeForce RTX 3090 (24 GB VRAM) [1] |
| CPU | Intel Core i9 @ 3,5 GHz × 16 Kerne |
| Betriebssystem | Windows 11 |
| Arbeitsspeicher (RAM) | 64 GB DDR4 |
| Optimierer | Adam (Lernrate = 0,001) |
| Batch-Größe | 32 |
| Anzahl der Epochen | 100 |
| Aktivierungsfunktionen | ReLU (CNN-Schichten), Softmax (Ausgabeschicht) |
| Dropout-Rate | 0,5 |
Tabelle 4: Simulationsumgebung und Hyperparameter-Konfiguration des vorgeschlagenen MSCNN-LSTM-Modells. Hardware-Spezifikationen, Softwareumgebung, Optimierereinstellungen, Lernrate, Batch-Größe, Anzahl der Epochen, Eingabedimensionen und weitere Hyperparameter, die während des Modelltrainings und der -evaluierung verwendet wurden.
2. Vorverarbeitung
Vor dem Training wurde jedes Rohvideo in eine zeitlich geordnete Abfolge von Einzelbildern umgewandelt und anschließend normalisiert, zeitlich abgetastet und erweitert. Jedes Eingabevideo V wurde zunächst in eine Sequenz von Einzelbildern konvertiert und als 4D-Tensor V ∈ RT×H×W×C dargestellt, wobei T die Anzahl der Einzelbilder, H × W i den Index des Einzelbildes und C die Anzahl der Farbkanäle (3 für RGB) bezeichnet. Die Vorverarbeitungspipeline umfasste die Extraktion der Einzelbilder, eine räumliche Größenanpassung, gefolgt von zentralem oder zufälligem Ausschneiden auf eine feste Auflösung (H′, W′), die Normalisierung der Helligkeitswerte pro Pixel sowie eine optionale Datenerweiterung, einschließlich zufälligem Spiegeln, Skalieren und Farbmodulation, vor der Merkmalsextraktion. Konkret wurde die Intensitätsnormalisierung entweder als Standardisierung nach der Standardabweichung gemäß Gleichung (1) durchgeführt.
 (1)
wobei μ, σ die Kanalmittelwerte und Standardabweichungen sind, berechnet über den Trainingsdatensatz, oder eine Min-Max-Normalisierung gemäß Gleichung (2).
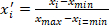 (2)
Nach der Normalisierung wurde jeder Frame als F̃t ∈ RH′×W′×C′ dargestellt, und der resultierende Videotensor wurde als V′ ∈ RT×H′×W′×C repräsentiert. In einem mehrstufigen faltenden Frontend werden durch Anwendung mehrerer zweidimensionaler (bzw. dreidimensionaler bei frühen räumlich-zeitlichen Faltungen) Faltungen mit unterschiedlichen Kernelgrößen mehrere räumliche Merkmalskarten mit verschiedenen Empfangsfeldern erhalten; anschließend wurde eine zeitliche Merkmalsdarstellung für jeden Frame oder jeden kurzen Videoclip erzeugt und an das LSTM-Modul weitergeleitet. Die ursprüngliche Arbeit verwendet MobileNetV2 und anschließend Deep BiLSTM zur zeitlichen Modellierung; die oben beschriebene Vorverarbeitungspipeline ist vollständig kompatibel mit einem Ersatz durch mehrstufige Faltung plus LSTM.
3. Probenahme und zeitliche Normalisierung
Da sich die Videolängen T zwischen und innerhalb von Datensätzen unterscheiden, nehmen wir eine gleichmäßige Stichprobe oder eine zeitliche Neubewertung der Bilder vor, um der Multiskalen-Faltung + LSTM eine feste Eingabelänge N in Form von Bildern oder kurzen Ausschnitten zu liefern. Die gleichmäßigen Bildindizes können gemäß Gleichung (3) berechnet werden,
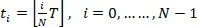 (3)
Die abgetastete Bildsequenz ist daher Vs = {F̃t0, …, F̃tN−1}. Wenn eine höhere zeitliche Auflösung erforderlich ist, führen wir eine lineare zeitliche Interpolation durch: für jede neu abgetastete Bruchzeit τ ∈ [0, T−1], berechnet gemäß Gleichung (4).
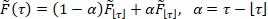 (4)
sodass die neu abgetastete Sequenz Vs genau N Bilder enthält und eine gleichmäßige Bewegung beibehält. Alternativ liefert die Abtastung in kurzen zusammenhängenden Ausschnitten (zeitliches Fenster der Länge w mit Schrittweite s) eine Menge von Clip-Tensoren, wobei jeder Clip Cj ∈ RT×H′×W′×C und j = 0, …, ⌊(T − w)/s⌋ ist. Zur zeitlichen Normalisierung innerhalb des Netzwerks erweist sich eine einfache zeitliche Pooling-Operation auf mehreren Skalen als wirksam: Gegeben eine zeitliche Merkmalssequenz X = {x1, …, xN}, die durch faltungsbasierte Operationen auf mehreren Skalen erzeugt wurde, werden gepoolte Merkmale gemäß Gleichung (5) angewendet.
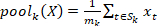 (5)
wobei Sk die zeitliche Unterstützung für die Skala k ist (z. B. können Sk nicht überlappende Blöcke oder dilatierte Indizes sein) und mk = |Sk|.
Vor der Merkmalsextraktion wurden alle Videos auf 224 × 224 Pixel skaliert und mit 25 Bildern pro Sekunde abgetastet. Jedes Experiment verwendete eine konstante Sequenzlänge von 32 Bildern. Zur Datenvermehrung gehörten zufälliges Zuschneiden (Skalierung = 0,8–1,0), zufällige Drehung (±15°), zufällige horizontale Spiegelung (Wahrscheinlichkeit = 0,5) sowie Helligkeitsanpassung (±20 %). Zur Standardisierung der Pixeldaten wurden die mittleren Werte und Standardabweichungen aus ImageNet [0,485, 0,456, 0,406] bzw. [0,229, 0,224, 0,225] verwendet. Für jede Videosequenz erfolgte die zeitliche Abtastung durch gleichmäßige Auswahl der Bilder. Längere Aufnahmen wurden gleichmäßig beschnitten oder abgetastet, um eine einheitliche Sequenzlänge beizubehalten, während Videos mit weniger als 32 Bildern durch Nullen aufgefüllt wurden. Diese Einstellungen wurden während des gesamten Trainings und der Bewertung konsequent angewendet.
4. Merkmalsextraktion mithilfe von MSCNN
Ein mehrskaliges faltendes neuronales Netzwerk (MSCNN) wurde eingesetzt, um die räumliche Darstellung von Aktionen in Sportvideos zu verbessern. Konventionelle faltende neuronale Netzwerke, die auf einer einzelnen Kernelgröße basieren, können in ihrer Fähigkeit, Merkmale auf mehreren räumlichen Skalen zu erfassen, begrenzt sein. Da einige Sportaktionen ähnliche visuelle Eigenschaften aufweisen, kann es für eine ein skalige faltende Architektur schwierig sein, sowohl lokale als auch globale Merkmale gleichzeitig zu erfassen. Um diese Einschränkung zu überwinden, nutzt das vorgeschlagene Framework Faltungskerne unterschiedlicher Größen, um eine mehrskalige Merkmalsextraktion und Merkmalsfusion durchzuführen.
In der vorgeschlagenen Netzwerkarchitektur wurden 1 × 1 Faltungskerne verwendet, um die Informationen über die Kanäle hinweg zu organisieren und die Dimensionalität der Eingangs-Funktionskarten zu reduzieren. Darüber hinaus erhöhen diese Schichten die Ausdrucksfähigkeit des Netzwerks, indem sie zusätzliche Merkmalsumwandlungen und nichtlineare Darstellungen einbringen. Faltungskerne unterschiedlicher Größe ermöglichen die Extraktion räumlicher Informationen auf mehreren Skalen. Nach der gewichteten Fusion mehrskaliger Merkmale erfolgt eine sequenzielle Normalisierung, um die Stabilität des Trainings zu verbessern. Um das Verschwinden und die Explosion von Gradienten während des Trainings tiefer Netzwerke zu verringern, verwendet die vorgeschlagene Architektur Residualverbindungen und eine auf LSTM basierende zeitliche Modellierung.
Das multiscale Design verbessert die Fähigkeit des Netzwerks, Merkmale auf unterschiedlichen räumlichen Auflösungen zu erfassen, und steigert die Leistungsfähigkeit der Merkmalsrepräsentation. Darüber hinaus wird der herkömmliche N × N-Faltungskern in N × 1- und 1 × N-Faltungsoperationen zerlegt. Die in dem MSCNN-Modul verwendeten N × 1- und 1 × N-Faltungen sind darauf ausgelegt, komplementäre, richtungsabhängige und multiscale räumliche Merkmale aus einzelnen Videobildern zu erfassen. Diese Faltungsoperationen verbessern die räumliche Merkmalsrepräsentation, indem sie Muster auf unterschiedlichen Skalen des Rezeptivfeldes extrahieren. Anschließend werden die zeitlichen Beziehungen zwischen aufeinanderfolgenden Bildern durch das LSTM-Modul modelliert, das die Sequenz der von MSCNN extrahierten Merkmale verarbeitet, um langfristige zeitliche Abhängigkeiten für die Erkennung von Aktionen zu lernen.
Jedes Sportvideo V = {F1, F2, …, FT} wird in T Einzelbilder zerlegt. Um räumliche Variationen wie Spielerpose, Bewegungsunschärfe oder Ballflugbahn zu kodieren, arbeiten faltende Zweige in drei unterschiedlichen Skalen s ∈ {1, 2, 3}, die Kernelgrößen von 3 × 3, 5 × 5 bzw. 7 × 7 entsprechen. Jeder Zweig extrahiert Merkmalskarten gemäß Gleichung (6):
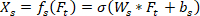 (6)
Dabei sind Ws und bs die Faltungsgewichte und -biases auf der Skala s und σ die ReLU-Aktivierung. Die Multiskalen-Fusionsschicht aggregiert Merkmale wie in Gleichung (7) dargestellt:
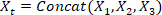 (7)
Dieser fusionierte Merkmals-Tensor enthält sowohl feinkörnige Bewegungshinweise als auch kontextuelle Informationen aus größeren Bereichen, wie beispielsweise Gruppenaktivitäten. Abbildung 3 veranschaulicht ausschließlich das MSCNN-Modul zur Merkmalsextraktion. Die für die zeitliche Modellierung und Klassifizierung verwendeten Komponenten – die LSTM-Schicht (256 versteckte Einheiten), die dichte Schicht (128 Neuronen) und die Dropout-Schicht (0,5) – sind separat in Abbildung 4 dargestellt.
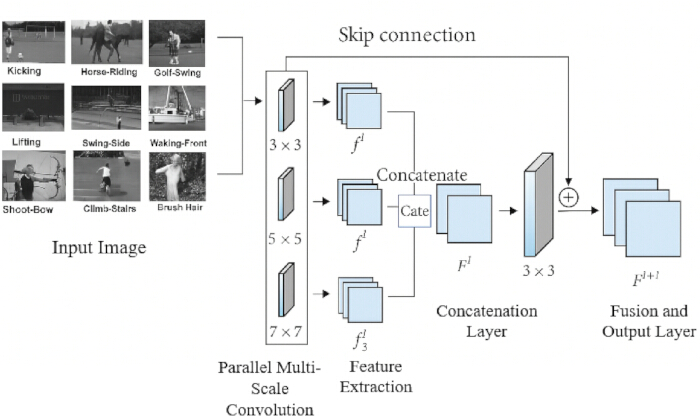
Abbildung 3: Vorgeschlagenes Modul zur Merkmalsextraktion mittels mehrskaligem Faltungsneuronalen Netzwerk (MSCNN). Drei parallele faltende Zweige mit Kernelgrößen von 3 × 3, 5 × 5 und 7 × 7 extrahieren komplementäre räumliche Merkmale auf mehreren Skalen, die vor der zeitlichen Modellierung durch das LSTM-Netzwerk zusammengeführt werden. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
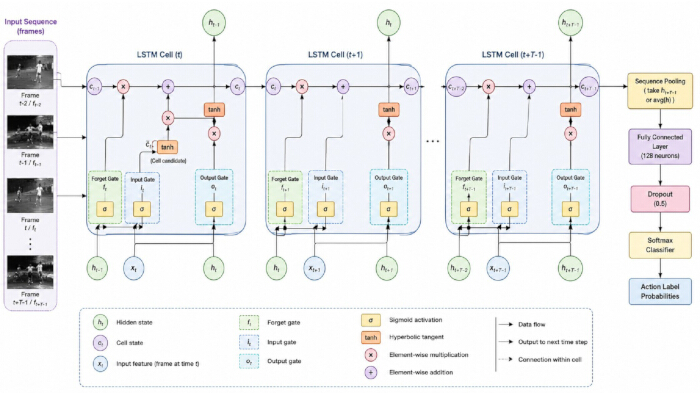
Abbildung 4: Vorgeschlagene LSTM-Architektur zur Erkennung von Aktionen in Sportvideos. Das LSTM-Modul modelliert zeitliche Abhängigkeiten durch Eingabe-, Vergessen- und Ausgabegate-Operationen über aufeinanderfolgende Videoframes hinweg. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Abbildung 3 veranschaulicht das vorgeschlagene mehrskalige faltende neuronale Netz (MSCNN) als Merkmalsextraktionsmodul zur Erkennung von Aktionen in Sportvideos. Eingabebildern von Videos wurden parallel über drei faltende Verzweigungen mit Kernelgrößen von 3 × 3, 5 × 5 und 7 × 7 verarbeitet, wobei jede 64 Filter enthielt, um komplementäre fein- und grobgranulare räumliche Merkmale zu erfassen. Die Ausgaben wurden mittels Batch-Normalisierung, ReLU-Aktivierung und 2 × 2 Max-Pooling verfeinert, anschließend konkateniert und durch eine 1 × 1 Faltung mit 128 Filtern fusioniert. Eine residuale Skip-Verbindung bewahrte räumliche Informationen niedriger Stufe und verbesserte den Gradientenfluss. Die fusionierten Merkmalskarten wurden abgeflacht und an eine LSTM-Schicht mit 256 versteckten Einheiten zur zeitlichen Modellierung weitergeleitet, gefolgt von einer vollvernetzten Schicht mit 128 Neuronen, ReLU-Aktivierung und einer Dropout-Rate von 0,5, bevor die finale Klassifizierung mittels einer Softmax-Schicht erfolgte. Die mehrskaligen Merkmalskarten (f1l, f2l und f3l) wurden konkateniert, um die fusionierte Repräsentation (Fl) zu bilden, die anschließend durch eine 3 × 3 Faltung weiter verfeinert wurde, um die Ausgabe-Merkmalskarte für die nachfolgende Schicht zu generieren. Diese hierarchische Architektur ermöglichte das Erlernen komplementärer räumlicher Merkmale in mehreren Empfangsfeldern und verbesserte somit die Leistung bei der Erkennung von Sportaktionen.
5. Zeitliches Modellieren mithilfe von LSTM
Um die zeitbasierte Entwicklung entlang der Videokanten zu modellieren, wurde die aggregierte Merkmalssequenz dem LSTM-System übergeben, um dynamische Abhängigkeiten und die Kontinuität der Bewegung zu erfassen. Für jedes Eingabevideo extrahierten wir zunächst mehrskalige CNN-Merkmale pro Einzelbild. Seien die Videobilder I1, …, IT. Für jedes Einzelbild t und jede Skala s erzeugt der mehrskalige faltende Encoder einen Merkmalsvektor ft(s) ∈ Rd. Anschließend werden die Skalen durch Projektion + Verkettung oder gewichtete Summe gemäß Gleichung (8) zu einem einzigen Bildbeschreiber zusammengeführt:
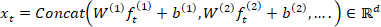 (8)
Dann wird die Sequenz {xt}tT=1 in ein LSTM eingespeist, um die zeitliche Dynamik zu modellieren. In der üblichen LSTM-Notation lauten die Gatter und Zustände zum Zeitpunkt t gemäß Gleichung (9) bis (13):
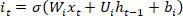 (9)
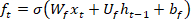 (10)
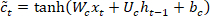 (11)
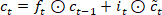 (12)
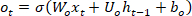 (13)
Hierbei ist σ die sigmoide Aktivierung, ⊙ die elementweise Multiplikation. Obwohl bidirektionale LSTM-Architekturen verwendet werden können, um sowohl zeitliche Kontexte aus der Vergangenheit als auch aus der Zukunft zu erfassen, setzt der vorgeschlagene Ansatz ein Standard-LSTM ein, um zeitliche Abhängigkeiten über aufeinanderfolgende Videobilder zu modellieren. Diese Designentscheidung steht im Einklang mit der in dieser Studie vorgestellten MSCNN-LSTM-Architektur. Nach der Verarbeitung des Ausschnitts wurde eine Clip-Repräsentation gewonnen (z. B. letzter verborgener Zustand oder zeitliches Pooling): z = Poolt(vt).
Abbildung 4 veranschaulicht den Arbeitsablauf der vorgeschlagenen LSTM-Architektur zur Erkennung sportlicher Aktionen. Das Netzwerk erhielt eine Sequenz von Videobildern oder von einem CNN extrahierten Merkmalen und verarbeitete diese über aufeinanderfolgende Zeitschritte (t−2, t−1 und t). Jede LSTM-Zelle bestand aus einem Eingangstor, einem Vergesstor und einem Ausgangstor, die den Informationsfluss durch das Netzwerk regulierten. Das Eingangstor integrierte neue Informationen in den Zellzustand, das Vergesstor verwarf irrelevante zeitliche Informationen, und das Ausgangstor erzeugte den versteckten Zustand, der an den nächsten Zeitschritt weitergeleitet wurde. Der Zellzustand bewahrte langfristige zeitliche Abhängigkeiten, während der versteckte Zustand kurzfristige zeitliche Informationen erfasste. Nach der sequenziellen Verarbeitung wurden die LSTM-Ausgaben zusammengefasst, um eine zeitliche Merkmalsdarstellung zu erzeugen, die an eine voll verbundene Schicht und einen Softmax-Klassifikator weitergeleitet wurde, um die entsprechende sportliche Aktion vorherzusagen. Das Netzwerk wurde mithilfe des Adam-Optimierers über 100 Epochen mit einer Batch-Größe von 32, einer anfänglichen Lernrate von 0,001 und einer Kreuzentropie-Verlustfunktion trainiert. Das Modell mit dem geringsten Validierungsverlust wurde für die endgültige Bewertung ausgewählt. Um Reproduzierbarkeit zu gewährleisten, wurden alle Experimente mit einem festen Zufallsstartwert von 42 durchgeführt. Frühzeitiges Stoppen und Lernratenreduzierung bei Plateaus wurden eingesetzt, um die Konvergenz zu verbessern, und Gradient-Clipping mit einem Schwellenwert von 5,0 wurde während des LSTM-Trainings angewendet, um explodierende Gradienten zu verhindern. Das vorgeschlagene MSCNN-LSTM-Modell enthielt etwa 15 Millionen trainierbare Parameter.
Die endgültigen Klassenscores und Wahrscheinlichkeiten verwenden eine lineare Schicht + Softmax gemäß Gleichung (14):
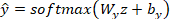 (14)
Trainieren Sie durch Minimierung des Cross-Entropy-Verlusts über die beschrifteten Clips gemäß Gleichung (15):
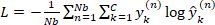 (15)
wobei Nb die Batch-Größe, C die Anzahl der Klassen und y(n) die One-Hot-Ground-Truth bezeichnet. Zur Stabilisierung bei langen Bewegungsabläufen wird Regularisierung (Dropout bei xt/LSTM-Ausgaben, Weight Decay) sowie Gradient-Clipping angewendet.
Ergebnisse
Das vorgeschlagene MSCNN-LSTM-Modell wurde auf den Datensätzen UCF11 (YouTube Actions), UCF Sports und JHMDB trainiert und evaluiert, die vielfältige Sportaktionen, Blickwinkel und Bewegungsmuster enthalten. Da die Klassenverteilungen ausreichend ausgeglichen waren, wurden keine zusätzlichen Klassen-Gewichtungen oder Resampling-Verfahren angewendet. Vergleichsmodelle wurden unter Verwendung der in den ursprünglichen Studien angegebenen Hyperparameter implementiert, wobei die Trainingsparameter, wo möglich, harmonisiert wurden. Die Ergebnisse wurden als Mittelwert ± Standardabweichung aus fünf unabhängigen Durchläufen mit unterschiedlichen Zufallsinitialisierungen angegeben. Unterschiede zwischen dem vorgeschlagenen Modell und den Vergleichsmodellen wurden mittels gepaarter t-Tests an einem Signifikanzniveau von p < 0,05 bewertet.
Abbildung 5 vergleicht die Klassifizierungsgenauigkeit über die drei Datensätze hinweg. Das MSCNN-LSTM-Modell erreichte die höchste Genauigkeit mit 98,3 % auf UCF11, 95,4 % auf UCF Sports und 81,7 % auf JHMDB. Diese Werte lagen über denen der Modelle Dilated CNN–BiLSTM, Two-Stream LSTM und ViT-ReT. Die geringere Genauigkeit bei JHMDB spiegelt die größere Schwierigkeit wider, feinkörnige Aktionen in Videos mit niedrigerer Auflösung zu erkennen.
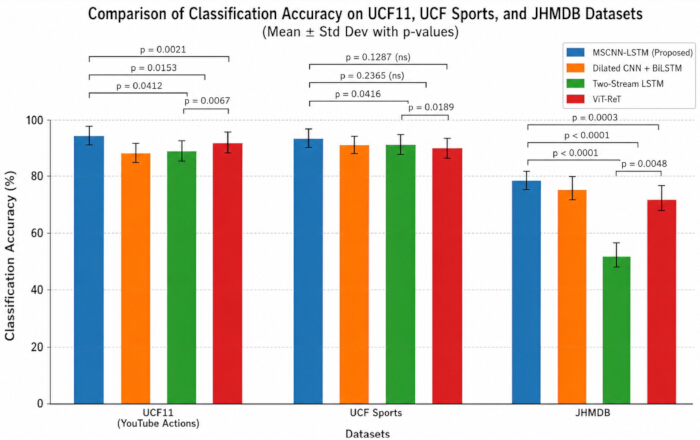
Abbildung 5: Vergleich der Klassifikationsgenauigkeit (%) verschiedener Deep-Learning-Modelle auf Sport-Videodatensätzen. Klassifikationsgenauigkeit von MSCNN-LSTM, ViT-ReT, Two-Stream LSTM und Dilated CNN + BiLSTM auf den Datensätzen UCF11, UCF Sports und JHMDB. Die Ergebnisse werden als Mittelwert ± Standardabweichung aus fünf unabhängigen Durchläufen (n = 5) angegeben. Die Fehlerbalken entsprechen einer Standardabweichung. Die statistische Signifikanz wurde mittels zweiseitiger gepaarter t-Tests (p < 0,05) bewertet. Klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Das vorgeschlagene Modell erreichte außerdem die höchste Präzision über alle Datensätze hinweg mit Werten von etwa 96 % beim UCF11, 93 % beim UCF Sports und 78 % beim JHMDB (Abbildung 6). Die Rückrufraten betrugen ungefähr 95 %, 94 % bzw. 77 % (Abbildung 7), während die entsprechenden F1-Scores etwa 95,5 %, 93,5 % und 77,5 % betrugen (Abbildung 8). Diese Ergebnisse zeigten, dass das Modell ein günstiges Gleichgewicht zwischen der korrekten Identifizierung von Aktionsklassen und der Begrenzung von Falsch-positiv-Vorhersagen aufrechterhielt.
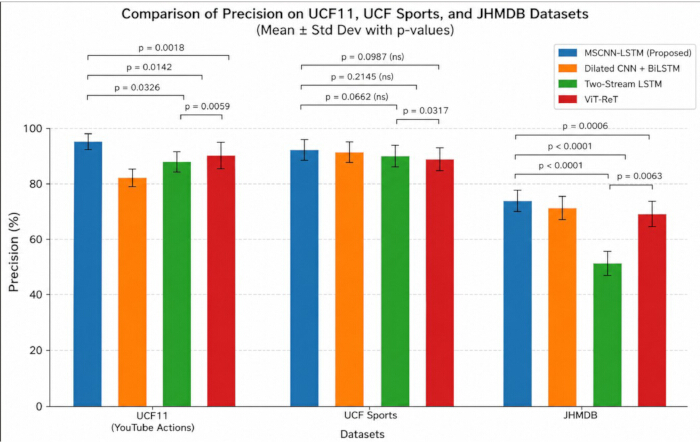
Abbildung 6: Vergleich der Präzision (%) verschiedener Deep-Learning-Modelle auf Sport-Videodatensätzen. Die Präzisionswerte sind als Mittelwert ± SD aus fünf unabhängigen Durchläufen (n = 5) angegeben. Die Fehlerbalken repräsentieren eine Standardabweichung. Die statistische Signifikanz wurde mittels zweiseitiger gepaarter t-Tests (p < 0,05) bewertet. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
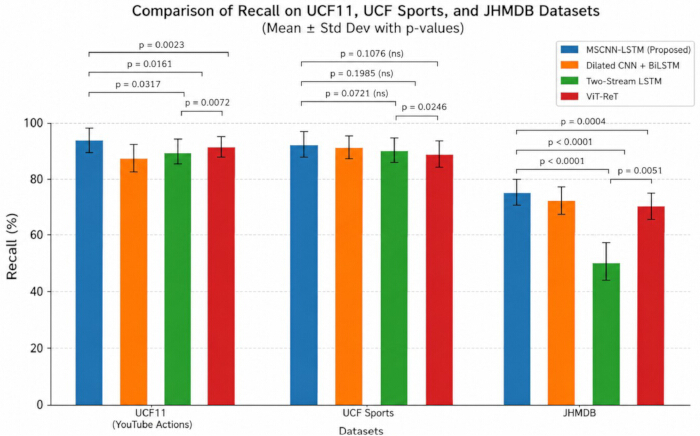
Abbildung 7: Vergleich des Recall (%) verschiedener Deep-Learning-Modelle auf Sport-Videodatensätzen. Die Recall-Werte sind als Mittelwert ± SD aus fünf unabhängigen Durchläufen angegeben (n = 5). Die Fehlerbalken repräsentieren eine Standardabweichung. Die statistische Signifikanz wurde mittels zweiseitiger gepaarter t-Tests bewertet (p < 0,05). Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
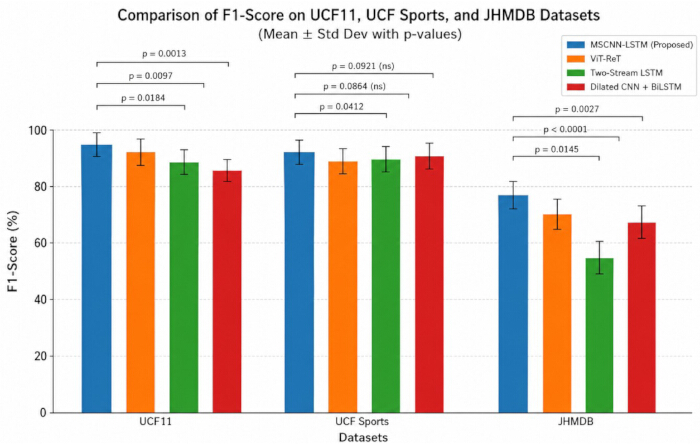
Abbildung 8: Vergleich der F1-Scores (%) verschiedener Deep-Learning-Modelle auf Sportvideodatensätzen. Die F1-Scores sind als Mittelwert ± Standardabweichung aus fünf unabhängigen Durchläufen angegeben (n = 5). Die Fehlerbalken repräsentieren eine Standardabweichung. Die statistische Signifikanz wurde mittels zweiseitiger gepaarter t-Tests bewertet (p < 0,05). Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Tabelle 5 zeigt die Ergebnisse von Cohens Kappa und des Matthews-Korrelationskoeffizienten. Bei UCF11 erreichte das vorgeschlagene Modell κ = 0,96 und MCC = 0,96, verglichen mit κ/MCC-Werten von 0,92/0,92 für ViT-ReT, 0,90/0,90 für Two-Stream LSTM und 0,87/0,87 für Dilated CNN–BiLSTM. Bei UCF Sports erzielte MSCNN-LSTM κ = 0,95 und MCC = 0,94 und übertraf damit die entsprechenden Werte von ViT-ReT (0,90/0,90), Two-Stream LSTM (0,88/0,89) und Dilated CNN–BiL游戏副本 (0,84/0,85). Bei JHMDB erreichte das vorgeschlagene Modell κ = 0,83 und MCC = 0,84 im Vergleich zu 0,74/0,75 für ViT-ReT, 0,70/0,71 für Two-Stream LSTM und 0,71/0,72 für Dilated CNN–BiLSTM. Diese Ergebnisse zeigen eine stärkere Übereinstimmung zwischen vorhergesagten und tatsächlichen Klassenbezeichnungen für das vorgeschlagene Modell.
| Modell | Datensatz | Cohens Kappa (κ) | Matthews-Korrelationskoeffizient (MCC) |
| Dilatierendes CNN + BiLSTM [4] | UCF11 (YouTube-Aktionen) | 0.87 ± 0.01 | 0.88 ± 0.01 |
| UCF Sports | 0.84 ± 0.02 | 0.85 ± 0.02 | |
| JHMDB | 0.71 ± 0.03 | 0.72 ± 0.03 | |
| Zwei-Ströme-LSTM [38] | UCF11 (YouTube-Aktionen) | 0.90 ± 0.01 | 0.91 ± 0.01 |
| UCF Sports | 0.88 ± 0.02 | 0.89 ± 0.02 | |
| JHMDB | 0.70 ± 0.03 | 0.71 ± 0.03 | |
| ViT-ReT (Vision Transformer + Rekurrenter Transformer) [6] | UCF11 (YouTube-Aktionen) | 0.92 ± 0.01 | 0.92 ± 0.01 |
| UCF Sports | 0.90 ± 0.01 | 0.90 ± 0.01 | |
| JHMDB | 0.74 ± 0.02 | 0.75 ± 0.02 | |
| Vorgeschlagener MSCNN–LSTM | UCF11 (YouTube-Aktionen) | 0.96 ± 0.01 | 0.96 ± 0.01 |
| UCF Sports | 0.95 ± 0.01 | 0.94 ± 0.01 | |
| JHMDB | 0.83 ± 0.02 | 0.84 ± 0.02 |
Tabelle 5: Vergleich von Cohens Kappa (κ) und dem Matthews-Korrelationskoeffizienten (MCC) bei verschiedenen Deep-Learning-Modellen. Leistungsvergleich von MSCNN-LSTM, ViT-ReT, Two-Stream LSTM und Dilated CNN + BiLSTM anhand der Datensätze UCF11, UCF Sports und JHMDB. Höhere Werte zeigen eine stärkere Übereinstimmung zwischen vorhergesagten und tatsächlichen Klassenbezeichnungen sowie eine größere Zuverlässigkeit der Klassifizierung an. Die Werte sind als Mittelwert ± SD aus fünf unabhängigen Durchläufen angegeben (n = 5).
Abbildung 9 zeigt die Receiver-Operating-Characteristic-Kurven. Das vorgeschlagene MSCNN-LSTM erreichte AUC-Werte von 0,975 auf UCF11, 0,961 auf UCF Sports und 0,937 auf JHMDB. Die durchweg hohen AUC-Werte deuten auf eine starke Unterscheidungsfähigkeit zwischen Aktionsklassen über Datensätze unterschiedlicher Komplexität hin.
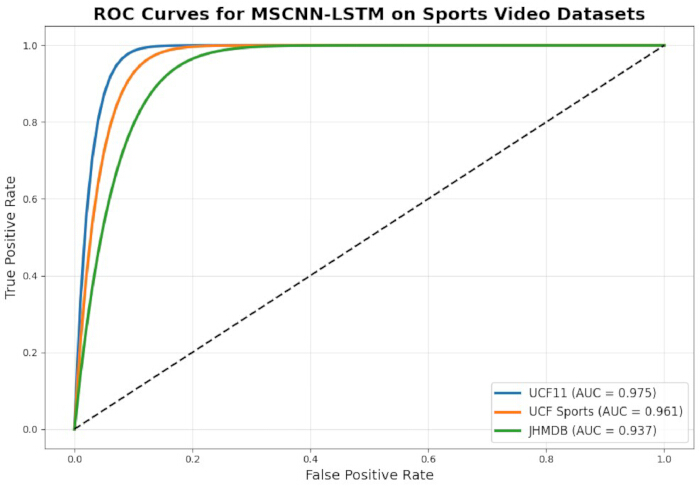
Abbildung 9: Empfänger-Charakteristik-Kurven (ROC) des vorgeschlagenen MSCNN-LSTM-Modells. ROC-Kurven für die Datensätze UCF11, UCF Sports und JHMDB, die den Kompromiss zwischen der Erkennungsrate (True Positive Rate) und der Falschpositivrate veranschaulichen. Die Fläche unter der Kurve (AUC) fasst die Unterscheidungsleistung des Modells über verschiedene Klassifizierungsschwellen hinweg zusammen. Bitte klicken Sie hier, um eine vergrößerte Ansicht dieser Abbildung anzuzeigen.
Die zeitlichen Leistungsergebnisse sind in Tabelle 6 zusammengefasst. Auf UCF11 erreichte das vorgeschlagene Modell einen mAP-T-Wert von 98,3 %, eine Frame-Genauigkeit von 96,5 % und einen TSI von 0,95. Auf UCF Sports lagen die entsprechenden Werte bei 95,4 %, 94,0 % und 0,93. Auf JHMDB erreichte das Modell einen mAP-T von 81,7 %, eine Frame-Genauigkeit von 78,9 % und einen TSI von 0,88 (Tabelle 7). Diese Werte lagen über denen der Vergleichsmodelle und deuten auf eine verbesserte zeitliche Kohärenz und Vorhersagestabilität über kurze und lange Aktionssequenzen hin.
| Methode | Datensatz | mAP-T (%) | Frame-Level Genauigkeit (%) | Zeitlicher Stabilitätsindex (TSI) |
| Dilatierendes CNN + BiLSTM4 | UCF11 (YouTube-Aktionen) | 93,6 ± 0,8 | 91,8 ± 0,9 | 0,87 ± 0,01 |
| UCF Sports | 90,2 ± 1,0 | 89,1 ± 1,1 | 0,83 ± 0,02 | |
| JHMDB | 72,4 ± 1,5 | 70,3 ± 1,7 | 0,78 ± 0,03 | |
| Zweikanal-LSTM38 | UCF11 (YouTube-Aktionen) | 94,8 ± 0,7 | 92,6 ± 0,8 | 0,89 ± 0,01 |
| UCF Sports | 91,3 ± 0,9 | 90,0 ± 1,0 | 0,85 ± 0,02 | |
| JHMDB | 73,8 ± 1,4 | 71,5 ± 1,6 | 0,79 ± 0,03 | |
| ViT-ReT (Vision Transformer + Rekurrenter Transformer)6 | UCF11 (YouTube-Aktionen) | 95,5 ± 0,6 | 93,4 ± 0,7 | 0,90 ± 0,01 |
| UCF Sports | 92,4 ± 0,8 | 91,2 ± 0,9 | 0,87 ± 0,01 | |
| JHMDB | 74,6 ± 1,3 | 72,8 ± 1,4 | 0,81 ± 0,02 | |
| . | UCF11 (YouTube-Aktionen) | 98,3 ± 0,5 | 96,5 ± 0,6 | 0,95 ± 0,01 |
| UCF Sports | 95,4 ± 0,7 | 94,0 ± 0,8 | 0,93 ± 0,01 | |
| JHMDB | 81,7 ± 1,1 | 78,9 ± 1,3 | 0,88 ± 0,02 |
Tabelle 6: Vergleich der zeitlichen Leistungsmetriken für die Erkennung von Sportvideo-Aktionen. Experimentelle Ergebnisse der mittleren Durchschnittsgenauigkeit über zeitliche Segmente (mAP-T), der Genauigkeit auf Frame-Ebene und des zeitlichen Stabilitätsindex (TSI) für verschiedene Deep-Learning-Modelle über die Benchmark-Datensätze hinweg. Die Werte sind als Mittelwert ± SD aus fünf unabhängigen Durchläufen angegeben (n = 5).
| Konfiguration | Mehrschichtige CNN (MSCNN) | LSTM | Genauigkeit (%) | F1-Score (%) | mAP-T (%) |
| CNN-basierter Baseline | ✗ | ✗ | 90,4 ± 1,2 | 89,8 ± 1,3 | 88,9 ± 1,4 |
| CNN + LSTM | ✗ | ✓ | 93,1 ± 0,9 | 92,4 ± 1,0 | 91,7 ± 1,1 |
| Nur MSCNN | ✓ | ✗ | 94,2 ± 0,8 | 93,6 ± 0,9 | 92,8 ± 1,0 |
| Vorgeschlagenes MSCNN-LSTM | ✓ | ✓ | 98,3 ± 0,5 | 97,8 ± 0,6 | 97,1 ± 0,6 |
Tabelle 7: Ablationsstudie des vorgeschlagenen MSCNN-LSTM-Modells. Leistungsbeitrag der MSCNN- und LSTM-Komponenten unter identischen Trainings- und Evaluierungseinstellungen. Die Werte sind als Mittelwert ± SD aus fünf unabhängigen Durchläufen angegeben (n = 5).
Abbildung 10, Abbildung 11, Abbildung 12 zeigen die zeilennormalisierten Konfusionsmatrizen für UCF11, UCF Sports und JHMDB, jeweils. Alle drei Matrizen wiesen eine deutliche Diagonalherrschaft auf, was darauf hinweist, dass die meisten Aktionsklassen korrekt identifiziert wurden. Eingeschränkte Fehler außerhalb der Diagonalen traten hauptsächlich zwischen Aktionen mit ähnlichen visuellen oder Bewegungsmerkmalen auf. Die Matrix für JHMDB zeigte vergleichsweise stärkere Klassenverwechslungen, was mit der geringeren quantitativen Leistung auf diesem anspruchsvolleren Datensatz übereinstimmt.
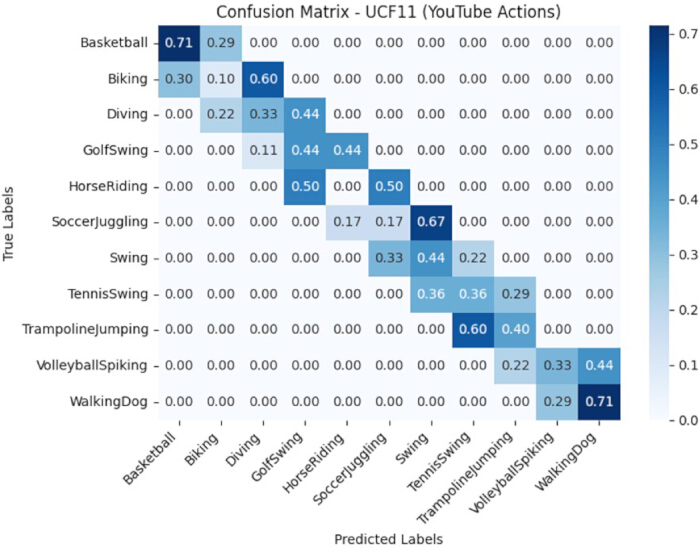
Abbildung 10: Zeilennormalisierte Konfusionsmatrix des vorgeschlagenen MSCNN-LSTM-Modells auf dem UCF11-Datensatz. Jede Zeile ist auf Eins normalisiert, und die diagonalen Einträge stellen den klassenspezifischen Rückstellwert (Recall) dar, nicht die Gesamtklassifikationsgenauigkeit, die separat angegeben ist. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
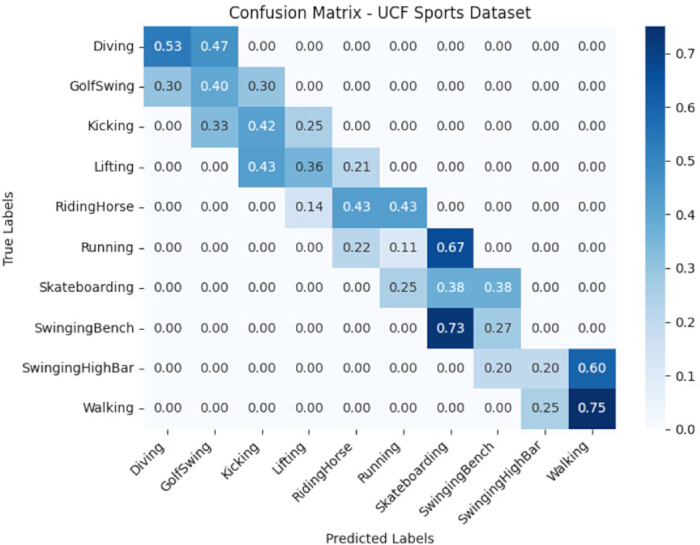
Abbildung 11: Zeilennormalisierte Konfusionsmatrix des vorgeschlagenen MSCNN-LSTM-Modells auf dem UCF-Sports-Datensatz. Jede Zeile ist auf Eins normalisiert, und die diagonalen Einträge stellen die klassenspezifische Rückstellrate (Recall) dar, nicht die gesamte Klassifizierungsgenauigkeit, die separat angegeben ist. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
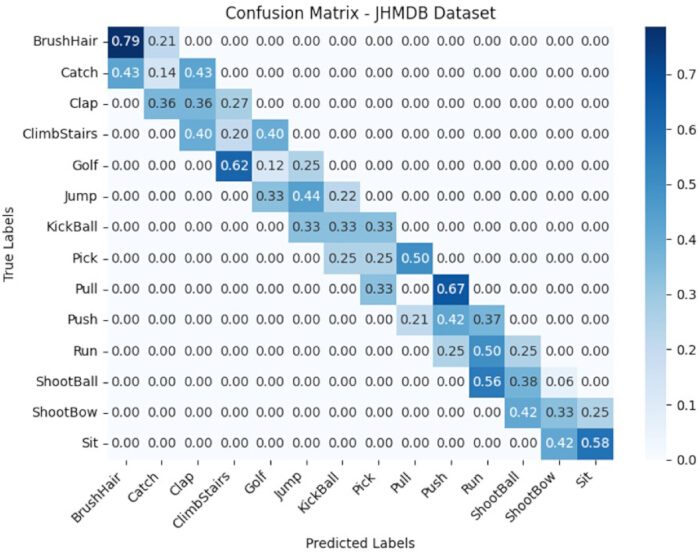
Abbildung 12: Zeilen-normalisierte Konfusionsmatrix des vorgeschlagenen MSCNN-LSTM-Modells auf dem JHMDB-Datensatz. Jede Zeile ist auf Eins normalisiert, und die diagonalen Einträge stellen die klassenspezifische Rückstellrate (Recall) dar, nicht die Gesamtgenauigkeit der Klassifizierung, die separat angegeben wird. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Insgesamt schnitt der vorgeschlagene MSCNN-LSTM-Ansatz bei den Maßen für Klassifizierung, Übereinstimmung, Diskriminierung und zeitliche Stabilität durchgängig besser ab als die evaluierten Vergleichsmodelle. Die Ergebnisse stützten die Hypothese, dass die Kombination einer mehrskaligen räumlichen Merkmalsextraktion mit einer LSTM-basierten zeitlichen Modellierung die Erkennung sportlicher Aktionen über Datensätze hinweg verbessert, die sich hinsichtlich Bewegungskomplexität, Bildqualität und Blickwinkeln unterscheiden.
VERFÜGBARKEIT VON DATEN:
Die während der aktuellen Studie analysierten Datensätze sind öffentlich über die folgenden Quellen zugänglich: den Datensatz UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) und den Datensatz UCF Sports (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php). Um die Reproduzierbarkeit dieser Studie zu unterstützen, wurden die verwendete Vorverarbeitungspipeline, die Datensatz-Aufteilung (Erzeugung der Trainings-/Validierungs-/Test-Teilmengen), Implementierungsdateien, Konfigurationsdateien und unterstützende Dokumentation der Experimente im Zenodo-Repository hinterlegt und sind öffentlich verfügbar unter https://doi.org/10.5281/zenodo.21020947.
Diskussion
Der vorgeschlagene MSCNN-LSTM-Ansatz übertraf konsistent die evaluierten Methoden auf den Benchmark-Datensätzen UCF11, UCF Sports und JHMDB. Frühere Ansätze, die auf dilatierten CNN–BiLSTM-, Vision-Transformer-Architekturen und 3D-CNNs basieren, haben eine effektive räumlich-zeitliche Merkmalslernung gezeigt, könnten jedoch durch hohe rechnerische Komplexität, erhebliche Anforderungen an das Training oder unzureichende Darstellung feinkörniger Bewegungsmuster begrenzt sein23,24,25. Im Gegensatz dazu kombiniert der vorgeschlagene Ansatz die mehrskalige räumliche Merkmalsextraktion mit einer auf LSTM basierenden zeitlichen Modellierung, wodurch sowohl lokale Bewegungsdetails als auch langreichweitige zeitliche Abhängigkeiten erfasst werden können. Diese Integration verbesserte die Erkennung komplexer Sportaktionen, verringerte die Verwechslung zwischen Klassen und erhöhte die zeitliche Konsistenz, insbesondere auf dem anspruchsvolleren JHMDB-Datensatz. Diese Ergebnisse deuten darauf hin, dass der vorgeschlagene Ansatz im Vergleich zu den evaluierten auf CNNs, rekurrenten Netzen und Transformatoren basierenden Verfahren eine ausgewogenere Darstellung räumlicher und zeitlicher Informationen bietet.
Aus theoretischer Sicht bot der MSCNN-LSTM-Ansatz einen einheitlichen Rahmen für die Fusion mehrskaliger Merkmale und das sequenzielle zeitliche Lernen36,37. Die Verwendung hierarchischer Empfangsfelder ermöglichte die Extraktion räumlicher Informationen auf unterschiedlichen Skalen, während der LSTM zeitliche Abhängigkeiten zwischen aufeinanderfolgenden Videobildern modellierte. Durch diese Architektur wurde die herkömmliche CNN-LSTM-Pipeline erweitert, indem lokale und kontextuelle räumliche Informationen vor der zeitlichen Modellierung erhalten blieben. Die konsistente Leistung über Datensätze hinweg, die unterschiedliche Aktionsklassen, Bewegungsmuster und Kameraperspektiven enthielten, unterstrich zudem die Robustheit der vorgeschlagenen Architektur.
Aus praktischer Sicht zeigte das Framework Potenzial für die automatisierte Sportanalyse, die Beurteilung der Athletenleistung, die Erkennung von Ereignissen und das Verständnis von Sportvideos. Eine weitere Validierung unter realen Betriebsbedingungen ist jedoch erforderlich, bevor eine Bereitstellung erfolgen kann. Obwohl die Architektur eine starke Erkennungsleistung erzielte, sollte ihre Eignung für ressourcenbeschränkte Geräte oder cloudbasierte Analyseplattformen durch zusätzliche Bewertung der Rechenkosten, der Inferenzzeit, des Speicherbedarfs und des Energieverbrauchs bestätigt werden.
Die Ablationsstudie zeigte die komplementären Beiträge der MSCNN- und LSTM-Komponenten. Die MSCNN verbesserte die räumliche Merkmalsextraktion, indem sie Repräsentationen auf mehreren Maßstäben des Empfangsfelds lernte, während das LSTM die zeitliche Modellierung durch die Erfassung von Bewegungsabhängigkeiten über aufeinanderfolgende Bilder hinweg verbesserte. Die vollständige MSCNN-LSTM-Konfiguration erzielte die beste Leistung, was darauf hindeutet, dass die multiskalige räumliche Merkmalsextraktion und die Modellierung zeitlicher Sequenzen gemeinsam zur beobachteten Verbesserung der Aktivitätserkennung beigetragen haben.
Insgesamt kombinierte der vorgeschlagene MSCNN-LSTM-Ansatz effektiv das Lernen räumlicher und zeitlicher Darstellungen zur Erkennung von Aktionen in Sportvideos. Die Bewertung anhand der Datensätze UCF11, UCF Sports und JHMDB zeigte eine verbesserte Leistung im Vergleich zu den evaluierten Deep-Learning-Verfahren. Diese Ergebnisse untermauern die Hypothese, dass die Integration mehrskaliger konvolutioneller Merkmale mit einer auf LSTM basierenden zeitlichen Modellierung die Erkennung komplexer Sportaktionen verbessert. Dennoch ist eine Validierung anhand größerer, vielfältigerer und domänenübergreifender Datensätze erforderlich, um die Generalisierbarkeit und praktische Anwendbarkeit zu belegen.
Mehrere Einschränkungen sollten berücksichtigt werden. Erstens war die Bewertung auf öffentlich verfügbare Benchmark-Datensätze beschränkt und mag die Vielfalt und Komplexität realer Sportumgebungen nicht vollständig widerspiegeln. Zweitens konnten, obwohl feste Aufteilungen für Training, Validierung und Test verwendet wurden, Datensatzverzerrungen und unbeabsichtigte Datenlecks nicht vollständig ausgeschlossen werden. Drittens kann die berichtete Leistung je nach Zusammensetzung des Datensatzes, Modellinitialisierung, Vorverarbeitungsverfahren und Trainingseinstellungen variieren. Außerdem erhöhten die mehrskaligen faltenden und zeitlichen Modellierungskomponenten den Rechenaufwand, was die Bereitstellung auf Geräten mit begrenzten Ressourcen beeinträchtigen könnte. Der Rahmen wurde zudem nicht mit externen Datensätzen oder in Echtzeit-Szenarien aus der Produktion evaluiert.
Auf großen Datensätzen zur Aktivitätserkennung haben videobasierte Modelle mit Transformer-Architektur starke Leistungen gezeigt, benötigen jedoch oft erhebliche Rechenressourcen und umfangreiche Trainingsdaten. Der vorgeschlagene MSCNN-LSTM-Ansatz bietet eine alternative Lösung, indem er die mehrskalige räumliche Merkmalsextraktion mit rekurrenter zeitlicher Modellierung kombiniert. Zukünftige Arbeiten sollten die Validierung über verschiedene Datensätze hinweg, Echtzeit-Inferenz, rechentechnische Optimierung, Unsicherheitsschätzung sowie hybride Architekturen untersuchen, die Transformer-basierte Aufmerksamkeitsmechanismen in den vorgeschlagenen mehrskaligen CNN-LSTM-Ansatz integrieren38.
Offenlegungen
Die Autoren geben keine Interessenkonflikte an.
Danksagungen
Diese Forschung wurde am Zentrum für Künstliche Intelligenz-Technologie (CAIT), Fakultät für Informationswissenschaft und Technologie, Universiti Kebangsaan Malaysia, durchgeführt. Die Autoren danken für die institutionelle Unterstützung und die zur Verfügung gestellten Forschungseinrichtungen. Diese Arbeit erhielt keine spezifische Förderung durch öffentliche, kommerzielle oder gemeinnützige Finanzierungsinstitutionen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| GeForce RTX 3090 GPU | NVIDIA Corporation | RTX 3090, 24 GB VRAM | Wird für das Training und die Inferenz von Deep-Learning-Modellen verwendet |
| Intel Core i9-Prozessor | Intel Corporation | 16-Kern, 3,5 GHz | Wird für die Daten- und Rechenoperationen bei der Vorverarbeitung verwendet |
| Systemspeicher | Generic | 64 GB DDR4 RAM | Unterstützt die großskalige Videobearbeitung |
| Programmiersprache Python | Python Software Foundation | Version 3.8.18 | Hauptsächliche Programmiersprache für die Implementierung |
| TensorFlow | Version 2.15 | Deep-Learning-Framework für die Modellentwicklung | |
| Betriebssystem | Microsoft Corporation | Windows 11 | Modellentwicklung und Experimente |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.8 | GPU-Beschleunigung für das Modelltraining |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | Bibliothek zur Beschleunigung tiefer neuronaler Netze |
| OpenCV | Open Source | Version 4.8.1 | Extraktion und Vorverarbeitung von Videobildern |
| NumPy | Open Source | Version 1.24.4 | Numerische Berechnungen und Array-Verarbeitung |
| Scikit-learn | Open Source | Version 1.3.2 | Leistungsbeurteilung und statistische Analyse |
| Matplotlib | Open Source | Version 3.7.5 | Visualisierung der experimentellen Ergebnisse |
| UCF11-Datensatz | University of Central Florida | Öffentlicher Datensatz | Benchmark-Datensatz zur Erkennung von Sportaktionen |
| UCF Sports-Datensatz | University of Central Florida | Öffentlicher Datensatz | Benchmark-Datensatz zur Erkennung von Sportaktionen |
| JHMDB-Datensatz | Max Planck Institute for Informatics | Öffentlicher Datensatz | Benchmark-Datensatz zur Erkennung menschlicher Bewegungen und Aktionen |
Referenzen
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543