Diese Studie schlägt einen Algorithmus vor, der die hierarchischen visuellen Merkmale, die von einem hierarchischen Transformer-Encoder mit verschobenem Fenster erfasst werden, eng mit der vorherigen Tiefe der durch Liniensegmenterkennung erzeugten 3D-Begrenzungsbox Manhattan verknüpft und so eine hochpräzise semantische Rekonstruktion komplexer Innenraumszenen erreicht.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Eine semantische Parsing-Methode für Bilder von Innenraumszenen, basierend auf Vorkenntnissen über Gebäudestrukturen
In diesem Artikel
Zusammenfassung
Zusammenfassung
Um semantische Vorhersagediskontinuitäten und physikalische Randverzerrungen durch Möbelverschluss in komplexen Innenräumen zu adressieren, schlägt diese Arbeit eine semantische Parsing vor, die Gebäude-Struktur-Vorprioritäten nutzt. Das Schema verwendet einen hierarchischen Transformer-Encoder mit verschobenem Fenster, um multiskalige visuelle Merkmale zu extrahieren, und kombiniert einen Gradienten-Richtungs-Konsistenz-Liniensegment-Erkennungsalgorithmus, um eine Manhattan-3D-Begrenzungsbox zu konstruieren. Diese Begrenzungsbox wird vor der Kodierung diskreter geometrischer Konturen in ein kontinuierliches physikalisches Potentialfeld (SDF) in ein vorzeichenmäßiges Distanzfeld (SDF) umgewandelt. Ein strukturgesteuerter Cross-Attention-Mechanismus zwingt die visuellen Signale dazu, sich mit realen 3D-orthogonalen geometrischen Grenzen auszurichten, wodurch die Merkmalskontinuität in verdeckten Bereichen wiederhergestellt wird. Ein räumlicher Adjazenzgraph, der aus Superpixelknoten konstruiert wird, treibt ein Graph Convolutional Network (GCN) an, um Merkmale zu aggregieren und so makroskopische semantische Konsistenz innerhalb der physischen tragenden Ebene sicherzustellen. Eine Kombination aus Pixelebene-Kreuzentropieverlust und einem speziell entwickelten strukturellen Konsistenzverlust verstärkt die Einschränkungen und bestraft Vorhersagen außerhalb der Grenzen. Experimente über mehrere unabhängige Durchläufe zeigen, dass der mittlere Durchschnitt über Union (mIoU) 68,7 % mit einer Standardabweichung von 0,2 % erreicht und der strukturelle Randwert F1 76,4 % mit einer Standardabweichung von 0,3 %, was die robuste Leistung der vorgeschlagenen Module bestätigt. Mit einer einzelnen Bildknotengröße von 256 blieb die durchschnittliche Schlusszeit bei 61 ms.
Einleitung
Die semantische Analyse von Indoor-Szenenbildern nimmt eine zentrale Rolle in dreidimensionaler räumlicher Kognition und intelligentem räumlichemDenken ein. Die visuelle Extraktion von Merkmalen in realen physischen Umgebungen wird oft stark durch komplexe räumliche Anordnungen behindert3. Die Lösung der semantischen Diskontinuität und der physikalischen Randverzerrung der Fundamentstruktur des Gebäudes. Die durch großflächige Möbelverschluss verursachte Fundamentstruktur ist wichtig für die räumliche Kognitionsforschung 4,5. Das genaue Entfernen von Störungen durch ungeordnete Objekte und die Wiederherstellung der physikalischen Kontinuität derselben Wand und derselben Bodens bestimmt direkt die Genauigkeit der dreidimensionalen Szenenrekonstruktion und der globalen räumlichen logischen Analyse6. Die semantische Diskontinuität, die durch großflächige Möbelverdichtung verursacht wird, und der strukturelle Reparatureffekt der vorgeschlagenen Gebäudevor-Leitlinie sind in Abbildung 1 dargestellt, wo der verdeckte Rot-Grün-Blau-(RGB)-Eingang in Tabelle 1A, die Basismaskenverzerrung in Abbildung 1B und das Struktur-Vor-Reparaturergebnis in Abbildung 1C unter demselben Indoor-Szenen-Zustand verglichen werden.
Um die Genauigkeitsanforderungen des räumlich-logischen Denkens zu erfüllen, stehen aktuelle mainstream pixelgesteuerte visuelle Netzwerke vor mehreren Hindernissen bei komplexen Innenraumumgebungen 7,8. Innenräume sind oft mit dichten Möbeln und überfüllten Möbeln gefüllt, was zu einem erheblichen Verlust der niedrigen visuellen Grenzsignale in den Bildern9 führt. Konventionelle Merkmalsextraktionsmechanismen verlassen sich übermäßig auf lokale zweidimensionale Farb- und Texturreaktionen und besitzen kein makroskopisches Verständnis der starren orthogonalen Gesetze dreidimensionaler menschengemachter Strukturen10. Diese Einschränkung des lokalen rezeptiven Feldes macht die Ausbreitung der Merkmale leicht unterbrochen, was es erschwert, die globale Topologie über Okklusionen11 zu erweitern. Derzeit besteht ein dringender Bedarf, das Kernproblem der semantischen Vorhersagediskontinuitäten und schwerwiegender Verzerrungen physikalischer Grenzen durch Okklusion und Interferenzzu lösen.
Um strukturelle Mängel in Gebäudefundamenten durch Verschluss und Interferenz zu beheben, hat die akademische Gemeinschaft eine Vielzahl gezielter Interventionsmaßnahmen entwickelt13. Crossmodale Merkmalaggregationsnetzwerke kompensieren effektiv die inhärenten Defizite einer einzelnen visuellen Modalität in der räumlichen Wahrnehmung, indem sie Tiefenkarten oder Textpriors einführen, um bei Rot-Grün-Blau (RGB) Bildern zu helfen14,15. Grenzwahrnehmungs- und adaptive Kontextauswahl-Frameworks bringen physische Konturverbesserungsstrategien in die Feature-Dekodierungsphase, was die Kantenanpassung von Vorhersageergebnissen in komplexen Szenen erheblich verbessert16,17. Inferenzmodelle, die auf GCNs und Merkmalsinteraktionsmechanismen basieren, verbessern die Funktionsglattheit und makrosemantische Konsistenz in homogenen Regionen erheblich, indem sie Verbindungen auf Knotenebene konstruieren18,19. Die Integration expliziter Manhattan-struktureller Vorpriore in die visuelle Merkmalsextraktionspipeline erzwingt geometrische Konsistenzgrenzen, was die Herausforderungen der Merkmalsunterbrechung durch umfangreiche Vordergrundobjekt-Okklusion20 adressiert.
Um die Kernherausforderung semantischer Vorhersagefehler und schwerwiegender Verzerrungen physikalischer Grenzen im Zusammenhang mit Infrastrukturgebäuden anzugehen, wird ein semantisches Parsing-Framework vorgeschlagen, das auf einem geschlossenen Kopplungsmechanismus basiert, der architektonische Vorpriore einbezieht. Dieses Rahmenwerk überwindet naive Engineering-Pipelines, indem es eine bidirektionale Abbildung zwischen kontinuierlichen geometrischen Potentialfeldern und diskreten visuellen Merkmaligkeiten etabliert und so eine nicht-triviale Synergie bildet, die Okklusionsfehler durch strukturelle Gesetze korrigiert. Dieses Schema basiert auf einem multiskaligen visuellen Backbone-Netzwerk und einem Liniensegment-Erkennungsalgorithmus, der auf der Verschwindungspunktschätzung basiert, um lokale Erscheinungsmerkmale und orthogonale Kantenpriore zu erfassen, die die Manhattan-3D-Begrenzungsbox parallel repräsentieren, und diese dann in eine SDF umzuwandeln. Der Algorithmus verwendet einen strukturgesteuerten Cross-Attention-Mechanismus, bei dem visuelle Merkmale als Abfragevektoren verwendet und SDF-Merkmale als Schlüssel und Werte für Dot-Produkt-Berechnungen behandelt werden, wodurch das visuelle Signal gezwungen wird, sich mit der realen 3D-geometrischen Grenze im Merkmalsraum auszurichten. Ein räumlicher Adjazenzgraph, der aus Superpixel-Knoten und räumlichen Koplanaritäts-Kantenmerkmalen konstruiert wird, wird in ein GCN eingespeist, um die Zusammenführung von Knotenmerkmalen und die Nachrichtenübermittlung durchzuführen. Der End-to-End-Parameteroptimierungsprozess verwendet gemeinsam Pixelebene-Kreuzentropie und eine benutzerdefinierte strukturelle Konsistenzverlustfunktion, die vorhergesagte Pixel, die die Gebäude-Vor-Grenze überschreiten, streng einschränkt und bestraft. Die vollständige semantische Parsing-Pipeline ist in Abbildung 2 zusammengefasst, die RGB-Bildeingabe, geometrische Prior-Extraktion, Kreuz-Aufmerksamkeits-Ausrichtung, Superpixel-Graph-Argumentation und semantische Maskendecodierung innerhalb einer einheitlichen Architektur verknüpft.
Frühe Szenenparsing-Netzwerke setzten auf Faltungsoperationen, um lokale Erscheinungstexturen zu erfassen, zeigten jedoch aufgrund von Einschränkungen in lokalen rezeptiven Feldern eine unzureichende semantische Kohärenz bei groß angelegten Zielen21,22. Frühere Studien haben das Selbstbeobachtungsmodul der Visual Transformer-Architektur eingesetzt, um globale kontextuelle Informationen zu extrahieren und Langstrecken-Pixel-Assoziationsmerkmale zu konstruieren23,24. Crossmodale Multi-View-Feature-Aggregationsstrategien extrahieren die dreidimensionalen geometrischen räumlichen Merkmale der Szene, indem sie Tiefenkarten-Punktwolken und Textbefehlseingänge fusionieren25,26. Hybride Fokussierungsmechanismen zur Feature-Fusion, die auf bestimmte Domänen abzielen, haben sich allmählich entwickelt. Durch den Bau von Merkmals-Interaktionsbrücken haben sie den Energieverlust und die Merkmalssparsamkeit bei der mehrskaligen Übertragung visueller Signale deutlich reduziert und die Robustheit des Parsings in komplexen Strukturen verbessert. Modernste Encoder-Designs integrieren und schließen gemeinsam räumliche Details aus hochfrequenten Bereichen neben globalen und lokalen Merkmalen ein, stärken die Fähigkeit des Netzwerks, feinkörnige semantische Kategorien mit hoher Ähnlichkeit zu unterscheiden, und verbessert die Genauigkeit der Indoor-Parsing27,28. Jüngste Fortschritte bei semantischen Segmentierungsarchitekturen liefern wertvolle Referenzen zur Optimierung der Recheneffizienz und räumlichen Wahrnehmung. Modelle, die für dichte Vorhersage und multiskalige kontextuelle Aggregation entwickelt wurden, extrahieren feinkörnige geometrische Merkmale aus komplexen Hintergründen. Feature-Entkopplung und synergetische Fusionsstrategien adressieren die semantische Mehrdeutigkeit in Grenzregionen. Leichte Aufmerksamkeitsmechanismen und gesperrte Aggregationsmodule optimieren die Parameterverteilung und beschleunigen so die Inferenz, während lokale strukturelle Details erhalten bleiben. Die Implementierung dieser effizienten architektonischen Entwürfe bietet theoretische Orientierung zur Reduzierung des rechnerischen Overheads nicht-euklidischer topologischer Inferenzoperationen im Indoor-Szenenparsing.
Gebäudestruktur-Priors und 3D-Layout-Schätzungen werden verwendet, um lokale visuelle Parsingfehler zu korrigieren29. Frühere Studien haben orthogonale und parallele geometrische Merkmale von Innengebäuden als Inferenzbeschränkungen extrahiert, um die Netzwerkvorhersage-Verzerrung durch überladene Innenkulissen zu reduzieren30,31. Bestehende Schemata verwenden Algorithmen zur Erkennung von Liniensegmenten und Techniken zur Bildablationspunkt-Analyse, um Manhattan 3D-Begrenzungsboxen zu erzeugen, die die physischen Grenzen von Räumen kartieren und bei der Lokalisierung der zugrundeliegenden visuellen Merkmalehelfen. Die gemeinsame Architektur des Grenzbewusstseinsmoduls und des Multi-Scale-Kontexts bettet vorherige strukturelle Informationen implizit in den hochdimensionalen Merkmalsdekodierungsprozess ein und zwingt das Netzwerk, semantische Masken auszugeben, die den realen physikalischen Konturen nahe kommen und so die Zackigkeit und Unschärfe der Objektkanteneffektiv verbessern 33. Halbüberwachte oder schwach überwachte Verlustfunktionsdesigns mit Randverbesserungseigenschaften wurden umfassend erforscht. Indem man sich auf rigorose mathematische Formeln stützt, um unabhängiges Pixelklassifikationsverhalten zu bestrafen, das gegen räumliche topologische Regeln verstößt, werden die geometrische Glattheit und strukturelle Integrität des endgültigen Segmentierungsergebnisses von der Quelle der Gradientenoptimierung34 garantiert.
Einige Studien haben neuronale Graphennetze verwendet, um domänenübergreifende Aggregation visueller Merkmale durchzuführen und über topologische Beziehungen im hochdimensionalen Raum35 zu schließen. Der Superpixel-Segmentierungsalgorithmus aggregiert benachbarte Pixelblöcke mit ähnlicher Farbantwort und Texturmerkmalen in unabhängige, verbundene Knoten. Der Superpixel-Segmentierungsalgorithmus komprimiert die rechnerische Redundanz der Graphenstruktur auf Bildebene und bewahrt die grundlegende geometrische Topologie des Bildes36. Das GCN, das auf dem hochdimensionalen Knoten-Merkmalsvektor basiert, und die Adjazenzmatrix, die räumliche Nähe darstellt, steuert die effiziente Richtungsübertragung und interaktive Verschmelzung von multiskaligen visuellen Informationen entlang des physikalisch verbundenen Graphen im räumlichenBereich 37,38. Die Anwendung des temporalen Informationsverbesserungsmoduls und des hybriden Multi-Scale-Skip-Verbindungsmechanismus unterdrückt die übermäßige Glättung und Homogenisierung von Knotenmerkmalen, die im Prozess des mehrschichtigen tiefen Nachrichtenübergangs39 entstehen. Die Multi-Skal-Graph-Wavelet-Transformationstechnologie und die Optimierungsstrategie für Pseudo-Label-Element-Lernen optimieren den Anti-Hintergrundrauschen-Mechanismus der Knotenfeature-Update-Formel, sodass Features mit denselben semantischen Attributen einen kooperativen Antwortmodus in komplexer Netzwerktopologie40 beibehalten. Der graphbasierte Schlussfolgerungsmechanismus bildet reguläre Pixelgitter auf nicht-euklidische topologische Räume ab, um Merkmalsaggregationsberechnungen unregelmäßiger Gebäudestrukturen und innerer Komponentendurchzuführen 41.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Indoor-RGB-Szenen-Datensätze und ihre semantischen Annotationen wurden vor dem Netzwerktraining vorbereitet. Der groß angelegte 3D-Datensatz für den Innenraum und der RGB-D-Datensatz für Innenszenen (siehe die Materialtabelle) wurden aus ihren offiziellen Repositorien bezogen. Innenraum-Aufnahmeszenen mit Möbelverschluss, Beleuchtungsvariationen, Unterbrechung von Wandgrenzen und komplexen räumlichen Layouts wurden beibehalten, um dem Ziel-Parsing-Szenario zu entsprechen. Semantische Labels wurden in indexierte Einzelkanal-PNG-Annotationsmasken umgewandelt, und alle RGB-Bilder und semantischen Masken wurden auf 512 × 512 Pixel verkleinert. Während des Trainings wurde eine Online-Datenerweiterung angewendet, mit zufälligem horizontalen Umdrehen bei einer Wahrscheinlichkeit von 0,5, zufälliger Helligkeitsskalierung zwischen 0,8 und 1,2 sowie zufälliger Rotation zwischen −10° und +10°, um die strukturelle Layoutverteilung zu erweitern. RGB-Kanäle wurden mit Mittelwerten von 0,485, 0,456 und 0,406 sowie Standardabweichungswerten von 0,229, 0,224 und 0,225 normalisiert. Der groß angelegte 3D-Benchmark in Innenräumen folgte der offiziellen Veröffentlichungsaufteilung in dieser Studie, mit 1201 Trainingsszenen und 312 Validierungsszenen für Modellentwicklung und Validierung. Der RGB-D Indoor-Szenen-Benchmark folgte dem offiziellen Bewertungsprotokoll mit 795 Trainingsbildern und 654 Testbildern. Auf diese beiden öffentlichen Benchmarks wurde keine zusätzliche prozentuale Aufteilung angewandt.
Ein visuelles Backbone-Netzwerk für einen hierarchischen Transformer mit verschobenem Fenster (siehe die Materialtabelle) wurde als Backbone des moving-window-Transformator-Encoders initialisiert. Die Größe der Patch-Einbettung war auf 4 x 4 Pixel konfiguriert. Die Einbettungsmaße der vier hierarchischen Stufen wurden auf 128, 256, 512 und 1024 gesetzt, und die Anzahl der Transformatorblöcke in den vier Stufen wurde auf 2, 2, 18 und 2 gesetzt. Die Größe des lokalen Aufmerksamkeitsfensters wurde auf 7 x 7 gesetzt, und die Anzahl der Aufmerksamkeitsköpfe auf 4, 8, 16 und 32 für die vier hierarchischen Stufen. In allen mehrschichtigen Perzeptronschichten wurden nichtlineare kontinuierliche Aktivierungsfunktionen verwendet. Das räumliche Downsampling erfolgte durch Patch-Merging-Operationen mit einem Schritt von 2 nach jeder hierarchischen Stufe. Die Kernnetzwerkarchitektur und die Hyperparameter des Faltungsinferenzmoduls wurden in Tabelle 1 zusammengefasst.
Anschließend wurde auf den Eingabe-Merkmalskarten die Extraktion der Self-Attention-Merkmale im verschobenen Fenster durchgeführt. Jede Merkmalskarte wurde in nicht überlappende lokale Fenster mit räumlichen Maßen 7 × 7 unterteilt. Regelmäßige Fensterbetreuung und verschobene Fenster wurden zwischen benachbarten Transformatorblöcken mit verschobenen Fenstern abwechselnd. Der zyklische Verschiebungsabstand wurde auf 3 Pixel gesetzt, und innerhalb jedes lokalen Aufmerksamkeitsfensters wurde eine relative Positionsbias-Codierung angewendet. Lokale visuelle Merkmale wurden über Multi-Head-Selbstaufmerksamkeit aggregiert, um hierarchische, multiskalierte Merkmalsrepräsentationen zu erzeugen.
Strukturelle Vorpriore in Manhattan wurden aus Indoor-RGB-Bildern extrahiert. Strukturelle Kantensegmente wurden mit einem Gradient-Richtung-Konsistenz-Liniensegment-Erkennungsalgorithmus erkannt. Dominante strukturelle Richtungen wurden durch einen RANSAC-Algorithmus (RANSAC) gruppiert (siehe Materialtabelle) basierend auf der Verschwindepunktschätzung. Drei sich gegenseitig orthogonale Manhattan-Richtungen wurden rekonstruiert, um die Manhattan 3D-Begrenzungsbox-Darstellung zu erzeugen. Die rekonstruierte strukturelle Grenze wurde in eine SDF-Karte umgewandelt, indem der minimale euklidische Abstand von jedem Pixel zum nächstgelegenen Grenzliniensegment berechnet wurde.
Strukturgesteuerte Cross-Attention-Merkmale wurden generiert, nachdem die visuellen Merkmale und SDF-Priors erfasst worden waren. Die visuelle Merkmaligfaltigkeit wurde über die lineare Transformationsmatrix W Sub Q der doppelt durchgestrichenen Kappe R auf die Formationsmatrix W sub Q der doppelt durchgestrichenen Kappe R auf die Formationsmatrix 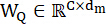 abgebildet. Das stetige Distanzfeld zuvor wurde über die Transformationsmatrizen
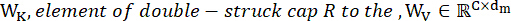 auf den Schlüsseltensor K und den Werttensor V abgebildet, und die Modelldimension wurde auf 512 gesetzt. Die Multi-Head-Modulation unterteilte den Projektionsraum in 8 unabhängige Unterräume, wobei jeder Kopf eine Dimension von 64 hatte. Das räumliche Layout vorher projizierte diskrete Pixelkoordinaten in ein kontinuierliches Potentialfeld und erzeugte die strukturelle Affinitätsmatrix S als explizite additive räumliche Verzerrung zur Modulation der Dot-Produkt-Ähnlichkeitsmatrix. Der visuelle Merkmalstensor wurde als Abfragequelle verwendet, da semantisches Parsing erfordert, dass jeder visuelle Ort aktiv strukturell konsistente Beweise aus dem geometrischen Vorraum abruft. Das SDF wurde zuvor als Schlüssel- und Wertquelle verwendet, da es kontinuierliche Grenzdistanz und Inner-Außen-Strukturhinweise speichert, die aus dem Manhattan-Layout abgeleitet sind. Der Dot-Produkt-Term maß die Kompatibilität zwischen dem semantischen Erscheinungsbild und dem geometrischen Prior, während der additive strukturelle Term λS die Aufmerksamkeitsgewichte auf Pixel auf derselben physikalischen Ebene oder nahe derselben architektonischen Kontur verlagerte. Der Koeffizient λ stellte das Vertrauen in das extrahierte strukturelle Prior dar und kontrollierte, inwieweit starre orthogonale Einschränkungen in die Aufmerksamkeitsverteilung integriert wurden. Diese Formulierung reduzierte die grenzüberschreitende Merkmale-Diffusion, verursacht durch Möbelverschluss, und behielt die adaptive Relaxation in Nicht-Manhattan-Layouts bei. Die strukturgesteuerte Aufmerksamkeitsverteilung wurde gemäß Gleichung 1 berechnet.
Gleichung 1: 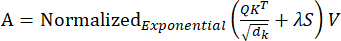
wobei A die strukturgesteuerte Aufmerksamkeitsaggregationsmatrix bezeichnet, Q den Abfragetensor, der aus visuellen Merkmalen generiert wird, K den Schlüsseltensor, der aus SDF-Vormerkmalen generiert wird, V den Werttensor aus strukturellen Vordarstellungen, dk die Merkmalsdimension des Schlüsseltensors, λ den adaptiven strukturellen Gewichtungskoeffizienten bezeichnet, der zur Identifizierung der geometrischen Sicherheit lokaler Regionen und zur Lockerung starrer orthogonaler Nebenbedingungen in nicht-Manhattan-räumlichen Räumlichkeiten verwendet wird Layouts, und S bezeichnet die SDF-Affinitätsmatrix. Die Teilung durch dk stabilisierte die Skala der Aufmerksamkeitslogits und verhinderte, dass große Feature-Dimensionen überkonzentrierte Aufmerksamkeitsgewichte erzeugten. Die normierte Exponentialfunktion (siehe Materialtabelle) wandelte die modulierten Ähnlichkeitswerte in eine normalisierte räumliche Verteilung um, sodass jedes Pixel strukturelle Vorinformationen basierend auf semantischer und geometrischer Konsistenz aggregieren konnte. Dieses Design erklärt, warum visuelles Erscheinungsbild und architektonische Grenzpriore auf Aufmerksamkeitsebene und nicht durch direkte Merkmalsverkettung verschmolzen sind.
Der Superpixel-Topologiegraph wurde aus der strukturausgerichteten Merkmalskarte konstruiert. Die Merkmalskarte wurde mithilfe eines Algorithmus zur Generierung räumlicher Regionen segmentiert. Die Superpixelzahl wurde auf 256 gesetzt, der Kompaktheitskoeffizient auf 10, der Gaußsche Glättungskoeffizient auf 1,0 und die Iterationszahl auf 10. Räumliche Nähebeschränkungen wurden erzwungen, indem das Gewicht der Entfernungsmetrik während des Clusterings auf ein konstantes Verhältnis von 1,0 zum Farbraumabstand des Merkmals gesetzt wurde, wodurch eine einheitliche Knotengenerierung über dichte Clutter-Grenzen hinweg erhalten blieb. Pixel mit homogenen semantischen Antworten wurden zu Superpixel-Knoten aggregiert. Graphkanten wurden entsprechend räumlicher Nachbarschaftsbeziehungen, SDF-Affinitätsstärke und koplanaren geometrischen Konsistenzbedingungen konstruiert. Der Konstruktionsprozess der strukturellen Affinitätsmatrix und der topologischen Konnektivität ist in Abbildung 3 dargestellt, die zeigt, wie SDF-Führung in geografische Beziehungen auf Graphenebene umgewandelt wurde.
Die Graphenformulierung wurde eingeführt, um dichtes pixelweises Denken über homogene strukturelle Bereiche in knotenweise räumliches Denken umzuwandeln. Jeder Superpixelknoten repräsentierte einen lokalen Bereich mit ähnlicher semantischer Antwort und räumlicher Kontinuität, während jede Kante einen zuverlässigen Weg für die Merkmalsübertragung darstellte, vorbehaltlich von Adjazenz, Entfernungsfeldaffinität und koplanaren Konsistenzbedingungen. Dieses Design reduzierte den Einfluss isolierter verrauschter Pixel und ermöglichte es verdeckten Wand-, Boden- und Deckenbereichen, Nachrichten von physisch benachbarten Knoten zu empfangen. Die Kantenkonstruktion diente daher als mathematische Brücke zwischen kontinuierlicher SDF-Führung und diskretem nicht-euklidischen Graphendenken.
Ein dreischichtiges Graphen-Konvolutions-Denknetzwerk wurde mit den versteckten Merkmalsdimensionen 512, 256 und 128 konfiguriert. Die Graph-Konfaltionsschicht führte eine Feature-Glättung über die Graphstruktur durch, basierend auf den räumlichen Beziehungen der Knoten. Die Selbstschleifen-Adjazenz behielt während der Nachrichtenübertragung den ursprünglichen Zustand jedes Knotens bei, wodurch verhindert wurde, dass die Merkmale einer kleinen strukturellen Region von umliegenden großen Bereichen gelöscht werden. Die symmetrische Normalisierung skalierte die Adjazenzmatrixelemente durch das Produkt der umgekehrten Quadratwurzeln der Knotengrade, sodass hochgradige und niedriggradige Knoten während der Ausbreitung unter vergleichbaren numerischen Größen beitrugen. Die Vorwärtsausbreitung führte eine lokalisierte räumliche Aggregation durch, bei der jeder Knotenzustand hochdimensionale Merkmale von benachbarten koplanaren Clustern absorbierte, bevor die elementweise nichtlineare Rektifikationsfunktion angewendet wurde. Diese Formulierung ließ die Graphen-Faltungsschicht die semantische Diffusion entlang physikalisch bedeutungsvoller Innenflächen approximieren, anstatt uneingeschränkte Glättung über die Grenzen nicht verwandter Objekte hinweg zu ermöglichen. Die Graphknotenmerkmale wurden gemäß Gleichung 2 bewertet.
Gleichung 2: 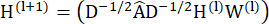
Die Projektion von dichten Pixelmerkmalen zu Superpixel-Knoten, das Austausch von Graphen-Faltungs-Nachrichten und die Koordinatenrückprojektion sind in Abbildung 4 dargestellt, die den Merkmalsaggregationspfad von regulären Bildgittern zu einer nicht-euklidischen Topologie und zurück zu einer dichten semantischen Darstellung erläutert. Die Projektion von dichten Pixelmerkmalen in Abbildung 4A zu Superpixel-Knoten in Abbildung 4B, der Graphen-Faltungs-Nachrichtenübermittlung in Abbildung 4C und die Koordinatenrückprojektion in Abbildung 4D verdeutlichen den Feature-Aggregationspfad von regulären Bildgittern zu einer nicht-euklidischen Topologie und zurück zu einer dichten semantischen Darstellung.
wobei H(l) den Knotenmerkmal-Tensor der l-ten Graphfaltungsschicht bezeichnet, Â die Adjazenzmatrix mit Selbstschleifenverbindungen, D die Gradmatrix der Adjazenzmatrix, W(l) die lernbare Gewichtungsmatrix der l-ten Graphfaltungsschicht und σ die rektive lineare Einheitsaktivierungsfunktion bezeichnet. Der Begriff ÂH(l) aggregierte Merkmale benachbarter Superpixel-Knoten, während D−1/2 und D−1/2 den Beitrag von Knoten mit unterschiedlichen Verbindungsdichten ausbalancierten. Die lernbare Matrix W(l) projizierte aggregierte Knotenmerkmale in einen neuen semantischen Raum und ermöglichte es der Graphenschicht, strukturelle Konsistenz von gewöhnlicher räumlicher Nähe zu unterscheiden. Die nichtlineare Aktivierung bewahrte den Unterschied in den Antworten zwischen koplanaren und nicht-koplanaren Regionen nach der Merkmalaggregation.
Semantische Segmentierungsmerkmale wurden nach Graphen-Argumentation entschlüsselt. Der Decoder wurde mit drei bilinearen Interpolations-Upsampling-Stufen und Schichtübergreifenden Skip-Connection-Fusionsoperationen konstruiert. Flache räumliche Encoderfunktionen wurden durch kanalweise Fusion mit hochstufigen semantischen Decoderfunktionen verkettet. Die Feature-Auflösung wurde auf die ursprüngliche Bildgröße zurückgesetzt, und die endgültige semantische Wahrscheinlichkeitsvorhersagekarte wurde über eine 1×-1-Faltungsschicht erzeugt.
Das vollständige semantische Parsing-Netzwerk wurde mit einem entkoppelten Gewichts-Abfall-Optimierer trainiert (siehe Materialtabelle). Die anfängliche Lernrate wurde auf 0,0001 gesetzt, der Gewichtsverfall auf 0,01 und die Batchgröße auf 8 für beide öffentlichen Benchmarks. Die erste Momentzerfallsrate wurde auf 0,9 gesetzt, die zweite auf 0,999 und der numerische Stabilitäts-Epsilonkoeffizient auf 1 × 10⁻8. Der Validierungsverlust wurde am Ende jeder Epoche überwacht, und Kontrollpunkte wurden gespeichert, wenn die mIoU im Validierungssatz stieg. Das Netzwerk wurde über 300 Epochen mit einer Polynom-Lernrate-Zerfallsstrategie mit einer Decay-Potenz von 0,9 trainiert. Fünf unabhängige Trainingsläufe wurden mit verschiedenen zufälligen Seed-Initialisierungen durchgeführt, um eine statistisch strenge Bewertungsbasis zu etablieren. Das Netzwerk wurde gemeinsam unter Verwendung von Pixelebene-Kreuzentropieverlust und struktureller Konsistenzverlust optimiert. Alle Experimente wurden auf einer Rechenplattform durchgeführt, die mit hochspeicherfähiger paralleler Rechenhardware ausgestattet war, und detaillierte Hardwareinformationen wurden in der Materialtabelle angegeben.
Die gemeinsame Optimierung erzwingt geometrische Randausrichtung durch Berechnung des räumlichen Gradientenbetrags des Klassenwahrscheinlichkeitstensors. Der strukturelle Konsistenzverlust wurde als Regularisator verwendet, indem die Norm der räumlichen Vorhersagegradienten mit den kontinuierlichen SDF-Werten multipliziert wurde. Die mathematische Begründung war, dass semantische Kategorienänderungen sich nahe realen architektonischen Konturen konzentrieren sollten, wo die SDF gegen Null geht, während flache Wände, Boden und Deckeninnenräume flüssige semantische Antworten aufrechterhalten sollten. Wenn ein großer Vorhersagegradient weit von einer strukturellen Grenze entfernt erschien, erhöhte der Distanzfeldterm die Strafe und entmutigte falsche semantische Übergänge innerhalb einer homogenen physikalischen Ebene. Wenn ein Vorhersagegradient in der Nähe einer Null-Entfernungs-Kurve auftrat, blieb die Strafe begrenzt und bewahrte legitime Klassenübergänge entlang architektonischer Grenzen. Semantische Übergangsregionen wurden darauf beschränkt, sich mit den Null-Distanz-Konturen der SDF auszurichten, wie sie durch Gleichung 3 gegeben sind.
Gleichung 3: 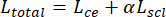
wobei Ltotal die endgültige Optimierungszielfunktion bezeichnet, Lce den Pixel-Ebene-Kreuzentropieverlust, Lscl den strukturellen Konsistenz-Strafverlust und α den strukturellen Verlustgewichtungskoeffizienten. Der Kreuzentropie-Term ermöglichte pixelfreie semantische Überwachung über Annotationsmasken, während der strukturelle Konsistenzterm eine geometrische Regularisierung unter Verwendung architektonischer Priors auferlegte. Der Gewichtungskoeffizient α ausgewogene Kategorienerkennung und Randausrichtung, wodurch verhindert wird, dass die Optimierung entweder die lokale Etikettengenauigkeit oder starre strukturelle Konturen überfittet. Dieses gemeinsame Ziel verband visuelle Semantik, physikalische Randkonsistenz und trainierbare Netzwerkparameter innerhalb eines einheitlichen Optimierungsziels.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Versuchsaufbau
Diese Studie verwendete zwei standardisierte Indoor-Szenen-Parsing-Datensätze, einen großformatigen Indoor-3D-Datensatz und einen RGB-D-Indoor-Szenen-Datensatz, um die Leistung zu bewerten und das Modell abzustimmen. Der groß angelegte 3D-Datensatz enthält realistisch gescannte, komplexe Szenen aus dem physischen Raum und hochauflösende RGB-Ansichten und bietet hochpräzise, pixel-für-Pixel 3D-Punktwolken-Semantik sowie 2D-Segmen...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Der Algorithmus dieses Artikels verknüpft die hierarchischen visuellen Merkmale, die von einem hierarchischen Transformer-Encoder mit verschobenem Fenster erfasst werden, eng mit der vorherigen Tiefe der durch Liniensegmenterkennung erzeugten 3D-Begrenzungsbox in Manhattan und erreicht so eine hochpräzise semantische Rekonstruktion komplexer Innenraumszenen. Ein strukturgesteuerter Cross-Attention-Mechanismus zwingt das visuelle Signal, sich mit der tatsächlichen geometrischen Grenze aus...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren erklären, dass sie keine finanziellen Interessenkonflikte haben.
Danksagungen
Finanzierung: Zentrales Forschungs- und Entwicklungsprogramm von Shaanxi (Programmnr. 2024CY2-GJHX-76).
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| AdamW optimizer | PyTorch Contributors | https://pytorch.org/ | |
| CCANet | Zihao Z. et al. | https://doi.org/10.1109/TCDS.2024.3455356 | |
| CMPFFNet | Zhou W. et al. | https://doi.org/10.1109/TASE.2023.3332021 | |
| ConvNeXt | Meta AI Research | https://github.com/facebookresearch/ConvNeXt | |
| InternImage | OpenGVLab | https://github.com/OpenGVLab/InternImage | |
| Mask2Former | Meta AI Research | https://github.com/facebookresearch/Mask2Former | |
| MaskDINO | IDEA-Research | https://github.com/IDEA-Research/MaskDINO | |
| NYUv2 | http://cs.nyu.edu/~silberman/datasets/nyu_depth_v2.html | ||
| OneFormer | SHI Labs | https://github.com/SHI-Labs/OneFormer | |
| RANSAC algorithm | scikit-learn developers | https://scikit-learn.org/ | |
| ScanNet V2 | http://www.scan-net.org/ | ||
| SegFormer | NVIDIA | https://github.com/NVlabs/SegFormer | |
| SGCA_GCN | Authors of this study | Proposed method (N/A) | |
| Softmax function | PyTorch Contributors | https://pytorch.org/ | |
| Swin Transformer | Microsoft Research | https://github.com/microsoft/Swin-Transformer |
Referenzen
- Zhang Z et al. CCANet: cross-modality comprehensive feature aggregation network for indoor scene semantic segmentation. IEEE Trans Cogn Dev Syst. 2024;17:366–378.
- Cui Y et al. Improving the segmentation of confusable indoor structures using point convolution and sparse vector attention. Geospat Inf Sci. 2025:1–22.
- Yang L, Cai H. Cost-efficient image semantic segmentation for indoor scene understanding using weakly supervised learning and BIM. J Comput Civ Eng. 2023;37:04022062–04022082.
- Uckan T, Aslan C, Hark C. A comprehensive hybrid approach for indoor scene recognition combining CNNs and text-based features. Sensors. 2025;25(17):5350. doi:10.3390/s25175350.
- Sun R et al. Training indoor and scene-specific semantic segmentation models to assist blind and low-vision users in activities of daily living. IEEE Open J Eng Med Biol. 2025;6:533–539.
- Ye S, Hu Y, Lin M. Indoor scene reconstruction with fine-grained details using hybrid representation and normal prior enhancement. IEEE Trans Vis Comput Graph. 2024;31:5275–5287.
- Naseer A et al. Multimodal scene recognition using semantic segmentation and deep learning integration. PeerJ Comput Sci. 2025;11. doi:10.7717/peerj-cs.2858.
- Bae JH, Yu GH, Lee JH. Superpixel image classification with graph convolutional neural networks based on learnable positional embedding. Appl Sci. 2022;12:9176–9190.
- Zhang H, Zou J, Zhang L. EMS-GCN: an end-to-end mixhop superpixel-based graph convolutional network for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2022;60:1–16.
- Mu Y, Ou L, Chen W. Superpixel-based graph convolutional network for UAV forest fire image segmentation. Drones. 2024;8:142–158.
- Khatun Z, Jonsson H Jr, Tsirilaki M. Beyond pixel: superpixel-based MRI segmentation through traditional machine learning and graph convolutional network. Comput Methods Programs Biomed. 2024;256:108398–108412.
- Yongyin L, Caixia Y. Cross-attention swin transformer for detailed segmentation of ancient architectural color patterns. Front Neurorobot. 2024;18:1513488–1513508.
- Zhou X, Zhou L, Gong S. Swin transformer embedding dual stream for semantic segmentation of remote sensing imagery. IEEE J Sel Top Appl Earth Obs Remote Sens. 2023;17:175–189.
- Ning X, Jiang L, Li W. Swin-MGNet: swin transformer-based multiview grouping network for 3D object recognition. IEEE Trans Artif Intell. 2024;6:747–758.
- Ke A, Luo J, Cai B. UNet-like network fused swin transformer and CNN for semantic image synthesis. Sci Rep. 2024;14:16761–16779.
- Li Y et al. IED-GCN: an internal and external decoupled graph convolutional network for landslide susceptibility assessment. IEEE Trans Geosci Remote Sens. 2025;63:1–17.
- He T, Chen J. DC-GCN: a lightweight graph convolutional network integrating local and global context for semantic segmentation. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:28283–28299. doi:10.1109/JSTARS.2025.3626006.
- Imani M. Superpixel-based graph convolutional neural network for polarimetric synthetic aperture radar image classification. Sci Rep. 2026;16:4736. doi:10.1038/s41598-025-34965-6.
- Wang S, Feng S, Wang Z. Structural prior-guided and feature-enhanced transformer with masked image modeling pretraining for retinal layers and fluid segmentation in macular edema OCT images. Biomed Opt Express. 2025;16:5096–5117.
- Yuan Z et al. Structure-aware progressive multimodal fusion network for RGB-T crack segmentation. J Imaging. 2025;11(11):384. doi:10.3390/jimaging11110384.
- Xu S, Shen R, Liu E. A structure-prior-guided adaptive context selection network for remote sensing semantic segmentation. Electron Lett. 2025;61. doi:10.1049/ell2.70161.
- Minaee S, Boykov Y, Porikli F. Image segmentation using deep learning: a survey. IEEE Trans Pattern Anal Mach Intell. 2021;44:3523–3542.
- Zhou E, Murray AT, Baik J. Mapping 3D classroom seats based on partial object point cloud completion. Cartogr Geogr Inf Sci. 2024;51:404–420.
- Nishi T, Kawasaki S, Iewaki K. M3R-CNN: on effective multimodal fusion of RGB and depth cues for instance segmentation in bin picking. Adv Robot. 2023;37:1143–1157.
- Zhou W, Xiao Y, Yan W. CMPFFNet: cross-modal and progressive feature fusion network for RGB-D indoor scene semantic segmentation. IEEE Trans Autom Sci Eng. 2023;21:5523–5533.
- Zhou W, Xiao Y, Liu Y. FIMKD: feature implicit mapping knowledge distillation for RGB-D indoor scene semantic segmentation. IEEE Trans Artif Intell. 2024;5:6488–6499.
- Liu J, Jiang Z, Xu X. Multi-robot collaborative complex indoor scene segmentation via multiplex interactive learning. CAAI Trans Intell Technol. 2025;10:1646–1660.
- Zhang S, Xie M. MIPANet: optimizing RGB-D semantic segmentation through multimodal interaction and pooling attention. Front Phys. 2024;12:1411559–1411572.
- Li JW et al. Construction of a multiscale feature fusion model for indoor scene recognition and semantic segmentation. Sci Rep. 2025;15:14701. doi:10.1038/s41598-025-95465-1.
- Liang X et al. Indoor building structure segmentation in unorganized point clouds based on corner feature. Eng Constr Archit Manag. 2025. doi:10.1108/ECAM-10-2024-1433.
- Wu LF, Wei D, Xu CA. CFANet: the cross-modal fusion attention network for indoor RGB-D semantic segmentation. J Imaging. 2025;11(6):177. doi:10.3390/jimaging11060177.
- Fan L, Zhou Y, Liu H. Combining swin transformer with UNet for remote sensing image semantic segmentation. IEEE Trans Geosci Remote Sens. 2023;61:1–11.
- Wang Z, Liao Z, Zhou B. SwinURNet: hybrid transformer-CNN architecture for real-time unstructured road segmentation. IEEE Trans Instrum Meas. 2024;73:1–16.
- Zhang H et al. Frequency-domain-guided swin transformer and global-local feature integration for remote sensing images semantic segmentation. IEEE Trans Geosci Remote Sens. 2025;63:5612611. doi:10.1109/TGRS.2025.3535724.
- Li GY, Chen J, Jang SI. SwinCross: cross-modal swin transformer for head and neck tumor segmentation in PET-CT images. Med Phys. 2024;51:2096–2107.
- Tang Y, Hu X, Ke T. Semantic segmentation of high-resolution remote sensing imagery via an end-to-end graph attention network with superpixel embedding. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:7236–7252.
- Wang R, Nie Y, Geng J. Multiscale superpixel-guided weighted graph convolutional network for polarimetric SAR image classification. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:3727–3741.
- Li S, Wu K, Liu H. Hyperspectral image classification based on multiscale feature search graph convolutional network with meta pseudo-labels. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:23485–23504.
- Yang B, Cheng X, Guo J. Temporal information-enhanced graph convolutional network with superpixel-pixel gated knowledge dynamic selection for change detection in satellite time series. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:18399–18412.
- Zhang H, Ku J, Zhao J. Multi-scale graph wavelet convolutional network for hyperspectral image classification. Front Remote Sens. 2025;6:1637820. doi:10.3389/frsen.2025.1637820.
- Zhou Q, Wang L, Gao G. Boundary-guided lightweight semantic segmentation with multiscale semantic context. IEEE Trans Multimedia. 2024;26:7887–7900.
- Xu X, Yen GG, Zhao C. Boundary-based active domain adaptation for semantic segmentation under adverse conditions. IEEE Trans Neural Netw Learn Syst. 2025;36:14721–14734.
- Tang Y, Feng S, Zhao C. A semantic change detection network based on boundary detection and task interaction for high-resolution remote sensing images. IEEE Trans Neural Netw Learn Syst. 2025;36:17184–17198.
- Guan L, Yuan X. Dynamic weighting and boundary-aware active domain adaptation for semantic segmentation in autonomous driving environment. IEEE Trans Intell Transp Syst. 2024;25:18461–18471.
- Fenglei W, Xin G, Zongze Z. A boundary-enhanced semantic segmentation model for buildings. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:5733–5748.
- Shan K, Tan L, Li Y, Jia T. Multi-scale boundary-aware network for remote sensing image semantic segmentation. Sci Rep. 2026;16:3797. doi:10.1038/s41598-025-33943-2.
- Wu D, Guo Z, Li A. Conditional boundary loss for semantic segmentation. IEEE Trans Image Process. 2023;32:3717–3731.
- Li Y, Zhang C, Wang H. Boundaries matter: a novel multibranch semisupervised semantic segmentation method. IEEE Intell Syst. 2024;40:35–44.
- Wang JQ, Chen T, Zheng L. A multiscale remote sensing semantic segmentation model with boundary enhancement based on UNetFormer. Sci Rep. 2025;15:14737. doi:10.1038/s41598-025-99663-9.
- Jung H, Choi HS, Kang M. Boundary enhancement semantic segmentation for building extraction from remote sensed image. IEEE Trans Geosci Remote Sens. 2021;60:1–12.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.