Dieses Protokoll erzeugt strukturbewusste Kleidungsrepräsentationen, indem semantische Komponentenparsung, Topologiemodellierung, duale Merkmalscodierung und strukturgeleitete Fusion integriert werden. Es ermöglicht Forschern im Bereich Computer Vision und Bekleidung, die Suche nach Kleidungsstücken sowie den Vergleich mit Designvorlagen basierend auf der Anordnung von Komponenten und dem Silhouettenlayout – statt auf Farbe oder Textur – durchzuführen.
Methodenartikel
Ein Protokoll zum Lernen von Bildmerkmalen basierend auf der Topologie von Kleidungsstücken auf Bildebene für die Abfrage von Designreferenzen
In diesem Artikel
Zusammenfassung
Zusammenfassung
Methoden zur Suche von Bekleidungsbildern betonen häufig Farbe und Textur, was zu Verwechslungen zwischen Kleidungsstücken führen kann, die eine ähnliche Optik aufweisen, sich jedoch in ihrer Komponentenanordnung unterscheiden. Diese Studie stellt ein protokollbasiertes, komponentenbewusstes Verfahren zum Erlernen von Merkmalen für die Suche nach Bekleidungsbildern und den Vergleich von Designvorlagen vor. Das Protokoll analysiert semantische Bekleidungsbereiche, erstellt einen bildweiten Graphen der Bekleidungskomponenten, kodiert Erscheinungsbild und Komponentenbeziehungen parallel und fusioniert beide Darstellungen unter Verwendung von Verlustfunktionen für strukturelle Konsistenz, strukturelle Beziehung und strukturelle Diskriminierung. DeepFashion2-Bilder werden auf 512 x 512 Pixel standardisiert, mit HRNet-W48 analysiert, mit ResNet-50 und Graph-Convolution kodiert und anhand struktureller Suche und Clusterung evaluiert. Das vollständige Modell erreichte einen strukturellen Konsistenzindex von 0,81, einen strukturellen Diskriminierungsindex von 0,71, einen Recall@5-Wert von 89,2 %, eine mittlere durchschnittliche Präzision von 86,4 % und einen Silhouettenkoeffizienten von 0,74. Das Protokoll ermöglicht die Suche nach Bekleidungsstrukturen, den strukturellen Vergleich sowie die Lokalisierung von Unterschieden, wenn das Oberflächenerscheinungsbild die Konstruktion des Kleidungsstücks nicht zuverlässig widerspiegelt.
Einleitung
Mit der zunehmenden Integration von Computer Vision und künstlicher Intelligenz in die Bekleidungsindustrie hat sich die Analyse von Bekleidungsbildern schrittweise von grundlegenden Erkennungsaufgaben hin zu designorientierten Analysen und der Entscheidungsunterstützung ausgeweitet1,2. Im Bekleidungsdesignprozess hängt der Unterschied zwischen Designs stärker von der strukturellen Zusammensetzung und den Beziehungen zwischen Komponenten ab als von einfachen Unterschieden im Erscheinungsbild, wodurch die strukturelle Aussagekraft der Bildmerkmale bei der Designunterstützung zu einem entscheidenden Faktor für die Effektivität der Analyse wird3,4. Die meisten bestehenden visuellen Methoden stützen sich jedoch weiterhin auf Textur, Farbe und globale Konturen als Hauptmerkmale, was eine systematische Analyse von Bekleidungshierarchien und Konstruktionsunterschieden im Designprozess erschwert5,6. Daher ist die Entwicklung einer strukturbewussten Methode zum Lernen von Bildmerkmalen für die Unterstützung im Bekleidungsdesign wichtig, um Objektivität und Konsistenz der Designanalyse zu verbessern7. Dieses Protokoll ist geeignet, wenn Bekleidungsstücke ähnliche Farben, Texturen oder globale Konturen aufweisen, sich jedoch in der Anordnung der Komponenten, den Verbindungsmustern oder der räumlichen Struktur unterscheiden. Unter diesen Bedingungen neigen darstellungsbezogene, auf das Erscheinungsbild ausgerichtete Merkmale dazu, strukturell unterschiedliche Designs im Merkmalsraum nahe beieinander anzuordnen, was die Zuverlässigkeit von Rückgewinnung und Designvergleich beeinträchtigt. Das Protokoll behandelt Aufgaben, bei denen die Beziehungen zwischen den Komponenten eines Bekleidungsstücks die Grundlage für die strukturelle Rückgewinnung, die Designbewertung und die Analyse lokaler Unterschiede bilden.
Hinsichtlich Datenumfang, Modellkomplexität und Aufgabenvielfalt hat die aktuelle Forschung zur automatischen Analyse und zum Verständnis von Bekleidungsbildern erhebliche Fortschritte erzielt8,9. In praktischen Anwendungen wird die strukturelle Information von Kleidungsstücken jedoch häufig nur implizit in Segmentierungs- oder Erkennungsergebnissen enthalten und im einheitlichen Modellierungsprozess der Merkmalslernphase nicht berücksichtigt, was zu einem Mangel an stabiler Unterscheidung zwischen unterschiedlichen Strukturdesigns im Merkmalsraum führt10,11. Die räumlichen Beziehungen, hierarchischen Einschränkungen und topologischen Strukturen zwischen Bekleidungskomponenten werden nicht explizit kodiert, wodurch es für die Merkmalsrepräsentationen schwierig wird, strukturelle Unterschiede auf Designebene widerzuspiegeln12,13. Das Fehlen einer expliziten Strukturmodellierung begrenzt die analytische Feinheit und die Zuverlässigkeit der Entscheidungsfindung anhand von Merkmalen aus Bekleidungsbildern in designunterstützenden Szenarien und stellt somit eine wesentliche Hürde für die Entwicklung intelligenter Designs Systeme mit tieferem semantischen Verständnis dar14.
Um das Lernen und die Analyse von Merkmalen in Bekleidungsbildern zu unterstützen, haben verwandte Studien mehrere technische Ansätze untersucht15. Methoden der semantischen Segmentierung und der Bekleidungsanalyse (garment parsing) ermöglichen eine feingliedrige Abgrenzung von Bekleidungsregionen und -komponenten durch pixelgenaue Annotation und schaffen damit die Grundlage für die Extraktion struktureller Informationen16,17. Bei der bildbasierten Abfrage von Bekleidungsstücken wurden Topologie und Farb-Textur-Fusion, globale und lokale Attention-Alignment, Bekleidungsanalyse, multiscale und multigranulare Repräsentation sowie Residual-Attention mit Merkmalsauswahl integriert. Diese Verfahren adressieren Katalogsuche, Consumer-to-Store-Matching, cross-domain-Produktsuche und visuelle Suche im E-Commerce. Ihre Anwendungsszenarien stehen eng im Zusammenhang mit der Designreferenzsuche, da jedes Verfahren Bekleidungsbilder basierend auf einer visuellen Abfrage sortiert, wobei ihre Repräsentationen jedoch nicht die benannten Nachbarschaftsbeziehungen der Komponenten und vertikalen Ordnungsrelationen während der Merkmalsfusion beibehalten18,19,20. Gleichzeitig hat die Forschung zu Design- und Empfehlungsszenarien schrittweise multimodale Fusion, Relationenmodellierung und Stilanalyse eingeführt und damit die Anwendungsgrenzen visueller Bekleidungsmerkmale erweitert21,22. Obwohl diese Methoden in ihren jeweiligen Aufgaben Fortschritte erzielt haben, basieren ihre Kernmerkmale weiterhin weitgehend auf Erscheinungsbeschreibungen, und strukturelle Informationen wurden nicht einheitlich als inhärente Einschränkung für das Lernen von Merkmalen modelliert, was die Erfüllung der Anforderungen an die Unterstützung von Bekleidungsdesign hinsichtlich struktureller Ausrichtung und strukturellem Vergleich erschwert23.
Um die unzureichende Fähigkeit zur strukturellen Differenzierung in der Unterstützung der Bekleidungsgestaltung zu überwinden, schlägt diese Arbeit eine Methode des Bildmerkmal-Lernens basierend auf der Wahrnehmung der Bekleidungsstruktur vor. Diese Methode integriert Ergebnisse der Bekleidungsanalyse und wesentliche strukturelle Informationen bereits in der Eingabestufe des Bekleidungsbildes und modelliert gemeinsam die Bereiche der Bekleidungskomponenten, räumliche Beziehungen sowie hierarchische Verbindungen. Durch die explizite Einbindung von strukturellen Beziehungen und visueller Merkmalsausrichtung werden Bekleidungsbedingungen direkt in den Merkmalslernprozess integriert, wodurch eine Darstellung entsteht, die sowohl das visuelle Erscheinungsbild als auch die strukturelle Konsistenz bewahrt. Diese Merkmalsrepräsentation charakterisiert strukturelle Unterschiede zwischen Bekleidungsstücken in einem einheitlichen Raum und bietet eine stabile Grundlage für nachfolgende Analysen zur strukturellen Ähnlichkeit, strukturelle Clusterung sowie designunterstützende Entscheidungsfindung. Dadurch wird das Problem der Merkmalsverwirrung verringert, das durch den Mangel an struktureller Modellierung in bestehenden Verfahren verursacht wird. Im Gegensatz zu allgemeinen Strategien der visuellen Suche, die strukturelle Informationen als lose verbundene Hilfsmerkmale behandeln, konstruiert dieser Ansatz einen merkmalsmodulierenden Mechanismus, der auf topologischen Beziehungen basiert. Dieser Mechanismus fördert eine vom sichtbaren Aufbau der Bekleidungsregionen geprägte Repräsentation und reduziert texturbasierte Reaktionen. Jeder Graphknoten steht für eine semantische Region auf Bildniveau, und jede Graphbeziehung beschreibt eine sichtbare Nachbarschaft oder eine normalisierte relative Position in der Bildebene. Die resultierende Einbettung ermöglicht den Vergleich von Komponentenanordnung und Silhouettenstruktur zwischen verschiedenen Bekleidungsbildern. Diese Regionen und Beziehungen entsprechen weder Nähschnitten, Nahtverbindungen, Konstruktionsmarken noch Größenstaffelungsparametern. Im Vergleich zu rein auf Erscheinung basierenden Suchverfahren bewahrt das vorgestellte Verfahren die explizite Topologie der Komponenten während des gesamten Merkmalslernens und behandelt strukturelle Informationen nicht erst als Ergebnis einer nachgelagerten Analyse. Im Vergleich zu Ansätzen, die strukturelle Hinweise nur als zusätzliche Eingaben nutzen, erhalten die duale Kodierung und die topologiekonsistente Fusion geometrische Beziehungen bei gleichzeitiger Reduzierung texturdominierter Reaktionen. Die resultierende Repräsentation unterstützt die Suche nach Bekleidungsstrukturen, strukturelle Clusterung, die Auswahl von Designreferenzen sowie die Analyse lokaler Gestaltungsunterschiede und liefert gleichzeitig nachvollziehbare Hinweise auf Komponentenebene, die im Kontext des Bekleidungsdesigns interpretierbar bleiben. Die Forschung zu diesem Verfahren umfasst Bereiche wie das Lernen von Merkmalen aus Bekleidungsbildern, die Modellierung von Bekleidungsstrukturen, strukturbezogene Repräsentationen und die visuelle Analyse zur Unterstützung der Bekleidungsgestaltung.
Auf der Ebene der Merkmalsrepräsentation hat die Forschung zu Bekleidungsbildern lange Zeit auf die Modellierung des Erscheinungsbilds, die Extraktion tiefer Merkmale und die mehrskalige Repräsentation abgehoben24,25. Frühe Arbeiten verwendeten faltungsneuronale Netze, um End-to-End-Modelle von Bekleidungsbildern für Klassifizierungs-, Abruf- und Ähnlichkeitsvergleichsaufgaben zu erstellen26,27. Anschließend wurden die Fusion mehrskaliger Merkmale und das Lernen über Domänen hinweg eingeführt, um Unterschiede bei Bekleidungsbildern unter verschiedenen Blickwinkeln, Posen und Aufnahmebedingungen zu verringern28,29. Bei Abrufaufgaben kamen Aufmerksamkeitsmechanismen und Strategien zur Merkmalskompression zum Einsatz, um die Unterscheidungsfähigkeit der Merkmale und die Recheneffizienz zu verbessern30,31. Diese Verfahren erreichen eine zuverlässige Unterscheidung des Erscheinungsbilds, doch ihre Merkmalslernverfahren konzentrieren sich weiterhin auf globale visuelle Informationen und weisen keine systematischen Repräsentationen interner Bekleidungsstrukturen auf32. Bei kombinierten Verfahren zum Auffinden von Modeartikeln wird ein Referenzbild mit textuellen Modifikationsanweisungen kombiniert, wodurch sich die Abfragemodalität jedoch von dem hier untersuchten rein bildbasierten Protokoll unterscheidet. Diese Verfahren werden als verwandter kommerzieller Abrichtungsansatz besprochen, sind jedoch im quantitativen Vergleich nicht enthalten, da zusätzliche Texteingaben eine kontrollierte Evaluierung mittels Bildabfrage verhindern würden.
Da die Analyse von Bekleidungsbildern sich zunehmend von der Unterscheidung des Erscheinungsbilds hin zum strukturellen Verständnis verlagert hat, rückt die Modellierung von Bekleidungskomponenten, geometrischen Beziehungen und topologischen Verbindungen verstärkt in den Forschungsfokus33. Semantische Segmentierungsnetzwerke haben die Analyse auf Ebene von Bekleidungskomponenten durch Merkmalsprojektion und Multi-Attention-Mechanismen erreicht und damit eine zuverlässige Grundlage für die Extraktion struktureller Informationen geschaffen34,35. Methoden zur Erkennung von Schlüsselpunkten und zur Modellierung der strukturellen Topologie haben darüber hinaus die Beziehung zwischen Bekleidungsumrissen und lokalen Strukturen charakterisiert und somit die Fähigkeit des Modells verbessert, die geometrischen Merkmale von Kleidung darzustellen36,37. Mehrere Studien haben Graphstrukturen und relationale Schlussfolgerungsnetzwerke eingeführt, um Beziehungen zwischen Bekleidungskomponenten abzubilden, wodurch die feinkörnige Erkennung sowie die Leistung bei der Quervergleichssuche verbessert wurde38,39. Diese Arbeiten haben die wichtige Rolle struktureller Informationen in der visuellen Analyse bestätigt, doch bisher wird die Struktur meist nur als unterstützendes Merkmal oder als Zwischenergebnis genutzt, und ein Merkmalslernsystem, das strukturelle Beschränkungen im Kern integriert, wurde noch nicht entwickelt40.
In der Bereichsunterstützung des Bekleidungsdesigns haben diese Entwicklungen Empfehlungen für das Design, Stilanalysen, den Aufbau interaktiver Systeme sowie die strukturorientierte Designbewertung unterstützt41. Die Forschung zu Empfehlungssystemen hat das Kombinieren von Bekleidungsstücken und personalisierte Empfehlungen erreicht, indem visuelle Merkmale mit Benutzerpräferenzen integriert wurden42. Arbeiten im Zusammenhang mit Designunterstützung haben neue Wege zur intelligenten Designunterstützung erforscht, indem generative Modelle, Stilmodellierung und Mensch-Computer-Kollaborationsmechanismen kombiniert wurden43. Forschung zu virtuellem Anprobieren, Größenmessung und Stilübertragung hat die Anwendung der visuellen Bekleidungsanalyse im gesamten Design- und Produktionsprozess erweitert. Obwohl diese Studien die technischen Formen der Unterstützung im Bekleidungsdesign bereichert haben, werden ihre zentralen visuellen Merkmale weiterhin hauptsächlich durch das Erscheinungsbild bestimmt und weisen einen Mangel an einheitlicher Repräsentation der Designstruktur für die Analyse auf. Im Gegensatz dazu betrachtet dieser Artikel die Bekleidungsstruktur als zentrale Einschränkung der Merkmalsrepräsentation und stellt eine visuelle Repräsentationsmethode für die strukturelle Analyse in der Unterstützung des Bekleidungsdesigns bereit.
Trotz dieser Entwicklungen behandeln neuere Methoden im generativen Design strukturelle Bedingungen häufig als lose räumliche Leitmatrizen innerhalb von Diffusionsprozessen. Aktuelle Rahmenwerke zur strukturellen Analyse stellen Topologien als zusätzliche semantische Kennzeichnungen dar, die getrennt vom primären visuellen Einbettungsraum existieren. Der vorgeschlagene Ansatz verändert dieses Prinzip, indem er eine graphenbasierte topologische Vorgabe definiert, die das Lernen visueller Merkmale auf Komponentenebene explizit moduliert. Das mehrstufige Konsistenzziel fördert, dass Bekleidungsstücke mit ähnlichen komponentenbasierten Anordnungen auf Bildniveau im Merkmalsraum nahe beieinander liegen, während sich Bekleidungsstücke mit unterschiedlichen sichtbaren Bereichsorganisationen voneinander trennen. Dieses Ziel verringert die Abhängigkeit von Textur im bewerteten Abrufkontext, schafft jedoch keine Invarianz gegenüber Änderungen in Material, Pose oder Hintergrund. Das Protokoll sollte gewählt werden, wenn das Eingabebild ein ausreichend sichtbares einzelnes Bekleidungsstück enthält, semantische Komponenten erkennbare Grenzen beibehalten und das analytische Ziel einen strukturellen Vergleich auf Komponentenebene erfordert, statt einer groben Kategorienidentifikation. Es richtet sich an Forschende im Bereich Computer Vision, Mode-Design-Forschende und digitale Entwicklungsteams für Bekleidung, die an struktursensitiver visueller Analyse arbeiten. Es ist nicht für Aufgaben gedacht, die ausschließlich auf Farb- oder Materialerkennung abzielen, oder für Bilder, bei denen die Bekleidungstopologie weitgehend verdeckt ist. Das folgende Protokoll stellt den Arbeitsablauf von der Datensatzvorbereitung und semantischen Wahrscheinlichkeitszuordnung über den Aufbau geometrischer Beziehungen, die zweigleisige Merkmalscodierung, die strukturgeführte Fusion bis hin zur konsistenzbasierten Optimierung dar. Der vollständige Arbeitsablauf ist in Abbildung 1 zusammengefasst.
Protokoll
Diese Studie verwendet öffentlich verfügbare Bilddatensätze von Bekleidungsstücken und rekrutiert keine menschlichen Teilnehmer, sammelt keine personenbezogenen Daten, führt keine Tierversuche durch und verwendet keine biologischen Materialien. Eine Genehmigung durch eine institutionelle Ethikkommission und die Einholung informierter Einwilligung sind nicht erforderlich.
1. Softwareumgebung und Projektkonfiguration
- Legen Sie die freigegebenen Projektdateien in ein Verzeichnis mit ausreichend Speicherplatz und öffnen Sie ein Terminal im Stammverzeichnis des Projekts.
- Führen Sie conda env create -f environment.yml aus, um die Softwareumgebung zu erstellen. Führen Sie conda activate garment_structure aus, um die Umgebung zu aktivieren.
- Führen Sie python --version, conda --version, pip show numpy, pip show torch, pip show torchvision und nvidia-smi aus. Speichern Sie die vollständige Ausgabe der Befehle in software_versions.txt.
- Verwenden Sie dieselbe aufgezeichnete Umgebung für die Vorverarbeitung, das Training, die Inferenz, die Effizienzmessung und die Auswertung. Notieren Sie den HRNet-W48-Checkpoint-Dateinamen und den dazugehörigen SHA-256-Wert, die Bezeichner und SHA-256-Werte der auf ImageNet vortrainierten ResNet-50-Gewichte, die Quelle der DeepFashion2-Version sowie die Kennung des Quellcode-Repositorys in derselben Datei.
- Erstellen Sie die Verzeichnisse data_raw, data_processed, parser_outputs, structural_priors, feature_outputs, checkpoints, logs und evaluation_results im Projekt-Stammverzeichnis.
- Öffnen Sie die Datei configs/protocol.yaml. Geben Sie das DeepFashion2-Verzeichnis in dataset_root, den Pfad zum vortrainierten HRNet-W48-Checkpoint in parser_checkpoint und das Ausgabeverzeichnis des Projekts in output_root ein.
- Setzen Sie input_height auf 512, input_width auf 512, batch_size auf 32, structural_categories_per_batch auf 8, samples_per_category auf 4, random_seed auf 42, feature_dimension auf 512, structural_constraint_weight auf 1,0, structural_relationship_weight auf 0,5, structural_discrimination_weight auf 1,0 und separation_threshold auf 0,3.
- Stellen Sie den Optimierer auf Mini-Batch-Stochastic-Gradient-Descent ein. Legen Sie initial_learning_rate auf 0,0001, momentum auf 0,9, weight_decay auf 0,0005, max_epochs auf 120, learning_rate_schedule auf Multi-Step-Decay und learning_rate_decay_factor auf 0,1 fest. Geben Sie die in der veröffentlichten Konfiguration verwendeten festgelegten Abnahmepochen in learning_rate_milestones ein.
- Führen Sie python tools/export_experiment_tables.py --config configs/protocol.yaml --output evaluation_results aus. Exportieren Sie die vollständige Modellkonfiguration nach model_setting_statistics.csv. Überprüfen Sie, dass die exportierte Datei die Eingabebildgröße, das Eingabeformat, die Batch-Zusammensetzung, den Optimierer, die Lernrate, den Lernraten-Plan, die Anzahl der Epochen, den Gewichtsverlust, den Impuls, die Augmentationswahrscheinlichkeiten, die Merkmalsdimension, die Gewichte für strukturelle Verluste, die Separationsschwelle, die Zufallsstarts, die Regel zur Checkpoint-Auswahl und die Anzahl unabhängiger Durchläufe erfasst.
- Erwartetes Ergebnis: Bestätigen Sie, dass die Softwareumgebung ohne Abhängigkeitsfehler startet, die Datei software_versions.txt den Umgebungsdatensatz enthält, alle Ausgabeverzeichnisse existieren und die Datei configs/protocol.yaml gültige absolute Pfade sowie numerische Einstellungen enthält.
HINWEIS: Verwenden Sie während der Datenverarbeitung, Modelltrainierung, Inferenz und Evaluation dieselbe Umgebung und dieselbe Konfigurationsdatei. Speichern Sie eine Kopie von configs/protocol.yaml zusammen mit jedem trainierten Checkpoint.
FEHLERBEHEBUNG: Falls die Erstellung der Umgebung aufgrund eines nicht verfügbaren Pakets abbricht, entfernen Sie die unvollständige Umgebung, überprüfen Sie die Paketquellen in environment.yml und erstellen Sie die Umgebung erneut. Falls nvidia-smi keine Grafikverarbeitungseinheit anzeigt, beenden Sie das Modelltraining und stellen Sie den Grafiktreiber sowie die CUDA-Laufzeitumgebung wieder her. Falls während der Ausführung ein Verzeichnisfehler auftritt, ersetzen Sie relative Pfade durch absolute Pfade und überprüfen Sie die Schreibberechtigung für output_root.
2. Eingabebildannahme, Datensatzkonstruktion und Vorverarbeitung
- Verwenden Sie ausschließlich Dateien mit den Endungen JPG, JPEG oder PNG. Verwenden Sie 8-Bit-RGB-Bilder, die ein einzelnes Hauptkleidungsstück enthalten.
- Behalten Sie 8-Bit-RGB-Bilder mit einer Breite und Höhe von mindestens 512 Pixeln und einem erkennbaren Hauptkleidungsstück bei. Lehnen Sie ein Bild ab, wenn der Vordergrund des Kleidungsstücks weniger als 15 % der gesamten Bildfläche einnimmt, wenn mehr als 5 % der Grenze der Kleidungsstückmaske mit dem Bildrand übereinstimmen, wenn ein sekundärer Bereich eines Kleidungsstücks mehr als 10 % der Fläche des Hauptkleidungsstücks einnimmt, wenn der geschätzte verdeckte Bereich mehr als 20 % der Maske des Hauptkleidungsstücks beträgt oder wenn die Varianz der Laplace-Response unter 100 liegt.
- Notieren Sie die Bildkennung, den gemessenen Wert, die ausgelöste Ausschlussregel und den Anmerkungspfad in der Datei excluded_samples.csv.
- Wenden Sie die Regeln zur Eingabeannahme auf die DeepFashion2-Quellbilder an, bevor die strukturelle Kennzeichnung und die Datenaufteilung erfolgen. Notieren Sie jede akzeptierte und abgelehnte Bildkennung, die ursprüngliche Datensatz-Aufteilung, die Kennung der Kleidungsstückanmerkung, die Quellpaar-Kennung, das Verhältnis der Vordergrundfläche, das Verhältnis des Randkontakts, das Verhältnis der Verdeckung, die Unschärfekennzahl und den endgültigen Beibehaltungszustand in data_filtering_manifest.csv.
- Führen Sie python tools/prepare_data.py --config configs/protocol.yaml aus.
- Lesen Sie die Begrenzungsbox des Kleidungsstücks aus der Datensatzanmerkung aus. Erweitern Sie die Begrenzungsbox um 5 % ihrer Breite und Höhe, ohne die Bildränder zu überschreiten.
- Schneiden Sie den Bereich des Kleidungsstücks zu, bewahren Sie das ursprüngliche Seitenverhältnis, fügen Sie Null-Padding hinzu, um ein quadratisches Bild zu erhalten, und ändern Sie die Größe des gepaddeten Bildes auf 512 × 512 Pixel.
- Konvertieren Sie das skalierte Bild in einen RGB-Tensor mit Gleitkommawerten. Teilen Sie jeden Pixelwert durch 255.
- Normalisieren Sie die Rot-, Grün- und Blaukanäle mit Mittelwerten von 0,485, 0,456 und 0,406 sowie Standardabweichungen von 0,229, 0,224 und 0,225.
- Wenden Sie horizontales Spiegeln mit einer Wahrscheinlichkeit von 0,5 und zufälliges Löschen mit einer Wahrscheinlichkeit von 0,2 auf Trainingsbilder an. Wenden Sie ausschließlich deterministisches Zuschneiden, Paddings, Größenändern und Normalisieren auf Validierungs- und Testbilder an.
- Führen Sie python tools/assign_structural_levels.py --config configs/protocol.yaml aus, nachdem die siebenkanaligen Komponentenkarten sowie die Matrizen für gemeinsame Grenzen und vertikale Reihenfolge generiert wurden. Berechnen Sie für jedes beibehaltene Bild die Anzahl aktiver Knoten, die Anzahl verbundener Komponenten, die Anzahl von Verzweigungsknoten, die Anzahl unabhängiger Zyklen und den längsten gerichteten Pfad der vertikalen Reihenfolge. Definieren Sie einen Verzweigungsknoten als aktiven Knoten, der im Graphen der gemeinsamen Grenzen mit mindestens drei anderen aktiven Knoten verbunden ist.
- Weisen Sie S1 zu, wenn der Graph zusammenhängend ist, keinen unabhängigen Zyklus enthält, keinen Verzweigungsknoten aufweist und der längste Pfad der vertikalen Reihenfolge aus höchstens zwei Kanten besteht. Weisen Sie S2 zu, wenn der Graph zusammenhängend ist, keinen unabhängigen Zyklus enthält, genau einen Verzweigungsknoten aufweist und der längste Pfad der vertikalen Reihenfolge aus höchstens zwei Kanten besteht. Weisen Sie S3 zu, wenn der Graph zusammenhängend ist, keinen unabhängigen Zyklus enthält und mindestens zwei Verzweigungsknoten oder einen Pfad der vertikalen Reihenfolge mit mindestens drei Kanten aufweist. Weisen Sie S4 zu, wenn der Graph zusammenhängend ist, genau einen unabhängigen Zyklus enthält und ein Pfad der vertikalen Reihenfolge aus höchstens zwei Kanten besteht. Weisen Sie S5 zu, wenn der Graph mindestens zwei unabhängige Zyklen enthält oder einen unabhängigen Zyklus zusammen mit einem Pfad der vertikalen Reihenfolge mit mindestens drei Kanten aufweist.
- Wenden Sie die Regeln in der Reihenfolge S5, S4, S3, S2 und S1 an und speichern Sie die berechneten Graphstatistiken, das zugewiesene Niveau und die Regelkennung in structural_level_manifest.csv.
- Generieren Sie die vorläufigen S1–S5-Kennzeichnungen automatisch aus den gespeicherten Komponentenmasken und Relationsmatrizen. Markieren Sie eine Probe als strukturell mehrdeutig, wenn ihr Komponentengraph mehr als eine zusammenhängende Komponente enthält, wenn die durchschnittliche maximale Komponentenwahrscheinlichkeit innerhalb des Vordergrunds des Kleidungsstücks unter 0,60 liegt, wenn eine aktive Komponente weniger als 1 % des Vordergrunds des Kleidungsstücks einnimmt oder wenn sich das zugewiesene strukturelle Niveau ändert, nachdem die Breite des Randkontakts von einem auf zwei Pixel geändert wurde.
- Reichen Sie jede mehrdeutige Probe zwei Autoren zur unabhängigen Prüfung des Quellbilds, der Komponentenkarte, der Matrix der gemeinsamen Grenzen, der Matrix der vertikalen Reihenfolge und des vorläufigen Graphen ein. Behalten Sie die Kennzeichnung bei, wenn beide Prüfungen übereinstimmen. Bei Uneinigkeit reichen Sie die Probe einem dritten Autor ein und verwenden Sie die Mehrheitsentscheidung als endgültige Kennzeichnung. Schließen Sie eine Probe aus, wenn nach der Überprüfung keine stabile Komponentenrelation wiederhergestellt werden kann. Notieren Sie die automatische Kennzeichnung, die Prüfkennzeichnungen, den Grund für die Uneinigkeit, die endgültige Kennzeichnung und den Ausschlussstatus in structural_label_audit.csv.
- Berechnen Sie den SHA-256-Wert jeder beibehaltenen Quelldatei und berechnen Sie einen 64-Bit-Wahrnehmungshash aus dem normalisierten Ausschnitt des Kleidungsstücks. Ordnen Sie Bilder mit identischen SHA-256-Werten derselben exakten Duplikatgruppe zu. Ordnen Sie Bilder, deren Wahrnehmungshashes eine Hamming-Distanz von höchstens vier aufweisen, derselben Gruppe nahezu identischer Duplikate zu, nachdem überprüft wurde, dass sie von derselben Instanz des Kleidungsstücks stammen.
- Verbinden Sie alle Bilder, die dieselbe DeepFashion2-Quellpaar-Kennung oder dieselbe Kleidungsstück-Identität teilen, zu einer Quellgruppe. Speichern Sie die Dateihashes, Wahrnehmungshashes, Quellkennungen und Duplikatgruppenkennungen in duplicate_group_manifest.csv.
- Führen Sie die Datenaufteilung auf Ebene der Quellgruppe statt auf Ebene des Einzelbilds durch. Weisen Sie jede exakte Duplikatgruppe, jede Gruppe nahezu identischer Duplikate und jede Quellidentitätsgruppe vollständig einem Teildatensatz zu. Überprüfen Sie alle Paare zwischen Teildatensätzen nach der Aufteilung und notieren Sie jeden erkannten Identitätskonflikt, Hashkonflikt und Wahrnehmungshashkonflikt in leakage_audit.csv. Erstellen Sie die Manifeste neu, bis leakage_audit.csv keine ungelösten Querschnittseinträge mehr enthält.
- Stratifizieren Sie die Quellgruppen nach den endgültigen S1–S5-Kennzeichnungen und weisen Sie vollständige Gruppen den Trainings-, Validierungs- und Testteildatensätzen gemäß der verifizierten Zuordnung in Tabelle 1 zu. Geben Sie die exakte Anzahl der Bilder und der Quellgruppen für jedes strukturelle Niveau und jeden Teildatensatz an.
- Berechnen Sie die realisierten Trainings-, Validierungs- und Testanteile aus dem endgültigen beibehaltenen Kollektiv, nicht aus dem ungefilterten Datensatz. Verwenden Sie Validierungs-, Test-, mehrdeutig ausgeschlossene Bilder oder Bilder, die zu ihren Duplikatgruppen gehören, nicht während des Parameterlernens, der Schwellenwertbestimmung, der Anpassung der strukturellen Niveauregeln oder der Checkpoint-Auswahl.
- Speichern Sie die verarbeiteten Bilder in data_processed/images. Speichern Sie train_manifest.csv, validation_manifest.csv, test_manifest.csv, pair_manifest.csv und structural_level_manifest.csv in data_processed/manifests.
- Lesen Sie die endgültigen strukturellen Kennzeichnungen, den Prüfstatus, die Duplikatgruppenkennungen, die Quellgruppenkennungen und die Teildatensatzkennungen aus den verarbeiteten Manifesten aus. Zählen Sie die automatisch akzeptierten Proben, manuell überprüften Proben, Ausschlüsse aufgrund von Mehrdeutigkeit, Ausschlüsse aufgrund von Duplikaten, Quellgruppen, Trainingsbilder, Validierungsbilder und Testbilder für S1 bis S5.
- Berechnen Sie die realisierten Teildatensatzverhältnisse, die durchschnittliche Anzahl aktiver Knoten, die durchschnittliche Anzahl von Verzweigungsknoten, die durchschnittliche Anzahl unabhängiger Zyklen, die durchschnittliche Tiefe der vertikalen Reihenfolge und die durchschnittliche Anzahl typisierter Kanten. Speichern Sie die vollständigen Statistiken in evaluation_results/dataset_statistics.csv.
- Erwartete Ausgabe: Stellen Sie sicher, dass jedes akzeptierte Bild ein 8-Bit-RGB-Bild mit einer Größe von 512 × 512 Pixeln ist und über einen Filtereintrag, eine endgültige strukturelle Niveaubezeichnung, eine Quellgruppenkennung, eine Duplikatgruppenkennung, eine Teildatensatzkennung und einen gültigen Anmerkungspfad verfügt. Stellen Sie sicher, dass jede mehrdeutige Probe einen vollständigen Prüfeintrag aufweist. Stellen Sie sicher, dass keine Quellkennung, exakte Duplikatgruppe, Gruppe nahezu identischer Duplikate oder Kleidungsstückidentität in mehr als einem Teildatensatz vorkommt. Stellen Sie sicher, dass die Bildanzahlen in train_manifest.csv, validation_manifest.csv, test_manifest.csv und dataset_statistics.csv identisch sind.
ANMERKUNG: Bewahren Sie die ursprünglichen unverarbeiteten Bilder in data_raw auf. Wenden Sie keine zufällige Erweiterung auf Validierungs- oder Testbilder an.
FEHLERBEHEBUNG: Wenn beim Zuschneiden ein Kragen, Ärmel, Saum oder Hosenbein entfernt wird, stellen Sie die ursprüngliche Anmerkung wieder her und vergrößern Sie den Rand der beibehaltenen Grenze. Wenn ein Kleidungsstück gestreckt erscheint, überprüfen Sie, ob vor der Größenänderung quadratisches Padding vorhanden ist. Wenn ein verarbeitetes Bild einen oder vier Kanäle enthält, konvertieren Sie die Quelldatei in 8-Bit-RGB und führen Sie die Vorverarbeitung erneut aus. Wenn doppelte Kennungen über Teildatensätze hinweg auftreten, erstellen Sie alle Teildatensatz-Manifeste vor dem Training neu.
3. Analyse der visuellen Komponenten und Erstellung von Wahrscheinlichkeitskarten mit beschränktem Vordergrund
- Führen Sie python tools/parse_components.py --config configs/protocol.yaml aus.
- Laden Sie den vortrainierten HRNet-W48-Kleidungs-Semantik-Parsing-Checkpoint aus parser_checkpoint. Überprüfen Sie, ob der Checkpoint die von der Datensatzannotation definierten Kleidungskomponenten-Kategorien ausgibt. Schalten Sie das semantische Parsing-Netzwerk in den Evaluierungsmodus und deaktivieren Sie die Gradientenberechnung.
- Lesen Sie die verarbeiteten Bilder nacheinander aus train_manifest.csv, validation_manifest.csv und test_manifest.csv ein.
- Extrahieren Sie einen siebenkanaligen semantischen Antworttensor aus jedem Eingabebild und setzen Sie K im gesamten Workflow auf sieben. Verwenden Sie die feste Kategorienreihenfolge Oberer Abschlussbereich, Halsausschnittbereich, Oberteilbereich, linker unterer Kleidungsbereich, rechter unterer Kleidungsbereich, mittlerer unterer Kleidungsbereich und Saumbereich. Bewahren Sie diese Reihenfolge in Wahrscheinlichkeitskarten, Komponentenmatrizen, Graphmatrizen, Merkmalenmatrizen, Manifesten und Visualisierungsdateien bei.
- Wenden Sie Softmax entlang der Kanaldimension an, um die semantische Komponenten-Wahrscheinlichkeitskarte P zu erzeugen. Überprüfen Sie, ob die Wahrscheinlichkeiten über alle K Kanäle hinweg an jedem Pixel innerhalb einer Toleranz von 0,0001 die Summe eins ergeben.
- Laden Sie die Vordergrundmaske des Kleidungsstücks aus der Datensatzannotation und richten Sie sie mit dem 512 × 512 verarbeiteten Bild aus. Setzen Sie die Wahrscheinlichkeit jeder Komponente außerhalb der Vordergrundmaske auf null. Normalisieren Sie die Komponentenwahrscheinlichkeiten innerhalb der Vordergrundmaske entlang der Kanaldimension erneut.
- Stellen Sie sicher, dass jeder aktive Komponentenbereich innerhalb der Vordergrundmaske des Kleidungsstücks bleibt. Weisen Sie die geparste Probe zurück, wenn ein farbiger Komponentenbereich in die umgebende Wand, den Boden, den Vorhang oder andere Hintergrundbereiche hineinreicht. Notieren Sie die Kennung des abgelehnten Bildes und den Parsedatenfehler in parsing_quality_log.csv.
- Berechnen Sie das Vordergrund-Abdeckungsverhältnis für jede Komponente und markieren Sie Komponenten mit fragmentierten Bereichen oder nicht unterstützten isolierten Flächen zur manuellen Überprüfung.
- Speichern Sie den semantischen Antworttensor in parser_outputs/logits. Speichern Sie die Wahrscheinlichkeitskarte in parser_outputs/probability_maps. Speichern Sie eine farbkodierte Komponentenvorschau in parser_outputs/previews.
- Erwartete Ausgabe: Bestätigen Sie, dass jedes akzeptierte Bild eine siebenkanalige, auf den Vordergrund beschränkte Wahrscheinlichkeitskarte mit einer räumlichen Größe von 512 × 512 Pixeln, einen siebenkanaligen semantischen Antworttensor und ein Vorschaubild erzeugt. Bestätigen Sie, dass die Kanalindizes eins bis sieben der festgelegten Komponentenreihenfolge aus Schritt 3.4 folgen. Bestätigen Sie, dass alle farbigen Komponentenbereiche innerhalb der Vordergrundmaske des Kleidungsstücks liegen und Hintergrundpixel die Komponentenwahrscheinlichkeit null aufweisen. Bestätigen Sie, dass die Dateikennung mit dem entsprechenden Eintrag im Quellmanifest übereinstimmt.
ANMERKUNG: Behalten Sie kontinuierliche Komponentenwahrscheinlichkeiten innerhalb der Vordergrundmaske während der strukturellen Modellierung bei. Behandeln Sie die resultierenden Bereiche als visuelle Analysebereiche. Interpretieren Sie deren Grenzen nicht als Nähte, Schnittkanten, Konturen von Schnittteilen, Abnäher, Markierungen oder Größenstaffelungsreferenzen.
FEHLERBEHEBUNG: Wenn alle Kanäle nahezu gleichmäßige Wahrscheinlichkeiten aufweisen, überprüfen Sie parser_checkpoint, die Reihenfolge der RGB-Kanäle und die Bildnormalisierung. Wenn eine Komponente in einer gesamten Teilmenge fehlt, vergleichen Sie den Annotationsindex mit dem Kanalindex der Parserausgabe. Wenn Komponentenfarben in den Hintergrund hineinreichen, überprüfen Sie die Ausrichtung der Vordergrundmaske, die Interpolationsparameter und die Koordinaten der Annotation vor der Graphkonstruktion. Wenn ein visueller Bereich mehrere nicht zusammenhängende Kleidungsbereiche umfasst, kennzeichnen Sie die Probe als Parsing-Fehler und schließen Sie sie von der Generierung struktureller Vorgaben aus. Wenn sich die Kanalwahrscheinlichkeiten nicht zu eins summieren, wenden Sie Softmax entlang der Kanaldimension anstatt entlang einer der räumlichen Dimensionen an. Wenn eine Ausgabedatei fehlt, suchen Sie die letzte verarbeitete Kennung im Parser-Protokoll und setzen Sie das Parsing mit der nächsten Kennung fort.
4. Modellierung der Geometrie und räumlichen Beziehungen auf Ebene von Bilddaten
- Laden Sie den Tensor der flachen visuellen Merkmale und die entsprechende Wahrscheinlichkeitskarte P für jedes Bild.
- Multiplizieren Sie jeden räumlichen Merkmalsvektor mit der Wahrscheinlichkeit, die der entsprechenden semantischen Komponente zugewiesen ist.
- Summieren Sie die gewichteten Merkmalsvektoren über die räumlichen Dimensionen und dividieren Sie die Summe durch die gesamte Wahrscheinlichkeitsmasse der Komponente.
- Weisen Sie jeder Komponente mit einer Wahrscheinlichkeitsmasse von null einen Nullvektor und einen Inaktivknoten-Indikator zu.
- Wenden Sie L2-Normalisierung auf jedes aktive Komponenten-Embedding an und stapeln Sie die Embeddings gemäß der festgelegten Reihenfolge der semantischen Komponenten.
- Berechnen Sie die horizontalen und vertikalen Bildebenen-Mittelpunktkoordinaten jeder visuellen Komponente aus ihrer vordergrundbeschränkten Wahrscheinlichkeitsverteilung. Normalisieren Sie die Koordinaten durch Bildbreite und Bildhöhe.
- Berechnen Sie die horizontale und vertikale Ausdehnung jeder visuellen Komponente im selben normalisierten Koordinatensystem. Verwenden Sie diese Werte ausschließlich zur Beschreibung des sichtbaren Bereichsumfangs im verarbeiteten Bild.
- Erstellen Sie sieben Graphknoten gemäß der festgelegten Komponentenreihenfolge und behalten Sie inaktive Komponenten als Nullknoten bei. Konstruieren Sie eine 7 × 7-Matrix für gemeinsame Grenzen mithilfe des Acht-Nachbarn-Kontakts zwischen den Vordergrund-Komponentenmasken. Konstruieren Sie eine 7 × 7-Matrix für die vertikale Anordnung mithilfe der festgelegten Beziehungen von der oberen Zierleiste zur Halsausschnittregion, von der Halsausschnittregion zur Oberteilregion, von der Oberteilregion zu jeder Unterteilregion und von jeder Unterteilregion zur Saumregion. Speichern Sie jede gültige Beziehung in beiden Richtungen.
- Fügen Sie vor der Graphfaltung eine Selbstschleife für jeden aktiven Knoten hinzu und halten Sie Beziehungen, die mit inaktiven Knoten verbunden sind, auf null.
- Berechnen Sie die relative Mittelpunktsverschiebung und die relative räumliche Streuung zwischen jedem geordneten Paar semantischer Komponenten. Stapeln Sie die paarweisen geometrischen Werte, um den geometrischen Beziehungstensor zu bilden.
- Berechnen Sie das Skalarprodukt zwischen jedem Paar normalisierter Komponenten-Embeddings. Wenden Sie eine zeilenweise Softmax-Funktion auf die resultierende Ähnlichkeitsmatrix an und verwenden Sie die Werte als Beziehungsgewichte.
- Multiplizieren Sie den geometrischen Beziehungstensor mit den entsprechenden Beziehungsgewichten und aggregieren Sie die gewichteten Beziehungen für jede Komponente.
- Speichern Sie die Komponenten-Embedding-Matrix, die Komponenten-Mittelpunkt-Matrix, die räumliche Streuungsmatrix, die gemeinsame Grenzmatrix, die vertikale Anordnungsmatrix, die Selbstschleifenmatrix, die Beziehungsgewichtsmatrix, die Inaktivknotenmaske, die Komponenten-Beschriftungszuordnung und die strukturelle Prior-Darstellung in structural_priors. Speichern Sie jede Matrix mit sieben Zeilen und sieben Spalten, wo zutreffend. Der vollständige Konstruktionsprozess von der vordergrundbeschränkten Komponentenkarte zur bildweiten Topologie-Prior der Bekleidungskomponenten ist in Abbildung 2 dargestellt.
- Generieren Sie die Komponenten-Graph-Überlagerung für jede Visualisierungsprobe aus der vordergrundbeschränkten Wahrscheinlichkeitskarte, der Komponenten-Mittelpunkt-Matrix, der typisierten Adjazenzmatrix, der Inaktivknotenmaske und der Komponenten-Beschriftungszuordnung.
- Platzieren Sie jeden aktiven Knoten im entsprechenden Komponentenmittelpunkt. Zeichnen Sie durchgezogene Kanten für gemeinsame Vordergrundgrenzen und gestrichelte Kanten für vordefinierte vertikale Anordnungsbeziehungen.
- Speichern Sie jede Graph-Überlagerung im Ordner structural_priors/visualizations unter Verwendung der Quellbildkennung. Notieren Sie den Pfad des Quellbilds, den Pfad der Wahrscheinlichkeitskarte, den Pfad des Komponentenmittelpunkts, den Pfad der typisierten Adjazenz, den Pfad der Inaktivknotenmaske, die Kennung des semantischen Parsing-Prüfpunkts und den Pfad der Graph-Überlagerung in der Datei component_graph_visualization_manifest.csv.
- Erwartete Ausgabe: Stellen Sie sicher, dass jedes Bild eine Komponenten-Embedding-Matrix mit K Zeilen, eine typisierte Adjazenzmatrix mit K Zeilen und K Spalten, eine Beziehungsgewichtsmatrix mit K Zeilen und K Spalten, eine Inaktivknotenmaske mit K Werten sowie eine bildweite strukturelle Prior-Darstellung erzeugt. Stellen Sie sicher, dass jede ausgewählte Visualisierungsprobe eine Komponenten-Graph-Überlagerung erzeugt, bei der sich aktive Knoten innerhalb der entsprechenden Bekleidungsregionen befinden.
HINWEIS: Behalten Sie dieselbe Reihenfolge der visuellen Komponenten in allen Matrizen, Manifesten, Graphen, Merkmalsdateien und Graph-Überlagerungen bei. Behandeln Sie Komponentenmittelpunkte, Werte der räumlichen Ausdehnung und Graphbeziehungen als Beschreiber von Bekleidungsregionen in der Bildfläche. Interpretieren Sie den Komponentengraphen nicht als menschliches Haltungsgerüst und leiten Sie seine Knoten nicht aus anatomischen Gelenkkoordinaten ab. Konvertieren Sie diese Beschreiber nicht in Nähtlängen, Krümmungsradien, Abnähermenge, Positionen von Markierungsschnitten, Faserrichtungen, Größenstaffelungszuwächse oder Schnittteilmassen.
FEHLERBEHEBUNG: Falls eine Matrix einen nicht-numerischen Wert enthält, überprüfen Sie den Nenner der Wahrscheinlichkeitsmasse und die Normalisierung der Koordinaten. Falls sich die Beziehungsgewichte auf eine einzige Komponente konzentrieren, subtrahieren Sie vor der Softmax-Funktion das Zeilenmaximum von der Ähnlichkeitsmatrix. Falls die Anzahl der Graphknoten zwischen den Bildern variiert, überprüfen Sie, ob inaktive Komponenten als Nullvektoren erhalten bleiben und nicht entfernt werden.
5. Strukturabhängige Merkmalscodierung mit zwei Datenströmen
- Laden Sie die auf ImageNet vortrainierten ResNet-50-Gewichte und entfernen Sie die abschließenden Pooling- und Klassifizierungsschichten.
- Leiten Sie jedes normalisierte Bekleidungsbild durch ResNet-50 und extrahieren Sie den Erscheinungstensor aus der durch appearance_stage in configs/protocol.yaml festgelegten Backbone-Stufe. Überprüfen Sie den Stufennamen, die Anzahl der Ausgangskanäle und die räumlichen Ausgangsdimensionen, die von der ausgewählten Backbone-Stufe für ein Eingangsbild von 512 x 512 Pixeln erzeugt werden. Verwenden Sie dieselbe Stufe bei jedem Training, bei jeder Inferenz, jeder Ablationsstudie und jedem Vergleich.
- Ändern Sie die Größe der semantischen Wahrscheinlichkeitskarte auf die räumliche Größe des Erscheinungstensors durch bilineare Interpolation. Multiplizieren Sie den Erscheinungstensor mit jeder umgrößerten Komponenten-Wahrscheinlichkeitskarte und aggregieren Sie anschließend die gewichteten Antworten über die räumlichen Dimensionen.
- Leiten Sie jedes Erscheinungsembettung der Komponenten durch die in configs/protocol.yaml definierte Kanal-Nachkalibrierungsschicht. Notieren Sie den Schichttyp, die Eingangsdimension, die Ausgangsdimension, das Reduktionsverhältnis, die Aktivierungsfunktion und die Regel zur Parameterfreigabe. Stapeln Sie die resultierenden sieben Komponentenvektoren in der festgelegten semantischen Reihenfolge, um die Erscheinungsmerkmal-Matrix zu bilden.
- Leiten Sie jeden geometrischen Beziehungsvektor durch die strukturelle Projektionsschicht und setzen Sie die Ausgangsdimension auf 512. Erstellen Sie den Komponentengraphen mit der Relations-Gewichtungsmatrix und der Maske für inaktive Knoten.
- Wenden Sie zwei graphenförmige Faltungsschichten mit einer Eingangsdimension von 512 und einer Ausgangsdimension von 512 an. Wenden Sie nach jeder graphenförmigen Faltungsschicht Batch-Normalisierung und anschließend LeakyReLU an. Notieren Sie den von LeakyReLU verwendeten Negativ-Steigungswert. Wenden Sie nach jeder Schicht die Maske für inaktive Knoten an, um Nullmerkmale für inaktive Komponenten beizubehalten.
- Wenden Sie die semantische Ausrichtung mit den normalisierten Komponentenembettungen an und stapeln Sie die resultierenden Vektoren, um die strukturelle Merkmal-Matrix zu bilden.
- Erwartete Ausgabe: Stellen Sie sicher, dass jedes Bild eine Erscheinungsmerkmal-Matrix und eine strukturelle Merkmal-Matrix erzeugt. Bestätigen Sie, dass beide Matrizen K Zeilen und 512 Spalten enthalten.
HINWEIS: Behalten Sie inaktive Komponenten als Nullvektoren bei und bewahren Sie die Reihenfolge der Komponenten, die während der Konstruktion des strukturellen Priors festgelegt wurde.
FEHLERBEHEBUNG: Falls die beiden Merkmal-Matrizen unterschiedliche Zeilenzahlen aufweisen, überprüfen Sie die Zuordnung der semantischen Kategorien und die Behandlung inaktiver Knoten. Falls bei der Matrixmultiplikation ein Dimensionsfehler gemeldet wird, überprüfen Sie, ob die Ausgangsdimension der strukturellen Projektion und die Dimensionen der Erscheinungskanäle beide 512 betragen. Falls die strukturellen Merkmale für alle aktiven Komponenten Null bleiben, überprüfen Sie, ob die Graphkanten und Relationsgewichte dem aktuellen Batch hinzugefügt wurden.
6. Strukturgeleitete Merkmalsfusion
- Wenden Sie die strukturgeführte Merkmalsfusion gemäß Abbildung 3 an. Leiten Sie die strukturelle Merkmalsmatrix durch die Fusion-Gewichtungsschicht und wenden Sie die Aktivierungsfunktion an, die in configs/protocol.yaml unter fusion_activation festgelegt ist. Notieren Sie den Namen der Aktivierungsfunktion, die Eingabedimension, die Ausgabedimension sowie die Angabe, ob Parameter über die sieben Komponenten-Knoten hinweg geteilt werden.
- Stellen Sie sicher, dass die generierte strukturelle Gewichtungsmatrix K Zeilen und 512 Spalten enthält.
- Multiplizieren Sie die Erscheinungsmerkmalsmatrix elementweise mit der strukturellen Gewichtungsmatrix.
- Konkatenieren Sie die modulierte Erscheinungsmatrix und die strukturelle Merkmalsmatrix entlang der Kanaldimension.
- Konkatenieren Sie für jede Komponente den 512-dimensionalen modulierten Erscheinungsvektor und den 512-dimensionalen strukturellen Vektor, um einen 1024-dimensionalen Vektor zu bilden. Leiten Sie den konkatenierten Vektor durch die Fusion-Projektionsschicht und reduzieren Sie seine Dimension von 1024 auf 512.
- Addieren Sie die ursprüngliche strukturelle Merkmalsmatrix zur projizierten Matrix über eine Residualverbindung.
- Stapeln Sie die fusionierten Komponentenvektoren in fester semantischer Reihenfolge und wenden Sie L2-Normalisierung auf die abgeflachte strukturbewusste Darstellung an.
- Speichern Sie die strukturelle Gewichtungsmatrix, die modulierte Erscheinungsmatrix, die fusionierte Komponentenmatrix und die endgültige strukturbewusste Darstellung in feature_outputs.
- Erwartete Ausgabe: Stellen Sie sicher, dass jedes Bild genau eine fusionierte Komponentenmatrix mit K Zeilen und 512 Spalten sowie einen normalisierten strukturbewussten Merkmalsvektor erzeugt, der mit der Quellbild-ID verknüpft ist.
HINWEIS: Behalten Sie die strukturelle Gewichtungsmatrix und die fusionierte Komponentenmatrix zur Visualisierung der Antwort und zur Analyse lokaler Unterschiede bei.
FEHLERBEHEBUNG: Wenn die fusionierten Werte weiter ansteigen, überprüfen Sie die Ausgabe der Aktivierungsfunktion und die Normalisierungsschicht. Wenn alle strukturellen Gewichte gegen denselben Wert konvergieren, stellen Sie sicher, dass sich die strukturellen Merkmale zwischen den Bildern unterscheiden und dass die Fusionsschicht Gradienten erhält. Falls Merkmalsdateien und Bild-IDs nicht übereinstimmen, erstellen Sie das Ausgabemanifest vor dem Training oder der Retrieval-Auswertung erneut.
7. Modelltraining und Konsistenzoptimierung
- Laden Sie die fünf zufälligen Startwerte aus configs/seeds.yaml. Legen Sie für jeden Durchlauf denselben Zufallsstartwert für Python, NumPy, PyTorch-CPU-Operationen und alle CUDA-Geräte fest. Aktivieren Sie deterministische Algorithmen, deaktivieren Sie den cuDNN-Benchmark-Modus und protokollieren Sie die exakten fünf Startwerte im entsprechenden Ausführungsverzeichnis.
- Laden Sie das verarbeitete Trainingsmanifest, das Paarmanifest, die Wahrscheinlichkeitskarten und die strukturellen Priors.
- Stellen Sie jeden Trainingsbatch aus acht strukturellen Kategorien zusammen, wobei jeweils vier erscheinungsvariable Proben aus jeder Kategorie enthalten sind.
- Berechnen Sie den strukturellen Konsistenzverlust anhand von positiven Stichprobenpaaren, die denselben strukturellen Prior teilen.
- Berechnen Sie den strukturellen Beziehungskonsistenzverlust anhand der paarweisen Abstände zwischen den Komponentenmerkmalen.
- Berechnen Sie den strukturellen Diskriminierungsverlust anhand von negativen Stichprobenpaaren mit heterogenen Strukturen und wenden Sie den Trennschwellenwert von 0,3 an.
- Kombinieren Sie das Erscheinungsziel, das strukturelle Konsistenzziel, das strukturelle Beziehungsziel und das strukturelle Diskriminierungsziel mit den in configs/protocol.yaml gespeicherten Gewichtungen. Der durch die drei strukturellen Ziele gesteuerte Optimierungsprozess im Merkmalsraum ist in Abbildung 4 dargestellt.
- Führen Sie python train.py --config configs/protocol.yaml aus. Aktualisieren Sie alle trainierbaren Parameter mittels Mini-Batch-Stochastic-Gradient-Descent unter Verwendung der in Schritt 1.8 definierten Anfangslernrate, des Impulses, der Gewichtsreduzierung, der Epochenanzahl, des Abnahmefaktors und der Abnahmeepochen. Protokollieren Sie die Lernrate nach jeder Epoche im Trainingsprotokoll.
- Protokollieren Sie nach jeder Epoche den Gesamtverlust, den Erscheinungsverlust, den strukturellen Konsistenzverlust, den strukturellen Beziehungsverlust, den strukturellen Diskriminierungsverlust, die Lernrate, den Structural Consistency Index (SCI), den Structural Discrimination Index (SDI) und Recall@5.
- Bewerten Sie das Modell nach jeder Epoche anhand von validation_manifest.csv. Speichern Sie den Checkpoint mit dem höchsten Validierungs-SCI in checkpoints/selected_model.pth.
- Wiederholen Sie das Training fünfmal mit den fünf aufgezeichneten Zufallsstartwerten. Speichern Sie jede Konfigurationsdatei, jedes Trainingsprotokoll und jeden ausgewählten Checkpoint in einem separaten Ausführungsverzeichnis.
- Erwartete Ausgabe: Stellen Sie sicher, dass jeder Durchlauf ein Trainingsprotokoll, ein Validierungsprotokoll, eine metrische Datei auf Epochen-Ebene und einen ausgewählten Checkpoint erzeugt. Stellen Sie sicher, dass der ausgewählte Checkpoint auf der Validierungsleistung und nicht auf der Testleistung basiert.
HINWEIS: Verwenden Sie bei jedem Modellvergleich und jeder Ablationsexperimentierung dieselben Trainings-, Validierungs- und Testmanifeste.
FEHLERBEHEBUNG: Wenn ein Verlust nicht-numerisch wird, stoppen Sie das Training, überprüfen Sie die Komponenten-Wahrscheinlichkeitsmassen, reduzieren Sie die Lernrate um den Faktor 10 und starten Sie erneut vom letzten gültigen Checkpoint. Wenn der Validierungs-SCI unverändert bleibt, während der Trainingsverlust abnimmt, überprüfen Sie, ob die Parameter für Graph-Propagation und Fusion Gradienten erhalten. Wenn der Grafikspeicher erschöpft ist, reduzieren Sie die Batchgröße und bewahren Sie eine effektive Batchgröße von 32 durch Gradientenakkumulation. Wenn sich die Validierungsleistung zwischen den Durchläufen stark ändert, überprüfen Sie den aufgezeichneten Zufallsstartwert und die Reihenfolge des Datenmanifests.
8. Inferenz, Rückgewinnung, Clusterung und Ausgabeverifikation
- Führen Sie python infer.py --config configs/protocol.yaml --checkpoint checkpoints/selected_model.pth aus. Generieren Sie Wahrscheinlichkeitskarten, strukturelle Priors, Erscheinungsmerkmal-Matrizen, strukturelle Merkmal-Matrizen, fusionierte Komponenten-Matrizen und finale Merkmalsvektoren für jedes Testbild.
- Speichern Sie alle Inferenzausgaben unter feature_outputs/test und notieren Sie deren Pfade in test_feature_manifest.csv. Berechnen Sie die Kosinus-Ähnlichkeit zwischen jedem Abfragemerkmal und allen Galeriemerkmalen. Sortieren Sie die Galerie-Identifikatoren in absteigender Ähnlichkeitsreihenfolge. Speichern Sie die fünf am höchsten bewerteten Ergebnisse für jede Abfrage in evaluation_results/retrieval_results.csv.
- Laden Sie für jede zur Visualisierung ausgewählte Abrufstichprobe die typisierte Adjazenzmatrix, die Relationsgewichtungsmatrix, die Komponentenmittelpunkt-Matrix, die Inaktivknotenmaske, die Komponentenlabelzuordnung und die fusionierte Komponentenmatrix des Abfragebilds. Laden Sie dieselben Dateien für das vom strukturbewussten Modell erzeugte bestplatzierte Ergebnis.
- Stellen Sie den Komponentengraphen der Abfrage und den Komponentengraphen des abgerufenen Bildes anhand ihrer gespeicherten Komponentenmittelpunkte und typisierten Adjazenzmatrizen dar. Bewahren Sie die feste Komponentenreihenfolge und die Relationstypen bei, die während der Modellinferenz verwendet wurden.
- Stellen Sie die typisierte Adjazenzmatrix der Abfrage als kategoriale Matrix dar. Verwenden Sie separate Matrixwerte für inaktive, gemeinsame Grenzen und vertikale Ordnungsrelationen. Beschriften Sie die horizontale und vertikale Achse mit den in der Komponentenlabelzuordnung gespeicherten Komponentenidentifikatoren.
- Wenden Sie L2-Normalisierung auf die fusionierte Komponentenmatrix der Abfrage und die fusionierte Komponentenmatrix des abgerufenen Bildes an. Berechnen Sie die Kosinus-Ähnlichkeit zwischen jeder Abfragekomponente und jeder Komponente des abgerufenen Bildes. Speichern Sie die resultierende K × K-Komponenten-Zuordnungsmatrix unter evaluation_results/structural_retrieval_evidence.
- Laden Sie für jedes zur lokalen Differenzanalyse ausgewählte Referenz-Ziel-Paar die typisierte Adjazenzmatrix, die Komponentenmittelpunkt-Matrix, die räumliche Dispersionsmatrix, die Relationsgewichtungsmatrix und die fusionierte Komponentenmatrix beider Bilder.
- Berechnen Sie die absolute Differenz zwischen den beiden typisierten Adjazenzmatrizen. Berechnen Sie die absoluten Differenzen in der Verschiebung der Komponentenmittelpunkte, der räumlichen Dispersion und der Relationsgewichte unter Verwendung der festen Komponentenreihenfolge. Speichern Sie die resultierende Topologie-Differenzmatrix und die Geometrie-Relations-Differenzmatrix unter evaluation_results/structural_difference_evidence.
- Berechnen Sie den L2-Abstand zwischen den entsprechenden Zeilen der beiden fusionierten Komponentenmatrizen. Normalisieren Sie die komponentenbasierten Abstände und weisen Sie sie den Knoten des Zielkomponentengraphen zu. Erhöhen Sie die Kantendicke entsprechend der normalisierten Differenz im Relationsgewicht. Speichern Sie den resultierenden Post-Fusion-Komponenten-Differenzgraphen.
- Notieren Sie die Bildidentifikatoren, Matrixpfade, Graphpfade, Komponentenreihenfolge, Checkpoint-Identifikator und Visualisierungsausgabepfade in structural_visualization_manifest.csv. Generieren Sie alle strukturellen Visualisierungen programmatisch aus den aufgezeichneten Dateien; fügen Sie keine Graphknoten, Graphkanten oder Matrixwerte manuell hinzu.
- Wenden Sie K-Means mit fünf Clustern auf die finalen Merkmalsvektoren an und speichern Sie die Clusterzuweisungen in evaluation_results/cluster_assignments.csv. Führen Sie python evaluate.py --config configs/protocol.yaml --feature_dir feature_outputs/test aus.
- Berechnen Sie SCI, SDI, Recall@5, mittlere durchschnittliche Präzision (mAP) und den Silhouettenkoeffizienten für jeden Durchlauf. Verwenden Sie SCI zur Beurteilung der Kompaktheit normalisierter Merkmale mit gleichem strukturellem Label und SDI zur Beurteilung der Trennung zwischen verschiedenen strukturellen Labels. Verwenden Sie Recall@5, um zu prüfen, ob eine relevante strukturelle Übereinstimmung in der kurzen Abrufliste erscheint, und mAP zur Beurteilung der Rangqualität über die gesamte Galerie. Verwenden Sie den Silhouettenkoeffizienten ausschließlich für die Clusteranalyse.
- Berechnen Sie das arithmetische Mittel und die Stichprobenstandardabweichung über fünf unabhängige Durchläufe. Behalten Sie die fünf durchlaufbasierten Werte für jede Methode und Metrik bei. Wenden Sie keine Min-Max-Normalisierung, Rangnormalisierung oder Umrechnung basierend auf den zu vergleichenden Methoden an. Führen Sie einen gepaarten t-Test mit Ergebnissen durch, die unter demselben Zufallsstartwert erzielt wurden, und notieren Sie die Teststatistik und den exakten zweiseitigen Signifikanzwert.
- Vergleichen Sie die Anzahl der verarbeiteten Testidentifikatoren, Merkmalsdateien, Abrufdatensätze und Clusterzuweisungen. Beheben Sie alle Unstimmigkeiten, bevor Sie die Evaluierungsergebnisse berichten oder interpretieren.
- Erwartete Ausgabe: Stellen Sie sicher, dass jedes Testbild einen vollständigen Inferenzdatensatz, eine Abrufliste, eine Clusterzuweisung und einen Satz Evaluierungseingaben besitzt. Stellen Sie sicher, dass jeder zur Visualisierung ausgewählte Abrufvorgang einen Abfragekomponentengraphen, einen Komponentengraphen des abgerufenen Bildes, eine typisierte Adjazenzmatrix und eine Korrespondenzmatrix der fusionierten Komponenten aufweist.
- Stellen Sie sicher, dass jeder strukturelle Differenzfall eine Topologie-Differenzmatrix, eine Geometrie-Relations-Differenzmatrix, einen Post-Fusion-Komponenten-Differenzgraphen, eine räumliche Differenz-Heatmap und eine Antwortüberlagerung besitzt. Stellen Sie sicher, dass alle Visualisierungsdateien über structural_visualization_manifest.csv mit ihren Quellmatrizen verknüpft sind. Speichern Sie die reine Heatmap, die Zielbildüberlagerung, die Vordergrundmaske und die Koordinaten des Bereichs mit der höchsten Antwort für jeden visualisierten Fall.
- Akzeptieren Sie eine berechnete Differenzantwort nur, wenn der dominante Bereich mit hoher Antwort mit dem Bekleidungsvordergrund überlappt und durch die entsprechende Änderung in der typisierten Adjazenz, der geometrischen Relationsänderung und dem Post-Fusion-Komponentenabstand gestützt wird. Wenn die stärkste Antwort hauptsächlich außerhalb des Bekleidungsvordergrunds liegt, überprüfen Sie die Parsing-Ausgabe, den Komponentengraphen und den Fusionseintrag.
HINWEIS: Verwenden Sie den aus dem Validierungsset ausgewählten Checkpoint für die Inferenz auf dem Testset. Wählen oder ersetze Sie keinen Checkpoint basierend auf Testset-Metriken. Verwenden Sie dieselbe Komponentenreihenfolge, Inaktivknotenregel, Kodierung der Relationstypen und Normalisierungsprozesse beim Generieren von Graphen und Matrizen während Inferenz und Visualisierung.
FEHLERBEHEBUNG: Wenn die Inferenz stoppt, bevor alle Testbilder verarbeitet wurden, suchen Sie den letzten Identifikator im Inferenzprotokoll und setzen Sie ab dem folgenden Identifikator fort. Wenn die Abrufergebnisse von Farbähnlichkeit dominiert werden, überprüfen Sie die strukturellen Priors und Fusionsausgaben und stellen Sie sicher, dass das Laden des Checkpoints erfolgreich war. Wenn die Evaluierung doppelte Identifikatoren meldet, erstellen Sie test_feature_manifest.csv neu und entfernen Sie doppelte Einträge vor der Neuberechnung. Wenn K-Means einen leeren Cluster erzeugt, überprüfen Sie die Merkmalsnormalisierung und führen Sie das Clustering mit dem aufgezeichneten Zufallsstartwert erneut durch.
9. Vergleichende Modellbewertung
- Führen Sie python compare_models.py --config configs/protocol.yaml aus.
- Trainieren und evaluieren Sie ResNet-50, Part-based Convolutional Baseline (PCB), GCN, FashionGraph, Swin Transformer, CLIP, Topology Feature Histogram mit Farb- und Texturfusion, Attention-Guided Cascade Network, MMFL-Net, FARE-RNET und die vorgeschlagene Methode mit denselben Trainings-, Validierungs- und Testmanifesten.
- Verwenden Sie für jede Methode dieselbe Bildgröße, dieselben Vorverarbeitungsschritte, Trainingsepochen, effektive Batch-Größe, Evaluierungsanfragen und Metrikimplementierung.
- Behalten Sie für ResNet-50 den globalen Durchschnittspooling bei. Wenden Sie bei PCB die horizontale Streifenausrichtung an. Verwenden Sie bei GCN einen festen bildweiten Bekleidungsgraphen. Wenden Sie bei FashionGraph die attributgesteuerte dynamische Graphinferenz an. Nutzen Sie die Standard-Bildencoder von Swin Transformer und CLIP. Implementieren Sie das Topology Feature Histogram mit Farb- und Texturfusion unter Verwendung von Topologie-, Farb- und Texturdeskriptoren. Implementieren Sie ein Attention-Guided Cascade Network unter Verwendung von globalen und lokalen Merkmalszweigen mit Bekleidungssegmentierung. Implementieren Sie MMFL-Net unter Verwendung von mehrskaligen und mehrgranularen Merkmalszweigen. Implementieren Sie FARE-RNET unter Verwendung von residueller Aufmerksamkeit, Merkmalsauswahl und dilatierter kontextueller Kodierung.
- Verwenden Sie nur den Bild-Anfrage-Zweig jeder Vergleichsmethode. Trainieren Sie jede trainierbare Methode erneut auf dem gemeinsamen Trainingsmanifest und wählen Sie den jeweiligen Checkpoint aus dem gemeinsamen Validierungsmanifest aus. Generieren Sie für jede Testanfrage eine ranggeordnete Galerieliste.
- Projizieren Sie jedes gelernte Embedding mithilfe einer registrierten trainierbaren linearen Schicht auf 512 Dimensionen, falls die ursprüngliche Dimension davon abweicht. Wenden Sie L2-Normalisierung vor der Rangfolge nach Kosinusähnlichkeit an. Verwenden Sie für alle Methoden dieselbe Zuweisung von Anfrage und Galerie sowie dieselbe Metrikimplementierung.
- Wiederholen Sie jede Vergleichsmethode mit denselben fünf zufälligen Startwerten. Geben Sie den Mittelwert und die Stichprobenstandardabweichung von SCI, SDI, Recall@5, mAP und Silhouettenkoeffizient an. Führen Sie für jede Metrik einen zweiseitigen gepaarten t-Test zwischen der vorgeschlagenen Methode und jeder Vergleichsmethode durch, wobei die Ergebnisse unter demselben zufälligen Startwert verwendet werden. Tragen Sie die fünf wertebasierten Laufzeiten, Teststatistik, Freiheitsgrade und exakten p-Werte in evaluation_results/comparison_metrics.csv ein.
- Berechnen Sie SCI, SDI, Recall@5, mAP und den Silhouettenkoeffizienten für jede Methode. Speichern Sie alle wertebasierten und aggregierten Werte in evaluation_results/comparison_metrics.csv.
- Erwartete Ausgabe: Stellen Sie sicher, dass comparison_metrics.csv dieselben Metrikfelder und dieselbe Anzahl unabhängiger Durchläufe für jede Vergleichsmethode enthält.
HINWEIS: Ändern Sie nicht die Datenaufteilungen, den Metrikcode oder die Zuweisung von Anfrage und Galerie zwischen den Vergleichsmethoden.
FEHLERBEHEBUNG: Falls ein Vergleichsmodell eine Merkmalsdimension liefert, die von 512 abweicht, fügen Sie eine einzelne registrierte lineare Projektionsschicht vor der Metrikberechnung hinzu und trainieren Sie diese Schicht zusammen mit dem entsprechenden Modell. Falls ein Modell bei der gemeinsamen Lernrate nicht konvergiert, verwenden Sie die Lernrate gemäß der veröffentlichten Implementierung und behalten Sie alle übrigen experimentellen Bedingungen bei. Dokumentieren Sie jede methode-spezifische Einstellung im Vergleichsprotokoll.
Ergebnisse
Alle beschriebenen Experimente wurden mithilfe der in Tabelle 2 und der Materialtabelle dokumentierten Hardware- und Softwareumgebung durchgeführt. Derselbe Grafiktreiber sowie dieselben Versionen von CUDA, cuDNN, Python, NumPy, PyTorch und torchvision wurden während der gesamten Vorverarbeitung, des Trainings, der Inferenz und der Auswertung verwendet. Die vollständige Hardware- und Softwareumgebung ist in Tabelle 2 und der Materialtabelle zusammengefasst. Tabelle 1 fasst die verarbeiteten Trainings-, Validierungs- und Testdatensätze zusammen, ergänzt um statistische Angaben zur Bild-Topologie. Tabelle 2 fasst die gemeinsame Konfiguration zusammen, die für alle Vergleichsmethoden verwendet wurde.
Ergebnisse der vergleichenden Bewertung
Die vergleichende Bewertung folgte den gemeinsamen Datenaufteilungen, Vorverarbeitungsschritten, Trainingskontrollen und Metrikdefinitionen, die in den Protokollabschnitten 7–9 festgelegt sind. Tabelle 3 vergleicht allgemeine visuelle Encoder, teilweise ausgerichtete Modelle, graphenbasierte Bekleidungsdarstellungen, cross-domänen Modeabrufnetzwerke, Methoden zur Fusion von Topologie und Erscheinungsbild sowie Methoden für den visuellen Abruf im E-Commerce, alle bewertet mit demselben Bildabfrageprotokoll. Die domänenspezifischen Methoden umfassen das Topology Feature Histogram mit Color and Texture Fusion (TFH-CT), das Attention-Guided Cascade Network (AGC-Net), das Multi-scale and Multi-granularity Feature Learning Network (MMFL-Net) und Fashion Retrieval using Residual Network with Egret Swarm Optimization (FARE-RNET). Alle Bewertungsmetriken in Tabelle 3 werden als Mittelwert und Stichprobenstandardabweichung über fünf unabhängige Durchläufe hinweg angegeben, wobei dieselben Zufallsseeds, Trainingsmanifeste, Validierungsmanifeste, Testmanifeste, Query-Gallery-Zuordnungen und Metrikimplementierungen verwendet wurden. Die gepaarten p-Werte wurden separat für SCI, SDI, Recall@5, mAP und den Silhouettenkoeffizienten berechnet, indem jede Methode unter identischen Bedingungen bezüglich der Zufallsseeds mit der vorgeschlagenen Methode verglichen wurde. Diese Ergebnisse liefern die quantitative Grundlage für die anschließenden strukturellen Visualisierungen, Abrufe, Clusteranalysen und designorientierten Untersuchungen.
Vertretende Protokollergebnisse und deren Interpretation
Ein erfolgreicher Protokollablauf zeigt sich darin, dass der aus den gespeicherten Parsing- und Graph-Dateien rekonstruierte komponentenbasierte Abbildungsgraph jeden aktiven Knoten innerhalb des entsprechenden Bekleidungsbereichs positioniert und die in der typisierten Adjazenzmatrix erfassten Relationstypen beibehält, wie in Abbildung 5C dargestellt. Die strukturbewusste Antwort sollte weiterhin auf den Vordergrund der Bekleidung konzentriert bleiben, wie in Abbildung 5D gezeigt. Abbildung 6E zeigt ein erwartetes Retrieval-Ergebnis, bei dem die vorgeschlagene Methode den Einfluss des roten Hintergrunds reduziert und Oberkörperbekleidung statt nicht verwandter roter Objekte findet. Abbildung 6B–G verdeutlicht zudem, dass die Retrieval-Rangfolge durch komponentenbasierte Abbildungsrelationen und die Korrespondenz der Komponenten nach der Fusion unterstützt wird. Dieses Ergebnis spiegelt die Wiederherstellung der groben Bekleidungskategorie wider, obwohl die Ärmellänge und die lokale Topologie unter den abgerufenen Beispielen weiterhin variieren.
Zu den häufigen Fehlerfällen gehören die texturbasierte Aktivierung in Abbildung 5B, die durch die Hintergrundfarbe verursachte Abrufung in der oberen Zeile von Abbildung 6 sowie die verbleibende Hintergrundaktivierung in Abbildung 7. Abbildung 7 ist als teilweise Lokalisierung zu interpretieren, da die dominante Reaktion der vergrößerten Silhouette des Unterkörpers und der rechten Kleidungsgrenze folgt, während eine Restaktivierung in benachbarten Hintergrundbereichen verbleibt. Die Lokalisierung wird nur dann als strukturell gestützt angesehen, wenn die Topologie-Differenz-Matrix, die geometrische-Beziehung-Differenz-Matrix, der Post-Fusion-Komponenten-Differenz-Graph und die räumliche Reaktion konsistente Kleidungsbereiche identifizieren. Ein räumlicher Hotspot ohne entsprechende Änderungen in der Matrix oder den Komponenten weist auf visuelle Störungen statt auf strukturelle Belege hin.
Ein Protokolllauf gilt als gültig, wenn jedes akzeptierte Bild eine normalisierte semantische Wahrscheinlichkeitskarte, eine Relationsmatrix mit K Zeilen und K Spalten, Erscheinungs- und Strukturmerkmal-Matrizen mit K Zeilen und 512 Spalten sowie einen endlichen fusionierten Merkmalsvektor erzeugt, der mit der korrekten Bildkennung verknüpft ist. Die visuelle Überprüfung sollte bestätigen, dass die Topologie den Kleidungsstückkomponenten folgt, dass die Antwort im Vordergrund die Antwort im Hintergrund übersteigt und dass die Abrufergebnisse durch die Kategorie und Struktur des Kleidungsstücks und nicht durch die Hintergrundfarbe gesteuert werden. Fragmentierte Wahrscheinlichkeitskarten, fehlende Komponentenknoten, nicht-numerische Matrizen, diffuse Hintergrundantworten oder farbdominierte Abrufe deuten auf eine fehlgeschlagene Ausführung hin und erfordern eine Überprüfung der Segmentierung, Graphkonstruktion, Merkmalsfusion oder des Ladens des Kontrollpunkts.
Visuelle Analyse der Reaktionen von Kleidungsstückkomponenten auf Bildebene
Abbildung 5 vergleicht die ResNet-50-Basislinie mit dem komponentenbewussten Modell unter Verwendung desselben Kleidungsstückbildes. Abbildung 5B zeigt die Klassenaktivierungskarte für die Erscheinungsbasislinie. Abbildung 5C zeigt den auf Bildniveau rekonstruierten Kleidungsstückkomponentengraphen, der aus der vordergrundbeschränkten Wahrscheinlichkeitskarte, der Komponentenmittelpunktmatrix, der typisierten Adjazenzmatrix, der Maske inaktiver Knoten und der Komponentenlabelzuordnung stammt, die in den Protokollabschnitten 3 und 4 generiert wurden. Abbildung 5D zeigt die Aktivierungsantwort der fusionierten Darstellung. Zur Erzeugung von Abbildung 5C wird kein Schätzer der menschlichen Körperhaltung oder Annotation der menschlichen Gelenke verwendet.
Die Basisantwort konzentrierte sich auf lokale Texturbereiche im unteren Kleidungsstück und folgte nicht konsistent der vollständigen Kleidungsgrenze, wie in Abbildung 5B gezeigt. In Abbildung 5C entspricht jeder Knoten dem Zentrum eines aktiven Kleidungskomponentenbereichs, während jede Kante eine gemeinsame Vordergrundgrenze oder eine vordefinierte vertikale Reihenfolgebeziehung darstellt. Der Graph spiegelt die Organisation der Kleidungsbereiche wider und stellt keine menschlichen anatomischen Gelenke dar. Die strukturbewusste Antwort erfasste den Hauptvordergrund des Kleidungsstücks, wobei die Aktivierung in den meisten Hintergrundbereichen niedriger blieb, wie in Abbildung 5D dargestellt. Diese Ergebnisse deuten darauf hin, dass der Komponentengraph und das Merkmalsfusion-Modul die texturbasierte Aktivierung im ausgewerteten Bild verringert haben.
Analysen der strukturellen Ähnlichkeit von Bekleidung und Ergebnisse als Designreferenz
Abbildung 6 zeigt die Abrangliste zusammen mit den strukturellen Belegen, die zur Interpretation herangezogen wurden. Der Abfragekomponentengraph in Abbildung 6B erfasst aktive Bekleidungsbereiche und ihre typisierten Beziehungen, während die Matrix in Abbildung 6C das Beziehungsmuster offenlegt, das der Graphweiterleitung bereitgestellt wird. Die Ergebnisse des Baseline-Verfahrens in Abbildung 6D werden weiterhin von roten Erscheinungsbildmerkmalen dominiert. Die strukturbewussten Ergebnisse in Abbildung 6E bewahren die Oberbekleidungskategorie über verschiedene Farben und Hintergründe hinweg. Der Komponentengraph des am höchsten eingestuften Ergebnisses in Abbildung 6F ermöglicht einen direkten Vergleich mit dem Abfragegraphen, und die Korrespondenzmatrix in Abbildung 6G zeigt auf, ob Komponenten mit denselben Kennungen nach der strukturgesteuerten Fusion weiterhin ausgerichtet bleiben. Die diagonale Korrespondenz sollte gemeinsam mit fehlenden Knoten und veränderten Graphbeziehungen interpretiert werden. Starke Ähnlichkeit im Erscheinungsbild ohne Übereinstimmung der Graphstruktur stellt keine erfolgreiche strukturelle Rückgewinnung dar.
Die abgerufenen Kleidungsstücke behalten die grobe Kategorie bei, doch Unterschiede in der Ärmelkonfiguration und in den lokalen Komponentenbeziehungen deuten auf eine unvollständige feingranulare Übereinstimmung hin. Die vorgeschlagene Methode erreichte einen Recall@5 von 89,2 % und einen mAP-Wert von 86,4 %, wie in Tabelle 3 berichtet. Diese quantitativen Werte beschreiben die Rangfolgeleistung, während Abbildung 6B–G intermediate strukturelle Belege liefert, die die Interpretation unterstützen. Die Schlussfolgerung bezüglich des Abrufs beschränkt sich somit auf eine verbesserte Widerstandsfähigkeit gegenüber Hintergrundfarbinterferenzen und eine stärkere organisationsebene Komponentenstruktur auf Ebene des Bildes unter der getesteten Abfrage.
Unterstützung bei der Analyse struktureller Unterschiedsreaktionen und der Entwurfsanalyse
Die reine Differenz-Antwort-Heatmap in Abbildung 7H zeigt, dass die dominante Antwort auf der vergrößerten unteren Körpersilhouette und der rechten Bekleidungsgrenze des Zielsbildes konzentriert ist. Die Überlagerung in Abbildung 7I zeigt, dass die stärkste Antwort weiterhin mit dem Hauptvordergrund der Bekleidung übereinstimmt, während eine schwächere Aktivierung in den benachbarten Vorhang- und Wandbereichen als residuelle Hintergrundinterferenz verbleibt. Die räumliche Antwort sollte gemeinsam mit den in Abbildungen 7C–G dargestellten Komponentengraphen und Matrixbefunden interpretiert werden. Eine Antwort wird nur dann als gültiger struktureller Unterschied betrachtet, wenn der Bereich mit hoher Antwort mit der Nachbarschaftsänderung, der Änderung der geometrischen Beziehung und dem Komponentenabstandsmuster nach der Fusion übereinstimmt.
Ein struktureller Unterschied wird nur akzeptiert, wenn die geänderte Nachbarschaftsbeziehung in Abbildung 7E oder die geänderte geometrische Relation in Abbildung 7F von einem vergrößerten Abstand der Komponenten in Abbildung 7G und einer vordergrundausgerichteten räumlichen Antwort in Abbildung 7H,I begleitet wird. Der vergrößerte untere Körperteil und die rechte Kleidungsrandlinie erfüllen dieses kriteriumsübergreifende Kriterium. Die Aktivierung über Vorhang und Wand entspricht nicht Änderungen in Komponenten-Knoten, Relationsmustern oder fusionierten Komponentenabständen und wird daher als nicht-strukturelle Restinterferenz abgelehnt. Das Ergebnis unterstützt die Lokalisierung von Unterschieden auf Bildebene, belegt jedoch keine Variation in Nähtechniken oder Konstruktionsparametern.
Räumliche Verteilung der Merkmale und strukturelle Clusteranalyse
Die Analyse der Verteilung des latenten Merkmalsraums zeigt die Fähigkeit des Modells auf, die strukturelle Semantik von Kleidungsstücken zu unterscheiden. Diese Analyse prüft, ob die strukturelle Vorinformation Kleidungsstücke mit unterschiedlichen topologischen Konfigurationen in getrennte Merkmalsmannigfaltigkeiten ordnet. Fünf repräsentative strukturelle Kategorien aus dem Testdatensatz – Oberteile mit kurzen Ärmeln, Hosen, Röcke, lange Mäntel und Kleider – wurden ausgewählt. Die hochdimensionalen Merkmalsvektoren wurden mithilfe der t-verteilten stochastischen Nachbarn-Einbettung (t-SNE) auf eine zweidimensionale Ebene projiziert. Die Kohäsion ähnlicher Stichproben und die Trennung unähnlicher Stichproben wurden bewertet, um die Organisation der strukturellen Semantik im Merkmalsraum zu charakterisieren. Die t-SNE-Verteilung des strukturwissenden Merkmalsraums ist in Abbildung 8 dargestellt.
Die t-SNE-Projektion bildete fünf Hauptmerkmalsbereiche mit begrenzter Überlappung zwischen benachbarten Kategorien, wie in Abbildung 8A dargestellt. Repräsentative Beispiele, die den fünf Kategoriebereichen entsprechen, sind in Abbildung 8B gezeigt. Der SCI von 0,81 spiegelt die Kompaktheit von Proben mit demselben strukturellen Label wider, und der SDI von 0,71 spiegelt die Trennung zwischen Proben mit unterschiedlichen strukturellen Labels wider, wie in Tabelle 3 berichtet und in Abbildung 8 veranschaulicht. Diese Indizes sollten als Maße für die Verteilung im Merkmalsraum interpretiert werden und stellen nicht direkt eine Falschalarmrate fest. Oberteile mit kurzen Ärmeln und Röcke nahmen unterschiedliche Hauptbereiche im projizierten Merkmalsraum ein, während eine geringe Anzahl von Proben in der Nähe benachbarter Kategoriegrenzen verblieb, wie in Abbildung 8A gezeigt. Hosen und Kleider zeigten ebenfalls eine klare Trennung von benachbarten Kategorien. Diese Verteilung weist darauf hin, dass die Graph-Vorgabe zur strukturellen Organisation auf Kategorieebene beigetragen hat, ohne eine vollständige Cluster-Trennung hervorzurufen. Die Bewertung trennt die Qualität der Repräsentation von der Effektivität des Abrufs. SCI bewertet, ob Bekleidungsstücke mit demselben strukturellen Label im gelernten Merkmalsraum kompakt bleiben, während SDI bewertet, ob Bekleidungsstücke mit unterschiedlichen strukturellen Labels getrennt bleiben. Diese Metriken entsprechen dem strukturellen Repräsentationsziel des Protokolls. Recall@5 misst, ob ein strukturell relevantes Bekleidungsstück unter den ersten fünf abgerufenen Ergebnissen erscheint, während mAP die Rangfolgequalität über alle relevanten Galerieproben hinweg bewertet. Diese Metriken entsprechen dem Abrufziel für Designreferenzen. Der Silhouettenkoeffizient wurde nur zur Bewertung der Clusterleistung verwendet, da SCI und SDI bereits die Organisation im Merkmalsraum charakterisieren.
Abbildung 9 zeigt die Rohdaten aus fünf Durchläufen für vier repräsentative Methoden ohne übergeordnete Normalisierung zwischen den Methoden. Abbildung 9A zeigt SCI und SDI in ihrem ursprünglichen Maßstab, während Abbildung 9B Recall@5 und mAP in Prozent angibt. Die Markierungen für einzelne Durchläufe sowie die Fehlerbalken für die Standardabweichung verdeutlichen die Variabilität aufgrund des Modelltrainings und nicht nur die aggregierte Rangfolge. Der auf Erscheinungsbild basierende Ansatz erreichte einen SCI-Wert von 0,62, während die vorgeschlagene Methode einen SCI von 0,81 und einen SDI von 0,71 erreichte (Tabelle 3 und Abbildung 9A). Die SCI- und SDI-Ergebnisse deuten auf eine stärkere Kompaktheit innerhalb der Klassen und eine bessere Trennung zwischen den Klassen unter den untersuchten Bedingungen hin. Die vorgeschlagene Methode erreichte einen Recall@5 von 89,2 % und einen mAP-Wert von 86,4 % (Tabelle 3 und Abbildung 9B). Diese Abrufmetriken bewerten unterschiedliche Eigenschaften der Rangfolge und werden separat von SCI und SDI interpretiert. Die konsistente Reihenfolge der Methoden über alle vier Metriken hinweg weist auf eine Übereinstimmung zwischen der Qualität der Repräsentation und der Abrufleistung hin, impliziert jedoch nicht, dass die relative Verbesserung über alle vier Evaluationsdimensionen hinweg identisch ist.
Ablationsversuche und Analyse der Wirksamkeit struktureller Module
Das Ablationsexperiment vergleicht das vollständige Modell mit Varianten, bei denen die strukturelle Vorgabe oder das Fusionmodul entfernt wurden. Alle drei Konfigurationen verwenden dieselben Referenz- und Zielbilder, wodurch ein direkter Vergleich der Hintergrundreaktion und der Lokalisierungskonzentration ermöglicht wird. Die Variante ohne strukturelle Vorgabe entfernt den bildbasierten Bekleidungskomponentengraphen und seine Relationsbeschränkungen und stützt sich ausschließlich auf den konvolutionalen Backbone, um Erscheinungsmerkmale zu extrahieren; die Nicht-Fusionsvariante behält die Graphinferenz bei, entfernt jedoch die Merkmalspyramide und nutzt lediglich hochwertige semantische Merkmale. Visualisierte Differenz-Heatmaps zeigen die spezifischen Rollen jedes Moduls bei der Rauschunterdrückung und der Grenzflächendefinition; ein qualitativer Vergleich der strukturellen Differenzreaktionen unter verschiedenen Modulkonfigurationen ist in Abbildung 10 dargestellt.
Die Reaktionskarten in Abbildung 10C–E wurden mit einer gemeinsamen Antwortskala und identischen Überlagerungseinstellungen dargestellt. Die Variante ohne Struktur-Vorgabe zeigte eine starke Aktivierung im linken Hintergrund und um nicht verwandte Umgebungsregionen, wie in Abbildung 10C dargestellt. Die Variante ohne das Fusionmodul reduzierte einen Teil dieser außerhalb des Kleidungsstücks liegenden Reaktion, behielt jedoch eine breitere Ausbreitung über dem unteren Kleidungsstück und der rechtsseitigen Umgebung bei, wie in Abbildung 10D gezeigt. Das vollständige Modell konzentrierte die dominante Reaktion weiter auf den Vordergrund des Hauptkleidungsstücks, wie in Abbildung 10E ersichtlich. Abbildung 10F veranschaulicht direkt den Unterschied in den auf den Vordergrund beschränkten Reaktionen zwischen der Variante ohne Fusion und dem vollständigen Modell und zeigt, dass das vollständige Modell die verbleibende seitliche Ausbreitung unterdrückt, während die primäre, am Kleidungsstück ausgerichtete Reaktion erhalten bleibt. Diese Ergebnisse deuten darauf hin, dass die Struktur-Vorgabe hauptsächlich Umgebungsrauschen reduzierte und dass das Fusionmodul die Reaktionskonzentration sowie die strukturelle Ausrichtung weiter verbesserte. Abbildung 10E stellt eine relative Verbesserung dar, keine vollständige Beseitigung der Hintergrundaktivierung.
Tabelle 4 zeigt SCI, SDI und Recall@5 für die Varianten ohne Struktur-Präferenz, ohne das Fusion-Modul und mit dem vollständigen Modell. Das Entfernen der Struktur-Präferenz verringerte den SCI von 0,81 auf 0,65 und reduzierte Recall@5 von 89,2 % auf 74,5 %. Das Weglassen des Fusion-Moduls senkte den SDI von 0,71 auf 0,64 und verringerte Recall@5 von 89,2 % auf 85,1 %, was einem Rückgang von 4,1 Prozentpunkten entspricht. Diese Ergebnisse zeigen, dass die Struktur-Präferenz einen stärkeren Einfluss auf strukturelle Konsistenz und Rückgewinnung hatte, während die Merkmalsfusion die Übereinstimmung zwischen Erscheinungsbild und strukturellen Informationen verbesserte.
Die Effizienzanalyse vergleicht die Rechenkosten des vollständigen Modells mit der ResNet-50-Baseline. Die ResNet-50-Baseline erforderte 25,6 Millionen Parameter und 4,1 Milliarden Gleitkommaoperationen. Das vollständige strukturbasierte Modell erforderte 29,3 Millionen Parameter und 5,4 Milliarden Gleitkommaoperationen. Die durchschnittliche Inferenzzeit betrug 15 Millisekunden pro Bild für die Baseline und 22 Millisekunden pro Bild für das vollständige Modell, eine Zunahme um 7 Millisekunden. Dieses Ergebnis weist auf messbare Rechenkosten hin, die bei der Anwendung des Protokolls in zeitkritischen Workflows berücksichtigt werden sollten (Tabelle 5). Das Gewicht der strukturellen Nebenbedingung wurde anhand des Validierungsdatensatzes vor der endgültigen Testauswertung bestimmt. Der Validierungs-Recall@5 wurde bei strukturellen Nebenbedingungsgewichten von 0,1, 0,3, 0,5, 0,8, 1,0, 1,2, 1,5 und 2,0 untersucht. Ein Gewicht von 1,0 wurde für alle nachfolgenden Trainings- und Testdurchläufe festgelegt. Abbildung 11 dokumentiert die auf Validierungsdaten basierende Auswahl eines strukturellen Nebenbedingungsgewichts von 1,0.
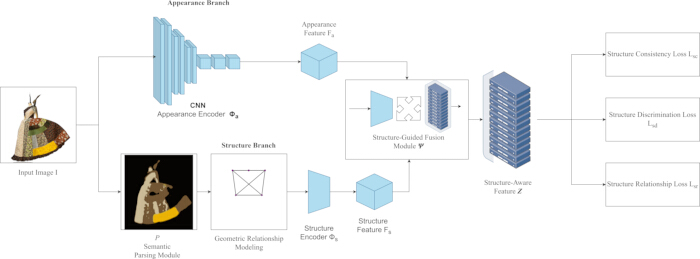
Abbildung 1: Gesamtablauf des Protokolls zum lernbasierten Erwerb strukturbewusster Merkmale aus Bekleidungsbildern. Das Eingangsbild des Bekleidungsstücks wird durch einen Zweig zur Erfassung von Erscheinungsmerkmalen und einen Zweig zur Erfassung struktureller Merkmale verarbeitet, wobei semantische Segmentierung und räumliche Graphmodellierung zum Einsatz kommen. Die beiden Darstellungen werden anschließend durch ein strukturgeleitetes Fusionmodul verarbeitet, um das endgültige strukturbewusste Merkmal zu erzeugen. Verlustfunktionen für strukturelle Konsistenz, strukturelle Diskriminierung und strukturelle Beziehungen beschränken gemeinsam den Merkmalsraum. Die Abbildung veranschaulicht, wie Erscheinungsbild und Komponententopologie des Bekleidungsstücks während des gesamten Lernprozesses integriert werden. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
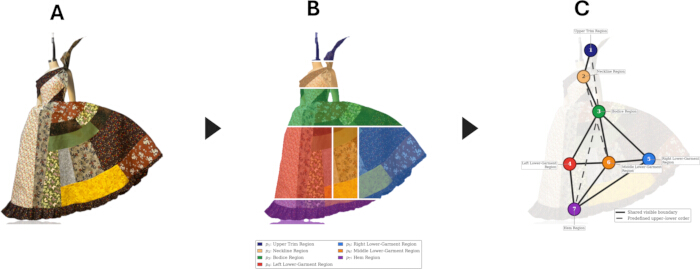
Abbildung 2: Konstruktion einer topologischen Vorlage auf Ebene von Kleidungsbestandteilen. (A) Das Eingabebild des Kleidungsstücks I. (B) Die auf den Vordergrund beschränkte Karte visueller Komponenten P, bei der sieben Farben die Bereiche des Kleidungsstücks auf Bildebene bezeichnen. Alle Hintergrundpixel sind von den Komponentenkanälen ausgeschlossen. (C) Der Relationsgraph der Komponenten auf Bildebene G. Die Knoten repräsentieren sichtbare Bereiche des Kleidungsstücks, durchgezogene Kanten stehen für gemeinsame Vordergrundgrenzen, und gestrichelte Verbindungen zeigen eine vordefinierte vertikale Reihenfolge an. Die Karte und der Graph unterstützen die Bildsuche und den Vergleich visueller Strukturen. Sie stellen keine Nähschnittteile, Nähtengeometrie, Taillierungselemente, Größenstaffelungsparameter oder Zuschnittanweisungen dar. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
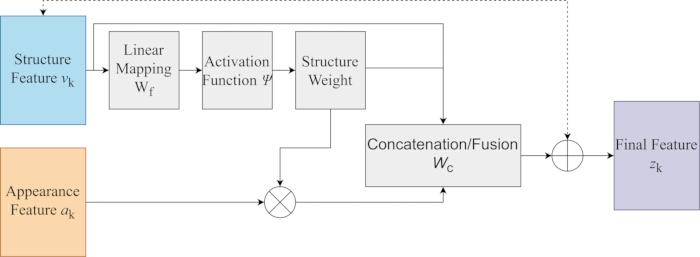
Abbildung 3: Strukturgeleitetes Modul zur Merkmalsfusion. Das strukturelle Merkmal wird durch die lineare Abbildung und die Aktivierungsfunktion Ψ transformiert, um ein Struktur-Gewicht zu erzeugen. Dieses Struktur-Gewicht moduliert das Erscheinungsbild-Merkmal durch elementweise Multiplikation. Das modulierte Erscheinungsbild-Merkmal und das strukturelle Merkmal werden verkettet und mittels Wc projiziert, woraufhin das residuale strukturelle Merkmal addiert wird, um das endgültige Komponentenmerkmal zu erzeugen. Die Abbildung zeigt, dass strukturelle Informationen die Gewichtung des Erscheinungsbild-Merkmals vor der endgültigen Fusion steuern. Klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
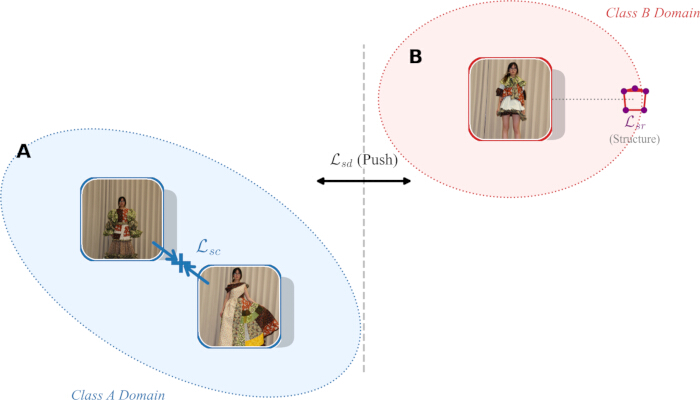
Abbildung 4: Optimierung des Merkmalsraums unter strukturellen Konsistenzbedingungen. (A) Proben, die derselben strukturellen Klasse angehören, werden durch den Strukturkonsistenzverlust näher zueinander gezogen, während ihre internen Komponentenbeziehungen durch den Strukturbeziehungsverlust erhalten bleiben. (B) Proben aus unterschiedlichen strukturellen Klassen werden durch den Strukturdiskriminierungsverlust voneinander weggedrängt. Die Abbildung zeigt, wie die drei strukturellen Zielvorgaben gemeinsam die Kompaktheit innerhalb der Klasse und die Trennung zwischen den Klassen erhöhen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
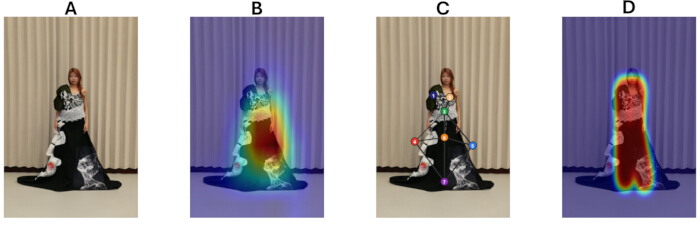
Abbildung 5: Repräsentative Merkmalsantworten des Bekleidungsstücks und Visualisierung als Komponentengraph. (A) Das Eingabebild des Bekleidungsstücks. (B) Die Klassenaktivierungsantwort der ResNet-50-Appearance-Basislinie. (C) Der komponentenbasierte Graph auf Bildniveau wurde aus der auf den Vordergrund beschränkten Komponentenkarte, der Komponentenmittelpunktmatrix, der typisierten Adjazenzmatrix, der Maske inaktiver Knoten und der Zuordnung der Komponentenlabels rekonstruiert, die während der Protokollabschnitte 3 und 4 gespeichert wurden. Knoten bezeichnen aktive Bereiche des Bekleidungsstücks, durchgezogene Kanten zeigen gemeinsame Vordergrundgrenzen an, und gestrichelte Kanten zeigen vordefinierte vertikale Ordnungsbeziehungen an. (D) Die Aktivierungsantwort der fusionierten, komponentenbezogenen Repräsentation. Der Vergleich zeigt den Unterschied zwischen texturbetonter Aktivierung und aktivierungsleitender Orientierung anhand der Bekleidungsbereiche. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
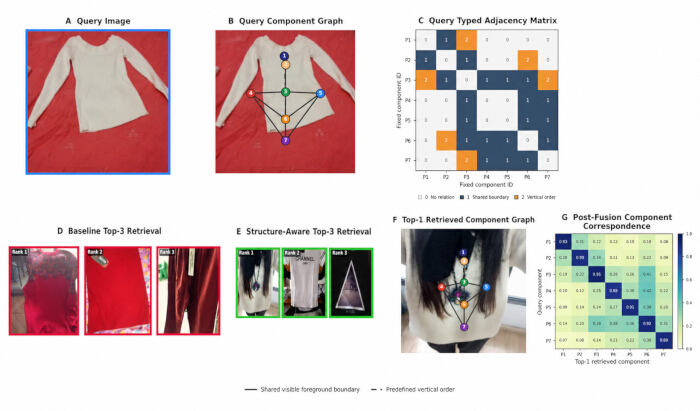
Abbildung 6: Rückgewinnungsergebnisse und strukturelle Zwischenergebnisse unter Interferenz mit rotem Hintergrund. (A) Das Abfragebild. (B) Der Abfrage-Komponentengraph wird aus den gespeicherten Komponentenzentren und der typisierten Adjazenzmatrix generiert. (C) Die typisierte Adjazenzmatrix der Abfrage, wobei die Matrixwerte inaktive Beziehungen, gemeinsame Vordergrundgrenzen und vordefinierte vertikale Ordnungsbeziehungen unterscheiden. (D) Die drei besten Rückgewinnungsergebnisse, erzeugt durch die Erscheinungsbasislinie. (E) Die drei besten Ergebnisse, erzeugt durch die strukturbewusste Repräsentation. (F) Der Komponentengraph des am höchsten bewerteten Ergebnisses der strukturbewussten Methode. (G) Die nach der Fusion ermittelte Komponentenzuordnungsmatrix zwischen der Abfrage und dem am höchsten bewerteten Ergebnis. Eine hohe diagonale Übereinstimmung weist auf Übereinstimmung zwischen Komponenten mit denselben Kennungen hin, während schwache oder verschobene Antworten auf fehlende oder falsch zugeordnete Komponentenorganisation hindeuten. Die Rückgewinnungsergebnisse bewahren die grobe Oberkörperkategorie bei, stellen jedoch keine vollständige Übereinstimmung in der Ärmelkonfiguration und lokalen Topologie her. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
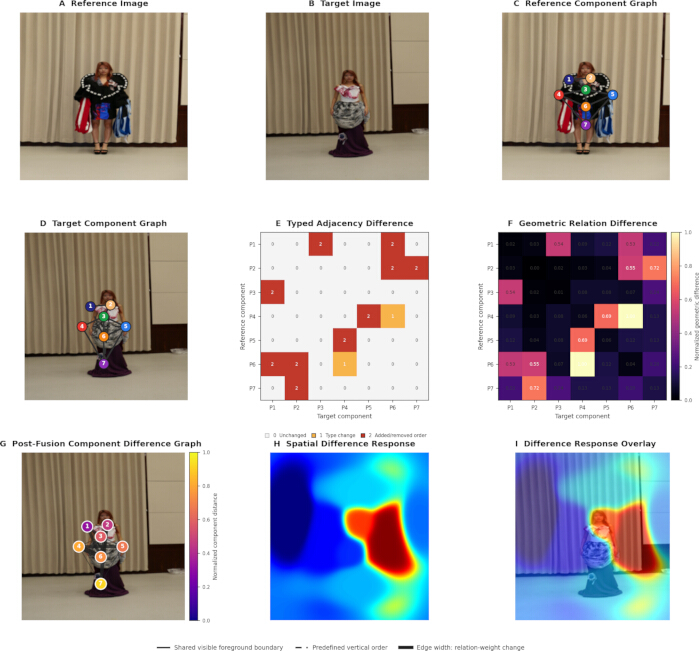
Abbildung 7: Nachverfolgung struktureller Unterschiede von der garment-Topologie auf Bildniveau bis zur räumlichen Reaktion. (A) Das Referenzbild. (B) Das Zielbild. (C) Der Referenzkomponentengraph. (D) Der Zielkomponentengraph. Beide Graphen wurden aus den gespeicherten Komponentenzentren und typisierten Adjazenzmatrizen rekonstruiert. (E) Die typisierte Adjazenzdifferenzmatrix. (F) Die Differenz der geometrischen Relation ergibt sich aus der Verschiebung der Komponentenzentren, räumlicher Streuung und Änderungen im Relationsgewicht. (G) Der postfusionale Differenzgraph der Komponenten, wobei die Knotenintensität den normalisierten Abstand zwischen den entsprechenden fusionierten Komponentenvektoren darstellt und die Kantendicke die Änderung des Relationsgewichts repräsentiert. (H) Die reine räumliche Differenz-Reaktions-Heatmap wurde mit derselben festen Reaktionsskala wie das Overlay dargestellt. (I) Die Reaktion überlagert auf dem Zielbild. Ein struktureller Unterschied wird nur akzeptiert, wenn die Änderung der Adjazenz, die Änderung der geometrischen Relation, die Änderung des Komponentenabstands und die vordergrundausgerichtete Heat-Response konsistent bleiben. Hintergrundaktivierung ohne entsprechende Hinweise auf Komponenten oder Relationen wird als residuale Interferenz und nicht als gültiger garment-struktureller Unterschied betrachtet. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
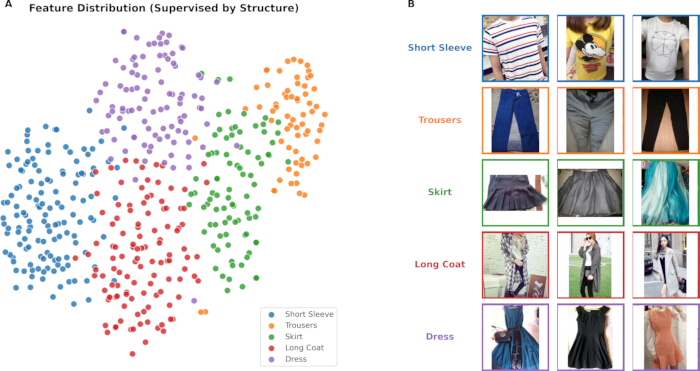
Abbildung 8: Strukturberücksichtigende Clusterung im Merkmalsraum. (A) Die t-SNE-Projektion von kurzärmligen Oberteilen, Hosen, Röcken, langen Mänteln und Kleidern. Die fünf Kategorien bilden Hauptmerkmalsbereiche mit begrenzter Überlappung in den Grenzbereichen zueinander. (B) Repräsentative Testbilder, die den fünf Bekleidungskategorien zugeordnet wurden, wobei die Rahmenfarbe der Kategoriefarbe in (A) entspricht. Die Abbildung zeigt die strukturelle Organisation auf Kategorieebene, wobei eine geringe Anzahl von Proben in der Nähe benachbarter Kategorienbereiche erhalten bleibt. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
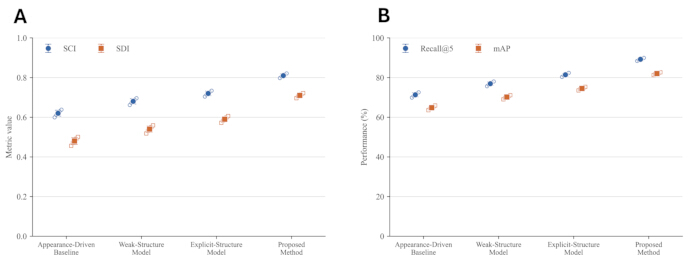
Abbildung 9: Direkter Vergleich der Rohleistung hinsichtlich Struktur des Merkmalsraums und Ziele der Abrangierung. (A) SCI und SDI für die auf Erscheinungsbild basierende Referenzmethode, das Modell mit schwacher Struktur, das Modell mit expliziter Struktur und die vorgeschlagene Methode. (B) Recall@5 und mAP für dieselben vier Methoden. Große Markierungen zeigen den arithmetischen Mittelwert aus fünf unabhängigen Durchläufen an, Fehlerbalken zeigen die Stichproben-Standardabweichung, und kleine Markierungen zeigen die Ergebnisse auf Durchlauf-Ebene. SCI und SDI sind auf einer festen Skala von null bis eins dargestellt, während Recall@5 und mAP auf einer festen prozentualen Skala von null bis einhundert abgebildet sind. Es wurde keine Min-Max-Normalisierung oder umverfahrensübergreifende Umrechnung vorgenommen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
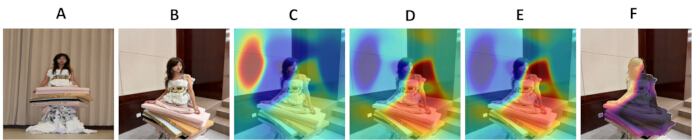
Abbildung 10: Strukturelle Unterschiedsantworten unter verschiedenen Modulkonfigurationen. (A) Das Referenzbild. (B) Das Zielbild. (C) Die Antwort der Variante ohne Struktur-Vorgabe. (D) Die Antwort der Variante ohne das Fusionmodul. (E) Die Antwort des vollständigen Modells. (C–E) werden mit derselben normalisierten Antwortskala, Farbkarte und Überlagerungseinstellungen dargestellt. (F) Die auf den Vordergrund beschränkte absolute Antwortdifferenz zwischen der Nicht-Fusionsvariante und dem vollständigen Modell. Das vollständige Modell erhält die hauptsächlich entlang der Kleidung ausgerichtete Antwort bei gleichzeitiger Verringerung der Streuung außerhalb des Hauptstrukturbereichs. Der Vergleich zeigt, dass die Struktur-Vorgabe Störungen außerhalb der Kleidung reduziert und das Fusionmodul die strukturelle Antwort weiter schärft. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
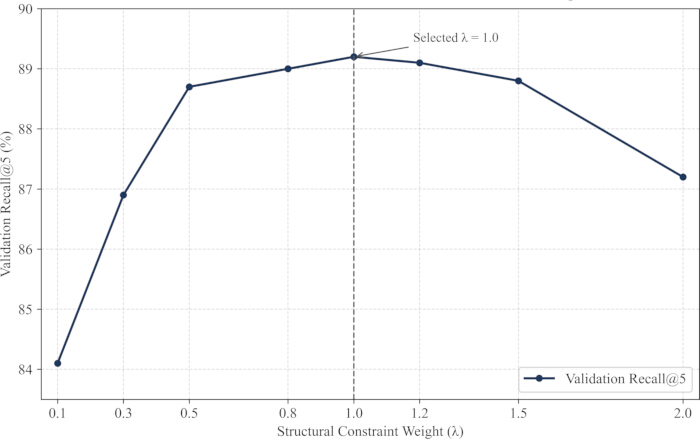
Abbildung 11: Validierungsbasierte Auswahl des Gewichts der strukturellen Nebenbedingung. Der Validierungs-Rückstellungsgrad bei 5 (Recall@5) ist für die Gewichte der strukturellen Nebenbedingung 0,1, 0,3, 0,5, 0,8, 1,0, 1,2, 1,5 und 2,0 dargestellt. Jeder Datenpunkt zeigt den arithmetischen Mittelwert aus fünf Validierungsdurchläufen an, und jede Fehlerbalken repräsentiert die empirische Standardabweichung. Das Gewicht wurde vor der endgültigen Testauswertung auf 1,0 festgelegt. Diese Abbildung dokumentiert das Verfahren zur Parameterauswahl und stellt keinen eigenständigen Beitrag zur Architektur dar. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Tabelle 1: Datensatzzuordnung und Bild-Ebenen-Topologie-Statistiken über die Kleidungsstück-Teilmengen S1 bis S5. Die Tabelle gibt die Anzahlen der Trainings-, Validierungs-, Test- und Gesamtbilder sowie die durchschnittliche Anzahl semantischer Komponenten, aktiver Knoten, typisierter Kanten und annotierter Bild-Ebenen-Landmarken für jede strukturelle Ebene an. Alle Werte wurden aus den verarbeiteten Datenmanifesten generiert. Die Anzahlen der Trainings-, Validierungs- und Testbilder wurden aus den endgültigen Teilmenge-Manifesten nach struktureller Überprüfung, Kontrolle von Duplikatgruppen und Prüfung auf Datenlecks gewonnen, während die Topologie-Statistiken aus den endgültigen Graph-Aufzeichnungen berechnet wurden, wobei dieselbe Komponentenreihenfolge und Relationsdefinitionen verwendet wurden wie bei der Modellbewertung. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Tabelle 2: Berechnungsumgebung, Eingabekonfiguration, Datenaugmentierung, Repräsentation, Optimierung, Verlustfunktion und Einstellungen zur Reproduzierbarkeit, die im gesamten Protokoll verwendet wurden. Die Tabelle gibt die genauen Versionen des Betriebssystems, Prozessors, installierten Speichers, Grafikprozessors, Grafikspeichers, Grafiktreibers, CUDA, cuDNN, Python, NumPy, PyTorch und torchvision sowie die Bildgröße, Batch-Zusammenstellung, den Optimierer, den Lernratenplan, die Anzahl der Epochen, Zufalls-Startwerte (random seeds), die Dimensionen der Repräsentation und die Gewichte der strukturellen Zielgrößen an. Jeder Wert ist verknüpft mit software_versions.txt, configs/protocol.yaml oder dem entsprechenden Trainingsprotokoll. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Tabelle 3: Quantitativer Vergleich allgemeiner Modelle zur visuellen Repräsentation, graphenbasierter Bekleidungsmodelle und domänenspezifischer Mode-Retrieval-Methoden. In der Tabelle werden Fokus und Abfragemodalität der Retrievalaufgabe sowie SCI, SDI, Recall@5, mAP und der Silhouettenkoeffizient für elf Methoden unter identischen Datenaufteilungen und Evaluierungsprotokollen angegeben. Jede Metrik wird als Mittelwert und Stichprobenstandardabweichung über fünf unabhängige Durchläufe berichtet. Die angegebenen p-Werte wurden mittels zweiseitiger gepaarter t-Tests ermittelt, bei denen jede Vergleichsmethode mit der vorgeschlagenen Methode unter Verwendung der Ergebnisse aus denselben fünf Zufalls-Saatwerten verglichen wurde. Die vorgeschlagene Methode gilt als Referenzzeile. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Tabelle 4: Ablationsresultate für die Struktur-Prior und das Feature-Fusion-Modul. Die Tabelle zeigt SCI, SDI und Recall@5 für die Variante ohne strukturelle Prior, die Variante ohne das Fusionmodul sowie das vollständige Modell. Der Wegfall der strukturellen Prior führt zu einer stärkeren Abnahme von SCI und Recall@5, während das Entfernen des Fusionmoduls SDI und die Übereinstimmung der Antworten verringert. Das vollständige Modell weist bei allen drei Metriken die höchsten Werte auf. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Tabelle 5: Berechnungseffizienz des ResNet-50-Basismodells und des vollständigen strukturbasierten Modells. In der Tabelle werden die anpassbaren Parameter, die Gleitkommaoperationen pro Bild sowie die durchschnittliche Inferenzzeit pro Bild unter exakt denselben Hardware- und Softwarebedingungen angegeben, die in Tabelle 2 und in der Materialtabelle dokumentiert sind. Beide Modelle verwenden dieselbe Bildauflösung, denselben Batch-Modus für die Inferenz, dieselben Vorverarbeitungsschritte und dieselbe Zeitmessmethode. Im Vergleich zum Basismodell fügt das vollständige Modell 3,7 Millionen Parameter, 1,3 Milliarden Gleitkommaoperationen und 7 Millisekunden Inferenzzeit pro Bild hinzu. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Die kritischsten Protokollschritte sind die textilerhaltende Vorverarbeitung und die semantische Segmentierung der Komponenten mit Beschränkung auf den Vordergrund. Komponentenzentren, räumliche Streuwerte, gemeinsame Grenzbeziehungen, vertikale Reihenfolgebeziehungen, Beziehungsgewichtungen und fusionierte Darstellungen werden alle aus der Segmentierungsausgabe abgeleitet. Grenzleckagen, verschmolzene Komponentenbereiche, fehlende Komponentenbereiche und falsche Kanalzuweisungen pflanzen sich durch die Graphkonstruktion und Merkmalsfusion fort. Diese Fehler können Graphdateien mit gültigen Dimensionen erzeugen, während die dargestellten Komponentenbeziehungen weiterhin inkonsistent mit dem ursprünglichen Kleidungsstück sind. Die Wahrscheinlichkeitskarte, die Beschränkung auf den Vordergrund, die Komponentenvorschau und die Aufzeichnung der Segmentierungsqualität müssen daher überprüft werden, bevor der strukturelle Vorgabewert akzeptiert wird.
Die Graphkonstruktion und Merkmalsfusion erfordern eine feste Reihenfolge semantischer Komponenten. Der Graph leitet sich aus den Vordergrund-Bekleidungskomponenten und deren Beziehungen in der Bildebene ab. Die Abbildungen zur Rückgewinnung und Differenz-Lokalisierung zeigen den strukturellen Verarbeitungsweg auf, anstatt lediglich endgültige, sortierte Bilder oder Antwort-Heatmaps darzustellen. Typisierte Adjazenzmatrizen dokumentieren diskrete Komponentenbeziehungen, geometrische Relationsmatrizen erfassen die normalisierte räumliche Organisation, und nach der Fusion entstandene Komponentenmatrizen dokumentieren die zur Rückgewinnung und Lokalisierung verwendete Repräsentation. Strukturelle Schlussfolgerungen sollten nur akzeptiert werden, wenn diese Zwischenrepräsentationen mit der endgültigen visuellen Ausgabe übereinstimmen. Der Komponentengraph verwendet keine anatomischen Markerpunkte, menschlichen Gelenkkoordinaten oder ein Pose-Schätzungssystem. Eine Graph-Überlagerung sollte nur dann akzeptiert werden, wenn ihre Knoten und Relationstypen aus den gespeicherten Komponenten- und Adjazenzdateien reproduziert wurden. Inaktive Komponenten sollten als Nullvektoren mit Indikatoren für inaktive Knoten bestehen bleiben, und die Erscheinungs- und Strukturmerkmalsmatrizen müssen jeweils K Zeilen und 512 Spalten enthalten, bevor die Fusion erfolgt. Diese Kontrollen verhindern, dass Knotenfehlausrichtungen und Dimensionsfehler fälschlicherweise als Modellverhalten interpretiert werden.
Die Fehlersuche sollte bei der ersten ungültigen Zwischenausgabe beginnen. Gleichförmige Wahrscheinlichkeitskarten deuten auf Fehler bei Prüfpunkten, Normalisierung oder Kategorie-Index hin; nicht-numerische strukturelle Matrizen weisen auf ungültige Wahrscheinlichkeitsnenner oder falsche Koordinatenskalierung hin; diffuse Reaktionen und farbdominierte Ergebnisse deuten auf schwache strukturelle A-priori-Annahmen, fehlgeschlagene Fusion oder falsches Laden des Prüfpunkts hin. Die Trainingsprotokolle sollten das Vorhandensein von Gradienten in den Graph- und Fusionschichten sowie die auf Validierung basierende Auswahl der Prüfpunkte bestätigen. Eine visuelle Wärme-Reaktion sollte nicht als alleinige strukturelle Schlussfolgerung verwendet werden. Sie muss anhand der gespeicherten Vordergrundmaske, der typisierten Nachbarschaftsänderung, der geometrischen Relationsmatrix und des Komponenten-Differenzgraphen nach der Fusion überprüft werden. Residuale Aktivierung außerhalb des Vordergrunds des Kleidungsstücks weist auf begrenzte Reaktionsspezifität hin, nicht auf einen validierten strukturellen Unterschied.
Im Vergleich zur aussehenbasierten Suche führt das Protokoll vor dem metrischen Lernen die Komponententopologie ein. Im Gegensatz zu schwachen strukturellen Einschränkungen und graphbasierten Modellen mit fester Topologie passen semantische Relationsgewichte die Graphausbreitung an das jeweilige Kleidungsstück an. Das vollständige Modell erreichte einen SCI von 0,81, einen SDI von 0,71, einen Recall@5 von 89,2 %, einen mAP von 86,4 % und einen Silhouettenkoeffizienten von 0,74, wie in Tabelle 3 berichtet. Die zusätzlichen strukturellen Module erhöhten die Anzahl der Parameter von 25,6 Millionen auf 29,3 Millionen und die Inferenzzeit von 15 auf 22 Millisekunden pro Bild, wie in Tabelle 4 angegeben. Der technische Beitrag des Protokolls liegt in der Erstellung eines bildbasierten Graphen für Kleidungskomponenten, der parallelen Kodierung von Erscheinungsbild und Komponentenbeziehungen, dem strukturgeleiteten Mechanismus zur Merkmalsfusion sowie den Zielfunktionen für strukturelle Konsistenz, Beziehung und Diskriminierung. Die in Abbildung 11 beschriebene Validierungsschleife dient lediglich zur Bestimmung eines festen Trainingskoeffizienten und wird nicht als Beitrag zur Netzwerkarchitektur oder zur Gestaltung der Zielfunktion präsentiert.
Das Protokoll bleibt empfindlich gegenüber starker Verdeckung, überlappenden Kleidungsstücken, kleinen Quellbildern, Posevariationen, komplexen Hintergründen und Bekleidungsstücken, deren sichtbare Struktur nicht dem festen Schema aus sieben Regionen entspricht. Asymmetrische Designs, abnehmbare Schichten, dichtes Falten, mehrschichtige Unterkleidung und überlappende dekorative Bereiche können mehrere semantische Regionen verschmelzen oder Komponentenbeziehungen einführen, die in der aktuellen Graphdefinition nicht enthalten sind. Verdeckung kann eine aktive Komponente unterdrücken, ihren Wahrscheinlichkeitsschwerpunkt verschieben und eine gültige gemeinsame Grenzbeziehung entfernen. Abbildung 6 zeigt die Rekonstruktion der groben Oberkörperkategorie, jedoch eine unvollständige Übereinstimmung der Ärmel-Topologie, während Abbildungen 7 und 10 Reaktionen in benachbarten Hintergrundbereichen aufweisen. Diese Ergebnisse zeigen, dass gültige Tensordimensionen und Graphverbindungen keine semantisch korrekte strukturelle Interpretation garantieren. Die vorliegende Studie unterstützt daher die bildbasierte Suche, das Clustering und die Lokalisierung von Unterschieden, nicht jedoch die Effizienz von Designarbeitsabläufen oder die direkte Schätzung von Schnittmusterparametern. Alle quantitativen Experimente der vorliegenden Studie wurden an der beibehaltenen und strukturell neu etikettierten DeepFashion2-Kohorte durchgeführt. Die aktuellen Ergebnisse belegen keine Robustheit über unabhängige Datensätze hinweg, die unterschiedliche Bekleidungstaxonomien, Annotationssysteme, kulturelle Kleidungskategorien, Bildquellen oder Aufnahmeumgebungen aufweisen. Die Übertragung auf einen anderen Datensatz könnte eine Neuzuordnung der sieben Komponentenkanäle und die Neukonstruktion des typisierten Relationsmodells erfordern. Die berichteten Schlussfolgerungen sind daher auf die ausgewertete Datenverteilung und die definitionsgemäße Komponentenbestimmung auf Bilderebene beschränkt.
Innerhalb dieser Grenzen bietet das Protokoll eine reproduzierbare Abfolge von Bekleidungsbildern zu komponentenbasierten Darstellungen durch semantische Analyse, Modellierung geometrischer Beziehungen, Dual-Stream-Kodierung und strukturgeleitete Fusion. Die zukünftige Validierung wird unabhängige Bekleidungsdatensätze mit unterschiedlichen Annotationssystemen, Bekleidungskategorien, Posen und Hintergrundbedingungen nutzen. Außerdem wird untersucht, ob die derzeitige Zuordnung zu sieben Regionen für asymmetrische, mehrschichtige, abnehmbare und kulturspezifische Bekleidungsstrukturen erweitert werden muss. Handgezeichnete Designs, Variationen über verschiedene Stoffarten hinweg sowie parametrische Schnittmusteranpassungen stellen separate Anwendungsrichtungen dar, die aufgabenspezifische Daten und Evaluierungsverfahren erfordern. Die professionelle Anwendbarkeit und die Effizienz von Designüberprüfungen erfordern eine gesondert dokumentierte Studie mit menschlichen Probanden, definierten Teilnehmern, Evaluierungskriterien und statistischen Verfahren.
Offenlegungen
Die Autoren haben keine Interessenkonflikte anzugeben.
Danksagungen
Diese Arbeit wurde unterstützt durch die zweite Runde der provinzialen Schlüsselprojekte zur Lehrreform für Bachelorstudiengänge im Rahmen des 14. Fünfjahresplans, Projekt mit dem Titel Lehrreform und Erkundung des Studiengangs „Bekleidung und Bekleidungsdesign“ auf der Grundlage des gemeinsamen Aufbaumodells „Drei Integrationen, drei Fusionen“ (Projektnummer JGZD2024096).
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Zentraleinheit | Intel Corporation | Intel Core i9-13900K, 24 Kerne, 32 Threads, bis zu 5,80 GHz | |
| Conda | Anaconda, Inc., anaconda.com | Miniconda3 23.11.0 | |
| CUDA Toolkit | NVIDIA Corporation, developer.nvidia.com | CUDA 11.8 | |
| cuDNN | NVIDIA Corporation, developer.nvidia.com | cuDNN 8.9.7 | |
| DeepFashion2-Datensatz | Die Chinese University of Hong Kong, github.com/switchablenorms/DeepFashion2 | Offizielle DeepFashion2-Version, Version 1.0 | |
| Graphikprozessor | NVIDIA Corporation | NVIDIA GeForce RTX 4090, 24 GB GDDR6X | |
| HRNet-W48-Semantischer Parsing-Checkpoint | HRNet-Projekt, github.com/HRNet/HRNet-Semantic-Segmentation | hrnet_w48_garment_parser_7class.pth, Projekt-Checkpoint Version 1.0 | |
| ImageNet-vortrainierte ResNet-50-Gewichte | PyTorch Foundation, pytorch.org | ResNet50_Weights.IMAGENET1K_V2 | |
| Matplotlib | Matplotlib-Entwicklungsteam, matplotlib.org | Version 3.8.2 | |
| NumPy | NumPy-Entwickler, numpy.org | Version 1.26.4 | |
| NVIDIA-Grafiktreiber | NVIDIA Corporation | Version 546.33 | |
| OpenCV-Python | OpenCV-Team, opencv.org | Version 4.8.1.78 | |
| Betriebssystem | Microsoft Corporation | Windows 11 Pro 23H2, 64-Bit, OS Build 22631.3155 | |
| Pandas | Pandas-Entwicklungsteam, pandas.pydata.org | Version 2.1.4 | |
| Python | Python Software Foundation, python.org | Version 3.10.13 | |
| PyTorch | PyTorch Foundation, pytorch.org | Version 2.1.2 mit CUDA 11.8 | |
| PyYAML | PyYAML-Projekt, pyyaml.org | Version 6.0.1 | |
| scikit-learn | scikit-learn-Entwickler, scikit-learn.org | Version 1.3.2 | |
| SciPy | SciPy-Entwickler, scipy.org | Version 1.11.4 | |
| Quellcode-Repository | Ergänzendes Quellcode-Archiv zur Manuskripteinreichung | Garment Topology Protocol, Version 1.0 | |
| Speichergerät | Samsung Electronics | Samsung 990 PRO NVMe SSD, 2 TB | |
| Arbeitsspeicher | Kingston Technology | Kingston FURY Beast DDR5, 64 GB, 2 × 32 GB, 5600 MHz | |
| torchvision | PyTorch Foundation, pytorch.org | Version 0.16.2 mit CUDA 11.8 | |
| Workstation | Eigenentwickelte Deep-Learning-Workstation | Intel Core i9-13900K, NVIDIA GeForce RTX 4090, 64 GB Speicher, 2 TB NVMe SSD |
Referenzen
- Xiang Z, Zhu C, Qian M, Shen Y, Shao Y. FashionSegNet: a model for high-precision semantic segmentation of clothing images. Vis Comput. 2024;40:1711-1727. doi:10.1007/s00371-023-02881-3.
- Sun K, Zhang J, Zhang P, Yuan K, Li G. TsrNet: a two-stage unsupervised approach for clothing region-specific textures style transfer. J Vis Commun Image Represent. 2023;91:103778. doi:10.1016/j.jvcir.2023.103778.
- Yang N, Ma X. Enhanced composed fashion image retrieval with a multi-hop reasoning framework. Sci Rep. 2025;15:32217. doi:10.1038/s41598-025-17402-6.
- Karthika Priya D, Sathyabama B. FARE-RNET: fashion cloth retrieval via Egret Swarm Optimization-based Convolutional Attention Module integrated ResNet. Int J Comput Intell Syst. 2026;19:29. doi:10.1007/s44196-025-00979-1.
- Köktürk Güzel BE. Efficient image retrieval in fashion: leveraging clustering and principal component analysis for search space reduction. Erzincan Univ J Sci Technol. 2024;17:638-649. doi:10.18185/erzifbed.1500279.
- Zhang X, Sun H, Ma J. Research on clothing image retrieval combining topology features with color texture features. Mathematics. 2024;12:2363. doi:10.3390/math12152363.
- Abbas W, Zhang Z, Asim M, Chen J, Ahmad S. AI-driven precision clothing classification: revolutionizing online fashion retailing with hybrid two-objective learning. Information. 2024;15:196. doi:10.3390/info15040196.
- Shirkhani S, Mokayed H, Saini R, Hum YC. Study of AI-driven fashion recommender systems. SN Comput Sci. 2023;4:514. doi:10.1007/s42979-023-01932-9.
- Balloni E, Pietrini R, Frontoni E, Mancini A, Paolanti M. OutfitAI: shop the outfit with a deep learning-based intelligent expert system. Multimed Tools Appl. 2025;84:40195-40214. doi:10.1007/s11042-025-20753-x.
- Kachbal I, El Abdellaoui S. Computer vision for fashion: a systematic review of design generation, simulation, and personalized recommendations. Information. 2026;17:11. doi:10.3390/info17010011.
- Saranya MS, Geetha P. Cross-domain fashion cloth retrieval via novel attention-guided cascade neural network and clothing parsing. Comput Vis Image Underst. 2023;235:103777. doi:10.1016/j.cviu.2023.103777.
- Ning T, Gao Y, Han Y. Segmentation of ethnic clothing patterns with fusion of multiple attention mechanisms. Complex Intell Syst. 2024;10:5759-5770. doi:10.1007/s40747-024-01457-5.
- Jiang A, Liu L, Fu X, Liu L, Peng W. Clothing hierarchical feature representation and association learning for cross-modal fashion retrieval. J Comput Aided Des Comput Graph. 2025;37:654-667. doi:10.3724/SP.J.1089.2023-00263.
- An H, Lee KY, Choi Y, Park M. Conceptual framework of hybrid style in fashion image datasets for machine learning. Fash Text. 2023;10:18. doi:10.1186/s40691-023-00338-8.
- Adel M, Mohammed AM, Elsaid AH, Abdelatey A. Deep learning for new fashion product demand prediction: integrating visual similarity and demand correction in cold-start scenarios. Int J Data Sci Anal. 2026;22:9. doi:10.1007/s41060-025-00888-8.
- Tang Y, Ye D, Tao F, Du G. Enhanced group relation learning via aligned attention masking for fashion product captioning. J King Saud Univ Comput Inf Sci. 2025;37:170. doi:10.1007/s44443-025-00195-z.
- Lyu X, Li X, Zhang Y, Lu W. Two-stage method for clothing feature detection. Big Data Cogn Comput. 2024;8:35. doi:10.3390/bdcc8040035.
- Tang G, Yu F, Li H, Shi Y, Liu L, Peng T, et al. ClothSeg: semantic segmentation network with feature projection for clothing parsing. J Vis Commun Image Represent. 2023;97:103980. doi:10.1016/j.jvcir.2023.103980.
- Cao S, Chai W, Hao S, Zhang Y, Chen H, Wang G. DiffFashion: reference-based fashion design with structure-aware transfer by diffusion models. IEEE Trans Multimedia. 2024;26:3962-3975. doi:10.1109/TMM.2023.3318297.
- Hou J, Lu Y, Yang Y, Liu Z. PDN: a priori dictionary network for fashion parsing. Appl Sci. 2024;14:3509. doi:10.3390/app14083509.
- Moratelli N, Barraco M, Morelli D, Cornia M, Baraldi L, Cucchiara R. Fashion-oriented image captioning with external knowledge retrieval and fully attentive gates. Sensors. 2023;23:1286. doi:10.3390/s23031286.
- Islam T, Miron A, Liu X, Li Y. Deep learning in virtual try-on: a comprehensive survey. IEEE Access. 2024;12:29475-29502. doi:10.1109/ACCESS.2024.3368612.
- Yan H, Zhang H, Liu L, Zhou D, Xu X, Zhang Z, et al. Toward intelligent design: an AI-based fashion designer using generative adversarial networks aided by sketch and rendering generators. IEEE Trans Multimedia. 2023;25:2323-2338. doi:10.1109/TMM.2022.3146010.
- Xie Z, Zhou Z, Wang Z, Ding H, Ma L. Multi-scale spatial feature-guided cloth landmark estimation. J Comput Aided Des Comput Graph. 2022;34:1763-1771. doi:10.3724/SP.J.1089.2022.19189.
- Jiang J, Wu D, Deng H, Long Y, Tang W, Li X, et al. HAIGEN: towards human-AI collaboration for facilitating creativity and style generation in fashion design. Proc ACM Interact Mob Wearable Ubiquitous Technol. 2024;8:107. doi:10.1145/3678518.
- Danner M, Brake E, Kosel G, Kyosev Y, Rose K, Rätsch M, et al. AI-assisted pattern generator for garment design. Commun Dev Assem Text Prod. 2024;5:195-206. doi:10.25367/cdatp.2024.5.p195-206.
- Bao C, Zhang X, Chen J, Miao Y. MMFL-net: multi-scale and multi-granularity feature learning for cross-domain fashion retrieval. Multimed Tools Appl. 2023;82:37905-37937. doi:10.1007/s11042-022-13648-8.
- Yang G. Clothing design style recommendation using optimized semantic-preserved generative adversarial network. J Electr Syst. 2024;20 Suppl 3:2396-2409. doi:10.52783/jes.3064.
- Wang Z, Tao X, Zeng X, Xing Y, Xu Z, Bruniaux P. Design of customized garments towards sustainable fashion using 3D digital simulation and machine learning-supported human-product interactions. Int J Comput Intell Syst. 2023;16:16. doi:10.1007/s44196-023-00189-7.
- Wu J, Huang Y, Gao M, Gao Z, Zhao J, Zhang H, et al. A two-stream hybrid convolution-transformer network architecture for clothing-change person re-identification. IEEE Trans Multimedia. 2024;26:5326-5339. doi:10.1109/TMM.2023.3331569.
- Khalid M, Keming M, Hussain T. Design and implementation of clothing fashion style recommendation system using deep learning. Rom J Inf Technol Autom Control. 2021;31:123-136. doi:10.33436/v31i4y202110.
- Wang Y, Liu L, Fu X, Liu L. MCCP: multi-modal fashion compatibility and conditional preference model for personalized clothing recommendation. Multimed Tools Appl. 2024;83:9621-9645. doi:10.1007/s11042-023-15659-5.
- Ma J, Sun H, Yang D, Zhang H. Personalized fashion recommendations for diverse body shapes and local preferences with contrastive multimodal cross-attention network. ACM Trans Intell Syst Technol. 2024;15:82. doi:10.1145/3637217.
- Yu Z, Zhao Y, Hong B, Jin Z, Huang J, Cai D, et al. Apparel-invariant feature learning for person re-identification. IEEE Trans Multimedia. 2022;24:4482-4492. doi:10.1109/TMM.2021.3119133.
- Peng D, Liu R, Lu J, Zhang S. Unsupervised multi-modal modeling of fashion styles with visual attributes. Appl Soft Comput. 2022;115:108214. doi:10.1016/j.asoc.2021.108214.
- Mathews A, Sejal N, Venugopal KR. Analysis of content based image retrieval using deep feature extraction and similarity matching. Int J Adv Comput Sci Appl. 2022;13:646-655. doi:10.14569/IJACSA.2022.0131277.
- Zhang C, Ji X, Cai L. Clothing recommendation with multimodal feature fusion: price sensitivity and personalization optimization. Appl Sci. 2025;15:4591. doi:10.3390/app15084591.
- Zhao M, Gao S, Ma J, Zhang Z. Joint clothes image detection and search via anchor-free framework. Neural Netw. 2022;155:84-94. doi:10.1016/j.neunet.2022.08.011.
- Fontanini T, Ferrari C. Would your clothes look good on me? Towards transferring clothing styles with adaptive instance normalization. Sensors. 2022;22:5002. doi:10.3390/s22135002.
- Kim S, Moon H, Oh J, Lee Y, Kwon H, Kim S. Automatic measurements of garment sizes using computer vision deep learning models and point cloud data. Appl Sci. 2022;12:5286. doi:10.3390/app12105286.
- Chang YH, Zhang YY. Deep learning for clothing style recognition using YOLOv5. Micromachines. 2022;13:1678. doi:10.3390/mi13101678.
- de Medeiros Dantas IJ, Curth M, Freire AG. Exploring databases for training models in machine learning in the fashion industry. DAT J. 2024;9:157-174. doi:10.29147/datjournal.v9i2.877.
- Zhu S, Zou X, Qian J, Wong WK. Learning structured relation embeddings for fine-grained fashion attribute recognition. IEEE Trans Multimedia. 2024;26:1652-1664. doi:10.1109/TMM.2023.3284593.