Diese Studie stellt einen zweistufigen Rahmen für die Klassifizierung von Hyperspektral- und LiDAR-Landbedeckungsdaten mithilfe der MetaFormer-Feature-Extraktion und bidirektionalen Flussanpassung zur Quermodus-Alignierung vor der Fusion vor. Die Bewertung anhand von drei öffentlichen Benchmark-Datensätzen zeigt einen wettbewerbsfähigen Klassifizierungsansatz unter festgelegten Benchmark-Protokollen.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Kontinuierliches crossmodales Vektorfeld-Lernen für die hyperspektrale und LiDAR-basierte Landbedeckungsklassifizierung
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die multimodale Fernerkundungsklassifizierung spielt eine wichtige Rolle bei Anwendungen wie der städtischen Kartierung und Umweltüberwachung. Heterogene Merkmalsverteilungen zwischen verschiedenen Sensormodalitäten können jedoch zu einer fehlerhaften Merkmalsausrichtung und semantischen Inkonsistenzen führen, was die Effektivität der multimodalen Fusion einschränkt. Bestehende Ansätze zur multimodalen Fusion – darunter faltungs-, graphen-, attention-, kontrastbasierte, transportorientierte und sequenzbasierte Methoden – können komplementäre Informationen nutzen, jedoch möglicherweise die modalitysspezifischen Merkmalsverteilungen nicht ausreichend angleichen. Diese Studie schlägt FlowErs vor, ein zweistufiges multimodales Klassifizierungsframework, das diese Herausforderung durch multimodale Flussanpassung (flow matching) angeht. Die Arbeitshypothese lautet, dass die Verringerung der Unterschiede zwischen gepaarten Merkmalsverteilungen vor der Merkmalsfusion die Klassifizierung der Landnutzung unter festgelegten Benchmark-Protokollen verbessert. In der ersten Stufe extrahieren modalitysspezifische MetaFormer-Encoder hierarchische Repräsentationen aus hyperspektralen Bilddaten (HSI) und Lidar-Daten (light detection and ranging, LiDAR). Ein multimodulares Flussanpassungsmodul lernt anschließend zeitabhängige Geschwindigkeitsfelder, um gepaarte Merkmalsverteilungen mithilfe einer bidirektionalen quadratischen Fehlerminimierung (mean-squared-error objective) in eine gemeinsame latente Repräsentation zu überführen. In der zweiten Stufe wird das vortrainierte Alignierungsmodul wiederverwendet, um multimodale Repräsentationen auszurichten, bevor ein leichtgewichtiger Fusionskopf eine pixelweise Klassifizierung durchführt. Die Evaluierung an drei öffentlichen Benchmark-Datensätzen ergab eine maximale Gesamtgenauigkeit (OA) von 97,56 % bei festgelegten Benchmark-Aufteilungen. Die Leistung variierte zwischen einzelnen Landnutzungsklassen; die Studie diskutiert klassenspezifische Limitationen sowie den Einfluss von Klassenungleichgewicht auf aggregierte Metriken. Die aktuelle Evaluierung beschränkt sich auf Experimente mit festen Aufteilungen, ohne statistische Analyse wiederholter Durchläufe oder eine Analyse des Rechenaufwands. Zukünftige Arbeiten werden die statistische Robustheit, die Recheneffizienz sowie die Generalisierbarkeit über verschiedene Regionen hinweg untersuchen.
Einleitung
Eine präzise Klassifizierung der Landnutzung und Landbedeckung (LULC) mithilfe fernerkundlicher Aufnahmen ist für eine Vielzahl praktischer Anwendungen unerlässlich, darunter städtische Entwicklung, Umweltüberwachung, Katastrophenmanagement und nachhaltige Entwicklung1. Multimodale Fernerkundungsdaten, einschließlich hyperspektraler Bilder (HSI), Lichtdetektion und -entfernungsmessung (LiDAR) sowie synthetischer Apertur-Radar (SAR), sind in den letzten Jahren zunehmend verfügbar geworden. Diese verbesserte Verfügbarkeit hat die Fähigkeiten der Fernerkundung zur detaillierten Klassifizierung der Landbedeckung erheblich erweitert2. Diese Erfassungsmodalitäten erfassen unterschiedliche, aber sich ergänzende Merkmale der Erdoberfläche. HSI liefert umfangreiche spektrale Informationen zur Charakterisierung der Materialzusammensetzung, während LiDAR präzise strukturelle und Höheninformationen bereitstellt3. Die Integration dieser heterogenen Datenquellen kann diskriminierendere, störunempfänglichere und semantisch umfassendere Merkmalsdarstellungen hervorbringen als jede einzelne Modalität für sich genommen4.
Dennoch stellt die effektive Nutzung multimodaler Daten nach wie vor eine langjährige Herausforderung dar5. Eine zentrale Schwierigkeit ergibt sich aus der inhärenten Heterogenität der Erfassungsmodalitäten, die sich in räumlicher Auflösung, Rauschverhalten, statistischen Verteilungen und semantischen Merkmalen unterscheiden6. Beispielsweise kann dasselbe Landbedeckungsobjekt in HSI als hochdimensionale Spektralsignatur und in LiDAR als spärliche geometrische Struktur dargestellt sein7. Folglich liegen modalitysspezifische Merkmale oft in unterschiedlichen Merkmalsmannigfaltigkeiten, wodurch eine direkte Merkmalsfusion ineffizient oder potenziell irreführend wird. Zudem gehen viele bestehende multimodale Fusionsansätze – einschließlich Methoden basierend auf Faltung, Aufmerksamkeit und Transformatoren – implizit davon aus, dass aus verschiedenen Sensoren extrahierte Merkmale bereits räumlich und semantisch ausgerichtet sind8. Diese Annahme ist jedoch in praktischen Anwendungen häufig nicht gültig. Einfache Merkmalsverkettung oder pixelweise Fusion können querschnittliche modale Unterschiede nicht ausreichend erfassen und führen möglicherweise zu instabiler Optimierung und verringerter Generalisierungsleistung. Darüber hinaus verbessern zwar aufmerksamkeitsbasierte Fusionsverfahren die Interaktion zwischen Merkmalen, bieten jedoch möglicherweise nur eine begrenzte Modellierung langreichweitiger querschnittlicher Abhängigkeiten, die für die Landbedeckungsklassifizierung in großem Maßstab oder mit hoher Auflösung erforderlich sind9. Daher bleibt eine effektive Ausrichtung heterogener Merkmalsrepräsentationen eine zentrale Herausforderung in der multimodalen Fernerkundung, da inkompatible Einbettungen die Integration komplementärer Informationen einschränken können.
Um diese Herausforderung zu bewältigen, wird die multimodale Ausrichtung als bedingtes Merkmals-Transportproblem formuliert. Das Fluss-Matching bietet einen mathematisch fundierten Rahmen, um kontinuierliche und umkehrbare Abbildungen zwischen heterogenen Merkmalsverteilungen zu erlernen10. Es transportiert eine Verteilung in Richtung einer anderen mithilfe eines zeitabhängigen Geschwindigkeitsfeldes, das durch eine gewöhnliche Differentialgleichung (ODE) parametrisiert ist, wodurch kontinuierliche Transformationen zwischen Merkmalsmannigfaltigkeiten ermöglicht werden11. Im Gegensatz zu diffusionsbasierten Modellen, die auf stochastischen Rauschstörungen oder implizitem Verteilungsabgleich durch adversarielles Training beruhen, lernt das Fluss-Matching deterministische, bijektive Transformationen zwischen strukturierten Merkmalsräumen12. Diese Eigenschaften machen das Fluss-Matching besonders geeignet für multimodale Fernerkundung, bei der HSI, LiDAR und SAR jeweils hochdimensionale Merkmalsmannigfaltigkeiten darstellen, die komplementäre Eigenschaften der Erdoberfläche erfassen13. Demnach bietet das Fluss-Matching einen systematischen Ansatz, um multimodale Korrespondenzen durch kontinuierlichen Merkmals-Transport herzustellen und gleichzeitig geometrische Konsistenz während der Merkmalsausrichtung zu gewährleisten. Unter geeigneten Regularitätsannahmen kann ein ODE-Fluss eine invertierbare Abbildung liefern; die exakte Invertierbarkeit und physikalische Interpretierbarkeit wurden in der vorliegenden Studie jedoch nicht empirisch überprüft. Die zugrundeliegende Arbeitshypothese lautet, dass die Verringerung von Diskrepanzen zwischen gepaarten Merkmalsverteilungen vor der Merkmalsfusion die Gesamtklassifizierung von Landnutzungsklassen bei festgelegten Benchmark-Aufteilungen verbessert.
Angesichts dieser Überlegungen integriert das vorgeschlagene Framework FlowErs eine auf Flussberechnung basierende Ausrichtungsstufe in eine zweistufige Architektur. In der ersten Stufe wird ein bidirektionales Flussnetzwerk trainiert, um die Merkmalsmannigfaltigkeiten jeder Modalität auszurichten. Konkret extrahieren modalitysspezifische MetaFormer-Backbones hierarchische Merkmalseinbettungen, und ein Fluss-Abstimmungsziel wird optimiert, um Proben zwischen modalitysspezifischen Merkmalsverteilungen zu übertragen. Dieser Prozess ermöglicht eine glatte und invertierbare Transformation zwischen den Merkmalsräumen und sorgt dafür, dass Repräsentationen derselben semantischen Klasse innerhalb eines gemeinsamen latenten Bereichs stärker zusammenrücken. In der zweiten Stufe wird der vortrainierte Flussausrichter fixiert, und neue multimodale Eingaben werden vor der Fusion durch einen leichten Klassifikator transformiert. Diese entkoppelte Trainingsstrategie trennt die geometrische Ausrichtung von der semantischen Klassifikation und ermöglicht es den beiden Stufen, komplementäre Ziele zu optimieren. Das Ausrichtungsmodul soll Merkmalsverteilungsunterschiede vor der Merkmalsfusion verringern, macht jedoch keinen Anspruch auf einen nachgewiesenen Volumenerhaltungsgarantie. Darüber hinaus bietet FlowErs eine explizite Formulierung des Merkmalstransports für die multimodale Fusion, wobei die Robustheit gegenüber Registrierungsfehlern in der vorliegenden Studie jedoch nicht separat bewertet wurde.
Die Hauptbeiträge dieser Studie lassen sich wie folgt zusammenfassen. FlowErs wird als zweistufiges Framework für die multimodale Klassifizierung von Landnutzungsflächen eingeführt. In dem vorgeschlagenen Framework werden zuerst modalitysspezifische Merkmale mithilfe von MetaFormer-Encodern extrahiert und anschließend durch ein auf Flussberechnungen basierendes Modul ausgerichtet, bevor eine effiziente Merkmalsfusion erfolgt. Dieses entkoppelte Design ermöglicht eine effiziente Optimierung und behält gleichzeitig Flexibilität über verschiedene Sensormodalitäten hinweg. Zusätzlich untersucht diese Studie das bedingte Fluss-Matching als Mechanismus zum Merkmals-Transport für die paarweise, krossmodale Merkmalsausrichtung in der multimodalen Fernerkundung. Das bidirektionale Flussmodul prognostiziert entgegengesetzte Geschwindigkeitsziele für gepaarte Merkmalsrepräsentationen vor der Merkmalsfusion und bietet somit eine explizite Ausrichtungsstrategie vor der multimodalen Integration. Darüber hinaus wird das vorgeschlagene Framework auf drei öffentlichen Benchmark-Datensätzen evaluiert und erreicht dabei eine maximale Gesamtgenauigkeit (OA) von 97,56 % gemäß den vorgegebenen festen Benchmark-Aufteilungen. Klassenspezifische Einschränkungen sowie der Umfang der vorliegenden Evaluation werden ebenfalls ausdrücklich dokumentiert.
Neuere Fortschritte im Bereich des Flow-Matchings haben es als leistungsstarkes generatives Modellierungsframework etabliert, das Diffusions-, Energie- und Transport-basierte Modelle vereint. Anstatt stochastische Trajektorien wie bei Diffusionsmodellen zu simulieren, lernt das Flow-Matching eine deterministische ODE, die eine einfache A-priori-Verteilung, beispielsweise Gaußsches Rauschen, mithilfe eines lernbaren Geschwindigkeitsfelds15 zur Ziel-Datenverteilung transportiert. Diese Formulierung stellt eine direkte Beziehung zwischen Score-Schätzung und Dichteentwicklung her, was zu glatteren Wahrscheinlichkeitstrajectorien und stabileren Trainingsdynamiken führt. Ein wesentlicher Vorteil des Flow-Matchings ist seine deterministische und recheneffiziente Formulierung. Rektifizierte Flow-Modelle16 vereinfachen die Transporttrajektorien weiter zu nahezu geraden Pfaden, verbessern dadurch die numerische Stabilität und ermöglichen die Erzeugung hochwertiger Stichproben mit vergleichsweise wenigen Integrationschritten. Nachfolgende Studien, darunter Konsistenzmodelle17, haben diffusionsinspirierte Lernziele in kompakte, auf Flows basierende Frameworks integriert, um bei effizienter Inferenz vergleichbare oder verbesserte Stichprobenqualität zu erreichen. Zudem kann das Training auf Basis von Flows auf vortrainierten Diffusions-Backbones aufbauen, wodurch die Nutzung großskaliger generativer A-priori-Modelle erleichtert und die Kosten für das Generieren von Stichproben reduziert werden. Jüngste Arbeiten haben das Flow-Matching auf eine breite Palette von Anwendungen ausgedehnt. Hu et al.18 untersuchten beispielsweise Transformer-Backbones und Manipulationen im Latentraum für steuerbare und kombinierbare Bildbearbeitung mittels Flow-Matching. Weitere Anwendungen umfassen die Bildsynthese19, die Diagnose von Lagerdefekten20 und das mehrzielige, mehrnähtige Roboterschweißen21. Insgesamt zeigen diese Studien, dass das Flow-Matching über hochauflösende und bedingte Bildsynthese hinaus anwendbar ist und gleichzeitig eine fundierte theoretische Grundlage bietet, die auch eine Generalisierung auf verschiedene Anwendungsgebiete ermöglicht. Durch das Lernen kontinuierlicher, deterministischer Transportabbildungen bietet das Flow-Matching ein ausgewogenes Verhältnis zwischen Effizienz, Steuerbarkeit und generativer Genauigkeit. Die auf ODEs basierende Formulierung liefert eine einheitliche Perspektive auf moderne generative Modellierung und schafft eine theoretische Grundlage für Anwendungen, die multimodale Datenrepräsentation und Merkmalsausrichtung beinhalten.
Die multimodale Fernerkundungsklassifizierung zielt darauf ab, die Einschränkungen einzelner Sensormodalitäten zu überwinden, indem komplementäre Informationen aus HSI, multispektralen Aufnahmen, LiDAR und SAR integriert werden. Frühe Fusionsansätze basierten auf manuell erstellten Merkmalen oder kernbasierten Algorithmen wie Support-Vektor-Maschinen (SVMs), waren jedoch durch hohe Dimensionalität und unzureichende intermodale Interaktion begrenzt22. Fortschritte im Bereich des Deep Learnings haben strukturierte Fusionsstrategien ermöglicht, darunter frühe, intermediäre und späte Fusion, wobei die Merkmalsfusion ein praktikables Gleichgewicht zwischen Informationsintegration und rechnerischer Komplexität bietet23. Faltungsneuronale Netze (CNNs) erfassen effektiv lokale räumlich-spektrale Informationen, während auf Transformatoren basierende Architekturen langreichweitige Abhängigkeiten modellieren, allerdings mit höherem Rechenaufwand24. Infolgedessen haben sich hybride CNN–Transformer-Architekturen zunehmend durchgesetzt, da sie die komplementären Stärken beider Ansätze vereinen. Repräsentative Beispiele umfassen Fusionsverfahren auf benachbarten Skalen, die kontextuelle Informationen durch inter-skale Interaktionen verbessern25, sowie mehrstufige Frameworks, die flache CNN-Merkmale mit tiefen Transformer-Darstellungen unter Verwendung adaptiver Aufmerksamkeitsmechanismen kombinieren26. Insgesamt unterstreichen diese Studien die Bedeutung effektiver inter-skalarer und intermodaler Interaktionen zur Reduzierung von Merkmalsredundanz und zur Verbesserung der semantischen Repräsentation.
Jüngste Entwicklungen haben auch komplementäre Strategien für multimodales Lernen untersucht. Beispielsweise verringern Methoden der Niedrigrang-Darstellung, wie der vom Ebbinghaus-Kurven-gestützte Ansatz, Überanpassung, indem sie die Mannigfaltigkeitsstruktur erhalten und gleichzeitig redundante Informationen unterdrücken27. Parallel dazu wurde verteiltes multimodales Lernen erforscht, um Datenschutz- und Kommunikationsbeschränkungen in praktischen Anwendungen zu adressieren. Beispielsweise projiziert FedFusion flache Merkmale in Niedrigrang-Unterräume, um föderiertes multimodales Lernen zu ermöglichen28. Insgesamt veranschaulichen diese Studien drei komplementäre Forschungsrichtungen: hybride CNN–Transformer-Architekturen zur Balance zwischen lokaler und globaler Merkmalsmodellierung, Niedrigrang-Lernen zur Reduzierung von Redundanz und Rauschen sowie verteiltes Lernen für skalierbare und datenschutzfreundliche Bereitstellung. Dennoch bestehen wichtige Herausforderungen weiterhin, darunter Modalitätsungleichgewicht, begrenzte Verfügbarkeit gekennzeichneter Daten sowie der Kompromiss zwischen Modellkomprimierung und Klassifizierungsgenauigkeit. Diese Herausforderungen haben die fortgesetzte Forschung an leichten, verallgemeinerungsfähigen multimodalen Fusionssystemen motiviert. Aktuelle Ansätze zur multimodalen Ausrichtung haben außerdem quersmodale Aufmerksamkeit, kontrastives Lernen, graphenbasierte Fusion, Domänenanpassung und Strategien zur Verteilungsanpassung integriert. Im Gegensatz dazu formuliert FlowErs die multimodale Ausrichtung als gepaarten, zeitbedingten Merkmals-Transport und wird als komplementäre Ausrichtungsstrategie vorgestellt, nicht als universeller Ersatz für bestehende Ansätze.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
In dieser Studie wurden ausschließlich öffentlich zugängliche Benchmark-Datensätze (Houston2013, Augsburg und MUUFL) für die Klassifizierung der Landbedeckung in der Fernerkundung verwendet. Es waren keine menschlichen Probanden, Tierversuche oder neu gewonnene biologische Proben beteiligt. Daher war eine Genehmigung durch eine institutionelle Ethikkommission nicht erforderlich.
Überblick über die Studie
Der vorgeschlagene FlowErs-Rahmen führt eine multimodale Klassifizierung der Landbedeckung mithilfe einer zweistufigen Lernstrategie durch. Der gesamte Arbeitsablauf ist in Abbildung 1A–C dargestellt. Der Rahmen umfasst drei Hauptkomponenten: (i) MetaFormer-basierte Encoder, die hierarchische Merkmalsdarstellungen aus heterogenen Sensormodalitäten extrahieren, (ii) ein multimodales Flussanpassungsmodul (MFM), das die verteilungen der Merkmale über verschiedene Modalitäten hinweg explizit ausrichtet, und (iii) einen leichten Klassifikationskopf, der Landbedeckungskategorien anhand der fusionierten Merkmalsdarstellungen vorhersagt. Der gesamte Arbeitsablauf extrahiert zunächst modalitysspezifische Merkmale, richtet diese anschließend innerhalb eines gemeinsamen latenten Raums durch bedingte Flussanpassung aus und führt schließlich eine pixelweise Klassifizierung der Landbedeckung anhand der ausgerichteten multimodalen Darstellungen durch.
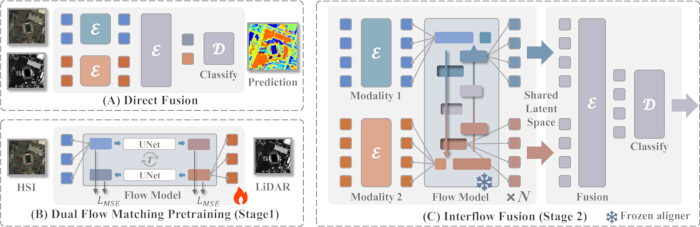
Abbildung 1: Überblick über das vorgeschlagene FlowErs-Framework zur multimodalen Klassifizierung der Landbedeckung. (A) Konventionelle direkte Merkmalsfusion, bei der modalitysspezifische Merkmale, die aus hyperspektralen Aufnahmen (HSI) und Light-Detection-and-Ranging-(LiDAR)-Daten extrahiert wurden, vor der Klassifizierung direkt verkettet werden. (B) Stufe 1: Bidirektionales multimodales Flow-Matching-Pretraining. Ein zeitkonditioniertes U-Net lernt kontinuierlichen bidirektionalen Merkmalsfluss zwischen modalitysspezifischen Merkmalsrepräsentationen mithilfe eines mittleren quadratischen Fehlerverlusts (mean-squared-error loss), um heterogene Merkmalsverteilungen auszurichten. (C) Stufe 2: Interflow-Fusion. Das vortrainierte Flow-Matching-Modul wird fixiert und wiederverwendet, um modalitysspezifische Merkmalsrepräsentationen vor einer leichten Merkmalsfusion und einer pixelweisen Klassifizierung der Landbedeckung auszurichten. E, Encoder; D, Decoder; T, Zeit-Embedding; , mittlerer quadratischer Fehlerverlust; S, gemeinsame latente Repräsentation. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Der vorgeschlagene Ansatz trennt die Merkmalsausrichtung von der semantischen Klassifizierung durch eine zweistufige Trainingsstrategie. In der ersten Stufe wird das MFM-Modul trainiert, um den bidirektionalen Merkmalsfluss zwischen modalitätsspezifischen Merkmalsmannigfaltigkeiten zu erlernen. In der zweiten Stufe wird das vortrainierte Flussausrichtungsmodul fixiert und wiederverwendet, um multimodale Merkmalsrepräsentationen vor einer leichten Merkmalsfusion und Klassifizierung auszurichten. Dieser entkoppelte Ansatz ermöglicht es dem Ausrichtungsmodul und dem Klassifikationsnetzwerk, komplementäre Zielsetzungen zu optimieren und gleichzeitig die Unterschiede in den Merkmalsverteilungen vor der multimodalen Fusion zu verringern.
Theoretische Übersicht
Flow-Matching ist ein kürzlich vorgeschlagenes Paradigma für generative Modelle, das eine kontinuierliche deterministische Transformation zwischen zwei Wahrscheinlichkeitsverteilungen lernt. Im Gegensatz zu diffusionsbasierten Modellen, die Stochastizität durch Rauschstörungen einführen, parametrisiert das Flow-Matching direkt ein lernbares Geschwindigkeitsfeld, das eine Wahrscheinlichkeitsverteilung kontinuierlich in eine andere überführt. Diese Formulierung des kontinuierlichen Transports ermöglicht die Merkmalsausrichtung über eine gewöhnliche Differentialgleichung (ODE), wodurch gepaarte Merkmalsrepräsentationen aus verschiedenen Sensormodalitäten entlang einer gemeinsamen Trajektorie vor der Merkmalsfusion weiterentwickelt werden können. In der vorliegenden Studie wird bedingtes Flow-Matching verwendet, um bidirektionalen Merkmals-Transport zwischen modalitysspezifischen Einbettungen zu lernen, die von den MetaFormer-Encodern extrahiert werden. Das Modell wird mithilfe eines bedingten Flow-Matching-Ziels trainiert, das die Abweichung zwischen vorhergesagten und Ziel-Geschwindigkeitsfeldern über interpolierte Merkmalsrepräsentationen minimiert. Die vollständige mathematische Formulierung, theoretische Herleitung, die zugrundeliegenden Gleichungen und das Trainingsziel sind in Supplementary File 1 enthalten.
Problembeschreibung
Die Klassifizierung der Landbedeckung anhand multimodaler Fernerkundungsdaten umfasst das Lernen semantischer Repräsentationen aus heterogenen Erfassungsmodalitäten wie HSI und LiDAR. Diese Modalitäten weisen unterschiedliche Erfassungseigenschaften auf. HSI erfasst reichhaltige spektrale Informationen mit Hunderten von Kanälen ( ), während LiDAR feinkörnige strukturelle Informationen mit vergleichsweise wenigen Kanälen bereitstellt (
 ). Dieses Ungleichgewicht zwischen spektraler Reichhaltigkeit und struktureller Sparsamkeit erzeugt eine beträchtliche Domänendifferenz in den Merkmalsverteilungen, wodurch eine direkte Merkmalsfusion suboptimal und potenziell instabil wird.
Formal gilt bei einem Paar multimodaler Eingaben, 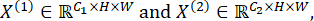 das Ziel darin, eine pixelweise semantische Karte gemäß Gleichung 1 vorherzusagen:
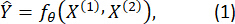
Hier ist 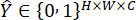 der one-hot-kodierte Label-Tensor, C bezeichnet die Gesamtanzahl der Landbedeckungskategorien und θ repräsentiert alle lernbaren Modellparameter. Der Houston2013-Datensatz weist eine Bildgröße von 349 × 1905 Pixeln mit 144 hyperspektralen (HSI) Bändern und 1 LiDAR-Band auf. Der Augsburg-Datensatz weist eine Bildgröße von 1152 × 480 Pixeln mit 224 HSI-Bändern und 1 LiDAR-Band auf. Der MUUFL-Datensatz weist eine Bildgröße von 325 × 220 Pixeln mit 64 HSI-Bändern und 2 LiDAR-Bändern auf. Für alle Datensätze wurden Eingabebildausschnitte vor dem Training auf 32 × 32 Pixel verkleinert.
Herkömmliche multimodale Ansätze verschmelzen modalitysspezifische Merkmale durch Verkettung oder Aufmerksamkeitsmechanismen, wobei implizit angenommen wird, dass verschiedene Modalitäten in einem kompatiblen Merkmalsraum vorliegen. Diese Annahme trifft jedoch selten auf Fernerkundungsdaten zu, da die modalitysspezifischen statistischen Verteilungen und räumlich-spektralen Eigenschaften erheblich voneinander abweichen.
Um diesen Unterschied explizit zu überbrücken, wird ein Flussanpassungsmodul,  , eingeführt. Das Modul wird durch
 parametrisiert und lernt kontinuierliche bidirektionale Transformationen zwischen modality-spezifischen Merkmalsmannigfaltigkeiten. Insbesondere (Gleichung 2):
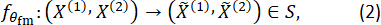
Hier bezeichnet S den gemeinsamen latenten Raum, in dem die modalitätsspezifischen Merkmalsrepräsentationen geometrisch ausgerichtet sind. Anschließend werden die ausgerichteten Merkmalsrepräsentationen fusioniert und gemäß Gleichung 3 wie folgt klassifiziert:
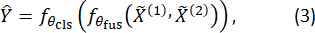
Hier bezeichnen  und
 jeweils das Merkmalsfusion- und das Klassifizierungsmodul. Diese Formulierung definiert das gesamte FlowErs-Framework. Anstatt ausschließlich auf eine implizite statistische Merkmalsfusion zu setzen, führt das vorgeschlagene Framework einen expliziten, flussbasierten Alignierungsmechanismus ein, der modalitysspezifische Merkmalsrepräsentationen kontinuierlich in einen gemeinsamen latenten Raum überführt, bevor die multimodale Merkmalsfusion und die semantische Vorhersage erfolgen.
MetaFormer-Encoder
FlowErs führt eine multimodale Merkmalsausrichtung mithilfe leichtgewichtiger, modalitysspezifischer Encoder durch, die informative und geometrisch konsistente Merkmalsrepräsentationen aus jeder Sensormodalität lernen. Wie in Abbildung 2 veranschaulicht, wird jede Modalität von einem unabhängigen Encoder verarbeitet, der auf der MetaFormer-Architektur basiert. MetaFormer verallgemeinert das grundlegende Transformer-Design, indem es das Token-Mixing von der Kanaltransformation entkoppelt, ohne explizit die Selbst-Attention zu berechnen. Dieses Design ermöglicht eine effiziente Verarbeitung hochdimensionaler HSI, bleibt dabei aber anpassungsfähig an Modalitäten mit geringer Kanalanzahl wie LiDAR.
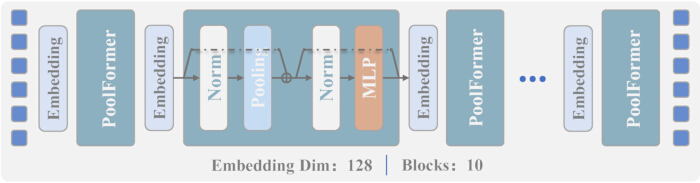
Abbildung 2: Architektur des modalitätsspezifischen MetaFormer-Encoders, der im vorgeschlagenen FlowErs-Framework verwendet wird. Der Encoder wandelt modalitätsspezifische Eingaben durch wiederholte Einbettung und PoolFormer-Blöcke in hierarchische Merkmalsdarstellungen um. Jeder PoolFormer-Block besteht aus Normalisierung, Pooling-basierter Token-Mischung, residueller Addition, Normalisierung und einem mehrschichtigen Perzeptron (MLP). Die resultierenden hierarchischen Merkmalsdarstellungen werden an das multimodale Flow-Matching-Modul zur quermodalen Merkmalsausrichtung weitergeleitet. Norm, Normalisierung; MLP, mehrschichtiges Perzeptron. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Für jede Modalität  , transformiert der MetaFormer-Encoder
 , die Eingabe
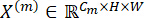 in eine Hierarchie latenter Merkmalsdarstellungen (Gleichung 4):
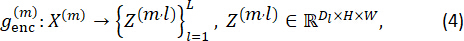
Hier bezeichnet L die Gesamtanzahl der Encoder-Stufen und Dl bezeichnet die Einbettungsdimension in der Stufe l. Der MetaFormer-Encoder besteht aus drei Stufen (N = 3) mit Einbettungsdimensionen von 64, 128 bzw. 256. Die entsprechenden Anzahlen der PoolFormer-Blöcke in jeder Stufe betragen 2, 6 und 2 und folgen der im Manuskript beschriebenen progressiv-hierarchischen Architektur.
Jeder Encoder beginnt mit einer 1 × 1-Faltung, die die Eingangskanäle in einen gemeinsamen Einbettungsraum projiziert (Gleichung 5):
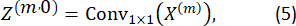
Dieser Projektionsschicht folgen L gestapelte MetaFormer-Blöcke. Jeder Block besteht aus zwei residualen Operationen: (i) Token-Mixing durch räumliches Pooling, um kontextuelle Informationen zu aggregieren, und (ii) Kanaltransformation durch ein mehrschichtiges Perzeptron (MLP), um spektral-räumliche Merkmalsdarstellungen zu verfeinern. Diese Operationen werden mithilfe von Gleichung 6 und 7 wie folgt ausgedrückt:
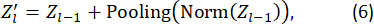

Hier bezeichnet Pooling(·) die räumliche Kontextaggregation basierend auf Mittelwert-Pooling und MLP(·) ein zweischichtiges konvolutionales Feed-Forward-Netzwerk mit GELU-Aktivierung und Dropout-Regularisierung.
Der Encoder folgt einer hierarchischen Architektur, bei der die Einbettungsdimension in aufeinanderfolgenden Stufen schrittweise ansteigt (beispielsweise 64  128 256). Diese schrittweise Gestaltung ermöglicht es tieferen Schichten, zunehmend komplexere räumlich-spektrale Informationen zu kodieren, während gleichzeitig die Repräsentationskapazität der gelernten Merkmale verbessert wird. Die Implementierung verwendet einen Pooling-Kern der Größe 3 × 3, eine MLP-Versteckte-Dimension von 128 und eine Dropout-Rate von 0,1. Alle faltenden Schichten innerhalb des MetaFormer-Encoders verwenden 1 × 1-Kerne mit einer Schrittweite von 1 und keiner Zufüllung. Der Pooling-Operator verwendet ein 3 × 3-Durchschnittspooling mit einer Schrittweite von 1 und einer Zufüllung von 1. Batch-Normalisierung (BatchNorm2d) wird im gesamten Encoder verwendet. Das MLP weist eine versteckte Dimension von 128 auf, verwendet die GELU-Aktivierungsfunktion und eine Dropout-Rate von 0,1. Die drei Encoder-Stufen enthalten jeweils 2, 6 und 2 PoolFormer-Blöcke, und diese architektonischen Einstellungen werden einheitlich über alle Stufen hinweg angewendet.
Im Vergleich zu auf Transformatoren basierenden Encodern eliminiert der MetaFormer-Encoder die quadratischen Rechenkosten, die mit der Selbst-Attention verbunden sind, und verringert gleichzeitig die modenspezifische Verzerrung während der Merkmalsextraktion. Sein auf Pooling basierender Token-Mixer aggregiert effizient lokalen räumlichen Kontext, während anschließend die multimodale Ausrichtung durch das Flow-Matching-Modul durchgeführt wird. Folglich liefern die auf höchster Ebene erzeugten Merkmalsrepräsentationen semantisch informative und geometrisch konsistente Eingaben für die multimodale Merkmalsausrichtung.
Mehrmodes Fluss-Matching
Die Hauptaufgabe nach der Merkmalsextraktion besteht in der Ausrichtung heterogener Merkmalsrepräsentationen, die aus unterschiedlichen Sensormodalitäten stammen und auf verschiedenen Merkmalsmannigfaltigkeiten liegen. Eine direkte Verkettung von  und
 führt häufig zu schlechten Ergebnissen, da die Merkmalsverteilungen inkonsistent sind und modalitätsspezifische Verzerrungen auftreten. FlowErs begegnet diesem Problem gezielt, indem es ein MFM-Modul einführt, das kontinuierliche, bidirektionale Transformationen zwischen den beiden Merkmalsräumen lernt, wie schematisch in Abbildung 1B veranschaulicht.
Sei 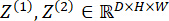 die von den MetaFormer-Encodern extrahierten Merkmalsdarstellungen. Ein kontinuierliches Strömungsfeld, parametrisiert durch die Interpolationszeit
 , wird mithilfe von Gleichung 8 wie folgt definiert:
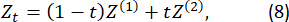
Hier entspricht t = 0 der Ausgangsmodalität und t = 1 der Zielmodalität.
Das Fluss-Matching-Modell, , wird als zeitbedingtes U-Net implementiert, das das momentane Geschwindigkeitsfeld vorhersagt, das die Transformation entlang dieser Interpolations-Trajektorie steuert. Jeder Flussprädiktor besteht aus drei Downsampling-Blöcken (64 128 256 512) und drei entsprechenden Upsampling-Blöcken (512 256 128 64), die 3 × 3-Faltungen, Batch-Normalisierung und ReLU-Aktivierung (rectified linear unit) verwenden. Zwischengeschaltete Zeit-Embeddings weisen jeweils die Dimensionen 128, 256, 512, 256 und 128 auf. Das Zeit-Embedding verwendet eine feste sinusförmige Positions-Codierung. Die ODE-Integration wird mittels des expliziten Euler-Verfahrens mit fester Schrittweite durchgeführt. Während des Trainings wurde die Anzahl der Integrations-Schritte auf 6 festgelegt, während standardmäßig 5 Integrations-Schritte während der Inferenz verwendet wurden. Die tatsächliche Anzahl der Integrationsschleifen-Iterationen wird als  berechnet.
Das vorhergesagte Geschwindigkeitsfeld ergibt sich aus Gleichung 9 wie folgt:
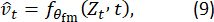
Hier bezeichnet  die vorhergesagte momentane Geschwindigkeit. Das Modell lernt, die Verschiebung
 zu approximieren, wodurch kontinuierliche Transformationen zwischen modalitätsspezifischen Merkmalsräumen gefördert werden. Die Trainingszielsetzung wird als zeitbedingter bidirektionaler mittlerer quadratischer Fehler (MSE) folgendermaßen formuliert (Gleichung 10):
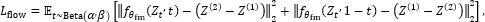 (10)
Die Stichprobenziehung von t aus der angegebenen Beta-Verteilung macht das Modell für Zwischenzustände der Interpolation zugänglich, stellt jedoch keine exakte Zyklenkonsistenz sicher. Im Gegensatz zu diffusionsbasierten Alignierungsverfahren ist die vorgeschlagene Formulierung des Flussabgleichs deterministisch, erfordert während der Inferenz keine stochastische Stichprobenziehung und kann mit sowohl gekennzeichneten als auch ungekennzeichneten Daten trainiert werden.
Ein trainiertes Flussmodell dient anschließend als deterministischer Alignmentsoperator, der modalitytätsspezifische Merkmalsrepräsentationen in einen gemeinsamen latenten Raum S projiziert. Die alignierten Repräsentationen werden wie folgt erhalten (Gleichung 11):
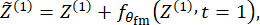
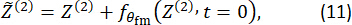
Hier bezeichnen  und
 die ausgerichteten Merkmalsdarstellungen. Die flussbasierte Ausrichtung wird auf die Zwischen-Merkmalsdarstellungen der ersten beiden Encoder-Stufen (Stufe 1 und 2) angewendet, deren Einbettungsdimensionen 64 bzw. 128 betragen. Die Merkmale der höchsten Encoder-Stufe (Stufe 3, Einbettungsdimension 256) werden nicht durch das Fluss-Abstimmungsmodul verarbeitet. Stattdessen werden diese Merkmale direkt verkettet und zur multimodalen Vorhersage an den Klassifikator übergeben.
Dieser bidirektionale Ausrichtungsmechanismus transportiert modenspezifische Merkmalsrepräsentationen schrittweise durch ein kontinuierliches Strömungsfeld in einen gemeinsamen latenten Raum. Folglich werden und enger miteinander ausgerichtet, bevor die multimodale Merkmalsfusion erfolgt, wodurch semantisch konsistente und geometrisch kompatible Merkmalsrepräsentationen für die anschließende Klassifizierung bereitgestellt werden.
Trainingspipeline
FlowErs nutzt sowohl gekennzeichnete als auch ungekennzeichnete Daten und gewährleistet gleichzeitig eine stabile multimodale Ausrichtung durch eine zweistufige Trainingsstrategie, wie in Abbildung 1(B,C) veranschaulicht. In der ersten Stufe wird ein modalitätsinvariantes Ausrichtungsmodul durch unüberwachtes Fluss-Matching erlernt. In der zweiten Stufe erfolgt die überwachte Klassifizierung unter Verwendung der ausgerichteten latenten Repräsentationen, wobei das vortrainierte Fluss-Ausrichtungsmodul wiederverwendet wird.
Stufe 1: Unüberwachtes Flow-Vortraining
Anhand multimodaler Bilddatenpaare werden modalityspezifische Merkmalsrepräsentationen  ,
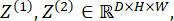 , mithilfe der MetaFormer-Encoder extrahiert. Zwischenliegende Merkmalsrepräsentationen werden unter Verwendung der in Gleichung 8 definierten Interpolation erzeugt, wobei
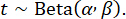 . Das Flusszuordnungsmodul
 , wird optimiert, indem das bidirektionale zeitbedingte Zielmaß gemäß Gleichung 10 minimiert wird, ohne Klassenlabels zu verwenden. In diesem Stadium werden ausschließlich die Parameter der Flusszuordnung,
 , aktualisiert, wodurch das Modell geometriebewusste Entsprechungen sowohl aus gekennzeichneten als auch ungekennzeichneten Proben lernen kann, bevor die überwachte Klassifizierung erfolgt. Stufe 1 (Vortraining der Flusszuordnung) wurde unter Verwendung des AdamW-Optimierers mit einer Lernrate von 1 × 10⁻4, einer Gewichtsreduzierung von 1 × 10⁻2 und einem Kosinus-Annealing-Lernratenplan durchgeführt. Für die Datensätze Houston2013 und Trento wurden Batchgrößen von 16 verwendet, während für die Datensätze Augsburg und MUUFL Batchgrößen von 32 verwendet wurden. Das Flusszuordnungsmodul wurde über 2.000 Epochen hinweg unter Verwendung sowohl gekennzeichneter als auch ungekennzeichneter Proben vortrainiert. Der Zufallsstartwert wurde auf 3407 festgelegt. Alle Experimente wurden mit PyTorch auf einer einzelnen NVIDIA A100-GPU (80 GB Speicher) durchgeführt.
Stufe 2: Überwachtes Klassifizieren mit einem gemeinsamen Aligner
Das vortrainierte Fluss-Matching-Modul wird während des überwachten Trainings wiederverwendet und auf die ersten beiden Encoder-Stufen angewendet, anstatt auf alle Merkmalsstufen. Die ausgerichteten Merkmalsdarstellungen werden anschließend mithilfe des Klassifikationskopfs fusioniert, um pixelweise Vorhersagen zu erzeugen. Die überwachte Optimierung minimiert den maskierten Cross-Entropy-Verlust (Gleichung 12):
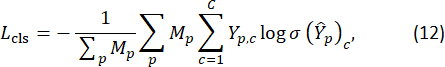
Hier bezeichnet M die Label-Maske, Y bezeichnet die one-hot-kodierten Ground-Truth-Labels und σ(·) bezeichnet die Softmax-Funktion. Während Phase 2 (überwachtes Training) blieb das vortrainierte Flow-Matching-Modul vollständig eingefroren und diente als fester, multimodaler Alignmentsoperator. Seine vortrainierten Gewichte wurden zu Beginn von Phase 2 geladen und während des überwachten Trainings nicht aktualisiert. Lediglich die Parameter des MetaFormer-Encoders und des Klassifizierers wurden optimiert. Das überwachte Training wurde mit dem AdamW-Optimierer durchgeführt, wobei datensatzspezifische Lernraten von 1 × 10⁻4 (Houston2013), 1 × 10⁻3 (Augsburg), 1 × 10⁻2 (MUUFL) und 1 × 10⁻5 (Trento) verwendet wurden. Die Gewichtsreduktion (Weight decay) wurde für alle Datensätze auf 1 × 10⁻2 festgelegt, mit Ausnahme von MUUFL, für den ein Wert von 5 × 10⁻2 verwendet wurde. Abhängig vom Datensatz kamen Batchgrößen von 16 oder 32 zum Einsatz. Die Modelle wurden für 100 Epochen (Houston2013 und MUUFL), 200 Epochen (Augsburg) bzw. 20 Epochen (Trento) mit einem Lernraten-Plan nach dem Kosinus-Annealing-Verfahren trainiert. Als Verlustfunktion wurde CrossEntropyLoss mit Mittelwertreduktion verwendet. Es wurde kein Early Stopping angewendet; stattdessen wurde der Modell-Checkpoint ausgewählt, der die höchste Gesamtgenauigkeit (OA) auf dem Testdatensatz erreichte, als endgültiges Modell. Der vollständige Implementierungsablauf des zweistufigen Trainingsverfahrens ist in Zusatzdatei S1 (Algorithmus S1) zusammengefasst.
Diese entkoppelte Trainingsstrategie trennt die geometrische Ausrichtung von der semantischen Diskriminierung. In Phase 1 lernt das Modell kontinuierliche bidirektionale Merkmalsabbildungen mithilfe der Fluss-Abstimmungs-Objektivfunktion. In Phase 2 stellt das vortrainierte Alignierungsmodul eine gemeinsame Merkmals-Transport-Operation vor der multimodalen Merkmalsfusion bereit, während das Klassifikationsnetzwerk klassendiskriminative Darstellungen aus dem ausgerichteten latenten Raum lernt. Die Wiederverwendung des vortrainierten Aligners fördert eine konsistente Merkmalsausrichtung vor der Fusion, stellt jedoch keine unabhängige Garantie für eine verbesserte Generalisierung dar.
Experimentelle Datensätze
Der vorgeschlagene Ansatz wurde anhand von drei repräsentativen multimodalen Fernerkundungs-Benchmark-Datensätzen evaluiert: Houston201329, Augsburg30 und MUUFL31.
Der Houston2013-Datensatz wurde im Rahmen des IEEE-GRSS-Datenfusionswettbewerbs veröffentlicht. Er stellt eine vielfältige städtische Landschaft in Houston, USA, dar und enthält 15 Landbedeckungsklassen, darunter Wohngebiete, Straßen, Vegetation und Gewässer. Der Datensatz umfasst HSI mit 144 Spektralbändern, die den sichtbaren bis nahinfraroten Bereich abdecken, sowie ein einbändiges, aus LiDAR-Daten abgeleitetes digitales Oberflächenmodell (DSM) mit einer räumlichen Auflösung von 2,5 m. Die komplexen städtischen Texturen und die erhebliche spektrale Variabilität innerhalb der Klassen machen diesen Datensatz herausfordernd für eine genaue Klassifizierung der Landbedeckung.
Der Augsburg-Datensatz wurde über einem dicht besiedelten urbanen Gebiet in Deutschland aufgenommen. Er umfasst hyperspektrale Bilder mit 224 spektralen Bändern, die den Wellenlängenbereich von 400–1000 nm abdecken, sowie ko-registrierte LiDAR-Höhendaten. Der Datensatz enthält 17 annotierte Landnutzungsklassen, darunter bebaute Flächen, nackter Boden, Asphalt, Vegetation und Schatten, bei einer räumlichen Auflösung von 2 m. Im Vergleich zu Houston2013 weist Augsburg stärkere spektrale Korrelationen sowie eine größere Klassenvielfalt auf und bietet somit eine anspruchsvolle Benchmark für die Bewertung der multimodalen Merkmalsausrichtung und Generalisierungsfähigkeit.
Der MUUFL-Gulfport-Datensatz wurde über einem Universitätscampus aufgenommen und stellt eine semiurbane Umgebung dar, die reichlich Vegetation sowie kleine, vom Menschen geschaffene Strukturen enthält. Der Datensatz umfasst entstörte hyperspektrale Bilder mit 64 Bändern zusammen mit zweibandigen LiDAR-Messungen, die aus Höhen- und Intensitätsinformationen bestehen. Er enthält 11 Landbedeckungsklassen und weist feine räumliche Details, gemischte Pixel sowie unterschiedliche Beleuchtungsbedingungen auf, was ihn besonders geeignet macht, um die multimodale Merkmalsfusion für die Klassifizierung kleiner Objekte zu evaluieren.
Insgesamt umfassen diese drei Benchmark-Datensätze erhebliche Variationen hinsichtlich räumlicher Auflösung (1–2,5 m), spektraler Dimensionalität (64–224 Bänder), Szenenkomplexität und Landbedeckungszusammensetzung. Folglich bieten sie eine vielfältige Grundlage zur Bewertung der Effektivität und Generalisierbarkeit multimodaler Methoden zur Klassifizierung der Landbedeckung. Die wichtigsten Merkmale der Datensätze sind in Tabelle 1 zusammengefasst. Die Aufteilungen in Trainings- und Testdatensätze für alle drei Datensätze entsprechen den offiziellen Benchmark-Aufteilungen der jeweiligen Datenanbieter. Konkret verwendet der Datensatz Houston2013 die offizielle Aufteilung des IEEE GRSS Data Fusion Contest 2013 mit 2.832 Trainingsstichproben und 12.197 Teststichproben. Der Augsburg-Datensatz verwendet die offiziell bereitgestellten Annotationen mask_train und mask_test und umfasst damit 4.538 Trainingsstichproben und 47.896 Teststichproben. Der MUUFL-Datensatz verwendet die offizielle Aufteilung train_test_gt.mat mit 28.645 Trainingsstichproben und 24.283 Teststichproben. Für jeden Datensatz wurde ein 32 × 32 Pixel großes Bildausschnitt, zentriert auf jedem markierten Pixel, als einzelne Trainings- oder Teststichprobe extrahiert. Es wurden keine weiteren Aufteilungen oder Resampling-Verfahren durchgeführt.
| Eigenschaft | Houston2013 | Augsburg | MUUFL |
| HSI-Bildgröße (Pixel) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| LiDAR-Bildgröße (Pixel) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| HSI-Spektralbänder | 144 | 224 | 64 |
| LiDAR-Bänder | 1 | 1 | 2 |
| HSI-Wellenlängenbereich | 0.38–1.05 µm | 0.40–1.00 µm | 375–1050 nm |
| LiDAR-Wellenlängenbereich | Nicht zutreffend | Nicht zutreffend | Nicht zutreffend |
| Räumliche Auflösung (HSI) | 2,5 m | 2,0 m | 0,54 m × 1,00 m |
| Räumliche Auflösung (LiDAR) | 2,5 m | 2,0 m | 0,60 m × 0,78 m |
| Anzahl der Landbedeckungsklassen | 15 | 17 | 11 |
Tabelle 1: Merkmale der drei multimodalen Fernerkundungsbenchmark-Datensätze, die für die Evaluierung verwendet wurden. Die Tabelle fasst die Bildabmessungen, spektralen Eigenschaften, räumlichen Auflösungen und die Anzahl der Landnutzungsklassen für die Houston2013-, Augsburg- und MUUFL-Benchmark-Datensätze zusammen, die zur Evaluierung des vorgeschlagenen FlowErs-Frameworks verwendet wurden.
Durchführungsdetails
Das FlowErs-Framework wurde in PyTorch implementiert und mithilfe einer Grafikverarbeitungseinheit (GPU) mit 80 GB Speicher trainiert und evaluiert. Das Training wurde über 100 Epochen mit einer Batch-Größe von 16 durchgeführt. Der AdamW-Optimierer wurde mit einer anfänglichen Lernrate von 1 × 10⁻⁴ und einer Gewichtsabnahme (weight decay) von 1 × 10⁻² verwendet. Ein Lernraten-Planer mit Kosinus-Annealing wurde eingesetzt, um die Lernrate während des Trainings anzupassen. Eine Dropout-Rate von 0,1 wurde angewendet, um die Generalisierung des Modells zu verbessern und Überanpassung zu reduzieren. Die Kreuzentropie-Verlustfunktion wurde für die überwachte Optimierung verwendet. Zur Reproduzierbarkeit wurden alle Experimente mit einem festen Zufallsstartwert (random seed) von 3407 initialisiert. Die bereitgestellten Trainings- und Testpartitionen wurden verwendet, ohne eine zusätzliche Validierungsaufteilung zu erstellen. Jeder Eingabe-Ausschnitt wurde vor dem Training auf 32 × 32 Pixel skaliert. Es wurde keine Datenaugmentierung, keine explizite Bildregistrierungskorrektur oder zusätzliche Normalisierung im Daten-Loader angewendet. Pixel, die mit negativen Labels assoziiert waren, wurden von der Berechnung des überwachten Verlusts ausgeschlossen. Die Behandlung fehlender oder verrauschter Pixel wurde nicht separat evaluiert.
Evaluationsmetriken
Zur Bewertung der Klassifikationsleistung wurden drei weit verbreitete Evaluierungsmetriken verwendet: Gesamtgenauigkeit (OA), durchschnittliche Genauigkeit (AA) und der Kappa-Koeffizient (k). Die OA misst den Anteil korrekt klassifizierter Proben an allen Proben, die AA stellt die mittlere Klassifikationsgenauigkeit über alle Landbedeckungsklassen hinweg dar, und der Kappa-Koeffizient quantifiziert die Übereinstimmung zwischen den vorhergesagten und den Referenzklassifikationen unter Berücksichtigung zufälliger Übereinstimmung. Höhere Werte aller drei Metriken weisen auf eine bessere Klassifikationsleistung hin. Alle in Tabellen 2–6 angegebenen Werte sind feste Punktenschätzungen, die unter Verwendung des Zufallsstarts 3407 ermittelt wurden. Konfidenzintervalle, statistische Signifikanztests oder p-Werte werden nicht angegeben.
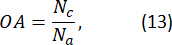
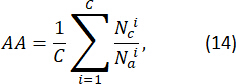
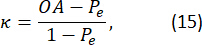
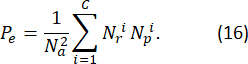
Hier, Nc und Na bezeichnen die Gesamtanzahl der korrekt klassifizierten Proben bzw. der ausgewerteten Proben.  und
 bezeichnen die Anzahl der korrekt klassifizierten Proben und die Gesamtanzahl der Proben für die i-ten Klasse, jeweils. Bei der Berechnung des Kappa-Koeffizienten Pe bezeichnet die Wahrscheinlichkeit einer zufälligen Übereinstimmung, und
 und
 bezeichnen die Referenz- und vorhergesagten Stichprobenanzahlen für die i-ten Klasse, jeweils.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Der gesamte Evaluierungsworkflow des vorgeschlagenen FlowErs-Frameworks ist in Abbildung 1 dargestellt, die die zweistufige multimodale Klassifizierungsstrategie zusammenfasst. Der modalitätsspezifische Prozess der Merkmalsextraktion, der auf dem MetaFormer-Encoder basiert, ist in Abbildung 2 gezeigt, und die wichtigsten Merkmale der drei als Benchmark verwendeten Datensätze sind in Tabelle 1 zusammengefasst. Die Klassifizierungsleistung wurde a...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Die vorliegende Studie stellt FlowErs vor, ein multimodales Fernerkundungs-Framework, das die kreuzmodale Merkmalsausrichtung von der semantischen Klassifizierung durch eine zweistufige Lernstrategie trennt. Anstatt heterogene, modalitysspezifische Merkmale direkt zu fusionieren, richtet das vorgeschlagene Framework zunächst die Merkmalsrepräsentationen mithilfe des bedingten Flussabgleichs aus, bevor die multimodale Fusion und Klassifizierung erfolgt. Dieser Ansatz adressiert die langjährige Herausforderung unterschiedl...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Interessenkonflikt:
Die Autoren erklären, dass sie keine Interessenkonflikte haben.
Danksagungen
This work was financially supported by the Scientific Research Fund Project of Shaanxi A&F University (Grant No. ZK25-38) and the Education Department of Shaanxi Province (Grant No. 24JK0734).
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| AdamW-Optimierer | PyTorch Foundation | In PyTorch enthalten | Wird für die Modell-Optimierung verwendet. PyTorch 2.5.0 wurde verwendet. |
| Augsburg-Benchmark-Datensatz | Hu J et al. (Earth System Science Data, 2022); Remote Sensing Technology, LMU München | https://doi.org/10.5281/zenodo.7185498 | Öffentlicher multimodaler Fernerkundungs-Benchmark-Datensatz, verwendet zur Modellbewertung. |
| CUDA Toolkit | NVIDIA | CUDA Toolkit 12.4; https://developer.nvidia.com/cuda-12-4-0-download-archive | Wird für GPU-beschleunigtes Modelltraining und -inferenz verwendet. |
| Graphikprozessor (GPU) | NVIDIA Corporation | NVIDIA A100 80 GB PCIe | Wird für das Modelltraining und die -bewertung verwendet. |
| Houston2013-Benchmark-Datensatz | IEEE Geoscience and Remote Sensing Society Data Fusion Contest | http://www.grss-ieee.org/community/technical-resources/data-fusion/2013-grss-data-fusion-contest/ | Öffentlicher Hyperspektralbild- und LiDAR-Benchmark-Datensatz, verwendet zur Modellbewertung. |
| MUUFL Gulfport-Benchmark-Datensatz | University of Florida (Gader P et al., Technical Report REP-2013-570) | https://github.com/GatorSense/MUUFLGulfport | Öffentlicher Hyperspektralbild- und LiDAR-Benchmark-Datensatz, verwendet zur Modellbewertung. |
| Betriebssystem | Canonical Ltd. | Ubuntu 22.04 LTS; https://ubuntu.com | Rechenumgebung, verwendet für die Modellentwicklung, das Training und die Bewertung. |
| PyTorch | PyTorch Foundation | PyTorch 2.5.0; https://pytorch.org/get-started/previous-versions/#v250 | Tiefenlern-Framework, verwendet zur Implementierung, zum Training und zur Bewertung des FlowErs-Modells. |
| Python | Python Software Foundation | Python 3.11; https://www.python.org/downloads/release/python-3110/ | Programmiersprache, verwendet zur Implementierung und Ausführung des rechnerischen Workflows. |
Referenzen
- Geng X, et al. Fast and effective: Progressive hierarchical fusion classification for remote sensing images. IEEE Trans Multimed. 2024;26:9776–89.
- Tian F, et al. HireNet: Hierarchical-relation network for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–10.
- Ye Z, et al. A multiscale incremental learning network for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Li Q, Chen Y, He X, Huang L. Co-training transformer for remote sensing image classification, segmentation, and detection. IEEE Trans Geosci Remote Sens. 2024;62:1–18.
- Qin A, et al. Deep updated subspace networks for few-shot remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Wang S, et al. Personalized multiparty few-shot learning for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Yang JY, et al. Multifrequency graph convolutional network with cross-modality mutual enhancement for multisource remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Zhou G, Qian L, Gamba P. A novel iterative self-organizing pixel matrix entanglement classifier for remote sensing imagery. IEEE Trans Geosci Remote Sens. 2024;62:1–21.
- Zhu J, et al. MVP: Meta visual prompt tuning for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–13.
- Gat I, et al. Discrete flow matching. Adv Neural Inf Process Syst. 2024;37:133345–85.
- Miller BK, Chen RT, Sriram A, Wood BM. FlowMM: Generating materials with Riemannian flow matching [Internet]. 2024 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2406.04713
- Xin Y, et al. Confidence-weighted dual-teacher networks with biased contrastive learning for semi-supervised semantic segmentation in remote sensing images. IEEE Trans Geosci Remote Sens. 2024;62:1–16.
- He Y, et al. IGroupSS-Mamba: Interval group spatial-spectral Mamba for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Liao D, Wang Q, Lai T, Huang H. Joint classification of hyperspectral and LiDAR data based on Mamba. IEEE Trans Geosci Remote Sens. 2026;19:11445–61.
- Lipman Y, et al. Flow matching for generative modeling [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=PqvMRDCJT9t
- Liu X, et al. Flow straight and fast: Learning to generate and transfer data with rectified flow [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=XVjTT1nw5z
- Geng Z, et al. Consistency models made easy [conference paper]. Presented at: 13th International Conference on Learning Representations (ICLR); 2025. Available from: https://openreview.net/forum id=1x7sJYh37d
- Hu VT, et al. Latent space editing in transformer-based flow matching [conference paper]. Presented at: AAAI Conference on Artificial Intelligence; 2024;38:2247–55. Available from: https://doi.org/10.1609/aaai.v38i3.28014
- Jeong J, Kim K, Kim W, Kim NJ. Real-time person image synthesis using a flow matching model [Internet]. 2025 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2505.03562
- Kakesh MH, et al. An efficient data generation method based on flow matching for bearing fault diagnosis under imbalanced data conditions. IEEE Trans Energy Convers. 2026;1–11.
- Chu Z, et al. End-to-end seam tracking with flow matching-based diffusion policy [conference paper]. Presented at: International Conference on Machine Intelligence and Nature-Inspired Computing (MIND); Xiamen, China; 2025. p. 304–9. Available from: https://doi.org/10.1109/MIND67540.2025.11351867
- Melgani F, Bruzzone L. Classification of hyperspectral remote sensing images with support vector machines. IEEE Trans Geosci Remote Sens. 2004;42:1778–90.
- Li J, et al. Deep learning in multimodal remote sensing data fusion: A comprehensive review. Int J Appl Earth Obs Geoinf. 2022;112:102926.
- Vaswani A, et al. Attention is all you need [Internet]. 2017 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/1706.03762
- Zhuang Y, Chen M, Zhu D. UWASR-GAN: An attention-guided multi-scale residual framework for underwater image enhancement in underwater Internet of Things applications. IEEE Internet Things J. 2026;12:29452–71.
- Ma X, Zhang X, Pun MO, Liu M. A multilevel multimodal fusion transformer for remote sensing semantic segmentation. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Xie W, Lu Y, Li D, Li Y. Ebbinghaus-curve guided low-rank component-induced attention for multisource remote sensing classification. IEEE Trans Geosci Remote Sens. 2024;62:1–12.
- Li D, Xie W, Li Y, Fang L. FedFusion: Manifold-driven federated learning for multi-satellite and multi-modality fusion. IEEE Trans Geosci Remote Sens. 2023;62:1–13.
- Debes C, et al. Hyperspectral and LiDAR data fusion: Outcome of the 2013 GRSS data fusion contest. IEEE J Sel Top Appl Earth Obs Remote Sens. 2014;7:2405–18.
- Hu J, et al. MDAS: A new multimodal benchmark dataset for remote sensing. Earth Syst Sci Data Discuss. 2022:1–26.
- Gader P, et al. MUUFL Gulfport hyperspectral and LiDAR airborne data set. University of Florida; Gainesville (FL); Technical Report REP-2013-570; 2013.
- Gao Y, et al. Hyperspectral and multispectral classification for coastal wetland using depthwise feature interaction network. IEEE Trans Geosci Remote Sens. 2021;60:1–15.
- Feng Y, Song L, Wang L, Wang X. DSHFNet: Dynamic scale hierarchical fusion network based on multiattention for hyperspectral image and LiDAR data classification. IEEE Trans Geosci Remote Sens. 2023;61:1–14.
- Hong D, et al. More diverse means better: Multimodal deep learning meets remote-sensing imagery classification. IEEE Trans Geosci Remote Sens. 2020;59:4340–54.
- Feng Z, et al. Cross-modal contrastive learning for remote sensing image classification. IEEE Trans Geosci Remote Sens. 2023;61:1–13.
- Xu X, et al. Multisource remote sensing data classification based on convolutional neural network. IEEE Trans Geosci Remote Sens. 2017;56:937–49.
- Yao J, et al. Extended vision transformer (ExViT) for land use and land cover classification: A multimodal deep learning framework. IEEE Trans Geosci Remote Sens. 2023;61:1–15.
- Chang H, et al. Deep symmetric fusion transformer for multimodal remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;63:1–15.
- Wang A, et al. CTPMSN: Enhancing multimodal remote sensing classification with composite text prompts. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:27960–27978.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.