Dieses Protokoll aus der Verhaltenswissenschaft und psychologischen Diagnostik standardisiert die Online-Durchführung von Fragebögen, die Auswertung, die Überprüfung der Datenqualität sowie die reproduzierbare Analyse, um Internetabhängigkeit und Schwierigkeiten bei der Emotionsregulation bei Studierenden zu erfassen.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Methodenartikel
Ein standardisiertes Fragebogenprotokoll zur Bewertung von Internetsucht und Emotionsregulation bei Universitätsstudierenden
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die Internetnutzung ist tief in das Universitätsleben integriert, doch eine problematische Internetnutzung kann nicht allein anhand der Nutzungsdauer angemessen bewertet werden. Befunde deuten darauf hin, dass maladaptive oder zwanghafte Muster der Internetnutzung mit Schwierigkeiten bei der Emotionsregulation verbunden sind, doch Inkonsistenzen in der Reihenfolge der Fragebögen, den Zulassungskriterien, den Screening-Schwellenwerten, den Bewertungsverfahren und der Darstellung der Analysen beeinträchtigen weiterhin die Vergleichbarkeit zwischen Studien. Dieser Methodenartikel stellt ein standardisiertes Fragebogenprotokoll für verhaltenswissenschaftliche und psychologische Untersuchungen zur Internetabhängigkeit und zu Schwierigkeiten bei der Emotionsregulation bei Studierenden vor. Der Arbeitsablauf umfasst eine feste Reihenfolge der Fragebögen, vorab festgelegte Zulassungskriterien, Pflichtangaben, anhand einer Pilotstudie definierte Schwellenwerte für die Bearbeitungsdauer, eine schrittweise Überprüfung der Datenqualität, eine standardisierte Auswertung des Internet Addiction Test und der 16-Item Difficulties in Emotion Regulation Scale sowie reproduzierbare deskriptive, korrelative und multivariable Regressionsanalysen. Das Protokoll sieht außerdem die Archivierung der Rohdaten, der Screening-Protokolle, von README-/Codebuch-Dateien und des endgültigen analysenfähigen Datensatzes vor. Eine repräsentative Durchführung wird beschrieben, um die Anwendung des Protokolls zu demonstrieren, nicht jedoch um die Instrumente zu validieren oder Prävalenzen festzulegen. In dieser Durchführung wurden 520 Studierende eingeladen, wovon 480 Fragebögen zurückgesandt wurden. Nach schrittweiser Ausschließung doppelter Einreichungen, zu schneller Antworten, fehlgeschlagener Aufmerksamkeitsprüfungen, systematischer Antwortmuster, logischer Inkonsistenzen und fehlender Kernangaben blieben 452 gültige Fragebögen erhalten. Die vorab festgelegte Analyse untersuchte den Zusammenhang zwischen der Gesamtpunktzahl des Internet Addiction Test und der Gesamtpunktzahl der Difficulties in Emotion Regulation Scale. Die verbleibende Stichprobe wies eine durchschnittliche Gesamtpunktzahl von 51,94 im Internet Addiction Test und von 35,95 in der Difficulties in Emotion Regulation Scale auf. Die Schwierigkeiten bei der Emotionsregulation nahmen mit steigender Schwere der Internetabhängigkeit zu, und der Zusammenhang blieb auch nach Berücksichtigung demografischer und verhaltensbezogener Kovariaten erkennbar. Dieses Protokoll bietet einen transparenten Arbeitsablauf, der wiederholt, überprüft und für zukünftige Querschnitts-, Messwiederholungs- oder Längsschnittstudien an Universitätsstichproben angepasst werden kann.
Einleitung
Die Nutzung des Internets ist ein gewöhnlicher Bestandteil des Universitätslebens geworden, einschließlich akademischer Arbeit, sozialer Kommunikation, Unterhaltung, Informationsbeschaffung und emotionaler Bewältigungsstrategien. Aus diesem Grund sollte das Internetnutzungsverhalten von Studierenden nicht einfach als Bildschirmzeit oder Online-Zeit interpretiert werden. Frühere Befunde zeigten, dass problematische Internetnutzung bereits bei Jugendlichen und Studierenden sichtbar war, bevor die heutige Umgebung mit mobilen Plattformen stark verbreitet war1. Neuere, an Universitäten durchgeführte Studien deuten zudem darauf hin, dass problematische Internetnutzung so verbreitet ist, dass eine systematische Erfassung erforderlich ist, anstatt lediglich informelle Beschreibungen vorzunehmen2.
Universitätsstudierende stellen eine besonders relevante Population für standardisierte Bewertungen dar, da akademischer Druck, soziale Umstellung, selbständiges Leben und erhöhte Autonomie häufig im selben Entwicklungsstadium auftreten. Diese Anforderungen werden oft mithilfe derselben digitalen Geräte und Plattformen bewältigt, die gleichzeitig schwer regulierbar werden können. Eine metaanalytische Übersichtsarbeit zeigte, dass problematischer Interneteinsatz bei Studierenden mit mehreren psychischen Gesundheitsauswirkungen assoziiert ist, was die Interpretation als umfassendes verhaltensbezogenes und psychologisches Problem statt als enges Technologie-Nutzungsproblem stützt3. Auch der wahrgenommene Stress wurde mit Mustern der Internetsucht bei Hochschulstudierenden in Verbindung gebracht, was darauf hindeutet, dass emotionale und kontextuelle Belastungen bei der Konzeption von fragebogenbasierten Studien in diesem Bereich berücksichtigt werden sollten4.
In dem vorliegenden Protokoll wird der Begriff „Internetabhängigkeit“ verwendet, wenn ausdrücklich auf das Konstrukt Bezug genommen wird, das mit dem Internet-Addiction-Test und dessen etablierten Punktekategorien gemessen wird. Der weiter gefasste Begriff „problematische Internetsnutzung“ wird verwendet, wenn die umfassendere Literatur zu maladaptivem, übermäßigem oder funktionell beeinträchtigendem internetbezogenen Verhalten diskutiert wird. Der Begriff „zwanghafte Internetsnutzung“ wird ausschließlich dann verwendet, wenn die zitierte Literatur den Verlust der Kontrolle, Handlungsdränge oder die wiederholte Nutzung trotz negativer Konsequenzen betont. Diese Begriffe sind daher miteinander verwandt, jedoch nicht als vollständig austauschbar anzusehen. Wenn das Protokoll unter Anwendung des Internet Addiction Test durchgeführt wird, bleibt „Internetabhängigkeit“ als instrumentenspezifische Terminologie erhalten; wenn alternative oder überarbeitete Instrumente verwendet werden, sollte die Terminologie an die Konstruktbezeichnungen und diagnostischen Annahmen des gewählten Messinstruments angepasst werden.
Die Emotionsregulation bietet einen plausiblen psychologischen Ansatzpunkt dafür, zu verstehen, warum einige Studierende von häufiger Internetnutzung zu einer maladaptiven Internetnutzung übergehen. Eine prospektive Studie über ein Jahr zeigte, dass Schwierigkeiten in der Emotionsregulation sowohl mit dem späteren Auftreten als auch mit der Remission von Internetabhängigkeit bei Studierenden zusammenhingen5. Dieser Befund ist wichtig für die Gestaltung von Studienprotokollen, da die Emotionsregulation nicht bloß ein weiterer Korrelat ist; sie kann beeinflussen, wie Studierende das Internet nutzen, um Belastung zu vermeiden, zu reduzieren oder zu bewältigen. Gleichzeitig bleibt die soziale Funktionsfähigkeit relevant. Problematische Internetnutzung war bei Studierenden mit sozialen Fähigkeiten assoziiert, was darauf hinweist, dass neben Variablen der digitalen Nutzung auch interpersonelle und emotionale Faktoren erfasst werden sollten6. Während der COVID-19-Phase trat problematische Internetnutzung bei chinesischen Studierenden zudem gemeinsam mit umfassenderen psychologischen Schwierigkeiten auf, was die Notwendigkeit einer strukturierten Beurteilung im universitären Umfeld weiter untermauert7.
Eine weitere Herausforderung besteht darin, dass digitales Verhalten heterogen ist. Studierende können digitale Plattformen für das Lernen, soziale Kontakte, Unterhaltung, Gesundheitsinformationen oder vorübergehende emotionale Entlastung nutzen, und nicht jede häufige Nutzung ist schädlich. Eine systematische Übersichtsarbeit über digitale Aktivitäten im Zusammenhang mit der psychischen Gesundheit bei Studierenden zeigte, dass digitale Nutzung mehrere psychologische Funktionen erfüllen kann8. Daher benötigt das Forschungsfeld Verfahren, die zwischen gewöhnlicher häufiger Nutzung und problematischer oder dysregulierter Nutzung unterscheiden. Neuere Erkenntnisse zur problematischen Smartphone-Nutzung bei Studierenden deuten ebenfalls darauf hin, dass das Risiko von Mustern, Funktionen und Kontexten des Verhaltens abhängt und nicht allein von der Nutzungsdauer9. Aus diesem Grund kombiniert das vorliegende Protokoll die Dauer der Internetnutzung, die Nutzung in der Nacht, die hauptsächliche Online-Aktivität und standardisierte Symptomwerte, anstatt sich auf einen einzelnen Expositionsindikator zu verlassen.
Die Messung ist eine weitere wesentliche Quelle von Inkonsistenzen. Der Internet-Addiction-Test bleibt eines der am häufigsten verwendeten Instrumente zur Erfassung von Symptomen einer Internetabhängigkeit, doch seine Dimensionalität und Interpretation haben je nach Anwendungskontext variiert. Systematische psychometrische Befunde zeigen, dass das Instrument zwar ausgiebig eingesetzt wurde, dabei aber weiterhin Fragen bezüglich seiner Faktorenstruktur und der Interpretation der Bewertungsskala aufwirft10. Ähnliche Bedenken wurden auch in Stichproben von Hochschulstudierenden berichtet, bei denen die weite Verbreitung der Skala die Unsicherheit über das tatsächlich erfasste Konstrukt nicht vollständig beseitigte11. Validierungsstudien an spanischen und peruanischen Universitätsbevölkerungen zeigen ebenfalls, dass das Instrument adäquat funktionieren kann, seine psychometrischen Eigenschaften jedoch stets im Kontext der jeweils adressierten Zielgruppe betrachtet werden sollten12,13.
Das Protokoll ist daher so konzipiert, dass der Arbeitsablauf stabil bleibt, die Auswahl der Instrumente jedoch anpassbar ist. Der Internetabhängigkeitstest wird hier aufgrund seiner historischen Verwendung, der verfügbaren Schwellenwerte und der Vergleichbarkeit mit früheren Studien an Universitätsstudierenden verwendet. Das Protokoll verlangt jedoch nicht, dass der Internetabhängigkeitstest dauerhaft das bevorzugte Instrument bleibt. Falls sich diagnostische Rahmenwerke weiterentwickeln oder neuere Instrumente für eine bestimmte Population besser geeignet sind, kann derselbe Arbeitsablauf beibehalten werden, während das instrumentspezifische Modul, der Bewertungsbereich, die Schweregrad-Schwellenwerte, die Codebucheinträge und die README-Dokumentation ersetzt werden. Ein solcher Austausch sollte vor Beginn der formalen Datenerhebung erfolgen und als Protokolländerung – nicht als ad-hoc-analytische Änderung – berichtet werden.
Das methodische Problem, das in diesem Artikel angesprochen wird, besteht nicht einfach darin, dass Studien zur Internetsucht und Emotionsregulation zu unterschiedlichen Schlussfolgerungen gelangen. Vielmehr unterscheiden sich viele Studien hinsichtlich der Reihenfolge der Fragebögen, der Einschlusskriterien, der Einstellungen der Umfrageplattform, der Behandlung von Doppelerfassungen, der Verfahren zur Aufmerksamkeitskontrolle, der Schwellenwerte für die Bearbeitungsdauer, der Regeln für fehlende Daten, der Überprüfung der Skalenergebnisse sowie der Berichterstattung über analysenfertige Datensätze. Diese Unterschiede erschweren den Vergleich, die Reproduktion und die Einbeziehung der Ergebnisse in spätere Evidenzsynthesen. Das vorliegende Protokoll reagiert auf diese Lücke, indem es die Reihenfolge der Durchführung, die Ausschlußlogik, die Skalenstruktur und den analytischen Weg so festlegt, dass sie wiederholbar, überprüfbar und transparent modifizierbar sind. Sein Beitrag ist daher protokollorientiert: Es stellt einen reproduzierbaren Arbeitsablauf für beobachtende Verhaltenswissenschafts- und psychologische Bewertungsstudien in universitären Populationen bereit, anstatt einen neuen psychologischen Konstrukt vorzuschlagen oder eine Prävalenzstudie als Hauptergebnis zu präsentieren.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Die Studie mit dem Titel „Ein standardisierter Fragebogen-Protokoll zur Beurteilung von Internetabhängigkeit und Emotionsregulation bei Universitätsstudierenden“ wurde vom Ethik- und Akademischen Ausschuss der Zhengzhou University of Economics and Business unter der Genehmigungsnummer 20260113004 überprüft und genehmigt, bevor die Rekrutierung der Teilnehmer begann14. Die Studie verwendete ein querschnittliches, anonymes Online-Fragebogen-Design mit Vollzeit-Universitätsstudierenden im Alter von 18–24 Jahren und wurde gemäß den institutionellen ethischen Anforderungen sowie der Deklaration von Helsinki durchgeführt. Eine elektronische informierte Einwilligung wurde vor dem Zugriff auf den Fragebogen eingeholt. Den Teilnehmenden wurde ein elektronisches Informationsschreiben zur Verfügung gestellt, das Ziel und Verfahren der Studie, den freiwilligen Charakter der Teilnahme sowie Maßnahmen zum Datenschutz erläuterte; außerdem konnten sie ihre Teilnahme jederzeit ohne Nachteile beenden. Im Haupterhebungsdatensatz wurden keine direkt identifizierbaren personenbezogenen Daten wie Name, Studierendenausweisnummer, genaue Adresse, Telefonnummer, private E-Mail-Adresse oder Social-Media-Accounts erhoben. Plattformgenerierte Identifikatoren dienten ausschließlich der Überprüfung auf doppelte Antworten und wurden vor der Datensatzanalyse entfernt. Alle Daten wurden sicher gespeichert und in anonymisierter Form analysiert. Dieser Fragebogen-Arbeitsablauf wurde vor Beginn der Teilnehmerrekrutierung nicht prospektiv registriert. Alle wesentlichen Protokollbestandteile, einschließlich der finalisierten Fragebogenversion, des README-/Codebuchs, des Screening-Protokolls, der Bewertungsregeln, der Analyse-Syntax und der analyseready Arbeitsablaufdateien, wurden jedoch archiviert und als ergänzende Arbeitsablaufmaterialien bereitgestellt, um Reproduzierbarkeit und Nachvollziehbarkeit zu gewährleisten.
Plattformerzeugte Antwortkennungen sowie technische Kennungen, die auf Geräte oder Konten beschränkt sind, wurden ausschließlich zur Identifizierung von Doppelerfassungen verwendet und aus dem endgültigen anonymisierten Datensatz für die Analyse entfernt. Die Kernvariablen und Bewertungsregeln sind in Tabelle 1 zusammengefasst, und das vollständige Variablenverzeichnis ist in Zusatztabelle 1 enthalten. Die Fragbogendateien, das Codebuch, das Screening-Protokoll, der Ausgabeplan sowie die analysereifen Arbeitsabläufe sind in Zusatzdatei 1 bereitgestellt.
| Bereich | Variable | Codierung/Bewertung | Rolle im Protokoll |
| Zulassungsvoraussetzung | Alter | Jahre; zulässiger Bereich 18–24 | Zulassungsvariable und Kovariate |
| Demografie | Geschlecht | 1 = männlich; 2 = weiblich; 3 = keine Angabe | Deskriptive Variable und Regressionskovariate |
| Demografie | Studienjahr | 1 = erstes Jahr; 2 = zweites Jahr; 3 = drittes Jahr; 4 = viertes Jahr oder höher; 5 = postgradual | Deskriptive Variable |
| Demografie | Fachbereichskategorie | 1 = Geistes- und Sozialwissenschaften; 2 = Naturwissenschaften und Ingenieurwesen; 3 = Wirtschaft und Management; 4 = Kunst und Design; 5 = sonstige | Deskriptive Variable |
| Demografie | Wohnform | 1 = Campus-Wohnheim; 2 = außeruniversitäre Wohnung; 3 = Elternhaus; 4 = sonstige | Deskriptive Variable |
| Demografie | Monatliche Lebenshaltungskosten | 1 = <1.000 CNY; 2 = 1.000–1.999 CNY; 3 = 2.000–2.999 CNY; 4 = ≥3.000 CNY | Deskriptive Variable |
| Nutzungsverhalten Internet | Internetnutzung an Wochentagen | 1 = <2 h; 2 = 2–3,9 h; 3 = 4–5,9 h; 4 = ≥6 h | Verhaltensbezogene Kovariate |
| Nutzungsverhalten Internet | Internetnutzung am Wochenende | 1 = <2 h; 2 = 2–3,9 h; 3 = 4–5,9 h; 4 = ≥6 h | Verhaltensbezogene Kovariate |
| Nutzungsverhalten Internet | Haupttätigkeit online | 1 = Lernen; 2 = soziale Medien; 3 = Gaming; 4 = Unterhaltung/Videos; 5 = Einkaufen; 6 = gemischte Nutzung; 7 = sonstige | Deskriptive Variable |
| Nutzungsverhalten Internet | Hauptzugangsgerät | 1 = Smartphone; 2 = Tablet; 3 = Laptop/PC; 4 = gemischte Geräte | Deskriptive Variable |
| Nutzungsverhalten Internet | Nutzung in der Nacht nach 23:00 Uhr | 1 = nie; 2 = weniger als einmal pro Woche; 3 = 1–2 Nächte/Woche; 4 = 3–5 Nächte/Woche; 5 = fast jede Nacht | Verhaltensbezogene Kovariate und Variable zur logischen Konsistenzprüfung |
| Kernskala | IAT-Gesamtpunktzahl | Summe aus 20 Items; jedes Item wird mit 1–5 bewertet; Gesamtbereich 20–100 | Primäre unabhängige Variable |
| Kernskala | IAT-Schweregradgruppe | 20–39 = normale Nutzung; 40–69 = problematische Nutzung; 70–100 = schwere problematische Nutzung | Gruppierungsvariable |
| Kernskala | DERS-16-Gesamtpunktzahl | Summe aus 16 Items nach erforderlicher Umkehrung der Bewertung; Gesamtbereich 16–80 | Primäre abhängige Variable |
| Kernskala | DERS-16-Subskalen | Berechnet gemäß dem festgelegten DERS-16-Bewertungsschlüssel | Deskriptive Ergebnisse zur Emotionsregulation |
| Kovariate | Schlafdauer | 1 = <6 h; 2 = 6–6,9 h; 3 = 7–7,9 h; 4 = ≥8 h | Anpassungsvariable |
| Kovariate | Wöchentliche körperliche Aktivität | 0 = keine; 1 = 1–2 Sitzungen; 2 = 3–4 Sitzungen; 3 = ≥5 Sitzungen | Anpassungsvariable |
| Kovariate | Studienstress | 1 = gering; 2 = mittel; 3 = hoch | Anpassungsvariable |
| Qualitätskontrolle | Aufmerksamkeitsprüfung | 1 = bestanden; 0 = nicht bestanden | Ausschlusskriterium |
| Qualitätskontrolle | Dauer der Bearbeitung | Bearbeitungsdauer in Sekunden | Zeitbasierte Screening-Variable |
| Qualitätskontrolle | Anzahl langer identischer Antwortsequenzen | Maximale Länge identischer Antworten über die 36 bewerteten Skalenitems hinweg | Screening-Variable für musterhafte Antworten |
| Qualitätskontrolle | Innerpersonale Standardabweichung (SD) | Innerpersonale Standardabweichung über die 36 bewerteten Skalenitems hinweg | Screening-Variable für invariable Antworten |
| Qualitätskontrolle | Logische Konsistenzmarke | 0 = keine Inkonsistenz; 1 = Inkonsistenz festgestellt | Screening-Variable für logische Konsistenz |
Tabelle 1: Kernvariablen, Kodierstruktur und Bewertungsregeln, die im standardisierten Fragebogenprotokoll verwendet werden. Diese Tabelle fasst die zentralen Variablen zur Erfassung von Eignung, Demografie, Internetnutzung, Skalen, Kovariaten und Qualitätskontrolle zusammen, die im Hauptarbeitsablauf verwendet werden. Sie enthält die Kodierwerte, Bewertungsbereiche, Bewertungsregeln sowie die Funktionen der wichtigsten Variablen, die für die Durchführung des Fragebogens, die Selektion, die Punktevergabe und die Analyse genutzt werden. Abkürzungen: IAT = Internet Addiction Test; DERS-16 = 16-Item-Difficulties-in-Emotion-Regulation-Skala. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
1. Einrichten der Studienpopulation, der Fragebogenstruktur und des Umfrageablaufs
- Definieren Sie die Zielgruppe und eine gültige Stichprobe
- Rekrutieren Sie Vollzeit-Studierende im Alter von 18–24 Jahren, die den Fragebogen eigenständig auf einem Mobiltelefon oder Computer ausfüllen können. Notieren Sie die Sprachversion des Fragebogens und verwenden Sie Skalenversionen, die für die Zielgruppe der Studierenden validiert oder angemessen angepasst wurden.
- Dokumentieren Sie vor der Datenerhebung alle Anpassungen hinsichtlich Barrierefreiheit oder Sprache, wenn internationale Studierende, Studierende mit Behinderungen oder mehrsprachige Studierendengruppen einbezogen werden.
- Beschränken Sie die Teilnahme auf eine vollständige Antwort pro Teilnehmer. Verwenden Sie, falls verfügbar, die Gerätebeschränkung, Kontobeschränkung, Cookie-Beschränkung oder die Authentifizierungs-Link-Funktion der Umfrageplattform.
HINWEIS: Wenn dasselbe Teilnehmerkonto Antworten von mehreren Geräten generiert, identifizieren und bereinigen Sie diese Datensätze während der Dublettenscreening-Phase anhand des kontobezogenen Identifikators, Zeitstempels, Fragebogenstatus und der Ähnlichkeit der Antwortmuster. - Legen Sie die Mindestgröße der endgültigen gültigen Stichprobe auf 450 Fragebögen fest und setzen Sie die Rekrutierung fort, bis der bereinigte Datensatz nach der Screening-Phase diesen Schwellenwert weiterhin übersteigt.
HINWEIS: Wenn eine schwere Form der problematischen Internetsnutzung oder eine andere kleine Untergruppe das primäre Analyseziel darstellt, legen Sie vor Beginn der Datenerhebung ein höheres Rekrutierungsziel fest. - Notieren Sie die Anzahl der Einladungen, die Anzahl der Rückmeldungen, die Anzahl der Ausschlüsse in jedem vorab festgelegten Screening-Schritt sowie die endgültige Anzahl der verbliebenen Teilnehmer, sodass der Teilnehmerfluss später in Abbildung 1 zusammengefasst werden kann.
- Erstellen Sie den Fragebogen in fester Reihenfolge
- Ordnen Sie den Fragebogen in der folgenden Reihenfolge an: informierte Einwilligung, Angaben zur Demografie, Verhalten bezüglich der Internetsnutzung, Internet Addiction Test, Kurzform der Skala für Schwierigkeiten bei der Emotionsregulation, Schlafdauer, wöchentliche körperliche Aktivität und wahrgenommener akademischer Stress. Behalten Sie diese Reihenfolge für alle Teilnehmer bei. Randomisieren Sie die Reihenfolge der Kernskalen nicht.
- Erfassen Sie Alter, Geschlecht, Studienjahr, Fachbereichskategorie, Wohnform und monatliche Lebenshaltungskosten mittels geschlossener Antwortkategorien. Kennzeichnen Sie alle demografischen Fragen als verpflichtend.
HINWEIS: Bei der Angabe des Geschlechts sind die Kategorien männlich, weiblich und „bevorzuge ich nicht zu sagen“ einzuschließen. Behalten Sie „bevorzuge ich nicht zu sagen“ in deskriptiven Analysen bei. In Regressionsanalysen kodieren Sie das Geschlecht mittels Indikatorvariablen, wobei männlich als Referenzkategorie dient, und fügen Sie separate Indikatoren für weiblich und „bevorzuge ich nicht zu sagen“ ein. Löschen Sie Teilnehmer nicht allein deshalb, weil sie „bevorzuge ich nicht zu sagen“ auswählen. - Erfassen Sie die Dauer der Internetsnutzung an Wochentagen, die Dauer der Internetsnutzung am Wochenende, die primäre Online-Aktivität, das primäre Zugangsgerät sowie die nächtliche Internetsnutzung nach 23:00 Uhr. Kodieren Sie die nächtliche Nutzung wie folgt: 1 = nie, 2 = weniger als einmal pro Woche, 3 = 1–2 Nächte pro Woche, 4 = 3–5 Nächte pro Woche, 5 = fast jede Nacht.
- Notieren Sie den akademischen Zeitraum, in dem der Fragebogen durchgeführt wird. In der repräsentativen Durchführung erfolgte die Befragung während eines regulären Lehrsemesters außerhalb der Prüfungswochen, speziell in den Semesterwochen 6–7.
- Durchführung und Auswertung der Kerninstrumente
- Führen Sie den 20-Item-Internet Addiction Test als verpflichtende Skala durch und bewerten Sie jedes Item von 1 bis 5. Addieren Sie alle 20 Items, um einen Gesamtwert zwischen 20 und 100 zu erhalten, und klassifizieren Sie anschließend 20–39 als normale Nutzung, 40–69 als problematische Nutzung und 70–100 als schwere problematische Nutzung15.
- Verwenden Sie den Begriff „Internetsucht“, wenn Sie Ergebnisse und Schweregrade auf Basis des IAT berichten. Verwenden Sie „problematische Internetsnutzung“ nur im Hinblick auf die breitere Literatur oder nicht-IAT-bezogene Konstrukte.
- Führen Sie unmittelbar nach dem Internet Addiction Test die 16-Item-Kurzform der Skala für Schwierigkeiten bei der Emotionsregulation durch und bewerten Sie jedes Item von 1 bis 5. Kodieren Sie die Items 1, 6 und 8 invertiert, bevor Sie summieren, und berechnen Sie anschließend einen Gesamtwert zwischen 16 und 80, wobei höhere Werte auf größere Schwierigkeiten bei der Emotionsregulation hinweisen16.
- Berechnen Sie nach Überprüfung der invertierten Items fünf Subskalenwerte für Nichtakzeptanz, Ziele, Impulsivität, Strategien und Klarheit.
- Überprüfen Sie erneut die Kodierungsrichtung aller invertierten Items, bevor Sie die Gesamt- und Subskalenwerte berechnen. Verwenden Sie für alle Teilnehmer denselben DERS-16-Auswertungsschlüssel und dokumentieren Sie diesen im README/Codebuch.
- Wenn ein überarbeitetes oder alternatives Instrument zur Erfassung der Internetsucht verwendet wird, ersetzen Sie das skalenbezogene Modul vor Beginn der Datenerhebung und aktualisieren Sie die Itemnamen, den Bewertungsbereich, die Schweregradschwellen, die Auswertungssyntax, das README/Codebuch, die Fragebogen-Screenshots sowie die Materialtabelle.
- Ergänzen Sie Kovariaten und ein Aufmerksamkeitscheck-Item
- Erfassen Sie die Schlafdauer als <6 h, 6–6,9 h, 7–7,9 h und ≥8 h. Erfassen Sie die Häufigkeit der wöchentlichen körperlichen Aktivität als 0, 1–2, 3–4 und ≥5 Sitzungen. Erfassen Sie den wahrgenommenen akademischen Stress als niedrig, mittel oder hoch. Definieren Sie eine Sitzung körperlicher Aktivität als ≥20 Minuten moderater oder intensiver Aktivität.
- Fügen Sie im Verhaltensabschnitt ein gerichtetes Aufmerksamkeitscheck-Item ein und fordern Sie den Teilnehmer auf, eine bestimmte Antwortoption auszuwählen. Das im repräsentativen Setting verwendete Aufmerksamkeitscheck-Item lautete: „Um zu bestätigen, dass Sie sorgfältig lesen, wählen Sie bitte ‚3 = manchmal‘ für dieses Item“. Kennzeichnen Sie jeden Fragebogen, der dieses Item nicht korrekt beantwortet, zur Ausschließung während der Datensäuberung17.
ENTSCHIDENDER SCHRITT: Ändern Sie nach Beginn der formalen Datenerhebung weder die Formulierung der Items, die Antwortanker, die Skalenreihenfolge, Ausschlusskriterien, Einstellungen der Umfrageplattform, Kodierungsregeln noch die Regeln für die statistische Analyse.
HINWEIS: Fassen Sie die Kernvariablen, Kodierungswerte, Bewertungsbereiche und Auswertungsregeln in Tabelle 1 zusammen. Stellen Sie das vollständige Variablendictionary, Felder zum Dateistatus, Screening-Markierungen, technische Identifikatorfelder, Variablen zur Datensatzverfolgung, Dateinamen und Softwareversionen in ergänzender Tabelle 1 sowie im README/Codebuch bereit.
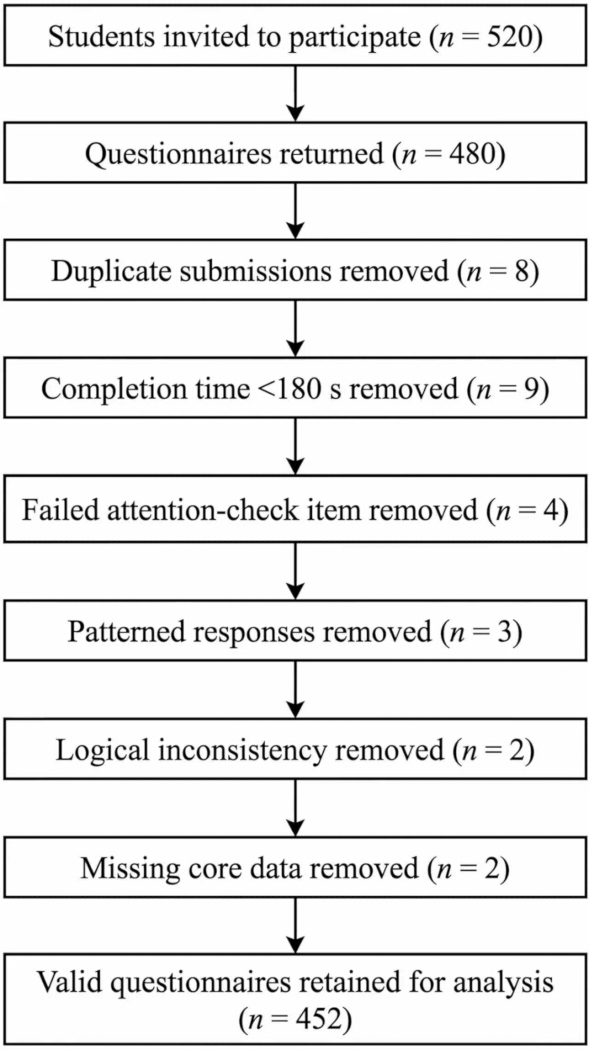
Abbildung 1: Ablaufschema des Fragebogens für Rekrutierung, Screening, Ausschluss und endgültige analytische Einbeziehung. Dieses Flussdiagramm zeigt den Verlauf von eingeladenen Studierenden zu zurückgesandten Fragebögen, gefolgt von schrittweisen Datenqualitätsprüfungen und Ausschlüssen nach vorab festgelegten Kriterien, bis hin zur endgültigen Einbeziehung gültiger Fragebögen zur Analyse. Die Abbildung zeigt die Anzahl der eingeladenen Studierenden, der zurückgesandten Fragebögen, der bei jedem Screening-Schritt ausgeschlossenen Datensätze sowie der endgültigen Stichprobe für die Analyse. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
2. Pilot-Test des Fragebogens durchführen und endgültige Feldversion sperren
- Testen Sie den vollständigen Fragebogen in einer Pilotstudie
- Reichen Sie den vollständigen Fragebogen bei 20–30 Studierenden ein, die die formalen Einschlusskriterien erfüllen, diese jedoch nicht in den endgültigen Datensatz übernommen werden.
- Dokumentieren Sie die Bearbeitungsdauer sowie schriftliches Feedback zur Klarheit, Antwortbelastung, technischem Zugang, Reihenfolge der Fragen, Verständnis der Aufmerksamkeitschecks und eventuellen Unklarheiten bei den Antwortoptionen zu demografischen oder verhaltensbezogenen Fragen.
- Notieren Sie die Stichprobengröße der Pilotstudie, die mediane Bearbeitungsdauer, den Interquartilsabstand, die minimale und maximale Bearbeitungsdauer sowie alle nach der Pilotstudie vorgenommenen Änderungen an der Formulierung.
- Bei der repräsentativen Durchführung umfasste die Pilotstudie 25 Studierende, die mediane Bearbeitungsdauer betrug 540 s, und die erwartete Bearbeitungsdauer wurde auf 6–8 min festgelegt.
- Überarbeiten Sie unklare Formulierungen, doppelte Bedeutungen, unklare Antwortoptionen oder Software-Anzeigeprobleme, die während der Pilotstudie identifiziert wurden, und schließen Sie anschließend die endgültige Version des Fragebogens vor der offiziellen Veröffentlichung ab.
HINWEIS: Falls die Studie mehrsprachige Studierende, ältere Erwachsene, Jugendliche oder Studierende mit Behinderungen einschließt, führen Sie vor der offiziellen Veröffentlichung zusätzliche kognitive Tests oder Pilotstudien an Subgruppen durch.
- Legen Sie die Betriebseinstellungen und Exportregeln fest
- Erstellen Sie ein neues Umfrageprojekt auf der ausgewählten Online-Umfrageplattform. Geben Sie die Einwilligungsseite als erste Seite ein und setzen Sie das Einwilligungsitem als erforderliches Verzweigungsitem.
- Konfigurieren Sie die Umfrage so, dass Teilnehmende, die keine Einwilligung erteilen, die Umfrage automatisch verlassen, ohne den eigentlichen Fragebogen zu sehen.
- Geben Sie alle demografischen Fragen, Fragen zur Internetnutzung, IAT-, DERS-16-, Kovariat- und Aufmerksamkeitscheck-Items unter Verwendung der festgelegten Formulierungen und Antwortanker ein. Legen Sie alle Kernitems als verpflichtend fest.
- Aktivieren Sie die automatische Aufzeichnung von Startzeit, Endzeit, Bearbeitungsdauer, Antwortstatus und plattformgenerierter Antwortkennung.
- Aktivieren Sie, falls verfügbar, Steuerungen für eine Antwort pro Teilnehmenden, einschließlich authentifizierter Umfragelinks, Gerätebeschränkungen, cookiebasierte Wiederholungsverhinderung, kontobasierte Wiederholungsverhinderung oder Einstellungen zur Überprüfung doppelter Antworten. Dokumentieren Sie die aktivierten Steuerungen im README/Codebuch.
- Deaktivieren Sie die Erfassung unnötiger direkter Identifikatoren. Falls die Plattform standardmäßig die IP-Adresse erfasst, deaktivieren Sie die Speicherung der IP-Adresse oder ersetzen Sie sie durch ein nicht identifizierendes Feld zur Dublettenerkennung, sofern dies gemäß der institutionellen Richtlinie zulässig ist.
HINWEIS: Wenn IP-Adressen oder Gerätemetadaten vorübergehend zur Dublettenerkennung gespeichert werden, dürfen diese nur in der verschlüsselten Rohdatei abgelegt, der Zugriff auf den Studienanalysten beschränkt und vor der Erstellung des endgültigen Analyse-Datensatzes entfernt werden. - Legen Sie fest, ob Unterbrechung und Fortsetzung erlaubt sind. In diesem Protokoll ist eine formale Speicher-und-Zurückkehren-Funktion über verschiedene Sitzungen hinweg nicht aktiviert. Teilnehmende dürfen nur innerhalb derselben geöffneten Browsersitzung pausieren, und die erfasste Bearbeitungsdauer umfasst die gesamte verstrichene Zeit.
- Exportieren Sie die Rohdatendatei bei Abschluss der Umfrage sowohl im Tabellenkalkulationsformat als auch im CSV-Format18. Exportieren Sie außerdem eine Umfrage-zu-Dokument-Datei oder eine PDF/A-Kopie, die die endgültige Fragebogenformulierung, die Reihenfolge der Items, Verzweigungseinstellungen, Einstellungen für verpflichtende Items und die Kodierungsstruktur enthält. Speichern Sie diese Dateien mit versionskontrollierten Namen.
- Berechnen Sie die mediane Bearbeitungsdauer aus der Pilotstudie und legen Sie die minimale gültige Bearbeitungsdauer auf etwa ein Drittel dieses Wertes fest. Setzen Sie die endgültige untere Schwelle auf 180 s und wenden Sie sie einheitlich während der offiziellen Prüfung an.
- Da dieser Grenzwert aus der Pilotstichprobe abgeleitet ist, legen Sie den Schwellenwert neu fest, wenn das Protokoll in einer deutlich anderen Population, auf einer anderen Plattform, in einer anderen Sprachversion oder in einem anderen institutionellen Umfeld angewendet wird.
HINWEIS: Archivieren Sie die endgültigen Fragebogen-Screenshots, den endgültigen Fragebogen-Export, das README/Codebuch, das Pilotprotokoll, die Formulierung der Aufmerksamkeitschecks, die Screening-Protokollvorlage, die Exporteinstellungen und die statistische Syntax als ergänzende oder Audit-Dateien.
3. Veröffentlichen Sie den Fragebogen und bewahren Sie den Rohdatensatz auf
- Rekrutieren Sie Teilnehmer über feste Kanäle
- Verteilen Sie eine standardisierte Einladung über studentische Kommunikationsgruppen, Klassenkanäle oder institutionelle Mailinglisten innerhalb eines festgelegten Erfassungszeitraums von 14 Tagen.
- Geben Sie im Einladungstext und auf der Einwilligungsseite den Studienzweck, die erwartete Bearbeitungsdauer von 6–8 Minuten, die anonyme Datenverarbeitung, die freiwillige Teilnahme sowie das Fehlen akademischer Sanktionen oder Belohnungen bei Nichtteilnahme an.
- Zeigen Sie die Einwilligungsseite an, bevor der erste Fragebogenpunkt erscheint, und verlangen Sie eine aktive Zustimmung, bevor der Zugang gewährt wird. Erlauben Sie keinen Zugriff auf den Fragebogen, solange keine ausdrückliche Einwilligung vorliegt.
- Informieren Sie auf der Einwilligungsseite, dass Teilnehmer jederzeit vor der endgültigen Übermittlung abbrechen können und dass unvollständige Antworten nicht in die abschließende Analyse einfließen werden.
- Verwenden Sie dieselbe gesperrte Version des Fragebogens über alle Rekrutierungskanäle hinweg. Falls mehrere Rekrutierungskanäle genutzt werden, erfassen Sie den Kanal nur, wenn er im Voraus als Studienvariable festgelegt wurde.
- Bewahren Sie die Rohdatei der Rückmeldungen auf
- Behalten Sie alle eingegangenen Datensätze, einschließlich unvollständiger und später ausgeschlossener Einreichungen, in der Rohexportdatei. Exportieren Sie den vollständigen Datensatz unmittelbar nach Abschluss der Umfrage und speichern Sie ihn als raw_returns_YYYYMMDD.csv und raw_returns_YYYYMMDD.xlsx.
- Bewahren Sie im Rohdatensatz die ursprüngliche Einreichungszeit, die Bearbeitungsdauer, den Antwortstatus, die plattformgenerierte Antwortkennung sowie geräte- oder kontobasierte technische Identifikatoren auf. Überschreiben Sie diese Felder während späterer Bereinigungen nicht.
- Speichern Sie eine schreibgeschützte Kopie der Rohdaten, bevor die Sichtung beginnt. Lagern Sie die Rohdatei, das Sichtungsprotokoll und den endgültigen Analyse-Datensatz in getrennten Ordnern. Beschränken Sie den Zugriff auf die Rohdatei mit technischen Identifikatoren auf autorisiertes Studienpersonal.
ACHTUNG: Erfassen Sie keine direkt identifizierbaren Informationen wie vollständigen Namen, Studierendenausweisnummer, genaue Wohnheimadresse, private Telefonnummer, private E-Mail-Adresse oder Social-Media-Konten in der Hauptumfragedatei.
HINWEIS: Unterbrechen Sie den Workflow nach dem Rohexport, speichern Sie eine schreibgeschützte Kopie des Rohdatensatzes und setzen Sie die Datenaufbereitung ausschließlich auf Basis dieser gesicherten Kopie fort.
4. Überprüfung der zurückgesandten Fragebögen und Erstellung des endgültigen Datensatzes für die Analyse
- Wenden Sie die Screening-Sequenz in einer festen Reihenfolge an
- Sortieren Sie alle zurückgegebenen Datensätze nach gerätebeschränkter Kennung, kontobeschränkter Kennung (falls verfügbar), Zeitstempel, Fragebogenstatus und Antwortähnlichkeit. Identifizieren Sie zunächst doppelte Einreichungen. Behalten Sie bei zwei oder mehr Einreichungen desselben Teilnehmers innerhalb desselben Erhebungszeitraums den frühesten vollständigen Datensatz bei.
- Wenn mehrere Einreichungen vom selben authentifizierten Konto, aber von verschiedenen Geräten stammen, behandeln Sie diese als doppelte Einreichungen desselben Teilnehmers. Behalten Sie den frühesten vollständigen Datensatz bei und schließen Sie spätere vollständige Datensätze aus. Wenn der früheste Datensatz unvollständig ist und ein späterer Datensatz vollständig ist, behalten Sie den frühesten vollständigen Datensatz bei.
- Entfernen Sie Datensätze mit einer Bearbeitungsdauer von <180 s, überprüfen Sie Datensätze, die in 180–240 s abgeschlossen wurden, und entfernen Sie Datensätze, die den vierten Aufmerksamkeitscheck mit vorgegebener Antwort nicht bestehen. Dokumentieren Sie die Anzahl der in jedem Schritt entfernten Datensätze in screening_log_v1.xlsx19.
- Prüfen Sie manuell die Datensätze, die in 180–240 s abgeschlossen wurden, anhand des Aufmerksamkeitscheck-Ergebnisses, der Markierung für langes identisches Antwortmuster, der intraindividuellen Standardabweichung und der Markierung für logische Inkonsistenz.
- Behalten Sie einen Datensatz mit grenzwertiger Bearbeitungsgeschwindigkeit nur dann bei, wenn kein weiteres Qualitätsmerkmal für die Daten vorliegt. Notieren Sie jede Entscheidung bezüglich grenzwertiger Geschwindigkeit im Screening-Protokoll.
- Entfernen Sie systematisch fehlerhafte, inkonsistente oder unvollständige Datensätze
- Entfernen Sie alle Fragebögen mit langem identischem Antwortmuster, definiert als 18 oder mehr aufeinanderfolgende identische Antworten bei den 36 bewerteten Skalenitems, oder mit einer intraindividuellen Standardabweichung ≤0,25 bei diesen Items.
- Entfernen Sie alle Fragebögen mit unmöglichen Kombinationen von Verhaltensangaben. Definieren Sie „die höchste Antwortkategorie bei nahezu allen Items des Internet-Addiction-Tests“ als eine Punktzahl von 5 bei mindestens 18 der 20 IAT-Items.
HINWEIS: Die Regel zur logischen Inkonsistenz greift, wenn ein Befragter sowohl die Internetnutzung an Wochentagen als auch am Wochenende in der niedrigsten Dauerkategorie angibt (<2 h pro Tag), die nächtliche Internetnutzung mit „fast jeden Abend“ codiert und eine Punktzahl von 5 bei mindestens 18 der 20 IAT-Items erreicht. Wenden Sie diese Regel erst an, nachdem die Prüfung auf Duplikate, Bearbeitungsdauer, Aufmerksamkeitschecks und systematische Antwortmuster abgeschlossen ist. - Entfernen Sie alle Fragebögen mit fehlenden Werten bei einem IAT-Item, einem DERS-16-Item oder einem vorab festgelegten Kovariat.
HINWEIS: Diese Complete-Case-Regel wird angewendet, da der Online-Fragebogen obligatorische Kernitems verwendet und das repräsentative Regressionsmodell einen festen Satz an Kovariaten erfordert. Wenn fehlende Kovariaten-Daten 5 % überschreiten, verwenden Sie ein vorab festgelegtes alternatives Verfahren zur Behandlung fehlender Daten, wie z. B. multiple Imputation. - Weisen Sie jedem behaltenen Datensatz eine anonyme Studien-ID zu und speichern Sie die verbleibende Datei als analytic_dataset_v1.csv und analytic_dataset_v1.xlsx.
- Entfernen Sie plattformgenerierte Antwortkennungen, gerätebeschränkte Kennungen, kontobeschränkte Kennungen, IP-Adressen (falls während des Screenings beibehalten) sowie Zeitstempel und Freitext-Anmerkungen aus dem endgültigen Analyse-Datensatz. Behalten Sie nur die anonyme Studien-ID und die Analysevariablen.
ENTSCHLÜSSELNDER SCHRITT: Wenden Sie die Screening-Sequenz bei jedem Datensatz in derselben Reihenfolge an und nehmen Sie zuvor ausgeschlossene Fälle in späteren Phasen nicht erneut auf. Weisen Sie das zuerst auslösende Ausschlusskriterium als primären Ausschlussgrund zu und dokumentieren Sie sekundäre Merkmale lediglich als Anmerkungen im Screening-Protokoll.
HINWEIS: Fassen Sie die endgültigen Ausschlusszahlen nach Grund in Tabelle 2 zusammen und stellen Sie sicher, dass diese Zahlen mit dem Teilnehmerfluss in Abbildung 1 übereinstimmen.
| Reihenfolge der Überprüfung | Überprüfungspunkt | Operative Regel | Überprüfungsmaßnahme | Dokumentationsregel |
| Schritt 1 | Sicherung der Rohdaten | Exportieren Sie alle zurückgegebenen Datensätze unmittelbar nach Abschluss der Befragung und speichern Sie sie als raw_returns_YYYYMMDD.csv und raw_returns_YYYYMMDD.xlsx | Bewahren Sie eine schreibgeschützte Kopie vor Beginn der Datensäuberung auf | Im Ordner „raw-data“ archivieren |
| Schritt 2 | Einwilligungs- und Zugriffsprüfung | Identifizieren Sie Datensätze ohne aktive elektronische informierte Einwilligung vor dem Zugriff auf den Fragebogen | Schließen Sie Datensätze ohne Einwilligung vom Analyseablauf aus | Protokollieren Sie ausgeschlossene oder nicht zugängliche Datensätze in screening_log_v1.xlsx, sofern sie im Plattformexport verbleiben |
| Schritt 3 | Doppelprüfung | Identifizieren Sie Datensätze mit identischem gerätebeschränktem Identifikator oder kontobeschränktem Identifikator innerhalb desselben Erhebungszeitraums, die hinsichtlich Geschlecht, Alter, Studienjahr und mindestens 80 % identischer Fragebogenantworten übereinstimmen | Behalten Sie den frühesten vollständigen Datensatz und schließen Sie alle späteren Duplikate aus | Protokollieren Sie die Anzahl der Ausgeschlossenen und die betroffenen raw_record_id-Werte in screening_log_v1.xlsx; weisen Sie primary exclusion_reason = 1 zu |
| Schritt 4 | Auflösung von Mehrgeräte-Duplikaten | Identifizieren Sie mehrere vollständige Einreichungen desselben authentifizierten Teilnehmerkontos über verschiedene Geräte hinweg | Behandeln Sie diese Datensätze als doppelte Einreichungen; behalten Sie den frühesten vollständigen Datensatz | Tragen Sie den kontobeschränkten Identifikator und die behaltene raw_record_id in screening_log_v1.xlsx ein; weisen Sie den späteren Datensätzen primary exclusion_reason = 1 zu |
| Schritt 5 | Prüfung der Bearbeitungsdauer | Identifizieren Sie alle Fragebögen mit einer Bearbeitungsdauer <180 s | Schließen Sie alle solchen Datensätze automatisch aus | Protokollieren Sie die Anzahl der Ausgeschlossenen in screening_log_v1.xlsx; weisen Sie primary exclusion_reason = 2 zu |
| Schritt 6 | Überprüfung von Grenzfällen bei der Bearbeitungsgeschwindigkeit | Identifizieren Sie alle Fragebögen mit einer Bearbeitungsdauer von 180–240 s | Prüfen Sie jeden Datensatz manuell anhand von Aufmerksamkeitschecks, Langketteneinträgen, innerpersonaler SD und Logikflags; behalten Sie nur Datensätze, bei denen kein weiteres Flag vorliegt | Tragen Sie jeden Fall als retained_after_manual_review = 1 oder excluded_after_manual_review = 1 in screening_log_v1.xlsx ein |
| Schritt 7 | Aufmerksamkeitscheck | Identifizieren Sie alle Datensätze, die den gerichteten Aufmerksamkeitscheck nicht bestehen | Schließen Sie alle fehlgeschlagenen Datensätze aus, sofern sie noch nicht in einem früheren Schritt ausgeschlossen wurden | Protokollieren Sie die Anzahl der Ausgeschlossenen in screening_log_v1.xlsx; weisen Sie primary exclusion_reason = 3 zu |
| Schritt 8 | Prüfung auf stereotype Antwortmuster | Identifizieren Sie Datensätze mit 18 oder mehr aufeinanderfolgenden identischen Antworten innerhalb der 36 skalierten Items oder mit einer innerpersonalen SD ≤0,25 über diese Items | Schließen Sie alle solchen Datensätze aus, sofern sie noch nicht in einem früheren Schritt ausgeschlossen wurden | Protokollieren Sie die Anzahl der Ausgeschlossenen in screening_log_v1.xlsx; weisen Sie primary exclusion_reason = 4 zu |
| Schritt 9 | Prüfung auf logische Konsistenz | Identifizieren Sie Datensätze mit der vorgegebenen unmöglichen Kombination von Verhaltensweisen: weekday_internet_use und weekend_internet_use beide mit <2 h kodiert, late_night_use als „fast jede Nacht“ kodiert und ein Score von 5 auf mindestens 18 der 20 IAT-Items | Schließen Sie alle solchen Datensätze aus, sofern sie noch nicht in einem früheren Schritt ausgeschlossen wurden | Protokollieren Sie die Anzahl der Ausgeschlossenen und eine Prüfnotiz in screening_log_v1.xlsx; weisen Sie primary exclusion_reason = 5 zu |
| Schritt 10 | Prüfung auf fehlende Kernvariablen | Identifizieren Sie Datensätze mit fehlenden Werten in IAT_1–IAT_20, DERS_1–DERS_16, Alter, Geschlecht, weekday_internet_use, weekend_internet_use, sleep_duration, physical_activity oder academic_stress; „lieber nicht angeben“ bei Geschlecht gilt als gültige Antwort, nicht als fehlend | Schließen Sie alle solchen Datensätze aus, sofern sie noch nicht in einem früheren Schritt ausgeschlossen wurden | Protokollieren Sie die Anzahl der Ausgeschlossenen in screening_log_v1.xlsx; weisen Sie primary exclusion_reason = 6 zu |
| Schritt 11 | Zuweisung des primären Ausschlussgrundes | Identifizieren Sie Datensätze, die mehr als ein Ausschlusskriterium erfüllen | Weisen Sie das zuerst ausgelöste Kriterium in der vorgegebenen Reihenfolge als primären Ausschlussgrund zu | Tragen Sie sekundäre Flags nur in den Prüfnotizen ein; weisen Sie keine mehrfachen primären Gründe zu |
| Schritt 12 | Entfernung technischer Identifikatoren | Identifizieren Sie plattformgenerierte Antwortkennungen, gerätebeschränkte Identifikatoren, kontobeschränkte Identifikatoren, Zeitstempel und alle vorübergehend beibehaltenen technischen Metadaten in der bereinigten Datei | Entfernen Sie diese Felder aus dem endgültigen Analyse-Datensatz nach Abschluss der Überprüfung | Dokumentieren Sie die Entfernung in screening_log_v1.xlsx |
| Schritt 13 | Endgültige Beibehaltung | Behalten Sie alle Datensätze, die alle vorherigen Überprüfungsschritte bestanden haben | Weisen Sie jedem behaltenen Datensatz eine anonyme Studien-ID zu | Speichern Sie als analytic_dataset_v1.csv und analytic_dataset_v1.xlsx |
| Schritt 14 | Zusammenfassung der Überprüfung | Zählen Sie die Anzahl der in jedem Schritt ausgeschlossenen Datensätze sowie die endgültige Anzahl der behaltenen Datensätze | Fassen Sie die endgültigen Zahlen für die Manuskriptberichterstattung zusammen | Stellen Sie sicher, dass die Zahlen in Tabelle 2 mit Abbildung 1 übereinstimmen |
| Schritt 15 | Sicherung der Audit-Trail | Bewahren Sie die Rohdatei, das Überprüfungsprotokoll und den endgültigen Analyse-Datensatz als separate Dateien auf | Überschreiben, zusammenführen oder manuell bearbeiten Sie archivierte Quelldateien nicht | Speichern Sie sie separat in den Ordnern „raw-data“, „screening“ und „analytic“ |
Tabelle 2: Vorgegebene Reihenfolge der Prüfung, Ausschlussschwellen, Prüfmaßnahmen und Dokumentationsregeln für die Bereinigung von Fragebögen. Diese Tabelle fasst die festgelegte Prüfreihenfolge zur Bereinigung zurückgesandter Fragebögen zusammen, einschließlich Einwilligungs- und Zugriffsprüfungen, Dublettenerkennung, Zusammenführung von Mehrfachgeräten, Prüfung der Bearbeitungsdauer, Überprüfung grenzwertiger Bearbeitungsgeschwindigkeit, Fehlschlagen von Aufmerksamkeitschecks, schematisches Antwortverhalten, logische Inkonsistenzen, fehlende Angaben zu Kernfragen, Entfernung technischer Identifikatoren, endgültige Aufbewahrung und Sicherstellung der Nachvollziehbarkeit. Abkürzungen: IAT = Internet Addiction Test; DERS-16 = 16-Item Difficulties in Emotion Regulation Scale. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
5. Variablen bewerten, Zuverlässigkeit überprüfen und die analysenfertige Datei vorbereiten
- Generieren Sie Gesamtpunktzahlen, Subskalen-Punktzahlen und abgeleitete kategoriale Variablen
- Summieren Sie die 20 IAT-Antworten, um die Gesamtpunktzahl für Internetsucht zu berechnen, und speichern Sie sowohl die kontinuierliche Punktzahl als auch die dreistufige Schwereklasse in der analysenfertigen Datei.
- Kodieren Sie die DERS-16-Items 1, 6 und 8 umgekehrt, berechnen Sie die Gesamtpunktzahl und die fünf Subskalen-Punktzahlen, und fügen Sie alle abgeleiteten Variablen dem gleichen datensatzbasierten Datensatz pro Teilnehmer hinzu.
- Führen Sie vor der Punktzahlberechnung eine Bereichsprüfung durch. Stellen Sie sicher, dass alle IAT- und DERS-16-Itemwerte im Bereich 1–5 liegen, alle umkodierten Werte im Bereich 1–5 liegen, die IAT-Gesamtpunktzahlen im Bereich 20–100 liegen und die DERS-16-Gesamtpunktzahlen im Bereich 16–80 liegen. Dokumentieren Sie die Ergebnisse der Bereichsprüfung im Bewertungsprotokoll.
- Kodieren Sie Kovariaten in feste analytische Kategorien um
- Kodieren Sie die Internetnutzungsdauer an Wochentagen und Wochenenden als <2 h, 2–3,9 h, 4–5,9 h und ≥6 h um. Kodieren Sie die nächtliche Internetnutzung als nie, <1 Nacht/Woche, 1–2 Nächte/Woche, 3–5 Nächte/Woche und fast jede Nacht.
- Kodieren Sie Schlafdauer, Häufigkeit körperlicher Aktivität und wahrgenommene akademische Belastung gemäß den vorgegebenen Kategorieregeln aus Abschnitt 1.4 und speichern Sie die umkodierten Werte unter festgelegten Variablennamen im selben Datensatz.
- Kodieren Sie das Geschlecht für die Regressionsanalyse mit zwei Indikatorvariablen: weiblich gegenüber männlich und keine Angabe gegenüber männlich. Dokumentieren Sie die Kodierung im Tabellenfußnote und in der README-/Codebuch-Datei.
- Überprüfen Sie die Integrität der Punktzahlermittlung und die innere Konsistenz
- Berechnen Sie Cronbachs Alpha für die IAT-Gesamtpunktzahl und die DERS-16-Gesamtpunktzahl vor der inferenzstatistischen Analyse. Überprüfen Sie erneut die Item-Kodierung, die Umkodierung und unmögliche Item-Bereiche, falls eines der Alphas <0,7020 beträgt. Berichten Sie die Werte von Cronbachs Alpha im Abschnitt Repräsentative Ergebnisse.
- Berechnen Sie Item-Gesamt-Korrelationen oder Alpha-bei-Item-Entfernung-Werte, falls eine der Skalen eine unerwartet niedrige innere Konsistenz aufweist. Entfernen Sie keine Items aus der primären Analyse, es sei denn, die Entfernung war vorab festgelegt oder die Studie ist explizit als psychometrische Validierungsstudie konzipiert.
- Speichern Sie den endgültigen analysenfertigen Datensatz zusammen mit einer README-Datei, die Variablennamen, Kodierungsregeln, Ausschlussgrenzwerte, Dateinamen, Softwareversionen, Fragebogenversion, Bewertungssyntax, Spezifikation des Regressionsmodells und die Verfahren zur Replikation des Datensatzes auflistet.
6. Analysieren Sie die Daten und bewahren Sie reproduzierbare Ergebnisse auf
- Deskriptive Statistiken und Gruppenvergleiche erstellen
- Stetige Variablen als Mittelwert ± Standardabweichung und kategoriale Variablen als Häufigkeit und Prozentsatz angeben. Demografische Merkmale, Internetnutzungsverhalten und Skalenwerte mithilfe der vordefinierten Ausgabestruktur zusammenfassen.
- Die Stichprobengröße für jede Analyse angeben. Die behaltene Analysestichprobe als Nenner verwenden, es sei denn, eine Tabelle gibt ausdrücklich etwas anderes an.
- DERS-16-Gesamt- und Unterskalenwerte über die drei IAT-Schweregradgruppen hinweg vergleichen und für die primären Analysen zweiseitige Tests mit α = 0,05 verwenden. Standardisierte Effektgrößen angeben, wo angebracht.
HINWEIS: Berichten Sie bei Gruppenvergleichen η2 oder partielles η2 für die Varianzanalyse oder eine äquivalente nichtparametrische Effektgröße, falls ein nichtparametrischer Test verwendet wird. Interpretieren Sie Vergleiche von Untergruppen mit schwerem problematischem Nutzungsmuster vorsichtig, wenn die Untergruppe klein ist. - Den Pearson-Korrelationskoeffizienten zwischen dem Gesamtwert der IAT und dem Gesamtwert der DERS-16 berechnen, wenn beide Variablen ein akzeptables Verteilungsverhalten zeigen; andernfalls als Sensitivitätsanalyse die Spearman-Korrelation verwenden. n, r oder ρ, 95 % Konfidenzintervall (sofern von der Statistiksoftware generiert), p-Wert und Interpretation der Effektstärke angeben.
- Das adjustierte Regressionsmodell schätzen und Ergebnisse archivieren
- Den DERS-16-Gesamtwert als abhängige Variable und den IAT-Gesamtwert als primäre unabhängige Variable verwenden. Alter, Geschlecht, Internetnutzung an Wochentagen, Internetnutzung am Wochenende, Schlafdauer, körperliche Aktivität und wahrgenommener akademischer Stress als Kovariaten einbeziehen. Dieses Modell stellt die vordefinierte analytische Demonstration des standardisierten Workflows dar.
- Vor der Interpretation des adjustierten Regressionsmodells die Regressionsannahmen und die Modellstabilität überprüfen. Residuen-gegen-Angepasst-Diagramme auf Linearität und Homoskedastizität prüfen, ein Q-Q-Diagramm oder einen Normalitätstest zur Prüfung der Residuenverteilung heranziehen und Varianzinflationsfaktoren berechnen, um Multikollinearität zu bewerten.
- Diese Diagnosen im Abschnitt „Repräsentative Ergebnisse“ oder in der Ausgabe ergänzender Analysen berichten.
- Falls heteroskedastische Residuen festgestellt werden, als Sensitivitätsanalyse heteroskedastie-robuste Standardfehler angeben.
- Falls einflussreiche Beobachtungen vorliegen, berichten, ob der primäre Koeffizient für den IAT-Gesamtwert nach Durchführung der Einflussdiagnostik im Wesentlichen unverändert bleibt. Einflussreiche Beobachtungen nicht entfernen, es sei denn, eine vorab festgelegte Datenqualitätsregel ist erfüllt.
- Nicht standardisierte Koeffizienten, Standardfehler, standardisierte Koeffizienten, p-Werte, Modell-R2, adjustiertes R2, Modell-F-Statistik und VIF-Bereich für das adjustierte Modell angeben. Die Stichprobengröße im Tabellentitel oder in einer Tabellenfußnote einbeziehen.
- Falls Interaktionen, Gruppeneffekte oder Mediationspfade getestet werden, müssen diese Analysen vor der Datenerhebung spezifiziert oder als explorativ gekennzeichnet werden. Der Kernprotokoll erfordert keine Interaktionstests, es sei denn, Gruppenunterschiede sind ein vorab festgelegtes Studienziel.
- Alle statistischen Syntaxdateien, Ausgabetabellen, Residuendiagramme, VIF-Ausgaben, Reliabilitätsausgaben und generierten Abbildungen unter versionskontrollierten Dateinamen speichern. Alle berichtsfähigen Ausgaben direkt aus analytic_dataset_v1 und nicht aus manuell bearbeiteten Dateien neu generieren.
HINWEIS: Den Protokolltext auf die Reproduktion des Workflows konzentrieren. Detaillierte repräsentative Statistiken, Untergruppenabbildungen, Regressionsdiagnosen, Multikollinearitätsbewertung und Modelleingaben im Abschnitt „Repräsentative Ergebnisse“ präsentieren.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Ablauf der Studie und endgültige analytische Berücksichtigung
Die Ergebnisse zeigen die Durchführung des standardisierten Fragebogen-Workflows, nicht jedoch eine unabhängige Validierung des Internet-Addiction-Tests oder des DERS-16. Während des 14-tägigen Erhebungszeitraums wurden 520 Studierende zur Teilnahme eingeladen, wovon 480 Fragebögen zurückgegeben wurden. Die Screening-Prozedur erfolgte in der vorgegebenen Reihenfolge. Zunächst wurden 8 doppelte Einreichungen entfernt...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Der Hauptbeitrag dieses Artikels liegt im standardisierten Fragebogenablauf und nicht in der beobachteten repräsentativen Assoziation zwischen Internetabhängigkeit und Schwierigkeiten bei der Emotionsregulation. Die Durchführung zeigte, dass eine feste Abfolge aus elektronischer Einwilligung, demographischen Angaben, Nutzungsmustern des Internets, IAT-Score, DERS-16-Score, Erfassung von Kovariaten, sequenzieller Datenaufbereitung zur Qualitätskontrolle und reproduzierbarer Regressionsanalyse in einer Stichprobe von Unive...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Der Autor hat nichts offenzulegen.
Danksagungen
Diese Arbeit wurde unterstützt durch das Soft-Science-Projekt der Provinz Henan 2025, „Untersuchung der Auswirkungen und des Optimierungswegs von Veränderungen der Schulalterbevölkerung auf die hochwertige Entwicklung der privaten Hochschulbildung in der Provinz Henan“ (Projektnummer 252400410490), sowie durch das Projekt des Doktorandenforschungsfonds der Zhengzhou University of Economics and Business 2025, „Untersuchung des Entstehungsmechanismus und des Mechanismus der öffentlichen Meinungsführung des Netzwerk-Clusterverhaltens von Studierenden“. Der Autor dankt der Zhengzhou University of Economics and Business für institutionelle Unterstützung.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Analysedatensatz | Studieninternes Dokument | analytic_dataset_v1.csv und analytic_dataset_v1.xlsx | Endgültiger anonymisierter Datensatz, der für alle berichtspflichtigen deskriptiven Analysen, Zuverlässigkeits-, Korrelations- und Regressionsanalysen verwendet wurde |
| Analysesyntax | Studieninternes Dokument | analysis_syntax_v1.R oder entsprechende Skriptdatei | Wird verwendet, um die Überprüfung der Punktevergabe, Zuverlässigkeitsprüfungen, deskriptiven Statistiken, Korrelationsanalysen, Regressionsmodellierungen, VIF-Berechnungen und diagnostischen Ausgaben nachzuvollziehen |
| Formulierung des Aufmerksamkeitsprüfungsitems | Studieninternes Dokument | attention_check_v1.txt | Festgelegte Formulierung des gerichteten Antwort-Aufmerksamkeitsprüfungsitems, das während der Fragebogenerhebung verwendet wurde |
| DERS-16-Fragebogen | Ursprüngliche Skalenquelle oder autorisierte/angepasste Fragebogenversion | 16-Item Difficulties in Emotion Regulation Scale Kurzform | Wird verwendet, um Schwierigkeiten bei der Emotionsregulation zu erfassen; die Bewertung erfolgt gemäß dem festgelegten DERS-16-Bewertungsschlüssel, der im Codebuch dokumentiert ist |
| Elektronisches Informationsblatt und Einwilligungsseite | Studieninternes Dokument | consent_form_v1.pdf oder Plattform-Einwilligungsseite | Wird verwendet, um Studieninformationen bereitzustellen und die elektronische informierte Einwilligung vor dem Zugriff auf den Fragebogen einzuholen |
| Dateibenennungskonvention | Studieninternes Dokument | file_naming_convention_v1.xlsx | Wird verwendet, um die Namen für Roh-, bereinigte, analytische, Screening-Log-, Codebuch- und Ausgabedateien zu standardisieren |
| Endgültige Fragebogenscreenshots | Studieninternes Dokument | questionnaire_screenshots_v1.pdf | Wird verwendet, um die festgelegte Umfrageanzeige, Itemreihenfolge, Antwortskalen und Pflichtangaben-Einstellungen zu dokumentieren |
| Integrierte Entwicklungsumgebung | Posit | RStudio Desktop | Wird verwendet, um Skripte, Protokolle und reproduzierbare Analyseabläufe zu verwalten |
| Internet Addiction Test-Fragebogen | Ursprüngliche Skalenquelle oder autorisierte/angepasste Fragebogenversion | 20-Item Internet Addiction Test | Wird verwendet, um Symptome einer Internetabhängigkeit zu erfassen und zwischen normalem Gebrauch, problematischem Gebrauch und schwerem problematischem Gebrauch zu differenzieren |
| Online-Umfrageplattform | Qualtrics | XM-Plattform; institutionelles oder lizenziertes Konto | Wird verwendet, um den Fragebogen zu erstellen, Pflichtangaben durchzusetzen, den einwilligungsbasierten Zugriff zu verwalten, wiederholte Einreichungen, wo möglich, zu beschränken und Antwortdaten zu exportieren |
| Optionales menügeführtes Statistikpaket | IBM | SPSS Statistics | Wird verwendet, wenn ein GUI-basierter Analyseablauf für deskriptive Statistiken, Zuverlässigkeitsprüfungen oder Regressionsanalysen erforderlich ist |
| README-/Codebuchdatei | Studieninternes Dokument | README_v1.txt oder codebook_v1.xlsx | Wird verwendet, um Variablennamen, Kodierungsregeln, Wertebereiche, Umkehrkodierungsregeln, Ausschlussgrenzwerte, Dateinamen und Softwareversionen zu dokumentieren |
| Schreibgeschützte Archivkopie | Portable Document Format | PDF/A oder institutionell genehmigtes Archiv-PDF | Wird verwendet, um den festgelegten Erhebungsinstrument, die Einwilligungsseite und die protokollunterstützenden Dokumente zu bewahren |
| Screening-Log-Arbeitsmappe | Studieninternes Dokument | screening_log_v1.xlsx | Wird verwendet, um doppelte Screenings, Zeit-basierte Screenings, fehlgeschlagene Aufmerksamkeitsprüfungen, musterhafte Antwortverhalten, logische Inkonsistenzen, fehlende Angaben, Entscheidungen bei manueller Überprüfung und endgültige Anzahl der eingeschlossenen Probanden zu dokumentieren |
| Tabellenkalkulationssoftware | Microsoft | Microsoft Excel-Arbeitsmappenformat (.xlsx) | Wird verwendet für Screening-Logs, Variablenlexikon, Aufzeichnungen der manuellen Überprüfung und die Erstellung ergänzender Arbeitsmappen |
| Statistische Rechenumgebung | R Foundation / CRAN | R 4.5.3 | Wird verwendet für die Überprüfung der Punktevergabe, deskriptive Statistiken, Zuverlässigkeitsprüfungen, Korrelationsanalysen, Regressionsanalysen, VIF-Berechnungen und diagnostische Ausgaben |
| Ergänzende Datei 1 | Studienbezogene ergänzende Datei | Supplementary File 1.xlsx | Enthält Materialien zum Fragebogenablauf, Codebuch, Screening-Log, Ausgabeprotokoll und Materialien für den analysereifen Arbeitsablauf |
| Ergänzende Tabelle S1 | Studienbezogene ergänzende Tabelle | Supplementary Table S1 | Enthält das vollständige Variablenverzeichnis, Dateivorhandensein, Kodierungsstruktur, technische Identifikatorfelder, Screening-Variablen und Felder zur Datensatzverfolgung |
| Umfrage-Exportdokument | Qualtrics | Umfrage-zu-Word-Export oder PDF-Export | Wird verwendet, um die endgültige Formulierung des Fragebogens, die Itemreihenfolge, Verzweigungseinstellungen, Pflichtangaben und die Antwortkodierung zu archivieren |
| Umfrage-Exportformat | Qualtrics | CSV-Export | Wird verwendet, um die Rohdaten zu sichern und den analysereifen Datensatz zu exportieren |
Referenzen
- Moreno MA, et al. Problematic internet use among US youth: a systematic review. Arch Pediatr Adolesc Med. 2011;165:797-805.
- Ramón-Arbués E, et al. Prevalence and factors associated with problematic internet use in a population of Spanish university students. Int J Environ Res Public Health. 2021;18:7620.
- Cai Z, et al. Associations between problematic internet use and mental health outcomes of students: a meta-analytic review. Adolesc Res Rev. 2023;8:45-62.
- Gong Z, Wang L, Wang H. Perceived stress and internet addiction among Chinese college students: mediating effect of procrastination and moderating effect of flow. Front Psychol. 2021;12:632461.
- Tsai JK, et al. Relationship between difficulty in emotion regulation and internet addiction in college students: a one-year prospective study. Int J Environ Res Public Health. 2020;17:4766.
- Romero-López M, Pichardo C, De Hoces I, García-Berbén T. Problematic internet use among university students and its relationship with social skills. Brain Sci. 2021;11:1301.
- Xie X, et al. Problematic internet use was associated with psychological problems among university students during COVID-19 outbreak in China. Front Public Health. 2021;9:675380.
- Montagni I, et al. Mental health-related digital use by university students: a systematic review. Telemed J E Health. 2020;26:131-146.
- Candussi CJ, Kabir R, Sivasubramanian M. Problematic smartphone usage, prevalence and patterns among university students: a systematic review. J Affect Disord Rep. 2023;14:100643.
- Moon SJ, Hwang JS, Kim JY, Shin AL, Bae SM, Kim JW. Psychometric properties of the Internet Addiction Test: a systematic review and meta-analysis. Cyberpsychol Behav Soc Netw. 2018;21:473-484.
- Jelenchick LA, Becker T, Moreno MA. Assessing the psychometric properties of the Internet addiction test in US college students. Psychiatry Res. 2012;196:296-301.
- Tafur-Mendoza AA, Acosta-Prado JC, Zárate-Torres RA, Ramírez-Ospina DE. Assessing the psychometric properties of the Internet addiction test in Peruvian university students. Int J Environ Res Public Health. 2020;17:5782.
- Fernández-Villa T, Molina AJ, García-Martín M, Llorca J, Delgado-Rodríguez M, Martín V. Validation and psychometric analysis of the Internet addiction test in Spanish among college students. BMC Public Health. 2015;15:953.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310:2191-2194.
- Wei Z, Hassan NC, Hassan SA, Ismail N, Gu X, Dong J. Psychometric validation of Young’s Internet addiction test among Chinese undergraduate students. PLoS One. 2025;20:e0320641.
- Bjureberg J, et al. Development and validation of a brief version of the Difficulties in emotion regulation scale : the DERS-16. J Psychopathol Behav Assess. 2016;38:284-296.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK: Research and Methods. 2023;32:3-38.
- Broman KW, Woo KH. Data organization in spreadsheets. Am Stat. 2018;72:2-10.
- Leiner DJ. Too fast, too straight, too weird: non-reactive indicators for meaningless data in internet surveys. Surv Res Methods. 2019;13:229-248.
- Taber KS. The use of Cronbach’s alpha when developing and reporting research instruments in science education. Res Sci Educ. 2018;48:1273-1296.
- Gioia F, Rega V, Boursier V. Problematic Internet use and emotional dysregulation among young people: a literature review. Clin Neuropsychiatry. 2021;18:41-54.
- Chen M, Zhang X. Factors influencing internet addiction among university students: the mediating roles of self-control and anxiety. Acta Psychol (Amst). 2024;250:104535.
- Akbari M, Seydavi M, Sheikhi S, Spada MM. Problematic smartphone use and sleep disturbance: the roles of metacognitions, desire thinking, and emotion regulation. Front Psychiatry. 2023;14:1137533.
- Wang S, Cheng Y, Yang Y, Lu B. The impact of physical activity on internet addiction among college students: the chain mediation role of rumination and mindfulness. BMC Public Health. 2025;25:3643.
- Struminskaya B, Sakshaug JW. Ethical considerations for augmenting surveys with auxiliary data sources. Public Opin Q. 2023;87:619-633.
- Yin J, et al. Associations between both smartphone addiction and objectively measured smartphone use and sleep quality and duration among university students: a cross-sectional study. JMIR Ment Health. 2025;12:e77796.
- Hainagiu SM, Neagu SN. Caught in the Web—emotional regulation difficulties and internet addiction among Romanian medical and technical university students: a pilot cross-sectional study. Healthcare (Basel). 2025;13:2528.
- Guo C, Chen M, Ji X, Li J, Ma Y, Zang S. Association between internet addiction and sleep quality in medical students: a longitudinal study. Front Psychol. 2025;16:1517590.
- Barker M, Chue Hong NP, Katz DS, Lamprecht AL, Martinez-Ortiz C, Psomopoulos F, et al. Introducing the FAIR Principles for research software. Sci Data. 2022;9:622.
- Nosek BA, Alter G, Banks GC, Borsboom D, Bowman SD, Breckler SJ, et al. Promoting an open research culture. Science. 2015;348:1422-1425.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.