Diese Studie stellt einen retrospektiven klinischen Workflow zur Abschätzung des Risikos einer pulmonalen Hypertonie bei älteren Patienten vor, die wegen einer akuten Exazerbation einer chronisch obstruktiven Lungenerkrankung hospitalisiert wurden, unter Verwendung routinemäßig verfügbarer klinischer Variablen und eines nomogrammbasierten Vorhersagemodells.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Routine-Daten-Nomogramm zur Abschätzung des Risikos für pulmonale Hypertonie bei älteren Patienten mit akuter Exazerbation einer chronisch obstruktiven Lungenerkrankung
In diesem Artikel
Zusammenfassung
Zusammenfassung
Pulmonale Hypertonie ist eine klinisch wichtige Komplikation bei älteren Patienten, die wegen einer akuten Exazerbation einer chronisch obstruktiven Lungenerkrankung hospitalisiert werden, doch eine frühe Risikoeinschätzung bleibt in primären und ressourcenbegrenzten Krankenhausumgebungen schwierig. Diese retrospektive Kohortenstudie entwickelte und evaluierte intern ein auf Routine-Daten basierendes Nomogramm zur Abschätzung des Risikos einer pulmonalen Hypertonie. Insgesamt wurden 230 ältere Patienten analysiert, die zwischen Mai 2023 und Mai 2025 wegen einer akuten Exazerbation einer chronisch obstruktiven Lungenerkrankung hospitalisiert wurden. Die Patienten wurden anhand der Ergebnisse der transthorakalen Echokardiographie in Gruppen mit und ohne pulmonale Hypertonie eingeteilt. Demografische Merkmale, Komorbiditäten, Parameter des vollständigen Blutbildes, Gerinnungsmarker, inflammatorische Marker und kardiale Belastungsmarker wurden zwischen den Gruppen verglichen. Kandidaten-Prädiktoren wurden mittels univarianter Analyse, Beurteilung der klinischen Relevanz, Redundanzanalyse und multivariater logistischer Regression ausgewählt. Vier Variablen – Quotient aus Neutrophilen und Lymphozyten, natriuretisches Peptid vom Typ B, D-Dimer und Asthmaanamnese – waren unabhängig mit pulmonaler Hypertonie assoziiert und wurden in das primäre Nomogramm integriert. Das Modell zeigte eine gute Diskriminierung mit einer Fläche unter der ROC-Kurve (Receiver Operating Characteristic) von 0,82. Die Entscheidungskurvenanalyse deutete einen potenziellen Nettovorteil über Schwellenwahrscheinlichkeiten von etwa 1 % bis 70 % an. Die Kalibrierungsergebnisse erforderten aufgrund einer verbleibenden Kalibrierungsabweichung eine vorsichtige Interpretation. Dieser Arbeitsablauf bietet einen praktikablen Ansatz für die frühe Risikostratifizierung einer pulmonalen Hypertonie bei älteren Patienten, die wegen einer akuten Exazerbation einer chronisch obstruktiven Lungenerkrankung hospitalisiert werden. Eine externe Validierung und eine Neukalibrierung des Modells sind jedoch erforderlich, bevor eine breitere klinische Anwendung möglich ist.
Einleitung
Die chronisch obstruktive Lungenerkrankung ist eine häufige chronische Atemwegserkrankung, die durch eine anhaltende Luftstrombegrenzung, respiratorische Symptome und wiederkehrende Episoden klinischer Verschlechterung gekennzeichnet ist. Sie bleibt weltweit eine wesentliche Ursache für Morbidität, Mortalität und Belastung des Gesundheitssystems1. Die akute Exazerbation der chronisch obstruktiven Lungenerkrankung bezeichnet eine akute Verschlechterung respiratorischer Symptome wie Dyspnoe, Husten und Auswurfproduktion und wird häufig durch Infektionen, Umweltexposition oder andere akute Noxen ausgelöst2. Bei älteren Patienten treten akute Exazerbationen oft vor dem Hintergrund multimorbider Zustände, eingeschränkter kardiopulmonaler Reserve, systemischer Entzündung und verminderten physiologischen Toleranz auf, was die frühzeitige Risikobewertung erschwert.
Pulmonale Hypertonie ist eine wichtige Komplikation der chronisch obstruktiven Lungenerkrankung, insbesondere während akuter Exazerbationen. Ihre Entstehung ist mit chronischer Hypoxie, Umbau des pulmonalen Gefäßsystems, endothelialer Dysfunktion, entzündlicher Aktivierung und erhöhter Nachlast des rechten Ventrikels assoziiert3. Eine erhöhte pulmonalarterielle Druckbelastung wurde bei Patienten mit akuter Exazerbation der chronisch obstruktiven Lungenerkrankung beobachtet und kann die respiratorische Insuffizienz, Belastung des rechten Herzens, die Hospitalisierungsdauer sowie die Überlebensprognose verschlechtern4. Diese prognostische Bedeutung ist besonders bei älteren Patienten und bei solchen mit fortgeschrittener kardiopulmonaler Erkrankung relevant5,6. Eine frühzeitige Identifizierung von Patienten mit erhöhtem Risiko für eine pulmonale Hypertonie könnte daher eine engmaschigere Überwachung, eine rechtzeitige echokardiographische Beurteilung und eine Überweisung zur weiteren kardiopulmonalen Abklärung unterstützen.
Die Rechtsherzkatheteruntersuchung bleibt der Referenzstandard zur Bestätigung einer pulmonalen Hypertonie; ihre Invasivität, die Kosten, die technischen Anforderungen und die begrenzte Verfügbarkeit schränken jedoch ihre Anwendung als erstes Screeningverfahren in vielen primären und regionalen Krankenhäusern ein7. Die transthorakale Echokardiographie wird häufig als nicht-invasives Beurteilungsverfahren eingesetzt, doch ihre Zuverlässigkeit kann durch Hyperinflation, ungünstige akustische Fenster und emphysematöse Veränderungen bei Patienten mit einer chronisch obstruktiven Lungenerkrankung beeinträchtigt werden8. Obwohl diese Einschränkungen den klinischen Wert der Echokardiographie nicht schmälern, verdeutlichen sie die Notwendigkeit eines einfachen Workflows zur Risikoeinschätzung, der vor oder parallel zur bildgebenden Diagnostik angewendet werden kann.
Routinemäßige klinische und laborchemische Parameter könnten helfen, diesem Bedarf gerecht zu werden. Das Neutrophile-zu-Lymphozyten-Verhältnis wird aus den Ergebnissen des vollständigen Blutbilds berechnet und spiegelt das Gleichgewicht zwischen neutrophilenvermittelter Entzündung und lymphozytenbezogener Immunregulation wider9. Es wurde mit der Krankheitsaktivität und ungünstigen Ergebnissen bei pulmonalen und kardiovaskulären Erkrankungen assoziiert10. Das B-Typ-Natriuretische Peptid ist ein leicht verfügbares Markerprotein für myokardiale Wandspannung, Überlastung des rechten Ventrikels und kardiopulmonale Belastung11. D-Dimer spiegelt die Aktivierung der Gerinnung und die sekundäre Fibrinolyse wider und kann während akuter Exazerbationen aufgrund von Hypoxämie, Infektion, endothelialer Schädigung und verminderter Mobilität ansteigen12. Allerdings ist es unwahrscheinlich, dass ein einzelner Biomarker das gesamte Risikoprofil der pulmonalen Hypertonie bei älteren Patienten mit akuter Exazerbation einer chronisch obstruktiven Lungenerkrankung erfasst.
Ein Nomogramm bietet eine praktische Möglichkeit, ein multivariables Vorhersagemodell in eine individuelle Risikoabschätzung zu übersetzen. Im Vergleich zur alleinigen Angabe von Regressionskoeffizienten ermöglicht es die Integration mehrerer patientenspezifischer Prädiktoren in ein klinisch interpretierbares Werkzeug13. Frühere klinische Vorhersageuntersuchungen haben nomogrammbasierte Modelle zur Unterstützung der Risikobewertung am Krankenbett verwendet, deren Nützlichkeit jedoch von einer transparenten Auswahl der Prädiktoren, angemessener Kalibrierung, Validierung und vorsichtiger Interpretation abhängt14. Die Neuheit der vorliegenden Studie besteht darin, einen auf Routine-Daten basierenden Workflow für ältere Patienten, die wegen einer akuten Exazerbation der chronisch obstruktiven Lungenerkrankung hospitalisiert wurden, zu entwickeln, indem entzündliche, kardiale Belastungs-, gerinnungsrelevante und Atemwegs-Phänotyp-Informationen in ein praktisches Nomogramm integriert werden. Ziel der Studie war es, klinische Prädiktoren zu identifizieren, die mit einer mittels Echokardiographie definierten pulmonalen Hypertonie assoziiert sind, und ein intern validiertes Modell zur frühen Risikostratifizierung – und nicht zur definitiven Diagnose – zu erstellen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Das Studienprotokoll wurde vom Ethikkomitee des Krankenhauses für Traditionelle Chinesische Medizin der Kreisstadt Santai in der Provinz Mianyang, Sichuan (Genehmigungsnummer 2025003), geprüft und genehmigt. Die Studie wurde gemäß den Grundsätzen der Deklaration von Helsinki durchgeführt. Vor der Aufnahme in die Studie wurde bei jedem Patienten oder einem Verwandten ersten Grades schriftlich informierte Einwilligung eingeholt. Diese retrospektive Kohortenstudie analysierte die klinischen Unterlagen älterer Patienten, die zwischen Mai 2023 und Mai 2025 aufgrund einer akuten Verschlechterung einer chronisch obstruktiven Lungenerkrankung (AECOPD) in der Abteilung für Pneumologie und Intensivmedizin des Krankenhauses für Traditionelle Chinesische Medizin der Kreisstadt Santai hospitalisiert wurden. Ziel der Studie war es, routinemäßig verfügbare klinische Prädiktoren für pulmonale Hypertonie (PH) zu identifizieren und ein Nomogramm zur individuellen Einschätzung des PH-Risikos zu entwickeln. Die in diesem Arbeitsablauf verwendeten Laborgeräte, das Echokardiographiesystem, die Blutentnahmematerialien, die Datengewinnungstools sowie die statistische Software sind in der Tabelle der Materialien aufgeführt.
1. Patienten-Screening und Eignungsbeurteilung
Hospitalisierte Patienten mit einer Entlassungsdiagnose einer akuten Exazerbation der COPD (AECOPD) während des Studienzeitraums wurden über das elektronische Krankenaktensystem der Stationen gescreent. Jeder Datensatz wurde überprüft, um sicherzustellen, dass der Patient mindestens 60 Jahre alt war und die Diagnose einer chronisch obstruktiven Lungenerkrankung den diagnostischen Kriterien der Global Initiative for Chronic Obstructive Lung Disease (GOLD) aus dem Jahr 2021 entsprach15. Eine AECOPD wurde definiert als eine akute Verschlechterung der Atemwegssymptome, die eine Hospitalisierung und zusätzliche Therapie erforderte. Bei Patienten mit mehr als einer AECOPD-Aufnahme während des Studienzeitraums wurde nur die erste berechtigte Hospitalisierung einbezogen.
Patienten wurden eingeschlossen, wenn alle folgenden Kriterien erfüllt waren: Alter von mindestens 60 Jahren; Krankenhauseinweisung wegen einer akuten Exazerbation der COPD (AECOPD) zwischen Mai 2023 und Mai 2025; verfügbare transthorakale Echokardiographie während der Indexhospitalisierung; verfügbare erste nüchterne venöse Blutprobe nach der Aufnahme; sowie vollständige klinische, laborchemische und echokardiographische Informationen, die für die Modellkonstruktion erforderlich sind. Patienten wurden ausgeschlossen, wenn sie eine schwere hepatische Insuffizienz, eine Nierenerkrankung im Endstadium, eine aktive maligne Erkrankung, eine pulmonale Hypertonie aufgrund anderer bekannter Ursachen, eine primäre Linksherzerkrankung, eine Bindegewebserkrankung wie systemische Sklerose, eine aktive pulmonale Tuberkulose oder fehlende Schlüsselvariablen, die für die Outcome-Klassifizierung oder die Modellkonstruktion erforderlich sind, aufwiesen.
Bevor Datensätze aufgrund unvollständiger Angaben, Alter, Geschlecht, Rauchgeschichte, Alkoholkonsumgeschichte, Arzneimittelallergiegeschichte, Hypertonie, Diabetes mellitus, koronare Herzkrankheit, Asthma, Bronchiektasen, pulmonale Infektion, Emphysem, respiratorische Insuffizienz, Herzinsuffizienz, echokardiographischem PH-Status, Parametern des vollständigen Blutbilds, Albumin, Kreatinin, hochsensitivem C-reaktivem Protein, D-Dimer, Fibrinogen, natriuretischem Peptid vom Typ B und Neutrophile-zu-Lymphozyten-Verhältnis entfernt wurden, wurden diese überprüft. Die Anzahl der geprüften und ausgeschlossenen Datensätze, die Ausschlussgründe sowie die endgültig eingeschlossenen Fälle wurden dokumentiert, um das Flussdiagramm zur Patientenauswahl zu erstellen (Abbildung 1).
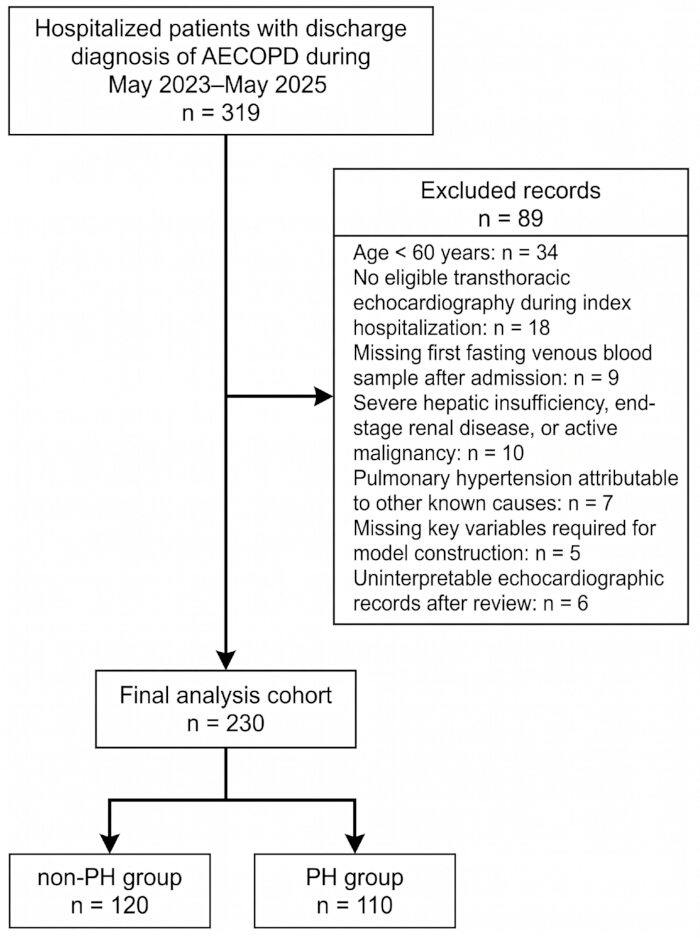
Abbildung 1: Patientenscreening und Kohortenbildung. Das Flussdiagramm zeigt die Identifizierung von Datensätzen, die Beurteilung der Eignung, Ausschlüsse und die endgültige Gruppierung älterer Patienten, die wegen einer akuten Exazerbation einer COPD (AECOPD) hospitalisiert wurden. Die Patienten wurden anhand der Ergebnisse der transthorakalen Echokardiographie in die Gruppe ohne pulmonale Hypertonie (non-PH) oder die Gruppe mit pulmonaler Hypertonie (PH) eingeteilt. Abkürzungen: AECOPD, akute Exazerbation der chronisch obstruktiven Lungenerkrankung; PH, pulmonale Hypertonie. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
2. Klinische Einteilung und diagnostische Definition der pulmonalen Hypertonie
Die eingeschlossenen Patienten wurden anhand der Ergebnisse der transthorakalen Echokardiographie während des Krankenhausaufenthalts in eine Nicht-PH-Gruppe oder eine PH-Gruppe klassifiziert. Der diagnostische Rahmen basierte auf den Leitlinien der Europäischen Gesellschaft für Kardiologie/Europäische Gesellschaft für Pneumologie aus dem Jahr 2015 für pulmonale Hypertonie16. Die ruhende transthorakale Echokardiographie diente als diagnostische Grundlage in diesem retrospektiven Datensatz. Die Untersuchungen wurden von geschulten Echokardiographie-Ärzten unter Verwendung standardmäßiger parasternaler, apikaler und subkostaler Ansichten durchgeführt. Die Interpretierbarkeit der Echokardiographie wurde vor der Gruppeneinteilung überprüft, da schlechte akustische Fenster bei Patienten mit chronisch obstruktiver Lungenerkrankung häufig vorkommen. Eine Aufzeichnung galt als geeignet für die Klassifizierung der pulmonalen Hypertonie, wenn das Doppler-Signal der Trikuspidalklappeninsuffizienz messbar war oder wenn die Größe des rechten Ventrikels, die Wanddicke und die systolische Funktion anhand interpretierbarer Herzansichten beurteilt werden konnten.
Der systolische pulmonalarterielle Druck wurde anhand der maximalen Trikuspidalinsuffizienzgeschwindigkeit und des geschätzten rechtsatrialen Drucks ermittelt. Der rechtsatriale Druck wurde aus dem Durchmesser der unteren Hohlvene und deren inspiratorischem Kollaps geschätzt, sofern beide Messungen verfügbar waren. Eine pulmonale Hypertonie (PH) wurde definiert als ein geschätzter systolischer pulmonalarterieller Druck von mindestens 40 mmHg. Wenn der systolische pulmonalarterielle Druck nicht zuverlässig geschätzt werden konnte, war für die Klassifizierung der PH indirekter echokardiographischer Befundnachweis einer Rechtsherzbeteiligung erforderlich, einschließlich Rechtsherzvergrößerung, Rechtsherzhypertrophie, systolischer Rechtsherzinsuffizienz, Flattening des interventrikulären Septums oder Erweiterung der Pulmonalarterie. Echokardiographische Befunde mit unscharfen Bildern, nicht nachvollziehbaren Doppler-Signalen der Trikuspidalinsuffizienz oder inkonsistenten Befunden der Rechtsherzstrukturen wurden vor der endgültigen Gruppeneinteilung von einem zweiten echokardiographisch tätigen Arzt überprüft. Befunde, die auch nach dieser Überprüfung nicht interpretierbar blieben, wurden von der endgültigen Analyse ausgeschlossen. In der endgültigen Kohorte erfüllten 230 ältere Patienten die Einschlusskriterien; 120 Patienten wurden der Nicht-PH-Gruppe und 110 Patienten der PH-Gruppe zugeordnet.
3. Extraktion demografischer und klinischer Variablen
Alle klinischen Daten wurden mithilfe eines standardisierten Erfassungsbogens aus dem elektronischen Patienten-Aktensystem der stationären Behandlung abgerufen. Es wurden Geschlecht, Alter, Rauchgeschichte, Alkoholkonsumgeschichte, Arzneimittelallergie-Anamnese, Hypertonie, Diabetes mellitus, koronare Herzkrankheit, Asthma, Bronchiektasen, pulmonale Infektion, Emphysem, Atemversagen und Herzinsuffizienz erfasst. Eine Rauchgeschichte wurde definiert als ein lebenslanger Konsum von mindestens 100 Zigaretten, eine Alkoholkonsumgeschichte als regelmäßiger Alkoholkonsum von mindestens zweimal pro Woche.
Eine pulmonale Infektion wurde durch die Integration von respiratorischen Symptomen, körperlichen Befunden, bildgebenden Thoraxbefunden und, falls verfügbar, mikrobiologischen Nachweisen diagnostiziert. Eine Herzinsuffizienz wurde entsprechend den klinischen Manifestationen, körperlichen Zeichen, den Werten des B-Typ-natriuretischen Peptids und echokardiographischen Befunden diagnostiziert. Informationen zu Komorbiditäten wurden anhand von Entlassungsdiagnosen, Verlaufsnotizen, bildgebenden Befunden, Laborbefunden und Konsiliarberichten, falls verfügbar, gegengeprüft.
4. Sammlung und Aufbereitung von Laborvariablen
Die erste nüchterne venöse Blutprobe, die am Morgen nach der Krankenhausaufnahme entnommen wurde, diente als Quelle für die Laborergebnisse. Dieser Zeitpunkt entsprach der ersten morgendlichen Blutentnahme nach der Aufnahme und vor der routinemäßigen Anpassung der Tagesbehandlung, sofern diese Informationen im medizinischen Befund verfügbar waren. Blutbildparameter, biochemische Parameter, Gerinnungsmarker, Entzündungsmarker und Marker für kardiale Belastung wurden aus dem Laborinformationssystem des Krankenhauses extrahiert.
Die Anzahl der Neutrophilen, die Anzahl der Lymphozyten, die Thrombozytenanzahl, das mittlere Thrombozytenvolumen und der Variationskoeffizient der roten Blutkörperchenverteilungsbreite wurden aus dem vollständigen Blutbildbericht erfasst. Das Neutrophilen-Lymphozyten-Verhältnis wurde wie folgt berechnet:
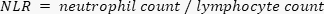
Albumin, Kreatinin, D-Dimer, Fibrinogen, hochsensitives C-reaktives Protein und BNP wurden aus den entsprechenden Laborberichten entnommen. Durchgängig wurden folgende Maßeinheiten im Datensatz verwendet: Albumin in g/L, Kreatinin in µmol/L, hochsensitives C-reaktives Protein in mg/L, D-Dimer in µg/mL, Fibrinogen in g/L, Neutrophile, Lymphozyten und Thrombozyten in ×109/L, mittleres Thrombozytenvolumen in fL sowie BNP in pg/mL.
5. Datenaufbereitung und Vorbereitung
Der Datensatz wurde vor der statistischen Analyse überprüft. Jeder eingeschlossene Datensatz wurde auf Eignung, Gruppenzugehörigkeit, Vollständigkeit der Laborergebnisse, Interpretierbarkeit der Echokardiographie und Verfügbarkeit der Kandidatenprädiktoren geprüft. Direkte personenbezogene Identifikatoren wurden entfernt, und jedem Patienten wurde eine Studien-ID zugewiesen. Doppelte Einträge, wiederholte Krankenhausaufenthalte, inkonsistente Gruppenbezeichnungen, unmögliche Daten und unplausible Laborwerte wurden mit der ursprünglichen elektronischen Patientenakte und dem Laborbericht abgeglichen. Es erfolgte keine Imputation für wesentliche Zielgrößen oder Prädiktorvariablen, da das endgültige Modell auf einer Analyse vollständiger Fälle basierte.
Stetige Variablen wurden hinsichtlich ihrer Verteilungseigenschaften überprüft. Normalverteilte Variablen wurden als Mittelwert ± Standardabweichung zusammengefasst; nicht normalverteilte Variablen als Median mit Interquartilsabstand; und kategoriale Variablen als Anzahlen und Prozentanteile. Vor der multivariablen Modellierung wurden klinisch verwandte Variablen auf Redundanz geprüft. Die Neutrophilenanzahl und die Lymphozytenanzahl wurden gemeinsam mit dem Neutrophilen-zu-Lymphozyten-Verhältnis betrachtet; die pulmonale Infektion wurde gemeinsam mit der Neutrophilenanzahl, hochsensitivem C-reaktivem Protein und dem Neutrophilen-zu-Lymphozyten-Verhältnis bewertet; die Herzinsuffizienz wurde gemeinsam mit dem B-Typ-natriuretischen Peptid und echokardiographischen Herzbefunden analysiert; D-Dimer und Fibrinogen wurden als gerinnungsrelevante Variablen betrachtet; und Thrombozytenanzahl, mittleres Thrombozytenvolumen sowie Koeffizient der Variation der roten Zellverteilungsbreite wurden als hämatologische Variablen ausgewertet.
6. Univariativer Vergleich zwischen Gruppen
Die demografischen Merkmale, Komorbiditäten, Laborparameter und die Gruppierungsechokardiographie-Variablen wurden zwischen der Nicht-PH- und der PH-Gruppe verglichen. Für normalverteilte stetige Variablen wurde ein t-Test für unabhängige Stichproben verwendet. Für nicht normalverteilte stetige Variablen kam der Mann-Whitney-U-Test zum Einsatz. Für kategoriale Variablen wurde je nach erwarteten Zellenhäufigkeiten der χ2-Test oder der exakte Fisher-Test angewendet. Ein zweiseitiger P-Wert unter 0,05 galt als statistisch signifikant. Variablen mit signifikanten Unterschieden zwischen den Gruppen wurden zusammen mit klinisch relevanten Prädiktoren in die multivariable Analyse einbezogen.
7. Multivariable logistische Regressionsanalyse
Die binäre logistische Regression wurde verwendet, um unabhängige Prädiktoren für pulmonale Hypertonie (PH) bei älteren Patienten mit AECOPD zu identifizieren. Der PH-Status wurde als abhängige Variable verwendet. Stetige Prädiktoren wurden in ihren ursprünglichen Messgrößen eingegeben, und kategoriale Prädiktoren wurden als binäre Variablen kodiert. Die Auswahl der Kandidatenvariablen erfolgte basierend auf univariaten Ergebnissen und klinischer Relevanz. Variablen mit einem P-Wert < 0,05 im univariaten Vergleich wurden zunächst identifiziert und anschließend auf Redundanz, Interpretierbarkeit und klinische Überschneidungen überprüft.
Zu den anfänglichen Kandidatenvariablen gehörten hochsensitives C-reaktives Protein, D-Dimer, Koeffizient der Variation der roten Blutkörperchenverteilungsbreite, Thrombozytenzahl, mittleres Thrombozytenvolumen, Neutrophile-zu-Lymphozyten-Quotient, B-Typ natriuretisches Peptid, koronare Herzkrankheit und Asthmaanamnese. Neutrophile und Lymphozyten wurden nicht zusammen mit dem Neutrophile-zu-Lymphozyten-Quotienten berücksichtigt, da sie Bestandteile dieses Quotienten sind. Pulmonale Infektion und Herzinsuffizienz wurden im Rahmen der Redundanzprüfung evaluiert. Um zu untersuchen, ob deren Ausschluss die Modellinterpretation beeinflusste, wurde eine Sensitivitätsanalyse durchgeführt, bei der pulmonale Infektion und Herzinsuffizienz dem primären Prädiktorensatz hinzugefügt wurden. Regressionsabschätzungen, Diskriminierung, Kalibrierung und klinischer Nutzen wurden zwischen dem primären und dem Sensitivitätsmodell verglichen.
Multikollinearität zwischen den Kandidatenprädiktoren wurde mithilfe von Varianzinflationsfaktoren bewertet. Kategoriale Variablen wurden vor der Berechnung codiert, und kontinuierliche Variablen wurden in den gleichen Einheiten eingegeben, die für die Regressionsmodellierung verwendet wurden. Ein Varianzinflationsfaktor unter 5 galt als Hinweis auf keine starke Multikollinearität. Regressionskoeffizienten, Standardfehler, Wald-χ2-Werte, Odds-Ratios, 95-%-Konfidenzintervalle, P-Werte und Varianzinflationsfaktoren wurden für die in das multivariable Modell aufgenommenen Variablen angegeben.
8. Nomogrammkonstruktion
Das Nomogramm wurde aus den unabhängigen Prädiktoren erstellt, die im multivariablen logistischen Regressionsmodell beibehalten wurden. Die endgültigen Prädiktoren waren D-Dimer, Neutrophile-zu-Lymphozyten-Verhältnis, B-Typ natriuretisches Peptid und Asthmaanamnese. Das logistische Regressionsmodell wurde mithilfe der R-Software und des rms-Pakets in ein punktbasiertes Nomogramm umgewandelt. Ein Datenverteilungsobjekt wurde für den Modellierungsdatensatz erstellt, das logistische Regressionsmodell wurde angepasst, und die Regressionskoeffizienten wurden verwendet, um jedem Prädiktor Punkte zuzuweisen. Bei jedem Patienten wurden die Punkte für D-Dimer, Neutrophile-zu-Lymphozyten-Verhältnis, B-Typ natriuretisches Peptid und Asthmaanamnese summiert, um eine Gesamtpunktzahl zu ermitteln, die anschließend der geschätzten Wahrscheinlichkeit für PH zugeordnet wurde.
Das Nomogramm wurde mithilfe standardmäßiger, punktbasierter Verfahren interpretiert, wie sie in früheren Studien zu klinischen Vorhersagemodellen beschrieben wurden17,18. Der D-Dimer-Wert des Patienten, das Verhältnis von Neutrophilen zu Lymphozyten, der Wert des B-Typ-natriuretischen Peptids sowie der Asthmastatus wurden auf den entsprechenden Achsen lokalisiert. Von jedem Prädiktorwert wurde eine senkrechte Linie zur Punkteskala gezogen. Die ermittelten Punkte wurden summiert, um die Gesamtpunktzahl zu erhalten, und von dieser Gesamtpunktzahl wurde eine senkrechte Linie zur Achse der vorhergesagten Wahrscheinlichkeit gezogen, um die individuell geschätzte Wahrscheinlichkeit für PH zu ermitteln. Der im Manuskript dargestellte Beispielpatient wurde anhand von Werten ausgewählt, die innerhalb oder nahe der beobachteten klinischen Verteilung der Kohorte lagen.
9. Bewertung der Modellleistung
Die Modell-Diskriminierung wurde mittels Analyse der Receiver-Operating-Characteristic-Kurve und der Fläche unter der Kurve bewertet. Die Fläche unter der Kurve wurde mit einem 95 %igen Konfidenzintervall angegeben. Das Nomogramm wurde mit einzelnen Prädiktoren sowie mit einem Modell verglichen, das quantitative laborchemische Marker kombiniert. Die Kalibrierung wurde durch den Vergleich vorhergesagter Wahrscheinlichkeiten mit beobachteten PH-Ergebnissen überprüft. Eine Kalibrierungskurve wurde mittels Bootstrap-Resampling erstellt. Kalibrierungsinterzept, Kalibrierungssteigung, mittlerer absoluter Fehler, Brier-Score und der Hosmer-Lemeshow-Test wurden berichtet. Zudem wurden der bootstrap-korrigierte Kalibrierungsinterzept und die bootstrap-korrigierte Kalibrierungssteigung berechnet. Der Hosmer-Lemeshow-Test wurde gemeinsam mit der Kalibrierungskurve und quantitativen Kalibrierungsindizes interpretiert.
Die klinische Nützlichkeit wurde mittels Entscheidungskurvenanalyse bewertet. Der Nettogewinn wurde über die Schwellenwahrscheinlichkeiten aufgetragen und mit den Referenzstrategien „alle behandeln“ und „keinen behandeln“ verglichen. Der Bereich der Schwellenwahrscheinlichkeit, in dem das Modell einen höheren Nettogewinn als die Referenzstrategien lieferte, wurde identifiziert.
10. Interne Validierung und Reproduzierbarkeit
Die interne Validierung erfolgte mittels Bootstrap-Resampling mit 1.000 Wiederholungen. Bei jedem Bootstrap-Durchlauf wurde das Modell erneut angepasst und getestet, um den Optimismus bezüglich der Modellleistung zu schätzen. Optimismus-korrigierte Diskriminierungs- und Kalibrationsindizes wurden berechnet und zusammen mit der scheinbaren Modellleistung angegeben.
Die statistischen Analysen wurden mit herkömmlicher statistischer Software und R-Version 4.5.2 durchgeführt. R-Pakete wurden für die logistische Regressionsmodellierung, die Erstellung von Nomogrammen, die Analyse der Receiver-Operating-Characteristic-Kurve, die Bewertung der Kalibrierung, die interne Validierung sowie die Entscheidungskurvenanalyse verwendet. Das Nomogramm wurde mit dem rms-Paket in R erstellt.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Patientscreening und Kohortenmerkmale
Insgesamt erfüllten 230 ältere Patienten, die wegen einer akuten Exazerbation der chronisch-obstruktiven Lungenerkrankung (AECOPD) hospitalisiert wurden, die Einschlusskriterien und wurden in die endgültige Analyse eingeschlossen. Gemäß der transthorakalen Echokardiographie wurden 120 Patienten der Gruppe ohne pulmonale Hypertonie (non-PH) und 110 Patienten der Gruppe mit pulmonaler Hypertonie (PH) zugeordnet (Abbildun...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Diese Studie entwickelte ein auf Routine-Daten basierendes Nomogramm zur Abschätzung des Risikos einer pulmonalen Hypertonie (PH) bei älteren Patienten, die wegen einer akuten Exazerbation einer chronisch obstruktiven Lungenerkrankung (AECOPD) hospitalisiert wurden. Vier leicht verfügbare Variablen – nämlich das Neutrophile-zu-Lymphozyten-Verhältnis (NLR), das B-Typ-Natriuretische Peptid (BNP), D-Dimer und die Anamnese eines Asthmas – blieben im primären Modell enthalten. Das Nomogramm zeigte eine bessere Diskriminierung...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren erklären, dass keine konkurrierenden finanziellen Interessen oder sonstige Interessenkonflikte in Bezug auf diese Arbeit bestehen.
Beitrag der Autoren
Mingfeng Wu: Studiendesign, Überwachung und Durchführung, Entwurf und Überarbeitung des Manuskripts sowie Koordination der Teamverantwortlichkeiten; Li Zhang: Datensammlung und -organisation, statistische Analyse sowie Entwurf des Manuskripts; Xiong Wang: Datensammlung und Manuskriptentwurf; Schaohua Xu: Statistische Analyse und Überarbeitung des Manuskripts; Li Xie: Überarbeitung des Manuskripts.
Danksagungen
Diese Studie wurde unterstützt durch die wissenschaftlichen Forschungsprojekte der Verwaltung für Traditionelle Chinesische Medizin der Provinz Sichuan, einschließlich Praktische Untersuchung zur Erstellung eines Vorhersagemodells für pulmonale Hypertonie bei älteren Patienten mit chronisch obstruktiver Lungenerkrankung basierend auf dem NLR-Verhältnis (Förderkennzeichen Nr. 25MSZX321) sowie Aufbau eines Laborversorgungsmodells für kommunale medizinische Gemeinschaften und politische Reaktionsforschung, angetrieben durch „Drohnenlieferung + KI-unterstützte Diagnose“ (Förderkennzeichen Nr. 25MSZX322). Die Autoren danken dem Krankenhaus für Traditionelle Chinesische Medizin in Santai County für die Unterstützung dieser Studie.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Automatischer klinischer Chemie-Analysator | Mindray Bio-Medical Electronics Co., Ltd. | BS-480 | Wird zur Bestimmung von Serumalbumin, Kreatinin und hochsensitivem C-reaktivem Protein in der routinemäßigen klinischen Labordiagnostik verwendet. |
| Automatischer Gerinnungsanalysator | Mindray Bio-Medical Electronics Co., Ltd. | C3510 | Wird zur Bestimmung von D-Dimer und Fibrinogen in der routinemäßigen Gerinnungsdiagnostik verwendet. |
| Automatischer Hämatologie-Analysator | Mindray Bio-Medical Electronics Co., Ltd. | BC-5380 | Wird zur Bestimmung der Neutrophilenanzahl, Lymphozytenanzahl, Thrombozytenanzahl, mittleren Thrombozytengröße und Variationskoeffizient der roten Blutkörperchenverteilungsbreite verwendet. |
| Chemilumineszenz-Immunoassay-Analysator | Mindray Bio-Medical Electronics Co., Ltd. | CL-1200i | Wird zur Bestimmung des B-typischen natriuretischen Peptids in der routinemäßigen klinischen Labordiagnostik verwendet. |
| Chemilumineszenz-Immunoassay-Reagenzien, Kalibratoren und Kontrollen | Mindray Bio-Medical Electronics Co., Ltd. | CL-Serie Reagenssystem | Wird für die Chemilumineszenz-Immunoassay-Diagnostik und Qualitätskontrolle verwendet. |
| Klinisch-chemische Reagenzien, Kalibratoren und Kontrollen | Mindray Bio-Medical Electronics Co., Ltd. | BS-Serie Reagenssystem | Wird für routinemäßige klinisch-chemische Assays auf dem BS-Serie-Analysator verwendet. |
| Gerinnungskalibratoren und -kontrollen | Mindray Bio-Medical Electronics Co., Ltd. | Produktspezifisch* | Wird für die Qualitätskontrolle und Kalibrierung von Gerinnungsassays verwendet. |
| dcurves-Paket | CRAN | dcurves | Wird zur Durchführung der Entscheidungskurvenanalyse und zur Berechnung des klinischen Nettogewinns über Schwellenwahrscheinlichkeiten hinweg verwendet. |
| EDTA-Venenblutentnahmeröhrchen | BD | Vacutainer K2EDTA-Röhrchen (REF 367856) | Wird für die vollständige Blutbildbestimmung verwendet. |
| Elektronisches Patientenaktensystem | Traditionelle Chinesische Medizin Klinik Santai County | Nicht zutreffend | Wird zur Erfassung der demografischen Merkmale stationärer Patienten, Aufnahmedaten, Entlassungsdiagnosen, Komorbiditäten, Verlaufsprotokolle, Bildgebungsberichte, Konsilberichte und klinischer Ergebnisse verwendet. |
| Hämatologie-Reagenzien, Kalibratoren und Kontrollen | Mindray Bio-Medical Electronics Co., Ltd. | BC-Serie Reagenssystem | Wird für die routinemäßige vollständige Blutbildbestimmung und die Qualitätskontrolle des Analysators verwendet. |
| IBM SPSS Statistics | IBM Corp. | Version 26.0 | Wird für deskriptive Statistiken, Gruppenvergleiche und vorläufige logistische Regressionsanalysen verwendet. |
| Laborinformationssystem | Traditionelle Chinesische Medizin Klinik Santai County | Nicht zutreffend | Wird zur Erfassung von Parametern der vollständigen Blutbildbestimmung, biochemischen Parametern, Gerinnungsmarkern, Entzündungsmarkern und kardialen Belastungsmarkern verwendet. |
| pROC-Paket | CRAN | pROC | Wird für die Analyse der Receiver-Operating-Characteristic-Kurve und die Schätzung der Fläche unter der Kurve verwendet. |
| R-Statistiksoftware | R Foundation for Statistical Computing | Version 4.5.2 | Wird für logistische Regressionsmodellierung, Nomogrammkonstruktion, ROC-Kurvenanalyse, Kalibrierungsbewertung, interne Bootstrap-Validierung und Entscheidungskurvenanalyse verwendet. |
| ResourceSelection-Paket | CRAN | ResourceSelection | Wird zur Durchführung des Hosmer-Lemeshow-Anpassungstests verwendet. |
| rms-Paket | CRAN (Frank E. Harrell Jr.) | rms | Wird für Regressionsmodellierung, Nomogrammkonstruktion, Kalibrierungsbewertung und interne Validierung verwendet. |
| Serumtrennröhrchen für die venöse Blutentnahme | BD | Vacutainer SST-Röhrchen (REF 367820) | Wird für die Bestimmung biochemischer und entzündungshemmender Marker im Serum verwendet. |
| Natriumcitrat-Venenblutentnahmeröhrchen | BD | Vacutainer Citrat-Röhrchen (REF 363080) | Wird für die Gerinnungsdiagnostik verwendet, einschließlich D-Dimer und Fibrinogen. |
| Standardisierter klinischer Datenerfassungsbogen | Vom Studienteam erstellt | Nicht zutreffend | Wird zur Erfassung vordefinierter demografischer, klinischer, laborchemischer und echokardiographischer Variablen aus retrospektiven Unterlagen verwendet. |
| Transthorakales Echokardiographiesystem | GE HealthCare | Vivid E95 | Wird zur Schätzung des systolischen pulmonalarteriellen Drucks und zur Beurteilung der Größe des rechten Ventrikels, der Wanddicke und der systolischen Funktion verwendet. |
Referenzen
- Adeloye D, et al. Global, regional, and national prevalence of, and risk factors for, chronic obstructive pulmonary disease (COPD) in 2019: a systematic review and modelling analysis. Lancet Respir Med. 2022;10:447-58.
- Chronic Obstructive Pulmonary Disease Group of Chinese Thoracic Society, Chronic Obstructive Pulmonary Disease Committee of Chinese Association of Chest Physician. Guidelines for the diagnosis and management of chronic obstructive pulmonary disease, revised version 2021. Chin J Tuberc Respir Dis. 2021;44:170-205.
- Johnson S, et al. Pulmonary hypertension: a contemporary review. Am J Respir Crit Care Med. 2023;208:528-48.
- Munshi RF, Pellegrini JR Jr, Patel P, Anjum F. Impact of pulmonary hypertension in patients with acute exacerbation of chronic obstructive pulmonary disease and its effect on healthcare utilization. Pulm Circ. 2021;11(3):20458940211046838.
- Prins KW, et al. Disproportionate right ventricular dysfunction and poor survival in group 3 pulmonary hypertension. Am J Respir Crit Care Med. 2018;197:1496-9.
- Andersen KH, et al. Prevalence, predictors, and survival in pulmonary hypertension related to end-stage chronic obstructive pulmonary disease. J Heart Lung Transplant. 2012;31:373-80.
- Chen Y, et al. Right heart catheterization-related complications: a review of the literature and best practices. Cardiol Rev. 2020;28:36-41.
- Younis M, et al. Echocardiography and pulmonary hypertension in patients with chronic obstructive pulmonary disease undergoing lung transplantation evaluation. Am J Med Sci. 2024;367:95-104.
- Pascual-González Y, López-Sánchez M, Dorca J, Santos S. Defining the role of neutrophil-to-lymphocyte ratio in COPD: a systematic literature review. Int J Chron Obstruct Pulmon Dis. 2018;13:3651-62.
- Lee SJ, et al. Usefulness of neutrophil to lymphocyte ratio in patients with chronic obstructive pulmonary disease: a prospective observational study. Korean J Intern Med. 2016;31:891-8.
- Leuchte HH, et al. Brain natriuretic peptide is a prognostic parameter in chronic lung disease. Am J Respir Crit Care Med. 2006;173:744-50.
- Husebø GR, et al. Coagulation markers as predictors for clinical events in COPD. Respirology. 2021;26:342-51.
- Iasonos A, Schrag D, Raj GV, Panageas KS. How to build and interpret a nomogram for cancer prognosis. J Clin Oncol. 2008;26:1364-70.
- Balachandran VP, Gonen M, Smith JJ, DeMatteo RP. Nomograms in oncology: more than meets the eye. Lancet Oncol. 2015;16(4):e173-e180.
- Global Initiative for Chronic Obstructive Lung Disease. Global Strategy for the Diagnosis, Management, and Prevention of Chronic Obstructive Pulmonary Disease: 2021 Report. Global Initiative for Chronic Obstructive Lung Disease; Fontana; 2021.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2016;37:67-119.
- Wu Z, Zhan S, Wang D, Tang C. A novel nomogram for predicting the risk of acute heart failure in intensive care unit patients with COPD. Chronic Obstr Pulm Dis. 2025;12(2):117-126.
- Cheng H, et al. A risk nomogram for predicting prolonged intensive care unit stays in patients with chronic obstructive pulmonary disease. Front Med. 2023;10:1177786.
- Zinellu A, et al. Clinical significance of the neutrophil-to-lymphocyte ratio and platelet-to-lymphocyte ratio in acute exacerbations of COPD: present evidence and future perspectives. Eur Respir Rev. 2022;31(166):220095.
- Jiang T, et al. Value of the neutrophil-to-lymphocyte ratio in chronic obstructive pulmonary disease complicated with pulmonary hypertension. J Int Med Res. 2023;51(1):3000605231200266.
- Hawkins NM, et al. B-type natriuretic peptides in chronic obstructive pulmonary disease: a systematic review. BMC Pulm Med. 2017;17:11.
- Hu G, et al. Prognostic role of D-dimer for in-hospital and 1-year mortality in exacerbations of COPD. Int J Chron Obstruct Pulmon Dis. 2016;11:2729-36.
- Zuo H, et al. Predictive value of novel inflammation-based biomarkers for pulmonary hypertension in the acute exacerbation of chronic obstructive pulmonary disease. Anal Cell Pathol (Amst). 2019;2019:5189165.
- Hayiroglu MI, Cicek V, Kilic S, Cinar T. Mean serum D-dimer level to predict in-hospital mortality in COVID-19 patients. Rev Assoc Med Bras (1992). 2021;67:1108-13.
- Guney BC, et al. Evaluation of N/LP ratio as a predictor of disease progression and mortality in COVID-19 patients admitted to the intensive care unit. Medeni Med J. 2021;36:241-8.
- Hayiroglu MI, Cinar T, Tekkesin AI. Fibrinogen and D-dimer variances and anticoagulation recommendations in COVID-19: current literature review. Rev Assoc Med Bras (1992). 2020;66:842-8.
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: the TRIPOD statement. Ann Intern Med. 2015;162:55-63.
- Moons KGM, et al. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: explanation and elaboration. Ann Intern Med. 2015;162(1):W1-W73.
- Kalenderoglu K, et al. Heart rate variability nomogram predicts atrial fibrillation in patients with moderate to high burden of premature ventricular complexes. Medicina (Kaunas). 2026;62:243.
- Cicek V, et al. A new risk prediction model for the assessment of myocardial injury in elderly patients undergoing non-elective surgery. J Cardiovasc Dev Dis. 2025;12(1):6.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.