Diese Studie stellt eine reproduzierbare Bioinformatik-Pipeline vor, die Transkriptomik, maschinelles Lernen und die Analyse der Immuninfiltration integriert, um potenzielle diagnostische Biomarker und regulatorische Netzwerke bei der chronisch obstruktiven Lungenerkrankung (COPD) zu identifizieren.
Forschungsartikel
UPP1 als diagnostischer Biomarker: Erkenntnisse aus integrativen Bioinformatik- und Immuninfiltration-Analysen bei COPD
* These authors contributed equally
In diesem Artikel
Zusammenfassung
Zusammenfassung
COPD ist eine fortschreitende Atemwegserkrankung, die durch eine persistierende Luftwegsobstruktion und chronische Entzündung gekennzeichnet ist, doch die Rolle der RNA-Modifikation N4-Acetylcytidin (ac4C) bei ihrer Pathogenese ist bisher weitgehend unerforscht. Diese Studie hatte das Ziel, systematisch ac4C-bezogene Gene (ac4C-RGs) aus einer veröffentlichten Datenbank zu identifizieren und ihre regulatorischen Netzwerke bei COPD zu untersuchen, um potenzielle Biomarker für weitere mechanistische Studien zu finden, ohne dabei eine direkte regulatorische Beziehung zwischen einem bestimmten Gen und der ac4C-Modifikation vorauszusetzen. Differenziell exprimierte Gene (DEGs) wurden aus transkriptomischen Profilen identifiziert, und eine gewichtete Gen-koexprimierungsnetzwerkanalyse (WGCNA) wurde angewandt, um wichtige Koexpressionsmodule aufzudecken. Eine Kreuzanalyse zwischen DEGs, signifikanten Modulen und ac4C-RGs wurde durchgeführt. Schlüsselgene wurden mithilfe der LASSO-Regression, XGBoost- und Random-Forest-Algorithmen ausgewählt und anschließend ein diagnostisches Modell auf Basis der logistischen Regression konstruiert. Die Modellleistung wurde mittels ROC-Kurvenanalyse (Receiver Operating Characteristic), Fläche unter der Kurve (AUC) mit 95 % Konfidenzintervallen, Kalibrierungskurvenbewertung und Entscheidungskurvenanalyse (DCA) bewertet. Insgesamt wurden 160 überlappende Gene identifiziert, und sechs Hub-Gene (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B und B4GALT2) wurden konsistent von allen drei maschinellen Lernalgorithmen ausgewählt. Das diagnostische Modell zeigte eine gute Diskriminierungsleistung mit AUC-Werten von 0,766, 0,759 und 0,723 in den Trainings-, internen Test- und externen Validierungsdatensätzen. Die Analyse der regulatorischen Netzwerke deutete auf potenzielle ceRNA-Achsen und Interaktionen mit Transkriptionsfaktoren hin, während die Profilierung der Immunzellinfiltration signifikante Korrelationen zwischen den Schlüsselgenen und mehreren Immunzellsubtypen ergab. Die Analyse der Arzneimittel-Gen-Interaktionen und molekulares Docking zeigten, dass Fluorouracil, Capecitabin und 5-Benzylacyclouridin möglicherweise günstige vorhergesagte Bindungsaffinitäten zu UPP1 aufweisen. Zusammenfassend wurden PTRF, PRKCDBP, UPP1, TOR3A, FAM168B und B4GALT2 als potenzielle ac4C-bezogene Biomarker bei COPD identifiziert, die möglicherweise an der Immun- und Stoffwechselregulation beteiligt sind und eine Grundlage für zukünftige funktionelle Untersuchungen und therapeutische Ansätze bieten.
Einleitung
COPD ist eine chronische und heterogene Atemwegserkrankung, die durch eine fortschreitende Luftwegsverengung gekennzeichnet ist, hervorgerufen durch Anomalien in der Struktur der Alveolen und Atemwege1,2. Ein Ungleichgewicht zwischen Proteasen und Antiproteasen, oxidativer Stress, chronische Entzündung und zelluläre Seneszenz stellen die zentralen pathophysiologischen Mechanismen der COPD dar, die zur strukturellen Zerstörung und funktionellen Beeinträchtigung des Lungengewebes führen3,4. Zudem wird die COPD durch mehrere Risikofaktoren beeinflusst, darunter langjähriges Rauchen, Umweltverschmutzung, berufliche Exposition, Atemwegsinfektionen und genetische Anfälligkeit5,6. Die COPD verursacht eine erhebliche Belastung für die globale Wirtschaft. Sie wird voraussichtlich zwischen 2020 und 2050 jährlich 0,111 % des weltweiten BIP ausmachen7. Obwohl aktuelle therapeutische Strategien wie Bronchodilatatoren, inhalative Kortikosteroide, pulmonale Rehabilitation und langfristige Sauerstofftherapie Symptome lindern können, bleibt die Eindämmung des Krankheitsverlaufs eine Herausforderung. Aufgrund der deutlichen klinischen Heterogenität variieren die Behandlungsergebnisse bei Patienten stark8. Daher werden dringend neue diagnostische Biomarker und prognostische Indikatoren benötigt, um das Management der COPD zu verbessern und die Überlebensrate der Patienten zu erhöhen.
RNA-Modifikation bezeichnet die chemische Veränderung von RNA-Molekülen, wodurch Struktur und Funktion der RNA verändert werden können, um die Genexpression zu regulieren9,10. Zu den häufigen RNA-Modifikationen gehören N6-Methyladenosin (m6A), Pseudouridin (Ψ), 5-Methylcytosin (m5C) und ac4C11. Die ac4C-Modifikation spielt eine entscheidende Rolle bei der Aufrechterhaltung der mRNA-Stabilität und der Förderung der mRNA-Translation12,13. NAT10 ist das einzige bekannte eukaryotische Enzym, das die ac4C-Modifikation katalysiert, und seine Aktivität ist für die Bildung dieser Modifikation unerlässlich14. Studien haben eine starke Korrelation zwischen oxidativem Stress, zellulärer Seneszenz, Entzündung und der ac4C-Modifikation gezeigt. Beispielsweise weisen CD4+ T-Lymphozyten in Kolongeweben von Personen mit chronisch-entzündlichen Darmerkrankungen (IBD) deutlich erhöhte NAT10-Spiegel auf15. NAT10 verstärkt die ac4C-Acetylierung der Chemokine CCL2 und CXCL1 und fördert dadurch das Einwandern von Makrophagen und Neutrophilen sowie die Verschärfung entzündlicher Schäden16. Die zelluläre Antwort auf oxidativen Stress könnte die ac4C-Modifikation beinhalten, wie durch den deutlichen Anstieg der ac4C-Spiegel unter oxidativem Stress belegt ist. Außerdem fördert NAT10 die durch PM2.5 induzierte pulmonale Fibrose, indem es den mRNA-Spiegel von TGFB1 über die ac4C-Modifikation stabilisiert und dadurch einen Übergang von epithelialen zu mesenchymalen Zellen auslöst17. Die Rolle der ac4C-Modifikation bei COPD ist jedoch weitgehend unerforscht, was die Notwendigkeit weiterer Untersuchungen in diesem Bereich unterstreicht.
Die GEO-Datenbank wurde in dieser Studie verwendet, um differentiell exprimierte Gene (DEGs) zwischen COPD-Patienten und Kontrollen zu identifizieren. Anschließend wurde eine veröffentlichte Liste von ac4C-regulierten Genen (ac4C-RGs), die aus Multiomik-Daten zusammengestellt wurde18, mit den DEGs kombiniert, um überlappende Kandidaten zu ermitteln. Da bekannt ist, dass die ac4C-Modifikation Entzündungsprozesse und oxidativen Stress – zentrale Mechanismen bei COPD – beeinflusst, ging die Hypothese davon aus, dass Gene des ac4C-Regulierungsnetzwerks bei COPD dysreguliert sein könnten. Die überlappenden Gene wurden jedoch nicht als direkte Substrate von NAT10 oder direkt durch ac4C-regulierte Gene betrachtet, sondern als Kandidaten, die mit dem ac4C-assoziierten Netzwerk verknüpft sind. Schlüsselgene wurden mittels mehrerer maschineller Lernalgorithmen ausgewählt, gefolgt von der Erstellung und Validierung eines diagnostischen Modells. Im Anschluss wurden relevante Signalwege, die an der COPD-Pathogenese beteiligt sind, identifiziert und potenzielle gezielte Wirkstoffe vorhergesagt. Schließlich wurden RT-qPCR-Analysen durchgeführt, um die Expressionsniveaus der Schlüsselgene zu bestätigen, wodurch vorläufige Erkenntnisse zur COPD-Pathophysiologie sowie potenzielle Ansatzpunkte für therapeutische Untersuchungen gewonnen wurden.
Protokoll
Stellungnahme der institutionellen Prüfkommission
Die Studie wurde gemäß der Deklaration von Helsinki durchgeführt. Das Protokoll wurde von dem Ethikkomitee des Shenzhen Luohu Krankenhauses für Traditionelle Chinesische Medizin genehmigt (Genehmigungsnummer 2024-LHQZYYYXLL-KY-039), und alle Teilnehmer gaben vor der Einschreibung ihre schriftliche informierte Einwilligung ab. Einzelheiten zu den in diesem Protokoll verwendeten Forschungsinstrumenten und Materialien sind in der Tabelle der Materialien enthalten.
Datenquelle und Datenverarbeitung
Genexpressionsdatensätze im Zusammenhang mit COPD wurden aus der Gene Expression Omnibus (GEO)-Datenbank bezogen. Der Datensatz GSE54837 wurde als Transkriptomdatensatz verwendet, und der Datensatz GSE112811 diente als Validierungsset (Tabelle 1). Die ac4C-regulierenden Gene (ac4C-RGs) wurden aus der Literatur zusammengestellt18. Differenziell exprimierte Gene (DEGs) zwischen den COPD- und Kontrollgruppen wurden mit dem R-Paket limma identifiziert. DEGs galten als statistisch signifikant, wenn |log2FC| > 0 und p < 0,05 waren. Volcano-Plots wurden erstellt, um die Gesamtverteilung der Genexpressionsänderungen zu visualisieren.
Aufbau der WGCNA
WGCNA wurde mit dem Datensatz GSE54837 unter Verwendung von R durchgeführt, um mit COPD assoziierte Module zu identifizieren. Vor dem Netzwerkaufbau wurden Ausreißerproben mittels hierarchischer Clusteranalyse unter Nutzung der Funktion hclust mit der Durchschnittsverknüpfungsmethode und einer euklidischen Distanzmetrik identifiziert und entfernt. Die optimale Soft-Thresholding-Potenz (β = 10) wurde gewählt, um einen skalenfreien Topologie-Anpassungsindex R2 ≥ 0,85 zu erreichen und dabei Skalenfreiheit und mittlere Verknüpfung auszugleichen. Eine Adjazenzmatrix wurde erstellt und in eine topologische Überlappungsmatrix (TOM) umgewandelt. Genmodule wurden mithilfe des dynamischen Baumzerschneidalgorithmus (deepSplit = 2, minClusterSize = 50) identifiziert. Module mit Eigenvektorkorrelationen > 0,75 wurden anschließend mit der Funktion mergeCloseModules zusammengeführt. Die Moduleigenvektoren wurden dann mittels Pearson-Korrelationskoeffizienten mit klinischen Merkmalen (COPD-Status, Alter, Geschlecht und Raucherstatus) korreliert, um COPD-assoziierte Module für die nachfolgende Analyse zu identifizieren.
Screening, Anreicherungsanalyse und PPI-Netzwerkanalyse überlappender Gene
Ein Venn-Diagramm wurde mit dem R-Paket ggvenn erstellt, um Gene zu identifizieren, die gemeinsam zwischen den DEGs, den MEsalmon-Modulgenen und den ac4C-RGs auftreten. Die funktionelle Anreicherungsanalyse der überlappenden Gene wurde mithilfe der Gene Ontology (GO) und der Kyoto Encyclopedia of Genes and Genomes (KEGG) mit dem R-Paket clusterProfiler durchgeführt. Protein-Protein-Interaktions-(PPI-)Informationen wurden aus der STRING-Datenbank (https://string-db.org/) abgerufen, um Interaktionen auf Proteinebene zwischen den überlappenden Genen zu analysieren. Die Software Cytoscape wurde verwendet, um das resultierende PPI-Netzwerk zu visualisieren.
Identifizierung wichtiger Gene mithilfe von maschinellem Lernen
Es wurden drei Machine-Learning-Methoden angewandt: die Regression mit der Least-Absolute-Shrinkage-and-Selection-Operator-Methode (LASSO), das extreme Gradient Boosting (XGBoost) und der Zufallswald (Random Forest, RF). Die LASSO-Regression wurde mit dem glmnet-Paket unter Verwendung einer 10-fachen Kreuzvalidierung durchgeführt, um den optimalen Bestrafungsparameter λ zu bestimmen. Der Parameter type.measure wurde auf „deviance“ und der Parameter family auf „binomial“ gesetzt. Der optimale λ-Wert wurde anhand des λmin-Kriteriums ausgewählt, das die kreuzvalidierte Devianz minimiert, wodurch 17 Gene ermittelt wurden. XGBoost wurde mit dem xgboost-Paket und folgenden Hyperparametern durchgeführt: nrounds = 100, max_depth = 6, eta = 0,3, subsample = 0,8, colsample_bytree = 0,8 und eval_metric = „logloss“. Die Wichtigkeit der Merkmale wurde anhand des Gain-Maßes bewertet, und die 30 wichtigsten Gene wurden ausgewählt. Der Zufallswald wurde mit dem randomForest-Paket mit ntree = 200 implementiert. Die Wichtigkeit der Merkmale wurde nach dem mittleren Abfall der Gini-Index bewertet, und erneut wurden die 30 wichtigsten Gene ausgewählt. Die von den drei Machine-Learning-Methoden identifizierten Gene wurden geschnitten, um Schlüsselgene für nachfolgende Analysen zu bestimmen.
Aufbau und Bewertung des logistischen Regressionsmodells zur Risikovorhersage
Der Datensatz GSE54837 wurde zufällig in einen Trainingsdatensatz (70 %) und einen Testdatensatz (30 %) aufgeteilt. Mithilfe der Funktion glm aus dem MASS-Paket wurde auf Basis des Trainingsdatensatzes ein logistisches Regressionsmodell erstellt, wobei die Expressionsniveaus der Schlüsselgene als Eingabemerkmale dienten. Die Modellleistung wurde anhand von ROC-Kurven bewertet, die mit dem pROC-Paket generiert wurden. Die 95-%-Konfidenzintervalle für die AUC wurden mittels 2.000 Bootstrap-Wiederholungen berechnet. Die Modellkalibrierung wurde anhand von Kalibrierungskurven überprüft, die mit 1.000 Bootstrap-Stichproben (rms-Paket) erstellt wurden. Die DCA wurde mit dem dca-Paket durchgeführt, um den klinischen Nutzen über einen Bereich von Schwellenwahrscheinlichkeiten hinweg zu bewerten. Ein Nomogramm wurde mithilfe der Funktion nomogram aus dem rms-Paket erstellt, um die individuelle Risikoeinschätzung zu erleichtern.
Die Regressionsgleichung lautete:
logit(P) = 0,5823 + 0,6010 × UPP1 - 0,6563 × PTRF + 0,3853 × B4GALT2 - 0,3972 × FAM168B + 0,1848 × PRKCDBP - 0,4787 × TOR3A. (1)
Hier steht P für die vorhergesagte Wahrscheinlichkeit einer COPD, und jeder Koeffizient repräsentiert den Beitrag des entsprechenden Genexpressionswerts zu den Log-Odds einer COPD.
Expressionsanalyse, GenMANIA-Netzwerk und molekulares regulatorisches Netzwerk
Die Genexpressionsniveaus zwischen den COPD- und Kontrollgruppen im GSE54837-Datensatz wurden mit dem Wilcoxon-Rangsummentest verglichen. Boxplots zur Visualisierung der Verteilung der Expressionsniveaus, mit Median, interquartilem Bereich (IQR) und überlagerten Einzeldatenpunkten, wurden mit dem ggplot2-Paket erstellt. GeneMANIA wurde verwendet, um Gen-Netzwerke aufzubauen und funktionelle Interaktionen vorherzusagen. Die Suche erfolgte mit Standardparametern: Spezies = Homo sapiens, maximale Anzahl verwandter Gene = 20. Das resultierende Netzwerk wurde heruntergeladen und visualisiert, wobei die Kantenfarben die Interaktionstypen anzeigten. Ein kompetitives endogenes RNA-Netzwerk (ceRNA) wurde konstruiert, um posttranskriptionelle regulatorische Mechanismen zu untersuchen. miRNAs, die die sechs Schlüsselgene targeten, wurden mithilfe zweier unabhängiger Datenbanken vorhergesagt: DIANA-microT (Score ≥ 0,8) und miRanda (Score ≥ 140, Energie ≤ −20 kcal/mol). Der Durchschnitt der von beiden Datenbanken identifizierten miRNAs wurde zur Erstellung von miRNA-mRNA-Paaren verwendet. Anschließend wurden lncRNAs, die diese miRNAs targeten, mittels der StarBase-Datenbank vorhergesagt. Ein lncRNA-miRNA-mRNA-regulatorisches Netzwerk wurde mit Cytoscape aufgebaut und visualisiert. Transkriptionelle regulatorische Beziehungen wurden mithilfe der ChIP-X Enrichment Analysis Version 3 (ChEA3) vorhergesagt. Für jedes Schlüsselgen mit vorhergesagten Transkriptionsfaktoren wurden die 10 Transkriptionsfaktoren mit den höchsten Anreicherungsscores ausgewählt. Ein TF-Ziel-Regulationsnetzwerk wurde in Cytoscape erstellt.
Analyse der Gen-Set-Anreicherung und Bewertung der Infiltration von Immunzellen
Die Analyse der Gen-Set-Enrichment (GSEA) wurde mit dem clusterProfiler-Paket durchgeführt, um die biologischen Funktionen jedes Schlüsselgens zu untersuchen. Für jedes Schlüsselgen wurden die Proben basierend auf dem Medianwert in Gruppen mit hoher und niedriger Expression unterteilt. Die differentielle Expressionsanalyse zwischen den beiden Gruppen wurde mit limma durchgeführt, und die resultierende Genliste wurde nach dem vorzeichenbehafteten log₂-Faltungsverhältnis (log₂ fold-change) sortiert. Die GSEA wurde mithilfe der Funktion gseGO für GO-Bioprozess-Terme und der Funktion gseKEGG für KEGG-Wege durchgeführt, mit folgenden Parametern: minGSSize = 10, maxGSSize = 500, pvalueCutoff = 0,05 und nPerm = 1.000. Die relative Häufigkeit von 28 Immunzelltypen wurde mittels single-sample Gene Set Enrichment Analysis (ssGSEA), wie sie im GSVA-Paket implementiert ist, geschätzt. Eine kuratierte Gen-Set-Signaturmatrix, die Marker-Gene für 28 Immunzelltypen umfasst, wurde aus früherer Literatur19 entnommen. Für jede Probe wurde die Funktion gsva mit method = „ssgsea“, ssgsea.norm = TRUE und kcdf = „Gaussian“ angewandt. Spearman-Korrelationskoeffizienten zwischen den ssGSEA-Enrichment-Scores und den Expressionsniveaus der sechs Schlüsselgene wurden mit der Funktion cor.test berechnet. Die p-Werte wurden mittels der Benjamini-Hochberg-Methode für Mehrfachvergleiche korrigiert. Die Korrelationsmatrix wurde als Heatmap mit dem pheatmap-Paket visualisiert.
Arzneimittelvorhersage, molekulares Docking und Analyse der Krankheitsassoziation
Mögliche therapeutische Wirkstoffe, die auf Schlüsselgene abzielen, wurden mithilfe der DrugBank-Datenbank identifiziert. Ein Interaktionsnetzwerk aus „Wirkstoffen, die auf Schlüsselgene abzielen“, wurde in Cytoscape erstellt, um vorhergesagte Wechselwirkungen zwischen Wirkstoffen und Genen zu visualisieren. Die molekulare Docking-Analyse wurde mit der CB-Dock2-Plattform durchgeführt, um Bindungsaffinitäten zu bewerten. Die dreidimensionale Proteinstruktur von menschlichem UPP1 wurde aus der Protein Data Bank abgerufen (PDB ID: 7B8T). Die molekularen Strukturen der Wirkstoffe (im SMILES-Format) stammten aus PubChem. Das Docking wurde mit der AutoDock Vina-Engine durchgeführt, und die Ergebnisse wurden nach Bindungsenergie (ΔG, in kcal/mol) sortiert. Die resultierenden Docking-Komplexe wurden mit PyMOL visualisiert. Zusammenhänge zwischen Schlüsselgenen und menschlichen Erkrankungen im Zusammenhang mit Umweltexpositionen wurden anhand der Comparative Toxicogenomics Database (CTD) untersucht. Jedes Gen wurde einzeln abgefragt, und die zehn am stärksten assoziierten Erkrankungen wurden extrahiert und mittels Radarplots dargestellt.
RT-qPCR-Protokoll
Periphere venöse Blutproben wurden von acht COPD-Patienten und acht gesunden Kontrollpersonen am Shenzhen Luohu Hospital of Traditional Chinese Medicine gesammelt. Die Diagnose COPD wurde gemäß den Kriterien der Global Initiative for Chronic Obstructive Lung Disease (GOLD) gestellt, definiert als FEV1/FVC nach Bronchodilatation < 0,70. Die Kontrollgruppe bestand aus alters- und geschlechtsangepassten gesunden Probanden ohne Anamnese respiratorischer Erkrankungen und normalen Lungenfunktionstests (vorhergesagtes FEV1% ≥ 80 % und FEV1/FVC ≥ 0,70). Die Basisinformationen der Patienten sind in Tabelle 2 dargestellt. Gesamt-RNA wurde aus den COPD-Blutproben mithilfe eines Blut-RNA-Extraktionskits isoliert. Für die cDNA-Synthese wurden 500 ng Gesamt-RNA unter Verwendung eines cDNA-Synthesekits und Entfernung genomischer DNA gemäß der beigefügten Anleitung revers transkribiert. Die erhaltene cDNA wurde auf 150 ng/μL verdünnt.
Die RT-qPCR wurde unter Verwendung eines auf SYBR Green basierenden qPCR-Mastermixes an einem Echtzeit-PCR-System durchgeführt. Jede 10 μL-Reaktion enthielt 5 μL 2x SYBR Green-Mastermix, jeweils 0,5 μL Vorwärts- und Rückwärtsprimer (10 μM), 1 μL verdünnte cDNA (15 ng/μL) und 3 μL nukleasefreies Wasser. Die Zyklierungsbedingungen bestanden aus einer initialen Denaturierung bei 95 °C für 5 min, gefolgt von 40 Zyklen mit 95 °C für 10 s und 60 °C für 30 s, sowie einer abschließenden Schmelzkurvenanalyse von 60 °C bis 95 °C zur Überprüfung der Amplifikationsspezifität. Alle Reaktionen wurden in technischen Triplikaten durchgeführt. β-Aktin wurde als endogenes Referenzgen verwendet. Die Primer-Effizienz für jedes Zielgen wurde mittels Standardkurven-Dilutionsreihen validiert und lag zwischen 90 % und 110 %. Die Genexpression wurde auf β-Aktin normalisiert, und die relative Expression wurde nach der 2-ΔΔCt-Methode berechnet. Statistische Vergleiche zwischen der COPD- und der Kontrollgruppe wurden mit dem Mann-Whitney-U-Test durchgeführt.
Statistische Analyse
Netzwerkvisualisierungen wurden mit Cytoscape erstellt und statistische Analysen mit der R-Software durchgeführt. Sofern nicht anders angegeben, wurde der Mann-Whitney-U-Test für nicht normalverteilte Daten und der t-Test nach Student für normalverteilte Daten zur Vergleichung von zwei Gruppen verwendet. Ein Wert von p < 0,05 galt als statistisch signifikant.
Ergebnisse
Identifizierung überlappender Gene, Anreicherungsanalyse und Konstruktion des PPI-Netzwerks
Aus dem GSE54837-Datensatz wurden 3.371 DEGs identifiziert, darunter 1.675 hochregulierte und 1.696 herunterregulierte DEGs. Die 10 Gene mit der stärksten Hoch- und Herunterregulierung sind in Abbildung 1A dargestellt. Eine hierarchische Clusteranalyse der GSE54837-Daten wurde durchgeführt (ergänzende Abbildung 1A), und eine Soft-Thresholding-Potenz von 10 wurde angewendet, um eine skalenfreie Netzwerktopologie sicherzustellen (Abbildung 1B). Gen-Koexpressionsmodule wurden mithilfe der dynamischen Baumzerlegungsmethode mit einer minimalen Modulgröße von 50 Genen konstruiert, und jedes Modul erhielt eine eigene Farbe (ergänzende Abbildung 1B). Module mit Eigenvektorkorrelationen > 0,75 wurden anschließend zusammengelegt (ergänzende Abbildung 1C, Abbildung 1C), was zu 14 verschiedenen Modulen führte. Basierend auf der Pearson-Korrelationsanalyse zwischen den Modul-Eigenvektoren und klinischen Merkmalen zeigte das MEsalmon-Modul (bestehend aus 5.226 Genen) die stärkste positive Korrelation mit COPD (r = 0,35, p = 7 × 10⁻8, Abbildung 1D). Eine Venn-Analyse identifizierte 160 gemeinsame Gene unter den 3.371 DEGs, den 5.226 MEsalmon-Modulgenen und den 2.118 ac4C-RGs (Abbildung 1E). Die funktionelle Anreicherungsanalyse dieser 160 Gene ergab, dass signifikante GO-Terme die Bindung an einzelsträngige RNA, die Regulation des mRNA-Stoffwechselprozesses und den RIG-I-Signalweg umfassten (Abbildung 1F). Zusätzlich zeigte die KEGG-Analyse, dass diese Gene hauptsächlich in der Fc-Gamma-R-vermittelten Phagozytose, dem mRNA-Überwachungsweg und der fokalen Adhäsion angereichert waren (Abbildung 1G). Das PPI-Netzwerk der überlappenden Gene enthielt 118 Knoten und 196 Kanten (Abbildung 1H).
Identifizierung von sechs Schlüsselgenen bei COPD
Um potenzielle Schlüsselgene unter den 160 überlappenden Kandidaten weiter zu identifizieren, wurden drei maschinelle Lernalgorithmen angewandt. Zunächst wurde eine LASSO-Regression mit Kreuzvalidierung durchgeführt, um den optimalen Strafparameter (λ) ≈ 0,091 zu bestimmen (Abbildung 2A). Das Koeffizienten-Profil-Diagramm zeigte, dass 17 Gene beim optimalen λ-Wert beibehalten wurden (Abbildung 2B). Die XGBoost-Analyse identifizierte die 30 Gene mit dem höchsten Gewinn, wobei PTRF, WBP11 und LDOC1L einen hohen Vorhersagewert aufwiesen (Abbildung 2C). Der RF-Algorithmus bewertete die 30 wichtigsten Gene entsprechend ihren Gini-Wichtigkeitsscores, wobei PTRF, RFX5 und PRKCDBP zu den aussagekräftigsten gehörten (Abbildung 2D). Die Schnittmengenanalyse der Gene, die von den drei Methoden ausgewählt wurden, ergab sechs wesentliche überlappende Gene: PTRF, PRKCDBP, UPP1, TOR3A, FAM168B und B4GALT2 (Abbildung 2E).
Konstruktion des diagnostischen Modells und Expressionsanalyse der Schlüsselgene
Unter Verwendung von 70 % des GSE54837-Datensatzes als Trainingsmenge wurde ein logistisches Regressionsmodell erstellt, das die sechs Schlüsselgene umfasst. Die ROC-Kurvenanalyse zeigte eine moderate diagnostische Leistungsfähigkeit mit AUC-Werten von 0,766 (95 % KI: 0,691–0,8417), 0,759 (95 % KI: 0,6368–0,8817) und 0,723 (95 % KI: 0,6085–0,8596) für die Trainings-, interne Test- und externe Validierungsmenge, jeweils (Abbildung 3A–C). Die Kalibrationsanalyse bestätigte eine hohe Zuverlässigkeit, und die DCA zeigte einen klaren klinischen Nutzen über einen breiten Bereich von Schwellenwahrscheinlichkeiten sowohl in den Trainings- (Abbildung 3D–E) als auch in den Validierungsmengen (Abbildung 3F–G). Ein Nomogramm wurde erstellt, um den Beitrag jedes Gens zu veranschaulichen und die individuelle Risikoeinschätzung zu erleichtern (Abbildung 3H). Die Expressionsanalyse ergab, dass B4GALT2, PRKCDBP und UPP1 in COPD-Proben signifikant hochreguliert waren, während FAM168B, PTRF und TOR3A herunterreguliert waren (Abbildung 3I).
Regulatorisches Netzwerk und funktionelle Analyse von Schlüsselgenen bei COPD
Mithilfe der GeneMANIA-Analyse wurde ein funktionelles Interaktionsnetzwerk erstellt, das die 20 Gene umfasst, die am stärksten mit den identifizierten Hub-Genen verwandt sind (Abbildung 4A). Physikalische Interaktionen machten den Großteil der Verbindungen aus, gefolgt von Ko-Expressions-Korrelationen und gemeinsamen Protein-Domänen. Die funktionelle Annotation zeigte eine signifikante Anreicherung in Prozessen wie dem katabolen Prozess von Nukleobasen enthaltenden kleinen Molekülen, dem katabolen Prozess von Nukleosiden und dem Raft der Plasmamembran. Die posttranskriptionelle Regulation wurde durch den Vergleich von miRNA-Vorhersagen aus den Datenbanken DIANA-microT und miRanda untersucht, wodurch acht überlappende miRNAs identifiziert wurden (Abbildung 4B). Anschließend wurde eine lncRNA-miRNA-mRNA-regulatorische Achse konstruiert. Laut dem Sankey-Diagramm wurden für zwei der identifizierten miRNAs, die beide mit der Regulation von FAM168B assoziiert sind, sieben lncRNAs als Zielvorhersagen ermittelt; für die übrigen fünf Hub-Gene wurden keine derartigen regulatorischen Interaktionen gefunden (Abbildung 4C). Die transkriptionelle Regulation wurde weiterhin mit Hilfe der ChEA3-Plattform untersucht, die upstream liegende Transkriptionsfaktoren (TFs) für B4GALT2, UPP1, FAM168B und TOR3A vorhersagte. Die jeweils zehn führenden TFs für jedes Gen wurden ausgewählt, um ein TF-Ziel-Regulationsnetzwerk aufzubauen (Abbildung 4D). GSEA wurde durchgeführt, um die biologischen Funktionen der sechs Schlüsselgene zu untersuchen. UPP1 war signifikant angereichert in biologischen Prozessen wie dem Stoffwechselprozess von Diacylglycerol und dem biosynthetischen Prozess von Purinnukleosidtriphosphat sowie in Wegen wie dem Proteasom und dem Metabolismus von Xenobiotika durch Cytochrom P450 (Abbildung 4E–F). Die Anreicherungsergebnisse für die übrigen fünf Schlüsselgene sind in Ergänzende Abbildung 2A–J dargestellt.
Immuninfiltration von UPP1 und Vorhersage von Arzneimittelzielen bei COPD
Die Infiltrationsgrade von 28 Immunzelltypen wurden in Kontroll- und COPD-Gruppen mithilfe des ssGSEA-Algorithmus bewertet. Bei COPD-Patienten wiesen Gedächtnis-B-Zellen, myeloide suppressorische Zellen und aktivierte dendritische Zellen signifikant höhere Anreicherungsscores auf. Im Gegensatz dazu zeigten T-Helferzellen vom Typ 1, aktivierte B-Zellen und unreife B-Zellen signifikant niedrigere Anreicherungsscores (Abbildung 5A). Es ist darauf hinzuweisen, dass ssGSEA relative Schätzungen der Immunzellanreicherung anhand transkriptomischer Daten liefert, anstatt direkte Messungen der Anteile von Immunzellen darzustellen. Die Korrelationsanalyse ergab, dass die sechs Schlüsselgene unterschiedliche Assoziationsmuster mit Untergruppen von Immunzellen aufwiesen. Insbesondere waren UPP1, PRKCDBP und B4GALT2 positiv mit den Infiltrationsgraden von Gedächtnis-B-Zellen, aktiven dendritischen Zellen und myeloiden suppressorischen Zellen korreliert (Spearman ρ > 0,4, p < 0,05), während PTRF, TOR3A und FAM168B negative Korrelationen mit T-Helferzellen vom Typ 1 und aktiven B-Zellen aufwiesen (Spearman ρ < −0,3, p < 0,05). Die vollständige Korrelationsmatrix ist in der Heatmap dargestellt (Abbildung 5B). Die Arzneimittelvorhersageanalyse identifizierte UPP1 als einziges Gen unter den sechs Kandidaten mit vorhergesagten Wechselwirkungen mit kleinen Molekülen. Drei Verbindungen, darunter Fluorouracil, Capecitabin und 5-Benzylacyclouridin, wurden aus der Datenbank als potenzielle UPP1-Interaktionsverbindungen identifiziert (Abbildung 5C). Diese Verbindungen werden hauptsächlich in der Onkologie oder experimentellen Anwendungen eingesetzt, und ihre Relevanz für COPD bedarf weiterer Untersuchungen. Berechnungen der Bindungsenergie ergaben, dass 5-Benzylacyclouridin die stärkste Bindungsaffinität aufwies, was auf eine relativ höhere vorhergesagte Bindungsaffinität hindeutet (Tabelle 3). Molekulare Docking-Visualisierungen für alle drei Verbindungen zeigten günstige vorhergesagte Bindungskonformationen mit UPP1, was mit computergestützten Docking-Vorhersagen und nicht mit experimenteller Validierung übereinstimmt (Abbildung 5D–F). Zusätzlich zeigte die CTD-Analyse, dass alle sechs Schlüsselgene stark mit verschiedenen Krankheitsphänotypen assoziiert waren, darunter verzögerte Effekte pränataler Exposition, Gewichtsverlust, Hepatomegalie und Entzündung (Abbildung 5G–L).
Validierung wichtiger diagnostischer Gene mittels RT-qPCR in klinischen Proben
Zur Validierung der Expressionslevel wichtiger Gene wurden Blutproben von acht COPD-Patienten und acht Kontrollpersonen gesammelt, und diese Analyse galt aufgrund der begrenzten Stichprobengröße als vorläufige Validierung. Wie in Abbildung 6A–F dargestellt, waren PTRF, TOR3A und FAM168B in COPD-Proben signifikant herunterreguliert, während PRKCDBP und UPP1 signifikant hochreguliert waren, was mit den in der bioinformatischen Analyse beobachteten Trends übereinstimmt. Im Gegensatz dazu zeigte sich kein signifikanter Unterschied in der Expression von B4GALT2 zwischen den beiden Gruppen. Diese Diskrepanz könnte auf die begrenzte Stichprobengröße oder Unterschiede in den Probentypen zwischen Datensätzen und klinischen Proben zurückzuführen sein.
ERKLÄRUNG ZUR VERFÜGBARKEIT VON DATEN:
Alle RNA-Sequenzierungsdaten wurden aus der Gene Expression Omnibus-Datenbank (GEO, https://www.ncbi.nlm.nih.gov) bezogen, wobei GSE54837 als Trainingsset und GSE112811 als Validierungsset ausgewählt wurden. Der in dieser Analyse verwendete Code kann unter https://doi.org/10.5281/zenodo.21771476 abgerufen werden.
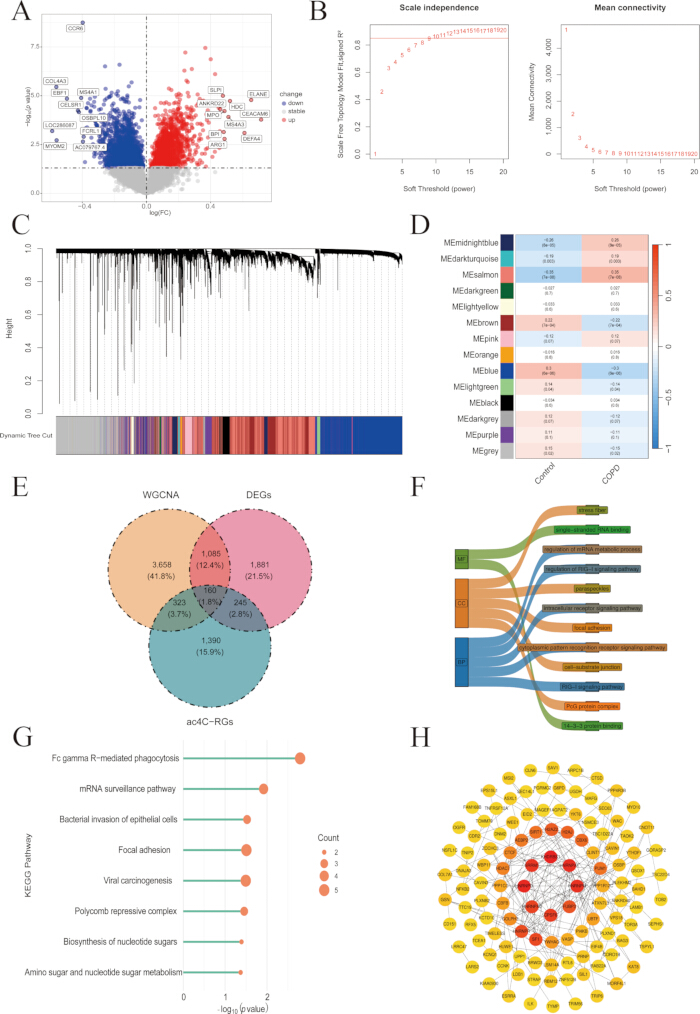
Abbildung 1: Identifizierung überlappender Gene, Anreicherungsanalyse und Konstruktion des PPI-Netzwerks. (A) Volcano-Plot der DEGs im GSE54837-Datensatz. (B) Soft-Threshold-Auswahl. (C) Modul-Clustering-Dendrogramm (nach dem Zusammenführen). (D) Wärmekarte der Korrelation zwischen Modulen und Merkmalen. (E) Venn-Diagramm zur Identifizierung überlappender Gene. (F) Maulbeerdiagramm der GO-Anreicherungsanalyse, das die wichtigsten Anreicherungsergebnisse der Schnittmengengene in MF, CC und BP zeigt. (G) Lollipop-Diagramm der KEGG-Signalweg-Anreicherungsanalyse, wobei die Blasengröße die Anzahl der angereicherten Gene repräsentiert. (H) PPI-Netzwerk der überlappenden Gene; Knoten repräsentieren Proteine und Kanten repräsentieren Protein-Protein-Interaktionen. Abkürzungen: DEGs = differentiell exprimierte Gene; PPI = Protein-Protein-Interaktion; GO = Genontologie; MF = molekulare Funktion; CC = zelluläre Komponente; BP = biologischer Prozess; KEGG = Kyoto-Enzyklopädie der Gene und Genome; ac4C-RGs = N4-Acetylcytidin-bezogene Gene. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
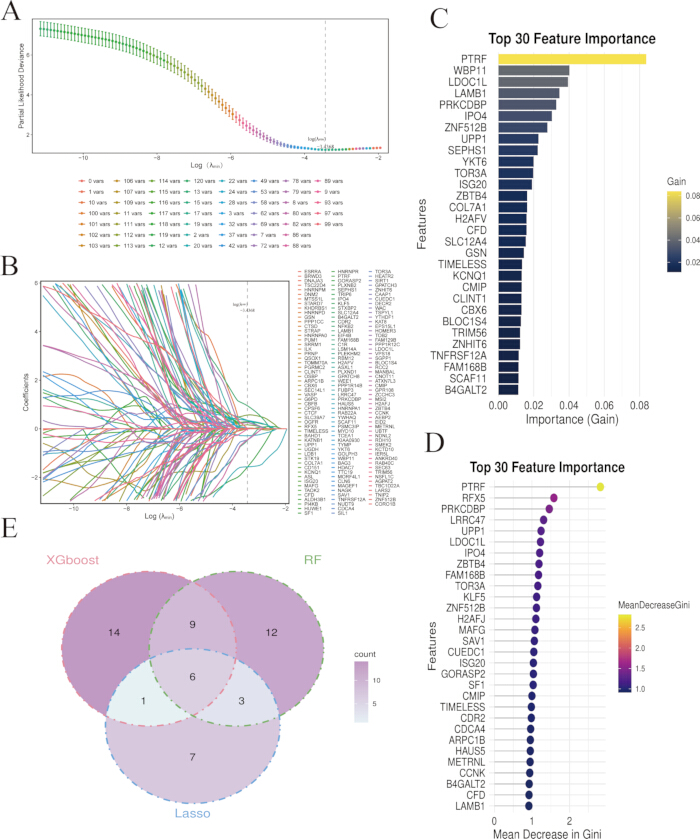
Abbildung 2: Identifizierung von sechs Schlüsselgenen bei COPD. (A) LASSO-Kreuzvalidierungskurve. (B) Pfaddiagramm der LASSO-Regressionskoeffizienten. Mit steigendem λ konvergieren die Koeffizienten unwichtiger Gene gegen 0. (C) Rangfolge der Merkmalswichtigkeit nach XGBoost. Die x-Achse zeigt den Gewinnwert (gain), die y-Achse den Gennamen und die Farbintensität stellt die Wichtigkeit dar. (D) Rangfolge der Merkmalswichtigkeit nach RF (Random Forest). Die x-Achse zeigt die mittlere Abnahme des Gini-Koeffizienten. (E) Das Venn-Diagramm der überlappenden Gene, die durch die Kreuzanalyse der drei Algorithmen ermittelt wurden. Abkürzungen: LASSO = least absolute shrinkage and selection operator; XGBoost = extreme gradient boosting; RF = random forest. Bitte klicken Sie hier, um eine vergrößerte Ansicht dieser Abbildung einzusehen.
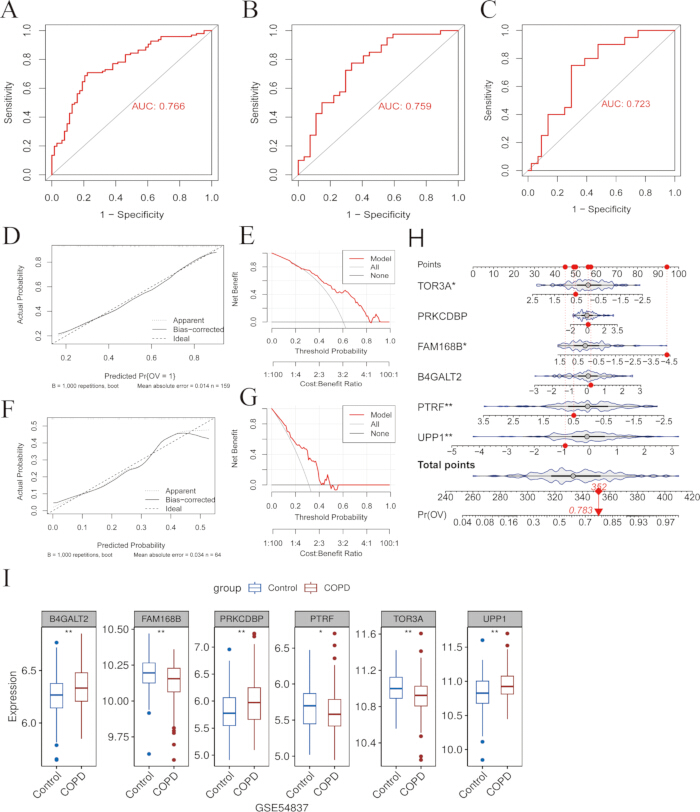
Abbildung 3: Erstellung eines diagnostischen Modells und Expressionsanalyse von Schlüsselgenen. (A) ROC-Kurve der Trainingsstichprobe. (B) ROC-Kurve der internen Teststichprobe. (C) ROC-Kurve der externen Validierungsstichprobe. (D) Kalibrationskurve der Trainingsstichprobe. (E) DCA der Trainingsstichprobe. (F) Kalibrationskurve der externen Validierungsstichprobe. (G) DCA der externen Validierungsstichprobe. (H) Nomogramm von sechs Schlüsselgenen. Zur Vorhersage des individuellen COPD-Risikos erhält jedes Gen eine entsprechende Punktzahl. (I) Expressionsanalyse der sechs Schlüsselgene in COPD- und Kontrollproben des GSE54837-Datensatzes. Abkürzungen: ROC = receiver operating characteristic; AUC = area under the curve; DCA = decision curve analysis; COPD = chronische obstruktive Lungenerkrankung. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
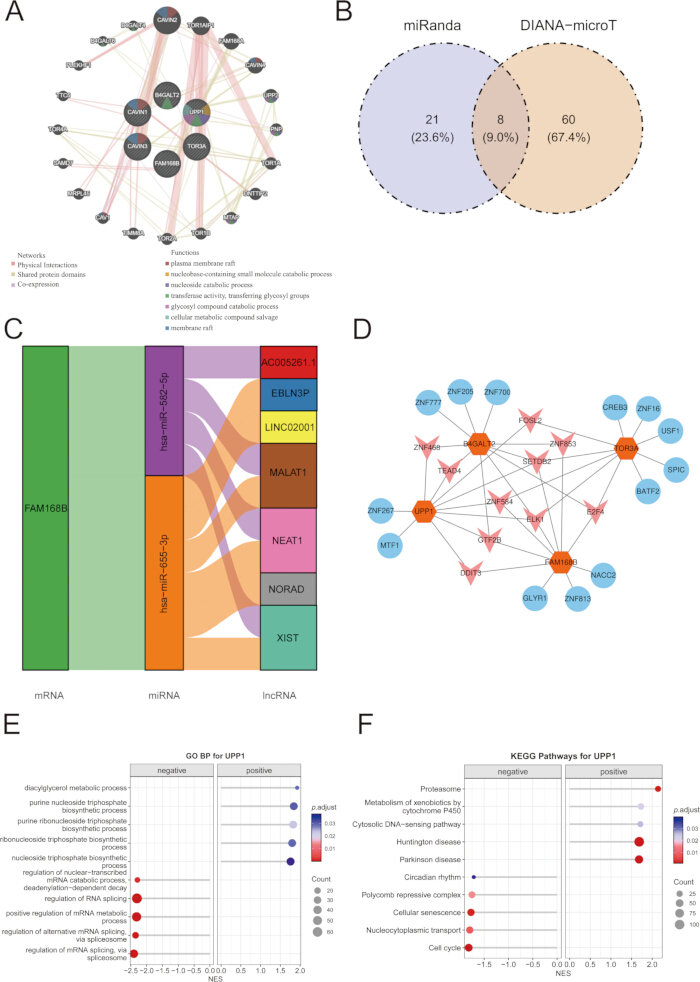
Abbildung 4: Regulatorisches Netzwerk und funktionelle Bedeutung zentraler Gene bei COPD. (A) Ergebnisse der GeneMANIA-Analyse für 6 zentrale Gene. Die Farbe der Linien zeigt die Korrelation zwischen den Genen an, die Farbe der Knoten zeigt unterschiedliche funktionelle Kategorien. (B) Venn-Diagramm der Kreuzanalyse der Datenbanken DIANA-microT und miRanda. (C) Maulbeer-Diagramm des ceRNA-Regulationsnetzwerks. (D) Potentielles regulatorisches Netzwerk von Transkriptionsfaktoren. Blaue Knoten repräsentieren Transkriptionsfaktoren, orangefarbene Knoten repräsentieren Zielgene. (E) Einzelgen-GSEA-Anreicherungsanalyse von UPP1, einschließlich GO. (F) Einzelgen-GSEA-Anreicherungsanalyse von UPP1, einschließlich KEGG. Abkürzungen: GO = Genontologie; KEGG = Kyoto-Enzyklopädie der Gene und Genome. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
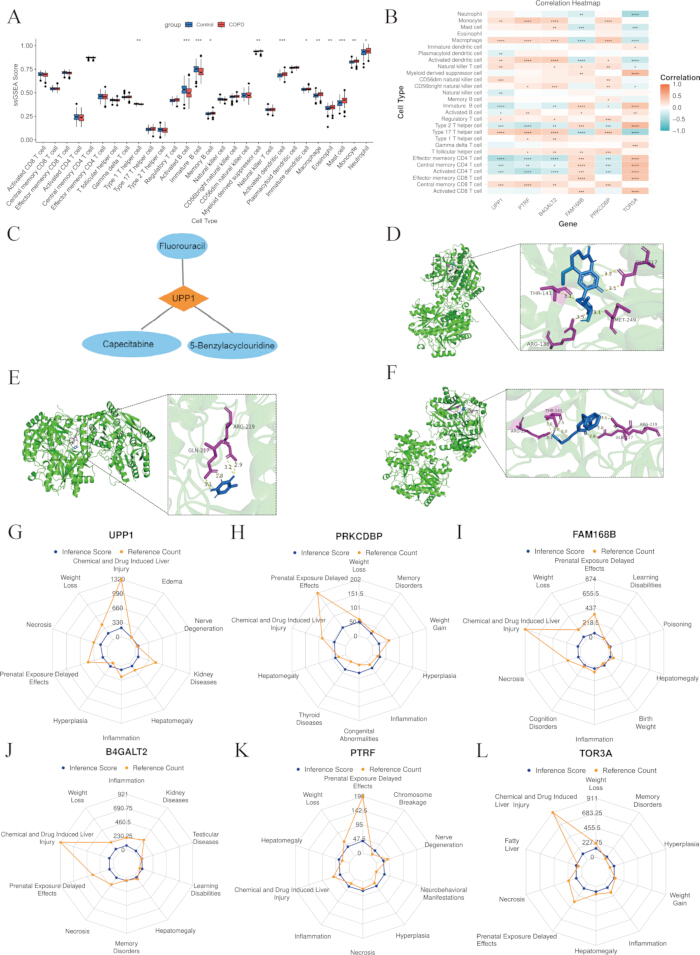
Abbildung 5: Immuninfiltration von Schlüsselgenen und Vorhersage von Arzneimittelzielen bei COPD. (A) Unterschiede in der Häufigkeit von Immunzellen zwischen den Gruppen. (B) Heatmap der Korrelation zwischen Immunzellen und Schlüsselgenen. (C) Interaktionsnetzwerk zwischen Schlüsselgenen und vorhergesagten Arzneimitteln. (D) Molekulares Docking von Fluorouracil mit UPP1. (E) Molekulares Docking von Capecitabin mit UPP1. (F) Molekulares Docking von 5-Benzylacyclouridin mit UPP1. Bei jeder Verbindung zeigt das linke Bild die gesamte Docking-Konformation und das rechte Bild die lokalen Bindungsinteraktionen. (G) CTD-Analyse von B4GALT2. (H) CTD-Analyse von FAM168B. (I) CTD-Analyse von PRKCDBP. (J) CTD-Analyse von PTRF. (K) CTD-Analyse von TOR3A. (L) CTD-Analyse von UPP1. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
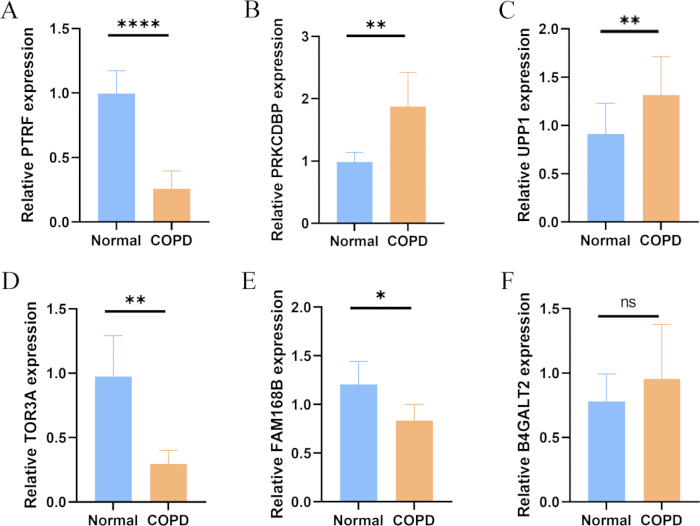
Abbildung 6: RT-qPCR-Validierung der Expression wichtiger Gene in COPD- und Kontrollproben. (A) Relative Expression von PTRF. (B) Relative Expression von PRKCDBP. (C) Relative Expression von UPP1. (D) Relative Expression von TOR3A. (E) Relative Expression von FAM168B. (F) Relative Expression von B4GALT2. ns = nicht signifikant, p > 0,05; * p < 0,05; ** p < 0,01; *** p < 0,001; **** p < 0,0001. Abkürzung: RT-qPCR = reverse Transkriptions-quantitative Polymerase-Kettenreaktion. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Erweiterte Abbildung 1: Proben des GSE54837-Datensatzes und Genmodul-Clustering. (A) Probendendrogramm des GSE54837-Datensatzes. (B) Modul-Clustering-Dendrogramm vor dem Zusammenführen. Gene wurden mithilfe der dynamischen Baumabschneidemethode gruppiert, um unterschiedliche Module zu identifizieren. (C) Dendrogramm der hierarchischen Clusterung von Moduleigenen. Module mit ähnlichen Expressionsmustern wurden basierend auf der Ähnlichkeit ihrer Eigenene gruppiert.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 2, Zusatzmaterial: GSEA-Anreicherungsanalyse. (A) GO-Analyse von PRKCDBP. (B) KEGG-Analyse von PRKCDBP. (C) GO-Analyse von PTRF. (D) KEGG-Analyse von PTRF. (E) GO-Analyse von TOR3A. (F) KEGG-Analyse von TOR3A. (G) GO-Analyse von FAM168B. (H) KEGG-Analyse von FAM168B. (I) GO-Analyse von B4GALT2. (J) KEGG-Analyse von B4GALT2. Abkürzungen: GO = Genontologie; KEGG = Kyoto-Enzyklopädie der Gene und des Genoms.Bitte klicken Sie hier, um diese Datei herunterzuladen.
| Datensatz | Kontrollen | Patienten | Sequenzierplattform |
| GSE54837 | 90 | 136 | GPL570 |
| GSE112811 | 44 | 20 | GPL570 |
Tabelle 1: Genexpressions-Datensätze, die in der Studie verwendet wurden. Merkmale der Datensätze GSE54837 und GSE112811, die zur Modellentwicklung/inneren Testung bzw. zur externen Validierung verwendet wurden.
| Patient | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| Geschlecht (w/m) | M | M | M | F | M | M | M | M |
| Alter (Jahre) | 69 | 72 | 75 | 73 | 68 | 70 | 69 | 71 |
| Raucherstatus | Ja | Ja | Aufgehört zu rauchen (2 Jahre) | Nein | Ja | Ja | Ja | Aufgehört zu rauchen (5 Jahre) |
| Packungsjahre | 20 pro Tag / 30 Jahre | 15 pro Tag / 35 Jahre | 20 pro Tag / 50 Jahre | 20 pro Tag / 40 Jahre | 30 pro Tag / 40 Jahre | 15 pro Tag / 40 Jahre | 20 pro Tag / 30 Jahre | |
| COPD-Gruppe | 2 | 3 | 3 | 2 | 2 | 3 | 2 | 3 |
Tabelle 2: Baseline-Charakteristika der Studienteilnehmer. Baseline-Demografika und klinische Charakteristika der COPD-Patienten und gesunden Kontrollen, die in die RT-qPCR-Validierung eingeschlossen wurden.
| Molekularer Name | Gen | Bewertung (kcal/mol) |
| 5-Benzylacyclouridin | UPP1 | -9.6 |
| Capecitabin | UPP1 | -6.1 |
| Fluorouracil | UPP1 | -5.5 |
Tabelle 3: Ergebnisse der molekularen Docking-Analyse für UPP1 und Kandidatenverbindungen.
Vorhergesagte Ergebnisse der molekularen Docking-Analyse für die Wechselwirkung von UPP1 mit Fluorouracil, Capecitabin und 5-Benzylacyclouridin, einschließlich ihrer Bindungsaffinitäten.
Diskussion
Die konservierte RNA-Modifikation ac4C, die vorwiegend in Boten-RNA (mRNA) und Transfer-RNA (tRNA) vorkommt, erhöht die mRNA-Stabilität und die Translations-Effizienz20. NAT10 ist die einzige bekannte RNA-Acetyltransferase, die die ac4C-Modifikation vermittelt21. Studien haben gezeigt, dass NAT10 in Lungenepithelzellen von COPD-Patienten hochreguliert ist. Die Herunterregulation von NAT10 stört die mitochondriale Funktion und transkriptomische Reaktionen22. Auf der Grundlage einer integrierten Multiomik-Analyse identifizierte diese Studie sechs Schlüsselgene, die eng mit COPD assoziiert sind, und entwickelte ein diagnostisches Modell, das eine moderate diagnostische Leistungsfähigkeit und ein Potenzial für weitere Untersuchungen aufzeigte. Weitere Analysen enthüllten die zentralen Rollen dieser Gene in der transkriptionellen Regulation, in ceRNA-Netzwerken und im immunologischen Mikromilieu. Darüber hinaus wurden potenzielle gezielte Arzneimittel vorhergesagt, was Einblicke in die Pathogenese von COPD ermöglicht und die Entwicklung personalisierter, präziser Behandlungsstrategien unterstützt. Wir identifizierten Gene, die sowohl in COPD differentiell exprimiert waren als auch in einer zuvor veröffentlichten ac4C-bezogenen Genliste enthalten waren, mithilfe der WGCNA und der differentiellen Expressionsanalyse. Es ist wichtig anzumerken, dass diese Gene aufgrund ihrer Assoziation mit dem ac4C-Regulationsnetzwerk ausgewählt wurden, nicht aufgrund nachgewiesener mechanistischer Verbindungen zu NAT10 oder der ac4C-Acetylierung, was insgesamt 160 Kandidatengene ergab. Sechs Schlüsselgene (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B und B4GALT2) wurden durch maschinelles Lernen identifiziert. Unter ihnen spielt PTRF eine entscheidende Rolle bei der durch Hausstaubmilben (HDM) induzierten Atemwegsinfektion, indem es die IL-33-ZBP1-vermittelte Nekroptose von Makrophagen reguliert, was darauf hindeutet, dass es an chronisch entzündlichen Lungenerkrankungen wie COPD beteiligt sein könnte23. Lai et al.24 zeigten, dass die exogene Gabe von Uridin die Ferroptose in Makrophagen über den Nrf2/SLC7A11/GPX4-Weg hemmt und somit die akute Lungenschädigung infolge von Sepsis lindert. Obwohl eine Hochregulation von UPP1, einem Schlüsselenzym im Uridin-Stoffwechsel, in Lungengewebe aus Modellen der akuten Lungenschädigung beobachtet wurde, bleibt seine genaue Rolle – und ob diese Hochregulation eine schützende Reaktion oder eine Folge von Gewebeschäden darstellt – noch weiterer Aufklärung bedürftig. Dennoch legt dieser Befund nahe, dass UPP1 eine potenzielle Assoziation mit den pathophysiologischen Prozessen entzündlicher Lungenerkrankungen wie COPD haben könnte, was weitere Untersuchungen rechtfertigt. Die übrigen vier Schlüsselgene wurden bei lungenspezifischen Erkrankungen bisher weniger untersucht, aber basierend auf ihren Funktionen bei anderen Krankheiten und unseren aktuellen Ergebnissen vermuten wir mögliche Signalwege, über die sie zur Pathogenese von COPD beitragen könnten.
Basierend auf den sechs Schlüsselgenen konstruierten wir ein diagnostisches Modell für COPD und validierten dessen gute Vorhersageleistung. Die Expressionsanalyse zeigte, dass UPP1, B4GALT2 und PRKCDBP signifikant hochreguliert waren, während FAM168B, PTRF und TOR3A bei COPD deutlich herunterreguliert waren. Obwohl B4GALT2 in der Datensatzanalyse als hochreguliert identifiziert wurde, wurde bei der RT-qPCR-Validierung kein signifikanter Unterschied beobachtet. Diese Diskrepanz könnte auf die begrenzte Stichprobengröße, die Kohortenheterogenität sowie Unterschiede in den Probenquellen zwischen den öffentlichen Datensätzen und klinischen Blutproben zurückzuführen sein. Die Gen-Set-Anreicherungsanalyse ergab, dass diese Schlüsselgene signifikant in der RNA-Spleißung und mRNA-Verarbeitung sowie in Wegen wie dem Zellzyklus und der Nikotinabhängigkeit angereichert waren. Ein irreversibler Zellzyklusarrest wird als primärer Mechanismus der zellulären Seneszenz anerkannt, der maßgeblich zur Pathophysiologie der COPD beitragen könnte25,26. Weitere Analysen deuteten darauf hin, dass das durch DNA-Schäden induzierte seneszenzassoziierte sekretorische Phänotyp (SASP) die anhaltende Progression der COPD fördern könnte, indem er die chronische Entzündung aufrechterhält und die Lungengewebeschädigung verstärkt27. Eine frühere Studie hat zudem die genetischen Verbindungen zwischen Nikotinabhängigkeit und COPD untersucht28. Obwohl Rauchen der wichtigste Risikofaktor für COPD ist, entwickelt nur ein kleiner Teil der Raucher die Erkrankung, was darauf hindeutet, dass genetische Faktoren sowohl bei COPD als auch bei Nikotinabhängigkeit eine wichtige Rolle spielen. Liu et al.29 fassten die Rollen von RNA-bindenden Proteinen (RBPs) bei COPD und pulmonaler Hypertonie (PH) zusammen und betonten deren Beteiligung an der Remodellierung des Lungengefäßsystems und an entzündlichen Reaktionen durch die Regulation der mRNA-Spleißung und der posttranskriptionellen Genexpression, wodurch deren Potenzial als Biomarker und therapeutische Zielstrukturen hervorgehoben wird. Zusammenfassend tragen die in dieser Studie identifizierten Schlüsselgene und assoziierten Signalwege nicht nur zu einem tieferen Verständnis der COPD-Pathogenese bei, sondern schaffen auch eine solide Grundlage für die Entwicklung zukünftiger diagnostischer Biomarker und gezielter therapeutischer Strategien.
Das ceRNA-Netzwerk umfasst verschiedene RNA-Spezies, darunter lncRNAs, circRNAs und mRNAs, die konkurrierend an gemeinsame miRNAs binden und dadurch wechselseitige regulatorische Beziehungen eingehen sowie die Genexpression beeinflussen30. Dieses komplexe Netzwerk ist an zahlreichen physiologischen und pathologischen Prozessen beteiligt und trägt zum Verständnis von Genregulationsmechanismen sowie der Pathogenese von Erkrankungen wie Krebs und chronisch-entzündlichen Störungen bei. Beispielsweise konstruierten Wang et al. ein ceRNA-Koexpressionnetzwerk, das aus 11 lncRNAs, fünf miRNAs und 16 mRNAs bestand, wobei das zentrale Teilnetzwerk mit Veränderungen der Anteile von Immunzellen und der Lungenfunktion bei COPD assoziiert war31. Ebenso entwickelten Zhang et al.32 ein circRNA-miRNA-mRNA-ceRNA-Netzwerk basierend auf peripheren mononukleären Blutzellen von männlichen Rauchern und identifizierten dysregulierte circRNAs sowie Schlüsselwege im Zusammenhang mit COPD. Unsere Analyse des Koexpressionsnetzwerks ergab, dass die Schlüsselgene hauptsächlich funktionale Verbindungen über physikalische Interaktionen, Koexpression und gemeinsame Proteindomänen aufbauten und signifikant in mehreren, metabolismusbezogenen Wegen angereichert waren. Auf Grundlage dieser Ergebnisse konstruierten wir zusätzlich ein Transkriptionsfaktor-(TF-)Ziel-Regulationsnetzwerk sowie eine miRNA-lncRNA-mRNA-Regulationsachse. Diese Ergebnisse deuten darauf hin, dass die Schlüsselgene in COPD möglicherweise durch mehrstufige Mechanismen, an denen lncRNAs, Transkriptionsfaktoren und miRNAs beteiligt sind, kooperativ reguliert werden.
Die Immuninfiltration spiegelt den Immunstatus wider, indem sie die Verteilung und Aktivität von Immunzellen in Geweben oder im Blut anzeigt. Auf dieser Grundlage wurden mithilfe computergestützter Screening-Verfahren potenzielle Wirkstoffkandidaten vorhergesagt und anschließend mittels molekularer Docking-Simulationen die Bindungsaffinität und Stabilität mit Zielproteinen bewertet. Zusammen ermöglichen diese Analysen die Identifizierung neuartiger therapeutischer Wirkstoffe und liefern tiefere Einblicke in Krankheitsmechanismen. In dieser Studie zeigten sechs Schlüsselgene eine positive Korrelation mit den meisten Immunzellinfiltraten. Die Wirkstoffvorhersage identifizierte potenzielle Wechselwirkungen zwischen UPP1 und Fluorouracil, Capecitabin sowie 5-Benzylacyclouridin, wobei letzteres die stärkste Bindungsaffinität aufwies, was durch molekulares Docking weiter bestätigt wurde. Bemerkenswerterweise werden Fluorouracil und Capecitabin hauptsächlich als Antitumorwirkstoffe eingesetzt und in dieser Studie als datenbankbasiert vorhergesagte, mit UPP1 interagierende Verbindungen identifiziert, nicht jedoch als validierte therapeutische Optionen für COPD. Frühere Studien berichteten, dass eine lokale Applikation von Fluorouracil die Durchgängigkeit der Atemwege bei schwerer Atemwegsobstruktion verbessern könnte33. Andere Belege deuten jedoch darauf hin, dass Fluorouracil und Capecitabin pulmonale Toxizität hervorrufen können, insbesondere bei Patienten mit vorbestehenden Lungenerkrankungen34. Daher bedarf es weiterer experimenteller und sicherheitsrelevanter Untersuchungen, um ihre potenzielle Relevanz für COPD zu überprüfen. Darüber hinaus zeigte die CTD-Analyse, dass alle sechs Schlüsselgene mit mehreren pathologischen Prozessen assoziiert sind. Insgesamt liefert die integrierte Analyse von Immuninfiltration, Wirkstoffvorhersage und molekularem Docking neue molekulare Zielstrukturen und eine theoretische Grundlage für die präzise Behandlung von COPD und fördert somit die Entwicklung und klinische Translation verwandter Arzneimittel.
Trotzdem sollten mehrere Einschränkungen berücksichtigt werden. Die Studie stützte sich auf öffentlich zugängliche Datensätze mit relativ begrenzten Probenquellen, was Batch-Effekte und eine mögliche Überanpassung des Modells verursachen könnte. Die Validierung mittels RT-qPCR erfolgte an einer kleinen Kohorte, und die beobachtete Inkonsistenz in der Expression von B4GALT2 deutet auf eine mögliche Heterogenität der Kohorte hin. Darüber hinaus waren die Analysen zur Immuninfiltration und Arzneimittelvorhersage rein rechnergestützt und bedürfen weiterer experimenteller Bestätigung. Außerdem wurde unser diagnostisches Modell als bioinformatische Untersuchung im Entdeckungsstadium hauptsächlich anhand von AUC-Werten mit 95 % Konfidenzintervallen bewertet. Umfassende Leistungsmetriken wie Sensitivität, Spezifität, Vorhersagewerte und detaillierte Kalibrierungsstatistiken wurden aufgrund des retrospektiven Charakters der öffentlichen Datensätze und der begrenzten Stichprobengrößen nicht vollständig erfasst. Daher sollte unser Modell als konzeptioneller Nachweiswerkzeug betrachtet werden, dessen klinische Anwendbarkeit in größeren, prospektiven Kohorten weiter validiert werden muss.
Durch integrative bioinformatische Analysen und maschinelles Lernen identifizierte diese Studie sechs Schlüsselgene, die signifikant mit der COPD assoziiert sind. Es wurde ein robustes diagnostisches Modell etabliert, das in mehreren Kohorten eine zuverlässige Vorhersageleistung zeigte. Funktionelle Analysen ergaben, dass diese Gene an wichtigen regulatorischen Netzwerken beteiligt sind, die die transkriptionelle und posttranskriptionelle Regulation, die Infiltration von Immunzellen sowie Signalwege im Zusammenhang mit Nikotinsucht und dem Zellzyklus umfassen. Die Vorhersage von Arzneimitteln und molekulare Docking-Analysen hoben UPP1 als vielversprechendes therapeutisches Ziel hervor, wobei mehrere Kandidatenverbindungen starke Bindungsaffinitäten aufwiesen. Insgesamt vertiefen diese Ergebnisse das Verständnis der COPD-Pathophysiologie und liefern wertvolle molekulare Zielstrukturen für die zukünftige Entwicklung von Therapeutika und Strategien der präzisen Medizin.
Offenlegungen
Die Autoren erklären, dass kein Interessenkonflikt besteht. Von allen an der Studie beteiligten Personen wurde eine informierte Einwilligung eingeholt.
Danksagungen
Wir danken dem Shenzhen Luohu Krankenhaus für Traditionelle Chinesische Medizin für die Bereitstellung der klinischen Einrichtungen und der administrativen Unterstützung, die für diese Studie unerlässlich waren. Schließlich sind wir allen Patienten und gesunden Probanden dankbar, die an dieser Forschung teilgenommen haben; ihr Beitrag war für diese Arbeit unverzichtbar. Diese Arbeit wurde unterstützt durch das Sanming-Projekt der Medizin in Shenzhen (Nr. SZZYSM202401018), die Fonds für vorrangige Fachgebiete des Luohu-Distrikts (Nr. LX202402021) und die Fonds für vorrangige Fachgebiete des Luohu-Distrikts (Nr. LX202302064).
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| β-Actin-Primer | Tsingke | N/V | Vorwärts: 5’-CATGTACGTTGCTATCCAGGC-3’ Rückwärts: 5’-CTCCTTAATGTCACGCACGAT-3’ |
| B4GALT2-Primer | Tsingke | N/V | Vorwärts: 5’-GGGCAGACTGCTGATCGAG-3’ Rückwärts: 5’-CCGGTGTCTAAAGGGGATGAT-3’ |
| CB-Dock2 | LabShare | Online | Molekulares Docking |
| clusterProfiler | Bioconductor | v4.14.6 | Anreicherungsanalyse |
| Cytoscape | Cytoscape-Konsortium | v3.8.3 | Netzwerkvisualisierung |
| DrugBank | University of Alberta | Online | Wirkstoffvorhersage |
| FAM168B-Primer | Tsingke | N/V | Vorwärts: 5’-TCTGGGGTTCCCTATGCAAAT-3’ Rückwärts: 5’-GTAGGATTCGCTCCAGGATACA-3’ |
| glmnet | CRAN | v4.1 | LASSO-Regression |
| GSVA | Bioconductor | v1.52.3 | ssGSEA-Analyse |
| Hifair III 1st Strand cDNA Synthesis Supermix | YEASEN | 11141ES | cDNA-Synthese |
| Hieff RTPCR SYBR Green Master Mix | YEASEN | 11201ES | qPCR-Amplifikation |
| limma | Bioconductor | v3.54.0 | Differenzielle Expression |
| LightCycler 480 II System | Roche | LightCycler 480 II | Echtzeit-PCR |
| PTRF-Primer | Tsingke | N/V | Vorwärts: 5’-GGGCCGTAGACCAGATCCA-3’ Rückwärts: 5’-CTTGCTCACCGTATTGCTCGT-3’ |
| PRKCDBP-Primer | Tsingke | N/V | Vorwärts: 5’-CACGTTCTGCTCTTCAAGGAG-3’ Rückwärts: 5’-TGTACCTTCTGCAATCCGGTG-3’ |
| R-Software | R Foundation | v4.4.2 | Statistische Datenverarbeitung |
| randomForest | CRAN | v4.7 | Random-Forest-Methode |
| RNA isolater MolPure Blood RNA Kit | YEASEN | 19241ES50 | RNA-Extraktion |
| STRING-Datenbank | EMBL | Online | PPI-Netzwerk |
| TOR3A-Primer | Tsingke | N/V | Vorwärts: 5’-CCCTTGCTCTGTCGTTCCAC-3’ Rückwärts: 5’-CCCGTCCCGATACAGGTTC-3’ |
| UPP1-Primer | Tsingke | N/V | Vorwärts: 5’-CTGTCAGTCATGGTATGGGCA-3’ Rückwärts: 5’-GAGCACCGGGCATAGTACA-3’ |
| WGCNA | CRAN | v1.72 | Ko-Expressionsnetzwerk |
| xgboost | CRAN | v1.7 | XGBoost-Algorithmus |
Referenzen
- Hogg JC. Pathophysiology of airflow limitation in chronic obstructive pulmonary disease. Lancet. 2004;364(9435):709-21.
- Baraldo S, Turato G, Saetta M. Pathophysiology of the small airways in chronic obstructive pulmonary disease. Respiration. 2012;84(2):89-97.
- Fischer BM, Pavlisko E, Voynow JA. Pathogenic triad in COPD: oxidative stress, protease-antiprotease imbalance, and inflammation. Int J Chron Obstruct Pulmon Dis. 2011;6:413-21.
- Pandey KC, De S, Mishra PK. Role of proteases in chronic obstructive pulmonary disease. Front Pharmacol. 2017;8:512.
- Wang L, Xie J, Hu Y, Tian Y. Air pollution and risk of chronic obstructed pulmonary disease: the modifying effect of genetic susceptibility and lifestyle. EBioMedicine. 2022;79:103994.
- Elonheimo HM, et al. Environmental substances associated with chronic obstructive pulmonary disease-a scoping review. Int J Environ Res Public Health. 2022;19(7):3945.
- Chen S, et al. The global economic burden of chronic obstructive pulmonary disease for 204 countries and territories in 2020-50: a health-augmented macroeconomic modelling study. Lancet Glob Health. 2023;11(8):e1183-e93.
- Rutten-van Mölken MP, et al. Costs and effects of inhaled corticosteroids and bronchodilators in asthma and chronic obstructive pulmonary disease. Am J Respir Crit Care Med. 1995;151(4):975-82.
- Ontiveros RJ, Stoute J, Liu KF. The chemical diversity of RNA modifications. Biochem J. 2019;476(8):1227-45.
- Roundtree IA, Evans ME, Pan T, He C. Dynamic RNA modifications in gene expression regulation. Cell. 2017;169(7):1187-200.
- Wang C, et al. RNA modification in cardiovascular disease: implications for therapeutic interventions. Signal Transduct Target Ther. 2023;8(1):412.
- Zhang W, et al. ac4C acetylation regulates mRNA stability and translation efficiency in osteosarcoma. Heliyon. 2023;9(6):e17103.
- Qiu L, Jing Q, Li Y, Han J. RNA modification: mechanisms and therapeutic targets. Mol Biomed. 2023;4(1):25.
- Luo J, Cao J, Chen C, Xie H. Emerging role of RNA acetylation modification ac4C in diseases: current advances and future challenges. Biochem Pharmacol. 2023;213:115628.
- Li H, et al. RNA cytidine acetyltransferase NAT10 maintains T cell pathogenicity in inflammatory bowel disease. Cell Discov. 2025;11(1):19.
- Wang JN, et al. NAT10 exacerbates acute renal inflammation by enhancing N4-acetylcytidine modification of the CCL2/CXCL1 axis. Proc Natl Acad Sci U S A. 2025;122(17):e2418409122.
- Shenshen W, et al. NAT10 accelerates pulmonary fibrosis through N4-acetylated TGFB1-initiated epithelial-to-mesenchymal transition upon ambient fine particulate matter exposure. Environ Pollut. 2023;322:121149.
- Liu J, et al. Unveiling ac4C modification pattern: a prospective target for improving the response to immunotherapeutic strategies in melanoma. J Transl Med. 2025;23(1):287.
- Su F, et al. Multimodal single-cell analyses outline the immune microenvironment and therapeutic effectors of interstitial cystitis/bladder pain syndrome. Adv Sci (Weinh). 2022;9(18):e2106063.
- Schiffers S, Oberdoerffer S. ac4C: a fragile modification with stabilizing functions in RNA metabolism. RNA. 2024;30(5):583-94.
- Jiao L, et al. Emerging role of N-acetyltransferase 10 in diseases: RNA ac4C modification and beyond. Mol Biomed. 2025;6(1):46.
- Zheng N, et al. Regulatory roles of NAT10 in airway epithelial cell function and metabolism in pathological conditions. Cell Biol Toxicol. 2023;39(4):1237-56.
- Du J, et al. PTRF-IL33-ZBP1 signaling mediating macrophage necroptosis contributes to HDM-induced airway inflammation. Cell Death Dis. 2023;14(7):432.
- Lai K, et al. Uridine alleviates sepsis-induced acute lung injury by inhibiting ferroptosis of macrophage. Int J Mol Sci. 2023;24(6):5093.
- Kumari R, Jat P. Mechanisms of cellular senescence: cell cycle arrest and senescence associated secretory phenotype. Front Cell Dev Biol. 2021;9:645593.
- Ogrodnik M, Salmonowicz H, Jurk D, Passos JF. Expansion and cell-cycle arrest: common denominators of cellular senescence. Trends Biochem Sci. 2019;44(12):996-1008.
- Kumar M, Seeger W, Voswinckel R. Senescence-associated secretory phenotype and its possible role in chronic obstructive pulmonary disease. Am J Respir Cell Mol Biol. 2014;51(3):323-33.
- Pérez-Rubio G, et al. Role of genetic susceptibility in nicotine addiction and chronic obstructive pulmonary disease. Rev Invest Clin. 2019;71(1):36-54.
- Liu Y, Wang R, Jiang T. RNA-binding proteins as a molecular link between COPD and pulmonary hypertension. Int J Med Sci. 2025;22(8):1979-91.
- Marques TM, Gama-Carvalho M. Network approaches to study endogenous RNA competition and its impact on tissue-specific microRNA functions. Biomolecules. 2022;12(2):332.
- Wang J, Xia B, Ma R, Ye Q. Comprehensive analysis of a competing endogenous RNA co-expression network in chronic obstructive pulmonary disease. Int J Chron Obstruct Pulmon Dis. 2023;18:2417-29.
- Zhang J, et al. Construction of a ceRNA network and screening of potential biomarkers and molecular targets in male smokers with chronic obstructive pulmonary disease. Front Genet. 2024;15:1376721.
- Celikoğlu F, Celikoğlu SI. Intratumoural chemotherapy with 5-fluorouracil for palliation of bronchial cancer in patients with severe airway obstruction. J Pharm Pharmacol. 2003;55(10):1441-8.
- Chan AK, Choo BA, Glaholm J. Pulmonary toxicity with oxaliplatin and capecitabine/5-fluorouracil chemotherapy: a case report and review of the literature. Onkologie. 2011;34(8-9):443-6.