Dieses Protokoll integriert mehrdimensionale transkriptomische Daten mit maschinellem Lernen, um alters- und mitochondrienassoziierte Gene bei dilatativer Kardiomyopathie für die Biomarkerentdeckung und molekulare Subtypisierung zu identifizieren.
Forschungsartikel
Identifizierung von Alterungs- und Mitochondrien-bezogenen Hub-Genen bei dilatativer Kardiomyopathie
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die dilatative Kardiomyopathie (DCM) ist gekennzeichnet durch eine Dilatation des linken Ventrikels und eine systolische Dysfunktion und geht mit einer mitochondrialen Dysfunktion sowie einer immuninflammatorischen Aktivierung einher. Die molekularen Alterungssignaturen und mitochondrialen Regulationswege bei DCM sind jedoch noch unvollständig verstanden. In dieser Studie wurden sechs Bulk-Transkriptomik-Datensätze und ein Einzelzell-RNA-Sequenzierungsdatensatz aus der Gene Expression Omnibus-Datenbank analysiert. Nach Datennormalisierung, Batch-Korrektur und Zelltyp-Annotation wurden alters- und mitochondrienbezogene Kandidatengene mittels differentieller Expressionsanalyse, gewichteter Gen-ko-Expressionsnetzwerkanalyse und Konstruktion von Protein-Protein-Interaktionsnetzwerken identifiziert. Kerngene wurden anschließend mittels Least-Absolute-Shrinkage-and-Selection-Operator-Regression, Random-Forest- und Support-Vector-Machine-Recursive-Feature-Elimination weiter eingegrenzt. Analysen zur Immunzellinfiltration, Zell-Zell-Kommunikation und molekularen Subtypisierung wurden durchgeführt, um das kardiale immunologische Mikromilieu bei DCM zu charakterisieren. Insgesamt waren 66 altersbezogene Gene und 16 mitochondrienbezogene Gene mit DCM assoziiert und vorwiegend in Hypoxie-induzierbaren Faktor-1-Signalwegen, oxidativer Phosphorylierung und nitric oxide synthase-assoziierten Wegen angereichert. Analysen mittels maschinellem Lernen und Einzelzell-RNA-Sequenzierung identifizierten SERPINE1, TGFB2, CYBB und TLR2 als Kerngene. CYBB und TLR2 wurden in Monozyten und Makrophagen stark exprimiert, während SERPINE1 und TGFB2 hauptsächlich in Stromazellen exprimiert wurden. Die Analyse des Immunlandschaftsprofils zeigte eine erhöhte proinflammatorische Makrophagenaktivierung und veränderte Zell-Zell-Kommunikation in DCM-Proben. Basierend auf der Expression der Kerngene wurden die DCM-Proben in zwei molekulare Subtypen unterteilt, die jeweils mit der Signalübertragung durch vaskulären endothelialen Wachstumsfaktor und der primären Biosynthese von Gallensäuren assoziiert waren. Dieses Protokoll bietet einen integrierten Ansatz zur Identifizierung von Kandidaten-Biomarkern und molekularen Subtypen bei DCM.
Einleitung
Die dilatative Kardiomyopathie (DCM) ist eine Myokarderkrankung, die durch eine Dilatation des linken Ventrikels und eine beeinträchtigte systolische Funktion gekennzeichnet ist. Sie ist die dritthäufigste Ursache für Herzinsuffizienz und weltweit die häufigste Indikation für eine Herztransplantation1. Bevölkerungsbasierte Studien schätzen eine Prävalenz von etwa 1 von 250 Erwachsenen, wobei die Prävalenz bei Männern höher ist und ein erheblicher Anteil der Fälle auf monogene Varianten zurückzuführen ist2. Diese Befunde deuten darauf hin, dass sowohl genetische Anfälligkeit als auch Umweltfaktoren zum Auftreten und Fortschreiten der DCM beitragen.
Die Pathogenese der DCM umfasst miteinander verknüpfte Prozesse wie entzündliche Aktivierung, oxidativen Stress, Apoptose der Kardiomyozyten und eine dysregulierte profibrotische Signalübertragung. Entzündliche genetische Polymorphismen, einschließlich Varianten des Tumornekrosefaktor-α-Promotors, wurden mit der Anfälligkeit für virale DCM assoziiert3. Erhöhter oxidativer Stress wurde ebenfalls mit dem Absterben von Kardiomyozyten und einer Dysfunktion des linken Ventrikels bei menschlichen DCM-Subtypen in Verbindung gebracht4. Darüber hinaus fördert die fehlerhafte Aktivierung der Wnt/β-Catenin- und Calcineurin/Kernfaktor-der-aktivierten-T-Zellen-Signalwege Myokardhypertrophie und interstitielle Fibrose und trägt somit zum Fortschreiten der Erkrankung bei5,6. Eine mitochondriale Dysfunktion ist ein weiterer wichtiger Bestandteil der DCM, da Kardiomyozyten einen hohen Energiebedarf haben. Die Störung der mitochondrialen Biogenese, des Calciumhaushalts, der Mitophagie und der Integrität der mitochondrialen DNA kann die oxidative Phosphorylierung beeinträchtigen und zur fortschreitenden Herzfunktionsstörung beitragen7,8,9,10.
Trotz dieser mechanistischen Erkenntnisse bestehen weiterhin wichtige Wissenslücken. Insbesondere die zeitlichen und kausalen Zusammenhänge zwischen der strukturellen Remodellierung der Mitochondrien und der bioenergetischen Dysfunktion während der Initiation und Progression der DCM sind noch nicht vollständig geklärt11. Es wurden mehrere therapeutische Strategien untersucht. Die Stammzelltherapie hat regeneratives Potenzial durch parakrine, zytoprotektive und immunmodulatorische Effekte gezeigt, doch die Optimierung der Zellquellen, Applikationswege und des Überlebens nach Transplantation ist weiterhin erforderlich12. Gentherapeutische Ansätze, einschließlich der adeno-assoziierten Virus-vermittelten Abgabe und der mittels „clustered regularly interspaced short palindromic repeats“ (CRISPR) basierenden Genomeditierung, bieten ebenfalls potenzielle präzise Behandlungsstrategien. Allerdings sind Limitationen bezüglich der kardialen Tropismus, der Vektor-Immunogenität und der Langzeit-Sicherheit weiterhin ungelöst13.
Öffentliche transkriptomische Datensätze aus Repositorien wie dem Gene Expression Omnibus (GEO) werden häufig für die Entdeckung von Biomarkern bei der dilatativen Kardiomyopathie (DCM) verwendet. Diese Ressourcen ermöglichen den Zugriff auf multizentrische klinische Kohorten, unterstützen kostengünstige und reproduzierbare Untersuchungen und können die statistische Aussagekraft durch die Integration mehrerer Datensätze erhöhen14. Die transkriptomische Profilierung erlaubt zudem eine genomweite Screening-Analyse von Kandidatengenen, molekulare Subtypisierung sowie Analysen auf Ebene biologischer Signalwege15. Öffentliche Datensätze weisen jedoch inhärente Einschränkungen auf, darunter technische Batch-Effekte, klinische und ätiologische Heterogenität, begrenzte Möglichkeiten zur kausalen Schlussfolgerung sowie unvollständige longitudinale oder prognostische Informationen16. Daher eignen sich aus öffentlichen transkriptomischen Datensätzen gewonnene Erkenntnisse am besten zur Hypothesengenerierung und Priorisierung von Kandidaten-Biomarkern und müssen in unabhängigen Kohorten sowie experimentellen Modellen validiert werden.
Viele bioinformatische Studien zur DCM stützen sich hauptsächlich auf die Analyse differentieller Expression, die falsch-positive Ergebnisse liefern kann und die Gen-Ko-Expressionsnetzwerke oder zelluläre Heterogenität im Herzmuskelgewebe nicht vollständig erfasst. Um diese Einschränkungen zu überwinden, wurde in der vorliegenden Studie eine integrierte analytische Strategie eingesetzt, die komplementäre Methoden kombiniert. Die transkriptomische Analyse auf Gewebeebene liefert expressionsmuster auf Gewebeebene, die für Fall-Kontroll-Vergleiche geeignet sind. Die gewichtete Gen-Ko-Expressionsnetzwerk-Analyse (WGCNA) identifiziert Genmodule, die mit phänotypischen Merkmalen assoziiert sind, und ermöglicht die Priorisierung funktionell verwandter Gensätze anstelle einzelner differentiell exprimierter Gene. Die Protein-Protein-Interaktions-(PPI-)Netzwerkanalyse identifiziert stark vernetzte Gene auf Grundlage der Netzwerktopologie. Drei maschinelle Lernalgorithmen – Regression mit Least Absolute Shrinkage and Selection Operator, Random Forest und Support Vector Machine mit rekursiver Merkmalseliminierung – wurden verwendet, um Kandidaten-Biomarker in den integrierten Datensätzen zu identifizieren¹⁷. Anschließend wurde die Einzelzell-RNA-Sequenzierung (scRNA-seq) eingesetzt, um zelltypspezifische Expressionsmuster und Netzwerke der interzellulären Kommunikation zu untersuchen18.
Obwohl mitochondriale Dysfunktion und altersbedingte molekulare Veränderungen jeweils bei der dilatativen Kardiomyopathie (DCM) untersucht wurden, sind ihre kombinierten Zusammenhänge mit krankheitsbedingten transkriptionellen Veränderungen bisher wenig erforscht. Die vorliegende Studie integrierte mehrere Bulk-Transkriptomik- und scRNA-seq-Datensätze, um alters- und mitochondrienassoziierte Hub-Gene bei DCM zu identifizieren, das kardiale immunologische Mikromilieu zu charakterisieren und molekulare Subtypen basierend auf den identifizierten Genen zu analysieren. Dieser integrierte Ansatz diente der Priorisierung potenzieller Biomarker und legte eine Grundlage für nachfolgende mechanistische und Validierungsstudien.
Protokoll
Alle Tierversuche wurden vom Ausschuss für Tierversuchsethik des Zweiten Angegliederten Krankenhauses der Universität für Chinesische Medizin Henan überprüft und genehmigt (Genehmigungsnummer: HNSZYYYJS2023011150). Alle Verfahren wurden gemäß den Leitlinien für die ethische Bewertung des Wohlergehens von Labortieren (GB/T 35892-2018) und den 3R-Grundsätzen der Ersetzung, Reduzierung und Verfeinerung durchgeführt. Die in dieser Studie verwendeten Reagenzien, Datenbanken, Software und Geräte sind in der Tabelle der Materialien aufgeführt.
1. Datenquellen und experimentelles Material
Männliche SPF-qualitative transgene CTNTR141W-Mäuse mit einem spontanen dilatativen Kardiomyopathie-(DCM-)Phänotyp und einem Körpergewicht von 25 ± 2 g wurden als Modellgruppe verwendet. Männliche SPF-qualitative C57BL/6J-Mäuse im gleichen Alter mit einem Körpergewicht von 25 ± 2 g dienten als Kontrollgruppe. Jede Gruppe umfasste 12 Mäuse. Alle Tiere stammten von Einrichtungen mit gültigen Produktionslizenzen für Laboratoriumstiere und wurden in einer SPF-qualitativen Barriereumgebung bei 22 ± 2 °C und einer relativen Luftfeuchtigkeit von 40–60 % bei einem 12-Stunden-Licht-/Dunkel-Wechselzyklus gehalten, mit freiem Zugang zu sterilisierter Nahrung und Wasser. Nach einer Akklimatisierungsphase von einer Woche wurden alle Mäuse weitere vier Wochen unter denselben Bedingungen gehalten, bevor die Beurteilung der Herzfunktion und die Probennahme erfolgten. Zu Beginn des Experiments waren alle Mäuse 6–8 Wochen alt. Die Mäuse wurden tief anästhesiert und durch Halsbruch euthanasiert.
Sieben öffentliche transkriptomische Datensätze von linksventrikularem Myokardgewebe von Patienten mit dilatativer Kardiomyopathie (DCM) wurden aus der Gene Expression Omnibus (GEO)19-Datenbank abgerufen. Diese Datensätze umfassten sechs Bulk-Transkriptomdatensätze und einen Einzelzell-RNA-Sequenzierungsdatensatz (scRNA-seq), GSE145154. Sowohl CD45-positive als auch CD45-negative Fraktionen wurden in die Analyse einbezogen. Die CD45-positiven und CD45-negativen Zellfraktionen wurden vor der Clusterung kombiniert. Die Probenidentität wurde als primäre Batch-Variable für die Harmony-Integration verwendet. Normale linksventrikuläre und DCM-linksventrikuläre Proben aus GSE145154 wurden einbezogen, insbesondere GSM4307515, GSM4307516, GSM4307520 und GSM4307521. Die in dieser Studie verwendeten Datensätze waren GSE145154, GSE5406, GSE42955, GSE57338, GSE79962, GSE116250 und GSE141910. Alle Proben, die nicht DCM betrafen, wurden ausgeschlossen, und nur Kontrollproben (Kontrollgruppe) und DCM-Proben (DCM-Gruppe) wurden beibehalten. Nach der Qualitätskontrolle wurden keine Proben entfernt. Die Probeninformationen der eingeschlossenen GEO-Datensätze sind wie folgt zusammengefasst: GSE5406 enthielt 102 Proben (16 Kontroll- und 86 DCM-Proben); GSE42955 enthielt 17 Proben (5 Kontroll- und 12 DCM-Proben); GSE57338 enthielt 231 Proben (136 Kontroll- und 95 DCM-Proben); GSE79962 enthielt 20 Proben (11 Kontroll- und 9 DCM-Proben); GSE116250 enthielt 51 Proben (14 Kontroll- und 37 DCM-Proben); und GSE141910 enthielt 322 Proben (161 Kontroll- und 161 DCM-Proben).
2. Vorverarbeitung von Bulk-Transkriptomdaten
Rohexpressionsmatrizen und klinische Anmerkungsdateien für die sechs Bulk-Datensätze wurden mithilfe des GEOquery-Pakets20 heruntergeladen. Für die Affymetrix-Microarray-Datensätze wurden die rohen CEL-Dateien abgerufen, für die RNA-seq-Datensätze die rohen Zählmatrizen. Die Hintergrundkorrektur, Quantilnormalisierung und Expressionsberechnung der Microarray-Daten erfolgten mit dem robusten Multi-Array-Average-Algorithmus, der im affy-Paket21 implementiert ist.
Die RNA-seq-Zähldaten wurden mit der Methode des gestutzten Mittelwerts der M-Werte im edgeR-Paket22 normalisiert und in log₂-transformierte Werte pro Million Zählungen umgewandelt. Die Probekennungen wurden mithilfe plattformspezifischer Anmerkungsdateien in offizielle Gensymbole umgewandelt. Wenn mehrere Proben auf dasselbe Gen abgebildet wurden, wurde der mittlere Expressionswert berechnet.
Technische Batch-Effekte zwischen Datensätzen wurden mithilfe des ComBat-Algorithmus im sva-Paket23 entfernt. Die Herkunft der Datensätze und die Nachweissplattform wurden als Batch-Faktoren angegeben. Eine Hauptkomponentenanalyse wurde vor und nach der Batch-Korrektur durchgeführt, um die Wirksamkeit der Entfernung von Batch-Effekten zu bewerten.
3. Vorverarbeitung von Einzelzell-Transkriptomdaten und Zellannotation
Die Genexpressionsmatrix aus GSE145154 wurde in Seurat importiert, um mithilfe von Seurat-Version 524 ein Seurat-Objekt zu erstellen. Zellen von geringer Qualität wurden anhand der folgenden Schwellenwerte ausgeschlossen: 200–6.000 nachgewiesene Gene pro Zelle, Gesamtanzahl eindeutiger molekularer Identifikatoren (unique molecular identifier) über 500 und Anteil an mitochondrialen Genen unter 25 %. Zellen außerhalb dieser Qualitätskontroll-Schwellenwerte wurden als Zellen geringer Qualität oder als beschädigte Zellen ausgeschlossen. Wir haben Zellen geringer Qualität ausschließlich anhand der oben beschriebenen Qualitätskontroll-Schwellenwerte ausgeschlossen.
Die Log-Normalisierung wurde mithilfe der NormalizeData-Funktion mit einem Skalierungsfaktor von 10.000 durchgeführt. Die 3.000 am stärksten variablen Gene wurden mit der FindVariableFeatures-Funktion und der vst-Methode ausgewählt. Die Daten wurden mit ScaleData skaliert und anschließend einer Hauptkomponentenanalyse zur linearen Dimensionsreduktion unterzogen.
Batch-Effekte wurden mithilfe des Harmony-Algorithmus25 über die Funktion RunHarmony korrigiert, wobei die Probenidentität als Gruppierungsvariable angegeben wurde. Die ersten 15 Hauptkomponenten wurden verwendet, um Zellen mithilfe der Funktionen FindNeighbors und FindClusters zu clustern. Das Clustering erfolgte mit dem Leiden-Algorithmus bei einer Auflösung von 0,15. Die nichtlineare Dimensionsreduktion und Visualisierung wurde mittels uniformer Mannigfaltigkeitsapproximation und -projektion durchgeführt.
Die Zelltypen wurden anhand kanonischer Markergene sowie mithilfe automatisierter Annotation mit dem SingleR-Paket26 annotiert. Die Markergene waren wie folgt: B-Zellen, IGKC, MS4A1 und CD79A; Kardiomyozyten, TNNI3, MYL2 und ACTC1; endotheliale Zellen, VWF, PECAM1 und EGFL7; Makrophagen, C1QC, C1QB und C1QA; Monozyten, S100A8, S100A9 und G0S2; natürliche Killerzellen, NKG7, GNLY und CCL5; glatte Muskelzellen, MYL9, TAGLN und ACTA2; Stromazellen, FBLN1, LUM und DCN; sowie T-Zellen, CD3E, CD3G und CD3D.
4. Analyse der differentiellen Expression und Bewertung der Anreicherung von Genen in Gruppen
Ein lineares Modell wurde unter Verwendung des limma-Pakets27 erstellt, um die Genexpression zwischen den DCM- und gesunden Kontrollgruppen zu vergleichen. Gene mit einem P-Wert < 0,05 und einer absoluten Fold-Change größer als 1,5, was einer absoluten log₂-Fold-Change größer als 0,58 entspricht, wurden als signifikant differentiell exprimiert definiert.
Die Einzelproben-Analyse der Gen-Set-Verdichtung wurde durchgeführt, um Verdichtungswerte für die altersbezogenen und mitochondrienbezogenen Gen-Sets in jeder Probe zu berechnen28. Unterschiede in den Verdichtungswerten zwischen der DCM- und der gesunden Kontrollgruppe wurden mittels des Wilcoxon-Rangsummentests bewertet, wobei ein P-Wert < 0,05 als statistisch signifikant angesehen wurde.
Auf Einzelzell-Ebene wurden altersbezogene und mitochondriale Modulwerte mithilfe der AddModuleScore-Funktion in Seurat berechnet. Unterschiede in den Modulwerten zwischen den Gruppen wurden mittels des Wilcoxon-Rangsummentests bewertet.
Gen-Signaturen im Zusammenhang mit dem Altern wurden aus der CellAge-Datenbank abgerufen (https://genomics.senescence.info/cells/), und Gen-Sets im Zusammenhang mit Mitochondrien wurden von GeneCards bezogen (https://www.genecards.org/). Die vollständigen Genlisten, die zur Bewertung verwendet wurden, sind in Zusatzdatei 1 enthalten.
5. Konstruktion des gewichteten Gen-Ko-Expressionsnetzwerks
Die 5000 Protein-kodierenden Gene mit der höchsten Expressionsvarianz in den Bulk-Transkriptomdaten wurden für die Netzwerkkonstruktion beibehalten. Die Funktion pickSoftThreshold wurde angewendet, um den Scale-Free-Topologie-Anpassungsindex unter mehreren Soft-Threshold-Potenzen zu berechnen. Der optimale Schwellenwert wurde als die minimale Potenz festgelegt, die ein Scale-Free-Netzwerk mit einem R2-Wert über 0,9 ergibt. Entsprechend wurde für die anschließende Netzwerkanalyse eine Soft-Threshold-Potenz von β = 5 gewählt.
Ein signiertes gewichtetes Ko-Expressionsnetzwerk wurde mithilfe der blockwiseModules-Funktion mit einer minimalen Modulgröße von 30 konstruiert. Zwischen jedem Moduleigenvektor und dem altersbezogenen oder mitochondriellen Anreicherungsscore wurden Pearson-Korrelationskoeffizienten berechnet. Module mit einem absoluten Korrelationskoeffizienten größer als 0,4 und einem P < 0,001 galten als signifikant assoziierte Module.
Gene in signifikant assoziierten Modulen wurden mit differenziell exprimierten Genen geschnitten, um Kandidatengene für das DCM-assoziierte Altern und Kandidatengene für DCM-assoziierte Mitochondrien zu identifizieren.
6. Funktionsanreicherungsanalyse
Funktionsanreicherungsanalysen, einschließlich der Genontologie (GO) und der Kyoto-Enzyklopädie für Gene und Genome (KEGG)-Pfadanalysen, wurden mit dem clusterProfiler-Paket29 an Kandidatengenen durchgeführt. Die GO-Anreicherung umfasste die drei Standardkategorien: biologischer Prozess, zelluläre Komponente und molekulare Funktion.
Alle Analysen wurden mit Anmerkungen zur menschlichen Spezies, einer falschen Entdeckungsrate (FDR) zur Korrektur des P-Werts und einer q-Wert-Schwelle von 0,05 durchgeführt. Gensätze wurden auf einen Größenbereich von 10–500 Genen beschränkt, und Terme mit einer FDR < 0,05 wurden als statistisch signifikant definiert. Schließlich wurden die GO-Anreicherungsergebnisse visualisiert über gruppierte Balkendiagramme, während die KEGG-Anreicherungsergebnisse mithilfe von Blasendiagrammen dargestellt wurden.
7. Konstruktion des PPI-Netzwerks und Identifizierung von Hub-Genen
Kandidatengene wurden in die STRING-Datenbank, Version 11.530, eingegeben, wobei der Organismus auf Homo sapiens festgelegt und die Schwellenwert für die Interaktionsvertrauenswürdigkeit auf einen kombinierten Score von mehr als 0,7 gesetzt wurde. Nicht verbundene Knoten wurden ausgeblendet, und die Interaktionsdaten wurden im tabulatorgetrennten Format exportiert.
Die Interaktionsdaten wurden zur Visualisierung in Cytoscape Version 3.9.1 importiert31. Knotentopologische Scores wurden mithilfe des CytoHubba-Plugins32 mit drei Algorithmen berechnet: Degree, maximale Nachbarschaftskomponente und maximale Cliquenzentralität.
Kernfunktionale Module innerhalb des Netzwerks wurden mithilfe des MCODE-Plugins33 mit folgenden Standardparametern identifiziert: Grad-Schwellenwert, 2; k-Core, 2; Knoten-Score-Schwellenwert, 0,2; und maximale Tiefe, 100. Gene, die von allen drei topologischen Algorithmen jeweils unter den ersten 10 platziert wurden, wurden mit Genen im MCODE-Kernsubnetzwerk geschnitten, um die endgültigen Hub-Gene der Protein-Protein-Interaktion zu identifizieren.
8. Auswahl von Kerngenen und Erstellung eines diagnostischen Modells basierend auf maschinellem Lernen
Um Reproduzierbarkeit und eine ausgewogene Repräsentation zu gewährleisten, wurde der integrierte Bulk-Transkriptomik-Datensatz mithilfe eines festgelegten Zufallsstarts (seed = 123456) zufällig im Verhältnis 7:3 in Trainings- und Validierungsdatensätze aufgeteilt. Die Aufteilung erfolgte stratifiziert nach Krankheitsgruppe (DCM vs. Kontrolle), um konstante Klassenanteile in beiden Datensätzen sicherzustellen. Vor der Aufteilung wurden Batch-Effekte unterschiedlicher Datensatzquellen mit dem sva-Paket korrigiert, und die integrierten Proben wurden während der zufälligen Zuordnung als eine einheitliche Kohorte behandelt.
Drei maschinelle Lernalgorithmen wurden zur Untersuchung von Kandidatengenen eingesetzt. Zunächst wurde eine logistische LASSO-Regression durchgeführt über die Funktion cv.glmnet im glmnet-Paket34Ein binäres Klassifizierungsmodell mit 5-facher Kreuzvalidierung wurde erstellt, wobei die AUC als Evaluierungsmetrik verwendet wurde. Gene mit nicht-null Koeffizienten bei lambda.min wurden als Kandidatengene beibehalten.
Zweitens wurde ein Random-Forest-Klassifizierungsmodell mit 500 Entscheidungsbäumen mithilfe des randomForest-Pakets35 erstellt. Die Anzahl der für jeden Split zufällig ausgewählten Variablen wurde auf die Quadratwurzel der Gesamtanzahl der Merkmale festgelegt. Die Wichtigkeit der Gene wurde anhand des Gini-Koeffizienten quantifiziert, und die 10 Gene mit den höchsten Wichtigkeitsscores wurden beibehalten.
Drittens wurde die SVM-RFE-Analyse mithilfe der rfe-Funktion im caret-Paket36 durchgeführt. Die Anzahl der Merkmale wurde im Bereich von 1–10 festgelegt, und eine 5-fache Kreuzvalidierung wurde für das Modelltraining angewandt. Die Gen-Teilmenge mit der optimalen Kreuzvalidierungsgenauigkeit wurde letztendlich ausgewählt.
Gene, die von allen drei Algorithmen identifiziert wurden, wurden als endgültige Kerngene definiert, die mit dem Altern und Mitochondrien in DCM assoziiert sind. Anschließend wurden diagnostische Modelle unter Verwendung von 10 Klassifikationsalgorithmen erstellt: Entscheidungsbaum, Gradient-Boosting-Maschine, gesteigertes generalisiertes lineares Modell, k-nächste Nachbarn, logistische Regression, neuronales Netzwerk, partielle kleinste Quadrate, zufälliger Wald, Support-Vektor-Maschine und extremes Gradient-Boosting.
Die Receiver-Operating-Characteristic-Kurven wurden mit dem pROC-Paket37 erstellt. Die Fläche unter der Kurve, die Genauigkeit, die Sensitivität und die Spezifität wurden berechnet, um die diagnostische Leistung in den Trainings- und Validierungssätzen zu bewerten.
Die SHapley Additive exPlanations-Analyse wurde durchgeführt, um den Beitrag jedes Kerngens zu den Modellvorhersagen zu berechnen38. Es wurden Zusammenfassungsdiagramme und wasserfallartige Diagramme pro Probe erstellt. Ein endgültiges diagnostisches Modell mit einer Fläche unter der Kurve von mehr als 0,8 in der Validierungsmenge galt als Modell mit guter diagnostischer Leistung.
9. Schlussfolgerung zur Zell-Zell-Kommunikation
Netzwerke der Zell-Zell-Kommunikation im kardialen Mikromilieu wurden mithilfe des CellChat-Pakets39 erschlossen. Ein CellChat-Objekt wurde unter Verwendung der Datenbank CellChatDB.human erstellt. Differenziell exprimierte Liganden und Rezeptoren wurden mit identifyOverExpressedGenes identifiziert, und signifikante Interaktionspaare wurden mittels identifyOverExpressedInteractions gefiltert.
Die Kommunikationswahrscheinlichkeiten zwischen Zelltypen wurden mithilfe von computeCommunProb berechnet. Das globale kommunikative Netzwerk auf Ebene der Zelltypen wurde mit aggregateNet aggregiert. Die Anzahl der Interaktionen und die Kommunikationsstärke zwischen jedem Paar von Zelltypen wurden quantifiziert und mittels Heatmaps sowie Balkendiagrammen visualisiert.
10. Quantifizierung der Immunzellinfiltration
Anreicherungsscores für 28 Immunzelltypen wurden für jede Bulk-Probe mithilfe der single-sample Gen-Set-Anreicherungsanalyse28 und eines Gen-Sets mit Immunzellsignatur40 berechnet. Der Wilcoxon-Rangsummentest wurde verwendet, um die Anreicherungsscores der Immunzellen zwischen der DCM- und der gesunden Kontrollgruppe zu vergleichen. Ein P-Wert < 0,05 wurde als statistisch signifikant angesehen.
Eine Pearson-Korrelationsanalyse wurde durchgeführt, um die Assoziation zwischen den Expressionsniveaus der Kerngene und den Anreicherungsscores für Immunzellen zu bewerten. Alle Korrelationen mit einem P-Wert < 0,05 wurden als statistisch signifikant angesehen.
11. Konsensclusterung zur molekularen Subtypisierung
Die unbeaufsichtigte Konsensclusterung von DCM-Proben wurde unter Verwendung von Kern-Expressionsprofilen von Genen durchgeführt über das ConsensusClusterPlus-Paket41Die Clustering-Parameter wurden wie folgt festgelegt: eine maximale Clusteranzahl von 6, 1000 Resampling-Iterationen und ein Resampling-Anteil von 0,8. Zur Durchführung des Clusterings wurde die Partitionierung um Medoide mit euklidischem Abstand verwendet, und ein fester Zufallsstartwert wurde gewählt, um die Reproduzierbarkeit sicherzustellen.
Die optimale Anzahl der Subtypen wurde anhand des Delta-Flächen-Diagramms und der Stabilitätswerte des Konsens-Clusterings bestimmt, wobei schließlich K = 2 ermittelt wurde. Eine Hauptkomponentenanalyse wurde zusätzlich durchgeführt, um die klare Trennung der beiden molekularen Subtypen zu überprüfen.
Die Gen-Set-Variationsanalyse42 wurde angewendet, um probenspezifische KEGG-Pfad-Anreicherungswerte zu berechnen. Mithilfe des limma-Pakets27 wurde die differenzielle Pfadaktivierung zwischen Subtypen ermittelt, wobei ein P-Wert von weniger als 0,05 als statistisch signifikant definiert wurde.
12. Echokardiographische Beurteilung der Herzfunktion
Die Mäuse wurden anästhesiert über intraperitoneale Injektion von 1 % Natriumpentobarbital (30 mg/kg) und Fixierung in Rückenlage auf einem thermostatischen Operationstisch. Nach der Entfernung der Brusthaare wurde Ultraschall-Kopplungsgel gleichmäßig auf dem präkordialen Bereich aufgetragen.
Die zweidimensional gesteuerte M-Modus-Echokardiographie wurde auf der Ebene der papillären Muskeln des linken Ventrikels mit einem Ultraschallsystem für Kleintiere durchgeführt. Drei aufeinanderfolgende stabile Herzzyklen wurden aufgezeichnet, um den enddiastolischen Durchmesser, den endsystolischen Durchmesser, die Ejektionsfraktion und die Fractional Shortening des linken Ventrikels zu bestimmen. Alle echokardiographischen Untersuchungen wurden von einem erfahrenen Ultraschalltechniker blind durchgeführt.
Drei Mäuse wurden zufällig aus jeder Gruppe für die echokardiographische Untersuchung ausgewählt, und diese insgesamt sechs Tiere wurden anschließend getötet, um Myokardgewebe zu gewinnen und ELISA-Messungen durchzuführen. Die verbleibenden Versuchstiere wurden weiteren parallelen Labortests unterzogen, deren Daten jedoch in die vorliegende Studie nicht einbezogen wurden.
13. Sammlung von myokardialem Gewebe, Proteingewinnung und enzyme-linked immunosorbent assay
Nach der echokardiographischen Beurteilung wurden die Mäuse unter tiefer Anästhesie euthanasiert. Herzgewebe wurde rasch entnommen. über medianer Thorakotomie wurde das Myokard des linken Ventrikels auf Eis disseziert. Die isolierten Gewebeproben wurden gründlich mit eiskalter, phosphatgepufferter Kochsalzlösung gespült, um verbleibendes intrakardiales Blut zu entfernen. Nachdem überschüssige Flüssigkeit mit steriler Filterpapier abgetupft worden war, wurden die Proben unverzüglich in flüssigem Stickstoff schockgefroren und bei −80 °C für die nachfolgende Proteingewinnung, wobei wiederholte Gefrier-Tau-Zyklen strikt vermieden werden müssen.
Gefrorene Myokardgewebe wurden gewogen und auf Eis in etwa 1 mm3 große Fragmente geschnitten. Die Gewebe wurden in eiskaltem RIPA-Lysepuffer, der Protease- und Phosphataseinhibitoren enthielt, im standardisierten Verhältnis von 100 µL Puffer pro 10 mg Gewebe lysiert. Die Proben wurden vollständig mechanisch auf Eis homogenisiert und 30 Minuten lang inkubiert, um eine vollständige Zelllyse zu erzielen.
Die Lysate wurden bei 4 °C 15 min bei 12.000 × g zentrifugiert. Die resultierenden Überstände wurden in enzymfreien Röhrchen gesammelt und die Gesamtproteinkonzentration mit einem Bicinchoninsäure-Protein-Assay-Kit gemäß den Herstellerprotokollen quantifiziert. Alle Proben wurden mit Lysepuffer auf eine identische Proteinkonzentration eingestellt.
Die Proteinausprägungsniveaus der vier Hub-Gene in myokardialen Lysaten wurden mithilfe der entsprechenden ELISA-Kits (enzyme-linked immunosorbent assay) gemessen. Seriell verdünnte Standardproben und normalisierte Gewebelysate wurden verdoppelt (100 µL pro Mulde) in vorkonfektionierte Mikroplatten gegeben. Die Platten wurden 2 Stunden bei Raumtemperatur inkubiert und anschließend gründlich mit dem im Kit enthaltenen Waschpuffer gewaschen.
Jeder Well wurde mit enzymkonjugiertem Antikörper versetzt und 1 h bei Raumtemperatur inkubiert, gefolgt von einer gründlichen Waschung. Anschließend wurde die Substrat-Chromogen-Lösung zugegeben, und die Platten wurden 20 min bei Raumtemperatur im Dunkeln inkubiert. Die Farbreaktion wurde mit der Stopplösung beendet, und die Absorptionswerte wurden bei 450 nm (Referenzwellenlänge: 570 nm) mithilfe eines Mikroplatten-Readers mit vollem Wellenlängenbereich gemessen.
14. Statistische Analyse
Alle statistischen Analysen und Datenvisualisierungen wurden mit R, Version 4.2.3, durchgeführt. Für die ELISA-Konzentrationsmessungen jedes Zielgens (TGFB2, SERPINE1, CYBB, TLR2) wurde zunächst der Shapiro-Wilk-Test angewendet, um die Normalverteilung der Daten in den Gruppen Kontrolle und DCM separat zu überprüfen. Anschließend wurde ein F-Test verwendet, um die Varianzhomogenität zwischen den beiden Gruppen zu bewerten. Die Methode für den intergruppellen Vergleich wurde anhand der Ergebnisse des Varianzhomogenitätstests festgelegt: Falls die Varianzen homogen waren (P ≥ 0,05), wurde ein ungepaarter Student-t-Test zur Gegenüberstellung der Mittelwerte zwischen den Gruppen verwendet; falls die Varianzen heterogen waren (P < 0,05), kam der korrigierte Welch-t-Test zur Analyse zum Einsatz. Alle Tests waren zweiseitig, und die Schwelle für statistische Signifikanz wurde bei P < 0,05 festgelegt. Die Daten wurden als Boxplots dargestellt, überlagert mit gestreuten Einzelpunkten. Die P-Werte aller Tests sowie die Art des jeweils verwendeten t-Tests wurden auf jedem Diagramm detailliert angegeben.
Ergebnisse
Daten-Vorverarbeitung und differentielle Expressionsanalyse
Alle sechs Bulk-Transkriptom-Datensätze wurden einer standardisierten Vorverarbeitung und Batch-Effekt-Korrektur vor der nachgeschalteten Analyse unterzogen. Microarray-Daten wurden mit dem Robust Multi-Array Average-Algorithmus normalisiert, während RNA-seq-Zähldaten mit der Methode des getrimmten Mittelwerts der M-Werte normalisiert wurden. Der ComBat-Algorithmus wurde angewendet, um technische Batch-Effekte, die mit der Datensatzquelle und der Nachweisplattform assoziiert waren, zu entfernen. Die Hauptkomponentenanalyse zeigte, dass die Proben vor der Korrektur nach Datensatzquelle gruppiert waren, danach jedoch gleichmäßiger verteilt waren, ohne sichtbare Trennung nach Batch.
Die Analyse der differentiellen Expression zwischen den Gruppen dilatierter Kardiomyopathie (DCM) und gesunder Kontrolle (HC) wurde mit dem limma-Paket durchgeführt. Die Heatmap der 20 signifikantesten differentiell exprimierten Gene zeigte eine Trennung der Expressionsprofile zwischen den beiden Gruppen (Abbildung 1A). Insgesamt wurden 1.473 differentiell exprimierte Gene anhand der Schwellenwerte P-Wert < 0,05 und |log₂-Fold-Change| > 0,58 identifiziert. Davon waren 819 Gene in DCM-Myokardproben hochreguliert und 654 Gene herunterreguliert (Abbildung 1B).
Anschließend wurde eine Einzelproben-Gen-Set-Enrichment-Analyse verwendet, um Enrichment-Scores für die altersbezogenen und mitochondrienbezogenen Gen-Sets in jeder Probe zu berechnen. Beide Scores unterschieden sich signifikant zwischen den DCM- und HC-Gruppen (Abbildung 1C).
Analysen gewichteter Gen-Ko-Expressionsnetzwerke
Es wurden Analysen gewichteter Gen-Ko-Expressionsnetzwerke durchgeführt, um Genmodule zu identifizieren, die mit altersbezogenen und mit mitochondrialer Anreicherung assoziierten Werten verknüpft sind. Die 5.000 Protein-codierenden Gene mit der höchsten Expressionsvarianz im Gesamt-Datensatz wurden zur Konstruktion des Netzwerks verwendet. Bei einer Soft-Thresholding-Potenz von β = 5 überstieg der Anpassungsindex für die skalenfreie Topologie R2 = 0,9 und erfüllte somit das Kriterium für ein skalenfreies Netzwerk (Abbildung 1D).
Die hierarchische Clusterung und Modulzusammenführung identifizierten drei Genmodule. Alle drei Module korrelierten signifikant mit dem altersbezogenen Score. Das türkisfarbene Modul zeigte die stärkste Korrelation mit dem altersbezogenen Score (r = 0,69, P < 0,001). Für den mitochondriellen Score waren die blauen und grauen Module signifikant korreliert, wobei das blaue Modul die stärkste Assoziation aufwies (r = 0,56, P < 0,001; Abbildung 1E). Daher wurde das türkisfarbene Modul für die altersbezogene Gen-Screening-Analyse ausgewählt und das blaue Modul für die mitochondrienbezogene Gen-Screening-Analyse.
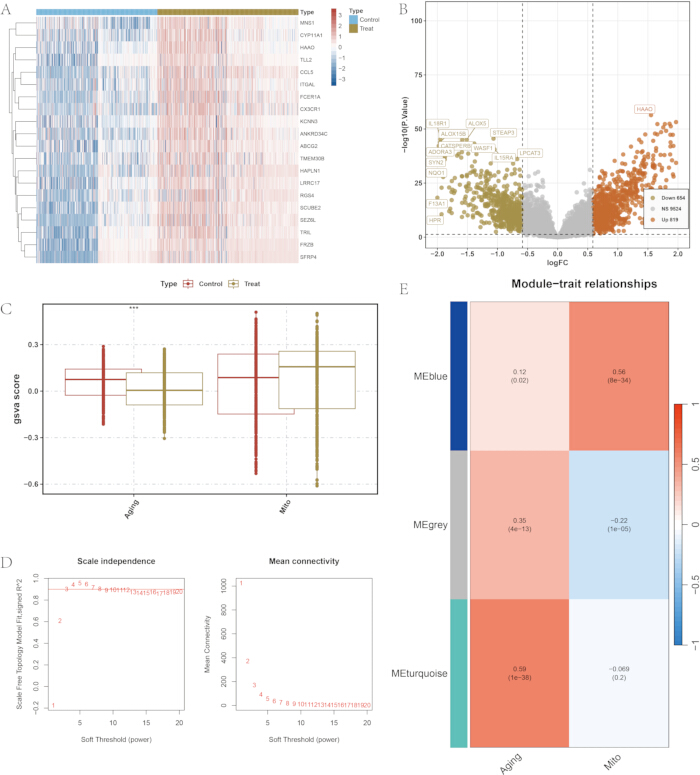
Abbildung 1: Analyse der differentiellen Expression und Konstruktion des gewichteten Gen-ko-Expressionsnetzwerks. (A) Heatmap der 20 signifikantesten differentiell exprimierten Gene zwischen den Gruppen mit dilatativer Kardiomyopathie (DCM) und gesunden Kontrollen (HC). (B) Volcano-Plot aller differentiell exprimierten Gene. Rot markierte Gene sind hochregulierte, grün markierte Gene niedrigregulierte und grau markierte Gene nicht signifikante Gene. Die Schwellenwerte waren P-Wert < 0,05 und |log₂-Fold-Change| > 0,58. (C) Boxplots der Einzelproben-Gen-Set-Anreicherungsanalysen (ssGSEA) für altersbezogene und mitochondrienbezogene Gen-Sets. (D) Auswahl des Soft-Schwellenwerts für die Analyse des gewichteten Gen-ko-Expressionsnetzwerks, dargestellt durch den Anpassungsindex der skalenfreien Topologie und die mittlere Verknüpfung bei verschiedenen Soft-Schwellenwerten. (E) Heatmap der Korrelationen zwischen den Moduleigengenen und den alters- sowie mitochondrienbezogenen Scores. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Identifizierung von alters- und mitochondrienbezogenen Kandidatengenen
Kandidatengene wurden durch den Schnitt der differenziell exprimierten Gene, der Gene in den ausgewählten Modulen der gewichteten Gen-ko-Expressionsnetzwerkanalyse und der entsprechenden Referenzgensätze identifiziert. Diese Analyse ergab 66 mit DCM assoziierte altersbezogene Kandidatengene (Abbildung 2A) und 16 mit DCM assoziierte mitochondrielle Kandidatengene (Abbildung 2B).
Die Überrepräsentationsanalyse der Genontologie zeigte, dass die altersassoziierten Kandidatengene in biologischen Prozessen angereichert waren, darunter die Biosynthese der Stickstoffmonoxid-Synthase und die Organisation der extrazellulären Matrix, die Kollagen enthält (Abbildung 2C). Die mitochondrienassoziierten Kandidatengene waren in Begriffe angereichert, die mit dem mitochondrialen Energiestoffwechsel verbunden sind, einschließlich der inneren mitochondrialen Membran und des Atmungskettenkomplexes (Abbildung 2D).
Die Analyse der Kyoto-Enzyklopädie für Gene und Genome zeigte, dass die altersassoziierten Kandidatengene in den Signalwegen des Hypoxie-induzierbaren Faktors 1, der Phosphoinositid-3-Kinase-Proteinkinase B sowie der fortgeschrittenen glykatisierten Endprodukte und deren Rezeptor angereichert waren (Abbildung 2E). Die mitochondrienassoziierten Kandidatengene waren in Signalwegen wie der oxidativen Phosphorylierung angereichert (Abbildung 2F).
Die unterschiedlichen Expressionsmuster der 66 altersbezogenen Kandidatengene zwischen den DCM- und HC-Gruppen wurden mithilfe einer Expressions-Heatmap dargestellt (Abbildung 2G). Die Expressionsmuster der 16 mitochondrienbezogenen Kandidatengene wurden mittels Boxplots veranschaulicht (Abbildung 2H).
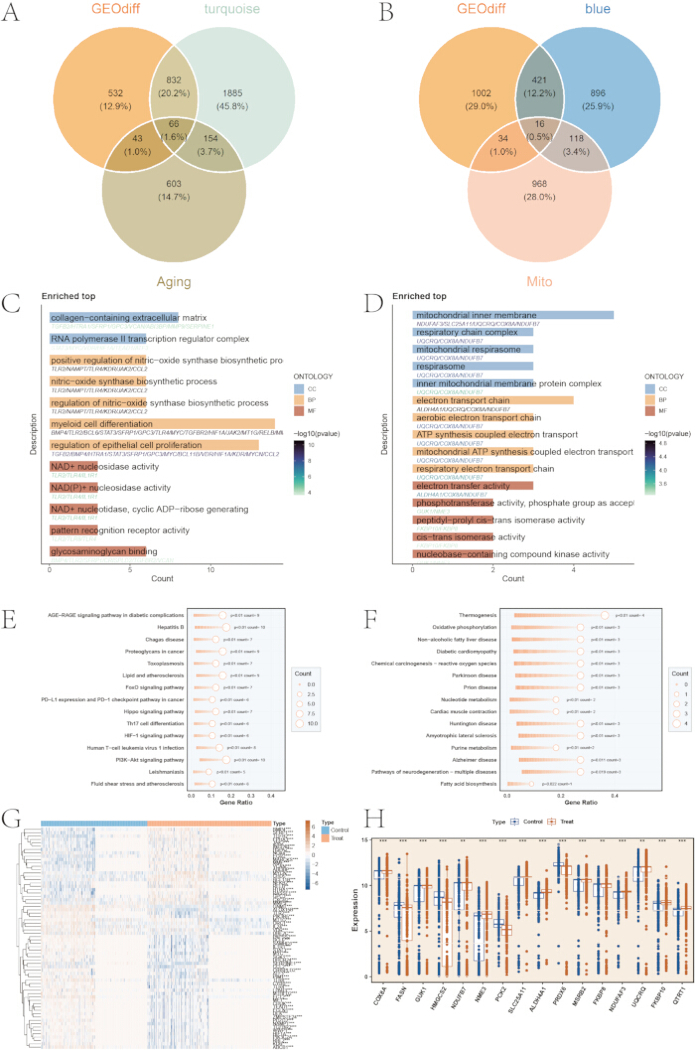
Abbildung 2: Screening und funktionelle Anreicherung von Kandidatengenen. (A) Venn-Diagramm, das den Durchschnitt der differentiell exprimierten Gene, der Gene aus dem gewichteten Gen-ko-Expressionsnetzwerk-Analysemodul und des altersbezogenen Referenzgen-Sets zeigt. (B) Venn-Diagramm, das den Durchschnitt der differentiell exprimierten Gene, der Gene aus dem gewichteten Gen-ko-Expressionsnetzwerk-Analysemodul und des mitochondrienbezogenen Referenzgen-Sets zeigt. (C) Genontologie-Anreicherungsanalyse der altersbezogenen Kandidatengene. (D) Genontologie-Anreicherungsanalyse der mitochondrienbezogenen Kandidatengene. (E) Kyoto Encyclopedia of Genes and Genomes (KEGG)-Pfad-Anreicherungsanalyse der altersbezogenen Kandidatengene. (F) Kyoto Encyclopedia of Genes and Genomes (KEGG)-Pfad-Anreicherungsanalyse der mitochondrienbezogenen Kandidatengene. (G) Expressions-Heatmap der 66 altersbezogenen Kandidatengene in den DCM- und HC-Gruppen. (H) Expressions-Boxplots der 16 mitochondrienbezogenen Kandidatengene in den DCM- und HC-Gruppen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Zelltypzuordnung des Einzelzell-RNA-Sequenzierungsdatensatzes
Der Einzelzell-RNA-Sequenzierungsdatensatz GSE145154 wurde zur Validierung auf Einzelzellauflösung verwendet. Nach Filterung der Qualitätskontrolle, log-Normalisierung und Harmonie-Batch-Korrektur waren die Zellen aus verschiedenen Proben im Uniform-Manifold-Approximation-and-Projection-Raum ohne sichtbare, probenspezifische Trennung verteilt. Unter Verwendung der ersten 15 Hauptkomponenten und einer Clusterauflösung von 0,15 wurden die Zellen in 9 Cluster unterteilt (Abbildung 3A).
Kanonische Markergene und die automatisierte Annotation mittels SingleR identifizierten neun Hauptzelltypen: Makrophagen, natürliche Killerzellen, T-Zellen, B-Zellen, endotheliale Zellen, glatte Muskelzellen, Monozyten, Stromazellen und Kardiomyozyten (Abbildung 3B). Die Expressionsmuster zelltypspezifischer Markergene stützten diese Annotationen (Abbildung 3C).
Mitochondriale Modulwerte wurden für jede Zelle mithilfe der AddModuleScore-Funktion berechnet und unterschieden sich signifikant zwischen der Gruppe mit dilatativer Kardiomyopathie und der gesunden Kontrollgruppe (P < 2,22 × 10⁻16; Abbildung 3D). Auch die Modulwerte für altersbezogene Gene unterschieden sich signifikant zwischen den beiden Gruppen (P < 2,22 × 10⁻16; Abbildung 3E). Die Projektion der mitochondrialen Werte in den Uniform-Manifold-Approximation-and-Projection-Raum zeigte, dass hohe Werte hauptsächlich in Kardiomyozyten beobachtet wurden (Abbildung 3F). Im Gegensatz dazu wurden hohe altersbezogene Werte vorwiegend in Makrophagen festgestellt (Abbildung 3G).
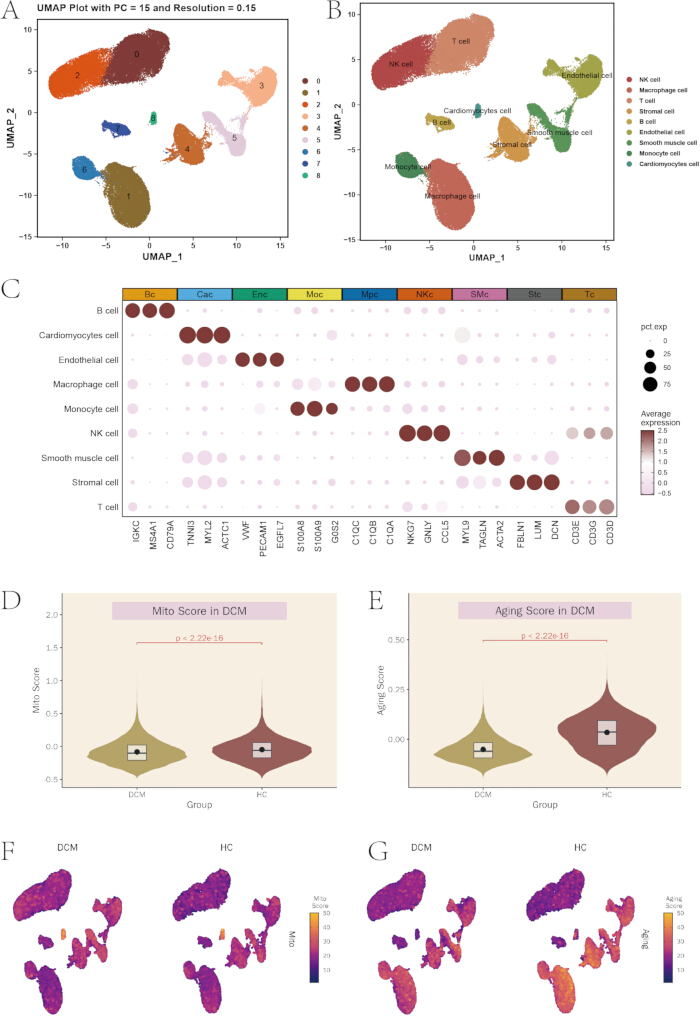
Abbildung 3: Annotation des Einzelzelltranskriptoms und Modul-Score-Analyse. (A) Uniform-Manifold-Approximation-and-Projection-Plot (UMAP) der Zellcluster, erzeugt unter Verwendung der ersten 15 Hauptkomponenten und einer Cluster-Auflösung von 0,15. (B) UMAP-Plot der annotierten Zelltypen. (C) Blasendiagramm zur Darstellung der Expression kanonischer Markergene über verschiedene Zelltypen hinweg. (D) Violin-Plot der mitochondriale Modul-Scores in den DCM- und HC-Gruppen. (E) Violin-Plot der altersbezogenen Modul-Scores in den DCM- und HC-Gruppen. (F) UMAP-Plot zur Darstellung der Verteilung der mitochondriale Modul-Scores über alle Zellen. (G) UMAP-Plot zur Darstellung der Verteilung der altersbezogenen Modul-Scores über alle Zellen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Konstruktion des Protein-Protein-Interaktionsnetzwerks
Der kombinierte Satz aus 66 altersbezogenen und 16 mitochondrienbezogenen Kandidatengenen wurde zur Erstellung eines Protein-Protein-Interaktionsnetzwerks mit einer Hochvertrauensschwelle (kombinierter Score > 0,7) in die STRING-Datenbank Version 11,5 eingegeben. Das Netzwerk wurde zur Visualisierung und topologischen Analyse in Cytoscape importiert (Abbildung 4A).
Grad, maximale Cliquenzentralität, maximale Nachbarschaftskomponente und MCODE-Analysen wurden verwendet, um stark vernetzte Knoten und kernhafte Teilnetzwerke zu identifizieren. Die durch diese Methoden identifizierten Teilnetzwerke sind in Abbildung 4B–E dargestellt.
Die 10 am höchsten bewerteten Gene, basierend auf Degree, maximaler Cliquen-Zentralität und maximalem Nachbarschaftskomponentenwert, wurden mit den Genen im MCODE-Kernsubnetzwerk geschnitten. Diese Analyse identifizierte 10 Kandidatengene: TGFB2, TLR2, SERPINE1, CYBB, KDR, TLR4, HIF1A, CCL2, MMP9 und CXCR2.
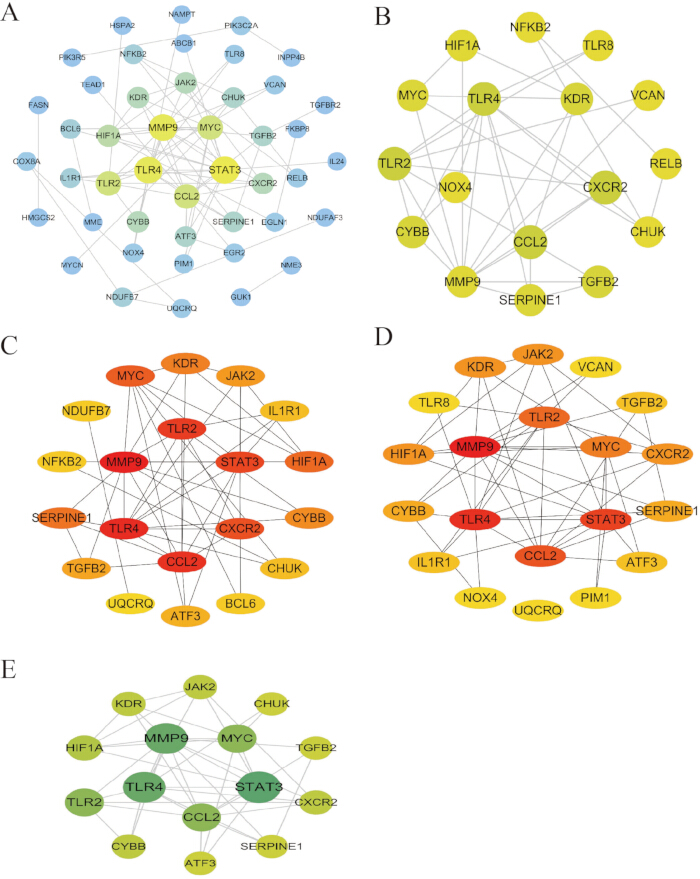
Abbildung 4: Konstruktion des Protein-Protein-Interaktionsnetzwerks und Identifizierung von Hub-Genen.
(A) Gesamtes Protein-Protein-Interaktionsnetzwerk der Kandidatengene. (B) Kern-Subnetzwerk, identifiziert mithilfe von MCODE. (C) Kern-Subnetzwerk, identifiziert mithilfe der maximalen Cliquenzentralität. (D) Kern-Subnetzwerk, identifiziert mithilfe der maximalen Nachbarschaftskomponente. (E) Kern-Subnetzwerk, identifiziert mithilfe des Grads. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Screening von Hub-Genen basierend auf maschinellem Lernen
Zur Identifizierung von Hub-Genen aus den 10 Protein-Protein-Interaktionskandidaten wurden drei Algorithmen des maschinellen Lernens eingesetzt: logistische Regression mit Least Absolute Shrinkage and Selection Operator (LASSO), Random Forest sowie Support Vector Machine mit rekursiver Merkmalseliminierung (SVM-RFE). Alle Analysen wurden mit einem festgelegten Zufallsstartwert (set.seed(12345)) und einer 5-fachen Kreuzvalidierung durchgeführt. Im LASSO-Modell wurden Gene mit von null verschiedenen Koeffizienten beim optimalen Lambda (lambda.min) als Kandidaten beibehalten (Abbildung 5A).
Im Support Vector Machine–rekursiven Feature-Eliminations-Modell wurde die höchste Kreuzvalidierungsgenauigkeit von 0,859 erreicht, wenn 10 Merkmale einbezogen wurden (Abbildung 5B), mit einer entsprechenden minimalen Fehlerquote von 0,141 (Abbildung 5C). Das Random-Forest-Modell mit 500 Entscheidungsbäumen zeigte eine stabile Konvergenz der Out-of-Bag-Fehlerquote (Abbildung 5D). Die Rangfolge der Genwichtigkeit basierend auf dem Gini-Koeffizienten platzierte TGFB2, TLR2, SERPINE1 und CYBB unter den am höchsten bewerteten Genen (Abbildung 5E). Der Durchschnitt der von allen drei Algorithmen ausgewählten Gene ergab vier endgültige Hub-Gene: CYBB, SERPINE1, TGFB2 und TLR2 (Abbildung 5F).
Die SHapley Additive exPlanations-Analyse wurde durchgeführt, um den Beitrag jedes Hub-Gens zu den Modellvorhersagen zu bewerten. TGFB2 wies den höchsten mittleren absoluten SHapley Additive exPlanations-Wert mit 0,249 auf, gefolgt von SERPINE1 mit 0,103, CYBB mit 0,083 und TLR2 mit 0,078 (Abbildung 6A). Das Zusammenfassungsdiagramm zeigte die Verteilung und Richtung der Genbeiträge über die Proben hinweg (Abbildung 6B). Abhängigkeitsdiagramme veranschaulichten die Beziehung zwischen individuellen Genwerten und Modellbeiträgen (Abbildung 6C), während Wasserfall-Diagramme pro Probe die Beiträge jedes Gens zu einzelnen Vorhersagen zeigten (Abbildung 6D).
Anschließend wurden diagnostische Klassifizierungsmodelle basierend auf den vier Hub-Genen unter Verwendung von 10 Klassifizierungsalgorithmen erstellt. Im Trainingsset erreichten die meisten Algorithmen Flächen unter der Kurve von über 0,85 (Abbildung 6E). Im internen Validierungssatz erreichten die meisten Algorithmen Flächen unter der Kurve von über 0,78 (Abbildung 6F).
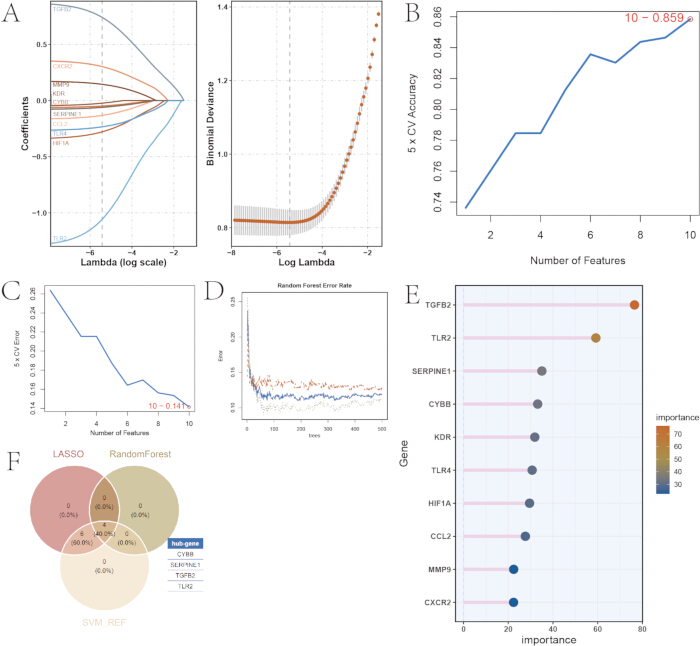
Abbildung 5: Maschinelles Lernen basierende Screening-Analyse von Hub-Genen. (A) Verlauf der Regressionskoeffizienten und optimale Lambda-Auswahl bei der Least-Absolute-Shrinkage-and-Selection-Operator-Regression. (B) Kreuzvalidierungskurve der Genauigkeit für das Support-Vektor-Maschine-Modell mit rekursiver Merkmalseliminierung. (C) Kreuzvalidierungsfehlerkurve für das Support-Vektor-Maschine-Modell mit rekursiver Merkmalseliminierung. (D) Out-of-Bag-Fehlerquotenkurve für das Random-Forest-Modell. (E) Rangfolge der Genwichtigkeit basierend auf dem Gini-Koeffizienten im Random-Forest-Modell. (F) Venn-Diagramm, das die von den drei Algorithmen des maschinellen Lernens identifizierten Hub-Gene zeigt. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
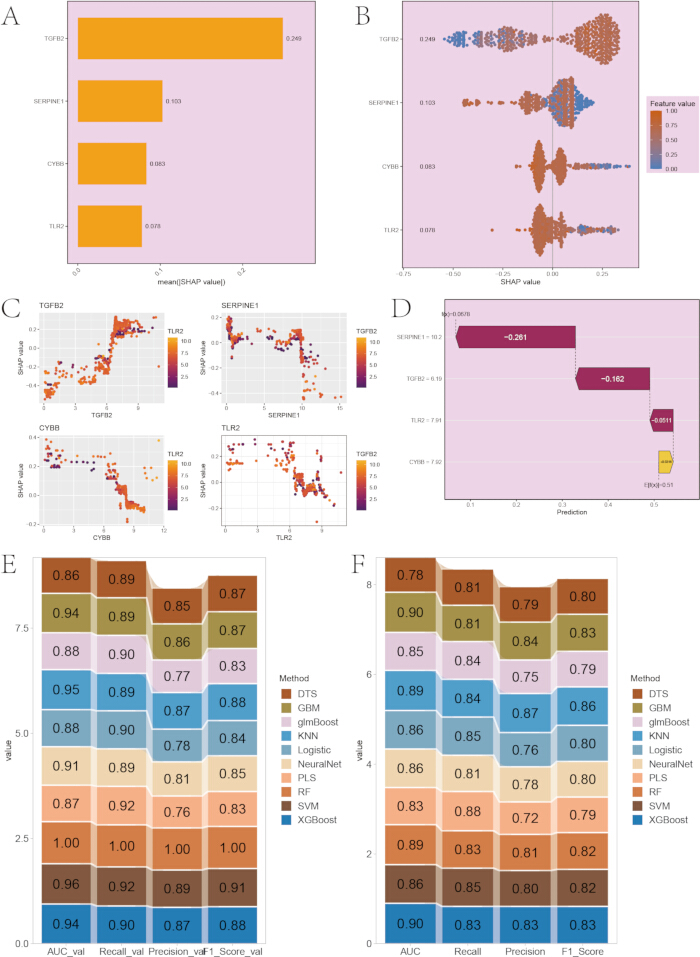
Abbildung 6: Bewertung des diagnostischen Modells und SHapley Additive exPlanations-Analyse. (A) Mittlere absolute SHapley Additive exPlanations-Werte für die vier Hub-Gene. (B) SHapley Additive exPlanations-Zusammenfassungsdiagramm, das die Verteilung und Richtung der Genbeiträge zeigt. (C) SHapley Additive exPlanations-Abhängigkeitsdiagramme für jedes Hub-Gen. (D) SHapley Additive exPlanations-Wasserfallplot für eine repräsentative Probe. (E) Heatmap der diagnostischen Leistung von 10 Klassifizierungsalgorithmen im Trainingsdatensatz. (F) Heatmap der diagnostischen Leistung von 10 Klassifizierungsalgorithmen im Validierungsdatensatz. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Validierung auf Einzelzellebene und Analyse der Zell-Zell-Kommunikation
Die Expressionsmuster der vier zentralen Gene wurden auf Einzelzellebene untersucht. Die Analyse der Zelltyp-Verteilung zeigte, dass CYBB und TLR2 in Monozyten und Makrophagen stark exprimiert waren, während SERPINE1 und TGFB2 vorwiegend in Stromazellen exprimiert wurden (Abbildung 7A).
Violin-Diagramme zeigten, dass die Expression von CYBB zwischen der Gruppe mit dilatativer Kardiomyopathie und der gesunden Kontrollgruppe signifikant unterschiedlich war (Abbildung 7B). SERPINE1 (Abbildung 7C), TGFB2 (Abbildung 7D) und TLR2 (Abbildung 7E) unterschieden sich zwischen den Gruppen ebenfalls signifikant. Alle vier Gene waren in der Gruppe mit dilatativer Kardiomyopathie im Vergleich zu den gesunden Kontrollen signifikant hochreguliert, wobei für jeden Vergleich ein P-Wert < 0,0001 ermittelt wurde.
Zell-Zell-Kommunikationsnetzwerke in der kardialen Mikroumgebung wurden mithilfe von CellChat und einer Ligand-Rezeptor-Datenbank erschlossen. Die Anzahl und die Gesamtstärke der Zell-Zell-Interaktionen unterschieden sich zwischen der Gruppe mit dilatativer Kardiomyopathie und der Kontrollgruppe (Abbildung 7F). Unterschiedliche Kommunikationsstärken zwischen Zelltypen wurden ebenfalls beobachtet (Abbildung 7G). Monozyten, Makrophagen, Kardiomyozyten und stromale Zellen waren maßgebliche Teilnehmer am Kommunikationsnetzwerk.
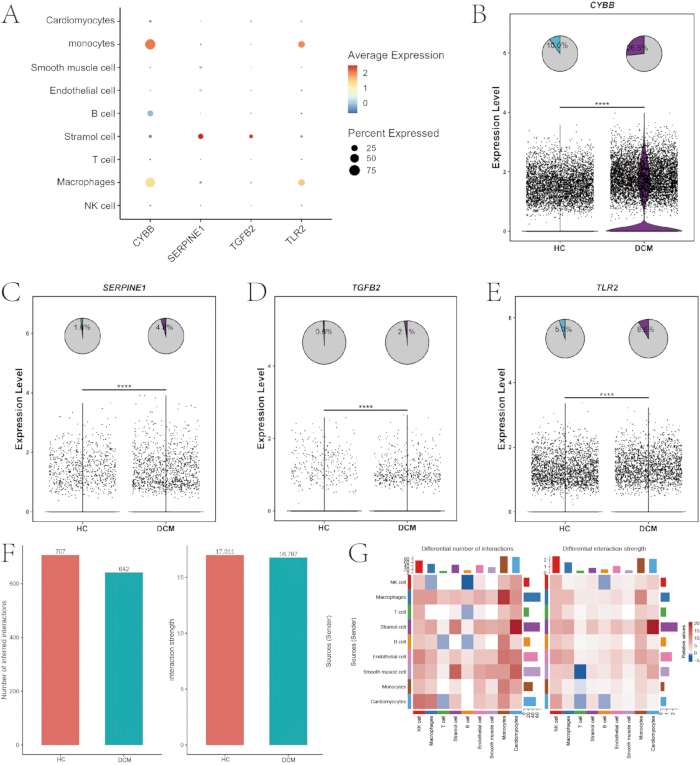
Abbildung 7: Einzelzell-Validierung von Hub-Genen und Analyse der Zell-Zell-Kommunikation. (A) Blasendiagramm, das die Expression der vier Hub-Gene über verschiedene Zelltypen hinweg zeigt. (B) Violindiagramm der CYBB-Expression in den DCM- und HC-Gruppen. (C) Violindiagramm der SERPINE1-Expression in den DCM- und HC-Gruppen. (D) Violindiagramm der TGFB2-Expression in den DCM- und HC-Gruppen. (E) Violindiagramm der TLR2-Expression in den DCM- und HC-Gruppen. (F) Balkendiagramm, das die Anzahl und die Gesamtstärke der Zell-Zell-Interaktionen zeigt. (G) Heatmap, die die unterschiedliche Stärke der Zell-Zell-Kommunikation zwischen den Gruppen darstellt. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Analyse der Immunzellinfiltration
Anreicherungsscores für 28 Untergruppen von Immunzellen wurden für jede Bulk-Probe mithilfe der single-sample Gene Set Enrichment Analysis berechnet. Die Häufigkeit der meisten Immunzelltypen unterschied sich signifikant zwischen der Gruppe mit dilatativer Kardiomyopathie und der gesunden Kontrollgruppe (Abbildung 8A).
Anschließend wurde eine Pearson-Korrelationsanalyse durchgeführt, um die Beziehung zwischen der Expression von Hub-Genen und den Anreicherungsscores für Immunzellen zu bewerten. Die Expression von CYBB korrelierte signifikant mit der Häufigkeit mehrerer Immunzelltypen (Abbildung 8B). Ähnliche Korrelationen wurden für SERPINE1 (Abbildung 8C), TGFB2 (Abbildung 8D) und TLR2 (Abbildung 8E) beobachtet. CYBB, SERPINE1 und TLR2 zeigten positive Korrelationen mit mehreren Populationen angeborener Immunzellen, einschließlich Monozyten und Makrophagen.
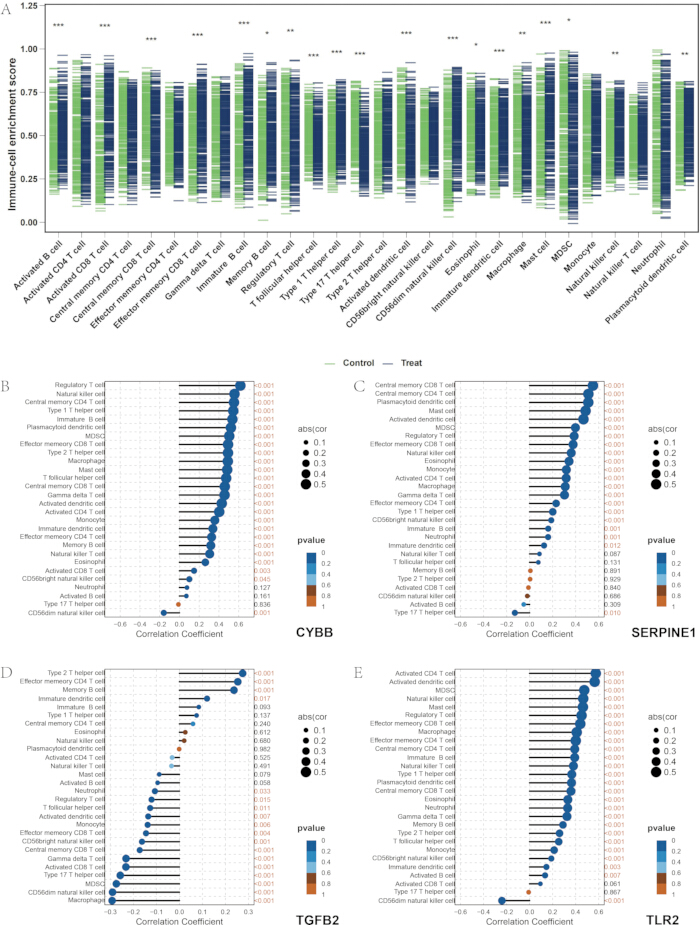
Abbildung 8: Immunzellinfiltration und Korrelationsanalyse. (A) Boxplots der Anreicherungsscores für 28 Immunzelltypen in den DCM- und HC-Gruppen. (B) Lollipop-Diagramm, das die Korrelationen zwischen der Expression von CYBB und der Häufigkeit von Immunzellen zeigt. (C) Lollipop-Diagramm, das die Korrelationen zwischen der Expression von SERPINE1 und der Häufigkeit von Immunzellen zeigt. (D) Lollipop-Diagramm, das die Korrelationen zwischen der Expression von TGFB2 und der Häufigkeit von Immunzellen zeigt. (E) Lollipop-Diagramm, das die Korrelationen zwischen der Expression von TLR2 und der Häufigkeit von Immunzellen zeigt. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Molekulare Subtypisierung der dilatativen Kardiomyopathie
Eine nichtüberwachte Konsens-Clustering-Analyse wurde an Proben der dilatativen Kardiomyopathie basierend auf den Expressionsprofilen der vier Hub-Gene durchgeführt. Die Konsens-Clustering-Matrix unterstützte eine Aufteilung bei K = 2 (Abbildung 9A). Der Delta-Area-Plot bestätigte K = 2 als optimale Clusteranzahl und unterteilte die Proben in zwei molekulare Subtypen, C1 und C2 (Abbildung 9B).
Die Expressionsniveaus von CYBB, SERPINE1 und TLR2 unterschieden sich signifikant zwischen den beiden Subtypen (Abbildung 9C). Auch die Häufigkeit mehrerer Immunzellsubgruppen unterschied sich zwischen den Subtypen (Abbildung 9D). Die Analyse der Genexpression zeigte eine relative Aktivierung des Signalwegs des vaskulären endothelialen Wachstumsfaktors im C1-Subtyp, während die Biosynthese primärer Gallensäuren und die Biosynthese von Glycosphingolipiden im C2-Subtyp angereichert waren (Abbildung 9E). Die Hauptkomponentenanalyse zeigte eine Trennung zwischen den den beiden Subtypen zugeordneten Proben (Abbildung 9F).
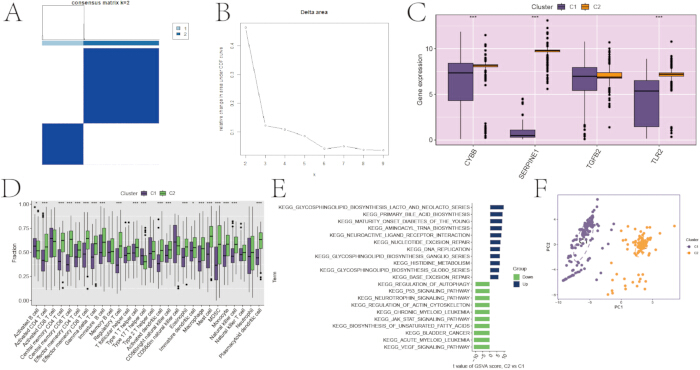
Abbildung 9: Konsens-Clustering zur molekularen Subtypisierung der dilatativen Kardiomyopathie. (A) Konsens-Clustering-Matrix bei K = 2. (B) Delta-Flächen-Diagramm zur Bestimmung der optimalen Anzahl an Clustern. (C) Boxplots der Hub-Genexpression in den beiden molekularen Subtypen. (D) Boxplots der Häufigkeit von Immunzellen in den beiden molekularen Subtypen. (E) Wärmekarte der unterschiedlich angereicherten Kyoto Encyclopedia of Genes and Genomes (KEGG)-Wege zwischen den beiden molekularen Subtypen. (F) Hauptkomponentenanalyse-Diagramm (PCA), das die Trennung zwischen den beiden molekularen Subtypen zeigt. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
In-vivo-Validierung im Mausmodell der dilatativen Kardiomyopathie
CTNTR141W-transgene Mäuse mit einem spontan auftretenden Phänotyp der dilatativen Kardiomyopathie wurden für die in-vivo-Validierung verwendet. Im Vergleich zu altersentsprechenden Wildtyp-Kontrollmäusen des Stammes C57BL/6J wiesen die transgenen Mäuse einen signifikant vergrößerten enddiastolischen linksventrikulären Durchmesser sowie eine verminderte linksventrikuläre Ejektionsfraktion auf, was mit einer Ventrikeldilatation und systolischer Dysfunktion übereinstimmt (Abbildung 10A).
Gesamtprotein wurde aus dem myokardialen Gewebe des linken Ventrikels extrahiert, und die Konzentrationen der von den vier Hub-Genen kodierten Proteine wurden mittels Enzym-gekoppelter Immunosorbent-Assay (ELISA) nach Normalisierung anhand der Gesamtproteinkonzentration mit der Bicinchoninsäure-Methode gemessen. Alle Assays wurden im Duplikat durchgeführt. Die Standardkurven wiesen Korrelationskoeffizienten (R2) ≥ 0,99 auf, und die Variationskoeffizienten zwischen den Duplikat-Vertiefungen lagen unter 10 %. Die statistische Signifikanz zwischen den Kontroll- und DCM-Gruppen wurde entweder mit dem t-Test nach Student oder dem t-Test nach Welch bewertet, abhängig von der Gleichheit der Varianzen, die mittels F-Test geprüft wurde (die Normalverteilung wurde durch den Shapiro-Wilk-Test bestätigt). Die myokardialen Proteinspiegel, die den vier Hub-Genen entsprechen, waren bei Mäusen mit dilatativer Kardiomyopathie (DCM) im Vergleich zu den Kontrollen signifikant erhöht (Abbildung 10B). Zur ELISA-Validierung wurden jeweils 3 biologische Replikate (individuelle Mäuse) pro Gruppe eingeschlossen. Für die ELISA-Validierung wurden drei unabhängige biologische Replikate pro Gruppe verwendet. Diese Ergebnisse sollten als vorläufig betrachtet und in einer größeren Kohorte bestätigt werden.
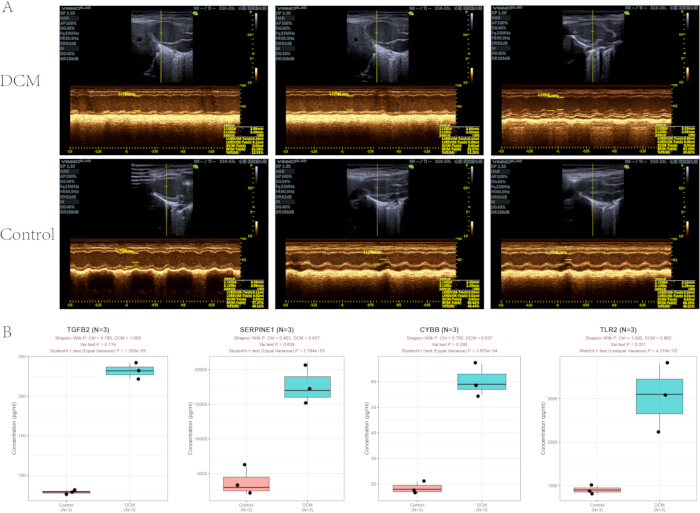
Abbildung 10: In-vivo-Validierung im CTNTR141W-transgenen Mausmodell der dilatativen Kardiomyopathie. (A) Repräsentative M-Modus-Echokardiographiebilder von CTNTR141W-transgenen DCM-Mäusen und wildtypischen Kontrollmäusen. (B) ELISA-basierte Quantifizierung von vier aus Hub-Genen abgeleiteten Proteinen in linken ventrikulären Myokardgeweben der Maus. Box-und-Whisker-Plots zeigen die Protein-konzentrationen für die Gruppen Kontrolle und DCM (n = 3 biologische Wiederholungen pro Gruppe). Bei jedem Boxplot kennzeichnet die durchgezogene horizontale Linie innerhalb der Box den Medianwert; die oberen und unteren Ränder der Box repräsentieren das 75. und 25. Perzentil (Interquartilsabstand, IQR); die oberen und unteren Whisker erstrecken sich zu den maximalen und minimalen Werten außerhalb der Ausreißer innerhalb von 1,5 × IQR; einzelne schwarze Punkte entsprechen unabhängigen biologischen Wiederholungen einzelner Tiere. Die y-Achse zeigt die absolute Protein-konzentration an: pg/mL für TGFB2 und CYBB, ng/mL für TLR2 und SERPINE1. Statistische Vergleiche zwischen zwei Gruppen wurden mittels Students t-Test (gleiche Varianz) oder Welch-Test (ungleiche Varianz) durchgeführt, wobei die Normalverteilung mit dem Shapiro-Wilk-Test und die Varianzhomogenität mit dem F-Test überprüft wurden. Einschränkungshinweis: Die aus n = 3 Wiederholungen gewonnenen ELISA-Ergebnisse sind vorläufige explorative Befunde, und eine zukünftige Validierung mit größerer Stichprobengröße ist erforderlich. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Datenverfügbarkeit:
Die sechs Bulk-Transkriptomik-Datensätze und der einzelne Einzelzell-RNA-Sequenzierungsdatensatz, die in dieser Studie analysiert wurden, sind öffentlich im Gene Expression Omnibus-Datenbank unter den Zugangsnummern GSE5406, GSE42955, GSE57338, GSE79962, GSE116250, GSE141910 und GSE145154 verfügbar. Die Einzelzellanalyse umfasste die Proben GSM4307515, GSM4307516, GSM4307520 und GSM4307521 aus GSE145154. Alle weiteren während dieser Studie generierten oder analysierten Daten sowie der Computercode sind in diesem publizierten Artikel und den zugehörigen ergänzenden Informationsdateien enthalten. Insbesondere enthält Supplementary File 1 die vollständigen Genlisten zu Alterung und Mitochondrien, die 28-Zell-Immunsignatur, benutzerdefinierte Analyse-Skripte, normalisierte transkriptomische Datenmatrizen, Quelldaten für ELISA-Assays sowie die rohen Quelldaten, die allen Abbildungen der Manuskriptversion zugrunde liegen.
Zusatzdatei 1: Gen-Sets bezüglich Alterung und Mitochondrien, Immun-Signaturen, Analyse-Skripte, normalisierte transkriptomische Daten und Quelldaten für Abbildungen. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Der integrierte mehrschichtige Workflow kombinierte eine Metaanalyse der Gesamttranskriptomik, den Aufbau gewichteter Gen-Koexpressionsnetzwerke, Ensemble-Maschinenlernen, die Validierung mittels Einzelzell-Transkriptomik und die in vivo-Verifizierung im Tiermodell. Vier alters- und mitochondrienbezogene Hub-Gene – CYBB, SERPINE1, TGFB2 und TLR2 – wurden als potenzielle diagnostische Biomarker für die dilatative Kardiomyopathie (DCM) identifiziert. Die Integration von sechs unabhängigen Transkriptomdatensätzen des linken Ventrikels aus dem Gene Expression Omnibus-Repository, darunter Microarray- und RNA-Sequenzierungsplattformen, verringerte die datensatzspezifische Verzerrung und erweiterte die statistische Grundlage der Analyse43,44,45. Die gewichtete Gen-Koexpressionsnetzwerkanalyse in Kombination mit vordefinierten, altersbezogenen und mitochondrialen Gen-Sets ermöglichte die Identifizierung funktioneller Module, die mit bestimmten Merkmalen assoziiert sind, anstatt allein auf differentielle Expressionsanalysen angewiesen zu sein46. Ensemble-Maschinenlernen reduzierte die algorithmusspezifische Verzerrung, die mit einzelnen Methoden zur Merkmalsauswahl verbunden ist47,48, während die SHapley Additive exPlanations-Analyse den Beitrag jedes Hub-Gens an den Modellvorhersagen quantifizierte49. Die Validierung anhand von Gesamt-Myokardtranskriptomen, Einzelzell-Transkriptomen und einem transgenen Mausmodell charakterisierte zudem die zelluläre Verteilung und die Proteinspiegel der ausgewählten Gene im Myokard weiter50.
Die Batch-Korrektur war ein entscheidender Schritt in der integrierten Analyse, da verbleibende, datensatzspezifische Variationen die differentielle Expressionsanalyse und die Modul-Merkmal-Assoziationen beeinflussen könnten. Die Datensatzherkunft und die Nachweisplattform wurden daher als Batch-Faktoren im ComBat-Modell berücksichtigt. Verbleibende, datensatzabhängige Clusterbildung in Hauptkomponentenanalyse-Diagrammen würde auf eine unvollständige Korrektur und ein mögliches systematisches Bias hindeuten44. Die Soft-Thresholding-Potenz war ebenfalls wichtig für den Aufbau des gewichteten Gen-Ko-Expressionsnetzwerks. Der kleinste Wert, der einen Skalen-freien Topologie-Anpassungsindex von R2 > 0,9 ergab, wurde gewählt, was zu β = 5 führte. Ein niedrigerer Wert könnte fragmentierte oder funktionell nicht aussagekräftige Module erzeugen, während ein höherer Wert die Genkonnektivität abschwächen und die statistische Power der Modul-Merkmal-Korrelationsanalyse verringern könnte46. Die Qualitätskontrollschwellenwerte für Einzelzellen wurden an kardiales Gewebe angepasst, da Kardiomyozyten eine hohe metabolische Aktivität aufweisen. Eine strenge Filterstrategie mit einem Anteil an mitochondrialen Genen unter 25 % und einem Bereich von 200–6.000 nachgewiesenen Genen wurde angewandt, um beschädigte und zelluläre Fragmente geringer Qualität zu entfernen, während Kardiomyozyten erhalten blieben50. Ein fester Zufallsstartwert, set.seed(12345), wurde für die Datensatz-Aufteilung, das Modelltraining und die Kreuzvalidierung verwendet, um die Variabilität bei wiederholten maschinellen Lernanalysen zu reduzieren47.
Die Genotypbestätigung, standardisierte Haltung und konsistente echokardiographische Messungen waren wichtig, um die phänotypische Stabilität in den Tierversuchen aufrechtzuerhalten. CTNTR141W-transgene Mäuse entwickeln nach der vorgegebenen Akklimatisierungs- und Fütterungszeit eine Dilatation des linken Ventrikels und eine systolische Dysfunktion51. Vor der Gruppeneinteilung ist eine Genotypverifizierung erforderlich, um nicht transgene Tiere auszuschließen und eine falsche phänotypische Klassifizierung zu vermeiden. Echokardiographische Messungen sollten einheitlich auf der Ebene der papillären Muskeln des linken Ventrikels durchgeführt werden, wobei die Werte aus drei aufeinanderfolgenden stabilen Herzzyklen gemittelt werden. Abweichungen in der Bildgebungsposition oder in der Tiefe der Anästhesie können die Variabilität der Messungen der Ejektionsfraktion des linken Ventrikels erhöhen51. Die Qualität des enzymgekoppelten Immunosorbens-Assays wurde anhand der Korrelationskoeffizienten der Standardkurve (R2 ≥ 0,99) und der Variationskoeffizienten (< 10 %) zwischen Duplikatproben bewertet. Eine schlechte Linearität der Standardkurve oder inkonsistente Messungen an Duplikaten können systematische Fehler bei der Schätzung der Proteinkonzentration verursachen.
Während der Implementierung des Workflows können mehrere analytische Probleme auftreten. Eine anhaltende Batch-Trennung nach ComBat-Korrektur kann auf eine Kollinearität zwischen Batch-Variablen und klinischen Faktoren, eine unzureichende Filterung von Genen mit geringer Expression oder eine nicht modellierte technische Variation hinweisen. Klinische Kovariaten wie Alter und Geschlecht können, falls verfügbar, als geschützte Variablen einbezogen werden, und Gene mit keiner Expression in mehr als 70 % der Proben können zur Rauschreduktion entfernt werden44. Eine zusätzliche Korrektur mittels removeBatchEffect kann in Betracht gezogen werden, wenn eine Resttrennung verbleibt. Eine unerwartet hohe oder niedrige Anzahl differentiell exprimierter Gene erfordert möglicherweise eine Überprüfung der Probenvielfalt, der Normalisierung, von Ausreißern und der Schwellenwertwahl27. Geringe Modul-Merkmal-Korrelationen können durch eine Neubewertung der Varianzschwelle, der Soft-Thresholding-Potenz und extremer Merkmalswerte behoben werden. Eine Erweiterung von den 5.000 auf die 7.500 am stärksten variablen Gene oder der Ersatz der Einzelprobe-Gen-Set-Enrichment-Analyse durch eine Gen-Set-Variationsanalyse kann die Modulerkennung verbessern46. Eine übermäßige Anzahl isolierter Knoten im Protein-Protein-Interaktionsnetzwerk erfordert möglicherweise eine Anpassung der STRING-Vertrauensschwelle oder eine Erweiterung des Kandidatengen-Sets30. Eine schlechte Leistung des maschinellen Lernens kann auf Verteilungsunterschiede zwischen Trainings- und Validierungsdatensätzen, Merkmalsredundanz oder Gruppenungleichgewicht zurückzuführen sein. Geschichtete Stichprobenziehung, Reduktion redundanter Merkmale oder eine Überrepräsentation der Minderheitsklasse können diese Effekte verringern47. Mehrdeutige Einzelzell-Clustering-Ergebnisse können eine Neubewertung der Harmony-Korrektur, der Auswahl der Hauptkomponenten und der Annotation von Markergenen erfordern50.
Mehrere Einschränkungen sollten berücksichtigt werden. Die transkriptomischen Datensätze wurden retrospektiv aus öffentlichen Repositorien bezogen, sodass die ursprünglichen Studiendesigns und klinischen Störfaktoren nicht kontrolliert werden konnten. Die klinischen Annotationen waren in den Datensätzen unvollständig, und die meisten Datensätze enthielten keine detaillierten Angaben zur Ätiologie, Medikationsanamnese, zum Patientenalter oder zu Langzeitergebnissen. Diese Einschränkungen verhinderten die Bewertung von Assoziationen zwischen den ausgewählten Genen und der Prognose, dem Ansprechen auf die Behandlung oder dem chronologischen Altern52. Restliche technische Variationen könnten trotz Batch-Korrektur weiterbestehen. Die Analyse basierte hauptsächlich auf der Expression von Boten-RNA und schloss keine integrierten epigenomischen, proteomischen oder metabolomischen Daten ein. Folglich konnten die Proteinfunktion, die posttranslationale Regulation und upstream liegende Mechanismen nicht bestimmt werden. Es wurde lediglich ein einziger Einzelzell-Datensatz einbezogen, was die Beurteilung der zellulären Heterogenität über verschiedene DCM-Ätiologien hinweg einschränkt50. Das CTNTR141W-transgene Modell stellt hauptsächlich die hereditäre DCM dar, die mit einer Mutation des kardialen Troponin T assoziiert ist, und könnte idiopathische, virale oder ischämische Formen der Erkrankung nicht reproduzieren51. Artunterschiede zwischen Mäusen und Menschen begrenzen zudem die direkte klinische Übertragbarkeit. Die Validierung auf Proteinebene beschränkte sich auf Myokardgewebe von Mäusen; große klinische Kohorten und Vergleiche mit etablierten Biomarkern wurden nicht durchgeführt. Die vier Hub-Gene sind nicht spezifisch für DCM und könnten auch bei anderen kardiovaskulären oder entzündlichen Erkrankungen verändert sein. Außerdem basierte die Auswahl der Kandidatengene auf vordefinierten Genmengen, die mit Alterung und Mitochondrien in Verbindung stehen. Diese hypothesengeleitete Strategie könnte Gene außerhalb der ausgewählten Referenzmengen ausschließen, während der Durchschnitt über drei maschinelle Lernalgorithmen Gene auslassen könnte, die nur von einer einzelnen Methode identifiziert wurden48.
Der analytische Rahmen könnte zukünftige molekulare Subtypisierungen, die Validierung von Biomarkern und Multi-Omics-Studien bei dilatativer Kardiomyopathie (DCM) unterstützen. Das Vier-Gen-Panel könnte in unabhängigen Kohorten aus peripherem Blut oder Myokard evaluiert werden, bevor es als diagnostisches oder Subtypisierungswerkzeug bewertet wird. Die Subtypen C1 und C2 wiesen unterschiedliche Profilierungen hinsichtlich immunologischer und metabolischer Signalwege auf, was eine Grundlage für die nachfolgende Validierung subtypspezifischer biologischer Merkmale bietet15. Die ausgewählten Gene könnten zudem in molekularen Docking-, zellulären und funktionellen Studien untersucht werden. TLR2 und CYBB sind mit entzündlichen Signalwegen und der Produktion reaktiver Sauerstoffspezies assoziiert, während TGFB2 und SERPINE1 mit Fibrose und kardialer Remodellierung verknüpft sind53. Die Integration mit proteomischen, metabolomischen, epigenomischen, genomweiten Assoziations- und Mendelschen Randomisierungsdaten könnte helfen, regulatorische Beziehungen und potenzielle kausale Assoziationen zu bewerten54. Der Workflow könnte ebenfalls auf transkriptomische Studien der hypertrophen Kardiomyopathie, der ischämischen Kardiomyopathie und der Herzinsuffizienz angepasst werden, indem die krankheitsspezifischen Datensätze und Referenz-Gen-Sets ausgetauscht werden45. Eine zukünftige Einbindung von Einzelzell-Analysen mittels transposasezugänglicher Chromatinsequenzierung (ATAC-seq) und räumlicher Transkriptomik könnte zusätzliche Erkenntnisse über zelluläre Regulation und räumliche Genexpression liefern. Die beobachtete Anreicherung altersbezogener Signaturen in Makrophagen sowie mitochondrialer Signaturen in Kardiomyozyten war konsistent mit früheren Berichten über entzündliche und mitochondriale Prozesse bei Herzerkrankungen55,56,57.
Diese Studie weist mehrere Einschränkungen auf, die berücksichtigt werden sollten. Insbesondere wurden kommerzielle ELISA-Kits zur Proteinquantifizierung verwendet, die offiziell für den Nachweis der Zielproteine in Serumproben validiert sind. In der vorliegenden Studie kamen jedoch lysierte myokardiale Gewebeproben als Nachweismatrix statt Serum zum Einsatz. Obwohl zur Sicherstellung der Zuverlässigkeit und Vergleichbarkeit der experimentellen Daten konsequente Probenvorbehandlungs- und Versuchsabläufe streng eingehalten wurden, könnte die fehlende offizielle Herstellervalidierung dieser ELISA-Kits für lysiertes myokardiales Gewebe zu potenziell geringfügigen Abweichungen bei den quantitativen Proteinergebnissen führen. Die Anwendung serumspezifischer ELISA-Kits auf lysiertes myokardiales Gewebe stellt daher eine methodische Einschränkung dieser Studie dar.
Offenlegungen
Der Autor erklärt keine Wettbewerbsinteressen.
Danksagungen
Die öffentlich zugänglichen Daten, die über die Gene Expression Omnibus-Datenbank bereitgestellt werden, werden dankend anerkannt. Ebenso gilt der Dank den Gutachtern und Herausgebern für ihre konstruktiven Kommentare zum Manuskript. Diese Arbeit wurde unterstützt durch das wissenschaftliche Forschungsprojekt auf Ebene der Provinzbehörde (Förderkennzeichen 2021JDZX2026), „Mechanismus der Yiqi Huoxue-Formel bei der Abschwächung der atherosklerotischen Gefäßremodelierung via KLF2-Nrf2-vermittelter inflammatorischer Regulation.“
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Aquasonic Clear Ultraschallgel | Parker Laboratories, Inc. | Mar-34 | Verwendet für die Echokardiographie-Bildgebung bei Kleintieren. |
| BCA-Proteinassay-Kit | Thermo Fisher Scientific | 23227 | Nachweis bei 562 nm; Bereich, 20–2.000 µg/mL; verwendet zur Quantifizierung des Gesamtproteins in lysierten Mausherzen. |
| CellAge-Datenbank | Human Ageing Genomic Resources | https://genomics.senescence.info/cells/ | Quelle für altersbezogene Gen-Signaturen. |
| CytoHubba, Cytoscape-Plugin | Cytoscape App Store | Version 0.1 | Verwendet zur Bewertung der Knotentopologie in Protein-Protein-Interaktionsnetzwerken. |
| Cytoscape | Cytoscape Consortium | Version 3.9.1 | Verwendet zur Visualisierung von Protein-Protein-Interaktionsnetzwerken. |
| Mikroplattenreader mit vollem Wellenlängenbereich | Thermo Fisher Scientific | Multiskan FC | Verwendet zur Messung der Absorption in ELISA-Assays. |
| Gene Expression Omnibus | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/geo/ | Öffentlich zugängliches Archiv zur Beschaffung transkriptomischer Datensätze. |
| GeneCards | Weizmann Institute of Science | https://www.genecards.org/ | Quelle für mitochondrienbezogene Gen-Sets. |
| Halt Protease- und Phosphatase-Inhibitor-Cocktail, 100×, EDTA-frei | Thermo Fisher Scientific | 78441 | Aufbewahrung bei 4 °C; unmittelbar vor der Verwendung dem RIPA-Puffer mit 10 µL/mL zugesetzt. |
| Flüssigstickstoff | Lokaler Labor-Gaslieferant | Nicht zutreffend | Verwendet zum Schnellschrecken von Myokardgewebe. |
| Männliche SPF-qualitätsgerechte C57BL/6J-Mäuse, 6–8 Wochen alt, 25 ± 2 g | Beijing Vital River Laboratory Animal Technology Co., Ltd. | Nicht zutreffend | Tierzuchtzulassung Nr. SCXK (Jing) 2021-0006; verwendet als normale Kontrollen. |
| Männliche SPF-qualitätsgerechte CTNTR141W-transgene DCM-Mäuse, 6–8 Wochen alt, 25 ± 2 g | Institut für Labortierwissenschaft, Chinesische Akademie der Medizinischen Wissenschaften | Nicht zutreffend | Tierzuchtzulassung Nr. SCXK (Jing) 2021-0065; verwendet als spontanes DCM-Modell. |
| MCODE, Cytoscape-Plugin | Cytoscape App Store | Version 2.0.2 | Verwendet zur Identifizierung zentraler funktioneller Subnetzwerke in Protein-Protein-Interaktionsnetzwerken. |
| Maus-CYBB-ELISA-Kit | Biogradetech | A-QEK09250-96wells | In dieser Studie verwendet, um CYBB in lysiertem Myokardgewebe von Mäusen zu messen. |
| Maus-PAI-1-ELISA-Kit | EK-BIO | ML30970 | In dieser Studie verwendet, um PAI-1, das von SERPINE1 kodierte Protein, in lysiertem Myokardgewebe von Mäusen zu messen. |
| Maus-TGF-β2-ELISA-Kit | ElaBoX | SEKM-0036 | In dieser Studie verwendet, um TGF-β2 in lysiertem Myokardgewebe von Mäusen zu messen. |
| Maus-TLR-2-ELISA-Kit | Solarbio | SEKM-0163 | In dieser Studie verwendet, um TLR-2 in lysiertem Myokardgewebe von Mäusen zu messen. |
| Phosphatgepufferte Kochsalzlösung, pH 7,4, calcium- und magnesiumfrei | Biological Industries | 02-024-1ACS | Sterile 1×-Lösung; Lagerung bei 4 °C; verwendet zum Spülen und Verdünnen von Gewebe. |
| R-Paket: caret | CRAN | Version 6.0-94 | Verwendet für die rekursive Merkmalsauswahl mittels Support-Vektor-Maschine. |
| R-Paket: CellChat | CellChat-Entwickler | Version 1.6.1 | Verwendet zur Ableitung von Zell-Zell-Kommunikation aus Einzelzell-RNA-Sequenzierungsdaten. |
| R-Paket: clusterProfiler | Bioconductor | Version 4.8.3 | Verwendet für die funktionelle Anreicherungsanalyse. |
| R-Paket: ConsensusClusterPlus | Bioconductor | Version 1.64.0 | Verwendet für die unsupervised Konsensclusterung. |
| R-Paket: edgeR | Bioconductor | Version 3.42.4 | Verwendet zur Normalisierung von RNA-Sequenzierungsdaten mit der Methode des gestutzten Mittelwerts der M-Werte. |
| R-Paket: GEOquery | Bioconductor | Version 2.68.0 | Verwendet zum Herunterladen von Daten aus dem Gene Expression Omnibus. |
| R-Paket: glmnet | CRAN | Version 4.1-8 | Verwendet für die logistische Regression mit Least Absolute Shrinkage and Selection Operator (LASSO). |
| R-Paket: limma | Bioconductor | Version 3.56.2 | Verwendet für die differentielle Expressionsanalyse und statistische Modellierung. |
| R-Paket: pROC | CRAN | Version 1.18.5 | Verwendet für die Analyse von ROC-Kurven (Receiver Operating Characteristic). |
| R-Paket: randomForest | CRAN | Version 4.7-1.2 | Verwendet für maschinelles Lernen mit Random Forest. |
| R-Paket: Seurat | CRAN | Version 5.0.1 | Verwendet für die Analyse von Einzelzell-RNA-Sequenzierungsdaten. |
| R-Paket: SingleR | Bioconductor | Version 2.2.0 | Verwendet für die automatisierte Annotation von Zelltypen. |
| R-Paket: sva | Bioconductor | Version 3.48.0 | Verwendet für die Batch-Effekt-Korrektur mittels ComBat. |
| Kühlzentrifuge | Sigma-Aldrich | SIGMA 3-K | Verwendet zum Zentrifugieren von lysiertem Myokardgewebe. |
| RIPA-Lysispuffer und Extraktionspuffer | Thermo Fisher Scientific | 89900 | Fertig zubereitete 1×-Lösung; Lagerung bei 4 °C; vor der Verwendung mit Protease- und Phosphatase-Inhibitoren ergänzt. |
| Ultraschallbildgebungssystem für Kleintiere | VINNO Technology Co., Ltd. | VINN06LAB | Verwendet zur echokardiographischen Beurteilung der Herzfunktion. |
| Natriumpentobarbital | Sinopharm Chemical Reagent Co. | 20040428 | Als 1%-ige Lösung (10 mg/mL) in steriler Kochsalzlösung hergestellt; verwendet zur intraperitonealen Anästhesie mit 30 mg/kg. |
| STRING-Datenbank | STRING-Konsortium | Version 11.5 | Verwendet zur Konstruktion von Protein-Protein-Interaktionsnetzwerken. |
| TGrinder H24 Gewebemischer | TIANGEN | OSE-TH-01 | Verwendet zum Homogenisieren von Maus-Myokardgewebe in RIPA-Puffer bei 6,0 m/s für 30–60 s über 2–3 Zyklen. |
| Thermostatisierte Tierplattform/Beheizter Operationstisch für Kleintiere | Shanghai Yuyan Scientific Instrument Co., Ltd. | T-30350 | Verwendet, um Mäuse während der Echokardiographie bei 37 °C zu halten; Betriebstemperaturbereich von Raumtemperatur bis 50 °C. |
Referenzen
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740