Dieses Protokoll demonstriert einen strukturierten und nachvollziehbaren Arbeitsablauf zur Verarbeitung anonymisierter Fragebogendaten zum Wohlbefinden von Studierenden im Grundstudium, beginnend mit der Rohdatenexportierung und der Überprüfung der Antworten bis hin zur Skalenbewertung, Reliabilitätsprüfung, Regressionsdiagnose, Verifizierung der Datenquellen für Abbildungen und der Erstellung von analytischen Ergebnissen, die für die Visualisierung vorbereitet sind.
Methodenartikel
Ein strukturierter Workflow für das Screening, Scoring und Visualisieren von Fragebogendaten zum Wohlbefinden von Studierenden im Grundstudium
In diesem Artikel
Zusammenfassung
Zusammenfassung
Auf Fragebögen basierende Studien werden häufig verwendet, um das Wohlbefinden von Studierenden zu untersuchen, doch der methodische Weg von den Rohantworten zu analysierbaren Variablen, statistischen Tabellen und visuellen Darstellungen wird oft unzureichend dokumentiert. Dieses Protokoll beschreibt einen strukturierten und nachvollziehbaren Arbeitsablauf zur Verarbeitung anonymisierter Fragebogendaten zum Wohlbefinden von Studierenden im Grundstudium, die mit mehreren Abschnitten nach dem Likert-Skalentyp erhoben wurden. Der Arbeitsablauf beginnt mit der Genehmigung durch die Ethikkommission, der Dokumentation der Einwilligung, der Konfiguration des Fragebogens und dem Export der Rohdaten und setzt sich dann mit der Überprüfung der Antworten, der Prüfung auf doppelte Antworten, der Behandlung fehlender Daten, der Items-Kodierung, der Umkehrung von Bewertungsskalen, der Reliabilitätsbewertung, der deskriptiven Analyse, der Korrelationsanalyse, dem kontrastiven Gruppenvergleich, der Regressionsmodellierung, der diagnostischen Überprüfung und der Vorbereitung der Bilddatenquellen fort. Der Beispiel-Fragebogen verwendet skalenbasierte Abschnitte, die auf dokumentierten Quellen und an die Studie angepasst sind und sich an den Depression Anxiety Stress Scales-21, der Tuckman Procrastination Scale, der Psychological Sense of School Membership Scale, der Literatur zur Messung höherer Denkprozesse sowie der Dokumentation zur subjektiven Wohlbefindensskala orientieren. Negative Emotionen, akademische Prokrastination, Zugehörigkeitsgefühl zur Schule, höheres Denken und subjektives Wohlbefinden dienen als Beispiel für Skalen-Ebene-Variablen, um zu zeigen, wie Item-Ebene-Antworten in nachvollziehbare analytische Ergebnisse umgewandelt werden können. Typische Ergebnisse umfassen eine Screening-Fluss-Tabelle, eine Zusammenfassung der Demografie, deskriptive und Bereichsverifikationsstatistiken, Schätzungen der internen Konsistenz, eine Korrelationsmatrix, Ergebnisse des kontrastiven Vergleichs, Regressionskoeffizienten, Residuen- und Einflussdiagnosen sowie Bilddatenquellen. Das Protokoll betont vorab festgelegte Entscheidungsregeln, eine verknüpfte Skalenübersicht, ein Screening-Protokoll vor der Analyse, die Überprüfung der Umkehrung von Bewertungsskalen und die numerische Verifizierung der Bilddatenquellen. Anstatt eine neue psychometrische Skala vorzuschlagen, ein Messmodell zu validieren oder kausale Zusammenhänge zu belegen, bietet diese Methode ein praktisches und überprüfbares Verfahren für Forschende, die Fragebogendaten zum Wohlbefinden von Studierenden im Grundstudium bereinigen, bewerten, analysieren und visualisieren müssen. Der Arbeitsablauf kann auf verwandte, auf Fragebögen basierende Studien übertragen werden, sofern die Skalenübersicht, die Genehmigung durch die Ethikkommission, die Bewertungsregeln, die Schwellenwerte für die Antwortprüfung und die Bilddatenquellen vor der Analyse definiert sind.
Einleitung
Das subjektive Wohlbefinden ist ein wichtiges Ergebnis in der Studierendenforschung, da es widerspiegelt, wie Studierende ihr Leben, ihre emotionalen Erfahrungen, sozialen Beziehungen und ihr tägliches Funktionieren in Lernumgebungen bewerten. In der Hochschulbildung ist das Wohlbefinden der Studierenden vielschichtig und beschränkt sich nicht allein auf Lebenszufriedenheit oder psychische Belastungen1. Fragebogendaten sind daher weiterhin nützlich, wenn Forschende emotionale, verhaltensbezogene, soziale, kognitive und wohlbefindensrelevante Erfahrungen innerhalb desselben analytischen Rahmens untersuchen müssen.
Der Wert von Fragebogendaten hängt nicht nur von den ausgewählten Konstrukten ab, sondern auch davon, wie rohe Antworten in analytische Variablen umgewandelt werden. Viele Studien berichten über Skalenwerte, Korrelationsmatrizen, Gruppenvergleiche oder Regressionsmodelle, ohne jedoch die Zwischenschritte offenzulegen, die rohe Datensätze mit den endgültigen Tabellen und Abbildungen verbinden. Fehlende Antworten werden möglicherweise inkonsistent behandelt, umgekehrt skalierte Items falsch kodiert, doppelte Einreichungen im Datensatz belassen, und unaufmerksame Antworten als gültige Beobachtungen eingestuft. Entscheidungen zum Umgang mit fehlenden Daten sollten daher geplant, dokumentiert und berichtet werden, anstatt als unsichtbarer a posteriori-Schritt behandelt zu werden2. Bei Online-Fragebogendaten sind außerdem explizite Regeln zur Antwortqualität erforderlich, da Schnelligkeit, monotone Antwortmuster („straight-lining“), widersprüchliche Angaben und andere Muster geringer Bearbeitungsintensität die deskriptiven Statistiken, Reliabilitätsschätzungen und beobachteten Zusammenhänge verzerren können3.
Die Neuheit dieses Protokolls liegt in der lückenlosen Rückverfolgbarkeit vom ursprünglichen Fragebogen-Export bis hin zu den endgültigen statistischen und visuellen Ergebnissen. Insbesondere fügt der Arbeitsablauf eine vollständige Skalen-Zuordnungstabelle, ein Screening-Protokoll vor der Analyse, eine Überprüfung für umgekehrte Wertung, ein Bestätigungsdokument zur Skalenberechnung, eine numerische Quellenkontrolle für Abbildungen sowie eine auditierbare Spur hinzu, die jede Tabelle oder Abbildung mit ihrer Quelldatei verknüpft. Dadurch unterscheidet sich die Methode von herkömmlichen Verfahren zur Bereinigung von Umfragedaten, zur Berechnung von Skalenwerten, zur Reliabilitätsprüfung oder zur Visualisierung. Anstatt lediglich anzugeben, dass die Fragebogendaten bereinigt und analysiert wurden, legt das Protokoll genau fest, welche Datei gesperrt, welche Datei überprüft, welche Regeln angewendet, welche Skalenwerte berechnet und auf welcher verifizierten numerischen Tabelle jede einzelne Abbildung basiert.
Der Workflow wird anhand anonymisierter Fragebogendaten von Hochschulstudierenden veranschaulicht, die fünf skalenbasierte Variablen enthalten: negative Emotionen, akademische Prokrastination, Zugehörigkeitsgefühl zur Schule, höherstufiges Denken und subjektives Wohlbefinden. Diese Konstrukte wurden ausgewählt, um emotionale, verhaltensbezogene, schulkontextuelle, kognitive und ergebnisorientierte Beispiele innerhalb eines strukturierten und nachvollziehbaren Workflows bereitzustellen. Akademische Prokrastination wurde bei Studierenden mit späteren psychischen Gesundheitsproblemen in Verbindung gebracht, einschließlich Depressionen, Angstzuständen und stressbedingten Folgen4. Zugehörigkeitsgefühl zur Schule und subjektives Wohlbefinden sind ebenfalls eng miteinander verknüpft, was die Einbeziehung von Messgrößen bezüglich Zugehörigkeit und Wohlbefinden innerhalb desselben Fragebogen-Auswertungsrahmens unterstützt5. In diesem Protokoll werden diese Konstrukte jedoch lediglich verwendet, um den Workflow zu demonstrieren, und nicht, um ein kausales psychologisches Modell aufzustellen.
Ein zentrales Merkmal des Protokolls ist die Trennung von Entscheidungen zur Datenverarbeitung von inhaltlichen Interpretationen. Die Skalenkarte wird vor der Analyse erstellt, die Kriterien zur Beurteilung der Antwortqualität werden vor der Skalenbewertung festgelegt, die Überprüfung der umgekehrten Bewertung erfolgt vor den statistischen Tests, und Abbildungen werden erst erstellt, nachdem ihre numerischen Quelltabelle geprüft wurden. Diese Abfolge ist wichtig, da Likert-artige Antwortskalen eine sorgfältige Ausrichtung zwischen Formulierung der Items, Antwortankern, Bewertungsrichtung und statistischer Behandlung erfordern6. Das Protokoll legt zudem den Schwerpunkt darauf, Modellkomplexität hinter einer transparenten Vorverarbeitung und Überprüfung der Bewertung zu stellen. Vorhersage- oder multivariable Modelle können in der studentischen Forschung nützlich sein7, und grafische Zusammenfassungen können die Interpretation verbessern, wenn sie weiterhin an verifizierte numerische Matrizen gebunden bleiben8; beides hängt jedoch von einer transparenten Aufbereitung der Eingangsvariablen ab. Aus diesem Grund nutzt der Arbeitsablauf die Korrelationsanalyse, kontrastive Gruppenvergleiche, Regressionsmodellierung, Diagnoseprüfungen und Visualisierung als Beispielmodule, nicht jedoch als verbindliche inhaltliche Aussagen.
Dieses Protokoll richtet sich an Forscher, die einen praktischen Workflow zur Verarbeitung anonymisierter Daten zum Wohlbefinden von Studierenden benötigen. Es ist geeignet, wenn die Antworten auf Ebene einzelner Items aus einer Online-Plattform exportiert wurden, Variablen auf Skalenebene aus Likert-artigen Items berechnet werden müssen und das Ziel darin besteht, transparente deskriptive, korrelationale, gruppenvergleichende, regressionsbasierte, diagnostische und visualisierungsgeeignete Ergebnisse zu erzeugen. Es ist nicht dafür konzipiert, kausale Zusammenhänge zu etablieren, neue Skalen zu validieren, eine Bestätigungsfaktorenanalyse zu ersetzen, Tests zur Messinvarianz zu ersetzen oder als Ersatz für Item-Response- oder latente Variablen-Modellierung zu dienen. Sein Beitrag ist prozeduraler Natur: Es macht den Weg von den Fragebogendaten zu den publizierten Tabellen und Abbildungen nachvollziehbar, wiederholbar und überprüfbar. Dieser Fokus entspricht aktuellen Bedenken hinsichtlich der Qualität von Online-Umfragedaten9, der Überprüfung von Regressionen und Einflussfaktoren10 sowie nachvollziehbaren, auf Fragebögen basierenden Analyse-Workflows11.
Protokoll
Diese Studie mit menschlichen Teilnehmern wurde vom Ethikkomitee des College of Aeronautics, Guizhou Open University, geprüft und genehmigt (Genehmigungsnummer GZOU-EDU-2024-015). Das Komitee stellte fest, dass die Studie Anspruch auf eine ethische Befreiung hatte, da sie anonyme, freiwillige Fragebogenverfahren nutzte und für die Teilnehmer kein mehr als minimales Risiko darstellte. Alle Teilnehmer gaben vor dem Ausfüllen des Fragebogens ihre elektronische informierte Einwilligung ab und konnten jederzeit ohne negative Konsequenzen mit der Beantwortung fortfahren oder diese abbrechen. Da mehrere Fragen negative Emotionen, Stress, Einsamkeit, Hilflosigkeit, Unzufriedenheit oder verwandte Wohlbefindensaspekte betrafen, enthielten die Einwilligungsseite und die letzte Seite des Fragebogens Kontaktinformationen des Forschers und der Institution für Teilnehmer, die Unbehagen verspürten. Der in diesem Protokoll verwendete Datensatz wurde vor der Überprüfung, Bewertung, Analyse und Visualisierung anonymisiert. Der vollständige Fragebogen ist als Zusatzdatei 1 beigefügt.
1. Bereiten Sie den Fragebogen, die Ethikunterlagen und die Workflow-Artefakte vor
- Definieren Sie die berechtigte Population, den Studienkontext, die Fragebogenkonstrukte und die geplanten analytischen Ergebnisse, bevor Sie den Fragebogen programmieren.
- Erstellen Sie einen Antrag auf ethische Genehmigung, der die Zielgruppe, den Rekrutierungsweg, den Inhalt des Fragebogens, die geschätzte Bearbeitungsdauer, den Schutz der Anonymität, die Datenspeicherung, das Verfahren zur Studienteilnahmebeendigung, Informationen zur Teilnehmerunterstützung sowie die geplanten Analysen abdeckt.
- Bewahren Sie das Dokument zur ethischen Genehmigung oder Befreiung, die Einwilligungserklärung, den Rekrutierungstext, die Fragebogenversion, die Informationen zur Teilnehmerunterstützung und den geplanten Arbeitsablauf vor Beginn der Datenerhebung im Projektmappenordner auf.
- Definieren Sie die Zielgruppe als Vollzeit-Studierende im Bachelorstudium, die mindestens 18 Jahre alt sind, derzeit an einer Hochschule eingeschrieben sind, den Fragebogen verstehen können und in der Lage sind, eine informierte Einwilligung abzugeben.
- Legen Sie Ausschlusskriterien vor der Rekrutierung fest. Schließen Sie Teilnehmer aus, die nicht einwilligen, die Definition der Zielgruppe nicht erfüllen, doppelte Antworten abgeben, die Schwelle für fehlende Daten überschreiten oder die kombinierten Kriterien für ungültige Antworten gemäß Schritt 1.4 erfüllen.
- Platzieren Sie die Erklärung zur informierten Einwilligung am Anfang des Fragebogens. Nennen Sie darin den Studienzweck, den freiwilligen Charakter der Teilnahme, die geschätzte Bearbeitungsdauer von 12 Minuten, den Schutz der Anonymität, das Recht auf Studienteilnahmebeendigung, den geplanten Datennutzungszweck, die Kontaktdaten der Forscher sowie Unterstützungs-Kontaktinformationen.
- Erfassen Sie keine direkt identifizierbaren Informationen, einschließlich Studierendenausweisnummern, nationaler Identifikationsnummern, Mobilfunknummern, privater E-Mail-Adressen, Wohnheimadressen oder anderer persönlicher Identifikatoren.
- Gliedern Sie den Fragebogen in folgender Reihenfolge: informierte Einwilligung, demografische Angaben, Fragen zu negativen Emotionen, Fragen zur akademischen Prokrastination, Fragen zum Zugehörigkeitsgefühl zur Schule, Fragen zum höheren Denken sowie Fragen zum subjektiven Wohlbefinden.
- Wählen Sie die Originalinstrumente aus, bevor Sie den Fragebogen programmieren. In diesem Protokoll wurde die Ausprägung negativer Emotionen mit der 21-Item Depression Anxiety Stress Scales-21 (DASS-21), die akademische Prokrastination mit der 16-Item Tuckman Procrastination Scale, das psychologische Zugehörigkeitsgefühl zur Schule mit der 18-Item Psychological Sense of School Membership Scale, das höhere Denken mit einem 20-Item-Fragebogen zum höheren Denken – angepasst aus veröffentlichter Literatur zur Messung höheren Denkens – und das subjektive Wohlbefinden mit einer 20-Item-Skala zum subjektiven Wohlbefinden für Studierende12,13,14,15,16 erfasst.
- Erstellen Sie vor der Programmierung des Fragebogens eine gesperrte Skalenübersicht. Diese soll den Konstruktnamen, den Originalskalennamen, die Originalquelle, die Sprachversion, den Genehmigungs- oder Autorisierungsstatus, das Übersetzungs- oder Adaptierungsverfahren, die Itemkennung, die Itemformulierung, den Antwortbereich, die Antwortankern, die Wertungsrichtung, den Status der invertierten Items, die finale skalare Variable und die Bewertungsregel enthalten.
- Bezeichnen Sie eine Itemgruppe nur dann als validierte Skala, wenn das Originalinstrument, die Quellenangabe, die Validierungsbelege sowie der Übersetzungs- oder Adaptierungsstatus dokumentiert sind. Kennzeichnen Sie alle vom Autor entwickelten oder studienspezifischen Itemgruppen in Tabelle 1 und Zusatzdatei 1.
- Sperren Sie das Messkonzept vor der Datenerhebung. Bei übersetzten oder adaptierten Instrumenten müssen Übersetzung, Überprüfung, Abstimmung und Pilotprüfung abgeschlossen sein, bevor die Rekrutierung beginnt.
- Erstellen Sie ein Audit-Paket für den Arbeitsablauf, das die gesperrte Fragebogendatei, die Skalenübersicht, die Checkliste für den Rohdaten-Export, das Screening-Protokoll, das Bewertungsverifikationsprotokoll, das Analyseprotokoll, die Vorlage für die Abbildungsquellentabelle sowie die Analyse-Syntax oder das Skript enthält.
- Verwenden Sie versionsnummerierte Dateinamen für alle Arbeitsablaufdokumente.
- Definieren Sie die erforderlichen Spalten für jede Audit-Datei.
- Das Screening-Protokoll enthält: Datensatz-ID, Screening-Kriterium, Flag-Status, Ausschlussstatus, Ausschlussgrund, Entscheidungsdatum und Initialen des Prüfers.
- Die Skalenübersicht enthält: Konstruktnamen, Skalenquelle, Itemkennung, Itemformulierung, Antwortbereich, Antwortankern, Status der invertierten Wertung, finale Variablenbezeichnung, Bewertungsregel sowie Genehmigungs- oder Adaptierungsstatus.
- Das Bewertungsverifikationsprotokoll enthält: Itemkennung, ursprünglichen Wertebereich, umkodierten Wertebereich, Formel zur invertierten Wertung, Ergebnis der Bereichsprüfung, Diskrepanzstatus, vorgenommene Korrektur und Datum der Korrektur.
- Die Abbildungsquellentabelle enthält: Abbildungsnummer, Panelnummer, Quelltabelle, dargestellte Variablen, angezeigte Statistik, Stichprobengröße und Verifizierungsstatus.
- Definieren Sie den analytischen Arbeitsablauf vor der Programmierung des Fragebogens: Durchführung der Befragung, Export der Rohdaten, Prüfung der Antworten, Skalenbewertung, Reliabilitätsprüfung, deskriptive Analyse, Korrelationsanalyse, Vergleich von Hoch- und Niedriggruppen, Regressionsmodellierung, diagnostische Prüfungen und Vorbereitung der Visualisierung17.
- Gestalten Sie das Protokoll anhand von Entscheidungen, Arbeitsschritten und Verifizierungsergebnissen und nicht anhand von Software-Menüpfaden.
- Stellen Sie Arbeitsablaufressourcen bereit, sofern dies durch institutionelle und zeitschriftliche Richtlinien erlaubt ist, einschließlich der Fragebogendatei, der Skalenübersicht, der Vorlage für das Screening-Protokoll, der Vorlage für das Bewertungsprotokoll, der Analyse-Syntax oder des Skripts sowie der Abbildungsquellentabellen.
ANMERKUNG: Abbildung 1 zeigt den Weg von der Vorbereitung des Fragebogens über den Export der Rohdaten, die Prüfung der Antworten, die Skalenbewertung, die statistische Analyse, diagnostische Prüfungen bis hin zur Visualisierung der Ergebnisse. Tabelle 1 gibt für jeden Konstrukt das Originalinstrument, die Anzahl der Items, den Antwortbereich, das Bewertungskonzept, die Regel für invertierte Items, den Genehmigungs- oder Adaptierungsstatus sowie die finale skalare Variable an.
2. Konfigurieren und verteilen Sie den Fragebogen
- Überprüfen Sie, ob die Fragebogenplattform die Einbindung einer Einwilligung, Pflichtangaben, die Überprüfung von doppelten Einreichungen, die Erfassung von Zeitstempeln und die Aufzeichnung der Antwortdauer unterstützt.
- Erstellen Sie den Fragebogen mithilfe der im Materialverzeichnis aufgeführten Online-Umfrageplattform. Programmieren Sie den Fragebogen gemäß der festgelegten Skalenübersicht.
- Vergleichen Sie den programmierten Fragebogen zeilenweise mit der festgelegten Skalenübersicht, bevor Sie den Umfragenlink freigeben. Dokumentieren Sie alle Korrekturen im Studienprotokoll.
- Legen Sie den Einwilligungsabschnitt als ersten Pflichtabschnitt fest. Beenden Sie den Fragebogen automatisch, wenn ein Teilnehmer „Ich stimme nicht zu, teilzunehmen“ auswählt.
- Programmieren Sie die Abschnitte zu demografischen Daten und psychologischen Skalen gemäß der in Schritt 1.8 festgelegten Reihenfolge. Verwenden Sie dabei Item-Codes, die mit der Skalenübersicht übereinstimmen.
- Legen Sie Items psychologischer Skalen nur dann als Pflichtfelder fest, wenn dies durch die ethische Genehmigung oder Befreiung erlaubt ist und Teilnehmer ohne Nachteile jederzeit vom Versuch zurücktreten können. Falls Pflichtantworten nicht zulässig sind, dokumentieren Sie die Regel zur Behandlung fehlender Daten vor Beginn der Datenerhebung.
- Zeigen Sie die Antwortkategorien vor jedem Skalenabschnitt an und halten Sie die Kategorien innerhalb jeder Skala konsistent18.
- Deaktivieren Sie mehrfache Einreichungen, sofern die Umfrageplattform diese Funktion bietet. Behalten Sie dabei alle anonymen Geräte-, Browser-, Plattform- oder Einreichungs-Identifikatoren zur Überprüfung von doppelten Antworten.
- Aktivieren Sie die automatische Aufzeichnung von Einreichungszeitpunkt und Bearbeitungsdauer.
- Legen Sie die Öffnungszeit des Fragebogens auf 7 Kalendertage fest oder verwenden Sie das von der Ethikkommission genehmigte Erhebungsintervall.
- Senden Sie den Fragebogenlink über den von der Institution genehmigten Rekrutierungsweg. Geben Sie allen Teilnehmern dieselben schriftlichen Anweisungen.
- Schließen Sie den Fragebogen nach Ablauf des vorab festgelegten Erhebungszeitraums.
HINWEIS: Bewahren Sie die Rekrutierungsformulierung, den Fragebogenlink, die Öffnungs- und Schließtermine, die Plattform-Einstellungen, die Einwilligungsformulierung, die endgültige Fragebogenversion und die Exporteinstellungen der Plattform im Studienprotokoll auf.
3. Exportieren und sichern Sie die Rohdaten
- Exportieren Sie die vollständig ausgefüllten Fragebogenantworten unmittelbar nach Schließen des Erhebungszeitraums als Tabellenkalkulationsdatei.
- Speichern Sie die erste exportierte Datei als gesperrten Rohdatensatz. Bearbeiten Sie diese Datei nicht.
- Erstellen Sie eine Arbeitskopie zur Überprüfung, Bewertung und Analyse. Benennen Sie die Datei mit Datum, Versionsnummer und Projektkennung.
- Stellen Sie sicher, dass die exportierte Datei eine Zeile pro Befragten und eine Spalte pro demografischen Variable, Fragebogenitem, Zeitstempelvariable, Plattformvariable oder abgeleitete Plattformfeld enthält.
- Bewahren Sie den gesperrten Rohdatensatz, die Arbeitskopie, die Skalenzuordnung, die Fragebogendatei, das Studientagebuch, das Screening-Protokoll, das Bewertungsverifizierungs-Protokoll, das Analysetagebuch, die Tabellen für Abbildungsquellen sowie die Syntax- oder Skriptdatei in einem passwortgeschützten Projektordner auf.
- Prüfen Sie, ob der Datensatz keine direkt identifizierbaren Informationen enthält. Entfernen Sie unerwartete identifizierende Felder aus der Arbeitskopie vor der Analyse, und dokumentieren Sie Feldname, Begründung für die Entfernung, Entfermungsdatum und verantwortliche Person im Studientagebuch.
- Prüfen Sie die indirekte Identifizierbarkeit, bevor personenbezogene Daten weitergegeben oder veröffentlicht werden. Überprüfen Sie kleine demografische Zellen, die durch Kombinationen von Geschlecht, Alter, Studienjahr, Institutionstyp und Fachrichtung entstehen. Wenn eine Zelle weniger als fünf Befragte enthält, kombinieren Sie Kategorien, unterdrücken Sie die Zelle oder geben Sie nur aggregierte Daten preis.
- Dokumentieren Sie den Status der Datenverfügbarkeit im Studientagebuch, einschließlich der Angabe, ob personenbezogene Daten verfügbar sind, aufgrund ethischer oder Datenschutzanforderungen eingeschränkt oder durch einen aggregierten Workflow-Datensatz ersetzt wurden.
- Erstellen Sie vor der Datensäuberung ein Screening-Protokoll. Tragen Sie die ursprüngliche Stichprobengröße, das Screening-Kriterium, die Anzahl der markierten Datensätze, die Anzahl der entfernten Datensätze, die Anzahl der beibehaltenen Datensätze, den Ausschlussgrund, das Entscheidungsdatum und die Initialen des Prüfers ein.
- Erstellen Sie vor der statistischen Analyse eine Nachverfolgungsdatei für die Analyse. Tragen Sie den Namen der Software, die Softwareversion, das Betriebssystem, die Dateinamen, die Datenversion, die Version des Skripts oder der Syntax sowie das Datum jedes Analyse-Durchlaufs ein.
ANMERKUNG: Verwenden Sie den gesperrten Rohdatensatz nur zur Verifizierung. Führen Sie alle Screening-, Bewertungs- und Analysearbeiten mit der Arbeitskopie durch.
4. Reaktionen auswerten und den Analyse-Datensatz erstellen
- Wenden Sie vor der Berechnung von Skalenwerten festgelegte Ausschluss- und Qualitätskontrollkriterien an.
- Wenden Sie die Screening-Regeln in dieser Reihenfolge auf die Arbeitskopie an: Einwilligungsstatus, Berechtigung, doppelte Einreichungen, fehlende Daten, Antwortdauer, lineares Antwortverhalten, Werte außerhalb des zulässigen Bereichs und kombinierte Indikatoren zur Antwortqualität.
- Notieren Sie nach jeder Screening-Aktion die Anzahl der markierten, entfernten und beibehaltenen Datensätze im Screening-Protokoll. Überschreiben Sie frühere Versionen der Arbeitsdatei nicht.
- Entfernen Sie alle Datensätze, bei denen das Feld zur informierten Einwilligung mit „Nein“ markiert oder unbeantwortet ist.
- Entfernen Sie alle Datensätze, die nicht die in Schritt 1.4 definierten Einschlusskriterien erfüllen.
- Prüfen Sie auf doppelte Einreichungen mithilfe anonymer Antwortkennungen, Einreichungszeitpunkte, Plattform-Hinweise auf doppelte Einreichungen und wiederkehrende Antwortmuster.
- Behalten Sie bei erkannten doppelten Einreichungen die erste vollständige Einreichung bei, es sei denn, es liegt ein dokumentierter Grund vor, eine spätere vollständige Einreichung zu bevorzugen.
- Korrigieren Sie alle Regeln zur Antwortqualität, bevor Sie Skalenwerte berechnen. Tabelle 2 fasst die Ausschluss- und Markierungsschwellenwerte, die Begründung, Literaturbelege und den Plan für die Sensitivitätsanalyse zusammen, die im Workflow verwendet wurden.
- Prüfen Sie auf fehlende Daten. Entfernen Sie einen Teilnehmer, wenn mehr als 20 % aller Skalenitems fehlen. Ersetzen Sie ein einzelnes fehlendes Item nur dann durch den Mittelwert des Teilnehmers für dieselbe Skala, wenn mindestens 80 % dieser Skala ausgefüllt wurden. Setzen Sie demografische Variablen nicht ein, es sei denn, die Variable wird in keiner Analyse verwendet.
- Notieren Sie die Anzahl der Teilnehmer, die aufgrund von mehr als 20 % fehlender Skalenitems ausgeschlossen wurden, sowie die Anzahl der Teilnehmer, die eine Imputation mittels Skalenmittelwert erhielten. Im vorliegenden Datensatz wurden 4 Teilnehmer aufgrund von mehr als 20 % fehlender Skalenitems ausgeschlossen, und 21 Teilnehmer erhielten eine Imputation mittels Skalenmittelwert für 37 einzelne fehlende Items.
- Prüfen Sie die Antwortdauer. Markieren Sie Antworten, die in weniger als 180 s abgeschlossen wurden. Behandeln Sie diesen Wert als Hinweis auf zu schnelles Antworten, nicht als automatischen Ausschluss.
- Prüfen Sie auf lineares Antwortverhalten. Markieren Sie eine Antwort, wenn dieselbe Antwortoption bei mehr als 90 % aller Likert-Skalenitems gewählt wurde. Behandeln Sie diesen Wert als Hinweis auf ein auffälliges Antwortmuster, nicht als automatischen Ausschluss.
- Prüfen Sie auf zusätzliche Indikatoren für geringe Bearbeitungsmotivation, einschließlich Hinweise auf doppelte Einreichungen, unmögliche Zeitstempel, wiederholte Antwortsequenzen in verschiedenen Einreichungen oder Widersprüche zwischen Plattform-Metadaten und Fragebogeninhalten.
- Entfernen Sie eine markierte Antwort erst, wenn mindestens zwei Qualitätskontrollindikatoren auf ungültige Beantwortung hindeuten, beispielsweise eine extrem kurze Bearbeitungsdauer in Kombination mit linearem Antwortverhalten, Hinweise auf doppelte Einreichungen oder unplausible Plattform-Metadaten19.
- Notieren Sie alle markierten Datensätze, auch wenn sie beibehalten werden. Im vorliegenden Datensatz wurden 19 Antworten aufgrund einer Bearbeitungsdauer < 180 s markiert, 8 Antworten wurden aufgrund von >90 % linearem Antwortverhalten markiert, und 13 Datensätze wurden ausgeschlossen, da sie zwei oder mehr Indikatoren zur Antwortqualität erfüllten.
- Prüfen Sie auf Werte außerhalb des zulässigen Bereichs. Stellen Sie sicher, dass Items zu negativen Emotionen im Bereich 1–4 liegen, Items zu akademischer Prokrastination, Schule-Zugehörigkeit und höherer kognitiver Verarbeitung im Bereich 1–5 und Items zum subjektiven Wohlbefinden im Bereich 1–6.
- Korrigieren Sie einen Wert nur dann, wenn im Originalexport eindeutig ein Formatierungsfehler erkennbar ist. Ändern Sie keine gültigen psychologischen Werte, auch wenn sie ungewöhnlich hoch oder niedrig erscheinen.
- Erstellen Sie eine Übersichtstabelle zum Screening-Fluss, die die eingereichten Fragebögen, Ausschlüsse aufgrund von Einwilligung oder Berechtigung, Ausschlüsse wegen doppelter Einreichungen, Ausschlüsse wegen fehlender Daten, gemeldete Qualitätsauffälligkeiten, kombinierte Ausschlüsse aufgrund der Antwortqualität, Imputationen einzelner Items, beibehaltene Datensätze für die Analyse und die endgültige Stichprobengröße für die Analyse enthält.
- Füllen Sie die Übersichtstabelle zum Screening-Fluss mithilfe des gesperrten Screening-Protokolls aus und speichern Sie eine exportierte Prüfprotokollierung der getroffenen Entscheidungen. Im vorliegenden Datensatz ergab sich folgender Screening-Fluss: eingereichte Fragebögen, n = 448; Ausschlüsse aufgrund von Einwilligung oder Berechtigung, n = 6; entfernte doppelte Einreichungen, n = 5; Ausschlüsse aufgrund von >20 % fehlender Skalenitems, n = 4; Ausschlüsse aufgrund von zwei oder mehr Indikatoren zur Antwortqualität, n = 13; endgültiger Analyse-Datensatz, n = 420.
- Speichern Sie die beibehaltenen Datensätze als Analyse-Datensatz. Verwenden Sie einen neuen, versionsnummerierten Dateinamen und bewahren Sie das Screening-Protokoll zusammen mit dem Analyse-Datensatz auf.
ANMERKUNG: Behalten Sie valide Extremwerte bei, es sei denn, ein dokumentierter Qualitätsmangel bei der Beantwortung liegt vor.
5. Auswertung der psychologischen Skalen
- Konvertieren Sie die Antwortwerte auf Item-Ebene in Skalenwerte erst, nachdem die Antwortprüfung abgeschlossen und der Analyse-Datensatz gespeichert wurde.
- Codieren Sie alle Likert-artigen Items gemäß den Antwortankern im gesperrten Fragebogen und den Bewertungsregeln in der Skalenkarte.
- Behalten Sie die ursprünglichen Item-Variablen unverändert. Erstellen Sie separate abgeleitete Variablen für umkodierte oder umgekehrt bewertete Items.
- Berechnen Sie jede Skala gemäß der gesperrten Skalenkarte und dem entsprechenden Originalinstrument oder Bewertungshandbuch.
- Führen Sie die Umkehrung der vorgesehenen Items zum subjektiven Wohlbefinden durch, bevor Sie den Wert für das subjektive Wohlbefinden berechnen. Verwenden Sie für die 1–6-Antwortskala bei jedem umgekehrten Item die Formel 7 minus der ursprünglichen Punktzahl und fügen Sie _R an den Namen der abgeleiteten Variablen an.
- Verwenden Sie beim Berechnen des subjektiven Wohlbefindens die umgekehrt bewerteten Variablen, nicht die ursprünglichen Variablen.
- Berechnen Sie jeden Skalenwert als Mittelwert der enthaltenen Items: negative Emotion, akademische Prokrastination, Zugehörigkeitsgefühl zur Schule, höherstufiges Denken und subjektives Wohlbefinden.
- Benennen Sie die endgültigen Skalenvariablen als Negative Emotion, Akademische Prokrastination, Zugehörigkeitsgefühl zur Schule, Höherstufiges Denken und Subjektives Wohlbefinden.
- Überprüfen Sie den minimalen und maximalen Wert jeder Skalenvariable anhand des theoretischen Antwortbereichs. Überprüfen Sie erneut die Codierung, die Umkehrung der Bewertung und die Behandlung fehlender Werte, falls ein Wert außerhalb des erwarteten Bereichs liegt.
- Überprüfen Sie vor der inferenzstatistischen Analyse die Richtung jeder Skala anhand der Skalenkarte. Höhere Werte sollten die intendierte Richtung des Konstrukts widerspiegeln.
- Führen Sie vor der Analyse eine Überprüfung der Umkehrungsbewertung durch. Berechnen Sie die umgekehrt bewerteten Items für eine zufällige Teilstichprobe oder, falls möglich, für alle umgekehrt bewerteten Items neu und dokumentieren Sie das Ergebnis der Prüfung im Bewertungsverifikationsprotokoll.
- Wenn ein Bewertungsfehler festgestellt wird, korrigieren Sie die abgeleitete Variable, generieren Sie den betroffenen Skalenwert neu, aktualisieren Sie das Bewertungsverifikationsprotokoll und führen Sie alle nachgelagerten Analysen und Tabellen für die Abbildungen basierend auf dem korrigierten Analyse-Datensatz erneut durch.
ANMERKUNG: Behandeln Sie die Umkehrungsbewertung und die Überprüfung des Wertebereichs als verpflichtende Kontrollpunkte vor der Korrelationsanalyse, Gruppenvergleichen, Regressionsmodellierung oder Visualisierung.
6. Überprüfen Sie die interne Konsistenz und beschreibenden Eigenschaften
- Berechnen Sie die interne Konsistenz, korrigierte Item-Gesamtkorrelationen und deskriptive Statistiken für jede Skala mithilfe der in der festgelegten Skalenkarte definierten Item-Variablen.
- Notieren Sie Cronbachs Alpha, die Anzahl der Items, die gültige Stichprobengröße, korrigierte Item-Gesamtkorrelationen sowie die Werte für „Alpha-bei-Item-Entfernung“ für jede Skala.
- Verwenden Sie einen Wert von 0,70 für Cronbachs Alpha als minimale akzeptable Reliabilitätsschwelle für diesen Arbeitsablauf. Bevor ein Item entfernt wird, überprüfen Sie die Itemformulierung, die Wertungsrichtung, die Umkehrwertung, die Konstruktalignment und die Dokumentation des Quellinstruments20.
- Berechnen Sie McDonalds Omega als zusätzliche Reliabilitätsschätzung, falls die Analyseumgebung dies unterstützt. Berichten Sie Omega zusammen mit Cronbachs Alpha, wenn die beiden Schätzungen zu unterschiedlichen Interpretationen der Reliabilität führen.
- Prüfen Sie jedes Item mit einer negativen oder sehr niedrigen korrigierten Item-Gesamtkorrelation vor einer möglichen Entfernung. Behandeln Sie dies zunächst als potenzielles Problem hinsichtlich Kodierung, Umkehrwertung oder Konstruktalignment.
- Entfernen Sie kein Item ausschließlich, um Cronbachs Alpha zu erhöhen. Die Entfernung eines Items muss durch das Wertungshandbuch, die Itemformulierung, die korrigierte Item-Gesamtkorrelation, die inhaltliche Passung und dokumentierte Wertungsüberprüfung begründet sein.
- Berechnen Sie die deskriptiven Statistiken für alle fünf skalenniveauigen Variablen, einschließlich Mittelwert, Standardabweichung, Minimum, Maximum, Schiefe und Kurtosis.
- Prüfen Sie auf Boden- oder Deckeneffekte, indem Sie den Anteil der Befragten mit minimalen und maximalen möglichen Skalenwerten erfassen.
- Tragen Sie die Reliabilitätsschätzungen, Item-Gesamtdiagnosen, deskriptiven Statistiken und alle Wertungsentscheidungen im Analyseprotokoll ein.
HINWEIS: Cronbachs Alpha dient als Reliabilitätscheckpunkt, nicht als vollständiges psychometrisches Validierungsverfahren. Wenn eine formale Messungsevaluation erforderlich ist, ergänzen Sie diesen Arbeitsablauf durch McDonalds Omega, konfirmatorische Faktorenanalyse, Messinvarianztests, Item-Response-Modellierung oder andere latente Variablenverfahren.
7. Durchführung der Korrelationsanalyse
- Verwenden Sie die fünf verifizierten Variablen auf Skalenebene: negative Emotionen, akademische Prokrastination, Zugehörigkeitsgefühl zur Schule, höherstufiges Denken und subjektives Wohlbefinden.
- Bevor Sie die Pearson-Korrelationen berechnen, untersuchen Sie die Verteilungen und die bivariaten Streudiagramme für jedes Paar von Variablen auf Skalenniveau.
- Beurteilen Sie, ob die Variablen annähernd kontinuierliche Wertvariationen aufweisen, starke Schiefe, nichtlineare Zusammenhänge oder einflussreiche Ausreißermuster zeigen.
- Berechnen Sie die Pearson-Korrelationskoeffizienten und zweiseitigen p-Werte für alle Paare von skalenbasierten Variablen, wenn die Annahmen für eine deskriptive Assoziationsanalyse akzeptabel sind.
- Notieren Sie den Korrelationskoeffizienten, pWert, Stichprobengröße und Richtung der Assoziation für jedes Variablenpaar.
- Geben Sie die Korrelationskoeffizienten auf drei Dezimalstellen genau an.
- Vergleichen Sie die Richtung jedes Koeffizienten mit der Skalenabbildung. Überprüfen Sie die Itemscoren erneut, wenn ein Koeffizient der beabsichtigten Konstruktrichtung widerspricht.
- Speichern Sie die verifizierte Korrelationsmatrix als numerische Quelltabelle für die Korrelations-Heatmap im Abschnitt Repräsentative Ergebnisse.
- Wenn die Verteilungen deutlich schief sind, eine Sensitivität auf ordinaler Skala erforderlich ist oder Streudiagramme monotone, aber nichtlineare Zusammenhänge nahelegen, sollte die Analyse mithilfe der Spearman-Korrelation wiederholt und die Richtung sowie die relative Stärke der Zusammenhänge verglichen werden.
- Notieren Sie, ob die Ergebnisse von Pearson und Spearman zu derselben inhaltlichen Interpretation führten.
HINWEIS: Verwenden Sie die Korrelationsanalyse sowohl als deskriptiven Assoziationscheck als auch als Überprüfung der Bewertungsrichtung.
8. Erstellen von Gruppen mit hohem und niedrigem subjektiven Wohlbefinden
- Verwenden Sie den bereinigten und gewichteten analytischen Datensatz. Greifen Sie nicht erneut auf den Rohexport für die Gruppenbildung zurück.
- Verwenden Sie den kontinuierlichen subjektiven Wohlbefindenswert als primäre Zielgröße für die Regressionsmodellierung. Nutzen Sie die Einteilung in hohe und niedrige Gruppen ausschließlich für den kontrastiven Profilvergleich.
- Sortieren Sie die Befragten nach ihrem Wert für subjektives Wohlbefinden von höchsten zu niedrigsten Werten.
- Wenden Sie die vorgegebene Regel für Extremergruppen von 27 % an, um die Gruppen mit hohem und niedrigem subjektiven Wohlbefinden festzulegen. Dokumentieren Sie die Begründung für diesen Schwellenwert in Tabelle 2 und im Analyseprotokoll.
- Weisen Sie die Befragten im oberen 27 %-Bereich der Gruppe mit hohem subjektivem Wohlbefinden und die im unteren 27 %-Bereich der Gruppe mit niedrigem subjektivem Wohlbefinden zu.
- Behalten Sie die mittleren 46 % im vollständigen analytischen Datensatz für deskriptive Statistiken, Korrelationsanalysen, Geschlechtsvergleiche und Regressionsmodellierungen bei, schließen Sie diese Fälle jedoch vom Vergleich der hohen und niedrigen Gruppen aus.
- Erstellen Sie eine Gruppierungsvariable mit dem Namen „Subjektive Wohlbefindensgruppe“. Kodieren Sie die obere Gruppe als „Hoch“, die untere Gruppe als „Niedrig“ und die verbleibenden Befragten als „Mittel“.
- Prüfen Sie, ob die Gruppen mit hohem und niedrigem Wohlbefinden die vorgesehene Fallzahl enthalten. Treten am 27 %-Grenzwert gebundene Werte auf, wenden Sie die festgelegte Regel zur Behandlung von Bindungen an und dokumentieren Sie die Entscheidung im Analyseprotokoll.
- Führen Sie eine Sensitivitätsprüfung durch, wenn die 27 %-Grenze aufgrund gebundener Werte oder einer geringen Stichprobengröße zu instabiler Gruppenzugehörigkeit führt. Wenden Sie eine alternative, im Voraus festgelegte Regel an, beispielsweise die Einteilung in Drittelgruppen (Tertile), und berichten Sie, ob sich die Interpretation dadurch nicht ändert.
HINWEIS: Die Einteilung in hohe und niedrige Gruppen ist ein deskriptives Kontrastverfahren. Sie sollte den kontinuierlichen Wert für subjektives Wohlbefinden im primären Regressionsmodell nicht ersetzen.
9. Vergleichen Sie Gruppen mit hohem und niedrigem subjektivem Wohlbefinden
- Filtern Sie den Analyse-Datensatz, um nur die Befragten beizubehalten, die in der Gruppierungsvariable des subjektiven Wohlbefindens als Hoch oder Niedrig kodiert sind.
- Vergleichen Sie die Hoch- und Niedriggruppen hinsichtlich negativer Emotionen, akademischer Prokrastination, Zugehörigkeitsgefühl zur Schule und des Denkens höherer Ordnung.
- Vor dem Gruppenvergleich sollten die gruppenbezogenen Verteilungen, Stichprobengrößen und die Gleichheit der Varianzen für jede Variable überprüft werden.
- Verwenden Sie einen unabhängigen Stichproben- t-Test, wenn die Verteilungs- und Varianzannahmen akzeptabel sind. Verwenden Sie den Welch-Test t-Test, wenn die Annahme der Varianzhomogenität nicht zutrifft.
- Notieren Sie die Gruppenmittelwerte, Standardabweichungen und Mittelwertdifferenzen, t-Werte, Freiheitsgrade, p-Werte und 95 % Konfidenzintervalle.
- Berechnen Sie Cohens d für jeden Gruppenunterschied und interpretieren Sie die Effektgröße zusammen mit dem p-Wert.
- Überprüfen Sie, ob die Richtung jeder Gruppendifferenz mit den Konstruktdefinitionen und der Korrelationsmatrix übereinstimmt.
- Speichern Sie die verifizierte Gruppenvergleichstabelle als numerische Quelle für jede Visualisierung von Gruppenvergleichen.
- Berichten Sie diese Analyse als einen Vergleich extremer subjektiver Wohlbefindenprofile.
HINWEIS: Interpretieren Sie den Vergleich zwischen hoch und niedrig nicht als kausalen Beleg.
10. Untersuchen Sie Geschlechtsunterschiede
- Entfernen Sie den Hoch-Tief-Gruppenfilter und kehren Sie zum vollständigen analytischen Datensatz zurück.
- Verwenden Sie das Geschlecht als beschreibende Gruppierungsvariable und nicht als kausale Exposition.
- Vergleichen Sie weibliche und männliche Befragte hinsichtlich negativer Emotionen, akademischer Prokrastination, Zugehörigkeitsgefühl zur Schule, höherer kognitiver Prozesse und subjektivem Wohlbefinden.
- Bevor ein Vergleich durchgeführt wird, sollten die gruppenspezifischen Stichprobenumfänge, Fehlendwerte, Verteilungen und die Gleichheit der Varianzen überprüft werden.
- Verwenden Sie eine unabhängige Stichprobe t-Test, wenn die Annahmen akzeptabel sind. Verwenden Sie den Welch’schen t-Test, wenn die Annahme der Varianzhomogenität nicht erfüllt ist.
- Notieren Sie die Gruppenmittelwerte, Standardabweichungen und Mittelwertdifferenzen, t-Werte, Freiheitsgrade, p-Werte, 95 %-Konfidenzintervalle und Cohen’s d-Werte.
- Interpretieren Sie Geschlechterunterschiede deskriptiv und berichten Sie Effektgrößen mit p-Werte.
- Verwenden Sie die Ergebnisse des Geschlechtsvergleichs nicht, um eine nachträgliche Ausschließung, Modifikation der Skala oder kausale Interpretation zu rechtfertigen.
HINWEIS: Geschlechtsvergleiche sind als deskriptive Untergruppenanalysen innerhalb dieses querschnittlichen Fragebogenablaufs enthalten.
11. Schätzen des Regressionsmodells
- Verwenden Sie das subjektive Wohlbefinden als abhängige Variable.
- Verwenden Sie negative Emotionen, akademische Prokrastination, Schulzugehörigkeit und höherstufiges Denken als simultane Prädiktoren auf Skalenniveau21.
- Verwenden Sie die kontinuierlichen Variablen auf Skalenniveau, die während der Skalenberechnung erstellt wurden. Ersetzen Sie die kontinuierliche subjektive-Wohlbefinden-Skala nicht durch die hoch-niedrig gruppierte Variable.
- Passen Sie das primäre Modell mittels simultaner multipler linearer Regression an.
- Notieren Sie unstandardisierte Koeffizienten, standardisierte Koeffizienten, Standardfehler, t-Werte, p-Werte, 95 % Konfidenzintervalle, R2, adjustiertes R2, Toleranz und Varianzinflationsfaktor.
- Verwenden Sie Varianzinflationsfaktor-Werte unter 5,00 als Schwelle für das Fehlen schwerwiegender Multikollinearität.
- Untersuchen Sie bivariate Streudiagramme, Partialregressionsdiagramme oder Komponente-plus-Residuen-Diagramme, um zu beurteilen, ob die Zusammenhänge zwischen den Prädiktoren und dem subjektiven Wohlbefinden annähernd linear sind.
- Beurteilen Sie die Unabhängigkeit der Residuen mithilfe der Durbin-Watson-Statistik.
- Beurteilen Sie die Normalverteilung der Residuen mithilfe eines Residuen-Q-Q-Diagramms und eines formellen Normalitätstests, sofern dies bei der vorliegenden Stichprobengröße angemessen ist.
- Beurteilen Sie die Homoskedastizität anhand eines Diagramms der standardisierten Residuen gegen die standardisierten vorhergesagten Werte.
- Speichern Sie standardisierte Residuen, standardisierte vorhergesagte Werte, Hebelwerte und Cooks Distanz zur diagnostischen Überprüfung.
- Schätzen Sie ein ergänzendes adjustiertes Modell, das die vier psychologischen Prädiktoren und die in der Stichprobenbeschreibung genannten demografischen Variablen enthält, darunter Geschlecht, Alter, Jahrgangsstufe, Institutionstyp und Studienfachbereich, sofern diese Variablen verfügbar und ausreichend verteilt sind.
- Vergleichen Sie das primäre Modell mit dem ergänzenden adjustierten Modell. Notieren Sie, ob Richtung, Größe und statistische Interpretation der vier psychologischen Prädiktoren nach der demografischen Adjustierung stabil bleiben.
- Speichern Sie die verifizierten standardisierten Koeffizienten und 95 % Konfidenzintervalle aus dem primären Modell als numerische Quelltabelle für das Koeffizientendiagramm im Abschnitt „Vertretende Ergebnisse“22.
ANMERKUNG: Interpretieren Sie Regressionskoeffizienten als bedingte Assoziationen, nicht als kausale Effekte. Das demografisch adjustierte Modell wird in einer Sensitivitätsanalyse verwendet, um zu prüfen, ob die Schlussfolgerungen des Arbeitsablaufs stabil bleiben, nachdem verfügbare Hintergrundvariablen berücksichtigt wurden.
12. Diagnostizieren Sie das Regressionsmodell
- Überprüfen Sie die standardisierten Residuen des angepassten Regressionsmodells. Markieren Sie Fälle mit einem absoluten standardisierten Residuum größer als 3,00.
- Überprüfen Sie Hebelwerte (Leverage-Werte) und Cooks Distanz auf Einflussnahme durch auffällige Beobachtungen.
- Markieren Sie Beobachtungen mit einer Cooks Distanz größer als 4/n als potenziell einflussreich, wobei n die Größe der analytischen Stichprobe ist. Behandeln Sie eine Cooks Distanz größer als 1,00 als strengen Referenzschwellenwert für starke Einflussnahme, nicht jedoch als einzige Ausschlussgrenze.
- Untersuchen Sie das Streudiagramm der Residuen gegen die vorhergesagten Werte auf Nichtlinearität, ungleiche Varianz und ungewöhnliche Clustering-Effekte.
- Prüfen Sie das Q-Q-Diagramm der Residuen und das Ergebnis des Normalitätstests für die Residuen. Notieren Sie, ob die Beurteilung der Normalverteilung die Anwendung des linearen Modells für die beschreibende Assoziationsanalyse unterstützt.
- Notieren Sie die Durbin-Watson-Statistik und prüfen Sie, ob die Unabhängigkeit der Residuen akzeptabel ist.
- Überprüfen Sie alle markierten Fälle anhand des Screening-Protokolls, des Überprüfungsprotokolls zur Wertung und der Zulassungskriterien.
- Behalten Sie markierte Fälle bei, wenn es sich um valide Beobachtungen handelt, die keine Eingabefehler, Bewertungsfehler, doppelte Einreichungen, Verstöße gegen die Zulassungskriterien oder dokumentierte Probleme mit der Antwortqualität widerspiegeln.
- Korrigieren oder entfernen Sie einen markierten Fall nur dann, wenn die Audit-Spur einen dokumentierten prozeduralen, zulässigkeitsbezogenen, Codierungs-, Bewertungs- oder Dateneingabefehler nachweist.
- Führen Sie das Regressionsmodell nach jeder dokumentierten Korrektur erneut durch und vergleichen Sie die Koeffizienten, Konfidenzintervalle, R2, adjustiertes R2 sowie die diagnostischen Ergebnisse mit dem ursprünglichen Modell.
- Führen Sie eine Sensitivitätsprüfung bezüglich des Einflusses durch, indem Sie das Modell erneut anpassen, nachdem Fälle mit einer Cooks Distanz größer als 4/n ausgeschlossen wurden. Berichten Sie, ob sich die inhaltliche Interpretation ändert.
- Notieren Sie die endgültige diagnostische Entscheidung im Analyseprotokoll, einschließlich der Anzahl der durch standardisierte Residuen markierten Fälle, der Anzahl der durch eine Cooks Distanz größer als 4/n markierten Fälle, der maximalen Cooks Distanz, der Durbin-Watson-Statistik und des Ergebnisses der Prüfungen auf Normalverteilung und Linearität der Residuen.
ANMERKUNG: Entfernen Sie einflussreiche Fälle nicht ausschließlich, um die Modellanpassung zu verbessern. Eine Entfernung oder Korrektur muss auf einem dokumentierten Grund aus der Audit-Spur basieren.
Ergebnisse
Analytischer Datensatz nach der Antwortprüfung erstellt
Der Antwortprüfungs-Workflow erzeugte einen analytischen Datensatz mit 420 anonymisierten Schülerakten aus 448 eingereichten Fragebögen. Das Prüfprotokoll dokumentierte jeden Entscheidungspunkt. Sechs Datensätze wurden entfernt, da die Einwilligungs- oder Eignungsvoraussetzungen nicht erfüllt waren, fünf doppelte Einreichungen wurden gelöscht, vier Datensätze wurden ausgeschlossen, weil mehr als 20 % aller Skalenitems fehlten, und 13 Datensätze wurden ausgeschlossen, weil sie zwei oder mehr Indikatoren für die Antwortqualität erfüllten. Neunzehn Antworten wurden aufgrund einer Bearbeitungsdauer <180 s markiert, acht Antworten wurden aufgrund von >90 % linearer Antwortmuster markiert, und bei 21 Befragten erfolgte die Imputation fehlender Einzelwerte mittels des Skalenmittelwerts für 37 isolierte fehlende Items. Der endgültige analytische Datensatz enthielt keine direkt identifizierbaren Teilnehmerinformationen, kein beibehaltener Fall überschritt die Schwelle für den Ausschluss aufgrund fehlender Daten, und alle beibehaltenen Item-Antworten lagen innerhalb der vorab definierten Antwortbereiche. Der Überblick über den Prüfungsablauf ist in Tabelle 3 zusammengefasst.
Die ausgewählte Stichprobe umfasste 275 weibliche und 145 männliche Befragte, was 65,5 % bzw. 34,5 % des analytischen Datensatzes entspricht. Das durchschnittliche Alter betrug 20,1 ± 1,2 Jahre. Die Befragten waren auf vier Studienjahre verteilt, wobei das erste bis vierte Studienjahr 27,1 %, 27,4 %, 25,5 % und 20,0 % der Stichprobe ausmachten. Der Datensatz enthielt außerdem drei institutionelle Kategorien und fünf Kategorien akademischer Fachrichtungen. Nach der Kategorisierung enthielt keine veröffentlichte demografische Zelle weniger als fünf Befragte. Die demografischen Merkmale des analytischen Datensatzes sind in Tabelle 4 zusammengefasst.
Konstruktion der Skala, Überprüfung der Wertebereiche und Beispiele suboptimaler Arbeitsabläufe
Nach der Itemsachkodierung und Umkehrung der Bewertungsskala wurden fünf skalenspezifische Variablen berechnet: negative Emotionen, akademische Prokrastination, Zugehörigkeitsgefühl zur Schule, höherstufiges Denken und subjektives Wohlbefinden. Jede erreichte Punktzahl lag innerhalb ihres theoretischen Antwortbereichs. Die Werte für negative Emotionen lagen zwischen 1,048 und 3,143 auf einer Skala von 1 bis 4. Die Werte für akademische Prokrastination, Zugehörigkeitsgefühl zur Schule und höherstufiges Denken lagen jeweils zwischen 1,312 und 4,250, 2,333 und 4,444 sowie 2,350 und 4,850 auf ihren jeweiligen 1–5-Skalen. Das subjektive Wohlbefinden lag zwischen 2,000 und 5,300 auf einer 1–6-Skala. Die Überprüfung der umgekehrten Bewertung zeigte keine Abweichungen zwischen den abgeleiteten, umgekehrt kodierten Variablen und der festgelegten Bewertungsregel im endgültigen Datensatz für die Analyse. Diese Kontrollen bestätigten, dass die Itemsachkodierung, die Umkehrung der Bewertungsskala, die Handhabung fehlender Angaben und die Aggregation der Punktzahlen ohne nachweisbare Bereichsfehler abgeschlossen wurden.
Der Workflow erzeugte außerdem suboptimale Prüfbeispiele, die verdeutlichen, wie Fehler oder fragwürdige Ergebnisse vor der endgültigen Analyse erkannt werden. Während eines Prüflaufs wurde ein falsch berechneter, umgekehrt kodierter Wert für subjektives Wohlbefinden erkannt, da das Überprüfungsdokument zur Bewertung den ursprünglichen Wert, die erwartete Formel „umgekehrter Wert = 7 – ursprünglicher Wert“, den berechneten Wert und den endgültigen Skalenbereich miteinander verglich. Die abgeleitete Variable wurde korrigiert, die Bewertung des subjektiven Wohlbefindens neu generiert, und sämtliche nachfolgenden deskriptiven, Korrelations-, Vergleichs-, Regressions-, Diagnose- sowie Abbildungsquellen-Ausgaben wurden erneut durchgeführt. In einer weiteren Zwischendatei wurde während der Bereichsprüfung ein außerhalb des zulässigen Bereichs liegender Itemwert identifiziert und auf die Bearbeitung in der Tabellenkalkulation – und nicht auf den gesperrten Rohexport – zurückgeführt. Die Arbeitskopie wurde korrigiert und dokumentiert, ohne gültige Extremantworten zu verändern. Eine Zuverlässigkeitswarnung wurde ebenfalls überprüft, als ein Item eine geringere korrigierte Item-Gesamtkorrelation aufwies als die anderen Items derselben Skala; da die Formulierung des Items, die Wertungsrichtung und die Konstruktausrichtung korrekt waren, wurde das Item beibehalten. Eine Diskrepanz in einer Entwurfsvisualisierung wurde bemerkt, als eine Abbildung nicht mit ihrer verifizierten numerischen Quelltabelle übereinstimmte; die Abbildung wurde aus der verifizierten Tabelle neu erstellt und der Quellennachweis für die Abbildung aktualisiert. Diese Beispiele zeigen, dass der Workflow nicht nur erfolgreiche Ergebnisse liefert, sondern auch Codierfehler, Bereichsprobleme, Zuverlässigkeitswarnungen, Diskrepanzen zwischen Abbildungen und ihren Datenquellen sowie Bedenken hinsichtlich der Antwortqualität über die Prüfprotokolle erkennen kann.
Deskriptive Eigenschaften und innere Konsistenz
Die fünf Skalenebene-Variablen zeigten brauchbare Variationen. Der mittlere Wert für negative Emotionen betrug 2,099 ± 0,391, und der mittlere Wert für akademisches Prokrastinieren lag bei 2,639 ± 0,484. Schulzugehörigkeit und höheres Denken wiesen moderat hohe Mittelwerte von 3,343 ± 0,390 bzw. 3,627 ± 0,418 auf. Der mittlere Wert für subjektives Wohlbefinden betrug 3,784 ± 0,543. Keine der Skalen zeigte ein offensichtliches Boden- oder Deckeneffekt-Muster, und der Anteil der Befragten am theoretischen Minimum oder Maximum lag bei jeder Skala unter 2,0 %.
Die innere Konsistenz war für alle fünf Skalen akzeptabel. Die Cronbachs-Alpha-Werte lagen zwischen 0,834 und 0,899 und überschritten damit die vorgegebene Schwelle von 0,70. Negative Emotionen wiesen die höchste innere Konsistenz auf, mit einem Cronbachs-Alpha von 0,899, gefolgt von subjektivem Wohlbefinden mit 0,895. Die McDonalds-Omega-Werte variierten zwischen 0,842 und 0,906, und die Omega-Schätzungen änderten die Interpretation der Reliabilität nicht. Die Überprüfung der korrigierten Item-Gesamtskala-Korrelationen ergab keine Items, die entfernt werden mussten. Die deskriptiven Statistiken und Reliabilitätsschätzungen sind in Tabelle 5 aufgeführt.
Korrelationsstruktur zwischen den Skalenebenen-Variablen
Die Korrelationsmatrix wurde als deskriptives Maß der Assoziation sowie zur Überprüfung der Bewertungsrichtung verwendet. Vor der Berechnung der Pearson-Korrelationen wurden die Verteilungen der Skalen und bivariate Streudiagramme untersucht. Keine Variable wies eine starke Schiefe oder Kurtosis auf, und kein bivariates Diagramm zeigte ein ausgeprägtes nichtlineares Muster, das eine deskriptive Pearson-Korrelationsanalyse ungültig gemacht hätte. Subjektives Wohlbefinden korrelierte negativ mit negativen Emotionen (r = -0,496) und akademischem Prokrastinieren (r = -0,294) und positiv mit Zugehörigkeitsgefühl zur Schule (r = 0,481) und höherer kognitiver Verarbeitung (r = 0,386). Die übrigen Assoziationen folgten derselben Bewertungslogik: Negative Emotionen waren positiv mit akademischem Prokrastinieren verbunden (r = 0,270) und negativ mit Zugehörigkeitsgefühl zur Schule (r = -0,346) sowie höherer kognitiver Verarbeitung (r = -0,205); akademisches Prokrastinieren war negativ mit Zugehörigkeitsgefühl zur Schule (r = -0,222) und höherer kognitiver Verarbeitung (r = -0,134) assoziiert; und Zugehörigkeitsgefühl zur Schule korrelierte positiv mit höherer kognitiver Verarbeitung (r = 0,310). Die vollständige Pearson-Korrelationsmatrix ist in Tabelle 6 dargestellt.
Eine Spearman-Sensitivitätsprüfung ergab die gleiche Richtungsinterpretation für alle Variablenpaare. Die Spearman-Korrelationen zwischen subjektivem Wohlbefinden und den vier Prädiktoren betrugen ρ = -0,502 für negative Emotionen, ρ = -0,301 für akademisches Prokrastinieren, ρ = 0,477 für Zugehörigkeitsgefühl zur Schule und ρ = 0,392 für höheres Denken. Die verifizierte Pearson-Matrix wurde als numerische Quelltabelle für die Visualisierung verwendet. Abbildung 2A zeigt die vollständige Korrelations-Heatmap über die fünf skalenbasierten Variablen. Abbildung 2B zeigt die vier Korrelationen mit dem subjektiven Wohlbefinden.
Kontrastive Demonstration anhand von Gruppen mit hohem und niedrigem subjektiven Wohlbefinden
Die 27-%-Regel wurde als kontrastive Workflow-Demonstration verwendet und nicht als inhaltliche Klassifizierung realer Wohlbefindensprofile. Die Regel ergab zwei gleich große Gruppen: 113 Befragte in der Gruppe mit hohem subjektiven Wohlbefinden und 113 in der Gruppe mit niedrigem subjektiven Wohlbefinden. Die mittleren 194 Befragten blieben im vollständigen Datensatz für die Analyse enthalten, wurden aber von diesem kontrastiven Vergleich ausgeschlossen. Keine Grenzfälligkeit veränderte die Gruppenzuteilung.
Dieses Modul zeigte, dass der Arbeitsablauf eine vorgegebene Gruppierungsvariable erzeugen, den Analyse-Datensatz filtern, gruppenspezifische deskriptive Statistiken berechnen, annähernd geeignete Gruppenvergleiche durchführen und eine verifizierte Quelltabelle zur Visualisierung exportieren konnte. Die Gruppe mit hohem subjektivem Wohlbefinden wies geringere negative Emotionen auf als die Gruppe mit niedrigem subjektivem Wohlbefinden (1,864 ± 0,358 vs. 2,335 ± 0,343; Mittelwertdifferenz = -0,472) sowie geringere akademische Prokrastination (2,455 ± 0,476 vs. 2,801 ± 0,483; Mittelwertdifferenz = -0,346). Zugehörigkeitsgefühl zur Schule und höherstufiges Denken waren in der Gruppe mit hohem subjektivem Wohlbefinden höher, mit Mittelwertdifferenzen von 0,454 bzw. 0,351. Alle vier Vergleiche waren signifikant (p < 0,001), mit Cohens d-Werten von -1,346 für negative Emotion, -0,722 für akademische Prokrastination, 1,279 für Zugehörigkeitsgefühl zur Schule und 0,860 für höherstufiges Denken. Der Welch-t-Test wurde verwendet, wenn die Annahme der Varianzhomogenität nicht erfüllt war; andernfalls wurde der standardmäßige t-Test für unabhängige Stichproben beibehalten. Diese Ergebnisse sollten nicht als Beleg dafür interpretiert werden, dass die ausgewählten Prädiktoren reale Wohlbefindensprofile von Schülerinnen und Schülern definieren, da die Gruppen anhand der Zielvariable gebildet und anschließend an korrelierten Variablen verglichen wurden. Die Gegenüberstellung der Gruppen mit hohem und niedrigem Wohlbefinden ist in Tabelle 7 zusammengefasst.
Beschreibender Vergleich nach Geschlecht
Das Geschlecht wurde als beschreibende Gruppierungsvariable untersucht. Befragte weibliche Personen wiesen einen leicht höheren mittleren Wert für negative Emotionen auf als männliche Befragte (2.129 ± 0.380 vs. 2.042 ± 0.407). Dieser Unterschied war statistisch signifikant, jedoch geringfügig in der Größe (p = 0.033; Cohens d = 0.224). Bei akademischer Prokrastination, Schule-Zugehörigkeit, höherem Denken und subjektivem Wohlbefinden zeigten sich keine bedeutsamen geschlechtsspezifischen Unterschiede. Die Mittelwerte für subjektives Wohlbefinden waren zwischen weiblichen und männlichen Befragten nahezu identisch (3.781 ± 0.521 vs. 3.789 ± 0.583; p = 0.887; Cohens d = -0.015). Sensitivitätsprüfungen mittels Welch’s t-Test änderten die Interpretation der Geschlechtsvergleichsergebnisse nicht. Die Ergebnisse zu geschlechtsspezifischen Unterschieden sind in Tabelle 8 dargestellt.
Regressionsmodell als Beispiel für die Modellerstellung und diagnostische Überprüfung
Das multiple lineare Regressionsmodell diente als Beispiel dafür, wie ein Modell anhand von Daten aus einem bewerteten Fragebogen erstellt, diagnostiziert und überprüft wird. Das subjektive Wohlbefinden wurde als abhängige Variable eingegeben, während negative Emotionen, akademische Prokrastination, Zugehörigkeitsgefühl zur Schule und höheres Denken gleichzeitig als Skalenniveau-Prädiktoren berücksichtigt wurden. Ziel dieses Moduls war es, die Extraktion von Koeffizienten, Prüfungen auf Multikollinearität, Residualdiagnostik, Einflussbewertung, eine sensomotorische Analyse mit Anpassung an demografische Merkmale sowie die Erstellung von Abbildungen und Quellen darzustellen.
Das Modell erklärte einen moderaten Anteil der Varianz im subjektiven Wohlbefinden mit R2 = 0,411 und einem adjustierten R2 = 0,406. Negative Emotionen wiesen den größten negativen standardisierten Koeffizienten auf (B = -0,450, standardisiertes β = -0,324). Akademische Prokrastination zeigte ebenfalls einen negativen Koeffizienten (B = -0,130, standardisiertes β = -0,116). Schulzugehörigkeit und höherstufiges Denken wiesen positive standardisierte Koeffizienten von β = 0,275 bzw. β = 0,218 auf. Alle vier Prädiktoren waren im geschätzten Modell statistisch signifikant: negative Emotionen, Schulzugehörigkeit und höherstufiges Denken bei p < 0,001 sowie akademische Prokrastination bei p = 0,004. Auf Multikollinearität wurde nicht hingewiesen, da alle Werte des Varianzinflationsfaktors unter 1,24 lagen. Diese Regressionsausgaben stellen repräsentative Modellprüfungsresultate dar, keine endgültige psychologische Erklärung des Wohlbefindens von Schülerinnen und Schülern. Tabelle 9 enthält die vollständige Regressionsausgabe.
Ein ergänzendes demografisch angepasstes Modell wurde geschätzt, indem Geschlecht, Alter, Studienjahr, Institutionstyp und Fachbereich den vier psychologischen Prädiktoren hinzugefügt wurden. Das angepasste Modell erklärte einen ähnlichen Anteil der Varianz mit R2 = 0,427 und korrigiertem R2 = 0,414. Die Richtung und statistische Interpretation der vier psychologischen Prädiktoren blieb nach der demografischen Anpassung unverändert. Das demografisch angepasste Sensitivitätsmodell ist in Tabelle 10 zusammengefasst. Abbildung 3A zeigt die standardisierten Koeffizienten und 95-%-Konfidenzintervalle für die vier Prädiktoren. Abbildung 3B zeigt die diagnostische Darstellung basierend auf standardisierten vorhergesagten Werten, standardisierten Residuen und Cooks Distanz.
Regressionsdiagnostik und Modellerhaltung
Die Regressionsdiagnostik ergab nicht, dass das angepasste Modell durch einen einzelnen einflussreichen Datensatz bestimmt wurde. Die bivariaten und partiellen Regressionsplots zeigten keine starke Nichtlinearität. Der Plot der Residuen gegen die Vorhersagewerte wies keine starke Heteroskedastizität oder ungewöhnliche Clusterbildung auf. Die Durbin-Watson-Statistik betrug 1,93 und spricht für eine akzeptable Unabhängigkeit der Residuen. Der Residuen-Q-Q-Plot zeigte keine starken Abweichungen von der Normalverteilung. Ein formeller Test auf Normalverteilung der Residuen war statistisch signifikant, W = 0,992, p = 0,031, doch der Q-Q-Plot und die Stichprobengröße rechtfertigten die Beibehaltung des linearen Modells für die deskriptive Assoziationsanalyse.
Zwei Datensätze wiesen absolute standardisierte Residuen größer als 3,00 auf. Kein Datensatz hatte eine Cooks-Distanz größer als 1,00. Unter Verwendung der empfindlicheren Schwelle für die Cooks-Distanz >4/n, wobei n = 420 und 4/n = 0,0095 beträgt, wurden 17 Datensätze als potenziell einflussreich markiert. Die größte Cooks-Distanz betrug 0,037. Die markierten Ausreißer und einflussreichen Fälle wurden anhand des Screening-Protokolls, des Überprüfungsprotokolls zur Bewertung und der Einschlusskriterien überprüft. Keiner zeigte Hinweise auf Dateneingabefehler, falsche Bewertung, doppelte Antworten, Nichteinhaltung der Einschlusskriterien oder dokumentierte Probleme bezüglich der Antwortqualität; daher wurden diese Fälle im endgültigen Modell beibehalten. Eine Sensitivitätsprüfung bezüglich des Einflusses, bei der Fälle mit einer Cooks-Distanz >4/n ausgeschlossen wurden, ergab dieselbe Interpretation des Workflows wie das primäre Modell. Die maximale absolute Änderung der standardisierten Koeffizienten betrug 0,026, und das adjustierte R2 veränderte sich von 0,406 auf 0,405. Die Ergebnisse der Diagnose und Sensitivitätsanalyse sind in Tabelle 11 zusammengefasst.
Interne Verifizierung der analytischen Pipeline
Der Workflow wurde anhand des bereinigten und bewerteten Analyse-Datensatzes unter Verwendung derselben Bewertungsregeln, Entscheidungsschwellen und Analyse-Protokolldatei wiederholt. Die Analyse der internen Konsistenz, deskriptive Statistiken, Korrelationsanalysen, Vergleiche zwischen Hoch- und Niedriggruppen, Geschlechtsvergleiche, Regressionsmodellierung, Diagnoseprüfungen und die Vorbereitung der Visualisierungsquellen wurden erneut durchgeführt. Die wiederholten Ergebnisse stimmten mit den ursprünglichen deskriptiven Statistiken, der Korrelationsmatrix, den Werten der Gruppenvergleiche, den Regressionskoeffizienten, den diagnostischen Ergebnissen und den Visualisierungsquellendateien überein. Dies bestätigte die rechnerische Stabilität der analytischen Pipeline bei Anwendung auf denselben gesperrten Analyse-Datensatz. Diese Prüfung stellt keine unabhängige prozedurale Reproduzierbarkeit dar, die erfordern würde, dass ein unabhängiger Analytiker den gesamten Workflow ausgehend vom gesperrten Rohexport durchführt und dieselben dokumentierten Ergebnisse erhält.
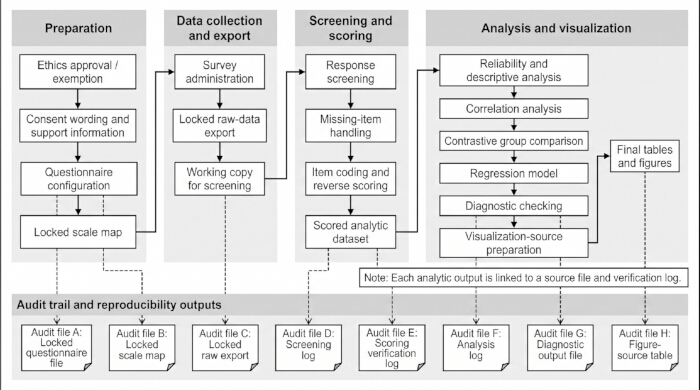
Abbildung 1: Workflow zur verarbeitungsbasierten subjektiven Wohlbefindensdaten aus Fragebögen. Das Schema zeigt die Abfolge des Protokolls und die wichtigsten Prüfungsresultate, einschließlich ethischer Vorbereitung, Fragebogenkonfiguration, Durchführung der Umfrage, Export der Rohdaten, Skalenübersicht, Überprüfungsprotokoll, bewerteter analytischer Datensatz, verifizierte Analysen-Tabellen, Regressionsdiagnosen, Quelldateien für Abbildungen und Visualisierungsergebnisse. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
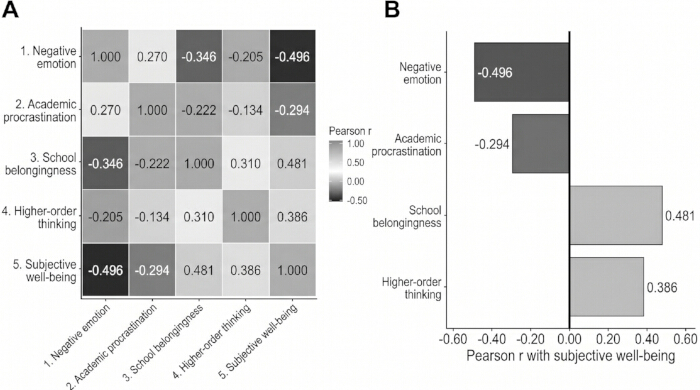
Abbildung 2: Korrelationsstruktur zwischen den Variablen auf Skalenebene. (A) Heatmap der Pearson-Korrelation, erstellt aus der überprüften Korrelationsmatrix in Tabelle 6. (B) Korrelationsprofil mit Fokus auf subjektives Wohlbefinden, abgeleitet aus derselben validierten Quelltabelle. Alle fünf Variablen auf Skalenebene sind dargestellt: negative Emotion, akademische Prokrastination, Zugehörigkeitsgefühl zur Schule, höheres Denken und subjektives Wohlbefinden. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
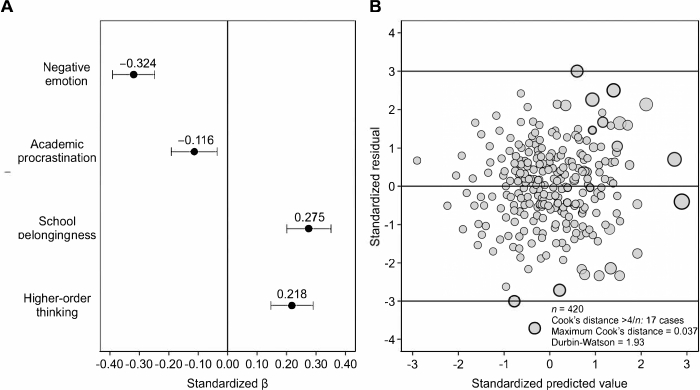
Abbildung 3: Regressionskoeffizienten und diagnostische Visualisierung. (A) Standardisierte Regressionskoeffizienten und 95 % Konfidenzintervalle, berechnet aus der primären Regressionsausgabe in Tabelle 9. (B) Regressionsdiagnose-Darstellung, erstellt anhand standardisierter vorhergesagter Werte, standardisierter Residuen und Cookscher Distanzwerte, zusammengefasst in Tabelle 11. Größere Werte der Cookschen Distanz weisen auf Beobachtungen mit größerem Einflusspotential auf das geschätzte Modell hin. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Tabelle 1: Struktur des Fragebogens und Bewertungsrahmen der Skala. Diese Tabelle fasst den Messrahmen zusammen, einschließlich Konstruktname, Quellinstrument, Quellenangabe, Anpassungs- oder Dokumentationsstatus, Anzahl der Items, Antwortbereich, Bewertungsrichtung, Erfordernis der Umkehrung der Bewertung, Bewertungsmethode, endgültige Skalenebene-Variable und Protokollrolle. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 2: Kriterien für die Reaktionsauswertung und analytische Entscheidungen. Diese Tabelle enthält die vorab festgelegten Kriterien für die Einwilligungsprüfung, Eignungsprüfung, Überprüfung doppelter Antworten, Umgang mit fehlenden Daten, Markierung der Antwortdauer, Erkennung linearer Antworten, gültige Antwortbereiche, Zuverlässigkeitsbewertung, Einteilung in Hoch-Niedrig-Gruppen, Regressionsdiagnose und Sensitivitätsprüfungen. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 3: Übersicht des Screening-Prozesses von eingereichten Fragebögen bis zum endgültigen Analyse-Datensatz. Diese Tabelle zeigt die Anzahl der eingereichten Fragebögen, markierten Datensätze, ausgeschlossenen Datensätze, beibehaltenen Datensätze sowie der Quellen zur Überprüfung in jedem Screening-Schritt. Die Dauer der Bearbeitung und das Antwortverhalten in gerader Linie wurden als Indikatoren für die Antwortqualität behandelt, nicht jedoch als automatische Ausschlusskriterien. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 4: Demografische Merkmale des Analyse-Datensatzes. Diese Tabelle fasst die behaltenen anonymisierten Schülerakten nach der Antwortprüfung zusammen, einschließlich Geschlecht, Alter, Studienjahr, Institutionstyp und Fachbereichskategorie. Demografische Angaben wurden vor der Veröffentlichung auf das Risiko einer indirekten Identifizierbarkeit überprüft. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 5: Deskriptive Statistiken, Überprüfung des Wertebereichs und innere Konsistenz der fünf Skalenvariablen. Diese Tabelle enthält die Angaben zur Anzahl der Items, dem theoretischen Bereich, dem beobachteten Bereich, dem Mittelwert, der Standardabweichung, Cronbachs Alpha, McDonalds Omega sowie zur Boden- und Deckeneffektkonzentration für negative Emotionen, akademisches Prokrastinieren, Schule-Zugehörigkeitsgefühl, höheres Denken und subjektives Wohlbefinden. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 6: Pearson-Korrelationsmatrix der skalenbasierten Variablen. Diese Tabelle zeigt die Pearson-Korrelationskoeffizienten zwischen negativen Emotionen, akademischem Prokrastinieren, Schule-Zugehörigkeit, Denken höherer Ordnung und subjektivem Wohlbefinden. Die Matrix diente als deskriptive Darstellung der Zusammenhänge sowie als Schritt zur Überprüfung der Richtung der Wertung. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 7: Kontrastiver Vergleich zwischen Gruppen mit hohem und niedrigem subjektiven Wohlbefinden. Diese Tabelle vergleicht negative Emotionen, akademisches Prokrastinieren, Zugehörigkeitsgefühl zur Schule und höheres Denken bei Befragten in den oberen 27 % und unteren 27 % der Werte für subjektives Wohlbefinden. Der Vergleich veranschaulicht den Ablauf der Gruppierung und des Vergleichs, nicht jedoch eine inhaltliche Klassifizierung von Wohlbefindensprofilen. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 8: Deskriptive Vergleiche nach Geschlecht. Diese Tabelle zeigt deskriptive Vergleiche von negativen Emotionen, akademischem Prokrastinieren, Schule-Zugehörigkeitsgefühl, höherem Denken und subjektivem Wohlbefinden nach Geschlecht. Das Geschlecht wurde als deskriptive Gruppierungsvariable behandelt. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 9: Primäres multiplines lineares Regressionsmodell zur Vorhersage des subjektiven Wohlbefindens. Diese Tabelle zeigt das primäre Regressionsmodell, bei dem das subjektive Wohlbefinden die abhängige Variable war und negative Emotionen, akademische Prokrastination, Zugehörigkeitsgefühl zur Schule sowie höheres Denken gleichzeitig als skalenbasierte Prädiktoren eingegeben wurden. Die Werte für Standardfehler, Konfidenzintervall und Varianzinflationsfaktor sind enthalten. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 10: Regressions-Sensitivitätsmodell mit Berücksichtigung demografischer Merkmale zur Vorhersage des subjektiven Wohlbefindens. Diese Tabelle zeigt die vier psychologischen Prädiktoren nach Anpassung für Geschlecht, Alter, Studienjahr, Hochschultyp und Fachbereichskategorie. Kategoriale demografische Variablen wurden mittels Dummy-Codierung eingegeben. Standardfehler, Konfidenzintervalle und Werte des Varianzinflationsfaktors sind enthalten. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 11: Regressionsdiagnosen und Einfluss-Sensitivitätsprüfungen. Diese Tabelle fasst Residuen-, Einfluss- und Modell-Diagnoseergebnisse zusammen, einschließlich standardisierter Residuen, Cooks Distanz > 1,00, Cooks Distanz > 4/n, maximale Cooks Distanz, Durbin-Watson-Statistik, Q-Q-Diagramm der Residuen, Normalitätstest der Residuen, Diagramm der Residuen gegen die vorhergesagten Werte, Linearitätsprüfung und Einfluss-Sensitivitätsanalyse. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Zusatzdatei 1: Fragebogenstruktur, Herkunft der Skalen und Dokumentation der Bewertung. Diese Zusatzdatei enthält die Reihenfolge der Fragebogenbefragung, den Wortlaut der Einwilligungserklärung, demografische Variablen, Dokumentation der Quellinstrumente, Item-Codes, Antwortankern, Informationen zur Adaptierung und zum Dokumentationsstatus, Bewertungsrichtung, Regeln zur Umkehrung der Bewertung, Konstruktion der endgültigen Skalenebene-Variablen, Regeln zum Umgang mit fehlenden Items, Felder zur Verknüpfung der Antwortqualität, Regeln zur Überprüfung der Wertebereiche sowie Referenzverknüpfungen für die fünf Fragebogenkonstrukte. Sie dient als ergänzender Fragebogen-Codebuch, um die Programmierung, Bewertung und Überprüfung der Skalen im Arbeitsablauf zu dokumentieren. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Dieses Protokoll standardisiert einen verbreiteten, aber oft unzureichend dokumentierten Prozess in Fragebogen-basierten Wohlbefinden-Studien: den Übergang von Rohdaten der Antworten zu geprüften Daten, skalierten Punktwerten, statistischen Ergebnissen und Dateien, die für Visualisierungen vorbereitet sind. Der Beitrag liegt nicht in der Entwicklung einer neuen Theorie zum subjektiven Wohlbefinden oder in der Vorschlagung eines kausalen Modells. Vielmehr bietet der Arbeitsablauf einen nachvollziehbaren Weg für die Konfiguration von Fragebögen, die Prüfung der Antworten, die Berechnung von Skalenwerten, die Überprüfung der Reliabilität, die deskriptive Analyse, die Analyse von Zusammenhängen, die Regressionsdiagnostik und die Verifizierung von Datenquellen für Abbildungen. Diese Unterscheidung ist wichtig, weil die Nachvollziehbarkeit in der auf Umfragen basierenden Fragebogenforschung von prozeduralen Entscheidungen abhängt, die oft bereits vor der statistischen Interpretation getroffen werden – beispielsweise welche Datensätze beibehalten werden, wie fehlende Angaben behandelt werden, wie umgekehrt codierte Items verarbeitet werden und wie numerische Quelltabelle mit visuellen Ausgaben verknüpft werden. Die explizite Festlegung dieser Entscheidungen verringert fragwürdige Messpraktiken in der skalenbasierten Forschung23 und fördert eine transparentere Forschungskultur24.
Ein zentrales Merkmal des Protokolls ist die Verwendung konkreter Audit-Artefakte anstelle alleiniger verbaler Beschreibung. Der überarbeitete Arbeitsablauf verknüpft jeden Konstrukt mit seinem Quellinstrument, dem Item-Bereich, den Antwortkategorien, der Wertungsrichtung, der Regel zur Umkehrung der Wertung, der endgültigen skalenebenebezogenen Variable sowie Informationen zur Anpassung oder Dokumentationsstatus. Die Audit-Spur umfasst die gesperrte Fragebogendatei, die gesperrte Skalenkarte, den gesperrten Rohexport, das Screening-Protokoll, das Wertungsverifikationsprotokoll, das Analyseprotokoll, die diagnostische Ausgabedatei und die Tabelle mit den Datenquellen für Abbildungen. Diese Dateien verdeutlichen, welche Version des Fragebogens verwendet wurde, welche Datensätze ausgeschlossen oder beibehalten wurden, wie die Werte berechnet wurden und welche verifizierte Tabelle zur Erstellung jeder Abbildung herangezogen wurde. Wenn individuelle Teilnehmerdaten nicht öffentlich geteilt werden können, ermöglicht ein synthetischer Datensatz mit gleicher Variablenstruktur sowie vollständigen Screening- und Wertungsprotokollen den Lesern, den Berechnungsablauf zu testen, ohne auf identifizierbare oder indirekt identifizierbare Datensätze zuzugreifen. Diese auf Artefakten basierende Struktur entspricht dem FAIR-Prinzip, wonach wiederverwendbare Forschungsergebnisse eine klare Herkunft, Struktur und Zugangsbedingungen erfordern25.
Die repräsentativen Ergebnisse sollten als Workflow-Ausgaben interpretiert werden, nicht als inhaltliche Belege für psychologische Determinanten des Wohlbefindens von Studierenden. Der Vergleich zwischen hohem und niedrigem subjektivem Wohlbefinden diente der Demonstration, wie eine vorgegebene Gruppierungsregel umgesetzt, überprüft und berichtet werden kann; er sollte nicht als realweltliche Klassifizierung von Wohlbefindensprofilen verstanden werden. Ebenso zeigt das Regressionsmodell auf, wie mittels Fragebogen erhobene Skalenwerte modelliert, auf Multikollinearität geprüft, mithilfe von Residual- und Einflussdiagnosen evaluiert und mit einer verifizierten Abbildungs-Quellentabelle verknüpft werden können. Es belegt jedoch nicht, dass negative Emotionen, akademische Prokrastination, Zugehörigkeitsgefühl zur Schule oder höherstufiges Denken kausal das subjektive Wohlbefinden bestimmen. Da alle wesentlichen Variablen mithilfe desselben Selbstberichts-Fragebogens zu einem einzigen Zeitpunkt erhoben wurden, können Methoden-Bias, Antwortstil-Effekte und gemeinsamer Messkontext nicht ausgeschlossen werden26.
Dieser Arbeitsablauf ersetzt ebenfalls keine vollständige psychometrische Validierung. Cronbachs Alpha, McDonalds Omega, Überprüfungen des beobachteten Wertebereichs, die Analyse der Item-Gesamtskala-Beziehungen sowie die Verifizierung der Umkehrungscodierung sind nützliche Qualitätskontrollschritte für einen nachvollziehbaren Bewertungsablauf, gewährleisten jedoch nicht die faktorielle Validität, Messinvarianz, die Eigenschaften der Item-Response-Funktionen oder die Vergleichbarkeit zwischen Gruppen. Studien, die den Fragebogen zur Überprüfung inhaltlicher Theorien verwenden, sollten eine Bestätigungsfaktoranalyse, Tests zur Messinvarianz über relevante demografische oder institutionelle Gruppen hinweg sowie gegebenenfalls zusätzliche Validitätsprüfungen durchführen27. Daher sollte das vorliegende Protokoll als nachvollziehbares Rahmenwerk für die Datenverarbeitung und Berichterstattung verstanden werden, nicht jedoch als vollständige Validierungsstudie für die enthaltenen Konstrukte.
Der Arbeitsablauf wurde an einer Stichprobe mit einem einzigen Studierenden demonstriert, wobei selbstberichtete Fragebogendaten, die zu einem einzigen Zeitpunkt erhoben wurden, ohne externe Validierung verwendet wurden. Seine Übertragbarkeit auf andere Populationen, Disziplinen, Institutionen, Sprachen und kulturelle Kontexte sollte nicht vorausgesetzt werden. Falls der Arbeitsablauf in einem anderen Kontext wiederverwendet wird, sollte die Skalenabbildung neu erstellt und nicht mechanisch kopiert werden. Forschende sollten Herkunft, Übersetzungs- oder Adaptierungsstatus, kulturelle und kontextuelle Abhängigkeit der Wohlbefindensitems, Antwortkategorien, Regeln zur Umkehrung der Wertung, Interpretation der Werte sowie lokale ethische Anforderungen überprüfen. Übersetzungs- und Adaptierungsverfahren erfordern eine ausdrückliche Dokumentation statt informeller Formulierungsänderungen28, und die Interpretation von Testwerten in Bildung und Psychologie sollte stets an die Evidenz für den vorgesehenen Verwendungszweck und die Zielgruppe gebunden bleiben29.
In der Praxis ist das Protokoll am nützlichsten als überprüfbarer Rahmen für die Datenverarbeitung und Berichterstattung in Fragebogen-basierten Untersuchungen zum Wohlbefinden. Es hilft Forschenden dabei, Entscheidungen bezüglich Datenaufbereitung, Skalierung, Diagnostik und Visualisierung sichtbar zu machen, bevor die Interpretation beginnt. Künftige Anwendungen sollten den Workflow an unabhängigen Stichproben, verschiedenen institutionellen Rahmenbedingungen, Längsschnittdesigns und unabhängig replizierenden Analyseteams testen. Externe Validierung, vorregistrierte Entscheidungsregeln, geteilte synthetische Datensätze, vollständige Beispiel-Protokolle für Screening und Skalierung sowie unabhängige Replikation durch Analyseteams würden die Übertragbarkeit und Glaubwürdigkeit des Workflows weiter stärken.
Offenlegungen
Die Autoren erklären, dass keine Interessenkonflikte bestehen.
Danksagungen
Die Autoren danken den Studierenden, die an der Fragebogenbefragung teilgenommen haben, für ihre Unterstützung während der Datensammlung. Außerdem danken die Autoren den zuständigen Dozenten und wissenschaftlichen Hilfskräften für ihre Hilfe bei der Verteilung der Fragebögen, der Datenaufbereitung, der Überprüfung der Ergebnisse sowie der Erstellung von Tabellen und Abbildungen. Diese Arbeit erhielt keine spezifische Förderung.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| R-Paket broom | CRAN | R-Paket | Wird verwendet, um Regressionsausgaben in strukturierte Tabellen mit Koeffizienten und Modellzusammenfassungen umzuwandeln. |
| R-Paket car | CRAN | R-Paket | Wird zur Überprüfung des Varianzinflationsfaktors und zur Unterstützung der Regressionsdiagnose verwendet. |
| Dokumentation der Depression Anxiety Stress Scales-21 | Psychology Foundation of Australia | Lovibond und Lovibond, 1995 | Quellendokumentation für den Bereich negative Emotionen. Der Workflow verwendete an die aktuelle Erfassung negativer emotionaler Zustände angepasste Formulierungen. |
| R-Paket dplyr | CRAN | R-Paket | Wird zur Datenfilterung, Umcodierung, Gruppierung, Zusammenfassung von Screening-Abläufen und Vorbereitung analytischer Tabellen verwendet. |
| R-Paket ggplot2 | CRAN | R-Paket | Wird zur Erstellung der Korrelations-Heatmap, des Korrelationsplots für subjektives Wohlbefinden, des Regressionskoeffizientenplots und der Diagnosegrafiken verwendet. |
| Dokumentation zur Messung höherer kognitiver Fähigkeiten | Springer Nature | DOI: 10.1038/s41598-024-70908-3 | Quellendokumentation für den Bereich höherer kognitiver Fähigkeiten. Der Workflow verwendete einen an die analytische, evaluative, reflektierende, integrative und evidenzbasierte Denkweise angepassten Itemsatz. |
| IBM SPSS Statistics | IBM Corp. | Version 29.0.2.0 | Wird für deskriptive Statistiken, Cronbach’s Alpha, Pearson-Korrelation, t-Tests für unabhängige Stichproben und Welch’s t-Test, multiple lineare Regression, Durbin-Watson-Statistik, standardisierte Residuen, Hebelwerte, Cook’s Distanz und Varianzinflationsfaktoren verwendet. |
| R-Paket psych | CRAN | R-Paket | Wird für psychometrische Zusammenfassungen, die Überprüfung von Cronbach’s Alpha und McDonald’s Omega verwendet. |
| Dokumentation der Psychological Sense of School Membership Scale | Wiley | Psychol Sch. 1993;30(1):79-90 | Quellendokumentation für den Bereich Schulzugehörigkeit. Der Workflow verwendete an die wahrgenommene Akzeptanz, Verbundenheit, Unterstützung und Zugehörigkeit im schulischen Umfeld angepasste Formulierungen. |
| Statistische Umgebung R | R Foundation for Statistical Computing | Version 4.4.2 | Wird für sekundäre analytische Überprüfungen, McDonald’s Omega, Spearman-Sensitivitätsprüfungen, Vorbereitung der Regressionsausgaben, Vorbereitung der Diagnoseausgaben und Vorbereitung der Visualisierungsquellen verwendet. |
| R-Paket readxl | CRAN | R-Paket | Wird verwendet, um Tabellenkalkulations-Exporte von Fragebögen in den R-Verifizierungsworkflow einzulesen. |
| Dokumentation der Subjective Well-being Scale for Chinese Citizens | Scientific & Academic Publishing | DOI: 10.5923/j.ijap.20190905.01 | Quellendokumentation für den Bereich subjektives Wohlbefinden. Der Workflow verwendete an die Lebenszufriedenheit, Sinnhaftigkeit, Unterstützung, Fortschritt, Unzufriedenheit, Hilflosigkeit und stressbezogene Wohlbefindenserfahrungen angepasste Formulierungen sowie invertiert bewertete Items. |
| Ergänzende Datei 1: Dokumentation zur Fragebogenstruktur und Skalen | Autoren | Ergänzende Datei 1 | Enthält die verwendete Fragebogenstruktur, Konstruktfolge, Herkunft der Skalen, Item-Codes, Antwortskalen, Bewertungsrichtung, Regeln zur Invertierung, Konstruktion der Skalenwerte sowie Informationen zum Dokumentationsstatus. |
| Dokumentation der Tuckman Procrastination Scale | SAGE Publications | Educ Psychol Meas. 1991;51(2):473-480 | Quellendokumentation für den Bereich akademische Prokrastination. Der Workflow verwendete an akademische Verzögerung und Aufschiebeverhalten angepasste Formulierungen. |
| Online-Fragebogenplattform Wenjuanxing | Changsha Ranxing Information Technology Co., Ltd. | Webbasierte Plattform | Wird für die elektronische Einwilligung, Programmierung des Fragebogens, Erfassung der Item-Antworten, Zeiterfassung, Aufzeichnung der Bearbeitungsdauer, Überprüfung doppelter Einreichungen und Export der Rohdaten verwendet. |
Referenzen
- 1. Khatri P et al. Student well-being in higher education: scale development and validation with implications for management education. Int J Manag Educ. 2024;22(1):100933.
- Mirzaei A, Carter SR, Patanwala AE, Schneider CR. Missing data in surveys: key concepts, approaches, and applications. Res Social Adm Pharm. 2022;18(2):2308-16.
- Gummer T, Roßmann J, Silber H. Using instructed response items as attention checks in web surveys: properties and implementation. Sociol Methods Res. 2021;50(1):238-64.
- Johansson F et al. Associations between procrastination and subsequent health outcomes among university students in Sweden. JAMA Netw Open. 2023;6(1):e2249346.
- Li X, Kuo YL, Huggins TJ. Perceived feedback and school belonging: the mediating role of subjective well-being. Front Psychol. 2024;15:1450788.
- Sönning L. Ordinal response scales: psychometric grounding for design and analysis. Res Methods Appl Linguist. 2024;3(3):100156.
- Song P et al. Predictive analysis of college students’ academic procrastination behavior based on a decision tree model. Humanit Soc Sci Commun. 2024;11:869.
- Dudáš A. Graphical representation of data prediction potential: correlation graphs and correlation chains. Vis Comput. 2024;40(10):6969-82.
- Niessen ASM, Meijer RR, Tendeiro JN. Detecting careless respondents in web-based questionnaires: which method to use? J Res Pers. 2016;63:1-11.
- Parsons J, Bao L. A unified approach for outliers and influential data detection: the value of information in retrospect. Stat. 2022;11(1):e442.
- Donche V et al. Careless responding in online student learning surveys: profiles and impact on data quality. Frontline Learn Res. 2026;13(3):1-14.
- Lovibond SH, Lovibond PF. Manual for the Depression Anxiety Stress Scales. 2nd ed. Psychology Foundation; Sydney; 1995.
- Tuckman BW. The development and concurrent validity of the Procrastination Scale. Educ Psychol Meas. 1991;51(2):473-80.
- Goodenow C. The psychological sense of school membership among adolescents: scale development and educational correlates. Psychol Sch. 1993;30(1):79-90.
- Li D, Fan X, Meng L. Development and validation of a higher-order thinking skills (HOTS) scale for major students in the interior design discipline for blended learning. Sci Rep. 2024;14:20287.
- Huang L, Xing Z. A nationwide study on Subjective Well-being Scale for Chinese Citizens (SWBS-cc). Int J Appl Psychol. 2019;9(5):117-27.
- DeSimone JA, Harms PD, DeSimone AJ. Best practice recommendations for data screening. J Organ Behav. 2015;36(2):171-81.
- Revilla MA, Saris WE, Krosnick JA. Choosing the number of categories in agree-disagree scales. Sociol Methods Res. 2014;43(1):73-97.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK Res Methods. 2023;32(1):3-38.
- McNeish D. Thanks coefficient alpha, we’ll take it from here. Psychol Methods. 2018;23(3):412-33.
- Romeo I, Stanislaw H, McCreary J, Hawley M. The importance of belonging for well-being in college students. PLOS Ment Health. 2024;1(1):e0000057.
- Kastellec JP, Leoni EL. Using graphs instead of tables in political science. Perspect Polit. 2007;5(4):755-71.
- Flake JK, Fried EI. Measurement schmeasurement: questionable measurement practices and how to avoid them. Adv Methods Pract Psychol Sci. 2020;3(4):456-65.
- Nosek BA et al. Promoting an open research culture. Science. 2015;348(6242):1422-5.
- Wilkinson MD et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903.
- Vandenberg RJ, Lance CE. A review and synthesis of the measurement invariance literature: suggestions, practices, and recommendations for organizational research. Organ Res Methods. 2000;3(1):4-70.
- van de Vijver FJR, Hambleton RK. Translating tests: some practical guidelines. Eur Psychol. 1996;1(2):89-99.
- American Educational Research Association, American Psychological Association, National Council on Measurement in Education. Standards for educational and psychological testing. American Educational Research Association; Washington, DC; 2014.