Diese Studie stellt einen erklärbaren KI-gestützten Cyber-Physischen-Kollaborationsrahmen für Industry 5.0 vor, der eine CNN-Transformer-Architektur und SHAP für die akustische Anomalieerkennung im MIMII-Datensatz verwendet. Die Integration von Edge-Computing ermöglicht eine interpretierbare, menschenzentrierte vorausschauende Wartung.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Erklärbare KI-gestützte cyber-physische Kollaboration für eine nachhaltige Fertigung in Industrie 5.0
In diesem Artikel
Zusammenfassung
Zusammenfassung
In dieser Studie stellen wir einen innovativen Ansatz zur nachhaltigen Herstellung industrieller Bauteile mithilfe eines auf erklärbarer künstlicher Intelligenz (XAI) basierenden cyber-physischen Kollaborationssystems für Industrie 5.0 vor. Bisherige cyber-physische Mensch-Systeme (CPHS) haben nur in begrenztem Maße KI integriert und weisen oft einen Mangel an Erklärbarkeit auf. Daher besteht Bedarf, ihre Skalierbarkeit und Flexibilität im Einklang mit den Grundsätzen der Industrie 5.0 – Widerstandsfähigkeit, langfristige Lebensfähigkeit und Menschzentriertheit – zu verbessern. Um diese Mängel zu beheben, führen wir eine Architektur ein, die Deep Learning und erklärbare KI in das Cyber-physische System (CPS) einbettet, um intelligente und nachvollziehbare Entscheidungsfindung zu ermöglichen. Konkret nutzen wir den Datensatz zur Untersuchung und Inspektion industrieller Maschinen mit Fehlfunktionen (MIMII) zur Erkennung von Maschinenfehlern anhand akustischer Signale. Audiosignale werden einer spektralen Transformation unterzogen, um Spektrogrammbilder zu erzeugen, die anschließend von einem faltenden neuronalen Netzwerk (CNN) zur räumlichen Merkmalsextraktion und einem Transformer-Encoder zur zeitlichen Merkmalsextraktion verarbeitet werden. Um die Transparenz zu erhöhen und die Zusammenarbeit mit menschlichen Akteuren zu erleichtern, hilft der auf Shapley-Additive-Erklärungen (SHAP) basierende Ansatz den Bedienern, den Entscheidungsprozess des Systems zu verstehen, indem er Eingabemerkmale hervorhebt, die die Modellvorhersagen beeinflussen. Darüber hinaus wird das Framework in einem auf Edge-Computing basierenden cyber-physischen System angewendet, um geringe Latenz und geringen Energieverbrauch zu erreichen und gleichzeitig zeitnahe Reaktionen zu gewährleisten, wodurch eine nachhaltige Produktionsumgebung unterstützt wird. Experimentelle Ergebnisse zeigen, dass die vorgeschlagene CNN-Transformer-Architektur eine Genauigkeit von 98,5 % erreicht und bestehende CPHS-Systeme übertrifft, während sie gleichzeitig eine geringe Latenz aufrechterhält. Der Einsatz erklärbarer KI in einem solchen cyber-physischen Kollaborationssystem erhöht das Vertrauen der Bediener erheblich und ermöglicht eine nahtlose Mensch-Maschine-Zusammenarbeit.
Einleitung
Der Übergang von der Industrie 4.0, die Technologie, Mechanisierung und Kommunikation betonte, zum neuen Modell der Industrie 5.0, das technologischen Fortschritt mit Anpassungsfähigkeit, nachhaltiger Entwicklung und einer menschenzentrierten Ausrichtung verbindet, hat die dynamische Weiterentwicklung industrieller Systeme beeinflusst.1,2Die Europäische Kommission definiert Industry 5.0 als Paradigma, das nicht nur auf Produktivität und Effizienz, sondern auch auf die drei Säulen der Menschzentrierung, Nachhaltigkeit und Resilienz ausgerichtet ist. Es ist wichtig anzumerken, dass aktuelle Forschungsergebnisse die Rolle von KI-Systemen, der Mensch-Maschine-Zusammenarbeit sowie der nachhaltigen Fertigung als zentrale Treiber von Industry-5.0-Umgebungen hervorheben.3,4. Herkömmliche Wartungsmethoden sind in diesem sich wandelnden industriellen Umfeld nicht mehr ausreichend. Um in komplexen, instabilen Kontexten Resilienz zu gewährleisten, muss die Wartung sich zu einer anpassungsfähigeren und systemischeren Form weiterentwickeln.5Seit 2011 ist die Industrie 4.0 das vorherrschende Modell für die industrielle Transformation in Europa und fördert die digitale Umgestaltung von Unternehmen, um die Abläufe zu verbessern und die verfügbaren Ressourcen optimal zu nutzen.4Die Steigerung der Effizienz in der Produktion, ohne die menschliche Arbeitskraft zu ersetzen, unter gleichzeitiger Wahrung der Gesundheit und Sicherheit der Arbeitnehmer, ist daher unerlässlich. Aus diesem Grund haben Unternehmen und Wissenschaftler begonnen, die Grundsätze des Industry-5.0-Paradigmas zu definieren.5,6,7, teilweise motiviert durch das japanische Konzept der Gesellschaft 5.08,9,10,11Trotz der zunehmenden Betonung nachhaltiger Instandhaltung in der aktuellen Literatur bleiben die meisten vorhandenen systematischen Bewertungen fragmentiert oder auf bestimmte Fachgebiete beschränkt und verfügen nicht über einen umfassenden Rahmen, der Resilienz, Nachhaltigkeit und Künstliche Intelligenz (KI) integriert. Beispielsweise untersuchen die Autoren nachhaltige Instandhaltungspraktiken für spezifische Systeme oder Strategien, wie die nachhaltige totale productive Instandhaltung (STPM), während andere Forscher die Einbindung von Nachhaltigkeitsaspekten in Instandhaltungsmethoden diskutieren.12,13,14. Autor führte eine umfassende Bewertung der Kriterien für die Einführung von Nachhaltigkeit durch und hob technologische Faktoren hervor, die es der verarbeitenden Industrie ermöglichen, eine positive nachhaltige Wirkung zu erzielen15Trotzdem sind im Rahmen des Industry-5.0-Paradigmas Nachhaltigkeit, Resilienz und auf KI basierende Entscheidungsfindung in keiner dieser Arbeiten vollständig integriert. Folglich werden Nachhaltigkeitsaspekte häufig durch separate Wartungsmethoden berücksichtigt. SHAP hebt sich unter den anderen erklärbarkeitsorientierten KI-Methoden (XAI) durch sein theoretisch fundiertes Verfahren zur Merkmalzuschreibung hervor.16,17,18.
Die datengestützte Entscheidungsfindung wird durch KI ermöglicht, aber genaue Modelle erfordern oft große Datenmengen. Herkömmliche maschinelle Lernverfahren (ML), wie Entscheidungsbäume, logistische Regression und lineare Regression, erzielen bei stark nichtlinearen Gegebenheiten häufig schlechte Ergebnisse, da sie relativ einfache Datenverteilungen annehmen19. Tiefe neuronale Netze (DNNs) umgehen diese Einschränkungen, indem sie komplexe Merkmalsdarstellungen aus umfangreichen Datensätzen erlernen20. Untersuchungen zeigen, dass tiefere Netze bei komplexen Entscheidungsaufgaben oft besser abschneiden als flachere Strukturen21, doch mit zunehmender Tiefe und Parameterkomplexität wird das Modell weniger interpretierbar22.
Ein Cyber-Physisches System (CPS) ist eine entscheidende Schlüsseltechnologie für die Industrie-5.0-Produktion, da es verteilte Intelligenz, eingebettete Computer, physikalische Prozesse und Kommunikation kombiniert. Um flexible, intelligente und echtzeitfähige industrielle Abläufe zu ermöglichen, integrieren moderne CPSs zunehmend Edge-Computing, Edge-AI und das grüne Internet der Dinge (G-IoT)23,24. Nachhaltigkeit und Resilienz wurden in jüngsten Studien zu Wartung 4.0 und intelligenter Wartung hervorgehoben. Während frühere Arbeiten die Bedeutung der Wartung-4.0-Technologie in der nachhaltigen Fertigung untersucht und Modellierungsrahmenwerke für eine nachhaltige Wartung vorgeschlagen haben, haben bibliometrische und systematische Studien intelligente Wartungstechnologien bewertet25,26,27,28. Weitere Forschungsarbeiten haben die Integration nachhaltiger Wartung in Industrie-4.0-Umgebungen sowie auf Nachhaltigkeit ausgerichtete Produktionssysteme untersucht29,30,31,32. Das Konzept des Operators 4.033, menschenzentrierte Industrie-5.0-Rahmenwerke34 und sozioökonomische Perspektiven35 haben allesamt erhebliche Aufmerksamkeit für die menschenzentrierte Wartung erregt. Zudem wurden Fortschritte bei der digitalen Wartung36, der prädiktiven und präskriptiven Wartung37,38 sowie nachhaltigen Wartungsstrategien39,40 in jüngsten Studien betont. Trotz dieser Fortschritte bleibt die Forschung verstreut, und nur wenige Studien bieten ein kohärentes Paradigma, das erklärbares KI, Nachhaltigkeit, Resilienz und menschenzentrierte cyber-physische Zusammenarbeit integriert. Cyber-Physische Systeme (CPSs) haben trotz zunehmender Implementierung keine vollständige Autonomie erreicht, und das Paradigma der Industrie 5.0 befürwortet dies auch nicht. Vielmehr legt die Industrie 5.0 stärkeren Wert auf menschliche Überwachung, Kooperation und Entscheidungsfindung. Durch die Einbindung menschlichen Denkens und Zusammenarbeit in cyber-physische Prozesse erweitern cyber-menschliche Systeme wie Cyber-Physische Systeme mit Mensch-in-der-Schleife (HiLCPSs)41, menschenzentrierte CPSs (HCPSs)42,43 und cyber-physisch-menschliche Systeme (CPHSs)44 die traditionellen CPSs. Diese Integration verbessert Anpassungsfähigkeit, Transparenz, Sicherheit und Resilienz, indem sie eine Echtzeit-Zusammenarbeit zwischen intelligenten Systemen und menschlichen Bedienern ermöglicht45,46.
Die industrielle Audio-Anomalieerkennung wurde durch neue Architekturen wie den Vision Transformer (ViT), den Audio Spectrogram Transformer (AST), den Conformer und das selbstüberwachte Lernen erheblich verbessert; ihre Integration in erklärungsorientierte cyber-physische Systeme für Industrie 5.0 bleibt jedoch begrenzt. Solange Erklärbarkeit, Edge-Deployment und menschliche Entscheidungsunterstützung nicht in einem einzigen Framework integriert sind, konzentriert sich die aktuelle Forschung hauptsächlich auf Klassifizierungsgenauigkeit oder auf nachträgliche, auf XAI basierende Interpretierbarkeit. Diese Studie schlägt eine neuartige, auf Erklärbarer KI basierende CNN-Transformer-Architektur für die Zusammenarbeit in cyber-physischen Systemen vor, die Edge-Computing, Modellierung zeitlicher Abhängigkeiten, SHAP-basierte Erklärbarkeit, räumliches Merkmalslernen und eine menschenzentrierte Entscheidungsunterstützung kombiniert, um eine nachhaltige Fertigung in der Industrie 5.0 zu ermöglichen und diese Einschränkungen zu überwinden.
Daher besteht weiterhin ein erheblicher Forschungsbedarf. Aktuelle akustische Anomalieerkennungsverfahren auf Basis von CNNs oder Transformatoren legen den Schwerpunkt auf Klassifizierungsgenauigkeit, weisen jedoch einen Mangel an cyber-physischer Zusammenarbeit und Erklärbarkeit auf. Während Industrie-5.0-Rahmenwerke konzeptionell menschenzentrierte Modelle bieten, integrieren sie nicht erklärbare Deep-Learning-Verfahren, Edge-Intelligenz und nutzerunterstützte Entscheidungsfindung in einem einzigen System. XAI-basierte prädiktive Wartungstechniken erhöhen zwar die Transparenz, arbeiten jedoch unabhängig von CPHS-Architekturen. Ein einziges Industrie-5.0-Cyber-physisches Mensch-System, das präzise akustische Anomalieerkennung, SHAP-basierte Erklärbarkeit, Edge-fähige Implementierung und menschliche Einbindung in den Entscheidungsprozess integriert, fehlt daher nach wie vor.
Dieser Artikel stellt ein neuartiges, auf Erklärbarer KI basierendes CNN-Transformer-Cyber-Physical-Collaboration-Paradigma für die Industrie 5.0 vor, um diese Einschränkungen zu überwinden. Die vorgeschlagene Architektur integriert die Bereitstellung am Edge-Computing, die räumliche Merkmalsextraktion auf Basis von CNNs, das Lernen zeitlicher Abhängigkeiten mithilfe von Transformern, Erklärbarkeit auf Basis von SHAP sowie die Entscheidungsunterstützung durch menschliche Beteiligung in einem einzigen CPHS-Rahmenwerk. Im Gegensatz zu bestehenden Ansätzen, die diese Aspekte unabhängig voneinander behandeln, bietet das vorgeschlagene Rahmenwerk eine integrierte Lösung, die gleichzeitig die Leistung bei der Anomalieerkennung, die Transparenz des Modells, die betriebliche Effizienz und die menschzentrierte Zusammenarbeit für eine nachhaltige Produktion verbessert.
Das Hauptziel dieser Studie ist es, ein erklärbares KI-gestütztes cyber-physisches Mensch-System (CPHS) für eine nachhaltige Industrie-5.0-Produktion zu entwickeln, indem Erklärbarkeit auf SHAP-Basis, Edge-Computing und eine Entscheidungsunterstützung mit Einbeziehung des Menschen mit einem hybriden, akustischen Ansatz zur Anomalieerkennung auf Basis von CNN-Transformer kombiniert werden. Insbesondere zielt der vorgeschlagene Rahmen darauf ab, die Genauigkeit der Anomalieerkennung zu verbessern, gleichzeitig klare und verständliche Vorhersagen zu liefern, eine effiziente Bereitstellung am Edge zu ermöglichen und die kooperative Entscheidungsfindung zwischen intelligenten Systemen und menschlichen Bedienern zu fördern. Durch die gleichzeitige Erreichung hoher Erkennungsleistung, Erklärbarkeit, Betriebs mit geringer Latenz und einer menschenzentrierten cyber-physischen Zusammenarbeit behebt diese integrierte Architektur die Schwächen bestehender Ansätze zur akustischen Anomalieerkennung, XAI-basierten prädiktiven Wartung sowie CPHS-Systemen.
Die vorgeschlagene Architektur stellt im Gegensatz zu aktuellen Verfahren zur akustischen Anomalieerkennung, die hauptsächlich auf Klassifikationsgenauigkeit abzielen, ein einheitliches erklärbares KI-gestütztes cyber-physisches Mensch-System (CPHS) für Industrie 5.0 vor. In einer einzigen Architektur kombiniert sie räumliche Merkmalsextraktion basierend auf CNNs, zeitliche Modellierung mittels Transformer, Erklärbarkeit auf Basis von SHAP, Edge-Computing und die Einbindung menschlicher Entscheidungsträger. Die vorgeschlagene Architektur adressiert zentrale Aspekte wie Transparenz, Unterstützung der Bediener und cyber-physische Zusammenarbeit, indem sie präzise Anomalieerkennung mit nachvollziehbarem Entscheidungsprozess und echtzeitfähiger Implementierung am Edge verbindet. Der wesentliche wissenschaftliche Beitrag dieser Arbeit liegt in der systemweiten Integration, wodurch sich der vorgeschlagene Ansatz von früheren Arbeiten unterscheidet, die entweder allein auf Anomalieerkennung, erklärbare KI oder Frameworks für Industrie 5.0 fokussiert waren.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Die vorgeschlagene Methodik verwendet einen systembasierten Ansatz des cyber-physischen Mensch-Systems (CPHS) gemäß Industrie 5.0, der erklärbares Deep Learning mit einem durch Edge Computing ermöglichten cyber-physischen Zusammenarbeitssystem kombiniert, um nachhaltige Fertigungsprozesse zu unterstützen. Zunächst wird das Problem angegangen, indem bestimmte Grenzen bestehender CPHS-Lösungen erkannt werden, wie beispielsweise der Mangel an KI-gestützter Intelligenz, Erklärbarkeit und menschenzentrierter Zusammenarbeit. Um die Herausforderungen zu bewältigen, nutzt die vorgeschlagene Lösung den MIMII-Datensatz für die Überwachung des Zustands industrieller Maschinen mittels akustischer Signalverarbeitung.
Der vorgeschlagene Ansatz beginnt damit, die erzeugten Spektrogramme einem CNN-Modell zuzuführen, das räumliche Merkmale extrahiert, indem es signifikante Frequenzmuster erkennt, die mit verschiedenen Maschinenzuständen assoziiert sind. Die extrahierten räumlichen Merkmale werden anschließend in Sequenzen umgewandelt und einem Transformer-Encoder-Modul zugeführt, um zeitliche Abhängigkeiten mittels Selbst-Attention zu erfassen. Die transformierte Merkmalsdarstellung wird danach an ein vollverknüpftes Klassifizierungsmodul weitergeleitet, um Maschinenzustände als normal oder abnormal einzustufen. Zusätzlich wird zur Gewährleistung von Transparenz und zur Unterstützung menschzentrierter Entscheidungsfindung der SHAP-Erklärbarkeitsansatz verwendet, um Vorhersagen zu erläutern, indem bedeutende Zeit-Frequenz-Bereiche in der Modellausgabe ausgewählt werden. Das entwickelte Modell wird in einer CPS-Umgebung mit Edge-Funktionalität implementiert, wodurch Echtzeit-Inferenz mit geringer Rechenlatenz und geringem Energieverbrauch ermöglicht wird. Außerdem wird ein Mensch-in-der-Schleife-Konzept integriert, sodass menschliche Bediener mithilfe der Erklärbarkeitsergebnisse Validierungen vornehmen können. Die Leistung wird anhand von Genauigkeit, Präzision, Sensitivität und F1-Score sowie weiteren systembezogenen Metriken wie Latenz und Energieeffizienz überprüft.
Der vorgeschlagene Rahmen ist ein XAI-gestützter CPHS-Mechanismus für nachhaltige Produktion im Kontext von Industry 5.0, und sein Workflow wird als Pipeline von der Datenerfassung bis zur intelligenten Entscheidungsfindung und -durchführung dargestellt, wie in Abbildung 1 gezeigt. In der Anfangsphase des Datenerfassungsverfahrens werden Schallsignale von Maschinen in Branchen wie Motoren, Pumpen und Lagern mithilfe von Datensätzen wie MIMII erfasst. Die so erhaltenen Datensignale werden an die nächste Stufe weitergeleitet, die als Daten-Präprozessierung bezeichnet wird, wo sie Filterung, Normalisierung und Segmentierung durchlaufen. Die segmentierten Datensignale werden abschließend in der Schicht der Merkmalsdarstellung mittels der Kurzzeit-Fourier-Transformation (STFT) in ein Spektrogramm umgewandelt.
Anschließend verwendet die KI-Modellschicht die Spektrogrammbilder, um mithilfe des CNN-Moduls Merkmale zu extrahieren und räumliche Muster sowie Anomalien zu identifizieren. Danach werden die extrahierten Merkmale umgeformt und in den Transformer-Encoder eingespeist, der zeitliche Abhängigkeiten und langreichweitige Beziehungen durch Selbstbeachtungsmechanismen lernt. Die resultierenden Merkmalsvektoren werden mittels der Klassifikationsschicht als normal oder abnormal klassifiziert. Um Transparenz im Vorhersageprozess sicherzustellen, verwendet die Erklärbarkeitsschicht SHAP, um bedeutende Zeit-Frequenz-Bereiche im Spektrogramm hervorzuheben.
Zusätzlich gibt es einen menschlich überwachten Prozess, bei dem Bediener die Ergebnisse des Modells interpretieren und Rückmeldungen dazu geben. In der Einsatzschicht läuft das Modell auf einer edge-basierten CPHS-Infrastruktur, wodurch eine schnelle Inferenz und ein geringer Energieverbrauch sichergestellt werden, und kann optional mit Cloud-Systemen für Speicherbedarf oder erweiterte Analysen verbunden sein. Insgesamt gewährleistet das Framework eine genaue Fehlererkennung, Nachvollziehbarkeit und einen effizienten Echtzeitbetrieb, die den Anforderungen von Industry 5.0 entsprechen.
Problembeschreibung und Anforderungsanalyse
Cyber-physikalische Mensch-Systeme (CPHS) in Industrie-5.0-Umgebungen versprechen Intelligenz, Nachhaltigkeit und eine menschenzentrierte Herangehensweise. Dennoch sind aktuelle Frameworks zur Entwicklung von CPHS durch einen Mangel an fortschrittlichen, KI-gestützten Fähigkeiten, Erklärbarkeit und ausreichender Unterstützung für die Mensch-Maschine-Zusammenarbeit eingeschränkt. Tatsächlich basieren herkömmliche CPHS auf regelbasierten oder nicht interpretierbaren Modellen, was die Anpassung an wechselnde industrielle Bedingungen erschwert und das Vertrauen der Bediener in die Automatisierung begrenzt. Zudem können herkömmliche CPHS hochkomplexe Daten, wie industrielle akustische Signale mit räumlichen (d. h. frequenzabhängigen) und zeitabhängigen Komponenten, die für die vorausschauende Wartung wichtig sind, nicht effektiv analysieren. Daher ist es notwendig, ein Framework zu entwickeln, das Maschinenanomalien mit hoher Genauigkeit erkennen, Erklärungen liefern und am Netzrand (Edge) arbeiten kann, wodurch CPS ermöglicht werden.
Hier ist x(t) das akustische Eingangssignal, S(f,t) ist die Spektrogrammdarstellung des Signals,  ist die Bezeichnung und θ ist der Parametersatz der CNN-Transformer-Architektur. Symbole, die in nachfolgenden Gleichungen verwendet werden, werden direkt nach ihrem ersten Auftreten eingeführt, um die mathematische Korrektheit zu gewährleisten.
Aus mathematischer Sicht lässt sich die Aufgabe als überwachtes Lernproblem formalisieren. Sei das industrielle akustische Signal mit x(t) bezeichnet. Die STFT von x(t) wird gemäß der folgenden Formel berechnet:
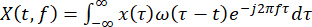 (1)
wo ω(.) ist die Fensterfunktion und f ist die Frequenz. Das erzeugte Spektrogramm 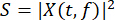 dient als Eingabe für den Deep-Learning-Algorithmus. Das Ziel besteht darin, die Abbildungsfunktion zu trainieren
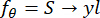 (2)
wobei die Klassenbezeichnung (entweder normal oder abnormal) ist und wobei S die spektrogrammbasierte Eingabe, y die vorhergesagte Ausgabebezeichnung und θ die Menge der lernbaren Parameter der CNN-Transformer-Architektur ist. Das Optimierungsproblem wird als Minimierung des Klassifizierungsverlusts formuliert:
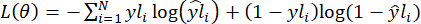 (3)
unter Berücksichtigung der Einschränkungen durch minimale Latenz  , Energieeffizienz
 und Interpretierbarkeit, wobei die Erklärung ∅(SHAP) die Bedeutung der Merkmale im Vorhersageprozess erfasst,
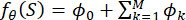 (4)
wobei  der Beitrag jedes einzelnen Merkmals ist. Entsprechend dem Vorstehenden umfasst die Konstruktionsanforderungen Folgendes: (i) zuverlässige Anomalieerkennung basierend auf hybriden Deep-Learning-Verfahren, (ii) interpretierbare Ausgaben für menschliches Eingreifen und (iii) Implementierung in einem edge-erweiterten CPS-Framework.
Erwerbung und Vorverarbeitung des Datensatzes
Zur Bewertung des vorgeschlagenen erklärbarkeitsbasierten CPHS-Frameworks auf KI-Basis wurde in diesem Zusammenhang der MIMII-Datensatz13 ausgewählt. Dieser Datensatz ist ein weithin genutzter Benchmark zur Erkennung von Anomalien in industriellen Maschinen mithilfe akustischer Signale. Die Datenbank enthält Tonaufnahmen verschiedener Maschinen, wie zum Beispiel von Schiebeschienen, Ventilatoren, Pumpen und Ventilen, sowohl unter normalen als auch unter fehlerhaften Betriebsbedingungen. Für jede Maschine variieren die Aufnahmen je nach unterschiedlichen Einstellungen und Geräuschumgebungen. Dadurch eignet sich der Datensatz gut zum Trainieren und Evaluieren von Modellen unter echtzeitnahen industriellen Bedingungen.
Während der MIMII-Datensatz in vielen Studien zur unüberwachten Anomalieerkennung verwendet wird, die ausschließlich auf normalen Beispielen während des Trainings beruhen, enthält er explizite Annotationen sowohl normaler als auch anormaler Maschinenzustände. Das Problem wird als überwachte binäre Klassifizierungsaufgabe formuliert, um die Fähigkeit der vorgeschlagenen erklärbarkeitsbasierten CNN-Transformer-Architektur zu testen, gesunde von fehlerhaften Maschinenzuständen zu unterscheiden. Dabei werden speziell die offiziellen MIMII-Kennzeichnungen verwendet, wobei die Klasse 0 normalen Beispielen und die Klasse 1 anormalen Beispielen zugewiesen wird.
Tabelle 1 zeigt die Details zur Datensatzbeschreibung. In der vorliegenden Studie wurden etwa 12.000 Aufzeichnungen akustischer Signale berücksichtigt, darunter sowohl normale als auch fehlerhafte Maschinenbetriebszustände. Gemäß den Anforderungen wurden alle Aufzeichnungen in dieser Studie mit 16 kHz abgetastet und sind jeweils 10 s lang. Obwohl der Datensatz etwa 12.000 Aufzeichnungen umfasst, wurde allein zur Visualisierung der Konfusionsmatrix ein klassenbalancierter Teildatensatz aus 2.000 Testaufzeichnungen ausgewählt. Alle angegebenen Leistungsmetriken wurden anhand des vollständigen Testdatensatzes (etwa 2.400 Aufzeichnungen) berechnet. Darüber hinaus erfolgte die Aufteilung von Trainings- und Testdaten im Verhältnis 80:20 zur Modelltrainierung. Diese Datenbank eignet sich besonders gut für Anwendungen im Bereich Industrie 5.0, da sie Echtzeit-Störgeräusche enthält. Die in dieser Studie verwendete Verteilung der Aufzeichnungen ist in Tabelle 2 dargestellt. Aus diesem Datensatz wurden etwa 12.000 Aufzeichnungen, die alle Maschinentypen und Signal-Rausch-Verhältnis-(SNR-)Bedingungen abdecken, für Experimente zur überwachten binären Klassifizierung unter Verwendung einer 80:20-Trainings-/Test-Aufteilung ausgewählt; diese zeigt die industriellen Maschinentypen, die entsprechenden Maschinenkennungen, die Gesamtanzahlen normaler und anormaler akustischer Aufzeichnungen, die SNR-Bedingungen sowie die für die überwachte binäre Klassifizierung verwendete experimentelle Aufteilung in Trainings- und Testdaten.
Das Experiment wurde mit dem MIMII-Datensatz (Malfunctioning Industrial Machine Investigation and Inspection), Version 1.0, durchgeführt, der vier Arten von Industriemaschinen umfasst: Ventilatoren, Pumpen, Ventile und Schiebeschienen. Die Daten wurden von verschiedenen Maschinen-IDs (ID00–ID06, abhängig vom Maschinentyp) und unter verschiedenen Bedingungen erfasst. Die MIMII-Datenbank enthält Daten, die bei Signal-Rausch-Verhältnissen (SNR) von −6 dB, 0 dB und +6 dB aufgezeichnet wurden. Normale Daten entsprechen dem gesunden Zustand der Industriemaschine, während anormale Daten einem anomalen Zustand entsprechen. Die Klassen wurden basierend auf der Annotation der Datenbank festgelegt, wobei normale Daten als Klasse 0 und anormale Daten als Klasse 1 gekennzeichnet wurden.
Ein faires Evaluierungsverfahren erforderte, dass die Aufteilung in Trainings- und Testmengen auf Ebene der ursprünglichen Audioaufnahmen erfolgte, bevor irgendwelche Teilungen, Datenaugmentierungen oder Erzeugungen von Spektrogrammen durchgeführt wurden. Dadurch konnten Audiodatenabschnitte aus derselben Aufnahme nicht sowohl in der Trainings- als auch in der Testmenge vorkommen. Für das Evaluierungsexperiment wurden Aufnahmen mit unterschiedlichen Signal-Rausch-Verhältnissen (−6 dB, 0 dB und +6 dB) verwendet, was die Möglichkeit bot, das vorgeschlagene Framework unter verschiedenen industriellen Bedingungen zu bewerten.
Um Datenlecks zu vermeiden, erfolgte die Aufteilung in Trainings- und Testmenge basierend auf der ursprünglichen Audiodatei, bevor eine Segmentierung oder Spektrogrammerzeugung durchgeführt wurde. Segmente aus der gleichen 10-s-Audioaufnahme wurden ausschließlich entweder der Trainings- oder der Testmenge zugeordnet, wobei keine Segmente in beiden Mengen vorhanden waren. Anschließend wurden die Spektrogramme separat für jeden Datensatz erzeugt und erweitert. Auf diese Weise wird das Problem von Datenlecks vermieden, wodurch eine übermäßig optimistische Bewertung der Leistung verhindert wird.
Vorverarbeitung des Datensatzes
Die unbehandelten akustischen Signale aus dem MIMII-Datensatz werden anschließend verarbeitet, um die Signalqualität zu verbessern und eine effektive Merkmalsextraktion zu ermöglichen. Das Eingangssignal wird mit x(t) bezeichnet, wobei t die Zeit darstellt. Der erste Schritt ist die Rauschfilterung, bei der Hintergrundgeräusche mithilfe einer Filterfunktion herausgefiltert werden, sodass gilt:
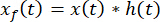 (5)
wobei ∗ den Faltungsprozess und h(t) die Impulsantwort des Filters darstellt. Dieser Prozess verbessert die Klarheit des akustischen Signals und minimiert die Auswirkungen von Rauschen, das in industriellen Umgebungen häufig auftritt. Die Signalnormalisierung dient dazu, sicherzustellen, dass die Amplituden aller Audiosignale vergleichbar sind, bevor sie in das Deep-Learning-Modell eingespeist werden. Das normalisierte Signal, bezeichnet als xn(t), wird berechnet als:
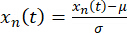 (6)
wobei μ und σ der Mittelwert und die Standardabweichung des Eingangssignals sind. Alle Eingangssignale weisen aufgrund dieses Verfahrens garantiert einen Mittelwert von null und Varianzen von eins auf. Schließlich wird das normalisierte Eingangssignal zur Verarbeitung in mehrere kleine Abschnitte unterteilt. Unter der Annahme, dass die Länge des gesamten Signals T beträgt, wird es mithilfe einer gleitenden Fensterfunktion in N überlappende Frames zerlegt, wobei jeder eine Länge L aufweist:
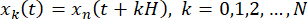 (7)
wobei H die Hop-Größe ist. Das Spektrogramm kann durch die folgende Formel definiert werden:
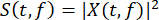 (8)
Die auf diese Weise gewonnenen Spektrogramme werden in das auf CNN-Transformern basierende Framework eingespeist, um räumliche und zeitliche Merkmale für eine erfolgreiche Anomalieerkennung zu extrahieren. Abbildung 2 zeigt die Vorverarbeitungspipeline.
Abbildung 2 veranschaulicht eine vertikale Vorverarbeitungspipeline, die für akustische Daten aus der Industrie verwendet werden kann. Zunächst werden die Rohaudiosignale aus dem MIMII-Datensatz extrahiert und zur Rauschunterdrückung weitergeleitet, um Störgeräusche zu reduzieren. Anschließend erfolgt die Normalisierung des Signals, um Amplitudenunterschiede auszugleichen und eine konsistente Signalqualität sicherzustellen. Danach wird das Signal in kleinere, sich überlappende Abschnitte unterteilt. Nach der Segmentierung werden STFT-Transformationen auf die Daten angewendet, um die Signale vom Zeitbereich in den Zeit-Frequenz-Bereich zu überführen. Daraufhin wird das Leistungsspektrum zur Erzeugung des Spektrogramms des Signals berechnet. Die vorverarbeiteten Spektrogramme sind somit das Ergebnis dieses Prozesses und werden im vorgeschlagenen CNN-Transformator-Modell verwendet.
Erzeugung von Spektrogrammen
Nach der Datennormalisierung und -segmentierung werden akustische Signale mithilfe der Kurzzeit-Fourier-Transformation (STFT) in eine Zeit-Frequenz-Darstellung umgewandelt. Das resultierende Spektrogramm liefert eine bildhafte Darstellung der Änderungen in der Frequenzzusammensetzung über den Analysezeitraum hinweg. In industriellen Anwendungen zeigen sich Maschinenstörungen gewöhnlich als Frequenzmuster, wodurch Spektrogramme besonders nützlich zur Erkennung von Maschinenanomalien sind.
Die resultierenden verarbeiteten Daten werden daher in Spektrogrammbilder umgewandelt, um zwischen normalen und abnormalen Fällen innerhalb der Maschinen zu unterscheiden. Die Audiodaten werden in mehrere Spektrogramme umgewandelt, damit das Lernmodell lokale Frequenzkomponenten und zeitliche Veränderungen im Maschinenprozess analysieren kann. Diese Bilder dienen als Eingabedaten für das CNN-Transformer-Modell, wobei das CNN räumliche (Frequenz-)Muster verarbeitet und die Transformer zeitliche Beziehungen erfassen.
Algorithmus 1: Erzeugung eines Spektrogramms aus akustischen Signalen
Eingabe: Roh-Audiosignal x(t)
Ergebnis: Spektrogramm S(t, f)
Schritt 1: Audiosignal x(t) laden
Schritt 2: Anwenden der Rauschfilterung
Schritt 3: Signal xn(t) normalisieren
Schritt 4: Signal in Rahmen segmentieren:
für k = 1 bis N ausführen
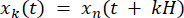
Ende für
Schritt 5: Eine Fensterfunktion w(t) auf jedes Segment anwenden
Schritt 6: Berechnung der STFT:
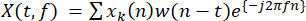 (9)
Schritt 7: Betrag berechnen:
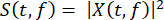 (10)
Schritt 8: Spektrogramm S(t, f) speichern
Schritt 9: Spektrogrammdatensatz zurückgeben
Der Prozess der Erzeugung von Spektrogrammen beginnt mit der Erfassung des ursprünglichen Audiosignals, gefolgt von Vorverarbeitungsschritten wie Rauschunterdrückung und Signalnormalisierung, um Integrität und Qualität des Signals sicherzustellen. Danach wird das normalisierte Audio in mehrere sich überlappende Fenster unterteilt, um die zeitlichen Eigenschaften sowohl über längere als auch kürzere Zeiträume hinweg zu erfassen. Um Spektralleckage zu vermeiden, wird jeder Ausschnitt vor der Weiterleitung an die Kurzzeit-Fourier-Transformation mit einer Fensterfunktion multipliziert. Anschließend wird das transformierte Signal als komplexwertige Funktion im Frequenzbereich dargestellt, und seine Beträge werden quadriert. So wird die Energie der Frequenzen über die gegebene Zeit durch die Spektrogramme repräsentiert. Schließlich werden sie als bilddatenähnliche Daten gespeichert und dem neuronalen Netzwerk zum Training zugeführt.
Räumliche Merkmalsextraktion unter Verwendung eines CNN
Nach dem Erstellen der Spektrogramme werden die resultierenden Zeit-Frequenz-Bilder als Eingaben verwendet und einem Faltungs-Neuronalen Netzwerk (CNN) zugeführt. Dabei wird das Eingabe-Spektrogramm als  , angenommen, wobei H den Frequenzbereich und W den Zeitbereich darstellt. Der Zweck der Verwendung des CNNs besteht darin, diskriminierende räumliche Merkmale aus dem Eingabe-Spektrogramm zu erlernen. Diese diskriminierenden räumlichen Merkmale ermöglichen es, zwischen normalem und abnormalem Maschinenverhalten in einer industriellen Umgebung zu unterscheiden.
Eine grundlegende Operation, die vom Faltungs-Neuronalen Netzwerk (CNN) durchgeführt wird, ist die Faltung. Die Faltung mit einem gegebenen Filter  wird wie folgt angegeben:
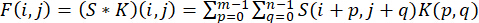 (11)
Der oben beschriebene Vorgang ermöglicht es dem neuronalen Netzwerk, lokale räumliche Merkmale wie Kanten, Frequenzen und harmonische Anteile im Spektrogramm zu erkennen. Dies erfolgt durch mehrere Filteroperationen, die verschiedene Merkmalsdarstellungen erzeugen und mehrere Merkmalskarten generieren. Auf die Faltung folgt eine nichtlineare Aktivierungsfunktion, wie unten dargestellt:
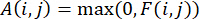 (12)
Diese Nichtlinearität ermöglicht es dem Netzwerk, komplexe Beziehungen zwischen Variablen zu erfassen und darzustellen. Die nächste Stufe in einem faltenden neuronalen Netzwerk umfasst die Anwendung von Pooling-Operationen. Die gängige Technik des Max-Pooling wird mathematisch wie folgt ausgedrückt:
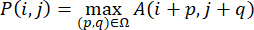 (13)
wobei Ω das Pooling-Fenster bezeichnet. Das Pooling trägt zur Erreichung von Translationsinvarianz bei und behält nur die relevanten Informationen bei, während Redundanzen verworfen werden. Von niedrigstufigen Variablen wie Frequenzen bis hin zu komplexem Maschinenverhalten können höherstufige Merkmale hierarchisch mithilfe eines faltenden neuronalen Netzwerks extrahiert werden. Folglich können Merkmalskarten verwendet werden, um die endgültige Ausgabe des Netzwerks darzustellen:
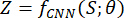 (14)
wobei die lernbaren Parameter des CNN darstellt. Die Merkmalskarten enthalten umfassende räumliche Informationen und werden in Sequenzen umgewandelt, um als Eingaben für den Transformer-Encoder in der nächsten Phase zu dienen. Der oben beschriebene Prozess der räumlichen Merkmalsextraktion ist entscheidend, um dem Modell die Erkennung minimaler Anomalien in industriellen akustischen Signalen zu ermöglichen.
Abbildung 3 zeigt, wie räumliche Merkmale mithilfe eines CNN-Modells horizontal aus dem Spektrogramm-Eingang extrahiert werden. Zunächst liegt das Eingabespektrogramm vor, das die Zeit-Frequenz-Eigenschaften des Audiosignals in bildlicher Form kodiert. Das Eingabespektrogramm wird anschließend über eine Faltungsschicht geleitet, in der verschiedene Filtertypen räumliche Merkmale wie Frequenzbänder, Kanten und Texturen extrahieren und dabei Merkmalskarten erzeugen. Danach durchlaufen die extrahierten Merkmalskarten eine nichtlineare Aktivierungsfunktion, die rectified linear unit (ReLU), wodurch das neuronale Netzwerk Abhängigkeiten in den Eingabedaten erkennen kann. Die Merkmalskarten werden danach über eine Pooling-Schicht geleitet, in der die Kartengröße reduziert wird, während ihre wichtigsten Merkmale erhalten bleiben. Dieser Prozess aus Faltungs-, Aktivierungs- und Pooling-Schichten wiederholt sich mehrfach und erzeugt eine Hierarchie der Merkmalsdarstellung, die mit einfachen Merkmalen beginnt und sich hin zu komplexeren Merkmalen entwickelt, die mit Maschinenoperationen zusammenhängen.
Zeitliche Modellierung unter Verwendung eines Transformer-Encoders
Sobald die räumlichen Merkmale mithilfe des CNN extrahiert wurden, besteht der nächste Schritt darin, Merkmalskarten auf hoher Ebene abzuleiten, die frequenzbasierte Muster erfassen, die aus dem Spektrogramm gelernt wurden. Die resultierenden Merkmalskarten werden anschließend abgeflacht und als Sequenzen umgeformt, um zeitliche Informationen im akustischen Signal zu erfassen. Unter der Annahme, dass die Merkmalskarten durch 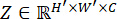 dargestellt werden, wobei H', W', und C jeweils Höhe, Breite und Kanäle bezeichnen, wird die folgende Sequenz abgeleitet:
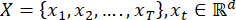 (15)
wobei T die Sequenzlänge und d die Merkmalsdimension darstellt. Der Transformer nutzt die obige Sequenz, um mithilfe eines Selbst-Attention-Mechanismus langfristige Abhängigkeiten zu modellieren. Im Gegensatz zu herkömmlichen rekurrenten Modellen verarbeitet das Transformer-Modell jedes Element der Sequenz parallel und verwendet Attention-Gewichte, um die relative Relevanz der einzelnen Elemente zu bestimmen. Der Attention-Mechanismus funktioniert, indem er Query-Q-, Key-K- und Value-V-Vektoren verwendet, die für jeden Eingang xt gemäß folgender Vorschrift erzeugt werden:
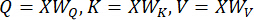 (16)
wobei WQ, WK, WV trainierbare Gewichte sind. Die Ähnlichkeiten zwischen den Elementen werden mithilfe folgender Gleichung bestimmt:
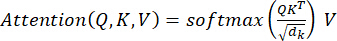 (17)
dk ist die Dimension der wichtigen Vektoren. Dieses Verfahren erleichtert es dem Modell, Abhängigkeiten aus entfernt liegenden Zeitpunkten des Signals zu lernen und sich ausschließlich auf die relevanten Zeitabschnitte zu konzentrieren. Um die Lernkapazität des Netzwerks zu erhöhen, wird die Multi-Head-Attention verwendet, bei der mehrere Attention-Köpfe parallel aus der Eingabe lernen:
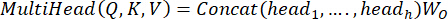 (18)
Jeder Kopf verarbeitet unterschiedliche Merkmale der zeitlichen Eingabesequenz. Dies wird gefolgt von feed-forward-Neuronalen Netzen und Residualverbindungen:
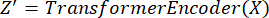 (19)
Die resultierende kodierte Sequenz erfasst sowohl die räumlichen als auch die zeitlichen Merkmale des Eingabesignals. Diese Sequenz wird zur Anomalieerkennung an die Klassifizierungsschicht gesendet.
Abbildung 4 zeigt den gesamten Prozess der zeitlichen Modellierung mithilfe eines Transformer-Encoders auf Merkmalen, die aus dem CNN extrahiert wurden. Zunächst werden die aus dem CNN extrahierten Merkmalskarten verwendet, die räumliche Informationen aus dem Spektrogramm enthalten. Die Merkmalskarten werden zu einer Sequenz abgeflacht, wobei jedes Element einem Zeitstempel entspricht. Anschließend durchläuft die Sequenz eine lineare Transformation, die die Daten in Vektoren einer bestimmten Dimension abbildet. Da Transformator-Modelle nicht in der Lage sind, zeitliche Abhängigkeiten zu erfassen, wird den Einbettungsvektoren zusätzlich eine Positions-Codierung hinzugefügt, um die zeitliche Struktur der Sequenz zu bewahren. Schließlich durchläuft die Sequenz einen Transformer-Encoder, der aus einem Stapel mehrerer Schichten besteht, in denen ein Multi-Head-Self-Attention-Mechanismus eingesetzt wird, um dem Modell das Erlernen von Zusammenhängen zwischen den Zeitstempeln in der Sequenz zu ermöglichen. Das Feed-Forward-Neurale-Netzwerk verbessert diese Einbettungen weiter, während Residualverbindungen sicherstellen, dass die Gradienten effizient weitergeleitet werden. Der Prozess wird über die gestapelten Transformer-Encoder-Schichten hinweg wiederholt, wodurch zunehmend komplexere zeitliche Wechselwirkungen erfasst werden. Am Ende werden die Sequenzeinbettungen durch Pooling (z. B. Mittelwert-Pooling oder das Klassifikationstoken (CLS)) zu einer Darstellung fester Länge kombiniert, wodurch eine globale zeitliche Merkmalsdarstellung entsteht.
Klassifikationsschicht
Nach der zeitlichen Kodierung mittels des Transformer-Encoders bestehen die Ausgaben aus einer Sequenz kodierter Vektoren, von denen jeder Merkmale enthält, die sowohl die räumlichen als auch die zeitlichen Aspekte des Eingangssignals betreffen. Der erste Schritt zur Klassifizierung anhand der kodierten Ausgaben besteht darin, all diese Merkmale zu einem einzigen Vektor zusammenzufassen. Dies wird entweder erreicht, indem auf die Sequenz der Merkmalsvektoren eine Mittelwert-Pooling-Operation angewendet wird, oder indem das sogenannte „Klassifizierungstoken“ verwendet wird. Angenommen, die Ausgabe des Transformers ist 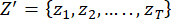 , wobei jeder
 . Das aggregierte Merkmal h wird berechnet als:
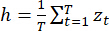 (20)
Anschließend stellt der aggregierte Merkmalsvektor h die Eingabe in kompakter Form dar und dient als Eingabe für den Klassifikator. Der Klassifikationsteil besteht aus einer oder mehreren dichten Schichten, die die gelernte Darstellung in den Ausgaberaum transformieren. Eine dichte Schicht implementiert eine Transformation, die wie folgt definiert ist:
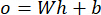 (21)
wobei o die Ausgabe (Logits), b der Bias-Vektor und W die Gewichtungsmatrix ist. Letztere stellen die Klassenscores in nicht normalisierter Form dar. Um Nichtlinearität in das Modell einzubauen, werden häufig Aktivierungsfunktionen wie ReLU verwendet. Abschließend wird eine Softmax-Aktivierungsfunktion auf die Logits angewendet, um die Wahrscheinlichkeit für jede Klasse zu erhalten:
 (22)
wobei C die Anzahl der Klassen darstellt (C = 2; normal und abnormal). Die Klassenvorhersage basiert auf dem maximalen Wahrscheinlichkeitswert. Während des Trainings werden die optimalen Werte der Modellparameter durch Minimierung des Cross-Entropy-Verlusts zwischen den tatsächlichen und vorhergesagten Beschriftungen ermittelt, wodurch eine genaue Klassifizierung der Maschinenzustände erreicht wird. Zusammenfassend erfüllt die Klassifizierungsschicht eine wesentliche Funktion bei der Umwandlung der mit der Transformer-Architektur extrahierten zeitlichen Merkmale in praktische Entscheidungen. Durch eine geeignete Unterscheidung zwischen gesunden und fehlerhaften Maschinenzuständen wird die Anomalieerkennung und eine intelligente Entscheidungsfindung im Rahmen des Industry-5.0-Paradigmas ermöglicht.
Abbildung 5 zeigt, wie die Klassifizierungsschicht funktioniert, die auf den Transformer-Encoder folgt. Der Prozess beginnt mit der codierten Sequenz-Ausgabe, bei der jeder Vektor zeitliche Informationen enthält, die aus der Eingabe gelernt wurden. Diese Vektoren werden zu einem einzigen Vektor kombiniert, der als globaler Merkmalsvektor bekannt ist. Im nächsten Schritt wird der globale Merkmalsvektor durch mehrere dichte neuronale Netzwerkschichten geleitet. In jeder dichten Schicht werden Matrixmultiplikationsoperationen durchgeführt, um lineare Kombinationen der Eingaben zu erzeugen. Danach kann eine nichtlineare Aktivierungsfunktion wie ReLU angewendet werden, um die Flexibilität beim Lernen von Entscheidungsgrenzen zu erhöhen. Am Ende der letzten dichten Schicht liegen Logit-Scores für jede Klasse vor. Diese Logit-Scores können in die Softmax-Funktion eingespeist werden, um Wahrscheinlichkeitswerte für jede Klasse zu berechnen. Mithilfe dieser Wahrscheinlichkeitswerte wird bestimmt, ob die Eingabe zur Klasse 0 (Normal) oder Klasse 1 (Abnormal) gehört.
Erklärbarkeit mithilfe von SHAP
Nachdem das Modell Eingangssignale klassifiziert hat, werden Vorhersagen daraufhin generiert, ob die Maschine normal oder abnormal arbeitet. Innerhalb der Industrie-5.0-Umgebung reicht die Erzeugung von Vorhersagen jedoch nicht aus; das System muss zudem Transparenz und Erklärbarkeit bieten, um die menschliche Entscheidungsfindung zu unterstützen. Der folgende Ansatz verwendet SHAP, ein auf der Spieltheorie basierendes Modell, das die Bedeutung jeder einzelnen Merkmalsausprägung für die getroffene Vorhersage quantifiziert. Auf diese Weise weist SHAP den Merkmalen Gewichtungen zu, wodurch man die relative Bedeutung verschiedener Abschnitte der Spektrogramm-Eingabe für die Gesamtvorhersage bewerten kann.
Die mathematische Formulierung von SHAP basiert auf einer Zerlegung des Modells f(x):
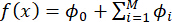 (23)
wobei ∅0 der Basiswert (mittlere Modellausgabe) ist, ∅i der Einfluss des i-ten Merkmals ist und M die Anzahl der Eingabemerkmale angibt. Im Rahmen dieser Studie handelt es sich bei den Merkmalen um die Zeit-Frequenz-Bins des Spektrogramms. SHAP-Werte sind positiv, wenn sie zur Wahrscheinlichkeit des abnormalen Zustands beitragen, andernfalls negativ. Diese Formulierung gewährleistet eine eindeutige, lokal konsistente Erklärung für jede Vorhersage. Die SHAP-Methode kann auf ein trainiertes CNN-Transformer-Modell angewendet werden, um eine Erklärung basierend auf der Merkmalsrelevanz zu liefern. Die visuelle Darstellung zeigt die wichtigsten Zeit-Frequenz-Bins im Spektrogramm, die den Entscheidungsprozess beeinflussen. Beispielsweise kann ein abnormales Verhalten der Ausrüstung bestimmte frequenzreiche Bereiche mit hoher Energie erzeugen, die das SHAP-Framework als wichtige Beiträge zum Entscheidungsprozess identifiziert.
Darüber hinaus kann SHAP die Zusammenarbeit zwischen Menschen und Maschinen in einer cyber-physischen Umgebung fördern. Dies liegt daran, dass die Vorhersagen mithilfe intuitiver Visualisierungen erklärbar sind, wodurch die Bediener und Entscheidungssysteme die Vorhersagen überprüfen, das Problem analysieren und geeignete Maßnahmen ergreifen können. Dies erhöht nicht nur das Vertrauen, sondern macht auch künstliche Intelligenz-basierte Fertigungsprozesse zuverlässig und nachvollziehbar. Durch die Integration von Deep-Learning-Algorithmen, die den aktuellen Leistungsstandards entsprechen, mit SHAP, das Erklärbarkeit bietet, erfüllt die vorgeschlagene Architektur die Anforderungen von Industrie 5.0.
Algorithmus 2: SHAP-basierte Erklärbarkeit für Modellvorhersagen
Eingabe: Trainiertes Modell f(x), Eingabespektrogramm S
Ergebnis: SHAP-Werte  und Erklärungskarte
Schritt 1: Spektrogramm S in ein trainiertes Modell eingeben
Schritt 2: Vorhersage berechnen: y = f(S)
Schritt 3: Initialisieren Sie einen auf maschinelles Lernen ausgerichteten SHAP-Erklärer
Schritt 4: Berechnung der SHAP-Werte:
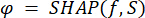
Schritt 5: Für jedes Merkmal i in S:
Berechnung des Beitrags 
Schritt 6: Erklärungskarte generieren:
Markieren Sie Bereiche mit hohem 
Schritt 7: Visualisierung der Merkmalswichtigkeit (Heatmap)
Schritt 8: SHAP-Werte und Erklärungskarte zurückgeben
Der auf SHAP basierende Erklärbarkeitsalgorithmus beginnt damit, ein vorverarbeitetes Spektrogrammbild als Eingabe zu erhalten und es in die trainierte CNN-Transformer-Architektur einzuspeisen, um Vorhersagen zu treffen (z. B. normaler oder abnormaler Maschinenzustand). Nachdem mit der trainierten Architektur Vorhersagen getroffen wurden, wird die SHAP-Methode verwendet, um das Modell zu interpretieren. Insbesondere werden die SHAP-Werte (ϕ) für jedes Eingabemerkmals berechnet, um herauszufinden, welche Zeit-Frequenz-Komponenten der Eingabe am stärksten zur Vorhersage beitragen. Um diese Werte zu berechnen, müssen die Modellausgaben für Eingaben mit und ohne bestimmte Merkmale verglichen werden.
Nach der Berechnung der SHAP-Werte für jedes Merkmal kann dessen Einfluss auf die Vorhersage anhand des Vorzeichens und der Größe des SHAP-Werts beurteilt werden. Beispielsweise beeinflussen Merkmale mit höheren SHAP-Werten das Ergebnis wahrscheinlicher, wobei ein positives oder negatives Vorzeichen angibt, dass das Merkmal die Vorhersage in Richtung der normalen beziehungsweise abnormalen Klasse lenkt. Basierend auf den Ergebnissen kann eine Erklärungskarte in Form einer Wärmekarte erstellt werden.
Abschließend gibt der Algorithmus sowohl die SHAP-Werte als auch die Visualisierungen aus, wodurch Einblicke in die Analyse der Modellentscheidungen durch Menschen ermöglicht werden. Die Methode erhöht die Transparenz des Prozesses und erlaubt es Menschen, sich an Entscheidungen zu beteiligen, wodurch sichergestellt wird, dass sowohl die Vorhersagen des Algorithmus als auch deren Zuverlässigkeit in der KI-gestützten Industrie erreicht werden. Repräsentative Testsamples wurden aus korrekt diagnostizierten anomalen Fällen verschiedener Maschinentypen ausgewählt, um die Zuverlässigkeit der Erklärbarkeitsanalyse zu verbessern. Während eine globale SHAP-Analyse der Merkmalswichtigkeit durch Aggregation der SHAP-Werte über den gesamten Testdatensatz durchgeführt wurde, um durchgängig einflussreiche Zeit-Frequenz-Bereiche zu identifizieren, wurden für diese repräsentativen Fälle lokale SHAP-Erklärungen erstellt. Diese integrierte lokale und globale Analyse bietet ohne Notwendigkeit einer Expertenannotation eine zuverlässige Interpretation der Modellvorhersagen.
Integration von CPS mit Edge-Funktionalität
Diese vorgeschlagene Lösung wird innerhalb des Edge-fähigen cyber-physischen Systems (CPS) eingesetzt, das Effizienz, Nachhaltigkeit und Echtzeit-Industrieoperationen anstrebt. Sobald das Modell trainiert wurde, wird der CNN-Transformer über einen Edge-Computing-Ansatz bereitgestellt. Die betreffende Edge-Computing-Schicht befindet sich in der Nähe von Geräten des industriellen Internets der Dinge (IIoT), einschließlich Sensoren und Maschinen. Anstatt alle gesammelten Daten in die Cloud zu übertragen, führt das Edge-Gerät die Inferenz des eintreffenden akustischen Signals durch, ohne es zuvor dorthin zu übermitteln. Dadurch kann das System Maschinenstörungen nahezu sofort erkennen und die erforderlichen Maßnahmen ergreifen, bevor sich die Situation weiter verschlechtert. Ein weiterer Vorteil dieses Edge-fähigen Ansatzes ist die verbesserte Latenz und Effizienz, da die Daten nahe dem Entstehungsort analysiert werden. Mit anderen Worten, im Gegensatz zum Cloud-Ansatz, bei dem die Inferenzzeit Tinf
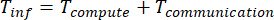 (24)
Die Latenz wird im Allgemeinen erheblich durch eine Verringerung von Tcommunication reduziert. Ein weiterer Vorteil besteht in geringerem Bandbreitenverbrauch und weniger Energieaufwand beim kontinuierlichen Übertragen von Daten. Daher ist dieses System für große Industrieanlagen mit zahlreichen vernetzten Geräten skalierbar und nachhaltig. Außerdem ermöglicht das CPS die Interaktion mit der physikalischen Schicht (Maschinen), der KI (rechnerischen Schicht) und der menschlichen Schicht.
Mensch-zentrierte Zusammenarbeit
Eine Schlüsselkomponente des vorgeschlagenen Industry-5.0-CPS, das menschliche Bediener umfasst, die aktiv gemeinsam mit KI-Modellen in den Entscheidungsprozess eingebunden sind, ist die Mensch-in-der-Schleife-Zusammenarbeit. Demnach wird das System gemäß dem entworfenen Rahmenwerk keine autonome Black-Box, sondern ermöglicht es Bedienern, mit ihm zu interagieren und nachvollziehbare Vorhersageergebnisse in Form von SHAP-Erklärungen zu beobachten. Die betreffenden Vorhersagen beziehen sich auf die Ergebnisse (normal/abnormal) und werden begleitet von Visualisierungen der Teile der Spektrogramme, die für deren Erstellung verwendet wurden.
Eine solche Interaktion hilft den Bedienern, besser zu verstehen, wie die Vorhersage zustande kommt und welche Faktoren zu ihr beitragen. Die Einbindung von Menschen beinhaltet die Überprüfung der Systemergebnisse und ermöglicht es den Bedienern, diese bei Bedarf auf der Grundlage ihres fachlichen Urteils zu überschreiben. Die Zusammenarbeit mit menschlichen Bedienern macht das System vertrauenswürdiger, effizienter, sicherer und zuverlässiger und hilft, Fehler zu vermeiden.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Das vorgestellte erklärbarkeitsbasierte KI-gestützte cyber-physische Kollaborationssystem wurde experimentell anhand von etwa 12.000 Audiodaten der MIMII-Datensammlung getestet, die sowohl normale als auch abnormale Maschinenzustände enthält. Der Trainingsdatensatz bestand aus ungefähr 9.600 Datensätzen, während der Testdatensatz etwa 2.400 Audiosignale umfasste. Basierend auf den Ergebnissen erreichte das vorgeschlagene CNN-Transformer-Modell eine Klassifikationsgenauigkeit von 98,5 % auf dem Testdatensatz, mit einem Be...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Die experimentellen Ergebnisse zeigen, dass die vorgeschlagene CNN-Transformer-Architektur einzelne Algorithmen übertrifft, indem sie das Lernen räumlicher und zeitlicher Merkmale effektiv integriert. Laut der Ablationsstudie verbessert der Transformer-Encoder die Modellleistung, indem er langreichweitige zeitliche Abhängigkeiten in akustischen Signalen erfasst, obwohl der CNN frequenzbasierte diskriminative Merkmale aus Spektrogrammen extrahiert. Darüber hinaus zeigt die Konfusionsmatrix nur sehr wenige falsch negative ...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Ein KI-Tool (ChatGPT) wurde ausschließlich zur Unterstützung bei der sprachlichen Bearbeitung sowie zur Verbesserung von Grammatik, Klarheit und Lesbarkeit verwendet. KI-Tools wurden nicht zur Erzeugung wissenschaftlicher Daten, Durchführung von Experimenten, Analyse von Ergebnissen, Interpretation von Befunden oder zur Ableitung wissenschaftlicher Schlussfolgerungen eingesetzt. Alle wissenschaftlichen Inhalte, Datenanalysen, Interpretationen und die endgültige Fassung des Manuskripts wurden unabhängig überprüft, verifiziert und von den Autoren genehmigt, die die vollständige Verantwortung für die Genauigkeit und Integrität der Arbeit übernehmen. Die Autoren haben keine Interessenkonflikte offenzulegen.
Danksagungen
FINANZIERUNG: Diese Arbeit wurde unterstützt durch das Schlüsselprojekt zur Hochschul-Lehrreform in der Provinz Shaanxi (Projekt-Nr. 23BG053); die Wissenschaftliche Forschungsstiftung für hochqualifizierte Fachkräfte der Shaanxi Polytechnic University (Projekt-Nr. BSJ-2023-08); sowie das wissenschaftliche Forschungsprojekt der Shaanxi Polytechnic University (Projekt-Nr. 2024YKYB-006). Die Autoren danken der Shaanxi Polytechnic University, Xianyang, China, und der Xi’an Traffic Engineering University, Xi’an, China, aufrichtig für die Bereitstellung der Einrichtungen und institutionellen Unterstützung, die diese Forschung ermöglicht haben.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Skala zur sozialen Unterstützung | Veröffentlichte akademische Skala; ursprünglich entwickelt von Park und überarbeitet/ergänzt von Kim | 25-Item-Version; Antwortformat nach Likert mit 5 Punkten; keine kommerzielle Katalognummer | Misst die wahrgenommene soziale Unterstützung bei angehenden Erzieherinnen für die frühe Kindheit in den Bereichen emotionale Unterstützung, informative Unterstützung, materielle Unterstützung und evaluative Unterstützung. Gesamt-Cronbach’s Alpha = 0,96. |
| Skala zur Lehrerselbstwirksamkeit | Veröffentlichte akademische Skala; ursprünglich entwickelt von Enochs und Riggs; chinesisch-adaptierte Studienversion | 25-Item-Version; Antwortformat nach Likert mit 5 Punkten; keine kommerzielle Katalognummer | Beurteilt die Lehrerwirksamkeit im chinesischen Kontext der Ausbildung für die frühe Kindheit in den Dimensionen allgemeine Lehrerselbstwirksamkeit und persönliche Lehrerselbstwirksamkeit. Gesamt-Cronbach’s Alpha = 0,96. |
| Skala zur Lehrer-Kind-Interaktion | Veröffentlichte akademische Skala; entwickelt von Lee und von einem Expertengremium der Studie für die Anwendung in China überprüft | 30-Item-Version; Antwortformat nach Likert mit 5 Punkten; keine kommerzielle Katalognummer | Beurteilt die selbstberichtete Kompetenz in der Interaktion zwischen Lehrkraft und Kind, nicht die beobachtete Qualität der Klassenrauminteraktion. Enthält emotionale Interaktion, verbale Interaktion und verhaltensbezogene Interaktion; Gesamt-Cronbach’s Alpha = 0,94. |
| Fragebogen zur Erhebung demografischer Informationen | Forschungsteam, Kooperation zwischen der Sichuan University of Arts and Science und der Daegu University | Individuell gestalteter Fragebogenabschnitt; keine kommerzielle Katalognummer | Erfasst Teilnehmermerkmale wie Geschlecht, Bildungshintergrund, Berufskategorie, Praktikumsort, Praktikumsdauer, Praktikumstyp und Kindergartentyp. |
| Informationen für Teilnehmer und Skript zur Einholung der informierten Einwilligung | Forschungsteam; genehmigt vom Ethikkomitee der Daegu University | Ethikgenehmigungsnummer: XXX; lokaler Genehmigungsnachweis zur Überprüfung | Wird vor der Verteilung des Fragebogens verwendet, um Ziel und Inhalt der Studie zu erläutern und die informierte Einwilligung der angehenden Erzieherinnen für die frühe Kindheit einzuholen. |
| Pilotbefragung – Fragebogenpaket | Forschungsteam und Expertengremium | Pilotversion verwendet vom 1.–5. Juni 2024; keine kommerzielle Katalognummer | Testete die Klarheit und Angemessenheit der Skalen zur beruflichen Wahrnehmung, sozialen Unterstützung, Lehrerselbstwirksamkeit, Lehrer-Kind-Interaktion sowie der demografischen Items an 50 angehenden Erzieherinnen für die frühe Kindheit. |
| Verfahren der Expertengremien-Überprüfung | Forschungsteam; Expertengremium bestehend aus zwei Professoren für frühe Kindheitserziehung, einer Leiterin eines Kindergartens, drei Praktikumsbetreuerinnen und dem Forschungsteam | Inhaltsüberprüfung auf Konsensbasis; kein kommerzielles Modell | Wurde verwendet, um die Skalenitems hinsichtlich Mehrdeutigkeit, Angemessenheit, semantischer Klarheit, entwicklungsbezogener Eignung und kultureller Relevanz vor der Hauptbefragung zu überarbeiten. |
| Gedruckte, vor-Ort-Fragebögen | Forschungsteam; lokale institutionelle Umfrageunterlagen | Papierbasierte Fragebögen; keine kommerzielle Katalognummer | Wurden zur vor-Ort-Durchführung der Befragung verwendet. In der endgültigen Stichprobe wurden 336 gültige vor-Ort-Fragebögen erhoben, bevor sie mit den Online-Fragebögen kombiniert wurden. |
| Tencent | WeChat-Mobilanwendung; Version sollte anhand der Geräte-/App-Aufzeichnung vom Juni–Juli 2024 überprüft werden | Wurde als Online-Verbreitungskanal für die Befragung genutzt; 27 vollständig ausgefüllte Online-Fragebögen wurden über den Online-/WeChat-Weg gesammelt. | |
| Telefonische und persönliche Rekrutierungsprozedur | Forschungsteam | Standardisiertes Rekrutierungsverfahren; keine kommerzielle Katalognummer | Wurde verwendet, um Institutionen/Teilnehmer zu kontaktieren, Ziel und Inhalt der Studie zu erläutern und die informierte Einwilligung vor der Befragung zu unterstützen. |
| SPSS Statistics | IBM | Version 27,0 | Wurde für deskriptive Statistiken, Pearson-Korrelationskoeffizienten, Reliabilitätsanalysen nach Cronbach’s Alpha, Normalitätsprüfungen mittels Schiefe und Kurtosis sowie den Harman’schen Ein-Faktor-Test zur Prüfung von Bias durch gemeinsame Methoden verwendet. |
| SPSS Amos | IBM | Version 26,0 | Wurde für die konfirmatorische Faktorenanalyse, Strukturgleichungsmodellierung, Testung der Messinvarianz in mehreren Gruppen, Bootstrap-Tests indirekter Effekte sowie den Vergleich alternativer Modelle verwendet. |
| Microsoft Excel | Microsoft | Microsoft 365 Excel oder lokal installierte Excel-Version; genaue lokale Version vor Einreichung überprüfen | Empfohlen/verwendet als Arbeitsumgebung zur Organisation codierter Umfragedaten, des Datenwörterbuchs, ergänzender Tabellen und der JoVE-Materialtabelle. Die genaue lokale Version sollte von den Autoren überprüft werden. |
| Kriterien für Anpassungsindizes bei der Strukturgleichungsmodellierung | Veröffentlichte methodische Leitlinien; in der Arbeit zitierte Referenzen von Schreiber et al. und Kline | Keine kommerzielle Katalognummer; Kriterien wurden im statistischen Analyseplan angewandt | Definiert und berichtet Anpassungsindizes des Modells, darunter Chi-Quadrat-Statistik, Chi-Quadrat geteilt durch Freiheitsgrade, Tucker-Lewis-Index, Vergleichsfit-Index, Adjustierter Goodness-of-Fit-Index, Incremental Fit Index, Root Mean Square Error of Approximation und Standardized Root Mean Square Residual. |
| Verfahren zum Bootstrap-Mediationstest | SPSS Amos / statistischer Analyseplan des Forschungsteams | 5.000 Bootstrap-Stichproben; 95 % bias-korrigierte Konfidenzintervalle | Wurde verwendet, um indirekte Zusammenhänge über die Lehrerselbstwirksamkeit zu testen. Indirekte Effekte wurden als signifikant angesehen, wenn das 95 % bias-korrigierte Konfidenzintervall nicht die Null enthielt. |
| Verfahren zur Testung der Messinvarianz | SPSS Amos / statistischer Analyseplan des Forschungsteams | Mehrfachgruppen-konfirmatorische Faktorenanalyse; ΔCFI < ,010 und ΔRMSEA < ,015 als Kriterien | Wurde verwendet, um die konfigurale, metrische und skalare Invarianz hinsichtlich Geschlecht, Studiengangstyp, Praktikumsdauer und Institution zu prüfen, bevor die gepoolten SEM-Schätzungen interpretiert wurden. |
Referenzen
- Fraga-Lamas P, Barros D, Lopes SI, Fernández-Caramés TM. Mist and edge computing cyber-physical human-centered systems for Industry 5.0: A cost-effective IoT thermal imaging safety system. Sensors (Basel). 2022;22(21):8500.
- Breque M, De Nul L, Petridis A. Industry 5.0: Towards a sustainable, human-centric and resilient European industry. Brussels: European Commission; 2021:https://research-and-innovation.ec.europa.eu/knowledge-publications-tools-and-data/publications/all-publications/industry-50-towards-sustainable-human-centric-and-resilient-european-industry_en.
- Sariişik G, Demir S. Industry 5.0: A human-centric paradigm for sustainable and resilient industrial transformation. Journal of Social Perspective Studies. 2025;2(2):50–66.
- Liu X et al. Evaluating the interactions of multi-dimensional value for sustainable product-service systems with a grey DEMATEL-ANP approach. J Manuf Syst. 2021;60:449–458.
- Di Nardo M et al. The maintenance in Industry 4.0: Assistance and implementation [conference paper]. Presented at: 32nd European Safety and Reliability Conference; Dublin, Ireland; 2022. p. 2286–2292. https://hdl.handle.net/20.500.12607/48222.
- Kagermann H, Lukas WD, Wahlster W. Industrie 4.0: Mit dem Internet der Dinge auf dem Weg zur 4. industriellen Revolution. VDI Nachrichten. 2011;(13):2–3. https://www.dfki.de/fileadmin/user_upload/DFKI/Medien/News_Media/Presse/Presse-Highlights/vdinach2011a13-ind4.0-Internet-Dinge.pdf.
- Council for Science, Technology and Innovation. Report on the Fifth Science and Technology Basic Plan. Tokyo: Cabinet Office, Government of Japan; 2015:https://www8.cao.go.jp/cstp/kihonkeikaku/5basicplan_en.pdf.
- Nahavandi S. Industry 5.0—A human-centric solution. Sustainability (Basel). 2019;11(16):4371.
- Paschek D, Mocan A, Draghici A. Industry 5.0—The expected impact of the next industrial revolution [conference paper]. Presented at: MakeLearn and TIIM International Conference; Piran, Slovenia; 2019. p. 125–132. https://toknowpress.net/ISBN/978-961-6914-25-3/papers/ML19-017.pdf.
- Maddikunta PKR et al. Industry 5.0: A survey on enabling technologies and potential applications. J Ind Inf Integr. 2022;26:100257.
- Longo F, Padovano A, Umbrello S. Value-oriented and ethical technology engineering in Industry 5.0: A human-centric perspective for the design of the factory of the future. Appl Sci (Basel). 2020;10(12):4182.
- Gong Y, Chung YA, Glass J. AST: Audio Spectrogram Transformer [conference paper]. Presented at: Interspeech 2021; Brno, Czech Republic; 2021. p. 571–575. https://www.isca-archive.org/interspeech_2021/gong21b_interspeech.html.
- Purohit H et al. MIMII dataset: Sound dataset for malfunctioning industrial machine investigation and inspection [conference paper]. Presented at: 4th Workshop on Detection and Classification of Acoustic Scenes and Events; New York, NY; 2019. p. 209–213. https://dcase.community/documents/workshop2019/proceedings/DCASE2019Workshop_Purohit_21.pdf.
- Hallioui A et al. A review of sustainable total productive maintenance. Sustainability (Basel). 2023;15(16):12362.
- Vasić S et al. Identification of criteria for enabling the adoption of sustainable maintenance practice: An umbrella review. Sustainability (Basel). 2024;16(2):767.
- Barredo Arrieta A et al. Explainable artificial intelligence: Concepts, taxonomies, opportunities, and challenges toward responsible AI. Inf Fusion. 2020;58:82–115.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions [conference paper]. Presented at: 31st International Conference on Neural Information Processing Systems; Long Beach, CA; 2017. p. 4765–4774. https://papers.nips.cc/paper/7062-a-unified-approach-to-interpreting-model-predictions.
- Du M, Liu N, Hu X. Techniques for interpretable machine learning. Commun ACM. 2020;63(1):68–77.
- Sarker IH. Machine learning: Algorithms, real-world applications and research directions. SN Comput Sci. 2021;2(3):160.
- Saxe A, Nelli S, Summerfield C. If deep learning is the answer, what is the question? Nat Rev Neurosci. 2021;22(1):55–67.
- Piccialli F et al. A survey on deep learning in medicine: Why, how and when? Inf Fusion. 2021;66:111–137.
- Li Z et al. A survey of convolutional neural networks: Analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2022;33(12):6999–7019.
- Gil M, Albert M, Fons J, Pelechano V. Engineering human-in-the-loop interactions in cyber-physical systems. Inf Softw Technol. 2020;126:106349.
- Krugh M, Mears L. A complementary cyber-human systems framework for Industry 4.0 cyber-physical systems. Manuf Lett. 2018;15:89–92.
- Jasiulewicz-Kaczmarek M et al. Recent advances in smart and sustainable maintenance [invited-session proposal]. Presented at: 10th IFAC Conference on Manufacturing Modelling, Management and Control; Nantes, France; 2022. https://hub.imt-atlantique.fr/mim2022/wp-content/uploads/2021/12/7a519.pdf.
- Jasiulewicz-Kaczmarek M, Gola A. Maintenance 4.0 technologies for sustainable manufacturing—An overview. IFAC-PapersOnLine. 2019;52(10):91–96.
- Saihi A, Ben-Daya M, As’ad RA. Maintenance and sustainability: A systematic review of modeling-based literature. J Qual Maint Eng. 2023;29(1):155–187.
- Bastas A. Sustainable manufacturing technologies: A systematic review of the latest trends and themes. Sustainability (Basel). 2021;13(8):4271.
- Franciosi C, Iung B, Miranda S, Riemma S. Maintenance for sustainability in the Industry 4.0 context: A scoping literature review. IFAC-PapersOnLine. 2018;51(11):903–908.
- Franciosi C et al. Measuring maintenance impacts on the sustainability of manufacturing industries: From a systematic literature review to a framework proposal. J Clean Prod. 2020;260:121065.
- Vrignat P, Kratz F, Avila M. Sustainable manufacturing, maintenance policies, prognostics and health management: A literature review. Reliab Eng Syst Saf. 2022;218:108140.
- Durán O, Aguilar J, Capaldo A, Arata A. Fleet resilience: Evaluating maintenance strategies in critical equipment. Appl Sci (Basel). 2021;11(1):38.
- Ciccarelli M, Papetti A, Germani M. Exploring how new industrial paradigms affect the workforce: A literature review of Operator 4.0. J Manuf Syst. 2023;70:464–483.
- Madzik P et al. Human-centricity in Industry 5.0—Revealing hidden research topics by unsupervised topic modeling using latent Dirichlet allocation. Eur J Innov Manag. 2025;28(1):113–138.
- Farivar F, Klarin A, Kanani-Moghadam V. Industry 5.0: A socio-technical system perspective on human agency and institutional legitimacy. J Manag Organ. 2026;32(4):1168–1189.
- Karki BR, Porras J. Digitalization for sustainable maintenance services: A systematic literature review. Digit Bus. 2021;1(2):100011.
- Santiago RAdF et al. Data-driven models applied to predictive and prescriptive maintenance of wind turbines: A systematic review of approaches based on failure detection, diagnosis, and prognosis. Energies (Basel). 2024;17(5):1010.
- Carvalho JN, Silva FR, Nascimento EGS. Challenges of the biopharmaceutical industry in the application of prescriptive maintenance in the Industry 4.0 context: A comprehensive literature review. Sensors (Basel). 2024;24(22):7163.
- Santos ACdJ, Cavalcante CAV, Wu S. Maintenance policies and models: A bibliometric and literature review of strategies for reuse and remanufacturing. Reliab Eng Syst Saf. 2023;231:108983.
- Orošnjak M, Brkljač N, Ristić K. Fostering cleaner production through the adoption of sustainable maintenance: An umbrella review with a questionnaire-based survey analysis. Clean Prod Lett. 2025;8:100095.
- Ji Z, Zhou Y, Wang B, Zang J. Human–cyber–physical systems in the context of new-generation intelligent manufacturing. Engineering (Beijing). 2019;5(4):624–636.
- Wang B et al. Toward human-centric smart manufacturing: A human–cyber–physical systems perspective. J Manuf Syst. 2022;63:471–490.
- Jiao J, Zhou F, Gebraeel NZ, Duffy V. Towards augmenting cyber-physical-human collaborative cognition for human–automation interaction in complex manufacturing and operational environments. Int J Prod Res. 2020;58(16):5089–5111.
- Yilma BA, Panetto H, Naudet Y. Systemic formalisation of cyber-physical-social systems: A systematic literature review. Comput Ind. 2021;129:103458.
- Zhou Y, Yu FR, Chen J, Kuo YH. Cyber-physical-social systems: A state-of-the-art survey, challenges and opportunities. IEEE Commun Surv Tutor. 2020;22(1):3
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.