Diese Studie bewertet ein Schulungsprotokoll für kollaborative virtuelle Realität in großräumiger Ko-Lokation, indem räumliche Präsenz, Teamkoordination, Lernengagement, kognitive Belastung, Sicherheit und kurzfristige Lernergebnisse über drei Trainingsbedingungen hinweg verglichen werden.
Forschungsartikel
Vergleichende Bewertung von Desktop-, Room-Scale- und großflächiger co-lokalisierter kollaborativer virtueller Realität in einem immersiven Training
In diesem Artikel
Zusammenfassung
Zusammenfassung
Großräumige, ko-lokalisierte kollaborative Virtual-Reality bietet eine Trainingsumgebung, in der Teilnehmer sich bewegen, kommunizieren und Aktionen in einem gemeinsamen immersiven Raum koordinieren können. Allerdings gibt es bisher nur begrenzte Hinweise darauf, ob diese Konfiguration die räumliche Präsenz, Teamkoordination und Lernbeteiligung über herkömmliche desktopbasierte Kollaboration oder verteilte raumskalierte Virtual-Reality hinaus verbessert. Diese Studie evaluierte einen einzelzentrischen, dreigruppigen experimentellen Protokollansatz mit 126 Teilnehmern, die 42 Dreier-Teams zugewiesen wurden. Die Teams wurden per Zufallsprinzip entweder einer desktopbasierten kollaborativen Simulation, einer raumskalierten verteilten kollaborativen Virtual-Reality oder einer großräumigen ko-lokalisierten kollaborativen Virtual-Reality zugeordnet. Alle Teams absolvierten eine 8-minütige Einführung, eine 20-minütige kollaborative Notfall-Logistik- und räumliche Navigationsaufgabe, unmittelbare Nachtrainingseinschätzungen sowie einen Wissenstest nach zwei Wochen. Primäre Endpunkte waren räumliche Präsenz, selbstbewertete Teamkoordination, beobachterbewertete Teamkoordination und Lernbeteiligung. Sekundäre Endpunkte umfassten Wissenswerte, kognitive Belastung, Simulationsunbehagen und Indikatoren für die Aufgabenabwicklung. Die Gruppe mit großräumiger ko-lokalisierter kollaborativer Virtual-Reality zeigte eine höhere räumliche Präsenz, bessere Teamkoordination und stärkere Lernbeteiligung als die Vergleichsgruppen. Der Wissenszuwachs war zugunsten der großräumigen Bedingung, während das angepasste Wissen nach dem Training und das Wissen nach zweiwöchiger Retention zwischen den Bedingungen nicht signifikant unterschiedlich war. Die kognitive Belastung stieg nicht signifikant an, und das Simulationsunbehagen blieb im Durchschnitt gering. Diese Ergebnisse deuten darauf hin, dass großräumige ko-lokalierte kollaborative Virtual-Reality am besten für Trainingsaufgaben geeignet sein könnte, die räumliche Orientierung, rollenbasierte Koordination und aktive Teambeteiligung erfordern, und weniger allein für kurzfristige Wissensaneignung.
Einleitung
Immersive Virtual-Reality-Technologien ermöglichen simulationsbasiertes Training in Umgebungen, die andernfalls gefährlich oder unzugänglich wären, indem sie visuelle Aufmerksamkeit und Körperbewegung mit kontextbezogenen Übungen verknüpfen1. Aktuelle Forschung geht zunehmend über bloße Machbarkeitsnachweise hinaus und konzentriert sich auf evidenzbasierte Implementierungen2. Dennoch bleibt die wichtige Frage offen, welche Hardware- und räumlichen Konfigurationen kollaboratives Lernen am besten unterstützen. Die räumliche Präsenz beeinflusst Aufmerksamkeit und Körpereigenheit3,4, während alleinige subjektive Immersion für komplexe, teambasierte Abläufe möglicherweise unzureichend ist. Effektive Zusammenarbeit erfordert gemeinsame Ziele, Aufgabenabhängigkeit und gegenseitige Echtzeitüberwachung5.
Aktuelle Forschungsarbeiten haben das Verständnis von räumlich ko-lokalisierter Virtual-Reality- und verkörperter Zusammenarbeit bei der Unterstützung von Teamarbeit vorangebracht. Hinsichtlich der pädagogischen Wirkungen unterschiedlicher räumlicher Strukturen liegen jedoch weiterhin uneinheitliche empirische Befunde vor6. Der Hauptbeitrag dieser Studie besteht in der systematischen Bewertung dreier funktional unterschiedlicher kollaborativer Umgebungen: desktopbasierte kollaborative Simulation, verteilte Virtual-Reality im Raummaßstab und großräumige räumlich ko-lokalisierte kollaborative Virtual Reality. Diese Bedingungen repräsentieren unterschiedliche Konfigurationen der simulationsbasierten Teamarbeit und ermöglichen einen Vergleich von visueller Immersion und gemeinsamer physischer Lokomotion in verschiedenen kollaborativen Train-ingsumgebungen. Die physikalischen Layouts der drei Konfigurationen sind in Abbildung 1 dargestellt.
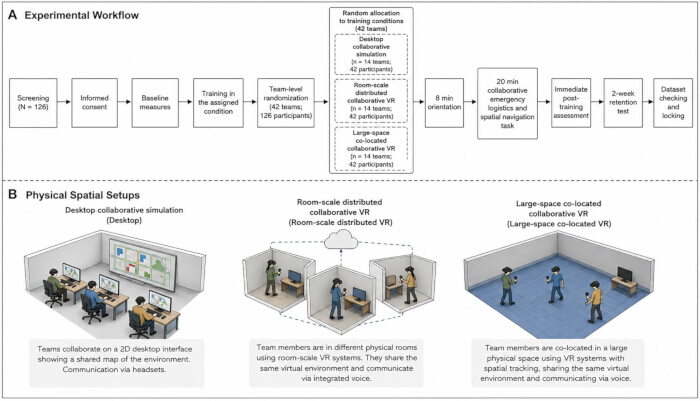
Abbildung 1: Experimenteller Arbeitsablauf und physische räumliche Anordnungen der drei kollaborativen Trainingsbedingungen. (A) Übersicht über den experimentellen Arbeitsablauf, beginnend mit der Teilnehmerauswahl und der Randomisierung auf Teamebene (N = 126 Teilnehmer; 42 Teams) bis hin zum Retentionstest nach zwei Wochen. (B) Schematische Darstellung der drei Trainingsumgebungen. Links: Kollaborative Simulation am Desktop, bei der Teammitglieder separate Arbeitsstationen nutzen und über zugewiesene Audiokanäle kommunizieren, ohne visuelle Immersion zu erfahren. Mitte: Räumlich verteilte kollaborative Virtual-Reality-Umgebung im Raummaßstab, bei der die Teilnehmer visuelle Immersion und live Teamkommunikation erleben, während sie in separaten physischen Tracking-Bereichen von jeweils 3 m × 3 m verbleiben. Rechts: Großräumige, gemeinsam genutzte kollaborative Virtual-Reality-Umgebung, in der Teammitglieder einen ungehinderten 8 m × 8 m großen Raum teilen, was synchronisierte körperliche Fortbewegung, verkörperte räumliche Referenzierung und Echtzeit-Cavigation ermöglicht. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Das Trainingsprotokoll verwendete ein kollaboratives Szenario für den Katastrophenlogistik- und räumlichen Orientierungsbereich. Im Gegensatz zum individuellen prozeduralen Training erfordert dieses Szenario eine gemeinsame räumliche Orientierung, zeitgleiche verbale Koordination und körperbasierte räumliche Handlungen. Diese Merkmale schaffen eine strukturierte Umgebung zur Bewertung der Möglichkeiten großräumiger, lokal koexistierender kollaborativer Virtual-Reality-Anwendungen. Abbildung 2 veranschaulicht die Schnittstellen und Interaktionsmodi, die in den Virtual-Reality- und Desktop-Bedingungen verwendet wurden. Die Theorie des körperbasierten Lernens besagt, dass räumliche Manipulationen Handlungsautonomie unterstützen können, wenn sie auf die Anforderungen der Aufgabe abgestimmt sind7, während die kognitive Belastungstheorie darauf hinweist, dass effektive Gruppenarbeit davon abhängt, kognitive Anforderungen zu verteilen, ohne unnötige Koordinationslasten zu erzeugen8.
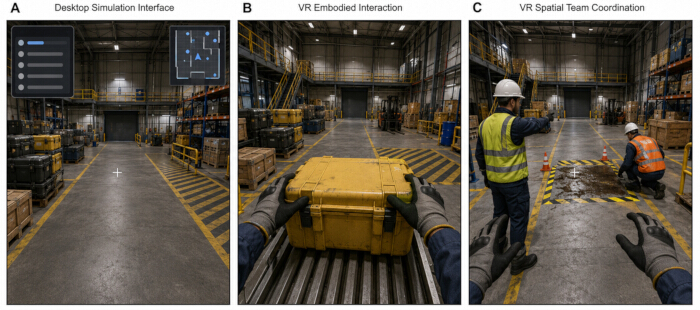
Abbildung 2: Vergleich der Schnittstellen und Paradigmen zur Aufgabenausführung unter verschiedenen Trainingsbedingungen. Das Szenario zur kollaborativen Katastrophenlogistik und räumlichen Navigation war für alle Gruppen standardisiert, wobei sich die Interaktionsmodalität als Hauptunterschied ergab. (A) Desktop-basierte kollaborative Simulationsschnittstelle, First-Person-Ansicht. Die Teilnehmer navigieren mithilfe von Tastatur- und Maussteuerung durch die industrielle Umgebung und orientieren sich an einem zentralen Fadenkreuz sowie zweidimensionalen grafischen Benutzeroberflächenelementen wie einer Minikarte und einer Aufgabenliste. (B) Immersive, körperbezogene Interaktion in der virtuellen Realität. In den immersiven Bedingungen führen die Teilnehmer Aufgaben wie das Sammeln und Handhaben von Ressourcen durch direkte physische Manipulation mittels getrackter Handgesten aus, anstatt Mausklicks zu verwenden. (C) Räumliche Teamkoordination in der Großraum-kollaborativen, ko-lokalen virtuellen Realität. Teammitglieder koordinieren rollenspezifische Aktionen – beispielsweise die des Navigators, Ressourcenmanagers und Sicherheitsbeauftragten – durch Echtzeitsichtbarkeit der Avatare, räumliche Zeigegesten und gemeinsame physische Orientierung in Bezug auf Gefahrenzonen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Daher wurden die Wirkungen der drei Trainingskonfigurationen hinsichtlich räumlicher Präsenz, Teamkoordination und Lernengagement bewertet. Da immersive Umgebungen eine starke subjektive Beteiligung hervorrufen können9, wurden diese Ergebnisse zusammen mit dem nach dem Training erworbenen Wissen und der kurzfristigen Behaltensleistung betrachtet, um unmittelbares Engagement von nachhaltigem Lernen zu unterscheiden. Da Fortbewegung und immersive Exposition zudem physische Belastungen verursachen, wurde die Simulatorunpässlichkeit als Implementierungsergebnis überwacht10.
Protokoll
Diese Studie, an der menschliche Teilnehmer beteiligt waren, wurde gemäß der Deklaration von Helsinki und den institutionellen Anforderungen für Verhaltens- und Bildungsforschung durchgeführt. Das Studienprotokoll wurde vom Ethikkomitee für Humanforschung der Stadtuniversität Shenyang genehmigt (Genehmigungsnummer: SU1992837; Genehmigungsdatum: 18. Januar 2025). Alle Teilnehmer gaben vor der Einschreibung eine schriftliche informierte Einwilligung ab. Ihnen wurde erläutert, dass die Studie eine immersive Virtual-Reality-Exposition, die Bearbeitung teambasierter Aufgaben, das Ausfüllen von Fragebögen, eine Verhaltensbeobachtung sowie eine kurzfristige Nachuntersuchung umfasst. Die Teilnahme war freiwillig, und ein Rückzug war jederzeit ohne akademische, berufliche oder institutionelle Nachteile möglich. Alle Studiendaten wurden vor der Analyse anonymisiert. Jedem Teilnehmer wurde ein numerischer Teilnahmecode zugewiesen, und jedes Team erhielt einen separaten Teamcode. Im analytischen Datensatz wurden keine Namen, Studentennummern, Telefonnummern, Gesichtsbilder oder direkt identifizierbaren Tonaufnahmen enthalten. Ausrüstungskategorien, Softwareversionen und zugehörige Replikationsressourcen sind in der Tabelle der Materialien aufgeführt.
1. Studiendesign und Setting
Diese abgeschlossene Studie verwendete ein einzentriges, dreigruppiges, parallelgruppiertes experimentelles Design, um zu untersuchen, ob kooperatives virtuelles Training in großräumigen, gemeinsam genutzten Umgebungen mit einer stärkeren räumlichen Präsenz, besserer Teamkoordination und höherer Lernbeteiligung während des immersiven Trainings verbunden ist. Die drei Trainingsbedingungen waren desktopbasierte kooperative Simulation, raumskalierte verteilte kooperative virtuelle Realität und großräumige, gemeinsam genutzte kooperative virtuelle Realität.
Die Bedingungen wurden als funktionale Vergleichsgrößen konzipiert und nicht als vollständige faktorielle Aufteilung von Immersion, Zusammenarbeit und Bewegungsraum. Die Desktop-Bedingung repräsentierte die Zusammenarbeit ohne Exposition gegenüber einem immersiven Head-Mounted Display. Die räumlich verteilte kollaborative Virtual-Reality-Bedingung auf Raumskalen-Niveau stand für immersive Teamzusammenarbeit in getrennten, kleinen Tracking-Bereichen. Die Großraum-Bedingung der gemeinsam genutzten kollaborativen Virtual Reality kombinierte ein immersives visuelles Erlebnis, geteilte physische Bewegung und zeitgleiche, körperbasierte Teaminteraktion innerhalb eines einzigen erfassten Trainingsraums. Gruppenunterschiede wurden daher als Unterschiede zwischen den vollständigen Trainingskonfigurationen interpretiert und nicht als Effekte, die auf eine einzelne Komponente zurückzuführen sind. Diese Struktur wurde gewählt, weil die Forschung zum immersiven Lernen räumliche Präsenz, Handlungsspielraum und Beteiligung als Mechanismen betrachtet, über die virtuelle Umgebungen das Lernverhalten beeinflussen können11.
Die Studie wurde vom 3. März 2025 bis zum 18. Juli 2025 im Labor für Immersives Lernen und Mensch-Computer-Interaktion der beteiligten Institution durchgeführt. Die Rekrutierung und die Baseline-Tests fanden vom 3. März bis zum 25. April 2025 statt. Die Interventionsphasen wurden vom 10. März bis zum 30. Mai 2025 durchgeführt. Die Retentionstests nach zwei Wochen wurden zwischen dem 24. März und dem 16. Juni 2025 abgeschlossen. Die Datenprüfung, die Bewertung durch Beobachter sowie die Datensatzsperre wurden bis zum 18. Juli 2025 abgeschlossen.
Alle Sitzungen fanden im selben Laborgebäude statt, um Beleuchtung, Temperatur, Internetverbindung, Aufgabenanweisungen und die Betreuung durch den Forscher zu kontrollieren. Bei der Großraum-Kollaborativen-Virtuelle-Realität-Bedingung kam ein uneingeschränkter Tracking-Bereich von 8 m × 8 m zum Einsatz. Bei der Raumskaligen Verteilten-Kollaborativen-Virtuelle-Realität-Bedingung wurden drei getrennte, markierte Bereiche von jeweils 3 m × 3 m verwendet. Bei der Desktop-Kollaborativen-Simulation-Bedingung kamen einzelne Computerarbeitsplätze zum Einsatz, die durch Schallabschirmungen voneinander getrennt waren, sodass die Teilnehmer nur über den zugewiesenen Kommunikationskanal miteinander kommunizieren konnten.
Die Teilnehmer wurden vor der Randomisierung Dreiergruppen zugewiesen. Die Gruppe diente als Trainingseinheit, da die Aufgabe eine verteilte Rollenausführung, verbale Koordination, gemeinsame Situationswahrnehmung und gemeinsames Problemlösen erforderte. Die Randomisierung erfolgte auf Gruppenebene, um eine Kontamination zwischen Teilnehmern innerhalb derselben Sitzung zu vermeiden. Der gesamte Studienablauf und die physische Konfiguration der drei Bedingungen sind in Abbildung 1 dargestellt.
2. Teilnehmer und Eignungsprüfung
Die Teilnehmer wurden aus Bachelor- und Masterstudiengängen der beteiligten Institution rekrutiert. In den Ausschreibungen wurde die Studie als ein immersives Trainingsprogramm beschrieben, das virtuelle Realität, Teamkoordination und Lernbewertung umfasst. Dabei wurde nicht darauf hingewiesen, dass eine bestimmte Trainingsbedingung überlegen sein könnte. Interessierte Teilnehmer füllten vor der Terminvereinbarung im Labor ein Online-Eignungsformular aus.
Teilnehmer waren berechtigt, wenn sie 18–35 Jahre alt waren, ein normales oder auf Normalwert korrigiertes Sehvermögen besaßen, die Trainingsprache verstehen konnten, noch nicht an demselben virtuellen Trainingsszenario teilgenommen hatten und mindestens 30 Minuten sicher stehen und sich bewegen konnten. Teilnehmer wurden ausgeschlossen, wenn sie über schwere Reisekrankheit berichteten, unbehandelte Epilepsie, eine aktuelle muskuloskelettale Verletzung, die das Gehen oder Gleichgewicht beeinträchtigte, nicht korrigierte Sehstörungen, schwere Vertigo, schwere nicht korrigierte Hörstörungen, eine akute aktuelle Erkrankung oder eine medizinische Erkrankung hatten, die eine Immersion in Virtual Reality unsicher machte. Teilnehmer wurden ebenfalls ausgeschlossen, wenn sie über umfangreiche Vorerfahrung mit dem exakten Trainingsszenario verfügten oder zuvor an Pilottests desselben Systems teilgenommen hatten.
Die Berechtigung wurde in zwei Schritten überprüft. Eine wissenschaftliche Hilfskraft prüfte zunächst das Online-Screening-Formular. Der Sitzungsforscher bestätigte anschließend am Tag der Untersuchung vor der Einwilligung mündlich die Berechtigung. Teilnehmer, die über leichte frühere Bewegungsunverträglichkeit berichteten, wurden nicht automatisch ausgeschlossen, jedoch genauer überwacht und darauf hingewiesen, dass die Teilnahme sofort abgebrochen werden könne, falls Unbehagen auftrete. Das vollständige Screening-Formular, die Berechtigungskriterien, der Basisfragebogen, Antwortformate und Kodierungsregeln sind in Supplementary File 1 enthalten.
Eine a priori Power-Analyse wurde mithilfe der G-Power-Software durchgeführt, um die erforderliche Stichprobengröße für den Versuchsplan zu bestimmen. Unter der Annahme eines mittleren erwarteten Effekts von f = 0,25 basierend auf bisheriger Literatur zu immersivem kooperativem Lernen, einem Alpha-Niveau von 0,05 und einer statistischen Power von 0,80 für eine Dreigruppenanalyse, waren mindestens 111 Teilnehmer erforderlich. Um die Teamstruktur mit drei Personen zu berücksichtigen und eine ausgeglichene Gruppenzuordnung über alle Bedingungen hinweg sicherzustellen, wurde die endgültige Stichprobe auf 126 Teilnehmer erweitert, die 42 unabhängige Teams umfassten. Da die Intervention auf Team-Ebene erfolgte, wurden die Teamkennungen für die Cluster-Anpassung, die beobachterbasierte Koordinierungsbewertung sowie für Sensitivitätsprüfungen beibehalten.
3. Randomisierung, Verblindung der Zuordnung und Verschleierung
Nachdem alle Mitglieder eines dreiköpfigen Teams die Bestätigung der Eignung abgeschlossen hatten, wurde das Team mithilfe einer computergenerierten Block-Randomisierungsliste mit einer festen Blockgröße von sechs Teams zufällig einer von drei Trainingsbedingungen zugewiesen. Die Zuordnungssequenz wurde vor der Datenerhebung mit einem Randomisierungspaket in der statistischen Softwareumgebung und einem reproduzierbaren Startwert (Seed) von 20250301 generiert.
Die Verblindung der Zuteilung wurde mithilfe von fortlaufend nummerierten, undurchsichtigen, manipulationssicheren Umschlägen gewährleistet, die von einem unabhängigen Forscher erstellt wurden, der weder an der Rekrutierung der Teilnehmer noch an der Durchführung der Intervention beteiligt war. Die Randomisierungsdatei wurde in einer passwortgeschützten Tabellenkalkulation gespeichert und war für die Outcome-Beurteiler nicht zugänglich.
Die Zuordnung wurde erst nach Abschluss des Basis-Fragebogens und des vor der Schulung durchgeführten Wissenstests offengelegt. Der für die Sitzung zuständige Forscher öffnete den nächsten versiegelten Zuordnungsumschlag unmittelbar vor dem Aufbau der Ausrüstung. Eine Verblindung der Teilnehmer hinsichtlich des körperlichen Trainingsformats war nicht möglich, da sich die drei Bedingungen optisch deutlich voneinander unterschieden. Den Teilnehmern wurde nicht mitgeteilt, welche Bedingung die besseren Leistungen erbringen sollte.
Zwei Beobachter bewerteten die Teamkoordination anhand standardisierter Bildschirmaufzeichnungen. Die Beobachter waren unkenntlich gemacht bezüglich der Studienhypothesen, der Trainingsbedingungsbezeichnungen und der Fragebogenergebnisse und waren nicht an der Durchführung des Trainings beteiligt. Videodateien wurden vor der Bewertung mit neutralen Teamcodes umbenannt. Bedingungsidentifizierende Interface-Bezeichnungen wurden vor der Bewertung durch die Beobachter, wo möglich, zugeschnitten oder verdeckt.
4. Trainingsszenario und Aufgabenstruktur
Das Trainingsszenario wurde als kollaborative Aufgabe im Bereich Notfalllogistik und räumliche Orientierung in einer simulierten industriellen Trainingsumgebung konzipiert. Jedes Dreier-Team musste virtuelle Ressourcen lokalisieren, räumliche Hinweise interpretieren, Routeninformationen kommunizieren, rollenspezifische Aktionen koordinieren und eine Abfolge von Missionsschritten innerhalb eines festgelegten Zeitfensters abschließen.
Jeder Teilnehmer übernahm eine von drei Rollen: Navigator, Ressourcenmanager oder Sicherheitsbeauftragter. Der Navigator interpretierte die Wegbeschreibung und die Reihenfolge der Zielorte. Der Ressourcenmanager identifizierte und sammelte für die Aufgabe relevante virtuelle Gegenstände. Der Sicherheitsbeauftragte überwachte Gefahren, bestätigte die korrekte Reihenfolge der Schritte und erinnerte das Team vor der endgültigen Abgabe.
Das Szenario enthielt vier Zonen: Orientierungszone, Ressourcenzone, Gefahrenzone und Abschlusszone. Jedes Team absolvierte acht vorgeschriebene Teilaufgaben: Identifizierung des Zielortes, Auswahl von drei korrekten Ressourcen aus sechs möglichen Ressourcen, Vermeidung von zwei falschen Routenabschnitten, Reaktion auf drei Gefahrenhinweise, Informationsaustausch zwischen den Teammitgliedern und Abgabe der endgültigen Aufgabensequenz. Die maximale Bearbeitungszeit betrug 20 min. Teams, die nicht alle erforderlichen Teilaufgaben innerhalb von 20 min abschlossen, wurden nach Ablauf der Zeitvorgabe gestoppt, und die Anzahl der abgeschlossenen Teilaufgaben wurde dokumentiert.
Vor der Hauptaufgabe absolvierten alle Teilnehmer eine standardisierte, 8 min dauernde Einführung. Die ersten 3 min erläuterten die Studienregeln und Sicherheitsmaßnahmen. Die folgenden 3 min stellten die Bedienelemente der Schnittstelle vor. In den abschließenden 2 min konnten die Teilnehmer Bewegung, Auswahl und Kommunikation in einer neutralen Übungsumgebung trainieren, die keine Objekte, Routen, Gefahren oder Antworten enthielt, die später im Hauptszenario verwendet wurden. Leistungsdaten aus der Übungsumgebung wurden nicht analysiert.
Derselbe Lerninhalt, dieselbe Aufgabenabfolge, dieselben Zielantworten, dieselbe Routenstruktur, dieselben Gefahrenhinweise und dieselben Bewertungskriterien wurden in allen drei Bedingungen verwendet. Die Bedingungen unterschieden sich hinsichtlich Interaktionsmodalität, Grad der Immersion, körperlicher Bewegung und räumlicher Konfiguration. Die immersiven Umgebungen wurden mithilfe einer kommerziellen Echtzeit-3D-Entwicklungsumgebung erstellt. Die Mehrspieler-Vernetzung und die Synchronisation des räumlichen Zustands wurden über ein dediziertes Mehrspieler-Synchronisierungs-Framework realisiert, das auf einer lokalen Gigabit-Ethernet-Architektur basiert. Teilnehmer, die den immersiven Virtual-Reality-Bedingungen zugewiesen wurden, nutzten hochauflösende Head-Mounted-Displays mit integrierten Kopfhörern und Mikrofonen. Die räumliche Verfolgung erfolgte mittels eines Infrarot-Laser-basierten Trackingsystems mit vier Basisstationen. Die Implementierung der Avatare verwendete Inverse-Kinematik-Algorithmen, um die Echtzeit-Telemetriedaten von Kopf und Handcontrollern auf artikulierte Arbeitnehmer-Avatare abzubilden.
5. Überprüfung der Verfahren vor der Studie und Verfeinerung der Messungen
Vor der offiziellen Datenerhebung wurden alle Fragetembogen-Items, Wissenstest-Items, Beobachter-Bewertungsregeln und Aufgabenabläufe von zwei Forschern mit Erfahrung im immersiven Lernen sowie einem Forscher mit Erfahrung in der Erziehungswissenschaftlichen Messung überprüft. Der Überprüfungsprozess konzentrierte sich auf die Klarheit der Items, die Übereinstimmung zwischen Rolle und Aufgabe, die Konsistenz der Bewertung, die Formulierung von Sicherheitshinweisen und die Ausrichtung an den theoretischen Konstrukten.
Eine Pilotprüfung wurde vom 17. bis 21. Februar 2025 mit sechs Teilnehmern durchgeführt, die denselben Einschlusskriterien wie die formale Stichprobe entsprachen. Der Pilotversuch untersuchte die Aufgabendauer, den Tragekomfort des Headsets, die Sicherheit der Bewegungen, die Klarheit der Anweisungen, die Dauer der Fragebogenbearbeitung, die Genauigkeit des Datenexports sowie die Durchführbarkeit von Beobachterbewertungen. Die Pilotdaten dienten ausschließlich dazu, Formulierungen, die Einrichtungsdauer, Sicherheitsanweisungen und Verfahren zum Protokoll-Export zu optimieren. Diese Teilnehmer wurden nicht in die endgültige Stichprobe einbezogen, und ihre Daten flossen nicht in die formale Analyse ein.
6. Bedingung der Desktop-gestützten Zusammenarbeitssimulation
In der Bedingung der Desktop-gestützten Zusammenarbeitssimulation verwendete jede Versuchsperson eine eigene Arbeitsstation, die an einen 24-Zoll-1080p-Monitor angeschlossen war. Die Eingabegeräte bestanden aus einer Computermaus und einer Tastatur, und die Audiokommunikation erfolgte über ein USB-Headset mit Mikrofon. Die Versuchspersonen saßen an getrennten Arbeitsplätzen und erhielten die Anweisung, keine Kommunikation außerhalb des Systems zu nutzen.
Die Desktop-Simulation verwendete dieselbe virtuelle Umgebung, dieselben Aufgabenobjekte, dieselbe Routenreihenfolge, dieselben Gefahrenhinweise und dieselbe Bewertungslogik wie die Virtual-Reality-Bedingungen. Die Kameraperspektive war die erste Person. Wie in Abbildung 2A dargestellt, navigierten die Teilnehmer der Desktopgruppe mittels Tastatureingaben und interagierten mit virtuellen Ressourcen durch Mausklicks über ein festes, zweidimensionales Monitor-Sichtfeld. Sichtfeld, Bewegungsgeschwindigkeit, Interaktionsdistanz und Audiokonfiguration wurden vor der Datensammlung festgelegt und zwischen den Sitzungen nicht verändert. Ein Forscher überwachte während jeder Sitzung die technische Stabilität, gab jedoch nach Beginn des Hauptszenarios keine Aufgabehinweise mehr.
7. Bedingung des raumskalierten verteilten kollaborativen Virtual-Reality-Setups
Unter der Bedingung des raumskalierten verteilten kollaborativen Virtual-Reality-Setups betraten die drei Teilnehmer dasselbe virtuelle Szenario von separaten, markierten Tracking-Bereichen der Größe 3 m × 3 m aus. Jeder Teilnehmer verwendete eine am Kopf getragene Anzeigeeinheit (Head-Mounted Display) und Handcontroller. Die Teammitglieder kommunizierten über den zugewiesenen Sprachkanal und führten dieselbe rollenbasierte Teamaufgabe durch, konnten jedoch nicht physisch gemeinsam in einem geteilten, großen Tracking-Bereich navigieren.
Vor der Hauptaufgabe wurden die Passform des Headsets, die Pupillenabstandseinstellung, das Begrenzungssystem und die Controller-Schlaufen angepasst. Den Teilnehmern wurde erklärt, dass sie unverzüglich anhalten sollten, falls Schwindel, Übelkeit, Augenbelastung, Kopfschmerzen, Gleichgewichtsverlust oder Angstgefühle auftreten. Während der gesamten Sitzung blieb ein Forscher innerhalb von 2 m zu jedem aktiven Erfassungsbereich, um die Sicherheit zu überwachen, ohne jedoch Hinweise zur Aufgabenbearbeitung zu geben.
Wenn ein Teilnehmer die markierte Grenze überschritt, wurde die Sitzung unterbrochen und der Teilnehmer neu positioniert. Wenn mittlere Beschwerden auftraten, definiert als eine subjektiv bewertete Beschwerdestärke von 5 oder höher auf einer Skala von 0–10 bei einem beliebigen Beschwerdeitem, wurde die Sitzung unterbrochen und der Teilnehmer zum Erholen hingesetzt. Wenn bei einem beliebigen Beschwerdeitem ein Wert von 7 oder höher erreicht wurde, wurde die Sitzung beendet.
8. Bedingung für kollaborative Virtual-Reality in großflächigen Räumen
Unter der Bedingung der kollaborativen Virtual-Reality in großflächigen Räumen betrat jedes Team aus drei Personen denselben getrackten Trainingsbereich von 8 m × 8 m. Jeder Teilnehmer trug ein Head-Mounted-Display, hielt zwei Controller und wurde durch einen rollenspezifischen Avatar repräsentiert, der für die anderen Teammitglieder sichtbar war. Die Teammitglieder kommunizierten in Echtzeit verbal, während sie sich physisch durch den gemeinsamen Trainingsraum bewegten. Das System synchronisierte die Position der Teilnehmer, Handbewegungen, Objektauswahl und Änderungen des Aufgabenstatus. Wie in Abbildung 2B und Abbildung 2C dargestellt, führten die Teilnehmer in den immersiven Bedingungen Aufgaben mittels dreidimensionaler räumlicher Handgesten mit getrackten Controllern sowie durch physische Kopfdrehung für ein 360°-Sichtfeld aus.
Bei der Large-Space-Bedingung wurden dieselben Aufgabeninhalte und eine Zeitbegrenzung von 20 Minuten wie bei den anderen Bedingungen verwendet. Die körperliche Bewegung wurde so kalibriert, dass die virtuelle Route innerhalb des markierten Sicherheitsbereichs blieb. Wenn sich die Teilnehmer der Kante der Tracking-Zone näherten, erschien eine Sicherheitsgrenze im Headset. Vor der Hauptaufgabe wurden Bodenfreiheit, kabelfreie Bewegung, Passform des Headsets, Tracking-Stabilität, Audioeingabe und Controller-Reaktion überprüft. Den Teilnehmern wurde angeordnet, natürliche physische Fortbewegung statt künstlicher Fortbewegungstechniken zur Navigation in der virtuellen Umgebung zu nutzen. Körperlicher Kontakt zwischen Teammitgliedern war untersagt. Wenn sich zwei Teilnehmer auf weniger als 0,5 m einander näherten, erfolgte eine neutrale Sicherheitserinnerung, ohne dass Aufgabeninformationen gegeben wurden.
Jede Sitzung im Großraum wurde von zwei Forschern überwacht. Ein Forscher überwachte das System-Dashboard und den Aufnahmezustand. Der zweite Forscher stand außerhalb des aktiven Erfassungsbereichs und achtete auf die Sicherheit der Teilnehmer. Die Aufgabe wurde unterbrochen, wenn der Trackingerfolg länger als 10 s verloren ging, wenn ein Teilnehmer Unwohlsein meldete oder wenn ein Teilnehmer die Sicherheitsgrenze überschritt. Falls die Unterbrechung weniger als 2 min dauerte und der Teilnehmer fortfahren wollte, wurde die Aufgabe vom zuletzt gespeicherten Zustand aus fortgesetzt. Falls die Unterbrechung länger als 2 min dauerte, wurde die Sitzung als unvollständig erfasst und im Intention-to-treat-Datensatz belassen.
9. Ergebnisparameter und Zeitpunkt der Bewertung
Die Bewertungen wurden zum Ausgangszeitpunkt, unmittelbar nach der Schulung und zwei Wochen nach der Schulung durchgeführt. Zu den Basisparametern gehörten Demografie, bisherige Erfahrungen mit virtueller Realität und Teamtraining, Vertrautheit mit Computerspielen sowie ein 30-Punkte-Wissenstest vor der Schulung. Unmittelbar nach der Schulung wurden räumliche Präsenz, selbst- und fremdbeurteilte Teamkoordination, Lernengagement, kognitive Belastung, Unbehagen im Simulator, Wissen nach der Schulung sowie Leistungsindikatoren bei der Aufgabenbearbeitung erfasst. Zum zweiwöchigen Follow-up wurde derselbe 30-Punkte-Wissenstest mit umgeordneten Items und geringfügigen Änderungen in der Formulierung verwendet. Der Bewertungszeitplan ist in Tabelle 1 dargestellt.
Tabelle 1: Zusammenfassung der primären und sekundären Messgrößen. Diese Tabelle fasst die Variablen, Messskalen, Zeitpunkte der Bewertung sowie Datenquellen für die primären Ergebnisse, sekundären Lernergebnisse und Sicherheits- sowie Prozessmaßnahmen zusammen, die im Verlauf des experimentellen Protokolls erhoben wurden. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Die räumliche Präsenz wurde unmittelbar nach dem Training mittels einer 8-stufigen, 7-Punkt-Skala gemessen, die aus etablierten Präsenzdimensionen adaptiert wurde12. Die Werte wurden gemittelt, wenn mindestens 80 % der Items ausgefüllt waren; andernfalls wurde der Wert als fehlend kodiert. Alle vollständigen Items und Bewertungsregeln sind in Zusätzliche Datei 1 enthalten.
Die selbst eingeschätzte Teamkoordination wurde mithilfe einer angepassten sechsteiligen Skala mit sieben Stufen erfasst, die Kommunikationsklarheit, Rollenwahrnehmung, gegenseitige Überwachung, Timing der Unterstützung, gemeinsames Aufgabenverständnis und Fehlerbehebung abdeckte. In einer Vorstudie mit 20 Teilnehmern wurde die Klarheit und Struktur der Items überprüft, und eine explorative Faktorenanalyse ergab einen einzigen dominierenden Faktor. Die innere Konsistenz in der Hauptstichprobe betrug Cronbachs α = 0,88. Die Punktzahlen der Teilnehmer wurden als Mittelwert der abgeschlossenen Items berechnet, die Team-Ebene-Punktzahlen als Mittelwert der drei Teilnehmerpunktzahlen. Die vollständigen Items und Bewertungskriterien sind in Supplementary File 1 enthalten.
Die beobachterbewertete Teamkoordination wurde mithilfe eines angepassten Bewertungsrasters erfasst, das Kommunikationszeitpunkt, Rollenausführung, gegenseitige Unterstützung, räumliche Koordination und Fehlerbehebung abdeckte. Jeder Bereich wurde von 0–20 punktiert, was zu einer Gesamtpunktzahl von 0–100 führte. Das Raster wurde von Experten überprüft, und zwei Beobachter absolvierten jeweils 10 Stunden Training vor der offiziellen Bewertung. Die Übereinstimmungsrate zwischen den Bewertenden wurde anhand eines intraklassenkorrelationskoeffizienten (ICC) mit zufälligen Effekten und zwei Faktoren für absolute Übereinstimmung ermittelt, wobei ein ICC ≥ 0,75 vor der endgültigen Bewertung erforderlich war. Bei Gesamtpunktdifferenzen von mehr als 12 Punkten erfolgte eine Konsensfindung; andernfalls wurde der Mittelwert der beiden Bewertungen verwendet. Das vollständige Bewertungsraster und das Abstimmungsverfahren sind in Supplementary File 1 enthalten.
Die Lernbeteiligung wurde unmittelbar nach dem Training mit einer 12-Item-kurzen Skala mit 7 Punkten gemessen13. Die Werte wurden über alle abgeschlossenen Items gemittelt, wobei höhere Werte auf eine stärkere Beteiligung hinweisen. Die innere Konsistenz wurde mithilfe von Cronbachs Alpha bewertet. Die kognitive Belastung wurde anhand von fünf Bewertungen von 1 bis 7 bezüglich geistiger Anforderungen, körperlicher Anforderungen, Zeitdruck, Aufwand und Frustration erfasst14. Vollständige Items und Bewertungsregeln sind in Zusatzdatei 1 enthalten.
Der Wissenszuwachs wurde anhand eines 30-Punkte-Tests überprüft, der aus 20 Einzelitems mit jeweils der jeweils besten Antwort und fünf kurzen Szenario-Urteilsaufgaben bestand. Derselbe Testrahmen wurde für den Vorabtest, den Nachtest und den Retentionstest nach zwei Wochen verwendet, wobei die Reihenfolge der Aufgaben verändert und äquivalente Formulierungsänderungen vorgenommen wurden. Ein Gewinn von mindestens 3 Punkten zwischen Vorabtest und Nachtest galt als praktisch bedeutsame, beschreibende Verbesserung. Der Testrahmen, die Bewertungsregeln und die Bewertungsskala sind in Supplementary File 1 enthalten.
Das Simulatorunbehagen wurde vor der Exposition, nach der Orientierung und nach der Hauptaufgabe anhand von fünf Symptombewertungen auf einer Skala von 0–10 erfasst. Der Mittelwert der fünf Einzelwerte bildete den Unbehagenindex. Die Sitzungen wurden abgebrochen, wenn bei einem der Werte eine Stärke von 7 oder höher erreicht wurde. Nach der Aufgabe erforderten Indizes über 6 eine Überwachung von mindestens 15 Minuten, und Indizes von 5 oder höher eine Nachbeobachtung nach 24 Stunden. Die vollständigen Regeln zur Sicherheitsbewertung sind in Supplementary File 1 enthalten.
Zu den Leistungsindikatoren gehörten der Abschlussstatus, die Abschlusszeit, die korrekt ausgewählten Ressourcen, die korrekt bearbeiteten Gefahrenhinweise, Routenfehler und Sicherheitsunterbrechungen. Unvollständigen Teams wurde eine Abschlusszeit von 1.200 s zugewiesen. Die Definitionen der Ergebnisse, Zeitpunkte, Bewertungsbereiche, Datenquellen und Analyseniveaus sind in Tabelle 1 zusammengefasst und in Zusatzdatei 1 ausführlich beschrieben.
10. Verfahren zur Datensammlung
Jede Sitzung folgte der gleichen Abfolge. Die Teilnehmer kamen 15 Minuten vor der geplanten Trainingszeit an. Die Identität wurde anhand der Terminliste überprüft, die Berechtigung erneut geprüft, das Einverständnisformular wurde erläutert und Fragen zum Ablauf beantwortet. Anschließend unterschrieben die Teilnehmer das Einverständnisformular und erhielten Teilnehmercodes. Es wurde nicht über die erwartete Überlegenheit einer Bedingung diskutiert.
Die Teilnehmer füllten den Basisfragebogen und den Wissenstest vor der Schulung auf einem Labor-Tablett aus. Die Baseline-Phase dauerte ungefähr 12 Minuten. Nach Abschluss der Baseline-Phase wurde die Teamzuordnung bekannt gegeben, und die zugewiesene Trainingseinrichtung wurde vorbereitet. Die Vorbereitung der Ausrüstung dauerte ungefähr 5 Minuten in der Desktop-Bedingung, 8 Minuten in der Bedingung des raumskalierten verteilten kollaborativen virtuellen Realitäts-Setups und 10 Minuten in der Bedingung des großflächigen ko-lokalisierten kollaborativen virtuellen Realitäts-Setups. Die Vorbereitung der Ausrüstung wurde nicht als Schulungsexposition gezählt.
Anschließend absolvierten alle Teilnehmer eine standardisierte 8-minütige Einführung. Die Hauptaufgabe begann unmittelbar nach der Einführung und dauerte bis zu 20 Minuten. Während der Hauptaufgabe wurden keine Anleitungen, Hinweise oder korrigierenden Rückmeldungen gegeben. Technische Unterstützung beschränkte sich auf die Wiederherstellung der Systemfunktion, die Anpassung der Kopfhörerpassform, die Neupositionierung der Teilnehmer innerhalb der Sicherheitsgrenze oder die Wiederholung zuvor erteilter Sicherheitshinweise. Nach Abschluss der Aufgabe entfernten die Teilnehmer die Ausrüstung und füllten an individuellen Arbeitsplätzen den Nachtraining-Fragebogen sowie den Nachtraining-Wissenstest aus. Die Nachtraining-Beurteilung dauerte etwa 15 Minuten.
Der 2-Wochen-Retentionstest wurde 14 Tage nach der Trainingssitzung online durchgeführt, wobei ein akzeptables Abschlussfenster von Tag 13 bis Tag 16 vorgesehen war. Die Teilnehmer erhielten eine Erinnerung 24 Stunden vor dem Fälligkeitszeitpunkt sowie eine weitere Erinnerung am Tag 15, falls der Test noch nicht abgeschlossen war. Antworten, die nach Tag 16 eingereicht wurden, blieben im Rohdatensatz enthalten, wurden jedoch von der primären Retentionsanalyse ausgeschlossen. Die tatsächliche Anzahl an Tagen zwischen Training und Nachuntersuchung wurde für eine Sensitivitätsanalyse erfasst.
11. Qualitätskontrolle der Daten
Elektronische Fragebögen enthielten Bereichsprüfungen für zentrale Ergebnisparameter, während demografische Angaben übersprungen werden konnten. Die Absendungszeiten wurden erfasst, und Fragebögen, die in weniger als einem Drittel der medianen Bearbeitungszeit abgeschlossen wurden, wurden zur Überprüfung markiert. Systemprotokolle wurden nach jeder Sitzung exportiert und innerhalb von 48 Stunden mit den Sitzungsdatensätzen abgeglichen; Unstimmigkeiten wurden mithilfe zeitgestempelter Aufzeichnungen behoben.
Die koordinationsbezogenen, durch Beobachter bewerteten Punktzahlen wurden unabhängig voneinander von zwei Beobachtern erfasst. Gesamtpunktzahldifferenzen von mehr als 12 Punkten wurden zur konsensbasierten Überprüfung markiert, und die endgültigen Punktzahlen wurden vor der Analyse auf Gruppenebene festgelegt. Punktzahlen für Mehrfachitemskalen wurden berechnet, wenn mindestens 80 % der Items ausgefüllt waren; andernfalls wurden die Punktzahlen als fehlend kodiert. Nicht beantwortete Wissensfragen mit jeweils einer einzigen richtigen Antwort wurden mit 0 bewertet. Bei den kurzen Szenariobewertungsitems erfolgte die Bewertung durch zwei unabhängige Prüfer, wobei Differenzen von mehr als einem Punkt durch einen dritten Prüfer überprüft wurden.
Der endgültige Datensatz wurde nach Überprüfung der Berechtigungsunterlagen, Teilnehmer- und Teamcodes, Fragebogenbereiche, Wissenswerte, Beobachterbewertungen, Systemprotokolle, Gültigkeit der Wiedergabetests, Datenzusammenführungen und fehlenden Angaben gesperrt. Detaillierte Regeln zur Bewertung, Bereinigung und Sperrung des Datensatzes sind in Supplementary File 1 enthalten.
12. Sicherheitsüberwachung und Abbruchkriterien
Während aller Trainingssitzungen erfolgte eine Sicherheitsüberwachung. Vor der Exposition wurde den Teilnehmern darauf hingewiesen, dass Unbehagen während des Virtual-Reality-Trainings auftreten könne und dass ein Rückzug jederzeit möglich sei. Während der Aufgabe wurden Haltung, Gleichgewicht, Bewegungsgeschwindigkeit und verbale Anzeichen von Unbehagen beobachtet. Die Aufgabe wurde unverzüglich abgebrochen, wenn ein Teilnehmer starke Schwindelgefühle, Übelkeit, visuelle Beschwerden, Kopfschmerzen, Angstzustände, Gleichgewichtsverlust oder den Wunsch äußerte, die Aufgabe zu beenden.
Vorab definierte Abbruchkriterien wurden konsequent angewendet. Die Sitzung wurde abgebrochen, wenn ein Unbehagen-Wert die Stufe 7 oder höher auf der Skala von 0–10 erreichte, wenn ein Teilnehmer zweimal innerhalb einer Sitzung die Sicherheitsgrenze überschritt, wenn der Trackingsverlust länger als 2 Minuten andauerte, wenn eine Gerätefunktionsstörung eine normale Interaktion verhinderte oder wenn eine Fortsetzung der Teilnahme als Sicherheitsrisiko eingestuft wurde. Abgebrochene Sitzungen wurden mittels eines Sitzungsunterbrechungsformulars dokumentiert. Nach dem Abbruch wurden die Teilnehmer sitzend überwacht, bis die Symptome auf ein geringes Ausmaß zurückgingen, definiert als alle Unbehagen-Werte unter 3. Es war keinem Teilnehmer gestattet, das Labor zu verlassen, solange er mittlere oder schwere Beschwerden angab.
13. Datenmanagement und Vertraulichkeit
Alle Daten wurden in einem anonymisierten Projektordner auf einer verschlüsselten institutionellen Festplatte gespeichert. Die Verknüpfungsdatei, die die Identitäten der Teilnehmer mit den Teilnehmercodes verbindet, wurde separat aufbewahrt und war nur dem leitenden Forscher zugänglich. Fragebogendaten, Aufgabenprotokolle, Beobachterbewertungen und Ergebnisse der Wissenstests wurden ausschließlich mithilfe der Teilnehmer- und Teamcodes zusammengeführt, und der analytische Datensatz enthielt keine personenbezogenen Angaben.
Die Daten wurden auf Teilnehmer- und Teamebene organisiert. Die Dateien auf Teilnehmerebene enthielten Identifikatoren, Zuweisung der Bedingung, demografische Variablen, Fragebogen-Ergebnisse, Wissensergebnisse und aufgabenbezogene Variablen. Die Dateien auf Teamebene enthielten Teamidentifikatoren, Zuweisung der Bedingung, beobachterbewertete Koordination, Aufgabenabschluss, Abschlusszeit, Ressourcenauswahl, Umgang mit Gefahren, Routenfehler und Sicherheitsunterbrechungen. Rohdaten der Beobachterbewertungen wurden vor dem Bilden von Mittelwerten oder der Konsensfindung separat aufbewahrt. Variablendefinitionen, Codierungsbereiche und die Struktur des Datensatzes sind in Supplementary File 1 enthalten.
14. Statistische Analyse
Die primären Endpunkte waren räumliche Präsenz, selbstbewertete Teamkoordination, beobachterbewertete Teamkoordination und Lernengagement. Zu den sekundären Endpunkten gehörten Wissen nach der Schulung, Wissenretention nach 2 Wochen, kognitive Belastung, Unbehagen im Simulator, Aufgabenabschluss, Abschlusszeit und Indikatoren für die Aufgabenbearbeitung. Die Trainingsbedingungen umfassten kollaborative Simulation am Desktop, räumlich verteilte kollaborative Virtual-Reality-Simulation im Raummaßstab und kollaborative Virtual-Reality-Simulation im großflächigen, gemeinsam genutzten Raum.
Teilnehmer- und Team-Ebene-Variablen wurden mithilfe geeigneter deskriptiver Statistiken zusammengefasst. Zu den Basislinienmerkmalen gehörten Alter, Geschlecht, bisherige Erfahrung mit virtueller Realität, Vertrautheit mit Computerspielen, frühere Erfahrung mit teambasierter Ausbildung sowie das Wissen vor der Schulung. Da die Randomisierung auf Teamebene erfolgte, wurden Intraklassenkorrelationskoeffizienten berechnet, um die Abhängigkeit innerhalb der Teams zu bewerten. Primäre Ergebnisse auf Teilnehmerebene wurden mittels linearer gemischter Modelle mit dem Trainingszustand als festem Effekt und der Teamkennung als zufälligem Achsenabschnitt analysiert. Die Modelle verwendeten die geschätzte begrenzte Maximum-Likelihood-Methode und beinhalteten verfügbare Daten unter der Annahme zufällig fehlender Werte. Für primäre Fragebogenergebnisse wurde keine Imputation vorgenommen. Geschätzte marginale Mittelwerte wurden mittels Tukey-korrigierter paarweiser Kontraste verglichen. Die von Beobachtern bewertete Koordination wurde auf Teamebene analysiert.
Das Verfahren der falschen Entdeckungsrate nach Benjamini-Hochberg wurde als Sensitivitätsanalyse für die vier primären Ergebnisse angewandt. Alle randomisierten Teams und Teilnehmer wurden gemäß der ursprünglichen Zuordnung analysiert. Skalenwerte aus mehreren Einzelitems wurden berechnet, wenn mindestens 80 % der Items ausgefüllt waren; andernfalls wurden die Werte als fehlend kodiert. Die Residualnormalverteilung wurde mithilfe von Q-Q-Diagrammen und Shapiro-Wilk-Tests überprüft, und die Varianzhomogenität wurde anhand des Levene-Tests beurteilt. Stark von der Normalverteilung abweichende Daten wurden zusätzlich mit dem Kruskal-Wallis-Test als Sensitivitätsanalyse untersucht.
Effektgrößen wurden zusammen mit p-Werten angegeben. Die Ergebnisse der Varianzanalyse enthielten Eta-Quadrat und partielles Eta-Quadrat; bei paarweisen Vergleichen wurde Cohens d mit 95-%-Konfidenzintervallen angegeben; gemischte Modelle berichteten geschätzte mittlere Unterschiede mit 95-%-Konfidenzintervallen. Statistische Signifikanz wurde als zweiseitiger p < 0,05 definiert. Zusammenhänge zwischen räumlicher Präsenz, Teamkoordination, Lernengagement und Wissensergebnissen wurden gegebenenfalls mithilfe von Pearson- oder Spearman-Korrelationen untersucht. Der statistische Syntax für deskriptive Analysen, gemischte Modelle, Analysen zur Teamkoordination auf Gruppenebene, Anpassungen bei mehrfachen Ergebnissen, Überprüfungen von Annahmen, Wissensanalysen und Korrelationsanalysen ist in Supplementary File 1 enthalten.
Ergebnisse
Teilnehmerfluss und Analysepopulationen
Insgesamt wurden 126 Teilnehmer rekrutiert und 42 Teams mit je drei Personen zugeordnet. Jede Trainingsbedingung erhielt 14 Teams zugewiesen, was 42 Teilnehmern in der Gruppe des kollaborativen Computersimulationstrainings, 42 in der Gruppe des räumlich verteilten kollaborativen Virtual-Reality-Trainings und 42 in der Gruppe des großräumigen ko-lokalen kollaborativen Virtual-Reality-Trainings entspricht. Alle Teams absolvierten die zugewiesene Trainingssitzung und blieben in dem für die Intention-to-treat-Analyse vorgesehenen Datensatz enthalten.
Die Datenlücken waren gering und nicht auf eine bestimmte Bedingung konzentriert. Für 124 Teilnehmer lagen Angaben zu räumlicher Präsenz vor, darunter 41 in der Desktop-Gruppe, 42 in der Raumskalengruppe und 41 in der Großraumgruppe. Selbstbewertete Werte zur Teamkoordination waren für 123 Teilnehmer verfügbar, jeweils 41 pro Gruppe. Lernengagement-Scores lagen für 122 Teilnehmer vor, darunter 40 in der Desktop-Gruppe, 41 in der Raumskalengruppe und 41 in der Großraumgruppe. Angaben zur Simulator-Beanspruchung waren für 124 Teilnehmer verfügbar, darunter 42 in der Desktop-Gruppe, 41 in der Raumskalengruppe und 41 in der Großraumgruppe. Gültige Wissensabfragen nach zweiwöchiger Retention lagen für 122 Teilnehmer vor, darunter 40 in der Desktop-Gruppe, 41 in der Raumskalengruppe und 41 in der Großraumgruppe. Die durch Beobachter bewertete Teamkoordination war für alle 42 Teams verfügbar. Der Teilnehmerfluss, die Zuordnung, die unmittelbare Beurteilung und die Absolvierung der Nachuntersuchung sind in Abbildung 3 zusammengefasst.
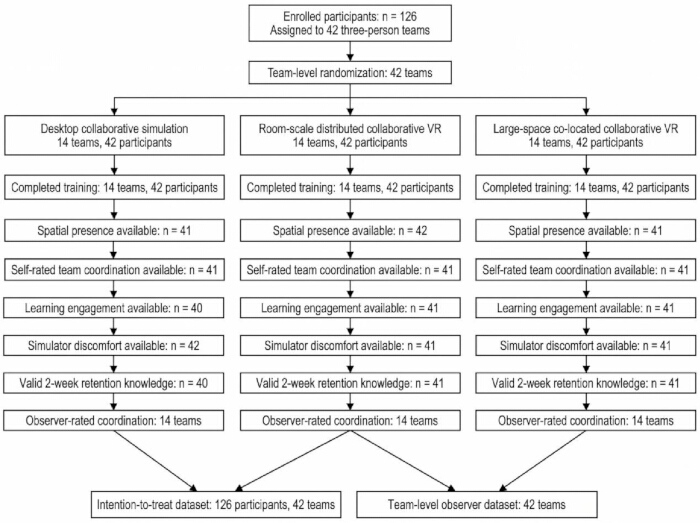
Abbildung 3: Teilnehmerfluss und Analysepopulationen. Das Flussdiagramm zeigt die Rekrutierung, Zuweisung von 126 Teilnehmern zu 42 Dreier-Teams, Abschluss der Schulung, unmittelbare Bewertung, beobachterbasierte Koordinationsscores sowie valide Follow-up-Daten nach zwei Wochen über alle drei Schulungsbedingungen hinweg. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Grundlegende Merkmale
Die grundlegenden demografischen und ausbildungsbezogenen Merkmale waren über die drei Bedingungen hinweg weitgehend vergleichbar. Die endgültige Stichprobe bestand aus jungen erwachsenen Studierenden und Doktoranden. Die drei Gruppen unterschieden sich nicht signifikant hinsichtlich Alter, bisheriger Erfahrung mit virtueller Realität, Vertrautheit mit Spielen oder Simulationen, früherer Erfahrung mit teambasierter Ausbildung sowie früherer Ausbildung in Notfalllogistik, Navigation oder industrieller Sicherheit.
Die Wissenswerte vor dem Training waren ebenfalls zwischen den Gruppen vergleichbar. Die durchschnittlichen Werte vor dem Training lagen bei 16,17 ± 3,09 in der Gruppe mit kollaborativer Simulation am Desktop, bei 16,10 ± 3,61 in der Gruppe mit räumlich verteiltem kollaborativem Virtual-Reality-System und bei 15,55 ± 3,23 in der Gruppe mit großräumiger ko-lokalisierter kollaborativer Virtual-Reality-Technologie. Der unadjustierte Vergleich zwischen den Gruppen war nicht statistisch signifikant, F(2, 123) = 0,44, p = 0,647, η2 = 0,007.
Die Basischarakteristika und Vorabmessungen vor dem Training sind in Tabelle 2 dargestellt. Vor der inferenzstatistischen Hypothesenprüfung zeigten diagnostische Analysen, dass die primären stetigen Variablen die Annahmen der Residualnormalverteilung und der Varianzhomogenität erfüllten. Die innere Konsistenz war bei allen psychometrischen Instrumenten hoch, mit Cronbachs Alpha-Koeffizienten von 0,86 für räumliche Präsenz, 0,88 für selbstbewertete Teamkoordination und 0,91 für Lernengagement. Alle statistisch signifikanten Gruppenunterschiede bezüglich der primären Endpunkte blieben auch nach Korrektur der Fehlentdeckungsrate nach Benjamini-Hochberg signifikant.
Tabelle 2: Baseline-Charakteristika und Vorabmessungen. Diese Tabelle zeigt die demografischen Daten der Teilnehmer, ihre bisherigen Erfahrungen mit virtueller Realität und Training, ihre Vertrautheit mit Spielen oder Simulationen, ihre Vorgeschichte bezüglich verwandter Trainingsmaßnahmen sowie ihre Wissenswerte vor dem Training in den drei experimentellen Bedingungen. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Räumliche Präsenz
Die räumliche Präsenz wurde mithilfe eines linearen gemischten Effektmodells analysiert, wobei der Trainingszustand als fester Effekt und die Teamkennung als zufälliger Achsenabschnitt berücksichtigt wurden. Für die Tests des gemischten Effektmodells wurden nach Satterthwaite adjustierte Freiheitsgrade verwendet. Das Modell zeigte einen signifikanten Einfluss der Trainingsbedingung auf die räumliche Präsenz, F(2, 39) = 23,91, p < 0,001. Die geschätzten Randmittelwerte betrugen 4,13 für die Gruppe mit kollaborativer Simulation am Desktop, 5,00 für die Gruppe mit raumskaliert verteilter kollaborativer Virtual-Reality und 5,42 für die Gruppe mit großräumig ko-lokalisierter kollaborativer Virtual-Reality.
Paarweise Vergleiche mit Tukey-Korrektur zeigten, dass die räumliche Präsenz in der Großraumgruppe höher war als in der Desktop-Gruppe, geschätzte Mittelwertdifferenz = 1,29, 95 % KI: 0,86 – 1,72, p < 0,001. Die räumliche Präsenz war auch in der Großraumgruppe höher als in der Raumskalengruppe, geschätzte Mittelwertdifferenz = 0,42, 95 % KI: 0,04 – 0,80, p = 0,027. Die Raumskalengruppe erzielte höhere Werte als die Desktop-Gruppe, geschätzte Mittelwertdifferenz = 0,87, 95 % KI: 0,45 – 1,29, p < 0,001.
Zum beschreibenden Vergleich betrugen die unadjustierten Mittelwerte ± Standardabweichung (SD) in der Desktop-Gruppe 4,13 ± 0,91, in der Raumskala-Gruppe 5,00 ± 0,79 und in der Großraum-Gruppe 5,42 ± 0,80. Die unadjustierte Varianzanalyse (ANOVA) zeigte dasselbe Muster, F(2, 121) = 25,68, p < 0,001, η2 = 0,298. Die Verteilungen der primären Endpunkte sind in Abbildung 4 dargestellt, und die entsprechenden gemischten Effekte sowie beschreibenden Statistiken sind in Tabelle 3 zusammengefasst.
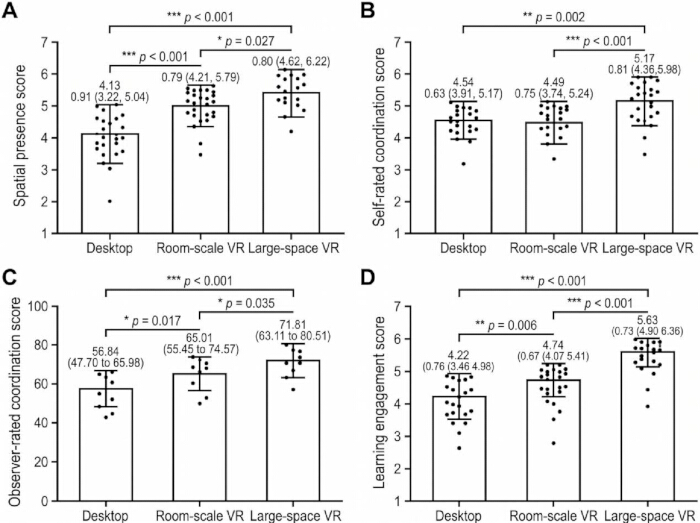
Abbildung 4: Primäre Ergebnisse über die Trainingsbedingungen hinweg. (A) Räumliche Präsenz. (B) Selbstbewertete Teamkoordination. (C) Durch Beobachter bewertete Teamkoordination. (D) Lernengagement. Räumliche Präsenz, selbstbewertete Teamkoordination und Lernengagement waren Ergebnisse auf Teilnehmerebene; die durch Beobachter bewertete Teamkoordination wurde auf Teamebene analysiert. Die Fehlerbalken zeigen die Standardabweichung an. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Tabelle 3: Primäre Ergebnisse. Diese Tabelle fasst räumliche Präsenz, selbstbewertete Teamkoordination, beobachterbewertete Teamkoordination und Lernengagement über die drei Trainingsbedingungen hinweg zusammen. Entsprechende inferenzstatistische Modelle und Sensitivitätsprüfungen zur Fehlentdeckungsrate werden ebenfalls dargestellt. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Teamkoordination
Die selbst eingeschätzte Teamkoordination wurde auf Ebene der Teilnehmer mithilfe eines linearen gemischten Modells mit dem Trainingszustand als festem Effekt und der Teamkennung als zufälligem Achsenabschnitt analysiert. Das Modell zeigte einen signifikanten Einfluss der Trainingsbedingung, F(2, 39) = 9,96, p < 0,001. Die geschätzten Randmittelwerte betrugen 4,54 in der Desktop-Gruppe, 4,49 in der Raumskala-Gruppe und 5,17 in der Großraum-Gruppe.
Tukey-angepasste Vergleiche zeigten, dass die selbstbewertete Teamkoordination in der Großraumgruppe höher war als in der Desktop-Gruppe, geschätzte Mittelwertdifferenz = 0,63, 95 % KI: 0,25 – 1,01, p = 0,002. Die Großraumgruppe erzielte ebenfalls höhere Werte als die Raumskalengruppe, geschätzte Mittelwertdifferenz = 0,68, 95 % KI: 0,29 – 1,07, p < 0,001. Die Desktop- und die Raumskalengruppe unterschieden sich nicht signifikant, geschätzte Mittelwertdifferenz = 0,05, 95 % KI: −0,33 – 0,43, p = 0,942. Zum deskriptiven Vergleich betrugen die unadjustierten Mittelwerte ± SD 4,54 ± 0,63 in der Desktop-Gruppe, 4,49 ± 0,75 in der Raumskalengruppe und 5,17 ± 0,81 in der Großraumgruppe. Die unadjustierte ANOVA ergab dasselbe Richtungsmuster, F(2, 120) = 10,84, p < 0,001, η2 = 0,153.
Die beobachterbewertete Teamkoordination wurde auf Teamebene wie vorgesehen analysiert. Die Inter-Rater-Reliabilität lag über der vordefinierten Schwelle, mit einem intraklassenkorrelationskoeffizienten nach dem Zwei-Wege-Zufallseffektmodell von ICC = 0,84. Bei drei Teamaufnahmen betrug der Gesamtpunkteunterschied zwischen den Beobachtern mehr als 12 Punkte und wurde durch konsensbasierte Überprüfung geklärt. Die beobachterbewertete Koordination unterschied sich signifikant zwischen den Bedingungen, F(2, 39) = 10,92, p < 0,001, η2 = 0,359. Die mittleren Werte auf Teamebene betrugen 56,84 ± 9,14 in der Desktop-Gruppe, 65,01 ± 9,56 in der Raumskalengruppe und 71,81 ± 8,70 in der Großraumgruppe. Tukey-korrigierte Vergleiche zeigten eine höhere beobachterbewertete Koordination in der Großraumgruppe im Vergleich zur Desktop-Gruppe, mittlerer Unterschied = 14,97, 95 % KI: 7,33 – 22,61, p < 0,001. Die Großraumgruppe erzielte ebenfalls höhere Werte als die Raumskalengruppe, mittlerer Unterschied = 6,80, 95 % KI: 0,42 – 13,18, p = 0,035. Die Raumskalengruppe erzielte höhere Werte als die Desktop-Gruppe, mittlerer Unterschied = 8,17, 95 % KI: 1,31 – 15,03, p = 0,017. Die selbstbewertete und die beobachterbewertete Koordination zeigten dieselbe Gruppenreihenfolge, wobei die Großraumgruppe bei beiden Messungen die höchsten Koordinationsscores aufwies.
Lernengagement
Das Lernengagement wurde mithilfe eines linearen gemischten Effektmodells analysiert, wobei der Trainingszustand als fester Effekt und die Teamkennung als zufälliger Achsenabschnitt berücksichtigt wurden. Das Modell zeigte einen signifikanten Einfluss des Trainingszustands, F(2, 39) = 37,46, p < 0,001. Die geschätzten Randmittelwerte betrugen 4,22 in der Desktop-Gruppe, 4,74 in der Raumskalengruppe und 5,63 in der Großraumgruppe. Tukey-korrigierte paarweise Vergleiche zeigten, dass das Engagement in der Großraumgruppe höher war als in der Desktop-Gruppe, geschätzte Mittelwertdifferenz = 1,41, 95 % KI: 1,03 – 1,79, p < 0,001. Das Engagement war auch in der Großraumgruppe höher als in der Raumskalengruppe, geschätzte Mittelwertdifferenz = 0,89, 95 % KI: 0,53 – 1,25, p < 0,001. Die Raumskalengruppe erzielte höhere Werte als die Desktop-Gruppe, geschätzte Mittelwertdifferenz = 0,52, 95 % KI: 0,15 – 0,89, p = 0,006.
Zum beschreibenden Vergleich betrugen die unadjustierten Mittelwerte ± SD 4,22 ± 0,76 in der Desktop-Gruppe, 4,74 ± 0,67 in der Raumskalengruppe und 5,63 ± 0,73 in der Großraumgruppe. Die unadjustierte ANOVA zeigte dasselbe Muster, F(2, 119) = 40,00, p < 0,001, η2 = 0,402.
Überprüfung der Empfindlichkeit der Falsch-Entdeckungs-Rate für die primären Endpunkte
Das Verfahren zur Kontrolle der Falsch-Entdeckungs-Rate nach Benjamini-Hochberg wurde auf die vier vorab festgelegten primären Endpunkte angewandt: räumliche Präsenz, selbstbewertete Teamkoordination, beobachterbewertete Teamkoordination und Lernengagement. Alle vier primären Endpunkte blieben nach der Anpassung statistisch signifikant. Die Sensitivitätsprüfung der Falsch-Entdeckungs-Rate ergab dasselbe Muster bei den primären Ergebnissen wie die Hauptanalysen.
Wissensergebnisse und -speicherung
Das unmittelbare Wissen nach der Schulung wurde mittels eines gemischten Modells mit dem Schulungszustand als fester Effekt, dem Wissen vor der Schulung als Kovariate und der Teamkennung als zufälligem Achsenabschnitt analysiert. Das angepasste Modell zeigte einen nicht signifikanten Gruppeneffekt für das Wissen nach der Schulung, F(2, 39) = 2,14, p = 0,131. Die geschätzten Randmittelwerte betrugen 20,12 für die Desktop-Gruppe, 20,96 für die Raumskalengruppe und 21,85 für die Großraumgruppe. Zu deskriptiven Vergleichszwecken lagen die mittleren Werte des Wissens nach der Schulung bei 20,09 ± 4,04 in der Desktop-Gruppe, 21,00 ± 4,57 in der Raumskalengruppe und 21,84 ± 3,95 in der Großraumgruppe. Der unangepasste zwischen-Gruppen-Vergleich war statistisch nicht signifikant, F(2, 123) = 1,83, p = 0,165, η2 = 0,029.
Der Wissenszuwachs von der Ausgangsbewertung bis zur unmittelbaren Nachtrainingseinschätzung wurde als sekundäres exploratives inferenzielles Ergebnis bewertet. Die mittleren Zuwächse betrugen 3,93 ± 2,88 Punkte in der Desktop-Gruppe, 4,91 ± 2,12 Punkte in der Raumskalengruppe und 6,30 ± 2,75 Punkte in der Großraumgruppe. Der nicht angepasste Gruppeneffekt war signifikant, F(2, 123) = 8,77, p < 0,001, η2 = 0,125. Tukey-angepasste Vergleiche zeigten einen größeren Wissenszuwachs in der Großraumgruppe im Vergleich zur Desktop-Gruppe, mittlere Differenz = 2,37, 95 % KI: 0,96 – 3,78, p < 0,001. Die Großraumgruppe wies auch einen größeren Zuwachs als die Raumskalengruppe auf, mittlere Differenz = 1,39, 95 % KI: 0,14 – 2,64, p = 0,026. Die Raumskalen- und Desktop-Gruppen unterschieden sich nicht signifikant, mittlere Differenz = 0,98, 95 % KI: −0,31 – 2,27, p = 0,171.
Bei der Nachuntersuchung nach zwei Wochen wurde das Behaltenswissen unter Teilnehmenden mit gültigen Retentionsergebnissen innerhalb des vordefinierten Zeitraums vom 13. bis 16. Tag analysiert. Das angepasste gemischte Modell, adjustiert für das Wissen vor der Schulung und mit Teamcode als zufälliger Achsenabschnitt, zeigte einen nicht signifikanten Gruppeneffekt, F(2, 39) = 1,68, p = 0,199. Die mittleren Retentionswerte betrugen 18,70 ± 4,55 in der Desktop-Gruppe, 19,62 ± 4,37 in der Raumskalengruppe und 20,42 ± 4,38 in der Großraumgruppe. Der nicht angepasste Gruppenvergleich war ebenfalls statistisch nicht signifikant, F(2, 119) = 1,53, p = 0,220, η2 = 0,025. Sekundäre Lernergebnisse sind in Tabelle 4 zusammengefasst.
Tabelle 4: Sekundäre Lernergebnisse über die Trainingsbedingungen hinweg. Diese Tabelle zeigt die Kenntnisse vor dem Training, die unmittelbaren Kenntnisse nach dem Training, den Wissenszuwachs und die Wissensbewahrung nach 2 Wochen über die drei Trainingsbedingungen hinweg auf. Angepasste Mixed-Effects-Modelle für die sekundären Lernergebnisse werden dargestellt. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Kognitive Belastung und Unbehagen beim Simulatortraining
Die kognitive Belastung wurde als sekundärer Endpunkt analysiert. Die mittlere kognitive Belastung betrug 4,22 ± 0,69 in der Desktop-Gruppe, 4,49 ± 0,62 in der Raumskala-Gruppe und 4,13 ± 0,82 in der Großraum-Gruppe. Der nicht angepasste Gruppeneffekt betrug F(2, 123) = 2,92, p = 0,058, η2 = 0,045. Dieses Ergebnis erreichte die vorab festgelegte Signifikanzschwelle nicht.
Die Simulator-Beanspruchung unterschied sich je nach Bedingung. Der mittlere Unwohlheitsindex nach der Aufgabe betrug 1,37 ± 0,71 in der Desktop-Gruppe, 2,18 ± 0,79 in der Raumskalengruppe und 2,42 ± 0,58 in der Großraumgruppe. Der nicht angepasste Gruppeneffekt war signifikant, F(2, 121) = 25,72, p < 0,001, η2 = 0,298. Die Unwohlheitswerte waren in den beiden Virtual-Reality-Gruppen höher als in der Desktop-Gruppe, blieben jedoch im Durchschnitt im leichten Bereich. Kein Teilnehmer erfüllte das vorab festgelegte Abbruchkriterium, wonach ein Wert ≥7 bei einem Unwohlheitsitem vorliegen musste. Sieben Teilnehmer wiesen nach der Aufgabe einen Unwohlheitsindex ≥5 auf und erhielten einen Kontakt für die Überprüfung der Symptomresolution nach 24 Stunden. Unter diesen Teilnehmern hatten vier einen post-task Unwohlheitsindex >6 und wurden zusätzlich vor Verlassen des Labors mindestens 15 Minuten lang beobachtet. Alle sieben Teilnehmer berichteten über eine vollständige Symptomresolution, ohne dass eine medizinische Weiterleitung erforderlich gewesen wäre. Keine Sitzung musste aufgrund von Simulator-Beanspruchung abgebrochen werden, und es wurde kein unerwünschtes Ereignis, das klinische Versorgung erforderte, dokumentiert. Die kognitive Belastung und die Simulator-Beanspruchung sind in Abbildung 5 dargestellt.
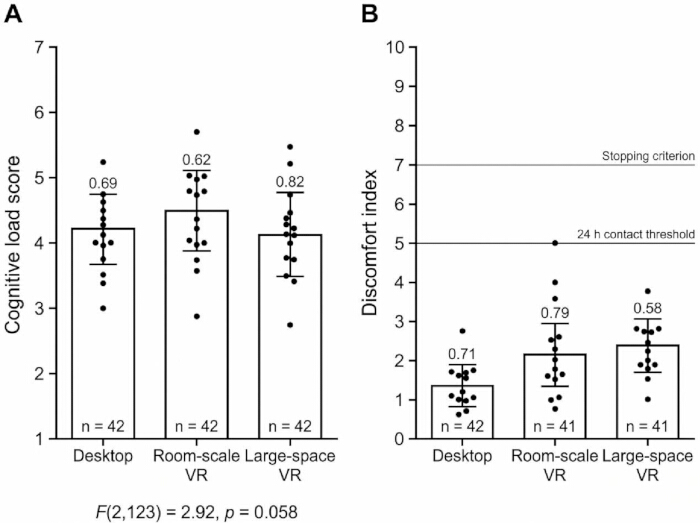
Abbildung 5: Kognitive Belastung und Unbehagen im Simulator über verschiedene Trainingsbedingungen hinweg. (A) Kognitive Belastung, bewertet von 1 bis 7, wobei höhere Werte für eine stärkere wahrgenommene Arbeitsbelastung stehen. (B) Simulatorbedingtes Unbehagen nach Abschluss der Aufgabe, bewertet von 0 bis 10 und basierend auf Übelkeit, Schwindel, Augenbelastung, Kopfschmerzen und Gleichgewichtsstörungen. Die Fehlerbalken zeigen die Standardabweichung an. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Aufgabenprozessindikatoren
Aufgabenprozessindikatoren wurden verwendet, um die Teamleistung während der 20-minütigen kollaborativen Trainingseinheit zu beschreiben. Die Aufgabenabschlussrate betrug 71,4 % in der Desktop-Gruppe, 78,6 % in der Raumskalengruppe und 85,7 % in der Großraumgruppe. Die mittlere Abschlusszeit lag bei 1.041,6 ± 162,4 s in der Desktop-Gruppe, 984,3 ± 151,8 s in der Raumskalengruppe und 931,7 ± 139,6 s in der Großraumgruppe. Da unvollständigen Teams eine Zeitschranke von 1.200 s gesetzt wurde, wurde die Abschlusszeit deskriptiv interpretiert.
Die durchschnittliche Anzahl korrekt ausgewählter Ressourcen betrug in der Desktop-Gruppe 2,21 ± 0,70, in der Raumskalengruppe 2,43 ± 0,65 und in der Großraumgruppe 2,64 ± 0,50. Die durchschnittlich korrekt bearbeiteten Gefahrenhinweise lagen bei 1,93 ± 0,83, 2,21 ± 0,70 bzw. 2,50 ± 0,65. Die durchschnittliche Anzahl von Routenfehlern betrug 2,07 ± 1,14 in der Desktop-Gruppe, 1,50 ± 0,94 in der Raumskalengruppe und 1,00 ± 0,78 in der Großraumgruppe. Sicherheitsunterbrechungen traten unter allen Bedingungen selten auf, mit Durchschnittswerten von 0,21 ± 0,43, 0,29 ± 0,47 bzw. 0,36 ± 0,50. Der Aufgabenabschlussstatus, die Abschlusszeit, die korrekte Auswahl von Ressourcen, korrekt bearbeitete Gefahrenhinweise, Routenfehler und Sicherheitsunterbrechungen sind in Tabelle 5 zusammengefasst.
Tabelle 5: Indikatoren des Aufgabenablaufs und Sicherheitsereignisse. Diese Tabelle fasst objektive Leistungsmessungen bei der Aufgabenbearbeitung zusammen, einschließlich Abschlussraten, Fehler bei der Routennavigation und dem Umgang mit Gefahren. Die Überwachung von Unbehagen im Simulator sowie dokumentierte unerwünschte klinische Ereignisse werden ebenfalls berichtet. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Beziehungen zwischen Präsenz, Koordination, Beteiligung und Lernen
Psychometrische Antworten auf Teilnehmerebene wurden vor der Integration mit beobachterbasierten Koordinationsmaßen zu teambezogenen Cluster-Mittelwerten aggregiert. Die Korrelationsanalyse auf Teamebene zeigte positive Zusammenhänge zwischen räumlicher Präsenz und Lernbeteiligung (r = 0.57), selbstbewerteter Teamkoordination (r = 0.26) sowie beobachterbewerteter Koordination (r = 0.32).
Das Korrelationsmuster zeigte einen mäßigen Überlapp zwischen Präsenz, Koordination und Engagement, während die Korrelationen mit dem Wissenszuwachs geringer waren. Das Korrelationsmuster deutete auf eine Übereinstimmung zwischen Präsenz, Koordination und Engagement hin, während die Zusammenhänge mit dem Wissenszuwachs kleiner ausfielen. Diese Analysen waren explorativ und belegen keine kausalen Zusammenhänge zwischen den gemessenen Ergebnissen. Die Korrelationsmatrix ist in Abbildung 6 dargestellt.
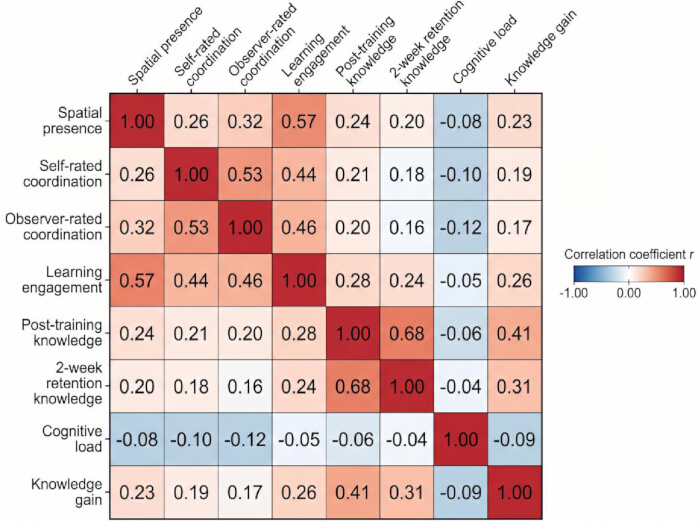
Abbildung 6: Korrelationsmatrix für Präsenz, Teamkoordination, Beteiligung und Lernergebnisse. Die Wärmekarte zeigt die Pearson-Korrelationskoeffizienten zwischen räumlicher Präsenz, selbstbewerteter Teamkoordination, beobachterbewerteter Teamkoordination, Lernbeteiligung, Wissen nach der Schulung, Wissen bei der Nachuntersuchung nach zwei Wochen, kognitiver Belastung und Wissenszuwachs. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Die Gruppe mit großräumigem, gemeinsam genutztem kollaborativem Virtual-Reality-System wies eine höhere räumliche Präsenz, selbstbewertete Teamkoordination, fremdbewertete Teamkoordination und Lernbeteiligung auf als die Vergleichsgruppen. Diese primären Ergebnisse blieben signifikant, nachdem Team-Clustering und die Anpassung der falschen Entdeckungsrate berücksichtigt wurden. Bei den sekundären Ergebnissen zeigte sich ein Vorteil für die Großraumgruppe hinsichtlich des Wissenszuwachses, während das adjustierte Wissen nach der Schulung und das Wissen nach zweiwöchiger Retention zwischen den Bedingungen nicht signifikant unterschiedlich waren. Die kognitive Belastung unterschied sich zwischen den Gruppen nicht signifikant, und die Simulator-Beanspruchung blieb im Durchschnitt gering, trotz höherer Werte in den Virtual-Reality-Bedingungen.
VERFÜGBARKEIT VON DATEN:
Der anonymisierte Analyse-Datensatz, das Datenwörterbuch, die Bewertungsraster und die statistische Syntax zur Unterstützung der Reproduzierbarkeit sind öffentlich im Zenodo-Repository verfügbar – https://zenodo.org/records/21991446. Zusätzliche Berichts-Checklisten, Instrumenten-Blaupausen, Bewertungsregeln und Dokumentationen zum Datensatz sind in dem ergänzenden Dateianhang 1 enthalten.
Ergänzende Datei 1: Unterlagen zur Reproduzierbarkeit der Studie zur kooperativen Virtual-Reality-Schulung in großräumiger Umgebung. Diese Datei enthält den Teilnehmerfragebogen, den Aufbau des Wissenstests, das beobachterbewertete Koordinationsraster, das Datenwörterbuch, die Regeln zur Bewertung und Datensäuberung, einen Überblick zur statistischen Syntax, die Struktur des anonymisierten analytischen Datensatzes sowie eine Checkliste für die Berichterstattung. Bitte klicken Sie hier, um die Datei herunterzuladen.
Diskussion
Diese Studie untersuchte, ob eine ko-lokale, kollaborative Virtual-Reality-Konfiguration mit großem Bewegungsspielraum andere Trainingserfahrungen hervorruft als die Zusammenarbeit am Desktop oder eine räumlich verteilte, kollaborative Virtual-Reality-Umgebung im Room-Scale-Format. Die stärksten und konsistentesten Ergebnisse zeigten sich hinsichtlich der räumlichen Präsenz, der Teamkoordination und der Lernbeteiligung. Diese Ergebnisse sind voneinander zu unterscheiden: Die räumliche Präsenz spiegelt das Ausmaß wider, in dem die Teilnehmenden das Gefühl hatten, sich innerhalb des Trainingsraums zu befinden; Koordination bezieht sich auf den Austausch von Informationen, die Ausführung von Rollen und die Fehlerbehebung; und Engagement beschreibt die kognitive und verhaltensbezogene Einbindung in die Aufgabe. Unter Berücksichtigung der Team-Clustering-Effekte und der Anpassung an die falsche Entdeckungsrate (False Discovery Rate) wies die Bedingung mit großem Bewegungsspielraum in allen drei Bereichen höhere Werte auf. Dieses Muster stimmt mit der weiter gefassten Auffassung überein, dass kollaborative Virtual Reality nicht nur als Anzeigetechnologie fungiert, sondern auch als Aufgaben-Ökologie, in der gemeinsame Handlungen, Kommunikation und die Struktur der Umgebung gemeinsam das Lernverhalten prägen15.
Der räumliche Präsenzfund ist relevant, weil sich die drei Trainingsbedingungen in der Organisation von Bewegung und gleichzeitiger Anwesenheit unterschieden. Die Desktop-Bedingung ermöglichte Zusammenarbeit, ohne eine immersive körperliche Platzierung zu bieten. Die räumlich verteilte Bedingung bot ein immersives visuelles Erlebnis und Live-Teamkommunikation, doch die Teilnehmer blieben in separaten kleinen Erfassungsbereichen. Die Großraum-Bedingung fügte eine gemeinsame physische Ko-Navigation hinzu, wodurch die Teilnehmer sich innerhalb derselben erfassten Umgebung bewegen, orientieren und handeln konnten. Der beobachtete Anstieg der räumlichen Präsenz sollte daher nicht allein auf den Gehraum zurückgeführt werden, sondern vielmehr auf die gesamte Trainingskonfiguration, die körperliche Bewegung, einen gemeinsamen räumlichen Bezug und Echtzeit-Sichtbarkeit des Teams kombiniert. Diese Interpretation stimmt mit Präsenzforschung überein, die zeigt, dass immersive Systeme die Präsenz verstärken können, wenn sensorimotorische Kontingenzen, räumliche Aktualisierung und Umweltkohärenz das Gefühl unterstützen, sich innerhalb der vermittelten Umgebung aufzuhalten16. Die Koordinationsergebnisse zeigten ein ähnliches Muster. Die Großraumgruppe wies eine höhere selbst- und beobachterbewertete Koordination auf. Die selbstbewertete Koordination kann von Genuss oder Neuheit beeinflusst sein, während die beobachterbewertete Koordination auf sichtbarem Kommunikationszeitpunkt, Rollenausführung, gegenseitiger Unterstützung, räumlicher Koordination und Fehlerbehebung basierte. Gemeinsame räumliche Informationen haben daher möglicherweise ein gemeinsames Referenzfeld für die Organisation der Teamhandlung bereitgestellt. Dieses Muster ist konsistent mit Forschung zum computergestützten kooperativen Lernen, die darauf hinweist, dass Zusammenarbeit von Kommunikationskanälen, gemeinsamen Repräsentationen, Aufgabenabhängigkeit und Überwachung des Teamfortschritts abhängt17.
Die Lernbeteiligung stieg ebenfalls in der Gruppe mit großräumigem Setting an, obwohl dieses Ergebnis im Hinblick auf die Lerneffektivität vorsichtig interpretiert werden muss. Die Kombination aus höherem unmittelbarem Wissenszuwachs mit nicht signifikanten adjustierten Ergebnissen nach der Schulung und beim Behaltensvermögen zeigt, dass eine stärkere erlebnisbasierte Beteiligung nicht mit einer durchgängig stärkeren Wissensspeicherung einherging. Eine einmalige Exposition mag daher stärkere Immersion und verhaltensmäßige Einbindung bewirken, ohne notwendigerweise dauerhafte Unterschiede im Wissenserwerb hervorzurufen. Die Vorteile großräumiger kollaborativer Umgebungen zeigten sich am deutlichsten bei der räumlichen Koordination und aktiven Situationsbeteiligung, nicht jedoch bei der nachhaltigen kognitiven Speicherung. Die Beteiligung bleibt eine Voraussetzung für das Lernen, nicht jedoch eine Garantie für Behalten. Forschung zum immersiven Lernen zeigt ähnlich, dass Präsenz und Beteiligung Aufmerksamkeit und Aufgabeneinbindung unterstützen können, während dauerhaftes Lernen zusätzlich von der Unterrichtsgestaltung, Rückmeldungen, Vorwissen und Gelegenheiten zum wiederholten Üben abhängt18. Die kognitive Belastung nahm in der Gruppe mit großräumigem Setting trotz der erforderlichen körperlichen Bewegung und Echtzeit-Teamkoordination nicht signifikant zu. Die räumlich verteilte Bedingung wies die höchste mittlere kognitive Belastung auf, obwohl der Gruppenunterschied die vorab definierte Signifikanzschwelle nicht erreichte. Bei der verteilten Kollaboration mussten die Teilnehmenden ihre Koordination über Sprache vornehmen, während sie in separaten kleinen Räumen handelten, was die Koordinationsanforderungen möglicherweise aufrechterhielt, ohne den gemeinsamen physischen Bezug zu besitzen, der im großräumigen Setting verfügbar war. Die kognitive Belastungstheorie besagt ähnlich, dass kollaboratives Lernen am effektivsten ist, wenn die Aufgabenstruktur die kognitiven Anforderungen verteilt, ohne unnötige Kommunikationslast hinzuzufügen19.
Die Simulator-Beanspruchung war in den beiden Virtual-Reality-Bedingungen höher als in der Desktop-Bedingung, obwohl die durchschnittlichen Werte gering blieben. Kein Teilnehmer erfüllte das Abbruchkriterium, bei dem ein Unwohlsein-Wert 7 erreichte, und es trat kein unerwünschtes Ereignis auf, das eine klinische Behandlung erforderte. Bei der großräumigen, ko-lokalisierten kollaborativen Virtual Reality ergeben sich Sicherheitsaspekte, da hier Kopf-Mounted-Displays, körperliche Bewegung und Nähe im Team kombiniert werden. Die implementierten Sicherheitsmaßnahmen beseitigten die Unpässlichkeit nicht vollständig, hielten die Symptome in dieser Stichprobe jedoch in einem beherrschbaren Bereich. Für eine breitere institutionelle Implementierung sind standardisierte Fehlerbehebungsverfahren erforderlich. Eine korrekte Passform der Headsets und die Kalibrierung des Pupillenabstands sind wichtig, um okulare Belastung zu verringern. Verlust der räumlichen Verfolgung oder erhöhte Netzwerk-Latenz erfordern eine sofortige Unterbrechung der Simulation, während Ausfälle in Audiokanälen lokale Hardware-Reset-Verfahren erfordern. Auch die Bewegungssicherheit in gemeinsamen Räumen erfordert ausschließlich Gehanweisungen und physische Grenzbeschränkungen, um Kollisionsrisiken zu reduzieren. Diese Verfahren entsprechen der Auffassung, dass Cybersickness und Unwohlsein in der Virtual-Reality-Ausbildung als Gestaltungs- und Überwachungsaspekte und nicht als zufällige Nebenwirkungen betrachtet werden sollten20.
Die Studie besitzt zudem methodologischen Wert, da der Vergleich über einen einfachen Kontrast zwischen Virtual-Reality- und Nicht-Virtual-Reality-Szenarien hinausging. Desktop-Kollaboration, verteilte immersive Kollaboration und ko-lokalisierte Kollaboration in großflächigen Räumen wurden als unterschiedliche Konfigurationen bewertet. Dieses Design ermöglichte die Untersuchung von Veränderungen, die mit räumlich geteilter immersiver Kollaboration verbunden sind, anstatt lediglich visueller Immersion oder verbaler Koordination. Die beobachteten Unterschiede waren am stärksten bei Präsenz, Koordination und Engagement und schwächer bei der behaltenen Wissensmenge. Dieses Muster stützt keine allgemeine Schlussfolgerung, dass größere oder immersivere Systeme sämtliche Lernergebnisse verbessern. Ko-lokale kollaborative Virtual-Reality-Umgebungen mit großflächigem Raumangebot sind daher möglicherweise am besten geeignet, wenn die Ausbildung räumliche Orientierung, Rollenverteilung, Echtzeit-Wechselseitigbeobachtung und koordinierte Bewegung erfordert, anstatt einfaches Faktenabrufen21.
Mehrere Einschränkungen sollten berücksichtigt werden. Die Studie wurde an einer einzigen Institution mit jungen erwachsenen Studierenden und Doktoranden durchgeführt, was die Übertragbarkeit auf ältere Auszubildende, professionelle Notfallteams und Lernende mit geringer Technikaffinität einschränkt. Die Aufgabe umfasste strukturierte Notfalllogistik und räumliche Navigation, und in Bereichen mit geringerer räumlicher Abhängigkeit könnten sich andere Muster ergeben. Die Leistungsbewertung basierte auf subjektiven Fragebögen, Bewertungen durch menschliche Beobachter und grundlegenden Systemprotokollen. Feingliedrige Verhaltens-Telemetriedaten, einschließlich Kommunikationshäufigkeit, kumulative Sprechzeit, Bewegungssynchronisation und gezieltes Blickverhalten, wurden nicht erfasst, was die Quantifizierung detaillierter Mechanismen der Teaminteraktion und Koordinationseffizienz begrenzt. Zukünftige Untersuchungen sollten physiologische Messungen wie kontinuierliche Herzfrequenzvariabilität und elektrodermale Aktivität zusammen mit umfassender räumlicher Telemetrie einbeziehen. Unabhängige, nicht-kollaborative Kontrollgruppen mit physischer Bewegungssteuerung sind ebenfalls erforderlich, um Effekte, die mit zwischenmenschlicher Zusammenarbeit verbunden sind, von solchen zu unterscheiden, die mit erhöhter körperlicher Fortbewegung einhergehen. Der Teilnehmerkohorte wurde aufgrund der Durchführbarkeit aus einer einzigen akademischen Institution rekrutiert, und die psychometrischen Instrumente sowie Beobachtungsrubriken wurden für dieses immersive Paradigma entwickelt oder angepasst. Obwohl interne Reliabilität und Konstruktvalidität geprüft wurden, sind Selbsteinschätzungen anfällig für Neuheitseffekte. Die Integration von Fragebogendaten auf Teilnehmerebene mit Beobachterbewertungen auf Team-Ebene führte zudem zu struktureller Komplexität; zur Angleichung der Analyseebenen wurden Cluster-Mittelwert-Aggregation und Mixed-Effects-Modelle verwendet, doch zukünftige Studien sollten die parallele multimodale Datenerhebung auf derselben operationellen Analyseeinheit priorisieren. Der zweiwöchige Nachbeobachtungszeitraum belegt nicht, ob Effekte über längere Zeiträume bestehen bleiben oder auf reale Leistungen übertragbar sind. Außerdem stellten die drei Trainingskonfigurationen ganzheitliche Umweltvergleiche dar und nicht einzelne Komponenten eines vollfaktoriellen Designs. Visuelle Immersion, physische Fortbewegung, Körperwahrnehmung und gemeinsame physische Präsenz blieben daher miteinander vermischt, sodass die beobachteten Unterschiede nicht auf eine einzelne Komponente zurückgeführt werden können. Zukünftige Studien sollten diese Faktoren durch faktorielle Manipulation trennen und wiederholte Trainingsphasen sowie Transferaufgaben in reale Anwendungsszenarien integrieren, um zu ermitteln, ob Verbesserungen der Koordination in klinischen oder industriellen Umgebungen anhalten22.
Offenlegungen
Die Autoren haben keine Interessenkonflikte.
BEITRAG DER AUTOREN:
Fu Bo hat die Studie konzipiert, die experimentellen Protokolle entwickelt, die Datenerhebung geleitet und den ersten Entwurf des Manuskripts verfasst. Meng Na hat die technische Implementierung der Virtual-Reality-Simulationsplattformen betreut, zur statistischen Programmierung beigetragen und das Manuskript inhaltlich kritisch mitüberarbeitet. Beide Autoren haben die endgültige Version zur Einreichung genehmigt
Danksagungen
Die Autoren danken der Fakultät für Intelligenz und Ingenieurwesen der Shenyang City University für die Unterstützung dieser Forschung. Besonderer Dank gilt dem Schlüssellabor für Virtual-Real Interaction und Digital Twin Technology Innovation , das die notwendige Ausrüstung und räumlichen Einrichtungen zur Durchführung der großräumigen, gemeinsam genutzten Experimente zur kollaborativen virtuellen Realität bereitgestellt hat. Sie danken auch allen Bachelor- und Masterstudenten, die sich freiwillig an den immersiven Trainingsveranstaltungen beteiligt haben. Ihr Engagement und ihre Kooperation waren entscheidend für den erfolgreichen Abschluss dieser Studie. Diese Arbeit wurde unterstützt durch das angewandte Grundlagenforschungsprogramm von Liaoning 2025 (Förderkennzeichen Nr. 2025JH2/101330049); die Natural Science Foundation der Provinz Liaoning 2024 (Förderkennzeichen Nr. 2024-MS-255); die Grundlagenforschungsmittel für Universitäten des Bildungsministeriums der Provinz Liaoning 2025 (Förderkennzeichen Nr. LJ212513220006); sowie die Grundlagenforschungsmittel für Universitäten des Bildungsministeriums der Provinz Liaoning 2024 (Förderkennzeichen Nr. LJ212413220001).
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| 24-Stunden-Symptomauflösungs-Kontaktformular | Vom Studienteam entwickeltes Nachverfolgungsformular | Version 1.0 | Wird verwendet, um die Symptomauflösung bei Teilnehmenden mit einem Unbehagen-Index nach der Aufgabe ≥5 zu dokumentieren |
| Schalldämmende Trennwände | Allgemeiner Lieferant für Labormöbel | Standardmäßige mobile Schalldämmwand, Höhe ca. 160–180 cm | Wird verwendet, um sitzende Teilnehmende voneinander zu trennen und Kommunikation außerhalb des vorgesehenen Kanals zu verhindern |
| Desinfektionstücher ohne Alkohol | Allgemeiner Lieferant für Laborygiene | Desinfektionstücher, sicher für Geräte | Wird verwendet, um Head-Mounted-Displays, Controller, Mikrofone, Tastaturen, Mäuse und gemeinsam genutzte Oberflächen zwischen den Sitzungen zu reinigen |
| Analysedatensatz | Von der Studie erstellte Datei | analytical_dataset.csv | Depersonalisierter Datensatz auf Teilnehmendenebene mit einer Zeile pro Teilnehmende/r |
| Basisbefragung | Vom Studienteam entwickelter Fragebogen | Version 1.0, finalisiert im Februar 2025 | Wird verwendet, um demografische Informationen, bisherige Erfahrungen mit virtueller Realität, Vertrautheit mit Computerspielen und frühere Erfahrungen mit Teamtrainings zu erfassen |
| Markierungsbänder für Begrenzungen | Allgemeiner Lieferant für Laborsicherheit | Rutschfestes Bodenmarkierungsband | Wird verwendet, um 3 m × 3 m große Raumskalen-Bereiche und den 8 m × 8 m großen Großraum-Trainingsbereich abzugrenzen |
| Kognitive-Belastungsskala | Von der Studie angepasstes Arbeitsbelastungs-Bewertungsformular | 5-Item-Version | Wird unmittelbar nach dem Training verwendet; die Items erfassen mentale Anforderungen, physische Anforderungen, Zeitdruck, Aufwand und Frustration |
| Computermaus | Allgemeiner Lieferant für Computerausrüstung | Standardmäßige kabelgebundene oder kabellose Maus | Wird für die Interaktion in der Desktop-Kollaborations-Simulationsbedingung verwendet |
| Datenbereinigungs-Protokoll | Von der Studie erstellte Datei | data_cleaning_log.xlsx | Dokumentiert Korrekturen von Bewertungen, Prüfungen auf fehlende Werte, Abstimmung von Beobachterbewertungen und Entscheidungen zur Datensatzfreigabe |
| Datendictionary | Von der Studie erstellte Datei | Version 1.0 | Definiert Variablennamen, Beschriftungen, Kodierungsregeln, Bewertungsbereiche, Regeln für fehlende Werte und Analyseebenen |
| Desktop-Monitor | Allgemeiner Lieferant für Computerausrüstung | 24-Zoll-Monitor, mindestens 1.920 × 1.080 Auflösung | Wird in der Desktop-Kollaborations-Simulationsbedingung verwendet |
| Desktop-Arbeitsstation | Allgemeiner Lieferant für Computerausrüstung | Mindestkonfiguration: Intel i5 oder vergleichbarer Prozessor, 16 GB RAM, dedizierte Grafikkarte, Windows 10 oder höher | Wird für Desktop-Simulation, lokale Überwachung, Fragebogenverwaltung und Datenverarbeitung verwendet |
| Einweg-Gesichtsauflagen für Headsets | Allgemeiner Hygienelieferant | Standardmäßige Einweg-Gesichtsauflagen für Head-Mounted-Displays | Wird zur Hygiene der Teilnehmenden während der Sitzungen in virtueller Realität verwendet |
| Notstopp-Checkliste | Vom Studienteam entwickeltes Sicherheitsformular | Version 1.0 | Wird verwendet, um Abbruchkriterien, Unbehagen-Ereignisse, Sicherheitsunterbrechungen und Nachverfolgung der Symptomauflösung zu dokumentieren |
| Verschlüsselter institutioneller Speicher | Teilnehmende Institution | Zugriffsgeschützter verschlüsselter Projektordner | Wird verwendet, um depersonalisierte Datensätze, Bewertungsdateien, Aufzeichnungen und Syntaxdateien zu speichern |
| Beobachterbewertungsskala für Koordination | Vom Studienteam entwickelte Bewertungsskala | 5-Bereiche, 100-Punkte-Version | Wird von zwei verblindeten Beobachter*innen verwendet, um Kommunikationszeitpunkt, Rollenausführung, gegenseitige Unterstützung, räumliche Koordination und Fehlerbehebung zu bewerten |
| Beobachter-Bewertungsdatensatz | Von der Studie erstellte Datei | observer_scores.csv | Enthält bewertete Werte auf Bereichsebene vor dem Mittelwertbildungs- oder Konsensabgleich |
| Online-Fragebogenplattform | Institutionelles oder lizenziertes Umfragesystem | Version aktiv während der Datenerhebung 2025 | Wird für die Screening-Befragung, Basisbefragung, Nachbefragung nach dem Training und den Retentionstest nach zwei Wochen verwendet |
| Paarweiser-Vergleichs-Package | R-Package | emmeans Version kompatibel mit R 4.3.2 | Wird verwendet für geschätzte marginale Mittelwerte und Tukey-korrigierte paarweise Vergleiche |
| Einwilligungserklärung der Teilnehmenden | Von der Studie genehmigtes Dokument | Ethisch geprüfte Version | Wird vor der Basisbeurteilung und Randomisierung verwendet |
| Teilnehmerfragebogen | Vom Studienteam entwickelter Fragebogen | Version 1.0 | Enthält Items zur Teilnahmevoraussetzungsprüfung, Basisbefragung, räumliche Präsenz, selbstbewertete Teamkoordination, Lernengagement, kognitive Belastung und Unbehagensskalen |
| Mobile Stühle | Allgemeiner Lieferant für Labormöbel | Standardmäßiger Laborstuhl | Wird für die Sitzgelegenheit der Teilnehmenden während der Einwilligung, der Fragebögen, der Erholungsphase und der Nachbeobachtung verwendet |
| R-Statistiksoftware | R Foundation for Statistical Computing | R-Version 4.3.2 | Wird verwendet für Datenbereinigung, Reliabilitätsanalyse, Mixed-Effects-Modelle, Korrelationsanalysen und Erstellung von Abbildungen |
| Reliabilitätsanalyse-Package | R-Package | psych Version kompatibel mit R 4.3.2 | Wird verwendet, um Cronbach’s Alpha und den Intraklassen-Korrelationskoeffizienten zu berechnen |
| Raumskalen-Tracking-Bereiche | Labor der teilnehmenden Institution | Drei getrennte, markierte 3 m × 3 m große Flächen | Wird für die räumlich verteilte kollaborative virtuelle Realität in Raumskalengröße verwendet |
| Sicherheitsüberwachungsformular | Vom Studienteam entwickeltes Formular | Version 1.0 | Wird verwendet, um Unbehagen-Werte, Grenzüberschreitungen, Tracking-Unterbrechungen und Erholungsstatus zu dokumentieren |
| Bildschirmaufzeichnungssoftware | Allgemeine kommerzielle oder Open-Source-Bildschirmaufzeichnungssoftware | Version aktiv während der Datenerhebung 2025 | Wird verwendet, um standardisierte Aufzeichnungen für die beobachterbasierte Koordinationsbewertung zu erstellen |
| Sitzungs-Checkliste | Vom Studienteam entwickelte Checkliste | Version 1.0 | Wird verwendet, um Anwesenheit, Bestätigung der Teilnahmeberechtigung, Geräteeinrichtung, Sicherheitschecks, Aufgabenabschluss und Unterbrechungen zu dokumentieren |
| Simulator-Unbehagen-Skala | Vom Studienteam entwickelte Symptombewertungsliste | 5-Item, 0–10 Version | Wird vor der Exposition, nach der Einführung und unmittelbar nach dem Training verwendet |
| Räumliche-Präsenz-Skala | Vom Studienteam angepasster Fragebogen | 8-Item-Version | Wird unmittelbar nach dem Training verwendet; Antwortbereich 1–7 |
| SPSS-Statistiksoftware | IBM Corp. | IBM SPSS Statistics Version 29.0 | Wird verwendet für deskriptive Statistiken, ANOVA, Welch-ANOVA, Chi-Quadrat-Tests und Prüfung der Voraussetzungen |
| Statistische Syntaxdatei | Von der Studie erstellte Datei | R-Syntaxdatei, Version 1.0 | Wird verwendet, um Datenbereinigung, Mixed-Effects-Modelle, ANOVA, Korrelationsanalysen und Ergebniserstellung reproduzierbar durchzuführen |
| System-Log-Exportmodul | Vom Studienteam entwickelte Exportfunktion | Version 1.0, gesperrt vor Beginn der offiziellen Datenerhebung | Exportiert Startzeitpunkt der Aufgabe, Endzeitpunkt der Aufgabe, Abschlussstatus, Objektauswahlen, Reaktionen auf Gefahren, Routenfehler und Unterbrechungen |
| Teamebene-Datensatz | Von der Studie erstellte Datei | team_level_dataset.csv | Enthält beobachterbewertete Koordinationswerte und Prozessindikatoren auf Teamebene |
| Virtual-Reality-Trackingsystem | Kommerzieller Anbieter von Virtual-Reality-Hardware | Kompatibel mit ausgewähltem Headset und Controllern | Wird verwendet, um Position und Handbewegungen der Teilnehmenden zu verfolgen |
| Virtuelle Trainingsumgebung | Individuell entwickelte Trainingssoftware | Version 1.0, gesperrt vor Beginn der offiziellen Datenerhebung | Stellt das kollaborative Notfall-Logistik- und räumliche Navigationszenario bereit |
| Sprachkommunikationsmodul | Eingebautes oder integriertes Kommunikationsmodul | Version gesperrt vor Beginn der offiziellen Datenerhebung | Wird für zugewiesene Team-Sprachkommunikationskanäle verwendet |
Referenzen
- Dede C. Immersive interfaces for engagement and learning. Science. 2009;323(5910):66-69.
- Radianti J, Majchrzak TA, Fromm J, Wohlgenannt I. A systematic review of immersive virtual reality applications for higher education: Design elements, lessons learned, and research agenda. Comput Educ. 2020;147:103778. https://doi.org/10.1016/j.compedu.2019.103778
- Cummings JJ, Bailenson JN. How immersive is enough A meta-analysis of the effect of immersive technology on user presence. Media Psychol. 2016;19(2):272-309.
- Makransky G, Petersen GB. The Cognitive Affective Model of Immersive Learning (CAMIL): A theoretical research-based model of learning in immersive virtual reality. Educ Psychol Rev. 2021;33(4):937-958.
- Dillenbourg P. What do you mean by collaborative learning In: Dillenbourg P, editor. Collaborative-learning: Cognitive and computational approaches. Oxford: Elsevier; 1999. p. 1-19.
- van der Meer N, van der Werf V, Brinkman WP, Specht M. Virtual reality and collaborative learning: A systematic literature review. Front Virtual Real. 2023;4:1159905. https://doi.org/10.3389/frvir.2023.1159905
- Johnson-Glenberg MC. Immersive VR and education: Embodied design principles that include gesture and hand controls. Front Robot AI. 2018;5:81. https://doi.org/10.3389/frobt.2018.00081
- Kirschner F, Paas F, Kirschner PA. A cognitive load approach to collaborative learning: United brains for complex tasks. Educ Psychol Rev. 2009;21(1):31-42.
- Fredricks JA, Blumenfeld PC, Paris AH. School engagement: Potential of the concept, state of the evidence. Rev Educ Res. 2004;74(1):59-109.
- Kourtesis P, Linnell J, Amir R, Argelaguet F, MacPherson SE. Cybersickness in virtual reality: The role of individual differences, cognitive functions, and virtual reality locomotion. Virtual Worlds. 2024;3(1):62-93.
- Dalgarno B, Lee MJW. What are the learning affordances of 3-D virtual environments Br J Educ Technol. 2010;41(1):10-32.
- Schubert T, Friedmann F, Regenbrecht H. The experience of presence: Factor analytic insights. Presence Teleoper Virtual Environ. 2001;10(3):266-281.
- O’Brien HL, Cairns P, Hall M. A practical approach to measuring user engagement with the refined User Engagement Scale (UES) and new User Engagement Scale Short Form (UES-SF). Int J Hum-Comput Stud. 2018;112:28-39.
- Hart SG, Staveland LE. Development of NASA-TLX (Task Load Index): Results of empirical and theoretical research. In: Hancock PA, Meshkati N, editors. Human mental workload. Amsterdam: North-Holland; 1988. p. 139-183.
- De Back TT, Tinga AM, Nguyen P, Louwerse MM. Learning in immersed collaborative virtual environments: Design and implementation. Interact Learn Environ. 2023;31(8):5364-5382.
- Slater M, Sanchez-Vives MV. Enhancing our lives with immersive virtual reality. Front Robot AI. 2016;3:74. https://doi.org/10.3389/frobt.2016.00074
- Roschelle J, Teasley SD. The construction of shared knowledge in collaborative problem solving. In: O’Malley C, editor. Computer supported collaborative learning. Berlin: Springer; 1995. p. 69-97.
- Merchant Z, Goetz ET, Cifuentes L, Keeney-Kennicutt W, Davis TJ. Effectiveness of virtual reality-based instruction on students' learning outcomes in K-12 and higher education: A meta-analysis. Comput Educ. 2014;70:29-40.
- Sweller J. Cognitive load during problem solving: Effects on learning. Cogn Sci. 1988;12(2):257-285.
- Stanney KM, Kennedy RS, Drexler JM, editors. Cybersickness is not simulator sickness. Proceedings of the Human Factors and Ergonomics Society Annual Meeting; 1997.
- Lindgren R, Johnson-Glenberg M. Emboldened by embodiment: Six precepts for research on embodied learning and mixed reality. Educ Res. 2013;42(8):445-452.
- Howard MC. A meta-analysis and systematic literature review of virtual reality rehabilitation programs. Comput Hum Behav. 2017;70:317-327.